
Dans le paysage foisonnant de la modélisation statistique et de l’analyse quantitative des données, rares sont les indices aussi universellement employés — et pourtant aussi fréquemment confondus — que le coefficient de corrélation R et le coefficient de détermination R-carré (noté R2). Qu’il s’agisse d’évaluer la force d’une association psychologique, de valider un protocole expérimental biomédical ou d’estimer la capacité prédictive d’un algorithme économétrique, ces deux métriques constituent le socle fondamental sur lequel reposent d’innombrables inférences empiriques. Pourtant, sous une apparente parenté algébrique symbolisée par une simple mise au carré, se dissimulent des architectures théoriques distinctes, des ambitions épistémologiques divergentes et des implications interprétatives qui ne sauraient être interchangées sans compromettre la rigueur de la démarche scientifique.
Cette ambiguïté récurrente trouve souvent sa source dans une formation méthodologique fragmentaire, où l’enseignement des statistiques appliquées privilégie parfois l’automatisation logicielle au détriment de l’exégèse conceptuelle. Les praticiens, confrontés à des tableaux de synthèse générés par des environnements d’analyse complexes, ont trop souvent tendance à assimiler l’intensité d’une relation bivariée à la proportion de variance expliquée par un modèle global. Une telle confusion n’est pas une simple querelle sémantique réservée aux théoriciens de la mesure ; elle engendre des biais tangibles dans la quantification des tailles d’effet, fausse l’évaluation clinique ou pédagogique des interventions, et favorise l’illusion d’une causalité là où ne réside qu’une banale covariance directionnelle.
L’objectif de cet article est de disséquer de manière exhaustive la frontière mathématique, philosophique et pragmatique qui sépare le coefficient R du coefficient R2. En cheminant des fondations de la corrélation linéaire vers la complexité des modèles multivariés, en examinant la géométrie des sommes des carrés et en scrutant les pièges de l’inflation statistique, cette étude entend doter les chercheurs, analystes et étudiants d’une grille de lecture lucide et intransigeante. À travers une exploration méticuleuse de leurs postulats, de leurs comportements face aux artefacts de mesure et de leurs protocoles de restitution dans la littérature évaluée par les pairs, nous mettrons en lumière pourquoi ces deux indices ne doivent pas être perçus comme des rivaux ou des substituts, mais comme des partenaires analytiques complémentaires, chacun détenant une clé spécifique dans l’intelligibilité des phénomènes observés.
1. Introduction épistémologique et distinction fondamentale entre R et R-carré
1.1 Origine de la confusion conceptuelle en statistique appliquée
L’histoire de la statistique inférentielle est jalonnée de rapprochements formels qui, s’ils témoignent de l’élégance de l’édifice mathématique, induisent une charge cognitive considérable chez les utilisateurs finaux. La proximité notationnelle entre le coefficient de corrélation r (ou R dans sa déclinaison générale) et le coefficient de détermination R2 représente sans conteste l’un des foyers de méprise les plus constants au sein de la littérature scientifique contemporaine. Cette proximité graphique incite insidieusement l’esprit humain à considérer ces deux mesures comme de simples variantes d’une même entité phénoménologique, réductibles à une banale transformation d’échelle. Or, si le passage de l’un à l’autre semble n’exiger qu’une opération arithmétique élémentaire dans le cadre restrictif du modèle linéaire univarié, la nature même de ce qu’ils mesurent appartient à des registres conceptuels distincts.
Le nœud du problème réside dans l’incapacité fréquente à dissocier l’intensité et l’orientation d’une association linéaire entre deux vecteurs continus, de la proportion de dispersion quantifiée et résorbée par une équation fonctionnelle. La corrélation interroge la synchronie du mouvement : dans quelle mesure deux grandeurs dévient-elles conjointement de leurs moyennes respectives ? En revanche, la détermination questionne l’efficacité structurelle d’une structure explicative : quelle part de la variabilité globale de la variable réponse est-elle mathématiquement redevable aux fluctuations des variables postulées comme prédictrices ? Cette nuance, fondamentale d’un point de vue analytique, se dissout trop souvent dans les pratiques routinières de publication où les chercheurs passent de l’une à l’autre de ces notions sans expliciter le saut conceptuel opéré.
Les conséquences de cet amalgame dans des disciplines empiriques telles que la psychologie, les sciences de l’éducation ou l’épidémiologie comportementale sont loin d’être anodines. Elles se traduisent régulièrement par une surévaluation flagrante de l’impact des prédicteurs psychométriques. Un chercheur découvrant une corrélation bivariée modérément robuste sera tenté d’en vanter les retombées pratiques, occultant le fait que la variance effectivement clarifiée demeure marginale. Ce décalage d’appréciation nourrit une crise de réplicabilité rampante, en instillant un optimisme injustifié quant à la robustesse prédictive de construits théoriques dont la portée explicative réelle s’avère particulièrement ténue à l’échelle populationnelle.
1.2 Aperçu sémantique et mathématique préliminaire
Pour clarifier sans ambiguïté les contours de ces deux indicateurs, il convient d’établir d’emblée leurs définitions opératoires. Le coefficient de corrélation linéaire, formalisé par Karl Pearson dans la continuité des travaux pionniers de Francis Galton, quantifie le degré d’association bidirectionnelle et symétrique existant entre deux variables aléatoires quantitatives. Exprimé de manière adimensionnelle, il traduit la pente standardisée de la relation observée. Sa nature est intrinsèquement vectorielle au sens informel du terme : il est doté d’une magnitude, qui reflète la compacité de la dispersion des points autour d’un axe linéaire idéal, mais également d’un signe algébrique (+ ou -), qui indique la polarité de cette concordance. Il informe le chercheur sur la direction du monde empirique : lorsque X croît, Y croît-il de concert ou décroît-il systématiquement ?
À l’inverse, le coefficient de détermination R2 se définit rigoureusement comme une mesure scalaire de la réduction d’incertitude. Conçu pour évaluer la performance globale d’un modèle de régression, il quantifie le ratio de la variance capturée par les prédicteurs sur la variance totale de la variable d’intérêt. Dépourvu de toute indication vectorielle ou directionnelle, le R-carré constitue un indice purement absolu, s’échelonnant sur une échelle proportionnelle universelle. Alors que le coefficient de corrélation de Pearson oscille continûment sur l’intervalle [-1,00 ; +1,00], matérialisant aussi bien l’opposition diamétrale que la concordance parfaite, le coefficient de détermination est strictement borné à l’espace [0,00 ; 1,00] ou [0 % ; 100 %] dans le cadre des moindres carrés conventionnels.
Cette différence d’échelle entraîne une divergence drastique dans la métrique cognitive de l’analyste. Le coefficient R s’interprète comme un indice de proximité structurelle le long d’une droite orientée dans un plan cartésien bivarié, tandis que le R2 se lit comme un bilan comptable d’entropie résiduelle. Confondre une magnitude signée avec un ratio de dispersion volumétrique revient à confondre la vitesse de déplacement d’un véhicule le long d’une trajectoire définie avec le pourcentage du territoire total couvert par l’ensemble de ses pérégrinations. L’étanchéité sémantique entre ces deux notions est le préalable méthodologique indispensable à toute modélisation rigoureuse.
1.3 Importance de la différenciation dans l’inférence scientifique
Au-delà des considérations algébriques, la distinction rigide entre R et R2 gouverne la dialectique même de l’inférence scientifique, notamment dans l’opposition classique entre modélisation explicative et modélisation purement prédictive. Dans une perspective exploratoire ou explicative fondamentale, le chercheur s’intéresse en priorité à l’existence, au sens et à l’intensité de la relation unitaire reliant deux construits latents. Le coefficient de corrélation R constitue ici le candidat privilégié, car il préserve l’essence même de l’hypothèse théorique : il permet d’affirmer si un phénomène est positivement ou négativement couplé à un autre, tout en fournissant une métrique brute de la force du signal relationnel au sein du bruit d’échantillonnage.
Toutefois, dès lors que la visée de l’investigation bascule vers l’ingénierie prédictive, l’évaluation des politiques publiques ou la prise de décision diagnostique, le coefficient de détermination R2 devient incontournable. Il ne suffit plus de savoir qu’un lien fonctionnel statistiquement significatif lie l’exposition à un programme éducatif et la réussite aux examens. Ce qui importe désormais au législateur ou au clinicien est de savoir quelle proportion concrète de la variance des performances est effectivement dominée par ladite intervention. Un modèle affichant un coefficient R prometteur peut masquer un R2 d’une indigence manifeste, signifiant que la quasi-totalité de la dispersion interindividuelle échappe aux leviers d’action identifiés.
Enfin, cette différenciation s’érige en rempart contre le piège tenace de la causalité illusoire. L’observance d’un coefficient R substantiel pousse fréquemment les esprits enthousiastes à inférer des mécanismes causaux directs, en oubliant la totale réversibilité mathématique de l’indice. Le recours lucide au R2, tout en ne garantissant en rien la causalité — qui demeure un enjeu d’architecture expérimentale et d’isolation contrefactuelle —, ramène continuellement l’analyste à la réalité probabiliste de son modèle : il lui rappelle brutalement le volume de variance qui demeure dans l’ombre des résidus et des facteurs non observés, tempérant ainsi l’hybris méthodologique.
2. Définition approfondie et propriétés mathématiques du coefficient R
2.1 Le coefficient de corrélation linéaire de Pearson
Le coefficient de corrélation produit-moment de Pearson, conventionnellement désigné par la lettre minuscule r lorsqu’il est calculé sur un échantillon empirique et par la lettre grecque ρ (rhô) à l’échelle de la population parente, représente la normalisation de la covariance de deux variables aléatoires réelles. Considérons deux séries statistiques de taille n, notées respectivement X et Y, de moyennes arithmétiques x̄ et ȳ, et d’écarts-types sX et sY. La covariance mesure la tendance conjointe de ces grandeurs à s’écarter simultanément de leurs barycentres respectifs. La formulation canonique du coefficient de Pearson s’exprime par le rapport direct de cette covariance empirique au produit strict des écarts-types marginaux :
r = [ ∑ (Xi – x̄)(Yi – ȳ) ] / [ √(∑ (Xi – x̄)2) × √(∑ (Yi – ȳ)2) ]
Sur le plan géométrique, cette équation équivaut rigoureusement au cosinus de l’angle θ formé par les deux vecteurs de données centrées dans un espace euclidien de dimension n. En vertu des propriétés intrinsèques de l’inégalité de Cauchy-Schwarz, la valeur absolue de la covariance ne peut jamais excéder le produit géométrique des dispersions individuelles. Par conséquent, l’intervalle de variation du coefficient R est mathématiquement contraint de manière absolue :
-1,00 ≤ R ≤ +1,00
Une propriété cardinale et souvent négligée de R réside dans son inféodation exclusive à la linéarité stricte. Le coefficient de Pearson ne mesure pas l’intensité d’une relation fonctionnelle arbitraire, mais exclusivement son adéquation à une ligne droite dans un plan cartésien à deux dimensions. Une association curviligne déterministe et parfaite — telle qu’une fonction parabolique parfaite Y = X2 sur un intervalle symétrique centré en zéro — générera un coefficient R exactement égal à 0,00. Cette cécité structurelle de l’indice aux morphologies non rectilignes constitue une limite inhérente que l’analyste doit constamment garder à l’esprit sous peine de déclarer absente une dépendance statistique pourtant absolue.
Par ailleurs, le coefficient R se caractérise par une vulnérabilité aiguë à deux distorsions empiriques majeures : la présence d’observations aberrantes (outliers) et le phénomène de restriction d’étendue (range restriction). Une seule observation excentrée, située à l’intersection d’écarts extrêmes sur les deux variables, possède un bras de levier suffisant pour gonfler artificiellement une corrélation par ailleurs inexistante au sein de la sous-population majoritaire, ou réciproquement pour réduire à néant une concordance pourtant remarquable. Inversement, l’échantillonnage d’une fraction tronquée de la distribution globale comprime mécaniquement la variance observée, induisant un affaiblissement spectaculaire de la magnitude apparente de R.
2.2 Signification de l’orientation et de la magnitude de R
L’herméneutique du coefficient R repose sur l’évaluation conjointe de deux composantes distinctes mais indissociables : son signe algébrique et sa valeur absolue. Le signe encode la directionnalité intrinsèque de la covariation. Un signe positif (+R) traduit une relation concordante ou homophile : les unités d’observation présentant des valeurs supérieures à la moyenne sur la variable X ont une propension systématique à afficher également des valeurs supérieures au centroïde sur la variable Y. Inversement, un signe négatif (-R) caractérise une relation discordante ou antagoniste : toute déviation positive sur un axe s’accompagne d’une déviation négative attendue sur le second, matérialisant un effet d’inversion proportionnelle.
La magnitude de l’indice, quantifiée par sa valeur absolue |R|, renseigne sur la compacité du nuage de points autour du modèle linéaire optimal. Afin de guider l’interprétation empirique dans les sciences humaines et sociales, le statisticien Jacob Cohen a établi une typologie heuristique largement consacrée par l’usage, tout en incitant à la prudence :
- Une valeur de |R| voisine de 0,10 correspond à un effet de faible magnitude, dénotant une association ténue souvent imperceptible sans le recours à des effectifs d’échantillonnage massifs ;
- Une valeur oscillant autour de 0,30 caractérise un effet d’intensité moyenne, typique des relations observées entre traits psychométriques et comportements réels ;
- Une valeur atteignant ou excédant 0,50 consacre un effet de forte amplitude, témoignant d’une proximité structurelle remarquable entre les deux construits mesurés.
Il est toutefois crucial de souligner la symétrie immuable qui caractérise le coefficient de corrélation R. Mathématiquement, r(X, Y) est rigoureusement identique à r(Y, X). Dans le calcul de R, il n’existe aucune asymétrie de statut : aucune variable n’est désignée comme cause antécédente (variable indépendante ou prédicteur) ni comme effet subséquent (variable dépendante ou critère). Le coefficient de corrélation traite les deux vecteurs de données avec une parfaite neutralité démocratique, ne mesurant rien d’autre que leur proximité dans un espace vectoriel normé.
2.3 Conditions d’application et postulats sous-jacents de R
L’inférence statistique valide adossée au coefficient R de Pearson — c’est-à-dire le calcul de son erreur-type, la détermination de sa significativité par le test de Student (t) et la construction d’intervalles de confiance crédibles — requiert le strict respect d’un ensemble de postulats probabilistes exigeants. Au premier rang de ces exigences figure l’hypothèse de normalité bivariée. Si la robustesse du coefficient face à de légères déviations de l’univariance est parfois tolérée dans les grands échantillons en vertu du théorème central limite, l’inférence formelle repose sur l’hypothèse que la distribution conjointe des couples (X, Y) épouse une surface gaussienne à deux dimensions, caractérisée par des courbes de niveau elliptiques régulières.
Un corollaire direct de la normalité bivariée est le postulat d’homoscédasticité. Ce principe impose que la variance conditionnelle de Y sachant X demeure rigoureusement constante sur l’intégralité du domaine de définition de X. Si le nuage de points adopte une morphologie en éventail, en entonnoir ou en fuseau asymétrique — traduisant une variabilité qui explose ou se contracte selon les valeurs du prédicteur —, la variance d’erreur devient hétérogène. Une telle hétéroscédasticité altère gravement l’estimation des erreurs-types du coefficient de corrélation, générant un risque substantiel de commettre des erreurs de type I (rejet abusif de l’hypothèse nulle) ou de type II (non-détection d’un effet véritable).
Enfin, la métrologie sous-jacente exige impérativement que les grandeurs soumises à l’analyse soient mesurées sur une échelle d’intervalles constants ou sur une échelle de rapports. L’application du coefficient de Pearson à des variables ordinales (où seules les positions relatives font sens, mais où les écarts arithmétiques ne sont pas constants) est une entorse méthodologique formelle qui conduit à des calculs de moyennes et d’écarts-types mathématiquement illégitimes. Dans ces contextes non métriques, le recours à des équivalents non paramétriques basés sur les rangs — tels que le rhô de Spearman ou le tau de Kendall — s’impose comme une nécessité absolue pour préserver la vérité distributionnelle des données.
3. Définition approfondie et propriétés théoriques du R-carré
3.1 Le coefficient de détermination comme proportion de variance
Alors que le coefficient de corrélation évolue dans le domaine des vecteurs et des angles de phase, le coefficient de détermination R2 appartient conceptuellement à l’univers de la mécanique des variances et de la théorie de l’information. Dans le cadre de la modélisation linéaire par la méthode des moindres carrés ordinaires (MCO), la variabilité intrinsèque d’un ensemble de scores observés Y constitue une masse d’incertitude globale que le chercheur cherche à éclairer. Le coefficient R2 formalise avec précision la fraction de cette variance totale qui est effectivement imputable, absorbée ou ordonnée par l’agencement structural des variables introduites dans l’équation de régression.
Cette approche s’articule autour d’une partition analytique fondamentale : la dispersion totale d’une réponse empirique se scinde en deux blocs mutuellement exclusifs et exhaustivement cumulatifs. D’une part, la variance expliquée (ou modélisée), qui correspond aux fluctuations structurelles que le modèle parvient à reproduire fidèlement grâce à ses covariables ; d’autre part, la variance résiduelle (ou d’erreur), qui agglomère l’ensemble des perturbations stochastiques, des biais de mesure instrumentaux et des influences systémiques non mesurées par l’investigateur. Le R-carré est précisément le ratio adimensionnel reliant cette variance capturée à l’ensemble du gisement de variance initiale disponible.
En vertu de cette structure de quotient de dispersion, le coefficient de détermination est rigoureusement borné par les limites absolues de l’espace unitaire :
0,00 ≤ R2 ≤ 1,00 (soit de 0 % à 100 %)
Une valeur de R2 égale à 0,00 indique l’échec explicatif le plus complet : les prédicteurs ne fournissent pas la moindre information pertinente pour anticiper la distribution du critère, la meilleure prédiction possible demeurant simplement la moyenne brute de la variable dépendante. À l’extrême opposé, un R2 égal à 1,00 dénote une adéquation déterministe parfaite : tous les points empiriques s’alignent sans la moindre déviation sur l’hyperplan de régression, résorbant l’intégralité de l’erreur empirique. Fait crucial : par construction quadratique, le R2 est totalement dépourvu de signe. Il ne renseigne jamais sur la polarité d’une relation, se contentant de dresser un inventaire de l’efficacité prédictive globale du système mathématique mobilisé.
3.2 Formulation algébrique par la somme des carrés
L’élégance du coefficient de détermination se manifeste avec éclat lorsqu’on examine son architecture algébrique, bâtie sur la partition de la variabilité mesurée par les sommes des carrés d’écarts (Sum of Squares). Soit Yi la valeur observée pour un individu donné, ȳ la moyenne générale de l’échantillon, et Ŷi (Y-chapeau) la valeur prédite par l’équation de régression linéaire ajustée. L’identité fondamentale de la régression repose sur la décomposition de chaque déviation individuelle par rapport à la moyenne :
(Yi – ȳ) = (Ŷi – ȳ) + (Yi – Ŷi)
Lorsqu’on élève cette relation au carré et qu’on somme l’ensemble des observations sous les hypothèses classiques des moindres carrés — où le produit croisé des termes de régression et des termes d’erreur s’annule par orthogonalité —, on aboutit au théorème de décomposition de la somme des carrés :
SStot = SSreg + SSres
Dans ce cadre formel :
- SStot représente la Somme des Carrés Totale (Total Sum of Squares), quantifiant l’inertie globale des données autour du centroïde : ∑(Yi – ȳ)2 ;
- SSreg symbolise la Somme des Carrés de la Régression (Regression Sum of Squares), capturant la dispersion des prédictions du modèle : ∑(Ŷi – ȳ)2 ;
- SSres désigne la Somme des Carrés Résiduelle (Residual Sum of Squares), mesurant la somme des erreurs de prédiction quadratiques : ∑(Yi – Ŷi)2.
Dès lors, le coefficient de détermination R2 peut s’exprimer mathématiquement sous deux formes analytiquement équivalentes :
R2 = SSreg / SStot = 1 – (SSres / SStot)
Cette formulation dévoile une propriété mathématique majeure et redoutable : la propriété de non-décroissance mécanique. Dès l’instant où un nouveau prédicteur est incorporé dans une équation de régression, la somme des carrés résiduelle SSres ne peut jamais augmenter ; au pire, si le prédicteur est rigoureusement orthogonal au résidu préexistant, la somme d’erreur demeure constante, mais elle ne peut croître. Par corollaire arithmétique strict, le R-carré ordinaire est mathématiquement condamné à demeurer stable ou à augmenter à chaque ajout de variable, que ladite variable possède une quelconque légitimité théorique ou qu’elle soit issue d’un générateur de nombres aléatoires sans rapport avec l’objet d’étude.
3.3 Interprétation théorique en sciences comportementales
Dans l’arsenal des métriques mobilisées par les sciences comportementales et sociales, le R2 fait figure d’indicateur standardisé par excellence de la qualité globale de l’ajustement (souvent désignée par l’anglicisme Goodness-of-Fit). Il offre un langage commun permettant aux chercheurs de dialoguer au-delà des particularismes d’unités de mesure physiques ou d’échelles de cotation arbitraires. Qu’un modèle traite de millisecondes de temps de réaction, de scores sur une échelle d’évaluation de la dépression en 30 points, ou de revenus annuels bruts, le R-carré condense la performance explicative sous la forme d’un pourcentage absolu immédiatement compréhensible par la communauté académique.
Toutefois, cette facilité apparente d’interprétation dissimule un écueil épistémologique pernicieux : la confusion entre la qualité de l’ajustement statistique et la pertinence théorique ou clinique d’un modèle. Un R2 modeste — par exemple de l’ordre de 0,08 (soit 8 % de variance expliquée) — est fréquemment qualifié de « décevant » par des observateurs profanes rompus aux sciences de la matière. Or, dans l’étude de la psychologie humaine, caractérisée par une étiologie profondément multifactorielle, un déterminisme éclaté et un bruit d’échantillonnage substantiel, isoler un prédicteur unique capable d’expliquer à lui seul 8 % d’un comportement d’addiction ou d’un échec scolaire peut représenter une découverte d’une portée heuristique et pratique inestimable.
À l’inverse, l’obtention d’un R2 très élevé (supérieur à 0,70 ou 0,80) dans une modélisation comportementale ne doit pas susciter une euphorie aveugle, mais plutôt une suspicion méthodologique réflexive. Une telle compacité peut simplement trahir une redondance tautologique entre la variable prédictrice et le critère (par exemple, prédire un diagnostic d’anxiété généralisée par un score sur une échelle d’inquiétude chronique), un artefact de surajustement statistique (overfitting) sur un échantillon restreint, ou encore une contamination par la variance de méthode partagée. L’utilité pratique d’un modèle ne se déduit donc jamais mécaniquement de la grandeur de son R-carré, mais exige une contextualisation métrologique impérative.
4. R vs R-carré dans le cadre de la régression linéaire simple
4.1 La relation fonctionnelle directe : R-carré égal au carré de r
Le cadre de la régression linéaire univariée (comportant un prédicteur unique X et un critère Y) constitue l’unique configuration mathématique au sein de laquelle le coefficient de corrélation R et le coefficient de détermination R2 sont liés par une relation fonctionnelle déterministe directe et symétrique. Dans ce cas particulier fondamental, le coefficient de détermination est rigoureusement et exactement équivalent au carré arithmétique du coefficient de corrélation bivarié de Pearson :
R2 = (r)2
Cette égalité formelle peut être démontrée avec une parfaite clarté algébrique. Dans une régression simple, la pente de la droite des moindres carrés standardisée est strictement égale à r. La prédiction s’écrit sous forme centrée-réduite zŶ = r × zX. La variance de cette variable prédite s’obtient donc en calculant la variance de (r × zX). Comme la variance d’une variable standardisée zX est égale à 1 par construction, il en découle immédiatement que la variance des valeurs prédites est égale à r2. La variance totale de zY étant également égale à 1, le ratio SSreg / SStot converge analytiquement et invariablement vers r2.
Cependant, cette opération mathématique fondamentale d’élévation au carré — si triviale en apparence — produit une altération épistémologique irréversible : l’oblitération absolue de l’information vectorielle et directionnelle. En subissant une transformation quadratique, toute valeur négative de corrélation voit son signe absorbé dans la positivité de l’exposant pair. Il en résulte un corollaire aux implications capitales pour l’analyste :
(-0,70)2 = (+0,70)2 = 0,49
Ainsi, deux réalités empiriques radicalement opposées — l’une décrivant un processus de dégradation proportionnelle sévère, l’autre traduisant une dynamique de renforcement mutuel vigoureuse — génèrent rigoureusement et trait pour trait le même coefficient de détermination de 0,49 (ou 49 % de variance expliquée). Se fier exclusivement au R2 dans un rapport de recherche occulte la dynamique même du système étudié. Cette propriété souligne l’indispensable préservation du coefficient R pour quiconque souhaite maintenir un regard intelligible sur la cinématique des variables en interaction.
4.2 Divergence de perception de la magnitude de l’effet
La non-linéarité inhérente à l’opération de mise au carré engendre un phénomène cognitif bien documenté chez les chercheurs : la distorsion d’appréciation de la taille d’effet. Parce que l’esprit humain est naturellement enclin à raisonner sur des échelles linéaires additives, nous avons tendance à projeter intuitivement la magnitude de r sur celle de R2. Or, l’élévation au carré comprime drastiquement les valeurs situées en deçà de l’unité, cette compression étant d’autant plus violente que la valeur d’origine est modeste.
Considérons une corrélation bivariée r de 0,50. Dans la nomenclature populaire de Cohen, un tel résultat est universellement célébré comme une corrélation « forte ». Pourtant, lorsqu’on le convertit en coefficient de détermination, le bilan de variance expliquée s’élève à seulement :
R2 = (0,50)2 = 0,25 (soit 25 %)
Cette conversion révèle une réalité souvent perçue comme un choc méthodologique : une corrélation de 0,50 laisse en réalité 75 % de la dispersion globale du critère totalement inexpliquée au sein des résidus d’erreur. Si nous examinons un coefficient de corrélation qualifié d’intermédiaire, tel que r = 0,30, la part de variance modélisée chute à un résidu de 0,09, soit à peine 9 %. Le tableau suivant illustre cette dynamique d’atténuation non linéaire :
- Pour r = 0,10 → R2 = 0,01 (1 % de variance expliquée, 99 % d’erreur résiduelle)
- Pour r = 0,30 → R2 = 0,09 (9 % de variance expliquée, 91 % d’erreur résiduelle)
- Pour r = 0,50 → R2 = 0,25 (25 % de variance expliquée, 75 % d’erreur résiduelle)
- Pour r = 0,70 → R2 = 0,49 (49 % de variance expliquée, 51 % d’erreur résiduelle)
- Pour r = 0,90 → R2 = 0,81 (81 % de variance expliquée, 19 % d’erreur résiduelle)
Cette discordance génère des controverses acharnées quant à l’évaluation des interventions thérapeutiques, pharmacologiques ou éducatives. Des détracteurs mal informés peuvent aisément discréditer une innovation médicale en arguant que son R2 n’est que de 0,04 (4 % de variance des guérisons expliquée), alors même que ce résultat dérive d’une corrélation r de 0,20 qui, à l’échelle d’une population de plusieurs dizaines de milliers de patients, représente des milliers de vies concrètement sauvées. L’incompréhension de l’écartement géométrique séparant l’échelle des R de celle des R2 est ainsi à la racine de jugements d’utilité publique erronés.
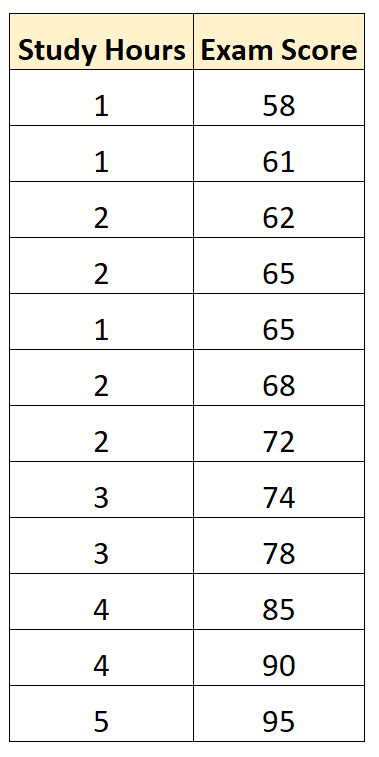
4.3 Comparaison sur un cas d’étude univarié : heures d’étude et notes d’examen
Pour matérialiser ces considérations théoriques, examinons un scénario empirique canonique en sciences de l’éducation : l’analyse de la relation univariée entre le temps consacré à la révision académique hebdomadaire (variable prédictive continue X, mesurée en heures) et la note finale obtenue à un examen standardisé de méthodologie statistique (variable critère continue Y, calibrée sur une échelle de 0 à 100 points). Supposons que l’analyse soit conduite sur un échantillon représentatif de n = 150 étudiants de licence universitaire.
L’estimation du coefficient de corrélation produit-moment de Pearson aboutit à une valeur de r = +0,60, assortie d’une significativité statistique indiscutable (p < 0,001). Ce résultat autorise l’analyste à conclure sans ambiguïté à l’existence d’une relation directionnelle positive solide : à mesure que les étudiants intensifient leur charge horaire d’étude, la performance finale tend systématiquement à s’accroître le long de la droite d’ajustement empirique.
Toutefois, lorsqu’on bascule vers l’estimation du coefficient de détermination, le calcul révèle :
R2 = (0,60)2 = 0,36
La formulation verbale académique rigoureuse de ce résultat s’énonce comme suit : « L’investissement temporel consenti par les étudiants permet d’expliquer 36 % de la dispersion globale des notes obtenues à l’examen. » Dès lors, l’analyste débutant est guetté par deux écueils interprétatifs symétriques. Le premier consisterait à affirmer à tort que « les étudiants augmentent leurs notes de 36 % », ce qui confondrait absurdement un ratio de variance avec une pente de régression non standardisée en points bruts d’examen. Le second piège consisterait à proclamer que le temps d’étude régit la majeure partie de la performance académique. Le calcul impose une vision plus nuancée : 64 % de la variabilité des résultats demeure irréductiblement liée à d’autres déterminants non modélisés — tels que les aptitudes cognitives antérieures, la qualité intrinsèque des stratégies d’apprentissage, l’anxiété de performance face à l’épreuve, ou encore la qualité du repos nocturne.
5. R vs R-carré dans le cadre de la régression linéaire multiple
5.1 Redéfinition du coefficient R multiple
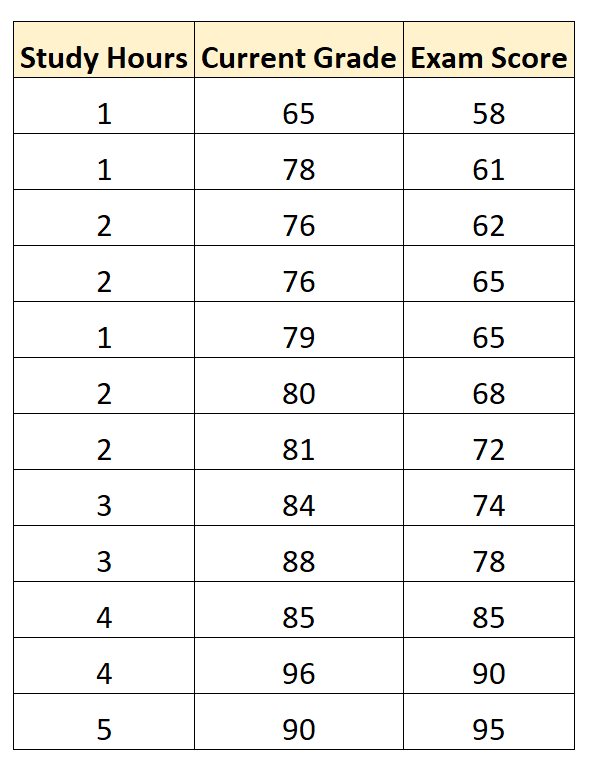
Dès lors que l’on s’émancipe du cadre simplifié de la régression linéaire simple pour aborder la régression linéaire multiple (intégrant un vecteur de k prédicteurs X1, X2, …, Xk pour modéliser une variable critère Y), l’analogie univariée s’effondre. Le coefficient r de Pearson bivarié ne suffit plus à capturer la complexité du système. C’est à ce carrefour méthodologique qu’intervient une redéfinition conceptuelle majeure : l’émergence du coefficient de corrélation multiple, conventionnellement désigné par la majuscule R.
Le R multiple ne représente plus la covariation entre deux variables physiques isolées. Il se définit rigoureusement comme le coefficient de corrélation linéaire simple calculé entre les valeurs réelles observées de la variable critère (Y) et les valeurs composées prédites issues de l’équation de régression linéaire combinée (Ŷ) :
R = r(Y, Ŷ)
Cette reformulation entraîne une conséquence fondamentale sur l’intervalle de définition de la statistique. Alors que le coefficient de corrélation bivarié r oscille librement de -1 à +1, le coefficient R multiple est structurellement incapable d’adopter une valeur négative. Son domaine de variation est strictement borné à l’espace semi-fermé :
0,00 ≤ R ≤ 1,00
Cette impossibilité mathématique d’un R multiple négatif découle directement des postulats d’optimisation par la méthode des moindres carrés ordinaires. L’algorithme des MCO calcule les coefficients de régression partiels de telle sorte que la droite (ou l’hyperplan) minimise la somme des carrés des erreurs. Si la relation globale entre la combinaison linéaire des prédicteurs et le critère tendait à s’inverser, l’algorithme inverserait simplement le signe des coefficients de régression β pour assurer que la corrélation finale entre ce que le modèle prédit (Ŷ) et ce qui est observé (Y) demeure systématiquement positive ou nulle. Le R multiple devient ainsi une mesure unilatérale de l’adéquation prédictive globale du conglomérat de régresseurs.
5.2 Signification du R-carré multivarié
Dans l’architecture multivariée, le coefficient de détermination R2 prend la dénomination formelle de coefficient de détermination multiple. Il conserve sa vocation de ratio de variance expliquée, formalisant la proportion conjointe de dispersion du critère Y capturée par l’ensemble des prédicteurs X1 à Xk agissant de concert. Mathématiquement, il correspond toujours rigoureusement au carré du coefficient de corrélation multiple :
R2 = (Rmultiple)2 = SSreg / SStot
Cependant, la partition de cette variance globale devient infiniment plus complexe en raison des intercorrélations inévitables qui lient les régresseurs entre eux, un phénomène connu sous le nom de multicolinéarité. En situation idéale d’orthogonalité parfaite (où toutes les covariables sont mutuellement décorrélées à 100 %), le R2 multiple serait simplement la somme arithmétique des r2 bivariés individuels de chaque prédicteur avec le critère. Or, dans les données empiriques réelles, les prédicteurs partagent presque toujours des portions significatives de variance commune.
Il devient dès lors nécessaire de recourir à la théorie des corrélations semi-partielles pour disséquer l’anatomie du R2 multivarié. La variance totale expliquée par le modèle se décompose en :
- Des fractions de variance unique, c’est-à-dire des tranches de dispersion de Y qui ne sont expliquées que par un prédicteur spécifique, à l’exclusion de tous les autres (mesurées par le carré des corrélations semi-partielles sri2) ;
- Des fractions de variance partagée ou commune, représentant des zones de recouvrement informationnel où plusieurs régresseurs revendiquent concurremment la même part de prédiction.
Le R2 multiple consolide ces fragments uniques et partagés en un indicateur synthétique d’ajustement global. Il quantifie l’efficacité prédictive finale du faisceau de variables sans toutefois pouvoir, à lui seul, révéler quel prédicteur détient la primauté explicative au sein de ce réseau d’interdépendances.
5.3 Illustration empirique : prédiction du bien-être psychologique
Considérons une investigation empirique en psychologie de la santé destinée à modéliser le niveau d’ajustement psychologique global (score continu de bien-être mental mesuré par un inventaire psychométrique validé, variable Y) au moyen de trois prédicteurs théoriquement motivés : la qualité subjective moyenne du sommeil (X1), le niveau de soutien social perçu (X2), et l’indice de stress perçu au travail (X3). Le protocole est administré à une cohorte de N = 320 professionnels de santé hospitaliers.
Après estimation de l’équation de régression linéaire multiple par les moindres carrés, le logiciel statistique renvoie les métriques synthétiques suivantes :
- Coefficient de corrélation multiple : R = 0,65 ;
- Coefficient de détermination multiple : R2 = 0,4225 (soit 42,3 % de variance expliquée) ;
- Coefficients de régression standardisés (β) : βsommeil = +0,32 (p < 0,001), βsoutien = +0,28 (p < 0,01), et βstress = -0,41 (p < 0,001).
L’analyse de ces indices offre une démonstration exemplaire de leur complémentarité fonctionnelle. Le coefficient R = 0,65 atteste d’une corrélation substantielle entre les profils de bien-être réels des soignants et les prédictions computationnelles forgées par le modèle d’ajustement composite. Le R2 multivarié de 0,423 établit que l’action conjointe de l’hygiène de sommeil, du réseau relationnel et de la charge de stress parvient à réguler plus de quatre dixièmes de la dispersion globale du bien-être au sein de cette population particulièrement vulnérable.
Toutefois, le R2 à lui seul occulterait la nature dynamique des forces à l’œuvre. C’est l’examen simultané des coefficients β qui restitue la polarité des associations : tandis que le sommeil et le réseau relationnel agissent comme des leviers protecteurs renforçant le bien-être (pentes positives), le stress perçu déploie un impact délétère majeur d’orientation inverse (pente négative). L’analyste articule ainsi le pouvoir explicatif global agrégé dans le R-carré avec les trajectoires causales spécifiques encodées dans les paramètres signés du modèle.
6. Fondements mathématiques : de la covariance à la décomposition des sommes des carrés
6.1 Architecture algébrique des sommes des carrés
Pour appréhender l’intimité structurelle du coefficient R2 et sa dissociation formelle d’avec le coefficient R, il est impératif d’examiner le formalisme matriciel et géométrique de la décomposition des sommes de carrés d’écarts. L’analyse statistique linéaire postule qu’en l’absence de tout modèle ou de toute information auxiliaire, la meilleure estimation prédictive assignable à une observation arbitraire Yi demeure la moyenne arithmétique globale de l’échantillon ȳ. L’écart (Yi – ȳ) matérialise donc l’erreur prédictive de base.
L’effort de modélisation introduit un vecteur de prédiction Ŷi, fractionnant cette incertitude originelle en deux vecteurs distincts :
(Yi – ȳ) = (Ŷi – ȳ) + (Yi – Ŷi)
En procédant à l’évaluation quadratique sur l’ensemble des n observations, nous développons la somme :
∑i=1…n (Yi – ȳ)2 = ∑i=1…n [ (Ŷi – ȳ) + (Yi – Ŷi) ]2
En développant le produit remarquable à l’intérieur de la sommation, on obtient trois termes distincts :
∑(Yi – ȳ)2 = ∑(Ŷi – ȳ)2 + ∑(Yi – Ŷi)2 + 2 ∑(Ŷi – ȳ)(Yi – Ŷi)
Or, sous le protocole de régression des moindres carrés ordinaires, la condition de premier ordre imposée pour minimiser la fonction de perte quadratique contraint le terme résiduel ei = (Yi – Ŷi) à être rigoureusement orthogonal à l’espace sous-tendu par les régresseurs, et par conséquent à être parfaitement orthogonal au vecteur des valeurs ajustées Ŷi ainsi qu’au vecteur unitaire constant associé à la moyenne. Par cette propriété d’orthogonalité géométrique stricte, le double produit croisé s’annule identiquement :
2 ∑ (Ŷi – ȳ)(Yi – Ŷi) = 0
Nous parvenons ainsi à l’inviolable identité pythagoricienne des sommes des carrés :
SST = SSR + SSE
(avec SST = Somme Totale des Carrés, SSR = Somme des Carrés de la Régression, et SSE = Somme des Carrés des Erreurs résiduelles).
6.2 Liaison formelle entre covariance bivariée et résidus
La dérivation formelle qui relie la covariance bivariée des données empiriques à la décomposition géométrique des résidus met en lumière le pont analytique qui unit r et R2. Rappelons que le coefficient de régression univarié (la pente brute b1) se définit comme le quotient de la covariance empirique sur la variance de la variable indépendante :
b1 = Cov(X, Y) / Var(X) = [ ∑(Xi – x̄)(Yi – ȳ) ] / [ ∑(Xi – x̄)2 ]
Dans cette configuration univariée, la valeur prédite par le modèle linéaire se formule par Ŷi = ȳ + b1(Xi – x̄). Dès lors, la somme des carrés de la régression SSR s’écrit :
SSR = ∑(Ŷi – ȳ)2 = ∑ [ b1(Xi – x̄) ]2 = b12 × ∑(Xi – x̄)2
En substituant l’expression explicite de la pente b1 dans cette équation, il vient :
SSR = [ ∑(Xi – x̄)(Yi – ȳ) ]2 / [ ∑(Xi – x̄)2 ]
Si l’on calcule désormais le ratio fondamental du coefficient de détermination R2 = SSR / SST, nous constatons que :
R2 = [ ∑(Xi – x̄)(Yi – ȳ) ]2 / [ ∑(Xi – x̄)2 × ∑(Yi – ȳ)2 ]
Cette fraction correspond rigoureusement et point par point au carré algébrique de la définition canonique du coefficient de corrélation de Pearson formalisée au chapitre 2. Cette preuve mathématique démontre sans équivoque que le R-carré n’est autre que la formalisation scalaire de la covariance au carré, normalisée par l’inertie globale des deux variables en présence. L’orthogonalité des moindres carrés garantit que ce rapport est invariant par toute transformation linéaire positive des variables, confirmant son statut d’indice d’effet standardisé universel.
6.3 Implications sur la non-linéarité des échelles de mesure
L’une des leçons mathématiques les plus impératives issues de cette formulation réside dans la disparité de progression géométrique existant entre l’échelle des coefficients R et celle des coefficients R2. L’application d’un exposant quadratique crée une distorsion dynamique : à mesure que le coefficient de corrélation R progresse de manière unitaire et régulière, le gain marginal induit sur la variance expliquée R2 suit une courbe exponentielle accélérée.
Examinons la dérivée première du coefficient de détermination par rapport au coefficient de corrélation univarié :
d(R2) / d(r) = 2r
Cette relation différentielle élémentaire prouve formellement que le taux d’accroissement instantané de la variance expliquée est proportionnel à la magnitude déjà atteinte par le coefficient de corrélation. Ainsi :
- Lorsque r croît modestement de 0,10 à 0,20 (Δr = 0,10), le R2 progresse de 0,01 à 0,04, libérant un gain dérisoire de seulement 3 % de variance expliquée additionnelle ;
- Lorsque r progresse du même intervalle unitaire de 0,10, mais cette fois en passant de 0,40 à 0,50 (Δr = 0,10), le R2 bondit de 0,16 à 0,25, octroyant un gain de 9 % de variance ;
- Enfin, si r effectue ce même bond de 0,10 dans les zones de haute corrélation, passant de 0,80 à 0,90 (Δr = 0,10), le R2 s’envole de 0,64 à 0,81, soit un différentiel massif de 17 % de variance expliquée supplémentaire pour une variation identique de l’indice de corrélation.
Cette non-équivalence métrique a des répercussions considérables sur l’évaluation des progrès théoriques en science empirique. Améliorer un modèle de mesure pour faire passer une corrélation critère de 0,80 à 0,90 requiert une capture d’information résiduelle bien plus prodigieuse et structurellement décisive que d’extraire un prédicteur naïf faisant osciller r de 0,10 à 0,20. Le chercheur doit impérativement intégrer cette géométrie sous peine de méconnaître l’effort analytique requis par l’optimisation des modèles prédictifs avancés.
7. Divergences conceptuelles et dimensions clés de comparaison
7.1 Directionnalité et polarité
La divergence la plus manifeste entre le coefficient de corrélation R et le coefficient de détermination R2 réside incontestablement dans le traitement de la directionnalité de l’effet. Le coefficient R est un indice conservateur de trajectoire : son signe algébrique est le témoin immédiat de la dynamique phénoménologique qui lie les variables. Il matérialise l’inclinaison de la pente d’ajustement. Grâce à lui, l’expérimentateur sait instantanément si une thérapeutique pharmacologique réduit ou amplifie la symptomatologie clinique d’un trouble, ou si une réforme managériale majore ou diminue l’attrition du personnel.
Le R-carré, quant à lui, opère une occultation complète de cette dimension directionnelle par son élévation au carré. Cette neutralisation de la polarité recèle un péril communicationnel majeur dans la restitution des données scientifiques. Un rapport d’évaluation qui se bornerait à claironner : « L’adjonction de notre nouveau protocole pédagogique explique un remarquable R2 de 30 % de la variance des résultats académiques » cacherait en réalité une ambiguïté potentiellement catastrophique. Si la corrélation sous-jacente est négative (r = -0,55), ce modèle triomphant décrirait en vérité une chute dramatique des performances scolaires consécutive à l’intervention.
Ce phénomène d’amnésie directionnelle fait du R-carré un indice incomplet pour la prise de décision empirique lorsqu’il est présenté de façon isolée. Aucun scientifique ou décideur ne peut engager de ressources stratégiques sur la seule base d’un R2 substantiel sans vérifier au préalable les vecteurs de régression directionnels associés. Le R capture le sens de l’histoire ; le R2 n’en quantifie que l’ampleur statistique globale.
7.2 Échelle de mesure et interprétabilité intuitive
Bien que le coefficient R préserve la direction de la relation, il souffre d’un déficit notoire d’intelligibilité intuitive en matière d’échelle quantitative directe. Que signifie concrètement une corrélation bivariée de 0,42 dans le monde réel ? L’unité de corrélation r ne correspond à aucune entité métrique directement tangible ou appréhendable par l’expérience sensorielle. Elle exprime une inclinaison d’axe dans un espace standardisé, un cosinus d’angle vectoriel dont la traduction verbale courante se limite souvent à des adjectifs flous et subjectifs (« modérée », « substantielle », « satisfaisante »).
À l’opposé, le coefficient de détermination R2 brille par une puissance d’évocation immédiate : son expression en proportion ou en pourcentage de variance globale résonne avec une clarté comptable absolue auprès de l’esprit humain. Dire qu’un facteur contrôle 45 % de la dispersion d’une maladie donne le sentiment d’une maîtrise tangible du domaine étudié. Le R-carré s’assimile spontanément à l’image didactique d’un diagramme circulaire — le fameux « camembert de variance » — dont on découperait des quartiers sous l’effet des variables explicatives jusqu’à saturer l’espace disponible.
Toutefois, cette séduction intuitive du camembert de variance recèle ses propres pièges intellectuels en sciences humaines. Découper la complexité d’un comportement psychologique ou social en parts étanches de variance présuppose souvent une linéarité et une additivité indépendantes qui sont des illusions méthodologiques. Comme l’ont souligné de nombreux psychométriciens contemporains, la variance n’est pas une substance physique distribuable ; elle n’est qu’une métrique d’instabilité statistique. Fétichiser le pourcentage de R2 au détriment de l’analyse fine des distributions peut conduire à confondre la comptabilisation mécanique de l’incertitude avec la compréhension des mécanismes causaux réels.
7.3 Sensibilité à l’ordre des variables et dépendance structurelle
Une dimension fondamentale de différenciation conceptuelle réside dans la symétrie relationnelle face à l’inversion des rôles attribués aux variables au sein de l’architecture d’analyse. Le coefficient de corrélation simple de Pearson est un modèle d’égalité structurelle stricte. Il ignore souverainement les concepts de variable explicative et de variable expliquée :
r(X, Y) = r(Y, X)
Que vous calculiez la corrélation de la dépression sur le statut socio-économique ou celle du statut socio-économique sur la dépression, le résultat mathématique demeure immuablement identique au millionième de décimale près.
En revanche, dès que l’on quitte le cas d’école univarié pour considérer le R2 au sein de la modélisation statistique avancée, cette symétrie s’effondre. Le coefficient de détermination est intimement tributaire d’une asymétrie décisionnelle imposée par le chercheur : la désignation rigide d’un statut dépendant (le critère Y) et d’un pool de statuts indépendants (les prédicteurs Xi). Le R-carré évalue la projection orthogonale d’un vecteur spécifique sur un hyperplan de sous-espace :
R2Y | (X1, X2) ≠ R2X1 | (Y, X2)
Si vous tentez de prédire le salaire annuel (Y) à partir de l’âge (X1) et du quotient intellectuel (X2), vous obtiendrez un R2 spécifique. Si vous permutez l’architecture pour tenter de prédire l’âge (X1) à partir du salaire (Y) et du QI (X2), la somme des carrés totale cible sera radicalement différente, le sous-espace projectif changera de nature géométrique, et le R2 obtenu n’aura aucune commune mesure avec le précédent. Le R2 est donc asservi à la théorisation causale ou prédictive postulée a priori par l’expérimentateur, là où le coefficient R demeure un simple témoin passif d’une liaison non orientée.
8. Le problème de l’inflation mécanique : R-carré ajusté versus R-carré ordinaire
8.1 Le biais d’optimisme statistique du R-carré
L’une des défaillances structurelles les plus insidieuses du coefficient de détermination ordinaire (noté R2 classique) réside dans sa vulnérabilité absolue au surajustement statistique, couramment désigné sous le terme anglo-saxon d’overfitting. En vertu de la décomposition des sommes des carrés explicitée au chapitre 3, la méthode des moindres carrés optimise les paramètres de régression de manière à s’adapter au plus près des singularités de l’échantillon empirique particulier soumis au calcul. L’algorithme mathématique ne discrimine pas entre le « signal » théorique pérenne et le « bruit » idiosyncratique ou stochastique lié aux fluctuations d’échantillonnage.
Il en résulte une loi mathématique implacable : chaque fois qu’un nouveau prédicteur est injecté dans un modèle de régression linéaire multiple, la somme des carrés résiduelle SSres décroît nécessairement (ou demeure au strict pire identique si le coefficient associé est exactement nul), ce qui provoque la hausse mécanique et artificielle inévitable du R2 ordinaire. Même si un chercheur intègre dans sa régression une série de variables générées par un tirage gaussien aléatoire totalement indépendant du phénomène étudié, le R2 affichera une progression positive continue.
Cette dynamique engendre un « biais d’optimisme statistique » majeur. Le R2 d’échantillon constitue une estimation systématiquement biaisée à la hausse du véritable pouvoir de détermination de la population parente. Ce phénomène est d’autant plus dévastateur que la taille de l’échantillon (n) est restreinte et que le nombre de régresseurs (k ou p) est élevé. Si un analyste ajuste un modèle comportant 20 prédicteurs sur un échantillon minuscule de 21 individus, le modèle atteindra mathématiquement un R2 déterministe absolu de 1,00 (100 % de variance prétendument expliquée), alors même que le modèle est une coquille statistique vide, dénuée de toute validité externe et incapable de prédire la moindre observation future.
8.2 Formulation mathématique et logique du R-carré ajusté
Conscients de cette dérive inflationniste qui menaçait la crédibilité des inférences multivariées, les statisticiens — sous l’impulsion pionnière de Mordecai Ezekiel en 1930 — ont développé une métrique corrective indispensable : le coefficient de détermination ajusté, conventionnellement symbolisé par R̄2 (R-carré barre) ou R2adj. La logique sous-jacente consiste à substituer aux sommes des carrés brutes leurs équivalents divisés par leurs degrés de liberté respectifs, transformant ainsi les sommes de carrés en variances non biaisées (carrés moyens ou Mean Squares).
La formulation algébrique rigoureuse du R-carré ajusté s’établit comme suit :
R2adj = 1 – [ (SSres / (n – p – 1)) / (SStot / (n – 1)) ]
ce qui peut être réécrit directement en fonction du R2 ordinaire :
R2adj = 1 – [ (1 – R2) × ((n – 1) / (n – p – 1)) ]
(où n représente la taille globale de l’échantillon et p le nombre total de variables indépendantes ou prédicteurs intégrés dans le modèle).
L’analyse de ce terme de correction ((n – 1) / (n – p – 1)) met en lumière le mécanisme de pénalisation algorithmique. Ce ratio est strictement supérieur à 1 dès lors que p ≥ 1. Par conséquent, l’adjonction d’un nouveau prédicteur déclenche désormais une tension antagoniste au sein de la formule :
- D’une part, l’apport du prédicteur tend à faire baisser (1 – R2), ce qui tire l’indice vers le haut ;
- D’autre part, la perte d’un degré de liberté au dénominateur majore le ratio de pénalisation ((n – 1) / (n – p – 1)), ce qui tire l’indice vers le bas.
Pour que le R2 ajusté progresse lors de l’intégration d’un nouveau prédicteur, il ne suffit plus que ce dernier absorbe un fragment marginal de variance : il faut impérativement que sa contribution explicative dépasse le coût statistique de la perte d’un degré de liberté (ce qui équivaut rigoureusement à exiger que la valeur de son test F partiel associé soit strictement supérieure à 1,00). Fait remarquable : si un bloc de prédicteurs futiles est adjoint à l’équation, le terme pénalisant l’emporte, et le R2 ajusté décroît. Il est même mathématiquement tout à fait possible que le R2 ajusté devienne négatif lorsque le R2 ordinaire est proche de zéro au sein d’un échantillon restreint saturé de régresseurs.
8.3 Critères de sélection de modèles en recherche comportementale
L’arbitrage entre R2 ordinaire et R2 ajusté structure l’art délicat de la sélection de modèles en recherche empirique. En vertu du canon épistémologique du rasoir d’Ockham — qui stipule que la pluralité des entités ne doit jamais être postulée sans nécessité —, la communauté scientifique accorde une primauté méthodologique absolue au principe de parcimonie : entre deux architectures affichant des capacités prédictives comparables, le modèle mobilisant le plus faible nombre de prédicteurs doit toujours être préféré.
Dans cette perspective de sélection, le R2 ordinaire est définitivement disqualifié en tant que critère décisionnel, car son penchant pour l’inflation conduirait immanquablement l’expérimentateur à retenir des modèles pléthoriques saturés de variables parasites. Si le R2 ajusté constitue un correcteur indispensable de premier niveau, la méthodologie contemporaine lui adjoint fréquemment des estimateurs pénalisateurs plus stricts fondés sur la théorie de l’information :
- Le Critère d’Information d’Akaike (AIC), qui optimise l’équilibre entre la vraisemblance empirique du modèle et sa divergence informationnelle de Kullback-Leibler ;
- Le Critère d’Information Bayésien (BIC ou critère de Schwarz), qui applique une pénalisation logarithmique log(n) beaucoup plus sévère vis-à-vis des degrés de liberté, protégeant drastiquement les modélisations sur grands échantillons contre la prolifération de régresseurs non essentiels.
Les directives méthodologiques actuelles imposent dès lors aux chercheurs une totale transparence : toute publication soumise à l’évaluation par les pairs doit mentionner conjointement le R2 brut (témoin de la performance descriptive brute sur l’échantillon analysé) et le R2 ajusté (estimateur non biaisé de l’efficacité transposable à la population parente). Cette double déclaration est le prérequis éthique à toute affirmation relative à l’adéquation d’un modèle linéaire.
9. Limites statistiques et pièges d’interprétation en psychométrie
9.1 Le quartet d’Anscombe et la rupture de linéarité
L’un des avertissements méthodologiques les plus célèbres et les plus percutants de l’histoire de la statistique computationnelle moderne a été formulé en 1973 par le statisticien britannique Francis Anscombe sous la forme d’une démonstration graphique magistrale : le « quartet d’Anscombe ». Cet ensemble pédagogique est constitué de quatre jeux de données synthétiques bivariés distincts (comprenant chacun 11 observations). Tous partagent rigoureusement et à la décimale près les mêmes métriques descriptives : une moyenne de X égale à 9,0, une moyenne de Y de 7,5, une droite de régression identique Y = 3 + 0,5X, un coefficient de corrélation r strictement égal à 0,816, et un coefficient de détermination R2 immuable de 0,667 (soit 66,7 % de variance expliquée).
Cependant, dès lors que l’analyste procède à l’inspection visuelle des diagrammes de dispersion correspondants, une réalité morphologique stupéfiante se dévoile :
- Le premier jeu de données illustre une relation linéaire classique, homoscédastique et bien ordonnée, pour laquelle les métriques R et R2 reflètent avec fidélité la réalité distributionnelle ;
- Le second jeu présente une relation déterministe parfaite, mais totalement curviligne et parabolique. L’équation linéaire sous-estime grossièrement la liaison réelle, le R linéaire de 0,816 masquant une fonction non linéaire dont l’ajustement quadratique réel atteindrait un R2 de 1,00 ;
- Le troisième jeu décrit une relation linéaire parfaite entre 10 des points, mais héberge une seule valeur aberrante sur l’axe des Y qui dégrade artificiellement la droite et fait chuter le coefficient ;
- Le quatrième jeu montre une disposition où 10 points partagent rigoureusement la même coordonnée X avec des Y dispersés (corrélation réelle nulle), tandis qu’un point isolé à l’extrême droite impose à lui seul la pente, forçant artificiellement un R2 impressionnant de 0,67 par un effet de levier mécanique absolu.
La leçon épistémologique du quartet d’Anscombe est impitoyable : s’appuyer aveuglément sur les grandeurs numériques condensées de R et de R2 sans inspecter préalablement et méticuleusement les distributions graphiques des résidus et des nuages de points relève de la négligence méthodologique pure. Des métriques en apparence irréprochables peuvent n’être que les paravents d’artefacts structurels dévastateurs ou de ruptures de linéarité méconnues.
9.2 Le piège de la restriction d’étendue et de la troncature d’échantillon
Un autre artefact statistique de première magnitude, fréquemment documenté dans la recherche psychométrique et la sélection de personnel, est le phénomène de restriction d’étendue (range restriction). Le coefficient de corrélation de Pearson, et consécutivement le R-carré qui en dérive, sont des indices dépendants de la variabilité globale des distributions marginales étudiées. Si un chercheur évalue la relation liant une variable d’aptitude cognitive générale (X) à la performance professionnelle subséquente (Y) en administrant son protocole uniquement à des candidats qui ont préalablement été admis au sein d’une organisation d’élite hautement sélective, il commet une troncature d’échantillonnage sévère.
En éliminant de facto la fraction médiane et basse de la distribution des aptitudes cognitives, la variance observée sX2 se trouve violemment comprimée. Or, l’examen de la formule du coefficient de corrélation montre que la réduction du dénominateur par rétrécissement du champ d’observation compresse artificiellement la covariance empirique. Il en résulte un effondrement spectaculaire de la magnitude apparente de r, qui peut chuter par exemple d’une valeur théorique populationnelle de 0,60 à une valeur tronquée de 0,20. Le coefficient de détermination associé subit une dégradation exponentielle, passant de 0,36 (36 % de variance) à un dérisoire 0,04 (4 % de variance).
L’expérimentateur imprudent conclura faussement que l’aptitude intellectuelle ne prédit pas la performance professionnelle, ignorant que cette absence d’association n’est qu’un artefact induit par son filtre de sélection amont. Pour pallier ce biais d’interprétation, les méthodologistes mobilisent les équations correctives de Thorndike, permettant de redresser mathématiquement les coefficients R et R2 observés à partir de la connaissance de la variance de la population générale non restreinte. Ces procédures rappellent que la grandeur de R et de R2 ne caractérise jamais un phénomène en soi, mais qualifie indissociablement un phénomène au sein d’un échantillon spécifique doté d’une étendue de variabilité déterminée.
9.3 Erreur écologique et confusion entre corrélation et causalité
L’écueil interprétatif le plus universellement répandu demeure la propension tenace à franchir indûment le gouffre qui sépare l’observation d’un couplage statistique de la démonstration d’un lien de causalité déterministe. Qu’un modèle multivarié affiche un R multiple de 0,85 et un R2 de 0,72 atteste indiscutablement de l’excellence de son ajustement aux patrons de covariance des données colligées. En aucun cas cela ne constitue une validation empirique de l’hypothèse que les prédicteurs constituent les causes efficientes des variations du critère.
Le spectre des corrélations fallacieuses (spurious correlations) hante l’ensemble des études corrélationnelles non expérimentales. Deux variables empiriques totalement déconnectées sur le plan fonctionnel peuvent exhiber des valeurs de R et de R2 prodigieuses sous l’effet d’une troisième variable non observée — une variable confondante ou facteur de confusion — qui module simultanément les deux termes de l’équation. L’exemple classique de la corrélation positive quasi parfaite entre les ventes de crèmes glacées et le nombre de noyades au cours de l’année ne découle d’aucun lien physiologique direct, mais de l’influence systémique d’une variable climatique saisonnière omise : la température extérieure.
De surcroît, le chercheur doit constamment se prémunir contre l’erreur écologique, théorisée par William Robinson en 1950. Ce sophisme consiste à déduire indûment des relations au niveau des individus à partir de corrélations massives calculées à l’échelle d’unités géographiques ou institutionnelles agrégées. Un R2 de 0,80 observé entre le revenu moyen par département et le taux de mortalité par maladie cardiovasculaire n’implique absolument pas qu’un individu fortuné possède une probabilité accrue de déclarer un infarctus. L’agrégation macroscopique élimine la variabilité intra-groupe et gonfle exponentiellement les métriques R et R2, tissant des liens statistiques collectifs qui se dissolvent totalement dès que la mesure redescend à l’échelle clinique unitaire.
10. Utilisation pratique et restitution des résultats dans les logiciels statistiques
10.1 Extraction et lecture des sorties sous le langage R
L’environnement de programmation statistique R s’est imposé comme le standard académique de référence pour l’analyse computationnelle des données. L’ajustement d’un modèle de régression linéaire s’opère typiquement via la fonction primitive lm() (linear model), et la restitution synthétique des indicateurs est dévolue à l’exécution de la méthode générique summary() appliquée à l’objet modélisé.
Dans la console textuelle générée par l’interpréteur R, l’investigateur doit porter son attention sur le bloc terminal de sortie, où coexistent deux lignes distinctes de métriques de détermination :
- La ligne
Multiple R-squaredreporte le coefficient de détermination ordinaire (R2 classique). Dans le cas d’une régression univariée, cette valeur équivaut exactement au carré de la commandecor(x, y)^2; - La ligne contiguë
Adjusted R-squaredfournit la valeur du R-carré ajusté (R2adj), calculée rigoureusement selon la formule d’Ezekiel pénalisant la complexité du modèle par les degrés de liberté résiduels.
Sur le plan programmatique, le chercheur soucieux d’automatiser ses analyses ou d’injecter ses estimations dans des rapports reproductibles sous RMarkdown ou Quarto évitera d’extraire ces données par un copier-coller manuel propice aux erreurs. On accède directement aux grandeurs d’intérêt en interrogeant la structure de liste interne de l’objet résumé. La syntaxe summary(modele)$r.squared extrait avec une précision flottante absolue la métrique de détermination ordinaire, tandis que la commande summary(modele)$adj.r.squared isole le R-carré ajusté. Le coefficient R multiple s’obtient aisément en calculant la racine carrée arithmétique de la composante ordinaire par la fonction sqrt(summary(modele)$r.squared).
10.2 Décodage des tableaux de synthèse de modèle sous IBM SPSS
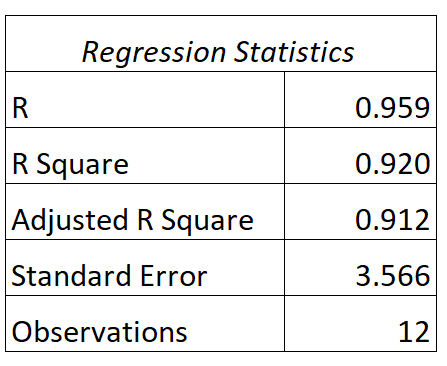
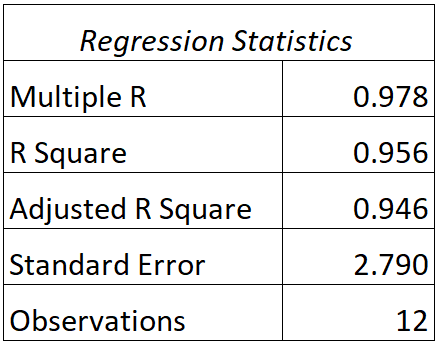
Dans le logiciel IBM SPSS Statistics, environnement graphique prépondérant dans de nombreux départements de psychologie et de sciences biomédicales, la régression linéaire produit une série de tableaux normalisés au sein du visualiseur de résultats. La table cardinale pour notre problématique s’intitule conventionnellement Récapitulatif des modèles (ou Model Summary dans la version anglaise du logiciel).
Ce tableau présente une lecture séquentielle structurée en colonnes standardisées :
- La colonne
Rprésente la magnitude du coefficient de corrélation. S’il s’agit d’une régression simple, cette case affiche la valeur absolue |r| du coefficient de Pearson (sans signe). S’il s’agit d’une modélisation multivariée, elle affiche le coefficient de corrélation multiple R = r(Y, Ŷ) ; - La colonne
R-deux(ou R Square) fournit le coefficient de détermination conventionnel, traduisant le pourcentage brut de variance expliquée sur l’échantillon ; - La colonne
R-deux ajusté(ou Adjusted R Square) délivre l’estimation redressée pour les degrés de liberté, indispensable à l’évaluation de la généralisabilité de l’ajustement.
Une vigilance particulière s’impose lors de la mise en œuvre d’une régression hiérarchique par blocs successifs sous SPSS. Le tableau de synthèse enrichit alors sa restitution d’une section intitulée Statistiques de changement (Change Statistics). La colonne critique Variation de R-deux (R Square Change, notée ΔR2) consacre l’apport incrémental strict du nouveau bloc de prédicteurs injecté, assortie de son propre test d’inférence via la colonne Signification de la variation de F (Sig. F Change). L’erreur fréquente chez les néophytes consiste à rapporter la valeur cumulée de la colonne R Square au lieu d’isoler l’apport marginal de ΔR2, conduisant à attribuer indûment aux nouvelles variables une part d’explication qui était déjà capturée par les covariables de contrôle introduites dans les blocs précédents.
10.3 Traitement sous Python (Statsmodels et Scikit-Learn)
Dans l’écosystème du langage Python, dédié conjointement à l’économétrie et à l’apprentissage automatique (machine learning), la manipulation de R et de R2 illustre deux philosophies computationnelles distinctes incarnées par les bibliothèques statsmodels et scikit-learn.
Le module statsmodels adopte une approche calquée sur la tradition statistique inférentielle classique. Lorsqu’on ajuste un modèle via smf.ols('y ~ x1 + x2', data=df).fit(), la méthode summary() génère un panneau d’analyse exhaustif quasi identique à celui de R. Les attributs .rsquared et .rsquared_adj de l’objet résultant fournissent respectivement le R2 brut et le R2 pénalisé d’Ezekiel, accompagnés des tests de Wald et de Student sur chaque paramètre β.
À l’opposé, la bibliothèque scikit-learn aborde la régression sous l’angle exclusif de la performance prédictive généralisable. Dans le paradigme machine learning, le coefficient R2 n’est pas calculé pour décrire les données d’entraînement, mais pour juger de la capacité du modèle à généraliser ses inférences sur des données tierces non vues (jeu de test). La fonction r2_score(y_true, y_pred) calcule la métrique en confrontant les vraies valeurs cibles d’un échantillon indépendant aux prédictions générées par l’algorithme :
R2test = 1 – [ ∑(Ytest – Ŷtest)2 / ∑(Ytest – ȳtest)2 ]
Cette approche d’évaluation croisée met en lumière une propriété vertigineuse que les statisticiens de laboratoire oublient parfois : lorsqu’il est appliqué à un jeu de test indépendant, le R-carré peut devenir arbitrairement négatif (pouvant chuter vers -∞). Un R2 négatif sur des données de test signifie formellement que le modèle entraîné réalise des prédictions pires que ne le ferait une simple ligne horizontale matérialisant la moyenne brute des données. L’analyste moderne privilégie cette validation croisée systématique pour démasquer l’optimisme trompeur des métriques R2 calculées intra-échantillon.
11. Normes de publication académique et directives de rédaction (Style APA)
11.1 Règles formelles de présentation selon l’APA 7e édition
L’American Psychological Association (APA), à travers la publication de la 7e édition de son manuel de normes rédactionnelles, régit avec une minutie chirurgicale la façon dont les indices statistiques doivent être typographiés et insérés au sein des manuscrits académiques internationaux. Le respect rigoureux de ces directives formelles constitue un critère discriminant majeur lors de l’évaluation par les comités de lecture des revues scientifiques.
Le premier principe typographique fondamental concerne l’usage strict de l’italique : tous les symboles statistiques désignés par des lettres latines doivent impérativement être composés en caractères italiques. Ainsi, on composera systématiquement r, R, R2, et R2adj, tandis que les lettres grecques canoniques (telles que β pour le coefficient de régression standardisé, ou ρ pour le coefficient de corrélation populationnel) demeurent rigoureusement en police romaine droite.
La seconde règle capitale concerne la gestion des décimales et l’omission obligatoire du zéro initial. Selon la norme APA 7, aucun zéro ne doit précéder la virgule ou le point décimal pour les grandeurs statistiques qui sont mathématiquement bornées et structurellement incapables de dépasser la valeur absolue de 1,00. Cette interdiction s’applique donc sans réserve :
- Au coefficient de corrélation bivarié r : on écrit de manière exemplaire r = ,45 ou r = -,32 (et jamais r = 0,45) ;
- Au coefficient de corrélation multiple R : on typographie R = ,68 ;
- Au coefficient de détermination R2 : on rapporte rigoureusement R2 = ,28 (et non R2 = 0,28) ;
- Aux valeurs de probabilité p : on formule p < ,001.
En revanche, pour les métriques non bornées pouvant théoriquement excéder l’unité unitaire — telles que les statistiques de test F de Snedecor, t de Student, les coefficients de régression non standardisés B ou les écarts-types —, le zéro initial doit être scrupuleusement restauré (ex. : F(2, 147) = 4,52 ; t(148) = 2,14). Par ailleurs, la norme préconise d’arrondir systématiquement les coefficients de corrélation et de détermination à deux décimales significatives, sauf impératif de précision métrologique exceptionnel.
11.2 Mise en contexte contextuelle de la taille d’effet
L’un des tournants épistémologiques majeurs actés par les méthodologistes au cours des deux dernières décennies réside dans le rejet formel de l’interprétation mécanique et décontextualisée des seuils de taille d’effet forgés historiquement par Jacob Cohen. Qualifier d’autorité un R2 de ,02 de « négligeable » ou un R2 de ,25 de « fort » relève d’une pensée dogmatique qui ignore les spécificités intrinsèques de l’objet d’étude et le coût économique ou sanitaire des phénomènes investigués.
Dans le domaine de l’épidémiologie clinique, de la médecine préventive ou de la santé publique, l’isolation d’un facteur comportemental ou environnemental affichant un R2 de seulement ,01 (soit un modeste 1 % de variance expliquée d’une pathologie létale) peut constituer une découverte de premier plan aux implications sanitaires monumentales. Lorsque ces fractions de pourcentage sont extrapolées à l’échelle d’une population continentale de plusieurs centaines de millions de citoyens, la résorption de ce modeste 1 % de dispersion peut se traduire mathématiquement par la prévention de dizaines de milliers d’admissions en soins intensifs ou de décès prématurés. À l’opposé, en psychométrie fondamentale de laboratoire ou lors du calibrage d’épreuves d’intelligence artificielle, un modèle n’atteignant pas un R2 de ,50 peut être jugé méthodologiquement insuffisant pour fonder un protocole diagnostique individualisé fiable.
En cohérence avec ces exigences, le style APA 7 impose désormais aux chercheurs de ne plus jamais se contenter de reporter des estimations ponctuelles isolées, mais d’adosser systématiquement aux coefficients R et R2 leurs intervalles de confiance à 95 % (notés IC 95 % [limite inférieure, limite supérieure]). Le calcul d’un intervalle de confiance autour d’un coefficient de Pearson r nécessite le recours à la transformation en z de Fisher, qui restaure la normalité asymptotique de la distribution d’échantillonnage de la statistique :
zr = 0,5 × ln[ (1 + r) / (1 – r) ]
Pour le coefficient R2 multivarié, le calcul de l’intervalle de confiance repose sur les distributions non centrales de Fisher-Snedecor. Déclarer que R2 = ,18, IC 95 % [,04, ,32] informe la communauté sur la précision métrologique réelle de l’investigation, rappelant que la variance expliquée dans la population parente peut légitimement osciller entre un effet marginal de 4 % et un impact robuste de 32 %.
11.3 Modèles de phrases types pour rapports de recherche
Afin de prémunir les chercheurs et étudiants contre les maladresses sémantiques ou les incorrections normatives, voici un florilège de gabarits rédactionnels standardisés conformes aux canons académiques les plus stricts.
Pour la restitution d’une régression linéaire univariée :
« Une analyse de régression linéaire simple a été conduite afin de déterminer dans quelle mesure le volume hebdomadaire d’activité physique (en minutes) prédit le niveau d’anxiété état mesuré par le score STAI-Y. Les résultats révèlent une relation linéaire statistiquement significative et négative entre les deux variables, r = -,46, t(198) = -7,28, p < ,001, IC 95 % [-,57, -,34]. Le coefficient de détermination associé indique que la pratique physique permet d’expliquer 21 % de la variance totale des scores d’anxiété au sein de la cohorte étudiée (R2 = ,21, R2adj = ,20). »
Pour la restitution d’une régression linéaire multiple hiérarchique :
« Pour tester l’hypothèse d’une contribution incrémentale de la flexibilité cognitive sur la réussite managériale au-delà des facteurs socio-démographiques, une analyse de régression multiple hiérarchique en deux étapes a été exécutée. L’introduction au Bloc 1 de l’âge et de l’ancienneté professionnelle génère un ajustement global statistiquement significatif, R = ,31, F(2, 247) = 12,85, p < ,001, expliquant 9,4 % de la variance de la performance (R2 = ,094, R2adj = ,087). L’incorporation au Bloc 2 de l’indice de flexibilité cognitive engendre une progression hautement significative du pouvoir prédictif du modèle, ΔR2 = ,142, ΔF(1, 246) = 45,12, p < ,001. Dans sa configuration finale, le modèle complet explique 23,6 % de la dispersion globale du critère (R = ,486, R2 = ,236, R2adj = ,227). Au sein de cette équation finale, la flexibilité cognitive constitue le prédicteur le plus substantiel (β = ,41, p < ,001), surpassant l’impact résiduel de l’ancienneté (β = ,18, p = ,004). »
12. Guide décisionnel et synthèse méthodologique pour le chercheur
12.1 Arbre décisionnel : quelle métrique privilégier et quand ?
Face à la dualité permanente entre R et R2, le chercheur doit structurer son choix analytique en fonction de la nature exacte de sa question de recherche, de la topologie de son design méthodologique et des impératifs de communicabilité des résultats. L’orientation ne doit rien laisser au hasard ou à l’habitude logicielle.
Cas 1 : Privilégier prioritairement le coefficient de corrélation bivarié R (ou r).
Ce scénario s’impose de façon indiscutable lorsque l’investigation empirique poursuit une visée strictement relationnelle, exploratoire ou épistémologique fondamentale sans assignation de rôles fonctionnels asymétriques. Lorsque vous étudiez l’association entre deux biomarqueurs sériques contemporains ou la corrélation d’équilibre entre deux traits de personnalité latents (par exemple l’extraversion et l’agréabilité), vous n’avez aucune base théorique légitime pour proclamer que l’un est prédicteur de l’autre. Le coefficient R s’impose alors avec force, car il est le seul à honorer la parfaite bidirectionnalité symétrique de la relation tout en conservant le signe algébrique de leur concordance.
Cas 2 : Privilégier prioritairement le coefficient de détermination R-carré (R2 ou R2adj).
Cette approche devient impérative dès lors que la recherche s’inscrit dans une perspective de modélisation asymétrique dirigée : validation de modèles explicatifs, ingénierie prédictive, économétrie décisionnelle ou évaluation des politiques publiques. Lorsque le chercheur postule formellement qu’un faisceau de covariables (temps d’apprentissage, statut socio-économique, encadrement tutorat) orchestre un critère explicité (taux d’insertion professionnelle), le R2 constitue la seule métrique adéquate pour dresser le bilan comptable de l’efficacité globale du système proposé. De surcroît, dès qu’au moins deux prédicteurs entrent en jeu (régression multiple), l’abandon de r au profit du couple R2 / R2adj est une obligation mathématique absolue pour neutraliser les redondances de variance colinéaires.
Cas 3 : Signaux d’alerte commandant l’abandon pur et simple de R et de R2 classiques.
L’analyste doit impérativement renoncer à l’emploi de ces deux métriques linéaires conventionnelles dans les contextes méthodologiques suivants :
- Inspection graphique révélant une morphologie fonctionnelle intrinsèquement non linéaire (relations quadratiques, exponentielles, sigmoïdes, en U inversé) : le recours aux modèles polynomiaux, aux splines de régression ou aux modèles additifs généralisés (GAM) devient obligatoire ;
- Variable critère discontinue, dichotomique ou polytomique : l’architecture des moindres carrés s’effondre au profit de la régression logistique binaire, multinomiale ou du modèle à risques proportionnels de Cox, imposant l’usage de pseudo-R2 spécifiques ;
- Présence avérée d’hétéroscédasticité sévère ou distribution fortement leptokurtique des résidus d’erreur : le recours à la régression robuste, aux estimateurs de sandwich de Huber-White ou à la régression quantile est requis.
12.2 Tableau comparatif exhaustif des attributs statistiques
Afin de condenser les enseignements mathématiques, conceptuels et opératoires développés tout au long de ce traité, le tableau synoptique ci-dessous synthétise les propriétés distinctives qui structurent l’opposition et la complémentarité entre le coefficient de corrélation R, le coefficient de détermination ordinaire R2 et sa déclinaison ajustée R2adj.
| Attribut Statistique | Coefficient de Corrélation (R / r) | Coefficient de Détermination Ordinaire (R2) | Coefficient de Détermination Ajusté (R2adj) |
|---|---|---|---|
| Domaine de variation | [-1,00 ; +1,00] en bivarié [0,00 ; 1,00] en multiple |
[0,00 ; 1,00] (0 % à 100 %) | ]-∞ ; 1,00] (peut théoriquement adopter des valeurs négatives) |
| Nature de l’information | Vectorielle / Signée (magnitude et direction de la relation) | Scalaire / Absolue (proportion de variance modélisée) | Scalaire / Débiaisée (variance populationnelle estimée) |
| Symétrie des rôles (X vs Y) | Parfaitement symétrique : r(X, Y) = r(Y, X) |
Strictement asymétrique en multivarié : tributaire du statut prédicteur / critère | Strictement asymétrique : asservi aux degrés de liberté de l’équation |
| Équivalence univariée | Indice source linéaire standardisé | Rigoureusement égal au carré arithmétique de r : R2 = (r)2 | Inférieur à r2 en raison de la correction d’échantillon |
| Comportement lors de l’ajout de prédicteurs | Non applicable en simple ; le R multiple augmente ou stagne | Monotone non-décroissant : augmente mécaniquement (biais d’optimisme) | Pénalisé : ne croît que si le gain dépasse la perte d’un degré de liberté (F > 1) |
| Objectif épistémologique primaire | Évaluer la force et le sens d’un couplage associatif bivarié | Quantifier la qualité d’ajustement globale (Goodness-of-Fit) intra-échantillon | Sélectionner des modèles parcimonieux et estimer la généralisabilité externe |
| Typographie normative (APA 7) | r ou R en italique, omission du zéro initial (ex. : ,54) | R2 en italique, omission du zéro initial (ex. : ,29) | R2adj en italique, omission du zéro initial (ex. : ,27) |
12.3 Perspectives avancées et au-delà des métriques linéaires classiques
L’exploration conjointe de R et de R2 met en évidence que ces métriques constituent les piliers historiques de l’analyse linéaire des moindres carrés. Toutefois, la science contemporaine des données évolue désormais dans des espaces probabilistes non gaussiens où la décomposition classique de la somme des carrés (SST = SSR + SSE) cesse d’être opérationnelle. Dans le cadre des Modèles Linéaires Généralisés (GLM) — tels que la régression logistique, la régression de Poisson pour données de comptage ou la régression Gamma —, l’absence de résidus gaussiens homoscédastiques interdit le calcul d’un R2 conventionnel.
Pour combler ce vide interprétatif, les biométriciens ont conçu une famille d’indices substitutifs désignés sous l’appellation générique de pseudo-R-carrés. Parmi les plus renommés :
- Le R2 de McFadden, enraciné dans le ratio de log-vraisemblance comparant le modèle ajusté au modèle nul : ρ2 = 1 – (ln Lmodèle / ln Lnul). Des valeurs oscillant entre 0,20 et 0,40 matérialisent déjà un ajustement d’une qualité exceptionnelle ;
- Le R2 de Cox & Snell, qui tente de préserver la notion de proportion géométrique de vraisemblance, mais souffre de l’incapacité théorique d’atteindre le plafond unitaire de 1,00 ;
- Le R2 de Nagelkerke (ou Cragg & Uhler), qui résout la défaillance de Cox & Snell en normalisant la formule par sa valeur maximale possible, restituant ainsi une échelle bornée entre 0 et 1.
En parallèle, l’essor contemporain de l’apprentissage automatique statistique (machine learning) a progressivement déplacé le barycentre de l’évaluation méthodologique. Si le R2 demeure employé pour jauger la généralisation sur les jeux de test, les algorithmes prédictifs modernes privilégient souvent des métriques d’erreur exprimées directement dans les unités réelles du phénomène sous observation. L’Erreur Quadratique Moyenne (Root Mean Squared Error ou RMSE) et l’Erreur Absolue Moyenne (Mean Absolute Error ou MAE) s’imposent aujourd’hui comme des compléments indispensables : elles mesurent avec une précision pragmatique immédiate l’écart physique moyen séparant les prédictions computationnelles de la réalité clinique ou industrielle.
En conclusion de cette analyse approfondie, il apparaît avec limpidité que le débat opposant le coefficient R au coefficient R2 n’a pas lieu d’être sous la forme d’une hiérarchie d’exclusion. Ils incarnent deux angles de vue géométriquement et conceptuellement indissociables sur le même objet statistique : le coefficient de corrélation R explore la direction et la compacité du chemin relationnel le long d’un axe orienté ; le coefficient de détermination R-carré quantifie le volume d’incertitude dompté par l’édifice mathématique dans l’espace des dispersions. Loin de toute confusion terminologique, c’est dans la maîtrise éclairée de leur synergie analytique que réside l’essence même de la rigueur scientifique appliquée.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Anscombe, F. J. (1973). Graphs in statistical analysis. The American Statistician, 27(1), 17–21. https://doi.org/10.2307/2682899
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Ezekiel, M. (1930). Methods of correlation analysis. John Wiley & Sons.
- Fisher, R. A. (1921). On the ‘probable error’ of a coefficient of correlation deduced from a small sample. Metron, 1, 3–32.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in econometrics (pp. 105–142). Academic Press.
- Nagelkerke, N. J. D. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London, Series A, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
- Robinson, W. S. (1950). Ecological correlations and the behavior of individuals. American Sociological Review, 15(3), 351–357. https://doi.org/10.2307/2087176
- Thorndike, R. L. (1949). Personnel selection: Test and measurement techniques. John Wiley & Sons.