
Dans le champ contemporain de la psychologie quantitative et des sciences comportementales, la modélisation statistique constitue le socle méthodologique sur lequel reposent l’inférence théorique et la validation empirique. Qu’il s’agisse d’évaluer l’efficacité différentielle d’une intervention psychothérapeutique, d’analyser l’effet des styles d’attachement sur l’alliance clinique ou de cartographier les déterminants psychosociaux de la dépression, les chercheurs sont constamment confrontés à l’intégration simultanée de variables de natures hétérogènes. Alors que les échelles psychométriques fournissent traditionnellement des scores continus ou pseudo-continus, les variables catégorielles — telles que le statut matrimonial, le diagnostic psychopathologique, le sous-type de personnalité ou l’assignation à un groupe expérimental — requièrent une transformation formelle préalable pour être intégrées dans le formalisme du modèle linéaire général.
Cette conversion passe inévitablement par l’élaboration de variables binaires indicatrices, universellement désignées sous le vocable anglo-saxon de dummy variables ou variables muettes. Bien que cette procédure d’encodage soit fondamentale et enseignée dès les premiers cycles de statistiques appliquées, elle dissimule une faille méthodologique et algébrique redoutable : le piège des variables muettes, ou dummy variable trap. Cette impasse computationnelle se produit lorsqu’un analyste, cherchant à représenter l’exhaustivité des modalités d’une variable qualitative, introduit simultanément une indicatrice pour chaque modalité tout en conservant le terme d’interception dans l’équation de régression. Le résultat de cette sur-spécification ne relève pas d’une simple imprécision d’échantillonnage, mais d’une anomalie géométrique absolue : l’émergence d’une colinéarité parfaite détruisant la résolubilité matricielle.
Le présent article propose une exploration exhaustive, rigoureuse et ancrée dans la pratique psychologique de cette pathologie statistique. Nous détaillerons les fondements théoriques de l’encodage catégoriel, la mécanique matricielle sous-jacente aux moindres carrés ordinaires, la preuve algébrique de la singularité, des exemples cliniques et psychométriques chiffrés, ainsi que l’ensemble des règles de paramétrisation, des schémas de contrastes alternatifs et des diagnostics logiciels indispensables à la conduite d’analyses empiriques irréprochables.
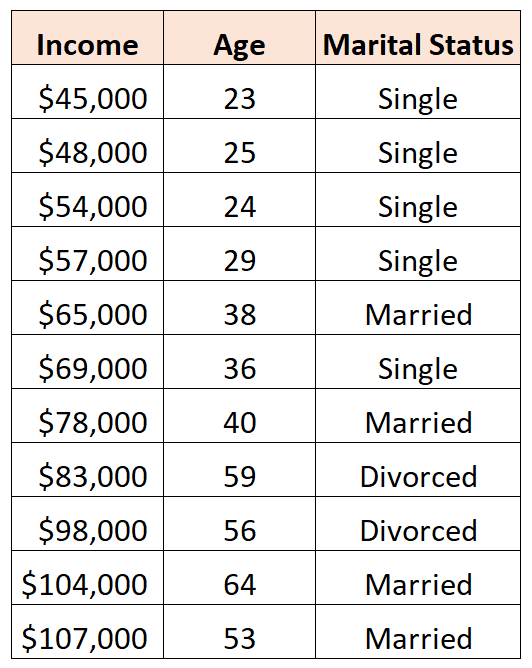
1. 1. Introduction aux variables catégorielles dans la modélisation statistique en psychologie
1.1 1.1 La distinction fondamentale entre variables quantitatives et qualitatives en psychométrie
En psychométrie et en conception expérimentale comportementale, la taxonomie des données constitue le premier filtre épistémologique conditionnant l’adéquation des outils statistiques. Les mesures quantitatives continues — à l’instar des temps de réaction millimétrés lors d’une tâche de Stroop, des indices de conductance cutanée ou des scores composites issus de batteries étalonnées comme les échelles de Wechsler — possèdent une structure métrique intrinsèque. Ces variables autorisent des opérations d’addition, de soustraction et de calcul de rapports de distances euclidiennes fondées sur un continuum d’intervalles constants. À l’opposé, les variables qualitatives ou catégorielles ordonnent les observations au sein de classes d’équivalence mutuellement exclusives et collectivement exhaustives. Ces classes décrivent des états, des entités typologiques ou des affiliations taxonomiques dénués de toute métrique spatiale naturelle.
Dans la pratique de la recherche clinique, une erreur pernicieuse consiste à assigner des valeurs numériques arbitraires — par exemple, affecter 1 aux célibataires, 2 aux personnes mariées, 3 aux personnes divorcées et 4 aux personnes veuves — et à injecter directement ce vecteur dans une équation de régression comme s’il s’agissait d’un continuum sous-jacent. Cette quantification brute impose artificiellement deux contraintes mathématiques infondées : d’une part, une relation d’ordre hiérarchique suggérant qu’un sujet veuf posséderait « quatre fois plus » de statut conjugal qu’un célibataire ; d’autre part, une stricte équidistance entre les échelons, postulant que la transition psychologique du célibat au mariage équivaut métriquement au passage du divorce au veuvage.
Une telle bévue méthodologique biaise lourdement les dérivées partielles du modèle linéaire, déforme l’estimation des erreurs types et mène à des inférences totalement aberrantes quant à l’action réelle des facteurs psychologiques. Pour respecter l’intégrité nominale des variables qualitatives sans induire de fausses relations de proportionnalité, la formalisation mathématique exige une transformation géométrique respectueuse de la nature non ordonnée des données : l’éclatement de la variable polytomique en un ensemble d’axes binaires orthogonaux.
1.2 1.2 Le principe de la régression linéaire appliquée aux données comportementales
Le modèle de régression linéaire multiple constitue le cheval de bataille de l’investigation empirique en psychologie quantitative. Sa structure canonique exprime une variable dépendante continue, notée Y, comme une combinaison linéaire de prédicteurs exogènes pondérés par des coefficients scalaires, complétée par un terme d’erreur stochastique représentant les fluctuations non expliquées :
Yi = β0 + β1X1i + β2X2i + … + βpXpi + εi
Sous les hypothèses classiques de Gauss-Markov, les résidus stochastiques εi sont postulés de moyenne nulle, homoscédastiques, mutuellement non corrélés et indépendants des prédicteurs. L’intégration de covariables démographiques, de scores cognitifs et d’indicateurs cliniques permet au chercheur d’isoler l’effet propre de chaque dimension tout en maintenant les autres constantes, un principe désigné sous le terme de condition ceteris paribus.
Dans ce paradigme, les coefficients partiels βj reflètent la variation moyenne attendue de la variable réponse psychologique pour chaque incrément unitaire du prédicteur Xj. Cependant, la validité mathématique fondamentale de cette architecture repose sur un postulat algébrique strict : l’indépendance linéaire des colonnes constituant la matrice des prédicteurs. Si l’un des régresseurs peut être formulé comme une combinaison linéaire exacte d’autres prédicteurs ou de la constante, l’espace vectoriel s’effondre, interdisant toute décomposition unique des parts de variance.
1.3 1.3 La transition incontournable vers l’encodage binaire des facteurs expérimentaux
Dès lors qu’un protocole expérimental psychologique intègre des facteurs nominaux polytomiques comportant k modalités distinctes, le recours à l’encodage binaire devient une nécessité technique. Cette manipulation consiste à fragmenter le facteur initial en un ensemble de nouvelles variables booléennes — les variables muettes — qui assument le statut de prédicteurs distincts au sein du vecteur d’observation. Chaque sujet se voit ainsi attribuer une coordonnée d’activation valant 1 s’il présente la modalité considérée, et 0 dans le cas contraire.
Cette approche unifie harmonieusement l’analyse de variance classique (ANOVA) et la régression linéaire au sein du cadre unifié du modèle linéaire généralisé (GLM). L’encodage binaire offre une flexibilité remarquable : il autorise le calcul des moyennes ajustées de chaque groupe, le contrôle simultané de covariables métriques continues au sein d’une analyse de covariance (ANCOVA), ainsi que l’examen approfondi des termes d’interaction inter-groupes.
Toutefois, cette démultiplication des axes vectoriels n’est pas sans danger. En cherchant à quantifier une modalité d’appartenance par un jeu de variables indicatrices sans en maîtriser les implications matricielles, le chercheur s’expose à un sur-encodage de l’information. Cette redondance mathématique artificielle génère précisément la pathologie géométrique connue sous le nom de piège des variables muettes, transformant une louable intention d’exhaustivité méthodologique en un blocage numérique insurmontable.
2. 2. Définition et mécanique des variables muettes (Dummy Variables)
2.1 2.1 Qu’est-ce qu’une variable muette ou indicatrice ?
Sur le plan formel, une variable muette (ou indicatrice) est une variable aléatoire discrète binaire générée par l’application d’une fonction caractéristique, notée classiquement IA(x) ou δ, sur l’espace fondamental des modalités d’une variable qualitative. Pour une modalité spécifique m d’un facteur M, la variable muette associée Dm est définie pour chaque observation individuelle i selon la fonction de décision :
Dmi = 1 si le participant i appartient à la modalité m ;
Dmi = 0 si le participant i appartient à toute autre modalité.
D’un point de vue structural au sein de l’équation de régression, l’insertion d’une variable indicatrice agit comme un commutateur numérique binaire, capable d’activer ou de désactiver sélectivement un coefficient additif modifiant l’ordonnée à l’origine de la droite de régression. Lorsque Dmi = 0, le terme βmDmi s’annule complètement, laissant le score prédit sous l’influence des autres paramètres. Inversement, lorsque Dmi = 1, le paramètre βm s’additionne algébriquement à la constante du modèle, translatant verticalement l’hyperplan de régression pour le sous-groupe d’individus concerné.
Il convient de distinguer conceptuellement l’encodage binaire d’un statut dichotomique naturel (ex. : condition contrôle versus condition entraînement à la pleine conscience) du codage disjonctif complet appliqué à une variable nominale polytomique (ex. : les typologies de troubles de la personnalité selon le DSM-5 : paranoïaque, schizoïde, schizotypique, etc.). Alors que le premier cas n’introduit qu’un unique degré de liberté, le second nécessite une décomposition méthodique rigoureuse sous peine de saturer les dimensions vectorielles du système linéaire.
2.2 2.2 L’attribution des valeurs numériques 0 et 1 et leur sens épistémologique
Le choix universel des valeurs discrètes 0 et 1 pour calibrer les variables muettes ne répond pas à une convention esthétique fortuite, mais à d’impérieuses nécessités d’algèbre linéaire. En adoptant le zéro comme élément absorbant de la multiplication et l’élément unitaire comme élément neutre, l’analyste garantit la neutralité métrique du modèle. Le produit scalaire du coefficient βm par le vecteur indicateur préserve exactement l’amplitude de l’effet différentiel, sans modifier l’échelle des unités de la variable réponse.
Si l’on assignait arbitrairement des valeurs non unitaires — par exemple, 10 et 20 — le coefficient associé serait comprimé d’un facteur proportionnel, dégradant la lisibilité immédiate des sorties statistiques et altérant le conditionnement numérique des calculs de matrices de dispersion. Dans le calcul des moindres carrés, la multiplication matricielle d’un vecteur binaire 0/1 par le vecteur des résidus isole précisément la somme des résidus appartenant aux membres du groupe codé 1. Cette propriété de sélection booléenne permet d’obtenir des estimateurs sans biais des espérances conditionnelles de sous-populations, formalisant les écarts inter-groupes sous forme de contrastes linéaires purs.
2.3 2.3 Le lien direct avec les matrices d’expérience en recherche expérimentale
Dans la théorie statistique formelle, toute modélisation linéaire s’exprime sous la forme matricielle compacte Y = Xβ + ε, où Y est le vecteur colonne des n observations de la variable dépendante, β est le vecteur des p paramètres à estimer, et X représente la matrice d’expérience (ou matrice de dessein, design matrix) de dimensions n × p. Dans une modélisation standard comportant une ordonnée à l’origine globale, la première colonne de la matrice X est uniformément constituée d’un vecteur unité composé exclusivement de 1 :
X0 = [1, 1, 1, …, 1]’
Lorsque des variables muettes sont intégrées pour modéliser les k modalités d’un facteur qualitatif, de nouvelles colonnes binaires viennent s’adjoindre à cette matrice de dessein. Chaque colonne correspond au vecteur d’indicatrice d’une modalité spécifique. Dans l’espace multidimensionnel des prédicteurs — un espace euclidien à n dimensions — ces colonnes binaires définissent des vecteurs de coordonnées discrètes dont l’orientation spatiale dépend de la répartition des sujets dans les conditions expérimentales. La condition sine qua non pour que le système d’équations normales admette une solution déterministe unique réside dans l’indépendance linéaire stricte de toutes les colonnes de X, c’est-à-dire l’absence totale de redondance dimensionnelle entre le vecteur d’interception et les vecteurs de modalités.
3. 3. Qu’est-ce que le piège des variables muettes ? Définition conceptuelle approfondie
3.1 3.1 Formulation théorique du Dummy Variable Trap
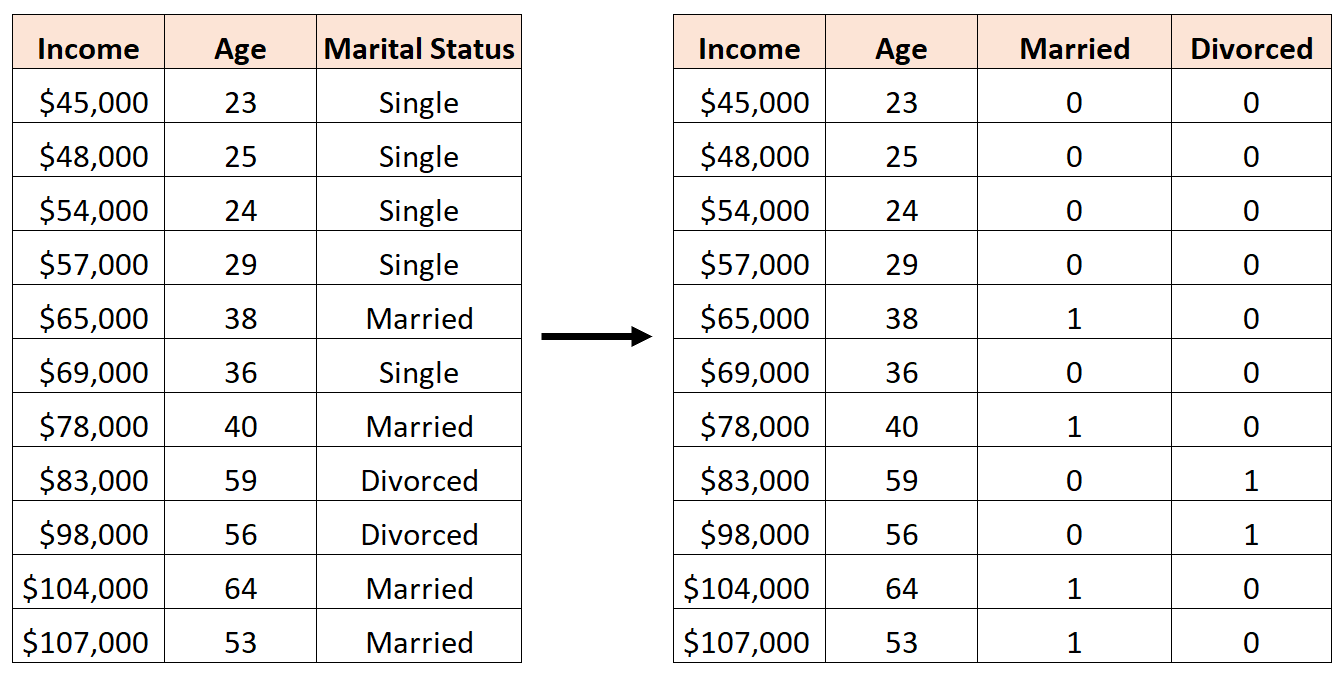
Le piège des variables muettes (Dummy Variable Trap) désigne la sur-spécification structurelle d’un modèle de régression linéaire provoquée par l’incorporation simultanée de k variables muettes distinctes pour coder un facteur qualitatif comportant exactement k modalités, tout en conservant le terme constant (l’interception β0) dans la spécification du modèle. Cette configuration génère une anomalie algébrique fatale : la création intentionnelle d’une relation d’interdépendance linéaire exacte entre les prédicteurs.
D’un point de vue conceptuel, ce piège illustre le paradoxe de la redondance absolue de l’information catégorielle. En effet, dès lors qu’un individu n’appartient à aucune des k – 1 premières modalités mutuellement exclusives d’un facteur, il appartient de manière déterministe et certaine à la k-ième modalité restante. Injecter cette dernière information sous forme d’une k-ième variable indicatrice n’apporte aucun gain d’information stochastique ou empirique ; cela injecte une copie purement redondante d’un espace vectoriel déjà complètement décrit par les autres termes et la constante. Le modèle devient incapable d’isoler la contribution mathématique propre de chaque catégorie, faute de disposer d’un point d’ancrage extérieur invariant pour calibrer ses estimations.
3.2 3.2 La relation d’équivalence absolue avec la constante du modèle
Pour appréhender l’essence mathématique du piège des variables muettes, il est instructif d’observer la somme vectorielle horizontale des variables indicatrices pour n’importe quel sujet i inclus dans l’échantillon. Puisque les k modalités associées au facteur catégoriel sont rigoureusement exhaustives et mutuellement exclusives, chaque participant se voit assigner la valeur 1 dans exactement une seule de ces colonnes et la valeur 0 dans toutes les autres. Par conséquent, pour chaque ligne i de la matrice d’expérience, la somme algébrique des k variables muettes est invariablement égale à l’unité :
∑j=1…k Dji = D1i + D2i + … + Dki = 1
Sur le plan matriciel, cela démontre que la somme vectorielle des k colonnes indicatrices reproduit à l’identique, sans la moindre déviation, le vecteur colonne de la constante X0 = [1, 1, …, 1]’. Nous sommes donc en présence d’une équation d’identité fonctionnelle :
X0 – D1 – D2 – … – Dk = 0
Cette relation linéaire parfaite entre la constante et l’ensemble des indicatrices crée un conflit direct dans la détermination de l’ordonnée à l’origine. L’espace vectoriel engendré par les variables muettes est strictement colinéaire au vecteur constant. Dès lors, estimer simultanément l’effet moyen absolu (l’interception) et l’ensemble des effets spécifiques des k groupes constitue une impossibilité mathématique élémentaire : il existe une infinité de décompositions possibles entre la constante et les coefficients de groupe aboutissant exactement à la même valeur prédite.
3.3 3.3 Distinction entre multicolinéarité imparfaite et colinéarité parfaite
Il importe de dissocier catégoriquement le piège des variables muettes de la simple multicolinéarité empirique fréquemment observée dans les recherches en psychologie quantitative. Dans les études comportementales, il est banal d’observer des corrélations modérées à élevées (par exemple, des coefficients de Pearson r oscillant entre 0,60 et 0,85) entre des scores mesurant des construits voisins, tels que l’anxiété-trait et la symptomatologie dépressive, ou l’extraversion et l’affectivité positive. Cette forme de colinéarité, dite imparfaite ou stochastique, découle de la structure sous-jacente des données observées. Elle complique l’estimation en gonflant les variances des estimateurs, mais n’empêche pas formellement l’inversion matricielle.
À l’inverse, le piège des variables muettes relève d’une colinéarité parfaite (ou multicolinéarité exacte), purement déterministe et algébrique. Il ne dépend en rien des caractéristiques psychologiques des sujets, de la qualité des instruments de mesure ou de la taille de l’échantillon expérimental : il découle exclusivement d’une erreur d’écriture mathématique commise par l’analyste lors de la structuration de sa matrice de dessein. Alors que la multicolinéarité imparfaite autorise des solutions statistiques palliatives (régression pénalisée, modélisation par équations structurelles, réduction de dimension factorielle), la colinéarité parfaite inflige un blocage mathématique absolu qui frappe le calcul des paramètres d’une incapacité fondamentale.
4. Les fondements mathématiques de la singularité matricielle
4.1 4.1 La résolution des équations normales par la méthode des moindres carrés ordinaires (MCO)
L’estimation des paramètres dans le cadre du modèle linéaire général repose traditionnellement sur le critère de minimisation de la somme des carrés des erreurs, formalisé par le théorème de Gauss-Markov sous le nom de méthode des Moindres Carrés Ordinaires (MCO). Dans sa formulation matricielle globale, le système d’équations normales s’écrit :
(X’X)β = X’Y
Pour déterminer de façon déterministe le vecteur des estimateurs b (qui estime le vecteur inconnu β), il est impératif d’isoler b en pré-multipliant les deux membres de l’égalité par la matrice inverse de la matrice carrée des produits croisés (X’X), ce qui donne la célèbre formule :
b = (X’X)-1 X’Y
Cette dérivation élégante n’est possible que si et seulement si la matrice carrée symétrique (X’X), de dimension (p + 1) × (p + 1), est strictement inversible, ou régulière. Or, les propriétés fondamentales de l’algèbre linéaire stipulent qu’une matrice n’est inversible que si son déterminant est strictement non nul : det(X’X) ≠ 0. Lorsque le chercheur introduit les k variables muettes aux côtés de la constante, l’existence d’une combinaison linéaire exacte entre les colonnes de X garantit mathématiquement que les colonnes de (X’X) sont elles-mêmes linéairement dépendantes.
Il en résulte immédiatement que le déterminant de la matrice de dispersion est nul : det(X’X) = 0. Par définition, l’inverse (X’X)-1 n’existe pas dans le corps des réels ; la matrice est qualifiée de singulière. L’application brute de la formule des moindres carrés ordinaires aboutit ainsi à une division formelle par zéro au niveau scalaire, empêchant tout calcul algébrique univoque des coefficients de régression.
4.2 4.2 Rang matriciel et déficience de rang dans le plan d’expérience
Cette impossibilité de calcul se théorise de manière encore plus rigoureuse à travers le concept de rang matriciel. Le rang d’une matrice correspond au nombre maximal de vecteurs colonnes (ou lignes) linéairement indépendants qui la constituent. Pour qu’une régression multiple comportant p prédicteurs plus une ordonnée à l’origine fournisse une solution unique, la matrice de dessein X doit impérativement être de rang plein (full rank), c’est-à-dire posséder un rang égal à son nombre de colonnes : rg(X) = p + 1.
Considérons un modèle incluant un terme d’interception et un facteur qualitatif composé de k modalités encodées sous forme de k indicatrices. Le nombre total de colonnes constituant la matrice d’expérience est donc de k + 1. Or, nous avons établi à la section 3.2 que la somme des k colonnes indicatrices reconstitue fidèlement la première colonne correspondant à l’interception. Il s’ensuit que la matrice d’expérience X est affectée d’une déficience de rang structurelle (rank deficiency) : son rang effectif est plafonné à k, alors qu’elle dénombre k + 1 colonnes :
rg(X) = k < k + 1
D’après le théorème fondamental de l’algèbre linéaire reliant les dimensions de l’image et du noyau, l’espace nul (null space) de la matrice X n’est plus réduit au vecteur nul ; sa dimension devient supérieure ou égale à 1. Cela implique qu’il existe une infinité de vecteurs non nuls v vérifiant Xv = 0. Sur le plan de l’optimisation des moindres carrés, cette déficience de rang signifie qu’il n’existe plus un point unique minimisant la surface quadratique de la somme des carrés des résidus (SSR). Au lieu d’une paraboloïde dotée d’un minimum absolu unique, la fonction de perte prend la forme d’une gouttière horizontale infinie, offrant une infinité de combinaisons scalaires distinctes pour les paramètres β qui génèrent exactement la même valeur minimale des résidus. Sans l’imposition arbitraire d’une contrainte d’identifiabilité extérieure, le système linéaire est formellement indéterminé.
4.3 4.3 Conséquences sur les erreurs types et l’estimation asymptotique
Dans la théorie asymptotique de l’estimation économétrique et psychométrique, la matrice de variance-covariance asymptotique du vecteur des estimateurs b est proportionnelle à l’inverse de la matrice d’information de Fisher, laquelle s’écrit sous hypothèse d’homoscédasticité :
Var(b) = σ2 (X’X)-1
où σ2 désigne la variance théorique des résidus. La variance d’un coefficient individuel bj peut également s’exprimer de manière transparente à travers le facteur d’inflation de la variance (VIF) :
Var(bj) = [ σ2 / (∑ (Xji – X̄j)2) ] × [ 1 / (1 – Rj2) ]
où Rj2 représente le coefficient de détermination issu de la régression auxiliaire du prédicteur Xj sur l’ensemble de tous les autres prédicteurs du modèle.
Dans le cas d’une colinéarité parfaite engendrée par le piège des variables muettes, le prédicteur Dk est une combinaison linéaire déterministe exacte des k – 1 autres indicatrices et du terme constant. Par conséquent, le coefficient de détermination de cette régression auxiliaire est rigoureusement égal à l’unité : Rk2 = 1. Le dénominateur de l’équation précédente (1 – Rk2) devient donc rigoureusement nul. La variance théorique de l’estimateur diverge alors vers l’infini :
Var(bk) → +∞
Cette divergence asymptotique a des répercussions immédiates sur le plan computationnel. Les algorithmes numériques d’inversion matricielle — qu’ils fassent appel à la décomposition de Cholesky, à l’élimination de Gauss-Jordan ou à la décomposition en valeurs singulières (SVD) — se heurtent à des valeurs propres nulles. L’instabilité numérique devient critique, provoquant des erreurs d’arrondi colossales ou l’incapacité d’extraire des racines carrées finies pour obtenir les erreurs types. La statistique de test de Student, définie par le ratio t = bj / SE(bj), voit son dénominateur s’effondrer ou exploser vers des grandeurs indéterminées, anéantissant toute possibilité d’inférence statistique valide sur les paramètres comportementaux.
5. 5. Exemple concret et détaillé : Modélisation de l’anxiété selon le statut matrimonial
5.1 5.1 Présentation de l’étude psychologique et formulation des hypothèses
Afin d’ancrer ces considérations formelles dans la réalité de l’investigation clinique, considérons un protocole de recherche portant sur les déterminants psychosociaux de la détresse émotionnelle. Une équipe de psychologues cliniciens souhaite évaluer l’impact du statut matrimonial sur l’intensité des manifestations anxieuses chez des adultes consultant dans un réseau de centres médico-psychologiques. Le niveau d’anxiété est quantifié à l’aide d’une échelle psychométrique continue validée, l’échelle d’anxiété de Hamilton (HAM-A), dont le score total varie théoriquement de 0 à 56 points, les scores élevés reflétant une symptomatologie anxieuse plus sévère.
Le facteur explicatif principal est une variable nominale qualitative non ordonnée, le Statut Matrimonial, comportant k = 4 modalités distinctes :
- Célibataire (modalité 1)
- Marié / Pacsé (modalité 2)
- Divorcé / Séparé (modalité 3)
- Veuf (modalité 4)
L’hypothèse clinique postule que la présence d’un soutien conjugal institutionnalisé agit comme un facteur de régulation émotionnelle protecteur, tandis que les transitions de rupture ou de perte deuil majorent significativement l’anxiété clinique par rapport à l’état de célibat de base. L’étude porte sur une cohorte représentative de n = 400 participants adultes ayant tous complété l’évaluation diagnostique et renseigné leur situation d’état civil.
5.2 5.2 La mise en œuvre erronée : Création et inclusion des quatre indicatrices
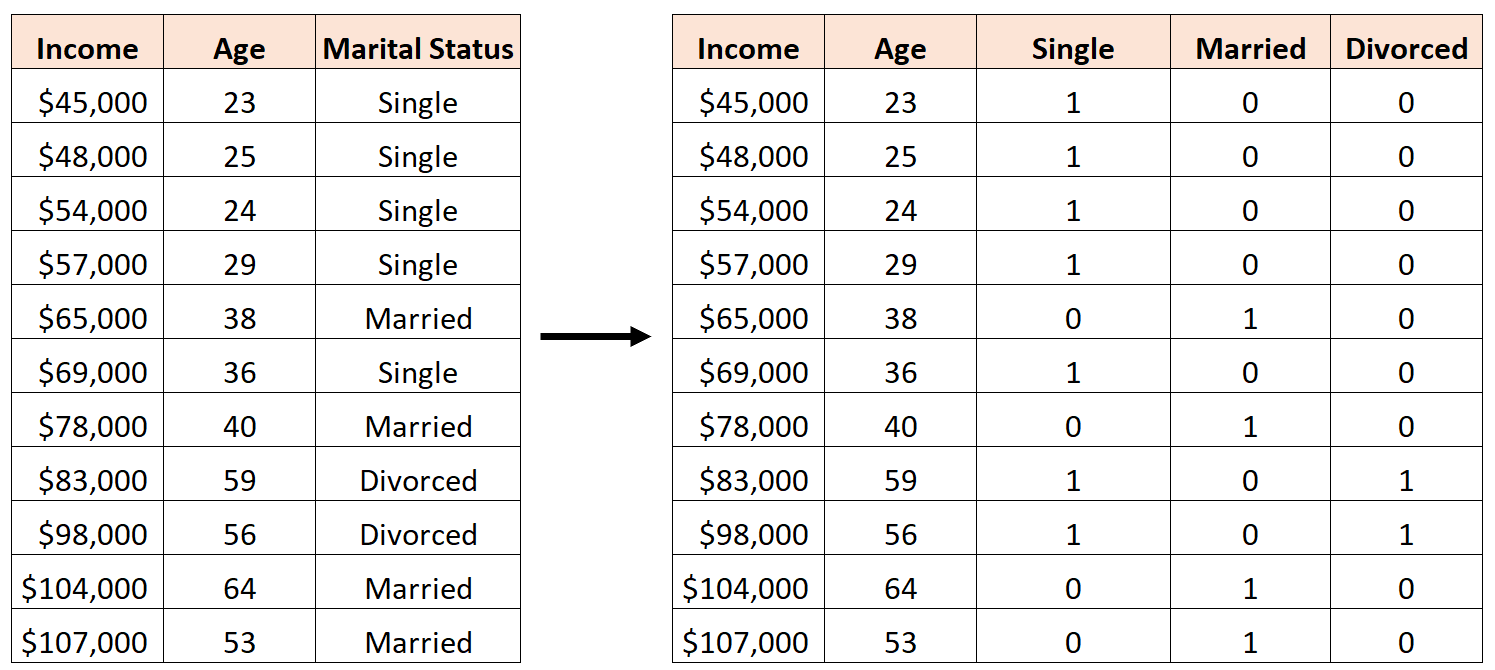
Dans une démarche d’encodage naïve, le jeune chercheur décide de créer une variable binaire pour chacune des quatre conditions répertoriées dans sa base de données. Il construit ainsi quatre colonnes booléennes :
- D1 = 1 si le sujet est Célibataire, 0 sinon
- D2 = 1 si le sujet est Marié, 0 sinon
- D3 = 1 si le sujet est Divorcé, 0 sinon
- D4 = 1 si le sujet est Veuf, 0 sinon
Souhaitant observer simultanément les scores moyens de chaque groupe tout en maintenant l’ordonnée à l’origine globale dans son modèle, il soumet à son logiciel de traitement statistique l’équation de régression suivante :
Score_HAMAi = β0 + β1(D1i) + β2(D2i) + β3(D3i) + β4(D4i) + εi
En commettant cette spécification, le chercheur bascule directement au cœur du piège des variables muettes. La matrice de dessein X intègre 5 colonnes : le vecteur constant X0 rempli de 1, suivi des colonnes D1, D2, D3 et D4. Or, pour chacun des 400 sujets sans exception, la relation structurelle suivante est satisfaite :
D1i + D2i + D3i + D4i = 1 = X0i
Face à cette matrice de dimensions 400 × 5 mais de rang effectif 4, le moteur de calcul matriciel se heurte à une singularité parfaite. Selon le logiciel utilisé et son niveau de tolérance numérique, le traitement générera une interruption brutale de l’analyse, assortie d’un message d’erreur explicite (« Singular matrix in ordinary least squares »), ou procédera à une suppression silencieuse et arbitraire de l’une des variables indicatrices afin d’éviter le plantage machine, laissant le chercheur non averti dans la plus totale incompréhension de la signification des coefficients affichés.
5.3 5.3 Résolution rigoureuse par l’application de la règle k-1
Pour éliminer définitivement cette redondance géométrique, il est impératif d’appliquer le principe de paramétrisation par catégorie de référence, couramment désigné sous le terme de règle des k – 1 catégories. Étant donné que le facteur comporte 4 modalités, il est formellement requis d’omettre l’une d’entre elles de l’équation de régression et de n’injecter que 4 – 1 = 3 variables muettes.
Sur le plan théorique et clinique, l’équipe choisit de désigner la catégorie Célibataire comme condition de base étalon (référence normative). L’équation de régression corrigée et statistiquement identifiable s’écrit désormais :
Score_HAMAi = β0 + β2(D2i) + β3(D3i) + β4(D4i) + εi
Dans ce modèle parfaitement régularisé, la matrice d’expérience redevient de rang plein (rang = 4 pour 4 paramètres à estimer), autorisant l’inversion univoque de la matrice des produits croisés. L’interprétation clinique des coefficients estimés prend une signification d’une clarté exemplaire :
- La constante (β0) : Elle représente l’espérance mathématique conditionnelle (le score moyen d’anxiété HAM-A) des sujets appartenant à la modalité de référence omise. Lorsque D2 = 0, D3 = 0 et D4 = 0, l’individu est nécessairement célibataire. Si le modèle calcule b0 = 18,4, cela signifie que le niveau moyen d’anxiété chez les célibataires est de 18,4 points.
- Le coefficient β2 (Marié) : Il représente l’écart différentiel de score moyen entre les personnes mariées et les célibataires. Si b2 = -4,2 (p < 0,01), les individus mariés affichent un score d’anxiété significativement inférieur de 4,2 points par rapport aux célibataires, soit une moyenne prédite de 18,4 – 4,2 = 14,2 points.
- Le coefficient β3 (Divorcé) : Il mesure l’écart différentiel entre les divorcés et les célibataires. Si b3 = +5,6 (p < 0,001), l’anxiété moyenne dans ce groupe culmine à 18,4 + 5,6 = 24,0 points.
- Le coefficient β4 (Veuf) : De même, si b4 = +7,1 (p < 0,001), le veuvage est corrélé à une élévation de 7,1 points d’anxiété par rapport au célibat, atteignant un score moyen de 25,5 points.
Grâce à la stricte application de la règle des k – 1, chaque paramètre partiel teste directement une hypothèse de contraste différentiel clinique par rapport au groupe célibataire, résolvant simultanément l’identifiabilité mathématique et la cohérence de l’interprétation psychologique.
6. 6. Exemple psychométrique : Styles d’attachement et prédiction de l’alliance thérapeutique
6.1 6.1 Typologie quadripartite de l’attachement adulte (Bartholomew & Horowitz)
L’évaluation des processus interpersonnels en psychothérapie fournit un second terrain d’application particulièrement instructif. Selon le modèle théorique classique de Bartholomew et Horowitz (1991), l’attachement adulte s’organise autour du croisement de deux dimensions internes : le modèle de soi (anxiété d’abandon) et le modèle d’autrui (évitement de l’intimité). Cette matrice dimensionnelle génère une typologie quadripartite catégorisant les individus selon quatre styles distincts :
- Sécure : vision positive de soi et d’autrui, aisance avec l’intimité et l’autonomie.
- Anxieux-préoccupé : vision négative de soi et valorisation excessive d’autrui, quête constante de réassurance.
- Évitant-détaché : vision défensivement positive de soi et négative d’autrui, rejet de la dépendance relationnelle.
- Désorganisé-craintif : vision négative de soi et d’autrui, désir d’affiliation contrarié par une intense peur de la vulnérabilité.
Dans le champ de la recherche sur les facteurs communs en psychothérapie, la qualité de l’alliance de travail (mesurée par le Working Alliance Inventory ou WAI) est le meilleur prédicteur empirique du succès thérapeutique. Une problématique classique consiste à vérifier si le style d’attachement initial du patient, évalué lors de l’entretien d’admission, permet d’anticiper la robustesse de l’alliance thérapeutique mesurée à la troisième séance de traitement.
6.2 6.2 Piège d’encodage lors de l’intégration simultanée de questionnaires catégorisés
Lors du recodage des profils issus d’un questionnaire d’attachement, le chercheur est tenté d’isoler chaque profil typologique au sein d’une variable indicatrice autonome : Att_Sec, Att_Anx, Att_Evit et Att_Desorg. S’il spécifie une équation visant à prédire le score d’alliance WAI en introduisant ces quatre variables en bloc aux côtés de la constante :
Score_WAI = β0 + β1(Att_Sec) + β2(Att_Anx) + β3(Att_Evit) + β4(Att_Desorg) + ε
il réitère exactement l’anomalie de rang décrite précédemment. Puisque chaque patient est classé de manière univoque dans l’une et une seule de ces quatre catégories d’attachement, la relation déterministe Att_Sec + Att_Anx + Att_Evit + Att_Desorg = 1 coïncide parfaitement avec le vecteur d’interception.
Les conséquences sur le dépouillement psychométrique sont particulièrement trompeuses. Si un logiciel statistique applique une compensation algorithmique par défaut en retranchant arbitrairement l’un des styles — par exemple l’attachement désorganisé — sans que l’analyste n’en ait conscience, l’interprétation des contrastes sera faussée. Le chercheur pourrait croire, en lisant un coefficient négatif significatif devant l’attachement sécure, que le style sécure nuit à l’alliance, alors que ce coefficient indique simplement que les sécures développent une alliance inférieure à celle d’un profil atypique choisi par le programme, inversant de fait le sens clinique de la conclusion scientifique.
6.3 6.3 Interprétation comparative de la catégorie de base : style Sécure comme étalon clinique
Pour conférer à l’analyse une portée théorique rigoureuse, la catégorie de référence doit être sélectionnée de manière intentionnelle et justifiée : il convient de choisir le style d’attachement Sécure comme condition de base étalon. En psychologie du développement et en clinique de l’adulte, l’attachement sécure incarne la condition prototypique de flexibilité relationnelle optimale, constituant la norme théorique à l’aune de laquelle les déficits d’alliance associés aux styles insécures doivent être quantifiés.
Le modèle correctement paramétré s’exprime donc par l’exclusion de l’indicatrice Att_Sec :
Score_WAIi = β0 + β1(Att_Anxi) + β2(Att_Eviti) + β3(Att_Desorgi) + εi
Dans ce modèle, la constante β0 correspond précisément au score moyen d’alliance thérapeutique attendu chez les patients sécures. Les coefficients partiels quantifient directement le déficit d’alliance relatif attribuable à chaque configuration insécure :
- β1 quantifie l’altération de l’alliance chez les patients anxieux-préoccupés par rapport aux patients sécures.
- β2 évalue l’érosion de l’alliance liée au détachement affectif des patients évitants comparativement au groupe sécure.
- β3 mesure l’ampleur de la rupture d’alliance prévisible chez les patients désorganisés-craintifs face à l’étalon sécure.
L’application de tests t de Student associés à chaque coefficient permet d’éprouver la significativité statistique de chaque contraste clinique individuel. L’estimation conjointe des intervalles de confiance à 95% offre une cartographie précise de l’amplitude des détériorations relationnelles anticipées, offrant aux cliniciens des repères diagnostiques précieux pour adapter le cadre de travail psychothérapeutique.
7. 7. Conséquences statistiques du piège des variables muettes sur l’analyse de données
7.1 7.1 Impossibilité de calcul ou instabilité extrême des coefficients
Les conséquences computationnelles du piège des variables muettes se manifestent avec une violence variable selon les algorithmes numériques mobilisés par les moteurs statistiques. Dans les implémentations matricielles strictes utilisant une résolution par inversion exacte, la tentative de division par le déterminant nul interrompt purement et simplement l’exécution du calcul. Le logiciel émet un message d’erreur d’inversion ou renvoie des vecteurs de coefficients remplis de valeurs NaN (Not a Number) ou indéterminées.
Dans les environnements recourant à des méthodes itératives d’optimisation numérique ou à des approximations d’inversion par moindres carrés amortis sans élimination de colonne, les algorithmes de type gradient conjugué ou Newton-Raphson oscillent indéfiniment sans converger. La surface d’erreur étant plate le long de la ligne de singularité, la méthode s’arrête à un seuil de tolérance machine arbitraire. Il en résulte des valeurs de coefficients aberrantes (par exemple des valeurs de l’ordre de 1014 et -1014 qui s’annulent mutuellement), totalement dénuées de pertinence psychométrique et excessivement sensibles aux moindres imprécisions de troncature des données d’entrée.
7.2 7.2 Inflation masquée des variances et tests de Student inexploitables
Lorsque le piège des variables muettes n’est pas bloqué de façon abrupte par le compilateur logiciel, la dégradation de la matrice d’information entraîne une explosion structurelle des erreurs types associées aux régresseurs. Comme nous l’avons démontré au niveau de la formule asymptotique du VIF, la variance théorique d’un prédicteur parfaitement colinéaire tend vers l’infini. Sur le plan pratique, les erreurs types calculées atteignent des grandeurs colossales, dépassant de plusieurs ordres de grandeur la valeur des coefficients eux-mêmes.
Consécutivement, le calcul des ratios de Wald pour les tests d’hypothèse individuelle :
t = bj / SE(bj)
produit des statistiques t infinitésimales s’effondrant vers zéro. Le chercheur observe alors des p-valeurs asymptotiques proches de 1,00 pour l’ensemble des modalités du facteur étudié. Cette pathologie conduit inévitablement à commettre une monumentale erreur de type II (non-rejet d’une hypothèse nulle totalement fausse) : le chercheur conclura à tort que son facteur expérimental n’exerce aucune influence sur la variable réponse comportementale, alors même que les moyennes de groupes pourraient être radicalement dissemblables dans les données réelles.
Parallèlement, la statistique globale F de Fisher-Snedecor — destinée à tester l’hypothèse nulle conjointe d’un pouvoir explicatif nul de l’ensemble des prédicteurs — devient elle-même incalculable ou profondément biaisée, car les degrés de liberté résiduels ne peuvent être attribués de façon cohérente dans une matrice affectée d’une perte de rang non résolue.
7.3 7.3 Dégradations secondaires lors de modélisations non linéaires
Si les conséquences du piège des variables muettes sont spectaculaires en régression linéaire standard, elles prennent des proportions encore plus complexes lors du passage aux modélisations non linéaires, telles que la régression logistique binaire, la régression logistique multinomiale ou la régression de Poisson — des techniques omniprésentes en psychopathologie quantitative pour modéliser la présence/absence d’un trouble ou le nombre de récidives cliniques.
Dans ces cadres non linéaires, l’estimation des paramètres ne repose plus sur une formule analytique fermée, mais sur l’estimation par le maximum de vraisemblance régie par l’algorithme itératif des Moindres Carrés Répétés Pondérés (IRLS). L’introduction de k variables muettes en présence de la constante crée une crête d’équi-vraisemblance infinie sur la surface de la log-vraisemblance. La matrice hessienne (dérivée seconde de la fonction de log-vraisemblance), qui correspond à la matrice d’information observée, devient singulière à chaque itération.
Ce phénomène mime les manifestations bien connues de la « séparation complète » (complete separation). L’algorithme itératif diverge, le nombre d’itérations atteint son plafond maximal sans converger, et les estimations des log-odds ratios s’envolent vers l’infini positif ou négatif. Les rapports de cotes (Odds Ratios) calculés affichent des valeurs fantaisistes (ex. : OR > 9999 ou OR = 0,000), accompagnés d’intervalles de confiance s’étalant de zéro à l’infini, rendant les conclusions cliniques inexploitables et scientifiquement caduques.
8. 8. La règle d’or des k-1 catégories et le choix critique de la catégorie de référence
8.1 8.1 Énoncé et justification formelle de la règle k-1
Pour se prémunir infailliblement contre le piège des variables muettes dans toute analyse de régression linéaire ou généralisée comportant une interception, il existe une règle absolue et universelle :
Pour un facteur catégoriel comportant k modalités distinctes, exhaustives et mutuellement exclusives, il faut introduire impérativement et strictement k – 1 variables muettes dans le modèle de régression.
La justification formelle de ce théorème de paramétrisation repose sur la restauration du rang plein de la matrice de dessein X. En retirant délibérément la k-ième indicatrice, on élimine la relation d’équivalence linéaire liant les prédicteurs à la colonne de constante X0. La matrice d’expérience possède alors p = (k – 1) + 1 = k colonnes qui forment une famille libre dans l’espace vectoriel euclidien. Son rang est rigoureusement égal à k. La matrice carrée (X’X) devient de rang plein, son déterminant redevient strictement supérieur à zéro, son inversion matricielle est déterministe et unique, et les théorèmes fondamentaux de l’inférence asymptotique s’appliquent sans aucune altération.
Il est crucial de souligner que cette omission volontaire d’une modalité n’entraîne absolument aucune perte d’information statistique ou empirique. La totalité de la variance inter-groupes collectée au cours de la recherche demeure intégralement préservée dans l’espace résiduel du modèle. L’information descriptive et différentielle relative à la k-ième catégorie omise n’a pas disparu : elle a été géométriquement absorbée et incorporée au sein du terme d’interception globale β0.
8.2 8.2 Critères psychologiques et théoriques pour fixer la modalité de référence
Puisque l’omission d’une catégorie conditionne directement l’ancrage du terme constant et la signification théorique de tous les coefficients différentiels, le choix de la modalité de référence (ou catégorie de base) ne doit jamais être laissé au hasard d’un tri alphabétique automatique imposé par un logiciel. En psychologie quantitative, ce choix doit répondre à des critères méthodologiques et cliniques mûrement réfléchis :
- Le groupe contrôle expérimental ou condition placebo : Dans un essai clinique randomisé ou une étude expérimentale, la condition de référence doit incontestablement être le groupe témoin (sans traitement, liste d’attente ou placebo actif). Les coefficients partiels associés aux autres indicatrices expriment alors immédiatement l’effet thérapeutique propre de chaque intervention active par rapport à l’absence de traitement spécifique.
- Le groupe normatif ou de référence démographique : Lorsque l’étude évalue des populations cliniques ou des groupes sous-représentés, il est judicieux de choisir la cohorte normative la plus documentée dans la littérature (ex. : individus neurotypiques dans une étude sur les troubles du spectre autistique). Cela permet de quantifier avec netteté les écarts cliniques moyens par rapport au fonctionnement standard.
- La modalité présentant le plus grand effectif d’échantillonnage : Sur le plan purement statistique, l’estimation du terme d’interception β0 — qui représente la moyenne de la condition de référence — possède une variance échantillonnale inversement proportionnelle à la taille du groupe de référence. Choisir la catégorie la plus populeuse permet d’ancrer le modèle sur l’estimation la plus stable possible (erreur type minimale sur la constante), ce qui optimise la puissance statistique de l’ensemble des contrastes différentiels t associés aux autres modalités.
Il convient d’éviter formellement le choix d’une catégorie marginale, atypique ou à effectif résiduel très faible (ex. : un sous-groupe diagnostique ne rassemblant que 5% de la cohorte) comme point de référence. Un tel ancrage fragiliserait l’ensemble de l’architecture du modèle, gonflant artificiellement les erreurs types de tous les coefficients de contraste et rendant la lecture clinique particulièrement laborieuse.
8.3 8.3 L’option alternative : Supprimer la constante du modèle (Régression sans interception)
Il existe une alternative mathématique permettant d’introduire l’intégralité des k variables muettes au sein du modèle sans tomber dans le piège de la colinéarité parfaite : elle consiste à contraindre explicitement l’ordonnée à l’origine à être nulle, c’est-à-dire à supprimer le terme de constante (β0 = 0). L’équation s’écrit alors :
Yi = β1(D1i) + β2(D2i) + … + βk(Dki) + εi
Dans cette configuration spécifique, la matrice d’expérience comprend k colonnes pour les k indicatrices, mais le vecteur unité d’interception a disparu. Les k vecteurs indicatrices étant orthogonaux entre eux (aucun sujet ne pouvant appartenir à deux catégories en même temps), la matrice X est de rang plein k. L’inversion matricielle redevient possible.
L’intérêt de cette approche est la lisibilité directe des paramètres : chaque coefficient βj correspond exactement et directement à la moyenne brute isolée du sous-groupe j sur la variable dépendante. Toutefois, cette apparente simplicité s’accompagne d’inconvénients méthodologiques majeurs :
- Les sorties logicielles ne fournissent plus aucun test de significativité des écarts différentiels entre modalités. Les tests t associés à chaque coefficient ne testent plus un contraste inter-groupes, mais l’hypothèse nulle triviale que la moyenne brute du groupe j est égale à zéro absolu (H0 : μj = 0), un test souvent vide de sens clinique.
- La suppression de l’interception perturbe profondément le calcul standardisé du coefficient de détermination R2. La décomposition canonique de la variance totale SSTot = SSReg + SSRes n’est plus garantie mathématiquement autour de la grande moyenne globale, conduisant de nombreux logiciels statistiques à produire des R2 artificiellement gonflés — voire négatifs — rendant caduque toute comparaison de la qualité d’ajustement.
9. 9. Schémas alternatifs d’encodage : Au-delà du codage de référence (Dummy Coding)
9.1 9.1 Le codage d’effet ou de déviance (Effect Coding / Sum-to-Zero)
Si le codage muet standard (dummy coding) est universellement privilégié pour mesurer des contrastes différentiels par rapport à une condition pivotale, la recherche en psychologie quantitative fait fréquemment appel au codage d’effet (effect coding), également désigné sous l’appellation d’encodage de déviance ou contrainte de somme nulle (sum-to-zero constraint).
Dans ce système de codage, le facteur comportant k modalités est toujours représenté par k – 1 variables prédictives, mais l’assignation numérique diffère. Pour une modalité donnée j (allant de 1 à k – 1), la variable associée Ej prend la valeur 1 pour les individus de cette modalité, la valeur 0 pour les individus des autres modalités intermédiaires, et la valeur -1 pour tous les individus appartenant à la k-ième modalité omise. Le modèle complet avec constante s’écrit :
Yi = β0 + β1(E1i) + … + βk-1(Ek-1,i) + εi
Cette paramétrisation réaligne parfaitement la régression sur le formalisme de l’analyse de variance factorielle classique (ANOVA). En effet, grâce à la contrainte d’équilibrage ∑ βj = 0, le terme d’interception β0 ne reflète plus la moyenne exclusive d’un groupe de référence, mais la grande moyenne non pondérée (grand mean) de l’ensemble de toutes les conditions expérimentales combinées. Chaque coefficient βj mesure l’écart déviantiel moyen de la modalité j par rapport à cette moyenne globale de l’échantillon. Cette formulation est particulièrement pertinente pour évaluer si l’impact d’une sous-population clinique s’écarte significativement de la moyenne générale d’une cohorte transversale.
9.2 9.2 Le codage par contrastes orthogonaux en psychométrie
Le codage par contrastes orthogonaux représente l’approche la plus sophistiquée et la plus rigoureuse sur le plan psychométrique lorsqu’un chercheur formule des hypothèses comparatives directionnelles hiérarchisées a priori. Contrairement au codage d’effet ou au codage muet simple, les contrastes orthogonaux décomposent la variance inter-groupes globale en k – 1 portions de variance strictement indépendantes et non redondantes.
Pour qu’un ensemble de k – 1 contrastes linéaires soit orthogonal, le produit scalaire des coefficients d’encodage de n’importe quelle paire de vecteurs de contrastes doit être rigoureusement nul, tout comme la somme des coefficients au sein de chaque contraste individuel. Prenons l’exemple d’un protocole évaluant l’efficacité clinique de 4 modalités de prise en charge psychologique :
- Groupe 1 : Liste d’attente (Témoin)
- Groupe 2 : Thérapie brève de soutien
- Groupe 3 : Thérapie Cognitive et Comportementale (TCC)
- Groupe 4 : Thérapie Psychanalytique brève
Le chercheur peut structurer ses 3 variables de contraste de manière hiérarchique :
- Contraste 1 (Traitement vs Contrôle) : Coefficients [-3, +1, +1, +1]. Il compare la condition témoin à la moyenne de toutes les conditions psychothérapeutiques actives.
- Contraste 2 (Type d’approche active) : Coefficients [0, -2, +1, +1]. Il compare l’intervention de soutien non spécifique aux deux psychothérapies structurées.
- Contraste 3 (Orientation théorique) : Coefficients [0, 0, +1, -1]. Il compare directement l’approche TCC à l’approche psychanalytique.
Ce schéma garantit une décomposition algébrique orthogonale sans aucune redondance d’information. Les tests t associés à chaque paramètre évaluent des hypothèses cliniques distinctes et indépendantes, offrant une immunité structurelle absolue contre toute forme de multicolinéarité.
9.3 9.3 Le codage séquentiel (Helmert et codage par paliers successifs)
Dans l’investigation des trajectoires développementales ou de la progression de la gravité psychopathologique, les chercheurs recourent fréquemment à des codages construits selon une logique cumulative ou séquentielle, à l’instar des contrastes de Helmert ou du codage par paliers consécutifs (repeated contrasts). Ces encodages s’avèrent particulièrement puissants pour modéliser des stades séquentiels — tels que les stades piagétiens du développement cognitif, les stades de motivation au changement selon Prochaska et DiClemente, ou les stades d’ajustement au deuil selon Kübler-Ross.
Le codage de Helmert consiste à comparer la moyenne de chaque catégorie successive à la moyenne cumulée pondérée de l’ensemble des catégories précédentes. Inversement, le contraste de Helmert inversé (ou codage de différence) compare chaque niveau à la moyenne cumulée des niveaux qui lui sont immédiatement inférieurs :
- Le niveau 2 est comparé au niveau 1.
- Le niveau 3 est comparé à la moyenne regroupée des niveaux 1 et 2.
- Le niveau 4 est comparé à la moyenne regroupée des niveaux 1, 2 et 3.
Cette structuration géométrique particulière génère une matrice de dessein à profil triangulaire qui est intrinsèquement de rang plein. De par sa construction algébrique par paliers incrémentaux, le codage de Helmert garantit l’indépendance linéaire stricte des colonnes d’estimation. Il élimine d’emblée toute possibilité de tomber dans le piège des variables muettes, tout en produisant des coefficients dont l’interprétation répond directement aux hypothèses de franchissement de paliers fonctionnels en sciences comportementales.
10. 10. Diagnostic et comportement des environnements logiciels (R, SPSS, Python)
10.1 10.1 Comportement et solutions dans l’environnement R
Dans l’écosystème open-source R, la gestion des variables catégorielles est optimisée nativement grâce à l’objet de type factor. Lorsqu’un chercheur intègre un facteur nominal dans la syntaxe canonique de modélisation linéaire lm(score ~ statut, data = base_donnees), R procède de manière automatique et transparente à l’application de la règle des k – 1 catégories en utilisant par défaut le codage muet (dummy coding), gouverné par la fonction contr.treatment().
Toutefois, si un utilisateur génère manuellement 4 variables indicatrices indépendantes (par exemple D1, D2, D3, D4) et force leur inclusion dans la formule lm(score ~ D1 + D2 + D3 + D4, data = base_donnees), R met en œuvre son mécanisme interne de détection des singularités matricielles basé sur la décomposition QR. Le logiciel constate la déficience de rang, élimine unilatéralement la dernière variable colinéaire et affiche l’avertissement caractéristique :
Coefficients: (1 not defined because of singularities)
La ligne associée au prédicteur évincé affiche des valeurs de coefficients, d’erreurs types et de statistiques de test marquées comme NA. Pour contrôler rigoureusement ce processus plutôt que de subir un arbitrage logiciel arbitraire, le psychométricien doit explicitement redéfinir la catégorie de référence souhaitée au niveau du facteur via la fonction relevel() :
base_donnees$statut <- relevel(base_donnees$statut, ref = "Celibataire")
Pour auditer l’absence de colinéarité résiduelle au sein de modèles plus complexes, l’analyste utilise la fonction vif() du paquet car. Alors qu’un VIF supérieur à 5 ou 10 indique une multicolinéarité empirique préoccupante, un VIF divergeant vers l’infini (ou provoquant une erreur de matrice singulière) signale infailliblement la subsistance du piège des variables muettes dans le jeu de données.
10.2 10.2 Pratiques et écueils sous IBM SPSS Statistics
Dans le progiciel commercial IBM SPSS Statistics, le traitement des variables qualitatives présente des disparités notables selon la commande statistique mobilisée par le chercheur. Au sein de la procédure classique de régression linéaire (Analyse > Régression > Linéaire), le logiciel n’assure aucune transformation factorielle automatique. Si le chercheur recourt manuellement à la fonction Recoder des variables pour concevoir k colonnes booléennes et les injecte simultanément dans la boîte des variables indépendantes, SPSS tente la résolution des équations normales.
Confronté à la colinéarité parfaite, l’algorithme d’élimination pas-à-pas de SPSS détecte une tolérance nulle pour la dernière variable introduite. Il exclut alors silencieusement cette variable du modèle final, la reléguant dans le tableau subsidiaire intitulé Variables exclues, assortie d’une statistique de tolérance égale à 0,000 et d’une valeur de corrélation partielle indéterminée. Si l’utilisateur ne prend pas soin d’examiner ce tableau annexe, il risque de méconnaître l’exclusion de sa condition expérimentale.
À l’inverse, lorsque le chercheur privilégie la procédure du Modèle Linéaire Général (Analyse > Modèle linéaire général > Univarié), SPSS requiert l’insertion de la variable catégorielle brute dans le champ des Facteurs fixes. Dans ce module, SPSS paramètre les contrastes par défaut en utilisant la dernière catégorie observée comme référence (contraste de type Dernier). Il est fortement recommandé d’accéder au sous-menu Contrastes pour basculer ce réglage vers le mode Premier ou pour spécifier des contrastes polynomiaux ou de déviance en fonction des hypothèses théoriques guidant la recherche.
10.3 10.3 Implémentation en Python avec Statsmodels et Scikit-Learn
Dans l’écosystème Python orienté vers la science des données et la recherche comportementale, le piège des variables muettes constitue un écueil récurrent lors de l’utilisation de bibliothèques complémentaires mais divergentes telles que Pandas, Statsmodels et Scikit-Learn.
Lors de la phase de manipulation des données tabulaires sous Pandas, la commande populaire pd.get_dummies() transforme une série catégorielle en colonnes indicatrices. Par défaut, cette fonction génère exactement k indicatrices pour k niveaux. Si ces données sont injectées directement dans un modèle de moindres carrés de Statsmodels (statsmodels.api.OLS) enrichi au préalable par la constante sm.add_constant(), le système s’avère déficient en rang. Pour désamorcer le piège dès l’amont, il est strictement impératif de stipuler le paramètre drop_first=True :
encoded_data = pd.get_dummies(df['statut'], drop_first=True)
Cette directive omet automatiquement la première modalité alphabétique, restaurant l’identifiabilité matricielle. De manière analogue, lors du prétraitement par la bibliothèque d’apprentissage machine Scikit-Learn via la classe OneHotEncoder, le paramétrage par défaut encode toutes les modalités existantes. Pour un usage en régression linéaire classique visant l’inférence paramétrique, l’ingénieur de recherche doit impérativement configurer le transformateur avec l’argument drop='first' :
encoder = OneHotEncoder(drop='first', sparse_output=False)
Sur le plan diagnostique, l’inspection des sorties de Statsmodels met à disposition le Condition Number (indice de conditionnement de la matrice X’X). Un indice dépassant 1000 indique une quasi-singularité sévère, tandis qu’une valeur convergeant vers l’infini machine alerte formellement sur la violation de l’indépendance linéaire des prédicteurs. Enfin, la vérification mathématique du rang plein s’exécute directement par l’évaluation de la fonction numpy.linalg.matrix_rank(X), dont la valeur retournée doit coïncider rigoureusement avec le nombre de colonnes de la matrice d’expérience.
11. 11. Pièges avancés : Interactions qualitatives et multi-catégorielles en sciences comportementales
11.1 11.1 L’effet combiné de deux facteurs nominaux et l’explosion combinatoire
La complexité de la modélisation s’accroît considérablement lorsque le plan expérimental comportemental intègre simultanément deux facteurs catégoriels et explore leur interaction réciproque. Prenons l’exemple d’un protocole étudiant l’anxiété en croisant le Genre (2 modalités : Femme, Homme) et le Statut Matrimonial (4 modalités : Célibataire, Marié, Divorcé, Veuf). Le plan factoriel complet est un plan 2 × 4 définissant 8 cellules d’observation distinctes.
Le risque de reproduction du piège des variables muettes se démultiplie alors lors de la création des termes d’interaction de premier ordre. Une formulation naïve consisterait à générer les variables indicatrices pour le Genre (G1, G2), les indicatrices pour le Statut (S1, S2, S3, S4) et l’ensemble des 8 termes de produits croisés Gi × Sj. Cette sur-spécification matricielle massive introduirait de multiples dépendances linéaires superposées, rendant la matrice totalement insoluble.
Pour formaliser rigoureusement un modèle d’interaction modéré respectant l’identifiabilité de rang, la règle générale impose :
- Une constante globale (1 paramètre) ;
- (2 – 1) = 1 variable muette pour l’effet principal du Genre ;
- (4 – 1) = 3 variables muettes pour l’effet principal du Statut ;
- (2 – 1) × (4 – 1) = 1 × 3 = 3 variables de produits croisés pour modéliser l’interaction.
Le modèle compte ainsi exactement 1 + 1 + 3 + 3 = 8 paramètres libres, correspondant fidèlement aux 8 moyennes des cellules du plan d’expérience. Toute inclusion d’un produit d’interaction impliquant la modalité de base de l’un des deux facteurs reproduirait instantanément le piège des variables muettes, détruisant la séparabilité de l’effet modérateur.
11.2 11.2 Le piège des catégories vides ou à effectif quasi-nul dans les sous-groupes
Dans les enquêtes épidémiologiques complexes en santé mentale ou en neuropsychologie, les cohortes d’échantillonnage clinique présentent souvent des répartitions démographiques hautement asymétriques. Ce déséquilibre structurel engendre fréquemment le phénomène des cellules empiriques vides ou à effectif quasi-nul (empty cells), une situation où aucune observation n’est enregistrée pour une intersection spécifique de facteurs.
Supposons que dans le croisement entre un trouble de l’attachement rare et une tranche d’âge marginale, aucun sujet n’apparaisse dans la cellule [Attachement Désorganisé × Grand Âge]. Si l’analyste programme un modèle intégrant le terme d’interaction binaire correspondant, le vecteur colonne généré pour cette cellule spécifique ne contiendra exclusivement que des zéros pour l’ensemble des n lignes d’observation : Dcellule = [0, 0, …, 0]’.
Sur le plan algébrique, ce vecteur nul est par définition colinéaire à n’importe quel autre vecteur de l’espace. La matrice X perd instantanément son rang plein. Cette anomalie engendre une pathologie strictement équivalente au piège classique des variables muettes : l’algorithme ne peut attribuer aucune valeur à un paramètre dont l’information stochastique est nulle. La stratégie de remédiation méthodologique impose de fusionner rationnellement les modalités marginales adjacentes sur des bases cliniques théoriques ou d’abandonner l’estimation des termes d’interactions d’ordre supérieur afin de préserver l’intégrité matricielle globale.
11.3 11.3 Interactions entre une variable continue et une variable muette (ANCOVA hétérogène)
L’évaluation des effets modérateurs en psychologie implique très fréquemment l’analyse conjointe d’un prédicteur continu (par exemple, le niveau d’exposition à un stressor traumatique mesuré sur une échelle d’événements de vie) et d’un facteur qualitatif binaire (par exemple, la présence ou l’absence d’une allèle génétique de vulnérabilité). Ce design correspond au modèle de régression modérée ou d’analyse de covariance avec hétérogénéité des pentes de régression.
Le piège du sur-paramétrage surgit ici lorsque le chercheur introduit dans son équation à la fois la pente continue globale, les variables muettes du facteur, et la totalité des termes de pente conditionnelle pour chaque modalité :
Y = β0 + β1X + β2D1 + β3D2 + β4(X × D1) + β5(X × D2) + ε
Dans cette écriture, deux pièges de variables muettes distincts se superposent : d’une part au niveau des ordonnées à l’origine (puisque D1 + D2 = 1), et d’autre part au niveau des pentes de régression, puisque le produit continu vérifie identiquement (X × D1) + (X × D2) = X. Le modèle souffre d’une double déficience de rang.
La spécification rigoureuse et identifiable impose d’omettre systématiquement l’indicatrice de base pour le terme additif ET pour le produit d’interaction :
Y = β0 + β1X + β2D2 + β3(X × D2) + ε
Dans ce modèle régularisé, β1 représente rigoureusement la pente de régression de Y sur X au sein du seul groupe de référence (D2 = 0), tandis que β3 quantifie l’altération différentielle de la pente (l’effet d’interaction modératrice) observée lorsque l’individu appartient au groupe codé D2 = 1. Cette rigueur dans la paramétrisation protège le chercheur contre les artefacts de multicolinéarité tout en fournissant des métriques d’interaction immédiatement interprétables.
12. 12. Synthèse méthodologique et guide de bonnes pratiques pour les chercheurs
12.1 12.1 Protocole systématique de préparation des données catégorielles
Pour prémunir les laboratoires de recherche contre les dérives statistiques associées au piège des variables muettes, il est recommandé d’intégrer un protocole d’assurance qualité méthodique en quatre phases préalables à toute modélisation linéaire :
- Étape 1 : Cartographie et audit taxonomique : Inventorier exhaustivement la nature dimensionnelle de chaque variable du protocole de recherche. Pour chaque facteur qualitatif nominal ou ordinal, dénombrer précisément le nombre de modalités effectives k et vérifier la complétude des assignations au sein du fichier de données brut.
- Étape 2 : Définition théorique des points d’ancrage : Ne jamais s’en remettre au hasard des conventions de tri machine. Sélectionner délibérément la condition de référence pour chaque facteur (groupe placebo, cohorte saine normative ou groupe modal majoritaire) en consignant le rationnel théorique dans le cahier de laboratoire statistique.
- Étape 3 : Application formalisée de la règle k – 1 : En cas de codage binaire manuel, s’assurer que strictement k – 1 colonnes indicatrices sont générées. Si des routines automatisées sont employées (ex. :
get_dummies,OneHotEncoder), certifier le déclenchement des options d’omission de la modalité initiale (drop_first=True). - Étape 4 : Diagnostic pré-inférentiel de singularité : Examiner systématiquement la table de corrélation matricielle, vérifier que le rang numérique de la matrice de dessein est strictement égal au nombre total de colonnes (rg(X) = p), et confirmer que les facteurs d’inflation de la variance (VIF) restent à des niveaux stables et bornés.
12.2 12.2 Liste de contrôle (Checklist) avant publication scientifique
En conformité avec les exigences de rigueur méthodologique promues par les directives de l’American Psychological Association (normes APA) et les comités de lecture des revues internationales de premier rang, les auteurs doivent s’assurer de la conformité des points suivants dans la section « Méthode » et « Résultats » de leurs manuscrits :
- Transparence de l’encodage : Spécifier explicitement dans le corps du texte le système de codage assigné aux facteurs qualitatifs (ex. : codage de référence/dummy coding, codage d’effet -1/0/1, ou contrastes orthogonaux polynomiaux).
- Identification formelle de la catégorie de référence : Indiquer sans ambiguïté quelle modalité constitue l’ancrage de base, à la fois dans le narratif méthodologique et sous forme de note explicative exhaustive en bas de chaque tableau de régression (ex. : « Note : Le groupe ‘Célibataire’ est la modalité de référence omise pour les variables muettes de statut marital »).
- Interprétation adéquate du terme constant : Valider que l’ordonnée à l’origine β0 fait l’objet d’une discussion conceptuelle conforme à son statut mathématique réel (valeur moyenne attendue pour l’intersection des modalités de base) et non comme une grandeur décontextualisée.
- Vérification des sorties computationnelles : S’assurer de l’absence totale de mentions relatives à des singularités, à des coefficients marqués NA ou à des colonnes arbitrairement exclues dans les annexes statistiques soumises aux évaluateurs, attestant ainsi de la reproductibilité parfaite des analyses.
12.3 12.3 Perspectives sur la modélisation avancée et régularisation
L’essor des méthodes d’apprentissage statistique et de la régularisation pénalisée en psychologie quantitative — notamment au travers des estimateurs de régression Ridge (pénalité L2), Lasso (pénalité L1) et ElasticNet — apporte un éclairage théorique novateur sur le problème de la colinéarité parfaite.
Dans la régression Ridge par exemple, la matrice des équations normales se voit adjoindre une pénalisation scalaire positive λ sur sa diagonale principale, modifiant le système en :
bRidge = (X’X + λI)-1 X’Y
Grâce à cette matrice d’amortissement λI, la matrice résultante (X’X + λI) redevient strictement définie positive et donc inversible, même si la matrice initiale X présentait une déficience de rang due à l’inclusion de k variables muettes aux côtés de la constante. La régularisation L2 « résout » donc le blocage mathématique sans nécessiter l’omission d’une modalité de référence, en contractant proportionnellement les coefficients vers zéro.
Toutefois, cette élégance algorithmique s’accompagne d’une perte d’interprétabilité majeure pour l’investigateur psychologue. L’estimateur régularisé introduit un biais délibéré dans les coefficients pour réduire la variance globale du système. Dès lors, les coefficients partiels ne reflètent plus des moyennes différentielles pures ou des contrastes cliniques clairs au sens de Gauss-Markov. Pour les praticiens et chercheurs dont l’objectif premier demeure l’inférence causale, la validation d’hypothèses théoriques précises et la comparaison clinique inter-groupes, la maîtrise rigoureuse des règles de paramétrisation classique — et en premier chef le respect absolu de la règle des k – 1 catégories pour contourner le piège des variables muettes — demeure une compétence fondamentale, indémodable et irremplaçable.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Bartholomew, K., & Horowitz, L. M. (1991). Attachment styles among young adults: A test of a four-category model. Journal of Personality and Social Psychology, 61(2), 226–244. https://doi.org/10.1037/0022-3514.61.2.226
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates.
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). Sage Publications.
- Greene, W. H. (2018). Econometric analysis (8th ed.). Pearson.
- Hamilton, M. (1959). The assessment of anxiety states by rating. British Journal of Medical Psychology, 32(1), 50–55. https://doi.org/10.1111/j.2044-8341.1959.tb00467.x
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Horvath, A. O., & Greenberg, L. S. (1989). Development and validation of the Working Alliance Inventory. Journal of Counseling Psychology, 36(2), 223–233. https://doi.org/10.1037/0022-0167.36.2.223
- Pedhazur, E. J. (1997). Multiple regression in behavioral research: Explanation and prediction (3rd ed.). Wadsworth Thomson Learning.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.