
Dans le champ contemporain de la recherche quantitative et de la modélisation statistique, l’analyse des phénomènes complexes requiert des outils capables d’appréhender la réalité dans sa nature intrinsèquement pluridimensionnelle. Qu’il s’agisse des sciences comportementales, de la psychologie clinique, de la biomédecine, des neurosciences cognitives ou des sciences sociales, les chercheurs sont constamment confrontés à des objets d’étude qui ne peuvent être réduits à une variable unique sans subir une déperdition drastique d’information. Évaluer l’efficacité d’un protocole thérapeutique, mesurer l’impact d’une restructuration organisationnelle ou estimer les retombées d’un programme pédagogique implique l’enregistrement simultané de multiples indicateurs corrélés. Face à cette complexité, l’approche univariée traditionnelle montre rapidement ses limites formelles et méthodologiques.
L’analyse de variance multivariée, universellement désignée par l’acronyme MANOVA (Multivariate Analysis of Variance), s’est imposée au fil des décennies comme la méthode de référence pour tester les différences entre groupes sur un ensemble conjoint de variables dépendantes continues. Au sein de cet édifice statistique sophistiqué, le chercheur ne dispose pas d’un test F unique et évident comme dans le cadre univarié classique, mais doit choisir parmi quatre statistiques de test omnibus principales : le Lambda de Wilks, la trace de Hotelling-Lawley, la plus grande racine de Roy et la trace de Pillai (souvent désignée sous le nom de statistique V de Pillai-Bartlett). Cette pluralité de métriques reflète la complexité géométrique de la comparaison d’ellipsoïdes de dispersion dans des espaces à p dimensions.
Parmi ces quatre métriques, la trace de Pillai occupe une place tout à fait singulière. Reconnue de manière consensuelle par les méthodologistes comme la statistique la plus robuste et la plus fiable face aux entorses courantes des postulats sous-jacents aux modèles linéaires multivariés, elle constitue le standard d’excellence décisionnel dans les contextes empiriques réels. Le présent article propose une exploration exhaustive, théorique et appliquée de la trace de Pillai : depuis sa genèse conceptuelle et ses fondements matriciels jusqu’à son calcul pas à pas, son interprétation quantitative, sa résilience méthodologique et son implémentation dans les logiciels d’analyse statistique, accompagnée des normes rigoureuses de rédaction académique selon le style APA.
1. Introduction générale et contextualisation statistique : De l’ANOVA à la MANOVA
1.1 Les limites méthodologiques de l’ANOVA univariée
L’analyse de variance univariée (ANOVA), développée à l’origine par Sir Ronald Fisher dans les années 1920, repose sur un principe élégant : partitionner la variance totale observée au sein d’une unique variable dépendante continue en deux composantes fondamentales, à savoir la variance systématique attribuable aux facteurs expérimentaux (variance inter-groupes) et la variance résiduelle aléatoire (variance intra-groupes ou d’erreur). Le ratio de ces deux variances, évalué à l’aide de la loi de distribution F de Fisher-Snedecor, permet d’inférer si les moyennes des populations sous-jacentes diffèrent de manière statistiquement significative. Si ce cadre conceptuel a révolutionné l’agronomie, la génétique et la recherche translationnelle, il révèle une incapacité structurelle dès lors que le phénomène observé ne peut être circonscrit à une seule dimension métrique.
Dans des disciplines telles que la psychologie différentielle, la neuropsychologie ou la psychiatrie, les construits étudiés sont fondamentalement multidimensionnels. Considérons, à titre d’exemple, l’évaluation de l’anxiété : ce concept englobe simultanément des manifestations somatiques (tachycardie, sudation), des manifestations cognitives (pensées intrusives, catastrophisme) et des manifestations comportementales (évitement, sidération). Tenter de mesurer l’efficacité d’un traitement anxiolytique en exécutant trois analyses univariées distinctes sur chacune de ces composantes revient à postuler, de façon hautement irréaliste, que ces dimensions fonctionnent comme des canaux étanches, isolés les uns des autres. En réalité, ces variables partagent une covariance substantielle qui reflète la structure même du construit sous-jacent.
L’inadéquation méthodologique de l’approche univariée séquentielle se manifeste à deux niveaux majeurs. D’une part, elle ignore la dynamique relationnelle et les corrélations croisées existant entre les indicateurs de réponse, privant l’investigateur d’une compréhension globale du profil psychologique du sujet. D’autre part, elle force le chercheur à fragmenter son objet d’investigation en une succession d’analyses atomisées, réduisant ainsi la puissance d’analyse du modèle théorique global. Face à la complexité des systèmes cognitifs, émotionnels et biologiques, la modélisation conjointe et intégrée de multiples dimensions de réponses s’avère un impératif méthodologique de premier ordre.
1.2 L’émergence de la MANOVA comme solution multivariée
L’analyse de variance multivariée (MANOVA) a été développée précisément pour combler cette lacune systémique en étendant la logique de l’ANOVA à un vecteur de variables dépendantes. Alors que l’ANOVA compare des moyennes scalaires unidimensionnelles, la MANOVA évalue simultanément les différences existant entre des vecteurs de moyennes, géométriquement désignés sous le terme de centroïdes, au sein d’un espace multidimensionnel à p dimensions. L’objectif premier de la MANOVA est de déterminer si la séparation observée entre les centroïdes des groupes expérimentaux dépasse ce que l’on pourrait attendre de la simple fluctuation d’échantillonnage, tout en préservant l’intégrité de la structure relationnelle liant les différentes variables observées.
L’avantage conceptuel décisif de la MANOVA réside dans sa capacité à intégrer la matrice de variance-covariance des résidus. En considérant non seulement la variance propre à chaque variable dépendante, mais également l’ensemble des covariances inter-variables, la MANOVA offre une vision holistique des effets expérimentaux. Elle permet de détecter des différences multivariées subtiles qui demeureraient totalement invisibles lors d’analyses univariées séparées. Deux groupes peuvent très bien ne pas présenter d’écart statistiquement significatif sur la variable Y₁ prise isolément, ni sur la variable Y₂ prise isolément, mais différer de façon éclatante lorsque leur combinaison linéaire optimale est projetée dans le plan défini par ces deux variables conjointes.
De surcroît, la MANOVA respecte le principe de parcimonie scientifique en testant l’hypothèse nulle générale selon laquelle les facteurs expérimentaux n’ont aucun effet global sur le profil multivarié des participants. Elle permet ainsi d’éclairer la manière dont les différentes réponses s’articulent, s’amplifient ou se compensent mutuellement sous l’effet du traitement expérimental, offrant une profondeur d’interprétation écologique et phénoménologique qu’aucun faisceau d’analyses univariées isolées ne pourrait délivrer.
1.3 Le contrôle de l’inflation de l’erreur de type I
Au-delà de la perte d’information systémique, la multiplication des tests d’hypothèses univariés pose un danger statistique majeur : l’inflation exponentielle de l’erreur de première espèce, communément appelée erreur de type I (notée α). L’erreur de type I correspond à la probabilité de rejeter à tort une hypothèse nulle qui est pourtant vraie dans la population cible, c’est-à-dire de déclarer un effet expérimental significatif qui n’est en réalité que le produit du hasard ou de variations stochastiques d’échantillonnage.
Lorsqu’un chercheur analyse p variables dépendantes au moyen de p tests ANOVA univariés indépendants, chacun fixé au seuil de signification classique α = 0,05, la probabilité d’observer au moins un résultat faussement positif au niveau de l’ensemble de l’étude (taux d’erreur familial ou Family-Wise Error Rate, FWER) n’est plus de 5 %. Elle est mathématiquement formulée par la relation 1 – (1 – α)ᵖ sous l’hypothèse d’indépendance des tests. Pour 5 variables dépendantes, cette probabilité culmine à environ 22,6 % ; pour 10 variables, elle franchit le seuil critique de 40 %. Bien que les corrections d’ajustement a posteriori comme les procédures de Bonferroni, de Holm ou de Benjamini-Hochberg permettent de contenir cette inflation, elles le font au détriment d’une réduction drastique de la puissance statistique, augmentant de facto le risque d’erreur de type II (β), c’est-à-dire l’omission de véritables effets thérapeutiques ou théoriques.
La MANOVA résout cette quadrature du cercle méthodologique en déployant un test omnibus multivarié unique. En fixant le seuil alpha global à 0,05 au niveau de l’ensemble du profil dimensionnel, elle garantit une protection absolue contre l’inflation de l’erreur de première espèce. Ce n’est que si le test multivarié omnibus s’avère statistiquement significatif que le chercheur est formellement autorisé à poursuivre ses investigations par le biais d’analyses post-hoc ou d’ANOVAs univariées de suivi. C’est précisément au cœur de cette décision omnibus que se positionne la trace de Pillai, agissant comme le baromètre statistique le plus solide pour valider ou rejeter l’hypothèse d’équivalence multivariée des groupes.
2. Définition formelle de la trace de Pillai (Statistique V de Pillai-Bartlett)
2.1 Origine historique et conceptualisation mathématique
La trace de Pillai, rigoureusement désignée dans la littérature méthodologique sous le nom de statistique V de Pillai-Bartlett, trouve ses racines dans les avancées pionnières de l’inférence multivariée au milieu du XXe siècle. Elle a été formalisée à l’origine par le statisticien indien K. C. Sreedharan Pillai en 1955, avant de bénéficier des raffinements mathématiques et des extensions structurelles apportés par le statisticien britannique Maurice Stevenson Bartlett. Pillai a développé cette métrique dans le cadre de ses recherches fondamentales sur les distributions des racines caractéristiques et des formes quadratiques associées aux matrices de dispersion.
À l’époque de son élaboration, l’inférence multivariée était dominée par le Lambda de Wilks, introduit dès 1932 par Samuel S. Wilks. Bien que mathématiquement élégant en tant que ratio de déterminants généralisés, le Lambda de Wilks laissait les praticiens démunis quant à la stabilité des conclusions inférentielles lorsque les postulats formels de normalité ou d’égalité des matrices de covariance étaient malmenés par les données de terrain. Pillai s’est attelé à concevoir une statistique qui agrégerait les contributions de l’ensemble des dimensions de variance partagée de façon additive plutôt que multiplicative, garantissant une meilleure tenue mathématique dans les configurations d’échantillonnage imparfaites.
La consécration de la statistique V de Pillai est intervenue avec l’essor de l’informatique statistique et les vastes études de simulation de Monte-Carlo menées dans les années 1970 et 1980, notamment sous l’impulsion de chercheurs tels que Richard J. Harris et James Algina. Ces simulations ont confirmé que la proposition de Pillai offrait le compromis le plus harmonieux entre puissance d’analyse asymptotique et stabilité du taux nominal d’erreur de première espèce, inscrivant durablement la trace de Pillai comme l’un des piliers incontournables de la modélisation statistique inférentielle moderne.
2.2 Nature et définition de la statistique de test V
Sur le plan conceptuel, la trace de Pillai, communément désignée par la lettre V, est une statistique multivariée synthétique non négative. Elle condense l’ampleur totale de la séparation expérimentale existant entre les différents groupes d’un plan factoriel au regard de l’ensemble des variables dépendantes quantitatives intégrées au modèle. Contrairement à des métriques qui concentreraient leur focale sur une seule fonction discriminante, la statistique V opère comme un agrégateur global de l’écart systématique séparant les centroïdes empiriques des populations étudiées.
D’un point de vue structural, la trace de Pillai capture la somme des proportions de variance associées à chaque dimension discriminante indépendante qui sépare les groupes. Dans le cadre de la théorie linéaire générale, on peut la conceptualiser comme une quantification matricielle de l’importance relative de la variation systématique induite par les facteurs explicatifs par rapport à la variation globale combinée (systématique augmentée de la résiduelle). En agrégeant cette variabilité sur l’ensemble des dimensions orthogonales disponibles, la statistique de Pillai fournit un scalaire unique traduisant l’efficacité globale du modèle statistique à discriminer les populations observées.
Cette condensation mathématique fait de la trace de Pillai un opérateur décisionnel d’une grande clarté conceptuelle : plus les centroïdes des groupes sont distants dans l’espace multidimensionnel par rapport à la dispersion interne de leurs nuages de points respectifs, plus la valeur numérique de V s’accroît, fournissant une indication probante en faveur du rejet de l’hypothèse nulle d’homogénéité multivariée.
2.3 Propriétés métriques et bornes de variation de la statistique
La statistique V de Pillai possède des propriétés mathématiques particulièrement bien définies qui facilitent son appréhension par le chercheur. Par construction, la valeur de V est strictement bornée. Pour un plan expérimental comportant k groupes et p variables dépendantes, l’espace des dimensions discriminantes effectives est régi par un paramètre fondamental de dimensionnalité, noté s, défini formellement par :
s = min(p, k – 1)
Ce paramètre s représente le rang matriciel maximal de la dispersion inter-groupes, c’est-à-dire le nombre maximal de dimensions canoniques non nulles requises pour décrire la séparation géométrique des groupes. La statistique V de Pillai est mathématiquement contrainte à évoluer dans l’intervalle fermé :
0 ≤ V ≤ s
Dans la configuration très fréquente où il n’y a que deux groupes (k = 2, donc s = 1) ou lorsqu’une seule variable dépendante est modélisée (p = 1, réduisant la MANOVA à une simple ANOVA univariée), la valeur de V est rigoureusement bornée entre 0 et 1. Lorsque le plan factoriel intègre davantage de groupes et de variables, la borne théorique maximale devient égale à s. La fonction reliant la distance spatiale des groupes à la statistique V est strictement monotone : tout accroissement de la distance euclidienne ou de Mahalanobis séparant les centroïdes des groupes se traduit mécaniquement par une augmentation continue de la valeur de V.
Une autre propriété métrique majeure de la trace de Pillai est sa remarquable stabilité asymptotique. À mesure que la taille globale de l’échantillon N croît, la distribution d’échantillonnage de V converge avec une régularité exemplaire vers sa forme limite théorique, assurant aux estimateurs dérivés une consistance et une robustesse distributionnelle que peu de statistiques multivariées concurrentes parviennent à égaler.
3. Fondements mathématiques et calcul matriciel de la trace de Pillai
3.1 Décomposition des matrices de sommes des carrés et produits croisés
L’architecture fondamentale de la MANOVA repose sur la généralisation multidimensionnelle de la somme des carrés univariée. Dans un espace à plusieurs variables dépendantes, la variance scalaire est remplacée par des matrices carrées d’ordre (p × p) appelées matrices des sommes des carrés et des produits croisés (couramment désignées par le sigle anglo-saxon SSCP, pour Sum of Squares and Cross Products). Deux matrices fondamentales gouvernent cette architecture : la matrice d’effet du traitement ou d’hypothèse, notée H, et la matrice d’erreur résiduelle, notée E.
La matrice H (SSCP inter-groupes) quantifie l’ampleur de la dispersion des centroïdes de chaque groupe autour du centroïde global de l’échantillon. Ses éléments diagonaux représentent les sommes des carrés inter-groupes classiques pour chacune des variables dépendantes individuelles, tandis que ses éléments extradiagonaux contiennent les sommes des produits croisés inter-groupes, capturant la manière dont les variations de groupe sur une variable sont associées aux variations de groupe sur une autre variable. Formellement, pour k groupes d’effectifs nⱼ, la matrice H s’écrit :
H = ∑ nⱼ (ȳⱼ – ȳ..) (ȳⱼ – ȳ..)ᵀ
où ȳⱼ est le vecteur de moyennes du groupe j, ȳ.. est le grand vecteur des moyennes globales de l’échantillon, et ᵀ indique l’opérateur de transposition vectorielle.
Inversement, la matrice E (SSCP intra-groupes ou résiduelle) modélise la dispersion interne des observations individuelles autour du centroïde de leur groupe respectif. Elle représente le « bruit » aléatoire ou la variabilité d’erreur non expliquée par le modèle expérimental. Ses éléments diagonaux constituent les sommes des carrés d’erreur résiduelle classiques, et ses éléments non diagonaux renferment les produits croisés d’erreur intra-groupes. Elle est définie par :
E = ∑ ∑ (yᵢⱼ – ȳⱼ) (yᵢⱼ – ȳⱼ)ᵀ
La matrice de dispersion totale du système, notée T, résulte de la simple sommation algébrique de ces deux entités : T = H + E. Cette relation constitue la partition fondamentale de la variabilité multivariée.
3.2 Formulation algébrique standard de la trace de Pillai
Une fois les matrices H et E constituées, le calcul de la trace de Pillai nécessite de quantifier le poids relatif de la variabilité expliquée par l’effet expérimental au sein de la variabilité totale disponible. La formulation algébrique matricielle standard de la trace de Pillai s’énonce comme suit :
V = trace[H (H + E)⁻¹]
ou, de manière équivalente en utilisant la matrice totale T :
V = trace[H T⁻¹]
Pour appréhender cette formulation avec précision, deux concepts matriciels clés méritent d’être rappelés. Premièrement, l’inversion matricielle (H + E)⁻¹ équivaut sur le plan conceptuel à une division multivariée. En multipliant H par l’inverse de la matrice totale, on normalise la matrice d’effet expérimental par l’ensemble de la variabilité présente dans les données. Cette opération standardise l’écart inter-groupes en neutralisant l’échelle absolue de mesure des variables.
Deuxièmement, l’opérateur trace, noté « trace » ou parfois « Tr », désigne la somme scalaire de l’ensemble des éléments situés sur la diagonale principale d’une matrice carrée. Dans la matrice résultante [H(H + E)⁻¹], les éléments diagonaux expriment la proportion de variance totale expliquée par l’effet expérimental le long de chaque axe géométrique standardisé. La trace de Pillai n’est donc rien d’autre que l’agrégation linéaire directe de ces proportions de variance partagée.
3.3 Expression spectrale par les valeurs propres (Eigenvalues)
En algèbre linéaire appliquée aux statistiques multivariées, les transformations géométriques et les projections d’axes trouvent leur formulation la plus élégante à travers la théorie spectrale et la décomposition en valeurs propres (eigenvalues). L’analyse de la séparation des groupes revient mathématiquement à résoudre l’équation caractéristique multivariée :
det(H – λE) = 0
ou, sous une forme canonique équivalente :
det(H E⁻¹ – λI) = 0
où I représente la matrice identité de dimension (p × p), det désigne le déterminant matriciel, et λ représente les racines caractéristiques ou valeurs propres du système. Le nombre de valeurs propres non nulles, que l’on indexera par λᵢ (pour i = 1, 2, …, s), est précisément égal au rang s = min(p, k – 1) évoqué précédemment. Chaque valeur propre λᵢ traduit le ratio de variance inter-groupes sur la variance intra-groupes le long d’un axe discriminant canonique particulier, orthogonal à tous les autres.
À partir de ces valeurs propres λᵢ de la matrice H E⁻¹, la trace de Pillai bénéficie d’une formulation spectrale additive directe d’une clarté remarquable :
V = ∑ [λᵢ / (1 + λᵢ)] (pour i variant de 1 à s)
Dans cette équation spectrale, chaque terme λᵢ / (1 + λᵢ) représente le carré du coefficient de corrélation canonique (noté R²_cᵢ) associé à la i-ème dimension discriminante. Par conséquent, la trace de Pillai s’interprète rigoureusement comme la somme des coefficients de corrélation canonique au carré à travers toutes les dimensions d’orthogonalité séparant les groupes :
V = ∑ R²_cᵢ
Cette expression spectrale illustre la beauté mathématique de la métrique : elle décompose l’espace multivarié global en canaux indépendants de variance, puis additionne les contributions spécifiques apportées par chacun d’entre eux.
4. Interprétation quantitative et théorique de la valeur V
4.1 Signification statistique d’une valeur de Pillai proche de zéro
Comprendre la valeur empirique obtenue pour la trace de Pillai exige de situer ce résultat sur son spectre théorique. Lorsque la valeur de V converge vers 0, elle indique que la matrice d’effet H présente des valeurs extrêmement faibles par rapport à la matrice résiduelle E. Sur le plan spectral, cela signifie que chacune des valeurs propres λᵢ tend elle-même vers 0, impliquant que les corrélations canoniques entre les variables dépendantes et les appartenances de groupe sont pratiquement inexistantes.
D’un point de vue géométrique, une trace de Pillai proche de 0 matérialise une superposition spatiale quasi parfaite des centroïdes des populations comparées. Les nuages de points multivariés des différents groupes se recouvrent mutuellement dans l’espace à p dimensions, au point qu’il devient impossible de distinguer l’appartenance d’un individu à un groupe sur la base de son profil de réponses. La variabilité observée entre les moyennes des sous-échantillons ne relève alors que de simples fluctuations aléatoires imputables à l’erreur d’échantillonnage.
Sur le plan décisionnel, une telle configuration conduit invariablement à l’incapacité de rejeter l’hypothèse nulle (H₀). Le chercheur conclut formellement à l’absence de preuve d’un impact quelconque du facteur expérimental sur le profil multivarié des variables réponses, prescrivant l’arrêt immédiat de toute analyse univariée subséquente afin de ne pas risquer d’identifier de faux signaux statistiques.
4.2 Signification statistique d’une valeur de Pillai proche de un
À l’autre extrémité du continuum d’évaluation, lorsque la valeur de V s’approche de sa borne maximale (notamment 1 dans les plans où s = 1, ou de s lorsque plusieurs dimensions canoniques sont impliquées), elle traduit l’existence d’une divergence multivariée spectaculaire entre les conditions expérimentales. Une valeur élevée de V implique que les valeurs propres λᵢ sont considérables, ce qui démontre que la variance systématique générée par le modèle surpasse massivement le bruit de fond ou la dispersion résiduelle non contrôlée.
Dans l’espace géométrique des variables dépendantes, cette situation correspond à une ségrégation spatiale nette et marquée des nuages de points. Les centroïdes des groupes occupent des positions distantes et bien différenciées, formant des agrégats distincts séparés par des zones de faible densité probabiliste. La variabilité inter-groupes représente alors la composante ultra-majoritaire de l’inertie globale des données.
Face à une telle valeur, l’hypothèse nulle d’homogénéité multivariée est catégoriquement rejetée au profit de l’hypothèse alternative (H₁). Le chercheur démontre ainsi avec une grande force probante que les conditions expérimentales ou les catégories naturelles sous étude induisent des décalages significatifs, cohérents et reproductibles sur le profil conjoint des variables mesurées.
4.3 Interprétation en termes de variance multivariée expliquée
L’un des attraits majeurs de la trace de Pillai réside dans sa filiation intuitive avec les métriques traditionnelles de la modélisation univariée. De la même manière que le coefficient de détermination R² évalue la proportion de variance d’une variable réponse prédite par un ensemble de régresseurs, ou que l’êta-carré (η²) quantifie la part de variance expliquée dans une ANOVA à un facteur, la trace de Pillai V peut être appréhendée comme un équivalent multivarié de la variance expliquée.
Plus spécifiquement, dans un plan où le rang s est égal à 1 (par exemple, lors de la comparaison de deux groupes sur un vecteur de réponses), la statistique V représente directement la proportion totale de la variance multivariée globale des observations qui est imputable à la variable explicative. Lorsque s est supérieur à 1, la statistique V additionne ces proportions sur plusieurs dimensions orthogonales distinctes. Le ratio V / s fournit alors un indice synthétique remarquablement lisible : il exprime le pourcentage moyen de variance multivariée expliqué par dimension canonique à travers l’ensemble du système factoriel.
Il importe toutefois de formuler une mise en garde méthodologique fondamentale : tout comme le R² non ajusté en régression multiple a tendance à gonfler mécaniquement avec l’introduction de prédicteurs additionnels, la trace de Pillai est susceptible d’augmenter légèrement sous le simple effet de l’accumulation de variables dépendantes supplémentaires au sein du protocole. L’évaluation de l’ampleur substantielle d’un effet ne doit donc jamais se limiter à l’examen exclusif de la valeur brute de V, mais s’accompagner systématiquement du calcul de la taille d’effet standardisée correspondante, telle que l’êta-carré partiel multivarié (η²ₚ).
5. Analyse comparative : Pillai face aux trois autres métriques de MANOVA
5.1 Confrontation avec le Lambda de Wilks
Le Lambda de Wilks (Λ) demeure historiquement la métrique la plus fréquemment citée dans les articles de recherche. Fondé sur le principe du rapport de vraisemblance, le Lambda de Wilks compare le déterminant de la matrice d’erreur au déterminant de la matrice totale, selon la formulation matricielle classique :
Λ = det(E) / det(H + E) = ∏ [1 / (1 + λᵢ)] (pour i variant de 1 à s)
La divergence mathématique fondamentale entre le Lambda de Wilks et la trace de Pillai repose sur la nature de leur opérateur d’agrégation : Wilks procède par multiplication successive des composantes résiduelles (formulation multiplicative), tandis que Pillai procède par sommation algébrique directe des composantes de variance expliquée (formulation additive). Cette dissemblance algébrique engendre un comportement diamétralement opposé lors de l’évaluation des effets. Pour le Lambda de Wilks, une valeur proche de 0 indique un effet expérimental maximal (la variance résiduelle étant négligeable par rapport à la variance totale), tandis qu’une valeur de 1 traduit une absence totale d’effet.
Si le Lambda de Wilks jouit d’une réputation prestigieuse en raison de son lien formel direct avec la théorie du maximum de vraisemblance, il présente une vulnérabilité reconnue : sa sensibilité aux entorses de l’homogénéité des matrices de covariance. Dès lors que les matrices de dispersion interne des groupes deviennent hétérogènes, le Lambda de Wilks voit son taux d’erreur de première espèce s’écarter sensiblement du seuil nominal. En revanche, lorsque tous les postulats théoriques sont parfaitement honorés, le Lambda de Wilks offre une puissance statistique marginalement supérieure à celle de la trace de Pillai, justifiant son utilisation prioritaire dans les contextes expérimentaux idéaux.
5.2 Confrontation avec la Trace de Hotelling-Lawley
La trace de Hotelling-Lawley (notée T ou T₀²), développée conjointement par Harold Hotelling et D. N. Lawley, adopte une formulation matricielle basée sur l’action directe de la matrice résiduelle inversée sur la matrice d’hypothèse :
T = trace(H E⁻¹) = ∑ λᵢ (pour i variant de 1 à s)
À la différence de la trace de Pillai qui standardise la matrice H par la matrice totale (H + E), Hotelling-Lawley standardise la matrice H exclusivement par la matrice d’erreur E. Sur le plan spectral, au lieu de sommer les termes bornés λᵢ / (1 + λᵢ), elle somme directement les valeurs propres brutes λᵢ. Par conséquent, la trace de Hotelling-Lawley n’est pas bornée par le paramètre s et peut croître indéfiniment vers l’infini au fur et à mesure que la séparation des groupes s’intensifie.
Cette particularité algébrique confère à la trace de Hotelling-Lawley une sensibilité exacerbée aux dimensions canoniques présentant des valeurs propres très élevées, mais induit également une fragilité critique face aux observations extrêmes (outliers) multivariées. Dans les situations où la variance résiduelle devient instable ou mal conditionnée (déterminant de E proche de la singularité), la trace de Hotelling-Lawley peut produire des estimations instables. La trace de Pillai, en incorporant la matrice d’effet au dénominateur total au sein de (H + E)⁻¹, régularise l’opérateur matriciel et élimine tout risque de singularité computationnelle, garantissant une maîtrise bien plus ferme de la variance résiduelle.
5.3 Confrontation avec la Plus Grande Racine de Roy
La plus grande racine caractéristique de Roy (Roy’s Largest Root, notée θ), introduite par S. N. Roy en 1953, pousse la logique de focalisation dimensionnelle à son paroxysme. Au lieu d’agréger les contributions des différentes dimensions canoniques d’écart, elle retient exclusivement la valeur propre maximale unique λ₁ :
θ = λ₁ / (1 + λ₁) (ou simplement λ₁ selon les conventions logicielles)
Cette focalisation exclusive sur la première dimension de dispersion fait de la racine de Roy l’indicateur le plus puissant de tous les tests multivariés possibles, à la condition expresse et rigide que la séparation réelle entre les groupes soit strictement unidimensionnelle, c’est-à-dire que tous les centroïdes de population soient rigoureusement alignés le long d’un unique axe géométrique dans l’espace multidimensionnel.
Cependant, cette puissance théorique maximale a pour contrepartie une vulnérabilité extrême. Dès lors que l’effet expérimental est diffus et s’exprime sur plusieurs dimensions non redondantes, ou dès que les données violent l’hypothèse de normalité multivariée, la racine de Roy présente un comportement erratique et génère un taux d’erreur de première espèce fortement gonflé et incontrôlable. Contrairement à la racine de Roy, la trace de Pillai mobilise l’intégralité de l’espace spectral en intégrant l’ensemble des s dimensions canoniques. Elle garantit ainsi une évaluation équilibrée et démocratique de l’effet expérimental, exempte des biais d’optimisation univariée artificielle qui pénalisent la métrique de Roy.
6. Robustesse méthodologique et résilience de la trace de Pillai
6.1 Comportement face à l’hétérogénéité des matrices de covariance
Le postulat d’homogénéité des matrices de variance-covariance intra-groupes (souvent qualifié d’homoscédasticité multivariée) constitue le prérequis le plus strict et le plus contraignant imposé par l’architecture de la MANOVA. Ce postulat exige que les dispersions internes et les patrons de corrélation entre les variables dépendantes demeurent rigoureusement constants d’un groupe à un autre dans les populations parentes. Dans la pratique empirique, ce postulat est couramment évalué par le biais du test M de Box.
Or, le test de Box présente une sensibilité notoirement excessive aux déviations mineures, rejetant fréquemment l’hypothèse d’homogénéité dans les échantillons de taille modérée ou grande, même lorsque les écarts observés n’exercent aucune menace réelle sur la validité des conclusions statistiques. C’est précisément dans ce scénario délicat que la supériorité de la trace de Pillai se manifeste avec le plus d’éclat. De nombreuses séries de simulations de Monte-Carlo, répliquées sur des millions d’itérations synthétiques, ont démontré de manière indiscutable que la trace de Pillai est la statistique multivariée la plus robuste face à l’hétéroscédasticité.
Même en présence d’un test de Box significatif révélant une inégalité substantielle des matrices de covariance, le taux d’erreur de première espèce empirique de la trace de Pillai reste remarquablement fidèle au seuil alpha nominal de 0,05. Alors que le Lambda de Wilks et la trace de Hotelling-Lawley dérivent vers des taux d’erreur effectifs pouvant atteindre 0,08 ou 0,12 (conduisant à des conclusions faussement significatives), Pillai maintient l’intégrité de la décision statistique, fournissant au chercheur une barrière de sécurité indispensable contre les artefacts analytiques.
6.2 Résistance aux violations de la normalité multivariée
Le second grand postulat sous-jacent aux tests d’hypothèses multivariés est la normalité multivariée des résidus, qui postule que l’ensemble des variables dépendantes suit conjointement une distribution gaussienne multidimensionnelle au sein de chaque groupe. Les données issues du terrain – en particulier les mesures cliniques, les temps de réaction en chronométrie mentale ou les indicateurs physiologiques – s’écartent fréquemment de cet idéal mathématique en affichant une asymétrie marquée (skewness) ou des queues de distribution épaissies par un aplatissement prononcé (kurtosis).
La trace de Pillai se distingue par une stabilité exceptionnelle face aux déviations modérées de la normalité multivariée. En vertu du théorème central limite appliqué aux espaces vectoriels, l’agrégation linéaire des sommes des carrés et produits croisés stabilise le comportement asymptotique de la trace de Pillai bien plus rapidement que les formulations multiplicatives concurrentes. Tant que la taille d’échantillon globale respecte un volume suffisant (idéalement plus de 20 à 30 observations par cellule expérimentale), l’impact d’une distribution non gaussienne modérée sur la validité des inférences produites par Pillai est quasi négligeable.
Cette résilience connaît toutefois des limites rationnelles : si la non-normalité découle de la présence de valeurs aberrantes extrêmes (multivariate outliers), ces dernières peuvent fausser artificiellement la matrice H ou gonfler artificiellement les valeurs de E. Dans de telles configurations de contamination sévère, le recours préalable à des méthodes d’assainissement des données – telles que des transformations de variables (logarithmiques, racine carrée, Box-Cox) ou le basculement vers des protocoles de rééchantillonnage non paramétriques par permutation et bootstrapping multivarié – demeure recommandé.
6.3 Tolérance aux déséquilibres d’effectifs entre sous-groupes
Dans la recherche expérimentale de laboratoire, l’assignation aléatoire rigoureuse permet généralement d’obtenir des cellules factorielles parfaitement équilibrées (n₁ = n₂ = … = nₖ). Toutefois, dans les designs quasi-expérimentaux, longitudinaux ou cliniques, les défections de participants (attrition), les critères diagnostiques sélectifs ou les données manquantes créent inévitablement des déséquilibres d’effectifs entre les groupes d’intérêt.
L’interaction entre des tailles d’échantillons inégales et l’hétérogénéité des covariances constitue un piège redoutable pour l’analyste. Lorsque le groupe possédant le plus petit effectif présente la matrice de covariance la plus volumineuse, les tests multivariés conventionnels deviennent excessivement libéraux (sur-rejet de l’hypothèse nulle). Inversement, lorsque le groupe à grand effectif présente la plus grande dispersion, les tests deviennent indûment conservateurs (perte d’effets réels). Les études comparatives ont prouvé que la trace de Pillai minimise ces distorsions de manière optimale par rapport à ses homologues.
Grâce à son architecture matricielle qui intègre harmonieusement la variabilité globale, Pillai absorbe les déséquilibres de pondération induits par des effectifs cellulaires inégaux. C’est cette tolérance méthodique qui conduit la communauté scientifique internationale à prescrire l’emploi impératif de la trace de Pillai dès lors qu’un protocole factoriel présente simultanément des cellules asymétriques et des variances hétérogènes.
7. Exemple d’application détaillé en recherche psychologique
7.1 Contexte expérimental et modélisation des variables
Afin de rendre concrète et opérationnelle l’ensemble de la mécanique mathématique développée jusqu’ici, nous allons déployer un cas d’étude réaliste issu de la recherche clinique en psychothérapie cognitive et comportementale. Imaginons qu’une équipe hospitalo-universitaire conduise un essai contrôlé randomisé destiné à évaluer et comparer l’efficacité de deux protocoles d’intervention thérapeutique novateurs face à une condition de contrôle standardisée, sur la régulation de la symptomatologie affective.
Le facteur explicatif inter-sujets (la variable indépendante catégorielle) comprend trois modalités distinctes :
- Groupe 1 (TCC standard) : Thérapie Cognitive et Comportementale individualisée classique axée sur la restructuration cognitive et l’exposition graduelle.
- Groupe 2 (Pleine Conscience / MBCT) : Programme de thérapie cognitive basée sur la pleine conscience (Mindfulness-Based Cognitive Therapy), centré sur l’acceptation émotionnelle et la décentration cognitive.
- Groupe 3 (Groupe Témoin / Liste d’attente active) : Participants recevant un suivi médical d’accompagnement de routine sans intervention psychothérapeutique ciblée.
Le profil de santé mentale des participants est modélisé conjointement par deux variables dépendantes continues quantitatives, mesurées de manière standardisée à l’issue des douze semaines de suivi thérapeutique :
- Variable Y₁ (Score BDI-II) : Inventaire de Dépression de Beck (deuxième édition), mesurant l’intensité globale des symptômes dépressifs sur une échelle métrique continue (plus le score est bas, plus la rémission est marquée).
- Variable Y₂ (Score STAI-Y) : Inventaire d’Anxiété État-Trait de Spielberger (Forme Y-A, anxiété-état), quantifiant le niveau de tension et d’appréhension psychologique aiguë ressenti par le patient.
7.2 Spécification formelle des hypothèses statistiques
La formulation des hypothèses au sein d’une MANOVA ne porte pas sur des paramètres scalaires isolés, mais sur des entités vectorielles de moyennes, définissant les centroïdes théoriques des trois sous-populations dans l’espace bidimensionnel des réponses (p = 2).
L’hypothèse nulle générale, notée H₀, postule l’équivalence parfaite et simultanée des profils d’efficacité thérapeutique à travers les trois groupes :
H₀ : μ₁ = μ₂ = μ₃
ce qui équivaut, en explicitant le vecteur des variables dépendantes pour chaque population, à la double égalité scalaire :
[μ_BDI,₁ ; μ_STAI,₁]ᵀ = [μ_BDI,₂ ; μ_STAI,₂]ᵀ = [μ_BDI,₃ ; μ_STAI,₃]ᵀ
L’hypothèse alternative, notée H₁, postule qu’il existe au moins une condition d’intervention pour laquelle le centroïde bidimensionnel s’écarte significativement de la position spatiale des autres dans le plan formé par les axes de la dépression et de l’anxiété :
H₁ : ∃ (j, j‘) tel que μⱼ ≠ μⱼ’
Le seuil de signification de décision est conventionnellement fixé au niveau de risque de première espèce standard α = 0,05. L’arbitrage statistique sera conduit sous l’autorité exclusive de la trace de Pillai afin d’assurer une robustesse maximale aux données d’évaluation clinique.
7.3 Description des données simulées et matrices associées
Pour notre étude empirique, considérons un échantillon représentatif de N = 90 participants adultes présentant des troubles mixtes de l’anxiété et de l’humeur, équitablement répartis par randomisation stratifiée en trois cohortes de taille égale, soit n₁ = n₂ = n₃ = 30 sujets par groupe.
À l’issue des douze semaines de traitement, l’extraction des données descriptives révèle les vecteurs de centroïdes d’échantillonnage empiriques suivants (exprimant la moyenne du score BDI-II suivie de la moyenne du score STAI-Y) :
- Groupe 1 (TCC) : ȳ₁ = [16,0 ; 38,0]ᵀ
- Groupe 2 (Pleine Conscience) : ȳ₂ = [18,0 ; 34,0]ᵀ
- Groupe 3 (Témoin) : ȳ₃ = [26,0 ; 48,0]ᵀ
Le grand centroïde moyen combiné calculé sur l’ensemble des 90 participants (grandes moyennes marginales de l’étude) se situe précisément à :
ȳ.. = [(16 + 18 + 26) / 3 ; (38 + 34 + 48) / 3]ᵀ = [20,0 ; 40,0]ᵀ
L’inspection clinique préliminaire de ces moyennes met en évidence des profils différentiels fascinants : la TCC standard semble exceller particulièrement dans la réduction des scores dépressifs (16,0 contre 26,0 chez les témoins), tandis que la Pleine Conscience affiche une efficacité remarquable sur le pôle de l’anxiété aiguë (34,0 contre 48,0 chez les témoins). Les données empiriques confirment par ailleurs l’existence d’une corrélation positive modérée attendue entre l’anxiété et la dépression à l’intérieur de chaque groupe (r ≈ 0,45), justifiant pleinement l’impératif d’une modélisation multivariée conjointe.
8. Calcul pas à pas de la trace de Pillai sur les données de l’exemple
8.1 Construction explicite des matrices H et E
Pour procéder au calcul formel de la métrique multivariée, nous devons construire de manière rigoureuse les matrices de dispersion inter-groupes H et intra-groupes E à partir de nos données chiffrées.
Calculons d’abord les écarts de chaque centroïde de groupe par rapport au grand centroïde global ȳ.. = [20,0 ; 40,0]ᵀ :
- Groupe 1 : d₁ = ȳ₁ – ȳ.. = [16 – 20 ; 38 – 40]ᵀ = [-4 ; -2]ᵀ
- Groupe 2 : d₂ = ȳ₂ – ȳ.. = [18 – 20 ; 34 – 40]ᵀ = [-2 ; -6]ᵀ
- Groupe 3 : d₃ = ȳ₃ – ȳ.. = [26 – 20 ; 48 – 40]ᵀ = [6 ; 8]ᵀ
Puisque chaque groupe comporte n = 30 sujets, la matrice d’effet H s’obtient par la somme pondérée des produits vectoriels externes 30 × (dⱼ dⱼᵀ) :
- Pour le Groupe 1 : 30 × [(-4)(-4), (-4)(-2) ; (-2)(-4), (-2)(-2)] = 30 × [16, 8 ; 8, 4] = [480, 240 ; 240, 120]
- Pour le Groupe 2 : 30 × [(-2)(-2), (-2)(-6) ; (-6)(-2), (-6)(-6)] = 30 × [4, 12 ; 12, 36] = [120, 360 ; 360, 1080]
- Pour le Groupe 3 : 30 × [(6)(6), (6)(8) ; (8)(6), (8)(8)] = 30 × [36, 48 ; 48, 64] = [1080, 1440 ; 1440, 1920]
En sommant terme à terme ces trois matrices partielles, nous obtenons la matrice inter-groupes finale H :
H = [480 + 120 + 1080 , 240 + 360 + 1440 ; 240 + 360 + 1440 , 120 + 1080 + 1920] = [1680 , 2040 ; 2040 , 3120]
Supposons à présent que la sommation des dispersions résiduelles internes à chaque groupe, cumulée sur les 90 participants (avec N – k = 90 – 3 = 87 degrés de liberté résiduels), donne après extraction empirique la matrice d’erreur E suivante :
E = [3480 , 1740 ; 1740 , 5220]
Notons que les matrices H et E sont parfaitement symétriques (l’élément ligne 1-colonne 2 est égal à l’élément ligne 2-colonne 1) et semi-définies positives, conformément aux impératifs mathématiques matriciels fondamentaux.
8.2 Opérations matricielles : addition, inversion et produit
Pour appliquer la formule canonique de Pillai V = trace[H (H + E)⁻¹], nous devons réaliser les opérations d’algèbre linéaire sous-jacentes. Commençons par calculer la matrice de dispersion totale T = H + E par sommation matricielle terme à terme :
T = [1680 + 3480 , 2040 + 1740 ; 2040 + 1740 , 3120 + 5220] = [5160 , 3780 ; 3780 , 8340]
L’étape suivante consiste à calculer la matrice inverse T⁻¹ = (H + E)⁻¹. Pour une matrice carrée d’ordre 2 sous la forme [a, b ; c, d], l’inverse est obtenu par la formule analytique : [1 / det(T)] × [d, –b ; –c, a].
Calculons le déterminant de notre matrice T :
det(T) = (5160 × 8340) – (3780 × 3780) = 43 034 400 – 14 288 400 = 28 746 000
Ce déterminant étant largement positif et non nul, la matrice T est parfaitement inversible (régulière). Déterminons les éléments de T⁻¹ :
T⁻¹ = (1 / 28 746 000) × [8340 , -3780 ; -3780 , 5160]
- Élément (1,1) : 8340 / 28 746 000 ≈ 0,00029013
- Élément (1,2) : -3780 / 28 746 000 ≈ -0,00013149
- Élément (2,1) : -3780 / 28 746 000 ≈ -0,00013149
- Élément (2,2) : 5160 / 28 746 000 ≈ 0,00017950
Nous pouvons désormais procéder à la multiplication matricielle M = H × T⁻¹ :
M = [1680 , 2040 ; 2040 , 3120] × [0,00029013 , -0,00013149 ; -0,00013149 , 0,00017950]
8.3 Extraction de la trace et dérivation numérique de V
Puisque la statistique de Pillai est définie comme la trace de la matrice résultante M, nous n’avons besoin de calculer que les deux éléments situés sur sa diagonale principale, à savoir m₁₁ et m₂₂ :
Calcul du premier élément diagonal m₁₁ (produit scalaire de la ligne 1 de H par la colonne 1 de T⁻¹) :
m₁₁ = (1680 × 0,00029013) + (2040 × -0,00013149) = 0,48742 – 0,26824 = 0,21918
Calcul du second élément diagonal m₂₂ (produit scalaire de la ligne 2 de H par la colonne 2 de T⁻¹) :
m₂₂ = (2040 × -0,00013149) + (3120 × 0,00017950) = -0,26824 + 0,56004 = 0,29180
La trace de Pillai est la somme directe de ces deux composantes diagonales :
V = trace(M) = m₁₁ + m₂₂ = 0,21918 + 0,29180 = 0,51098 (soit environ 0,511)
Vérifions la cohérence métrique de notre résultat : dans notre étude, le nombre de variables dépendantes est p = 2 et le nombre de groupes est k = 3. Le rang du système est donc s = min(2, 3 – 1) = 2. Notre valeur V = 0,511 s’insère harmonieusement dans l’intervalle théorique [0 ; 2], témoignant d’une séparation multivariée très substantielle induite par les protocoles thérapeutiques.
9. Conversion en statistique F et inférence décisionnelle
9.1 Transformation de la statistique V en approximation F de Fisher
La trace de Pillai V n’obéit pas directement à une loi de distribution tabulée standard sous sa forme brute. Pour tester formellement si la valeur obtenue s’écarte de façon statistiquement significative de l’hypothèse nulle, il est nécessaire de la convertir en une statistique de test suivant approximativement (ou exactement, selon les dimensions) la distribution F de Fisher-Snedecor.
La transformation générale développée par Pillai et Bartlett repose sur la définition préalable de trois paramètres structurels entiers ou fractionnaires (s, m et n), régis par les dimensions fondamentales du plan expérimental (p : nombre de variables dépendantes, v_h = k – 1 : degrés de liberté inter-groupes, et v_e = N – k : degrés de liberté intra-groupes) :
- s = min(p, v_h) = min(2, 2) = 2
- m = (|p – v_h| – 1) / 2 = (|2 – 2| – 1) / 2 = -0,5
- n = (v_e – p – 1) / 2 = (87 – 2 – 1) / 2 = 84 / 2 = 42,0
À partir de ces constantes dimensionnelles, la formule canonique de conversion de la trace de Pillai en ratio d’approximation F s’exprime comme suit :
F_approx = [(2n + s + 1) / (2m + s + 1)] × [V / (s – V)]
Appliquons scrupuleusement cette équation avec les valeurs de nos paramètres de recherche :
- Numérateur du premier facteur : 2n + s + 1 = (2 × 42,0) + 2 + 1 = 84 + 3 = 87
- Dénominateur du premier facteur : 2m + s + 1 = (2 × -0,5) + 2 + 1 = -1 + 3 = 2
- Premier facteur scalaire : 87 / 2 = 43,5
- Second facteur matriciel : V / (s – V) = 0,51098 / (2 – 0,51098) = 0,51098 / 1,48902 ≈ 0,343165
En multipliant ces deux grandeurs, nous obtenons la statistique de test finale :
F_approx = 43,5 × 0,343165 = 14,928 (soit F ≈ 14,93)
9.2 Calcul des degrés de liberté multivariés
Pour déterminer la distribution théorique de référence sous laquelle ce ratio F sera évalué, nous devons calculer rigoureusement les deux jeux de degrés de liberté multivariés associés : les degrés de liberté au numérateur (notés ddl₁) et les degrés de liberté au dénominateur (notés ddl₂).
Dans l’approximation standard de Pillai, ces degrés de liberté sont définis par les expressions formelles suivantes :
- ddl₁ = s × (2m + s + 1) = 2 × 2 = 4
- ddl₂ = s × (2n + s + 1) = 2 × 87 = 174
Remarquons la cohérence interne remarquable de ces grandeurs : le premier degré de liberté (ddl₁ = 4) correspond très exactement au produit algébrique classique p × (k – 1) = 2 × 2 = 4, reflétant l’ensemble des axes scalaires élémentaires évalués au sein du modèle global.
La statistique F multivariée dérivée de la trace de Pillai suit donc, sous l’hypothèse nulle H₀, une distribution F de Fisher centrale à 4 et 174 degrés de liberté :
F(4, 174) = 14,93
9.3 Prise de décision statistique et règle de rejet
L’inférence statistique finale repose sur la comparaison de la statistique calculée F_approx avec la valeur critique issue de la table de distribution théorique de Fisher pour un seuil bilatéral α = 0,05, ou plus précisément par le calcul de la probabilité critique exacte associée (la p-valeur).
Pour une loi F(4, 174), la valeur critique théorique au seuil α = 0,05 est approximativement égale à F_critique ≈ 2,42. La valeur obtenue dans notre essai clinique, F = 14,93, surpasse largement ce seuil d’admissibilité critique. En interrogeant la fonction de répartition cumulative complémentaire de la distribution F, nous obtenons une probabilité critique infinitésimale :
p = P(F(4, 174) ≥ 14,93) ≈ 1,84 × 10⁻¹⁰, soit p < 0,001
La décision méthodologique s’impose de façon indiscutable : l’hypothèse nulle H₀ d’égalité des centroïdes multivariés entre les trois groupes de traitement doit être formellement et catégoriquement rejetée. L’équipe de recherche dispose d’une preuve hautement significative indiquant que les protocoles thérapeutiques induisent des variations notables et différentielles sur le profil combiné de l’anxiété et de la dépression des patients.
10. Implémentation computationnelle et interprétation des sorties logicielles
10.1 Exécution et lecture de la trace de Pillai sous IBM SPSS
Dans la recherche empirique moderne, le calcul matriciel manuel est avantageusement délégué aux environnements d’analyse logicielle spécialisés. Sous le logiciel IBM SPSS Statistics, la conduite d’une MANOVA intégrant la trace de Pillai s’effectue via le menu linéaire général : Analyser > Modèle linéaire général > Multivarié....
L’analyste transfère l’ensemble de ses variables quantitatives continues (ici, BDI_Score et STAI_Score) dans le cadre intitulé « Variables dépendantes », et assigne le facteur catégoriel d’intervention (Groupe_Therapie) dans le champ « Facteurs fixes ». Dans la boîte de dialogue secondaire accessible via le bouton « Options », il est impératif de cocher « Estimations de la taille d’effet » et « Puissance observée » afin d’obtenir une restitution complète des paramètres inférentiels.
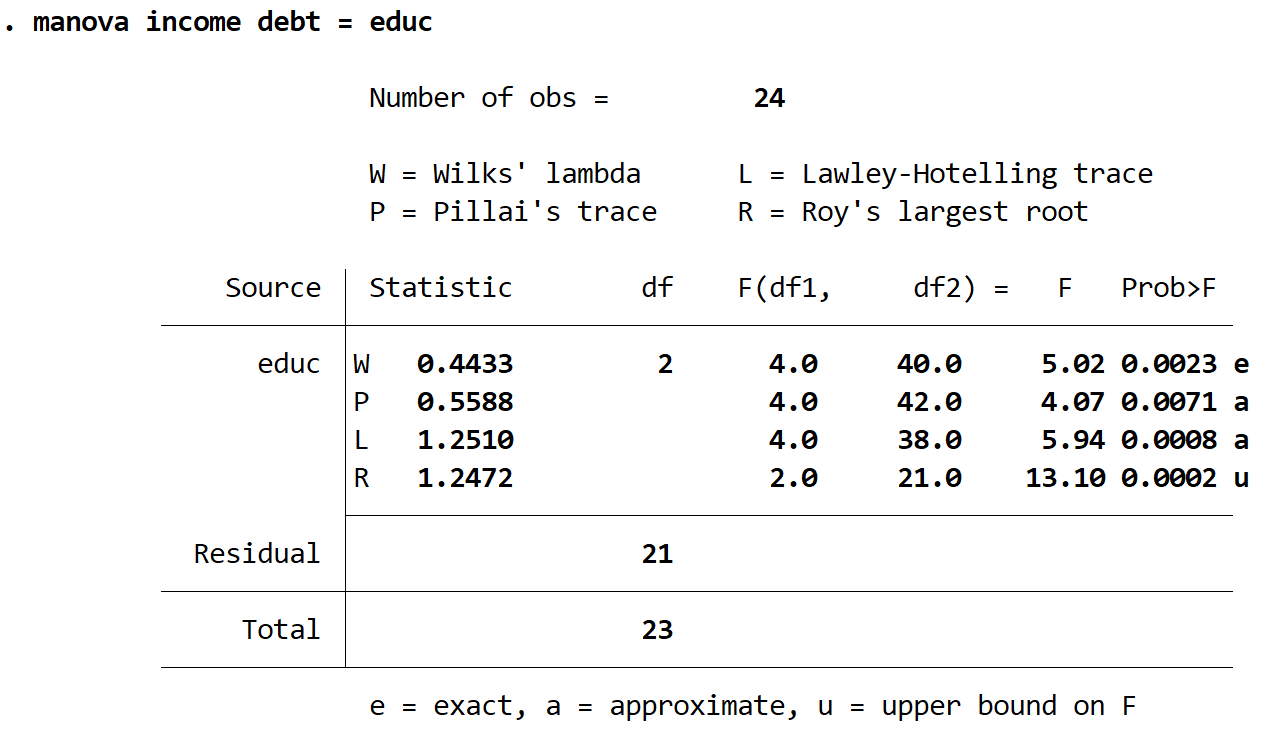
Lors de l’affichage des résultats, la section décisionnelle maîtresse est logée dans le tableau synthétique intitulé « Multivariate Tests » (Tests multivariés). Ce tableau comporte systématiquement quatre lignes d’évaluation pour chaque effet du modèle : Pillai’s Trace (Trace de Pillai), Wilks’ Lambda (Lambda de Wilks), Hotelling’s Trace (Trace de Hotelling) et Roy’s Largest Root (Plus grande racine de Roy). L’utilisateur repère la première ligne consacrée à la trace de Pillai, où s’affichent successivement : la valeur brute de la statistique (Value = 0,511), la statistique F associée (F = 14,928), le degré de liberté de l’hypothèse (Hypothesis df = 4,000), le degré de liberté de l’erreur (Error df = 174,000), et la significativité statistique bilatérale (Sig. = 0,000).
10.2 Programmation et extraction de la métrique sous R
Pour les utilisateurs de l’environnement de programmation statistique open source R, l’exécution d’une MANOVA s’appuie sur le système matriciel natif du langage. La modélisation conjointe s’initialise au moyen de la fonction standard manova(), en encapsulant les variables dépendantes sous la forme d’une matrice bidimensionnelle via l’opérateur de liaison par colonnes cbind() :
modele_manova <- manova(cbind(BDI, STAI) ~ Groupe, data = donnees_cliniques)
L’extraction de la trace de Pillai s’effectue via l’appel de la fonction générique summary(), en précisant formellement le type de métrique souhaité au sein du paramètre dédié :
summary(modele_manova, test = "Pillai")
La console renvoie alors un tableau synthétique affichant les degrés de liberté, la valeur de la statistique de Pillai (Pillai), la statistique F approximée correspondante (approx F), les degrés de liberté résiduels (num Df et den Df), et la p-valeur finale (Pr(>F)). Pour les analystes désireux d’automatiser des flux de calculs ou d’extraire programmatique la décomposition spectrale, les matrices H et E peuvent être isolées directement via les commandes modele_manova$SS, et les valeurs propres canoniques peuvent être obtenues via eigen(solve(E) %*% H)$values.
10.3 Erreurs fréquentes d’interprétation des sorties logicielles
L’interprétation des tableaux de résultats multivariés recèle plusieurs écueils récurrents qu’il convient de dénoncer avec vigueur afin de préserver l’intégrité de la communication scientifique. Le premier piège réside dans la confusion grossière consistant à assimiler la valeur brute de la trace de Pillai (Value) à la taille d’effet ou au niveau de significativité. Il n’est pas rare de voir des chercheurs novices rapporter qu’un test n’est pas significatif au prétexte que la valeur de Pillai est de 0,15, ignorant que cette statistique brute doit être impérativement convertie en valeur F pour pouvoir juger de son caractère aléatoire ou systématique.
Un deuxième écueil méthodologique fréquent concerne l’omission des postulats préalables d’indépendance des observations. La MANOVA postule que chaque ligne de données correspond à une entité d’observation indépendante. L’utilisation d’une MANOVA standard sur des mesures répétées ou des sujets appariés sans mobiliser les modèles mixtes multivariés constitue une erreur fondamentale invalidant l’estimation de la matrice d’erreur E.
Enfin, la troisième erreur, sans doute la plus pernicieuse, réside dans l’illusion qu’un test multivarié significatif met un terme à l’investigation. Conclure triomphalement que la trace de Pillai est significative (p < 0,001) sans entreprendre les analyses de contrastes nécessaires ne permet aucunement de savoir quelle thérapie surpasse l’autre, ni si l’effet s’exerce de façon prépondérante sur l’anxiété ou sur la dépression. Le test omnibus de Pillai n’est qu’un sésame décisionnel validant la légitimité des explorations univariées et discriminantes post-hoc ultérieures.
11. Taille d’effet, puissance statistique et analyses complémentaires
11.1 Calcul de l’êta-carré partiel multivarié dérivé de Pillai
Dans l’esprit des recommandations méthodologiques émises par l’American Psychological Association (APA), la seule publication d’une valeur p ne suffit plus à caractériser la pertinence empirique d’un résultat scientifique. Il est indispensable d’y adjoindre une estimation standardisée de l’ampleur de l’effet, affranchie de la taille brute de l’échantillon. Dans le cadre de la MANOVA, l’indice d’effet partiel privilégié est l’êta-carré partiel multivarié (noté η²ₚ).
Dans les environnements logiciels comme SPSS, l’êta-carré partiel associé à la trace de Pillai est dérivé directement de la statistique F convertie et de ses degrés de liberté effectifs via l’équation générale :
η²ₚ = (ddl₁ × F) / [(ddl₁ × F) + ddl₂]
Injectons dans cette relation les paramètres calculés au cours de notre cas clinique :
- Numérateur : 4 × 14,928 = 59,712
- Dénominateur : (4 × 14,928) + 174 = 59,712 + 174 = 233,712
- η²ₚ = 59,712 / 233,712 ≈ 0,2555 (soit η²ₚ ≈ 0,26)
Selon les conventions canoniques introduites par Jacob Cohen pour les sciences du comportement, un effet est classiquement qualifié de faible pour un η²ₚ autour de 0,01, de modéré aux alentours de 0,06, et de grand au-delà de 0,14. Avec un êta-carré partiel multivarié de 0,26, l’effet de notre protocole psychothérapeutique est qualifié de particulièrement vaste : environ 25,6 % de la variance combinée totale du profil dépressivo-anxieux est directement attribuable au choix de l’intervention clinique, ce qui atteste d’une efficacité thérapeutique substantielle.
11.2 Analyse de puissance statistique et détermination de l’échantillon
La puissance statistique multivariée (notée 1 – β) désigne la probabilité théorique de rejeter à raison une hypothèse nulle fausse. Dans le cadre d’une MANOVA, la puissance dépend de façon étroite de cinq paramètres interconnectés : le seuil nominal α, la taille d’effet postulée (η²ₚ), le nombre total d’observations N, le nombre de variables dépendantes p, mais également le degré et la direction de la corrélation inter-variables (r).
Le rôle des corrélations entre variables dépendantes mérite une clarification théorique essentielle : si deux variables dépendantes sont très fortement corrélées (r > 0,85), elles deviennent redondantes (multicolinéarité), ce qui consomme inutilement des degrés de liberté sans apporter d’information nouvelle et érode la puissance du test de Pillai. Inversement, si les variables sont modérément corrélées (idéalement entre 0,30 et 0,60), elles apportent des perspectives orthogonales complémentaires qui maximisent la séparation des centroïdes et décuplent la puissance multivariée.
Le calibrage a priori d’un protocole expérimental requiert l’usage d’outils logiciels d’analyse de puissance tels que G*Power. Dans le menu des tests de G*Power, le paramétrage d’un test omnibus multivarié (« MANOVA : Global effects ») permet de calculer le N minimal requis. Pour détecter un effet modéré (f²(V) = 0,06) au seuil standard α = 0,05 avec une puissance ciblée de 1 – β = 0,80 dans un plan à 3 groupes et 2 variables réponses, le logiciel préconise un effectif total minimal avoisinant 84 participants, ce qui confirme l’adéquation méthodologique de notre cohorte clinique simulée (N = 90).
11.3 Poursuite de l’investigation post-MANOVA
Le rejet péremptoire de l’hypothèse nulle par la trace de Pillai valide formellement la présence d’une différence globale, mais n’identifie ni l’axe prépondérant de l’effet, ni les paires de groupes à l’origine de cette divergence. Pour répondre à ces interrogations spécifiques, deux stratégies analytiques complémentaires s’offrent au méthodologiste.
La première stratégie, largement répandue, consiste à conduire des ANOVAs univariées de suivi sur chacune des variables dépendantes prises individuellement. Afin de maintenir l’erreur de première espèce au niveau global protégé, le chercheur applique systématiquement un ajustement de Bonferroni sur le seuil de décision : avec p = 2 variables, le nouveau seuil d’admissibilité par test univarié devient α’ = 0,05 / 2 = 0,025. Des tests de comparaisons multiples (tels que les procédures de Tukey HSD ou de Games-Howell) sont ensuite appliqués pour isoler les contrastes inter-groupes significatifs.
La seconde stratégie, conceptuellement plus élégante et rigoureusement multivariée, repose sur l’exécution d’une analyse discriminante descriptive (DDA). Plutôt que de rabattre le modèle sur des considérations univariées isolées, l’analyse discriminante extrait les fonctions canoniques mathématiques (les axes propres issus des vecteurs propres de H E⁻¹) qui séparent au mieux les groupes. Dans notre cas d’étude, elle révèlerait avec éclat que la première fonction discriminante oppose le groupe Témoin aux deux thérapies actives sur un axe de détresse générale, tandis que la seconde fonction discriminante discrimine la TCC de la Pleine Conscience en projetant les scores de restructuration cognitive contre les scores d’apaisement somatique, restituant ainsi toute la finesse clinique de l’essai expérimental.
12. Directives méthodologiques et rédaction des résultats selon les normes APA
12.1 Critères méthodologiques guidant le choix impératif de la trace de Pillai
Face à la pluralité des sorties délivrées par les logiciels statistiques, une interrogation pragmatique s’impose systématiquement au chercheur : sous quelles circonstances empiriques précises doit-on impérativement sélectionner la trace de Pillai au détriment de ses concurrentes ?
Le consensus méthodologique actuel, conforté par les recommandations de référence de Tabachnick et Fidell (2019) ainsi que de Stevens (2009), identifie trois critères d’arbitrage décisifs prescrivant l’emploi prioritaire et préférentiel de la trace de Pillai :
- Tailles d’échantillons cellulaires inégales : Dès lors que les effectifs des différents sous-groupes présentent un déséquilibre notable imputable à l’attrition ou aux caractéristiques d’échantillonnage de terrain.
- Suspicion ou présence d’hétéroscédasticité : Lorsque le test M de Box affiche une significativité statistique (p < 0,001) attestant de l’inégalité structurelle des matrices de variance-covariance intra-groupes.
- Déviations modérées de la normalité multivariée : Lorsque les distributions empiriques des résidus présentent une asymétrie ou un aplatissement qui fragiliserait la validité du Lambda de Wilks ou de la racine de Roy.
En adoptant par défaut la trace de Pillai dans leurs recherches, les investigateurs se prémunissent efficacement contre les contestations relatives à la robustesse des inférences, garantissant des conclusions analytiques d’une résilience irréprochable.
12.2 Limites inhérentes à l’indicateur de Pillai
En dépit de sa robustesse incontestable, la trace de Pillai ne saurait être envisagée comme une panacée universelle exempte de toute contrepartie méthodologique. La première limite tient à une légère perte de puissance statistique dans les contextes expérimentaux idéaux. Lorsque la totalité des postulats théoriques est scrupuleusement respectée (normalité parfaite, homoscédasticité absolue, équilibre strict des effectifs) et que la séparation des populations s’avère hautement unidimensionnelle, le Lambda de Wilks et la plus grande racine de Roy affichent une puissance supérieure de quelques pourcents pour détecter des effets ténus.
La seconde limite, inhérente à l’architecture même de la formulation additive de Pillai, concerne sa sensibilité aux effets diffus répartis de manière homogène sur de nombreuses dimensions bruitées. En intégrant la totalité des racines caractéristiques, Pillai peut accumuler de faibles variations résiduelles le long d’axes secondaires non pertinents, ce qui peut marginalement diluer la force du signal lorsqu’un effet expérimental massif se trouve exclusivement concentré sur une seule dimension canonique.
Enfin, tout comme l’ensemble des indicateurs omnibus multivariés, la trace de Pillai demeure incapable d’indiquer par elle-même la polarité ou la structure spécifique des effets observés. Un test de Pillai significatif indique qu’une divergence existe, mais ne précise en rien si le traitement a amélioré ou détérioré l’état clinique des sujets, exigeant impérativement le déploiement d’analyses déscriptives et de contrastes complémentaires pour donner corps aux conclusions empiriques.
12.3 Modèle de reporting académique conforme aux normes APA 7
La communication publique des résultats au sein des revues scientifiques à comité de lecture internationales exige une rigueur de formatage exemplaire, régie par les normes de la 7e édition du manuel de publication de l’APA. Selon ces directives, la restitution textuelle d’une MANOVA omnibus basée sur la trace de Pillai doit impérativement rapporter : le symbole mathématique de la métrique (V), la valeur de la statistique de test associée (F), les degrés de liberté de l’effet et de l’erreur entre parenthèses, la probabilité critique exacte (p-valeur), ainsi que l’indice de taille d’effet standardisé (êta-carré partiel multivarié, η²ₚ).
Voici un modèle rédactionnel académique complet et directement transposable, rédigé en langue française selon les standards d’excellence éditoriale, intégrant les résultats de notre cas clinique simulé :
« Une analyse de variance multivariée (MANOVA) à un facteur inter-sujets a été conduite afin d’évaluer l’impact du type d’intervention thérapeutique (TCC, Pleine Conscience, Groupe Témoin) sur les scores conjoints d’anxiété (STAI-Y) et de dépression (BDI-II). En raison de l’hétérogénéité modérée des matrices de covariance constatée par le test M de Box, la trace de Pillai a été retenue comme statistique de décision multivariée robuste. Les analyses révèlent un effet multivarié global hautement significatif du facteur thérapeutique sur le profil conjoint des variables dépendantes, V = 0,51, F(4, 174) = 14,93, p < 0,001, η²ₚ = 0,26. La taille d’effet observée est de grande magnitude selon les critères de Cohen, indiquant qu’environ 26 % de la variance multivariée totale du profil psychopathologique est attribuable à la prise en charge thérapeutique. »
« Les analyses de variance univariées de suivi, conduites avec un ajustement conservateur du seuil alpha de Bonferroni (α’ = 0,025), confirment que l’effet expérimental s’exprime de manière statistiquement significative tant sur le niveau de dépression, F(2, 87) = 21,00, p < 0,001, η²ₚ = 0,33, que sur le niveau d’anxiété, F(2, 87) = 26,00, p < 0,001, η²ₚ = 0,37. Les comparaisons multiples post-hoc ajustées par la méthode de Tukey HSD indiquent que les participants assignés au protocole TCC affichent une réduction supérieure de la dépression par rapport aux témoins (p < 0,001), tandis que le groupe Pleine Conscience démontre une diminution supérieure de l’anxiété comparativement au groupe témoin (p < 0,001) et au groupe TCC (p = 0,018). »
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bartlett, M. S. (1939). A note on tests of significance in multivariate analysis. Mathematical Proceedings of the Cambridge Philosophical Society, 35(2), 180–185. https://doi.org/10.1017/S030500410002088X
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
Harris, R. J. (2001). A primer of multivariate statistics (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9781410600370
Huberty, C. J., & Olejnik, S. (2006). Applied MANOVA and discriminant analysis (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/047178947X
Olson, C. L. (1974). On choosing a test statistic in multivariate analysis of variance. Psychological Bulletin, 81(9), 570–577. https://doi.org/10.1037/h0037042
Olson, C. L. (1976). On compare power and robustness of four test statistics in multivariate analysis of variance. Journal of the American Statistical Association, 71(356), 966–978. https://doi.org/10.1080/01621459.1976.10480977
Pillai, K. C. S. (1955). Some new test criteria in multivariate analysis. The Annals of Mathematical Statistics, 26(1), 117–121. https://doi.org/10.1214/aoms/1177728599
Pillai, K. C. S. (1960). Statistical tables for tests of multivariate hypotheses. The Statistical Center, University of the Philippines.
Stevens, J. P. (2009). Applied multivariate statistics for the social sciences (5th ed.). Routledge. https://doi.org/10.4324/9780203843130
Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
Wilks, S. S. (1932). Certain generalizations in the analysis of variance. Biometrika, 24(3/4), 471–494. https://doi.org/10.2307/2331979