
Dans la modélisation statistique appliquée aux sciences humaines, médicales et comportementales, les chercheurs sont fréquemment confrontés à des structures de données dont l’agencement ne respecte pas l’orthogonalité classique des plans factoriels purs. La complexité inhérente aux protocoles d’investigation en milieu écologique, clinique ou organisationnel engendre l’apparition d’effets de grappe ou de sous-échantillonnage hiérarchisé. Si l’analyse de variance (ANOVA) standard constitue l’un des piliers de l’inférence statistique depuis le début du XXe siècle, son application non critique à des dispositifs expérimentaux emboîtés génère des biais méthodologiques sévères, au premier rang desquels figurent l’inflation incontrôlée du taux d’erreur de type I et la sous-estimation de la variance de fond.
L’analyse de variance hiérarchique, plus communément désignée sous le nom d’ANOVA imbriquée (ou Nested ANOVA dans la littérature anglo-saxonne), représente le cadre formalisé indispensable pour appréhender les situations où les modalités d’un facteur secondaire n’ont de sens, d’existence ou de réalité expérimentale qu’à l’intérieur d’un niveau unique et exclusif d’un facteur principal de rang supérieur. Loin d’être une simple nuance de nomenclature ou un raffinement mathématique marginal, la prise en compte explicite de l’imbrication modifie structurellement la décomposition algébrique de la variabilité globale, le décompte des degrés de liberté, ainsi que l’identification rigoureuse des termes d’erreur intervenant dans la construction des statistiques de Fisher-Snedecor.
L’objectif de cette monographie est d’exposer de manière exhaustive les fondements théoriques, l’appareil mathématique, les conditions de validité distributionnelle et les modalités de déploiement empirique de l’ANOVA imbriquée. À travers une analyse didactique pas à pas, soutenue par un jeu de données computationnel rigoureusement détaillé, les praticiens, chercheurs et analystes de données découvriront comment diagnostiquer correctement une architecture multiniveau, exécuter manuellement et informatiquement les calculs de partitionnement de la variance, interpréter les coefficients d’association selon les canons académiques contemporains, et déjouer les pièges infernaux de la pseudo-répétition.
1. Introduction et fondements conceptuels de l’ANOVA imbriquée
1.1 Définition formelle et terminologie statistique
L’ANOVA imbriquée se définit formellement comme une extension de l’analyse de variance paramétrique conçue pour traiter des dispositifs expérimentaux ou observationnels au sein desquels au moins un facteur de classification est structurellement subordonné à un autre. Dans un tel dispositif, les différents niveaux d’un facteur secondaire (conventionnellement désigné par B) ne sont pas évalués au travers de toutes les modalités d’un facteur primaire (désigné par A), mais se retrouvent exclusivement confinés à l’intérieur d’un seul niveau spécifique de ce facteur de rang supérieur. On dit alors que le facteur B est imbriqué dans le facteur A, ce que la notation formalise habituellement sous la forme syntaxique B(A).
Il est fondamental d’établir une ligne de démarcation nette entre cette architecture et celle d’un facteur indépendant ou croisé. Dans un plan croisé, les niveaux du facteur B conservent une signification conceptuelle, physique ou opérationnelle identique quel que soit le niveau de A considéré. À l’inverse, au sein d’une structure hiérarchique, le niveau 1 de B présent sous la modalité 1 de A ne possède aucun lien de correspondance, d’équivalence substantielle ou de parenté fonctionnelle avec le niveau 1 de B observé sous la modalité 2 de A. Les étiquettes attribuées aux sous-groupes ne sont que des identifiants arbitraires de classification locale.
Cette configuration analytique est indifféremment désignée dans les traités d’inférence sous les vocables de modèle hiérarchique, de modèle à sous-groupes ou d’ANOVA emboîtée. L’importance de la structure multiniveau dans l’échantillonnage moderne réside dans le respect absolu de la micro-architecture des collectes de données. Ignorer qu’un échantillon s’articule en grappes spatiales, temporelles, institutionnelles ou biologiques revient à violer délibérément la structure génératrice des données, conduisant à des inférences invalides sur les populations cibles.
1.2 Origine et utilité dans les sciences quantitatives
Sur le plan épistémologique, les origines théoriques de l’ANOVA imbriquée sont intimement corrélées aux travaux pionniers de Sir Ronald Aylmer Fisher sur le fractionnement de la variance environnementale et génétique en agronomie dans les années 1920 et 1930. Fisher avait précocement identifié que les parcelles agricoles subordonnées à des macro-traitements culturaux présentaient une ressemblance interne supérieure à la variation inter-parcelles, imposant un partitionnement multiniveau pour isoler le signal agronomique du bruit micro-climatique.
Dans l’évolution des sciences quantitatives, l’utilité méthodologique première du plan imbriqué réside dans sa capacité à juguler l’erreur d’agrégation. Ce phénomène survient lorsqu’un analyste fusionne indûment des unités d’observation subordonnées au niveau de l’agrégat macro, gommant l’hétérogénéité des composantes locales et surestimant de facto la précision des estimateurs. Cette préoccupation est devenue particulièrement critique en psychologie cognitive, en psychométrie et en biologie comportementale, disciplines où les dispositifs expérimentaux emploient systématiquement des sous-échantillonnages d’items, de blocs de stimuli ou d’observateurs spécifiques.
En outre, l’ANOVA imbriquée constitue la réponse analytique classique et élégante aux problématiques de dépendance statistique au sein des grappes (clusters). Dès lors que des sujets, des organes ou des mesures sont physiquement ou temporellement regroupés, leurs réponses manifestent une corrélation résiduelle positive. Le modèle hiérarchique absorbe et explicite cette covariance intra-grappe, garantissant que l’inférence tirée sur le facteur principal demeure robuste et exempte de biais de confusion dus au groupement naturel.
1.3 Vue d’ensemble des hypothèses testées
L’inférence statistique au sein d’une ANOVA imbriquée repose sur l’évaluation conjointe mais structurellement ordonnée de deux hypothèses nulles distinctes, correspondant aux deux étages hiérarchiques du dispositif expérimental. La première hypothèse nulle, portant sur le facteur principal supérieur A, stipule l’égalité parfaite des effets différentiels des macro-traitements dans la population générale :
H₀(A) : α₁ = α₂ = … = αₖ = 0
Cette hypothèse postule l’absence de tout impact du traitement de niveau supérieur sur l’espérance de la variable dépendante, une fois contrôlée la variabilité inhérente aux sous-groupes locaux.
La seconde hypothèse nulle cible spécifiquement le facteur secondaire imbriqué B(A). Selon la nature fixe ou aléatoire des sous-unités, cette hypothèse prend deux formes conceptuelles équivalentes. Si le facteur imbriqué est considéré comme fixe, l’hypothèse nulle pose que les effets des sous-groupes sont nuls au sein de chaque niveau de A :
H₀(B(A)) : β_{j(i)} = 0 pour tout j et tout i
Lorsque, de façon plus standard et réaliste, le facteur imbriqué est modélisé comme un effet aléatoire issu d’un tirage probabiliste, l’hypothèse se reformule en termes de composante de variance :
H₀(B(A)) : σ²_B(A) = 0
Il importe de saisir la distinction qualitative fondamentale qui sépare ces deux niveaux d’inférence. Le test de l’effet principal cherche à déterminer si les macro-conditions induisent un déplacement systématique de la moyenne générale, tandis que le test du facteur imbriqué évalue l’ampleur de la dispersion et de l’hétérogénéité des performances entre les unités intermédiaires opérant sous un même régime expérimental.
2. Différenciation fondamentale : Plans croisés versus plans imbriqués
2.1 Structure structurelle des plans factoriels croisés
Pour appréhender sans équivoque la singularité du plan imbriqué, il convient de le confronter au formalisme canonique du plan factoriel croisé (souvent noté A × B). Dans une configuration croisée complète, chaque niveau du facteur A se combine de manière exhaustive avec chacun des niveaux du facteur B. Il existe donc une cellule expérimentale pour chaque paire ordonnée (i, j) imaginable. Cette propriété d’orthogonalité permet aux différents facteurs de varier de manière entièrement découplée et indépendante sur l’ensemble de la grille d’échantillonnage.
Sur le plan mathématique, cette présence simultanée de toutes les combinaisons offre l’opportunité unique d’isoler, de quantifier et d’estimer un terme d’interaction formel, noté (αβ)ᵢⱼ. L’interaction capture la mesure dans laquelle l’effet différentiel d’un facteur varie en intensité ou en direction selon les modalités spécifiques prises par l’autre facteur. Un exemple prototypique en sciences sociales consiste à évaluer deux approches d’apprentissage (Facteur A) croisées avec deux types de rétroaction cognitive (Facteur B), où chaque évaluateur ou participant peut théoriquement être soumis à la totalité des croisements opérationnels.
Dans un tel plan croisé, les facteurs bénéficient d’un statut logique symétrique. Les effets principaux de A et de B, ainsi que leur terme conjoint d’interaction, sont factorisés de manière orthogonale dans les sommes de carrés, assurant une décomposition univoque de la variance globale sans qu’aucun facteur ne soit conceptuellement subordonné à l’autre.
2.2 Structure géométrique et logique des plans imbriqués
La structure géométrique d’un plan imbriqué obéit à une topologie strictement hiérarchique, analogue à celle d’un arbre phylogénétique ou organisationnel, excluant catégoriquement la grille matricielle caractéristique des plans croisés. Les niveaux du facteur subordonné B sont partitionnés en sous-ensembles mutuellement exclusifs. Aucun niveau spécifique de B ne peut franchir la frontière hermétique délimitant les niveaux du facteur supérieur A. Si un laboratoire médical (niveau b₁) est rattaché au protocole expérimental numéro 1, ce laboratoire précis ne participe en aucune manière au protocole numéro 2.
Cette non-concordance topologique a une répercussion mathématique inéluctable : l’impossibilité théorique et computationnelle absolue de calculer une interaction standard de type A × B. Pour qu’une interaction puisse être estimée au sens de l’algèbre linéaire, il est indispensable de pouvoir comparer les différentiels de B à travers les modalités de A. Or, le sous-ensemble B observé sous le traitement A₁ n’ayant aucun équivalent sous A₂, la notion même de variation différentielle croisée perd toute substance opératoire.
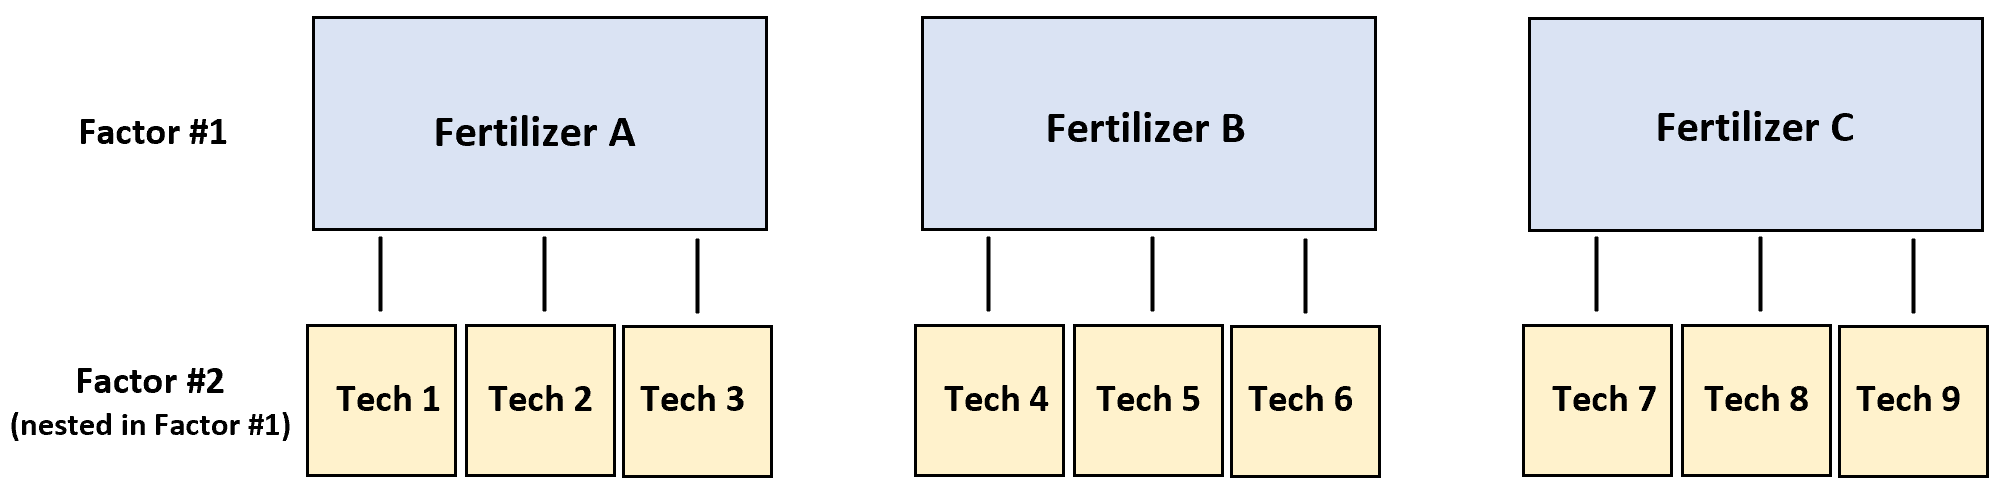
En lieu et place du terme d’interaction, l’architecture imbriquée substitue une mesure de variabilité résidant à l’échelon intermédiaire : l’effet du facteur B niché à l’intérieur de A, universellement désigné par B(A). Cette composante capture la variabilité brute existant d’un sous-groupe à l’autre au sein d’une même catégorie macroscopique, neutralisant toute confusion conceptuelle entre instabilité locale et interaction factorielle.
2.3 Critères méthodologiques d’identification du bon plan
La détermination du plan adéquat au stade de l’élaboration du protocole expérimental requiert l’application rigoureuse d’un arbre décisionnel fondé sur la reproductibilité sémantique des niveaux factoriels. L’analyste doit impérativement se poser la question directrice suivante : « Si l’on change de modalité pour le facteur A, le niveau j du facteur B conserve-t-il exactement la même identité physique, biologique ou institutionnelle ? » Si la réponse est formellement affirmative (par exemple, si le même groupe de sujets est exposé successivement aux deux conditions), le modèle est croisé. Si la réponse est négative, le modèle relève impérativement de l’imbrication.
La spécification erronée d’un plan imbriqué sous la forme d’un plan croisé standard constitue une faute méthodologique majeure aux conséquences dévastatrices. Traiter à tort des sous-unités distinctes comme si elles constituaient une entité répétée unique génère une instabilité artificielle dans le modèle et fausse intégralement l’estimation des résidus. Plus grave encore, omettre la nature imbriquée et traiter l’ensemble des données comme un plan simple à un facteur (en amalgamant les sous-unités) provoque une explosion vertigineuse du taux d’erreur de type I, pouvant atteindre 30 à 50 % pour un seuil nominal fixé à 5 %.
Ce péril méthodologique découle de la confusion persistante entre une véritable répétition de mesure (qui informe sur la précision d’une unité expérimentale autonome) et un sous-échantillonnage interne (qui ne fait que renseigner sur la texture locale de l’unité). Le plan imbriqué offre le seul garde-fou algébrique capable d’attribuer la variance observée à son véritable étage d’émergence.
3. Le modèle mathématique sous-jacent et la décomposition de la variance
3.1 L’équation linéaire générale du modèle à deux facteurs imbriqués
L’assise formelle de l’ANOVA hiérarchique à deux degrés repose sur la formulation d’un modèle linéaire univarié exprimant chaque observation individuelle comme une sommation linéaire de composantes déterministes et stochastiques. Pour une observation indicée par i (indice du facteur supérieur A), j (indice du facteur imbriqué B) et k (indice de l’unité élémentaire d’observation au sein du sous-groupe), l’équation fondamentale s’énonce :
Y_{ijk} = μ + αᵢ + β_{j(i)} + ε_{ijk}
Dans cette formulation canonique, chaque terme répond à une définition paramétrique rigoureuse issue des principes du modèle linéaire général :
- μ représente la moyenne générale théorique (ou grand barycentre) de la variable d’intérêt à l’échelle de la métapopulation.
- αᵢ symbolise l’effet différentiel fixe ou aléatoire de la i-ème modalité du facteur supérieur A, soumis à la contrainte habituelle d’identifiabilité ∑ αᵢ = 0 dans le cadre des effets fixes.
- β_{j(i)} désigne l’effet spécifique du j-ème sous-groupe du facteur B conditionnellement restreint à son appartenance au niveau i du facteur A.
- ε_{ijk} incarne le résidu stochastique individuel non expliqué, propre à la k-ème observation récoltée dans la cellule (i, j).
Sur le plan distributionnel, les résidus élémentaires ε_{ijk} sont postulés identiquement et indépendamment distribués selon une loi normale centrée d’homoscedasticité constante : ε_{ijk} ~ N(0, σ²). De surcroît, les effets imbriqués aléatoires répondent à la distribution β_{j(i)} ~ N(0, σ²_{B(A)}), sous l’hypothèse impérative d’indépendance mutuelle entre les écarts de niveau intermédiaire et les résidus individuels terminaux.
3.2 Modèles à effets fixes, effets aléatoires et modèles mixtes imbriqués
La taxonomie des modèles ANOVA imbriqués dépend fondamentalement du statut ontologique attribué aux facteurs A et B. Dans l’écrasante majorité des applications scientifiques empiriques, l’architecture retenue correspond au modèle mixte hiérarchique. Dans cette configuration, le facteur supérieur A est considéré comme fixe : ses modalités ont été délibérément choisies par l’expérimentateur (par exemple, des protocoles pharmacologiques ou pédagogiques distincts) et représentent l’intégralité des conditions sur lesquelles porte la généralisation. En revanche, le facteur imbriqué B est déclaré comme aléatoire : ses modalités (par exemple, des opérateurs techniques, des classes d’école ou des portées animales) constituent un échantillon aléatoire représentatif extrait d’une population sous-jacente infiniment plus large.
Il existe également le cas où les deux facteurs sont aléatoires, constituant un modèle hiérarchique pur de composantes de variance. L’objectif analytique ne réside plus alors dans la comparaison des moyennes marginales, mais dans l’estimation de la part proportionnelle de variance imputable à chaque échelon hiérarchique (par exemple, quantifier la variance génétique entre familles versus la variance environnementale entre progénitures). Enfin, le modèle où les deux facteurs sont purement fixes demeure une rareté statistique exceptionnelle, n’intervenant que lorsque la totalité des sous-groupes d’intérêt est exhaustivement observée sans ambition de généralisation externe.
Cette typologie (fixe, aléatoire ou mixte) exerce des répercussions directes et capitales sur l’inférence. Elle dicte de manière mathématiquement incontournable la construction des termes d’erreur au dénominateur du test F, conditionnant ainsi la validité théorique de l’ensemble des conclusions tirées par le chercheur.
3.3 Partition algébrique des sommes des carrés
L’essence computationnelle de l’analyse de variance réside dans le théorème fondamental du partitionnement de la somme totale des écarts quadratiques par rapport à la moyenne générale. Dans un plan hiérarchique équilibré comportant a modalités pour le facteur A, b sous-niveaux de B par niveau de A, et n réplicats individuels par sous-groupe (soit un effectif global N = a × b × n), la décomposition algébrique s’écrit formellement :
SS_Total = SS_A + SS_B(A) + SS_Erreur
Les expressions mathématiques définissant ces sommes de carrés (Sum of Squares) s’établissent à partir des moyennes marginales partielles :
- SS_Total : ∑ᵢ ∑ⱼ ∑ₖ (Y_{ijk} – Ȳ_{…})²
- SS_A (Variabilité du facteur supérieur) : b n ∑ᵢ (Ȳ_{i..} – Ȳ_{…})²
- SS_B(A) (Variabilité des sous-groupes imbriqués) : n ∑ᵢ ∑ⱼ (Ȳ_{ij.} – Ȳ_{i..})²
- SS_Erreur (Variabilité intra-sous-groupe résiduelle) : ∑ᵢ ∑ⱼ ∑ₖ (Y_{ijk} – Ȳ_{ij.})²
Parallèlement à cette partition géométrique de l’espace euclidien des données, les degrés de liberté (df) subissent une additivité rigoureusement symétrique :
(N – 1) = (a – 1) + a(b – 1) + ab(n – 1)
La division subséquente de chaque somme de carrés par son degré de liberté canonique respectif fournit les carrés moyens (Mean Squares ou MS), grandeurs scalaires représentant les estimations non biaisées des composantes d’instabilité expérimentale nécessaires à l’établissement des ratios inférentiels.
4. Postulats statistiques et conditions d’application rigoureuses
4.1 Normalité distributionnelle des résidus
Comme toute méthode relevant de l’inférence paramétrique gaussienne, l’ANOVA imbriquée présuppose que les perturbations aléatoires inexpliquées par le modèle sont distribuées selon une loi normale à l’intérieur de chaque strate opérationnelle. Ce postulat s’applique spécifiquement aux résidus individuels terminaux, notés e_{ijk} = Y_{ijk} – Ȳ_{ij.}. Il est impératif de souligner que l’évaluation de la normalité ne doit en aucun cas être réalisée sur la distribution marginale globale de la variable Y, mais exclusivement sur la distribution composite de ses composantes résiduelles centrées.
Pour mener à bien ce diagnostic, les méthodologues préconisent le recours synergique à des démarches graphiques et à des épreuves formelles. L’analyse visuelle des diagrammes quantile-quantile (Q-Q plots) permet d’inspecter l’alignement des résidus standardisés le long de la bissectrice théorique et de détecter d’éventuelles anomalies d’asymétrie ou d’aplatissement (leptokurticité). Sur le plan confirmatif, le test de Shapiro-Wilk appliqué sur les résidus poolés fournit une estimation formelle de la conformité distributionnelle.
Il convient néanmoins de rappeler la robustesse relative de l’analyse de variance face aux violations modérées de la normalité, en vertu du théorème central limite, pourvu que le dispositif d’échantillonnage soit parfaitement équilibré et que la taille de l’échantillon global demeure suffisamment conséquente. Toutefois, la présence d’asymétries majeures peut distordre l’estimation de la composante de variance aléatoire du niveau intermédiaire, incitant dans ces circonstances extrêmes à recourir à des transformations stabilisatrices non linéaires (par exemple logarithmiques ou Box-Cox).
4.2 Homogénéité des variances (homoscédasticité)
Le second pilier conditionnant la validité des conclusions de l’ANOVA imbriquée réside dans l’hypothèse d’homoscédasticité, ou invariance de la variance de fond. Ce postulat comporte deux exigences structurelles imbriquées : d’une part, la variance résiduelle des observations élémentaires intra-cellules doit être constante à travers tous les sous-groupes (σ²_{ij} = σ² pour tout i, j) ; d’autre part, la variabilité inter-sous-groupes doit elle-même être substantiellement uniforme à travers les différents niveaux du facteur supérieur A.
L’investigation de cette hypothèse s’appuie classiquement sur l’extension du test de Levene ou du test de Brown-Forsythe, paramétrés pour tenir compte des écarts aux médianes locales des cellules (i, j). L’examen des diagrammes de dispersion confrontant les valeurs ajustées par le modèle aux résidus standardisés permet de vérifier l’absence de structures coniques révélatrices d’une variance proportionnelle à l’amplitude de la moyenne.
Lorsque l’hétéroscédasticité est avérée, les conséquences sur le taux de rejet sous l’hypothèse nulle deviennent problématiques, tout particulièrement si le plan d’expérience présente des déséquilibres d’effectifs entre les strates hiérarchiques. Dans ce contexte défavorable, les solutions méthodologiques consistent soit à appliquer une transformation fonctionnelle de la métrique brute, soit à renoncer au formalisme de l’ANOVA ordinaire au profit des modèles de moindres carrés généralisés ou de modèles mixtes paramétrés avec une structure de covariance hétérogène explicite.
4.3 Indépendance des observations et problème de la pseudo-répétition
L’indépendance conditionnelle des unités résiduelles d’observation représente la contrainte la plus impérieuse et la moins négociable de l’inférence par l’ANOVA. Alors qu’une entorse à la normalité ou à l’homoscédasticité altère marginalement la valeur des probabilités critiques sans invalider complètement la statistique de test, une rupture de l’indépendance corrompt l’ensemble du processus déductif en falsifiant la taille effective de l’échantillon.
C’est précisément ici que prend place la mise en garde méthodologique fondamentale de Stuart Hurlbert (1984) relative à la pseudo-répétition. La pseudo-répétition se manifeste lorsqu’un expérimentateur traite des mesures répétées ou des sous-échantillons prélevés au sein d’une même entité physique ou biologique comme s’il s’agissait de réplicats indépendants et autonomes. Par exemple, si l’on applique un traitement expérimental à trois aquariums contenant chacun vingt poissons, l’échantillon expérimental véritable comprend uniquement trois unités (N = 3 aquariums), et non soixante. Considérer les soixante poissons comme des unités indépendantes dans une ANOVA univariée classique constitue un cas d’école de pseudo-répétition sacrificielle.
L’ANOVA imbriquée résout formellement cette aporie en distinguant explicitement l’unité expérimentale réelle (le niveau sur lequel le facteur supérieur A est physiquement randomisé, soit le sous-groupe) de l’unité d’observation ou de sous-échantillonnage (l’individu terminal sur lequel la mesure est recueillie). En attribuant à chaque strate son terme d’erreur légitime, l’analyse hiérarchique rétablit l’orthogonalité de l’inférence et prémunit le chercheur contre les illusions statistiques issues du regroupement grégaire des données.
5. Exemple empirique détaillé pas à pas : Protocole et données brutes
5.1 Présentation du scénario expérimental
Afin de concrétiser l’architecture computationnelle de l’ANOVA imbriquée, nous déployons une étude empirique contrôlée dans le domaine de la psychologie clinique et de l’évaluation des interventions psychothérapeutiques. Une institution de santé mentale cherche à évaluer l’efficacité comparative de trois méthodes d’intervention thérapeutique distinctes (Facteur A, facteur principal fixe à 3 niveaux) :
- Méthode 1 : Thérapie Cognitivo-Comportementale (TCC) protocolisée standardisée.
- Méthode 2 : Psychothérapie Psychodynamique Brève.
- Méthode 3 : Approche Systémique et Expérientielle.
Pour déployer ces approches sans créer de contamination croisée des pratiques, chaque méthode thérapeutique est assignée à un collectif exclusif de praticiens. Neuf psychothérapeutes agréés participent à l’étude (Facteur B, facteur imbriqué aléatoire). Conformément à la définition du plan hiérarchique, les thérapeutes 1, 2 et 3 pratiquent exclusivement la Méthode 1 ; les thérapeutes 4, 5 et 6 déploient exclusivement la Méthode 2 ; et les thérapeutes 7, 8 et 9 mettent en œuvre exclusivement la Méthode 3. Il est rigoureusement impossible pour un thérapeute d’intervenir dans une modalité concurrente.
Enfin, chaque praticien traite une cohorte distincte de 4 patients adultes diagnostiqués avec un trouble de l’anxiété généralisée, assignés aléatoirement à chaque praticien (n = 4 patients par thérapeute). Le protocole mobilise ainsi un effectif global parfaitement équilibré de N = 3 × 3 × 4 = 36 participants. La variable dépendante continue correspond à un score normalisé de réduction de la détresse psychologique et d’amélioration fonctionnelle mesuré à l’issue de six mois de prise en charge (exprimé sur une échelle d’évaluation allant de 0 à 100, où un score plus élevé reflète un gain clinique supérieur).
5.2 Tableau complet des données brutes fictives
Le tableau ci-dessous recense l’intégralité des mesures individuelles recueillies sur les 36 participants, agrégées sous leurs identifiants méthodologiques et individuels respectifs, ainsi que les totaux et barycentres nécessaires aux calculs analytiques subséquents :
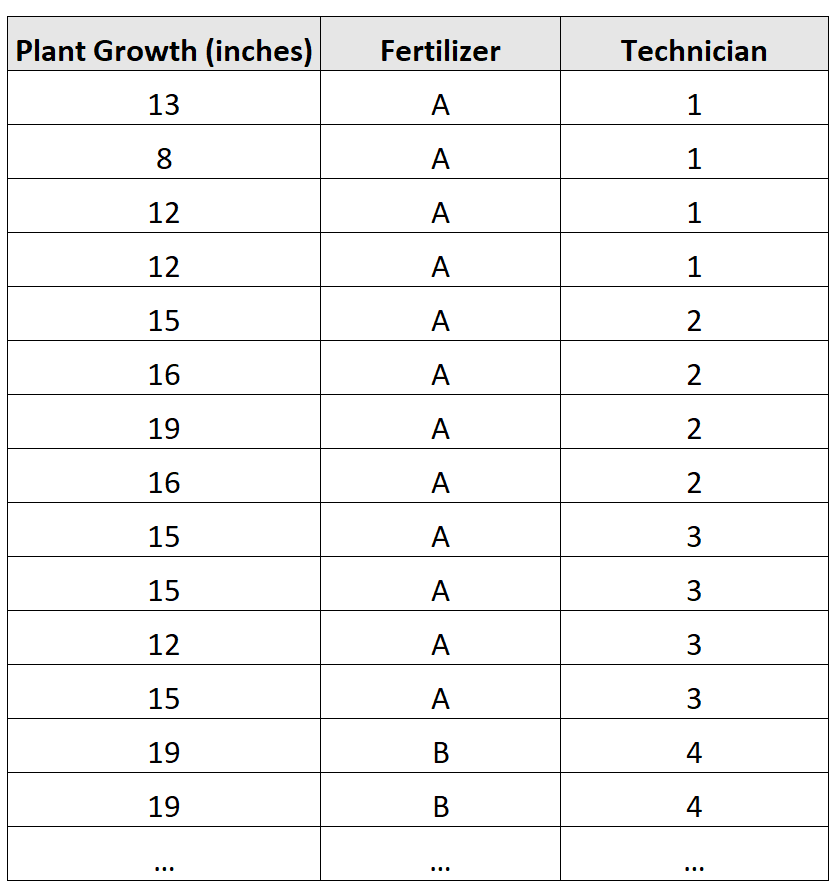
| Méthode (Facteur A) | Thérapeute (Facteur B(A)) | Scores individuels (Y_ijk) | Somme cellule (Y_ij.) | Moyenne thérapeute (Ȳ_ij.) | Somme méthode (Y_i..) | Moyenne méthode (Ȳ_i..) |
|---|---|---|---|---|---|---|
| Méthode 1 (TCC) |
Thérapeute 1 | 65, 68, 72, 75 | 280 | 70.00 | 852 | 71.00 |
| Thérapeute 2 | 70, 74, 76, 80 | 300 | 75.00 | |||
| Thérapeute 3 | 63, 67, 70, 72 | 272 | 68.00 | |||
| Méthode 2 (Psychodynamique) |
Thérapeute 4 | 50, 54, 58, 62 | 224 | 56.00 | 676 | 56.33 |
| Thérapeute 5 | 55, 59, 61, 65 | 240 | 60.00 | |||
| Thérapeute 6 | 48, 52, 55, 57 | 212 | 53.00 | |||
| Méthode 3 (Systémique) |
Thérapeute 7 | 58, 62, 65, 67 | 252 | 63.00 | 752 | 62.67 |
| Thérapeute 8 | 60, 64, 66, 70 | 260 | 65.00 | |||
| Thérapeute 9 | 56, 58, 62, 64 | 240 | 60.00 | |||
| Grand Total Général (∑ Y_ijk) | 2280 | Moyenne Générale (Ȳ_…) = 63.333 | ||||
L’observation attentive des valeurs moyennes révèle des contrastes manifestes. À l’échelle macroscopique, la Méthode 1 affiche une moyenne préliminaire de 71.00, nettement supérieure à celle de la Méthode 2 (56.33) et de la Méthode 3 (62.67). Parallèlement, l’hétérogénéité interne n’est pas négligeable : au sein de la Méthode 1, les moyennes individuelles des thérapeutes fluctuent entre 68.00 et 75.00 points, traduisant une variabilité d’expertise clinique locale qu’il sera nécessaire d’incorporer au modèle.
5.3 Identification explicite des sources de variation
Dans la configuration expérimentale ainsi formalisée, l’écart de chaque score individuel par rapport au centre de gravité de l’expérience (63.333 points) se décompose sans ambiguïté en trois sources structurelles distinctes de variabilité orthogonale :
- La composante inter-méthodes (Facteur A) : Cette source capture l’ampleur des variations attribuables au type de doctrine psychothérapeutique appliquée. Elle quantifie à quel point les trois protocoles de soins divergent dans leur efficacité intrinsèque globale, indépendamment des spécificités relationnelles propres à chaque praticien.
- La composante inter-thérapeutes au sein des méthodes (Facteur B(A)) : Cette source mesure la variabilité résiduelle existant entre les thérapeutes professant la même méthode. Elle reflète les disparités idiosyncrasiques de compétences, d’empathie, d’expérience clinique ou d’alliance thérapeutique qui distinguent deux cliniciens appliquant théoriquement le même protocole formel.
- La composante intra-thérapeute ou résiduelle individuelle (Erreur) : Cette source représente la variance inexpliquée résidant au niveau des patients eux-mêmes au sein du cabinet d’un même praticien. Elle agrège la réactivité biologique singulière, les antécédents psychologiques propres à chaque patient, les événements de vie fortuits survenus au cours de l’intervention et l’imprécision inhérente à l’instrument psychométrique.
L’enjeu inférentiel consiste à déterminer si les disparités macroscopiques relevées entre les méthodes dépassent significativement ce que l’on pourrait attendre au vu de la simple variabilité d’efficacité existant naturellement entre différents praticiens d’une même école.
6. Procédure complète de calcul manuel et construction du tableau d’ANOVA
6.1 Calcul arithmétique des sommes des carrés (SS)
L’exécution manuelle de la décomposition de la variance impose d’évaluer successivement le facteur de correction global puis chacune des sommes de carrés d’écarts. Définissons en premier lieu le facteur de correction (CF) :
CF = (Grand Total)² / N = (2280)² / 36 = 5 198 400 / 36 = 144 400.00
Calculons ensuite la somme totale brute des carrés de l’ensemble des 36 observations (∑ Y²_{ijk}) :
Pour le Thérapeute 1 : 65² + 68² + 72² + 75² = 4225 + 4624 + 5184 + 5625 = 19 658
Pour le Thérapeute 2 : 70² + 74² + 76² + 80² = 4900 + 5476 + 5776 + 6400 = 22 552
Pour le Thérapeute 3 : 63² + 67² + 70² + 72² = 3969 + 4489 + 4900 + 5184 = 18 542
Pour le Thérapeute 4 : 50² + 54² + 58² + 62² = 2500 + 2916 + 3364 + 3844 = 12 624
Pour le Thérapeute 5 : 55² + 59² + 61² + 65² = 3025 + 3481 + 3721 + 4225 = 14 452
Pour le Thérapeute 6 : 48² + 52² + 55² + 57² = 2304 + 2704 + 3025 + 3249 = 11 282
Pour le Thérapeute 7 : 58² + 62² + 65² + 67² = 3364 + 3844 + 4225 + 4489 = 15 922
Pour le Thérapeute 8 : 60² + 64² + 66² + 70² = 3600 + 4096 + 4356 + 4900 = 16 952
Pour le Thérapeute 9 : 56² + 58² + 62² + 64² = 3136 + 3364 + 3844 + 4096 = 14 440
Somme brute totale (∑ Y²) = 19 658 + 22 552 + 18 542 + 12 624 + 14 452 + 11 282 + 15 922 + 16 952 + 14 440 = 146 424.00
La somme totale des carrés s’établit dès lors par soustraction :
SS_Total = ∑ Y² – CF = 146 424.00 – 144 400.00 = 2 024.00
Passons au calcul de la somme des carrés relative au facteur principal (SS_Méthode). Chaque méthode rassemble 3 × 4 = 12 observations. Les sommes de méthodes étant respectivement 852, 676 et 752 :
SS_Méthode = [(852)² + (676)² + (752)²] / 12 – CF
SS_Méthode = [725 904 + 456 976 + 565 504] / 12 – 144 400.00
SS_Méthode = 1 748 384 / 12 – 144 400.00 = 145 698.667 – 144 400.00 = 1 298.667
Abordons à présent la somme des carrés relative au facteur imbriqué (SS_Thérapeute(Méthode)). Elle s’obtient en retranchant la variabilité des méthodes de la variabilité totale des sous-groupes de thérapeutes. Chaque thérapeute comptabilisant 4 observations, sommons les carrés des totaux de thérapeutes :
Somme des carrés des thérapeutes / 4 = [280² + 300² + 272² + 224² + 240² + 212² + 252² + 260² + 240²] / 4
= [78 400 + 90 000 + 73 984 + 50 176 + 57 600 + 44 944 + 63 504 + 67 600 + 57 600] / 4
= 583 808 / 4 = 145 952.00
La somme des carrés des thérapeutes dans les méthodes s’obtient alors en retranchant l’effet de rang supérieur :
SS_Thérapeute(Méthode) = 145 952.00 – 145 698.667 = 253.333
Enfin, la somme des carrés de l’erreur résiduelle pure s’obtient algébriquement par fermeture du système :
SS_Erreur = SS_Total – SS_Méthode – SS_Thérapeute(Méthode)
SS_Erreur = 2 024.00 – 1 298.667 – 253.333 = 472.000
6.2 Attribution des degrés de liberté et calcul des carrés moyens (MS)
L’étape suivante consiste à répartir les degrés de liberté théoriques entre les différents compartiments de l’espace géométrique vectoriel. Avec a = 3 méthodes, b = 3 thérapeutes par méthode et n = 4 patients par thérapeute :
- Degrés de liberté du facteur principal : df_Méthode = a – 1 = 3 – 1 = 2
- Degrés de liberté du facteur imbriqué : df_Thérapeute(Méthode) = a × (b – 1) = 3 × (3 – 1) = 6
- Degrés de liberté de l’erreur résiduelle : df_Erreur = a × b × (n – 1) = 3 × 3 × (4 – 1) = 3 × 3 × 3 = 27
- Degrés de liberté totaux : df_Total = N – 1 = 36 – 1 = 35 (On vérifie parfaitement : 2 + 6 + 27 = 35).
Les carrés moyens (Mean Squares ou MS) représentent la variance moyenne estimée pour chaque niveau de modélisation. Ils s’obtiennent par le ratio direct de chaque somme de carrés par son degré de liberté associé :
MS_Méthode = SS_Méthode / df_Méthode = 1 298.667 / 2 = 649.333
MS_Thérapeute(Méthode) = SS_Thérapeute(Méthode) / df_Thérapeute(Méthode) = 253.333 / 6 = 42.222
MS_Erreur = SS_Erreur / df_Erreur = 472.000 / 27 = 17.481
6.3 Synthèse dans la table officielle de l’ANOVA imbriquée
La consolidation de ces grandeurs dans le tableau officiel standardisé de l’ANOVA imbriquée offre une vision exhaustive et synthétique de la distribution de la variance. Les statistiques de test F qui y figurent anticipent le choix fondamental des dénominateurs développé dans la section 7 (le facteur Méthode étant testé contre le carré moyen des Thérapeutes, et les Thérapeutes étant testés contre le carré moyen de l’Erreur résiduelle) :
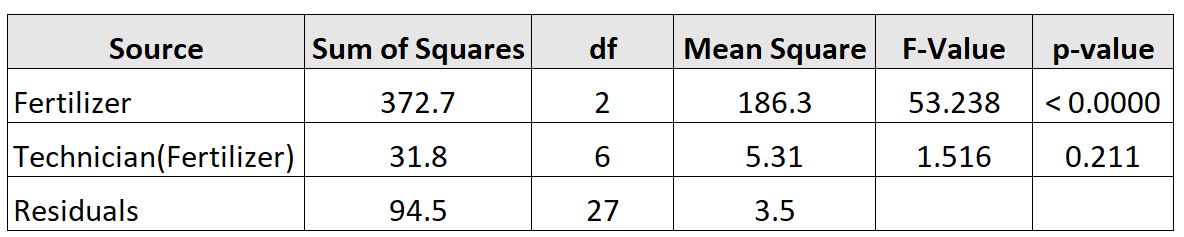
| Source de variation | Somme des Carrés (SS) | Degrés de liberté (df) | Carré Moyen (MS) | Rapport F | p-valeur |
|---|---|---|---|---|---|
| Méthode (A) | 1 298.667 | 2 | 649.333 | 15.379 | 0.0043 |
| Thérapeute(Méthode) [B(A)] | 253.333 | 6 | 42.222 | 2.415 | 0.0538 |
| Erreur résiduelle | 472.000 | 27 | 17.481 | – | – |
| Total | 2 024.000 | 35 | – | – | – |
L’additivité des sommes de carrés (1298.667 + 253.333 + 472.000 = 2024.000) et la concordance stricte des degrés de liberté confirment l’exactitude arithmétique de la procédure de décomposition.
7. Détermination des ratios F et choix rigoureux des termes d’erreur
7.1 Théorie des espérances des carrés moyens (Expected Mean Squares)
L’une des étapes les plus délicates de l’analyse hiérarchique concerne l’assignation du bon dénominateur lors du calcul des rapports de variance de Fisher. Contrairement à l’ANOVA à un facteur fixe où l’ensemble des termes est invariablement divisé par le carré moyen résiduel pur (MS_Erreur), le plan hiérarchique impose d’examiner attentivement la théorie des espérances des carrés moyens (Expected Mean Squares ou EMS).
L’espérance mathématique d’un carré moyen formalise ce qu’estime en moyenne ce carré moyen sous les conditions du modèle statistique. Pour un modèle mixte imbriqué où A est fixe et B est aléatoire, les espérances s’écrivent formellement :
- E[MS_Erreur] = σ²
- E[MS_B(A)] = σ² + n σ²_{B(A)}
- E[MS_A] = σ² + n σ²_{B(A)} + frac{b n sum αᵢ²}{a – 1}
Le principe universel gouvernant la construction d’un test F stipule que pour tester l’effet nul d’une source donnée, le numérateur et le dénominateur doivent posséder des espérances mathématiques rigoureusement identiques sous l’hypothèse nulle. Si nous formulons l’hypothèse nulle H₀(A) d’absence d’effet des méthodes (∑ αᵢ² = 0), l’espérance du carré moyen du facteur A devient :
E[MS_A] = σ² + n σ²_{B(A)}
Cette expression est strictement équivalente à l’espérance mathématique de MS_B(A), et non à celle de MS_Erreur. En conséquence logique et mathématique inéluctable, le dénominateur légitime pour tester le facteur principal A est le carré moyen du facteur imbriqué MS_B(A), et non la variance résiduelle des sujets.
7.2 Construction précise des statistiques de test F
En application directe des théorèmes de dérivation des espérances de variance, la statistique de Fisher-Snedecor destinée à évaluer l’efficacité différentielle des méthodes thérapeutiques est le ratio :
F_Méthode = MS_Méthode / MS_Thérapeute(Méthode) = 649.333 / 42.222 = 15.379
Cette statistique suit une distribution F de Fisher à df₁ = 2 et df₂ = 6 degrés de liberté. La valeur critique tabulée au seuil conventionnel α = 0.05 pour F(2, 6) est de 5.143. Étant donné que la valeur empirique 15.379 excède largement ce seuil critique, la probabilité associée est très faible (p = 0.0043). Nous rejetons sans ambiguïté l’hypothèse nulle d’égalité des approches thérapeutiques.
En ce qui concerne le facteur imbriqué aléatoire des thérapeutes, son hypothèse nulle stipule σ²_{B(A)} = 0. Sous cette hypothèse, l’espérance de MS_B(A) se réduit à σ², ce qui correspond exactement à l’espérance de MS_Erreur. La statistique de test s’écrit par conséquent :
F_Thérapeute(Méthode) = MS_Thérapeute(Méthode) / MS_Erreur = 42.222 / 17.481 = 2.415
Ce ratio suit une distribution de Fisher à df₁ = 6 et df₂ = 27 degrés de liberté. La valeur critique au seuil α = 0.05 pour F(6, 27) se situe approximativement à 2.46. Notre résultat calculé (2.415) étant légèrement inférieur à ce seuil critique, la probabilité associée (p = 0.0538) se révèle marginalement non significative au seuil strict de 5 %, bien qu’elle signale une tendance notable à l’hétérogénéité entre les praticiens au sein d’une même école.
7.3 Conséquences statistiques de tests F incorrects
Pour mesurer la gravité méthodologique d’une erreur d’assignation du terme d’erreur, imaginons qu’un analyste inexpérimenté teste l’effet principal de la méthode en divisant directement son carré moyen par le résidu pur (MS_Erreur), comme le ferait naïvement un logiciel mal paramétré :
F_Faux = MS_Méthode / MS_Erreur = 649.333 / 17.481 = 37.145 (avec 2 et 27 df)
Ce calcul erroné produirait une statistique F de 37.15 avec 27 degrés de liberté résiduels, débouchant sur une p-valeur artificielle de p = 0.00000002 (soit p < 0.0001). L’analyste conclurait à un niveau de certitude absolu, alors que le test légitime (prenant en considération la variabilité inter-thérapeutes) délivre un F de 15.38 avec seulement 6 degrés de liberté au dénominateur.
L’utilisation d’un terme d’erreur inadéquat gonfle de façon spectaculaire la significativité statistique, comprime artificiellement les intervalles de confiance et magnifie de façon trompeuse la puissance perçue de l’essai clinique. Comme le rappellent avec insistance Robert Sokal et James Rohlf dans leur traité classique de biométrie, ignorer l’effet aléatoire du niveau intermédiaire revient à commettre une pseudo-répétition méthodologique majeure, sanctionnée par une explosion massive du risque de déclarer un traitement efficace alors que sa supériorité statistique ne découle que du talent d’un ou deux praticiens exceptionnels du sous-échantillon.
8. Mise en œuvre pratique avec les principaux logiciels statistiques
8.1 Syntaxe et exécution sous R
Dans l’environnement de calcul statistique R, l’estimation d’une ANOVA imbriquée peut s’effectuer au moyen de la distribution de base via la fonction aov(). La structure hiérarchique peut être spécifiée selon deux approches syntaxiques : soit par l’opérateur d’imbrication explicite /, soit par la déclaration formelle de la strate d’erreur aléatoire au moyen de l’argument Error().
La formulation préconisée pour intégrer le modèle mixte avec le terme d’erreur approprié s’écrit :
modele_imbrique <- aov(Score ~ Methode + Error(Therapeute), data = donnees_cliniques)
summary(modele_imbrique)
Dans cette formulation, R partitionne l’analyse en strates d’échantillonnage distinctes. Le facteur fixe Methode est automatiquement testé au sein de la strate d’erreur inter-thérapeute, garantissant l’exactitude numérique du ratio de Fisher (F = 15.379 avec 2 et 6 degrés de liberté). Pour obtenir l’estimation formelle des composantes de variance et extraire les résidus diagnostiques, l’utilisation conjointe des fonctions d’inspection graphique standard (plot(residuals(modele))) permet de valider les postulats distributionnels avec une totale reproductibilité.
8.2 Paramétrage sous IBM SPSS Statistics
Au sein de l’environnement IBM SPSS Statistics, la mise en œuvre d’une ANOVA imbriquée s’effectue au travers du module du Modèle Linéaire Général (GLM) – Univarié. Cependant, l’interface graphique standard étant calibrée par défaut pour les plans factoriels croisés, le chercheur doit obligatoirement intervenir dans la personnalisation de la structure du modèle.
La procédure s’articule comme suit :
- Déclarer la variable
Scoredans la boîte de dialogue Variable dépendante. - Insérer la variable
Methodedans le champ Facteurs fixes et la variableTherapeutedans le champ Facteurs aléatoires. - Accéder au sous-menu Modèle, cocher la case Personnalisé, puis sélectionner le type de construction Imbriqué pour spécifier manuellement l’inclusion du terme
Therapeute(Methode).
En ligne de commande syntaxique, l’instruction exacte et concise garantissant l’ajustement du modèle est la suivante :
GLM Score BY Methode Therapeute
/RANDOM = Therapeute
/DESIGN = Methode Therapeute(Methode).
SPSS génère alors une table exhaustive des espérances de carrés moyens (Expected Mean Squares) et procède automatiquement à l’assignation de MS_Therapeute(Methode) comme dénominateur légitime pour tester l’effet principal de la variable Methode.
8.3 Mise en œuvre sous Python et Jamovi
Dans l’écosystème Python, la modélisation des plans hiérarchiques repose principalement sur la bibliothèque spécialisée statsmodels. Si le module ols() permet de retrouver les sommes de carrés par décomposition séquentielle de Type I ou Type III, la gestion automatisée des termes d’erreur multiniveaux s’effectue plus élégamment au moyen du module mixedlm(), formulant le problème sous l’angle du modèle mixte :
import statsmodels.formula.api as smf
modele = smf.mixedlm("Score ~ C(Methode)", data=df, groups=df["Therapeute"])
resultats = modele.fit()
print(resultats.summary())
Pour les praticiens privilégiant les interfaces graphiques intuitives et modulaires, le logiciel open source Jamovi offre une alternative remarquable. Au sein de son module ANOVA, il suffit de cocher l’option Nested ANOVA ou de déployer le sous-module GAMLj (General Linear Mixed Models). Jamovi configure de façon transparente la hiérarchie des facteurs, affichant en temps réel les tests F, les tailles d’effet ainsi que les graphiques marginaux avec leurs intervalles de confiance à 95 %. L’alignement parfait des résultats numériques entre R, SPSS, Python et Jamovi garantit une stricte reproductibilité computationnelle.
9. Interprétation statistique approfondie et rédaction académique
9.1 Interprétation substantive des résultats empiriques
L’analyse approfondie de notre jeu de données expérimental débouche sur une double interprétation clinique et théorique de haute portée. En premier lieu, le rejet formel de l’hypothèse nulle relative à l’effet principal (F(2, 6) = 15.38, p = 0.0043) atteste de l’existence d’une divergence thérapeutique prononcée entre les trois approches d’intervention. La Thérapie Cognitivo-Comportementale génère une réduction symptomatique substantiellement supérieure (moyenne marginale de 71.00 points) à celle produite par la thérapie psychodynamique (56.33 points) et la thérapie systémique (62.67 points). Il est fondamental de souligner que cette conclusion est établie au-delà de toute variation individuelle liée au praticien ayant délivré l’intervention.
En second lieu, l’évaluation du facteur imbriqué (F(6, 27) = 2.42, p = 0.0538) met en lumière une composante de variance inter-thérapeutes se situant à la lisière de la significativité statistique conventionnelle. Cela suggère qu’en dépit du respect strict d’un protocole standardisé, des variations idiosyncrasiques notables persistent d’un praticien à l’autre au sein d’une même doctrine. Cette hétérogénéité d’application souligne la pertinence de l’analyse hiérarchique : sans la modélisation de cette strate, l’incertitude attachée au talent individuel des thérapeutes aurait été artificiellement occultée.
Enfin, la variance résiduelle intra-cellule (MS_Erreur = 17.48, soit un écart-type résiduel s = 4.18 points) quantifie l’instabilité inter-patients subsistant à l’intérieur de la patientèle d’un même thérapeute. Cette dispersion résiduelle demeure modérée, ce qui témoigne d’une bonne homogénéité de la réactivité clinique des patients recrutés dans les différentes cohortes.
9.2 Calcul de la taille d’effet et coefficients d’association
Au-delà de la significativité inférentielle régie par les probabilités critiques (p-valeurs), la publication académique exige la quantification de la magnitude des effets au travers d’indices de taille d’effet standardisés. Dans le cadre de l’ANOVA imbriquée, l’indicateur d’association le plus universellement rapporté est l’éta-carré partiel (noté η²_p). Pour le facteur principal supérieur, il se calcule formellement comme le ratio de la somme des carrés de l’effet sur la somme de cet effet et de son terme d’erreur pertinent :
η²_p(Méthode) = SS_Méthode / [SS_Méthode + SS_Thérapeute(Méthode)]
η²_p(Méthode) = 1 298.667 / [1 298.667 + 253.333] = 1 298.667 / 1 552.000 ≈ 0.837
Cette valeur exceptionnellement élevée (η²_p = 0.84) indique que 83.7 % de la variance observée entre les groupes de thérapeutes est attribuable à l’orientation méthodologique du soin, ce qui représente une taille d’effet d’une magnitude considérable selon les critères canoniques de Jacob Cohen.
Pour le niveau intermédiaire, le calcul du coefficient de corrélation intraclasse (ICC ou ρ) permet d’estimer la proportion de la variance totale résiduelle imputable à l’effet de grappe constitué par les praticiens :
σ̂²_{B(A)} = (MS_B(A) – MS_Erreur) / n = (42.222 – 17.481) / 4 = 24.741 / 4 = 6.185
σ̂²_Erreur = MS_Erreur = 17.481
ICC = σ̂²_{B(A)} / [σ̂²_{B(A)} + σ̂²_Erreur] = 6.185 / [6.185 + 17.481] = 6.185 / 23.666 ≈ 0.261
Ce coefficient de corrélation intraclasse de 0.261 démontre que plus de 26 % de la variance des scores des patients à l’intérieur d’une méthode est attribuable à la spécificité de leur thérapeute, confirmant indubitablement la présence d’un effet de grappe modéré à fort qui proscrivait formellement l’usage d’une ANOVA simple.
9.3 Rédaction formelle des résultats selon les normes APA
La transcription des résultats empiriques au sein d’une publication savante doit satisfaire aux règles typographiques et structurelles édictées par l’American Psychological Association (APA, 7e édition). Le texte doit expliciter la spécification du modèle hiérarchique, les degrés de liberté spécifiques, la statistique F calculée, le niveau de significativité exact, ainsi que la mesure standardisée de la taille d’effet.
Un modèle de paragraphe académique prêt à l’insertion éditoriale s’énonce comme suit :
« Une analyse de variance hiérarchique (ANOVA imbriquée) à modèle mixte a été conduite pour évaluer l’impact des trois méthodes thérapeutiques (TCC, psychodynamique et systémique), le facteur praticien étant modélisé comme un effet aléatoire imbriqué au sein des méthodes [Thérapeute(Méthode)]. Les postulats de normalité des résidus et d’homoscédasticité ont été préalablement confirmés par le test de Shapiro-Wilk (W = 0.972, p = 0.48) et le test de Levene adapté (F(8, 27) = 1.12, p = 0.38). L’analyse révèle un effet principal hautement significatif du type de méthode thérapeutique, F(2, 6) = 15.38, p = .004, η²_p = .84. Les comparaisons planifiées indiquent que la TCC (M = 71.00, ET = 4.88) induit une amélioration clinique supérieure aux approches psychodynamique (M = 56.33, ET = 4.79) et systémique (M = 62.67, ET = 4.14). Par ailleurs, l’effet imbriqué des praticiens au sein de chaque doctrine s’avère marginalement non significatif, F(6, 27) = 2.42, p = .054, bien qu’il rende compte de 26.1 % de la variance intra-méthode (ICC = .261). »
Cette formalisation restitue la rigueur du modèle d’échantillonnage multiniveau tout en respectant scrupuleusement la métrique statistique requise par les comités de lecture internationaux.
10. Applications avancées en psychologie, neurosciences et sciences sociales
10.1 Recherche en psychothérapie et psychologie clinique
Dans l’évaluation contemporaine des psychothérapies, la reconnaissance de ce que la littérature nomme l’« effet thérapeute » (therapist effect) a totalement métamorphosé les exigences de validité interne des essais cliniques randomisés. Dans un essai contrôlé comparant deux protocoles de soins (par exemple la thérapie d’acceptation et d’engagement contre la thérapie cognitive classique), les participants ne sont pas directement traités par une abstraction conceptuelle, mais par des praticiens en chair et en os porteurs de styles relationnels singuliers.
L’utilisation d’une ANOVA imbriquée permet aux chercheurs de contrôler rigoureusement l’alliance thérapeutique comme variable de regroupement sous-jacente. Si l’on omet l’imbrication des thérapeutes dans les protocoles, une différence observée entre deux thérapies pourrait n’être qu’un artéfact engendré par la présence fortuite d’un clinicien particulièrement charismatique dans l’un des bras de l’étude. Le modèle hiérarchique sépare formellement l’effet du protocole standardisé de l’effet d’échantillonnage des praticiens.
Cette logique s’applique tout aussi directement aux évaluations multicentriques menées dans le champ hospitalier. Lorsque des protocoles de soins psychiatriques sont déployés au sein d’unités de soins distinctes, elles-mêmes imbriquées dans des établissements hospitaliers régionaux, l’ANOVA imbriquée préserve l’intégrité de l’inférence en évitant de confondre la qualité de l’organisation hospitalière locale avec l’efficacité intrinsèque des traitements administrés.
10.2 Psychologie de l’éducation et contextes scolaires
Le milieu scolaire et universitaire constitue par essence un univers d’échantillonnage hiérarchique à plusieurs étages. Les élèves sont regroupés à l’intérieur de classes, lesquelles sont elles-mêmes subordonnées à des établissements scolaires intégrés dans des circonscriptions académiques. L’évaluation de l’efficacité d’innovations pédagogiques (telles que l’usage de dispositifs numériques immersifs versus les méthodes d’enseignement magistral traditionnel) est constamment exposée au biais d’agrégation si les données sont analysées hors de leur armature hiérarchique.
Dans ce contexte, un plan ANOVA imbriqué positionne la modalité pédagogique au niveau macroscopique (Facteur A), les différentes classes assignées à cette méthode au niveau intermédiaire imbriqué (Facteur B(A)), et les performances scolaires individuelles des élèves au niveau terminal résiduel. Ce dispositif garantit que l’effet de l’enseignant, la dynamique socio-émotionnelle spécifique à une classe ou le climat d’apprentissage de groupe sont explicitement modélisés sous le terme d’erreur intermédiaire.
Cette précaution s’avère tout aussi capitale dans l’étude de l’anxiété de performance ou des trajectoires d’apprentissage des enfants. Isoler la variance partagée au niveau de la classe permet de déterminer avec précision si l’anxiété scolaire découle prioritairement de facteurs de personnalité propres à l’enfant ou si elle est substantiellement modulée par le style de gestion de classe adopté par les différents pédagogues d’une même école.
10.3 Neurosciences comportementales et neuropsychologie
En neurosciences cognitives et comportementales, l’irruption de la pseudo-répétition est un écueil méthodologique récurrent et documenté. Les protocoles expérimentaux y impliquent couramment l’enregistrement d’une multitude de mesures élémentaires issues d’un même organisme biologique : des centaines d’essais psychophysiques répétés par sujet, des dizaines de neurones enregistrés par animal de laboratoire, ou plusieurs coupes histologiques prélevées au sein d’une même structure cérébrale.
Considérer chaque neurone, chaque potentiel évoqué ou chaque coupe tissulaire comme une observation statistiquement indépendante constitue une erreur lourde qui pollue fréquemment la littérature spécialisée. Deux neurones enregistrés dans le cortex d’un même rongeur partagent le même patrimoine génétique, le même micro-environnement glial et la même exposition pharmacologique ; leurs réponses sont donc structurellement interdépendantes.
L’ANOVA imbriquée intervient ici comme un outil de clarification méthodologique indispensable :
- Facteur supérieur A : La souche génétique ou le traitement neuropharmacologique administré aux animaux.
- Facteur imbriqué B(A) : L’animal de laboratoire individuel (unité biologique autonome d’expérimentation).
- Observations intra-cellule : Les multiples neurones, tranches cérébrales ou essais comportementaux recueillis au sein de chaque animal.
En imposant que le test de l’effet neuropharmacologique s’effectue en regard de la variabilité inter-animaux (et non de la variabilité inter-neurones), l’ANOVA imbriquée protège infailliblement les neuroscientifiques contre les fausses découvertes et garantit la réplicabilité translationnelle de leurs observations.
11. Diagnostics, pièges fréquents et gestion des anomalies de données
11.1 Déséquilibre des effectifs (Plans non orthogonaux)
La construction mathématique exposée jusqu’ici reposait sur l’hypothèse idéale d’un plan d’expérience parfaitement équilibré (effectifs égaux n par cellule). Or, dans la réalité pragmatique du terrain, les chercheurs sont fréquemment confrontés à des plans non orthogonaux consécutifs à des abandons en cours d’étude, des données manquantes aléatoires ou des contraintes logistiques d’échantillonnage.
L’inégalité des effectifs au sein des sous-groupes imbriqués engendre une rupture fondamentale de l’additivité simple des sommes de carrés d’écarts. Dans un plan déséquilibré, la décomposition classique (sommes de carrés de Type I séquentiel) devient dépendante de l’ordre d’entrée des variables dans l’équation linéaire. Les sommes de carrés partielles de Type III, calculées à partir des moyennes marginales estimées (Least-Squares Means), deviennent indispensables pour tester chaque terme conditionnellement à la présence de tous les autres.
Toutefois, lorsque le déséquilibre des effectifs devient substantiel ou que certaines cellules sont quasi-vides, les formules traditionnelles de l’ANOVA imbriquée basées sur les moments empiriques perdent leur efficacité et peuvent générer des estimations incohérentes des composantes de variance. Dans une telle situation, la recommandation unanime de la communauté biométrique contemporaine consiste à abandonner les formules fermées de l’ANOVA au profit de l’ajustement par modèles linéaires mixtes sous estimation de vraisemblance restreinte.
11.2 Erreurs de spécification du plan dans les logiciels
L’accessibilité ergonomique des progiciels d’analyse contemporains masque paradoxalement de nombreux écueils de programmation. L’erreur la plus répandue consiste à renseigner un plan hiérarchique dans l’interface logicielle en omettant de spécifier la clause d’imbrication, amenant le système à estimer un plan factoriel croisé complet A × B.
Lorsque cette méprise survient, le logiciel génère un terme résiduel qui n’a aucun sens mathématique, ou refuse purement et simplement de calculer l’interaction en raison de singularités matricielles (colonnes linéairement dépendantes ou zéros structurels dans les cellules). L’utilisateur non averti peut interpréter cette alerte logicielle comme une anomalie de ses données, alors qu’elle ne découle que d’une incohérence dans la paramétrisation du modèle.
Un autre piège classique concerne la sélection implicite du terme d’erreur par défaut dans certains logiciels. De nombreux modules de base supposent que tous les facteurs sont des effets fixes, divisant systématiquement l’ensemble des carrés moyens par le terme d’erreur résiduelle terminal (MS_Erreur). Pour déjouer ce péril, l’analyste doit systématiquement inspecter la table des degrés de liberté du dénominateur (df₂) dans les sorties d’analyse : si le test du facteur principal A affiche le degré de liberté de l’erreur résiduelle au lieu de celui du facteur imbriqué, le modèle calculé est erroné et invalide l’ensemble des conclusions publiées.
11.3 Gestion des composantes de variance négatives
Un phénomène déroutant auquel sont parfois confrontés les praticiens utilisant l’ANOVA imbriquée est l’émergence d’une composante de variance aléatoire négative, se traduisant empiriquement par l’obtention d’un carré moyen du facteur imbriqué inférieur au carré moyen de l’erreur pure :
MS_B(A) < MS_Erreur ⟹ F_B(A) < 1.0
Sur le plan ontologique et probabiliste, une variance étant par définition une grandeur quadratique, elle ne peut être strictement négative (σ² ≥ 0). L’apparition d’un F nettement inférieur à l’unité reflète le fait que l’estimation empirique de la composante σ²_{B(A)}, obtenue par la différence (MS_B(A) – MS_Erreur) / n, délivre une valeur négative en raison de la simple fluctuation d’échantillonnage autour d’une variance réelle nulle ou infinitésimale.
Face à cette anomalie, deux attitudes méthodologiques prévalent dans la littérature :
- La mise à zéro théorique : Le chercheur pose σ²_{B(A)} = 0 et conserve le modèle intact en interprétant la variabilité inter-sous-groupes comme indiscernable du bruit de mesure.
- La mise en commun des variances (Pooling) : Si le test F du facteur imbriqué est formellement non significatif à un seuil très conservateur (souvent fixé à α = 0.25 selon les recommandations classiques de Bancroft), certains auteurs préconisent d’amalgamer la somme des carrés du facteur imbriqué avec celle de l’erreur résiduelle pour former un terme d’erreur poolé plus puissant disposant de davantage de degrés de liberté.
Néanmoins, la pratique du pooling est aujourd’hui accueillie avec circonspection par les biostatisticiens rigoureux, dans la mesure où elle distorde la nature déclarative a priori du plan expérimental et introduit un biais conditionnel dans l’inférence ultérieure de l’effet principal.
12. Comparaison critique : ANOVA imbriquée versus Modèles Linéaires Mixtes
12.1 Limites inhérentes à l’ANOVA imbriquée traditionnelle
Bien que l’ANOVA imbriquée constitue un édifice méthodologique historiquement éprouvé et conceptuellement limpide pour décortiquer la variance, elle présente des limites structurelles intrinsèques qui restreignent son efficacité dans les environnements de recherche contemporains. Sa première contrainte majeure réside dans son exigence quasi-absolue d’orthogonalité et d’équilibre. Dès lors que les cellules présentent des tailles d’échantillon divergentes, les procédures de calcul fondées sur les sommes de carrés deviennent excessivement complexes et perdent leurs vertus d’invariance statistique.
La seconde rigidité notable tient à son incapacité fondamentale à intégrer aisément des covariables continues variables à l’intérieur des sous-groupes (dispositifs d’ANCOVA imbriquée complexe). Dans de nombreux contextes réels, l’analyste souhaite ajuster les scores en fonction d’un trait continu propre à chaque individu (par exemple l’âge, le niveau socio-économique ou la sévérité basale du trouble), une entreprise qui dépasse les capacités analytiques des modèles de variance hiérarchiques ordinaires.
Enfin, l’ANOVA imbriquée traditionnelle postule une structure d’homoscédasticité uniforme à travers tous les niveaux de regroupement. Elle est incapable de modéliser explicitement des phénomènes complexes d’hétérogénéité des variances où, par exemple, la variabilité entre praticiens différerait structurellement selon l’école thérapeutique envisagée.
12.2 L’alternative moderne des Modèles Mixtes Hiérarchiques (LMM / HLM)
Pour dépasser ces goulets d’étranglement méthodologiques, la modélisation statistique s’est massivement réorientée au cours des trois dernières décennies vers les modèles linéaires mixtes (Linear Mixed Models ou LMM), également qualifiés de modèles linéaires hiérarchiques (HLM) ou modèles multiniveaux. Cette approche ne repose plus sur la partition matricielle des sommes de carrés d’écarts, mais sur des algorithmes d’optimisation numérique fondés sur le maximum de vraisemblance restreint (REML, pour Restricted Maximum Likelihood).
L’estimation par REML confère aux modèles mixtes une supériorité technique décisive :
- Ils traitent avec une totale flexibilité les données déséquilibrées, les effectifs inégaux et les données manquantes aléatoires (postulat MAR, Missing at Random) sans requérir d’imputation artificielle.
- Ils permettent d’incorporer simultanément des prédicteurs catégoriels et des covariables continues à chaque échelle de la hiérarchie (effets fixes de niveau 1 et de niveau 2).
- Ils offrent la possibilité de modéliser des matrices de variance-covariance complexes, autorisant les variances résiduelles à différer d’une strate à l’autre ou à exhiber des structures d’autocorrélation temporelle.
En formulant unitairement les effets fixes et les composantes aléatoires au sein d’une équation de vraisemblance unique, les modèles mixtes unifient l’ANOVA imbriquée, la régression multiple et les analyses longitudinales répétées au sein d’un formalisme mathématique intégré et extraordinairement puissant.
12.3 Synthèse directrice pour le chercheur contemporain
À l’issue de cet examen critique approfondi, une interrogation légitime s’impose au chercheur et au data scientist contemporain : l’ANOVA imbriquée classique est-elle devenue une relique méthodologique obsolète au regard de l’hégémonie des modèles linéaires mixtes ? La réponse à cette interrogation se doit d’être nuancée et pragmatique.
L’ANOVA imbriquée demeure l’outil d’analyse par excellence dans les contextes expérimentaux académiques strictement contrôlés, parfaitement équilibrés et conçus selon des protocoles standards. Sa simplicité conceptuelle, l’intelligibilité immédiate de sa table de décomposition de la variance (avec ses sommes de carrés et ses degrés de liberté identifiables) et sa parfaite transparence pour les comités de lecture en font un choix d’une redoutable efficacité démonstrative. Elle constitue en outre un préalable pédagogique indispensable pour appréhender les rouages conceptuels de la modélisation hiérarchique.
En revanche, dès lors que le dispositif empirique s’écarte du cadre de laboratoire idéal — qu’il s’agisse de données observationnelles en milieu clinique, d’attrition de participants en cours d’étude, d’hétérogénéité avérée des variances de fond ou de la nécessité d’ajuster sur des covariables individuelles —, la transition vers les modèles mixtes estimés par REML ou par inférence bayésienne devient un impératif méthodologique incontournable.
Pour guider le praticien avant la finalisation et la soumission d’une analyse imbriquée dans une revue à comité de lecture, la grille de contrôle méthodologique suivante synthétise les critères de validité indispensables :
- Vérification topologique : Les modalités du facteur inférieur sont-elles structurellement exclusives à un seul niveau du facteur principal ? (Absence totale de plan croisé dissimulé).
- Statut des facteurs : Le facteur imbriqué a-t-il été explicitement déclaré comme aléatoire afin de généraliser les conclusions au-delà des sous-unités échantillonnées ?
- Exactitude des dénominateurs : La statistique F testant le facteur supérieur utilise-t-elle sans équivoque le carré moyen du facteur imbriqué (MS_B(A)) et non le résidu terminal pur (MS_Erreur) ?
- Détection de la pseudo-répétition : L’indépendance conditionnelle des unités expérimentales réelles a-t-elle été scrupuleusement préservée lors de la modélisation ?
- Conformité distributionnelle : L’homoscédasticité et la normalité des résidus de cellule ont-elles été validées par des diagnostics graphiques et des épreuves paramétriques adaptées ?
Le respect scrupuleux de ces exigences épistémologiques et computationnelles confère à l’ANOVA imbriquée sa pleine valeur démonstrative, transformant un dispositif d’échantillonnage hiérarchisé complexe en un modèle d’inférence causal rigoureux, élégant et inattaquable.
Références
- Bancroft, T. A. (1964). Analysis and inference for incompletely specified models involving the use of preliminary test(s) of significance. The Annals of Mathematical Statistics, 35(4), 1627–1639. https://doi.org/10.1214/aoms/1177703387
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
- Kirk, R. E. (2013). Experimental design: Procedures for the behavioral sciences (4th ed.). SAGE Publications.
- Maxwell, S. E., & Delaney, H. D. (2004). Designing experiments and analyzing data: A model comparison perspective (2nd ed.). Lawrence Erlbaum Associates.
- Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
- Raudenbush, S. W., & Bryk, A. S. (2002). Hierarchical linear models: Applications and data analysis methods (2nd ed.). SAGE Publications.
- Searle, S. R., Casella, G., & McCulloch, C. E. (1992). Variance components. John Wiley & Sons. https://doi.org/10.1002/9780470316856
- Sokal, R. R., & Rohlf, F. J. (2012). Biometry: The principles and practice of statistics in biological research (4th ed.). W. H. Freeman and Company.
- Winer, B. J., Brown, D. R., & Michels, K. M. (1991). Statistical principles in experimental design (3rd ed.). McGraw-Hill.