
La modélisation statistique repose fondamentalement sur la recherche d’une harmonie intelligible au sein de la variabilité empirique. Qu’il s’agisse de théoriser les déterminants cognitifs de l’apprentissage, de prédire des trajectoires cliniques en psychopathologie ou d’estimer des équilibres macroéconomiques, le chercheur tente d’abstraire le réel par le biais d’équations mathématiques formelles. Pourtant, quelle que soit la sophistication conceptuelle d’un modèle de régression, celui-ci demeure une réduction idéalisée de phénomènes naturels éminemment stochastiques et multivariés. C’est précisément à l’intersection de cette abstraction théorique et de la contingence observationnelle que surgit la notion fondamentale de résidu statistique.
Trop souvent relégués au rang de simples sous-produits de calcul ou de déchets arithmétiques, les résidus constituent en réalité le cœur battant du diagnostic méthodologique. Ils incarnent l’empreinte matérielle de tout ce qui échappe à la formalisation prédictive : les influences non mesurées, le bruit de mesure inhérent aux instruments psychométriques, les non-linéarités sous-jacentes et les singularités individuelles. Loin d’être un aveu d’échec de la modélisation, le résidu fournit le miroir critique au sein duquel s’évalue la validité empirique des hypothèses de recherche. Comprendre la nature, la structure et la distribution des résidus, c’est s’autoriser à interroger la rigueur et la véracité des inférences statistiques tirées d’un échantillon.
Cet article propose une exploration exhaustive et théorique de la nature des résidus en statistique descriptive, inférentielle et appliquée. À travers l’analyse de leurs fondements mathématiques, de leurs propriétés géométriques au sein de la méthode des moindres carrés ordinaires, de leurs typologies diagnostiques et de leurs applications concrètes dans les sciences du comportement, ce guide offre aux chercheurs, cliniciens et data scientists les clés indispensables pour déchiffrer l’information contenue dans ce que le modèle ne parvient pas à expliquer.
1. Fondements théoriques et définition mathématique des résidus
1.1 La formule fondamentale : écart entre valeur observée et valeur prédite
Au niveau le plus élémentaire de l’analyse de régression univariée ou multivariée, le résidu représente la divergence arithmétique directe entre la réalité observée sur le terrain et la prévision formulée par le modèle mathématique. Pour une observation individuelle donnée, indexée par l’indice i au sein d’un échantillon de taille n, le résidu empirique ordinaire, universellement désigné par la lettre ei, est formalisé par l’équation canonique suivante :
ei = yi – ŷi
Dans cette formalisation fondamentale, yi correspond à la valeur effective mesurée de la variable dépendante (ou variable réponse) pour le sujet i. À l’opposé, la quantité ŷi (couramment lue « y chapeau ») représente la valeur ajustée ou prédite par la fonction de régression pour cette même observation, calculée en injectant les coordonnées des régresseurs du sujet dans l’équation paramétrique estimée. Le résidu mesure ainsi l’erreur d’ajustement ponctuelle commise par la structure déterministe du modèle à l’égard de ce point précis de données.
Il est impératif, sur le plan épistémologique et méthodologique, d’opérer une distinction rigoureuse entre le résidu empirique ei et le terme d’erreur théorique, traditionnellement noté par la lettre grecque epsilon (εi). Le terme d’erreur εi est une variable stochastique latente, intrinsèque à la population parente globale et fondamentalement inobservable. Il capture la divergence absolue entre la véritable fonction génératrice des données dans la population (qui demeure inconnue) et le phénomène réel. En revanche, le résidu ei constitue un estimateur empirique calculé à partir d’un sous-ensemble échantillonnal spécifique et dépend directement des estimateurs paramétriques dérivés par l’algorithme d’optimisation.
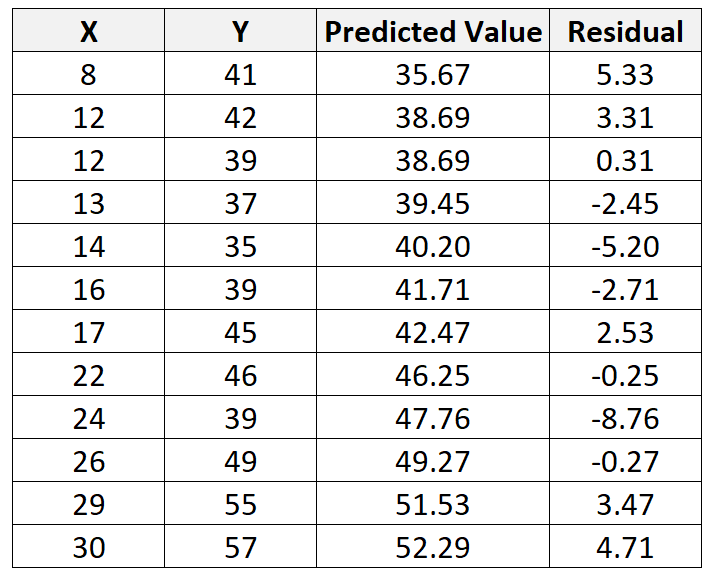
Cette articulation met en lumière la dualité structurelle de tout modèle linéaire généralisé : une composante déterministe constituée par la combinaison linéaire des variables explicatives pondérées par leurs coefficients respectifs, et une composante stochastique incarnée au niveau de l’échantillon par la distribution des résidus. Les résidus matérialisent ainsi la part d’aléa, de complexité résiduelle ou d’imperfection analytique qui subsiste après extraction du signal systématique contenu dans les données observées.
1.2 Représentation géométrique : la distance verticale sur le plan cartésien
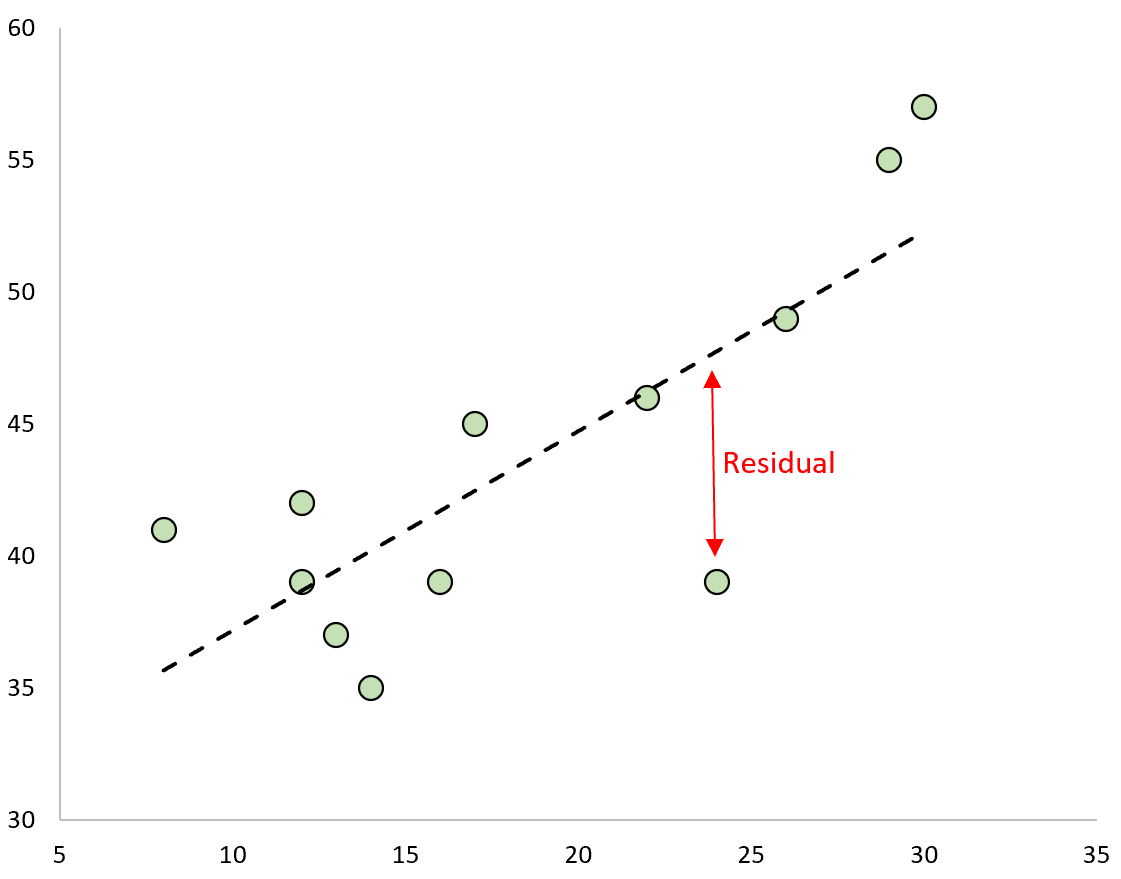
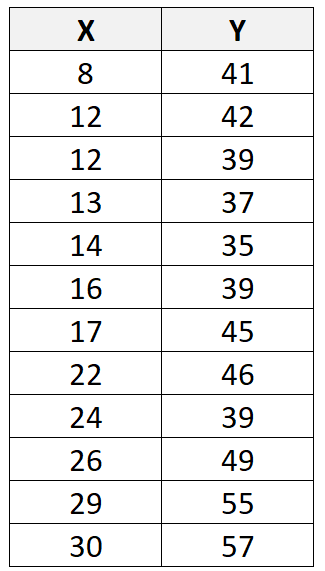
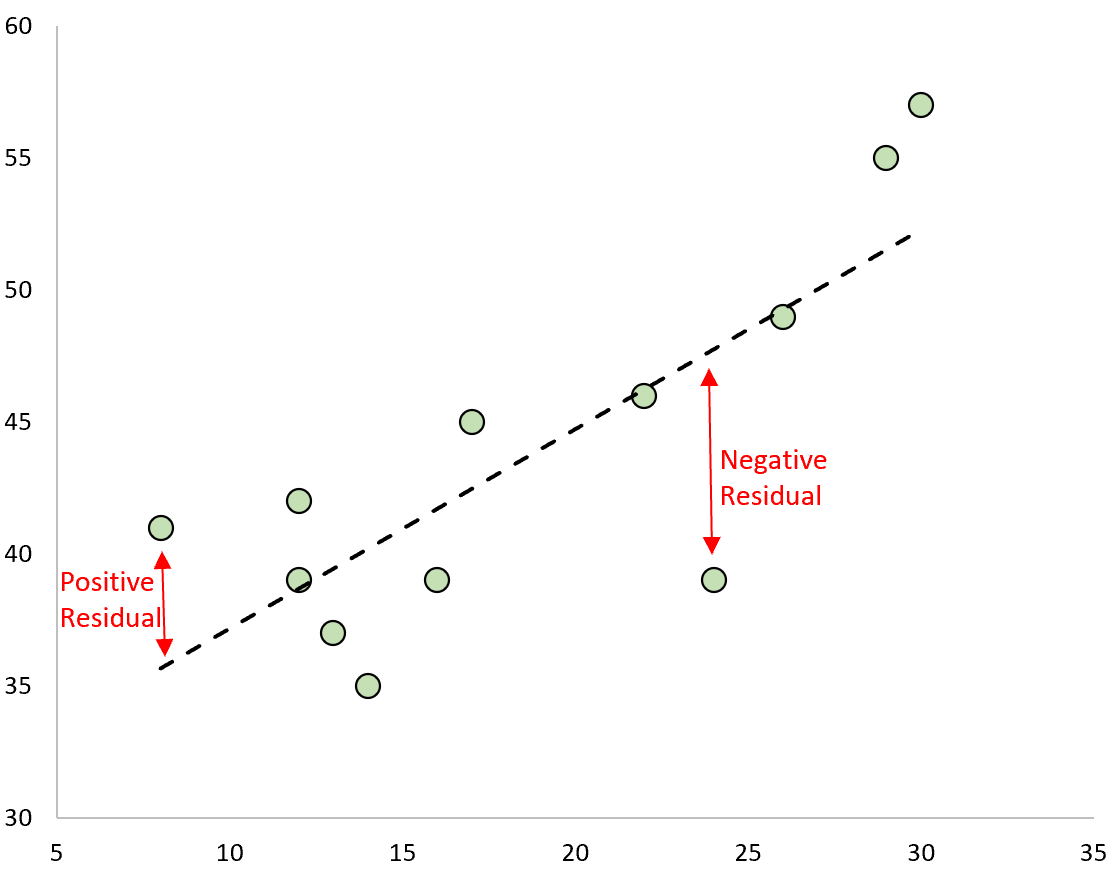
L’appréhension intuitive des résidus gagne immensément à être abordée sous l’angle de la géométrie euclidienne. Sur un plan cartésien bidimensionnel standard, représentant une régression linéaire simple reliant une variable dépendante Y à un prédicteur unique X, chaque sujet ou observation est figuré par un point distinct dont les coordonnées spatiales sont définies par le couple (xi, yi). La droite de régression issue de l’estimation statistique trace une trajectoire continue modélisant la réponse conditionnelle attendue.
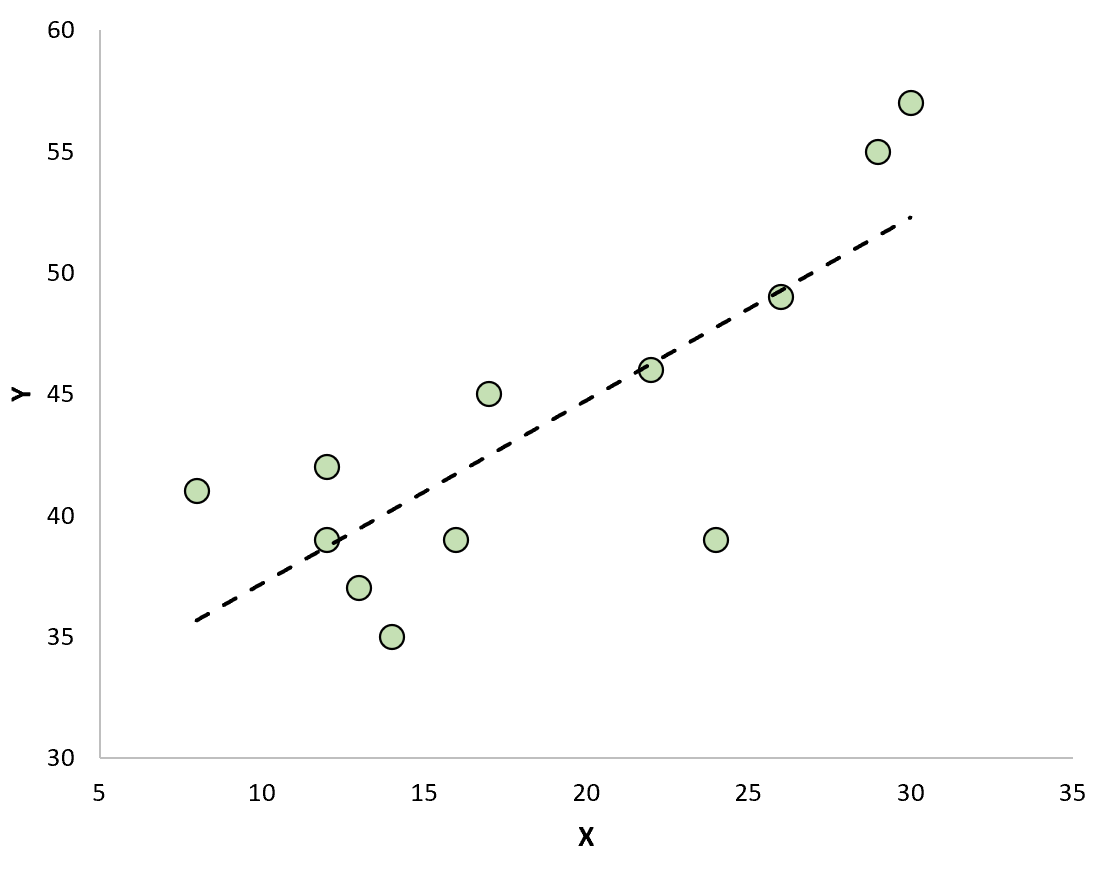
Dans cette disposition spatiale, le résidu statistique correspond rigoureusement à la distance verticale, mesurée parallèlement à l’axe des ordonnées, séparant le point empirique réel de son point de projection vertical situé sur la droite d’ajustement. Cette verticalité géométrique est capitale : le résidu ne mesure en aucune manière la distance orthogonale minimale séparant le point de la droite dans l’espace euclidien bidimensionnel. Cette divergence méthodologique permet d’établir une frontière théorique nette entre la régression linéaire par les moindres carrés ordinaires et les approches basées sur l’analyse en composantes principales (ACP) ou la régression orthogonale (modèle de Deming).
En régression MCO, la variable explicative X est postulée comme exogène et mesurée sans erreur stochastique, ce qui contraint l’optimisation à évaluer l’incertitude prédictive exclusivement selon la direction de l’axe vertical Y. Dès lors, lorsqu’un ensemble d’observations présente une dispersion spatiale hétérogène autour de la droite d’ajustement, la visualisation géométrique met en évidence des segments verticaux d’amplitudes variables. La somme et la distribution de ces distances verticales définissent la structure géométrique globale de l’ajustement statistique, illustrant comment le plan de régression tente de se positionner au barycentre directionnel des projections résiduelles.
1.3 Propriété d’orthogonalité et somme nulle des résidus
L’estimation des coefficients de régression par la méthode des moindres carrés ordinaires confère aux résidus un ensemble de propriétés algébriques strictes et universelles, dès lors que le modèle intègre un terme d’interception (la constante β0). La première et la plus célèbre de ces propriétés réside dans le fait que la somme algébrique des résidus bruts calculés sur l’ensemble de l’échantillon est strictement égale à zéro :
∑ ei = 0, pour i allant de 1 à n.
Cette propriété découle directement des conditions du premier ordre appliquées lors de la dérivation analytique de la fonction de perte quadratique. En annulant la dérivée partielle de la somme des carrés des erreurs par rapport à la constante du modèle, l’équation normale impose mécaniquement que l’écart cumulé positif compense exactement l’écart cumulé négatif. Par voie de conséquence directe, la moyenne arithmétique de la distribution résiduelle au sein de l’échantillon d’ajustement est invariablement nulle (ē = 0). Cette caractéristique garantit un centrage automatique et rigoureux du modèle autour du barycentre des points d’observation.
La seconde propriété structurelle d’une portée théorique majeure concerne l’orthogonalité vectorielle. Au sens de l’algèbre linéaire, le vecteur colonne des résidus empiriques e est strictement orthogonal à l’espace vectoriel engendré par les colonnes de la matrice des régresseurs X, ce qui se formule matriciellement par la relation XTe = 0. Sur le plan statistique, cela signifie qu’il n’existe rigoureusement aucune covariance ou corrélation linéaire entre les variables explicatives incluses dans le modèle et les résidus résultants. Toute l’information linéaire contenue dans les régresseurs a été entièrement extraite et transférée dans les valeurs ajustées ŷ, ne laissant dans le résidu aucune trace linéaire exploitable par ces prédicteurs.
2. Le rôle des résidus dans la méthode des moindres carrés ordinaires (MCO)
2.1 Le principe d’optimisation par la minimisation de la somme des carrés
L’histoire de la statistique moderne s’est cristallisée autour de la recherche d’un critère optimal permettant d’ajuster une équation prédictive à des données bruitées. Initiée par Carl Friedrich Gauss et Adrien-Marie Legendre, la méthode des moindres carrés ordinaires (MCO) adopte pour fondement la minimisation mathématique globale de la somme des carrés des résidus, fréquemment désignée par l’acronyme SSE (Sum of Squared Errors) ou SCE (Somme des Carrés des Erreurs) :
SSE = ∑ ei2 = ∑ (yi – ŷi)2
Le recours à l’élévation au carré de chaque écart individuel s’explique par deux impératifs majeurs. D’une part, comme démontré précédemment, la simple somme arithmétique des résidus bruts s’annule en permanence sous l’effet de la compensation des signes positifs et négatifs, ce qui la rend impropre à servir de fonction objective d’optimisation. L’élévation quadratique permet de transformer l’ensemble des écarts en grandeurs strictement positives. D’autre part, la fonction quadratique présente des propriétés de différentiabilité idéales autorisant une résolution analytique exacte via le calcul différentiel matriciel, conduisant aux équations normales sans exiger d’itérations numériques complexes.
Toutefois, cette formalisation quadratique possède une contrepartie structurelle lourde de conséquences : elle confère un poids disproportionné aux écarts de grande amplitude. Un résidu d’une magnitude de 4 unités génère une pénalité de 16 dans la fonction de coût, tandis qu’un écart de 10 unités contribue à hauteur de 100. Cette sensibilité exacerbée rend les estimateurs des MCO remarquablement vulnérables aux données aberrantes ou aux déviations distributionnelles sévères, imposant une surveillance continue de l’intégrité de la dispersion des erreurs.
2.2 Différenciation entre résidus empiriques et erreurs théoriques
Pour appréhender correctement l’inférence statistique et le calcul des tests de significativité, le chercheur doit constamment naviguer entre l’espace conceptuel de la population parente et l’espace empirique de l’échantillon collecté. Dans la population, le modèle théorique est défini par Y = Xβ + ε, où β représente le vecteur immuable des vrais paramètres populationnels et ε symbolise le vecteur des erreurs théoriques non observables. Dans ce cadre ontologique, chaque composante εi possède une variance théorique constante σ2.
Lorsque le modèle est estimé sur un échantillon empirique, l’équation devient Y = Xb + e, où b constitue le vecteur des estimateurs calculés et e le vecteur des résidus observables. Bien que les résidus ei soient conçus pour estimer les erreurs théoriques εi, ils ne possèdent pas rigoureusement les mêmes propriétés distributionnelles en tout point. En effet, l’estimation des p coefficients de régression consomme un nombre équivalent de degrés de liberté au sein de l’espace vectoriel des observations.
Par conséquent, pour estimer de manière non biaisée la variance inconnue σ2 du terme d’erreur théorique, le statisticien ne peut pas simplement diviser la somme des carrés des résidus par la taille de l’échantillon n. Il est mathématiquement impératif de corriger cette estimation par les degrés de liberté résiduels résiduels, donnant lieu à la variance résiduelle échantillonnale s2 :
s2 = SSE / (n – p – 1), où p représente le nombre total de régresseurs sans inclure la constante.
Cette correction compense le fait que les résidus empiriques ont tendance, par construction mathématique de minimisation sur l’échantillon, à être légèrement plus resserrés autour de la droite d’ajustement que ne le sont les véritables erreurs théoriques par rapport à la véritable fonction génératrice.
2.3 Décomposition de la variance totale et coefficient de détermination
L’analyse de la variance dans le modèle linéaire repose sur une décomposition fondamentale de la variabilité globale de la variable réponse en deux composantes orthogonales mutuellement exclusives. La somme totale des carrés (SST pour Total Sum of Squares), qui quantifie l’inertie globale des données empiriques autour de leur moyenne arithmétique ȳ, est partitionnée selon la relation algébrique exacte :
SST = SSM + SSE (ou SC Totale = SC Modèle + SC Résiduelle)
La composante SSM (Model Sum of Squares) représente la dispersion expliquée de façon linéaire par la combinaison des variables prédictives, tandis que la composante SSE synthétise la somme des carrés des résidus non expliquée par l’architecture du modèle. Cette décomposition éclaire de façon limpide la genèse du coefficient de détermination, le célèbre R2, largement mobilisé pour caractériser la qualité globale d’ajustement de la régression :
R2 = 1 – (SSE / SST) = SSM / SST
Le résidu statistique agit ainsi comme l’arbitre absolu de la performance explicative. Plus la somme des carrés résiduels est réduite par rapport à la variabilité totale initiale, plus le ratio SSE / SST tend vers zéro, propulsant le coefficient R2 vers l’unité. Parallèlement, l’erreur type de la régression (l’écart-type résiduel s, racine carrée de la MSE ou Mean Squared Error) traduit cette dispersion résiduelle dans l’unité de mesure originale de la variable Y, fournissant un indicateur concret et interprétable de l’incertitude moyenne qui pèse sur chaque prédiction individuelle émise par le modèle.
3. Signe et amplitude des résidus : interprétation analytique
3.1 Comprendre les résidus positifs : sous-estimation structurelle
L’examen directionnel du résidu individuel fournit des enseignements diagnostiques qualitatifs d’une importance primordiale. D’un point de vue arithmétique formel, un résidu positif (ei > 0) survient dès lors que la coordonnée empiriquement enregistrée yi excède la prédiction statistique formulée par le modèle, soit yi > ŷi. Dans cette configuration, le modèle a sous-estimé la valeur effective présentée par l’observation.
Dans les sciences humaines et la psychométrie appliquée, l’identification de résidus positifs d’amplitude substantielle revêt une signification théorique féconde. Considérons par exemple une recherche visant à prédire le niveau d’anxiété clinique à partir de l’exposition à des événements de vie stressants. Un individu caractérisé par un large résidu positif manifeste une détresse psychologique considérablement plus aiguë que celle que son exposition au stress objectif ne laissait présager. Ce constat clinique signale la présence potentielle de facteurs de vulnérabilité individuels non inclus dans l’équation, tels qu’un biais d’attention cognitive, un attachement insécurisant ou des anomalies de régulation neurobiologique.
Sur le plan géométrique, l’observation correspondante se positionne physiquement au-dessus de la droite ou de l’hyperplan de régression. Lorsque des résidus positifs tendent à se regrouper systématiquement sur un segment spécifique de la plage prédictive, ce phénomène indique fréquemment une mauvaise spécification fonctionnelle, telle que l’omission d’une non-linéarité concave ou la non-prise en compte d’un phénomène de saturation psychologique au-delà d’un certain seuil d’activation environnementale.
3.2 Comprendre les résidus négatifs : surestimation du modèle
Symétriquement, un résidu négatif se matérialise lorsque la valeur empiriquement constatée est inférieure à la valeur dérivée par l’algorithme prédictif (ei < 0, c’est-à-dire yi < ŷi). En deçà du plan d’ajustement, l’observation incarne une situation où le modèle surestime l’ampleur du phénomène réel.
En psychologie du travail ou de l’éducation, imaginons un modèle prédisant l’engagement professionnel ou les scores de réussite académique sur la base d’indices de motivation intrinsèque et de quotient intellectuel. Un élève ou un employé caractérisé par un résidu lourdement négatif produit une performance ou un niveau d’implication nettement inférieur aux attentes formulées par le modèle linéaire. Cette sous-performance inattendue invite le chercheur ou le clinicien à investiguer des variables inhibitrices masquées : présence d’un syndrome dépressif comorbide, harcèlement environnemental, distractibilité cognitive ou déficit d’adaptation méthodologique.
D’un point de vue statistique pur, la survenue récurrente de résidus négatifs particulièrement prononcés aux valeurs extrêmes des prédicteurs constitue l’un des symptômes classiques de l’extrapolation abusive. Lorsqu’un modèle linéaire est sollicité pour extrapoler des estimations en dehors de la plage d’étalonnage de l’échantillon de référence, la rigidité mathématique de la trajectoire linéaire conduit fréquemment à prédire des scores irréalistes ou impossibles (tels que des taux de réponse négatifs ou des performances dépassant les plafonds psychométriques), engendrant des résidus négatifs d’une ampleur aberrante.
3.3 L’amplitude absolue et l’erreur d’estimation ponctuelle
Si la direction du résidu, dictée par son signe, indique la nature du biais prédictif local (sur- ou sous-évaluation), sa magnitude absolue, mesurée par la valeur absolue |ei|, quantifie directement la précision ou l’imprécision de l’estimation pour l’observation examinée. Plus l’amplitude absolue d’un résidu se rapproche de zéro, plus la concordance entre la trajectoire théorique du modèle et l’observation empirique est intime.
Dans les applications d’évaluation individualisée — qu’il s’agisse de la délivrance d’un diagnostic neuropsychologique ou du calibrage d’une aide financière prédictive —, une faible amplitude absolue conditionne l’utilité clinique du modèle. Une équation affichant un R2 séduisant de 0,60 peut néanmoins dissimuler des amplitudes absolues individuelles rédhibitoires pour la prise de décision clinique, générant des erreurs ponctuelles inacceptables à l’échelle du sujet singulier. C’est ici que l’amplitude résiduelle se connecte conceptuellement à la notion d’intervalle de prédiction : plus la dispersion des amplitudes absolues est vaste, plus l’incertitude projetée autour de toute prédiction future devient large.
Pour résumer l’amplitude globale des erreurs sur l’ensemble d’un protocole sans subir la sensibilité excessive des carrés face aux points aberrants, les analystes recourent fréquemment à l’Erreur Absolue Moyenne (MAE pour Mean Absolute Error) :
MAE = (1 / n) ∑ |ei|
En conservant l’échelle métrique naturelle des variables d’intérêt, la MAE fournit une lecture directe et intuitive de l’amplitude moyenne typique des erreurs résiduelles générées par le système prédictif, offrant une perspective complémentaire indispensable aux métriques quadratiques traditionnelles.
4. Les différentes typologies de résidus dans la modélisation statistique
4.1 Les résidus bruts ou ordinaires
Les résidus bruts, tels que définis par l’opération élémentaire ei = yi – ŷi, constituent la matière première de l’analyse d’adéquation statistique. Leur principal avantage réside dans leur transparence interprétative : ils s’expriment rigoureusement dans la même métrique physique ou psychométrique que la variable dépendante Y étudiée (par exemple des millisecondes pour un temps de réaction, des points sur une échelle d’anxiété de Hamilton ou des pourcentages de réussite).
Néanmoins, cette dépendance métrique représente simultanément leur plus redoutable faiblesse méthodologique. D’une part, il s’avère rigoureusement impossible de comparer directement l’amplitude d’un résidu brut issu d’une échelle d’estime de soi graduée de 10 à 40 points avec celle d’un résidu calculé sur un test d’aptitude générale gradué de 0 à 1000. D’autre part, et cela constitue une propriété mathématique souvent méconnue des praticiens, les résidus bruts ne possèdent pas une variance théorique constante à travers l’échantillon, même lorsque l’hypothèse d’homoscédasticité des erreurs fondamentales est scrupuleusement respectée dans la population.
En vertu de la matrice de projection orthogonale (ou matrice chapeau H), la variance d’un résidu brut particulier ei dépend étroitement de la localisation de l’observation dans l’espace multidimensionnel des prédicteurs, selon la formulation analytique :
Var(ei) = σ2 (1 – hii)
Où hii correspond à l’élément diagonal de la matrice chapeau mesurant le levier de l’observation. Ainsi, plus une observation se situe loin du barycentre des prédicteurs (levier élevé), plus sa variance résiduelle brute est mécaniquement comprimée, rendant l’examen exclusif des résidus bruts potentiellement trompeur pour détecter les anomalies de modélisation.
4.2 Les résidus standardisés (centrés-réduits)
Afin de s’émanciper des contraintes d’échelle et de conférer aux résidus une métrique universellement interprétable, les statisticiens ont développé des procédures de standardisation. Le résidu standardisé (parfois désigné sous le terme de résidu centré-réduit) s’obtient en divisant le résidu brut ordinaire par l’écart-type résiduel global du modèle estimé :
zi = ei / s, où s est la racine carrée de la variance résiduelle s2.
Par cette transformation mathématique simple, les résidus sont convertis en unités universelles d’écarts-types, de manière tout à fait analogue aux notes standardisées (z-scores) couramment mobilisées en psychométrie différentielle. Sous l’hypothèse de normalité de la distribution sous-jacente, environ 95 % des résidus standardisés doivent impérativement être compris dans l’intervalle [-1,96 ; +1,96], et plus de 99 % au sein de l’intervalle [-2,58 ; +2,58].
Cette standardisation universelle permet d’établir des heuristiques décisionnelles simples et automatisables au sein des progiciels statistiques : tout résidu standardisé dont la valeur absolue excède 2 ou 3 sera immédiatement étiqueté comme suspect et susceptible de constituer une valeur divergente. Toutefois, le résidu standardisé souffre encore de l’omission du paramètre de levier hii : en divisant uniformément tous les résidus par la même quantité scalaire s, il échoue à égaliser rigoureusement les variances résiduelles locales lorsque les leviers sont hétérogènes.
4.3 Les résidus studentisés internes et externes
Pour remédier définitivement au biais induit par la variation du levier d’une observation à l’autre, la théorie statistique a introduit le concept de résidu studentisé. Le résidu studentisé interne (souvent qualifié simplement de résidu studentisé) normalise l’écart brut en intégrant au dénominateur l’erreur-type exacte propre à chaque observation :
ri = ei / [s √(1 – hii)]
Dans cette équation, la correction par le terme √(1 – hii) neutralise précisément la dépression artificielle de variance qui frappe les points à fort levier, rétablissant une variance théorique strictement unitaire (égale à 1) pour l’ensemble des points d’ajustement. Toutefois, une faiblesse persiste : si l’observation i constitue une valeur aberrante extrême, sa magnitude démesurée gonfle artificiellement l’estimateur de l’écart-type résiduel global s, introduisant un effet de masque qui atténue la détection de cette même anomalie.
C’est pourquoi la référence diagnostique absolue réside dans le résidu studentisé externe (ou résidu Jackknife ou deleted studentized residual), noté ti. Dans ce schéma computationnel itératif, l’écart-type résiduel s(i) est calculé en excluant explicitement l’observation i de l’estimation de l’équation de régression :
ti = ei / [s(i) √(1 – hii)]
Ce ratio suit rigoureusement une distribution théorique de Student à (n – p – 2) degrés de liberté. Cette propriété mathématique exacte autorise l’exécution de tests d’hypothèse formels pour déterminer si une observation individuelle s’écarte significativement de la fonction de régression établie sur le reste de l’échantillon, offrant une sensibilité sans égale face aux valeurs aberrantes masquées.
4.4 Les résidus de Pearson et les résidus de déviance
L’expansion de la modélisation statistique au-delà du cadre gaussien classique, cristallisée par la formalisation des Modèles Linéaires Généralisés (GLM) par Nelder et Wedderburn en 1972, a exigé une refondation conceptuelle de la métrique résiduelle. Lorsque la variable dépendante répond à une distribution binomiale (régression logistique) ou de Poisson (régression pour données de comptage), la variance de la réponse n’est plus une constante indépendante σ2, mais une fonction directe de son espérance mathématique μi.
Le résidu de Pearson adapte la logique de la standardisation en divisant l’écart brut par l’écart-type théorique dicté par la fonction de variance V(μi) propre à la famille de distribution postulée :
rP,i = (yi – μ̂i) / √[V(μ̂i)]
Dans un contexte de régression de Poisson par exemple, la variance équivalant à l’espérance conditionnelle, le dénominateur s’établit à √μ̂i. La somme des carrés de ces résidus de Pearson converge directement vers la statistique du Chi-deux de Pearson utilisée pour juger de la surdispersion du modèle.
Parallèlement, la théorie des GLM a introduit le résidu de déviance, issu du cadre de la théorie du maximum de vraisemblance. La déviance totale mesure l’écart entre le modèle saturé (ajustement parfait accordant un paramètre par point de données) et le modèle ajusté. Le résidu de déviance di représente la contribution algébrique individuelle de l’observation i à cette déviance globale. Attribué du signe du résidu brut sous-jacent, il constitue la mesure d’adéquation la plus stable et la plus proche d’un comportement normal standard lorsque les variables réponses sont discrètes, guidant avec finesse le diagnostic des modèles logistiques en psychopathologie clinique ou en recherche comportementale.
5. Les postulats de la régression linéaire évalués par les résidus
5.1 Hypothèse de linéarité de la relation sous-jacente
L’édifice mathématique de la régression linéaire classique repose sur l’hypothèse fondamentale que la relation unissant les régresseurs à la variable dépendante est intrinsèquement linéaire dans ses paramètres. Formellement, cette exigence se traduit par le postulat d’une espérance mathématique conditionnelle nulle des erreurs stochastiques pour toute configuration des variables indépendantes :
E(ε | X) = 0
Dans l’univers empirique, la violation de cette hypothèse cardinale se répercute de manière immédiate et transparente dans la distribution des résidus. Lorsque le phénomène psychologique ou comportemental étudié obéit en réalité à une dynamique curviligne — telle que la fameuse loi de Yerkes-Dodson décrivant une relation en U inversé entre niveau d’éveil physiologique et performance cognitive —, l’imposition rigide d’une trajectoire linéaire pure produit une onde résiduelle hautement structurée.
Au lieu de fluctuer de manière purement stochastique autour de la valeur zéro, les résidus manifestent des phases d’erreurs systématiquement positives pour les faibles valeurs de X, s’enfoncent dans des valeurs négatives pour les valeurs intermédiaires, puis redeviennent positifs pour les scores élevés. Une telle configuration invalide l’estimation des coefficients de régression, qui cessent d’être des représentations fidèles de la cinétique du phénomène, imposant l’adjonction de termes polynomiaux ou l’exploration de modèles non linéaires.
5.2 Hypothèse d’homoscédasticité : constance de la variance résiduelle
Le postulat d’homoscédasticité stipule que la dispersion de la composante d’erreur stochastique demeure rigoureusement constante le long de l’ensemble de la surface de régression tracée par les prédicteurs. Sur le plan mathématique formel, cette condition s’énonce :
Var(ε | X) = σ2, pour toute valeur prise par la matrice X.
La rupture de ce postulat engendre l’hétéroscédasticité, une pathologie méthodologique particulièrement prévalente dans les études quantitatives en sciences du comportement et en économétrie. Elle se manifeste graphiquement par une distribution des résidus dont la dispersion verticale s’élargit ou se resserre de manière continue à mesure que les valeurs ajustées augmentent, adoptant classiquement la morphologie d’un cône, d’un éventail ou d’un entonnoir.
Ce phénomène s’enracine fréquemment dans la variabilité intrinsèque des sujets. Par exemple, lors de l’étude du développement cognitif de l’enfant en fonction de l’âge, il est fréquent que les enfants plus jeunes manifestent des scores cognitifs très homogènes et resserrés (faible variance résiduelle), tandis que l’accumulation différentielle des expériences éducatives chez les adolescents génère un écartèlement considérable des performances individuelles (forte variance résiduelle). Bien que l’hétéroscédasticité ne biaise pas directement l’estimation ponctuelle des coefficients de régression, elle dénature en profondeur l’estimation de leur matrice de variance-covariance, faussant irrémédiablement le calcul des erreurs-types et l’exactitude des tests inférentiels.
5.3 Hypothèse de normalité de la distribution des termes d’erreur
L’application rigoureuse des procédures d’inférence statistique classique associées à la régression linéaire — à savoir le calcul des intervalles de confiance paramétriques et l’exécution des tests de significativité t de Student sur les coefficients individuels et F de Fisher sur la significativité globale du modèle — requiert que les termes d’erreur théoriques soient distribués selon une loi normale :
ε ~ N(0, σ2 I)
Bien que le célèbre théorème central limite (TCL) confère aux estimateurs des coefficients de régression une distribution asymptotiquement normale lorsque la taille d’échantillon devient substantielle (traditionnellement n > 100), la préservation de la normalité des erreurs demeure critique dans les études conduites sur de petits effectifs cliniques ou neuro-imageriques où les approximations asymptotiques sont inopérantes.
L’évaluation de ce postulat requiert une distinction rigoureuse entre deux anomalies morphologiques majeures : l’asymétrie distributionnelle (skewness) et l’aplatissement anormal (kurtosis). Une asymétrie résiduelle marquée signale fréquemment qu’une transformation non linéaire de la variable dépendante est requise pour rétablir la symétrie. D’autre part, une leptokurticité sévère (queues de distribution résiduelle excessivement épaisses) trahit la présence de chocs stochastiques violents ou d’un mélange de sous-populations cliniques non identifiées, augmentant considérablement le risque d’enregistrer des taux d’erreur de première espèce (rejet erroné de l’hypothèse nulle) bien supérieurs au seuil alpha nominal de 5 %.
5.4 Hypothèse d’indépendance des erreurs et absence d’autocorrélation
Le dernier postulat fondamental gouvernant l’architecture du modèle linéaire standard impose que toutes les observations soient stochastiquement mutuellement indépendantes. Cela implique que l’erreur associée à la mesure d’un individu i ne fournisse absolument aucune information prédictive quant à l’erreur affectant l’individu j :
Cov(εi, εj) = 0, pour tout couple i ≠ j.
Cette hypothèse d’indépendance des erreurs est systématiquement mise en péril lors de deux configurations empiriques majeures en psychologie et en sociologie : les designs de mesures répétées ou longitudinaux, et les protocoles d’échantillonnage en grappes. Dans les études longitudinales où un même patient est évalué quotidiennement au moyen d’un smartphone (méthodologie de l’Évaluation Écologique Momentanée ou EMA), les états affectifs résiduels d’un jour donné sont fréquemment corrélés à ceux de la veille, générant une autocorrélation temporelle sérielle.
De même, lorsque des élèves sont échantillonnés au sein de classes scolaires distinctes, la proximité contextuelle et les caractéristiques partagées de l’enseignant induisent une corrélation intra-classe des erreurs (autocorrélation spatiale ou groupée). La violation de cette condition d’indépendance conduit à une sous-estimation dramatique de l’erreur-type des estimateurs, faisant apparaître des associations purement fallacieuses comme statistiquement hautement significatives.
6. Méthodes graphiques d’analyse et de diagnostic des résidus
6.1 Le graphique des résidus en fonction des valeurs ajustées
Parmi l’arsenal méthodologique dédié au diagnostic de régression, le diagramme confrontant les résidus aux valeurs ajustées (Residuals vs Fitted plot) constitue sans conteste l’outil le plus polyvalent, le plus informatif et le premier qui doive être systématiquement inspecté par l’analyste. Ce tracé cartésien positionne en abscisse les valeurs prédites par l’équation ŷi et en ordonnée les résidus bruts ou studentisés ei ou ri.
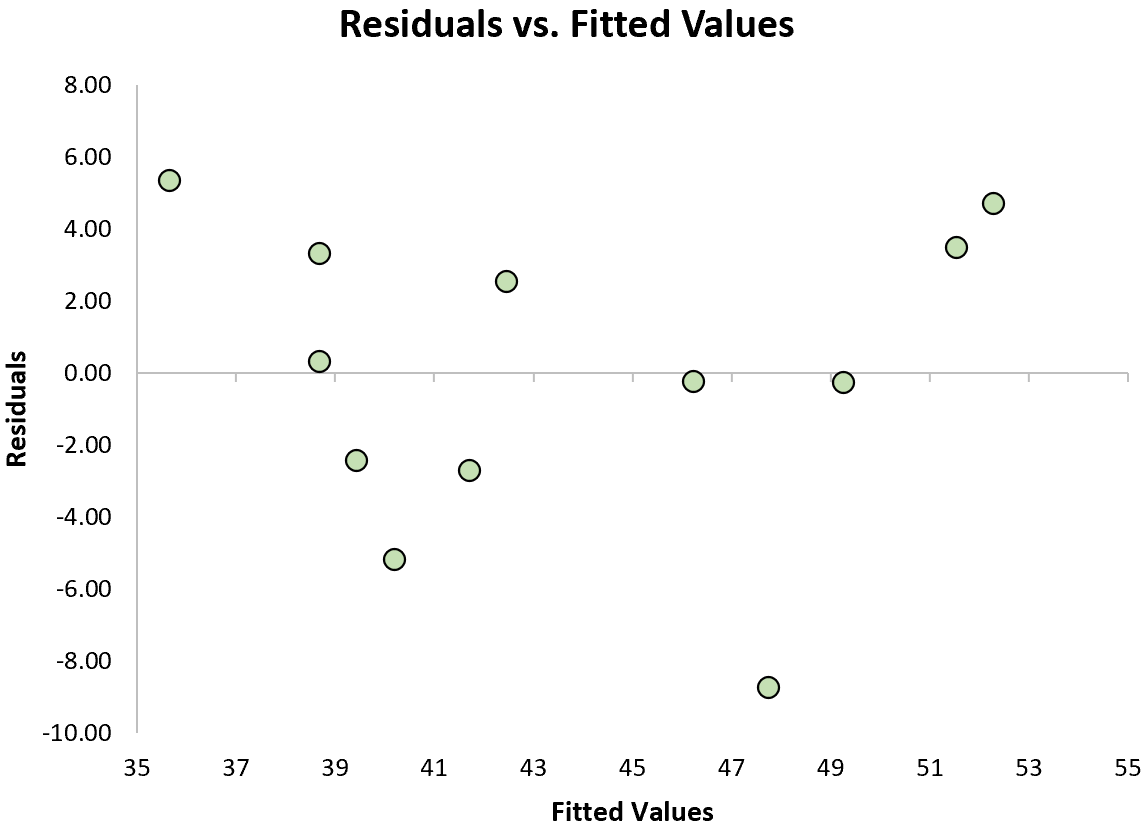
L’idéal théorique recherché dans ce diagramme correspond à ce que les méthodologistes qualifient d’« image de ciel étoilé » ou de dispersion purement aléatoire. Dans ce cas de figure parfait, le nuage de points s’organise selon une bande horizontale homogène, centrée rigoureusement sur la ligne zéro, sans aucune morphologie identifiable, sans courbure visible et avec une dispersion verticale constante tout au long de l’axe horizontal.
Dès que le modèle souffre d’une pathologie de spécification, ce graphique la met immédiatement en relief. Une courbure parabolique ou sinusoïdale trahit instantanément la non-linéarité sous-jacente du phénomène empirique, suggérant l’ajout de puissances polynomiales ou d’une paramétrisation logarithmique. Inversement, l’élargissement progressif ou l’amincissement systématique du nuage de points le long de l’axe des abscisses matérialise l’hétéroscédasticité sous une forme visuelle saisissante, guidant le statisticien vers des corrections adaptées bien avant la consultation de tout test d’hypothèse formel.
6.2 Le diagramme quantile-quantile (Q-Q plot) normal
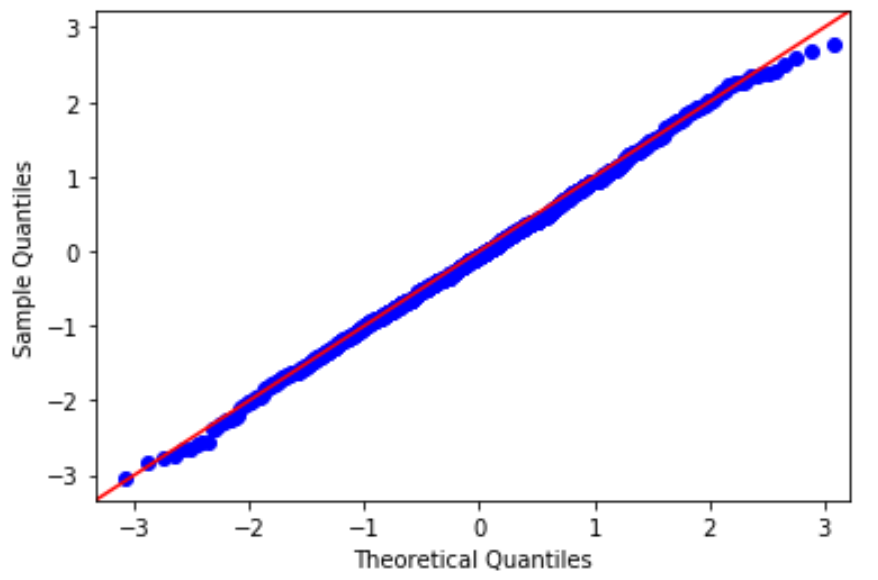
L’évaluation visuelle fine de la conformité de la distribution résiduelle avec la loi de Gauss s’effectue préférentiellement via le diagramme quantile-quantile normal, universellement désigné sous le terme de Normal Q-Q Plot. Le principe algorithmique sous-tendant cet outil repose sur la confrontation directe des quantiles empiriques calculés à partir de la série ordonnée des résidus standardisés de l’échantillon aux quantiles théoriques issus de la distribution normale standard N(0, 1).
Dans l’hypothèse où les résidus répondent fidèlement au postulat de normalité, les coordonnées des points se superposent étroitement à une ligne de référence diagonale rectiligne tracée à 45 degrés. Tout écart systématique vis-à-vis de cette droite idéale traduit une pathologie distributionnelle précise qu’un regard expérimenté identifie sans équivoque.
Une configuration dans laquelle les points s’incurvent nettement au-dessus de la droite à l’extrémité droite et plongent au-dessous de la droite à l’extrémité gauche signale des queues de distribution beaucoup plus lourdes que celles prévues par la loi normale (leptokurticité). À l’inverse, une forme en « S » inversé reflète des queues légères (platykurticité). De même, une déviation unilatérale où les deux extrémités du graphique fléchissent dans la même direction révèle une asymétrie résiduelle prononcée (positive ou négative), orientant le chercheur vers des stratégies de réexpression des données.
6.3 Le graphique Scale-Location (racine carrée des résidus standardisés)
Bien que le graphique standard des résidus en fonction des valeurs ajustées permette d’appréhender l’hétéroscédasticité, les limites perceptives de l’œil humain face à des dispersions asymétriques ou bidirectionnelles peuvent rendre l’évaluation visuelle incertaine. Pour pallier cette faiblesse, les statisticiens emploient le graphique Scale-Location (également désigné sous l’appellation de diagramme de dispersion-localisation ou Spread-Location plot).
Ce graphique applique une double transformation mathématique sur les résidus studentisés : il prend d’abord leur valeur absolue pour éliminer le signe directionnel, puis en extrait la racine carrée, générant la métrique √( |ri| ) positionnée en ordonnée face aux valeurs ajustées en abscisse. Cette opération comprime la variabilité des écarts extrêmes tout en redressant l’ensemble de la dispersion dans le quadrant positif.
L’interprétation de ce diagnostic s’appuie généralement sur une courbe d’ajustement non paramétrique locale de type LOWESS (Locally Weighted Scatterplot Smoothing) tracée à travers le nuage de points. Si l’hypothèse d’homoscédasticité est rigoureusement valide, cette ligne de lissage se déploie de manière parfaitement horizontale le long de l’axe des valeurs prédites. Une trajectoire ascendante ou descendante marquée de la courbe LOWESS confirme formellement l’instabilité de la variance de l’erreur résiduelle, démontrant sans ambiguïté que la dispersion des écarts dépend étroitement du niveau prédit de la réponse.
6.4 Le graphique des résidus selon l’ordre chronologique de collecte
Dans une proportion significative de protocoles empiriques, les données sont colligées de manière séquentielle dans le temps : passations expérimentales successives en laboratoire de psychologie cognitive, recueil longitudinal de questionnaires cliniques ou séquences de panels industriels. Le graphique traçant les résidus en fonction de l’ordre temporel d’acquisition constitue l’instrument d’investigation primordial pour détecter les violations de l’hypothèse d’indépendance sérielle.
Dans ce diagnostic, l’axe horizontal représente simplement l’identifiant séquentiel ou l’horodatage exact de l’observation (de 1 à n), tandis que l’axe vertical accueille les résidus ordinaires ou standardisés. L’émergence d’une dérive continue — par exemple une pente résiduelle globalement décroissante au fil du temps — peut refléter un phénomène d’usure ou de fatigue progressive des expérimentateurs, une modification thermique non contrôlée des appareils d’enregistrement psychophysiologique ou un glissement d’étalonnage des instruments de mesure.
Parallèlement, la présence d’oscillations ondulatoires régulières ou de regroupements alternés de résidus de même signe trahit immédiatement une autocorrélation d’ordre supérieur ou la présence d’un cycle périodique omis (effets saisonniers, rythmes circadiens ou séquences d’apprentissage au fil de la tâche). Ce type d’artefact impose l’intégration formelle de composantes autorégressives ou de variables indicatrices de temps au sein du modèle.
7. Tests statistiques formels appliqués aux distributions résiduelles
7.1 Tests d’inférence de la normalité résiduelle
Si le diagnostic graphique fournit une compréhension qualitative irremplaçable de la physionomie des erreurs, la rigueur académique exige fréquemment l’appui de tests d’hypothèse formels pour statuer sur la normalité résiduelle. Dans ce cadre inférentiel, l’hypothèse nulle (H0) postule systématiquement que les résidus sont issus d’une population normalement distribuée.
Parmi l’éventail des tests disponibles, le test de Shapiro-Wilk s’impose comme la référence méthodologique la plus puissante, particulièrement adaptée aux échantillons de taille petite à modérée (typiquement n < 50). Il évalue la corrélation linéaire entre les résidus ordonnés et les scores théoriques attendus d’une loi normale. Pour les échantillons plus volumineux, le test de Kolmogorov-Smirnov assorti de la correction impérative de Lilliefors (qui ajuste le test au fait que la moyenne et la variance résiduelles ne sont pas connues a priori mais estimées sur les données) est régulièrement mobilisé.
Une alternative économétrique très populaire réside dans le test de Jarque-Bera, dont la statistique repose explicitement sur les coefficients de dissymétrie (skewness, S) et d’aplatissement (kurtosis, K) des résidus :
JB = (n / 6) [S2 + ((K – 3)2 / 4)]
Cette statistique suit asymptotiquement une loi du Chi-deux à 2 degrés de liberté. Il convient toutefois de formuler une mise en garde épistémologique cruciale : sur de très grands échantillons (n > 500), ces tests d’hypothèse deviennent extrêmement sensibles et rejettent systématiquement H0 pour des déviations minimes et sans aucune conséquence pratique sur l’inférence (sur-significativité statistique). L’analyste avisé privilégiera toujours dans cette situation l’inspection conjointe du Q-Q plot.
7.2 Tests formels de vérification de l’homoscédasticité
L’inférence statistique formelle relative à la constance de la variance résiduelle mobilise principalement des procédures basées sur des régressions auxiliaires. Le test de Breusch-Pagan constitue sans doute le protocole le plus universellement implémenté pour vérifier l’hypothèse nulle d’homoscédasticité. Il procède en régressant les carrés des résidus standardisés du modèle initial sur l’ensemble des prédicteurs suspectés d’induire une fluctuation de variance.
La statistique du test, calculée par le produit de la taille d’échantillon et du coefficient de détermination auxiliaire (n × R2aux), suit sous l’hypothèse nulle une loi du Chi-deux dont les degrés de liberté correspondent au nombre de variables explicatives intégrées dans la régression auxiliaire. Une valeur p inférieure au seuil alpha conventionnel de 0,05 conduit au rejet de l’homoscédasticité.
Cependant, le test de Breusch-Pagan classique postule lui-même la normalité des termes d’erreur pour être valide. Face à des données présentant une déviation de la normalité, le test de White offre une alternative robuste fondamentale. Il enrichit la régression auxiliaire en intégrant non seulement les régresseurs sous leur forme linéaire, mais également tous leurs carrés ainsi que l’ensemble de leurs produits croisés (interactions du second ordre). Cette formulation permet au test de White de détecter des formes d’hétéroscédasticité hautement non linéaires sans exiger aucune spécification a priori de la structure de l’hétérogénéité de la variance.
Enfin, dans les contextes où l’échantillon peut être naturellement ordonné selon un prédicteur quantitatif continu, le test de Goldfeld-Quandt offre une approche directe en scindant les données en deux sous-groupes extrêmes (après suppression d’un segment central) et en comparant le ratio de leurs variances résiduelles respectives via une distribution de Fisher-Snedecor.
7.3 Tests d’autocorrélation et de dépendance résiduelle
Pour statuer rigoureusement sur l’absence de corrélation sérielle de premier ordre au sein des séries résiduelles, la statistique de Durbin-Watson (d) demeure le test classique le plus célèbre et le plus largement documenté :
d = [ ∑ (et – et-1)2 ] / [ ∑ et2 ], pour t allant de 2 à n.
La valeur numérique de la statistique de Durbin-Watson oscille structurellement entre 0 et 4. Lorsque les résidus sont parfaitement indépendants et dépourvus d’autocorrélation, la valeur attendue de d s’établit très exactement autour de 2 (puisque d ≈ 2(1 – r), où r représente le coefficient d’autocorrélation d’ordre 1). Une valeur tendant vers 0 révèle une autocorrélation positive sévère, tandis qu’une valeur se rapprochant de 4 atteste d’une autocorrélation négative.
Néanmoins, le test de Durbin-Watson est assujetti à des restrictions méthodologiques strictes : il requiert un ordonnancement temporel continu rigide sans données manquantes, ne teste que les dépendances d’ordre 1 (immédiatement adjacentes) et perd sa validité mathématique si la matrice des prédicteurs incorpore des valeurs retardées de la variable dépendante elle-même (modèles autorégressifs).
Pour surmonter ces contraintes, l’économétrie et les statistiques appliquées privilégient le test de Breusch-Godfrey (également dénommé test LM pour Lagrange Multiplier). Ce test évalue l’indépendance résiduelle en régressant le résidu courant sur les régresseurs initiaux et sur une succession de résidus retardés jusqu’à un ordre arbitraire p (et-1, et-2, …, et-p). Cette flexibilité mathématique permet de valider ou d’infirmer l’indépendance face à des structures de dépendance temporelle complexes et étendues.
8. Détection des valeurs aberrantes et des observations influentes via les résidus
8.1 Identification des valeurs aberrantes (outliers) par résidus studentisés
Au sein d’un ensemble de données empiriques, une valeur aberrante (ou outlier) sur la variable réponse se définit comme une observation dont la coordonnée yi s’écarte radicalement de la valeur conditionnelle ŷi prédite par le modèle mathématique. Dès lors que l’on souhaite identifier ces points avec rigueur statistique, le recours aux résidus bruts s’avère insuffisant et méthodologiquement vicié en raison des fluctuations locales de variance évoquées précédemment.
Le protocole analytique d’excellence repose sur l’évaluation des résidus studentisés externes (résidus Jackknife, ti). Comme mentionné au sein de la section 4.3, chaque statistique ti suit une distribution théorique de Student t(n – p – 2) sous l’hypothèse nulle stipulant que l’observation appartient à la même population que le reste de l’échantillon. Toutefois, lorsque l’analyste passe au crible l’ensemble des n résidus de son échantillon, il se heurte immédiatement au péril redoutable des comparaisons multiples : la probabilité d’observer fortuitement au moins un résidu extrême dépasse largement le seuil nominal alpha.
Pour conjurer cette inflation de l’erreur de type I, l’application d’une correction rigoureuse de Bonferroni est indispensable. Le seuil de significativité individuel critique α* appliqué à chaque test de résidu studentisé s’établit alors à :
α* = α / n
Toute observation dont la valeur p associée au résidu studentisé externe demeure inférieure à ce seuil corrigé est formellement déclarée comme valeur aberrante sur la réponse. Cette identification statistique constitue le point de départ d’une enquête diagnostique minutieuse : il convient impérativement de vérifier s’il s’agit d’une grossière erreur de saisie typographique, d’un dysfonctionnement instrumental avéré ou d’un sujet clinique singulier dont la trajectoire éclaire les limites de la théorie en vigueur.
8.2 La notion d’effet de levier (leverage) et la matrice de projection
Il est fondamental de dissocier conceptuellement une valeur aberrante sur la variable réponse Y d’un point présentant une configuration atypique sur l’ensemble des variables explicatives X. Cette seconde anomalie multidimensionnelle est quantifiée mathématiquement par la notion d’effet de levier (leverage).
L’effet de levier d’une observation découle des propriétés algébriques de la matrice de projection orthogonale, universellement désignée sous le nom de matrice chapeau H (Hat matrix), qui transforme par multiplication le vecteur des observations réelles en vecteur des prédictions : ŷ = HY, avec :
H = X (XT X)-1 XT
Les éléments situés sur la diagonale principale de cette matrice carrée n × n, notés hii, mesurent géométriquement la distance séparant les coordonnées prédictives de l’observation i du centre de gravité multidimensionnel de l’ensemble des prédicteurs de l’échantillon. Ces coefficients sont rigoureusement bornés au sein de l’intervalle mathématique [1/n ; 1], et leur somme cumulée équivaut exactement au nombre total de paramètres estimés dans le modèle, soit ∑ hii = p + 1.
Les seuils heuristiques conventionnels fixent l’alerte dès lors qu’un levier individuel excède deux à trois fois la valeur moyenne du levier de l’échantillon, soit classiquement :
hii > 2(p + 1) / n ou hii > 3(p + 1) / n
Une observation à fort levier possède un potentiel de basculement mécanique phénoménal sur l’orientation de l’hyperplan d’ajustement. Pour autant, un fort levier ne préjuge pas nécessairement d’une déformation effective du modèle : si ce point isolé dans l’espace des prédicteurs se situe exactement dans le prolongement de la trajectoire naturelle tracée par les autres observations, son résidu sera quasi nul et son impact sur les coefficients s’avérera anodin.
8.3 Indicateurs d’influence globale : distance de Cook et DFFITS
L’influence statistique réelle d’une observation se définit comme la résultante dynamique de la conjonction entre son amplitude résiduelle (déviation sur Y) et son effet de levier (isolement sur X). Une observation influente est un point dont le retrait isolé modifie substantiellement les paramètres du modèle de régression.
La mesure d’influence synthétique la plus célébrée au sein de la littérature statistique est la Distance de Cook (Di), formulée par R. Dennis Cook en 1977. Elle condense élégamment le résidu studentisé interne et le facteur de levier au sein d’une seule métrique globale :
Di = [ ri2 / (p + 1) ] × [ hii / (1 – hii) ]
La structure de cette équation est remarquablement éclairante : la distance de Cook est le produit direct du carré de l’écart résiduel et du ratio de levier. Si l’une des deux composantes est nulle, l’influence s’effondre. Pour franchir les seuils de criticité, un point doit impérativement combiner un résidu substantiel et un levier non négligeable. Si les manuels classiques suggèrent prudemment un seuil critique d’influence fixé à 1 (ou le 50e percentile de la distribution de Fisher), la pratique méthodologique contemporaine adopte un seuil ajusté à la taille de l’échantillon, traditionnellement formulé par :
Di > 4 / (n – p – 1)
Parallèlement, la statistique DFFITS (Difference in Fits) évalue l’ampleur de la translation subie par la prédiction individuelle du point considéré lorsque ce dernier est exclu de l’estimation, le seuil d’alerte s’établissant couramment à 2√[(p+1)/n]. Enfin, les mesures DFBETAS décomposent cette influence observation par observation au niveau de chaque coefficient de régression individuel βj, offrant une granularité diagnostique maximale pour repérer quel prédicteur spécifique est déstabilisé par une donnée singulière.
9. Conséquences de la violation des hypothèses résiduelles sur l’inférence
9.1 Impact de l’hétéroscédasticité sur les erreurs-types et les tests d’hypothèse
Une incompréhension persistante au sein des sciences appliquées concerne les retombées exactes de l’hétéroscédasticité sur les résultats statistiques. Il est impératif d’affirmer avec force que la rupture du postulat de variance résiduelle constante n’introduit aucun biais au sein de l’estimation ponctuelle des coefficients de régression par les MCO. Les coefficients b demeurent mathématiquement sans biais et continuent de converger fidèlement vers les véritables paramètres populationnels β au fur et à mesure que la taille d’échantillon s’accroît.
Le ravage provoqué par l’hétéroscédasticité se situe intégralement au niveau du calcul de la matrice de variance-covariance des estimateurs. L’algorithme standard des MCO présume une variance résiduelle scalaire uniforme σ2, conduisant à la formule classique Var(b) = σ2 (XT X)-1. En présence d’hétéroscédasticité, la véritable matrice de variance-covariance prend une configuration beaucoup plus complexe, dite en « sandwich » :
Var(b) = (XT X)-1 (XT Ω X) (XT X)-1, où Ω est la matrice diagonale des variances résiduelles hétérogènes.
En ignorant la structure réelle de Ω, la méthode des MCO ordinaire produit des erreurs-types systématiquement erronées, le plus souvent sévèrement sous-estimées. En conséquence directe, les ratios t de Student calculés en divisant le coefficient par son erreur-type sont artificiellement gonflés. Cette distorsion engendre une explosion des erreurs de type I, induisant le chercheur à déclarer des relations hautement significatives qui ne sont en réalité que des artefacts de variance instable, tout en générant des intervalles de confiance excessivement étroits et trompeurs.
9.2 Biais d’omission de variables et corrélation régresseurs-résidus
Si l’hétéroscédasticité n’altère pas la justesse des coefficients, la violation du postulat d’exogénéité stricte — qui requiert l’absence de covariance entre les prédicteurs et le terme d’erreur théorique (Cov(X, ε) = 0) — entraîne quant à elle des distorsions scientifiques dramatiques. Le mécanisme le plus fréquent générant cette pathologie est le biais de variable omise.
Lorsqu’un chercheur omet d’inclure dans son modèle une variable explicative fondamentale qui influence simultanément la variable réponse Y et l’un des régresseurs X retenus, l’impact causal de ce facteur absent est mécaniquement refoulé et absorbé par la composante résiduelle stochastique. Dès lors, le régresseur inclus et le terme d’erreur se retrouvent mathématiquement corrélés à travers ce vecteur commun sous-jacent :
Cov(Xinclus, ε) ≠ 0
Cette endogénéité détruit irrémédiablement l’impartialité des estimateurs des moindres carrés. Le coefficient de régression estimé capte indûment une partie de l’effet de la variable fantôme non mesurée, subissant un biais d’omission structurel d’amplitude et de direction proportionnelles à la corrélation partagée. Aucune augmentation de la taille d’échantillon ne permet de purger ce biais : l’estimateur devient asymptotiquement inconsistant, rendant toute revendication d’inférence causale formellement caduque et scientifiquement illégitime.
9.3 Perte d’efficacité des estimateurs MCO et théorème de Gauss-Markov
Dans le panthéon des théorèmes statistiques fondamentaux, le théorème de Gauss-Markov occupe une place fondatrice. Il établit formellement que, sous les conditions de linéarité, d’absence de biais des erreurs (espérance nulle), d’homoscédasticité et d’absence totale d’autocorrélation, les estimateurs issus des moindres carrés ordinaires sont les meilleurs estimateurs linéaires non biaisés (propriété BLUE : Best Linear Unbiased Estimator).
Le qualificatif « meilleur » (Best) possède une acception mathématique extrêmement rigoureuse : il signifie que parmi l’infinité d’estimateurs linéaires envisageables qui ne commettent pas d’erreur systématique en moyenne, l’estimateur des MCO est celui qui atteint la plus petite variance d’échantillonnage possible. Il offre la précision statistique maximale et produit les intervalles de confiance les plus resserrés que l’on puisse mathématiquement dériver des données empiriques disponibles.
Cependant, dès lors que les hypothèses régissant les résidus défaillent — en particulier en présence d’hétéroscédasticité ou d’autocorrélation temporelle ou spatiale —, le théorème de Gauss-Markov s’effondre. Bien que les estimateurs MCO puissent préserver leur statut d’estimateurs sans biais, ils perdent définitivement leur statut BLUE. Ils cessent d’être efficients. Il existe alors des estimateurs concurrents alternatifs — tels que les moindres carrés généralisés ou pondérés — capables de fournir une précision paramétrique considérablement supérieure avec des erreurs-types intrinsèquement plus faibles, restaurant une puissance statistique optimale pour les études quantitatives.
10. Stratégies de remédiation face aux pathologies résiduelles
10.1 Transformations mathématiques des variables dépendantes et explicatives
Face au constat empirique d’anomalies structurelles au sein des résidus, la première ligne de défense méthodologique consiste à appliquer des transformations mathématiques judicieuses sur les variables avant d’abandonner le cadre familier de la régression linéaire. La transformation logarithmique (naturelle ou décimale) de la variable dépendante Y s’impose historiquement comme l’antidote le plus élégant pour stabiliser une variance résiduelle hétéroscédastique augmentant proportionnellement au niveau de la réponse, tout en comprimant simultanément l’asymétrie positive des erreurs.
Dans les registres comportementaux impliquant des données de dénombrement ou de cinétique cognitive (fréquences d’erreurs, temps de latence), la transformation par la racine carrée √Y ou la transformation réciproque 1/Y permet fréquemment de linéariser la relation prédictive tout en normalisant le comportement des résidus. Lorsque le choix de la transformation fonctionnelle ne s’impose pas de manière théorique évidente, l’algorithme paramétrique de Box-Cox offre une formalisation systématique optimale :
y(λ) = (yλ – 1) / λ (pour λ ≠ 0), et y(λ) = ln(y) (pour λ = 0).
En estimant par le maximum de vraisemblance la valeur numérique du paramètre lambda (λ) qui maximise la normalité et l’homoscédasticité résiduelle au sein d’une grille continue (variant généralement de -2 à +2), la méthode de Box-Cox guide le choix vers la métrique mathématique la plus conforme aux exigences du modèle linéaire. L’analyste gardera néanmoins à l’esprit que toute transformation altère la nature interprétative directe des coefficients, imposant d’exprimer les prédictions finales par un re-calibrage exponentiel ou une interprétation en termes d’élasticités relatives.
10.2 Moindres carrés pondérés (WLS) et moindres carrés généralisés (GLS)
Lorsque la structure de l’hétérogénéité de la variance résiduelle est connue ou peut être estimée de façon robuste en fonction d’un régresseur identifiable, la méthode des Moindres Carrés Pondérés (WLS pour Weighted Least Squares) offre une remédiation théoriquement irréprochable. Le principe d’action repose sur l’attribution à chaque observation d’un poids statistique différentiateur wi, inversement proportionnel à la variance résiduelle locale σi2 qui lui est associée :
wi = 1 / σi2
Sous cette pondération analytique, les observations caractérisées par une imprécision majeure (large variance résiduelle) reçoivent un poids atténué dans la fonction de coût d’optimisation, tandis que les observations d’une fiabilité remarquable (faible variance résiduelle) exercent une influence prépondérante dans la détermination des coefficients de régression. Cette stratégie compresse mathématiquement la variabilité hétérogène et rétablit une homoscédasticité parfaite sur le système transformé, restaurant pleinement les propriétés d’efficacité BLUE du théorème de Gauss-Markov.
À un niveau de généralisation supérieur, la méthode des Moindres Carrés Généralisés (GLS pour Generalized Least Squares), formalisée par Alexander Aitken, intègre directement la matrice de covariance résiduelle complète Ω dans l’équation d’optimisation :
bGLS = (XT Ω-1 X)-1 XT Ω-1 Y
Cette approche monumentale traite simultanément les structures hétéroscédastiques complexes et les autocorrélations sérielles étendues, constituant le cadre théorique par excellence des modèles linéaires généraux appliqués aux séries temporelles et aux panels répétés.
10.3 Estimateurs de variance-covariance robustes (Sandwich / Huber-White)
Dans la pratique contemporaine de l’analyse de données, il s’avère fréquemment hasardeux ou fastidieux de modéliser avec certitude la structure mathématique formelle de l’hétéroscédasticité sous-jacente. Face à cette incertitude, la statistique computationnelle moderne privilégie l’usage des estimateurs de variance-covariance robustes à l’hétéroscédasticité, universellement désignés sous le terme d’estimateurs Sandwich ou de corrections de Huber-White.
Le génie de cette méthode réside dans sa neutralité à l’égard des coefficients : l’équation de régression originelle demeure estimée strictement par les MCO ordinaires, préservant l’intégrité de son interprétation usuelle. L’intervention s’effectue exclusivement lors du calcul rétrospectif de la matrice de covariance asymptotique des paramètres, en remplaçant la matrice théorique Ω par le produit des résidus MCO réels observés sur chaque point d’échantillon. Plusieurs variantes correctives successives ont été conçues pour affiner cette correction sur des effectifs limités :
- HC0 : La formalisation originale de White (1980), asymptotiquement valide mais excessivement optimiste en petits échantillons.
- HC1 : Une correction intégrant les degrés de liberté résiduels en multipliant la matrice par le ratio n / (n – p – 1).
- HC2 : Une correction pondérant chaque résidu carré empirique par le terme de levier (1 – hii) pour compenser la dépression de variance locale.
- HC3 : L’estimateur robuste le plus performant et universellement préconisé pour les échantillons de taille petite à moyenne, intégrant une pénalisation quadratique du levier (1 – hii)2.
L’adoption quasi systématique de l’estimateur robuste HC3 au sein des recherches quantitatives permet d’obtenir des erreurs-types rigoureusement valides, des valeurs p exactes et des intervalles de confiance d’une fiabilité irréprochable, immunisant l’analyste contre les conséquences pernicieuses de l’hétéroscédasticité résiduelle sans déformer la nature paramétrique du modèle.
10.4 Modélisation non linéaire et modèles additifs généralisés (GAM)
Lorsque le tracé des résidus met en lumière une violation persistante et irréductible de l’hypothèse de linéarité que de simples transformations de variables ne parviennent pas à apaiser harmonieusement, le chercheur doit franchir le pas vers une architecture algorithmique non linéaire flexible. L’adjonction de termes polynomiaux d’ordres supérieurs (X2, X3) constitue un premier recours direct, bien qu’elle expose au risque d’instabilité aux extrémités de distribution et à une forte colinéarité structurelle.
Une alternative moderne réside dans l’adoption des Modèles Additifs Généralisés (GAM pour Generalized Additive Models), popularisés par Trevor Hastie et Robert Tibshirani. Dans un modèle GAM, la contrainte de linéarité rigide βjXj est remplacée par une fonction de lissage non paramétrique lisse et flexible fj(Xj), classiquement articulée autour de splines de régression pénalisées :
Y = β0 + ∑ fj(Xj) + ε
Cette approche permet à la fonction d’épouser fidèlement les inflexions, accélérations ou seuils de saturation révélés initialement par les ondes résiduelles, sans imposer arbitrairement une forme géométrique prédéterminée. Une pénalisation intégrée sur la rugosité de la dérivée seconde préserve l’estimation du surapprentissage mathématique. La réévaluation des résidus après l’ajustement d’un modèle GAM témoigne quasi invariablement d’un rétablissement spectaculaire de l’homogénéité et de l’espérance conditionnelle nulle, prouvant que l’anomalie originelle ne résidait pas dans la stochastique des données, mais dans la rigidité conceptuelle du modèle linéaire initial.
11. Application des résidus dans la recherche empirique en psychologie
11.1 Diagnostic de validité des modèles de régression psychométriques
L’évaluation quantitative des construits psychologiques complexes — qu’il s’agisse de l’intelligence fluide, du névrosisme, de l’épuisement professionnel ou de la symptomatologie dépressive — s’appuie sur des métriques invariablement entachées d’erreurs de mesure substantielles. Dans cet univers psychométrique, l’analyse scrupuleuse des résidus ne représente pas une simple formalité mathématique, mais une condition sine qua non de la validité de construit.
Lors de la prédiction de l’épuisement professionnel à partir de la charge de travail perçue et du climat organisationnel, l’examen des résidus studentisés externes permet fréquemment d’isoler des biais de réponse systématiques chez certains participants. Un résidu positif massif et atypique peut révéler un phénomène de surdéclaration symptomatique lié à un bénéfice secondaire ou à une détresse existentielle globale non captée par l’instrument psychométrique. Inversement, des séries de résidus fortement négatifs peuvent traduire l’opération d’un biais de désirabilité sociale majeur incitant certains sujets à minimiser sciemment leur souffrance réelle.
De surcroît, le regroupement structuré de résidus au sein de certains sous-groupes démographiques (selon le genre, la culture ou la catégorie socioprofessionnelle) signale impérativement une absence d’invariance de mesure au sein de l’échelle d’évaluation. L’instrument ne mesure pas le phénomène avec la même acuité à travers l’ensemble des segments de la population, trahissant un fonctionnement différentiel des items (DIF) qui vicie les comparaisons interindividuelles et impose une refonte psychométrique de l’outil diagnostique.
11.2 Gestion des résidus dans les modèles multi-niveaux et longitudinaux
La recherche psychologique contemporaine a largement dépassé les designs d’évaluation transversaux statiques au profit de modélisations hiérarchiques complexes et de suivis longitudinaux intensifs. Dans les modèles linéaires mixtes ou multi-niveaux (HLM), la structure des erreurs subit un partitionnement hiérarchique explicite entre plusieurs strates stochastiques distinctes.
Pour un protocole évaluant les performances scolaires d’élèves imbriqués au sein d’écoles, le résidu d’une observation individuelle est théoriquement décomposé en une composante résiduelle de niveau 1 (eij), mesurant la déviation de l’élève individuel par rapport à la moyenne de son établissement, et une composante résiduelle de niveau 2 (u0j), quantifiant la déviation aléatoire globale de l’école j par rapport à la moyenne générale du système éducatif. L’analyste doit impérativement conduire un double examen diagnostique résiduel indépendant :
- Évaluer la normalité et l’homoscédasticité des résidus individuels au niveau 1, afin de garantir l’absence de biais intra-classe.
- Vérifier scrupuleusement la distribution normale bivariée ou multivariée des effets aléatoires résiduels au niveau 2, sous peine d’invalider les inférences relatives aux caractéristiques institutionnelles ou environnementales.
Dans les plans d’Évaluation Écologique Momentanée (EMA), où chaque individu renseigne ses affects plusieurs fois par jour durant plusieurs semaines, l’analyse des résidus du niveau 1 exige l’incorporation formelle de structures autorégressives d’ordre 1 [AR(1)] ou de matrices de Toeplitz pour absorber l’inertie émotionnelle intra-individuelle. L’omission de cette modélisation résiduelle sophistiquée conduit inévitablement à un écrasement artificiel des erreurs-types des coefficients temporels, invalidant les conclusions cliniques tirées de la dynamique écologique.
11.3 L’utilisation des scores résiduels pour isoler des construits psychologiques
Au-delà de leur rôle diagnostique, les résidus statistiques sont fréquemment détournés de manière heuristique par les chercheurs en psychologie pour créer de nouveaux scores d’évaluation purifiés de l’influence de variables parasites ou confondantes. Cette technique méthodologique porte le nom d’analyse de résidualisation ou de contrôle statistique par résidu.
Un cas d’école emblématique concerne l’évaluation neuropsychologique de la mémoire de travail chez le sujet vieillissant. Sachant que le déclin de la vitesse de traitement de l’information constitue une variable confondante massive qui pénalise mécaniquement les épreuves mnésiques chronométrées, le chercheur peut régresser les scores bruts de mémoire de travail sur la vitesse de traitement sensorimoteur. Le résidu extrait pour chaque sujet (ei = Mémoireobservée – Mémoireprédite par vitesse) est alors converti en un score d’« efficience mnésique résiduelle », conceptualisé comme mesurant les capacités mémorielles intrinsèques rigoureusement isolées de la lenteur motrice.
Néanmoins, cette pratique séduisante suscite de vifs débats méthodologiques au sein de la communauté académique. De nombreux psychométriciens soulignent que l’utilisation ultérieure de ces scores résiduels comme prédicteurs dans de nouvelles régressions secondaires viole l’orthodoxie statistique et génère des erreurs de type I substantielles, en raison de l’omission de l’incertitude liée à l’étape d’estimation préalable. Les spécialistes préconisent aujourd’hui de substituer à ces résidualisations séquentielles archaïques des Modèles d’Équations Structurelles (SEM) complets, où les construits latents sont modélisés conjointement avec leurs erreurs de mesure dans un cadre probabiliste global.
12. Guide computationnel pour calculer et diagnostiquer les résidus
12.1 Extraction et analyse diagnostique des résidus avec le langage R
Le langage statistique et environnement de programmation open-source R constitue le standard d’excellence académique pour la modélisation statistique avancée et le diagnostic résiduel. Lors de l’estimation d’un modèle linéaire par la fonction de base lm(), R génère automatiquement l’ensemble des structures résiduelles exploitables via des commandes dédiées :
L’extraction des résidus bruts s’opère directement par l’appel de la fonction générique residuals(modele) ou de son alias syntaxique modele$residuals. Pour obtenir les résidus standardisés et studentisés décrits dans les sections méthodologiques précédentes, l’analyste fait respectivement appel aux fonctions rstandard(modele) et rstudent(modele). L’effet de levier individuel (les valeurs hii) est instantanément dérivé par l’instruction hatvalues(modele), tandis que la matrice des distances de Cook s’obtient via cooks.distance(modele).
Pour générer d’un seul bloc le quadrant visuel classique de diagnostic graphique, l’analyste dispose de l’instruction native plot(modele), qui délivre séquentiellement : le tracé des résidus face aux valeurs ajustées, le Normal Q-Q Plot, le graphique Scale-Location et le diagramme évaluant les résidus en fonction de l’effet de levier avec superposition des contours critiques de la distance de Cook. Pour une esthétique contemporaine vectorisée, le package ggfortify permet de synthétiser l’ensemble de ces visualisations au moyen de la commande autoplot(modele) intégrée à l’écosystème ggplot2.
Sur le plan inférentiel formel, l’écosystème de packages lmtest, car et sandwich fournit une armada de tests d’une puissance exceptionnelle :
- Le test de Breusch-Pagan pour l’homoscédasticité s’exécute par
bptest(modele)au sein delmtest. - Le test de Durbin-Watson pour l’autocorrélation temporelle s’active via
dwtest(modele). - Le test d’alignement de la normalité de Shapiro-Wilk s’invoque directement sur la série résiduelle par
shapiro.test(residuals(modele)). - La correction robuste de la matrice de covariance de type Huber-White HC3 s’intègre au modèle via
coeftest(modele, vcov = vcovHC(modele, type = "HC3"))issu du packagesandwich.
12.2 Procédures d’analyse résiduelle sous IBM SPSS Statistics
Au sein des facultés de psychologie et des institutions de recherche clinique, le logiciel IBM SPSS Statistics demeure extrêmement répandu pour l’analyse quantitative standardisée. La configuration des analyses résiduelles s’y déploie au moyen d’interfaces graphiques paramétriques et d’une syntaxe déclarative robuste.
Lors du paramétrage de la procédure via le menu déroulant Analyser > Régression > Linéaire, le chercheur doit obligatoirement configurer deux sous-menus fondamentaux :
- Le menu « Enregistrer » (Save) : Il permet d’ordonner à SPSS de calculer et d’injecter directement au sein de la matrice de données active de nouvelles colonnes de variables représentant pour chaque sujet : les résidus bruts (
RES_1), les résidus standardisés (ZRE_1), les résidus studentisés externes (SRE_1), les valeurs de levier (LEV_1) ainsi que les distances de Cook (COO_1). - Le menu « Tracés » (Plots) : Il offre l’environnement graphique dédié à la vérification des postulats. L’analyste glisse la variable
*ZRESID(résidus standardisés) sur l’axe des ordonnées Y et la variable*ZPRED(valeurs prédites standardisées) sur l’axe des abscisses X afin de générer le graphique d’adéquation fondamental. Le cochage des options « Histogramme » et « Tracé de probabilité normale » déclenche la génération automatique du Q-Q plot des erreurs.
Dans la boîte de dialogue « Statistiques », l’activation de l’option « Diagnostic par observation » (Casewise diagnostics) permet à SPSS d’isoler automatiquement dans le tableau de sortie toutes les observations empiriques dont le résidu standardisé franchit un seuil critique absolu paramétrable (traditionnellement fixé à 2 ou 3 écarts-types). Enfin, l’inspection finale du tableau récapitulatif intitulé « Statistiques résiduelles » (Residuals Statistics) fournit une vue synthétique des amplitudes minimales, maximales, moyennes et des déviations standard des résidus et des métriques de Cook, guidant le clinicien dans le repérage exhaustif des distorsions échantillonnales.
12.3 Diagnostic des résidus en Python avec Statsmodels et Scikit-Learn
Dans le secteur de la science des données, du machine learning et de la recherche computationnelle contemporaine, le langage Python s’est imposé comme un pilier fondamental. Au sein de cet écosystème, deux bibliothèques logicielles dominent le paysage de la régression : statsmodels, dédié à la modélisation statistique inférentielle académique, et scikit-learn, orienté vers la performance prédictive et le déploiement algorithmique.
Dans la bibliothèque statsmodels, la formulation d’une régression par les MCO s’opère via la classe OLS issue du module statsmodels.api. Une fois la méthode d’ajustement .fit() exécutée, l’objet résultat regorge d’attributs résiduels directement indexables :
- L’attribut
resultats.residdélivre le vecteur complet des résidus bruts ordinaires. - La méthode
resultats.get_influence()génère une instance d’influence riche contenant les résidus studentisés externes (resid_studentized_external), les valeurs diagonales de levier (hat_matrix_diag) et les distances de Cook (cooks_distance). - Le tracé vectoriel des graphiques diagnostiques s’articule aisément à l’aide des bibliothèques
matplotlib.pyplotetseaborn, exploitant la fonctionstatsmodels.graphics.gofplots.qqplot()pour tracer en deux lignes de code le diagramme Q-Q plot normé avec sa ligne de référence à 45 degrés.
Pour l’exécution des tests statistiques d’homoscédasticité et de spécification, le sous-module statsmodels.stats.diagnostic fournit des fonctions spécialisées ultra-rapides, telles que het_breuschpagan() pour le test de Breusch-Pagan et het_white() pour le test exhaustif de White. Si l’analyste opère au sein du pipeline prédictif de scikit-learn (utilisant la classe LinearRegression), il calcule manuellement les résidus par l’opération vectorielle vectorisée e = y - model.predict(X), avant de mobiliser le module sklearn.metrics pour dériver l’erreur absolue moyenne (mean_absolute_error) et la racine carrée de l’erreur quadratique moyenne (root_mean_squared_error). Cette double instrumentation confère au praticien une maîtrise diagnostique totale, unissant la rigueur inférentielle de la tradition statistique classique à la puissance d’industrialisation du génie logiciel contemporain.
Références
- Aitken, A. C. (1936). On least squares and linear combinations of observations. Proceedings of the Royal Society of Edinburgh, 55, 42-48. https://doi.org/10.1017/S037016460001443X
- Belsley, D. A., Kuh, E., & Welsch, R. E. (1980). Regression diagnostics: Identifying influential data and sources of collinearity. John Wiley & Sons. https://doi.org/10.1002/0471725153
- Box, G. E., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211-243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287-1294. https://doi.org/10.2307/1911963
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15-18. https://doi.org/10.1080/00401706.1977.10489493
- Cook, R. D., & Weisberg, S. (1982). Residuals and influence in regression. Chapman & Hall.
- Durbin, J., & Watson, G. S. (1950). Testing for serial correlation in least squares regression: I. Biometrika, 37(3/4), 409-428. https://doi.org/10.2307/2332388
- Fox, J. (2016). Applied regression analysis and generalized linear models (3e éd.). SAGE Publications.
- Hastie, T. J., & Tibshirani, R. J. (1990). Generalized Additive Models. Chapman & Hall/CRC. https://doi.org/10.1201/9780203753781
- Huber, P. J. (1967). The behavior of maximum likelihood estimates under nonstandard conditions. Proceedings of the Fifth Berkeley Symposium on Mathematical Statistics and Probability, 1, 221-233.
- Jarque, C. M., & Bera, A. K. (1987). A test for normality of observations and regression residuals. International Statistical Review / Revue Internationale de Statistique, 55(2), 163-172. https://doi.org/10.2307/1403192
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217-224. https://doi.org/10.1080/00031305.2000.10474549
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370-384. https://doi.org/10.2307/2344614
- Shapiro, S. S., & Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika, 52(3/4), 591-611. https://doi.org/10.2307/2333709
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817-838. https://doi.org/10.2307/1912934