
Le traitement des données empiriques constitue l’un des défis les plus délicats et déterminants de la recherche contemporaine, en particulier au sein des sciences comportementales, de la psychologie quantitative et de la biomédecine. Face à une série d’observations, le chercheur ou l’analyste de données est inévitablement confronté à la présence de points qui s’écartent de manière spectaculaire de la tendance centrale : les valeurs aberrantes ou outliers. Ces données singulières suscitent une tension permanente entre la tentation d’une purification algorithmique destinée à optimiser la significativité statistique et l’impératif déontologique de préserver l’intégrité du phénomène observé.
Pendant des décennies, la pratique courante a oscillé entre deux écueils méthodologiques majeurs. D’un côté, une élimination aveugle et opportuniste de toute observation dépassant un seuil conventionnel arbitraire a nourri les dérives du p-hacking et fragilisé la reproductibilité des résultats scientifiques. De l’autre, la conservation dogmatique d’anomalies techniques manifestes a distordu les estimations paramétriques, ruiné la puissance statistique d’études coûteuses et induit en erreur la modélisation théorique. L’évaluation de ces points de friction exige une rupture avec les automatismes simplificateurs au profit d’une démarche raisonnée, contextualisée et documentée.
Ce guide exhaustif a pour ambition de poser les jalons théoriques, mathématiques et déontologiques d’une gestion rigoureuse des valeurs aberrantes. En explorant leur genèse épistémologique, leurs causes mécaniques ou humaines, l’arsenal d’outils univariés et multivariés permettant de les quantifier, ainsi que les alternatives à l’amputation pure et simple des échantillons, ce document propose un protocole décisionnel universel. L’objectif ultime n’est pas de prescrire une recette universelle et rigide, mais de doter les praticiens et chercheurs d’une grille d’audit robuste, capable de résister aux exigences critiques de la science ouverte et de l’intégrité de la recherche.
1. Introduction et fondements conceptuels des valeurs aberrantes en psychométrie
1.1 Définition épistémologique de la valeur aberrante en sciences comportementales
Dans le domaine des sciences comportementales, la définition d’une valeur aberrante dépasse largement le cadre d’un simple calcul d’écart à la moyenne. D’un point de vue épistémologique, une valeur aberrante représente une observation qui semble contredire la théorie sous-jacente ou le modèle de génération de données postulés par l’expérimentateur. Selon la définition canonique formulée par Frank Grubbs (1969), une observation aberrante est une valeur qui dévie de manière si marquée par rapport aux autres membres de l’échantillon dans lequel elle apparaît qu’elle éveille des soupçons quant à son origine ou à son mécanisme de production. Cette formulation met en lumière la nature fondamentalement inférentielle et probabiliste du diagnostic : une valeur n’est jamais aberrante en soi, elle l’est toujours relativement à un modèle de distribution présumé.
La psychométrie et les sciences comportementales se heurtent à une difficulté ontologique majeure : la nature distributionnelle des construits psychologiques. Alors que la statistique paramétrique classique repose quasi systématiquement sur le postulat de la distribution normale gaussienne, les variables psychologiques réelles présentent fréquemment des asymétries prononcées (skewness), des aplatissements anormaux (kurtosis) ou des queues de distribution épaisses (heavy tails). Les distributions de temps de réaction, par exemple, suivent presque universellement des lois ex-gaussiennes ou de Wald, caractérisées par une longue traînée vers les valeurs positives élevées. De même, les mesures d’affects négatifs, de traits cliniques ou de comportements déviants au sein de populations non cliniques adoptent naturellement des formes fortement asymétriques où la majorité des participants obtiennent des scores proches de zéro, tandis qu’une minorité valide s’étale sur des valeurs très élevées.
Dès lors, la fixation d’une frontière nette entre une observation valide et une anomalie empirique pose un problème épistémologique majeur. Décréter qu’un individu se situant à plus de trois écarts-types de la moyenne doit être retranché du jeu de données revient souvent à confondre la rareté phénoménologique avec l’invalidité métrologique. Cette coupure arbitraire postule implicitement que la réalité psychologique doit se plier aux contraintes de la courbe en cloche. Historiquement, depuis les débuts de la psychophysique avec Gustav Fechner et Wilhelm Wundt, le traitement des variations extrêmes a toujours oscillé entre la recherche d’une constance universelle des lois de la perception et la reconnaissance de l’idiosyncrasie humaine. Les pionniers de la psychométrie se sont rapidement aperçus que l’élimination hâtive des réponses extrêmes privait le chercheur de la compréhension des états limites du fonctionnement psychique, un constat qui demeure éminemment d’actualité dans les protocoles contemporains.
1.2 Le dilemme du chercheur : biais de validité versus perte d’information écologique
Tout analyste quantitatif fait face à un arbitrage complexe : le risque de distorsion des estimateurs paramétriques versus la menace d’une amputation de la validité écologique de l’échantillon. Au cœur de ce dilemme se trouve l’extrême sensibilité de la moyenne arithmétique et de la variance — pierres angulaires des tests classiques tels que le test t de Student, l’analyse de variance (ANOVA) ou la régression linéaire ordinaire — à la présence d’une seule valeur extrême. Une unique observation située très loin dans la queue d’une distribution peut faire basculer la significativité statistique d’un modèle, inverser le signe d’un coefficient de régression ou gonfler artificiellement les erreurs types, masquant ainsi un effet réel existant dans la population (erreur de type II) ou créant une association chimérique (erreur de type I).
Cependant, le revers méthodologique de la purification statistique est dévastateur. En éliminant méthodiquement les profils atypiques au nom de la normalisation mathématique, le chercheur s’expose à un appauvrissement critique de son corpus empirique. Les profils psychologiques rares, qu’il s’agisse de trajectoires de résilience exceptionnelle face à un traumatisme sévère, de compétences cognitives hautement divergentes ou de réactions émotionnelles aiguës, constituent souvent l’essence même de l’investigation clinique. Les exclure du champ analytique revient à étudier une version aseptisée et stéréotypée du comportement humain, incapable de rendre compte de la variabilité réelle observée dans les contextes écologiques non contrôlés.
Cette tension entre l’épuration du signal statistique et la sauvegarde de la complexité phénoménologique entretient un lien direct avec la crise de la reproductibilité scientifique. La littérature a amplement documenté comment des décisions arbitraires et opaques relatives à l’exclusion d’observations permettent d’ajuster opportunément les seuils de significativité afin d’atteindre le fameux p < 0,05. Lorsqu’une découverte repose sur un échantillon dont les marges ont été rabotées sans justification théorique explicite, sa réplication au sein d’une cohorte indépendante devient presque impossible. La préservation de l’information écologique n’est donc pas une simple coquetterie humaniste, mais une condition nécessaire à la robustesse externe et à la pérennité des conclusions scientifiques.
2. Typologie et étiologie des données aberrantes : erreurs techniques versus variabilité humaine
2.1 Les anomalies purement instrumentales et mécaniques
Dans la taxonomie des valeurs aberrantes, la première catégorie rassemble les observations dont l’origine est intrinsèquement exogène au phénomène psychologique ou biologique étudié. Il s’agit des anomalies résultant de défaillances techniques, d’erreurs matérielles ou de ruptures de chaîne de traitement de l’information. L’exemple le plus trivial, mais omniprésent dans les études reposant sur des protocoles physiques, réside dans l’erreur d’encodage manuel. L’inversion de chiffres lors de la transcription (par exemple, coder « 91 » au lieu de « 19 » pour l’âge d’un participant) ou l’ajout accidentel d’un zéro supplémentaire introduit instantanément une aberration mathématique d’une magnitude considérable, susceptible de déstabiliser une matrice entière de corrélations.
Dans le domaine des neurosciences cognitives et de la psychophysiologie, la genèse d’artefacts instrumentaux atteint un degré de complexité supérieur. Lors de l’acquisition de signaux d’électroencéphalographie (EEG), le décrochage passager d’une électrode consécutif à une impédance excessive ou la dérive galvanique du signal cutané génère des variations d’amplitude de plusieurs centaines de microvolts qui dépassent l’activité cérébrale sous-jacente. De même, en imagerie par résonance magnétique fonctionnelle (IRMf), les micromouvements de la tête du participant dans le scanner induisent des distorsions spatiales massives du signal BOLD, créant de faux foyers d’activation neuronale s’ils ne sont pas identifiés et purgés en amont de l’estimation statistique.
L’essor des passations expérimentales décentralisées sur Internet a également introduit de nouvelles typologies de bugs algorithmiques. Le moissonnage automatisé des temps de réaction via des scripts JavaScript exécutés sur des navigateurs clients hétérogènes subit couramment l’interférence de processus d’arrière-plan du système d’exploitation, engendrant des latences parasites de plusieurs secondes là où une réponse cognitive réelle s’exprime en millisecondes. Enfin, l’intégration contemporaine de banques de données multi-sources expose fréquemment les chercheurs à des incohérences d’échelles : la concaténation brute d’un jeu de données mesurant une variable sur une échelle de Likert en 5 points avec un jeu similaire étalonné en 7 ou 10 points génère instantanément un cluster artificiel d’anomalies si aucune normalisation préalable n’a été implémentée.
2.2 Les anomalies attribuables aux artéfacts comportementaux des participants
Une deuxième classe d’aberrations tire sa source directe du comportement du sujet expérimental, non pas en tant qu’expression d’un trait psychologique authentique, mais en tant que manifestation d’un désengagement flagrant vis-à-vis de la tâche assignée. Avec la prolifération des plateformes de travail rémunéré en ligne (telles que Prolific, MTurk ou CloudResearch), le phénomène des réponses non réfléchies et des conduites opportunistes a pris une ampleur critique. De nombreux participants adoptent des stratégies de complétion ultra-rapides destinées à maximiser leur ratio de rétribution horaire, répondant systématiquement par le même choix d’ancrage sur une échelle de Likert (biais d’acquiescement systématique ou réponse rectiligne) sans même avoir pris connaissance des énoncés.
Ces artéfacts se manifestent également par des patterns de tricherie caractérisés ou l’utilisation d’outils d’assistance logicielle automatisée. Dans les tests de performance cognitive ou de créativité administrés en ligne, il n’est plus rare de constater des copier-coller instantanés de réponses rédigées par des modèles de langage d’intelligence artificielle, produisant des métriques textuelles totalement désalignées avec la distribution normale des participants humains. De même, l’incompréhension linguistique manifeste des items, fréquente lorsque des questionnaires n’ont pas été validés transculturellement ou lorsque des participants bilingues évaluent mal leur compétence dans la langue de passation, conduit à des associations sémantiques aberrantes qui polluent le modèle de mesure.
Enfin, l’état clinique transitoire ou circonstanciel d’un individu au moment exact de l’expérimentation peut constituer une source majeure de perturbation sans pour autant refléter son profil dispositionnel stable. L’irruption d’une crise de panique aiguë chez un participant lors d’une tâche de mémoire de travail, un désengagement cognitif total lié à un manque aigu de sommeil ou une intoxication alcoolique non déclarée sont autant de variables parasites qui créent des points aberrants. Dans ces circonstances, l’observation enregistrée ne mesure pas le construit cible de l’étude, mais un artéfact interactionnel entre l’individu et un contexte environnemental dégradé.
2.3 La variabilité authentique : les valeurs extrêmes légitimes
À l’opposé fondamental des deux premières catégories se dresse la variabilité authentique : les valeurs extrêmes légitimes. Ces points de données, bien que statistiquement exceptionnels et isolés dans les queues de distribution, constituent des mesures parfaitement valides, rigoureuses et non corrompues de la réalité psychologique. Dans les modèles de personnalité tels que le modèle à cinq facteurs (Big Five), un score situé à plus de trois écarts-types au-dessus de la moyenne sur l’échelle de névrosisme ou d’extraversion ne traduit ni une panne informatique ni une tricherie, mais la réalité clinique d’un individu manifestant une hyper-réactivité affective spectaculaire ou un besoin grégaire exceptionnellement marqué.
Il en va de même dans le champ de la psychologie différentielle et de l’étude des performances cognitives de haut niveau. Les profils à très haut potentiel intellectuel, les virtuoses du calcul mental ou les individus présentant un syndrome du savant réalisent des performances aux épreuves de raisonnement matriciel ou de mémoire visuo-spatiale qui pulvérisent les plafonds théoriques attendus pour la population générale. Considérer ces scores extraordinaires comme des aberrations à biffer d’un revers de main méthodologique reviendrait à détruire précisément l’objet de recherche que l’on se propose d’élucider.
Dans les paradigmes neuro-économiques d’apprentissage par renforcement et de prise de décision risquée, des sujets adoptent parfois des stratégies d’aversion totale à la perte ou, à l’inverse, des conduites d’une audace extravagante qui défient les fonctions d’utilité standard. Ces comportements marginaux recèlent une valeur diagnostique inestimable pour la recherche en psychopathologie et en psychiatrie computationnelle : ils permettent souvent de tester la validité des modèles théoriques dans leurs limites de rupture. Le tableau ci-après synthétise les propriétés fondamentales de ces trois régimes d’aberrance empirique.
| Catégorie d’anomalie | Mécanisme générateur | Nature de l’impact | Recommandation méthodologique |
|---|---|---|---|
| Instrumentale / Mécanique | Défaillance matérielle, erreur de saisie, bug logiciel, inadéquation d’unités | Bruit non substantiel, contamination pure du signal | Exclusion systématique ou correction déterministe supervisée |
| Artéfact comportemental | Absence d’engagement, réponses aléatoires, tricherie, rupture d’attention | Invalidation du construit psychologique mesuré | Exclusion motivée après recoupement avec indices d’attention |
| Variabilité authentique | Expression extrême d’un trait, performance cognitive atypique, cas limite | Information écologique cruciale, révélateur de non-linéarités | Préservation impérative ; recours à la modélisation robuste |
3. L’arbre décisionnel d’évaluation : méthodologie systématique de triage
3.1 Architecture séquentielle du processus décisionnel
L’évaluation des valeurs aberrantes ne doit jamais être abandonnée à l’intuition du chercheur au moment où celui-ci découvre la configuration visuelle de ses données. Elle requiert une architecture séquentielle formalisée, opérant selon une suite logique d’étapes de vérification, de filtrage et de modélisation. Ce processus ordonné permet d’éradiquer les décisions opportunistes prises en fonction de l’impact des exclusions sur les valeurs de p. Le premier jalon de cet arbre décisionnel est l’audit d’intégrité brute des données : il s’agit de s’assurer que le chiffre enregistré correspond rigoureusement à l’action physique ou psychologique effectuée par le sujet, en traquant les éventuelles corruptions de fichiers, duplications de lignes ou ruptures d’encodage.
La deuxième étape consiste à éprouver la conformité des observations par rapport aux critères formels d’inclusion expérimentaux pré-établis. Le participant était-il pleinement éligible ? A-t-il suivi l’intégralité du protocole sans interruption technique majeure ? A-t-il franchi avec succès les vérifications d’attention intégrées ? Si une observation échoue à ce stade, son statut de donnée valide s’effondre avant même d’avoir interrogé sa position géométrique dans l’espace statistique. Ce n’est qu’une fois ces deux filtres franchis que le chercheur peut aborder l’étape avancée : la quantification du levier statistique et de l’influence mathématique de l’observation sur les paramètres d’intérêt.
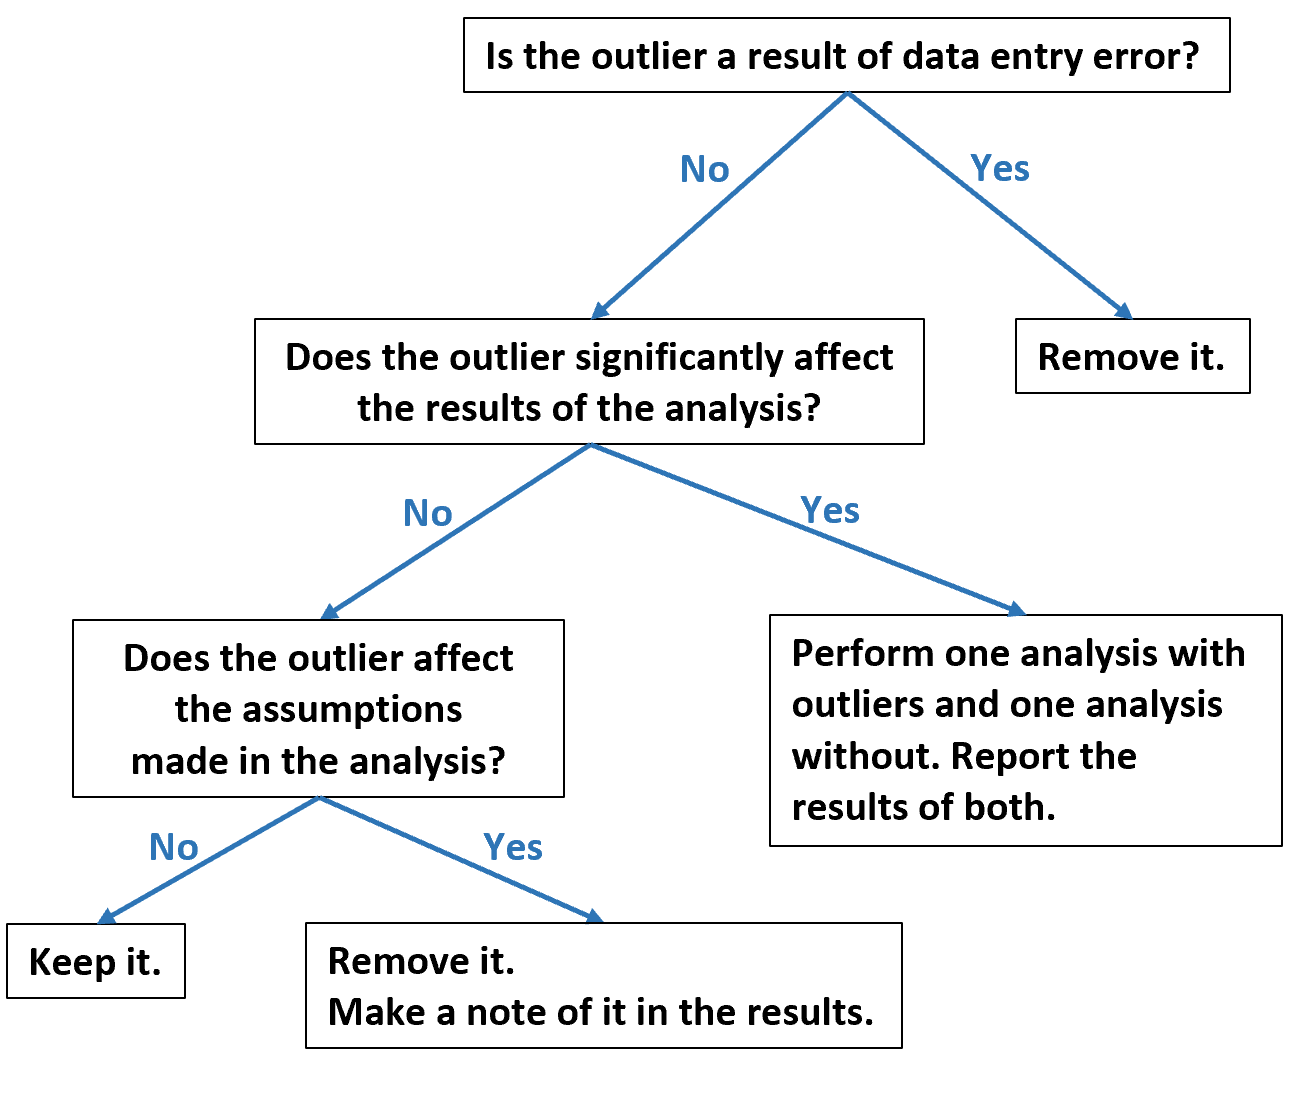
Cette troisième étape sépare les observations extrêmes inoffensives (qui n’altèrent pas substantiellement les estimations théoriques) des points à forte influence qui exercent une traction disproportionnée sur les estimateurs. Enfin, le critère de clôture impose que toute exclusion définitive soit adossée à une justification théorique et empirique formalisée. Aucune donnée ne doit être rayée d’un jeu d’analyse sans que son motif d’exclusion ne soit étiqueté, répertorié dans un journal de traitement reproductible et consigné pour une communication transparente lors de la soumission des manuscrits aux revues scientifiques.
3.2 Formalisation de la matrice de décision pour les protocoles quantitatifs
La formalisation opérationnelle de cette méthodologie repose sur l’élaboration d’une matrice de décision adossée à un protocole de pré-enregistrement (preregistration). Les pratiques modernes de la recherche ouverte, encouragées par des institutions comme l’American Psychological Association et l’Open Science Framework, stipulent que les règles de gestion des données extrêmes doivent être gravées dans le marbre méthodologique avant le début effectif du recueil de données. Cela implique de définir en amont les seuils quantitatifs de coupure, les critères d’invalidation des sessions et les algorithmes de détection qui seront déployés.
Dans cette matrice, une distinction fondamentale doit être opérée entre les erreurs déterministes corrigibles et les données invalides irrémédiables. Une erreur de saisie manuscrite vérifiable par consultation du questionnaire papier original n’implique pas le rejet du participant : elle commande une correction directe et traçable. En revanche, un pattern de réponses généré en un tiers du temps minimal nécessaire à la lecture mécanique des énoncés constitue une violation irrémédiable de validité, justifiant l’éviction définitive de la session d’analyse.
La matrice de décision doit également intégrer un protocole de traitement spécifique pour les cas ambigus. Lorsqu’une observation présente un score extrême sans qu’aucune cause technique ou comportementale flagrante ne puisse être prouvée, l’analyste ne doit ni la supprimer discrètement ni ignorer son potentiel destructeur sur le modèle linéaire classique. La règle d’or consiste alors à basculer vers des procédures d’analyse de sensibilité, consistant à comparer systématiquement les résultats statistiques obtenus avec et sans l’inclusion de ces observations marginales, ou à recourir à des estimateurs robustes dont la sensibilité au point de rupture est documentée.
4. Étape 1 : Identification et traitement des erreurs de saisie et de conversion
4.1 Détection des anomalies numériques hors bornes physiologiques et d’échelles
L’étape inaugurale du nettoyage de données repose sur l’audit des bornes d’échelles et la vérification de la cohérence biomécanique des grandeurs enregistrées. Il s’agit du niveau le plus fondamental de détection, accessible par des requêtes d’inspection logique automatisées. Dans le cadre d’échelles psychométriques standardisées, telles qu’une échelle de type Likert bornée entre 1 (« Pas du tout d’accord ») et 7 (« Tout à fait d’accord »), l’apparition d’une valeur « 77 », d’un chiffre négatif ou d’un zéro représente indéniablement une anomalie syntaxique ou un artefact d’encodage. Ces valeurs dites « hors bornes » doivent être traquées de manière systématique avant toute tentative de calcul de score agrégé ou d’indice factoriel.
Dans les protocoles intégrant des mesures physiologiques ou comportementales continues, le contrôle repose sur les limites de la plausibilité biologique humaine. Dans une étude monitorant la fréquence cardiaque par photopléthysmographie, un intervalle inter-battement correspondant à une fréquence cardiaque de 320 battements par minute au repos chez un adulte sain témoigne sans équivoque d’un artéfact de double détection de l’onde de pouls ou d’un parasitage électrostatique, la physiologie cardiaque ventriculaire interdisant un tel régime sans collapsus immédiat. De même, des temps de réaction motrice à un stimulus visuel complexe enregistrés en deçà de 100 millisecondes violent les lois incompressibles de la conduction axonale et du délai synaptique de l’arc réflexe rétino-cortico-moteur, signalant des réponses anticipatoires émises au hasard.
Un autre foyer récurrent d’incohérence provient des ruptures d’unités de mesure lors de l’agrégation de fichiers de données. L’erreur classique consiste à concaténer des séries temporelles exprimées en secondes avec des séries enregistrées en millisecondes, générant artificiellement des groupes de données différant d’un facteur 1000. Enfin, l’analyste doit impérativement distinguer les zéros structurels (l’absence réelle et signifiante d’un comportement, par exemple un score de zéro consommation d’alcool chez un individu abstinent) des zéros aléatoires ou d’encodage (le chiffre zéro utilisé par défaut par un logiciel pour signifier qu’une question a été sautée par le répondant). Confondre ces deux modalités entraîne des biais dévastateurs sur l’estimation des distributions empiriques.
4.2 Procédures de correction supervisée sans perte de cas
L’identification d’une erreur matérielle ne doit pas conduire par automatisme à la suppression sèche de la ligne de données associée au participant, ce qui constituerait une perte injustifiée de puissance statistique et d’information empirique. Dès lors qu’une anomalie mécanique est repérée, la première démarche méthodologique consiste à engager une procédure de correction supervisée par recoupement documentaire. Si la saisie a été effectuée manuellement à partir de formulaires imprimés, la consultation du document source original permet dans l’immense majorité des cas de constater le lapsus calami du transcripteur (par exemple, un trait d’écriture ambigu ayant transformé un « 1 » en « 7 ») et de rétablir la valeur véridique.
Dans les environnements informatisés, des algorithmes heuristiques de détection de fautes de frappe peuvent être appliqués avec prudence. Sur un pavé numérique standard, la proximité physique des touches explique de nombreuses erreurs de double frappe ou de glissement de doigt. Lorsque l’historique des frappes (keystroke logging) est disponible dans les métadonnées expérimentales, l’analyse de la micro-chronologie des événements d’entrée permet de confirmer avec un haut degré de certitude qu’une valeur extravagante résulte de l’activation accidentelle conjointe de deux touches adjacentes.
Si la donnée source ne peut être recouvrée avec certitude, la stratégie la plus économe et scientifiquement rigoureuse consiste à convertir la valeur erronée en valeur manquante ponctuelle (missing data) plutôt que d’évincer l’intégralité des mesures du participant. Dès lors que cette absence n’affecte qu’une fraction marginale des variables du protocole pour le sujet considéré, des techniques d’imputation multiple contemporaines (comme l’imputation par équations chaînées, MICE) ou l’utilisation d’estimateurs à information complète (FIML, Full Information Maximum Likelihood) permettent d’exploiter la totalité des autres réponses valides du sujet au sein de la modélisation statistique, sans introduire de distorsion paramétrique.
5. Étape 2 : Évaluation des violations de protocole et non-conformité expérimentale
5.1 Contrôle de l’attention et détection des réponses non engagées
L’administration dématérialisée de protocoles psychométriques à grande échelle exige la mise en place d’un système de surveillance rigoureux destiné à intercepter les comportements de non-engagement. Les items de contrôle attentionnel (communément désignés sous le terme de trap questions ou attention check items) constituent la première ligne de défense méthodologique. Il s’agit d’instructions insérées subreptice au milieu d’un inventaire de personnalité ou d’une échelle d’attitude, énonçant explicitement : « Pour confirmer que vous lisez bien les instructions, veuillez cocher la case « Pas du tout d’accord » pour cette ligne ». L’échec d’un participant à ces tests probatoires ne relève pas d’une originalité psychologique, mais démontre formellement qu’il ne traite pas l’information sémantique des stimuli.
Au-delà de ces pièges discrets, l’analyse computationnelle de la dispersion intra-individuelle des réponses fournit un indicateur précieux du désengagement cognitif. La métrique de l’écart-type intra-individuel (Intra-Individual Response Variability, IRV) permet de quantifier la variance des réponses d’un sujet à travers une batterie d’items partageant une même échelle de cotation. Un score d’IRV nul ou infinitésimal sur une longue séquence d’énoncés comprenant des items inversés révèle une stratégie de réponse rectiligne (straightlining), où l’individu coche invariablement la même option d’un bout à l’autre de l’épreuve par pur confort d’achèvement rapide.
L’exploration des profils temporels de réponse (page submit times) complète ce diagnostic. La littérature en psychométrie cognitive a établi des seuils incompressibles de vitesse de lecture et de traitement perceptif, généralement estimés à environ 200 à 250 mots par minute pour une compréhension fonctionnelle de base. Tout participant dont la durée globale de complétion implique une vitesse de lecture de 800 mots par minute sur des items conceptuels complexes opère selon un régime de clics aléatoires. Enfin, dans les panels en ligne, les analystes doivent désormais appliquer des algorithmes de filtrage de scripts malveillants et d’agents conversationnels automatisés (bots) via l’analyse des signatures de navigation, des résolutions d’écran et des adresses IP redondantes, dont les réponses massives polluent dramatiquement les espaces factoriels.
5.2 Non-respect des conditions expérimentales de laboratoire
Même au sein des laboratoires de psychologie expérimentale et de neurosciences cognitives, soumis à un contrôle environnemental plus strict que les collectes en ligne, les violations de protocole ne sont pas rares et doivent être rigoureusement documentées pour légitimer l’exclusion d’une série de mesures. L’une des causes prépondérantes réside dans la non-conformité biologique ou pharmacologique du participant. Si un protocole d’exploration de la vigilance attentionnelle ou de la réactivité émotionnelle requiert l’abstinence de toute substance stimulante ou sédative, la déclaration post-expérimentale par le participant de la consommation d’une dose massive de caféine, de nicotine, de médicaments anxiolytiques ou de cannabis constitue une violation flagrante des conditions d’éligibilité.
Les perturbations physiques de l’environnement constituent une autre source irréfutable de non-conformité. L’irruption soudaine d’une alarme incendie, un bruit strident de travaux de voirie à proximité immédiate de la cabine insonorisée, une panne momentanée du moniteur tachistoscopique ou le décrochage physique d’un capteur de réponse tactile interrompent le flux cognitif du sujet. Les données recueillies durant ou immédiatement après ces incidents majeurs ne peuvent être considérées comme le reflet fidèle de la performance psychologique standard de l’individu et doivent faire l’objet d’une exclusion tracée pour incident matériel.
Enfin, le chercheur doit être particulièrement vigilant quant à la découverte post-hoc d’un non-respect des critères démographiques ou cliniques d’inclusion, ou encore de la compromission de la naïveté expérimentale. Si un sujet participant à une étude sur l’amorçage subliminal ou la déception sociale (deception paradigms) révèle lors du débriefing standardisé qu’il est étudiant en master de psychologie dans le laboratoire même et qu’il avait parfaitement anticipé l’hypothèse de travail et la manipulation expérimentale (effets de demande de l’expérimentateur), ses réponses sont fondamentalement biaisées. Sa présence dans l’échantillon détruit la validité interne du paradigme, justifiant un rejet méthodologique formel et pré-spécifié.
6. Étape 3 : Préservation des valeurs extrêmes légitimes issues de la diversité psychologique
6.1 La valeur heuristique des extrêmes dans les théories dimensionnelles
Une fois les erreurs instrumentales et les violations manifestes de protocole écartées, l’analyste se trouve confronté au défi le plus noble et le plus complexe : la gestion des individus qui dévient statistiquement de la masse tout en ayant accompli la tâche avec une rigueur irréprochable. Dans les sciences comportementales contemporaines, régies par des cadres théoriques dimensionnels (tels que le système RDoC, Research Domain Criteria, en psychopathologie), ces valeurs extrêmes possèdent une valeur heuristique fondamentale. Elles constituent les points d’ancrage essentiels pour éprouver la solidité, la portée et les limites de validité des modèles psychométriques.
Dans l’analyse factorielle confirmatoire et la modélisation par équations structurelles, l’inclusion d’individus situés aux confins des traits latents est indispensable pour tester l’invariance de mesure et vérifier si la structure dimensionnelle se maintient sur l’ensemble du continuum psychologique. Supprimer les scores très élevés sous prétexte qu’ils « étirent » la distribution revient à s’interdire d’observer d’éventuelles discontinuités qualitatives ou l’émergence de sous-populations cliniques discrètes (taxométrie). De nombreux phénomènes psychopathologiques n’obéissent pas à des lois strictement linéaires : des effets de seuil et des bifurcations dynamiques n’apparaissent qu’au-delà de certains niveaux critiques d’intensité symptomatique.
L’histoire de la neuropsychologie clinique et des sciences de la mémoire témoigne avec force de la primauté des cas uniques et des observations hors normes. Les fondements des théories contemporaines des systèmes mnésiques n’auraient jamais pu être découverts si les neuropsychologues avaient exclu le patient H.M. (Henry Molaison) de leurs analyses au motif que ses scores d’amnésie antérograde se situaient à des dizaines d’écarts-types en dessous des performances des groupes témoins. Les cas atypiques ne sont pas des pollutions mathématiques ; ils sont souvent des révélateurs théoriques qui forcent les modèles conceptuels à s’élargir pour embrasser l’intégralité du spectre de la variabilité biologique et cognitive humaine.
6.2 Les dangers méthodologiques de l’hypersélection des données
L’hypersélection des données — c’est-à-dire l’habitude de tronquer les observations dès qu’elles s’écartent modérément du centre de la distribution — représente une dérive méthodologique lourde de conséquences pour l’édifice scientifique. La première conséquence directe de cette pratique est la surestimation artificielle des tailles d’effet dans certaines configurations et, plus pervers encore, la distorsion imprévisible des relations d’association. En rabotant artificiellement la variance d’une variable indépendante par élimination de ses queues, on peut réduire drastiquement l’amplitude apparente de sa corrélation avec une variable dépendante, ou au contraire générer de faux coefficients standardisés en tronquant un sous-groupe spécifique d’observations résiduelles.
Cette forme d’élagage opportuniste amplifie de façon spectaculaire le taux d’erreur de type I (faux positifs). En effet, le chercheur qui teste différents seuils d’exclusion et ne retient que celui qui produit une valeur de p statistiquement significative s’adonne sans toujours le conscientiser à du data dredging. Comme l’ont démontré Simmons, Nelson et Simonsohn (2011) dans leur article fondateur sur les degrés de liberté non documentés du chercheur, le choix arbitraire de règles d’exclusion de valeurs aberrantes constitue l’un des leviers les plus puissants pour faire émerger des effets purement illusoires à partir de bruit statistique pur.
Enfin, l’hypersélection des cas ruine totalement la validité externe et l’applicabilité pratique des conclusions de recherche. Lorsqu’un essai clinique évalue l’efficacité d’une nouvelle psychothérapie ou d’une molécule pharmacologique en retranchant systématiquement tous les patients dont les scores de dépression ou d’anxiété de base sont excessivement élevés (ou dont les variations symptomatiques initiales sont atypiques), les résultats obtenus ne peuvent en aucun cas être extrapolés à la pratique clinique réelle. En aseptisant artificiellement son échantillon, le chercheur s’enferme dans un laboratoire idéalisé où les modèles fonctionnent d’autant mieux qu’ils ne s’appliquent plus à personne dans le monde réel.
7. Techniques univariées de détection : de la théorie paramétrique aux approches robustes
7.1 Le score standardisé Z et ses hypothèses restrictives
La technique univariée la plus universellement enseignée et appliquée pour la détection des valeurs aberrantes repose sur le calcul du score standardisé Z. Mathématiquement, pour chaque observation $x_i$ d’un échantillon de taille $n$, le score Z est formulé comme suit :
z_i = (x_i – x̄) / s
où $x̄$ désigne la moyenne arithmétique de l’échantillon et $s$ son écart-type d’échantillonnage. Selon la convention canonique adossée aux propriétés de la distribution normale standard, les analystes retiennent fréquemment des seuils de coupure stricts : une observation est suspectée d’aberrance si son score absolu dépasse 2,58 (seuil de probabilité bilatéral de 1 %) ou 3,29 (seuil de probabilité de 0,1 %).
Bien que cette démarche séduise par son apparente simplicité de mise en œuvre calculatoire, elle souffre de faiblesses structurelles redoutables qui la rendent inappropriée dans de nombreux contextes réels. La première contradiction théorique réside dans le fait que les deux paramètres servant à calibrer le filtre — à savoir la moyenne et l’écart-type — sont eux-mêmes excessivement sensibles aux valeurs aberrantes qu’ils sont censés débusquer. Une valeur aberrante de grande amplitude va gonfler de façon spectaculaire l’écart-type $s$ du jeu de données, ce qui aura pour effet d’écraser artificiellement les scores Z de l’ensemble des observations. Ce phénomène pervers est documenté sous le terme d’« effet de masquage » (masking effect) : une observation hautement anormale dissimule sa propre présence (ou celle d’autres points anormaux voisins) en étirant l’unité de mesure de détection.
À l’inverse, l’« effet de submersion » (swamping effect) peut survenir lorsqu’un groupe d’observations déviantes entraîne un décalage de la moyenne tel que des points parfaitement représentatifs du reste de l’échantillon se voient attribuer des scores Z excessifs et sont étiquetés à tort comme aberrants. De surcroît, le calcul du score Z repose sur le postulat indépassable de la normalité de la distribution sous-jacente. Si la distribution parente est intrinsèquement asymétrique (comme c’est systématiquement le cas pour les revenus, la consommation de substances ou les temps de latence cognitive), l’application symétrique d’un seuil $|Z| > 3$ est méthodologiquement erronée : elle conduit à exclure mécaniquement et systématiquement des données réelles situées dans la longue queue naturelle de la distribution, tout en étant incapable d’identifier des anomalies situées du côté opposé.
7.2 La méthode de Tukey : écart interquartile et diagramme en boîte
Pour s’affranchir de la dépendance aveugle à la moyenne et à l’écart-type, John Tukey a développé dans son ouvrage fondateur sur l’analyse exploratoire des données (Tukey, 1977) une méthode devenue universelle : la règle de l’écart interquartile (Interquartile Range, IQR), intrinsèquement liée au tracé du diagramme en boîte (boxplot). Cette méthode substitue des estimateurs d’ordre, par essence beaucoup plus résistants, aux moments d’ordre 1 et 2 de la distribution. On définit l’écart interquartile comme :
IQR = Q_3 – Q_1
où $Q_1$ et $Q_3$ correspondent respectivement au premier quartile (25e percentile) et au troisième quartile (75e percentile) de la série d’observations ordonnées.
À partir de ces points d’ancrage, Tukey a fixé deux ensembles de frontières géométriques (les barrières intérieures et extérieures). Les limites de détection standards (barrières intérieures) se calculent selon les formulations :
Borne inférieure = Q_1 – 1,5 × IQR
Borne supérieure = Q_3 + 1,5 × IQR
Toute observation s’aventurant au-delà de ces bornes est qualifiée de valeur aberrante modérée (outlier). Pour identifier les valeurs aberrantes sévères (extreme outliers), le multiplicateur de dispersion est porté à 3 :
Borne extrême inférieure = Q_1 – 3 × IQR
Borne extrême supérieure = Q_3 + 3 × IQR
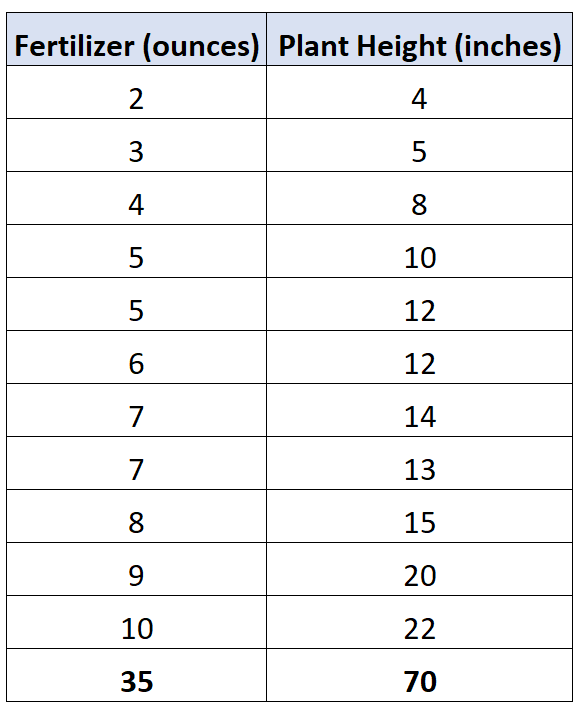
L’immense mérite de la méthode de Tukey réside dans sa résistance : le premier et le troisième quartile possèdent un point de rupture (breakdown point) de 25 %, ce qui signifie qu’un quart de l’échantillon peut être contaminé par des valeurs extravagantes sans que les barrières de détection ne perdent leur sens géométrique. Néanmoins, la formule classique de Tukey conserve une limite importante : elle suppose implicitement une symétrie relative de la distribution autour de la médiane. En présence d’asymétrie forte, la méthode classique sur-identifie les données de la longue queue comme des anomalies tout en sous-détectant les points suspects de l’autre bord.
Pour surmonter cette entrave sans renoncer à la philosophie de Tukey, les statisticiens ont développé une extension robuste : le diagramme en boîte ajusté (adjusted boxplot pour données asymétriques), formalisé par Hubert et Vandervieren (2008). Cette approche intègre une mesure non paramétrique d’asymétrie appelée le médcouple ($MC$). Les bornes d’exclusion sont alors modulées par une fonction exponentielle du médcouple, étendant dynamiquement la barrière du côté de la longue traîne et resserrant la barrière opposée, ce qui préserve la validité du diagnostic même face à des lois de distribution non symétriques.
7.3 L’écart absolu médian (MAD) : l’alternative robuste optimale
Dans la théorie moderne de la statistique robuste, conceptualisée par Peter Rousseeuw et Christophe Croux (1993), l’outil univarié le plus performant et le plus recommandé pour la détection des valeurs aberrantes n’est ni le score Z classique ni la règle de Tukey, mais le score standardisé modifié fondé sur l’écart absolu médian (Median Absolute Deviation, MAD). La médiane empirique ($Med$) et la MAD incarnent le summum de la robustesse, affichant un point de rupture optimal de 50 %, ce qui implique que la moitié exacte de l’échantillon peut être arbitrairement corrompue sans que ces estimateurs ne dérapent vers l’infini.
Pour un échantillon de valeurs $X = {x_1, x_2, dots, x_n}$, la MAD correspond à la médiane des écarts absolus par rapport à la médiane de l’échantillon :
MAD = Med(|x_i – Med(X)|)
Afin d’assurer une parfaite comparabilité asymptotique entre la MAD et l’écart-type classique sous l’hypothèse d’une loi de distribution gaussienne pure, la MAD brute doit impérativement être ajustée par un facteur d’échelle multiplicatif constant, égal à $1 / \Phi^{-1}(0,75) \approx 1,4826$. On définit ainsi l’écart absolu médian normalisé :
MADN = 1,4826 × MAD
À partir de cet estimateur robuste d’échelle, on calcule pour chaque sujet le score Z modifié ($M_i$) :
M_i = (x_i – Med(X)) / MADN
La supériorité de cette approche est indiscutable dans la littérature méthodologique spécialisée (notamment les travaux de référence de Rand Wilcox). Les simulations de Monte Carlo prouvent de manière répétée que le score Z modifié basé sur la MAD ne souffre ni de l’effet de masquage ni de l’effet de submersion qui ruinent le score Z classique. Le seuil empirique communément recommandé pour délimiter une valeur suspecte avec le score Z modifié se situe entre $|M_i| > 2,5$ et $|M_i| > 3,0$. Son implémentation dans les environnements de calcul contemporains tels que les paquets de statistiques sous R (par exemple la fonction mad() du socle de base ou les fonctions du paquet WRS2) et Python (via scipy.stats.median_abs_deviation) est immédiate et devrait représenter la norme méthodologique par défaut pour toute analyse univariée exploratoire.
8. Techniques multivariées et spatiales : appréhender l’atypisme configurationnel
8.1 Distance de Mahalanobis et matrice de covariance robuste
L’évaluation des données quantitatives ne peut se cantonner à une succession d’analyses univariées isolées. Dans les configurations multidimensionnelles, une observation peut présenter des valeurs parfaitement normales et centrales sur chacune des variables considérées individuellement, tout en incarnant une anomalie multivariée flagrante en raison d’une configuration conjointe hautement improbable. C’est l’essence même de l’atypisme configurationnel. L’outil classique pour quantifier l’éloignement multidimensionnel d’un vecteur d’observations $\mathbf{x}_i = (x_{i1}, dots, x_{ip})^T$ par rapport au centre de gravité d’un ensemble de données de dimension $p$ est la distance de Mahalanobis ($D_M$) :
D_M(mathbf{x}_i) = sqrt{(mathbf{x}_i – mathbf{bar{x}})^T mathbf{S}^{-1} (mathbf{x}_i – mathbf{bar{x}})}
où $\mathbf{\bar{x}}$ représente le vecteur des moyennes d’échantillonnage et $\mathbf{S}$ la matrice de variance-covariance de l’échantillon. En introduisant la matrice inverse $\mathbf{S}^{-1}$, la distance de Mahalanobis réalise une déformation spatiale tenant compte des corrélations entre variables et de leurs échelles de dispersion respectives. Sous l’hypothèse de normalité multivariée, le carré de la distance de Mahalanobis ($D_M^2$) suit théoriquement une distribution du Chi-deux à $p$ degrés de liberté ($\chi^2_p$). Les valeurs dépassant le quantile critique $\chi^2_{p, 1 – \alpha}$ (avec typiquement $\alpha = 0,001$) sont alors identifiées comme des aberrations multivariées potentielles.
Cependant, la distance de Mahalanobis classique souffre exactement du même vice congénital que le score Z univarié : elle s’appuie sur le vecteur des moyennes et sur la matrice empirique de covariance, qui sont tous deux hyper-sensibles aux anomalies multivariées. Quelques points excentrés suffisent à tordre le centre estimé et à gonfler artificiellement les covariances, provoquant un masquage massif. Pour remédier à cet écueil, les chercheurs doivent substituer aux estimateurs classiques des estimateurs de dispersion et de localisation à haut point de rupture. Le standard d’excellence est l’estimateur du déterminant de la covariance minimale (Minimum Covariance Determinant, MCD), développé par Rousseeuw.
L’algorithme MCD recherche le sous-ensemble de taille $h$ (où $h$ est typiquement compris entre la moitié et les trois quarts de l’échantillon total) dont la matrice de covariance classique affiche le déterminant le plus faible possible (c’est-à-dire l’hyper-volume le plus compact). La moyenne et la covariance calculées exclusivement sur ce sous-ensemble non contaminé permettent ensuite d’évaluer la distance de Mahalanobis robuste (souvent notée $RD$). Cette démarche protège l’analyse contre les effets pervers de clusters cachés d’aberrations multivariées, assurant une détection sans distorsion même dans des espaces de haute dimension.
8.2 Distances d’influence dans les modèles de régression : Cook et DFFITS
Dans le cadre de la modélisation explicative par régression linéaire multiple ou par modèles linéaires généralisés, l’identification des points singuliers nécessite de distinguer rigoureusement deux concepts fondamentaux : l’atypisme résiduel et l’effet de levier (leverage). Un point résiduel est une observation dont la valeur observée pour la variable dépendante s’écarte considérablement de la valeur prédite par l’équation de régression (mesuré via les résidus studentisés désélectionnés). Un point de levier correspond quant à lui à un individu présentant des valeurs extrêmes sur l’espace conjoint des variables prédictives (exogènes), quantifié par les éléments diagonaux $h_{ii}$ de la matrice de projection chapeau (hat matrix, $\mathbf{H} = \mathbf{X}(\mathbf{X}^T\mathbf{X})^{-1}\mathbf{X}^T$).
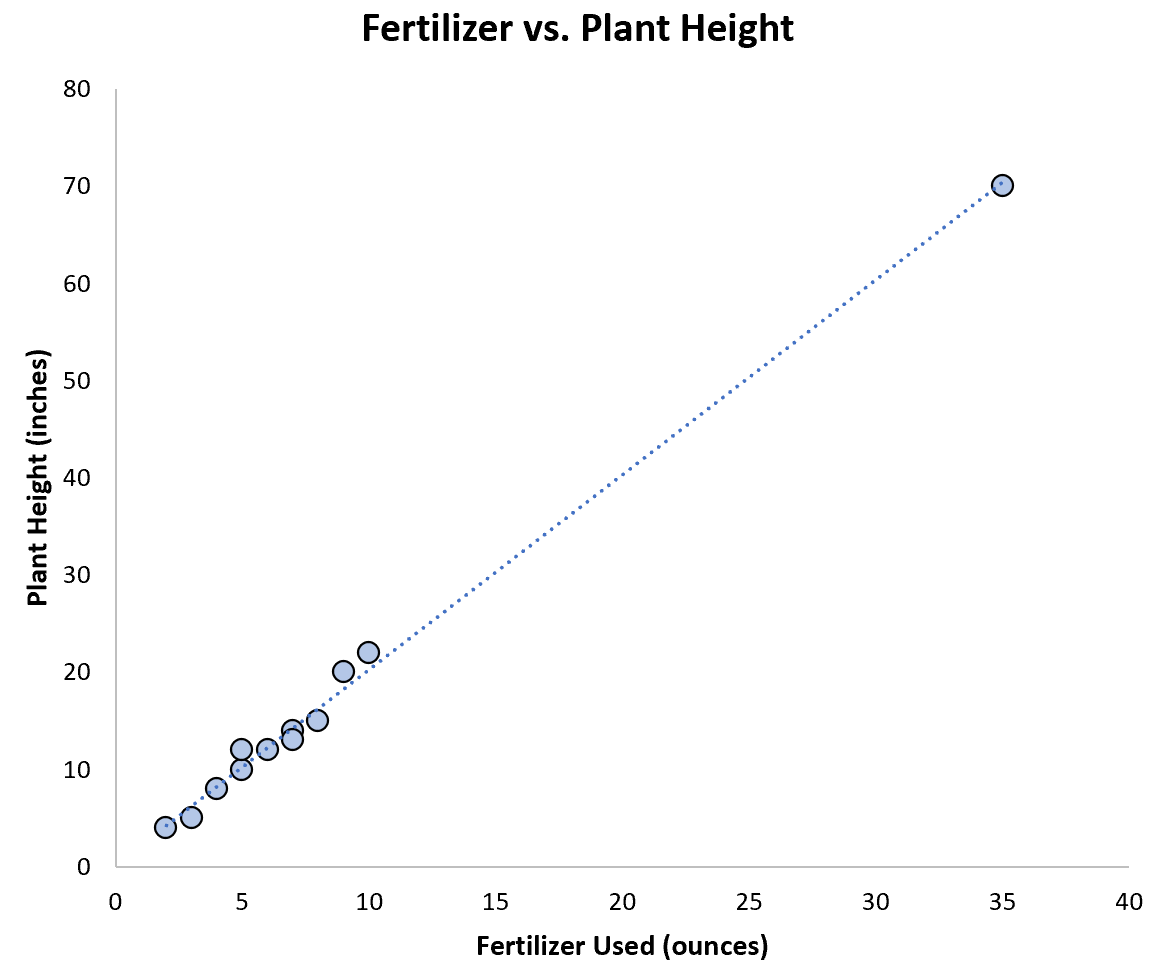
Un point de fort levier n’est pas nécessairement délétère s’il se situe dans l’alignement exact de la tendance de régression générale. Le péril méthodologique émerge lorsqu’un point combine simultanément un fort levier et un résidu élevé : il devient alors un point d’influence, capable d’infléchir à lui seul la pente du modèle et d’inverser le verdict des tests d’hypothèse. Pour quantifier cette force de basculement, la distance de Cook ($D_i$) représente l’indicateur diagnostique de référence. Formulée par R. Dennis Cook (1977), elle mesure le décalage global qu’enregistreraient les coefficients vectoriels de régression $\mathbf{\hat{\beta}}$ si l’observation $i$ était purement et simplement retranchée de l’estimation :
D_i = frac{sum_{j=1}^n (hat{y}_j – hat{y}_{j(i)})^2}{p times MSE} = frac{r_i^2}{p} left( frac{h_{ii}}{1 – h_{ii}} right)
où $\hat{y}_{j(i)}$ est la valeur prédite pour l’individu $j$ par le modèle réestimé sans le point $i$, $r_i$ est le résidu studentisé interne, $p$ le nombre de paramètres du modèle et $MSE$ l’erreur quadratique moyenne.
Pour l’interprétation empirique de la distance de Cook, bien qu’un seuil conventionnel classique de $D_i > 1,0$ soit fréquemment mentionné dans les manuels introductifs, la littérature moderne recommande l’utilisation de seuils relatifs bien plus sensibles, ajustés à la taille de l’échantillon, tels que $D_i > 4 / (n – p – 1)$. Un outil diagnostique complémentaire très prisé est le DFFITS (Difference in Fits), qui évalue spécifiquement l’impact de l’exclusion d’un point sur sa propre prédiction ajustée, standardisée par son écart-type. La visualisation graphique des résidus studentisés croisés avec les valeurs de levier $h_{ii}$ constitue l’un des graphiques de diagnostic indispensables de tout compte-rendu économétrique ou psychométrique rigoureux.
8.3 Approches d’apprentissage non supervisé pour structures complexes
Lorsque la structure des données défie les postulats des modèles géométriques linéaires — notamment en présence de non-linéarités complexes, de multimodalité ou d’une très haute dimensionnalité impliquant des dizaines d’échelles psychométriques et d’indicateurs physiologiques continus —, les méthodes d’apprentissage machine non supervisé offrent des perspectives de détection particulièrement sophistiquées. Parmi ces algorithmes, la forêt d’isolement (Isolation Forest), introduite par Liu, Ting et Zhou (2008), s’est imposée comme une approche d’une efficacité computationnelle et statistique remarquable.
Le principe théorique fondamental d’une forêt d’isolement est aussi élégant que contre-intuitif : au lieu de modéliser les zones de forte densité pour délimiter ensuite les contours où se nichent les anomalies, l’algorithme cherche à isoler directement les points marginaux. Il construit un ensemble d’arbres de décision binaires aléatoires. À chaque nœud d’un arbre, une variable est sélectionnée au hasard, et une coupure aléatoire est opérée entre ses valeurs minimale et maximale. Les observations aberrantes, étant structurellement peu nombreuses et isolées dans des zones périphériques clairsemées de l’espace hyperspatial, sont séparées du reste de l’échantillon en très peu de bifurcations récursives (longueur de chemin courte dans l’arbre). À l’inverse, les points situés au cœur des clusters denses nécessitent un nombre élevé de partitions pour être isolés. Un indice de score d’anomalie normalisé compris entre 0 et 1 permet ainsi d’extraire les profils hautement déviants sans formuler d’hypothèse distributionnelle paramétrique préalable.
Une alternative complémentaire majeure est l’algorithme du facteur d’anomalie locale (Local Outlier Factor, LOF), proposé par Breunig et al. (2000). Contrairement aux méthodes globales qui comparent un point à l’ensemble du corpus de données, le LOF mesure le degré d’isolement d’une observation par rapport à son voisinage local déterminé par ses $k$ plus proches voisins. Il quantifie la densité locale de portée (local reachability density) d’un point et la compare à celle de ses voisins. Un score LOF proche de 1 indique que l’observation réside au sein d’une zone de densité homogène ; un score significativement supérieur à 1 signale que le point se trouve dans une poche de très faible densité en périphérie immédiate d’un cluster dense. Cette granularité locale est particulièrement précieuse en psychologie lorsque l’échantillon comprend des sous-groupes cliniques typologiques distincts d’inégale densité d’effectif.
9. Conséquences statistiques : quantifier le coût de l’inclusion versus l’exclusion
9.1 Impact direct sur la puissance statistique et l’erreur d’échantillonnage
L’arbitrage entre l’inclusion et l’exclusion des valeurs singulières se manifeste immédiatement sur les métriques fondamentales de l’inférence statistique. La première conséquence mécanique de la conservation d’une valeur aberrante non substantielle (liée par exemple à du bruit expérimental) au sein d’un modèle paramétrique réside dans le gonflement spectaculaire de la variance résiduelle et, par ricochet, de l’erreur type des estimateurs. Dans un test t de Student indépendant ou une régression ordinaire, la statistique de test est inversement proportionnelle à cette erreur type. Dès lors que la variance d’échantillonnage est indûment étirée par un artefact, le dénominateur de la fraction explose, provoquant un affaissement critique de la valeur de la statistique de test et une perte drastique de puissance statistique.
Cette érosion de la puissance place le chercheur dans un risque incontrôlé de commettre une erreur de type II : échouer à rejeter l’hypothèse nulle ($H_0$) alors qu’un effet théorique authentique existe bel et bien dans la population générale. Une manipulation expérimentale subtile mais cliniquement cruciale peut ainsi passer totalement inaperçue parce que deux ou trois sessions corrompues ont quadruplé l’estimation de la variance d’erreur. Inversement, l’impact sur le coefficient de corrélation linéaire de Pearson ($r$) est d’une versatilité notoire : un seul point extrême situé dans un quadrant diagonalement opposé au nuage de points principal peut anéantir une corrélation substantielle de $r = 0,60$ pour la faire basculer à une valeur statistiquement non significative proche de zéro, ou, dans le scénario inverse, engendrer de toutes pièces une association artificielle de $r = 0,45$ entre deux variables pourtant totalement indépendantes.
Dans les techniques d’analyse multivariée plus poussées, telles que l’analyse factorielle exploratoire (AFE) ou confirmatoire (AFC), l’impact déstabilisateur des données singulières est tout aussi corrosif. Les matrices de corrélation déformées par des observations à fort levier altèrent l’extraction des vecteurs propres et des valeurs propres (eigenvalues), faussent l’évaluation du nombre optimal de dimensions à retenir selon le critère de Kaiser ou l’analyse parallèle de Horn, et créent des contaminations croisées de saturation factorielle qui ruinent la validité conceptuelle d’échelles psychométriques entières en phase de validation.
9.2 Le biais d’attrition artificielle et la menace sur la validité externe
Si l’inclusion d’artefacts dégrade la précision paramétrique, l’élagage agressif et systématique des valeurs extrêmes fait payer un tribut méthodologique tout aussi lourd sur un autre versant : celui de la validité externe et de la représentativité écologique. L’exclusion répétée des cas marginaux engendre ce que l’on qualifie de biais d’attrition artificielle ou d’échantillonnage sélectif post-hoc. En purgeant délibérément les individus affichant les comportements les plus intenses, les temps de réponse les plus longs ou les symptômes les plus aigus, l’analyste altère subrepticement la définition même de la population cible sous-jacente.
Ce phénomène induit une sous-estimation dramatique de la prévalence réelle des troubles psychopathologiques et de l’ampleur de la morbidité psychologique dans les études épidémiologiques et de cohorte. Si les participants les plus sévèrement atteints sont systématiquement écartés sous prétexte que leurs scores aux échelles d’évaluation déstabilisent la normalité des résidus de l’échantillon, le chercheur publie des résultats qui ne décrivent en réalité qu’une sous-population modérée, « sage » et conforme aux attentes théoriques. Les interventions préconisées sur la base de telles études s’avèrent invariablement sous-calibrées lorsqu’elles sont ensuite déployées dans des contextes cliniques réels.
De plus, cette amputation artificielle de la variance naturelle porte un coup fatal à la reproductibilité des recherches. Un modèle statistique estimé sur un échantillon hyper-épuré affiche souvent des indices d’ajustement flatteurs (par exemple un $R^2$ exceptionnellement élevé ou des métriques de type RMSEA et CFI parfaites en modélisation structurelle). Toutefois, dès lors qu’une équipe indépendante tente de répliquer le protocole sur un échantillon aléatoire non trié, la structure statistique s’effondre lamentablement. L’impossibilité de généraliser les conclusions obtenues en laboratoire à des contextes réels provient fréquemment de ce biais de sélection silencieux où la variabilité humaine légitime a été méthodologiquement sacrifiée sur l’autel de la complaisance statistique.
10. Alternatives méthodologiques à l’exclusion radicale des données
10.1 Transformations mathématiques des variables continues
Face à la présence d’observations extrêmes au sein d’une distribution asymétrique continue, l’amputation chirurgicale des données n’est jamais la seule modalité opératoire envisageable. La première alternative classique consiste à recourir à des transformations mathématiques non linéaires appliquées à l’ensemble de la variable continue. L’objectif fondamental d’une telle transformation est de modifier l’échelle métrique d’expression de la variable de manière à comprimer les grands écarts relatifs situés dans la queue de distribution tout en préservant scrupuleusement l’ordre de classement originel des participants.
Pour les distributions présentant une asymétrie positive modérée à sévère (caractéristique typique des temps de réaction ou des concentrations de biomarqueurs salivaires de stress comme le cortisol), la transformation logarithmique népérienne ou décimale ($x’ = ln(x)$ ou $x’ = \log_{10}(x)$) constitue un traitement classique. En réduisant drastiquement les intervalles entre les grandes valeurs tout en dilatant les écarts entre les petites, le logarithme ramène les valeurs extrêmes légitimes dans un intervalle compatible avec les postulats de la loi normale. Pour les asymétries plus modérées, la transformation par racine carrée ($x’ = \sqrt{x}$) offre une compression plus douce, tandis que la transformation inverse ($x’ = 1 / x$), couramment adoptée en chronométrie cognitive pour transformer les temps de latence en vitesses d’exécution, traite les asymétries positives ultra-sévères.
Pour systematiser le choix de la transformation optimale sans tâtonnements arbitraires, la famille des transformations paramétriques de Box-Cox (1964) offre une formalisation rigoureuse. Elle est définie pour toute valeur positive $x > 0$ par l’expression :
x^{(lambda)} = begin{cases} frac{x^lambda – 1}{lambda} & text{si } lambda neq 0 ln(x) & text{si } lambda = 0 end{cases}
L’estimation par le maximum de vraisemblance du paramètre continu $lambda$ identifie automatiquement la transformation de puissance géométrique qui optimise la normalité des résidus de la variable. Cependant, ces manipulations ont un coût interprétatif non négligeable : elles compliquent sérieusement la signification substantielle des grandeurs mesurées. Raisonner sur le « logarithme d’un temps de réaction » ou l’« inverse d’un score d’anxiété » prive le clinicien d’une lecture intuitive des résultats et complexifie la comparaison directe entre différentes études scientifiques.
10.2 Techniques de Winsorisation et troncature contrôlée
Une alternative élégante et largement validée sur le plan computationnel consiste à employer la technique de Winsorisation (nommée en hommage au biostatisticien Charles P. Winsor). Contrairement à la troncature pure et simple (trimming) qui supprime physiquement les observations déviantes et réduit ainsi la taille de l’échantillon $N$, la Winsorisation préserve l’intégralité du volume d’échantillon initial en ramenant les valeurs marginales à des seuils percentiles prédéterminés. Le principe de la Winsorisation symétrique à un niveau de risque donné $\gamma$ (par exemple 5 %) consiste à identifier toutes les observations situées en deçà du percentile $\gamma$ ($P_\gamma$) et au-delà du percentile $1 – \gamma$ ($P_{1 – \gamma}$), et à remplacer leur valeur brute par la valeur exacte de ce percentile respectif.
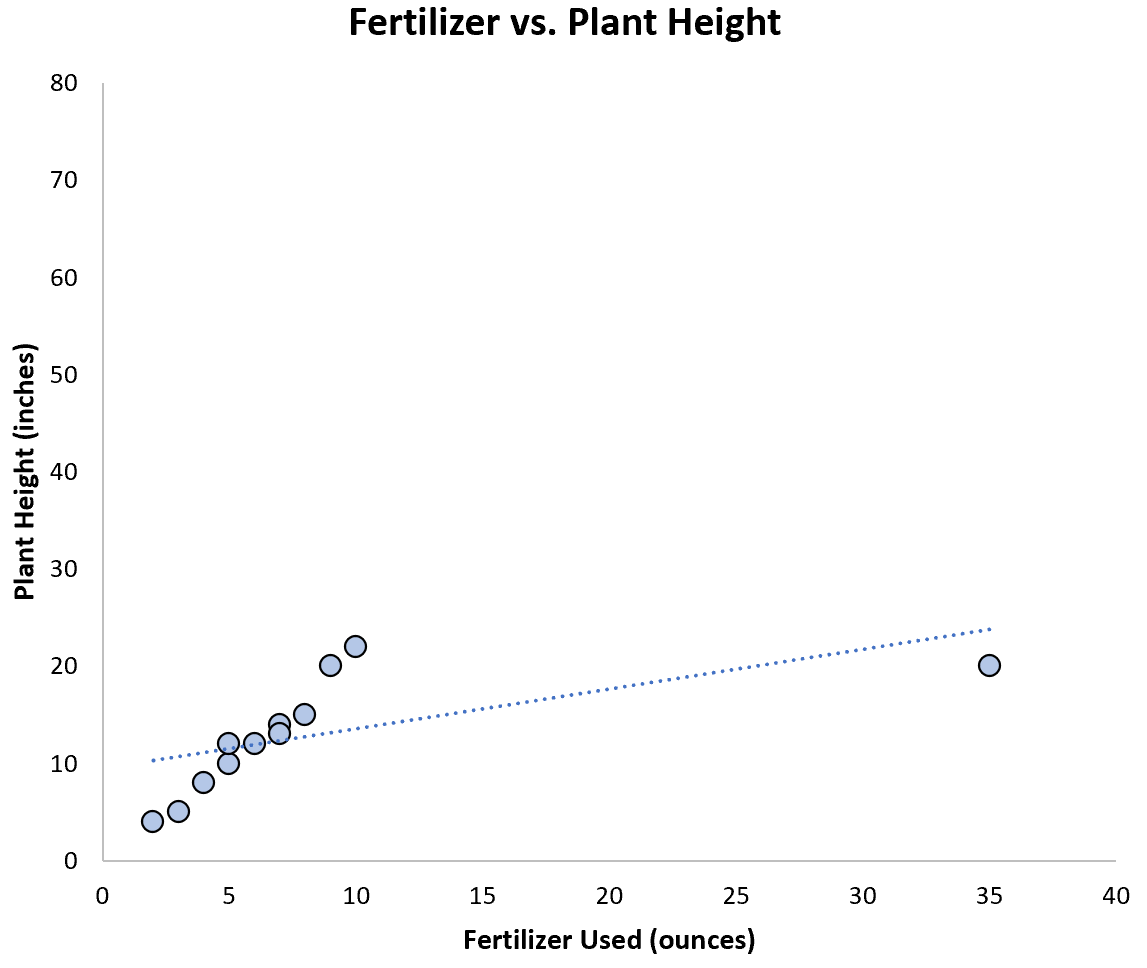
Concrètement, dans un échantillon de 100 sujets winsorisé à 5 %, les 5 observations les plus basses se voient toutes réassigner la valeur exacte du 5e percentile, et les 5 observations les plus hautes adoptent la valeur exacte du 95e percentile. Cette manipulation permet de neutraliser totalement la force de traction excessive exercée par une valeur extravagante sur la moyenne et l’écart-type, tout en évitant d’introduire des données manquantes dans le tableau de recueil. La structure ordinale des observations est conservée, et la variance n’est pas rabotée aussi brutalement qu’avec une élimination de ligne.
La littérature en méthodologie psychologique recommande généralement de circonscrire les taux de Winsorisation à des proportions modérées, typiquement comprises entre 1 % et 5 % des queues de distribution, sous peine de modifier excessivement la distribution empirique authentique. La troncature contrôlée (trimmed samples), quant à elle, retranche un pourcentage fixe d’observations aux deux extrémités avant de calculer des estimateurs d’intérêt, à l’instar de la moyenne tronquée à 20 % (20% trimmed mean). Cette dernière approche forme le socle de nombreuses méthodes de comparaison non paramétriques modernes particulièrement résistantes.
10.3 Modélisation statistique robuste et méthodes non paramétriques
La réponse méthodologique la plus moderne et la plus rigoureuse face à la présence de données atypiques ne réside pas dans la modification cosmétique des données elles-mêmes (qu’il s’agisse de suppression, de transformation ou de Winsorisation), mais dans l’adaptation du modèle mathématique d’inférence. Les techniques d’inférence statistique robuste ont été spécifiquement conçues pour délivrer des estimations non biaisées et des tests d’hypothèse fiables même lorsque les postulats de distribution gaussienne ou d’homoscédasticité sont massivement violés par la présence d’aberrations.
Pour la comparaison de groupes expérimentaux, le test de Yuen fondé sur les moyennes tronquées (Yuen’s test) supplante avantageusement le test t de Student classique. En combinant la troncature symétrique des données marginales avec une estimation corrigée des degrés de liberté et de l’erreur type, le test de Yuen conserve une puissance statistique remarquable et un taux d’erreur de type I nominalement contrôlé, y compris sous des distributions sévèrement contaminées par des valeurs aberrantes ou caractérisées par des variances hétérogènes (problème de Behrens-Fisher).
Dans l’univers de la régression, les estimateurs M, S et MM (introduits par Yohai, 1987) constituent l’alternative reine à la méthode des moindres carrés ordinaires (MCO). Les estimateurs M modulent la fonction de perte : au lieu de minimiser la somme des carrés des résidus (qui accorde un poids géométrique disproportionné aux grands écarts), ils appliquent une fonction de pondération décroissante (comme la fonction biséquarrée de Tukey ou la fonction de Huber) qui atténue progressivement l’influence des résidus volumineux. Les estimateurs MM combinent un point de rupture élevé (50 %) face aux points de fort levier sur les prédicteurs avec une haute efficacité statistique asymptotique (souvent fixée à 95 % de l’efficacité des MCO sous distribution normale pure).
Enfin, le recours aux architectures de rééchantillonnage non paramétrique par Bootstrap (notamment le bootstrap à percentiles corrigé du biais et accéléré, BCa) permet de construire des intervalles de confiance robustes pour n’importe quel paramètre statistique sans formuler aucune hypothèse préalable quant à la normalité de la distribution d’échantillonnage. En complément, les modèles linéaires généralisés (GLM), configurés avec des distributions de réponse adaptées aux queues épaisses (comme la loi Gamma, la loi binomiale négative ou la loi log-normale), permettent de modéliser avec élégance la variabilité intrinsèque sans jamais amputer la richesse du signal expérimental.
11. Éthique, pré-enregistrement et transparence dans la science ouverte
11.1 L’exclusion post-hoc comme pratique de recherche discutable (QRP)
L’épuration des données n’est pas qu’un enjeu technique : elle constitue un carrefour déontologique fondamental. La manipulation rétrospective des critères d’exclusion des observations a été formellement identifiée comme l’une des pratiques de recherche discutables (Questionable Research Practices, QRP) les plus délétères pour l’intégrité de la littérature scientifique contemporaine. Dans son essence la plus insidieuse, l’exclusion post-hoc prend la forme d’un processus itératif opaque où le chercheur scrute l’évolution de ses valeurs de p au fur et à mesure qu’il élimine arbitrairement tel ou tel individu marginal, s’arrêtant dès que le seuil fétiche de $p < 0,05$ est franchi.
Ce comportement, désigné sous le terme générique de p-hacking ou d’« ajustement opportuniste des données », détruit la signification mathématique de l’inférence statistique. Le calcul des probabilités associé aux tests d’hypothèse repose sur le postulat strict que l’échantillon d’analyse n’a pas été conditionné par le résultat même du test. Dès lors qu’un point singulier n’est évincé que parce que son maintien affaiblit la significativité de l’hypothèse de recherche initiale, le processus scientifique se transforme en un exercice d’auto-confirmation circulaire. Les conséquences systémiques de ces dérives sont désastreuses : elles engorgent la littérature académique de faux positifs non réplicables et fragilisent la confiance des pairs et de la société civile envers la recherche quantitative.
Les comités d’éthique et les revues scientifiques de premier plan ne considèrent plus ces pratiques comme de simples libertés analytiques vénielles. De nombreuses rétractions d’articles prestigieux intervenues au cours de la dernière décennie ont eu pour origine directe la découverte de suppressions sélectives d’observations dans des fichiers Excel ou des scripts de calcul, dissimulées sous des justifications vagues de « valeurs aberrantes ». La transparence absolue sur l’ensemble de la chaîne de transformation des données constitue désormais un impératif catégorique non négociable pour tout chercheur aspirant à produire un savoir pérenne.
11.2 Protocoles de pré-enregistrement et analyses de sensibilité obligatoires
Le moyen le plus efficace pour éradiquer les soupçons d’ajustement opportuniste des données consiste à formaliser la procédure de nettoyage en amont du recueil à travers le pré-enregistrement d’un plan d’analyse statistique (Statistical Analysis Plan, SAP) sur des plateformes institutionnelles ouvertes dédiées, telles que l’Open Science Framework (OSF) ou AsPredicted. Dans ce document horodaté et public, les investigateurs spécifient formellement :
- Les critères explicites d’invalidation d’une session de recueil (seuils temporels de complétion, scores maximaux d’échec aux items de contrôle attentionnel) ;
- Les algorithmes exacts et les packages logiciels assignés au diagnostic univarié et multivarié des anomalies (par exemple, le score Z modifié basé sur la MAD avec seuil $|M| > 3,0$) ;
- La politique de traitement qui sera appliquée (correction supervisée, Winsorisation ou bascule vers des estimateurs robustes de type régression MM) ;
- L’engagement formel à rapporter l’intégralité des analyses de sensibilité comparative.
L’analyse de sensibilité représente la clé de voûte de la probité méthodologique lorsqu’un jeu de données recèle des points singuliers dont le statut demeure équivoque. Cette procédure consiste à exécuter et à documenter en miroir la totalité du pipeline analytique sous deux conditions d’estimation : le scénario primaire (avec conservation intégrale des données suspectes ou traitement robuste) et le scénario secondaire (après retranchement des observations désignées). Si les conclusions théoriques fondamentales, les directions d’effet et les magnitudes d’association demeurent stables et congruentes à travers les deux approches, l’analyste peut affirmer avec confiance que ses inférences ne dépendent pas d’un artefact marginal isolé.
Dans l’hypothèse où les conclusions divergeraient significativement entre les deux modèles — par exemple, un effet hautement significatif dans le jeu complet devenant parfaitement nul après l’exclusion de deux sujets isolés —, le chercheur a le devoir déontologique de présenter les deux configurations de résultats en toute transparence dans le corps de son article scientifique. Il appartient alors à la communauté des pairs d’évaluer la fragilité intrinsèque de l’effet rapporté. Cette transparence implique également la mise à disposition publique, au sein de répertoires ouverts, des jeux de données bruts anonymisés et des scripts complets de nettoyage (écrits en R, Python, Julia ou syntaxe SPSS), garantissant une reproductibilité computationnelle immédiate par tout vérificateur indépendant.
12. Protocole opérationnel et checklist finale pour les chercheurs et analystes
12.1 Grille d’audit systématique avant toute décision définitive
Afin de structurer le flux de travail des équipes d’analyse et de prévenir toute prise de décision hâtive, nous proposons ci-après une grille d’audit séquentielle en quatre phases distinctes. Chaque étape commande une série de vérifications documentées avant de pouvoir passer à la phase subséquente.
Phase 1 : Identification visuelle et calculatoire initiale
- Inspection visuelle systématique des distributions univariées au moyen d’histogrammes à granularité fine, de diagrammes de densité de probabilité et de boxplots ajustés aux asymétries.
- Génération de nuages de points bivariés (scatterplots) croisant les variables clés pour repérer les découplages configurationnels.
- Calcul des indices descriptifs de forme : coefficient d’asymétrie (skewness) et d’aplatissement (kurtosis).
- Calcul des scores standardisés robustes fondés sur la médiane et l’écart absolu médian normalisé (MADN) avec un seuil de vigilance fixé à $|M_i| > 2,5$.
- Calcul systématique des résidus studentisés, des leviers diagonaux $h_{ii}$ et des distances de Cook pour tous les modèles explicatifs linéaires implémentés.
Phase 2 : Enquête qualitative sur l’étiologie du signal
- Vérification méticuleuse des bornes formelles des échelles de cotation pour intercepter d’éventuelles erreurs typographiques.
- Recoupement systématique avec les fiches sources imprimées ou les journaux de saisie bruts (raw server logs).
- Examen des indicateurs de complétion temporelle : élimination des sessions invalidées par des vitesses d’exécution incompatibles avec les processus neuro-cognitifs fondamentaux.
- Vérification du score de conformité aux items pièges d’attention (attention check items) et détection des profils de réponses rectilignes (variance intra-individuelle nulle).
- Vérification de l’absence de violation des critères physiologiques d’inclusion expérimentale (interférences environnementales documentées, substances exogènes).
Phase 3 : Évaluation de l’impact paramétrique et modélisation comparative
- Exécution du modèle statistique paramétrique standard sur le corpus complet d’observations valides.
- Quantification formelle de la variation relative des coefficients d’effet ($\Delta \beta$) induite par la présence des points singuliers identifiés.
- Test comparatif d’une alternative robuste : estimation par régression robuste (estimateurs MM), moyenne tronquée de Yuen ou modélisation GLM sous distribution adaptée.
- Application éventuelle d’une Winsorisation symétrique modérée (1 % à 5 %) pour préserver l’effectif total tout en contenant la dispersion.
Phase 4 : Validation éthique et archivage reproductible
- Confrontation scrupuleuse des actions de nettoyage entreprises avec le protocole de pré-enregistrement originel de l’étude.
- Consignation formalisée de chaque rejet individuel dans un registre d’exclusion détaillant la cause technique ou comportementale univoque.
- Intégration d’un script d’audit automatisé et reproductible au sein du code source de l’étude (traçabilité intégrale de la donnée brute à la donnée analysée).
12.2 Recommandations de rédaction scientifique pour les revues à comité de lecture
La rédaction de la section méthodologique d’un manuscrit scientifique soumis à une revue à comité de lecture doit refléter fidèlement le standard de rigueur appliqué au traitement des données marginales. Les formules génériques, laconiques et opaques du type « les valeurs aberrantes ont été éliminées avant l’analyse » doivent être formellement bannies de la pratique rédactionnelle. Elles éveillent immédiatement les soupçons légitimes des réviseurs quant à l’occurrence d’un éventuel ajustement opportuniste des données.
Les auteurs doivent détailler avec précision la chaîne méthodologique dans un paragraphe dédié de la sous-section « Traitement préliminaire des données » (Data Screening). Ce paragraphe doit expliciter :
- Le nombre précis d’observations écartées, exprimé en valeur absolue et en pourcentage de l’échantillon initial recueilli ;
- La décomposition exacte des motifs d’exclusion par catégorie étanche (par exemple : « $n = 3$ pour défaillance technique du capteur PPG, $n = 12$ pour échec avéré à deux pièges attentionnels consécutifs, $n = 4$ pour temps de latence globale inférieur au seuil de lecture incompressible de 180 secondes ») ;
- La méthode mathématique exacte de détection mobilisée pour repérer d’éventuels cas d’atypisme statistique résiduel, en mentionnant explicitement les packages logiciels et leurs versions de déploiement ;
- Le renvoi formel vers un tableau comparatif d’analyse de sensibilité présenté dans le corps de l’article ou dans les annexes en ligne (Supplementary Materials).
Ce tableau comparatif d’analyse de sensibilité doit présenter côte à côte les paramètres essentiels (coefficients de régression non standardisés et standardisés, erreurs types, intervalles de confiance à 95 %, statistiques de test et tailles d’effet telles que le $d$ de Cohen ou le $\eta^2$ partiel) calculés sous les différentes variantes de modélisation (échantillon complet, échantillon épuré des cas non conformes, et modélisation robuste non paramétrique). La structure générale recommandée pour cette synthèse comparative est illustrée ci-après.
| Modèle analytique | $N$ effectif | Coefficient de régression ($\beta$) | Erreur type ($SE$) | Intervalle de confiance (95 %) | Taille d’effet | Verdict statistique |
|---|---|---|---|---|---|---|
| Modèle brut MCO (Jeu complet non épuré) | 250 | 0,28 | 0,11 | [0,06 ; 0,50] | $R^2 = 0,08$ | $p = 0,012$ |
| Modèle épuré MCO (Exclusion des cas suspects) | 241 | 0,34 | 0,08 | [0,18 ; 0,50] | $R^2 = 0,14$ | $p < 0,001$ |
| Modèle robuste (Régression MM biséquarrée) | 250 | 0,32 | 0,09 | [0,14 ; 0,50] | $R^2_{\text{rob}} = 0,12$ | $p < 0,001$ |
En adoptant cette discipline de transparence absolue, le chercheur transforme ce qui est traditionnellement perçu comme une corvée méthodologique ou une source d’ambiguïté en un puissant témoignage de probité intellectuelle. L’exposition claire de la stabilité des résultats à travers différents choix analytiques prémunit l’étude contre les soupçons de manipulation empirique, rehausse la crédibilité de ses inférences et contribue activement à l’effort collectif d’assainissement et de consolidation de la recherche contemporaine en sciences quantitatives.
Références
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://www.jstor.org/stable/2984418
- Breunig, M. M., Kriegel, H.-P., Ng, R. T., & Sander, J. (2000). LOF: Identifying density-based local outliers. ACM SIGMOD Record, 29(2), 93–104. https://doi.org/10.1145/335191.335388
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Grubbs, F. E. (1969). Procedures for detecting outlying observations in samples. Technometrics, 11(1), 1–21. https://www.jstor.org/stable/1266673
- Hubert, M., & Vandervieren, E. (2008). An adjusted boxplot for skewed distributions. Computational Statistics & Data Analysis, 52(12), 5186–5201. https://doi.org/10.1016/j.csda.2007.11.008
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Liu, F. T., Ting, K. M., & Zhou, Z.-H. (2008). Isolation forest. In Eighth IEEE International Conference on Data Mining (pp. 413–422). IEEE. https://doi.org/10.1109/ICDM.2008.17
- Mahalanobis, P. C. (1936). On the generalized distance in statistics. Proceedings of the National Institute of Sciences of India, 2(1), 49–55.
- Maronna, R. A., Martin, R. D., Yohai, V. J., & Salibián-Barrera, M. (2019). Robust statistics: Theory and methods (with R) (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119214656
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273–1283. https://doi.org/10.1080/01621459.1993.10476408
- Rousseeuw, P. J., & Driessen, K. V. (1999). A fast algorithm for the minimum covariance determinant estimator. Technometrics, 41(3), 212–223. https://doi.org/10.1080/00401706.1999.10485670
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02293-6
- Yohai, V. J. (1987). High breakdown-point and high efficiency robust estimates for regression. The Annals of Statistics, 15(2), 642–656. https://www.jstor.org/stable/2240560