
Dans le paysage des sciences quantitatives, de la biométrie et de la psychométrie, la modélisation statistique constitue le pont méthodologique indispensable entre l’observation brute du réel et l’élaboration de lois théoriques générales. L’analyse de régression linéaire, développée à l’origine par des pionniers tels qu’Adrien-Marie Legendre, Carl Friedrich Gauss et Francis Galton, repose sur une quête fondamentale : comprendre comment une ou plusieurs variables explicatives permettent d’anticiper ou d’expliquer les fluctuations d’un phénomène d’intérêt. Au cœur même de cet édifice mathématique trône une entité symbolique omniprésente, souvent désignée par le terme technique de Y chapeau, typographiquement formalisé par le glyphe ŷ. Bien plus qu’un simple artifice d’écriture ou une commodité calculatoire, ce symbole incarne la frontière épistémologique séparant le fait empirique observé de sa reconstruction idéale par l’esprit et l’algorithme.
Comprendre ce que représente ŷ est un prérequis absolu pour quiconque souhaite interpréter adéquatement un modèle d’inférence statistique, évaluer la précision prédictive d’un protocole expérimental ou diagnostiquer la viabilité clinique d’une échelle de mesure. Alors que la variable Y renvoie à la contingence du réel — avec son lot inévitable d’erreurs d’échantillonnage, de bruits de mesure et de fluctuations stochastiques —, la variable ajustée ŷ cristallise la réponse systématique formulée par le modèle mathématique. En statistique théorique et appliquée, ŷ se définit comme l’estimation de la moyenne conditionnelle de la variable dépendante pour une configuration donnée de régresseurs, ou comme la prédiction déterministe assignée à une observation singulière. L’ensemble de la mécanique inférentielle, de la minimisation de la variance d’erreur jusqu’au calcul des intervalles de confiance et de prédiction, s’articule autour de cette quantité pivotale.
Le présent article propose une exploration exhaustive, rigoureuse et approfondie de la notion de Y chapeau. En parcourant ses fondements algébriques, géométriques et probabilistes, nous mettrons en lumière la manière dont les moindres carrés ordinaires projettent les données de l’espace empirique vers le sous-espace des prédictions. Nous analyserons comment se structure le résidu d’estimation, de quelle façon la généralisation matricielle mène au concept fondamental de la matrice chapeau, et en quoi l’usage clinique et psychologique de ŷ requiert une vigilance méthodologique sans faille pour éviter les écueils de l’extrapolation fallacieuse ou de l’illusion causale. À travers cette étude détaillée, le lecteur découvrira l’architecture complète d’un des piliers méthodologiques les plus influents des sciences empiriques contemporaines.
1. Introduction et fondements conceptuels de Y chapeau (ŷ)
1.1 Définition formelle et symbolique du terme ŷ
L’usage du symbole « chapeau » (l’accent circonflexe surmontant une lettre, circumflex en typographie internationale) constitue l’une des conventions les plus stables et universelles de la statistique mathématique moderne. Historiquement popularisée par des mathématiciens et statisticiens du XXe siècle pour différencier formellement les grandeurs non observables des entités calculées à partir de données empiriques, cette diacritique indique systématiquement une estimation. Ainsi, lorsque le caractère Y majuscule ou minuscule désigne la variable dépendante réelle mesurée sur un échantillon ou existant au sein d’une population parente, le symbole ŷ (prononcé « Y chapeau » ou Y-hat en anglais) désigne formellement la valeur ajustée, prédite ou estimée de cette même variable par l’intermédiaire d’un modèle statistique spécifique.
Sur le plan de l’épistémologie des sciences, cette distinction graphique matérialise la rupture entre le monde ontologique des phénomènes observés et le domaine théorique des abstractions mathématiques. Dans une étude portant sur le comportement humain, par exemple, un chercheur observe des scores réels de bien-être psychologique chez des sujets particuliers. Ces scores sont désignés par Yi pour chaque individu i. Dès l’instant où un modèle de régression est ajusté pour formaliser la trajectoire de ces scores en fonction d’indicateurs environnementaux, les valeurs générées par la fonction mathématique ne sont plus des observations brutes, mais des constructions synthétiques. En coiffant la variable dépendante de ce circonflexe, le statisticien rappelle en permanence que ŷ est un estimateur paramétrique, conditionné à la fois par la structure mathématique imposée au modèle et par les particularités intrinsèques de l’échantillon d’étalonnage.
Cette symbolique s’étend naturellement à d’autres entités au sein de l’analyse inférentielle : les paramètres de population réels, souvent notés par des lettres grecques comme le coefficient d’interception β0 ou la pente théorique β1, demeurent perpétuellement inconnus dans leur essence asymptotique. Leurs équivalents empiriques, calculés directement à partir des données de l’échantillon, sont fréquemment désignés par β̂0 et β̂1, ou par les notations latines b0 et b1. Par conséquent, ŷ représente la synthèse opérationnelle de ces coefficients estimés lorsqu’ils sont combinés aux observations des variables indépendantes. C’est le point de contact précis entre l’univers abstrait des paramètres probabilistes et la réalité concrète du terrain expérimental.
1.2 Place de Y chapeau au sein de l’analyse de régression
Au sein de la théorie générale de l’analyse multivariée, l’analyse de régression occupe une position cardinale en fournissant un cadre unifié pour explorer les relations fonctionnelles entre variables. Dans ce contexte opérationnel, ŷ représente le terme de sortie principal du système. La modélisation peut répondre à deux impératifs scientifiques distincts mais complémentaires : la modélisation explicative ou confirmatoire, et la modélisation prédictive. Dans le cadre explicatif, l’intérêt se porte principalement sur la quantification et la significativité statistique des coefficients de liaison ; néanmoins, ŷ y joue un rôle déterminant en tant qu’étalon de comparaison permettant de vérifier dans quelle mesure la structure théorique proposée réussit à reproduire fidèlement les patrons de données observés.
Dans le paradigme prédictif, prédominant en apprentissage statistique contemporain et en épidémiologie pronostique, l’estimation des paramètres individuels est parfois reléguée au second plan au profit de l’exactitude de ŷ lui-même. La performance globale d’un algorithme est alors jugée sur sa capacité à générer des valeurs de ŷ qui minimisent l’écart quadratique par rapport aux futures réalisations de Y issues d’échantillons indépendants. Cette divergence d’objectifs épistémologiques n’altère en rien la nature mathématique de la valeur prédite : que l’on cherche à isoler un mécanisme causal sous-jacent ou à anticiper une tendance future avec le plus grand pragmatisme, ŷ demeure la projection formelle de l’information multidimensionnelle contenue dans les régresseurs sur une dimension unidimensionnelle interprétable.
L’importance structurelle de ŷ réside également dans le fait qu’il incarne le pont analytique permettant de scinder la variabilité empirique en deux composantes orthogonales fondamentales : la variabilité intelligible, captée par l’agencement théorique des prédicteurs, et la variabilité résiduelle, imputable aux bruits aléatoires, aux erreurs d’instrumentation et aux facteurs causaux omis. Sans la dérivation explicite de ŷ, la formalisation de concepts aussi déterminants que le coefficient de détermination, les résidus standardisés ou les mesures d’influence géométrique demeurerait impossible.
1.3 Importance de la variable dépendante estimée dans la recherche
Dans le domaine de la recherche empirique, et plus particulièrement au sein des sciences humaines, cognitives et médicales, la modélisation de phénomènes complexes implique de composer avec une variabilité interindividuelle considérable. Les chercheurs ne disposent que très rarement de systèmes déterministes parfaits où une loi universelle simple gouvernerait sans faille chaque unité statistique. Dès lors, le calcul systématique de ŷ remplit une fonction fondamentale de réduction de l’incertitude. En quantifiant précisément la réponse moyenne attendue pour un ensemble donné de caractéristiques prédictives continues ou discrètes, ŷ permet de dégager des invariants structurels au milieu du chaos apparent des données d’observation.
En psychométrie et en psychologie quantitative, la modélisation à l’aide de ŷ permet d’estimer avec rigueur des scores de fonctionnement cognitif, des niveaux de dépression prévisibles ou des trajectoires d’apprentissage en milieu scolaire. Par exemple, lorsqu’un protocole évalue l’impact du stress perçu et du soutien social sur la qualité du sommeil, chaque participant présente un score singulier de perturbation nocturne (Y). La prédiction ŷ fournie par l’équation de régression linéaire représente le score typique que l’on est en droit d’attendre pour un individu partageant ce niveau précis de stress et de soutien social. Cela offre un point de référence objectif indispensable : si le score effectif d’un sujet dévie massivement de son ŷ respectif, le chercheur ou le clinicien est alerté sur la présence potentielle de mécanismes protecteurs exceptionnels ou de facteurs de vulnérabilité non pris en compte par la formulation initiale du modèle.
Enfin, l’évaluation globale de l’adéquation d’une théorie scientifique repose presque toujours sur la comparaison macroscopique entre l’ensemble des vecteurs observés et l’ensemble des vecteurs prédits. Lorsque les valeurs calculées de ŷ épousent fidèlement les contours des valeurs mesurées à travers diverses conditions expérimentales, l’hypothèse sous-jacente gagne en crédibilité empirique. Inversement, une divergence systématique entre les trajectoires de ŷ et de Y constitue un diagnostic irréfutable de mauvaise spécification théorique, invitant le chercheur à enrichir son modèle par des non-linéarités, des termes d’interaction ou l’introduction de nouvelles variables de contrôle.
2. Distinction mathématique fondamentale : Y observé contre Y chapeau
2.1 La valeur observée (Y) : Nature ontologique et variabilité
Pour appréhender la mécanique de la régression, il est impératif d’établir une démarcation nette entre la nature de la variable observée et celle de la variable ajustée. La valeur observée, universellement notée Y, renvoie à la donnée brute, récoltée in vivo ou in vitro lors de la phase de recueil empirique. Elle représente une mesure concrète effectuée sur une unité statistique donnée (un être humain, un animal de laboratoire, une cellule, une entreprise ou une région géographique). En tant que telle, la valeur Y est intrinsèquement stochastique dans le contexte de l’observation expérimentale : elle est le produit composite d’une multiplicité de forces causales déterministes, d’influences environnementales fugaces et d’erreurs inhérentes au processus de mesure lui-même.
Même avec les instruments les plus sophistiqués, la mesure d’une variable continue comporte une part inévitable d’imprécision instrumentale. De surcroît, dans les disciplines comportementales, la fidélité des échelles d’évaluation n’est jamais parfaite, ce qui signifie qu’un score observé contient toujours une part d’erreur systématique et une part d’erreur purement aléatoire. L’ensemble des valeurs observées {Y1, Y2, …, Yn} compose la distribution empirique de la variable réponse au sein de l’échantillon. Cette distribution possède sa propre moyenne empirique, notée Ȳ, et sa propre variance totale empirique, notée sY2. Ces grandeurs mesurées constituent la vérité matérielle du jeu de données, la base factuelle indiscutable à laquelle toute tentative de théorisation devra se confronter.
2.2 La valeur prédite (ŷ) : Un produit déterministe du modèle
À l’opposé de la nature contingente de la valeur observée, la valeur prédite ŷ est une entité rigoureusement déterministe une fois que les paramètres du modèle ont été calibrés sur les données. Pour une valeur fixée du vecteur de régresseurs, disons xi, le calcul de ŷi ne laisse place à aucune ambiguïté stochastique : il est le résultat strict de l’application d’une fonction mathématique prédéfinie. Si l’on réinjecte dix fois, cent fois ou mille fois la même valeur de xi dans l’équation estimée, la valeur calculée ŷi demeurera invariablement identique. Ainsi, alors que deux individus distincts peuvent partager rigoureusement le même score sur la variable explicative X tout en présentant des valeurs observées Y différentes en raison de leur idiosyncrasie, ils recevront obligatoirement la même valeur prédite ŷ.
D’un point de vue géométrique, si l’on se place dans un espace euclidien de dimension n (où n est le nombre total d’observations), le vecteur des valeurs observées Y est un point quelconque de cet espace. En revanche, le vecteur des valeurs prédites Ŷ est contraint d’appartenir exclusivement au sous-espace vectoriel de dimension p sous-tendu par les colonnes de la matrice des régresseurs. En d’autres termes, ŷ n’est rien d’autre que la projection orthogonale de Y sur ce sous-espace linéaire. Cette perspective vectorielle illustre de façon limpide la nature synthétique de ŷ : c’est l’ombre déterministe projetée par la réalité tridimensionnelle complexe des observations sur le plan conceptuel simplifié établi par le modélisateur.
2.3 La valeur espérée E(Y|X) et son approximation par ŷ
L’articulation théorique la plus féconde entre Y et ŷ réside dans le concept d’espérance conditionnelle, formellement notée dans le formalisme des probabilités par E(Y|X = x). Dans la population parente infinie, si nous pouvions interroger une infinité de sujets présentant tous rigoureusement la même valeur de prédicteur x, la distribution de leurs variables réponses Y admettrait une moyenne théorique. C’est précisément cette espérance conditionnelle théorique que la régression cherche à formaliser. Dès lors, ŷ ne doit pas être interprété comme une tentative divinatoire d’anticiper la valeur exacte d’un individu isolé dans toute sa singularité, mais plutôt comme l’estimation ponctuelle de la moyenne conditionnelle de la population pour ce sous-groupe de sujets.
Sous les hypothèses classiques du modèle linéaire de Gauss-Markov (notamment l’hypothèse de spécification correcte de la forme fonctionnelle et l’indépendance de l’erreur par rapport aux prédicteurs), la valeur calculée ŷ converge asymptotiquement vers la véritable espérance conditionnelle au fur et à mesure que la taille de l’échantillon n tend vers l’infini :
plim ŷ = E(Y | X = x)
Dans un échantillon de taille finie, ŷ demeure une variable aléatoire au sens où sa valeur numérique dépend de l’échantillon particulier qui a servi à estimer les coefficients de la droite. Néanmoins, son espérance mathématique d’échantillonnage coïncide exactement avec la moyenne de la population parente au point considéré, conférant à ŷ le statut fondamental d’estimateur sans biais de l’espérance conditionnelle. Cette propriété garantit qu’en répétant l’expérience un grand nombre de fois sur des échantillons indépendants, la moyenne des prédictions calculées pour une valeur x donnée entourera sans dérive systématique la véritable valeur espérée théorique.
3. L’équation de régression linéaire simple et le rôle de Y chapeau
3.1 Structure analytique de l’équation prédictive
L’architecture fondamentale de la régression linéaire simple lie une variable explicative unique X à une variable réponse Y. Sur le plan populationnel abstrait, le modèle probabiliste s’écrit traditionnellement sous la forme :
Yi = β0 + β1 xi + εi
où β0 représente la véritable ordonnée à l’origine dans la population, β1 est la véritable pente de la droite de régression, et εi est la perturbation stochastique ou l’erreur résiduelle non observable propre à l’observation i. Lorsque ce modèle théorique est confronté à des données d’échantillon via des méthodes d’optimisation, l’équation empirique servant à produire les valeurs ajustées s’affranchit du terme d’erreur résiduel et se formule de la façon suivante :
ŷi = b0 + b1 xi
Certains manuels d’économétrie et de statistique mathématique préfèrent la notation équivalente ŷi = β̂0 + β̂1 xi. L’absence patente du terme d’erreur (qu’il soit noté ε ou e) dans la formulation analytique de ŷ est un élément capital : la prédiction correspond au comportement structurel du modèle, dépouillé de toute composante aléatoire résiduelle. L’ordonnée à l’origine estimée b0 fixe la ligne de base du système lorsque le prédicteur x est nul, tandis que le coefficient directeur empirique b1 régit l’inclinaison de la droite prédictive dans le repère cartésien en deux dimensions.
3.2 Interprétation de l’ordonnée à l’origine dans les contextes réels
L’ordonnée à l’origine empirique, notée b0, représente le point d’intersection précis où la droite des prédictions coupe l’axe vertical des ordonnées, c’est-à-dire la valeur exacte que prend ŷ lorsque la variable indépendante x est rigoureusement égale à zéro. Bien que sa signification mathématique soit limpide, son interprétation substantielle au sein de la recherche empirique requiert une grande lucidité analytique. Dans de nombreuses situations concrètes, l’existence d’une valeur nulle pour la variable explicative relève de l’absurdité biologique, psychologique ou sociale. Par exemple, si l’on modélise l’estime de soi en fonction du score de quotient intellectuel ou de la taille corporelle en centimètres, une valeur de x = 0 n’a aucune réalité physique ou psychologique concevable.
Dans un tel contexte, le terme b0 sert d’ancrage mécanique indispensable au bon positionnement vertical de la trajectoire prédictive dans l’espace des données, mais sa valeur brute prise isolément ne possède aucun sens clinique. Pour remédier à cette lacune interprétative fréquente, les méthodologistes recourent couramment à la technique du centrage de la variable prédictive sur la moyenne de l’échantillon. En soustrayant la moyenne X̄ de chaque observation individuelle avant d’estimer les paramètres, la nouvelle variable explicative transformée devient x*i = xi – X̄. L’équation de prédiction devient alors :
ŷi = b*0 + b1 (xi – X̄)
Grâce à cette manipulation algébrique élémentaire, la pente b1 demeure strictement inchangée, mais la nouvelle ordonnée à l’origine b*0 acquiert une signification théorique immédiate : elle équivaut exactement à la valeur prédite ŷ pour un sujet présentant le niveau moyen de l’échantillon sur la variable prédictive (puisque xi – X̄ = 0). Dans la régression linéaire simple ordinaire, ce terme b*0 devient alors rigoureusement égal à la moyenne arithmétique globale de la variable réponse (Ȳ), ce qui simplifie grandement l’interprétation clinique des résultats.
3.3 Le coefficient de régression en tant que multiplicateur dynamique
Si l’ordonnée à l’origine confère à ŷ son niveau moyen de référence, le coefficient de régression b1 représente le moteur dynamique de l’équation prédictive. D’un point de vue différentiel, b1 correspond à la dérivée première de la valeur prédite par rapport à la variable explicative :
b1 = ∂ŷ / ∂x
Cette relation indique que pour chaque augmentation d’une unité sur l’échelle de mesure de la variable indépendante x, la valeur attendue ŷ subit une modification marginale d’une amplitude égale à b1 unités de la variable dépendante. La trajectoire de ŷ dépend directement du signe et de l’amplitude de ce coefficient :
- Si b1 > 0, l’association est positive : à mesure que le prédicteur croît, la valeur prédite ŷ progresse vers le haut.
- Si b1 < 0, l’association est négative : l’accroissement du prédicteur entraîne une diminution systématique de ŷ.
- Si b1 = 0, la droite prédictive est strictement horizontale ; la valeur prédite ŷ devient alors invariable et égale à la moyenne arithmétique Ȳ, quelle que soit la valeur de x considérée.
Dans l’évaluation de la puissance de prédiction, les chercheurs calculent souvent des coefficients standardisés, conventionnellement désignés par le coefficient bêta (β standardisé). En exprimant à la fois X et Y sous forme de scores centrés-réduits (scores z ayant une moyenne de 0 et un écart-type de 1), l’ordonnée à l’origine disparaît purement et simplement de l’équation, et la pente standardisée devient directement comparable à d’autres facteurs de régression, facilitant ainsi la hiérarchisation des prédicteurs dans la construction de ŷ.
4. Calcul et dérivation de Y chapeau par la méthode des moindres carrés ordinaires
4.1 Critère d’optimisation des moindres carrés ordinaires (MCO)
L’obtention des coefficients b0 et b1, et par voie de conséquence la génération concrète de chaque valeur ŷi, découle d’un critère d’optimisation mathématique rigoureux : la méthode des moindres carrés ordinaires. Face à un nuage de points bidimensionnel représentant les données collectées, une infinité de droites imaginables pourraient être tracées. Le postulat fondamental des MCO, initialement formalisé de manière indépendante par Gauss et Legendre, stipule que la meilleure droite possible est celle qui minimise la somme globale des carrés des écarts verticaux entre les valeurs observées Yi et les valeurs prédites ŷi.
La fonction de coût à minimiser, traditionnellement qualifiée de somme des carrés des erreurs résiduelles (notée SSE pour Sum of Squared Errors), s’exprime formellement comme :
SSE(b0, b1) = ∑i=1n (Yi – ŷi)2 = ∑i=1n [Yi – (b0 + b1 xi)]2
La justification du recours aux carrés plutôt qu’aux valeurs absolues des écarts repose sur plusieurs considérations théoriques majeures. D’une part, l’élévation au carré supprime le problème de la compensation des signes (les écarts positifs et négatifs ne s’annulant pas mutuellement) tout en étant infiniment dérivable sur le plan infinitésimal, ce qui autorise une résolution analytique directe sans recourir à des algorithmes d’optimisation non différentiables. D’autre part, sur le plan de la théorie statistique avancée, si les erreurs sont distribuées de manière normale et indépendante, l’estimateur des moindres carrés ordinaires coïncide rigoureusement avec l’estimateur du maximum de vraisemblance, conférant à ŷ des vertus d’efficacité asymptotique optimales.
4.2 Résolution des équations normales
Pour déterminer les valeurs exactes des paramètres minimisant la fonction de perte SSE, on calcule les dérivées partielles de cette fonction par rapport à chaque paramètre inconnu, à savoir b0 et b1, et on force ces gradients à s’annuler simultanément :
∂SSE / ∂b0 = -2 ∑i=1n (Yi – b0 – b1 xi) = 0
∂SSE / ∂b1 = -2 ∑i=1n xi (Yi – b0 – b1 xi) = 0
Ce système de deux équations à deux inconnues constitue le système canonique des équations normales. En simplifiant la première équation par division par -2 et en distribuant la sommation, on obtient :
∑ Yi – n b0 – b1 ∑ xi = 0 ⟹ Ȳ = b0 + b1 X̄
Cette dérivation élémentaire met au jour une propriété universelle remarquable de la régression linéaire classique : la droite de prédiction passe impérativement et sans exception par le centre de gravité des données, c’est-à-dire le point défini par les moyennes d’échantillon (X̄, Ȳ). En réorganisant les termes, on en déduit immédiatement la formulation exacte de la constante :
b0 = Ȳ – b1 X̄
En substituant cette expression dans la seconde équation normale et en factorisant les termes, la formule analytique fermée de la pente empirique b1 apparaît sous sa forme classique, définie comme le ratio de la covariance empirique entre X et Y sur la variance empirique de X :
b1 = [ ∑ (xi – X̄)(Yi – Ȳ) ] / [ ∑ (xi – X̄)2 ] = Cov(X, Y) / Var(X)
4.3 Calcul pas à pas sur un jeu de données restreint
Pour ancrer ces formules dans la réalité pratique de l’analyse empirique, considérons un échantillon illustratif réduit composé de cinq sujets (n = 5), sur lesquels nous mesurons une variable prédictive X (par exemple, le nombre d’heures de sommeil précédant une évaluation cognitive) et une variable réponse Y (la note obtenue à un test d’attention soutenue sur une échelle de 0 à 20).
Soient les paires de données suivantes pour nos cinq observations :
- Sujet 1 : x1 = 4, Y1 = 8
- Sujet 2 : x2 = 6, Y2 = 12
- Sujet 3 : x3 = 7, Y3 = 13
- Sujet 4 : x4 = 9, Y4 = 15
- Sujet 5 : x5 = 10, Y5 = 18
Calculons dans un premier temps les moyennes arithmétiques des deux variables :
X̄ = (4 + 6 + 7 + 9 + 10) / 5 = 36 / 5 = 7,2
Ȳ = (8 + 12 + 13 + 15 + 18) / 5 = 66 / 5 = 13,2
Établissons ensuite les écarts à la moyenne et leurs produits croisés :
- Pour i = 1 : (4 – 7,2) = -3,2 ; (8 – 13,2) = -5,2 ; Produit = 16,64 ; Écart de x au carré = (-3,2)2 = 10,24
- Pour i = 2 : (6 – 7,2) = -1,2 ; (12 – 13,2) = -1,2 ; Produit = 1,44 ; Écart de x au carré = (-1,2)2 = 1,44
- Pour i = 3 : (7 – 7,2) = -0,2 ; (13 – 13,2) = -0,2 ; Produit = 0,04 ; Écart de x au carré = (-0,2)2 = 0,04
- Pour i = 4 : (9 – 7,2) = +1,8 ; (15 – 13,2) = +1,8 ; Produit = 3,24 ; Écart de x au carré = (+1,8)2 = 3,24
- Pour i = 5 : (10 – 7,2) = +2,8 ; (18 – 13,2) = +4,8 ; Produit = 13,44 ; Écart de x au carré = (+2,8)2 = 7,84
En effectuant la sommation de ces colonnes, nous obtenons la covariance brute non divisée (le numérateur de la pente) et la somme des carrés de X (le dénominateur) :
Numérateur = 16,64 + 1,44 + 0,04 + 3,24 + 13,44 = 34,8
Dénominateur = 10,24 + 1,44 + 0,04 + 3,24 + 7,84 = 22,8
Nous pouvons dès lors dériver précisément la pente empirique b1 et la constante b0 :
b1 = 34,8 / 22,8 ≈ 1,5263
b0 = Ȳ – b1 X̄ = 13,2 – (1,5263 × 7,2) = 13,2 – 10,9894 = 2,2106
L’équation formelle de prédiction régissant ce jeu de données s’établit par conséquent à : ŷ = 2,2106 + 1,5263 x. Nous pouvons maintenant substituer chaque score individuel xi pour générer la série complète des valeurs prédites ŷi :
- ŷ1 = 2,2106 + 1,5263 × 4 = 8,3158 (alors que Y1 = 8)
- ŷ2 = 2,2106 + 1,5263 × 6 = 11,3684 (alors que Y2 = 12)
- ŷ3 = 2,2106 + 1,5263 × 7 = 12,8947 (alors que Y3 = 13)
- ŷ4 = 2,2106 + 1,5263 × 9 = 15,9473 (alors que Y4 = 15)
- ŷ5 = 2,2106 + 1,5263 × 10 = 17,4736 (alors que Y5 = 18)
Ce calcul pas à pas démontre de façon concrète comment la machinerie des MCO convertit des scores réels bruts en un ensemble régularisé de prédictions systématiques alignées sur une droite mathématique unique.
5. Le concept fondamental de résidu : L’écart entre Y et Y chapeau
5.1 Définition mathématique du résidu ordinaire
La confrontation entre la mesure empirique réelle et l’approximation déterministe fournie par le modèle fait jaillir une entité centrale de l’analyse inférentielle : le résidu statistique ordinaire. Pour chaque observation individuelle i, le résidu, systématiquement noté ei, est défini comme la différence algébrique stricte entre la valeur observée et la valeur prédite :
ei = Yi – ŷi
Il est fondamental de dissocier conceptuellement le résidu empirique ei de la perturbation stochastique théorique εi. L’erreur théorique εi est une variable latente, intrinsèquement non mesurable, qui relie l’observation réelle aux vrais paramètres de population inaccessibles (Yi = β0 + β1 xi + εi). Le résidu ei, quant à lui, est une quantité calculable directement sur l’échantillon à partir des estimateurs empiriques b0 et b1. Le résidu est donc une approximation ou une réalisation concrète de l’erreur théorique, filtrée à travers les lunettes d’un modèle estimé sur des données d’échantillon.
Une conséquence algébrique directe des équations normales des MCO réside dans la propriété de centrage absolu des résidus. Lorsque l’équation de régression comprend une ordonnée à l’origine libre, la somme arithmétique de l’ensemble des résidus ordinaires d’un échantillon est rigoureusement nulle :
∑i=1n ei = ∑i=1n (Yi – ŷi) = 0
Par implication immédiate, la moyenne arithmétique empirique des résidus ē est exactement égale à zéro. Cela signifie que la droite de régression orchestrée par ŷ agit comme un centre de gravité parfait : les sous-estimations (où Yi > ŷi, générant des résidus positifs) compensent arithmétiquement et à l’unité près les surestimations (où Yi < ŷi, générant des résidus négatifs).
5.2 Orthogonalité des résidus et des valeurs prédites
L’une des propriétés les plus élégantes et profondes de l’estimation par moindres carrés réside dans le principe géométrique de l’orthogonalité. En vertu de la seconde équation normale, le vecteur des résidus e est strictement orthogonal à chaque variable explicative incluse dans le modèle, ainsi qu’au vecteur unitaire associé à la constante. Par combinaison linéaire directe, il s’ensuit que le vecteur des résidus ordinaires est rigoureusement orthogonal au vecteur des valeurs prédites Ŷ :
∑i=1n ŷi ei = 0
Cette orthogonalité algébrique implique une conséquence statistique fondamentale : la covariance empirique entre les valeurs prédites ŷ et les résidus e est strictement nulle. Sur le plan conceptuel, cette propriété démontre que le processus d’ajustement des moindres carrés ordinaires a réussi à extraire la totalité de l’information linéaire disponible contenue dans les régresseurs pour bâtir ŷ. Il ne subsiste aucune corrélation résiduelle linéaire entre ce que le modèle prédit et les erreurs qu’il commet. Si une telle corrélation subsistait, cela signifierait qu’une part de la dynamique des erreurs aurait pu être anticipée à partir des prédictions elles-mêmes, ce qui trahirait une sous-optimalité dans la calibration des paramètres.
5.3 Décomposition de la somme des carrés (SST = SSR + SSE)
Cette indépendance linéaire et cette orthogonalité géométrique entre ŷ et e permettent d’appliquer directement le théorème de Pythagore dans l’espace multidimensionnel des observations, aboutissant au théorème universel de décomposition de la variance en régression linéaire. En réécrivant l’écart d’une observation par rapport à la moyenne générale sous la forme d’une identité décomposée :
(Yi – Ȳ) = (ŷi – Ȳ) + (Yi – ŷi) = (ŷi – Ȳ) + ei
Si l’on élève cette égalité au carré et que l’on effectue la sommation sur l’intégralité des n observations, le double produit croisé 2 ∑ (ŷi – Ȳ) ei s’annule rigoureusement en raison de l’orthogonalité démontrée précédemment. Il ne subsiste alors que l’identité fondamentale des sommes de carrés :
∑ (Yi – Ȳ)2 = ∑ (ŷi – Ȳ)2 + ∑ (Yi – ŷi)2
Cette égalité structurante s’abrège canoniquement sous la forme :
SST = SSR + SSE
- SST (Total Sum of Squares) : La somme totale des carrés, quantifiant la dispersion empirique globale de la variable observée Y autour de sa propre moyenne arithmétique.
- SSR (Regression Sum of Squares) : La somme des carrés de la régression, mesurant la variabilité capturée, expliquée et régularisée par les valeurs prédites ŷ autour de la moyenne globale.
- SSE (Sum of Squared Errors) : La somme des carrés des erreurs résiduelles, évaluant la dispersion non expliquée, c’est-à-dire l’énergie résiduelle des fluctuations qui échappent à l’emprise du modèle prédictif.
Cette tripartition quantitative constitue le socle mathématique sur lequel reposent le coefficient de détermination (R2), l’analyse de variance appliquée à la régression (test F global) et l’estimation de la variance de l’erreur du modèle.
6. Application concrète de Y chapeau en psychologie quantitative
6.1 Exemple d’application : Heures d’étude et scores à un examen académique
Pour illustrer la portée concrète de ŷ dans l’analyse comportementale, penchons-nous sur une problématique classique en psychologie de l’éducation : la modélisation des performances académiques à une épreuve d’évaluation finale en fonction du temps investi par les apprenants dans leurs révisions personnelles. Considérons une cohorte d’étudiants universitaires chez lesquels le volume horaire d’étude autonome hebdomadaire (variable X) et la performance chiffrée finale sur 100 points (variable Y) ont été rigoureusement répertoriés.
Supposons qu’après estimation sur un échantillon représentatif, le modèle de régression linéaire simple aboutisse aux coefficients empiriques suivants :
ŷ = 66,615 + 5,0769 × (Heures)
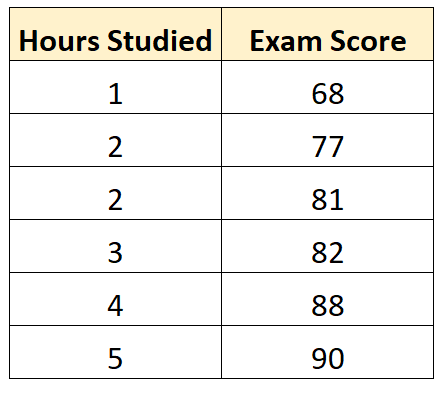
Dans ce modèle, l’ordonnée à l’origine b0 = 66,615 suggère que, selon l’extrapolation théorique de la droite, un étudiant qui ne consacrerait aucune heure à la révision spécifique (x = 0) recevrait une prédiction théorique ŷ de 66,615 points. La pente b1 = 5,0769 indique que chaque heure additionnelle d’étude hebdomadaire engendre un gain moyen anticipé d’environ 5,08 points sur l’examen final.
Appliquons cette équation à trois profils distincts d’étudiants :
- Profil A (Faible investissement) : xA = 2 heures. La valeur prédite s’établit à ŷA = 66,615 + 5,0769(2) = 76,77 points. Si la note réellement obtenue par cet étudiant est YA = 72 points, son résidu est eA = 72 – 76,77 = -4,77. Cet étudiant a obtenu un score inférieur de près de 5 points à ce que prédisait son investissement horaire.
- Profil B (Investissement moyen) : xB = 5 heures. La valeur prédite est ŷB = 66,615 + 5,0769(5) = 91,999 ≈ 92 points. Si son score réel est YB = 95, le résidu est positif (eB = +3 points).
- Profil C (Investissement élevé) : xC = 8 heures. L’équation prédit ŷC = 66,615 + 5,0769(8) = 107,23 points.
Ce dernier profil C illustre de façon flagrante un problème fondamental récurrent en psychologie quantitative : la production par ŷ d’une valeur mathématiquement valide au sein de l’équation linéaire mais physiquement impossible dans la réalité, l’examen étant plafonné à 100 points. Cela met en lumière la nécessité pour le chercheur de comprendre que ŷ est le reflet d’une fonction linéaire continue non bornée, alors que les mesures réelles sont souvent soumises à des effets de plancher et de plafond.
6.2 Exemple d’application clinique : Dosage thérapeutique et diminution des symptômes
Considérons à présent un protocole de recherche clinique en psychothérapie cognitive et comportementale visant à traiter le trouble panique ou l’anxiété généralisée. La variable explicative X représente le nombre de séances de psychothérapie standardisée suivies par le patient au cours d’un cycle de soins de six mois. La variable réponse Y est le score d’anxiété mesuré à l’issue du protocole à l’aide d’un instrument psychométrique validé, tel que l’inventaire d’anxiété de Beck (Beck Anxiety Inventory, BAI), dont l’échelle s’étend de 0 à 63 points (les scores élevés traduisant une symptomatologie sévère).
L’ajustement du modèle de régression linéaire sur la cohorte clinique produit l’équation de prédiction suivante :
ŷ = 38,40 – 1,45 × (Séances)
L’interprétation clinique de cette formulation s’avère particulièrement éclairante pour l’équipe soignante. La constante b0 = 38,40 possède ici une pertinence substantielle directe : elle représente le score d’anxiété moyen prédit pour un patient qui n’aurait bénéficié d’aucune séance de thérapie (x = 0) au sein du cadre étudié. Un score de 38,40 signale un niveau d’anxiété clinique modéré à sévère. Le coefficient de pente b1 = -1,45 quantifie l’efficacité marginale moyenne du suivi psychologique : chaque séance complétée s’accompagne d’une réduction moyenne estimée de 1,45 point sur l’échelle de Beck.
Cette valeur prédite ŷ permet d’établir des jalons pronostiques et de fixer des objectifs thérapeutiques quantifiés. Par exemple, pour espérer abaisser le score prédit d’anxiété sous le seuil d’anxiété légère (généralement fixé en dessous de 16 points sur le BAI), l’équipe peut résoudre l’inéquation :
38,40 – 1,45 x < 16 ⟹ 1,45 x > 22,40 ⟹ x > 15,45
Le modèle suggère ainsi qu’un cycle d’au moins 16 séances est requis en moyenne pour qu’un patient typique de cette population atteigne une rémission clinique substantielle. Si un patient singulier, après avoir complété 16 séances, conserve un score réel observé de Y = 32 points, son résidu est exceptionnellement élevé (e = 32 – 15,20 = +16,8 points). Cette anomalie attire immédiatement l’attention du clinicien sur une possible résistance au protocole standard, nécessitant un réajustement diagnostique ou une réorientation vers une approche pharmacologique conjointe.
6.3 Interprétation contextuelle et prudence psychométrique
L’utilisation pratique de ŷ dans les disciplines de la santé mentale et du comportement impose une rigueur d’interprétation accrue, dictée par la nature spécifique des grandeurs psychométriques. Contrairement aux variables physiques (telles que la masse, la température absolue ou la pression artérielle), les échelles d’attitudes, d’affects ou d’aptitudes cognitives ne sont pas des échelles de ratio possédant un zéro absolu immuable. Elles sont au mieux des échelles d’intervalles approximatives, dotées de bornes formelles infranchissables.
Un praticien ou un chercheur manipulant ŷ doit systématiquement se poser trois questions critiques :
- Le respect du domaine de mesure : La droite de régression étant mathématiquement infinie, le calcul de ŷ peut engendrer des scores prévus négatifs sur une échelle qui ne tolère que des valeurs positives, ou des scores supérieurs au maximum théorique de l’instrument. Si de telles aberrations surviennent au sein de l’échantillon d’étude, cela révèle que le postulat de linéarité globale est erroné et qu’un modèle non linéaire (par exemple, une régression logistique, sigmoïdale ou ordinale) est méthodologiquement requis.
- La faillibilité de la prédiction ponctuelle : Fournir un unique score prédit ŷ à un patient ou à une institution scolaire véhicule une illusion trompeuse de certitude déterministe. Une prédiction statistique ponctuelle n’a de validité scientifique que lorsqu’elle est assortie de sa marge d’erreur, sous la forme d’un intervalle de prédiction probabiliste.
- La labilité contextuelle : Une équation formulée pour estimer ŷ dans une population spécifique (par exemple, des étudiants universitaires occidentaux) perd toute validité si elle est appliquée à des populations présentant des profils culturels ou socioéconomiques radicalement dissemblables. Le transfert de ŷ hors de sa population d’étalonnage engendre un biais de spécification majeur.
7. Généralisation : Y chapeau dans la régression linéaire multiple
7.1 Extension de l’équation à plusieurs variables prédictives
Dans la grande majorité des investigations scientifiques réelles, un phénomène comportemental ou biologique ne dépend jamais d’une cause isolée. La régression linéaire multiple permet d’élargir la construction de ŷ en incorporant simultanément un vecteur de k variables prédictives {X1, X2, …, Xk}. L’équation empirique de prédiction prend alors la forme générale suivante :
ŷi = b0 + b1 x1i + b2 x2i + … + bk xki
Dans cette formulation étendue, chaque coefficient de régression bj (pour j allant de 1 à k) n’est plus une simple pente bivariée, mais un coefficient de régression partielle. Il quantifie la variation attendue sur la prédiction ŷ lorsqu’on incrémente d’une unité la variable Xj, toutes les autres variables prédictives du modèle étant maintenues rigoureusement constantes (le fameux postulat ceteris paribus).
Cette notion de contrôle statistique confère à ŷ une valeur épistémologique infiniment supérieure à celle tirée de relations bivariées isolées. Par exemple, si l’on cherche à prédire la réussite universitaire (Y), l’incorporation conjointe du nombre d’heures de révision (X1) et du niveau de connaissances initiales (X2) permet de calculer une valeur prédite ŷ qui neutralise mathématiquement l’effet confondant des disparités de départ entre les étudiants. La prédiction ŷ devient ainsi le résultat synthétique d’une combinaison linéaire pondérée et optimisée de multiples dimensions explicatives.
7.2 Formulation matricielle de Y chapeau
Lorsque le nombre de régresseurs et le volume d’observations augmentent, l’algèbre scalaire devient rapidement inopérante. Le formalisme de l’algèbre linéaire et du calcul matriciel offre un cadre d’une concision et d’une puissance remarquables pour exprimer ŷ. Considérons le vecteur colonne Y de dimension (n × 1), la matrice des données explicatives X de dimension (n × p) — où la première colonne est constituée de 1 pour modéliser la constante et p = k + 1 —, et le vecteur des coefficients estimés b de dimension (p × 1).
Le système des valeurs prédites Ŷ s’exprime alors simplement par le produit matriciel :
Ŷ = X b
Selon la théorie des moindres carrés ordinaires, le vecteur optimal des coefficients s’obtient par la résolution directe des équations normales matricielles (X‘X)b = X‘Y. En supposant que la matrice d’information (X‘X) est inversible (c’est-à-dire qu’aucune colonne n’est une combinaison linéaire exacte d’autres colonnes), l’estimateur de Gauss s’écrit de façon canonique :
b = (X’ X)-1 X’ Y
En substituant cette solution formelle dans l’équation d’évaluation de Ŷ, nous faisons émerger un opérateur central de la statistique linéaire :
Ŷ = X (X’ X)-1 X’ Y
Cette relation fondamentale s’abrège canoniquement sous la forme :
Ŷ = H Y
La matrice H, de dimensions (n × n), définie par :
H = X (X’ X)-1 X’
est universellement baptisée la matrice chapeau (Hat Matrix en anglais), précisément parce qu’elle possède la propriété algébrique magique de transformer mathématiquement le vecteur Y en son homologue chapeauté Ŷ.
La matrice chapeau H jouit de deux propriétés géométriques capitales :
- Symétrie : La transposée de H est égale à elle-même (H‘ = H).
- Idempotence : Le produit de la matrice par elle-même reproduit fidèlement la matrice d’origine (H2 = H · H = H).
Sur le plan géométrique, l’idempotence prouve sans conteste que H est un opérateur de projection orthogonale. Si l’on applique à nouveau la matrice de projection sur le vecteur déjà projeté Ŷ, rien ne change : H Ŷ = H (H Y) = H2 Y = H Y = Ŷ. Une fois qu’une observation a été projetée sur l’hyperplan sous-tendu par les prédicteurs, une seconde projection n’altère plus sa position.
De surcroît, les éléments situés sur la diagonale principale de cette matrice, conventionnellement notés hii, possèdent une signification métrologique cruciale : ils mesurent le levier statistique (leverage) de chaque observation i. Le levier hii quantifie à quel point la valeur observée Yi d’un individu pèse directement et unilatéralement sur la constitution de sa propre valeur prédite ŷi (puisque ŷi = hii Yi + ∑j≠i hij Yj). Une valeur de hii anormalement élevée révèle un profil atypique sur les prédicteurs, conférant à ce point une influence potentiellement disproportionnée sur la droite de régression.
7.3 Phénomène de multicolinéarité et impact sur la stabilité de ŷ
L’un des défis majeurs dans l’élaboration de ŷ en régression multiple réside dans la présence potentielle de multicolinéarité. Ce phénomène survient lorsque deux ou plusieurs variables explicatives introduites simultanément dans le modèle sont fortement corrélées entre elles. Sur le plan algébrique, la multicolinéarité entraîne la quasi-singularité de la matrice (X‘X), ce qui fait exploser les erreurs types associées aux coefficients partiels bj.
Curieusement, l’impact de la multicolinéarité sur les prédictions ŷ présente un contraste méthodologique fascinant :
- Instabilité des coefficients partiels : Les coefficients b1, b2, etc., pris individuellement, deviennent extrêmement instables et erratiques ; un léger remaniement de l’échantillon peut modifier drastiquement leur amplitude voire inverser leur signe algébrique, rendant toute interprétation substantielle hasardeuse.
- Maintien de la fidélité de ŷ : En revanche, tant que le chercheur limite ses prédictions à l’espace multidimensionnel défini par les données existantes, les valeurs prédites ŷ demeurent remarquablement stables et précises. Les prédicteurs colinéaires se partagent le poids prédictif sans dégrader la somme totale combinée Xb.
Cependant, si le modèle est utilisé pour prédire ŷ sur une nouvelle observation présentant une configuration de régresseurs violant la structure de corrélation originale (par exemple, un individu affichant une valeur très élevée sur X1 mais très faible sur X2, alors que ces deux facteurs étaient synchrones dans l’échantillon d’apprentissage), la variance d’échantillonnage de ŷ explose, générant des prédictions hautement fantaisistes. Le diagnostic systématique de la colinéarité à l’aide du facteur d’inflation de la variance (Variance Inflation Factor, VIF) est par conséquent indispensable pour garantir la robustesse structurelle de ŷ.
8. Propriétés distributionnelles et inférentielles de Y chapeau
8.1 Propriétés d’espérance et de non-biais
Pour qu’un outil de prédiction soit reconnu comme statistiquement valide, il ne suffit pas qu’il optimise une fonction de perte mécanique sur un échantillon donné ; il doit posséder des propriétés inférentielles éprouvées dans le cadre de la répétition asymptotique d’expériences aléatoires. À cet égard, la valeur prédite ŷ bénéficie de propriétés optimales sous les conditions classiques du théorème de Gauss-Markov.
Considérons un vecteur de valeurs explicatives fixé, noté x0 = [1, x01, x02, …, x0k]’. La prédiction associée à ce point s’écrit ŷ0 = x‘0 b. Quelle est l’espérance mathématique de cette grandeur ? En utilisant la linéarité de l’opérateur d’espérance et le caractère non biaisé prouvé des estimateurs MCO (E[b] = β) :
E(ŷ0) = E(x’0 b) = x’0 E(b) = x’0 β = E(Y | X = x0)
Ce résultat formel atteste du non-biais fondamental de ŷ. En d’autres termes, ŷ ne surestime ni ne sous-estime systématiquement la réponse moyenne de la population. En moyenne sur l’ensemble des échantillons aléatoires concevables issus de la même distribution, l’estimation ŷ cible précisément et sans distorsion l’espérance conditionnelle théorique de la variable réponse.
En vertu du théorème de Gauss-Markov, au sein de la classe des estimateurs linéaires et non biaisés de l’espérance conditionnelle, ŷ est celui qui présente la plus petite variance d’échantillonnage concevable (statut de BLUE : Best Linear Unbiased Estimator). Cette efficacité statistique garantit qu’aucune autre combinaison linéaire non biaisée des observations Y ne saurait fournir une prédiction plus stable autour de la véritable moyenne populationnelle.
8.2 Erreur type et variance de la valeur moyenne estimée
Bien que ŷ soit un estimateur non biaisé, sa valeur exacte oscille inévitablement d’un échantillon à un autre en raison de la variabilité inhérente au tirage aléatoire des sujets. Il est donc fondamental de dériver la variance d’échantillonnage théorique de ŷ. Dans le cas de la régression linéaire simple, pour une valeur spécifique du régresseur notée x0, la variance de la réponse moyenne estimée s’exprime par la formule analytique suivante :
Var(ŷ0) = σ2 [ (1 / n) + ( (x0 – X̄)2 / ∑ (xi – X̄)2 ) ]
où σ2 représente la véritable variance résiduelle de la perturbation stochastique dans la population parente, généralement estimée par le carré moyen des résidus de l’échantillon se2 = SSE / (n – 2). L’erreur type de la valeur moyenne estimée, notée SE(ŷ0), s’obtient en extrayant la racine carrée de cette variance :
SE(ŷ0) = se √[ (1 / n) + ( (x0 – X̄)2 / ∑ (xi – X̄)2 ) ]
L’examen minutieux de cette équation révèle des propriétés intuitives d’une importance capitale :
- Effet de la taille de l’échantillon (n) : Plus le nombre d’observations augmente, plus le terme 1/n diminue, réduisant la variance d’échantillonnage de ŷ. Lorsque n tend vers l’infini, l’incertitude pesant sur l’estimation de la moyenne tend vers zéro.
- Effet de la dispersion du prédicteur : Plus la somme des carrés de X au dénominateur est large (c’est-à-dire plus les données expérimentales couvrent une plage étendue sur l’axe horizontal), plus l’estimation de la pente est robuste, ce qui stabilise la prédiction ŷ.
- Comportement hyperbolique de la variance : Le numérateur (x0 – X̄)2 montre que l’erreur type de ŷ est à son minimum strict lorsque le prédicteur est évalué exactement au centre de gravité des données (lorsque x0 = X̄). À mesure que l’on s’éloigne de la moyenne pour s’approcher des extrémités des observations, le numérateur croît quadratiquement, entraînant un élargissement hyperbolique spectaculaire de l’incertitude entourant ŷ.
8.3 Intervalles de confiance pour la réponse moyenne estimée
La quantification de l’erreur type autorise la construction formelle d’un intervalle de confiance probabiliste autour de la valeur prédite ŷ. Cet intervalle permet de délimiter une zone dans laquelle nous avons un degré de certitude spécifié (typiquement 95 %) de voir se trouver la véritable espérance conditionnelle de population E(Y|X = x0).
Sous l’hypothèse de normalité des perturbations résiduelles (εi ~ N(0, σ2)), le ratio pivot statistique suit une distribution de Student à n – p degrés de liberté (avec p = 2 dans le cas de la régression simple). L’intervalle de confiance bilatéral à (1 – α)% pour la réponse moyenne prend donc la forme :
IC(1-α) [E(Y | x0)] = ŷ0 ± t(α/2, n-p) × SE(ŷ0)
Sur le plan graphique, lorsque l’on trace cet intervalle pour l’ensemble du continuum des valeurs de x, les limites supérieure et inférieure ne forment pas des lignes droites parallèles à la droite de régression, mais dessinent une enveloppe curviligne concave, communément désignée sous le nom de courbes de confiance hyperboliques ou bandes de Working-Hotelling. Cette géométrie rappelle visuellement à l’analyste que la certitude quant à la position réelle de la moyenne est maximale au cœur de l’échantillon et s’érode à mesure que l’on s’aventure vers les marges du domaine d’observation.
8.4 Distinction cruciale : Intervalle de confiance vs intervalle de prédiction
Une confusion épistémologique et technique fréquente dans l’interprétation des résultats statistiques consiste à assimiler l’intervalle de confiance de la réponse moyenne à un intervalle de prédiction pour une observation individuelle. Bien que ces deux procédures s’articulent autour du même centre géométrique ŷ0, leurs finalités théoriques et leurs amplitudes numériques sont profondément dissemblables.
L’intervalle de confiance estime l’emplacement de la moyenne asymptotique d’un groupe infini de sujets partageant la même caractéristique x0. En revanche, l’intervalle de prédiction vise à encadrer la valeur singulière et spécifique Ynouv d’un unique individu futur non encore observé. Or, un sujet singulier ne se contente pas de varier en raison de l’incertitude liée à l’estimation de la droite (capturée par Var(ŷ0)) ; il est également soumis à sa propre composante stochastique idiosyncrasique, modélisée par la variance résiduelle pure σ2.
La variance de prédiction d’une valeur individuelle intègre donc nécessairement ces deux sources d’incertitude indépendantes :
Var(Ynouv – ŷ0) = Var(ŷ0) + σ2 = σ2 [ 1 + (1 / n) + ( (x0 – X̄)2 / ∑ (xi – X̄)2 ) ]
L’erreur type de prédiction individuelle s’établit par conséquent à :
SE(prédiction) = se √[ 1 + (1 / n) + ( (x0 – X̄)2 / ∑ (xi – X̄)2 ) ]
L’intervalle de prédiction individuelle en découle immédiatement :
IP(1-α) [Ynouv | x0] = ŷ0 ± t(α/2, n-p) × SE(prédiction)
La présence du chiffre « 1 » sous le radical modifie substantiellement le comportement asymptotique de cet intervalle : même si la taille de l’échantillon n devenait virtuellement infinie, réduisant l’erreur d’estimation des paramètres de la droite à zéro, l’intervalle de prédiction individuel ne convergerait jamais vers une largeur nulle. Il conserverait une largeur incompressible égale à ± zα/2 σ, reflétant le bruit fondamental irréductible inhérent à la nature humaine ou aux systèmes physiques mesurés. L’intervalle de prédiction individuelle est donc toujours strictement et substantiellement plus large que l’intervalle de confiance de la moyenne.
9. Évaluation quantitative de la précision de Y chapeau
9.1 Le coefficient de détermination (R²) et son lien direct avec ŷ
Pour juger de l’utilité pratique d’un ensemble de valeurs prédites ŷ, la statistique descriptive et inférentielle a développé plusieurs métriques globales d’adéquation. La plus emblématique demeure sans conteste le coefficient de détermination, universellement désigné par le symbole R2. Mathématiquement ancré dans le théorème de décomposition de la variance (SST = SSR + SSE), le R2 s’exprime comme la proportion de la variabilité globale de la variable réponse qui est fidèlement reconstituée par la trajectoire de ŷ :
R2 = SSR / SST = 1 – (SSE / SST)
Cette mesure prend des valeurs comprises dans l’intervalle fermé [0, 1] lorsque le modèle comprend une ordonnée à l’origine libre. Un R2 égal à 1 signifie que la somme des carrés des erreurs SSE est rigoureusement nulle, ce qui implique que chaque valeur observée Yi coïncide à la perfection avec sa valeur prédite respective ŷi. À l’inverse, un R2 égal à 0 signale que les variables explicatives n’apportent aucune information linéaire exploitable ; la meilleure prédiction déterministe ŷ se réduit alors à la constante horizontale Ȳ, incapable d’expliquer le moindre écart individuel.
Une identité mathématique fondamentale lie directement le vecteur des valeurs observées Y et celui des valeurs prédites Ŷ : dans toute régression linéaire simple ou multiple estimée par les moindres carrés, le coefficient de détermination R² équivaut exactement au carré du coefficient de corrélation linéaire de Pearson entre les valeurs observées Y et les valeurs ajustées ŷ :
R2 = [ r(Y, ŷ) ]2
Cette équivalence souligne une perspective intuitive : évaluer la qualité d’ajustement globale d’un modèle de régression revient à calculer à quel point les prédictions produites par la machinerie mathématique covarient avec les réalités mesurées sur le terrain expérimental.
9.2 Erreur quadratique moyenne (EQM / MSE) et racine de l’EQM (RMSE)
Bien que le R2 offre une mesure standardisée sans dimension très appréciée pour sa comparabilité d’un domaine à un autre, il souffre d’une dépendance directe vis-à-vis de la variance totale de l’échantillon. Pour évaluer la précision prédictive de ŷ dans les unités matérielles de la variable mesurée, les statisticiens privilégient l’erreur quadratique moyenne (Mean Squared Error, MSE) et son extraction dérivée, la racine de l’erreur quadratique moyenne (Root Mean Squared Error, RMSE).
Le MSE d’échantillon se calcule comme la moyenne des résidus au carré, ajustée par les degrés de liberté résiduels :
MSE = se2 = (1 / (n – p)) ∑i=1n (Yi – ŷi)2
Le RMSE s’obtient simplement en prenant la racine carrée de cette grandeur :
RMSE = √MSE = √[ (1 / (n – p)) ∑i=1n (Yi – ŷi)2 ]
Le RMSE présente l’avantage considérable de s’exprimer rigoureusement dans la même métrique physique ou psychométrique que la variable réponse Y (en milligrammes par litre, en points d’examen, en millisecondes de temps de réaction, etc.). Il s’interprète directement comme l’écart-type d’échantillonnage moyen des observations réelles autour de la surface des prédictions matérialisée par ŷ. Un RMSE de 4 points sur un test cognitif indique qu’en moyenne géométrique, l’écart typique entre ce que le modèle prédit (ŷ) et ce que le sujet réalise (Y) est de l’ordre de 4 points.
Toutefois, la pénalisation quadratique opérée par le RMSE le rend particulièrement sensible aux valeurs aberrantes (outliers) : un unique résidu massif pèse lourdement sur la moyenne finale des carrés, ce qui peut artificiellement dégrader l’évaluation globale de ŷ alors que la droite reste excellente pour la majorité écrasante des sujets.
9.3 Erreur absolue moyenne (MAE) et métriques robustes
Pour contourner l’hyper-réactivité quadratique du RMSE face aux données atypiques, les praticiens de la science des données et de la psychométrie appliquée se tournent fréquemment vers une métrique linéaire robuste : l’erreur absolue moyenne (Mean Absolute Error, MAE). Cette dernière se formule simplement comme la moyenne arithmétique des valeurs absolues des résidus :
MAE = (1 / n) ∑i=1n |Yi – ŷi|
Contrairement au MSE et au RMSE, la MAE attribue un poids strictement proportionnel à chaque écart. Une erreur d’estimation de 10 unités pèse exactement deux fois plus lourd qu’une erreur de 5 unités, et non quatre fois plus comme c’est le cas sous le régime quadratique. Par conséquent, la MAE fournit une estimation de l’erreur typique plus robuste et moins biaisée par la présence d’irrégularités distributionnelles extrêmes.
Sur le plan méthodologique, la comparaison conjointe entre la MAE et le RMSE constitue un indicateur diagnostique remarquable de la structure des erreurs entourant ŷ :
- Si le RMSE est très proche de la MAE, cela démontre que les erreurs d’estimation commises par ŷ sont de magnitude uniforme et homogène sur l’ensemble des observations.
- Si le RMSE excède substantiellement la MAE, cela signale sans ambiguïté l’existence de quelques observations isolées pour lesquelles la valeur prédite ŷ s’écarte dramatiquement de la réalité, invitant à un audit clinique ou expérimental de ces cas discordants.
10. Diagnostics graphiques des hypothèses reposant sur Y chapeau
10.1 Le graphique des résidus en fonction des valeurs prédites (e vs ŷ)
La validité mathématique des inférences reposant sur ŷ dépend intégralement du respect d’un ensemble de postulats théoriques régissant la structure des erreurs du modèle. L’un des outils de diagnostic les plus cruciaux et les plus universellement utilisés en régression est le graphique bidimensionnel des résidus en fonction des valeurs prédites, couramment abrégé en tracé « e contre ŷ » (ou Residuals vs Fitted plot).
Sur ce graphique, l’axe horizontal des abscisses représente les valeurs prédites ŷi, tandis que l’axe vertical des ordonnées affiche les résidus correspondants ei = Yi – ŷi. Une ligne horizontale de référence est tracée au niveau de l’ordonnée zéro. Si le modèle linéaire est parfaitement bien spécifié et que les postulats gaussiens sont honorés, le nuage de points doit présenter l’aspect visuel d’une bande rectangulaire totalement aléatoire, uniforme et homogène, dépourvue de tout motif géométrique discernible, s’étendant symétriquement de part et d’autre de la ligne zéro.
Ce graphique permet de diagnostiquer instantanément les défaillances de modélisation les plus critiques :
- Non-linéarité : Si le nuage de points dessine une courbure systématique (par exemple, une forme parabolique en U ou en U inversé), cela atteste formellement que la relation sous-jacente entre les variables n’est pas strictement linéaire. Le calcul linéaire de ŷ sous-estime les valeurs aux extrêmes et les surestime au centre (ou inversement), indiquant qu’un terme quadratique (X2) ou une transformation logarithmique doit impérativement être intégré au modèle.
- Biais de spécification : Toute tendance systématique décelée le long de l’axe des ŷ révèle que la formulation de ŷ échoue à extraire une dynamique fonctionnelle structurante.
10.2 Détection de l’hétéroscédasticité via la dispersion autour de ŷ
Le postulat d’homoscédasticité (ou d’égalité des variances conditionnelles) exige que la variance de l’erreur résiduelle σ2 demeure rigoureusement constante sur l’intégralité du domaine de prédiction. Lorsque cette condition n’est pas remplie, le système souffre d’hétéroscédasticité. Cette anomalie compromet gravement la fiabilité des erreurs types, invalidant du même coup les tests de significativité t et F, ainsi que les intervalles de confiance et de prédiction construits autour de ŷ.
Le graphique des résidus en fonction de ŷ constitue l’instrument diagnostique visuel privilégié pour identifier l’hétéroscédasticité. Lorsque celle-ci est présente, la dispersion verticale des résidus se modifie de façon continue à mesure que l’on progresse de gauche à droite sur l’axe des valeurs prédites :
- Motif en entonnoir ou en mégaphone : Les résidus sont très resserrés autour de zéro pour les faibles valeurs de ŷ, puis s’écartent de plus en plus largement à mesure que ŷ s’élève. Ce patron est omniprésent dans les sciences économiques et sociales (par exemple, la variance de la consommation s’accroît naturellement avec le niveau de revenu prédit).
- Motif en fuseau : La variance est faible aux deux extrémités de ŷ et maximale au centre du domaine de prédiction.
Face à la détection d’une telle anomalie visuelle, confirmée par des tests d’hypothèse formels tels que le test de Breusch-Pagan ou le test de White, le chercheur ne peut maintenir l’utilisation des intervalles standard associés à ŷ. Il doit recourir à des estimateurs d’erreurs types robustes (tels que les estimateurs de White-Huber-sandwich) ou appliquer une transformation stabilisatrice de variance (comme une transformation logarithmique ou la méthode de Box-Cox) sur la variable dépendante Y avant de recalculer les prédictions.
10.3 Identification des observations aberrantes et points de levier
La confrontation continue entre Y et ŷ sert également de matrice opérationnelle pour repérer les observations singulières susceptibles de biaiser l’analyse. Trois concepts interdépendants mais distincts permettent de classifier ces observations problématiques :
- La valeur aberrante (Outlier) : Une observation dont la réponse mesurée Yi s’écarte considérablement de la réponse modélisée ŷi. Elle génère un résidu de très grande magnitude. Pour normaliser cette appréciation indépendamment des unités d’échelle, on examine les résidus studentisés : un résidu dépassant en valeur absolue le seuil critique de 2 ou 3 signale un sujet atypique méritant une inspection clinique approfondie.
- Le point de levier (High Leverage Point) : Une observation affichant une configuration extrême sur l’une ou plusieurs variables explicatives X, indépendamment de sa valeur sur Y. Comme nous l’avons établi dans la formalisation matricielle, le levier d’une observation correspond à son élément diagonal hii dans la matrice chapeau H. Un levier supérieur à deux ou trois fois la valeur moyenne (2p/n) identifie une observation située aux confins géométriques de l’espace vectoriel d’étude.
- Le point d’influence (Influential Observation) : Une observation qui modifie substantiellement à elle seule l’estimation des paramètres du modèle lorsqu’elle est exclue de l’échantillon. Une observation peut posséder un résidu important sans être influente (si son levier est nul), ou posséder un fort levier sans être influente (si sa trajectoire s’aligne fidèlement sur la droite tracée par les autres points). L’influence survient lorsque le levier et l’écart résiduel se conjuguent.
L’indicateur le plus réputé pour quantifier cette influence globale sur la stabilité des valeurs prédites ŷ est la distance de Cook (notée Di). Pour chaque observation, la distance de Cook mesure le déplacement quadratique moyen de l’ensemble du vecteur des prédictions Ŷ lorsque l’observation i est omise du processus d’étalonnage :
Di = [ ∑j=1n (ŷj – ŷj(i))2 ] / [ p × MSE ]
où ŷj(i) représente la valeur prédite pour le sujet j par un modèle recalculé après suppression définitive du sujet i. Une distance de Cook Di approchant ou dépassant la valeur conventionnelle de 1 (ou le percentile de 50 % de la distribution de Fisher) révèle un individu dont la présence infléchit unilatéralement la trajectoire de l’ensemble des valeurs calculées ŷ, imposant une justification scientifique impérative quant à son maintien ou son exclusion du protocole de modélisation.
11. Extraction et calcul pratique de Y chapeau dans les logiciels statistiques
11.1 Génération de ŷ dans l’environnement R
L’environnement open-source R, devenu la référence internationale pour l’analyse statistique avancée, propose des mécanismes particulièrement élégants pour calculer, manipuler et extraire le vecteur des valeurs prédites ŷ. L’estimation canonique repose sur l’appel à la fonction universelle lm() (Linear Model) en utilisant la syntaxe par formule symbolique :
modele <- lm(score_examen ~ heures_etude + soutien_social, data = echantillon)
Une fois l’objet de classe lm instancié en mémoire, l’extraction de la série des valeurs ajustées ŷ pour l’ensemble des données d’apprentissage s’opère instantanément à l’aide de la fonction générique fitted() ou de sa variante directe predict() sans argument additionnel :
y_chapeau <- fitted(modele)
# Alternative strictement équivalente :
y_chapeau <- predict(modele)
L’un des atouts majeurs de l’écosystème R réside dans l’utilisation de predict() pour déployer le modèle sur une table indépendante de nouvelles données expérimentales (newdata), tout en générant automatiquement les bornes probabilistes inférentielles décrites précédemment. Pour calculer les intervalles de confiance de la moyenne conditionnelle estimée par ŷ :
nouvelles_obs <- data.frame(heures_etude = c(3, 6, 9), soutien_social = c(12, 15, 18))
predict(modele, newdata = nouvelles_obs, interval = "confidence", level = 0.95)
Pour générer l’intervalle de prédiction individuelle englobant la variabilité résiduelle stochastique future :
predict(modele, newdata = nouvelles_obs, interval = "prediction", level = 0.95)
La structure matricielle de la matrice chapeau H peut également être sondée directement par la fonction hatvalues(modele), qui extrait la suite vectorielle des leviers hii pour chaque observation du groupe d’étalonnage.
11.2 Implémentation sous Python avec SciPy, Statsmodels et Scikit-Learn
Dans l’écosystème informatique Python, le traitement et la production de ŷ s’opèrent à travers deux paradigmes complémentaires : le paradigme inférentiel académique incarné par la bibliothèque statsmodels, et le paradigme d’apprentissage automatique industriel porté par scikit-learn.
Sous la bibliothèque statsmodels, la syntaxe est directement calquée sur les conventions psychométriques de R via son sous-module formula.api :
import statsmodels.formula.api as smf
resultats = smf.ols('score_examen ~ heures_etude', data=dataframe).fit()
# Extraction immédiate de la série vectorielle des y chapeau :
y_chapeau = resultats.fittedvalues
La méthode get_prediction() de cet objet fournit une table analytique complète intégrant la valeur prédite ponctuelle, les erreurs types analytiques de l’estimation, ainsi que les intervalles de confiance et de prédiction à tout seuil de significativité spécifié.
Dans le paradigme orienté prédiction de scikit-learn, l’accent est mis sur l’encapsulation algorithmique unifiée. La classe LinearRegression issue du module sklearn.linear_model sépare formellement l’apprentissage des paramètres et l’inférence :
from sklearn.linear_model import LinearRegression
regresseur = LinearRegression(fit_intercept=True)
regresseur.fit(X_train, y_train)
# Génération déterministe de Y chapeau sur le jeu de test :
y_chapeau_test = regresseur.predict(X_test)
Dans cette approche, ŷ est produit de manière purement fonctionnelle par multiplication matricielle directe des matrices de tenseurs, sans calcul systématique préalable des propriétés distributionnelles inférentielles, optimisant ainsi le temps d’exécution pour des volumétries de données massives.
11.3 Traitement de Y chapeau sous SPSS et tableurs
Pour de nombreux praticiens, cliniciens et étudiants en sciences sociales, l’environnement graphique de SPSS Statistics demeure l’interface de travail de prédilection. Dans SPSS, la génération de ŷ ne nécessite l’écriture d’aucun script complexe : elle s’effectue via les options de configuration de la boîte de dialogue de régression linéaire (Analyse > Régression > Linéaire).
En cliquant sur le sous-menu Enregistrer… (Save…), l’utilisateur a la possibilité de cocher la case Valeurs prédites non standardisées (Unstandardized Predicted Values). Lors de l’exécution de la procédure, SPSS calcule instantanément l’équation des moindres carrés et crée automatiquement une nouvelle variable dans la matrice de données active, conventionnellement nommée PRE_1. Cette colonne n’est rien d’autre que l’incarnation numérique de ŷ pour chaque sujet du fichier. De la même manière, le logiciel propose d’enregistrer simultanément les résidus ordinaires (RES_1), les leviers (LEV_1) et la distance de Cook (COO_1), permettant une inspection transversale immédiate de la qualité d’ajustement.
Dans des tableurs grand public tels que Microsoft Excel ou Google Sheets, le calcul de ŷ peut s’effectuer selon deux modalités :
- Par dérivation analytique des paramètres : En utilisant les fonctions natives
PENTE(Y_plage; X_plage)etORDONNEE.ORIGINE(Y_plage; X_plage)dans deux cellules dédiées, puis en saisissant dans une colonne adjacente la formule dynamique=$B$0 + $B$1 * X_cellulerecopiée verticalement. - Par appel direct aux fonctions intégrées : En mobilisant directement la fonction matricielle
TENDANCE(Y_connus; X_connus; X_nouveaux)ou la fonction scalairePREVISION.LINEAIRE(x; Y_connus; X_connus), qui délivrent immédiatement la valeur calculée de ŷ sans exiger la formalisation séparée des coefficients intermédiaires.
12. Limites critiques, sophismes d’interprétation et mise en garde méthodologique
12.1 Le piège de l’extrapolation au-delà du domaine d’observation
L’un des écueils méthodologiques les plus fréquents et les plus destructeurs dans l’exploitation pratique de ŷ réside dans la tentation de l’extrapolation hors domaine. L’équation de régression linéaire est calibrée pour optimiser la trajectoire de ŷ sur une plage géographique restreinte, strictement délimitée par les valeurs minimales et maximales des variables prédictives présentes dans l’échantillon empirique : [Xmin, Xmax].
Calculer une valeur prédite ŷ pour une observation dont le prédicteur x se situe substantiellement en dehors de cet intervalle constitue un saut logique injustifiable sur le plan scientifique. Le modèle postule une relation strictement linéaire entre les grandeurs. Or, dans les systèmes réels, la quasi-totalité des relations qui apparaissent approximativement linéaires sur un intervalle restreint finissent inévitablement par fléchir, saturer ou s’effondrer sous l’effet de seuils biologiques, d’épuisement cognitif ou de contraintes structurelles.
Par exemple, si l’on modélise l’efficacité de la mémorisation en fonction du temps d’exposition à un stimulus entre 1 et 10 secondes, l’équation linéaire peut présenter un excellent ajustement avec une pente fortement positive. Extrapoler cette équation pour calculer le score prédit ŷ d’un individu exposé pendant 10 heures relève du non-sens absolu : le modèle prédira un score d’apprentissage surhumain astronomique, ignorant totalement les mécanismes d’interférence proactive, de fatigue attentionnelle et de saturation neurobiologique. La règle d’or de la méthodologie quantitative stipule donc que la validité de ŷ s’éteint dès que l’on franchit le périmètre de l’enveloppe convexe des données d’étalonnage.
12.2 Confusion entre prédiction ajustée (ŷ) et causalité avérée
Un sophisme d’interprétation omniprésent dans la littérature empirique consiste à attribuer une valeur causale mécanique à l’équation générant ŷ. Constater qu’un modèle de régression affiche un R2 exceptionnel de 0,85 et que la pente b1 est hautement significative sur le plan inférentiel (p < 0,001) n’autorise en aucun cas à déduire que modifier artificiellement la variable indépendante X d’une unité entraînera mécaniquement une translation d’amplitude b1 sur la variable réelle Y.
La régression par les moindres carrés est un algorithme purement observationnel fondé sur des corrélations symétriques et des projections vectorielles. L’équation calculant ŷ est extrêmement vulnérable au biais de variable omise : si un facteur non mesuré (une variable confondante Z) influence simultanément X et Y, la pente empirique capturée par le modèle sera fallacieusement gonflée, attribuant à X un pouvoir moteur qui appartient en réalité à Z. Par exemple, une forte relation linéaire prédit d’excellents scores de vocabulaire chez les jeunes enfants (ŷ) en fonction de la pointure de leurs chaussures. Cette corrélation descriptive est indiscutable : la taille des pieds permet d’anticiper avec précision le vocabulaire. Pour autant, faire porter des chaussures plus grandes à un nourrisson n’aura strictement aucun impact causal sur ses compétences lexicales, l’âge chronologique étant la variable sous-jacente déterminant simultanément les deux métriques.
Pour qu’une prédiction ŷ puisse prétendre guider des décisions causales ou des interventions thérapeutiques réelles, le protocole de recherche doit impérativement reposer sur un véritable essai contrôlé randomisé, ou mobiliser des méthodologies d’inférence causale formelle sophistiquées (telles que les variables instrumentales, la méthode des doubles différences ou les modèles de régression sur discontinuité).
12.3 Surapprentissage et dégradation de la performance prédictive
Une pathologie classique guettant la construction de ŷ en recherche multivariée est le phénomène de surapprentissage (overfitting). Lorsqu’un analyste intègre un nombre excessif de prédicteurs, de termes polynomiaux de degrés élevés ou d’interactions complexes par rapport au nombre effectif d’observations disponibles, le modèle mécanique augmente mathématiquement son coefficient de détermination R2 jusqu’à des niveaux artificiellement flatteurs.
Dans cette configuration, les valeurs prédites ŷ finissent par épouser le moindre méandre stochastique, le bruit d’échantillonnage et les singularités non reproductibles du jeu de données ayant servi à l’étalonnage. Le modèle cesse d’abstraire la règle structurelle générale sous-jacente pour mémoriser par cœur les anomalies spécifiques de l’échantillon. L’illusion d’une adéquation parfaite masque alors une vulnérabilité critique : si ce modèle surajusté est appliqué à un nouvel échantillon indépendant tiré de la même population, la valeur prédictive de ŷ s’effondre dramatiquement, générant des sommes d’erreurs SSE colossales.
Pour immuniser l’élaboration de ŷ contre ce péril méthodologique, l’usage des techniques de validation croisée (k-fold cross-validation), l’ajustement du coefficient de détermination (R2 ajusté pénalisant le nombre de variables) et le recours à des algorithmes de régularisation paramétrique (tels que la régression Ridge ou Lasso) sont formellement requis dès lors que la dimensionnalité des prédicteurs commence à peser sur la représentativité statistique du modèle.
12.4 Considérations éthiques et psychométriques de la décision fondée sur ŷ
Enfin, le déploiement opérationnel de ŷ dans les domaines appliqués soulève d’immenses enjeux déontologiques et humains que le statisticien ne saurait éluder. Dès lors que les valeurs prédites ŷ ne sont plus cantonnées à des articles de recherche fondamentale mais servent d’instruments d’aide à la décision pour orienter des parcours scolaires, allouer des bourses d’études, accorder des libérations conditionnelles en justice pénale ou refuser des polices d’assurance médicale, la nature probabiliste de ŷ entre en conflit direct avec le principe d’équité individuelle.
Fonder une décision déterminante affectant la vie d’un être humain sur son score estimé ŷ revient à substituer au traitement de la personne singulière une projection statistique conditionnelle d’un comportement de groupe moyen. Cela expose au risque majeur de prophétie autoréalisatrice : un étudiant étiqueté par un faible score d’aptitude prédit ŷ peut se voir refuser l’accès à des ressources pédagogiques stimulantes, matérialisant rétroactivement l’échec que le modèle prétendait avoir simplement anticipé de manière neutre.
De surcroît, si les données historiques ayant servi à paramétrer la matrice de régression incorporent des biais sociologiques ou des discriminations systémiques passées, l’algorithme projettera ces biais dans le calcul futur de ŷ sous une apparence trompeuse d’objectivité mathématique. Les spécialistes de la psychométrie et de la bioéthique rappellent donc avec insistance que la valeur estimée ŷ doit demeurer un indicateur informatif parmi d’autres, devant impérativement être confronté à l’expertise clinique qualitative, au jugement éthique contextuel et à la reconnaissance explicite de la marge d’incertitude irréductible qui caractérise l’observation de toute condition humaine.
Références
- Cohen, J., Cohen, P., West, S. G., & Aiken, L. S. (2003). Applied multiple regression/correlation analysis for the behavioral sciences (3rd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203774441
- Draper, N. R., & Smith, H. (1998). Applied regression analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118625590
- Fox, J. (2016). Applied regression analysis and generalized linear models (3rd ed.). SAGE Publications.
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The elements of statistical learning: Data mining, inference, and prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- Kutner, M. H., Nachtsheim, C. J., Neter, J., & Li, W. (2005). Applied linear statistical models (5th ed.). McGraw-Hill Irwin.
- Montgomery, D. C., Peck, E. A., & Vining, G. G. (2021). Introduction to linear regression analysis (6th ed.). John Wiley & Sons.
- Weisberg, S. (2014). Applied linear regression (4th ed.). John Wiley & Sons. https://doi.org/10.1002/9781118594858
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.