
Dans le domaine de l’épidémiologie moderne, de la biostatistique et de la recherche clinique, la quantification précise de la relation unissant une exposition environnementale ou comportementale à la survenue d’une affection constitue une pierre angulaire méthodologique. Si les praticiens et les chercheurs ont historiquement privilégié le risque relatif et le rapport de cotes pour évaluer la force purement étiologique d’une association statistique, ces indicateurs multiplicatifs s’avèrent structurellement insuffisants lorsqu’il s’agit d’orienter les décisions de santé publique et de mesurer le fardeau réel supporté par une population. C’est précisément au sein de cette dichotomie fondamentale entre la force de l’association étiologique et son impact sanitaire concret qu’émerge le concept de risque attribuable.
Le risque attribuable, également qualifié de différence de risque ou d’excès de risque, incarne une approche arithmétique additive visant à déterminer la proportion absolue de l’incidence d’une maladie directement imputable à un facteur d’exposition spécifique. Loin d’être un simple artifice calculatoire, cet instrument mathématique permet d’isoler la charge morbide qui disparaîtrait de manière effective si le facteur incriminé venait à être intégralement éradiqué. Ainsi, il établit une passerelle essentielle entre la physiopathologie observationnelle et la mise en œuvre de programmes préventifs ciblés, qu’il s’agisse de la lutte contre les pathologies cardiovasculaires, des plans de contrôle du tabagisme ou des interventions de pointe en psychiatrie et psychologie comportementale.
Comprendre la mécanique analytique, les hypothèses sous-jacentes et les subtilités d’interprétation du risque attribuable s’avère indispensable pour quiconque souhaite analyser rigoureusement la littérature biomédicale contemporaine. À travers cet article encyclopédique, nous explorerons les fondements théoriques, la formalisation matricielle au moyen des tableaux de contingence, les dérivations mathématiques précises, ainsi que les prolongements populationnels et méthodologiques de cette métrique cardinale de l’épidémiologie quantitative.
1. Introduction et fondements conceptuels du risque attribuable
1.1 Émergence historique et contextualisation épidémiologique
L’histoire de l’épidémiologie quantitative au cours du vingtième siècle est intrinsèquement liée à la transition épidémiologique, caractérisée par le recul progressif des grandes épidémies infectieuses au profit de maladies chroniques non transmissibles d’origine multifactorielle. Lors des premières grandes enquêtes de cohortes prospectives, à l’instar de la célèbre étude de Framingham initiée en 1948 ou des travaux pionniers de Sir Richard Doll et Austin Bradford Hill sur le tabagisme chez les médecins britanniques, les chercheurs se sont rapidement heurtés aux limites interprétatives des mesures purement relatives. Si le risque relatif permettait d’établir avec éclat la force biologique du lien de causalité entre l’inhalation de fumée de tabac et le carcinome bronchique, il laissait dans l’ombre une dimension cruciale : le volume absolu de drames cliniques directement engendrés par cette habitude toxique au sein de la population générale.
Cette lacune conceptuelle a conduit des méthodologistes comme Morton Levin, en 1953, à formaliser des instruments mathématiques capables d’estimer l’impact absolu et populationnel des expositions. La transition paradigmatique de l’évaluation du risque relatif vers la mesure de l’impact absolu a marqué la naissance de l’épidémiologie décisionnelle. Il ne s’agissait plus seulement de comprendre la susceptibilité biologique individuelle ou la puissance cytotoxique intrinsèque d’un agent, mais de quantifier le fardeau sanitaire global afin d’éclairer l’allocation des ressources collectives.
Dans le domaine de la santé publique et de l’épidémiologie comportementale, cette distinction s’est avérée fondamentale. Un facteur conférant un risque relatif modeste mais ubiquitaire au sein du corps social engendre en pratique un nombre de victimes infiniment plus élevé qu’un toxique hautement virulent mais confiné à une micro-population d’individus exposés. Le risque attribuable a ainsi fourni aux hygiénistes et aux administrateurs sanitaires l’étalon de mesure indispensable pour évaluer le rendement réel des politiques préventives et fonder la médecine préventive sur une base empirique objective.
1.2 Définition formelle de la différence de risque
D’un point de vue conceptuel et statistique, le risque attribuable est défini comme la différence absolue entre le taux d’incidence d’un événement morbide chez les individus exposés à un déterminant donné et le taux d’incidence de ce même événement chez les individus rigoureusement non exposés. Cette soustraction arithmétique postule que l’incidence mesurée au sein du groupe non exposé représente le risque de base, c’est-à-dire le taux spontané ou inhérent d’apparition de la maladie résultant de l’ensemble des autres facteurs génétiques, environnementaux et stochastiques non mesurés.
La comparaison théorique entre la cohorte exposée et la cohorte non exposée repose sur l’hypothèse contrefactuelle : que se passerait-il chez les individus exposés si, par un artifice théorique, nous pouvions supprimer rétroactivement leur exposition tout en maintenant invariables l’ensemble de leurs autres caractéristiques biopsychosociales ? Le surplus d’incidence constaté chez les exposés au-delà du risque de base est dès lors considéré comme directement causé par le facteur étudié. Cette différence mesure précisément l’excès de risque absolu, reflétant la fraction de survenue du trouble qui peut être légitimement imputée à l’exposition.
Sur le plan de la signification clinique et biologique, l’excès de risque observé incarne la surcharge pathologique directe supportée par les personnes exposées. Contrairement au rapport d’incidence qui standardise les grandeurs et masque les échelles réelles, la différence de risque conserve les unités de mesure physiques du phénomène : elle exprime un nombre net de cas pathologiques supplémentaires par unité de temps et par unité d’effectif humain exposé. Cette quantification concrète constitue l’indicateur le plus limpide du préjudice sanitaire unitaire imposé par le déterminant de santé.
1.3 Rôle clé dans l’évaluation causale en psychologie de la santé
L’extension du concept de risque attribuable à la psychologie de la santé et à la psychiatrie épidémiologique contemporaine a permis de franchir un cap qualitatif déterminant dans l’étude des facteurs psychosociaux. Pendant des décennies, l’investigation des déterminants comportementaux — tels que le stress au travail, l’isolement social, l’anxiété chronique ou la détresse psychologique — a souffert d’un cantonnement méthodologique à la démonstration de simples corrélations bivariées ou de coefficients de régression aux implications concrètes difficilement perceptibles.
L’introduction de la différence de risque a favorisé le passage indispensable d’une corrélation statistique descriptive à l’estimation de l’impact direct des stresseurs environnementaux sur l’organisme. Par exemple, en mesurant l’excès absolu d’épisodes dépressifs majeurs survenant au sein d’une cohorte soumise à des conditions de travail dégradées par rapport à une cohorte témoin bénéficiant d’un climat organisationnel favorable, les épidémiologistes du comportement peuvent évaluer la morbidité psychique directement générée par ces contraintes ergonomiques et psychosociales.
Cette approche est particulièrement pertinente dans l’évaluation de l’étiologie complexe des troubles psychosomatiques et des pathologies mentales chroniques. Elle permet d’apprécier la part des décompensations cliniques imputables à des traits de personnalité dysfonctionnels, à des stratégies de coping inopérantes ou à des événements de vie traumatisants. Ce faisant, le risque attribuable confère à la psychologie de la santé un instrument analytique d’une grande rigueur, indispensable pour démontrer l’efficience médico-économique des psychothérapies préventives et des interventions de soutien psychologique structurées.
2. Le tableau de contingence 2×2 comme socle méthodologique
2.1 Structure formelle du tableau croisé d’exposition
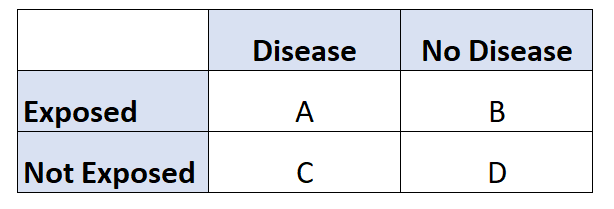
Le socle méthodologique incontournable de tout calcul épidémiologique repose sur la configuration du tableau de contingence à double entrée, conventionnellement désigné sous l’appellation de table 2×2. Cette matrice croise de manière exhaustive le statut d’exposition des participants à une étude prospective avec le statut d’occurrence de l’événement clinique ou psychologique d’intérêt au cours d’un intervalle temporel de suivi préalablement défini.
La structure formelle s’organise selon un partitionnement rigoureux en quatre cellules fondamentales. La cellule A regroupe les sujets exposés au facteur de risque ayant développé l’affection (les vrais positifs de l’exposition morbide). La cellule B rassemble les individus exposés qui demeurent indemnes de toute manifestation pathologique au terme de l’observation. La cellule C quantifie les participants non exposés qui développent néanmoins la maladie, représentant ainsi le niveau basal de morbidité non liée au facteur. Enfin, la cellule D collige les sujets non exposés et indemnes de la maladie.
À partir de cette distribution quadripartite, le calcul des totaux marginaux s’impose comme une étape préalable indispensable. La somme de la première ligne, notée (A + B), représente l’effectif global de la sous-cohorte exposée. La somme de la seconde ligne, notée (C + D), correspond à l’effectif total de la sous-cohorte de référence non exposée. De manière analogue, les totaux verticaux indiquent respectivement le nombre total de malades dans la cohorte globale, (A + C), et le nombre total de sujets indemnes, (B + D). La grande somme marginale, formalisée par N = A + B + C + D, matérialise la taille totale de l’échantillon analysé.
2.2 Paramétrage des variables et calcul des taux d’incidence
L’exploitation de la matrice de contingence nécessite le paramétrage rigoureux des variables épidémiologiques afin d’en dériver les mesures fondamentales de morbidité. Le paramètre central est le taux d’incidence cumulée, qui exprime la probabilité mathématique qu’un individu initialement indemne contracte l’affection au cours de la période de suivi.
Le taux d’incidence cumulée chez les sujets exposés, désigné conventionnellement par la notation Ie ou Re, s’obtient en divisant le nombre de cas incidents apparus dans cette strate par l’effectif total initialement exposé au risque, soit :
Ie = A / (A + B)
Symétriquement, le taux d’incidence cumulée chez les sujets non exposés, noté I0 ou R0, découle du rapport entre le nombre de cas incidents observés parmi les individus préservés du facteur et la cohorte totale non exposée :
I0 = C / (C + D)
La validité interne de ces deux formulations exige une comparabilité temporelle et démographique parfaite entre les groupes. Il est impératif que la durée d’exposition et la fenêtre d’observation soient strictement identiques pour les exposés et les non-exposés. Tout déséquilibre dans la censure des données, dans l’attrition de l’échantillon ou dans la surveillance clinique compromet irrémédiablement l’exactitude des taux d’incidence calculés et, par voie de conséquence directe, la fiabilité de toutes les déductions ultérieures concernant le risque attribuable.
2.3 Précautions d’échantillonnage et validité des données
L’adéquation théorique de la table 2×2 pour le calcul direct du risque attribuable est intimement subordonnée au devis expérimental ou observationnel mis en œuvre par le chercheur. La formulation standard du risque attribuable présuppose la possibilité d’estimer directement les véritables taux d’incidence en population. Par conséquent, les études de cohorte prospectives, dans lesquelles un échantillon initial représentatif et indemne est suivi longitudinalement, constituent le modèle de référence par excellence pour alimenter cette matrice matricielle.
En revanche, la transposition directe de ces équations au sein d’études rétrospectives de type cas-témoins est rigoureusement proscrite sur le plan biostatistique. Dans un protocole cas-témoins classique, les proportions marginales de sujets malades (A + C) et de témoins (B + D) sont arbitrairement fixées par l’investigateur en fonction de critères de recrutement et de puissance statistique. De ce fait, les rapports A / (A + B) et C / (C + D) ne représentent en aucune manière des taux d’incidence biologique, privant la soustraction d’incidence de toute signification empirique valide, à moins d’intégrer des correctifs mathématiques reposant sur la prévalence externe de la maladie.
En outre, le contrôle draconien des biais de classification s’avère indispensable lors de l’assignation des participants aux cellules A, B, C et D. Une erreur de classification de l’exposition — qu’elle découle d’un questionnaire imprécis, d’un biomarqueur instable ou d’un biais de mémorisation du sujet — induit une distorsion systématique de l’estimation. Si cette mauvaise classification est non différentielle, elle aura pour effet mathématique d’atténuer la différence observée, orientant artificiellement le risque attribuable vers l’hypothèse nulle d’absence d’effet pathologique.
3. Formulation mathématique du risque attribuable (RA)
3.1 Dérivation de l’équation standard du risque attribuable
La formalisation mathématique du risque attribuable procède directement de la logique de soustraction des risques absolus mise en lumière par les équations matricielles fondamentales. Dans sa version standardisée, le risque attribuable chez les exposés — fréquemment désigné par l’acronyme RA, ou RD pour l’anglais Risk Difference — est l’expression de la soustraction du taux d’incidence de base chez les témoins non exposés au taux d’incidence relevé chez les individus soumis à l’action de l’agent pathogène :
RA = Ie – I0 = [A / (A + B)] – [C / (C + D)]
Cette dérivation élégante met en exergue la mécanique de l’ajustement arithmétique. En soustrayant le terme C / (C + D), le biostatisticien neutralise la part d’incidence qui n’a aucun lien causal avec l’exposition d’intérêt. L’équation retire du dénominateur global de l’incidence chez les exposés toutes les pathologies résultant du vieillissement normal, de la susceptibilité génétique polygénique ou des agressions environnementales ambiantes non mesurées.
Le résultat chiffré issu de cette formulation capture l’excès net d’événements néfastes strictement imputable à la présence de la variable indépendante. Il quantifie sans ambiguïté le surplus arithmétique de cas de maladie qui, sous l’hypothèse stricte d’un lien de causalité direct et non biaisé, ne se seraient jamais matérialisés dans la cohorte si l’exposition n’avait pas eu lieu.
3.2 Interprétation de la valeur absolue obtenue
L’analyse de la valeur numérique générée par le calcul du risque attribuable requiert une grille de lecture épidémiologique rigoureuse. Trois cas de figure fondamentaux peuvent se présenter lors de la résolution de l’équation différentielle :
- Un risque attribuable strictement supérieur à zéro (RA > 0) : Il démontre que l’exposition exerce une action délétère sur la santé des sujets. Le facteur analysé amplifie la survenue de la pathologie. La valeur numérique indique avec précision la quantité d’incidents supplémentaires provoqués par l’exposition au cours de la période d’observation.
- Un risque attribuable rigoureusement égal à zéro (RA = 0) : Il confirme l’hypothèse nulle statistique d’égalité parfaite des incidences entre les groupes. L’exposition n’a aucun impact détectable sur le déterminisme de la maladie. La variable étudiée s’avère neutre sur le plan étiologique.
- Un risque attribuable strictement inférieur à zéro (RA < 0) : Dans cette configuration particulière, l’incidence observée chez les sujets exposés est inférieure à celle du groupe témoin. Le facteur étudié ne constitue pas un inducteur de risque, mais plutôt un élément protecteur, prophylactique ou thérapeutique. Dans la terminologie clinique, cette différence est alors désignée sous l’appellation de réduction absolue du risque (RAR).
L’unité de mesure du risque attribuable doit toujours être explicitée avec soin. Il ne s’agit jamais d’un pourcentage abstrait sans échelle, mais d’une quantité d’individus affectés par unité de population suivie sur un horizon temporel déterminé. Par exemple, un risque attribuable de 0,05 signifie que l’exposition engendre un surplus net de 5 événements pathologiques pour 100 individus exposés au terme du suivi. Il est capital de dissocier l’ampleur statistique d’un résultat de sa pertinence clinique : un RA numériquement modeste peut posséder une importance capitale lorsqu’il s’applique à une affection particulièrement létale ou invalidante.
3.3 Propriétés statistiques et calcul des intervalles de confiance
Comme toute mesure inférentielle dérivée d’un échantillon empirique, le risque attribuable est sujet à des variations d’échantillonnage aléatoires. Il importe dès lors de quantifier son incertitude stochastique par la détermination de sa variance asymptotique et la construction d’un intervalle de confiance bilatéral, le plus souvent calé au seuil d’admissibilité de 95 %.
Sous l’hypothèse de distributions binomiales indépendantes pour le nombre de cas survenant au sein des deux sous-cohortes, la variance de la différence de risque s’obtient par la sommation pondérée des variances respectives des deux proportions d’incidence cumulée :
Var(RA) = [Ie(1 – Ie) / Ne] + [I0(1 – I0) / N0]
où Ne = A + B et N0 = C + D. L’erreur type du risque attribuable, désignée sous le symbole SE(RA) (pour Standard Error), s’obtient immédiatement par l’extraction de la racine carrée de cette variance combinée :
SE(RA) = √[Var(RA)] = √([A(B) / (A + B)3] + [C(D) / (C + D)3])
Dès lors, en s’appuyant sur le théorème central limite qui garantit la convergence asymptotique de la loi de distribution vers une loi normale centrée réduite dès lors que les effectifs de chaque cellule sont suffisamment substantiels (idéalement supérieurs à 5), les bornes de l’intervalle de confiance à 95 % se définissent par la formule canonique :
IC95%(RA) = RA ± 1,96 × SE(RA)
L’observation empirique de cet intervalle de confiance permet d’exécuter un test d’hypothèse sans recours obligatoire à des distributions de probabilité complexes. Si la valeur zéro est exclue de l’intervalle calculé — c’est-à-dire si la borne inférieure est strictement positive dans le cas d’un agent délétère —, le chercheur peut réfuter l’hypothèse d’équivalence au seuil de significativité alpha de 5 %, attestant ainsi que la surcharge morbide observée ne résulte pas d’une simple fluctuation d’échantillonnage.
4. Le pourcentage de risque attribuable chez les exposés (PRA / FEe)
4.1 Définition et formule de la fraction attribuable chez les exposés
Si le risque attribuable absolu offre une mesure concrète du nombre de cas surnuméraires, il ne permet pas de conceptualiser aisément la proportion interne de danger que cette surcharge représente par rapport à l’ensemble du risque subi par un individu exposé. Pour répondre à cette nécessité descriptive, les épidémiologistes ont forgé le concept de pourcentage de risque attribuable chez les exposés, également désigné dans la nomenclature sous les termes de fraction attribuable chez les exposés (FEe) ou de fraction étiologique du risque.
Sur le plan algébrique, le pourcentage de risque attribuable exprime le rapport mathématique entre le risque attribuable absolu et le taux d’incidence globale enregistré dans la population exposée. Il s’énonce selon la formulation suivante :
PRA% = [RA / Ie] × 100 = [(Ie – I0) / Ie] × 100
En introduisant dans cette équation la définition standard du risque relatif, défini par le quotient RR = Ie / I0, une simplification mathématique élégante permet d’exprimer la fraction attribuable chez les exposés sans avoir nécessairement recours à la connaissance préalable des valeurs absolues de l’incidence :
PRA% = [(RR – 1) / RR] × 100
Cette seconde formulation souligne le caractère intrinsèquement étiologique de l’indicateur. Elle quantifie la proportion relative de la survenue de la maladie qui aurait pu être théoriquement évitée chez les individus exposés si le facteur de risque incriminé avait été totalement annihilé avant l’initiation du processus pathologique.
4.2 Distinction conceptuelle entre RA absolu et fraction relative
L’une des erreurs d’interprétation les plus préjudiciables en biomédecine réside dans la confusion cognitive entre le risque attribuable absolu et sa fraction relative. Bien que procédant de la même table de contingence, ces deux métriques véhiculent des informations fondamentalement dissemblables qu’il convient de décrypter en parallèle.
Considérons une pathologie orpheline rarissime dont l’incidence basale chez les non-exposés est infinitésimale, par exemple de 1 cas pour 1 000 000 d’individus-années. Supposons qu’une exposition environnementale multiplie cette fréquence par cinq, portant l’incidence chez les exposés à 5 cas pour 1 000 000 d’individus-années. Le risque relatif s’élève ici à 5. En appliquant la formule de la fraction attribuable chez les exposés, nous obtenons :
PRA% = [(5 – 1) / 5] × 100 = 80 %
Un tel chiffre suggère un impact individuel écrasant : 80 % des cas chez les exposés semblent exclusivement imputables au facteur. Pourtant, la différence absolue de risque n’est que de 4 cas supplémentaires pour un million de personnes exposées (RA = 0,000004).
Ce cas d’école démontre avec acuité qu’un risque de base infime peut générer un pourcentage de risque attribuable spectaculairement élevé, alors même que le fardeau clinique réel mesuré par le risque attribuable absolu demeure négligeable sur le plan opérationnel. Inversement, pour une pathologie commune à forte prévalence basale comme les maladies coronariennes, une fraction attribuable modérée de 15 % peut correspondre à une différence absolue d’incidence considérable. Il est donc impératif, conformément aux meilleures pratiques de communication scientifique, de présenter conjointement et sans exclusion mutuelle les métriques d’impact absolu et d’impact relatif.
4.3 Implications cliniques et communication du risque individuel
Dans la pratique clinique quotidienne et dans le colloque singulier qui unit le thérapeute à son patient, la communication sur le risque individuel se heurte fréquemment à des biais cognitifs majeurs. Les êtres humains perçoivent mal les probabilités abstraites et réagissent de façon asymétrique selon le cadrage sémantique retenu par le soignant. Dans ce contexte, l’usage du pourcentage de risque attribuable chez les exposés représente un levier motivationnel d’une grande puissance didactique.
En psychologie de la santé et dans le cadre des thérapies comportementales appliquées au sevrage tabagique, alcoolique ou à la modification des habitudes diététiques, annoncer à un patient que son risque relatif d’accident ischémique est de 2,0 produit souvent une réaction de sidération passive ou de déni statistique. En revanche, lui expliquer au travers du PRA% que 50 % de sa vulnérabilité cardiovasculaire globale est directement et exclusivement le fruit de sa consommation de tabac, et que cette fraction de danger disparaîtra progressivement s’il réussit son protocole de sevrage, restitue au patient un sentiment d’auto-efficacité salvateur.
Néanmoins, les cliniciens doivent veiller scrupuleusement à éviter les sophismes probabilistes. Il convient de ne jamais affirmer à un sujet présentant une maladie que son affection personnelle relève de façon certaine de l’exposition au motif que le PRA% excède 50 %. Sur le plan épistémologique, le pourcentage de risque attribuable est une propriété distributionnelle de cohorte qui ne saurait être mécaniquement rétro-projetée comme une certitude médico-légale à l’échelle d’un individu singulier sans l’analyse d’autres éléments biomédicaux convergents.
5. Le risque attribuable en population (RAP) et sa fraction (FRAP)
5.1 Définition et formule du risque attribuable populationnel (RAP)
Tandis que le risque attribuable chez les exposés restreint son champ d’observation aux seuls sujets ayant été soumis au déterminant, les épidémiologistes de santé publique doivent impérativement évaluer les conséquences d’un facteur à l’échelle de la collectivité globale, laquelle inclut nécessairement un mélange hétérogène de personnes exposées et de personnes préservées. C’est à cet impératif programmatique que répond le risque attribuable en population (RAP), désigné en littérature internationale sous l’appellation de Population Attributable Risk (PAR).
Le risque attribuable en population quantifie le surplus d’incidence cumulée observé au sein de la population totale considérée dans son ensemble, par rapport au risque de base prévalant chez les sujets non exposés. Sur le plan algébrique, sa définition s’énonce de la façon suivante :
RAP = Ip – I0
Dans cette relation, Ip incarne le taux d’incidence moyen mesuré dans la population globale. En reprenant les notations de notre tableau de contingence 2×2, ce taux d’incidence global s’exprime par le quotient de tous les cas pathologiques survenus par l’effectif de la population totale :
Ip = (A + C) / N
Le taux d’incidence globale Ip peut également être modélisé comme la moyenne pondérée des incidences respectives des deux groupes, en introduisant la prévalence de l’exposition dans la collectivité, dénotée par la lettre grecque pe (où pe = (A + B) / N) :
Ip = (Ie × pe) + [I0 × (1 – pe)]
En substituant cette équation dans la formule matricielle du RAP, nous obtenons après factorisation arithmétique :
RAP = pe × (Ie – I0) = pe × RA
Cette dérivation met en évidence que le risque attribuable populationnel est le produit direct du risque attribuable individuel par la prévalence de l’exposition. Il mesure l’excès de cas moyen réparti sur la totalité du corps social.
5.2 Calcul de la fraction attribuable en population (FRAP / PAR%)
Le prolongement logique du RAP est sa conversion en une proportion relative mesurant l’efficacité théorique des stratégies de santé publique universelles. Cette métrique correspond à la fraction attribuable en population (FRAP), également désignée sous l’acronyme anglophone PAR% (pour Population Attributable Risk Fraction) ou fraction attribuable populationnelle (FAP).
La formule standard s’écrit comme le rapport du risque attribuable en population sur l’incidence globale observée dans cette même population :
PAR% = [RAP / Ip] × 100 = [(Ip – I0) / Ip] × 100
En 1953, l’épidémiologiste Morton Levin a dérivé une formulation alternative de référence qui permet de calculer le PAR% à partir exclusivement de deux indicateurs macroscopiques universellement documentés : la proportion de sujets exposés au sein de la population générale (pe) et le risque relatif (RR) engendré par cette exposition :
PAR% = [pe(RR – 1) / (pe(RR – 1) + 1)] × 100
Une variante méthodologique cruciale a été formulée ultérieurement par Miettinen en 1974, permettant de dériver cette fraction en se fondant sur la proportion d’exposés observée spécifiquement chez les sujets atteints par la pathologie (désignée conventionnellement par pc, avec pc = A / (A + C)) :
PAR% = pc × [(RR – 1) / RR] × 100
Quelle que soit l’équation employée, le résultat formalise le pourcentage de réduction de l’incidence globale de l’affection que la communauté pourrait espérer obtenir si le facteur de risque était complètement supprimé de l’environnement humain.
5.3 L’impact de la prévalence de l’exposition dans la population générale
L’examen approfondi des équations du RAP et du PAR% révèle une vérité épidémiologique fondamentale : la charge pathologique globale infligée par un déterminant dépend bien davantage de son omniprésence dans le tissu sociétal que de sa virulence biologique intrinsèque.
Pour illustrer ce phénomène mathématique, comparons deux scénarios théoriques distincts :
- Agent A (Toxique rare hautement virulent) : Risque relatif d’infarctus RR = 10, mais touchant une frange marginale de la population, avec une prévalence pe = 0,001 (0,1 %). En appliquant la formule de Levin :
PAR% = [0,001 × 9 / (0,001 × 9 + 1)] × 100 = [0,009 / 1,009] × 100 ≈ 0,89 % - Agent B (Comportement sédentaire ubiquitaire modéré) : Risque relatif d’infarctus très faible, RR = 1,3, mais prévalence massive dans la société moderne, pe = 0,60 (60 %). En réinjectant ces valeurs dans la formule :
PAR% = [0,60 × 0,3 / (0,60 × 0,3 + 1)] × 100 = [0,18 / 1,18] × 100 ≈ 15,25 %
La comparaison numérique est sans appel : un facteur presque anodin sur le plan individuel (surrisque de 30 % pour la sédentarité contre 900 % pour le produit toxique A) s’avère responsable de plus de 15 % de la mortalité coronarienne globale, alors que le toxique spectaculaire n’explique même pas 1 % des cas survenant dans le pays. Cette modélisation fonde mathématiquement l’impératif pour les agences sanitaires de prioriser la modification des comportements sociétaux massifs plutôt que de se concentrer exclusivement sur les anomalies étiologiques exceptionnelles.
6. Étude de cas détaillée : Exemple pratique de calcul pas à pas
6.1 Présentation des données empiriques (tabagisme et pathologie cardiovasculaire)
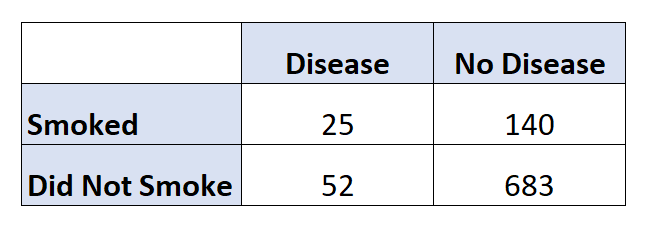
Pour illustrer concrètement l’ensemble de ces propositions algébriques, nous allons développer pas à pas une étude de cas épidémiologique reposant sur une cohorte fermée et prospective de grande envergure. Considérons une cohorte fictive mais représentative de 100 000 individus adultes suivis sur une période longitudinale ininterrompue de 10 années consécutives, afin d’évaluer l’impact direct du tabagisme actif régulier sur la survenue d’accidents vasculaires cérébraux (AVC) ischémiques.
Au début de l’investigation, tous les sujets sont rigoureusement indemnes de tout antécédent neurovasculaire. La répartition méthodologique des effectifs s’établit selon les paramètres empiriques suivants :
- Effectif total des fumeurs réguliers (groupe exposé) : 30 000 participants (soit une prévalence d’exposition pe = 30 %).
- Effectif total des non-fumeurs stricts (groupe non exposé) : 70 000 participants.
Au terme des dix années de suivi clinique exhaustif, le système de recueil collige les données morbides suivantes :
- Parmi les 30 000 sujets exposés au tabagisme, nous enregistrons la survenue de 1 200 cas incidents d’AVC ischémique validés par imagerie cérébrale.
- Parmi les 70 000 sujets préservés du tabac, nous identifions l’apparition de 1 400 cas incidents d’AVC ischémique au cours de la même fenêtre temporelle.
L’insertion méthodique de ces paramètres dans notre matrice de contingence 2×2 standardisée se structure de la manière suivante :
- Cellule A (Exposés / Malades) = 1 200
- Cellule B (Exposés / Sains) = 30 000 – 1 200 = 28 800
- Cellule C (Non-exposés / Malades) = 1 400
- Cellule D (Non-exposés / Sains) = 70 000 – 1 400 = 68 600
Les totaux marginaux se vérifient immédiatement : ligne exposée (A + B) = 30 000, ligne non exposée (C + D) = 70 000, total des malades (A + C) = 2 600, et taille totale de la cohorte N = 100 000.
6.2 Résolution pas à pas du calcul du risque attribuable (RA)
La première phase de la résolution arithmétique consiste à déterminer les incidences cumulées sur dix ans au sein de chacune des deux sous-populations de l’échantillon d’étude.
Le calcul explicite du taux d’incidence cumulée chez les individus exposés au tabagisme s’effectue comme suit :
Ie = A / (A + B) = 1 200 / 30 000 = 0,04 (soit 4,00 % ou 40 cas d’AVC pour 1 000 fumeurs sur 10 ans).
Le calcul explicite du taux d’incidence cumulée chez les individus non-fumeurs s’établit selon l’équation :
I0 = C / (C + D) = 1 400 / 70 000 = 0,02 (soit 2,00 % ou 20 cas d’AVC pour 1 000 non-fumeurs sur 10 ans).
À partir de ces deux valeurs fondamentales, nous pouvons résoudre l’équation du risque relatif (RR) pour apprécier la force de l’association étiologique :
RR = Ie / I0 = 0,04 / 0,02 = 2,00
Le tabagisme double donc statistiquement la probabilité de développer un AVC ischémique au cours des dix années de suivi.
Nous pouvons à présent dériver le risque attribuable absolu (RA) par simple soustraction différentielle :
RA = Ie – I0 = 0,04 – 0,02 = 0,02
La conclusion chiffrée s’énonce avec clarté : le tabagisme est directement responsable d’un surplus absolu de 0,02 cas d’accident vasculaire cérébral par personne exposée sur une période de dix ans. Exprimé de manière standardisée et intelligible pour les cliniciens et le public, le risque attribuable indique que l’inhalation régulière de fumée de tabac engendre 20 cas d’AVC supplémentaires pour 1 000 fumeurs suivis pendant une décennie, au-delà de l’incidence spontanée attendue.
6.3 Calcul et interprétation du PRA% et du PAR%
Disposant de l’ensemble des données d’incidence, nous pouvons calculer les deux métriques relatives de risque attribuable pour dégager une lecture comparative exhaustive.
Appliquons en premier lieu la formule de la fraction attribuable chez les exposés (PRA%) :
PRA% = [RA / Ie] × 100 = [0,02 / 0,04] × 100 = 50,00 %
Ou, en utilisant la formule équivalente fondée sur le risque relatif :
PRA% = [(2,0 – 1) / 2,0] × 100 = [1 / 2] × 100 = 50,00 %
Interprétation clinique : au sein de la population des patients fumeurs ayant été victimes d’un AVC au cours de cette étude, la moitié exacte (50 %) des accidents vasculaires cérébraux est directement imputable au tabac. En supposant l’absence de biais de confusion, la moitié des malades fumeurs auraient été épargnés de cette pathologie invalidante s’ils n’avaient jamais fumé.
Procédons maintenant à la modélisation à l’échelle de la communauté entière par le calcul de la fraction attribuable en population (PAR%). Nous déterminons d’abord l’incidence globale dans la cohorte complète :
Ip = (A + C) / N = 2 600 / 100 000 = 0,026 (soit 26 pour 1 000)
Le risque attribuable en population absolu s’élève à :
RAP = Ip – I0 = 0,026 – 0,020 = 0,006 (soit 6 cas surnuméraires pour 1 000 habitants)
Calculons le PAR% via la formule canonique :
PAR% = [RAP / Ip] × 100 = [0,006 / 0,026] × 100 ≈ 23,08 %
Vérifions par la formule de Levin, avec pe = 0,30 et RR = 2,0 :
PAR% = [0,30(2 – 1) / (0,30(2 – 1) + 1)] × 100 = [0,30 / 1,30] × 100 ≈ 23,08 %
Synthèse analytique : si les politiques publiques de santé parvenaient à l’éradication totale et définitive de l’usage du tabac dans cette population, l’incidence globale de l’AVC dans l’ensemble de la société chuterait immédiatement de 23,08 %. Sur les 2 600 AVC survenus, 600 événements auraient été théoriquement évités au cours de la décennie.
7. Application empirique en psychologie clinique et comportementale
7.1 Modélisation du stress chronique comme facteur de risque de dépression
L’extension opérationnelle du calcul du risque attribuable au périmètre de la psychopathologie et des neurosciences comportementales apporte un éclairage décisif sur les liens reliant la biologie du stress aux décompensations affectives majeures. Sur le plan physiopathologique, l’exposition prolongée à des stresseurs environnementaux sévères induit une dérégulation de l’axe hypothalamo-hypophyso-surrénalien, matérialisée par une hypersécrétion soutenue de cortisol, une atrophie dendritique hippocampique et une élévation de la charge allostatique globale.
Dans le cadre d’études épidémiologiques menées sur la santé mentale au travail, les chercheurs appliquent la métrique du risque attribuable pour modéliser la part des épisodes dépressifs majeurs directement causés par le syndrome d’épuisement professionnel (burn-out) ou le stress chronique professionnel objectivé par le modèle de déséquilibre efforts-récompenses de Siegrist. En comparant une cohorte de salariés soumis à une contrainte psychique extrême à une cohorte évoluant dans un environnement soutenant, l’estimation d’une différence de risque RA = 0,08 indique l’apparition de 8 cas de dépression supplémentaire pour 100 travailleurs exposés chaque année.
Ces données quantitatives permettent de rationaliser le déploiement d’interventions psychothérapeutiques préventives. En déterminant la fraction de dépression attribuable au stress chronique non régulé, les directeurs d’établissements de santé et les psychologues du travail peuvent mesurer le gain épidémiologique exact que générerait la mise en place systématique de programmes de gestion du stress basés sur la pleine conscience ou sur les thérapies cognitives et comportementales (TCC).
7.2 Risque attribuable aux traumatismes de l’enfance sur les troubles anxieux
L’un des apports majeurs de l’épidémiologie psychiatrique de ces vingt dernières années réside dans la quantification de l’impact des traumatismes développementaux précoces grâce à l’utilisation systématique des scores ACE (pour Adverse Childhood Experiences). Ces instruments standardisés recensent l’exposition infantile aux maltraitances physiques, psychologiques, aux abus sexuels et aux dysfonctionnements familiaux sévères.
L’intégration des scores ACE au sein d’une modélisation par tableau croisé 2×2 met en évidence que l’accumulation d’au moins quatre événements indésirables majeurs durant l’enfance est associée à une augmentation spectaculaire du risque d’apparition des troubles anxieux généralisés et des attaques de panique à l’âge adulte. L’application des formulations du risque attribuable chez les exposés montre fréquemment des fractions étiologiques (PRA%) dépassant le seuil critique des 40 à 50 %. Cela signifie que près de la moitié des pathologies anxieuses documentées chez ces adultes vulnérables trouvent leur origine causale directe dans ces blessures affectives précoces.
Pour les décideurs publics et les professionnels de la pédopsychiatrie, le risque attribuable en population (PAR%) calculé à partir de ces cohortes constitue un argument d’une portée majeure. Il prouve de manière empirique que les financements alloués aux services de protection maternelle et infantile et à la prise en charge précoce des violences intrafamiliales ne constituent pas de simples dépenses médico-sociales, mais d’authentiques investissements prophylactiques capables de réduire d’au moins 20 à 30 % la charge globale des troubles psychiatriques dans la population adulte future.
7.3 Calcul de l’impact des comportements sédentaires sur le bien-être psychologique
L’émergence des nouvelles technologies de communication et la prolifération des supports numériques portables ont induit des transformations comportementales drastiques caractérisées par une explosion des conduites sédentaires et une utilisation compulsive des écrans interactifs. Les psychologues s’interrogent de manière croissante sur la proportion de détresse psychologique, d’anhédonie et de troubles du sommeil directement imputables à ces nouvelles habitudes de vie.
Dans les enquêtes de cohorte évaluant les adolescents et les jeunes adultes, le croisement matriciel d’un temps d’écran récréatif supérieur à six heures quotidiennes avec l’échelle de bien-être mental de Warwick-Édimbourg révèle un excès absolu de risque de morosité et de baisse de l’estime de soi statistiquement significatif. L’estimation du risque attribuable permet d’isoler l’impact négatif intrinsèque de l’hyper-connexion en contrôlant pour les biais de confusion usuels tels que le milieu socio-économique ou les antécédents familiaux.
Parallèlement, le calcul de la fraction de risque populationnelle attribuable au manque chronique d’activité physique arie entre 10 % et 15 % pour les troubles de l’humeur d’intensité légère à modérée. Ces données objectives guident directement les interventions en thérapie comportementale et cognitive : elles justifient la prescription d’une activation comportementale structurée et de programmes de réhabilitation physique comme composantes thérapeutiques à part entière, dotées d’une efficacité démontrable sur l’allègement de la morbidité psychique collective.
8. Distinctions comparatives : Risque attribuable vs Risque relatif et Odds Ratio
8.1 Risque attribuable versus Risque relatif (RR)
La distinction épistémologique entre le risque attribuable et le risque relatif relève d’une divergence fondamentale dans la nature même de l’opération arithmétique employée. Le risque attribuable s’inscrit dans une mesure additive : il quantifie la distance géométrique absolue séparant deux taux d’incidence par une soustraction (Ie – I0). À l’inverse, le risque relatif se définit comme une mesure multiplicative : il évalue la force proportionnelle d’une liaison étiologique par une division (Ie / I0).
Cette différence structurelle entraîne des comportements statistiques divergents selon le niveau de base de la pathologie dans la collectivité. Le risque relatif est extrêmement sensible aux maladies orphelines ou hautement inhabituelles. Lorsque l’incidence basale I0 tend vers des valeurs microscopiques, une faible élévation arithmétique du nombre de cas chez les exposés génère une explosion mathématique du ratio, produisant un risque relatif potentiellement astronomique sans pour autant que la situation n’ait de portée sanitaire majeure à l’échelle d’une nation.
À l’opposé, le risque attribuable privilégie l’utilité clinique concrète en exprimant l’ampleur brute du phénomène. Si un chercheur désire percer la physiopathologie intime d’un agent mutagène et sa puissance cancérigène relative en laboratoire, le risque relatif s’impose comme l’outil privilégié. Mais si un administrateur d’hôpital doit dimensionner un service de soins intensifs pour absorber le surplus de morbidité hivernale généré par un virus, seul le risque attribuable fournit la métrique prédictive adéquate. L’épidémiologie moderne récuse l’opposition stérile de ces concepts et préconise leur utilisation complémentaire rigoureuse.
8.2 Risque attribuable versus Rapport de cotes (Odds Ratio – OR)
Le rapport de cotes, ou Odds Ratio (OR), constitue l’indice d’association privilégié des études cas-témoins où les taux d’incidence cumulée ne peuvent pas être directement calculés. Dans ce type de devis de recherche, le chercheur sélectionne rétrospectivement un effectif donné de cas avérés et de témoins sains, mesurant chez chacun la présence passée de l’exposition. Dès lors, le calcul matriciel compare la cote d’exposition chez les malades à celle prévalant chez les non-malades :
OR = (A / C) / (B / D) = (A × D) / (B × C)
Il est scientifiquement erroné d’assimiler l’Odds Ratio à un équivalent direct du risque attribuable, ou même du risque relatif, dès lors que la pathologie étudiée n’est pas exceptionnelle au sein du groupe étudié. Si l’affection est courante (prévalence > 10 %), l’OR amplifie systématiquement la force de l’association, surévaluant l’effet comparativement au RR réel.
Toutefois, sous certaines hypothèses méthodologiques spécifiques — notamment l’hypothèse de maladie rare (rare disease assumption) où l’incidence basale demeure infinitésimale —, l’Odds Ratio constitue une excellente approximation asymptotique du Risque Relatif (OR ≈ RR). Dans ce cas précis, et à la condition formelle de disposer d’une estimation externe et fiable de la prévalence de l’exposition au sein de la population source (pe), les épidémiologistes peuvent dériver indirectement la fraction attribuable en population grâce à la formule de Levin adaptée :
PAR%estimé = [pe(OR – 1) / (pe(OR – 1) + 1)] × 100
Cette dérivation indirecte demeure toutefois tributaire des biais inhérents aux études rétrospectives et doit faire l’objet de précautions interprétatives rigoureuses.
8.3 Pièges d’interprétation et paradoxes statistiques fréquents
L’un des défis majeurs dans l’appropriation du risque attribuable par les analystes réside dans l’intégration cognitive du célèbre paradoxe de Geoffrey Rose, énoncé par l’illustre épidémiologiste britannique en 1985. Ce théorème démontre qu’un grand nombre de personnes exposées à un faible risque engendre presque invariablement davantage de cas de maladie qu’un petit nombre de personnes exposées à un risque élevé.
Ce phénomène contraint les experts de la santé publique à une vigilance constante : focaliser l’ensemble des moyens financiers et technologiques sur la détection des individus à ultra-haut risque individuel (ceux dont le risque relatif et le risque attribuable individuel sont considérables) s’avère fréquemment une stratégie inefficace pour réduire le fardeau pathologique d’une société. La majeure partie des infarctus, des dépressions ou des accidents de la circulation surviennent au sein de la masse considérable des sujets classés en risque faible à modéré, parce que cette strate démographique concentre la quasi-totalité de la population.
Une confusion récurrente consiste également à concevoir le risque attribuable comme une probabilité individuelle garantie. Lorsqu’un article scientifique communique un risque attribuable de 10 % pour une anomalie métabolique, des journalistes ou des cliniciens non avertis traduisent souvent à tort que « chaque individu exposé a 10 % de risque d’être malade », confondant l’incidence propre du groupe exposé (Ie) avec le différentiel net d’incidence (Ie – I0). De telles dérives rhétoriques sapent la confiance du grand public et nuisent à l’adhésion aux messages de prévention primaire.
9. Considérations méthodologiques : Biais, confusion et causalité
9.1 L’impact des variables de confusion sur l’estimation du RA
L’estimation non biaisée du risque attribuable suppose l’absence de distorsion étiologique induite par une variable de confusion. Un facteur de confusion est défini par trois propriétés épidémiologiques simultanées : il doit être associé de façon statistiquement indépendante à l’exposition d’intérêt, être un facteur de risque autonome pour la maladie étudiée, et ne pas se situer sur la chaîne de causalité intermédiaire reliant l’exposition à la survenue du trouble.
Si la variable de confusion n’est pas neutralisée lors du devis ou de l’analyse, la différence brute d’incidence calculée entre exposés et non-exposés incorpore mécaniquement l’effet du tiers facteur, induisant une surestimation ou une sous-estimation systématique du risque attribuable réel. Pour corriger cette distorsion au stade analytique, les biostatisticiens emploient la stratification selon la méthode de Mantel-Haenszel appliquée aux différences de risques. Cette procédure consiste à partitionner la cohorte totale en K strates homogènes pour le facteur de confusion, puis à calculer une différence de risque pondérée globale (RAMH) :
RAMH = ∑ [wk × RAk] / ∑ wk
où wk représente un facteur de pondération statistique calculé à partir de la taille d’échantillon de la sous-strate considérée.
Dans les configurations d’investigation multifactorielle complexe, où de multiples variables confondantes continues et qualitatives s’entremêlent, le recours à la modélisation multivariée s’avère incontournable. Les modèles de régression linéaire généralisée utilisant une fonction de lien d’identité ou les modèles de régression logistique marginaux permettent d’extraire des différences de risques standardisées, contrôlant l’ensemble des biais de confusion observés afin d’approcher l’effet causal contrefactuel pur.
9.2 Biais de sélection et d’information dans les études observationnelles
Au-delà de la confusion, la validité interne de la mesure du risque attribuable est tributaire de l’absence de biais systématiques au cours du déroulement de l’enquête épidémiologique. Le premier écueil d’envergure est constitué par les biais de sélection, particulièrement redoutables au sein des cohortes prospectives de longue durée. L’attrition différentielle de l’échantillon, caractérisée par une proportion disproportionnée de perdus de vue chez les sujets hautement exposés et précarisés, produit un effondrement artificiel de l’incidence mesurée dans ce groupe, conduisant à une sous-estimation substantielle de la différence de risque.
Le second écueil réside dans les biais d’information ou de mesure, qui altèrent l’exactitude du statut d’exposition ou de morbidité attribué aux participants. En psychologie clinique, l’utilisation fréquente de questionnaires rétrospectifs rend les données particulièrement vulnérables au biais de mémoire (ou rappel mnésique). Les sujets souffrant d’un épisode dépressif caractérisé ont une propension neuropsychologique documentée à scruter leur passé avec une sélectivité négative, se remémorant des événements stressants infantiles ou professionnels qui auraient été omis par des témoins sains.
Une mauvaise classification différentielle de l’exposition a pour conséquence mathématique de gonfler artificiellement le risque attribuable calculé. À l’inverse, si l’imprécision du système de mesure s’exerce de manière strictement aléatoire et symétrique dans les deux groupes (erreur de classification non différentielle), elle tend invariablement à gommer les contrastes statistiques et à rapprocher le risque attribuable de zéro. Une vigilance extrême s’impose donc dans le choix des outils psychométriques et des critères nosologiques retenus.
9.3 Critères de causalité de Bradford Hill appliqués au risque attribuable
Sur le plan de l’épistémologie de la recherche médicale, il est capital de réaffirmer qu’une différence de risque arithmétique strictement positive ne prouve jamais, à elle seule, l’existence d’une relation de cause à effet. Le terme même d’« attribuable » implique un postulat d’imputabilité directe qui exige, pour être légitime, la validation préalable de l’ensemble des critères d’inférence causale établis en 1965 par le statisticien médical Sir Austin Bradford Hill.
Le premier critère incontournable est la temporalité : l’exposition incriminée doit précéder chronologiquement et indubitablement les premières manifestations infra-cliniques de la pathologie. Ce critère est formellement vérifié dans les cohortes longitudinales rigoureuses mais fait défaut dans les études transversales. Le second critère capital est la plausibilité biologique et la cohérence physiopathologique, garantissant que l’excès de risque observé s’appuie sur des mécanismes cellulaires, neuroendocriniens ou psychodynamiques crédibles à la lumière des connaissances scientifiques fondamentales du moment.
Un autre jalon fondamental est la mise en évidence d’une relation dose-réponse (ou gradient biologique) : la démonstration que le risque attribuable croît proportionnellement avec l’intensité, la fréquence ou la durée de l’exposition apporte un argument empirique de premier ordre en faveur de la causalité. Ce n’est qu’au terme de cette démarche d’évaluation critique que l’on peut affirmer sans imposture méthodologique que la suppression de l’exposition entraînera une chute concordante de l’incidence des maladies répertoriées.
10. Logiciels statistiques et implémentation computationnelle
10.1 Implémentation du calcul du risque attribuable sous R
L’écosystème open-source du langage de programmation R représente aujourd’hui le standard international pour l’analyse statistique et la modélisation en épidémiologie. De nombreuses bibliothèques spécialisées intègrent des fonctions optimisées permettant de dériver de manière automatisée le risque attribuable, sa variance, son intervalle de confiance ainsi que ses fractions relatives à partir de tables de contingence ou de micro-données longitudinales.
Parmi ces outils, les packages epiR et epitools occupent une place prépondérante. Par exemple, la fonction epi.2by2 issue du package epiR permet de spécifier la matrice d’incidence sous forme de tableau factoriel et de produire un rapport complet incluant le Risk Difference (RA), l’Attributable Fraction in the Exposed (PRA%) et la Population Attributable Fraction (PAR%). L’utilisateur peut paramétrer la méthode de calcul des intervalles de confiance en optant soit pour l’approximation asymptotique classique de Wald, soit pour des techniques plus robustes face aux petits effectifs d’échantillonnage, telles que les méthodes exactes de Clopper-Pearson, le score de Wilson ou les intervalles de confiance fondés sur les profils de vraisemblance.
Ces outils informatiques garantissent une reproductibilité totale des calculs statistiques au sein de la communauté scientifique, réduisant drastiquement les risques d’erreurs de calcul inhérents aux procédures manuelles et assurant une standardisation rigoureuse des formats de publication.
10.2 Procédures d’analyse sous Python et modules épidémiologiques
Dans l’univers de la science des données et de l’apprentissage automatique, le langage Python s’est également doté d’une panoplie d’outils statistiques permettant la manipulation et l’analyse épidémiologique à grande échelle. L’exploitation conjointe des bibliothèques fondamentales pandas pour le formatage tabulaire et numpy pour la vectorisation mathématique offre une efficacité computationnelle optimale lors du traitement de registres de santé comprenant plusieurs millions d’enregistrements.
Pour dériver le risque attribuable et ses dérivés sous Python, les analystes s’appuient fréquemment sur la bibliothèque statsmodels, et plus spécifiquement sur le module statsmodels.stats.contingency_tables. L’objet Table2x2 implémente nativement des méthodes calculant la différence de proportion avec ses intervalles de confiance asymptotiques et de Jeffreys. Parallèlement, des développements récents ont vu émerger des bibliothèques dédiées comme statsmodels.imputation ou des scripts personnalisés permettant d’automatiser le calcul du RAP et du PAR% dans le cadre de pipelines de données complexes.
Cette intégration au sein de l’environnement Python autorise également l’articulation directe des estimations du risque attribuable avec des algorithmes prédictifs plus généraux, facilitant la transition entre la modélisation étiologique causale et le déploiement de modèles de risque prédictif individualisé en milieu clinique hospitalier.
10.3 Gestion des grands jeux de données et bootstrapping pour intervalles de confiance
Lorsque les épidémiologistes sont confrontés à des cohortes massives combinant des structures d’exposition hautement asymétriques, des données manquantes informatives ou des violations flagrantes des hypothèses de normalité asymptotique, les méthodes de calcul d’erreur type standard atteignent leurs limites opérationnelles. Dans ce contexte analytique exigeant, la technique computationnelle du bootstrapping (rééchantillonnage non paramétrique avec remise) s’impose comme la méthodologie de choix.
Cette approche algorithmique consiste à générer par simulation informatique plusieurs milliers de sous-échantillons pseudo-aléatoires (généralement B = 2 000 à B = 10 000) à partir de la base de données source, en reproduisant rigoureusement la taille originelle de l’échantillon. Pour chaque itération de rééchantillonnage, le tableau de contingence 2×2 est reconstruit et la valeur du risque attribuable recalculée. La distribution empirique des milliers de valeurs de RA ainsi synthétisées permet d’extraire directement les centiles 2,5 % et 97,5 %, fournissant un intervalle de confiance par bootstrap percentile d’une robustesse exceptionnelle, totalement affranchi de tout postulat paramétrique théorique préalable.
Le recours aux méthodes de rééchantillonnage informatique permet également de modéliser avec élégance l’incertitude entourant le calcul du risque attribuable en population (PAR%), dont la formule multiplicative intègre simultanément l’erreur stochastique sur la prévalence de l’exposition et celle sur le risque relatif. La visualisation graphique sous forme d’aires de densité de probabilité ou de courbes de calibration offre aux investigateurs une vision nuancée et intègre de l’espace d’incertitude dans lequel s’inscrivent leurs conclusions statistiques.
11. Applications aux politiques publiques et prévention en santé mentale
11.1 Priorisation des interventions de santé publique via le RAP
La finalité ultime de la métrologie du risque en santé publique réside dans l’optimisation décisionnelle de la dépense collective. Les ministères de la Santé et les agences gouvernementales évoluent sous une contrainte budgétaire permanente qui leur impose de hiérarchiser leurs priorités programmatiques de manière transparente et rigoureuse. C’est dans ce cadre stratégique que le risque attribuable en population (RAP et PAR%) assume son rôle d’arbitre démocratique et économique.
Une erreur classique des comités décisionnels consisterait à allouer les fonds publics aux seuls facteurs présentant le risque relatif individuel le plus effrayant. L’analyse par le RAP permet de corriger ce biais de perception : elle guide l’allocation optimale des ressources financières vers les déterminants sociaux, environnementaux et comportementaux qui génèrent le volume brut de morbidité évitable le plus massif au sein du corps électoral. En orientant par exemple les investissements vers la lutte contre le harcèlement en milieu scolaire ou vers la promotion de l’accès aux espaces verts en milieu urbain — facteurs caractérisés par des risques relatifs unitaires modérés mais touchant l’ensemble des citoyens —, l’impact sur les hospitalisations psychiatriques globales est largement maximisé.
Cette priorisation rationnelle éclaire également le débat classique opposant les stratégies préventives universelles aux approches sélectives ciblées. Lorsque le PAR% révèle qu’un déterminant de risque mental est très largement diffus au sein de la population générale, seule une intervention structurelle populationnelle globale (comme la régulation de l’exposition aux écrans chez les jeunes enfants ou la modification des normes ergonomiques du travail) est susceptible de faire reculer efficacement l’incidence du trouble, là où des consultations cliniques ciblées sur quelques sujets symptomatiques n’endigueront jamais la vague épidémiologique.
11.2 Estimation du bénéfice populationnel d’une réduction de facteur de risque
Dans la réalité concrète de l’action publique, l’éradication totale, immédiate et définitive d’un facteur de risque sociétal relève de l’utopie théorique. Il est irréaliste de postuler qu’une campagne préventive parviendra à ramener à zéro absolu la consommation d’alcool, le stress au travail ou l’inactivité physique. Pour contourner cette limite du PAR% conventionnel de Levin, les biostatisticiens ont développé une extension mathématique : la fraction d’impact potentiel (Potential Impact Fraction – PIF), également nommée fraction attribuable généralisée.
La PIF évalue la proportion de cas morbides qui seraient évités à la suite d’une modification partielle réaliste du profil d’exposition au sein de la population générale. Si une campagne d’information parvient à réduire de 20 % la prévalence du manque de sommeil chronique ou à faire baisser de 15 % la consommation d’aliments ultra-transformés, l’équation de la PIF intègre ces nouvelles distributions contrefactuelles :
PIF = [∑ (pi × RRi) – ∑ (p’i × RRi)] / [∑ (pi × RRi)]
où pi représente la prévalence empirique de chaque strate d’exposition initiale et p’i formalise la prévalence prévisionnelle projetée après la mise en œuvre de la mesure préventive.
Ce formalisme permet d’établir des projections dynamiques d’une grande valeur prédictive, fournissant aux autorités sanitaires le nombre exact de pathologies psychiatriques ou cardiovasculaires que chaque scénario interventionnel réaliste permettra d’épargner au système de soins sur les cinq, dix ou vingt prochaines années.
11.3 Évaluation médico-économique et rentabilité des programmes préventifs
L’argumentation épidémiologique trouve son prolongement naturel dans le champ de la pharmacoéconomie et de l’évaluation médico-économique. Le risque attribuable sert de socle de calcul direct pour dériver l’impact des expositions sur la charge globale de morbidité, usuellement mesurée par l’Organisation mondiale de la santé à travers l’indicateur des DALY (Disability-Adjusted Life Years, ou Années de Vie Ajustées sur l’Incapacité).
En couplant le risque attribuable en population au nombre d’années de vie perdues prématurément et aux années vécues avec une incapacité, les économistes de la santé peuvent calculer avec exactitude le ratio coût-efficacité incrémental (ICER) de tout programme préventif. Si une politique d’intervention psychologique ciblée en milieu scolaire présente un coût global d’implantation de 2 millions d’euros mais permet, au travers de la réduction du risque attribuable de dépression adolescente, de prévenir 1 000 DALY d’une valeur médico-sociale unitaire estimée à 50 000 euros, la rentabilité de l’action publique est incontestablement démontrée sur le plan financier.
Cette traduction en indicateurs monétaires et en fardeaux tangibles constitue le vecteur de communication le plus persuasif lors des arbitrages parlementaires et des négociations budgétaires. Le risque attribuable cesse alors d’être un paramètre confiné aux traités universitaires de biomédecine pour s’ériger en un puissant instrument de gouvernance sanitaire.
12. Synthèse, perspectives critiques et bonnes pratiques de rapportage
12.1 Normes de publication scientifique (lignes directrices STROBE)
Face aux dérives historiques observées dans la littérature biomédicale — où les auteurs ont trop souvent mis en avant des risques relatifs sensationnels en omettant de préciser l’ampleur microscopique des risques absolus correspondants —, la communauté épidémiologique internationale a instauré des standards de transparence méthodologique stricts. L’initiative internationale STROBE (Strengthening the Reporting of Observational Studies in Epidemiology) constitue la référence incontournable guidant la rédaction et la publication d’études observationnelles de cohortes, cas-témoins et transversales.
Les recommandations formelles de la grille STROBE imposent aux chercheurs de ne jamais consigner une mesure d’association relative sans rapporter concomitamment les mesures d’impact absolu correspondantes. Les auteurs d’un protocole sont ainsi tenus de publier de manière exhaustive les effectifs non tronqués des cellules des tables de contingence (numérateurs et dénominateurs complets), les taux d’incidence cumulée observés, les différences de risques absolues (RA), ainsi que leurs intervalles de confiance à 95 % respectifs.
Ces directives méthodologiques visent à préserver l’intégrité de la communication scientifique et à prémunir les médias grand public comme les praticiens de terrain contre les déformations sensationnalistes. Une annonce prétendant qu’un facteur « double le risque de développer un trouble psychique rare » prend une signification radicalement différente dès lors que le rapport STROBE impose de préciser que le risque attribuable absolu ne s’élève qu’à 1 cas supplémentaire pour 50 000 personnes-années.
12.2 Limites inhérentes à l’extrapolation causale univariée
En dépit de son élégance mathématique et de son utilité opérationnelle, le modèle classique du risque attribuable se heurte à des limites conceptuelles majeures lorsqu’il est confronté à la réalité biologique des affections multifactorielles. Le piège épidémiologique le plus spectaculaire est le célèbre paradoxe de la somme des fractions attribuables, dans lequel l’addition des fractions attribuables en population (PAR%) calculées de façon isolée pour plusieurs facteurs de risque distincts d’une même maladie dépasse allègrement le seuil logique des 100 %.
Ce résultat en apparence absurde s’explique par le fait que les différentes causes d’une maladie n’agissent pas comme des tiroirs indépendants et étanches, mais interagissent de façon synergique au sein de ce que Kenneth Rothman a modélisé sous le concept de « causes suffisantes et composantes ». Un accident cardiaque peut résulter de l’action conjointe et simultanée d’un terrain génétique sensible, du tabagisme, de l’hypertension artérielle et du stress psychologique. Dès lors, la suppression théorique de n’importe lequel de ces quatre composants interconnectés aurait pu suffire à briser la chaîne causale et à éviter l’accident, de sorte que le même cas d’infarctus est simultanément « attribuable » à chacun des quatre facteurs pris isolément.
Cette réalité biologique disqualifie toute tentative d’extrapolation simpliste fondée sur des modèles univariés. Elle exige, particulièrement en psychopathologie et en médecine interne, le recours à des approches étiologiques systémiques capables de modéliser les interactions gène-environnement, les effets modérateurs et les non-linéarités caractérisant la vulnérabilité humaine.
12.3 Synthèse intégrative et recommandations pour les chercheurs
Au terme de ce parcours approfondi, il apparaît manifeste que le risque attribuable et ses prolongements populationnels constituent des jalons irremplaçables pour quiconque œuvre dans les domaines de la recherche biomédicale, de la psychologie de la santé et de l’administration des systèmes de soins. Le tableau synthétique suivant résume les caractéristiques cardinales des principales métriques étudiées afin de guider le chercheur dans la sélection de l’indicateur le plus pertinent selon ses objectifs :
- Risque Relatif (RR = Ie / I0) : Métrique multiplicative pure. Utilisée pour évaluer la force étiologique biologique d’un agent indépendamment du volume de population. Indispensable pour la recherche fondamentale et les études mécanistiques.
- Risque Attribuable / Différence de Risque (RA = Ie – I0) : Métrique additive d’impact absolu chez les exposés. Quantifie l’excès brut de cas par individu exposé. Indispensable pour le clinicien, la relation thérapeutique individualisée et l’évaluation du bénéfice clinique direct.
- Pourcentage de Risque Attribuable chez les exposés (PRA% = [RA / Ie] × 100) : Fraction proportionnelle individuelle. Mesure la part du risque d’un sujet exposé exclusivement causée par le facteur. Indispensable pour l’entretien motivationnel et la compréhension du patient.
- Risque Attribuable en Population (RAP = Ip – I0) : Métrique d’impact absolu populationnel. Évalue le surplus global de morbidité rapporté à l’ensemble de la communauté. Indispensable pour quantifier la charge collective de morbidité.
- Fraction Attribuable en Population (PAR% = [RAP / Ip] × 100) : Indicateur de santé publique universelle. Estime le pourcentage de chute globale de l’incidence consécutif à l’éradication du risque. Indispensable pour l’arbitrage ministériel et l’allocation des budgets préventifs.
Les perspectives d’évolution de la discipline s’inscrivent résolument dans les cadres modernes de l’inférence causale formelle théorisée par Donald Rubin et Judea Pearl. À travers l’utilisation des graphes acycliques dirigés (DAGs), des scores de propension et des modèles structurels marginaux, les épidémiologistes contemporains parviennent désormais à extraire des risques attribuables contrefactuels débarrassés des biais de confusion les plus retors, réaffirmant le rôle de cette métrique comme la boussole incontournable d’une médecine et d’une santé publique fondées sur les preuves.
Références
Benichou, J. (2001). A review of attributable risk: Definition, estimation and application. Methods of Information in Medicine, 40(3), 241-248. https://doi.org/10.1055/s-0038-1634483
Doll, R., & Hill, A. B. (1954). The mortality of doctors in relation to their smoking habits: A preliminary report. British Medical Journal, 1(4877), 1451-1455. https://doi.org/10.1136/bmj.1.4877.1451
Greenland, S., & Robins, J. M. (1988). Conceptual problems in the definition and interpretation of attributable fractions. American Journal of Epidemiology, 128(6), 1185-1197. https://doi.org/10.1093/oxfordjournals.aje.a115073
Levin, M. L. (1953). The occurrence of lung cancer in man. Acta Unio Internationalis Contra Cancrum, 9(3), 531-541.
Miettinen, O. S. (1974). Proportion of disease caused or prevented by a given exposure, trait or intervention. American Journal of Epidemiology, 99(5), 325-332. https://doi.org/10.1093/oxfordjournals.aje.a121617
Rose, G. (1985). Sick individuals and sick populations. International Journal of Epidemiology, 14(1), 32-38. https://doi.org/10.1093/ije/14.1.32
Rothman, K. J., Greenland, S., & Lash, T. L. (2008). Modern Epidemiology (3rd ed.). Lippincott Williams & Wilkins.
von Elm, E., Altman, D. G., Egger, M., Pocock, S. J., Gøtzsche, P. C., Vandenbroucke, J. P., & STROBE Initiative. (2007). The Strengthening the Reporting of Observational Studies in Epidemiology (STROBE) statement: Guidelines for reporting observational studies. The Lancet, 370(9596), 1453-1457. https://doi.org/10.1016/S0140-6736(07)61602-X