
Dans le paysage foisonnant de la théorie des probabilités et de la statistique inférentielle, la distribution catégorielle occupe une position charnière, à la croisée de la formalisation mathématique pure et des sciences empiriques appliquées. Fréquemment désignée sous les vocables de loi multinomiale généralisée à tirage unique ou de distribution de Bernoulli polytomique, elle constitue le modèle canonique par excellence pour représenter tout phénomène aléatoire dont l’issue se traduit par un choix parmi un ensemble discret, fini et mutuellement exclusif d’événements. Alors que l’analyse statistique s’est historiquement construite autour de variables continues régies par la loi normale de Gauss, la réalité des observations humaines, biologiques et comportementales relève très souvent de l’irréductibilité de classifications qualitatives : états cliniques, préférences électorales, typologies nosographiques ou réponses discrètes à des inventaires psychométriques.
La compréhension rigoureuse de la distribution catégorielle ne se résume pas à l’énumération de probabilités associées à des modalités arbitraires. Elle implique une immersion approfondie dans la géométrie de l’espace des probabilités — le simplexe unitaire —, une compréhension méticuleuse de la structure de covariance induite par les contraintes de fermeture sommatrice, ainsi qu’une maîtrise des techniques d’estimation modernes, qu’elles relèvent de la tradition fréquentiste du maximum de vraisemblance ou des paradigmes bayésiens exploitant la distribution de Dirichlet comme loi a priori conjuguée. À l’heure où l’apprentissage automatique, les modèles de traitement du langage naturel et les réseaux de neurones profonds mobilisent la fonction Softmax comme dernière couche de classification, la distribution catégorielle s’affirme comme le cœur battant de la décision algorithmique probabiliste.
Le présent article propose une analyse exhaustive et encyclopédique de la distribution catégorielle. En explorant ses fondements axiomatiques, son articulation avec les lois de Bernoulli et multinomiale, ses applications prépondérantes en psychométrie et en sciences sociales, ainsi que les écueils computationnels liés à la rareté des données et aux biais méthodologiques, ce travail vise à fournir aux chercheurs, modélisateurs et statisticiens une référence théorique et pratique intégrale. De la démonstration de son appartenance à la famille exponentielle aux subtilités de l’analyse en classes latentes, nous explorerons les multiples facettes de cet outil mathématique indispensable.
1. Introduction et définition fondamentale de la distribution catégorielle
1.1 Origine conceptuelle et définition statistique générale
D’un point de vue conceptuel, la distribution catégorielle s’impose lorsqu’un chercheur observe un phénomène dont l’aboutissement ne peut être quantifié le long d’un continuum métrique, mais doit être assigné à une et une seule étiquette qualitative au sein d’un répertoire délimité. Formellement, si l’on considère un espace probabilisable muni de sa tribu et de sa mesure de probabilité, une variable aléatoire catégorielle est une fonction mesurable qui prend ses valeurs dans un ensemble fini comprenant un nombre K d’états distincts, traditionnellement indexés de 1 à K. Chaque modalité possible se voit assigner une probabilité intrinsèque, reflétant sa propension stochastique à émerger lors de la réalisation de l’expérience aléatoire. Ce mécanisme sous-tend la nature discrète de la variable, interdisant toute valeur intermédiaire ou fractionnaire entre deux états déterminés.
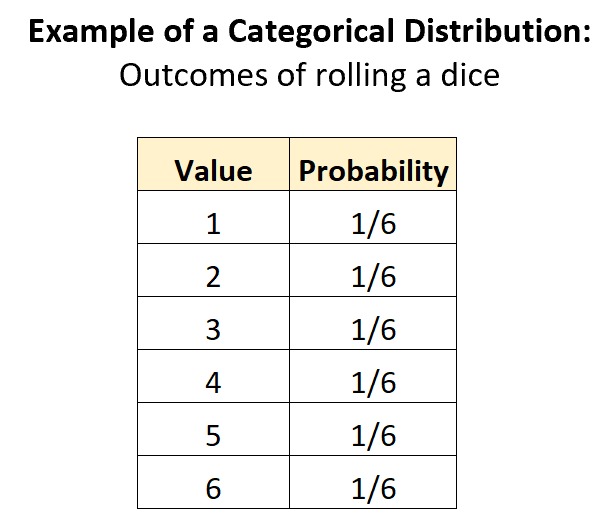
L’illustration la plus universelle et pédagogique de cette loi demeure l’analogie canonique du lancer d’un dé cubique régulier à six faces. Dans cette expérience, l’ensemble des modalités possibles est constitué des six faces numérotées, et la distribution catégorielle attribue à chaque face une probabilité rigoureusement égale à un sixième sous l’hypothèse de symétrie physique. Si le dé est pipé, les probabilités diffèrent, mais la structure formelle demeure rigoureusement une distribution catégorielle à six états. Cette analogie met en lumière l’exigence d’exclusion mutuelle : l’obtention d’une face exclut simultanément la survenue de toutes les autres lors d’un même essai unitaire.
Il est par ailleurs fondamental d’établir d’emblée une différenciation épistémologique stricte entre les catégorisations purement nominales et les catégorisations ordonnées. Dans une distribution catégorielle nominale, l’indexation numérique des catégories n’emporte aucune signification algébrique, spatiale ou hiérarchique : désigner l’état « Célibataire » par 1, « Marié » par 2 et « Divorcé » par 3 relève d’une pure convention de codage. Aucune relation d’ordre ne permet de postuler que l’état 2 est supérieur à l’état 1, ou que la distance entre 1 et 2 équivaut à la distance entre 2 et 3. Inversement, les échelles ordinales introduisent une transitivité directionnelle, bien qu’elles partagent la machinerie probabiliste des distributions discrètes polytomiques.
1.2 Les critères de classification stricts
Pour qu’une structure stochastique puisse être rigoureusement qualifiée de distribution catégorielle au sens mathématique, elle doit impérativement satisfaire un corpus de critères formels immuables. Le premier critère réside dans la finitude et la discontinuité absolue de son espace d’échantillonnage. Contrairement aux lois discrètes infinies telles que la distribution de Poisson ou la loi géométrique, dont le support s’étend sur l’ensemble dénombrable des entiers naturels, la loi catégorielle confine strictement ses réalisations à un ensemble borné d’issues discrètes. Aucun débordement hors de cette frontière d’états préétablis n’est admis par la théorie.
Le second critère pose la condition d’existence minimale : le nombre d’états potentiels K doit être un entier naturel supérieur ou égal à deux. Dans le cas dégénéré où K serait égal à un, la variable cesserait d’être aléatoire pour devenir déterministe, annulant l’intérêt de la modélisation probabiliste. Lorsque K est strictement égal à deux, la distribution catégorielle se simplifie en une loi binaire classique, rejoignant la formulation élémentaire de Jacques Bernoulli.
Le troisième critère découle de la théorie générale de la mesure et stipule la non-négativité stricte ainsi que la limitation unitaire de chaque probabilité individuelle. Pour toute catégorie k appartenant à l’ensemble des issues, le paramètre probabiliste associé doit être compris dans l’intervalle fermé allant de zéro à un. Enfin, le quatrième critère, cardinal et structurant, impose la condition d’exhaustivité : la somme algébrique des probabilités affectées à chacune des K modalités doit être rigoureusement égale à un. Cette contrainte de fermeture sommatrice n’est pas un simple artefact arithmétique ; elle lie intimement les probabilités entre elles, induisant que l’accroissement de la propension d’une classe impose mécaniquement la décroissance de la somme des probabilités dévolues aux classes restantes.
1.3 Importance épistémologique dans la recherche quantitative
Sur le plan épistémologique, la distribution catégorielle réalise un pont méthodologique indispensable entre la complexité phénoménologique des sciences humaines et la rigueur de l’analyse quantitative formelle. Dans l’observation du monde réel, les comportements, les décisions subjectives, les diagnostics de pathologies et les affiliations sociologiques se manifestent sous une forme éminemment qualitative. Refuser l’existence de la distribution catégorielle reviendrait à contraindre artificiellement la réalité empirique au sein de métriques continues arbitraires, au risque de dénaturer profondément la structure de l’information brute recueillie sur le terrain.
En offrant un cadre statistique rigoureux pour modéliser des choix polytomiques sans postuler l’existence d’une échelle sous-jacente continue, cette loi de probabilité permet aux chercheurs d’étudier scientifiquement des variations comportementales complexes. Que ce soit dans l’analyse des trajectoires de santé mentale, l’étude des décisions électorales ou la mesure des dynamiques organisationnelles, elle confère aux entités qualitatives le statut d’objets mathématiques manipulables par l’inférence. Elle autorise le calcul d’espérances sous forme d’indicateurs, l’évaluation de vraisemblances et l’estimation d’incertitudes avec le même degré de précision analytique que celui réservé aux grandeurs physiques traditionnelles.
Au sein de la taxinomie probabiliste moderne, la distribution catégorielle occupe ainsi une fonction de brique élémentaire fondamentale. Elle constitue le noyau constitutif des processus de Markov discrets, des modèles de mélange fini, des architectures de classification supervisée et non supervisée, ainsi que des théories contemporaines de la décision rationnelle. Son étude approfondie ne relève donc pas d’une simple curiosité technique, mais de l’acquisition d’un langage fondamental indispensable à tout analyste confronté à l’irréductible diversité des typologies empiriques.
2. Axiomes mathématiques et propriétés structurales
2.1 Axiomatique des probabilités appliquées aux catégories
L’assise mathématique de la distribution catégorielle repose sur l’application rigoureuse des axiomes fondamentaux énoncés par Andreï Kolmogorov en 1933, adaptés à un univers probabilisé fini. Considérons un univers d’échantillonnage Omega composé de K événements élémentaires mutuellement exclusifs, notés de omega_1 à omega_K. La tribu d’événements associée est naturellement définie comme l’ensemble des parties de cet univers, formant une algèbre booléenne complète. La mesure de probabilité assigne à chaque singleton constitué par un événement élémentaire une valeur scalaire réelle respectant le premier axiome de positivité, interdisant toute valeur négative.
Le second axiome, dit de normalisation, impose que la mesure de probabilité de l’univers total soit strictement unitaire. Cela implique directement que la somme des mesures attribuées à chaque catégorie singulière s’élève exactement à l’unité. Géométriquement, l’ensemble des vecteurs de probabilités admissibles ne remplit pas l’intégralité de l’espace euclidien de dimension K, mais se trouve confiné à un sous-espace affine restreint : le simplexe unitaire standard, souvent noté Delta de dimension K-1. Ce confinement géométrique confère à la distribution des propriétés structurales remarquables, limitant ses degrés de liberté effectifs à K-1, la dernière probabilité étant automatiquement déterminée par le complément à l’unité de la somme des précédentes.
Enfin, le troisième axiome kolmogorovien, relatif à la sigma-additivité, se décline ici dans sa forme finie : la probabilité de survenue de l’union de plusieurs catégories disjointes est rigoureusement équivalente à la somme des probabilités de chacune de ces catégories prises isolément. L’exclusion mutuelle parfaite assure l’absence d’intersections non nulles entre les événements élémentaires. Il en découle une partition exacte de l’espace des événements, garantissant que toute réalisation de l’expérience engendre obligatoirement l’activation d’un et d’un seul état catégoriel, sans ambiguïté ni chevauchement distributionnel possible.
2.2 Moments et caractérisation distributionnelle
La dérivation des moments statistiques d’une variable catégorielle requiert une précaution analytique impérative : dans la mesure où les catégories ne possèdent pas de valeur métrique intrinsèque, le calcul d’une espérance ou d’une variance directement sur l’indice scalaire de la catégorie est dénué de validité mathématique. Pour surmonter cette limitation, la caractérisation distributionnelle s’opère en décomposant la variable catégorielle en un vecteur aléatoire d’indicatrices binaires, de dimension K. Chaque composante Y_k de ce vecteur prend la valeur 1 si la catégorie k se réalise, et 0 dans le cas contraire.
Dès lors, l’espérance mathématique de la variable indicatrice Y_k s’établit de façon élégante comme étant rigoureusement égale au paramètre de probabilité pi_k associé à cette catégorie spécifique. En d’autres termes, l’espérance du vecteur catégoriel n’est autre que le vecteur des paramètres probabilistes lui-même. En ce qui concerne les moments d’ordre deux, la variance marginale de chaque variable indicatrice correspond à la variance classique d’un processus de Bernoulli, soit le produit du paramètre pi_k par son complémentaire unitaire (1 – pi_k).
La structure de dépendance interne du système se révèle pleinement à travers la matrice de covariance entre les différentes composantes du vecteur indicateur. Pour tout couple d’indices distincts j et k, la covariance est systématiquement négative et s’exprime par le produit négatif de leurs probabilités respectives, soit – pi_j * pi_k. Cette négativité universelle des covariances croisées découle mécaniquement de la contrainte de normalisation sommatrice : l’occurrence certaine d’une modalité donnée rend simultanément impossible l’occurrence de toutes les autres. Le tableau ci-dessous synthétise ces propriétés pour les deux premiers moments d’une loi catégorielle générale :
- Espérance marginale de la catégorie k : E[Y_k] = pi_k
- Variance marginale de la catégorie k : Var(Y_k) = pi_k * (1 – pi_k)
- Covariance croisée entre catégories j et k (j différent de k) : Cov(Y_j, Y_k) = – (pi_j * pi_k)
2.3 Entropie de Shannon et degré d’incertitude
Au-delà des moments conventionnels, la caractérisation intrinsèque du désordre ou du contenu informationnel véhiculé par une distribution catégorielle s’effectue au moyen de l’entropie de Shannon, concept emprunté à la théorie de l’information. Pour une loi catégorielle régie par un vecteur de paramètres de dimension K, l’entropie, conventionnellement notée H, s’exprime sous la forme de l’opposé de la somme, étendue sur l’ensemble des K catégories, du produit de chaque probabilité par le logarithme de cette même probabilité. Le choix de la base logarithmique (népérienne, binaire ou décimale) détermine l’unité de mesure de l’information, le nats ou le bit.
L’entropie de Shannon quantifie de manière optimale le degré d’incertitude présent dans le système avant l’observation de l’expérience aléatoire. Elle atteint son minimum absolu, égal à zéro, lorsqu’une catégorie possède une probabilité unitaire et que toutes les autres possèdent une probabilité rigoureusement nulle. Dans cette configuration déterministe, le système ne contient aucune incertitude, et l’observation n’apporte aucun gain d’information. Inversement, l’entropie atteint son extremum théorique maximal lorsque le système se trouve dans un état d’équiprobabilité parfaite, où chaque paramètre est exactement égal à 1/K. La valeur de cette entropie maximale équivaut alors au logarithme naturel de K.
Cette mesure de l’hétérogénéité catégorielle joue un rôle capital dans l’évaluation des profils empiriques en sciences humaines et en statistiques appliquées. Contrairement à la variance qui nécessite un support ordonné ou métrique, l’entropie constitue une métrique d’évaluation de la dispersion parfaitement adaptée aux variables purement qualitatives. Elle permet d’apprécier si une population présente une polarisation prononcée vers un sous-groupe préférentiel ou si, à l’inverse, elle manifeste une dispersion maximale et homogène à travers l’ensemble des modalités envisageables.
3. Formalisation mathématique et notation statistique
3.1 Paramétrage vectoriel et notations conventionnelles
La formalisation mathématique rigoureuse d’une distribution catégorielle exige l’abandon des notations scalaires réductrices au profit d’un paramétrage vectoriel structuré. On définit ainsi le vecteur des paramètres probabilistes, généralement désigné par la lettre grecque pi ou theta, appartenant au simplexe unitaire de dimension K-1. Ce vecteur est constitué de la suite ordonnée des K réels représentant les probabilités respectives de chaque issue : pi = [pi_1, pi_2, …, pi_K]. Chaque composante satisfait la condition fondamentale de positivité et leur somme unitaire est garantie par construction analytique.
La fonction de masse de probabilité (désignée sous l’acronyme PMF pour Probability Mass Function) formalise la loi attribuant sa probabilité à toute réalisation x de la variable aléatoire. Dans la littérature contemporaine, la formulation la plus concise et algébriquement féconde s’écrit sous la forme d’un produit tensoriel de puissances. En représentant la variable d’observation non pas comme un entier scalaire mais sous la forme d’un vecteur indicatif y de dimension K, la fonction de masse de probabilité s’énonce comme le produit, pour k variant de 1 à K, des termes pi_k élevés à la puissance y_k. Dans cette écriture, la présence de la puissance assure que seul le paramètre associé à la catégorie effectivement observée (pour laquelle l’indicatrice vaut 1) est conservé, tous les autres termes s’élevant à la puissance 0 et devenant ainsi neutres pour le produit multiplicatif.
Sur le plan des abréviations et des conventions d’écriture au sein de la littérature statistique internationale, il est d’usage d’indiquer qu’une variable X suit une loi catégorielle en écrivant X ~ Cat(pi) ou encore X ~ Categorical(K, pi). Certains auteurs privilégient la désignation Multinomial(1, pi), mettant directement en exergue sa nature de cas limite unitaire de la loi multinomiale, bien que l’appellation « catégorielle » demeure sémantiquement plus précise pour désigner l’épreuve élémentaire non agrégée.
3.2 Encodage par vecteur indicateur ou One-Hot Encoding
L’utilisation de l’encodage par vecteur indicateur, omniprésent sous l’appellation anglo-saxonne de one-hot encoding dans les sciences des données, ne constitue pas une simple commodité informatique, mais bien une nécessité théorique fondamentale pour le calcul tensoriel et matriciel. Cet encodage consiste à transformer la modalité qualitative observée en un vecteur binaire standardisé de dimension K, dans lequel une seule composante prend la valeur numérique 1 tandis que l’ensemble des K-1 autres composantes est strictement fixé à 0. Si un individu sélectionne la catégorie numéro trois parmi cinq modalités possibles, son vecteur d’observation sera rigoureusement transcrit sous la forme du vecteur [0, 0, 1, 0, 0].
Sur le plan de l’algèbre linéaire, cette représentation transforme l’espace qualitatif d’origine en une base orthonormée au sein de l’espace vectoriel réel de dimension K. Les vecteurs résultants correspondent exactement aux vecteurs de la base canonique euclidienne. Cette propriété confère une neutralité arithmétique remarquable aux opérations de projection. Notamment, le produit scalaire entre le vecteur d’observation encodé en one-hot et le vecteur des paramètres probabilistes pi permet d’extraire instantanément la probabilité de l’événement réalisé, sans nécessiter d’instructions conditionnelles de rupture dans les algorithmes numériques.
De surcroît, cet encodage prévient tout biais d’interprétation fallacieux lors de l’intégration de variables qualitatives au sein de modèles de régression linéaire ou de réseaux neuronaux profonds. Conserver un codage scalaire entier arbitraire (1, 2, 3…) induirait une fausse métrique et obligerait le modèle à postuler des relations de linéarité ou de proportionnalité totalement artificielles entre des catégories qualitatives par nature incomparables sur une droite réelle.
3.3 Forme générale de la famille exponentielle
Une propriété théorique de premier ordre concernant la distribution catégorielle réside dans sa stricte appartenance à la prestigieuse famille exponentielle de distributions statistiques. Cette famille regroupe les lois de probabilité dont la fonction de densité ou de masse peut s’exprimer sous une forme canonique combinant des fonctions de base, des statistiques exhaustives, des paramètres naturels et une fonction de partition logarithmique. La mise sous cette forme canonique s’effectue en réécrivant la fonction de masse probabiliste sous forme exponentielle en exploitant les propriétés élémentaires du logarithme appliqué au produit des puissances.
Cependant, en raison de la contrainte linéaire stipulant que la somme des probabilités équivaut à un, les K composantes du vecteur de paramètres ne sont pas linéairement indépendantes. Pour lever cette dégénérescence et obtenir une paramétrisation minimale et identifiable, il est indispensable de sélectionner une catégorie de référence, conventionnellement fixée à la modalité K. Dès lors, les paramètres naturels, souvent notés eta_k, apparaissent analytiquement comme les logarithmes des rapports de cotes (ou log-odds) mesurés par rapport à la catégorie de référence, soit le logarithme népérien du quotient de pi_k par pi_K pour tout indice k inférieur à K.
La fonction de log-partition associée, qui assure la normalisation de la mesure, correspond au logarithme de la somme unitaire enrichie des exponentielles des paramètres naturels. Cette formalisation confère d’immenses avantages analytiques. En vertu des propriétés universelles de la famille exponentielle, le problème d’optimisation de la fonction de vraisemblance devient strictement concave. L’absence garantie d’optima locaux non globaux assure ainsi une convergence robuste et stable lors de l’utilisation d’algorithmes d’estimation numérique, qu’il s’agisse de la méthode de Newton-Raphson, du gradient conjugué ou des méthodes de gradient stochastique.
4. Liens conceptuels avec d’autres lois de probabilité
4.1 Généralisation de la distribution de Bernoulli
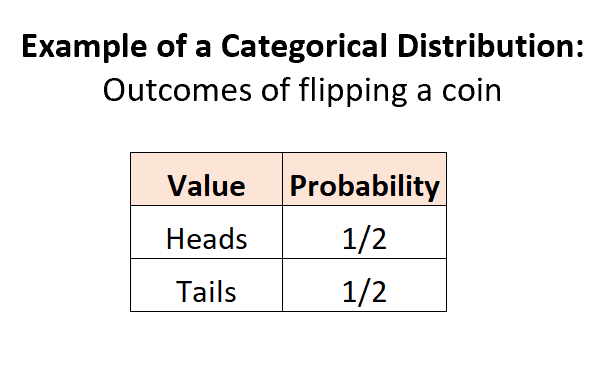
L’articulation entre la distribution catégorielle et la loi de Bernoulli se comprend au mieux par une relation de généralisation dimensionnelle directe. La distribution de Bernoulli, introduite originellement pour modéliser le résultat d’un tirage binaire élémentaire (succès ou échec, présence ou absence), représente le cas particulier le plus élémentaire de la loi catégorielle où le nombre total d’états K est rigoureusement fixé à deux. Il existe une stricte équivalence théorique et opérationnelle entre une loi catégorielle à deux modalités et une distribution de Bernoulli régie par le paramètre scalaire p.
Dans ce cadre binaire restreint, le simplexe unitaire de dimension un se réduit à un segment de droite délimité par les valeurs zéro et un. La probabilité de la seconde catégorie est automatiquement déduite par le complémentaire scalaire 1 – p. Lors du passage à la distribution catégorielle générale pour un entier K quelconque supérieur à deux, le scalaire unique de probabilité est généralisé en un vecteur d’espace multidimensionnel, opérant l’extension du segment unidimensionnel vers un simplexe à géométrie polytopique.
Cette continuité conceptuelle s’observe avec la même netteté dans l’analyse des fonctions génératrices des moments et des fonctions caractéristiques. En projetant la fonction caractéristique de la loi catégorielle sur un espace bidimensionnel, on retrouve trait pour trait l’expression mathématique de la fonction caractéristique de la loi de Bernoulli, confirmant que cette dernière n’est rien d’autre que la trace unidimensionnelle de la famille catégorielle plus vaste.
4.2 Rapport direct avec la loi multinomiale
L’amalgame terminologique entre distribution catégorielle et loi multinomiale est extrêmement fréquent dans la littérature scientifique. Pourtant, une distinction conceptuelle fondamentale sépare ces deux objets mathématiques. La distribution catégorielle modélise le comportement stochastique d’un unique essai unitaire produisant une issue parmi K états possibles. Elle opère donc exclusivement à l’échelle de l’événement atomique individuel. En revanche, la loi multinomiale caractérise la distribution conjointe des vecteurs de comptages obtenus lors de la répétition d’un nombre N d’essais catégoriels indépendants et identiquement distribués.
Formellement, la distribution catégorielle n’est donc rien d’autre qu’une loi multinomiale pour laquelle la taille d’échantillon N est explicitement et irrévocablement fixée à l’unité (N = 1). Lorsqu’on agrège N réalisations indépendantes issues d’une même distribution catégorielle de paramètre pi, le vecteur résultant, dont chaque composante enregistre le nombre total de réalisations observées pour la catégorie correspondante, suit très exactement une loi multinomiale de paramètres N et pi.
Cette dichotomie structurelle entraîne des implications opérationnelles majeures. L’espace d’échantillonnage de la loi catégorielle est constitué de vecteurs binaires ne contenant qu’un seul chiffre 1, tandis que l’espace d’échantillonnage de la loi multinomiale englobe des vecteurs d’entiers naturels dont la somme globale est égale à N. En recherche empirique, la distribution catégorielle sera mobilisée dès lors que l’unité d’analyse demeure l’observation individuelle microscopique (par exemple, le choix d’un consommateur donné), tandis que la loi multinomiale interviendra lors du traitement de données agrégées ou de tables de contingence macroscopiques.
4.3 Conjugaison naturelle avec la loi de Dirichlet
Dans le cadre de l’inférence statistique bayésienne, la distribution catégorielle entretient une symbiose analytique parfaite avec la loi de Dirichlet. Cette dernière joue le rôle canonique de loi a priori conjuguée pour les paramètres d’une distribution catégorielle ou multinomiale. La notion de conjugaison implique ici que si la distribution a priori attribuée au vecteur de paramètres pi est une loi de Dirichlet, alors, après observation d’un ensemble de réalisations catégorielles, la distribution a posteriori conditionnée par les données appartient à la même famille fonctionnelle de Dirichlet.
La loi de Dirichlet est elle-même paramétrée par un vecteur d’hyperparamètres positifs, traditionnellement désignés par la lettre grecque alpha, de dimension K. Une interprétation bayésienne intuitive et puissante consiste à concevoir ces hyperparamètres comme des « pseudo-comptages » ou des observations virtuelles préalables acquises par l’analyste avant même le recueil effectif des données d’expérience. Ainsi, un a priori de Dirichlet non informatif et plat (où chaque composante d’alpha vaut 1) équivaut à postuler une densité uniforme sur l’ensemble de la surface du simplexe unitaire.
L’actualisation bayésienne découle alors d’une simplicité algébrique remarquable : il suffit d’additionner au vecteur d’hyperparamètres a priori le vecteur empirique des effectifs réels observés pour chaque classe. La distribution a posteriori obtenue s’établit alors instantanément comme une nouvelle loi de Dirichlet dont les paramètres sont la somme composante par composante d’alpha et des occurrences observées. Cette propriété d’actualisation analytique directe élimine le recours systématique aux algorithmes d’intégration numérique lourds et permet de calculer immédiatement la moyenne a posteriori ainsi que les intervalles de crédibilité des paramètres.
5. Représentation graphique et interprétation des variables catégorielles
5.1 Visualisations classiques : diagrammes en barres et graphiques en bâtons
La restitution visuelle d’une distribution catégorielle constitue une étape cruciale pour l’analyse exploratoire des données, mais elle se heurte fréquemment à des confusions graphiques fondamentales. L’outil de représentation standardisé le plus rigoureux demeure le diagramme en barres (ou graphique en bâtons), dans lequel chaque modalité discrète est disposée le long d’un axe cartésien non métrique, tandis que la hauteur de la barre ou du bâton reflète proportionnellement sa probabilité marginale théorique ou sa fréquence relative observée.
Il est impératif d’éviter rigoureusement l’usage des histogrammes pour représenter des distributions catégorielles nominales. Dans un histogramme authentique, les rectangles se touchent pour signaler la continuité physique de la variable sous-jacente, et c’est l’aire des surfaces — et non pas simplement la hauteur — qui traduit la densité de probabilité. L’application d’un histogramme à une loi catégorielle génère un artefact visuel trompeur en suggérant fallacieusement un continuum inexistant entre des modalités par nature disjointes. Par conséquent, les diagrammes en barres dédiés aux variables catégorielles doivent obligatoirement maintenir un espacement physique net et régulier entre chaque barre afin d’incarner géométriquement la rupture d’états.
Un autre écueil récurrent réside dans l’utilisation non critique des diagrammes circulaires (ou camemberts). Bien qu’ils traduisent visuellement l’idée d’une somme égale à cent pour cent, les mécanismes de la perception visuelle humaine apprécient très mal les comparaisons d’angles ou de surfaces sectorielles non alignées, particulièrement lorsque le nombre de catégories K dépasse quatre ou cinq modalités. Le diagramme en barres horizontales ou verticales, rigoureusement ordonné selon les probabilités décroissantes, offre une lisibilité cognitive largement supérieure pour hiérarchiser les catégories.
5.2 Projection géométrique sur le simplexe
Pour appréhender la structure globale d’une distribution catégorielle indépendamment du découpage par modalités isolées, la projection géométrique directement sur le simplexe unitaire offre une perspective spatiale d’une remarquable fécondité. Pour un système constitué de trois catégories (K = 3), le simplexe de dimension deux se matérialise visuellement sous la forme d’un triangle équilatéral dans un espace bidimensionnel, universellement désigné sous le nom de diagramme ternaire ou triangle de De Finetti en théorie probabiliste.
Dans ce repère géométrique, chacun des trois sommets du triangle représente l’assignation déterministe unitaire à l’une des trois catégories : le sommet supérieur correspond par exemple à une probabilité de 1 pour la catégorie A et de 0 pour les autres. Le barycentre exact du triangle matérialise quant à lui le point d’équiprobabilité absolue, où chaque modalité dispose d’une cote précisément égale à un tiers. Tout état de distribution catégorielle trinaire se traduit ainsi par un point spatial unique à l’intérieur du périmètre du triangle, dont la position relative dérive de ses coordonnées barycentriques.
Cette approche graphique permet de tracer des trajectoires dynamiques temporelles pour illustrer l’évolution d’un système catégoriel soumis à des influences extérieures, ou encore de visualiser la convergence d’estimateurs statistiques. L’éloignement progressif d’un point vis-à-vis du centre barycentrique vers l’un des sommets traduit sans ambiguïté la transition d’un régime de dispersion hétérogène vers une dominance unilatérale d’une classe prépondérante.
5.3 Représentation des fréquences empiriques versus distributions théoriques
L’évaluation comparative entre les probabilités assignées par un modèle théorique et la distribution empirique effective recueillie sur un échantillon d’individus requiert des dispositifs visuels spécifiques d’aide à la décision. Le procédé conventionnel consiste à superposer, sur un même axe, les barres d’effectifs observés et des segments de mire horizontaux marquant les probabilités attendues sous le modèle d’hypothèse nulle. Ce dispositif met en exergue immédiate les surplus et les déficits d’occurrence affectant chacune des classes d’observation.
Une modalité plus sophistiquée de visualisation repose sur la cartographie graphique des résidus standardisés de Pearson. Pour chaque catégorie k, le résidu est calculé sous forme de l’écart arithmétique entre l’effectif observé et l’effectif théorique attendu, divisé par la racine carrée de ce dernier. En représentant ces résidus sous forme d’écarts centrés sur une ligne de flottaison zéro, l’analyste repère instantanément les catégories dont les déviations statistiques excèdent les seuils critiques conventionnels de dispersion, signalant ainsi une mauvaise spécification du modèle catégoriel sous-jacent.
Enfin, dès lors que l’on analyse l’interaction stochastique entre plusieurs variables catégorielles conjointes au sein d’une population, les diagrammes en mosaïque (ou mosaic plots) s’imposent comme le standard de représentation graphique. Dans ces visualisations multidimensionnelles, l’aire de chaque pavé rectangulaire est strictement proportionnelle à la probabilité conjointe observée, permettant une détection visuelle intuitive des associations inter-catégorielles et des ruptures d’indépendance statistique.
6. Estimation des paramètres d’une distribution catégorielle
6.1 Estimation par le maximum de vraisemblance (EMV)
L’inférence fréquentiste des paramètres inconnus d’une distribution catégorielle repose de manière prépondérante sur le principe d’estimation par le maximum de vraisemblance. Considérons un échantillon de N observations indépendantes et identiquement distribuées, représentées chacune sous la forme d’un vecteur binaire encodé en one-hot. La fonction de vraisemblance conjointe est formulée comme le produit, sur l’ensemble des N individus, de leurs fonctions de masse probabilistes respectives. Le passage classique au logarithme népérien conduit à la fonction de log-vraisemblance, laquelle se réduit analytiquement à la somme sur k du produit du comptage empirique de la classe k par le logarithme du paramètre pi_k.
Toutefois, la maximisation de cette log-vraisemblance ne peut s’effectuer par une simple annulation des dérivées partielles premières, car les paramètres pi_k sont assujettis à la contrainte d’égalité stipulant que leur somme doit être strictement égale à l’unité. La méthode d’optimisation adaptée consiste donc à introduire un multiplicateur de Lagrange. Le lagrangien du système intègre ainsi la fonction de log-vraisemblance augmentée du produit du multiplicateur par la contrainte de fermeture unitaire.
En dérivant ce lagrangien par rapport à chaque paramètre individuel pi_k et en annulant les gradients obtenus, on démontre avec élégance que chaque probabilité estimée par le maximum de vraisemblance est rigoureusement égale au quotient de l’effectif observé pour cette classe par la taille totale de l’échantillon N. L’estimateur du maximum de vraisemblance se révèle donc être tout simplement la proportion empirique observée au sein de la cohorte d’étude. Cet estimateur jouit de propriétés mathématiques remarquables : il est sans biais, convergent et asymptotiquement efficace.
6.2 Approche bayésienne et régularisation
Nonobstant son élégance, l’estimateur par maximum de vraisemblance manifeste une vulnérabilité critique lorsqu’il est confronté à des échantillons de taille modeste ou à des événements rares : le problème des effectifs nuls. Si, au cours d’une campagne de recueil de données, une catégorie particulière n’est observée aucune fois (effectif égal à 0), l’estimateur du maximum de vraisemblance assignera à cette catégorie une probabilité strictement nulle. Cette déduction s’avère théoriquement intenable, car elle confère une impossibilité absolue à un événement qui n’est, en réalité, qu’improbable ou insuffisamment échantillonné.
Pour remédier à cette pathologie d’estimation, l’inférence bayésienne propose une régularisation naturelle par le biais de la loi a priori conjuguée de Dirichlet dotée d’un vecteur d’hyperparamètres alpha. Deux estimateurs bayésiens sont alors couramment dérivés :
- Le maximum a posteriori (MAP) : il maximise la densité a posteriori globale et correspond à la proportion intégrant des hyperparamètres décrémentés de 1. Il n’est défini que pour des hyperparamètres supérieurs à 1.
- La moyenne a posteriori : elle représente l’espérance mathématique de la distribution de Dirichlet a posteriori. L’estimation de chaque probabilité équivaut alors à la somme de l’effectif observé et de son hyperparamètre alpha_k, divisée par la somme globale de l’échantillon N augmenté de la somme de l’ensemble des composantes d’alpha.
Le cas particulier emblématique de cette régularisation est le célèbre lissage de Laplace (ou règle de succession de Laplace), obtenu en fixant uniformément chaque hyperparamètre alpha_k à 1. Dans ce cas, on ajoute virtuellement une observation fictive à chaque catégorie d’événement. Cette démarche garantit qu’aucune probabilité n’est estimée à zéro, introduisant un compromis optimal entre l’information empirique brute et la prudence inductive face à la rareté d’échantillonnage.
6.3 Propriétés asymptotiques et précision de l’estimation
L’étude asymptotique de l’estimateur d’une distribution catégorielle mobilise les théorèmes fondamentaux de la statistique mathématique. En vertu de la loi forte des grands nombres, la consistance forte de l’estimateur de proportions est assurée : lorsque la taille de l’échantillon N tend vers l’infini, l’estimateur converge presque sûrement vers la valeur authentique du paramètre de probabilité sous-jacent.
L’évaluation de la variance asymptotique et de la précision d’estimation passe par la détermination de la matrice d’information de Fisher. Pour une loi catégorielle à K états, la matrice d’information de Fisher relative aux K-1 paramètres indépendants présente une structure analytique remarquable, combinant des termes diagonaux inversement proportionnels aux probabilités des catégories et un terme d’interaction constant issu de la modalité de référence. L’inversion de cette matrice permet d’atteindre la borne inférieure de Cramér-Rao, prouvant formellement qu’aucun estimateur sans biais ne saurait présenter une variance d’échantillonnage inférieure à celle de l’estimateur par maximum de vraisemblance dans le régime asymptotique.
Par application directe du théorème central limite multidimensionnel, le vecteur normalisé des proportions empiriques suit asymptotiquement une loi normale multivariée centrée sur le vecteur des véritables probabilités. Sa matrice de variance-covariance asymptotique n’est autre que la matrice de covariance théorique divisée par N. Cette normalité asymptotique fonde la construction des ellipsoïdes de confiance conjoints et des intervalles de confiance asymptotiques multivariés indispensables à la validation statistique des profils catégoriels estimés.
7. Applications de la distribution catégorielle en psychométrie et évaluation
7.1 Modélisation des échelles de type Likert et inventaires d’attitudes
Dans l’écosystème de la psychométrie contemporaine, la distribution catégorielle constitue le socle opérationnel sur lequel repose l’ensemble des instruments de mesure d’attitudes, à commencer par les échelles polytomiques de type Likert. Lorsqu’un répondant positionne son degré d’accord face à un énoncé psychologique (par exemple de « Pas du tout d’accord » à « Tout à fait d’accord » à travers cinq échelons d’ancrage), la réponse enregistrée n’est pas un nombre métrique pur, mais une manifestation polytomique discrète relevant directement de la distribution catégorielle.
Cette réalité génère un dilemme méthodologique récurrent en sciences sociales. Une tradition analytique contestable persiste à assigner des valeurs scalaires arbitraires (de 1 à 5) à ces échelons pour ensuite leur appliquer sans discernement des statistiques paramétriques conçues pour des variables continues (moyennes, écarts-types, régressions des moindres carrés ordinaires). Or, cette pratique postule implicitement et sans justification formelle que les intervalles subjectifs séparant deux échelons successifs possèdent une amplitude métrique strictement identique.
La modélisation psychométrique rigoureuse rejette cette fiction arithmétique et traite les réponses à l’item comme les réalisations d’une distribution catégorielle ordonnée. Les modèles d’évaluation avancés préservent ainsi l’intégrité de la validité de construit en reliant la probabilité conditionnelle d’activation de chaque catégorie discrète à un niveau de trait latent psychologique non observable, évitant les distorsions inférentielles majeures induites par la fausse linéarisation continue des réponses qualitatives.
7.2 Nosographie clinique et typologies diagnostiques
Le champ de la psychopathologie clinique et de la nosographie psychiatrique illustre de façon magistrale l’application des distributions catégorielles au diagnostic médical. Les nomenclatures taxonomiques internationales de référence, telles que le Manuel diagnostique et statistique des troubles mentaux (DSM) ou la Classification internationale des maladies (CIM), procèdent fondamentalement par partition catégorielle : un clinicien examine les manifestations syndromiques d’un patient pour l’assigner à une catégorie diagnostique exclusive parmi un ensemble de pathologies délimitées.
Dans les enquêtes épidémiologiques en santé mentale, la prévalence des différentes affections au sein d’une cohorte de patients est systématiquement modélisée par une distribution catégorielle globale. L’estimation des probabilités associées à chaque profil pathologique conditionne les décisions d’allocation de ressources hospitalières et la planification thérapeutique publique. La distribution catégorielle permet de formaliser mathématiquement le passage de critères sémiologiques discrets à une affectation diagnostique unique.
En outre, la nosographie clinique moderne intègre de plus en plus la gestion formelle de l’incertitude évaluative. Au lieu de contraindre le praticien à un diagnostic binaire déterministe souvent prématuré, les approches probabilistes contemporaines utilisent la distribution catégorielle pour attribuer un vecteur de probabilités d’appartenance à différents sous-types syndromiques. Le diagnostic devient alors une variable catégorielle conditionnelle reflétant le niveau de preuve clinique accumulé au cours du bilan psychologique ou psychiatrique.
7.3 Paradigmes de choix forcé en psychologie cognitive expérimentale
L’investigation expérimentale des fonctions cognitives recourt très largement à des protocoles de laboratoire reposant sur des tâches de choix forcé à options alternatives multiples (paradigmes dits de forced-choice). Dans une tâche classique de psychophysique visuelle ou de décision perceptuelle, un stimulus visuel bref est projeté sur un tachistoscope, et le participant doit obligatoirement catégoriser ce qu’il a perçu en appuyant sur l’une des K touches d’un clavier dédié.
La distribution empirique des sélections comportementales observées dans ce type d’épreuve constitue une réalisation directe d’une loi catégorielle régie par des mécanismes attentionnels et décisionnels. L’analyse ne se borne pas à quantifier le simple taux d’exactitude global ; elle dissèque minutieusement la répartition des probabilités affectées aux catégories erronées. En mémoire de travail ou en psycholinguistique, l’examen de la distribution des confusions catégorielles (erreurs phonologiques, erreurs sémantiques, erreurs de proximité spatiale) permet de cartographier l’architecture cognitive des représentations mentales sous-jacentes.
De même, dans les protocoles chronométriques mesurant des temps de réaction discrets sous forte contrainte temporelle, les réponses motrices alternatives se distribuent selon des lois catégoriel-dynamiques. L’évolution des probabilités catégorielles en fonction du délai d’exposition au stimulus renseigne les chercheurs sur la dynamique d’accumulation d’information neuronale et sur les seuils d’activation requis pour déclencher un comportement moteur sélectif.
8. Modélisation statistique avancée et modèles à variables latentes
8.1 Régression logistique multinomiale
Dès lors que l’on cherche à expliquer ou prédire une variable dépendante catégorielle à partir d’un ensemble de prédicteurs explicatifs continus ou qualitatifs, la régression logistique multinomiale s’affirme comme le modèle linéaire généralisé standard. Cette méthode procède en étendant le modèle logit binaire classique par l’établissement d’une série de fonctions de liaison polytomiques reliant les covariables aux probabilités de la loi catégorielle sous-jacente.
Pour assurer la stricte identification statistique des paramètres du modèle, une catégorie de référence est obligatoirement isolée. Pour chacune des K-1 catégories restantes, le modèle formule une équation log-linéaire distincte représentant le logarithme du rapport des cotes entre la probabilité de cette catégorie spécifique et celle de la catégorie de référence. Les coefficients de régression estimés s’interprètent alors sous la forme de rapports de cotes relatifs (Relative Risk Ratios). La transformation inverse, permettant de restituer les probabilités catégorielles normalisées à partir des prédicteurs, mobilise rigoureusement la fonction mathématique Softmax.
Toutefois, la validité de la régression logistique multinomiale repose de manière critique sur une hypothèse théorique extrêmement contraignante : l’indépendance des alternatives non pertinentes (souvent désignée par l’acronyme anglophone IIA, pour Independence of Irrelevant Alternatives). Selon cet axiome issu de la théorie du choix de Luce, le rapport des cotes de sélection entre deux catégories quelconques doit rester strictement insensible à l’adjonction ou à la suppression d’une tierce option dans le répertoire du modèle. Lorsque cette hypothèse est violée — comme dans le célèbre paradoxe de l’autobus bleu et de l’autobus rouge en économétrie des transports —, il devient impératif de recourir à des formulations plus flexibles telles que les modèles logit imbriqués ou les modèles probit multinomiaux à matrice de covariance non contrainte.
8.2 Analyse de classes latentes (LCA)
L’analyse de classes latentes (LCA, pour Latent Class Analysis) est une technique statistique non supervisée d’une extraordinaire fécondité pour la modélisation de distributions catégorielles multivariées. Elle postule que l’hétérogénéité et les associations complexes observées entre un ensemble d’items catégoriels manifestes s’expliquent intégralement par l’existence d’une variable nominale sous-jacente, non mesurable directement, appelée classe latente. Le modèle global se formalise donc comme un modèle de mélange fini de lois catégoriel-conditionnelles.
L’architecture mathématique de la LCA s’articule autour de deux types fondamentaux de paramètres probabilistes, tous régis par des lois catégorielles :
- Les probabilités de prévalence des classes latentes : elles décrivent la taille relative de chaque sous-groupe non observé au sein de la population et forment une distribution catégorielle globale à C modalités.
- Les probabilités de réponse conditionnelle : pour chaque item catégoriel et au sein de chaque classe latente spécifique, elles définissent la distribution catégorielle conditionnelle d’activation des modalités de l’item.
L’estimation conjointe de ces paramètres repose de façon canonique sur l’algorithme espérance-maximisation (EM). Cet algorithme itératif alterne une phase d’espérance, où les probabilités a posteriori d’appartenance aux classes sont calculées pour chaque individu à la lumière de ses réponses effectives, et une phase de maximisation, où les paramètres des lois catégorielles sont réactualisés pour maximiser la log-vraisemblance espérée. En psychologie clinique et sociologie, la LCA permet ainsi d’identifier des typologies comportementales émergentes, des profils de comorbidité psychiatrique ou des sous-types de consommateurs sans imposer d’hypothèse nosographique préalable a priori.
8.3 Modèles de la théorie de la réponse à l’item (TRI) pour données polytomiques
La formalisation avancée de l’évaluation psychométrique et pédagogique trouve son expression la plus accomplie au sein de la Théorie de la Réponse à l’Item (TRI). Lorsque les items d’un test ne sont pas dichotomiques mais polytomiques (comme dans les questionnaires de personnalité ou les épreuves académiques attribuant des crédits partiels), la probabilité d’activer chaque modalité est modélisée par une distribution catégorielle conditionnée par la position du sujet sur le continuum du trait latent latent unitaire (traditionnellement noté par la lettre grecque theta).
Parmi les formulations les plus renommées figurent le modèle de réponse graduée de Fumiko Samejima (Graded Response Model) et le modèle du crédit partiel de Geofferey Masters (Partial Credit Model). Dans ce dernier, qui constitue une extension directe du modèle logistique unitaire de Rasch, la probabilité d’obtenir une catégorie de réponse ordonnée k plutôt que la catégorie immédiatement inférieure k-1 est régie par une fonction logistique de la distance séparant le trait latent individuel du seuil de difficulté spécifique à cette transition d’échelon.
Les courbes caractéristiques de catégories (CCC) issues de ces modèles ne sont rien d’autre que la représentation géométrique continue d’une suite de distributions catégorielles conditionnelles. Pour chaque niveau donné de trait latent sur l’axe des abscisses, la tranche verticale correspondante définit un vecteur probabiliste catégoriel sommant rigoureusement à l’unité. L’estimation conjointe, menée par marginalisation de vraisemblance, permet d’extraire des mesures invariantes de la compétence des individus et de la difficulté des échelons d’item, affranchissant définitivement l’évaluation des biais inhérents aux scores bruts traditionnels.
9. Tests d’adéquation et inférence statistique
9.1 Test d’adéquation du Khi-deux de Pearson
L’évaluation empirique de l’adéquation d’une distribution catégorielle observée face à une distribution théorique postulée repose historiquement sur le célèbre test d’adéquation du Khi-deux formulé par Karl Pearson en 1900. L’hypothèse nulle (H0) pose formellement que le vecteur des probabilités empiriques de la population sous-jacente est rigoureusement identique à un vecteur de probabilités cibles prédéterminé, qu’il s’agisse d’une distribution équiprobable théorique ou de proportions calibrées par la littérature scientifique.
La dérivation de la statistique de test procède par l’agrégation quadratique des écarts d’effectifs observés par rapport aux effectifs théoriques attendus. Pour chacune des K catégories du système, on calcule la différence entre l’effectif constaté et l’effectif théorique attendu sous l’hypothèse nulle, on élève cet écart au carré afin d’éliminer les compensations de signes, et on le normalise en divisant par l’effectif attendu. La somme de ces K composantes normalisées engendre la statistique globale du Khi-deux de Pearson.
Sous réserve de la validité de l’hypothèse nulle et du respect des conditions asymptotiques d’échantillonnage, cette statistique converge en loi vers une distribution théorique du Khi-deux. Le nombre de degrés de liberté associé est rigoureusement égal à K – 1 lorsque les paramètres théoriques sont spécifiés a priori sans estimation préalable sur l’échantillon. Cette soustraction d’un degré de liberté reflète mathématiquement la contrainte de normalisation sommatrice qui lie indissolublement les effectifs des K classes, réduisant la variabilité indépendante du système à K – 1 dimensions effectives.
9.2 Test du rapport de vraisemblance (statistique G2)
Alternative méthodologique de premier ordre au test de Pearson, le test du rapport de vraisemblance, matérialisé par la statistique G2 (parfois qualifiée de statistique de déviance ou de test de Wilks), s’ancre profondément dans la théorie de l’information statistique. La statistique G2 est construite en formant le double de la somme, étendue à toutes les classes, du produit de chaque effectif empirique observé par le logarithme népérien du quotient de cet effectif observé par son homologue théorique attendu.
Sur le plan conceptuel, cette formulation s’avère intimement liée à la divergence de Kullback-Leibler, métrique asymétrique fondamentale mesurant la perte d’information occasionnée par l’approximation d’une distribution empirique de référence par un modèle théorique simplifié. La statistique G2 quantifie directement la distance informationnelle séparant le modèle catégoriel non contraint (le modèle saturé parfait) du modèle restreint sous l’hypothèse nulle.
La statistique G2 jouit d’une propriété analytique exceptionnelle que ne possède pas le Khi-deux de Pearson : l’additivité stricte lors de la décomposition hiérarchique de modèles emboîtés, ce qui en fait le critère de choix pour l’évaluation des modèles log-linéaires et des régressions multinomiales avancées. Bien que le Khi-deux de Pearson et la statistique G2 soient asymptotiquement rigoureusement équivalents lorsque la taille d’échantillon N tend vers l’infini, leurs comportements peuvent diverger notablement dans les échantillons de taille modérée, la statistique G2 étant reconnue pour présenter une sensibilité différente aux déséquilibres d’effectifs marginaux.
9.3 Tests exacts pour faibles effectifs en psychologie clinique
L’un des défis majeurs auxquels est confrontée l’inférence sur les distributions catégorielles en sciences du comportement et en recherche clinique tient à l’effondrement des approximations asymptotiques. Les théorèmes assurant la convergence de la statistique de Pearson ou du G2 vers une loi continue du Khi-deux exigent que la taille de l’échantillon soit suffisamment vaste. Une règle empirique canonique, dite de Cochran, impose que l’ensemble des effectifs théoriques attendus soit supérieur à un, et qu’au moins 80 % d’entre eux soient strictement supérieurs ou égaux à cinq.
Lorsque cette condition fondamentale est violée — situation omniprésente lors de l’étude de pathologies psychiatriques rares, de mutations génétiques isolées ou d’échantillons cliniques pédiatriques restreints —, l’utilisation du Khi-deux asymptotique induit des erreurs d’inférence majeures, sous forme d’une inflation incontrôlée de l’erreur de type I (rejet intempestif de l’hypothèse nulle). Il devient alors impératif d’abandonner l’asymptotique au profit des tests exacts. L’extension du test exact de Fisher aux distributions catégoriel-multinomiales à K dimensions calcule analytiquement la probabilité hypergéométrique exacte de chaque configuration de comptage observable conditionnellement aux marges marginales fixées.
Toutefois, dès lors que le nombre d’états K ou les effectifs totaux s’accroissent modérément tout en restant trop faibles pour l’asymptotique, l’énumération combinatoire intégrale de toutes les tables possibles engendre une explosion combinatoire insoluble sur le plan computationnel. On fait alors appel aux méthodes de rééchantillonnage de Monte-Carlo appliquées aux tests exacts. En simulant un nombre massif (par exemple un million) de tirages catégoriels aléatoires sous l’hypothèse nulle contrainte, on estime avec une précision empirique parfaite la p-valeur exacte, garantissant une inférence clinique irréprochable sans aucune distorsion d’échantillon.
10. Gestion des biais, rareté des données et catégories déséquilibrées
10.1 Problématique des cellules vides et des zéros structurels
L’analyse des distributions catégoriel-multinomiales complexes se heurte fréquemment à la survenue d’occurrences nulles au sein de certains croisements de modalités. Il est méthodologiquement primordial d’établir une ligne de démarcation épistémologique absolue entre deux formes irréductibles de néant observationnel :
- Les zéros accidentels (ou zéros d’échantillonnage) : ils proviennent de la finitude de l’échantillon collecté. La catégorie présente une probabilité théorique non nulle dans la population, mais le hasard de l’échantillonnage a fait qu’aucun individu manifestant cet état n’a été inclus dans la cohorte observée.
- Les zéros structurels (ou impossibilités logiques) : ils traduisent une interdiction ontologique absolue imposée par la nature ou la définition même des concepts. Par exemple, au sein d’un croisement catégoriel entre le sexe biologique et le diagnostic médical, la cellule correspondant au diagnostic de « cancer de la prostate » chez une femme biologique constitue un zéro structurel rigoureux, dont la probabilité théorique est ontologiquement égale à zéro.
La confusion entre ces deux types de zéros conduit à des catastrophes analytiques. Ignorer la nature accidentelle d’un zéro induit l’effondrement des algorithmes d’estimation par maximum de vraisemblance, provoquant la divergence des paramètres dans les régressions logistiques multinomiales (phénomène de quasi-séparation ou séparation complète). Pour stabiliser l’inférence, on applique des techniques de pénalisation formelle, telles que la régularisation de Firth (qui ajoute une pénalité dérivée de la matrice d’information de Fisher à la log-vraisemblance) ou l’injection de pseudo-observations bayésiennes, permettant de maintenir l’estimation au sein d’un espace de paramètres fini et calculable.
Inversement, le traitement des zéros structurels exige de modifier l’espace d’échantillonnage lui-même en supprimant formellement ces cellules de la fonction de partition du système. On recourt alors à des modèles catégoriels tronqués ou à des modèles log-linéaires incomplets dits de quasi-indépendance, au sein desquels les dimensions impossibles sont neutralisées en amont de toute estimation statistique.
10.2 Impact du déséquilibre extrême des classes en psychologie appliquée
Dans la grande majorité des applications en sciences sociales, de santé publique et en psychométrie clinique, les distributions catégorielles observées s’écartent radicalement du profil symétrique d’équiprobabilité. L’analyste se trouve confronté au phénomène récurrent du déséquilibre extrême des classes (class imbalance). Dans les inventaires de personnalité ou les échelles de bien-être subjectif administrées à des populations tout-venant, on observe quasi systématiquement une hypertrophie massive des réponses centrales modérées ou des options marquant l’approbation conforme, tandis que les catégories reflétant des conduites marginales, des pulsions autodestructrices ou des états délirants ne regroupent qu’une fraction infime des répondants.
Ce déséquilibre catégoriel engendre de lourdes distorsions méthodologiques. Il comprime artificiellement la variance perçue et engendre une estimation instable et volatile de l’entropie de Shannon, les estimateurs classiques tendant à sous-estimer systématiquement le désordre réel en présence de classes microscopiques. En modélisation prédictive ou d’apprentissage automatique, un classifieur optimisant le taux d’exactitude global aura tendance à ignorer purement et simplement la modalité rarissime en assignant l’ensemble de la population à la classe majoritaire, annihilant tout intérêt clinique de dépistage précoce.
Pour neutraliser ce biais structural, diverses stratégies quantitatives sont mobilisées. Au niveau de la modélisation statistique, on applique des pondérations inverses de prévalence (Inverse Probability Weighting) modifiant la contribution de chaque observation à la fonction de log-vraisemblance. Dans d’autres contextes, des techniques d’échantillonnage stratifié ou de génération synthétique de profils catégoriels rares par interpolation sont appliquées en amont afin de rééquilibrer la structure géométrique du simplexe d’apprentissage.
10.3 Biais de désirabilité sociale et distorsion des réponses déclaratives
Lorsque la distribution catégorielle est mobilisée pour mesurer des construits sensibles en psychologie sociale ou en criminologie (par exemple la prévalence des comportements sexuels à risque, l’évasion fiscale, l’adhésion à des stéréotypes xénophobes ou l’usage de substances illicites), les probabilités observées ne reflètent que très imparfaitement les probabilités réelles. Elles sont systématiquement déformées par le biais de désirabilité sociale, qui incite les répondants à sur-sélectionner les modalités valorisées par le groupe et à fuir les catégories perçues comme déviantes ou infamantes.
Sur le plan mathématique, cette distorsion peut être formalisée comme un processus de perturbation stochastique agissant sur la distribution catégorielle authentique. On modélise alors l’observation comme le produit de la véritable variable catégorielle latente par une matrice de transition de distorsion probabiliste, dont les coefficients traduisent la probabilité qu’un individu appartenant en réalité à une catégorie stigmatisée dévie sa réponse vers une catégorie socialement acceptable. Cette dynamique altère également l’estimation en créant des tendances massives à l’acquiescement passif, brouillant l’indépendance conditionnelle des réponses.
Pour contourner cette falsification déclarative et restaurer l’intégrité de la distribution catégorielle théorique, les chercheurs recourent aux techniques de réponse randomisée (introduites originellement par Stanley Warner en 1965) ou aux modèles de la liste non appariée (Item Count Technique). En introduisant un mécanisme aléatoire privé dont le résultat est masqué à l’expérimentateur (comme le lancer discret d’une pièce de monnaie dictant si le répondant doit répondre avec sincérité ou obligatoirement sélectionner une modalité imposée), l’anonymat mathématique est garanti. La distribution catégorielle réelle de la population peut ensuite être rigoureusement déconvoluée et restaurée par déduction analytique à partir de la distribution observée biaisée.
11. Implémentation informatique et calculatoire
11.1 Manipulation et échantillonnage sous le langage R
Le langage de programmation statistique R fournit un environnement algorithmique particulièrement abouti pour la simulation, l’estimation et la manipulation de variables distribuées selon une loi catégorielle. Pour l’échantillonnage aléatoire basique, la fonction native du moteur de base sample() permet de générer instantanément des réalisations d’une variable catégorielle en spécifiant le vecteur d’états et le vecteur des probabilités associées via son argument dédié, avec remplacement obligatoire. Pour des opérations matricielles plus rigoureuses encodant directement les résultats sous forme de comptages ou de formats vectoriels unitaires, la fonction rmultinom() avec le paramètre de taille unitaire size = 1 s’avère optimale sur le plan calculatoire.
Lorsqu’il s’agit de modéliser des distributions catégorielles conditionnées par des prédicteurs complexes, l’écosystème de packages R offre des solutions logicielles standardisées de référence :
- Le package nnet et sa fonction
multinom(): constituent la bibliothèque de choix pour l’ajustement de régressions logistiques multinomiales sans contrainte d’ordre par maximum de vraisemblance. - Le package mlogit : permet la modélisation de choix discrets polytomiques intégrant à la fois des caractéristiques propres aux individus et des attributs spécifiques aux alternatives de choix.
- Le package poLCA : permet l’estimation d’analyses de classes latentes pour données polytomiques à l’aide de l’algorithme EM.
L’extraction computationnelle des intervalles de confiance bayésiens pour les proportions d’une distribution catégorielle s’effectue quant à elle avec une remarquable fluidité grâce aux fonctions dédiées des bibliothèques telles que MCMCpack, lesquelles permettent d’échantillonner selon la loi conjuguée de Dirichlet et d’extraire directement les quantiles de crédibilité des paramètres marginaux sans approximations numériques hasardeuses.
11.2 Écosystème scientifique Python pour la modélisation probabiliste
L’essor fulgurant du langage Python au sein des sciences des données et de l’apprentissage automatique s’est accompagné du développement d’outils hautement optimisés pour le traitement tensoriel des distributions catégorielles. Au sein de la bibliothèque de calcul scientifique fondamentale scipy.stats, la classe dédiée multinomial permet de définir et de manipuler formellement des lois catégorielles en fixant rigoureusement le paramètre n à l’unité. Les méthodes intégrées offrent un accès immédiat au calcul analytique de la fonction de masse de probabilité (PMF), de la log-vraisemblance conjointe, ainsi qu’au calcul d’entropie informationnelle.
Pour la modélisation probabiliste bayésienne avancée, l’environnement PyMC constitue le cadre de programmation probabiliste de référence. L’architecture de PyMC permet de déclarer formellement des variables aléatoires catégorielles via sa primitive native pm.Categorical, alimentée par un vecteur de paramètres a priori modélisé par pm.Dirichlet. L’inférence sur le simplexe unitaire est ensuite exécutée à l’aide d’algorithmes d’échantillonnage hamiltonien de Monte-Carlo par chaînes de Markov (MCMC), et plus spécifiquement le No-U-Turn Sampler (NUTS), garantissant une exploration optimale des géométries de probabilités complexes et hautement corrélées.
À l’échelle du calcul haute performance et de l’apprentissage profond, la manipulation des distributions catégorielles s’effectue via des tenseurs optimisés sous NumPy, PyTorch ou TensorFlow. Dans ces bibliothèques, la distribution catégorielle est étroitement associée à la fonction Softmax et aux fonctions de perte d’entropie croisée catégorielle (Categorical Cross-Entropy). La vectorisation tensorielle permet d’évaluer simultanément des millions de distributions catégorielles individuelles en exploitant l’accélération matérielle des processeurs graphiques (GPU), conférant une scalabilité inégalée aux modèles prédictifs polytomiques contemporains.
11.3 Diagnostics de convergence et validation croisée des distributions
L’application rigoureuse d’algorithmes informatiques à l’estimation de lois catégorielles requiert la mise en place de protocoles stricts de contrôle qualité algorithmique et de validation statistique croisée. Lorsque l’inférence fait intervenir des algorithmes itératifs d’optimisation non convexe ou des chaînes de Markov de Monte-Carlo, la surveillance de la stabilité des paramètres estimés constitue un impératif méthodologique absolu. L’analyste examine ainsi le coefficient d’échelle de réduction potentiel (la statistique R-hat de Gelman-Rubin) pour certifier l’absence de non-convergence ou de piégeage métastable dans des modes locaux distincts du simplexe unitaire.
En contexte fréquentiste, l’évaluation de la robustesse de la distribution catégorielle estimée s’opère canoniquement par le recours aux procédures de bootstrap non paramétrique. En rééchantillonnant massivement avec remplacement des milliers de sous-échantillons à partir des données observées initiales, on dérive la distribution d’échantillonnage empirique des vecteurs de proportions. Cette méthode permet de cartographier avec précision les biais éventuels d’asymétrie affectant les composantes individuelles du vecteur sans postuler l’hypothèse de normalité asymptotique.
Enfin, la comparaison quantitative entre différentes distributions catégorielles candidates — par exemple entre la distribution prédite par un modèle statistique et la distribution réelle recueillie sur un échantillon de test indépendant — exige le calcul de métriques formelles de divergence probabiliste. On mobilise ainsi préférentiellement la divergence de Jensen-Shannon (version symétrique et toujours bornée de la divergence de Kullback-Leibler) ou le coefficient de Bhattacharyya. Ces indicateurs délivrent une mesure géométrique scalaire de la proximité globale entre deux lois catégorielles, dictant de façon impartiale le choix de la modélisation la plus parcimonieuse et fidèle à la réalité empirique.
12. Perspectives critiques et limites méthodologiques en sciences humaines
12.1 Les coûts analytiques de la discrétisation arbitraire
L’adoption d’un formalisme catégoriel ne saurait être exonérée d’un examen épistémologique critique, particulièrement lorsqu’elle résulte de l’action de discrétiser une variable phénoménologiquement continue. En sciences humaines, en médecine et en économie, une pratique ancestrale consiste à segmenter artificiellement des dimensions continues en tranches catégorielles étiquetées (par exemple scinder le niveau d’anxiété en « Normal », « Modéré » et « Sévère », ou binariser les revenus financiers). Si cette démarche flatte le besoin pragmatique d’étiquetage décisionnel, elle entraîne des coûts analytiques considérables.
Le premier tribut payé à la discrétisation réside dans une déperdition massive d’information et une perte substantielle de puissance statistique. Deux individus situés de part et d’autre d’un seuil de découpage arbitraire se trouvent assignés à des catégories probabilistes disjointes, tandis que deux individus situés aux deux extrémités d’une même catégorie sont agrégés comme strictement identiques. Des études méthodologiques ont démontré que la réduction d’un continuum en deux catégories peut équivaloir à la destruction d’un tiers de la taille effective de l’échantillon d’observation. De surcroît, la discrétisation artificielle augmente considérablement le risque d’inflation d’erreurs de type I ou de type II lors de l’estimation de corrélations avec d’autres variables.
Un écueil encore plus redoutable réside dans la vulnérabilité au célèbre paradoxe de Simpson. Lorsqu’on agrège ou discrétise arbitrairement des données continues au sein d’une distribution catégorielle, il est parfaitement possible de faire émerger des associations statistiques fallacieuses qui contredisent, voire inversent rigoureusement, les relations fonctionnelles observées au niveau continu sous-jacent. L’usage de la distribution catégorielle doit donc découler de la nature intrinsèquement discrète de l’objet d’étude et non d’une démarche de simplification arbitraire des protocoles de recueil.
12.2 Catégorisation stricte versus frontières floues (Fuzzy Sets)
Le fondement même de la distribution catégorielle repose sur l’axiome aristotélicien du tiers exclu : un élément appartient intégralement à une catégorie ou ne lui appartient pas du tout. Cette frontière nette (crisp boundaries) montre d’importantes limites lorsqu’elle est confrontée aux concepts intrinsèquement ambigus, fluides et dynamiques caractéristiques des sciences psychologiques et psychiatriques. Les entités cliniques ne se laissent que très imparfaitement emprisonner dans des cases étanches, et de multiples états phénoménologiques se déploient dans des zones grises transitionnelles de chevauchement syndromique.
Face à cette rigidité constitutive, des perspectives novatrices explorent l’hybridation féconde entre la théorie des probabilités et la logique des sous-ensembles flous (Fuzzy Sets), conceptualisée par Lotfi Zadeh. Dans ce paradigme élargi, une observation n’est pas contrainte d’appartenir exclusivement à une modalité singulière d’un espace discret, mais se voit attribuer des degrés d’appartenance graduels et simultanés à de multiples classes conceptuelles.
L’intégration de la logique floue au sein des modèles probabilistes engendre des distributions catégorielles floues ou possibilistes, où l’incertitude stochastique relative à l’occurrence d’un événement se combine harmonieusement avec le flou ontologique de sa définition sémantique. Ces modèles fournissent une description phénoménologiquement plus fidèle des réalités subjectives humaines, évitant de forcer les réponses des sujets au sein de cadres diagnostiques excessivement réducteurs et prématurément rigides.
12.3 Évolutions contemporaines : réseaux bayésiens et intelligence artificielle
Loin d’être un reliquat théorique du passé, la distribution catégorielle se trouve aujourd’hui au cœur des mutations conceptuelles et technologiques les plus spectaculaires de l’intelligence artificielle et de la science computationnelle contemporaine. Au sein des réseaux bayésiens (ou modèles graphiques probabilistes acycliques), les distributions catégorielles conditionnelles constituent les briques fonctionnelles élémentaires par lesquelles se propage l’inférence. Dans ces graphes, chaque nœud catégoriel met à jour son vecteur de probabilités à la lueur des données accumulées en exploitant le message probabiliste transmis par ses nœuds parents, fournissant un outil décisionnel d’une puissance inégalée pour le diagnostic médical assisté par ordinateur et l’évaluation médico-légale des risques.
Parallèlement, la révolution des réseaux de neurones profonds et des modèles de fondation génératifs de type transformeur (tels que les Large Language Models) repose directement sur l’extension massive de la distribution catégorielle. Lorsqu’un modèle de traitement du langage génère un mot ou un jeton textuel (token), sa couche terminale calcule, via une fonction d’activation Softmax, une distribution catégorielle géante s’étendant sur un vocabulaire fini de plusieurs dizaines ou centaines de milliers d’états discrets. La sélection du mot suivant découle d’un échantillonnage au sein de cette gigantesque loi catégorielle paramétrique, modulé par un facteur d’échelle thermique (temperature) ajustant son entropie informationnelle.
Ces avancées technologiques s’accompagnent toutefois de formidables défis épistémiques. L’interprétabilité humaine de distributions catégorielles multidimensionnelles hautement enchevêtrées au sein d’espaces latents complexes soulève d’immenses questions éthiques et scientifiques. Comment garantir l’équité, l’absence de biais algorithmiques sous-jacents et la robustesse de l’assignation de probabilités catégorielles lorsque les décisions concernent l’orientation scolaire, l’octroi d’un crédit ou la mise en liberté conditionnelle d’un justiciable ? La maîtrise fondamentale de la distribution catégorielle, de ses présupposés mathématiques et de ses biais structurels s’avère plus que jamais une compétence citoyenne et scientifique vitale à l’ère numérique.
Références
Agresti, A. (2013). Categorical data analysis (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471249684
Bishop, C. M. (2006). Pattern recognition and machine learning. Springer. https://www.microsoft.com/en-us/research/publication/pattern-recognition-and-machine-learning/
Cochran, W. G. (1954). Some methods for strengthening the common chi-squared tests. Biometrics, 10(4), 417-451. https://doi.org/10.2307/3001616
Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian data analysis (3rd ed.). CRC Press. https://doi.org/10.1201/b16018
Kolmogorov, A. N. (1933). Grundbegriffe der Wahrscheinlichkeitsrechnung. Julius Springer. https://doi.org/10.1007/978-3-642-49888-6
Koller, D., & Friedman, N. (2009). Probabilistic graphical models: Principles and techniques. MIT Press. https://mitpress.mit.edu/9780262013192/probabilistic-graphical-models/
Luce, R. D. (1959). Individual choice behavior: A theoretical analysis. John Wiley & Sons. https://doi.org/10.1037/14396-000
Masters, G. N. (1982). A Rasch model for partial credit scoring. Psychometrika, 47(2), 149-174. https://doi.org/10.1007/BF02296272
McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in Econometrics (pp. 105-142). Academic Press. https://eml.berkeley.edu/reprints/mcfadden/zarembka.pdf
Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine, Series 5, 50(302), 157-175. https://doi.org/10.1080/14786440009463897
Samejima, F. (1969). Estimation of latent ability using a response pattern of graded scores. Psychometrika Monograph Supplement, 34(4, Pt. 2), 1-100. https://doi.org/10.1007/BF03372160
Shannon, C. E. (1948). A mathematical theory of communication. Bell System Technical Journal, 27(3), 379-423. https://doi.org/10.1002/j.1538-7305.1948.tb01338.x
Warner, S. L. (1965). Randomized response: A survey technique for eliminating evasive answer bias. Journal of the American Statistical Association, 60(309), 63-69. https://doi.org/10.1080/01621459.1965.10480775
Zadeh, L. A. (1965). Fuzzy sets. Information and Control, 8(3), 338-353. https://doi.org/10.1016/S0019-9958(65)90241-X