
Dans le domaine de l’économétrie et de l’analyse statistique appliquée, l’un des postulats les plus fondamentaux et pourtant les plus vulnérables du modèle de régression linéaire classique repose sur la constance temporelle et structurelle des paramètres estimés. Lorsqu’un analyste cherche à quantifier la relation existant entre une variable dépendante et un ensemble de covariables, il suppose implicitement que les mécanismes générateurs de données demeurent invariants tout au long de la période d’observation ou au sein de l’ensemble des sous-groupes de la population étudiée. Toutefois, les systèmes réels, qu’ils soient économiques, financiers, sociaux ou comportementaux, subissent continuellement l’impact de perturbations exogènes, de réformes institutionnelles, de crises financières ou de transitions démographiques susceptibles de briser l’équilibre préexistant et d’altérer la nature même des relations observées.
Face à cette problématique fondamentale, le test de Chow s’impose depuis plusieurs décennies comme l’une des méthodologies inférentielles les plus célèbres, élégantes et rigoureuses pour valider ou réfuter l’hypothèse de stabilité paramétrique. Développé initialement par l’économiste Gregory Chow en 1960, ce test d’hypothèse statistique fournit un cadre mathématique permettant d’évaluer formellement si une rupture structurelle prédéterminée scinde un échantillon en deux régimes statistiquement distincts, ou si l’agrégation de l’ensemble des observations au sein d’une seule et même équation de régression demeure méthodologiquement licite.
Le présent article propose une exploration exhaustive, approfondie et multidimensionnelle du test de Chow. De ses fondements théoriques et historiques à sa dérivation mathématique matricielle, en passant par ses postulats de validité stochastique, ses limites opérationnelles et ses applications concrètes en économétrie et en sciences comportementales, cette synthèse offre un guide méthodologique de référence destiné aux chercheurs, économistes, data scientists et étudiants désireux de maîtriser l’art de l’inférence en présence d’instabilité structurelle.
1. Introduction et fondements théoriques du test de Chow
Pour appréhender la portée du test de Chow, il est indispensable de comprendre le contexte intellectuel dans lequel il a émergé et la rupture paradigmatique qu’il a introduite dans la pratique de la modélisation statistique. Avant sa formalisation, la plupart des praticiens de la régression supposaient implicitement l’homogénéité absolue des coefficients, risquant d’agréger des processus générateurs foncièrement divergents.
1.1 Origine historique et contribution de Gregory Chow
Au milieu du XXe siècle, l’économétrie connaissait un essor sans précédent sous l’impulsion des travaux de la Commission Cowles et de pionniers tels que Jan Tinbergen et Ragnar Frisch. La modélisation macroéconomique reposait alors largement sur des systèmes d’équations estimées par les moindres carrés ordinaires (MCO), dont les prévisions reposaient sur l’hypothèse d’une fixité absolue des lois économiques dans le temps. C’est dans ce contexte que Gregory C. Chow, économiste sino-américain diplômé de l’Université de Chicago et professeur à Princeton, publie en 1960 dans la revue Econometrica son article séminal intitulé « Tests of Equality Between Sets of Coefficients in Two Linear Regressions ».
L’apport de Chow consistait à apporter une réponse statistique formelle et unifiée à une interrogation concrète : les paramètres décrivant la demande d’automobiles aux États-Unis étaient-ils demeurés stables avant et après la Seconde Guerre mondiale ? Chow a démontré qu’au lieu d’évaluer intuitivement la proximité des estimations obtenues sur différentes périodes, il était possible de construire un test de quotient de variance basé sur la distribution de Fisher-Snedecor, permettant d’éprouver la nullité conjointe des écarts paramétriques entre deux régressions indépendantes.
Cette percée méthodologique a marqué la transition de l’économétrie descriptive vers une économétrie de la vérification structurelle. Elle a contraint les modélisateurs à admettre que les coefficients de régression ne sont pas de simples constantes physiques immuables, mais des paramètres conditionnés par des contextes institutionnels, des régimes de politique économique et des comportements humains intrinsèquement dynamiques.
1.2 Définition conceptuelle et objectif principal
Sur le plan conceptuel, le test de Chow est un test d’hypothèse statistique qui vise à déterminer si les coefficients d’une régression linéaire diffèrent significativement lorsqu’un échantillon de données est segmenté en deux sous-ensembles mutuellement exclusifs. Cette segmentation repose généralement sur une variable de partitionnement, le plus souvent temporelle (par exemple, avant et après une date charnière $T^*$), mais pouvant également être spatiale, démographique ou catégorielle (telle que la distinction entre deux groupes expérimentaux).
L’objectif fondamental consiste à arbitrer entre deux modélisations concurrentes :
- Le modèle contraint (ou restreint) : une équation unique appliquée à l’échantillon groupé, imposant que l’ordonnée à l’origine et l’ensemble des pentes marginales soient identiques pour toutes les observations.
- Le modèle non contraint (ou non restreint) : deux équations distinctes estimées de manière autonome sur chacun des sous-échantillons, permettant à chaque paramètre de varier librement d’un sous-groupe à l’autre.
En quantifiant la réduction de la somme des carrés des résidus induite par le passage du modèle contraint au modèle non contraint, le test de Chow permet d’établir formellement si cette amélioration de l’ajustement est le fruit du hasard de l’échantillonnage ou si elle traduit une véritable hétérogénéité des structures relationnelles. Ce test constitue ainsi une passerelle essentielle vers les démarches modernes d’inférence causale, servant à valider la rupture des tendances séculaires lors d’expériences quasi-naturelles.
1.3 Domaines d’application transversaux
Bien que conçu initialement pour les sciences économiques, le test de Chow s’est rapidement diffusé à l’ensemble des disciplines quantitatives empiriques en raison de son universalité mathématique. En macroéconomie et en finance de marché, il demeure un outil classique pour examiner la validité des politiques monétaires, l’impact des accords de change internationaux ou la résilience des structures financières face aux crises systémiques telles que celle des subprimes en 2008 ou de la dette souveraine européenne.
Au-delà de la sphère financière, les sciences sociales et la psychologie quantitative ont progressivement intégré le test de Chow pour formaliser les ruptures de trajectoires individuelles ou collectives. Dans les études longitudinales sur le développement cognitif, il permet de vérifier si la relation unissant le statut socio-économique aux capacités d’apprentissage subit une mutation structurelle à l’entrée dans l’adolescence. De même, en psychométrie et en santé publique, le test est régulièrement employé pour valider l’invariance de mesure d’un construit théorique entre différentes cohortes générationnelles ou pour vérifier si l’implémentation d’un programme thérapeutique modifie profondément le lien fonctionnel entre les stresseurs environnementaux et les manifestations symptomatiques.
2. Le concept de rupture structurelle dans l’analyse de régression
L’hypothèse de stabilité structurelle constitue la clé de voûte de toute inférence menée sur des séries de données chronologiques ou transversales hiérarchisées. Cependant, le concept de rupture structurelle lui-même recouvre des réalités géométriques et empiriques variées qu’il convient de formaliser avec précision avant d’engager toute démarche de modélisation.
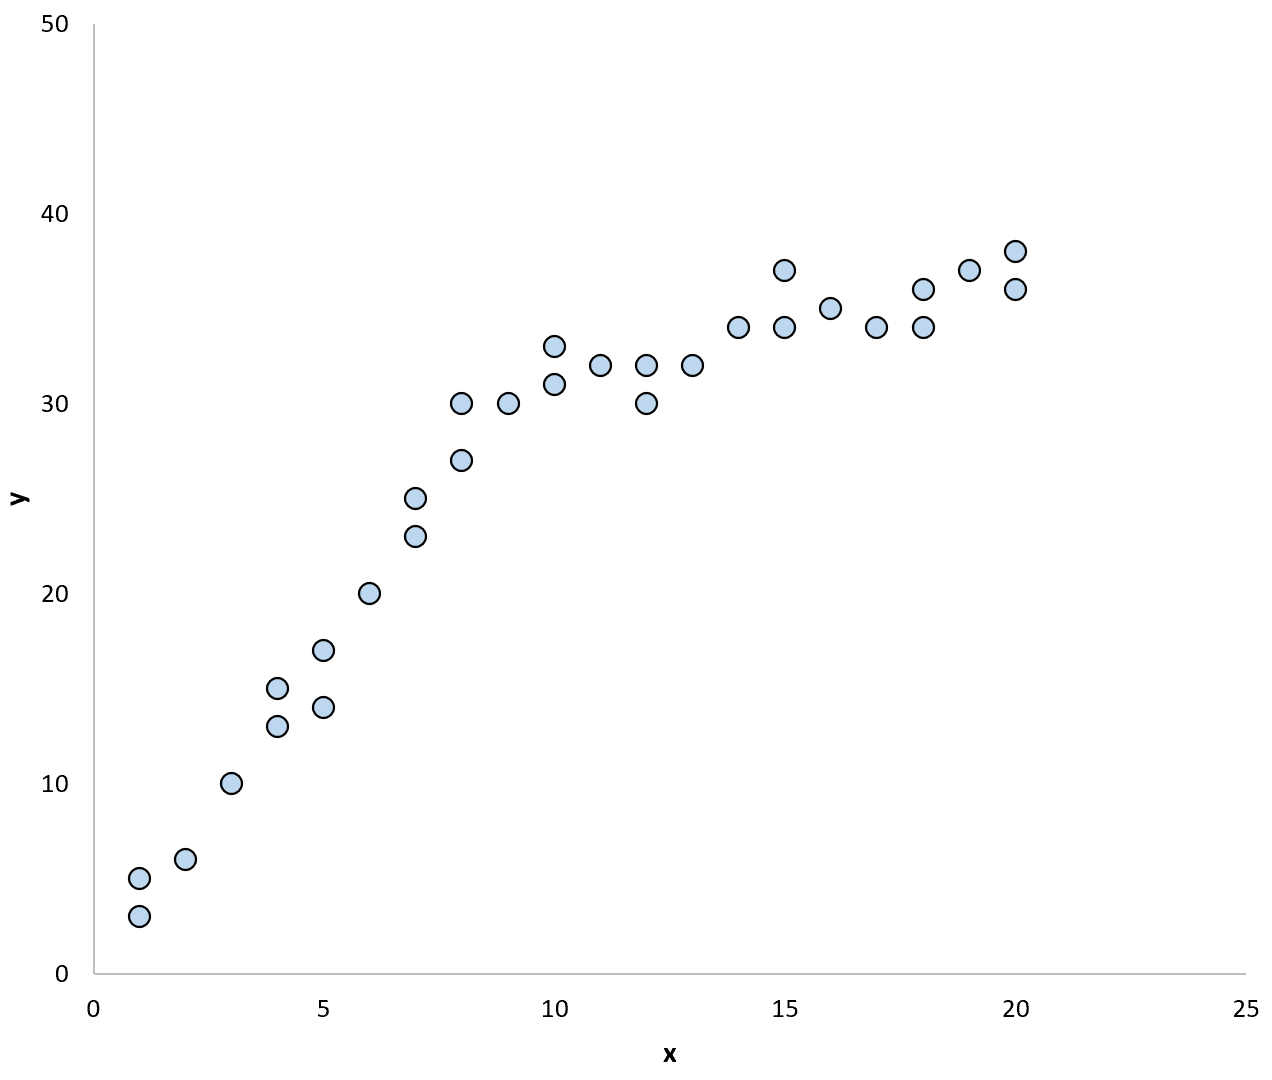
2.1 Définition et typologie des ruptures structurelles
Une rupture structurelle survient lorsque les propriétés statistiques du processus générateur de données sous-jacent subissent une modification soudaine ou discontinue. Dans le cadre d’un modèle linéaire, cette instabilité peut affecter plusieurs composantes distinctes du vecteur de paramètres, modifiant de fait la configuration géométrique de la droite ou du plan de régression.
On distingue principalement trois types de modifications paramétriques :
- Rupture du terme constant (ordonnée à l’origine) : elle se traduit par un décalage parallèle de la droite de régression. Le niveau moyen de la variable dépendante subit un choc permanent sans que la sensibilité marginale aux prédicteurs ne soit altérée.
- Rupture des coefficients de pente : l’ordonnée à l’origine demeure stable, mais l’angle d’inclinaison de la droite se modifie. Cela signifie que l’intensité de l’impact d’une ou plusieurs variables explicatives sur la variable à expliquer a changé sous l’effet d’une nouvelle dynamique structurelle.
- Rupture structurelle complète : le terme constant et l’ensemble des pentes marginales subissent une transformation simultanée, redéfinissant entièrement le plan de régression entre les deux périodes observées.
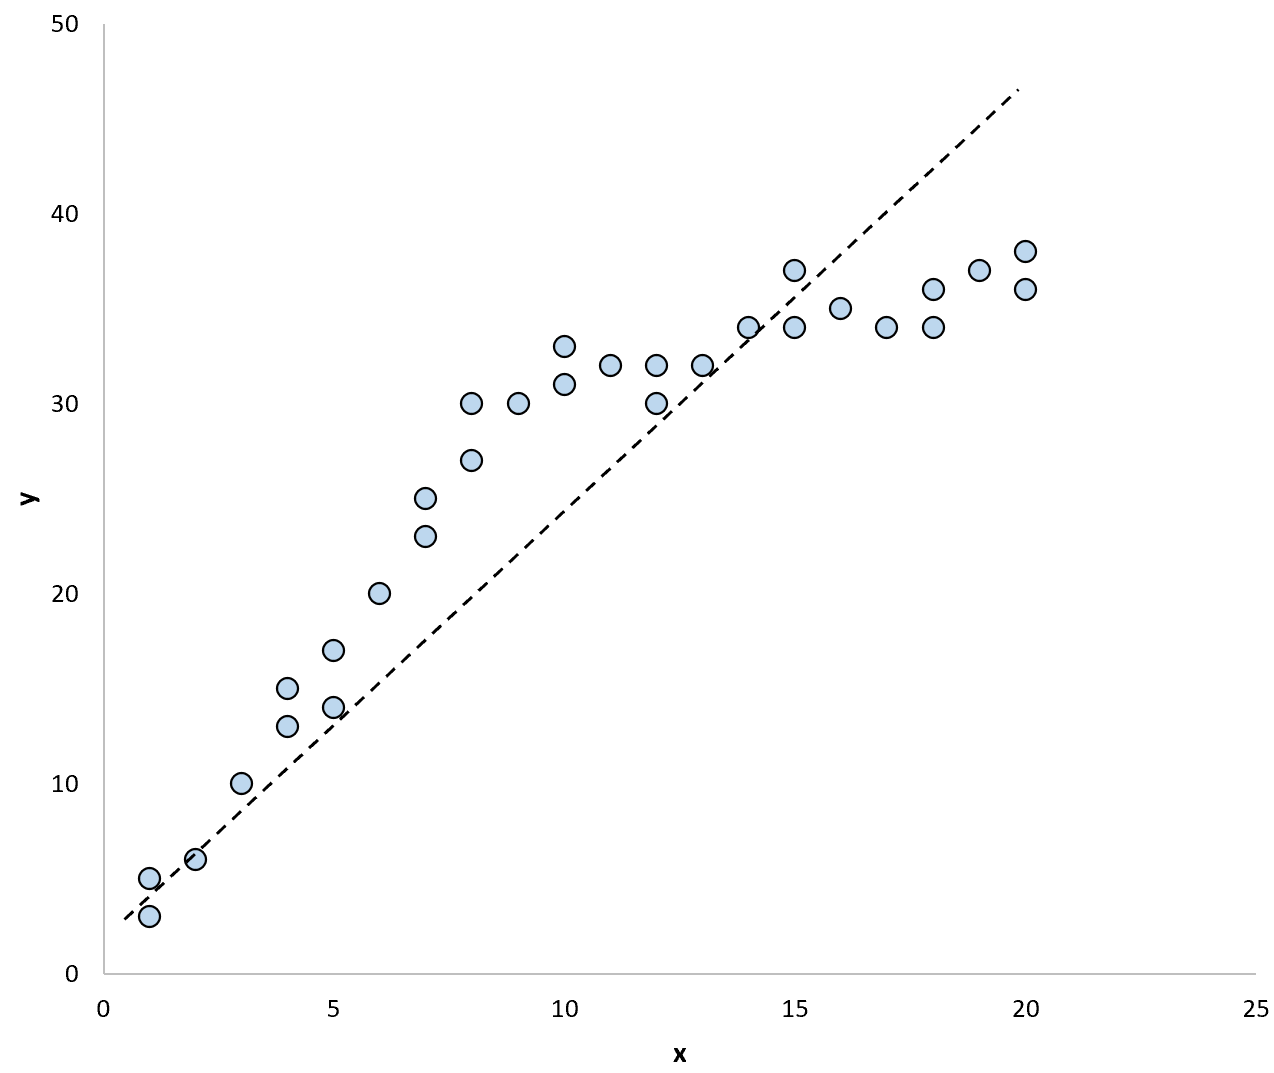
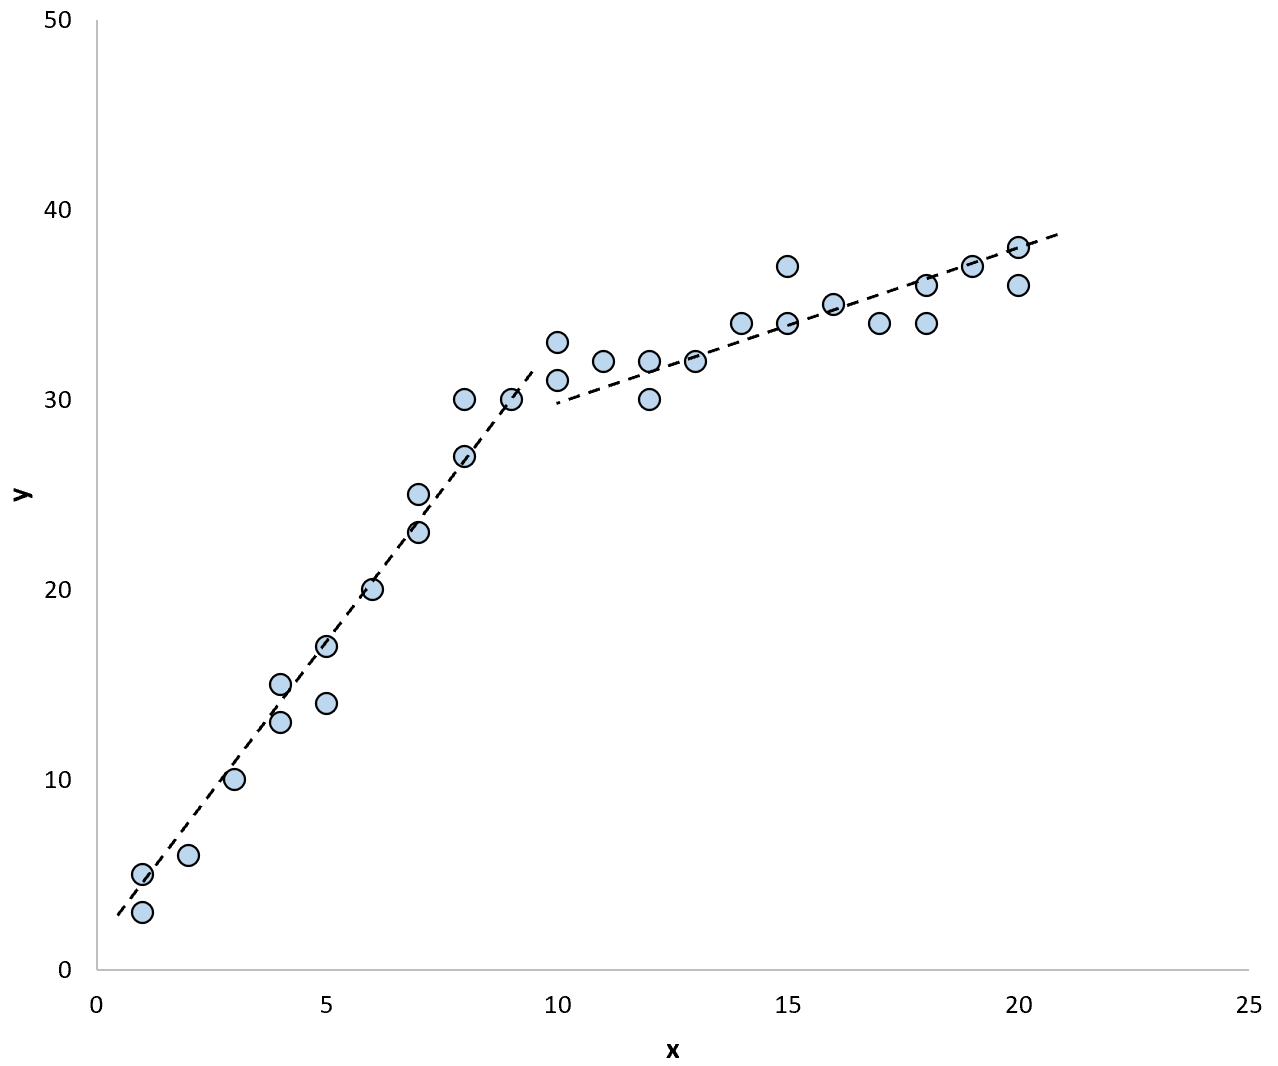
En ignorant une telle discontinuité, l’estimateur des moindres carrés ordinaires tente d’ajuster une droite médiane unique à travers deux nuages de points divergents, produisant une représentation erronée qui ne reflète fidèlement la réalité d’aucun des deux sous-régimes.
2.2 Causes sous-jacentes d’un changement structurel
Les origines d’une instabilité paramétrique sont multiples et dépendent étroitement de la discipline considérée. En économie, les chocs d’offre ou de demande constituent des facteurs fréquents de rupture : une hausse brutale des cours des matières premières, l’effondrement d’un système bancaire ou une modification radicale de la régulation des marchés financiers sont susceptibles de transformer l’élasticité de consommation des ménages ou la propension à investir des entreprises.
Dans le domaine politique et institutionnel, l’instauration d’une nouvelle loi fiscale, le basculement d’un régime de taux de change fixe vers un régime flottant, ou une réforme majeure des régimes de retraite redéfinissent les règles du jeu microéconomique. De même, les crises sanitaires mondiales, à l’instar de la pandémie de COVID-19, ont engendré des chocs comportementaux majeurs : les structures de dépenses, les modes d’organisation du travail et les relations de connectivité technologique ont subi des décalages historiques instantanés.
En sciences comportementales, les ruptures peuvent provenir d’événements de vie critiques (traumatismes, séparations, transitions professionnelles) ou d’interventions thérapeutiques ciblées qui reconfigurent durablement la dynamique de réponse affective d’un individu face à des stimuli anxiogènes.
2.3 Conséquences statistiques de la non-prise en compte d’une rupture
Le fait de négliger une rupture structurelle et de forcer l’estimation d’un modèle contraint unique entraîne des pathologies statistiques majeures qui compromettent la validité scientifique des conclusions. Premièrement, cela induit un biais de spécification par omission de structure. Les estimateurs des coefficients deviennent inconsistants ou inefficaces, car ils agrègent artificiellement des espérances conditionnelles hétérogènes.
Deuxièmement, la somme des carrés des résidus du modèle contraint se trouve mécaniquement gonflée. Les résidus ne sont plus distribués de manière purement aléatoire autour de zéro : ils présentent des écarts systématiques et persistants, positifs sur une sous-période et négatifs sur l’autre. Cette dispersion artificielle élève la variance résiduelle estimée $\hat{\sigma}^2$, ce qui élargit abusivement les erreurs-types des coefficients et réduit drastiquement la puissance des tests de significativité de Student conventionnels.
Enfin, cette erreur de spécification engendre une fausse impression d’autocorrélation sérielle des erreurs ou une pseudo-hétéroscédasticité. Les tests diagnostiques classiques (comme ceux de Durbin-Watson ou de Breusch-Pagan) concluent fréquemment à des violations des postulats gaussiens alors que ces anomalies ne sont que le symptôme mathématique d’une rupture paramétrique non modélisée.
3. Formulation mathématique et hypothèses statistiques du test de Chow
La puissance du test de Chow repose sur la rigueur de sa formulation dans le cadre de la théorie des modèles linéaires généraux. La décomposition matricielle permet d’exprimer avec clarté la confrontation entre l’hypothèse de stabilité et celle de segmentation.
3.1 Spécification formelle des modèles de régression
Considérons un échantillon global composé de $N$ observations ordonnées chronologiquement ou partitionnées selon un critère binaire, tel que $N = N_1 + N_2$. Soit un ensemble de $k$ variables explicatives (incluant la constante). Le modèle contraint, postulant l’homogénéité absolue des coefficients sur l’ensemble de l’échantillon, s’écrit sous forme matricielle :
$$Y = X\beta + \varepsilon$$
Où $Y$ est un vecteur colonne d’ordre $(N \times 1)$, $X$ est une matrice de plan d’expérience de dimension $(N \times k)$ supposée de rang plein $k$, $\beta$ est le vecteur unique des $k$ paramètres à estimer, et $varepsilon$ est le vecteur des termes d’erreur stochastiques d’ordre $(N \times 1)$.
Supposons désormais qu’une rupture structurelle survienne à une date ou un seuil d’observation connu $T^* = N_1$. L’échantillon se scinde en deux sous-régimes non contraints modélisés séparément :
Pour le premier sous-groupe ($t = 1, dots, N_1$) :
$$Y_1 = X_1\beta_1 + \varepsilon_1$$
Pour le second sous-groupe ($t = N_1 + 1, dots, N_1 + N_2$) :
$$Y_2 = X_2\beta_2 + \varepsilon_2$$
Dans cette spécification, $Y_1$ et $Y_2$ sont respectivement de dimensions $(N_1 \times 1)$ et $(N_2 \times 1)$, tandis que $X_1$ et $X_2$ sont de dimensions $(N_1 \times k)$ et $(N_2 \times k)$. Les vecteurs $\beta_1$ et $\beta_2$ représentent les coefficients propres à chaque régime, et $\varepsilon_1, \varepsilon_2$ leurs termes d’erreur respectifs.
3.2 Hypothèses nulle et alternative
Le test de Chow consiste à éprouver la restriction linéaire d’égalité parfaite entre les vecteurs de coefficients des deux sous-périodes. L’hypothèse nulle ($H_0$) et l’hypothèse alternative ($H_1$) sont formellement formulées comme suit :
$$H_0 : \beta_1 = \beta_2$$
$$H_1 : \beta_1 \neq \beta_2$$
L’hypothèse nulle $H_0$ stipule que les $k$ composantes du vecteur $\beta_1$ sont rigoureusement identiques aux $k$ composantes du vecteur $\beta_2$. Il s’agit donc d’une hypothèse conjointe testant simultanément l’égalité des constantes et de l’ensemble des pentes marginales associées à chaque variable explicative :
$$\beta_{1,0} = \beta_{2,0}, \quad \beta_{1,1} = \beta_{2,1}, \quad dots, \quad \beta_{1,k-1} = \beta_{2,k-1}$$
L’hypothèse alternative $H_1$ n’exige pas que tous les coefficients divergent ; il suffit qu’au moins un coefficient présente un écart statistiquement significatif entre les deux périodes pour rejeter l’hypothèse de stabilité structurelle globale.
3.3 Construction de la statistique de test F
La statistique du test de Chow repose sur la comparaison de la variance résiduelle observée sous la contrainte d’égalité ($H_0$) avec la variance résiduelle non contrainte obtenue lorsque les deux sous-échantillons sont estimés de manière indépendante. Définissons les grandeurs résiduelles fondamentales :
- $SSR_C$ (ou $SCR_C$) : la somme des carrés des résidus du modèle contraint global estimé sur les $N$ observations.
- $SSR_1$ : la somme des carrés des résidus du premier sous-modèle estimé sur les $N_1$ observations.
- $SSR_2$ : la somme des carrés des résidus du second sous-modèle estimé sur les $N_2$ observations.
La somme des carrés des résidus du modèle non contraint ($SSR_{NC}$) est égale à la somme arithmétique directe des résidus des deux sous-périodes :
$$SSR_{NC} = SSR_1 + SSR_2$$
La statistique du test de Chow, notée $F_{Chow}$, s’obtient en calculant le rapport entre le gain d’ajustement normalisé par le nombre de restrictions et la variance résiduelle non contrainte normalisée par ses degrés de liberté :
$$F_{Chow} = \frac{(SSR_C – SSR_{NC}) / k}{SSR_{NC} / (N_1 + N_2 – 2k)} = \frac{(SSR_C – (SSR_1 + SSR_2)) / k}{(SSR_1 + SSR_2) / (N – 2k)}$$
Sous l’hypothèse nulle $H_0$ et sous réserve du respect des postulats gaussiens classiques, cette statistique suit exactement une distribution de Fisher-Snedecor à $k$ degrés de liberté au numérateur et $N – 2k$ degrés de liberté au dénominateur :
$$F_{Chow} \sim \mathcal{F}(k, , N – 2k)$$
4. Conditions préalables et postulats du modèle linéaire classique
Comme toute procédure d’inférence exacte, la validité du test de Chow dépend strictement de la satisfaction de plusieurs conditions préalables relatives à la distribution des erreurs et à la structure des données. Toute violation non corrigée de ces postulats peut fausser les niveaux de significativité nominaux.
4.1 Normalité et indépendance des termes d’erreur
Pour que la statistique de Chow suive rigoureusement une loi de Fisher-Snedecor en échantillon fini, les termes d’erreur $varepsilon$ doivent être distribués selon une loi normale d’espérance nulle : $\varepsilon \sim \mathcal{N}(0, \sigma^2 I)$. Bien que le théorème central limite confère une robustesse asymptotique raisonnable à la statistique lorsque $N_1$ et $N_2$ sont suffisamment élevés, des déviations majeures de la normalité (présence de queues épaisses ou de valeurs aberrantes extrêmes) peuvent altérer la probabilité critique réelle du test.
Par ailleurs, l’indépendance sérielle des erreurs ($Cov(\varepsilon_t, \varepsilon_s) = 0$ pour $t \neq s$) est impérative dans les applications chronologiques. Si les résidus présentent une autocorrélation positive, la somme des carrés résiduels sera artificiellement sous-estimée, ce qui gonflera indûment la statistique $F_{Chow}$ et conduira à un rejet excessif de l’hypothèse de stabilité structurelle (taux d’erreur de type I supérieur au seuil $\alpha$ théorique). Il est donc indispensable d’exécuter des tests préalables de Ljung-Box ou de Breusch-Godfrey afin de confirmer l’absence de dépendance sérielle.
4.2 Hypothèse d’homoscédasticité stricte entre les sous-échantillons
Le postulat le plus critique et le plus sensible du test de Chow conventionnel concerne l’égalité absolue de la variance des termes d’erreur entre les deux régimes. Le modèle impose que :
$$\sigma_1^2 = \sigma_2^2 = \sigma^2$$
Si cette condition d’homoscédasticité inter-régimes n’est pas remplie ($\sigma_1^2 \neq \sigma_2^2$), la statistique $F_{Chow}$ ne suit plus une distribution de Fisher, même asymptotiquement. Ce problème correspond à une transposition du célèbre problème de Behrens-Fisher à l’analyse de régression.
Lorsque la variance des erreurs augmente ou diminue substantiellement après la rupture supposée, le test de Chow tend à confondre une variation d’échelle stochastique avec une instabilité des coefficients de régression. Des diagnostics préalables, tels que le test de Goldfeld-Quandt ou le test d’homogénéité des variances de Breusch-Pagan appliqué comparativement aux deux segments, doivent systématiquement être mis en œuvre. En présence d’hétéroscédasticité confirmée, des formulations alternatives adaptées doivent être substituées au test classique.
4.3 Exigences relatives à la taille des échantillons et à l’identification
L’estimation distincte des deux modèles sectoriels requiert que chaque sous-échantillon dispose d’un nombre d’observations strictement supérieur au nombre de régresseurs $k$. Pour que les matrices de variance-covariance $(X_1’X_1)^{-1}$ et $(X_2’X_2)^{-1}$ soient inversibles (condition de rang plein), il est obligatoire de respecter les contraintes suivantes :
$$N_1 > k \quad \text{et} \quad N_2 > k$$
Si une rupture structurelle est suspectée très près du début ou de la fin de l’échantillon d’observation (par exemple $N_2 < k$), il devient mathématiquement impossible d'estimer les paramètres du second régime par les MCO traditionnels. Dans un tel cas de figure, le test de Chow standard est inapplicable, et il convient de se tourner vers une variante spécifique connue sous le nom de test de prévision de Chow (Chow’s prediction test).
De surcroît, la réduction du nombre d’observations au sein des sous-groupes accroît le risque de multicolinéarité locale entre les variables explicatives, ce qui peut gonfler l’imprécision d’estimation des pentes sectorielles.
5. Procédure de calcul étape par étape de la statistique F de Chow
L’exécution manuelle ou algorithmique du test de Chow suit une séquence ordonnée en trois étapes majeures, fondée sur l’ajustement successif du modèle restreint et des modèles libres.
5.1 Étape 1 : Estimation du modèle global contraint
La première phase opérationnelle consiste à estimer le modèle linéaire sur l’ensemble complet des $N = N_1 + N_2$ données sans tenir compte de la rupture hypothétique :
$$\hat{Y}_t = \hat{\beta}_0 + \hat{\beta}_1 X_{1t} + dots + \hat{\beta}_{k-1} X_{(k-1)t}, \quad t = 1, dots, N$$
Une fois les coefficients estimés via l’opérateur $\hat{\beta} = (X’X)^{-1}X’Y$, le chercheur extrait les résidus d’ajustement contraints :
$$e_{C,t} = Y_t – \hat{Y}_t$$
La somme des carrés des résidus contraints ($SSR_C$) est alors calculée de la manière suivante :
$$SSR_C = \sum_{t=1}^{N} e_{C,t}^2 = e_C’ e_C$$
Cette grandeur comptabilise l’intégralité de la dispersion non expliquée par l’équation unique. Ce modèle possède $N – k$ degrés de liberté.
5.2 Étape 2 : Estimation des modèles sectoriels non contraints
La seconde phase consiste à fractionner le jeu de données en deux blocs au point de césure désigné $T^* = N_1$, puis à exécuter deux régressions MCO totalement indépendantes :
- Régression sur la période 1 ($t = 1, dots, N_1$) :
$$\hat{\beta}_1 = (X_1’X_1)^{-1}X_1’Y_1$$
Extraction des résidus $e_{1,t} = Y_{1,t} – X_{1,t}\hat{\beta}_1$ et calcul de :
$$SSR_1 = \sum_{t=1}^{N_1} e_{1,t}^2 = e_1′ e_1$$
- Régression sur la période 2 ($t = N_1 + 1, dots, N$) :
$$\hat{\beta}_2 = (X_2’X_2)^{-1}X_2’Y_2$$
Extraction des résidus $e_{2,t} = Y_{2,t} – X_{2,t}\hat{\beta}_2$ et calcul de :
$$SSR_2 = \sum_{t=N_1+1}^{N} e_{2,t}^2 = e_2′ e_2$$
On procède ensuite à la sommation de ces deux valeurs pour obtenir la somme non contrainte :
$$SSR_{NC} = SSR_1 + SSR_2$$
Ce modèle globalement partitionné utilise $2k$ paramètres au total, laissant $N – 2k$ degrés de liberté pour la variance résiduelle.
5.3 Étape 3 : Calcul arithmétique de la statistique F et détermination de la p-valeur
Disposant de $SSR_C$, $SSR_{NC}$, $k$ et $N$, le calcul de la statistique de test s’effectue par substitution algébrique :
$$F_{calc} = \frac{\Delta SSR / k}{SSR_{NC} / (N – 2k)} = \frac{(SSR_C – (SSR_1 + SSR_2)) / k}{(SSR_1 + SSR_2) / (N_1 + N_2 – 2k)}$$
La valeur numérique obtenue est ensuite confrontée à la valeur critique théorique issue de la table de Fisher-Snedecor pour un seuil d’erreur de première espèce choisi $\alpha$ (classiquement 0,05 ou 0,01) :
$$F_{crit} = \mathcal{F}_{\alpha}(k, , N – 2k)$$
Conjointement, la probabilité critique exacte ($p$-valeur) est déterminée par :
$$p\text{-valeur} = P\left(\mathcal{F}(k, N – 2k) ge F_{calc}\right)$$
Si cette probabilité est inférieure au seuil critique $\alpha$, le rejet formel de l’invariance paramétrique est prononcé.
6. Interprétation des résultats et prise de décision statistique
Le calcul de la statistique $F_{Chow}$ ne constitue pas une fin en soi ; il conditionne la stratégie de modélisation ultérieure et guide l’interprétation des relations économiques ou comportementales examinées.
6.1 Critères de rejet et analyse de la significativité
La règle décisionnelle obéit aux canons usuels du test d’hypothèse de Neyman-Pearson :
- Cas 1 : $F_{calc} > F_{crit}$ (ou $p\text{-valeur} < \alpha$). On rejette formellement l’hypothèse nulle d’invariance des paramètres. Les données fournissent des preuves empiriques suffisantes indiquant que la structure relationnelle liant les prédicteurs à la variable dépendante s’est modifiée entre les deux sous-périodes. L’estimation d’une droite de régression unique est biaisée et scientifiquement infondée.
- Cas 2 : $F_{calc} le F_{crit}$ (ou $p\text{-valeur} ge \alpha$). On ne peut pas rejeter l’hypothèse nulle. La différence observée entre les coefficients estimés sur les deux sous-échantillons n’est pas statistiquement discernable des fluctuations d’échantillonnage aléatoires. Rien ne justifie la scission du modèle en deux équations séparées.
Il importe toutefois de distinguer la significativité statistique de la significativité économique ou pratique. Dans de très grands échantillons ($N$ très volumineux), des divergences paramétriques infinitésimales peuvent être déclarées hautement significatives par le test de Chow sans pour autant induire un changement structurel matériellement pertinent.
6.2 Diagnostic approfondi de la source de l’instabilité
Un rejet de l’hypothèse nulle par le test de Chow indique simplement que le vecteur $\beta_1$ diffère de $\beta_2$, sans préciser quelle variable en est la cause directe. Pour identifier la source exacte de la rupture, le statisticien doit mener un diagnostic analytique complémentaire :
L’inspection des coefficients estimés sous chaque régime permet d’évaluer les écarts ponctuels $\hat{\beta}_{1,j} – \hat{\beta}_{2,j}$. L’examen des intervalles de confiance à 95 % respectifs montre si ces intervalles se chevauchent ou s’ils sont totalement disjoints pour un régresseur donné.
De plus, l’analyse graphique des résidus du modèle contraint fournit de précieux enseignements. Une dérive prononcée de la moyenne des résidus au-delà de la date de rupture suggère une rupture de l’ordonnée à l’origine, tandis qu’une modification visible de la dispersion ou de la pente des résidus face à une covariable met en évidence une instabilité des coefficients directeurs.
6.3 Conséquences modélisatrices suite au résultat du test
La décision inférentielle impose un choix méthodologique strict pour la suite de l’analyse :
En présence d’une stabilité confirmée ($H_0$ conservée), le modèle contraint unique doit être conservé. Il offre une plus grande précision d’estimation grâce aux gains de degrés de liberté conférés par l’utilisation de l’ensemble de l’échantillon ($N – k$ degrés de liberté au lieu de sous-échantillons restreints).
En cas d’instabilité avérée ($H_0$ rejetée), deux options majeures s’offrent au chercheur :
- Segmenter définitivement la modélisation en estimant deux équations indépendantes, limitant les interprétations et prévisions à leur régime respectif.
- Spécifier un modèle unifié enrichi de variables indicatrices muettes (dummy variables) et de termes d’interaction multiplicative. Cette démarche permet d’isoler avec précision les composantes ayant effectivement divergé tout en maintenant un cadre d’estimation global.
7. Exemple pratique détaillé : Analyse d’une rupture temporelle dans les données
Afin d’illustrer concrètement la mise en œuvre empirique du test de Chow, nous développons ci-après un cas pratique documenté simulant une étude de performance industrielle sur une série trimestrielle de 40 observations.
7.1 Contexte de l’étude et présentation du jeu de données
Une entreprise technologique évalue la relation liant son score global d’efficacité opérationnelle ($Y_t$) à deux facteurs déterminants : le montant des investissements alloués à la recherche organisationnelle ($X_{1t}$, exprimé en dizaines de milliers d’euros) et le taux de charge de travail des équipes opérationnelles ($X_{2t}$, mesuré en indice de 0 à 100).
La série temporelle s’étend sur 40 trimestres consécutifs ($N = 40$). Au cours du trimestre 21 ($T^* = 21$), l’entreprise a mis en place une transformation numérique intégrale et une refonte de sa gouvernance managériale. Le chercheur souhaite déterminer si cette réorganisation a modifié structurellement la fonction de production industrielle. L’échantillon est scindé en deux sous-périodes de taille égale :
- Période 1 (Pré-réforme, $t = 1$ à 20) : $N_1 = 20$ trimestres.
- Période 2 (Post-réforme, $t = 21$ à 40) : $N_2 = 20$ trimestres.
Le modèle compte $k = 3$ paramètres (la constante $\beta_0$, la pente $\beta_1$ pour l’investissement, et la pente $\beta_2$ pour la charge de travail).
7.2 Exécution numérique des régressions et résultats chiffrés
L’estimation par les moindres carrés ordinaires des trois régressions (globale contrainte, période 1, période 2) fournit les résultats empiriques suivants :
1. Régression globale contrainte (Échantillon total, $N = 40$) :
$$\hat{Y}_t = 12,450 + 2,105 X_{1t} + 0,432 X_{2t}$$
L’extraction des résidus fournit une somme des carrés résiduelle contrainte :
$$SSR_C = 845,320$$
Degrés de liberté associés : $N – k = 40 – 3 = 37$.
2. Régression secteur pré-réforme (Période 1, $N_1 = 20$) :
$$\hat{Y}_{1t} = 18,320 + 1,210 X_{1t} + 0,615 X_{2t}$$
La somme des carrés des résidus pour ce sous-modèle s’établit à :
$$SSR_1 = 212,450$$
Degrés de liberté associés : $N_1 – k = 20 – 3 = 17$.
3. Régression secteur post-réforme (Période 2, $N_2 = 20$) :
$$\hat{Y}_{2t} = 5,640 + 3,450 X_{1t} + 0,220 X_{2t}$$
La somme des carrés des résidus pour ce sous-modèle s’établit à :
$$SSR_2 = 184,630$$
Degrés de liberté associés : $N_2 – k = 20 – 3 = 17$.
On en déduit la somme des carrés des résidus non contrainte :
$$SSR_{NC} = SSR_1 + SSR_2 = 212,450 + 184,630 = 397,080$$
Les degrés de liberté totaux du dénominateur sont :
$$N – 2k = 40 – (2 \times 3) = 34$$
7.3 Calcul pas à pas de la valeur F et conclusion pratique
Nous pouvons à présent injecter l’ensemble de ces valeurs numériques au sein de la formule de Gregory Chow :
$$F_{calc} = \frac{(SSR_C – SSR_{NC}) / k}{SSR_{NC} / (N – 2k)} = \frac{(845,320 – 397,080) / 3}{397,080 / 34}$$
Calculons le numérateur :
$$\Delta SSR = 845,320 – 397,080 = 448,240$$
$$\text{Carré moyen au numérateur} = \frac{448,240}{3} \approx 149,4133$$
Calculons le dénominateur :
$$\text{Carré moyen au dénominateur} = \frac{397,080}{34} \approx 11,6788$$
Rapportons les deux termes :
$$F_{calc} = \frac{149,4133}{11,6788} \approx 12,793$$
Consultons la valeur critique dans les tables statistiques de Fisher-Snedecor pour $k_1 = 3$ et $k_2 = 34$ degrés de liberté au seuil conventionnel $\alpha = 0,05$ :
$$F_{0,05}(3, 34) \approx 2,883$$
Pour le seuil plus exigeant de $\alpha = 0,001$ :
$$F_{0,001}(3, 34) \approx 6,68$$
La comparaison numérique montre sans ambiguïté :
$$F_{calc} = 12,793 > 2,883 \quad (p < 0,0001)$$
Conclusion statistique et managériale : L’hypothèse nulle d’invariance des paramètres est rejetée au seuil de confiance de 99,9 %. La mise en œuvre de la réforme managériale au trimestre 21 a entraîné une mutation structurelle profonde. L’analyse des coefficients confirme que le rendement de l’investissement organisationnel a quasiment triplé (la pente passant de 1,210 à 3,450), tandis que la sensibilité à la charge de travail a fortement diminué (passant de 0,615 à 0,220). Maintenir un modèle unique aurait faussé l’évaluation des rendements et conduit à des arbitrages budgétaires inadaptés.
8. Application du test de Chow en psychologie quantitative et sciences du comportement
Bien que formalisé initialement dans une perspective économétrique, le test de Chow constitue un dispositif d’évaluation précieux pour la recherche clinique, comportementale et psychométrique contemporaine.
8.1 Évaluation de l’efficacité d’interventions thérapeutiques
Dans les protocoles expérimentaux longitudinaux ou quasi-expérimentaux à séries temporelles interrompues (interrupted time series design), le clinicien cherche fréquemment à vérifier si un traitement (médicamenteux, cognitivo-comportemental ou éducatif) a modifié la dynamique relationnelle liant un facteur d’exposition psychologique à un trouble mesuré.
Prenons l’exemple d’une étude portant sur la relation entre le niveau de stress perçu (auto-évalué sur une échelle standardisée) et l’intensité des symptômes dépressifs chez un groupe de patients suivis de manière répétée. Avant l’intervention thérapeutique, chaque augmentation d’une unité de stress peut induire une hausse marquée de la symptomatologie dépressive (forte pente positive). L’introduction d’un protocole de réduction du stress basé sur la pleine conscience à un moment $T^*$ vise à développer des capacités de régulation émotionnelle.
L’application du test de Chow permet d’évaluer si la pente de vulnérabilité a subi une atténuation statistiquement significative après l’intervention. Rejeter l’hypothèse nulle valide le fait que la thérapie n’a pas simplement réduit le niveau moyen de dépression (rupture de la constante), mais qu’elle a modifié la sensibilité psychologique structurelle face aux stresseurs du quotidien (rupture de pente).
8.2 Différences intergroupes et invariance de mesure
En psychométrie, le test de Chow est couramment appliqué pour comparer l’équivalence des fonctions de prédiction entre différentes strates d’une population (par exemple, entre un groupe témoin et un groupe clinique, ou entre des cohortes d’âges distincts). Cette démarche s’avère conceptuellement très proche des tests d’invariance de mesure multigroupes conduits dans les modèles à équations structurelles (SEM).
Si l’on cherche à prédire l’anxiété de performance académique à partir de traits de personnalité tels que le perfectionnisme névrotique et le sentiment d’auto-efficacité, la question se pose de savoir si ce modèle fonctionne de manière identique chez les étudiants de sexe masculin et féminin. En posant la partition de l’échantillon sur la variable indicatrice du sexe, le test de Chow permet de tester l’égalité simultanée de l’ordonnée à l’origine et des coefficients de régression.
Un rejet de l’invariance paramétrique signale un fonctionnement différentiel des prédicteurs, indiquant que les leviers motivationnels influençant l’anxiété opèrent selon des dynamiques distinctes d’un genre à l’autre, ce qui interdit toute standardisation aveugle des interventions de soutien pédagogique.
8.3 Modélisation des transitions développementales critiques
La psychologie du développement cognitif postule que la maturation humaine n’évolue pas toujours selon des trajectoires linéaires et monotones, mais traverse des périodes de réorganisation critique (théorie des stades piagétiens ou bifurcations de l’adolescence). Les modèles linéaires continus échouent souvent à rendre compte de ces transitions abruptes.
Grâce au test de Chow, les chercheurs en neurosciences développementales peuvent tester empiriquement l’existence de fenêtres développementales charnières. Par exemple, l’impact des fonctions exécutives (inhibition, mémoire de travail) sur l’acquisition du langage complexe peut être modélisé avant et après l’âge pivot de 7 ans (marquant classiquement l’accès aux opérations concrètes).
De même, dans les études sur la plasticité de la personnalité chez l’adulte vieillissant, le test permet d’analyser si la survenue de la retraite ou le décès d’un conjoint introduit une discontinuité structurelle dans la relation reliant l’engagement social au sentiment d’épanouissement psychologique. Cette segmentation empirique permet de réconcilier les théories développementales fondées sur des stades qualitatifs avec l’exigence de validation statistique quantitative rigoureuse.
9. Limites méthodologiques et écueils courants du test de Chow
En dépit de son élégance algébrique et de sa grande popularité, le test de Chow souffre de plusieurs limites méthodologiques intrinsèques qu’un praticien averti doit impérativement appréhender afin d’éviter des déductions erronées.
9.1 La dépendance à la connaissance préalable de la date de rupture
La limite la plus contraignante du test de Chow standard réside dans son caractère strictement exogène : la date ou le seuil de rupture structurelle ($T^*$) doit être connu avec certitude et formulé a priori par le chercheur avant toute manipulation des données. Cette condition est satisfaite lorsqu’il existe un repère historique, légal ou événementiel clair (un vote de loi, une dévaluation monétaire, le début d’un confinement).
Cependant, dans de nombreuses situations réelles, l’instant précis de la transition demeure inconnu ou diffus. Si un chercheur tente de déterminer le point de rupture en exécutant de multiples tests de Chow sur chaque date candidate possible afin de retenir celle qui maximise la valeur de $F$, il commet un biais d’exploration statistique majeur (p-hacking / data mining). Cette démarche entraîne une sévère inflation du risque d’erreur de première espèce : la statistique $F$ maximale ainsi obtenue ne suit absolument plus une loi de Fisher conventionnelle, conduisant à détecter des pseudo-ruptures purement fortuites.
Pour surmonter cet écueil fondamental, il devient nécessaire de recourir à des tests d’estimation endogène de ruptures à date inconnue.
9.2 Sensibilité extrême à l’hétéroscédasticité des erreurs
Comme énoncé dans l’examen des postulats fondamentaux, le test de Chow classique confond aisément une rupture de la variance résiduelle ($\sigma_1^2 \neq \sigma_2^2$) avec un déplacement des coefficients de régression ($\beta_1 \neq \beta_2$). L’architecture mathématique du test suppose la constance de la variance globale sous-jacente.
Lorsque la volatilité des résidus s’accroît brutalement au cours de la seconde période (phénomène très commun lors des crises financières ou des périodes de grande incertitude macroéconomique), le terme d’erreur non contraint est dominé par la dispersion du second sous-échantillon. Cette violation engendre une sur-rejection systématique et massive de l’hypothèse nulle : le test de Chow signale une rupture de coefficients hautement significative alors que les véritables relations causales sont demeurées strictement invariantes et que seule l’intensité du bruit stochastique s’est amplifiée.
Il est donc imprudent d’interpréter un test de Chow sans avoir formellement validé au préalable l’homogénéité des variances entre les sous-groupes à l’aide de procédures diagnostiques spécifiques.
9.3 Incapacité à isoler les composantes de la variation paramétrique
Le test de Chow est un test d’hypothèse globale de type omnibus : il agrège au sein d’une seule statistique de synthèse la divergence de l’ensemble des $k$ paramètres du modèle. Par conséquent, il présente une forme d’opacité analytique.
D’une part, un résultat significatif ne renseigne pas le chercheur sur la nature fine de la rupture : est-ce uniquement l’ordonnée à l’origine qui a glissé, ou est-ce la pente d’un régresseur spécifique ? Le test ne permet pas de le savoir de manière autonome.
D’autre part, le test peut souffrir d’un déficit de puissance lorsque des effets compensatoires se produisent entre coefficients. Si un paramètre augmente modérément tandis qu’un autre diminue dans des proportions antagonistes, la statistique $F$ agrégée peut diluer la significativité de chaque changement individuel sous le poids des degrés de liberté globaux, échouant ainsi à déceler une restructuration interne majeure.
10. Alternatives et extensions modernes au test de Chow
Face aux limites du cadre originel de 1960, la littérature économétrique moderne a développé un riche éventail d’extensions méthodologiques permettant d’étudier l’instabilité structurelle dans des configurations bien plus complexes et réalistes.
10.1 L’approche par variables indicatrices et termes d’interaction
L’alternative la plus directe et pédagogique au test de Chow repose sur la spécification d’un modèle de régression unique incorporant une variable muette dichotomique $D_t$ ($D_t = 0$ pour la période 1, $D_t = 1$ pour la période 2) et l’ensemble de ses interactions multiplicatives avec chaque régresseur :
$$Y_t = \beta_0 + \gamma_0 D_t + \beta_1 X_{1t} + \gamma_1 (D_t \times X_{1t}) + dots + \beta_p X_{pt} + \gamma_p (D_t \times X_{pt}) + \varepsilon_t$$
Dans cette équation unifiée :
- $\beta_0, \beta_1, dots, \beta_p$ représentent les coefficients de base pour le régime 1 ($D_t = 0$).
- $\gamma_0$ mesure spécifiquement le saut de l’ordonnée à l’origine entre les deux régimes.
- $\gamma_1, dots, \gamma_p$ représentent les modifications d’inclinaison des pentes respectives lors du basculement vers le régime 2 ($D_t = 1$).
Cette approche présente une équivalence algébrique absolue avec le test de Chow lorsqu’on éprouve l’hypothèse de nullité conjointe de l’ensemble des coefficients différentiels :
$$H_0 : \gamma_0 = \gamma_1 = dots = \gamma_p = 0$$
La statistique $F$ associée à ce test de restriction conjointe est rigoureusement identique à la statistique $F_{Chow}$. Cependant, cette formulation interactive offre un avantage diagnostique considérable : le chercheur peut tester individuellement la significativité de chaque $\gamma_j$ via un test de Student classique, isolant précisément les variables sources de l’instabilité structurelle.
10.2 Tests de détection endogène des ruptures structurelles
Pour s’affranchir de la contrainte d’une date de rupture fixée a priori, Richard Quandt a introduit le test du ratio de vraisemblance suprême, connu sous le nom de Quandt Likelihood Ratio (QLR) ou Sup-F test. Ce test calcule la statistique de Chow pour chaque date possible au sein d’une fenêtre centrale de l’échantillon (généralement entre 15 % et 85 % de la série pour préserver les degrés de liberté) et retient la valeur maximale observée :
$$\text{Sup-F} = \max_{\tau in [\tau_1, \tau_2]} F_{Chow}(\tau)$$
La distribution asymptotique de cette statistique n’étant plus une loi de Fisher classique, elle a été dérivée par Donald Andrews en 1993 sous la forme d’une fonctionnelle de pont brownien.
Cette approche a été magistralement généralisée par Jushan Bai et Pierre Perron (1998, 2003), qui ont développé un algorithme de programmation dynamique permettant d’estimer simultanément le nombre optimal et l’emplacement exact de ruptures structurelles multiples inconnues dans les séries chronologiques, révolutionnant la macroéconométrie moderne.
Parallèlement, les tests basés sur les sommes cumulées des résidus récursifs, à l’image du célèbre test CUSUM et CUSUMSQ de Brown, Durbin et Evans (1975), permettent d’examiner la stabilité des paramètres en temps réel au fur et à mesure de l’acquisition des données.
10.3 Adaptations pour variances inégales et modèles non linéaires
Pour remédier à la défaillance du test de Chow en présence d’hétéroscédasticité inter-régimes, les statisticiens ont développé des formulations robustes basées sur le test de Wald asymptotique. En combinant les matrices de variance-covariance estimées avec la correction d’hétéroscédasticité de White, la statistique de Wald robuste s’exprime comme suit :
$$W = (\hat{\beta}_1 – \hat{\beta}_2)’ \left[ \widehat{Var}(\hat{\beta}_1) + \widehat{Var}(\hat{\beta}_2) \right]^{-1} (\hat{\beta}_1 – \hat{\beta}_2)$$
Sous l’hypothèse nulle de stabilité paramétrique, cette statistique $W$ converge en loi vers une distribution du Chi-deux à $k$ degrés de liberté :
$$W x\rightarrow{d} \chi^2(k)$$
Cette méthodologie affranchit l’analyste de l’obligation d’égalité des variances résiduelles.
De plus, le concept de rupture de Chow s’étend aujourd’hui aux modèles de choix discrets (régressions logistiques et probit), aux modèles linéaires généralisés (GLM) et aux panels dynamiques avec effets fixes, souvent couplé à des techniques de rééchantillonnage non paramétrique (bootstrap) pour approcher la distribution empirique exacte des estimateurs sans dépendre d’hypothèses distributionnelles restrictives.
11. Implémentation informatique : Tutoriels pratiques (R et Python)
Afin de concrétiser l’exécution de ces procédures statistiques, nous détaillons ci-dessous leur mise en œuvre computationnelle au sein des deux environnements logiciels dominants en data science et analyse économétrique : l’écosystème R et le langage Python.
11.1 Exécution sous l’environnement R
Dans le langage statistique R, le package de référence dédié à la modélisation des changements structurels s’intitule strucchange. Il contient une routine optimisée permettant d’exécuter le test de Chow via la fonction générique sctest (structural change test).
La mise en œuvre pratique débute par l’importation de la bibliothèque et la formalisation de la relation linéaire à éprouver :
Dans un premier temps, l’utilisateur charge le paquet via la commande library(strucchange). Supposons que le jeu de données soit stocké au sein d’un dataframe nommé donnees_economiques, comportant la variable cible Y et les régresseurs X1 et X2.
L’exécution du test de Chow pour une rupture localisée à la 21e observation s’effectue simplement en spécifiant l’argument point au sein de la fonction :
resultat_chow <- sctest(Y ~ X1 + X2, data = donnees_economiques, type = "Chow", point = 21)
L’affichage de l’objet resultat_chow renvoie directement la statistique $F$ observée, les degrés de liberté théoriques correspondants ($k$ et $N – 2k$), ainsi que la $p$-valeur exacte associée.
Pour une visualisation graphique élégante des segments ajustés avant et après rupture, l’analyste peut recourir à la bibliothèque ggplot2 en projetant la variable temporelle sur l’axe des abscisses et en appliquant un tracé séparé par la fonction geom_smooth(method = "lm") conditionné par une variable de groupe binaire marquant le seuil de césure.
11.2 Implémentation en Python via statsmodels
En Python, bien que le package statsmodels ne comporte pas de fonction native portant explicitement le nom « chow_test », sa construction arithmétique s’exécute avec clarté en s’appuyant sur les modules statsmodels.api, pandas et scipy.stats.
La méthodologie algorithmique suit fidèlement les étapes décrites dans la section 5 :
- On scinde le DataFrame global
dfen deux sous-ensembles :df_regime1 = df.iloc[:20]etdf_regime2 = df.iloc[20:]. - On ajuste le modèle global à l’aide de l’estimateur OLS :
mod_c = sm.OLS(df['Y'], sm.add_constant(df[['X1', 'X2']])).fit(), d’où l’on extrait la somme résiduelle :ssr_c = mod_c.ssr. - On ajuste de façon analogue les deux modèles partitionnés :
mod_1 = sm.OLS(df_regime1['Y'], sm.add_constant(df_regime1[['X1', 'X2']])).fit()etmod_2 = sm.OLS(df_regime2['Y'], sm.add_constant(df_regime2[['X1', 'X2']])).fit(). - On extrait leurs sommes de carrés respectives :
ssr_1 = mod_1.ssretssr_2 = mod_2.ssr, puis l’on calculessr_nc = ssr_1 + ssr_2. - Les degrés de liberté sont définis :
k = 3etdf_denom = len(df) - 2 * k. - La statistique de Chow est obtenue :
f_stat = ((ssr_c - ssr_nc) / k) / (ssr_nc / df_denom). - La $p$-valeur est dérivée via la fonction de survie de la distribution F :
p_val = scipy.stats.f.sf(f_stat, k, df_denom).
Cette séquence de calcul matriciel offre une totale transparence d’exécution et permet d’encapsuler la routine au sein d’une fonction réutilisable pour tout pipeline d’analyse industrielle ou prédictive.
11.3 Interprétation comparée des sorties logicielles
Lorsqu’ils sont appliqués à un jeu de données strictement identique, R et Python fournissent des résultats rigoureusement concordants jusqu’à la dernière décimale pour la statistique $F$, ses degrés de liberté et sa probabilité critique. Les divergences apparentes rencontrées par certains analystes proviennent presque exclusivement de deux sources d’erreurs fréquentes :
- La gestion de la constante : R inclut par défaut une ordonnée à l’origine dans sa formule linéaire (sauf exclusion explicite via
- 1), tandis questatsmodelsen Python requiert l’adjonction explicite d’une colonne unitaire viasm.add_constant(). L’omission de cette constante en Python modifie profondément les degrés de liberté et la somme des carrés résiduels. - L’indexation de l’observation charnière : Il convient de vérifier soigneusement si le point d’observation $T^*$ indiqué est inclus au sein du premier régime ou du second, l’indexation débutant à 1 en R et à 0 en Python.
Dans un rapport de recherche académique, il est recommandé de consigner systématiquement : la taille des deux sous-échantillons ($N_1, N_2$), le nombre de covariables ($k$), les valeurs respectives de $SSR_C$ et $SSR_{NC}$, la statistique $F$ observée et la $p$-valeur exacte, afin de garantir une reproductibilité computationnelle totale.
12. Bonnes pratiques de recherche et synthèse méthodologique
Pour conclure cette étude approfondie du test de Chow, nous synthétisons les règles méthodologiques fondamentales et l’arbre décisionnel permettant aux chercheurs d’adopter une démarche empirique robuste, exempte de biais inférentiels.
12.1 Liste de contrôle méthodologique avant exécution
Avant d’engager le calcul de la statistique de Chow et de fonder des conclusions substantielles sur ses résultats, le praticien doit impérativement valider la check-list suivante :
- Justification théorique de la rupture : L’instant de rupture $T^*$ repose-t-il sur une argumentation contextuelle, institutionnelle ou empirique documentée en amont, indépendante de toute observation visuelle préalable du nuage de points ?
- Validation des hypothèses d’erreurs : L’indépendance sérielle des résidus a-t-elle été formellement vérifiée ? En présence d’autocorrélation, la statistique $F$ est artificiellement gonflée.
- Contrôle d’homogénéité des variances : La variance des résidus du premier sous-échantillon est-elle comparable à celle du second ? Un test d’homoscédasticité a-t-il été validé ?
- Suffisance d’échantillonnage : Chaque sous-échantillon dispose-t-il d’un effectif suffisant ($N_1 gg k$ et $N_2 gg k$) pour éviter toute singularité matricielle et assurer la stabilité numérique de l’inversion des MCO ?
- Stabilité des régresseurs : La matrice de covariance des prédicteurs $X$ ne subit-elle pas une colinéarité excessive au sein de l’un des sous-groupes partitionnés ?
12.2 Rédaction et communication des résultats dans une publication
La présentation des résultats du test de Chow dans un article scientifique obéit aux normes rédactionnelles académiques les plus strictes (notamment celles de l’American Psychological Association ou des revues d’économétrie appliquée). La communication doit éviter de se limiter à la simple mention d’une $p$-valeur décontextualisée.
Le chercheur doit présenter dans un tableau récapitulatif synthétique :
- Les coefficients estimés ($\hat{\beta}$) et leurs erreurs-types associées pour les trois régressions (modèle global restreint, sous-régime 1, sous-régime 2).
- Les coefficients de détermination $R^2$ respectifs et les sommes des carrés des résidus ($SSR$).
- La valeur de la statistique $F$ explicitant ses deux degrés de liberté sous la forme standardisée canonique : $F(k, N – 2k) = \text{valeur}, p = \text{valeur}$.
- Une discussion approfondie portant sur l’interprétation concrète des écarts de coefficients observés, en précisant si l’instabilité découle d’un changement de niveau global (constante) ou d’une modification structurelle des rendements marginaux (pentes).
Cette transparence descriptive garantit la pleine crédibilité de l’inférence et permet aux lecteurs d’apprécier la pertinence matérielle des résultats au-delà du simple verdict statistique.
12.3 Arbre décisionnel pour l’analyse de stabilité structurelle
Pour orienter le chercheur confronté à l’analyse de la stabilité de ses régressions, la démarche d’ensemble peut être structurée sous la forme d’un protocole logique rigoureux :
Étape 1 : Le point de rupture potentiel est-il connu a priori ?
- Oui : On s’oriente vers le cadre d’analyse de Chow.
- Non : On applique des tests de détection endogène de ruptures à date inconnue (test Sup-F de Quandt ou algorithme de Bai-Perron).
Étape 2 : L’hypothèse d’homogénéité des variances résiduelles ($\sigma_1^2 = \sigma_2^2$) est-elle respectée ?
- Oui : L’exécution du test de Chow canonique fondé sur la distribution $\mathcal{F}(k, N – 2k)$ est pleinement licite.
- Non : Abandonner le test de Chow classique et utiliser la statistique de Wald robuste asymptotique (correction de White) suivant une distribution du $\chi^2(k)$, ou appliquer une procédure de rééchantillonnage par bootstrap.
Étape 3 : Quel est le résultat du test de stabilité retenu ?
- Échec de rejet de $H_0$ ($p ge \alpha$) : Maintien du modèle contraint unique estimé sur l’échantillon groupé pour maximiser la précision des estimateurs.
- Rejet formel de $H_0$ ($p < \alpha$) : Rejet du modèle unique. Estimer un modèle à variables indicatrices avec interactions pour identifier précisément les coefficients instables, ou partitionner définitivement les régressions en fonction des deux régimes temporels ou catégoriels.
En observant scrupuleusement ces principes directeurs, l’analyste prémunit ses modélisations contre les erreurs de spécification et transforme l’identification des ruptures structurelles en une opportunité féconde pour éclairer la complexité dynamique des phénomènes empiriques observés.
Références
Voici les références bibliographiques fondamentales relatives à la stabilité structurelle et au test de Chow, rédigées selon les normes académiques de l’APA (7e édition) :
- Andrews, D. W. K. (1993). Tests for parameter instability and structural change with unknown change point. Econometrica, 61(4), 821–856. https://doi.org/10.2307/2951764
- Bai, J., & Perron, P. (1998). Estimating and testing linear models with multiple structural changes. Econometrica, 66(1), 47–78. https://doi.org/10.2307/2998540
- Bai, J., & Perron, P. (2003). Computation and analysis of multiple structural change models. Journal of Applied Econometrics, 18(1), 1–22. https://doi.org/10.1002/jae.659
- Brown, R. L., Durbin, J., & Evans, J. M. (1975). Techniques for testing the constancy of regression relationships over time. Journal of the Royal Statistical Society: Series B (Methodological), 37(2), 149–163. https://doi.org/10.1111/j.2517-6161.1975.tb01532.x
- Chow, G. C. (1960). Tests of equality between sets of coefficients in two linear regressions. Econometrica, 28(3), 591–605. https://doi.org/10.2307/1910133
- Greene, W. H. (2018). Econometric analysis (8e éd.). Pearson.
- Quandt, R. E. (1960). Tests of the hypothesis that a linear regression system obeys two separate regimes. Journal of the American Statistical Association, 55(290), 324–330. https://doi.org/10.1080/01621459.1960.10482067
- Stock, J. H., & Watson, M. W. (2019). Introduction to econometrics (4e éd.). Pearson.
- Toyoda, T. (1974). Use of the Chow test under heteroscedasticity. Econometrica, 42(3), 601–608. https://doi.org/10.2307/1911798
- Zeileis, A., Leisch, F., Hornik, K., & Kleiber, C. (2002). strucchange: An R package for testing for structural change in linear regression models. Journal of Statistical Software, 7(2), 1–38. https://doi.org/10.18637/jss.v007.i02