
L’inférence statistique moderne repose sur une tension fondamentale entre l’observation empirique d’un échantillon restreint et la volonté d’extrapoler des vérités universelles à l’échelle d’une population tout entière. Dans les disciplines quantitatives, notamment les sciences du comportement, la psychologie expérimentale, la médecine clinique et la neuro-imagerie, cette démarche inductrice se heurte inéluctablement à la stochasticité inhérente aux données. Lorsqu’un chercheur évalue l’efficacité d’un nouveau protocole thérapeutique ou la réalité d’un mécanisme attentionnel, il s’expose invariablement à des jugements probabilistes sous incertitude. Dans cette arène épistémologique, la gestion et la quantification des risques de fausse conclusion constituent la clé de voûte de la validité scientifique.
Si la culture académique s’est historiquement focalisée de manière presque obsessionnelle sur le risque de « faux positif » — incarné par le célèbre seuil alpha (α) et la sacro-sainte valeur p inférieure à 0,05 —, cette précaution asymétrique a longtemps laissé dans l’ombre une menace épistémologique tout aussi délétère : l’erreur de type II, formellement quantifiée par le niveau bêta (β). L’erreur de type II représente l’incapacité d’un protocole expérimental à détecter un phénomène, un lien causal ou une différence pourtant bien réels dans la nature. Négliger le niveau bêta équivaut à concevoir des télescopes aveugles aux planètes qu’ils prétendent observer, conduisant les scientifiques à déclarer inexistants des effets thérapeutiques majeurs ou des mécanismes psychologiques déterminants par simple manque de sensibilité méthodologique.
Cet article propose une exploration exhaustive, théorique et appliquée du niveau bêta en statistique. À travers la déconstruction de la logique de Neyman-Pearson, l’analyse des déterminants mathématiques de la puissance statistique, la mise en lumière de cas concrets issus de la psychologie clinique et l’examen critique de la crise de la réplicabilité, nous mettrons en lumière le rôle central du risque bêta. Comprendre, calculer et maîtriser le niveau bêta n’est pas un simple exercice d’algèbre computationnelle : c’est un impératif d’intégrité intellectuelle, une condition nécessaire pour préserver la recherche empirique de l’amnésie scientifique et des abandons prématurés d’hypothèses fécondes.
1. Fondements de l’inférence statistique et logique du test d’hypothèses
1.1 Le paradigme décisionnel de Neyman-Pearson dans les sciences du comportement
L’architecture contemporaine du test d’hypothèses résulte d’une fusion — souvent qualifiée d’hybridation conflictuelle — entre deux approches philosophiquement divergentes de l’inférence statistique : le test de signification inductif formalisé par Ronald Fisher et la théorie de la décision binaire conçue par Jerzy Neyman et Egon Pearson. Là où Fisher envisageait la valeur p comme un indice continu mesurant la plausibilité des données au regard d’une seule hypothèse nulle, sans considération explicite d’une alternative formalisée, Neyman et Pearson ont introduit un cadre décisionnel normatif et pragmatique. Dans cette optique, le chercheur ne cherche pas à établir la « vérité » au sens métaphysique, mais à définir une règle d’action optimale garantissant un taux de contrôle des erreurs à long terme lors de décisions répétées.
Dans les sciences du comportement, où les données sont affectées par un niveau de bruit individuel, situationnel et métrologique considérable, l’adoption d’un tel cadre décisionnel binaire s’est avérée indispensable. La validation ou le rejet d’un modèle en psychologie expérimentale requiert de trancher nettement entre le maintien du statu quo théorique et l’acceptation d’un changement paradigmatique. Ce mécanisme de décision repose entièrement sur l’échantillonnage probabiliste. La quantification rigoureuse de l’incertitude scientifique ne peut s’effectuer sans admettre que tout échantillon fini n’est qu’une instanciation aléatoire issue d’une distribution théorique infinie. Dès lors, toute règle mécanique destinée à accepter ou repousser une découverte s’inscrit au sein d’une économie d’arbitrage probabiliste régie par des seuils de décision prédéterminés.
Ce paradigme impose donc une discipline méthodologique stricte : avant même de recueillir la moindre mesure empirique, l’expérimentateur doit circonscrire l’espace décisionnel en précisant le protocole sous lequel les données contraindront le comportement scientifique. L’inférence ne consiste plus en une appréciation subjective de la singularité d’un tracé de données, mais en une procédure algorithmique calibrée pour cantonner les défaillances de jugement dans des limites numériques tolérables.
1.2 Formulation des hypothèses statistiques : hypothèse nulle (H0) et hypothèse alternative (H1)
L’armature logique de l’inférence de Neyman-Pearson exige la spécification a priori de deux propositions théoriques rivales, mutuellement exclusives et collectivement exhaustives dans l’espace des paramètres considérés : l’hypothèse nulle, notée H0, et l’hypothèse alternative, notée H1. L’hypothèse nulle représente conventionnellement l’hypothèse de parité, d’absence d’effet, de stabilité du système ou d’invariance paramétrique. En psychologie cognitive ou clinique, elle formalise l’assertion selon laquelle la différence observée entre deux conditions expérimentales — par exemple entre un groupe exposé à un entraînement mnémotechnique et un groupe contrôle — est strictement imputable aux fluctuations stochastiques de l’échantillonnage et que la véritable différence populationnelle est nulle (Δ = 0).
À l’opposé, l’hypothèse alternative incarne la conceptualisation théorique d’un processus psychologique non aléatoire. Elle postule que le facteur manipulé par le chercheur engendre une modification substantielle de la variable dépendante, se traduisant par un paramètre de population non nul (Δ ≠ 0 dans les tests bilatéraux, ou Δ > 0 dans les démarches unilatérales directionnelles). Loin d’être une simple négation abstraite, H1 devrait idéalement spécifier une amplitude attendue de l’effet, ancrée dans la littérature empirique ou modélisée théoriquement. Cette formalisation conditionne l’ensemble de la mécanique du test.
Le caractère mutuellement exclusif des deux hypothèses signifie qu’une seule d’entre elles décrit la réalité sous-jacente du phénomène biologique ou cognitif investigué ; leur caractère exhaustif implique que l’expérimentateur restreint son analyse à ce diptyque conceptuel. Cette structuration manichéenne est le prix épistémologique à payer pour autoriser un calcul probabiliste rigoureux : l’expérimentateur établit une cartographie des probabilités conditionnelles qui permettra d’assigner à chaque issue empirique une conséquence décisionnelle non ambiguë.
1.3 La matrice de décision statistique et les quatre issues possibles
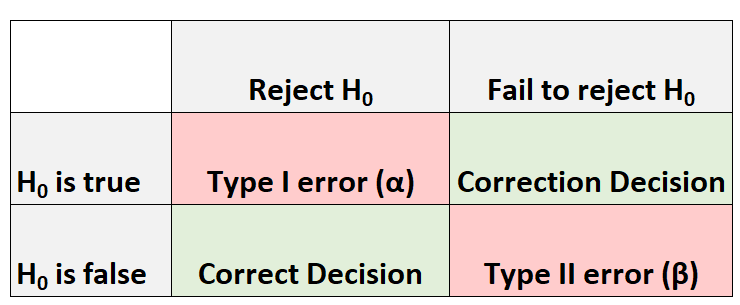
L’acte d’inférence statistique sur un échantillon peut se résumer à une confrontation entre l’état de la nature, qui demeure fondamentalement inconnu du chercheur, et le verdict algorithmique issu de l’observation empirique. Cette confrontation se modélise à travers une matrice de décision à deux entrées croisant la réalité populationnelle (H0 vraie vs H1 vraie) et la décision statistique arrêtée (rejet de H0 vs maintien de H0). De ce croisement émergent quatre issues logiques distinctes, dont deux correspondent à des inférences justes et deux constituent des erreurs d’échantillonnage.
Les deux décisions correctes sont :
- Le rejet légitime de l’hypothèse nulle : la décision est prise de rejeter H0 alors que cette dernière est factuellement fausse dans la population générale (l’effet existe réellement). La probabilité de cette issue est désignée sous le terme de puissance statistique, formalisée par 1 − β.
- Le maintien légitime de l’hypothèse nulle : l’expérimentateur décide de ne pas rejeter H0 alors qu’il n’existe effectivement aucun effet dans la population. La probabilité associée à cette issue de prudence épistémique est notée 1 − α, représentant le niveau de confiance du test.
À l’inverse, l’inférence est sujette à deux types d’erreurs stochastiques inhérentes à la variabilité des données :
- L’erreur de type I (probabilité α) : survenue d’un résultat d’échantillonnage atypique conduisant à rejeter H0 alors qu’elle est vraie dans la population (le « faux positif » ou la fausse alarme).
- L’erreur de type II (probabilité β) : incapacité des données empiriques à atteindre le seuil de significativité critique, aboutissant au maintien de H0 alors que celle-ci est fausse et qu’un effet réel existe (le « faux négatif » ou l’occasion manquée).
Cette matrice met en relief le gouffre ontologique séparant la réalité objective du monde (l’état latent de la population) de la décision statistique dépendante de l’échantillon. L’observateur ne connaît jamais la réalité absolue ; il ne manipule que les probabilités conditionnelles de commettre ces erreurs d’évaluation.
2. Définition formelle du niveau bêta (β) et nature de l’erreur de type II
2.1 Conceptualisation de l’erreur de type II : le résultat faussement négatif
L’erreur de type II se définit conceptuellement comme l’omission méthodologique de rejeter une hypothèse nulle qui s’avère pourtant factuellement erronée au regard des lois régissant la population étudiée. Dans le domaine de la recherche psychologique et clinique, ce phénomène équivaut à un rendez-vous manqué avec la découverte scientifique : il s’agit de passer à côté d’un mécanisme cognitif effectif, d’ignorer la validité d’un biomarqueur neurologique, ou de disqualifier une psychothérapie pourtant efficiente pour soulager un trouble mental, simplement parce que l’échantillon prélevé a produit une fluctuation aléatoire défavorable.
Une confusion épistémologique fréquente, profondément enracinée chez les praticiens, consiste à assimiler la rétention de H0 à la démonstration de sa véracité. Dans le paradigme inférentiel standard, un test statistique non significatif ne démontre jamais que « H0 est vraie ». Il établit uniquement que les données recueillies n’apportent pas un faisceau de preuves jugé suffisant pour justifier l’abandon du modèle de base au seuil décisionnel retenu. Comme l’exprimait le statisticien Carl Sagan dans une maxime populaire : « l’absence de preuve n’est pas la preuve de l’absence ». L’erreur de type II est précisément la matérialisation probabiliste de cette nuance : les données échouent à dénoncer la fausseté de l’hypothèse nulle alors même que la nature abrite la régularité postulée.
Ce faux négatif n’implique pas nécessairement une malfaçon procédurale de la part du chercheur. Il s’agit d’une fatalité mathématique inhérente à la nature échantillonnée de la science : ponctuellement, le tirage au sort des sujets d’étude agrège des individus dont la variance masque la réalité de l’effet moyen populationnel. C’est l’ampleur tolérée de cet aveuglement statistique que quantifie formellement le niveau bêta.
2.2 Définition mathématique et probabiliste du niveau bêta (β)
D’un point de vue formel et rigoureux, le niveau bêta (β) est une probabilité conditionnelle. Il s’exprime mathématiquement par l’équation canonique suivante :
$$\beta = P(\text{Conserver } H_0 mid H_1 \text{ est vraie})$$
Ou, formulé sous l’angle de la théorie du rejet décisionnel face à une statistique de test observée T et une valeur critique c définissant la région de rejet R :
$$\beta = P(T \notin R mid \theta = \theta_1)$$
où θ représente le paramètre populationnel d’intérêt et θ1 une valeur spécifique de ce paramètre incarnant l’hypothèse alternative retenue.
Pour appréhender cette probabilité, il est impératif de considérer la distribution d’échantillonnage de la statistique de test non plus sous le régime de l’hypothèse nulle (centrée conventionnellement sur 0), mais sous le régime de la distribution réelle postulée par l’hypothèse alternative, déplacée le long de l’axe des valeurs par le paramètre d’effet θ1. Le niveau bêta correspond très exactement à l’intégrale de cette distribution d’échantillonnage alternative calculée sur l’intervalle spatial délimité par la région d’acceptation de H0, région initialement bornée par la valeur critique dérivée du seuil alpha.
Dans un protocole expérimental rigoureux, le niveau bêta n’est pas une simple valeur observée a posteriori au gré du hasard ; il s’agit d’un seuil maximal de tolérance fixé délibérément par l’expérimentateur lors de la phase de conception du design. En définissant a priori le plafond de bêta que l’on est prêt à tolérer pour une amplitude d’effet minimale scientifiquement intéressante, le chercheur circonscrit le risque d’invisibilité auquel il consent à soumettre ses hypothèses de travail.
2.3 Distinction fondamentale entre le niveau alpha (α) et le niveau bêta (β)
La distinction entre le niveau alpha (α) et le niveau bêta (β) repose sur une asymétrie qualitative entre les deux formes d’égarement logique du statisticien. L’erreur de type I (α) agit comme une fausse alerte : elle conduit la communauté scientifique à s’enthousiasmer pour une chimère, à orienter des programmes de recherche coûteux sur des voies de garage méthodologiques ou à autoriser la commercialisation d’interventions sans efficacité spécifique réelle. C’est l’illusion de la découverte là où ne réside que du bruit stochastique.
À l’inverse, l’erreur de type II (β) se présente sous les traits d’une occasion manquée. Elle se caractérise par l’invisibilité d’un phénomène véritable. Le risque bêta frappe de mutisme un signal pourtant présent dans les données, condamnant à l’oubli des intuitions théoriques révolutionnaires ou des molécules pharmaceutiques prometteuses simplement parce que le dispositif d’enregistrement n’a pas atteint la sensibilité discriminante requise.
L’histoire de la statistique inférentielle a été marquée par une asymétrie monumentale accordée au contrôle strict du risque alpha, érigé au rang de standard quasi dogmatique (α = 0,05 voire α = 0,001 dans certains contextes génomiques). Ce biais conservateur puise ses racines dans la philosophie des sciences poppérienne et la prudence médicale classique (primum non nocere) : il a longtemps été jugé infiniment plus grave d’affirmer une fausseté que de négliger une vérité embryonnaire. Toutefois, cette primauté accordée au risque de type I a masqué pendant des décennies les ravages épistémiques d’un risque bêta débridé dans les sciences humaines et biomédicales.
3. Le compromis fondamental et l’arbitrage entre alpha et bêta
3.1 La relation mécanique inverse entre les risques alpha et bêta
L’une des contraintes les plus fondamentales de l’inférence classique réside dans l’interdépendance antagoniste liant les erreurs de type I et de type II. Pour une taille d’échantillon rigoureusement constante, il est mathématiquement impossible de réduire l’un de ces risques sans aggraver mécaniquement l’autre. Cette interconnexion découle du positionnement géométrique de la valeur critique servant de démarcation décisionnelle le long de l’axe de la statistique de test.
Considérons la représentation géométrique classique superposant la courbe de distribution sous H0 et la courbe de distribution sous H1. Le seuil alpha découpe une aire dans la queue extrême de la courbe H0, fixant ainsi l’abscisse de la valeur critique. Si l’expérimentateur, guidé par une louable volonté de prudence, décide de durcir drastiquement son critère d’exigence contre les faux positifs en déplaçant le seuil alpha de 0,05 à 0,01, la valeur critique se déplace vers la droite (dans un test unilatéral supérieur). En glissant de la sorte, elle empiète inéluctablement sur l’espace couvert par la distribution de H1.
L’aire sous la courbe de H1 située à gauche de cette nouvelle valeur critique — qui constitue par définition l’aire bêta — s’en trouve augmentée d’autant. En d’autres termes, plus l’on verrouille les portes du laboratoire pour empêcher l’intrusion du hasard sous la forme d’un faux positif, plus l’on empêche simultanément les effets bien réels de franchir le seuil d’admissibilité de la preuve. Ce balancement pendulaire illustre le tiraillement permanent entre hypersensibilité et hyperconservatisme.
3.2 L’impossibilité mathématique de minimiser simultanément les deux erreurs à taille d’échantillon constante
La source structurelle de cette friction réside dans la variance d’échantillonnage, laquelle demeure invariable tant que le volume des observations N reste fixé. La variance de la distribution d’échantillonnage définit la dispersion intrinsèque des deux densités de probabilité H0 et H1. Tant que cette largeur est maintenue, la surface globale de chevauchement mutuel des deux distributions demeure strictement constante. Toute tentative de délimiter l’espace décisionnel ne fait que redistribuer la surface de ce chevauchement entre la queue supérieure de H0 (α) et la queue inférieure de H1 (β).
La recherche d’une certitude absolue — qui consisterait à exiger un niveau alpha tendant vers zéro pour éradiquer tout risque de contamination théorique par des faux positifs — aboutit inéluctablement, à N constant, à une élévation du niveau bêta vers des valeurs proches de l’unité (1,0). Dans un tel scénario d’hyperprudence paranoïaque, le dispositif méthodologique est frappé d’une paralysie quasi totale : aucun résultat empirique ne parvenant à franchir l’inaccessible mur critique érigé, la science devient incapable d’identifier la moindre régularité empirique, sombrant dans un scepticisme stérile.
Le chercheur est donc inévitablement assigné à la formulation d’un compromis méthodologique. L’inférence statistique n’offre aucune formule magique capable d’éliminer simultanément la duplicité du hasard et le brouillage de l’invisibilité sans une modification des paramètres structurels du design, au premier rang desquels figure le volume des mesures empiriques collectées.
3.3 Considérations éthiques et épistémologiques du compromis en psychologie
La calibration du ratio d’arbitrage entre alpha et bêta ne relève pas exclusivement d’une délibération mathématique abstraite ; elle est intimement subordonnée à une éthique de la responsabilité scientifique et humaine. En fonction de l’objet d’étude et des répercussions pratiques des décisions prises, le coût asymétrique des erreurs peut renverser radicalement la hiérarchie traditionnelle accordant la primauté au contrôle du risque alpha.
En psychologie clinique et en psychiatrie, imaginons l’évaluation d’un outil diagnostique automatisé visant à détecter l’émergence de signaux d’alerte suicidaires à partir de l’analyse lexicale de messages sur des réseaux d’assistance, ou le screening des effets hépatotoxiques d’une molécule psychotrope novatrice. Dans de telles configurations, l’erreur de type II est infiniment plus dévastatrice que l’erreur de type I : un faux négatif (bêta) signifie qu’une détresse vitale ou un effet iatrogène mortel n’est pas détecté, entraînant la perte de vies humaines. À l’opposé, un faux positif (alpha) ne se traduit que par une alerte d’investigation complémentaire non confirmée par un médecin. Dans ces circonstances, tolérer un bêta habituel de 0,20 constitue une faute éthique majeure : le seuil doit être abaissé au maximum, quitte à tolérer une inflation substantielle de l’erreur alpha.
Inversement, considérons l’évaluation d’une politique publique impliquant l’implantation à grande échelle d’un programme d’entraînement cognitif hautement invasif, onéreux et exigeant des millions d’heures de réquisition scolaire. Ici, l’erreur de type I — déclarer efficiente une méthode pédagogique qui ne produit en réalité aucun effet — dilapiderait des fonds publics considérables et léserait des générations d’élèves. L’erreur de type I est alors la plus préjudiciable, imposant un blindage drastique d’alpha. Il appartient au chercheur, conscient des ramifications sociétales de son travail, de justifier explicitement la pondération des coûts associés à chaque issue décisionnelle.
4. Le niveau bêta et sa complémentarité directe avec la puissance statistique
4.1 Définition de la puissance statistique comme le complément à 1 du risque bêta
Le risque bêta entretient une relation géométrique et mathématique de complémentarité absolue avec l’un des concepts les plus cardinaux de l’analyse expérimentale : la puissance statistique. Par définition, la puissance statistique d’un test correspond à la probabilité de rejeter l’hypothèse nulle lorsque celle-ci est réellement fausse dans la population. Elle s’exprime avec une élégante simplicité déductive par la relation :
$$\text{Puissance} = 1 – \beta = P(\text{Rejeter } H_0 mid H_1 \text{ est vraie})$$
Sur le plan opérationnel, la puissance statistique représente le rendement discriminatoire, ou l’acuité visuelle, de la machinerie statistique. Elle quantifie la capacité d’une démarche d’observation à capter un signal théoriquement prédéfini au milieu du grondement de fond aléatoire des données. Dès lors que le niveau bêta toléré est abaissé, la puissance statistique s’accroît d’une amplitude rigoureusement équivalente. Une recherche caractérisée par un niveau bêta de β = 0,20 possède structurellement une puissance statistique de 1 − 0,20 = 0,80 (soit 80 % de chances d’aboutir à un rejet régulier de H0).
Cette relation dyadique indissoluble scelle le sort méthodologique de tout protocole d’investigation : renoncer à contrôler son niveau bêta revient purement et simplement à abdiquer toute maîtrise sur la sensibilité de son test d’hypothèse. Par conséquent, théoriser sur la minimisation de bêta équivaut systématiquement à raisonner en termes de maximisation de la puissance expérimentale.
4.2 Les conventions normatives de Jacob Cohen : la justification du seuil bêta à 0,20
Dans l’histoire moderne de la psychologie quantitative, le statisticien et psychologue Jacob Cohen a joué un rôle d’évangélisation méthodologique déterminant, notamment à travers son ouvrage séminal Statistical Power Analysis for the Behavioral Sciences. Constatant que la quasi-totalité des chercheurs de son époque dimensionnaient leurs protocoles au hasard en ne se préoccupant que du seuil alpha de 0,05, Cohen a milité pour l’instauration d’un seuil conventionnel par défaut pour le risque de type II, fixant ce compromis normatif à β = 0,20, soit une puissance cible de 1 − β = 0,80 (80 %).
Pour étayer philosophiquement cette préconisation, Cohen a formulé ce qui est aujourd’hui désigné comme le « ratio d’arbitrage 4 pour 1 ». En observant la communauté académique, il a souligné que celle-ci accordait implicitement une gravité environ quatre fois supérieure à l’erreur de type I comparativement à l’erreur de type II :
$$\frac{\beta}{\alpha} = \frac{0{,}20}{0{,}05} = 4$$
Selon cette logique, tolérer un faux positif une fois sur vingt (α = 0,05) s’équilibre de façon heuristique avec l’acceptation de laisser échapper une opportunité de découverte une fois sur cinq (β = 0,20).
Si la convention de Cohen d’un niveau bêta fixé à 0,20 s’est rapidement érigée en dogme d’évaluation au sein des comités de lecture des revues scientifiques, elle fait aujourd’hui l’objet de réserves critiques légitimes. De nombreux méthodologistes contemporains rappellent que ce ratio 4:1 n’a aucune validité divine universelle. Consacrer aveuglément β = 0,20 sans considérer les contraintes économiques, sanitaires ou théoriques spécifiques du domaine investigué témoigne d’une standardisation réflexe dénuée de justification épistémique réelle.
4.3 Les périls méthodologiques des études à faible puissance (bêta excessif)
L’acceptation implicite ou ignorée d’un niveau bêta démesurément haut — atteignant fréquemment 0,50 voire 0,70 dans de larges pans de la recherche expérimentale contemporaine — déclenche une cascade d’effets pervers déstabilisant l’ensemble de l’édifice scientifique. Le premier péril est la prolifération de résultats fallacieusement négatifs ou inconséquents, conduisant la littérature à stagner dans des débats stériles où des équipes de recherche successives échouent successivement à répliquer un effet authentique en raison de l’atrophie sensorielle de leurs protocoles.
Un danger mathématique plus insidieux réside dans ce que la littérature appelle la « malédiction du gagnant » (winner’s curse). Dans un contexte où le niveau bêta est massif (β > 0,50), les seules rares occurrences où la statistique de test parvient miraculeusement à franchir la frontière de significativité surviennent lorsque les fluctuations aléatoires de l’échantillon s’additionnent par chance à l’effet réel, le gonflant artificiellement. Il en résulte que lorsqu’une découverte est proclamée à partir d’une étude sous-puissante, la taille de l’effet rapportée est presque systématiquement et substantiellement surestimée par rapport à sa magnitude réelle dans la population.
Enfin, comme l’a démontré le médecin et épidémiologiste John Ioannidis, un niveau bêta incontrôlé engendre un effondrement direct de la valeur prédictive positive (VPP) des annonces de découverte scientifique. Dans un champ de recherche où la majorité des hypothèses investiguées ont une faible plausibilité a priori et où le niveau bêta moyen est élevé, la proportion de résultats statistiquement significatifs qui sont en réalité de faux positifs peut excéder 50 %, rendant la littérature officielle structurellement trompeuse.
5. Les déterminants statistiques modulant l’ampleur du niveau bêta
5.1 L’influence prépondérante de la taille de l’échantillon (N)
Parmi tous les leviers dont dispose l’expérimentateur pour moduler l’ampleur du risque bêta, la taille de l’échantillon (notée N) constitue sans conteste le paramètre structural le plus puissant et le plus direct. L’action régulatrice du volume d’observations s’exprime fondamentalement à travers le mécanisme de l’erreur type de la moyenne (σx̄), dont la formulation classique découle du théorème central limite :
$$\sigma_{\bar{x}} = \frac{\sigma}{\sqrt{N}}$$
où σ symbolise l’écart-type de la variable au sein de la population parente.
À mesure que la taille d’échantillon N s’accroît, le dénominateur √N croît de façon monotone, comprimant inexorablement l’erreur type. Sur le plan de la géométrie des distributions, cette compression engendre un resserrement notable des deux courbes d’échantillonnage de H0 et de H1 autour de leurs moyennes respectives. En devenant plus leptokurtiques et étroites, les distributions se découplent spatialement l’une de l’autre, ce qui a pour conséquence mécanique de faire fondre la surface de chevauchement mutuel au sein de laquelle s’abritait l’aire d’erreur bêta.
En psychologie cognitive ou en sciences du comportement, l’optimisation du recrutement de participants — bien que logistiquement contraignante — représente ainsi le moyen le plus sain de réduire simultanément le niveau bêta sans devoir dégrader la protection contre le risque alpha. Ce resserrement asymptotique permet d’atteindre des niveaux d’acuité expérimentale capables de distinguer les nuances théoriques les plus ténues.
5.2 La magnitude de la taille d’effet réelle dans la population
Le second déterminant gouvernant le niveau bêta est intrinsèque à la nature des choses : il s’agit de la taille d’effet réelle existant dans la population, mesurée par des indices standardisés d’écartement des moyennes tels que le d de Cohen, le coefficient de corrélation r de Pearson, ou le η² partiel en analyse de variance. Alors que l’échantillon N relève de l’ingénierie méthodologique, la taille d’effet réelle constitue un paramètre ontologique immuable sur lequel l’expérimentateur n’a aucune emprise directe.
Sur le plan distributionnel, la taille d’effet représente la distance physique brute séparant le centroïde de la distribution sous H0 du centroïde de la distribution alternative sous H1. Plus le phénomène investigué est massif dans la population — par exemple l’impact d’un traumatisme crânien majeur sur le temps de réaction —, plus la distribution H1 est repoussée loin le long de l’axe des abscisses. La queue gauche de H1 est alors mécaniquement projetée bien au-delà de la valeur critique d’alpha, entraînant l’effondrement quasi immédiat du niveau bêta vers des valeurs infimes, même en présence d’échantillons modestes.
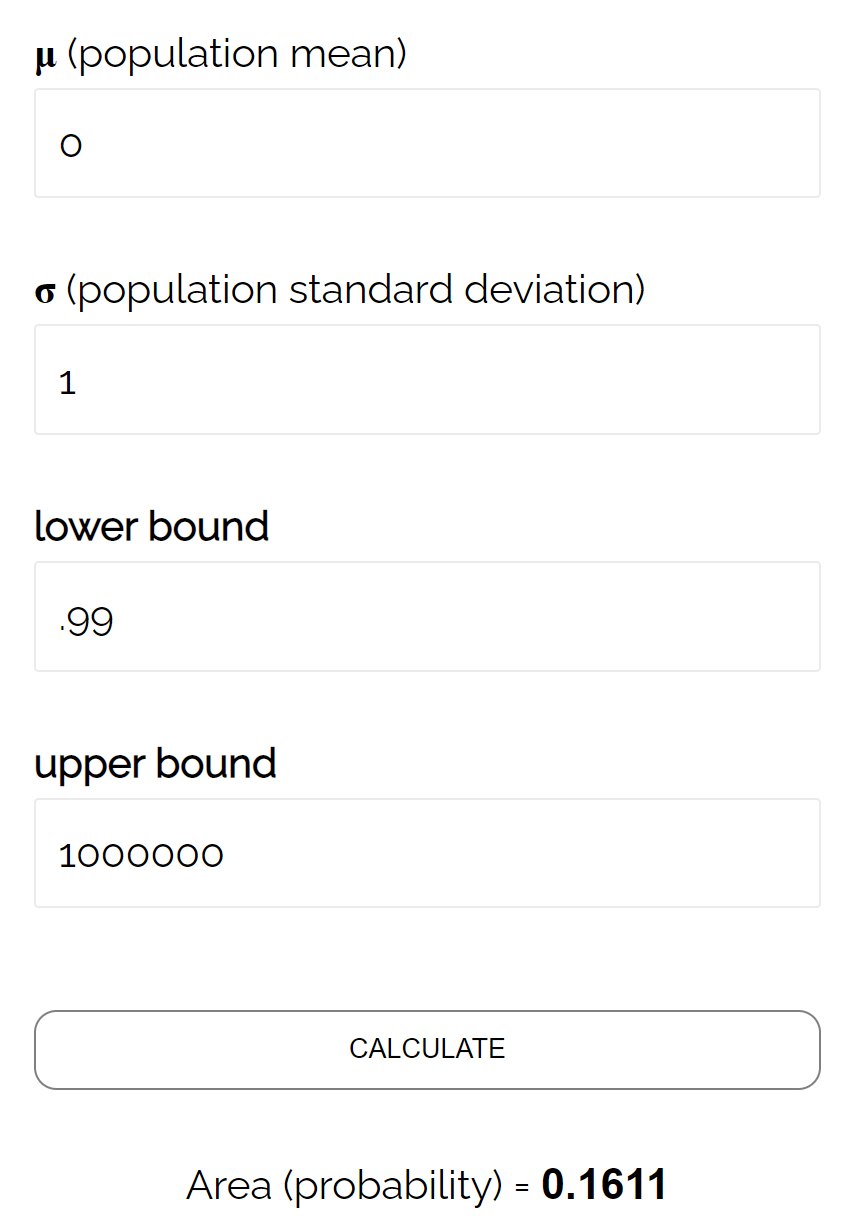
À l’inverse, lorsqu’un chercheur s’attelle à l’identification d’effets psychologiques hautement subtils, complexes ou multifactoriels (tels que l’influence d’un amorçage sémantique imperceptible sur un choix moral), la taille d’effet populationnelle est intrinsèquement minuscule (par ex., d = 0,15). Dans ce scénario, les deux distributions se superposent de façon presque symbiotique. Le maintien du niveau bêta en deçà du seuil usuel de 0,20 nécessite alors un volume d’observations exponentiel, sans lequel le test d’hypothèse s’avère totalement myope face à la réalité du mécanisme investigué.
5.3 La précision des mesures et la maîtrise de la variance résiduelle
Une variable souvent sous-estimée dans le calcul et la maîtrise du niveau bêta réside dans la variance d’erreur, c’est-à-dire le bruit de mesure global qui gonfle artificiellement la dispersion des distributions d’échantillonnage. Cette dispersion totale est composée de deux sources de variabilité : la variance biologique ou psychologique authentique propre aux sujets de l’étude, et la variance d’erreur pure induite par l’imprécision des instruments métrologiques utilisés.
En psychométrie, l’impact de la fidélité des instruments de mesure (généralement évaluée par des coefficients de cohérence interne) sur la puissance statistique est direct et massif. L’utilisation d’une échelle d’auto-évaluation dont le coefficient de fiabilité est médiocre introduit un bruit aléatoire colossal qui dégrade la taille d’effet observée selon la loi d’atténuation de Spearman :
$$r_{\text{observé}} = r_{\text{vrai}} \times \sqrt{r_{xx} \cdot r_{yy}}$$
Cette dilution métrologique rapproche artificiellement la distribution H1 de la distribution nulle H0, gonflant le niveau bêta effectif.
Par conséquent, un contrôle expérimental rigoureux, passant par la standardisation impeccable de l’environnement de passation, l’étalonnage précis du matériel chronométrique en temps de réaction et l’utilisation de batteries psychométriques rigoureusement validées, permet de juguler la variance résiduelle sans nécessiter l’enrôlement d’une pléthore de nouveaux sujets. Purger les données du bruit instrumental constitue une modalité élégante et économique pour compresser substantiellement le risque bêta.
5.4 La directionalité du test statistique : choix unilatéral versus bilatéral
Le positionnement de l’expérimentateur quant à la directionalité de son hypothèse alternative exerce une influence mathématique directe sur le calibrage du niveau bêta. Dans un test bilatéral (à deux queues), la zone de rejet alpha est scindée équitablement en deux moitiés distinctes réparties aux deux extrémités extrêmes de la distribution sous H0 (soit α/2 de chaque côté, classiquement 0,025 pour un alpha global de 0,05). Cette dispersion impose une valeur critique plus éloignée du centre de la distribution de référence (par ex., z = 1,96).
Dans un test unilatéral (à une queue), dès lors que la théorie scientifique pose fermement a priori l’orientation vectorielle du phénomène (par exemple en formulant que la nouvelle thérapie ne peut qu’abaisser le niveau d’anxiété et non l’augmenter), la totalité de la marge d’erreur alpha est condensée dans une seule queue de la distribution. Cette concentration stratégique a pour conséquence immédiate de rapprocher la valeur critique du centre de H0 (par ex., z = 1,645 pour un α unilatéral de 0,05).
En rapprochant la frontière critique de la moyenne de référence, l’expérimentateur ampute immédiatement une tranche substantielle de la queue gauche de la distribution alternative H1, diminuant ainsi directement le niveau bêta et augmentant consécutivement la puissance du test pour la direction prédite. Toutefois, cette manœuvre ne doit pas constituer une opportunité opportuniste (p-hacking) : elle exige une justification théorique préalable stricte, car elle frappe le test d’une cécité absolue si la réalité devait produire un effet d’une amplitude colossale dans la direction inverse à celle anticipée.
6. Exemple détaillé et contextualisé en psychologie clinique et cognitive
6.1 Scénario expérimental : essai randomisé contrôlé d’une thérapie cognitivo-comportementale
Afin d’ancrer ces concepts théoriques au cœur de la pratique empirique, développons un cas concret issu de la psychologie clinique et cognitive. Imaginons une équipe hospitalo-universitaire concevant un essai contrôlé randomisé (ECR) destiné à évaluer l’efficience d’un nouveau protocole d’exposition par réalité virtuelle immersive (TERV) contre l’agoraphobie sévère, comparativement à une prise en charge standard consistant en un protocole de relaxation guidée non spécifique.
La variable dépendante retenue est quantitative et continue : il s’agit du différentiel de score obtenu par les participants à l’inventaire d’anxiété et de phobie sociale standardisé (STAI-Y), administré avant la première séance et immédiatement au terme des huit semaines de prise en charge thérapeutique. La métrique retenue pour chaque individu correspond à la réduction brute du score d’anxiété :
$$\Delta = \text{Score}_{\text{pré}} – \text{Score}_{\text{post}}$$
Plus Δ est élevé, plus le soulagement clinique est substantiel.
Les paramètres statistiques du protocole sont formulés comme suit :
- L’hypothèse nulle postule une stricte absence de supériorité de l’immersion en réalité virtuelle par rapport à la relaxation :
$$H_0 : \mu_{\text{TERV}} – \mu_{\text{Relaxation}} = 0$$ - L’hypothèse alternative, formalisée sur la base des modélisations de l’apprentissage de l’extinction en neurosciences cognitives, pose l’existence d’une différence positive cliniquement pertinente :
$$H_1 : \mu_{\text{TERV}} – \mu_{\text{Relaxation}} > 0$$
6.2 Paramétrage initial des risques décisionnels et dimensionnement de l’échantillon
Dans la phase de planification rigoureuse de cette étude, l’équipe cherche à se conformer aux standards méthodologiques les plus stricts. Les investigateurs fixent le seuil d’erreur de type I à la valeur conventionnelle de α = 0,05 (en bilatéral, conservant ainsi une posture académique prudente). Pour prémunir leur essai contre le risque de faux négatif, ils retiennent la recommandation normative de Cohen en fixant le niveau bêta à β = 0,20, garantissant ainsi formellement une puissance statistique cible de :
$$1 – \beta = 0{,}80 \quad (80,%)$$
En s’appuyant sur une méta-analyse récente de la littérature portant sur les psychothérapies cognitives médiatisées par les technologies numériques, les chercheurs anticipent une taille d’effet modérée standardisée de :
$$d = 0{,}50$$
Cette valeur de d de Cohen correspond à un décalage des moyennes égal à un demi-écart-type entre les deux groupes de patients.
En utilisant la formule analytique pour un test t de Student bilatéral pour deux échantillons indépendants de variances équivalentes, le nombre de sujets requis par groupe, noté n, s’obtient via l’approximation suivante :
$$n \approx 2 \cdot \left( \frac{z_{1 – alpha/2} + z_{1 – \beta}}{d} \right)^2 = 2 \cdot \left( \frac{1{,}96 + 0{,}84}{0{,}50} \right)^2 = 2 \cdot \left( \frac{2{,}80}{0{,}50} \right)^2 = 2 \cdot (5{,}6)^2 = 2 \cdot 31{,}36 \approx 63$$
Le dimensionnement optimal impose donc le recrutement de 64 patients par groupe thérapeutique, soit une cohorte globale strictement égale à 128 sujets, afin de sceller le niveau bêta à exactement 20 % face à une véritable taille d’effet de d = 0,50.
6.3 Simulation d’une erreur de type II : survenue concrète d’un faux négatif
Supposons désormais que les chercheurs soient confrontés aux vicissitudes habituelles du terrain clinique : contraintes budgétaires brutales, pannes d’équipements informatiques et défections de participants (attrition). En lieu et place des 128 patients programmés a priori, l’équipe ne parvient à recruter et évaluer que 26 individus par condition expérimentale, ramenant l’effectif total effectif de l’étude à :
$$N = 52 \text{ patients}$$
Que devient alors l’architecture décisionnelle de l’étude ? Alors que le seuil de tolérance nominal affiché dans l’introduction de l’article reste fièrement à α = 0,05, la réduction drastique de l’effectif entraîne une répercussion mathématique immédiate sur le niveau bêta. Le paramètre de non-centralité du test t, qui gouverne le décalage de la distribution sous H1, chute de façon critique :
$$\delta = d \cdot \sqrt{\frac{n}{2}} = 0{,}50 \cdot \sqrt{\frac{26}{2}} = 0{,}50 \cdot \sqrt{13} \approx 0{,}50 \cdot 3{,}605 = 1{,}80$$
En interrogeant la loi de Student correspondante avec 50 degrés de liberté, la puissance réelle du test ne s’établit plus qu’à environ 55 %. En corollaire direct, le niveau bêta effectif a bondi sans que les cliniciens en aient pleinement conscience pour atteindre :
$$\beta = 1 – 0{,}55 = 0{,}45 \quad (45,%)$$
Au terme de l’essai, imaginons que la thérapie d’exposition par réalité virtuelle fonctionne exactement comme théorisé, générant une différence moyenne standardisée authentique de d = 0,50 dans l’échantillon. En soumettant ces mesures empiriques au logiciel de traitement statistique, le chercheur observe la statistique de test suivante :
$$t(50) = 1{,}78, \quad p = 0{,}081$$
La règle décisionnelle binaire prescrit formellement que la valeur p (0,081) excédant le seuil alpha prédéterminé de 0,05, l’expérimentateur n’a d’autre choix que d’échouer à rejeter l’hypothèse nulle. La conclusion du rapport d’étude déclare ainsi solennellement : « La différence observée entre l’exposition par réalité virtuelle et la relaxation n’est pas statistiquement significative (p > 0,05) ; nos données n’apportent aucun soutien à la supériorité de la réalité virtuelle. » L’erreur de type II est consommée dans toute sa rigueur mécanique : un protocole thérapeutique viable et novateur vient d’être rejeté par le laboratoire.
6.4 Analyse critique des retombées scientifiques et cliniques de ce faux négatif
L’occurrence concrète de ce résultat faussement négatif déploie des conséquences néfastes à de multiples échelles du tissu biomédical et sociétal. Sur le plan de la santé publique, cette conclusion erronée scelle l’arrêt prématuré d’une innovation thérapeutique prometteuse. Des dizaines de patients souffrant de phobies invalidantes continueront d’être pris en charge par des stratégies traditionnelles d’une efficacité moindre, privés d’une alternative technologique performante qui a été jugée inopérante par simple myopie statistique.
Sur le plan de l’économie de la recherche, les subventions allouées pour cet essai clinique — représentant potentiellement des centaines de milliers d’euros — sont purement et simplement stérilisées. L’équipe académique, découragée par ce résultat non significatif, abandonnera cette ligne de recherche prometteuse pour réorienter ses efforts vers d’autres objets, tandis que de jeunes doctorants et chercheurs verront la progression de leur carrière compromise par l’absence d’articles publiables dans des revues prestigieuses.
Pour immuniser les institutions contre de tels désastres invisibles, il est impératif d’intégrer des procédures d’audit méthodologique rétrospectif. Tout résultat statistique non significatif obtenu au terme d’une recherche empirique doit obligatoirement s’accompagner d’une déconstruction rigoureuse du niveau bêta effectif associé à la taille de l’échantillon recueilli, rappelant au lecteur que le rejet de l’effet n’était probablement qu’un artefact dérivé d’un sous-dimensionnement chronique.
7. Calcul analytique et modélisation mathématique du niveau bêta
7.1 Dérivation analytique à partir de la distribution normale standardisée
Pour percer les rouages computationnels du niveau bêta, il convient de formaliser sa dérivation analytique dans le cadre idéalisé du test Z univarié, où la variance populationnelle σ² est supposée connue. Soit une population normale suivant une loi Ν(μ, σ²). Nous cherchons à tester l’hypothèse nulle bilatérale H0 : μ = μ0 contre l’alternative directionnelle unilatérale supérieure H1 : μ = μ1, avec μ1 > μ0.
La règle décisionnelle associée au seuil de signification alpha α délimite une valeur critique sur l’échelle de la moyenne d’échantillon X̄, notée X̄crit, définie comme suit :
$$\bar{X}_{\text{crit}} = \mu_0 + z_{1 – \alpha} \cdot \frac{\sigma}{\sqrt{N}}$$
où z1−α représente le quantile de rang 1 − α de la loi normale centrée réduite standard Ν(0, 1). La région de maintien de l’hypothèse nulle correspond à l’ensemble des moyennes empiriques inférieures à ce seuil : X̄ ≤ X̄crit.
Le niveau bêta correspond mathématiquement à la probabilité que la statistique X̄ prenne une valeur inférieure ou égale à X̄crit alors que la loi régissant véritablement le prélèvement empirique est celle dictée par l’hypothèse alternative, à savoir Ν(μ1, σ²/N). Pour calculer cette probabilité sous la distribution H1, nous devons standardiser la variable critique X̄crit en soustrayant la nouvelle moyenne μ1 et en divisant par l’erreur type :
$$z_{\beta} = \frac{\bar{X}_{\text{crit}} – \mu_1}{\frac{\sigma}{\sqrt{N}}} = \frac{\mu_0 + z_{1 – \alpha} \cdot \frac{\sigma}{\sqrt{N}} – \mu_1}{\frac{\sigma}{\sqrt{N}}}$$
En factorisant et en réduisant les termes de la fraction, nous obtenons l’expression algébrique canonique suivante :
$$z_{\beta} = z_{1 – \alpha} – \frac{\mu_1 – \mu_0}{\frac{\sigma}{\sqrt{N}}} = z_{1 – \alpha} – \left( \frac{\mu_1 – \mu_0}{\sigma} \right) \cdot \sqrt{N} = z_{1 – \alpha} – d \cdot \sqrt{N}$$
où d représente la taille d’effet standardisée dans la population. Dès lors, le niveau bêta s’obtient directement via l’évaluation de la fonction de répartition cumulative (CDF), universellement notée Φ, de la distribution normale standard :
$$\beta = \Phi(z_{\beta}) = \Phi(z_{1 – \alpha} – d \cdot \sqrt{N})$$
Cette dérivation élégante met en pleine lumière l’interaction directe entre le quantile alpha, l’amplitude du phénomène d et le volume d’observations N dans la constitution de la masse probabiliste de bêta.
7.2 Les distributions non centrales et le paramètre de non-centralité (δ)
Dans la réalité quotidienne de la recherche empirique, la variance populationnelle σ² n’est quasiment jamais connue d’avance par l’expérimentateur ; elle doit être estimée à partir de la variance de l’échantillon s². Cette transition impose de substituer le test Z classique par le test t de Student. Ce glissement paramétrique complexifie substantiellement le calcul du niveau bêta : sous l’hypothèse alternative H1, la statistique t ne suit plus une loi de Student standard (laquelle est obligatoirement symétrique et centrée sur 0), mais une loi de Student non centrale (noncentral t-distribution).
La distribution de Student non centrale est gouvernée par deux paramètres distincts : ses degrés de liberté ν = N − 1 (pour un échantillon unique) et son paramètre de non-centralité, universellement désigné par la lettre grecque δ (delta). Ce paramètre δ condense la totalité de la structure informative du protocole expérimental :
$$\delta = d \cdot \sqrt{N} \quad \text{(échantillon unique)} \qquad \text{ou} \qquad \delta = d \cdot \sqrt{\frac{N_1 \cdot N_2}{N_1 + N_2}} \quad \text{(deux groupes)}$$
Si la taille d’effet d est nulle (sous H0), δ s’annule, et la distribution redevient la loi de Student centrale usuelle.
Sous H1, la fonction de densité de probabilité de t est asymétrique et translatée vers des valeurs positives proportionnellement à l’amplitude de δ. Le calcul formel du niveau bêta requiert l’évaluation de l’intégrale de cette loi non centrale, bornée supérieurement par la valeur critique centrale tcrit,ν,α :
$$\beta = \int_{-\infty}^{t_{\text{crit}, \nu, \alpha}} f(t; \nu, \delta) , dt$$
En raison de la présence de fonctions hypergéométriques confluentes au sein de l’expression de la densité non centrale f(t; ν, δ), cette intégrale n’admet aucune primitive analytique simple. Son extraction exacte exige des algorithmes d’approximation numérique itératifs, intégrés nativement dans les progiciels statistiques contemporains.
7.3 La construction et la lecture géométrique des courbes caractéristiques de fonctionnement (ROC)
Pour transcender les limitations d’une analyse figée sur un couple de valeurs alpha et bêta arbitraires, les méthodologistes recourent fréquemment à la théorie de la détection du signal (TDS) et aux courbes caractéristiques de fonctionnement du récepteur (courbes ROC). Une courbe ROC représente graphiquement l’évolution de la sensibilité statistique — qui n’est autre que la puissance (1 − β) positionnée sur l’axe des ordonnées — en fonction du taux de faux positifs (le niveau alpha α) déployé le long de l’axe des abscisses, à mesure que l’expérimentateur fait varier de manière continue le seuil critique de décision c de −∞ à +∞.
L’examen géométrique de cette trajectoire offre une lecture intuitive de l’efficacité intrinsèque du test :
- Une procédure statistique sans aucun pouvoir de discrimination (taille d’effet d = 0) produit une courbe linéaire diagonale parfaite joignant le point (0,0) au point (1,1), traduisant une stricte égalité entre la puissance et le taux de faux positifs :
$$1 – \beta = \alpha$$ - À l’inverse, à mesure que la magnitude du phénomène sous-jacent d croît ou que l’échantillon N augmente, la courbe s’incurve vigoureusement vers le coin supérieur gauche du graphique, indiquant qu’il devient possible d’atteindre une puissance colossale (faible bêta) tout en maintenant le risque de faux positif α à un niveau dérisoire.
L’aire sous la courbe (Area Under the Curve ou AUC) synthétise de façon globale la qualité de la procédure d’inférence. Une AUC de 0,50 sanctionne un test statistique équivalant à un tirage à pile ou face, incapable de protéger l’expérimentateur contre l’un ou l’autre des risques décisionnels, tandis qu’une AUC approchant 1,00 reflète un dispositif expérimental doté d’une immunité quasi totale contre l’erreur de type II tout en neutralisant l’erreur de type I.
8. Outils informatiques et instrumentation du calcul de bêta
8.1 Implémentation pratique via le logiciel spécialisé G*Power
L’émancipation des chercheurs face aux équations intégrales complexes des distributions non centrales a été rendue possible par l’avènement de suites logicielles dédiées, au premier rang desquelles trône le gratuiciel G*Power, conçu et maintenu par l’équipe de Franz Faul à l’Université de Düsseldorf. Véritable standard de l’instrumentation statistique en sciences humaines, G*Power offre une interface graphique interactive permettant de paramétrer instantanément des protocoles d’échantillonnage rigoureux.
Pour configurer le calcul du niveau bêta dans le cadre d’un test t de Student pour deux échantillons indépendants, le praticien sélectionne la famille de tests « t tests » puis la fonction statistique « Means: Difference between two independent means (two groups) ». Le module requiert ensuite de spécifier la nature du calcul à accomplir dans l’onglet « Type of power analysis ». Pour calibrer délibérément le niveau bêta en amont du protocole, l’utilisateur sélectionne l’option « A priori: Compute required sample size – given α, power (1 – β), and effect size ».
L’interface réclame l’encodage précis des paramètres prédictifs :
- La directionalité du test (Tail(s) : One ou Two) ;
- La taille d’effet standardisée cible d de Cohen (par ex., 0,50) ;
- Le niveau de risque alpha α toléré (par ex., 0,05) ;
- La puissance cible 1 − β souhaitée (par ex., 0,80, garantissant ainsi formellement β = 0,20) ;
- Le ratio d’allocation des effectifs entre les deux groupes (Allocation ratio N2/N1, classiquement 1).
En cliquant sur « Calculate », le logiciel génère non seulement la taille d’échantillon totale nécessaire, mais projette également une visualisation graphique spectaculaire superposant la distribution nulle centrale et la distribution alternative non centrale, matérialisant en couleurs distinctes les surfaces exactes découpées par le risque alpha et le niveau bêta.
8.2 Programmation et calcul du niveau bêta dans l’environnement R
Pour les chercheurs s’inscrivant dans une démarche de science ouverte et de modélisation scriptée et reproductible, l’écosystème open-source R constitue l’environnement privilégié. Le calcul standardisé de bêta et de la puissance s’articule prioritairement autour du package dédié pwr, implémentant les formulations analytiques de Cohen. À titre d’illustration, la commande permettant de déterminer les paramètres d’un test t s’exécute via la fonction suivante :
library(pwr)

pwr.t.test(d = 0.5, sig.level = 0.05, power = 0.80, type = "two.sample", alternative = "two.sided")
Cette instruction renvoie un effectif requis d’exactement n = 63,76 observations par groupe, confirmant qu’une taille de 64 sujets scelle le niveau bêta à 0,20.
Toutefois, dès lors que le protocole expérimental abandonne les plans de comparaison basiques pour adopter des architectures complexes — telles que les modèles linéaires à effets mixtes (LMM), les modèles hiérarchiques emboîtés ou les régressions logistiques multivariées —, les dérivations analytiques en forme close atteignent leurs limites. L’estimation du niveau bêta s’opère alors via des techniques de simulation de Monte Carlo, magnifiquement instrumentées par des bibliothèques logicielles comme le package simr.
Le principe computationnel consiste à instancier algorithmiquement des milliers de jeux de données artificiels (par exemple 1 000 ou 5 000 itérations) présentant des caractéristiques de distribution rigoureusement calquées sur les hypothèses du chercheur (effet fixe spécifié, variance résiduelle et variances d’interception aléatoires). Pour chaque échantillon synthétique généré, le modèle linéaire mixte est estimé et la valeur p extraite. Le niveau bêta effectif se calcule alors de façon purement empirique comme la proportion exacte de ces simulations itératives où le modèle a échoué à rejeter H0 :
$$\beta = \frac{\text{Nombre de simulations a\vec } p ge 0{,}05}{\text{Nombre total de simulations exécutées}}$$
Cette approche algorithmique universelle permet d’évaluer le risque de faux négatif sous n’importe quelle structure expérimentale.
8.3 Typologie des analyses de puissance : a priori, a posteriori et d’arbitrage
La littérature méthodologique formalise plusieurs typologies d’analyses de puissance selon la temporalité et l’objectif visé par la démarche statistique :
1. L’analyse de puissance a priori : Menée impérativement avant le recueil des données, elle fixe délibérément les valeurs seuils de α, de β (puissance 1 − β) et de la taille d’effet anticipée d afin d’en dériver mécaniquement la taille d’échantillon N minimale requise. C’est l’unique procédure reconnue garante de la rigueur épistémique de l’inférence.
2. L’analyse de puissance a posteriori (ou « puissance observée ») : Conduite après la collecte des données et l’obtention d’un résultat non significatif, cette manœuvre consiste à injecter la taille d’effet empiriquement observée dans l’échantillon et le N utilisé au sein des formules de puissance pour calculer la probabilité rétrospective que le test avait de détecter cet effet. De nombreux statisticiens ont démontré de façon irréfutable le non-sens et le caractère fallacieusement circulaire de cette approche (observed power fallacy). La puissance observée n’est qu’une transformation mathématique directe 1-à-1 de la valeur p obtenue : une valeur p supérieure à 0,05 donnera toujours mécaniquement une puissance rétrospective médiocre. Cette analyse rétrospective n’apporte strictement aucune information interprétative indépendante et doit être bannie des sections de résultats.
3. L’analyse de compromis (compromise power analysis) : Mobilisée lorsqu’un chercheur est irrémédiablement contraint par des ressources physiques infranchissables limitant de façon absolue la taille de son échantillon (par ex., une cohorte médicale rarissime plafonnée à N = 20 patients), cette approche refuse de subir passivement un niveau bêta cataclysmique. Elle consiste à expliciter à l’avance le ratio d’arbitrage désiré (par ex., q = β/α = 1 ou 2) et à laisser l’algorithme ajuster dynamiquement les frontières de décision d’alpha et de bêta pour que la taille d’échantillon disponible satisfasse équitablement cette balance éthique.
9. Le niveau bêta au cœur de la crise de la réplicabilité en sciences humaines
9.1 L’épidémiologie des études sous-dimensionnées dans la littérature psychologique
Dès les prémices des années 1960, Jacob Cohen publiait un audit statistique dévastateur de la littérature parue dans le réputé Journal of Abnormal and Social Psychology. En disséquant systématiquement les plans d’échantillonnage déployés par ses pairs, Cohen révéla que la puissance statistique médiane pour détecter des tailles d’effet modérées oscillait tragiquement autour de 0,46, ce qui révélait un niveau bêta médian effectif supérieur à 0,54 (β > 54 %). En clair, la probabilité pour un psychologue moyen de son époque de passer à côté d’une théorie authentiquement valide s’apparentait à un jeu de hasard défavorable.
Vingt-sept années plus tard, en 1989, Peter Sedlmeier et Gerd Gigerenzer ont répliqué méthodiquement l’enquête de Cohen sur les publications d’un panel élargi de revues de référence en psychologie. Leurs conclusions furent consternantes : en dépit de trois décennies de plaidoyers pédagogiques, la puissance médiane n’avait pas progressé d’un iota, le niveau bêta résiduel stagnant à des niveaux structurellement supérieurs à 50 %. Cette chronicité a maintenu la discipline dans une situation d’amnésie méthodologique systémique.
Le risque systémique engendré par cette tolérance passive envers des niveaux bêta excessifs s’est révélé au grand jour lors de l’explosion de la crise de la réplicabilité au début des années 2010. Lorsque des consortiums internationaux, à l’instar de l’Open Science Collaboration (2015), ont tenté de reproduire fidèlement 100 protocoles expérimentaux emblématiques de la psychologie contemporaine, moins de 40 % des réplications ont produit un résultat statistiquement significatif. Cette hécatombe expérimentale trouve l’une de ses sources maîtresses dans l’illusion de robustesse causée par des décennies d’études princeps sous-dimensionnées, où le niveau alpha avait été minutieusement verrouillé mais où le risque bêta avait été laissé libre de biaiser les estimations.
9.2 L’interaction perverse entre le biais de publication et le niveau bêta
L’effet dévastateur du niveau bêta sur la littérature académique est considérablement démultiplié par son interaction toxique avec une dérive structurelle de l’édition scientifique : le biais de publication, métaphoriquement baptisé par Robert Rosenthal le « problème du tiroir de classement » (file-drawer problem). Historiquement, les comités de lecture des revues savantes ont manifesté une aversion prononcée à l’égard de la publication d’études rapportant des résultats non significatifs (p > 0,05), les reléguant au fond des tiroirs des laboratoires sous l’étiquette méprisante d’« études ratées ».
Or, que deviennent mathématiquement les milliers d’erreurs de type II produites annuellement par des protocoles sous-puissants caractérisés par des niveaux bêta de 0,40 ou 0,60 ? Elles sont purement et simplement censurées de la littérature officielle. Les rares études parvenant par aberration d’échantillonnage à franchir le filtre de significativité voient leurs données publiées et encensées, tandis que l’armée silencieuse des faux négatifs est dissimulée au regard des méta-analystes.
Cette sélection unilatérale opère une distorsion délétère de l’état de l’art scientifique :
- Les méta-analyses compilent des échantillons artificiellement hypertrophiés, générant des synthèses quantitatives qui surestiment de façon spectaculaire l’efficacité réelle des interventions testées ;
- La communauté scientifique gaspille des millions d’heures à tenter d’édifier des théories complexes pour expliquer pourquoi telle ou telle équipe ne parvient pas à répliquer un résultat, ignorant que l’inconsistance observée n’est que la conséquence directe d’un niveau bêta massif agissant dans l’ombre.
Cette pathologie a incité les revues progressistes à promouvoir de nouveaux formats éditoriaux éradiquant structurellement cette perversion, réhabilitant la place des résultats non significatifs rigoureusement documentés.
9.3 L’erreur logique récurrente : assimiler la non-significativité à l’absence d’effet
Au cœur de la mauvaise interprétation du niveau bêta git un paralogisme épistémique persistant : le réflexe intellectuel consistant à conclure formellement à l’inactivité d’une condition expérimentale au seul motif que l’analyse produit une valeur p excédant le seuil alpha canonique de 0,05. Des générations d’étudiants et de chercheurs chevronnés continuent d’écrire en toute bonne foi dans leurs sections de discussion : « L’absence de différence significative entre les groupes démontre que le traitement n’a pas d’effet. »
Cette inférence constitue une violation directe des fondements du calcul des probabilités conditionnelles de Neyman-Pearson. Un test statistique caractérisé par un niveau bêta élevé (β = 0,50 par exemple) est structurellement incapable d’opérer la moindre discrimination entre deux réalités physiques totalement discordantes :
1. L’inexistence factuelle de tout effet dans la nature (l’hypothèse nulle est rigoureusement exacte) ;
2. La présence d’un effet thérapeutique ou cognitif bien réel, d’une amplitude colossale, que l’outil métrologique s’est avéré incapable d’enregistrer en raison de la trop grande dispersion des données ou de la faiblesse numérique de l’échantillon.
Dans un protocole dont le niveau bêta n’a pas été formellement comprimé en amont à des valeurs infinitésimales, le verdict d’une valeur p non significative reflète une simple agnosie expérimentale : le test n’a rien vu, mais il était structurellement aveugle. Il est donc impératif de bannir toute déduction d’équivalence ou d’absence d’effet de la rhétorique scientifique lorsque le design d’investigation tolère un risque d’erreur de type II substantiel.
10. Stratégies méthodologiques avancées pour compresser le niveau bêta
10.1 Optimisation des plans expérimentaux : plans factoriels et mesures répétées
Face aux coûts financiers, temporels et logistiques prohibitifs qu’implique l’augmentation brute de la taille de l’échantillon inter-sujets pour écraser le niveau bêta, l’ingénierie méthodologique offre une alternative bien plus féconde : l’optimisation de l’architecture du plan d’expérience. La transition d’un devis inter-sujets (between-subjects) vers un plan à mesures répétées ou intra-sujets (within-subjects) constitue le levier le plus spectaculaire pour éradiquer le risque d’erreur de type II.
Dans un protocole inter-sujets classique, la majeure partie de la variance résiduelle au dénominateur du test statistique est alimentée par la variabilité interindividuelle : les différences idiosyncrasiques fondamentales de base séparant un participant d’un autre (capacités cognitives générales, profil génétique, traits de personnalité, humeur instantanée). En soumettant chaque participant à l’ensemble des conditions expérimentales de façon contrebalancée, le sujet devient son propre contrôle statistique. La variabilité interindividuelle globale s’extirpe alors du terme d’erreur de l’équation pour être isolée mathématiquement dans un facteur de variance spécifique lié au sujet.
L’erreur résiduelle s’en trouve dramatiquement purgée et l’erreur type de la différence de moyennes se contracte selon la formule :
$$\sigma_{D} = \sqrt{\frac{\sigma_1^2 + \sigma_2^2 – 2 \cdot r \cdot \sigma_1 \cdot \sigma_2}{N}}$$
Dès lors que les mesures répétées présentent une forte corrélation positive intra-individuelle (ce qui est la norme psychologique, r oscillant souvent entre 0,60 et 0,80), le terme de soustraction 2rσ1σ2 effondre la variance du dénominateur. Il en résulte un saut quantique de la statistique de test, comprimant le niveau bêta à des fractions marginales sans exiger de multiplier le nombre de volontaires recrutés.
10.2 Intégration de covariables et modèles de régression multivariés (ANCOVA)
Lorsque des contraintes de contamination expérimentale (effets d’apprentissage irréversibles ou protocoles longitudinaux d’intervention clinique) interdisent l’usage des devis intra-sujets, la modélisation statistique avancée permet de reproduire artificiellement cette réduction d’erreur grâce à l’analyse de covariance (ANCOVA) ou aux régressions linéaires multivariées intégrant des covariables explicatives continues.
Le principe sous-jacent repose sur l’absorption ciblée de la variance d’erreur. Si l’expérimentateur prend soin de mesurer avant l’application du traitement une variable cognitive ou démographique prédictive substantiellement corrélée à la variable dépendante d’intérêt (par exemple, le score initial d’anxiété pré-thérapeutique ou le niveau d’intelligence fluide), l’inclusion formelle de ce régresseur dans le modèle linéaire va expliquer une part importante de la dispersion résiduelle des scores.
La somme des carrés des erreurs résiduelles (SSerreur) s’en trouve mathématiquement amputée :
$$SS_{\text{résiduelle (ANCOVA)}} = SS_{\text{résiduelle (ANOVA)}} \cdot (1 – r^2)$$
où r symbolise la corrélation liant la covariable à la réponse mesurée. Cette purge mécanique diminue directement le dénominateur de la statistique F de Fisher ou du test t. Sur le plan de la dynamique géométrique, cette manœuvre augmente immédiatement la valeur du paramètre de non-centralité δ, provoquant un écartement accru des distributions d’échantillonnage standardisées et réduisant ainsi drastiquement l’aire bêta résiduelle.
10.3 Amélioration des qualités métrologiques des instruments d’évaluation
Une troisième stratégie d’avant-garde — trop souvent négligée par les chercheurs obnubilés par la puissance computationnelle — cible directement l’amont de la production de données : la fiabilité et l’acuité psychométrique des instruments de mesure. Selon les postulats de la théorie classique des tests (TCT), tout score empiriquement collecté X est l’addition d’un score vrai V et d’une composante d’erreur stochastique pure E :
$$X = V + E$$
Lorsque le coefficient de cohérence interne d’une batterie d’évaluation (mesuré par l’oméga de McDonald ω ou l’alpha de Cronbach αC) s’avère insuffisant, la variance d’erreur Var(E) vient contaminer les observations, dégradant la magnitude apparente des corrélations et des écarts entre conditions. En allongeant judicieusement le nombre d’items standardisés d’une échelle — conformément à ce que prédit la formule d’amplification de Spearman-Brown — ou en optimisant le protocole de cotation par des entraînements inter-juges rigoureux, l’expérimentateur étouffe la variance parasite.
L’introduction d’indicateurs physiologiques objectifs à haute résolution temporelle (oculométrie, électroencéphalographie à haute densité, chronométrie mentale informatisée standardisée à la milliseconde) permet d’extraire des signaux théoriques débarrassés du flou inhérent aux questionnaires déclaratifs approximatifs. La compression du niveau bêta s’obtient alors non par l’accumulation quantitative d’une masse de données bruitées, mais par l’élévation qualitative de la pureté du signal expérimental.
11. Paradigmes alternatifs : au-delà de la dichotomie fréquentiste alpha/bêta
11.1 L’approche bayésienne : s’émanciper des seuils rigides de Neyman-Pearson
Les apories et les frictions décisionnelles inhérentes au compromis fréquentiste entre alpha et bêta ont incité une part croissante de la communauté scientifique à opérer une transition paradigmatique vers l’inférence bayésienne. Dans le cadre théorique fondé sur le théorème de Thomas Bayes, l’analyste ne raisonne plus en termes d’erreurs commises à long terme lors de tirages répétés sous le régime d’hypothèses immuables, mais quantifie l’évolution continue de son degré de croyance envers différentes thèses théoriques à la lumière des données collectées.
Dans ce cadre, la dépendance rigide à un seuil décisionnel binaire prédéterminé (α = 0,05 versus β = 0,20) s’efface au profit du calcul du Facteur de Bayes (noté BF). Le facteur de Bayes quantifie le rapport des vraisemblances marginales des données observées sous le modèle de l’hypothèse alternative comparativement au modèle de l’hypothèse nulle :
$$BF_{10} = \frac{P(\text{Données} mid H_1)}{P(\text{Données} mid H_0)}$$
Réciproquement, son inverse BF01 = 1 / BF10 mesure avec une transparence absolue la force probante des données empiriques en faveur explicite de l’hypothèse nulle.
Le saut épistémologique est considérable : là où le fréquentisme s’avérait structurellement incapable d’établir la validité de H0 en présence d’un résultat non significatif (paralysé par le risque résiduel bêta), l’analyse bayésienne permet d’affirmer avec rigueur mathématique que les données observées sont, par exemple, huit fois plus plausibles sous le postulat d’absence d’effet que sous l’hypothèse alternative (BF01 = 8). L’ambiguïté stochastique du résultat faussement négatif se dissout au profit d’un gradient quantifié d’évidence relative.
11.2 Les tests d’équivalence (TOST) : tester scientifiquement l’absence d’effet
Pour les chercheurs souhaitant demeurer dans le giron de l’orthodoxie fréquentiste tout en s’affranchissant de l’incapacité formelle à démontrer l’absence d’effet, la méthodologie des tests d’équivalence — singulièrement la procédure des deux tests unilatéraux combinés (Two One-Sided Tests ou TOST), théorisée par des méthodologistes comme Daniël Lakens — constitue une avancée décisive.
Le postulat central du TOST consiste à renverser la charge philosophique de la preuve. Plutôt que de formuler une hypothèse nulle d’invariance absolue Δ = 0 (qu’un test classique surpuissant finira toujours par rejeter face au moindre écart microscopique dénué de pertinence), l’expérimentateur commence par définir des bornes d’équivalence pratique ±ΔL (par exemple, d = −0,20 et d = +0,20). Ces bornes circonscrivent la plus petite taille d’effet scientifiquement ou cliniquement significative (Smallest Effect Size of Interest ou SESOI) : tout écart inférieur à ce seuil est considéré comme dénué de portée réelle.
La procédure algorithmique du TOST exécute simultanément deux tests unilatéraux :
- Le premier teste l’hypothèse que l’effet observé est inférieur à la borne inférieure négative :
$$H_{01} : \Delta le -\Delta_L$$ - Le second teste l’hypothèse que l’effet observé est supérieur à la borne supérieure positive :
$$H_{02} : \Delta ge +\Delta_L$$
Si ces deux tests s’avèrent statistiquement significatifs au seuil alpha choisi, le chercheur peut formellement rejeter la présence de tout effet scientifiquement pertinent et proclamer une équivalence statistique formelle. Le problème du niveau bêta se métamorphose alors en une validation positive et contrôlée de l’absence de retombée clinique ou pratique.
11.3 L’approche par estimation et intervalles de confiance standardisés
Face aux égarements décisionnels engendrés par la fixation exclusive des scientifiques sur la valeur p et les seuils d’erreur binaire α et β, un vaste mouvement méthodologique — impulsé notamment par Geoff Cumming sous l’appellation de The New Statistics — préconise de substituer l’inférence par test d’hypothèse par une approche centrée sur l’estimation continue des paramètres et la publication systématique des intervalles de confiance standardisés.
Dans ce cadre interprétatif, la conclusion d’une recherche empirique ne s’exprime plus sous la forme tranchée d’un « rejet » ou d’un « maintien » mécanique d’une hypothèse, mais par la présentation conjointe de la magnitude d’effet observée (par ex. d = 0,45) flanquée de son intervalle de confiance à 95 % :
$$\text{IC}_{95%} = [0{,}10 ; 0{,}80]$$
La lecture de la précision expérimentale devient alors directe et visuelle : la largeur absolue de l’intervalle de confiance reflète immédiatement le degré d’incertitude du protocole.
Cette approche réconcilie intuitivement le lecteur avec la réalité du risque bêta : un intervalle de confiance démesurément large (par ex. d = 0,15 avec IC95% [−0,35 ; +0,65]) illustre de façon flagrante l’atrophie informative du dispositif empirique, rendant immédiatement perceptible l’impossibilité de conclure sans stigmatiser les données sous le vocable trompeur de « résultat négatif ». À l’opposé, un intervalle étroitement circonscrit autour de valeurs proches de zéro témoigne d’une haute précision métrologique, garantissant qu’aucun effet significatif n’a été manqué.
12. Synthèse et guide de bonnes pratiques pour les chercheurs et praticiens
12.1 Protocole séquentiel d’audit et de maîtrise du risque bêta avant une recherche
Afin de prémunir les projets d’investigation scientifique contre l’écueil des faux négatifs, il est impératif que les équipes de recherche intègrent une routine séquentielle rigoureuse de planification méthodologique bien avant de collecter la première observation empirique. Ce protocole opérationnel s’articule idéalement en trois étapes chronologiques incontournables :
Étape 1 : Spécification formalisée de la taille d’effet minimale d’intérêt (SESOI)
Le chercheur doit rompre avec l’habitude de postuler paresseusement des tailles d’effet issues d’études exploratoires antérieures (lesquelles sont structurellement gonflées par le biais de publication). Il convient de définir, sur des bases théoriques solides, des impératifs cliniques ou des modèles socio-économiques pragmatiques, le seuil sous lequel l’amplitude de l’effet n’apporte plus aucune utilité théorique ou pratique concrète.
Étape 2 : Justification théorique argumentée du ratio d’arbitrage alpha/bêta
L’expérimentateur ne doit plus adopter par mimétisme passif le diptyque standard α = 0,05 et β = 0,20. Il est de sa responsabilité éthique d’évaluer les conséquences sociétales et épistémologiques d’une fausse découverte comparativement à une occasion manquée, et d’ajuster le niveau bêta toléré en conséquence (par exemple, β = 0,05 ou 0,10 dans les contextes de sécurité sanitaire ou d’évaluations cliniques majeures).
Étape 3 : Calcul transparent de la taille d’échantillon nécessaire et simulation de sensibilité
À l’aide d’outils analytiques vérifiés (G*Power, package pwr sous R) ou de simulations itératives de Monte Carlo dans les plans de modélisation complexe, l’équipe établit l’effectif plancher requis pour garantir le niveau bêta scellé à l’étape 2. Il est hautement recommandé d’exécuter une analyse de sensibilité secondaire afin de vérifier l’évolution du niveau bêta résiduel sous des scénarios plus pessimistes d’attrition de l’échantillon ou de dispersion accrue des variances.
12.2 Exigences de transparence et pré-enregistrement auprès des instances scientifiques (APA, OSF)
L’élévation des standards de rigueur méthodologique portée par la communauté académique internationale se traduit aujourd’hui par des obligations formelles de transparence stipulées par les plus grandes instances savantes, à l’instar des normes rédactionnelles de l’American Psychological Association (APA 7e édition). Les directives méthodologiques imposent désormais la description exhaustive, dans les sections « Méthode », des calculs de puissance a priori ayant guidé la constitution de la cohorte d’étude, incluant la mention explicite du niveau bêta toléré et de ses fondements empiriques.
L’arme institutionnelle la plus performante pour juguler la prolifération des faux négatifs dissimulés réside dans le pré-enregistrement formel des protocoles expérimentaux sur des plateformes de science ouverte telles que l’Open Science Framework (OSF). En gelant publiquement le plan d’échantillonnage, la taille cible de la cohorte et les seuils d’erreur alpha et bêta avant l’amorce des passations, le chercheur s’interdit toute révision opportuniste a posteriori de ses hypothèses ou toute suspension anticipée de ses recrutements.
Mieux encore, le format éditorial des Registered Reports (rapports enregistrés avec évaluation par les pairs en amont de la collecte) représente une révolution systémique. La revue accepte ou refuse de publier l’article sur la seule base de la rigueur de la théorie et de la solidité du contrôle du niveau bêta dans la méthodologie planifiée. Si le protocole garantit une puissance colossale (par ex. 1 − β ≥ 0,90), l’article est formellement accepté pour publication quel que soit le résultat empirique final. Les résultats négatifs cessent ainsi d’être stigmatisés, ce qui élimine radicalement le biais du tiroir de classement.
12.3 Foire aux questions conceptuelles et pièges interprétatifs autour de bêta
Pour parachever cette synthèse, il apparaît nécessaire de dissiper trois confusions et pièges d’interprétation tenaces qui continuent d’altérer la compréhension du niveau bêta chez les praticiens :
Question 1 : Si la taille d’échantillon devient gargantuesque, le niveau bêta s’annule-t-il totalement ?
Réponse : Oui, d’un point de vue purement mathématique, lorsque N tend vers l’infini, l’erreur type s’évanouit, les distributions d’échantillonnage deviennent des lignes verticales sans chevauchement et le niveau bêta s’effondre asymptotiquement vers 0. Toutefois, cette configuration engendre un effet pervers symétrique : l’hypertrophie de la sensibilité. Un test surpuissant détectera comme « hautement statistiquement significative » (p < 0,0001) une différence de score infinitésimale (par exemple d = 0,01) totalement dépourvue de la moindre répercussion théorique ou utilité clinique dans le monde réel. Réduire bêta est indispensable, mais l’éradiquer au prix d’une futilité pratique des découvertes fragilise la pertinence de la science.
Question 2 : Le niveau bêta est-il mathématiquement égal à l’opposé du niveau alpha (β = 1 − α) ?
Réponse : Absolument pas. Cette confusion tragique procède d’un amalgame entre deux distributions mathématiques distinctes. Le niveau alpha (α) est calculé en découpant une aire sous la courbe de l’hypothèse nulle H0. Le niveau bêta (β) est dérivé de l’aire découpée sous la courbe de l’hypothèse alternative H1. La seule relation de complémentarité exacte et universelle est celle unissant bêta et la puissance statistique : Puissance = 1 − β. Alpha et bêta évoluent en sens inverse, mais leur relation n’est en aucun cas linéaire ni de somme égale à 1.
Question 3 : En conclusion, que reflète fondamentalement la maîtrise du niveau bêta pour le scientifique ?
Réponse : Le respect rigoureux du niveau bêta constitue l’indice d’une authentique probité épistémique. Réduire le niveau bêta, c’est respecter les efforts des participants qui se soumettent aux protocoles expérimentaux en garantissant que leur contribution permettra d’aboutir à une conclusion informative univoque. C’est préserver la science du nihilisme méthodologique en évitant d’enterrer sous des étiquettes de non-significativité des théories audacieuses qui n’avaient besoin que d’un instrument d’observation suffisamment puissant pour être révélées au grand jour.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1962). The statistical power of abnormal-social psychological research: A review. The Journal of Abnormal and Social Psychology, 65(3), 145–153. https://doi.org/10.1037/h0045186
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Gelman, A., & Carlin, J. (2014). Beyond power calculations: Assessing type S (sign) and type M (magnitude) errors. Perspectives on Psychological Science, 9(6), 641–651. https://doi.org/10.1177/1745691614551642
- Ioannidis, J. P. A. (2005). Why most published research findings are false. PLoS Medicine, 2(8), Article e124. https://doi.org/10.1371/journal.pmed.0020124
- Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
- Lakens, D. (2017). Equivalence testing for psychological research: A tutorial. Advances in Methods and Practices in Psychological Science, 1(2), 259–269. https://doi.org/10.1177/2515245918770963
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), Article aac4716. https://doi.org/10.1126/science.aac4716
- Rosenthal, R. (1979). The file drawer problem and tolerance for null results. Psychological Bulletin, 86(3), 638–641. https://doi.org/10.1037/0033-2909.86.3.638
- Sedlmeier, P., & Gigerenzer, G. (1989). Do studies of statistical power have an effect on the power of studies? Psychological Bulletin, 105(2), 309–316. https://doi.org/10.1037/0033-2909.105.2.309