
Dans le domaine des sciences quantitatives, de la psychologie empirique, des neurosciences cognitives et de l’épidémiologie clinique, l’investigation empirique repose sur une tension fondamentale entre le tout et la partie. Toute recherche aspire fondamentalement à énoncer des vérités générales, à mettre au jour des lois invariantes du comportement ou à quantifier des dynamiques psychologiques universelles. Pourtant, le chercheur se heurte inéluctablement à une contrainte matérielle indépassable : l’impossibilité pratique, économique et temporelle d’observer la totalité des entités vivantes concernées par son questionnement théorique. Cette aporie méthodologique constitue le socle même de la démarche scientifique moderne, articulée autour de la distinction conceptuelle et opérationnelle entre la population et l’échantillon.
Comprendre la dichotomie entre ces deux entités ne relève pas d’une simple convention terminologique destinée aux manuels de statistique élémentaire. Il s’agit d’un enjeu épistémologique majeur qui conditionne la validité scientifique de toute inférence. Confondre les métriques calculées sur un groupe restreint d’individus avec les constantes réelles régissant la collectivité mère conduit inévitablement à des erreurs diagnostiques, à des biais méthodologiques critiques et à la publication d’effets illusoires. Ce phénomène a d’ailleurs largement alimenté la crise contemporaine de la reproductibilité qui traverse les sciences humaines et biomédicales. L’échantillon n’est pas un substitut passif de la population ; il constitue une lentille réfractive à travers laquelle nous tentons d’estimer, avec une marge d’incertitude rigoureusement quantifiable, des réalités structurelles inaccessibles.
Ce traité encyclopédique se propose d’explorer de manière exhaustive, rigoureuse et multidimensionnelle les fondements théoriques, mathématiques et pratiques séparant la population de l’échantillon. À travers un prisme analytique nourri des avancées de la psychométrie contemporaine, de la théorie des probabilités et de la méthodologie de recherche en sciences cognitives, nous examinerons les mécanismes de transition qui permettent à la pensée scientifique de s’élever du microcosme empirique de l’échantillon vers la macro-population cible. De l’élaboration formelle des paramètres statistiques aux plans de sondage probabilistes sophistiqués, des pièges de l’attrition longitudinale aux protocoles de régulation de la puissance statistique, cette analyse approfondie constitue un guide méthodologique de référence pour le chercheur, l’étudiant avancé et le praticien de la recherche quantitative.
1. Fondements épistémologiques : Définition de la population et de l’échantillon
1.1 Définition conceptuelle de la population statistique
D’un point de vue strictement épistémologique et statistique, la population désigne l’ensemble exhaustif et intégral des unités d’observation, d’analyse ou de mesure qui partagent une ou plusieurs caractéristiques communes rigoureusement définies par le protocole expérimental. Loin de se cantonner à une acception purement démographique ou géographique relative à l’agrégation de résidents d’un territoire donné, le concept de population statistique incarne un horizon d’exhaustivité mathématique. Cet univers de référence regroupe l’intégralité des éléments satisfaisant aux prédicats théoriques formulés par le chercheur, sans qu’aucun élément éligible n’en soit exclu a priori. La délimitation d’une population implique une clôture logique impérative : elle trace une frontière absolue entre les entités qui satisfont l’ensemble des critères d’appartenance et celles qui en demeurent extérieures.
Dans le champ de la recherche en psychologie clinique et en psychiatrie cognitive, une population statistique peut se matérialiser sous des formes hautement spécifiques et complexes. On peut conceptualiser la population comme l’ensemble exhaustif de tous les adultes diagnostiqués avec un trouble du déficit de l’attention avec ou sans hyperactivité (TDAH) selon les classifications nosologiques en vigueur à l’échelle internationale. Dans une tout autre perspective, en psychologie sociale ou cognitive générale, la population peut englober la totalité des étudiants universitaires inscrits dans un cursus de premier cycle à l’échelle mondiale, ou même l’universalité des individus humains dotés d’un cortex cérébral fonctionnel dans le cadre de recherches fondamentales sur les mécanismes de la perception visuelle précoce.
L’exhaustivité de la population implique qu’elle contient la totalité de l’information théorique relative au phénomène étudié. Si l’accès à cette totalité était matériellement réalisable, le chercheur se situerait dans le paradigme du recensement complet. Dans cette configuration idéale, l’incertitude statistique disparaîtrait totalement : la variance observée exprimerait fidèlement la variabilité intrinsèque de la nature humaine, sans qu’aucune approximation, marge d’erreur stochastique ou extrapolation inductrice ne soit nécessaire pour formuler une loi scientifique absolue.
1.2 Définition conceptuelle de l’échantillon
L’échantillon se définit formellement comme un sous-ensemble fini, restreint et sélectif extrait de la population parente, soumis de manière directe et empirique à l’observation, à l’expérimentation ou à la passation psychométrique. Si la population représente l’idéal théorique et la totalité abstraite, l’échantillon matérialise la dimension concrète, pragmatique et tangible de la collecte de données sur le terrain. Il constitue une fraction incarnée du tout, prélevée selon des protocoles méthodologiques délibérés, dont les attributs spécifiques sont mesurés en vue de dégager des régularités empiriques transposables au-delà de sa propre sphère circonscrite.
Le caractère inévitablement fragmentaire de l’échantillon découle de la finitude spatio-temporelle de l’activité humaine. Un échantillon de recherche en neuropsychologie clinique ne comptera, par exemple, que soixante-dix patients souffrant d’une lésion du cortex préfrontal ventromédian, sélectionnés au sein de quelques départements hospitaliers spécialisés. Cet échantillon n’a pas de valeur heuristique autonome en tant que simple agrégat de soixante-dix individus distincts ; son utilité scientifique réside exclusivement dans son rôle de vecteur d’extrapolation empirique. L’échantillon est un modèle analogique, un microcosme expérimental dont la légitimité repose sur sa capacité à refléter fidèlement les mécanismes causaux qui opèrent à l’échelle de la macro-population dont il est issu.
Dès lors, l’acte d’échantillonnage ne consiste pas seulement à collecter des observations accessibles, mais à isoler une parcelle du réel capable d’autoriser une induction rigoureuse. L’échantillon est l’intermédiaire obligé par lequel la méthode expérimentale interroge le monde réel : c’est sur lui que s’exercent les mesures comportementales, les temps de réaction, les variations hémodynamiques captées par résonance magnétique fonctionnelle ou les scores obtenus aux échelles psychométriques d’anxiété. L’échantillon porte la charge de la matérialité empirique, mais sa finalité demeure résolument théorique.
1.3 L’impératif de la distinction dans la démarche scientifique
La confusion entre les propriétés intrinsèques de l’échantillon et les lois universelles qui gouvernent la population représente l’une des erreurs conceptuelles les plus pernicieuses de la démarche scientifique. Cette défaillance de raisonnement procède souvent d’une illusion réaliste naïve, qui postule que ce qui est directement observé au sein d’un groupe expérimental restreint constitue ipso facto une vérité générale applicable à l’ensemble du genre humain. Or, les données empiriques recueillies sur un groupe particulier ne sont que des instanciations locales, contingentes et inévitablement affectées par des fluctuations aléatoires propres aux conditions de recueil.
Cette distinction opère un impact décisif et structurant sur la formulation des hypothèses de recherche. Une hypothèse scientifique ne concerne jamais l’échantillon en lui-même. Formuler l’hypothèse selon laquelle « les 45 participants soumis à l’intervention cognitive présenteront un score moyen de mémoire supérieur de 12 points aux 45 participants témoins » constitue une absurdité méthodologique majeure. L’hypothèse scientifique postule une relation théorique fondamentale régissant la population dans sa globalité : « l’administration de l’intervention cognitive accroît l’efficience de la mémoire de travail chez les adultes sains d’âge mûr ». L’échantillon n’intervient qu’au moment d’évaluer la vraisemblance de cette proposition théorique à la lumière des lois de la probabilité statistique.
Maintenir une démarcation imperméable entre le niveau de l’échantillon et celui de la population s’avère indispensable pour préserver la validité de construit et la validité externe du protocole expérimental. Sans cette séparation stricte, le chercheur s’expose à réifier des artefacts expérimentaux locaux, à élever des particularités idiosyncrasiques de sa cohorte au rang de lois psychologiques pérennes, et à ruiner toute possibilité d’élaborer une science cumulative, universelle et falsifiable au sens poppérien.
2. La Population en recherche psychologique : Caractéristiques et typologies
2.1 Population cible versus population accessible
Dans l’architecture conceptuelle d’un projet de recherche, il est impératif d’opérer une dissociation méthodique entre la population cible (ou théorique) et la population accessible (ou parente opérationnelle). La population cible incarne l’ensemble exhaustif des individus auxquels le chercheur ambitionne théoriquement d’étendre la portée de ses conclusions scientifiques. Si l’on investigue les corrélats neurobiologiques de l’attachement anxieux chez le jeune adulte, la population cible réunit l’intégralité des individus émergents de 18 à 25 ans à travers l’ensemble des cultures et des contextes socio-économiques du globe. C’est sur ce continent théorique idéal que se déploient les modèles psychologiques généraux.
Cependant, la réalité opérationnelle impose une délimitation bien plus modeste : la population accessible circonscrit la fraction précise, géographique, temporelle et institutionnelle de la population cible que le chercheur est effectivement capable de joindre, de solliciter et de mesurer à travers ses protocoles institutionnels. Dans l’exemple précité, la population accessible se limitera aux étudiants inscrits en première année de psychologie dans deux universités publiques de la région francilienne durant l’année universitaire en cours. Bien que cette population accessible soit plus vaste que l’échantillon final qui sera prélevé en son sein, elle représente déjà une contraction majeure de l’horizon théorique d’origine.
L’écart systématique qui sépare inévitablement la population cible de la population accessible engendre un risque considérable d’érosion de la portée théorique de la recherche. Si la population accessible présente des spécificités structurelles divergentes de la population cible — telles qu’un niveau de capital culturel supérieur, une relative homogénéité ethnique ou une prévalence anormale de profils urbains diplômés —, les inférences produites au terme de l’étude ne pourront être légitimement extrapolées à la population cible sans distorsion majeure du cadre épistémique.
2.2 Populations finies versus populations infinies
La formalisation mathématique de l’analyse statistique impose une distinction rigoureuse entre les populations dites finies et les populations modélisées comme étant infinies. Une population finie est un ensemble d’unités d’observation dont l’effectif total, conventionnellement désigné par la lettre majuscule $N$, est strictement borné, dénombrable et répertoriable par des méthodes de comptage standardisées. Par exemple, la totalité des psychologues cliniciens actuellement inscrits au registre officiel d’un ordre professionnel national constitue une population finie, dont la taille exacte peut être établie à l’unité près à une date calendaire précise.
À l’inverse, en psychologie cognitive expérimentale, en psychophysique et dans l’étude des processus d’apprentissage moteur, la population de référence est généralement modélisée comme théoriquement infinie. Cette conceptualisation abstraite découle du postulat selon lequel le phénomène étudié — par exemple, le temps nécessaire au système nerveux central pour intégrer un stimulus visuel incongru — correspond à une infinité potentielle d’essais expérimentaux pouvant être réitérés indéfiniment à travers le temps et l’espace chez tout sujet biologique existant, passé ou futur. Les individus mesurés ne représentent alors qu’un échantillon fini prélevé sur une ligne temporelle et biologique continue et illimitée.
Cette distinction comporte des implications directes et profondes sur le plan de la théorie statistique appliquée. Lorsqu’un échantillon de taille $n$ est extrait d’une population finie $N$ sans remise, et que cet échantillon représente une proportion substantielle de ladite population (généralement lorsque la fraction de sondage $n/N$ dépasse le seuil critique de 5 % ou 0,05), l’indépendance statistique des observations successives se trouve violée. Pour préserver l’exactitude des calculs de variance de la distribution d’échantillonnage et éviter une sous-estimation systématique de l’erreur type, les statisticiens doivent appliquer le facteur de correction pour population finie (FCPF), formellement formulé par le multiplicateur radical :
$$\sqrt{\frac{N – n}{N – 1}}$$
À mesure que la taille de la population $N$ tend vers l’infini, cette expression converge asymptotiquement vers la valeur 1, rendant superflue toute correction et validant l’utilisation des équations standard de l’inférence asymptotique classique.
2.3 Critères d’inclusion et d’exclusion
Pour définir sans ambiguïté les contours de la population parente, l’expérimentateur doit élaborer une charte rigoureuse de critères d’inclusion et d’exclusion. Les critères d’inclusion formalisent les variables démographiques, cliniques, cognitives ou comportementales indispensables pour qu’un individu soit reconnu comme éligible à la population d’intérêt. À titre d’illustration, un essai clinique visant à tester l’efficacité d’une thérapie cognitivo-comportementale informatisée pour la dépression majeure établira des critères d’inclusion stricts : tranche d’âge de 25 à 55 ans, diagnostic formel d’épisode dépressif caractérisé selon les critères du DSM-5, et score minimal requis à l’Inventaire de Dépression de Beck (BDI-II).
Conjointement, les critères d’exclusion identifient des caractéristiques dont la présence chez un individu théoriquement inclus invaliderait l’interprétation causale des mécanismes testés. Ces critères peuvent inclure la comorbidité avec des troubles psychotiques, une dépendance active à des substances psychoactives, un antécédent récent de traumatisme crânien avec perte de conscience prolongée, ou la prise concurrente d’une pharmacothérapie instable. L’application impitoyable de ces filtres a pour objectif primaire d’homogénéiser le groupe expérimental en neutralisant les sources massives de variance non contrôlée (variables parasites ou confondantes), maximisant ainsi la puissance du signal statistique interne.
Toutefois, cette recherche maniaque d’homogénéité méthodologique comporte une rançon épistémologique particulièrement lourde : le risque aigu de restriction de la validité écologique. En sur-sélectionnant des individus exempts de toute comorbidité au sein d’une population psychiatrique où la polypathologie constitue la norme clinique universelle, le chercheur s’enferme dans un isolat artificiel. La population accessible ainsi purifiée ne reflète plus la réalité brute des patients rencontrés en cabinet libéral ou en milieu hospitalier public, compromettant substantiellement l’extrapolabilité clinique des avancées thérapeutiques issues du laboratoire.
3. L’Échantillon : Nécessité pratique et justification méthodologique
3.1 Contraintes économiques, éthiques et temporelles
L’observation intégrale d’une population cible demeure, dans l’immense majorité des contextes de recherche fondamentale ou appliquée, une utopie logistique absolue. Le recours au recueil de données par échantillonnage ne constitue pas une concession paresseuse face à la rigueur, mais une nécessité structurante dictée par des contraintes matérielles, financières, éthiques et chronologiques insurmontables. Déployer un recensement exhaustif pour étudier un profil psychologique à l’échelle d’une nation exigerait des centaines de millions d’euros d’allocation budgétaire, mobilisant des dizaines de milliers d’assistants de recherche pendant des années pour un rendement informatif souvent redondant.
Sur le plan éthique, le principe directeur de parcimonie scientifique enjoint d’exposer le nombre minimal nécessaire d’êtres humains à des protocoles potentiellement invasifs, stressants, anxiogènes ou consommateurs de temps. Si un paradigme de recherche en psychologie sociale manipule la menace du stéréotype ou expose les sujets à des dilemmes moraux douloureux, soumettre l’intégralité d’une communauté à de telles épreuves violerait de manière flagrante les impératifs déontologiques fondamentaux codifiés par la Déclaration d’Helsinki. L’échantillonnage calibré permet de préserver l’intégrité globale de la population tout en extrayant le quantum d’information probabiliste indispensable à la confirmation ou à l’infirmation des lois théoriques.
Enfin, le facteur temporel s’avère critique pour préserver la « fraîcheur » et l’homogénéité temporelle des données recueillies. L’évaluation psychologique d’un très large effectif menée sur une période dilatée de plusieurs décennies serait inéluctablement contaminée par des effets d’histoire, des mutations culturelles globales, des changements technologiques majeurs et des glissements sociodémographiques structurels. L’échantillon permet de capturer une image quasi instantanée de la dynamique psychique, minimisant la variance parasite induite par l’écoulement non maîtrisé du temps séculier.
3.2 Qualité de mesure et contrôle expérimental
Une proposition méthodologique paradoxale mais empiriquement avérée enseigne qu’un échantillon méticuleusement contrôlé procure fréquemment des données de qualité scientifique infiniment supérieure à celles issues d’un recensement massif et désorganisé. En réduisant drastiquement l’échelle de l’investigation à une cohorte de taille modérée mais représentative, le chercheur peut dédier des ressources substantielles à l’optimisation des instruments de mesure, à la sophistication des dispositifs techniques et à la supervision rigoureuse de la fidélité inter-évaluateurs.
Dans le cadre d’un protocole d’observation en psychologie du développement examinant les modalités d’interaction mère-nourrisson selon la grille d’analyse du paradigme de la situation étrange, l’évaluation qualitative fine exige le codage seconde par seconde d’enregistrements vidéo haute définition par des experts formés et accrédités pendant de longs mois. Mener un tel niveau d’examen micrométrique sur une population entière relèverait de la pure impossibilité technique et matérielle ; l’entreprise sombrerait inévitablement dans la dégradation chaotique de la standardisation de l’évaluation, multipliant les dérives de cotation entre observateurs non supervisés.
De surcroît, le travail sur un échantillon restreint permet une traçabilité expérimentale absolue : détection immédiate des dysfonctionnements du matériel de recueil des temps de réaction, identification des biais de passation, vérification de l’adhésion scrupuleuse des sujets aux consignes de la tâche cognitive, et exclusion chirurgicale des données parasitées par des artefacts motrices ou attentionnels. Le gain obtenu sur la validité interne de l’expérience compense très largement la restriction quantitative de l’effectif observé.
3.3 L’unité d’analyse en sciences cognitives et sociales
Au cœur de la formalisation de tout échantillon réside la question fondamentale de l’identification de l’unité d’analyse (ou unité d’échantillonnage). Dans la majorité écrasante des protocoles en psychologie quantitative, l’individu singulier constitue l’unité élémentaire de mesure psychométrique et comportementale. Les scores compilés dans la matrice de données correspondent aux performances, aux choix décisionnels, aux réponses d’auto-évaluation et aux signaux physiologiques enregistrés chez chaque participant appréhendé comme une entité autoportante et indépendante.
Toutefois, la réalité des dynamiques humaines impose fréquemment de concevoir des unités composites d’un niveau d’agrégation supérieur. En psychologie de la famille et en thérapie systémique, l’unité d’analyse pertinente n’est souvent pas l’individu pris isolément, mais la dyade conjugale ou parentale, voire le noyau familial dans sa dynamique transactionnelle. Dans le champ de la psychologie organisationnelle ou du travail, les unités d’échantillonnage peuvent s’incarner dans des équipes de travail autonomes, des départements de production, ou des firmes multinationales entières.
Cette distinction entre le niveau individuel et le niveau agrégé requiert une vigilance méthodologique extrême sous peine de commettre des erreurs de raisonnement dévastatrices, telles que la fallacie écologique (inférer des dynamiques psychologiques individuelles à partir de corrélations observées à l’échelle d’unités groupales agrégées) ou son symétrique inverse, l’erreur atomiste. Lorsque des individus sont imbriqués au sein de structures collectives partagées — des élèves regroupés dans des classes, elles-mêmes intégrées dans des établissements scolaires distincts —, l’échantillonnage doit impérativement être modélisé selon des méthodologies hiérarchiques ou multiniveaux, sous peine de violer le postulat fondamental d’indépendance des observations.
4. Paramètres de population versus Statistiques d’échantillon
4.1 Conventions de notation mathématique
Pour éviter toute ambiguïté sémiotique et conceptuelle lors de la modélisation mathématique des données, la communauté statistique internationale a codifié de manière unifiée un ensemble de conventions typographiques strictes. Par convention universelle, toute entité quantitative décrivant une caractéristique intrinsèque et non observée d’une population est désignée par des lettres grecques. Inversement, toute mesure calculée directement à partir des observations réelles constituant un échantillon est systématiquement formalisée à l’aide de lettres latines de l’alphabet standard.
Le tableau paradigmatique des correspondances s’établit avec une rigueur absolue :
- La Moyenne arithmétique : Elle est formalisée par la lettre grecque $\mu$ (mu) lorsqu’elle caractérise l’espérance mathématique de la population, alors qu’elle s’écrit $\bar{X}$ (X-barre) ou $M$ lorsqu’elle est calculée sur les valeurs observées au sein de l’échantillon empirique.
- La Variance : Elle est notée $\sigma^2$ (sigma carré) pour la population, tandis que son homologue échantillonnale est symbolisée par $s^2$ ou $SD^2$.
- L’Écart-type : La mesure brute de dispersion s’écrit $\sigma$ (sigma minuscule) au niveau populationnel, et $s$ (ou $SD$ pour Standard Deviation) au niveau de l’échantillon.
- La Proportion : La proportion réelle d’un attribut catégoriel dans la population est représentée par $P$ ou $Pi$ (pi majuscule), tandis que la fréquence relative observée dans l’échantillon est notée $p$ ou $\hat{p}$ (p-chapeau).
- Le Coefficient de corrélation linéaire : L’intensité de la relation entre deux variables est symbolisée par le coefficient $rho$ (rhô) dans la population, et par $r$ dans l’échantillon.
Ces distinctions de pure notation sont cruciales : apercevoir un symbole grec dans un article scientifique indique immédiatement au lecteur averti qu’il s’agit d’une cible théorique, inaccessible et estimée, tandis que la présence d’un symbole latin renvoie directement à une mesure empirique tangible, calculée sur les données concrètes de l’étude.
4.2 Constante théorique versus variable aléatoire
L’abîme épistémologique séparant le paramètre de la statistique réside dans leur statut ontologique respectif : le paramètre de la population est une constante théorique invariable mais inconnue, tandis que la statistique d’échantillon constitue une variable aléatoire intrinsèquement fluctuante. Dans une population fermée et définie à un instant précis du temps, la moyenne réelle d’un trait psychologique — par exemple, le quotient intellectuel mesuré par une échelle standardisée — possède une valeur unique, fixe et déterministe. Cette valeur $\mu$ existe objectivement dans la réalité mathématique, même si aucun chercheur ne parvient à la quantifier avec une exactitude absolue.
À l’opposé, la moyenne empirique $\bar{X}$ dérivée d’un échantillon de cent participants sélectionnés aléatoirement dans cette même population est assujettie au phénomène universel de la fluctuation d’échantillonnage. Si l’on extrait consécutivement dix échantillons distincts de taille identique au sein de la même population, on obtiendra inéluctablement dix valeurs numériques de $\bar{X}$ légèrement dissemblables. La statistique d’échantillon n’est donc pas une entité fixe, mais une fonction probabiliste gouvernée par une distribution sous-jacente.
Dans ce cadre, la statistique agit comme un estimateur ponctuel du paramètre d’intérêt. La qualité théorique d’un estimateur se juge à l’aune de propriétés mathématiques rigoureusement définies par la théorie statistique : son absence de biais (sa valeur espérée doit coïncider exactement avec la cible théorique), son efficacité (il doit présenter la variance la plus faible possible parmi tous les estimateurs concurrents), et sa consistance ou convergence (sa précision doit croître à mesure que le volume d’échantillonnage augmente).
4.3 Biais et convergence de l’estimateur
La question du biais statistique illustre avec éclat les subtilités mathématiques sous-jacentes à la transition de l’échantillon vers la population. Un estimateur est qualifié de non biaisé (ou sans biais) lorsque son espérance mathématique formelle $E(\hat{\theta})$ est égale au paramètre théorique inconnu $\theta$ qu’il est chargé de modéliser. C’est précisément le cas pour la moyenne d’échantillon :
$$E(\bar{X}) = \mu$$
En moyenne, à travers une infinité théorique de tirages aléatoires répétés, la moyenne des moyennes d’échantillon correspond exactement à la moyenne de la population.
Il en va tout autrement de la variance d’échantillon. Si l’on calcule la variance d’un échantillon en utilisant la formule classique de dispersion arithmétique :
$$\frac{1}{n} \sum_{i=1}^n (X_i – \bar{X})^2$$
cet estimateur se révèle mathématiquement biaisé. Étant donné que les écarts individuels sont calculés par rapport à la moyenne locale de l’échantillon $\bar{X}$ (qui minimise structurellement ces distances) et non par rapport à la véritable moyenne inconnue de la population $\mu$, cette formule sous-estime systématiquement la variance réelle de la population sous-jacente. Pour neutraliser cette distorsion arithmétique, les statisticiens appliquent la célèbre correction de Bessel, consistant à diviser la somme des carrés des écarts non par $n$, mais par les degrés de liberté résiduels, c’est-à-dire $n – 1$ :
$$s^2 = \frac{1}{n – 1} \sum_{i=1}^n (X_i – \bar{X})^2$$
Cette correction permet à $s^2$ de devenir un estimateur sans biais de $\sigma^2$, tel que $E(s^2) = \sigma^2$. Parallèlement, la consistance de ces estimateurs est garantie sur le plan théorique par la Loi forte des grands nombres formulée par Émile Borel et Andreï Kolmogorov. Cette loi énonce que la statistique empirique converge presque sûrement vers la constante théorique de la population à mesure que la taille de l’échantillon $n$ tend vers l’infini, scellant l’alignement asymptotique progressif entre le microcosme empirique et le macrocosme théorique.
5. Méthodes d’échantillonnage probabiliste en psychologie
5.1 Échantillonnage aléatoire simple
L’échantillonnage aléatoire simple représente l’étalon-or épistémologique et la condition première de la quasi-totalité des modèles d’inférence statistique formelle. Dans cette modalité probabiliste rigoureuse, chaque membre identifiable de la population statistique parente possède une probabilité rigoureusement identique, strictement supérieure à zéro et parfaitement calculable d’être sélectionné au sein de l’échantillon final. De surcroît, chaque combinaison imaginable de $n$ individus tirés au sein de la population $N$ bénéficie d’une probabilité d’occurrence rigoureusement équivalente à celle de n’importe quelle autre combinaison de même taille.
Sur le plan opérationnel, la réalisation d’un échantillonnage aléatoire simple exige au préalable la constitution ou la possession d’une base de sondage exhaustive et intégrale, répertoriant individuellement chaque unité de la population sous un identifiant unique non ambigu. Une fois ce répertoire consolidé, le tirage au sort des sujets s’effectue sans aucune interférence humaine, par l’entremise de générateurs de nombres pseudo-aléatoires cryptographiquement sûrs intégrés dans les logiciels d’analyse statistique modernes, ou historiquement par le recours à des tables de nombres aléatoires homologuées comme celles de Kendall et Babington Smith.
Cependant, en dépit de sa perfection mathématique incontestée, l’échantillonnage aléatoire simple se heurte régulièrement à des barrières infranchissables lors de sa mise en pratique dans le champ des sciences du comportement. Dans la vaste majorité des paradigmes psychologiques, il est totalement impossible d’obtenir une base de sondage globale énumérant, par exemple, la totalité des enfants souffrant d’anxiété de séparation ou l’ensemble des adultes bipolaires d’un pays. De surcroît, les coûts logistiques inhérents à la dispersion géographique des individus sélectionnés au hasard sur un vaste territoire constituent une entrave financière rédhibitoire pour la plupart des laboratoires de recherche académique.
5.2 Échantillonnage stratifié proportionnel et non proportionnel
Pour pallier les aléas de tirage inhérents à l’échantillonnage aléatoire simple, qui peut par pur hasard sélectionner une fraction disproportionnée d’un sous-groupe particulier au détriment d’un autre, les chercheurs ont développé l’échantillonnage stratifié. Cette méthode consiste à segmenter préalablement la population accessible en sous-groupes non recouvrants, hautement homogènes en leur sein mais mutuellement hétérogènes entre eux, désignés sous le terme de strates. Ces strates sont érigées à partir de variables auxiliaires dont la littérature scientifique a démontré l’impact critique sur le phénomène étudié : la tranche d’âge, le genre biologique, le niveau socio-économique ou la sévérité d’un diagnostic clinique.
Dans l’approche de l’échantillonnage stratifié proportionnel, la fraction d’individus extraite au sein de chaque strate correspond scrupuleusement au pourcentage réel occupé par cette strate dans la structure démographique de la population mère. Si une population d’intérêt est composée de 65 % de femmes et de 35 % d’hommes, un échantillon stratifié proportionnel de 1 000 participants sera contraint d’intégrer précisément 650 femmes et 350 hommes, chacun étant sélectionné aléatoirement à l’intérieur de sa sous-cohorte respective. Ce protocole garantit une réduction sensible de la variance d’échantillonnage par rapport à un tirage purement aléatoire, assurant une précision métrique optimale sur les estimateurs globaux.
À l’inverse, l’échantillonnage stratifié non proportionnel (ou avec sur-échantillonnage) déroge délibérément à la parité démographique réelle. Cette stratégie s’impose lorsque l’objectif de la recherche implique la réalisation d’analyses statistiques comparatives fines au sein de sous-populations ultra-minoritaires. Si une strate ne représente que 2 % de la population globale (par exemple, les individus transgenres dans une étude sur le climat scolaire), un échantillonnage purement proportionnel de 500 sujets n’inclurait que 10 personnes, rendant tout calcul d’inférence formelle rigoureusement impossible par manque de puissance statistique. On sur-échantillonnera donc cette strate pour atteindre, par exemple, 100 participants. Cette distorsion délibérée imposera ultérieurement l’application de pondérations statistiques lors de l’estimation des paramètres de la population globale.
5.3 Échantillonnage en grappes et systématique
L’échantillonnage en grappes répond à une logique spatiale et institutionnelle diamétralement opposée à celle de l’échantillonnage stratifié. Au lieu d’extraire des individus isolés distribués de manière éparse, le chercheur sélectionne aléatoirement des unités collectives naturelles préexistantes, appelées grappes. Dans le milieu scolaire, la grappe sera une école primaire ou une salle de classe spécifique ; dans le domaine médical, un centre hospitalier de jour ; dans le champ organisationnel, une agence régionale. Une fois les grappes tirées au sort avec des probabilités assignées, l’intégralité des individus résidant au sein de chaque grappe sélectionnée est intégrée au protocole expérimental (échantillonnage en grappes à un degré).
L’immense avantage logistique de cette méthode est qu’elle ne réclame pas une base de sondage nominative de tous les individus, mais simplement la liste récapitulative des grappes existantes. En revanche, l’échantillonnage en grappes induit un lourd tribut méthodologique désigné sous le terme d’effet de grappe ou de plan. En raison de la proximité environnementale et relationnelle, les membres d’une même grappe ont tendance à se ressembler beaucoup plus entre eux qu’avec des membres extérieurs (corrélation intra-classe élevée, $\rho_{icc}$). Cela entraîne une réduction drastique de l’indépendance des observations et de l’efficience statistique : un échantillon de 500 élèves issus de 5 classes de 100 élèves fournit une quantité d’information réelle bien inférieure à un échantillon aléatoire simple de 500 élèves indépendants.
L’échantillonnage systématique, pour sa part, consiste à sélectionner des individus à partir d’un registre linéaire selon un intervalle régulier $k$, défini par le rapport entre la taille de la population et celle de l’échantillon visé ($k = N/n$). Après avoir tiré au sort un point de départ aléatoire entre 1 et $k$, le chercheur sélectionne méthodiquement chaque $k$-ième élément. Cette méthode, extrêmement fluide dans son exécution opérationnelle, recèle cependant un péril méthodologique redoutable : si la base de sondage sous-jacente présente une périodicité cachée alignée sur l’intervalle $k$ (par exemple, des dossiers classés de telle sorte que chaque huitième dossier correspond à un chef de famille), l’échantillon final sera grevé d’un biais systématique destructeur pour toute représentativité.
6. Méthodes d’échantillonnage non probabiliste et risques associés
6.1 Échantillonnage de convenance
L’échantillonnage de convenance (ou accidentel) constitue la modalité de constitution de cohorte la plus omniprésente et la plus décriée dans l’histoire de la psychologie empirique. Elle consiste à recruter les participants non pas sur la base d’un calcul probabiliste d’inclusion, mais sur des critères d’accessibilité géographique immédiate, de proximité institutionnelle, de disponibilité temporelle et de faible coût de mise en œuvre. Dans ce paradigme pragmatique, la probabilité d’inclusion d’un membre de la population générale est rigoureusement indéterminable, et d’immenses segments de la population parente se voient privés de toute chance physique d’intégrer le groupe mesuré.
L’incarnation paroxystique de ce procédé réside dans le recours massif et endémique aux cohortes d’étudiants de premier cycle inscrits dans les départements universitaires de psychologie. Pendant des décennies, des pans entiers de la théorie de la cognition sociale, de la mémoire épisodique, de la perception morale et de la dynamique motivationnelle ont été échafaudés à partir de données recueillies auprès de jeunes adultes âgés de 19 à 22 ans, issus des classes moyennes supérieures occidentales, participant à des protocoles de laboratoire en échange de la validation de crédits de cours obligatoires.
Les conséquences de cette hégémonie de l’échantillonnage de convenance sur la validité externe des découvertes scientifiques sont particulièrement délétères. Les processus psychologiques observés chez ces panels ultra-sélectionnés — qui possèdent des capacités d’abstraction cognitive, une littératie numérique et une habituation aux tests formels bien au-delà des moyennes observées en population générale — ne peuvent être étendus à d’autres tranches d’âge, à d’autres classes sociales ou à d’autres cultures sans commettre un abus inductif caractérisé.
6.2 Échantillonnage intentionnel et méthode des quotas
L’échantillonnage intentionnel (ou par jugement raisonné) s’émancipe de la sélection aléatoire pour reposer sur l’expertise subjective du chercheur, qui sélectionne sciemment des individus dont il estime qu’ils incarnent de façon exemplaire les caractéristiques typiques, extrêmes ou critiques du phénomène investigué. Dans le cadre de recherches qualitatives ou mixtes sur l’expertise décisionnelle sous stress extrême, le chercheur recrutera délibérément une dizaine de chirurgiens traumatologues seniors ou de pilotes d’essai militaires, considérant que leur profil cognitif spécifique recèle des clés de compréhension inaccessibles au citoyen lambda.
Dans une perspective quantitative plus formalisée, la méthode des quotas cherche à reproduire artificiellement la structure démographique de la population mère sans jamais recourir au tirage au sort probabiliste. Les chercheurs définissent une matrice de quotas croisant des variables descriptives clefs (âge, sexe, catégorie socio-professionnelle, région) calquée sur les données du recensement national. Les enquêteurs se déploient ensuite sur le terrain ou via des panels d’accès numérique avec pour consigne de remplir ces différentes « cases » jusqu’à saturation des effectifs prévus.
Bien que la méthode des quotas donne l’illusion séduisante d’une parfaite conformité démographique marginale avec la macro-population, elle s’avère lourdement vulnérable à des biais d’échantillonnage pernicieux et invisibles. Les enquêteurs ou les plateformes en ligne tendent irrémédiablement à sélectionner, au sein de chaque quota démographique, les individus les plus facilement joignables, les plus sociables, les plus coopératifs ou les plus connectés technologiquement. Dès lors, si la structure d’âge et de genre est parfaitement respectée sur le papier, la distribution des variables psychologiques fondamentales (traits de personnalité, stabilité émotionnelle, ouverture à l’expérience) demeure totalement asymétrique par rapport à la population réelle.
6.3 Échantillonnage par réseau ou boule de neige
L’échantillonnage par réseau, universellement désigné sous la métaphore de la méthode de la « boule de neige » (snowball sampling), constitue une technique non probabiliste spécifiquement élaborée pour accéder à des populations cachées, hautement marginalisées, stigmatisées, clandestines ou structurellement réticentes à tout contact avec les institutions académiques et étatiques. Dans ces contextes singuliers (usagers de drogues injectables par voie intraveineuse, travailleurs du sexe clandestins, individus engagés dans des idéologies radicales violentes, patients souffrant de psychopathologies particulièrement honteuses ou rares), l’absence totale de base de sondage interdit toute velléité de tirage aléatoire classique.
Le protocole s’initie par l’identification méticuleuse et la prise de contact avec un nombre très restreint d’individus clés (« graines » ou informateurs privilégiés), qui bénéficient d’une légitimité et d’une confiance établies au sein de la communauté ciblée. Après avoir participé au protocole de recherche sous anonymat strict, ces premiers répondants sont sollicités pour relayer l’invitation auprès de leurs pairs, qui recrutent à leur tour leurs propres contacts relationnels, générant ainsi une dynamique de diffusion pyramidale successive à travers les chaînes du réseau social interstitiel.
Si cette approche offre un accès irremplaçable à des terrains humains impénétrables par d’autres voies, sa faille méthodologique structurelle réside dans la violation frontale du principe de l’indépendance des observations. Les sujets ne sont pas agrégés au hasard : ils partagent des réseaux de sociabilité communs, des affinités idéologiques partagées et des profils comportementaux corrélés, créant un biais d’homophilie massif. Les individus isolés au sein de la sous-culture ciblée, n’ayant que peu de liens sociaux, possèdent une probabilité quasi nulle d’être intégrés dans la chaîne de cooptation, ce qui vicie profondément la représentativité des micro-données ainsi amassées.
7. Représentativité et biais d’échantillonnage
7.1 Le biais de sélection et l’erreur d’auto-sélection
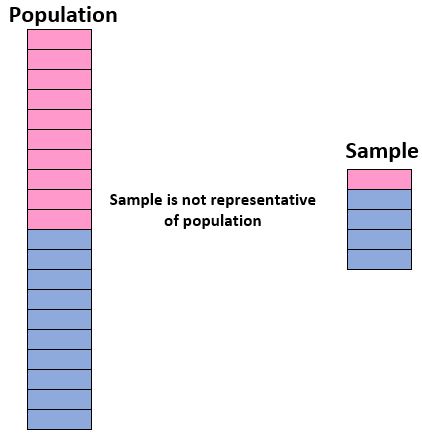
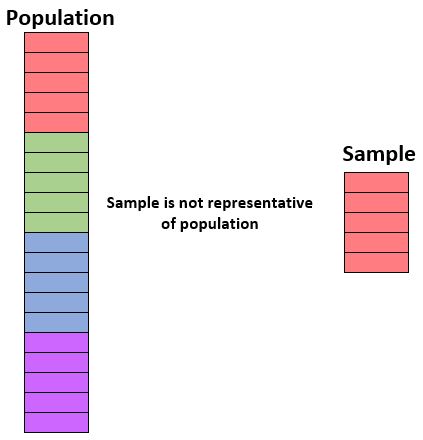
Le concept de représentativité incarne l’idéal méthodologique suprême de la recherche quantitative. Un échantillon est réputé représentatif lorsqu’il reflète, avec une fidélité structurelle et proportionnelle exemplaire, l’ensemble des caractéristiques, de la variabilité et des distributions de traits qui coexistent au sein de la population parente. Lorsque cette condition d’isomorphisme n’est pas remplie, l’échantillon est qualifié de biaisé, introduisant des distorsions mathématiques incontrôlables dans l’estimation des paramètres réels.
Le biais de sélection survient dès lors qu’il existe une corrélation non nulle entre la probabilité d’un individu d’intégrer l’échantillon et sa valeur sur les variables sous examen. Ce biais se manifeste de manière particulièrement féroce sous la forme de l’erreur d’auto-sélection (ou effet du volontariat), théorisée de longue date en psychologie par Robert Rosenthal. Lorsqu’un appel à volontaires est diffusé publiquement pour participer à une étude sur les styles relationnels ou la santé mentale, les personnes qui choisissent délibérément de s’inscrire diffèrent radicalement, sur le plan de leur structure de personnalité, de celles qui ignorent l’invitation.
Les recherches empiriques consacrées aux profils psychologiques des volontaires démontrent avec constance qu’ils présentent en moyenne des niveaux significativement plus élevés d’ouverture à l’expérience, d’extraversion, d’altruisme social, d’intelligence verbale et d’adhésion aux valeurs académiques, mais des niveaux inférieurs d’anxiété sociale et de méfiance paranoïde. Par conséquent, toute mesure psychologique collectée auprès d’une cohorte d’auto-sélectionnés surestimera structurellement l’optimisme, l’engagement et le bien-être subjectif de la population générale, tout en occultant les profils psychopathologiques les plus sévères.
7.2 La crise des échantillons WEIRD
Au cours de la décennie 2010, les sciences du comportement ont été ébranlées par une prise de conscience épistémologique majeure portée par les travaux pionniers de Joseph Henrich, Steven Heine et Ara Norenzayan quant à la composition socioculturelle aberrante des cohortes de recherche en psychologie. Les auteurs ont forgé le célèbre acronyme WEIRD pour souligner que l’immense majorité des publications scientifiques de référence s’appuyaient exclusivement sur des participants originaires de sociétés Occidentales, Éduquées, Industrialisées, Riches et Démocratiques (Western, Educated, Industrialized, Rich, and Democratic).
Or, d’un point de vue démographique et anthropologique planétaire, les populations WEIRD ne représentent qu’environ 12 % de l’humanité, et constituent souvent des cas extrêmes et idiosyncrasiques sur un spectre très large de variables psychologiques. Que ce soit au niveau de la vulnérabilité aux illusions perceptives visuelles élémentaires (telle que l’illusion de Müller-Lyer), des conceptions morales du bien et de la justice punitive, de la prévalence des modes de pensée holistiques versus analytiques, ou de la conceptualisation de soi comme entité indépendante versus interdépendante, les individus WEIRD se situent systématiquement aux bornes extrêmes des distributions statistiques mondiales.
La critique épistémologique formulée à l’encontre de la crise WEIRD est sans appel : pendant plus d’un siècle, la psychologie académique a commis une généralisation universelle frauduleuse en requalifiant des particularismes psychologiques propres à une minorité d’étudiants nord-américains et européens de « lois universelles de la nature humaine ». Ce constat a imposé une mutation progressive des pratiques contemporaines, incitant les chercheurs à s’engager dans de vastes collaborations transnationales et transculturelles pour diversifier de manière radicale les panels empiriques et tester la robustesse inter-populations des modèles cognitifs.
7.3 Biais d’attrition et perte de représentativité
Même lorsqu’un chercheur parvient à constituer un échantillon initial d’une rigueur probabiliste et démographique irréprochable, cette représentativité n’est jamais acquise de manière définitive ; elle demeure fragile et susceptible de se dégrader sous l’effet du biais d’attrition (perte sélective de sujets). Ce phénomène destructeur sévit avec une intensité maximale dans les devis de recherche longitudinaux, où les participants doivent être réévalués à plusieurs reprises au fil de mois ou d’années d’investigation.
L’attrition devient catastrophique dès lors que les abandons en cours d’étude ne surviennent pas de manière aléatoire (Missing Completely at Random – MCAR), mais obéissent à des dynamiques systématiques corrélées aux variables psychologiques et cliniques explorées. Dans une étude longitudinale évaluant le déclin cognitif associé au vieillissement, les participants qui quittent prématurément le protocole sont précisément ceux dont la santé physique se dégrade le plus vite, dont les ressources économiques sont les plus faibles, ou dont les scores mnésiques s’effondrent de façon précoce.
Cette érosion différentielle produit un phénomène pervers de biais du survivant : la cohorte finale réévaluée lors de la cinquième vague d’observation ne ressemble plus en rien à la cohorte stratifiée initiale. Elle se compose majoritairement d’individus ultra-résilients, socialement stabilisés et cognitivement préservés, conduisant à une sous-estimation systématique et tragique de l’ampleur réelle du déclin neurodégénératif dans la population d’origine. Pour contrer ces artefacts d’attrition, la méthodologie contemporaine impose le déploiement d’analyses comparatives rigoureuses des profils perdus de vue et le recours à des algorithmes de modélisation statistique avancés fondés sur l’imputation multiple ou l’estimation par maximum de vraisemblance à information complète (FIML).
8. L’Inférence statistique : Du microcosme d’échantillon à la macro-population
8.1 Le théorème central limite et la distribution d’échantillonnage
Le passage logique et mathématique permettant d’extrapoler des conclusions rigoureuses de l’observation d’un modeste groupe empirique vers l’immensité invisible d’une population cible repose sur l’un des piliers mathématiques les plus admirables de l’histoire des sciences : le Théorème Central Limite (TCL), formalisé successivement par Abraham de Moivre, Pierre-Simon de Laplace et Aleksandr Liapounov. Ce théorème fondamental s’intéresse non pas à la distribution des observations au sein d’un échantillon unique, mais à la distribution d’échantillonnage théorique de la statistique si l’on répétait le processus de sélection une infinité de fois.
Le théorème stipule que, quelle que soit la forme de la distribution de probabilité d’origine de la variable dans la population mère — qu’elle soit asymétrique, bimodale, uniforme ou hautement aplatie —, la distribution d’échantillonnage de la moyenne $\bar{X}$ calculée sur des échantillons aléatoires indépendants de taille $n$ tend inéluctablement vers une distribution normale gaussienne à mesure que la taille $n$ de l’échantillon s’accroît. Dans la pratique de la recherche, dès lors que la taille de l’échantillon franchit le seuil conventionnel de $n \geq 30$, l’approximation normale est considérée comme hautement robuste.
De surcroît, le Théorème Central Limite fixe avec une clarté absolue les paramètres de cette distribution d’échantillonnage asymptotique : son espérance est rigoureusement identique à la moyenne théorique $\mu$ de la population, et sa variance est égale à la variance de la population divisée par la taille de l’échantillon ($\sigma^2 / n$). L’écart-type de cette distribution d’échantillonnage, universellement désigné sous le vocable d’erreur type de la moyenne ($SE$ ou $\sigma_{\bar{X}}$), se calcule selon l’équation fondamentale :
$$SE = \frac{\sigma}{\sqrt{n}}$$
Cette relation établit que la variabilité de nos estimations diminue proportionnellement à la racine carrée du volume de l’échantillon, posant le fondement mathématique absolu qui autorise l’induction scientifique universelle.
8.2 Estimation par intervalle de confiance
En raison de l’inévitabilité de la fluctuation d’échantillonnage, fournir une simple estimation ponctuelle du paramètre de population (par exemple affirmer que « la moyenne du niveau d’anxiété dans la population est de 42,3 » parce que notre échantillon a produit ce score précis) s’avère méthodologiquement insuffisant et trompeur. La pratique scientifique moderne exige donc de substituer ou d’adjoindre à l’estimation ponctuelle une estimation par intervalle de confiance, capable de circonscrire la précision de notre mesure et le degré d’incertitude associé.
Un intervalle de confiance (généralement calculé au seuil standard de 95 %) délimite une zone probabiliste calculée à partir des statistiques de l’échantillon, formalisée par la moyenne observée flanquée de sa marge d’erreur :
$$IC_{95%} = \bar{X} \pm (t_{\text{critique}} \times SE)$$
Toutefois, l’interprétation épistémique de l’intervalle de confiance à 95 % est fréquemment entachée d’erreurs d’interprétation grossières chez les praticiens non statisticiens. Il est rigoureusement faux de déclarer qu’« il y a 95 % de chances que le véritable paramètre inconnu $\mu$ de la population se trouve à l’intérieur de l’intervalle calculé pour notre étude spécifique ». Dans le paradigme statistique fréquentiste, le paramètre $\mu$ est une constante fixe : il se trouve ou ne se trouve pas dans l’intervalle donné avec une probabilité binaire de 1 ou 0.
L’exacte interprétation stipule que si l’on répétait à l’infini notre protocole d’échantillonnage dans les mêmes conditions expérimentales et que l’on calculait un intervalle de confiance pour chacun des milliers d’échantillons prélevés, 95 % de l’ensemble de ces intervalles ainsi générés recouvriraient la véritable constante $\mu$ de la population, tandis que 5 % la manqueraient. La largeur même de l’intervalle observé constitue l’indicateur direct de notre incertitude métrique : un intervalle resserré reflète une mesure hautement précise et informative, tandis qu’un intervalle démesurément large signale un sous-calibrage de l’échantillon, incapable d’éclairer utilement la théorie.
8.3 Test d’hypothèse nulle (NHST) et généralisation
L’articulation entre l’échantillon et la population trouve son expression la plus controversée mais la plus institutionnalisée dans le paradigme du test de signification de l’hypothèse nulle (Null Hypothesis Significance Testing – NHST), architecturé par Ronald Fisher, Jerzy Neyman et Egon Pearson. Ce cadre décisionnel confronte une hypothèse nulle par défaut ($H_0$), postulant l’absence totale de différence ou d’effet au sein de la macro-population ($\mu_1 – \mu_2 = 0$), à une hypothèse alternative théorique ($H_1$) prédisant l’existence d’une divergence systématique non nulle.
Le mécanisme logique consiste à calculer la probabilité conditionnelle d’obtenir, par simple hasard d’échantillonnage, une statistique empirique au moins aussi divergente que celle observée dans nos données locales, sous l’hypothèse stricte où l’hypothèse nulle serait véritablement vraie dans la population globale. Cette métrique probabiliste est la célèbre p-value ($p$). Si cette valeur de $p$ se révèle inférieure à un seuil critique conventionnel préalablement assigné (généralement $\alpha = 0,05$), le chercheur conclut au rejet de $H_0$ et à la significativité statistique du résultat, autorisant la généralisation théorique de l’effet à l’échelle de la population cible.
Toutefois, l’épistémologie contemporaine met en garde contre les dérives dogmatiques associées à cette dichotomie binaire significatif/non significatif. Une $p$-value n’informe aucunement sur la magnitude de l’effet, sur sa pertinence concrète, ni sur la probabilité que l’hypothèse de recherche soit théoriquement exacte. Une différence minuscule et dénuée de tout intérêt clinique au niveau psychologique peut aisément franchir le seuil fatidique de $p < 0,001$ dès lors que la taille de l'échantillon devient colossalement vaste, révélant la nécessité impérative de dépasser le carcan du NHST au profit d'une focalisation sur les tailles d'effet et les approches bayésiennes de l'inférence.
9. Erreurs d’échantillonnage versus Erreurs de mesure
9.1 Erreur d’échantillonnage aléatoire
Dans l’architecture de la recherche quantitative, il convient de distinguer avec une rigueur absolue la notion d’erreur d’échantillonnage aléatoire de celle d’erreur de mesure pure. L’erreur d’échantillonnage aléatoire ne découle pas d’une maladresse expérimentale, d’une négligence méthodologique ou d’une défaillance instrumentale de l’investigateur. Elle représente l’écart résiduel, naturel et purement stochastique qui émerge inévitablement du simple fait que les calculs statistiques portent sur une sous-fraction finie du monde au lieu d’intégrer l’ensemble exhaustif des individus de la population parente.
Mathématiquement, l’erreur d’échantillonnage s’exprime par la distance arithmétique séparant la statistique observée de l’échantillon du paramètre théorique sous-jacent :
$$\epsilon = \bar{X} – \mu$$
En vertu des lois fondamentales de la probabilité, les erreurs d’échantillonnage aléatoires obéissent à une distribution d’attente nulle ($E(epsilon) = 0$). Elles sont bidirectionnelles : dans certains tirages, l’échantillon surévaluera légèrement la moyenne réelle ; dans d’autres, il la sous-évaluera avec une amplitude et une fréquence rigoureusement équivalentes, s’annulant mutuellement sur le plan asymptotique.
La caractéristique cardinale de l’erreur d’échantillonnage aléatoire réside dans sa réductibilité mathématique directe. Comme l’indique la formule de l’erreur type, la marge d’erreur d’un échantillon est inversement proportionnelle à la racine carrée de sa taille ($1/\sqrt{n}$). Par conséquent, le chercheur dispose d’un levier d’action opérationnel universel pour juguler cette erreur aléatoire : accroître le volume d’observations. Quadrupler le nombre de participants réduit ainsi mécaniquement de moitié l’ampleur de l’erreur d’échantillonnage aléatoire, rapprochant l’estimateur de sa cible asymptotique.
9.2 Erreurs systématiques indépendantes de l’échantillonnage
À l’opposé de la nature stochastique et auto-compensatrice de l’erreur d’échantillonnage, les erreurs systématiques indépendantes de l’échantillonnage (ou erreurs de mesure et biais méthodologiques) constituent les menaces les plus pernicieuses pour l’édifice scientifique. Une erreur systématique est une distorsion directionnelle constante, invariante et cumulative, qui tire les données de manière unidirectionnelle et délibérée à l’écart de la réalité du paramètre sous-jacent, indépendamment de toute considération de taille d’échantillon.
Ces défaillances trouvent leur source dans une multitude de vulnérabilités méthodologiques :
- Défauts psychométriques structurels des échelles d’évaluation, caractérisés par une mauvaise validité de contenu, des formulations d’items équivoques ou une instabilité temporelle du coefficient de fidélité test-retest.
- Biais de réponse universels chez les sujets humains, au premier rang desquels figure le biais de désirabilité sociale, l’acquiescement systématique (tendance à valider systématiquement les énoncés) ou les effets d’ancrage contextuels.
- Effets d’attente de l’expérimentateur (effet Pygmalion) et failles dans le protocole de double aveugle, où l’attitude inconsciente de l’évaluateur oriente insidieusement les comportements des participants.
- Erreurs de codage, pertes de calibration des dispositifs de neuro-imagerie fonctionnelle ou algorithmes de traitement du signal hémodynamique défaillants.
Le péril épistémologique absolu de ces erreurs systématiques réside dans le fait dramatique qu’aucune augmentation de la taille de l’échantillon ne peut les corriger. Interroger 50 000 participants à l’aide d’un questionnaire mal calibré et vicié par la désirabilité sociale ne fait que produire une estimation extraordinairement précise d’une valeur totalement fausse. L’erreur systématique confère une certitude statistique aveugle à l’erreur scientifique, ce que l’adage informatique résume sous la maxime impitoyable : « Garbage in, garbage out ».
9.3 Arbitrage entre validité interne et validité externe
La dialectique continue entre la maîtrise des erreurs de mesure et la quête de représentativité populationnelle met en lumière un conflit épistémologique historique théorisé par Donald Campbell : l’arbitrage structurel et inévitable entre la validité interne et la validité externe du protocole expérimental.
Pour maximiser la validité interne — c’est-à-dire l’assurance inébranlable que les variations observées sur la variable dépendante sont formellement et exclusivement causées par la manipulation de la variable indépendante —, le chercheur est contraint d’ériger un contrôle expérimental draconien. Cela implique une homogénéisation quasi chirurgicale de l’échantillon via des critères d’exclusion multiples, le confinement des sujets dans des laboratoires insonorisés, et la standardisation millimétrée de stimuli décontextualisés. Ce faisant, le chercheur réduit drastiquement l’erreur systématique et le bruit de mesure local, mais son échantillon devient une anomalie sociologique ne ressemblant à aucune population du monde réel.
Inversement, privilégier d’emblée la validité externe — la capacité de généraliser immédiatement les conclusions à l’hétérogénéité des populations naturelles dans leur écologie quotidienne — impose d’échantillonner des profils humains complexes, diversifiés et désordonnés, au sein d’environnements ouverts et non contrôlés. Si cette approche garantit une excellente résonance avec la macro-population cible, elle dilue la force du signal causal dans un océan de variance résiduelle non contrôlée et d’erreurs de mesure parasites.
La recherche contemporaine ne cherche plus à trancher brutalement ce dilemme par un choix exclusif, mais préconise des stratégies séquentielles de recherche. Ces architectures programmatiques initient les explorations par des phases expérimentales ultra-contrôlées en laboratoire sur échantillons homogènes pour valider l’existence du mécanisme causal fondamental (priorité à la validité interne), avant de déployer des études de réplication à grande échelle au sein de cohortes cliniques diversifiées et d’environnements ouverts pour en asseoir l’universalité populationnelle (priorité à la validité externe).
10. Détermination de la taille de l’échantillon et puissance statistique
10.1 Taille d’effet attendue et pertinence clinique
La détermination scientifique du volume d’un échantillon ne saurait en aucun cas relever d’une approximation empirique, d’une habitude transmise entre générations de chercheurs ou d’un compromis arbitraire d’opportunité. Elle doit impérativement découler d’un calcul méthodique d’ingénierie statistique a priori, fondé au premier chef sur l’estimation rigoureuse de la taille d’effet attendue (effect size). La taille d’effet constitue la métrique standardisée quantifiable de la magnitude, de la puissance ou de l’intensité concrète de la relation unissant les variables au sein de la population parente.
Parmi les indices de taille d’effet les plus répandus dans la littérature psychologique et biomédicale, on compte :
- Le d de Cohen pour les écarts entre deux moyennes indépendantes (différenciant les effets faibles avec $d \approx 0,20$, modérés avec $d \approx 0,50$, et puissants avec $d \geq 0,80$).
- Le coefficient de corrélation linéaire $r$ de Pearson pour les patterns d’association continue.
- L’êta-carré partiel ($\eta_p^2$) ou l’oméga-carré ($\omega^2$) dans le cadre des analyses de variance (ANOVA).
- Le rapport de cotes (Odds Ratio – OR) en épidémiologie psychiatrique et en analyse de régression logistique.
Il est décisif d’opérer une distinction conceptuelle fondamentale entre la signification statistique d’un effet et sa pertinence clinique (ou sociale). Une différence mesurée sur une échelle de mémoire équivalant à un gain de 0,5 % peut s’avérer hautement significative sur le plan statistique au sein d’un méga-échantillon de 20 000 participants, tout en présentant un impact clinique rigoureusement nul pour le fonctionnement quotidien d’un patient souffrant d’amnésie. Le calibrage a priori d’une recherche doit toujours s’indexer sur la taille d’effet minimale présentant un intérêt pratique concret et significatif pour la théorie ou pour l’action thérapeutique.
10.2 Régulation des erreurs de type I et de type II
La dynamique formelle de l’inférence statistique au sein du paradigme neyman-pearsonien est régie par l’arbitrage structurel entre deux typologies d’erreurs probabilistes mutuellement entrelacées :
L’Erreur de type I (ou risque $\alpha$) correspond au rejet tragique d’une hypothèse nulle qui est pourtant fondamentalement vraie dans la population. C’est l’erreur du « faux positif » : le chercheur s’enthousiasme pour la découverte d’un effet thérapeutique ou cognitif qui n’est en réalité qu’une illusion stochastique produite par un hasard d’échantillonnage malheureux. Par convention quasi sacralisée dans l’ensemble de la littérature académique internationale, le seuil de tolérance maximale pour l’erreur de type I est strictement bridé à $\alpha = 0,05$ (ou 5 %).
L’Erreur de type II (ou risque $\beta$) survient à l’inverse lorsqu’un chercheur échoue à rejeter une hypothèse nulle qui est pourtant fondamentalement fausse dans la macro-population. C’est l’erreur du « faux négatif » : un mécanisme théorique réel ou une molécule pharmacologique authentiquement efficace passe totalement inaperçu sous le radar de l’investigateur en raison d’une sensibilité métrique défaillante. La puissance statistique, formalisée par l’expression complémentaire :
$$\text{Puissance} = 1 – \beta$$
représente la probabilité exacte que le protocole expérimental détecte formellement un effet d’une ampleur donnée si cet effet existe bel et bien au sein de la population. Les standards contemporains exigent une puissance minimale de 0,80 (soit une tolérance de $\beta = 0,20$), bien que les plans de recherche les plus rigoureux visent désormais une puissance optimale de 0,90 voire 0,95.
L’histoire de la psychologie a tristement documenté les ravages scientifiques induits par l’oubli méthodologique de la puissance statistique. Des centaines d’études ont historiquement été conduites avec des échantillons dramatiquement sous-dimensionnés (des cohortes de 15 à 20 sujets par condition), générant des puissances statistiques effectives ne dépassant pas 0,20 à 0,35 pour la détection d’effets modérés. Cette sous-puissance chronique engendre une cascade de conséquences dévastatrices : multiplication de faux négatifs massifs, mais également et surtout surestimation spectaculaire des tailles d’effet des rares résultats significatifs publiés par le mécanisme dit de « la malédiction du vainqueur » (winner’s curse), constituant le combustible historique primordial de la dramatique crise de reproductibilité des sciences comportementales.
10.3 Analyse de puissance a priori via logiciels spécialisés
Pour éliminer définitivement l’arbitraire lors de la phase de conception d’une recherche, les standards méthodologiques actuels imposent la réalisation systématique d’une analyse de puissance statistique a priori, intégrée et formalisée dans les dossiers de demande de financement éthique et institutionnel. Cette démarche analytique permet de déduire par le calcul formel le nombre minimal précis d’unités d’observation qu’il est indispensable d’intégrer à l’échantillon pour garantir la détection statistique d’un effet présumé avec un niveau de confiance fixé d’avance.
Cette modélisation computationnelle mobilise des outils logiciels de référence ouverts et homologués par la communauté internationale, au premier rang desquels figure le logiciel G*Power développé par l’Université de Düsseldorf, ou des bibliothèques algorithmiques dédiées sous l’environnement R (telles que le paquetage pwr). Le paramétrage rigoureux d’une analyse a priori réclame l’injection délibérée de quatre paramètres fondamentaux interdépendants :
- La nature spécifique du test statistique projeté (Test $t$ de Student pour échantillons indépendants, régression linéaire multiple, ANOVA factorielle à mesures répétées, modèle de survie).
- Le seuil de significativité critique retenu (typiquement $\alpha = 0,05$).
- La puissance statistique minimale ciblée par l’équipe (par exemple $1 – \beta = 0,80$ ou $0,90$).
- La taille d’effet prévisionnelle standardisée minimale attendue dans la population, soigneusement estimée à partir d’une méta-analyse antérieure ou de considérations cliniques théoriques strictes.
Si l’on postule un effet modéré de $d = 0,50$ au sein d’un test $t$ bilatéral pour deux groupes indépendants, le logiciel G*Power démontre de façon imparable qu’il est rigoureusement impératif de recruter un effectif minimal de $n = 64$ participants par groupe, soit une cohorte totale consolidée de 128 individus. Tenter de réaliser ce même protocole expérimental avec un effectif de 20 participants par condition relève d’une abdication méthodologique totale, condamnant la recherche à une sous-puissance statistique fatale et invalidant par avance toute inférence prétendant dialoguer avec la réalité de la population cible.
11. Études de cas appliquées en psychologie : Modèles d’échantillonnage
11.1 Essais contrôlés randomisés en psychothérapie
L’investigation de l’efficacité d’une modalité psychothérapeutique inédite au sein d’un essai contrôlé randomisé (ECR ou Randomized Controlled Trial) constitue une illustration emblématique des tensions inhérentes à la définition des populations et des échantillons. Dans cette architecture méthodologique rigoureuse, le chercheur s’adresse théoriquement à la population globale des personnes souffrant d’une entité nosologique circonscrite, telle que le Trouble Dépressif Majeur.
Le protocole de sélection s’amorce par la mise en œuvre de critères d’inclusion et d’exclusion drastiques dans la population accessible afin de constituer un échantillon homogène : diagnostic validé par entretien standardisé (comme la MINI ou le SCID), seuil minimal de sévérité symptomatique sur l’échelle de Hamilton, exclusion des comorbidités psychotiques, addictives ou suicidaires aiguës. Une fois le consentement libre et éclairé formellement paraphé, les participants composant cet échantillon sont distribués par assignation aléatoire (randomisation en blocs stratifiés) entre la condition thérapeutique expérimentale et une condition de contrôle active ou liste d’attente.
La randomisation n’agit pas ici sur le prélèvement de la population vers l’échantillon (qui demeure non probabiliste dans son recrutement), mais opère à l’intérieur même de l’échantillon pour neutraliser les variables confondantes préexistantes entre les bras expérimentaux. Dès lors, le chercheur jouit d’une exceptionnelle validité interne lui permettant d’affirmer avec certitude que les bénéfices psychiques observés dans son échantillon résultent des ingrédients actifs de la psychothérapie testée. Toutefois, la question de la généralisabilité de ces conclusions à la macro-population réelle des patients de santé publique — souvent polymorbides, sous polymédication et confrontés à des précarités socioéconomiques exclues du protocole expérimental — demeure le champ de confrontation théorique permanent séparant les essais d’efficacité (en conditions idéales de laboratoire) des essais d’effectivité (en conditions pragmatiques de vie réelle).
11.2 Recherches en neurosciences cognitives par imagerie
Le champ des neurosciences cognitives contemporaines s’appuyant sur l’imagerie par résonance magnétique fonctionnelle (IRMf) illustre de manière spectaculaire les risques méthodologiques liés aux contraintes matérielles d’échantillonnage. En raison des coûts financiers exorbitants inhérents à l’acquisition du temps de scanner (fréquemment de 600 à 1 000 euros par heure d’examen), de la lourdeur des analyses physiques et du temps de traitement informatique requis pour le pré-traitement des signaux BOLD (Blood-Oxygen-Level Dependent), l’immense majorité des études publiées au cours des deux décennies passées s’appuyait sur des échantillons de convenance extrêmement ténus, oscillant traditionnellement entre 12 et 25 participants seulement.
Comme l’a formellement mis en lumière la méta-analyse retentissante de Katherine Button et ses collaborateurs en 2013, ces cohortes minuscules ont plongé les neurosciences cognitives dans un marasme statistique structurel caractérisé par une puissance moyenne médiane d’environ 20 %. Dans ce contexte, la découverte fortuite d’un « cluster d’activation statistiquement significatif » dans le cortex cingulaire antérieur lors d’une tâche de régulation affective relève souvent de l’artefact d’échantillonnage amplifié par le problème des comparaisons multiples à travers les dizaines de milliers de voxels cérébraux analysés en parallèle.
Cette impasse méthodologique a contraint le domaine de la neuro-imagerie à une révolution paradigmatique sans précédent. La reconnaissance collective de l’incapacité d’un échantillon de 20 individus à modéliser adéquatement les paramètres neurofonctionnels de l’espèce humaine a sonné le glas des petites cohortes de laboratoire isolées. Elle a impulsé l’avènement historique des consortiums internationaux et des « méga-bases de données » neurobiologiques ouvertes, à l’image du projet Human Connectome Project ou de l’UK Biobank, qui mettent à disposition de la communauté mondiale des banques d’imagerie cérébrale standardisées collectées sur des dizaines de milliers d’individus représentatifs de vastes populations démographiques.
11.3 Enquêtes épidémiologiques en santé mentale publique
À l’opposé des protocoles de laboratoire à micro-cohortes, l’épidémiologie psychiatrique et les agences nationales de veille sanitaire déploient des modèles d’échantillonnage probabiliste hautement sophistiqués pour estimer les taux de prévalence réels des troubles mentaux à l’échelle de populations entières. Un cas d’école emblématique s’incarne dans les enquêtes mondiales sur la santé mentale patronnées par l’Organisation Mondiale de la Santé (le projet World Mental Health Survey).
Pour parvenir à radiographier fidèlement l’état de souffrance psychique de populations comptant des dizaines de millions d’âmes sans céder aux biais déformants, ces enquêtes mettent en œuvre des plans d’échantillonnage aréolaire stratifié à plusieurs degrés. À la première étape, des unités territoriales primaires (régions ou départements) sont sélectionnées de manière stratifiée en fonction de leur densité de population et de leur niveau d’urbanisation. Au deuxième degré, des unités géographiques plus restreintes (communes, quartiers, îlots cadastraux) sont tirées au sort au sein de chaque strate géographique. Au troisième degré, des adresses d’habitation précises sont extraites aléatoirement des répertoires cadastraux officiels. Enfin, au quatrième degré, l’enquêteur identifie l’ensemble des résidents du foyer et utilise une table de randomisation standardisée (comme la méthode de Kish) pour désigner un seul et unique membre éligible qui passera l’évaluation clinique.
L’achèvement de ces protocoles herculéens ne s’arrête pas au recueil de terrain. Les épidémiologistes appliquent ensuite des pondérations statistiques correctives multidimensionnelles fondées sur l’inverse de la probabilité de sélection de chaque répondant individuel, couplées à des algorithmes de redressement pour compenser le taux inévitable de non-réponse et de refus initial. Grâce à cette armature méthodologique rigoureuse, les taux de prévalence annuels ou sur la vie entière de la dépression majeure, des troubles anxieux ou des dépendances addictives dérivés de ces échantillons de 10 000 à 20 000 sujets constituent des reflets d’une exactitude scientifique inégalée des paramètres de la population globale, guidant avec précision les décisions de politique publique et l’allocation des budgets sanitaires étatiques.
12. Cadre décisionnel et recommandations pour la pratique de recherche
12.1 Matrice décisionnelle pour le choix de la méthode d’échantillonnage
Afin de guider rationnellement le chercheur dans le dédale des méthodologies envisageables lors de la genèse d’un protocole expérimental, il est opportun de formaliser une matrice décisionnelle séquentielle articulant les finalités épistémiques fondamentales du projet aux contraintes pragmatiques matérielles. Le choix d’une architecture d’échantillonnage ne doit jamais résulter de la simple commodité, mais d’un alignement parfait entre la question théorique, les ressources allouées et le niveau de transférabilité statistique requis.
Le processus décisionnel peut s’articuler autour d’interrogations programmatiques clés :
- La recherche vise-t-elle l’exploration théorique qualitative ou l’estimation quantitative ? Dans le premier cas, un échantillonnage intentionnel ou théorique saturé s’avère optimal. Dans le second cas, l’impératif probabiliste s’impose d’emblée.
- Existe-t-il une base de sondage nominative, exhaustive et fiable de la population d’intérêt ? En cas de réponse affirmative, l’échantillonnage aléatoire simple ou stratifié proportionnel représente la voie royale incontournable. En l’absence de base de sondage nominative globale, le chercheur doit bifurquer vers l’échantillonnage en grappes ou à plusieurs degrés s’il s’agit d’une population institutionnelle (écoles, hôpitaux), ou vers des protocoles de type Respondent-Driven Sampling (RDS) s’il explore une population marginalisée ou dissimulée.
- Les sous-groupes minoritaires doivent-ils faire l’objet de comparaisons statistiques indépendantes ? Si tel est le cas, le chercheur doit renoncer au tirage purement proportionnel pour adopter sans hésitation un plan d’échantillonnage stratifié non proportionnel avec sur-échantillonnage délibéré, en prévoyant explicitement dans son plan de traitement analytique les coefficients de pondération d’inverse de probabilité pour les synthèses populationnelles ultérieures.
Le tableau analytique ci-dessous synthétise la typologie comparée des architectures d’échantillonnage selon leurs caractéristiques structurelles fondamentales :
| Méthode d’échantillonnage | Nature probabiliste | Base de sondage requise | Niveau de validité externe | Coût et complexité logistique |
|---|---|---|---|---|
| Aléatoire simple | Oui | Indispensable et exhaustive | Maximale | Élevé à très prohibitif |
| Stratifié proportionnel | Oui | Exhaustive avec variables de strates | Optimale (variance réduite) | Très élevé |
| En grappes | Oui | Liste des grappes uniquement | Intermédiaire (effet de plan) | Modéré à maîtrisé |
| Par quotas | Non | Non (structure marginale seule) | Faible à suspecte | Modéré |
| De convenance | Non | Absente | Minimale à nulle | Très faible |
| Boule de neige | Non | Absente (populations cachées) | Restreinte au réseau | Faible à moyen |
12.2 Standardisation du reporting selon les normes APA
L’édification d’une science cumulative et reproductible dépend directement de la transparence absolue déployée par les auteurs dans la restitution écrite de leurs protocoles d’échantillonnage. Les recommandations méthodologiques standardisées édictées par l’American Psychological Association dans son manuel de style (7e édition), à travers les normes JARS (Journal Article Reporting Standards), exigent un niveau de granularité documentaire exhaustif et sans complaisance au sein de la section « Méthode » de tout manuscrit soumis à évaluation par les pairs.
Les chercheurs ont le devoir académique impérieux de documenter scrupuleusement les axes suivants :
- Délimitation précise de la population cible et de la population accessible : Spécification intégrale des critères formels d’inclusion et d’exclusion diagnostiques, démographiques, linguistiques et physiologiques.
- Procédure exacte de recrutement : Déclaration sans artifice de la méthode d’échantillonnage mise en œuvre (convenance, quotas, tirage au sort informatique, etc.), du lieu physique, institutionnel ou numérique de sollicitation, et de l’existence éventuelle d’incitations financières, matérielles ou pédagogiques proposées aux participants.
- Flux des participants et attrition détaillée : Présentation systématique d’un diagramme de flux conforme aux exigences du protocole CONSORT (pour les essais randomisés), énumérant précisément le nombre d’individus sollicités, le nombre de sujets ayant refusé de participer, les exclusions sur critères préalables, le nombre final de participants inclus, ainsi que le décompte exact et les motifs circonstanciés des défections, abandons ou pertes de vue survenus lors des vagues de suivi successives.
- Caractéristiques sociodémographiques complètes : Description de la distribution de l’âge (moyenne, écart-type, médiane et étendue), de la répartition biologique du sexe et de l’identité de genre, de l’origine ethno-culturelle autodéclarée, du niveau d’éducation formelle et du statut socio-économique des participants pour permettre au lecteur d’évaluer concrètement l’indice de représentativité globale du panel.
- Justification a priori de la taille de la cohorte : Restitution transparente de l’analyse de puissance computationnelle menée en amont, stipulant le logiciel exploité, les valeurs attribuées à $\alpha$ et $1 – \beta$, la taille d’effet minimale attendue étayée par la littérature, et la démonstration formelle de l’adéquation de l’effectif recruté avec ces impératifs d’inférence.
Parallèlement, la section « Discussion » de l’article doit impérativement comporter une sous-partie dédiée aux limites de validité externe. Les chercheurs doivent y expliciter avec une honnêteté intellectuelle rigoureuse les entraves pesant sur la généralisation de leurs résultats, en interrogeant explicitement l’impact potentiel des caractéristiques spécifiques de leur échantillon local sur la portée théorique des conclusions énoncées.
12.3 Perspectives futures : Échantillonnage numérique et science ouverte
L’ère contemporaine est le théâtre d’une métamorphose radicale des pratiques de collecte de données en sciences comportementales et sociales, sous la double impulsion de la numérisation globale des interactions humaines et de l’essor institutionnel du mouvement pour la Science Ouverte (Open Science). Le recrutement empirique s’est massivement déplacé des laboratoires universitaires physiques vers des plateformes participatives numériques en ligne hautement automatisées, telles que Prolific Academic, Amazon Mechanical Turk (MTurk) ou CloudResearch.
Ces plateformes en ligne offrent aux équipes de recherche un pouvoir opérationnel sans précédent dans l’histoire des sciences : la capacité de mobiliser en quelques heures des milliers de participants diversifiés, d’accéder instantanément à des strates démographiques réparties sur plusieurs continents, et d’administrer des protocoles psychométriques complexes pour une fraction dérisoire des coûts logistiques d’antan. Néanmoins, cette abondance numérique recèle de nouveaux périls méthodologiques de premier ordre. Les chercheurs se trouvent désormais confrontés à la prolifération de participants professionnels ultra-rompus aux paradigmes classiques de psychologie, à l’intervention de « fermes de clics », ou encore à l’utilisation frauduleuse d’algorithmes et de modèles de langage d’intelligence artificielle générative répondant automatiquement aux questionnaires sans conscience humaine réelle. Ces dérives imposent l’incorporation systématique de tests de vérification de l’attention rigoureux (attention checks), de filtres temporels impitoyables et de protocoles de détection algorithmique des incohérences syntaxiques.
Conjointement, le paradigme de la Science Ouverte apporte des réponses structurales indispensables pour assainir durablement la relation épistémique unissant la population à l’échantillon. Le déploiement institutionnel du préenregistrement des protocoles (preregistration) sur des plateformes dédiées comme le Center for Open Science (OSF) contraint désormais les équipes de recherche à déposer publiquement leur plan d’échantillonnage, leur calcul formel de taille d’effectif a priori et leurs règles d’exclusion de données avant même l’inclusion du tout premier participant. Ce verrouillage institutionnel en amont interdit formellement les pratiques de manipulation méthodologique opportunistes (telles que le p-hacking, le HARKing ou l’échantillonnage opportuniste consistant à arrêter la collecte au moment précis où le résultat devient significatif sous le seuil $\alpha$).
Enfin, la mutualisation transnationale des micro-données brutes au sein d’entrepôts ouverts et vérifiables (data sharing) permet aux méta-analystes de compiler, de fusionner et d’agréger les échantillons restreints issus d’une multitude de laboratoires indépendants à travers le monde. Cette mutualisation collaborative transforme des fragments de microcosmes empiriques jadis dispersés et fragiles en de vastes corpus harmonisés de macro-données, rapprochant plus que jamais l’investigation empirique moderne de son horizon de référence : la compréhension objective, universelle, rigoureuse et émancipatrice de la population humaine globale dans l’intégralité de sa foisonnante complexité.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Button, K. S., Ioannidis, J. P., Mokrysz, C., Nosek, B. A., Flint, J., Robinson, E. S., & Munafò, M. R. (2013). Power failure: Why small sample size undermines the reliability of neuroscience. Nature Reviews Neuroscience, 14(5), 365–376. https://doi.org/10.1038/nrn3475
- Campbell, D. T., & Stanley, J. C. (1966). Experimental and quasi-experimental designs for research. Rand McNally.
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2-3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Ioannidis, J. P. (2005). Why most published research findings are false. PLoS Medicine, 2(8), Article e124. https://doi.org/10.1371/journal.pmed.0020124
- Kish, L. (1965). Survey sampling. John Wiley & Sons.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Nosek, B. A., Alter, G., Banks, G. C., Borsboom, D., Bowman, S. D., Breckler, S. J., Buck, S., Chambers, C. D., Chin, G., Christensen, G., Contestabile, M., Dafoe, A., Eich, E., Freese, J., Glennerster, R., Goroff, D., Green, D. P., Hesse, B., Humphreys, M., … Yarkoni, T. (2015). Promoting an open research culture. Science, 348(6242), 1422–1425. https://doi.org/10.1126/science.aab2374
- Rosenthal, R., & Rosnow, R. L. (1975). The volunteer subject. John Wiley & Sons.
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin.