
Dans la conduite de la recherche scientifique, qu’elle s’enracine dans les stations agronomiques expérimentales, les laboratoires de neurosciences cognitives ou les unités de recherche clinique, la planification expérimentale représente la clé de voûte de la validité inférentielle. Dès l’instant où un chercheur cherche à évaluer simultanément l’impact de plusieurs variables indépendantes sur une variable réponse, l’idéal théorique promu par la statistique classique préconise l’utilisation d’un plan factoriel complètement randomisé. Dans un tel dispositif, chaque combinaison de traitements est assignée de manière purement aléatoire et indépendante à des unités expérimentales homogènes. Cependant, la confrontation avec la réalité du terrain, qu’il s’agisse de la lourdeur logistique d’un matériel agricole, du coût prohibitif d’un changement de configuration industrielle ou de l’irréversibilité de certains états physiologiques chez des sujets humains, fait voler en éclats cette belle simplicité géométrique.
C’est précisément pour surmonter cette aporie pratique qu’a été forgé le plan en parcelles divisées, universellement désigné sous son appellation anglophone de split-plot design. Conçu initialement pour résoudre des contraintes physiques d’application de traitements à grande échelle dans les champs agricoles, ce dispositif méthodologique s’est imposé comme l’un des monuments les plus féconds de la statistique appliquée. Sa particularité réside dans l’introduction délibérée et rigoureusement modélisée d’une hiérarchie d’unités expérimentales et d’une double randomisation, rompant avec le dogme de l’indépendance globale des observations au profit d’une structure d’erreur multiniveau élégante et extraordinairement puissante.
Comprendre le plan split-plot ne se résume pas à maîtriser une variante technique de l’analyse de variance (ANOVA) ; cela exige une véritable plongée dans l’épistémologie de la causalité expérimentale, la structure des variances résiduelles et la théorie des modèles linéaires mixtes. Le présent traité méthodologique propose une exploration exhaustive de cette architecture expérimentale : depuis ses origines historiques à la station de Rothamsted sous la direction de Sir Ronald Fisher jusqu’à ses transpositions contemporaines dans les neurosciences et la psychologie comportementale (sous la forme des plans mixtes dits between-within), en passant par sa formulation mathématique, ses pièges inférentiels redoutables telle la pseudo-réplication, et les protocoles stricts guidant sa mise en œuvre.
1. Introduction fondamentale aux plans en parcelles divisées (split-plot)
1.1 Définition conceptuelle et taxonomie expérimentale
Le plan en parcelles divisées, ou split-plot design, se définit conceptuellement comme un dispositif expérimental multifactoriel caractérisé par une structure hiérarchique et emboîtée des unités expérimentales, au sein duquel différents facteurs sont appliqués à des unités de tailles distinctes générées par des processus de randomisation séparés. Dans la taxonomie des plans d’expérience, il occupe une place singulière : il ne s’agit ni d’un plan factoriel complètement randomisé, ni d’un simple plan en blocs complets au sens classique, mais d’une hybridation structurelle conçue pour concilier des contraintes d’échelle hétérogènes.
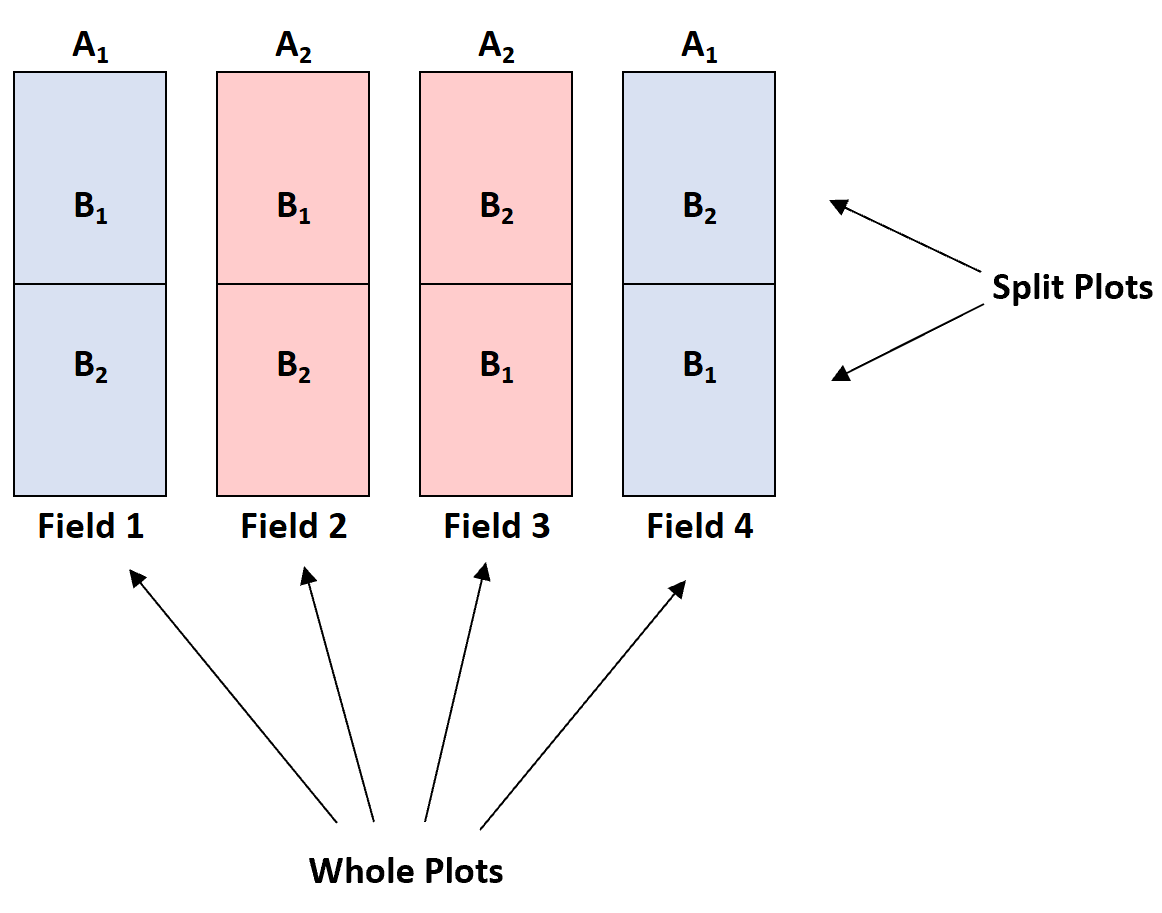
Dans un plan factoriel standard à deux facteurs $A$ et $B$, chaque unité expérimentale élémentaire a une probabilité égale de recevoir n’importe quelle combinaison des niveaux $A_i B_j$. Une telle approche présuppose que les niveaux des deux facteurs peuvent être modifiés, combinés et assignés avec une liberté et une fluidité opérationnelles absolues. Or, dans le plan split-plot, cette interchangeabilité est rompue. Les unités expérimentales primaires, appelées parcelles principales (ou whole-plots), reçoivent l’application d’un premier facteur, tandis que ces unités sont elles-mêmes subdivisées en unités secondaires, dénommées sous-parcelles (ou split-plots), auxquelles sont alloués les niveaux d’un second facteur.
Cette différenciation structurelle découle presque toujours d’une nécessité méthodologique imposée par des contraintes matérielles, économiques ou temporelles insurmontables. Si un facteur exige un appareillage massif, un coût financier exorbitant par changement de réglage ou un volume d’espace considérable, il devient virtuellement impossible d’en changer le niveau à chaque répétition élémentaire. Le plan split-plot résout cette contrainte en acceptant que ce facteur lourd soit appliqué à grande échelle, tout en greffant à l’intérieur de chaque unité ainsi traitée des sous-unités recevant les niveaux d’un facteur beaucoup plus agile et facile à manipuler.
1.2 La double échelle de randomisation
Le principe fondamental qui gouverne et authentifie le plan split-plot réside dans sa double échelle de randomisation. Contrairement à une croyance répandue qui réduirait le split-plot à une simple commodité de collecte de données, il s’agit d’un protocole d’assignation aléatoire à deux phases distinctes et consécutives, régies par des lois probabilistes autonomes mais articulées.
La première phase de randomisation opère au niveau macroscopique : les niveaux du facteur principal sont tirés au sort et attribués aux parcelles principales (ou à des blocs de parcelles principales). À cette étape, l’unité expérimentale est la parcelle principale dans sa globalité. Une fois cette configuration établie, intervient la seconde phase de randomisation, strictement confinée à l’intérieur des frontières de chaque parcelle principale : les niveaux du facteur secondaire sont alors assignés par tirage au sort aux sous-parcelles qui la composent. Il n’existe donc aucune randomisation globale permettant à une sous-parcelle de la parcelle $1$ d’échanger sa condition avec une sous-parcelle de la parcelle $2$ si leurs parcelles d’appartenance ne partagent pas le même niveau du facteur principal.
Les conséquences directes de cette double assignation sur la structure de variance sont considérables. Puisque les sous-parcelles appartenant à une même parcelle principale partagent un environnement commun, des caractéristiques intrinsèques ou une histoire temporelle identique, leurs réponses tendent inévitablement à être positivement corrélées. Dès lors, la variance résiduelle se scinde mathématiquement en deux composantes indépendantes :
- Une variance inter-groupes (ou inter-parcelles principales), qui reflète la variabilité naturelle existant entre les grandes unités expérimentales et sert de terme d’erreur pour tester le facteur principal ;
- Une variance intra-groupe (ou intra-parcelles principales), qui quantifie les fluctuations aléatoires résiduelles entre les sous-parcelles situées au sein d’une même entité macroscopique, servant de terme d’erreur pour le facteur secondaire et son interaction avec le facteur principal.
1.3 Pertinence épistémologique dans les sciences empiriques
D’un point de vue épistémologique, le plan split-plot incarne une réponse sophistiquée à la tension permanente entre la validité interne du laboratoire et la validité écologique du terrain. Dans les sciences empiriques, l’isolation parfaite des variables et la randomisation intégrale constituent souvent un idéal chimérique dont la poursuite aveugle engendre des coûts prohibitifs ou détruit précisément le phénomène que l’on prétend mesurer.
En acceptant formellement l’hétérogénéité des unités et la dépendance contextuelle locale, le split-plot réalise un compromis optimal : il préserve une rigueur déductive irréprochable grâce au contrôle probabiliste des deux strates d’erreur, tout en s’adaptant avec souplesse aux contraintes logistiques du monde réel. Cette pertinence explique pourquoi le dispositif a transcendé son berceau originel pour essaimer dans l’ensemble des sciences appliquées. Initialement forgé pour évaluer l’interaction entre les grands modes de labourage et les engrais chimiques, il a été réapproprié par le génie des procédés industriels (fours de traitement thermique abritant différentes pièces usinées), l’écologie des communautés (macro-habitats fragmentés soumis à des micro-interventions) et, de manière spectaculaire, les sciences du comportement.
Dans ces dernières, le passage du champ agricole à l’esprit humain s’est opéré par une analogie fonctionnelle parfaite : l’individu ou le groupe clinique est devenu la parcelle principale, porteuse de caractéristiques stables et difficiles à modifier, tandis que la succession des stimuli cognitifs ou des mesures répétées dans le temps constitue la trame des sous-parcelles. Ce glissement historique témoigne de la fécondité universelle d’un concept qui a su mathématiser l’inévitable hiérarchie du réel.
2. Origines historiques et fondements méthodologiques selon Ronald Fisher
2.1 Le contexte agronomique de Rothamsted en 1925
Pour appréhender la mécanique intime du split-plot, il est indispensable de se replacer dans l’effervescence intellectuelle de la station agronomique de Rothamsted, en Angleterre, au début des années 1920. C’est en ce lieu mythique que Sir Ronald Aylmer Fisher révolutionna à jamais la statistique moderne en publiant en 1925 son œuvre magistrale, Statistical Methods for Research Workers, suivie de The Design of Experiments en 1935.
À cette époque, les agronomes de Rothamsted faisaient face à des impasses logistiques récurrentes. L’étude conjointe de facteurs agronomiques exigeait souvent de combiner des interventions mécaniques lourdes — telles que la profondeur de labourage par traction à vapeur ou l’irrigation par canalisation — avec des interventions manuelles ou chimiques légères, comme le dosage de superphosphates ou le semis de différentes variétés de céréales. Modifier la profondeur de labourage parcelle par parcelle sur des bandes de quelques mètres carrés était techniquement absurde et matériellement irréalisable, car les charrues nécessitaient de longues distances pour manœuvrer. La randomisation complète d’un plan factoriel aurait imposé des centaines de changements de réglages de machines, menant à une explosion des coûts et à des bordures de parcelles labourées chaotiques faussant les résultats.
Face à cette aporie, Fisher formalisa une solution théorique audacieuse : renoncer à l’uniformité de l’échelle expérimentale. Il proposa d’appliquer les labours mécaniques sur de grandes bandes de terre homogènes, puis de diviser transversalement chacune de ces bandes en parcelles secondaires plus petites recevant les différentes variétés végétales ou engrais. En dérivant les fondements mathématiques de l’analyse de variance appliquée à ces structures parcellaires gigognes, Fisher venait de donner naissance au premier plan en parcelles divisées.
2.2 L’évolution de la théorie des plans d’expérience
L’introduction du plan split-plot par Fisher a marqué une rupture épistémologique majeure avec le dogme alors dominant de la randomisation totale uniforme. Jusqu’alors, la doctrine statistique stipulait que l’inférence causale valide reposait exclusivement sur une assignation aléatoire indépendante et identiquement distribuée de chaque traitement unitaire. Fisher a démontré avec éclat que la randomisation n’était pas nécessairement un processus plat et isotrope, mais qu’elle pouvait être stratifiée pour refléter la structure des hétérogénéités spatiales du terrain.
Cette percée a conduit à la formalisation mathématique de ce que l’on nomme aujourd’hui les strates d’erreur (error strata). Fisher a compris que l’hétérogénéité spatiale d’un sol agricole n’est pas un bruit blanc amorphe : deux bandes de terre adjacentes au sein d’une même zone partagent une fertilité, une humidité et une composition microbienne plus proches que deux bandes situées aux extrémités opposées du domaine. Dès lors, vouloir agréger toutes les variations résiduelles au sein d’un dénominateur unique revenait à commettre une faute logique lourde, conduisant à masquer des effets réels ou à gonfler artificiellement la significativité statistique.
La péréquation subtile entre la théorie mathématique de l’échantillonnage et les contraintes mécaniques du terrain a ainsi établi qu’une expérience bien conçue ne force pas la nature à se plier à un modèle mathématique simpliste, mais enrichit le formalisme statistique pour épouser fidèlement l’architecture physique des contraintes expérimentales.
2.3 Héritage et modernisation du concept
Au fil des décennies qui ont suivi les découvertes de Fisher, le concept de split-plot s’est émancipé de ses oripeaux purement agricoles pour faire l’objet de généralisations mathématiques spectaculaires. Les travaux de statisticiens éminents tels que Frank Yates, George Box et Oscar Kempthorne ont formalisé la décomposition des espérances des carrés moyens (Expected Mean Squares), clarifiant les règles d’attribution des tests d’hypothèse pour une myriade de configurations complexes, incluant les plans en parcelles sous-divisées (split-split-plot) et les plans en bandes croisées (strip-plot).
À partir des années 1970 et 1980, l’avènement de l’informatique statistique a propulsé le dispositif dans l’ère moderne des modèles linéaires généralisés à effets mixtes (GLMM). Les chercheurs ont réalisé que le split-plot représentait le cas particulier le plus élégant d’un modèle hiérarchique linéaire comportant des effets fixes (les traitements dont on souhaite mesurer l’impact systématique) et des effets aléatoires (les parcelles ou sujets tirés au sort dans une population plus vaste). Cette modernisation a permis de dépasser les limitations rigides de l’ANOVA traditionnelle sur données équilibrées pour traiter avec une rigueur statistique optimale des jeux de données marqués par des valeurs manquantes, des distributions non gaussiennes ou des structures d’autocorrélation complexes.
3. Les deux niveaux de facteurs : Facteur difficile vs facteur facile à modifier
3.1 Typologie du facteur principal (difficile à modifier)
Au cœur de la structure binaire d’un plan split-plot se trouve une asymétrie opérationnelle fondamentale entre deux types de variables explicatives. La première catégorie correspond au facteur principal, couramment désigné dans la littérature d’ingénierie et d’optimisation expérimentale sous le terme de facteur Hard-to-Change (HTC). Cette variable se singularise par l’impossibilité ou l’extrême difficulté pratique de modifier ses niveaux de manière dynamique, rapide ou économique au fil des essais successifs.
Les sources de cette rigidité sont multiples et dépendent étroitement du domaine d’application :
- L’inertie temporelle et thermique : dans un procédé métallurgique ou céramique, modifier la température d’un four industriel de cuisson de $800,^circ\text{C}$ à $1200,^circ\text{C}$ exige des heures de chauffe ou de refroidissement avant d’atteindre un état d’équilibre stationnaire ;
- Le coût financier prohibitif : le nettoyage, la vidange et le reparamétrage d’une cuve de bioréacteur de plusieurs milliers de litres pour changer le type de substrat fermentaire représente un coût d’arrêt de production majeur ;
- La nature intrinsèque ou spatiale de l’unité : en agronomie, l’installation d’un réseau d’irrigation goutte-à-goutte lourd ne peut être réaménagée d’un mètre carré à l’autre ; en recherche médicale ou humaine, l’appartenance d’un patient à un groupe d’âge, un sexe ou une catégorie clinique pathologique est un état fixé et immuable.
Dans l’architecture du split-plot, ce facteur contraignant est assigné de manière exclusive à l’unité expérimentale de premier niveau, la parcelle principale. De fait, le chercheur choisit délibérément de minimiser le nombre de transitions et de reconfigurations de ce facteur en maintenant son niveau constant sur un macro-bloc d’essais.
3.2 Typologie du facteur secondaire (facile à modifier)
À l’opposé diamétral du facteur principal se trouve le facteur secondaire, qualifié de facteur Easy-to-Change (ETC). Cette variable présente une souplesse opérationnelle élevée, autorisant des permutations rapides, peu coûteuses et spatialement ou temporellement localisées sans perturber le déroulement global du protocole expérimental.
Dans un contexte agronomique, il s’agira par exemple du choix de la semence ou de la pulvérisation manuelle d’un oligo-élément à l’aide d’un pulvérisateur portatif, tâche pouvant varier instantanément d’une micro-parcelle à la parcelle voisine. Dans un laboratoire industriel, il s’agira du temps d’immersion d’un échantillon dans un bain chimique ou de la pression de découpe appliquée par une tête laser sur différentes zones d’un même panneau préalablement chauffé. En psychologie cognitive, il s’agira de la présentation aléatoire à l’écran d’un mot à valence émotionnelle négative suivi immédiatement d’un mot neutre lors d’une tâche informatisée.
Chaque unité principale hébergeant un niveau fixé du facteur difficile à modifier est subdivisée pour accueillir l’ensemble (ou une fraction planifiée) des niveaux du facteur facile à modifier. Cette modularité permet de croiser les effets sans multiplier les manipulations structurelles lourdes qui ruineraient la faisabilité logistique de l’étude.
3.3 Matrice de croisement et contraintes d’indépendance
L’assemblage d’un facteur difficile à modifier et d’un facteur facile à modifier au sein d’un même dispositif produit une matrice de traitement croisée en apparence similaire à celle d’un plan factoriel classique. Pourtant, la structure d’assignation sous-jacente génère des contraintes d’indépendance fondamentales qui modifient substantiellement les propriétés statistiques de l’expérience.
Puisque les modalités du facteur secondaire sont imbriquées et testées à l’intérieur des parcelles principales, les observations recueillies au sein d’une même parcelle principale partagent une covariance environnementale non nulle. L’indépendance statistique totale des observations — hypothèse cardinale des modèles linéaires ordinaires — est donc formellement violée. Chaque donnée issue d’une sous-parcelle est conditionnée par l’effet de groupe de son unité d’accueil.
Cette dépendance contextuelle a un impact direct sur le calcul et la distribution des degrés de liberté résiduels. Alors qu’un plan factoriel totalement randomisé calcule ses degrés de liberté sur la totalité des observations moins le nombre de cellules de traitement, le plan split-plot séquestre les degrés de liberté en deux compartiments étanches :
- Ceux dévolus à l’évaluation du facteur principal, restreints par le faible nombre de parcelles principales indépendantes ;
- Ceux alloués à l’évaluation du facteur secondaire et de l’interaction, démultipliés par le nombre total de sous-parcelles.
Il en résulte une asymétrie de puissance expérimentale structurelle qu’aucun artifice mathématique a posteriori ne saurait totalement gommer.
4. Anatomie structurelle : Parcelles principales et sous-parcelles
4.1 L’unité de parcelle principale (Whole-Plot)
L’unité de parcelle principale, ou whole-plot, constitue l’entité macroscopique fondamentale du dispositif. Sa délimitation physique, géographique ou temporelle définit le périmètre d’homogénéité relative au sein duquel est maintenue constante une modalité du facteur difficile à changer. Dans l’espace agronomique originel, elle représente une bande de terre continue de plusieurs dizaines ou centaines de mètres carrés labourée d’un seul trait. Dans une chaîne de fabrication de semi-conducteurs, elle correspond à une chambre de dépôt chimique en phase vapeur traitant une fournée complète de plaquettes de silicium.
D’un point de vue statistique, la parcelle principale fonctionne comme un bloc naturel incomplet vis-à-vis des autres modalités du facteur principal, mais complet vis-à-vis des modalités du facteur secondaire. En hébergeant un ensemble de mesures réalisées sous des conditions similaires, la parcelle principale induit une corrélation intra-classe inévitable : deux sous-unités issues de la même parcelle principale sont structurellement plus semblables entre elles que deux sous-unités issues de parcelles principales différentes, même si ces dernières partagent le même niveau de traitement. C’est précisément l’oubli de ce statut de macro-unité qui conduit aux pires dérives inférentielles de la littérature scientifique contemporaine.
4.2 L’unité de sous-parcelle (Split-Plot)
L’unité de sous-parcelle, ou split-plot proprement dite, résulte de la partition délibérée de la parcelle principale en fragments distincts et spatialement contigus. Ces fragments doivent être calibrés de façon à minimiser l’hétérogénéité interne de la parcelle d’accueil, assurant ainsi que chaque modalité du facteur secondaire soit exposée à des conditions micro-environnementales aussi équivalentes que possible.
La randomisation des niveaux du facteur secondaire est opérée de manière rigoureuse et indépendante à l’intérieur de chaque unité principale. Par conséquent, chaque parcelle principale agit comme un mini-univers au sein duquel les sous-traitements sont réassignés aléatoirement. Cette proximité physique ou temporelle immédiate entre sous-parcelles au sein d’une même macro-unité confère au dispositif une sensibilité expérimentale remarquable. En éliminant les variations de fond inter-parcelles lors des comparaisons directes entre sous-parcelles, le chercheur bénéficie d’un rapport signal/bruit considérablement amélioré pour détecter les effets propres du facteur facile à modifier ainsi que les interactions complexes.
4.3 Relations hiérarchiques et emboîtement expérimental
L’architecture formelle d’un plan split-plot repose sur un paradoxe apparent qu’il importe de clarifier : il s’agit d’un dispositif simultanément emboîté (nested) sur le plan physique et croisé (crossed) sur le plan factoriel et conceptuel. Cette dualité se déploie selon des axes bien distincts :
- L’emboîtement physique des unités : Les sous-parcelles sont physiquement nichées à l’intérieur des parcelles principales. La sous-parcelle numéro $1$ de la parcelle principale $A$ ne possède aucun lien généalogique ou physique avec la sous-parcelle numéro $1$ de la parcelle principale $B$. Elles ne partagent qu’un label formel d’assignation ;
- Le croisement factoriel des traitements : En revanche, les niveaux des facteurs $A$ et $B$ sont intégralement croisés. Chaque niveau du facteur $B$ est testé en combinaison avec chaque niveau du facteur $A$. Il est donc possible d’estimer sans ambiguïté l’effet d’interaction $A \times B$, ce qui distingue radicalement le plan split-plot d’un plan hiérarchique pur (où les niveaux d’un facteur sont uniques et subordonnés à un niveau donné de l’autre facteur, rendant toute interaction incalculable).
Cette relation hiérarchique impose que l’allocation des traitements s’effectue selon une cascade descendante, conditionnant l’ensemble des espérances mathématiques associées aux différentes strates du modèle linéaire.
5. Exemple canonique agronomique : L’irrigation et les fertilisants revisités
5.1 Mise en place du dispositif de terrain
Pour illustrer de manière limpide la mécanique d’un plan en parcelles divisées, considérons l’exemple agronomique historique revisité : l’évaluation conjointe de deux régimes d’irrigation et de deux types de fertilisants azotés sur le rendement du blé dur. Supposons un protocole d’étude mobilisant quatre grands champs agricoles distincts, caractérisés par une superficie suffisante pour déployer des systèmes d’arrosage automatisés.
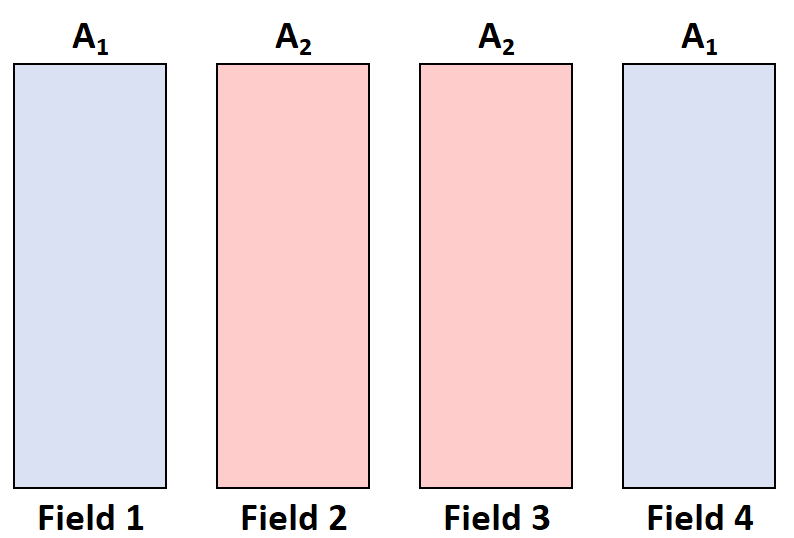
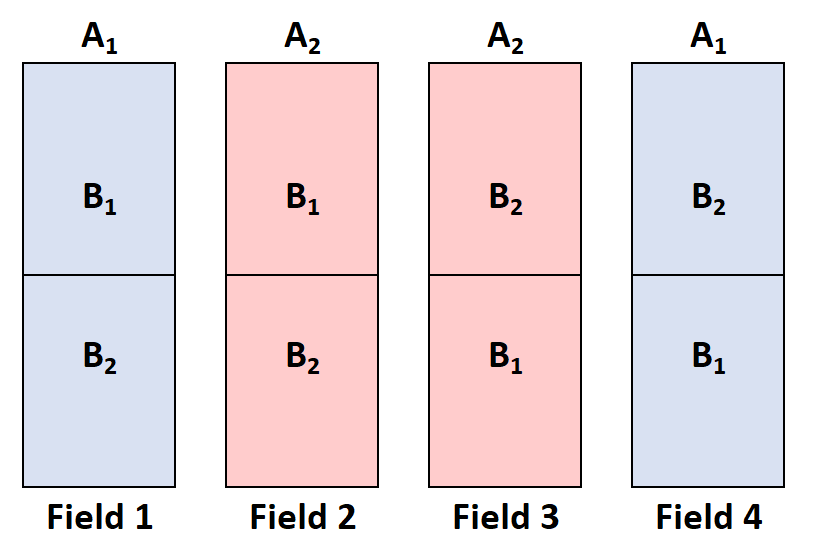
Le facteur principal, hautement difficile à modifier en raison de la plomberie et des canalisations de surface requises, est le mode d’irrigation, décliné en deux modalités : l’irrigation par aspersion classique ($A_1$) et l’irrigation goutte-à-goutte de précision ($A_2$). Les quatre champs disponibles constituent nos parcelles principales. Par tirage au sort (première randomisation), deux champs reçoivent la modalité $A_1$ (Champs 1 et 3), et les deux autres reçoivent la modalité $A_2$ (Champs 2 et 4). Nous disposons ainsi de deux répétitions ($r = 2$) pour chaque niveau d’irrigation.
Le facteur secondaire, éminemment flexible, est le type de fertilisant, comparant un engrais minéral standard ($B_1$) à une formulation organo-minérale enrichie à libération lente ($B_2$). Chaque champ (parcelle principale) est scindé en deux sections d’égale superficie : les sous-parcelles. À l’intérieur de chaque champ, un tirage au sort indépendant (seconde randomisation) détermine quelle sous-section reçoit l’engrais $B_1$ et laquelle reçoit l’engrais $B_2$. La cartographie finale totalise donc huit sous-parcelles d’observation, organisées en quatre paires structurellement corrélées.
5.2 Identification des sources de variation
L’analyse rigoureuse d’un tel dispositif impose de disséquer minutieusement la variabilité globale observée sur le rendement en grains. Les sources de variation se déploient selon une hiérarchie à trois étages :
- La variation macroscopique entre les champs : Les quatre champs présentent des variations pédologiques, une profondeur de sol arable ou une exposition au vent divergentes. Une fraction de cette variabilité est attribuable à l’effet réel du mode d’irrigation ($A_1$ vs $A_2$), tandis que le reliquat reflète les fluctuations aléatoires entre champs recevant un même traitement d’irrigation (variabilité inter-champs non contrôlée) ;
- La variation microscopique au sein des champs : Au sein d’un même champ, les deux moitiés de parcelle présentent une continuité édaphique remarquable. Les écarts de rendement observés entre ces deux sous-sections reflètent l’impact propre du fertilisant ($B_1$ vs $B_2$), ainsi que le bruit de fond micro-local résiduel ;
- L’interaction irrigation $\times$ fertilisant : Le dispositif permet d’examiner si le différentiel d’efficacité entre l’engrais à libération lente et l’engrais standard est magnifié ou annihilé par le passage de l’aspersion au goutte-à-goutte. Si l’engrais à libération lente n’exprime son plein potentiel qu’en présence de l’humidité constante fournie par le goutte-à-goutte, une interaction synergique majeure émerge des données.
5.3 Traitement de l’erreur expérimentale agronomique
La quintessence de l’approche réside dans la séparation étanche des termes d’erreur. Si nous commettions l’erreur d’analyser ces huit parcelles au moyen d’une ANOVA factorielle classique à un seul terme résiduel, nous commettrions une bévue méthodologique rédhibitoire. Dans le split-plot agronomique, deux erreurs distinctes sont calculées :
L’Erreur A (erreur inter-parcelles principales) découle de la variance observée entre les champs traités de manière identique. Elle possède ici seulement $2 \times (2 – 1) = 2$ degrés de liberté. C’est cette variance, relativement élevée en raison de la variabilité spatiale macro-géographique, qui sert de dénominateur pour calculer le test $F$ de Fisher mesurant l’effet de l’irrigation. La puissance pour détecter l’effet de l’irrigation est donc intrinsèquement modérée.
L’Erreur B (erreur intra-parcelles ou résiduelle des sous-parcelles) capture la variabilité résiduelle des interactions entre les sous-parcelles et les blocs au sein de chaque grand champ. Disposant également ici de $2$ degrés de liberté (dans cet exemple minimaliste à deux répétitions), cette variance est généralement beaucoup plus faible que l’Erreur A, car elle est purgée de toute l’hétérogénéité spatiale globale existant entre les différents champs. C’est elle qui sert de dénominateur pour tester la significativité du fertilisant ($B$) et de l’interaction irrigation $\times$ fertilisant ($A \times B$). Il en résulte que le dispositif est incomparablement plus sensible et précis pour juger des effets de l’engrais que pour juger de ceux de l’irrigation.
6. Transposition en psychologie expérimentale : Les plans mixtes sujets-stimuli
6.1 L’analogie structurelle : Participants et sessions de test
L’une des migrations conceptuelles les plus remarquables de la statistique moderne s’est opérée lorsque les psychologues expérimentalistes et les spécialistes des sciences du comportement ont transposé la logique agronomique de Fisher à l’étude de l’esprit humain. Dans les publications contemporaines en psychologie cognitive, en neuropsychologie ou en sciences de l’éducation, le terme split-plot design est souvent employé comme un strict synonyme de plan d’expérience mixte (souvent désigné sous l’expression between-within design ou split-plot ANOVA).
L’analogie structurelle qui fonde cette équivalence est d’une grande limpidité géométrique :
- Le participant humain (ou le groupe d’individus) est rigoureusement équivalent à la parcelle principale (whole-plot). Chaque sujet constitue une entité biologique complexe, porteuse d’une variance basale idiosyncrasique, d’une histoire développementale et d’un génotype qui lui sont propres ;
- Les essais successifs, blocs temporels ou conditions de tests répétés imposés à ce même sujet correspondent trait pour trait aux sous-parcelles (split-plots). Ces mesures répétées interviennent au sein de l’enveloppe psychophysique unifiée d’un même individu.
Cette correspondance mathématique parfaite implique que les données comportementales issues de protocoles mixtes partagent exactement la même structure de covariance et exigent le même traitement matriciel que les données de récolte issues des champs de blé de Rothamsted.
6.2 Facteurs inter-sujets comme facteurs difficiles à modifier
Dans la recherche sur l’humain, les facteurs inter-sujets (between-subjects factors) jouent exactement le rôle des facteurs difficiles à changer (Hard-to-Change). Ces facteurs renvoient à des caractéristiques stationnaires du sujet ou à des assignations protocolaires lourdes dont il est impossible de changer la modalité d’un essai à l’autre de manière instantanée.
On retrouve dans cette catégorie :
- Les variables d’état ou de classification quasi-expérimentale : le groupe diagnostique (sujets atteints de la maladie d’Alzheimer débutante versus témoins sains appariés), le niveau d’expertise motrice (athlètes d’élite versus novices) ou le profil génétique (porteurs de l’allèle à risque d’un transporteur de dopamine versus non-porteurs) ;
- Les interventions thérapeutiques ou éducatives longitudinales : l’administration d’un programme d’entraînement cognitif de six semaines versus un programme de remédiation contrôle, ou la prise quotidienne d’un antidépresseur au long cours versus un placebo.
Un être humain ne pouvant pas être simultanément dépressif et sain lors d’une même fraction de seconde, ni avoir complété et non complété une formation pédagogique au même moment, ces facteurs s’imposent à l’échelle de l’individu tout entier. Le sujet devient ainsi l’unité de randomisation et d’échantillonnage de premier niveau.
6.3 Facteurs intra-sujets comme facteurs faciles à modifier
À l’inverse, les facteurs intra-sujets (within-subjects factors) correspondent aux facteurs faciles à changer (Easy-to-Change). Ils incarnent des modulations éphémères, dynamiques et réversibles de l’environnement cognitif ou sensoriel du participant.
Au cours d’une même session expérimentale, un chercheur peut aisément alterner sur un écran d’ordinateur des stimuli visuels affichant des visages à expression faciale effrayée, joyeuse ou neutre. De même, la difficulté d’un calcul mental (addition simple versus équation algébrique), l’intervalle de rétention mnésique (2 secondes versus 15 secondes) ou la modalité sensorielle de présentation (auditive versus visuelle) sont des facteurs hautement plastiques. Le sujet traverse successivement ces différentes conditions expérimentales au gré des essais.
Toutefois, la transposition en psychologie introduit un défi méthodologique absent de l’agronomie classique : l’esprit humain est doué d’apprentissage, de mémoire et d’anticipation. Les sous-parcelles temporelles ne sont pas immobiles dans l’espace comme des bandes de terre ; l’exposition à la condition $B_1$ peut contaminer durablement la réponse à la condition $B_2$. Le contrebalancement rigoureux de l’ordre de présentation des stimuli (par exemple au moyen de carrés latins) devient alors un impératif absolu pour préserver la randomisation de seconde strate.
7. Exemple concret en recherche psychologique et neurosciences cognitives
7.1 Protocole d’étude sur la mémoire de travail et le stress aigu
Pour matérialiser la puissance du paradigme split-plot en neurosciences comportementales, étudions un protocole expérimental destiné à élucider l’impact d’un stress psychologique aigu sur les différentes charges de la mémoire de travail exécutive. Ce protocole illustre la structure mixte $2 \times 3$.
Le facteur principal (inter-sujets, HTC) est l’induction de stress aigu. Quarante participants volontaires sains sont recrutés et assignés aléatoirement à l’un des deux groupes expérimentaux ($N = 20$ par condition) :
- Le groupe Stress : les sujets sont soumis au Trier Social Stress Test (TSST), un protocole standardisé combinant une prise de parole en public improvisée devant un jury d’évaluateurs impassibles et une épreuve d’arithmétique mentale à rebours sous contrainte de temps sévère ;
- Le groupe Contrôle : les sujets accomplissent une tâche équivalente mais dépourvue de toute composante évaluative ou stressante (lecture libre à voix basse et additions simples en solitaire).
Le facteur secondaire (intra-sujets, ETC) est la charge de la mémoire de travail, opérationnalisée au moyen de la tâche classique du n-back. Immédiatement après l’induction ou la phase contrôle, chaque participant accomplit, dans un ordre contrebalancé, trois blocs consécutifs de la tâche :
- Condition 1-back (faible charge mnésique : indiquer si la lettre actuelle est identique à la lettre immédiatement précédente) ;
- Condition 2-back (charge mnésique intermédiaire) ;
- Condition 3-back (forte charge mnésique exigeant une actualisation continue et un contrôle exécutif lourd).
7.2 Collecte et structure des données comportementales
L’expérience génère deux flux majeurs d’indicateurs empiriques. D’une part, un contrôle de manipulation physiologique est réalisé par le prélèvement d’échantillons de cortisol salivaire à $T_0$ (ligne de base), $T_{10}$ (post-manipulation immédiat) et $T_{30}$ (fin de session), confirmant l’activation effective de l’axe hypothalamo-hypophyso-surrénalien dans le groupe stressé par rapport au groupe neutre.
D’autre part, les données comportementales cibles sont enregistrées en continu au fil des 120 essais constituant chaque bloc de n-back. Deux variables dépendantes cardinales sont isolées :
- Le temps de réaction médian (en millisecondes) sur les essais corrects, mesurant la vitesse de traitement et l’inhibition motrice ;
- L’indice de discriminabilité $d’$ (dérivé de la théorie de la détection du signal), synthétisant le taux de détection correcte des cibles et le taux de fausses alarmes face aux distracteurs.
Les données se structurent ainsi sous la forme d’un tableau matriciel à double strate : chaque sujet fournit trois valeurs scalaires distinctes de performance (une pour chaque charge de n-back), générant un ensemble de 120 points d’observation comportementale organisés en 40 clusters individuels de trois mesures imbriquées.
7.3 Interprétation de l’interaction stress-complexité
L’application d’une ANOVA split-plot (ou modèle linéaire mixte) à ces données met en lumière la finesse diagnostique du dispositif. Supposons que l’analyse statistique révèle les résultats suivants :
- Un effet principal du stress non significatif ($F(1, 38) = 1.84, p = 0.182$) ;
- Un effet principal de la charge de mémoire massif ($F(2, 76) = 142.30, p < 0.001$) ;
- Une interaction stress $\times$ charge de mémoire hautement significative ($F(2, 76) = 18.65, p < 0.001$).
La décomposition des effets simples lève immédiatement le voile sur ce pattern remarquable : en condition de faible charge (1-back), les participants soumis au stress aigu obtiennent des performances strictement identiques, voire légèrement plus rapides en temps de réaction, que les sujets du groupe contrôle, suggérant un niveau d’éveil (arousal) adaptatif stimulant les réponses automatisées. En revanche, à mesure que la charge cognitive s’élève (2-back, puis 3-back), la performance des sujets stressés s’effondre dramatiquement par rapport à celle des témoins, tant en précision qu’en variabilité des temps de réponse.
L’interaction split-plot valide magistralement l’hypothèse neuropsychologique d’un épuisement sélectif des ressources préfrontales dorsolatérales sous l’influence des catécholamines et des glucocorticoïdes : le stress ne détruit pas uniformément toutes les fonctions cognitives, mais sature spécifiquement les processus d’inhibition et d’actualisation de haut niveau. Sans la précision d’un plan split-plot permettant de tester l’interaction à l’intérieur de la seconde strate d’erreur, ce phénomène subtil aurait pu être masqué par l’imposante variabilité interindividuelle de base des 40 participants.
8. La structure de variance et la gestion des termes d’erreur distincts
8.1 Pourquoi un seul terme d’erreur résiduelle est invalide
L’écueil analytique le plus funeste rencontré dans l’exploitation de données issues d’un plan split-plot consiste à exécuter une analyse de variance factorielle ordinaire traitant l’ensemble des observations comme si elles étaient mutuellement indépendantes, en ne spécifiant qu’un unique carré moyen résiduel au dénominateur des tests $F$. Cette pratique viole frontalement l’axiome fondamental d’homoscédasticité et d’indépendance de l’erreur du modèle linéaire général.
Lorsqu’un plan expérimental comporte des mesures répétées ou des sous-parcelles agrégées au sein de macro-unités, les covariances entre les observations issues d’une même unité sont intrinsèquement positives. Si un statisticien force l’algorithme à agréger la variance inter-parcelles et la variance intra-parcelle en un seul terme d’erreur composite, deux distorsions dramatiques surviennent immédiatement :
- Pour le facteur principal (inter-unités) : Le dénominateur utilisé pour calculer la statistique $F$ sera artificiellement sous-estimé, car il incorpore la variance intra-parcelle, généralement beaucoup plus faible. Les degrés de liberté résiduels seront par ailleurs indûment gonflés. Il en résulte une explosion catastrophique du taux d’erreur de type I (rejet à tort de l’hypothèse nulle d’absence d’effet), conduisant le chercheur à déclarer hautement significatif un effet qui n’est que du bruit environnemental inter-groupes ;
- Pour le facteur secondaire et l’interaction (intra-unités) : À l’inverse, le terme d’erreur unique sera gonflé par l’inclusion de la variance inter-parcelles, rendant le test $F$ excessivement conservateur. Le risque d’erreur de type II explose alors, étouffant la capacité du chercheur à détecter des effets et des interactions réels.
8.2 Décomposition mathématique de l’Erreur A et de l’Erreur B
Pour conjurer cette invalidité, le formalisme de l’ANOVA split-plot décompose rigoureusement la somme des carrés totale ($SS_{Total}$) en deux compartiments orthogonaux, chacun doté de sa propre variance résiduelle :
La strate de la parcelle principale (Strate A) partitionne la somme des carrés inter-parcelles :
- $SS_A$ : Somme des carrés associée à l’effet fixe du facteur principal $A$ ;
- $SS_{Erreur(A)}$ (ou Erreur A) : Somme des carrés résiduelle entre les parcelles principales soumises au même traitement $A$. Mathématiquement, dans un plan en blocs, elle correspond à l’interaction entre les blocs et le facteur principal : $\text{Blocs} \times A$. Le carré moyen de cette strate est $MS_{Erreur(A)} = \frac{SS_{Erreur(A)}}{df_{Erreur(A)}}$.
La statistique de test pour le facteur principal est donc rigoureusement formulée par le ratio de Snedecor :
$$F_A = \frac{MS_A}{MS_{Erreur(A)}}$$
La strate de la sous-parcelle (Strate B) partitionne la somme des carrés intra-parcelles :
- $SS_B$ : Somme des carrés associée à l’effet fixe du facteur secondaire $B$ ;
- $SS_{AB}$ : Somme des carrés associée à l’interaction $A \times B$ ;
- $SS_{Erreur(B)}$ (ou Erreur B) : Somme des carrés résiduelle des sous-parcelles, capturant les fluctuations aléatoires résiduelles au sein des unités principales après retrait des effets fixes et des blocs. Son carré moyen est $MS_{Erreur(B)} = \frac{SS_{Erreur(B)}}{df_{Erreur(B)}}$.
Les statistiques de test pour le facteur secondaire et l’interaction s’expriment ainsi par les ratios suivants :
$$F_B = \frac{MS_B}{MS_{Erreur(B)}} \quad \text{et} \quad F_{AB} = \frac{MS_{AB}}{MS_{Erreur(B)}}$$
8.3 L’impact sur la précision des estimations
Cette architecture binaire confère au plan split-plot une géométrie de précision asymétrique hautement prévisible. La précision d’une estimation statistique étant inversement proportionnelle à la variance de l’erreur associée, les contrastes portant sur les moyennes du facteur principal $A$ sont affectés d’une erreur type plus importante. Ils requièrent des tailles d’effet substantielles pour émerger victorieux du seuil de significativité statistique, en raison de la modicité des degrés de liberté de l’Erreur A et de l’amplitude naturelle du bruit inter-parcelles.
À l’inverse, les comparaisons relatives au facteur secondaire $B$ et aux composantes de l’interaction $A \times B$ bénéficient d’une précision analytique remarquable. L’Erreur B agissant comme un filtre ayant purgé toute la variabilité interindividuelle ou inter-champs, le rapport signal sur bruit s’en trouve démultiplié. Cette propriété fait du split-plot le dispositif de prédilection lorsque l’objectif premier du chercheur n’est pas tant de mesurer l’effet absolu d’une macro-intervention, mais de déterminer avec une acuité chirurgicale comment différentes sous-conditions réagissent différentiellement à cette intervention.
9. Analyse statistique : Modèles linéaires mixtes et ANOVA split-plot
9.1 Formulation mathématique du modèle linéaire mixte
Si l’ANOVA traditionnelle de Fisher a longtemps constitué le véhicule privilégié pour traiter les plans split-plot, la théorie statistique contemporaine privilégie désormais le formalisme des modèles linéaires mixtes (Linear Mixed Models, LMM). Ce cadre unificateur offre une robustesse et une élégance supérieures pour modéliser simultanément les tendances de population et les dépendances structurelles.
Dans sa forme univariée classique, le modèle split-plot pour une réponse $Y_{ijk}$ (où $i$ indexe le niveau du facteur principal, $j$ le bloc ou sujet, et $k$ le niveau du facteur secondaire) s’écrit formellement :
$$Y_{ijk} = \mu + \alpha_i + \beta_j + \eta_{ij} + \gamma_k + (\alpha\gamma)_{ik} + \epsilon_{ijk}$$
Dans cette formulation paramétrique :
- $\mu$ représente la moyenne générale théorique ;
- $\alpha_i$ symbolise l’effet fixe du $i$-ème niveau du facteur principal $A$ ;
- $\beta_j$ représente l’effet de bloc (qui peut être fixé ou aléatoire selon l’échantillonnage) ;
- $\eta_{ij}$ est l’effet aléatoire de la parcelle principale (l’Erreur A), distribué selon une loi normale $\mathcal{N}(0, \sigma^2_{\text{whole}})$ ;
- $\gamma_k$ est l’effet fixe du $k$-ème niveau du facteur secondaire $B$ ;
- $(\alpha\gamma)_{ik}$ matérialise l’effet fixe d’interaction entre le facteur principal et le facteur secondaire ;
- $\epsilon_{ijk}$ représente l’erreur résiduelle stochastique de la sous-parcelle (l’Erreur B), distribuée selon $\mathcal{N}(0, \sigma^2_{\text{sub}})$.
L’estimation des composantes de variance s’effectue usuellement par la méthode du maximum de vraisemblance restreint (REML), qui corrige le biais inhérent à l’estimation classique du maximum de vraisemblance en prenant en compte la perte de degrés de liberté due à l’estimation des paramètres des effets fixes.
9.2 Hypothèses sous-jacentes : Sphéricité et normalité
L’application rigoureuse du modèle split-plot, singulièrement sous sa déclinaison d’ANOVA à mesures répétées, repose sur un ensemble d’hypothèses distributionnelles strictes :
La première est la normalité des résidus aux deux échelons : les erreurs de la parcelle principale ($\eta_{ij}$) tout comme les erreurs de la sous-parcelle ($\epsilon_{ijk}$) doivent suivre des distributions gaussiennes. Grâce au théorème central limite, l’inférence sur les moyennes demeure relativement robuste à des déviations modérées de la normalité pour peu que les tailles d’échantillons soient suffisantes.
La seconde hypothèse, souvent méconnue mais cruciale dès lors que le facteur secondaire comporte trois niveaux ou plus ($k ge 3$), est la condition de sphéricité (ou de circularité), formalisée par le test de sphéricité de Mauchly. La sphéricité exige que les variances des différences entre toutes les paires possibles de niveaux du facteur intra-sujets soient rigoureusement égales :
$$\text{Var}(Y_{ik} – Y_{ik’}) = \text{constante}, \quad \forall k \neq k’$$
Lorsque cette condition de sphéricité est violée (ce qui est fréquent dans les séries temporelles où deux points proches dans le temps sont plus corrélés que deux points distants), la distribution théorique de la statistique $F$ est faussée, provoquant une augmentation artificielle du taux d’erreur de type I. Le statisticien doit alors appliquer des facteurs de correction correctifs aux degrés de liberté de l’Erreur B, principalement l’indice $epsilon$ de Greenhouse-Geisser (plus conservateur) ou celui de Huynh-Feldt (plus libéral). Dans le cadre des modèles mixtes contemporains, cette difficulté est élégamment contournée en spécifiant explicitement des structures de covariance alternatives pour les résidus, telles que des matrices autorégressives de premier ordre ($AR(1)$) ou des matrices totalement non structurées (unstructured).
9.3 Implémentation sous R et logiciels statistiques
La traduction opérationnelle de cette architecture dans les logiciels de traitement de données contemporains illustre parfaitement la double nature du dispositif. Dans l’environnement statistique de référence R, deux approches computationnelles coexistent.
L’approche classique par l’ANOVA de Fisher mobilise la fonction générique aov() en intégrant explicitement la hiérarchie d’erreur au sein de la formule de modélisation :
Dans cette syntaxe, l’inclusion du terme d’erreur hiérarchique séquestre immédiatement les résidus en deux tables distinctes : le facteur principal est testé contre la variabilité du sujet ou de la parcelle principale, tandis que le facteur secondaire et l’interaction sont évalués au regard de la variance résiduelle fine des sous-mesures.
Cependant, le standard contemporain repose sur la modélisation mixte via le package lme4 et la fonction lmer(), ou via le package nlme. La spécification se décline alors selon le modèle à intercept aléatoire par parcelle :
Sous des environnements graphiques largement adoptés en sciences humaines tels que IBM SPSS ou JASP, le chercheur sélectionne l’interface du Modèle Linéaire Généralisé à Mesures Répétées (GLM Repeated Measures). Le facteur principal y est introduit dans le champ des facteurs inter-sujets (Between-Subjects Factors), tandis que le facteur secondaire est déclaré dans le constructeur des facteurs intra-sujets (Within-Subjects Factors), le logiciel exécutant automatiquement la partition matricielle appropriée.
10. Avantages comparatifs face aux plans entièrement aléatoires
10.1 Optimisation des ressources et réduction des coûts
L’adoption réfléchie d’un plan en parcelles divisées plutôt que d’un plan factoriel entièrement randomisé procure des gains d’efficience opérationnelle et logistique souvent spectaculaires. Dans une myriade de contextes industriels et agronomiques, le coût d’une expérimentation est très majoritairement indexé sur la fréquence des transitions et des reconfigurations d’équipements lourds.
Considérons une expérience factorielle $4 \times 4$ nécessitant 4 répétitions par condition, soit un total de 64 essais élémentaires. Si le facteur $A$ requiert le réglage thermique d’un haut-fourneau :
- Dans un plan complètement randomisé, l’assignation aléatoire intégrale impose en moyenne une cinquantaine de modifications thermiques majeures, occasionnant des délais de stabilisation immenses, une dépense énergétique colossale et une usure prématurée des instruments ;
- Dans un plan split-plot, en utilisant les 4 réglages thermiques comme parcelles principales avec 4 réplications par niveau de four, le nombre de réglages thermiques est drastiquement réduit à 16. Au sein de chaque fournée thermique stabilisée, les 4 niveaux du facteur secondaire $B$ sont testés simultanément ou consécutivement sans nouvel arrêt thermique.
Le gain budgétaire et logistique est ici supérieur à 70 %, sans qu’aucune concession n’ait été faite sur la validité théorique des comparaisons relatives au facteur $B$ ou à l’interaction $A \times B$.
10.2 Gain d’efficacité statistique sur les effets d’interaction
Sur le plan purement statistique, le split-plot opère une redistribution stratégique de la puissance de test. Dans un plan factoriel classique totalement randomisé, la variance d’erreur résiduelle unique reflète l’ensemble des sources de bruit incontrôlées, ce qui tend à masquer les effets dont la magnitude est modérée.
En isolant et en évacuant la variabilité inter-parcelles (ou inter-individuelle) de la strate résiduelle B, le split-plot dote le test de l’effet d’interaction d’une sensibilité analytique incomparable. En psychologie comme en médecine, la variabilité physiologique ou cognitive d’un individu à l’autre est notoirement supérieure à la variabilité des réponses qu’un même individu émet au cours d’une heure de test. En agissant comme son propre témoin au sein de la parcelle principale, le sujet fournit des données dont le différentiel élimine le bruit de fond personnel. Il devient alors mathématiquement aisé de prouver l’existence d’une interaction croisée subtile entre une pathologie sous-jacente et un type de stimulus sensoriel, là où un plan factoriel inter-sujets complet aurait échoué par manque de puissance statistique faute de recruter des milliers de volontaires.
10.3 Flexibilité expérimentale et réalisme écologique
Au-delà de la métrique des coûts et de la puissance des tests, le plan split-plot brille par sa capacité à préserver le réalisme écologique des protocoles de recherche. Dans les contextes appliqués, les phénomènes étudiés s’articulent naturellement selon des structures hiérarchiques et des regroupements collectifs que le chercheur ne peut dissoudre arbitrairement :
- En sciences de l’éducation, les élèves sont physiquement regroupés au sein de classes scolaires. Il est impensable d’assigner aléatoirement une méthode pédagogique différente à chaque élève assis sur son banc sans susciter un chaos organisationnel immédiat. La classe constitue la parcelle principale recevant le programme éducatif (facteur difficile à changer), tandis que les différents types d’exercices d’évaluation assignés individuellement aux élèves matérialisent les sous-parcelles ;
- En recherche hospitalière, un service de soins intensifs applique une politique d’hygiène macroscopique (parcelle principale), tandis que différentes posologies médicamenteuses sont administrées aux lits individuels (sous-parcelles).
Le split-plot permet d’intégrer des covariables tant au niveau macroscopique qu’au niveau microscopique, ouvrant la voie à des quasi-expérimentations rigoureusement modélisées là où un puriste de la randomisation complète conclurait à l’impossibilité d’expérimenter.
11. Pièges méthodologiques, pseudo-réplication et erreurs courantes
11.1 Le risque critique de la pseudo-réplication
Le piège le plus insidieux et dévastateur guettant les utilisateurs non avertis du plan split-plot est sans conteste la pseudo-réplication, un concept méthodologique immortalisé par Stuart Hurlbert dans son article séminal de 1984 (Pseudoreplication and the design of ecological field experiments). La pseudo-réplication survient lorsqu’un chercheur confond l’unité physique d’observation (le point de mesure élémentaire) avec l’unité expérimentale réelle (l’entité indépendamment assignée à un traitement).
Dans un dispositif split-plot, si un chercheur dispose de 4 parcelles principales pour tester deux modes de labourage (soit 2 parcelles par modalité), et découpe chaque parcelle en 10 sous-sections, il recueille 40 points de mesure. La faute gravissime consiste à traiter ces 40 observations dans un logiciel en déclarant un effectif d’échantillon de $N = 40$ pour tester le mode de labourage. Les sous-parcelles d’une même parcelle principale ne sont aucunement des répétitions indépendantes pour le facteur principal : elles ne constituent que des sous-échantillons dépendants d’une seule et unique unité expérimentale d’attribution. Ignorer l’Erreur A et tester le facteur principal sur la base des 38 degrés de liberté apparents revient à commettre une pseudo-réplication flagrante. Les valeurs de $p$ ainsi calculées s’effondrent de manière fallacieuse vers zéro, transformant des artéfacts aléatoires en découvertes scientifiques illusoires.
11.2 L’asymétrie de puissance statistique entre facteurs
Un défaut récurrent de conception tient à l’asymétrie radicale de puissance statistique logée au cœur de la structure split-plot. Trop de projets de recherche sont dimensionnés en négligeant le fait que le facteur de parcelle principale exige un nombre suffisant de répétitions indépendantes macroscopiques pour atteindre une puissance statistique adéquate ($1 – \beta ge 0.80$).
Les concepteurs d’expériences sont souvent trompés par l’abondance de données générées au niveau des sous-parcelles. Un neuroscientifique qui recrute 6 patients atteints d’une pathologie rare et 6 témoins sains, et leur fait accomplir 500 essais comportementaux informatisés par condition, dispose de milliers d’enregistrements temporels. Pourtant, pour tester la différence globale entre les patients et les témoins (le facteur principal inter-sujets), la taille d’échantillon effective demeure désespérément ancrée à $N = 12$, dotant le test $F$ de seulement $10$ degrés de liberté au dénominateur de l’Erreur A. Le risque d’erreur de type II (omission de détecter un effet réel de la maladie par sous-dimensionnement de l’échantillon primaire) est alors gigantesque, quand bien même la puissance sur l’effet du stimulus intra-sujets friserait les 100 %.
11.3 Effets de report et contamination résiduelle
Lorsque le plan split-plot est transposé dans le temps (mesures répétées au fil des sessions ou passage successif par plusieurs conditions expérimentales), il s’expose au danger mortel des effets de report (carry-over effects). Contrairement aux sous-parcelles d’un champ qui sont protégées par des allées neutres éliminant les transferts chimiques horizontaux, le sujet humain ou l’organisme biologique conserve des traces physiologiques et psychologiques durables de ses expositions antérieures.
Ces effets pervers prennent des formes multiples :
- L’effet d’apprentissage ou de pratique : le participant devient systématiquement plus rapide et précis sur les dernières sous-conditions simplement parce qu’il s’est familiarisé avec la tâche ;
- L’effet de fatigue ou d’épuisement cognitif : à l’inverse, l’attention s’effondre lors des blocs terminaux, pénalisant arbitrairement les traitements assignés en fin de protocole ;
- La rémanence pharmacologique ou physiologique : la substance active ou le stress induit lors de la première condition continue d’agir silencieusement durant la seconde.
Pour parer à ce péril, le chercheur doit obligatoirement intégrer des périodes de repos (wash-out periods) suffisantes entre les sous-traitements et formaliser des plans de contrebalancement systématiques (carrés latins digrammes équilibrés) afin d’assurer que chaque condition succède à chaque autre avec une fréquence rigoureusement égale.
12. Bonnes pratiques de conception, puissance statistique et reporting scientifique
12.1 Calcul de la taille d’effet et de la puissance a priori
La planification rigoureuse d’un dispositif split-plot requiert un calcul de puissance statistique a priori différencié pour chacune des strates du modèle. Il est illusoire d’espérer déterminer la taille d’échantillon globale à l’aide des formules simples dédiées aux plans complètement randomisés. Les logiciels spécialisés tels que G*Power ou le package statistique WebPower pour R exigent la spécification précise de plusieurs paramètres cruciaux :
- La magnitude attendue de la taille d’effet pour chaque facteur et l’interaction, usuellement exprimée par le $f$ de Cohen ou le coefficient $\eta^2_p$ (êta-carré partiel) ;
- Le niveau de corrélation moyen attendu entre les mesures répétées ($r$) issues des sous-parcelles au sein d’une même unité principale ;
- Le coefficient de non-sphéricité estimé ($epsilon$) pour corriger l’inflation potentielle des degrés de liberté de la strate intra-unités.
Une règle directrice fondamentale s’impose : le nombre d’unités de parcelles principales (nombre de champs ou effectif total de sujets recrutés) doit être calibré avant tout pour satisfaire les exigences de puissance de la strate la plus vulnérable, c’est-à-dire le facteur principal $Hard\text{-}to\text{-}Change$.
12.2 Normes de reporting selon l’APA et directives équivalentes
La publication de résultats issus d’un plan split-plot obéit à des règles de transparence éditoriale strictes, édictées notamment par l’American Psychological Association (APA 7th edition) et les directives EQUATOR pour la recherche biomédicale. Le rapport scientifique doit impérativement expliciter la séparation des deux strates d’erreur afin de permettre aux pairs d’évaluer la validité du modèle.
Dans la section Méthode, l’architecture du dispositif doit être qualifiée sans équivoque en détaillant le protocole de randomisation à deux niveaux. Les critères d’appariement ou de blocage des parcelles principales doivent être minutieusement documentés.
Dans la section Résultats, il est formellement requis de rapporter pour chaque test d’hypothèse :
- La valeur exacte de la statistique $F$, accompagnée de ses degrés de liberté spécifiques séparés par une virgule : $df_{\text{numérateur}}$ et $df_{\text{dénominateur}}$, ce dernier reflétant soit l’Erreur A, soit l’Erreur B ;
- La valeur exacte de la probabilité critique $p$ (par exemple $p = 0.024$ plutôt que $p < 0.05$) ;
- L’indice de taille d’effet standardisé approprié, de préférence l’êta-carré partiel ($\eta^2_p$) ou, idéalement, l’oméga-carré partiel ($\omega^2_p$), ce dernier offrant un estimateur non biaisé de la variance expliquée en population ;
- En cas de violation avérée de la sphéricité, la valeur de l’indice $epsilon$ de correction appliqué aux degrés de liberté de la sous-parcelle doit être explicitement mentionnée (ex. : $F(1.42, 53.96) = 8.12, p = 0.003, \epsilon_{\text{GG}} = 0.71$).
12.3 Guide décisionnel pour le chercheur contemporain
Pour naviguer avec discernement dans le choix d’un design expérimental, le chercheur contemporain peut s’appuyer sur une démarche d’arbitrage rationnelle. L’adoption d’un plan split-plot s’impose de manière élective dès lors que les conditions suivantes sont concomitamment réunies :
- Au moins une des variables indépendantes d’intérêt majeur présente une contrainte logistique, spatiale, temporelle ou financière qui rend impossible sa variation rapide essai par essai ;
- Une ou plusieurs variables secondaires complémentaires peuvent, sans dommage méthodologique, être subdivisées ou administrées de manière flexible à l’intérieur des macro-environnements générés par la première variable ;
- L’intérêt scientifique principal du protocole réside substantiellement dans l’examen de l’effet d’interaction unissant les deux dimensions d’intervention.
Face à ces exigences, le chercheur doit scrupuleusement procéder à la vérification d’une check-list pré-expérimentale rigoureuse : s’assurer du contrôle effectif de la pseudo-réplication par un nombre suffisant de répétitions authentiques de premier niveau, mettre en œuvre une procédure d’assignation aléatoire à deux phases distinctes, et programmer en amont l’architecture analytique (ANOVA split-plot ou modèle linéaire mixte) garantissant que chaque hypothèse sera mise à l’épreuve face à son terme d’erreur légitime.
En conjuguant ainsi réalisme de terrain et rigueur déductive, le plan split-plot demeure, près d’un siècle après sa conception dans les sillons fertiles de Rothamsted, l’un des joyaux les plus éclatants de l’ingénierie statistique universelle.
Références
Bates, D., Mächler, M., Bolker, B., & Walker, S. (2015). Fitting linear mixed-effects models using lme4. Journal of Statistical Software, 67(1), 1–48. https://doi.org/10.18637/jss.v067.i01
Box, G. E. P., Hunter, J. S., & Hunter, W. G. (2005). Statistics for experimenters: Design, innovation, and discovery (2nd ed.). John Wiley & Sons.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
Hurlbert, S. H. (1984). Pseudoreplication and the design of ecological field experiments. Ecological Monographs, 54(2), 187–211. https://doi.org/10.2307/1942661
Kirk, R. E. (2013). Experimental design: Procedures for the behavioral sciences (4th ed.). SAGE Publications.
Montgomery, D. C. (2017). Design and analysis of experiments (9th ed.). John Wiley & Sons.
Pinheiro, J. C., & Bates, D. M. (2000). Mixed-effects models in S and S-PLUS. Springer. https://doi.org/10.1007/b98882
Yates, F. (1937). The design and analysis of factorial experiments. Imperial Bureau of Soil Science.