
Dans le champ contemporain de l’analyse quantitative, de la psychométrie appliquée et de la science des données, le traitement préalable des variables constitue une étape déterminante dont dépend directement la validité des inférences statistiques ultérieures. Les jeux de données empiriques se caractérisent presque universellement par une disparité structurelle majeure : la coexistence d’attributs quantifiés selon des unités physiques, physiologiques ou psychologiques incommensurables. Qu’il s’agisse de confronter des temps de latence cognitive exprimés en millisecondes à des scores de précision sur des échelles discrètes, ou d’intégrer des marqueurs biométriques continus au sein d’un modèle d’apprentissage supervisé, la disparité des ordres de grandeur et des dispersions introduit des biais métriques substantiels qui faussent les calculs de distance et les estimations paramétriques.
Pour neutraliser ces artéfacts sans altérer les propriétés distributionnelles fondamentales des variables sous-jacentes, la statistique inférentielle a développé un ensemble de transformations linéaires regroupées sous le vocable de mise à l’échelle. Parmi ces techniques, la normalisation par score Z — traditionnellement dénommée « standardisation centrée réduite » dans la littérature francophone — occupe une place épistémologique et pratique prépondérante. En projetant n’importe quelle série de mesures sur un repère invariant caractérisé par une moyenne nulle et un écart-type unitaire, cette méthode offre une métrique universelle d’écartement relatif par rapport au barycentre des observations.
Ce guide exhaustif a pour vocation d’analyser en profondeur les principes algébriques, les propriétés probabilistes, les déclinaisons cliniques et les implémentations computationnelles de la normalisation par score Z. À travers une déconstruction rigoureuse de ses fondements mathématiques, l’exposition d’applications concrètes en neuropsychologie et en modélisation multivariée, ainsi que la discussion systématique de ses limites inhérentes, ce document constitue une référence théorique et opérationnelle destinée aux chercheurs, psychomètres, biostatisticiens et ingénieurs de données confrontés aux défis de l’harmonisation quantitative.
1. 1. Introduction fondamentale à la normalisation par score Z
1.1 1.1 Origine conceptuelle et place dans l’analyse de données
L’émergence historique du concept de standardisation statistique s’inscrit au cœur des révolutions méthodologiques du dix-neuvième et du début du vingtième siècle, portées par les travaux pionniers d’Adolphe Quetelet sur l’« homme moyen », puis développées de manière formelle par Francis Galton et Karl Pearson. Face à la complexité croissante des données anthropométriques et biométriques, ces précurseurs ont rapidement identifié l’impasse méthodologique consistant à comparer des variables possédant des unités de mesure distinctes et des variances hétérogènes. La nécessité d’éliminer l’effet d’échelle s’est imposée dès lors que les statisticiens ont cherché à quantifier l’intensité des associations bivariées et la corrélation entre caractères héréditaires, aboutissant à la formulation du coefficient de corrélation produit-moment.
Dans l’architecture moderne de l’analyse de données, le centrage-réduction constitue un prérequis indispensable pour l’ensemble des modèles linéaires généraux et des algorithmes multivariés. En l’absence de transformation, les dimensions caractérisées par les plus fortes amplitudes numériques dominent artificiellement les fonctions d’optimisation, les calculs de distances euclidiennes et l’extraction des composantes principales. Ainsi, lors d’une régression pénalisée de type Ridge ou Lasso, les coefficients associés aux variables à grande variance subissent une pénalisation disproportionnée si une standardisation préalable n’a pas été rigoureusement exécutée.
Il convient d’établir d’emblée une distinction épistémologique rigoureuse entre la « normalisation » au sens large et la « standardisation centrée réduite ». Dans la littérature internationale, le terme « normalisation » englobe un spectre étendu de transformations affines ou non linéaires visant à contraindre des données dans un intervalle borné prédéfini — tel que le rééchelonnement unitaire Min-Max sur l’intervalle [0, 1] — ou à modifier la courbure d’une distribution pour la rapprocher de la loi normale (via des transformations de Box-Cox ou logarithmiques). À l’inverse, la standardisation par score Z représente une transformation affine stricte qui ne modifie aucunement la morphologie de la distribution parente, mais redéfinit exclusivement son origine et son unité de dispersion.
1.2 1.2 Définition formelle de la normalisation par score Z
La normalisation par score Z est une transformation mathématique linéaire qui convertit une mesure brute individuelle en un indice d’éloignement relatif exprimé sous la forme d’un nombre algébrique d’écarts-types. L’opération repose sur deux étapes successives et indissociables : le centrage, qui consiste à soustraire la moyenne arithmétique de la série à chaque observation, suivi de la réduction, qui divise l’écart obtenu par l’écart-type de cette même série. Cette procédure assure un alignement systématique et universel des paramètres descriptifs du premier et du second ordre : la distribution résultante présente impérativement une moyenne théorique égale à 0 et un écart-type rigoureusement égal à 1.
Une caractéristique fondamentale et souvent méconnue de cette opération réside dans la préservation absolue de la forme originale de la distribution sous-jacente. Si la distribution empirique d’origine est asymétrique, bimodale ou présente un aplatissement prononcé, la distribution des scores Z présentera exactement les mêmes coefficients d’asymétrie (skewness) et d’aplatissement (kurtosis). Contrairement à ce que suggère le mot « normalisation », la transformation n’a en aucun cas le pouvoir magique de métamorphoser une variable non gaussienne en une variable suivant la loi normale de Laplace-Gauss.
Sur le plan interprétatif, le score Z se comprend intuitivement comme une distance signée par rapport au centre de gravité arithmétique des données. Un score Z de valeur zéro correspond strictement à l’observation coïncidant avec la moyenne du groupe. Une valeur positive indique que l’individu ou le point de mesure se situe au-dessus de cette référence centrale, l’amplitude numérique indiquant le nombre exact d’écarts-types séparant ce point de la moyenne. Réciproquement, un score Z négatif quantifie un déficit relatif ou un positionnement en deçà du barycentre empirique. Cette standardisation métrique confère aux chercheurs un langage commun pour appréhender des phénomènes distincts sur une échelle dimensionnelle partagée.
1.3 1.3 Pertinence méthodologique en sciences psychologiques et comportementales
Dans le domaine des sciences psychologiques, de la neuropsychologie et des sciences du comportement, la normalisation par score Z constitue l’un des piliers de la méthodologie quantitative. Les instruments psychométriques mobilisent une diversité considérable de formats de réponse : échelles de Likert graduées de 1 à 5 pour l’évaluation des traits de personnalité, temps de réaction chronométrés en centièmes de seconde dans les paradigmes attentionnels, ou nombre brut de mots correctement rappelés au sein d’épreuves mnésiques. L’évaluation simultanée de ces dimensions se heurterait à une incohérence arithmétique insurmontable si les données brutes devaient être amalgamées sans étalonnage préalable.
La standardisation permet d’éliminer les artéfacts métriques inhérents aux conventions arbitraires de notation lors de l’estimation d’attributs latents. Par exemple, un individu obtenant un score brut de 45 à un questionnaire d’anxiété et un score de 110 à une tâche de flexibilité mentale ne peut faire l’objet d’aucune comparaison directe sur la seule base de ces grandeurs numériques. En revanche, si la conversion en scores Z indique un score de +2,5 sur l’échelle d’anxiété et de -0,2 sur l’épreuve de flexibilité, le praticien ou le chercheur peut déduire immédiatement que le sujet présente une symptomatologie anxieuse exceptionnellement marquée par rapport à sa population de référence, tandis que ses fonctions exécutives se situent dans la stricte moyenne normative.
Par ailleurs, cette normalisation facilite considérablement l’agrégation de sous-échelles multiples au sein de batteries de tests neuropsychologiques complexes. L’élaboration d’indices composites de fonctionnement cognitif global repose presque exclusivement sur la moyenne pondérée de scores Z dérivés d’épreuves spécifiques. Cette approche évite que les épreuves dotées d’étendues numériques larges n’exercent un poids prépondérant non justifié au détriment des épreuves aux échelles restreintes, assurant ainsi une contribution théoriquement équilibrée de chaque domaine cognitif à l’indice synthétique final.
2. 2. Fondements mathématiques et formulation algébrique
2.1 2.1 L’équation canonique du score Z
L’armature algébrique du score Z s’articule autour d’une formulation élégante et compacte qui matérialise la double opération de translation et de dilatation géométrique. Dans un cadre théorique populationnel où les paramètres d’espérance et de dispersion sont connus de façon exhaustive et non stochastique, l’équation canonique s’écrit formellement :
Z = (X – μ) / σ
Dans cette expression, X représente la variable aléatoire continue ou discrète observée, μ désigne la moyenne arithmétique de la population globale (l’espérance mathématique E[X]), et σ symbolise l’écart-type de cette même population, représentant la racine carrée de la variance paramétrique.
Lorsqu’on bascule vers l’inférence pratique et l’analyse d’échantillons empiriques de taille finie n, les paramètres vrais sont inconnus et doivent être substitués par leurs estimateurs ponctuels respectifs. L’expression prend alors la forme suivante :
z = (x – x̄) / s
où x incarne la valeur brute mesurée pour une observation donnée, x̄ représente la moyenne arithmétique échantillonnale, et s symbolise l’écart-type non biaisé de l’échantillon.
L’analyse fonctionnelle de cette équation révèle l’action conjointe de deux opérateurs affines distincts. Le numérateur, (x – x̄), réalise une opération géométrique de translation spatiale : il décale l’ensemble de la distribution le long de l’axe des abscisses pour positionner le centre de gravité sur l’origine zéro. Cette opération élimine l’effet de niveau de base ou d’ordonnée à l’origine. Le dénominateur, s, agit quant à lui comme un facteur de dilatation ou de contraction scalaire : en divisant la distance par l’unité de dispersion empirique, il compresse ou étend la distribution de telle sorte que l’unité de mesure devienne précisément l’écart-type, rendant la grandeur résultante entièrement adimensionnelle.
2.2 2.2 Démonstration analytique des paramètres résultants
Pour fonder mathématiquement la validité du score Z, il est indispensable de démontrer analytiquement que la variable transformée Z possède nécessairement une espérance nulle et une variance unitaire. Considérons la transformation linéaire générale définie par la fonction Z = aX + b, où nous posons les constantes scalaires a = 1/σ et b = -μ/σ.
En appliquant l’opérateur linéaire d’espérance mathématique E(·), nous obtenons :
E(Z) = E((X – μ) / σ) = (1 / σ) * E(X – μ) = (1 / σ) * (E(X) – E(μ))
Par définition, μ étant une constante égale à E(X), il s’ensuit que :
E(X) – E(μ) = μ – μ = 0
Par conséquent, nous établissons rigoureusement que :
E(Z) = (1 / σ) * 0 = 0
Abordons à présent la démonstration de la variance unitaire en mobilisant les propriétés de l’opérateur de variance Var(·) sur les transformations affines, sachant que pour toute constante scalaire k, Var(kX) = k² * Var(X) et Var(X + k) = Var(X) :
Var(Z) = Var((X – μ) / σ) = Var((1 / σ) * X – (μ / σ))
Le terme constant -(μ / σ) n’exerçant aucune influence sur la dispersion spatiale des points, l’équation se simplifie immédiatement :
Var(Z) = (1 / σ)² * Var(X) = (1 / σ²) * Var(X)
Puisque la variance fondamentale de la variable originale X est par définition égale à σ², la substitution donne :
Var(Z) = (1 / σ²) * σ² = 1
L’écart-type étant défini comme la racine carrée arithmétique positive de la variance, nous en déduisons de manière immédiate que σZ = √1 = 1.
Sur le plan des moments d’ordre supérieur, l’application d’une fonction affine strictement croissante garantit l’invariance absolue des coefficients sans dimension d’asymétrie (skewness) et d’aplatissement (kurtosis). Le coefficient de Fisher-Pearson pour l’asymétrie s’écrit en effet :
γ1 = E[((X – μ) / σ)³] = E[Z³]
Ce résultat démontre sans ambiguïté que le calcul du score Z n’altère en rien la morphologie interne de la série statistique originale. Enfin, cette linéarité préserve strictement la matrice de covariance normalisée : le coefficient de corrélation linéaire de Pearson entre deux variables X et Y demeure rigoureusement identique au coefficient calculé sur leurs transformations standardisées respectives, r(X, Y) = r(ZX, ZY) = Cov(ZX, ZY).
2.3 2.3 Distinction critique entre paramètres de population et estimations d’échantillon
La rigueur statistique impose une distinction méthodologique radicale entre la standardisation théorique opérée à partir de paramètres de population exhaustifs et la standardisation empirique effectuée sur un échantillon probabiliste. Lorsque les vrais paramètres μ et σ sont connus — situation courante lors de l’étalonnage de tests neuropsychologiques standardisés sur des cohortes représentatives de dizaines de milliers d’individus —, la variable Z dérivée suit exactement les propriétés attendues de la loi cible.
En revanche, dans le contexte de la recherche empirique courante, la variance populationnelle est inconnue et doit être estimée à partir de la variance d’échantillon. Cette estimation requiert l’application de la correction de Bessel pour éviter un biais systématique par sous-estimation de la dispersion réelle. L’écart-type échantillonnal non biaisé s est donc calculé avec un dénominateur ajusté à n – 1 degrés de liberté :
s = √[ (1 / (n – 1)) * ∑i=1n (xi – x̄)² ]
L’omission de cette correction — c’est-à-dire l’usage erroné d’une division par n — conduirait à un écart-type empirique systématiquement sous-évalué et, par ricochet, à des scores standardisés artificiellement gonflés en valeur absolue, particulièrement au sein d’échantillons de faible effectif.
Ce glissement méthodologique du statut de paramètre connu vers celui d’estimateur a des répercussions profondes sur la théorie de l’échantillonnage. Lorsque l’on soustrait la moyenne échantillonnale et que l’on divise par l’écart-type empirique calculé sur de petits effectifs (typiquement n < 30), la statistique résultante ne suit plus rigoureusement une loi normale centrée réduite N(0, 1), mais obéit à une distribution t de Student à n – 1 degrés de liberté. Cette distribution se caractérise par des queues plus épaisses (excès de kurtosis positif), traduisant une incertitude accrue et une probabilité supérieure d’observer des déviations extrêmes par le simple jeu des fluctuations d’échantillonnage.
3. 3. Propriétés statistiques de la distribution centrée réduite
3.1 3.1 La règle empirique et la distribution normale standard N(0,1)
Lorsque la variable continue originale X est distribuée selon une loi gaussienne, notée X ~ N(μ, σ²), l’application du score Z génère une variable aléatoire standardisée suivant rigoureusement la loi normale standard, modélisée sous la forme canonique Z ~ N(0, 1). Cette distribution théorique universelle présente des propriétés de symétrie géométrique parfaites autour de son axe vertical passant par l’abscisse z = 0, conférant au mode, à la médiane et à la moyenne arithmétique une stricte superposition centrale.
Cette configuration distributionnelle permet d’énoncer la règle empirique des trois sigmas (souvent désignée sous l’appellation de règle 68-95-99,7), qui régit la concentration probabiliste des observations autour de la valeur moyenne :
- L’intervalle [-1 ; +1] : comprend environ 68,26 % de la population globale des observations. Cela implique qu’environ deux tiers des individus d’une cohorte normale manifestent des performances ou des traits compris dans une fourchette d’un écart-type autour de la tendance centrale.
- L’intervalle [-2 ; +2] : englobe précisément 95,44 % de la masse de probabilité (le seuil conventionnel d’inférence statistique bilatérale à 95 % correspondant très exactement aux bornes critiques de [-1,96 ; +1,96]).
- L’intervalle [-3 ; +3] : sature la quasi-totalité de la distribution empirique en regroupant 99,74 % des observations observées. Les observations au-delà de ces frontières se révèlent hautement exceptionnelles sous l’hypothèse de normalité.
Cette symétrie structurelle induit également que la probabilité d’obtenir un score inférieur à une borne négative -z est mathématiquement équivalente à la probabilité d’obtenir un score supérieur à la borne positive correspondante +z. Cette propriété est exploitée de façon systématique pour tester des hypothèses alternatives directionnelles ou bidirectionnelles dans le cadre des analyses inférentielles paramétriques.
3.2 3.2 Conversion en probabilités et utilisation de la table normale
L’avantage opérationnel majeur de la distribution normale standard réside dans l’existence d’une bijection mathématique absolue entre la valeur continue d’un score Z et sa probabilité cumulée d’occurrence. La densité de probabilité de la variable normale standard s’exprime selon la fonction mathématique suivante :
φ(z) = (1 / √(2π)) * exp(-z² / 2)
Pour calculer la probabilité d’observer un score inférieur ou égal à une valeur spécifique z0, il est nécessaire d’évaluer la fonction de répartition cumulative, notée traditionnellement Φ(z0), qui correspond à l’intégrale définie de la fonction de densité entre l’infini négatif et le seuil considéré :
Φ(z0) = P(Z ≤ z0) = ∫-∞z0 [ (1 / √(2π)) * exp(-u² / 2) ] du
Puisque cette intégrale ne possède pas de primitive analytique pouvant s’exprimer par des fonctions élémentaires, les praticiens ont historiquement eu recours aux tables de la loi normale standard imprimées, remplacées aujourd’hui par des algorithmes numériques haute précision (tels que l’approximation de Chebyshev ou l’expansion en fractions continues). La valeur résultante détermine la valeur p (p-value) associée au score, permettant d’arbitrer le rejet ou le maintien de l’hypothèse nulle avec une précision absolue.
En psychométrie, cette intégrale cumulée offre une passerelle directe vers la détermination des centiles. Le centile associé à un score Z donné indique la proportion exacte d’individus de l’échantillon normatif qui obtiennent une performance inférieure ou égale à cette marque. Par exemple, un score Z de 0 correspond rigoureusement au 50e percentile (la médiane parfaite). Un score Z de +1 correspond au 84,13e percentile, indiquant que le sujet surpasse approximativement 84 % de sa cohorte de référence. Inversement, un score de -1,65 isole le 5e percentile, seuil fréquemment retenu en diagnostic clinique pour signaler une altération fonctionnelle significative.
3.3 3.3 Préservation des rangs et des relations structurales
Du point de vue de la théorie de la mesure, la standardisation par score Z constitue un isomorphisme d’ordre et de distance relative. En tant que transformation affine strictement monotone de la forme f(x) = ax + b avec un multiplicateur a = 1/s > 0, elle satisfait formellement aux axiomes de conservation de l’ordonnancement. Pour tout couple d’observations (xi, xj) appartenant au domaine de mesure :
xi < xj ⇔ zi < zj
Cette stricte monotonie assure qu’aucune inversion hiérarchique ne peut survenir lors du processus de centrage et de réduction. L’ordre des individus le long du continuum métrique demeure absolument immuable, ce qui garantit la cohérence des interprétations ordinales et non paramétriques dérivées de la distribution initiale.
Au-delà de la simple hiérarchie des rangs, la transformation linéaire possède la propriété fondamentale de préserver scrupuleusement les rapports d’espacement relatif entre les paires d’observations. Soient quatre observations quelconques x1, x2, x3, x4 ; le rapport de leurs distances respectives demeure rigoureusement invariant sous la transformation standardisée :
(x1 – x2) / (x3 – x4) = (z1 – z2) / (z3 – z4)
Cette conservation des proportions géométriques implique que la structure topologique interne du nuage de points est intégralement respectée. Par voie de conséquence, les matrices de corrélation produit-moment de Pearson calculées entre plusieurs variables demeurent parfaitement inchangées que l’on manipule les séries brutes ou leurs formes standardisées respectives. Le score Z déploie ainsi une métrique normalisée exempte de toute distorsion structurale.
4. 4. Démonstration de calcul pas à pas avec un jeu de données empirique
4.1 4.1 Présentation des données brutes et calcul des statistiques descriptives
Pour ancrer ces développements théoriques dans la pratique expérimentale, examinons un échantillon empirique contrôlé issu d’un paradigme de neurophysiologie cognitive. L’expérience implique dix participants adultes (n = 10) soumis à une tâche informatisée d’inhibition motrice de type Go/Nogo. La variable dépendante recueillie correspond au temps de réaction moyen mesuré en millisecondes (ms) lors des essais d’inhibition réussis. Les données brutes recueillies sont présentées ci-dessous :
Temps de réaction (ms) : 420, 380, 460, 410, 390, 510, 370, 440, 430, 490
La première phase calculatoire consiste à déterminer la moyenne arithmétique empirique x̄ de cet échantillon. Nous procédons à la sommation algébrique exhaustive des valeurs d’observations :
∑i=110 xi = 420 + 380 + 460 + 410 + 390 + 510 + 370 + 440 + 430 + 490 = 4300 ms
La moyenne arithmétique s’obtient immédiatement en divisant cette somme par la taille d’échantillon n = 10 :
x̄ = 4300 / 10 = 430,0 ms
La seconde phase consiste à évaluer la dispersion empirique en établissant la somme des carrés des écarts à la moyenne arithmétique (Sum of Squares, notée SS) :
- (420 – 430)² = (-10)² = 100
- (380 – 430)² = (-50)² = 2500
- (460 – 430)² = (+30)² = 900
- (410 – 430)² = (-20)² = 400
- (390 – 430)² = (-40)² = 1600
- (510 – 430)² = (+80)² = 6400
- (370 – 430)² = (-60)² = 3600
- (440 – 430)² = (+10)² = 100
- (430 – 430)² = (0)² = 0
- (490 – 430)² = (+60)² = 3600
La somme globale des carrés des écarts s’élève à :
SS = 100 + 2500 + 900 + 400 + 1600 + 6400 + 3600 + 100 + 0 + 3600 = 19200
Nous déterminons ensuite la variance échantillonnale non biaisée s² en divisant cette quantité par le nombre de degrés de liberté n – 1 = 9 :
s² = 19200 / 9 ≈ 2133,333 ms²
L’écart-type échantillonnal non biaisé s s’obtient en extrayant la racine carrée arithmétique de la variance :
s = √2133,333 ≈ 46,188 ms
4.2 4.2 Application pas à pas de la formule de normalisation
Une fois les paramètres x̄ = 430,0 et s = 46,188 consolidés, nous pouvons procéder à l’application systématique de la formule de standardisation zi = (xi – x̄) / s pour chaque individu de la série expérimentale.
Examinons en détail le calcul pour trois profils caractéristiques de l’échantillon :
- Observation inférieure à la moyenne (Participant 7, x = 370 ms) : Ce sujet démontre une vitesse de traitement très rapide. L’écart brut est négatif : 370 – 430 = -60 ms. L’application du dénominateur donne : z = -60 / 46,188 = -1,299. Le score Z négatif confirme que la vitesse du sujet se situe à 1,30 écart-type en deçà de la moyenne du groupe.
- Observation coïncidant avec la moyenne (Participant 9, x = 430 ms) : L’écart au centre de gravité est nul : 430 – 430 = 0 ms. Le score résultant est formellement égal à zéro : z = 0 / 46,188 = 0,000. L’individu s’aligne exactement sur le barycentre empirique de la distribution.
- Observation nettement supérieure à la moyenne (Participant 6, x = 510 ms) : Ce sujet présente une latence décisionnelle très marquée. L’écart positif est important : 510 – 430 = +80 ms. La division scalaire donne : z = +80 / 46,188 = +1,732. Le temps de réaction dépasse la moyenne de plus de 1,73 écart-type.
Le tableau ci-dessous résume l’intégralité des transformations individuelles pour la cohorte étudiée :
| Participant | Temps brut xi (ms) | Écart au centre (xi – x̄) | Score Z résultant zi | Rang percentile estimé |
|---|---|---|---|---|
| Participant 1 | 420 | -10 | -0,216 | 41,4 % |
| Participant 2 | 380 | -50 | -1,083 | 13,9 % |
| Participant 3 | 460 | +30 | +0,650 | 74,2 % |
| Participant 4 | 410 | -20 | -0,433 | 33,3 % |
| Participant 5 | 390 | -40 | -0,866 | 19,3 % |
| Participant 6 | 510 | +80 | +1,732 | 95,8 % |
| Participant 7 | 370 | -60 | -1,299 | 9,7 % |
| Participant 8 | 440 | +10 | +0,216 | 58,6 % |
| Participant 9 | 430 | 0 | 0,000 | 50,0 % |
| Participant 10 | 490 | +60 | +1,299 | 90,3 % |
4.3 4.3 Vérification post-calculatoire de l’intégrité de la distribution
L’intégrité algorithmique du centrage-réduction impose d’exécuter un contrôle post-calculatoire rigoureux sur la série transformée des zi. Ce processus repose sur deux vérifications mathématiques indispensables : la confirmation de la nullité de l’espérance arithmétique et la confirmation de la valeur unitaire de la variance d’échantillon.
Procédons initialement à la sommation algébrique des scores standardisés individuels :
∑i=110 zi = (-0,216) + (-1,083) + (+0,650) + (-0,433) + (-0,866) + (+1,732) + (-1,299) + (+0,216) + (0,000) + (+1,299)
En regroupant les composantes positives et négatives :
Scores positifs = +0,650 + +1,732 + +0,216 + +1,299 = +3,897
Scores négatifs = -0,216 + -1,083 + -0,433 + -0,866 + -1,299 = -3,897
La sommation donne de manière exacte :
∑ zi = +3,897 – 3,897 = 0,000
La moyenne empirique calculée z̄ = (∑ zi) / 10 = 0,000 / 10 = 0 valide formellement l’alignement parfait du barycentre sur l’origine.
Abordons ensuite le calcul de la somme des carrés des scores Z pour tester la dispersion unitaire :
∑ zi² = (-0,216)² + (-1,083)² + (0,650)² + (-0,433)² + (-0,866)² + (1,732)² + (-1,299)² + (0,216)² + (0,000)² + (1,299)²
∑ zi² ≈ 0,0467 + 1,1729 + 0,4225 + 0,1875 + 0,7500 + 2,9998 + 1,6874 + 0,0467 + 0,0000 + 1,6874 = 9,0009
En divisant par les degrés de liberté n – 1 = 9 :
sz² = 9,0009 / 9 = 1,0001 ≈ 1,000
L’écart-type résultant est rigoureusement égal à 1 (les infimes variations au quatrième rang décimal découlant exclusivement des arrondis intermédiaires). La distribution standardisée répond donc aux exigences formelles.
Sur le plan géométrique, si nous comparions l’histogramme des données brutes en millisecondes et l’histogramme des scores Z standardisés, nous constaterions une superposition morphologique parfaite. L’allure générale, la présence d’un éventuel étirement vers les valeurs lentes à droite (asymétrie positive) et l’amplitude relative des barres demeurent strictement identiques. Seule l’étiquette de l’axe horizontal a subi une métamorphose : les valeurs originales fluctuant entre 370 et 510 ms sont désormais cartographiées sur un intervalle continu borné entre -1,30 et +1,73.
5. 5. Applications de la normalisation par score Z en psychométrie et psychologie
5.1 5.1 Harmonisation des échelles d’évaluation neuropsychologique
La pratique clinique neuropsychologique confronte quotidiennement le praticien à l’évaluation diagnostique de fonctions cognitives hautement spécialisées, investiguées au moyen d’instruments métriques profondément hétérogènes. Considérons le bilan d’un patient victime d’un accident vasculaire cérébral ou suspecté d’une pathologie neurodégénérative naissante. L’exploration clinique mobilise typiquement des paradigmes d’empan mnésique envers (score brut borné entre 2 et 9 éléments), des épreuves de fluence verbale catégorielle (quantifiées par le nombre brut de substantifs produits en 60 secondes, variant habituellement entre 5 et 35 mots), et des épreuves de praxies constructives (telles que la copie de la figure complexe de Rey, scorée sur une échelle ordinale de 0 à 36 points).
Toute tentative d’agréger directement ces scores bruts pour formuler un bilan cognitif synthétique constituerait une aberration méthodologique majeure. L’échelle de praxie dominerait arithmétiquement l’évaluation globale par son étendue numérique, tandis que les variations subtiles de l’empan mnésique — où un écart d’un seul élément peut refléter un basculement pathologique critique — se trouveraient entièrement diluées et indétectables.
Grâce à la normalisation par score Z adossée à des tables normatives représentatives (ajustées selon l’âge et le niveau socio-éducatif du patient), le clinicien convertit chaque résultat brut en un indice standardisé sans dimension. Si le patient obtient z = -2,2 en fluence verbale, z = -0,1 en copie de figure complexe et z = +0,4 en empan mnésique, le profil fonctionnel apparaît avec une netteté immédiate. Il est dès lors possible de calculer un indice composite de fonctionnement exécutif par une moyenne pondérée transparente, sans qu’aucun artéfact métrique ne vienne dénaturer la réalité clinique sous-jacente.
5.2 5.2 Évaluation de la personnalité et inventaires multi-échelles
Dans le domaine de la psychologie différentielle et de l’évaluation de la personnalité, les modèles dominants — tels que le Modèle des Big Five ou les questionnaires psychologiques à large spectre comme le NEO-PI-3 — comportent des dizaines de sous-échelles conçues pour mesurer des construits latents spécifiques : névrosisme, extraversion, ouverture, agréabilité et conscience. Bien que les concepteurs de tests s’efforcent d’uniformiser le nombre d’items par facette (par exemple, 8 items cotés de 1 à 5 sur une échelle de Likert), les propriétés distributionnelles empiriques divergent systématiquement.
Ces divergences proviennent de biais de désirabilité sociale différentiels ou de propriétés lexicales propres aux formulations. L’échelle d’agréabilité présente fréquemment une moyenne élevée et une variance comprimée en population générale, tandis que l’échelle de névrosisme tend à présenter une dispersion beaucoup plus étendue et une asymétrie positive marquée. La manipulation de scores bruts non standardisés biaiserait lourdement les profils de personnalité individuels, suggérant artificiellement des déviations là où n’existent que des variations d’échelles locales.
La normalisation par score Z permet d’égaliser la variance des sous-échelles et de neutraliser les fluctuations arbitraires de dispersion. Ce redressement métrique s’avère absolument indispensable pour exécuter des analyses typologiques (cluster analysis) ou des modélisations en classes latentes. En ramenant chaque trait de personnalité à une métrique d’écart-type centrée sur zéro, les algorithmes de partitionnement spatial mesurent de véritables proximités psychologiques au lieu d’agréger des sujets sur la base de biais d’amplitude numérique artificielle.
5.3 5.3 Suivi longitudinal et études interventionnelles
L’évaluation rigoureuse des interventions thérapeutiques, qu’il s’agisse d’essais cliniques pharmacologiques ou de protocoles de remédiation cognitive et psychothérapeutique, repose sur des devis longitudinaux mesurant l’évolution pré- et post-traitement. Un défi analytique récurrent réside dans le fait que les instruments psychométriques administrés lors de la ligne de base doivent parfois être substitués par des formes parallèles alternatives lors des phases d’évaluation ultérieures pour éviter les effets d’apprentissage ou de familiarisation avec les items de test.
La standardisation par score Z résout cette difficulté méthodologique en offrant un repère stable. La métrique du score Z s’apparente directement à l’un des indicateurs les plus réputés de l’ampleur d’un effet thérapeutique : le d de Cohen. Le calcul de la taille d’effet standardisée intra-individuelle s’exprime selon l’équation :
d = (x̄post – x̄pre) / spooled
Cette formulation n’est rien d’autre qu’un score Z appliqué à la différence moyenne entre deux conditions d’observation, mis à l’échelle par la racine de la variance mutualisée (pooled standard deviation).
En outre, dans l’analyse de cas individuels (Single-Case Experimental Designs), la normalisation par score Z permet de vérifier le critère de « changement cliniquement significatif » (Clinically Significant Change) popularisé par Jacobson et Truax. En modélisant la trajectoire d’un patient sous forme de déplacement le long du continuum standardisé, le clinicien peut vérifier avec une rigueur paramétrique si la transition post-thérapeutique du patient le replace effectivement à l’intérieur d’un corridor de normalité (généralement défini par z > -1,0 ou -1,5), validant ainsi l’impact thérapeutique concret au-delà des considérations théoriques.
6. 6. Analyse comparative inter-individuelle et intra-individuelle
6.1 6.1 Comparaison inter-individuelle : positionner le sujet par rapport à la norme
L’analyse inter-individuelle constitue l’application la plus familière de la psychométrie standardisée. Elle consiste à situer les performances ou les dispositions d’un sujet singulier par rapport à celles d’un groupe de référence auquel il est structurellement apparenté. L’élaboration de ce groupe de référence repose sur la constitution rigoureuse d’un échantillon normatif représentatif, stratifié selon des variables démographiques déterminantes telles que les tranches d’âge chronologique, le genre et le niveau d’instruction formelle (couramment divisé en niveaux d’études primaires, secondaires et universitaires).
Le positionnement par score Z permet d’attribuer une signification probabiliste immédiate aux écarts observés vis-à-vis de la moyenne des pairs :
- Écart de |z| > 1,65 : Dans une perspective unilatérale, cet écart correspond au seuil probabiliste alpha de 5 %. Il indique une déviation atypique, le sujet se situant au sein des 5 % les plus extrêmes de la population normale de référence.
- Écart de |z| > 1,96 : Il matérialise le seuil critique conventionnel bilatéral de 5 % (2,5 % à chaque extrémité). En pratique clinique et médico-légale, ce seuil délimite traditionnellement la frontière entre une variation normale et une altération potentiellement pathologique ou une excellence cognitive hors norme.
- Écart de |z| > 2,58 : Associé au niveau de significativité de 1 % bilatéral (et au 99,5e percentile ou 0,5e percentile), ce niveau de déviation signale une condition clinique hautement sévère ou un profil cognitif exceptionnel, survenant chez moins d’une personne sur deux cents.
Cette formalisation protège le praticien contre les erreurs d’appréciation subjective : un écart de performance n’a de valeur diagnostique que s’il excède significativement la variabilité aléatoire observée chez des individus sains de même profil socio-démographique.
6.2 6.2 Profilage intra-individuel : détection des dissociations cognitives
Si la comparaison inter-individuelle s’avère indispensable, l’examen de la cohérence interne des scores d’un même individu — le profilage intra-individuel — constitue le cœur battant de la neuropsychologie cognitive. Dans ce paradigme fondé sur les travaux de Tim Shallice et d’Elizabeth Warrington, le clinicien cherche à déceler des « dissociations simples » ou des « dissociations doubles » au sein de l’architecture fonctionnelle cérébrale, afin d’attester de l’indépendance de sous-systèmes modulaires lésés ou épargnés.
Considérons un patient cérébro-lésé présentant un score standardisé en mémoire rétrograde sémantique de z = -0,2 (parfaitement intègre par rapport à la moyenne normative) et un score en mémoire épisodique antérograde de z = -2,8. La simple comparaison inter-individuelle isole un déficit en mémoire épisodique. Toutefois, l’analyse intra-individuelle révèle un écart structurel entre les deux domaines fonctionnels de :
Δz = zépisodique – zsémantique = -2,8 – (-0,2) = -2,6 écarts-types
Pour déterminer si cette disparité intra-individuelle est cliniquement significative et n’est pas imputable à l’imprécision inhérente aux instruments de mesure, le psychomètre calcule l’écart-type de la différence entre les deux scores standardisés, paramétré par la fidélité de chaque sous-test (notée rxx et ryy) :
sdiff = √[ 2 – rxx – ryy ]
En divisant la différence observée Δz par cet écart-type d’erreur sdiff, on obtient un score Z de contraste critique. Si ce contraste excède les seuils d’invariance statistique, le neuropsychologue peut affirmer l’existence d’une dissociation fonctionnelle hautement probante chez le patient, attestant d’une atteinte ciblée d’un module cognitif singulier sur fond de préservation relative des autres facultés intellectuelles.
6.3 6.3 Pièges d’interprétation lors de la comparaison de populations distinctes
L’application non critique de la normalisation par score Z recèle des pièges interprétatifs majeurs lorsque les données d’un groupe spécifique sont projetées sur des étalonnages conçus pour d’autres populations. Le risque d’erreur le plus critique provient de l’utilisation d’échantillons normatifs non représentatifs ou obsolètes. Si la cohorte d’étalonnage initiale présente des biais d’échantillonnage (par exemple, un sur-recrutement d’individus issus de milieux académiques favorisés), la moyenne μ sera artificiellement surestimée et l’écart-type σ possiblement comprimé. Tout sujet issu d’un milieu socio-économique plus modeste verra son score Z dévalué de manière systématique, générant des faux positifs cliniques.
Un autre défi méthodologique concerne la validité transculturelle des étalonnages. L’application directe de normes nord-américaines ou d’Europe occidentale à des cohortes évaluées dans des contextes linguistiques, culturels ou éducatifs différents fausse gravement l’interprétation des scores Z. Les stimuli verbaux, la vitesse d’exécution valorisée dans les tâches chronométrées et la familiarité générale avec les formats de tests constituent des modérateurs culturels puissants qui modifient structurellement la moyenne et la dispersion des mesures.
Enfin, le phénomène séculaire d’évolution intellectuelle connu sous le nom d’effet Flynn — documentant une progression continue des performances moyennes aux tests d’aptitude générale au fil des décennies au cours du vingtième siècle — impose une mise à jour périodique rigoureuse des étalonnages. Si un praticien évalue un patient contemporain à l’aide d’une batterie de tests standardisée trente ans auparavant, la moyenne normative obsolète sera trop basse : le patient paraîtra statistiquement surperformant, ses scores Z étant artificiellement gonflés d’une demi-déviation standard voire plus, masquant de potentielles détériorations cliniques débutantes.
7. 7. Détection des valeurs aberrantes et diagnostic clinique
7.1 7.1 Règle de décision statistique pour l’identification des outliers
Dans la phase exploratoire du nettoyage de données scientifiques, le repérage et le traitement rigoureux des valeurs aberrantes (outliers) conditionnent la robustesse des modélisations ultérieures. Les scores Z fournissent une règle de décision statistique standardisée, objective et universelle pour opérationnaliser le statut d’extrême numérique. La procédure consiste à convertir l’ensemble des observations brutes en scores standardisés, puis à appliquer des seuils de démarcation conventionnels :
- Seuil modéré (|z| > 2,0) : Identifie les points se situant en dehors des 95 % centraux d’une distribution normale. Ce filtre sert couramment d’alarme précoce pour inciter le chercheur à un examen visuel de la donnée.
- Seuil conventionnel (|z| > 2,58 ou 3,0) : Dans les protocoles de recherche expérimentale, le critère d’exclusion le plus répandu fixe le seuil de coupure à |z| > 3,0. La probabilité qu’une observation issue d’une population gaussienne légitime dépasse 3 écarts-types par pur hasard est infinitésimale (environ 0,26 % d’occurrence conjointe bilatérale, soit 13 cas sur 10 000 par queue).
Une distinction épistémologique cruciale doit être opérée entre les erreurs de mesure expérimentales et les extrêmes statistiques biologiquement ou psychologiquement valides. Une valeur aberrante résultant d’un dysfonctionnement instrumental (artéfact d’enregistrement électrophysiologique, inadvertance de saisie typographique, inattention totale d’un sujet pressant une mauvaise touche) doit être impérativement éliminée ou imputée. En revanche, un point extrême représentant une authentique variabilité inter-individuelle ne saurait être exclu sans justification théorique explicite, sous peine de biaiser lourdement l’estimation de la variance populationnelle réelle et de dégrader la validité écologique des modèles statistiques.
7.2 7.2 Diagnostic des troubles neurodéveloppementaux et cognitifs
Les taxonomies nosographiques internationales majeures en psychiatrie et en médecine, telles que le Manuel diagnostique et statistique des troubles mentaux (DSM-5) et la Classification internationale des maladies (CIM-11), ont formellement institutionnalisé des seuils quantitatifs fondés sur la déviation standardisée pour circonscrire plusieurs entités cliniques.
L’exemple le plus emblématique réside dans la caractérisation dimensionnelle du Trouble du développement intellectuel (déficience intellectuelle). Le critère psychométrique formel exige la constatation d’un fonctionnement intellectuel général significativement inférieur à la moyenne, opérationnalisé par une performance se situant à au moins deux écarts-types en deçà de la norme :
z ≤ -2,00
Sur l’échelle standardisée du quotient intellectuel (QI de déviation de Wechsler, caractérisée par une moyenne μ = 100 et un écart-type σ = 15), ce seuil critique de deux écarts-types correspond très précisément à l’équation linéaire :
QI = 100 + 15 * (-2,00) = 70
Tout score de QI inférieur ou égal à 70 se traduit par un score Z égal ou inférieur à -2,00, situant l’individu sous le 2,27e percentile de la population générale.
À l’autre extrémité de la distribution cognitive, la définition psychométrique conventionnelle du haut potentiel intellectuel (HPI) ou de la douance intellectuelle applique une symétrie mathématique exacte :
z ≥ +2,00
Ce seuil correspond à un QI de déviation supérieur ou égal à 130 (100 + 15 * 2 = 130), isolant les 2,27 % supérieurs de la distribution normale théorique. Des critères similaires régissent l’identification des troubles des apprentissages (dyslexie, dyscalculie, dysorthographie) ou du trouble du déficit de l’attention avec ou sans hyperactivité (TDAH), où des déficits isolés atteignant z ≤ -1,65 ou z ≤ -2,00 sur des épreuves neuropsychologiques standardisées viennent corroborer l’observation anamnestique et fonctionnelle du praticien.
7.3 7.3 Sensibilité du score Z face à la présence de valeurs extrêmes
En dépit de son élégance formelle, la méthode de détection des outliers par score Z classique présente une vulnérabilité mathématique structurelle : son effondrement face aux valeurs extrêmes massives préexistantes dans l’échantillon. La moyenne arithmétique x̄ et l’écart-type empirique s sont deux estimateurs statistiques dits « non robustes », dotés d’un point de rupture (breakdown point) théorique de 0 %. Cela signifie qu’une unique valeur aberrante d’amplitude astronomique suffit à elle seule à faire diverger arbitrairement la moyenne et à dilater démesurément l’écart-type du groupe.
Cette sensibilité engendre deux phénomènes pathologiques bien identifiés en statistique exploratoire :
- L’effet de masquage (Masking) : La présence d’une ou de plusieurs valeurs aberrantes extrêmement divergentes augmente artificiellement la variance globale s de manière tellement excessive que le dénominateur de l’équation standardisée devient gigantesque. Par conséquent, d’autres observations authentiquement anormales voient leur score Z comprimé en deçà du seuil critique (par exemple, |z| = 2,2 au lieu de 3,1) et échappent complètement à la détection algorithmique.
- L’effet de submersion (Swamping) : L’attraction de la moyenne arithmétique vers un outlier situé sur une queue distale peut décaler le centre de gravité à un point tel que des observations centrales ordinaires se retrouvent rejetées du côté opposé avec des scores Z artificiellement gonflés, conduisant à les classifier faussement comme suspectes.
Pour contourner cette limite rédhibitoire, les statisticiens Boris Iglewicz et David Hoaglin ont formalisé le « score Z modifié » (Modified Z-score), qui substitue les paramètres paramétriques sensibles par des estimateurs statistiques de haute robustesse :
Mi = 0,6745 * (xi – x̃) / MAD
Dans cette formulation alternative, x̃ représente la médiane empirique de l’échantillon (insensible aux extrêmes distaux) et MAD symbolise la déviation absolue médiane (Median Absolute Deviation), définie comme la médiane de la série des écarts absolus par rapport à la médiane : MAD = median(|xi – x̃|). Le coefficient multiplicateur de correction 0,6745 correspond à l’inverse du troisième quartile d’une loi normale standard (1 / 1,4826) ; il assure que l’estimateur MAD ajusté converge vers l’écart-type standard lorsque les données sous-jacentes suivent fidèlement une distribution normale. Tout point présentant un score modifié |Mi| > 3,5 est considéré avec une robustesse exemplaire comme une valeur aberrante uncontestable, exempte des effets pervers de masquage.
8. 8. Comparaison du score Z avec d’autres méthodes de mise à l’échelle
8.1 8.1 Normalisation Min-Max (mise à l’échelle unitaire [0, 1])
La normalisation Min-Max représente l’alternative d’ingénierie de données la plus fréquente à la standardisation par score Z, notamment au sein des architectures d’apprentissage machine et d’optimisation numérique. Sa formulation mathématique opère une compression affine délimitant rigoureusement les données brutes à l’intérieur d’un intervalle numérique fermé, typiquement borné entre 0 et 1 :
xnorm = (x – xmin) / (xmax – xmin)
où xmin et xmax désignent respectivement les minima et maxima observés de la caractéristique continue.
Cette approche offre des atouts majeurs lors de l’entraînement d’algorithmes requérant des entrées numériques strictement positives et homogènes. C’est typiquement le cas des réseaux de neurones artificiels exploitant des fonctions d’activation non linéaires non symétriques telles que la fonction sigmoïde unitaire, ou des algorithmes de factorisation matricielle non négative (NMF) et des modèles de traitement d’images basés sur des intensités de pixels codées de 0 à 255.
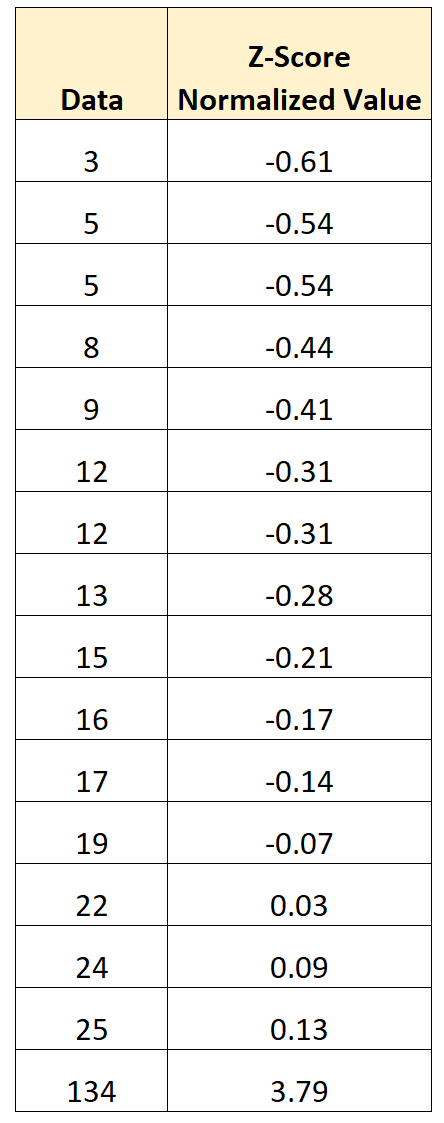
Toutefois, la normalisation Min-Max présente un écueil analytique colossal en présence de valeurs aberrantes. Si un unique point d’observation anormalement élevé s’introduit dans le jeu de données, la borne xmax est catapultée vers une valeur démesurée. Le dénominateur (xmax – xmin) explose instantanément, provoquant l’écrasement mécanique de l’ensemble de la masse des observations légitimes dans une sous-bande infinitésimale (par exemple entre 0,00 et 0,05). La variance utile du jeu de données se trouve totalement annihilée, altérant l’apprentissage algorithmique. Le score Z, ne reposant pas sur les bornes extrêmes absolues, amortit infiniment mieux cette distorsion.
8.2 8.2 Standardisation robuste (Robust Scaler)
Pour combler les déficiences structurelles du score Z classique (fondé sur les estimateurs sensibles de moyenne et de variance) et de la normalisation Min-Max (fondée sur les extrema absolus), la littérature méthodologique contemporaine a institué la standardisation robuste, abondamment popularisée sous l’appellation de RobustScaler dans les librairies scientifiques.
Cette transformation mobilise des statistiques d’ordre hautement résilientes aux perturbations locales. La métrique repose sur le calcul de la médiane empirique (percentile 50) pour fixer l’origine, couplée à l’écart interquartile (Interquartile Range, noté IQR) pour normaliser la dispersion de l’échelle :
xrobust = (x – Q2) / (Q3 – Q1)
où Q1 représente le premier quartile (percentile 25), Q2 la médiane centrale, et Q3 le troisième quartile (percentile 75) de la distribution empirique.
L’écart interquartile IQR = Q3 – Q1 quantifie l’étendue occupée par les 50 % centraux des données, se révélant insensible aux déformations survenant sur les queues distales de distribution. La standardisation robuste neutralise totalement l’influence des valeurs aberrantes massives, qui peuvent subsister aux confins du jeu de données sans jamais perturber le rééchelonnement du noyau central. Cette technique est donc l’approche recommandée en présence de séries statistiques hautement asymétriques, contaminées par un bruit instrumental sévère ou comportant des queues lourdes de type lois de Cauchy ou de Pareto.
8.3 8.3 Tableau synthétique comparatif et critères de sélection
Le choix méthodologique entre ces trois grandes philosophies de mise à l’échelle ne relève pas de la convenance arbitraire mais doit s’aligner sur la nature probabiliste des données et les réquisits fonctionnels des modèles avals. Le tableau comparatif suivant synthétise leurs caractéristiques distinctives :
| Caractéristique | Standardisation Score Z | Normalisation Min-Max | Standardisation Robuste |
|---|---|---|---|
| Formulation algébrique | (x – x̄) / s | (x – xmin) / (xmax – xmin) | (x – Q2) / IQR |
| Paramètres centraux | Moyenne arithmétique (E(X) = 0) | Borne minimale (Min = 0) | Médiane empirique (Med = 0) |
| Paramètres de dispersion | Écart-type unitaire (s = 1) | Étendue totale (Max – Min = 1) | Écart interquartile unitaire (IQR = 1) |
| Bornes de sortie | Théoriquement non bornées [-∞, +∞] | Strictement bornées [0, 1] ou [-1, 1] | Théoriquement non bornées [-∞, +∞] |
| Sensibilité aux outliers | Modérée à forte (déplacement de x̄ et s) | Extrême (écrasement complet de la variance) | Nulle à quasi-nulle (haute résilience) |
| Hypothèse distributionnelle | Présume une forme symétrique ou normale | Aucune hypothèse préalable | Adaptée aux distributions asymétriques |
| Algorithmes privilégiés | ACP, Régression Ridge/Lasso, SVM, k-means | Réseaux neuronaux profonds, k-NN, Traitement d’images | Modélisations sur données financières, séries bruitées |
Les critères décisionnels doivent découler de ce comparatif : en présence d’une variable raisonnablement symétrique et en vue d’alimenter des méthodes paramétriques fondées sur la variance (comme l’Analyse en Composantes Principales ou les séparateurs à vaste marge), le score Z demeure le standard absolu d’excellence. Dès lors que les données intègrent des valeurs aberrantes indélébiles, le RobustScaler s’impose de facto.
9. 9. Dérivation d’autres échelles standardisées en sciences humaines
9.1 9.1 Échelle des scores T de McCall
Si la métrique du score Z s’avère irréprochable sur le plan des propriétés algébriques, sa transposition en milieu clinique ou éducatif soulève des résistances d’ordre pratique et psychologique. La manipulation courante de signes négatifs (par exemple signifier à un individu ou à un parent un score de -1,8) engendre de fréquentes incompréhensions, tandis que la gestion de valeurs décimales alourdit inutilement les rapports d’expertise. Pour pallier ces écueils ergonomiques, le statisticien William A. McCall a introduit dans les années 1920 l’échelle des scores T.
Le score T est une dérivation linéaire directe du score Z, paramétrée de telle sorte que sa moyenne arithmétique normative soit impérativement fixée à 50 et son écart-type unitaire étalonné à 10. La fonction de conversion affine s’exprime par l’équation générale :
T = 50 + 10 * Z
L’avantage pragmatique de cette métrique est immédiat : une déviation de trois écarts-types autour de la moyenne déploie une étendue numérique continue comprise entre 20 (50 + 10 * (-3)) et 80 (50 + 10 * (+3)). Les valeurs négatives se trouvent ainsi totalement éradiquées de la pratique diagnostique, et les scores s’énoncent sous forme d’entiers naturels facilement mémorisables.
L’usage du score T est universellement prépondérant dans les inventaires cliniques de personnalité et les évaluations psychopathologiques standardisées. L’illustration la plus représentative est le questionnaire de personnalité MMPI (Minnesota Multiphasic Personality Inventory). Dans ce dernier, les sous-échelles cliniques (Dépression, Hystérie, Paranoïa, etc.) sont systématiquement exprimées en scores T normalisés. Le clinicien retient une règle d’évaluation universelle : un score T excédant le seuil de 65 (correspondant formellement à z = +1,50) ou de 70 (correspondant à z = +2,00) est qualifié d’« élévation clinique significative », signalant l’expression aiguë d’une configuration pathologique potentielle.
9.2 9.2 Échelle du quotient intellectuel standard (QI de déviation de Wechsler)
L’histoire de la quantification des capacités intellectuelles a été marquée par une rupture conceptuelle fondamentale opérée par David Wechsler à la fin des années 1930. Les échelles pionnières de Binet-Simon et de Terman mobilisaient originellement la notion de « Quotient Intellectuel de développement », calculé selon le ratio entre l’« âge mental » et l’« âge chronologique », multiplié par 100 : QI = (Âge mental / Âge chronologique) * 100. Cette approche arithmétique s’est révélée désastreuse dès lors qu’elle était appliquée à des adultes, la maturation intellectuelle brute plafonnant naturellement à la fin de l’adolescence alors que l’âge chronologique continue inexorablement de croître, entraînant un effondrement artificiel du QI avec le vieillissement.
Wechsler a définitivement balayé cette logique de ratio développemental pour lui substituer le modèle mathématique du « QI de déviation », qui repose sur une stricte transformation affine du score Z. L’échelle de Wechsler est calibrée pour présenter une moyenne générale de 100 et un écart-type de 15 points :
QI = 100 + 15 * Z
Cette échelle standardisée déploie des correspondances probabilistes invariantes qui structurent la classification psychométrique des aptitudes humaines à l’échelle planétaire :
- QI = 100 (z = 0,00) : Performance intellectuelle médiane stricte, correspondant au 50e percentile de la population générale.
- QI compris entre 85 et 115 (z ∈ [-1,00 ; +1,00]) : Englobe approximativement 68,26 % de la population générale, circonscrivant la zone dite de normalité intellectuelle moyenne.
- QI ≤ 70 (z ≤ -2,00) : Isole les 2,27 % d’individus présentant un déficit cognitif sévère, critère statistique fondamental pour le diagnostic du handicap intellectuel.
- QI ≥ 130 (z ≥ +2,00) : Isole les 2,27 % supérieurs de la distribution, définissant le seuil académique usuel de très haute aptitude cognitive ou douance intellectuelle.
Grâce à cette conversion linéaire systématique, un QI obtenu par un sujet de 20 ans présente la même signification d’éloignement normatif qu’un QI calculé chez un individu de 75 ans, chacun étant évalué exclusivement par rapport à sa propre cohorte de référence.
9.3 9.3 Échelles des stens, stanines et notes standard
Au fil du développement de la psychométrie appliquée au monde militaire, éducatif et des ressources humaines, d’autres échelles dérivées du score Z ont été standardisées pour répondre à des impératifs opérationnels spécifiques :
L’échelle des Stanines (Standard Nines) : Conçue durant la Seconde Guerre mondiale par l’aviation militaire américaine pour faciliter le stockage d’aptitudes cognitives sur les premières cartes perforées informatiques (qui ne toléraient qu’un unique caractère numérique par colonne), l’échelle Stanine segmente la distribution continue en 9 classes numériques ordinales distinctes, de 1 à 9. Elle est mathématiquement paramétrée par une moyenne fixée à 5 et un écart-type fixé à 2 :
Stanine = 5 + 2 * Z (avec un arrondissement à l’entier le plus proche, plafonné à 1 et 9).
L’échelle des Stens (Standard Tens) : Introduite par Raymond Cattell lors de la modélisation du questionnaire de personnalité 16 PF, cette métrique découpe l’espace distributionnel en 10 classes étalonnées, de 1 à 10. Son paramétrage affine repose sur une moyenne de 5,5 et un écart-type de 2 :
Sten = 5,5 + 2 * Z
L’avantage psychologique de cette échelle est que la note 5,5 ne peut être attribuée (l’échelle utilisant des nombres entiers), forçant ainsi le positionnement du profil soit dans la moitié inférieure (Stens 1 à 5), soit dans la moitié supérieure (Stens 6 à 10), évitant la complaisance d’un classement médian ambigu.
Les notes standard de sous-tests de Wechsler : Au sein des batteries d’intelligence contemporaines (WAIS-IV, WISC-V), les épreuves individuelles élémentaires (matrices, vocabulaire, mémoire des chiffres) ne sont pas étalonnées directement en QI mais converties en « notes standard sous-échelles » (scaled scores). Cette distribution est calibrée selon une moyenne arithmétique de 10 et un écart-type fixé à 3 :
Note standard = 10 + 3 * Z
Cette gradation resserrée permet d’apprécier la morphologie fine d’un profil cognitif avant l’agrégation finale en indices composites globaux.
10. 10. Limites méthodologiques et hypothèse de non-normalité
10.1 10.1 Le mythe de la normalisation de la forme de distribution
L’une des erreurs conceptuelles les plus persistantes au sein de la communauté des praticiens et des étudiants en sciences humaines réside dans la croyance erronée selon laquelle l’application d’une formule de normalisation par score Z conférerait une distribution normale (gaussienne) à n’importe quel ensemble de données empiriques. Cette confusion sémantique découle directement du mot polysémique « normalisation ».
Il est impératif de rappeler un axiome fondamental de l’algèbre statistique : le calcul du score Z est une transformation strictement affine de la forme f(x) = ax + b. Par définition géométrique, les transformations affines ne modifient jamais la distribution de probabilité relative intrinsèque des points dans l’espace. Si l’on soumet une variable fortement asymétrique (présentant par exemple une asymétrie positive avec une longue queue vers la droite, comme des temps de latence ou des revenus financiers) à une standardisation par score Z, la série résultante sera invariablement asymétrique, affichant exactement le même coefficient de skewness de Fisher-Pearson que la série brute d’origine.
L’illusion d’une normalisation de la morphologie distributionnelle induit des erreurs diagnostiques graves. Si un praticien présume à tort que sa variable transformée obéit désormais à la loi N(0, 1), il appliquera inconsidérément les pourcentages de la table normale standard : il affirmera qu’un score z = +1,96 sépare précisément 2,5 % des individus, alors qu’au sein de la distribution asymétrique parente, ce seuil numérique peut en réalité recouvrir 8 %, 12 % ou 0,5 % de la cohorte ! L’inférence probabiliste devient factuellement fausse. Pour transformer la distribution d’une variable non gaussienne vers une forme approximativement normale, le chercheur doit recourir à des transformations non linéaires spécifiques — telles que la transformation logarithmique, la racine carrée, ou la famille paramétrique des transformations de Box-Cox et de Yeo-Johnson.
10.2 10.2 Effet de plancher et effet de plafond
Une limitation méthodologique critique de la standardisation quantitative concerne la présence d’artéfacts de mesure instrumentale désignés sous les vocables d’effet de plancher (floor effect) et d’effet de plafond (ceiling effect). Ces phénomènes surviennent dès lors qu’un instrument psychométrique ou une épreuve cognitive s’avère manifestement inadapté au niveau fonctionnel de la population ciblée :
- Effet de plancher : L’épreuve est trop ardue pour les sujets. Une proportion substantielle de la cohorte évaluée (par exemple 40 % des patients déments) accumule le score brut minimal de zéro ou un score infinitésimal.
- Effet de plafond : L’épreuve est trop élémentaire. Une fraction dominante des participants (par exemple 70 % d’étudiants surdoués à une épreuve de mémoire courante) atteint sans coup férir le score maximal théorique permis par l’instrument.
D’un point de vue distributionnel, ces artéfacts se traduisent par une accumulation massive et anormale de fréquences sur l’une des bornes d’évaluation, créant une distribution tronquée dépourvue de variabilité naturelle. Si l’on applique machinalement l’équation du score Z sur de telles données, les paramètres résultants induisent en erreur :
En présence d’un effet de plafond massif, la moyenne empirique x̄ se retrouve collée au sommet de l’échelle, et la variance s apparaît fortement réduite. Pour le sujet atteignant la note parfaite, l’écart (xmax – x̄) sera mathématiquement minime, générant un score standardisé médiocre (par exemple z = +0,6). Le clinicien conclura faussement que le sujet n’a qu’un niveau très moyen, ignorant que la limitation instrumentale l’a empêché de manifester son niveau cognitif réel. De surcroît, le pouvoir discriminant du test aux extrémités s’avère rigoureusement nul, plusieurs sujets aux compétences latentes disparates se trouvant tous amalgamés sous un score standardisé identique.
10.3 10.3 Dépendance stricte à l’échantillon d’étalonnage
Le score Z ne possède aucune existence ontologique autonome : il n’est qu’un indicateur de positionnement strictement relatif. Sa validité scientifique dépend de la fidélité de l’échantillon normatif mobilisé pour estimer la moyenne arithmétique μ et l’écart-type σ. Toute modification dans la structure ou l’échantillonnage de la population d’étalonnage redéfinit instantanément les scores standardisés attribués aux sujets, quand bien même leurs compétences intrinsèques demeureraient parfaitement invariantes.
Cette instabilité est particulièrement exacerbée au sein des recherches portant sur des échantillons restreints. En vertu du théorème de la variance d’échantillonnage, la fluctuation stochastique de l’écart-type empirique s est substantielle lorsque l’effectif n est réduit. Standardiser un score individuel en divisant par un paramètre s instable revient à injecter un bruit de mesure considérable dans la variable finale, affectant gravement la réplicabilité des résultats empiriques.
Enfin, cette dépendance paradigmatique soulève des considérations éthiques fondamentales en pratique diagnostique. L’évaluation de personnes issues de minorités linguistiques, culturelles ou d’environnements sociologiques marginalisés à l’aune de normes élaborées sur des groupes dominants engendre une pathologisation systématique de la différence. La responsabilité déontologique du chercheur et du praticien réside dans l’exigence d’une explicitation exhaustive de l’échantillon d’étalonnage utilisé et dans le refus d’attribuer une portée universelle à des scores Z dérivés de contextes d’observation particuliers.
11. 11. Implémentation computationnelle sous R et Python
11.1 11.1 Calcul et manipulation en langage R
Dans l’écosystème de programmation statistique R, la transformation centrée réduite constitue une primitive native matérialisée par la fonction de base scale(). Cette fonction opère de manière vectorisée et générique sur des vecteurs numériques, des matrices ou des tableaux de données multidimensionnels (dataframes). La fonction s’articule autour de deux arguments booléens fondamentaux : center = TRUE, qui commande l’exécution de la translation spatiale en soustrayant la moyenne de colonne, et scale = TRUE, qui régit la division par l’écart-type échantillonnal calculé selon n – 1 degrés de liberté.
L’implémentation opérationnelle requiert une vigilance particulière quant au format de sortie retourné par la fonction. Par conception, scale() renvoie un objet matriciel doté d’attributs spécifiques (notamment scaled:center et scaled:scale, conservant la trace exacte des paramètres empiriques mobilisés). Pour réintégrer la variable standardisée au sein d’un dataframe compatible avec le tidyverse ou les fonctions d’analyse bivariée standard, il est d’usage de contraindre le vecteur via l’instruction as.vector(scale(x)).
La manipulation de données réelles impose également une gestion explicite des valeurs manquantes. Si le vecteur original comporte des entrées nulles ou manquantes codées NA, l’évaluation de la moyenne et de la dispersion échouera, propageant des valeurs manquantes sur l’intégralité des scores transformés. L’instruction préalable nécessite soit une imputation rigoureuse, soit la spécification de l’argument na.rm = TRUE lors du calcul matriciel.
Sur le plan de la validation graphique, l’environnement ggplot2 offre les outils analytiques pour attester de la préservation morphologique de la distribution. En traçant côte à côte la densité de probabilité continue de la variable brute et celle de la variable centrée-réduite via la commande geom_density(), le statisticien visualise l’alignement du barycentre sur zéro et la mise à l’échelle de la variance tout en vérifiant visuellement l’invariance absolue du profil de courbure et des asymétries structurales.
11.2 11.2 Programmation scientifique en Python avec NumPy et SciPy
Dans l’écosystème scientifique Python, les bibliothèques fondamentales NumPy et SciPy constituent le socle computationnel de la standardisation matricielle. La démarche la plus élémentaire repose sur une implémentation vectorisée manuelle tirant parti du principe de diffusion (broadcasting) des tableaux multidimensionnels numpy.ndarray.
Une distinction algorithmique déterminante doit être soulignée concernant l’estimation de l’écart-type avec NumPy. Par défaut, la méthode numpy.std() calcule l’écart-type populationnel biaisé, en appliquant un dénominateur égal à n (correspondant au paramètre implicite ddof=0, pour « delta degrees of freedom »). Pour se conformer à la rigueur de la théorie statistique de l’échantillonnage et obtenir l’estimateur non biaisé avec n – 1 degrés de liberté (la correction de Bessel), le praticien doit obligatoirement forcer le paramètre :
ecart_type = np.std(donnees, ddof=1)
Le calcul du score Z s’exécute alors selon l’expression vectorisée directe :
z_scores = (donnees - np.mean(donnees)) / np.std(donnees, ddof=1)
Pour un traitement clé en main au sein d’un pipeline d’analyse formel, le module statistique spécialisé scipy.stats met à disposition la fonction optimisée zscore(). Cette fonction offre une exécution computationnelle extrêmement rapide sur des structures tensorielles complexes. De la même manière, le paramétrage des degrés de liberté s’effectue au moyen de l’argument explicite ddof pour préserver la cohérence des estimations entre les différents environnements computationnels.
11.3 11.3 Normalisation de grands volumes de données avec Scikit-Learn et Pandas
Dès lors que l’on aborde l’apprentissage machine et l’ingénierie de données à grande échelle via Pandas et Scikit-Learn, la standardisation par score Z s’inscrit au cœur des pré-traitements algorithmiques grâce à la classe StandardScaler logée au sein du module sklearn.preprocessing.
L’utilisation de cette classe repose sur le patron de conception (design pattern) unifié de Scikit-Learn, articulé autour de trois méthodes fondamentales dont la distinction conceptuelle est capitale pour la validité méthodologique globale :
- La méthode
fit(): Se charge d’examiner le jeu de données d’entraînement (training set) afin de calculer et de stocker en mémoire les paramètres statistiques requis : la moyenne empirique (conservée dans l’attributmean_) et la variance (stockée dansvar_). Aucun calcul de transformation n’est effectué à cette étape. - La méthode
transform(): Mobilise les paramètres statistiques précédemment calculés par lefit()pour appliquer rigoureusement l’équation du score Z sur le jeu de données cible, retournant la matrice des données standardisées. - La méthode
fit_transform(): Combine atomiquement les deux opérations préalables au sein d’une routine computationnellement optimisée, idéale pour traiter le jeu d’apprentissage initial.
Cette dissociation algorithmique constitue le rempart méthodologique absolu contre le risque critique de « fuite de données » (data leakage). Dans un pipeline de validation croisée rigoureux, il est formellement interdit d’exécuter un fit() ou un fit_transform() sur l’intégralité du jeu de données agrégé. Agir ainsi conduirait à contaminer le processus d’estimation avec des informations statistiques issues du jeu de test (test set), biaisant artificiellement les métriques d’évaluation de la capacité de généralisation du modèle. Le protocole d’ingénierie impose donc d’ajuster le StandardScaler exclusivement sur le sous-ensemble d’entraînement (via scaler.fit(X_train)), puis de déployer l’opérateur de transformation obtenu de manière aveugle sur le sous-ensemble de test (via scaler.transform(X_test)).
12. 12. Bonnes pratiques méthodologiques et recommandations de rédaction
12.1 12.1 Protocoles de rapport selon les normes APA (7e édition)
La communication scientifique des résultats empiriques standardisés au sein de revues à comité de lecture est régie par les standards éditoriaux de l’American Psychological Association (normes APA, 7e édition). La restitution d’analyses mobilisant des scores Z ne peut s’effectuer sous forme d’énoncés abstraits déconnectés de la métrique originale.
Le protocole de rapportage académique impose la mention explicite et exhaustive des statistiques descriptives brutes fondamentales — la moyenne arithmétique (symbolisée conventionnellement par la lettre italique M) et l’écart-type non biaisé (symbolisé par SD) — préalablement à l’exposé de toute variable centrée réduite. L’exposition des données doit permettre au lecteur de reconstruire mathématiquement n’importe quel score brut à partir de son indice standardisé.
Dans le corps du texte ou au sein des tableaux scientifiques synthétiques, la notation formelle obéit à des conventions typographiques strictes :
- Le score Z individuel s’écrit au moyen de la lettre minuscule latine en italique suivie de sa valeur numérique arrondie à deux décimales exactes (par exemple, z = 1,45 ou z = -0,78).
- Le zéro initial avant la virgule doit être impérativement conservé (on écrit z = 0,85 et non z = ,85), dans la mesure où un score Z peut mathématiquement excéder l’unité unitaire, contrairement aux coefficients de corrélation ou aux probabilités qui sont intrinsèquement bornés à l’intervalle [0, 1].
- La désignation précise de la population ou de l’échantillon normatif mobilisé pour fixer l’étalonnage doit figurer de manière indélébile dans la section Méthode (incluant l’année de l’étalonnage, l’effectif N et les critères de stratification sociodémographique retenus).
12.2 12.2 Arbre décisionnel pour le choix de la méthode de standardisation
Pour assister le chercheur et le biostatisticien dans le choix méthodique de l’opérateur de mise à l’échelle adéquat, la procédure peut être formalisée sous la forme d’un arbre décisionnel séquentiel structuré :
Étape 1 : Évaluation de la normalité et de la symétrie distributionnelle.
Le protocole débute par l’application d’un test formel de normalité (test de Shapiro-Wilk pour n < 50, ou test de Kolmogorov-Smirnov avec correction de Lilliefors et test de D’Agostino-Pearson pour les cohortes larges), doublé d’une inspection des coefficients de dissymétrie (skewness) et d’aplatissement (kurtosis).
→ Si la distribution est approximativement symétrique et ne manifeste pas de déviation univariée majeure : orienter l’analyse vers le traitement paramétrique usuel.
→ Si la distribution est structurellement asymétrique ou multimodale : privilégier des transformations non linéaires préalables ou une méthode non paramétrique.
Étape 2 : Détection et examen de la nature des valeurs aberrantes.
Calcul des scores Z exploratoires et des scores Z modifiés basés sur la déviation absolue médiane (MAD).
→ En l’absence de valeurs aberrantes ou si les valeurs extrêmes correspondent à des variations théoriquement maîtrisées : l’application de la Standardisation par Score Z classique s’impose comme optimale.
→ En présence de valeurs aberrantes extrêmes sévères ou de queues de distribution lourdes qui ne peuvent être éliminées : retenir impérativement la Standardisation Robuste (RobustScaler) basée sur la médiane et l’IQR.
Étape 3 : Examen des impératifs des algorithmes d’analyse avals.
→ L’algorithme réclame-t-il des bornes numériques closes [0, 1] (ex. réseaux neuronaux convolutifs, classification basée sur l’entropie) ? S’orienter vers la Normalisation Min-Max (après élimination préalable impérative des outliers sous peine d’écrasement de variance).
→ L’algorithme repose-t-il sur des calculs d’inertie, de variance euclidienne ou de régularisation linéaire (ex. ACP, régression pénalisée, k-means) ? Retenir la Standardisation par Score Z.
12.3 12.3 Synthèse des principes directeurs pour la recherche expérimentale
En ultime analyse, la normalisation par score Z ne doit jamais être appréhendée comme un automatisme calculatoire neutre ou anodin, mais comme un acte épistémologique structurant qui redéfinit l’ensemble des grandeurs manipulées par le chercheur. Pour garantir l’intégrité et la reproductibilité des protocoles de recherche en sciences quantitatives, trois principes directeurs fondamentaux doivent guider l’analyste :
Premièrement, l’exigence de transparence computationnelle absolue : les équations de transformation, le traitement des degrés de liberté, la gestion des valeurs manquantes et les paramètres empiriques (x̄ et s) doivent être systématiquement documentés et rendus accessibles dans les dépôts de données ouvertes (Open Science Framework, GitHub). Cette exhaustivité assure qu’un re-calcul indépendant puisse restituer exactement les grandeurs natives sans ambiguïté métrique.
Deuxièmement, la circonspection herméneutique quant à la signification clinique des écarts statistiques : la mise en évidence d’une déviation standardisée (par exemple z = -1,85) ne constitue en aucun cas un verdict diagnostique mécanique. Le score Z n’est qu’un indicateur de rareté relative au sein d’une distribution normative. Sa transmutation en diagnostic pathologique exige impérativement la convergence d’éléments cliniques qualitatifs, anamnestiques et écologiques attestant d’une rupture adaptative avérée dans la vie quotidienne de l’individu.
Troisièmement, la veille critique face aux dérives de l’impérialisme métrique : la conversion systématique de phénomènes psychologiques complexes en indices numériques centrés réduits ne dispense jamais le chercheur d’une réflexion approfondie sur la nature ontologique des construits qu’il explore. La normalisation par score Z constitue un serviteur mathématique d’une puissance méthodologique inégalée, à la condition expresse que son utilisateur en maîtrise scrupuleusement les ressorts formels, les vertus analytiques et les limites inhérentes.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Galton, F. (1889). Natural inheritance. Macmillan and Co. https://doi.org/10.5962/bhl.title.27468
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Iglewicz, B., & Hoaglin, D. C. (1993). How to detect and handle outliers. ASQC Basic References in Quality Control, Vol. 16, Quality Press.
- Jacobson, N. S., & Truax, P. (1991). Clinical significance: A statistical approach to defining meaningful change in psychotherapy research. Journal of Consulting and Clinical Psychology, 59(1), 12–19. https://doi.org/10.1037/0022-006X.59.1.12
- McCall, W. A. (1922). How to measure in education. Macmillan.
- Pedhazur, E. J., & Schmelkin, L. P. (1991). Measurement, design, and analysis: An integrated approach. Lawrence Erlbaum Associates.
- Pearson, K. (1896). Mathematical contributions to the theory of evolution. III. Regression, heredity, and panmixia. Philosophical Transactions of the Royal Society of London, Series A, 187, 253–318. https://doi.org/10.1098/rsta.1896.0007
- Shallice, T. (1988). From neuropsychology to mental structure. Cambridge University Press. https://doi.org/10.1017/CBO9780511526817
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wechsler, D. (2008). Wechsler Adult Intelligence Scale–Fourth Edition (WAIS-IV). NCS Pearson.