
Dans l’arsenal méthodologique des sciences humaines, sociales et comportementales, la quête d’élucidation des dynamiques causales se heurte continuellement à une aporie fondamentale : l’impossibilité éthique ou pratique d’assigner aléatoirement des individus à des conditions expérimentales prolongées. Qu’il s’agisse d’évaluer l’impact réciproque de la dépression et de l’isolement social, de la précarité économique et des troubles cognitifs, ou encore de l’exposition aux écrans et des troubles attentionnels, les chercheurs ont longtemps été cantonnés à des corrélations transversales insatisfaisantes, vulnérables à l’ambiguïté directionnelle et aux variables confondantes non observées. Pour transcender ces impasses sans sacrifier la validité écologique des observations de terrain, la modélisation statistique s’est orientée vers l’exploitation du temps en tant que levier analytique de premier ordre.
Le modèle de panel à décalage croisé, universellement désigné par l’acronyme anglophone CLPM (Cross-Lagged Panel Model), constitue précisément l’une des tentatives les plus influentes et sophistiquées pour trancher l’éternel dilemme de la poule et de l’œuf dans les données non expérimentales. Ancré au cœur de la modélisation par équations structurelles (SEM), ce cadre analytique permet de suivre simultanément deux ou plusieurs variables mesurées de manière répétée auprès d’une même cohorte d’individus à travers plusieurs vagues temporelles successives. En décomposant la covariance temporelle en trajectoires de stabilité autorégressive, en corrélations synchrones résiduelles et en effets d’influence croisée, le CLPM offre une matrice d’inférence rigoureuse permettant d’examiner si une variable X précède et prédit les variations ultérieures d’une variable Y, tout en contrôlant l’inertie historique propre à Y et l’effet réciproque potentiel de Y sur X.
Ce guide exhaustif a pour vocation d’offrir une exploration intégrale et didactique du modèle de panel à décalage croisé. De sa genèse historique au sein des plans quasi-expérimentaux jusqu’à ses formulations mathématiques contemporaines, en passant par ses applications cliniques, ses contraintes d’invariance de mesure et ses extensions récentes telles que le modèle à interceptes aléatoires (RI-CLPM), nous détaillerons chaque rouage conceptuel, statistique et interprétatif indispensable au chercheur rigoureux. À travers l’analyse d’un cas empirique complet et l’examen critique des débats épistémologiques actuels, cet article constitue une référence académique pour quiconque souhaite modéliser la réciprocité, la causalité directionnelle et la dynamique temporelle des processus psychologiques et sociaux.
1. Introduction fondamentale au modèle de panel à décalage croisé (CLPM)
1.1 Définition conceptuelle et genèse historique
Le modèle de panel à décalage croisé trouve ses origines intellectuelles directes dans les réflexions épistémologiques pionnières de Donald T. Campbell et Julian C. Stanley au cours des années 1960. Dans le cadre de leurs travaux fondateurs sur les plans quasi-expérimentaux, Campbell cherchait désespérément une stratégie permettant d’extraire des indices de prépondérance causale à partir de données corrélationnelles longitudinales, sans qu’il soit nécessaire de manipuler directement les variables indépendantes. Initialement formulée comme une technique de comparaison des corrélations bivariées croisées (la technique dite de Cross-Lagged Panel Correlation ou CLPC), l’approche a rapidement révélé d’importantes limites statistiques, notamment son incapacité à neutraliser les différences de variance et la stabilité différentielle des construits au fil du temps.
C’est avec l’avènement et la maturation de l’analyse factorielle confirmatoire et de la modélisation par équations structurelles (SEM) dans les décennies 1970 et 1980, sous l’impulsion de statisticiens tels que Karl Jöreskog, que le CLPM a acquis sa formulation moderne rigoureuse. Au sein de ce cadre, le modèle n’est plus une simple comparaison de corrélations brutes, mais un système formel de régressions linéaires multiples simultanées intégrant des équations structurelles. Il se distingue radicalement des études transversales simples, qui capturent un instantané anhistorique incapable de distinguer la cause de l’effet, ainsi que des études longitudinales classiques univariées, qui se bornent à observer la trajectoire d’une seule variable sans modéliser l’interdépendance transactionnelle de systèmes en interaction continue.
Dans l’écosystème des sciences humaines, l’importance méthodologique de ce design réside principalement dans son aptitude à opérationnaliser le principe de préséance temporelle. En permettant d’isoler l’influence prospective d’une variable sur une autre tout en maintenant constant le niveau de départ de cette dernière, le CLPM fournit une approximation robuste de la dépendance conditionnelle temporelle. Cette démarche a profondément transformé la psychologie du développement, la sociologie de l’éducation et la psychiatrie épidémiologique, en dotant les chercheurs d’un instrument analytique capable d’éprouver empiriquement des hypothèses théoriques relatives à l’étiologie et à la réciprocité comportementale.
1.2 Démystification de la nomenclature : ‘Croisé’ et ‘Décalé’
Pour appréhender pleinement la mécanique interne de ce modèle, il est impératif de déconstruire méticuleusement la terminologie qui le désigne. Le terme « panel » renvoie à un protocole de recherche longitudinal spécifique au sein duquel un échantillon rigoureusement identique d’unités d’observation — qu’il s’agisse d’individus, de familles, d’écoles ou d’organisations — est interrogé ou mesuré à plusieurs reprises au cours d’intervalles temporels discrets, communément appelés des « vagues » (ou waves). Cette constance de l’échantillon permet de suivre les trajectoires individuelles et d’éliminer les biais d’échantillonnage inter-cohortes inhérents aux designs transversaux répétés où les participants diffèrent à chaque mesure.
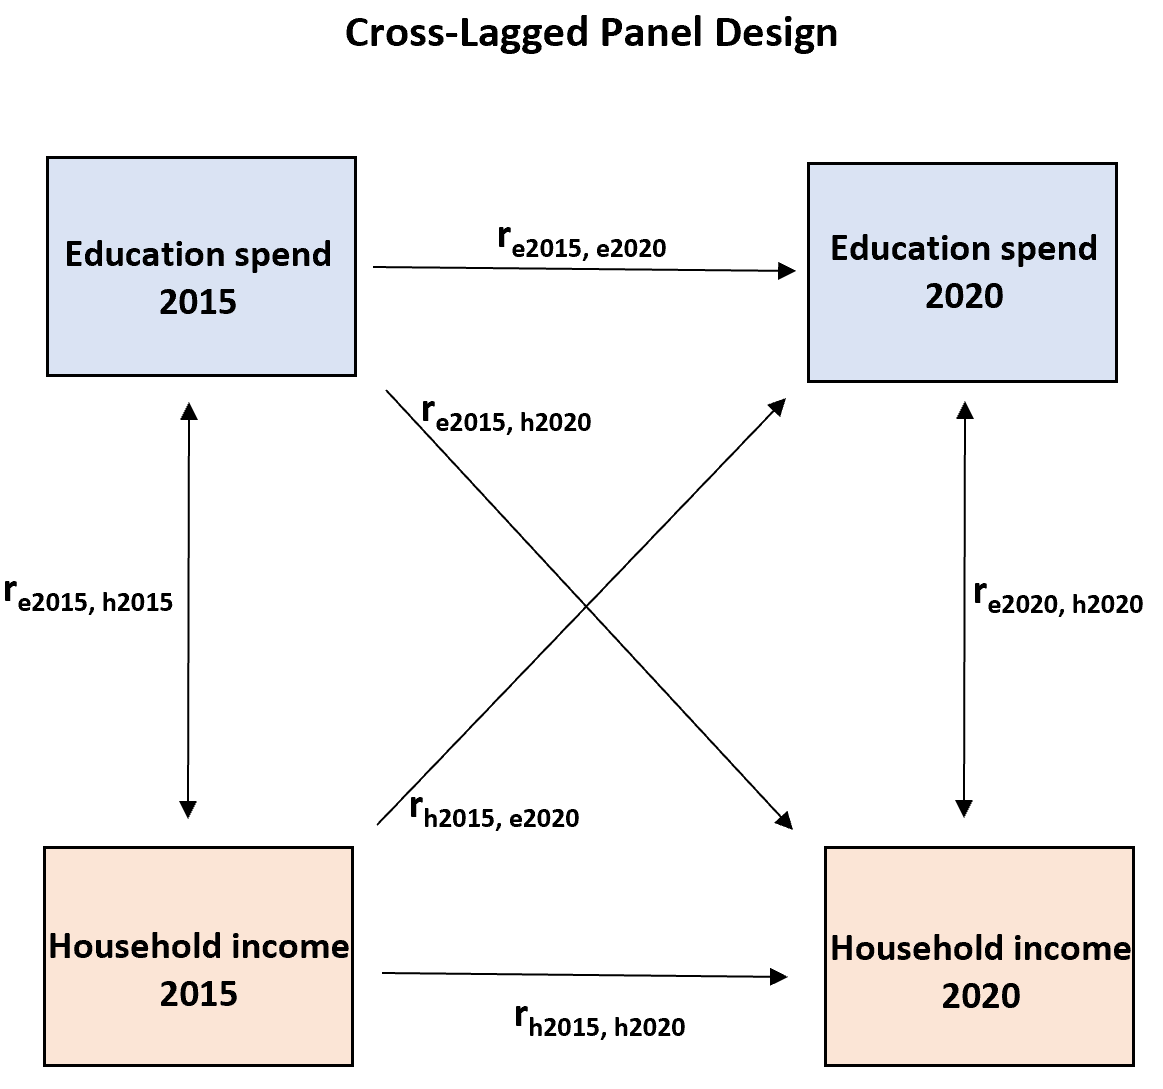
Le qualificatif « décalé » (lagged) désigne la dimension chronologique séquentielle qui sous-tend la modélisation des relations prédictives. Contrairement aux associations synchrones où prédicteur et critère sont mesurés simultanément, une relation décalée implique qu’une variable observée à un temps T sert à prédire une variable observée à un temps ultérieur T + 1. Ce décalage temporel explicite constitue la condition minimale nécessaire pour satisfaire le postulat causal fondamental selon lequel une cause doit nécessairement précéder son effet dans l’ordre chronologique de la réalité physique et psychique.
Enfin, la notion de dimension « croisée » (cross) incarne le cœur opérationnel de la réciprocité bidirectionnelle. Elle signifie que le modèle ne teste pas uniquement si la variable X au temps 1 prédit la variable Y au temps 2, mais qu’il estime simultanément, au sein de la même matrice statistique, le chemin inverse reliant la variable Y au temps 1 à la variable X au temps 2. L’objectif primaire et fondamental du CLPM réside donc dans sa capacité à confronter ces deux influences prospectives concurrentes pour démêler l’ambiguïté causale inhérente aux corrélations simples, offrant ainsi une réponse quantitative à la question de savoir si l’une des directions d’influence domine l’autre ou s’il existe une transaction mutuelle équilibrée.
1.3 Pertinence du design dans la recherche psychologique contemporaine
Dans la recherche psychologique contemporaine, le CLPM s’est imposé comme une méthodologie quasi incontournable pour résoudre les inextricables dilemmes de la poule et de l’œuf qui abondent dans l’étude de l’esprit humain. Par exemple, l’estime de soi favorise-t-elle la réussite académique, ou est-ce l’accumulation de succès scolaires qui consolide le sentiment de compétence personnelle ? De même, l’engagement sur les réseaux sociaux aggrave-t-il la détresse psychologique des adolescents, ou les jeunes présentant une vulnérabilité dépressive préexistante tendent-ils à s’isoler davantage dans des espaces virtuels ? En confrontant directement ces hypothèses rivales, le CLPM permet d’échapper aux assertions spéculatives fondées sur des devis transversaux limités.
Cette approche se révèle particulièrement féconde pour cartographier les trajectoires complexes du développement cognitif, affectif et comportemental tout au long du cycle de vie. Les théories modernes du développement conçoivent l’individu non pas comme un récepteur passif des influences environnementales, mais comme un agent actif qui sélectionne, modifie et co-construit son propre contexte écologique. Le modèle à décalage croisé permet de formaliser cette perspective transactionnelle en évaluant simultanément comment l’environnement façonne l’individu et comment l’individu rétroagit sur son environnement au fil du temps.
Enfin, le positionnement stratégique du CLPM s’avère déterminant face aux impératifs déontologiques qui contraignent l’expérimentation humaine. Il serait éthiquement inacceptable, pour des raisons évidentes, de soumettre expérimentalement des participants à un stress professionnel chronique, à des conflits conjugaux sévères ou à des environnements traumatiques pour observer l’émergence consécutive d’une psychopathologie. Le recours à un panel longitudinal analysé via un CLPM permet d’observer ces phénomènes dans leur contexte naturel d’occurrence tout en introduisant un contrôle statistique rigoureux sur les facteurs de confusion, offrant ainsi le plus haut niveau de plausibilité causale accessible en l’absence de randomisation expérimentale.
2. Fondements théoriques et épistémologiques du CLPM
2.1 Les conditions d’inférence causale selon Granger et la préséance temporelle
L’assise épistémologique du modèle de panel à décalage croisé s’enracine profondément dans la conception de la causalité formalisée par le lauréat du prix Nobel Clive Granger dans le domaine de l’économétrie. La causalité au sens de Granger repose sur un principe opérationnel d’une rigoureuse simplicité : une variable X est dite causer une variable Y si la connaissance des valeurs passées et présentes de X permet d’obtenir une prédiction significativement plus précise des valeurs futures de Y que celle que l’on obtiendrait en se fondant uniquement sur l’historique passé de Y lui-même. Bien que conçue initialement pour des séries chronologiques denses comptant des dizaines ou des centaines de points de mesure, cette logique s’applique avec une pertinence conceptuelle remarquable aux panels longitudinaux plus courts en psychologie.
Le CLPM opérationnalise cette exigence par l’entremise d’un contrôle statistique systématique de l’état initial de la variable critère. Lorsque le modèle estime le coefficient reliant X au temps 1 à Y au temps 2, il n’estime pas la corrélation brute entre ces deux mesures distantes. Il modélise la capacité de X au temps 1 à prédire la variance résiduelle de Y au temps 2, c’est-à-dire précisément la fraction de variance qui n’est pas déjà expliquée ou capturée par le niveau antérieur de Y au temps 1. Par conséquent, le coefficient croisé reflète l’influence prospective de X sur le changement relatif ou l’ajustement de la trajectoire de Y survenu entre les deux temps d’observation.
Ce mécanisme de contrôle sépare catégoriquement la corrélation bivariée de la causalité présumée dans les panels. Deux variables peuvent exhiber une corrélation transversale très élevée simplement parce qu’elles partagent des antécédents historiques communs ou qu’elles sont toutes deux soumises à une tendance séculaire générale. Si, après avoir contrôlé l’inertie propre de Y, l’inclusion de X au temps précédent n’apporte aucun gain d’information prédictive substantiel, le coefficient croisé s’annule, révélant ainsi que l’association observée n’était que le reflet d’une concomitance dépourvue d’efficacité dynamique prospective.
2.2 La modélisation de la réciprocité et des boucles de rétroaction
Le paradigme causal hérité du positivisme classique a longtemps privilégié des modèles mécanistes linéaires et unidirectionnels, au sein desquels une cause indépendante générait invariablement un effet subordonné sans subir de répercussion en retour. Cependant, les systèmes vivants, psychologiques et sociaux transcendent cette vision réductrice. Le CLPM constitue l’une des incarnations statistiques les plus fidèles des modèles dits transactionnels et interactionnistes, tels qu’articulés notamment par la théorie sociale cognitive d’Albert Bandura et son concept de déterminisme réciproque triadique.
Dans un système transactionnel, les variables s’influencent mutuellement par le biais de boucles de rétroaction qui peuvent être stabilisatrices (rétroaction négative ou homéostasie) ou amplificatrices (rétroaction positive). Par exemple, dans l’étude des relations conjugales, un comportement d’évitement émotionnel manifesté par un partenaire peut accroître l’hostilité verbale de l’autre partenaire au temps ultérieur, laquelle hostilité renforce à son tour le retrait défensif du premier partenaire lors de la vague suivante. Le CLPM formalise ces boucles dynamiques en traitant chaque variable alternativement comme un prédicteur exogène et comme une variable endogène réceptrice, permettant ainsi de capturer la circularité du comportement humain.
La détection de ces influences mutuelles permet d’analyser ce que la littérature nomme les « effets d’entraînement cumulatifs » ou les cascades développementales. Une influence croisée modeste, lorsqu’elle opère de manière bidirectionnelle répétée sur plusieurs intervalles successifs, peut générer des divergences phénoménologiques majeures à long terme. Le CLPM offre ainsi aux chercheurs un cadre analytique capable de modéliser mathématiquement comment des micro-ajustements comportementaux réciproques cristallisent des trajectoires développementales stables ou déclenchent des spirales psychopathologiques ascendantes.
2.3 Cadre statistique : L’intégration dans les modèles d’équations structurelles (SEM)
Bien qu’il soit techniquement possible d’estimer les équations d’un panel à décalage croisé par le biais de régressions linéaires multiples ordinaires exécutées séparément, l’intégration du CLPM dans le cadre formel de la modélisation par équations structurelles confère des avantages statistiques immenses et décisifs. La régression multiple classique exige l’estimation disjointe de chaque équation dépendante, ce qui postule implicitement l’indépendance statistique des termes d’erreur résiduels entre les différentes équations. Cette hypothèse est presque systématiquement violée dans les données longitudinales, où des facteurs environnementaux imprévus affectent souvent simultanément toutes les variables au cours du même intervalle de mesure.
Le cadre SEM résout élégamment cette difficulté en intégrant l’intégralité des variables dépendantes, des prédicteurs, des relations régressives et des covariances résiduelles au sein d’une seule et unique matrice de covariance empirique. L’estimation des paramètres s’effectue de manière simultanée via des algorithmes d’optimisation numérique sophistiqués, le plus répandu étant l’estimation par le maximum de vraisemblance (Maximum Likelihood, ML). Cette estimation globale permet non seulement d’obtenir des erreurs-types non biaisées pour les coefficients de régression, mais également de tester des contraintes d’égalité formelles sur les paramètres au moyen de tests de rapport de vraisemblance.
De surcroît, le cadre SEM offre la possibilité cruciale d’intégrer des variables latentes mesurées par de multiples indicateurs manifestes. Dans le CLPM avec variables latentes, l’erreur de mesure aléatoire inhérente aux instruments psychométriques (questionnaires, tests neuropsychologiques) est mathématiquement isolée et extraite de la variance vraie du construit. Il en résulte que les coefficients autorégressifs et croisés estimés entre variables latentes sont exempts de l’atténuation due aux erreurs de mesure, garantissant une estimation d’une fidélité et d’une précision analytique incomparablement supérieures à celles obtenues sur des scores composites observés.
Enfin, l’approche structurelle offre une panoplie d’indices d’ajustement global permettant de juger empiriquement de la conformité du modèle théorique avec les données réelles :
- Le Chi-deux d’ajustement (χ²), qui teste l’hypothèse nulle d’une adéquation parfaite entre la matrice de covariance observée et la matrice reproduite par le modèle ;
- Le CFI (Comparative Fit Index) et le TLI (Tucker-Lewis Index), qui comparent l’ajustement du modèle spécifié à celui d’un modèle nul d’indépendance, avec des seuils conventionnels d’acceptabilité fixés au-dessus de 0,90 ou 0,95 ;
- Le RMSEA (Root Mean Square Error of Approximation), qui pénalise la complexité excessive du modèle et dont les valeurs inférieures à 0,06 ou 0,08 attestent d’une bonne approximation dans la population ;
- Le SRMR (Standardized Root Mean Square Residual), qui quantifie l’écart moyen standardisé entre les corrélations observées et attendues.
3. Anatomie structurelle : Les trois relations fondamentales du CLPM
3.1 Les relations synchrones (corrélations concurrentes)
L’anatomie d’un modèle de panel à décalage croisé classique à deux vagues et deux variables (le design standard dit 2×2) s’articule autour d’une triade de relations paramétriques distinctes. La première de ces relations concerne les associations synchrones, également qualifiées de corrélations ou covariances concurrentes, qui relient les variables observées au sein d’une seule et même vague temporelle d’évaluation.
Au temps initial de mesure (temps 1 ou T1), les deux variables X₁ et Y₁ sont considérées comme strictement exogènes au sein du modèle. Dans la mesure où le CLPM n’intègre aucune mesure préalable à T1 pour expliquer l’émergence de ces variables, leur association est modélisée sous la forme d’une simple covariance non directionnelle libre. Cette covariance capture l’intégralité de l’histoire développementale, biologique et contextuelle partagée par les participants antérieurement au début de l’investigation scientifique. Elle constitue le point d’ancrage empirique à partir duquel le changement futur sera calculé.
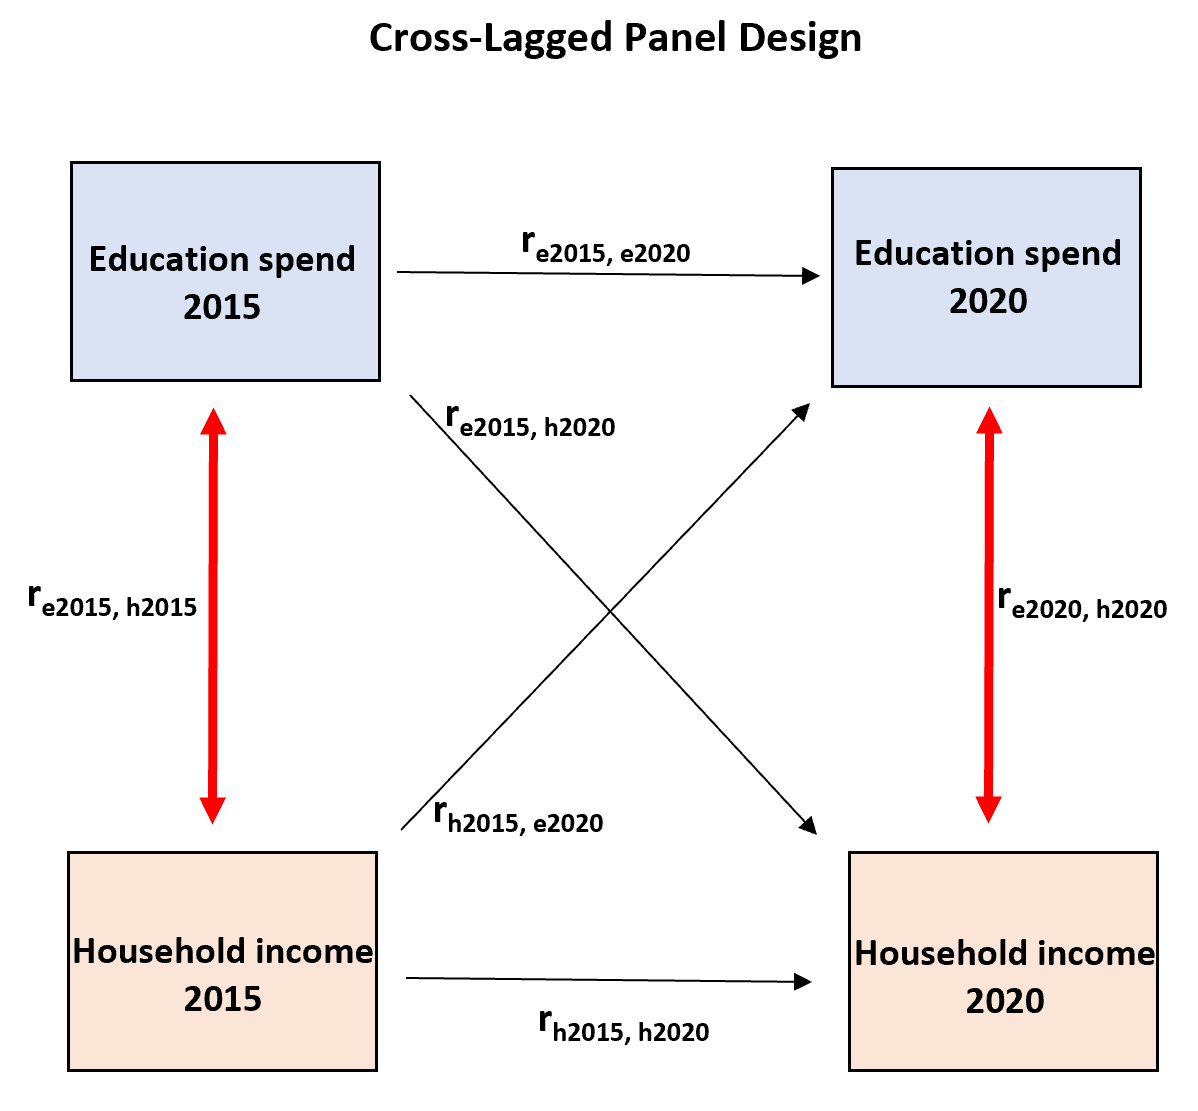
Au temps ultérieur (temps 2 ou T2), les variables X₂ et Y₂ deviennent des variables endogènes, expliquées par les prédicteurs du temps 1. Par conséquent, la relation synchrone à T2 ne s’exprime plus comme une corrélation directe entre les scores observés, mais comme une covariance entre les termes d’erreur résiduelle des deux équations structurelles. Cette corrélation résiduelle revêt une signification conceptuelle majeure : elle quantifie la mesure dans laquelle des fluctuations non expliquées par le passé surviennent simultanément sur X et sur Y entre T1 et T2. Une covariance résiduelle synchrone élevée suggère la présence de chocs environnementaux contextuels imprévus, d’événements de vie concomitants ou de facteurs confondants non mesurés influençant parallèlement les deux dimensions au cours de l’intervalle d’investigation.
3.2 Les relations de stabilité (effets autorégressifs)
La deuxième composante fondamentale du CLPM est constituée par les trajets autorégressifs, fréquemment désignés sous le vocable de relations de stabilité ou d’inertie temporelle. Ces paramètres correspondent aux coefficients de régression structurelle reliant une variable observée à un temps T à cette même variable mesurée au temps immédiatement consécutif T + 1 (par exemple, le trajet orienté de X₁ vers X₂, et de Y₁ vers Y₂).
Sur le plan psychométrique et substantiel, ces coefficients quantifient la stabilité temporelle interindividuelle du construit au cours de l’intervalle étudié. Ils reflètent dans quelle mesure les rangs des individus au sein de la distribution de l’échantillon demeurent invariants d’une vague à l’autre. Une forte stabilité autorégressive (avec des coefficients standardisés approchant 0,70 ou 0,80) indique que le phénomène psychologique investigué présente une très grande inertie, assimilable à la persistance d’un trait de personnalité stable, d’une prédisposition génétique immuable ou d’un environnement socio-économique structurellement figé.
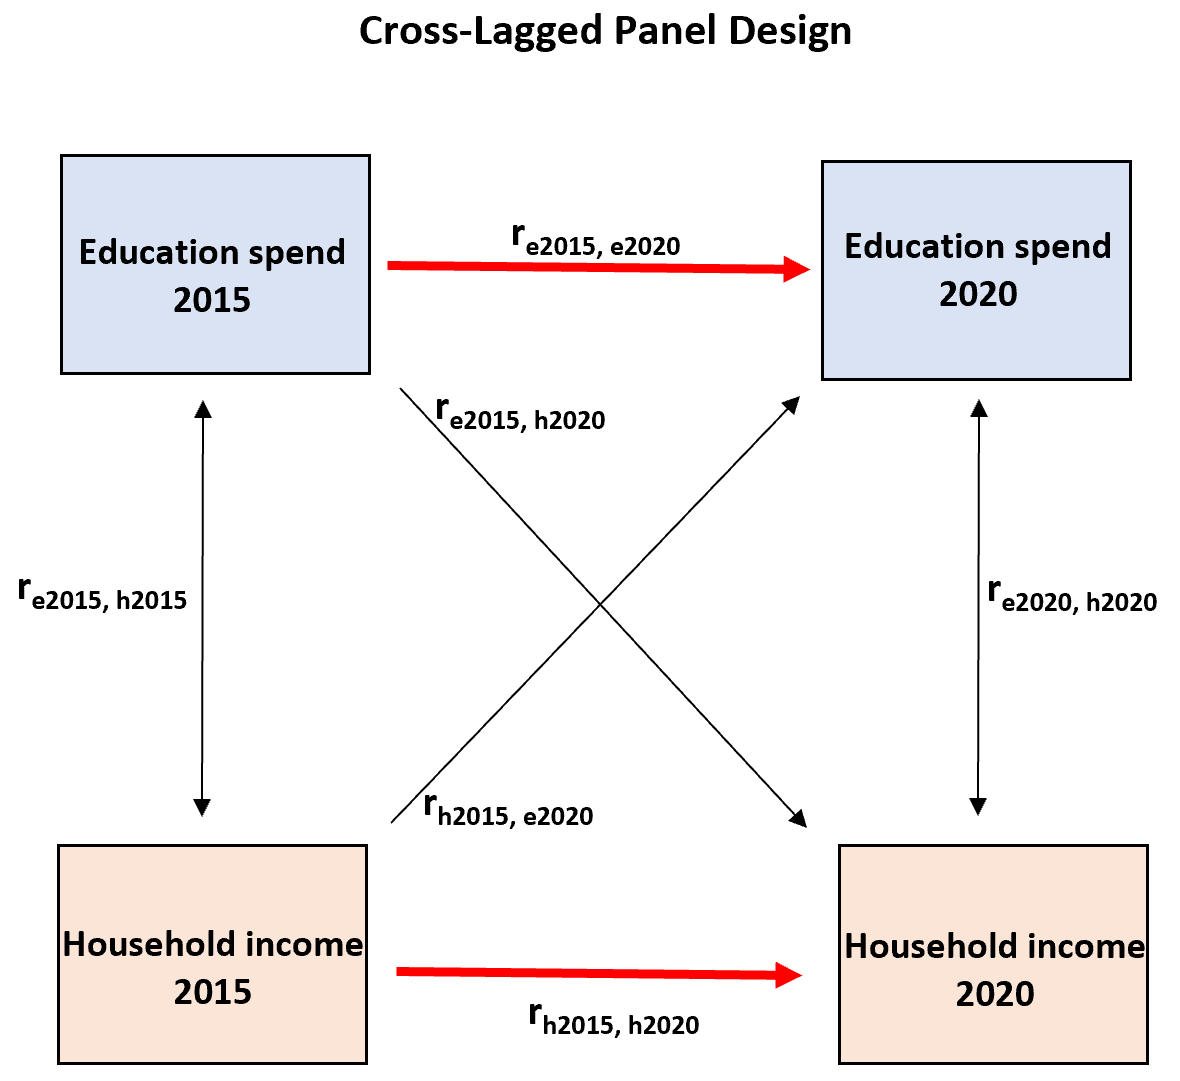
Le rôle statistique de ces effets de stabilité est prépondérant dans l’architecture du modèle. En absorbant l’écrasante majorité de la variance temporelle d’une variable expliquée par son propre passé, le coefficient autorégressif agit comme un puissant filtre analytique. Il restreint le volume de variance résiduelle disponible pour être expliquée par l’autre variable croisée. De ce fait, plus la stabilité autorégressive d’un phénomène est élevée, plus il devient statistiquement exigeant pour le prédicteur croisé de démontrer une influence significative. Cette propriété immunise le chercheur contre les illusions d’impact prédictif induites par la simple continuité historique des comportements.
3.3 Les relations à décalage croisé (effets ‘cross-lagged’)
La troisième et plus emblématique catégorie de paramètres comprend les effets à décalage croisé (cross-lagged paths), qui confèrent au modèle son appellation. Ces relations sont matérialisées par des flèches directionnelles asymétriques traversant les frontières des construits : l’une reliant la variable X₁ à la variable Y₂, et l’autre reliant la variable Y₁ à la variable X₂. Elles incarnent précisément l’opérationnalisation mathématique de l’influence prospective mutuelle.
L’estimation d’un coefficient à décalage croisé indique l’ampleur et la direction du changement prédit dans une variable critère consécutivement à une variation d’une unité dans le prédicteur croisé antérieur, après avoir statistiquement purgé et contrôlé l’effet de la stabilité autorégressive de la variable critère ainsi que sa corrélation synchrone initiale. Rejeter l’hypothèse nulle (selon laquelle le coefficient β est égal à zéro) sur un trajet croisé atteste que le prédicteur apporte une contribution d’information prospective statistiquement significative pour rendre compte des altérations de trajectoire de l’autre variable au fil du temps.
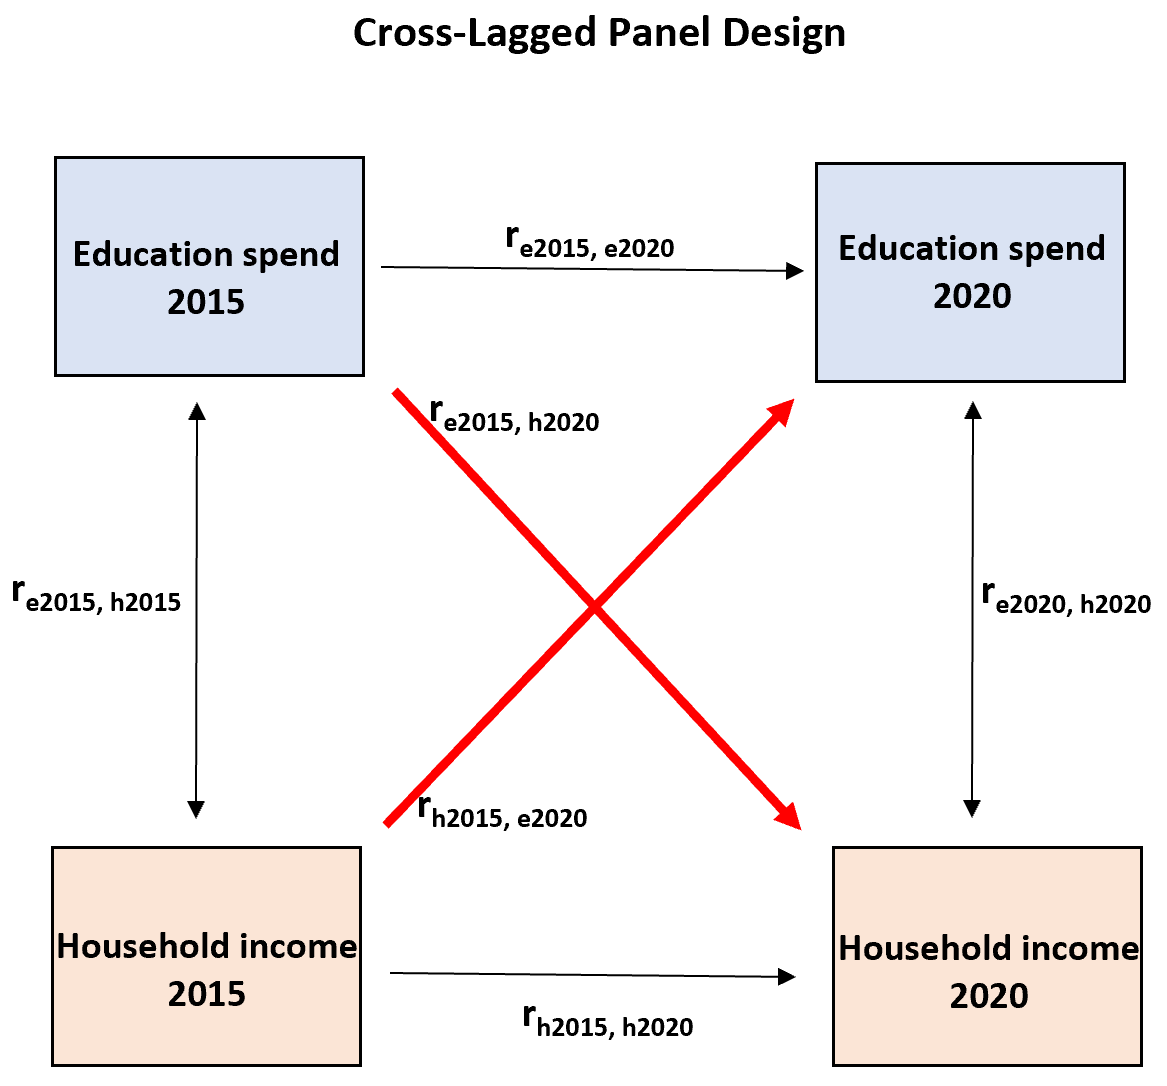
La confrontation de la magnitude relative, du signe et de la significativité statistique de ces deux trajets croisés permet d’aboutir à quatre grandes configurations théoriques :
- Le modèle d’indépendance croisée : les deux coefficients croisés sont nuls ; les phénomènes coexistent et possèdent une stabilité propre, mais n’exercent aucune influence prospective l’un sur l’autre.
- La dominance unidirectionnelle de X sur Y : le trajet de X₁ vers Y₂ est statistiquement significatif, tandis que le trajet de Y₁ vers X₂ est statistiquement nul ou négligeable.
- La dominance unidirectionnelle de Y sur X : inversement, seul le trajet prospectif émanant de Y₁ vers X₂ démontre une efficacité prédictive.
- Le modèle de réciprocité transactionnelle complète : les deux trajets sont simultanément significatifs, attestant de l’existence d’une régulation mutuelle continue et de boucles de rétroaction empiriquement observables entre les deux sphères de fonctionnement.
4. Exemple empirique détaillé : Dépenses éducatives et revenu des ménages
4.1 Présentation du cas d’étude macro-psychologique et socio-économique
Afin d’ancrer ces développements conceptuels dans une réalité empirique concrète, analysons une problématique classique à l’interface de l’économie comportementale, de la psychologie sociale et de la sociologie de l’éducation : l’interdépendance dynamique entre l’investissement financier consenti pour l’éducation des enfants au sein du foyer et le revenu global disponible des ménages. Depuis des décennies, les chercheurs débattent avec véhémence de la mécanique causale sous-jacente à ce lien empirique bien documenté.
D’un côté, les partisans de la théorie du capital humain postulent que des dépenses éducatives accrues (financement de cours de soutien, achat de matériel informatique, activités parascolaires d’enrichissement cognitif, inscriptions dans des filières d’excellence) constituent un levier direct d’amélioration des capacités intellectuelles et professionnelles, lequel engendre ultérieurement une hausse mécanique des revenus générés par la famille ou ses descendants. De l’autre côté, les tenants des théories de la reproduction sociale et de la privation matérielle soutiennent l’hypothèse inverse : c’est l’abondance préalable de ressources financières qui autorise mécaniquement les familles à consacrer des sommes substantielles aux biens éducatifs superflus, l’éducation n’étant ici qu’un marqueur de consommation somptuaire permis par l’aisance monétaire initiale.
Pour arbitrer cette controverse, imaginons une étude de panel représentative menée auprès d’une cohorte de 2 500 ménages suivis rigoureusement sur un intervalle de cinq ans. Deux points de mesure standardisés sont retenus : l’année 2015 (Temps 1) et l’année 2020 (Temps 2). Deux variables continues sont opérationnalisées : le Revenu médian standardisé du foyer (noté REV, exprimé en dizaines de milliers d’euros annuels) et le Montant annuel des dépenses éducatives ciblées (noté EDU, exprimé en milliers d’euros). Le choix délibéré d’un décalage de cinq années se justifie théoriquement : les retombées économiques d’une trajectoire d’investissement éducatif exigent un délai de maturation substantiel pour se concrétiser sur le marché du travail ou l’optimisation des revenus, rendant un décalage temporel plus court (par exemple, six mois) conceptuellement inopérant.
4.2 Diagramme de cheminement et décomposition des six paramètres
L’application d’un modèle CLPM standard à deux vagues à ce cas d’étude impose la spécification formelle et l’estimation simultanée de six paramètres structurels distincts, qui définissent intégralement les flux de variance au sein du système bivarié. Dans une représentation par diagramme de cheminement (path diagram), ces paramètres s’articulent rigoureusement entre les quatre variables manifestes observées (EDU₁₅, REV₁₅, EDU₂₀, REV₂₀).
La configuration de ces six paramètres s’énonce comme suit :
- Paramètre 1 : La covariance synchrone initiale (T1). Matérialisée par une double flèche courbe reliant EDU₁₅ et REV₁₅. Elle quantifie le degré d’association brute existant entre les ressources financières et l’effort d’éducation au moment où l’investigation scientifique commence.
- Paramètre 2 : L’autorégression de l’éducation (Stabilité EDU). Flèche rectiligne dirigée de EDU₁₅ vers EDU₂₀. Ce paramètre mesure l’inertie longitudinale des comportements d’investissement éducatif des familles à travers le quinquennat.
- Paramètre 3 : L’autorégression du revenu (Stabilité REV). Flèche rectiligne dirigée de REV₁₅ vers REV₂₀. Il capture la stabilité temporelle structurelle de la situation financière des ménages.
- Paramètre 4 : Le trajet décalé croisé Éducation → Revenu. Flèche rectiligne orientée de EDU₁₅ vers REV₂₀. Ce paramètre constitue l’épreuve directe de la théorie du capital humain : un effort éducatif soutenu en 2015 prédit-il une élévation du revenu en 2020 au-delà de la stabilité financière préexistante ?
- Paramètre 5 : Le trajet décalé croisé Revenu → Éducation. Flèche rectiligne orientée de REV₁₅ vers EDU₂₀. Ce paramètre teste l’hypothèse de la disponibilité des ressources : un revenu élevé en 2015 est-il le moteur direct stimulant l’allocation future de ressources à l’éducation ?
- Paramètre 6 : La covariance résiduelle synchrone finale (T2). Double flèche courbe reliant les perturbations d’erreur εEDU₂₀ et εREV₂₀. Elle rend compte des corrélations fortuites ou des événements macro-économiques imprévus survenus entre 2015 et 2020 ayant affecté conjointement les deux paramètres.
4.3 Scénarios d’interprétation des résultats statistiques simulés
L’estimation numérique du modèle permet de trancher empiriquement entre plusieurs scénarios théoriques rivaux, selon la configuration des coefficients de régression standardisés (β) et leur significativité statistique (seuil conventionnel de p < 0,05).
Examinons le Scénario A (L’effet d’investissement capacitaire exclusif). Dans ce modèle, supposons que le trajet autorégressif de REV soit de β = 0,55 (p < 0,001) et celui de EDU de β = 0,40 (p < 0,001). Le trajet croisé reliant EDU₁₅ à REV₂₀ ressort à β = 0,22 (p = 0,002), tandis que le trajet réciproque de REV₁₅ vers EDU₂₀ affiche une magnitude statistiquement négligeable de β = 0,03 (p = 0,48). L’interprétation scientifique est limpide : le revenu ne détermine pas prospectivement l’effort éducatif futur, mais les choix délibérés d’investissement pédagogique opèrent comme un puissant levier d’ascension économique ultérieure, corroborant avec éclat la théorie du capital humain.
À l’inverse, considérons le Scénario B (L’effet d’aisance budgétaire unilatérale). Ici, le trajet EDU₁₅ vers REV₂₀ est nul (β = 0,01, p = 0,89), alors que le trajet REV₁₅ vers EDU₂₀ est massif et hautement significatif (β = 0,31, p < 0,001). Ce profil statistique disqualifie formellement l’hypothèse capacitaire : dépenser davantage pour l’éducation n’enrichit pas les familles ; c’est simplement le fait d’être riche à l’origine qui conditionne mécaniquement la capacité d’investir des fonds excédentaires dans le secteur éducatif au fil des ans.
Dans un Scénario C (La réciprocité transactionnelle vertueuse), les deux coefficients croisés se révèlent simultanément significatifs (β = 0,18 pour EDU₁₅ → REV₂₀ et β = 0,16 pour REV₁₅ → EDU₂₀, les deux à p < 0,01). Ce résultat modélise un cercle vertueux d’amplification mutuelle : l’aisance financière dynamise l’engagement éducatif, lequel consolide et développe en retour les assises économiques du foyer à travers le temps.
Enfin, le Scénario D (L’inertie déterministe découplée) verrait l’effondrement des deux trajets croisés au profit d’autorégressions écrasantes (β > 0,80). Une telle observation démontrerait que l’association observée en coupe transversale n’était qu’une corrélation fallacieuse maintenue par des facteurs historiques stables, aucune influence prospective mutuelle dynamique n’opérant en réalité sur l’intervalle temporel considéré.
5. Formulation mathématique et spécification statistique du modèle
5.1 Système d’équations structurelles simultanées
Sur le plan formel, le modèle de panel à décalage croisé classique à deux vagues s’articule comme un système de deux équations de régression linéaire simultanées appliquées aux variables endogènes mesurées au temps T + 1, conditionnées par l’ensemble des variables exogènes observées au temps T. La formulation algébrique générale pour une unité d’observation individuelle i (avec i = 1, …, N) se déploie de la manière suivante :
Première équation pour la variable endogène Y au temps 2 :
Y_{i,2} = α_{Y} + β_{YY} cdot Y_{i,1} + β_{YX} cdot X_{i,1} + epsilon_{i,Y2}
Seconde équation pour la variable endogène X au temps 2 :
X_{i,2} = α_{X} + β_{XX} cdot X_{i,1} + β_{XY} cdot Y_{i,1} + epsilon_{i,X2}
Dans cette formalisation mathématique rigoureuse :
- α_{Y} et α_{X} représentent les constantes ou intercepts des équations respectives ;
- β_{YY} et β_{XX} désignent les coefficients autorégressifs longitudinaux quantifiant la stabilité temporelle propre de chaque construit ;
- β_{YX} représente le paramètre d’effet croisé crucial mesurant l’influence prospective de la variable exogène X₁ sur la variable endogène ultérieure Y₂, nette de l’effet de Y₁ ;
- β_{XY} représente symétriquement le coefficient d’effet croisé quantifiant l’influence prospective de Y₁ sur X₂, nette de l’apport de X₁ ;
- epsilon_{i,Y2} et epsilon_{i,X2} incarnent les perturbations stochastiques résiduelles individuelles, supposées suivre une distribution normale multivariée d’espérance nulle.
Le point névralgique de la spécification réside dans la modélisation de la matrice de variance-covariance de ces résidus stochastiques (notée traditionnellement Ψ dans la notation matricielle de LISREL). Contrairement aux hypothèses des moindres carrés ordinaires indépendants, le modèle postule expressément que les erreurs résiduelles contemporaines sont corrélées :
Cov(epsilon_{i,Y2}, epsilon_{i,X2}) = psi_{YX} neq 0
Cette covariance résiduelle non nulle constitue la condition sine qua non pour préserver la neutralité et la cohérence des estimations des coefficients de régression croisés β face aux chocs contemporains non observés.
5.2 Identification du modèle et degrés de liberté
L’une des propriétés méthodologiques les plus remarquables du modèle CLPM standard à deux variables et deux vagues de mesure (le design 2×2 sous sa forme manifeste pure) réside dans son statut d’identification mathématique. En modélisation par équations structurelles, l’identification repose sur le ratio entre le nombre de moments empiriques distincts disponibles dans les données observées et le nombre de paramètres libres que le chercheur cherche à estimer.
Le nombre de moments empiriques uniques (variances et covariances non redondantes) fournis par une matrice de covariance contenant p variables observées est rigoureusement déterminé par la formule classique :
Moments = p(p + 1) / 2
Dans un modèle 2×2, nous manipulons p = 4 variables manifestes (X₁, Y₁, X₂, Y₂). Le calcul arithmétique donne :
Moments = 4(4 + 1) / 2 = 20 / 2 = 10 moments empiriques uniques (à savoir 4 variances et 6 covariances bivariées distinctes).
Examinons à présent le décompte scrupuleux des paramètres libres à estimer dans le modèle non contraint :
- 2 variances des variables exogènes initiales (Var(X₁), Var(Y₁)) ;
- 1 covariance exogène initiale (Cov(X₁, Y₁)) ;
- 2 coefficients autorégressifs de stabilité (β_{XX}, β_{YY}) ;
- 2 coefficients de régression à décalage croisé (β_{XY}, β_{YX}) ;
- 2 variances des perturbations résiduelles contemporaines (Var(epsilon_{X2}), Var(epsilon_{Y2})) ;
- 1 covariance résiduelle contemporaine (Cov(epsilon_{X2}, epsilon_{Y2})).
La sommation révèle l’estimation exacte de 10 paramètres libres. En appliquant l’équation fondamentale des degrés de liberté :
Degrés de liberté (ddl) = Moments empiriques – Paramètres estimés = 10 – 10 = 0
Ce résultat démontre formellement que le CLPM manifeste standard à deux temps est un modèle saturé (ou juste identifié). Par conséquent, sa valeur de Chi-deux (χ²) est mathématiquement nulle et ses indices d’ajustement global (CFI, TLI, RMSEA) sont trivialement parfaits (CFI = 1,00 ; RMSEA = 0,000), empêchant le chercheur de tester empiriquement la conformité globale de la structure avec les données. Pour obtenir des degrés de liberté positifs et procéder à un véritable test d’ajustement, le méthodologiste doit soit introduire des vagues de mesure supplémentaires (T ≥ 3), soit contraindre certains paramètres à des valeurs théoriques fixes (par exemple imposer la nullité des effets croisés ou l’égalité des régressions), soit modéliser les construits sous forme de variables latentes avec plusieurs indicateurs observables.
5.3 Extension matricielle aux panels à vagues multiples (T ≥ 3)
Dès lors que le protocole de recherche s’enrichit d’une troisième vague de mesure ou davantage (T = 3, 4, …), le modèle de panel à décalage croisé s’affranchit de la contrainte de saturation et déploie l’intégralité de sa puissance statistique. Dans un modèle à trois vagues comprenant X et Y mesurés à T1, T2 et T3, le nombre de variables observées s’élève à p = 6, générant 6(7) / 2 = 21 moments empiriques, alors que le modèle standard ne requiert l’estimation que de 16 paramètres libres, dégageant ainsi ddl = 5 pour tester l’adéquation structurelle globale.
L’architecture matricielle s’étend alors selon une logique markovienne d’ordre 1, où l’état du système au temps T prédit l’état du système au temps T + 1, lequel prédit à son tour le temps T + 2. Cette configuration séquentielle autorise l’investigation empirique d’une hypothèse fondamentale en modélisation longitudinale : l’invariance temporelle des paramètres (ou stationnarité). En contraignant les coefficients autorégressifs et les coefficients croisés à l’égalité stricte d’un intervalle à l’autre (par exemple, en imposant l’égalité β_{YX, T1→T2} = β_{YX, T2→T3}), le chercheur teste formellement l’hypothèse selon laquelle les dynamiques transactionnelles sous-jacentes opèrent avec une intensité stable et invariante au fil du développement.
De surcroît, l’inclusion de trois vagues de mesure permet de modéliser mathématiquement des mécanismes de médiation séquentielle longitudinale. Il devient possible de tester formellement des effets indirects longitudinaux au moyen du calcul du produit des coefficients :
Effet indirect = β_{YX, T1→T2} cdot β_{XY, T2→T3}
Cette formulation permet d’éprouver empiriquement l’existence de cascades développementales où la modification précoce d’une variable X₁ induit une altération intermédiaire de Y₂, laquelle modifie en retour la trajectoire ultérieure de X₃. Une telle chaîne transactionnelle demeure mathématiquement indétectable au sein d’un format restreint à deux vagues.
6. Hypothèses méthodologiques, conditions d’application et postulats d’invariance
6.1 L’invariance de mesure à travers le temps (Measurement Invariance)
L’une des conditions préalables les plus cruciales — et pourtant fréquemment négligée dans les publications empiriques — pour garantir la validité interne des conclusions tirées d’un modèle de panel à décalage croisé est l’établissement formel de l’invariance de mesure longitudinale (longitudinal measurement invariance). Ce postulat épistémologique stipule que l’instrument de mesure utilisé doit capturer rigoureusement le même construit psychologique, avec les mêmes propriétés métriques, à chacune des vagues successives d’investigation.
Si la signification psychométrique des indicateurs subit une dérive temporelle (par exemple, en raison du vieillissement cognitif des répondants, de l’apprentissage des items ou de mutations sémantiques culturelles), toute variation observée sur les coefficients autorégressifs ou croisés ne reflétera pas un véritable changement dynamique du construit, mais constituera un artefact statistique résultant de la mutation métrique de l’outil de recueil. Lorsque le modèle est estimé à l’aide de variables latentes, il est impératif d’évaluer séquentiellement trois niveaux hiérarchiques d’invariance temporelle :
- L’invariance configurationnelle : vérification que la structure factorielle (le patron de liaisons entre les indicateurs manifestes et les facteurs latents) est rigoureusement identique à travers toutes les vagues de mesure.
- L’invariance métrique (ou faible) : imposition de l’égalité stricte des saturations factorielles (coefficients λ) au fil du temps. Ce niveau est absolument obligatoire pour pouvoir interpréter de manière valide les covariances, les coefficients autorégressifs et les effets à décalage croisé.
- L’invariance scalaire (ou forte) : imposition de l’égalité des seuils ou des intercepts des items manifestes à travers les vagues. Cette condition devient requise dès lors que le chercheur souhaite comparer les moyennes latentes absolues au fil du temps.
L’évaluation statistique de cette invariance repose sur la comparaison de modèles emboîtés. Si l’imposition des contraintes de métrique n’entraîne pas de dégradation significative de l’ajustement global du modèle — évaluée conventionnellement par une diminution du CFI inférieure à 0,010 (ΔCFI ≥ -0,010) et une augmentation du RMSEA inférieure à 0,015 (ΔRMSEA ≤ 0,015), selon les critères classiques établis par Cheung et Rensvold — l’invariance métrique est déclarée acquise, autorisant le chercheur à interpréter les trajets croisés en toute confiance méthodologique.
6.2 L’adéquation de l’intervalle temporel (Lag Length Selection)
Le choix de l’intervalle temporel séparant les différentes collectes de données (la longueur du décalage ou lag length) représente sans conteste l’arbitrage méthodologique le plus délicat et le plus critique lors de la conception d’un panel à décalage croisé. Le modèle mathématique postule implicitement que l’espacement chronologique sélectionné coïncide précisément avec la cinétique naturelle d’éclosion du phénomène causal sous investigation.
Si l’intervalle retenu est excessivement bref par rapport à l’inertie du processus réel (par exemple, mesurer l’impact de la formation universitaire sur le salaire à deux semaines d’intervalle), le chercheur commet une erreur de type II : l’effet causal n’a pas encore eu le temps physique ou institutionnel de se matérialiser, et le coefficient croisé apparaîtra erronément nul. Inversement, si l’intervalle sélectionné est démesurément étendu (par exemple, mesurer l’impact d’un épisode de stress aigu sur l’anxiété à dix ans d’intervalle), l’influence prospective a de fortes chances d’avoir été totalement résorbée, neutralisée par des mécanismes homéostatiques ou masquée par une multitude d’événements de vie intercalaires, conduisant là encore à une conclusion faussement négative.
Il n’existe aucune formule mathématique universelle permettant de déterminer a priori l’intervalle optimal, car ce dernier dépend exclusivement de la théorie substantielle du domaine considéré. Les processus neurophysiologiques et émotionnels requièrent des décalages d’heures ou de jours, les transformations comportementales et attitudinales se déploient sur des semaines ou des mois, tandis que les trajectoires socio-économiques et institutionnelles exigent des pas de temps pluriannuels. La sélection de l’intervalle doit donc faire l’objet d’une justification théorique exhaustive dans toute publication rigoureuse.
6.3 Traitement de l’attrition, des données manquantes et de l’attrition sélective
Par essence, les études de panel exposent inévitablement les chercheurs au phénomène d’attrition, c’est-à-dire la perte progressive de participants entre les vagues successives d’investigation (déménagements, désistements volontaires, décès ou impossibilité technique de recontact). Cette attrition porte un préjudice direct à la validité interne et externe des analyses statistiques si elle n’est pas traitée avec des algorithmes appropriés.
Le danger majeur ne réside pas tant dans la perte de puissance statistique brute que dans l’émergence d’une attrition sélective. Si les participants qui quittent l’étude partagent des caractéristiques systématiques — par exemple, les ménages les plus précarisés ou les individus présentant la détresse psychologique la plus sévère — le mécanisme de manquement n’est plus aléatoire. En statistique contemporaine selon la typologie de Donald Rubin, on distingue rigoureusement :
- Les données manquantes complètement au hasard (MCAR, Missing Completely At Random), situation idéale mais rarissime où le manquement ne dépend d’aucune variable mesurée ou non mesurée ;
- Les données manquant au hasard (MAR, Missing At Random), où la probabilité de données manquantes dépend statistiquement de variables observées au temps antérieur (par exemple, le score de dépression au temps 1 prédit l’absence de réponse au temps 2) ;
- Les données manquantes non aléatoires (MNAR, Missing Not At Random), où le manquement dépend directement de la valeur non observée elle-même (par exemple, un participant ne répond pas au temps 2 précisément parce qu’il est en crise dépressive aiguë à cet instant).
Pour immuniser les estimations du CLPM contre les biais dévastateurs de l’attrition (sous l’hypothèse MAR), les pratiques méthodologiques obsolètes telles que la suppression de liste (listwise deletion) ou l’imputation par la moyenne doivent être formellement proscrites. Le standard de référence absolu réside dans l’utilisation conjointe de l’estimation par le maximum de vraisemblance à information complète (FIML, Full Information Maximum Likelihood) ou de l’imputation multiple par équations enchaînées (MICE). L’algorithme FIML estime les paramètres du modèle directement à partir de tous les fragments d’information disponibles pour chaque participant sans jamais supprimer la moindre observation partielle, produisant ainsi des estimations asymptotiquement non biaisées et préservant l’intégrité de la puissance statistique du panel.
7. Protocole pas-à-pas pour la mise en œuvre et l’estimation statistique
7.1 Préparation des données et vérification des conditions préalables
La mise en œuvre opérationnelle d’un modèle de panel à décalage croisé requiert une structuration matricielle scrupuleuse des données en amont de toute syntaxe statistique. Contrairement aux modèles multiniveaux ou aux modèles de survie qui exploitent un format long (où chaque ligne représente une observation répétée pour un participant donné), la modélisation SEM exige impérativement une organisation des données en format large (wide format). Dans cette disposition, chaque ligne du fichier correspond à une unité d’observation unique (le participant), et chaque variable répétée au fil des vagues temporelles est représentée par une colonne distincte portant un identifiant temporel spécifique (par exemple, Depression_T1, Depression_T2, Stress_T1, Stress_T2).
Une fois cette structuration accomplie, le chercheur doit procéder à un examen approfondi de la normalité multivariée des distributions. Les estimateurs standards par maximum de vraisemblance postulent que le vecteur combiné des variables observables suit une distribution gaussienne multivariée. L’asymétrie (skewness) prononcée ou l’aplatissement excessif (kurtosis), fréquemment rencontrés dans les mesures cliniques ou de consommation, peuvent conduire à une sous-estimation artificielle des erreurs-types et à un gonflement fallacieux de la statistique du Chi-deux. Le calcul du coefficient de Mardia permet de quantifier formellement cette déviation. En cas de non-normalité avérée, le chercheur privilégiera l’estimateur MLR (maximum de vraisemblance avec erreurs-types robustes de type sandwich de Huber-White et correction d’échelle de Satorra-Bentler).
Enfin, l’inspection des données impose l’analyse de la multicolinéarité via le calcul des facteurs d’inflation de la variance (VIF). Bien qu’une corrélation élevée entre X₁ et X₂ soit précisément attendue en vertu de la stabilité autorégressive, une colinéarité quasi parfaite (> 0,90) menacerait l’inversion des matrices lors de l’estimation numérique et traduirait une absence pathologique de variance résiduelle exploitable pour l’explication croisée.
7.2 Syntaxe et spécification pratique sous R (package lavaan)
Dans l’écosystème open-source contemporain, le package lavaan (Latent Variable Analysis) développé par Yves Rosseel s’est imposé comme l’outil privilégié au sein de l’environnement de programmation statistique R. Sa syntaxe déclarative, élégante et rigoureuse, permet de spécifier un CLPM en quelques instructions limpides.
Pour illustrer la mise en œuvre d’un modèle bivarié à deux temps portant sur le stress perçu (STR) et les symptômes dépressifs (DEP), la syntaxe lavaan s’articule formellement autour de trois opérateurs structurels distincts :
- L’opérateur ~ (tilde unique) spécifie une régression directionnelle où la variable de gauche est prédite par les variables de droite.
- L’opérateur ~~ (double tilde) spécifie une covariance bivariée ou une corrélation résiduelle symétrique.
- L’opérateur de labellisation alphabétique permet de contraindre ou d’extraire des paramètres spécifiques à des fins de comparaison d’hypothèses.
Considérons la spécification formelle du script d’estimation :
Dans le modèle textuel, les équations de régression pour les variables au temps 2 s’écrivent : DEP_T2 ~ a1*DEP_T1 + c1*STR_T1 (qui spécifie simultanément la stabilité autorégressive a1 et l’effet croisé c1), et STR_T2 ~ a2*STR_T1 + c2*DEP_T1 (qui spécifie la stabilité a2 et l’effet croisé réciproque c2). La corrélation synchrone initiale s’écrit DEP_T1 ~~ STR_T1, et la covariance résiduelle contemporaine à la vague consécutive se formalise par l’instruction DEP_T2 ~~ STR_T2.
L’ajustement du modèle au jeu de données s’exécute par l’appel de la commande sem(), en désignant explicitement le modèle spécifié, la base de données analysée, la méthode de traitement des données manquantes via l’argument missing = "fiml", et l’estimateur souhaité via estimator = "MLR". L’affichage des sorties numériques complètes s’obtient par l’instruction summary(fit, fit.measures = TRUE, standardized = TRUE), permettant d’extraire simultanément les indices d’ajustement global, les coefficients de régression non standardisés, les erreurs-types corrigées, les valeurs p et les estimations standardisées STDYX nécessaires à la publication scientifique.
7.3 Spécification équivalente dans Mplus et comparaison des sorties
Bien que les outils R connaissent une expansion fulgurante, le logiciel commercial Mplus développé par Bengt Muthén demeure une référence institutionnelle majeure dans la recherche psychométrique avancée. La structure des commandes Mplus obéit à une architecture modulaire par blocs d’instructions prédéfinis d’une redoutable concision syntaxique.
Au sein du bloc d’instructions MODEL: de Mplus, les relations structurelles s’écrivent directement à l’aide des opérateurs réservés ON et WITH :
- L’opérateur
ON(abréviation de regressed ON) formalise les relations régressives asymétriques. Les deux équations s’énoncent simplement :DEP_T2 ON DEP_T1 STR_T1;etSTR_T2 ON STR_T1 DEP_T1;. L’analyste peut associer des labels entre parenthèses pour tester ultérieurement des contraintes d’égalité formelles. - L’opérateur
WITHcapture les associations covariantes bidirectionnelles. La commandeDEP_T2 WITH STR_T2;instruit le logiciel d’estimer librement la covariance entre les perturbations d’erreur résiduelles des deux variables endogènes contemporaines.
Si les variables manipulées présentent une nature catégorielle ordonnée (par exemple des échelles de Likert comptant moins de cinq modalités), Mplus permet de substituer instantanément l’estimateur robuste des moindres carrés pondérés diagonalement (WLSMV, Weighted Least Squares Mean and Variance adjusted) via l’instruction ANALYSIS: ESTIMATOR = WLSMV;, adaptant ainsi parfaitement l’estimation aux variables ordinales non continues. Les sorties fournies par Mplus et lavaan sont rigoureusement convergentes sur le plan algorithmique dès lors que les options d’optimisation numérique et de correction des erreurs-types sont harmonisées, garantissant une reproductibilité parfaite des résultats à travers les plateformes informatiques.
8. Interprétation des coefficients et évaluation de la causalité directionnelle
8.1 Décomposition et lecture critique des paramètres estimés
L’extraction des résultats numériques d’un CLPM exige une lecture prudente, nuancée et exempte de confusions statistiques courantes. La première distinction impérative à opérer concerne la dualité entre coefficients non standardisés (généralement désignés par la lettre B) et coefficients standardisés (notés β ou solution STDYX). Le coefficient non standardisé exprime la modification attendue de la variable dépendante (dans son unité de mesure d’origine) pour chaque augmentation d’une unité de l’échelle du prédicteur. Bien que le coefficient B soit indispensable pour tester des contraintes d’égalité d’un groupe à l’autre ou évaluer des grandeurs économiques tangibles, seul le coefficient standardisé β autorise la comparaison de la magnitude relative d’effets reliant des variables mesurées sur des métriques hétérogènes.
L’interprétation de la valeur p et des erreurs-types doit être systématiquement complétée par l’analyse des intervalles de confiance à 95%. Un effet croisé statistiquement significatif au seuil de p = 0,049 mais dont l’intervalle de confiance frôle zéro avec une borne inférieure infinitésimale (ex. [0,001 ; 0,15]) ne saurait porter le même crédit substantiel qu’un paramètre solidement ancré loin de l’hypothèse nulle. De plus, il est crucial de rappeler qu’une significativité statistique n’équivaut en rien à une pertinence clinique ou sociétale : dans des méga-échantillons regroupant des dizaines de milliers d’individus, des coefficients croisés dérisoires (β = 0,02) atteindront des seuils de significativité extrêmes (p < 0,001) en dépit d’une vacuité explicative quasi totale dans le monde réel.
Enfin, l’examen scrupuleux du coefficient de détermination multiple (R²) pour chaque variable endogène fournit une indication synthétique sur l’adéquation explicative globale du modèle. Le chercheur doit méticuleusement décomposer ce R² : quelle part de variance expliquée procède simplement de la stabilité autorégressive (l’inertie comportementale intrinsèque) et quelle part relève de l’apport incrémental spécifique des prédicteurs croisés ? L’inclusion d’une variable croisée n’améliorant le R² que de 0,5% incite à une modestie interprétative de rigueur quant à l’efficacité du levier causal identifié.
8.2 Critères de décision pour déterminer la prédominance directionnelle
L’objectif épistémologique premier du CLPM réside dans l’attribution de la prépondérance causale relative entre deux entités en interaction dynamique. Pour conclure formellement qu’une direction causale domine l’autre (par exemple, que X est un déterminant plus puissant de Y que l’inverse), il ne suffit pas de constater visuellement qu’un coefficient standardisé est numériquement plus grand que son homologue (β_{YX} = 0,25 versus β_{XY} = 0,12).
La validation scientifique de cette asymétrie impose le déploiement d’un test de différence de modèles emboîtés (Nested Model Comparison) ou d’un test de Wald. Le protocole analytique se déploie en deux temps rigoureux :
- On estime d’abord le modèle de référence où les deux coefficients croisés sont libres et estimés indépendamment sans contrainte d’égalité (Modèle Non Contraint).
- On estime ensuite un modèle concurrent rigoureusement identique, à l’exception près que l’on impose une contrainte d’égalité formelle sur les deux trajets non standardisés (B_{YX} = B_{XY}), modélisant l’hypothèse nulle d’une parfaite symétrie d’influence réciproque (Modèle Contraint).
- On compare ensuite la variation de la statistique du Chi-deux entre ces deux modèles au moyen d’un test de rapport de vraisemblance (Log-Likelihood Ratio Test ou correction de Satorra-Bentler pour MLR) sur 1 degré de liberté.
Si le test de différence du Chi-deux s’avère statistiquement significatif (Δχ² sur 1 ddl > 3,84, p < 0,05), cela prouve mathématiquement que la contrainte d’égalité dégrade significativement l’ajustement du modèle aux données. Le chercheur est alors fondé à rejeter l’hypothèse de symétrie et à affirmer la prédominance directionnelle statistiquement prouvée du coefficient présentant la plus forte magnitude.
En revanche, si la différence de Chi-deux n’atteint pas la significativité statistique, le principe de parcimonie scientifique impose de conclure à l’équivalence des forces d’influence réciproques, rejetant toute assertion de supériorité causale unilatérale. Sur le plan de la communication académique, il est impératif de proscrire l’affirmation péremptoire de « preuve causale absolue », pour lui substituer la terminologie rigoureuse d’« association prospective incrémentale directionnelle compatible avec une plausibilité causale ».
8.3 Exemple appliqué en psychologie clinique : Stress perçu et symptômes dépressifs
Pour illustrer l’élégance de cette démarche décisionnelle, examinons son application emblématique à une controverse majeure en psychopathologie clinique : l’interdépendance entre le stress perçu issu des tracas quotidiens et les symptômes dépressifs majeurs au fil du temps. Deux théories psychologiques s’affrontent historiquement dans la littérature :
La première, la théorie de la vulnérabilité au stress (ou modèle diathèse-stress classique), postule que l’exposition chronique aux événements stressants érode les ressources d’adaptation de l’individu, précipitant consécutivement l’apparition de l’effondrement thymique dépressif (flèche causale prospective allant du Stress vers la Dépression).
La seconde, l’audacieuse théorie de la génération de stress formalisée par Constance Hammen, postule que les individus présentant des caractéristiques dépressives ou des dysfonctionnements interpersonnels sous-jacents génèrent activement, par leurs comportements de retrait, d’irritabilité ou d’évitement, des événements de vie stressants et des tensions conflictuelles dans leur environnement relationnel (flèche causale prospective allant de la Dépression vers le Stress).
Considérons une étude de panel clinique menée auprès d’une cohorte de 1 200 participants évalués à l’aide d’échelles validées à six mois d’intervalle. Les résultats du CLPM standardisé révèlent les paramètres suivants :
- Stabilité autorégressive de la dépression : β = 0,62 (p < 0,001) ;
- Stabilité autorégressive du stress perçu : β = 0,48 (p < 0,001) ;
- Covariance contemporaine initiale (T1) : r = 0,54 (p < 0,001) ;
- Trajet croisé Stress T1 → Dépression T2 : β = 0,21 (p < 0,001) ;
- Trajet croisé Dépression T1 → Stress T2 : β = 0,19 (p < 0,001) ;
- Covariance contemporaine résiduelle (T2) : r = 0,33 (p < 0,001).
L’application d’un test de rapport de vraisemblance contraignant les deux trajets croisés à l’égalité ne révèle aucune dégradation statistique significative de l’ajustement (Δχ²(1) = 0,42, p = 0,52). Ce résultat apporte une validation éclatante et empiriquement irréfutable de la nature transactionnelle bidirectionnelle de la psychopathologie : la vulnérabilité au stress et la génération de stress ne sont pas deux hypothèses mutuellement exclusives, mais les deux rouages synchronisés d’une même dynamique cyclique infernale, au sein de laquelle la souffrance subjective génère les conditions contextuelles mêmes de son propre maintien dans le temps.
9. Limites méthodologiques et critiques contemporaines du modèle classique
9.1 Le problème de la confusion entre variance interindividuelle et intra-individuelle
En dépit de son élégance apparente et de son statut historique d’instrument de choix en sciences sociales, le modèle de panel à décalage croisé classique a essuyé au cours de la dernière décennie un tir de barrage méthodologique d’une rare intensité. La critique la plus dévastatrice — et désormais universellement acceptée par la communauté des méthodologistes quantitatifs — a été formalisée de manière magistrale dans l’article séminal de Hamaker, Kuiper et Grasman (2015), intitulé avec provocation : « A Critique of the Cross-Lagged Panel Model ».
Le reproche fondamental articulé par Ellen Hamaker et ses collègues réside dans l’incapacité structurelle du CLPM classique à opérer la distinction mathématique entre deux niveaux de variance ontologiquement et statistiquement totalement hétérogènes : la variance interindividuelle (between-person variance) et la variance intra-individuelle (within-person variance).
Pour saisir l’acuité de ce problème, il convient de définir rigoureusement ces deux dimensions :
- La variance interindividuelle reflète les différences stables et durables qui séparent les individus les uns des autres (des traits invariants, des prédispositions génétiques, des capitaux culturels ou des caractéristiques socio-démographiques fixes). Un individu peut avoir, de façon générale et pérenne, un niveau moyen de stress plus élevé qu’un autre individu.
- La variance intra-individuelle quantifie les fluctuations dynamiques, les états passagers et les oscillations temporelles qui surviennent au cours de la vie au sein d’une seule et même personne par rapport à sa propre moyenne de base. Si un individu subit un choc aigu cette semaine, il s’écarte temporairement de sa moyenne personnelle habituelle.
Or, la plupart des théories psychologiques portent intrinsèquement sur des processus de niveau intra-individuel : affirmer que le stress accroît la dépression signifie que lorsque le niveau de stress d’une personne donnée s’élève au-delà de son seuil habituel, cette même personne éprouvera subséquemment une recrudescence de ses symptômes dépressifs. Le drame méthodologique du CLPM classique réside dans le fait qu’il compresse, fusionne et agrège aveuglément ces deux niveaux de variance au sein d’un vecteur statistique unique. Les coefficients autorégressifs et les coefficients croisés du CLPM traditionnel sont ainsi un amalgame mathématiquement indémêlable de différences stables entre personnes et de processus dynamiques au sein de la personne.
Cette agrégation fallacieuse peut engendrer des paradoxes statistiques spectaculaires, relevant du classique paradoxe de Simpson. Il a été formellement démontré par des simulations de Monte-Carlo qu’un effet au niveau intra-individuel peut être strictement nul, ou même rigoureusement négatif, alors que le CLPM traditionnel rapportera un coefficient croisé hautement significatif et positif, uniquement sous l’effet de corrélations de trait non modélisées au niveau interindividuel. Dans de telles circonstances, l’interprétation causale des coefficients du CLPM classique devient une pure illusion mathématique.
9.2 La vulnérabilité aux variables confondantes omises et stables
Corollaire direct de son incapacité à dissocier les niveaux de variance, le modèle de panel à décalage croisé classique s’avère extraordinairement vulnérable à l’action de facteurs de confusion invariants dans le temps. Dans toute étude observationnelle non randomisée, il existe une infinité de caractéristiques individuelles stables qui ne sont pas mesurées par l’investigateur : polymorphisme génétique, traits profonds de personnalité (ex. neuroticisme), intelligence cristallisée, traumatismes infantiles précoces ou statut socio-économique d’origine de la famille.
Dans un CLPM traditionnel, si une caractéristique stable non observée (par exemple, le niveau d’extraversion fondamentale) influence simultanément la sociabilité au temps 1 et le sentiment d’épanouissement au temps 2, cette influence de trait invariant ne disposant d’aucun réceptacle formel pour être isolée va se diffuser de manière parasite à travers l’ensemble des chemins régressifs du modèle. Il en résulte deux distorsions majeures :
- Un gonflement artificiel démesuré des coefficients autorégressifs : la stabilité temporelle calculée ne reflète pas une véritable inertie dynamique d’état, mais capture mécaniquement la présence de cette composante de trait fixe omniprésente à travers les vagues.
- Une spécification erronée des coefficients à décalage croisé : le modèle interprète comme une influence prédictive dynamique d’une variable sur l’autre ce qui n’est en réalité que la signature indirecte et passive du facteur de confusion non contrôlé agissant continuellement en arrière-plan.
Cette vulnérabilité rédhibitoire fragilise considérablement la portée épistémologique des décennies de littérature empirique ayant utilisé le CLPM classique pour clamer l’existence d’effets transactionnels en psychologie.
9.3 Dépendance critique envers le choix arbitraire de l’intervalle temporel
La troisième limitation fondamentale du CLPM traditionnel a trait à son hypothèse sous-jacente selon laquelle le monde empirique se comporte comme un automate à temps discret. Les modèles d’équations structurelles classiques modélisent les relations temporelles comme si les variables n’existaient ou n’interagissaient qu’aux instants précis où l’expérimentateur administre ses questionnaires.
Dans la réalité ontologique, les processus biopsychosociaux opèrent sous la forme d’un flux temporel continu. Comme l’ont démontré les travaux méthodologiques approfondis d’Oud, Voelkle et Kuiper, l’estimation des paramètres dans un cadre à temps discret dépend de manière critique et non linéaire de la durée exacte du décalage (Δt) arbitrairement sélectionné par le chercheur. Si l’on étudie le même phénomène transactionnel auprès de cohortes identiques mais en modifiant simplement le pas de temps d’observation (par exemple 3 mois contre 6 mois ou 12 mois) :
- La magnitude relative des coefficients autorégressifs et croisés peut fluctuer de manière imprévisible ;
- La prédominance directionnelle peut s’inverser totalement (X semblant dominer Y à 3 mois, tandis que Y semble dominer X à 12 mois) ;
- Le signe du coefficient croisé peut théoriquement basculer de positif à négatif si le phénomène implique une dynamique oscillatoire sous-jacente amortie.
Cette sensibilité aiguë met en exergue les écueils inhérents aux panels discrets et souligne l’urgence pour la recherche translationnelle d’évoluer vers des formulations mathématiques en temps continu (telles que le Continuous-Time Structural Equation Modeling ou CT-SEM), capables de modéliser des équations différentielles stochastiques affranchies du pas de mesure empirique.
10. L’évolution méthodologique : Le modèle RI-CLPM (Random Intercept Cross-Lagged Panel Model)
10.1 Architecture et principes du RI-CLPM selon Hamaker (2015)
Face à la faillite méthodologique avérée du CLPM classique relative à la confusion des niveaux de variance, Ellen Hamaker et ses collaborateurs ont forgé une innovation architecturale décisive qui a révolutionné la modélisation longitudinale contemporaine : le modèle de panel à décalage croisé à interceptes aléatoires (RI-CLPM, Random Intercept Cross-Lagged Panel Model).
L’intuition fondamentale du RI-CLPM consiste à intégrer formellement la décomposition de la variance issue des modèles multiniveaux au sein de la modélisation par équations structurelles. Au sein du RI-CLPM, chaque variable observée au cours de chaque vague temporelle est mathématiquement partitionnée et désagrégée en deux composantes strictement orthogonales et indépendantes :
X_{i,t} = mu_{X,t} + RI_{X,i} + W_{X,i,t}
Où :
- mu_{X,t} représente la moyenne de l’échantillon au temps t ;
- RI_{X,i} est un intercepte aléatoire (Random Intercept) propre à l’individu i. Il représente le niveau moyen temporellement stable et invariant de cette personne à travers l’ensemble de l’étude (la composante de trait interindividuel). Pour capturer cette permanence absolue, les charges factorielles reliant l’intercepte aléatoire aux variables observées à travers toutes les vagues de mesure sont toutes mathématiquement contraintes à la valeur fixe de 1,00 ;
- W_{X,i,t} constitue la déviation résiduelle ou l’écart passager (within-person deviation) de l’individu par rapport à son propre niveau moyen de base au temps t (la composante d’état intra-individuel).
La transformation méthodologique radicale opérée par le RI-CLPM réside dans le fait que l’ensemble des relations autorégressives et des relations à décalage croisé n’est plus estimé sur les variables manifestes brutes, mais s’exécute exclusivement entre les variables d’écarts intra-individuels latents (W). L’intercepte aléatoire absorbe l’intégralité de la variance de trait stable ainsi que l’effet de toutes les variables confondantes invariantes dans le temps, qu’elles soient mesurées ou non. Les coefficients croisés résultants reflètent ainsi avec une pureté méthodologique irréprochable la mesure dans laquelle une déviation temporaire par rapport à sa propre moyenne habituelle sur X prédit une déviation future par rapport à sa propre moyenne habituelle sur Y.
10.2 Comparaison directe : CLPM traditionnel versus RI-CLPM
Pour apprécier le saut qualitatif offert par cette avancée, il s’avère indispensable de juxtaposer analytiquement les caractéristiques, le comportement et l’interprétation du CLPM traditionnel face à ceux du RI-CLPM au sein d’un tableau comparatif détaillé :
| Critère Méthodologique | CLPM Traditionnel (Classique) | RI-CLPM (Interceptes Aléatoires) |
|---|---|---|
| Niveau de variance ciblé | Mélange indistinct et agrégé des niveaux inter- et intra-individuels. | Séparation formelle et orthogonale du niveau inter (trait) et intra (état). |
| Interprétation de l’effet croisé | Une personne ayant un score plus élevé sur X qu’une autre aura-t-elle ultérieurement un score plus élevé sur Y ? | Lorsqu’un individu s’écarte temporairement de sa propre moyenne sur X, s’écarte-t-il ensuite de sa moyenne sur Y ? |
| Magnitude des coefficients autorégressifs | Généralement très élevée et gonflée artificiellement par la stabilité de trait persistante. | Considérablement réduite, ne mesurant que la persistance temporelle réelle de déviations à court terme. |
| Contrôle des facteurs confondants stables | Nul. Extrêmement vulnérable aux tiers facteurs invariants non mesurés (génétique, etc.). | Optimal et automatique : les interceptes aléatoires absorbent 100% des confusions stables non observées. |
| Nombre minimal de vagues (T) | Identification possible dès T = 2 vagues de mesure. | Identification structurelle requérant impérativement un minimum de T ≥ 3 vagues (sauf contraintes très fortes). |
| Exigences de taille d’échantillon (N) | Modeste. Converge fréquemment avec des échantillons de N = 150 à 300. | Élevée. Requiert des échantillons massifs (idéalement N > 500) sous peine d’instabilité numérique. |
Cette distinction conceptuelle modifie radicalement la portée théorique des résultats. Nombre de publications récentes réanalysant des panels historiques à succès ont mis au jour une disparition totale des effets croisés significatifs dès lors que le RI-CLPM était substitué au CLPM classique, révélant que les prétendues relations causales n’étaient que l’écho de corrélations de trait préexistantes et stables.
10.3 Quand privilégier le CLPM traditionnel face au RI-CLPM ?
À la lumière de ces constats critiques, une tentation méthodologique courante consisterait à disqualifier universellement le CLPM classique pour lui substituer aveuglément le RI-CLPM dans toutes les investigations empiriques. Une telle attitude relèverait toutefois d’un dogmatisme réducteur ignorant les contraintes statistiques inhérentes à l’estimation de modèles complexes.
Il subsiste des situations méthodologiques rigoureuses où le recours au CLPM traditionnel demeure pleinement légitime, voire mathématiquement incontournable :
- La contrainte irrémédiable d’un design à deux vagues (T = 2). Sur le plan mathématique formel, un modèle RI-CLPM standard appliqué à deux points de mesure sans contraintes drastiques est structurellement sous-identifié. Il est impossible d’estimer simultanément les variances des interceptes aléatoires et les paramètres d’état sur seulement deux temps d’observation sans imposer des postulats d’égalité héroïques et indéfendables. Si le chercheur ne dispose factuellement que de deux vagues, le CLPM classique demeure le seul modèle manifeste estimable, sous réserve expresse de documenter scrupuleusement cette limite dans la discussion.
- La nature conceptuelle du construit étudié. L’architecture du RI-CLPM postule ontologiquement que le phénomène psychologique est dominé par un point d’équilibre homéostatique stable vers lequel l’individu retourne invariablement après une fluctuation passagère. Si l’objet de recherche est un processus d’apprentissage cumulatif unidirectionnel (ex. l’acquisition du vocabulaire chez l’enfant, l’apprentissage d’une langue étrangère, ou l’accumulation irréversible d’un capital financier), la notion d’un intercepte aléatoire stable autour duquel l’individu fluctue n’a aucun sens théorique substantiel.
- Les problèmes d’insolvabilité numérique et les échantillons modestes. En raison de sa haute paramétrisation, le RI-CLPM souffre fréquemment, sur des échantillons réduits (N < 300), de problèmes de non-convergence algorithmique, d’instabilité matricielle et d’estimations aberrantes hors limites (les célèbres Heywood cases ou variances négatives estimées). Face à un RI-CLPM incapable de converger sans violer les axiomes de variance positive, le maintien d’un CLPM parcimonieux s’impose par nécessité empirique.
11. Comparaison avec les approches longitudinales alternatives en psychologie
11.1 CLPM vs Modèles de courbes de croissance latente (Latent Growth Curve Models – LGCM)
Dans la boîte à outils du psychologue quantitatif, le CLPM partage le paysage méthodologique avec d’autres paradigmes analytiques puissants, au premier rang desquels figurent les modèles de courbes de croissance latente (LGCM). Bien que tous deux s’appliquent à des données de panel issues de vagues multiples, leur philosophie analytique et leur questionnement substantiel divergent fondamentalement.
Le modèle de croissance latente vise principalement à décrire et modéliser la forme géométrique globale de la trajectoire de changement systématique d’une population au fil du temps. Il décompose la variance répétée en un facteur de niveau de départ (l’intercepte moyen et sa variance interindividuelle) et un ou plusieurs facteurs de taux d’évolution ou de pente (les slopes linéaires, quadratiques ou libres), permettant d’examiner si les individus grandissent, déclinent ou stagnent en moyenne, et quelles caractéristiques prédisent l’accélération ou le ralentissement de cette trajectoire globale.
À l’inverse, le CLPM n’a que faire de la tendance globale séculaire moyenne ; son objectif primaire réside dans l’analyse transactionnelle couplée pas à pas. Il cherche à déterminer si, au-delà de la trajectoire propre de chaque individu, une poussée sur une variable à un instant précis dévie la trajectoire consécutive de l’autre variable au temps suivant. Pour tenter de réconcilier le meilleur de ces deux mondes, des méthodologistes ont élaboré des architectures hybrides d’une grande sophistication :
- Les modèles de croissance à processus parallèles (Parallel Process LGCM), qui modélisent la corrélation entre les interceptes et les pentes de deux construits évoluant parallèlement ;
- Les modèles de différence latente (Latent Change Score ou LCS models), conceptualisés notamment par John McArdle, qui intègrent au sein d’un même cadre mathématique formel l’estimation des pentes de croissance sous-jacentes et les influences autorégressives et croisées directes sur le changement unitaire latent.
11.2 CLPM vs Modélisation multiniveau pour données intensives (ESM / EMA)
L’essor des technologies mobiles et des applications pour smartphones a démocratisé l’utilisation des méthodes d’évaluation écologique instantanée (EMA, Ecological Momentary Assessment) ou méthode d’échantillonnage des expériences (ESM), où les participants sont sollicités plusieurs fois par jour durant quelques semaines. Cette prolifération de données longitudinales intensives (ILD) a mis en lumière le fossé opérationnel séparant les panels classiques des approches multiniveaux dynamiques.
Tandis que le CLPM s’adapte idéalement à des designs macro-temporels comportant un petit nombre de vagues (2 à 5 temps) espacées de plusieurs mois ou années mesurées sur de larges cohortes (N élevé, T faible), l’ESM génère des séries chronologiques denses (N modéré, T élevé, souvent de 30 à 100 points de mesure par sujet). L’analyse de ces micro-dynamiques requiert des outils d’une tout autre nature, incarnés par la modélisation par équations structurelles dynamiques (DSEM, Dynamic Structural Equation Modeling) développée par Muthén et Asparouhov.
Le DSEM formalise des processus autorégressifs vectoriels (VAR) d’ordre 1 au niveau intra-individuel tout en permettant à chacun des paramètres d’inertie autorégressive et de couplage croisé d’être aléatoire d’un individu à l’autre (random slopes). Ces deux approches ne sont nullement concurrentes mais profondément complémentaires : le DSEM capture les micro-mécanismes de régulation affective opérant à l’échelle de quelques heures, tandis que le CLPM et le RI-CLPM capturent la cristallisation à long terme de ces interactions sous la forme de transformations développementales majeures à l’échelle de la vie humaine.
11.3 CLPM vs Modèles à effets fixes et effets aléatoires en économétrie
Il est intellectuellement enrichissant de souligner que les controverses ayant agité la psychométrie autour du CLPM et de l’intercepte aléatoire ne sont que la redécouverte d’un débat résolu depuis plus de quatre décennies dans la tradition économétrique des modèles de données de panel (Panel Data Econometrics). Les économistes ont historiquement abordé l’analyse des séries longitudinales courtes par le biais des modèles à effets fixes (Fixed Effects – FE) et à effets aléatoires (Random Effects – RE).
Le modèle économétrique à effets fixes élimine mathématiquement l’intégralité des caractéristiques non observées invariantes dans le temps par l’opération de différenciation première ou de transformation intra (within-transformation), une démarche conceptuellement équivalente à l’extraction de l’intercepte aléatoire dans le RI-CLPM. Lorsque les économistes ont cherché à intégrer des variables dépendantes retardées (l’équivalent de la stabilité autorégressive dans le CLPM) au sein de modèles à effets individuels non observés, ils se sont heurtés au redoutable biais de Nickell (l’endogénéité mécanique entre la variable dépendante désaisonnalisée et le terme d’erreur transformé).
Pour surmonter cette impasse, l’économétrie a conçu des estimateurs par la méthode des moments généralisés (GMM), tels que les célèbres estimateurs d’Arellano-Bond (1991) et de Blundell-Bond, qui instrumentent les prédicteurs retardés par leurs niveaux ou différences historiques passées. Alors que la tradition économétrique résout ce problème par des manipulations d’algèbre matricielle et l’utilisation de variables instrumentales dans un cadre de régression, la tradition psychométrique SEM le résout par la projection explicite de variables latentes d’erreur et d’interceptes non corrélés. La convergence intellectuelle contemporaine entre ces deux traditions épistémologiques offre aujourd’hui un socle d’une robustesse sans précédent pour l’inférence causale en sciences humaines.
12. Bonnes pratiques de publication, rapport académique et conclusion
12.1 Checklist pour la rédaction rigoureuse des résultats (normes APA)
La publication d’un modèle de panel à décalage croisé dans une revue académique à comité de lecture exige le respect scrupuleux de standards de transparence méthodologique, conformes aux recommandations internationales des normes APA (7e édition) et des directives JARS (Journal Article Reporting Standards). Toute omission d’informations métriques clés affaiblit la confiance des évaluateurs dans la rigueur des inférences rapportées.
Pour garantir une conformité éditoriale irréprochable, l’équipe de recherche veillera à cocher l’ensemble des points d’exigence de la checklist méthodologique suivante :
- Rapportage détaillé de l’échantillonnage et de la temporalité : documentation précise de la taille initiale de la cohorte (N), du calendrier exact des collectes, de l’intervalle chronologique exact séparant chaque vague, et des taux d’attrition spécifiques vague par vague avec analyse comparative des répondants versus non-répondants.
- Statistiques descriptives et matrices complètes : mise à disposition systématique de la matrice complète des covariances ou des corrélations bivariées entre toutes les variables du modèle à tous les temps de mesure, accompagnée des moyennes et écarts-types, autorisant ainsi la réplication computationnelle stricte des calculs.
- Preuve de l’invariance de mesure : si des variables latentes sont employées, présentation tabulaire détaillée de la comparaison séquentielle des modèles d’invariance (configurationnelle, métrique, scalaire) avec indication exhaustive des variations d’indices (Δχ², ΔCFI, ΔRMSEA).
- Tableau complet des estimations structurelles : un tableau publiant exhaustivement pour chaque trajet (autorégressif, croisé, covariance résiduelle) : l’estimation brute non standardisée (B), l’erreur-type asymptotique (SE), le ratio critique ou la statistique de Wald, la valeur p exacte, l’intervalle de confiance à 95%, et le coefficient standardisé (β ou STDYX).
- Indication rigoureuse de l’ajustement global : rapport systématique du Chi-deux avec ses degrés de liberté (χ², ddl, valeur p associée), ainsi que des indices descriptifs multivariés (CFI, TLI, RMSEA avec son intervalle de confiance à 90%, et SRMR).
- Représentation graphique professionnelle : inclusion d’un diagramme de cheminement complet et lisible, distinguant graphiquement par des traits pleins les trajets statistiquement significatifs et par des traits pointillés les trajets non significatifs, avec indication explicite des coefficients standardisés directement adossés aux flèches correspondantes.
12.2 Lignes directrices pour la discussion nuancée des implications causales
La section discussion d’un manuscrit exploitant un CLPM constitue l’épreuve de vérité épistémologique du chercheur. C’est à cet endroit précis que se dévoile la maturité méthodologique de l’auteur, qui doit naviguer avec équilibre entre la mise en valeur légitime de la plus-value de son design longitudinal et l’évitement scrupuleux de tout triomphalisme causal inconsidéré.
Il convient de proscrire rigoureusement les formulations assertives radicales affirmant péremptoirement que « l’étude prouve que la variable X cause la variable Y ». Une telle prétention demeure abusive dans un cadre observationnel non randomisé. L’attitude scientifique exemplaire consiste à employer le cadre conceptuel de la « plausibilité causale conditionnelle » : on argumentera que les résultats observés fournissent une présomption empirique solide appuyant l’existence d’une dépendance directionnelle prospective, laquelle survit au contrôle de l’inertie historique propre et des covariations contemporaines.
Le chercheur doit obligatoirement discuter de manière proactive les hypothèses alternatives et théories rivales susceptibles d’engendrer un patron statistique identique. Pourrait-il exister une tierce variable non mesurée agissant sur un pas de temps différent ? La durée du décalage retenue (lag length) est-elle susceptible d’avoir sous-estimé l’effet en raison d’une cinétique plus rapide ou plus lente du processus sous-jacent ? La discussion doit s’achever sur des recommandations opérationnelles concrètes, formulant la manière dont les prédictions directionnelles dégagées par le modèle de panel mériteraient d’être confrontées ultérieurement à des interventions quasi-expérimentales contrôlées, des protocoles de démantèlement thérapeutique ou des essais randomisés ciblant spécifiquement la variable manipulable identifiée comme causalement dominante.
12.3 Synthèse conclusive sur la place du CLPM dans l’arsenal du chercheur
Au terme de cette analyse exhaustive, le modèle de panel à décalage croisé apparaît non pas comme une panacée statistique absolue, mais comme une étape charnière et hautement sophistiquée dans l’évolution de la méthodologie quantitative contemporaine. Sa force incontestable réside dans sa structure formelle élégante, capable d’arracher l’inférence non expérimentale à la paralysie des corrélations transversales naïves et de confronter empiriquement la réversibilité et la réciprocité transactionnelle du comportement humain.
Toutefois, la science statistique ne tolère aucun immobilisme. L’émergence triomphale du modèle RI-CLPM est venue corriger la cécité congénitale du modèle classique face à l’hétérogénéité des niveaux de variance. Dès lors qu’un protocole de recherche dispose d’un minimum de trois vagues de mesure (T ≥ 3) et d’un échantillon suffisamment vaste, la migration vers le RI-CLPM — ou vers les modèles hybrides de courbes de croissance à différence latente — ne relève plus d’une simple coquetterie technique, mais d’une ardente obligation méthodologique pour qui prétend sonder avec fidélité les dynamiques intra-individuelles de l’esprit humain.
En dernière analyse, il convient de réaffirmer la primauté absolue de la réflexion théorique sur l’instrument computationnel. Aucun raffinement algorithmique, aucun logiciel de modélisation structurelle aussi puissant soit-il, ne pourra jamais compenser l’incohérence d’une hypothèse substantive, l’inadéquation d’un instrument psychométrique ou le choix erroné d’une temporalité d’observation. C’est uniquement lorsque la clarté conceptuelle guide la main du méthodologiste lors de la spécification de son modèle de panel que les équations mathématiques cessent d’être de froides abstractions pour devenir des instruments d’élucidation incomparables de la complexité humaine.
Références
- Arellano, M., & Bond, S. (1991). Some tests of specification for panel data: Monte Carlo evidence and an application to employment equations. The Review of Economic Studies, 58(2), 277-297. https://doi.org/10.2307/2297968
- Bandura, A. (1986). Social foundations of thought and action: A social cognitive theory. Prentice-Hall.
- Campbell, D. T., & Stanley, J. C. (1963). Experimental and quasi-experimental designs for research. Rand McNally.
- Cheung, G. W., & Rensvold, R. B. (2002). Evaluating goodness-of-fit indexes for testing measurement invariance. Structural Equation Modeling, 9(2), 233-255. https://doi.org/10.1207/S15328007SEM0902_5
- Granger, C. W. J. (1969). Investigating causal relations by econometric models and cross-spectral methods. Econometrica, 37(3), 424-438. https://doi.org/10.2307/1912791
- Hamaker, E. L., Kuiper, R. M., & Grasman, R. P. (2015). A critique of the cross-lagged panel model. Psychological Methods, 20(1), 102-116. https://doi.org/10.1037/met0000010
- Hammen, C. (1991). Generation of stress in the course of unipolar depression. Journal of Abnormal Psychology, 100(4), 555-561. https://doi.org/10.1037/0021-843X.100.4.555
- Jöreskog, K. G. (1970). A general method for analysis of covariance structures. Biometrika, 57(2), 239-251. https://doi.org/10.1093/biomet/57.2.239
- Kline, R. B. (2023). Principles and practice of structural equation modeling (5th ed.). Guilford Press.
- McArdle, J. J. (2009). Latent variable modeling of differences and changes with longitudinal data. Annual Review of Psychology, 60, 577-605. https://doi.org/10.1146/annurev.psych.60.110707.163612
- Muthén, B., & Asparouhov, T. (2018). Recent innovations in dynamic structural equation modeling. Frontiers in Psychology, 9, 2110. https://doi.org/10.3389/fpsyg.2018.02110
- Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software, 48(2), 1-36. https://doi.org/10.18637/jss.v048.i02
- Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581-592. https://doi.org/10.1093/biomet/63.3.581
- Voelkle, M. C., Oud, J. H., Davidov, E., & Schmidt, P. (2012). An SEM approach to continuous time modeling of panel data: Relating authoritarianism and anomia. Psychological Methods, 17(2), 176-192. https://doi.org/10.1037/a0027543