
Dans le champ de l’analyse quantitative et du traitement des données empiriques, l’identification rigoureuse des observations extrêmes constitue une étape préliminaire décisive. Loin de représenter une simple opération de nettoyage technique, le traitement des valeurs atypiques touche directement à la validité interne des inférences statistiques, à la fiabilité des modélisations prédictives et à la réplicabilité des résultats de recherche. Une observation déviante non détectée peut modifier substantiellement l’estimation des paramètres fondamentaux d’une population, distordre la structure factorielle d’une échelle de mesure ou provoquer un rejet erroné de l’hypothèse nulle. À l’inverse, l’élimination injustifiée d’observations légitimes appauvrit la variabilité naturelle d’un phénomène et compromet la portée écologique des conclusions scientifiques.
Face aux limites inhérentes aux méthodes classiques fondées sur les moments gaussiens — telles que le score d’écart-réduit, particulièrement vulnérable aux distorsions induites par les données mêmes qu’il est censé réguler —, la statistique exploratoire et non-paramétrique a développé des instruments analytiques d’une résilience remarquable. Au cœur de cette méthodologie figurent les clôtures statistiques, universellement désignées sous les appellations de limite inférieure (lower fence) et limite supérieure (upper fence). Conçues pour opérer sans dépendre d’un postulat rigide de normalité distributionnelle, ces barrières délimitent avec précision l’intervalle au sein duquel les données observées peuvent être considérées comme appartenant raisonnablement à la masse principale de la distribution empirique.
Le présent article propose un examen exhaustif et didactique des clôtures de Tukey, combinant développements théoriques, fondements algébriques, applications pratiques pas à pas et protocoles algorithmiques en environnements de programmation scientifique. Que vous soyez chercheur en psychologie cognitive confronté à l’analyse de temps de réaction asymétriques, data scientist soucieux d’assainir des pipelines d’apprentissage automatique ou étudiant préparant un mémoire de recherche quantitative, la maîtrise des limites inférieure et supérieure constitue un jalon méthodologique incontournable pour conférer à vos analyses empiriques une robustesse mathématique irréprochable.
1. Introduction conceptuelle aux limites supérieure et inférieure en statistique
1.1 Définition théorique des clôtures statistiques selon John Tukey
L’émergence formelle des clôtures statistiques s’inscrit dans la révolution conceptuelle opérée par John Wilder Tukey à la fin des années 1970. Dans son ouvrage séminal publié en 1977, intitulé Exploratory Data Analysis (souvent abrégé EDA), le mathématicien américain remet en question la prédominance quasi monopolistique des approches inférentielles confirmatrices qui dominaient alors le paysage de la statistique appliquée. Tukey postule qu’avant toute formulation d’hypothèses rigides ou toute application de modèles probabilistes paramétriques contraignants, le chercheur a le devoir d’explorer visuellement et arithmétiquement la morphologie brute de ses données. C’est dans ce cadre novateur qu’il théorise les notions de « clôtures » (fences), qui sont des seuils mathématiques de coupure destinés à séparer la structure ordonnée des données de leur bruit périphérique.
D’un point de vue formel, une clôture statistique n’est pas une frontière absolue imposée de manière dogmatique ou arbitraire, mais un filtre analytique dérivé directement des propriétés ordinales de la série observée. Elle établit une ligne de démarcation numérique permettant de classer les observations en deux catégories distinctes : d’un côté, les valeurs régulières, représentatives de la dynamique sous-jacente du processus étudié ; de l’autre, les observations périphériques, dont l’écart par rapport au noyau central de la distribution suggère l’intervention d’une source de variabilité distincte. L’apport fondamental de Tukey réside dans l’utilisation exclusive d’indicateurs de position insensibles aux valeurs aberrantes pour définir ces clôtures, écartant délibérément la moyenne arithmétique et la variance classique au profit des quantiles.
Sur le plan épistémologique, la mise en place de ces barrières soulève une question fondamentale en philosophie des sciences : comment distinguer la variabilité naturelle inhérente à un phénomène de l’apparition d’une observation pathologique ou non conforme ? Dans toute distribution biologique, psychologique ou sociale, une certaine dispersion est consubstantielle à la réalité observée. Tukey ne cherche pas à nier cette variabilité naturelle, mais à établir un critère probabiliste et robuste permettant d’isoler les points dont la probabilité d’occurrence conjointe avec le reste de l’échantillon devient marginale, sans pour autant préjuger de la cause sous-jacente de cette singularité.
1.2 Rôle des limites dans la détection des valeurs aberrantes
La caractérisation objective d’une valeur aberrante — ou observation atypique (outlier) — représente l’une des tâches les plus délicates de l’analyse exploratoire. Traditionnellement, une valeur aberrante est définie comme une observation qui s’écarte tellement des autres données qu’elle éveille le soupçon d’avoir été générée par un mécanisme sous-jacent fondamentalement différent. L’écueil majeur des méthodes traditionnelles réside dans leur dépendance circulaire à l’égard de la distribution normale : pour évaluer si un point s’écarte excessivement du centre, ces méthodes utilisent la moyenne et l’écart-type. Or, un seul point extrême possède le pouvoir de distordre la moyenne vers lui et d’accroître artificiellement l’écart-type, biaisant ainsi le diagnostic statistique de façon substantielle.
Les limites supérieure et inférieure de Tukey résolvent élégamment ce problème de masquage statistique. En s’appuyant sur l’intervalle interquartile, les clôtures délimitent un espace d’acceptabilité statistique dont les bornes demeurent remarquablement stables, même en présence d’une contamination sévère des extrémités de la distribution. En pratique, tout point situé en deçà de la limite inférieure ou au-delà de la limite supérieure se trouve automatiquement étiqueté comme un candidat sérieux au statut de valeur aberrante. Ce processus opère de manière objective, automatisable et déterministe, garantissant une impartialité totale lors de la phase préliminaire d’inspection des distributions numériques.
Dans le diagnostic de la qualité des données préalable à la modélisation statistique avancée, l’identification précoce de ces anomalies est vitale. Qu’il s’agisse de déployer des modèles de régression linéaire, des analyses de variance (ANOVA) ou des équations structurelles, l’influence démesurée exercée par des observations situées hors clôtures peut entraîner une dégradation drastique de la précision des coefficients estimés, gonfler la variance résiduelle et accroître le risque d’erreurs de type I (faux positifs) ou de type II (faux négatifs). L’établissement rigoureux des limites de Tukey constitue ainsi la première ligne de défense de l’intégrité métrique du chercheur.
1.3 Importance méthodologique en recherche psychologique et quantitative
En sciences du comportement et en recherche psychologique quantitative, les contraintes expérimentales génèrent fréquemment des distributions asymétriques et polluées par des artefacts comportementaux. L’un des exemples les plus emblématiques concerne le recueil des temps de réaction (TR) dans les paradigmes d’attention visuelle ou de prise de décision cognitive. Lors d’une tâche d’inhibition de type Stroop ou Go/No-Go, un participant peut répondre de manière prématurée en raison d’une anticipation motrice involontaire (générant une latence anormalement basse, comme 90 millisecondes) ou, inversement, subir un décrochage attentionnel transitoire ou une distraction externe (produisant un temps de réaction excessif de plusieurs milliers de millisecondes). L’usage des limites inférieure et supérieure permet de délimiter le registre temporel valide pour chaque individu ou pour la cohorte sans biaiser les paramètres du groupe.
De même, dans le cadre de la passation de batteries de tests psychométriques ou de questionnaires d’évaluation de la personnalité reposant sur des échelles de Likert, l’analyse des clôtures statistiques est essentielle pour repérer les biais de réponse systématiques. Les participants inattentifs, les répondeurs aléatoires ou ceux adoptant des stratégies de sabotage expérimental génèrent souvent des scores composites cumulés qui se détachent nettement des frontières de dispersion normale de l’échantillon. L’application des limites de Tukey permet d’isoler ces profils sans devoir recourir à des critères d’exclusion subjectifs ou arbitraires définis a posteriori par le chercheur au gré de ses résultats.
Enfin, la rigueur méthodologique imposée par la crise de la réplicabilité dans les sciences contemporaines exige une transparence absolue quant aux critères d’élagage des données. La spécification préalable et standardisée des limites supérieure et inférieure de Tukey garantit un protocole de nettoyage indépendant des attentes de l’expérimentateur. En ancrant le filtrage des observations dans un formalisme mathématique universellement reconnu par les revues à comité de lecture, le chercheur prémunit son étude contre les soupçons de manipulation opportuniste des données (communément qualifiée de p-hacking) et contribue à l’édification d’un corpus scientifique fiable et reproductible.
2. Les fondements mathématiques : Quartiles et intervalle interquartile
2.1 Compréhension des quartiles (Q1, Q2 et Q3)
Pour appréhender le fonctionnement géométrique et arithmétique des limites statistiques, il est impératif d’examiner en détail l’infrastructure sur laquelle elles reposent : les quantiles de rang, et plus précisément les quartiles. Contrairement aux paramètres de position classiques fondés sur la sommation des scores, les quartiles sont des mesures de position non-paramétriques basées sur l’ordonnancement d’un échantillon de données univariées de taille n ordonnées par ordre croissant : x(1) ≤ x(2) ≤ … ≤ x(n). Ces mesures divisent la série ordonnée en quatre segments contenant chacun exactement vingt-cinq pour cent de l’ensemble des observations disponibles.
Le premier quartile, universellement désigné par le symbole Q1 (ou 25e percentile), correspond à la valeur au-dessous de laquelle se situent 25 % des observations les plus basses de l’échantillon, tandis que 75 % des valeurs lui sont supérieures. D’un point de vue conceptuel, Q1 matérialise la coupure médiane de la moitié inférieure de la série statistique. Sa détermination numérique exacte dépend de l’algorithme d’interpolation utilisé, bien qu’il s’agisse fondamentalement de l’observation occupant le rang (n + 1) / 4 dans une distribution continue ordonnée.
Le deuxième quartile, noté Q2, n’est autre que la célèbre médiane de l’échantillon, représentant le 50e percentile. La médiane scinde la distribution en deux moitiés équiprobables : 50 % des observations lui sont inférieures ou égales, et 50 % lui sont supérieures ou égales. Enfin, le troisième quartile, désigné par Q3 (ou 75e percentile), marque le seuil sous lequel sont comprises 75 % des observations les plus petites, isolant ainsi le quart supérieur constitué des scores les plus élevés de la distribution. Ces trois points pivots constituent le socle de ce que Tukey a formalisé sous le terme de « résumé à cinq nombres » (five-number summary), regroupant la valeur minimale, le premier quartile, la médiane, le troisième quartile et la valeur maximale observée.
2.2 Calcul et propriétés de l’écart interquartile (IQR)
À partir des jalons posés par le premier et le troisième quartile, la théorie statistique définit une mesure fondamentale de la dispersion robuste : l’écart interquartile, traditionnellement abrégé sous l’acronyme IQR (pour Interquartile Range). L’expression arithmétique de l’IQR est d’une grande simplicité tout en étant dotée d’une portée théorique considérable :
IQR = Q3 – Q1
Cette différence algébrique pure représente l’étendue spatiale couverte par le segment central de cinquante pour cent de la série statistique analysée. Géométriquement, l’IQR mesure l’envergure du cœur de la distribution, en ignorant délibérément les vingt-cinq pour cent des valeurs les plus basses et les vingt-cinq pour cent des valeurs les plus hautes. Cette caractéristique confère immédiatement à l’écart interquartile une propriété mathématique essentielle : la résistance statistique.
Contrairement à l’étendue totale (définie par la différence entre la valeur maximale et la valeur minimale), qui s’avère infiniment sensible à la moindre altération d’une seule mesure périphérique, l’IQR présente un point de rupture (breakdown point) remarquable de 25 %. Cela signifie qu’il est possible de modifier, de corrompre ou de propulser vers l’infini jusqu’à un quart entier des données de chaque côté de la distribution ordonnée sans que la valeur numérique de l’IQR ne subisse la moindre altération. Cette robustesse intrinsèque fait de l’écart interquartile l’étalon de dispersion le plus fiable pour calibrer des seuils d’anomalie au sein d’environnements de données incertains ou asymétriques.
2.3 Sensibilité comparée face aux paramètres gaussiens
Pour saisir la supériorité opérationnelle des clôtures basées sur l’IQR, il convient de confronter directement son comportement à celui des paramètres gaussiens traditionnels : la moyenne arithmétique (μ) et l’écart-type (σ). Considérons une distribution de scores psychométriques contaminée par une erreur de saisie ou un comportement aberrant, où une mesure s’élève à dix fois sa valeur attendue. Dans une telle situation, la moyenne se déplace mécaniquement vers cette valeur extrême, tandis que l’écart-type explose littéralement, puisque sa formulation repose sur la somme des carrés des écarts à la moyenne. L’estimateur censé mesurer l’amplitude de l’erreur est lui-même submergé par celle-ci.
Le tableau ci-dessous illustre la divergence fondamentale de résilience entre ces deux systèmes d’estimation lorsqu’ils sont appliqués à une distribution théorique soumise à des perturbations asymétriques :
- Système paramétrique (Moyenne et Écart-type) : Point de rupture théorique de 0 %. Une seule valeur extrême suffit à rendre l’estimation non informative. Dépendance étroite vis-à-vis d’une symétrie parfaite et de queues de distribution exponentiellement décroissantes.
- Système non-paramétrique robuste (Médiane et IQR) : Point de rupture de 25 % pour l’IQR et de 50 % pour la médiane. Résistance absolue aux contaminations unilatérales modérées. Préservation fidèle de la dispersion réelle du corps central des données.
Il existe néanmoins une passerelle asymptotique élégante reliant ces deux paradigmes dans le cas très particulier où les données suivent rigoureusement une distribution normale théorique. Dans ce cadre gaussien idéal, l’intervalle interquartile correspond très exactement à la distance séparant les percentiles 25 (-0,6745 σ) et 75 (+0,6745 σ). Il en découle l’équivalence asymptotique classique :
IQR ≈ 1,34898 × σ (ou réciproquement : σ ≈ IQR / 1,349)
Dès lors que la distribution empirique s’écarte de la normalité — ce qui constitue la règle quasi universelle en sciences du comportement, en sociologie quantitative ou en biométrie clinique —, cette relation d’équivalence s’effondre, démontrant sans équivoque la supériorité des indicateurs de rang pour calibrer des barrières d’exclusion d’observations suspectes.
3. Formulation formelle des clôtures de Tukey
3.1 Équation mathématique de la limite inférieure
La formulation algébrique développée par John Tukey pour fixer la démarcation basse des observations recevables est désignée sous le terme technique de limite inférieure (lower fence ou inner lower fence). Son objectif est de projeter, en direction des valeurs décroissantes, un faisceau de tolérance proportionnel à la compacité du cœur de la distribution. L’équation formelle s’énonce comme suit :
Limite inférieure = Q1 – (1,5 × IQR)
Dans cette structure mathématique, le premier quartile (Q1) sert de point d’ancrage basal. L’algorithme soustrait de cette charnière inférieure une distance normée égale à une fois et demie l’écart interquartile. Tout score empirique xi satisfaisant à l’inégalité stricte xi < Limite inférieure est formellement catégorisé comme une valeur aberrante inférieure.
Dans la pratique analytique appliquée, l’interprétation de la limite inférieure impose de prendre en considération ce que les méthodologistes appellent les valeurs planchers empiriques ou les contraintes d’admissibilité physique. Dans de nombreuses disciplines scientifiques, certaines variables sont bornées par nature à zéro ou à des entiers positifs : c’est le cas des temps de réaction, du nombre d’enfants par foyer, des concentrations sanguines d’un biomarqueur ou encore des scores obtenus sur des échelles d’évaluation standardisées. Il arrive fréquemment que le calcul mécanique donne une limite inférieure négative (par exemple, Limite inférieure = -15,4). Dans une telle conjoncture, cette valeur négative n’a pas de signification ontologique ; elle indique simplement qu’au regard de la dispersion du modèle, aucune observation positive ne saurait être considérée comme anormalement basse. La barrière inférieure ne trouve alors aucun point d’application réel au sein de la série de données positives.
3.2 Équation mathématique de la limite supérieure
Symétrique dans sa conception bien qu’indépendante dans son point d’application, la limite supérieure (upper fence ou inner upper fence) est conçue pour fixer le plafond d’acceptabilité statistique au-dessus de la moitié supérieure des scores ordonnés. Sa formulation arithmétique rigoureuse s’écrit :
Limite supérieure = Q3 + (1,5 × IQR)
Cette fois, le pivot de référence est constitué par le troisième quartile (Q3), qui borne la tranche des 75 % des valeurs les plus basses. À cette borne haute est adjointe une marge de tolérance équivalente à une fois et demie l’étendue interquartile. En conséquence, toute observation individuelle xi qui excède cette borne critique, vérifiant xi > Limite supérieure, est identifiée comme une valeur aberrante supérieure.
L’existence de cette frontière supérieure pose des enjeux épistémologiques et cliniques majeurs. Dans les études d’évaluation de la performance humaine, de la créativité divergente, du potentiel intellectuel ou des richesses économiques, les observations qui franchissent le seuil supérieur ne résultent que très rarement d’erreurs de mesure fortuites. Elles matérialisent souvent des performances véritablement exceptionnelles, des génies cognitifs ou des fortunes financières disproportionnées. L’analyste doit veiller à ne pas confondre le concept de rareté statistique avec celui de pathologie du signal : une valeur au-dessus de la clôture supérieure constitue une anomalie statistique au sens probabiliste, mais peut incarner l’observation empirique la plus riche d’enseignements pour la théorie sous-jacente.
3.3 Justification théorique du coefficient multiplicateur 1,5
Une interrogation récurrente chez les étudiants et les chercheurs en statistiques appliquées concerne la genèse du coefficient multiplicateur 1,5 : s’agit-il d’un nombre magique, d’une constante universelle ou d’un choix purement arbitraire arrêté par John Tukey ? La réponse réside dans un arbitrage pragmatique fondé sur les propriétés probabilistes de la loi normale, documenté de manière rétrospective par les disciples de Tukey, notamment Hoaglin, Mosteller et Tukey dans leurs écrits sur l’évaluation robuste (1983).
Imaginons une population parente régie par une distribution strictement gaussienne N(μ, σ²). Comme établi précédemment, les quartiles théoriques se situent à μ – 0,6745 σ pour Q1 et à μ + 0,6745 σ pour Q3, ce qui attribue à l’écart interquartile la valeur exacte de 1,349 σ. Si l’on applique le multiplicateur k = 1,5 aux équations des clôtures sous ce régime gaussien, nous obtenons les projections suivantes :
- Distance ajoutée ou soustraite : 1,5 × IQR = 1,5 × (1,349 σ) ≈ 2,0235 σ.
- Limite inférieure théorique : (μ – 0,6745 σ) – 2,0235 σ = μ – 2,698 σ.
- Limite supérieure théorique : (μ + 0,6745 σ) + 2,0235 σ = μ + 2,698 σ.
Or, dans une distribution normale, la probabilité cumulée qu’une observation franchisse le seuil de 2,698 écarts-types par rapport à la moyenne dans une direction donnée est d’environ 0,0035 (soit 0,35 %). En sommant les deux queues de la distribution, la proportion totale d’observations théoriquement exclues par les clôtures de 1,5 × IQR au sein d’une population gaussienne parfaite s’établit à approximativement 0,7 % (soit un taux de rétention d’environ 99,3 %).
Tukey considérait qu’un coefficient de 1,0 éliminait trop d’observations valides (près de 5 % d’erreurs de détection sous loi normale, ce qui constitue un taux de faux positifs trop élevé pour de l’exploration préliminaire), tandis qu’un coefficient de 2,0 se révélait trop laxiste, laissant passer des anomalies flagrantes générées par des perturbations locales. Le facteur 1,5 a donc été retenu comme le point d’équilibre optimal : un compromis heuristique élégant, offrant une spécificité élevée tout en préservant une sensibilité adéquate face aux véritables déviations empiriques.
4. Démonstration pas à pas : Exemple complet de calcul sur données empiriques
4.1 Présentation de la distribution et ordonnancement
Afin d’ancrer ces développements théoriques dans la réalité opératoire, procédons à une démonstration intégrale sur un échantillon concret. Considérons une série de mesures représentant les scores bruts obtenus par un groupe d’individus lors d’un test standardisé de flexibilité cognitive. L’échantillon brut collecté par l’expérimentateur comporte n = 15 observations présentées initialement de façon désordonnée : 24, 14, 38, 16, 45, 11, 36, 18, 13, 27, 34, 15, 22, 14, 41.
L’étape préliminaire et incompressible de tout traitement par clôtures statistiques consiste en l’agencement par ordre croissant monotone des valeurs recueillies. Cette opération de tri est indispensable pour identifier les rangs percentiles. Après tri, la séquence ordonnée s’établit formellement comme suit :
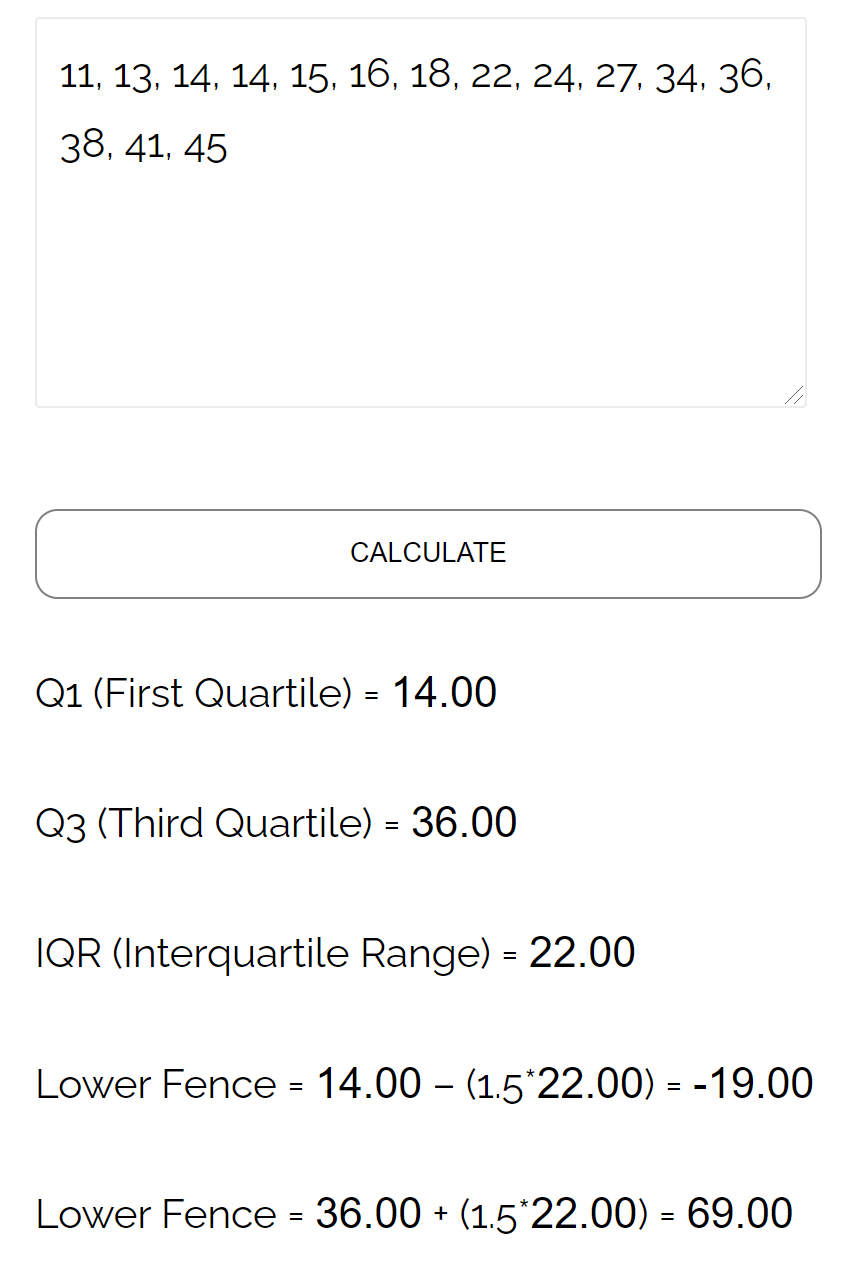
11, 13, 14, 14, 15, 16, 18, 22, 24, 27, 34, 36, 38, 41, 45
Pour déterminer la médiane (Q2), nous appliquons la règle classique pour un échantillon de taille impaire (n = 15). La position médiane correspond au rang (n + 1) / 2, soit (15 + 1) / 2 = 8e observation de la série ordonnée. En dénombrant les valeurs, nous constatons que la 8e observation correspond à la valeur 22. Cette médiane divise parfaitement notre échantillon en deux blocs symétriques de sept observations chacun :
- Sous-ensemble inférieur (observations 1 à 7) : {11, 13, 14, 14, 15, 16, 18}
- Point pivot central (médiane, 8e observation) : 22
- Sous-ensemble supérieur (observations 9 à 15) : {24, 27, 34, 36, 38, 41, 45}
4.2 Détermination pas à pas de Q1, Q3 et de l’IQR
L’étape subséquente requiert l’identification rigoureuse des premier et troisième quartiles. Dans la tradition méthodologique de Tukey (méthode dite des charnières ou hinges), Q1 est défini comme la médiane du sous-ensemble inférieur, tandis que Q3 représente la médiane du sous-ensemble supérieur.
Examinons le sous-ensemble inférieur composé de sept valeurs : {11, 13, 14, 14, 15, 16, 18}. La taille de ce segment étant impaire (7 points), la médiane se situe exactement au rang (7 + 1) / 2 = 4e position de ce sous-ensemble. La quatrième valeur de cette série est 14. Par conséquent, nous établissons formellement :
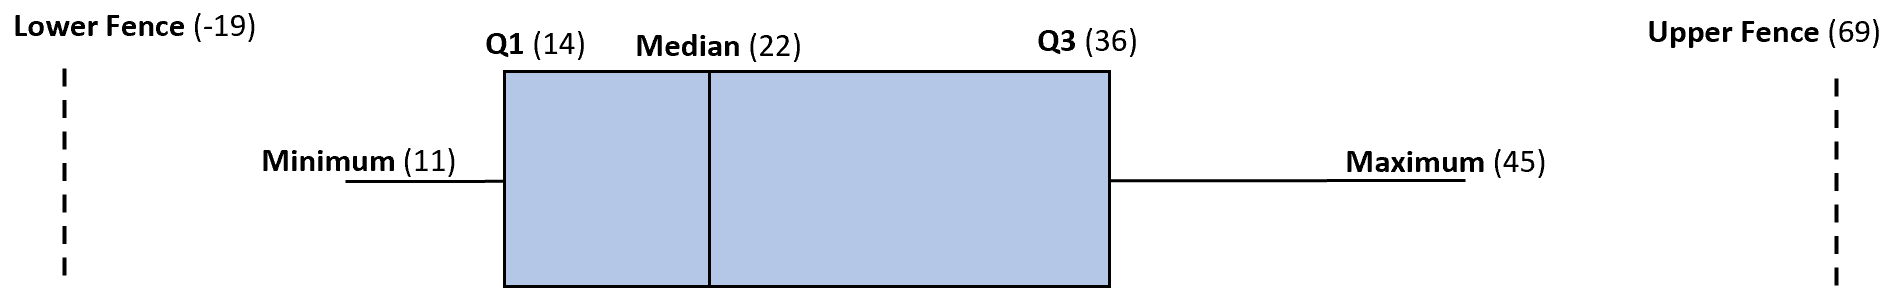
Q1 = 14
Appliquons le même raisonnement analytique au sous-ensemble supérieur constitué des sept valeurs : {24, 27, 34, 36, 38, 41, 45}. La position médiane est à nouveau la 4e valeur de ce bloc de données. En parcourant ce sous-groupe, nous isolons la quatrième observation qui est 36. Nous pouvons donc poser :
Q3 = 36
Disposant désormais des deux bornes du segment central, l’estimation de l’écart interquartile se déduit par une soustraction élémentaire :
IQR = Q3 – Q1 = 36 – 14 = 22
La dispersion centrale de notre échantillon est donc caractérisée par un IQR de 22 unités scalaires. Cela signifie qu’un intervalle de 22 points suffit à englober la moitié centrale des individus ayant participé à cette évaluation.
4.3 Calcul arithmétique précis des barrières de détection
Possédant l’ensemble des termes de l’équation de Tukey, nous pouvons désormais évaluer le produit pondéré de dispersion et déterminer avec exactitude les deux barrières de détection d’observations atypiques. La première opération arithmétique consiste à calculer le terme d’extension correspondant au facteur 1,5 :
1,5 × IQR = 1,5 × 22 = 33
Ce résultat intermédiaire de 33 unités représente la distance critique qu’il convient de soustraire de la borne Q1 pour obtenir la limite inférieure, et d’additionner à la borne Q3 pour obtenir la limite supérieure. Procédons d’abord au calcul de la limite inférieure :
Limite inférieure = Q1 – (1,5 × IQR) = 14 – 33 = -19
Calculons ensuite la limite supérieure en projetant l’extension au-delà de la charnière haute :
Limite supérieure = Q3 + (1,5 × IQR) = 36 + 33 = 69
Nos deux clôtures de sécurité statistique se trouvent désormais solidement fixées : toute valeur qui serait strictement inférieure à -19 sera signalée comme une anomalie basse, tandis que toute valeur qui dépasserait strictement 69 sera identifiée comme une anomalie haute.
4.4 Interprétation décisionnelle des données de l’échantillon
L’étape conclusive de la démarche consiste à confronter l’ensemble des observations réelles de la série empirique aux deux seuils de coupure ainsi établis. Puisque les données ont été préalablement ordonnées de façon monotone, il n’est pas nécessaire de tester chaque élément unitairement : il suffit d’examiner attentivement les extrêmes de la série, c’est-à-dire le minimum absolu et le maximum absolu.
Considérons tout d’abord l’extrémité gauche de la distribution. Le minimum empirique de notre série statistique est x(1) = 11. Comparons cette valeur à notre limite inférieure :
x(1) = 11 > -19 (Limite inférieure)
Le minimum réel se situe nettement au-dessus de la barrière critique de -19. Par conséquent, il n’existe aucune valeur aberrante inférieure dans ce jeu de données. Le fait que la barrière inférieure soit négative (-19) alors que la variable mesurée ne peut théoriquement descendre en dessous de zéro indique que la distribution est suffisamment condensée pour qu’aucun score positif ne puisse être qualifié d’anormalement bas au regard de la dispersion globale.
Examinons désormais l’extrémité droite de notre distribution. La valeur maximale enregistrée est x(15) = 45. Comparons cette donnée à notre plafond calculé :
x(15) = 45 < 69 (Limite supérieure)
Le score le plus élevé de la cohorte est substantiellement inférieur à la limite supérieure de 69 unités. Par conséquent, nous concluons à l’absence totale de valeur aberrante supérieure au sein de cet échantillon. L’ensemble des 15 observations recueillies peut être légitimement considéré comme appartenant à la même population statistique et conservé intégralement pour les étapes de modélisation inférentielle ultérieures.
5. Représentation graphique : Intégration dans la boîte à moustaches
5.1 Anatomie de la boîte à moustaches (Boxplot)
L’une des contributions les plus pérennes de John Tukey à la sémiotique graphique scientifique est l’invention du diagramme de dispersion en boîte, universellement désigné en français sous le terme de boîte à moustaches et en anglais sous le nom de boxplot. Ce diagramme a été précisément conçu pour traduire visuellement le résumé à cinq nombres et spatialiser les limites statistiques d’une distribution sans nécessiter la consultation de tableaux d’effectifs rébarbatifs.
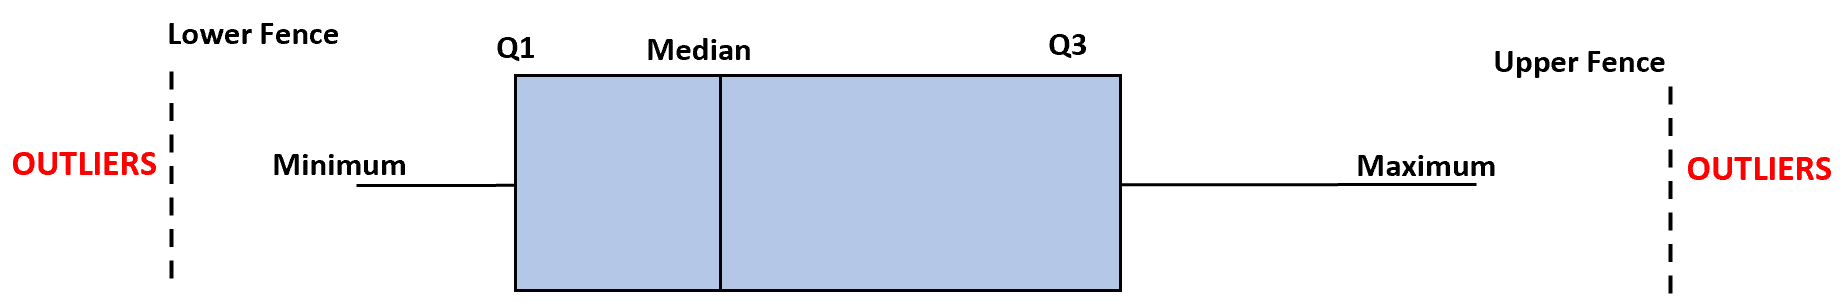
L’architecture anatomique d’un boxplot standard s’organise autour d’un rectangle central (la boîte proprement dite). L’arête inférieure de cette boîte coïncide rigoureusement avec le premier quartile (Q1), tandis que l’arête supérieure s’aligne parfaitement sur le troisième quartile (Q3). La hauteur verticale du corps de la boîte représente donc graphiquement l’écart interquartile (IQR), renfermant visuellement la moitié centrale exacte de toutes les données observées. À l’intérieur de ce polygone, un trait horizontal renforcé (ou parfois une ligne de couleur contrastée) matérialise l’emplacement exact de la médiane (Q2), permettant d’apprécier d’emblée la position du centre de gravité des données au sein du cœur de dispersion.
5.2 Règles de tracé des moustaches relatives aux clôtures
C’est au niveau du tracé des lignes divergentes — communément nommées les moustaches (whiskers) — que se produit la confusion la plus fréquente parmi les praticiens de la statistique. Une erreur conceptuelle largement répandue consiste à croire que les moustaches se terminent systématiquement aux bornes théoriques calculées par les équations de Tukey (c’est-à-dire précisément à Q1 – 1,5×IQR et Q3 + 1,5×IQR). Or, la règle sémiologique établie par Tukey est sensiblement plus subtile.
Dans la convention graphique rigoureuse de Tukey, les clôtures statistiques sont des lignes invisibles (ou des repères virtuels de calcul). Les moustaches ne sont jamais tracées dans le vide : elles s’arrêtent impérativement aux valeurs réelles les plus extrêmes situées à l’intérieur des clôtures. Plus précisément :
- La moustache inférieure prend naissance sur la bordure de Q1 et s’arrête à la plus petite valeur empirique de la base de données qui demeure supérieure ou égale à la limite inférieure calculée : min(xi | xi ≥ Q1 – 1,5 × IQR).
- La moustache supérieure émerge de Q3 et s’interrompt à la plus grande valeur empirique observée qui reste inférieure ou égale à la limite supérieure calculée : max(xi | xi ≤ Q3 + 1,5 × IQR).
Lorsque des observations individuelles franchissent ces frontières virtuelles et se situent au-delà des clôtures de Tukey, elles ne sont jamais incluses dans les moustaches. Elles font l’objet d’une figuration sémiotique distincte : chaque valeur aberrante est matérialisée par un glyphe isolé (généralement un point, un petit cercle évidé ou un astérisque) aligné le long de l’axe vertical. Ce mode d’affichage attire immédiatement l’attention du chercheur sur la singularité métrique de ces entités isolées tout en conservant la traçabilité intégrale de leur magnitude d’écart.
5.3 Diagnostic visuel de l’asymétrie et de la dispersion
Au-delà de sa fonction de dépistage des anomalies, la boîte à moustaches constitue un outil de diagnostic morphologique d’une formidable efficacité pour évaluer en un clin d’œil les distorsions d’une série statistique, en particulier l’asymétrie distributionnelle (skewness) et l’étalement relatif des queues de distribution. L’inspection conjointe de la boîte et des moustaches fournit des indices qualitatifs immédiats :
Si la ligne de la médiane n’occupe pas le centre géométrique de la boîte interquartile mais se trouve déportée vers le bas (proche de Q1), et que simultanément la moustache supérieure est notablement plus longue que la moustache inférieure, la distribution présente une asymétrie positive prononcée (déviation vers la droite). Ce pattern visuel traduit une concentration des observations dans les valeurs faibles et une traîne étirée de valeurs élevées, configuration récurrente dans les chronométries cognitives ou les indicateurs de salaires. Réciproquement, une médiane décalée vers Q3 assortie d’une longue moustache inférieure dénote une asymétrie négative (déviation vers la gauche).
L’observation simultanée de la présence de valeurs isolées au-delà des moustaches et de l’étirement asymétrique de celles-ci renseigne également sur l’éventuelle nature multimodale des données. Si plusieurs points se regroupent à une distance équivalente au-delà de la clôture supérieure, cela peut signaler non pas une série d’accidents métrologiques fortuits, mais l’existence d’une sous-population latente au sein de l’échantillon (par exemple, des individus porteurs d’une variante génétique spécifique ou des sujets ayant utilisé une stratégie de compensation cognitive non identifiée), justifiant des analyses de mélanges finis plutôt qu’une simple exclusion mathématique.
6. Clôtures internes versus clôtures externes : Nuancer les valeurs atypiques
6.1 Définition et calcul des clôtures externes (Outer Fences)
Dans l’architecture conceptuelle complète développée par Tukey, la classification des observations singulières ne se réduit pas à une catégorisation binaire naïve séparant le « normal » de l’« aberrant ». Tukey a introduit une graduation du niveau d’anomalie en introduisant une distinction technique entre les barrières proximales — qualifiées de clôtures internes (inner fences) — et des barrières distales plus radicales, formellement nommées clôtures externes (outer fences).
Pour ériger ces clôtures externes, le modèle statistique amplifie le coefficient multiplicateur en portant le facteur de tolérance de 1,5 à 3,0. Les formulations analytiques régissant ces frontières de second niveau s’écrivent de la manière suivante :
Clôture externe inférieure = Q1 – (3,0 × IQR)
Clôture externe supérieure = Q3 + (3,0 × IQR)
En doublant l’excursion spatiale allouée autour du noyau interquartile, les clôtures externes définissent un périmètre d’exception statistique majeure. Alors que les clôtures internes à 1,5 × IQR repèrent toute déviation méritant un réexamen critique, les clôtures externes à 3,0 × IQR délimitent la frontière au-delà de laquelle l’observation ne peut presque plus être rattachée à la dynamique ordinaire de la population parente.
6.2 Typologie différentielle des anomalies : modérées versus sévères
L’interaction conjointe entre clôtures internes et clôtures externes engendre une typologie différentielle hautement opérationnelle pour la prise de décision analytique. Cette taxonomie se structure rigoureusement en trois zones d’appartenance métrique :
- Observations régulières : Toute donnée localisée à l’intérieur des clôtures internes, soit dans l’intervalle fermé [Q1 – 1,5×IQR, Q3 + 1,5×IQR]. Ces scores représentent la composante fondamentale et attendue du phénomène sous étude.
- Valeurs aberrantes modérées (mild outliers) : Toute donnée située au-delà d’une clôture interne, mais demeurant en deçà de la clôture externe correspondante. Formellement, il s’agit des points appartenant à l’intervalle [Q1 – 3,0×IQR ; Q1 – 1,5×IQR[ ou à l’intervalle ]Q3 + 1,5×IQR ; Q3 + 3,0×IQR]. Sur les logiciels de statistique avancée comme SPSS, ces valeurs sont couramment représentées par de simples cercles.
- Valeurs aberrantes extrêmes ou sévères (extreme outliers) : Toute donnée située au-delà d’une clôture externe, satisfaisant à la condition xi < Q1 – 3,0×IQR ou xi > Q3 + 3,0×IQR. Dans les environnements graphiques, ces anomalies critiques sont systématiquement identifiées par des symboles d’astérisques (*).
Cette différenciation typologique a une portée directe sur la recherche des causes de déviation. Une valeur aberrante modérée reflète fréquemment une variation biologique ou comportementale réelle, bien qu’inhabituelle, ou un léger bruit de fond expérimental. En revanche, le franchissement d’une clôture externe suggère avec une probabilité écrasante l’existence d’un accident méthodologique patent : défaillance mécanique d’un capteur, erreur matérielle de saisie dactylographique (par exemple, encoder un âge de 220 ans au lieu de 22 ans) ou rupture absolue du respect du protocole expérimental par le sujet testé.
6.3 Seuils probabilistes sous hypothèse de normalité
Pour mesurer à quel point le franchissement d’une clôture externe est un événement extraordinaire sous l’angle de la théorie des probabilités, il est instructif d’en quantifier la vraisemblance dans le cadre d’un échantillonnage gaussien idéal. En reprenant l’équivalence asymptotique de l’écart interquartile sous la loi normale (IQR ≈ 1,349 σ), projetons les équations des clôtures externes au sein de l’espace standardisé :
- Distance ajoutée : 3,0 × IQR = 3,0 × (1,349 σ) ≈ 4,047 σ.
- Clôture externe inférieure théorique : (μ – 0,6745 σ) – 4,047 σ = μ – 4,7215 σ.
- Clôture externe supérieure théorique : (μ + 0,6745 σ) + 4,047 σ = μ + 4,7215 σ.
La surface intégrée sous la courbe gaussienne au-delà de 4,72 écarts-types par rapport à l’espérance mathématique est infime : elle correspond à une probabilité d’occurrence unilatérale de l’ordre de 0,00000116, soit environ un cas sur un million ! Même en considérant les deux extrémités cumulées, la probabilité d’observer fortuitement une valeur au-delà d’une clôture externe dans une distribution strictement normale s’élève à approximativement 0,0002 %.
Ce résultat théorique offre un critère d’arbitrage d’une redoutable efficacité lors du traitement des cohortes massives (big data) en sciences sociales et en bio-informatique. Alors que dans un échantillon de 10 000 participants, l’apparition de plusieurs dizaines de valeurs aberrantes modérées (au-delà de 1,5 × IQR) est un phénomène attendu lié aux propriétés combinatoires de l’échantillonnage, la survenue d’un seul point au-delà du seuil de 3,0 × IQR indique sans équivoque une anomalie qualitative qu’il convient d’isoler sous peine de déstabiliser les calculs matriciels de grande dimension.
7. Applications empiriques en psychologie et sciences comportementales
7.1 Nettoyage des chronométries et temps de réaction (TR)
Dans le domaine de la psychologie cognitive expérimentale, l’analyse des chronométries mentales — mesurées par le temps s’écoulant entre la présentation d’un stimulus et l’émission d’une réponse motrice — est au cœur de l’inférence sur l’architecture cognitive. Or, les distributions de temps de réaction ne sont jamais gaussiennes : elles sont intrinsèquement bornées à gauche par des contraintes physiologiques insurmontables et exhibent invariablement une queue asymétrique étirée vers la droite, s’apparentant à des lois de distribution de type Ex-Gaussienne ou de Weibull.
Historiquement, de nombreux laboratoires appliquaient des règles de coupure brutes et uniformes, consistant par exemple à supprimer indistinctement tout essai inférieur à 200 ms ou supérieur à 2 000 ms. Cette méthode mécanique pèche par son absence de contextualisation : un temps de réponse de 800 ms peut être aberrant lors d’une tâche de détection simple, tout en représentant une latence parfaitement régulière lors d’une tâche de raisonnement analogique complexe. L’application individualisée des limites de Tukey (calculées pour chaque sujet au sein de chaque condition expérimentale) résout cette carence :
- La limite inférieure basée sur Q1 – 1,5×IQR élimine avec une haute sensibilité les réponses motrices prématurées et les impulsions non contrôlées, sans amputer la tranche rapide des véritables processus attentionnels.
- La limite supérieure calibrée via Q3 + 1,5×IQR tronque spécifiquement les épisodes où le sujet a décroché de la consigne (micro-sommeils, distractions sensorielles, réajustements posturaux) sans altérer la variance propre aux réponses lentes mais engagées cognitivement.
7.2 Détection des biais de réponse aux questionnaires psychométriques
L’administration d’inventaires d’auto-évaluation en psychométrie clinique (comme le BDI pour la dépression, le STAI pour l’anxiété ou le NEO-PI-R pour la personnalité) fait constamment face à des artefacts de complétion. Les participants peuvent répondre à la hâte en cochant systématiquement la même modalité de réponse (effet d’acquiescement passif), produire des réponses en dents de scie totalement incohérentes ou simuler une détresse psychologique extrême (falsification délibérée).
L’extraction des limites supérieure et inférieure sur des scores composites dérivés (tels que la variabilité intra-individuelle des réponses ou le temps moyen passé par item) permet de repérer instantanément ces comportements de réponse frauduleux. Lorsqu’un sujet présente un score d’incohérence inter-items qui outrepasse la clôture externe supérieure de l’échantillon de standardisation, son protocole peut être écarté de façon objective avant toute inclusion dans l’étalonnage psychométrique. Cette dépuration préalable assainit la matrice de covariance inter-items, prévient la dégradation artificielle des coefficients de cohérence interne (alpha de Cronbach, oméga de McDonald) et garantit la réplicabilité de la structure factorielle sous-jacente lors des analyses factorielles confirmatoires.
7.3 Études neuropsychologiques et données à forte variance
En neuropsychologie clinique, le paradigme change radicalement de perspective : la variance n’est plus un simple bruit de mesure indésirable, elle constitue la signature même du tableau lésionnel ou dégénératif du patient. Dans l’évaluation de cohortes cérébrolésées (victimes d’accidents vasculaires cérébraux, traumatisés crâniens ou personnes souffrant d’affections neurodégénératives du type maladie d’Alzheimer), les distributions de performances sont frappées d’une très forte dispersion naturelle et d’une asymétrie extrême.
Dans ce contexte hautement vulnérable, l’utilisation aveugle de seuils statistiques rigides soulève d’immenses questions éthiques et scientifiques. Si un neuropsychologue élimine automatiquement les performances qui franchissent la limite supérieure sous prétexte qu’elles constituent des anomalies numériques, il risque de supprimer les données des patients qui ont développé des processus de compensation cérébrale remarquables ou, inversement, les profils témoignant d’un déficit cognitif sévère ciblé. L’approche méthodologique recommandée consiste à utiliser les clôtures de Tukey non pas comme un hachoir automatique d’exclusion, mais comme un indicateur clinique formalisé, orientant l’investigateur vers un examen qualitatif approfondi de l’étiologie des profils ainsi étiquetés.
8. Comparaison critique avec les autres méthodes de détection d’anomalies
8.1 Limites de Tukey versus méthode des scores Z (Z-scores)
La confrontation méthodologique entre les limites de Tukey et la technique universellement répandue des scores centrés réduits — ou scores Z — mérite un examen approfondi, tant l’erreur consistant à privilégier aveuglément les scores Z demeure ancrée dans la pratique de nombreux chercheurs. La méthode classique du Z-score déclare atypique toute observation xi dont le score standardisé zi = (xi – μ) / σ présente une valeur absolue supérieure à un seuil prédéterminé, généralement fixé à 2,5 ou 3,0.
Cette approche paramétrique souffre d’un vice de conception majeur connu sous le nom d’effet de masquage (masking effect). Lorsqu’un échantillon contient une ou plusieurs valeurs très aberrantes, ces observations contaminent immédiatement le calcul de la moyenne (qui se décale vers l’anomalie) et gonflent artificiellement l’écart-type. En conséquence, le dénominateur de l’équation du score Z devenant excessivement volumineux, les scores standardisés de l’ensemble de l’échantillon sont comprimés vers zéro. L’anomalie sévère parvient ainsi à masquer sa propre déviance en sabotant l’étalon même de sa détection !
À l’inverse, les limites de Tukey sont totalement immunisées contre ce dysfonctionnement systémique grâce au point de rupture élevé de la médiane et de l’écart interquartile. Même en présence de perturbations massives aux extrémités de l’échantillon, la distance interquartile reste ancrée sur le corps central des observations, permettant d’identifier avec une fiabilité constante les points atypiques sans subir de distorsion d’échelle.
8.2 Comparaison avec l’écart absolu à la médiane (MAD)
Dans l’arsenal de la statistique non-paramétrique hautement résistante, un autre estimateur fait figure de concurrent direct des clôtures de Tukey : l’écart absolu à la médiane, universellement désigné par son acronyme anglophone MAD (Median Absolute Deviation). Formellement, le MAD se définit comme la médiane des écarts absolus par rapport à la médiane de l’échantillon :
MAD = Médiane(|xi – Médiane(X)|)
D’un point de vue de la pure théorie de la robustesse, le MAD possède des propriétés asymptotiques encore plus impressionnantes que l’IQR. En effet, le point de rupture du MAD atteint le seuil théorique ultime de 50 %, contre 25 % pour l’écart interquartile de Tukey. Cela signifie qu’une distribution peut tolérer jusqu’à la moitié de données totalement corrompues avant que le MAD ne devienne erratique.
Néanmoins, les limites basées sur l’IQR de Tukey conservent une supériorité pragmatique déterminante dans la pratique quotidienne de la recherche. D’une part, elles s’intègrent organiquement à la représentation géométrique intuitive de la boîte à moustaches, ce qui facilite leur communication visuelle immédiate. D’autre part, dans les distributions modérément asymétriques ou granulaires (comme les scores entiers d’échelles psychométriques), le calcul du MAD a tendance à s’effondrer à zéro dès lors que plus de 50 % des observations partagent la même valeur centrale, rendant impossible toute détection d’anomalies, un écueil auquel l’écart interquartile de Tukey échappe très largement.
8.3 Distinction avec les méthodes multivariées
Il est crucial de circonscrire précisément le domaine de validité des limites inférieure et supérieure : il s’agit d’une technique d’inspection strictement univariée. Cette caractéristique impose d’en reconnaître les frontières conceptuelles face aux défis posés par les ensembles de données multidimensionnels. Une observation peut parfaitement se conformer aux limites univariées de Tukey lorsqu’on examine chaque variable isolément, tout en incarnant une anomalie multivariée flagrante lorsqu’on évalue l’interaction simultanée de ces dimensions.
Considérons un exemple intuitif : une étude mesurant l’âge des individus et leur niveau d’expertise professionnelle. Un âge de 11 ans est une valeur régulière au sein d’une distribution pédiatrique générale ; un statut de chirurgien neurovasculaire est une modalité parfaitement valide au sein d’une distribution de professions hospitalières. Pourtant, l’observation conjointe d’un individu âgé de 11 ans exerçant la profession de chirurgien neurovasculaire représente une anomalie multivariée absolue qu’aucun test univarié de Tukey ne pourra jamais intercepter sur les variables prises individuellement.
Pour résoudre ce type de singularité dimensionnelle, l’analyste doit relayer les clôtures de Tukey par des instruments d’évaluation multivariés, au premier rang desquels figure la distance de Mahalanobis, qui calcule l’éloignement d’une observation par rapport au centre de gravité multidimensionnel tout en tenant compte de la structure de covariance globale. L’inspection univariée par les clôtures de Tukey demeure cependant l’étape préalable obligatoire : nettoyer d’abord les anomalies univariées brutes évite d’injecter des matrices d’échelle distordues au sein des algorithmes multivariés.
9. Avantages méthodologiques et robustesse des clôtures de Tukey
9.1 Propriétés non-paramétriques et absence d’hypothèse de distribution
L’avantage le plus décisif des clôtures de Tukey réside dans leur nature intrinsèquement non-paramétrique et leur affranchissement total vis-à-vis de tout postulat préalable de distributionnalité. La très grande majorité des tests d’hypothèses conventionnels reposent sur l’hypothèse contraignante que les données sont issues d’une population gaussienne ou qu’elles obéissent à des conditions d’homoscédasticité strictes. Dans la recherche de terrain réelle, ces conditions idéales ne sont presque jamais réunies.
Parce qu’elles reposent exclusivement sur les rangs et les distances ordinales, les limites inférieure et supérieure de Tukey s’appliquent avec une rigueur égale à n’importe quelle morphologie distributionnelle : distributions bimodales, distributions fortement asymétriques, variables tronquées ou échelles d’intervalles subjectives. Cette polyvalence universelle garantit que la procédure d’inspection reste mathématiquement valide et méthodologiquement défendable, quel que soit l’objet de recherche analysé.
De surcroît, cette neutralité distributionnelle confère aux analyses préliminaires une stabilité inter-échantillons remarquable. Dans les protocoles expérimentaux multi-sites ou les études répliquées au sein de différents laboratoires à travers le monde, la mise en œuvre des clôtures de Tukey garantit que le filtrage des données ne sera pas biaisé par de légères variations locales de la variance ou de la kurtose, assurant ainsi une harmonisation parfaite des procédures de contrôle de qualité des données.
9.2 Résistance à l’effet de masquage et à l’effet de débordement
En statistique des valeurs extrêmes, deux pathologies algorithmiques classiques guettent l’analyste non averti : l’effet de masquage (masking) et l’effet de débordement (swamping). Nous avons vu comment le masquage survient lorsque la présence d’un agrégat d’anomalies distord tellement les paramètres de dispersion classiques (écart-type) que ces anomalies deviennent invisibles au crible statistique. L’effet inverse, le débordement, se manifeste lorsqu’une anomalie extrêmement sévère gonfle l’écart-type au point de déclarer aberrantes des observations qui, en réalité, appartenaient légitimement au corps central de la population.
Les clôtures de Tukey offrent une protection mathématique remarquable contre ces deux écueils grâce à la stabilité de l’intervalle interquartile :
- Immunité contre le masquage : Même si plusieurs observations périphériques se regroupent au-delà de la limite supérieure, tant que leur nombre ne dépasse pas 25 % de l’effectif total de l’échantillon, la charnière Q3 et l’IQR restent insensibles à leur magnitude. Les clôtures ne s’écartent pas vers l’extérieur et l’algorithme signale rigoureusement l’intégralité de ces points atypiques.
- Préservation contre le débordement : La présence d’un point colossalement éloigné ne peut en aucun cas accroître la valeur de l’IQR (puisque celui-ci ne dépend que des positions ordinales 25 % et 75 %). En conséquence, les clôtures ne s’élargissent pas démesurément, évitant ainsi d’aspirer ou de rejeter indûment des observations régulières adjacentes.
9.3 Facilité d’interprétation et standardisation académique
La puissance d’une méthode méthodologique dépend également de sa capacité à être comprise, communiquée et acceptée sans équivoque au sein de la communauté scientifique internationale. Les équations de Tukey brillent par leur élégante simplicité algébrique : elles ne nécessitent aucune formulation intégrale complexe, aucune itération stochastique exigeante en calcul et aucune transformation d’espace vectoriel obscure. Cette transparence mathématique rend la démarche accessible et explicable à des comités de lecture, des étudiants ou des praticiens non-statisticiens.
Cette clarté d’interprétation a favorisé l’intégration des clôtures de Tukey au sein des standards méthodologiques les plus rigoureux, notamment ceux édictés par l’American Psychological Association (normes APA) pour la restitution des statistiques descriptives et le traitement préalable des données empiriques. Lorsqu’un article scientifique stipule dans sa section Méthode : « Les valeurs atypiques ont été identifiées selon le protocole standardisé de Tukey (1977), fondé sur un seuil de 1,5 fois l’écart interquartile au-delà des charnières Q1 et Q3 », l’ensemble des réviseurs pairs comprend instantanément la logique d’épuration mise en œuvre, garantissant une crédibilité immédiate à la démarche analytique.
10. Limites intrinsèques et précautions d’emploi
10.1 Comportement sur des échantillons de faible taille
En dépit de ses multiples atouts, la technique des limites de Tukey n’est pas exempte d’imperfections méthodologiques et réclame certaines précautions opérationnelles, tout particulièrement lorsque l’investigateur travaille sur des cohortes de petite taille (échantillons où n < 20 ou 30 observations). Dans les petits groupes, l’estimation des quantiles devient hautement granulaire et instable : le déplacement d’un seul point empirique peut modifier substantiellement le rang effectif et la valeur interpolée de Q1 ou Q3.
Dans un très petit échantillon (par exemple, n = 8 ou n = 10), le calcul de l’IQR est soumis à une variance d’échantillonnage considérable. Dans de telles conditions, le risque d’erreur de diagnostic statistique augmente de manière exponentielle :
- Risque de sur-détection fortuite : L’aléa d’échantillonnage peut resserrer artificiellement les quartiles, abaissant indûment les seuils de clôture et conduisant l’analyste à étiqueter à tort des observations régulières comme des valeurs aberrantes.
- Risque de sous-détection : Réciproquement, si les rares observations recueillies sont fortuitement dispersées, l’IQR s’élargit massivement, projetant les limites de Tukey à des distances si excessives qu’aucune observation aberrante ne pourra plus être identifiée.
Sur les échantillons restreints typiques de protocoles cliniques rares ou d’études d’imagerie cérébrale fonctionnelle préliminaires, il est impératif de coupler l’examen des limites de Tukey à une inspection visuelle manuelle des diagrammes de dispersion bruts et à l’utilisation de tests de significativité spécifiques adaptés aux petits effectifs, tels que le test de Grubbs ou le test de Dixon.
10.2 Inadéquation pour les distributions exponentielles ou très dissymétriques
L’autre écueil majeur de l’approche standard de Tukey réside dans son comportement symétrique face à des phénomènes intrinsèquement dissymétriques. Les équations de Tukey appliquent la même marge multiplicative (1,5 × IQR) du côté inférieur et du côté supérieur. Or, pour les distributions caractérisées par une queue lourde unilatérale — comme les distributions exponentielles, log-normales, ou régies par des lois de puissance —, cette symétrie algorithmique génère un biais systématique de diagnostic.
Sur une distribution à forte asymétrie positive (par exemple, le montant des subventions allouées aux laboratoires de recherche), la boîte à moustaches de Tukey aura tendance à classer un volume considérable d’observations légitimes de la queue droite parmi les « valeurs aberrantes supérieures », tout en produisant une limite inférieure négative totalement dépourvue d’efficacité opérationnelle. Le taux de fausses alertes sur la queue longue de la distribution devient alors inacceptable.
Pour surmonter cette faiblesse structurelle, les statisticiens contemporains ont développé des extensions adaptatives, au premier rang desquelles figure la boîte à moustaches ajustée pour distributions asymétriques (adjusted boxplot) introduite par Hubert et Vandervieren en 2008. Cette méthode intègre une mesure robuste de l’asymétrie appelée le Medcouple (MC) directement dans le facteur d’excursion des clôtures, modulant de façon différenciée les barrières inférieure et supérieure :
Limite supérieure ajustée = Q3 + 1,5 × e(3 × MC) × IQR (si MC ≥ 0)
Cette calibration morphologique empêche l’amputation injustifiée des observations situées sur la traîne naturelle des distributions asymétriques.
10.3 Le piège de la suppression aveugle des observations
Le danger méthodologique le plus sournois guettant les utilisateurs des clôtures statistiques est l’illusion de confort intellectuel procurée par l’automatisation. L’informatique moderne permet d’exécuter une ligne de commande pour purger en une milliseconde toutes les données franchissant les limites supérieure et inférieure d’un tableau d’expérimentation. Cette pratique d’éviction automatisée non discriminante — couramment désignée comme le « nettoyage aveugle » — constitue une faute méthodologique lourde sur le plan épistémologique.
Supprimer d’office toute valeur au-delà des clôtures entraîne un appauvrissement factice de la variance naturelle d’un phénomène. Cette mutilation des données compresse artificiellement l’erreur standard des estimateurs, gonfle frauduleusement les tailles d’effet (comme le d de Cohen ou le r de Pearson) et favorise l’obtention de seuils de significativité p fallacieux. De surcroît, l’histoire des découvertes scientifiques rappelle qu’une observation singulière et apparemment aberrante est souvent le premier signe tangible d’une révolution de paradigme, révélant une interaction inconnue ou une anomalie théorique fondamentale plutôt qu’une poussière technique. L’analyste doit impérativement s’astreindre à investiguer la cause empirique de toute déviation avant d’envisager une quelconque action d’exclusion.
11. Protocoles de gestion et traitement des données au-delà des limites
11.1 Typologie des causes d’apparition des valeurs hors clôtures
Dès lors que le calcul des limites de Tukey signale des observations localisées en dehors des frontières de dispersion normale, le chercheur doit mener une véritable enquête diagnostique pour en établir l’étiologie. Les causes de franchissement se structurent en trois catégories herméneutiques distinctes, exigeant des réponses opérationnelles divergentes :
- Erreurs matérielles d’instrumentation ou de saisie : Il s’agit des anomalies résultant d’une panne mécanique, d’un bug dans l’acquisition numérique d’un signal ou d’une coquille dactylographique humaine lors de la transcription manuelle des données. Lorsqu’une preuve directe de cette défaillance est identifiée, l’observation doit être soit corrigée à la source (en consultant le registre original), soit purement et simplement retirée de la banque de données sans hésitation méthodologique.
- Non-respect manifeste des consignes expérimentales : Le sujet a utilisé son téléphone portable pendant l’enregistrement d’une tâche d’attention soutenue, a avoué avoir répondu au hasard ou présente des critères d’exclusion clinique prédéfinis non respectés (consommation de psychotropes avant passation, par exemple). L’exclusion de ces données est pleinement justifiée et doit être documentée sur la base d’arguments comportementaux indépendants du résultat statistique lui-même.
- Variabilité naturelle extrême et authentique : L’observation provient d’un sujet ayant parfaitement respecté le protocole, le capteur n’a subi aucune défaillance, mais l’individu manifeste une réponse biologique, affective ou cognitive exceptionnellement intense. Ces points doivent être impérativement conservés dans la dynamique de modélisation, car ils incarnent la réalité de la population cible sous peine de biaiser irrémédiablement l’écologie du modèle.
11.2 Stratégies d’ajustement : Suppression, winsorisation et transformation
Lorsque des valeurs situées au-delà des clôtures s’avèrent authentiques (non issues d’erreurs matérielles) mais exercent une influence disproportionnée menaçant la validité des modèles paramétriques, plusieurs stratégies de remédiation méthodologique standardisées s’offrent au chercheur :
La première stratégie, la plus radicale, est la troncature ou élagage (trimming). Elle consiste à supprimer l’observation atypique de l’analyse concernée. Cette approche a l’inconvénient de réduire la puissance statistique en diminuant l’effectif n de l’échantillon et d’introduire des données manquantes complexes dans les plans à mesures répétées.
La deuxième alternative, élégante et très appréciée en statistique robuste, est la winsorisation (du nom du biostatisticien Charles Winsor). Au lieu d’effacer les valeurs au-delà des clôtures de Tukey, la winsorisation consiste à ramener ces points aberrants à la valeur frontière la plus proche considérée comme acceptable. Ainsi, une valeur située au-delà de la limite supérieure se voit réassignée la valeur exacte de la limite supérieure (ou du 95e percentile), tandis qu’une valeur inférieure à la clôture basse prend la valeur de cette dernière. Cette technique préserve l’intégralité de l’effectif et l’ordre de rang des individus tout en neutralisant l’effet de levier déstabilisateur des valeurs extrêmes sur les calculs de variance.
Enfin, la troisième option réside dans l’application préalable d’une transformation mathématique non-linéaire sur l’intégralité de la variable empirique. En appliquant une transformation logarithmique (log(x)), une racine carrée (√x) ou une transformation inverse (1 / x), le chercheur compresse de façon continue les écarts géométriques au sommet de l’échelle, ramenant naturellement les queues asymétriques à l’intérieur des clôtures statistiques sans avoir à manipuler artificiellement les observations individuelles.
11.3 Recommandations de transparence méthodologique (Normes APA)
La crédibilité contemporaine de la recherche quantitative repose sur le respect scrupuleux des critères d’intégrité et de transparence méthodologique, formalisés avec force dans les dernières éditions du manuel de style de l’APA. La manipulation des valeurs situées au-delà des limites de Tukey ne doit jamais demeurer un processus opaque ou occulté dans les archives du chercheur.
La norme académique exige que les publications scientifiques explicitent intégralement les étapes de diagnostic au sein de la section Méthode :
- Mentionner expressément le critère utilisé pour le calcul des limites (par exemple : clôtures de Tukey avec coefficient 1,5 appliqué sur les quartiles non-pondérés).
- Rapporter le nombre exact et le pourcentage d’observations ayant franchi les barrières inférieure et supérieure.
- Déclarer en toute clarté le protocole d’ajustement retenu (exclusion définitive, imputation, winsorisation ou transformation mathématique) en motivant ce choix sur le plan théorique.
- La recommandation méthodologique la plus rigoureuse — considérée aujourd’hui comme la règle d’or — consiste à exécuter et publier une analyse de sensibilité : présenter les résultats statistiques des modèles finaux à la fois avec le jeu de données intégrales et avec le jeu de données épuré des observations hors clôtures. Si les conclusions scientifiques demeurent identiques sous les deux approches, la solidité des inférences s’en trouve puissamment démontrée.
12. Implémentation algorithmique : R, Python et SPSS
12.1 Programmation et automatisation en environnement R
Le langage statistique open-source R constitue sans doute le cadre de calcul le plus naturel pour exploiter les limites de Tukey, le système de modélisation graphique de base de R ayant été historiquement conçu par des pionniers formés à l’école de l’analyse exploratoire de Princeton. En programmation R, plusieurs fonctions natives permettent d’extraire instantanément ces métriques sans recourir à des formules manuelles laborieuses.
La méthode la plus rapide et la plus robuste pour extraire les barrières et les valeurs aberrantes repose sur l’appel combiné de la commande boxplot.stats() sur un vecteur numérique donné. Cette fonction calcule automatiquement les quartiles de Tukey, projette les limites inférieure et supérieure selon le coefficient multiplicateur 1,5, et isole l’ensemble des points aberrants dans une composante dédiée accessible via la syntaxe boxplot.stats(x)$out. Si l’analyste souhaite expliciter arithmétiquement les étapes dans un script reproductible, il utilisera la fonction quantile() en spécifiant les percentiles cibles (probabilités 0.25 et 0.75), combinée à la fonction IQR() pour calculer l’écart interquartile et déduire les clôtures supérieure et inférieure par opérations vectorisées.
Pour la restitution visuelle dans un rapport scientifique de haute qualité typographique, l’écosystème ggplot2 offre une standardisation irréprochable. L’adjonction de la couche géométrique geom_boxplot() trace un diagramme strictement conforme aux canons de Tukey : le corps de la boîte délimite fidèlement l’intervalle interquartile, les moustaches se projettent jusqu’aux données réelles les plus extrêmes situées à l’intérieur des clôtures, et tout franchissement est automatiquement visualisé sous la forme de points dispersés. Le chercheur peut contrôler avec une précision millimétrique la couleur, la transparence et le dimensionnement de ces glyphes grâce à des arguments standardisés comme outlier.colour et outlier.shape.
12.2 Mise en œuvre avec Python (NumPy, Pandas, Seaborn)
Dans l’écosystème Python orienté vers la science des données et l’apprentissage automatique, le calcul des limites de Tukey s’intègre harmonieusement aux structures d’analyse tabulaire offertes par les bibliothèques Pandas et NumPy. L’évaluation s’exécute généralement par le biais de méthodes vectorisées appliquées directement sur les séries de données d’un DataFrame.
Pour déterminer les clôtures d’une colonne de mesures, l’analyste fait appel à la méthode quantile(0.25) pour isoler Q1 et à quantile(0.75) pour extraire Q3. L’écart interquartile se déduit immédiatement par simple soustraction logique dans une variable IQR. Dès lors, les limites s’expriment par de courtes syntaxes fonctionnelles :
limite_inf = q1 – (1.5 * iqr)
limite_sup = q3 + (1.5 * iqr)
L’extraction concrète des observations hors clôtures s’effectue ensuite au moyen d’un masque d’indexation booléenne élégant combinant les deux conditions d’exclusion au moyen de l’opérateur logique d’union bit-à-bit : donnees[(donnees < limite_inf) | (donnees > limite_sup)]. Cette formulation vectorisée permet de traiter des millions d’enregistrements en une infime fraction de seconde avec une consommation de mémoire optimisée.
Sur le plan du diagnostic visuel exploratoire, les librairies graphiques Matplotlib et Seaborn fournissent une prise en charge complète des spécifications de Tukey. L’exécution de la méthode seaborn.boxplot() sur une colonne numérique trace immédiatement un diagramme conforme, le paramètre interne whis=1.5 venant précisément stipuler la position des clôtures statistiques conformément à la recommandation d’origine de l’inventeur. Les points figurant au-delà de cette marge d’acceptabilité sont mis en évidence de façon autonome, offrant une compatibilité parfaite avec les scripts d’analyse automatisés en production.
12.3 Exécution interactive dans le logiciel SPSS
Pour les praticiens de la recherche en sciences humaines et sociales qui privilégient les environnements logiciels interactifs sous interface graphique, IBM SPSS Statistics offre une intégration native et éprouvée des protocoles de Tukey à travers son module d’exploration générale des données.
La voie la plus directe pour obtenir le diagnostic complet des limites inférieure et supérieure consiste à emprunter le chemin de menu Analyser > Statistiques descriptives > Explorer. Dans la boîte de dialogue contextuelle, l’utilisateur insère la variable cible dans la boîte des variables dépendantes, puis s’assure de cocher l’option Graphiques en veillant à ce que le bouton Boîtes à moustaches soit configuré sur Regroupements de facteurs ou Niveaux de dépendance.
La sortie SPSS standard génère automatiquement deux éléments informatifs clés :
- Un tableau récapitulatif détaillé d’indicateurs de dispersion robuste présentant avec exactitude la médiane, le 25e percentile, le 75e percentile et l’intervalle interquartile.
- Un diagramme en boîte à moustaches rigoureux respectant scrupuleusement la sémiotique différentielle de Tukey : les observations situées au-delà de 1,5 fois l’IQR (franchissement de la clôture interne) sont annotées d’un symbole de cercle accompagné du numéro exact de la ligne du participant dans la base de données, tandis que les anomalies sévères dépassant 3,0 fois l’IQR (franchissement de la clôture externe) sont formellement identifiées par des symboles d’astérisques (*).
Cette indexation numérique explicite permet à l’utilisateur de SPSS de retourner immédiatement à la ligne de matrice correspondante pour vérifier l’exactitude de la transcription, examiner le profil complet du sujet et appliquer, au besoin, la syntaxe de transformation ou de filtrage adaptée avant de poursuivre les analyses inférentielles confirmatoires.
Références
- Hoaglin, D. C., Mosteller, F., & Tukey, J. W. (Eds.). (1983). Understanding Robust and Exploratory Data Analysis. John Wiley & Sons. https://www.wiley.com/en-us/Understanding+Robust+and+Exploratory+Data+Analysis-p-9780471384915
- Hubert, M., & Vandervieren, E. (2008). An adjusted boxplot for skewed distributions. Computational Statistics & Data Analysis, 52(12), 5186–5201. https://doi.org/10.1016/j.csda.2007.11.008
- Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764–766. https://doi.org/10.1016/j.jesp.2013.03.013
- Maronna, R. A., Martin, R. D., Yohai, V. J., & Salibián-Barrera, M. (2019). Robust Statistics: Theory and Methods (with R) (2nd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119214656
- Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273–1283. https://doi.org/10.1080/01621459.1993.10476408
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley. https://www.pearson.com/en-us/subject-catalog/p/exploratory-data-analysis/P200000003507
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wilcox, R. R. (2017). Introduction to Robust Estimation and Hypothesis Testing (4th ed.). Academic Press. https://doi.org/10.1016/C2015-0-02264-5