
Dans le champ contemporain de l’analyse exploratoire des données, de l’épidémiologie clinique, de l’économétrie et de la recherche translationnelle, la représentation graphique des distributions statistiques constitue une étape fondamentale préalable à toute modélisation inférentielle. La prolifération de volumétries informationnelles complexes et hétérogènes exige des outils d’une rigueur absolue pour synthétiser, comparer et interpréter la variabilité sous-jacente des phénomènes observés. Développée originellement par le statisticien John Tukey dans son ouvrage fondateur de 1977 consacré à l’exploration visuelle des données, la boîte à moustaches, ou boxplot, s’est imposée comme le paradigme standard pour condenser les propriétés distributionnelles univariées sans postuler a priori une quelconque normalité paramétrique.
L’environnement logiciel SAS (Statistical Analysis System), déployé à l’échelle planétaire au sein des industries pharmaceutiques, des institutions financières et des centres de recherche publique, propose une infrastructure computationnelle d’une robustesse inégalée pour construire ces représentations graphiques. La boîte à moustaches stratifiée par groupe permet d’analyser simultanément plusieurs sous-populations, de visualiser les variations d’échelles, d’évaluer la stabilité des médianes et de vérifier l’hypothèse cruciale d’homoscédasticité indispensable à l’application des tests d’hypothèses classiques. Grâce aux fonctionnalités avancées d’ODS Graphics (Output Delivery System) et particulièrement aux procédures modernes telles que PROC SGPLOT, l’analyste dispose d’un contrôle typographique et vectoriel absolu pour traduire des structures matricielles denses en représentations graphiques conformes aux plus hautes exigences des revues à comité de lecture.
Ce traité exhaustif expose de manière méthodique et programmatique les fondements théoriques, la structuration technique des données, l’ingénierie syntaxique et les bonnes pratiques éditoriales nécessaires à la production de boîtes à moustaches comparatives hautement sophistiquées dans l’écosystème SAS. De la dissection mathématique des quartiles de Tukey jusqu’à l’automatisation modulaire par macro-programmation, en passant par le traitement des valeurs aberrantes et la conformité aux directives académiques internationales, cet article constitue un manuel de référence exhaustif destiné aux statisticiens, biostatisticiens et data scientists soucieux d’excellence méthodologique.
1. Fondements théoriques et utilité de la boîte à moustaches par groupe
1.1 Composantes du résumé à cinq nombres dans les visualisations SAS
La boîte à moustaches repose fondamentalement sur le concept mathématique du résumé à cinq nombres formalisé par John Tukey, complété par une identification rigoureuse des observations marginales. Au sein du système SAS, l’architecture graphique matérialise en premier lieu le premier quartile (noté Q1 ou 25e centile) et le troisième quartile (noté Q3 ou 75e centile). Ces deux valeurs délimitent le corps rectangulaire de la boîte, dont la hauteur absolue correspond précisément à l’écart interquartile, désigné couramment sous l’acronyme anglais IQR (Interquartile Range). L’écart interquartile englobe la fraction médiane centrale de 50 % des observations collectées et constitue un indicateur de dispersion hautement résistant, insensible aux fluctuations stochastiques des queues de distribution.
À l’intérieur de ce polygone rectangulaire, une ligne transversale matérialise la médiane empirique, ou second quartile (Q2 ou 50e centile). La position relative de cette ligne médiane au sein du rectangle interquartile fournit un diagnostic visuel direct quant à l’asymétrie de la distribution centrale : un positionnement décentré vers le bord inférieur dénote une asymétrie positive (étalement vers la droite), tandis qu’un rapprochement du bord supérieur signale une asymétrie négative (étalement vers la gauche). Par défaut, SAS enrichit cette représentation par l’insertion d’un symbole distinctif, généralement un losange ou un cercle plein, positionné à la coordonnée exacte de la moyenne arithmétique. La distance séparant la médiane de la moyenne constitue un indicateur immédiat de l’intensité de la déviation paramétrique causée par les queues de distribution ou les observations atypiques.
Les moustaches (whiskers) s’étendent de part et d’autre des arêtes du rectangle jusqu’aux bornes de données adjacentes les plus éloignées, sans jamais excéder les limites théoriques définies par la clôture de Tukey. Ces clôtures théoriques sont calculées mathématiquement par l’adjonction ou la soustraction d’un facteur d’échelle équivalant à 1,5 fois l’écart interquartile : Q3 + 1,5×IQR pour la clôture supérieure et Q1 – 1,5×IQR pour la clôture inférieure. Les valeurs observées franchissant ces frontières conventionnelles sont extraites de l’ancrage continu des moustaches et reçoivent un traitement géométrique individualisé sous la forme de points de dispersion discrets, permettant ainsi de cartographier immédiatement l’existence de données aberrantes.
1.2 Avantages comparatifs des analyses factorielles groupées
Dans l’investigation empirique multivariée, l’évaluation isolée de distributions univariées sans stratification factorielle s’avère souvent fallacieuse, masquant des hétérogénéités structurelles profondes. L’intégration d’une dimension de regroupement permet de déployer côte à côte, le long d’un repère orthonormé partagé, les boîtes à moustaches associées à chaque modalité d’une variable qualitative indépendante. Ce procédé offre une densité d’information exceptionnelle tout en prévenant la saturation perceptive inhérente aux superpositions de densités de Kernel ou aux histogrammes multifactoriels enchevêtrés. L’analyste peut ainsi sonder instantanément la cohérence interne de sous-populations distinctes au sein d’un même espace graphique standardisé.
L’un des apports majeurs de la boîte à moustaches par groupe réside dans sa capacité à révéler les violations de l’homoscédasticité, condition sine qua non de validité pour une multitude d’analyses inférentielles traditionnelles. L’inégalité des largeurs de boîtes ou la disproportion flagrante de la longueur des moustaches entre divers sous-groupes signale immédiatement une hétérogénéité des variances résiduelles. Ce diagnostic graphique immédiat guide le chercheur vers des approches statistiques compensatoires, telles que les corrections de Welch-Satterthwaite, les modèles linéaires généralisés à variance hétérogène ou les transformations mathématiques stabilisatrices de variance comme la famille de Box-Cox.
Par ailleurs, la juxtaposition spatiale des boîtes autorise une appréciation visuelle continue des décalages d’ordre stochastique entre conditions d’observation. En confrontant directement les hauteurs relatives des médianes de plusieurs cohortes, le praticien repère instantanément les tendances d’efficacité thérapeutique, les disparités socio-économiques ou les variations temporelles de processus industriels. Cette lecture bidimensionnelle synthétise les propriétés de position, de dispersion et de forme sans obliger l’utilisateur à naviguer à travers d’interminables tableaux numériques de statistiques descriptives, optimisant de fait la vitesse et la pertinence des arbitrages analytiques.
1.3 Applications statistiques dans les protocoles de recherche
L’utilité méthodologique de la boîte à moustaches par groupe se manifeste avec une acuité particulière lors des phases exploratoires précédant l’application de l’analyse de variance univariée (ANOVA) ou multivariée (MANOVA). Avant de soumettre un modèle linéaire à l’évaluation formelle du test F de Fisher, il est impératif d’évaluer la distribution des résidus au sein de chaque cellule du plan expérimental. La boîte à moustaches groupée permet de vérifier graphiquement la symétrie locale et de déceler la présence éventuelle de points hautement influents capables de distordre unilatéralement l’estimation des sommes des carrés et d’induire des erreurs de type I ou II lors des prises de décision d’inférence statistique.
Dans le domaine des essais cliniques randomisés et des protocoles pharmacologiques, les directives réglementaires internationales exigent une transparence absolue quant à la variabilité des biomarqueurs d’efficacité et de sécurité à travers les différents bras de traitement. Les visualisations groupées permettent de tracer l’évolution comparative de paramètres physiologiques continus (tels que la clairance rénale, la concentration plasmatique ou la pression artérielle) entre des cohortes recevant divers paliers posologiques ou un placebo. L’identification visuelle immédiate des sujets non répondeurs ou manifestant une toxicité biologique inattendue facilite la prise de décision rapide au cours des analyses intermédiaires protocolaires.
De surcroît, les sciences comportementales, l’éducation et la psychométrie recourent massivement aux boîtes à moustaches segmentées pour comparer des scores standardisés ou des indices d’aptitude cognitive entre plusieurs strates démographiques, socioculturelles ou expérimentales. L’absence de postulats paramétriques rigides inhérente au format de Tukey autorise la comparaison de variables ordinales ou de mesures d’attitudes sans risquer les artefacts interprétatifs associés aux distributions fortement tronquées ou multimodales qui caractérisent couramment les échelles de type Likert agrégées.
2. Préparation et structuration rigoureuse du jeu de données dans SAS
2.1 Création programmatique du tableau de données avec l’étape DATA
Pour exploiter pleinement la puissance des moteurs de rendu graphique de SAS, les données sources doivent impérativement respecter une architecture dimensionnelle précise. L’environnement SAS repose sur la distinction conceptuelle entre jeux de données au format large (wide format) et au format long (long format). Les procédures de visualisation distributionnelle moderne, notamment PROC SGPLOT, exigent une structuration rigoureuse au format long : chaque observation élémentaire doit occuper une ligne physique distincte de la table SAS, comportant au minimum une variable continue portant la mesure quantitative et une variable catégorielle servant de clé de regroupement factoriel.
La génération programmatique de ce canevas s’opère canoniquement au moyen de l’étape DATA, via l’invocation conjointe des instructions de lecture INPUT et d’alimentation DATALINES (ou CARDS). Lors de la déclaration des variables de regroupement catégoriel au niveau de l’instruction INPUT, le développeur doit adjoindre le modificateur typologique dollar ($) immédiatement à la suite de l’identifiant de la colonne. Cette syntaxe indique au compilateur SAS d’allouer un descripteur de mémoire alphanumérique pour stocker les modalités factorielles, prévenant ainsi les erreurs de troncature ou de conversion de type non sollicitée.
La structuration longue permet également de stocker des attributs d’identification transversaux, tels que les identifiants uniques de patients ou de lots d’échantillonnage, qui s’avèrent ultérieurement indispensables pour l’étiquetage personnalisé des valeurs aberrantes. Un agencement méthodique au sein de l’étape DATA évite le recours ultérieur à des opérations de transposition computationnellement onéreuses via la procédure PROC TRANSPOSE, garantissant ainsi un traitement économe des ressources système face à des volumétries de données massives.
2.2 Validation des formats et codification des variables de regroupement
L’intégrité de la segmentation graphique dépend directement de la propreté structurelle de la variable de classification. Au sein de SAS, une variable catégorielle alphanumérique est particulièrement sensible aux dérives typographiques microscopiques : la présence d’espaces insécables résiduels, de tabulations invisibles ou de divergences de casse (majuscules contre minuscules) amène le moteur analytique à fragmenter artificiellement une même modalité biologique ou expérimentale en plusieurs sous-groupes graphiques orphelins. L’analyste doit donc systématiquement assainir ses chaînes de caractères au moyen de fonctions vectorielles spécialisées telles que STRIP, TRIM et UPCASE au sein de l’étape DATA préliminaire.
Au-delà du simple assainissement textuel, l’application formelle de formats définis par l’utilisateur via la procédure PROC FORMAT constitue la méthode d’excellence pour administrer les variables de regroupement. En associant des libellés intelligibles et académiquement rigoureux à des codes numériques sous-jacents (par exemple en assignant la chaîne ‘Groupe Témoin (Placebo)’ à la valeur discrète 0, et ‘Traitement Actif 50mg’ à la valeur 1), le statisticien garantit l’indépendance entre la logique de stockage interne et la couche de présentation visuelle. L’ordre logique des formats facilite en outre l’ordonnancement séquentiel des boîtes lors du rendu final.
Il convient également d’ajuster avec minutie la longueur déclarée (length) des variables textuelles. Une allocation mémoire insuffisante lors de la phase de compilation entraîne la troncature silencieuse des libellés de facteurs longs, provoquant la fusion accidentelle de modalités distinctes qui partageraient des préfixes identiques. La spécification explicite d’une instruction LENGTH en amont de toute assignation garantit que chaque étiquette catégorielle préservera son intégralité orthographique et sémantique dans l’arborescence des métadonnées de la table.
2.3 Prétraitement et gestion des valeurs manquantes par groupe
La gestion des enregistrements incomplets requiert une vigilance absolue afin d’éviter toute distorsion analytique ou biais d’attrition non contrôlé. Le système SAS adopte des comportements différenciés et strictement encadrés selon que la valeur manquante (représentée par un point pour les variables numériques ou par une chaîne d’espaces vides pour les variables textuelles) se situe sur la composante quantitative ou sur le vecteur de classification catégorielle. Par défaut, lorsqu’une observation présente une valeur absente sur la variable continue dépendante, PROC SGPLOT omet cette ligne spécifique du calcul des résumés à cinq nombres sans exclure pour autant le groupe correspondant de l’axe factoriel.
En revanche, si l’absence de donnée affecte la variable de regroupement elle-même, SAS réagit par défaut en générant une boîte à moustaches distincte assignée à la modalité manquante, matérialisée par un blanc ou un point sur l’axe des catégories. Cette ségrégation visuelle automatique, bien qu’utile pour auditer la complétude d’un fichier source, s’avère totalement inacceptable au sein d’un manuscrit scientifique destiné à la publication. Le statisticien doit alors déployer des filtres de sélection formels à l’aide de l’instruction WHERE pour purger le flux d’analyse de toutes les observations non indexées catégoriellement avant la compilation graphique.
Il est de surcroît recommandé de quantifier systématiquement la prévalence du manque d’information au sein de chaque strate expérimentale. L’exécution préalable d’une procédure de croisement descriptive comme PROC FREQ permet de détecter d’éventuels déséquilibres structurels dans l’attrition des données. Si une sous-population expérimentale présente un taux d’observations manquantes disproportionné, l’interprétation des boîtes à moustaches associées doit impérativement s’accompagner d’avertissements méthodologiques explicites afin de ne pas induire en erreur le lectorat quant à la représentativité des quartiles affichés.
3. Mise en œuvre fondamentale de PROC SGPLOT avec l’instruction VBOX
3.1 Syntaxe de base de l’instruction VBOX avec l’option GROUP
L’instruction VBOX constitue l’épine dorsale de la procédure moderne PROC SGPLOT pour l’édification de boîtes à moustaches orientées selon une géométrie verticale conventionnelle. Sa syntaxe de base réclame la désignation explicite de la variable quantitative dont on souhaite cartographier la dispersion en tant qu’argument primaire immédiat de la commande. Dans sa configuration la plus simple, sans partitionnement factoriel, la commande engendre un tracé univarié monolithique ancré au centre de la fenêtre de traçage. Pour injecter la dimension analytique de segmentation, le praticien doit impérativement exploiter les arguments de sous-classification intégrés.
L’option GROUP= transforme radicalement le comportement d’évaluation de la procédure. En ajoutant cette instruction suivie de l’identifiant de la variable catégorielle, le moteur ODS Graphics partitionne instantanément l’échantillon global en sous-ensembles mutuellement exclusifs correspondant aux niveaux du facteur désigné. Le moteur calcule de façon autonome les résumés à cinq nombres spécifiques à chaque sous-cohorte et applique une différenciation graphique dynamique, associant par défaut à chaque boîte une couleur de remplissage et un style de contour distincts issus du schéma de style ODS actif lors de la session de compilation.
Cette approche synthétique offre un gain de productivité remarquable par rapport aux anciennes routines matricielles du langage SAS. Aucune boucle itérative n’est requise de la part du programmeur : l’algorithme sous-jacent orchestre la lecture du jeu de données, la stratification en mémoire tampon, le calcul déterministe des quartiles selon la méthodologie de Tukey et l’assemblage géométrique proportionnel des vecteurs graphiques dans le conteneur visuel de sortie.
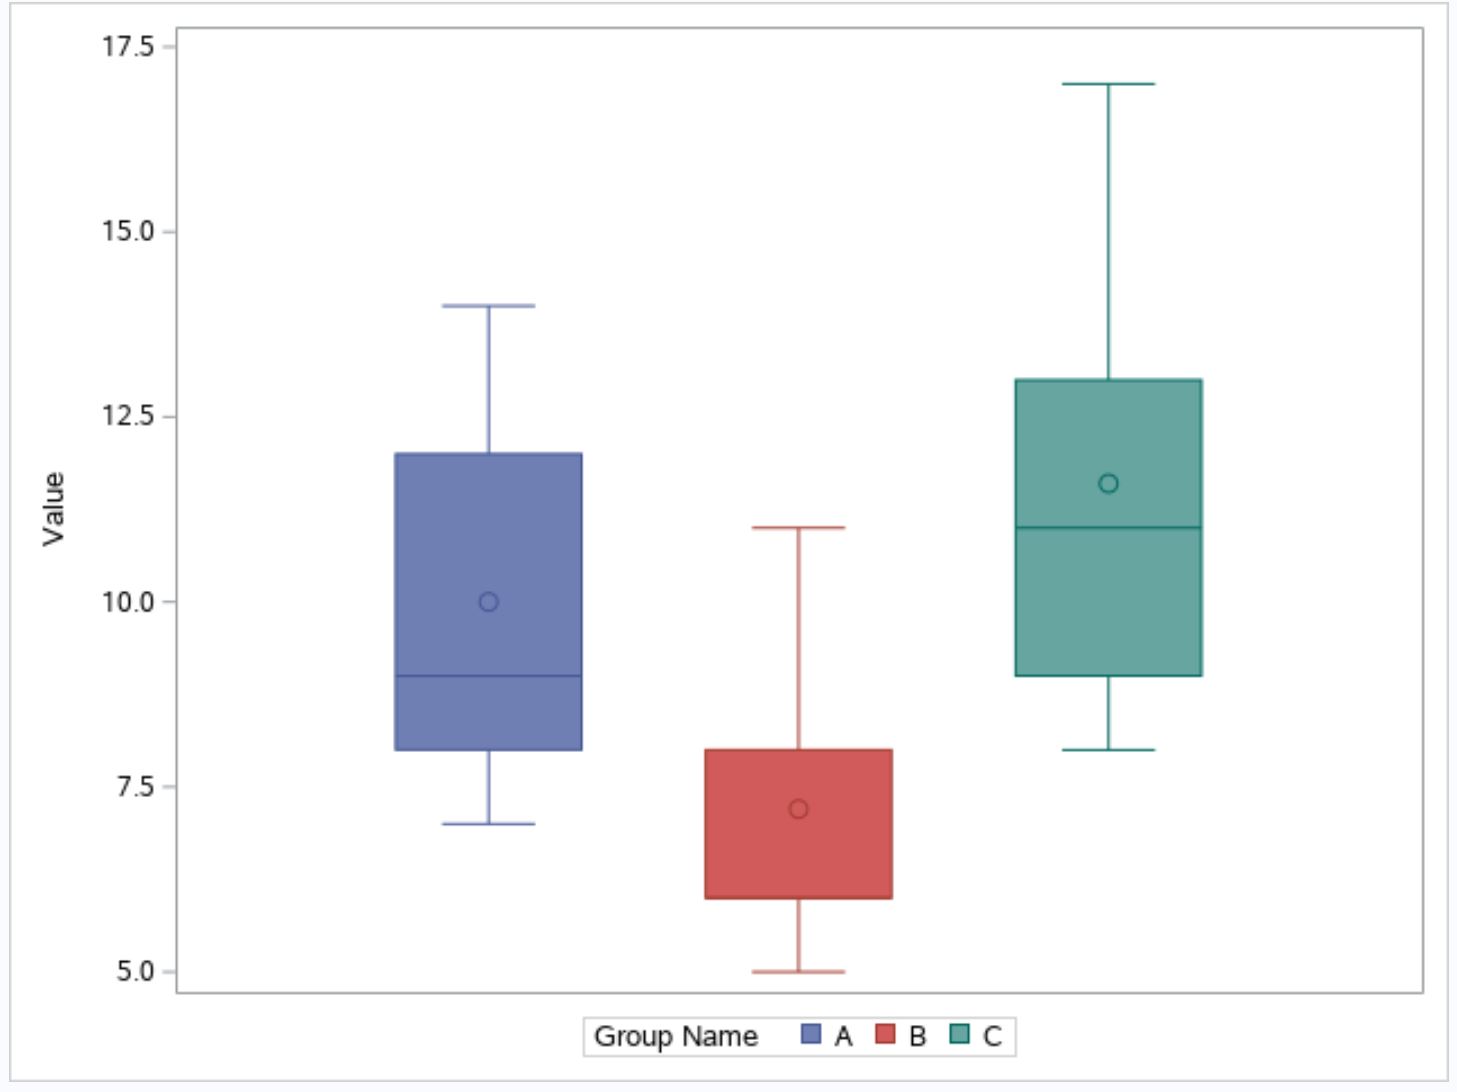
3.2 Distinction fondamentale entre l’option GROUP et l’option CATEGORY
Une confusion récurrente chez les programmeurs SAS novices réside dans l’interchangeabilité supposée des paramètres GROUP= et CATEGORY= au sein de l’instruction VBOX. Il existe pourtant une frontière conceptuelle et géométrique tranchée entre ces deux options. L’argument CATEGORY= gouverne exclusivement l’implantation physique et la répartition discrète des boîtes le long de l’axe des abscisses horizontales. Lorsque l’option CATEGORY= est invoquée isolément, SAS instancie des coordonnées indépendantes sur l’axe X pour chaque modalité, conférant à chaque boîte une assise spatiale dédiée, généralement habillée d’une teinte uniforme définie par les paramètres de tracé par défaut.
À l’inverse, l’option GROUP= porte une charge esthétique et relationnelle orientée vers la discrimination colorimétrique et l’empilement ou le regroupement conditionnel (clustering). Si un analyste applique GROUP= en l’absence de toute spécification de l’option CATEGORY=, le système positionnera l’ensemble des boîtes générées sur un axe horizontal virtuel réduit à un emplacement unique, provoquant une superposition ou une juxtaposition très étroite de tracés polychromes dépourvus d’étiquetage nominal distinct sur l’axe principal.
La véritable puissance analytique de la procédure émerge lors de la fusion synergique de ces deux paramètres : l’assignation simultanée d’une variable primaire à l’instruction CATEGORY= et d’une variable de stratification secondaire à l’instruction GROUP=. Ce couplage syntaxique autorise la création de représentations multivariées imbriquées, au sein desquelles des sous-groupes expérimentaux différenciés par la couleur sont méticuleusement regroupés en grappes sous l’égide de catégories fonctionnelles d’ordre supérieur, démultipliant ainsi la finesse de restitution des plans d’expérience factoriels complexes.
3.3 Exécution et analyse d’un premier exemple reproductible
Pour concrétiser cette méthodologie, considérons la modélisation programmatique standard d’un protocole expérimental à trois groupes parallèles : un groupe placebo, un groupe recevant une faible dose thérapeutique et un troisième soumis à une dose élevée. Le modèle minimal est initié en soumettant une étape DATA structurée, suivie de l’appel direct à PROC SGPLOT. Au sein du corps de la procédure, l’instruction VBOX est paramétrée en désignant le biomarqueur continu d’intérêt en abscisse d’analyse, complétée par l’option CATEGORY= pointant vers le libellé du groupe de randomisation.
Dès la validation de l’instruction RUN, le premier réflexe méthodologique du statisticien consiste à inspecter méticuleusement le journal des événements de SAS (le SAS Log). Ce fichier de trace technique doit certifier l’absence absolue de tout message d’avertissement (WARNING) ou d’erreur de syntaxe (ERROR). Le journal confirme le nombre exact d’observations lues au sein de la table source et le nombre d’enregistrements effectivement intégrés à l’algorithme de tracé, assurant ainsi qu’aucun enregistrement n’a été indûment écarté pour des problèmes d’incompatibilité de type.
Le rendu visuel délivré permet une confrontation immédiate des trois profils d’action. L’analyste observe directement sur le graphique la trajectoire de la ligne médiane à travers les trois compartiments : une progression ascendante monotone de la médiane du placebo vers la forte dose constitue la signature empirique d’un effet dose-réponse. Concomitamment, la stabilité de la hauteur des rectangles interquartiles atteste de l’homogénéité de la dispersion intra-groupe, validant visuellement la robustesse du protocole expérimental sans nécessiter le décryptage initial de volumineux rapports scalaires.
4. Génération de boîtes à moustaches horizontales avec l’instruction HBOX
4.1 Adaptation syntaxique de la déclaration HBOX dans PROC SGPLOT
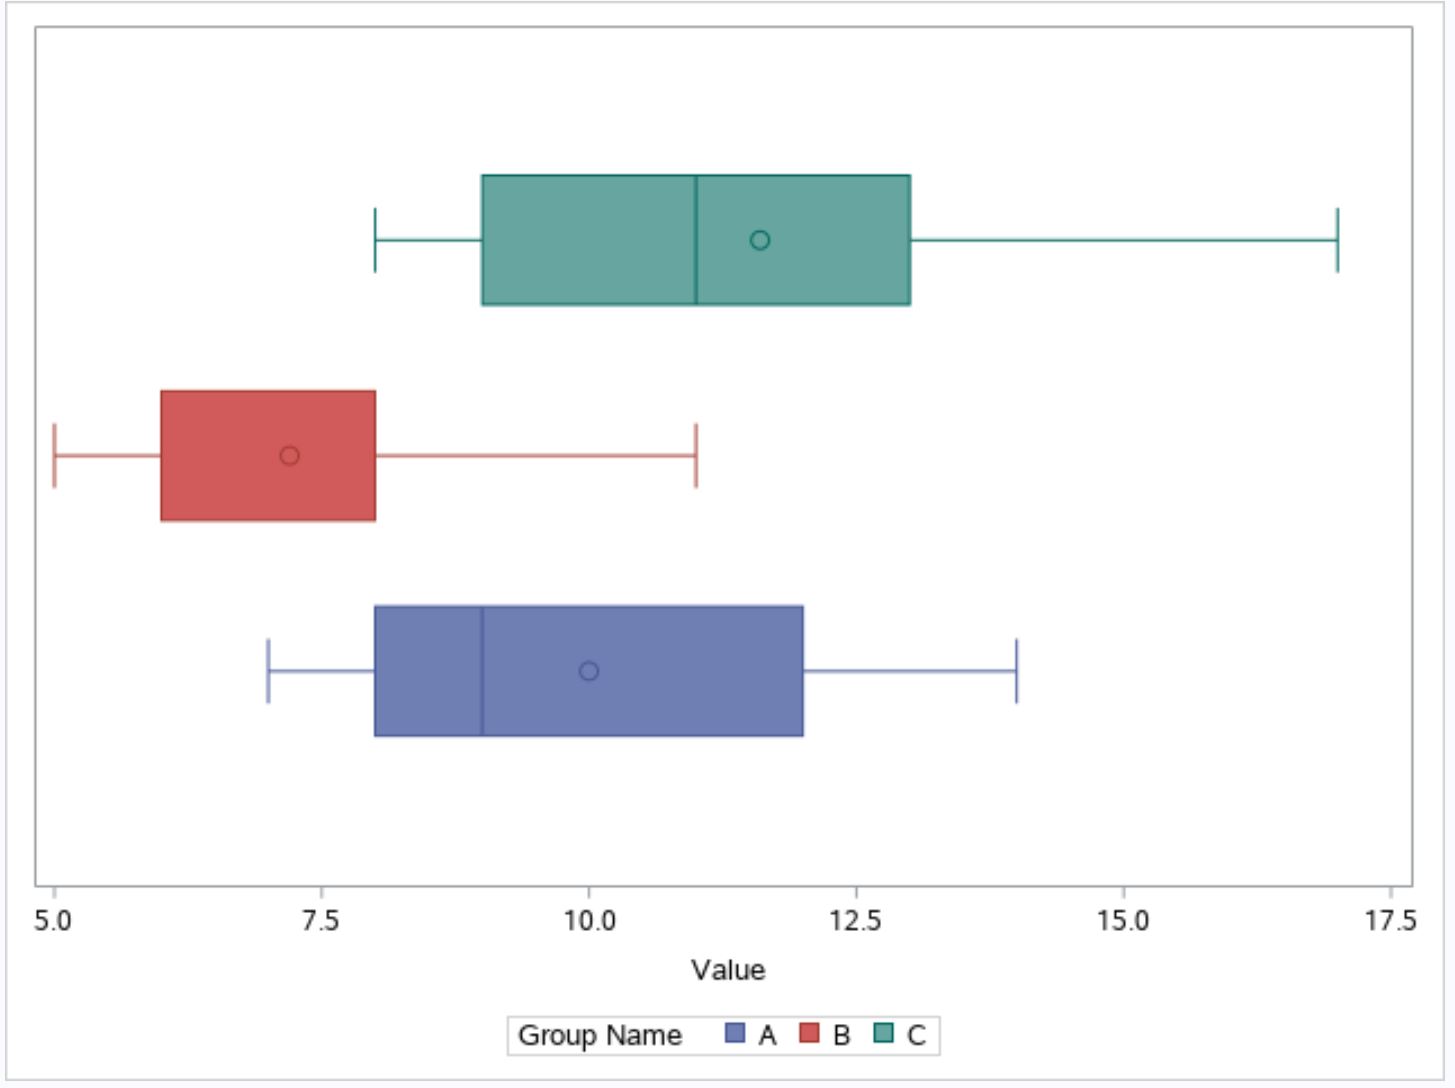
L’exploration des données quantitatives ne saurait être confinée à une projection strictement verticale. Pour répondre à des impératifs variés d’agencement visuel, la procédure PROC SGPLOT met à disposition l’instruction symétrique HBOX, conçue pour matérialiser des boîtes à moustaches orientées horizontalement. La transition syntaxique d’une modélisation VBOX vers HBOX s’opère avec une fluidité déconcertante mais requiert la réévaluation des correspondances d’axes dimensionnels. Dans la déclaration HBOX, la variable continue continue d’occuper la première position syntaxique immédiate après le mot-clé, mais elle sera désormais projetée le long de l’axe des abscisses horizontales (X).
Par conséquent, l’argument CATEGORY= reçoit la variable qualitative de regroupement qui viendra désormais s’échelonner de manière étagée le long de l’axe des ordonnées verticales (Y). Les algorithmes internes de calcul des statistiques non paramétriques (médiane, quartiles, limites de Tukey et identification des écarts) demeurent strictement identiques à ceux déployés pour l’instruction VBOX. L’inversion spatiale est purement géométrique et ne modifie en rien la rigueur mathématique des résumés distributionnels produits.
Cette symétrie syntaxique illustre la remarquable cohérence conceptuelle du système ODS Graphics de SAS. Grâce à cette uniformité opérationnelle, le passage d’une perspective à l’autre n’impose aucune restructuration du jeu de données d’entrée : la même table au format long alimente indifféremment l’une ou l’autre des représentations, offrant une souplesse d’expérimentation graphique indispensable aux cycles rapides de prototypage analytique.
4.2 Critères méthodologiques guidant le choix entre tracé vertical et horizontal
Le choix délibéré entre une orientation verticale ou horizontale transcende les simples préférences d’ordre purement esthétique ; il repose sur des critères stricts d’ergonomie cognitive et de typographie graphique. L’argument le plus déterminant en faveur de l’utilisation de l’instruction HBOX concerne la gestion des libellés textuels descriptifs longs. Sur un axe horizontal conventionnel (VBOX), l’alignement de nombreuses étiquettes catégoriel-les détaillées force le moteur SAS à appliquer des compromis typographiques dégradant la lisibilité : chevauchement de textes, réduction agressive de la taille de police, troncature ou rotation à 45 ou 90 degrés qui contraint le lecteur à une pénible inclinaison cervicale.
Le déploiement horizontal opéré par HBOX résout élégamment ce goulet d’étranglement typographique. En disposant les groupes de classification verticalement les uns au-dessus des autres le long de l’axe Y, l’espace horizontal disponible pour afficher les libellés de catégories devient virtuellement illimité. Les descriptions complexes, comportant des dénominations chimiques exhaustives, des nomenclatures nosologiques internationales ou des intitulés d’unités administratives peuvent ainsi s’écrire horizontalement de gauche à droite, respectant le sens naturel de lecture occidentale.
De plus, lorsque l’échantillon analysé intègre une stratification factorielle particulièrement dense, comptant dix, quinze ou vingt modalités distinctes (comme la comparaison de performances régionales ou de panels de génomique), la boîte horizontale prévient la sensation d’écrasement latéral. La page graphique peut s’étendre verticalement dans un format rapport ou une page de publication, conférant à chaque boîte un couloir visuel parfaitement dégagé pour apprécier sans distorsion la portée exacte de ses moustaches de dispersion.
4.3 Modifications structurelles des échelles de mesure en mode HBOX
L’inversion structurelle des coordonnées opérée par l’instruction HBOX entraîne une permutation logique du rôle des instructions de contrôle d’axes au sein de la syntaxe de PROC SGPLOT. L’instruction XAXIS, qui gérait les catégories nominales en configuration verticale, devient l’organe de contrôle exclusif de la variable continue de mesure. C’est donc désormais au sein du bloc XAXIS que le statisticien doit déclarer les spécifications de seuils, les intervalles de graduation numérique continue (via les paramètres VALUES= ou INCREMENT=) ainsi que l’insertion d’échelles de transformation logarithmique si la dynamique des données l’exige.
Réciproquement, l’instruction YAXIS assume désormais le pilotage de l’axe factoriel discret hébergeant les diverses boîtes stratifiées. C’est à ce niveau précis qu’il convient de paramétrer l’espacement inter-boîtes afin de bannir tout risque de recouvrement des moustaches horizontales lorsque des distributions adjacentes présentent des variances étendues. L’analyste veille également à configurer l’orientation séquentielle des modalités sur l’axe Y, s’assurant que la progression de bas en haut ou de haut en bas obéisse à un ordonnancement intuitif ou protocolaire.
L’harmonisation des lignes de repère exige également une adaptation topologique : pour faciliter la projection mentale des valeurs le long des axes, l’activation d’une grille de fond s’effectue désormais en insérant l’argument GRID au sein de l’instruction XAXIS. Des lignes verticales pointillées traversent ainsi le panneau graphique de haut en bas, permettant à l’œil d’intercepter instantanément la position exacte des médianes et des valeurs marginales sur l’échelle continue sous-jacente.
5. Contrôle esthétique des groupes : palettes, styles et marqueurs
5.1 Gestion des palettes chromatiques et du style ODS Graphics
L’impact persuasif et la clarté sémiologique d’une visualisation scientifique dépendent largement de la politique colorimétrique mise en œuvre. L’environnement SAS encadre l’esthétique générale de ses restitutions à travers l’architecture des styles ODS (tels que HTMLBlue, Journal, Daisy ou Statistical). Bien que le style par défaut fournisse un rendu propre et standardisé, il répond rarement aux chartes contraignantes des maisons d’édition académiques. Le recours au style Journal, par exemple, convertit instantanément l’ensemble de la palette en dégradés de niveaux de gris rigoureusement étalonnés, condition indispensable pour l’impression physique sans surcoût chromatique.
Pour un contrôle fin et indépendant des thèmes globaux, la procédure PROC SGPLOT propose l’instruction de bas niveau STYLEATTRS, véritable centre de pilotage de l’identité visuelle de la figure. En spécifiant l’option DATACOLORS=(liste_de_couleurs), le concepteur injecte un vecteur de teintes personnalisées qui supplantera l’ordre d’attribution automatique du logiciel. Les couleurs peuvent être déclarées au moyen de leurs désignations nominales standardisées ou par l’intermédiaire de leurs codes hexadécimaux stricts (ex. #1A5276), autorisant une reproduction fidèle des chartes institutionnelles.
Il est de rigueur éthique et méthodologique d’adopter des palettes chromatiques adaptées aux personnes atteintes d’anomalies de la perception des couleurs (dyschromatopsies telles que la deutéranopie ou la protanopie). L’usage exclusif de combinaisons rouge-vert doit être rigoureusement proscrit au profit de nuanciers perceptuellement uniformes et contrastés, comme les palettes inspirées de Viridis, Magma ou des travaux de Cynthia Brewer (ColorBrewer), garantissant une accessibilité universelle à la lecture des preuves empiriques.
5.2 Paramétrage des contours et des textures de remplissage
Dans un contexte de publication scientifique noir et blanc ou lorsque la reproduction graphique est susceptible de subir une dégradation de contraste, le recours univoque à la différenciation par la couleur constitue une fragilité méthodologique. Pour contourner cette limite, SAS permet de combiner la couleur avec des attributs de texture et de typographie vectorielle de surface. L’option FILLPATTERNS, intégrée au sein de PROC SGPLOT, active le remplissage des corps de boîtes par des hachures géométriques différentielles (lignes obliques, croisillons, rayures horizontales). Cette stratification texturée garantit que chaque groupe factoriel demeure parfaitement identifiable, même sous une photocopie dégradée en basse résolution.
Le contour des boîtes requiert également un ajustement géométrique précis au moyen du paramètre LINEATTRS. Cette commande autorise le réglage conjoint de l’épaisseur de trait (thickness), de la couleur de délimitation et de la nature de la ligne (pleine, tiretée, pointillée). Un contour noir net de largeur intermédiaire (par exemple 1,5 point) enserrant une surface colorée claire permet de stabiliser visuellement la boîte à moustaches et de détacher impeccablement son emprise spatiale par rapport au fond graphique de l’image.
De plus, l’analyste peut moduler le degré d’opacité de la surface interne de la boîte grâce à l’option globale TRANSPARENCY=, qui prend une valeur scalaire comprise entre 0 (opacité intégrale) et 1 (transparence totale). L’assignation d’une valeur de transparence équilibrée (autour de 0,3 à 0,4) s’avère particulièrement judicieuse lorsque le tracé de la boîte à moustaches est combiné en surimpression avec des nuages de dispersion de points individuels (jitter plots), permettant ainsi de visualiser la boîte tout en observant simultanément la densité exacte des observations sous-jacentes.
5.3 Affichage et personnalisation du symbole de la moyenne arithmétique
Par défaut, l’instruction VBOX de SAS inclut automatiquement la représentation de la moyenne arithmétique sous la forme d’un marqueur ponctuel inséré dans la boîte. Toutefois, selon les revues ou les objectifs de communication, il est souvent impératif de contrôler rigoureusement la présence et l’esthétique de ce paramètre. La directive DISPLAY= permet d’activer ou d’occulter sélectivement les composantes anatomiques du tracé : en stipulant DISPLAY=(CAPS FILL MEDIAN), le programmeur conserve les barres d’extrémités des moustaches, le remplissage et la ligne médiane, tout en éliminant délibérément le symbole de la moyenne arithmétique si celui-ci risque d’alourdir l’interprétation.
À l’inverse, si le protocole requiert une mise en exergue spectaculaire de la moyenne pour illustrer l’écart à la médiane (asymétrie), l’instruction MEANATTRS confère une liberté totale de personnalisation géométrique. L’analyste peut y redéfinir la nature de la forme symbolique (cercle plein, carré, triangle, astérisque ou losange), ajuster sa taille en pixels ou en points typographiques, et affecter une teinte distincte de celle du contour de la boîte pour maximiser la saillance perceptive.
Cette confrontation visuelle entre le centre de gravité paramétrique (la moyenne, influencée par l’amplitude des valeurs extrêmes) et le point de balance robuste non paramétrique (la médiane, invariante aux queues de distribution) offre une valeur diagnostique immédiate. Dans les distributions de variables biologiques ou économiques lourdement dissymétriques, constater que le marqueur de la moyenne est violemment propulsé vers la moustache supérieure pendant que la médiane demeure ancrée dans le bas de la boîte permet d’alerter sans équivoque le lecteur sur l’inadéquation structurelle des estimateurs gaussiens pour le jeu de données sous revue.
6. Configuration ergonomique et avancée de la légende via KEYLEGEND
6.1 Syntaxe générale et positionnement stratégique de KEYLEGEND
Dès lors qu’une variable de stratification est introduite au moyen de l’argument GROUP=, le moteur graphique de SAS initialise automatiquement la création d’une légende visant à décoder les associations d’attributs visuels (couleurs, textures, symboles). Néanmoins, l’implantation par défaut régie par les automatismes du compilateur respecte rarement les canons de l’ergonomie visuelle moderne. L’instruction explicite KEYLEGEND permet de neutraliser le positionnement aveugle de SAS et de reprendre le contrôle intégral de la spatialisation de cet élément critique.
L’argument central POSITION= régit l’ancrage spatial de la légende selon une玫瑰 des vents directionnelle : BOTTOM, TOP, RIGHT, LEFT, ainsi que leurs déclinaisons combinées (TOPRIGHT, BOTTOMLEFT, etc.). Le choix d’implantation doit découler de la morphologie du canevas : pour des boîtes verticales standard, une disposition transversale en position inférieure (BOTTOM) libère l’amplitude latérale nécessaire à l’étalement non contraint des axes. Parallèlement, l’argument LOCATION= arbitre si le bloc d’informations sémiotiques doit résider en dehors de la grille de traçage proprement dite (OUTSIDE) ou s’imbriquer à l’intérieur du repère cartésien (INSIDE), option très efficace pour coloniser les zones résiduelles exemptes de toute observation statistique.
La structuration matricielle de la légende s’ajuste quant à elle via les directives ACROSS= et DOWN=. En déclarant formellement DOWN=1, le statisticien impose un déploiement strictement linéaire et horizontal de l’ensemble des descripteurs de groupes, une organisation particulièrement sobre qui se loge parfaitement sous l’axe horizontal, éliminant tout encombrement vertical stérile.
6.2 Personnalisation sémantique et typographique du titre de légende
L’une des manifestations d’amateurisme les plus courantes dans la production graphique informatisée réside dans la persistance des noms de variables internes bruts (comme ‘grp_trt_arm_v2’) en guise d’en-tête de légende. L’option TITLE= »Texte explicite » au sein de la commande KEYLEGEND permet de substituer à ces identifiants informatiques obscurs un titre hautement compréhensible, scientifiquement irréprochable et prêt pour publication (par exemple : ‘Bras expérimental de randomisation’).
Le contrôle typographique de cet en-tête s’exerce via l’argument TITLEATTRS=(attributs). Cette clause offre la possibilité d’adapter la famille de polices d’écriture pour l’accorder avec celle du corps du texte du rapport hôte (Arial, Helvetica, Times New Roman), d’ajuster l’échelle de corps en points (size=), et de moduler la graisse typographique (weight=bold) ou la posture (style=italic). Cette harmonisation rigoureuse confère au document final une cohésion éditoriale sans faille.
Il arrive fréquemment, dans le cadre d’articles académiques aux libellés auto-explicatifs, que la présence même d’un titre de légende devienne redondante et vienne saturer l’espace pour une faible valeur ajoutée d’information. SAS permet l’oblitération formelle de ce titre par la spécification d’une chaîne vide TITLE= » » ou par l’application de paramètres d’exclusion dédiés, concrétisant ainsi le principe d’économie d’encre cher aux pionniers de la sémiologie graphique.
6.3 Harmonisation des étiquettes individuelles des groupes
Au-delà du titre fédérateur, les libellés élémentaires désignant chacune des modalités du facteur doivent faire l’objet d’un contrôle typographique équivalent à travers l’instruction VALUEATTRS=. Les directives appliquées au niveau de VALUEATTRS s’impriment directement sur les étiquettes textuelles alignées face aux vignettes chromatiques ou aux symboles de texture. L’analyste doit veiller à préserver un corps de police légèrement inférieur à celui des titres d’axes afin d’instaurer une hiérarchie perceptive fluide et naturelle lors du parcours visuel.
Dans certaines configurations analytiques sophistiquées, le modèle statistique de base peut inclure des strates techniques de contrôle ou des résidus d’échantillonnage qu’il ne convient pas d’ébruiter dans la légende finale. Bien que le filtrage préalable des données via une instruction WHERE demeure la voie royale, certaines options avancées de KEYLEGEND permettent de cibler précisément l’identifiant de tracé (via l’argument de nomination assigné sur VBOX avec l’étiquette NAME=) pour n’incorporer dans la légende que les composantes factorielles validées, excluant les artefacts parasites.
Enfin, l’habillage géométrique du cadre de la légende s’arbitre à l’aide de l’option unitaire BORDER ou NOBORDER. Alors que les chartes graphiques de l’ingénierie privilégient parfois un encadrement plein matérialisé pour compartimenter l’espace, la quasi-totalité des styles académiques contemporains privilégient l’instruction NOBORDER. La suppression de la boîte de délimitation extérieure allège considérablement la figure, permettant aux composantes de légende de flotter harmonieusement sans rivaliser avec les données distributionnelles qui doivent demeurer le foyer d’attention exclusif.
7. Gestion des axes, du tri catégoriel et du formatage des graduations
7.1 Ordonnancement logique et contrôle de l’ordre des groupes
L’ordonnancement selon lequel les boîtes à moustaches s’alignent le long de l’axe discret conditionne profondément la dynamique de transmission des résultats. Par défaut, la procédure PROC SGPLOT applique un tri fondé sur la valeur interne brute de la variable catégorielle, ce qui aboutit généralement à un classement par ordre alphabétique strict si la variable est de nature textuelle. Ce comportement déterministe peut s’avérer néfaste d’un point de vue scientifique, brisant des logiques d’exposition évidentes comme la progression chronologique, des échelons hiérarchiques de gravité ou une chronologie d’inclusion dans une étude clinique.
Pour forcer SAS à respecter une disposition sur-mesure, le paramètre DISCRETEORDER= au sein de l’instruction XAXIS (ou YAXIS en mode horizontal) constitue l’outil de référence. En définissant DISCRETEORDER=DATA, l’analyste contraint le système graphique à disposer les groupes rigoureusement dans la séquence temporelle selon laquelle ils se manifestent lors de la lecture séquentielle de la table SAS d’origine. Cette flexibilité autorise un tri en amont du jeu de données selon des métriques externes avant l’injection dans la routine visuelle.
Une démarche analytique particulièrement élégante consiste à ordonner les groupes en fonction de la valeur ascendante ou descendante de leurs médianes respectives. Cet arrangement hiérarchique trié optimise la perception des décalages d’échelle entre cohortes et guide instantanément le regard de la modalité la plus défavorable vers la modalité affichant la plus grande performance. Ce tri peut être orchestré élégamment en calculant les médianes via PROC MEANS, en fusionnant ce vecteur de synthèse dans le fichier source, puis en triant la table maîtresse selon ce critère quantitatif avant la compilation graphique gouvernée par DISCRETEORDER=DATA.
7.2 Personnalisation des repères, étiquettes et grilles d’arrière-plan
La crédibilité académique d’un graphique passe par un étalonnage rigoureux de son infrastructure d’axes. L’instruction continue (généralement YAXIS en tracé vertical) requiert l’activation judicieuse de lignes de référence par le paramètre GRID. L’intégration d’une grille discrète d’arrière-plan, préférablement configurée avec un style de ligne pointillé fin et une couleur estompée (comme un gris clair métallique), offre un support visuel capital pour relier mentalement les sommets des moustaches et les paliers de médiane aux valeurs chiffrées de l’axe sans induire de bruit optique perturbateur.
Le formatage des valeurs numériques d’étalonnage s’opère quant à lui de façon transparente via l’option VALUESFORMAT=. Cette clause permet de greffer n’importe quel format numérique standard de SAS ou défini par l’utilisateur (par exemple PERCENT8.1, DOLLAR10.2 ou un format scientifique E12.), assurant que les graduations d’axes n’affichent pas de décimales superflues ou d’approximations de virgule flottante susceptibles de discréditer la rigueur du rendu.
Sur l’axe catégoriel hébergeant les dénominations de groupes, la congestion spatiale peut provoquer l’occultation ou la superposition de libellés volumineux. Pour éradiquer ce problème sans basculer vers un mode horizontal, l’instruction DISCRETEVALUEATTRS combinée avec le paramètre VALUESROTATE= offre une échappatoire technique efficace. L’introduction de VALUESROTATE=DIAGONAL ou d’un angle explicite de 45 degrés incline harmonieusement l’ensemble des mentions textuelles le long de l’axe X, préservant l’intégrité de chaque lettre tout en évitant les collisions spatiales mutuelles.
7.3 Transformation mathématique des échelles sur l’axe continu
De nombreux phénomènes biologiques, financiers ou environnementaux présentent des dynamiques exponentielles ou des distributions lourdement asymétriques à queue droite (telles que les concentrations de cytokines sanguines, les coûts médico-économiques ou la dispersion de polluants atmosphériques). Si ces variables sont projetées sur une échelle linéaire conventionnelle, la majorité des boîtes à moustaches se retrouvent écrasées contre la bordure inférieure de l’axe, tandis que quelques observations gigantesques étirent démesurément la hauteur totale du repère, annihilant toute possibilité d’analyse visuelle fine des groupes.
La solution mathématique et logicielle consiste à modifier la géométrie de projection de l’axe continu par l’entremise du paramètre TYPE=LOG greffé à l’instruction d’axe continu. L’introduction d’une échelle logarithmique (en base 10 ou base e) permet de dilater les zones de forte concentration à petites valeurs et de contracter les espaces d’observations extrêmes. SAS recalcule dynamiquement le positionnement de tous les résumés à cinq nombres sur cette échelle transformée avec une précision irréprochable.
Cependant, l’utilisation d’une échelle logarithmique impose une vigilance méthodologique extrême lors de la rédaction de la note d’accompagnement de la figure. En échelle log, la longueur physique d’une moustache au-dessus de la boîte n’a plus une correspondance linéaire directe avec la longueur sous la boîte : les distances représentent désormais des ratios multiplicatifs et non plus des décalages additifs. Le statisticien doit stipuler formellement que l’évaluation des seuils de Tukey (1,5×IQR) est opérée soit sur la variable préalablement transformée, soit projetée mathématiquement, afin que les lecteurs avertis ne commettent pas d’erreur d’interprétation quant à la variance géométrique affichée.
8. Détection, caractérisation et traitement des valeurs aberrantes par groupe
8.1 Formulation algorithmique de détection des outliers dans SAS
Le traitement des observations situées aux marges extrêmes de la distribution constitue l’un des atouts analytiques majeurs de la boîte à moustaches de Tukey. Contrairement aux approches paramétriques basées sur l’écart-type (qui souffrent du paradoxe d’être déformées par les valeurs aberrantes qu’elles cherchent précisément à traquer), l’algorithme de Tukey s’appuie sur des métriques invariantes aux valeurs extrêmes : les charnières de quantiles. Le système SAS implémente rigoureusement cette formulation en calculant pour chaque sous-groupe l’écart interquartile IQR = Q3 – Q1.
À partir de cet écart pivot, l’algorithme érige deux types de frontières mathématiques : les clôtures internes (inner fences) situées à [Q1 – 1,5×IQR ; Q3 + 1,5×IQR] et les clôtures externes (outer fences) ancrées à [Q1 – 3,0×IQR ; Q3 + 3,0×IQR]. Dans le rendu standard de PROC SGPLOT, toute observation stationnant au-delà des clôtures internes est qualifiée de valeur atypique ou aberrante légère, et son ancrage géométrique est rompu par rapport aux moustaches, qui s’arrêtent impérativement sur la valeur d’observation valide la plus lointaine ne franchissant pas la clôture interne.
Il est capital de souligner que la sensibilité de cette règle d’exclusion de 1,5×IQR dépend de la taille de l’échantillon analysé et de la loi de probabilité sous-jacente. Pour une distribution gaussienne théorique pure, la probabilité stochastique d’identifier faussement une observation comme atypique selon la règle de Tukey est d’environ 0,7 % par observation individuelle. Dès lors qu’une cohorte comporte plusieurs centaines ou milliers d’enregistrements, la présence de points isolés au-delà des moustaches devient mathématiquement inévitable sans qu’il ne s’agisse pour autant d’anomalies de mesure ou de populations contaminantes.
8.2 Personnalisation graphique des symboles d’aberrance
La restitution visuelle des valeurs aberrantes ne doit pas être laissée au hasard des configurations par défaut de la station de travail. L’argument OUTLIERATTRS=(paramètres) implanté au cœur de l’instruction VBOX offre une latitude absolue pour styliser ces points marginaux. L’utilisateur avisé peut en redéfinir le symbole graphique (cercle ouvert, croix, étoile, point), la taille géométrique en pixels afin de prévenir les artefacts d’empilement dense (overplotting), ainsi que la teinte chromatique, en attribuant par exemple une nuance d’alerte rouge sang pour détacher sans ambiguïté les déviances biomécaniques ou cliniques.
Dans certaines circonstances d’ingénierie statistique ou de diffusion grand public, il peut être requis de masquer délibérément les valeurs aberrantes individuelles, notamment pour focaliser l’attention exclusive sur les propriétés massiques des quartiles ou pour respecter des règles strictes d’anonymisation de données hautement identifiantes en santé. L’exclusion des marqueurs d’outliers s’obtient alors via la directive DISPLAY=(NOMARKERS) ou DISPLAY_OUTLIERS=FALSE selon les versions de maintenance SAS, forçant les moustaches à s’afficher de manière épurée sans la constellation de points extérieurs.
En revanche, dans un processus d’investigation et d’assurance qualité des données, la traçabilité de ces observations atypiques est vitale. SAS autorise l’enrichissement interactif ou statique des outliers via des fonctionnalités d’étiquetage automatique : en combinant l’instruction DATALABEL= avec une variable contenant l’identifiant des sujets (ex. ID_Patient), chaque point divergent projeté au-delà des moustaches se voit annoté de sa référence alphanumérique exacte, accélérant d’autant l’investigation clinique dans les tables sources ou les dossiers de pharmacovigilance.
8.3 Interprétation analytique des valeurs aberrantes entre sous-populations
L’observation d’une concentration asymétrique de valeurs aberrantes au sein d’un sous-groupe factoriel particulier recèle une charge informationnelle diagnostique considérable qui dépasse le simple cadre de l’affichage graphique. Si le groupe témoin ne manifeste aucune valeur hors-clôture tandis que le groupe traité à forte dose projette une multitude de valeurs extrêmes au-delà de la moustache supérieure, ce déséquilibre traduit soit une variabilité de réponse pharmacologique radicale (présence de super-répondeurs biologiques), soit l’émergence d’une sous-population physiologiquement distincte métabolisant le composé de façon divergente.
Le statisticien ne doit jamais céder au réflexe naïf d’éliminer automatiquement ces observations sans justification clinique ou expérimentale formalisée. L’exclusion brutale d’outliers au seul motif de leur éloignement visuel sur la boîte à moustaches biaise irréversiblement l’estimation des quartiles subséquents et fausse l’évaluation du risque dans les modèles prédictifs. La comparaison des boîtes avant et après exclusion hypothétique permet d’évaluer la sensibilité des indicateurs non paramétriques face aux fluctuations marginales.
En accord avec les standards méthodologiques internationaux et les directives de publication de l’APA (American Psychological Association), toute figure intégrant des valeurs aberrantes sectorielles doit s’accompagner d’une note textuelle exhaustive décrivant la formule de détection appliquée, quantifiant le volume exact de points exclus ou annotés, et explicitant si les analyses inférentielles subséquentes ont été conduites sur l’échantillon complet ou épuré, assurant ainsi une reproductibilité totale des inférences tirées par la communauté scientifique.
9. Exploration comparative : utilisation de la procédure historique PROC BOXPLOT
9.1 Syntaxe générale de PROC BOXPLOT et exigence préalable de tri
Bien que la suite moderne ODS Graphics et la procédure PROC SGPLOT représentent le standard contemporain recommandé par SAS Institute, l’histoire informatique du logiciel impose la connaissance de la procédure patrimoniale PROC BOXPLOT, issue originellement du module SAS/QC dédié au contrôle statistique de la qualité industrielle. Cette procédure historique obéit à une philosophie architecturale et syntaxique fondamentalement différente de celle des outils graphiques de dernière génération.
La contrainte technique la plus rigide et incompressible régissant PROC BOXPLOT réside dans l’obligation formelle d’ordonnancement préalable de la table de données d’entrée. L’appel de PROC BOXPLOT sur un jeu de données non trié se solde instantanément par un arrêt d’exécution assorti d’une erreur bloquante dans le journal SAS. L’analyste doit impérativement exécuter au préalable une procédure de tri dédiée : PROC SORT sur la variable de regroupement. Ce prérequis découle du mode de traitement par blocs séquentiels hérité des architectures informatiques des années 1980.
Sur le plan de la syntaxe de tracé, la déclaration s’effectue au moyen de l’instruction d’action PLOT, qui exploite une notation matricielle unifiée sous la forme symbolique `PLOT variable_continue * variable_groupe;`. Cette notation de croisement factoriel illustre l’approche mathématique directe de l’ancienne école SAS, où l’axe des ordonnées précède systématiquement l’axe des abscisses au sein de l’expression algorithmique.
9.2 Comparaison technique et graphique entre PROC BOXPLOT et PROC SGPLOT
L’évaluation comparative entre PROC BOXPLOT et PROC SGPLOT met en exergue le gouffre qualitatif séparant les deux générations d’outils. PROC BOXPLOT produit historiquement des graphiques vectoriels ou matriciels monolithiques dont la flexibilité typographique s’avère restreinte : l’administration des fontes de caractères, l’implémentation de transparences alpha, l’usage de palettes de couleurs haute définition contemporaines et l’intégration dynamique de feuilles de styles complexes demeurent laborieux, voire impossibles sans manipulation obscure de variables de commande graphique (GOPTIONS).
En contrepartie, PROC SGPLOT tire parti de l’infrastructure native d’ODS Graphics et du moteur sous-jacent GTL (Graph Template Language). Cette architecture assure un rendu vectoriel anti-aliasé d’une finesse incomparable, une adaptation automatique aux densités d’écrans rétina et une interopérabilité immédiate avec les flux documentaires modernes (HTML5, PDF vectoriel avec signets, formats SVG éditables). Le traitement des étiquettes d’axes et de légendes y est totalement automatisé et immunisé contre les collisions typographiques.
Toutefois, PROC BOXPLOT conserve un avantage architectural unique : sa capacité native à générer sous le graphique des tableaux de contingence statistique parfaitement synchronisés et alignés verticalement sous chaque boîte. L’instruction BOXSTYLE permettait dès l’origine d’appliquer diverses variantes de modélisation squelettique des boîtes (styles Tukey, Scheffé ou industriels), intégrant des tables d’effectifs d’échantillons (N) directement ancrées dans l’axe de projection sans exiger de programmation matricielle complexe.
9.3 Cas d’usage spécifiques justifiant l’emploi de PROC BOXPLOT
Malgré l’avènement et la suprématie de PROC SGPLOT, plusieurs environnements applicatifs continuent de légitimer le maintien opérationnel de PROC BOXPLOT au sein des entreprises et des laboratoires de recherche. Le premier de ces contextes concerne la maintenance et la validation réglementaire de chaînes de production de code patrimonial hautement validées. Dans les essais cliniques de phase III ou le contrôle qualité nucléaire et aérospatial, revalider un programme de calcul et d’affichage implique des coûts de requalification considérables qui incitent les directions informatiques à sanctuariser le code existant tant que celui-ci satisfait aux exigences de certification.
Le second cas d’usage réside dans les routines industrielles de surveillance de processus de fabrication séquentiels en continu (Statistical Process Control). PROC BOXPLOT s’intègre nativement avec des blocs d’instructions spécialisés capables de calculer et de projeter en surimpression des limites de contrôle industrielles (seuils d’alerte à 3 sigmas, limites d’action spécifiques), offrant ainsi aux ingénieurs qualité un tableau de bord visuel opérationnel pour traquer instantanément les dérives d’usinage ou les contaminations de lots chimiques à travers le temps.
Enfin, la possibilité d’implanter sans effort algorithmique des tables descriptives complexes sous l’axe X (affichant simultanément les effectifs par sous-groupe, les pourcentages de dérive, ou les p-values de conformité) confère à PROC BOXPLOT un rôle utilitaire apprécié pour les rapports d’audit interne, où la sobriété spartiate d’un tableau chiffré intégré prime sur la sophistication esthétique du design graphique contemporain.
10. Visualisation multivariée : combinaisons multi-groupes et panneaux SGPANEL
10.1 Stratification à deux facteurs combinant CATEGORY et GROUP dans PROC SGPLOT
L’approfondissement de l’analyse exploratoire requiert souvent de modéliser des interactions factorielles complexes impliquant au minimum deux dimensions qualitatives simultanées. Dans l’enceinte de PROC SGPLOT, ce déploiement bidimensionnel s’articule magistralement en couplant l’argument CATEGORY= avec le paramètre de stratification GROUP=. Le facteur fondamental d’ancrage territorial (par exemple la pathologie ou le pays d’expérimentation) est assigné à CATEGORY=, tandis que la sous-classification expérimentale (par exemple le genre biologique ou le bras de dosage thérapeutique) est confiée à GROUP=.
Pour parfaire l’exposition de ces sous-ensembles au sein de chaque niveau principal, l’introduction de l’option GROUPDISPLAY=CLUSTER s’avère indispensable. Sans cette spécification critique, le moteur SAS superposerait aveuglément les boîtes associées aux différentes modalités du groupe sur une même ligne d’axe, rendant la visualisation totalement illisible. L’option CLUSTER impose un décalage géométrique latéral systématique (clustering), rangeant les boîtes secondaires côte à côte dans une alcôve spatiale dédiée propre à chaque modalité maîtresse.
L’écartement physique séparant ces boîtes contiguës au sein d’une grappe peut être modulé à l’aide de l’option CLUSTERWIDTH=, qui accepte une valeur relative comprise entre 0,1 et 1,0. Un ajustement équilibré (généralement fixé à 0,8) garantit une séparation visuelle franche entre les différentes grappes catégorielles tout en maintenant une proximité esthétique et fonctionnelle rassurante entre les sous-boîtes d’un même groupement, simplifiant ainsi le décodage immédiat des interactions croisées.
10.2 Construction de treillis multi-panneaux avec la procédure PROC SGPANEL
Lorsque la structure factorielle intègre un troisième paramètre qualitatif (comme des examens répétés à travers des temps de visite protocolaires successifs ou des analyses stratifiées par tranches d’âge), la capacité d’absorption visuelle d’un panneau graphique unique atteint ses limites de saturation. Le statisticien doit alors migrer vers la procédure spécialisée PROC SGPANEL, spécifiquement architecturée pour générer des matrices visuelles en treillis (trellis displays ou small multiples selon le concept d’Edward Tufte).
Au cœur de PROC SGPANEL, l’instruction fondamentale PANELBY remplace les commandes habituelles de fenêtrage. En stipulant `PANELBY variable_tertiaire / columns=2 rows=2;`, la procédure segmente l’espace global en un damier de sous-graphiques autonomes, allouant à chaque modalité de la variable de stratification une cellule graphique distincte dotée de sa propre boîte à moustaches groupée. Cette technique préserve une lisibilité absolue en évitant la surcharge cognitive sur un axe unique saturé d’informations disparates.
La règle d’or méthodologique régissant la confection de graphiques en treillis impose l’uniformisation stricte des échelles de coordonnées d’un panneau à l’autre. Par défaut, PROC SGPANEL impose l’option UNISCALE=ALL, garantissant que toutes les cellules de la matrice partagent une échelle dimensionnelle rigoureusement identique sur les axes X et Y. Cette uniformité est vitale : autoriser des échelles flottantes indépendantes induirait un biais cognitif majeur, conduisant l’observateur à comparer visuellement des grandeurs physiques dont les repères mathématiques réels différeraient radicalement d’une cellule à la suivante.
10.3 Interprétation d’interactions factorielles complexes
L’exploitation conjointe des regroupements par grappes et des matrices en treillis transforme la boîte à moustaches en un puissant outil de diagnostic heuristique pour repérer les interactions factorielles d’ordre supérieur. Sur le plan sémiologique, l’analyste scrute les variations de profils d’un panneau à l’autre : si la hiérarchie relative des médianes entre les sous-groupes (colorés par GROUP=) demeure strictement parallèle à travers toutes les catégories de l’axe et toutes les cellules du panneau, l’absence d’interaction statistique est visuellement plausible, suggérant un modèle purement additif des effets factoriels.
À l’inverse, si l’on observe une inversion brutale de la hiérarchie des médianes — par exemple si un traitement s’avère spectaculairement supérieur au placebo chez les cohortes masculines au sein du panneau « Visite 1 », mais voit son efficacité s’effondrer sous le niveau du placebo chez les femmes au sein du panneau « Visite 4 » — cette morphologie graphique instancie la signature sans équivoque d’une interaction d’ordre 2 ou 3 (Traitement * Sexe * Visite). Ce repérage visuel oriente d’emblée la spécification formelle des termes d’interaction au sein des procédures mixtes ou des modèles de régression subséquents (PROC MIXED, PROC GLIMMIX).
La traçabilité et la documentation rigoureuse de ces configurations visuelles complexes sont primordiales dans les protocoles d’investigation multicentriques. L’intégration de cartouches textuels normalisés dans l’en-tête de chaque cellule du panneau garantit que l’interprétation croisée des résumés à cinq nombres repose sur une contextualisation immédiate des strates biologiques ou temporelles correspondantes, limitant drastiquement les risques de fausses interprétations lors des réunions de synthèse multidisciplinaires.
11. Exportation haute définition et conformité aux standards académiques
11.1 Configuration des destinations ODS Graphics pour l’exportation vectorielle
L’aboutissement du processus d’analyse graphique réside dans la génération de fichiers physiques répondant aux spécifications techniques intransigeantes des éditeurs scientifiques internationaux (tels qu’Elsevier, Springer, Nature Publishing Group ou les presses de l’IEEE). Une capture d’écran sommaire ou une exportation matricielle basse résolution est inadmissible pour publication. Le compilateur SAS doit être piloté avec précision en configurant l’environnement ODS Graphics via l’instruction système ODS GRAPHICS / RESET=ALL, complétée d’instructions formelles de dimensionnement et de résolution.
Le paramétrage fondamental de la résolution spatiale s’opère par la directive DPI= (Dots Per Inch). Les revues biomédicales et d’ingénierie imposent une résolution minimale absolue de 300 DPI pour les illustrations en tons continus, et de 600 voire 1200 DPI pour les schémas vectoriels au trait comportant de la typographie fine. La configuration s’illustre sous la syntaxe `ODS GRAPHICS / IMAGENAME= »Figure1″ IMAGEFMT=TIFF DPI=300 WIDTH=16CM HEIGHT=12CM;`, laquelle produit une image matricielle non compressée parfaitement proportionnée au gabarit d’impression d’une colonne de texte académique.
Cependant, le summum de la qualité éditoriale est atteint en recourant à des formats purement vectoriels exempts de tout concept de pixellisation, tels que le format PDF natif ou le format SVG (Scalable Vector Graphics). En encapsulant la procédure graphique entre les balises de destination `ODS PDF FILE= »Figure1.pdf »` et `ODS PDF CLOSE;`, chaque trait, rectangle, étiquette typographique et marqueur ponctuel de boîte à moustaches est sérialisé sous la forme d’équations géométriques vectorielles. Le fichier généré peut ainsi subir des agrandissements microscopiques infinis sans souffrir de la moindre perte de netteté sur les presses industrielles des maisons d’édition.
11.2 Intégration directe des graphiques dans les documents ODS RTF et HTML
Dans le cadre de la constitution de rapports d’études cliniques intégrés (Clinical Study Reports conformes aux directives de l’ICH E3) ou de la confection de thèses universitaires, les visualisations doivent s’insérer harmonieusement au sein de documents textuels modifiables sans nécessiter de fastidieux collages manuels post-compilation. La destination ODS RTF (Rich Text Format) constitue la passerelle technologique d’excellence vers l’écosystème de traitement de texte Microsoft Word.
Pour réussir cette intégration automatisée, le programmeur doit veiller à désactiver les attributs de marge résiduels qui caractérisent les conteneurs SAS par défaut. En appliquant l’option BODYTITLE au sein de la déclaration ODS RTF, les titres formels déclarés par l’instruction TITLE de SAS sont transférés directement dans le corps de la page Word plutôt que d’être séquestrés dans les en-têtes d’impression du document, assurant ainsi un flux rédactionnel naturel et respectueux des styles de mise en page institutionnels.
De façon analogue, la publication de rapports d’audit interactifs à destination de l’intranet d’une entreprise ou d’un comité de surveillance de données s’appuie massivement sur la destination ODS HTML5. Ce protocole d’exportation permet d’embarquer les graphiques SVG vectoriels directement au cœur du code balisé de la page web, tout en neutralisant les bordures de conteneur invasives via des styles CSS épurés. Les utilisateurs finaux peuvent ainsi zoomer dynamiquement sur les distributions par groupe directement depuis leur navigateur internet sans distorsion graphique.
11.3 Respect des directives typographiques et visuelles APA
La mise en conformité visuelle avec les canons de l’édition scientifique, notamment les recommandations du Manuel de style de l’APA (7e édition), exige une stricte ascèse stylistique guidée par le principe fondamental de réduction de l’encre superflue formulé par le théoricien de l’information Edward Tufte. Selon ces préceptes de sémiologie graphique, chaque goutte d’encre imprimée doit véhiculer une particule d’information statistique irréductible : les arrière-plans colorés, les ombrages tridimensionnels, les bordures d’encadrement épaisses et les grilles quadrillées agressives doivent être impitoyablement éradiqués.
La typographie employée au sein des instructions de label d’axes et de légendes doit entrer en résonance absolue avec le corps de texte du manuscrit global. L’utilisation d’une police unique sans empattement hautement lisible (telle qu’Arial ou Helvetica) ou avec empattement traditionnel (Times New Roman), paramétrée rigoureusement à des corps échelonnés entre 8 et 10 points pour les annotations et 10 à 12 points pour les titres d’axes, prévient les déséquilibres esthétiques criants lors de la réduction à l’échelle de la colonne de publication.
Enfin, l’appareil graphique doit impérativement être complété par une légende académique formelle (Figure Note) positionnée immédiatement sous l’illustration dans le manuscrit. Cette note descriptive normalisée explicite le sens exact des éléments géométriques présentés : elle doit confirmer sans ambiguïté que la ligne transversale matérialise la médiane, que les bornes de la boîte circonscrivent l’intervalle interquartile (25e et 75e centiles), que les moustaches déploient l’étendue des données adjacentes bornées par la règle de 1,5 fois l’IQR de Tukey, et détailler la signification biologique de chaque marqueur individualisé au titre des valeurs marginales observées.
12. Résolution des erreurs fréquentes et automatisation par macro-programmation
12.1 Diagnostic des avertissements et anomalies structurelles récurrentes
L’exploitation quotidienne des procédures graphiques de SAS confronte régulièrement l’analyste à des anomalies d’exécution dont la résolution exige une solide maîtrise des diagnostics système. L’erreur la plus banale mais bloquante survient lors de l’inversion involontaire des natures de variables au niveau des arguments de l’instruction VBOX. Si un statisticien assigne par inadvertance une variable alphanumérique en tant qu’argument dépendant primaire de VBOX, le compilateur interrompt instantanément le traitement avec un message d’erreur stipulant l’impossibilité d’exécuter des opérations d’analyse distributionnelle continue sur des chaînes de texte.
Une autre anomalie visuelle fréquente concerne l’apparition de « groupes fantômes » ou de catégories dédoublées de façon aberrante sur l’axe horizontal. Ce phénomène découle systématiquement d’un défaut d’assainissement préalable des métadonnées au sein de l’étape DATA : la présence d’espaces typographiques résiduels en fin de chaîne, de différences de capitalisation ou de formats d’affichage mal alignés amène le processeur graphique à considérer des libellés comme sémantiquement distincts. L’analyste remédiera à ce comportement en encapsulant systématiquement ses variables de classification dans une fonction STRIP ou UPCASE avant la compilation visuelle.
Enfin, lors du traitement de jeux de données massifs (Big Data en bio-informatique ou en flux transactionnels), l’utilisateur peut se heurter à un effondrement de la session d’exécution accompagné d’un message d’alerte relatif au dépassement des quotas de mémoire allouée à la machine virtuelle Java sous-jacente d’ODS Graphics. Ce blocage se résout par la purge préventive de l’environnement graphique via l’instruction `ODS GRAPHICS / RESET;` et l’incrémentation des capacités d’allocation mémoire au lancement de la session SAS via les options système globales (ex. `-Xmx2048m`).
12.2 Standardisation industrielle par la création de macros SAS modulaires
Dans un contexte de recherche clinique ou de biostatistique appliquée, il est couramment exigé de produire des dizaines, voire des centaines de boîtes à moustaches stratifiées pour auditer l’ensemble des variables démographiques, des bilans biochimiques et des critères d’efficacité d’une étude. La réécriture séquentielle manuelle de blocs de code PROC SGPLOT pour chaque paramètre constitue une pratique archaïque, chronophage et hautement vulnérable à l’introduction d’erreurs humaines de copier-coller. La solution méthodologique d’excellence repose sur la compilation d’une macro-commande SAS modulaire et paramétrable.
Une macro-commande industrielle rigoureuse doit encapsuler l’ensemble des arguments de variabilité : le nom de la table source, l’identifiant de la variable dépendante continue, la variable factorielle de regroupement, la présence optionnelle d’une sous-stratification par grappe, le titre académique de la figure et le chemin de destination du fichier haute résolution généré. À l’intérieur de la macro, l’intégration de tests conditionnels préalables basés sur les dictionnaires de métadonnées de SAS (via les tables système `SASHELP.VCOLUMN`) permet de vérifier automatiquement l’existence formelle et la conformité typologique des variables avant d’autoriser le déclenchement de la procédure graphique proprement dite.
Cette architecture paramétrique autorise ensuite l’orchestration de boucles d’automatisation massives. En couplant la macro à une routine itérative ou à une exécution séquentielle pilotée par PROC SQL, le statisticien peut déclencher en une seule soumission de programme la génération industrialisée, standardisée et esthétiquement parfaite d’un atlas graphique distributionnel complet couvrant l’intégralité des biomarqueurs d’un essai clinique, chaque tracé obéissant au millimètre près aux directives de style définies pour le protocole.
12.3 Bonnes pratiques de gouvernance de code et de traçabilité scientifique
La confection de graphiques statistiques destinés à orienter des décisions de santé publique, des homologations de médicaments ou des arbitrages économiques majeurs s’inscrit dans un devoir de transparence et d’intégrité scientifique inconditionnel. La reproductibilité computationnelle absolue doit être garantie à chaque étape de la chaîne de production graphique. Tout programme SAS générant des boîtes à moustaches doit ainsi s’ouvrir par un cartouche d’en-tête formalisé mentionnant la version exacte du système SAS déployé, l’architecture du système d’exploitation hôte, l’identifiant de l’analyste responsable, la date de génération et l’arborescence absolue des jeux de données d’entrée.
Les données brutes ne doivent en aucun cas subir de modifications manuelles non documentées en amont de la procédure graphique. Tout nettoyage, exclusion d’observations manquantes ou conversion d’échelles de variables de regroupement doit impérativement s’exécuter par des étapes de programmation transparentes, tracées dans les fichiers journaux (Logs) qui doivent être archivés systématiquement aux côtés des livrables visuels finaux. L’ancrage de filigranes temporels discrets et du nom du script source en bas de page des graphiques d’audit constitue une pratique d’assurance qualité fortement recommandée dans l’industrie pharmaceutique.
Enfin, il est impératif d’opérer une validation croisée systématique entre les visualisations géométriques délivrées par PROC SGPLOT et les résumés scalaires déterministes produits par des procédures statistiques dédiées telles que PROC UNIVARIATE ou PROC MEANS. L’analyste doit vérifier méthodiquement que les coordonnées physiques des lignes médianes, des charnières de quartiles et des clôtures de moustaches affichées sur l’image coïncident au bit près avec les valeurs des centiles calculées formellement dans les tables descriptives, garantissant ainsi que l’élégance du rendu graphique repose sur un socle de rigueur statistique inattaquable.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cleveland, W. S. (1993). Visualizing Data. Hobart Press.
- Friendly, M. (2000). Visualizing Categorical Data. SAS Institute.
- Heath, D. (2020). SAS ODS Graphics: Tips, Tricks, and Techniques for Data Visualization. SAS Institute.
- Kuhfeld, W. F. (2016). Statistical Graphics in SAS: An Introduction to the Graph Template Language and the Statistical Graphics Procedures. SAS Institute.
- Matange, S. R. (2013). Getting Started with the Graph Template Language in SAS: Examples, Tips, and Techniques for Creating Custom Graphs. SAS Institute.
- SAS Institute Inc. (2023). SAS/GRAPH 9.4: Statistical Graphics Procedures Guide (7th ed.). SAS Institute. https://documentation.sas.com/doc/en/pgmsascdc/9.4_3.5/grstatproc/titlepage.htm
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Tukey, J. W. (1977). Exploratory Data Analysis. Addison-Wesley.
- Wickham, H., & Stryjewski, L. (2011). 40 years of boxplots. Technical Report, Had.co.nz.