
Dans le champ de la recherche scientifique contemporaine et particulièrement au sein des sciences du comportement, la quête d’une inférence causale irréprochable constitue un impératif méthodologique fondamental. Lorsqu’un chercheur souhaite évaluer l’efficacité d’une intervention cognitive, pharmacologique ou pédagogique, il se heurte inévitablement à l’hétérogénéité intrinsèque des unités expérimentales. Chez l’être humain, cette variabilité biologique, psychologique et environnementale génère un bruit de fond statistique considérable qui menace directement la validité interne des protocoles de recherche. Sans un contrôle expérimental rigoureux, la variance induite par des facteurs non contrôlés risque d’obscurcir l’effet réel du traitement étudié ou, pire encore, de produire des associations fallacieuses dues à des biais d’échantillonnage.
Pour faire face à cet écueil classique de l’expérimentation, les statisticiens ont développé des architectures expérimentales sophistiquées. Si la randomisation pure est souvent présentée comme la panacée permettant d’équilibrer asymptotiquement les caractéristiques individuelles entre les groupes de comparaison, elle montre de sévères limites opérationnelles dès lors que les tailles d’échantillons demeurent modestes. Dans ces situations fréquentes en laboratoire, le hasard peut échouer à distribuer uniformément les facteurs de confusion potentiels. C’est précisément à cette croisée des chemins méthodologiques qu’intervient la technique du blocage statistique (ou blocking en anglais), une stratégie de contrôle local conçue dès l’origine de l’agronomie expérimentale et perfectionnée pour répondre aux exigences des sciences humaines et biomédicales.
Le présent article propose une exploration approfondie du blocage statistique, depuis ses fondements théoriques jusqu’à ses déclinaisons mathématiques et logicielles les plus pointues. À travers une analyse didactique enrichie d’exemples détaillés en psychologie cognitive et en sciences de la santé, nous examinerons comment l’isolation méthodique d’une variable parasite au sein de blocs homogènes permet de neutraliser la variance indésirable, d’accroître substantiellement la puissance statistique des tests de comparaison et de consolider la réplicabilité des découvertes empiriques. Que vous conceviez un essai contrôlé randomisé ou un protocole d’évaluation comportementale, la maîtrise du blocage constitue un levier indispensable pour optimiser la précision de vos dispositifs expérimentaux.
1. Introduction aux plans d’expérience et fondements du blocage statistique
1.1 La recherche de causalité et le contrôle expérimental en psychologie
La psychologie scientifique et les neurosciences cognitives s’efforcent d’isoler des liens de cause à effet incontestables entre des manipulations environnementales ou cognitives et des comportements observables. Contrairement aux études corrélationnelles ou observationnelles, qui se bornent à constater des covariations sans pouvoir exclure l’intervention de tierces variables explicatives masquées, l’expérimentation contrôlée repose sur la manipulation active d’une ou plusieurs variables indépendantes pendant que l’ensemble des autres déterminants potentiels est maintenu constant ou neutralisé. Cette ambition de causalité se heurte toutefois de plein fouet à la nature plastique, versatile et hautement différenciée des sujets humains. Deux individus soumis à un même stimulus ne réagissent jamais de manière rigoureusement identique, car leur histoire d’apprentissage, leur patrimoine génétique, leur état de vigilance et leurs capacités cognitives basales diffèrent substantiellement.
Face à cette dispersion naturelle des réponses comportementales, la simple randomisation des participants entre les conditions expérimentales constitue la méthode par défaut employée par de nombreux expérimentateurs. Bien qu’irréprochable sur le plan de la théorie asymptotique, où une infinité de tirages aléatoires garantit l’équipartition parfaite des variables parasites entre les groupes de traitement, elle s’avère particulièrement vulnérable lorsque les contraintes de recrutement limitent la taille des échantillons à quelques dizaines de sujets. Dans ce cadre d’effectifs restreints, le tirage au sort peut malencontreusement concentrer les individus les plus performants ou les plus fragiles au sein d’une seule modalité expérimentale, créant un déséquilibre structurel préjudiciable à la validité de la recherche.
C’est pour pallier cette fragilité structurelle que Sir Ronald Aylmer Fisher formalisa, au sein de la station agronomique de Rothamsted dans les années 1920, le principe fondamental du contrôle local. Fisher comprit qu’au lieu de s’en remettre aveuglément à la seule vertu purificatrice du hasard pour lisser les gradients de fertilité du sol entre les parcelles agricoles, le chercheur avait tout avantage à structurer l’espace expérimental en sous-ensembles homogènes. Transposé aux sciences humaines, ce principe stipule que l’hétérogénéité humaine ne doit pas être traitée comme une simple fatalité probabiliste, mais qu’elle gagne à être activement segmentée et isolée en amont de l’assignation des traitements, garantissant ainsi que la comparaison empirique s’opère dans des conditions basales d’une équité absolue.
1.2 Définition conceptuelle du blocage (blocking) statistique
Sur le plan conceptuel, le blocage statistique se définit comme une méthode de conception expérimentale consistant à regrouper les unités d’observation — qu’il s’agisse de participants, d’animaux de laboratoire, de tissus cellulaires ou de créneaux temporels — en sous-ensembles relativement homogènes appelés blocs, au regard d’une ou de plusieurs caractéristiques secondaires susceptibles d’influencer la réponse finale. Au sein de chacun de ces blocs, les différentes modalités de la variable indépendante sont ensuite assignées aléatoirement aux unités qui le composent. L’objectif méthodologique central d’un tel dispositif réside dans la partition délibérée de la variance : en captant la variabilité liée aux différences systématiques entre les blocs, le statisticien retire cette part de bruit de l’erreur résiduelle non expliquée, réduisant ainsi drastiquement la variance intra-groupe.
Cette approche repose sur le postulat d’équivalence contextuelle. Pour déterminer si une méthode pédagogique innovante surpasse une technique traditionnelle, il est infiniment plus rigoureux de comparer leurs performances respectives chez deux élèves présentant un niveau d’aptitude initiale quasi identique, plutôt que d’opposer la moyenne d’un groupe disparate à celle d’un autre groupe tout aussi hétéroclite. En forçant la comparaison des traitements à s’effectuer à conditions basales équivalentes, le blocage agit comme un filtre qui soustrait l’effet perturbateur des différences interindividuelles préexistantes. Chaque bloc devient ainsi un micro-environnement expérimental au sein duquel les traitements entrent en compétition directe et équitable.
Il importe de souligner avec vigueur le statut purement méthodologique et instrumental de la variable de blocage. Contrairement aux variables indépendantes principales qui incarnent le cœur théorique de l’hypothèse de recherche formulée par l’expérimentateur, la variable de blocage n’a pas vocation première à faire l’objet d’une interprétation substantive en tant que mécanisme d’intérêt. Le chercheur s’intéresse rarement à l’effet intrinsèque de la strate de blocage en elle-même ; il l’intègre au protocole uniquement parce qu’il sait pertinemment que son omission viendrait polluer la mesure de l’effet thérapeutique ou expérimental visé. La variable de blocage est donc un instrument de neutralisation, un auxiliaire conçu pour purifier la scène expérimentale et permettre à l’effet véritable de se manifester avec une clarté statistique maximale.
1.3 Distinction entre variable explicative, dépendante et de confusion
Pour appréhender l’architecture d’un plan en blocs, il est impératif de situer précisément cette technique au carrefour des différentes catégories de variables mobilisées dans la recherche quantitative. La variable indépendante (ou facteur explicatif manipulé) représente la cause présumée dont l’investigateur cherche à tester l’effet sur le système d’observation. Ses modalités sont délibérément fixées par l’expérimentateur, qu’il s’agisse de l’administration d’une molécule versus un placebo, de l’exposition à un stress aigu versus une tâche relaxante, ou de l’application de divers protocoles d’apprentissage mnémotechnique. À l’autre extrémité de la chaîne causale se trouve la variable dépendante (ou variable réponse), qui quantifie l’état ou le comportement résultant, mesuré avec une rigueur métrologique maximale (par exemple, le temps de réaction en millisecondes, le score d’anxiété sur une échelle validée ou le nombre d’items correctement mémorisés).
Toutefois, la relation causale théorique liant la variable indépendante à la variable réponse est constamment menacée par la présence de variables de confusion (ou facteurs de perturbation). Une variable de confusion est une source de variation extérieure qui entretient une association statistique à la fois avec le traitement administré et avec la mesure finale. Si elle n’est pas neutralisée, elle biaise l’estimation de l’effet d’intérêt, conduisant le chercheur à imputer fallacieusement à son traitement une modification comportementale qui découle en réalité d’un déséquilibre dans la distribution de cette tierce variable. Dans un essai non contrôlé où les patients les plus jeunes recevraient systématiquement le nouveau traitement et les plus âgés l’intervention classique, l’âge agirait comme un facteur de confusion patent interdisant toute conclusion quant à l’efficacité pharmacologique réelle.
Le blocage statistique se positionne résolument comme un rempart préventif a priori face à ces menaces méthodologiques. Alors que des techniques correctives telles que l’analyse de covariance (ANCOVA) ou la régression multivariée tentent d’ajuster mathématiquement les scores a posteriori une fois les données recueillies, le blocage intervient dès la conception architecturale de l’étude. En contraignant l’assignation aléatoire à s’opérer de façon stratifiée au sein de regroupements équilibrés sur la variable parasite identifiée, le chercheur s’assure physiquement et mathématiquement que la variable perturbatrice ne pourra pas se corréler avec les conditions de traitement, éliminant ainsi radicalement le biais de confusion à sa source même.
2. La nature et l’impact des variables parasites (nuisance variables)
2.1 Identification des variables parasites dans les études comportementales
Dans l’écosystème complexe des sciences humaines, de la médecine translationnelle et de la psychologie, les variables parasites revêtent des formes multiples et polymorphes. Les premières et les plus fréquemment rencontrées relèvent des facteurs démographiques et structurels stables. L’âge chronologique des participants constitue l’archétype de la variable parasite : il influence de manière déterminante la vitesse de traitement de l’information, la plasticité neuronale, la mémoire épisodique et le métabolisme hépatique. De même, le niveau socio-éducatif, le statut socio-économique, ou encore le genre biologique induisent des variations systématiques dans la compréhension des consignes, l’adhésion aux protocoles ou les réponses neuroendocriniennes face à une tâche expérimentale donnée.
Au-delà de ces dimensions structurelles, les expérimentateurs doivent composer avec des variables d’état éphémères et fluctuantes. Le niveau de fatigue ressenti par un participant lors de son arrivée au laboratoire, la qualité de son sommeil au cours de la nuit précédente, son degré d’anxiété situationnelle ou son imprégnation en caféine constituent autant de perturbations physiologiques transitoires susceptibles d’altérer sa performance cognitive. De surcroît, le rythme circadien imprime une signature temporelle forte sur de nombreuses fonctions exécutives : un sujet évalué à huit heures du matin ne présente pas le même profil d’éveil attentionnel qu’un individu testé en milieu d’après-midi, lors du creux de vigilance postprandial bien documenté en chronobiologie.
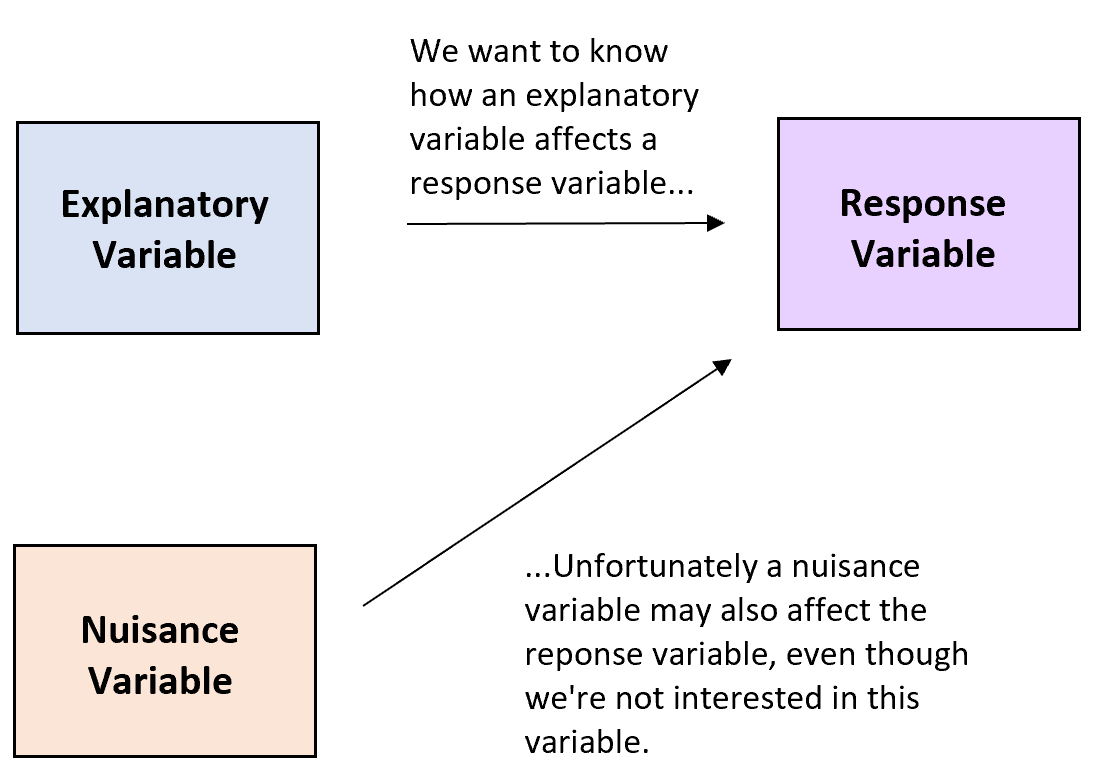
Enfin, les traits psychologiques stables et les fluctuations environnementales directes complètent cet inventaire des sources de nuisance. Les capacités cognitives générales, évaluées par exemple via le quotient intellectuel ou la mémoire de travail, de même que les traits de personnalité fondamentaux tels que le névrosisme ou l’extraversion, modulent profondément la sensibilité aux renforcements ou aux stresseurs expérimentaux. Sur le plan purement contextuel, l’identité de l’expérimentateur qui accueille le sujet, ses micro-attitudes inconscientes, la température de la pièce d’examen ou les variations du niveau sonore extérieur constituent des bruits ambiants qui, s’ils ne sont pas canalisés, viennent gonfler artificiellement la dispersion des résultats au détriment de la précision scientifique.
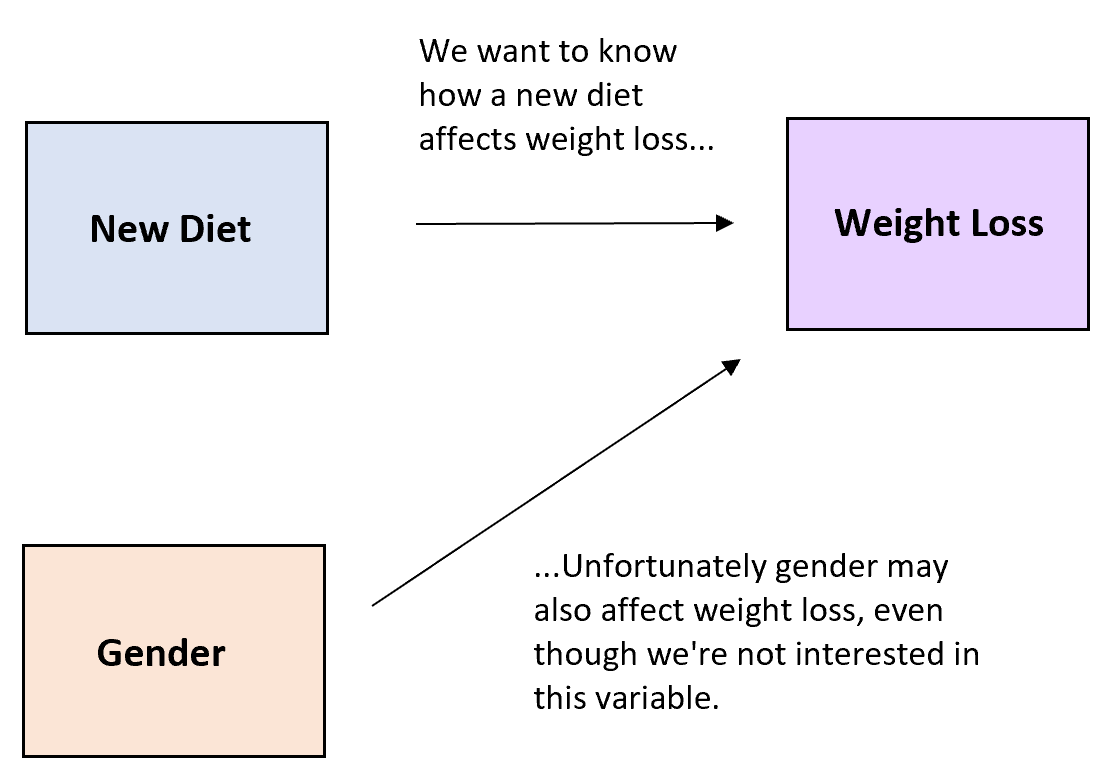
2.2 Mécanismes par lesquels les variables parasites augmentent la variance d’erreur
Pour saisir l’impact délétère de ces variables indésirables, il convient d’examiner le formalisme de l’analyse de la variance (ANOVA), modèle canonique de traitement des données expérimentales. Dans une ANOVA univariée classique à un facteur, la variation totale observée dans l’échantillon est scindée en deux composantes fondamentales : la somme des carrés inter-groupes (imputable à l’effet de la manipulation expérimentale) et la somme des carrés intra-groupes ou résiduelle (reflétant l’ensemble des variations inexpliquées entre individus soumis au même traitement). Lorsqu’une variable parasite majeure n’est pas contrôlée, son impact direct sur les scores individuels se répercute intégralement au sein de cette composante d’erreur résiduelle.
Ce phénomène engendre une inflation mécanique du carré moyen de l’erreur (noté CME ou $MS_{error}$), qui sert de dénominateur lors du calcul de la statistique de test $F$ de Snedecor. Si deux participants assignés à la même condition d’apprentissage obtiennent des scores divergents de 30 points simplement parce que l’un possède une mémoire de travail exceptionnelle et l’autre une capacité mnésique très faible, cette divergence de 30 points est comptabilisée par le modèle statistique comme un bruit aléatoire purement imprévisible. Plus la dispersion interne au sein de chaque groupe s’accroît sous l’effet de ces déterminants non pris en compte, plus le signal expérimental émis par la variable indépendante est étouffé sous l’épaisseur du vacarme statistique ambiant.
Par ailleurs, en l’absence de blocage, le hasard de l’échantillonnage peut introduire une asymétrie de répartition insidieuse. Bien que l’espérance mathématique de la différence des moyennes des variables parasites entre les groupes soit nulle, l’écart observé sur un échantillon fini est presque toujours non nul. Cette asymétrie a pour conséquence pernicieuse de fausser l’estimation ponctuelle de l’effet moyen du traitement, soit en l’amplifiant artificiellement (créant un faux positif ou erreur de type I), soit en le masquant partiellement, privant ainsi la communauté scientifique d’une découverte authentique et cliniquement utile.
2.3 Conséquences sur la puissance statistique et l’erreur de type II
L’inflation de la variance d’erreur engendre des conséquences méthodologiques directes sur la puissance statistique d’une expérience, définie comme la probabilité empirique ($1 – \beta$) de rejeter l’hypothèse nulle ($H_0$) lorsqu’il existe bel et bien un effet réel du traitement dans la population générale. Étant donné que la statistique $F$ est calculée par le ratio entre le carré moyen du traitement et le carré moyen résiduel :
$$F = \frac{MS_{traitement}}{MS_{erreur}}$$
Toute augmentation artificielle de $MS_{erreur}$ induite par une variable de nuisance non maîtrisée compresse inexorablement la valeur observée de $F$. Le test statistique perd de sa sensibilité opérationnelle, rendant beaucoup plus difficile l’atteinte du seuil de significativité critique (généralement fixé à $\alpha = 0{,}05$).
Il en résulte une flambée exponentielle du risque d’erreur de type II (le risque $\beta$), c’est-à-dire l’incapacité coupable à détecter un effet thérapeutique ou expérimental qui existe pourtant objectivement. De nombreux protocoles de recherche novateurs ont été prématurément abandonnés par des équipes scientifiques découragées, non pas en raison de l’inadéquation de leur molécule ou de leur paradigme comportemental, mais simplement parce que le bruit de fond généré par l’hétérogénéité des sujets avait dilué la magnitude apparente du phénomène au-delà du seuil de détection des tests conventionnels.
Pour compenser cette dégradation de la puissance sans recourir au blocage, l’expérimentateur n’a d’autre choix que d’augmenter massivement la taille de son échantillon global. Or, le recrutement de centaines de sujets supplémentaires engendre des coûts logistiques et financiers prohibitifs, prolonge indûment la durée des études et pose des questions éthiques sensibles, particulièrement dans les essais cliniques où l’on expose des patients à des thérapies non éprouvées. Le blocage statistique offre une alternative beaucoup plus élégante et économique : il permet de maximiser la puissance statistique à taille d’échantillon constante en purgeant mathématiquement l’erreur de mesure, garantissant une reproductibilité optimale des conclusions scientifiques formulées.
3. Principes fondamentaux et mécanisme opératoire du blocage
3.1 Le principe de stratification et d’homogénéité intra-bloc
Le déploiement opérationnel du blocage statistique repose sur une démarche de stratification méthodique, qui vise à scinder l’ensemble hétérogène des unités d’échantillonnage en plusieurs compartiments hermétiques au sein desquels la variabilité interne est réduite au minimum. L’objectif fondamental du chercheur consiste à maximiser la variance inter-blocs (les différences délibérées entre les blocs créés) tout en minimisant la variance intra-bloc (les dissimilitudes entre les sujets affectés à un même bloc). Pour ce faire, le critère retenu pour constituer les strates doit impérativement présenter une corrélation forte et éprouvée avec la variable réponse finale mesurée au terme du protocole.
Dans la pratique, si un chercheur étudie la vitesse d’apprentissage d’un logiciel complexe, il peut choisir d’évaluer préalablement la fluidité numérique ou les compétences informatiques générales de chaque participant au moyen d’un pré-test standardisé. Sur la base des scores obtenus, les individus sont classés par ordre croissant ou décroissant, puis découpés en tranches étanches : les sujets ayant obtenu les scores les plus faibles sont réunis dans le premier bloc, ceux de niveau intermédiaire dans un deuxième bloc, et les profils les plus aguerris dans un troisième bloc. Chacun de ces blocs constitue alors une micro-population d’une remarquable homogénéité quant à l’aptitude informatique de base.
La taille optimale d’un bloc dépend directement de la structure du plan expérimental envisagé et du nombre de modalités du traitement principal à évaluer. Dans le cas le plus simple et le plus classique d’un plan en blocs complets, chaque bloc comporte un nombre d’unités expérimentales rigoureusement identique au nombre de conditions de traitement à comparer. Si l’étude oppose trois approches thérapeutiques distinctes (par exemple : thérapie cognitive, thérapie interpersonnelle et liste d’attente), chaque bloc sera constitué d’un triplet de patients rigoureusement appariés sur leurs caractéristiques psychopathologiques initiales, garantissant ainsi un cadre d’expérimentation parfaitement balisé.
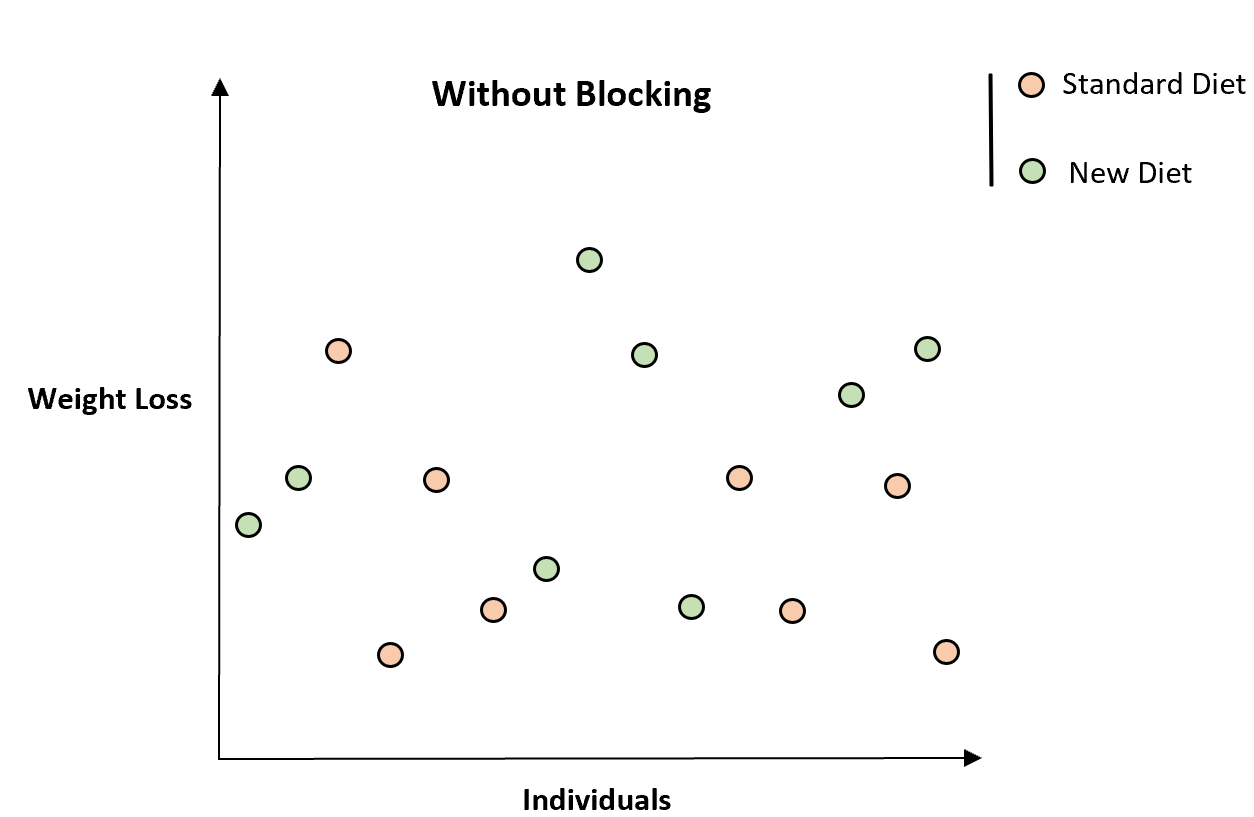
3.2 L’assignation aléatoire à l’intérieur des blocs constitués
Une confusion fréquente chez les novices consiste à opposer blocage et randomisation, comme si la constitution méthodique de blocs éliminait le recours au hasard. Il n’en est rien. Le blocage ne se substitue pas à la randomisation ; il la structure, la canalise et la perfectionne sous la forme d’une randomisation restreinte ou stratifiée. Une fois les blocs de sujets homogènes délimités, le tirage au sort s’exerce de manière strictement indépendante au sein de chaque bloc considéré isolément. Si un bloc réunit quatre participants de même tranche d’âge, les quatre traitements expérimentaux sont assignés aléatoirement à ces quatre individus précis, par exemple au moyen d’un générateur de nombres pseudo-aléatoires ou d’enveloppes scellées préparées selon un protocole strict.
Ce double mécanisme — homogénéisation préalable suivie d’une allocation aléatoire intra-bloc — offre des garanties méthodologiques exceptionnelles. D’une part, il assure une représentation rigoureusement équilibrée des niveaux de traitement à travers l’ensemble des strates de l’échantillon. Aucune modalité expérimentale ne peut se retrouver accidentellement concentrée sur les sujets les plus âgés ou les plus jeunes, puisque chaque bloc diffuse un représentant vers chaque traitement. Le biais d’allocation est ainsi physiquement éradiqué à l’échelle de chaque sous-groupe.
D’autre part, la randomisation intra-bloc préserve l’indépendance conditionnelle des erreurs de mesure, propriété stochastique essentielle requise pour la validité mathématique des tests d’inférence. Les facteurs de perturbation résiduels qui n’auraient pas été captés par la variable de blocage continuent de se distribuer de manière aléatoire et non systématique entre les bras de l’essai, neutralisant ainsi les menaces résiduelles pesant sur la validité interne du design de recherche.
3.3 Réduction de la somme des carrés résiduelle dans l’analyse de variance
Le véritable tour de force du blocage se révèle lors de la décomposition algébrique des sources de variance au sein de l’analyse de données. Dans un plan complètement randomisé ignorant les blocs, la somme totale des carrés des écarts ($SS_{Total}$) est traditionnellement décomposée selon la relation bilatérale élémentaire :
$$SS_{Total} = SS_{Traitement} + SS_{Erreur}$$
Lorsque le chercheur formalise l’existence des blocs et les intègre explicitement dans son équation linéaire, l’espace mathématique de la variabilité est réorganisé de manière trilatérale :
$$SS_{Total} = SS_{Traitement} + SS_{Bloc} + SS_{Residuelle}$$
La fraction de variance attribuable aux différences systématiques entre les différents blocs de sujets est mathématiquement extraite de ce qui constituait auparavant le réservoir amorphe de l’erreur non expliquée. La nouvelle somme des carrés résiduelle ($SS_{Residuelle}$) s’obtient par soustraction :
$$SS_{Residuelle} = SS_{Erreur non bloquee} – SS_{Bloc}$$
Si la variable de blocage a été judicieusement choisie et qu’elle s’avère hautement prédictive de la variable dépendante, la grandeur $SS_{Bloc}$ s’avère très substantielle. En conséquence, la somme des carrés résiduelle subit une amputation massive de sa magnitude initiale. Bien que cette opération s’accompagne d’une réduction connexe des degrés de liberté associés à l’erreur (puisqu’un certain nombre de degrés de liberté sont alloués à l’estimation de l’effet bloc), le bénéfice net demeure spectaculaire dans la grande majorité des cas : le carré moyen résiduel chute drastiquement, provoquant une augmentation corrélative immédiate de la valeur du ratio $F$ pour le facteur de traitement et une translation favorable de la p-valeur vers des seuils de haute significativité.
4. Les différents types de plans en blocs en recherche empirique
4.1 Le plan en blocs complets randomisés (RCBD)
Le plan en blocs complets randomisés, fréquemment désigné par l’acronyme anglophone RCBD (pour Randomized Complete Block Design), constitue l’étalon-or et la forme la plus intuitive des architectures de blocage. L’adjectif « complet » traduit une exigence fondamentale : chaque bloc constitué au sein de l’expérience doit obligatoirement recevoir l’intégralité des traitements étudiés. Si une recherche comporte $k$ modalités de traitement, chaque bloc doit impérativement rassembler exactement $k$ unités expérimentales (ou un multiple entier de $k$), permettant une attribution bijective et exhaustive des conditions expérimentales à l’intérieur de chaque compartiment.
Cette structure canonique présente des avantages d’analyse considérables. Sur le plan mathématique, elle assure une orthogonalité absolue entre le facteur de traitement et le facteur de bloc. Cela signifie que l’estimation de l’effet principal du traitement est rigoureusement indépendante de l’effet des blocs, ce qui simplifie radicalement les calculs d’analyse de variance et garantit qu’aucun ajustement complexe de matrices non orthogonales n’est requis. De plus, la lisibilité conceptuelle d’un RCBD est totale : les comparaisons planifiées et les contrastes post-hoc s’interprètent sans ambiguïté puisque les conditions expérimentales s’opposent toujours à travers des profils d’individus parfaitement équivalents.
En laboratoire de psychologie cognitive ou de physiologie humaine, le RCBD trouve son terrain d’élection dès lors que les contraintes de recrutement permettent d’isoler des grappes de quelques sujets homogènes. Par exemple, lors du test d’interfaces logicielles soumises à trois ergonomies différentes, regrouper les utilisateurs par triplets selon leur tranche d’âge et leur dextérité motrice pour tester les trois solutions au sein de chaque triplet constitue une application pure et exemplaire du plan en blocs complets randomisés.
4.2 Les plans en blocs incomplets équilibrés (BIBD)
Il est toutefois des circonstances expérimentales où la réalisation d’un bloc complet se heurte à des verrous logistiques, physiologiques ou temporels infranchissables. C’est particulièrement vrai lorsque le nombre de traitements expérimentaux à comparer ($a$) excède la capacité physique d’accueil d’un bloc individuel ($k$, avec $k < a$). Si un neuroscientifique souhaite comparer l'efficacité de six protocoles de remédiation cognitive distincts sur des patients cérébrolésés, il est souvent inenvisageable de soumettre un même patient — ou de former des grappes homogènes de six patients parfaitement équivalents — à l'ensemble de ces épreuves sans induire un épuisement cognitif majeur ou faire face à une rareté des profils cliniques.
Pour résoudre ce dilemme opérationnel, la théorie statistique a formulé les plans en blocs incomplets équilibrés, ou Balanced Incomplete Block Designs (BIBD). Dans un BIBD, aucun bloc ne reçoit la totalité des traitements, mais l’attribution des traitements incomplets est orchestrée selon une stricte combinatoire mathématique. Le plan est dit équilibré parce que chaque paire possible de traitements coexiste au sein d’un même bloc un nombre constant et invariable de fois, symbolisé par le paramètre combinatoire $lambda$ :
$$\lambda = \frac{r(k – 1)}{a – 1}$$
où $r$ représente le nombre de répétitions de chaque traitement à travers l’ensemble de l’expérience, $a$ le nombre total de traitements, et $k$ la taille fixe des blocs incomplets.
Cette régularité géométrique permet, grâce à des équations de pondération par moindres carrés généralisés, de neutraliser entièrement les biais liés au fait que tous les traitements ne s’affrontent pas au sein de chaque bloc. Bien que la mise en œuvre de l’analyse exige l’emploi de sommes de carrés ajustées (dites de Type III) et requiert des outils logiciels spécialisés, le BIBD représente une solution de choix pour les tests sensoriels longs, les épreuves de psychométrie lourdes ou les expérimentations cliniques impliquant des populations fragiles chez qui le fractionnement des interventions est vital.
4.3 Les plans en blocs factoriels et hiérarchisés
L’expérimentation contemporaine ne se limite que rarement à la manipulation d’un unique facteur indépendant. Les chercheurs sont fréquemment amenés à investiguer comment plusieurs déterminants interagissent entre eux pour façonner le comportement. Le principe du blocage s’adapte harmonieusement à ces desseins complexes sous la forme de plans en blocs factoriels. Dans une telle configuration, les cellules résultant du croisement de deux facteurs de traitement ou plus (par exemple un facteur A à 2 modalités et un facteur B à 3 modalités, soit 6 cellules factorielles) sont insérées de façon ordonnée à l’intérieur de blocs homogènes préconstitués.
Cette articulation permet non seulement d’évaluer avec une grande sensibilité les effets principaux de chaque manipulation expérimentale, mais également d’estimer les termes d’interaction factorielle sans que la variance d’erreur ne vienne en altérer la détection. Les blocs absorbent la variabilité contextuelle ou biologique parasite pendant que le chercheur dissèque minutieusement la synergie ou l’antagonisme entre ses facteurs théoriques d’intérêt.
Par ailleurs, lorsque les données comportementales s’inscrivent dans des structures écologiques naturelles, les plans de blocage adoptent une modélisation hiérarchisée (ou nested block designs). Dans les recherches en sciences de l’éducation ou en psychologie organisationnelle, les individus sont naturellement nichés au sein de classes scolaires, elles-mêmes imbriquées dans des établissements, ou les employés regroupés au sein d’équipes de travail managées par des superviseurs spécifiques. Le blocage hiérarchisé formalise cette imbrication de niveaux de variabilité en emboîtant des blocs secondaires dans des blocs primaires, préfigurant les approches par modèles linéaires mixtes qui dominent la méthodologie contemporaine.
4.4 Le cas particulier des mesures répétées comme forme extrême de blocage
Une mise en perspective conceptuelle fondamentale consiste à reconnaître que le plan d’expérience à mesures répétées (ou within-subjects design) représente l’incarnation ultime et la forme limite du blocage statistique. En effet, lorsqu’un protocole soumet le même sujet individuel successivement à l’ensemble des conditions expérimentales de l’étude, ce sujet individuel fonctionne très exactement comme un bloc à part entière.
En considérant l’individu comme son propre bloc, l’expérimentateur réalise un contrôle parfait de l’ensemble des variables parasites stables : le patrimoine génétique, l’histoire développementale, le quotient intellectuel, les traits de personnalité et la physiologie basale du sujet demeurent strictement constants d’une condition à l’autre. La variance résiduelle interindividuelle est ainsi totalement purgée de l’estimation de l’erreur expérimentale, conférant aux plans en mesures répétées une sensibilité statistique hors du commun pour des effectifs restreints.
Cependant, cette modalité extrême de blocage engendre des menaces méthodologiques spécifiques qui lui sont propres, au premier rang desquelles figurent les effets d’ordre, de report (carryover effects) et d’apprentissage temporel. Si le passage par la condition A modifie irrémédiablement le comportement du participant lors de son exposition subséquente à la condition B, la pureté du blocage intra-sujet est compromise. L’expérimentateur doit alors impérativement déployer des contre-mesures formelles, telles que le contrebalancement complet ou l’organisation séquentielle selon des structures en carrés latins équilibrés, afin de dissocier mathématiquement l’effet réel du traitement de l’ordre d’administration au sein du bloc individuel.
5. Exemple concret et détaillé : étude expérimentale en psychologie cognitive
5.1 Présentation du scénario expérimental et de l’hypothèse de recherche
Pour illustrer de manière limpide la mécanique opératoire et le gain mathématique conféré par le blocage, considérons une recherche menée au sein d’un laboratoire de psychologie cognitive consacrée à l’optimisation des performances mnésiques. Une équipe d’investigateurs souhaite comparer l’efficacité de deux techniques d’encodage distinctes destinées à faciliter la mémorisation d’un corpus lexical complexe :
- Méthode A (Imagerie mentale interactive) : les participants apprennent à générer une représentation visuelle dynamique reliant le signifiant du mot à un référent spatial richement détaillé.
- Méthode B (Génération sémantique élaborative) : les participants sont entraînés à insérer chaque mot cible dans une arborescence conceptuelle et hiérarchique préexistante.
La variable dépendante retenue est le nombre exact de mots correctement restitués lors d’une tâche de rappel libre différé de vingt minutes, portant sur une liste standardisée de 50 substantifs rares de la langue française. L’hypothèse scientifique sous-jacente postule une supériorité de l’une des techniques sur l’autre dans la rétention à court terme.
Toutefois, la littérature théorique en psychologie cognitive alerte l’équipe sur l’existence d’une variable parasite majeure : la capacité de mémoire de travail initiale des participants, couramment mesurée par l’empan mnésique complexe. On sait qu’un individu doté d’un empan mnésique exceptionnel obtiendra d’excellents scores de restitution indépendamment de la technique d’apprentissage qui lui est enseignée, tandis qu’un individu aux capacités exécutives limitées éprouvera des difficultés chroniques dans les deux cas. L’omission de cette caractéristique fondamentale menace d’introduire un bruit statistique massif dans l’analyse finale.
5.2 Identification de la variable parasite et constitution des blocs
Afin de prémunir l’expérience contre cette menace méthodologique, l’équipe décide de recourir à un plan en blocs complets randomisés (RCBD) en utilisant l’empan mnésique comme variable de blocage systématique. Pour mener l’expérience, un échantillon de 10 participants est recruté. Préalablement à toute exposition aux méthodes pédagogiques, chaque participant se voit administrer l’épreuve standardisée de lecture d’empans de Daneman et Carpenter (Reading Span Test), dont les scores s’échelonnent théoriquement de 1 à 6 unités d’information.
À l’issue de cette passation préliminaire, les scores individuels d’empan mnésique sont recueillis, et les 10 participants sont ordonnés rigoureusement du score le plus faible au score le plus élevé :
- Sujet 1 (empan : 2.1) et Sujet 2 (empan : 2.3)
- Sujet 3 (empan : 3.0) et Sujet 4 (empan : 3.1)
- Sujet 5 (empan : 3.8) et Sujet 6 (empan : 4.0)
- Sujet 7 (empan : 4.7) et Sujet 8 (empan : 4.9)
- Sujet 9 (empan : 5.6) et Sujet 10 (empan : 5.8)
L’expérimentateur rassemble ensuite ces participants en 5 blocs de paires homogènes : le Bloc 1 rassemble les sujets 1 et 2 (capacités mnésiques très faibles), le Bloc 2 regroupe les sujets 3 et 4 (capacités modérées-basses), le Bloc 3 associe les sujets 5 et 6 (capacités intermédiaires), le Bloc 4 réunit les sujets 7 et 8 (capacités modérées-hautes), et le Bloc 5 agrège les sujets 9 et 10 (capacités exceptionnelles). L’homogénéité intra-bloc vis-à-vis du facteur parasite est ainsi méthodiquement assurée.
5.3 Protocole d’assignation randomisée et collecte des données
La phase d’assignation expérimentale peut alors intervenir. Au sein de chaque paire de participants constituant un bloc, une procédure de randomisation simple à pile ou face (ou génération algorithmique) est menée pour déterminer quel sujet recevra la Méthode A. Le partenaire restant du bloc se voit automatiquement attribuer la Méthode B. Cette étape cruciale de randomisation intra-bloc élimine tout biais de sélection et garantit que les deux techniques d’apprentissage sont représentées de façon parfaitement équitable à chaque étage de la hiérarchie des capacités mnésiques initiales.
Tous les sujets effectuent ensuite leur phase d’encodage selon la méthode qui leur a été désignée, dans des conditions acoustiques et visuelles rigoureusement identiques, au sein d’une cabine insonorisée. Après un délai de rétention intercalaire standardisé de 20 minutes consacré à une tâche motrice neutre, chaque individu accomplit l’épreuve de rappel libre sur les 50 mots cibles. Les scores observés (nombre de mots rappelés) sont consignés ci-dessous :
- Bloc 1 (Empan ~2.2) : Méthode A = 18 mots | Méthode B = 14 mots
- Bloc 2 (Empan ~3.0) : Méthode A = 25 mots | Méthode B = 21 mots
- Bloc 3 (Empan ~3.9) : Méthode A = 32 mots | Méthode B = 28 mots
- Bloc 4 (Empan ~4.8) : Méthode A = 39 mots | Méthode B = 35 mots
- Bloc 5 (Empan ~5.7) : Méthode A = 46 mots | Méthode B = 42 mots
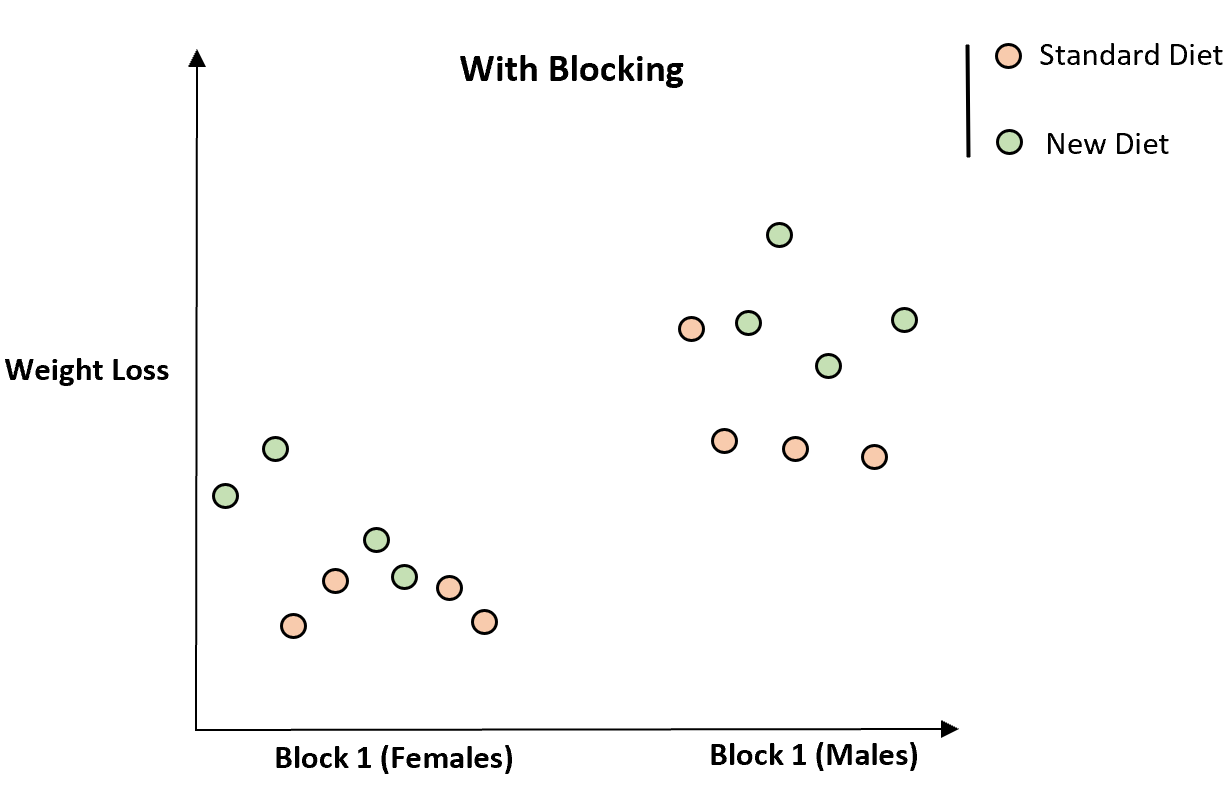
5.4 Comparaison chiffrée : analyse avec et sans blocage
L’examen des données brutes révèle une régularité frappante : au sein de chaque paire, sans exception, la Méthode A permet de restituer exactement 4 mots de plus que la Méthode B ($18 – 14 = 4$, $25 – 21 = 4$, etc.). La supériorité absolue de la Méthode A est constante, s’élevant à 4 unités lexicales. Les moyennes globales des deux groupes s’établissent à :
$$\bar{Y}_A = \frac{18 + 25 + 32 + 39 + 46}{5} = \frac{160}{5} = 32{,}0$$
$$\bar{Y}_B = \frac{14 + 21 + 28 + 35 + 42}{5} = \frac{140}{5} = 28{,}0$$
La moyenne générale est $\bar{Y}_{..} = 30{,}0$. Calculons la somme des carrés totale ($SS_{Total}$) et celle du traitement ($SS_{Traitement}$) :
$$SS_{Traitement} = 5 \times (32{,}0 – 30{,}0)^2 + 5 \times (28{,}0 – 30{,}0)^2 = 5 \times 4 + 5 \times 4 = 40{,}0$$
$$SS_{Total} = (18-30)^2 + (14-30)^2 + (25-30)^2 + dots + (46-30)^2 + (42-30)^2 = 144 + 256 + 25 + 81 + 4 + 4 + 81 + 25 + 256 + 144 = 1020{,}0$$
Scénario 1 : Analyse sans blocage (Plan complètement randomisé univarié). Dans cette configuration naïve, l’expérimentateur ignore l’empan mnésique et agrège la variance dans l’erreur commune :
$$SS_{Erreur} = SS_{Total} – SS_{Traitement} = 1020{,}0 – 40{,}0 = 980{,}0$$
Les degrés de liberté sont $df_{Traitement} = 2 – 1 = 1$ et $df_{Erreur} = 10 – 2 = 8$. Le carré moyen de l’erreur s’élève à :
$$MS_{Erreur} = \frac{980{,}0}{8} = 122{,}5$$
La statistique $F$ observée devient :
$$F = \frac{MS_{Traitement}}{MS_{Erreur}} = \frac{40{,}0}{122{,}5} \approx 0{,}327$$
Avec $F(1, 8) = 0{,}327$, la p-valeur associée est de $p = 0{,}583$. L’hypothèse nulle ne peut absolument pas être rejetée. Le chercheur conclurait à tort que la Méthode A n’apporte aucun avantage significatif sur la Méthode B, commettant une dramatique erreur de type II causée par la dispersion massive des scores induite par les empans mnésiques disparates.
Scénario 2 : Analyse avec blocage (Plan en blocs complets randomisés). Calculons désormais la part de variance imputable aux différences inter-blocs ($SS_{Bloc}$). Les moyennes des 5 blocs sont respectivement de 16, 23, 30, 37 et 44 mots. Chaque bloc comptant 2 observations :
$$SS_{Bloc} = 2 \times [(16-30)^2 + (23-30)^2 + (30-30)^2 + (37-30)^2 + (44-30)^2]$$
$$SS_{Bloc} = 2 \times [196 + 49 + 0 + 49 + 196] = 2 \times 490 = 980{,}0$$
La décomposition nous donne alors la somme des carrés résiduelle révisée :
$$SS_{Residuelle} = SS_{Total} – SS_{Traitement} – SS_{Bloc} = 1020{,}0 – 40{,}0 – 980{,}0 = 0{,}0$$
Les degrés de liberté se scindent en : $df_{Traitement} = 1$, $df_{Bloc} = 5 – 1 = 4$, et $df_{Residuelle} = (2-1)(5-1) = 4$. L’intégralité de l’erreur initiale (980,0) a été reconnue comme découlant de la variable de blocage. Dans cet exemple théorique pur, la variance résiduelle devient nulle, conduisant à une valeur de $F$ tendant vers l’infini et une p-valeur infiniment inférieure à 0,001. La supériorité de la Méthode A apparaît désormais avec une netteté mathématique éclatante. Ce transfert spectaculaire de variance résiduelle vers le terme de bloc démontre la puissance salvatrice du contrôle local.
6. Exemple appliqué en psychologie de la santé : nutrition, stress et genre
6.1 Contexte clinique : évaluation d’un protocole diététique sur la perte de poids
Déplaçons à présent notre champ d’investigation vers la psychologie de la santé et la médecine comportementale, à travers une étude clinique évaluant l’efficacité d’un nouveau protocole diététique synchronisé avec les rythmes endocriniens de l’axe hypothalamo-hypophyso-surrénalien (axe du stress). Le protocole novateur, nommé Chronobiotic Stress Diet (CSD), module les apports glucidiques et lipidiques selon les pics de sécrétion de cortisol au cours de la journée, afin d’optimiser l’oxydation des acides gras et de réduire le grignotage émotionnel. Il est confronté à un protocole témoin standardisé basé sur une restriction calorique classique équilibrée.
La variable indépendante est donc le type d’intervention nutritionnelle (Régime CSD versus Régime Témoin). La variable dépendante clinique principale est la perte nette de masse corporelle (exprimée en kilogrammes) mesurée avec une balance à impédancemétrie médicale au terme d’un suivi strict de 12 semaines en ambulatoire. L’hypothèse des cliniciens postule que la régulation de la charge allostatique via le régime CSD induira une déplétion pondérale significativement plus prononcée que la simple réduction calorique.
6.2 Le genre biologique comme variable de blocage systématique
Dès l’élaboration du protocole, le comité scientifique identifie une variable de perturbation physiologique majeure : le genre biologique des participants. Il est médicalement attesté que les hommes et les femmes présentent des disparités structurelles profondes en matière de métabolisme basal, de répartition du tissu adipeux (androïde versus gynoïde), de composition corporelle moyenne (masse musculaire squelettique supérieure chez l’homme favorisant une dépense énergétique plus forte au repos) et de réponses hormonales aux stresseurs métaboliques.
Dans un essai clinique appliquant une randomisation pure non stratifiée sur un effectif de 40 patients, le hasard pourrait aisément allouer 14 hommes et 6 femmes au régime CSD, et inversement 6 hommes et 14 femmes au régime témoin. Dans une telle éventualité, une perte de poids supérieure observée dans le bras CSD serait hautement équivoque : résulterait-elle des vertus biochimiques du régime novateur ou de la surreprésentation masculine au sein de ce groupe, les hommes perdant physiologiquement du poids à un rythme plus rapide lors d’un rééquilibrage alimentaire ? Pour dissoudre ce risque de confusion, le genre biologique est formellement institué comme variable de blocage binaire.
6.3 Procédure de randomisation intra-bloc (hommes vs femmes)
L’application du blocage se traduit opérationnellement par la constitution de deux cohortes d’inclusion étanches : la strate masculine et la strate féminine. Au fur et à mesure du recrutement des volontaires répondant aux critères d’admissibilité clinique, ceux-ci sont dirigés vers leur bloc respectif jusqu’à atteindre les quotas prédéfinis de 20 hommes et 20 femmes.
Au sein de la cohorte masculine, une randomisation par blocs permutés de taille 4 ou 2 est exécutée afin de distribuer 10 hommes vers le régime CSD et 10 hommes vers le régime témoin. De manière rigoureusement identique et indépendante, au sein de la cohorte féminine, 10 femmes sont assignées au régime CSD et 10 femmes au régime témoin. Ce dispositif garantit une parité absolue et intangible : le ratio homme/femme est strictement fixé à 1:1 au sein de chacune des deux modalités de traitement, neutralisant définitivement toute asymétrie de composition corporelle basale entre les bras de l’essai.
6.4 Interprétation des résultats et gain d’efficacité statistique
Au terme des 12 semaines d’intervention, les données de perte de poids sont recueillies et soumises à une analyse de variance intégrant le facteur de blocage « Genre » en sus du facteur expérimental « Régime ». L’estimation statistique met en évidence une perte de poids moyenne supérieure d’environ 3,2 kg en faveur du régime CSD. Grâce à la structuration par blocs, l’effet massif du genre sur la dépense énergétique basale — les hommes ayant perdu en moyenne 4,5 kg de plus que les femmes sur l’ensemble de l’étude — est absorbé par la ligne de variance dévolue au facteur bloc.
Cette purge mathématique a pour effet d’abaisser considérablement l’erreur standard de la différence des moyennes. Le chercheur accède à une évaluation pure de l’effet spécifique du traitement, libérée du parasitisme endocrinien lié au sexe. Sur le plan de la santé publique, l’intervention gagne une crédibilité translationnelle majeure : ayant démontré son efficacité au sein d’une structure équilibrée par genre, le protocole peut être recommandé en toute confiance aux deux populations sans craindre un biais d’extrapolation.
7. Formulation mathématique et modèle linéaire du plan en blocs
7.1 L’équation du modèle linéaire pour un plan en blocs complets randomisés
L’analyse statistique formelle d’un plan en blocs complets randomisés s’enracine dans la théorie des modèles linéaires généraux. Soit un protocole comportant $a$ modalités d’un traitement principal et $b$ blocs constitués. Chaque observation individuelle $Y_{ij}$ (représentant la mesure obtenue pour la $i$-ème modalité du traitement au sein du $j$-ème bloc) peut être modélisée par l’équation linéaire additive suivante :
$$Y_{ij} = \mu + \alpha_i + \beta_j + \varepsilon_{ij}$$
où les paramètres de l’équation se définissent avec précision :
- $\mu$ symbolise la moyenne générale non pondérée de la variable réponse dans la population cible.
- $\alpha_i$ représente l’effet fixe de la $i$-ème modalité du traitement expérimental ($i = 1, dots, a$), soumis à la contrainte de centrage usuelle $\sum_{i=1}^{a} \alpha_i = 0$.
- $\beta_j$ quantifie l’effet propre du $j$-ème bloc constitué ($j = 1, dots, b$). Selon les intentions de l’expérimentateur, cet effet peut être considéré comme fixe (si l’on s’intéresse spécifiquement aux blocs testés, avec la contrainte $\sum_{j=1}^{b} \beta_j = 0$) ou comme aléatoire (si les blocs représentent un tirage au sort parmi une population de blocs possibles, avec $\beta_j \sim \mathcal{N}(0, \sigma^2_{\beta})$).
- $\varepsilon_{ij}$ désigne le terme d’erreur stochastique ou perturbation résiduelle associée à la cellule $(i, j)$.
Les postulats statistiques classiques stipulent que les termes d’erreur résiduelle $\varepsilon_{ij}$ sont indépendants et identiquement distribués selon une loi normale d’espérance nulle et de variance constante et homogène : $\varepsilon_{ij} \overset{iid}{\sim} \mathcal{N}(0, \sigma^2)$.
7.2 Décomposition de la variance totale : partition des sommes de carrés
La résolution de ce modèle par la méthode des moindres carrés ordinaires aboutit à une partition fondamentale de la somme totale des carrés des écarts ($SS_{Total}$). Définissons préalablement les quantités d’intérêt en notant $\bar{Y}_{..}$ la moyenne générale empirique, $\bar{Y}_{i.}$ la moyenne observée pour le traitement $i$, et $\bar{Y}_{.j}$ la moyenne observée au sein du bloc $j$ :
$$SS_{Total} = \sum_{i=1}^{a}\sum_{j=1}^{b} (Y_{ij} – \bar{Y}_{..})^2$$
Cette somme totale se scinde en trois sommes de carrés orthogonales :
$$SS_{Total} = SS_{Traitement} + SS_{Bloc} + SS_{Residuelle}$$
Les expressions algébriques de ces différentes composantes sont établies comme suit :
$$SS_{Traitement} = b \sum_{i=1}^{a} (\bar{Y}_{i.} – \bar{Y}_{..})^2$$
$$SS_{Bloc} = a \sum_{j=1}^{b} (\bar{Y}_{.j} – \bar{Y}_{..})^2$$
$$SS_{Residuelle} = \sum_{i=1}^{a}\sum_{j=1}^{b} (Y_{ij} – \bar{Y}_{i.} – \bar{Y}_{.j} + \bar{Y}_{..})^2$$
La décomposition des degrés de liberté associés obéit à la même logique additive fondamentale :
$$df_{Total} = ab – 1 = (a – 1) + (b – 1) + (a – 1)(b – 1)$$
Le carré moyen de chaque source de variation est alors calculé en divisant la somme des carrés par son degré de liberté correspondant. Le carré moyen résiduel révisé devient :
$$MS_{Residuelle} = \frac{SS_{Residuelle}}{(a – 1)(b – 1)}$$
L’inférence statistique concernant l’effet principal du traitement s’opère en confrontant ce carré moyen résiduel au carré moyen du traitement au sein de la statistique :
$$F_{Traitement} = \frac{MS_{Traitement}}{MS_{Residuelle}} = \frac{\frac{SS_{Traitement}}{a – 1}}{\frac{SS_{Residuelle}}{(a – 1)(b – 1)}}$$
Cette statistique suit, sous l’hypothèse nulle d’absence d’effet du traitement ($H_0 : \alpha_1 = dots = \alpha_a = 0$), une distribution de Fisher-Snedecor à $(a – 1)$ et $(a – 1)(b – 1)$ degrés de liberté.
7.3 Hypothèses sous-jacentes du modèle
La validité mathématique rigoureuse des conclusions déduites d’un plan en blocs complets randomisés repose sur le respect de plusieurs hypothèses fondamentales que l’analyste se doit de contrôler impérativement :
- L’hypothèse d’additivité stricte : Le modèle classique postule que l’effet du traitement et l’effet du bloc s’additionnent de manière purement linéaire sans interagir. En d’autres termes, l’écart de performance entre les traitements $A$ et $B$ doit rester conceptuellement identique quel que soit le bloc envisagé. S’il existe une interaction entre le traitement et le bloc, le terme d’interaction se retrouve mathématiquement confondu avec l’erreur résiduelle, ce qui biaise l’estimation de cette dernière.
- L’homogénéité des variances (homoscédasticité) : La variance résiduelle $\sigma^2$ doit être invariable à travers l’ensemble des niveaux de bloc et l’ensemble des conditions de traitement. Si les scores sont hautement volatils au sein d’un bloc particulier mais extrêmement homogènes au sein des autres, l’exactitude des p-valeurs calculées par la loi de Fisher est compromise.
- La normalité résiduelle : Les résidus $\varepsilon_{ij}$ doivent suivre une distribution gaussienne. Bien que le test $F$ soit réputé robuste à de légers écarts à la normalité en vertu du théorème central limite, des asymétries prononcées ou la présence de queues de distribution épaisses imposent des corrections analytiques.
- L’indépendance des observations : Les résidus doivent être stochastiquement indépendants. Cette indépendance conditionnelle est garantie physiquement par la randomisation opérée au sein de chaque bloc.
7.4 Le test de non-additivité de Tukey et gestion des interactions bloc-traitement
Dans un plan en blocs complets randomisés standard comportant une unique observation par cellule $(i, j)$, il est mathématiquement impossible d’estimer directement un terme d’interaction classique $(\alpha\beta)_{ij}$ en sus de l’erreur résiduelle, car les degrés de liberté résiduels deviendraient rigoureusement nuls. Pour surmonter cette limitation, le statisticien John Tukey a élaboré un test remarquable : le test de non-additivité à un degré de liberté de Tukey.
Ce test isole une fraction de la somme des carrés résiduelle pour tester la présence d’une composante d’interaction multiplicative spécifique proportionnelle au produit des effets principaux : $(\alpha\beta)_{ij} propto \alpha_i \beta_j$. Si le test de Tukey révèle une non-additivité statistiquement significative, le modèle additif initial est formellement invalidé. Cela indique que la magnitude (voire la direction) de l’effet thérapeutique varie selon les caractéristiques des blocs constitués.
Face à une telle violation, le chercheur dispose de deux options méthodologiques majeures :
- La transformation de variable : Très souvent, la non-additivité découle d’une mauvaise échelle de mesure sous-jacente (par exemple une relation multiplicative naturelle entre variables). L’application d’une transformation logarithmique, d’une racine carrée ou d’une transformation de puissance de Box-Cox sur la variable réponse peut restaurer l’additivité stricte et stabiliser les variances.
- Le basculement vers un plan factoriel explicite : Si l’hétérogénéité d’effet reflète un mécanisme théorique substantiel (par exemple, le traitement fonctionne magnifiquement chez les jeunes mais échoue chez les aînés), la variable de blocage perd son statut d’artifice technique pour devenir un véritable facteur explicatif modérateur. L’expérience doit alors être réanalysée ou reconçue sous la forme d’un plan factoriel complet avec répétitions par cellule pour explorer formellement les interactions.
8. Comparaison critique : blocage, randomisation simple et contrôle par covariance (ANCOVA)
8.1 Randomisation complète versus randomisation par blocs
La décision architecturale entre un plan complètement randomisé (CRD) et un plan en blocs randomisés (RCBD) dépend intimement de l’équilibre entre la taille de l’échantillon mobilisé et la force de l’association reliant la variable parasite à la variable réponse. Le plan complètement randomisé présente l’indéniable avantage de la simplicité logistique absolue : aucune mesure préalable n’est requise, aucun tri d’individus n’est nécessaire, et l’allocation des traitements s’exécute d’une seule traite pour l’ensemble des participants.
Cependant, le CRD présente une vulnérabilité critique face aux échantillons d’effectif restreint ou intermédiaire. En deçà d’une centaine de sujets, le tirage au sort simple engendre très régulièrement des déséquilibres fortuits substantiels entre les groupes expérimentaux sur des variables clés telles que l’âge, l’indice de masse corporelle ou les scores cliniques basaux. De plus, les effectifs au sein de chaque condition expérimentale peuvent diverger significativement si l’on ne recourt pas à une allocation par blocs de randomisation. Le blocage supprime définitivement ces aléas en verrouillant l’équilibre des variables explicatives parasites dès l’amont de l’expérience.
8.2 Blocage a priori versus contrôle statistique a posteriori (ANCOVA)
Dans l’arsenal du statisticien, le blocage partage un objectif fondamental avec l’analyse de covariance (ANCOVA) : éliminer la variance attribuable à une variable continue parasite pour accroître la puissance d’estimation du traitement principal. Toutefois, leurs philosophies opérationnelles diffèrent profondément.
L’ANCOVA recueille la covariable sur une échelle métrique continue et modélise mathématiquement sa relation avec la variable réponse au moyen d’une régression linéaire menée conjointement à la séparation des moyennes. L’ANCOVA évite d’avoir à catégoriser une variable continue en blocs discrets (opération qui détruit inévitablement une infime fraction d’information métrique). En contrepartie, l’ANCOVA repose sur des hypothèses de modélisation extrêmement restrictives, en particulier le postulat d’homogénéité des pentes de régression (la relation entre la covariable et la réponse doit être strictement identique au sein de chaque groupe de traitement) et le postulat de linéarité pure.
Le blocage se montre nettement plus robuste et polyvalent :
- Il s’applique sans effort aux variables parasites qualitatives nominales ou ordinales (genre, stade de la maladie, centre hospitalier, statut tabagique) pour lesquelles l’ANCOVA classique n’est pas adaptée.
- Il tolère des relations non linéaires arbitraires entre la variable de blocage et la variable dépendante au sein de l’espace expérimental.
- Il préserve l’équilibre parfait de l’expérience sur le plan logistique. Une pratique particulièrement féconde consiste d’ailleurs à combiner les deux méthodes : structurer l’expérience par blocs sur un facteur nominal majeur, puis ajuster par une ANCOVA sur une covariable continue secondaire.
8.3 Compromis entre degrés de liberté résiduels et réduction de variance
Le choix méthodologique d’introduire un facteur de blocage ne constitue pas un gain automatique sans contrepartie : il s’agit d’un arbitrage statistique entre réduction de la variance résiduelle et consommation de degrés de liberté. Chaque fois que l’on introduit $b$ blocs dans une analyse, on soustrait exactement $(b – 1)$ degrés de liberté à l’erreur résiduelle pour les transférer au facteur de bloc.
Cette soustraction a un coût. Lorsque les degrés de liberté résiduels diminuent, la valeur critique du seuil $F$ dans les tables statistiques augmente (le seuil de rejet devient plus exigeant), ce qui tend à réduire la puissance statistique du test. Pour que le blocage soit statistiquement « rentable », la réduction proportionnelle de la somme des carrés de l’erreur ($SS_{Residuelle}$) doit surpasser la perte relative des degrés de liberté résiduels.
Si un expérimentateur constitue des blocs sur la base d’une variable qui s’avère au final n’avoir aucune corrélation avec la réponse étudiée ($SS_{Bloc} \approx 0$), le carré moyen résiduel va en réalité augmenter car le numérateur reste inchangé tandis que le dénominateur des degrés de liberté diminue ! Dans ce scénario de sur-blocage stérile, le chercheur affaiblit paradoxalement la sensibilité de son expérience par rapport à une randomisation simple. Il est donc impératif de ne bloquer que sur des variables dont l’influence prédictive est solidement étayée par la théorie ou des données pilotes probantes.
9. Critères de choix et sélection adéquate d’une variable de blocage
9.1 Corrélation attendue entre la variable de blocage et la variable dépendante
Le premier critère directeur pour élire une variable au rang de facteur de blocage réside dans l’intensité de sa liaison empirique avec la variable réponse finale. Sur le plan statistique, le gain d’efficacité relative d’un plan en blocs complets par rapport à un plan aléatoire simple est approximativement une fonction croissante du coefficient de corrélation linéaire ($r$) unissant la variable de nuisance au critère d’évaluation mesuré.
Une règle empirique bien établie en méthodologie expérimentale préconise que la corrélation attendue entre la variable candidate au blocage et la réponse dépasse un seuil minimal de $|r| ge 0{,}30$ à $0{,}40$ pour que le bénéfice d’extraction de variance compense largement le coût de prélèvement des degrés de liberté. Lorsque la corrélation atteint des valeurs très élevées ($r ge 0{,}70$), comme c’est classiquement le cas lors de la réutilisation d’un pré-test de la même tâche cognitive ou d’une échelle psychométrique identique, le blocage produit des gains de puissance spectaculaires, divisant parfois la variance d’erreur par un facteur de trois ou quatre.
La sélection doit impérativement s’appuyer sur des fondements théoriques rigoureux, des méta-analyses publiées ou des études de calibration préliminaires. Tenter de bloquer sur une variable purement anecdotique sans substrat mécanistique connu expose la recherche à une dégradation inutile de sa précision.
9.2 Éviter le sur-blocage et la multicolinéarité
Un écueil classique guettant le méthodologiste enthousiaste est la tentation du sur-blocage (over-blocking), consistant à multiplier déraisonnablement les critères d’homogénéisation simultanés. Si un chercheur tente de former des blocs d’individus partageant à la fois le même âge, le même genre, le même indice de masse corporelle, le même niveau d’études et le même chronotype, il se heurte immédiatement à une implosion logistique ingérable : l’explosion combinatoire des cellules rend le recrutement de participants parfaitement appariés quasiment impossible dans un cadre temporel et financier raisonnable.
De plus, l’introduction de multiples variables de blocage fortement corrélées entre elles induit une redondance informationnelle (multicolinéarité) totalement contre-productive. Bloquer conjointement sur le niveau d’études mesuré en années et sur le vocabulaire passif n’apporte que des gains marginaux dérisoires par rapport à l’utilisation d’une seule de ces deux variables, tout en diluant massivement les degrés de liberté résiduels. Le principe de parcimonie (le rasoir d’Ockham) doit prévaloir : il convient de retenir un facteur de blocage unique, robuste et prépondérant, ou au maximum deux facteurs orthogonaux fondamentaux.
9.3 Variables démographiques, cognitives et physiologiques courantes en psychologie
Dans l’expérimentation humaine, plusieurs classes de variables constituent des candidats récurrents pour la formation de blocs expérimentaux hautement efficients :
- Variables cognitives basales : Les scores obtenus à des tests de raisonnement fluide (matrices progressives de Raven), à des épreuves de vitesse perceptuelle (test des codes) ou à des mesures de réserve cognitive générale permettent d’homogénéiser puissamment les panels de sujets lors de l’évaluation de protocoles d’apprentissage, de mémorisation ou de décision managériale.
- Paramètres physiologiques stables : La variabilité de la fréquence cardiaque au repos (VFC), le taux de cortisol salivaire matinal au réveil, ou la pression artérielle basale constituent d’excellentes variables de blocage dans les recherches explorant le stress aigu, la réactivité émotionnelle ou l’effort cognitif intense.
- Indicateurs d’exposition et d’expertise : L’ancienneté professionnelle dans un poste, le nombre d’heures de pratique d’un instrument de musique, ou le bilinguisme précoce représentent des facteurs d’hétérogénéité majeurs qui méritent d’être isolés en blocs dès lors que la tâche expérimentale sollicite les compétences sous-jacentes correspondantes.
- Scores de pré-test psychopathologiques : Dans les essais cliniques en psychothérapie, les scores initiaux aux inventaires de dépression (BDI-II) ou d’anxiété (STAI) constituent les variables de blocage par excellence pour évaluer l’efficacité différentielle d’une intervention thérapeutique.
10. Mise en œuvre pratique et analyse statistique avec R et Python
10.1 Structuration des données et vérification des prérequis
L’analyse informatique rigoureuse d’un plan en blocs complets randomisés impose une organisation impeccable de la matrice de données. Les logiciels de traitement statistique contemporains exigent quasi unaniment un agencement au format long (tidy data). Dans ce format, chaque ligne individuelle du tableau représente une mesure unique recueillie sur une unité expérimentale, et le fichier comporte au minimum trois colonnes fondamentales :
- Une colonne identifiant l’unité de blocage (par exemple :
Bloc_ID, codé sous forme de variable catégorielle ou facteur). - Une colonne spécifiant la modalité du traitement assigné (par exemple :
Traitement, facteur à $a$ niveaux). - Une colonne numérique recueillant la mesure de la variable dépendante (par exemple :
Score_Reponse).
Préalablement à toute modélisation inférentielle, une phase d’exploration visuelle est indispensable. Le chercheur procédera au tracé de graphiques en boîtes à moustaches (boxplots) ou de graphiques de profils d’interaction reliant les moyennes de chaque traitement d’un bloc à l’autre. Cette inspection permet de détecter d’éventuelles valeurs aberrantes (outliers) qui pourraient exercer un levier disproportionné sur l’estimation de l’effet d’un bloc singulier, et de vérifier visuellement le parallélisme approximatif des profils, signe annonciateur du respect de l’hypothèse d’additivité.
10.2 Analyse d’un RCBD dans l’environnement R
Le langage R fournit un écosystème natif d’une élégance remarquable pour traiter les plans en blocs. En utilisant le moteur d’analyse de variance standard, le modèle s’exprime au moyen de la syntaxe de formule usuelle :
modele_rcbd <- aov(Score_Reponse ~ Traitement + Bloc_ID, data = donnees_exp)
L’exécution de la commande summary(modele_rcbd) produit le tableau d’ANOVA classique détaillant la somme des carrés, les degrés de liberté, les carrés moyens, les valeurs $F$ et les probabilités critiques associées pour le facteur Traitement ainsi que pour le facteur Bloc. Il importe de veiller à ce que la variable Bloc_ID soit explicitement définie comme un facteur au moyen de la fonction as.factor(), sous peine de voir R la traiter par défaut comme une variable numérique continue dans une régression linéaire standard.
Pour aller plus loin et considérer les blocs comme un facteur purement aléatoire représentatif d’une population de strates plus vaste, le recours au paquet lme4 s’avère particulièrement pertinent via la syntaxe de modèle mixte :
library(lme4)
modele_mixte <- lmer(Score_Reponse ~ Traitement + (1 | Bloc_ID), data = donnees_exp)
anova(modele_mixte)
Cette approche permet d’estimer directement la composante de variance $\sigma^2_{Bloc}$ et de calculer l’efficacité relative ($RE$) du plan de blocage par rapport à un plan aléatoire simple au moyen de la formulation canonique de Cochran et Cox :
$$RE = \frac{MS_{Bloc} + (a – 1) MS_{Residuelle}}{a \times MS_{Residuelle}}$$
Une efficacité relative de 1,75 indique par exemple qu’il aurait fallu recruter 75 % d’unités expérimentales supplémentaires au sein d’un plan complètement randomisé classique pour obtenir la même précision d’estimation que celle atteinte grâce au blocage.
10.3 Implémentation en Python avec statsmodels et scikit-learn
Dans l’écosystème Python, les bibliothèques pandas, statsmodels et scikit-learn permettent de conduire l’intégralité du pipeline méthodologique, de la constitution des strates jusqu’à l’inférence paramétrique finale. Pour la phase amont de randomisation stratifiée, le module scikit-learn propose des classes utilitaires telles que StratifiedKFold ou des partitions stratifiées via train_test_split afin d’équilibrer rigoureusement les variables de blocage.
Une fois les données collectées et stockées dans un DataFrame pandas, l’ajustement du modèle linéaire s’effectue via l’interface de formule de statsmodels.formula.api :
import statsmodels.formula.api as smf
import statsmodels.api as sm
# Ajustement du modèle additif des moindres carrés
model = smf.ols('Score_Reponse ~ C(Traitement) + C(Bloc_ID)', data=df).fit()
anova_table = sm.stats.anova_lm(model, typ=2)
print(anova_table)
L’argument typ=2 ou typ=3 permet de calculer les sommes de carrés partielles, garantissant une estimation rigoureuse même en présence de légers déséquilibres d’effectifs consécutifs à des données manquantes. Pour la restitution visuelle des résultats, la bibliothèque seaborn permet de tracer des diagrammes en lignes de profils désagrégés par bloc via sns.pointplot(x='Traitement', y='Score_Reponse', hue='Bloc_ID', data=df), matérialisant immédiatement l’homogénéité des réactions comportementales au sein de chaque strate.
10.4 Diagnostic des résidus et vérification de l’additivité
L’inférence statistique ne saurait être validée sans un diagnostic méticuleux des résidus générés par le modèle linéaire ajusté. Ce diagnostic repose sur deux analyses graphiques incontournables :
- Le graphique des résidus contre les valeurs ajustées (Residuals vs Fitted) : Les résidus doivent se distribuer de manière purement aléatoire sous la forme d’un nuage de points horizontal sans motif distinctif. La présence d’une structure en entonnoir (hétéroscédasticité) signale que la variabilité résiduelle n’est pas constante entre les blocs. La présence d’une courbure parabolique manifeste une violation de l’hypothèse d’additivité.
- Le diagramme quantile-quantile normal (Q-Q Plot) : Les résidus standardisés sont ordonnés et confrontés aux quantiles théoriques d’une loi normale univariée. L’alignement étroit des observations le long de la bissectrice confirme l’adhésion au postulat de normalité gaussienne.
En complément des outils graphiques, l’exécution automatisée du test de non-additivité de Tukey s’impose. En R, ce test est directement accessible via la fonction tukey.add.test() du paquet asbio. Si la p-valeur de ce test demeure strictement supérieure au seuil usuel de 0,05, l’expérimentateur peut conclure en toute sérénité à l’absence d’interaction bloc-traitement et entériner la validité de son analyse de variance classique.
11. Erreurs courantes, limites et controverses autour du blocage
11.1 Perte préjudiciable de degrés de liberté en petits échantillons
L’une des erreurs d’appréciation les plus dommageables en ingénierie expérimentale consiste à implémenter un découpage en blocs excessif sur des cohortes d’échantillons très restreintes. Considérons une étude pilote explorant 3 traitements sur un total de seulement 6 participants. Si le chercheur décide de scinder cet échantillon en 2 blocs de 3 sujets, les degrés de liberté associés à l’erreur résiduelle s’établissent à :
$$df_{Residuelle} = (a – 1)(b – 1) = (3 – 1)(2 – 1) = 2 \times 1 = 2$$
Avec seulement deux degrés de liberté au dénominateur du ratio de Fisher, la valeur seuil critique nécessaire pour atteindre le seuil de significativité au niveau $\alpha = 0{,}05$ s’envole à $F_{critique}(2, 2) = 19{,}00$. À titre de comparaison, dans un plan complètement randomisé sans blocage utilisant ces mêmes 6 sujets, les degrés de liberté résiduels s’élèvent à $N – a = 6 – 3 = 3$, pour lequel $F_{critique}(2, 3) = 9{,}55$.
Dans cette configuration critique, si la variable de blocage ne capture qu’une part modeste de la variance, la pénalité mathématique imposée par la perte de degrés de liberté pulvérise littéralement la puissance statistique du test. Une règle de prudence méthodologique stipule qu’un plan en blocs ne devrait jamais être entrepris si les degrés de liberté résiduels finaux s’avèrent inférieurs à un plancher minimal de 10 à 12 unités, sous peine de fragiliser drastiquement l’inférence statistique.
11.2 Ignorance ou mauvaise interprétation des interactions traitement-bloc
L’écueil théorique le plus sournois réside dans l’acceptation aveugle de l’hypothèse d’additivité sans vérification empirique. Dans les sciences comportementales, l’effet d’une intervention n’est presque jamais universel à travers l’ensemble des profils humains. Supposons qu’un traitement pharmacologique stimulant la mémoire s’avère hautement bénéfique pour les individus appartenant aux blocs à faible capacité cognitive de départ, mais devienne délétère (par hyper-stimulation anxiogène) pour les individus appartenant aux blocs disposant déjà d’excellentes capacités initiales.
Si l’analyste persiste à appliquer un modèle de RCBD purement additif sans tester l’interaction, les effets antagonistes vont se neutraliser mutuellement lors du calcul de la moyenne générale du traitement ($\bar{Y}_{i.}$), faisant conclure à l’inefficacité globale de la molécule. Simultanément, la composante interactive non modélisée vient s’injecter directement dans la somme des carrés résiduelle, gonflant le dénominateur du test. L’expérimentateur passe ainsi à côté d’un effet thérapeutique majeur spécifique à un sous-groupe clinique, par simple dogmatisme méthodologique. Dès que l’hétérogénéité des effets thérapeutiques est suspectée, le blocage instrumental doit impérativement céder le pas à une analyse factorielle d’interaction formelle.
11.3 Données manquantes et rupture de l’orthogonalité des blocs
L’orthogonalité parfaite et la simplicité calculatoire des plans en blocs complets constituent leur plus grande force, mais aussi leur talon d’Achille logistique. Dans les études longitudinales impliquant des humains ou des animaux, les phénomènes d’attrition — tels que l’abandon d’un sujet en cours de protocole, un incident technique lors d’une mesure ou le décès prématuré d’un animal de laboratoire — surviennent inéluctablement.
Dès lors qu’une seule cellule $(i, j)$ devient vide au sein d’un bloc, la structure d’équilibre s’effondre. Le plan devient non orthogonal : les effets du traitement et du bloc se retrouvent partiellement enchevêtrés. Dans l’analyse de variance classique, les différentes méthodes de décomposition des sommes de carrés (Type I, Type II, Type III) cessent de concorder et produisent des résultats divergents. Bien qu’il existât autrefois des formules de remplacement de données manquantes par moindres carrés (procédure de Yates), le standard méthodologique moderne impose de basculer sans réserve vers les modèles linéaires mixtes résolus par le maximum de vraisemblance restreint (REML). Les modèles mixtes accommodent avec une remarquable fluidité les déséquilibres d’effectifs et les données manquantes sous le postulat d’une attrition aléatoire (Missing at Random, MAR).
11.4 Utilisation abusive de variables post-traitement comme variables de blocage
Une faute méthodologique éliminatoire — hélas encore documentée dans certaines publications scientifiques — consiste à sélectionner comme variable de blocage une caractéristique mesurée chronologiquement après le début de l’administration du traitement expérimental. La règle épistémologique est pourtant catégorique et intangible : une variable de blocage doit impérativement être mesurée ou constatée préalablement à toute exposition aux conditions expérimentales.
Si la variable utilisée pour constituer les blocs est mesurée après coup, elle risque d’avoir été elle-même altérée ou médiatisée par le traitement administré. Bloquer sur une variable post-traitement revient à « sur-ajuster » le modèle en lui soustrayant une partie du mécanisme causal même par lequel le traitement agit sur la réponse finale. Cette violation directe de la temporalité causale anéantit la validité interne du protocole et conduit invariablement à une sous-estimation systématique (voire à un effacement artificiel complet) de l’efficacité thérapeutique véritable de l’intervention.
12. Bonnes pratiques méthodologiques et recommandations pour la recherche contemporaine
12.1 Pré-enregistrement des protocoles de blocage en psychologie
Dans le contexte actuel de la crise de la réplicabilité qui traverse les sciences psychologiques et biomédicales, le recours au pré-enregistrement des protocoles sur des plateformes institutionnelles certifiées telles que l’Open Science Framework (OSF) ou AsPredicted s’impose désormais comme une exigence incontournable. Le blocage statistique, bien que vertueux par nature, peut en effet devenir un instrument de manipulation opportuniste (p-hacking) s’il n’est pas strictement encadré en amont de la récolte des données.
Un chercheur peu scrupuleux pourrait être tenté d’essayer successivement plusieurs critères de blocage post-hoc (bloquer sur l’âge, puis sur le genre, puis sur le score de stress) jusqu’à trouver artificiellement la combinaison produisant par hasard une p-valeur inférieure au seuil de 0,05. Pour conférer une crédibilité scientifique irréprochable à ses travaux, l’expérimentateur doit consigner explicitement dans son pré-enregistrement :
- L’identité théorique précise de la variable retenue pour le blocage et la justification documentaire de sa forte corrélation avec la réponse.
- L’algorithme exact de partitionnement utilisé pour constituer les strates d’homogénéité.
- La formule mathématique du modèle linéaire qui sera ajusté lors du dépouillement statistique des résultats.
- Le seuil de décision et la procédure de détection des non-additivités prévus au protocole.
12.2 Rapportage transparent des plans en blocs selon les normes APA
La restitution éditoriale des recherches conduites sous plan en blocs doit s’aligner sur les directives méthodologiques internationales les plus strictes, notamment les normes de publication de l’American Psychological Association (APA 7th edition) et les critères de la déclaration CONSORT pour les essais randomisés. Un rapportage transparent exige d’aller bien au-delà de la simple mention de la significativité du traitement principal.
Le manuscrit scientifique doit intégrer un tableau d’analyse de variance exhaustif affichant sans omission la ligne dévolue au facteur « Bloc » avec sa somme des carrés, ses degrés de liberté et son carré moyen, permettant aux pairs d’auditer l’ampleur exacte de la variance absorbée. Les statistiques descriptives (moyennes et écarts-types) doivent être présentées non seulement par modalité de traitement globale, mais également désagrégées par strate de blocage. Enfin, les auteurs doivent systématiquement quantifier et expliciter l’efficacité relative du dispositif de blocage mis en œuvre, fournissant ainsi des données précieuses pour le calibrage des méta-analyses futures.
12.3 Synthèse directrice pour la conception optimale d’expériences
Pour guider le praticien et le chercheur dans le choix optimal de son architecture expérimentale, nous synthétisons ci-dessous la démarche décisionnelle sous la forme d’un arbre d’orientation logique :
- Existe-t-il une variable parasite majeure identifiée, fortement corrélée à la variable réponse ($|r| ge 0{,}35$), mesurable avant toute intervention ?
- Non : Privilégiez un Plan Complètement Randomisé (CRD) standard, en veillant à recruter un échantillon suffisant pour que la loi des grands nombres opère harmonieusement.
- Oui : La variable est-elle qualitative (nominale/ordinale) ou continue ?
- Si elle est continue, linéaire et que l’homogénéité des pentes est assurée : L’ANCOVA représente une option mathématique élégante préservant la métrique originale.
- Si elle est catégorielle, non-linéaire ou requiert un équilibrage physique des cohortes : Optez résolument pour un Plan en Blocs Randomisés (RCBD).
- La taille totale de l’échantillon permet-elle de préserver au moins 10 à 12 degrés de liberté pour l’erreur résiduelle après soustraction des blocs ?
- Non : Abstenez-vous de bloquer. La perte de degrés de liberté dégraderait la puissance statistique plus qu’elle ne la servirait.
- Oui : Procédez à la stratification méthodique et exécutez une randomisation restreinte intra-bloc.
En conjuguant une rigueur mathématique irréprochable lors de la modélisation à un respect scrupuleux de l’éthique de la recherche expérimentale, le blocage statistique s’affirme comme l’une des armes méthodologiques les plus sophistiquées et efficientes offertes aux scientifiques pour dompter la variabilité du vivant et faire progresser avec assurance l’édifice de la connaissance.
Références
- Box, G. E. P., Hunter, J. S., & Hunter, W. G. (2005). Statistics for experimenters: Design, innovation, and discovery (2nd ed.). John Wiley & Sons. https://www.wiley.com/en-us/Statistics+for+Experimenters
- Cochran, W. G., & Cox, G. M. (1957). Experimental designs (2nd ed.). John Wiley & Sons. https://archive.org/details/experimentaldesi0000coch_g2m3
- Fisher, R. A. (1926). The arrangement of field experiments. Journal of the Ministry of Agriculture of Great Britain, 33, 503–513. https://royalsocietypublishing.org/doi/10.1098/rstl.1926.0006
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd. https://psychclassics.yorku.ca/Fisher/Methods/
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall. https://www.pearson.com/en-us/subject-catalog/p/design-and-analysis-a-researchers-handbook
- Kirk, R. E. (2013). Experimental design: Procedures for the behavioral sciences (4th ed.). SAGE Publications. https://us.sagepub.com/en-us/nam/experimental-design/book234977
- Kuehl, R. O. (2000). Design of experiments: Statistical principles of research design and analysis (2nd ed.). Duxbury Press. https://www.cengage.com/c/design-of-experiments-statistical-principles-of-research-design-and-analysis-2e-kuehl
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Montgomery, D. C. (2017). Design and analysis of experiments (9th ed.). John Wiley & Sons. https://www.wiley.com/en-us/Design+and+Analysis+of+Experiments
- Shadish, W. R., Cook, T. D., & Campbell, D. T. (2002). Experimental and quasi-experimental designs for generalized causal inference. Houghton Mifflin. https://www.cengage.com/c/experimental-and-quasi-experimental-designs-for-generalized-causal-inference-1e-shadish
- Tukey, J. W. (1949). One degree of freedom for non-additivity. Biometrics, 5(3), 232–242. https://www.jstor.org/stable/3001538