
Dans le paysage contemporain de la modélisation statistique et de l’apprentissage automatique, l’évaluation de la performance prédictive constitue la pierre angulaire de toute démarche empirique rigoureuse. Face à la prolifération de modèles algorithmiques sophistiqués capables d’épouser avec une fidélité trompeuse les moindres aspérités d’un échantillon d’apprentissage, la communauté scientifique s’est trouvée confrontée à l’impératif catégorique de distinguer l’ajustement de surface de la véritable capacité de généralisation. L’enjeu transcende la simple optimisation mathématique : en psychologie quantitative, en neurosciences cognitives, en épidémiologie ou en économétrie, un modèle incapable d’extrapoler ses prédictions à de nouvelles cohortes produit des conclusions fallacieuses, stériles pour l’avancement théorique et potentiellement préjudiciables lors de leur translation clinique ou décisionnelle.
Parmi les stratégies élaborées pour estimer de manière non biaisée l’erreur de généralisation hors échantillon, les techniques de rééchantillonnage se sont imposées comme le standard méthodologique par excellence. Au sein de cette famille d’approches, la validation croisée Leave-One-Out (LOOCV, pour Leave-One-Out Cross-Validation) occupe une position théorique et épistémologique singulière. Poussant la logique de partitionnement itératif à son paroxysme déterministe, la LOOCV érige chaque observation empirique en un ensemble de test autonome, mobilisant l’intégralité du reste de l’échantillon pour calibrer la structure prédictive. Cette architecture confère à l’estimateur un biais infinitésimal, particulièrement convoité lors de l’investigation de cohortes restreintes où chaque unité statistique recèle une valeur informationnelle inestimable.
Toutefois, la pureté conceptuelle de la LOOCV s’accompagne d’arbitrages statistiques et computationnels complexes qu’aucun chercheur ne saurait ignorer sans péril. Entre explosion de la charge de calcul pour les modèles non linéaires, instabilité structurelle induite par la corrélation des estimations et vulnérabilités manifestes face aux données dépendantes ou hiérarchiques, son emploi requiert une maîtrise méthodologique pointue. Cet article propose une exploration exhaustive, rigoureuse et didactique de la validation croisée Leave-One-Out. De ses fondements mathématiques à ses applications contemporaines dans la recherche comportementale, en passant par ses raffinements computationnels et ses variantes avancées, ce guide offre aux analystes et aux chercheurs un cadre décisionnel complet pour déployer cette approche avec pertinence et discernement.
1. Fondements de l’évaluation des modèles statistiques et prédictifs
1.1 La nécessité d’évaluer la précision prédictive
La finalité ultime d’un modèle statistique dépasse presque toujours la simple description synthétique d’un jeu de données préexistant. Qu’il s’agisse d’anticiper la trajectoire cognitive de patients au stade préclinique de la maladie d’Alzheimer, de prédire le risque de récidive dépressive à partir de marqueurs neurobiologiques ou de modéliser des choix économiques sous incertitude, le véritable test de validité réside dans la concordance entre les prédictions théoriques générées par le modèle et des observations empiriques non encore advenues. Historiquement, la tradition statistique classique accordait une prépondérance absolue aux mesures d’adéquation intra-échantillon, telles que le coefficient de détermination ou la déviance résiduelle. Or, une concordance parfaite sur les données d’ajustement reflète fréquemment un phénomène délétère de surapprentissage (overfitting), où l’algorithme assimile non seulement le signal régulier sous-jacent, mais également le bruit idiosyncrasique propre à l’échantillon collecté.
Dans ce contexte, l’erreur quadratique moyenne (confinée sous l’acronyme anglophone MSE, pour Mean Squared Error) s’est érigée en indicateur canonique de la précision prédictive continue. Le MSE quantifie l’espérance mathématique de l’écart au carré entre les valeurs observées et les prédictions délivrées par la fonction estimée. Son statut privilégié découle directement de sa décomposition analytique canonique : il combine harmonieusement le carré du biais prédictif et la variance de l’estimateur, tout en intégrant la variance irréductible inhérente au système étudié. Minimiser cette grandeur sur des données indépendantes garantit que le modèle présente un compromis optimal entre rigidité structurelle et flexibilité fonctionnelle.
Au sein des sciences quantitatives, et plus spécifiquement dans la recherche psychométrique et psychosociale contemporaine, la question de la généralisabilité constitue le pivot central de la réplication empirique. Les protocoles expérimentaux sont assujettis à une multitude de sources de variations contextuelles, instrumentales et inter-individuelles. Si un modèle mathématique n’est calibré que pour optimiser sa performance sur un groupe confiné de participants, sa transposabilité théorique s’effondre, réduisant l’inférence causale ou prédictive à un artéfact statistique d’échantillonnage. Dès lors, l’évaluation rigoureuse de l’extrapolation devient la condition sine qua non de toute validation de théorie scientifique.
1.2 La division classique entraînement-test et ses limites
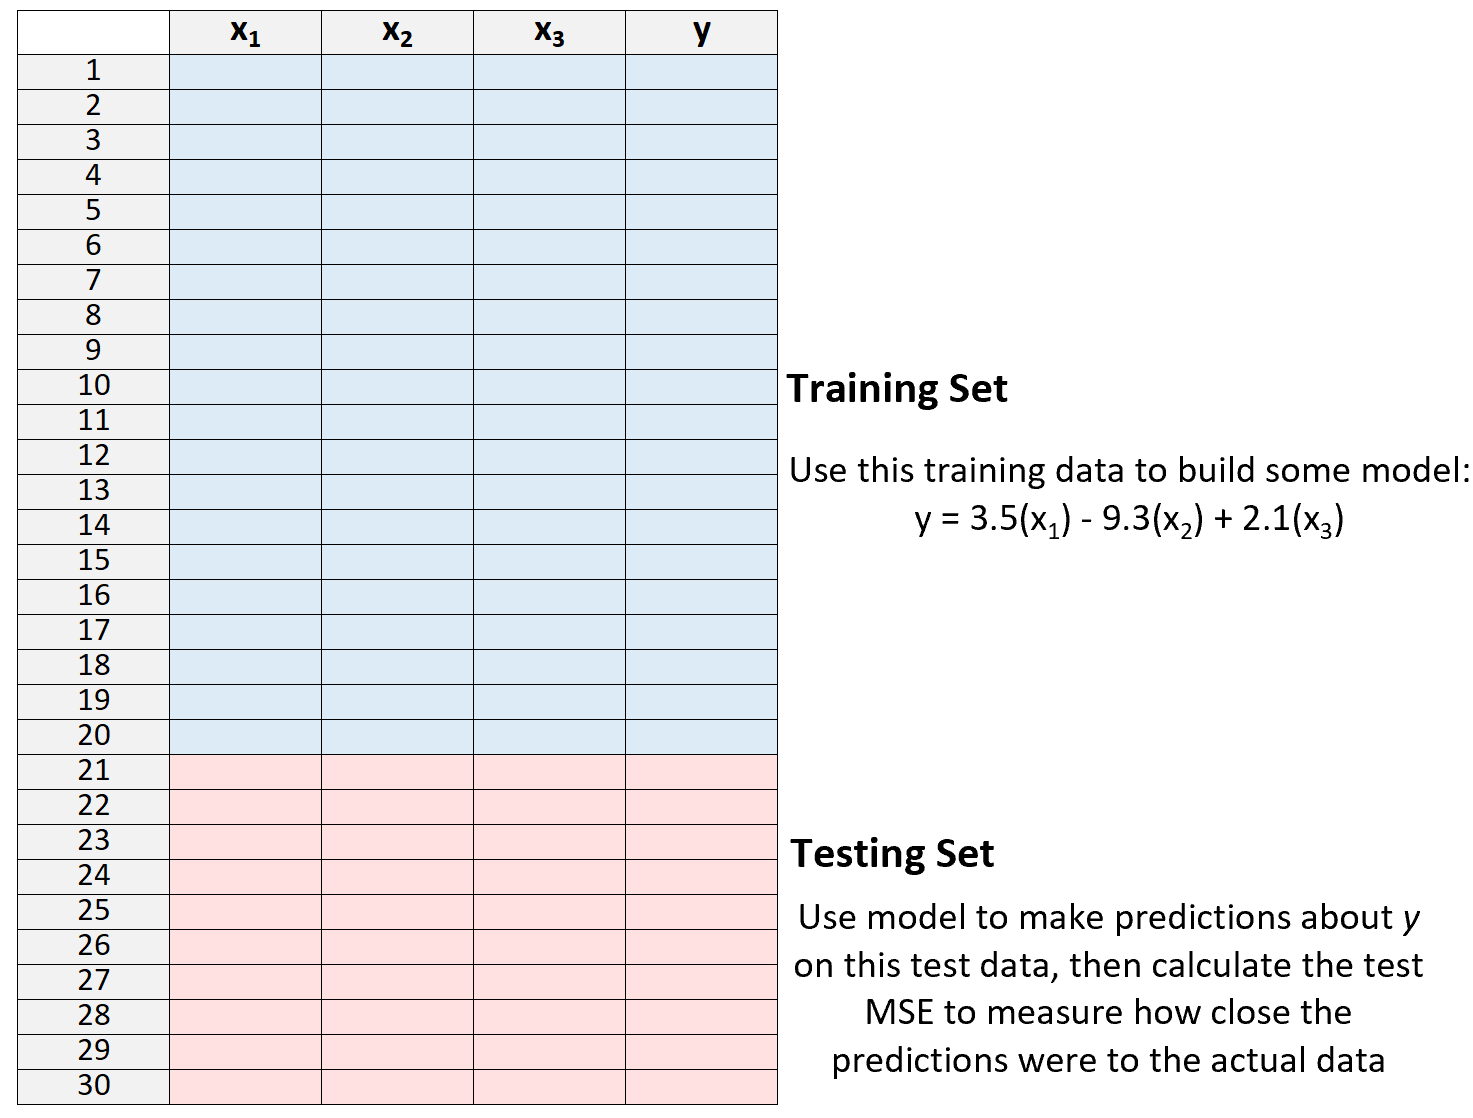
Pour parer aux illusions du surapprentissage, le paradigme fondamental de l’apprentissage statistique a instauré le principe du partitionnement simple, scindant de manière étanche les observations disponibles en deux blocs mutuellement exclusifs : l’ensemble d’entraînement (training set) et l’ensemble de test (test set). Dans ce schéma classique, le modèle ajuste ses paramètres libres exclusivement sur le premier contingent, tandis que la métrique de performance est calculée sur le second, demeuré rigoureusement vierge de toute interférence avec la phase d’optimisation. Cette scission garantit conceptuellement que le test reflète fidèlement la capacité d’extrapolation vers de nouvelles entités statistiques issues de la même population parente.
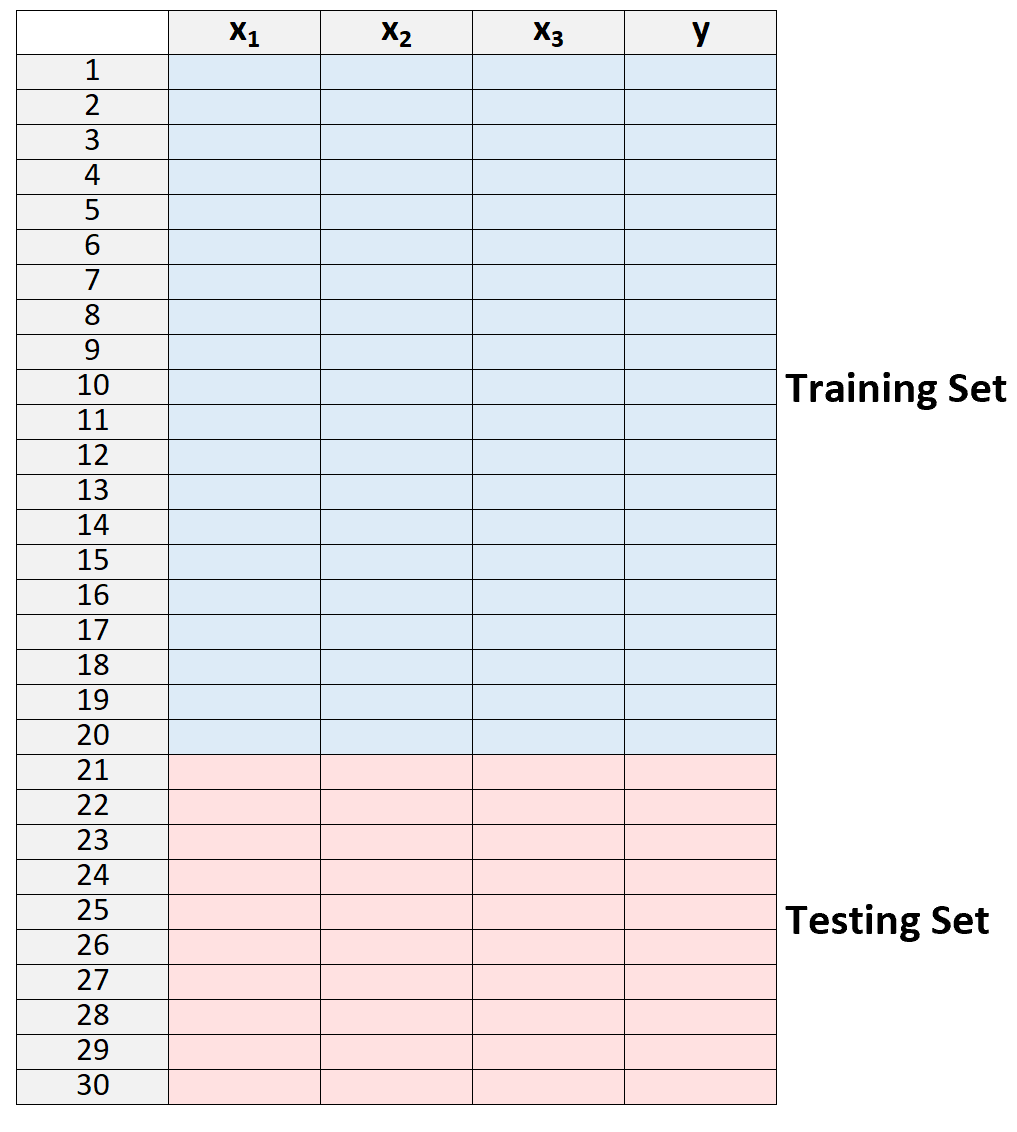
Néanmoins, cette dichotomie statique, séduisante par sa simplicité opératoire, présente des fragilités structurelles majeures qui s’accentuent dramatiquement dès lors que l’effectif total se trouve contraint. La première limite réside dans la sensibilité extrême de l’indicateur d’erreur de test vis-à-vis des aléas du partitionnement. Selon la répartition fortuite des observations via le tirage pseudo-aléatoire initial, l’ensemble de test peut hériter d’une proportion anormalement élevée de cas atypiques, entraînant une explosion artificielle du MSE, ou au contraire concentrer des profils particulièrement consensuels, conduisant à une sous-estimation dangereuse du risque d’erreur. Cette dépendance stochastique induit une variance d’estimation intolérable lorsque l’expérience est répliquée avec des graines aléatoires distinctes.
La seconde limitation, souvent rédhibitoire dans la recherche fondamentale, concerne la déperdition quantitative d’informations. Amputer une cohorte de 20 %, 30 % voire 50 % de son volume pour constituer le sanctuaire de test prive le processus d’estimation d’une masse critique d’observations. En présence de petits échantillons — situation prévalente lors du recours à l’imagerie par résonance magnétique fonctionnelle (IRMf), à des biomarqueurs invasifs ou à des panels cliniques hautement ciblés —, cette amputation appauvrit le modèle. Ce dernier est contraint d’apprendre sur un sous-échantillon sous-dimensionné, ce qui dégrade ses estimations paramétriques et majore artificiellement le biais de l’erreur mesurée par rapport à ce que produirait un modèle ajusté sur la totalité des données existantes.
1.3 Émergence des techniques de rééchantillonnage itératif
Face aux apories du partitionnement binaire figé, la théorie statistique a développé dès la seconde moitié du vingtième siècle des méthodologies fondées sur le rééchantillonnage itératif et la réutilisation cyclique des données disponibles. Ces approches partent d’un postulat élégant : puisque l’accès à de nouveaux contingents d’observations externes s’avère souvent prohibitif sur les plans logistique, financier ou éthique, il convient de simuler la variabilité populationnelle en faisant tourner méthodiquement les statuts d’apprentissage et d’évaluation au sein de l’échantillon maître. En exploitant la puissance computationnelle grandissante des ordinateurs, ces protocoles dynamiques permettent de réconcilier l’exigence d’indépendance du test et la maximisation de l’efficience empirique.
La transition conceptuelle du découpage statique vers la validation croisée multivariée a profondément renouvelé l’épistémologie de l’estimation de l’erreur. Au lieu d’accepter une estimation ponctuelle dépendante d’un unique découpage du sort, l’analyste génère une distribution d’erreurs locales dont l’agrégation synthétique converge vers une approximation nettement plus robuste de l’erreur de généralisation. Le principe directeur veut que chaque observation contribue alternativement à l’élaboration de la fonction de décision et à sa sanction évaluative, éliminant le sacrifice définitif d’une fraction de la cohorte.
Dans ce spectre de méthodologies itératives, la validation croisée Leave-One-Out émerge comme la formulation la plus radicale et la plus déterministe. Alors que les schémas à partitions multiples de type k-fold divisent les données en blocs arbitraires dont la constitution demeure tributaire d’un tirage au sort, la méthode Leave-One-Out pousse le raffinement jusqu’à sa limite théorique : l’évaluation unitaire. Cette position singulière lui octroie des propriétés statistiques remarquables qui méritent une formalisation rigoureuse.
2. Qu’est-ce que la validation croisée Leave-One-Out (LOOCV) ?
2.1 Définition conceptuelle et mécanisme de base
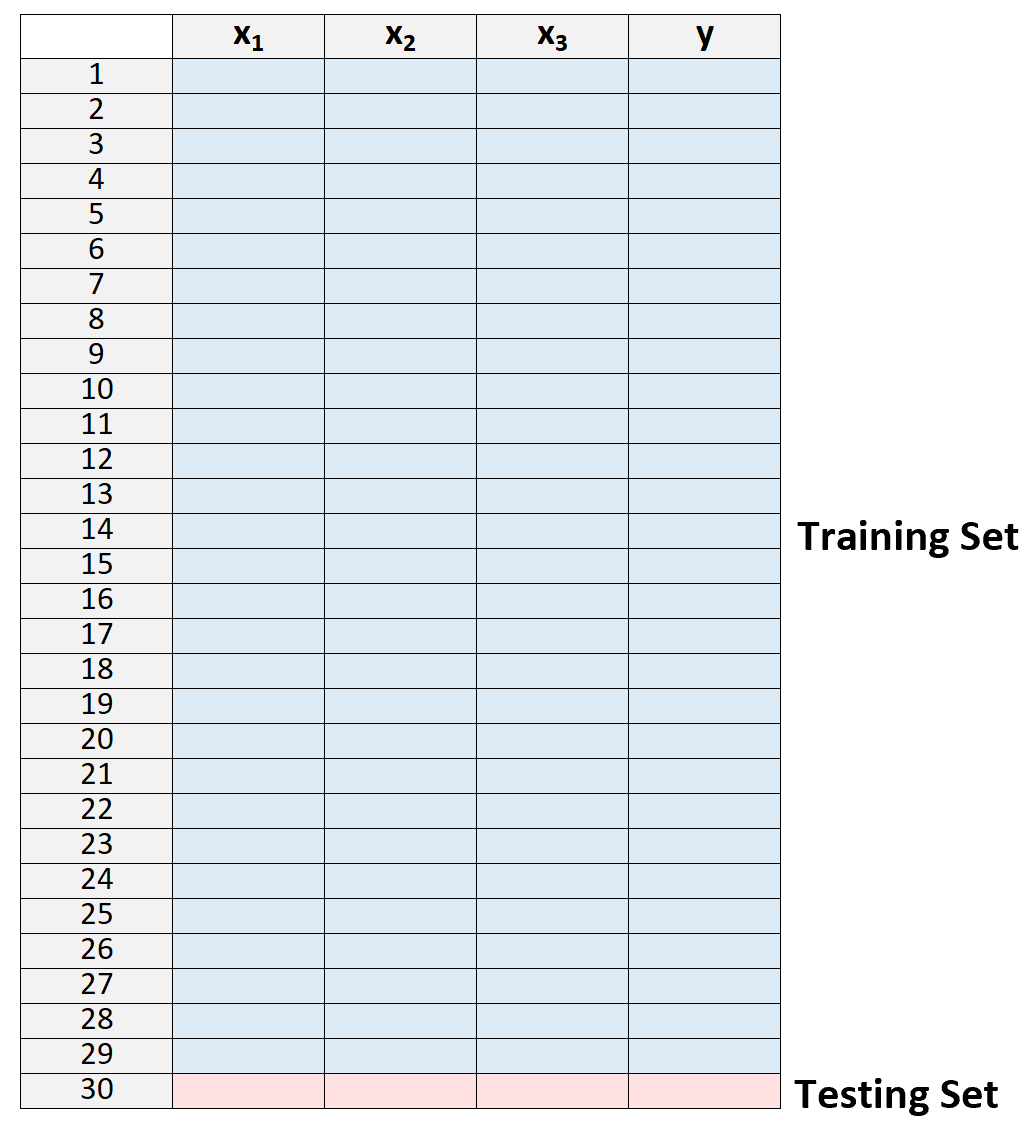
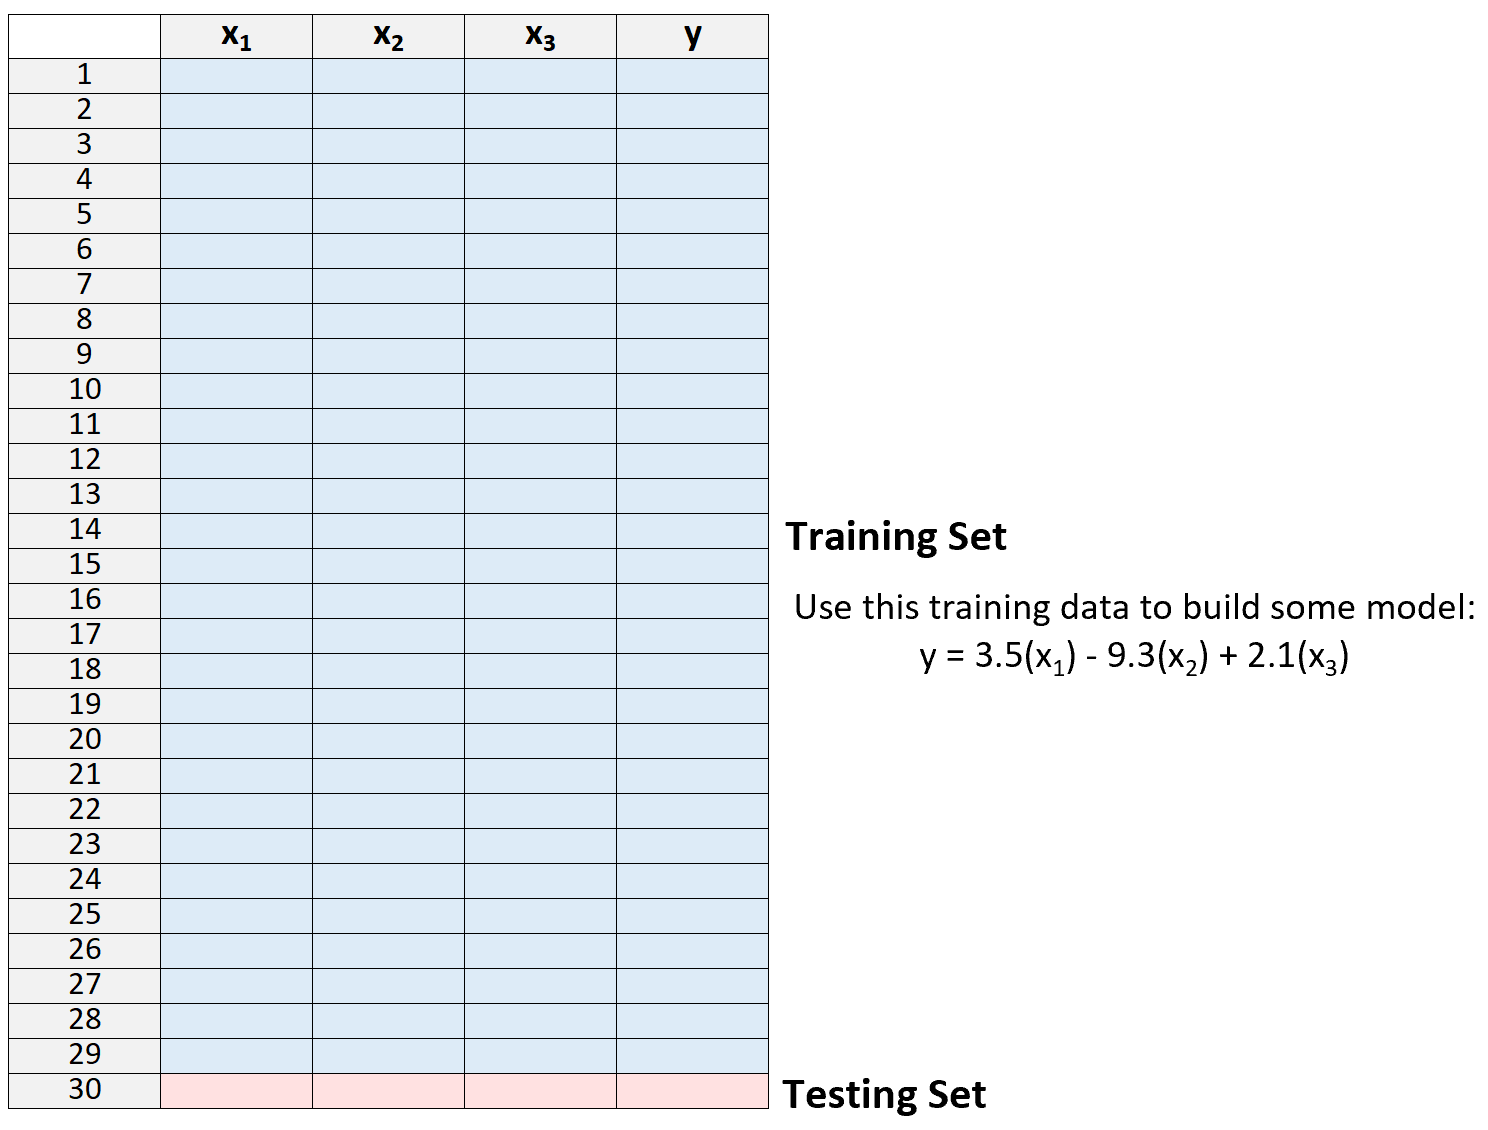
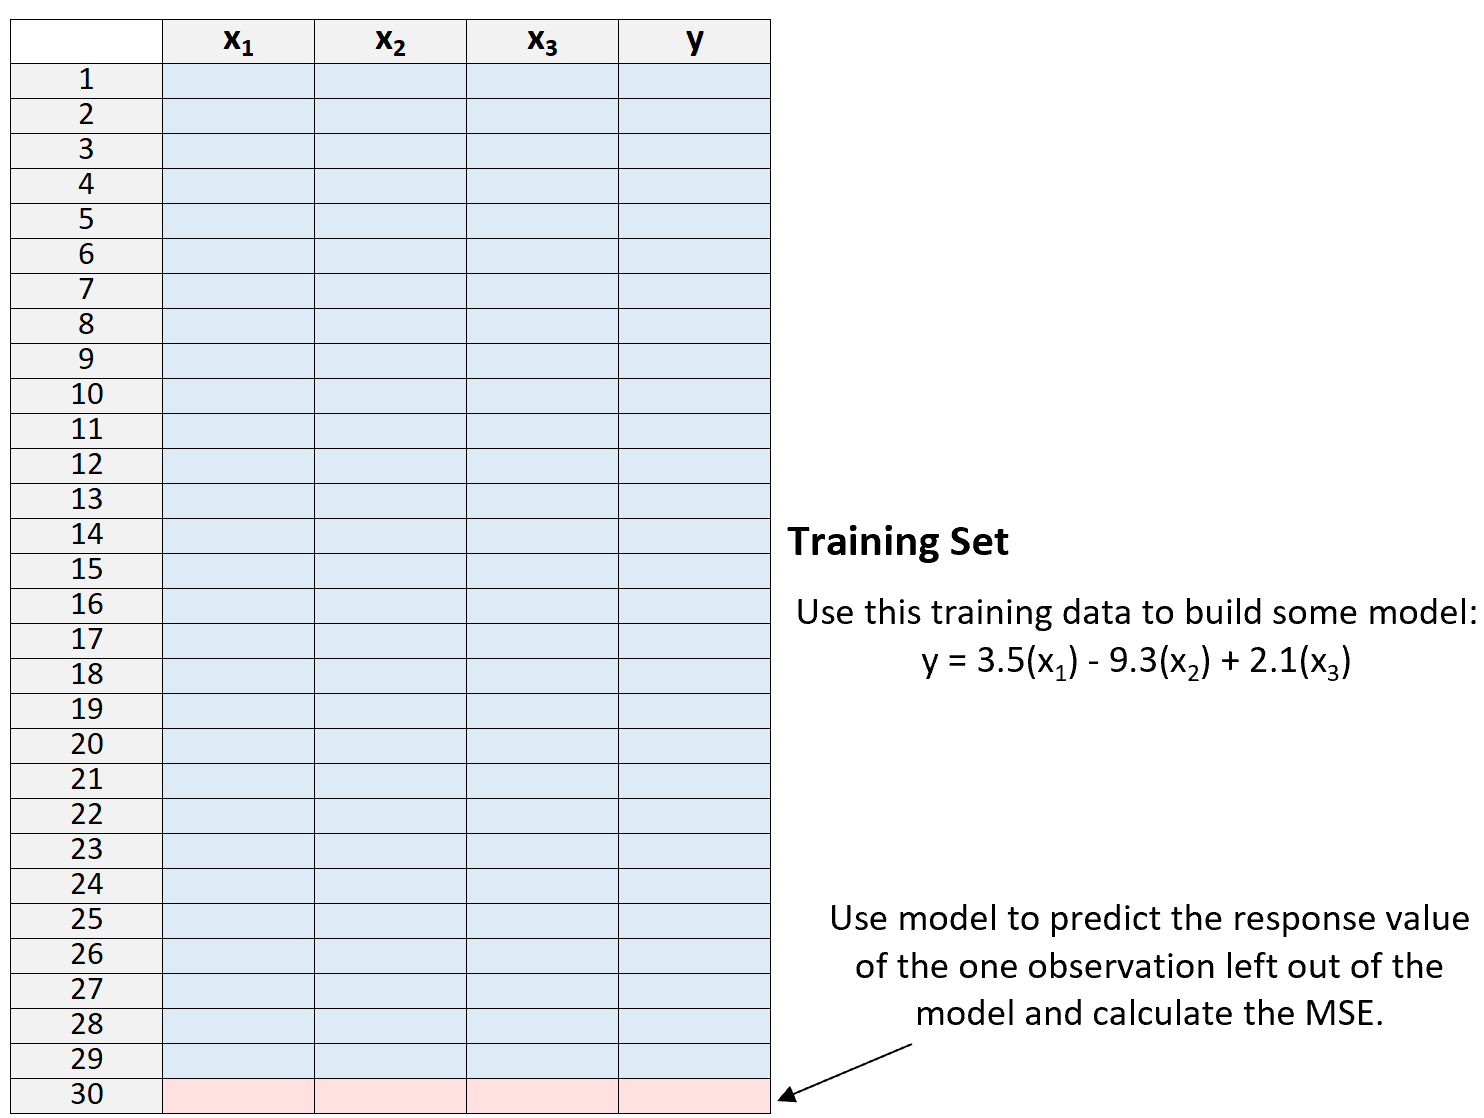
La validation croisée Leave-One-Out se définit formellement comme une procédure d’évaluation de la performance prédictive dans laquelle chaque observation individuelle d’une cohorte statistique de taille n est successivement et exclusivement isolée pour faire office d’ensemble de validation unitaire. L’architecture algorithmique repose sur une asymétrie maximale entre la phase d’apprentissage et la phase de vérification : à chaque itération du processus, exactement une seule observation est écartée de l’ensemble d’entraînement, lequel rassemble l’ensemble résiduel composé de n – 1 unités statistiques.
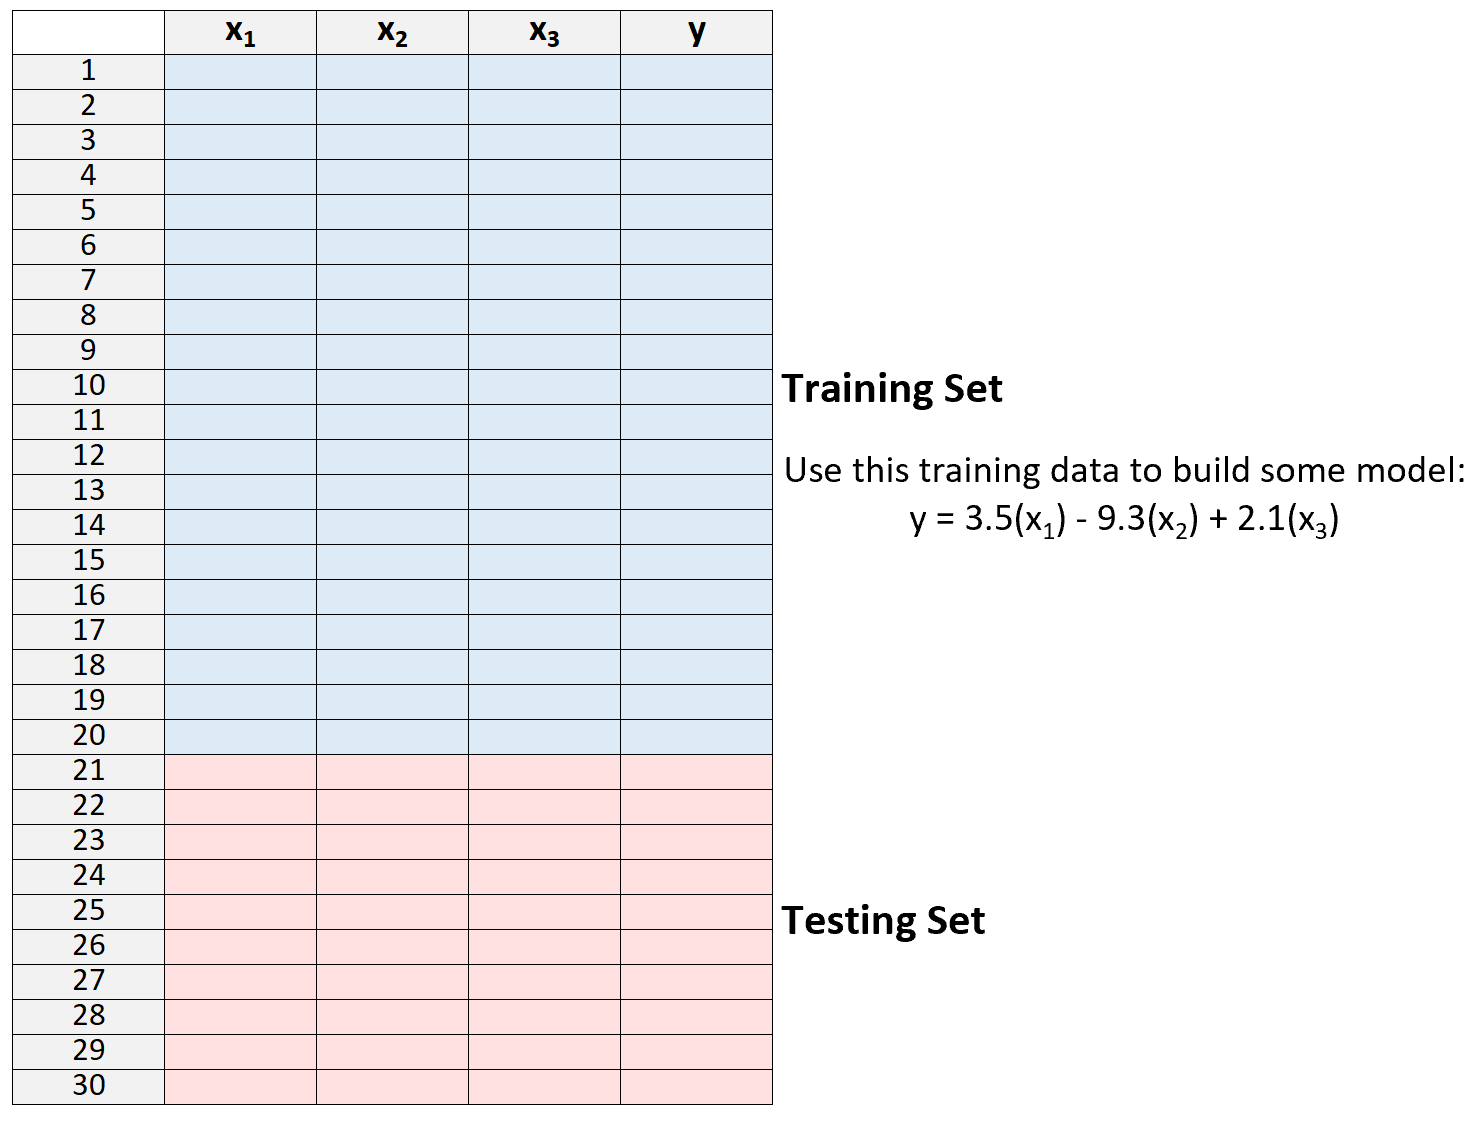
Le modèle sous-jacent est alors intégralement calibré à partir des seules informations contenues dans ces n – 1 points de données, excluant rigoureusement tout accès direct ou indirect à l’observation mise en quarantaine. Une fois les paramètres structurels et les coefficients fonctionnels stabilisés, ce modèle transitoire génère une prédiction pour l’unique individu préalablement écarté. Puisque cette entité n’a exercé aucune influence sur l’optimisation mathématique du modèle, la confrontation de la valeur prédite avec la valeur empirique réellement observée constitue une mesure authentiquement hors-échantillon de la précision locale de l’ajustement.
Ce mécanisme élémentaire est répété méthodiquement de manière à ce que chaque composante vectorielle de la base de données originelle expérimente, exactement une fois au cours du protocole, le statut d’échantillon test. Il n’existe ainsi aucun traitement asymétrique : la totalité des individus contribue à égalité à l’évaluation finale du système prédictif, tout en assurant que le modèle dispose à chaque instant de la quasi-totalité de l’information structurelle disponible pour configurer ses représentations fonctionnelles.
2.2 Algorithme pas à pas de la procédure itérative
Pour appréhender l’orthogonalité opérationnelle de la LOOCV, il s’avère instructif de décomposer son exécution séquentielle sous la forme d’un protocole algorithmique déterministe. Considérons un échantillon de données composé de n paires ordonnées d’observations, notées (x_i, y_i), où x_i représente le vecteur de variables explicatives et y_i la variable cible ou le critère à prédire pour le i-ème individu, l’indice i parcourant l’ensemble discret de 1 jusqu’à n.
La démarche algorithmique se déploie selon les étapes successives suivantes :
- Initialisation : Création d’une structure vectorielle de stockage de taille n, destinée à recueillir l’ensemble des résidus ou des erreurs de prédiction unitaires générés au fil des itérations.
- Boucle itérative principale : Pour chaque indice i évoluant séquentiellement de 1 à n :
- Partitionnement déterministe extrayant l’observation (x_i, y_i) pour constituer le sous-ensemble de test temporaire T_i.
- Agrégation de toutes les autres observations { (x_j, y_j) tel que j ≠ i } afin de configurer la matrice d’entraînement d’effectif n – 1.
- Ajustement complet et autonome de l’algorithme ou du modèle statistique désigné sur cette matrice d’entraînement d’effectif réduit, aboutissant à une fonction de prédiction spécifique f_{-i}(x).
- Calcul de la valeur prédite spécifiquement associée à l’observation exclue, notée ŷ_i = f_{-i}(x_i).
- Calcul et consignation de la perte locale, communément formalisée par l’écart quadratique individuel e_i = (y_i – ŷ_i)².
- Clôture du cycle : Fin de la structure itérative après exécution rigoureuse de n cycles d’entraînement et d’évaluation indépendants.
Ce protocole garantit une couverture exhaustive et systématique de l’espace empirique disponible, sans introduire la moindre dérive de sélection arbitraire au cours de son déroulement séquentiel.
2.3 Agrégation finale et métrique globale de performance
L’aboutissement de la séquence itérative réside dans la synthèse quantitative des n pertes unitaires recueillies dans le vecteur résiduel. Dans le cadre canonique des problèmes de régression où la variable dépendante adopte une nature quantitative continue, l’indicateur synthétique de référence est l’erreur quadratique moyenne de validation croisée Leave-One-Out, désignée conventionnellement par la métrique LOOCV MSE. Cette valeur s’obtient par le calcul de la moyenne arithmétique simple des écarts quadratiques individuels enregistrés à chaque pas :
LOOCV_MSE = (1 / n) * ∑_{i=1}^{n} (y_i – f_{-i}(x_i))²
Sur le plan de l’interprétation clinique, psychologique et statistique, cette grandeur synthétique traduit l’erreur quadratique moyenne à laquelle l’analyste doit rationnellement s’attendre lorsque le modèle, calibré sur un volume d’observations égal à n – 1, est confronté à un nouvel individu issu de la même population source. Une valeur restreinte du LOOCV MSE témoigne d’une haute fidélité d’extrapolation et rassure sur le fait que la structure fonctionnelle identifiée ne résulte pas d’une capitalisation fortuite sur les particularismes de l’échantillon initial.
À l’inverse, une divergence prononcée entre cette métrique agrégée et l’erreur quadratique moyenne intra-échantillon (calculée sur le jeu de données d’apprentissage conventionnel sans exclusion) constitue le signal diagnostique indiscutable d’un surajustement pathologique. En mesurant l’amplitude de cet écart, le praticien dispose d’un instrument de mesure transparent de la fragilité de son modèle, lui permettant de rejeter des spécifications trop permissives au profit d’architectures plus parcimonieuses.
3. Formalisation mathématique et propriétés statistiques de LOOCV
3.1 Formulation algébrique détaillée de la métrique
Pour appréhender avec finesse les fondements théoriques de la LOOCV, il convient d’expliciter son formalisme algébrique au regard des propriétés d’estimation statistique. Considérons l’espace des données défini par une loi de probabilité conjointe P(X, Y) d’où est extrait de manière indépendante et identiquement distribuée l’échantillon D = {(x_1, y_1), …, (x_n, y_n)}. L’erreur de généralisation réelle, ou risque théorique R(f), d’une règle d’apprentissage produisant un prédicteur f à partir d’un échantillon de taille m s’écrit sous la forme de l’espérance mathématique de la fonction de coût L(Y, f(X)) par rapport à la distribution conjointe sous-jacente :
R(f_m) = E_{(X,Y)} [ L(Y, f_m(X)) ]
Dans cette perspective probabiliste, le risque empirique usuel calculé directement sur le jeu de données complet — couramment désigné sous le terme de MSE d’entraînement — s’avère un estimateur structurellement biaisé vers l’optimisme. En effet, les données ayant servi à contraindre les paramètres d’optimisation participent directement à l’évaluation de la perte :
MSE_{train} = (1 / n) * ∑_{i=1}^{n} L(y_i, f_n(x_i))
Puisque l’algorithme de minimisation a précisément sélectionné la fonction f_n de façon à réduire au maximum cette quantité résiduelle sur l’échantillon D, l’espérance de ce MSE d’entraînement est systématiquement et strictement inférieure au risque théorique réel : E[MSE_{train}] < R(f_n). C’est précisément pour dissoudre cette contamination endogène que la formalisation algébrique de la LOOCV substitue à la fonction globale f_n la famille de prédicteurs {f_{-i}}_{i=1}^n, garantissant une pondération strictement uniforme de chaque observation au sein de la somme d’évaluation finale :
R̂_{LOOCV} = (1 / n) * ∑_{i=1}^{n} L(y_i, f_{-i}(x_i))
Cette formulation neutralise le biais d’optimisme intra-échantillon en rétablissant l’indépendance statistique stricte entre la cible d’évaluation (x_i, y_i) et la règle de décision conditionnée f_{-i}.
3.2 L’astuce computationnelle pour les modèles de régression linéaire
L’un des accomplissements les plus élégants de l’analyse linéaire multivariée réside dans la démonstration qu’il n’est nullement nécessaire de réajuster n fois un modèle de régression par moindres carrés ordinaires (OLS) pour calculer de manière exacte l’erreur LOOCV. Cette propriété d’une remarquable efficience computationnelle découle des propriétés géométriques de la matrice de projection orthogonale, universellement désignée sous l’appellation de « matrice chapeau » (hat matrix), traditionnellement notée H.
Dans une régression linéaire standard de forme matricielle Y = Xβ + ε, où X désigne la matrice des prédicteurs de dimension (n × p) et Y le vecteur des observations continues de dimension (n × 1), le vecteur des valeurs ajustées Ŷ s’obtient par la transformation projective orthogonale Ŷ = HY, avec :
H = X (X^T X)^{-1} X^T
Les éléments diagonaux de cette matrice semi-définie positive, notés h_{ii}, quantifient l’effet de levier (leverage) exercé par chaque observation individuelle sur sa propre valeur ajustée. Plus h_{ii} est proche de l’unité, plus l’observation correspondante tire à elle le plan de régression multidimensionnel. À partir du lemme d’inversion matricielle de Sherman-Morrison-Woodbury, des statisticiens de renom ont établi que le résidu d’exclusion unitaire (y_i – f_{-i}(x_i)) s’exprime très exactement comme une mise à l’échelle du résidu standard intra-échantillon e_i = (y_i – ŷ_i), modulée par le complément à un de son levier statistique :
y_i – f_{-i}(x_i) = (y_i – ŷ_i) / (1 – h_{ii})
En conséquence immédiate de cette identité analytique spectaculaire, la métrique globale LOOCV MSE d’un modèle linéaire sous moindres carrés ordinaires s’obtient à partir d’un unique ajustement réalisé sur l’échantillon complet de taille n, via l’équation close :
LOOCV_MSE = (1 / n) * ∑_{i=1}^{n} [ (y_i – ŷ_i) / (1 – h_{ii}) ]²
Ce résultat capital réduit la complexité temporelle théorique de l’opération d’un facteur n, rendant l’exécution de la LOOCV instantanée même pour des cohortes comprenant des centaines de milliers de lignes, pourvu que le cadre théorique demeure strictement ancré dans l’algèbre des moindres carrés linéaires. Par ailleurs, cette formulation met en lumière le rôle central des résidus studentisés dans la détection des points aberrants exerçant une tension excessive sur la surface de régression.
3.3 Propriétés de quasi-absence de biais de l’estimateur
Sur le plan fondamental de la théorie de l’estimation, la qualité primordiale de la validation croisée Leave-One-Out réside dans son statut d’estimateur quasi non biaisé du risque d’extrapolation d’un modèle entraîné sur un échantillon d’effectif n. Pour comprendre l’origine de cette vertu, il convient de souligner que la performance d’un algorithme statistique dépend intrinsèquement du volume quantitatif de données alloué à son ajustement : c’est la notion de courbe d’apprentissage (learning curve).
Lorsqu’un modèle est évalué au moyen d’une validation croisée k-fold conventionnelle (avec par exemple k = 5), chaque sous-modèle est contraint d’apprendre ses paramètres sur seulement 80 % du corpus empirique global. Dès lors, l’erreur mesurée par ce découpage k-fold reflète en réalité la compétence d’un modèle entraîné sur 0,8 * n observations, et non sur la totalité de l’effectif n. Cette amputation dimensionnelle induit un biais de pessimisme systématique : l’erreur de généralisation estimée a tendance à surestimer le taux d’erreur réel du modèle final qui bénéficiera, lui, de 100 % des données disponibles lors de son déploiement pratique.
Dans l’architecture LOOCV, la taille du sous-ensemble d’apprentissage à chaque itération est de n – 1. Pour toute cohorte d’ampleur raisonnable, le ratio (n – 1) / n tend asymptotiquement vers l’unité. Il en découle que le modèle évalué opère dans des conditions de complétude informationnelle pratiquement indiscernables de celles du modèle définitif. Par conséquent, le biais d’espérance mathématique de la LOOCV MSE par rapport au risque R(f_n) s’avère infinitésimal :
Biais(R̂_{LOOCV}) = | E[R̂_{LOOCV}] – R(f_n) | ≈ 0
Cette quasi-absence de biais confère à la LOOCV une légitimité théorique incomparable face aux partitions plus grossières, faisant d’elle le critère d’or pour juger fidèlement du potentiel d’un algorithme sans subir l’artifice distordant d’une amputation d’apprentissage.
4. LOOCV face à la validation croisée k-Fold : Analyse comparative
4.1 LOOCV comme cas limite où k est égal à n
Sur le plan structural, la validation croisée Leave-One-Out ne constitue pas une méthode hétérogène ou isolée, mais incarne l’extrémité asymptotique de la vaste famille des méthodes de validation croisée à k blocs (k-Fold Cross-Validation). Dans un protocole k-fold usuel, le jeu de données d’origine est partitionné de manière aléatoire en k sous-ensembles équilibrés et disjoints appelés « plis » ou « blocs ». L’algorithme itère ensuite k fois, réservant à chaque étape un pli pour l’évaluation et exploitant les k – 1 plis restants pour la calibration paramétrique.
Lorsque le statisticien paramètre délibérément le nombre de plis pour qu’il coïncide rigoureusement avec la taille absolue de l’échantillon, soit k = n, chaque pli individuel se contracte nécessairement en une entité unitaire contenant précisément une et une seule observation. Dès lors, le mécanisme de k-fold s’efface pour laisser place, par identité structurelle, au protocole Leave-One-Out. Cette équivalence établit la LOOCV comme le cas limite déterministe absolu de la validation croisée.
Cette mutation d’une partition probabiliste vers une partition unitaire entraîne une conséquence méthodologique cardinale : l’élimination totale et définitive de la composante aléatoire associée à la distribution des observations au sein des plis. Dans un k-fold standard où k < n, deux analystes manipulant le même modèle sur le même jeu de données mais initialisant leur générateur avec des graines de hasard distinctes convergeront vers des scores de MSE légèrement différents. À l’opposé, la LOOCV produit une partition invariante et univoque : son exécution ne tolère aucune ambiguïté stochastique, scellant une uniformité analytique parfaite.
4.2 Le dilemme fondamental du compromis biais-variance
Si la LOOCV triomphe incontestablement sur le front de la réduction du biais, elle se heurte en contrepartie à un écueil statistique redoutable au regard du compromis biais-variance appliqué aux estimateurs d’erreur eux-mêmes. Il est en effet indispensable de distinguer deux composantes de variance distinctes : la variance interne du modèle prédictif d’une part, et la variance de l’estimateur de performance par rapport aux fluctuations de l’échantillonnage de la population d’autre part.
Dans la LOOCV, chacun des n modèles ajustés est calibré sur un sous-ensemble d’apprentissage d’effectif n – 1. Cela implique structurellement que deux modèles successifs quelconques f_{-i} et f_{-j} partagent exactement n – 2 observations communes au sein de leur matrice de calibrage. Lorsque n présente une valeur substantielle, le taux de recouvrement informationnel entre deux ajustements successifs frôle les 100 %. Par voie de conséquence directe, les différents modèles générés au cours de la procédure itérative sont quasi identiques et leurs prédictions unitaires respectives s’avèrent très fortement et positivement corrélées entre elles.
Or, les théorèmes fondamentaux de la statistique rappellent que la variance de la moyenne arithmétique de variables aléatoires positivement corrélées est une fonction croissante de leur niveau de corrélation mutuelle :
Var( (1 / n) * ∑ X_i ) = (1 / n²) * ∑ Var(X_i) + (1 / n²) * ∑_{i ≠ j} Cov(X_i, X_j)
Puisque la covariance Cov(e_i, e_j) entre les erreurs locales issues de modèles presque clones est considérablement élevée, la variance globale de l’estimateur LOOCV MSE peut se révéler substantiellement plus lourde que celle d’une validation croisée 10-fold, dans laquelle les ensembles d’entraînement partagent proportionnellement moins de matière empirique. Dans des scénarios stochastiques instables ou fortement bruités, l’indicateur LOOCV peut ainsi fluctuer de manière imprévisible d’un échantillon expérimental à un autre, trahissant un manque critique de stabilité comparativement aux partitions à k blocs plus modérées.
4.3 Reproductibilité et standardisation méthodologique
En dépit du risque d’inflation de variance évoqué ci-dessus, la validation croisée Leave-One-Out jouit d’un prestige méthodologique singulier dans les laboratoires de recherche en raison de sa reproductibilité absolue. La crise de la reproductibilité qui secoue les sciences empiriques depuis une décennie a mis en lumière la vulnérabilité des protocoles analytiques assujettis à des tirages pseudo-aléatoires mal documentés. L’altération marginale d’une valeur de graine aléatoire dans un algorithme k-fold suffit parfois à faire osciller un p-value de généralisation au-dessus ou en-dessous du seuil alpha critique de significativité.
En éradiquant le besoin de partitionnement aléatoire, la LOOCV garantit l’invariance absolue des métriques publiées. Quel que soit le système d’exploitation utilisé, quel que soit le logiciel statistique mobilisé (R, Python, Julia ou MATLAB), et quel que soit le praticien aux commandes de la syntaxe, l’application de la LOOCV sur un fichier de données figé génère des résultats rigoureusement indiscernables au millième de décimale près. Cette propriété constitue un rempart inestimable contre le soupçon de sélection rétrospective favorable ou d’optimisation opportuniste des graines algorithmiques.
Par ailleurs, cette standardisation facilite la rédaction des protocoles au sein des sections de méthodologie scientifique. Les chercheurs n’ont plus à consigner une longue justification sur les modalités de stratification de leurs plis, le nombre d’itérations de réplication avec réassignation des blocs, ou le choix empirique de la valeur de k. La LOOCV impose une élégance déclarative minimale : le protocole d’évaluation se suffit à lui-même, s’intégrant sans friction dans le canon de la science ouverte.
5. Principaux avantages de l’approche Leave-One-Out
5.1 Maximisation du volume de données d’apprentissage
Le privilège opérationnel cardinal de la LOOCV réside dans son aptitude à exploiter la quasi-totalité de l’espace empirique disponible lors de la calibration des paramètres structurels. Dans de multiples branches de la science contemporaine, la collecte d’un échantillon ne saurait être assimilée à une simple extraction de flux numériques automatisés : l’acquisition de données biomédicales, neuropsychologiques ou génétiques requiert des investissements humains, temporels et financiers considérables, imposant de travailler avec des cohortes numériquement exiguës.
Lorsque la cohorte d’intérêt se borne à vingt ou trente sujets — cas typique d’une étude d’activation cérébrale par tomographie par émission de positons ou de l’analyse comportementale de patients atteints d’un syndrome neurologique orphelin —, amputer les données de 20 % ou 30 % pour élaborer un échantillon de test conventionnel constitue un gaspillage méthodologique dommageable. Priver un estimateur linéaire ou régularisé de six ou sept sujets altère profondément la précision d’estimation de ses coefficients, majorant l’erreur type des paramètres et compromettant la convergence de la surface d’ajustement.
En réservant n – 1 unités statistiques pour l’entraînement, la LOOCV préserve l’intégrité informationnelle du jeu de données. Le modèle exploite à plein régime les structures de covariance, les effets d’interaction subtils et la distribution réelle des variables explicatives. Cette maximisation algorithmique offre la robustesse d’ajustement la plus élevée qu’il soit techniquement possible d’atteindre sous contrainte d’évaluation externe, apportant une réponse adaptée aux contextes de recherche où chaque degré de liberté supplémentaire revêt une importance capitale.
5.2 Suppression de l’arbitraire du découpage d’échantillon
Le second atout décisif de la méthode réside dans la neutralisation méthodique du biais d’échantillonnage inhérent à tout découpage arbitraire. Dans une partition classique 70-30 ou 80-20, l’analyste confie au tirage au sort le destin statistique de son étude. Même avec des mécanismes de stratification par classes, il demeure tout à fait possible que le sous-ensemble de test concentre par inadvertance une majorité de profils faciles à modéliser, générant un score d’exactitude artificiellement flatteur, ou à l’inverse qu’il absorbe des sujets particulièrement atypiques, précipitant l’effondrement prématuré de la métrique de performance.
Cette vulnérabilité ouvre inconsciemment la porte au phénomène pernicieux de « cherry-picking » accidentel. Face à un résultat d’évaluation marginalement non significatif, un expérimentateur peut être tenté, consciemment ou non, de tester une pluralité de graines de tirage aléatoire jusqu’à isoler une répartition des plis conférant à son modèle le seuil d’adéquation convoité. La LOOCV élimine cette zone de vulnérabilité éthique et analytique en proposant une configuration unique, déterministe et exhaustive.
Dans ce cadre rigide, chaque observation empirique sans exception subit rigoureusement le même traitement : elle est confrontée aux prédictions d’un modèle instruit par le reste de la communauté des données, puis rejoint le bloc de calibration pour soumettre à l’épreuve l’observation suivante. Cette symétrie garantit un traitement équitable de chaque point de données et délivre une sanction prédictive dont l’intégrité méthodologique échappe à toute contestation d’arbitraire expérimental.
5.3 Sensibilité fine à la détection des cas aberrants
Au-delà de sa mission première d’estimation globale du risque, la LOOCV s’avère un remarquable outil d’investigation diagnostique pour mettre en lumière la présence d’observations aberrantes (outliers) ou d’individus exerçant une influence démesurée sur l’architecture du modèle. Contrairement aux approches par blocs où les erreurs sont sommées au sein de chaque pli de taille substantielle, la LOOCV produit une série granulaire de n résidus d’exclusion strictement individualisés :
e_i^{loo} = y_i – f_{-i}(x_i)
L’analyse fine du profil de distribution de ces résidus unitaires offre un éclairage direct sur les singularités de la cohorte. Une observation pour laquelle l’erreur e_i^{loo} prend des proportions démesurées par rapport à la dispersion générale des résidus indique une rupture de généralisation criante. Deux hypothèses diagnostiques émergent alors : soit l’individu en question possède un profil clinique ou comportemental hautement idiosyncrasique qui échappe aux régularités générales de la population, soit il représente un point d’appui toxique qui, lorsqu’il est réintégré dans le modèle, infléchit artificiellement l’ensemble des coefficients.
Cette sensibilité granulaire s’avère particulièrement précieuse lors de la modélisation de traits psychologiques complexes. Examiner le vecteur des erreurs Leave-One-Out permet aux psychométriciens d’isoler des participants ayant adopté des stratégies de réponse déviantes, d’identifier des erreurs matérielles de saisie ou de transcription, ou encore de déceler des sous-groupes cliniques méconnus dont la typologie exige un modèle distinct. L’indicateur individuel de LOOCV s’érige ainsi en instrument de raffinement qualitatif de la recherche scientifique.
6. Limites critiques et contraintes computationnelles
6.1 Complexité temporelle et explosion du coût de calcul
Le revers majeur de la LOOCV réside dans l’explosion de sa charge computationnelle, une contrainte qui limite sévèrement son applicabilité aux modèles de grande échelle et aux volumétries de données massives contemporaines. Par construction théorique, la procédure exige l’exécution d’exactement n ajustements complets et autonomes de l’algorithme sous-jacent. Si cette exigence s’accommode des régressions linéaires standards grâce au raccourci analytique de la matrice chapeau, elle devient rédhibitoire dès lors que l’on mobilise des algorithmes dont l’optimisation requiert des procédures numériques itératives non linéaires.
Considérons des architectures d’apprentissage sophistiquées telles que les réseaux de neurones profonds (deep learning), les forêts aléatoires massives comprenant des milliers d’arbres décisionnels ou les machines à vecteurs de support (SVM) à noyaux complexes optimisées par décomposition séquentielle quadratique. L’ajustement unitaire d’un seul de ces modèles sur une station de travail peut requérir plusieurs minutes, voire plusieurs heures de calcul matriciel intensif. Multiplier ce temps de base par un facteur n — ne serait-ce que pour une cohorte clinique modeste de n = 500 individus — aboutit à une durée globale d’évaluation prohibitive, souvent incompatible avec les délais de la recherche opérationnelle.
Dès lors, face à des bases de données volumineuses excédant plusieurs dizaines de milliers d’enregistrements (big data), l’application de la LOOCV brute relève de l’impasse technique pure et simple. Même les algorithmes régularisés classiques tels que le Lasso ou l’Elastic Net, qui exigent la résolution numérique de trajectoires complètes de pénalisation le long d’une grille de paramètres, voient leur déploiement sous LOOCV ralentir de manière substantielle en l’absence de solveurs spécifiquement parallélisés. L’analyste se trouve alors contraint d’abandonner l’exhaustivité unitaire pour se rabattre sur des compromis k-fold nettement plus économiques en cycles de processeur.
6.2 Instabilité potentielle liée à la corrélation des modèles
Une incompréhension fréquente chez les praticiens non statisticiens consiste à postuler que, parce que la LOOCV affiche un biais quasi nul, elle constitue universellement le « meilleur » estimateur de performance prédictive. Cette déduction néglige l’instabilité potentielle induite par la corrélation structurelle des modèles ajustés, formalisée dans les travaux fondateurs de Kohavi (1995) et documentée par Hastie, Tibshirani et Friedman dans leur traité de référence.
Comme explicité dans l’analyse du compromis biais-variance, les n fonctions estimées f_{-i} partagent la quasi-totalité de leur substrat empirique. Si la base de données de départ comporte une fraction de bruit stochastique particulièrement délétère ou si la surface de coût présente de multiples minima locaux, les n modèles reproduiront de manière convergente les mêmes fragilités inductives. La métrique globale LOOCV MSE devient alors une variable aléatoire hautement susceptible de varier drastiquement si l’on répétait l’ensemble de l’expérience en collectant une cohorte entièrement nouvelle auprès de la même population.
Cette vulnérabilité s’avère particulièrement préjudiciable dans les contextes de sélection de modèles ou de réglage fin d’hyperparamètres (hyperparameter tuning). Confronté à une surface d’erreur rugueuse et volatile, le score LOOCV peut favoriser une configuration algorithmique marginalement surajustée, abusé par l’absence de pénalisation sur la covariance des résidus. Il a été démontré mathématiquement que, dans certaines configurations de régression polynomiale ou de sélection de sous-ensembles de variables, le critère LOOCV n’est pas asymptotiquement consistant : il conserve une propension irréductible à sélectionner des modèles plus complexes que le véritable générateur de données sous-jacent, à l’inverse de critères pénalisés plus sévères tels que le BIC.
6.3 Vulnérabilité face aux données dépendantes ou groupées
La faille théorique la plus périlleuse guettant l’application naïve de la LOOCV réside dans l’inadéquation de son architecture unitaire face aux données violant l’hypothèse canonique d’indépendance et de distribution identique (i.i.d.). Dans les investigations en sciences cognitives, en écologie humaine ou en épidémiologie comportementale, la structure des observations est fréquemment hiérarchique, emboîtée ou longitudinale. Les protocoles recueillent communément des dizaines, voire des centaines de mesures répétées issues d’un même sujet, ou déploient des mesures groupées par grappes (classes scolaires, services hospitaliers, familles).
Dans un tel contexte d’interdépendance structurelle, exclure un seul point de données lors d’une itération LOOCV classique conduit à une contamination méthodologique catastrophique. Considérons le cas d’un essai longitudinal où un participant a répondu à cinquante essais comportementaux successifs : écarter le cinquantième essai pour le tester sur un modèle entraîné sur les quarante-neuf autres essais du même participant constitue une parodie d’évaluation externe. Le modèle conserve en son sein la signature stylistique, la moyenne idiosyncrasique, le temps de réaction de base et l’ensemble des corrélations intra-sujets de l’individu évalué.
Cette perméabilité flagrante pulvérise l’étanchéité théorique entre apprentissage et validation, générant une fuite d’information systémique majeure (data leakage). Les performances hors-échantillon affichées par la LOOCV standard dans ces scénarios atteignent des niveaux d’optimisme illusoires, masquant l’incapacité totale du modèle à se généraliser à de véritables nouveaux participants non encore répertoriés dans la base d’apprentissage. Dans de telles structures dépendantes, l’emploi de la LOOCV atomique unitaire doit être formellement proscrit au profit de variantes par grappes rigoureusement adaptées.
7. Applications méthodologiques en recherche psychologique et cognitive
7.1 Évaluation de petits échantillons cliniques et neuropsychologiques
La recherche clinique et neuropsychologique contemporaine se heurte fréquemment à des contraintes structurelles indépassables de recrutement de participants. Les protocoles expérimentaux explorant les corrélats anatomo-fonctionnels d’états pathologiques rares, tels que le locked-in syndrome, les amnésies rétrogrades pures consécutives à des lésions cérébrales spécifiques ou certaines démences précoces d’origine génétique, doivent composer avec des échantillons extrêmement ténus, oscillant typiquement entre dix et quarante sujets. Parallèlement, le coût unitaire de l’imagerie par résonance magnétique fonctionnelle (IRMf) ou de la magnétoencéphalographie (MEG) restreint la constitution de volumineux panels d’apprentissage.
Dans cet univers méthodologique sous haute contrainte, la LOOCV s’est affirmée comme l’outil privilégié de validation interne pour la découverte de biomarqueurs prédictifs. Face à un jeu de données contenant vingt-cinq scans cérébraux individuels dont l’objectif est d’inférer la conversion d’un déficit cognitif léger vers une pathologie neurodégénérative avérée, sacrifier sept ou huit patients au sein d’un pli de test k-fold traditionnel altérerait la détection des réseaux cérébraux discriminants. La LOOCV permet d’entraîner l’algorithme sur vingt-quatre cerveaux à chaque itération, préservant la richesse topologique des motifs d’activation neuronale sans renoncer à la sévérité d’un test externe.
Les neurosciences computationnelles ont ainsi largement documenté l’intérêt de la LOOCV pour calibrer les classifieurs par motifs multivariés (MVPA, pour Multi-Voxel Pattern Analysis). En garantissant un accès quasi complet aux volumes d’imagerie disponibles lors de la cartographie des fonctions cérébrales, la LOOCV assure une estimation fidèle du taux d’exactitude diagnostique que le clinicien peut raisonnablement anticiper face à un nouveau patient admis au sein de son service hospitalier.
7.2 Psychométrie et étalonnage des échelles comportementales
La modélisation psychométrique et l’élaboration d’instruments d’évaluation de la personnalité constituent un autre domaine d’élection de la validation croisée unitaire. Lors de la construction d’inventaires psychologiques ou d’échelles de mesure des états affectifs, les théoriciens cherchent à concevoir des scores composites fondés sur un sous-ensemble minimal d’items hautement informatifs, incarnant le principe de parcimonie scientifique. Le risque est alors d’ajuster une régression multivariée sur les réponses à un questionnaire de sorte que les pondérations factorielles reflètent les idiosyncrasies de l’échantillon d’étalonnage plutôt que les véritables dimensions latentes de l’esprit humain.
L’intégration de la LOOCV au cœur des procédures d’étalonnage psychométrique permet de quantifier avec une rigueur accrue la stabilité prédictive des traits latents identifiés. Par exemple, lorsqu’il s’agit de prédire le niveau d’alexithymie ou la propension à l’épuisement professionnel à partir d’une batterie préliminaire d’items comportementaux, la LOOCV permet d’évaluer la dégradation de performance prédictive subie par le modèle lorsqu’un participant n’a pas été inclus dans la pondération des items. Si le score prédictif individuel s’effondre de manière dramatique sous exclusion unitaire, l’échelle révèle une vulnérabilité psychométrique masquée par les coefficients de corrélation internes conventionnels.
En outre, la méthode offre un étalon robuste pour départager différentes formules d’agrégation d’échelles. Entre un modèle factoriel exploratoire saturé et un modèle factoriel confirmatoire contraint à quelques liaisons théoriques clés, la comparaison de leurs LOOCV MSE respectifs constitue une mesure empirique directe de leur capacité à extrapoler leurs prédictions psychométriques à de futurs répondants, renforçant la validité écologique de l’instrument avant sa commercialisation ou sa dissémination académique.
7.3 Modélisation computationnelle du comportement décisionnel
L’essor de la psychiatrie et de l’économie comportementale computationnelles a substitué aux questionnaires statiques des paradigmes d’apprentissage expérimental dans lesquels les participants prennent des centaines de décisions consécutives face à des récompenses probabilistes ou des renforcements asymétriques. Les chercheurs déploient alors des architectures formelles issues de la théorie de l’apprentissage par renforcement (reinforcement learning) ou des modèles de diffusion séquentielle pour cartographier les mécanismes cognitifs sous-tendant les arbitrages individuels.
Dans ce paradigme de modélisation mathématique, les paramètres individuels libres — tels que le taux d’apprentissage alpha, la température d’exploration comportementale bêta dans la règle de décision Softmax, le taux d’actualisation temporelle ou le coefficient d’aversion aux pertes — sont ajustés pour maximiser la vraisemblance des comportements observés chez chaque sujet. Lorsque la recherche vise à prédire des phénotypes cliniques globaux (comme l’impulsivité pathologique ou le risque addictif) à partir de ces paramètres computationnels latents, la validation croisée Leave-One-Out intervient comme l’arbitre quantitatif ultime.
La LOOCV permet d’entraîner des fonctions de prédiction macroscopiques reliant les profils computationnels de n – 1 participants à leurs diagnostics médicaux, puis de tester le pouvoir discriminant de ces paramètres sur le sujet isolé. Cette approche fournit une démonstration directe de la pertinence neurobiologique des modèles formels : elle atteste que les paramètres extraits au prix d’un formalisme mathématique sophistiqué ne sont pas de simples artefacts d’ajustement local, mais constituent des prédicteurs généraux transposables d’un individu à un autre au sein de la population humaine.
8. Adaptation de la LOOCV aux problèmes de classification
8.1 Transposition de la méthode aux cibles discrètes et binaires
Bien que son formalisme initial et ses raccourcis computationnels soient fréquemment introduits à travers le prisme de la régression continue sous erreur quadratique, la validation croisée Leave-One-Out s’adapte avec rigueur aux problèmes de classification statistique, qu’ils impliquent des cibles binaires ou des assignations multinomiales discrètes. Dans cette typologie d’investigation, l’objectif fondamental consiste à anticiper l’appartenance d’une observation à une catégorie nominale qualitative spécifique — par exemple, discriminer un état de rémission clinique d’un état de rechute symptomatique en psychopathologie.
La transposition conceptuelle demeure rigoureusement identique dans son exécution séquentielle : à chaque itération, l’algorithme de classification affine sa frontière de décision à partir des n – 1 observations d’entraînement, puis attribue une classe prédite ŷ_i à l’observation mise en réserve. L’indicateur synthétique élémentaire devient alors le taux d’erreur de classification Leave-One-Out, qui mesure la proportion relative de mauvaises affectations catégorielles enregistrées sur l’ensemble du cycle itératif :
Erreur_{classif}^{LOOCV} = (1 / n) * ∑_{i=1}^{n} I(y_i ≠ ŷ_i)
où I(·) désigne la fonction indicatrice booléenne qui renvoie la valeur 1 lorsque l’inégalité est vérifiée (discordance prédictive) et la valeur 0 dans le cas contraire (classification exacte). Cette métrique offre au praticien une lecture directe et intuitive de l’inadéquation opérationnelle de son modèle de diagnostic automatisé.
8.2 Indicateurs de performance alternatifs au MSE
L’usage du taux d’erreur brut ou de son complémentaire, l’exactitude globale (accuracy), présente toutefois des lacunes analytiques reconnues, en occultant le degré d’incertitude associé aux décisions prises par les algorithmes probabilistes. De nos jours, des modèles tels que la régression logistique ou les forêts aléatoires de classification génèrent non seulement des étiquettes binaires, mais avant tout des probabilités conditionnelles calibrées d’appartenance à la classe cible, notées p̂_{-i}(x_i) = P(Y = 1 | X = x_i).
Pour exploiter cette finesse informationnelle, l’analyste privilégiera des fonctions de perte strictement probabilistes, au premier rang desquelles figure la perte logarithmique (log-loss ou déviance unitaire). La déviance LOOCV se formalise comme la moyenne des logarithmes négatifs des probabilités conditionnelles assignées à la véritable modalité survenue :
LogLoss_{LOOCV} = – (1 / n) * ∑_{i=1}^{n} [ y_i * ln(p̂_{-i}(x_i)) + (1 – y_i) * ln(1 – p̂_{-i}(x_i)) ]
Cette formulation pénalise sévèrement les modèles délivrant des prédictions erronées avec un indice de confiance élevé, orientant ainsi l’optimisation vers une calibration probabiliste bien plus fiable. Parallèlement, l’agrégation ordonnée des probabilités hors-échantillon p̂_{-i} permet de construire la courbe des caractéristiques de fonctionnement du récepteur (courbe ROC) et d’estimer l’aire sous la courbe (AUC, pour Area Under the Curve) sans subir le moindre biais d’optimisme intra-échantillon. Cette métrique synthétique permet de quantifier avec acuité le pouvoir de discrimination du modèle clinique, indépendamment du seuil de décision arbitraire retenu pour la binarisation.
8.3 Gestion des déséquilibres de classes dans la validation unitaire
L’application de la LOOCV en classification se heurte néanmoins à un point de rupture statistique majeur dès lors que la distribution de la variable cible présente un déséquilibre prononcé (class imbalance). Cette asymétrie caractérise couramment les études épidémiologiques axées sur des psychopathologies sévères ou des comportements autodestructeurs rares au sein de la population générale (comme la tentative de suicide), où la prévalence de la classe pathologique minoritaire peut ne représenter que 2 % ou 5 % du total des cas répertoriés.
Dans un échantillon de n = 50 participants ne comportant que deux cas appartenant à la classe positive, la LOOCV classique génère un déséquilibre méthodologique sévère. Lorsque le protocole isole délibérément l’un de ces deux cas rares pour constituer l’ensemble de test, le modèle d’entraînement se retrouve avec 49 sujets parmi lesquels ne figure plus qu’un unique représentant de la classe cible. La prévalence d’apprentissage chute instantanément de moitié par rapport à la distribution empirique native, affaiblissant dramatiquement la capacité de l’algorithme à calibrer la frontière décisionnelle de la modalité minoritaire.
Si la cohorte ne compte qu’une seule observation positive pour 49 contrôles, l’exclusion de ce sujet unique crée une situation d’apprentissage aberrante : le modèle est entraîné sur un échantillon mono-classe où la classe cible est totalement absente, rendant formellement impossible la prédiction de cette modalité lors de l’évaluation unitaire. Face à de telles distributions fortement asymétriques, la LOOCV conventionnelle doit être ajustée au moyen de techniques de rééquilibrage interne (telles que le suréchantillonnage de type SMOTE strictement confiné au bloc d’entraînement n – 1) ou cédée au profit d’une validation croisée k-fold stratifiée, capable de verrouiller des proportions de classes identiques au sein de chaque subdivision de l’espace empirique.
9. Implémentation pratique : Outils, environnements et code
9.1 Mise en œuvre dans l’environnement R
L’environnement statistique de programmation R offre un écosystème d’une maturité exceptionnelle pour déployer la validation croisée Leave-One-Out, grâce à ses paquets historiques dédiés à la modélisation rigoureuse. L’architecture la plus réputée et la plus éprouvée repose sur le métapaquet de référence caret (Classification and Regression Training), développé pour unifier la syntaxe d’évaluation à travers des centaines d’algorithmes sous-jacents. La configuration de la méthode s’opère par l’intermédiaire de l’objet de contrôle fonctionnel trainControl, au sein duquel il convient d’expliciter le paramètre formel method = "LOOCV".
Lorsque cette directive est transmise à la fonction générique d’ajustement train, le moteur d’exécution de caret orchestre de manière entièrement transparente l’extraction séquentielle des n sous-ensembles, l’ajustement de la fonction et la consolidation des résidus. Parallèlement, pour les modèles appartenant à la vaste famille des modèles linéaires généralisés (GLM), le paquet boot met à disposition la fonction hautement optimisée cv.glm. Si l’argument désignant le nombre de plis (K) n’est pas spécifié, cette routine bascule par défaut vers une exécution intégrale de la LOOCV en mobilisant des approximations analytiques dérivées des leviers statistiques, évitant ainsi la réitération lourde des boucles d’optimisation numérique.
Enfin, dans l’hypothèse où l’analyste recourt au modèle linéaire classique calibré par les moindres carrés ordinaires via la primitive de base lm, il est possible d’extraire directement les éléments diagonaux de la matrice de projection orthogonale au moyen de l’instruction native hatvalues(modele). Cette extraction permet de calculer instantanément le vecteur des résidus LOOCV sans solliciter aucune bibliothèque tierce, assurant une légèreté d’exécution maximale dans les scripts de production analytique.
9.2 Mise en œuvre sous Python avec Scikit-Learn
Au sein de l’écosystème open-source Python dédié à la science des données et à l’intelligence artificielle, la bibliothèque standardisée Scikit-Learn propose une suite d’abstractions de haut niveau remarquablement articulées. L’objet central dédié à la mise en œuvre de la validation unitaire est la classe d’itération LeaveOneOut, localisée au sein du module d’évaluation sklearn.model_selection. Cette classe agit comme un générateur efficace d’indices binaires, scindant itérativement une matrice de caractéristiques multidimensionnelle de taille n en masques booléens d’apprentissage et de test.
Pour mesurer la performance d’un estimateur sans avoir à écrire manuellement la structure séquentielle de la boucle for, le chercheur encapsule l’estimateur et le modèle dans la fonction modulaire cross_val_score, en transmettant l’instance de partitionnement à l’argument dédié : cv = LeaveOneOut(). Cette fonction retourne de manière automatisée un tableau NumPy unidimensionnel regroupant les n scores de perte unitaire, dont il suffit ensuite d’extraire la moyenne et l’écart-type d’échantillonnage pour consolider la métrique agrégée.
Alternativement, l’emploi de l’instruction cross_val_predict s’avère particulièrement pertinent lorsque l’analyste désire récupérer le vecteur complet des prédictions générées exclusivement hors-échantillon. Cette structure de données vectorielle permet d’alimenter directement des calculs subséquents de matrices de confusion désagrégées, de tracés de distributions résiduelles ou de calibrations de courbes ROC. Il est toutefois recommandé de procéder à un profilage algorithmique méthodique de l’exécution (au moyen des utilitaires standards de mesure de temps) avant d’engager ce processus sur des jeux de données d’envergure, afin de prévenir tout gel d’exécution mémoire face à des modèles computationally prohibitifs.
9.3 Prévention rigoureuse des fuites d’information (data leakage)
L’implémentation opérationnelle de la LOOCV expose les praticiens à une erreur de protocole insidieuse, fréquemment passée sous silence mais dévastatrice pour la validité des conclusions : la fuite d’information hors-échantillon (data leakage). Ce phénomène pernicieux se manifeste dès lors que des décisions ou des transformations appliquées à la matrice de données mobilisent, directement ou subrepticement, des informations issues de l’observation censée demeurer strictement invisible au cours de l’itération évaluative.
L’illustration la plus universelle de cette dérive méthodologique concerne les opérations de prétraitement élémentaires, telles que le centrage et la réduction des variables explicatives (standardisation par le Z-score) ou l’imputation de valeurs manquantes par la moyenne empirique. Procéder à la standardisation de l’intégralité de la base de données de taille n avant d’enclencher la boucle itérative Leave-One-Out constitue une violation grave de l’étanchéité expérimentale. En effet, la moyenne globale et l’écart-type mobilisés pour standardiser chaque observation incorporent alors la valeur de l’observation de test mise en quarantaine, contaminant le modèle par une connaissance a priori de la dispersion générale.
La règle d’or d’une implémentation hermétique impose que l’intégralité des prétraitements, incluant sans exception le centrage, la réduction, la sélection discriminante de prédicteurs par seuillage ou l’extraction de composantes principales (PCA), soit rigoureusement encapsulée à l’intérieur de chaque pas itératif et calibrée exclusivement sur les n – 1 données d’entraînement. En Python, cette sanctuarisation s’opère impérativement par l’emploi des pipelines Scikit-Learn (sklearn.pipeline.Pipeline), qui garantissent que les transformateurs ne soient instruits (fit) que sur le pli actif d’apprentissage avant d’être appliqués sans réajustement (transform) à l’observation test unitaire.
10. Diagnostic, interprétation et valorisation des résultats
10.1 Analyse empirique de la distribution des résidus d’exclusion
Une fois le cycle des n évaluations unitaires accompli avec succès, l’étape analytique essentielle consiste à analyser la structure des résidus d’exclusion (ou résidus PRESS, pour Prediction Residual Error Sum of Squares). Se borner à synthétiser cette masse de données sous la forme d’un indicateur scalaire unique — le MSE agrégé — appauvrit substantiellement la compréhension des mécanismes prédictifs. L’analyse visuelle et diagnostique du nuage de points reliant les prédictions unitaires ŷ_i aux valeurs empiriques observées y_i constitue la première vérification empirique fondamentale.
Cette représentation graphique permet d’identifier l’émergence d’éventuelles non-linéarités sous-jacentes. Si le nuage des écarts d’exclusion présente une déviation curvilinéaire ou une structure en entonnoir, cela traduit l’incapacité du modèle à capturer fidèlement la géométrie des données aux extrêmes de la distribution. Cette inspection visuelle permet en outre de vérifier l’hypothèse d’homoscédasticité des prédictions hors-échantillon : une variance d’erreur d’extrapolation s’amplifiant avec la magnitude de la cible prédite signale une instabilité prédictive nécessitant une transformation stabilisatrice préalable de la variable dépendante (par exemple, une conversion logarithmique).
Enfin, le tri décroissant des résidus e_i^{loo} permet d’isoler les participants atypiques générant les tensions résiduelles les plus sévères. L’analyste doit inspecter minutieusement le dossier empirique de ces observations isolées : reflètent-elles des comportements d’évaluation aberrants, des biais de mesure instrumentaux ou, plus fondamentalement, des limites intrinsèques à la théorie psychologique formulée par le modèle ? L’analyse de ces échecs prédictifs ciblés constitue fréquemment le point de départ de découvertes théoriques plus élaborées.
10.2 Sélection et arbitrage entre modèles concurrents
L’un des rôles majeurs dévolus à la validation croisée Leave-One-Out réside dans l’arbitrage quantitatif et la sélection de modèles statistiques concurrents. Face à une pluralité d’hypothèses scientifiques concurrentes matérialisées par des architectures fonctionnelles distinctes — par exemple, un modèle linéaire simple, un modèle polynomial d’ordre croissant ou un modèle additif généralisé —, la comparaison de leurs scores LOOCV MSE offre un critère empirique objectif pour déterminer quelle formulation optimise l’équilibre fondamental entre adéquation et complexité.
Sur le plan épistémologique, la LOOCV matérialise le principe de parcimonie selon le principe du rasoir d’Ockham : une architecture trop dépouillée générera des prédictions sous-ajustées médiocres (biais élevé), tandis qu’une formulation artificiellement surparamétrée sera lourdement sanctionnée par la volatilité de ses prédictions hors-échantillon (variance élevée). La spécification qui minimise le critère LOOCV MSE constitue dès lors la formulation la plus robuste pour approcher la fonction génératrice des données sans verser dans la surinterprétation du bruit expérimental.
Dans cette perspective décisionnelle, il est particulièrement formateur de confronter le comportement de la LOOCV à celui des critères d’information théoriques traditionnels fondés sur la théorie de la décision, tels que le critère d’Akaike (AIC) ou le critère d’information bayésien (BIC). Les travaux de Stone (1977) ont formellement démontré une équivalence asymptotique remarquable : dans le cadre de la régression linéaire et des modèles de vraisemblance, sélectionner un modèle par minimisation de l’erreur LOOCV équivaut asymptotiquement à minimiser l’AIC. Cette convergence mathématique valide l’usage de la LOOCV comme une alternative empirique puissante lorsque les hypothèses de régularité paramétrique nécessaires à la dérivation analytique de l’AIC ne sont pas rigoureusement vérifiées.
10.3 Communication académique des métriques selon les normes
La publication des résultats issus d’une validation croisée Leave-One-Out au sein de revues scientifiques à comité de lecture exige une transparence méthodologique absolue, en accord avec les standards rédactionnels les plus exigeants de la communauté scientifique, notamment les recommandations de l’American Psychological Association (APA 7th edition). Les pratiques méthodologiques proscrivent formellement de communiquer une simple valeur brute d’exactitude ou de MSE sans expliciter l’ensemble des conditions computationnelles ayant présidé à son extraction.
Le corps du manuscrit doit documenter de manière non ambiguë les éléments suivants :
- La justification explicite du choix de la méthode LOOCV au regard des contraintes dimensionnelles de l’échantillon collecté et de la nature structurelle du modèle mobilisé.
- La formulation rigoureuse de la fonction de coût utilisée pour quantifier la performance unitaire (erreur quadratique moyenne, perte absolue, déviance logarithmique ou taux d’erreur de classification).
- La mention explicite de l’herméticité des prétraitements, attestant formellement qu’aucun centrage, réduction ou sélection de descripteurs n’a été exécuté en amont de la boucle de partitionnement itératif.
- La publication conjointe, aux côtés de la moyenne agrégée de l’erreur, d’une mesure de dispersion statistique reflétant la variabilité d’estimation — typiquement l’écart-type de la distribution des résidus d’exclusion unitaires ou un intervalle de confiance bootstrap calculé sur ces derniers.
Une telle rigueur déclarative garantit non seulement l’intégrité intellectuelle des résultats rapportés, mais offre également aux futurs pairs évaluateurs et aux réplicateurs potentiels les spécifications techniques requises pour reproduire fidèlement les analyses sur des cohortes indépendantes.
11. Variantes avancées pour structures de données spécifiques
11.1 Leave-One-Subject-Out (LOSO) et approches par grappes
Pour surmonter l’impasse méthodologique évoquée précédemment face aux données dépendantes, la théorie statistique contemporaine a forgé une adaptation élégante : la validation croisée Leave-One-Subject-Out (LOSO), également conceptualisée sous le vocable de Leave-One-Cluster-Out. Cette méthodologie s’impose comme le standard méthodologique impératif pour l’analyse des protocoles écologiques momentanés (EMA), des séries longitudinales de neuro-imagerie ou de tout dispositif d’évaluation répétée au sein duquel chaque unité statistique fournit une multitude de points de données distincts.
Au lieu de scinder les données de manière atomique au niveau des observations isolées, l’approche LOSO réorganise le partitionnement en s’alignant sur l’entité statistique de rang supérieur : le sujet ou la grappe. À chaque itération du protocole :
- L’intégralité des mesures associées à un participant donné (qu’il s’agisse de dix, de cent ou de mille mesures temporelles) est simultanément extraite pour composer l’ensemble de test unitaire.
- Le modèle prédictif est ajusté exclusivement sur les données provenant des m – 1 autres sujets composant la cohorte.
- L’évaluation prédictive est ensuite menée sur le bloc de mesures réservé, mesurant la capacité du modèle à prédire les comportements d’un esprit humain entièrement nouveau.
Cette sanctuarisation rétablit l’indépendance statistique fondamentale entre le corpus d’entraînement et le sous-ensemble d’évaluation. Les corrélations idiosyncrasiques propres au fonctionnement intime d’un participant ne peuvent plus contaminer les étapes de calibration. Bien qu’elle entraîne une diminution prévisible des scores d’exactitude comparativement à une LOOCV naïve, la LOSO délivre une mesure authentiquement écologique de la transférabilité inter-individuelle, constituant la seule mesure prédictive éthiquement et méthodologiquement recevable lors du déploiement de logiciels d’assistance au diagnostic clinique.
11.2 Adaptation aux séries chronologiques et données séquentielles
Dans l’analyse des séries temporelles univariées ou multivariées — telles que l’évolution continue des cours boursiers, les enregistrements électroencéphalographiques (EEG) ou le monitoring continu de biomarqueurs physiologiques —, la dimension temporelle impose une contrainte d’antériorité causale inviolable. Dans ce contexte, la validation croisée Leave-One-Out standard s’avère fondamentalement inapplicable en raison de son anachronisme inhérent : écarter une observation à l’instant t pour l’évaluer à partir d’un modèle instruit par des données recueillies à t – 1 mais également à t + 1 équivaut à exploiter le futur pour prédire le passé.
Pour préserver l’ordre chronologique des processus stochastiques dynamiques, la LOOCV doit muter vers une architecture séquentielle par chaînage avant (forward-chaining ou rolling-origin evaluation). Dans cette transposition causale, l’évaluation de l’observation à l’instant temporel t s’effectue exclusivement au moyen d’un modèle calibré sur la fenêtre temporelle des observations antérieures couvrant l’intervalle de 1 jusqu’à t – 1. Une fois la prédiction formulée et le résidu consigné, la fenêtre d’apprentissage s’étend pour englober le point t, et le modèle est réajusté pour prédire l’instant t + 1.
Cette approche séquentielle neutralise toute contamination informationnelle rétrograde. Elle reproduit fidèlement la réalité phénoménologique de la prévision opérationnelle, où l’analyste ne dispose jamais d’aucun regard sur l’avenir pour ajuster ses anticipations décisionnelles. Si cette procédure déroge à la règle de taille constante d’échantillon d’apprentissage propre à la LOOCV classique, elle incarne la seule déclinaison rigoureuse de l’évaluation itérative continue face à des séries dynamiques non stationnaires.
11.3 Approximations bayésiennes : la méthode PSIS-LOO
Dans le paradigme de l’inférence bayésienne computationnelle, l’évaluation des modèles hiérarchiques se heurte de manière critique au coût de calcul des simulations par chaînes de Markov Monte Carlo (MCMC). Ajuster un modèle bayésien complexe au moyen d’algorithmes comme NUTS (No-U-Turn Sampler) sous le langage de programmation probabiliste Stan peut exiger des dizaines de minutes d’échantillonnage pour atteindre la convergence diagnostique des chaînes. Dans ces conditions, répéter l’estimation MCMC intégrale n fois dans le cadre d’une LOOCV exacte représente un coût computationnel rédhibitoire pour la recherche appliquée.
Pour résoudre cette équation logistique complexe, Vehtari, Gelman et Gabry (2017) ont formulé une avancée algorithmique majeure : la méthode PSIS-LOO (Pareto Smoothed Importance Sampling Leave-One-Out). Cette technique d’approximation bayésienne permet d’estimer avec une fidélité mathématique remarquable la distribution prédictive a posteriori hors-échantillon LOOCV à partir d’un seul et unique échantillonnage MCMC mené sur le modèle complet de taille n.
Le tour de force théorique de la PSIS-LOO repose sur le recours à l’échantillonnage d’importance (importance sampling), qui pondère les tirages de la distribution conjointe a posteriori globale pour simuler l’absence de l’observation i. Pour corriger l’instabilité chronique et la variance potentiellement infinie des poids d’importance bruts, les auteurs ont introduit une procédure d’ajustement semi-paramétrique lissant la queue de distribution des poids au moyen d’une loi de Pareto généralisée. Cette modélisation fournit en outre un indicateur diagnostique inestimable : le paramètre de forme de Pareto, universellement désigné par l’indice k̂ (k-hat).
Si la valeur estimée k̂ pour une observation demeure strictement inférieure au seuil critique de 0,7, l’approximation théorique de la LOOCV est considérée comme extrêmement robuste, dispensant le chercheur de tout réajustement numérique lourd. Si k̂ franchit ce seuil pour un contingent restreint d’observations instables, seules ces entités spécifiques font l’objet d’un réajustement MCMC ciblé sans approximation. Intégrée nativement au cœur des bibliothèques bayésiennes contemporaines comme brms et loo sous R, ou ArviZ sous Python, la méthode PSIS-LOO s’est imposée comme le standard dominant de comparaison de modèles cognitifs et hiérarchiques bayésiens.
12. Synthèse critique et arbre de décision méthodologique
12.1 Arbre décisionnel pour guider le choix du chercheur
Face à la multiplicité des méthodologies d’évaluation empirique disponibles, le praticien ou le chercheur quantitatif a besoin d’un cadre heuristique clair et structuré pour arbitrer entre la LOOCV et ses approches concurrentes. Le choix méthodologique ne saurait relever d’une simple préférence stylistique individuelle : il procède d’une analyse systématique des contraintes dimensionnelles de l’échantillon, de la nature mathématique du modèle algorithmique mobilisé et de la structure probabiliste des données expérimentales.
L’arbre de décision méthodologique suivant résume les règles de décision canoniques pour sélectionner la stratégie d’évaluation idoine :
- Cas 1 : Taille d’échantillon très restreinte (n < 50 à 100 observations)
- Structure de données indépendantes (i.i.d.) : Privilégier formellement la LOOCV. Dans ce régime dimensionnel contraint, la maximisation du volume d’apprentissage (n – 1) est essentielle pour préserver la qualité d’ajustement paramétrique, et le biais quasi-nul de l’estimateur compense largement son éventuelle instabilité de variance.
- Structure hiérarchique, groupée ou mesures répétées : Proscrire la LOOCV unitaire atomique et déployer impérativement la méthode Leave-One-Subject-Out (LOSO) ou une partition par grappes adaptée.
- Cas 2 : Échantillon d’envergure intermédiaire ou massive (n > 500 à 100 000+ observations)
- Modèle de régression linéaire sous moindres carrés : L’usage de la LOOCV via la matrice chapeau demeure pertinent et quasi instantané sur le plan computationnel.
- Modèles non-linéaires complexes, réseaux profonds ou méthodes d’ensemble : Rejeter la LOOCV en raison de sa charge temporelle prohibitive. Orienter le protocole vers une validation croisée k-fold stratifiée (k = 5 ou 10), potentiellement répliquée plusieurs fois pour stabiliser la mesure de variance.
- Cas 3 : Séries temporelles dynamiques et signaux continus
- Exclure formellement la LOOCV standard en raison des risques de contamination temporelle rétrograde. Recourir exclusivement au chaînage séquentiel avant (rolling-origin).
- Cas 4 : Modélisation statistique bayésienne complexe sous MCMC
- Écarter la LOOCV par rééchantillonnage exhaustif au profit de l’approximation bayésienne PSIS-LOO, tout en vérifiant rigoureusement que les diagnostics k̂ demeurent sous la barre des 0,7.
12.2 Récapitulatif des pièges analytiques courants
L’exploitation de la LOOCV dans la littérature scientifique contemporaine demeure fréquemment entachée d’erreurs d’interprétation qui en altèrent les conclusions. Le tableau ci-dessous récapitule les trois pièges analytiques les plus répandus, leurs conséquences statistiques directes, ainsi que les stratégies de remédiation méthodologique associées :
- Piège 1 : Ignorer la dépendance structurelle des données.
Conséquence directe : Fuite systémique d’information (data leakage) conduisant à un optimisme prédictif trompeur et à une absence totale de généralisation clinique réelle.
Remédiation : Identifier rigoureusement l’unité statistique d’indépendance de plus haut niveau et basculer sans compromis vers une architecture Leave-One-Subject-Out (LOSO). - Piège 2 : Prétraiter les prédicteurs en amont du partitionnement.
Conséquence directe : Biais de circularité inductif lors du centrage, de la réduction ou de la sélection univariée de descripteurs sur le jeu complet.
Remédiation : Encapsuler impérativement chaque phase de transformation logicielle au moyen de pipelines d’exécution hermétiques qui n’instruisent les paramètres de transformation que sur le contingent résiduel de calibration unitaire. - Piège 3 : Sur-interpréter des micro-différences de scores d’adéquation.
Conséquence directe : Sélection d’architectures instables ou surparamétrées due à la méconnaissance de la variance propre de l’estimateur LOOCV en milieu bruité.
Remédiation : Ne jamais statuer sur la supériorité d’un modèle sur la foi d’un écart infinitésimal de MSE ; accompagner systématiquement l’analyse d’un test formel de comparaison de modèles (comme le test de DeLong ou un test de comparaison apparié de résidus d’exclusion) et confronter les sélections aux critères théoriques pénalisés de type BIC.
12.3 Perspectives futures de l’évaluation prédictive
Au confluent de la science ouverte, de l’apprentissage automatique et des sciences comportementales, l’évaluation des modèles prédictifs connaît une profonde mutation méthodologique. La démarcation historique qui scindait autrefois les statisticiens de l’inférence causale — focalisés sur la significativité paramétrique intra-échantillon (valeurs de p) — et les praticiens du machine learning — orientés exclusivement vers l’adéquation algorithmique brute — tend progressivement à s’estomper. Dans ce mouvement de convergence épistémologique, la validation croisée Leave-One-Out joue un rôle pivot.
L’intégration systématique des techniques de rééchantillonnage itératif au sein des protocoles de recherche fondamentale constitue désormais une norme d’excellence. En imposant aux modèles explicatifs de prouver leur résilience unitaire face à des observations isolées, les communautés scientifiques élèvent considérablement le niveau d’exigence méthodologique des résultats publiés. Ce filtre rigoureux prévient l’inflation de théories éphémères échafaudées sur des corrélations accidentelles, assainissant durablement la littérature scientifique face aux défis récurrents de la réplication.
Enfin, l’émergence conjointe de solveurs algébriques haute performance, d’architectures de parallélisation massive et de métriques d’approximation probabiliste de type PSIS-LOO repousse continuellement les frontières computationnelles qui entravaient jadis l’approche unitaire. Maîtrisée dans ses fondements mathématiques, comprise dans ses forces d’invariance et surveillée dans ses limites de corrélation, la validation croisée Leave-One-Out s’affirme plus que jamais comme un instrument incontournable de l’arsenal méthodologique contemporain, garantissant une recherche rigoureuse, transparente et résolument tournée vers la robustesse prédictive.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://doi.org/10.1007/978-0-387-84858-7
- James, G., Witten, D., Hastie, T., & Tibshirani, R. (2021). An Introduction to Statistical Learning: with Applications in R (2nd ed.). Springer. https://doi.org/10.1007/978-1-0716-1418-1
- Kohavi, R. (1995). A study of cross-validation and bootstrap for accuracy estimation and model selection. In Proceedings of the 14th International Joint Conference on Artificial Intelligence (IJCAI), 2, 1137–1145.
- Stone, M. (1974). Cross-validatory choice and assessment of statistical predictions. Journal of the Royal Statistical Society: Series B (Methodological), 36(2), 111–133. https://doi.org/10.1111/j.2517-6161.1974.tb00994.x
- Stone, M. (1977). An asymptotic equivalence of choice of model by cross-validation and Akaike’s criterion. Journal of the Royal Statistical Society: Series B (Methodological), 39(1), 44–47. https://doi.org/10.1111/j.2517-6161.1977.tb01603.x
- Vehtari, A., Gelman, A., & Gabry, J. (2017). Practical Bayesian model evaluation using leave-one-out cross-validation and WAIC. Statistics and Computing, 27(5), 1413–1432. https://doi.org/10.1007/s11222-016-9696-4
- Yarkoni, T., & Westfall, J. (2017). Choosing prediction over explanation in psychology: An evaluation of machine learning approaches. Perspectives on Psychological Science, 12(6), 1100–1122. https://doi.org/10.1177/1745691617693393