
L’espérance mathématique constitue la pierre angulaire de la théorie des probabilités et de la statistique inférentielle moderne. Historiquement formulée au milieu du dix-septième siècle à travers la correspondance entre Blaise Pascal et Pierre de Fermat au sujet du problème des partis, elle formalise l’intuition du gain moyen qu’un observateur peut escompter d’un phénomène aléatoire répété un grand nombre de fois. Dans le paradigme contemporain de la science des données, de l’apprentissage automatique et de l’économétrie financière, cette grandeur stochastique transcende largement le cadre des jeux de hasard pour devenir l’opérateur fondamental guidant l’optimisation des fonctions de perte, l’évaluation des risques et la prise de décision en situation d’incertitude.
La manipulation computationnelle de ce concept exige toutefois une articulation rigoureuse entre la rigueur mathématique de la théorie de la mesure et l’efficacité algorithmique des architectures logicielles actuelles. Le langage Python, fort de son écosystème scientifique comprenant NumPy, SciPy et Pandas, offre un environnement d’une puissance exceptionnelle pour modéliser, estimer et analyser l’espérance de variables aléatoires tant discrètes que continues. Néanmoins, l’ingénieur ou le chercheur confronté à des espaces d’états volumineux ou à des densités complexes doit appréhender avec précision les mécanismes sous-jacents d’arrondi numérique, de vectorisation et de convergence asymptotique pour éviter les biais d’estimation.
Ce traité exhaustif a pour vocation d’exposer de manière méthodique les fondements théoriques, les implémentations algorithmiques et les applications avancées du calcul de l’espérance mathématique en Python. De la programmation fonctionnelle pure aux architectures orientées objet hautement optimisées, en passant par l’intégration numérique adaptative et les simulations stochastiques de Monte-Carlo, chaque étape sera analysée sous le prisme de l’exactitude mathématique et de l’ingénierie logicielle de pointe.
1. Fondements théoriques de l’espérance mathématique
1.1 Définition mathématique et formalisme stochastique
Dans le cadre axiomatique formalisé par le mathématicien Andreï Kolmogorov en 1933, un phénomène aléatoire est modélisé par un espace probabilisé défini par un triplet canonique comprenant un ensemble fondamental d’événements élémentaires, une tribu ou algèbre d’événements fermée sous les opérations ensemblistes dénombrables, et une mesure de probabilité assignant une valeur comprise entre zéro et un à chaque élément de cette tribu. Une variable aléatoire réelle discrète constitue une fonction mesurable appliquant cet espace fondamental dans l’ensemble des nombres réels, prenant un nombre fini ou infini dénombrable de valeurs distinctes.
L’espérance mathématique de cette variable, universellement notée sous le symbole de l’opérateur d’espérance ou par la lettre grecque mu, se définit formellement comme la somme pondérée de toutes les réalisations possibles de la variable, multipliées par leurs probabilités d’occurrence respectives. Si l’espace d’états discret est indexé par un ensemble fini ou dénombrable d’indices, l’expression prend la forme analytique fondamentale où l’espérance est égale à la sommation de chaque valeur réalisable multipliée par la fonction de masse de probabilité évaluée en cette même valeur. Cette sommation représente le barycentre ou centre de gravité de la distribution de probabilité, matérialisant le point d’équilibre statique de la masse probabiliste distribuée le long de la droite réelle.
Il est impératif d’opérer une distinction épistémologique et technique stricte entre cette espérance théorique et la moyenne empirique calculée sur un échantillon d’observations. L’espérance mathématique est une constante déterministe intrinsèque à la loi de probabilité gouvernant la variable aléatoire, accessible uniquement lorsque la distribution sous-jacente est parfaitement connue a priori. À l’opposé, la moyenne empirique est elle-même une variable aléatoire fluctuante, dérivée d’un tirage fini de réalisations indépendantes et identiquement distribuées. La convergence de cette dernière vers l’espérance théorique n’est garantie qu’asymptotiquement, lorsque la taille de l’échantillon tend vers l’infini, en vertu des théorèmes limites fondamentaux du calcul stochastique.
1.2 Variables aléatoires discrètes versus continues
La nature mathématique de l’espace d’états conditionne fondamentalement l’opérateur analytique employé pour calculer l’espérance. Dans le domaine discret, l’opérateur se résume à une sommation discrète, finie ou dénombrable. Lorsque l’espace des réalisations possibles est dénombrable mais infini, à l’instar d’une loi de Poisson régissant des comptages d’événements ou d’une loi géométrique modélisant le temps d’attente d’un premier succès, l’espérance n’est mathématiquement définie que si la série infinie converge absolument. Cette condition d’intégrabilité absolue impose que la sommation de la valeur absolue de chaque réalisation multipliée par sa probabilité demeure strictement inférieure à l’infini, écartant ainsi les paradoxes d’indétermination liés à l’ordre des termes.
Dans le domaine continu, la variable aléatoire peut assumer n’importe quelle valeur au sein d’un intervalle continu de la droite réelle ou sur l’ensemble complet des réels. La probabilité ponctuelle d’observer une valeur exacte quelconque est rigoureusement nulle. L’analyse probabiliste recourt alors à une fonction de densité de probabilité, continue ou continue par morceaux, dont l’intégrale sur un borélien donné fournit la probabilité que la variable appartienne à cet ensemble. L’espérance mathématique est alors formulée par l’intégrale de Lebesgue-Stieltjes, se simplifiant pour les densités usuelles en l’intégrale de Riemann du produit de la variable par sa fonction de densité sur l’ensemble de son support, s’étendant fréquemment de l’infini négatif à l’infini positif.
L’existence de cette intégrale continue est soumise à des exigences de régularité strictes. Si l’intégrale de la valeur absolue de la variable multipliée par sa densité diverge, l’espérance est dite indéfinie ou inexistante au sens strict. Un exemple paradigmatique réside dans la distribution de Cauchy standard, dont la densité symétrique en cloche présente des queues de distribution épaisses à décroissance polynomiale quadratique. Bien que la distribution soit parfaitement symétrique autour de zéro, l’intégrale définissant son espérance diverge en valeur absolue vers l’infini, privant cette distribution de moyenne théorique et invalidant de facto l’application naïve des techniques d’échantillonnage statistique conventionnelles.
1.3 Propriétés algébriques de l’opérateur d’espérance
L’opérateur d’espérance possède des propriétés algébriques fondamentales qui structurent l’ensemble des manipulations analytiques et computationnelles en statistique. La propriété cardinale est sans conteste la linéarité. Soient une variable aléatoire réelle, et deux scalaires déterministes réels a et b. L’espérance de la transformation affine aX + b est rigoureusement égale à a multiplié par l’espérance de X augmenté de la constante b. Cette propriété découle directement de la linéarité de l’intégrale et des séries absolument convergentes. Elle implique qu’un changement d’échelle ou un décalage d’origine sur des mesures expérimentales se répercute de manière strictement proportionnelle sur le moment d’ordre un.
Cette linéarité s’étend avec une élégance remarquable à la somme de plusieurs variables aléatoires, indépendamment de leur structure de dépendance stochastique mutuelle. Pour deux variables aléatoires quelconques définies sur le même espace probabilisé, l’espérance de leur somme est invariablement équivalente à la somme de leurs espérances individuelles. Que les variables soient mutuellement indépendantes, corrélées positivement, ou liées par des dépendances non linéaires complexes, l’additivité demeure inviolée. Cette caractéristique permet de décomposer des problèmes probabilistes multidimensionnels inextricables en une cascade de sous-problèmes univariés traitables analytiquement.
En revanche, le comportement de l’opérateur face au produit de variables aléatoires requiert des hypothèses probabilistes additionnelles. L’espérance du produit de deux variables coïncide avec le produit de leurs espérances respectives si et seulement si la covariance entre ces deux variables est strictement nulle, condition systématiquement remplie lorsque les variables sont stochastiquement indépendantes. Enfin, l’opérateur respecte le principe de monotonie : si une variable aléatoire est presque sûrement inférieure ou égale à une autre variable sur l’espace probabilisé, son espérance sera inférieure ou égale à celle de la seconde. Ces théorèmes forment l’armature logique sur laquelle reposent les algorithmes d’estimation statistique implémentés en Python.
2. Configuration de l’environnement Python pour les calculs statistiques
2.1 Installation et importation des bibliothèques fondamentales
La mise en place d’un environnement computationnel rigoureux constitue le prérequis indispensable à l’exécution stable et reproductible de calculs probabilistes. Bien que l’interpréteur Python standard fournisse des modules arithmétiques de base, l’échelle et la complexité des calculs scientifiques imposent le recours à des bibliothèques hautement optimisées écrites en C et en Fortran. L’écosystème de référence repose sur la triade constituée par NumPy pour la manipulation de structures matricielles denses, SciPy pour l’intégration numérique et les lois statistiques analytiques, et Pandas pour la manipulation de séries de données annotées.
Afin de garantir l’isolation stricte des dépendances et de prévenir les conflits de versions susceptibles d’altérer la fidélité des calculs numériques, l’usage d’un environnement virtuel dédié s’impose. L’utilitaire standard venv ou le gestionnaire multi-plateforme Conda permettent d’instancier un espace hermétique. L’installation s’effectue via le gestionnaire de paquets officiel en ciblant les versions stables les plus récentes. Dans un fichier de configuration de projet ou directement dans le terminal de commande, les bibliothèques sont déployées avec la commande d’installation standard pip install numpy scipy pandas.
Une fois les paquets déployés au sein de l’environnement isolé, leur incorporation dans le code source doit respecter les conventions de nommage unifiées préconisées par la communauté scientifique internationale. On procède à l’importation de NumPy sous l’alias np, de SciPy avec ses sous-modules spécialisés tels que scipy.stats et scipy.integrate, ainsi que de Pandas sous l’alias pd. Il est recommandé d’inclure des routines de vérification dynamique des versions au démarrage des pipelines de production, garantissant que les comportements de vectorisation et les algorithmes sous-jacents de quadrature numérique demeurent strictement déterministes d’une machine à l’autre.
2.2 Structures de données appropriées pour les lois de probabilité
Le choix de la structure de données pour représenter une loi de probabilité conditionne drastiquement les performances d’exécution et l’exactitude des calculs. Les listes natives de Python, bien qu’extrêmement flexibles grâce à leur nature hétérogène et dynamique, présentent des limitations majeures pour le calcul scientifique intensif. Chaque élément d’une liste native est encapsulé dans un objet complet requérant des métadonnées substantielles en mémoire vive, ce qui induit une indirection par pointeurs dispersés et anéantit tout bénéfice lié à la mémoire cache du microprocesseur central.
Pour surmonter ces goulets d’étranglement, le tableau multidimensionnel ndarray de NumPy constitue la structure canonique par excellence. Il stocke les données numériques de manière contiguë dans la mémoire vive sous un type de données homogène. Dans le cadre des calculs probabilistes, la norme industrielle exige l’emploi du type à virgule flottante double précision sur soixante-quatre bits, désigné par float64 selon la norme IEEE 754. Ce format alloue cinquante-deux bits pour la mantisse, onze bits pour l’exposant et un bit pour le signe, assurant une précision d’environ quinze à dix-sept chiffres décimaux significatifs, ce qui est critique pour prévenir les dérives d’arrondi lors de sommations cumulatives de probabilités infinitésimales.
L’organisation structurelle de l’espace probabilisé s’articule généralement autour de deux vecteurs unidimensionnels synchronisés de taille identique : le premier encapsule l’espace d’états, c’est-à-dire l’ensemble exhaustif des réalisations numériques de la variable, tandis que le second matérialise le vecteur des poids stochastiques ou probabilités associées. Pour des systèmes multivariés plus sophistiqués, cette architecture s’étend sous la forme de matrices de probabilités conjointes ou de structures de tenseurs d’états, où chaque cellule de la grille multidimensionnelle correspond à l’intersection d’événements aléatoires discrets.
2.3 Règles d’hygiène de code en calcul scientifique
La robustesse d’un logiciel scientifique repose sur une hygiène de programmation intransigeante. L’absence de vérification formelle des données en amont des calculs constitue la source prépondérante d’erreurs silencieuses en modélisation probabiliste. L’adoption du typage statique au moyen du module standard typing, renforcé par les extensions spécifiques de NumPy comme numpy.typing, permet d’expliciter sans ambiguïté la nature des structures attendues par les fonctions de calcul. Les arguments d’entrée doivent être formellement annotés comme des tableaux à une dimension de nombres réels.
La documentation des fonctions doit impérativement respecter les conventions académiques formelles, telles que le standard de docstrings de NumPy ou de Google. Chaque routine doit détailler méticuleusement la base mathématique sous-jacente, la description exhaustive des paramètres scalaires ou vectoriels d’entrée, les structures renvoyées, ainsi que les exceptions susceptibles d’être levées en cas de violation des axiomes stochastiques. Cette transparence documentaire est indispensable pour faciliter l’audit de code et la reproductibilité par des pairs dans un contexte de recherche ou d’ingénierie critique.
Enfin, la gestion préventive des exceptions doit intercepter toute anomalie structurelle dès l’entrée dans le pipeline computationnel. Le passage de vecteurs de dimensions divergentes, la transmission de probabilités négatives, l’omission de normalisation ou la présence de valeurs non numériques doivent déclencher des interruptions immédiates au moyen de l’instruction raise associée à des exceptions de type ValueError ou TypeError. L’intégration systématique d’assertions défensives protège les couches logicielles avales contre l’incorporation de valeurs corrompues dans les estimateurs statistiques.
3. Calcul de l’espérance en Python pur sans dépendance externe
3.1 Implémentation itérative avec boucles for
Avant d’exploiter la puissance des accélérateurs vectoriels matriciels, il est pédagogiquement et techniquement éclairant de comprendre l’implémentation de l’espérance mathématique en Python pur, en n’utilisant que la syntaxe standard du langage. L’approche itérative élémentaire repose sur l’instanciation de deux listes synchronisées de nombres réels : une liste contenant les valeurs de la variable aléatoire et une liste contenant les probabilités respectives associées à chaque réalisation. Un algorithme d’accumulation séquentielle parcourt simultanément ces collections pour agréger les contributions partielles au sein d’un accumulateur scalaire initialisé à zéro.
D’un point de vue algorithmique, la procédure déploie une boucle itérative indexée de zéro jusqu’à la taille de la collection moins un. À chaque pas d’itération, l’algorithme extrait la valeur scalaire courante, extrait la probabilité correspondante, réalise leur produit arithmétique et incrémente l’accumulateur de cette quantité pondérée. L’implémentation prend la forme suivante :
Une fonction pure nommée calculer_esperance_iterative peut être définie en prenant comme arguments les listes valeurs et probabilites. Au sein du corps de la fonction, une variable esperance est initialisée à 0.0. Une boucle for itérant sur un indice i variant sur la plage de longueur de la liste des valeurs réalise l’opération esperance += valeurs[i] * probabilites[i]. La fonction renvoie finalement la valeur accumulée au terme du cycle d’itération complet.
L’analyse de la complexité computationnelle de cet algorithme démontre une complexité temporelle asymptotique rigoureusement linéaire en notation grand O de n, où n représente le nombre total de réalisations possibles dans l’espace d’états discret. Chaque paire de données fait l’objet d’un accès mémoire, d’une multiplication et d’une addition en temps constant. La complexité spatiale auxiliaire est optimale en grand O de 1, puisqu’aucune structure de données intermédiaire n’est allouée en mémoire vive au-delà de la variable scalaire d’accumulation. Néanmoins, l’interprétation dynamique instruction par instruction par la machine virtuelle CPython engendre un surcoût substantiel d’exécution.
3.2 Approche fonctionnelle avec zip, map et sum
Python autorise un paradigme de programmation fonctionnelle particulièrement expressif et élégant, permettant d’éliminer la gestion manuelle des indices et les mutations d’états propres aux boucles itératives impératives. L’association des primitives intégrées zip, map ou des expressions génératrices constitue l’approche idiomatique par excellence pour condenser le calcul de l’espérance mathématique en une écriture mathématiquement limpide et hautement lisible.
La fonction native zip prend en argument les deux collections de valeurs et de probabilités et génère un itérateur de tuples associant chaque réalisation à son poids stochastique correspondant, s’interrompant dès que la collection la plus courte est épuisée. En combinant cet outil avec une expression génératrice, le calcul prend la forme concise d’un appel à la fonction sommatoire sum(x * p for x, p in zip(valeurs, probabilites)). Dans cette construction, l’expression génératrice évalue les produits pondérés de manière paresseuse, sans matérialiser de liste intermédiaire dans la mémoire vive du système.
Cette approche fonctionnelle présente des avantages déterminants par rapport à la boucle for classique. En éliminant l’indexation explicite par crochets, elle prévient tout risque d’erreur d’indice hors limites et améliore considérablement la clarté du code. Sur le plan de la gestion des ressources système, l’empreinte mémoire demeure strictement bornée en grand O de 1 grâce à l’évaluation différée de l’itérateur. L’architecture interne de CPython optimise en outre les boucles d’itération implicites des fonctions compilées en C comme sum, conférant à cette solution une vitesse d’exécution légèrement supérieure à celle d’une boucle impérative écrite manuellement en Python standard.
3.3 Limites de l’approche native pour les grands ensembles de données
En dépit de leur élégance stylistique et de leur accessibilité conceptuelle, les solutions purement natives en Python se heurtent à des limitations rédhibitoires dès lors que la cardinalité de l’espace d’états atteint des ordres de grandeur industriels, tels que des millions d’événements discrets. Le premier obstacle majeur réside dans l’incapacité de l’interpréteur standard à vectoriser les calculs au niveau du matériel sous-jacent. Contrairement aux instructions machine modernes capables d’effectuer simultanément la même opération arithmétique sur plusieurs registres de données via les extensions matérielles de type SIMD, le code Python pur exécute chaque multiplication de manière séquentielle et scalaire.
Le second écueil réside dans la surcharge cognitive et temporelle inhérente au typage dynamique et au déréférencement d’objets. À chaque itération de la boucle, l’environnement CPython doit inspecter dynamiquement le type des opérandes, vérifier l’existence de la méthode spéciale de multiplication, allouer un nouvel objet flottant pour accueillir le résultat intermédiaire et gérer le compteur de références du ramasse-miettes. Cette gymnastique logicielle induit un facteur de ralentissement se situant fréquemment entre cinquante et cent fois par rapport à une boucle de calcul bas niveau nativement compilée.
Enfin, l’accumulation séquentielle de flottants natifs dans un ordre non contrôlé expose le calcul à des erreurs d’arrondi cumulatives sévères. La norme IEEE 754 de représentation à virgule flottante ne garantit pas l’associativité stricte de l’addition en raison des pertes de précision sur les bits de poids faible lors de l’alignement des exposants. Lorsque l’on somme de très petites probabilités multipliées par de très grandes valeurs, l’erreur de troncature peut se propager de manière désastreuse. Ces contraintes d’échelle et d’intégrité numérique rendent indispensable la transition vers l’écosystème vectorisé spécialisé de NumPy.
4. Implémentation vectorisée canonique avec la bibliothèque NumPy
4.1 Définition de la fonction personnalisée expected_value
La bibliothèque NumPy révolutionne le calcul probabiliste en introduisant le paradigme de la vectorisation, où les opérations arithmétiques sont appliquées simultanément à des blocs de données entiers via des bibliothèques d’algèbre linéaire compilées en C et Fortran, à l’instar de BLAS et LAPACK. Pour ériger une fonction de calcul d’espérance d’une robustesse professionnelle, il convient de concevoir une fonction personnalisée qui tire pleinement parti de ces architectures vectorielles tout en offrant une flexibilité totale quant aux types d’entrées transmises par l’utilisateur.
La première exigence consiste à convertir les structures itérables d’entrée en tableaux ndarray au moyen de l’instruction np.asarray. Cette méthode présente l’avantage critique d’opérer la conversion sans duplication mémoire inutile si l’argument est déjà un tableau NumPy conforme. Une fois les données standardisées sous forme de vecteurs unidimensionnels, le calcul du produit pondéré s’effectue par une multiplication élément par élément vectorisée, matérialisée par l’opérateur arithmétique étoile ou par la fonction np.multiply. Les éléments de même indice sont multipliés en parallèle à la vitesse maximale du processeur.
L’implémentation algorithmique finale de cette fonction canonique encapsule la multiplication vectorielle et la réduction sommatoire :
La fonction expected_value reçoit un paramètre values et un paramètre weights. Elle commence par convertir les deux arguments en tableaux NumPy via x = np.asarray(values, dtype=np.float64) et w = np.asarray(weights, dtype=np.float64). Elle calcule ensuite la somme des produits élément par élément divisée par la somme globale des poids stochastiques : return np.sum(x * w) / np.sum(w). Cette formulation compacte s’avère non seulement d’une lisibilité mathématique absolue, mais elle libère également le code de toute gestion itérative explicite tout en garantissant des performances de premier ordre.
4.2 Gestion de la normalisation des poids
L’un des atouts conceptuels majeurs de la fonction définie précédemment réside dans sa capacité à traiter de manière totalement transparente aussi bien des distributions de probabilité canoniques strictement normalisées que des vecteurs de pondérations relatives non normalisées. Dans les développements mathématiques théoriques, il est invariablement postulé que la somme des probabilités élémentaires est rigoureusement égale à un. Toutefois, dans les applications pratiques d’ingénierie et d’analyse de données expérimentales, les fréquences observées ou les poids de vraisemblance ne satisfont pas spontanément cette contrainte unitaire.
En intégrant explicitement la division par la somme totale du vecteur de poids au dénominateur du calcul, l’algorithme procède à une normalisation stochastique dynamique. Si l’utilisateur transmet un vecteur de cotes, de pourcentages entiers sommant à cent, ou de fréquences absolues issues d’un histogramme de comptage, la fonction rétablit immédiatement la mesure de probabilité unitaire sous-jacente sans altérer les rapports d’importance relative entre les différents états. Cette opération neutralise l’impact d’un facteur d’échelle multiplicatif global appliqué aux poids.
Néanmoins, cette flexibilité impose une vigilance algorithmique accrue face à l’éventualité d’une somme de poids nulle. Si l’ensemble des pondérations transmises est constitué de zéros, l’évaluation du dénominateur aboutit à une division par zéro, générant un résultat indéfini de type NaN selon la norme IEEE 754, assorti d’un avertissement d’exécution émis par NumPy. Une fonction destinée à un environnement de production critique doit donc impérativement intercepter cette condition limite en amont et lever une exception circonstanciée avant d’engager les calculs vectoriels.
4.3 Utilisation de la méthode native np.average
Bien que la conception d’une fonction personnalisée vectorisée permette de maîtriser l’ensemble du flux d’instructions, la bibliothèque NumPy intègre nativement une fonction précompilée d’une efficacité redoutable pour calculer l’espérance mathématique : la fonction np.average. Cette méthode générale calcule la moyenne pondérée d’un tableau de données le long d’un axe dimensionnel spécifié, en acceptant un paramètre optionnel nommé weights qui correspond précisément à notre vecteur de probabilités ou de pondérations relatives.
L’utilisation de cette routine native se caractérise par une simplicité syntaxique exemplaire. L’appel np.average(valeurs, weights=probabilites) exécute en arrière-plan une chaîne d’instructions hautement optimisée, écrite directement au niveau du noyau en langage C de NumPy. Si le vecteur de pondérations est omis, la méthode se replie automatiquement sur le calcul de la moyenne arithmétique simple via np.mean. Lorsque le paramètre weights est renseigné, la fonction prend en charge de façon transparente la multiplication tensorielle, la réduction sommatoire et la normalisation par la somme des poids.
Sur le plan des performances pures, np.average surpasse généralement les fonctions personnalisées écrites en Python pour les vecteurs de dimensions moyennes et élevées. Elle bénéficie d’une gestion interne poussée de l’alignement mémoire, d’une réduction optimisée du produit scalaire évitant la création de tableaux intermédiaires superflus, et d’un contrôle rigoureux de la dimensionnalité des entrées. Par conséquent, dans le cadre de développements logiciels professionnels où la réinvention de la roue doit être proscrite au profit de composants certifiés, l’emploi de np.average constitue la recommandation méthodologique prépondérante.
5. Exemple pratique : Calcul des buts attendus lors d’un match de football
5.1 Description de la distribution de probabilité empirique
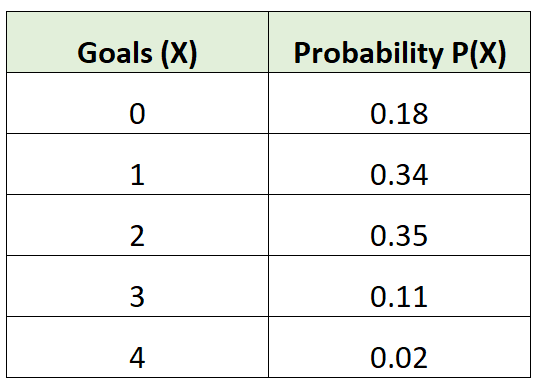
Afin d’ancrer ces développements théoriques et algorithmiques dans un cas d’usage concret, considérons une problématique contemporaine issue de l’analyse statistique des performances sportives : l’évaluation du nombre de buts attendus marqués par une équipe lors d’une confrontation de football de haut niveau. Dans ce contexte, la variable aléatoire discrète X modélise le nombre total de buts inscrits par l’équipe au terme du temps réglementaire de jeu. L’espace d’états réalisable est naturellement constitué d’entiers naturels non négatifs.
Supposons qu’une analyse quantitative approfondie des données historiques et de la qualité des phases offensives d’une équipe permette d’établir une loi de probabilité discrète empirique bornée sur l’ensemble fini {0, 1, 2, 3, 4}. Les probabilités d’occurrence associées à chacune de ces issues ont été rigoureusement quantifiées de la manière suivante :
- Probabilité de ne marquer aucun but, P(X = 0) : 0.18 (soit 18 % de chances)
- Probabilité de marquer exactement un but, P(X = 1) : 0.34 (soit 34 % de chances)
- Probabilité de marquer exactement deux buts, P(X = 2) : 0.35 (soit 35 % de chances)
- Probabilité de marquer exactement trois buts, P(X = 3) : 0.11 (soit 11 % de chances)
- Probabilité de marquer exactement quatre buts, P(X = 4) : 0.02 (soit 2 % de chances)
Avant d’engager le moindre calcul automatisé, l’intégrité de cette distribution empirique doit être validée au regard du second axiome de Kolmogorov. La sommation des probabilités élémentaires donne 0.18 + 0.34 + 0.35 + 0.11 + 0.02, ce qui équivaut rigoureusement à 1.00. La mesure stochastique est donc parfaitement normalisée et l’espace probabilisé est clos, garantissant que la variable aléatoire admet une espérance mathématique finie et univoque.
5.2 Traduction du problème et exécution du code Python
La transcription computationnelle de cette modélisation probabiliste s’opère avec une clarté remarquable au moyen des bibliothèques scientifiques de Python. Les valeurs de l’espace d’états discret et les probabilités empiriques correspondantes sont instanciées sous forme de structures de données synchronisées. Le script instancie un premier tableau désigné par values contenant les entiers de 0 à 4, et un second tableau probs contenant la série de flottants [0.18, 0.34, 0.35, 0.11, 0.02].
L’évaluation de l’espérance mathématique est ensuite exécutée en sollicitant la fonction vectorisée de NumPy. L’exécution de la commande np.average(values, weights=probs) renvoie instantanément la valeur scalaire de 1.450000 dans la console de l’interpréteur. Ce résultat computationnel reproduit avec une exactitude absolue la décomposition arithmétique manuelle du barycentre probabiliste :
L’analyse détaillée du calcul sous-jacent révèle l’accumulation successive des contributions pondérées de chaque issue : zéro multiplié par 0.18 égale 0.00 ; un multiplié par 0.34 égale 0.34 ; deux multiplié par 0.35 égale 0.70 ; trois multiplié par 0.11 égale 0.33 ; et enfin quatre multiplié par 0.02 égale 0.08. La sommation algébrique directe de ces produits partiels (0.00 + 0.34 + 0.70 + 0.33 + 0.08) converge précisément vers le total arithmétique de 1.45, confirmant que le pipeline vectorisé exécute fidèlement le formalisme de Kolmogorov sans l’introduction du moindre artéfact de calcul.
5.3 Interprétation statistique du résultat obtenu
L’obtention d’une valeur fractionnaire de 1.45 but pour une variable aléatoire structurellement discrète et entière soulève une question fondamentale d’interprétation statistique. Il est évident qu’au cours d’un match de football unique et isolé, une équipe ne peut physiquement inscrire 1.45 but : le nombre réel de buts sera invariablement un nombre entier (zéro, un, deux, trois ou quatre). L’espérance mathématique ne constitue en aucun cas une prédiction modalement réalisable d’une occurrence singulière déterminée.
L’espérance mathématique matérialise la tendance centrale asymptotique du phénomène stochastique à très long terme. En vertu de la loi forte des grands nombres, si cette même équipe disputait une infinité de confrontations sportives rigoureusement identiques dans des conditions physiques et tactiques parfaitement stationnaires, la moyenne arithmétique du nombre total de buts marqués sur l’ensemble de ces matchs convergerait presque sûrement vers la valeur théorique de 1.45 but par rencontre. Cette grandeur représente le taux de rendement stochastique structurel du dispositif offensif de l’équipe.
Dans l’écosystème contemporain de l’analyse sportive prédictive, ce concept s’articule directement avec la métrique révolutionnaire des Expected Goals, universellement abrégée sous l’acronyme xG. Les modèles de régression logistique et d’apprentissage profond évaluent la probabilité de conversion de chaque tentative de tir en fonction de multiples variables spatio-temporelles. La somme de ces probabilités infinitésimales correspond précisément à l’application de la propriété de linéarité de l’espérance mathématique, fournissant aux états-majors des clubs un indicateur de performance sous-jacente infiniment plus prédictif que le résultat brut et volatile d’une rencontre unique.
6. Traitement des distributions continues avec SciPy
6.1 Formulation intégrale de l’espérance continue
Le passage du domaine discret au domaine continu impose une refonte méthodologique de l’outillage computationnel. Lorsque l’espace d’états d’une variable aléatoire X est un continuum non dénombrable, tel que le temps d’attente avant la défaillance d’un composant électronique ou la taille d’une population biologique, la distribution de probabilité est caractérisée par une fonction de densité continue f(x). L’espérance mathématique est alors formellement définie par l’intégrale sur la droite réelle du produit x multiplié par f(x)dx.
Puisque la plupart des densités continues ne possèdent pas de primitives analytiques exprimables sous forme de fonctions élémentaires finies, la détermination de leur espérance en Python requiert le recours aux techniques d’intégration numérique par quadrature adaptative. Le sous-module scipy.integrate met à la disposition des scientifiques la fonction quad, qui encapsule les bibliothèques Fortran de référence QUADPACK. Cette routine divise l’intervalle d’intégration de manière adaptative en sous-intervalles plus fins dans les zones où l’intégrande présente de fortes oscillations ou de forts gradients.
Pour calculer l’espérance d’une densité continue personnalisée avec SciPy, il convient de définir informatiquement la fonction intégrande sous la forme d’une fonction Python ou d’une expression lambda recevant l’abscisse x et renvoyant le produit de x par la fonction de densité. L’appel à scipy.integrate.quad prend en arguments cette fonction intégrande ainsi que les bornes inférieure et supérieure d’intégration, pouvant s’étendre de -np.inf à np.inf. La fonction renvoie un tuple contenant la valeur estimée de l’intégrale ainsi qu’une borne supérieure rigoureuse de l’erreur absolue d’intégration numérique.
6.2 Exploitation du module scipy.stats pour les lois usuelles
Bien que la quadrature numérique permette de traiter n’importe quelle densité de probabilité exotique définie arbitrairement par l’utilisateur, la bibliothèque SciPy dispose au sein de son sous-module scipy.stats d’une infrastructure orientée objet extrêmement riche modélisant l’intégralité des lois de probabilité canoniques de la statistique mathématique, qu’elles soient continues à l’instar des lois normale, exponentielle, gamma, bêta ou de Cauchy, ou discrètes comme les lois binomiale ou de Poisson.
Chaque loi de probabilité continue est représentée par une classe dédiée héritant de rv_continuous, qui fournit une panoplie de méthodes hautement spécialisées pour extraire les caractéristiques stochastiques de la distribution sans nécessiter d’intégration manuelle. La méthode la plus directe est la méthode .expect(), qui implémente une intégration numérique adaptative préconfigurée optimisée pour le support spécifique de la loi considérée. Par exemple, pour une variable suivant une loi normale d’espérance 5.0 et d’écart-type 2.0, l’instruction stats.norm.expect(loc=5.0, scale=2.0) exécute la quadrature et converge fidèlement vers 5.0.
En outre, pour les distributions paramétriques usuelles dont les moments analytiques sont connus de manière exacte sous forme close, SciPy court-circuite totalement l’intégration numérique au profit d’évaluations algébriques instantanées. La méthode .stats(moments=’m’) extrait directement le premier moment centré à l’origine, correspondant à l’espérance théorique exacte. Cette méthode garantit une précision absolue jusqu’au dernier bit de la mantisse, tout en s’exécutant en une fraction infime de microseconde, constituant ainsi l’approche optimale lors de la manipulation de modèles stochastiques standards.
6.3 Comparaison entre résolution analytique et quadrature numérique
La confrontation systématique entre les solutions analytiques fermées et les résultats issus de la quadrature numérique permet d’appréhender les subtilités et les compromis inhérents au calcul numérique continu. La quadrature adaptative de Gauss-Kronrod mise en œuvre par la routine quad de SciPy déploie une stratégie sophistiquée : elle évalue la fonction en des nœuds d’abscisse soigneusement sélectionnés selon les zéros de polynômes orthogonaux pour approcher l’aire sous la courbe avec une précision exponentielle en fonction du nombre de nœuds.
Cependant, l’intégration numérique demeure sujette à des écueils lorsque l’intégrande présente des singularités asymptotiques ou lorsque les bornes d’intégration s’étendent à l’infini. Dans le cas de queues de distribution particulièrement longues, telles que celles d’une loi de Pareto à faible coefficient de forme ou d’une loi log-normale à forte variance, l’algorithme adaptatif peut échouer à détecter une masse de probabilité significative située à une distance substantielle de l’origine si le pas d’exploration initial est inadapté, conduisant à une sous-estimation systématique de l’espérance.
Sur le plan de la stabilité algorithmique et du coût en temps de calcul, l’évaluation analytique close surpasse la quadrature numérique par plusieurs ordres de grandeur. L’intégration numérique nécessite des dizaines voire des centaines d’évaluations de la fonction de densité pour converger sous le seuil de tolérance requis, induisant une surcharge substantielle lors de son insertion dans des boucles d’optimisation non linéaire ou des chaînes de Markov Monte-Carlo. Par conséquent, il est impératif pour l’ingénieur de privilégier les solutions analytiques dès qu’elles sont dérivables mathématiquement, et de réserver la quadrature numérique aux densités empiriques ou non standard dépourvues de forme close.
7. Structuration et analyse des espérances avec la bibliothèque Pandas
7.1 Intégration d’une table de probabilités dans un DataFrame
Dans les contextes d’ingénierie des données et de modélisation prédictive d’entreprise, les distributions statistiques ne se présentent que rarement sous la forme de vecteurs mathématiques isolés ; elles sont le plus souvent intégrées au sein de tables d’enregistrements complexes regroupant de multiples attributs qualitatifs et quantitatifs. La bibliothèque Pandas offre un cadre structurel idéal pour organiser, transformer et documenter des distributions de probabilités au travers de sa structure fondamentale bidimensionnelle : le DataFrame.
L’intégration s’effectue en créant une structure tabulaire dotée d’au moins deux séries fondamentales : une première colonne encapsulant les états ou réalisations quantitatives possibles de la variable aléatoire, et une seconde colonne documentant les probabilités de masse correspondantes ou les fréquences relatives observées. L’immense avantage de Pandas réside dans sa capacité à aligner automatiquement les données sur la base de leurs index et à appliquer des transformations arithmétiques vectorisées avec une syntaxe remarquablement expressive.
Le calcul de l’espérance s’articule alors en créant une colonne dérivée temporaire représentant la contribution stochastique individuelle de chaque état, obtenue par la multiplication vectorisée de la colonne des réalisations par celle des probabilités. L’instruction dataframe[‘produit_pondere’] = dataframe[‘valeur’] * dataframe[‘probabilite’] opère la multiplication élément par élément à une vitesse optimisée en s’appuyant sur le moteur interne de NumPy. L’évaluation de l’espérance globale se résume ensuite à l’agrégation sommatoire dataframe[‘produit_pondere’].sum(), offrant une traçabilité totale des étapes intermédiaires du calcul pour des audits analytiques.
7.2 Calcul de l’espérance conditionnelle via groupby
La puissance analytique de Pandas s’exprime pleinement lors de la manipulation d’espérances conditionnelles stratifiées par catégories, un besoin récurrent en économétrie, en marketing quantitatif et en épidémiologie. L’espérance conditionnelle permet d’évaluer la valeur moyenne attendue d’une variable quantitative sachant l’appartenance des observations à une sous-population spécifique délimitée par une ou plusieurs variables qualitatives contextuelles.
Le paradigme split-apply-combine, orchestré par la méthode groupby de Pandas, constitue la méthode d’excellence pour exécuter ces calculs segmentés à grande échelle. Supposons un jeu de données contenant des réalisations aléatoires, des poids d’échantillonnage associés, et une colonne catégorielle segmentant les observations selon des régions géographiques ou des typologies de profils clients. L’instruction de regroupement partitionne le jeu de données en sous-espaces stochastiques hermétiques.
L’application d’une fonction d’agrégation personnalisée au sein de chaque groupe permet d’extraire simultanément l’espérance de chaque strate. En combinant la méthode groupby avec la méthode apply et une expression lambda invoquant la fonction vectorisée np.average, telle que :
df.groupby(‘segment’).apply(lambda g: np.average(g[‘valeur’], weights=g[‘poids’])). Cette syntaxe compacte génère une nouvelle série de données indexée par les différents segments, où chaque valeur scalaire correspond rigoureusement à l’espérance conditionnelle locale du segment considéré, normalisée de manière indépendante pour chaque sous-groupe.
7.3 Exportation et visualisation synthétique des résultats
Une fois les espérances calculées et consolidées au sein de structures Pandas, l’étape terminale consiste à synthétiser et valoriser ces métriques pour faciliter la prise de décision. Pandas offre une interopérabilité directe avec les formats de stockage scientifique standardisés. Les structures de données résultantes peuvent être instantanément persistées vers des fichiers structurés au format CSV, vers des formats tabulaires optimisés tels que Parquet, ou insérées au sein de bases de données relationnelles SQL via les interfaces de connexion dédiées.
Au-delà de la persistance brute des données, l’interprétabilité des espérances mathématiques est grandement magnifiée par leur mise en regard visuelle avec les distributions sous-jacentes. En couplant Pandas avec des bibliothèques de visualisation de pointe telles que Matplotlib ou Seaborn, l’analyste peut superposer la valeur théorique centrale de l’espérance sous forme d’une ligne verticale proéminente sur l’histogramme des réalisations ou le tracé de la fonction de masse de probabilité.
Cette mise en scène graphique éclaire immédiatement la morphologie de la distribution en révélant son asymétrie. Dans le cadre d’une distribution symétrique, l’espérance coïncide visuellement avec le sommet de la cloche et la médiane. En revanche, face à une distribution asymétrique présentant un étalement à droite prononcé, à l’image des distributions de revenus ou de sinistres d’assurance, la visualisation matérialise sans ambiguïté le décalage de l’espérance par rapport au mode, démontrant de manière pédagogique l’influence disproportionnée des valeurs extrêmes sur le centre de gravité probabiliste.
8. Validation rigoureuse des données et contrôle des erreurs
8.1 Contrôle des axiomes stochastiques de Kolmogorov
Dans un contexte computationnel industriel où les données d’entrée proviennent d’extractions automatisées, de capteurs physiques ou de prédictions de modèles intermédiaires d’apprentissage machine, il est rigoureusement impératif de valider que les structures numériques transmises respectent strictement les axiomes fondamentaux de la théorie des probabilités. L’omission de cette étape de contrôle expose le système à des calculs mathématiquement dénués de sens et à des propagations silencieuses d’erreurs critiques.
Le premier contrôle stochastique porte sur la non-négativité de la mesure de probabilité. L’algorithme doit vérifier que chaque probabilité élémentaire est supérieure ou égale à zéro, et idéalement inférieure ou égale à un. Si une seule valeur du vecteur de pondérations présente un signe négatif, résultant d’un artefact numérique ou d’une erreur d’indexation, le calcul doit être immédiatement interrompu. Cette vérification s’opère de manière vectorisée au moyen de l’expression conditionnelle np.any(p < 0), qui inspecte la positivité globale sans dégradation des temps de traitement.
Le second contrôle fondamental concerne la contrainte unitaire de fermeture, exigeant que la sommation de toutes les probabilités de l’espace fondamental soit rigoureusement égale à un. Cependant, en arithmétique à virgule flottante, une comparaison d’égalité stricte utilisant l’opérateur d’égalité double est strictement proscrite. L’addition de plusieurs nombres flottants engendre d’inévitables approximations résiduelles au niveau des bits de poids faible de la mantisse, pouvant donner une somme totale de 0.9999999999999999 au lieu de 1.0. Pour pallier cette contrainte physique du matériel, il convient d’utiliser la fonction np.isclose de NumPy, qui intègre une tolérance d’écart relatif et absolu pour certifier la conformité unitaire.
8.2 Gestion des incohérences dimensionnelles et types de données
Au-delà de la validation des contraintes purement probabilistes, l’architecture logicielle doit impérativement certifier l’intégrité structurelle des vecteurs de données manipulés. L’incohérence dimensionnelle constitue l’anomalie la plus récurrente : si le vecteur des valeurs et le vecteur des probabilités présentent des longueurs divergentes, l’appariement bijectif des états et de leurs poids respectifs est rompu, rendant le calcul de l’espérance impossible.
L’implémentation doit confronter explicitement les dimensions des tableaux d’entrée à l’aide de l’attribut .shape ou de la fonction len(). Tout différentiel dimensionnel doit déclencher la levée immédiate d’une exception de type ValueError, assortie d’un message diagnostique explicite précisant la cardinalité respective de chaque vecteur. De même, les dimensions supérieures à un doivent être aplaties ou rejetées si la routine n’a pas été conçue pour gérer la multidimensionnalité des tenseurs d’entrée.
Un autre vecteur de vulnérabilité numérique réside dans l’intrusion insidieuse de valeurs non finies, telles que les marqueurs de données manquantes NaN ou les divergences vers l’infini positif ou négatif inf. Ces entités non numériques contaminent instantanément toute opération arithmétique vectorisée de NumPy, entraînant un effondrement global du calcul sous la forme d’un résultat final indéfini. Les routines np.isnan et np.isneginf couplées à np.isposinf doivent scanner préventivement l’ensemble des données d’entrée pour interdire l’exécution du calcul en présence de données corrompues.
8.3 Tolérance numérique et normalisation sécurisée
Pour concilier la rigueur mathématique la plus absolue avec la résilience logicielle requise en environnement de production, il convient de formaliser une fonction de validation et de normalisation sécurisée unifiée. Cette routine encapsule les meilleures pratiques de contrôle numérique et sert de point de passage obligé avant l’évaluation de toute grandeur statistique dérivée.
La tolérance numérique est paramétrée au moyen d’une constante epsilon, généralement configurée à un seuil standard de l’ordre de 1e-7 ou 1e-9. Si la somme des probabilités brutes s’écarte de la valeur cible 1.0 d’une quantité inférieure à ce seuil critique, la fonction n’interrompt pas le flux mais procède de manière autonome à une renormalisation fine en divisant chaque poids par la somme effective observée. Cette approche prévient l’arrêt intempestif des pipelines industriels face à de simples dérives d’arrondi de la machine.
En revanche, si la somme brute s’écarte substantiellement de l’unité ou si la somme totale est rigoureusement égale à zéro, rendant toute normalisation mathématiquement impossible par indétermination de la forme zéro sur zéro, la routine bascule vers un protocole d’arrêt strict en levant une exception bloquante. L’encapsulation de ces règles défensives garantit que l’opérateur d’espérance s’exécute exclusivement sur des espaces d’états stochastiquement valides, pérennisant ainsi la crédibilité des décisions quantitatives fondées sur ces métriques.
9. Théorème de l’espérance totale et espérances conditionnelles
9.1 Formulation théorique de la loi des espérances itérées
Le théorème de l’espérance totale, également consigné dans la littérature mathématique sous l’appellation de loi des espérances itérées ou théorème de la tour, constitue l’un des principes les plus profonds et puissants de la théorie moderne des probabilités. Soient deux variables aléatoires réelles X et Y définies conjointement sur un même espace de probabilité. L’espérance conditionnelle de X sachant Y, notée E[X | Y], n’est pas un scalaire déterministe fixe, mais représente elle-même une nouvelle variable aléatoire stochastique, fonction directe de la variable conditionnante Y.
Le théorème de l’espérance totale postule avec une rigueur formelle absolue que l’espérance mathématique globale de cette variable aléatoire conditionnelle est rigoureusement identique à l’espérance non conditionnelle marginale de la variable d’intérêt X. En notation stochastique formelle, ce principe fondamental s’écrit de manière universelle : E[X] = E[E[X | Y]]. Cette formulation signifie que si l’on moyenne l’ensemble des espérances conditionnelles locales en pondérant chacune d’elles par la probabilité marginale de l’état conditionnant correspondant, on reconstitue exactement le centre de gravité global de la distribution de X.
Sur le plan épistémologique et algorithmique, ce théorème offre un instrument d’une efficacité redoutable pour désamorcer la complexité computationnelle. Il permet d’aborder des problèmes stochastiques multidimensionnels intraitables par une approche de type diviser pour régner : l’espace d’états global est décomposé en une série de sous-scénarios ou régimes conditionnels étanches, au sein desquels l’espérance locale est aisément calculable, avant de réagréger les résultats partiels au prorata de l’importance stochastique de chaque régime.
9.2 Calcul en Python à l’aide de matrices de probabilités conjointes
La mise en œuvre numérique de ces concepts conditionnels requiert la modélisation explicite de la structure de dépendance conjointe liant les variables X et Y. Dans le domaine discret, cette interaction s’exprime sous la forme d’une matrice bidimensionnelle de probabilités conjointes, où chaque élément à la ligne i et à la colonne j représente la probabilité d’intersection simultanée de l’état x_i pour la variable X et de l’état y_j pour la variable Y.
La manipulation de ces structures matricielles s’exécute avec une grande fluidité grâce aux opérations axiales de NumPy. Les lois marginales des deux variables sont instantanément extraites par des sommations directionnelles : la loi marginale de X est obtenue par la sommation le long de l’axe des colonnes via np.sum(P_xy, axis=1), tandis que la loi marginale de Y est calculée par la sommation le long de l’axe des lignes via np.sum(P_xy, axis=0). L’axiome de Kolmogorov impose que la sommation totale de l’intégralité des cellules de cette matrice soit égale à un.
La détermination des lois conditionnelles découle directement de la définition de Thomas Bayes : la distribution conditionnelle de X sachant Y = y_j s’obtient en isolant la j-ième colonne de la matrice conjointe et en divisant chacun de ses éléments par la probabilité marginale correspondante de y_j. Dès lors, l’espérance conditionnelle E[X | Y = y_j] se calcule par le produit vectoriel entre le vecteur des états de X et cette colonne conditionnelle renormalisée. Cette opération peut être vectorisée sur l’ensemble des colonnes simultanément grâce aux mécanismes de diffusion ou broadcasting de NumPy.
9.3 Vérification computationnelle du théorème de l’espérance totale
Afin de valider informatiquement la loi des espérances itérées, il est hautement instructif de concevoir un script Python comparant les deux voies de résolution alternatives à partir d’une matrice de probabilités conjointes arbitraire et de vérifier leur convergence vers une valeur rigoureusement identique.
D’un côté, le calcul direct évalue l’espérance marginale globale de X en appliquant la fonction vectorisée np.average sur le vecteur des réalisations de X, pondéré par son vecteur de probabilités marginales préalablement extrait par sommation axiale. Ce calcul s’exécute selon l’instruction directe E_X_direct = np.average(valeurs_x, weights=loi_marginale_x). Cette approche ignore totalement les interactions avec Y et traite X comme une entité stochastique isolée.
D’un autre côté, l’approche conditionnelle calcule d’abord le vecteur complet des espérances conditionnelles locales pour chaque modalité possible de Y, stocké sous forme d’un tableau unidimensionnel. Ensuite, l’algorithme calcule l’espérance de ces espérances en appliquant à nouveau np.average sur ce vecteur d’espérances conditionnelles, en utilisant cette fois la loi marginale de Y comme système de pondération stochastique : E_X_iteree = np.average(esperances_conditionnelles, weights=loi_marginale_y).
La confrontation finale des deux résultats scalaires par l’instruction np.isclose(E_X_direct, E_X_iteree) renvoie invariablement la valeur booléenne True. Cette équivalence computationnelle parfaite illustre avec éclat l’invariance de l’opérateur d’espérance face aux décompositions stochastiques emboîtées, validant expérimentalement l’exactitude des algorithmes d’agrégation multiniveaux utilisés dans les modèles bayésiens hiérarchiques et les réseaux de neurones probabilistes.
10. Simulation de Monte-Carlo pour l’approximation empirique de l’espérance
10.1 Principe de la loi forte des grands nombres
Lorsque la structure analytique d’une loi de probabilité devient d’une complexité insurmontable en raison de non-linéarités extrêmes ou d’un nombre colossal de dimensions d’intégration, le calcul exact de l’espérance mathématique par quadrature ou sommation déterministe devient matériellement infaisable. Les scientifiques recourent alors aux méthodes stochastiques de Monte-Carlo, dont le socle mathématique repose sur la loi forte des grands nombres démontrée par Émile Borel et consolidée par Andreï Kolmogorov.
Ce théorème fondamental stipule que si l’on génère une suite de variables aléatoires indépendantes et identiquement distribuées selon une même loi de probabilité admettant une espérance théorique finie mu, la moyenne empirique arithmétique calculée sur ces tirages converge presque sûrement vers cette espérance théorique lorsque la taille N de l’échantillon tend vers l’infini. Le terme de convergence presque sûre exprime que la probabilité que la moyenne empirique ne se stabilise pas sur l’espérance théorique à la limite infinie est rigoureusement nulle.
La puissance conceptuelle de l’échantillonnage de Monte-Carlo réside dans son affranchissement total de la malédiction de la dimensionnalité qui paralyse les méthodes de quadrature numérique traditionnelles. Alors que l’effort de calcul d’une grille numérique déterministe croît de façon exponentielle avec le nombre de dimensions de l’espace d’intégration, la vitesse de convergence stochastique de la méthode de Monte-Carlo demeure intrinsèquement insensible à la dimension de l’espace d’états, faisant de cette approche l’instrument roi de la physique statistique et de la valorisation de produits dérivés financiers complexes.
10.2 Génération de tirages aléatoires pondérés avec NumPy
L’implémentation de simulations de Monte-Carlo en Python bénéficie du sous-module aléatoire ultra-performant numpy.random, refondu autour du générateur de nombres pseudo-aléatoires moderne PCG64 qui surpasse historiquement le traditionnel Mersenne Twister en termes de période stochastique et de propriétés d’équidistribution multidimensionnelle.
Pour simuler une variable aléatoire discrète obéissant à une distribution de probabilité paramétrée, la fonction centrale par excellence est la méthode np.random.choice, désormais accessible préférentiellement via l’interface moderne du générateur instancié par np.random.default_rng(). Cette routine permet de tirer un échantillon massif de taille N en sélectionnant des valeurs parmi un tableau fini d’états possibles, conformément à un vecteur de probabilités stochastiques spécifié via le paramètre p.
Un script de simulation typique instancie un générateur de nombres aléatoires via rng = np.random.default_rng(graine_initiale), puis génère de manière entièrement vectorisée un vecteur contigu de tirages synthétiques à l’aide de l’instruction echantillon = rng.choice(valeurs, size=1_000_000, p=probabilites). L’évaluation de l’espérance simulée s’effectue ensuite en un temps record en sollicitant la primitive np.mean(echantillon). L’ensemble de cette séquence est exécuté au niveau natif du processeur, autorisant la production et l’agrégation de plusieurs millions de tirages en quelques millisecondes seulement.
10.3 Analyse de la vitesse de convergence et de l’erreur d’estimation
Bien que la convergence asymptotique de la simulation de Monte-Carlo soit mathématiquement garantie par la loi forte des grands nombres, la quantification de la précision obtenue pour un échantillon de taille N finie requiert la mobilisation du théorème central limite formalisé par Pierre-Simon de Laplace. Ce théorème enseigne que l’erreur d’estimation, c’est-à-dire l’écart entre la moyenne empirique observée et l’espérance théorique inconnue, suit asymptotiquement une loi normale centrée dont la variance est proportionnelle à la variance intrinsèque du phénomène divisée par la taille de l’échantillon N.
Il en découle une propriété structurelle déterminante des simulations de Monte-Carlo : l’erreur standard d’estimation décroît selon une cinétique proportionnelle à l’inverse de la racine carrée de la taille de l’échantillon, notée 1/sqrt(N). Par conséquent, pour diviser l’erreur statistique moyenne par un facteur dix et gagner ainsi un chiffre significatif d’exactitude sur l’espérance calculée, il est mathématiquement incontournable de multiplier la taille de l’échantillon synthétique par un facteur cent. Cet accroissement quadratique du coût computationnel impose d’ajuster soigneusement le volume de tirages en fonction de la tolérance d’erreur admissible.
En instrumentant le script de simulation Python, il est aisé d’enregistrer la trajectoire de la moyenne cumulée en fonction de l’indice de tirage au moyen de la méthode vectorisée np.cumsum(echantillon) divisée par un vecteur d’indices croissants. La représentation graphique de cette trajectoire d’estimation met en évidence les oscillations stochastiques initiales erratiques lorsque N est faible, suivies d’un amortissement progressif spectaculaire de la variance empirique confinant la moyenne dans un intervalle de confiance asymptotiquement resserré autour de l’espérance mathématique théorique exacte.
11. Applications psychologiques et modélisation de la prise de décision
11.1 Théorie de l’utilité espérée de von Neumann-Morgenstern
L’application brute de l’espérance mathématique monétaire s’est historiquement heurtée à des paradoxes empiriques majeurs, dont le plus célèbre est le paradoxe de Saint-Pétersbourg exposé par Daniel Bernoulli en 1738. Ce paradoxe démontre que les êtres humains refusent rationnellement d’engager des sommes substantielles pour participer à des jeux de hasard dont l’espérance de gain monétaire est pourtant strictement infinie. Cette divergence fondamentale a conduit à l’émergence de la théorie de la décision et de la psychologie cognitive quantitative, formalisées au vingtième siècle par John von Neumann et Oskar Morgenstern à travers la théorie de l’utilité espérée.
Le postulat cardinal de cette modélisation réside dans la dissociation conceptuelle entre la valeur monétaire nominale objective d’une issue et l’utilité psychologique subjective qu’en retire l’agent décisionnaire. L’opérateur stochastique n’est plus appliqué directement sur la variable aléatoire des flux financiers X, mais sur une transformation fonctionnelle non linéaire u(X), désignée sous le terme de fonction d’utilité individuelle. L’espérance mathématique de cette utilité subjective, formulée analytiquement par E[u(X)], devient le critère normatif guidant l’arbitrage décisionnel sous incertitude.
La courbure mathématique de cette fonction d’utilité permet de capturer les différentes attitudes psychologiques face au risque. Une fonction d’utilité strictement concave, caractérisée par une dérivée seconde négative telle que la fonction logarithmique ou la fonction puissance d’exposant strictement inférieur à un, formalise l’aversion universelle au risque : l’individu préfère recevoir de manière certaine l’espérance monétaire d’une loterie plutôt que de participer à la loterie elle-même. À l’inverse, une fonction convexe traduit une propension au risque, tandis qu’une fonction strictement linéaire caractérise la neutralité parfaite au risque où l’utilité espérée coïncide fidèlement avec l’espérance mathématique classique.
11.2 Théorie des perspectives de Kahneman et Tversky
Bien que la théorie de l’utilité espérée constitue un cadre normatif d’une grande rigueur mathématique, les expériences comportementales conduites par les psychologues Daniel Kahneman et Amos Tversky ont mis en lumière des violations systématiques et prédictibles de ses axiomes par les agents humains. Dans leur publication fondatrice de 1979 consacrée à la théorie des perspectives, complétée par la théorie cumulative des perspectives en 1992, les auteurs proposent une modélisation descriptive infiniment plus fidèle des biais cognitifs structurant la décision sous incertitude.
La théorie des perspectives substitue à la fonction d’utilité classique une fonction de valeur comportementale v(x) qui présente deux caractéristiques psychologiques déterminantes. D’une part, les issues ne sont plus évaluées par rapport à un niveau de richesse absolue, mais sous forme d’écarts relatifs par rapport à un point de référence psychologique neutre, discriminant explicitement les gains et les pertes. D’autre part, la courbe présente une asymétrie fondamentale désignée sous le concept d’aversion aux pertes : la pente de la fonction de valeur est nettement plus abrupte dans le domaine des pertes que dans celui des gains, traduisant empiriquement le fait psychologique que la douleur associée à une perte monétaire est environ deux fois plus aiguë que le plaisir procuré par un gain de magnitude strictement équivalente.
Parallèlement, la théorie révolutionne l’intégration des probabilités en démontrant que le cerveau humain ne pondère pas les issues de manière linéaire selon leurs probabilités objectives réelles. Kahneman et Tversky introduisent une fonction de déformation cognitive des probabilités, qui tend à surpondérer systématiquement les probabilités d’événements extrêmement rares et à sous-pondérer les probabilités moyennes et élevées. L’espérance décisionnelle perçue résulte alors du produit croisé entre la fonction de valeur psychologique et cette fonction de distorsion des poids stochastiques, s’écartant drastiquement de l’espérance mathématique de Kolmogorov.
11.3 Modélisation computationnelle du comportement de choix
La puissance du langage Python permet de concevoir des scripts computationnels comparatifs illustrant avec une netteté saisissante les disparités prédictives entre l’espérance mathématique pure, l’utilité espérée von Neumann-Morgenstern et la valeur prospective de la théorie des perspectives. Une telle implémentation formalise les mécanismes cognitifs sous-jacents et fournit aux chercheurs en sciences comportementales un banc d’essai paramétrable pour modéliser le comportement de sujets soumis à des paradigmes expérimentaux de loteries complexes.
Un script Python d’analyse comportementale instancie typiquement les fonctions mathématiques régissant chaque théorie. Pour la théorie des perspectives de Tversky et Kahneman, la fonction de valeur v(x) est codée au moyen de conditions vectorisées : si le gain est positif ou nul, elle élève la valeur à la puissance alpha (paramètre empirique de sensibilité décroissante calibré autour de 0.88) ; si l’issue est négative, elle calcule l’opposé de la constante d’aversion à la perte lambda (fixée usuellement à 2.25) multipliée par la valeur absolue élevée à la puissance bêta. De même, la fonction de pondération pi(p) est modélisée par l’équation non linéaire non monotone caractéristique de la littérature cognitive.
En confrontant les métriques obtenues sur des scénarios d’arbitrage financier risqués, l’ingénieur constate que des loteries présentant une espérance mathématique strictement positive peuvent générer une valeur prospective perçue profondément négative en raison du poids psychologique disproportionné attribué à une faible probabilité de perte financière sévère. L’espérance mathématique objective demeure ainsi la référence normative absolue de rationalité computationnelle, tandis que ses dérivations non linéaires constituent les piliers de l’économie comportementale et des neurosciences computationnelles de la décision.
12. Optimisation des performances et bonnes pratiques logicielles
12.1 Benchmark comparatif des différentes techniques de calcul
Dans le domaine de l’ingénierie logicielle et du traitement de flux massifs de données, l’évaluation de la performance computationnelle brute constitue un arbitrage technique critique. Pour guider le choix architectural de l’ingénieur, il est impératif de réaliser un banc d’essai comparatif rigoureux mesurant le temps d’exécution requis par les différentes approches de calcul de l’espérance mathématique exposées tout au long de ce traité, sur des vecteurs de données dont la cardinalité s’étend de dix éléments à plusieurs millions de réalisations stochastiques.
L’instrumentation de ce benchmark s’effectue en exploitant le module standard timeit ou la fonction haute précision time.perf_counter_ns, en exécutant des boucles de mesure répétées plusieurs centaines de fois afin d’éliminer la gigue d’ordonnancement du système d’exploitation et de calculer des moyennes d’exécution représentatives. Les approches mises en concurrence comprennent : la boucle for native itérative manuelle, la formulation fonctionnelle native avec sum et zip, l’appel à la fonction personnalisée NumPy vectorisée, la méthode précompilée interne np.average, ainsi que la méthode .expect() issue du sous-module scipy.stats.
Les résultats empiriques révèlent une hiérarchie indiscutable. Pour de très petits ensembles de données comprenant moins de vingt éléments, les fonctions Python natives purs affichent des temps d’exécution extrêmement faibles, car elles ne subissent pas la surcharge d’initialisation inhérente aux appels de l’API C de NumPy. Cependant, dès que la cardinalité dépasse quelques milliers d’éléments, la vectorisation de NumPy pulvérise les solutions natives en s’exécutant entre cinquante et quatre-vingts fois plus rapidement. La méthode native np.average se positionne systématiquement au sommet des performances, exploitant les instructions vectorielles SIMD des processeurs modernes pour traiter des millions de couples d’états en une fraction de milliseconde, tandis que les méthodes d’intégration numérique de SciPy, grevées par leur boucle adaptative continue, s’avèrent infiniment plus lentes et doivent être réservées exclusivement aux densités de probabilités continues non discrétisables.
12.2 Encapsulation dans un module orienté objet réutilisable
Afin de capitaliser sur l’ensemble des concepts stochastiques, des mécanismes défensifs et des optimisations vectorielles développés, l’ingénierie logicielle préconise l’encapsulation de ces fonctionnalités au sein d’une classe métier autonome et réutilisable selon les principes de la programmation orientée objet. Cette approche consolide l’état probabiliste du système et fournit une interface applicative hautement cohérente et maintenable.
La classe, que l’on peut nommer formellement DiscreteRandomVariable, accueille au sein de son constructeur __init__ le vecteur d’états et le vecteur de probabilités d’occurrence. Dès l’instanciation, le constructeur délègue les données à des méthodes internes privées de validation qui appliquent l’ensemble des règles d’hygiène stochastique : conversion impérative en float64 NumPy, vérification de l’égalité dimensionnelle des vecteurs, inspection de l’absence de valeurs négatives ou non numériques NaN, et renormalisation sécurisée par rapport à la tolérance epsilon.
L’architecture de cette classe enrichit ensuite l’objet en exposant une collection de propriétés et de méthodes calculant à la volée les différents moments de la distribution stochastique :
- Une propriété @property expected_value qui invoque l’évaluation vectorisée optimisée de l’espérance mathématique via np.average et met en cache le résultat scalaire pour éviter des recalculs redondants lors d’appels subséquents.
- Une propriété variance qui calcule le moment centré d’ordre deux en appliquant l’opérateur d’espérance sur le carré des écarts à la moyenne : E[(X – E[X])²], fournissant instantanément la mesure canonique de dispersion stochastique.
- Une propriété standard_deviation extrayant la racine carrée de la variance, rétablissant la mesure de dispersion dans l’unité physique originelle de la variable aléatoire.
- Une méthode générale raw_moment(order) permettant de calculer de façon vectorisée n’importe quel moment ordinaire non centré d’ordre k par la sommation du produit des réalisations élevées à la puissance k par les probabilités associées.
12.3 Récapitulatif des pièges courants et recommandations finales
Au terme de cette analyse approfondie du calcul de l’espérance mathématique en Python, il apparaît essentiel de dresser un panorama synthétique des écueils techniques majeurs qui jalonnent le déploiement de ces algorithmes en environnement industriel, et d’énoncer les directives méthodologiques garantissant une rigueur infaillible dans l’analyse stochastique de données.
Le premier piège, omniprésent mais fréquemment occulté, réside dans l’omission du contrôle de normalisation stochastique au sein des pipelines de données automatisés. Supposer aveuglément qu’un vecteur extrait d’une source externe somme exactement à un constitue une faute architecturale critique. Les ingénieurs doivent systématiquement implémenter des assertions défensives ou déléguer la sommation au paramètre weights de fonctions assurant la normalisation dynamique, sous peine de fausser l’ensemble des moments d’ordre supérieur du système.
Le second écueil réside dans la confusion pernicieuse entre l’espérance inconditionnelle globale et l’espérance conditionnelle locale lors de l’analyse de données partitionnées. L’agrégation imprudente de sous-groupes sans tenir compte de leurs probabilités marginales respectives viole le théorème de l’espérance totale et expose l’analyste au paradoxe de Simpson, où des tendances locales conditionnelles s’inversent de façon trompeuse lors de leur consolidation globale.
Enfin, la recherche effrénée d’optimisation prématurée ne doit jamais compromettre la lisibilité et l’intégrité arithmétique du code. Pour la modélisation de distributions discrètes, l’adoption inconditionnelle de la fonction native np.average combinée à des structures vérifiées en float64 constitue la recommandation industrielle standard définitive. Pour les distributions continues, la primauté doit être accordée aux solutions mathématiques analytiques fermées de scipy.stats, en limitant l’emploi des quadratures adaptatives lourdes aux seules fonctions de densité expérimentales dépourvues de primitives formelles.
Références
- Bernoulli, D. (1954). Exposition of a new theory on the measurement of risk. Econometrica, 22(1), 23-36. (Ouvrage original publié en 1738). https://doi.org/10.2307/1909829
- Harris, C. R., Millman, K. J., van der Walt, S. J., Gommers, R., Virtanen, P., Cournapeau, D., … & Oliphant, T. E. (2020). Array programming with NumPy. Nature, 585(7825), 357-362. https://doi.org/10.1038/s41586-020-2649-2
- Kahneman, D., & Tversky, A. (1979). Prospect theory: An analysis of decision under risk. Econometrica, 47(2), 263-291. https://doi.org/10.2307/1914185
- Kolmogorov, A. N. (1956). Foundations of the theory of probability (2e éd.). Chelsea Publishing Company. (Ouvrage original publié en allemand en 1933).
- McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51-56). https://doi.org/10.25080/Majora-92bf1924-00a
- Tversky, A., & Kahneman, D. (1992). Advances in prospect theory: Cumulative representation of uncertainty. Journal of Risk and Uncertainty, 5(4), 297-323. https://doi.org/10.1007/BF00122574
- Virtanen, P., Gommers, R., Oliphant, T. E., Haberland, M., Reddy, T., Cournapeau, D., … & SciPy 1.0 Contributors. (2020). SciPy 1.0: Fundamental algorithms for scientific computing in Python. Nature Methods, 17(3), 261-272. https://doi.org/10.1038/s41592-019-0686-2
- von Neumann, J., & Morgenstern, O. (1944). Theory of games and economic behavior. Princeton University Press.
- Wackerly, D. D., Mendenhall, W., & Scheaffer, R. L. (2008). Mathematical statistics with applications (7e éd.). Cengage Learning.