
Dans le paysage des sciences humaines et du comportement, l’appréhension de la complexité psychologique exige des outils méthodologiques à la fois rigoureux et conceptuellement féconds. De l’étude des processus cognitifs fondamentaux jusqu’à l’examen des dynamiques psychopathologiques, le chercheur en psychologie est perpétuellement confronté à la nécessité de dépasser la simple observation isolée des phénomènes pour scruter leurs interactions mutuelles. L’exploration de la vie mentale ne saurait en effet se satisfaire d’une taxonomie statique ou d’une compilation de mesures déconnectées les unes des autres. C’est précisément au carrefour où deux dimensions de l’expérience humaine se rencontrent que s’enracine l’analyse bivariée, véritable pierre angulaire du raisonnement scientifique empirique.
Historiquement issue des travaux pionniers de la biométrie et de la psychométrie au tournant du vingtième siècle, notamment impulsés par l’histoire de la pensée statistique et les recherches de Francis Galton et Karl Pearson, l’analyse bivariée a fourni à la psychologie moderne son premier cadre formel de quantification des relations. Qu’il s’agisse de mesurer la façon dont le niveau d’anxiété fluctue de concert avec les performances mnésiques, de déterminer si un style d’attachement infantile prédit la satisfaction conjugale à l’âge adulte, ou d’évaluer l’efficacité différentielle de deux protocoles psychothérapeutiques, cette approche offre une grille de lecture indispensable pour ordonner le réel empirique.
L’ambition de ce traité exhaustif est de proposer une exploration systématique, théorique et appliquée de l’analyse bivariée à l’usage des étudiants, chercheurs et praticiens de la psychologie. Loin de se réduire à un simple inventaire mécanique de formules mathématiques, cet ouvrage s’attache à expliciter les fondements épistémologiques des techniques d’association, à cartographier la typologie des variables psychométriques, à décortiquer les méthodes paramétriques et non paramétriques, tout en alertant le lecteur sur les redoutables pièges d’interprétation inhérents à l’inférence causale. À travers une démarche pédagogique rigoureuse alliant démonstrations conceptuelles, protocoles logiciels et étude de cas concrète, ce guide constitue une référence approfondie pour quiconque souhaite maîtriser l’art et la science de l’analyse des relations bivariées.
1. Fondements conceptuels de l’analyse bivariée en psychologie
La recherche scientifique en psychologie repose sur la modélisation des relations qui unissent les variables de l’esprit, du comportement et de l’environnement. Si la description élémentaire d’un trait constitue un préalable nécessaire, elle demeure insuffisante pour rendre compte de l’architecture fonctionnelle des processus psychologiques. L’analyse bivariée intervient dès lors comme la première étape formelle permettant d’examiner la régularité des variations conjointes entre deux construits mesurés au sein d’une même population.
1.1 Définition et étymologie du terme bivarié
D’un point de vue purement étymologique, le vocable « bivarié » procède de l’adjonction du préfixe latin bi-, signifiant « deux » ou « double », et du terme variabilis, qui désigne ce qui est susceptible de changer, de fluctuer ou de prendre différentes valeurs au sein d’un ensemble déterminé. Transposée dans le domaine de la méthodologie quantitative, l’analyse bivariée renvoie très précisément à l’étude conjointe de deux caractéristiques statistiques mesurées simultanément sur une même unité d’observation, qu’il s’agisse d’un individu singulier, d’un groupe social ou d’une dyade relationnelle.
En psychologie différentielle et expérimentale, l’objet central de cette démarche réside dans la saisie empirique de la covariation. Il ne s’agit plus d’estimer les paramètres centraux d’un phénomène isolé, mais de déterminer dans quelle mesure les fluctuations observées au niveau d’une première dimension psychologique – par exemple, l’intensité des symptômes dépressifs – sont systématiquement synchronisées avec les variations constatées sur une seconde dimension, telle que l’altération du fonctionnement exécutif. Cette observation simultanée permet de tester des postulats d’association directe sans pour autant préjuger, à ce stade préliminaire, de la nature causale du phénomène.
Il convient d’établir une distinction épistémologique cruciale entre l’observation passive de deux variables et leur manipulation au sein d’un plan d’expérience contrôlé. Dans l’observation passive ou corrélationnelle, le psychologue recueille les données telles qu’elles se manifestent spontanément chez les participants, sans intervenir sur leur genèse; la structure bivariée reflète alors l’état écologique des relations interindividuelles. À l’inverse, dans un cadre expérimental, l’une des deux variables est délibérément manipulée par l’expérimentateur en tant que variable indépendante afin d’en scruter les répercussions directes sur une variable dépendante, conférant ainsi à l’association bivariée un statut heuristique radicalement distinct.
1.2 Distinction épistémologique : univariée, bivariée et multivariée
L’analyse univariée s’attache à la caractérisation exhaustive d’une seule et unique variable à la fois. Sa visée demeure fondamentalement descriptive et synthétique : elle mobilise des indicateurs de tendance centrale à l’instar de la moyenne arithmétique, de la médiane ou du mode, ainsi que des indices de dispersion tels que la variance statistique, l’écart-type et l’intervalle interquartile. Bien qu’indispensable pour attester de la normalité distributionnelle d’un score psychométrique ou pour identifier des erreurs potentielles de saisie, l’analyse univariée présente des limites intrinsèques majeures. Elle s’avère totalement aveugle à la moindre dynamique relationnelle, réduisant le profil psychologique d’un échantillon à une juxtaposition de métriques atomisées et dénuées d’articulation fonctionnelle.
Le passage à l’analyse bivariée marque une rupture conceptuelle qualitative dans la construction du savoir empirique. En mettant en relation deux variables, elle permet de dépasser le simple constat d’état pour aborder la question de la contingence et de l’interdépendance. C’est à ce niveau d’investigation que le chercheur peut formaliser des lois d’association directes, quantifier l’intensité du lien qui unit deux construits et tester des hypothèses de recherche opérationnalisées sous forme d’asymétrie ou de corrélation. L’analyse bivariée constitue en ce sens le premier niveau d’intelligibilité relationnelle au sein des données comportementales, révélant la structure dyadique des mécanismes sous-jacents.
Toutefois, la réalité psychologique est rarement le fruit d’interactions dyadiques isolées du reste de l’appareil mental. L’analyse bivariée se heurte ainsi inévitablement au risque de simplification excessive, ignorant les phénomènes de modération, de médiation ou de confusion. C’est pourquoi elle sert de tremplin vers l’analyse multivariée, laquelle mobilise des outils probabilistes plus sophistiqués – tels que les régressions multiples, les analyses de variance factorielles ou les équations structurelles – permettant d’isoler la part de variance partagée exclusive entre deux construits tout en maintenant constants d’autres facteurs de confusion potentiels.
1.3 Rôle de l’analyse bivariée dans la démarche empirique
Dans le déploiement d’un protocole empirique en neurosciences cognitives et en psychologie clinique, l’analyse bivariée remplit d’abord une mission indispensable de validation préliminaire des hypothèses de recherche. Avant de mobiliser des architectures analytiques lourdes nécessitant une puissance statistique considérable, l’examen bivarié permet d’attester de la réalité tangible d’une association théoriquement postulée. Par exemple, si une théorie cognitive avance que la vitesse de traitement de l’information constitue le facteur limitant de la mémoire de travail chez le sujet vieillissant, la mise en évidence préalable d’une corrélation significative entre les scores de ces deux fonctions cognitives s’impose comme une condition sine qua non à la poursuite de l’investigation.
Sur le plan exploratoire, l’analyse bivariée se révèle être un instrument diagnostique irremplaçable lors des phases d’inspection des matrices de données. Elle permet aux chercheurs de cartographier rapidement l’ensemble des relations potentielles au sein d’un jeu de variables complexes, facilitant l’émergence d’intuitions théoriques inédites ou la détection d’incohérences de mesure. En outre, dans les protocoles de validation d’échelles psychométriques, l’examen bivarié intervient systématiquement pour évaluer la fidélité test-retest d’un instrument, sa consistance interne ou encore la validité de critère concurrente, garantissant ainsi que l’outil mesure bien le construit psychologique qu’il prétend évaluer.
Enfin, cette démarche participe directement à l’évaluation de la pertinence théorique globale des modèles explicatifs du fonctionnement humain. En documentant avec précision l’ampleur numérique des liens observés sur le terrain, l’analyse bivariée protège la communauté scientifique contre l’écueil des spéculations désincarnées. Elle soumet les élaborations conceptuelles à l’épreuve de la réfutabilité poppérienne en démontrant sans ambiguïté si deux dimensions de la subjectivité ou du comportement partagent, ou non, une part substantielle de leur variance empirique.
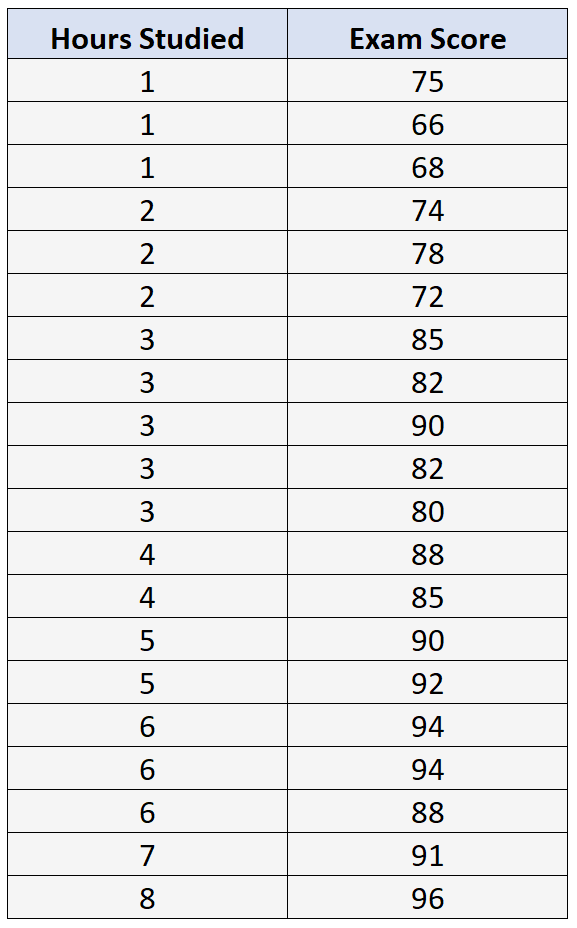
2. Typologie des variables et échelles de mesure en psychologie
L’implémentation adéquate de l’analyse bivariée est subordonnée à une compréhension rigoureuse de la nature mathématique et métrique des grandeurs considérées. Selon la taxonomie classique formulée par le psychologue et métrologiste Stanley Smith Stevens, la nature de l’information contenue dans une mesure dicte de façon univoque la classe d’opérations mathématiques permises et, par voie de conséquence, les familles de tests statistiques bivariés qu’il est légitime de mobiliser pour tester les hypothèses du chercheur.
2.1 Variables quantitatives continues et discrètes
Les variables quantitatives se caractérisent par le fait que leurs modalités numériques expriment de véritables grandeurs métriques, autorisant l’usage direct des opérations arithmétiques fondamentales telles que l’addition, la soustraction, la multiplication ou la division. Au sein de cette catégorie, la psychométrie et les neurosciences s’appuient fréquemment sur les échelles d’intervalle et de rapport. Une échelle d’intervalle se distingue par l’existence d’une unité de mesure constante et arbitraire, sans zéro absolu représentatif de l’absence totale du phénomène; c’est typiquement le cas des scores standardisés d’efficience intellectuelle comme le quotient intellectuel issu des échelles de Wechsler, où un score de zéro ne traduit nullement une absence intégrale d’activité cognitive.
À l’opposé, les échelles de rapport possèdent un zéro absolu naturel, traduisant le néant de la dimension considérée. Les variables chronométriques, à l’instar des temps de réaction enregistrés au milliseconde près dans des tâches de détection visuelle ou d’amorçage sémantique, relèvent incontestablement de ce statut métrique. De même, les mesures d’amplitude électrodermale, les fréquences cardiaques ou les concentrations de cortisol salivaire collectées en psychobiologie du stress s’inscrivent pleinement dans le registre des échelles de rapport, autorisant les comparaisons directes de proportions entre participants.
Il est par ailleurs fondamental de dissocier les variables continues des variables discrètes. Une variable continue peut théoriquement prendre une infinité indénombrable de valeurs intermédiaires au sein d’un intervalle défini, sa granularité n’étant limitée que par la sensibilité technique de l’instrument d’enregistrement. Les variables discrètes, quant à elles, procèdent le plus souvent de dénombrements finis : il s’agit, par exemple, du nombre de réponses erronées relevées lors de la passation d’un test d’attention sélective ou du nombre d’événements de vie traumatiques déclarés. Cette distinction affecte substantiellement la conformité aux hypothèses de continuité et de normalité statistique sous-jacentes à certains modèles d’association bivariée.
2.2 Variables qualitatives nominales et ordinales
Les variables qualitatives décrivent des attributs, des états ou des caractéristiques intrinsèquement non métriques. Au niveau le plus élémentaire de la taxonomie de Stevens se trouvent les variables nominales. Leurs modalités constituent des classes d’équivalence mutuellement exclusives et exhaustivement réparties, sans qu’aucune relation de supériorité, d’ordonnancement hiérarchique ou de distance mathématique ne puisse être établie entre elles. En psychopathologie clinique, les classifications diagnostiques catégorielles – qu’il s’agisse de la présence ou de l’absence d’un trouble panique, ou de l’appartenance à un sous-type nosographique spécifique selon le DSM-5 – relèvent rigoureusement de ce registre nominal.
Les variables ordinales introduisent, au-delà de la catégorisation, un principe d’ordonnancement hiérarchique strict entre les modalités. Si l’on peut affirmer sans équivoque qu’un niveau d’observation est supérieur, égal ou inférieur à un autre, la distance numérique séparant deux échelons successifs demeure indéterminée et non standardisée. Le champ de la psychologie sociale et de l’évaluation de la personnalité fait un usage massif des échelles d’évaluation graduées, désignées conventionnellement sous le terme d’échelles de Likert. L’adhésion à une proposition psychologique variant de « Pas du tout d’accord » à « Tout à fait d’accord » illustre parfaitement ce format ordinal.
Le mode de codage numérique appliqué à ces grandeurs qualitatives emporte de lourdes conséquences méthodologiques. Assigner arbitrairement les chiffres 1, 2, 3 et 4 aux différents échelons d’une échelle ordinale ne confère en aucun cas à cette variable les propriétés métriques d’une échelle d’intervalle. Réaliser la moyenne arithmétique de tels scores sans précaution psychométrique constitue un glissement analytique contestable. Ce format de mesure impose impérativement le recours à des algorithmes bivariés fondés sur les distributions de rangs ou sur l’analyse des tableaux de contingence, afin de respecter scrupuleusement la métrique d’origine des données.
2.3 Matrice de décision méthodologique pour le choix des tests
Afin de naviguer avec rigueur à travers l’arsenal des méthodes d’analyse bivariée, le chercheur doit se référer à une matrice de décision méthodologique rationnelle, articulée autour de la nature conjointe des deux variables investiguées. Le croisement des formats de mesure dicte en effet la famille de procédures mathématiques adaptées, évitant ainsi le risque d’appliquer des estimateurs biaisés ou invalides :
- Deux variables quantitatives continues : Lorsque l’investigation met en regard deux métriques continues (par exemple, le volume d’activité sportive mesuré en heures et le score global de bien-être subjectif sur une échelle d’intervalle validée), l’analyse s’oriente préférentiellement vers la corrélation linéaire de Pearson ou la modélisation par régression linéaire simple. Si l’une des dimensions viole l’exigence de continuité ou de normalité, les coefficients de corrélation de rangs sont alors convoqués en substitution.
- Deux variables qualitatives nominales ou catégorielles : Dans le cas où l’on s’intéresse à l’association entre deux facteurs discrets sans métrique ordonnée (à l’instar de l’orientation thérapeutique principale d’un clinicien et l’issue clinique binaire d’un traitement : rémission complète versus échec), l’outil de référence demeure le test d’indépendance du Chi-deux, complété d’indices d’intensité d’association tels que le V de Cramer ou le coefficient Phi.
- Une variable qualitative catégorielle et une variable quantitative métrique : Ce croisement typique correspond à la comparaison de groupes dans les plans quasi-expérimentaux ou différentiels (par exemple, confronter le niveau de performance mnésique continue entre un groupe recevant un placebo et un groupe recevant une substance nootropique). Lorsque la variable nominale ne comporte strictement que deux modalités, le test t de Student pour échantillons indépendants s’impose, relayé par le test U de Mann-Whitney si les postulats distributionnels font défaut.
Cette typologie fonctionnelle constitue le socle sur lequel repose l’ensemble des inférences statistiques ultérieures. Transgresser les frontières métriques d’une variable revient à compromettre irrémédiablement la validité interne des conclusions tirées par l’investigateur.
3. La représentation graphique : les nuages de points
Préalablement à tout calcul d’estimateurs numériques sophistiqués, l’exploration graphique des données s’affirme comme une étape fondamentale de la démarche scientifique. Dans le cadre de l’analyse bivariée consacrée aux variables continues, le nuage de points – ou diagramme de dispersion – constitue l’outil visuel le plus puissant pour sonder la réalité empirique du lien suspecté.
3.1 Principes fondamentaux de construction du nuage de points
La construction rigoureuse d’un nuage de points obéit à des conventions géométriques précises issues du système de coordonnées cartésiennes. L’espace bidimensionnel est structuré par deux axes orthogonaux : l’axe horizontal des abscisses (noté conventionnellement X) et l’axe vertical des ordonnées (noté Y). Lorsque la problématique de recherche implique une asymétrie fonctionnelle entre les variables, il est d’usage immuable d’assigner la variable présumée explicative, indépendante ou prédictive à l’axe des abscisses, tandis que la variable critère, réponse ou dépendante vient se déployer le long de l’axe des ordonnées.
Chaque unité statistique observée au sein de l’échantillon expérimental se trouve dès lors matérialisée par un point géométrique unique dans le plan. Les coordonnées de ce point correspondent très exactement au couple de valeurs prises par le participant considéré sur les deux dimensions évaluées. L’agrégation visuelle de la totalité des points engendre une configuration spatiale globale dont l’examen permet de saisir instantanément l’architecture relationnelle des données.
Une vigilance méthodologique accrue doit être accordée au calibrage et à la mise à l’échelle des axes graphiques. Une troncature malavisée de l’origine, une asymétrie disproportionnée des rapports d’échelle ou une compression excessive de l’axe des ordonnées peuvent induire de sévères distorsions perceptuelles chez le chercheur. De tels biais graphiques risquent d’exagérer artificiellement l’ampleur apparente d’une corrélation quasi inexistante ou, à l’inverse, d’écraser visuellement une relation empirique pourtant substantielle.
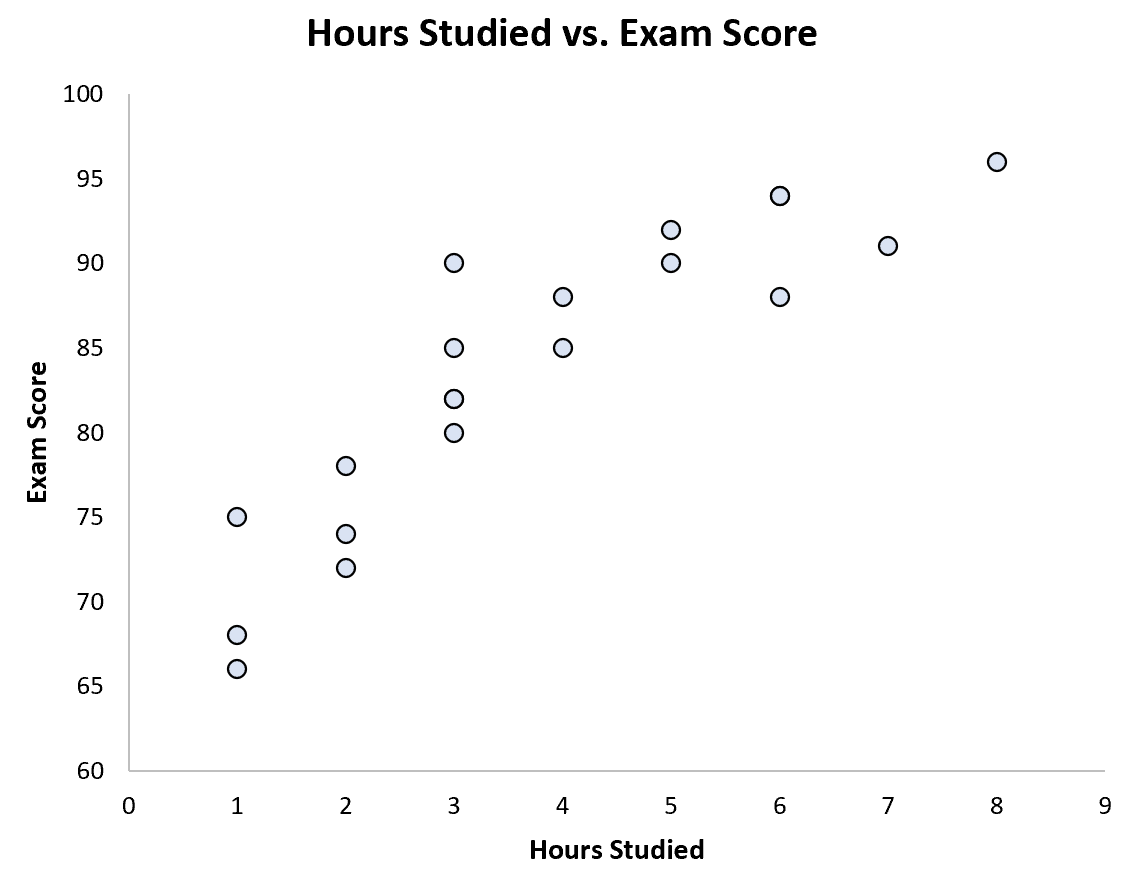
3.2 Identification visuelle de la forme et de la direction du lien
L’inspection du tracé graphique offre en premier lieu l’opportunité de caractériser la direction de l’association empirique. Une configuration de points s’étirant de bas en haut et de gauche à droite témoigne de la présence d’une association linéaire ascendante ou positive : l’augmentation systématique des valeurs de la variable X coïncide statistiquement avec une élévation des scores sur la variable Y. Inversement, une trajectoire orientée du quadrant supérieur gauche vers le quadrant inférieur droit matérialise une association descendante ou négative, signifiant qu’un accroissement de la grandeur prédictive s’accompagne d’une régression conjointe de la réponse mesurée.
Au-delà de la directionnalité, le nuage de points joue un rôle de filtre diagnostique capital en révélant la forme fonctionnelle réelle de la liaison. Les modèles statistiques paramétriques standard postulent une cinématique strictement rectiligne. Or, la psychologie recèle de processus biologiques et cognitifs répondant à des dynamiques non linéaires ou curvilignes. L’exemple historique de la loi de Yerkes-Dodson illustre parfaitement ce phénomène : la performance cognitive s’accroît avec le niveau d’éveil émotionnel jusqu’à un seuil d’activation optimal, avant de se détériorer drastiquement en cas d’hyper-activation anxieuse, décrivant un motif en cloche (ou U inversé) qu’une analyse corrélationnelle linéaire standard serait incapable de saisir fidèlement.
Enfin, l’amplitude de la dispersion des observations individuelles autour de la trajectoire générale constitue l’indice visuel direct de la magnitude de la relation. Plus les points se resserrent étroitement le long d’une droite imaginaire, plus la force de covariation entre les deux construits est robuste, suggérant un niveau d’erreur aléatoire minime. Si, en revanche, le graphique se présente sous la forme d’une nébuleuse diffuse et circulaire sans orientation discernable, le chercheur peut d’emblée conclure à une absence quasi totale de dépendance linéaire entre les dimensions investiguées.
3.3 Détection visuelle des anomalies et sous-groupes
Le nuage de points est le dispositif par excellence pour traquer les valeurs aberrantes ou atypiques, communément désignées sous l’anglicisme outliers. Si certaines anomalies sont aisément identifiables dès l’analyse univariée parce qu’elles se situent à plus de trois écarts-types de la moyenne d’un score isolé, d’autres n’apparaissent qu’à la lumière de leur positionnement conjoint. Une valeur aberrante bivariée correspond à une observation dont les scores univariés s’avèrent tout à fait ordinaires lorsqu’ils sont pris isolément, mais dont la combinaison singulière défie radicalement l’architecture générale de l’échantillon. Un unique point atypique isolé peut, par son effet de levier géométrique, créer une corrélation artificielle ou pulvériser une relation robuste.
Par ailleurs, l’examen de la distribution spatiale des points permet de détecter l’émergence éventuelle de sous-groupes distincts au sein de l’échantillon réuni. Si le nuage laisse transparaître deux ou plusieurs agglomérations denses séparées par un vide spatial, cette bimodalité conjointe signale la présence probable d’une variable modératrice latente non prise en compte par le modèle, telle que le genre, l’étiologie clinique ou le niveau de scolarisation des participants. Traiter une telle distribution comme un ensemble unifié sans procéder à une analyse stratifiée constituerait une faute méthodologique avérée.
Enfin, les anomalies métriques structurelles se révèlent visuellement par des phénomènes de troncature. Un alignement artificiel horizontal ou vertical d’un nombre important d’observations à l’extrémité supérieure ou inférieure de l’un des axes traduit sans équivoque la présence d’un effet de plafond ou d’un effet de plancher. Un test d’évaluation cognitive excessivement aisé ou trop ardu sature les capacités de discrimination de l’instrument, entraînant un écrasement brutal de la variance qui masque inexorablement l’ampleur véritable de l’association bivariée sous-jacente.
4. Les coefficients de corrélation paramétriques : le r de Pearson
Lorsque la structure du nuage de points confirme la plausibilité d’une association linéaire entre deux grandeurs quantitatives, le statisticien fait appel à l’indice d’association paramétrique standard conçu par Karl Pearson. Ce coefficient, condensé rigoureux de la théorie des probabilités, standardise la mesure de la covariation pour fournir un indicateur synthétique sans unité, universellement intelligible et directement comparable à travers différents domaines de la psychologie empirique.
4.1 Définition mathématique et concept de covariance
La compréhension formelle du coefficient de corrélation linéaire nécessite en premier lieu l’assimilation du concept fondamental de covariance bivariée. La covariance mesure la moyenne arithmétique des produits croisés des écarts des variables X et Y par rapport à leurs moyennes respectives. Mathématiquement, pour un échantillon de taille N, la covariance empirique s’exprime sous la forme suivante :
Cov(X, Y) = Σ [(Xi – X̄)(Yi – Ȳ)] / (N – 1)
Si la covariance remplit une fonction fondamentale en indiquant l’orientation générale du lien – une valeur positive traduit une progression conjointe, tandis qu’une valeur négative signale une opposition de phase –, elle souffre d’une limite opérationnelle majeure : elle dépend intégralement des unités de mesure utilisées. La covariance calculée entre des millisecondes et des scores cliniques produira un chiffre monumental et ininterprétable en soi. Pour neutraliser cette contingence d’échelle, Karl Pearson a proposé de normaliser la covariance en la divisant par le produit géométrique des écarts-types des deux variables, aboutissant à la formulation du coefficient r :
r = Cov(X, Y) / [sX × sY] = Σ [(Xi – X̄)(Yi – Ȳ)] / √[ Σ (Xi – X̄)² × Σ (Yi – Ȳ)² ]
Cette opération algébrique confère au coefficient de corrélation paramétrique une remarquable propriété d’invariance d’échelle. Que le chercheur exprime le temps de réaction en fractions de secondes ou en microsecondes, que les échelles psychométriques soient augmentées ou multipliées par une constante positive, la magnitude numérique de r demeure strictement inaltérée, consacrant sa robustesse métrologique.
4.2 Interprétation de la magnitude et de la direction
En vertu de l’inégalité mathématique de Cauchy-Schwarz, la valeur calculée du coefficient de corrélation de Pearson est strictement bornée au sein d’un intervalle théorique fermé oscillant entre -1,00 et +1,00. Un coefficient atteignant exactement +1,00 signale une dépendance linéaire positive déterministe parfaite, où chaque point de mesure s’aligne rigoureusement sur une trajectoire rectiligne montante. Inversement, une valeur de -1,00 matérialise une relation linéaire inverse intégrale. Enfin, un score de r nul n’atteste que d’une chose : l’absence totale de relation linéaire entre les deux variables au sein de la population étudiée.
Dans la pratique de la recherche psychologique, la caractérisation de l’intensité pratique d’un coefficient repose traditionnellement sur la grille d’interprétation formulée par le statisticien Jacob Cohen. Selon ces balises heuristiques universellement acceptées :
- Un coefficient compris entre |0,10| et |0,29| correspond à un effet de faible magnitude, rendant compte de relations subtiles fréquemment rencontrées dans les enquêtes d’attitudes ou de personnalité.
- Une valeur se situant entre |0,30| et |0,49| désigne un effet de taille moyenne, observable lors de liens substantiels entre processus cognitifs apparentés.
- Une intensité atteignant ou excédant |0,50| qualifie un effet de forte magnitude, typique de la fidélité test-retest d’épreuves psychométriques ou de la convergence d’outils mesurant des construits hautement imbriqués.
Il importe toutefois de maintenir une dissociation conceptuelle inflexible entre la significativité statistique d’un coefficient et sa pertinence clinique ou substantielle. Sous l’effet d’une taille d’échantillon très importante comprenant plusieurs milliers de participants, un coefficient infinitésimal de r = 0,06 peut fort bien franchir le seuil fatidique de la significativité statistique (p < 0,05). Cette significativité ne prouve rien d’autre que l’improbabilité mathématique d’une telle déviation sous l’hypothèse d’une nullité stricte dans la population parente; elle n’implique absolument pas que l’association observée recèle la moindre utilité diagnostique ou prédictive pour la compréhension du fonctionnement psychologique individuel.
4.3 Conditions d’application et postulats fondamentaux
La validité inférentielle du coefficient r de Pearson n’est garantie que si les données satisfont un ensemble d’exigences méthodologiques strictes. En premier lieu figure l’hypothèse de distribution normale bivariée. Ce postulat dépasse la simple vérification de la normalité univariée de chaque variable prise isolément; il exige que pour chaque valeur donnée de la variable X, la distribution correspondante des scores sur la dimension Y suive une loi normale parfaite, et réciproquement. La conformité à ce modèle se vérifie notamment par l’allure ellipsoïdale symétrique du nuage de points tracé dans l’espace bidimensionnel.
La deuxième condition réside dans l’exigence absolue de linéarité sous-jacente. Comme souligné précédemment, l’algorithme de Pearson est exclusivement calibré pour capter la présence d’une composante rectiligne. Si la trajectoire de l’association emprunte un profil exponentiel, logarithmique ou polynomial, le coefficient sous-estimera dramatiquement l’intensité effective de la dépendance entre les construits, pouvant conduire le chercheur à conclure faussement à l’indépendance de deux phénomènes pourtant organiquement liés.
Enfin, le modèle de Pearson fait preuve d’une vulnérabilité pathologique face aux observations aberrantes et à l’hétérogénéité de la variance. La présence d’un unique score déviant peut artificiellement propulser un coefficient proche de zéro vers des sommets flatteurs, ou annihiler une association authentique par inflation excessive de la somme des carrés des résidus. Dès lors que l’une de ces hypothèses fondatrices est transgressée par le matériel clinique ou comportemental, le recours aux alternatives non paramétriques devient une impérieuse nécessité scientifique.
5. Les alternatives de corrélation non paramétriques
Face aux distributions asymétriques, aux échelles ordinales ou aux effectifs échantillonnaux restreints si répandus dans la pratique clinique hospitalière et la neuropsychologie, les statistiques non paramétriques offrent des outils de modélisation bivariée remarquablement robustes. En s’affranchissant du postulat contraignant de normalité, ces méthodes préservent la puissance du test tout en garantissant l’exactitude de l’inférence.
5.1 Le coefficient rho de Spearman pour rangs ordonnés
Formulé par Charles Spearman, ce coefficient non paramétrique contourne élégamment les limitations de l’échelle d’intervalle en substituant aux grandeurs brutes observées leur classement hiérarchique séquentiel. La procédure initiale consiste à classer l’ensemble des scores des participants pour la variable X par ordre croissant, leur attribuant des rangs entiers allant de 1 jusqu’à N. La même procédure d’ordonnancement est ensuite appliquée indépendamment aux valeurs de la variable Y. Dès lors, le coefficient rho (noté rs) correspond très exactement au coefficient de Pearson calculé non plus sur les données métriques originelles, mais sur les séries ordonnées de ces rangs transformés.
Lorsque aucun ex æquo n’est relevé dans la hiérarchie des observations, l’équation mathématique du rho de Spearman se simplifie sous une formule célèbre et rapide :
rs = 1 – [ 6 × Σ di² ] / [ N × (N² – 1) ]
Dans cette formalisation, le symbole di représente la différence algébrique mesurée entre le rang attribué au sujet i sur la première variable et son rang sur la seconde. Cette conversion mathématique opère une désensibilisation radicale face aux distorsions d’échelle : le coefficient de Spearman ne jauge plus la linéarité stricte de la relation, mais sa monotonicité globale. Il mesure ainsi fidèlement si l’élévation des scores sur une variable s’accompagne constamment d’une progression hiérarchique sur l’autre, que cette dynamique prenne une forme droite, incurvée ou asymptotique.
Cette approche s’impose naturellement comme la méthode de choix pour l’analyse d’inventaires de personnalité structurés en échelles de Likert ou d’épreuves d’évaluation des attitudes. Les biais d’ancrage psychologique déformant fréquemment les intervalles subjectifs séparant les options de réponse, la transformation en rangs permet de neutraliser ces artefacts de cotation tout en conservant l’information relative à l’ordre séquentiel des profils individuels.
5.2 Le tau de Kendall pour échantillons réduits
Conçu par le mathématicien Maurice Kendall, le coefficient tau (noté τ) constitue une seconde alternative non paramétrique prestigieuse, fondée sur une logique combinatoire radicalement différente de celle de Spearman. L’algorithme de Kendall scrute méthodiquement l’ensemble des paires de participants qu’il est possible de former au sein d’une cohorte statistique de taille N. Deux observations distinctes sont dites « concordantes » si l’ordre relatif de leurs scores respectifs sur la variable X est parfaitement identique à leur ordre hiérarchique sur la variable Y. Si les orientations hiérarchiques divergent, la paire est alors qualifiée de « discordante ».
Le tau de Kendall évalue précisément le rapport entre le surnombre de paires concordantes et l’ensemble de l’espace combinatoire disponible. Dans sa formulation de base (tau-a), il s’exprime par le calcul :
τ = [ Paires concordantes – Paires discordantes ] / [ N(N – 1) / 2 ]
En présence d’ex æquo fréquents, situation récurrente lorsque les items d’évaluation ne comportent qu’un spectre très restreint d’échelons de réponse, la version amendée désignée sous le terme de tau-b intègre un ajustement pénalisant qui corrige rigoureusement la métrique finale pour préserver la comparabilité de l’estimation statistique.
Sur le plan des propriétés inférentielles, le coefficient de Kendall démontre une supériorité mathématique tangible sur le rho de Spearman dès lors que l’on travaille sur des échantillons très réduits (par exemple, des séries cliniques en neurosciences ou l’étude de pathologies cognitives rarissimes n’impliquant qu’une douzaine de patients). Sa distribution d’échantillonnage converge de surcroît beaucoup plus rapidement vers la normalité asymptotique, conférant aux tests d’hypothèses qui lui sont adossés une marge de précision supérieure et des intervalles de confiance d’une fiabilité remarquable.
5.3 Critères de sélection entre approches paramétriques et de rangs
Le choix ultime entre le coefficient classique de Pearson et les alternatives de rangs de Spearman ou Kendall ne saurait être guidé par une préférence subjective ou par l’automatisme routinier d’un logiciel. Ce choix engage la responsabilité méthodologique de l’investigateur et procède d’un arbitrage délicat entre préservation de la puissance d’analyse et robustesse statistique :
- Le respect de la métrique originelle : Lorsque les variables analysées répondent rigoureusement aux critères des échelles d’intervalle et que les postulats de normalité bivariée sont respectés, l’usage délibéré d’un test de rangs conduit à une perte d’information préjudiciable. En convertissant des écarts continus mesurés en simples échelons séquentiels, le chercheur gaspille la granularité fine de ses mesures expérimentales et subit une réduction d’environ 10 % de sa puissance statistique.
- La sensibilité aux asymétries distributionnelles : Si les données présentent une asymétrie marquée (un coefficient de dissymétrie ou skewness prononcé) ou un aplatissement inhabituel (kurtosis), l’estimateur de Pearson devient erratique. Dans ce contexte précis, la transformation en rangs neutralise l’impact délétère des valeurs extrêmes, restituant au test de Spearman une puissance d’inférence très supérieure à celle d’un test paramétrique corrompu.
- La clarté du compte rendu scientifique : Les directives contemporaines de reporting méthodologique en psychologie et en sciences comportementales (telles que stipulées par l’American Psychological Association) exigent que le statisticien explicite sans équivoque les motivations régissant le choix de son indicateur. Si des coefficients non paramétriques sont retenus, le manuscrit scientifique doit scrupuleusement mentionner les violations précises qui ont proscrit l’approche paramétrique, en renseignant systématiquement la présence d’ex æquo et la nature exacte des corrections appliquées.
6. La régression linéaire simple : modéliser la prédiction
Si la corrélation bivariée se contente d’évaluer la force et l’orientation d’une relation symétrique d’interdépendance, la démarche scientifique aspire fréquemment à une formalisation fonctionnelle asymétrique. La régression linéaire simple franchit cette étape décisive en instaurant un modèle mathématique orienté, où l’on cherche à prédire les variations d’une variable critère à partir de l’observation d’un facteur prédicteur identifié.
6.1 De l’association descriptive à la prédiction unilatérale
Le saut conceptuel séparant l’analyse de corrélation de celle de la régression tient tout entier dans la désignation délibérée d’une hiérarchie entre les variables. Au sein du formalisme régressif, la variable X est promue au rang de variable prédictive (ou explicative), tandis que la variable Y est qualifiée de variable critère (ou variable à prédire). Il ne s’agit plus seulement de constater que X et Y évoluent de concert, mais de construire une fonction algébrique capable de délivrer une estimation attendue de la valeur prise par Y dès lors que l’on connaît la valeur assignée à X.
Le modèle fondamental de la régression linéaire simple postule que la relation empirique observable peut être approximée de manière optimale par une trajectoire géométrique rectiligne, désignée sous le terme de droite des moindres carrés ordinaires. L’équation formelle reliant chaque observation individuelle prend la forme suivante :
Yi = β0 + β1Xi + εi
Dans cette structure mathématique fondamentale :
- β0 (l’ordonnée à l’origine ou constante) représente la valeur prévisionnelle théorique adoptée par la variable réponse Y lorsque le prédicteur X est strictement égal à zéro. Sur le plan psychologique, cette valeur n’a parfois aucun sens direct si la variable prédictive ne peut physiologiquement jamais atteindre le zéro (comme dans le cas de l’âge adulte ou de la tension artérielle), mais elle demeure le point d’ancrage géométrique incontournable du tracé.
- β1 (la pente de régression) constitue le paramètre central du modèle. Elle quantifie le taux de variation espéré sur le critère Y pour chaque augmentation unitaire enregistrée sur la variable prédictive X. Si la pente est positive, chaque unité additionnelle de X accroît le score prédit de Y d’une quantité équivalente à β1.
- εi (le terme d’erreur ou résidu statistique) matérialise l’écart vertical incompressible mesuré pour l’individu i entre sa valeur réelle observée et la valeur théorique projetée par la droite de régression. Ce résidu incarne la part d’imprévisibilité biologique, les imprécisions psychométriques et l’influence des multiples facteurs résiduels non inclus dans le modèle bivarié.
6.2 Évaluation de la qualité d’ajustement du modèle
Une fois les paramètres de la droite de régression calibrés par la minimisation géométrique de la somme des carrés des erreurs résiduelles, l’investigateur doit impérativement évaluer la qualité globale de cet ajustement empirique. Cette évaluation repose sur le principe fondamental de la décomposition de la variance totale de la variable dépendante. La somme totale des carrés des écarts à la moyenne (SST) est partitionnée de manière additive en deux composantes indépendantes :
SST = Somme des Carrés Modèle (SSM) + Somme des Carrés Résiduelle (SSR)
Le ratio confrontant la variance expliquée par le modèle à la variance totale du critère débouche sur le calcul du coefficient de détermination, universellement symbolisé par R² :
R² = SSM / SST = 1 – [ SSR / SST ]
Dans le cadre exclusif de la régression linéaire simple bivariée, une propriété mathématique remarquable établit que la valeur de R² correspond très exactement au carré algébrique direct du coefficient de corrélation linéaire de Pearson (r²). Ce paramètre se prête à une interprétation cognitive immédiate : il exprime la proportion rigoureuse de la variance de la variable critère directement attribuable, expliquée ou partagée par les variations du prédicteur. Un R² de 0,36 atteste ainsi que 36 % de la variabilité interindividuelle observée sur le critère est systématiquement modélisée par le prédicteur, laissant 64 % de variance inexpliquée abandonnée aux résidus.
En complément du coefficient de détermination, le statisticien s’appuie sur l’erreur standard d’estimation (notée se), laquelle quantifie l’écart-type moyen des résidus autour de la droite de régression. Exprimée dans l’unité métrique originelle de la variable à prédire, cette statistique offre une évaluation concrète de la marge d’erreur inhérente aux projections individuelles, permettant de calculer les intervalles de prédiction autour des futurs scores cliniques ou académiques.
6.3 Diagnostic des postulats de la régression linéaire simple
L’inférence statistique déployée au sein du modèle de régression linéaire simple repose sur un faisceau d’hypothèses relatives aux résidus, dont la vérification constitue la phase de diagnostic du modèle. Ignorer cette vérification expose le clinicien ou l’expérimentateur à utiliser des intervalles de confiance dramatiquement erronés et à formuler des prédictions trompeuses :
- L’indépendance des erreurs : Les résidus doivent être statistiquement indépendants les uns des autres, ce qui prohibe l’existence d’autocorrélations sérielles souvent relevées dans les séries temporelles de mesures répétées. Ce postulat est traditionnellement éprouvé à l’aide de la statistique de Durbin-Watson.
- La normalité des résidus : Les écarts résiduels εi doivent se distribuer selon une loi normale centrée sur zéro. Ce contrôle s’effectue visuellement via l’inspection des tracés quantiles-quantiles (diagrammes Q-Q plot) ou de façon formelle par l’application de tests de normalité d’ajustement comme le test de Shapiro-Wilk.
- L’homoscédasticité : Ce terme savant désigne l’uniformité de la variance des résidus sur l’ensemble du continuum de la variable prédictive. L’amplitude des résidus ne doit ni enfler ni rétrécir à mesure que X croît. Une configuration résiduelle en entonnoir ou en mégaphone dénonce une hétéroscédasticité manifeste, invalidant l’estimation standard des erreurs de prédiction et requérant l’emploi de correcteurs de variance robuste (tels que les estimateurs de White).
- L’identification des observations influentes : Enfin, le chercheur évalue l’influence disproportionnée exercée par certains participants atypiques en calculant la distance de Cook. Cet indice multivarié quantifie l’ampleur globale du déplacement que subiraient tous les coefficients de la droite si l’observation suspecte venait à être purement et simplement retranchée de l’échantillon. Une distance de Cook excédant le seuil de 1 signale généralement un point d’influence critique capable de biaiser l’interprétation théorique du modèle.
7. Analyse bivariée pour variables catégorielles : le test du Chi-deux
Lorsque les questions de recherche transcendent la mesure continue pour s’intéresser à des classifications, des typologies ou des proportions au sein de groupes discrets, les méthodes fondées sur les moyennes et les covariances deviennent inapplicables. C’est ici qu’intervient l’analyse des tableaux de contingence, dont le fondement probabiliste majeur s’articule autour du célèbre test d’indépendance du Chi-deux formalisé par Karl Pearson au tournant du vingtième siècle.
7.1 Tableaux de contingence et fréquences théoriques
L’organisation matricielle des observations qualitatives constitue le socle indispensable de l’analyse bivariée des données catégorielles. Deux variables nominales ou ordinales sont croisées pour donner naissance à un tableau de contingence de dimensions k × l, où k figure le nombre total de modalités distinctes offertes par la première variable (en lignes) et l le nombre de classes de la seconde (en colonnes). Chaque cellule interne de cette matrice contient un effectif empirique observé (noté Oij), désignant le nombre absolu de participants cumulant précisément la modalité i sur le premier facteur et la modalité j sur le second.
La mécanique probabiliste du test d’indépendance repose sur la confrontation systématique de ces effectifs observés avec une configuration de fréquences théoriques attendues (notées Eij). Ces fréquences correspondent très rigoureusement à la distribution statistique que l’on observerait sous le postulat absolu de l’hypothèse nulle d’indépendance parfaite des deux construits. En vertu du théorème de multiplication des probabilités d’événements indépendants, l’effectif attendu pour toute cellule d’intersection s’obtient par la formule :
Eij = (Total de la ligne i × Total de la colonne j) / Ntotal
Pour assurer la validité asymptotique de l’approximation par la loi continue du Chi-deux, un ensemble de prérequis méthodologiques universellement reconnus (formulés notamment par W. G. Cochran) doit impérativement être honoré :
- Aucune cellule du tableau de contingence ne doit comporter un effectif théorique attendu strictement nul (Eij > 0).
- Au moins 80 % des cellules de l’ensemble de la grille doivent afficher des effectifs théoriques attendus strictement supérieurs ou égaux à 5. Si ce postulat est transgressé, les probabilités associées calculées par le modèle sont compromises, imposant un regroupement de modalités ou le repli sur le test exact de Fisher.
7.2 Statistique du Chi-deux d’indépendance
La formalisation du test du Chi-deux (symbolisé par χ²) consiste en une sommation standardisée des divergences quadratiques relevées sur l’intégralité des cellules de la matrice entre le réel empirique et l’attente théorique. Sa formulation algébrique canonique s’exprime ainsi :
χ² = Σ [ (Oij – Eij)² / Eij ]
Plus l’écart cumulé entre ce qui est effectivement mesuré sur le terrain clinique et ce que prédirait le hasard pur est gigantesque, plus la valeur finale du χ² s’élève. Cette valeur empirique est alors comparée à la loi théorique de probabilité du Chi-deux régie par un paramètre fondamental : les degrés de liberté (notés dl). Dans une table de contingence de taille k × l, ces degrés de liberté se calculent selon le produit des dimensions marginales libres :
dl = (k – 1) × (l – 1)
Si la statistique empirique calculée dépasse la valeur critique tabulée pour un risque d’erreur alpha prédéfini (usuellement fixé à 0,05), l’hypothèse nulle d’indépendance est formellement rejetée au profit de l’hypothèse alternative d’une association non fortuite entre les deux caractéristiques catégorielles.
Il importe de souligner une précaution technique cruciale relative aux tables d’effectifs de format 2 × 2 (comportant 1 seul degré de liberté). Du fait de l’approximation d’une distribution discrète par une fonction continue, la statistique standard tend à être légèrement surestimée. Frank Yates a ainsi formulé une correction de continuité consistant à soustraire systématiquement la quantité absolue 0,5 à l’écart unitaire observé avant d’en calculer le carré, minorant ainsi la statistique de test pour prémunir le chercheur contre les rejets hâtifs de l’hypothèse nulle.
7.3 Mesures de la force d’association nominale
De même qu’un coefficient de corrélation de Pearson ne saurait se réduire à sa seule p-valeur, le test du Chi-deux ne renseigne en rien sur l’amplitude concrète du lien découvert. La statistique χ² étant intrinsèquement proportionnelle à la taille d’échantillon globale N, une cohorte immense débouchera quasi inéluctablement sur un résultat statistiquement hautement significatif, quand bien même la réalité de l’association nominale s’avérerait dérisoire. Pour combler cette béance descriptive, les méthodologues ont élaboré des indices d’intensité d’association normalisés.
Dans le cadre restreint des tables de contingence 2 × 2, l’indice d’effet de référence est le coefficient Phi (noté φ). Ce dernier standardise directement la statistique du Chi-deux par la taille totale de l’échantillon :
φ = √[ χ² / N ]
Le coefficient Phi partage des propriétés d’interprétation parfaitement analogues à celles du coefficient de corrélation linéaire, variant entre 0 (indépendance absolue) et 1 (dépendance catégorielle parfaite), permettant une estimation directe de la force d’impact clinique du facteur binaire considéré.
Dès lors que le tableau matriciel excède le format 2 × 2 pour englober des architectures polytomiques plus vastes, le coefficient Phi tend à dépasser indûment la valeur unitaire. Le statisticien Harald Cramér a donc formalisé un prolongement universel, le V de Cramér, dont l’équation incorpore le nombre minimal de lignes ou de colonnes libres du tableau :
V = √[ χ² / (N × min(k – 1, l – 1)) ]
Ce coefficient standardisé oscille rigoureusement dans l’intervalle [0, 1]. Dans le champ de l’épidémiologie psychiatrique et de la psychologie médico-sociale, le V de Cramér sert de mesure étalon pour qualifier la magnitude substantielle des relations entre des classifications nosologiques complexes et des profils socio-démographiques stratifiés.
8. Comparaison de deux groupes : le test t de Student bivarié
Un pan massif de l’investigation empirique en psychologie s’articule autour de la confrontation de deux conditions expérimentales ou de deux sous-populations identifiées au regard d’une variable métrique d’intérêt. Bien que cette démarche soit fréquemment qualifiée de comparaison de moyennes, elle s’inscrit au sens le plus pur dans l’analyse bivariée : elle examine l’interdépendance systématique unissant une variable explicative catégorielle binaire (le statut d’appartenance à un groupe) et une variable réponse quantitative continue.
8.1 Cadre d’application d’une variable binaire et d’une variable continue
L’expérimentation standard en sciences cognitives procède classiquement par opposition contrastée : un groupe expérimental soumis à une manipulation ciblée (par exemple, l’entraînement à une technique de remédiation métacognitive) est directement comparé à un groupe témoin recevant une intervention contrôle inerte ou neutre. Dans cette configuration, la méthodologie inférentielle mobilise le test t formalisé originellement par William Sealy Gosset sous le pseudonyme de « Student ».
La formulation théorique des hypothèses bivariées s’établit avec netteté :
- L’hypothèse nulle (H0) : Elle postule que les deux échantillons proviennent d’une même population mère et que l’espérance de leurs moyennes respectives est rigoureusement identique (μ1 = μ2), la variation constatée entre les deux moyennes échantillonnales n’étant que le pur reflet d’une fluctuation aléatoire d’échantillonnage.
- L’hypothèse alternative bilatérale (H1) : Elle avance l’existence d’une divergence systématique réelle entre les deux moyennes de population (μ1 ≠ μ2), imputable à l’action spécifique de la condition expérimentale.
Le calcul de la statistique de test consiste à rapporter la différence observée entre les deux moyennes arithmétiques empiriques (X̄1 – X̄2) à une estimation de l’erreur standard de cette différence. Pour deux échantillons indépendants de tailles n1 et n2, sous le postulat d’homogénéité des variances, cette erreur standard s’appuie sur une estimation de la variance combinée (sp²) :
sp² = [ (n1 – 1)s1² + (n2 – 1)s2² ] / [ n1 + n2 – 2 ]
t = (X̄1 – X̄2) / √[ sp² × (1/n1 + 1/n2) ]
La valeur de t ainsi générée est projetée sur la distribution théorique de Student dotée de n1 + n2 – 2 degrés de liberté pour statuer formellement sur le rejet ou le maintien de l’hypothèse d’équivalence.
8.2 Échantillons indépendants versus mesures répétées
L’implémentation de la procédure de Student exige une distinction conceptuelle fondamentale liée à l’architecture du plan de recherche : les protocoles à groupes indépendants versus les protocoles à mesures répétées (plans appariés).
Dans un plan à échantillons indépendants (dit inter-sujets), chaque unité statistique appartient exclusivement à une seule et unique modalité de la variable binaire. Un participant ne peut figurer simultanément dans le groupe traité et dans le groupe témoin. L’aléa individuel et les variations interindividuelles agissent pleinement comme des sources de variance résiduelle non contrôlée que le dénominateur du test s’efforce d’intégrer.
À l’inverse, dans un protocole à mesures répétées (dit intra-sujet ou apparié), le chercheur évalue les mêmes participants à deux moments distincts de leur trajectoire (typiquement lors d’une mesure pré-test suivie d’une mesure post-test) ou constitue des paires de sujets appariés jumeaux sur des critères cognitifs spécifiques. L’existence d’une corrélation intra-sujet marquée entre les deux scores successifs change radicalement la donne statistique : chaque individu servant de son propre contrôle, la variance d’erreur interindividuelle est méthodologiquement neutralisée.
La statistique du test t apparié se calcule alors directement sur la série des différences individuelles observées pour chaque sujet (notées Di = Xi, post – Xi, pre). En isolant la moyenne des écarts intra-individuels (D̄) et leur écart-type spécifique (sD), la formule s’établit comme suit pour un échantillon de N paires de mesures :
t = D̄ / [ sD / √N ]
Cette méthodologie d’appariement décuple littéralement la puissance statistique du dispositif empirique, permettant de détecter des effets bivariés d’une finesse clinique remarquable tout en nécessitant une cohorte de participants substantiellement plus modeste.
8.3 Homoscédasticité et quantification de la taille de l’effet
L’usage valide du test t pour échantillons indépendants est tributaire de l’hypothèse d’homogénéité des variances ou homoscédasticité : la variance des scores au sein de la première population doit être statistiquement comparable à celle de la seconde population parente (σ1² = σ2²). Ce postulat préalable est systématiquement soumis à une vérification empirique via le test d’homogénéité de Levene ou le test de Bartlett.
Lorsque le test de Levene rejette formellement l’égalité des variances (p < 0,05), persister dans l’emploi du test t standard expose le chercheur à un gonflement dramatique du taux d’erreur de première espèce (rejet erroné de l’hypothèse nulle). Face à cette hétéroscédasticité manifeste, la communauté scientifique préconise l’usage systématique de l’alternative de Welch. Le test t de Welch n’impose aucun postulat sur l’égalité des variances et opère un ajustement correctif dynamique des degrés de liberté, garantissant une intégrité inférentielle sans faille même en présence d’échantillons d’effectifs très déséquilibrés.
Enfin, aucune démarche comparative bivariée ne saurait être tenue pour complète sans l’évaluation de l’amplitude de l’effet pratique découvert. La métrique universelle d’évaluation est ici le d de Cohen, qui standardise la différence des moyennes en la divisant par l’écart-type combiné des groupes :
d = (X̄1 – X̄2) / sp
Cette statistique sans unité exprime la divergence existant entre les deux cohortes en fractions pures d’écart-type. Un d de Cohen égal à 0,80 révèle par exemple que le groupe expérimental se situe en moyenne près d’un écart-type complet au-dessus de la moyenne du groupe contrôle, offrant un indice transparent de l’efficacité intrinsèque d’un dispositif thérapeutique ou éducatif indépendant de la taille de l’échantillon investigué.
9. Alternatives non paramétriques de comparaison de groupes
Lorsque la variable quantitative continue présente de sévères entorses à l’hypothèse de normalité distributionnelle, qu’elle manifeste une asymétrie rédhibitoire ou que l’on manipule en réalité des données d’ordre psychométrique ordonnées, les modèles de Student perdent leur validité mathématique. L’arsenal statistique propose alors de puissantes procédures de comparaison de rangs non paramétriques.
9.1 Le test U de Mann-Whitney pour échantillons indépendants
Formulé par Henry Mann et Donald Whitney pour faire suite aux intuitions fondamentales de Frank Wilcoxon, le test U de Mann-Whitney (parfois désigné sous l’appellation de test de la somme des rangs de Wilcoxon) constitue l’alternative non paramétrique directe au test t de Student pour deux échantillons indépendants. Sa philosophie opératoire réside dans l’affranchissement des métriques absolues au profit d’un classement ordinal complet.
La procédure débute par l’agrégation de la totalité des scores des participants issus des deux groupes expérimentaux au sein d’une seule série continue ordonnée comptant N = n1 + n2 observations. Chaque sujet se voit assigner un rang hiérarchique unique allant de 1 jusqu’à N (les éventuels ex æquo recevant le rang moyen de leur classe). Ensuite, le statisticien procède à la sommation arithmétique distincte des rangs obtenus par les membres du premier groupe (notée W1) et de ceux du second groupe (W2).
La statistique U de Mann-Whitney évalue le décalage observé par rapport à une répartition purement aléatoire des rangs entre les deux conditions :
U1 = n1n2 + [ n1(n1 + 1) / 2 ] – W1
U2 = n1n2 + [ n2(n2 + 1) / 2 ] – W2
U = min(U1, U2)
L’hypothèse nulle sous-jacente avance que la probabilité qu’une observation issue de la première population surpasse une observation de la seconde est exactement égale à 0,50. Si les distributions des deux groupes partagent une forme géométrique similaire, le test U de Mann-Whitney s’interprète rigoureusement comme un test de divergence entre les médianes de ces deux populations, déployant une remarquable robustesse face aux asymétries prononcées et aux valeurs déviantes isolées.
9.2 Le test de Wilcoxon pour observations appariées
Pour les devis longitudinaux ou appariés transgressant les exigences du test paramétrique, Frank Wilcoxon a développé le test des rangs signés. Cette procédure substitue à la confrontation pure des moyennes un algorithme raffiné ciblé sur les variations intra-individuelles ordonnées.
Le calcul s’articule selon une séquence méthodologique en quatre étapes :
- Calcul des écarts de score bruts individuels entre le post-test et le pré-test pour chacune des paires d’observations : Di = Yi – Xi.
- Exclusion pure et simple des cas d’égalité parfaite où la différence calculée s’avère nulle (Di = 0).
- Conversion des écarts résiduels en valeurs absolues (|Di|), puis classement ordinal de ces amplitudes de la plus infime jusqu’à la plus marquée, en leur assignant des rangs conventionnels de 1 jusqu’à Nréduit.
- Réattribution à chaque rang calculé du signe algébrique originel (+ ou -) porté par l’écart dont il dérive, avant d’opérer la sommation séparée des rangs positifs (T+) et des rangs négatifs (T–).
La statistique finale du test correspond au plus petit de ces deux totaux :
T = min(T+, T–)
En accordant délibérément un poids plus substantiel aux participants ayant manifesté des mutations comportementales massives par rapport à ceux n’ayant présenté que des fluctuations marginales, le test des rangs signés de Wilcoxon optimise magistralement l’analyse d’efficacité des protocoles thérapeutiques courts conduits sur des cohortes cliniques aux distributions très asymétriques.
9.3 Calcul de la taille d’effet non paramétrique
Trop souvent, les publications se cantonnent à rapporter la significativité probabiliste des tests de rangs sans en caractériser l’amplitude clinique standardisée. Il est pourtant indispensable de convertir la statistique issue d’un test U de Mann-Whitney ou d’un test de Wilcoxon en un indice d’effet universel comparable.
Une première approche consiste à estimer la corrélation bisérielle de rang (notée rrb), qui exprime le différentiel relatif unissant la proportion de rangs favorables à l’une des hypothèses par rapport à l’ensemble du volume des rangs investis dans l’analyse.
La méthode la plus largement adoptée en métrologie contemporaine repose sur la formulation proposée par Robert Rosenthal. Cette stratégie consiste à extraire la statistique standardisée Z dérivant de l’approximation normale asymptotique du test de rangs, puis à la normaliser par la racine carrée de la taille globale de l’échantillon d’observations engagé (N) :
r = |Z| / √N
Cet indicateur non paramétrique r possède des bornes conceptuelles s’alignant rigoureusement sur celles d’un coefficient de corrélation conventionnel, oscillant entre 0 et 1. Sa communication explicite garantit la transparence scientifique indispensable à l’intégration ultérieure de la recherche au sein des méta-analyses systématiques publiées dans la littérature internationale.
10. Pièges interprétatifs majeurs : corrélation versus causalité
L’accessibilité logicielle contemporaine offre aux étudiants et chercheurs la possibilité d’exécuter des centaines d’analyses bivariées en quelques fractions de seconde. Cependant, cette aisance instrumentale amplifie dramatiquement le risque de dérives interprétatives. L’une des exigences fondamentales de l’épistémologie quantitative réside dans la vigilance constante à l’égard de l’adage immuable : corrélation n’est point causalité.
10.1 Le problème de la troisième variable et causalité fallacieuse
La démonstration empirique irréfutable d’une covariation intense et statistiquement significative entre une variable A et une variable B ne permet en aucun cas de statuer sur l’existence d’une influence causale directe de l’une sur l’autre. L’un des écueils majeurs réside dans l’intervention insidieuse d’une troisième variable non mesurée (variable confondante ou facteur de confusion) qui pilote secrètement les deux construits observés.
La psychologie du développement foisonne d’exemples classiques d’associations purement fallacieuses ou illusoires. Il est par exemple aisé de mettre en évidence au sein d’une école primaire une corrélation positive puissante entre la pointure des souliers portés par les enfants et leurs capacités de raisonnement mathématique abstrait. Conclure que posséder de grands pieds favorise le développement des compétences arithmétiques relèverait de l’absurdité théorique; cette relation empirique n’est que la conséquence directe d’une variable confondante évidente : l’âge chronologique des écoliers, qui conditionne simultanément la maturation cérébrale et la croissance anatomique.
Pour parer méthodologiquement au piège des relations fallacieuses, l’investigateur ne peut se reposer uniquement sur la sophistication statistique post-hoc. Seul le déploiement d’un plan d’expérimentation scrupuleux prévoyant l’assignation aléatoire intégrale des participants aux différentes conditions expérimentales (la randomisation pure) permet d’équilibrer l’influence des variables parasites entre les groupes. En brisant la dépendance structurelle entre les tiers facteurs potentiels et la variable manipulée, l’expérimentateur s’octroie enfin le droit de formuler une véritable inférence causale.
10.2 Directionnalité inverse et causalité circulaire
Même en l’absence avérée de toute variable confondante masquée, l’analyse bivariée extraite d’un protocole transversal – où l’ensemble des données est recueilli à un instant unique – se trouve dans l’incapacité logique de trancher la direction du vecteur causal. Si un lien robuste est attesté entre un faible niveau d’estime de soi et une intensité prononcée de symptômes dépressifs, deux interprétations diamétralement opposées demeurent également fondées sur le strict plan de la métrique bivariée :
- Une baisse chronique de l’estime de soi favorise l’effondrement thymique du patient en érodant ses mécanismes de régulation psychologique (causalité classique).
- L’avènement d’un épisode dépressif modifie drastiquement les filtres attentionnels du sujet, générant des biais cognitifs qui dégradent consécutivement l’évaluation qu’il porte sur sa propre valeur (directionnalité inverse).
En outre, la complexité des systèmes psychologiques et biologiques implique fréquemment des boucles de rétroaction bidirectionnelles ou causales circulaires. Un faible sentiment d’auto-efficacité peut précipiter l’anxiété de performance lors d’une épreuve académique, dont les conséquences délétères sur les notes viennent à leur tour fragiliser davantage le sentiment de compétence de l’étudiant. Ces spirales d’influence mutuelle défient la modélisation unilatérale propre aux équations bivariées simples.
Pour espérer démêler l’écheveau de la temporalité causale, le recours à des architectures de recherche longitudinales prospectives s’impose impérativement. Les plans à panels croisés-décalés (cross-lagged panel models), en mesurant conjointement les deux construits à plusieurs vagues temporelles successives, permettent de quantifier dans quelle mesure le niveau initial de la variable A au temps T1 prédit les variations de la variable B au temps T2 après contrôle rigoureux du niveau de référence antérieur de cette dernière.
10.3 Le paradoxe de Simpson et les artefacts statistiques
Parmi les chausse-trappes statistiques les plus vertigineuses de l’analyse bivariée figure le redoutable paradoxe de Simpson. Ce phénomène mathématique paradoxal survient lorsqu’une association bivariée observée de manière globale sur l’intégralité d’un échantillon agrégé s’inverse radicalement ou disparaît purement et simplement lorsque les données sont segmentées et analysées au sein de chacun des sous-groupes constitutifs de cet échantillon.
En psychologie du travail, un observateur pourrait par exemple constater une corrélation bivariée négative globale entre le volume horaire consacré à la formation continue et le niveau de satisfaction professionnelle au sein d’une grande entreprise : les salariés accumulant le plus d’heures de formation déclareraient un bien-être global inférieur. Une lecture superficielle inciterait à proscrire la formation. Pourtant, en ventilant les résultats selon la nature des postes occupés (cadres dirigeants versus employés de production soumis à une restructuration industrielle), on peut découvrir avec stupeur qu’au sein de chacun des sous-groupes pris isolément, la formation continue prédit vigoureusement une élévation de la satisfaction professionnelle. Le biais bivarié d’agrégation masquait le fait que la direction imposait massivement la formation comme mesure d’urgence aux départements déjà confrontés à une détresse organisationnelle aiguë.
Un autre artefact récurrent réside dans le phénomène de restriction d’étendue (ou troncature de la variance). Lorsque le protocole de sélection des participants n’échantillonne qu’une fraction hyper-sélective de la variabilité populationnelle (comme l’évaluation des aptitudes intellectuelles menée exclusivement auprès d’étudiants admis dans les filières universitaires d’élite hautement sélectives), la dispersion de la variable indépendante est drastiquement comprimée. Cette contraction artificielle de la variance atténue dramatiquement la valeur du coefficient de corrélation, pouvant faire chuter un lien populationnel authentique de r = 0,60 à un coefficient échantillonnal anémique de r = 0,15, induisant des conclusions erronées sur la pertinence psychométrique de l’outil.
11. Étude de cas empirique : temps d’étude et performance académique
Afin d’ancrer les concepts mathématiques et méthodologiques exposés précédemment dans la réalité vivante de la pratique analytique, développons pas à pas une étude empirique simulée. Cette illustration pratique parcourt l’intégralité de la démarche, de l’exploration descriptive jusqu’à la modélisation régressive.
11.1 Description de l’échantillon et exploration des données
Considérons une cohorte homogène de N = 20 étudiants inscrits en première année de licence de psychologie au sein d’une université publique. La problématique investiguée vise à modéliser la relation bivariée unissant l’investissement académique mesuré par le volume hebdomadaire moyen consacré aux révisions personnelles durant le semestre universitaire (Variable X, exprimée en heures continues) et la note finale obtenue lors de l’examen terminal semestriel de psychométrie et statistiques (Variable Y, cotée sur une échelle de 0 à 100 points continus).
Le recueil empirique délivre la matrice brute suivante pour les vingt participants observés :
- Étudiant 01 : X = 6 h ; Y = 52 / 100
- Étudiant 02 : X = 8 h ; Y = 58 / 100
- Étudiant 03 : X = 9 h ; Y = 54 / 100
- Étudiant 04 : X = 10 h ; Y = 62 / 100
- Étudiant 05 : X = 11 h ; Y = 60 / 100
- Étudiant 06 : X = 12 h ; Y = 66 / 100
- Étudiant 07 : X = 13 h ; Y = 63 / 100
- Étudiant 08 : X = 14 h ; Y = 68 / 100
- Étudiant 09 : X = 15 h ; Y = 74 / 100
- Étudiant 10 : X = 15 h ; Y = 70 / 100
- Étudiant 11 : X = 16 h ; Y = 72 / 100
- Étudiant 12 : X = 17 h ; Y = 78 / 100
- Étudiant 13 : X = 18 h ; Y = 75 / 100
- Étudiant 14 : X = 19 h ; Y = 82 / 100
- Étudiant 15 : X = 20 h ; Y = 80 / 100
- Étudiant 16 : X = 21 h ; Y = 86 / 100
- Étudiant 17 : X = 22 h ; Y = 84 / 100
- Étudiant 18 : X = 23 h ; Y = 90 / 100
- Étudiant 19 : X = 24 h ; Y = 88 / 100
- Étudiant 20 : X = 27 h ; Y = 96 / 100
L’exploration descriptive univariée préalable livre les paramètres fondamentaux suivants :
- Volume d’étude (X) : Moyenne (X̄) = 16,00 heures ; Écart-type (sX) = 5,46 heures ; Médiane = 15,50 heures.
- Note à l’examen (Y) : Moyenne (Ȳ) = 71,90 points ; Écart-type (sY) = 12,56 points ; Médiane = 71,00 points.
L’inspection des coefficients d’asymétrie et d’aplatissement confirme la normalité univariée acceptable des deux dimensions, sans détection d’observations aberrantes périphériques démesurées.
11.2 Visualisation et calcul du coefficient de corrélation
Le traçage géométrique du nuage de points plaçant les heures de travail personnel en abscisse et la note en ordonnée révèle une disposition spatiale régulière. Les points s’agencent le long d’une bande ascendante étroite et rectiligne s’étirant de façon homogène sans courbure notable ni fragmentation en grappes isolées, attestant de la totale pertinence du modèle paramétrique linéaire.
Pour quantifier cette covariation, procédons au calcul algébrique des sommes des produits croisés d’écarts à partir des données observées :
- Somme des carrés des écarts de X (SSX) = Σ (Xi – X̄)² = 566,00
- Somme des carrés des écarts de Y (SSY) = Σ (Yi – Ȳ)² = 3001,80
- Somme des produits croisés des écarts (SPXY) = Σ [ (Xi – X̄)(Yi – Ȳ) ] = 1282,00
À partir de ces éléments de variance, la covariance empirique s’établit à :
Cov(X, Y) = 1282,00 / (20 – 1) = 1282,00 / 19 = 67,47
L’estimation du coefficient de corrélation paramétrique r de Pearson en découle directement :
r = SPXY / √[ SSX × SSY ] = 1282,00 / √[ 566,00 × 3001,80 ] = 1282,00 / √[ 1699018,8 ] = 1282,00 / 1303,46 = +0,9835
Cette estimation de r = 0,984 traduit une association linéaire positive d’une magnitude exceptionnelle selon les standards psychométriques habituels. Pour éprouver l’hypothèse nulle (H0 : ρ = 0), nous calculons la statistique t de Student associée, dotée de N – 2 = 18 degrés de liberté :
t = r × √[ (N – 2) / (1 – r²) ] = 0,9835 × √[ 18 / (1 – 0,9673) ] = 0,9835 × √[ 18 / 0,0327 ] = 0,9835 × √550,46 = 0,9835 × 23,46 = 23,08
Confrontée aux tables statistiques critiques pour dl = 18 à un seuil alpha bilatéral de 0,001 (tcritique = 3,922), la valeur empirique obtenue de 23,08 excède colossalement le seuil de rejet, nous autorisant à conclure à l’existence d’une corrélation positive statistiquement ultra-significative (p < 0,0001).
11.3 Modélisation régressive et projection de résultats
Désirant prédire la performance académique à partir du temps de révision hebdomadaire, calibrons désormais les paramètres de la droite de régression des moindres carrés ordinaires :
β1 (pente) = SPXY / SSX = 1282,00 / 566,00 = 2,265
β0 (ordonnée à l’origine) = Ȳ – β1X̄ = 71,90 – (2,265 × 16,00) = 71,90 – 36,24 = 35,66
L’équation de modélisation prédictive définitive s’énonce donc textuellement ainsi :
Note prédite = 35,66 + 2,265 × (Heures de révision)
L’interprétation clinique et pédagogique de ces coefficients est limpide :
- La pente (2,265) signifie que pour chaque heure supplémentaire d’étude consentie chaque semaine, la note terminale prédite à l’examen de psychométrie progresse en moyenne de 2,26 points sur 100.
- La constante (35,66) correspond au score moyen estimé pour un étudiant qui ne consacrerait aucune heure (X = 0) aux révisions personnelles durant son semestre.
Le calcul du coefficient de détermination livre quant à lui :
R² = (0,9835)² = 0,9673
Cet indicateur révèle que 96,7 % de la variance totale des résultats à l’examen est directement modélisée par l’investissement horaire consenti par les étudiants au sein de cette cohorte. Pour concrétiser l’utilité prédictive de ce modèle bivarié, considérons le cas hypothétique d’un étudiant planifiant d’investir exactement 12 heures hebdomadaires à son travail :
Note prédite = 35,66 + (2,265 × 12) = 35,66 + 27,18 = 62,84 / 100
L’étudiant peut ainsi anticiper avec une marge d’erreur quantifiable le franchissement aisé de la barre de validation de son unité d’enseignement.
12. Protocoles d’application logicielle et restitution académique
La mise en œuvre pratique de l’analyse bivariée passe obligatoirement par la maîtrise des progiciels statistiques contemporains. Que l’on privilégie l’environnement open-source programmable sous R ou l’interface propriétaire IBM SPSS Statistics, le traitement rigoureux des matrices et la restitution standardisée des sorties constituent des compétences indispensables à tout chercheur en psychologie.
12.1 Syntaxe et exécution sous le logiciel R
Le logiciel d’analyse computationnelle GNU R offre un écosystème idéal pour déployer des analyses bivariées avec une flexibilité technique totale. En environnement natif de base, le test de l’association linéaire s’exécute à l’aide de la fonction standard cor.test(), dont les arguments permettent de moduler la méthode de corrélation (par défaut paramétrique avec Pearson, ou non paramétrique via les mentions "spearman" ou "kendall"), ainsi que l’orientation bilatérale ou unilatérale du test probabiliste associé.
Pour calibrer un modèle de prédiction par régression linéaire simple, l’utilisateur sollicite la fonction générique d’ajustement lm() (pour linear model), articulée autour d’une syntaxe fonctionnelle claire reliant le critère à son prédicteur (notée conventionnellement sous la forme formelle Y ~ X). L’invocation de la fonction complémentaire summary() sur l’objet régressif généré restitue immédiatement la matrice des coefficients estimés, les erreurs standards associées, les valeurs t individuelles, les p-valeurs, sans oublier le coefficient de détermination R² et la statistique globale F de Fisher.
En matière d’exploration visuelle de haut niveau, le package graphique ggplot2 s’est imposé comme le standard académique universel. L’adjonction de la couche géométrique geom_point() permet d’implanter le nuage de points avec gestion de la transparence des marques (via l’argument alpha), tandis que l’appel de geom_smooth(method = "lm", se = TRUE) surajoute automatiquement la droite d’ajustement linéaire flanquée de son ruban ombré matérialisant l’intervalle de confiance à 95 % de la trajectoire moyenne. L’extraction diagnostique des tracés de résidus s’obtient enfin instantanément par l’application de la syntaxe de base plot(modele_lineaire), générant en série les tracés de dispersion des résidus et le diagramme de normalité Q-Q plot.
12.2 Procédures guidées sous IBM SPSS Statistics
Au sein des structures hospitalières et des laboratoires de psychologie clinique préférant les environnements graphiques guidés par menus, IBM SPSS Statistics demeure un outil extrêmement répandu. Pour déployer une analyse de corrélation bivariée standard, l’utilisateur navigue dans la barre d’outils supérieure vers le chemin : Analyser > Corrélation > Bivariée…
Dans la boîte de dialogue contextuelle, les deux variables d’intérêt sont déplacées vers le volet central d’analyse. Le chercheur coche expressément les coefficients requis (Pearson, et le cas échéant Spearman ou Kendall), tout en sollicitant dans le sous-menu des options l’exportation des moyennes arithmétiques, des écarts-types et de la matrice complète des produits croisés de covariance. La sortie tabulaire générée par SPSS fournit une matrice carrée symétrique affichant pour chaque croisement d’items la valeur numérique de l’indicateur de liaison, le degré d’erreur probabiliste bilatéral précis (qu’il convient d’extraire textuellement plutôt que de se contenter de la mention restrictive « .000 »), ainsi que l’effectif exact d’échantillon pris en compte après épuration des valeurs manquantes.
Pour la modélisation régressive linéaire, la navigation requiert l’accès au menu : Analyser > Régression > Linéaire… La désignation de la variable dépendante et de la variable indépendante s’effectue par glissement sélectif. Dans le sous-menu Statistiques, il est vivement recommandé d’activer l’affichage des intervalles de confiance à 95 % pour les estimations de la pente (B), ainsi que les métriques diagnostiques d’homoscédasticité et les distances de Cook. Enfin, le module Graphiques > Générateur de graphiques autorise l’exportation vectorielle de diagrammes de dispersion bivariés d’une netteté visuelle conforme aux standards d’édition scientifique.
12.3 Normes de présentation des résultats selon le format APA
L’écriture académique des résultats issus d’une analyse bivariée doit se conformer de façon intangible aux normes stylistiques et typographiques prescrites par l’American Psychological Association (7e édition du manuel de publication APA). Cette rigueur formelle garantit l’intégrité, la lisibilité et l’universalité de la communication scientifique à travers la communauté internationale.
Lors de la transcription narrative au fil du texte d’un test de corrélation paramétrique, les symboles statistiques métriques doivent impérativement être typographiés en italique (r, t, p, R²). Les degrés de liberté du test doivent être explicitement mentionnés entre parenthèses immédiatement après la lettre désignant le coefficient. En outre, pour les coefficients statistiques qui, par nature mathématique, ne peuvent jamais excéder l’unité (comme le r de Pearson ou la p-valeur), il est de règle stricte d’omettre le zéro initial devant la virgule ou le point décimal. Ainsi, une restitution textuelle formelle prendra l’allure suivante :
Une corrélation linéaire de Pearson statistiquement significative et de magnitude particulièrement élevée a été mise en évidence entre le temps d’étude hebdomadaire et la performance obtenue à l’examen terminal, r(18) = ,98, p < ,001, attestant que l’investissement horaire rend compte de 96,7 % de la variance globale des notes observées (R² = ,97).
S’agissant des tableaux de synthèses matricielles bivariées inter-items, abondamment exploités lors de la validation d’échelles de personnalité ou de questionnaires multidimensionnels, les normes APA imposent une épuration visuelle radicale. Tout quadrillage intérieur vertical est strictement proscrit. Seules trois lignes horizontales principales doivent structurer le tableau : une bordure sous le titre général des colonnes, une démarcation sous la rangée des en-têtes d’items, et une bordure inférieure fermant le tableau avant l’insertion des notes de bas de page explicitant les seuils de significativité conventionnels (par exemple : *p < ,05 ; **p < ,01 ; ***p < ,001). Les colonnes doivent présenter la numérotation séquentielle des variables pour éviter de répéter leurs libellés textuels dans les en-têtes horizontaux, et la diagonale principale d’auto-corrélation (où chaque item est corrélé avec lui-même, produisant un coefficient trivial de 1,00) doit être neutre ou exploitée pour inscrire les indices de consistance interne de l’alpha de Cronbach.
Enfin, l’éthique de la recherche contemporaine en psychologie – profondément renouvelée par la crise de la reproductibilité – encourage activement la transparence des données brutes. Les manuscrits soumis aux revues à comité de lecture doivent de plus en plus fréquemment inclure l’accès ouvert (Open Science) aux scripts d’analyse complets (fichiers R script ou syntaxes SPSS) ainsi qu’aux jeux de données anonymisés déposés sur des entrepôts pérennes (tels que l’Open Science Framework), permettant ainsi à tout relecteur d’éprouver la robustesse empirique des associations bivariées proclamées par les auteurs.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cramér, H. (1946). Mathematical methods of statistics. Princeton University Press.
- Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5th ed.). SAGE Publications.
- Galton, F. (1886). Regression towards mediocrity in hereditary stature. The Journal of the Anthropological Institute of Great Britain and Ireland, 15, 246–263. https://doi.org/10.2307/2841583
- Kendall, M. G. (1938). A new measure of rank correlation. Biometrika, 30(1/2), 81–93. https://doi.org/10.1093/biomet/30.1-2.81
- Mann, H. B., & Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. The Annals of Mathematical Statistics, 18(1), 50–60. https://doi.org/10.1214/aoms/1177730491
- Pearson, K. (1895). Note on regression and inheritance in the case of two parents. Proceedings of the Royal Society of London, 58, 240–242. https://doi.org/10.1098/rspl.1895.0041
- Pearson, K. (1900). On the criterion that a given system of deviations from the probable in the case of a correlated system of variables is such that it can be reasonably supposed to have arisen from random sampling. Philosophical Magazine, 50(302), 157–175. https://doi.org/10.1080/14786440009463897
- Rosenthal, R. (1991). Meta-analytic procedures for social research (Rev. ed.). SAGE Publications. https://doi.org/10.4135/9781412984997
- Simpson, E. H. (1951). The interpretation of interaction in contingency tables. Journal of the Royal Statistical Society: Series B (Methodological), 13(2), 238–241. https://doi.org/10.1111/j.2517-6161.1951.tb00088.x
- Spearman, C. (1904). The proof and measurement of association between two things. The American Journal of Psychology, 15(1), 72–101. https://doi.org/10.2307/1412159
- Stevens, S. S. (1946). On the theory of scales of measurement. Science, 103(2684), 677–680. https://doi.org/10.1126/science.103.2684.677
- « Student » [Gosset, W. S.]. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.1093/biomet/6.1.1
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.1093/biomet/34.1-2.28
- Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin, 1(6), 80–83. https://doi.org/10.2307/3001968
- Yates, F. (1934). Contingency tables involving small numbers and the χ² test. Supplement to the Journal of the Royal Statistical Society, 1(2), 217–235. https://doi.org/10.2307/2983604
- Yerkes, R. M., & Dodson, J. D. (1908). The relation of strength of stimulus to rapidity of habit-formation. Journal of Comparative Neurology and Psychology, 18(5), 459–482. https://doi.org/10.1002/cne.920180503