
Dans l’éventail des méthodologies quantitatives appliquées aux sciences humaines, sociales et biomédicales, l’analyse des variables discrètes constitue un défi méthodologique récurrent. Les chercheurs en psychologie, en épidémiologie comportementale ou en sociologie se heurtent fréquemment à des distributions empiriques qui défient les postulats de la modélisation gaussienne standard. Qu’il s’agisse de mesurer la fréquence hebdomadaire des crises de panique chez des patients souffrant de trouble panique, le nombre de lapsus verbaux au cours d’une tâche d’interférence cognitive, ou le dénombrement des consultations médicales d’urgence au sein d’une cohorte clinique, ces données possèdent une structure numérique fondamentalement différente des grandeurs physiques continues. Elles sont confinées aux entiers naturels non négatifs, présentent souvent une asymétrie positive prononcée et exhibent une variance qui s’accroît systématiquement avec la moyenne.
Pendant plusieurs décennies, la réponse analytique par défaut a consisté à forcer ces données dans le moule familier de la régression linéaire par les moindres carrés ordinaires (MCO), moyennant des transformations mathématiques ad hoc telles que le logarithme ou la racine carrée. Bien que séduisantes par leur apparente simplicité opératoire, ces approches compensatoires introduisent des distorsions conceptuelles et statistiques substantielles : création d’estimations absurdes situées sous la borne zéro, biais systématiques induits par l’inégalité de Jensen lors de la réversion d’échelle, perte d’efficacité asymptotique et altération du contrôle du taux d’erreur de première espèce. Face à ces impasses méthodologiques, le cadre unificateur des modèles linéaires généralisés (GLM), formalisé par John Nelder et Robert Wedderburn au début des années 1970, a apporté une réponse mathématiquement élégante et empiriquement rigoureuse.
Au cœur de cette architecture se trouve la régression de Poisson, une technique spécifiquement calibrée pour modéliser des taux d’occurrence et des fréquences d’événements. En substituant l’hypothèse d’une distribution normale des résidus par celle d’une loi de Poisson gouvernée par un paramètre d’intensité conditionnelle, ce modèle préserve l’intégrité de l’échelle originelle de mesure tout en garantissant des prédictions strictement plausibles. Le présent guide se propose d’offrir une exploration approfondie, progressive et didactique de la modélisation de Poisson. En partant des fondements probabilistes de base jusqu’aux extensions requises face aux pathologies de dispersion et à l’excès de zéros, ce texte fournira aux chercheurs et analystes de données les outils conceptuels, algébriques et pratiques indispensables pour conduire et rapporter des analyses de comptage avec le plus haut degré de rigueur académique.
1. Fondements conceptuels des données de comptage en recherche quantitative
1.1 Définition et nature mathématique des variables de comptage
Une variable de comptage représente la quantification numérique du nombre de fois où un événement discret se réalise à l’intérieur d’un domaine d’observation délimité, qu’il s’agisse d’un intervalle de temps, d’une aire géographique ou d’un volume spatial. Mathématiquement, ces variables prennent leurs valeurs dans l’ensemble des entiers naturels, noté N zéro (incluant les entiers 0, 1, 2, 3 jusqu’à l’infini théorique). Cette caractéristique de discrétisation stricte exclut d’emblée toute valeur fractionnaire ou décimale au niveau de la mesure brute : il est conceptuellement impossible d’observer 2,4 crises d’angoisse ou 1,7 rechute dépressive au cours d’une semaine d’évaluation clinique. L’espace d’échantillonnage est donc fondamentalement dénombrable et discontinu.
Il est primordial d’établir une distinction formelle entre les comptages stricts, les variables continues bornées et les échelles de mesure de type ordinal. Une variable continue, telle que le temps de réaction mesuré en millisecondes ou le taux de cortisol salivaire exprimé en microgrammes par décilitre, peut en théorie adopter une infinité non dénombrable de valeurs intermédiaires entre deux points quelconques du continuum de mesure, dépendant uniquement de la précision technique de l’instrument d’enregistrement. À l’inverse, une échelle ordinale, à l’image des échelles d’évaluation de Likert fréquemment employées en psychométrie (allant par exemple de 1 pour « pas du tout d’accord » à 5 pour « tout à fait d’accord »), ordonne hiérarchiquement des catégories qualitatives subjectives, sans que la distance métrique séparant deux échelons successifs ne soit constante ou quantifiable sur une base physique objective. Les données de comptage, quant à elles, possèdent une métrique fixe, constante et universelle : l’intervalle séparant 0 et 1 unité d’occurrence est rigoureusement identique à celui qui sépare 4 et 5 unités d’occurrence, à savoir l’apparition empirique d’un événement supplémentaire unitaire.
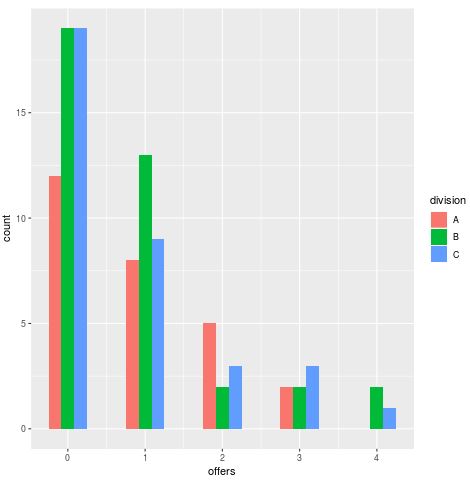
Dans les disciplines comportementales et psychopathologiques, ces structures de dénombrement sont omniprésentes. Considérons l’enregistrement quotidien de la fréquence des compulsions de vérification chez des sujets diagnostiqués avec un trouble obsessionnel-compulsif (TOC), le nombre d’oublis mnésiques répertoriés lors d’un protocole d’évaluation neuropsychologique de la mémoire prospective, ou encore le nombre de consultations non programmées en pédopsychiatrie durant une année de suivi. Dans chacune de ces situations d’évaluation, la variable dépendante se heurte à une borne physique et logique infranchissable située à zéro. L’impossibilité théorique d’enregistrer des réalisations négatives confère à la distribution empirique une asymétrie droite marquée, d’autant plus aiguë que le taux moyen d’occurrence de l’événement est faible. Cette contrainte de positivité absolue modifie radicalement la forme de la distribution théorique des erreurs aléatoires, rendant obsolète l’hypothèse classique de symétrie sous-jacente aux modèles statistiques linéaires traditionnels.
1.2 Limites de la transformation de données pour l’analyse linéaire
Face à l’asymétrie manifeste des données de comptage et à l’impossibilité d’appliquer directement les modèles linéaires classiques, une pratique méthodologique historique a consisté à soumettre la variable réponse à des transformations mathématiques univariées avant d’appliquer une régression linéaire standard. La transformation la plus fréquemment observée dans la littérature consiste à calculer le logarithme naturel des observations. Néanmoins, en présence de zéros empiriques réels — une situation structurelle incontournable dans les processus de dénombrement où de nombreux participants ne manifestent pas l’événement d’intérêt durant la période d’observation —, la fonction logarithmique naturelle n’étant pas définie pour la valeur zéro, les chercheurs ont massivement adopté la transformation ad hoc log(Y + c), où c représente une constante arbitraire, le plus souvent fixée à 1 ou à de petites fractions telles que 0,5 ou 0,1.
Cette approche, bien que tolérée par le passé en raison des contraintes de calcul computationnel, engendre de graves distorsions statistiques et conceptuelles. Sur le plan de l’interprétation, le choix de la constante de translation n’a aucun fondement théorique et exerce pourtant une influence disproportionnée sur l’amplitude des coefficients de régression estimés ainsi que sur les conclusions des tests d’hypothèse. Modifier la valeur de la constante ajoutée altère artificiellement la structure de covariance entre la variable transformée et les régresseurs indépendants, menant potentiellement à des variations drastiques de la significativité statistique sans aucune justification empirique. De plus, les coefficients obtenus après une régression sur log(Y + 1) ne renseignent plus directement sur la moyenne arithmétique de la variable d’origine, mais modélisent une espérance géométrique déformée, complexifiant inutilement la restitution des conclusions cliniques aux praticiens de terrain.
Sur le plan mathématique, cette méthode palliative échoue à satisfaire les conditions de validité du modèle de régression ordinaire. En vertu de l’inégalité de Jensen, qui stipule que l’espérance mathématique d’une fonction convexe d’une variable aléatoire est supérieure ou égale à la fonction appliquée à l’espérance de cette même variable, reconvertir les valeurs prédites par exponentiation introduit un biais systématique par sous-estimation de la véritable espérance conditionnelle de comptage. Par ailleurs, la transformation logarithmique échoue généralement à homogénéiser la variance lorsque la distribution initiale présente une forte proportion de zéros : les observations initialement nulles se retrouvent compressées sur une valeur arbitraire fixe tandis que la queue de distribution conserve une variance hétérogène. Plutôt que de contraindre la réalité empirique des données dans un cadre mathématique inapproprié au prix de transformations distordantes, la rigueur méthodologique contemporaine impose d’adapter le modèle d’échantillonnage théorique à la distribution probabiliste naturelle du phénomène étudié.
2. La distribution de Poisson : propriétés probabilistes et postulats formels
2.1 Origine et formulation mathématique de la loi de Poisson
La formalisation théorique de la distribution régissant les processus de comptage trouve son origine dans les travaux du mathématicien français Siméon Denis Poisson, exposés en 1837 dans son traité sur la probabilité des jugements en matière criminelle et civile. Historiquement, cette loi de probabilité a été déduite comme un cas limite de la loi binomiale lorsque le nombre d’épreuves de Bernoulli tend vers l’infini tandis que la probabilité individuelle de succès à chaque épreuve devient infinitésimale, de telle sorte que le produit des deux — représentant le nombre moyen d’occurrences attendu — demeure constant et égal à une valeur finie positive, traditionnellement désignée par la lettre grecque lambda.
Formellement, soit une variable aléatoire discrète Y représentant le nombre d’événements observés dans un intervalle fixé. La loi de Poisson stipule que la probabilité d’observer exactement k réalisations de cet événement (où k est un entier positif ou nul) est donnée par sa fonction de masse de probabilité :
P(Y = k) = (lambda^k * exp(-lambda)) / k!
Dans cette formulation analytique, le paramètre lambda constitue le paramètre d’intensité ou taux moyen d’occurrence du processus étudié, la constante exp représente la base du logarithme népérien, et k! désigne la factorielle de l’entier k. Ce modèle mathématique repose sur deux postulats probabilistes fondamentaux :
- L’hypothèse d’indépendance conditionnelle : La survenue d’un événement au sein d’un sous-intervalle infinitésimal ne modifie en rien la probabilité d’occurrence d’un autre événement dans n’importe quel autre sous-intervalle disjoint. Il ne doit exister aucun mécanisme de contagion ou d’inhibition séquentielle entre les événements.
- L’hypothèse de stationnarité (ou homogénéité temporelle) : Le taux d’intensité moyen du processus demeure rigoureusement invariant sur l’ensemble de la fenêtre d’observation. Deux intervalles de durée strictement identique possèdent exactement la même espérance de comptage.
- L’hypothèse de rareté locale : La probabilité d’observer simultanément deux événements ou plus dans un intervalle de temps tendant vers zéro est négligeable, garantissant que les événements se produisent de manière isolée et séquentielle.
Si la stationnarité ou l’indépendance des occurrences vient à faire défaut dans le protocole expérimental — par exemple lorsqu’une crise d’angoisse initiale augmente considérablement la vulnérabilité psychophysiologique du patient à en subir une seconde dans les heures suivantes —, l’espérance du processus n’est plus constante et la formulation classique de Poisson devient théoriquement caduque, requérant des extensions méthodologiques spécifiques.
2.2 L’équidispersion : pilier théorique et contrainte structurelle
L’une des particularités mathématiques les plus saillantes et les plus exigeantes de la distribution de Poisson réside dans la relation d’identité stricte reliant ses moments statistiques d’ordre un et d’ordre deux. Par dérivation directe de sa fonction génératrice des moments, il est aisé de démontrer que l’espérance mathématique E(Y) et la variance Var(Y) d’une variable aléatoire suivant une loi de Poisson de paramètre lambda sont parfaitement équivalentes :
E(Y) = lambda
Var(Y) = lambda
Cette propriété structurelle d’égalité mathématique absolue entre la tendance centrale et la variabilité d’échantillonnage porte le nom d’équidispersion. Elle implique sur le plan conceptuel que le niveau de bruit statistique aléatoire associé à une mesure de comptage est intrinsèquement fonction de la magnitude de l’événement. Pour un processus caractérisé par un taux moyen très faible (lambda = 0,5), la dispersion des données autour de cette moyenne sera restreinte, la variance théorique valant également 0,5. À l’opposé, si le taux d’intensité augmente substantiellement (lambda = 25), la variance théorique s’élèvera conjointement à 25, étalant ainsi considérablement l’éventail des comptages observables.
Dans les dispositifs de recherche en laboratoire hautement standardisés, où la variance non contrôlée est drastiquement minimisée par l’isolation expérimentale, l’hypothèse d’équidispersion peut se vérifier avec une remarquable précision. Cependant, dans les recherches appliquées impliquant des cohortes humaines en milieu naturel, cette identité moyenne-variance constitue une contrainte méthodologique extrêmement lourde. Lorsque les individus de l’échantillon présentent des caractéristiques latentes non mesurées qui modulent leur réactivité, ou lorsque les événements se manifestent en grappes interconnectées, la variance empirique dépasse presque systématiquement l’espérance mathématique. L’ignorance délibérée de cette discordance dans l’application naïve du modèle de Poisson compromet gravement la validité des déductions statistiques inférentielles, en biaisant vers le bas le calcul des erreurs types des estimateurs.
3. Inadéquation des moindres carrés ordinaires pour les données discrètes
3.1 Violation des postulats classiques de normalité et d’homoscédasticité
L’utilisation de la régression linéaire classique par les moindres carrés ordinaires (MCO) pour analyser des variables dépendantes de dénombrement engendre une rupture simultanée de la quasi-totalité des hypothèses du théorème de Gauss-Markov. Le premier écueil concerne l’hypothèse de normalité de la distribution conditionnelle des erreurs résiduelles. Par nature, lorsque l’espérance de comptage lambda est de faible à modérée (typiquement inférieure à 10), la distribution empirique est fortement asymétrique vers la droite, marquée par une accumulation de valeurs proches de zéro et une longue traîne vers les valeurs élevées positives. L’imposition d’une loi de densité symétrique gaussienne engendre des résidus systématiquement non normaux, violant les prérequis fondamentaux autorisant l’usage direct des tests de Student ou de Fisher sur de petits échantillons.
Plus dommageable encore pour la robustesse de l’inférence est la violation structurelle du postulat d’homoscédasticité, qui exige que la variance du terme d’erreur résiduelle demeure rigoureusement constante à travers tous les niveaux des variables indépendantes introduites dans l’équation :
Var(epsilon | X) = sigma^2
Or, comme démontré précédemment par les propriétés intrinsèques des processus de dénombrement, la variance conditionnelle des données de comptage est une fonction croissante de la moyenne conditionnelle. Si l’espérance augmente sous l’influence d’un prédicteur statistique, la variabilité des données observées s’accroît automatiquement dans les mêmes proportions. Il existe donc une hétéroscédasticité structurelle inhérente à la nature même des comptages.
Dans ces conditions d’hétéroscédasticité fonctionnelle, bien que les estimateurs MCO des coefficients de pente puissent demeurer mathématiquement sans biais sur le plan asymptotique, ils perdent complètement leur statut d’estimateurs linéaires sans biais à variance minimale (BLUE). Les formules conventionnelles d’estimation de l’erreur type basées sur l’hypothèse de variance constante deviennent totalement inefficaces et inexactes. En règle générale, les erreurs types calculées par MCO sur des données asymétriques hétéroscédastiques tendent à être substantiellement sous-estimées dans les régions de faible intensité et faussées globalement, produisant des ratios t anormalement élevés. Cette distorsion méthodologique génère une inflation dramatique du taux d’erreur de première espèce (taux de faux positifs), conduisant les chercheurs à rejeter à tort l’hypothèse nulle d’absence d’effet et à déclarer fallacieusement significatifs des prédicteurs qui n’exercent aucune influence réelle.
3.2 Le problème fondamental des prédictions mathématiquement impossibles
Au-delà des distorsions affectant l’inférence statistique, la régression par moindres carrés souffre d’une incohérence structurelle relative à son espace de prédiction. Une fonction de régression linéaire classique postule une relation linéaire directe entre la combinaison des covariables explicatives et l’espérance de la réponse :
Y = beta_0 + beta_1 * X_1 + … + beta_p * X_p + epsilon
L’image mathématique de ce prédicteur linéaire s’étend sur la droite réelle tout entière, de moins l’infini à plus l’infini. Dès lors que l’échantillon d’étude comporte des sujets affichant des valeurs faibles de la variable dépendante couplées à des scores extrêmes sur des covariables associées à des coefficients négatifs, l’équation linéaire produira inévitablement des valeurs ajustées (Y chapeau) strictement inférieures à zéro. En contexte clinique, cela équivaudrait à prédire qu’un individu bénéficiant d’un facteur de protection psychologique élevé manifestera un score attendu de -1,8 crise de boulimie par mois, ou subira -0,5 épisode de panique. Une telle prédiction est dépourvue de sens biologique, comportemental ou mathématique.
Ce paradoxe géométrique s’étend de façon encore plus préjudiciable aux intervalles de confiance construits autour des trajectoires prédictives. Dans la mesure où les distributions normales d’erreurs présument une symétrie bilatérale infinie, les bornes inférieures des intervalles de confiance à 95 % associées aux estimations prédictives pour des individus à faible risque s’enfoncent régulièrement et profondément dans les valeurs négatives. Pour tenter d’atténuer artificiellement cette aberration, certains analystes tronquent arbitrairement leurs prédictions négatives à zéro dans leurs représentations graphiques. Néanmoins, cette opération a posteriori détruit les propriétés d’estimation non biaisée du modèle moyen et crée une accumulation artificielle sur la frontière de troncature, soulignant la distorsion de la relation fonctionnelle à l’approche de la borne naturelle d’extinction du phénomène.
L’utilisation de modèles linéaires généralisés intégrant des fonctions de lien non linéaires permet de circonscrire naturellement et rigoureusement ce problème. En restreignant le domaine d’arrivée de la fonction d’espérance à l’intervalle ouvert des réels strictement positifs ]0, +infini[, l’architecture GLM garantit que toute combinaison linéaire des prédicteurs, quelle que soit son intensité négative ou positive, se projettera obligatoirement sur une prédiction de comptage physiquement réalisable et toujours supérieure à zéro.
4. Architecture du modèle linéaire généralisé appliqué à la loi de Poisson
4.1 Les trois composants canoniques du modèle linéaire généralisé
Pour dépasser les limitations structurelles des modèles d’analyse de variance et de régression linéaire conventionnels, John Nelder et Robert Wedderburn ont élaboré le cadre théorique unificateur du modèle linéaire généralisé. Cette architecture modulaire repose sur la dissociation fondamentale entre la distribution d’échantillonnage de la réponse et la linéarité des relations prédictives. Tout GLM, et en particulier le modèle de régression de Poisson, se décompose invariablement en trois éléments canoniques étroitement articulés :
- La composante aléatoire : Elle spécifie la loi de probabilité attribuée à la variable dépendante Y, conditionnellement aux prédicteurs observés. Dans le cadre précis de la modélisation de comptage standard, on postule formellement que chaque observation conditionnelle Y_i suit une distribution de Poisson discrète de paramètre lambda_i, appartenant à la grande famille des lois exponentielles canoniques.
- La composante systématique : Elle synthétise l’ensemble des prédicteurs cliniques, démographiques ou expérimentaux sous la forme classique d’une combinaison linéaire de paramètres inconnus. Ce vecteur de synthèse, désigné par la lettre grecque êta (eta_i), est dénommé prédicteur linéaire :
eta_i = beta_0 + beta_1 * X_i1 + beta_2 * X_i2 + … + beta_k * X_ik
Cette formulation préserve toute la souplesse matricielle de la régression linéaire multivariée, autorisant sans restriction l’inclusion conjointe de variables continues, d’indicatrices catégorielles (variables indicatrices ou dummy variables), de termes d’interaction complexes et de fonctions polynomiales.
- La fonction de lien : Représentée fonctionnellement par g(.), cette fonction monotone et dérivable assure la connexion mathématique entre l’espérance mathématique de la composante aléatoire (notée mu_i, équivalente ici à lambda_i) et la composante systématique linéaire, selon l’équation :
eta_i = g(mu_i)
Pour la distribution de Poisson, la fonction de lien canonique, issue des propriétés intrinsèques de l’exponentielle de la famille canonique, est la fonction de lien logarithmique naturel :
g(mu_i) = ln(mu_i) = eta_i
Ce couplage non linéaire constitue le moteur central du modèle. Il résout élégamment l’incompatibilité spatiale entre le prédicteur linéaire êta, libre d’évoluer sur tout le domaine des nombres réels ]-infini, +infini[, et l’espérance d’occurrence mu, strictement confinée à l’espace des réels positifs ]0, +infini[.
4.2 Formulation algébrique de la régression de Poisson
L’application rigoureuse du lien logarithmique canonique permet d’exprimer la relation reliant la moyenne conditionnelle attendue de la variable réponse Y_i au vecteur des variables explicatives X_i. La formulation s’établit d’abord sur l’échelle de la fonction de lien :
ln(E(Y_i | X_i)) = ln(mu_i) = beta_0 + beta_1 * X_i1 + beta_2 * X_i2 + … + beta_k * X_ik
Afin de restituer la prédiction dans l’échelle d’origine des observations brutes — c’est-à-dire en nombre moyen d’événements observés —, il suffit d’appliquer l’opération inverse du logarithme népérien, à savoir la transformation exponentielle, aux deux membres de l’égalité :
mu_i = exp(eta_i) = exp(beta_0 + beta_1 * X_i1 + beta_2 * X_i2 + … + beta_k * X_ik)
En vertu des propriétés analytiques élémentaires de l’algèbre des puissances, l’exponentielle d’une somme de termes s’écrit de manière équivalente comme le produit des exponentielles individuelles de chaque terme :
mu_i = exp(beta_0) * exp(beta_1 * X_i1) * exp(beta_2 * X_i2) * … * exp(beta_k * X_ik)
Cette forme multiplicative fondamentale révèle la dynamique fonctionnelle sous-jacente au modèle de Poisson : l’effet des variables explicatives sur le taux d’occurrence sous-jacent n’est pas additif, comme c’est systématiquement le cas dans les équations MCO linéaires classiques, mais strictement multiplicatif. Chaque incrément d’une unité sur une variable indépendante X_j n’ajoute pas un contingent fixe d’événements au comptage prédit, mais multiplie l’espérance d’occurrence d’un facteur constant équivalent à exp(beta_j).
Cette propriété multiplicative garantit de manière structurelle et absolue l’admissibilité physique des prédictions statistiques : pour n’importe quelle valeur assignée aux covariables explicatives et pour n’importe quelle estimation négative extrême prise par le vecteur de coefficients bêta, la fonction exponentielle demeurera invariablement et strictement asymptotique à zéro par le haut, ne pouvant mathématiquement jamais franchir la frontière de nullité vers le domaine négatif.
5. Applications contextuelles en psychologie et sciences comportementales
5.1 Modélisation des épisodes psychopathologiques récurrents
L’analyse des troubles psychiatriques récurrents fournit un champ d’investigation privilégié pour la régression de Poisson. Dans les recherches sur la récurrence du trouble dépressif caractérisé, les cliniciens s’intéressent particulièrement aux déterminants psychologiques prédisposant les patients en rémission à multiplier les épisodes aigus à long terme. Soit un protocole de recherche longitudinale suivant une cohorte de 300 adultes rémittents sur une durée standardisée de cinq années civiles. La variable dépendante Y représente le dénombrement précis des épisodes dépressifs majeurs validés par l’entretien standardisé SCID au fil de la période. Les prédicteurs d’intérêt incluent le niveau de vulnérabilité cognitive mesuré par l’échelle de style cognitif de Seligman (variable continue) et l’historique d’adversité infantile sévère (variable binaire codée 0 pour absence et 1 pour présence de maltraitance documentée).
L’application d’un modèle de Poisson permet ici de tester rigoureusement si les traumatismes de l’enfance agissent comme un amplificateur multiplicatif du taux de décompensation psychologique. L’inclusion conjointe de la sévérité du trauma infantile et des scores de dysfonctionnement cognitif permet d’ajuster l’effet de la vulnérabilité actuelle sur les antécédents développementaux. Dans ce contexte, l’estimation associée au coefficient du trauma infantile quantifie précisément la modification proportionnelle du taux d’incidence des rechutes dépressives chez les adultes traumatisés comparativement aux témoins non traumatisés, à niveau de distorsion cognitive rigoureusement équivalent.
Une démarche analytique analogue s’avère particulièrement éclairante dans l’étude du Trouble du Déficit de l’Attention avec ou sans Hyperactivité (TDAH). Chez des adolescents diagnostiqués, les chercheurs cherchent souvent à dénombrer les comportements impulsifs à risque élevé (épisodes de conduite dangereuse, suspensions scolaires ou passages à l’acte agressifs) sur une période de suivi de six mois. En ajustant pour le dosage pharmacologique d’agents psychostimulants et l’adhérence thérapeutique, le modèle de Poisson permet d’isoler l’effet direct des fonctions exécutives d’inhibition motrice sur la réduction objective du taux de survenue de ces incidents graves.
5.2 Dénombrement des interactions sociales et dynamiques interpersonnelles
L’évaluation des compétences relationnelles et de l’intégration sociale nécessite fréquemment la quantification directe des comportements manifestés en milieu écologique. Dans le domaine des troubles du spectre de l’autisme (TSA), les protocoles d’observation standardisée en milieu scolaire répertorient le nombre d’initiations verbales spontanées émises par l’enfant envers ses pairs au cours de sessions récréatives de durée calibrée. La variable de résultat constitue un comptage typique, souvent caractérisé par une médiane basse et une variabilité interindividuelle prononcée.
Dans un tel devis de recherche, les régresseurs peuvent incorporer le ratio d’encadrement spécialisé disponible dans la classe, le degré d’intensité des particularités sensorielles de l’enfant et son score d’âge verbal. Grâce au modèle log-linéaire, l’analyste examine l’impact différentiel des aménagements environnementaux scolaires sur la fréquence horaire des interactions prosociales. On peut notamment modéliser si l’introduction d’un dispositif de soutien par les pairs double le taux moyen d’initiation communicationnelle comparativement à un environnement traditionnel non structuré.
De manière similaire, les recherches contemporaines sur la cyberpsychologie exploitent abondamment la régression de Poisson pour étudier l’impact de l’hyperconnectivité sur la symptomatologie anxieuse. Les chercheurs quantifient objectivement le nombre d’activations quotidiennes de l’écran d’un ordiphone ou le dénombrement des messages interactifs échangés au sein de réseaux sociaux chez des étudiants universitaires. Ces données de fréquence d’interaction numérique, confrontées à des mesures psychométriques de l’anxiété sociale et de la sensibilité à l’exclusion relationnelle (phénomène FOMO pour Fear of Missing Out), révèlent précisément comment l’intensité de la détresse sociale prédit de façon exponentielle la compulsion de vérification communicationnelle en ligne.
5.3 Réussite académique et persévérance dans l’enseignement supérieur
Dans l’analyse des trajectoires universitaires au sein de l’enseignement supérieur, l’évaluation de la performance académique s’exprime régulièrement par le dénombrement de modules pédagogiques ou d’unités d’enseignement capitalisées à la fin d’une année universitaire. Soit une cohorte académique où l’on enregistre le nombre d’unités de cours validées (allant de zéro pour un abandon total à huit cours obligatoires annuels), en fonction de la moyenne globale obtenue à l’examen d’admission dans l’enseignement supérieur, du statut de bénéficiaire d’une bourse sur critères sociaux, et du genre déclaré de l’étudiant.
L’application du modèle de Poisson offre ici un cadre analytique bien supérieur à la régression linéaire standard pour appréhender le phénomène de non-linéarité à l’approche du seuil maximal de validation. Par ailleurs, la problématique inverse des abandons scolaires et des absences injustifiées enregistrées durant le premier semestre universitaire relève exactement de la même logique de dénombrement. La modélisation de ces comportements d’évitement académique permet d’identifier l’effet protecteur de variables psycho-éducatives, telles que le sentiment d’efficacité personnelle académique ou la flexibilité cognitive, sur le taux d’absentéisme.
L’estimation des ratios de taux d’occurrence dérivés de la régression de Poisson permet aux doyens de facultés et aux planificateurs éducatifs de quantifier précisément le gain marginal en termes d’assiduité ou de réussite découlant de la participation à des ateliers de tutorat par les pairs, en comparant les taux d’absentéisme attendus entre cohortes tutorées et non tutorées après neutralisation complète des disparités socio-économiques initiales.
6. Estimation des paramètres par la méthode du maximum de vraisemblance
6.1 Construction de la fonction de vraisemblance et de log-vraisemblance
Contrairement aux modèles de régression linéaire par moindres carrés dont les coefficients analytiques se calculent directement par projection matricielle fermée (la célèbre équation normale), l’estimation des coefficients vectoriels bêta dans le cadre d’un modèle de régression de Poisson repose intégralement sur la méthode du maximum de vraisemblance (MLE pour Maximum Likelihood Estimation). Cette approche statistique fondamentale consiste à identifier le jeu de paramètres bêta qui rend l’échantillon empirique observé le plus hautement probable sous l’hypothèse de la loi de distribution postulée.
Considérons un échantillon de n observations indépendantes et identiquement distribuées, caractérisé par les couples (Y_i, X_i). Sous l’hypothèse que la variable dépendante conditionnelle Y_i suit une distribution de Poisson d’espérance mu_i = exp(X_i * beta), la fonction de vraisemblance conjointe L(beta) équivaut au produit matriciel des probabilités individuelles discrètes données par la fonction de masse :
L(beta) = Produit de i=1 à n [ (mu_i^Y_i * exp(-mu_i)) / Y_i! ]
Puisque la maximisation directe d’un vaste produit d’exponentielles pose d’évidentes difficultés algébriques et numériques, on applique une transformation strictement monotone croissante en extrayant le logarithme naturel de la fonction de vraisemblance. Cette fonction, notée ell(beta) ou log-vraisemblance, transforme le produit initial en une sommation linéaire bien plus simple à manipuler :
ell(beta) = Somme de i=1 à n [ Y_i * ln(mu_i) – mu_i – ln(Y_i!) ]
En substituant la relation canonique du modèle log-linéaire mu_i = exp(X_i * beta) dans l’expression de la log-vraisemblance, celle-ci devient une fonction explicite du vecteur des paramètres bêta :
ell(beta) = Somme de i=1 à n [ Y_i * (X_i * beta) – exp(X_i * beta) – ln(Y_i!) ]
Pour maximiser cette fonction par rapport à un paramètre de pente beta_j particulier, on calcule sa dérivée partielle première, formalisant ainsi la j-ième composante du vecteur score U(beta) :
d(ell(beta)) / d(beta_j) = Somme de i=1 à n [ (Y_i – exp(X_i * beta)) * X_ij ] = Somme de i=1 à n [ (Y_i – mu_i) * X_ij ]
L’équation de score vectorielle globale s’obtient en annulant simultanément ces dérivées partielles premières :
Somme de i=1 à n [ (Y_i – mu_i) * X_i ] = 0
Cette condition d’optimalité analytique stipule qu’au point d’estimation maximale, la somme pondérée des résidus bruts d’ajustement (Y_i – mu_i) projetés sur chaque régresseur X_ij doit s’annihiler rigoureusement. Les estimateurs du maximum de vraisemblance ainsi obtenus bénéficient d’excellentes propriétés mathématiques asymptotiques : ils sont convergents (ils convergent vers la vraie valeur inconnue lorsque n croît indéfiniment), asymptotiquement sans biais, et asymptotiquement efficaces, atteignant la borne d’information minimale fixée par l’inégalité de Cramér-Rao.
6.2 Algorithmes itératifs et résolution numérique
L’équation vectorielle du gradient établie ci-dessus ne possède aucune solution analytique sous forme fermée isolable en raison de la présence non linéaire de l’inconnue bêta dans le terme exponentiel mu_i = exp(X_i * beta). Il est par conséquent impératif de recourir à des algorithmes d’optimisation numérique itératifs exécutés par ordinateur pour converger vers la solution optimale.
L’algorithme de référence le plus célèbre dans l’univers des GLM est la méthode des moindres carrés récursivement repondérés (connue sous l’acronyme anglophone IRLS pour Iteratively Reweighted Least Squares), qui se révèle formellement équivalente à l’algorithme d’optimisation de Newton-Raphson combiné à la méthode de score de Fisher. Cette procédure itérative utilise non seulement le vecteur gradient des dérivées premières (le score), mais également la matrice carrée des dérivées partielles secondes, appelée matrice hessienne H(beta). Pour la régression de Poisson, l’élément d’intersection ligne j et colonne k de cette matrice s’exprime ainsi :
d^2(ell(beta)) / (d(beta_j) * d(beta_k)) = – Somme de i=1 à n [ exp(X_i * beta) * X_ij * X_ik ] = – Somme de i=1 à n [ mu_i * X_ij * X_ik ]
Cette formulation matricielle révèle une propriété fondamentale : la matrice hessienne est l’opposée exacte d’une forme quadratique semi-définie positive, ce qui signifie que la dérivée seconde de la log-vraisemblance est strictement négative en tout point de l’espace paramétrique. La fonction de log-vraisemblance d’une régression de Poisson est donc universellement et strictement concave. Cette concavité garantit l’existence théorique d’un extremum unique : tout maximum local identifié par l’algorithme constitue obligatoirement le maximum global unique de la fonction, écartant ainsi tout danger de convergence vers des sous-optima locaux trompeurs.
L’actualisation numérique du vecteur des coefficients entre l’itération m et l’itération (m + 1) s’opère selon l’équation matricielle récursive standard :
beta^(m+1) = beta^(m) – [ H(beta^(m)) ]^(-1) * U(beta^(m))
Le processus computationnel itératif se poursuit séquentiellement jusqu’à ce que la différence absolue ou relative entre les vecteurs de paramètres bêta de deux itérations consécutives devienne inférieure à un seuil infinitésimal prédéfini de convergence (souvent 10^-8). Néanmoins, des instabilités numériques peuvent émerger en pratique, notamment en cas de séparation quasi-complète des données (lorsqu’une combinaison spécifique de prédicteurs sépare parfaitement les valeurs nulles des valeurs positives) ou en présence de comptages extrêmes créant des dépassements de capacité arithmétique lors des étapes d’exponentiation.
7. Interprétation des coefficients et ratios des taux d’incidence (IRR)
7.1 Interprétation des estimations sur l’échelle logarithmique
La sortie standard des progiciels de modélisation statistique (tels que R, Stata, SAS ou SPSS) restitue en premier lieu les coefficients de régression sur l’échelle d’estimation directe du modèle, à savoir l’échelle de la fonction de lien logarithmique. Il est capital pour l’analyste de saisir avec précision la signification sémantique exacte de ces valeurs numériques brutes avant toute opération de transformation.
L’estimation de l’ordonnée à l’origine (beta_0) reflète le logarithme naturel de l’espérance de comptage conditionnelle lorsque l’ensemble des prédicteurs quantitatifs et des variables indicatrices inclus dans le modèle systématique sont rigoureusement fixés à zéro. Mathématiquement, exp(beta_0) représente donc le taux moyen de base du phénomène sous conditions nulles de référence. Pour une pente partielle beta_j associée à un régresseur continu X_j, le coefficient traduit la variation absolue attendue du logarithme de l’espérance du comptage induite par l’accroissement unitaire d’un point sur la variable X_j, en maintenant toutes les autres covariables du modèle rigoureusement constantes :
Delta ln(mu) = ln(mu_(X+1)) – ln(mu_X) = beta_j
Lorsque la magnitude du coefficient bêta est de faible amplitude (approximativement située dans l’intervalle entre -0,10 et +0,10), une propriété analytique standard des séries de Taylor permet d’approximer la variation proportionnelle relative de la réponse par le produit direct du coefficient multiplié par 100 :
% Delta mu = (exp(beta_j) – 1) * 100 ~~ 100 * beta_j
Par exemple, une estimation brute de bêta égale à +0,042 peut s’interpréter de façon préliminaire comme une majoration d’environ 4,2 % du taux moyen d’événements pour chaque élévation d’une unité sur le prédicteur. Toutefois, cette approximation devient rapidement trompeuse dès lors que le coefficient s’écarte de zéro. En outre, communiquer des conclusions de recherche sous forme de variations d’unités log-linéaires (« chaque point d’anxiété supplémentaire augmente le log du nombre de crises de panique de 0,35 ») constitue un obstacle majeur à la compréhension pour les professionnels de santé et les décideurs politiques non spécialistes en statistique mathématique.
7.2 Exponentiation des coefficients et utilisation des IRR
Pour rétablir une interprétabilité clinique et intuitive directe sur l’échelle naturelle des données, la pratique standardisée consiste à soumettre chaque coefficient de pente estimé à la transformation exponentielle. Cette grandeur transformée est universellement dénommée le ratio des taux d’incidence (noté IRR pour Incidence Rate Ratio, ou rapport de taux d’incidence en français) :
IRR_j = exp(beta_j)
L’IRR exprime le facteur multiplicatif par lequel le taux d’occurrence moyen de la variable dépendante est altéré lors d’une progression d’une unité sur la variable prédictive examinée, sous condition d’ajustement pour l’ensemble des autres termes de l’équation. La grille d’interprétation s’articule rigoureusement autour de la valeur neutre 1,00 :
- Si IRR = 1,00 (ce qui équivaut à beta = 0) : Le prédicteur n’exerce aucun effet sur le phénomène. L’espérance du comptage reste stationnaire à travers les variations de la covariable (hypothèse nulle).
- Si IRR > 1,00 (ce qui équivaut à beta > 0) : Le prédicteur agit comme un facteur de risque ou d’amplification. Le taux d’occurrence augmente multiplicativement. L’ampleur de la progression relative en pourcentage s’obtient par la formule : (IRR – 1) * 100.
- Si IRR < 1,00 (ce qui équivaut à beta < 0) : Le prédicteur agit comme un facteur protecteur ou inhibiteur. Le taux d’occurrence décroît multiplicativement. La réduction relative en pourcentage s’obtient par la formule : (1 – IRR) * 100.
L’inférence statistique sur l’IRR exige impérativement la construction d’un intervalle de confiance à 95 %. En raison de la forte asymétrie de la distribution d’échantillonnage de l’IRR (strictement bornée à zéro mais illimitée vers le haut), il est formellement erroné d’additionner et de soustraire deux erreurs types autour de l’IRR exponentié. Le protocole méthodologique valide impose de construire d’abord l’intervalle symétrique de Wald sur l’échelle logarithmique d’estimation, puis d’appliquer l’exponentiation aux deux bornes ainsi calculées :
IC_95%(IRR) = [ exp(beta_j – 1,96 * SE(beta_j)) ; exp(beta_j + 1,96 * SE(beta_j)) ]
Considérons un exemple quantitatif concret issu d’une étude sur l’agressivité comportementale en milieu hospitalier. Supposons qu’un modèle de Poisson évaluant le nombre d’incidents d’agressivité verbale au cours d’un trimestre produise, pour une covariable binaire désignant la participation à un atelier de régulation émotionnelle (codée 1 pour le groupe expérimental et 0 pour le groupe contrôle sur liste d’attente), un coefficient bêta de -0,446 avec une erreur type de 0,115. L’exponentiation fournit :
IRR = exp(-0,446) = 0,640
IC_95% = [ exp(-0,446 – 1,96 * 0,115) ; exp(-0,446 + 1,96 * 0,115) ] = [ exp(-0,6714) ; exp(-0,2206) ] = [ 0,511 ; 0,802 ]
L’interprétation académique formelle s’énonce comme suit : après ajustement sur les covariables du modèle, les patients ayant bénéficié de l’atelier de régulation émotionnelle manifestent un taux moyen attendu d’incidents d’agressivité verbale réduit de 36 % par rapport aux patients du groupe contrôle non traité ((1 – 0,640) * 100 = 36 %), l’intervalle de confiance à 95 % certifiant que la véritable réduction au sein de la population se situe entre 19,8 % et 48,9 %.
7.3 Calcul et visualisation des effets marginaux moyens
Bien que le ratio des taux d’incidence fournisse une synthèse relative particulièrement compacte, il masque la variabilité de l’impact absolu de l’intervention à travers les différents niveaux des sujets. En effet, une réduction relative de 36 % ne produit pas le même impact clinique concret selon qu’elle s’applique à un individu à très haut risque manifestant initialement 20 incidents hebdomadaires (soit un gain absolu substantiel d’environ 7,2 incidents évités) ou à un patient stable ne présentant que 0,5 incident par mois (soit une diminution modeste de 0,18 incident).
Pour appréhender cette dimension clinique concrète, la méthodologie moderne recourt au calcul des effets marginaux moyens (AME pour Average Marginal Effects). L’effet marginal instantané d’une variable continue X_j sur l’échelle absolue de la réponse conditionnelle mu_i est formalisé par la dérivée partielle de l’espérance par rapport à ce prédicteur :
d(mu_i) / d(X_ij) = beta_j * exp(X_i * beta) = beta_j * mu_i
Cette dérivée démontre avec clarté que la variation absolue induite par l’incrément d’une unité sur X dépend intrinsèquement de la valeur de départ de mu_i, et donc de la configuration globale de toutes les caractéristiques du sujet. Deux approches computationnelles s’opposent historiquement dans la littérature quantitative :
- L’effet marginal à la moyenne (MEM pour Marginal Effect at the Mean) : L’analyste substitue les moyennes empiriques de l’ensemble des covariables du modèle dans l’équation pour créer un « participant moyen synthétique », puis calcule la dérivée au point résultant. Cette méthode est désormais déconseillée car elle évalue l’effet sur un profil composite qui peut n’avoir aucune existence concrète au sein de l’échantillon (par exemple un individu possédant 0,54 enfant et 0,48 statut marital).
- L’effet marginal moyen dans l’échantillon (AME) : Cette procédure supérieure consiste à calculer l’effet marginal spécifique de chaque individu réel de la base de données en utilisant son profil propre de covariables, puis à moyenner l’ensemble des dérivées individuelles obtenues sur la taille totale de l’échantillon :
AME_j = (1 / n) * Somme de i=1 à n [ beta_j * mu_i ]
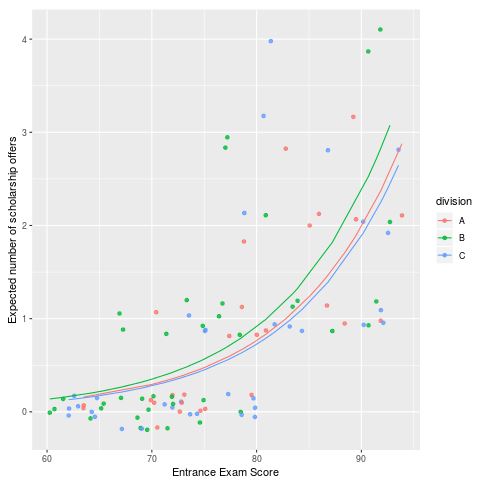
La communication des résultats dans les revues académiques à fort impact gagne considérablement à compléter les tableaux numériques d’IRR par des représentations graphiques visualisant les trajectoires d’espérance de réponse absolue (courbes d’ajustement marginales prédites assorties de leurs bandes de confiance à 95 %). Ces figures illustrent élégamment la non-linéarité fondamentale du modèle en traduisant l’accélération exponentielle du nombre d’événements à mesure que les scores psychométriques de risque progressent le long de l’échelle d’évaluation.
8. Prise en compte de l’exposition temporelle ou spatiale : la variable offset
8.1 Différenciation entre comptage brut et taux d’occurrence standardisé
L’application rigoureuse du modèle de Poisson sous la forme discutée jusqu’ici repose sur un postulat implicite crucial : chaque unité statistique d’observation a été surveillée pendant une durée d’exposition rigoureusement identique, ou au sein d’une aire spatiale d’égale étendue. Cependant, dans une multitude de protocoles empiriques longitudinaux, cette uniformité d’exposition n’est absolument pas respectée. Dans une cohorte observationnelle clinique, les patients intègrent le protocole à des dates différentes, abandonnent l’étude prématurément, ou manquent certains jalons d’évaluation en raison d’événements concurrents indépendants. De même, lors d’analyses épidémiologiques basées sur des territoires géographiques, les aires administratives comparées présentent des densités de population radicalement dissemblables.
Comparer de manière brute le comptage des événements sans corriger pour la durée d’exposition respective constituerait une erreur méthodologique gravissime. Un sujet ayant manifesté 6 rechutes addictives au cours d’une période de surveillance active continue de 24 mois affiche une stabilité psychopathologique infiniment supérieure à un patient ayant présenté 4 rechutes en l’espace de seulement 2 mois de suivi. La cible d’intérêt scientifique fondamentale n’est donc pas le comptage brut absolu en tant que tel, mais le taux d’occurrence par unité d’exposition (le flux temporel ou spatial du processus).
Il est fondamental de maintenir une stricte séparation conceptuelle entre une covariable ordinaire et une variable d’exposition temporelle ou spatiale (notée t_i). Une covariable conventionnelle est intégrée au modèle pour examiner comment ses fluctuations quantitatives modifient le taux d’intensité via un coefficient bêta librement estimé par les données. À l’opposé, la durée d’exposition t_i représente le cadre physique dans lequel le phénomène a l’opportunité de s’exprimer. Son association avec le comptage attendu est théoriquement proportionnelle et mécanique : si l’on double le temps d’observation d’un individu dont l’état clinique demeure parfaitement stationnaire, son espérance de comptage brut double rigoureusement par simple effet d’opportunité d’échantillonnage.
8.2 Intégration mathématique et paramétrage du terme d’offset
Pour incorporer mathématiquement cette contrainte de proportionnalité stricte au sein du formalisme linéaire généralisé, la variable dépendante d’intérêt devient le ratio moyen d’occurrence par unité de temps ou d’espace, à savoir (mu_i / t_i). En appliquant la fonction de lien logarithmique canonique à ce ratio de taux, l’équation s’écrit formellement :
ln(mu_i / t_i) = X_i * beta
En exploitant les propriétés fondamentales des logarithmes stipulant que le logarithme d’un quotient est égal à la différence des logarithmes individuels, l’expression se décompose immédiatement :
ln(mu_i) – ln(t_i) = X_i * beta
En basculant le terme ln(t_i) de l’autre côté de l’égalité afin de réisoler le logarithme de l’espérance brute du comptage (ln(mu_i)) en position de variable réponse du modèle, on obtient la formulation canonique standard de la régression de Poisson avec variable d’exposition :
ln(mu_i) = X_i * beta + ln(t_i)
Le terme ln(t_i) ainsi positionné porte le nom de variable offset (ou terme d’exposition log-transformé). Sur le plan structurel, l’offset agit comme une variable explicative tout à fait singulière : elle intègre la combinaison linéaire systématique avec un coefficient de régression fixé de façon rigide et absolue à l’unité (+1,00). Ce coefficient n’est donc pas estimé par l’algorithme d’optimisation numérique, mais imposé par contrainte structurelle.
Dans la pratique informatique de la modélisation, une erreur d’implémentation particulièrement destructrice consiste à introduire directement la variable temporelle brute t_i en tant qu’offset sans lui appliquer préalablement la transformation logarithmique népérienne. L’algorithme exécuterait alors un modèle mathématiquement incohérent en additionnant directement une durée brute en jours ou en mois à une combinaison d’estimations situées sur une échelle logarithmique. De même, traiter la variable d’exposition temporelle comme un régresseur linéaire libre standard doté d’un coefficient librement estimé beta_t altère l’hypothèse de proportionnalité stricte au temps, modifiant fondamentalement la cible de l’estimation épidémiologique.
9. Évaluation de la qualité de l’ajustement et diagnostic du modèle
9.1 Mesures globales de déviance et tests du chi-carré
Une fois les paramètres du modèle de Poisson estimés par le maximum de vraisemblance, il est indispensable de soumettre l’adéquation générale du modèle à une évaluation diagnostique approfondie. L’indicateur central de qualité d’ajustement dans la théorie des GLM est la déviance résiduelle (désignée par D). Elle quantifie la distance statistique globale séparant le modèle spécifié par le chercheur d’un modèle saturé théorique idéal. Le modèle saturé représente un modèle imaginaire parfait comportant exactement autant de paramètres libres qu’il y a d’observations uniques dans la base de données, permettant d’ajuster sans la moindre erreur chaque point observé (mu_i chapeau = Y_i).
Formellement, la déviance s’exprime comme le double de la différence entre la log-vraisemblance maximale atteignable sous le modèle saturé ell(Y) et la log-vraisemblance calculée sous le modèle proposé ell(mu chapeau) :
D = 2 * [ ell(Y) – ell(mu chapeau) ] = 2 * Somme de i=1 à n [ Y_i * ln(Y_i / mu_i chapeau) – (Y_i – mu_i chapeau) ]
En complément de la déviance, la statistique globale du chi-carré de Pearson (X^2) calcule la somme des carrés des écarts entre comptages observés et comptages prédits, pondérée par la variance conditionnelle théorique de Poisson :
X^2 = Somme de i=1 à n [ (Y_i – mu_i chapeau)^2 / mu_i chapeau ]
Sous réserve de validité des hypothèses d’échantillonnage et pour des tailles d’échantillon suffisamment grandes avec des moyennes individuelles modérées, ces deux statistiques d’adéquation suivent approximativement une loi du chi-carré dont les degrés de liberté correspondent à la taille de l’échantillon n diminuée du nombre total p de paramètres estimés (ddl = n – p). Un ratio empirique entre la déviance résiduelle (ou le chi-carré de Pearson) et ses degrés de liberté s’écartant drastiquement de la valeur 1,00 constitue une alerte méthodologique majeure. Un ratio nettement supérieur à 1 signale une grave sous-estimation de la variabilité réelle (surdispersion), tandis qu’une valeur largement inférieure à 1 indique une sous-dispersion anormale.
Pour l’arbitrage entre modèles concurrents non emboîtés, les critères d’information d’Akaike (AIC) et bayésien de Schwarz (BIC) permettent d’évaluer le compromis optimal entre parcimonie paramétrique et qualité d’ajustement empirique :
AIC = -2 * ell(mu chapeau) + 2 * p
BIC = -2 * ell(mu chapeau) + p * ln(n)
Lorsque deux modèles emboîtés sont comparés — par exemple lors de l’adjonction d’un bloc de plusieurs facteurs psychologiques à un modèle de base incluant uniquement des variables de contrôle sociodémographiques —, on recourt au test du rapport de vraisemblance (LRT pour Likelihood Ratio Test). La statistique différentielle de déviance Delta D = 2 * [ ell(modèle complexe) – ell(modèle restreint) ] est alors confrontée à une distribution du chi-carré dont les degrés de liberté équivalent au nombre de paramètres additionnels testés.
9.2 Analyse approfondie des résidus pour modèles de comptage
L’évaluation visuelle et numérique de la distribution spatiale des résidus d’ajustement permet de localiser les défaillances locales du modèle que les métriques globales d’ajustement ne parviennent pas à isoler. L’analyse ne peut cependant pas s’appuyer sur les résidus bruts conventionnels (e_i = Y_i – mu_i chapeau) : en raison de la relation fonctionnelle intrinsèque liant la moyenne à la variance, ces résidus bruts présentent une hétéroscédasticité structurelle massive, leur variabilité intrinsèque s’élevant continuellement à mesure que le comptage prédit progresse.
Pour neutraliser cette instabilité d’échelle, on utilise les résidus standardisés de Pearson (r_i^P), qui divisent l’écart brut par l’écart type théorique dérivé de l’hypothèse de Poisson :
r_i^P = (Y_i – mu_i chapeau) / racine_carree(mu_i chapeau)
Bien qu’utiles, les résidus de Pearson conservent une asymétrie résiduelle substantielle lorsque la moyenne sous-jacente est faible. Les spécialistes recommandent par conséquent l’examen prioritaire des résidus de déviance (r_i^D). Le résidu de déviance individuel correspond formellement à la contribution de la i-ième observation à la déviance résiduelle globale calculée précédemment, assortie du signe de la différence observée :
r_i^D = signe(Y_i – mu_i chapeau) * racine_carree( 2 * [ Y_i * ln(Y_i / mu_i chapeau) – (Y_i – mu_i chapeau) ] )
Lorsque Y_i est nul, l’expression du résidu de déviance se simplifie analytiquement en :
r_i^D = – racine_carree( 2 * mu_i chapeau )
Les résidus de déviance présentent l’inestimable avantage mathématique de converger beaucoup plus rapidement vers une distribution de densité normale standard centrée réduite N(0, 1) que les résidus de Pearson, facilitant le diagnostic graphique des anomalies d’ajustement par le biais de diagrammes quantile-quantile (Q-Q plots).
Enfin, le diagnostic de robustesse s’achève par le dépistage des observations atypiques dotées d’une influence disproportionnée sur le positionnement du prédicteur linéaire. L’évaluation s’opère par l’analyse conjointe des valeurs de levier (les coefficients diagonaux h_ii de la matrice chapeau généralisée W^(1/2) * X * (X^T * W * X)^(-1) * X^T * W^(1/2)) et du calcul de la distance de Cook généralisée. Les points combinant à la fois un résidu de déviance anormalement prononcé et un fort bras de levier doivent faire l’objet d’audits méthodologiques approfondis afin de certifier l’absence d’erreurs d’encodage clinique.
10. La surdispersion : causes, diagnostics et modèles alternatifs
10.1 Causes étiologiques et conséquences statistiques de la surdispersion
L’écueil méthodologique le plus prévalent dans la pratique de la régression de Poisson réside dans le phénomène de surdispersion (ou overdispersion en anglais). Il y a surdispersion dès lors que la variance empirique conditionnelle des données s’avère nettement supérieure à leur espérance mathématique :
Var(Y | X) > E(Y | X)
L’apparition de cette pathologie distributionnelle trouve son origine dans plusieurs configurations structurelles inhérentes aux données humaines :
- L’hétérogénéité non observée : Dans toute étude observationnelle en psychologie ou en épidémiologie, il est impossible de mesurer la totalité des déterminants causaux et des facteurs de vulnérabilité individuels. Lorsque des variables explicatives importantes sont omises du modèle systématique, leurs effets s’amalgament au sein du terme d’erreur stochastique, provoquant un étalement de la variabilité au-delà des limites théoriques du processus de Poisson pur.
- La contagion et dépendance d’événements : Contrairement au postulat formel d’indépendance conditionnelle, de nombreux processus comportementaux présentent des dynamiques de dépendance temporelle positive. Dans l’étude des conduites toxicomaniaques ou des actes d’automutilation non suicidaire, la survenue d’un premier épisode affaiblit considérablement les défenses psychologiques du patient et majore exponentiellement le risque d’apparition d’épisodes ultérieurs rapprochés (phénomène de renforcement stochastique).
- Le regroupement hiérarchique (clustering) : L’échantillonnage de sujets nichés au sein de structures partagées (patients suivis par un même thérapeute, élèves regroupés par classes scolaires) induit une corrélation intra-classe qui gonfle mécaniquement la variance résiduelle des observations.
Les conséquences de l’ignorance délibérée de la surdispersion sont particulièrement délétères pour l’inférence statistique. Alors que les estimateurs du maximum de vraisemblance des coefficients bêta conservent leur propriété mathématique de convergence et demeurent sans biais, le calcul conventionnel de la matrice de variance-covariance des paramètres s’effondre. Le modèle postule une précision d’échantillonnage totalement fictive en sous-estimant massivement les erreurs types associées aux coefficients. Cette compression artificielle des erreurs types engendre un rétrécissement indu des intervalles de confiance et gonfle dramatiquement les statistiques de test de Wald. Les chercheurs s’exposent dès lors à un taux alarmant de faux positifs statistiques (erreurs de type I), attribuant une efficacité clinique ou une significativité académique à des prédicteurs dont l’effet relève en réalité du pur bruit statistique.
Pour dépister formellement cette anomalie, on emploie le test de Cameron-Trivedi. Ce test de régression auxiliaire évalue si les résidus ajustés vérifient l’hypothèse nulle d’équidispersion contre une alternative de dépendance fonctionnelle quadratique :
[ (Y_i – mu_i chapeau)^2 – Y_i ] / mu_i chapeau = alpha * mu_i chapeau + epsilon_i
Un rejet statistiquement significatif de l’hypothèse nulle (alpha = 0) apporte la preuve irréfutable que le modèle de Poisson conventionnel est inadéquat et doit être impérativement remplacé par une modélisation alternative adaptée.
10.2 Modélisation Quasi-Poisson et corrections d’erreurs types
La première stratégie de remédiation méthodologique face à la surdispersion modérée est l’approche de quasi-vraisemblance formalisée par Robert Wedderburn, communément désignée sous le vocable de modèle Quasi-Poisson. Cette méthode conserve rigoureusement la structure fonctionnelle de l’équation moyenne originale ainsi que la fonction de lien logarithmique, mais assouplit l’hypothèse stricte d’égalité des moments en introduisant un paramètre de dispersion scalaire libre, noté phi :
E(Y_i | X_i) = mu_i
Var(Y_i | X_i) = phi * mu_i
Dans ce formalisme étendu, lorsque phi est rigoureusement égal à 1,00, on retrouve le modèle de Poisson conventionnel équidispersé. Lorsque phi est supérieur à 1,00, le modèle capture fidèlement la surdispersion en postulant que la variance empirique est proportionnelle à la moyenne, amplifiée d’un facteur d’échelle constant phi. L’estimation empirique de ce paramètre scalaire s’effectue généralement à partir de la statistique du chi-carré de Pearson divisée par ses degrés de liberté :
phi chapeau = X^2 / (n – p) = (1 / (n – p)) * Somme de i=1 à n [ (Y_i – mu_i chapeau)^2 / mu_i chapeau ]
La puissance pratique de cette correction réside dans sa neutralité sur les estimations ponctuelles : les coefficients de régression bêta calculés sous le quasi-Poisson sont strictement identiques à ceux obtenus par la régression de Poisson canonique standard. En revanche, la matrice asymptotique de variance-covariance des estimateurs est systématiquement multipliée par le facteur scalaire d’inflation phi chapeau. Par conséquent, les erreurs types corrigées des coefficients équivalent aux erreurs types initiales multipliées par la racine carrée du paramètre de dispersion :
SE_corrigee(beta_j) = SE_standard(beta_j) * racine_carree(phi chapeau)
Une alternative non paramétrique tout aussi rigoureuse consiste à employer les estimateurs de variance robustes dits en sandwich de Huber-White. Cette procédure asymptotique ajuste empiriquement la matrice de covariance en exploitant la dispersion réelle des résidus individuels sans formuler aucune hypothèse rigide sur la structure fonctionnelle de la variance.
Le principal talon d’Achille théorique du quasi-Poisson réside dans le fait qu’il ne repose sur aucune véritable distribution de probabilité paramétrique sous-jacente. Ne disposant pas d’une véritable fonction de vraisemblance complète mais seulement d’une quasi-vraisemblance, il devient conceptuellement impossible de calculer des métriques d’information d’Akaike ou de Schwarz conventionnelles (AIC, BIC), complexifiant l’arbitrage automatique dans les procédures de sélection algorithmique de modèles.
10.3 La régression binomiale négative comme solution paramétrique
Lorsque la surdispersion mesurée au sein des données empiriques est d’une intensité substantielle, l’approche paramétrique la plus rigoureuse et la plus élégante consiste à abandonner la distribution de Poisson univariée au profit de la distribution binomiale négative (particulièrement sa paramétrisation quadratique, désignée conventionnellement sous le sigle NB2).
Sur le plan théorique, le modèle binomial négatif découle élégamment d’un mélange continu Poisson-Gamma. On postule que conditionnellement à un facteur d’hétérogénéité latent inobservé nu_i spécifique à chaque individu, la variable dépendante suit une loi de Poisson : Y_i | nu_i ~ Poisson(mu_i * nu_i). On suppose ensuite que ce terme stochastique individuel nu_i suit lui-même au sein de la population générale une distribution Gamma continue d’espérance égale à 1 et de variance constante égale à alpha. En intégrant analytiquement l’ensemble des valeurs possibles de l’aléa individuel nu_i hors de l’équation marginale, la distribution composite résultante se reformule exactement selon la loi binomiale négative.
Cette dérivation enrichit considérablement la structure de la variance conditionnelle théorique, qui incorpore désormais un terme quadratique proportionnel au carré de l’espérance d’occurrence :
E(Y_i | X_i) = mu_i
Var(Y_i | X_i) = mu_i + alpha * (mu_i)^2
Dans cette formulation, le coefficient scalaire alpha désigne le paramètre de surdispersion quadratique (ou paramètre d’hétérogénéité). Si alpha tend mathématiquement vers zéro, le second terme s’annihile complètement et la fonction de variance se réduit exactement à Var(Y) = mu, restaurant la loi de Poisson pure comme un cas limite particulier de la binomiale négative.
Contrairement au modèle quasi-Poisson, la régression binomiale négative constitue un modèle probabiliste pleinement paramétrique. Elle engendre une véritable fonction de log-vraisemblance maximisée, permettant l’extraction immédiate des indices AIC et BIC ainsi que l’exécution de tests formels du rapport de vraisemblance pour évaluer la significativité statistique de la réduction de déviance induite par l’inclusion du paramètre d’hétérogénéité alpha. En sciences cliniques et comportementales, où les profils individuels manifestent presque invariablement une forte variabilité résiduelle inobservée, la régression binomiale négative s’est progressivement imposée comme la référence méthodologique standard pour l’investigation empirique des dénombrements surdispersés.
11. Modélisation de l’excès de zéros : approches Zero-Inflated et Hurdle
11.1 Dualité conceptuelle des zéros : structurels versus aléatoires
L’un des défis analytiques les plus complexes soulevés par l’analyse empirique des dénombrements réside dans la présence fréquente d’une concentration massive d’observations nulles, excédant largement ce que les distributions classiques de Poisson ou même de la binomiale négative sont théoriquement capables de prédire. Face à un tableau clinique caractérisé par une telle prolifération de zéros, la modélisation statistique avancée impose d’opérer une décomposition philosophique et opérationnelle cruciale entre deux catégories épistémologiques distinctes de scores nuls :
- Les zéros structurels (ou absolus) : Ils correspondent à des unités statistiques qui se situent totalement hors d’atteinte du phénomène comportemental ou clinique investigué. Ces individus appartiennent à une sous-population spécifique qui ne manifeste aucune propension intrinsèque à réaliser l’événement d’intérêt durant la période d’observation. Dans une étude portant sur le dénombrement de la consommation d’unités d’alcool, un individu ayant souscrit un engagement formel d’abstème permanent (témoin abstinent à vie) produit un zéro structurel : son score nul est immuable et indépendant du contexte d’échantillonnage temporel.
- Les zéros d’échantillonnage (ou aléatoires) : Ils émanent d’individus qui sont de véritables participants actifs au processus stochastique étudié, mais qui, par pur aléa d’échantillonnage temporel ou en raison d’une intensité comportementale momentanément basse, n’ont pas manifesté l’événement précis lors de la fenêtre d’enregistrement. Dans la même étude sur les habitudes de consommation éthylique, un buveur social modéré qui s’est trouvé n’avoir consommé aucune boisson alcoolisée durant la semaine exacte couverte par l’évaluation prospective génère un zéro d’échantillonnage. Si le protocole avait prolongé la durée de mesure de quelques semaines supplémentaires, son score de dénombrement se serait inévitablement converti en une valeur strictement positive.
La coexistence simultanée de ces deux mécanismes générateurs crée une distribution empirique bimodale, marquée par une hyper-concentration ponctuelle sur la valeur zéro couplée à une distribution asymétrique continue sur les valeurs supérieures. Une modélisation de Poisson classique appliquée aveuglément à de telles configurations tente vainement d’accommoder cette masse initiale en comprimant excessivement l’espérance lambda vers le bas, conduisant à une sous-estimation systématique des comptages élevés parmi les participants actifs.
11.2 Les modèles de Poisson à inflation de zéros (ZIP)
Pour résoudre cette mixité générative au sein de la population, le statisticien Diane Lambert a développé en 1992 la méthodologie des modèles de Poisson à inflation de zéros (universellement désignés par le sigle ZIP pour Zero-Inflated Poisson). Le modèle ZIP aborde le problème sous l’angle théorique d’un mélange fini binaire latent : il postule que la population échantillonnée est une composition hybride formée de deux sous-classes latentes distinctes et inobservables à l’œil nu.
La première composante est un modèle de classification binaire régissant l’appartenance à la sous-population des zéros certains (les zéros structurels). Cette propension latente, notée pi_i, est modélisée par une équation logistique conventionnelle (logit) :
logit(pi_i) = ln(pi_i / (1 – pi_i)) = Z_i * gamma
La seconde composante est un modèle de comptage de Poisson standard régissant le comportement de la sous-population des individus susceptibles de manifester l’événement (générant à la fois des zéros d’échantillonnage et des comptages strictement positifs) :
ln(mu_i) = X_i * beta
Dans ce modèle de mélange, la fonction de masse de probabilité conjointe se scinde en deux branches conditionnelles élégantes :
P(Y_i = 0) = pi_i + (1 – pi_i) * exp(-mu_i)
P(Y_i = k) = (1 – pi_i) * [ (mu_i^k * exp(-mu_i)) / k! ] , pour tout k > 0
La probabilité d’enregistrer un comptage nul découle donc de la superposition de deux chemins probabilistes : soit le participant appartient d’emblée à la classe structurellement nulle (probabilité pi_i), soit il appartient à la classe active (probabilité 1 – pi_i) mais n’a manifesté aucune occurrence durant la période par simple hasard d’échantillonnage (terme exp(-mu_i)). En cas de surdispersion additionnelle affectant les comptages positifs, le modèle se généralise immédiatement en un modèle binomial négatif à inflation de zéros (ZINB).
L’arbitrage formel entre un modèle de comptage standard et son homologue à inflation de zéros s’opère canoniquement par le biais du test de Vuong. Ce test évalue la divergence de Kullback-Leibler moyenne séparant les deux modèles concurrents non emboîtés. Une valeur de statistique de Vuong strictement supérieure à +1,96 soutient significativement la supériorité du modèle avec inflation de zéros par rapport au modèle standard homogène.
11.3 Les modèles à barrière de franchissement (Hurdle models)
Une alternative conceptuelle majeure à la logique de mélange des modèles ZIP est offerte par les modèles à barrière de franchissement (familièrement dénommés modèles Hurdle, introduits par John Mullahy en 1986). La divergence fondamentale entre ces deux philosophies réside dans le statut ontologique accordé aux observations nulles : alors que le ZIP postule que les zéros constituent un agrégat mixte issu de deux processus non discernables, le modèle Hurdle conceptualise le phénomène comme un processus développemental séquentiel en deux étapes imperméables.
Dans l’architecture du modèle Hurdle, le participant doit d’abord franchir avec succès une première « barrière psychologique ou comportementale » pour faire basculer son score de zéro vers une valeur positive quelconque :
- Étape 1 (Le franchissement du seuil) : La totalité des zéros empiriques observés sans distinction est assignée à un processus binaire exhaustif modélisé par une régression logistique ou probit. Cette équation prédit la probabilité générale d’observer une réalisation strictement positive P(Y > 0) versus un score nul P(Y = 0).
- Étape 2 (Le comptage conditionnel positif) : Conditionnellement au franchissement victorieux du seuil initial (dès lors que Y > 0), la magnitude numérique du dénombrement est modélisée par une distribution de Poisson (ou binomiale négative) formellement tronquée à zéro. La troncature élimine mathématiquement la possibilité théorique de produire un zéro dans la seconde phase.
La fonction de masse de la loi de Poisson tronquée à zéro (notée P_tronquee(Y = k)) s’obtient en divisant la probabilité de Poisson ordinaire par la masse de probabilité conditionnelle cumulée située au-dessus de zéro (1 – exp(-mu)) :
P_tronquee(Y = k | Y > 0) = [ (mu^k * exp(-mu)) / k! ] / (1 – exp(-mu)) , pour tout k >= 1
L’immense avantage méthodologique des modèles Hurdle réside dans la séparation complète de l’estimation numérique. Les deux fonctions de vraisemblance étant mathématiquement séparables et indépendantes, les paramètres gamma de la partie binaire et les paramètres bêta de la partie tronquée peuvent s’estimer de manière totalement disjointe sans instabilité de convergence. Sur le plan de la théorie clinique, cette dissociation autorise une variable explicative à exercer des rôles opposés lors des deux phases : par exemple, un trait de tempérament particulier peut significativement freiner l’initiation initiale d’une thérapie comportementale (faible probabilité de franchir le seuil zéro), mais stimuler considérablement la fréquence des séances d’approfondissement une fois le cadre d’alliance thérapeutique formellement établi.
Le tableau comparatif ci-dessous synthétise les propriétés, postulats et scénarios d’application clinique privilégiés pour chacune des architectures de modélisation de comptage explorées :
| Architecture de Modèle | Hypothèse sur la Variance | Gestion des Zéros | Cas d’Application Privilégié |
|---|---|---|---|
| Régression de Poisson standard | Équidispersion stricte : Var(Y) = E(Y) | Traités de façon homogène selon le paramètre lambda | Expériences de laboratoire contrôlées, événements rares et indépendants sans clustering. |
| Quasi-Poisson | Dispersion linéaire : Var(Y) = phi * E(Y) | Traités de façon homogène selon le paramètre lambda | Surdispersion d’ampleur faible à modérée lorsque le calcul d’indices de vraisemblance n’est pas requis. |
| Binomiale Négative (NB2) | Dispersion quadratique : Var(Y) = mu + alpha * mu^2 | Absorption partielle de l’excès de zéros via la variance élargie | Données observationnelles de cohortes humaines présentant une forte hétérogénéité individuelle résiduelle. |
| Poisson à Inflation de Zéros (ZIP) | Équidispersion conditionnelle au sein du mélange | Mélange binaire dual : zéros structurels + zéros d’échantillonnage | Présence avérée d’une sous-population inéligible ou réfractaire mêlée à des participants actifs. |
| Modèle à Barrière (Hurdle) | Flexibilité selon la distribution de troncature retenue | Séparation nette en deux étapes : seuil binaire global puis comptages tronqués | Processus séquentiels à deux vitesses régis par des mécanismes motivationnels ou biologiques distincts. |
12. Recommandations pratiques, protocole d’analyse et rapport scientifique
12.1 Protocole séquentiel d’analyse des données de comptage
Afin de maximiser la reproductibilité computationnelle et la rigueur inférentielle des analyses quantitatives de dénombrement, il est fortement conseillé de déployer un protocole d’analyse séquentiel rigoureux en quatre phases successives :
- Étape 1 : Analyse descriptive exploratoire et vérification des moments
Avant tout ajustement paramétrique, l’analyste doit impérativement dresser l’histogramme des fréquences brutes, dénombrer la proportion exacte de valeurs nulles observées (pourcentage de zéros), et calculer la moyenne arithmétique empirique ainsi que la variance empirique de la variable réponse non transformée. Un ratio variance/moyenne substantiellement supérieur à 1,5 fournit un indice diagnostique préliminaire éclatant en faveur de la surdispersion. Examiner les durées de surveillance individuelles afin de formaliser l’éventuelle variable d’exposition temporelle. - Étape 2 : Spécification et ajustement du modèle de référence
Ajuster une régression de Poisson standard baseline incorporant le vecteur des prédicteurs théoriques d’intérêt, les covariables d’ajustement clinique, et le logarithme de l’exposition temporelle positionné formellement en variable offset le cas échéant. - Étape 3 : Diagnostics d’adéquation et dépistage formel de la surdispersion
Extraire la déviance résiduelle et le chi-carré de Pearson du modèle de Poisson. Calculer les ratios respectifs déviance/ddl et chi-carré/ddl. Conduire le test auxiliaire de Cameron-Trivedi pour statuer statistiquement sur la présence de surdispersion. Inspecter attentivement les résidus de déviance et les distances de Cook généralisées pour repérer d’éventuels points à fort bras de levier. - Étape 4 : Arbitrage et sélection de l’architecture probabiliste finale
En présence d’une surdispersion avérée sans prolifération aberrante de zéros, spécifier un modèle binomial négatif (NB2) et conduire un test de rapport de vraisemblance sur le paramètre de dispersion alpha. Si le pourcentage de zéros empiriques excède massivement les projections de la loi binomiale négative, arbitrer conceptuellement entre le modèle Hurdle et le modèle ZIP/ZINB : si la population comporte manifestement des individus structurellement insensibles, privilégier le ZIP et administrer un test de Vuong ; si le phénomène relève d’un seuil séquentiel d’engagement comportemental, privilégier le modèle Hurdle. Sélectionner la spécification optimale en comparant conjointement les indices AIC et BIC.
12.2 Normes de restitution des résultats selon les standards académiques de l’APA
La diffusion des résultats issus d’une modélisation de Poisson ou binomiale négative dans les revues affiliées à l’American Psychological Association (APA) obéit à des standards de clarté et de transparence méthodologique stricts. L’écueil le plus récurrent consiste à omettre les grandeurs exponentiées pour ne présenter que des estimations brutes indéchiffrables sur l’échelle de la fonction de lien logarithmique.
Les tableaux récapitulatifs de régression doivent comporter au minimum, pour chaque paramètre estimé :
- Le coefficient brut d’échelle logarithmique (bêta) accompagné de son erreur type standardisée (SE).
- Le ratio des taux d’incidence dérivé (IRR) accompagné de son intervalle de confiance à 95 % asymétrique rigoureusement formaté entre crochets : [Borne Inférieure ; Borne Supérieure].
- La valeur exacte de la statistique de test associée (la statistique z de Wald) et la valeur-p correspondante rapportée avec trois décimales (ou p < 0,001).
- En pied de tableau, les indices globaux d’ajustement du modèle : la taille finale de l’échantillon analysé (n), la log-vraisemblance maximale, le critère d’information d’Akaike (AIC), la statistique de déviance résiduelle associée à ses degrés de liberté, et l’estimation du paramètre de surdispersion (phi pour le Quasi-Poisson ou alpha pour la Binomiale négative) avec son test d’inférence.
Sur le plan de la restitution textuelle narrative, la formulation des conclusions doit impérativement abandonner le champ sémantique linéaire additif au profit d’une prose reflétant la dynamique multiplicative sous-jacente. Il est méthodologiquement erroné d’écrire que « le traitement X a réduit le score moyen de 2,3 unités ». La formulation standardisée rigoureuse s’énonce selon le canevas suivant :
« Une régression de Poisson avec terme d’offset logarithmique pour la durée d’exposition a été conduite afin d’évaluer l’impact de la thérapie comportementale dialectique sur la fréquence annuelle des consultations médicales d’urgence non programmées. L’adjonction d’un modèle binomial négatif a révélé une amélioration très significative de la déviance globale par rapport au modèle de Poisson équidispersé (test du rapport de vraisemblance : Chi-deux(1) = 48,22, p < 0,001 ; alpha = 0,38), confirmant la présence d’une surdispersion quadratique substantielle au sein de la cohorte. Après ajustement complet pour la sévérité initiale du trouble borderline et l’historique thérapeutique antérieur, l’engagement dans la thérapie comportementale dialectique s’est avéré être un prédicteur protecteur hautement significatif de la fréquence des consultations d’urgence (bêta = -0,483, SE = 0,104, z = -4,64, p < 0,001). Exprimé en ratio de taux d’incidence, le groupe traité affiche un IRR de 0,617 (IC à 95 % [0,503 ; 0,756]), ce qui correspond à une réduction moyenne attendue de 38,3 % du taux annuel de consultations d’urgence comparativement au groupe bénéficiant du suivi habituel standard. »
En observant scrupuleusement ces directives structurelles, mathématiques et rédactionnelles, les chercheurs garantissent une transparence analytique totale, préservent l’intégrité empirique de leurs données de comptage et hissent leurs travaux quantitatifs aux plus hauts standards de rigueur scientifique internationale.
Références
- Agresti, A. (2015). Foundations of Linear and Generalized Linear Models. John Wiley & Sons. https://doi.org/10.1002/9781118730034
- Atkins, D. C., & Gallop, R. J. (2007). Rethinking how family researchers model infrequent events: A tutorial on count regression and zero-inflated models. Journal of Family Psychology, 21(4), 726–735. https://doi.org/10.1037/0893-3200.21.4.726
- Cameron, A. C., & Trivedi, P. K. (2013). Regression Analysis of Count Data (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9781139013567
- Cohen, P., West, S. G., & Aiken, L. S. (2014). Applied Multiple Regression/Correlation Analysis for the Behavioral Sciences (3rd ed.). Psychology Press. https://doi.org/10.4324/9780203774441
- Coxe, S., West, S. G., & Aiken, L. S. (2009). The analysis of count data: A gentle introduction to Poisson regression and its alternatives. Journal of Personality Assessment, 91(2), 121–136. https://doi.org/10.1080/00223890802634175
- Hilbe, J. M. (2011). Negative Binomial Regression (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511973420
- Hilbe, J. M. (2014). Modeling Count Data. Cambridge University Press. https://doi.org/10.1017/CBO9781139236065
- Lambert, D. (1992). Zero-inflated Poisson regression, with an application to defects in manufacturing. Technometrics, 34(1), 1–14. https://doi.org/10.2307/1269547
- Long, J. S. (1997). Regression Models for Categorical and Limited Dependent Variables. SAGE Publications.
- McCullagh, P., & Nelder, J. A. (1989). Generalized Linear Models (2nd ed.). Chapman & Hall/CRC. https://doi.org/10.1007/978-1-4899-3242-6
- Mullahy, J. (1986). Specification and testing of some modified count data models. Journal of Econometrics, 33(3), 341–365. https://doi.org/10.1016/0304-4076(86)90002-3
- Nelder, J. A., & Wedderburn, R. W. M. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Osgood, D. W. (2000). Poisson-based regression analysis of aggregate crime rates. Journal of Quantitative Criminology, 16(1), 21–43. https://doi.org/10.1023/A:1007521427059
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier.
- Vuong, Q. H. (1989). Likelihood ratio tests for model selection and non-nested hypotheses. Econometrica, 57(2), 307–333. https://doi.org/10.2307/1912557
- Wedderburn, R. W. M. (1974). Quasi-likelihood functions, generalized linear models, and the Gauss—Newton method. Biometrika, 61(3), 439–447. https://doi.org/10.1093/biomet/61.3.439