
L’analyse des phénomènes psychologiques et comportementaux confronte fréquemment le chercheur à des variables d’intérêt qualitatives et intrinsèquement dichotomiques. Qu’il s’agisse de modéliser la rémission clinique d’un épisode dépressif caractérisé, l’abandon précoce d’une psychothérapie, l’échec ou la réussite à une tâche d’inhibition exécutive, ou encore l’apparition d’un état de stress post-traumatique suite à un événement critique, les données recueillies refusent de se plier à la distribution normale requise par la régression linéaire classique. L’application mécanique des moindres carrés ordinaires à de telles données conduit inévitablement à des aberrations statistiques, notamment la prédiction de probabilités impossibles inférieures à zéro ou supérieures à l’unité, ainsi qu’à une violation fondamentale du postulat d’homoscédasticité. Face à ces impasses méthodologiques, la régression logistique binaire s’impose comme le paradigme standard et la référence incontournable de la modélisation statistique contemporaine en sciences humaines.
Intégrée dans le cadre unificateur des modèles linéaires généralisés (GLM) développé par Nelder et Wedderburn, la régression logistique contourne les restrictions du modèle linéaire par l’introduction d’une fonction de lien non linéaire : la transformation logit. En projetant la probabilité d’occurrence d’un événement depuis l’intervalle restreint [0, 1] vers l’ensemble des réels non bornés, cette approche préserve la structure additive et interprétable des régressions classiques tout en respectant scrupuleusement les contraintes probabilistes inhérentes aux distributions de Bernoulli. Parallèlement, le passage des probabilités aux rapports de cotes (odds ratios) offre une grille de lecture épidémiologique et clinique d’une puissance analytique remarquable, autorisant la quantification précise du risque ou du bénéfice associé à chaque unité de mesure psychométrique supplémentaire.
Ce guide exhaustif a pour ambition d’accompagner pas à pas les chercheurs, doctorants et praticiens de la psychologie dans la maîtrise complète, théorique et appliquée, de la régression logistique sous l’environnement de programmation statistique R. Du déchiffrement des fondements mathématiques sous-jacents aux exigences de publication académique les plus strictes de l’American Psychological Association (APA 7e édition), chaque étape du pipeline analytique sera décortiquée. Nous aborderons la préparation scrupuleuse des données psychométriques, l’exploration descriptive bivariée, le diagnostic minutieux des postulats théoriques, l’ajustement du modèle avec la fonction de base de R, la modélisation des interactions de modération clinique, l’analyse des résidus et des observations influentes, ainsi que l’évaluation approfondie de la calibration et de la discrimination par l’analyse ROC et la validation croisée.
1. Fondements théoriques et mathématiques de la régression logistique en psychologie
1.1 La nature des variables dépendantes binaires en sciences du comportement
En psychologie expérimentale, en neuropsychologie et en psychopathologie quantitative, la mesure se heurte régulièrement à une discontinuité fondamentale de l’objet d’étude. Tandis que de nombreux construits latents sont modélisés comme des traits continus à distribution gaussienne (à l’instar de l’intelligence générale mesurée par le quotient intellectuel ou du niveau de névrosisme quantifié par des échelles de Likert), la décision clinique ou comportementale finale est fréquemment dichotomique : un patient répond positivement aux critères diagnostiques du DSM-5 ou ne s’y conforme pas ; un participant réussit une épreuve de Stroop sous charge cognitive ou commet une erreur d’interférence ; un consommateur de substances rechute après six mois de sevrage ou maintient son abstinence.
Historiquement, les chercheurs ont parfois tenté d’appliquer le modèle de régression linéaire par les moindres carrés ordinaires (MCO) directement sur ces variables codées de façon binaire (0 ou 1), sous l’appellation de modèle de probabilité linéaire (MPL). Cette approche souffre cependant de défaillances structurelles rédhibitoires. D’une part, le modèle linéaire suppose par définition que la relation entre les prédicteurs et la variable dépendante est constante sur l’ensemble du continuum de la variable explicative. Dès lors, lorsque la valeur du prédicteur devient extrêmement faible ou extrêmement élevée, l’équation linéaire produit des valeurs ajustées qui sortent irrémédiablement de l’intervalle d’admissibilité des probabilités, générant des prédictions absurdes telles que des probabilités négatives (-0,25) ou des probabilités supérieures à la certitude absolue (1,30).
D’autre part, la variable dépendante binaire suit intrinsèquement une distribution de Bernoulli, dont le paramètre de succès est la probabilité p. Par définition, la variance d’une variable de Bernoulli est égale au produit de sa probabilité de succès par sa probabilité d’échec, soit p multiplié par (1 – p). Puisque cette probabilité dépend directement des valeurs prises par les variables explicatives du modèle, la variance des erreurs n’est pas constante d’un individu à un autre : elle atteint son maximum lorsque la probabilité est égale à 0,5 et s’effondre lorsque la probabilité s’approche de 0 ou de 1. Ce phénomène engendre une hétéroscédasticité structurelle et indépassable qui invalide les tests de significativité statistique basés sur les moindres carrés, rendant les erreurs-types artificiellement biaisées et les intervalles de confiance erronés.
1.2 La transformation logit et le passage des probabilités aux logarithmes de cotes
Pour résoudre l’incompatibilité entre la droite infinie des réels et l’intervalle fermé des probabilités, les mathématiciens ont développé la transformation logit, qui agit comme une fonction de lien canonique au sein des modèles linéaires généralisés. La première étape conceptuelle consiste à abandonner la mesure directe de la probabilité d’occurrence d’un événement, notée p, au profit de la notion de cote, désignée sous le terme anglais d’odds. La cote se définit rigoureusement comme le rapport entre la probabilité que l’événement se produise et la probabilité complémentaire qu’il ne se produise pas, soit p divisé par (1 – p). Si un patient souffrant d’anxiété sociale a une probabilité de rémission de 0,80 suite à une thérapie d’exposition, sa probabilité d’échec est de 0,20 ; la cote de rémission est alors de 0,80 / 0,20 = 4,00, ce qui signifie qu’il a quatre fois plus de chances de guérir que de ne pas guérir.
Bien que la cote élimine la borne supérieure de 1 et s’étende théoriquement de 0 à plus l’infini, elle demeure asymétrique et contrainte par la borne inférieure de 0. Pour parachever la linéarisation, on applique à cette cote le logarithme népérien, ce qui donne naissance à la variable logit, également dénommée logarithme de cote ou log-odds. La fonction logit s’écrit formellement : logit(p) = ln(p / (1 – p)). Cette transformation mathématique réalise une bijection parfaite entre l’intervalle probabiliste ouvert ]0, 1[ et l’ensemble infini des nombres réels ]-infini, +infini[. Un log-odds de zéro correspond très exactement à une probabilité de 0,5 (la cote valant 1), des log-odds négatifs correspondent à des probabilités inférieures à 0,5, et des log-odds positifs renvoient à des probabilités supérieures à 0,5.
Pour revenir de l’échelle linéaire des log-odds vers l’échelle naturelle des probabilités, essentielle pour l’interprétation clinique, on applique la fonction inverse du logit, communément appelée fonction logistique standard ou fonction sigmoïde. Mathématiquement, la probabilité prédite p pour un individu s’exprime comme l’exponentielle de la combinaison linéaire des prédicteurs divisée par 1 plus cette même exponentielle, ou de manière équivalente : p = 1 / (1 + exp(-beta_0 – sum(beta_i * X_i))). Cette courbe en S présente des propriétés asymptotiques remarquables : elle ne franchit jamais les seuils critiques de 0 et de 1, ralentit son taux de variation à mesure qu’elle s’approche des extrémités, et présente une symétrie parfaite autour du point d’inflexion situé précisément à p = 0,5.
1.3 L’estimation par le maximum de vraisemblance (MLE)
Contrairement aux modèles de régression linéaire qui emploient la méthode des moindres carrés pour minimiser analytiquement la somme des carrés des résidus verticaux, la régression logistique ne possède aucune solution analytique sous forme matricielle directe (équation normale fermée). Les paramètres du modèle doivent impérativement être estimés par l’intermédiaire de la méthode du maximum de vraisemblance (Maximum Likelihood Estimation ou MLE). Ce paradigme d’inférence repose sur un principe intuitif inversé : étant donné les données empiriques observées dans l’échantillon clinique, quelles sont les valeurs des coefficients de régression (beta) qui maximisent la probabilité globale d’avoir précisément généré ces observations ?
La fonction de vraisemblance globale est le produit des probabilités individuelles assignées par le modèle à chaque participant de l’étude, conditionnellement à son statut réel (succès ou échec). Pour des raisons d’optimisation computationnelle et de stabilité numérique, on maximise en réalité la log-vraisemblance (log-likelihood), qui transforme le produit probabiliste en une somme arithmétique de termes logarithmiques. Dans l’écosystème R, la fonction d’ajustement fait appel à l’algorithme des moindres carrés récursivement repondérés (Iteratively Reweighted Least Squares ou IRLS), qui constitue une déclinaison de la méthode d’optimisation de Newton-Raphson. Cet algorithme calcule à chaque itération le vecteur gradient (la fonction de score) et la matrice hessienne des dérivées secondes (la matrice d’information de Fisher), mettant à jour successivement les poids accordés à chaque observation jusqu’à ce que la variation des coefficients entre deux itérations consécutives devienne inférieure à un seuil de tolérance infinitésimal prédéterminé.
La supériorité théorique de l’estimation par le maximum de vraisemblance réside dans ses propriétés asymptotiques optimales : sous réserve que la taille de l’échantillon soit suffisamment grande, les estimateurs du maximum de vraisemblance sont convergents (ils tendent vers la vraie valeur du paramètre dans la population), asymptotiquement non biaisés et asymptotiquement efficaces (leur variance atteint la borne minimale théorique de Cramér-Rao). De plus, l’inverse de la matrice d’information observée fournit directement une estimation robuste de la matrice de variance-covariance des coefficients, rendant possibles le calcul immédiat des erreurs-types et la construction des intervalles de confiance de Wald ou des intervalles de vraisemblance profilée.
2. Préparation de l’environnement de travail et importation des données dans R
2.1 Configuration de RStudio et installation des bibliothèques spécialisées
Une analyse statistique moderne, reproductible et rigoureuse exige une organisation exemplaire de l’espace de programmation sous RStudio. La première directive méthodologique consiste à ne jamais travailler dans un environnement global sans projet structuré. Il convient de créer un projet RStudio dédié (fichier avec extension .Rproj), garantissant que le répertoire de travail racine soit automatiquement défini de manière relative à l’emplacement du projet, bannissant définitivement les chemins absolus codés en dur qui compromettent la reproductibilité sur d’autres postes informatiques. La configuration des options de session doit interdire la sauvegarde automatique de l’espace de travail (.RData) lors de la fermeture, assurant qu’aucune variable orpheline ou objet résiduel ne vienne contaminer les futures itérations d’ajustement.
L’arsenal méthodologique de la régression logistique sous R repose sur un ensemble de packages spécialisés, couvrant la manipulation de données, les diagnostics post-estimation et la modélisation graphique. Les bibliothèques indispensables incluent le tidyverse pour la manipulation vectorielle et la visualisation, car pour le calcul des facteurs d’inflation de la variance et des diagnostics de colinéarité, ResourceSelection pour les tests d’adéquation globale, pROC pour l’analyse des courbes caractéristiques du fonctionnement du récepteur, gtsummary pour l’édition de tableaux conformes aux canons des revues biomédicales, et pscl pour l’extraction des indices de pseudo-R². Pour rationaliser l’installation et le chargement de ces dépendances sans saturer la console de messages d’avertissement, le recours au gestionnaire de packages pacman et à sa fonction p_load représente la meilleure pratique.
Enfin, dès l’initialisation du script d’analyse, il est impératif de fixer la graine du générateur de nombres pseudo-aléatoires à l’aide de la commande set.seed(42) (ou tout autre entier constant). Cette précaution garantit l’exacte reproductibilité des processus stochastiques mobilisés ultérieurement dans le protocole, notamment lors du partitionnement aléatoire des données pour la validation croisée, de la ré-échantillonnage par bootstrap ou des imputations multiples des valeurs manquantes.
2.2 Importation et structuration d’un jeu de données psychométriques
Pour ancrer cette démonstration dans la réalité de la pratique de recherche, nous structurerons un jeu de données simulant une étude clinique multicentrique en psychologie de la santé. L’objectif est de prédire la rémission clinique complète d’un trouble dépressif majeur (variable binaire nommée remission) à l’issue d’un protocole de thérapie cognitive et comportementale (TCC) standardisé de seize semaines, auprès d’une cohorte de 600 patients adultes. Les prédicteurs collectés à l’inclusion comprennent des variables quantitatives continues (le score initial d’anxiété mesuré par l’inventaire BAI de Beck, l’âge en années révolues, le score d’alliance thérapeutique précoce évalué par la WAI) et des variables qualitatives catégorielles (le sous-type dépressif, le niveau de scolarité et l’adhésion pharmacologique conjointe).
L’importation de fichiers de données tabulaires (au format délimité CSV ou au format binaire natif RDS) s’effectue de manière optimale à l’aide des fonctions de lecture rapide du paquetage readr, telles que read_csv(). Immédiatement après l’importation dans l’espace de données (data frame ou tibble), une inspection minutieuse de la structure s’impose. L’utilisation conjointe des fonctions str() et glimpse() permet de vérifier le formatage de chaque colonne, le nombre d’observations effectives et l’absence de colonnes parasitaires générées lors de l’exportation depuis un tableur externe.
La gestion rigoureuse des données manquantes (missing data) constitue un impératif éthique et statistique. Dans les protocoles cliniques psychologiques, les données manquantes résultent souvent de l’attrition des participants ou de refus de réponse sur des échelles sensibles. Par défaut, la régression logistique sous R applique une suppression par liste (listwise deletion), excluant tout participant possédant au moins une valeur manquante sur l’une des variables incluses dans l’équation. Si le mécanisme générateur des données manquantes est de nature ignorable (données manquantes complètement au hasard, MCAR), cette élimination préserve l’absence de biais des coefficients au détriment de la puissance statistique. En revanche, si le mécanisme est manquant au hasard (MAR), une procédure d’imputation multiple par équations chaînées (via le package mice) doit être envisagée en amont pour éviter l’introduction de distorsions systématiques d’échantillonnage.
2.3 Vérification du typage des variables et encodage des facteurs
L’une des sources d’erreurs les plus pernicieuses lors de l’ajustement d’un modèle linéaire généralisé sous R réside dans l’ambiguïté du typage de la variable dépendante. La fonction glm() tolère une variable réponse codée sous forme numérique binaire (vecteur d’entiers ne contenant rigoureusement que des 0 et des 1), sous forme de facteur à deux modalités ou sous forme de vecteur logique (TRUE/FALSE). Cependant, pour garantir une interprétation univoque et un contrôle total sur l’événement modélisé, l’encodage explicite en facteur à l’aide de la fonction factor() est la démarche recommandée. R considère par défaut la première modalité du facteur (par ordre alphanumérique) comme la modalité de référence (valeur 0), et la seconde modalité comme l’événement cible d’intérêt (valeur 1). Si le facteur contient les étiquettes « Non-rémission » et « Rémission », le modèle estimera par défaut la probabilité de rémission.
Une vigilance redoublée s’impose lorsque la variable binaire est importée sous forme de chaînes textuelles telles que « Echec » et « Succes », car l’ordre alphabétique désignerait involontairement « Echec » comme modalité de base (0) et « Succes » comme modalité cible (1), ce qui est cohérent. Mais dans le cas de couples lexicaux comme « Contrôle » et « Cas », l’ordre alphabétique attribue le niveau de base à « Cas », inversant intégralement la direction de tous les coefficients log-odds estimés. Il convient d’utiliser systématiquement la fonction relevel() ou de spécifier l’argument levels dans factor() pour fixer intentionnellement et sans équivoque la modalité de référence.
Les prédicteurs qualitatifs indépendants doivent également faire l’objet d’un examen rigoureux. Les variables nominales sans hiérarchie (par exemple, le centre de traitement ou le sous-type dépressif : mélancolique, atypique, réactionnel) doivent être converties en facteurs non ordonnés, générant automatiquement un codage en variables indicatrices (dummy coding) où chaque modalité non basale est comparée à la catégorie de référence choisie. Pour les prédicteurs ordinaux (tels que les paliers de scolarité : primaire, secondaire, supérieur), le chercheur doit arbitrer entre un encodage en facteur ordonné générant des contrastes polynomiaux (linéaire, quadratique), souvent ardus à interpréter, ou la conversion en facteur nominal standard avec contrastes de traitement, privilégiant la clarté des comparaisons binaires par rapport à un seuil éducatif de référence.
3. Exploration préalable des données et analyse descriptive bivariée
3.1 Examen de la distribution de la variable dépendante
Avant d’engager la moindre démarche d’inférence multivariée, le diagnostic de la prévalence marginale de l’événement cible dans l’échantillon d’étude s’avère indispensable. Dans le cadre de notre cohorte psychométrique, il convient de calculer les fréquences absolues et relatives de la variable de rémission à l’aide de tableaux de comptage et de proportions. Si sur 600 patients, 240 connaissent une rémission et 360 maintiennent leur état dépressif, la prévalence observée s’établit à 40 %, ce qui représente une répartition équilibrée offrant des conditions de puissance statistique idéales pour l’estimation par le maximum de vraisemblance.
En psychopathologie et en neuropsychologie clinique, les chercheurs sont cependant fréquemment confrontés au défi méthodologique du déséquilibre de classes (class imbalance), survenant lorsque l’événement pathologique étudié est rare dans la population générale (par exemple, un passage à l’acte suicidaire, un diagnostic de psychose précoce ou une sortie prématurée d’institution, n’affectant parfois que 2 % à 5 % de la cohorte). Lorsque la prévalence chute en dessous de 10 %, les algorithmes d’estimation standard du modèle linéaire généralisé subissent une compression de variance, et la matrice de prédiction tend à sous-estimer systématiquement la probabilité de survenue de l’événement minoritaire. Ce phénomène nécessite une détection précoce, car il peut imposer le recours ultérieur à des pénalisations spécifiques (telle que la régression logistique de Firth) ou à des stratégies de rééchantillonnage adaptées.
La transcription visuelle de cette distribution initiale s’opère élégamment à l’aide de la grammaire des graphiques du package ggplot2. Un diagramme en barres élégant, paramétré avec des pourcentages normalisés sur l’axe des ordonnées et une palette chromatique accessible, permet d’appréhender instantanément le ratio d’asymétrie de la variable dépendante, servant de référence de base (le modèle nul) auquel tout gain d’ajustement ultérieur sera comparé.
3.2 Analyse descriptive des covariables selon l’état de la variable réponse
L’étape exploratoire subséquente repose sur le croisement bivarié systématique entre chaque variable explicative candidate et la variable dépendante dichotomisée. Pour les variables quantitatives continues (scores psychométriques d’anxiété BAI, score d’alliance thérapeutique WAI, âge), il est requis de calculer non seulement les moyennes et les écarts-types, mais également les médianes et les intervalles interquartiles, ventilés selon que les individus appartiennent au groupe « Rémission » ou « Non-rémission ». Une disparité substantielle des médianes entre les deux strates fournit une première indication empirique sur la force de discrimination univariée du prédicteur envisagé.
La représentation graphique de ces associations univariées continues s’articule autour de boîtes à moustaches comparatives (boxplots) superposées de nuages de points jitterisés (dispersion aléatoire fine), révélant la présence potentielle d’asymétries distributionnelles, de planchers de mesure ou d’observations extrêmes univariées. Un graphique montrant que les scores d’alliance thérapeutique se concentrent massivement vers le haut chez les patients en rémission, tandis qu’ils s’étalent vers les valeurs basses chez les non-répondeurs, constitue un puissant argument visuel préliminaire.
Pour les covariables qualitatives discrètes (par exemple, la présence d’une comorbidité anxieuse ou la typologie de l’intervention), l’analyse descriptive s’appuie sur la génération de tableaux de contingence croisés à double entrée (tableaux 2×2 ou 2xK). Ces tableaux doivent impérativement afficher à la fois les effectifs marginaux observés et les pourcentages en ligne ou en colonne. L’application d’un test d’indépendance du Chi-carré de Pearson (avec correction de continuité de Yates pour les tables 2×2) ou du test exact de Fisher (indispensable lorsque certains effectifs théoriques calculés sous l’hypothèse nulle d’indépendance sont inférieurs à 5) permet de rejeter formellement l’absence d’association bivariée avant toute complexification mathématique.
3.3 Détection précoce des problèmes de quasi-séparation
L’un des écueils techniques les plus insidieux et dévastateurs de la régression logistique réside dans le phénomène de séparation complète (complete separation) ou de quasi-séparation (quasi-complete separation), identifié pour la première fois de manière formelle par Albert et Anderson (1984). La séparation complète survient lorsqu’un prédicteur univarié (ou une combinaison linéaire de plusieurs prédicteurs) permet de classifier parfaitement et sans la moindre erreur la variable dépendante pour toutes les observations de l’échantillon. Par exemple, si l’ensemble des patients ayant un score d’anxiété supérieur à 45 échouent systématiquement à atteindre la rémission, tandis que tous ceux en deçà de 45 y parviennent sans aucune exception, il existe un point de rupture absolu séparant les deux populations.
La quasi-séparation est une variante plus pernicieuse où la séparation est parfaite à l’exception d’un sous-ensemble d’observations partageant exactement la même valeur frontière, ou lorsqu’une cellule d’une table croisée entre deux variables qualitatives présente un effectif strictement égal à zéro (par exemple, aucun patient du sous-type dépressif atypique n’a obtenu de rémission clinique). D’un point de vue mathématique, la présence d’une séparation parfaite signifie que pour maximiser la vraisemblance, le coefficient de régression beta associé à ce prédicteur doit converger vers plus ou moins l’infini. En conséquence directe, l’algorithme IRLS échoue à stabiliser son estimation : la déviance cesse de décroître, le modèle diverge numériquement, et la console R émet un avertissement explicite signalant que des probabilités ajustées numériquement égales à 0 ou 1 sont apparues.
Le symptôme statistique le plus révélateur de la quasi-séparation dans la table de résultats de R est l’explosion invraisemblable de l’erreur-type du coefficient associé (souvent affichée à des valeurs aberrantes de plusieurs centaines ou milliers, comme SE = 3452,8), conduisant paradoxalement à une statistique de Wald proche de zéro et à une valeur-p non significative de 0,999 ou 1,000 pour un prédicteur qui est pourtant parfaitement prédictif. L’inspection méticuleuse des tables croisées en amont de la modélisation permet d’identifier ces cellules vides. Si la situation se présente, le chercheur doit opérer un regroupement conceptuel de modalités (collapsing categories), exclure la variable problématique ou opter pour une approche bayésienne pénalisée telle que la méthode de régression logistique de Firth implémentée dans le package logistf.
4. Vérification rigoureuse des postulats de la régression logistique
4.1 Test de linéarité du logit pour les variables continues
Bien que la régression logistique s’affranchisse de l’hypothèse de normalité résiduelle propre au modèle linéaire général, elle n’est pas pour autant exempte de postulats paramétriques structurels. L’exigence la plus fondamentale concerne l’hypothèse de linéarité : la relation entre chaque prédicteur quantitatif continu et la variable dépendante doit impérativement être linéaire sur l’échelle du logit. Cela signifie que l’effet d’une augmentation d’un point sur le score psychométrique de base doit induire une modification constante des log-odds de l’événement, quel que soit le niveau initial de l’individu sur cette échelle.
La méthode empirique de référence pour tester formellement ce postulat est le test de transformation de Box-Tidwell. Ce test consiste à introduire dans le modèle de régression un terme d’interaction supplémentaire entre la variable continue candidate (notée X) et son propre logarithme naturel, soit le terme produit X * ln(X). Dans la mesure où le logarithme naturel n’est défini que pour des valeurs strictement positives, il est impératif d’ajouter une constante positive unitaire à toute variable psychométrique susceptible de comporter des valeurs nulles ou négatives avant le calcul. Si le coefficient associé à cette interaction non linéaire s’avère statistiquement significatif au seuil conventionnel de p < 0,05, le postulat de linéarité du logit est violé pour cette variable spécifique.
En cas de non-respect de ce postulat, le chercheur dispose d’alternatives méthodologiques pour visualiser et corriger la non-linéarité. L’intégration de fonctions splines de lissage ou l’ajustement d’un modèle additif généralisé (GAM) via le package mgcv permet de tracer visuellement la fonction de lien empirique. Si la déviation observée présente une allure quadratique en U ou en U inversé (par exemple, un niveau modéré d’anxiété favorisant la rémission thérapeutique alors qu’une anxiété nulle ou paralysante l’inhibe), l’introduction d’un terme polynomial au carré (I(X^2)) ou la discrétisation théoriquement motivée de la variable en tranches cliniques permet de restaurer la validité interne du modèle.
4.2 Évaluation de la multicolinéarité entre prédicteurs
Dans la recherche psychologique et neuropsychologique, les prédicteurs intégrés dans un même protocole partagent fréquemment un socle de variance substantiel en raison du chevauchement conceptuel des construits mesurés. Ainsi, l’anxiété état, la dépression et le stress perçu présentent des corrélations inter-échelles élevées. La présence d’une multicolinéarité sévère ne biaise pas directement l’estimation ponctuelle des coefficients du modèle, mais elle gonfle de manière artificielle la variance d’échantillonnage de ces estimateurs. Les erreurs-types deviennent disproportionnées, provoquant une perte catastrophique de puissance statistique qui empêche les prédicteurs pertinents d’atteindre le seuil de significativité individuel, et rend les signes des coefficients hautement instables à la moindre modification de l’échantillon.
Le diagnostic de colinéarité s’opère par le calcul systématique du facteur d’inflation de la variance (VIF, Variance Inflation Factor) et de son pendant mathématique inverse, la tolérance (égale à 1 / VIF). Sous R, l’évaluation s’exécute à l’aide de la fonction vif() issue du package car, appliquée directement sur l’objet de régression logistique ajusté. Le VIF quantifie la proportion de variance d’un prédicteur donné qui est expliquée par l’ensemble des autres variables indépendantes incluses dans le modèle : un VIF de 1 indique une absence totale de corrélation avec les autres covariables, tandis qu’un VIF supérieur signale un gonflement proportionnel de la variance de son coefficient.
Dans la littérature méthodologique contemporaine, les seuils critiques d’alerte font l’objet d’un consensus nuancé. Un VIF excédant 5 (correspondant à une tolérance inférieure à 0,20) doit inciter le chercheur à la prudence, tandis qu’un VIF supérieur à 10 (tolérance < 0,10) signale une multicolinéarité critique inacceptable exigeant une remédiation immédiate. Face à une telle redondance empirique, plusieurs stratégies sont recevables : l’agrégation statistique des échelles redondantes en un score composite de détresse psychologique globale par analyse en composantes principales, l’élimination motivée de la variable la moins robuste sur le plan théorique, ou l’utilisation de méthodes de pénalisation comme la régression Ridge ou Elastic Net.
4.3 Diagnostic de l’indépendance des erreurs et de la surdispersion
Le postulat d’indépendance conditionnelle stipule que les observations colligées dans l’échantillon doivent être mutuellement indépendantes, ce qui signifie que la probabilité d’occurrence de l’événement pour un individu ne doit en aucun cas être influencée par celle d’un autre participant du jeu de données. Ce postulat fondamental est irrémédiablement violé lorsque les données proviennent de protocoles longitudinaux avec mesures répétées intra-sujets (par exemple, des évaluations écologiques momentanées sur smartphone plusieurs fois par jour), de designs hiérarchiques ou de regroupements naturels (patients imbriqués au sein de différents thérapeutes, ou élèves au sein de classes scolaires distinctes). Dans ces configurations clusterisées, l’utilisation de la régression logistique standard sous-estime drastiquement les erreurs-types et produit des taux alarmants de faux positifs (erreur de type I) ; il convient alors d’abandonner le GLM simple au profit des modèles linéaires mixtes généralisés (GLMM via le package lme4) ou des équations d’estimation généralisées (GEE via geepack).
Un autre dysfonctionnement statistique potentiel propre aux données binaires regroupées (par exemple, si les données sont structurées sous forme de proportions de succès par groupe expérimental plutôt que sous forme de données individuelles Bernoulli) est le phénomène de surdispersion (overdispersion). La surdispersion caractérise une situation où la variance résiduelle empirique observée dépasse la variance théorique postulée par la loi binomiale. Elle découle fréquemment de l’omission de prédicteurs pertinents ou d’une corrélation résiduelle positive non modélisée entre les individus d’un même groupe.
Le diagnostic de surdispersion sous R s’évalue en examinant le ratio entre la déviance résiduelle du modèle et le nombre de degrés de liberté résiduels associés. Si ce quotient est substantiellement supérieur à 1 (par exemple > 1,5 ou 2,0), une surdispersion problématique est avérée. Pour restaurer l’intégrité des inférences sans modifier la valeur ponctuelle des coefficients, le statisticien peut spécifier la famille quasibinomial au sein de la fonction glm() de R. Cette spécification introduit un paramètre d’échelle libre calculé d’après les résidus de Pearson, qui repondère proportionnellement les erreurs-types des coefficients par la racine carrée du paramètre de dispersion, ajustant rigoureusement les tests d’hypothèses et les valeurs-p.
5. Ajustement du modèle de régression logistique binaire avec la fonction glm()
5.1 Syntaxe fondamentale et paramétrage du modèle univarié
Dans l’architecture native du logiciel R, l’ajustement de modèles statistiques avancés s’appuie sur une cohérence syntaxique remarquable. L’outil fondamental pour calibrer un modèle logistique binaire est la fonction glm(), acronyme de Generalized Linear Models. Contrairement à la régression linéaire simple qui fait appel à la fonction lm(), l’appel de glm() requiert la spécification formelle de la structure d’erreur distributionnelle et de la fonction de lien canonique associée, transmises par l’intermédiaire de l’argument family.
La syntaxe canonique d’un modèle univarié prédisant notre variable clinique dichotomique de rémission par le niveau d’anxiété initial se formule par l’écriture : glm(formula = remission ~ anxiete_bai, data = df_clinique, family = binomial(link = « logit »)). Le paramètre family = binomial informe le moteur computationnel que la variable dépendante est distribuée selon une loi binomiale (ou de Bernoulli dans le cas individuel), tandis que l’argument explicite link = « logit » verrouille la transformation logarithmique des cotes. Si l’argument de lien est omis, R adopte par défaut le logit pour la famille binomiale, mais sa mention explicite garantit une transparence programmatique irréprochable au sein des scripts de recherche.
L’exécution de cette commande produit un objet complexe de classe glm et lm. Pour ausculter les résultats générés, l’appel de la fonction générique summary(modele_univarie) déploie dans la console l’ensemble des composantes inférentielles : le rappel de la formule, la distribution synthétique des résidus de déviance, le tableau des coefficients estimés assortis de leurs erreurs-types asymptotiques, les statistiques de test de Wald, les valeurs-p associées, ainsi que les métriques de déviance nulle, de déviance résiduelle et le critère d’information d’Akaike (AIC).
5.2 Extension vers le modèle multivarié additif
L’ambition première de la modélisation en sciences du comportement réside dans l’estimation conjointe de multiples déterminants psychologiques et environnementaux, tout en neutralisant statistiquement l’impact de facteurs de confusion démographiques (confounders). L’extension vers le modèle logistique multivarié s’effectue dans R par l’ajout additif de termes dans la formule de régression, séparés par l’opérateur arithmétique d’addition « + ».
Considérons un modèle multivarié théoriquement motivé intégrant à la fois le score d’anxiété initiale (variable continue), le score d’alliance thérapeutique précoce (variable continue), le sous-type de dépression (facteur qualitatif à trois modalités : mélancolique, atypique, réactionnelle) et les covariables de contrôle que sont l’âge et le niveau d’éducation. La syntaxe prend alors la forme : glm(formula = remission ~ anxiete_bai + alliance_wai + subtype_dep + age + education, data = df_clinique, family = binomial(link = « logit »)). R se charge de transformer automatiquement le facteur qualitatif du sous-type dépressif en k – 1 variables binaires indicatrices, en omettant par défaut la modalité de référence pour prévenir toute singularité matricielle.
Cette approche multivariée permet de procéder à un ajustement mutuel rigoureux : le coefficient partiel obtenu pour l’alliance thérapeutique reflète l’effet propre de la qualité de la relation soignant-soigné sur la probabilité de rémission, à niveau d’anxiété initial, âge, scolarité et sous-type de trouble parfaitement constants. Il est également possible d’employer une notation abrégée sous R, telle que remission ~ ., qui ordonne d’inclure toutes les autres colonnes présentes dans la table de données comme prédicteurs. Cependant, cette pratique est vivement déconseillée dans les protocoles de recherche rigoureux, car elle risque d’incorporer à l’insu de l’analyste des identifiants de patients, des métadonnées ou des variables post-traitement constituant des collisionneurs (colliders) susceptibles de générer des biais d’endogénéité majeurs.
5.3 Sélection de modèles et critères d’information
Une question récurrente en modélisation concerne l’arbitrage entre la parcimonie du modèle (privilégier le plus petit nombre possible de paramètres) et sa complétude explicative (maximiser l’ajustement aux données empiriques). Pour comparer formellement des modèles concurrents emboîtés (c’est-à-dire un modèle restreint M1 dont les variables constituent un sous-ensemble strict d’un modèle plus étendu M2), la démarche classique repose sur l’analyse de déviance par le test du rapport de vraisemblance (Likelihood Ratio Test ou LRT). Sous R, ce test s’exécute en fournissant les deux objets de régression à la fonction anova(modele_reduit, modele_complet, test = « LRT »), qui confronte la baisse de déviance observée à la distribution du Chi-carré au prorata de la différence de degrés de liberté.
Pour la comparaison de modèles non emboîtés ou issus de théories concurrentes, les chercheurs recourent aux critères d’information pénalisés : le critère d’Akaike (AIC, Akaike Information Criterion) et le critère bayésien de Schwarz (BIC, Bayesian Information Criterion), calculables respectivement via les fonctions AIC() et BIC(). L’AIC quantifie la perte relative d’information en introduisant une pénalité égale à deux fois le nombre de paramètres estimés (2k), favorisant des modèles prédictifs riches. Le BIC applique une pénalité plus sévère proportionnelle au logarithme népérien de la taille de l’échantillon (k * ln(N)), favorisant la parcimonie et la détection de la véritable structure génératrice des données. Dans les deux cas, le modèle présentant la valeur la plus faible est considéré comme statistiquement optimal.
Il est capital de souligner les dangers méthodologiques liés aux algorithmes de sélection automatique pas-à-pas (stepwise selection ascendante, descendante ou bidirectionnelle via la fonction step()). Bien que populaires par le passé, ces procédures empiriques aveugles sont aujourd’hui massivement réprouvées par les statisticiens méthodologues. Elles exploitent le bruit d’échantillonnage, entraînent une inflation incontrôlable du taux d’erreur de type I, biaisent positivement l’amplitude des coefficients retenus et génèrent des erreurs-types artificiellement étroites en occultant l’incertitude inhérente au processus même de sélection. En psychologie clinique, la sélection des prédicteurs doit impérativement découler d’un cadre conceptuel déduit a priori, de méta-analyses préexistantes ou de diagrammes causaux orientés (DAG).
6. Interprétation statistique et psychologique des coefficients estimés
6.1 Compréhension des coefficients bruts en log-odds
L’affichage produit par la fonction summary() d’un modèle logistique génère une colonne de coefficients désignés sous l’appellation « Estimate ». L’une des difficultés pédagogiques majeures de la régression logistique réside dans le fait que ces coefficients bruts n’expriment pas des modifications directes de pourcentages ou de probabilités, mais traduisent des variations quantifiées sur l’échelle abstraite des logarithmes de cotes (log-odds). Pour interpréter correctement ces valeurs, le chercheur doit maîtriser la métrique sous-jacente.
L’ordonnée à l’origine, ou constante du modèle (beta_0, l’Intercept), représente la valeur attendue du logit de la variable réponse lorsque l’ensemble des prédicteurs continus et qualitatifs inclus dans l’équation sont strictement nuls. Si tous les prédicteurs ont été préalablement centrés sur leur moyenne empirique, l’exponentielle de cet intercepte donne la cote moyenne de base de rémission clinique dans l’échantillon. En revanche, si les variables continues ne sont pas centrées, cet intercepte peut représenter le log-odds d’un individu d’âge zéro et d’anxiété nulle, une valeur dénuée de sens psychologique mais mathématiquement nécessaire à l’ajustement du plan de régression.
Les coefficients de pente (beta_j) indiquent la variation du logarithme de cote associée à l’augmentation d’une unité de mesure sur le prédicteur X_j correspondant, toutes les autres covariables du modèle étant maintenues rigoureusement constantes. Un coefficient négatif, tel qu’un beta de -0,045 associé à l’échelle d’anxiété de Beck, indique qu’à chaque point supplémentaire d’anxiété initiale, le log-odds de rémission diminue de 0,045. Pour chaque paramètre, R calcule la statistique de Wald en divisant le coefficient estimé par son erreur-type asymptotique (z = beta / SE). Sous l’hypothèse nulle d’un effet nul dans la population parente, ce ratio suit asymptotiquement une loi normale centrée réduite N(0,1), autorisant le calcul de la valeur-p bilatérale.
6.2 Conversion en rapports de cotes (Odds Ratios) et calcul des intervalles de confiance
L’abstraction conceptuelle inhérente aux log-odds rend leur communication ardue auprès des cliniciens, des décideurs de santé et des comités éditoriaux. L’usage académique universel commande donc de transformer ces coefficients additifs en une métrique multiplicative universellement comprise : le rapport de cotes, internationalement désigné sous l’acronyme OR pour Odds Ratio. L’obtention de l’Odds Ratio s’effectue par une simple opération d’exponentiation du coefficient estimé : OR = exp(beta).
Sous R, cette transformation s’applique directement sur le vecteur des coefficients du modèle via la fonction exp(coef(modele)). Pour évaluer la précision statistique de cette estimation ponctuelle, il est obligatoire de calculer son intervalle de confiance à 95 %. Deux méthodologies computationnelles s’opposent ici : l’approche standard de Wald, qui calcule l’intervalle symétrique en ajoutant et retranchant 1,96 fois l’erreur-type avant d’exponentier (exp(confint.default(modele))), et la méthode plus robuste de la vraisemblance profilée (profile likelihood confidence intervals), invoquée nativement par la commande exp(confint(modele)). L’intervalle profilé est asymétrique et offre une couverture probabiliste nettement supérieure lorsque la taille de l’échantillon est modérée ou que les distributions sont asymétriques.
L’interprétation clinique de l’Odds Ratio s’organise rigoureusement autour du seuil critique de 1,00, qui matérialise l’absence totale d’effet :
- OR = 1,00 : L’exposition au prédicteur ne modifie en rien la cote d’occurrence de l’événement clinique. L’hypothèse nulle ne peut être rejetée.
- OR > 1,00 : Le prédicteur agit comme un facteur favorisant ou protecteur. Par exemple, un OR de 1,35 pour l’alliance thérapeutique indique qu’à chaque point supplémentaire gagné sur l’échelle WAI, la cote d’obtenir une rémission augmente de 35 % (calculé par (OR – 1) * 100), toutes choses étant égales par ailleurs.
- OR < 1,00 : Le prédicteur constitue un facteur de risque ou d’inhibition. Un OR de 0,80 pour un indicateur de sévérité signifie que chaque unité additionnelle réduit la cote de rémission de 20 % (calculé par (1 – OR) * 100).
6.3 Traduction substantielle des résultats dans le cadre de la recherche clinique
L’une des dérives d’interprétation les plus fréquentes dans la littérature psychologique consiste à confondre délibérément l’Odds Ratio avec le Risque Relatif (RR). Le Risque Relatif représente le rapport de deux probabilités absolues, tandis que l’Odds Ratio représente le rapport de deux cotes. Lorsque l’événement cible est rare dans la population étudiée (prévalence < 5 % ou 10 %), l’OR approxime fidèlement le RR. En revanche, dès lors que l’événement est fréquent (comme dans notre échantillon où la rémission touche 40 % des patients), l’Odds Ratio s’éloigne drastiquement du Risque Relatif et tend à exagérer de façon spectaculaire la magnitude de l’effet clinique perçu. Qualifier un OR de 2,50 de « deux fois et demie plus de probabilité de guérir » constitue une faute méthodologique majeure : cela signifie seulement que la cote (le rapport succès/échec) est multipliée par 2,50.
Une autre précaution capitale concerne l’amplitude de l’unité de mesure sur les échelles psychométriques. Lorsqu’un inventaire clinique comprend une échelle totale variant de 0 à 100 points, l’effet associé à une augmentation infinitésimale d’une seule unité (un point d’anxiété) est mathématiquement minuscule, produisant fréquemment des Odds Ratios trompeurs compris entre 0,98 et 1,02, qui peuvent sembler négligeables au praticien bien qu’ils soient hautement significatifs. Pour redonner une pertinence clinique substantielle aux estimations, le chercheur a tout intérêt à standardiser au préalable ses prédicteurs continus (scores z centrés-réduits, moyenne = 0, écart-type = 1). L’Odds Ratio ainsi calculé reflète l’impact d’une élévation d’un écart-type complet sur le score du patient, offrant une métrique d’effet standardisée immédiatement comparable entre différents instruments d’évaluation clinique.
7. Modélisation des interactions et effets modérateurs sous R
7.1 Formulation théorique de la modération en régression logistique
Dans la recherche contemporaine en psychologie du développement, en psychopathologie et en psychologie clinique, les modèles théoriques postulent rarement des liens causaux directs et universels. Ils s’articulent préférentiellement autour d’hypothèses de vulnérabilité-stress (diathèse-stress) ou de plasticité différentielle, postulant que l’effet d’un facteur de risque psychologique ou génétique sur une issue clinique dépend directement du niveau d’une seconde variable, dénommée modérateur (par exemple, le soutien social ou la résilience psychologique). En modélisation statistique, cette modération se traduit par l’introduction d’un terme d’interaction multiplicatif entre les deux variables explicatives.
Une distinction fondamentale doit être immédiatement posée concernant la nature non linéaire de la régression logistique. Alors que dans un modèle de régression linéaire classique, l’absence d’interaction implique que l’effet marginal est strictement identique pour tous les individus, en régression logistique, un modèle purement additif sur l’échelle des log-odds est déjà non additif et interactif sur l’échelle des probabilités absolues. En effet, l’impact d’une modification d’un point d’anxiété sur la probabilité absolue dépend mécaniquement de l’endroit où se situe l’individu sur la sigmoïde. Lorsque nous modélisons une interaction formelle sous R, nous testons une déviation par rapport à la stricte additivité sur l’échelle du logit, ce qui correspond à une modification multiplicative de l’Odds Ratio à travers les niveaux du modérateur.
Dans la syntaxe du langage R, la spécification d’un effet d’interaction s’opère au moyen de deux opérateurs distincts. L’opérateur deux-points « : » calcule exclusivement le terme produit de niveau supérieur entre deux variables (par exemple, anxiete:soutien_social). L’opérateur astérisque « * » constitue un raccourci syntaxique précieux : l’instruction anxiete * soutien_social indique à R d’inclure simultanément les effets simples de chaque variable ainsi que leur terme d’interaction croisé (équivalent strict à l’écriture anxiete + soutien_social + anxiete:soutien_social). Il est indispensable de ne jamais omettre les effets simples lorsque leur interaction est incluse dans l’équation, sous peine de violer le principe de hiérarchie marginale et de produire des coefficients d’interaction biaisés et non interprétables.
7.2 Ajustement et évaluation statistique du modèle avec interaction
L’introduction de termes produits entre variables quantitatives continues génère inévitablement une multicolinéarité structurelle mécanique entre les termes de premier ordre et leur produit multiplicatif. Bien que cette colinéarité artificielle n’altère en rien l’ajustement global du modèle, l’estimation du terme d’interaction ou le calcul des probabilités prédites, elle bouleverse radicalement l’interprétation des effets dits « principaux ». Dans un modèle comportant l’interaction X * Z, le coefficient associé à X n’exprime plus du tout l’effet moyen de X sur l’ensemble de l’échantillon, mais représente l’effet conditionnel de X uniquement pour le sous-groupe précis chez qui la variable Z prend rigoureusement la valeur zéro.
Pour conférer une intelligibilité immédiate aux paramètres du modèle, la démarche méthodologique standard consiste à centrer les variables continues sur leur moyenne d’échantillon avant de calculer l’interaction, ou d’utiliser des scores standardisés. Grâce au centrage préalable, le coefficient de premier ordre de l’anxiété s’interprète désormais comme l’effet de l’anxiété chez un patient présentant un niveau moyen de soutien social, ce qui restitue une pertinence clinique immédiate aux tests de Wald affichés dans le résumé statistique.
Pour statuer formellement sur l’apport explicatif de l’effet de modération, la simple inspection de la valeur-p de Wald associée au terme interactif peut s’avérer insuffisante, particulièrement dans les échantillons de taille modeste. Il est hautement recommandé de confronter le modèle additif sans interaction au modèle élargi incluant l’interaction par le biais d’un test du rapport de vraisemblance (LRT), via la syntaxe : anova(modele_additif, modele_interaction, test = « LRT »). Une réduction statistiquement significative de la déviance globale atteste que la modération améliore véritablement la capacité prédictive du modèle clinique au-delà du simple effet cumulatif des prédicteurs isolés.
7.3 Visualisation et analyse des pentes simples (Simple Slopes Analysis)
L’analyse d’une interaction statistiquement significative ne saurait s’arrêter à la lecture du signe de son coefficient produit ; elle requiert impérativement une décomposition clinique approfondie à travers l’analyse des pentes simples (simple slopes analysis). Cette méthode consiste à examiner la force, la direction et la significativité statistique de la relation entre le prédicteur central et la variable dépendante à différents niveaux stratégiques fixés de la variable modératrice. Par convention psychométrique, on étudie généralement l’effet conditionnel du prédicteur à trois niveaux du modérateur : à la moyenne de l’échantillon, à un écart-type en dessous de la moyenne (représentant un niveau bas de la caractéristique), et à un écart-type au-dessus de la moyenne (représentant un niveau élevé).
Pour exécuter ces calculs complexes et extraire les contrastes conditionnels sous R, le package emmeans (Estimated Marginal Means) s’impose comme l’outil d’excellence. La fonction emtrends() permet de calculer les pentes linéaires du logit en fonction des différentes valeurs cibles du modérateur, et de convertir ces contrastes en Odds Ratios conditionnels avec leurs intervalles de confiance respectifs. Cette analyse permet par exemple de démontrer que chez les patients bénéficiant d’un soutien social élevé (+1 SD), l’anxiété initiale n’exerce plus aucun impact délétère sur la rémission (OR conditionnel proche de 1,00, non significatif), alors que chez les individus isolés (-1 SD), une anxiété élevée s’avère massivement pénalisante pour le pronostic thérapeutique.
La compréhension pleine et entière de la modération exige une transcription graphique soignée. L’utilisation conjointe des bibliothèques interactions (via la fonction interact_plot()) ou sjPlot (via plot_model()) permet de générer des figures de haute qualité publiable. Ces outils tracent sur l’axe des ordonnées les probabilités absolues prédites d’atteindre la rémission clinique en fonction du score continu d’anxiété sur l’axe des abscisses, en projetant des courbes distinctes pour les différents niveaux du modérateur accompagnées de leurs bandes de confiance à 95 %. Ces représentations révèlent immédiatement la non-linéarité inhérente au modèle logistique et la façon dont le modérateur amplifie ou tamponne la réponse thérapeutique.
8. Évaluation de la qualité d’ajustement globale du modèle (Goodness-of-Fit)
8.1 Analyse de la déviance globale et test du rapport de vraisemblance
L’estimation des coefficients de régression étant achevée, l’évaluation de la validité scientifique d’un modèle logistique requiert l’examen de sa performance globale : dans quelle mesure le modèle théorique spécifié parvient-il à rendre compte des données réelles observées dans l’échantillon clinique comparativement à une situation d’ignorance totale ? Dans le cadre des modèles linéaires généralisés, la mesure cardinale de l’erreur d’ajustement est la déviance, qui se conceptualise comme l’équivalent de la somme des carrés des erreurs de la régression linéaire classique, mesurée sur l’échelle logarithmique.
R fournit systématiquement deux indicateurs de déviance dans les sorties d’un GLM :
- La déviance nulle (Null Deviance) : Elle quantifie l’erreur globale d’ajustement d’un modèle ne comportant aucun prédicteur, se résumant uniquement à sa constante (l’intercepte). Elle reflète la variabilité totale présente dans les données empiriques.
- La déviance résiduelle (Residual Deviance) : Elle mesure la variabilité résiduelle inexpliquée persistante une fois que l’ensemble des prédicteurs psychométriques et sociodémographiques ont été incorporés dans l’équation de prédiction.
Le test omnibus de validité du modèle consiste à calculer la différence arithmétique entre la déviance nulle et la déviance résiduelle, souvent désignée sous le nom de statistique de déviance du modèle (G = Déviance nulle – Déviance résiduelle). Sous l’hypothèse nulle stipulant que tous les coefficients de pente du modèle sont conjointement égaux à zéro dans la population, cette statistique suit asymptotiquement une loi du Chi-carré dont les degrés de liberté correspondent au nombre de paramètres estimés (hors intercepte). La commande sous R : pchisq(modele$null.deviance – modele$deviance, df = modele$df.null – modele$df.residual, lower.tail = FALSE) permet d’extraire la valeur-p exacte de ce test omnibus. Une valeur-p inférieure à 0,001 indique que le modèle multivarié réduit de façon hautement significative l’erreur de prédiction par rapport au modèle de base purement aléatoire.
8.2 Indices de pseudo-R² et interprétation de la variance expliquée
Dans la communication des résultats de recherche, les praticiens et relecteurs issus de la tradition corrélationnelle sollicitent presque systématiquement la mention d’un coefficient de détermination R² pour évaluer la part de variance expliquée. Or, en régression logistique binaire, la variable réponse ne possédant pas une variance continue observable, le coefficient R² conventionnel des moindres carrés n’existe pas. Pour combler cette attente d’estimation de taille d’effet globale, les statisticiens ont formalisé plusieurs métriques d’approximation désignées sous le vocable d’indices de pseudo-R².
Le pseudo-R² le plus rigoureux et le plus recommandé d’un point de vue théorique est le pseudo-R² de McFadden, fondé directement sur la comparaison des log-vraisemblances : McFadden R² = 1 – (ln(L_modele) / ln(L_nul)). Cet indice compare la log-vraisemblance du modèle ajusté à celle du modèle restreint à la constante. Le package pscl sous R permet d’extraire l’ensemble de ces indices via la fonction pR2(modele). Contrairement au R² linéaire classique, les valeurs du R² de McFadden sont intrinsèquement plus modestes : un indice compris entre 0,20 et 0,40 reflète déjà un ajustement exceptionnellement satisfaisant de la dynamique comportementale étudiée.
D’autres alternatives populaires incluent le R² de Cox et Snell, basé sur la réduction de déviance normalisée par la taille d’échantillon, et sa correction mathématique développée par Nagelkerke. La formule originelle de Cox et Snell présente le désavantage structurel de ne jamais pouvoir atteindre la valeur théorique maximale de 1,00, même dans le cas d’un ajustement parfait sans la moindre erreur de prédiction. Nagelkerke a donc introduit un facteur de normalisation divisant l’indice par sa borne supérieure théorique. Toutefois, le chercheur doit se garder de considérer ces pseudo-R² comme une stricte « proportion de variance expliquée » au sens de la variance d’un signal gaussien ; il s’agit d’indices de concordance empirique et de réduction relative d’incertitude informationnelle.
8.3 Test de calibrage de Hosmer-Lemeshow
L’évaluation globale d’un modèle logistique ne saurait se limiter à sa capacité à expliquer la variance ; elle impose de vérifier minutieusement son calibrage (calibration). Le calibrage évalue la concordance numérique directe entre les probabilités individuelles prédites par le modèle mathématique et les taux de succès réels observés au sein de sous-groupes de patients. Un modèle parfaitement calibré assignant une probabilité de rémission de 70 % à un ensemble d’individus doit constater empiriquement qu’environ 70 % de ces mêmes individus connaissent effectivement une issue thérapeutique favorable.
L’approche classique la plus répandue pour tester cette propriété est le test de Hosmer-Lemeshow. La procédure consiste à classer l’ensemble des participants par ordre croissant de leurs probabilités prédites, puis à scinder l’échantillon en un nombre déterminé de groupes d’effectifs égaux (usuellement dix déciles de risque, g = 10). Au sein de chaque décile, le test compare les effectifs observés de succès et d’échecs aux effectifs théoriques prédits par le modèle via une statistique du Chi-carré de Pearson spécifique dotée de g – 2 degrés de liberté. Sous R, ce test est implémenté au sein du package ResourceSelection à travers l’instruction hoslem.test(x = modele$y, y = fitted(modele), g = 10).
Une précaution interprétative majeure s’impose ici : à l’inverse de la majorité des tests statistiques où l’on convoite une valeur-p significative pour rejeter l’hypothèse nulle, le test de Hosmer-Lemeshow postule l’adéquation parfaite entre prédictions et observations sous son hypothèse nulle H0. Par conséquent, l’obtention d’une valeur-p non significative (p > 0,05) est recherchée, témoignant de l’absence d’écart systématique inacceptable entre le modèle et la réalité empirique. Toutefois, ce test subit d’importantes critiques méthodologiques : il présente une sensibilité excessive à la taille de l’échantillon (devenant presque systématiquement significatif dans les très grandes cohortes pour des déviations infimes) et son résultat dépend arbitrairement du nombre de déciles g sélectionné. Dans les analyses contemporaines, il est judicieusement complété par des courbes de calibration flexibles basées sur des régressions non paramétriques (loess).
9. Diagnostics des résidus et détection des observations influentes
9.1 Calcul et analyse graphique des résidus de Pearson et de déviance
Dans le cadre linéaire classique, les résidus ordinaires bruts (y_i – y_chapeau_i) fournissent une indication directe sur la qualité de l’ajustement local. En régression logistique binaire, ces résidus bruts ne peuvent prendre que deux valeurs possibles pour une valeur prédite donnée : (1 – p_i) si l’événement s’est produit, ou (0 – p_i) s’il ne s’est pas produit. La distribution des résidus bruts est donc intrinsèquement discontinue et hétéroscédastique, rendant leur inspection directe totalement inappropriée pour détecter des anomalies de spécification. Pour pallier cette difficulté, la théorie des GLM définit des résidus standardisés adaptés.
Les résidus de Pearson divisent le résidu brut par l’écart-type théorique de la distribution de Bernoulli locale : r_P = (y_i – p_i) / racine(p_i * (1 – p_i)). Bien qu’ils standardisent l’échelle, les résidus de déviance (deviance residuals) leur sont généralement préférés car leur somme quadratique reconstitue très exactement la déviance résiduelle globale du modèle. Chaque résidu de déviance r_D_i mesure la contribution individuelle de l’observation à la déviance totale. Sous R, les résidus standardisés se récupèrent sans peine via les fonctions rstandard(modele, type = « deviance ») ou rstudent(modele).
L’examen diagnostique repose sur la projection graphique de ces résidus standardisés en fonction des probabilités prédites ou de l’indice des observations. Dans un modèle convenablement spécifié, les résidus standardisés doivent se distribuer de façon aléatoire le long de deux bandes horizontales (l’une pour y = 0, l’autre pour y = 1), sans concentration aberrante au-delà des limites critiques de -2 et +2 (ou -3 et +3 pour des seuils plus conservateurs). L’apparition de courbures systématiques ou d’asymétries massives dans ces tracés résiduels signale généralement l’omission d’une non-linéarité fondamentale ou la présence de sous-populations cliniques non modélisées.
9.2 Identification des valeurs aberrantes et des leviers (Leverage)
Une observation peut présenter une valeur singulière ou atypique sur ses prédicteurs sans que cela ne perturbe nécessairement l’équation de régression, ou au contraire exercer une contrainte disproportionnée sur la topologie du plan d’ajustement. Pour analyser cette dynamique, il convient de quantifier l’effet de levier (leverage) de chaque participant. L’effet de levier mesure l’éloignement d’une observation par rapport au centre de gravité multidimensionnel de l’espace vectoriel formé par l’ensemble des covariables indépendantes.
Dans l’environnement computationnel de R, les valeurs de levier se calculent à partir de la diagonale principale de la matrice chapeau étendue aux GLM (hat matrix), et s’extraient via l’instruction hatvalues(modele). Ces valeurs, traditionnellement notées h_ii, sont strictement positives et leur somme totale équivaut au nombre total de paramètres estimés (p) au sein du modèle. La valeur de levier moyenne pour un individu s’établit par conséquent à p / N, où N représente la taille de l’échantillon d’étude.
Les standards méthodologiques définissent des règles décisionnelles précises : une observation est identifiée comme possédant un levier potentiellement problématique lorsque sa statistique h_ii excède le double ou le triple du levier moyen (soit h_ii > 2p / N ou 3p / N). Une observation clinique présentant un score d’anxiété exceptionnellement extrême combiné à un âge très atypique bénéficiera d’un levier mathématique massif. Toutefois, un fort levier n’implique pas obligatoirement une anomalie : si la trajectoire clinique de ce patient atypique est rigoureusement conforme aux prédictions du modèle logistique général, sa présence ne fait que conforter l’estimation des paramètres.
9.3 Distance de Cook et statistiques DFBETAS
Le danger méthodologique majeur pour la validité d’une recherche ne provient pas des points de fort levier isolés, mais des observations influentes : des participants qui combinent à la fois un résidu standardisé important (mauvais ajustement local) et un levier substantiel (position excentrée). Ces individus singuliers exercent une attraction démesurée sur les coefficients de régression, au point que leur simple présence ou omission peut basculer un Odds Ratio d’une valeur significative vers la non-significativité, ou en inverser la polarité théorique.
Pour mesurer de manière globale l’influence exercée par chaque individu sur la totalité du vecteur des coefficients de régression, la distance de Cook adaptée aux GLM s’avère l’indicateur universel. Elle quantifie le décalage quadratique induit sur l’ensemble des probabilités prédites si l’observation venait à être intégralement retranchée de l’échantillon d’apprentissage. L’extraction sous R s’exécute par cooks.distance(modele). Bien que le seuil critique conservateur hérité de la régression linéaire fixe l’alerte à une distance de Cook supérieure à 1,0, ce seuil est quasiment inaccessible dans les grands échantillons cliniques. Les analystes préconisent plutôt d’examiner le seuil empirique de 4 / (N – p – 1) ou de repérer visuellement les points se détachant nettement du reste de la distribution sur un graphique généré par plot(modele, which = 4).
Pour approfondir le diagnostic à l’échelle de chaque prédicteur individuel, les statistiques DFBETAS mesurent l’amplitude du changement subi par chaque coefficient spécifique beta_j, standardisé par son erreur-type, lors de l’exclusion de l’individu i (obtenues sous R par dfbetas(modele)). Tout DFBETAS dont la valeur absolue excède le seuil de 2 / racine(N) révèle un individu déformant unilatéralement l’effet clinique d’un prédicteur donné. Face à de tels cas influents, le chercheur ne doit en aucun cas procéder à une suppression aveugle et opportuniste. Il convient de vérifier l’absence d’erreurs matérielles de saisie, d’examiner le profil psychopathologique singulier du patient, et de réaliser une analyse de sensibilité rigoureuse documentant la stabilité des résultats avec et sans l’inclusion de ces observations critiques au sein du rapport de recherche.
10. Calcul des probabilités prédites et optimisation de la matrice de confusion
10.1 Génération et distribution des probabilités estimées
Au-delà de l’interprétation théorique des Odds Ratios à l’échelle de la population, la régression logistique offre une utilité fondamentale pour la médecine personnalisée et l’évaluation psychologique individuelle : elle permet de calculer la probabilité prédite d’occurrence de l’événement clinique pour n’importe quel profil de covariables spécifique. L’extraction de ces probabilités pour l’ensemble des individus de l’échantillon sous R s’exécute à l’aide de la fonction générique predict().
Une précaution de programmation capitale doit être soulignée : par défaut, l’instruction predict(modele) calcule les prédictions sur l’échelle de la fonction de lien linéaire, renvoyant les log-odds prédits (équivalent à type = « link »). Pour obtenir les probabilités absolues d’occurrence comprises dans l’intervalle [0, 1], il est impératif d’adjoindre l’argument type = « response » : probabilites <- predict(modele, type = « response »). Ces valeurs peuvent être intégrées directement au tableau de données initial pour des analyses personnalisées.
L’inspection de la distribution des probabilités prédites, ventilée selon l’état réel des patients, constitue un diagnostic qualitatif de discrimination remarquable. À l’aide de ggplot2, le chercheur peut superposer les courbes de densité ou tracer des histogrammes semi-transparents des probabilités ajustées pour les deux groupes cliniques réels. Un modèle performant générera une distribution bimodale nettement ségrégée : les patients n’ayant pas atteint la rémission présenteront des densités massées au voisinage de zéro, tandis que les patients en rémission se concentreront vers le pôle de probabilité 1,0. Le degré de chevauchement entre ces deux densités délimite très exactement la zone d’incertitude décisionnelle maximale du modèle.
10.2 Construction de la matrice de confusion et métriques de classification
Pour convertir les probabilités prédites continues en une décision de classification binaire opérationnelle (par exemple, catégoriser un patient comme futur répondeur ou non-répondeur au traitement), il est nécessaire de fixer un seuil décisionnel ou seuil de coupure (cutoff value, noté c). Par convention historique, le seuil standard est arbitrairement fixé à c = 0,50 : tout individu dont la probabilité prédite est supérieure ou égale à 0,50 est prédit comme appartenant au groupe cible (1), tandis que ceux dont la probabilité est strictement inférieure à 0,50 sont assignés au groupe de référence (0).
La confrontation systématique entre les classes ainsi prédites par le modèle et les statuts pathologiques réels des participants donne naissance à la matrice de confusion (tableau 2×2). De ce croisement résultent quatre issues empiriques fondamentales :
- Les Vrais Positifs (VP) : Patients en rémission réelle correctement classés en rémission par le modèle.
- Les Vrais Négatifs (VN) : Patients non-répondeurs réels correctement identifiés comme tels.
- Les Faux Positifs (FP, Erreur de Type I) : Patients n’ayant pas guéri que le modèle a pourtant prédits à tort comme répondeurs.
- Les Faux Négatifs (FN, Erreur de Type II) : Patients en rémission réelle tragiquement omis par le modèle et classés en échec.
L’exploitation de cette matrice repose sur le calcul de métriques opérationnelles standardisées. La sensibilité (Sensitivity ou taux de vrais positifs) correspond à la proportion d’événements réels correctement repérés : VP / (VP + FN). La spécificité (Specificity ou taux de vrais négatifs) mesure la proportion de non-événements réels correctement écartés : VN / (VN + FP). La valeur prédictive positive (VPP ou précision) désigne la probabilité qu’un individu prédit positif le soit réellement : VP / (VP + FP), tandis que la valeur prédictive négative (VPN) quantifie l’assurance qu’un individu prédit négatif soit véritablement indemne : VN / (VN + FN). L’exactitude globale (Accuracy) résume le pourcentage total de classifications correctes : (VP + VN) / Total. Le package caret sous R simplifie ces calculs exhaustifs par la fonction confusionMatrix(data = factor(predictions_binaires), reference = factor(donnees$remission), positive = « 1 »).
10.3 Optimisation du seuil décisionnel selon le coût des erreurs cliniques
L’application rigide et aveugle du seuil par défaut de c = 0,50 constitue l’une des lacunes décisionnelles les plus sévères observées dans les publications biomédicales. Ce seuil arbitraire ne repose sur aucune justification statistique intrinsèque : il part du postulat implicite que la distribution des classes dans la population est parfaitement équilibrée (50/50) et que le coût clinique, humain et financier d’une erreur par faux positif est strictement équivalent au coût d’un faux négatif. Or, ces deux postulats sont quasi systématiquement faux en psychologie clinique.
Dans le dépistage d’un risque suicidaire ou d’un déclin cognitif précoce, commettre un faux négatif (ne pas détecter une personne à risque imminent de passage à l’acte, la laissant sans surveillance médicale) entraîne des conséquences infiniment plus dramatiques que de commettre un faux positif (orienter temporairement un patient sain vers une évaluation psychiatrique approfondie). Dans ce contexte d’asymétrie majeure des coûts du préjudice, le clinicien doit abaisser délibérément le seuil décisionnel (par exemple à c = 0,20 ou 0,30), maximisant la sensibilité du modèle au détriment assumé de sa spécificité.
Pour optimiser mathématiquement ce seuil en l’absence de pondération monétaire des erreurs, la méthode la plus élégante repose sur la maximisation de l’indice de Youden (J). L’indice de Youden est défini pour chaque seuil potentiel par l’équation : J = Sensibilité + Spécificité – 1. Le seuil optimal de Youden correspond au point géométrique de la performance discriminante qui maximise conjointement la sensibilité et la spécificité, accordant un poids symétrique aux deux composantes de validité. Le calcul automatisé de ce seuil idéal s’exécute sous R via le package pROC par l’instruction : coords(courbe_roc, « best », best.method = « youden »).
11. Validation croisée et évaluation discriminante par la courbe ROC
11.1 Tracé et analyse de la courbe ROC avec le package pROC
Pour s’affranchir définitivement de la dépendance envers un seuil décisionnel arbitraire, l’évaluation de la performance prédictive globale d’un modèle logistique recourt universellement à la courbe ROC, acronyme de Receiver Operating Characteristic. Développée initialement par les ingénieurs des transmissions radar durant la Seconde Guerre mondiale pour distinguer les signaux d’aéronefs ennemis du bruit de fond météorologique, cette méthodologie graphique a été adoptée par la psychophysique et l’épidémiologie clinique pour évaluer l’exactitude des systèmes diagnostiques continus.
La courbe ROC est une représentation bidimensionnelle générée en faisant varier le seuil de décision c de façon continue sur l’ensemble du continuum des probabilités prédites, de 0 à 1. Pour chaque seuil infinitésimal testé, on calcule et projette le taux de vrais positifs (la sensibilité) sur l’axe vertical des ordonnées, face au taux de faux positifs (égal à 1 – la spécificité) sur l’axe horizontal des abscisses. La courbe démarre obligatoirement à l’origine (0, 0), où le seuil c = 1 ne classifie aucun individu comme positif (sensibilité nulle, zéro faux positif), et se termine à l’angle supérieur droit (1, 1), où le seuil c = 0 prédit tous les individus comme positifs (sensibilité maximale mais taux de faux positifs de 100 %).
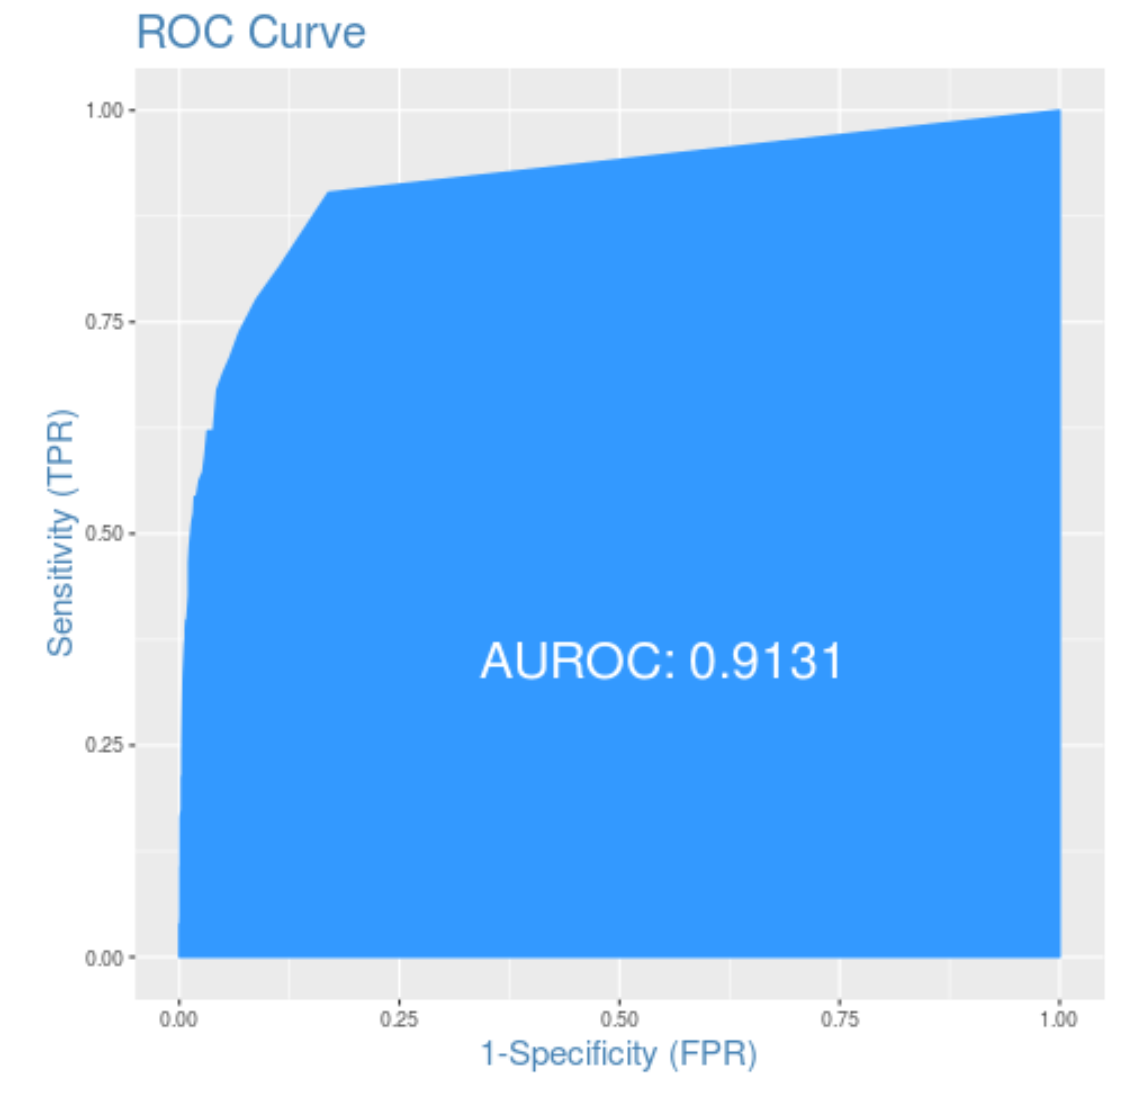
Sous R, le paquetage pROC offre une infrastructure complète pour tracer et personnaliser ces courbes. Après avoir modélisé l’objet ROC par la commande roc_obj <- roc(response = df_clinique$remission, predictor = fitted(modele), ci = TRUE), le tracé graphique se déploie par un appel à la fonction plot(roc_obj) ou par son intégration au sein de calques ggplot2 via la fonction ggroc(). L’inclusion des intervalles de confiance à 95 % sous forme de rubans ombrés encadrant la trajectoire de la courbe, calculés par ré-échantillonnage par bootstrap, offre une appréciation visuelle rigoureuse de la marge d’erreur d’échantillonnage.
11.2 Interprétation substantielle de l’aire sous la courbe (AUC)
La synthèse quantitative de la capacité discriminante d’un modèle logistique est formalisée par le calcul de l’Aire Sous la Courbe (AUC, Area Under the Curve), qui équivaut rigoureusement à la statistique de concordance C (C-statistic). L’AUC possède une signification probabiliste concrète : si l’on extrait aléatoirement dans la population un patient ayant effectivement atteint la rémission et un patient n’y étant pas parvenu, l’AUC représente la probabilité exacte que le modèle assigne une probabilité prédite de rémission plus élevée au patient répondeur qu’au patient non-répondeur.
L’échelle métrique de l’AUC s’étend théoriquement de 0,50 à 1,00. Une AUC strictement égale à 0,50 indique une absence totale de pouvoir discriminant, le modèle produisant des prédictions équivalentes à un tirage à pile ou face (représenté graphiquement par la diagonale d’invariance joignant (0,0) à (1,1)). Les repères diagnostiques établis par Hosmer et Lemeshow font autorité dans la littérature académique :
- 0,50 < AUC < 0,70 : Discrimination médiocre ou faible, insuffisante pour orienter une décision clinique individuelle.
- 0,70 ≤ AUC < 0,80 : Discrimination acceptable, fréquente et recevable pour des modèles explicatifs en sciences comportementales.
- 0,80 ≤ AUC < 0,90 : Discrimination excellente, témoignant d’un instrument pronostique robuste.
- AUC ≥ 0,90 : Discrimination exceptionnelle, rarement observée en psychologie sans la présence suspecte d’un prédicteur redondant ou d’une fuite d’information (data leakage).
Le package pROC permet en outre de comparer formellement la performance discriminante de deux modèles logistiques concurrents ajustés sur le même échantillon (par exemple, un modèle de base intégrant uniquement les facteurs démographiques versus un modèle enrichi incorporant les scores psychométriques et l’alliance thérapeutique). L’exécution du test non paramétrique de DeLong via l’instruction : roc.test(roc_modele1, roc_modele2, method = « delong ») confronte statistiquement la divergence des deux surfaces sous la courbe et délivre une valeur-p certifiant si l’ajout des dimensions psychologiques confère un gain diagnostique incrémentiel statistiquement probant.
11.3 Validation croisée à k-blocs (k-fold Cross-Validation)
L’évaluation de la performance prédictive et du pouvoir discriminant d’un modèle de régression réalisée sur l’échantillon même qui a servi à estimer ses paramètres mathématiques souffre d’un vice méthodologique majeur : le biais d’optimisme d’échantillonnage. En cherchant à maximiser la vraisemblance sur les données disponibles, l’algorithme capte inévitablement les singularités idiosyncrasiques et le bruit d’échantillonnage propre à cette cohorte spécifique, un phénomène connu sous le terme de surajustement (overfitting). Présenter l’AUC apparente d’apprentissage comme le reflet de la qualité du modèle surestime systématiquement son efficacité réelle lorsqu’il sera déployé sur de nouveaux patients en pratique courante.
Pour mesurer la capacité de généralisation hors échantillon (out-of-sample performance), la démarche méthodologique de référence est la validation croisée à k-blocs (k-fold Cross-Validation), communément paramétrée avec 5 ou 10 blocs (k = 10). La méthode procède en fragmentant aléatoirement l’échantillon clinique de N participants en 10 sous-ensembles d’effectifs égaux et mutuellement exclusifs. À chaque itération, 9 blocs sont combinés pour servir d’échantillon d’entraînement sur lequel le modèle logistique est réajusté, tandis que le 10e bloc restant est scrupuleusement préservé pour servir de jeu de test indépendant. Le modèle ajusté prédit alors les probabilités pour les participants de ce bloc test, qui n’ont jamais participé à l’estimation des coefficients.
Cette boucle computationnelle est répétée 10 fois, chaque sous-ensemble jouant tour à tour le rôle de jeu de test. La concaténation finale des prédictions hors-échantillon permet de calculer une AUC validée par croisement exempte de biais d’optimisme. Sous R, la bibliothèque caret automatise cette séquence méthodologique à travers la fonction trainControl(method = « cv », number = 10, classProbs = TRUE, summaryFunction = twoClassSummary) couplée à la fonction train(…, method = « glm », family = « binomial »). Si l’AUC apparente sur l’échantillon complet s’élevait à 0,84 et que l’AUC obtenue par validation croisée à 10 blocs se maintient à 0,82, le chercheur a la démonstration empirique formelle de la stabilité et de la robustesse pronostique de son modèle face à de futures données cliniques non observées.
12. Rédaction académique des résultats et directives de présentation aux normes APA 7
12.1 Conception des tableaux récapitulatifs selon les normes APA
La transcription des résultats d’une régression logistique binaire au sein d’un manuscrit soumis aux revues de l’APA (telles que le Journal of Consulting and Clinical Psychology ou Psychological Assessment) est assujettie à des normes typographiques et structurelles inflexibles codifiées dans le manuel de style APA 7e édition. Un tableau statistique ne doit comporter aucune ligne verticale de séparation et ne tolère que trois lignes horizontales principales de pleine largeur : une délimitant le sommet de l’en-tête, une séparant l’en-tête du corps des résultats, et une clôturant la base du tableau au-dessus des notes infrapaginales.
Le tableau récapitulatif d’un modèle logistique doit présenter les colonnes ordonnées selon la séquence formelle standardisée suivante :
- Variable explicative : Intitulé clair de chaque prédicteur, avec indication explicite de la catégorie de référence pour les facteurs qualitatifs.
- B : Le coefficient brut de régression logit estimé (arrondi à deux ou trois décimales constantes).
- SE B : L’erreur-type asymptotique associée au coefficient B.
- Wald chi2 (ou z) : La statistique de test de Wald évaluant la significativité du prédicteur.
- p : La valeur-p exacte (sans zéro devant la virgule selon la règle APA pour les valeurs bornées à 1, par exemple .004, et notée p < .001 si elle est inférieure à un millième).
- Odds Ratio (OR) : L’exponentielle du coefficient B (parfois désigné sous le terme de Risque Relatif Estimé).
- 95% IC pour OR : L’intervalle de confiance à 95 % de l’Odds Ratio, présenté sous la forme [Borne Inf, Borne Sup].
Pour s’affranchir des fastidieuses et périlleuses opérations manuelles de recopie de nombres vers un traitement de texte, l’écosystème R moderne intègre des bibliothèques dédiées à l’édition automatisée de tableaux de publication conformes aux critères de l’APA. La bibliothèque gtsummary permet, par l’entremise de la commande tbl_regression(modele, exponentiate = TRUE), de générer directement un tableau impeccablement mis en forme, incorporant automatiquement les Odds Ratios, leurs intervalles de confiance et les valeurs-p formatées selon les canons académiques. Ces tableaux peuvent ensuite être exportés directement vers des formats Word (.docx) ou LaTeX sans rupture de la chaîne de reproductibilité.
12.2 Formulation textuelle rigoureuse dans la section Résultats
L’exposé narratif des résultats au sein de la section dédiée du rapport de recherche doit respecter une articulation rhétorique rigoureuse, progressant de la validation macroscopique globale du modèle vers le décryptage microscopique de chaque prédicteur individuel. Le texte doit débuter par le rappel explicite du test omnibus de rapport de vraisemblance, des degrés de liberté, de la valeur du Chi-carré et du niveau de significativité, complété par la mention des indices d’adéquation globale (test de Hosmer-Lemeshow et pseudo-R² de McFadden ou Nagelkerke).
Voici un canevas exemplaire de rédaction conforme aux normes APA 7 :
« Une régression logistique binaire multivariée a été réalisée pour évaluer l’impact des scores d’anxiété initiale, de l’alliance thérapeutique précoce et de la typologie dépressive sur la probabilité de rémission clinique complète après 16 semaines de thérapie cognitive et comportementale. Le modèle global incluant l’ensemble des prédicteurs s’avère statistiquement significatif comparativement au modèle nul, chi2(5, N = 600) = 84,32, p < .001, attestant que les variables prédictives permettent de discriminer significativement les patients en rémission des patients non répondeurs. L’ajustement global du modèle aux données empiriques est satisfaisant, comme en témoigne le test de calibrage de Hosmer-Lemeshow, chi2(8) = 6,45, p = .597, et le modèle parvient à rendre compte d’une part substantielle de variabilité (pseudo-R2 de Nagelkerke = .325 ; pseudo-R2 de McFadden = .218). L’aire sous la courbe ROC évaluée par validation croisée à 10 blocs s’établit à AUC = .812, IC à 95 % [.776, .848], démontrant une excellente capacité de discrimination clinique hors-échantillon. »
La section doit ensuite expliciter les résultats analytiques associés aux prédicteurs cibles :
« L’analyse des contributions individuelles révèle que l’alliance thérapeutique précoce constitue un prédicteur positif indépendant majeur de la rémission clinique (B = 0,084, SE = 0,019, z = 4,42, p < .001). Toutes choses étant égales par ailleurs, chaque point supplémentaire sur l’échelle WAI est associé à une augmentation de 8,8 % de la cote d’atteindre une rémission (OR = 1,088, IC à 95 % [1,048, 1,129]). Inversement, un score d’anxiété pré-traitement élevé réduit significativement la cote de rémission clinique (B = -0,038, SE = 0,011, z = -3,45, p < .001, OR = 0,963, IC à 95 % [0,942, 0,984]). L’effet d’interaction hypothétisé entre l’anxiété et le soutien social n’a pas atteint le seuil de significativité statistique, B = 0,004, SE = 0,006, p = .510, indiquant que l’effet délétère de l’anxiété initiale s’exerce de manière homogène quel que soit le degré d’isolement perçu du patient. »
12.3 Pratiques de science ouverte et reproductibilité du code R
Les sciences psychologiques traversent une profonde transformation épistémologique incarnée par le mouvement de la science ouverte (Open Science), visant à éradiquer la crise de la reproductibilité par la transparence intégrale des protocoles de recherche et des chaînes de traitement analytique. Les revues de premier rang exigent désormais des auteurs qu’ils déposent leurs jeux de données dé-identifiés et l’intégralité de leur code source sur des dépôts institutionnels publics pérennes tels que l’Open Science Framework (OSF) ou Zenodo, permettant un audit par les pairs indépendant et vérifiable.
Pour se conformer à ces standards d’intégrité scientifique, le chercheur doit structurer ses scripts d’analyse sous la forme de documents informatiques exécutables dynamiques, en exploitant les technologies Quarto ou R Markdown (.qmd / .Rmd). Ces formats unifiés fusionnent dans un unique document le texte narratif de l’article scientifique, les blocs d’instructions programmatiques R et les tables de résultats ou visualisations générées directement à la volée lors de la compilation. Cette démarche écarte définitivement les erreurs de saisie manuelles et garantit que tout résultat chiffré rapporté dans le corps du texte dérive directement du jeu de données brut.
Enfin, la reproductibilité à long terme impose une gestion rigoureuse des dépendances logicielles. L’évolution constante de l’écosystème R entraîne inévitablement la modification ou la dépréciation progressive de certains arguments ou fonctions au fil des mises à jour de packages, risquant de rendre un script d’analyse inopérant plusieurs années après sa publication. L’adoption du gestionnaire d’environnement renv résout cette vulnérabilité en créant un fichier de verrouillage (lockfile hermétique) qui archive l’arborescence des dépendances logicielles et les numéros de version rigoureusement exacts de l’ensemble des bibliothèques mobilisées au moment précis de l’analyse, assurant ainsi la pérennité computationnelle de la recherche.
Références
- Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control, 19(6), 716–723. https://doi.org/10.1109/TAC.1974.1100705
- Albert, A., & Anderson, J. A. (1984). On the existence of maximum likelihood estimates in logistic regression models. Biometrika, 71(1), 1–10. https://doi.org/10.1093/biomet/71.1.1
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E., & Tidwell, P. W. (1962). Transformation of the independent variables. Technometrics, 4(4), 531–550. https://doi.org/10.1080/00401706.1962.10487791
- Cook, R. D. (1977). Detection of influential observation in linear regression. Technometrics, 19(1), 15–18. https://doi.org/10.1080/00401706.1977.10489493
- Cox, D. R. (1958). The regression analysis of binary sequences. Journal of the Royal Statistical Society: Series B (Methodological), 20(2), 215–232. https://doi.org/10.1111/j.2517-6161.1958.tb00292.x
- DeLong, E. R., DeLong, D. M., & Clarke-Pearson, D. L. (1988). Comparing the areas under two or more correlated receiver operating characteristic curves: A nonparametric approach. Biometrics, 44(3), 837–845. https://doi.org/10.2307/2531595
- Firth, D. (1993). Bias reduction of maximum likelihood estimates. Biometrika, 80(1), 27–38. https://doi.org/10.1093/biomet/80.1.27
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). SAGE Publications.
- Hosmer, D. W., Lemeshow, S., & Sturdivant, R. X. (2013). Applied logistic regression (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781118548387
- McFadden, D. (1974). Conditional logit analysis of qualitative choice behavior. In P. Zarembka (Ed.), Frontiers in Econometrics (pp. 105–142). Academic Press.
- Nagelkerke, N. J. (1991). A note on a general definition of the coefficient of determination. Biometrika, 78(3), 691–692. https://doi.org/10.1093/biomet/78.3.691
- Nelder, J. A., & Wedderburn, R. W. (1972). Generalized linear models. Journal of the Royal Statistical Society: Series A (General), 135(3), 370–384. https://doi.org/10.2307/2344614
- Robin, X., Turck, N., Hainard, A., Tiberti, N., Lisacek, F., Sanchez, J. C., & Müller, M. (2011). pROC: An open-source package for R and S+ to analyze and compare ROC curves. BMC Bioinformatics, 12(1), Article 77. https://doi.org/10.1186/1471-2105-12-77
- Youden, W. J. (1950). Index for rating diagnostic tests. Cancer, 3(1), 32–35. <a href="https://doi.org/10.1002/1097-0142(1950)3:13.0.CO;2-3″>https://doi.org/10.1002/1097-0142(1950)3:13.0.CO;2-3