
L’inférence statistique contemporaine au sein des sciences du comportement traverse depuis plusieurs décennies une profonde remise en question épistémologique, fréquemment désignée sous le terme de crise de la réplicabilité. Au cœur de cette tourmente méthodologique se trouve la manipulation, souvent naïve ou involontaire, de tests d’hypothèses répétés sur des jeux de données complexes. Lorsqu’un chercheur multiplie les analyses statistiques sans précaution mathématique, la probabilité d’observer un résultat apparemment significatif sous le seul effet des fluctuations d’échantillonnage croît de manière vertigineuse, menaçant la solidité même des théories psychologiques publiées.
Face à cet écueil probabiliste fondamental, l’approche statistique orthodoxe a longtemps imposé des sanctions draconiennes à travers le contrôle strict du taux d’erreur par famille d’hypothèses (Family-Wise Error Rate ou FWER), illustré au premier chef par la célèbre correction de Bonferroni. Néanmoins, cette rigueur aveugle s’est rapidement révélée être une arme à double tranchant : en cherchant à anéantir tout risque de faux positif à un niveau collectif, les chercheurs se sont condamnés à une perte massive de puissance statistique, passant régulièrement sous silence de réelles découvertes scientifiques au nom d’un conservatisme mathématique excessif.
C’est précisément pour dépasser cette aporie que les statisticiens israéliens Yoav Benjamini et Yosef Hochberg ont proposé, dans un article séminal paru en 1995, un changement de paradigme conceptuel révolutionnaire : le contrôle du taux de fausses découvertes (False Discovery Rate ou FDR). Cet article offre un examen exhaustif, théorique, pratique et computationnel de la procédure de Benjamini-Hochberg. Conçu spécifiquement pour les chercheurs, doctorants et analystes en sciences psychologiques et neurocognitives, ce guide détaille les mécanismes intimes, les conditions d’application, les extensions modernes et les protocoles de restitution conformes aux exigences les plus rigoureuses de la recherche internationale.
1. Introduction au problème des comparaisons multiples en psychologie
1.1 L’inflation du risque d’erreur de type I
Dans le cadre conventionnel de l’inférence statistique fréquentiste formalisée par Ronald Fisher, Jerzy Neyman et Egon Pearson, la décision de rejeter une hypothèse nulle $H_0$ repose sur un compromis probabiliste explicite. Par convention séculaire dans les sciences comportementales, le seuil nominal de significativité $\alpha$ est fixé à 0,05. Cette valeur seuil stipule que le chercheur tolère délibérément une probabilité de 5 % de rejeter l’hypothèse nulle alors que celle-ci est fondamentalement vraie dans la population parente, ce qui constitue une erreur de type I, couramment qualifiée de faux positif. Ce garde-fou élémentaire fonctionne de manière optimale lorsqu’une seule conjecture théorique est soumise à une unique épreuve empirique sur un échantillon donné.
Dès lors qu’un protocole expérimental implique la réalisation simultanée ou séquentielle de plusieurs tests statistiques indépendants portant sur le même jeu de données, ce modèle d’assurance probabiliste s’effondre. Le mécanisme d’accumulation du risque d’erreur s’explique par les lois fondamentales de la théorie des probabilités appliquées aux événements conjoints. Si l’on conduit $m$ tests statistiques mutuellement indépendants, la probabilité de ne commettre aucune erreur de type I sur l’ensemble de la série de tests équivaut au produit des probabilités individuelles de ne pas commettre d’erreur pour chaque test unitaire, soit $(1 – \alpha)^m$. Par voie de conséquence directe, la probabilité cumulée de commettre au moins une erreur de type I au sein de cette famille d’analyses, notée $\alpha_{\text{global}}$, s’exprime rigoureusement selon la formule probabiliste suivante :
$$\alpha_{\text{global}} = 1 – (1 – \alpha)^m$$
Pour illustrer la sévérité de cette dérive stochastique dans la pratique de la recherche psychologique, considérons un protocole classique où un investigateur administre une batterie neuropsychologique comprenant 20 épreuves cognitives distinctes à deux groupes de participants. En testant ces 20 variables sans correction avec un seuil nominal $\alpha = 0,05$, la probabilité d’observer au moins un résultat artificiellement significatif sous l’hypothèse nulle universelle s’élève à :
$$\alpha_{\text{global}} = 1 – (1 – 0,05)^{20} = 1 – (0,95)^{20} \approx 1 – 0,3585 = 0,6415$$
Le chercheur est désormais confronté à un risque supérieur à 64 % de publier une illusion statistique comme une découverte authentique. Lorsque le nombre de tests $m$ atteint plusieurs centaines ou milliers, comme dans le cas des enregistrements électroencéphalographiques (EEG) ou de l’imagerie par résonance magnétique fonctionnelle (IRMf), cette probabilité cumulée tend asymptotiquement vers 1. Cette réalité mathématique a constitué le principal combustible de la crise de la réplicabilité en psychologie expérimentale, où une part alarmante des effets rapportés dans les revues à comité de lecture s’est révélée impossible à reproduire lors de réplications méthodologiquement indépendantes.
1.2 La notion fondamentale de fausse découverte
Sur le plan conceptuel, il est impératif d’opérer une scission nette entre l’état de nature inobservable d’un phénomène psychologique et la décision inférentielle prononcée par l’analyste. L’hypothèse nulle $H_0$ postule l’absence totale de différence intergroupe, d’effet de traitement ou de corrélation dans la population cible. Un rejet erroné de cette hypothèse survient lorsque la variabilité idiosyncrasique des participants, les erreurs de mesure intrinsèques aux échelles psychométriques ou le bruit expérimental s’agrègent de telle sorte que l’indice statistique observé s’éloigne drastiquement de la valeur attendue sous $H_0$.
Dans les études comportementales, les échantillons aléatoires de taille restreinte à modérée sont particulièrement vulnérables à la présence d’individus atypiques ou de configurations accidentelles de scores. Si un chercheur évalue, par exemple, les temps de réaction sous diverses conditions lumineuses et d’amorçage affectif, une simple asymétrie fortuite dans la distribution d’échantillonnage peut générer une valeur empirique de la statistique de Student ou de Fisher située au-delà du seuil critique théorique. L’observateur conclut alors à l’existence d’une modulation cognitive substantielle là où seule la stochasticité a agi.
L’accumulation insidieuse de ces faux positifs contamine durablement la littérature scientifique internationale. Une fois imprimées dans les pages des périodiques académiques, ces fausses découvertes induisent des programmes de recherche coûteux et infructueux, obscurcissent la méta-analyse cumulative et corrompent la modélisation théorique du fonctionnement mental. Cette dérive met en exergue la nécessité méthodologique absolue d’instaurer des procédures d’ajustement rigoureuses des valeurs de probabilité ($p$-valeurs), capables de filtrer les artéfacts aléatoires sans paralyser la dynamique de la recherche empirique.
1.3 Le dilemme de la puissance statistique face aux corrections conservatrices
Tout raisonnement statistique mené dans le cadre de Neyman-Pearson s’articule autour d’un arbitrage incompressible entre l’erreur de type I et l’erreur de type II, généralement notée $\beta$. Tandis que l’erreur de type I correspond au faux positif, l’erreur de type II représente l’échec de détection d’un effet réel préexistant au sein de la population étudiée. La puissance statistique d’une analyse, quantifiée par la métrique complémentaire $1 – \beta$, exprime la probabilité formelle pour une méthodologie donnée d’identifier avec succès un effet non nul.
Face au péril de l’inflation de l’erreur globale, les premières générations de méthodologistes ont recouru à des corrections arithmétiques drastiques fondées sur la partition stricte de l’erreur globale. Ces approches ultra-conservatrices, au rang desquelles trône la correction unitaire de Bonferroni, divisent purement et simplement le seuil nominal de décision par le volume total des comparaisons envisagées. Si cette politique d’hyper-prudence garantit une imperméabilité quasi absolue contre les faux positifs, elle produit corrélativement une dégradation cataclysmique de la puissance statistique expérimentale.
En psychologie et en neurosciences cognitives, où les grandeurs d’effet réelles oscillent fréquemment entre des niveaux faibles et modérés (typiquement un $d$ de Cohen compris entre 0,20 et 0,50), l’élévation démesurée de l’exigence de significativité condamne les expérimentateurs à éliminer aveuglément d’authentiques découvertes neurocomportementales. Cet excès d’orthodoxie stérilise l’innovation scientifique en induisant une proportion intolérable de faux négatifs. Le besoin historique pressant d’une solution médiane s’est ainsi manifesté : une voie méthodologique nouvelle, armée d’une flexibilité mathématique supérieure, permettant de préserver un niveau décent de puissance statistique tout en imposant une régulation probabiliste formelle sur l’agrégat des hypothèses explorées.
2. Origine et cadre théorique de la procédure de Benjamini-Hochberg
2.1 La publication séminale de 1995
L’année 1995 marque un tournant paradigmatique dans l’histoire de la statistique appliquée moderne avec la diffusion, au sein du prestigieux Journal of the Royal Statistical Society: Series B, de l’article fondateur rédigé par les chercheurs israéliens Yoav Benjamini et Yosef Hochberg, intitulé « Controlling the False Discovery Rate: A Practical and Powerful Approach to Multiple Testing ». Les auteurs y constataient avec acuité que les outils d’ajustement conçus au milieu du XXe siècle n’étaient plus du tout adaptés à la transition technologique des protocoles expérimentaux, caractérisés par l’émergence d’analyses hautement multidimensionnelles.
Au cours des décennies précédentes, la statistique s’était presque exclusivement focalisée sur le contrôle sans concession du taux d’erreur par famille d’hypothèses, considérant qu’un seul rejet injustifié d’hypothèse nulle suffisait à vicier l’intégralité d’un programme d’expérimentation. Benjamini et Hochberg ont remis en question le bien-fondé épistémologique universel de cet axiome sous-jacent. Ils ont démontré qu’exiger qu’aucune erreur ne soit commise au cours d’un balayage de 50 ou 1000 variables était une entrave disproportionnée, non seulement intenable en pratique, mais conceptuellement inadaptée aux visées de la science moderne exploratoire.
Initialement reçue avec un scepticisme poli par une frange traditionaliste de la communauté statistique qui craignait un affaiblissement de la rigueur mathématique, la procédure de Benjamini-Hochberg (fréquemment abrégée en procédure BH) s’est progressivement imposée comme l’un des algorithmes d’ajustement les plus cités et les plus implémentés de toute l’histoire scientifique. La démocratisation fulgurante de la génomique fonctionnelle, du séquençage à haut débit et de l’imagerie cérébrale a rapidement converti cette proposition théorique en un standard méthodologique international incontournable.
2.2 Le changement de paradigme vers le False Discovery Rate (FDR)
La rupture intellectuelle majeure opérée par Yoav Benjamini et Yosef Hochberg réside dans la substitution d’une logique binaire par une logique proportionnelle. Au lieu de focaliser l’évaluation du risque d’erreur sur la probabilité d’enregistrer au moins une fausse découverte au sein d’une grappe d’analyses, les auteurs ont proposé de modéliser et de borner formellement la proportion espérée de faux rejets parmi l’ensemble des rejets effectivement prononcés par le chercheur. Ce concept novateur a été désigné sous le vocable de Taux de Fausses Découvertes ou False Discovery Rate (FDR).
D’un point de vue opérationnel, adopter le contrôle du FDR revient à concéder en toute connaissance de cause l’admission d’un faible contingent d’erreurs statistiques, à condition expresse que ce volume résiduel de bruit demeure rigoureusement proportionnel au nombre global d’hypothèses déclarées significatives. Si une procédure configurée à un seuil FDR de 5 % aboutit au rejet de 100 hypothèses nulles, le protocole offre la garantie mathématique que, sur le long terme de réplications similaires, l’espérance mathématique du nombre d’erreurs de type I au sein de ces déclarations positives ne dépassera pas 5. Les 95 rejets restants constituent de véritables découvertes.
Cette réorientation philosophique constitue un équilibre pragmatique exceptionnel entre la tolérance à un bruit contrôlé et la maximisation de la capacité de détection d’effets réels. Au lieu de contraindre le chercheur à une paralysie cognitive en imposant des pénalités arithmétiques exorbitantes sur chaque test unitaire, le FDR proportionne la tolérance au risque à l’ampleur même des résultats découverts : plus le chercheur identifie d’effets substantiels au sein de ses données, plus la méthode lui autorise une marge stochastique proportionnelle pour explorer ces pistes novatrices.
3. Distinction cruciale : FWER versus FDR
3.1 Le taux d’erreur par famille d’hypothèses (FWER)
Afin de saisir la singularité opérationnelle de la méthode de Benjamini-Hochberg, il est indispensable de formaliser rigoureusement le cadre mathématique classique dont elle s’émancipe. Considérons un scénario expérimental où $m$ hypothèses nulles notées $H_{0,1}, H_{0,2}, dots, H_{0,m}$ sont soumises à vérification empirique. Parmi ces $m$ hypothèses, une quantité inconnue $m_0$ correspond à des hypothèses nulles authentiquement vraies dans la réalité de la nature, tandis que le reliquat $m_1 = m – m_0$ représente des hypothèses nulles fausses (où un effet authentique existe). Soit $V$ la variable aléatoire désignant le nombre d’erreurs de type I (faux positifs) et $R$ la variable aléatoire indiquant le volume total d’hypothèses rejetées (découvertes déclarées).
Le taux d’erreur par famille d’hypothèses, ou FWER (Family-Wise Error Rate), se définit mathématiquement comme la probabilité que la variable aléatoire $V$ soit strictement supérieure ou égale à 1. Formellement, son expression probabiliste s’énonce :
$$\text{FWER} = P(V ge 1)$$
Contrôler le FWER à un seuil $\alpha$ conventionnel de 0,05 signifie que le statisticien s’engage à garantir que la probabilité d’admettre même une unique erreur de type I sur l’ensemble des $m$ décisions ne dépassera en aucun cas 5 %. Cette exigence absolutiste est parfaitement appropriée dans des cadres cliniques stricts, par exemple lors d’un essai de phase III où l’autorisation de mise sur le marché d’une molécule thérapeutique repose sur plusieurs critères d’efficacité principaux. Néanmoins, dans les phases hautement exploratoires de la psychologie contemporaine, cette contrainte élimine massivement la possibilité d’isoler des signaux discrets au sein de données volumineuses.
3.2 Le taux de fausses découvertes (FDR)
À l’opposé de cette intolérance unitaire au faux positif, le FDR oriente son attention statistique sur le ratio d’erreurs au sein de la population des résultats empiriquement découverts. Définissons la variable aléatoire $Q$ représentant la proportion de fausses découvertes parmi les rejets réels :
$$Q = \begin{\cases} \frac{V}{R} &a\mp; \text{si } R > 0 0 &a\mp; \text{si } R = 0 \end{\cases}$$
Le Taux de Fausses Découvertes s’exprime comme l’espérance mathématique de cette variable aléatoire $Q$. La formalisation mathématique rigoureuse développée par Benjamini et Hochberg s’écrit comme suit :
$$\text{FDR} = E[Q] = E\left[ \frac{V}{R} ;middle|; R > 0 \right] P(R > 0)$$
Cette formulation élégante met en lumière la nature conditionnelle du raisonnement : lorsque l’expérimentateur ne rejette aucune hypothèse nulle ($R = 0$), le ratio $V/R$ est indéfini mais conventionnellement posé à 0, car aucune fausse découverte ne saurait être déplorée en l’absence totale de prétention de découverte. Lorsque $R > 0$, l’analyste assume délibérément l’existence d’une fraction résiduelle d’erreurs parmi les signaux isolés. Si toutes les hypothèses nulles sont vraies ($m_0 = m$, situation dite de l’hypothèse nulle globale universelle), alors tout rejet éventuel est obligatoirement une fausse découverte ($V = R$), ce qui implique mathématiquement l’équivalence parfaite :
$$\text{FDR} = E\left[\frac{V}{R}\right] = E[1] \cdot P(R > 0) = P(V ge 1) = \text{FWER}$$
Le contrôle du FDR garantit donc également un contrôle strict du FWER sous l’hypothèse nulle universelle. Dès lors qu’au moins un effet authentique est présent dans les données ($m_0 < m$), le FDR diverge radicalement du FWER et autorise des gains de puissance considérables.
3.3 Comparaison structurelle des deux approches
L’analyse structurelle des seuils de décision imposés par le FWER et le FDR révèle une asymétrie profonde dans la gestion du doute scientifique. Le contrôle du FWER traite chaque nouvelle hypothèse testée comme une charge statistique négative qui pénalise instantanément et indistinctement l’ensemble des autres pistes de recherche. À l’inverse, le contrôle du FDR introduit un mécanisme de pondération auto-ajustable : la sévérité du seuil d’exclusion s’adapte en temps réel à l’abondance des signaux statistiquement remarquables présents dans le jeu de données.
Cette divergence technique a des répercussions spectaculaires sur la taille d’échantillon minimale exigée pour qu’une étude expérimentale atteigne une puissance statistique jugée acceptable (typiquement fixée à 80 %). Pour détecter une série d’effets faibles à moyens sous une régulation de type FWER, un laboratoire de psychologie doit souvent mobiliser des cohortes d’une envergure logistiquement inatteignable. Sous un contrôle par FDR, la puissance statistique s’avère nettement supérieure pour un effectif identique, car la règle de décision n’est pas bridée par le conservatisme du pire scénario possible.
Le choix entre ces deux paradigmes ne relève donc pas d’une simple préférence computationnelle arbitraire, mais d’une adéquation stricte avec l’objectif épistémologique de la recherche :
- Le cadre confirmatoire : Vise la validation formelle d’une prédiction théorique unique ou d’un nombre très restreint d’hypothèses pré-spécifiées. L’admission d’un faux positif peut altérer des lignes de conduite sociétales ou médicales. Le FWER y demeure la référence normative impérative.
- Le cadre exploratoire : Vise le criblage d’un ensemble de mécanismes, de variables comportementales ou d’aires anatomocérébrales dans le but de dégager des patrons novateurs à soumettre ultérieurement à réplication. L’élimination du faux négatif y prime sur le bannissement aveugle du faux positif. Le FDR s’y impose comme la stratégie méthodologique d’élection.
4. Fonctionnement algorithmique de la procédure pas à pas
4.1 Étape 1 : Collecte et ordonnancement des p-valeurs
La mise en œuvre de la procédure de Benjamini-Hochberg obéit à une logique algorithmique déterministe d’une grande élégance computationnelle. La première phase opérationnelle consiste à conduire de manière indépendante chacun des $m$ tests statistiques planifiés dans le cadre de l’investigation (qu’il s’agisse de tests $t$ de Student, d’analyses de variance univariées, de tests de corrélation de Pearson ou de modèles linéaires généralisés). De chacune de ces épreuves inférentielles, le chercheur extrait la $p$-valeur brute bilatérale correspondante, générant ainsi un vecteur non trié d’indices de significativité :
$$P = {p_1, p_2, dots, p_m}$$
L’étape critique immédiate impose d’ordonner ces $p$-valeurs de manière strictement ascendante, de la plus faible (représentant la preuve empirique la plus défavorable à l’hypothèse nulle unitaire) à la plus élevée (reflétant l’écart le plus faible avec le modèle aléatoire). On obtient alors la suite ordonnée des statistiques de rang :
$$p_{(1)} le p_{(2)} le p_{(3)} le dots le p_{(m)}$$
À chaque $p$-valeur ordonnée $p_{(i)}$ est alloué un indice de rang entier désigné par la variable $i$, dont la valeur discrète s’échelonne séquentiellement de $i = 1$ jusqu’à $i = m$. Ce rang relatif constitue la variable d’ancrage qui permettra d’ajuster dynamiquement le niveau d’exigence de la procédure pour chaque test individuel.
4.2 Étape 2 : Calcul des seuils critiques individuels
Une fois les $p$-valeurs sérialisées, le chercheur détermine le niveau nominal de contrôle du FDR qu’il s’assigne à respecter. Par cohérence avec les standards de la communauté scientifique, ce taux cible, couramment dénoté par la lettre $Q$ ou $\alpha_{\text{FDR}}$, est généralement calibré à 0,05, bien que des contextes hautement préliminaires puissent justifier une tolérance fixée à 0,10. Contrairement aux méthodes unilatérales classiques qui appliquent un seuil statique invariant à toutes les analyses, la procédure de Benjamini-Hochberg génère un seuil critique adaptatif spécifique à chaque rang $i$.
Pour chaque test unitaire de rang $i$, le seuil de significativité critique dynamique, noté $l_i$, est calculé par la fonction arithmétique fondamentale :
$$l_i = \frac{i}{m} \times Q$$
Cette relation affine induit une pente linéaire strictement ascendante. Pour le test présentant l’écart empirique le plus extrême ($i = 1$), le seuil est extrêmement sévère et s’établit à $Q/m$, ce qui coïncide rigoureusement avec la valeur critique prescrite par la correction de Bonferroni. Toutefois, au fur et à mesure que le rang $i$ croît, le seuil $l_i$ s’assouplit de manière linéaire et constante. Au dernier échelon de la séquence ($i = m$), le seuil critique calculé culmine à $(m/m) \times Q = Q$, rétablissant intégralement le seuil nominal conventionnel sans la moindre pénalité.
4.3 Étape 3 : Règle de décision descendante
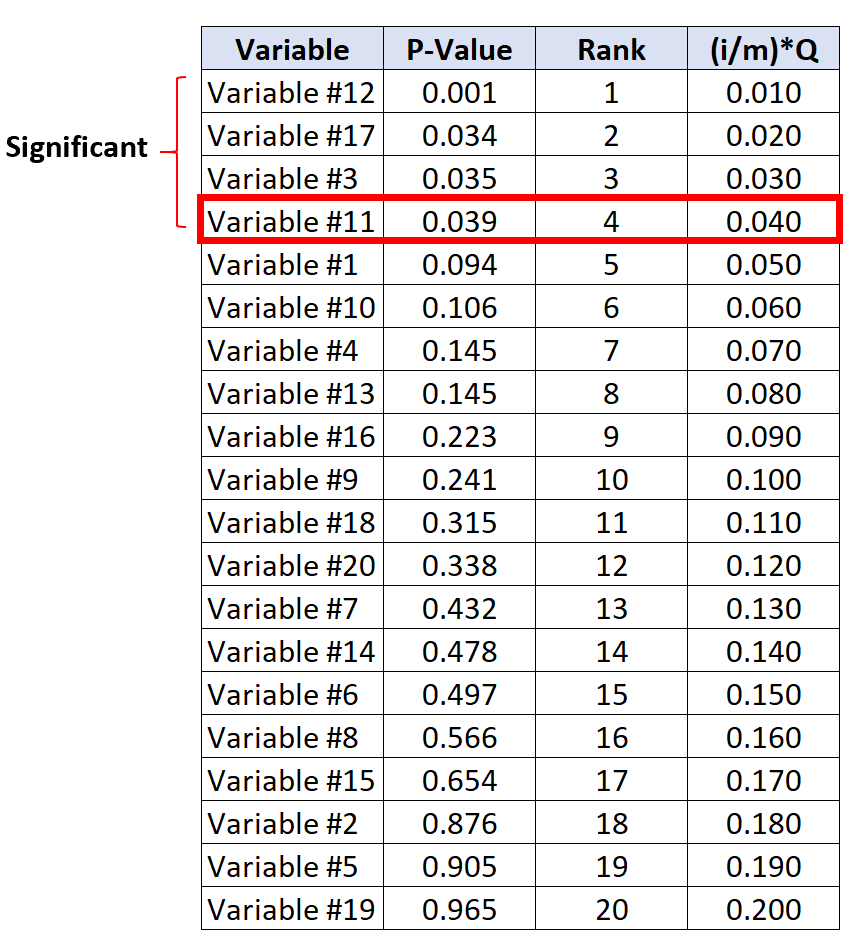
L’arbitrage inférentiel ne repose pas sur une simple comparaison directe élément par élément entre $p_{(i)}$ et $l_i$. La procédure de Benjamini-Hochberg met en œuvre un algorithme séquentiel ascendant ou descendant, classé dans la littérature internationale sous la désignation technique de procédure step-up. Le chercheur inspecte la série ordonnée afin d’identifier le rang maximal, formellement désigné par l’indice $k$, qui valide la condition de rejet unilatérale :
$$k = \max \left{ i ;middle|; p_{(i)} le \frac{i}{m} Q \right}$$
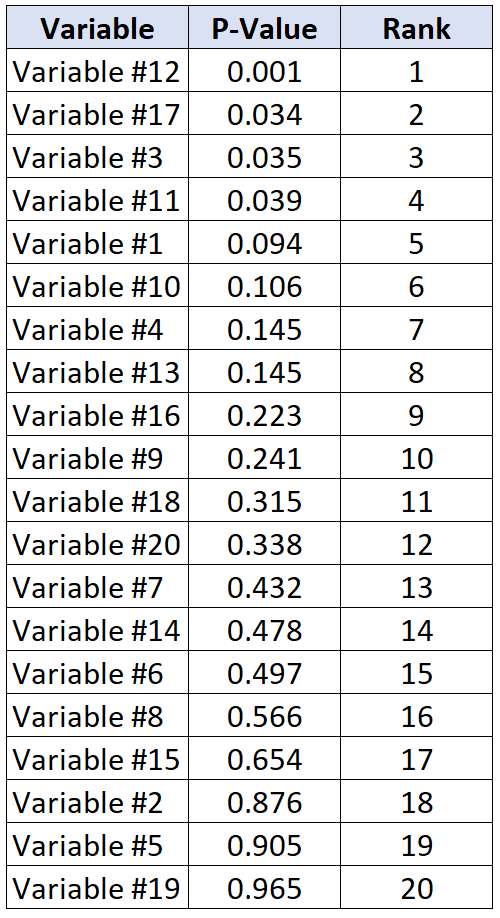
La règle d’inférence universelle édictée par Benjamini et Hochberg s’énonce alors sans équivoque : si un tel indice maximal $k$ existe au sein de la série ordonnée, le chercheur a la légitimité mathématique de rejeter systématiquement et simultanément toutes les hypothèses nulles associées aux rangs inférieurs ou égaux à $k$, soit l’ensemble des hypothèses correspondant aux indices :
$$i in {1, 2, dots, k}$$
Réciproquement, pour toute la portion terminale de la série ordonnée dont le rang dépasse strictement $k$ (c’est-à-dire pour tous les indices $i > k$), l’hypothèse nulle est irrévocablement maintenue. La puissance algorithmique de ce mécanisme step-up réside dans sa capacité de sauvetage statistique : même si une $p$-valeur d’un rang intermédiaire $j$ (avec $j j$ qui parvient, elle, à se situer sous son seuil respectif $l_k$.
5. Étude de cas pratique en psychologie expérimentale
5.1 Présentation du protocole expérimental
Afin de concrétiser les concepts théoriques précédents, examinons une étude empirique fictive mais représentative des neurosciences comportementales contemporaines. Une équipe d’expérimentateurs évalue les retombées neurobiologiques et cognitives d’un programme intensif de huit semaines de méditation de pleine conscience (Mindfulness-Based Stress Reduction) administré à un groupe expérimental en comparaison d’un groupe contrôle actif soumis à de la relaxation simple. Les investigateurs mesurent 10 biomarqueurs et indicateurs neurocognitifs distincts ($m = 10$).
Les 10 variables investiguées couvrent des domaines variés tels que le taux de cortisol salivaire matinal, les scores d’attention soutenue sur tâche de vigilance, la réactivité électrodermale, le volume hippocampique mesuré par IRM volumétrique, l’amplitude de l’onde P300, l’expression de marqueurs inflammatoires (IL-6), la variabilité de la fréquence cardiaque, la mémoire de travail spatiale, les scores d’empathie auto-rapportés et l’épaisseur du cortex préfrontal dorsolatéral. Chaque test d’hypothèse nulle $H_{0,i}$ postule qu’il n’existe aucune différence significative entre les moyennes du groupe méditation et du groupe contrôle sur la variable $i$. Les analyses conduites sur le logiciel d’extraction statistique génèrent les $p$-valeurs brutes non corrigées suivantes :
- Test 1 (Cortisol matinal) : $p = 0,0081$
- Test 2 (Attention soutenue) : $p = 0,0004$
- Test 3 (Réactivité électrodermale) : $p = 0,0420$
- Test 4 (Volume hippocampique) : $p = 0,0280$
- Test 5 (Amplitude P300) : $p = 0,0110$
- Test 6 (Interleukine 6) : $p = 0,0025$
- Test 7 (Variabilité cardiaque) : $p = 0,1230$
- Test 8 (Mémoire spatiale) : $p = 0,0062$
- Test 9 (Score d’empathie) : $p = 0,0310$
- Test 10 (Épaisseur cortex préfrontal) : $p = 0,0001$
5.2 Exécution numérique manuelle de la procédure
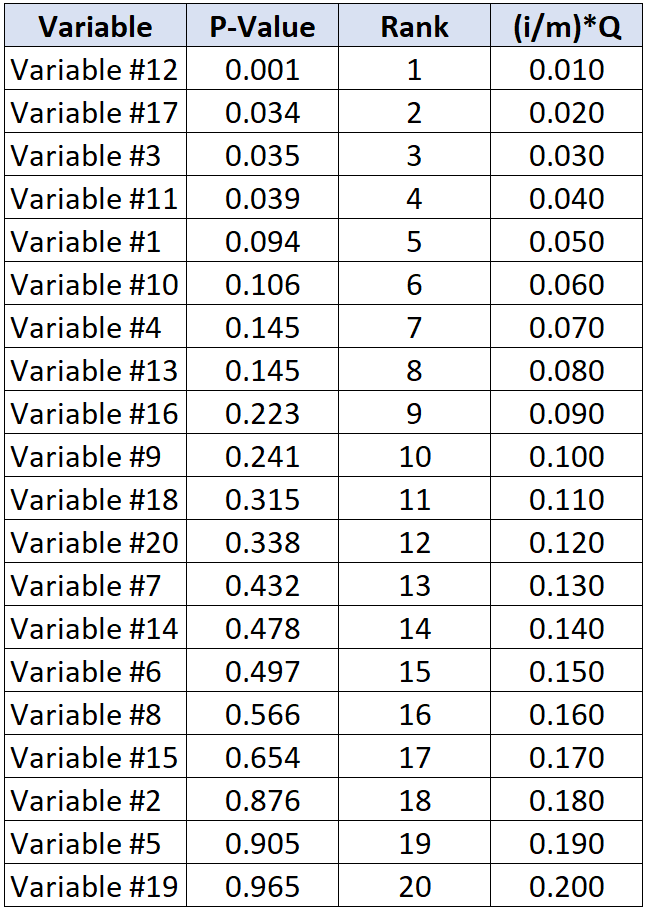
Pour appliquer la procédure de Benjamini-Hochberg avec un taux cible de fausses découvertes fixé à $Q = 0,05$, la première tâche consiste à sérialiser ces 10 résultats dans l’ordre croissant des probabilités observées, d’associer à chaque test son rang respectif $i in {1, 10}$, puis de calculer la valeur critique correspondante via la formule $l_i = (i / 10) \times 0,05 = i \times 0,005$.
Le tableau analytique complet s’établit comme suit :
| Rang ($i$) | Variable psychocognitive | $p$-valeur brute ordonnée $p_{(i)}$ | Seuil Benjamini-Hochberg $l_i = (i/10) \times 0,05$ | Condition $p_{(i)} le l_i$ |
|---|---|---|---|---|
| 1 | Épaisseur cortex préfrontal | 0,0001 | 0,0050 | Vérifiée ($0,0001 le 0,0050$) |
| 2 | Attention soutenue | 0,0004 | 0,0100 | Vérifiée ($0,0004 le 0,0100$) |
| 3 | Interleukine 6 (IL-6) | 0,0025 | 0,0150 | Vérifiée ($0,0025 le 0,0150$) |
| 4 | Mémoire spatiale | 0,0062 | 0,0200 | Vérifiée ($0,0062 le 0,0200$) |
| 5 | Cortisol matinal | 0,0081 | 0,0250 | Vérifiée ($0,0081 le 0,0250$) |
| 6 | Amplitude P300 | 0,0110 | 0,0300 | Vérifiée ($0,0110 le 0,0300$) |
| 7 | Volume hippocampique | 0,0280 | 0,0350 | Vérifiée ($0,0280 le 0,0350$) |
| 8 | Score d’empathie | 0,0310 | 0,0400 | Vérifiée ($0,0310 le 0,0400$) |
| 9 | Réactivité électrodermale | 0,0420 | 0,0450 | Vérifiée ($0,0420 le 0,0450$) |
| 10 | Variabilité cardiaque | 0,1230 | 0,0500 | Non vérifiée ($0,1230 > 0,0500$) |
L’application de la règle de décision impose d’examiner le tableau en partant du bas (procédure step-up). Au rang $i = 10$, la condition échoue ($0,1230 > 0,0500$). L’analyste remonte alors au rang immédiatement supérieur : au rang $i = 9$, la condition est parfaitement satisfaite puisque $0,0420 le 0,0450$. Par conséquent, le rang maximal est formellement identifié à :
$$k = 9$$
5.3 Interprétation des résultats ajustés
L’identification de la valeur pivotale $k = 9$ entraîne le rejet formel et univoque des hypothèses nulles associées aux rangs 1 à 9 inclus. L’équipe de recherche conclut légitimement que l’intervention de méditation a exercé un effet statistiquement robuste sur neuf des dix indicateurs cognitifs et physiologiques testés. Seule l’hypothèse nulle concernant la variabilité de la fréquence cardiaque ($i = 10$) ne peut être rejetée.
Pour mesurer la portée de cet arbitrage, mesurons le contraste avec la décision qu’aurait imposée l’orthodoxie d’un contrôle FWER standard par la correction unitaire de Bonferroni. Avec cette dernière, le seuil absolu unique pour l’ensemble des dix analyses aurait été fixé sans distinction à :
$$\alpha_{\text{Bonferroni}} = \frac{0,05}{10} = 0,005$$
Sous ce régime d’hyper-sévérité, seules les variables des rangs 1, 2 et 3 (épaisseur préfrontale, attention soutenue et IL-6) auraient pu prétendre au statut de découverte scientifique. Les variables des rangs 4 à 9 (mémoire spatiale, cortisol, onde P300, volume hippocampique, empathie et réactivité électrodermale) auraient été écartées et qualifiées de non significatives, privant la communauté académique d’indications substantielles relatives à l’impact de la remédiation cognitive.
La conclusion formulée sous le contrôle du FDR s’énonce ainsi avec une probité épistémologique exemplaire : le chercheur affirme que l’intervention produit un effet significatif sur les neuf indicateurs identifiés, tout en concédant explicitement que, selon l’espérance mathématique de la procédure, environ 5 % des résultats proclamés découverts (soit concrètement $9 \times 0,05 = 0,45$, c’est-à-dire moins d’une variable en moyenne) sont susceptibles de découler d’un faux positif résiduel. Cette balance opérationnelle concilie puissance pragmatique et modération probabiliste.
6. Benjamini-Hochberg versus Bonferroni et Holm
6.1 Comparaison avec la correction de Bonferroni
La méthode de Bonferroni, enracinée dans l’inégalité booléenne fondamentale (aussi désignée sous le nom d’inégalité de Boole-Fréchet), stipule que la probabilité de l’union d’un ensemble d’événements ne peut excéder la somme arithmétique des probabilités individuelles de chacun de ces événements pris isolément. Pour garantir que la probabilité globale d’admettre au moins une erreur de type I ($P(V ge 1)$) ne dépasse pas le seuil toléré $\alpha$, Bonferroni prescrit l’application systématique d’un seuil critique individuel invariant :
$$\alpha_B = \frac{\alpha}{m}$$
Bien que cette règle mathématique présente l’avantage d’une simplicité de calcul élémentaire et assure un contrôle universel du FWER quelles que soient les structures de dépendance reliant les tests, elle souffre d’un caractère excessivement pénalisant dès lors que le nombre d’épreuves $m$ franchit un palier modeste. Dans une étude d’association pangénomique comportementale ou une analyse voxel à voxel en imagerie cérébrale impliquant 100 000 tests, le seuil unitaire s’effondre à $0,05 / 100,000 = 5 \times 10^{-7}$.
À de tels niveaux d’exigence, l’erreur de type II s’amplifie démesurément : la méthode exige des tailles d’effet spectaculaires ou des échantillons colossaux pour déclarer le moindre résultat. En comparaison, la procédure de Benjamini-Hochberg affranchit la recherche empirique de cet étau en faisant glisser le seuil critique de manière adaptative : là où Bonferroni fige l’exigence au niveau du rang $i = 1$, Benjamini-Hochberg l’assouplit linéairement à proportion du rang $i$, autorisant des rejets salvateurs pour les signaux intermédiaires et modérés.
6.2 Comparaison avec la méthode séquentielle de Holm
Conscient de l’extrémisme conservateur de Bonferroni, le statisticien suédois Sture Holm a développé en 1979 une procédure séquentielle descendante (dite méthode de Holm-Bonferroni ou step-down FWER) qui améliore substantiellement la puissance statistique tout en préservant le contrôle absolu du taux d’erreur par famille au niveau nominal $\alpha$. La méthode de Holm s’initie également par l’ordonnancement ascendant strict des $p$-valeurs ($p_{(1)} le p_{(2)} le dots le p_{(m)}$), mais ajuste son seuil critique par une division itérative dégressive :
$$l_i^{\text{Holm}} = \frac{\alpha}{m – i + 1}$$
L’algorithme de Holm opère selon une logique séquentielle descendante stricte : dès qu’une valeur ordonnée $p_{(i)}$ échoue à passer sous le seuil critique $l_i^{\text{Holm}}$, la procédure s’interrompt brutalement. Aucune des hypothèses de rang ultérieur ne peut être rejetée, même si leurs $p$-valeurs individuelles s’avéraient très basses. La méthode de Holm est mathématiquement supérieure à celle de Bonferroni en tous points, car elle contrôle strictement le FWER tout en étant uniformément plus puissante.
Cependant, en dépit de ce gain notable par rapport à Bonferroni, la procédure de Holm demeure rivée à la philosophie du FWER. Dès lors que $m$ s’accroît ou que la distribution sous-jacente des données comprend une abondance d’effets réels de faible intensité, Holm se montre impuissante à isoler ces dynamiques, là où Benjamini-Hochberg, régulée par le FDR, révèle toute sa puissance discriminative.
6.3 Synthèse des compromis méthodologiques
Le choix raisonné d’une stratégie de contrôle d’erreurs multiples impose de mettre en balance la philosophie de découverte, la perte de puissance tolérable et la complexité computationnelle. Le tableau analytique suivant récapitule les divergences structurelles fondamentales régissant les trois grandes méthodologies de référence :
| Critère méthodologique | Correction de Bonferroni | Méthode séquentielle de Holm | Procédure de Benjamini-Hochberg |
|---|---|---|---|
| Métrique contrôlée | FWER strict ($P(V ge 1) le \alpha$) | FWER strict ($P(V ge 1) le \alpha$) | FDR ($E[V/R] le Q$) |
| Mécanisme algorithmique | Seuil fixe invariant unitaire | Séquentiel descendant (step-down) | Séquentiel ascendant (step-up) |
| Formule du seuil critique | $\alpha / m$ | $\alpha / (m – i + 1)$ | $(i / m) \times Q$ |
| Puissance statistique | Minimale (hyper-conservatrice) | Intermédiaire (supérieure à Bonferroni) | Optimale (maximisation des découvertes) |
| Dépendance entre tests | Robuste à toute dépendance | Robuste à toute dépendance | Robuste à l’indépendance et au PRDS |
| Champ préférentiel | Essais cliniques critiques confirmatifs | Validation confirmatoire de sous-groupes | Criblage exploratoire, neuroimagerie, génomique |
Face aux comités de lecture des revues académiques, la sélection de l’une ou l’autre de ces options méthodologiques doit être défendue par des arguments épistémologiques précis. Un relecteur exigeant l’application d’un contrôle de Bonferroni dans une étude exploratoire à haute dimension peut être courtoisement mais fermement réorienté en arguant qu’une telle correction anéantirait la puissance de détection et induirait un taux inacceptable de faux négatifs, contredisant la finalité même du projet de recherche qui visait l’identification systématique de pistes théoriques novatrices.
7. Hypothèses sous-jacentes et conditions de validité mathématique
7.1 L’hypothèse d’indépendance statistique
L’édifice mathématique originel élaboré par Yoav Benjamini et Yosef Hochberg dans leur démonstration théorique de 1995 reposait sur une condition formelle cardinale : l’indépendance statistique mutuelle des statistiques de test associées aux hypothèses nulles véritables ($H_{0} in \mathcal{H}_0$). Sous cette hypothèse d’indépendance, la distribution conjointe des $p$-valeurs sous $H_0$ se décompose en un produit direct de distributions uniformes standard sur l’intervalle $[0, 1]$.
La preuve analytique de la majoration du FDR repose sur la modélisation de l’espérance mathématique de la somme des indicatrices d’erreur, pondérée par l’inverse de la quantité totale de rejets $R$. Benjamini et Hochberg ont magistralement établi que lorsque les tests sont mutuellement indépendants, le taux de fausses découvertes effectif est non seulement inférieur ou égal au seuil $Q$ fixé par le chercheur, mais qu’il respecte rigoureusement l’inégalité asymptotique exacte :
$$\text{FDR} le \frac{m_0}{m} Q le Q$$
Cette inégalité révèle que si une fraction substantielle des hypothèses alternatives est vraie ($m_0 < m$), la procédure se montre en réalité légèrement conservatrice, le FDR réel étant minoré d'un facteur proportionnel au ratio d'hypothèses nulles authentiques $m_0 / m$. Bien que cette démonstration originale ait été une percée théorique magistrale, la communauté scientifique a rapidement souligné une difficulté pragmatique : dans le champ réel des données psychologiques, psychométriques ou biomédicales, l'indépendance absolue entre les variables mesurées constitue une exception quasi inexistante.
7.2 La propriété de dépendance de régression positive (PRDS)
Afin de résoudre l’inadéquation entre l’axiome d’indépendance stricte et la réalité empirique des corrélations naturelles, Benjamini et Daniel Yekutieli ont publié en 2001 une extension théorique décisive démontrant que la procédure BH standard conserve l’exactitude de son contrôle du FDR sous une classe bien plus vaste et réaliste de dépendances statistiques, qualifiée de dépendance de régression positive sur chaque sous-ensemble (Positive Regression Dependency on each Subset, ou PRDS).
Vulgarisée à l’usage des sciences comportementales, la condition PRDS stipule qu’une association positive globale prévaut entre les statistiques de test. Autrement dit, si l’on sait que la statistique de test associée à une variable donnée est élevée (reflétant une tendance marquée à s’écarter de $H_0$), cette information conditionnelle ne diminue en rien la probabilité que les statistiques de test associées aux autres variables liées soient elles aussi élevées. En termes simples, il s’agit d’une généralisation multidimensionnelle du concept de corrélation non négative.
Cette validation sous condition PRDS revêt une importance capitale pour la recherche psychologique. Dans l’immense majorité des paradigmes expérimentaux, les indicateurs mesurés partagent des substrats biologiques ou cognitifs communs : les temps de réaction sur diverses modalités sensorielles sont positivement corrélés entre eux par le biais de la vitesse générale de traitement de l’information (facteur $g$), tout comme les différentes sous-échelles d’un inventaire clinique d’anxiété partagent une variance commune issue du névrosisme. Ces configurations respectant naturellement le cadre de la dépendance de régression positive, la procédure classique de Benjamini-Hochberg y garantit formellement un contrôle sans faille du taux de fausses découvertes.
7.3 Conséquences de la violation des conditions d’application
L’immunité mathématique de la procédure BH connaît toutefois des bornes précises qu’un méthodologiste chevronné ne saurait occulter. Lorsque le jeu de données présente des structures de dépendance fortement antagonistes ou des corrélations négatives systématiques et intenses entre les variables analysées, la condition PRDS n’est plus satisfaite. C’est également le cas lors de dépendances non linéaires complexes, oscillatoires ou cycliques.
Dans de tels contextes de violation théorique, la machinerie statistique de Benjamini-Hochberg peut subir des distorsions : le taux de fausses découvertes réel est susceptible de dépasser de manière substantielle la valeur cible $Q$ contractualisée par le chercheur. Une inflation non contrôlée du FDR réel (pouvant culminer à 0,10 ou 0,15 pour une valeur nominale affichée de 0,05) expose alors la recherche à une prolifération subreptice de fausses découvertes, recréant insidieusement les conditions d’instabilité réplicative que le statisticien cherchait précisément à conjurer.
Il incombe dès lors à l’analyste de conduire un diagnostic minutieux des données brutes préalablement à la phase de test. L’examen des matrices d’inter-corrélations des résidus, la détection de dynamiques d’inhibition compétitive entre indicateurs comportementaux ou la présence de contraintes de somme constante (données compositionnelles où l’élévation d’un score force l’affaissement mécanique d’un autre) constituent des signaux d’alerte méthodologiques. Dans ces situations pathologiques, le recours à la variante conservatrice de Benjamini-Yekutieli ou à des approches par rééchantillonnage non paramétrique devient un impératif d’intégrité scientifique.
8. Extensions pour dépendances complexes : La procédure de Benjamini-Yekutieli
8.1 Le formalisme de Benjamini-Yekutieli (BY)
Conscients de l’impasse méthodologique que représentait l’existence de dépendances statistiques non couvertes par la propriété PRDS, Yoav Benjamini et Daniel Yekutieli ont formalisé dans leur article de 2001 une modification universelle de la procédure BH, désignée dans la taxonomie contemporaine sous l’appellation de procédure de Benjamini-Yekutieli (couramment notée procédure BY). Cette formulation offre la garantie absolue et irrévocable de contrôler le FDR à un niveau inférieur ou égal à $Q$, quelle que soit la complexité ou la nature de la distribution conjointe des données, y compris sous de fortes corrélations négatives.
Pour immuniser l’algorithme contre toute forme de distorsion de corrélation, Benjamini et Yekutieli ont démontré qu’il convenait d’infliger un facteur de correction harmonique au dénominateur du seuil critique dynamique. Ce terme régulateur universel, noté $c(m)$, équivaut à la somme des inverses de la série harmonique des entiers s’échelonnant de 1 à $m$ :
$$c(m) = \sum_{j=1}^{m} \frac{1}{j} = 1 + \frac{1}{2} + \frac{1}{3} + dots + \frac{1}{m}$$
Le calcul du seuil dynamique unitaire pour chaque test de rang ordonné $i$ s’énonce dès lors selon la nouvelle relation mathématique :
$$l_i^{\text{BY}} = \frac{i}{m \cdot c(m)} Q = \frac{i}{m \cdot \sum_{j=1}^m \frac{1}{j}} Q$$
L’algorithme décisionnel de tri et d’identification du point de bascule $k$ demeure strictement identique à celui de la procédure classique (recherche du rang maximal $k$ tel que $p_{(i)} le l_i^{\text{BY}}$ et rejet synchronisé des hypothèses 1 à $k$). Par cette pénalisation globale, Benjamini et Yekutieli ont offert à la science empirique une procédure universellement robuste, mathématiquement immunisée contre les géométries de dépendance les plus hostiles.
8.2 Coût statistique et perte de puissance avec la méthode BY
Cette garantie théorique universelle n’est pas sans contrepartie : elle s’accompagne d’un coût statistique considérable en termes de puissance. La constante harmonique de pénalisation $c(m)$ s’accroît de façon logarithmique à mesure que le volume de tests s’étend. Pour un jeu de données comprenant $m = 50$ tests, la somme harmonique s’élève à :
$$c(50) \approx \ln(50) + \gamma \approx 3,912 + 0,577 \approx 4,499$$
Pour un balayage génomique ou neuro-computationnel de $m = 10,000$ variables, ce facteur multiplicateur franchit le seuil de 9,78. Cela signifie que l’ensemble des seuils critiques calculés par la méthode BY se trouve divisé d’un facteur 4 à 10 par rapport aux seuils originaux de Benjamini-Hochberg. Cette amputation drastique rapproche paradoxalement la sévérité de Benjamini-Yekutieli de celle de la méthode conservatrice de Bonferroni, réduisant substantiellement le gain de puissance qui motivait initialement l’adoption d’un paradigme FDR.
Il est donc déconseillé d’appliquer mécaniquement la correction de Benjamini-Yekutieli par excès de zèle méthodologique. Son usage ne doit être réservé qu’aux circonstances dûment documentées où les variables présentent des patterns d’inhibition réciproque ou des structures de covariance bipolaires affirmées. Dans tous les autres contextes, où les inter-corrélations positives dominent ou restent modérées, le maintien de la procédure classique BH constitue le standard méthodologique optimal.
8.3 Approches adaptatives et estimation de la proportion d’hypothèses nulles
L’inégalité centrale établie par Benjamini et Hochberg ($\text{FDR} le (m_0 / m) Q$) montre que la procédure est d’autant plus conservatrice que la proportion d’hypothèses nulles réelles dans l’expérience, formellement modélisée par le paramètre :
$$\pi_0 = \frac{m_0}{m}$$
est substantiellement inférieure à 1. Si, au sein d’un paradigme de neurophysiologie, 60 % des variables investiguées réagissent effectivement à la tâche cognitive ($\pi_0 = 0,40$), la procédure BH calibrée à un taux nominal $Q = 0,05$ va en réalité brider le taux d’erreur effectif à une valeur réelle de $0,40 \times 0,05 = 0,02$. L’expérimentateur s’avère donc involontairement plus sévère que son engagement théorique initial ne l’exigeait.
Pour récupérer cette puissance statistique perdue, des statisticiens novateurs, emmenés notamment par John Storey en 2002, ont formalisé des procédures dites adaptatives en deux étapes. Ces approches consistent à mobiliser la distribution globale empirique des $p$-valeurs observées au-delà d’un seuil prédéterminé (par exemple l’intervalle $[0,5 ; 1,0]$, où l’on postule qu’aucune hypothèse alternative ne réside) afin d’estimer avec précision la quantité inconnue $\hat{\pi}_0$ :
$$\hat{\pi}_0(\lambda) = \frac{#{p_i > \lambda}}{m(1 – \lambda)}$$
Une fois cette estimation robuste obtenue, la procédure de Benjamini-Hochberg est réexécutée en calibrant le niveau cible d’erreur non plus sur la valeur brute $Q$, mais sur un seuil expansé et dynamiquement corrigé $Q^* = Q / \hat{\pi}_0$. Ces méthodologies adaptatives avancées permettent des gains marginaux de puissance considérables dans les études psychométriques massives et le traitement automatisé de données comportementales à grande échelle.
9. Domaines d’application privilégiés en sciences psychologiques
9.1 Neuroimagerie fonctionnelle et électrophysiologie
L’exploration du système nerveux central par le prisme de l’IRMf constitue l’archétype par excellence du problème des comparaisons multiples massives en psychologie cognitive. Une cartographie encéphalique standard acquise en résolution millimétrique segmente le parenchyme cérébral en un volume tridimensionnel découpé en un maillage comprenant entre 50 000 et 200 000 unités élémentaires désignées sous le nom de voxels. Évaluer si une tâche d’inhibition cognitive active spécifiquement certaines structures cérébrales implique d’ajuster un modèle linéaire général univarié (GLM) sur chacun de ces voxels de manière individualisée.
Dans ce contexte à haute densité, l’application aveugle d’une correction de Bonferroni atomiserait totalement la sensibilité statistique des imageurs, conduisant les chercheurs à ne détecter que les épicentres d’activation les plus intenses et à ignorer les réseaux distribués à connectivité subtile. La transposition de la procédure de Benjamini-Hochberg au traitement du signal neuro-anatomique a révolutionné l’imagerie cérébrale en permettant la détection de motifs d’activation fonctionnelle étendus, tout en bornant rigoureusement la proportion de voxels erronément allumés.
Une démarche similaire s’applique à l’électroencéphalographie (EEG) et à la magnétoencéphalographie (MEG) contemporaines, notamment dans l’analyse spatio-temporelle continue des potentiels évoqués (Event-Related Potentials ou ERP). Les chercheurs y analysent des dizaines d’électrodes à travers des fenêtres temporelles découpées en centaines de millisecondes, générant des matrices d’analyse croisée de plusieurs milliers de points de contact. L’application du contrôle FDR, couplée à des techniques non paramétriques de permutations par grappes spatiales (cluster-based permutation tests), forme désormais le socle incontesté de l’inférence neurophysiologique rigoureuse.
9.2 Génétique comportementale et études d’association globale (GWAS)
La génétique du comportement s’est radicalement affranchie des études sur gènes candidats pour adopter le cadre méthodologique des études d’association pangénomique (Genome-Wide Association Studies ou GWAS). Ces investigations ambitieuses s’efforcent de cartographier les fondements génomiques de traits psychologiques d’une grande complexité, tels que l’efficience cognitive générale, la vulnérabilité aux troubles schizophréniques, l’extraversion ou la prédisposition aux comportements addictifs.
L’architecture de ces protocoles impose d’éprouver simultanément les corrélations statistiques reliant un trait comportemental quantitatif à plusieurs centaines de milliers, voire plusieurs millions de polymorphismes nucléotidiques simples (Single Nucleotide Polymorphisms ou SNP) répartis sur l’ensemble du génome humain. Si la référence historique du domaine s’est fixée autour d’un seuil de significativité pangénomique ultra-rigide fondé sur Bonferroni ($p < 5 \times 10^{-8}$), la détection de profils polygéniques fins requiert désormais des procédures d'ajustement plus flexibles.
La mise en œuvre des extensions de Benjamini-Hochberg et des formulations locales du FDR permet aux généticiens comportementaux d’isoler des réseaux de variants génétiques exerçant des effets infinitésimaux mais cumulatifs. Les comités de rédaction des revues internationales de premier rang exigent désormais une transparence méthodologique absolue sur la régulation de ces taux d’erreur, positionnant le cadre FDR au centre de la validation moderne de l’architecture génétique humaine.
9.3 Psychométrie computationnelle et fouille de données d’enquêtes
L’ère du numérique a bouleversé l’échelle de collecte des données en psychologie sociale et différentielle. Les chercheurs n’opèrent plus seulement sur des échantillons restreints administrés en laboratoire, mais déploient des enquêtes psychométriques en ligne touchant des cohortes de dizaines de milliers de répondants, ou analysent les traces comportementales et textuelles issues des réseaux sociaux numériques.
Dans ce cadre, la construction, le calibrage et la validation transculturelle de vastes inventaires de personnalité (tels que des instruments mesurant le modèle Big Five étendu ou des facettes cliniques complexes) impliquent l’exploration systématique de gigantesques matrices de corrélations croisées item par item, ainsi que l’évaluation itérative du fonctionnement différentiel des items (DIF) au sein de sous-populations multiples. Sans une régulation statistique stricte, cette volumétrie génère des centaines d’associations factices assimilables à du simple bruit d’échantillonnage.
La procédure de Benjamini-Hochberg agit ici comme un régulateur fondamental contre les dérives pernicieuses du dragage de données (fréquemment formalisé dans le milieu académique sous les termes de p-hacking ou d’exploration opportuniste des données). En imposant un crible FDR systématique et transparent à l’intégralité des matrices d’inter-corrélations générées lors de la fouille de ces grandes cohortes observationnelles, les psychométriciens pérennisent la reproductibilité des structures factorielles identifiées et restaurent la validité de construit de leurs instruments de mesure.
10. Mise en œuvre computationnelle dans les logiciels statistiques
10.1 Implémentation sous l’écosystème R
L’environnement statistique matriciel R constitue le standard d’analyse privilégié de la recherche académique en sciences du comportement et en neurosciences. L’intégration de la procédure de Benjamini-Hochberg est nativement disponible au sein du système de base à travers l’appel de la fonction générique p.adjust(). Cette routine accepte en argument vectoriel une collection brute de $p$-valeurs non ordonnées et retourne directement les valeurs ajustées correspondantes (parfois appelées $q$-valeurs au sens de Benjamini-Hochberg) :
Le chercheur spécifie simplement le paramètre technique method = "BH" (l’argument synonyme "fdr" étant également reconnu par le compilateur). Le code s’articule conventionnellement ainsi :
p_ajustees <- p.adjust(p_brutes, method = "BH")
La valeur de probabilité ajustée pour une observation de rang $i$ correspond au calcul progressif :
$$p_{(i)}^{\text{ajustée}} = \min \left( \min_{k ge i} \left{ \frac{m}{k} p_{(k)} \right}, 1 \right)$$
Ce calcul garantit la monotonicité de la séquence ajustée sans obliger le chercheur à recalculer les seuils à la main. Pour des modélisations plus sophistiquées, notamment l’estimation non paramétrique du paramètre $\pi_0$ et le calcul individualisé des véritables $q$-valeurs bayésiennes empiriques, la communauté s’appuie sur le package spécialisé qvalue issu du dépôt Bioconductor, ainsi que sur la suite logicielle multtest. Ces bibliothèques fournissent des fonctions graphiques avancées permettant d’afficher simultanément la décroissance des densités de probabilités observées face aux courbes théoriques du modèle d’absence d’effet.
10.2 Mise en œuvre en Python pour les neurosciences computationnelles
Avec l’essor du machine learning et de la science des données appliquée à la modélisation cognitive, le langage Python est devenu un vecteur prépondérant de l’analyse expérimentale, en particulier au travers de la suite scientifique SciPy et de l’écosystème Statsmodels. La gestion des comparaisons multiples est principalement confiée au sous-module dédié statsmodels.stats.multitest.
La fonction de référence opérationnelle s’intitule multipletests. Elle reçoit en entrée un tableau unidimensionnel (de type NumPy array ou une série Pandas) regroupant les $p$-valeurs brutes calculées en amont. Pour activer la procédure de Benjamini-Hochberg classique, l’argument formel method='fdr_bh' est assigné au pipeline. La signature syntaxique standard prend la forme :
reject, p_corrected, alphacSidak, alphacBonf = multipletests(pvals, alpha=0.05, method='fdr_bh')
La fonction retourne une collection tuple structurée fournissant un tableau booléen (reject) spécifiant pour chaque variable si son hypothèse nulle respective doit être formellement rejetée, ainsi qu’un vecteur flottant (p_corrected) consignant les probabilités corrigées prêtes à l’emploi. Si le contexte requiert l’activation de la variante rigide de Benjamini-Yekutieli en raison d’interdépendances négatives avérées, la syntaxe s’adapte en substituant la commande par method='fdr_by'. Ces fonctions s’intègrent organiquement dans les chaînes de traitement automatisées de la bibliothèque Scikit-Learn afin d’effectuer le filtrage préalable des descripteurs (feature selection) avant l’entraînement de modèles prédictifs comportementaux.
10.3 Application dans les logiciels dédiés aux sciences sociales (SPSS et JASP)
Bien que le scripting programmatique sous R et Python s’étende, une proportion importante de la recherche en psychologie clinique, différentielle et cognitive s’effectue au travers de progiciels à interface graphique, principalement IBM SPSS Statistics et la plateforme d’inférence ouverte JASP.
Historiquement, SPSS ne proposait pas d’option native cliquable pour la procédure de Benjamini-Hochberg dans ses menus déroulants de base, limitant ses options automatiques à Bonferroni, Sidak ou Scheffé. Pour contourner cette limite dans les versions classiques, les chercheurs doivent soit injecter un script d’extension Python directement dans la fenêtre de syntaxe SPSS (via la commande SPSSINC MULT TEST), soit exécuter des macros de syntaxe matricielle programmées pour calculer manuellement le rang $i$ et le seuil critique $(i/m) \times Q$ à partir du tableau des sorties de test.
À l’avant-garde des initiatives pour une science ouverte et reproductible, le logiciel JASP (développé par le laboratoire de méthodologie de l’Université d’Amsterdam sous la direction d’Eric-Jan Wagenmakers) intègre nativement et de façon totalement transparente le contrôle par le FDR. Lors de la réalisation de matrices de corrélations ou d’analyses de variance univariées et multivariées, une simple case à cocher étiquetée « FDR (Benjamini-Hochberg) » applique la correction dynamique aux matrices de données. Les sorties tabulaires générées affichent immédiatement les $p$-valeurs réajustées, permettant une exportation fluide de résultats directement exploitables et vérifiables vers les logiciels de traitement de texte académiques.
11. Normes de publication et reporting scientifique (Normes APA)
11.1 Directives de rédaction des résultats
La publication d’analyses statistiques au sein des revues affiliées à l’American Psychological Association (normes APA, 7e édition) impose des standards de limpidité et de précision formelle particulièrement exigeants. L’époque où un chercheur pouvait simplement apposer un astérisque générique signalant un vague « $p < 0,05$ » sans autre détail méthodologique est révolue. Dès lors que plusieurs tests sont menés, la politique de contrôle de l'erreur d'échantillonnage doit être exhaustivement explicitée dans la section « Analyses statistiques » de l'article.
Le manuscrit doit formaliser sans ambiguïté les trois éléments structurants suivants :
- La justification théorique : L’explication claire du choix du Taux de Fausses Découvertes (FDR) au détriment du FWER en vertu de la nature exploratoire ou de l’envergure dimensionnelle des données.
- Les paramètres contractuels : La déclaration explicite du seuil cible contractualisé (usuellement $Q = 0,05$).
- La double quantification : La communication conjointe, au sein du corps du texte ou des tableaux de synthèse, des $p$-valeurs brutes initiales ainsi que des $p$-valeurs ajustées (souvent notées $p_{\text{FDR}}$ ou $q$), accompagnées systématiquement des tailles d’effet associées (telles que le $d$ de Cohen ou le $\eta_p^2$).
Une formulation textuelle académique exemplaire conforme aux normes de l’APA s’énoncera, par exemple, comme suit :
« En raison de la multiplicité des analyses cognitives conduites simultanément sur les dix sous-échelles de l’attention ($m = 10$), le risque d’erreur a été régulé par l’application de la procédure de Benjamini-Hochberg pour contrôler le Taux de Fausses Découvertes (FDR) à un seuil nominal $Q = 0,05$. L’effet principal de l’intervention de remédiation sur le score d’attention focalisée s’est révélé robuste après correction ($t(48) = 2,84$, $p_{\text{brut}} = 0,006$, $p_{\text{FDR}} = 0,015$, $d = 0,81$). Les dix seuils dynamiques calculés ainsi que les $p$-valeurs brutes et ajustées pour chaque sous-test sont compilés de façon exhaustive au Tableau 2. »
11.2 Transparence méthodologique et distinction confirmatif/exploratoire
L’application légitime de la procédure de Benjamini-Hochberg exige une probité totale quant au statut épistémologique des hypothèses évaluées. L’un des écueils majeurs ayant précipité la crise de confiance dans les sciences empiriques réside dans la pratique trompeuse du HARKing (Hypothesizing After the Results are Known), qui consiste à présenter rétrospectivement des découvertes fortuites issues d’un crible exploratoire massif comme s’il s’agissait de confirmations d’hypothèses théoriques formulées a priori.
Le mouvement contemporain pour la science ouverte (Open Science) requiert une dissociation étanche entre les deux régimes d’investigation :
- Analyses confirmatoires pré-enregistrées : Les hypothèses fondamentales doivent faire l’objet d’un pré-enregistrement formel (preregistration) sur des plateformes institutionnelles dédiées telles que l’Open Science Framework (OSF) préalablement à toute collecte de données. Le plan d’analyse pré-enregistré doit fixer à l’avance la méthode exacte de gestion de la multiplicité.
- Analyses exploratoires post-hoc : Toute analyse statistique non planifiée initialement, menée dans un second temps pour explorer des pistes inattendues, doit être explicitement signalée comme « exploratoire » dans le texte final. C’est précisément au sein de ce compartiment exploratoire que la procédure de Benjamini-Hochberg déploie son plein potentiel méthodologique.
Pour assurer la reproductibilité intégrale des traitements statistiques, il est vivement recommandé de verser sur les dépôts de science ouverte non seulement les données brutes anonymisées, mais également les scripts exécutables intégraux (fichiers R, syntaxes SPSS ou notebooks Jupyter) démontrant l’exécution étape par étape de l’ajustement séquentiel.
11.3 Représentation graphique rigoureuse
L’exposition visuelle des inférences issues d’analyses multiples ne saurait se cantonner à de simples diagrammes en barres affublés de barres d’erreur. Les normes actuelles de communication scientifique préconisent l’usage de visualisations bidimensionnelles globales permettant au lecteur d’appréhender instantanément la distribution des preuves statistiques et l’action de la correction de Benjamini-Hochberg.
Le dispositif d’affichage par excellence est le Volcano plot (graphique en volcan), massivement popularisé par la génomique et aujourd’hui très usité en neurosciences comportementales et en psychologie computationnelle. Ce diagramme de dispersion projette en abscisse l’amplitude de la taille de l’effet clinique ou psychologique mesuré (par exemple la différence standardisée des moyennes ou le log du rapport de cotes) et en ordonnée l’opposé du logarithme décimal de la $p$-valeur brute, soit :
$$-\log_{10}(p)$$
Dans ce plan factoriel, la ligne de démarcation imposée par un seuil fixe conventionnel se matérialise sous la forme d’une droite horizontale rigide. En revanche, l’application de la procédure de Benjamini-Hochberg se traduit graphiquement par une frontière dynamique dont la ligne de coupe s’ajuste de façon individualisée à chaque variable. Les points situés dans les quadrants supérieurs gauche et droit identifient les variables satisfaisant simultanément à une taille d’effet substantielle et à un rejet valide de l’hypothèse nulle sous contrôle FDR, conférant à la restitution graphique une lisibilité analytique immédiate.
12. Limites critiques, écueils courants et perspectives
12.1 Idées reçues et erreurs d’interprétation fréquentes
L’utilisation généralisée de la procédure de Benjamini-Hochberg dans les laboratoires s’accompagne régulièrement de glissements interprétatifs néfastes qu’il convient de dissiper rigoureusement. La confusion conceptuelle la plus répandue consiste à assimiler la $q$-valeur calculée pour un test spécifique (ou la $p$-valeur ajustée Benjamini-Hochberg) à la probabilité intrinsèque que cette hypothèse précise constitue une fausse découverte. Il s’agit là d’une mécompréhension fondamentale : le FDR est une espérance mathématique définie à l’échelle d’un ensemble de décisions collectives.
Attribuer un sens individuel à une métrique collective relève du sophisme écologique d’inférence. Si une variable affiche une $p$-valeur ajustée sous Benjamini-Hochberg de 0,04, cela n’autorise aucunement l’expérimentateur à déduire qu’il existe 4 % de risques que cet effet spécifique soit fallacieux. La seule déduction valide est la suivante : au sein de la totalité des tests déclarés statistiquement significatifs jusqu’à ce rang de coupure dans l’expérience, la proportion moyenne espérée d’erreurs d’attribution ne dépassera pas 4 % sur le long terme.
Un second écueil tenace réside dans l’illusion méthodologique que le contrôle du FDR prémunirait l’analyste contre les biais expérimentaux extrastatistiques. Aucune procédure d’ajustement mathématique ne saurait corriger les distorsions induites par un échantillon non probabiliste fortement biaisé, un manque de puissance chronique ou des variables résiduelles de confusion non contrôlées. Enfin, il demeure impératif de se rappeler qu’une significativité confirmée par Benjamini-Hochberg ne préjuge en rien de la pertinence clinique ou sociétale d’un résultat : une variable affichant une association statistiquement validée sous contrôle FDR peut très bien présenter une taille d’effet microscopique et être totalement dépourvue de signification théorique concrète.
12.2 Situations où la procédure Benjamini-Hochberg est inadaptée
L’universalité n’existant pas en méthodologie quantitative, il existe des configurations expérimentales précises où la mobilisation de la procédure de Benjamini-Hochberg doit être déconseillée au profit d’autres solutions inférentielles :
- Les essais cliniques de validation thérapeutique (Phase III) : Lorsqu’un protocole interventionnel évalue l’efficacité et l’innocuité d’un nouveau traitement psychothérapeutique ou neuropharmacologique sur plusieurs critères d’évaluation majeurs fondamentaux, l’admission du moindre faux positif peut conduire à la mise sur le marché d’une approche inefficace. Dans ce cas, la tolérance d’un ratio de fausses découvertes est éthiquement et scientifiquement inacceptable ; le contrôle rigide du FWER via Bonferroni ou Holm demeure le seul étalon admissible par les agences de régulation internationales.
- Les protocoles à très faible volumétrie de tests ($m < 4$ ou $5$) : Lorsque le nombre global de comparaisons planifiées est extrêmement réduit, le mécanisme d’assouplissement séquentiel du FDR n’a matériellement pas l’espace stochastique suffisant pour opérer efficacement. Les seuils de Benjamini-Hochberg s’y révèlent presque identiques à ceux de Holm, rendant la transition conceptuelle vers le FDR sans bénéfice statistique tangible.
- La présence de structures de covariance fortement négatives : Comme documenté précédemment, si les variables expérimentales manifestent des antagonismes systématiques intenses (comme dans les systèmes de vases communicants psychométriques), la condition PRDS est enfreinte, imposant l’abandon de la procédure classique au profit de la méthode de Benjamini-Yekutieli ou de méthodes de rééchantillonnage bootstrap adaptées.
12.3 Évolution vers les méthodes modernes d’inférence sélective
L’héritage de Benjamini et Hochberg a ouvert une avenue théorique prolifique qui s’étend aujourd’hui bien au-delà de leur formulation originelle de 1995. Les frontières actuelles de la statistique appliquée en psychologie computationnelle et en sciences cognitives s’orientent vers l’inférence post-sélection (Selective Inference). Ce courant novateur s’efforce de résoudre le défi posé par les algorithmes d’apprentissage automatique qui sélectionnent d’abord les variables les plus prédictives au sein de jeux de données massifs avant d’effectuer les tests inférentiels sur ces variables préalablement tamisées.
Parallèlement, la statistique bayésienne contemporaine a développé ses propres déclinaisons du concept de fausse découverte. En substituant aux valeurs $p$ traditionnelles des probabilités a posteriori issues de modèles hiérarchiques de mélanges, les approches du Local FDR (fdr local formalisé par Bradley Efron) permettent d’estimer la probabilité spécifique qu’une hypothèse particulière soit nulle conditionnellement à la statistique de test précisément observée pour cette variable unitaire :
$$\text{fdr}(z) = P(H_0 mid Z = z)$$
Cette hybridation féconde entre la souplesse pragmatique du contrôle des fausses découvertes et la richesse interprétative des distributions a posteriori bayésiennes trace la trajectoire de l’inférence scientifique future. Trois décennies après sa publication séminale, la procédure de Benjamini-Hochberg demeure le socle fondateur indispensable de cette quête continue d’une science du comportement rigoureuse, puissante et reproductible.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Benjamini, Y., & Yekutieli, D. (2001). The control of the false discovery rate in multiple testing under dependency. The Annals of Statistics, 29(4), 1165–1188. https://doi.org/10.1214/aos/1013699998
- Benjamini, Y., & Yekutieli, D. (2005). False discovery rate-adjusted multiple confidence intervals for selected parameters. Journal of the American Statistical Association, 100(469), 71–81. https://doi.org/10.1198/016214504000001907
- Bonferroni, C. E. (1936). Teoria statistica delle classi e calcolo delle probabilità. Pubblicazioni del R Istituto Superiore di Scienze Economiche e Commerciali di Firenze, 8, 3–62.
- Efron, B. (2010). Large-scale inference: Empirical Bayes methods for estimation, testing, and prediction. Cambridge University Press. https://doi.org/10.1017/CBO9780511761362
- Gelman, A., Hill, J., & Yajima, M. (2012). Why we (usually) don’t have to worry about multiple comparisons. Journal of Research on Educational Effectiveness, 5(2), 189–211. https://doi.org/10.1080/19345747.2011.618213
- Groppe, D. M., Urbach, T. P., & Kutas, M. (2011). Mass univariate analysis of event-related brain potentials/fields I: A critical tutorial review. Psychophysiology, 48(12), 1711–1725. https://doi.org/10.1111/j.1469-8986.2011.01273.x
- Holm, S. (1979). A simple sequentially rejective multiple test procedure. Scandinavian Journal of Statistics, 6(2), 65–70. https://www.jstor.org/stable/4615733
- Ioannidis, J. P. A. (2005). Why most published research findings are false. PLOS Medicine, 2(8), Article e124. https://doi.org/10.1371/journal.pmed.0020124
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Nichols, T., & Hayasaka, S. (2003). Controlling the familywise error rate in functional neuroimaging: A comparative review. Statistical Methods in Medical Research, 12(5), 419–446. https://doi.org/10.1191/0962280203sm341ra
- Nosek, B. A., Ebersole, C. R., DeHaven, A. C., & Mellor, D. T. (2018). The preregistration revolution. Proceedings of the National Academy of Sciences, 115(11), 2600–2606. https://doi.org/10.1073/pnas.1708274114
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), Article aac4716. https://doi.org/10.1126/science.aac4716
- Pashler, H., & Wagenmakers, E.-J. (2012). Editors’ introduction to the special section on replicability in psychological science: A crisis of confidence? Perspectives on Psychological Science, 7(6), 528–530. https://doi.org/10.1177/1745691612465253
- Shaffer, J. P. (1995). Multiple hypothesis testing. Annual Review of Psychology, 46(1), 561–584. https://doi.org/10.1146/annurev.ps.46.020195.003021
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Storey, J. D. (2002). A direct approach to false discovery rates. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 64(3), 479–498. https://doi.org/10.1111/1467-9868.00346
- Storey, J. D., & Tibshirani, R. (2003). Statistical significance for genomewide studies. Proceedings of the National Academy of Sciences, 100(16), 9440–9445. https://doi.org/10.1073/pnas.1530509100
- Wagenmakers, E.-J., Wetzels, R., Borsboom, D., & van der Maas, H. L. J. (2011). Why psychologists must change the way they analyze their data: The case of psi: Comment on Bem (2011). Journal of Personality and Social Psychology, 100(3), 426–432. https://doi.org/10.1037/a0022790