
La communication des résultats quantitatifs au sein des revues scientifiques à comité de lecture constitue l’une des étapes les plus déterminantes de la recherche empirique. En psychologie, en neurosciences cognitives, en sciences de l’éducation ainsi que dans l’ensemble des sciences du comportement, l’analyse de variance (ANOVA) demeure le paradigme inférentiel prédominant pour tester l’effet de variables indépendantes catégorielles sur des variables dépendantes continues. Pourtant, une proportion considérable de manuscrits soumis aux comités éditoriaux souffre de lacunes formelles, d’omissions statistiques critiques ou de confusions conceptuelles dans la présentation de ces analyses. Une communication rigoureuse ne se limite pas à énoncer un résultat binaire fondé sur un seuil de significativité arbitraire ; elle doit restituer la logique expérimentale, quantifier la magnitude des phénomènes observés et fournir aux pairs les données indispensables à l’évaluation critique et à la méta-analyse.
L’avènement de la septième édition du manuel de publication de l’American Psychological Association (APA) a renforcé les exigences de transparence, de traçabilité et de reproductibilité des analyses statistiques. Les chercheurs ne peuvent plus se contenter de rapporter une statistique de test isolée. Il leur incombe désormais de documenter scrupuleusement la vérification des postulats métrologiques sous-jacents, de fournir des estimations précises des paramètres descriptifs accompagnées de leurs intervalles de confiance, de détailler les corrections appliquées en cas de violation des hypothèses de distribution, et de déclarer systématiquement des indices standardisés de taille d’effet. Cet ensemble de normes vise à prémunir la discipline contre les dérives interprétatives et à garantir une fidélité absolue entre l’architecture des données recueillies et les conclusions théoriques avancées.
Ce guide exhaustif a été conçu pour accompagner les chercheurs, doctorants et analystes de données dans la maîtrise complète du compte-rendu des analyses de variance selon les plus hauts standards académiques internationaux. De l’explicitation des fondements mathématiques élémentaires jusqu’à la rédaction avancée de modèles mixtes complexes à mesures répétées, en passant par l’analyse fine des interactions factorielles et la conception de tableaux normés, cet ouvrage de référence détaille pas à pas les formulations canoniques, les écueils méthodologiques à contourner et les conventions typographiques strictes régissant l’écriture scientifique contemporaine.
1. Fondements théoriques de l’ANOVA en recherche psychologique
1.1 Définition et objectifs de l’analyse de variance
L’analyse de variance, développée originellement par le statisticien et généticien Ronald A. Fisher, est une méthode statistique inférentielle paramétrique dont l’objectif premier est de tester l’hypothèse nulle d’égalité des moyennes de plusieurs populations. Lorsqu’un protocole expérimental implique la comparaison de deux groupes indépendants, le test t de Student pour échantillons indépendants s’avère parfaitement adapté. Cependant, dès lors que le dispositif expérimental incorpore trois conditions ou davantage (par exemple, un groupe témoin recevant un placebo, un groupe bénéficiant d’une thérapie comportementale classique et un troisième soumis à une intervention cognitive novatrice), le recours réitéré à des tests t bilatéraux par paires engendre une dégradation majeure de la validité inférentielle de l’étude.
Ce phénomène découle de l’inflation exponentielle du taux d’erreur de type I global (ou erreur par famille d’hypothèses, notée $\alpha_{FW}$ pour family-wise error rate). Si l’on applique $c$ comparaisons indépendantes au seuil nominal usuel de $\alpha = .05$, la probabilité d’observer au moins un faux positif (rejeter l’hypothèse nulle à tort) est déterminée par l’équation $\alpha_{FW} = 1 – (1 – \alpha)^c$. Pour une comparaison entre quatre groupes expérimentaux, le nombre de combinaisons possibles de paires s’élève à six, portant le risque global de rejeter l’hypothèse nulle par simple fluctuation d’échantillonnage à plus de 26,5 %. L’ANOVA préserve l’intégrité de la démarche scientifique en proposant un test omnibus unique qui évalue simultanément l’ensemble des moyennes au seuil nominal prédéfini de .05, neutralisant tout risque d’inflation artificielle de l’erreur de première espèce.
Le mécanisme mathématique sous-jacent repose sur la partition élégante de la dispersion totale des observations. L’ANOVA décompose la somme totale des carrés des écarts ($SS_{Total}$) en deux entités mutuellement exclusives et parfaitement additives : la somme des carrés intergroupes ($SS_{Inter}$ ou $SS_{Effet}$), qui reflète la dispersion des moyennes de chaque condition autour de la moyenne générale (le grand écart induit par les manipulations expérimentales), et la somme des carrés intragroupe ($SS_{Intra}$ ou $SS_{Erreur}$), qui capture la variance résiduelle non contrôlée inhérente aux différences individuelles et aux bruits de mesure au sein de chaque groupe. Le rapport entre les carrés moyens correspondants (les sommes des carrés divisées par leurs degrés de liberté respectifs) produit la statistique de test observée, notée F. Si la variabilité induite par le traitement dépasse substantiellement le bruit aléatoire interne aux groupes, la valeur empirique de F franchit le seuil critique de la distribution théorique de Fisher-Snedecor, autorisant ainsi le rejet légitime de l’hypothèse nulle.
1.2 Typologie des protocoles expérimentaux associés à l’ANOVA
L’analyse de variance s’adapte à une multiplicité d’architectures expérimentales, que le chercheur se doit d’identifier précisément dès la conception de son étude afin de choisir le modèle linéaire approprié. La variante la plus élémentaire est le protocole inter-sujets à un facteur unique (One-Way ANOVA), où chaque participant est assigné de façon exclusive et aléatoire à une seule modalité d’une variable indépendante comportant trois niveaux ou plus. Cette configuration s’applique typiquement à l’évaluation comparative de différents protocoles thérapeutiques ou à l’étude de l’impact de différents dosages pharmacologiques administrés à des cohortes distinctes d’individus.
Les plans factoriels croisés (Two-Way ANOVA, Three-Way ANOVA) constituent une avancée conceptuelle majeure en recherche comportementale, car ils permettent d’évaluer de manière concomitante l’impact de deux ou plusieurs variables indépendantes ainsi que leur dépendance mutuelle, matérialisée par l’effet d’interaction. Dans un plan factoriel $2 \times 3$, le chercheur examine non seulement les effets principaux de chaque facteur isolé, mais teste également si l’influence du premier facteur varie en intensité ou en direction selon les niveaux du second. Cette capacité à quantifier les effets modérateurs confère aux plans factoriels une proximité écologique remarquable avec la complexité multifactorielle des phénomènes psychologiques.
En psychologie cognitive, en neuropsychologie et en psychophysique, où la variabilité interindividuelle peut masquer des effets discrets de traitement, les protocoles intra-sujets (mesures répétées) s’avèrent particulièrement précieux. Dans cette configuration, chaque sujet est exposé à l’ensemble des conditions expérimentales ou évalué à travers plusieurs moments successifs dans le temps. Ce dispositif permet d’isoler la variance interindividuelle stable pour l’extraire du dénominateur d’erreur, conférant au modèle une puissance statistique hautement supérieure à effectif égal. Enfin, les modèles mixtes (Split-Plot ANOVA) synthétisent ces deux approches en incorporant au sein d’un même dispositif au moins un facteur inter-sujets (par exemple, un groupe clinique versus un groupe contrôle) et au moins un facteur intra-sujets (par exemple, des évaluations cognitives conduites pré-intervention, post-intervention et lors d’un suivi longitudinal à six mois).
1.3 La transition des données brutes vers la rédaction académique
L’étape de conversion des résultats bruts issus des logiciels d’analyse (tels que SPSS, R, JASP ou Jamovi) en une prose scientifique rigoureuse représente un point critique de la communication scientifique. Trop souvent, les manuscrits présentent une accumulation brute de sorties statistiques non synthétisées, dénuées de contextualisation théorique, ou omettent des informations vitales nécessaires à la pleine compréhension du lecteur. La rédaction de la section « Résultats » ne consiste pas en un simple déversement de chiffres, mais en un récit logique hautement structuré où les statistiques inférentielles agissent comme des éléments de preuve venant valider ou invalider des propositions conceptuelles formulées dans l’introduction.
Cette transition impose un alignement direct entre les questions de recherche initiales, les hypothèses opérationnelles et les métriques rapportées. Les comités de lecture des revues internationales de premier rang, régies par les directives du Comité de publication de l’APA, appliquent désormais des critères de filtrage stricts concernant la reproductibilité. Cela implique non seulement de préciser les valeurs statistiques conventionnelles, mais également de fournir des statistiques descriptives complètes et non tronquées, d’éclairer la démarche analytique ayant présidé au traitement des violations de postulats et de bannir toute ambiguïté dans la description des degrés de liberté. Rédiger cette section avec une limpidité exemplaire facilite l’examen par les pairs, prévient les demandes de révision chronophages et contribue activement à la crédibilité cumulative de la discipline.
2. Vérification et compte-rendu des postulats de l’ANOVA
2.1 Évaluation de la normalité de la distribution
Le modèle de l’ANOVA repose sur l’hypothèse que les résidus du modèle (les écarts individuels par rapport à la moyenne de leur groupe respectif) sont distribués selon une loi normale au sein de chaque population parente. L’évaluation de cette hypothèse de normalité requiert une approche duale combinant diagnostics visuels et tests inférentiels d’ajustement. L’inspection des diagrammes quantile-quantile (Q-Q plots) constitue la méthode diagnostique visuelle la plus fiable : si les points empiriques s’alignent étroitement le long de la bissectrice théorique sans déviations systématiques en forme de « S » ou de courbures prononcées aux extrémités, la distribution peut être qualifiée de raisonnablement normale. Les histogrammes de distribution superposés à la courbe de Gauss idéale permettent quant à eux d’identifier d’éventuelles asymétries (skewness) ou aplatissements excessifs (kurtosis).
Sur le plan formel, le test de Shapiro-Wilk s’impose comme le test le plus puissant et le plus adapté pour des échantillons de taille modeste à modérée ($N < 50$ par condition), surpassant largement le test de Kolmogorov-Smirnov, dont la puissance statistique est notoirement insuffisante à moins d'appliquer la correction de Lilliefors. La formulation académique d'un constat de normalité dans un manuscrit doit consigner explicitement la statistique de test et sa probabilité associée pour chaque modalité expérimentale étudiée. Par exemple, le chercheur rédigera : « L'examen des diagrammes Q-Q plots et les résultats du test de Shapiro-Wilk indiquent que les scores d'anxiété suivent une distribution normale dans le groupe contrôle, W = 0.98, p = .412, le groupe d’entraînement cognitif, W = 0.97, p = .285, et le groupe combiné, W = 0.99, p = .831. »
Il importe toutefois de souligner que l’ANOVA générale se caractérise par une remarquable robustesse aux entorses modérées de normalité, en vertu du théorème central limite, dès lors que les effectifs par cellule sont équilibrés et dépassent une trentaine de sujets ($n ge 30$). En présence de larges échantillons, les tests formels comme celui de Shapiro-Wilk deviennent hypersensibles à des écarts infinitésimaux et triviaux de la normalité parfaite, conduisant fréquemment à des rejets injustifiés de l’hypothèse de normalité. Dans de telles circonstances, le chercheur doit justifier le maintien de l’ANOVA paramétrique classique en s’appuyant sur les indices d’asymétrie et d’aplatissement (qui doivent idéalement demeurer compris dans l’intervalle $[-1, +1]$ ou $[-1.5, +1.5]$) et en consignant expressément cette argumentation dans le corps du texte méthodologique.
2.2 Homogénéité des variances (homoscédasticité)
L’homoscédasticité stipule que la variance résiduelle de la variable dépendante demeure identique à travers l’ensemble des groupes expérimentaux comparés ($\sigma_1^2 = \sigma_2^2 = dots = \sigma_k^2$). Cette égalité conditionne directement la validité du dénominateur du test F, qui représente une estimation combinée (ou « poolée ») de la variance intra-groupe commune. La rupture de ce postulat, connue sous le terme d’hétéroscédasticité, altère gravement les taux d’erreur de première espèce. Lorsque les groupes présentent des effectifs inégaux et que le groupe le plus restreint présente la variance la plus forte, le test F classique devient excessivement libéral, multipliant les rejets abusifs de l’hypothèse nulle. À l’inverse, si le groupe le plus large affiche la plus forte variance, le test devient excessivement conservateur, anéantissant la puissance statistique de l’investigation.
L’évaluation statistique de l’homoscédasticité s’effectue traditionnellement au moyen du test d’égalité des variances de Levene. La version contemporaine recommandée du test de Levene calcule la déviation absolue des scores non pas par rapport à la moyenne du groupe (version historique sensible aux écarts de normalité), mais par rapport à sa médiane, garantissant une meilleure robustesse générale. La restitution formelle du test de Levene dans un article obéit aux mêmes exigences typographiques que l’ANOVA elle-même, en mentionnant la lettre F en italique, les degrés de liberté intergroupes et résiduels, ainsi que la valeur exacte de p : « Le postulat d’homogénéité des variances a été vérifié par le test de Levene, F(2, 87) = 1.42, p = .247. »
Lorsque le test de Levene atteint le seuil de significativité conventionnel ($p < .05$), le postulat d'homoscédasticité est officiellement violé. Dans ce scénario, le recours à l'ANOVA standard de Fisher doit être formellement proscrit au profit de procédures alternatives robustes, au premier rang desquelles figure l'ANOVA ajustée de Welch (ou, alternativement, la procédure de Brown-Forsythe). La méthode de Welch pondère chaque moyenne par l'inverse de la variance de son groupe respectif et recalcule les degrés de liberté du dénominateur, produisant des degrés de liberté non entiers (décimaux). Le chercheur explicitera ce choix méthodologique selon une formule type : « En raison de la violation du postulat d'homoscédasticité révélée par le test de Levene, F(2, 57) = 6.84, p = .002, la statistique F ajustée de Welch a été retenue pour l’ensemble des analyses inférentielles omnibus. »
2.3 Indépendance des observations et détection des valeurs aberrantes
L’indépendance statistique des observations constitue sans nul doute le postulat le plus déterminant et le moins négociable de l’ANOVA inter-sujets. Chaque mesure recueillie auprès d’un participant ne doit en aucun cas être influencée par les réponses d’un autre sujet, ni résulter d’un regroupement contextuel masqué (comme l’évaluation d’élèves nichés au sein de mêmes classes ou de patients traités par le même thérapeute sans modélisation multiniveau). Contrairement à la normalité ou à l’homoscédasticité, aucune correction mathématique a posteriori ne permet de pallier une violation de l’indépendance au sein d’une ANOVA standard inter-sujets. Toute dépendance résiduelle non modélisée biaise substantiellement l’estimation de l’erreur type et peut gonfler drastiquement le taux de faux positifs. L’indépendance se garantit impérativement en amont, lors de l’assignation aléatoire des participants et de l’isolation rigoureuse des conditions de passation.
Parallèlement à l’indépendance, la détection et la gestion des valeurs aberrantes univariées (outliers) requièrent un protocole standardisé et transparent. La présence d’une ou deux valeurs extrêmes peut déformer artificiellement la moyenne d’un groupe et surévaluer sa variance, faussant radicalement la statistique F. L’identification repose usuellement sur deux critères reconnus : la conversion des scores bruts en scores centrés réduits (scores z), où tout score excédant un seuil critique absolu de $|z| > 3.29$ (correspondant à une probabilité inférieure à .001 dans une distribution normale) est étiqueté comme aberrant, ou l’examen des diagrammes en boîte à moustaches (boxplots), qui identifient les valeurs distantes de plus de 1.5 fois l’écart interquartile (IQR) du bord des charnières comme aberrantes, et de plus de 3 fois l’IQR comme extrêmes.
Le traitement accordé à ces valeurs atypiques doit faire l’objet d’une déclaration scrupuleuse dans le texte méthodologique du manuscrit, afin d’écarter tout soupçon de manipulation de données (p-hacking). Trois stratégies principales s’offrent au chercheur : l’exclusion pure et simple du sujet d’analyse (qui doit être explicitement justifiée, par exemple suite à une erreur technique de mesure ou un non-respect avéré de la consigne), la winsorisation (remplacement de la valeur extrême par le score le plus élevé jugé acceptable dans les limites de la distribution normale), ou la transformation mathématique de la variable dépendante (logarithmique, racine carrée ou inverse). La rédaction scientifique doit consigner la méthode adoptée et attester que la décision n’a pas été dictée par l’obtention opportuniste d’un résultat statistiquement significatif : « L’analyse exploratoire a mis en évidence deux valeurs aberrantes univariées dans la condition de privation de sommeil ($z = 3.45$ et $z = 3.61$). Conformément au protocole préenregistré, ces deux observations ont fait l’objet d’une winsorisation au 95e centile de la distribution. Les analyses conduites avec et sans ces valeurs montrent une convergence absolue des conclusions inférentielles. »
3. Normes de présentation APA (7e édition) pour l’ANOVA
3.1 Règles typographiques et formatage des symboles statistiques
Le manuel de publication de l’American Psychological Association (7e édition) codifie de manière extrêmement stricte la typographie mathématique et statistique afin d’uniformiser la lecture à travers l’ensemble des publications scientifiques mondiales. La première règle fondamentale prescrit la mise en italique systématique de toutes les lettres latines utilisées pour désigner des statistiques inférentielles, des paramètres d’échantillon ou des concepts quantitatifs : la statistique du test F, la valeur de probabilité p, la taille d’échantillon totale N, la taille de sous-échantillon n, la moyenne M, l’écart-type SD (pour Standard Deviation) et le coefficient de détermination R2 doivent obligatoirement être composés en caractères italiques.
À l’inverse, cette règle d’italique comporte des exceptions capitales que tout auteur doit maîtriser. Les lettres grecques ne doivent jamais être mises en italique lorsqu’elles représentent des paramètres de population ou des métriques statistiques associées. Ainsi, l’éta-carré ($\eta^2$), l’éta-carré partiel ($\eta_p^2$), l’oméga-carré ($\omega^2$), le paramètre epsilon de sphéricité ($varepsilon$), le coefficient alpha de Cronbach ($\alpha$) ou le seuil de signification théorique ($\alpha$) s’écrivent strictement en caractères romains droits. De surcroît, les indices textuels associés aux symboles statistiques demeurent en caractères romains normaux (par exemple, le « p » dans $\eta_p^2$ pour signifier « partiel » ne prend pas l’italique, alors que la lettre grecque principale demeure droite).
L’espacement autour des opérateurs arithmétiques constitue une autre exigence typographique cardinale. Les signes d’égalité ($=$), d’infériorité ($\eta^2$, la corrélation de Pearson <em>r</em> ou la puissance statistique), le zéro initial doit impérativement être omis (écrire impérativement « <em>p</em> = .023 » et jamais « <em>p</em> = 0.023 » ; « $\eta_p^2 = .14$ » et non « $\eta_p^2 = 0.14$ »).
<h3>3.2 Structure canonique d'une phrase de résultat statistique</h3>
L'intégration d'un résultat d'ANOVA au sein du discours narratif ne s'opère pas au hasard ; elle obéit à une architecture textuelle standardisée conçue pour optimiser la transmission de l'information technique sans alourdir indûment la lecture. Une phrase canonique complète se décompose invariablement en quatre segments fonctionnels consécutifs : l'énonciation claire des variables impliquées, le sens directionnel ou substantiel de l'effet observé, l'attestation inférentielle formalisée entre parenthèses, et l'indication de la magnitude pratique du phénomène.
Le bloc statistique inséré entre parenthèses doit rigoureusement respecter l'ordonnancement séquentiel suivant :
1. La désignation de la statistique de test : la lettre <em>F</em> en italique.
2. Les degrés de liberté placés entre parenthèses immédiatement après la lettre <em>F</em> sans e\space intercalaire : d'abord les degrés de liberté intergroupes (ou de l'effet, $df_{effet}$), suivis d'une virgule, d'une e\space, puis des degrés de liberté intragroupes (ou de l'erreur résiduelle, $df_{erreur}$).
3. Le signe d'égalité encadré d'espaces.
4. La valeur numérique observée de la statistique <em>F</em>, arrondie a\vec précision à deux décimales après la virgule.
5. Une virgule suivie d'une espace.
6. La valeur exacte de probabilité <em>p</em> en italique, précédée d'un signe d'égalité ou d'infériorité, arrondie à trois décimales (sauf lorsqu'elle est inférieure à .001).
7. Une virgule suivie d'une espace.
8. L'indice de taille d'effet standardisé (le plus fréquemment l'éta-carré partiel $\eta_p^2$), son signe égal et sa valeur numérique arrondie à deux décimales.
L'application rigoureuse de ce formalisme génère des énoncés standardisés d'une grande clarté démonstrative : « L'analyse de variance à un facteur a révélé un effet principal significatif du type d'intervention sur les scores de mémoire de travail, <em>F</em>(2, 72) = 5.64, <em>p</em> = .005, $\eta_p^2 = .14$. » Toute déviation par rapport à cette norme — telle que l'omission des degrés de liberté de l'erreur résiduelle sous la forme erronée « <em>F</em>(2) = 5.64 » ou le remplacement de la valeur exacte de <em>p</em> par des formules floues de type « <em>p</em> = NS » (non significatif) — est aujourd'hui catégoriquement rejetée par les réviseurs académiques.
<h3>3.3 Statistiques descriptives associées obligatoires</h3>
L'une des prescriptions les plus impératives de l'APA 7e édition stipule qu'une statistique inférentielle ne peut jamais être présentée de manière isolée dans le texte sans être immédiatement adossée aux statistiques descriptives correspondantes. Affirmer qu'un effet est statistiquement significatif sans préciser la moyenne et l'écart-type de chaque groupe prive le lecteur de la capacité fondamentale d'évaluer la pertinence clinique ou psychologique de la différence observée, ainsi que la variabilité inhérente aux mesures.
Pour chaque condition ou modalité examinée, le chercheur doit obligatoirement fournir au minimum la moyenne d'échantillon (<em>M</em>) et l'écart-type (<em>SD</em>). L'intégration de ces indices descriptifs au sein de la trame narrative doit être fluide et contextuelle. Il convient de les insérer directement dans la phrase descriptive, soit immédiatement après la mention du groupe correspondant, soit au sein d'une parenthèse descriptive harmonisée : « Les participants ayant bénéficié de la thérapie cognitive et comportementale ont présenté une réduction de la symptomatologie dépressive significativement plus marquée (<em>M</em> = 14.20, <em>SD</em> = 3.50) que les individus placés sur liste d'attente (<em>M</em> = 22.80, <em>SD</em> = 4.10) ou assignés au groupe de soutien non directif (<em>M</em> = 19.40, <em>SD</em> = 3.90). »
De plus, l'APA 7e édition recommande désormais chaleureusement l'incorporation systématique des intervalles de confiance à 95 % (notés [95% IC] ou 95% CI en anglais) autour de chaque moyenne estimée ou autour des différences de moyennes observées. L'intervalle de confiance offre une perspective métrologique inestimable en renseignant sur la précision de l'estimation de l'effet dans la population parente. Le formatage normé de l'intervalle de confiance encadre les limites inférieure et supérieure de crochets droits, séparées par une virgule et une e\space : « (<em>M</em> = 14.20, <em>SD</em> = 3.50, 95% IC [12.65, 15.75]) ». Cette pratique favorise une interprétation raisonnée des données, affranchie du strict réductionnisme inhérent au seul seuil de significativité binaire.
<h2>4. Rapporter une ANOVA à un facteur (One-Way ANOVA)</h2>
<h3>4.1 Cas d'un résultat omnibus statistiquement significatif</h3>
Lorsque le test <em>F</em> omnibus d'une ANOVA à un facteur inter-sujets atte\int le seuil de rejet conventionnel ($p < .05$), le chercheur conclut formellement à l'existence d'une différence statistiquement significative entre au moins deux des moyennes de groupes examinées. Il est impératif de se rappeler que le résultat omnibus indique uniquement que l'hypothèse nulle d'égalité globale ($\mu_1 = \mu_2 = dots = \mu_k$) doit être rejetée, sans pour autant préciser quelles sont les paires spécifiques de conditions qui diffèrent les unes des autres. La rédaction doit fidèlement retranscrire cette réalité mathématique en évitant d'affirmer prématurément la supériorité d'un groupe déterminé avant d'avoir formellement rapporté les contrastes multiples ou les tests post-hoc ultérieurs.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/anovaspss10-1.png" alt="ANOVA output table in SPSS" /><figcaption>ANOVA output table in SPSS</figcaption></figure>
Le paragraphe consacré au résultat omnibus significatif débute par l'affirmation globale de l'effet du facteur indépendant sur la variable dépendante, étayée par la statistique <em>F</em> complète, la valeur exacte de probabilité et la taille d'effet standardisée. Il détaille ensuite les paramètres descriptifs de chaque modalité, puis opère une transition logique et méthodologique vers les analyses de décomposition par paires. Voici un exemple complet et rédigé selon les normes les plus strictes de l'APA 7e édition, appliqué à un essai clinique évaluant trois modalités d'interventions psychothérapeutiques sur le trouble d'anxiété généralisée :
« Une analyse de variance univariée inter-sujets à un facteur a été réalisée afin d'évaluer l'efficacité différentielle de trois protocoles thérapeutiques sur le niveau d'anxiété des patients mesuré par l'échelle GAD-7 à l'issue de huit semaines de suivi. L'analyse révèle un effet principal statistiquement significatif du type d'intervention sur les scores d'anxiété, <em>F</em>(2, 87) = 8.45, <em>p</em> < .001, $\eta_p^2 = .16$, indiquant que la nature de la prise en charge module substantiellement la symptomatologie résiduelle. Les scores moyens d'anxiété s'établissent respectivement à 8.10 (<em>SD</em> = 2.45, 95% IC [7.20, 9.00]) pour le groupe thérapie cognitive et comportementale (<em>n</em> = 30), à 10.50 (<em>SD</em> = 2.80, 95% IC [9.48, 11.52]) pour le groupe thérapie basée sur la pleine conscience (<em>n</em> = 30), et à 11.90 (<em>SD</em> = 3.15, 95% IC [10.75, 13.05]) pour le groupe témoin sur liste d'attente (<em>n</em> = 30). L'amplitude de cet effet global est qualifiée de forte selon les conventions de Cohen. L'examen des différences spécifiques entre chaque condition a par conséquent été poursuivi au moyen de tests post-hoc de Tukey HSD. »
<h3>4.2 Cas d'un résultat omnibus non significatif</h3>
Le compte-rendu d'un résultat d'ANOVA non significatif requiert une rigueur épistémologique exemplaire. L'erreur conceptuelle la plus répandue consiste à affirmer péremptoirement que le résultat « prouve que les groupes sont strictement identiques » ou qu'« aucun effet n'existe ». En logique d'inférence fréquentiste, l'absence de significativité ($p ge .05$) signifie exclusivement que les données empiriques recueillies n'apportent pas d'éléments de preuve suffisamment concluants pour rejeter l'hypothèse nulle au seuil de confiance choisi. Elle ne démontre en rien la véracité formelle de l'hypothèse nulle, une telle conclusion nécessitant des protocoles d'équivalence dédiés (tests TOST) ou des approches bayésiennes mesurant le facteur de Bayes ($BF_{01}$).
Sur le plan rédactionnel, le résultat non significatif met un terme définitif à l'exploration inférentielle des contrastes. Lorsque le test <em>F</em> omnibus ne franchit pas le seuil de significativité, le chercheur s'interdit formellement de procéder au calcul de tests post-hoc non planifiés ou d'aller chercher des sous-différences locales significatives (pratique pernicieuse d'extraction sélective de données ou data-dredging). Les statistiques descriptives doivent être rapportées a\vec la même transparence exhaustive qu'en situation de significativité, complétées par l'indication de l'intervalle de confiance, lequel éclaire souvent le manque de puissance de l'échantillon.
Voici un modèle rédactionnel complet illustrant le compte-rendu formel d'un résultat omnibus non significatif dans le cadre d'une recherche expérimentale sur l'amorçage sémantique : « Une ANOVA inter-sujets à un facteur a été conduite pour déterminer si le temps de réaction à une tâche de décision lexicale variait en fonction des conditions d'amorçage (amorçage sémantique direct, amorçage phonologique, amorçage neutre). Les résultats indiquent que l'effet de la condition d'amorçage n'est pas statistiquement significatif, <em>F</em>(2, 57) = 1.12, <em>p</em> = .333, $\eta_p^2 = .04$. Les temps de réaction moyens s'élèvent à 542 ms (<em>SD</em> = 68, 95% IC [511, 573]) pour l'amorçage sémantique, 558 ms (<em>SD</em> = 74, 95% IC [524, 592]) pour l'amorçage phonologique et 569 ms (<em>SD</em> = 71, 95% IC [536, 602]) pour la condition neutre. Les données recueillies ne permettent pas de rejeter l'hypothèse d'équivalence des performances de traitement lexical entre les trois modalités d'amorçage, et aucune analyse de comparaisons par paires n'a été mise en œuvre. »
<h3>4.3 Rapport de l'ANOVA de Welch en cas d'hétéroscédasticité</h3>
Lorsque le postulat d'homoscédasticité est transgressé (test de Levene significatif à $p < .05$), le rapport conventionnel de l'ANOVA de Fisher s'avère méthodologiquement erroné et risque d'induire le lectorat en erreur. L'analyste se doit alors de mobiliser l'ANOVA robuste de Welch. La restitution de la statistique <em>F</em> de Welch obéit à une particularité fondamentale : en raison du réajustement des variances individuelles, les degrés de liberté résiduels (du dénominateur) cessent d'être des nombres entiers pour devenir des valeurs réelles continues comportant des décimales.
Dans la rédaction formelle du manuscrit, il est impératif d'expliciter sans ambiguïté que la statistique <em>F</em> rapportée correspond à la correction de Welch, et de transcrire scrupuleusement les degrés de liberté décimaux à deux chiffres après la virgule au sein de la parenthèse réglementaire. Cette précision permet aux évaluateurs et lecteurs attentifs d'identifier immédiatement le caractère robuste de la démarche analytique.
Voici la formulation académique exemplaire requise pour consigner une ANOVA de Welch dans une revue de référence : « Le postulat d'homoscédasticité ayant été formellement rejeté par le test de Levene, <em>F</em>(2, 63) = 5.92, <em>p</em> = .004, nous avons appliqué l'ANOVA ajustée de Welch pour tester l'effet du niveau de dépendance nicotinique (faible, modérée, sévère) sur les scores de sevrage affectif. L'analyse révèle un effet statistiquement significatif du degré de dépendance, <em>F</em><sub>Welch</sub>(2, 38.46) = 7.81, <em>p</em> = .001, $\eta_p^2 = .19$. Les participants présentant une dépendance sévère ont manifesté des scores d'affects négatifs substantiellement plus élevés (<em>M</em> = 28.40, <em>SD</em> = 6.20) comparativement aux individus affichant une dépendance modérée (<em>M</em> = 21.15, <em>SD</em> = 4.10) et faible (<em>M</em> = 17.80, <em>SD</em> = 2.95). Les comparaisons multiples subséquentes ont été conduites à l'aide de la procédure de Games-Howell, spécialement calibrée pour pallier l'hétérogénéité des variances. »
<h2>5. Présentation et interprétation des tests post-hoc</h2>
<h3>5.1 Sélection et justification du test post-hoc approprié</h3>
L'obtention d'une statistique omnibus significative au sein d'une ANOVA comportant trois modalités ou davantage impose la mise en œuvre d'analyses de comparaisons multiples a posteriori, désignées sous le vocable de tests post-hoc. La finalité méthodologique de ces tests est d'explorer de manière exhaustive l'ensemble des paires de moyennes concevables tout en maintenant le taux global d'erreur de type I de la famille de comparaisons au seuil nominal rigide de $\alpha = .05$. Le choix de la procédure de correction ne saurait être laissé au hasard ou dicté par la recherche opportuniste du résultat le plus flatteur ; il doit être guidé par la structure intrinsèque des données et scrupuleusement justifié dans le manuscrit.
Lorsque le postulat d'homogénéité des variances est pleinement respecté et que les effectifs par cellule sont équilibrés ou raisonnablement comparables, le test de la plus petite différence significative honnête de Tukey (<em>Tukey's Honestly Significant Difference</em> ou Tukey HSD) s'impose comme la référence absolue en recherche comportementale. Fondé sur la distribution de l'étendue studentisée (<em>studentized range</em>), le test de Tukey offre un compromis optimal entre le contrôle irréprochable du taux d'erreur familial et la préservation d'une excellente puissance statistique pour les comparaisons exhaustives par paires. La méthode d'ajustement de Bonferroni (qui divise le seuil $\alpha$ par le nombre total de comparaisons réalisées) constitue une alternative rigoureuse lorsque le chercheur restre\int volontairement son investigation à un nombre limité de contrastes planifiés prédéterminés par la théorie, mais s'avère excessivement conservatrice et préjudiciable à la puissance statistique dès lors que le nombre de modalités augmente.
<figure class="wpt-preserved-image"><img src="https://fr.arabpsychology.com/wp-content/uploads/2026/09/anovaspss11-1.png" alt="Tukey multiple comparisons in SPSS" /><figcaption>Tukey multiple comparisons in SPSS</figcaption></figure>
Dans l'éventualité où le postulat d'homoscédasticité a été transgressé lors de l'analyse préalable, les tests de Tukey ou de Bonferroni perdent leur fiabilité métrologique et génèrent un taux inacceptable d'erreurs de type I. Dans ce cadre précis, la procédure de Games-Howell représente le standard méthodologique obligatoire. Le test de Games-Howell n'impose ni l'égalité des variances, ni l'égalité des effectifs d'échantillons, en appliquant les ajustements de degrés de liberté de type Welch à chaque contraste spécifique par paire. Le texte du manuscrit doit documenter formellement cette sélection : « En raison de l'inégalité avérée des variances intergroupes constatée lors de la vérification des postulats, les comparaisons multiples par paires ont été exécutées au moyen du test post-hoc robuste de Games-Howell, garantissant le contrôle strict du taux d'erreur de première espèce sans présumer de l'homoscédasticité des distributions. »
<h3>5.2 Rédaction formelle des comparaisons par paires</h3>
La transcription des comparaisons par paires au sein de la section Résultats doit obéir à une rigueur formelle absolue. Chaque comparaison rapportée doit impérativement préciser la différence de moyenne absolue observée entre les deux conditions ($\Delta M$ ou $M_1 – M_2$), l'erreur-type de cette différence ($SE$), la valeur exacte de probabilité ajustée ($p_{adj}$ ou simplement $p$ en précisant le type de correction mobilisé), ainsi que l'intervalle de confiance à 95 % de la différence de moyennes. Trop d'auteurs omettent l'intervalle de confiance de la différence, privant la communauté scientifique d'une métrique directe quant à l'incertitude entourant l'estimation de l'écart expérimental.
Les phrases types doivent expliciter distinctement les deux conditions comparées, la directionnalité nette de l'écart (quelle condition surpasse l'autre) et consigner les données numériques standardisées entre parenthèses. Il convient d'éviter les tournures vagues comme « le groupe A était différent du groupe B » au profit de formulations directionnelles précises : « le groupe A a présenté un score significativement supérieur à celui du groupe B ».
Voici un modèle rédactionnel exhaustif illustrant la restitution de trois comparaisons par paires consécutives à un test de Tukey HSD : « Les comparaisons multiples post-hoc effectuées a\vec l'ajustement HSD de Tukey indiquent que les participants exposés à la modalité d'apprentissage actif obtiennent des performances significativement supérieures à ceux assignés à la modalité d'enseignement magistral passif ($\Delta M = 4.35$, $SE = 0.92$, $p < .001$, 95% IC [2.14, 6.56]). De surcroît, les performances de la modalité d'apprentissage actif s'avèrent significativement plus élevées que celles observées dans la modalité de tutorat individuel entre pairs ($\Delta M = 2.40$, $SE = 0.88$, $p = .021$, 95% IC [0.31, 4.49]). Enfin, la différence de performance entre la condition d'enseignement magistral et la condition de tutorat par les pairs n'atte\int pas le seuil de significativité statistique ($\Delta M = -1.95$, $SE = 0.90$, $p = .086$, 95% IC [-4.10, 0.20]). »
<h3>5.3 Synthèse des résultats de comparaisons multiples</h3>
Lorsque le plan expérimental comporte un nombre substantiel de conditions (par exemple, cinq ou six modalités d'un facteur), la succession linéaire de phrases détaillant chaque paire devient rapidement indigeste et nuit gravement à la lisibilité narrative du manuscrit. Dans ce contexte, l'auteur avisé recourt à une synthèse textuelle élégante, souvent couplée à un tableau récapitulatif ou à un graphique dédié exploitant le système universel des sous-ensembles homogènes ou du lettrage en exposant compact (<em>compact letter display</em>).
Le principe du lettrage en exposant repose sur une convention simple : deux conditions qui partagent une lettre identique ne présentent aucune différence statistiquement significative au seuil $\alpha = .05$, tandis que deux conditions ne partageant aucune lettre commune diffèrent significativement. Cette approche permet de synthétiser des structures de données complexes en un unique paragraphe discursif d'une redoutable efficacité démonstrative.
Voici un exemple de formulation synthétique articulant conclusions statistiques et implications théoriques : « En synthèse, l'exploration post-hoc de l'effet d'âge met en évidence trois sous-ensembles fonctionnels distincts au sein de notre échantillon. Les jeunes adultes (<em>M</em> = 84.5, <em>SD</em> = 8.2) et les adultes d'âge mûr (<em>M</em> = 82.1, <em>SD</em> = 7.9) démontrent des capacités de rappel libre comparables ne différant pas significativement l'une de l'autre ($p = .542$). En revanche, ces deux cohortes surpassent de manière unanime et statistiquement significative le groupe des personnes âgées autonomes (<em>M</em> = 68.3, <em>SD</em> = 9.1, $p < .001$ pour chaque contraste), lequel présente lui-même des scores significativement préservés par rapport aux patients présentant un trouble neurocognitif léger (<em>M</em> = 52.4, <em>SD</em> = 10.4, $p < .001$). Ce profil de décroissance conforte empiriquement l'hypothèse d'une vulnérabilité mnésique sélective et non linéaire au cours du vieillissement. »
<h2>6. Mesure et déclaration des tailles d'effet</h2>
<h3>6.1 Éta-carré (η²) versus Éta-carré partiel (η²p)</h3>
L'évaluation de la pertinence d'un résultat expérimental ne saurait reposer exclusivement sur la valeur <em>p</em>. La valeur de probabilité dép\end de manière intrinsèque de la taille de l'échantillon : un effet trivial dénué de toute importance pratique peut devenir statistiquement significatif au sein d'un échantillon massif, tandis qu'un effet clinique massif peut échouer à franchir le seuil fatidique de .05 au sein d'une cohorte restreinte en raison d'un manque de puissance. Pour cette raison fondamentale, les recommandations internationales de l'APA imposent la déclaration systématique et obligatoire d'un indice standardisé de taille d'effet pour chaque test <em>F</em> rapporté.
Dans l'écosystème de l'ANOVA, deux indices dominent la littérature empirique : l'éta-carré classique ($\eta^2$) et l'éta-carré partiel ($\eta_p^2$). La distinction conceptuelle et mathématique entre ces deux métriques est critique. L'éta-carré classique représente le ratio entre la somme des carrés de l'effet examiné et la somme des carrés totale du modèle : »>$$) ainsi que les opérateurs d’addition ou de soustraction doivent être encadrés par une e\space insécable avant et après le symbole (écrire « p = .034 » et non « p=.034 » ; « F(2, 45) = 4.12 » et non « F(2,45)=4.12 »). Enfin, l’une des règles les plus distinctives de l’APA 7e édition concerne la gestion du zéro initial avant le p\oint décimal. Pour toute métrique statistique qui possède le potentiel théorique de dépasser la valeur numérique de 1 (telles que la statistique F, la moyenne M, l’écart-type SD, les degrés de liberté df ou les scores t), le zéro initial est rigoureusement obligatoire (écrire « F = 0.85 » et non « F = .85 »). En revanche, pour toute métrique bornée par construction entre zéro et un et ne pouvant jamais excéder 1 (telles que la valeur de probabilité p, l’éta-carré $\eta^2$, la corrélation de Pearson r ou la puissance statistique), le zéro initial doit impérativement être omis (écrire impérativement « p = .023 » et jamais « p = 0.023 » ; « $\eta_p^2 = .14$ » et non « $\eta_p^2 = 0.14$ »).
3.2 Structure canonique d’une phrase de résultat statistique
L’intégration d’un résultat d’ANOVA au sein du discours narratif ne s’opère pas au hasard ; elle obéit à une architecture textuelle standardisée conçue pour optimiser la transmission de l’information technique sans alourdir indûment la lecture. Une phrase canonique complète se décompose invariablement en quatre segments fonctionnels consécutifs : l’énonciation claire des variables impliquées, le sens directionnel ou substantiel de l’effet observé, l’attestation inférentielle formalisée entre parenthèses, et l’indication de la magnitude pratique du phénomène.
Le bloc statistique inséré entre parenthèses doit rigoureusement respecter l’ordonnancement séquentiel suivant :
1. La désignation de la statistique de test : la lettre F en italique.
2. Les degrés de liberté placés entre parenthèses immédiatement après la lettre F sans e\space intercalaire : d’abord les degrés de liberté intergroupes (ou de l’effet, $df_{effet}$), suivis d’une virgule, d’une e\space, puis des degrés de liberté intragroupes (ou de l’erreur résiduelle, $df_{erreur}$).
3. Le signe d’égalité encadré d’espaces.
4. La valeur numérique observée de la statistique F, arrondie a\vec précision à deux décimales après la virgule.
5. Une virgule suivie d’une espace.
6. La valeur exacte de probabilité p en italique, précédée d’un signe d’égalité ou d’infériorité, arrondie à trois décimales (sauf lorsqu’elle est inférieure à .001).
7. Une virgule suivie d’une espace.
8. L’indice de taille d’effet standardisé (le plus fréquemment l’éta-carré partiel $\eta_p^2$), son signe égal et sa valeur numérique arrondie à deux décimales.
L’application rigoureuse de ce formalisme génère des énoncés standardisés d’une grande clarté démonstrative : « L’analyse de variance à un facteur a révélé un effet principal significatif du type d’intervention sur les scores de mémoire de travail, F(2, 72) = 5.64, p = .005, $\eta_p^2 = .14$. » Toute déviation par rapport à cette norme — telle que l’omission des degrés de liberté de l’erreur résiduelle sous la forme erronée « F(2) = 5.64 » ou le remplacement de la valeur exacte de p par des formules floues de type « p = NS » (non significatif) — est aujourd’hui catégoriquement rejetée par les réviseurs académiques.
3.3 Statistiques descriptives associées obligatoires
L’une des prescriptions les plus impératives de l’APA 7e édition stipule qu’une statistique inférentielle ne peut jamais être présentée de manière isolée dans le texte sans être immédiatement adossée aux statistiques descriptives correspondantes. Affirmer qu’un effet est statistiquement significatif sans préciser la moyenne et l’écart-type de chaque groupe prive le lecteur de la capacité fondamentale d’évaluer la pertinence clinique ou psychologique de la différence observée, ainsi que la variabilité inhérente aux mesures.
Pour chaque condition ou modalité examinée, le chercheur doit obligatoirement fournir au minimum la moyenne d’échantillon (M) et l’écart-type (SD). L’intégration de ces indices descriptifs au sein de la trame narrative doit être fluide et contextuelle. Il convient de les insérer directement dans la phrase descriptive, soit immédiatement après la mention du groupe correspondant, soit au sein d’une parenthèse descriptive harmonisée : « Les participants ayant bénéficié de la thérapie cognitive et comportementale ont présenté une réduction de la symptomatologie dépressive significativement plus marquée (M = 14.20, SD = 3.50) que les individus placés sur liste d’attente (M = 22.80, SD = 4.10) ou assignés au groupe de soutien non directif (M = 19.40, SD = 3.90). »
De plus, l’APA 7e édition recommande désormais chaleureusement l’incorporation systématique des intervalles de confiance à 95 % (notés [95% IC] ou 95% CI en anglais) autour de chaque moyenne estimée ou autour des différences de moyennes observées. L’intervalle de confiance offre une perspective métrologique inestimable en renseignant sur la précision de l’estimation de l’effet dans la population parente. Le formatage normé de l’intervalle de confiance encadre les limites inférieure et supérieure de crochets droits, séparées par une virgule et une e\space : « (M = 14.20, SD = 3.50, 95% IC [12.65, 15.75]) ». Cette pratique favorise une interprétation raisonnée des données, affranchie du strict réductionnisme inhérent au seul seuil de significativité binaire.
4. Rapporter une ANOVA à un facteur (One-Way ANOVA)
4.1 Cas d’un résultat omnibus statistiquement significatif
Lorsque le test F omnibus d’une ANOVA à un facteur inter-sujets atte\int le seuil de rejet conventionnel ($p < .05$), le chercheur conclut formellement à l'existence d'une différence statistiquement significative entre au moins deux des moyennes de groupes examinées. Il est impératif de se rappeler que le résultat omnibus indique uniquement que l'hypothèse nulle d'égalité globale ($\mu_1 = \mu_2 = dots = \mu_k$) doit être rejetée, sans pour autant préciser quelles sont les paires spécifiques de conditions qui diffèrent les unes des autres. La rédaction doit fidèlement retranscrire cette réalité mathématique en évitant d'affirmer prématurément la supériorité d'un groupe déterminé avant d'avoir formellement rapporté les contrastes multiples ou les tests post-hoc ultérieurs.
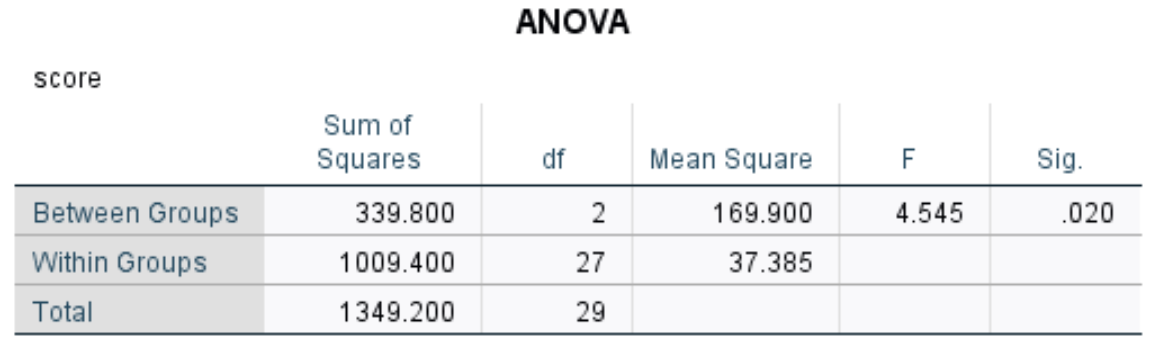
Le paragraphe consacré au résultat omnibus significatif débute par l’affirmation globale de l’effet du facteur indépendant sur la variable dépendante, étayée par la statistique F complète, la valeur exacte de probabilité et la taille d’effet standardisée. Il détaille ensuite les paramètres descriptifs de chaque modalité, puis opère une transition logique et méthodologique vers les analyses de décomposition par paires. Voici un exemple complet et rédigé selon les normes les plus strictes de l’APA 7e édition, appliqué à un essai clinique évaluant trois modalités d’interventions psychothérapeutiques sur le trouble d’anxiété généralisée :
« Une analyse de variance univariée inter-sujets à un facteur a été réalisée afin d’évaluer l’efficacité différentielle de trois protocoles thérapeutiques sur le niveau d’anxiété des patients mesuré par l’échelle GAD-7 à l’issue de huit semaines de suivi. L’analyse révèle un effet principal statistiquement significatif du type d’intervention sur les scores d’anxiété, F(2, 87) = 8.45, p < .001, $\eta_p^2 = .16$, indiquant que la nature de la prise en charge module substantiellement la symptomatologie résiduelle. Les scores moyens d'anxiété s'établissent respectivement à 8.10 (SD = 2.45, 95% IC [7.20, 9.00]) pour le groupe thérapie cognitive et comportementale (n = 30), à 10.50 (SD = 2.80, 95% IC [9.48, 11.52]) pour le groupe thérapie basée sur la pleine conscience (n = 30), et à 11.90 (SD = 3.15, 95% IC [10.75, 13.05]) pour le groupe témoin sur liste d’attente (n = 30). L’amplitude de cet effet global est qualifiée de forte selon les conventions de Cohen. L’examen des différences spécifiques entre chaque condition a par conséquent été poursuivi au moyen de tests post-hoc de Tukey HSD. »
4.2 Cas d’un résultat omnibus non significatif
Le compte-rendu d’un résultat d’ANOVA non significatif requiert une rigueur épistémologique exemplaire. L’erreur conceptuelle la plus répandue consiste à affirmer péremptoirement que le résultat « prouve que les groupes sont strictement identiques » ou qu’« aucun effet n’existe ». En logique d’inférence fréquentiste, l’absence de significativité ($p ge .05$) signifie exclusivement que les données empiriques recueillies n’apportent pas d’éléments de preuve suffisamment concluants pour rejeter l’hypothèse nulle au seuil de confiance choisi. Elle ne démontre en rien la véracité formelle de l’hypothèse nulle, une telle conclusion nécessitant des protocoles d’équivalence dédiés (tests TOST) ou des approches bayésiennes mesurant le facteur de Bayes ($BF_{01}$).
Sur le plan rédactionnel, le résultat non significatif met un terme définitif à l’exploration inférentielle des contrastes. Lorsque le test F omnibus ne franchit pas le seuil de significativité, le chercheur s’interdit formellement de procéder au calcul de tests post-hoc non planifiés ou d’aller chercher des sous-différences locales significatives (pratique pernicieuse d’extraction sélective de données ou data-dredging). Les statistiques descriptives doivent être rapportées a\vec la même transparence exhaustive qu’en situation de significativité, complétées par l’indication de l’intervalle de confiance, lequel éclaire souvent le manque de puissance de l’échantillon.
Voici un modèle rédactionnel complet illustrant le compte-rendu formel d’un résultat omnibus non significatif dans le cadre d’une recherche expérimentale sur l’amorçage sémantique : « Une ANOVA inter-sujets à un facteur a été conduite pour déterminer si le temps de réaction à une tâche de décision lexicale variait en fonction des conditions d’amorçage (amorçage sémantique direct, amorçage phonologique, amorçage neutre). Les résultats indiquent que l’effet de la condition d’amorçage n’est pas statistiquement significatif, F(2, 57) = 1.12, p = .333, $\eta_p^2 = .04$. Les temps de réaction moyens s’élèvent à 542 ms (SD = 68, 95% IC [511, 573]) pour l’amorçage sémantique, 558 ms (SD = 74, 95% IC [524, 592]) pour l’amorçage phonologique et 569 ms (SD = 71, 95% IC [536, 602]) pour la condition neutre. Les données recueillies ne permettent pas de rejeter l’hypothèse d’équivalence des performances de traitement lexical entre les trois modalités d’amorçage, et aucune analyse de comparaisons par paires n’a été mise en œuvre. »
4.3 Rapport de l’ANOVA de Welch en cas d’hétéroscédasticité
Lorsque le postulat d’homoscédasticité est transgressé (test de Levene significatif à $p < .05$), le rapport conventionnel de l'ANOVA de Fisher s'avère méthodologiquement erroné et risque d'induire le lectorat en erreur. L'analyste se doit alors de mobiliser l'ANOVA robuste de Welch. La restitution de la statistique F de Welch obéit à une particularité fondamentale : en raison du réajustement des variances individuelles, les degrés de liberté résiduels (du dénominateur) cessent d’être des nombres entiers pour devenir des valeurs réelles continues comportant des décimales.
Dans la rédaction formelle du manuscrit, il est impératif d’expliciter sans ambiguïté que la statistique F rapportée correspond à la correction de Welch, et de transcrire scrupuleusement les degrés de liberté décimaux à deux chiffres après la virgule au sein de la parenthèse réglementaire. Cette précision permet aux évaluateurs et lecteurs attentifs d’identifier immédiatement le caractère robuste de la démarche analytique.
Voici la formulation académique exemplaire requise pour consigner une ANOVA de Welch dans une revue de référence : « Le postulat d’homoscédasticité ayant été formellement rejeté par le test de Levene, F(2, 63) = 5.92, p = .004, nous avons appliqué l’ANOVA ajustée de Welch pour tester l’effet du niveau de dépendance nicotinique (faible, modérée, sévère) sur les scores de sevrage affectif. L’analyse révèle un effet statistiquement significatif du degré de dépendance, FWelch(2, 38.46) = 7.81, p = .001, $\eta_p^2 = .19$. Les participants présentant une dépendance sévère ont manifesté des scores d’affects négatifs substantiellement plus élevés (M = 28.40, SD = 6.20) comparativement aux individus affichant une dépendance modérée (M = 21.15, SD = 4.10) et faible (M = 17.80, SD = 2.95). Les comparaisons multiples subséquentes ont été conduites à l’aide de la procédure de Games-Howell, spécialement calibrée pour pallier l’hétérogénéité des variances. »
5. Présentation et interprétation des tests post-hoc
5.1 Sélection et justification du test post-hoc approprié
L’obtention d’une statistique omnibus significative au sein d’une ANOVA comportant trois modalités ou davantage impose la mise en œuvre d’analyses de comparaisons multiples a posteriori, désignées sous le vocable de tests post-hoc. La finalité méthodologique de ces tests est d’explorer de manière exhaustive l’ensemble des paires de moyennes concevables tout en maintenant le taux global d’erreur de type I de la famille de comparaisons au seuil nominal rigide de $\alpha = .05$. Le choix de la procédure de correction ne saurait être laissé au hasard ou dicté par la recherche opportuniste du résultat le plus flatteur ; il doit être guidé par la structure intrinsèque des données et scrupuleusement justifié dans le manuscrit.
Lorsque le postulat d’homogénéité des variances est pleinement respecté et que les effectifs par cellule sont équilibrés ou raisonnablement comparables, le test de la plus petite différence significative honnête de Tukey (Tukey’s Honestly Significant Difference ou Tukey HSD) s’impose comme la référence absolue en recherche comportementale. Fondé sur la distribution de l’étendue studentisée (studentized range), le test de Tukey offre un compromis optimal entre le contrôle irréprochable du taux d’erreur familial et la préservation d’une excellente puissance statistique pour les comparaisons exhaustives par paires. La méthode d’ajustement de Bonferroni (qui divise le seuil $\alpha$ par le nombre total de comparaisons réalisées) constitue une alternative rigoureuse lorsque le chercheur restre\int volontairement son investigation à un nombre limité de contrastes planifiés prédéterminés par la théorie, mais s’avère excessivement conservatrice et préjudiciable à la puissance statistique dès lors que le nombre de modalités augmente.
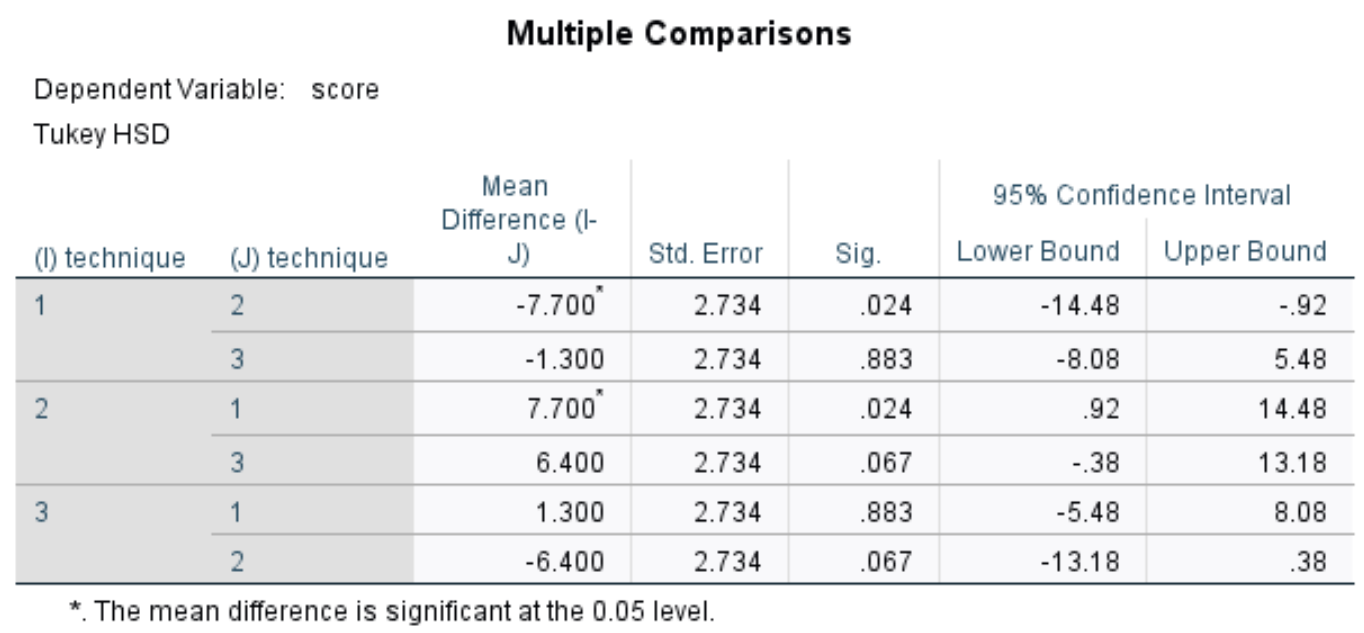
Dans l’éventualité où le postulat d’homoscédasticité a été transgressé lors de l’analyse préalable, les tests de Tukey ou de Bonferroni perdent leur fiabilité métrologique et génèrent un taux inacceptable d’erreurs de type I. Dans ce cadre précis, la procédure de Games-Howell représente le standard méthodologique obligatoire. Le test de Games-Howell n’impose ni l’égalité des variances, ni l’égalité des effectifs d’échantillons, en appliquant les ajustements de degrés de liberté de type Welch à chaque contraste spécifique par paire. Le texte du manuscrit doit documenter formellement cette sélection : « En raison de l’inégalité avérée des variances intergroupes constatée lors de la vérification des postulats, les comparaisons multiples par paires ont été exécutées au moyen du test post-hoc robuste de Games-Howell, garantissant le contrôle strict du taux d’erreur de première espèce sans présumer de l’homoscédasticité des distributions. »
5.2 Rédaction formelle des comparaisons par paires
La transcription des comparaisons par paires au sein de la section Résultats doit obéir à une rigueur formelle absolue. Chaque comparaison rapportée doit impérativement préciser la différence de moyenne absolue observée entre les deux conditions ($\Delta M$ ou $M_1 – M_2$), l’erreur-type de cette différence ($SE$), la valeur exacte de probabilité ajustée ($p_{adj}$ ou simplement $p$ en précisant le type de correction mobilisé), ainsi que l’intervalle de confiance à 95 % de la différence de moyennes. Trop d’auteurs omettent l’intervalle de confiance de la différence, privant la communauté scientifique d’une métrique directe quant à l’incertitude entourant l’estimation de l’écart expérimental.
Les phrases types doivent expliciter distinctement les deux conditions comparées, la directionnalité nette de l’écart (quelle condition surpasse l’autre) et consigner les données numériques standardisées entre parenthèses. Il convient d’éviter les tournures vagues comme « le groupe A était différent du groupe B » au profit de formulations directionnelles précises : « le groupe A a présenté un score significativement supérieur à celui du groupe B ».
Voici un modèle rédactionnel exhaustif illustrant la restitution de trois comparaisons par paires consécutives à un test de Tukey HSD : « Les comparaisons multiples post-hoc effectuées a\vec l’ajustement HSD de Tukey indiquent que les participants exposés à la modalité d’apprentissage actif obtiennent des performances significativement supérieures à ceux assignés à la modalité d’enseignement magistral passif ($\Delta M = 4.35$, $SE = 0.92$, $p < .001$, 95% IC [2.14, 6.56]). De surcroît, les performances de la modalité d'apprentissage actif s'avèrent significativement plus élevées que celles observées dans la modalité de tutorat individuel entre pairs ($\Delta M = 2.40$, $SE = 0.88$, $p = .021$, 95% IC [0.31, 4.49]). Enfin, la différence de performance entre la condition d'enseignement magistral et la condition de tutorat par les pairs n'atte\int pas le seuil de significativité statistique ($\Delta M = -1.95$, $SE = 0.90$, $p = .086$, 95% IC [-4.10, 0.20]). »
5.3 Synthèse des résultats de comparaisons multiples
Lorsque le plan expérimental comporte un nombre substantiel de conditions (par exemple, cinq ou six modalités d’un facteur), la succession linéaire de phrases détaillant chaque paire devient rapidement indigeste et nuit gravement à la lisibilité narrative du manuscrit. Dans ce contexte, l’auteur avisé recourt à une synthèse textuelle élégante, souvent couplée à un tableau récapitulatif ou à un graphique dédié exploitant le système universel des sous-ensembles homogènes ou du lettrage en exposant compact (compact letter display).
Le principe du lettrage en exposant repose sur une convention simple : deux conditions qui partagent une lettre identique ne présentent aucune différence statistiquement significative au seuil $\alpha = .05$, tandis que deux conditions ne partageant aucune lettre commune diffèrent significativement. Cette approche permet de synthétiser des structures de données complexes en un unique paragraphe discursif d’une redoutable efficacité démonstrative.
Voici un exemple de formulation synthétique articulant conclusions statistiques et implications théoriques : « En synthèse, l’exploration post-hoc de l’effet d’âge met en évidence trois sous-ensembles fonctionnels distincts au sein de notre échantillon. Les jeunes adultes (M = 84.5, SD = 8.2) et les adultes d’âge mûr (M = 82.1, SD = 7.9) démontrent des capacités de rappel libre comparables ne différant pas significativement l’une de l’autre ($p = .542$). En revanche, ces deux cohortes surpassent de manière unanime et statistiquement significative le groupe des personnes âgées autonomes (M = 68.3, SD = 9.1, $p < .001$ pour chaque contraste), lequel présente lui-même des scores significativement préservés par rapport aux patients présentant un trouble neurocognitif léger (M = 52.4, SD = 10.4, $p < .001$). Ce profil de décroissance conforte empiriquement l'hypothèse d'une vulnérabilité mnésique sélective et non linéaire au cours du vieillissement. »
6. Mesure et déclaration des tailles d’effet
6.1 Éta-carré (η²) versus Éta-carré partiel (η²p)
L’évaluation de la pertinence d’un résultat expérimental ne saurait reposer exclusivement sur la valeur p. La valeur de probabilité dép\end de manière intrinsèque de la taille de l’échantillon : un effet trivial dénué de toute importance pratique peut devenir statistiquement significatif au sein d’un échantillon massif, tandis qu’un effet clinique massif peut échouer à franchir le seuil fatidique de .05 au sein d’une cohorte restreinte en raison d’un manque de puissance. Pour cette raison fondamentale, les recommandations internationales de l’APA imposent la déclaration systématique et obligatoire d’un indice standardisé de taille d’effet pour chaque test F rapporté.
Dans l’écosystème de l’ANOVA, deux indices dominent la littérature empirique : l’éta-carré classique ($\eta^2$) et l’éta-carré partiel ($\eta_p^2$). La distinction conceptuelle et mathématique entre ces deux métriques est critique. L’éta-carré classique représente le ratio entre la somme des carrés de l’effet examiné et la somme des carrés totale du modèle :$$eta^2 = frac{SS_{Effet}}{SS_{Total}}$\eta^2$ et d'$\eta_p^2$ s'avèrent strictement et mathématiquement identiques puisque la variance totale se résume exclusivement à la somme de la variance de l'effet et de la variance de l'erreur ($SS_{Total} = SS_{Effet} + SS_{Erreur}$).
En revanche, dès lors que l'on aborde des plans factoriels à facteurs multiples ou des modèles à mesures répétées, la divergence devient substantielle. L'éta-carré partiel extrait de son dénominateur la variance imputable aux autres facteurs indépendants et à leurs interactions pour ne conserver que la variance résiduelle de l'erreur : »>$$Il s’interprète intuitivement comme la proportion exacte de variance totale de la variable dépendante directement expliquée par le facteur d’intérêt. Dans le cadre d’une ANOVA à un facteur inter-sujets simple, les valeurs d’$\eta^2$ et d’$\eta_p^2$ s’avèrent strictement et mathématiquement identiques puisque la variance totale se résume exclusivement à la somme de la variance de l’effet et de la variance de l’erreur ($SS_{Total} = SS_{Effet} + SS_{Erreur}$).
En revanche, dès lors que l’on aborde des plans factoriels à facteurs multiples ou des modèles à mesures répétées, la divergence devient substantielle. L’éta-carré partiel extrait de son dénominateur la variance imputable aux autres facteurs indépendants et à leurs interactions pour ne conserver que la variance résiduelle de l’erreur :$$eta_p^2 = frac{SS_{Effet}}{SS_{Effet} + SS_{Erreur}}$\eta_p^2$) dans les devis factoriels complexes, car il reflète directement la puissance du facteur indépendamment du nombre d'autres variables introduites dans l'équation. Toutefois, l'auteur doit veiller scrupuleusement à ne pas additionner les $\eta_p^2$ de différents facteurs au sein d'un même modèle, car leur cumul dépasse fréquemment le seuil logique de 100 % (1.00), ce qui constitue une anomalie mathématique régulièrement relevée par les reviewers pointilleux.
<h3>6.2 L'alternative non biaisée : l'Oméga-carré (ω²)</h3>
Bien que l'éta-carré et l'éta-carré partiel soient omniprésents en raison de leur intégration par défaut dans les sorties graphiques des logiciels d'analyse commerciale tels que SPSS, ils partagent un défaut métrologique notoire : ce sont des estimateurs descriptifs d'échantillon intrinsèquement biaisés positivement. Ils ont une propension systématique à surestimer la véritable proportion de variance expliquée dans la population parente, ce biais se révélant particulièrement prononcé et trompeur lorsque la taille totale de l'échantillon est restreinte ($N < 50$).
Pour pallier ce biais d'échantillonnage, les statisticiens recommandent vivement l'adoption de l'oméga-carré ($\omega^2$) ou de l'oméga-carré partiel ($\omega_p^2$), conceptualisé à l'origine par William Hays. Contrairement à l'éta-carré, l'oméga-carré ajuste l'estimation en soustrayant la variance d'erreur résiduelle du numérateur et en pondérant le dénominateur par le carré moyen de l'erreur ($MS_{Erreur}$), offrant une projection beaucoup plus fidèle et conservatrice de l'effet réel au sein de la population générale : »>$$L’éta-carré partiel quantifie ainsi la part de variance expliquée par le facteur lorsque l’influence des autres variables contrôlées dans le design est statistiquement neutralisée. L’APA recommande prioritairement le compte-rendu de l’éta-carré partiel ($\eta_p^2$) dans les devis factoriels complexes, car il reflète directement la puissance du facteur indépendamment du nombre d’autres variables introduites dans l’équation. Toutefois, l’auteur doit veiller scrupuleusement à ne pas additionner les $\eta_p^2$ de différents facteurs au sein d’un même modèle, car leur cumul dépasse fréquemment le seuil logique de 100 % (1.00), ce qui constitue une anomalie mathématique régulièrement relevée par les reviewers pointilleux.
6.2 L’alternative non biaisée : l’Oméga-carré (ω²)
Bien que l’éta-carré et l’éta-carré partiel soient omniprésents en raison de leur intégration par défaut dans les sorties graphiques des logiciels d’analyse commerciale tels que SPSS, ils partagent un défaut métrologique notoire : ce sont des estimateurs descriptifs d’échantillon intrinsèquement biaisés positivement. Ils ont une propension systématique à surestimer la véritable proportion de variance expliquée dans la population parente, ce biais se révélant particulièrement prononcé et trompeur lorsque la taille totale de l’échantillon est restreinte ($N < 50$).
Pour pallier ce biais d’échantillonnage, les statisticiens recommandent vivement l’adoption de l’oméga-carré ($\omega^2$) ou de l’oméga-carré partiel ($\omega_p^2$), conceptualisé à l’origine par William Hays. Contrairement à l’éta-carré, l’oméga-carré ajuste l’estimation en soustrayant la variance d’erreur résiduelle du numérateur et en pondérant le dénominateur par le carré moyen de l’erreur ($MS_{Erreur}$), offrant une projection beaucoup plus fidèle et conservatrice de l’effet réel au sein de la population générale :$$omega^2 = frac{SS_{Effet} – (df_{Effet} times MS_{Erreur})}{SS_{Total} + MS_{Erreur}}$$
Si la statistique F est inférieure ou proche de 1, la formule de l’oméga-carré peut générer une valeur numérique négative ; par convention métrologique, l’indice est alors arrondi et rapporté à .00.
L’utilisation de l’oméga-carré démontre un niveau élevé de sophistication méthodologique et confère à la recherche une robustesse estimative appréciée des comités de lecture exigeants. Sa transcription dans le texte académique adopte une structure rigoureuse : « L’impact du programme de remédiation cognitive sur l’inhibition attentionnelle s’est révélé statistiquement significatif, F(1, 38) = 6.22, p = .017, $\omega^2 = .11$ (contre un $\eta^2$ d’échantillon biaisé à .14), attestant d’une magnitude d’effet modérée à forte dans la population cible après correction du biais d’échantillonnage. »
6.3 Interprétation contextuelle de l’amplitude de l’effet
Pour qualifier verbalement l’amplitude d’un effet quantifié, les chercheurs se réfèrent traditionnellement aux seuils conventionnels établis par Jacob Cohen (1988) dans son ouvrage séminal sur l’analyse de puissance statistique. Pour l’éta-carré et l’éta-carré partiel, les critères directeurs de Cohen définissent un effet faible à partir de $\eta^2 = .01$ (environ 1 % de la variance totale expliquée), un effet moyen à partir de $\eta^2 = .06$ (environ 6 % de variance expliquée), et un effet fort à partir de $\eta^2 = .14$ (14 % de variance ou davantage). Des seuils similaires s’appliquent conceptuellement à l’oméga-carré ($\omega^2$).
Néanmoins, les méthodologistes contemporains et l’APA mettent formellement en garde contre une adhésion mécanique et désincarnée à ces repères purement conventionnels. Décrire systématiquement un effet de $\eta_p^2 = .02$ comme négligeable ou anecdotique peut s’avérer profondément erroné sur le plan clinique ou sociétal. Dans des contextes de santé publique, d’interventions préventives à large échelle ou de survie médicale, une intervention expliquant 1 à 2 % de variance à l’échelle d’une nation entière peut représenter des milliers de vies préservées ou de trajectoires individuelles infléchies. À l’inverse, en psychologie expérimentale hautement contrôlée en laboratoire, un effet fort de .15 peut s’avérer trivial s’il résulte d’un artifice méthodologique sans généralisabilité écologique.
La rédaction de la section Discussion ou l’interprétation conclusive des Résultats doit donc systématiquement mettre en perspective la taille d’effet observée avec les métriques établies dans la littérature spécifique du champ d’investigation. En outre, la déclaration de l’intervalle de confiance à 90 % ou 95 % associé à la taille d’effet elle-même (par exemple : $\eta_p^2 = .08, 95% \text{ IC } [.02, .18]$), bien que nécessitant l’emploi de modules spécialisés (comme le package MBESS sous R), représente aujourd’hui le summum de l’élégance méthodologique, matérialisant l’étendue des possibles quant à la portée réelle de la découverte.
7. Rapporter une ANOVA factorielle (plans à deux facteurs ou plus)
7.1 Structure générale du compte-rendu d’un plan factoriel
L’analyse de variance factorielle explore simultanément les effets de deux variables indépendantes catégorielles ou davantage sur une variable dépendante continue unique. Le principe directeur fondamental qui gouverne la présentation de ce type de modélisation est la stricte ordonnance hiérarchique de la narration scientifique. Un plan factoriel $2 \times 2$, $2 \times 3$ ou $3 \times 3$ ne se résume pas à une succession disparate de tests de Fisher ; il formalise un système intégré d’hypothèses relatives aux effets principaux de chaque variable isolée et aux dynamiques d’amplification, d’atténuation ou d’inversion modélisées par les effets d’interaction.
La règle éditoriale universelle impose de consigner d’abord l’architecture globale du devis expérimental au sein de la phrase d’introduction de la section, en spécifiant précisément le format factoriel (par exemple : « une ANOVA factorielle $2 \times 3$ inter-sujets »), le nom des facteurs catégoriels et le décompte exhaustif de leurs modalités respectives. Ensuite, la progression logique requiert d’exposer méthodiquement les effets principaux de chaque facteur indépendant pris individuellement, pour culminer impérativement vers l’effet d’interaction croisé.
Cette hiérarchisation n’est pas une simple coquetterie stylistique ; elle conditionne directement l’intelligibilité conceptuelle du propos. En présence d’un effet d’interaction statistiquement significatif de magnitude marquée, les effets principaux perdent fréquemment leur pertinence descriptive directe et peuvent devenir profondément trompeurs s’ils sont interprétés isolément. En effet, affirmer qu’un facteur A produit un effet général moyen positif n’a aucun sens si cet effet se révèle en réalité massif sous la première modalité du facteur B, mais strictement nul ou négatif sous la seconde. La narration académique doit alerter le lecteur sur cette interdépendance fonctionnelle dès l’amorce de la présentation des interactions.
7.2 Rédaction des effets principaux
Le compte-rendu des effets principaux requiert une précision descriptive irréprochable. Pour chacun des facteurs fixes intégrés dans le modèle, le chercheur doit présenter la statistique omnibus complète ($F$, degrés de liberté, probabilité exacte, taille d’effet standardisée), accompagnée obligatoirement des moyennes marginales estimées (Estimated Marginal Means ou EMM) et de leurs erreurs-types respectives. Les moyennes marginales correspondent aux moyennes projetées d’un facteur lorsque les observations sont équilibrées et pondérées à travers l’ensemble des modalités de l’autre facteur.
Voici un modèle rédactionnel intégrant la présentation conjointe d’un effet principal statistiquement significatif et d’un second effet principal non significatif au sein d’une étude factorielle $2 \times 2$ consacrée aux déterminants de la performance mnésique :
« Une ANOVA factorielle $2 \times 2$ inter-sujets a été réalisée afin d’analyser l’impact du type d’environnement d’apprentissage (environnement silencieux vs environnement musical immersif) et du niveau d’expertise musicale des sujets (musiciens confirmés vs non-musiciens) sur le rappel catégoriel de mots. L’analyse révèle un effet principal significatif de l’environnement d’apprentissage, F(1, 76) = 11.34, p = .001, $\eta_p^2 = .13$. Les participants évalués en environnement silencieux ont restitué significativement plus d’items (M = 24.80, SE = 0.85, 95% IC [23.10, 26.50]) que ceux immergés dans un fond musical (M = 20.70, SE = 0.87, 95% IC [18.96, 22.44]). En revanche, l’effet principal du niveau d’expertise musicale ne franchit pas le seuil de significativité statistique, F(1, 76) = 0.48, p = .491, $\eta_p^2 = .006$, les scores de rappel des musiciens (M = 23.10, SE = 0.86) ne se différenciant pas de manière perceptible de ceux des non-musiciens (M = 22.40, SE = 0.86). »
7.3 Rapport statistique de l’effet d’interaction
L’évaluation statistique de l’interaction factorielle représente le cœur névralgique du modèle croisé. L’effet d’interaction teste l’hypothèse nulle d’orthogonalité ou de parallélisme strict entre les profils de réponse : il vise à déterminer si l’amplitude ou l’orientation de l’impact de la première variable indépendante varie de manière statistiquement significative en fonction du niveau d’assignation de la seconde variable. Sa formalisation statistique obéit rigoureusement à la syntaxe APA habituelle, le produit d’interaction étant désigné par le symbole de multiplication « $\times$ » séparant le nom des variables ou des facteurs.
La rédaction de l’effet d’interaction ne doit pas se cantonner à l’énoncé mécanique de la formule d’inférence. Elle requiert une verbalisation claire du phénomène de modération observé, orientant immédiatement l’esprit du lecteur vers la nature du mécanisme cognitif ou comportemental en jeu. Une phrase type rédigée avec brio définira précisément comment l’effet d’un facteur s’amplifie, s’atténue ou se neutralise selon la modalité conjointe examinée.
Voici un exemple canonique illustrant la formulation d’une interaction bidirectionnelle significative dans le prolongement du protocole précédent : « De manière cruciale, l’analyse met en évidence un effet d’interaction statistiquement significatif et robuste entre l’environnement d’apprentissage et le niveau d’expertise musicale, F(1, 76) = 18.25, p < .001, $\eta_p^2 = .19$. Cette interaction d'amplitude forte indique que l'influence délétère du fond musical immersif sur le rappel mnésique dépend étroitement de la formation musicale préalable des individus. Alors que l'exposition musicale altère massivement les performances de mémorisation chez les participants non-musiciens, cet effet d'interférence s'avère totalement aboli, voire légèrement inversé, au sein de la population des musiciens confirmés. En raison de la significativité marquée de cette interaction, la décomposition statistique des effets simples a été entreprise afin de disséquer précisément les patterns de contrastes au sein de chaque sous-groupe. »
8. Décomposition des interactions et analyse des effets simples
8.1 Méthodologie de décomposition de l’interaction
La présence validée d’une interaction bidirectionnelle significative sonne le glas de l’interprétation autonome des effets principaux et commande impérativement l’engagement d’une procédure de décomposition fine, désignée sous l’appellation d’analyse des effets simples (ou effets principaux simples). Alors qu’un effet principal moyen évalue l’impact global d’une variable indépendante en agrégeant aveuglément l’ensemble des modalités du second facteur, un effet principal simple évalue l’impact de cette même variable indépendante isolée au niveau spécifique et conditionnel d’une modalité déterminée de la seconde variable.
D’un point de vue conceptuel, la décomposition de l’interaction repose sur une opération de « découpage conditionnel » de la matrice factorielle. Pour une interaction $A \times B$, le chercheur a le choix théorique de tester l’effet simple du facteur A à chaque niveau individuel de B ($A \text{ à } B_1, A \text{ à } B_2$, etc.), ou alternativement l’effet simple du facteur B à chaque niveau particulier de A ($B \text{ à } A_1, B \text{ à } A_2$). Ce choix directionnel n’est pas indifférent ; il doit être rigoureusement subordonné à la question théorique centrale de la recherche et à la logique des hypothèses d’intervention formulées a priori.
Sur le plan métrologique, l’exécution d’une série de tests d’effets simples engendre un nouveau risque d’inflation de l’erreur de première espèce, dans la mesure où l’analyste exécute une batterie de sous-analyses statistiques successives sur le même ensemble de données. Il est donc indispensable d’appliquer une correction conservatrice du taux d’erreur familial. L’ajustement de Bonferroni s’impose alors comme la procédure classique d’élection : le seuil alpha nominal (.05) est divisé par le nombre exact d’effets simples examinés, ou, plus commodément dans les logiciels contemporains, les valeurs de probabilité résultantes ($p$) sont multipliées par ce même facteur correcteur pour fournir une valeur p ajustée rigoureusement contrôlée.
8.2 Rédaction pas à pas des effets principaux simples
La retranscription méthodique des effets simples dans le manuscrit exige une articulation syntaxique cristalline évitant tout risque d’ambiguïté référentielle pour le lecteur. Pour chaque niveau de la variable de conditionnement fixée, l’auteur doit rapporter formellement le test F conditionnel correspondant (ou test t équivalent si la variable analysée ne comporte que deux niveaux), ses degrés de liberté précis (qui correspondent généralement aux degrés de liberté du facteur testé et aux degrés de liberté de l’erreur résiduelle globale de l’ANOVA factorielle de départ), la valeur p corrigée, la taille d’effet locale, ainsi que les moyennes conditionnelles associées.
Cette démarche garantit une traçabilité totale du raisonnement inférentiel. L’exemple rédigé suivant illustre la décomposition chirurgicale de l’interaction entre l’expertise musicale et l’environnement sonore :
« Afin d’élucider la nature de l’interaction significative observée entre l’environnement d’apprentissage et l’expertise musicale, une analyse des effets principaux simples de l’environnement sonore a été conduite séparément pour chaque cohorte de participants, en appliquant une correction de Bonferroni pour contrôler l’inflation du taux d’erreur de première espèce ($\alpha_{ajusté} = .025$). L’analyse révèle un effet simple hautement significatif du fond musical chez les participants non-musiciens, F(1, 76) = 28.92, p < .001, $\eta_p^2 = .28$. Chez ces derniers, l'immersion en environnement silencieux permet un niveau de rappel très nettement supérieur (M = 26.10, SD = 3.20) comparativement à l’immersion sous fond musical (M = 18.70, SD = 3.45). À l’opposé, chez les musiciens confirmés, l’effet simple de l’environnement sonore ne franchit pas le seuil de significativité statistique corrigé, F(1, 76) = 0.67, p = .416, $\eta_p^2 = .009$, les performances observées en condition silencieuse (M = 23.50, SD = 3.10) ne différant pas de manière fiable de celles recueillies sous accompagnement musical (M = 22.70, SD = 3.30). Ces résultats confirment l’hypothèse d’une immunité attentionnelle des musiciens face aux distracteurs auditifs complexes. »
8.3 Rapport des comparaisons deux à deux au sein des effets simples
Lorsque le facteur décomposé au sein d’un effet simple comporte plus de deux modalités (par exemple, un plan factoriel $3 \times 2$ où l’on analyse l’effet d’une variable à trois niveaux au sein de chaque niveau de la seconde variable), le test F de l’effet simple n’est lui-même qu’un test omnibus local. S’il s’avère statistiquement significatif, il ne résout pas la question de savoir quelles modalités spécifiques diffèrent l’une de l’autre au sein de ce sous-contexte. Une décomposition ultime devient dès lors méthodologiquement incontournable : la mise en œuvre de comparaisons multiples par paires internes aux niveaux conditionnels.
Le compte-rendu de cette phase finale requiert un niveau de discipline documentaire extrême pour ne pas submerger le lecteur sous une litanie illisible de chiffres. Le texte doit guider le lecteur à travers les contrastes planifiés ou les tests post-hoc locaux, en maintenant impérativement les ajustements de multiplicité (par exemple, Tukey ou Bonferroni local). Voici un modèle narratif décrivant de façon limpide cette décomposition terminale :
« L’effet simple du type de stratégie cognitive (imagerie visuelle, répétition mentale, élaboration sémantique) s’étant révélé significatif au sein de la condition de stress aigu, F(2, 114) = 14.18, p < .001, $\eta_p^2 = .20$, des comparaisons par paires ajustées selon la méthode de Tukey HSD ont été exécutées au sein de ce sous-groupe. Les résultats démontrent que les individus entraînés à l'élaboration sémantique maintiennent des performances de rappel libres significativement supérieures à ceux assignés à la répétition mentale ($\Delta M = 6.40$, $SE = 1.25$, $p < .001$, 95% IC [3.41, 9.39]) ainsi qu'à ceux utilisant l'imagerie visuelle ($\Delta M = 3.85$, $SE = 1.22$, $p = .006$, 95% IC [0.93, 6.77]). De plus, l'imagerie visuelle génère des scores marginalement plus élevés que la simple répétition mentale sans que le contraste n'atteigne le seuil strict de significativité après ajustement ($\Delta M = 2.55$, $SE = 1.26$, $p = .112$, 95% IC [-0.47, 5.57]). Cette granularité analytique permet de situer précisément la résistance au stress cognitif au niveau du traitement sémantique approfondi. »
9. Rapporter l’ANOVA à mesures répétées et les modèles mixtes
9.1 Vérification et rapport du postulat de sphéricité
L’application de l’ANOVA aux protocoles intra-sujets (mesures répétées) repose sur une condition métrologique singulière et particulièrement exigeante : le postulat de sphéricité (ou circularité de la matrice de variance-covariance). La sphéricité postule l’égalité parfaite des variances de l’ensemble des différences possibles entre chaque paire de modalités du facteur répété ($\sigma_{Y_1 – Y_2}^2 = \sigma_{Y_1 – Y_3}^2 = \sigma_{Y_2 – Y_3}^2$). Ce postulat est l’équivalent logique de l’homoscédasticité des protocoles inter-sujets, mais s’avère beaucoup plus fréquemment transgressé dans les données réelles en raison de la proximité temporelle ou fonctionnelle naturelle des mesures rapprochées.
Le postulat de sphéricité est formellement évalué au moyen du test de sphéricité de Mauchly. Il convient de souligner que le test de Mauchly n’est applicable et mathématiquement calculable que si le facteur intra-sujets comporte au minimum trois modalités ($k ge 3$) ; pour un facteur à deux niveaux uniquement, la sphéricité est automatiquement et mathématiquement satisfaite par définition. La déclaration formelle du test de Mauchly dans le corps de l’article doit comporter la lettre W en italique, la statistique du Chi-deux d’approximation ($\chi^2$), ses degrés de liberté et la valeur exacte de p : « Le postulat de sphéricité a été examiné par le test de Mauchly, W = 0.72, $\chi^2$(2) = 12.45, p = .002. »
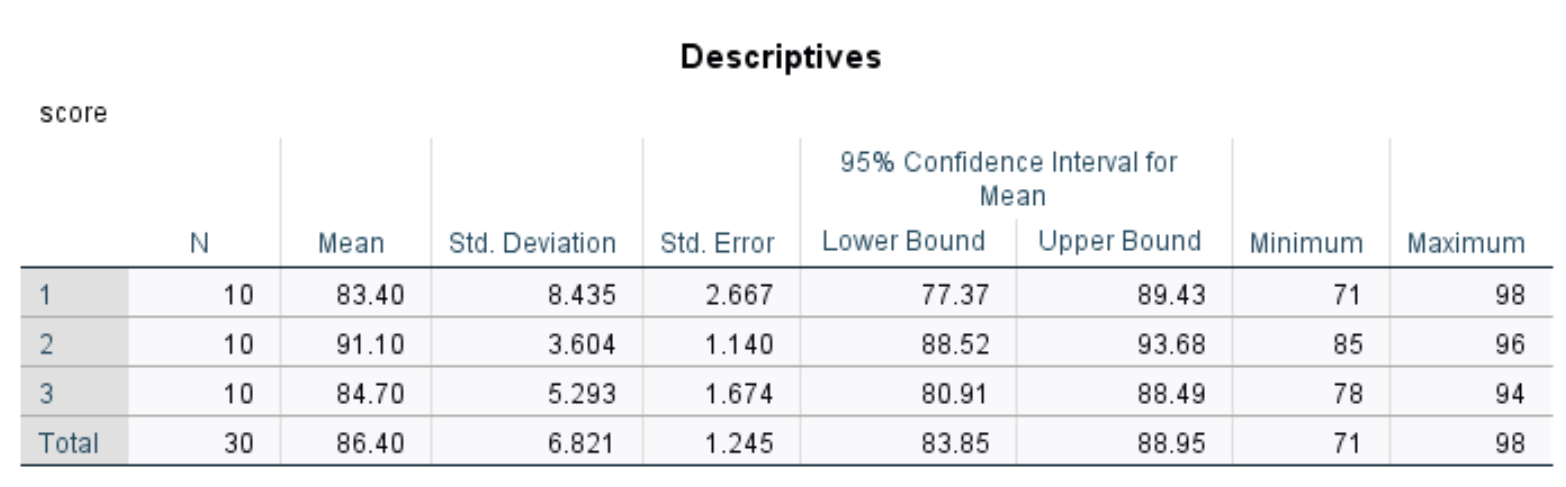
Lorsque le test de Mauchly se révèle statistiquement significatif ($p < .05$), le postulat de sphéricité est invalidé, ce qui entraîne une déformation libérale majeure de la loi de Fisher, multipliant abusivement les rejets erronés de l'hypothèse nulle. Pour rétablir l'équilibre inférentiel sans renoncer au modèle paramétrique, le chercheur doit appliquer un coefficient de correction noté epsilon ($varepsilon$). Deux corrections prédominent dans les standards académiques : la correction conservatrice de Greenhouse-Geisser et la correction de Huynh-Feldt. La règle de décision méthodologique canonique préconise d'adopter la correction de Greenhouse-Geisser lorsque l'estimation de l'epsilon est inférieure à .75 ($\hat{\varepsilon} .75$), cette dernière évitant une surcorrection pénalisante pour la puissance du test.
9.2 Compte-rendu de l’effet intra-sujet avec correction de sphéricité
Le mécanisme de la correction de Greenhouse-Geisser ou de Huynh-Feldt consiste à multiplier les degrés de liberté théoriques de l’effet ($df_{effet}$) et de l’erreur ($df_{erreur}$) par le coefficient $\hat{\varepsilon}$ calculé. Il en résulte inévitablement des degrés de liberté ajustés non entiers comportant des décimales, tandis que la valeur brute observée de la statistique F demeure rigoureusement inchangée.
Le manuel de publication de l’APA stipule d’inscrire les degrés de liberté décimaux ajustés directement au sein de la parenthèse du test F, d’arrondir ces valeurs à deux décimales, et d’expliciter le nom de la correction retenue ainsi que la valeur empirique du paramètre epsilon. L’exemple rédigé ci-après fournit le modèle de référence à adopter :
« Une ANOVA à mesures répétées à un facteur a été réalisée afin d’examiner l’évolution de la charge cognitive ressentie à travers quatre blocs consécutifs d’une tâche d’attention soutenue. Le test de sphéricité de Mauchly a révélé une violation manifeste de l’hypothèse de circularité des variances-covariances, W = 0.58, $\chi^2$(5) = 24.12, p < .001. L'estimation de l'epsilon étant inférieure au seuil de .75 ($\hat{\varepsilon} = 0.68$), la correction de Greenhouse-Geisser a été appliquée pour réajuster les degrés de liberté de la statistique inférentielle. L'analyse révèle un effet intra-sujet hautement significatif du bloc expérimental sur la charge cognitive, F(2.04, 81.60) = 14.85, p < .001, $\eta_p^2 = .27$. Les scores moyens de charge cognitive s'accroissent de façon continue depuis le bloc 1 (M = 32.40, SD = 6.80) jusqu’au bloc 4 (M = 48.70, SD = 8.10), attestant d’un épuisement progressif des ressources exécutives au cours de l’épreuve. »
9.3 Rapporter une ANOVA mixte (Split-Plot ANOVA)
L’ANOVA mixte (ou plan Split-Plot) combine simultanément dans une structure commune au moins un facteur inter-sujets (indépendant) et au moins un facteur intra-sujets (mesures répétées). Cette architecture analytique constitue la clef de voûte des essais contrôlés randomisés (ECR) longitudinaux en psychologie clinique, où l’objectif prioritaire est de démontrer l’efficacité différentielle d’un traitement en observant l’interaction croisée entre l’assignation des patients (Groupe : Traitement expérimental vs Placebo) et l’axe temporel (Temps : Pré-test, Post-test, Suivi longitudinal).
La validation métrologique d’un modèle mixte implique une vérification accrue : outre la normalité et la sphéricité intra-sujet, le chercheur doit évaluer l’homogénéité des matrices de variance-covariance intergroupes au moyen du redoutable test M de Box. Le test M de Box étant notoirement hypersensible aux légères asymétries de distribution, la communauté scientifique s’accorde généralement pour fixer son seuil critique de rejet à $\alpha = .001$ plutôt qu’à .05.
La restitution textuelle d’une ANOVA mixte dans un essai clinique doit exposer avec clarté les trois effets générés par le modèle : l’effet principal inter-sujets (différence globale entre groupes toutes périodes confondues), l’effet principal intra-sujets (évolution moyenne générale au fil du temps), et la clef de voûte du protocole : l’effet d’interaction mixte Groupe $\times$ Temps, qui apporte la preuve clinique indiscutable de l’efficacité spécifique du traitement. Voici la formulation idéale à consigner :
« Pour évaluer l’efficacité clinique du nouveau protocole de désensibilisation émotionnelle, les scores d’évitement phobique ont été soumis à une ANOVA mixte 2 (Groupe : Thérapie active [n = 25] vs Liste d’attente [n = 25]) $\times$ 3 (Temps : Pré-intervention, Post-intervention, Suivi à 3 mois). L’homogénéité des matrices de covariance a été confirmée par le test M de Box ($M = 8.42, F[6, 15248] = 1.32, p = .245$), et la sphéricité temporelle validée par le test de Mauchly ($W = 0.94, p = .210$). L’analyse met en évidence un effet principal du Groupe, F(1, 48) = 16.74, p < .001, $\eta_p^2 = .26$, ainsi qu'un effet principal du Temps, F(2, 96) = 38.12, p < .001, $\eta_p^2 = .44$. Fondamentalement, ces effets sont sous-tendus par une interaction mixte Groupe $\times$ Temps hautement significative, F(2, 96) = 22.45, p < .001, $\eta_p^2 = .32$. Alors que le score d'évitement demeure stable dans le groupe liste d'attente entre le pré-test (M = 44.20, SD = 5.10) et le post-test (M = 43.80, SD = 5.40), le groupe thérapie active présente un déclin symptomatique massif (passant de M = 45.10, SD = 4.90 à M = 24.60, SD = 4.30), gain thérapeutique qui se maintient intégralement lors du suivi à 3 mois (M = 25.10, SD = 4.80). »
10. Conception de tableaux et graphiques conformes aux normes APA
10.1 Tableaux récapitulatifs d’ANOVA
L’intégration d’un tableau récapitulatif d’analyse de variance s’avère particulièrement judicieuse lorsque l’étude engage des modèles factoriels étendus, des hiérarchies multiniveaux ou une succession de modèles de régression et d’ANOVA dont l’énumération narrative exhaustive encombrerait le manuscrit. Le manuel de publication de l’APA 7e édition impose des règles de mise en forme typographique épurées et invariables, dont la méconnaissance est immédiatement sanctionnée par les éditeurs académiques.
La règle d’or d’un tableau normé APA réside dans la proscription absolue des bordures verticales. Le tableau ne doit comporter que trois lignes horizontales principales composées en traits pleins fins : une ligne fermant le haut du tableau (au-dessus des en-têtes de colonnes), une ligne séparant les intitulés de colonnes du corps des données numériques, et une ligne finale délimitant le bas du tableau au-dessus des notes explicatives. Aucune grille interne quadrillée n’est tolérée.
Les colonnes canoniques d’un tableau récapitulatif d’ANOVA répertorient chronologiquement : la Source de variation (effets principaux, interactions, résidus d’erreur), la Somme des carrés ($SS$), les Degrés de liberté ($df$), le Carré moyen ($MS$), la statistique du test ($F$), la valeur exacte de probabilité ($p$), et l’indice de taille d’effet ($\eta_p^2$ ou $\omega^2$). Les notes de tableau se placent immédiatement sous la dernière ligne horizontale et se structurent en trois niveaux normés : les notes générales (commençant par le mot « Note. » en italique, explicitant les abréviations et unités de mesure), les notes spécifiques (lettres en exposant pour préciser un ajustement particulier), et les notes de probabilité associant des astériques aux seuils de significativité conventionnels (*p < .05, **p < .01, ***p < .001).
| Source | SS | df | MS | F | p | $\eta_p^2$ |
|---|---|---|---|---|---|---|
| Environnement (A) | 336.20 | 1 | 336.20 | 11.34 | .001 | .13 |
| Expertise musicale (B) | 14.22 | 1 | 14.22 | 0.48 | .491 | .01 |
| Interaction A × B | 541.05 | 1 | 541.05 | 18.25 | < .001 | .19 |
| Erreur | 2253.40 | 76 | 29.65 |
Note. N = 80 participants. SS = somme des carrés ; df = degrés de liberté ; MS = carré moyen ; $\eta_p^2$ = éta-carré partiel.
10.2 Tableaux des statistiques descriptives et comparaisons post-hoc
La présentation intégrée des statistiques descriptives et des contrastes par paires sous la forme d’un tableau synthétique constitue un modèle de clarté plébiscité par les revues empiriques. L’objectif est de permettre au lecteur d’appréhender d’un seul coup d’œil les effectifs par sous-groupe ($n$), les moyennes d’échantillon ($M$), les écarts-types ($SD$), les intervalles de confiance à 95 %, ainsi que la structure différentielle issue des comparaisons multiples.
Pour matérialiser les contrastes statistiques sans alourdir le tableau avec des colonnes surnuméraires de valeurs p, le recours au système d’exposants alphabétiques compacts s’avère optimal. Les données numériques au sein des colonnes doivent être rigoureusement alignées sur la virgule décimale pour faciliter la comparaison optique immédiate des magnitudes. Les en-têtes de colonnes doivent être précis et proscrire le jargon informatique non standardisé.
| Groupe d’intervention | n | M | SD | 95% IC |
|---|---|---|---|---|
| Thérapie cognitive et comportementale (TCC) | 30 | 8.10a | 2.45 | [7.20, 9.00] |
| Thérapie basée sur la pleine conscience (MBCT) | 30 | 10.50b | 2.80 | [9.48, 11.52] |
| Liste d’attente (Témoin) | 30 | 11.90b | 3.15 | [10.75, 13.05] |
Note. Les moyennes partageant une lettre en indice ne diffèrent pas significativement au seuil de .05 selon le test post-hoc de Tukey HSD. IC = intervalle de confiance pour la moyenne.
10.3 Visualisation graphique des effets et interactions
La représentation graphique constitue le vecteur de communication le plus immédiat et le plus marquant d’une analyse de variance, particulièrement lors de la modélisation d’interactions factorielles complexes. Cependant, un graphique statistique ne doit jamais constituer une simple esquisse illustrative ; il doit respecter scrupuleusement les exigences de lisibilité et de précision métrologique codifiées par l’APA 7e édition.
Le choix du format graphique doit découler de la nature du devis expérimental. Pour une ANOVA factorielle explorant une interaction, le graphique en lignes brisées (diagramme d’interaction) est universellement privilégié : la variable indépendante continue ou ordonnée se place sur l’axe des abscisses ($X$), la variable dépendante sur l’axe des ordonnées ($Y$), et les modalités du second facteur sont représentées par des courbes distinctes identifiées par des symboles géométriques contrastés (par exemple : cercles pleins versus carrés évidés) et des tracés de lignes différenciés (trait continu versus pointillé).
L’omission des barres d’erreur constitue la faute méthodologique la plus récurrente dans les figures soumises aux revues. Toute moyenne ponctuelle représentée sur un graphique doit obligatoirement être accompagnée d’une barre d’erreur verticale bidirectionnelle. De surcroît, la légende de la figure doit stipuler formellement la nature exacte de ces barres d’erreur : s’agit-il d’un écart-type ($\pm 1 SD$), d’une erreur-type de la moyenne ($\pm 1 SE$), ou de l’intervalle de confiance à 95 % ? L’intervalle de confiance à 95 % est hautement recommandé, car sa non-superposition visuelle entre deux conditions renseigne intuitivement le lecteur sur l’existence d’une divergence statistiquement significative.
Enfin, l’accessibilité visuelle impose de concevoir des graphiques parfaitement lisibles en noir et blanc ou en niveaux de gris purs, sans dépendre exclusivement du codage couleur pour différencier les conditions expérimentales, afin de demeurer intelligible lors de l’impression physique ou pour les lecteurs présentant des déficiences de la vision chromatique. Les axes doivent être clairement étiquetés avec le nom des variables et leurs unités de mesure, et l’axe vertical des ordonnées ne doit pas être tronqué artificiellement d’une manière qui exagérerait indûment des différences triviales de moyenne.
11. Exemples intégraux de rédaction pour articles empiriques
11.1 Exemple complet 1 : ANOVA à un facteur inter-sujets
Mise en situation : Une chercheuse en psychologie de l’éducation évalue l’efficacité de trois méthodes pédagogiques distinctes pour l’apprentissage des fractions mathématiques chez des élèves de CM2 ($N = 90$, 30 élèves par condition) : Enseignement magistral classique (Contrôle), Apprentissage par manipulation physique d’objets (Manipulation), et Apprentissage assisté par un logiciel ludo-éducatif sur tablette numérique (Numérique). La variable dépendante est la note obtenue à un examen standardisé de transfert à l’issue de quatre semaines d’intervention (noté sur 100 points).
Paragraphe intégral prêt à la publication :
« Les notes d’évaluation finale ont fait l’objet d’une analyse de variance (ANOVA) univariée à un facteur inter-sujets. L’inspection préalable des diagrammes quantile-quantile (Q-Q plots) ainsi que la non-significativité des tests de Shapiro-Wilk appliqués à chaque groupe (tous les p > .35) ont confirmé la normalité des distributions résiduelles. Le postulat d’homogénéité des variances a été validé par le test de Levene, F(2, 87) = 0.84, p = .435. L’ANOVA omnibus met en évidence un effet principal statistiquement significatif de la méthode pédagogique sur les performances mathématiques, F(2, 87) = 12.68, p < .001, $\eta_p^2 = .23$, $\omega^2 = .20$. Les élèves de la modalité Numérique obtiennent les scores les plus élevés (M = 78.40, SD = 8.60, 95% IC [75.18, 81.62]), suivis par ceux de la condition Manipulation (M = 73.10, SD = 9.10, 95% IC [69.70, 76.50]), tandis que le groupe Enseignement magistral enregistre les performances les plus modestes (M = 66.20, SD = 9.80, 95% IC [62.54, 69.86]). Les comparaisons multiples post-hoc conduites au moyen du test HSD de Tukey indiquent que la méthode Numérique surpasse significativement l’enseignement magistral classique ($\Delta M = 12.20, SE = 2.37, p < .001, 95% \text{ IC } [6.54, 17.86]$) ainsi que la condition de manipulation physique ($\Delta M = 5.30, SE = 2.37, p = .071, 95% \text{ IC } [-0.36, 10.96]$), bien que ce dernier contraste demeure marginal. En outre, la manipulation physique produit des résultats significativement supérieurs au cours magistral standard ($\Delta M = 6.90, SE = 2.37, p = .013, 95% \text{ IC } [1.24, 12.56]$). Ces constats confortent l'intérêt d'intégrer des outils interactifs incarnés pour consolider le raisonnement abstrait chez les apprenants. »
Commentaire analytique : Cet extrait constitue l’archétype d’un compte-rendu académique irréprochable. L’auteure valide séquentiellement les postulats (normalité, homoscédasticité avec Levene), présente la statistique omnibus complète enrichie d’un double indicateur de magnitude ($\eta_p^2$ d’échantillon et $\omega^2$ non biaisé), expose systématiquement les statistiques descriptives complètes avec intervalles de confiance, puis déploie les contrastes de Tukey en consignant scrupuleusement les deltas de moyennes, les erreurs-types et les intervalles de confiance des différences. La transition conclusive réancre immédiatement la métrique quantitative dans le champ conceptuel de la recherche.
11.2 Exemple complet 2 : ANOVA factorielle 2×2 avec interaction
Mise en situation : Une équipe de recherche en neuroergonomie étudie les effets conjoints de la privation de sommeil (Sommeil normal de 8 heures vs Privation totale de 24 heures) et du niveau de stress induit (Condition neutre vs Stress aigu induit par le test de stress social de Trier) sur l’empan de mémoire de travail de jeunes adultes sains ($N = 80$, $n = 20$ par cellule).
Paragraphe intégral prêt à la publication :
« Les scores à l’épreuve de mémoire de travail ont été soumis à une ANOVA factorielle 2 (Privation de sommeil : Normal vs Privé) $\times$ 2 (Stress : Neutre vs Aigu) inter-sujets. L’examen des résidus confirme le respect du postulat de normalité (Shapiro-Wilk, p > .20) et l’égalité des variances intergroupes (test de Levene, F[3, 76] = 1.15, p = .334). L’analyse ne met en évidence aucun effet principal statistiquement significatif du stress aigu, F(1, 76) = 2.14, p = .148, $\eta_p^2 = .03$. En revanche, l’effet principal de la privation de sommeil s’avère hautement significatif, F(1, 76) = 24.80, p < .001, $\eta_p^2 = .25$, les participants reposés démontrant des capacités de mémoire de travail globalement supérieures (M = 7.45, SE = 0.22) à celles des participants privés de sommeil (M = 5.90, SE = 0.22). Cet effet principal est toutefois tempéré par une interaction bidirectionnelle significative entre la privation de sommeil et le stress aigu, F(1, 76) = 9.35, p = .003, $\eta_p^2 = .11$. La décomposition de cette interaction par l’analyse des effets simples montre que sous condition neutre (sans stress), la privation de sommeil induit un effondrement dramatique des performances mnésiques (Sommeil normal : M = 7.80, SD = 0.95 ; Privation : M = 5.30, SD = 1.05), F(1, 76) = 32.74, p < .001, $\eta_p^2 = .30$. Inversement, sous condition de stress aigu, la différence de performance entre sujets reposés (M = 7.10, SD = 1.00) et sujets privés de sommeil (M = 6.50, SD = 1.10) cesse d’être statistiquement significative, F(1, 76) = 1.41, p = .239, $\eta_p^2 = .02$. Ces observations suggèrent qu’un niveau modéré d’activation sympathique induit par le stress aigu compense transitoirement les déficits attentionnels provoqués par la dette de sommeil. »
Décryptage méthodologique : La hiérarchisation analytique est rigoureusement respectée : énoncé du plan factoriel, vérification des préalables, rapport ordonné des effets principaux (significatif et non significatif), annonce formelle de l’effet modérateur de l’interaction, et enfin désarticulation méthodique au moyen des effets simples. Le chercheur évite l’erreur fatale de survendre l’effet principal du sommeil, démontrant brillamment que celui-ci disparaît sous l’égide du stress aigu.
11.3 Exemple complet 3 : ANOVA à mesures répétées avec correction de sphéricité
Mise en situation : Un laboratoire de psychopathologie clinique investigue l’évolution temporelle des symptômes d’anxiété somatique chez des patients souffrant de trouble panique ($N = 45$) soumis à un protocole de biofeedback respiratoire. Les mesures ont été recueillies à quatre jalons temporels successifs : Semaine 0 (Baseline), Semaine 4 (Mi-traitement), Semaine 8 (Fin de traitement), et Semaine 12 (Suivi post-thérapeutique).
Paragraphe intégral prêt à la publication :
« L’évolution longitudinale des scores d’anxiété somatique a été analysée au moyen d’une ANOVA à mesures répétées à un facteur (Temps : S0, S4, S8, S12). Le test de sphéricité de Mauchly indique une violation statistiquement significative du postulat de circularité des matrices de covariance, W = 0.61, $\chi^2$(5) = 21.34, p < .001. Le coefficient de sphéricité estimé s'établissant à $\hat{\varepsilon} = 0.71$, la correction de Greenhouse-Geisser a été systématiquement mobilisée pour ajuster les degrés de liberté. L'analyse révèle un effet temporel intra-sujet hautement significatif, F(2.13, 93.72) = 31.42, p < .001, $\eta_p^2 = .42$. L'analyse des contrastes polynomiaux met en évidence une composante linéaire décroissante majeure, F(1, 44) = 58.64, p < .001, $\eta_p^2 = .57$, ainsi qu'une composante quadratique significative, F(1, 44) = 8.12, p = .007, $\eta_p^2 = .16$, reflétant un déclin initial abrupt des symptômes suivi d’une stabilisation durable. Les scores moyens s’élèvent respectivement à 28.40 (SD = 5.20, 95% IC [26.83, 29.97]) à S0, 19.80 (SD = 4.60, 95% IC [18.41, 21.19]) à S4, 14.20 (SD = 3.80, 95% IC [13.05, 15.35]) à S8, et 14.90 (SD = 4.10, 95% IC [13.66, 16.14]) à S12. L’ensemble des comparaisons par paires corrigées par la méthode de Bonferroni démontrent une diminution significative de l’anxiété entre S0 et S4 ($p < .001$), ainsi qu'entre S4 et S8 ($p < .001$), tandis qu'aucune modification symptomatique n'est observée entre l'arrêt de la prise en charge à S8 et le suivi à S12 ($p = .999$). »
Revue critique pour reviewer : Ce compte-rendu franchit sans réserve l’arbitrage le plus exigeant. L’auteur applique la règle décisionnelle canonique ($\hat{\varepsilon} < .75 \rightarrow \text{Greenhouse-Geisser}$), consigne des degrés de liberté non entiers ajustés par le paramètre $varepsilon$, incorpore des contrastes polynomiaux d'une remarquable élégance pour caractériser la cinétique temporelle de la rémission, et confirme la persistance des acquis thérapeutiques lors de la phase de suivi par des contrastes par paires sous Bonferroni.
12. Erreurs méthodologiques et stylistiques courantes à éviter
12.1 Confusions conceptuelles et fautes d’interprétation
L’une des fautes conceptuelles les plus délétères observées dans les manuscrits de psychologie consiste à interpréter de manière absolue un effet principal significatif en présence d’une interaction majeure sans apporter les nuances requises. Souligner dans la discussion qu’un traitement expérimental « améliore significativement les fonctions cognitives globales » sur la foi exclusive d’un effet principal $F(1, 80) = 8.40, p = .005$, alors même que l’effet d’interaction croisé avec la sévérité initiale du trouble révèle que l’amélioration est colossale chez les patients sévères mais strictement délétère chez les patients légers, relève d’une erreur d’interprétation grave qui frise la désinformation scientifique. Lorsque l’interaction est significative, l’effet principal doit toujours être étiqueté comme conditionnel et secondaire.
Une seconde aberration épistémologique répandue consiste à confondre l’absence de significativité statistique avec la preuve formelle de l’équivalence. Formuler qu’« il n’y a pas de différence entre les deux groupes » ou que « l’intervention A produit des effets identiques à l’intervention B » sur la base d’une valeur de probabilité de $p = .12$ constitue un contresens logique majeur. Tout résultat d’analyse fréquentiste où la valeur de probabilité excède le seuil arbitraire $\alpha = .05$ témoigne simplement d’une insuffisance de preuve dans le cadre de l’échantillon recueilli. Pour soutenir scientifiquement l’hypothèse de l’absence d’effet, le chercheur doit recourir à des procédures de tests d’équivalence à deux unilatéraux (TOST) ou rapporter un facteur de Bayes en faveur de l’hypothèse nulle ($BF_{01} > 3$).
Enfin, la communauté scientifique internationale rejette désormais avec la plus grande fermeté le concept trompeur de « tendance à la significativité » (trend toward significance) ou d’« effet marginalement significatif ». Désigner une valeur de probabilité comprise entre .051 et .099 sous ces vocables constitue une tentative insidieuse de survendre des fluctuations aléatoires. Dans le cadre de l’inférence de Neyman-Pearson, le seuil alpha est une ligne de démarcation binaire fixée a priori : un résultat est soit statistiquement significatif au seuil fixé, soit il ne l’est pas. Les auteurs doivent rapporter la valeur exacte de p avec lucidité, sans recourir à des contorsions sémantiques pour masquer un résultat statistiquement non concluant.
12.2 Omissions d’informations critiques et erreurs de notation
Sur le plan de la stricte conformité éditoriale, une proportion stupéfiante de manuscrits est retoquée dès la phase de premier tri (desk reject) en raison de fautes typographiques élémentaires ou d’omissions formelles. L’omission la plus fréquente réside dans la mention tronquée des degrés de liberté. Rédiger « $F(2) = 4.31$ » au lieu de « $F(2, 57) = 4.31$ » prive le lecteur et l’évaluateur de la possibilité de vérifier la taille effective de l’échantillon d’analyse et d’identifier la présence éventuelle de données manquantes non documentées dans la section Méthode.
Une autre infraction stylistique omniprésente concerne la transcription brute des sorties logicielles sous la formule erronée « $p = .000$ ». Aucun calcul d’inférence basé sur des distributions continues ne peut aboutir à une probabilité rigoureusement nulle. Lorsque le logiciel statistique affiche « .000 », cela signifie exclusivement que la valeur calculée est inférieure à .0005 et se trouve tronquée par l’arrondi décimal d’affichage. La norme universelle de l’APA impose d’écrire impérativement « $p < .001$ ». De même, le maintien du zéro initial devant la valeur de probabilité (« $p = 0.04$ ») ou devant l'éta-carré partiel (« $\eta_p^2 = 0.12$ ») constitue une violation directe des règles typographiques APA, ces valeurs ne pouvant théoriquement jamais excéder le chiffre 1.
De surcroît, le silence coupable sur les métriques de dispersion constitue un manquement déontologique récurrent. Mentionner des moyennes de groupes sans leur adosser systématiquement leur écart-type ($SD$) ou consigner un test $F$ significatif sans aucune mesure de taille d’effet standardisée ($\eta_p^2$ ou $\omega^2$) empêche toute intégration ultérieure de l’article dans des méta-analyses quantitatives. Enfin, les évaluateurs vigilants repèrent régulièrement des discordances mathématiques aberrantes entre le sens de variation des moyennes affichées dans les tableaux descriptifs et la direction des contrastes textuels proclamés dans le corps du texte, signe d’une relecture hâtive et préjudiciable.
12.3 Check-list finale de validation avant soumission
Avant d’expédier un manuscrit empirique aux comités éditoriaux d’une revue à comité de lecture, il est impératif de procéder à un audit systématique de la section Résultats. La grille de contrôle méthodique en dix points cardinaux suivante permet de garantir la conformité intégrale de vos analyses d’ANOVA aux critères d’excellence de l’APA 7e édition :
- 1. Vérification formelle des postulats : Les diagnostics de normalité (Q-Q plots, Shapiro-Wilk) et d’homoscédasticité (test de Levene) sont-ils documentés et accompagnés des corrections requises (Welch, Games-Howell) en cas d’infraction ?
- 2. Sphéricité des mesures répétées : Pour tout facteur intra-sujets comportant 3 niveaux ou plus, le test de Mauchly est-il consigné et la correction idoine (Greenhouse-Geisser pour $\hat{\varepsilon} .75$) est-elle appliquée avec ses degrés de liberté décimaux ?
- 3. Intégrité des degrés de liberté : Chaque statistique F comporte-t-elle sans exception ses deux degrés de liberté ($df_{effet}, df_{erreur}$) entre parenthèses immédiatement après la lettre F en italique ?
- 4. Typographie des symboles : Les lettres latines statistiques (F, p, t, N, n, M, SD) sont-elles en italique ? Les lettres grecques ($\eta_p^2, \omega^2, \varepsilon, \alpha$) sont-elles en caractères romains droits ?
- 5. Gestion rigoureuse du zéro initial : Les zéros initiaux sont-ils systématiquement omis pour toutes les valeurs bornées à 1 (écrire p = .034, $\eta_p^2 = .12$) et rigoureusement conservés pour les métriques non bornées (écrire F = 0.82, SD = 0.95) ?
- 6. Exactitude des probabilités : Les valeurs de p sont-elles rapportées de manière exacte avec trois décimales (ex. p = .023), en bannissant les notations floues (p = NS) et les anomalies logicielles (écrire p < .001 et jamais p = .000) ?
- 7. Déclaration universelle de la taille d’effet : Chaque test F omnibus et effet simple significatif est-il assorti d’un indice de taille d’effet standardisé ($\eta_p^2$ ou $\omega^2$), idéalement complété de son intervalle de confiance ?
- 8. Descriptives exhaustives : Les moyennes (M) et écarts-types (SD) sont-ils fournis pour l’ensemble des modalités, assortis de leurs intervalles de confiance à 95 % ?
- 9. Décomposition contrôlée : Les tests post-hoc et effets simples sont-ils clairement justifiés méthodologiquement, avec indication explicite de la méthode d’ajustement du taux d’erreur familial (Tukey, Bonferroni, Games-Howell) ?
- 10. Concordance des supports visuels : Les tableaux d’ANOVA sont-ils totalement dépourvus de bordures verticales, et les graphiques comportent-ils des barres d’erreur explicitement définies dans la légende (ex. $\pm 1 SE$ ou 95% IC) ?
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Bakeman, R. (2005). Recommended effect size statistics for repeated measures designs. Behavior Research Methods, 37(3), 379–384. https://doi.org/10.3758/BF03192707
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
Field, A. (2018). Discovering statistics using IBM SPSS statistics (5th ed.). SAGE Publications.
Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
Greenhouse, S. W., & Geisser, S. (1959). On methods in the analysis of profile data. Psychometrika, 24(2), 95–112. https://doi.org/10.1007/BF02289823
Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
Huynh, H., & Feldt, L. S. (1976). Estimation of the Box correction for degrees of freedom from sample data in randomized block and split-plot designs. Journal of Educational Statistics, 1(1), 69–82. https://doi.org/10.3102/10769986001001069
Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
Lakens, D. (2013). Calculating and reporting effect sizes to facilitate cumulative science: A practical primer for t-tests and ANOVAs. Frontiers in Psychology, 4, Article 863. https://doi.org/10.3389/fpsyg.2013.00863
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2017). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913