
L’expérimentation scientifique au sein des sciences du comportement, de la psychologie cognitive, de la biomédecine et des sciences sociales contemporaines repose fondamentalement sur la capacité du chercheur à isoler, manipuler et mesurer des variables dans des environnements rigoureusement contrôlés. Historiquement, l’approche scientifique classique préconisait le principe du facteur unique, selon lequel une seule variable indépendante devait être manipulée à la fois, toutes les autres conditions étant maintenues strictement constantes. Bien que cette démarche cartésienne ait permis des avancées indéniables, elle a rapidement montré ses limites face à la complexité intrinsèque des organismes vivants et des dynamiques psychologiques, où les phénomènes résultent presque invariablement d’interactions multifactorielles et non d’effets isolés.
Le développement des plans factoriels, amorcé au début du XXe siècle, a constitué une véritable révolution épistémologique et méthodologique. Parmi ces architectures expérimentales, le plan factoriel 2×3 (deux par trois) occupe une place privilégiée. Ce dispositif bifactoriel permet d’examiner simultanément l’impact de deux variables indépendantes distinctes — l’une comportant deux modalités et l’autre trois — sur une ou plusieurs variables dépendantes quantitatives. L’élégance de cette structure réside non seulement dans son économie logistique substantielle, mais surtout dans sa puissance analytique inégalée : elle offre la possibilité d’étudier conjointement les effets principaux de chaque facteur et, de manière déterminante, leur effet d’interaction synergique ou antagoniste.
Ce guide exhaustif a pour vocation d’explorer l’ensemble des dimensions théoriques, mathématiques, computationnelles et pratiques inhérentes au plan factoriel 2×3. De la décomposition de la variance par l’intermédiaire de l’analyse de variance (ANOVA) jusqu’aux subtilités des analyses de contrastes a posteriori, en passant par le dimensionnement rigoureux de l’échantillon et la modélisation sous le format des normes de l’American Psychological Association (APA 7e édition), cet ouvrage de référence s’adresse aux chercheurs, doctorants et statisticiens soucieux d’optimiser la validité interne et externe de leurs protocoles de recherche.
1. Introduction et fondements épistémologiques du plan factoriel 2×3
1.1 Définition structurelle et notation mathématique
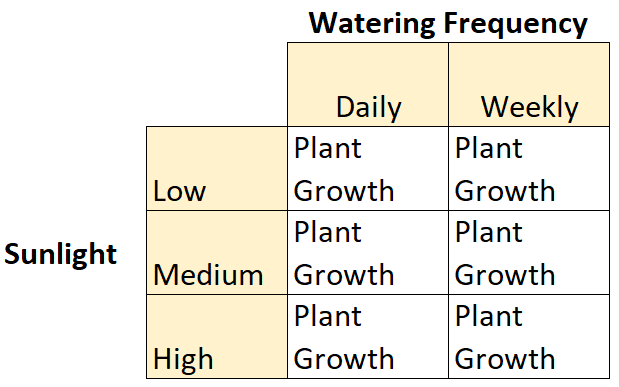
Dans la taxonomie de la méthodologie expérimentale, un plan factoriel est qualifié de « 2×3 » en vertu d’une convention de notation standardisée qui renseigne instantanément sur son architecture fondamentale. Le premier chiffre indique que la première variable indépendante (souvent désignée conventionnellement sous la lettre Facteur A) est partitionnée en deux modalités ou niveaux distincts. Le second chiffre stipule que la seconde variable indépendante (le Facteur B) se déploie à travers trois modalités distinctes. Le produit cartésien de ces deux ensembles de niveaux détermine le nombre total de conditions expérimentales uniques, communément appelées « cellules de traitement ». Ainsi, un devis factoriel 2×3 génère invariablement un total de 2 × 3 = 6 cellules de traitement distinctes, au sein desquelles les observations empiriques sont recueillies.
L’attribution des unités expérimentales (qu’il s’agisse de participants humains, de modèles animaux ou d’échantillons biologiques) au sein de ces six cellules structure l’espace paramétrique de l’expérience. D’un point de vue typologique, il convient d’établir une distinction fondamentale entre les variables indépendantes catégorielles manipulées par l’expérimentateur (telles que le dosage pharmacologique, le type d’intervention psychologique ou la nature d’un stimulus perceptif) et les variables de classification ou invoquées (telles que le genre biologique, la catégorie socioprofessionnelle ou un profil psychopathologique préexistant). Dans tous les cas, le plan factoriel 2×3 traite ces variables comme des facteurs discrets, dont les combinaisons orthogonales créent les contextes au sein desquels la variable dépendante continue sera mesurée.
La variable dépendante (VD) doit impérativement posséder des propriétés métriques adaptées à la modélisation linéaire générale. En psychométrie et en neurosciences comportementales, la VD est généralement mesurée sur une échelle d’intervalles ou de rapports (temps de réaction en millisecondes, scores standardisés à des batteries d’évaluations cognitives, concentrations hormonales salivaires, etc.). La distribution continue de cette variable est indispensable pour autoriser le calcul des moyennes cellulaires, des écarts-types et la décomposition subséquente des différentes sources de variance qui constituent le cœur mathématique de l’analyse inférentielle.
1.2 Évolution historique de l’expérimentation univariée vers les devis factoriels
L’histoire de la méthodologie expérimentale a longtemps été dominée par le postulat isolationniste hérité du rationalisme classique. Les chercheurs ont traditionnellement présumé que pour identifier avec certitude la causalité liant un stimulus à une réponse, il était impératif de maintenir immobiles toutes les composantes de l’environnement expérimental sauf une. Toutefois, cette approche univariée classique a révélé des carences épistémologiques majeures lorsqu’elle a été confrontée à l’étude des processus mentaux supérieurs, de la pharmacodynamique complexe ou des systèmes sociaux. En isolant artificiellement un facteur de son écologie fonctionnelle, le chercheur s’exposait au risque de masquer des phénomènes de dépendance contextuelle où l’effet d’une variable s’annule, s’inverse ou s’amplifie en présence d’une autre.
L’avènement des plans factoriels modernes est indissociable des travaux pionniers du statisticien et généticien britannique Sir Ronald Aylmer Fisher dans les années 1920 et 1930 à la station agronomique de Rothamsted. Fisher a démontré avec une rigueur mathématique inédite que non seulement l’expérimentation multifactorielle ne compromettait pas la validité interne du dispositif, mais qu’elle présentait une supériorité statistique et méthodologique écrasante sur les séries d’expériences univariées successives. Par l’invention de l’analyse de variance factorielle, Fisher a offert un cadre analytique unifié capable d’évaluer simultanément plusieurs hypothèses causales tout en contrôlant l’erreur aléatoire globale.
Dans le domaine des sciences du comportement, l’adoption progressive des principes fisheriens au milieu du XXe siècle a catalysé l’émergence d’une psychologie expérimentale multidimensionnelle. Elle a permis aux chercheurs de s’affranchir de situations de laboratoire trop simplistes pour concevoir des paradigmes expérimentaux dotés d’une validité écologique considérablement accrue. Le plan 2×3 s’est imposé comme l’archétype du compromis optimal : suffisamment élaboré pour capturer des nuances paramétriques et des interactions complexes, mais suffisamment compact pour éviter la prolifération incontrôlée de cellules qui caractérise les plans d’ordre supérieur (tels que les plans 3x3x3 ou 2x2x2x2), dont l’interprétation théorique devient fréquemment inextricable.
1.3 Pertinence méthodologique en sciences du comportement
La pertinence méthodologique du plan factoriel 2×3 dans les sciences comportementales contemporaines repose en premier lieu sur son aptitude à modéliser la variabilité et l’hétérogénéité des réponses humaines. Le comportement humain n’est que très exceptionnellement réductible à des réactions linéaires directes face à un événement isolé. Il constitue plutôt l’aboutissement d’une convergence dynamique entre des caractéristiques individuelles stables (dispositionnelles) et des sollicitations environnementales immédiates (situationnelles). Le plan 2×3 constitue l’instrument d’investigation privilégié pour tester ces conjonctions théoriques : il permet d’intégrer, par exemple, un facteur dispositionnel à deux modalités et un facteur situationnel modulé selon trois intensités distinctes.
En outre, le plan factoriel 2×3 offre une remarquable économie d’échantillonnage comparativement à la mise en œuvre de protocoles indépendants distincts. Dans une approche univariée séquentielle, examiner l’effet d’un traitement binaire nécessiterait un premier échantillon de participants, tandis que l’évaluation d’un second facteur à trois conditions exigerait un échantillon distinct supplémentaire. Le plan factoriel fusionne ces deux interrogations en une seule démarche empirique, exploitant les mêmes sujets pour estimer simultanément deux effets principaux distincts avec une précision statistique équivalente ou supérieure, tout en maintenant constante la consommation globale de ressources matérielles et temporelles.
Enfin, la valeur ajoutée ultime de ce devis réside dans sa capacité unique à révéler l’effet d’interaction. Les théories psychologiques les plus sophistiquées prédisent rarement des effets principaux universels ; elles formulent plutôt des hypothèses conditionnelles (par exemple, « l’intervention thérapeutique A surpassera le traitement B uniquement si le niveau d’anxiété initial du patient est sévère, mais demeurera sans avantage distinctif si l’anxiété est faible ou modérée »). Seul un plan multifactoriel tel que le 2×3 permet de soumettre de telles propositions conceptuelles complexes à une épreuve empirique décisive et réfutable.
2. Architecture des variables : Facteurs indépendants et variables dépendantes
2.1 Le premier facteur : Structure binaire (2 niveaux)
L’inclusion d’un premier facteur à structure binaire (2 niveaux) confère au plan 2×3 une assise d’évaluation comparative directe. Sur le plan opérationnel, ce facteur dichotomique peut incarner une multiplicité de contrastes conceptuels fondamentaux. Dans les recherches interventionnelles ou translationnelles, il prend classiquement la forme d’une opposition entre un groupe expérimental recevant un traitement actif et un groupe contrôle recevant un placebo ou soumis à une condition d’attente. Dans d’autres contextes, il peut opposer deux variantes qualitatives d’une même tâche cognitive (par exemple, un encodage sémantique versus un encodage perceptif superficiel) ou deux populations naturelles distinctes (individus diagnostiqués avec un trouble de l’attention versus témoins neurotypiques).
D’un point de vue purement statistique, un facteur à deux modalités ne possède qu’un seul degré de liberté inter-groupes ($df_A = k_A – 1 = 2 – 1 = 1$). Cette propriété métrique implique que toute variation attribuable à ce facteur est nécessairement unidimensionnelle : il existe une unique comparaison possible entre la moyenne marginale du premier niveau et celle du second niveau. L’interprétation de l’effet principal de ce facteur est donc immédiate : si la statistique du test inférentiel s’avère significative, le chercheur peut conclure sans ambiguïté à l’existence d’un écart fiable entre ces deux modalités, sans qu’il soit requis de déployer des procédures de tests a posteriori ou de décompositions polynomiales supplémentaires.
L’assignation aléatoire des participants au sein des deux niveaux de ce facteur — lorsqu’il s’agit d’une variable manipulée — doit faire l’objet de protocoles de randomisation rigoureux (randomisation simple, par blocs ou stratifiée). Cette randomisation garantit l’équivalence initiale probabiliste des sous-échantillons par rapport aux variables parasites non mesurées, fondant ainsi la validité des inférences causales directes que l’analyse statistique tentera d’extraire de la variance observée.
2.2 Le second facteur : Structure ternaire (3 niveaux)
Le second facteur du devis, caractérisé par sa structure ternaire (3 niveaux), introduit un degré de complexité et de finesse méthodologique déterminant. Contrairement au facteur binaire qui ne peut témoigner que d’un contraste linéaire d’état, l’intégration de trois modalités autorise l’expérimentateur à explorer des gradations tant qualitatives que quantitatives. Dans le registre quantitatif, ce facteur peut représenter une échelle paramétrique continue discrétisée, telle qu’une gradation d’intensité d’un stimulus (faible, modérée, élevée), un dosage pharmacologique (0 mg, 25 mg, 50 mg) ou une durée d’exposition temporelle (immédiate, différée de 24 heures, différée d’une semaine).
La valeur heuristique majeure d’un facteur à trois modalités réside dans sa sensibilité intrinsèque aux relations non linéaires et curvilinéaires. La psychologie et la biologie regorgent de phénomènes illustrés par la célèbre loi de Yerkes-Dodson, selon laquelle la relation entre l’activation physiologique (le stress) et la performance suit une courbe en U inversé. Un facteur à deux modalités serait intrinsèquement incapable de détecter une telle non-linéarité, risquant de conclure à tort à l’absence d’effet si les conditions extrêmes présentent par hasard des moyennes empiriques identiques. Le facteur ternaire, disposant de deux degrés de liberté ($df_B = k_B – 1 = 3 – 1 = 2$), permet de dissocier mathématiquement une tendance linéaire globale d’une tendance quadratique ou de courbure.
Toutefois, cette richesse informative s’accompagne d’une exigence analytique accrue. Un rejet de l’hypothèse nulle globale pour ce facteur ternaire n’informe pas sur la localisation précise de la différence statistique : il atteste simplement qu’au moins deux des trois moyennes marginales diffèrent l’une de l’autre. Le chercheur se voit donc contraint de mobiliser des analyses de comparaisons multiples systématiques pour élucider si le niveau intermédiaire se distingue statistiquement des deux bornes ou s’il s’agrège à l’une d’entre elles.
2.3 La variable dépendante : Critères de validité et métrologie
La variable dépendante (VD) constitue le prisme métrologique exclusif à travers lequel les conséquences de la manipulation des facteurs A et B sont quantifiées. Pour garantir l’adéquation épistémologique et la validité des conclusions mathématiques issues de l’ANOVA, la VD doit satisfaire à des standards psychométriques stricts. Elle doit obligatoirement être opérationnalisée sous forme d’une variable quantitative continue, mesurée idéalement sur une échelle d’intervalles constants ou une échelle de rapports absolus, conformément aux canons métrologiques formalisés par Stevens.
La fidélité de l’instrument de mesure (évaluée par sa cohérence interne, sa stabilité test-retest ou sa fidélité inter-juges) conditionne directement la magnitude de la variance d’erreur aléatoire intra-cellulaire. Un instrument imprécis ou bruité gonfle artificiellement le terme d’erreur de l’analyse, réduisant d’autant la puissance statistique nécessaire pour isoler les effets réels des facteurs manipulés. Parallèlement, la validité de construit doit assurer que la variable quantifiée reflète fidèlement l’entité théorique cible et non un artefact expérimental ou une réponse de complaisance sociale.
Un enjeu métrologique primordial dans les plans 2×3 concerne le contrôle impératif des effets de plancher (floor effects) et de plafond (ceiling effects). Si une tâche d’évaluation s’avère trop ardue ou, à l’inverse, excessivement aisée, les scores d’une proportion substantielle de participants viendront s’agglutiner aux bornes minimales ou maximales de l’échelle de mesure. De telles saturations tronquent artificiellement la distribution de la VD, compressent la variance réelle et masquent mécaniquement d’éventuels effets d’interaction. Le chercheur se doit donc de pré-tester soigneusement ses instruments afin de s’assurer d’une sensibilité discriminative maximale sur l’ensemble du continuum d’évaluation.
3. Théorie et décomposition des effets principaux
3.1 Conceptualisation de l’effet principal du facteur à deux modalités
Dans le cadre d’un modèle factoriel orthogonal, un effet principal quantifie l’influence isolée d’un facteur indépendant donné sur la variable dépendante, considérée sur l’ensemble des modalités de l’autre facteur indépendant. Pour le premier facteur à deux modalités (le Facteur A), l’effet principal s’évalue par l’écart existant entre les deux moyennes marginales correspondantes, dénotées respectivement $\mu_{A1}$ et $\mu_{A2}$. La moyenne marginale pour le niveau 1 du facteur A correspond rigoureusement à l’espérance mathématique des scores observés dans les cellules associées ($AB_{11}, AB_{12}, AB_{13}$), moyennée arithmétiquement sur les trois niveaux du facteur B.
L’estimation de cet effet principal procède d’une abstraction statistique : elle simule la réponse moyenne qu’induirait le facteur A si le facteur B n’exerçait aucune différenciation ou si ses trois conditions étaient parfaitement équilibrées et confondues au sein de la population. L’équation de l’effet principal du facteur A peut être exprimée formellement par le contraste linéaire :
$$\alpha_i = \mu_{Ai} – \mu_{..}$$
où $\mu_{..}$ désigne la moyenne générale (le grand mean) de l’ensemble de l’espace factoriel expérimental. La signification statistique de cet effet est évaluée par un test F de Fisher unilatéral à $(1, N – 6)$ degrés de liberté, comparant la variance inter-groupes générée par les deux niveaux de A à la variance résiduelle intra-cellulaire.
3.2 Conceptualisation de l’effet principal du facteur à trois modalités
L’effet principal associé au second facteur indépendant (le Facteur B) repose sur une logique computationnelle homologue, mais s’étend sur trois moyennes marginales : $\mu_{B1}$, $\mu_{B2}$, et $\mu_{B3}$. Chacune de ces moyennes représente l’agrégation transversale des observations recueillies au sein des deux niveaux du Facteur A pour une modalité spécifique de B (par exemple, $\mu_{B1} = (\mu_{11} + \mu_{21}) / 2$, dans le cas d’un effectif équilibré). L’effet principal de B quantifie la dispersion de ces trois points de repère marginaux autour de la moyenne globale de l’expérience.
La somme des carrés afférente à cet effet ($SS_B$) capture l’ampleur totale des variations attribuables au Facteur B. Étant donné que le facteur comporte trois niveaux, le test d’hypothèse associé est un test omnibus régi par deux degrés de liberté au numérateur ($df_B = 2$). Le rejet de l’hypothèse nulle omnibus ($H_{0_B}: \mu_{B1} = \mu_{B2} = \mu_{B3}$) certifie l’existence d’une hétérogénéité significative au sein de ce trio de moyennes, sans pour autant préjuger de la configuration géométrique de cette dispersion.
Pour affiner cette caractérisation globale, la théorie linéaire permet de décomposer ces deux degrés de liberté en deux composantes orthogonales indépendantes : un contraste linéaire, qui évalue la présence d’une progression monotone continue des moyennes à travers les trois paliers du facteur, et un contraste quadratique, qui évalue la convexité ou la concavité de la trajectoire (la présence d’une courbure centrale traduisant une déviation par rapport à la simple linéarité). Cette décomposition structurelle enrichit considérablement l’interprétation substantielle de l’action du facteur ternaire.
3.3 Risques de mauvaise interprétation en présence de modération
L’un des écueils méthodologiques les plus insidieux dans l’analyse des devis factoriels réside dans l’interprétation aveugle et décontextualisée des effets principaux. Lorsqu’un plan factoriel révèle un effet principal statistiquement significatif pour l’un des facteurs, l’expérimentateur non averti est fréquemment tenté d’affirmer de manière péremptoire que ce facteur produit une variation systématique universelle sur la variable dépendante. Or, une telle généralisation s’avère profondément trompeuse, voire fallacieuse, dès lors qu’un effet d’interaction significatif coexiste au sein du même modèle.
En présence d’une interaction factorielle prononcée, la moyenne marginale n’est qu’une abstraction mathématique qui ne reflète fidèlement la réalité d’aucun des sous-groupes expérimentaux réels. Considérons le cas d’une interaction croisée où le Facteur A améliore massivement les performances des sujets sous la modalité 1 du Facteur B, mais dégrade d’une magnitude rigoureusement équivalente ces mêmes performances sous la modalité 3 de B, tout en demeurant neutre sous la modalité 2. Dans une telle conjoncture, les moyennes marginales de A s’équilibreront mathématiquement et le test F de l’effet principal de A conclura à une absence totale d’effet ($F \approx 0, p \approx 1$). Pourtant, affirmer que le facteur A n’a pas d’influence constituerait une erreur scientifique majeure.
Par conséquent, les règles épistémologiques de l’inférence factorielle imposent une préséance herméneutique absolue de l’interaction sur les effets principaux. Avant de commenter et de valoriser un effet principal moyen, le chercheur a le devoir d’examiner l’architecture de l’interaction. Si cette dernière s’avère substantielle, les effets principaux doivent être immédiatement rétrogradés au statut d’artefacts d’agrégation, l’effort analytique devant se concentrer exclusivement sur la description des effets conditionnels locaux.
4. L’effet d’interaction : Dynamique et synergie factorielle
4.1 Nature géométrique et conceptuelle de l’interaction (2×3)
L’effet d’interaction constitue l’essence même de l’expérimentation factorielle. Conceptuellement, il survient lorsque l’effet d’une variable indépendante sur la variable dépendante change de direction, de magnitude ou de forme en fonction des niveaux spécifiques adoptés par une seconde variable indépendante. Dans un plan 2×3, l’interaction matérialise le fait que la différence observée entre les deux modalités du Facteur A n’est pas constante d’un palier à l’autre du Facteur B, ou symétriquement, que le profil de réponse suscité par les trois niveaux du Facteur B varie selon la modalité active du Facteur A.
Sur le plan géométrique, l’interaction se manifeste visuellement par le non-parallélisme des fonctions de réponse reliant les moyennes cellulaires. Lorsque l’on trace un graphique bidimensionnel plaçant les trois modalités du Facteur B sur l’axe des abscisses et la variable dépendante sur l’axe des ordonnées, et que l’on relie les points correspondant aux moyennes des deux niveaux du Facteur A pour former deux lignes distinctes, l’hypothèse de non-interaction ($H_0$) correspond mathématiquement à un parallélisme parfait de ces deux segments ou courbes. Tout écart statistiquement fiable par rapport à ce parallélisme strict témoigne de l’existence d’une interaction factorielle $A \times B$.
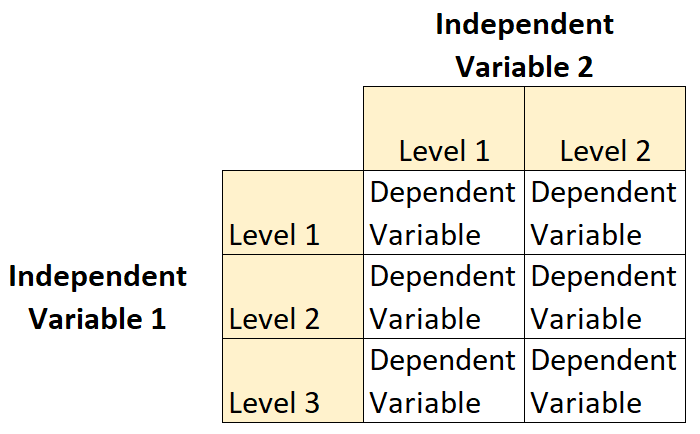
Dans l’espace factoriel à six cellules, l’interaction s’exprime comme l’écart entre la valeur réellement observée dans chaque cellule de traitement ($\mu_{ij}$) et la valeur qui serait prédite par la simple sommation linéaire de la moyenne générale et des deux effets principaux isolés :
$$(\alpha\beta)_{ij} = \mu_{ij} – (\mu_{..} + \alpha_i + \beta_j)$$
L’effet d’interaction capture donc précisément la part de variance « non additive », c’est-à-dire la synergie ou l’antagonisme propre à chaque conjonction expérimentale spécifique.
4.2 Typologie des interactions statistiques
L’analyse qualitative et fonctionnelle des interactions dans un devis 2×3 requiert une classification typologique rigoureuse. Les statisticiens et méthodologistes distinguent traditionnellement deux grandes catégories d’interactions factorielles : les interactions ordinales et les interactions désordinales (ou croisées).
Une interaction est qualifiée d’ordinale lorsque la magnitude de l’écart entre les niveaux du Facteur A fluctue en fonction des modalités du Facteur B, mais que le classement hiérarchique des modalités de A demeure rigoureusement invariant sur l’ensemble des conditions. Par exemple, si le niveau A1 surpasse systématiquement le niveau A2 sur les trois paliers de B, mais que cette supériorité est marginale sous B1, modérée sous B2 et massive sous B3, l’interaction est ordinale. Dans une telle situation, les deux lignes du graphique divergent ou convergent sans jamais s’entrecroiser. L’interprétation de l’effet principal de A conserve alors une certaine validité descriptive générale (le niveau A1 demeure globalement supérieur à A2), bien que l’ampleur exacte de cette supériorité soit conditionnelle à B.
À l’opposé, une interaction est dite désordinale ou croisée lorsque le sens de l’effet d’un facteur s’inverse formellement selon les modalités de l’autre facteur. Les lignes reliant les moyennes se croisent explicitement au sein de l’espace géométrique du graphique factoriel. Par exemple, le niveau A1 peut générer une performance significativement supérieure à A2 sous la condition B1, mais s’avérer significativement inférieur à A2 sous la condition B3. Les interactions désordinales représentent des ruptures théoriques d’une importance capitale : elles invalident totalement toute tentative d’extrapolation basée sur les effets principaux et révèlent des frontières de validité strictes quant à l’opérabilité des phénomènes psychologiques investigués.
4.3 Décomposition des degrés de liberté de l’interaction
La structure formelle de l’interaction dans un plan factoriel est régie par ses degrés de liberté ($df_{AB}$). Sur le plan algébrique, les degrés de liberté associés au terme d’interaction bidirectionnel sont donnés par le produit direct des degrés de liberté de chaque facteur constitutif :
$$df_{AB} = (k_A – 1) \times (k_B – 1) = (2 – 1) \times (3 – 1) = 1 \times 2 = 2$$
L’obtention de deux degrés de liberté confère à l’interaction 2×3 une polyvalence analytique remarquable. Ces deux degrés de liberté signifient que la non-additivité globale du modèle n’est pas réductible à un simple écart ponctuel, mais se déploie à travers deux dimensions orthogonales indépendantes dans l’espace des données. Mathématiquement, cela autorise l’expérimentateur à partitionner la somme des carrés de l’interaction ($SS_{AB}$) en deux contrastes bilinéaires distincts.
Le premier contraste examine généralement l’interaction entre le facteur A et la composante linéaire du facteur B (interaction Linéaire × Binaire). Il évalue si la pente linéaire de réponse à travers les trois modalités de B est significativement plus abrupte pour le groupe A1 que pour le groupe A2. Le second contraste teste l’interaction entre le facteur A et la composante quadratique du facteur B (interaction Quadratique × Binaire), vérifiant si la concavité ou l’inversion de courbure de B se manifeste sélectivement dans l’un des deux sous-groupes de A. Cette flexibilité dimensionnelle permet une autopsie extrêmement fine des mécanismes statistiques opérant sous la surface des tests omnibus.
5. Typologie des plans factoriels 2×3 : Variantes de devis expérimentaux
5.1 Le plan factoriel 2×3 inter-sujets (indépendant)
Le plan factoriel 2×3 inter-sujets (également qualifié de plan à groupes indépendants) constitue l’architecture expérimentale la plus classique et la plus robuste face aux biais d’administration séquentielle. Dans cette configuration, chaque participant est assigné de manière aléatoire et stricte à une seule et unique cellule de traitement parmi les six que compte le modèle. Si l’on fixe conventionnellement une taille cellulaire de $n = 20$ participants pour assurer une puissance adéquate, l’expérience complète exige donc le recrutement, le conditionnement et l’évaluation de $N = 20 \times 6 = 120$ participants distincts.
L’avantage méthodologique prépondérant de ce devis réside dans l’éradication structurelle absolue des effets d’ordre, de report (carryover effects), d’apprentissage ou de fatigue cognitive. Dans la mesure où chaque individu n’est exposé qu’à une combinaison factorielle singulière, aucune contamination temporelle ne peut venir corrompre les réponses ultérieures. Ce format est particulièrement incontournable lorsqu’une condition expérimentale induit des modifications cognitives, affectives ou physiologiques irréversibles (par exemple, l’enseignement explicite d’une stratégie mnémotechnique ou l’administration d’un psychotrope à longue demi-vie).
En contrepartie, le plan inter-sujets présente une vulnérabilité inhérente : il demeure exposé à la variance d’échantillonnage interindividuelle. Toute différence systématique préexistante entre les participants des différents groupes vient directement gonfler la variance d’erreur intra-groupe ($MS_{residual}$), réduisant la sensibilité du test statistique F. De surcroît, le coût en matière de recrutement de cohortes massives de volontaires peut s’avérer prohibitif dans les contextes de recherche spécialisés ou cliniques.
5.2 Le plan factoriel 2×3 intra-sujets (mesures répétées)
À l’opposé diamétral du modèle à groupes indépendants se déploie le plan factoriel 2×3 intra-sujets, couramment désigné sous le terme de plan à mesures répétées. Dans cette architecture intensément économique, chaque sujet est exposé séquentiellement à la totalité des six conditions expérimentales ($2 \times 3$). Dès lors, un échantillon initial de seulement 20 participants génère l’intégralité des 120 observations requises par l’analyse computationnelle.
La puissance statistique intrinsèque de ce devis est prodigieusement supérieure à celle du plan inter-sujets équivalent. En utilisant chaque sujet comme son propre témoin de référence, le statisticien est en mesure d’extraire mathématiquement la variance systématique stable attribuable aux différences interindividuelles globales (le Facteur Sujet) et de l’expurger du dénominateur du test F. Le terme d’erreur résiduelle s’en trouve drastiquement comprimé, ce qui maximise l’aptitude du modèle à détecter des tailles d’effet ténues au sein des effets principaux et de l’interaction.
Cependant, cette puissance méthodologique requiert une vigilance absolue quant à l’organisation temporelle des passations. La répétition de six tâches consécutives engendre inéluctablement des risques massifs d’effets d’apprentissage, d’habituation ou d’épuisement attentionnel. Pour neutraliser ces biais parasites, le recours à des procédures de contrebalancement systématique ou à des matrices de carrés latins rigoureusement équilibrées est une obligation méthodologique incontournable. De surcroît, le chercheur doit valider le postulat de sphéricité (ou condition de circularité de la matrice de covariance), dont la violation impose des corrections de degrés de liberté contraignantes telles que celles de Greenhouse-Geisser ou de Huynh-Feldt.
5.3 Le plan factoriel 2×3 mixte (split-plot)
Le plan factoriel 2×3 mixte — historiquement dérivé des plans agronomiques dits split-plot formalisés par Fisher — représente une synthèse méthodologique alliant un facteur inter-sujets et un facteur intra-sujets. Cette configuration hybride constitue sans doute l’architecture expérimentale la plus courante et la plus féconde dans le champ de la psychologie clinique, de la neuropsychologie et des neurosciences comportementales translationnelles.
Dans un plan mixte classique, le premier facteur à deux modalités est manipulé ou observé entre les sujets (par exemple, Groupe Clinique de patients dépressifs versus Groupe Témoin sain, ou Groupe Thérapie Innovante versus Groupe Traitement Médicamenteux Standard), tandis que le second facteur à trois modalités est déployé intra-sujets sous forme d’une série de mesures longitudinales répétées (par exemple, Évaluation Pré-traitement, Post-traitement immédiat, et Suivi longitudinal à 6 mois). Chaque participant appartient exclusivement à l’un des deux groupes, mais complète l’ensemble des trois jalons temporels d’évaluation.
La spécificité analytique du plan mixte réside dans la décomposition bipartite de son équation de variance. Le modèle engendre deux termes d’erreur résiduelle distincts : une première variance résiduelle inter-sujets ($Error_{between}$), servant à tester statistiquement la signification de l’effet principal du Facteur A, et une seconde variance résiduelle intra-sujets ($Error_{within}$), conditionnant les ratios F associés à l’effet principal du Facteur B (l’évolution temporelle) ainsi qu’au terme d’interaction $A \times B$. Cette architecture fournit un cadre idéal pour tester rigoureusement l’hypothèse centrale des essais cliniques randomisés : l’existence d’une trajectoire différentielle de rémission temporelle chez les patients bénéficiant du nouveau protocole thérapeutique par rapport aux témoins.
6. Formulation rigoureuse des hypothèses statistiques et théoriques
6.1 Opérationnalisation des hypothèses nulles (H0)
La logique inférentielle de l’approche néo-fisherienne et de Neyman-Pearson exige que l’expérimentateur traduise ses questionnements théoriques en un ensemble formalisé d’hypothèses nulles ($H_0$). Dans le cadre strict d’un modèle factoriel 2×3 à effets fixes, le dispositif d’analyse statistique ne teste pas une hypothèse globale unique, mais évalue formellement trois hypothèses nulles orthogonales distinctes, chacune gouvernée par sa propre statistique de test.
La première hypothèse nulle concerne l’absence d’effet principal pour le Facteur A ($H_{0_A}$). Elle postule l’égalité parfaite des deux moyennes marginales théoriques de ce facteur, indépendamment de toute modulation induite par B :
$$H_{0_A}: \mu_{A1} = \mu_{A2} \quad \text{ou de manière équivalente} \quad \alpha_1 = \alpha_2 = 0$$
La deuxième hypothèse nulle postule l’invariance stricte des réponses moyennes à travers l’ensemble des trois modalités constitutives du Facteur B ($H_{0_B}$), ce qui revient à poser l’égalité simultanée des trois moyennes marginales théoriques associées :
$$H_{0_B}: \mu_{B1} = \mu_{B2} = \mu_{B3} \quad \text{ou} \quad \beta_1 = \beta_2 = \beta_3 = 0$$
Enfin, la troisième hypothèse nulle — fréquemment la plus déterminante sur le plan théorique — pose l’absence intégrale d’interaction factorielle ($H_{0_AB}$). Elle postule que chaque paramètre de non-additivité cellulaire est rigoureusement égal à zéro sur l’ensemble des six conditions expérimentales :
$$H_{0_AB}: (\alpha\beta)_{ij} = 0, \quad \forall i in {1, 2}, \forall j in {1, 2, 3}$$
Ces trois hypothèses jouissent d’une indépendance conceptuelle totale au sein des plans équilibrés : le rejet ou le maintien de l’une n’exerce aucune contrainte logique directe sur l’issue des deux autres tests.
6.2 Définition des hypothèses alternatives (H1) directionnelles et non directionnelles
Face à chaque hypothèse nulle se dresse une hypothèse alternative ($H_1$) représentant l’état du monde physique ou psychologique anticipé par les théories scientifiques sous-jacentes. Dans le cadre de l’ANOVA factorielle standard, les hypothèses alternatives omnibus sont par définition non directionnelles : l’hypothèse $H_{1_B}$ affirme simplement qu’au moins une des trois moyennes marginales dévie des autres ($\exists (j, j’) : \mu_{Bj} \neq \mu_{Bj’}$), sans préjuger de la polarité ou du sens de cette asymétrie.
Cependant, dans la pratique de la recherche empirique mature, le chercheur formule rarement des suppositions agnostiques. La modélisation psychologique exige la formulation d’hypothèses alternatives directionnelles hautement spécifiques, traduisant des patrons prédéterminés d’activation cognitive, d’inhibition comportementale ou de remédiation clinique. Par exemple, au lieu de postuler simplement que « le temps de réaction variera sous les trois charges de travail », l’hypothèse alternative théorique prévoira explicitement que la latence cognitive augmentera de manière strictement monotone et croissante : $\mu_{B1} < \mu_{B2} < \mu_{B3}$.
Ce niveau d’opérationnalisation directionnelle prend toute son acuité lors de la spécification de l’interaction factorielle. Une théorie robuste ne se borne pas à prédire une interaction quelconque ; elle anticipe une topographie cellulaire précise (par exemple, une configuration où le Facteur A déploie un effet massif au niveau B3, un effet intermédiaire au niveau B2, et s’annule totalement sous B1). La clarté de ces prédictions a priori dictera directement le choix entre l’examen passif des tests omnibus ou le recours stratégique à des contrastes planifiés directionnels.
6.3 Gestion des taux d’erreur de première espèce (alpha inflationniste)
L’exécution conjointe de multiples tests statistiques sur un même jeu de données empiriques pose le défi fondamental du contrôle du taux d’erreur de première espèce ($\alpha$), c’est-à-dire la probabilité de rejeter à tort une hypothèse nulle qui est pourtant vraie dans la population (le faux positif). Dans un devis factoriel 2×3 standard, le fait de tester simultanément trois hypothèses omnibus distinctes ($Facteur A$, $Facteur B$, $Interaction AB$) au seuil nominal classique de $\alpha = 0,05$ expose l’expérimentateur au phénomène de l’inflation de l’alpha par famille de tests (Familywise Error Rate, FWER).
Si les trois tests étaient strictement stochastiquement indépendants, la probabilité d’observer au moins un faux positif parmi les trois décisions inférentielles serait quantifiée par la formule de Bernoulli :
$$\alpha_{FWER} = 1 – (1 – \alpha)^k = 1 – (1 – 0,05)^3 = 1 – (0,95)^3 \approx 0,1426$$
Le risque effectif de fausse découverte culmine ainsi à plus de 14 %, bien au-delà de la norme convenue de 5 %. Si la convention scientifique dominante tolère ce risque accru pour les trois tests omnibus fondamentaux de l’ANOVA au motif que chacun répond à une question de recherche distincte délimitée a priori, cette permissivité s’effondre totalement dès lors que l’expérimentateur s’engage dans les étapes ultérieures : les décompositions des effets simples et les comparaisons multiples inter-cellules.
Face à la prolifération de contrastes a posteriori non planifiés, la mobilisation d’ajustements stochastiques devient impérative. Les chercheurs doivent arbitrer entre des techniques conservatrices mais réductrices de puissance statistique (telle que la classique correction de Bonferroni ou la méthode de Šidák) et des approches plus sophistiquées optimisant l’équilibre entre la rigueur de contrôle et la sensibilité aux effets réels, à l’instar des procédures de Tukey HSD, de Holm-Bonferroni ou de la régulation du taux de fausses découvertes (FDR – False Discovery Rate) formalisée par Benjamini et Hochberg.
7. Puissance statistique, taille d’effet et dimensionnement de l’échantillon
7.1 Calcul de la taille d’effet : Eta-carré partiel et Omega-carré
L’inférence statistique contemporaine a largement dépassé le diktat exclusif de la seule p-valeur. La significativité statistique n’étant qu’une fonction conjointe de l’ampleur réelle du phénomène et de la taille de l’échantillon analysé, la quantification métrique de la magnitude des effets observés au moyen d’indices de taille d’effet standardisés constitue une exigence scientifique cardinale. Dans le cadre d’un plan factoriel 2×3, la métrique la plus omniprésente dans les logiciels de traitement de données (notamment SPSS, SAS et JASP) est l’êta-carré partiel ($\eta_p^2$).
L’êta-carré partiel se définit mathématiquement comme la proportion de variance attribuable à une source de variation spécifique (effet principal ou interaction), après avoir déduit de la variance totale toute variation expliquée par les autres facteurs du modèle :
$$\eta_p^2 = \frac{SS_{Effet}}{SS_{Effet} + SS_{Erreur}}$$
Bien que son calcul soit aisé et son interprétation intuitive, l’êta-carré partiel présente une tare statistique documentée : il constitue un estimateur paramétrique biaisé positivement. Dans les petits échantillons, il surestime systématiquement la proportion réelle de variance expliquée au sein de la population parente.
Pour pallier ce biais d’échantillonnage, la littérature méthodologique la plus rigoureuse préconise le recours à l’oméga-carré partiel ($\omega_p^2$), qui ajuste l’estimation de la variance en intégrant les carrés moyens de l’erreur résiduelle :
$$\omega_p^2 = \frac{df_{Effet} \times (MS_{Effet} – MS_{Erreur})}{SS_{Effet} + (N – df_{Effet}) \times MS_{Erreur}}$$
Selon les conventions canoniques établies par Jacob Cohen, adaptées aux plans d’analyse de variance, des seuils de référence sont généralement mobilisés pour caractériser l’importance substantielle d’un effet : une valeur de $\eta_p^2 \approx 0,01$ (ou $f = 0,10$) dénote un effet de faible magnitude ; $\eta_p^2 \approx 0,06$ ($f = 0,25$) caractérise un effet moyen ; tandis qu’un indice $\eta_p^2 ge 0,14$ ($f = 0,40$) consacre un effet de grande envergure empirique.
7.2 Détermination a priori de la taille d’échantillon requise
L’optimisation de la puissance statistique ($1 – \beta$) constitue le rempart méthodologique fondamental contre l’erreur de seconde espèce (le faux négatif). Il est notoirement inadmissible d’engager des moyens expérimentaux substantiels sans s’assurer au préalable que le plan factoriel disposera d’une probabilité suffisante (généralement fixée à $1 – \beta ge 0,80$, voire 0,90 ou 0,95 dans les études confirmatoires critiques) de rejeter formellement l’hypothèse nulle si l’effet prédit existe réellement dans la population.
La détermination a priori du dimensionnement de la cohorte s’effectue couramment à l’aide d’environnements logiciels spécialisés, à l’instar de la référence internationale G*Power. Dans un plan factoriel 2×3 inter-sujets à effets fixes, le paramétrage de l’algorithme de calcul de puissance exige la définition de quatre métriques d’entrée :
- Le risque d’erreur de première espèce nominal (usuellement $\alpha = 0,05$).
- La puissance statistique minimale requise ($1 – \beta = 0,80$).
- Le nombre de degrés de liberté du numérateur afférents à la source testée (pour l’effet principal de A, $df = 1$ ; pour l’effet de B et pour l’interaction $A \times B$, $df = 2$).
- La taille d’effet minimale anticipée, convertie sous l’indice f de Cohen ($f = \sqrt{\eta_p^2 / (1 – \eta_p^2)}$).
Un constat méthodologique primordial concerne la détection de l’effet d’interaction. Les chercheurs commettent fréquemment l’erreur de calculer leur échantillon uniquement sur la base de l’effet principal escompté. Or, la détection d’une interaction d’ampleur modérée ou subtile requiert typiquement des volumes de participants très supérieurs à ceux nécessaires pour isoler un effet principal franc. Un sous-dimensionnement chronique de l’échantillon conduit inéluctablement à une perte tragique de puissance pour le terme d’interaction, exposant le laboratoire à manquer les synergies fonctionnelles qui constituent pourtant le cœur névralgique de leur modélisation conceptuelle.
7.3 Plans équilibrés vs non équilibrés (tailles d’échantillons inégales)
Un devis factoriel 2×3 est qualifié d’équilibré lorsque toutes les cellules de traitement accueillent un effectif rigoureusement identique de participants ($n_{11} = n_{12} = dots = n_{23} = n$). Cet équilibre n’est pas un simple raffinement esthétique : il garantit la propriété mathématique d’orthogonalité stricte des facteurs. Sous des effectifs cellulaires égaux, la somme des carrés totale se partitionne de manière purement additive, de sorte que la variance expliquée par le Facteur A, le Facteur B et l’Interaction $A \times B$ ne partagent aucun chevauchement informationnel. Les trois effets sont stochastiquement décorrélés.
Dès lors que des contingences empiriques (perte de sujets au suivi, attrition expérimentale asymétrique, erreurs d’échantillonnage) engendrent des effectifs inégaux au sein des six cellules, le plan devient non équilibré. Cette rupture de symétrie anéantit l’orthogonalité du modèle linéaire. Les sommes de carrés deviennent partiellement interdépendantes et se chevauchent, ce qui contraint l’analyste à choisir explicitement une stratégie de partitionnement de la variance parmi les trois grandes méthodes d’ajustement algorithmique :
- Sommes des carrés de Type I (Méthode séquentielle) : La variance est attribuée de manière ordonnée hiérarchique au premier facteur saisi, puis au second, puis à l’interaction. L’ordre d’entrée des variables dans la ligne de commande altère dramatiquement les résultats numériques, ce qui rend cette approche généralement inadaptée aux plans factoriels orthogonaux d’expérimentation standard.
- Sommes des carrés de Type II (Méthode hiérarchique sans interaction) : Chaque effet principal est estimé en contrôlant la présence de l’autre effet principal, mais en négligeant l’interaction. Cette méthode ne conserve de validité statistique que si le terme d’interaction s’avère empiriquement strictement nul.
- Sommes des carrés de Type III (Méthode marginale globale) : Chaque terme du modèle (les deux effets principaux et l’interaction) est rigoureusement évalué après avoir extrait toute la variance commune partagée avec l’intégralité des autres termes du modèle factoriel. C’est l’approche par défaut et la norme absolue imposée par les logiciels statistiques modernes (tels que R, SPSS et JASP) pour traiter les devis factoriels déséquilibrés, car elle préserve la comparabilité directe des moyennes marginales non pondérées.
8. Déroulement computationnel de l’ANOVA bifactoriale (2×3)
8.1 Partition de la somme totale des carrés (SST)
L’assise mathématique de l’analyse de variance bifactorielle 2×3 repose sur la partition algébrique intégrale de la dispersion globale observée sur la variable dépendante. La somme totale des carrés ($SS_{Total}$) mesure l’écart quadratique cumulé de chaque observation individuelle par rapport à la moyenne générale de l’échantillon complet ($N$ sujets) :
$$SS_{Total} = \sum_{i=1}^{a} \sum_{j=1}^{b} \sum_{k=1}^{n} (Y_{ijk} – \bar{Y}_{…})^2$$
Dans un plan équilibré comprenant $a = 2$ niveaux pour le Facteur A, $b = 3$ niveaux pour le Facteur B, et $n$ observations par cellule ($N = 2 \times 3 \times n$), cette variance totale est rigoureusement décomposée en quatre composantes mutuellement exclusives et parfaitement additives :
$$SS_{Total} = SS_A + SS_B + SS_{AB} + SS_{Erreur}$$
La somme des carrés associée au premier facteur binaire quantifie l’écart des moyennes marginales de A à la grande moyenne, pondéré par le nombre d’observations rassemblées dans chaque strate de ce facteur :
$$SS_A = b \cdot n \sum_{i=1}^{a} (\bar{Y}_{i..} – \bar{Y}_{…})^2 = 3n \sum_{i=1}^{2} (\bar{Y}_{i..} – \bar{Y}_{…})^2$$
La somme des carrés associée au facteur ternaire B quantifie l’hétérogénéité propre à ses trois moyennes marginales :
$$SS_B = a \cdot n \sum_{j=1}^{b} (\bar{Y}_{.j.} – \bar{Y}_{…})^2 = 2n \sum_{j=1}^{3} (\bar{Y}_{.j.} – \bar{Y}_{…})^2$$
La somme des carrés de l’interaction factorielle ($SS_{AB}$) isole l’amplitude résiduelle de variation inter-cellulaire qui ne peut être réconciliée par la simple addition linéaire des effets principaux $A$ et $B$ :
$$SS_{AB} = n \sum_{i=1}^{a} \sum_{j=1}^{b} (\bar{Y}_{ij.} – \bar{Y}_{i..} – \bar{Y}_{.j.} + \bar{Y}_{…})^2$$
Enfin, la somme des carrés résiduelle ou intra-cellulaire ($SS_{Erreur}$) capture la dispersion aléatoire intrinsèque constatée au sein de chacune des six cellules expérimentales, traduisant les variations individuelles inhérentes aux sujets soumis à un traitement rigoureusement identique :
$$SS_{Erreur} = \sum_{i=1}^{a} \sum_{j=1}^{b} \sum_{k=1}^{n} (Y_{ijk} – \bar{Y}_{ij.})^2$$
8.2 Calcul des carrés moyens et des rapports F de Fisher
Les sommes des carrés étant des agrégats quadratiques cumulatifs tributaires de leur nombre d’éléments respectifs, elles ne peuvent être comparées directement pour inférer des propriétés causales. Elles doivent préalablement être standardisées en carrés moyens (Mean Squares, MS), qui correspondent à des estimations non biaisées de la variance. Cette standardisation s’obtient en divisant chaque somme de carrés par son degré de liberté canonique associé :
- Carré moyen du Facteur A : $MS_A = \frac{SS_A}{df_A} = \frac{SS_A}{a – 1} = \frac{SS_A}{2 – 1} = \frac{SS_A}{1}$
- Carré moyen du Facteur B : $MS_B = \frac{SS_B}{df_B} = \frac{SS_B}{b – 1} = \frac{SS_B}{3 – 1} = \frac{SS_B}{2}$
- Carré moyen de l’Interaction : $MS_{AB} = \frac{SS_{AB}}{df_{AB}} = \frac{SS_{AB}}{(a – 1)(b – 1)} = \frac{SS_{AB}}{(1)(2)} = \frac{SS_{AB}}{2}$
- Carré moyen de l’Erreur résiduelle : $MS_{Erreur} = \frac{SS_{Erreur}}{df_{Erreur}} = \frac{SS_{Erreur}}{N – ab} = \frac{SS_{Erreur}}{N – 6}$
Dans un modèle d’analyse de variance à effets fixes (où l’ensemble des modalités d’intérêt a été délibérément sélectionné et épuisé par l’expérimentateur), le terme d’erreur utilisé au dénominateur pour tous les tests de significativité est invariablement le carré moyen résiduel intra-cellulaire ($MS_{Erreur}$). Les trois ratios empiriques de Fisher-Snedecor sont ainsi dérivés formellement :
$$F_A = \frac{MS_A}{MS_{Erreur}}, \quad F_B = \frac{MS_B}{MS_{Erreur}}, \quad F_{AB} = \frac{MS_{AB}}{MS_{Erreur}}$$
Chacun de ces ratios confronte une hypothèse selon laquelle la variance inter-conditions dépasse substantiellement le bruit de fond stochastique attendu sous l’hypothèse nulle. Si un modèle intégrait des facteurs à effets aléatoires, les dénominateurs des tests F devraient être profondément remaniés selon les tables d’espérances des carrés moyens (Expected Mean Squares, EMS) de Cornfield et Tukey.
8.3 Construction et lecture de la table récapitulative de l’ANOVA
L’aboutissement formel du calcul inférentiel s’incarne dans la confection standardisée de la table récapitulative de l’ANOVA factorielle 2×3. Cette table organise synthétiquement l’ensemble des grandeurs computationnelles selon une structure matricielle universellement reconnue dans la communication scientifique internationale.
La première colonne détaille exhaustivement les Sources de variation (Facteur A, Facteur B, Interaction A × B, Erreur ou Résiduelle, et Total). La deuxième colonne consigne les Sommes des Carrés ($SS$). La troisième colonne renseigne les Degrés de liberté ($df$). Une vérification arithmétique fondamentale de cohérence interne s’opère immédiatement à ce niveau : l’addition des degrés de liberté sectoriels doit correspondre rigoureusement au degré de liberté total :
$$df_{Total} = df_A + df_B + df_{AB} + df_{Erreur} = 1 + 2 + 2 + (N – 6) = N – 1$$
La quatrième colonne présente les Carrés Moyens ($MS$), obtenue par le quotient des deux colonnes précédentes. La cinquième colonne affiche les statistiques empiriques F de Fisher, et la sixième colonne livre les valeurs p asymptotiques calculées à partir de la distribution cumulative théorique de Fisher correspondant aux degrés de liberté du numérateur et du dénominateur. Une septième colonne intègre très fréquemment les indices de taille d’effet, tels que l’êta-carré partiel ($\eta_p^2$).
La lecture de ce tableau impose une démarche déductive structurée : le regard de l’analyste doit se porter en premier lieu sur la ligne de l’interaction ($A \times B$). Si la p-valeur de l’interaction est inférieure au seuil critique $\alpha$ retenu (ex. $p < 0,05$), le rejet de l'hypothèse nulle d'indépendance factorielle impose d'interrompre l'interprétation linéaire des deux lignes supérieures (effets principaux) et commande le passage immédiat aux analyses de décomposition a posteriori.
9. Analyses a posteriori : Contrastes et effets simples dans le plan 2×3
9.1 Analyse des effets simples (Simple Effects Analysis)
L’analyse des effets simples (ou effets principaux simples) constitue la stratégie analytique impérative dès lors qu’un terme d’interaction factorielle significatif émerge d’un devis 2×3. Contrairement à l’effet principal global qui moyenne artificiellement les données à travers les niveaux de l’autre facteur, un effet simple examine l’impact spécifique et circonscrit d’une variable indépendante à un niveau unique et déterminé de la seconde variable indépendante.
Dans un plan factoriel 2×3, le chercheur dispose d’une alternative directionnelle quant à l’angle d’attaque méthodologique de ses effets simples :
- Option 1 : Examiner l’effet du Facteur A (2 niveaux) à chacun des trois niveaux distincts du Facteur B. Cette approche se concrétise par la conduite de trois tests inférentiels unilatéraux distincts (trois comparaisons par paires, ou trois mini-ANOVAs à un facteur). L’analyste se demande successivement : l’effet de A est-il significatif au palier B1 ? Est-il significatif au palier B2 ? Demeure-t-il significatif au palier B3 ?
- Option 2 : Examiner l’effet du Facteur B (3 niveaux) à chacun des deux niveaux distincts du Facteur A. Cette modalité implique de réaliser deux analyses de variance univariées séparées à trois modalités. La première ANOVA analyse l’impact de B exclusivement chez les participants relevant de la condition A1, tandis que la seconde évalue le rôle de B chez les individus de la condition A2.
Le choix entre ces deux cheminements de décomposition ne relève pas d’une contingence algorithmique : il doit être dicté par la logique conceptuelle de l’hypothèse de recherche. Dans les études d’efficacité clinique évaluant un groupe expérimental face à un groupe témoin (Facteur A) avant, après et à distance de l’intervention (Facteur B), c’est généralement l’Option 1 qui s’avère la plus informative : elle permet de tester formellement si la divergence entre les deux groupes thérapeutiques s’installe sélectivement lors de la phase post-interventionnelle et si elle se maintient lors du suivi longitudinal.
9.2 Comparaisons multiples post-hoc pour le facteur à trois modalités
Lorsqu’une analyse révèle un effet principal significatif du facteur ternaire (en l’absence d’interaction) ou qu’une analyse d’effets simples confirme une modulation significative de ce facteur ternaire au sein de l’un des niveaux du facteur binaire, l’expérimentateur se heurte à la limite inhérente aux tests omnibus : le test atteste l’existence d’une hétérogénéité parmi les trois moyennes, mais échoue à désigner quelles paires spécifiques divergent réellement.
Pour trancher cette interrogation sans succomber à l’explosion des faux positifs inhérente à la répétition non contrôlée de tests de Student classiques, l’usage de procédures de tests post-hoc formalisées s’avère incontournable. Le test de la différence honnêtement significative de Tukey (Tukey’s Honest Significant Difference, HSD) représente la référence internationale par excellence face à des données satisfaisant au postulat d’homogénéité des variances. Il calibre la distribution de l’écart studentisé (Studentized Range Distribution, $q$) pour confronter simultanément l’ensemble des trois comparaisons binaires possibles ($\mu_1 \text{ vs } \mu_2$, $\mu_1 \text{ vs } \mu_3$, et $\mu_2 \text{ vs } \mu_3$) tout en verrouillant rigoureusement le risque d’erreur de première espèce global au niveau nominal exact de 5 %.
Si le chercheur anticipe une violation sensible de l’homoscédasticité inter-cellulaire (variances inégales confirmées par le test de Levene), les corrections paramétriques standards s’effondrent. Il devient alors obligatoire de substituer à Tukey des algorithmes de correction robustes, à l’image du test de Games-Howell. Ce dernier opère sans requérir l’égalité des variances intra-cellulaires ni des effectifs d’échantillonnage, en dérivant des degrés de liberté corrigés dérivés de l’approximation de Welch-Satterthwaite pour chaque comparaison par paire.
9.3 Contrastes planifiés orthogonaux (a priori)
Bien que les démarches exploratoires post-hoc décrites précédemment soient courantes, l’épistémologie de la méthode expérimentale accorde une supériorité heuristique et statistique indiscutable aux contrastes planifiés orthogonaux formulés a priori. Un chercheur qui possède un ancrage théorique fort n’a nullement besoin de scruter passivement l’issue d’un test F omnibus pour ensuite chercher à l’aveugle d’où proviennent ses résultats : il formule préalablement des hypothèses comparatives ciblées, encodées sous forme de vecteurs de coefficients de contraste polynomiaux.
Dans le cadre de l’évaluation du facteur à trois modalités, les deux degrés de liberté associés permettent de bâtir une famille de deux contrastes orthogonaux indépendants ($c_1$ et $c_2$). Pour respecter la condition d’orthogonalité stricte, deux contraintes mathématiques doivent être rigoureusement satisfaites par les pondérations attribuées aux modalités :
$$\sum_{j=1}^{3} c_{1j} = 0, \quad \sum_{j=1}^{3} c_{2j} = 0, \quad \text{et} \quad \sum_{j=1}^{3} c_{1j} c_{2j} = 0$$
Sur le plan substantiel, ces coefficients encodent fréquemment des contrastes de décomposition de tendance (contrastes polynomiaux). Si les trois modalités de B incarnent une progression métrique équidistante (ex. charge cognitive : nulle, modérée, sévère), le premier vecteur de coefficients attribuera les poids $[-1, 0, +1]$, capturant ainsi sélectivement la composante de tendance linéaire. Le second vecteur adoptera les pondérations $[+1, -2, +1]$, isolant spécifiquement la composante de tendance quadratique (la courbure en U ou en cloche).
L’avantage décisif de cette approche réside dans sa puissance statistique décuplée : chaque contraste planifié est testé directement par un test $F$ univarié à 1 degré de liberté (ou un test $t$ associé), sans subir la pénalisation probabiliste sévère qui afflige les tests post-hoc conventionnels, tout en apportant une réponse théorique d’une précision conceptuelle infiniment supérieure.
10. Études de cas appliquées en psychologie
10.1 Cas en psychologie cognitive : Type de mémoire et charge cognitive
Afin d’illustrer la matérialité empirique d’un devis factoriel 2×3, examinons une première recherche standard conduite dans le champ de la psychologie cognitive et des neurosciences de l’apprentissage. Cette investigation se propose d’évaluer l’efficacité différentielle de deux stratégies distinctes d’encodage mnésique sous différentes contraintes de ressources attentionnelles en mémoire de travail.
Le protocole expérimental s’articule autour des deux facteurs orthogonaux suivants :
- Facteur A (Stratégie d’encodage, inter-sujets, 2 modalités) : Le premier sous-groupe de participants est entraîné à mobiliser une stratégie d’imagerie mentale visuo-spatiale interactive (A1), tandis que le second sous-groupe est astreint à une procédure d’auto-répétition subvocalique de maintien (A2).
- Facteur B (Charge cognitive concurrente, inter-sujets, 3 modalités) : Au cours de la phase de mémorisation des listes de stimuli verbaux, les participants sont soumis à une tâche concurrente de génération aléatoire de chiffres : condition de charge nulle (B1), charge modérée (B2 : cadence de 1 chiffre toutes les 3 secondes), et charge sévère (B3 : cadence soutenue de 1 chiffre par seconde).
- Variable dépendante : Le pourcentage d’items textuels correctement restitués lors d’une épreuve ultérieure de rappel libre différé (variable continue bornée de 0 à 100 %).
L’analyse statistique des données empiriques recueillies sur une cohorte équilibrée de $N = 120$ adultes sains ($n = 20$ par cellule) produit la table de variance suivante : un effet principal massif de la stratégie d’encodage ($F(1, 114) = 38,42, p < 0,001, \eta_p^2 = 0,252$), un effet principal tout aussi net de la charge cognitive concurrente ($F(2, 114) = 54,18, p < 0,001, \eta_p^2 = 0,487$), et de manière cruciale, une interaction factorielle significative de grande ampleur ($F(2, 114) = 11,26, p < 0,001, \eta_p^2 = 0,165$).
L’examen des effets simples révèle le locus fonctionnel sous-jacent : sous charge nulle (B1), l’imagerie mentale confère un avantage mnésique colossal sur la simple répétition ($\bar{X}_{A1B1} = 84 % \text{ vs } \bar{X}_{A2B1} = 58 %, p < 0,001$). Sous charge modérée (B2), cet écart s'amenuise substantiellement tout en demeurant significatif ($\bar{X}_{A1B2} = 62 % \text{ vs } \bar{X}_{A2B2} = 48 %, p = 0,012$). Cependant, sous la condition de charge sévère (B3), l'avantage de l'imagerie mentale s'effondre totalement : les deux groupes affichent des performances faibles et statistiquement indiscernables ($\bar{X}_{A1B3} = 32 % \text{ vs } \bar{X}_{A2B3} = 30 %, p = 0,724$). Ce patron illustre une interaction ordinale convergente typique, corroborant la théorie cognitive selon laquelle l'élaboration d'images mentales spatiales requiert un volant substantiel de ressources exécutives centrales, devenant inopérante lorsque l'espace de travail est saturé.
10.2 Cas en psychologie clinique : Psychothérapie et sévérité initiale
Considérons un second scénario expérimental relevant du domaine de la psychiatrie biologique et de la psychologie clinique translationnelle. Une équipe hospitalo-universitaire entend tester l’efficacité relative d’un nouveau protocole de thérapie cognitivo-comportementale digitalisée (TCC-D) comparativement à une prise en charge médicale conventionnelle sur la rémission des symptômes dépressifs, tout en cherchant à identifier si l’intensité initiale de l’état clinique modère cette efficacité thérapeutique.
L’architecture méthodologique est modélisée selon les spécifications suivantes :
- Facteur A (Modalité d’intervention, inter-sujets, 2 niveaux) : Groupe A1 bénéficiant du protocole de TCC-D enrichi par biofeedback versus Groupe A2 recevant la prise en charge pharmacologique habituelle avec soutien clinique standard.
- Facteur B (Sévérité psychopathologique basale, inter-sujets, 3 niveaux) : Les patients sont stratifiés à l’inclusion selon leur score initial à l’inventaire de dépression de Beck (BDI-II) : sévérité légère (B1), sévérité modérée (B2), et sévérité sévère (B3).
- Variable dépendante : L’amplitude de réduction des symptômes dépressifs à 12 semaines post-randomisation, mesurée par le différentiel de points d’amélioration standardisés ($\Delta_{score} = Score_{Baseline} – Score_{Post}$).
L’analyse de variance bifactorielle met en exergue une absence d’effet principal significatif pour la modalité de prise en charge ($F(1, 174) = 1,84, p = 0,177$), un effet principal significatif du niveau de sévérité initiale ($F(2, 174) = 22,91, p < 0,001$), mais révèle par-dessus tout une interaction désordinale (croisée) hautement significative ($F(2, 174) = 16,73, p < 0,001, \eta_p^2 = 0,161$).
L’autopsie des contrastes par paires illustre les dangers d’une lecture hâtive des effets principaux. Chez les patients présentant une symptomatologie légère (B1), l’intervention digitalisée surpasse très nettement la médication conventionnelle en matière de soulagement ressenti ($p < 0,001$). Chez les patients présentant une symptomatologie modérée (B2), les deux modalités génèrent des gains thérapeutiques strictement superposables ($p = 0,845$). En revanche, chez les patients souffrant d'une dépression sévère (B3), la dynamique s'inverse radicalement : la pharmacothérapie standard s'avère infiniment supérieure au protocole digitalisé ($p < 0,001$), ce dernier apparaissant manifestement inadapté à la prise en charge d'épisodes majeurs invalidants sans encadrement humain intensif. Cette découverte fondamentale fournit un cadre empirique pour la personnalisation des parcours de soins en santé mentale.
10.3 Cas en psychologie sociale : Genre et exposition aux stéréotypes
Une troisième application fondamentale prend racine dans le champ de la psychologie sociale expérimentale, autour des mécanismes de la théorie de la « menace du stéréotype » théorisée originellement par Steele et Aronson. Cette recherche examine comment l’activation d’un stéréotype social négatif relatif aux compétences analytiques altère les capacités d’inhibition et de flexibilité mentale de jeunes adultes soumis à une épreuve de raisonnement logique.
Le devis méthodologique 2×3 s’élabore ainsi :
- Facteur A (Genre auto-déclaré, facteur quasi-expérimental invoqué, 2 modalités) : Participants s’identifiant au genre féminin (A1) versus participants s’identifiant au genre masculin (A2).
- Facteur B (Contexte évaluatif inducteur, facteur manipulé inter-sujets, 3 modalités) : Consigne de passation neutre (B1 : tâche présentée comme un simple jeu cognitif non diagnostique), consigne d’activation stéréotypique explicite (B2 : avertissement préalable indiquant que le test met traditionnellement en lumière des divergences de genre substantielles), et consigne de valorisation réductrice d’anxiété (B3 : mention explicite affirmant que la tâche neutralise totalement toute distorsion genrée et mesure le pur potentiel créatif).
- Variable dépendante : Le score d’efficience cognitive global obtenu sur une batterie standardisée de matrices de Raven en temps contraint.
Les résultats statistiques de l’ANOVA révèlent un effet d’interaction marquant entre le genre et le contexte inducteur ($F(2, 234) = 8,97, p < 0,001, \eta_p^2 = 0,071$). L'analyse des contrastes montre qu'en condition neutre (B1) tout comme en condition de valorisation (B3), aucune divergence de performance statistique n'émerge entre les hommes et les femmes ($p = 0,612$ et $p = 0,489$ respectivement). En revanche, sous la condition d'activation de la menace (B2), le groupe féminin enregistre une chute statistiquement brutale de son niveau d'efficience comparativement au groupe masculin ($p < 0,001$). Ce cas met en relief l'importance des plans factoriels pour explorer des théories d'interaction personne-situation dans l'espace des sciences sociales.
11. Diagnostic méthodologique, postulats statistiques et robustesse
11.1 Validation des postulats fondamentaux de l’ANOVA
L’ensemble de la machinerie inférentielle de l’analyse de variance bifactorielle repose sur un socle de trois postulats distributionnels fondamentaux dont la méconnaissance compromet l’exactitude des calculs de probabilités associées aux statistiques F. L’expérimentateur a la responsabilité méthodologique de tester formellement ces postulats avant de procéder à l’interprétation définitive des résultats.
Le premier postulat exige la normalité de la distribution des résidus. Il postule que la dispersion de l’erreur aléatoire au sein de chacune des six cellules expérimentales obéit à une loi normale gaussienne théorique :
$$\epsilon_{ijk} \sim \mathcal{N}(0, \sigma^2)$$
L’évaluation diagnostique de ce postulat s’opère par des instruments numériques formels, tels que le test de Shapiro-Wilk (adapté aux échantillons de taille modeste) ou le test de Kolmogorov-Smirnov avec correction de Lilliefors, systématiquement corroborés par une inspection visuelle des diagrammes quantile-quantile (Normal Q-Q Plots) confrontant les quantiles des résidus standardisés aux quantiles théoriques.
Le second postulat requiert l’homoscédasticité ou l’homogénéité des variances intra-cellulaires. Il stipule que la variance intrinsèque de l’erreur doit être rigoureusement équivalente au sein de l’ensemble des six conditions de traitement :
$$\sigma_{11}^2 = \sigma_{12}^2 = dots = \sigma_{23}^2 = \sigma^2$$
Ce postulat est classiquement testé à l’aide du test d’homogénéité des variances de Levene (basé sur la déviation absolue à la médiane, plus résistant aux asymétries de distribution que le test historique de Bartlett). Si la valeur p du test de Levene s’avère non significative ($p > 0,05$), l’égalité des variances est considérée comme raisonnablement préservée.
Le troisième postulat, de loin le plus fondamental et le plus critique, réside dans l’indépendance stricte des observations. Chaque donnée recueillie doit être stochastiquement autonome par rapport aux autres. Contrairement aux violations de normalité ou d’homogénéité qui altèrent modérément la validité du modèle, une violation du postulat d’indépendance (due par exemple à l’administration collective de questionnaires où les individus s’influencent mutuellement, ou au recrutement de fratries) gonfle de manière catastrophique le taux de faux positifs, rendant les inférences statistiques de l’ANOVA totalement caduques.
11.2 Gestion des violations des postulats dans un plan 2×3
Lorsque le diagnostic méthodologique met en évidence des distorsions empiriques substantielles par rapport aux postulats distributionnels, le chercheur ne doit pas capituler mais mobiliser des stratégies d’ajustement correctif validées.
Face à une asymétrie marquée (skewness) ou à une violation conjointe de la normalité et de l’homoscédasticité, la première ligne de défense consiste en l’application d’une transformation mathématique non linéaire de la variable dépendante d’origine. Si la distribution est fortement étirée vers la droite, une transformation logarithmique ($Y’ = ln(Y)$ ou $Y’ = \log_{10}(Y)$) permet fréquemment de compresser l’échelle et de stabiliser les variances. Pour des données modérément asymétriques, une transformation par racine carrée ($Y’ = \sqrt{Y}$) ou réciproque ($Y’ = 1/Y$) peut restaurer les conditions de conformité. Les procédures automatisées d’optimisation paramétrique de Box-Cox permettent d’identifier l’exposant $lambda$ exact maximisant la normalité résiduelle.
Néanmoins, les transformations de données modifient l’échelle de mesure et compliquent singulièrement l’interprétation substantielle des moyennes métriques d’origine. Une alternative contemporaine infiniment supérieure réside dans l’adoption de l’analyse de variance robuste, développée notamment par le statisticien Rand Wilcox. Ces protocoles statistiques calculent les ratios F sur des moyennes élaguées (trimmed means à 20 %, expurgeant les valeurs extrêmes des queues de distribution) et des variances de Winsor, conférant au modèle une imperméabilité remarquable aux écarts de normalité et aux asymétries sans obliger à abandonner l’échelle de la VD.
Enfin, lorsque les données sont radicalement non conformes ou ordinales pures, l’expérimentateur peut se tourner vers les approches computationnelles intensives de rééchantillonnage par bootstrap ou vers les tests de permutations non paramétriques bifactoriels. Ces algorithmes génèrent empiriquement la distribution d’échantillonnage de la statistique F par des dizaines de milliers d’itérations de réattribution aléatoire des étiquettes de traitement, affranchissant définitivement l’inférence de toute assise paramétrique a priori.
11.3 Gestion des données aberrantes et manquantes
La présence de valeurs extrêmes ou aberrantes (outliers) et l’existence de données manquantes (missing data) constituent des menaces sévères pesant sur la robustesse d’un devis factoriel 2×3.
La détection des données aberrantes s’opère au niveau univarié par le calcul des scores $Z$ standardisés (les observations au-delà de $|Z| > 3,29$ étant suspectes d’anomalie méthodologique) et par l’examen des tracés en boîtes à moustaches (boxplots). Au niveau multivarié, le calcul de la distance de Cook ($D_i$) permet d’évaluer le degré de levier et l’influence disproportionnée qu’une observation singulière exerce sur les paramètres estimés des moindres carrés ordinaires. L’expérimentateur ne doit jamais éliminer arbitrairement une donnée discordante au motif qu’elle contredit son hypothèse : toute exclusion doit être documentée, motivée par une justification technique formelle (panne d’appareil, tricherie délibérée, non-respect avéré des critères d’inclusion) et assortie idéalement d’une analyse de sensibilité comparant les résultats avant et après éviction.
Concernant les données manquantes, les approches obsolètes consistant en l’élimination systématique de l’ensemble du dossier du participant (listwise deletion) induisent une amputation dommageable de la puissance statistique et créent des biais systématiques si la perte de données n’est pas strictement aléatoire (Missing Completely at Random, MCAR). Les standards méthodologiques contemporains préconisent sans équivoque la mise en œuvre de protocoles d’imputation multiple par équations chaînées (MICE) ou le recours à l’estimation par maximum de vraisemblance à information complète (FIML – Full Information Maximum Likelihood). Ces techniques permettent de modéliser la structure de corrélation globale de l’expérience factorielle pour imputer des valeurs plausibles aux cellules fragmentaires, préservant ainsi l’orthogonalité cellulaire sans fausser les estimations de la variance d’erreur.
12. Rapport scientifique et visualisation des résultats selon les normes APA
12.1 Standards de rédaction textuelle (normes APA 7e édition)
La transmission académique des résultats d’un plan factoriel 2×3 est régie par les canons rédactionnels formalisés dans le manuel de publication de l’American Psychological Association (APA 7e édition). La rédaction scientifique doit se caractériser par une rigueur syntaxique, une clarté narrative absolue et une transparence statistique irréprochable.
Sur le plan textuel, chaque test inférentiel omnibus issu de l’ANOVA doit être rapporté dans le corps du texte selon une nomenclature précise intégrant : la lettre statistique F en italique, les degrés de liberté du numérateur et du dénominateur séparés par une virgule et encadrés de parenthèses, la valeur numérique arrondie au centième de la statistique F calculée, la valeur p exacte arrondie au millième (ou indiquée sous la forme $p < 0,001$ si le seuil est inférieur), et l'indice de taille d'effet standardisé (typiquement $\eta_p^2$ ou $\omega_p^2$).
Un modèle de rédaction narrative académique optimale se formule de la manière suivante :
« Une analyse de variance factorielle 2 × 3 inter-sujets a été réalisée afin d’évaluer l’impact de la stratégie d’encodage (imagerie mentale vs répétition) et du niveau de charge cognitive concurrente (nulle, modérée, sévère) sur le pourcentage d’items correctement rappelés. L’analyse révèle un effet principal significatif de la stratégie d’encodage, F(1, 114) = 38,42, p < 0,001, ηp2 = 0,25, IC à 95 % [0,13, 0,38], indiquant que l’imagerie mentale conduit à un rappel moyen globalement supérieur (M = 59,33 %, ET = 21,45) à celui de la répétition (M = 45,33 %, ET = 14,82). L’effet principal de la charge cognitive s’avère également hautement significatif, F(2, 114) = 54,18, p < 0,001, ηp2 = 0,49, IC à 95 % [0,36, 0,58]. De manière fondamentale, ces effets principaux sont qualifiés par une interaction bidirectionnelle statistiquement significative entre la stratégie d’encodage et la charge cognitive, F(2, 114) = 11,26, p < 0,001, ηp2 = 0,16, IC à 95 % [0,06, 0,27]. Conformément aux préconisations d’usage, l’analyse des effets simples montre que la supériorité de l’imagerie mentale s’exprime massivement sous charge nulle (p < 0,001) et modérée (p = 0,012), mais s'évanouit entièrement sous charge sévère (p = 0,724). »
12.2 Création de visualisations graphiques académiques
La restitution visuelle des données d’un devis factoriel 2×3 joue un rôle communicatif aussi fondamental que le texte narratif. En accord avec les exigences de l’APA, une figure ne doit jamais dupliquer passivement les données du texte, mais enrichir la compréhension cognitive globale des configurations interactionnelles complexes.
Le choix typologique entre un graphique linéaire (line graph) et un graphique en barres groupées (grouped bar chart) est dicté par la nature du second facteur ternaire. Si le Facteur B est de nature quantitative continue discrétisée (ex. dosages, durées, intensités métriques), le graphique linéaire est formellement requis : il permet à l’œil de suivre la trajectoire dynamique des pentes et de saisir intuitivement les ruptures de parallélisme. Si le Facteur B est de nature strictement catégorielle qualitative (ex. trois techniques psychothérapeutiques distinctes sans hiérarchie métrique), le graphique en barres groupées s’avère plus rigoureux épistémologiquement, évitant de simuler une continuité spatiale artificielle qui n’a pas de fondement empirique.
Les standards graphiques imposent l’incorporation systématique de barres d’erreur (error bars) centrées au sommet de chaque point ou colonne de moyenne cellulaire. L’auteur doit obligatoirement expliciter dans la légende descriptive de la figure la métrique exacte représentée par ces barres d’erreur : s’agit-il d’écarts-types élémentaires ($SD$), de l’erreur type de la moyenne ($SEM = SD/\sqrt{n}$), ou idéalement d’intervalles de confiance à 95 % ($IC_{95%}$). Les figures destinées aux revues indexées doivent être nettoyées de tout ornement visuel superflu (pas de quadrillage de fond lourd, pas de textures tridimensionnelles, typographies uniformisées de type sans serif comme Arial ou Calibri) et calibrées pour assurer un contraste parfait en niveaux de gris et en impression monochrome.
12.3 Présentation tabulaire formelle
L’organisation tabulaire des statistiques descriptives et inférentielles d’un plan factoriel 2×3 obéit à des contraintes typographiques rigides fixées par l’APA (norme Table Formatting). La règle visuelle fondamentale exclut catégoriquement toute ligne verticale de séparation : une table APA ne comporte strictement que des lignes horizontales maîtresses bordant l’en-tête, séparant les sous-colonnes de données et clôturant le corps du tableau.
Pour un devis 2×3, deux tables formelles sont usuellement produites :
La première table recense les statistiques descriptives complètes des six cellules factorielles. Elle dispose en colonnes les trois modalités du Facteur B, et en lignes les deux modalités du Facteur A, intégrant des marges d’agrégation globale pour présenter également les moyennes marginales de chaque niveau ainsi que le grand mean expérimental. Chaque cellule de la table doit mentionner simultanément la moyenne non biaisée ($M$) et l’écart-type ($SD$), idéalement complétés de l’effectif cellulaire effectif ($n$).
La seconde table synthétise l’analyse de variance factorielle complète. Elle aligne dans un format compact et épuré les colonnes suivantes : Source, SS (Somme des carrés), df (Degrés de liberté), MS (Carré moyen), F, p, et $\eta_p^2$. Des notes de bas de tableau spécifiques (signalées par des astérisques standards, ex. $^{*}p < 0,05$, $^{**}p < 0,01$, $^{***}p < 0,001$) permettent de clarifier instantanément les seuils conventionnels de rejet statistique sans surcharger le corps de la matrice numérique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). https://doi.org/10.1037/0000165-000
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Faul, F., Erdfelder, E., Lang, A.-G., & Buchner, A. (2007). G*Power 3: A flexible statistical power analysis program for the social, behavioral, and biomedical sciences. Behavior Research Methods, 39(2), 175–191. https://doi.org/10.3758/BF03193146
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Fisher, R. A. (1935). The design of experiments. Oliver and Boyd.
- Howell, D. C. (2012). Statistical methods for psychology (8th ed.). Cengage Learning.
- Keppel, G., & Wickens, T. D. (2004). Design and analysis: A researcher’s handbook (4th ed.). Pearson Prentice Hall.
- Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3rd ed.). Routledge. https://doi.org/10.4324/9781315642956
- Olejnik, S., & Algina, J. (2003). Generalized eta and omega squared statistics: Measures of effect size for some common research designs. Psychological Methods, 8(4), 434–447. https://doi.org/10.1037/1082-989X.8.4.434
- Rosenthal, R., & Rosnow, R. L. (2008). Essentials of behavioral research: Methods and data analysis (3rd ed.). McGraw-Hill.
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Tukey, J. W. (1949). Comparing individual means in the analysis of variance. Biometrics, 5(2), 99–114. https://doi.org/10.2307/3001913
- Wilcox, R. R. (2017). Introduction to robust estimation and hypothesis testing (4th ed.). Academic Press.