
Dans le domaine de l’analyse statistique et de la recherche scientifique contemporaine, la communication visuelle des données constitue une composante indissociable de la rigueur méthodologique. Le langage R, développé initialement par Ross Ihaka et Robert Gentleman à l’Université d’Auckland, s’est imposé depuis plusieurs décennies comme l’environnement de référence pour le calcul statistique et la représentation graphique. Si des bibliothèques plus récentes fondées sur la grammaire des graphiques ont acquis une popularité indéniable, le moteur graphique natif de R demeure un pilier fondamental, caractérisé par une vélocité d’exécution exceptionnelle, une autonomie logicielle totale et une précision chirurgicale dans la manipulation des éléments géométriques et typographiques.
Cependant, la maîtrise de ce système historique exige une compréhension approfondie de ses mécanismes de bas niveau, particulièrement en ce qui concerne la gestion de la typographie. Nombreux sont les chercheurs, analystes et praticiens qui se heurtent à des figures dont les textes s’avèrent illisibles lors de projections publiques, tronqués au sein des marges périphériques, ou disproportionnés par rapport à la densité des données tracées. La mise à l’échelle typographique ne se résume pas à une simple considération cosmétique ; elle répond à des impératifs stricts de perception visuelle et de sémiotique graphique, déterminant directement l’efficacité cognitive avec laquelle une audience assimile des distributions complexes ou des relations inférentielles.
Ce guide exhaustif a pour vocation d’analyser de manière détaillée l’ensemble des mécanismes régissant le dimensionnement des polices de caractères au sein du système graphique de base de R. En explorant la mécanique de l’argument d’expansion de caractères, ses déclinaisons spécialisées selon les composantes du tracé, l’administration globale via les paramètres d’environnement graphique, ainsi que les stratégies de gestion des conflits spatiaux, ce document fournit les compétences nécessaires pour hisser vos visualisations aux plus hauts standards éditoriaux et académiques.
1. Introduction aux paramètres graphiques et à la typographie sous R de base
1.1 Architecture du système graphique natif de R
L’infrastructure graphique originelle de R repose principalement sur le package standard nommé graphics, intimement couplé au moteur sous-jacent grDevices. Contrairement aux approches déclaratives modernes popularisées par le formalisme de Leland Wilkinson, où le graphique est conçu comme un empilement de couches sémantiques interconnectées, le système de base fonctionne selon le paradigme de la « boîte à peinture » ou du dessin séquentiel immédiat. Dès lors qu’un élément graphique élémentaire ou textuel est projeté sur le dispositif d’affichage, il modifie irrévocablement la mémoire tampon de la trame sans conserver de trace relationnelle avec les entités géométriques préexistantes. Cette architecture linéaire procure une vélocité de rendu incomparable, essentielle lors du traitement de jeux de données massifs ou de la génération industrielle de milliers de figures statistiques.
Dans ce modèle d’exécution directe, la typographie n’est pas traitée comme une simple propriété stylistique abstraite mais comme un objet géométrique discret soumis aux transformations du repère cartésien et aux capacités intrinsèques du pilote graphique actif. Les appels graphiques de base interagissent directement avec les routines C internes du moteur de R, qui calculent les boîtes englobantes des glyphes en fonction de la résolution du périphérique de sortie, qu’il s’agisse d’un affichage matriciel standard ou d’un flux vectoriel destiné à l’impression scientifique. Cette liaison directe garantit une empreinte mémoire minimale et une compatibilité ascendante quasi parfaite avec les travaux d’analyse publiés au cours des trois dernières décennies.
La pérennité de ce système graphique traditionnel s’explique également par son indépendance totale vis-à-vis des écosystèmes de paquets externes, prévenant ainsi toute rupture d’API susceptible d’altérer la reproductibilité computationnelle. Pour les analyses préliminaires rapides, l’exploration de données en ligne de commande ou la production de visualisations répondant à des contraintes de calcul distribué sans interface serveur complexe, la maîtrise du sous-système graphics demeure une compétence technique indispensable pour le data scientist et le chercheur quantitatif.
1.2 Nécessité de la hiérarchisation visuelle des textes
Les théories de la perception visuelle, notamment développées dans le cadre de la psychologie de la Forme (Gestalt) et formalisées pour le traitement graphique par Jacques Bertin dans son ouvrage séminal Sémiologie Graphique, établissent que l’œil humain extrait l’information selon un ordre de priorité guidé par les contrastes visuels. Dans une figure statistique, le texte ne joue pas un rôle ornemental accessoire : il ancre les axes dimensionnels, explicite la nature des métriques évaluées, qualifie les seuils d’interprétation critique et prévient les erreurs de jugement cognitif. Sans une structure typographique rigoureusement articulée, l’observateur consacre un effort attentionnel disproportionné à déchiffrer les légendes au détriment de l’analyse des tendances mathématiques.
L’établissement d’une hiérarchie visuelle efficiente repose sur une différenciation marquée entre le niveau macroscopique, constitué par le titre général de la figure, le niveau intermédiaire regroupant les étiquettes des axes et les légendes, et le niveau microscopique comprenant les graduations numériques et les annotations ponctuelles. Une égalisation uniforme de la taille des polices de caractères engendre une uniformité visuelle délétère où aucune information ne se démarque, augmentant drastiquement la charge cognitive extrinsèque. À l’inverse, une disproportion accentuée distord l’attention et peut induire des biais d’interprétation en survalorisant visuellement des éléments secondaires, tels qu’une annotation marginale, au détriment de la distribution statistique principale.
Dans le domaine académique, l’illisibilité des annotations textuelles constitue l’une des causes majeures de rejet de figures lors des processus d’évaluation par les pairs. Lorsque les graphiques sont réduits pour s’insérer dans les gabarits éditoriaux bi-colonnes des revues scientifiques, un sous-dimensionnement typographique initial rend les graduations indéchiffrables, compromettant la lisibilité immédiate des preuves statistiques avancées. La typographie doit donc être pensée comme un vecteur d’intelligibilité scientifique, calibré avec minutie pour garantir la transmission sans distorsion des conclusions de l’étude.
1.3 Limitations des configurations par défaut
L’environnement R standard est calibré par défaut pour un affichage interactif sur des terminaux graphiques dotés d’une résolution modeste, généralement une fenêtre écran standard de sept pouces sur sept pouces opérant à 72 ou 96 points par pouce. Dans ce contexte d’affichage restreint, les tailles de police par défaut sont calculées selon un équilibre générique qui s’avère particulièrement inadapté dès lors que l’on s’écarte de cette configuration basique. Les valeurs unitaires de base produisent des libellés souvent étriqués, manquant d’autorité visuelle pour guider la lecture d’un public éloigné ou pour satisfaire les critères éditoriaux modernes.
L’écueil le plus redoutable survient lors de la redirection du tracé vers des dispositifs d’exportation de haute résolution, tels que les pilotes matriciels TIFF ou PNG paramétrés à trois cents ou six cents points par pouce pour l’édition imprimée. Sans une reconfiguration explicite des multiplicateurs typographiques, le ratio entre la dimension des pixels et la métrique des fontes produit des textes lilliputiens, presque invisibles à l’œil nu. Les titres principaux perdent leur statut de repère structurel, tandis que les graduations numériques le long des axes se transforment en motifs punctiformes indéchiffrables.
Par ailleurs, les paramètres standards de R ne prennent pas en considération les contraintes ergonomiques spécifiques des supports contemporains, tels que les diapositives de présentation haute définition au format seize neuvièmes ou les affiches de congrès scientifiques destinées à être consultées à plusieurs mètres de distance. Cette standardisation rigide impose au praticien de s’émanciper des routines automatisées de bas niveau et de prendre le contrôle manuel absolu sur chaque paramètre dimensionnel régissant l’affichage des chaînes de caractères au sein de l’environnement graphique.
2. Le paramètre fondamental cex : Comprendre l’échelle d’agrandissement relatif
2.1 Définition et mécanique du coefficient de grossissement
Au cœur de la manipulation textuelle dans le système graphique de base se trouve le paramètre universel désigné sous l’acronyme cex, abréviation directe de l’expression anglaise Character EXpansion. Loin de représenter une unité de mesure physique absolue telle que le millimètre, le centimètre ou le point typographique PostScript usuel, le coefficient d’expansion de caractères opère comme un scalaire sans dimension. Sa valeur numérique définit un facteur d’échelle multiplicatif appliqué directement sur la taille nominale de la police définie au niveau du pilote graphique ou du contexte de dessin actif.
Par convention immuable dans l’architecture de R, la valeur unitaire standard de ce paramètre est établie à 1,0. Toute assignation numérique supérieure à l’unité, telle qu’une valeur fixée à 1,5, engendre un grossissement de cinquante pour cent de la dimension linéaire des glyphes typographiques par rapport au gabarit standard du périphérique. Réciproquement, une valeur comprise strictement entre 0 et 1 entraîne une réduction proportionnelle : une configuration paramétrée à 0,8 provoque une rétraction de vingt pour cent de la hauteur et de la largeur de l’ensemble des caractères dessinés sous cette instruction.
Il est fondamental de noter que l’agrandissement opéré par ce paramètre n’est pas discontinu mais rigoureusement continu sur le plan arithmétique. Le moteur typographique réévalue la taille effective en multipliant la taille en points de base de la police de référence par la valeur décimale spécifiée. Ce calcul influe non seulement sur la hauteur de la ligne de base à la ligne de tête des majuscules, mais également sur l’ensemble de la boîte d’encombrement horizontal et vertical de la chaîne de caractères, modifiant par ricochet les besoins d’espacement au sein de la zone de composition graphique.
2.2 Comportement global du paramètre cex dans la fonction plot()
L’application directe du paramètre général au sein de l’appel d’une fonction de haut niveau, à l’instar de la célèbre fonction générique plot(), dévoile une particularité comportementale qui surprend fréquemment les néophytes. Dans cette situation, le paramètre agit de façon ubiquitaire : il modifie simultanément l’échelle des symboles de traçage géométriques disséminés dans le plan cartésien ainsi que la taille des éléments textuels attachés à la structure fondamentale de la figure, tels que les axes et leurs libellés.
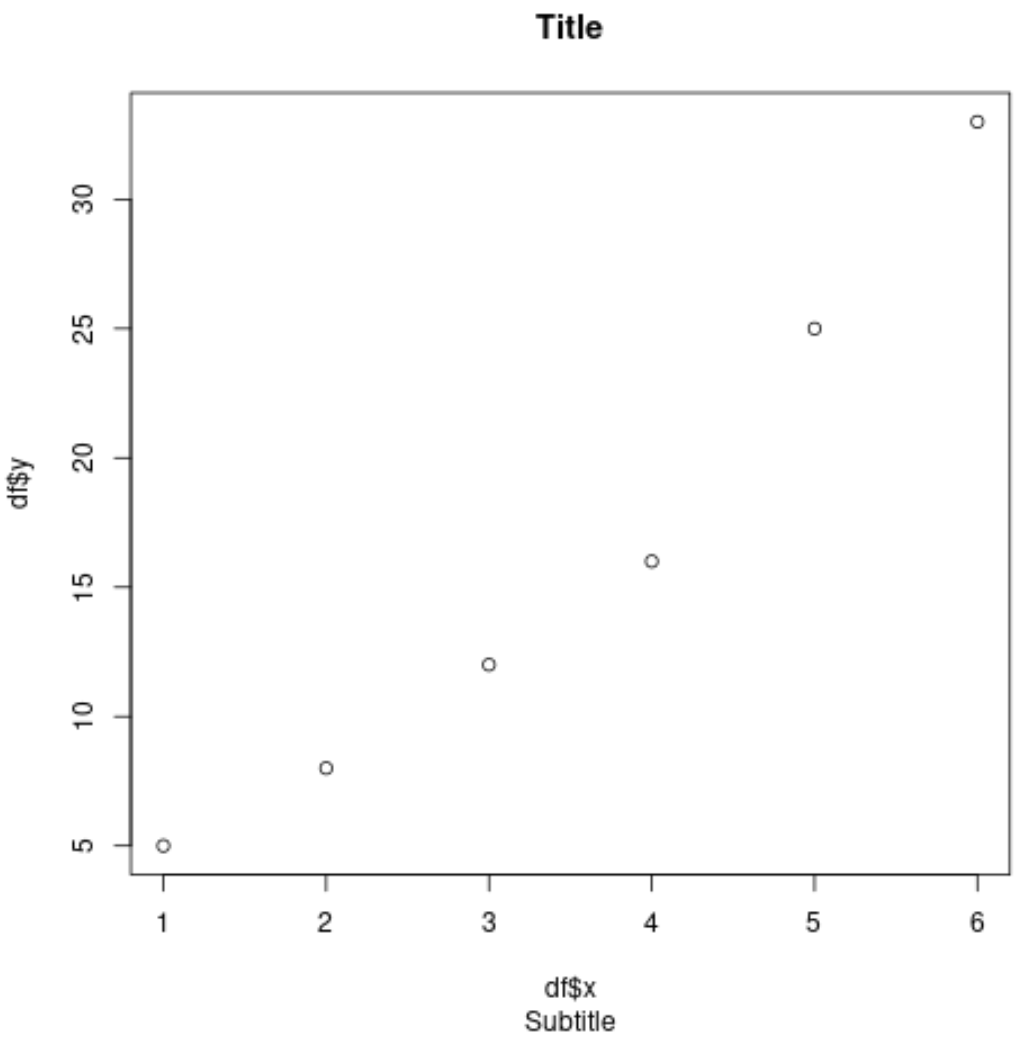
Cette double affectation signifie que l’ajustement global de l’argument modifie l’équilibre visuel entre les données empiriques et leurs repères sémantiques. Si l’on augmente la valeur scalaire pour accroître la lisibilité d’un titre, les cercles, triangles ou croix matérialisant les observations statistiques voient leur diamètre s’élargir dans des proportions strictement identiques, ce qui peut engendrer un chevauchement massif des points d’observation et occulter la distribution spatiale sous-jacente par un phénomène de sursaturation visuelle (overplotting).
Pour cette raison fondamentale, l’utilisation brute de l’argument d’expansion généralisé au sein des fonctions graphiques principales est le plus souvent déconseillée lorsqu’il s’agit d’orchestrer une mise en page typographique rigoureuse. Le moteur graphique a donc été doté d’une famille d’arguments spécialisés, préfixés par la racine typographique mais ciblant des composantes anatomiques précises de la composition graphique, permettant ainsi de découpler le dimensionnement des données géométriques de celui de l’armature textuelle.
2.3 Différence entre taille relative et taille absolue en typographie numérique
Comprendre la dichotomie entre taille relative et dimension absolue s’avère indispensable dès lors que l’on produit des figures statistiques destinées à des canaux de diffusion hétérogènes. Dans l’univers de la typographie imprimée traditionnelle, la taille d’une fonte est quantifiée en points typographiques, où un point équivaut conventionnellement à un soixante-douzième de pouce (soit approximativement 0,3528 millimètre). Dans le sous-système de R, la taille de référence absolue en points est initialisée lors de l’ouverture du périphérique graphique, couramment via l’argument pointsize des fonctions de pilotage graphique.
Le paramètre d’expansion de caractères intervient exclusivement comme une modulation relative en aval de cette définition initiale. Cela implique qu’une valeur scalaire donnée de 1,5 ne correspondra pas à la même hauteur physique de caractère si le pilote sous-jacent a été initialisé avec une taille de base de 10 points ou une taille de base de 14 points. Dans le premier cas, la taille apparente résultante sera de 15 points, tandis que dans le second cas, elle atteindra 21 points physiques. La typographie dans le moteur natif de R procède ainsi d’un calcul cascadé où le facteur relatif magnifie ou contracte une unité de base définie au niveau du système de bas niveau.
Cette relativité dimensionnelle confère une grande souplesse, mais impose une discipline méthodologique constante. Lors du redimensionnement interactif d’une fenêtre graphique à l’écran, le ratio d’aspect et la surface de projection changent continuellement. Si le périphérique ne recalcule pas dynamiquement la taille en points de référence, les textes agrandis via un coefficient relatif constant risquent d’entrer en collision spatiale avec les marges physiques ou les tracés de données, brisant l’harmonie de la composition visuelle originellement calibrée.
3. Personnalisation du titre principal avec cex.main
3.1 Syntaxe formelle et implémentation pratique
Pour isoler le titre principal du graphique de toute interférence dimensionnelle avec les symboles d’observation ou les axes de coordonnées, le système graphique de R met à disposition le sous-paramètre spécifique cex.main. Cette variable d’ajustement s’insère directement comme un argument nommé au sein de l’instruction de traçage d’origine, telle que la fonction d’affichage bivarié standard, ou au niveau de l’appel autonome de la fonction d’enrichissement de titre appelée title().
Sur le plan syntaxique, l’assignation s’opère de manière déclarative en fournissant un scalaire strictement positif. À titre d’illustration méthodologique, une configuration établissant ce paramètre à une valeur de 1,8 garantit que le texte renseigné sous l’argument de libellé principal bénéficiera d’une expansion dimensionnelle de quatre-vingts pour cent par rapport au gabarit de police unitaire de la session active. Réciproquement, pour des besoins de discrétion éditoriale ou face à des intitulés descriptifs très denses, une configuration de valeur minorée à 0,9 autorise une réduction typographique contrôlée sans altérer la taille des graduations numériques périphériques.
Le moteur d’agencement vertical calcule automatiquement la ligne d’assise du titre au sein de la marge supérieure de la figure en se basant sur la valeur spécifiée par cet argument. Plus le coefficient d’agrandissement est élevé, plus la hauteur de la boîte typographique s’accroît, incitant le moteur de rendu à décaler vers le haut la position médiane des glyphes pour préserver un espacement suffisant avec la bordure supérieure du rectangle de traçage cartésien, évitant ainsi un télescopage entre les éléments textuels et les symboles de données les plus élevés.
3.2 Synergie avec les propriétés de graisse et de style
L’optimisation d’un titre graphique ne procède pas uniquement de son échelle dimensionnelle, mais découle de son interaction harmonique avec les attributs de graisse et de famille typographique. Dans les fonctions graphiques de base, le style du titre est régi conjointement par l’argument font.main. Par défaut, le moteur de R applique une graisse forte (valeur numérique entière équivalente à deux, correspondant à la graisse bold) aux chaînes de caractères déclarées pour le titre principal, conférant d’emblée à ce dernier une présence optique supérieure à celle du corps de texte standard.
Une interaction esthétique subtile apparaît lorsque l’on manipule conjointement ces deux paramètres : l’application d’un coefficient d’expansion particulièrement élevé combiné à une police en graisse lourde produit une masse visuelle considérable, souvent trop dominante dans le quadrant supérieur du graphique. Il s’avère fréquemment pertinent de modérer la graisse en sélectionnant un style typographique standard non enrichi (valeur entière un) lorsque l’on fait le choix d’un coefficient dimensionnel important, équilibrant ainsi la lisibilité par la taille plutôt que par l’épaisseur du tracé des lettres.
L’intégration de familles typographiques distinctes, via l’argument de famille générale désigné par le paramètre family, complexifie encore cette équation d’équilibre. L’utilisation d’une police à empattements de type serif exige généralement un coefficient d’expansion légèrement supérieur à celui d’une police linéale sans empattements pour maintenir un niveau de lisibilité équivalent à distance, les déliés fins des polices traditionnelles ayant tendance à s’estomper sous de faibles résolutions d’affichage matriciel.
3.3 Gestion des titres longs et retours à la ligne
Un écueil classique lors de l’application de facteurs d’agrandissement élevés sur le titre réside dans le débordement horizontal en dehors des limites physiques de la fenêtre graphique. Le moteur natif de R ne dispose d’aucun algorithme intrinsèque de césure automatique ou de retour à la ligne contextuel pour les chaînes de texte excédant la largeur de la boîte de traçage. Si la chaîne textuelle agrandie dépasse la largeur allouée au canevas, les extrémités gauche et droite sont impitoyablement tronquées à la lisière du cadre du périphérique sans émission d’avertissement bloquant.
Pour prévenir cette dégradation inélégante de l’affichage, il est impératif d’introduire manuellement des caractères d’échappement de saut de ligne, matérialisés dans la syntaxe des chaînes de caractères par la séquence conventionnelle barre oblique inversée suivie de la lettre minuscule n. Cette technique permet de scinder une longue proposition d’hypothèse scientifique en deux ou trois segments textuels superposés de manière parfaitement maîtrisée, conservant une typographie volumineuse sans courir le risque d’une amputation de l’intitulé.
Toutefois, l’introduction de retours à la ligne au sein d’un titre caractérisé par un coefficient dimensionnel important consomme un espace vertical substantiel dans la marge supérieure du graphique. Chaque ligne supplémentaire requiert une hauteur d’interlignage proportionnelle au facteur de grossissement appliqué. Le praticien doit impérativement anticiper cette occupation volumique accrue sous peine de voir la ligne supérieure du titre déborder au-dessus de la bordure maximale de l’image, une problématique spatiale dont la résolution technique sera approfondie dans les sections dédiées aux marges intérieures du tracé.
4. Ajustement du sous-titre graphique à l’aide de cex.sub
4.1 Rôle structurel du sous-titre dans les figures scientifiques
Au sein de la mise en page d’une visualisation scientifique rigoureuse, le sous-titre remplit une fonction contextuelle et explicative essentielle. Alors que le titre principal formule généralement l’affirmation fondamentale ou la nature du phénomène sous observation, le sous-titre est conventionnellement mobilisé pour stipuler la taille d’échantillon analysée, les conditions de contrôle expérimental, les unités de normalisation employées ou les intervalles de confiance associés aux mesures. Il opère ainsi comme un relais sémantique de second niveau entre l’accroche thématique globale et la rigueur technique des axes de mesure.
Dans l’architecture typographique standard de R, le sous-titre occupe une position singulière qui déconcerte fréquemment les analystes habitués aux normes éditoriales du web ou du traitement de texte. Par défaut, le sous-titre n’est pas localisé directement sous le titre principal au sommet de la figure, mais est rejeté tout en bas de la composition, précisément en dessous de l’étiquette descriptive de l’axe horizontal des abscisses. Cette disposition historique vise à ancrer les métadonnées méthodologiques au pied du visuel, fonctionnant à la manière d’une note de bas de page immédiatement associée au système d’axes cartésiens.
Cette implantation basse impose le respect strict d’une relation de hiérarchisation visuelle descendante. Le sous-titre ne doit en aucun cas rivaliser visuellement avec le titre principal, ni entrer en concurrence avec la lisibilité du descripteur de l’axe des abscisses. Sa taille doit refléter son statut subordonné tout en demeurant pleinement décryptable par un lecteur attentif examinant les détails du protocole expérimental.
4.2 Mise en œuvre technique de cex.sub
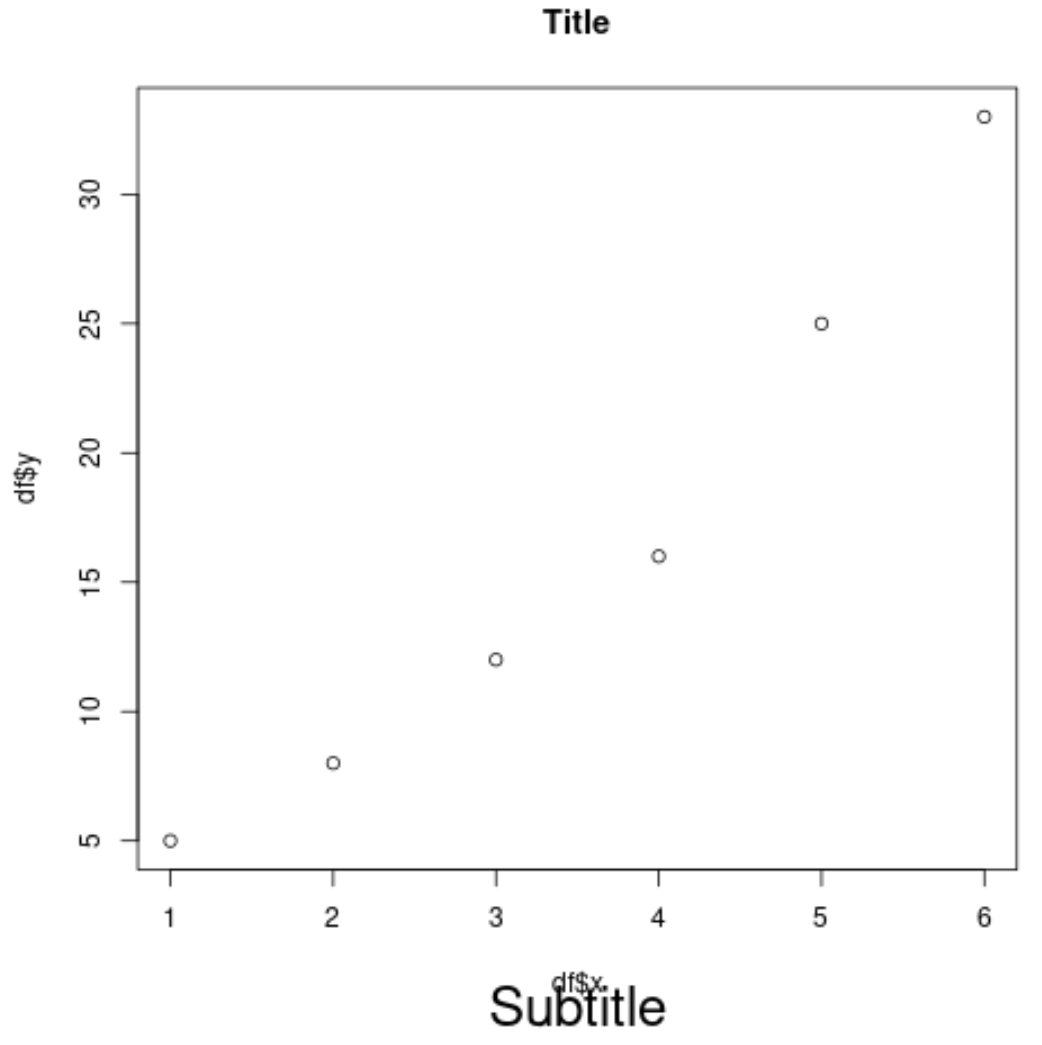
L’administration de la taille du sous-titre s’effectue au moyen de l’argument dédié cex.sub. Tout comme les autres paramètres dérivés de l’expansion de caractères, il accepte une valeur décimale positive agissant comme multiplicateur relatif de la fonte unitaire de l’environnement graphique en cours d’exécution. Sa spécification peut avoir lieu au sein de la fonction d’initialisation du graphique ou lors d’un appel ultérieur à la fonction spécialisée title() pourvue de l’argument correspondant.
Sur le plan des équilibres morphologiques, il est largement admis que la valeur attribuée à ce paramètre doit se situer dans une plage numérique strictement inférieure à celle conférée au titre principal. Si ce dernier arbore une valeur scalaire de 1,5, une configuration harmonieuse pour le sous-titre oscillera généralement entre 0,8 et 1,0. Une telle gradation permet d’établir une cadence visuelle naturelle facilitant la décomposition séquentielle de l’information par les aires corticales dédiées à la lecture graphique.
Lors de l’application conjointe de multiples paramètres au sein d’une même instruction graphique, le moteur typographique de R évalue l’expression de ce paramètre de manière parfaitement hermétique par rapport aux autres directives scalaires. Il n’existe pas d’interférence directe entre le redimensionnement du sous-titre et l’échelle attribuée aux étiquettes des axes, ce qui offre une indépendance absolue dans l’ajustement esthétique de la composition finale, qu’il s’agisse d’un histogramme unidimensionnel ou d’un nuage de dispersion multivarié.
4.3 Prévention des conflits d’espacement avec les légendes inférieures
En raison de sa localisation native sous l’axe des abscisses, l’amplification dimensionnelle du sous-titre représente une source majeure d’interférences typographiques indésirables. Lorsque l’argument d’expansion du sous-titre se voit assigner une valeur supérieure à l’unité, la zone d’encombrement du texte s’étend verticalement vers le haut et vers le bas. Ce comportement engendre fréquemment un télescopage matériel avec le libellé de l’axe horizontal si celui-ci est également présent dans cette zone inférieure.
Pour prévenir cette superposition textuelle préjudiciable à la clarté du document, deux approches méthodologiques complémentaires s’offrent à l’analyste. La première consiste à calibrer l’argument d’espacement des lignes de marge via les fonctions de contrôle spatial pour accroître la distance relative séparant l’axe des abscisses de la zone réservée au sous-titre. La seconde approche, souvent plus satisfaisante sur le plan éditorial, préconise d’abandonner l’usage du sous-titre natif au profit d’annotations manuelles dans la marge supérieure ou d’une légende textuelle encapsulée à l’extérieur de la surface de traçage des données.
Dans le cas d’une production destinée à un article de recherche académique répondant aux critères des éditeurs internationaux, l’usage de ce sous-titre basique inférieur est généralement supplanté par l’intégration d’un paragraphe descriptif placé directement dans la mise en page de la publication scientifique. Toutefois, pour des documents auto-suffisants, tels que des fiches de synthèse analytique ou des rapports opérationnels générés de façon automatisée, la maîtrise de ce coefficient d’expansion garantit une transmission sans ambiguïté des conditions méthodologiques de l’expérimentation.
5. Modification de la taille des étiquettes des axes avec cex.lab
5.1 Ciblage exclusif des libellés de variables (xlab et ylab)
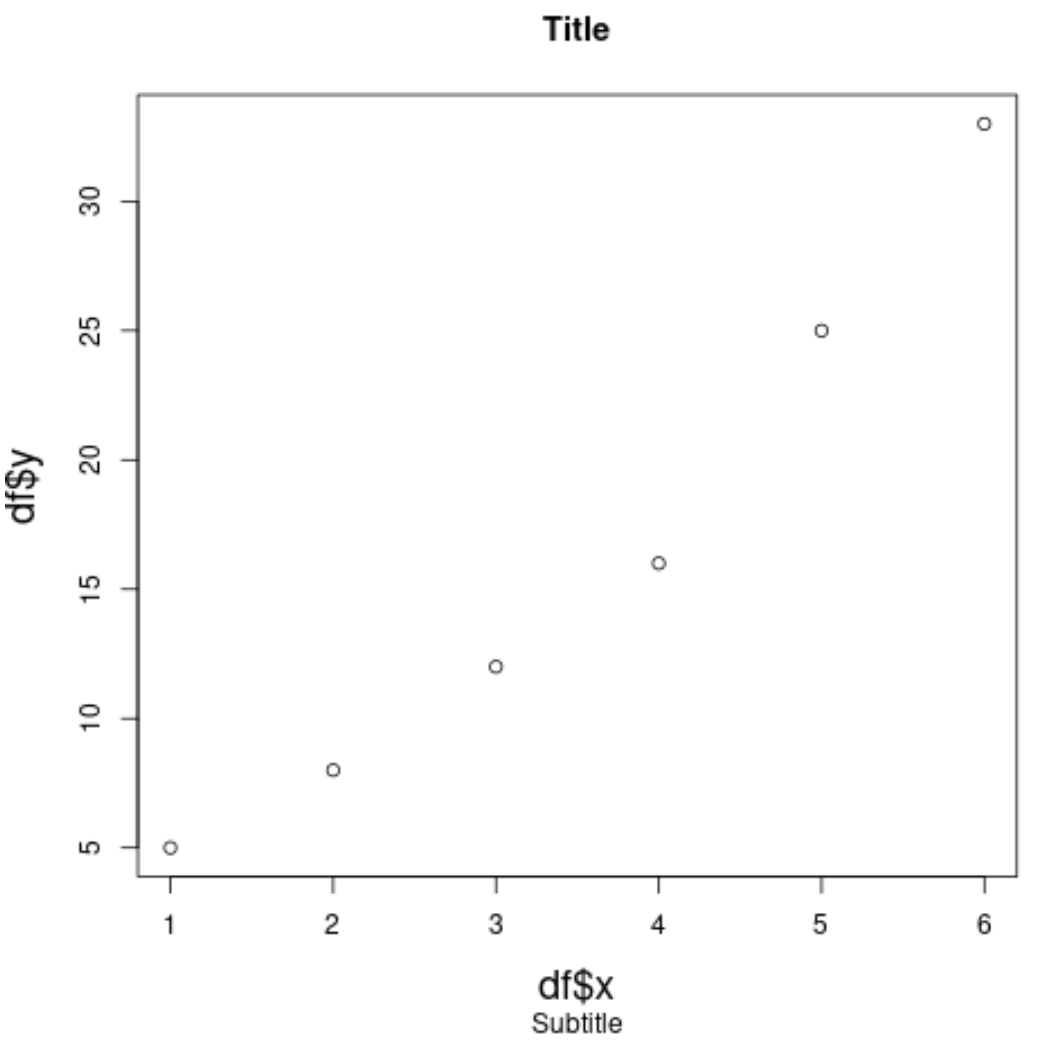
Les descripteurs textuels associés aux axes cartésiens, couramment renseignés via les arguments d’abscisse et d’ordonnée dans la fonction de tracé, constituent les clés d’ancrage sémantique indispensables à la lecture de toute distribution de données. Sans eux, une trajectoire ou un nuage de points n’est qu’une abstraction géométrique dépourvue de sens physique ou empirique. Pour piloter sélectivement la taille de police de ces descripteurs de variables sans altérer la dimension des marques numériques, le moteur de R propose le paramètre cex.lab.
L’argument dédié à l’expansion des étiquettes s’applique de façon symétrique aux libellés de l’axe horizontal et de l’axe vertical. Son assignation isole rigoureusement ces deux éléments textuels de la taille des graduations arithmétiques. Cette séparation fonctionnelle est essentielle : le descripteur d’axe requiert une lisibilité immédiate et une typographie affirmée pour permettre une identification instantanée des concepts statistiques évalués, incluant la métrique et les unités de mesure associées entre crochets ou parenthèses.
L’utilisation judicieuse de ce multiplicateur d’étiquette permet de valoriser les axes de coordonnées tout en maintenant une distinction nette avec le titre supérieur. Dans les publications imprimées où la largeur totale de la figure excède rarement huit centimètres, une légère accentuation de la taille des étiquettes compense la réduction globale de la figure et maintient la clarté de la légende d’échelle sans qu’il soit nécessaire d’augmenter excessivement la dimension des autres composantes textuelles du tracé.
5.2 Cas pratiques d’agrandissement pour présentations scientifiques
Lors de la conception de supports de présentation destinés à une projection devant un auditoire ou pour l’impression de posters dans le cadre de colloques internationaux, les paramètres standards de dimensionnement des libellés s’avèrent presque systématiquement déficients. À une distance de lecture de plusieurs mètres, les descripteurs d’axes calibrés à l’échelle unitaire deviennent indiscernables, privant l’auditoire de la compréhension des métriques projetées. Il est alors requis d’appliquer des coefficients d’expansion de l’ordre de 1,4 à 1,8 pour garantir un confort visuel optimal.
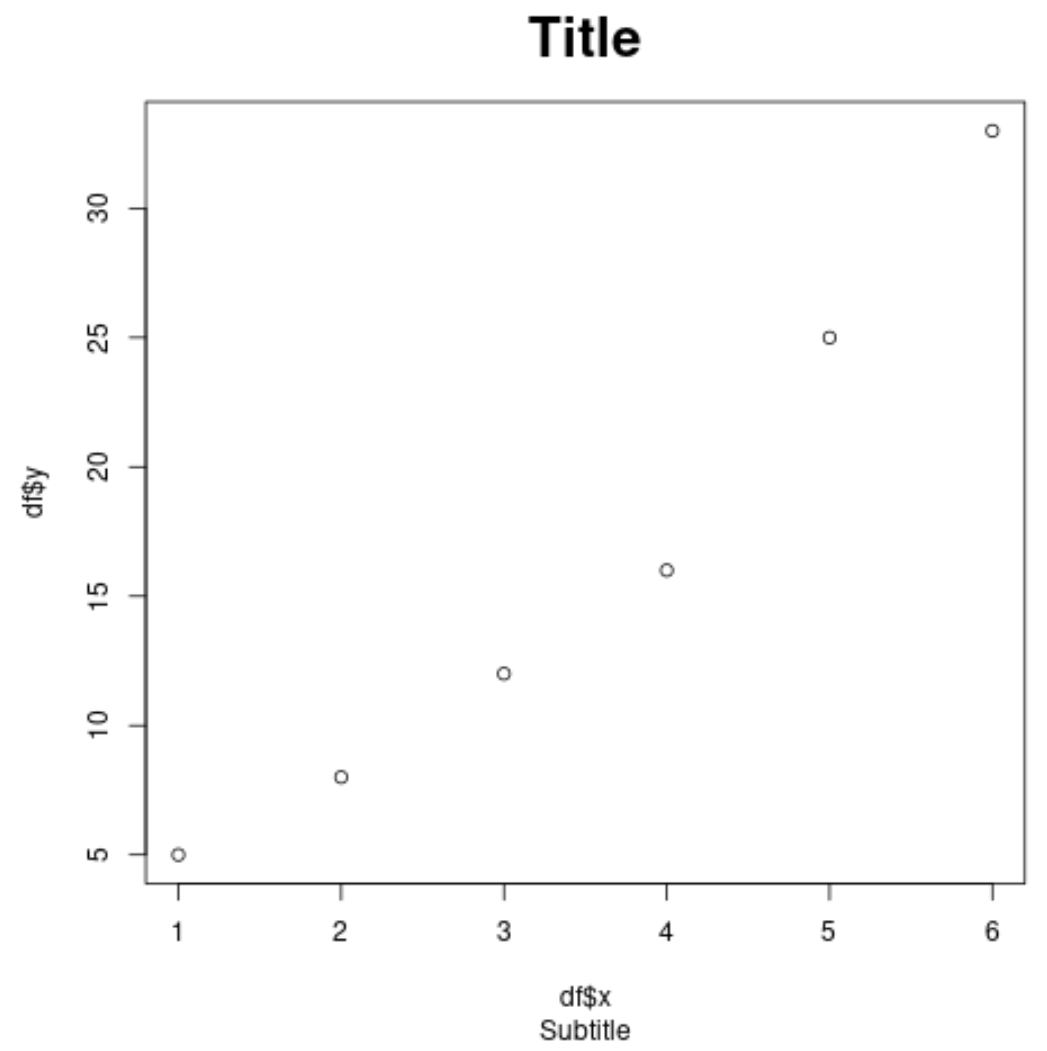
Ce besoin de grossissement soulève fréquemment une contrainte géométrique asymétrique liée à la disparité de longueur textuelle entre les deux dimensions du plan. L’axe des ordonnées présente une vulnérabilité particulière au phénomène de tronquage : son libellé étant tracé verticalement par défaut, le texte s’étend dans la marge gauche du graphique. Si la valeur de grossissement attribuée est trop élevée et que la chaîne descriptive comporte de nombreux caractères, la marge gauche se trouve saturée, coupant le début ou la fin de la mention descriptive de la variable dépendante.
Pour résoudre cette difficulté dans le cadre d’un protocole d’analyse rigoureux, le programmeur doit coupler l’ajustement du multiplicateur d’étiquettes à une reconfiguration des marges de tracé du périphérique graphique actif. L’élargissement maîtrisé de l’espace latéral gauche permet alors de déployer des libellés de grande dimension, offrant une lisibilité irréprochable sans créer de distorsion de l’espace alloué au nuage d’observations empiriques situé au centre de la composition graphique.
5.3 Intégration d’expressions mathématiques et symboles grecs
Dans les disciplines quantitatives telles que la biométrie, l’économétrie ou les neurosciences computationnelles, les étiquettes des axes ne se limitent pas à des chaînes de caractères alphanumériques triviales. Elles intègrent régulièrement une notation mathématique rigoureuse comprenant des lettres grecques, des indices, des exposants, des barres de moyenne ou des symboles d’opérateurs formels. Au sein de R, cette formalisation est prise en charge par le mécanisme syntaxique articulé autour de la fonction de méta-évaluation expression().
L’application du facteur d’échelle textuelle sur des expressions mathématiques sophistiquées se caractérise par une préservation rigoureuse des proportions internes de la notation symbolique. Le moteur de rendu typographique redimensionne de manière cohérente les composants de l’expression : les symboles grecs subissent la même amplification scalaire que les caractères latins, et les indices ou exposants demeurent calculés selon un ratio d’échelle subordonné harmonieux, préservant la lisibilité des fractions et des puissances statistiques complexes.
Il importe de souligner que l’imbrication d’expressions mathématiques contenant des intégrales, des sommations ou des fractions à double étage modifie considérablement l’encombrement vertical de l’étiquette le long de l’axe. Sous l’effet d’une valeur élevée de l’argument d’expansion, cet encombrement transversal peut déborder au-delà des limites de la marge allouée. Une évaluation minutieuse du rendu final est donc indispensable pour vérifier que les indices les plus bas ou les barres supérieures de moyenne ne subissent aucune troncation lors de l’exportation finale de la planche de recherche.
6. Contrôle de l’échelle des graduations numériques avec cex.axis
6.1 Distinction technique entre cex.lab et cex.axis
L’une des sources de confusion les plus répandues lors de l’apprentissage du système de tracé de base réside dans l’amalgame fait entre le descripteur d’axe et les valeurs de graduation qui le jalonnent. Alors que le nom de la variable relève du contrôle d’étiquette explicité précédemment, les repères numériques positionnés le long des segments orthonormés dépendent d’un mécanisme de mise à l’échelle totalement distinct régi par l’argument cex.axis.
L’argument d’échelle de graduation s’applique spécifiquement aux chaînes numériques marquant les échelons discrets, que l’échelle soit arithmétique, logarithmique ou catégorielle. Sa dissociation structurelle par rapport au libellé descriptive de l’axe répond à une règle typographique stricte régissant la visualisation scientifique des données : les graduations doivent systématiquement présenter une discrétion visuelle relative par rapport au descripteur global de la variable. Dans une composition équilibrée, le coefficient des graduations doit généralement être calibré à une valeur inférieure de quinze à trente pour cent par rapport à celui alloué au descripteur de l’axe.
Transgresser cette règle de proportionnalité en appliquant un coefficient de graduation disproportionné génère une saturation visuelle immédiate. Les chiffres attirent indûment l’attention focale du lecteur, formant un bruit de fond visuel lourd qui entre en compétition avec la morphologie intrinsèque des données tracées, telle qu’une courbe de régression ou une surface de densité statistique, au détriment de l’analyse globale du phénomène représenté.
6.2 Résolution des problèmes d’encombrement sur l’axe horizontal
L’amplification de la dimension des graduations à l’aide de ce paramètre scalaire engendre rapidement un conflit spatial sévère le long de l’axe horizontal des abscisses. Les nombres multi-chiffres, tels que des années calendaires ou des identifiants continus comportant plusieurs décimales, voient leur boîte englobante s’étendre latéralement. Lorsque le produit de la largeur des textes par le nombre de graduations excède la longueur physique du segment de l’axe horizontal, les libellés se chevauchent de façon chaotique, rendant la lecture des coordonnées rigoureusement impossible.
Pour décongestionner cet espace saturé sans renoncer à une échelle typographique confortable pour la lecture, la stratégie privilégiée consiste à modifier l’orientation de lecture des caractères numériques au moyen de l’argument d’orientation textuelle nommé las. Par défaut, les graduations sont tracées de manière parallèle à l’axe correspondant (valeur zéro). En appliquant une valeur de 1, l’ensemble des graduations bascule dans une orientation strictement horizontale. Si l’on applique une valeur de 2, les étiquettes deviennent rigoureusement perpendiculaires au tracé de l’axe, alignant verticalement les nombres sous l’axe des abscisses.
Cette orientation perpendiculaire libère un espace horizontal substantiel, autorisant l’emploi d’un coefficient d’expansion nettement plus généreux sans risque d’interférence entre les nombres contigus. Néanmoins, cette disposition accroît significativement l’occupation spatiale vers le bas, imposant derechef une révision proportionnelle de la marge inférieure de la zone de composition afin que les terminaisons numériques des nombres longs ne disparaissent pas au-delà du cadre du tracé.
6.3 Personnalisation fine axe par axe
L’appel global de la fonction de tracé applique uniformément la valeur du multiplicateur de graduation à l’ensemble des axes générés par le moteur automatique. Dans un grand nombre de situations analytiques sophistiquées, cette symétrie s’avère pénalisante. C’est notamment le cas lors de la réalisation de graphiques à échelles hétérogènes, où l’axe des ordonnées présente des étiquettes textuelles qualitatives nécessitant une fonte modeste, tandis que l’axe des abscisses porte des valeurs quantitatives discrètes pouvant être mises en valeur par une typographie plus prononcée.
Pour déployer un contrôle asymétrique millimétré, l’approche préconisée consiste à désactiver la génération automatisée des axes lors de l’appel initial en positionnant l’argument booléen d’inhibition des axes à faux (à savoir l’argument axes = FALSE). Le praticien reprend alors l’entière maîtrise du canevas en dessinant individuellement chaque échelle dimensionnelle par l’intermédiaire de la fonction primitive axis().
Cette fonction spécialisée accepte son propre argument d’expansion de caractères, autorisant une personnalisation sélective et différentielle selon la face du tracé considérée. Il devient ainsi envisageable d’assigner une valeur modérée de 0,8 à l’axe des abscisses tout en conférant un facteur d’échelle de 1,2 aux graduations de l’axe vertical gauche, ajustant avec une exactitude absolue la lisibilité de chaque dimension en fonction de sa complexité cognitive et de la densité de ses points de repère.
7. Configuration globale et centralisée via la fonction par()
7.1 Gestion globale de l’environnement graphique
Au-delà de la personnalisation locale et ponctuelle élément par élément au sein des instructions de traçage, le moteur graphique natif de R met à disposition un centre névralgique de configuration globale incarné par la fonction primordiale par(). Cette fonction administre l’état global du périphérique graphique actif pour toute la durée de la session de dessin en cours. Toute altération paramétrique validée par cette fonction persiste pour l’ensemble des graphiques subséquents jusqu’à ce que le pilote soit explicitement réinitialisé ou fermé.
L’assignation du multiplicateur de base au sein de cet appel central établit une nouvelle valeur de référence unitaire pour tout le système. Il s’opère alors un phénomène fondamental d’héritage cascadé : tous les paramètres spécifiques d’expansion typographique, qu’il s’agisse de la configuration des titres, des sous-titres, des descripteurs de variables ou des graduations, adoptent ce nouveau scalaire comme point de référence relatif unitaire. L’application d’un facteur d’expansion global de 1,2 redimensionne l’intégralité du système typographique de vingt pour cent au-dessus de sa dimension fondamentale native.
Il convient de faire preuve d’une grande vigilance analytique quant à la superposition multiplicative de ces paramètres. Si l’on configure préalablement une valeur globale de 1,5 au niveau du moteur par la fonction d’environnement, puis que l’on assigne ultérieurement une valeur spécifique de 1,5 au titre principal dans l’appel du tracé, l’effet d’expansion effectif résultant n’est pas arithmétique mais multiplicatif : le titre sera tracé avec un facteur d’agrandissement net de 2,25 par rapport à la fonte de base du système. Cette cascade multiplicative peut conduire à des désordres typographiques majeurs si elle n’est pas anticipée de manière rigoureuse.
7.2 Sauvegarde et réinitialisation des paramètres graphiques
En raison de la nature persistante et invasive des modifications apportées par la fonction d’administration graphique, la manipulation de ces paramètres exige l’application scrupuleuse d’une règle d’or d’ingénierie logicielle : la sauvegarde préventive de l’état graphique initial suivie de sa restauration systématique à la fin du cycle de traitement. L’omission de cette routine élémentaire expose les scripts subséquents à des effets de bord imprévisibles, où des mises en forme typographiques antérieures viennent dégrader des visualisations n’ayant aucun lien fonctionnel avec l’analyse précédente.
La mise en œuvre canonique de ce paradigme technique s’exécute en interceptant l’état des paramètres système via une assignation préalable, en veillant à restreindre la capture aux seuls paramètres non restreints en lecture seule à l’aide de l’argument dédié. Cette structure garantit la sauvegarde intégrale des valeurs natives dans un objet de configuration en mémoire vive. Au terme du processus d’assemblage et d’exportation de la figure scientifique, une simple réinjection de cet objet permet de rétablir la configuration initiale du terminal graphique.
Dans le cadre du développement de fonctions graphiques réutilisables ou de paquets logiciels d’analyse de données, ce mécanisme doit être impérativement couplé à des directives de nettoyage automatique telles que l’instruction on.exit() disponible dans le langage. Cette discipline d’encapsulation évite toute pollution de l’espace de travail de l’utilisateur final et garantit que chaque script d’analyse opère dans un environnement graphique sain, reproductible et standardisé.
7.3 Préservation de la lisibilité dans les grilles multi-panneaux
L’un des défis les plus redoutables de la mise en page sous R intervient lors de la partition de la surface graphique en panneaux multiples, classiquement orchestrée par la modification des paramètres d’agencement matriciel en lignes et colonnes, connus sous les identifiants mfrow ou mfcol. Lorsque le praticien ordonne une subdivision de l’espace, par exemple en instanciant une grille de deux lignes par deux colonnes, le moteur interne de R applique une réduction automatique et drastique de la taille des polices de caractères pour tenter de préserver l’espace utile réservé au tracé des données.
Cette compensation automatique native se traduit presque systématiquement par un effondrement visuel : les textes deviennent minuscules, décharnés et totalement inaptes à une exploitation scientifique sérieuse. Pour contrecarrer ce comportement réducteur automatique et restaurer la clarté visuelle de chaque sous-panneau, il est impératif de surcompenser cette baisse d’échelle en manipulant le paramètre d’expansion au niveau global ou en spécifiant des multiplicateurs locaux généreux pour chaque composante typographique de chaque panneau élémentaire.
L’équilibrage typographique dans les figures composites impose également une contrainte d’uniformité stricte. Si quatre distributions doivent être comparées au sein d’une même figure, les graduations des axes et les étiquettes dimensionnelles doivent obligatoirement arborer une dimension strictement identique d’un panneau à l’autre, sous peine de biaiser l’estimation perceptive de l’amplitude des données par l’observateur. L’établissement d’une configuration globale centralisée s’avère ici être la méthode la plus fiable pour maintenir une harmonie visuelle exemplaire à travers l’ensemble des matrices de traçage.
8. Contrôle typographique des annotations textuelles : text() et mtext()
8.1 Dimensionnement du texte à l’intérieur de la zone de traçage avec text()
Au cours de l’exploration approfondie de données complexes, la seule lecture des repères cartésiens s’avère fréquemment insuffisante. Il devient nécessaire d’adjoindre des libellés nominatifs directement au cœur de la surface des données afin de mettre en lumière des points d’observation remarquables, des valeurs aberrantes révélatrices ou des barycentres de clusters statistiques. L’implémentation de ces annotations internes s’opère par l’intermédiaire de la primitive graphique de bas niveau nommée text().
Cette primitive positionne les chaînes de caractères selon les coordonnées cartésiennes explicites de l’espace de données et dispose de son propre argument nommé d’expansion de caractères. La valeur fournie à ce paramètre modifie localement l’échelle du texte projeté sans altérer les autres éléments de la composition. Cette propriété offre une opportunité analytique exceptionnelle : il est possible de faire varier la dimension du texte annoté de manière dynamique en lui affectant un vecteur de multiplicateurs calculé à partir d’une variable quantitative tierce, matérialisant ainsi une troisième dimension d’information sur un graphique bidimensionnel standard.
Cependant, l’insertion de texte annoté à l’intérieur du repère cartésien requiert une calibration dimensionnelle subtile. Un coefficient d’expansion trop élevé risque d’occulter les symboles d’observation voisins ou de chevaucher les lignes de niveau sous-jacentes. L’ajustement minutieux de l’échelle typographique doit s’accompagner d’un étalonnage de l’alignement textuel au moyen de l’argument de justification pour garantir que l’annotation s’insère harmonieusement dans les interstices disponibles sans détériorer la lisibilité de la structure géométrique globale.
8.2 Ajout et dimensionnement d’annotations marginales avec mtext()
Toutes les métadonnées textuelles n’ont pas vocation à être incorporées à l’intérieur du rectangle de traçage cartésien. Il est souvent infiniment plus pertinent de loger des annotations méthodologiques, des indications de sources institutionnelles ou des valeurs de tests statistiques d’hypothèse le long des bordures extérieures du graphique. Cette opération de placement marginal est dévolue à la fonction primitive spécialisée nommée mtext(), abréviation canonique de l’expression anglaise Margin Text.
La commande permet de déployer une chaîne de caractères sur l’une quelconque des quatre marges encadrant la zone de données centrale, sélectionnée par l’argument d’orientation latérale acceptant un index numérique variant de un à quatre, correspondant respectivement au bord inférieur, gauche, supérieur et droit de la figure. L’argument d’expansion dédié s’intègre au sein de cette instruction pour ajuster précisément l’échelle du texte projeté dans ces espaces périphériques.
L’accroissement de la taille d’une police dans les marges périphériques soulève immédiatement un problème de centrage transversal : plus le caractère est étendu, plus il risque de déborder au-delà des lignes de marge imparties. Pour pallier cet inconvénient géométrique, il convient de maîtriser conjointement l’argument de positionnement transversal en nombre de lignes, qui permet de repousser ou de rapprocher le texte marginal par rapport à l’arête du cadre du tracé, garantissant ainsi un positionnement équilibré, aéré et exempt de tout chevauchement avec les graduations numériques régulières.
8.3 Cohérence esthétique entre texte interne et annotations de marge
L’articulation harmonieuse entre les annotations internes dispersées parmi les observations et les annotations marginales fixées en périphérie constitue la signature d’une visualisation de données de niveau professionnel. L’écueil stylistique majeur consiste à juxtaposer des éléments textuels aux dimensions disparates sans respecter une progression logique. Si une annotation interne désignant un point atypique présente une échelle typographique supérieure à l’étiquette de l’axe de référence, la cohérence sémiotique du document se trouve rompue.
Pour préserver une cadence visuelle ordonnée, il est recommandé d’adopter une règle d’étalonnage stricte : le texte interne d’annotation ponctuelle doit systématiquement arborer une dimension inférieure ou au plus égale à celle des graduations de l’axe le plus proche. Les annotations de marge réservées aux métadonnées scientifiques, telles que l’explicitation d’une p-valeur de Student ou d’une taille d’effet de Cohen, doivent quant à elles adopter un coefficient d’expansion discret, typiquement calibré entre 0,7 et 0,9 par rapport à l’unité de référence.
En maintenant une telle uniformité dans les rapports d’échelle, l’analyste guide l’œil du lecteur selon un parcours d’exploration naturel : appréhension du thème principal par le titre supérieur, identification des dimensions par les étiquettes d’axes, évaluation des amplitudes par les graduations numériques, et enfin consultation des détails analytiques fins portés par les annotations textuelles intérieures et marginales.
9. Ajustement de la taille de police dans les légendes avec legend()
9.1 Application de l’argument cex au composant de légende
Dès lors qu’un graphique statistique intègre une stratification multivariée, qu’il s’agisse de distinguer différentes cohortes cliniques, des facteurs expérimentaux ou des trajectoires temporelles distinctes, la boîte de légende s’impose comme la clé de déchiffrage indispensable. L’insertion de ce bloc sémantique complexe est confiée à la fonction standardisée legend(), laquelle possède un comportement hautement spécifique en ce qui a trait à la manipulation de l’argument de grossissement typographique.
Lorsque le praticien spécifie l’argument d’expansion de caractères au sein de cette fonction spécialisée, le moteur applique une mise à l’échelle non seulement aux chaînes de caractères explicatives décrivant chaque groupe expérimental, mais également à l’ensemble des éléments géométriques qui leur sont associés. Les segments de ligne modélisant les styles de trait, les symboles géométriques d’exemple ainsi que les rectangles de couleur voient leurs dimensions intrinsèques s’adapter proportionnellement à la taille du texte sélectionné afin de préserver l’équilibre morphologique de l’ensemble de l’encart.
Cette réaction globale de la légende exige un contrôle minutieux des paramètres d’espacement interligne et intercolonne. En modifiant l’argument de grossissement, la boîte englobante de la légende s’élargit ou se contracte. Il devient alors souvent nécessaire de retoucher manuellement les arguments d’espacement vertical et horizontal pour éviter que les éléments graphiques et textuels ne se retrouvent comprimés ou excessivement dispersés à l’intérieur du cadre protecteur de la légende.
9.2 Intégration d’une légende dans un espace contraint
L’implantation d’une légende pourvue d’une police de caractères généreuse soulève inévitablement la question de l’encombrement de la zone centrale d’affichage des données. Dans de nombreuses configurations expérimentales, l’encart de légende agrandi vient recouvrir physiquement des points de données critiques, masquant des corrélations ou des singularités distributionnelles fondamentales. La réduction drastique de la typographie constitue une mauvaise réponse qui nuit à la lisibilité générale du document.
Une première méthode architecturale pour résoudre cette tension consiste à exploiter l’argument de multi-colonnes en structurant la légende non plus selon une liste verticale monotone mais sous la forme d’un tableau horizontal à plusieurs colonnes. Cette restructuration spatiale permet de loger confortablement une légende de typographie moyenne dans l’espace libre ménagé au sommet ou au pied de la distribution des données, sous la courbe ou au-dessus des observations.
Une seconde approche, encore plus élégante sur le plan de la sémiotique visuelle, consiste à expulser totalement la légende hors du cadre de traçage en autorisant le dessin dans les marges extérieures. En positionnant le paramètre de neutralisation du découpage graphique à vrai (argument d’environnement xpd = TRUE), la fonction permet de déposer une légende lisible, dotée d’un facteur d’expansion confortable, directement dans la marge droite de la figure, préservant ainsi l’intégralité du rectangle central pour l’affichage sans entrave des distributions statistiques.
9.3 Étalonnage harmonieux de la légende avec les autres composants
L’étalonnage de l’échelle typographique au sein d’une boîte de légende doit s’inscrire dans une continuité stylistique avec le reste de la visualisation. Une erreur méthodologique récurrente consiste à attribuer un facteur d’échelle à la légende sans tenir compte de la taille des étiquettes et des graduations des axes. Une légende dotée d’une typographie supérieure à celle des descripteurs des variables d’axes attire artificiellement le regard et surcharge le graphique au détriment des axes fondamentaux de la modélisation.
En pratique éditoriale rigoureuse, la taille de police adoptée pour les descripteurs de la légende doit être strictement équivalente ou légèrement subordonnée à celle attribuée aux étiquettes des axes. Si ces dernières sont calibrées à une valeur scalaire de 1,2, les mentions textuelles de la légende doivent idéalement adopter une valeur oscillant entre 1,0 et 1,1. Cet équilibre assure une identification limpide des groupes expérimentaux tout en laissant la primauté visuelle aux axes dimensionnels du graphique.
Dans les matrices de dispersion multivariées ou les tracés de profils factoriels multiples, où plusieurs légendes thématiques peuvent coexister, cette règle d’uniformité typographique devient impérative. La répétition constante d’une même échelle textuelle sur l’ensemble des cartouches d’identification garantit à l’expérimentateur ainsi qu’à ses pairs une grille de lecture visuelle homogène, condition indispensable à l’interprétation comparative rigoureuse des données empiriques.
10. Résolution des conflits de marges et de débordements textuels
10.1 Comprendre le système de marges intérieures avec par(mar = …)
L’agrandissement méthodique des composants textuels d’un graphique de base de R aboutit inévitablement à une confrontation directe avec les limites spatiales des marges intérieures entourant la boîte cartésienne centrale. Le système graphique subdivise l’espace total de la fenêtre en deux zones distinctes : la zone de traçage proprement dite, réservée aux points, lignes et polygones, et les marges périphériques, destinées à accueillir les axes, leurs libellés, le titre principal et le sous-titre. La gestion de cet espace périphérique s’opère au moyen du vecteur d’ajustement de marges au sein de la fonction d’environnement graphique, désigné par l’identifiant par(mar = …).
Ce paramètre attend un vecteur numérique ordonné composé rigoureusement de quatre valeurs quantifiant l’épaisseur des marges en unités de lignes de texte, en partant du bord inférieur et en tournant dans le sens horaire : marge inférieure (bas), marge latérale (gauche), marge supérieure (haut) et marge latérale opposée (droite). Par défaut, le moteur applique une configuration standardisée représentée par le vecteur c(5.1, 4.1, 4.1, 2.1). Si cette géométrie suffit pour des textes de taille unitaire, elle devient rapidement obsolète dès lors que l’on manipule des coefficients d’expansion supérieurs à l’unité.
Lorsque le descripteur d’axe vertical se voit assigner un coefficient multiplicateur important, la largeur physique de la chaîne de caractères excède les 4,1 lignes allouées à la marge gauche. Le texte commence alors à déborder en dehors de la lisière de la fenêtre graphique, provoquant la troncature inacceptable de l’étiquette. Pour rétablir l’équilibre, le chercheur doit étendre explicitement cette marge gauche en déclarant une valeur supérieure, par exemple 6 ou 7 lignes, compensant la surface consommée par la typographie enrichie et restaurant une aération visuelle impeccable.
10.2 Utilisation des marges extérieures avec par(oma = …)
Lorsque la structure graphique se complexifie, notamment lors de l’assemblage de grilles matricielles combinant plusieurs sous-panneaux d’analyse statistique, la modification des seules marges intérieures s’avère insuffisante pour loger des intitulés typographiques de grande ampleur. C’est ici qu’intervient le concept fondamental de la zone de marges extérieures, configuré par le vecteur par(oma = …), abréviation directe de l’expression Outer Margin Area.
À l’état initial, le vecteur des marges extérieures est calibré à zéro ligne sur l’ensemble des quatre faces de la composition. L’attribution de valeurs positives à ce vecteur crée une ceinture spatiale protectrice ceignant l’intégralité de la composition multi-panneaux. Cette zone périphérique offre un canevas idéal pour l’apposition d’un titre général englobant ou de mentions méthodologiques communes à l’ensemble des graphiques de la série sans cannibaliser l’espace interne dévolu à chaque sous-figure.
L’exploitation conjointe de cette zone extérieure s’opère par l’intermédiaire de la primitive de texte marginal couplée à l’argument booléen d’externalisation positionné à vrai (argument outer = TRUE). Cette technique de haut vol permet d’appliquer un coefficient d’agrandissement très substantiel au titre principal global tout en préservant des marges intérieures compactes pour chaque facette analytique, éliminant ainsi les redondances typographiques au sein des compositions scientifiques complexes.
10.3 Résolution du message d’erreur ‘figure margins too large’
Tout utilisateur régulier du système graphique natif de R a inévitablement fait face à l’interruption inattendue de son script par l’affichage d’un message d’erreur d’une concision abrupte : l’invalidation signalant que les marges de la figure sont trop volumineuses par rapport au canevas disponible. Cette rupture d’exécution n’est pas le fruit d’une corruption de données mais d’une contrainte géométrique formelle imposée par le moteur de rendu graphique natif.
Cette condition d’erreur bloquante survient mathématiquement lorsque la somme cumulée des marges intérieures opposées (marge inférieure plus marge supérieure, ou marge gauche plus marge droite), éventuellement additionnée des marges extérieures correspondantes, excède la dimension physique totale de la fenêtre graphique active dans cette direction. Le rectangle résiduel théoriquement réservé à la projection des données se trouve alors mathématiquement réduit à une dimension nulle ou négative, interdisant au moteur d’initialiser le repère cartésien.
L’agrandissement de la typographie constitue l’un des déclencheurs prépondérants de ce dysfonctionnement spatial. Face à ce blocage, le praticien doit mettre en œuvre une stratégie conjointe : d’une part, ajuster les dimensions physiques de la fenêtre ou du fichier de sortie en modifiant les arguments de largeur et de hauteur lors de l’instanciation du périphérique d’exportation ; d’autre part, réévaluer avec pragmatisme le calibrage des coefficients d’expansion typographique et des marges intérieures associées, jusqu’à rétablir une surface de traçage cartésien viable au centre de la composition graphique.
11. Applications pratiques aux visualisations de recherche psychologique
11.1 Graphiques de profils psychométriques et échelles psychologiques
Dans le domaine de la recherche psychologique et du diagnostic comportemental, la restitution visuelle des inventaires de personnalité et des batteries psychométriques requiert une sensibilité typographique particulière. Les profils d’évaluation, à l’instar de ceux issus des modèles dimensionnels du modèle à cinq facteurs (Big Five) ou des inventaires cliniques standardisés, impliquent fréquemment la présentation d’une succession d’échelles de mesure aux intitulés descriptifs relativement élaborés sur l’axe vertical ou horizontal.
L’application judicieuse du multiplicateur d’axe le long des étiquettes des dimensions psychologiques permet d’éviter l’écueil classique de l’abréviation obscure. L’utilisation d’un coefficient modéré garantit que chaque trait de personnalité est immédiatement identifiable dans sa dénomination complète, facilitant la communication des résultats tant aux pairs scientifiques qu’aux praticiens de terrain ou aux patients dans le cadre d’une restitution clinique.
Parallèlement, la mise en évidence des seuils pathologiques ou normatifs sur ces graphiques de profils s’appuie fréquemment sur des tracés de lignes d’interception complétés par des annotations directes via la primitive de texte interne. Le dimensionnement de ces libellés de seuils cliniques à une valeur d’expansion maîtrisée assure qu’ils soient lisibles sans masquer les points du score individuel du sujet évalué, garantissant ainsi une synthèse diagnostique optimale.
11.2 Diagrammes de dispersion pour études corrélationnelles cognitives
Les investigations en neuropsychologie et en sciences cognitives s’articulent très largement autour de devis corrélationnels modélisant les liens d’interdépendance entre des mesures de performance comportementale, telles que les temps de réaction exprimés en millisecondes, et des indices de précision de la mémoire de travail ou des scores de connectivité neuronale fonctionnelle. La visualisation canonique de ces relations repose sur l’exploitation du nuage de dispersion bivarié enrichi d’une droite d’ajustement linéaire.
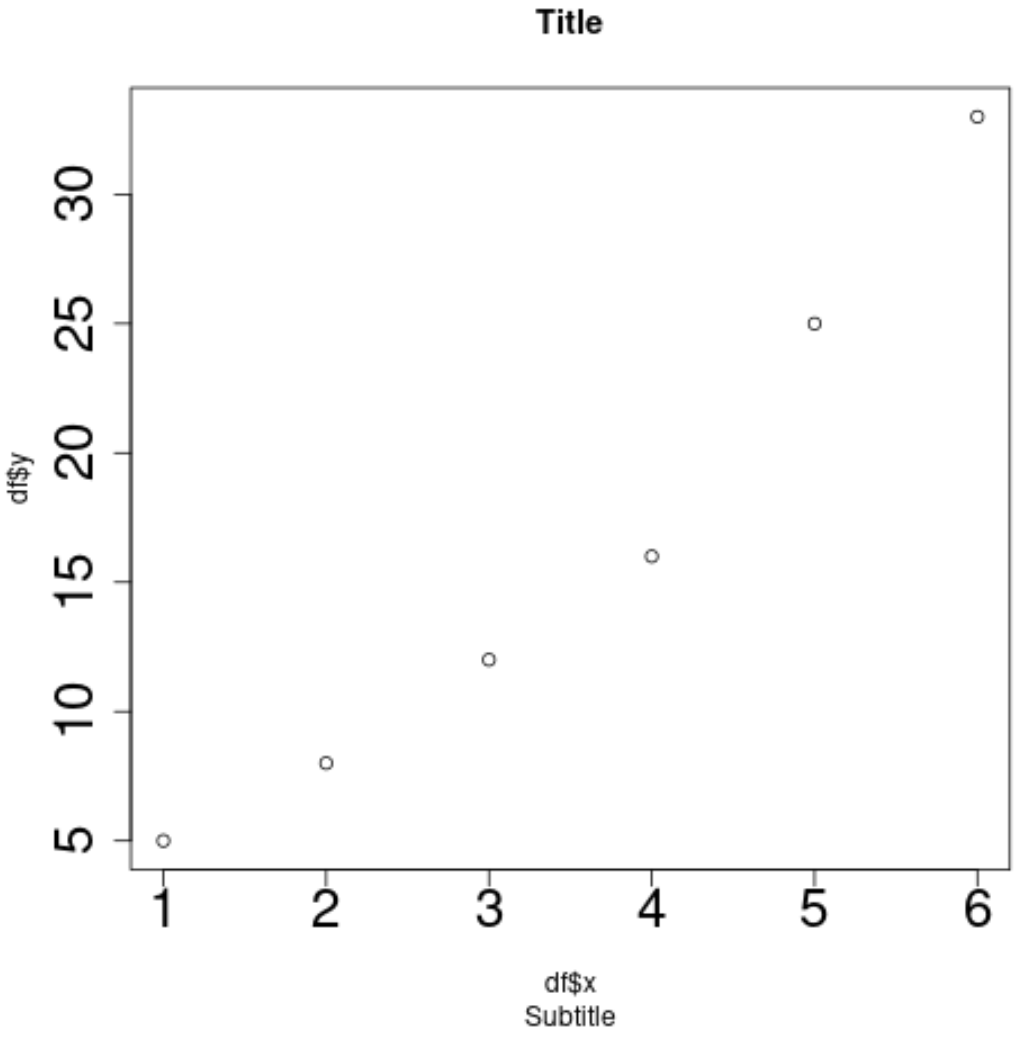
Dans ce contexte analytique formel, la valeur informative de la figure réside non seulement dans la nébuleuse des points mais également dans l’affichage sans ambiguïté des indicateurs de la statistique inférentielle : le coefficient de corrélation de Pearson, son intervalle de confiance bilatéral et le niveau de significativité statistique associé. L’adjonction de ces mentions mathématiques via une annotation marginale ou interne requiert un ajustement typographique précis.
En calibrant avec rigueur le multiplicateur textuel appliqué à l’expression formelle contenant ces métriques statistiques, le chercheur s’assure que la force et la direction du lien cognitif observé s’imposent d’emblée à la perception visuelle de l’observateur. Ce dimensionnement typographique renforcé confère à la figure une autonomie documentaire absolue, rendant le graphique parfaitement intelligible et autosuffisant en dehors même de la lecture du corps de texte de l’article scientifique.
11.3 Représentation de comparaisons de groupes expérimentaux
L’évaluation des protocoles d’intervention en psychologie expérimentale mobilise de manière quasi systématique la comparaison de distributions empiriques à travers différents groupes de sujets, qu’il s’agisse de cohortes témoins, de groupes soumis à un paradigme d’entraînement cognitif ou de conditions sous administration de placebo. Les diagrammes en boîte à moustaches constituent l’outil de référence pour restituer l’hétérogénéité de ces distributions intergroupes.
L’ajustement du coefficient d’échelle appliqué aux étiquettes catégorielles sous chaque boîte s’avère ici déterminant. Les intitulés des conditions expérimentales doivent être mis en valeur afin d’éviter toute méprise sur la nature des traitements comparés. Une expansion de l’ordre de 1,2 à 1,4 sous l’axe des abscisses permet de poser les bases d’une lecture comparative sans ambiguïté.
Enfin, l’insertion des accolades de contraste statistique marquant les différences significatives entre conditions exige un contrôle proportionné de la taille des astérisques de significativité. Une astérisque sous-dimensionnée disparaît lors de la réduction éditoriale, tandis qu’un caractère disproportionné déséquilibre la géométrie du tracé. L’étalonnage précis du coefficient d’agrandissement sur ces symboles discrets parachève la confection d’une figure expérimentale conforme aux plus hautes exigences de la méthode scientifique.
12. Standards typographiques et bonnes pratiques pour l’édition scientifique
12.1 Conformité avec les normes de publication académique (notamment style APA)
L’édition scientifique internationale est régie par des conventions éditoriales formalisées, parmi lesquelles le manuel de publication de l’American Psychological Association (APA) constitue une référence majeure dans les sciences du comportement et de la santé. Ces normes stipulent des impératifs stricts quant à la clarté, la sobriété et l’économie visuelle des figures insérées dans les manuscrits soumis à l’évaluation par les pairs. Les figures de recherche ne doivent contenir aucun ornement superficiel ni artifice graphique susceptible de parasiter la transmission pure de la preuve statistique.
Sur le plan strictement typographique, le style APA proscrit l’utilisation de polices fantaisistes et prescrit l’emploi exclusif de polices de caractères sans empattements (linéales) d’une grande neutralité, telles qu’Arial, Helvetica ou Calibri, en raison de leur lisibilité supérieure sur des supports numériques hétérogènes. La taille apparente des caractères au sein d’une figure publiée doit impérativement s’établir dans une fourchette stricte comprise entre huit et quatorze points dans le gabarit définitif de mise en page de la revue.
Ces directives imposent de calibrer minutieusement l’interaction entre la taille de police nominale du dispositif graphique et les multiplicateurs d’expansion de caractères dans R. Un titre trop protubérant ou des graduations miniatures violent frontalement les préceptes de neutralité et d’intelligibilité de l’APA. La sobriété s’exprime également dans le refus de multiplier les graisses et les styles : la hiérarchie visuelle doit reposer prioritairement sur une variation mesurée de l’échelle d’expansion plutôt que sur l’accumulation de graisses lourdes ou de déclinaisons italiques superflues.
12.2 Gestion de la typographie lors des exports vectoriels haute résolution
La pérennité de la netteté typographique dépend intimement du canal technologique mobilisé pour l’exportation des figures depuis l’environnement R vers le manuscrit final. Deux paradigmes d’exportation coexistent : les formats matriciels, découpant l’image en une matrice fixe de pixels, et les formats vectoriels, décrivant mathématiquement chaque tracé géométrique et chaque glyphe textuel sous forme de coordonnées et de courbes de Bézier indépendantes de toute résolution matérielle.
Pour la soumission d’articles scientifiques, les formats vectoriels, pilotés par les dispositifs d’exportation standard de type PDF ou PostScript encapsulé, représentent la norme d’excellence absolue. Lors de l’utilisation de ces pilotes vectoriels, les chaînes de caractères redimensionnées par les paramètres d’expansion ne souffrent d’aucun phénomène de pixellisation ni d’effet de crénelage, quelle que soit l’échelle d’agrandissement adoptée à la lecture ou à l’impression. La police est soit directement vectorisée, soit intégrée sous forme de fonte vectorielle dans le corps du fichier de sortie.
Toutefois, une vigilance particulière s’impose lors de l’exportation vers des formats matriciels à haute résolution requis par certains éditeurs. Si le chercheur configure une image de grande dimension en pixels pour satisfaire un critère de résolution élevé sans ajuster simultanément la taille de référence en points typographiques du pilote, l’ensemble des textes tracés avec des facteurs d’expansion unitaires apparaîtra microscopique. Il est alors obligatoire d’harmoniser la taille de base initiale du fichier matriciel avec les multiplicateurs typographiques pour garantir une parfaite équivalence visuelle avec le rendu vectoriel de référence.
12.3 Accessibilité universelle et conception visuelle inclusive
Dans le sillage des directives internationales promues par le World Wide Web Consortium (W3C) à travers les règles d’accessibilité des contenus Web, la communauté scientifique accorde désormais une attention croissante à la conception de figures de recherche accessibles à l’ensemble des membres du corps académique et de la société, incluant les individus présentant des déficiences visuelles ou des troubles de la perception des contrastes chromatiques.
L’accessibilité typographique repose sur deux piliers indissociables : une taille de glyphe minimale garantie et un niveau de contraste de luminance suffisant par rapport au fond d’affichage. Dans le cadre de l’instrumentation graphique de R, cela implique de proscrire définitivement les coefficients de réduction d’expansion inférieurs à 0,7 pour tout élément sémantique indispensable à l’interprétation des données. Les textes secondaires ne doivent en aucun cas être sacrifiés sous prétexte de contraintes spatiales ; la solution réside toujours dans la réorganisation de la surface de traçage ou dans l’augmentation du gabarit dimensionnel global du document.
Par ailleurs, l’évaluation de la lisibilité doit systématiquement intégrer l’éventualité d’une impression monochrome en niveaux de gris. Une typographie trop fine ou de couleur intermédiaire perd son contraste dès lors qu’elle est reproduite sur une imprimante standard de bureau. L’utilisation d’une fonte purement noire pour l’intégralité de l’armature textuelle, associée à un coefficient d’expansion assurant une graisse minimale aux contours des lettres, constitue la méthode la plus robuste pour certifier que vos visualisations de données statistiques traverseront les canaux de diffusion sans aucune perte d’intelligibilité scientifique.
Références
- American Psychological Association. (2020). Publication Manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Bertin, J. (1967). Sémiologie Graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Cleveland, W. S., & McGill, R. (1984). Graphical perception: Theory, experimentation, and application to the development of graphical methods. Journal of the American Statistical Association, 79(387), 531-554. https://doi.org/10.1080/01621459.1984.10478080
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299-314. https://doi.org/10.1080/10618600.1996.10474713
- Murrell, P. (2018). R Graphics (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429447471
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Tufte, E. R. (2001). The Visual Display of Quantitative Information (2nd ed.). Graphics Press.
- Wickham, H. (2016). ggplot2: Elegant Graphics for Data Analysis. Springer-Verlag New York. https://doi.org/10.1007/978-3-319-24277-4
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer-Verlag New York. https://doi.org/10.1007/0-387-28695-0
- World Wide Web Consortium. (2018). Web Content Accessibility Guidelines (WCAG) 2.1. W3C Recommendation. https://www.w3.org/TR/WCAG21/