
Dans le domaine de l’analyse exploratoire et de la communication scientifique des données, la visualisation graphique ne constitue pas un simple artifice d’illustration, mais un vecteur essentiel d’inférence et de transmission de connaissances. L’écosystème Python, soutenu par des bibliothèques telles que Seaborn et Matplotlib, s’est imposé comme une référence incontournable pour les chercheurs, biostatisticiens et ingénieurs en apprentissage automatique. Toutefois, la production d’une figure informatiquement exacte ne garantit aucunement son efficacité communicationnelle. La lisibilité typographique représente l’un des écueils majeurs auxquels sont confrontés les auteurs lors de la soumission d’articles scientifiques ou de rapports décisionnels. Un graphique dont la taille de police est mal calibrée dégrade l’expérience du lecteur, fausse la hiérarchie visuelle et peut dissimuler des tendances empiriques critiques sous une couche d’inconfort cognitif.
Par défaut, Seaborn applique des configurations esthétiques optimisées pour une visualisation interactive au sein d’environnements tels que les notebooks Jupyter. Bien que ces réglages soient adaptés à la phase exploratoire sur un écran haute résolution individuel, ils révèlent de profondes limites lorsqu’il s’agit de transposer ces artefacts graphiques dans des manuscrits académiques mis en page sur deux colonnes, sur des posters scientifiques ou lors de présentations magistrales. La réduction d’échelle imposée lors de la publication entraîne fréquemment une miniaturisation des étiquettes d’axes, des graduations numériques et des légendes, les rendant virtuellement indéchiffrables. Pour pallier cette défaillance sans dénaturer la qualité vectorielle du tracé, le praticien doit impérativement maîtriser les mécanismes formels d’ajustement typographique offerts par l’architecture conjointe de Seaborn et du moteur sous-jacent de Matplotlib.
Le présent article propose une exploration exhaustive, rigoureuse et didactique des méthodologies permettant de modifier la taille de la police dans les figures Seaborn. De la manipulation globale des échelles scalaires via des fonctions de haut niveau aux ajustements chirurgicaux ciblant les objets géométriques individuels du canevas, chaque approche est analysée sous l’angle de sa syntaxe, de son comportement en mémoire et de ses retombées sur la mise en page. Que votre objectif consiste à standardiser une feuille de style institutionnelle conforme aux exigences de revues à fort facteur d’impact ou à concevoir des visualisations robustes et reproductibles pour la science ouverte, ce guide fournit l’ensemble des fondements théoriques et des implémentations logicielles nécessaires à la maîtrise totale de votre typographie de données.
1. Introduction à la typographie et à la lisibilité des graphiques Seaborn en recherche empirique
1.1 Rôle de l’échelle typographique dans la communication scientifique
L’échelle typographique au sein d’une figure empirique conditionne directement l’efficacité du traitement perceptif et cognitif de l’information par le lecteur. Dans le cadre de la publication scientifique, le graphique constitue une synthèse visuelle autonome qui doit pouvoir être comprise sans recourir systématiquement au corps du texte. À ce titre, la lisibilité textuelle obéit aux principes fondamentaux de la psychologie de la forme (théorie de la Gestalt) et de la sémiologie graphique développée par Jacques Bertin. Si le contraste ou la taille des glyphes est insuffisant, l’œil humain peine à discriminer les catégories, à identifier les unités de mesure ou à interpréter les seuils de significativité statistique. Cette friction cognitive ralentit la lecture critique et peut engendrer des erreurs d’interprétation méthodologique préjudiciables à la validité des résultats présentés.
Les maisons d’édition académiques imposent des cahiers des charges particulièrement stricts concernant la conformité visuelle des illustrations. Les directives aux auteurs stipulent généralement que la taille finale des caractères textuels, une fois la figure insérée et redimensionnée dans le gabarit d’impression (sur une colonne standard de 80 à 90 millimètres ou sur deux colonnes de 180 millimètres), ne doit en aucun cas descendre en deçà de 6 à 8 points typographiques (pt). Cela impose au chercheur une anticipation rigoureuse dès la génération du graphique sous Python, car une police définie arbitrairement à 10 points dans un environnement virtuel peut s’effondrer à 4 points lors de la mise en page finale par l’éditeur, rendant l’article non conforme dès la phase d’évaluation technique initiale.
Enfin, la hiérarchie typographique participe activement à la structuration logique des données. Un graphique rigoureusement composé applique une décroissance progressive de la taille des polices selon l’importance sémantique des éléments : le titre du tracé ou de la figure globale requiert une présence visuelle dominante pour poser le contexte expérimental ; les étiquettes des axes dimensionnels doivent être immédiatement identifiables pour expliciter les variables dépendantes et indépendantes ; les graduations chiffrées et les annotations textuelles secondaires nécessitent une taille modérée afin de ne pas saturer l’espace métrique utile ; et la légende doit s’intégrer de manière fluide sans concurrencer la lecture des données primitives. L’évitement de la surcharge visuelle passe par cet équilibre subtil des proportions textuelles.
1.2 Limites des paramètres d’affichage par défaut de Seaborn
L’esthétique native de Seaborn est largement reconnue pour son élégance contemporaine, rompant avec la rugosité fonctionnelle historique des premières versions de Matplotlib. Par défaut, Seaborn applique des fonds grisés ou blancs quadrillés, des palettes chromatiques désaturées et un calibrage textuel optimisé pour un affichage plein écran sur des moniteurs informatiques modernes. Cette configuration, gouvernée par le contexte implicite nommé notebook, privilégie une discrétion du texte au profit de la mise en valeur des densités de dispersion, des violons ou des surfaces lissées. Dans le flux d’un notebook interactif, ce ratio offre une expérience fluide, car l’espace d’affichage est généreux et le zoom numérique demeure possible.
Cette configuration de base devient toutefois profondément problématique dès que le graphique quitte l’environnement dynamique pour être exporté sous un format figé (formats matriciels PNG ou vectoriels PDF). Lors de la mise à l’échelle d’une figure destinée à s’insérer dans la colonne d’un périodique, la réduction physique de l’image compresse proportionnellement la matrice de pixels ou le tracé vectoriel. Les étiquettes d’axes créées avec la taille par défaut (souvent fixée autour de 10 à 11 points sur une figure de 6 pouces de large) subissent un rétrécissement géométrique qui anéantit leur lisibilité. Ce phénomène est accentué lorsque la figure comporte des facettes multiples (sous-graphiques en grilles), où l’espace imparti à chaque sous-tracé réduit drastiquement la surface disponible pour la typographie.
En conséquence, l’absence de personnalisation proactive engendre des incohérences dommageables au sein des laboratoires de recherche. Deux collaborateurs travaillant sur des ordinateurs dotés de densités de pixels différentes (par exemple un écran standard Full HD face à un écran haute résolution Retina ou 4K) généreront des rendus visuels divergents si la taille des polices n’est pas fixée de façon absolue et reproductible dans le code source d’analyse. La standardisation algorithmique du redimensionnement textuel n’est donc pas une option de confort esthétique, mais une exigence méthodologique au cœur de la reproductibilité scientifique des protocoles de visualisation de données.
1.3 Vue d’ensemble des différentes approches techniques d’ajustement
Pour modifier la taille de la police dans Seaborn, le développeur dispose d’une palette d’outils hiérarchisés, s’étendant du paramétrage systémique universel jusqu’à la manipulation chirurgicale au niveau de l’objet graphique individuel. Cette polyvalence s’explique par la nature architecturale de Seaborn, conçu comme une surcouche de haut niveau au-dessus de Matplotlib. Seaborn ne réinvente pas le modèle de rendu vectoriel ; il fournit des wrappers élégants et des configurations statistiques qui instancient ultimement des objets conteneurs de Matplotlib, principalement des figures et des repères cartésiens (objets nommés Figure et Axes). Comprendre ce double niveau d’abstraction est la clé d’un contrôle typographique absolu.
La première catégorie de méthodes relève de l’ajustement global. Elle permet de redimensionner d’un seul coup l’intégralité du texte du graphique via un coefficient multiplicateur ou des contextes prédéfinis. Les fonctions historiques ou modernes telles que sns.set(), sns.set_theme() et sns.set_context() appartiennent à ce registre. Elles agissent en amont du tracé en modifiant les variables d’environnement de la session d’exécution Python. Cette approche est idéale pour modifier rapidement l’échelle d’une figure selon qu’elle est destinée à un article, un poster ou un diaporama, en garantissant que la proportion relative entre le titre, les axes et les graduations demeure harmonieuse sans nécessiter d’intervention ligne par ligne.
La seconde catégorie repose sur l’ajustement granulaire composant par composant. Ici, le praticien exploite les références retournées par Seaborn (qui sont des instances d’objets Axes ou de grilles FacetGrid) pour solliciter des méthodes spécifiques de Matplotlib. Cette approche permet de dissocier les comportements : définir un titre monumental en gras tout en contraignant les graduations numériques à un format compact, modifier la taille de la légende indépendamment du reste de la scène visuelle, ou appliquer des échelles asymétriques aux axes des abscisses et des ordonnées. Ce guide examinera méthodiquement ces différentes strates techniques afin de vous permettre de choisir l’outil optimal en fonction des exigences de votre projet.
2. Fondements techniques de l’ajustement global avec sns.set() et font_scale
2.1 Fonctionnement mathématique et opératoire du paramètre font_scale
La méthode historique la plus directe pour altérer l’ensemble des typographies d’un graphique Seaborn sans déconstruire manuellement chaque élément textuel repose sur l’utilisation du paramètre font_scale. Ce dernier agit comme un scalaire multiplicatif à virgule flottante qui vient s’appliquer sur la matrice sous-jacente des tailles de base définies dans les paramètres de configuration globale de Matplotlib (connus sous le nom de rcParams). Par convention, la valeur d’origine correspond à un scalaire neutre de font_scale=1.0, ce qui équivaut à conserver l’étalonnage standard configuré pour le thème actif de la bibliothèque.
Sur le plan mathématique, l’algorithme interne de Seaborn ne se contente pas d’attribuer une valeur fixe absolue à tous les éléments. Il préserve les ratios typographiques régissant la composition visuelle. Lorsqu’un utilisateur définit par exemple font_scale=1.5, Seaborn prend chaque taille de police de référence du contexte sélectionné (par exemple, 12 points pour les titres d’axes, 10 points pour les graduations et 14 points pour les titres principaux) et les multiplie de façon linéaire par ce facteur de 1,5. Ainsi, les titres passent à 21 points, les étiquettes à 18 points et les graduations à 15 points. Cette proportionnalité stricte prévient la rupture de hiérarchie visuelle qu’entraînerait une assignation brute d’une valeur uniforme à tous les composants textuels.
Ce multiplicateur opère de concert avec les dimensions physiques définies pour le conteneur graphique (la figure). Il est crucial de noter que le paramètre font_scale ne modifie pas les dimensions spatiales de la fenêtre d’affichage (la largeur et la hauteur en pouces, définies typiquement par l’argument figsize). Dès lors, l’augmentation du multiplicateur accroît l’empreinte spatiale occupée par les caractères au détriment de l’espace alloué au tracé géométrique des données. Une valeur excessivement élevée sans ajustement corrélatif des dimensions physiques de la figure entraînera invariablement des troncatures ou des chevauchements d’éléments sur les bordures extérieures du canevas.
2.2 Exemple pratique : tracé linéaire comparatif avant et après redimensionnement
Pour appréhender l’impact concret de cette modification globale, considérons un cas d’usage classique en analyse temporelle où un chercheur observe l’évolution de métriques cognitives au fil d’une série de sessions d’expérimentation. Le jeu de données synthétique peut être structuré à l’aide de la bibliothèque Pandas sous la forme d’une table comprenant les pas de temps, les scores standardisés et les identifiants de groupes expérimentaux. Lors de l’exécution d’un appel standard à sns.lineplot() sans configuration préalable, le système produit un tracé avec les tailles textuelles d’usine :
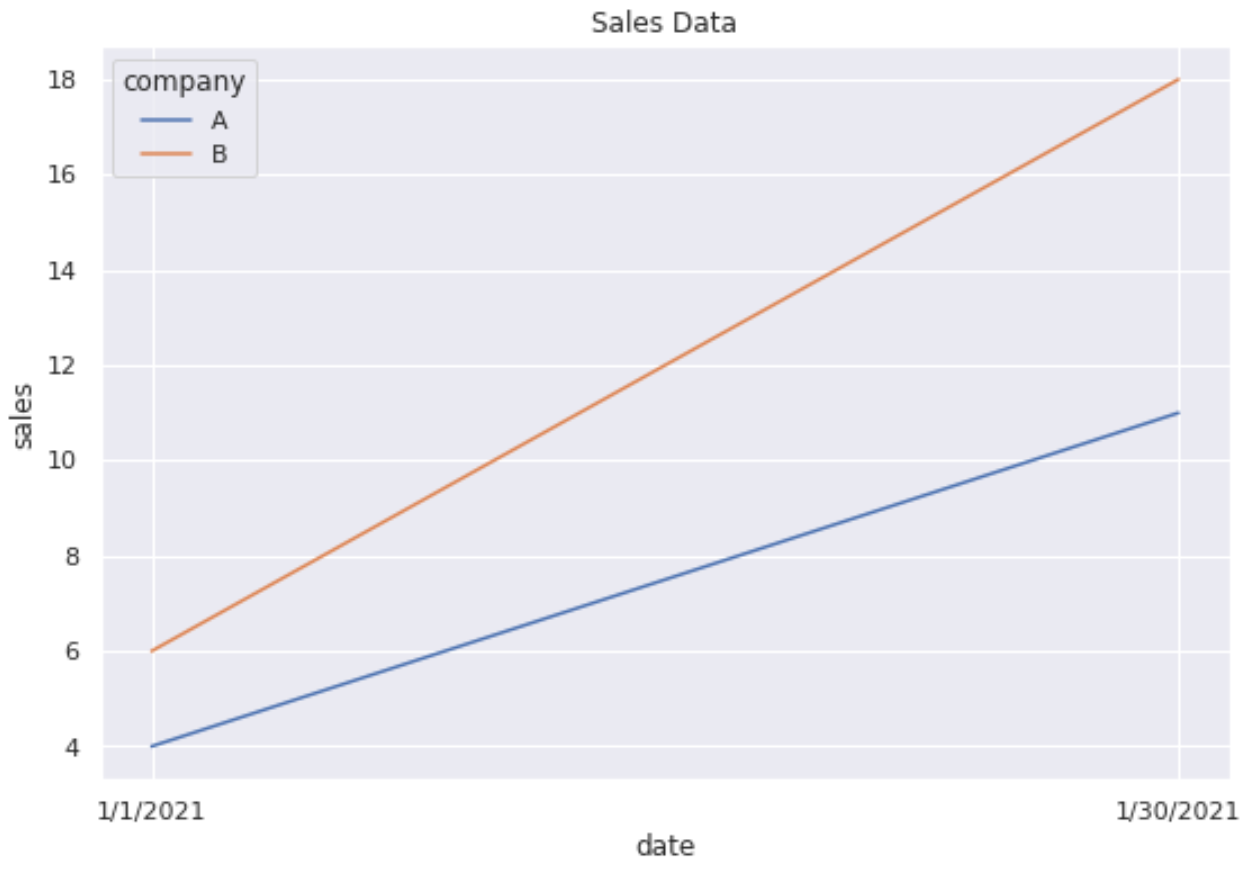
Dans ce premier état par défaut (correspondant implicitement à font_scale=1.0), l’épaisseur des lignes et la taille du texte sont discrètes. Les chiffres positionnés le long des axes X et Y sont petits, et le titre de la figure, s’il est présent, dispose d’un poids graphique modéré. Si cette figure est directement intégrée dans un document au format A4 avec une largeur réduite pour occuper une demi-page, le déchiffrage des étiquettes des pas de temps impose un effort d’accommodation visuelle pénalisant. De plus, la légende identifiant les cohortes expérimentales présente des libellés minuscules dont les glyphes risquent de perdre leur lisibilité lors d’une impression matricielle de faible résolution.
L’application préalable de l’instruction sns.set(font_scale=1.8) transforme radicalement le comportement d’affichage de la commande sns.lineplot() subséquente. D’une seule ligne d’instruction, l’ensemble de la scène graphique voit sa structure textuelle s’épaissir et croître en dimensions. Les étiquettes « Session expérimentale » et « Score Z normalisé » adoptent une prestance visuelle immédiate, parfaitement lisible même à distance de l’écran ou sur un document imprimé de petite dimension. Les graduations numériques s’agrandissent dans les mêmes proportions mathématiques, tout comme le titre de la légende et ses éléments textuels associés. L’occupation spatiale du texte augmente au détriment relatif des marges, créant une composition dense, équilibrée et prête pour une présentation académique percutante.
2.3 Persistance des paramètres dans l’environnement d’exécution
L’un des comportements fondamentaux de sns.set() qu’il convient de maîtriser pour éviter des effets de bord déconcertants réside dans la persistance d’état au sein de la session Python. Contrairement aux arguments passés directement dans une fonction de tracé (comme palette ou linewidth qui n’affectent que l’objet en cours de création), les fonctions de configuration globale modifient les valeurs du dictionnaire interne de Matplotlib, qui agit comme un état mutable partagé durant toute la durée de vie du processus Python ou du noyau (kernel) Jupyter actif.
Ce mécanisme signifie concrètement que dès lors que l’instruction sns.set(font_scale=2.0) a été exécutée dans une cellule de code, l’ensemble des tracés générés ultérieurement — qu’ils soient construits avec Seaborn ou même directement avec des commandes natives de bas niveau comme plt.plot() — hériteront irréversiblement de ce facteur d’échelle de 2,0. Si le data scientist enchaîne immédiatement avec un graphique d’un autre type nécessitant une finesse typographique plus grande (par exemple une matrice de corrélation dense à 50 variables), le tracé sera visuellement dévasté par des polices géantes qui se chevaucheront de façon désordonnée.
Pour prémunir son environnement d’analyse contre cette contamination visuelle inter-graphiques, il est essentiel d’intégrer des procédures de réinitialisation dans son flux de travail. L’instruction formelle sns.reset_orig() permet de restaurer instantanément la configuration de Matplotlib à ses paramètres d’usine initiaux, purgés de toute surcharge injectée par Seaborn. Alternativement, la commande sns.reset_defaults() restaure le thème et l’échelle par défaut propres à Seaborn. Une saine pratique de programmation consiste à encapsuler les modifications globales dans des cellules dédiées ou à recourir à des gestionnaires de contexte pour isoler hermétiquement les altérations visuelles au périmètre d’un graphique unique.
3. Utilisation moderne de sns.set_theme() pour le contrôle textuel global
3.1 Transition de l’API : de sns.set() à sns.set_theme()
Avec l’avènement des versions modernes de la bibliothèque Seaborn (notamment à partir de la version 0.11.0 et consolidée dans les versions 0.12 et ultérieures), les concepteurs du paquet ont entrepris une vaste refonte architecturale destinée à homogénéiser la sémantique de l’API. Dans les versions antérieures, la fonction sns.set() remplissait un rôle polyvalent mais ambigu, agissant simultanément sur le style d’arrière-plan, la palette chromatique, le contexte typographique et divers paramètres d’exécution. Pour lever ces imprécisions de vocabulaire et aligner la bibliothèque sur les standards modernes du génie logiciel, la fonction sns.set_theme() a été introduite en tant que remplaçante canonique officielle.
Bien que sns.set() demeure présente pour des raisons évidentes de rétrocompatibilité avec les scripts historiques, son utilisation est aujourd’hui formellement déconseillée dans les nouveaux développements. La fonction sns.set_theme() offre une clarté sémantique supérieure en explicitant dès sa signature qu’elle opère une reconfiguration thématique globale de l’environnement graphique. Elle élimine les ambiguïtés structurelles et garantit une interaction prévisible avec les nouveaux systèmes d’objets introduits dans l’écosystème Python contemporain.
L’adoption de sns.set_theme() procure en outre une robustesse accrue lors de l’intégration dans des pipelines d’intégration continue ou de production automatisée de rapports scientifiques. Son interface documente explicitement la séparation entre le style structurel (les bordures, la présence ou l’absence de quadrillage), la palette de couleurs applicative et la composante typographique, offrant ainsi un point d’entrée unique et pérenne pour définir l’identité graphique intégrale de vos publications de recherche.
3.2 Mise en œuvre concrète du paramètre font_scale au sein de set_theme()
L’exploitation de font_scale au sein de sns.set_theme() s’effectue au moyen d’une syntaxe déclarative fluide et intuitive. L’utilisateur peut simultanément orchestrer le style du canevas, la nature du contexte et le coefficient d’agrandissement textuel. Par exemple, l’appel conjoint spécifiant un style à fond blanc doté d’un quadrillage discret (style='whitegrid') associé à une échelle de texte augmentée de 30 % s’écrit formellement sous la forme : sns.set_theme(style='whitegrid', font_scale=1.3). Cette instruction configure en une passe atomique l’intégralité du moteur de rendu.
Cette approche unifiée est particulièrement avantageuse lors de la transition entre différents styles graphiques institutionnels. Le style ticks, qui ajoute des marques physiques le long des axes tout en supprimant le quadrillage intérieur conformément aux conventions des revues de biologie et de médecine (telles que Nature ou The Lancet), s’associe idéalement avec une valeur de font_scale comprise entre 1.2 et 1.4 pour des figures de taille standard. Seaborn recalibre alors en interne non seulement le texte, mais préserve les espacements géométriques nécessaires pour que les marques de graduation ne coupent pas les glyphes des nombres.
Le contrôle combiné permet également d’assurer l’harmonie entre l’épaisseur des éléments vectoriels de données (comme la largeur des barres d’un histogramme ou l’épaisseur d’une courbe de régression) et la taille du texte qui les légende. En ajustant font_scale au sein de set_theme(), l’algorithme sous-jacent s’assure que le contraste dimensionnel reste ergonomique, évitant l’écueil classique d’un tracé affichant des courbes ultraminces dominées par une typographie disproportionnée, ou inversement, des éléments de données massifs masquant un texte anémique.
3.3 Surcharge granulaire via l’argument rc de set_theme()
Bien que le scalaire font_scale procure une solution globale élégante, certaines situations exigent une directivité accrue que le simple étirement proportionnel ne peut fournir. C’est précisément à ce stade qu’intervient l’argument rc de la fonction sns.set_theme(). Cet argument accepte un dictionnaire Python de paires clé-valeur permettant d’injecter des directives de configuration directement dans le système de variables de Matplotlib. Il s’agit d’une passerelle de surcharge permettant de combiner un redimensionnement général et des exceptions ciblées.
Considérons le cas où un auteur souhaite appliquer une échelle globale généreuse de font_scale=1.4 pour assurer la lisibilité sur un poster, tout en étant soumis à une contrainte éditoriale stricte imposant que les titres d’axes ne dépassent jamais 14 points et que la typographie employée appartienne impérativement à la famille typographique des polices avec empattement (serif, comme Times New Roman). L’argument rc permet d’exprimer cette règle composite avec une précision chirurgicale en surchargeant sélectivement les clés de configuration cibles :
Dans cette configuration, l’utilisateur passe à sns.set_theme() un dictionnaire définissant explicitement 'font.family': 'serif', 'axes.labelsize': 14 et 'axes.titlesize': 16, tout en conservant le paramètre font_scale=1.4 pour tout le reste (notamment les graduations, les légendes et les annotations). Seaborn applique d’abord l’échelle générale, puis écrase les paramètres ciblés par les valeurs précises fournies dans le dictionnaire rc. Cette méthode de personnalisation hybride constitue le standard d’excellence pour l’élaboration de chartes graphiques complexes prêtes pour la publication sans jamais rompre l’automatisation du script.
4. Modification granulaire des titres de graphiques et de sous-graphiques
4.1 Ciblage via les méthodes d’objet Axes avec set_title()
Lorsque le statisticien s’affranchit des configurations globales pour façonner l’architecture fine d’une visualisation, il manipule directement les objets géométriques créés par la bibliothèque. Dans l’écosystème de Seaborn, la majorité des fonctions dites de niveau repère (axes-level functions, à l’image de sns.scatterplot(), sns.boxplot() ou sns.histplot()) renvoient explicitement une instance de l’objet matplotlib.axes.Axes. Cet objet constitue la poignée de contrôle par laquelle s’exercent toutes les modifications granulaires.
Pour assigner ou modifier la taille du titre d’un graphique individuel, la démarche la plus rigoureuse consiste à intercepter cet objet de retour en lui affectant une variable explicite (par convention universelle, ax = sns.scatterplot(...)). Dès lors, la méthode d’instance ax.set_title() devient accessible. Cette méthode expose l’argument formel fontsize (dont l’alias synthétique size est également toléré), acceptant soit une valeur numérique absolue exprimée en points typographiques réels (par exemple fontsize=16), soit une chaîne descriptive relative conforme aux normes CSS (telles que 'small', 'medium', 'large', 'x-large', 'xx-large').
L’utilisation d’une valeur numérique absolue est hautement recommandée en contexte de recherche car elle élimine toute ambiguïté d’interprétation par le moteur de rendu. De surcroît, la méthode autorise la spécification conjointe de la graisse textuelle via le paramètre fontweight='bold' ou fontweight='semibold', ainsi que la distance de séparation verticale entre le tracé géométrique et la ligne de base du texte par l’argument pad. Cette maîtrise micrométrique permet de conférer au titre d’une figure une présence structurante irréprochable, isolée de toute interférence avec les autres composantes graphiques de la scène.
4.2 Ajustement des titres globaux de figures composites avec suptitle()
Dès lors qu’une analyse empirique requiert la juxtaposition de plusieurs sous-graphiques au sein d’un même canevas visuel (par exemple, deux graphiques disposés côte à côte comparant un groupe témoin et un groupe traité), une distinction conceptuelle fondamentale s’impose entre le titre propre à un sous-axe individuel et le super-titre chapeautant la globalité du conteneur. Si chaque sous-graphique peut légitimement arborer son propre titre descriptif via ax.set_title(), la composition visuelle nécessite impérativement un titre d’ensemble unificateur.
Ce rôle d’orchestration typographique incombe à la méthode suptitle(), rattachée directement à l’objet conteneur suprême : la figure (matplotlib.figure.Figure). Lorsque l’architecture du tracé a été initialisée via l’instruction standard fig, axes = plt.subplots(1, 2, figsize=(12, 5)), c’est sur la variable fig qu’il convient de solliciter fig.suptitle("Intitulé Global de l'Étude", fontsize=20). Ce mécanisme alloue un texte qui n’appartient géométriquement à aucun système d’axes particulier, mais plane au sommet de la hiérarchie spatiale.
L’enjeu majeur de l’emploi de suptitle() avec des tailles de police imposantes (telles que 18 ou 22 points) réside dans la gestion de l’espacement vertical. Par défaut, un super-titre de grande dimension aura tendance à entrer en collision visuelle directe avec les titres individuels des sous-axes situés immédiatement en dessous de lui. Pour résoudre ce conflit avec élégance, le chercheur doit combiner l’argument typographique fontsize avec le paramètre de positionnement vertical y (par exemple fig.suptitle(..., fontsize=18, y=1.03)) ou ajuster l’enveloppe supérieure des sous-graphiques au moyen de la méthode de mise en page fig.tight_layout(rect=[0, 0, 1, 0.95]). Cet ajustement réserve un bandeau d’en-tête vierge garantissant une respiration typographique optimale.
4.3 Contrôle des titres au sein des structures multi-grilles FacetGrid et PairGrid
L’une des plus éclatantes réussites de Seaborn réside dans sa capacité à partitionner un jeu de données complexe à travers des grilles multi-panneaux en quelques lignes d’instructions déclaratives, via des classes spécialisées de haut niveau comme FacetGrid, ou ses wrappers dédiés relplot(), catplot() et pairplot(). Toutefois, ces objets n’héritent pas directement de la classe Axes ; ils constituent des gestionnaires de collection d’axes. Modifier la taille du titre de chaque panneau individuel impose dès lors une logique différente de celle du simple ax.set_title().
Pour ajuster uniformément la taille des titres assignés automatiquement à chaque facette (par exemple les facettes ventilant l’analyse par tranche d’âge ou par site expérimental), l’objet de grille expose la méthode dédiée set_titles(). Cette fonction fournit un argument de gabarit textuel (template) couplé au paramètre size. L’instruction formelle g.set_titles(template='Cohorte : {col_name}', size=14) permet d’itérer instantanément sur l’ensemble des sous-axes matriciels de la grille pour leur appliquer un étiquetage homogène à 14 points, tout en interpolant dynamiquement le nom des modalités statistiques correspondantes.
Dans ce scénario multi-grille, l’attribution d’un titre général suprême s’opère également via la figure parente encapsulateur, accessible à travers la propriété g.figure.suptitle(). Le statisticien veillera alors à calibrer un contraste typographique significatif : par exemple, un titre de figure à fontsize=18, des titres de facettes internes à size=13, et des étiquettes de graduation ramenées à 10 points. Cette gradation assure que le lecteur identifie immédiatement le niveau d’abstraction correspondant à chaque strate textuelle de l’illustration matricielle.
5. Contrôle de la taille des étiquettes d’axes (Axes Labels)
5.1 Configuration directe via set_xlabel() et set_ylabel()
Les étiquettes d’axes (axes labels) remplissent une mission critique dans l’intelligibilité d’une visualisation de données : elles explicitent sans équivoque la nature physique, psychométrique ou biologique des dimensions projetées, ainsi que leurs unités de mesure associées (par exemple, concentration en micromoles par litre ou temps de réaction en millisecondes). Une police d’étiquette d’axe sous-dimensionnée compromet la compréhension immédiate du tracé, tandis qu’une police surdimensionnée empiète sur les marges extérieures de la figure. L’assignation granulaire précise s’opère via les méthodes dédiées set_xlabel() et set_ylabel().
Une fois le graphique Seaborn matérialisé sous la variable d’axe ax, ces méthodes permettent d’écraser la chaîne textuelle générée automatiquement par Seaborn (qui emprunte par défaut le nom littéral de la colonne issue du DataFrame Pandas) tout en spécifiant sa taille d’affichage. La syntaxe canonique prend la forme suivante : ax.set_xlabel("Pression artérielle systolique (mmHg)", fontsize=14). De manière strictement symétrique, l’axe vertical est configuré par l’instruction : ax.set_ylabel("Fréquence cardiaque (bpm)", fontsize=14). L’utilisation d’une valeur numérique identique sur les deux dimensions garantit une cohérence perceptuelle indispensable au respect de l’isométrie graphique.
Outre la taille brute, ces fonctions acceptent des ajustements d’alignement et de décalage spatial particulièrement utiles pour peaufiner la mise en page. Par exemple, l’argument labelpad=12 permet d’éloigner le libellé de l’axe par rapport aux chiffres des graduations, empêchant tout télescopage lorsque la taille des glyphes a été substantiellement accrue. L’alignement peut également être ajusté via le paramètre loc, bien que le centrage standard demeure la règle universelle dans les protocoles de publication académique.
5.2 Utilisation avancée du dictionnaire fontdict
Lorsque le script de visualisation comporte de multiples tracés séquentiels ou des sous-graphiques indépendants au sein d’un grand tableau de bord expérimental, la répétition d’arguments typographiques dans chaque appel de méthode viole le principe fondamental de non-redondance du code (Don’t Repeat Yourself). Pour répondre aux exigences de propreté architecturale et d’évolutivité logicielle, Matplotlib et Seaborn prennent en charge l’encapsulation intégrale des attributs de texte au sein d’une structure de dictionnaire formalisée : le paramètre fontdict.
Un dictionnaire fontdict regroupe en une structure de données unique l’ensemble des directives stylistiques devant s’appliquer à l’étiquette. Ce dictionnaire peut agréger non seulement la taille de la police ('fontsize'), mais également la famille typographique ('family', par exemple 'sans-serif' ou 'DejaVu Sans'), la graisse ('weight', comme 'normal' ou 'bold'), le style d’inclinaison ('style', tel que 'italic') et la couleur spectrale ('color', sous forme de chaîne nommée ou de code hexadécimal). L’application s’effectue ensuite de manière compacte : ax.set_xlabel("Variable Indépendante", fontdict=mon_style_label).
Cette approche apporte une modularité exemplaire dans le cadre de projets collaboratifs ou de thèses universitaires. Si le comité éditorial exige en phase finale de révision de réduire toutes les étiquettes d’axes de 14 à 12 points tout en substituant une teinte gris anthracite ('#333333') au noir pur pour adoucir le contraste d’impression, une modification unique de la valeur au sein du dictionnaire racine suffit à propager instantanément cette refonte typographique à travers l’ensemble des figures générées par la chaîne de traitement statistique.
5.3 Ajustement groupé avec ax.set(xlabel=…, ylabel=…)
Dans un souci de concision syntaxique, Matplotlib dote l’objet Axes d’une méthode générique nommée ax.set(). Cette méthode agit comme un répartiteur de propriétés (property setter), acceptant une vaste panoplie d’arguments nommés destinés à configurer simultanément les limites spatiales, les échelles logarithmiques et les étiquetages. Si cette méthode est particulièrement appréciée pour la compacité du code qu’elle autorise au sein de notebooks interactifs, son comportement concernant le contrôle typographique mérite un éclairage analytique strict.
Lors d’un appel standard sous la forme ax.set(xlabel="Temps (s)", ylabel="Amplitude (mV)"), la méthode attribue les libellés mais n’expose pas directement des arguments nommés indépendants tels que xlabelfontsize ou ylabelfontsize dans sa signature primitive. Tenter de passer de telles pseudo-clés déclenchera invariablement une exception de type AttributeError. L’ajustement direct de la taille au sein de cette méthode générique impose donc des solutions de contournement précises.
La solution la plus élégante pour conserver la concision de ax.set() tout en maîtrisant la taille de la police consiste à coupler son appel avec l’héritage d’un thème préalablement paramétré (via sns.set_theme() ou plt.rc()), ou à enchaîner l’extraction immédiate des objets textes par ax.xaxis.label.set_size(14) et ax.yaxis.label.set_size(14). Bien que cette formulation groupée soit idéale pour des scripts exploratoires rapides, elle s’avère souvent moins explicite que l’utilisation méthodique de set_xlabel() et set_ylabel() avec l’argument fontsize dans les pipelines de production où la transparence du code prime sur la brièveté.
6. Ajustement de la taille des graduations d’axes (Tick Labels)
6.1 Configuration universelle avec la méthode tick_params()
Les graduations d’axes (tick labels) sont les indications numériques ou textuelles discrètes disposées le long des marqueurs géométriques des axes (les tirets de graduation). Contrairement aux étiquettes d’axes qui renseignent sur la variable, les graduations quantifient les coordonnées spatiales ou identifient les modalités qualitatives d’un facteur expérimental. La maîtrise de leur taille est cruciale : si elles sont trop volumineuses, elles finissent par fusionner visuellement en une chaîne ininterrompue de chiffres illisibles ; si elles sont trop ténues, le lecteur se trouve dans l’incapacité d’effectuer des lectures quantitatives précises sur le tracé.
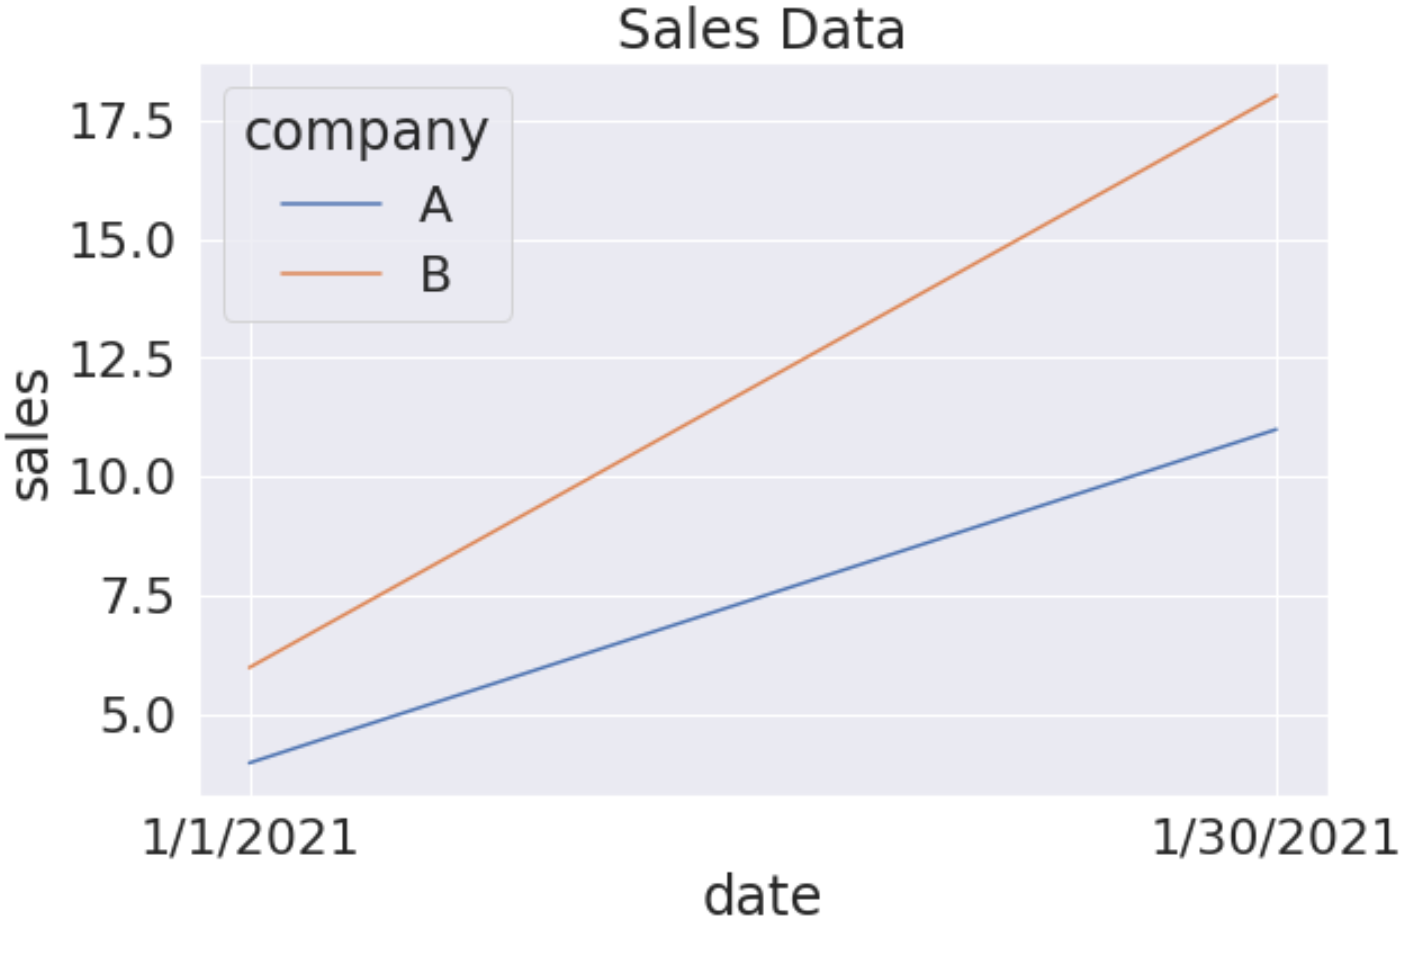
L’instrument universel, performant et hautement recommandé pour contrôler la typographie de ces éléments est la méthode ax.tick_params(). Cette méthode offre une interface unifiée permettant de manipuler simultanément ou sélectivement la taille des caractères, la direction des graduations (vers l’intérieur ou l’extérieur du canevas), leur couleur et leur épaisseur. Pour modifier universellement la taille du texte numérique sur les deux axes X et Y à la fois, une seule instruction suffit : ax.tick_params(axis='both', labelsize=12). L’argument labelsize accepte indifféremment des points scalaires absolus ou des qualificatifs textuels.
La méthode autorise également une ségrégation analytique fine. Il est tout à fait possible d’appliquer ax.tick_params(axis='x', labelsize=10) pour l’axe horizontal tout en conservant ax.tick_params(axis='y', labelsize=14) pour l’axe vertical. Cette flexibilité s’étend en outre à la hiérarchie interne des graduations : en exploitant l’argument which='major' ou which='minor', le biostatisticien peut calibrer des graduations majeures proéminentes à 12 points associées à des graduations mineures intermédiaires très compactes à 8 points, optimisant ainsi le rendu visuel de tracés à échelle logarithmique sans encombrer la zone périphérique.
6.2 Manipulation ciblée via set_xticklabels() et set_yticklabels()
Une alternative historique couramment rencontrée dans le code hérité consiste à invoquer les méthodes ax.set_xticklabels() et ax.set_yticklabels(). Ces fonctions permettent théoriquement de passer une liste de chaînes textuelles personnalisées tout en spécifiant un paramètre fontsize dédié (par exemple ax.set_xticklabels(categories, fontsize=11)). Toutefois, cette approche requiert une vigilance méthodologique extrême en raison des évolutions récentes apportées au moteur d’affichage de Matplotlib.
Dans les versions contemporaines de Matplotlib (versions 3.3 et ultérieures), l’appel de set_xticklabels() sans avoir préalablement verrouillé manuellement la position géométrique des repères au moyen d’un appel formel à ax.set_xticks() déclenche un avertissement explicite (UserWarning: FixedFormatter should only be used together with FixedLocator). Ce comportement a été introduit pour éviter de rompre le couplage dynamique entre les coordonnées réelles des données et le formatage des chaînes textuelles lors des opérations de zoom ou de redimensionnement de canevas. Ignorer cet avertissement expose l’utilisateur à des décalages dramatiques où les étiquettes catégorielles sont affectées aux mauvaises coordonnées métriques.
Si cette approche doit néanmoins être retenue pour effectuer simultanément un redimensionnement de police et une rotation angulaire des étiquettes (pour contourner l’encombrement horizontal), la séquence rigoureuse doit impérativement s’écrire en deux temps : d’abord fixer formellement les localisateurs par ax.set_xticks(positions), puis assigner les libellés stylisés par ax.set_xticklabels(labels, fontsize=11, rotation=45, ha='right'). L’ajustement du point d’ancrage horizontal (ha='right') garantit que l’extrémité du texte pivoté s’aligne précisément avec le trait physique de graduation, évitant toute ambiguïté de lecture.
6.3 Optimisation des graduations denses pour données psychométriques ou temporelles
Certains protocoles de recherche génèrent des graphiques dont l’axe des abscisses est saturé de libellés textuels denses, longs et non réductibles. C’est typiquement le cas des inventaires psychométriques comportant de multiples échelles de Likert d’évaluation comportementale, ou des études pharmacologiques évaluant des cinétiques à des dizaines d’intervalles temporels consécutifs tracées au moyen d’un sns.barplot(). Dans ces configurations, l’application d’une taille de police standard engendre un chevauchement illisible où les étiquettes se superposent en une masse indéchiffrable.
La résolution rigoureuse de cette pathologie graphique passe par une approche combinée associant réduction proportionnelle de la taille textuelle et optimisation de l’espace métrique. Plutôt que de préserver une taille de 12 points, le chercheur réduira stratégiquement les graduations de l’axe X à une dimension compacte de 8 ou 9 points via ax.tick_params(axis='x', labelsize=8.5), tout en augmentant la hauteur physique de la figure (dimension figsize) pour redonner une proportion harmonieuse à l’ensemble du tracé.
Dans les situations extrêmes où les libellés de l’axe représentent des énoncés verbaux complexes, la réduction typographique doit s’accompagner d’une transformation structurelle du graphique : transposer le repère cartésien en inversant les axes X et Y (graphique à barres horizontales) permet de transformer une contrainte d’espacement horizontal critique en un alignement vertical naturel. Le texte bénéficie alors de la pleine largeur de lecture occidentale (de gauche à droite), autorisant le maintien d’une police confortable de 10 à 11 points sans risque de collision ou de troncature visuelle.
7. Personnalisation de la taille du texte des légendes
7.1 Ajustement via la fonction ax.legend() et paramètres fontsize
La légende constitue la clé de décodage indispensable des représentations graphiques multivariées, où des attributs chromatiques (argument hue), morphologiques (argument style) ou dimensionnels (argument size) encodent des dimensions supplémentaires de données statistiques. Par défaut, Seaborn compile et insère automatiquement une légende raffinée dans le repère cartésien. Néanmoins, sa taille typographique standard est souvent modeste, ce qui peut nuire à l’accessibilité cognitive lors de lectures en conditions dégradées.
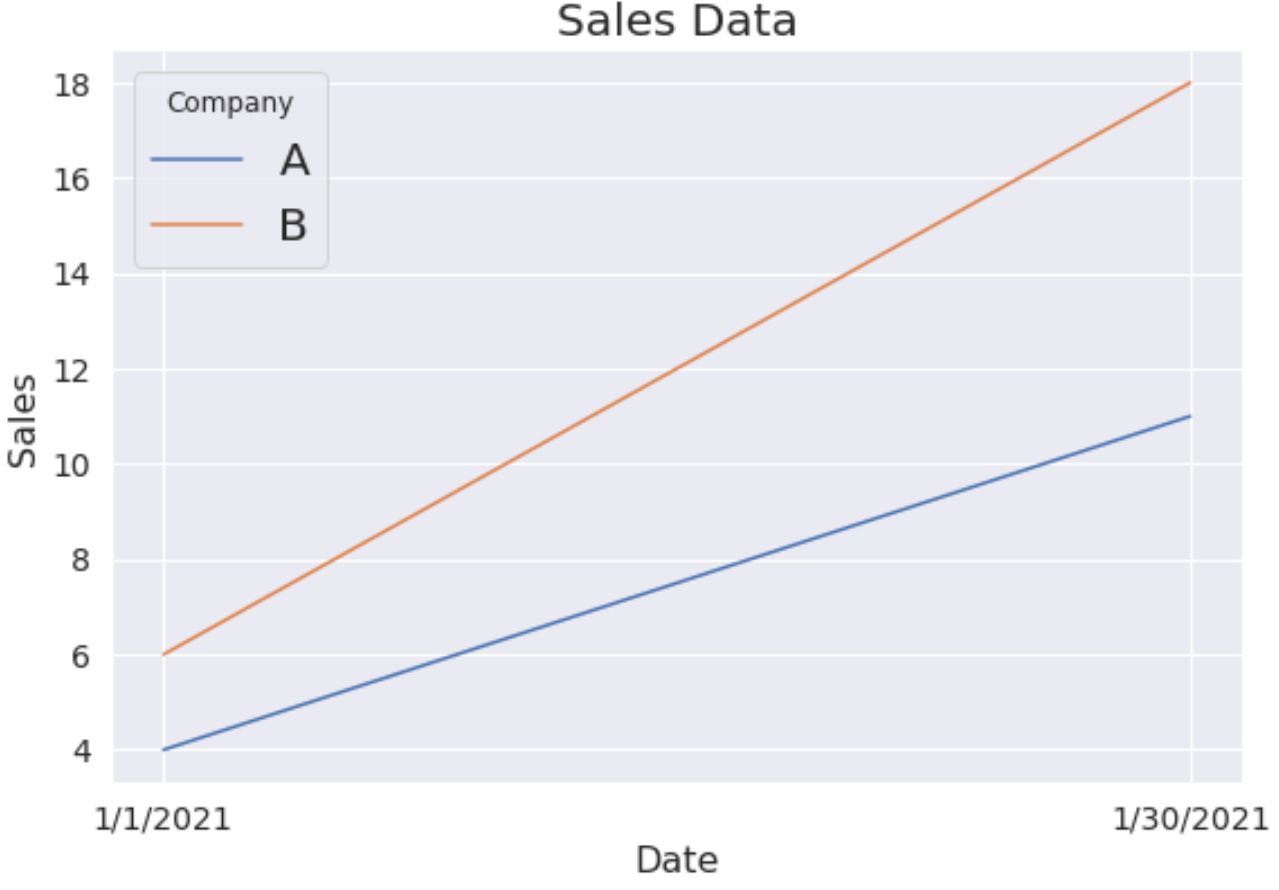
L’ajustement direct de la légende peut s’opérer en réinvoquant la méthode ax.legend() sur l’objet repère. Lors de cet appel, Matplotlib reconstruit le conteneur de légende en capturant les descripteurs visuels préexistants. Deux paramètres typographiques majeurs s’offrent alors au statisticien : fontsize, qui pilote la taille des libellés individuels des modalités de variables (les entrées textuelles décrivant chaque groupe), et title_fontsize, qui contrôle spécifiquement la taille de la police appliquée à l’en-tête nominatif de la légende. Par exemple, l’instruction ax.legend(fontsize=12, title_fontsize=14) instaure instantanément une hiérarchie typographique élégante entre le titre de la légende et ses composantes discrètes.
Il est important de souligner que la réinvocation manuelle de ax.legend() sans précaution peut parfois altérer des marqueurs complexes générés par des fonctions Seaborn avancées (comme les doubles encodages associant taille de point et teinte de couleur). Lorsque l’on emploie cette technique, il est judicieux de récupérer au préalable les poignées graphiques (handles) et les étiquettes correspondantes au moyen de handles, labels = ax.get_legend_handles_labels(), avant de les réinjecter de façon totalement transparente dans l’appel révisé : ax.legend(handles=handles, labels=labels, fontsize=12, title_fontsize=14).
7.2 Modification programmatique sur l’objet Legend existant
Pour contourner les risques inhérents à la reconstruction complète d’une légende sophistiquée et préserver scrupuleusement l’intégrité de tous les glyphes graphiques élaborés par Seaborn, l’approche la plus chirurgicale consiste à accéder directement à l’instance de l’objet matplotlib.legend.Legend déjà instanciée au sein de l’axe, puis à modifier ses propriétés textuelles internes en place.
Cette méthodologie d’ingénierie logicielle exploite la méthode d’extraction legend = ax.get_legend(). Si la légende existe effectivement sur le canevas, cet objet expose une suite de méthodes de bas niveau permettant d’itérer sur les composants primitifs de texte. Pour altérer la taille de l’en-tête de la légende sans toucher à son positionnement spatial, on invoquera l’instruction directe : legend.get_title().set_fontsize(14). La modification s’applique instantanément à l’élément de texte correspondant en mémoire.
De manière analogue, la taille de l’ensemble des entrées de légende catégorielles peut être réajustée au moyen d’une boucle itérative concise sollicitant la méthode get_texts(), qui renvoie la liste complète des instances d’objets matplotlib.text.Text contenus dans la boîte englobante :
En écrivant for text_element in legend.get_texts(): text_element.set_fontsize(11), chaque étiquette textuelle individuelle se voit assigner la dimension de 11 points sans qu’aucun autre attribut géométrique (comme la taille des marqueurs colorés ou le cadre de délimitation semi-transparent) ne soit altéré ou réinitialisé par inadvertance. Cette approche programmatique offre une résilience maximale dans le cadre d’automatisations de graphiques complexes à facteurs multiples.
7.3 Gestion de la légende dans les fonctions de niveau figure (displot, catplot)
Les fonctions de haut niveau dites de niveau figure (figure-level functions), telles que sns.relplot(), sns.catplot(), sns.displot() ou sns.lmplot(), n’agrègent pas leur légende au sein d’un axe cartésien unique, mais au niveau de l’enveloppe globale de l’objet de grille FacetGrid. Dans cette architecture spécifique, la boîte de légende est très fréquemment déportée en dehors du cadre des tracés, ancrée sur la marge extérieure droite pour ne pas dissimuler les données des multiples facettes sous-jacentes. Les méthodes classiques basées sur ax.legend() ou ax.get_legend() sont dès lors inopérantes ou retournent la valeur None.
Historiquement, manipuler la légende d’un FacetGrid exigeait de naviguer laborieusement à travers les attributs internes de l’objet (via g._legend). Dans les versions récentes de Seaborn, une fonction utilitaire canonique a été intégrée pour simplifier drastiquement cette opération : sns.move_legend(). Cette fonction permet de repositionner la légende tout en modifiant simultanément l’ensemble de ses propriétés typographiques et géométriques, quel que soit le niveau hiérarchique du conteneur d’origine.
La syntaxe de cette commande est d’une grande puissance expressive : sns.move_legend(g, "upper right", bbox_to_anchor=(1, 1), fontsize=11, title_fontsize=13, frameon=True). En un seul appel atomique, le chercheur déplace la boîte d’information à des coordonnées précises tout en recalibrant uniformément la taille du texte des libellés et du titre. De surcroît, le moteur interne de move_legend() recalcule automatiquement les marges extérieures de la figure composite afin d’empêcher que la légende redimensionnée ne soit tronquée lors de l’exportation du canevas vers un format d’image vectoriel ou matriciel.
8. Utilisation stratégique du paramètre de contexte avec sns.set_context()
8.1 Analyse des quatre contextes prédéfinis de Seaborn
L’un des atouts conceptuels majeurs de Seaborn réside dans sa séparation formelle entre l’esthétique stylistique d’une part (le thème définissant les palettes et les arrière-plans) et l’échelle d’application d’autre part, gouvernée par la notion fondamentale de contexte. Seaborn intègre nativement quatre contextes prédéfinis conçus pour adapter instantanément le poids visuel d’un graphique à sa destination finale de diffusion : 'paper', 'notebook', 'talk' et 'poster'.
Le contexte 'notebook' constitue l’étalonnage par défaut de la bibliothèque, servant de référence absolue avec un coefficient multiplicateur intrinsèque de 1,0. Le contexte 'paper' est quant à lui spécifiquement calibré pour les manuscrits imprimés ou les documents PDF scientifiques : il réduit la taille des polices (multiplicateur effectif d’environ 0,8) ainsi que l’épaisseur relative des tracés et des marqueurs pour tenir compte de la haute résolution et de la densité spatiale de l’impression sur papier. Les contextes 'talk' (multiplicateur d’environ 1,3) et 'poster' (multiplicateur massif d’environ 1,6) augmentent considérablement l’échelle de tous les éléments typographiques et vectoriels pour garantir une visibilité parfaite à plusieurs mètres de distance sur des écrans de projection de salle de conférence ou sur des panneaux d’affichage de congrès scientifiques.
Le tableau analytique suivant synthétise le comportement comparatif de ces quatre contextes directeurs, illustrant comment l’architecture de Seaborn adapte dynamiquement les grandeurs typographiques de base en fonction du canal de communication visée :
- paper : Multiplicateur global ~0,8. Usage : Impression académique, manuscrits de revues, rapports denses. Épaisseur des lignes affinée, texte compact optimisé pour des figures réduites sur une colonne.
- notebook : Multiplicateur global 1,0 (référence). Usage : Analyse exploratoire interactive sur écrans de travail, notebooks Jupyter et rapports HTML d’entreprise.
- talk : Multiplicateur global ~1,3. Usage : Présentations orales, diapositives (PowerPoint/Keynote) projetées en amphithéâtre. Typographie rehaussée pour rester lisible depuis le fond de la salle.
- poster : Multiplicateur global ~1,6 à 2,0. Usage : Posters scientifiques grand format (formats A0 ou A1). Caractères massifs et traits renforcés conçus pour un décryptage immédiat en déambulation.
8.2 Combinaison synergique du contexte et de l’argument font_scale
L’intérêt architectural de la fonction sns.set_context() réside dans sa capacité à fusionner la sélection d’un contexte métier prédéfini avec l’argument multiplicateur font_scale. Au lieu de considérer les contextes comme des catégories rigides et immuables, l’analyste peut les employer comme des socles d’ajustement dynamique permettant un calibrage d’une extrême précision.
Considérons l’instruction canonique : sns.set_context('paper', font_scale=1.35). Dans ce scénario, Seaborn initialise d’abord les règles propres au contexte paper (qui contraignent l’épaisseur des bordures, la taille des tirets de graduation et le rayon des points de dispersion pour conserver un dessin fin et élégant), puis applique le facteur font_scale=1.35 sur l’ensemble du système typographique. Cette configuration confère au graphique une finesse vectorielle adaptée aux revues à fort impact tout en garantissant que les caractères ne sombrent pas dans l’illisibilité lors de la réduction physique à la mise en page.
Cette synergie évite le piège habituel consistant à augmenter artificiellement la taille de chaque police de façon isolée tout en oubliant d’adapter l’épaisseur des lignes géométriques ou la dimension des marqueurs. En déléguant cette harmonisation à sns.set_context(), le moteur visuel assure une balance parfaite entre la masse textuelle et la masse vectorielle des données empiriques représentées.
8.3 Automatisation du rendu multi-formats pour la recherche
Dans la vie d’un projet de recherche empirique, un même graphique est invariablement appelé à être diffusé sur des supports aux contraintes divergentes : dans un manuscrit soumis à évaluation par les pairs, sur un poster affiché lors d’un congrès international, et sur les diapositives de soutenance de thèse. Dupliquer le code source de tracé pour adapter les tailles de polices à chaque format constitue une faute méthodologique majeure génératrice d’erreurs de maintenance logicielle.
L’implémentation d’une fonction réutilisable exploitant l’argumentation contextuelle de Seaborn permet de résoudre cette équation avec une élégance absolue. En paramétrant une fonction d’exportation acceptant un argument de modalité de diffusion (target='paper', 'talk' ou 'poster'), le script conditionne l’appel de sns.set_context() en amont de l’exécution du tracé invariable. La même fonction Python compile et sauvegarde les artefacts visuels correspondants avec des ratios de police nativement ajustés à chaque support cible, automatisant intégralement le cycle de restitution graphique.
9. Configuration via les paramètres globaux Matplotlib rcParams dans Seaborn
9.1 Identification des clés de police critiques dans rcParams
En tant que surcouche construite sur le socle de Matplotlib, Seaborn puise la totalité de ses conventions typographiques initiales dans le système central de paramètres de configuration nommé rcParams. Ce système s’apparente à une immense base de registre de variables gérée sous la forme d’un dictionnaire global. La connaissance approfondie des clés de configuration critiques relatives à la typographie permet d’asseoir une autorité technique totale sur la mise en forme de vos graphiques de recherche.
Les variables fondamentales gouvernant la dimension des textes se structurent selon une arborescence logique précise :
'font.size': Le pivot typographique central. Cette valeur absolue (par exemple 12 points) sert d’étalon de référence à l’ensemble des éléments qui ne font pas l’objet d’une déclaration explicite plus spécifique.'axes.labelsize': Contrôle exclusivement la taille des étiquettes des axes X et Y. Accepte des points typographiques réels (par exemple 14) ou des descripteurs scalaires relatifs (tels que'large').'axes.titlesize': Détermine la taille des titres de chaque repère cartésien individuel (généralement calibré à une valeur supérieure de 2 à 4 points par rapport aux étiquettes d’axes).'xtick.labelsize'et'ytick.labelsize': Paramètrent indépendamment la taille des caractères numériques ou catégoriels ornant les graduations respectives des axes horizontaux et verticaux.'legend.fontsize': Fixe la taille de la police attribuée aux entrées descriptives contenues au sein des boîtes de légendes.'legend.title_fontsize': Configure la taille typographique de l’en-tête thématique de la légende (introduit pour dissocier formellement la légende de son titre).'figure.titlesize': Régit la taille par défaut appliquée aux super-titres de niveau figure instanciés parfig.suptitle().
9.2 Méthodes d’application des dictionnaires rc
Pour injecter ces directives typographiques au sein de l’environnement Python, le praticien dispose de trois vecteurs méthodologiques distincts. Le premier, comme abordé précédemment, réside dans le passage direct d’un sous-ensemble de clés à la fonction Seaborn via sns.set_theme(rc={'axes.labelsize': 14, 'xtick.labelsize': 10}). Cette méthode a l’avantage de circonscrire l’intention stylistique dans le vocabulaire propre à Seaborn.
Le second procédé consiste à intervenir directement sur le dictionnaire de Matplotlib par l’instruction : plt.rcParams.update({'axes.labelsize': 14, 'xtick.labelsize': 10}). Cette mise à jour est immédiate et s’applique sans délai à tous les graphiques ultérieurs. C’est l’approche privilégiée pour initialiser l’environnement de travail dès la première cellule de configuration d’un projet de calcul scientifique.
Enfin, le troisième procédé, hautement raffiné, exploite le gestionnaire de contexte matplotlib.rc_context(). Cette instruction permet d’isoler une suite de modifications typographiques temporaires au moyen d’un bloc d’indentation Python with :
En encapsulant la génération d’un graphique Seaborn dans un bloc with plt.rc_context({'font.size': 16, 'axes.labelsize': 18}):, les nouvelles dimensions textuelles ne s’appliquent qu’exclusivement aux tracés exécutés à l’intérieur de cette indentation. Dès la sortie du bloc, l’interpréteur Python restaure silencieusement l’état typographique antérieur. Cette méthodologie d’isolation stricte prévient toute pollution croisée des styles visuels au sein de pipelines analytiques complexes comportant des dizaines de visualisations hétérogènes.
9.3 Élaboration d’une feuille de style institutionnelle pour publications
Dans le cadre de consortiums de recherche ou d’organismes académiques produisant des publications sérielles, la conformité typographique stricte (par exemple, le respect rigoureux des normes de présentation de l’American Psychological Association ou des standards éditoriaux de l’IEEE) impose d’interdire les paramétrages ad hoc disséminés dans les scripts des différents chercheurs. L’élaboration d’une feuille de style institutionnelle pérenne constitue la réponse d’ingénierie adéquate.
Une feuille de style pour Matplotlib et Seaborn prend la forme d’un fichier texte portant l’extension .mplstyle. Ce fichier déclare de manière épurée et sans code Python l’ensemble des règles graphiques et typographiques : la famille de polices autorisée (ex. font.family : sans-serif, font.sans-serif : Arial), la taille de base (font.size : 10), les tailles respectives des axes (axes.labelsize : 11, axes.titlesize : 12) et les dimensions des légendes (legend.fontsize : 9).
L’activation de cette charte graphique s’effectue alors en début de protocole expérimental par une instruction unique : plt.style.use('ma_charte_laboratoire.mplstyle'). Lorsque Seaborn est invoqué par-dessus cette initialisation, il hérite harmonieusement de l’ensemble de ces contraintes de dimensionnement textuel. L’équipe de recherche s’assure ainsi d’une homogénéité visuelle absolue de ses figures à travers l’ensemble des thèses, articles et communications orales émanant de ses travaux.
10. Gestion des annotations textuelles et étiquettes de données individuelles
10.1 Dimensionnement des cellules textuelles dans les cartes thermiques (Heatmaps)
Les cartes thermiques ou matrices de corrélation (heatmaps) générées par l’intermédiaire de la fonction sns.heatmap() représentent l’un des archétypes visuels les plus denses en information de la science empirique contemporaine. Dans ces représentations matricielles, chaque cellule colorée affiche fréquemment sa valeur numérique exacte (coefficients de corrélation de Pearson, valeurs de p ou abondances transcriptomiques relatives) dès lors que l’argument annot=True est spécifié. Toutefois, le calibrage de la taille de ces annotations internes s’avère hautement délicat.
Si la police des chiffres est trop volumineuse, les annotations dépassent des bordures de la cellule et tronquent les caractères adjacents ; si elle est trop réduite, la lecture chiffrée devient impossible sans loupe numérique. Pour gouverner la taille du texte matriciel, Seaborn n’utilise pas l’argument fontsize au premier niveau de la fonction, mais met à disposition le dictionnaire spécialisé annot_kws. L’assignation formelle s’opère par l’instruction : sns.heatmap(data, annot=True, annot_kws={'size': 10}) (la clé 'fontsize' est également acceptée au sein du dictionnaire).
Ce dictionnaire autorise une modulation complète des attributs de police : outre la dimension scalaire 'size', l’utilisateur peut y stipuler la graisse typographique ('weight': 'bold') ou la police de caractères spécifique. Dans le cas de matrices à haute dimensionnalité (par exemple une matrice de corrélation 30×30 variables génomiques), une optimisation algorithmique consiste à calculer dynamiquement la valeur de la taille de la police en fonction inverse du nombre de colonnes de la matrice (par exemple taille_police = max(6, 120 / n_colonnes)), garantissant que l’annotation s’ajuste continuellement à l’espace géométrique réel de chaque alvéole matricielle.
10.2 Insertion d’annotations statistiques manuelles avec ax.text() et ax.annotate()
L’enrichissement sémantique d’un graphique de recherche ne se borne pas aux étiquettes des axes : il implique régulièrement l’insertion manuelle de métriques statistiques inférentielles directement au cœur de la zone de données. L’affichage d’un coefficient de détermination R², d’une taille d’effet (le d de Cohen ou l’êta-carré partiel) ou de barres de comparaison couronnées d’astérisques de significativité statistique (ex. p < 0.001) relève de cette pratique rigoureuse.
Ces insertions reposent sur les méthodes graphiques ax.text() et ax.annotate(). Lors de l’utilisation de ax.text(x, y, "R² = 0.84", fontsize=12), la taille de la police est assignée directement via le paramètre fontsize. Il est impératif d’ajuster ce paramètre en corrélation étroite avec la taille des graduations numériques de l’axe : une annotation méthodologique doit généralement arborer une dimension égale ou légèrement supérieure à celle des graduations pour signifier son statut d’information de second niveau.
La méthode ax.annotate(), plus sophistiquée, permet de dissocier les coordonnées de la cible visuelle pointée (par exemple le sommet d’une barre d’erreur statistique) de l’emplacement de l’annotation textuelle via une flèche vectorielle de guidage. La maîtrise de la taille typographique s’effectue toujours par le biais de l’argument fontsize, couplé impérativement aux paramètres d’alignement vertical (va='center' ou 'bottom') et horizontal (ha='center' ou 'left'). Cet alignement géométrique rigoureux prévient tout contact disgracieux entre le texte explicatif et les éléments géométriques de dispersion.
10.3 Étiquetage direct des barres et points avec les méthodes natives récentes
L’affichage direct des valeurs métriques au-dessus de chaque barre d’un diagramme en bâtons (barplot) constitue un standard ergonomique hautement plébiscité, dispensant le lecteur de fastidieuses projections visuelles vers l’axe des ordonnées. Historiquement, cette opération exigeait des boucles itératives fastidieuses extrayant la géométrie de chaque rectangle (patch) du tracé pour en calculer le barycentre. Depuis les versions récentes de Matplotlib intégrées dans l’écosystème Seaborn, cette tâche est totalement automatisée par la méthode native ax.bar_label().
Après avoir généré un diagramme à l’aide de sns.barplot(), l’appel de ax.bar_label(ax.containers[0], fontsize=11, padding=3) analyse instantanément la collection géométrique des conteneurs de barres pour y inscrire leur valeur nominale à une dimension précisément calibrée de 11 points. Le paramètre padding assure une séparation verticale de sécurité, empêchant que le texte ne chevauche le sommet du rectangle vectoriel.
Cette méthode autorise en outre des formatages numériques avancés via le paramètre fmt='%.2f' tout en acceptant des fonctions de transformation personnalisées. Lorsque la taille de la police appliquée aux étiquettes directes est relativement grande par rapport à la largeur géométrique des colonnes, un risque de collision textuelle latérale peut émerger. Dans ce contexte, l’utilisateur veillera soit à orienter le tracé horizontalement, soit à associer l’argument typographique avec une réduction calculée du nombre de décimales affichées pour préserver l’intégrité de l’espacement inter-barres.
11. Résolution des conflits et erreurs fréquentes de mise à l’échelle
11.1 Problèmes de chevauchement et débordement textuel hors cadre
L’un des dysfonctionnements les plus fréquemment observés lors de l’application d’un facteur font_scale élevé ou de l’augmentation substantielle des dimensions absolues des polices réside dans le phénomène de troncature spatiale. Lorsque la taille du titre ou des étiquettes d’axes s’accroît, la boîte englobante (bounding box) du texte s’étend au-delà des limites géométriques prévues par défaut par la figure. Il en résulte des étiquettes partiellement amputées de leurs lettres descendantes (comme les glyphes « p », « q » ou « y ») ou des titres tout bonnement coupés au sommet du canevas exporté.
La première réponse méthodologique à ce désordre consiste à solliciter systématiquement la méthode d’optimisation de la disposition spatiale : plt.tight_layout(). Cet algorithme évalue dynamiquement l’empreinte surfacique réelle occupée par chaque composant textuel de la scène et recalcule en conséquence les marges intérieures du repère cartésien pour tout contenir harmonieusement dans les dimensions de la figure. En alternative moderne et hautement recommandée dans les versions récentes, l’initialisation du canevas avec l’argument d’agencement contraint : fig, ax = plt.subplots(figsize=(8, 6), layout='constrained') résout ces collisions de manière encore plus robuste, notamment lors de l’usage de barres de couleurs complexes ou de sous-graphiques imbriqués.
La seconde ligne de défense, cruciale lors de l’écriture physique du fichier image sur le disque dur, réside dans l’utilisation du paramètre bbox_inches='tight' au sein de la fonction d’exportation. L’instruction formelle plt.savefig("ma_figure.pdf", bbox_inches='tight') demande à Matplotlib d’ignorer la boîte englobante théorique initiale et de calculer l’enveloppe convective réelle englobant l’intégralité des glyphes textuels et des graduations les plus périphériques. Cette directive garantit qu’aucun fragment de texte agrandi ne subisse de troncature lors de l’enregistrement final.
11.2 Conflits d’écrasement entre Seaborn et Matplotlib
Un piège récurrent dans lequel tombent fréquemment les praticiens de la visualisation de données réside dans les conflits d’écrasement temporel de configuration. De par leur architecture partagée, Seaborn et Matplotlib modifient le même dictionnaire sous-jacent rcParams. Dès lors, l’ordre séquentiel d’exécution des lignes de code au sein du script devient absolument critique pour l’obtention du résultat typographique escompté.
Considérons l’erreur d’architecture logicielle suivante : un utilisateur initialise méticuleusement ses paramètres d’axes via plt.rcParams['axes.labelsize'] = 16, puis appelle immédiatement à la ligne suivante sns.set_theme(style='darkgrid') avant de tracer ses données. Dans ce scénario précis, la fonction sns.set_theme() réinitialise et écrase la totalité du dictionnaire de configuration de Matplotlib pour lui substituer ses propres valeurs d’usine par défaut. Le paramètre axes.labelsize précédemment configuré à 16 points est instantanément pulvérisé et réinitialisé à la valeur par défaut du thème Seaborn (11 points), plongeant l’analyste dans l’incompréhension face à l’absence apparente d’effet de sa commande.
La règle d’or pour prévenir ces écrasements intempestifs impose d’ordonnancer strictement votre code selon le triptyque séquentiel suivant :
- Initialisation thématique globale : Invocation préalable de
sns.set_theme()ou définition des contextes généraux (qui posent les fondations esthétiques de base). - Surcharges et configurations fines : Modification consécutive des dictionnaires
rcParamsou injection de paramètres via l’argumentrcdeset_theme(). - Génération géométrique et finitions d’axes : Appel des fonctions de tracé Seaborn, immédiatement suivi des méthodes granulaires d’objets (
ax.set_title(),ax.tick_params()).
Le respect intransigeant de cette chronologie séquentielle garantit que chaque strate d’instructions s’applique en surcouche pérenne sur la précédente sans jamais subir d’annihilation rétroactive.
11.3 Incohérences de rendu selon la résolution d’exportation (DPI)
Une incompréhension tenace concerne l’interaction entre la taille nominale des polices de caractères (exprimée en points typographiques réels, où 1 point équivaut rigoureusement à 1/72 de pouce) et la résolution d’échantillonnage de l’image exportée, mesurée en points par pouce (Dots Per Inch ou DPI). De nombreux utilisateurs constatent avec désarroi qu’un graphique dont les polices semblaient confortablement dimensionnées à l’écran apparaît disproportionné ou flou une fois exporté en haute résolution à 300 DPI pour l’impression.
Il est fondamental de rappeler que la taille en points est une grandeur physique absolue par rapport aux dimensions physiques de la figure définies en pouces. Si votre figure est initialisée à figsize=(4, 3) (un petit format) avec une police de 12 points, le texte occupera une proportion surfacique considérable du canevas. Si vous initialisez au contraire une figure gigantesque à figsize=(16, 12) tout en conservant une police de 12 points, le texte semblera microscopique, quelle que soit la résolution DPI choisie lors de l’exportation. Le paramètre DPI ne modifie pas la proportion géométrique relative entre le texte et les lignes ; il ne détermine que le nombre de pixels générés pour échantillonner cette géométrie dans un format matriciel.
Pour stabiliser rigoureusement le rendu typographique sur des fichiers de publication scientifique de type matriciel (PNG, TIFF) :
- Fixez d’abord la dimension physique réelle de la figure (
figsize) en stricte conformité avec la largeur de colonne de la revue cible (par exemple 3.5 pouces pour une colonne standard ou 7 pouces pour une pleine page). - Déterminez ensuite les tailles de polices en points absolus pour qu’elles s’inscrivent dans la plage lisible requise (généralement 8 à 10 points pour les graduations, 11 à 12 points pour les axes, 13 à 14 points pour les titres).
- Exportez enfin avec un taux d’échantillonnage élevé au moyen de
plt.savefig("figure.png", dpi=300, bbox_inches='tight'). Les glyphes vectoriels seront matricialisés avec une netteté cristalline tout en préservant scrupuleusement la proportion typographique planifiée à la conception.
12. Études de cas intégrales et protocoles d’exportation pour manuscrits scientifiques
12.1 Cas 1 : Graphique linéaire longitudinal multi-groupes haute visibilité
Pour consolider l’ensemble des notions théoriques et opérationnelles développées tout au long de cet article, examinons un premier cas pratique complet représentatif d’une étude d’intervention cognitive randomisée en double aveugle. Dans cette simulation, des participants répartis en deux cohortes (Groupe Contrôle vs Groupe Intervention Cognitive) sont évalués sur un score d’efficience mnésique standardisé au fil de quatre temps de mesure longitudinaux consécutifs (Ligne de base, Post-test immédiat, Suivi à 3 mois, Suivi à 6 mois).
L’objectif technique consiste à générer une figure irréprochable prête pour une publication dans un périodique de neuropsychologie de premier rang. Le tracé doit être rendu dans un style sobre et lisible, avec un contraste typographique soutenu permettant une reproduction fidèle même en cas d’impression en noir et blanc haute résolution. L’architecture logicielle mobilise l’initialisation par sns.set_theme(), l’ajustement contextuel avec font_scale, et une finalisation granulaire sur l’objet Axes :
Le pipeline commence par charger les bibliothèques indispensables (import seaborn as sns, import matplotlib.pyplot as plt, import pandas as pd, import numpy as np). Seaborn est configuré au moyen de l’instruction sns.set_theme(style='ticks', font_scale=1.25), instaurant immédiatement un arrière-plan blanc dépouillé avec tirets d’axes et une échelle de base agrandie de 25 %. La figure est créée avec des dimensions physiques normalisées via fig, ax = plt.subplots(figsize=(7, 4.5), layout='constrained'). La fonction sns.lineplot() trace les trajectoires avec barres d’erreur basées sur l’intervalle de confiance à 95 %.
Le raffinement typographique ciblé s’opère par l’invocation de ax.set_title("Trajectoire Longitudinale de l'Efficience Mnésique", fontsize=15, fontweight='bold', pad=12). Les étiquettes d’axes sont redéfinies avec autorité : ax.set_xlabel("Temps d'Évaluation Clinique", fontsize=13, labelpad=8) et ax.set_ylabel("Score Z Mnésique (M ± IC 95%)", fontsize=13, labelpad=8). Les graduations bénéficient d’un calibrage net par ax.tick_params(axis='both', labelsize=11). Enfin, la légende est optimisée avec des entrées à 11 points et un titre à 12 points via ax.legend(title="Cohorte Expérimentale", fontsize=11, title_fontsize=12, frameon=True), parachevant une visualisation d’une clarté exemplaire.
12.2 Cas 2 : Matrice de corrélation multi-variables avec annotations dimensionnées
Le second cas pratique aborde le défi de la visualisation multidimensionnelle dense à travers une matrice de corrélation psychométrique examinant les interrelations entre huit construits psychologiques : anxiété situationnelle, anxiété trait, dépression, fatigue cognitive, flexibilité exécutive, vitesse de traitement, réserve cognitive et âge chronologique des sujets. Ce type de figure s’insère typiquement dans un gabarit de demi-page de manuscrit scientifique.
La complexité graphique repose sur la nécessité d’orchestrer harmonieusement trois niveaux de typographie textuelle au sein d’un même artefact visuel : les libellés des variables disposés le long des graduations diagonales, le texte numérique discret imprimé au cœur de chaque cellule matricielle, et l’étiquetage de l’échelle chromatique (la barre de couleur ou colorbar). L’implémentation algorithmique requiert une orchestration précise des dictionnaires de paramètres dédiés :
Le script calcule la matrice de corrélation de Pearson à partir des données empiriques et configure une figure carrée via fig, ax = plt.subplots(figsize=(6.5, 6), layout='constrained'). Le tracé est opéré par sns.heatmap() en combinant un masque triangulaire supérieur (pour éliminer la redondance d’information) et les arguments typographiques spécialisés : annot=True et annot_kws={'size': 9, 'weight': 'semibold'}. Ce dimensionnement garantit que chaque coefficient de corrélation s’inscrit au millimètre près au centre de sa boîte colorée sans jamais déborder sur le quadrillage de séparation.
Les graduations d’axes supportant les intitulés des construits psychologiques sont configurées pour garantir une lisibilité sans torsion du cou : ax.tick_params(axis='x', labelsize=10, rotation=45) et ax.tick_params(axis='y', labelsize=10, rotation=0). Le titre général est injecté avec prestance par ax.set_title("Matrice Inter-Corrélations des Variables Psychométriques", fontsize=13, fontweight='bold', pad=15). Enfin, la barre de couleur est interceptée via cbar = ax.collections[0].colorbar, permettant de calibrer la taille des graduations numériques du gradient chromatique par cbar.ax.tick_params(labelsize=9). L’ensemble produit une composition scientifique harmonieuse, dense et immédiatement intelligible.
12.3 Protocole d’exportation vectorielle et matricielle haute fidélité
L’aboutissement de tout travail de mise au point typographique réside dans la phase d’exportation physique du graphique. Une composition parfaite à l’écran au sein d’une session Python peut voir sa typographie anéantie par un choix inadapté de format de fichier de sortie ou de paramètres de compression. Pour clore ce guide méthodologique, nous formalisons le protocole d’exportation universel garantissant le respect exact des propriétés de taille de police élaborées dans votre code.
Deux formats de fichiers principaux dominent la communication scientifique rigoureuse :
- Le format vectoriel (PDF / SVG / EPS) : C’est le format d’excellence absolue pour les manuscrits soumis aux éditeurs académiques. Contrairement aux images matricielles basées sur des pixels, les formats vectoriels encodent les glyphes typographiques et les tracés géométriques sous forme de primitives mathématiques (courbes de Bézier). La netteté du texte demeure absolue et sans aucune pixellisation, quelle que soit la puissance de grossissement appliquée lors de la lecture sur écran ou de l’impression professionnelle. L’exportation s’effectue via
plt.savefig("figure1.pdf", format='pdf', bbox_inches='tight'). - Le format matriciel haute fidélité (TIFF / PNG) : Exigé par certaines revues médicales pour des figures incorporant des photographies microscopiques ou des surfaces lissées complexes. Ce format impose de verrouiller une résolution d’échantillonnage élevée. Pour satisfaire aux standards de publication, l’instruction formelle s’écrit :
plt.savefig("figure1.tiff", format='tiff', dpi=300, pil_kwargs={"compression": "tiff_lzw"}, bbox_inches='tight'). L’utilisation de l’algorithme de compression sans perte LZW prévient la dégradation des glyphes textuels tout en réduisant le poids binaire du fichier final.
En adoptant avec constance ces protocoles techniques de gestion typographique sous Seaborn et Matplotlib — de la structuration globale via sns.set_theme() au contrôle millimétrique des objets Axes et des légendes —, vous conférez à vos productions visuelles une rigueur formelle et une clarté cognitive répondant aux exigences les plus élevées de la recherche empirique internationale.
Références
- Bertin, J. (1967). Sémiologie graphique : Les diagrammes, les réseaux, les cartes. Gauthier-Villars.
- Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
- Matplotlib Development Team. (2023). Customizing Matplotlib with style sheets and rcParams. Matplotlib Documentation. https://matplotlib.org/stable/tutorials/introductory/customizing.html
- Tufte, E. R. (2001). The visual display of quantitative information (2e éd.). Graphics Press.
- Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media.