
Dans le champ contemporain de la science des données et de l’analyse exploratoire, la capacité à synthétiser visuellement des distributions statistiques complexes constitue une compétence méthodologique indispensable. Face à des jeux de données multidimensionnels comprenant d’innombrables variables continues, les chercheurs et analystes sont constamment confrontés au défi de comparer des distributions de manière à la fois compacte, rigoureuse et exempte de biais d’interprétation. Les statistiques descriptives univariées, bien qu’essentielles, échouent souvent à rendre compte de la forme sous-jacente des données, masquant des asymétries prononcées, des empilements multimodaux ou des valeurs aberrantes qui influencent lourdement les modèles prédictifs et les inférences statistiques.
Pour répondre à cette exigence, la boîte à moustaches, formalisée à l’origine par le statisticien John Tukey sous l’appellation de diagramme de dispersion à cinq nombres, s’est imposée comme un standard incontournable de l’analyse statistique exploratoire. Cependant, la mise en œuvre pratique de ce diagramme sur plusieurs colonnes simultanées au sein d’un environnement de calcul comme Python révèle fréquemment des frictions techniques et conceptuelles. La tension entre les paradigmes de structuration de données dits en format large et ceux en format long requiert une maîtrise approfondie des outils de manipulation matricielle et des bibliothèques graphiques de haut niveau.
L’écosystème Python propose une réponse particulièrement élégante à cette problématique à travers la bibliothèque de visualisation statistique Seaborn. Construite sur les fondations robustes et hautement configurables de Matplotlib tout en s’articulant intimement avec les structures de données tabulaires de Pandas, Seaborn permet de transformer des tableaux de données bruts en représentations graphiques publiables répondant aux standards les plus stricts du monde académique et industriel. Ce guide exhaustif explore les dimensions théoriques, architecturales et techniques nécessaires pour concevoir, personnaliser et interpréter des boîtes à moustaches appliquées à plusieurs colonnes, en examinant chaque articulation logique du pipeline d’ingénierie et de visualisation de données.
1. Introduction à la visualisation comparative avec Seaborn et les boîtes à moustaches
1.1 Pertinence de la boîte à moustaches dans l’analyse exploratoire de données
L’analyse exploratoire de données, théorisée de manière fondatrice par John W. Tukey dans son ouvrage séminal Exploratory Data Analysis, accorde une priorité absolue aux représentations visuelles capables de synthétiser l’information sans contraindre les distributions au sein d’un modèle paramétrique prédéterminé. Dans cette optique, la boîte à moustaches, communément appelée boxplot, offre une synthèse visuelle d’une efficacité remarquable en intégrant simultanément cinq valeurs de référence : le minimum empirique non aberrant, le premier quartile marquant le 25e percentile, la médiane correspondant au 50e percentile, le troisième quartile correspondant au 75e percentile, et le maximum empirique non aberrant. Cette décomposition permet d’appréhender instantanément la tendance centrale et la dispersion des données sans souffrir des distorsions induites par les observations extrêmes.
Lorsqu’il s’agit d’évaluer la dispersion statistique entre différentes conditions expérimentales, cohortes cliniques ou variables financières, la boîte à moustaches se révèle nettement supérieure aux représentations traditionnelles par histogrammes juxtaposés. Les histogrammes souffrent en effet d’une dépendance critique vis-à-vis du choix de la largeur des intervalles de classe (ou bins), un arbitrage qui peut artificiellement dissimuler des disparités ou accentuer des bruits d’échantillonnage mineurs. De plus, la superposition de plusieurs histogrammes sur un même axe génère une surcharge cognitive considérable due au chevauchement visuel des barres, rendant la comparaison de plus de trois variables simultanées particulièrement ardue.
Sur le plan méthodologique, la boîte à moustaches permet d’identifier sans ambiguïté les asymétries de distribution (skewness) par l’observation du décentrement de la ligne médiane à l’intérieur de la boîte interquartile et par l’inégalité de longueur des moustaches supérieure et inférieure. Elle isole également de manière formelle les valeurs aberrantes (outliers), évitant ainsi qu’elles ne soient confondues avec la variabilité naturelle du phénomène étudié. Cette propriété confère aux analystes un outil de diagnostic rapide pour repérer les anomalies de mesure, les artefacts de collecte ou les queues de distribution épaisses caractéristiques des phénomènes à forte variance.
1.2 L’écosystème Python pour la visualisation : l’apport de Seaborn
Dans l’écosystème du calcul scientifique en langage Python, la bibliothèque Seaborn a été développée par Michael Waskom pour pallier l’extrême verbosité et la complexité de bas niveau inhérentes à Matplotlib. Bien que Matplotlib offre un contrôle quasi absolu sur chaque pixel et chaque élément vectoriel d’une figure, la création de visualisations statistiques comparatives requiert traditionnellement des dizaines de lignes de code procédural pour calculer manuellement les regroupements, formater les étiquettes et synchroniser les échelles. Seaborn intervient comme une couche d’abstraction déclarative et orientée objet, spécifiquement conçue pour dialoguer de façon transparente avec les structures de données bidimensionnelles de la bibliothèque Pandas.
L’intégration de Seaborn avec les DataFrames de Pandas permet de déléguer la quasi-totalité des opérations d’agrégation, de calcul statistique et de stratification visuelle au moteur interne de la bibliothèque. Au lieu de disséquer manuellement des tableaux NumPy pour itérer sur des colonnes individuelles, le praticien formule sa requête graphique en associant directement les noms des variables aux attributs visuels tels que la position spatiale, la couleur ou la séparation en panneaux distincts. Cette approche déclarative accélère considérablement l’exploration de données en éliminant les risques d’erreurs d’indexation tout en garantissant une cohérence stylistique immédiate.
En outre, Seaborn prend en charge de façon totalement automatisée les inférences graphiques complexes, telles que l’estimation de densités, le calcul d’intervalles de confiance par rééchantillonnage bootstrap ou le positionnement dynamique d’éléments catégoriels non chevauchants. Dans le cas spécifique des boîtes à moustaches, la bibliothèque ne se contente pas de tracer des formes géométriques : elle implémente rigoureusement les algorithmes statistiques de Tukey pour déterminer l’emplacement des coupures interquartiles, le prolongement des moustaches et l’identification des points isolés, conférant aux représentations une valeur probante incontestable.
1.3 Objectifs pédagogiques et méthodologiques du guide
L’ambition première de ce traité est de doter les chercheurs, ingénieurs et analystes d’une maîtrise complète des méthodologies permettant d’afficher plusieurs colonnes d’un jeu de données au sein d’une ou plusieurs boîtes à moustaches unifiées. La manipulation de multiples variables continues soulève des problématiques techniques précises qui dépassent la simple exécution d’une ligne d’instructions : elle implique de comprendre la morphologie des structures de données en mémoire et les implications architecturales des choix de formatage.
Ce guide détaille pas à pas les paradigmes sous-jacents opposant le format large (wide format), courant dans les collectes expérimentales initiales, et le format long (long format ou tidy data), standard méthodologique promu pour l’analyse computationnelle moderne. Nous explorerons comment transcender les blocages syntaxiques habituels grâce à des fonctions de restructuration avancées telles que la méthode melt de Pandas, tout en analysant les scénarios où l’interrogation directe d’un tableau large s’avère pertinente et efficace pour des diagnostics rapides.
Enfin, nous élèverons le niveau d’exigence technique en abordant la personnalisation esthétique approfondie, le contrôle des paramètres chromatiques accessibles pour les publications évaluées par les pairs, la gestion des asymétries par transformation d’échelle, l’intégration de sous-groupes catégoriels imbriqués via le paramètre de teinte (hue), et la superposition de nuages de points individuels. L’objectif final est de transformer un processus de traçage parfois heuristique en une routine analytique robuste, reproductible et conforme aux critères les plus stricts de l’édition scientifique internationale.
2. Fondements statistiques de la boîte à moustaches (Boxplot)
2.1 Anatomie mathématique du diagramme de Tukey
Pour exploiter pleinement la boîte à moustaches et interpréter avec acuité les représentations générées par Seaborn, il est indispensable d’en décomposer les mécanismes mathématiques fondamentaux. Le cœur du diagramme repose sur l’ordonnancement rigoureux d’un échantillon univarié de valeurs continues triées par ordre croissant. La médiane, notée Q2 ou 50e percentile, scinde l’échantillon en deux sous-ensembles de cardinalité égale. Le premier quartile, Q1 ou 25e percentile, représente la valeur sous laquelle se situent exactement 25 % des observations, tandis que le troisième quartile, Q3 ou 75e percentile, correspond au seuil sous lequel sont comprises 75 % des valeurs. La boîte centrale matérialise l’étendue de ces deux jalons, enfermant ainsi la moitié centrale de la distribution des données.
L’écart interquartile (noté IQR pour Interquartile Range) est défini rigoureusement par la relation différentielle :
IQR = Q3 – Q1
Cette grandeur constitue un indicateur non paramétrique de dispersion remarquablement robuste, totalement insensible aux fluctuations extrêmes affectant les extrémités de la distribution. Les moustaches ne s’étendent pas systématiquement jusqu’aux valeurs minimales et maximales absolues de l’échantillon, ce qui constitue une confusion fréquente chez les néophytes. Dans l’implémentation standard de Tukey adoptée par Seaborn, la limite supérieure de la moustache s’établit au maximum empirique contenu dans l’intervalle fermé défini par Q3 + 1,5 * IQR. Symétriquement, la limite inférieure de la moustache correspond à la valeur observée minimale comprise dans l’intervalle défini par Q1 – 1,5 * IQR.
Toute observation se situant au-delà de ces frontières théoriques est formellement catégorisée comme une valeur aberrante (outlier) et fait l’objet d’une représentation individuelle distincte sous la forme d’un symbole ponctuel (flier). Ce seuil multiplicateur de 1,5 fois l’écart interquartile n’a pas été choisi arbitrairement par Tukey : pour une distribution parfaitement normale, cet intervalle englobe environ 99,3 % des observations, ne laissant qu’une fraction marginale de 0,7 % de points susceptibles d’apparaître naturellement comme des valeurs atypiques, offrant ainsi un équilibre optimal entre sensibilité de détection et résistance aux fausses alertes.
2.2 Comparaison de distributions multiples : enjeux d’échelle et de normalité
L’un des atouts méthodologiques majeurs de la boîte à moustaches lors de la juxtaposition de multiples colonnes réside dans sa neutralité distributionnelle. Contrairement aux diagrammes en barres affichant la moyenne arithmétique assortie d’une barre d’erreur matérialisant l’écart-type, le boxplot n’impose aucun postulat de normalité (loi gaussienne) sur les données sous-jacentes. La moyenne et l’écart-type sont des estimateurs extrêmement vulnérables à l’asymétrie statistique (skewness) et à l’aplatissement (kurtosis). L’introduction d’une unique valeur aberrante de grande magnitude peut décaler significativement la moyenne et gonfler artificiellement l’écart-type, offrant une impression fallacieuse de dispersion généralisée là où la grande majorité des observations reste concentrée dans un intervalle restreint.
En visualisant côte à côte plusieurs colonnes, la boîte à moustaches met immédiatement en lumière les discordances structurelles entre les variables. Si la médiane d’une colonne est plaquée contre le premier quartile alors que la moustache supérieure est considérablement étirée, l’analyste déduit instantanément la présence d’une asymétrie positive prononcée, caractéristique de phénomènes économiques (tels que la répartition des revenus) ou de métriques opérationnelles (telles que les temps de latence réseau). À l’inverse, une distribution symétrique se signalera par une médiane équidistante des charnières Q1 et Q3 et par des moustaches d’amplitudes comparables.
Un autre enjeu critique lors de l’évaluation comparée de plusieurs colonnes est l’identification de l’hétéroscédasticité, c’est-à-dire l’hétérogénéité des variances entre les différents groupes ou conditions expérimentales. Une série temporelle de mesures ou une collection de variables biomédicales peuvent présenter des médianes strictement identiques mais des écarts interquartiles radicalement discordants. La boîte à moustaches permet de diagnostiquer cette instabilité de variance en un coup d’œil, orientant le chercheur vers des modélisations statistiques appropriées, telles que l’application de tests non paramétriques (test de Wilcoxon-Mann-Whitney ou de Kruskal-Wallis) ou de régressions robustes adaptées aux distributions non homoscédastiques.
3. Configuration de l’environnement de programmation Python
3.1 Importation des bibliothèques fondamentales
L’élaboration d’un pipeline d’analyse graphique rigoureux débute par l’orchestration maîtrisée de l’environnement d’exécution Python. La manipulation efficace de jeux de données tabulaires et la génération de tracés statistiques nécessitent le chargement de trois bibliothèques complémentaires fondamentales : Pandas, Seaborn et le module pyplot de Matplotlib. Il est d’usage conventionnel, dans la communauté scientifique internationale, d’importer ces outils sous leurs alias canoniques respectifs afin d’assurer l’interopérabilité et la lisibilité du code par l’ensemble des collaborateurs.
L’environnement technique repose sur le rôle précis dévolu à chaque composant : Pandas fournit les structures de données DataFrame et Series indispensables à l’ingénierie, au nettoyage, au filtrage et au pivotement structurel des matrices de variables. Seaborn s’appuie directement sur ces objets pour en extraire les méta-informations sémantiques (telles que le nom des colonnes servant de libellés d’axes) et applique les algorithmes de synthèse statistique descriptive. Matplotlib, quant à lui, opère en arrière-plan comme le moteur de rendu vectoriel sous-jacent, conférant à l’utilisateur la capacité d’intervenir au niveau granulaire sur les dimensions du canevas, les délimitations spatiales, les ticks d’axes et la hiérarchie typographique.
Pour assurer la reproductibilité stricte des résultats expérimentaux, notamment lors de l’évaluation de scripts contenant des phases de rééchantillonnage ou d’injection de bruits synthétiques à des fins de démonstration, il est vivement conseillé de fixer les graines de génération pseudo-aléatoire via NumPy. L’importation conjointe de NumPy permet également d’accéder aux primitives de manipulation de vecteurs de nombres réels et de gérer de façon contrôlée les vecteurs contenant des valeurs manquantes normalisées, garantissant un environnement de travail d’une stabilité absolue avant d’aborder les phases de traçage graphique.
3.2 Initialisation des paramètres graphiques globaux
L’obtention de tracés de qualité publication ne peut s’accommoder des réglages stylistiques par défaut, qui privilégient souvent une esthétique orientée vers l’affichage rapide sur écran basse résolution plutôt que vers l’exigence des revues scientifiques. Seaborn propose un système complet de gestion des contextes graphiques via la fonction set_theme, qui autorise la modification unifiée du thème esthétique, de l’échelle des éléments textuels et de la palette par défaut. Le choix du style d’arrière-plan constitue une première décision méthodologique d’importance : le style whitegrid est fréquemment plébiscité pour les boîtes à moustaches, car l’insertion d’une grille cartésienne subtile facilite l’alignement visuel et la lecture des cotes médianes et des valeurs aberrantes sur l’axe des ordonnées, sans surcharger le tracé.
Au-delà des styles thématiques prédéfinis, la configuration experte de l’environnement requiert la modification ciblée du dictionnaire des paramètres d’exécution de Matplotlib, désigné sous l’identifiant rcParams. Ce dictionnaire contrôle l’intégralité des variables de configuration matérielle et esthétique, depuis l’épaisseur minimale des traits de crayon jusqu’à la famille de polices de caractères vectorielles injectées dans le document final. C’est à ce niveau que l’on détermine la taille par défaut des figures, en fixant des dimensions géométriques harmonieuses garantissant que les libellés de multiples colonnes disposeront d’un espacement suffisant pour demeurer lisibles sans empiéter sur l’espace dévolu aux boîtes.
Un paramètre crucial pour l’édition académique et professionnelle concerne la résolution spatiale du tracé, quantifiée par le nombre de points par pouce (DPI pour Dots Per Inch). L’initialisation de ce facteur à une valeur de 300 DPI, voire 600 DPI, dès l’amorce de la session de travail assure que les versions matricielles de prévisualisation conserveront une netteté absolue lors de zooms profonds sur les valeurs aberrantes isolées. De même, l’activation des options de gestion automatique de l’agencement spatial (tight_layout ou constrained_layout) permet de prévenir les phénomènes fâcheux de troncature des légendes et des intitulés d’abscisses, fréquemment observés lorsque l’on juxtapose de multiples colonnes aux noms descriptifs longs.
4. Paradigmes de données : format large (Wide) versus format long (Long)
4.1 Le format large (Wide Format) et ses caractéristiques
Pour appréhender la mécanique de création d’une boîte à moustaches regroupant plusieurs variables avec Seaborn, il est indispensable de maîtriser la distinction structurelle entre les formats de données matriciels. Le format large, traditionnellement désigné sous l’anglicisme wide format, représente l’organisation la plus intuitive et la plus répandue au sein des feuilles de calcul de type tableur, des fichiers CSV conventionnels et des bases de données de laboratoire. Dans cette configuration, chaque unité statistique ou observation expérimentale est représentée par une ligne unique, tandis que chaque variable mesurée ou condition expérimentale occupe une colonne dédiée et distincte.
Considérons à titre d’illustration une étude évaluant les performances hémodynamiques de patients soumis à différents protocoles d’effort. Dans un format large, le tableau comportera une colonne pour la pression artérielle au repos, une seconde colonne pour la pression après cinq minutes d’exercice modéré, et une troisième pour la pression consécutive à une épreuve maximale. Cette structure présente une lisibilité humaine immédiate et facilite la saisie directe des données lors des phases de collecte sur le terrain. Elle s’avère également optimale pour calculer rapidement des différences univariées ou des ratios mathématiques entre deux variables spécifiques via des opérations vectorisées élémentaires sous Pandas.
Néanmoins, le format large révèle rapidement des limitations majeures dès lors que l’on souhaite mobiliser les bibliothèques de programmation graphique modernes qui reposent sur la grammaire des graphiques. Les fonctions de haut niveau de Seaborn sont conçues pour mapper des canaux perceptifs abstraits (la position sur l’abscisse x, l’ordonnée y, la couleur hue, ou la taille size) à des colonnes sémantiques uniques. Or, dans un tableau large, la nature même de la mesure est fragmentée à travers les en-têtes de plusieurs colonnes différentes, empêchant l’affectation directe d’une variable unique à l’axe des catégories et forçant l’utilisateur à des contorsions syntaxiques pour traiter les colonnes de manière unifiée.
4.2 Le format long (Long Format ou Tidy Data)
Le format long, formalisé de manière paradigmatique par Hadley Wickham sous le concept de Tidy Data, propose une réorganisation conceptuelle stricte de l’information statistique. Selon ces principes d’hygiène des données, un ensemble est qualifié de rangé (tidy) lorsque trois conditions fondamentales sont simultanément satisfaites : chaque variable mesurée forme une colonne distincte, chaque observation ou événement élémentaire forme une ligne unique, et chaque type d’unité observationnelle forme une table dédiée. Appliqué à notre problématique de visualisation multicolonne, cela implique de dissoudre les multiples colonnes de valeurs en un couple unifié constitué d’une colonne de catégorisation et d’une colonne de mesures continues.
Dans cette architecture, si nous reprenons l’exemple des mesures physiologiques, le tableau transformé ne comportera plus trois colonnes distinctes pour les trois états hémodynamiques. Il présentera à la place une colonne qualitative, génériquement nommée Condition ou Phase, dont les modalités textuelles indiqueront l’état d’effort, et une seconde colonne quantitative, nommée Pression, consignant la valeur numérique observée. Ainsi, un patient initialement représenté par une seule ligne s’étendant sur trois colonnes de mesure verra désormais ses données réparties sur trois lignes distinctes, associées à un identifiant unique de participant.
Cette restructuration en format long s’aligne de façon symbiotique avec l’architecture logicielle de Seaborn. L’attribution des rôles visuels devient alors d’une clarté conceptuelle absolue : l’analyste spécifie simplement que l’axe horizontal x reçoit la colonne catégorielle désignant les variables à comparer, que l’axe vertical y reçoit la colonne unique des mesures continues, et que la source globale est le DataFrame ainsi pivoté. Cette structure ouvre également la voie à l’adjonction immédiate de dimensions d’analyse supplémentaires, telles que la stratification par groupe démographique ou traitement pharmacologique, via un simple passage de paramètre complémentaire.
4.3 Matrice de décision : quand convertir ses données ?
Bien que le format long représente la norme de référence pour l’analyse visuelle et statistique déclarative, le choix d’opérer une conversion structurelle explicite via des routines de restructuration en amont du tracé graphique doit résulter d’un arbitrage technique éclairé. Deux critères cardinaux doivent guider l’analyste : la complexité dimensionnelle de la visualisation envisagée et le volume volumétrique absolu du jeu de données manipulé en mémoire vive.
La conversion vers un format long s’impose de façon indiscutable dès lors que l’objectif dépasse la simple juxtaposition statique de quelques colonnes. Si vous envisagez de stratifier chaque boîte à moustaches par une variable tierce (par exemple, comparer les distributions de quatre biomarqueurs différents en séparant simultanément les hommes et les femmes au sein de chaque biomarqueur via des boîtes juxtaposées par couleur), le format long est impératif. De même, si vous planifiez de décomposer l’analyse sous forme d’une matrice de sous-graphiques en utilisant les fonctionnalités de treillis (FacetGrid ou catplot), le format long constitue la seule structure compatible avec les algorithmes d’instanciation automatique de sous-figures de Seaborn.
À l’inverse, lorsque l’exploration s’effectue sur des jeux de données massifs comportant des dizaines de millions de lignes et plusieurs dizaines de colonnes numériques, la duplication des identifiants et des libellés textuels induite par le déploiement en format long peut engendrer une empreinte mémoire prohibitive et dégrader significativement les temps de calcul du processeur. Dans ces circonstances, si le besoin se limite à une comparaison transversale immédiate de plusieurs distributions continues sans stratification par un facteur catégoriel additionnel, l’interrogation directe du DataFrame en format large, sans duplication structurelle des enregistrements, constitue une stratégie pragmatique et hautement efficiente qu’il convient de privilégier.
5. Restructuration du DataFrame avec la fonction pandas.melt()
5.1 Mécanisme fondamental de pandas.melt()
Pour concrétiser la transition du format large vers le format long au sein de l’environnement Python, la bibliothèque Pandas met à disposition la fonction melt, accessible soit comme une fonction de premier niveau à l’échelle du module, soit comme une méthode directement attachée aux objets de type DataFrame. Le terme anglophone melt, qui évoque la fonte ou la liquéfaction d’une structure rigide, décrit métaphoriquement l’opération par laquelle des colonnes alignées horizontalement sont désassemblées puis empilées verticalement pour former un flux continu de données univariées indexées par des étiquettes.
Le fonctionnement interne de pandas.melt s’articule autour de quatre arguments cardinaux qu’il convient de paramétrer avec rigueur :
- id_vars : Définit la liste des colonnes qui doivent demeurer inchangées et servir d’identifiants de référence. Ces colonnes ne subissent aucune déformation ; leurs valeurs sont répétées autant de fois qu’il y a de variables de mesure pivotées pour chaque observation.
- value_vars : Spécifie la liste exhaustive des colonnes numériques que l’on désire dissoudre et empiler dans la nouvelle structure. Si cet argument est omis, Pandas capture automatiquement l’intégralité des colonnes qui n’ont pas été explicitement déclarées au sein du paramètre id_vars.
- var_name : Détermine le nom de la nouvelle colonne textuelle qui hébergera les anciens en-têtes des colonnes sélectionnées dans value_vars. Il est méthodologiquement recommandé d’attribuer un nom sémantiquement porteur, tel que Variable, Mesure ou Condition.
- value_name : Établit l’intitulé de la nouvelle colonne numérique qui recevra l’ensemble des données quantitatives précédemment dispersées dans le tableau large. Ce nom reflétera idéalement l’unité ou la nature physique du phénomène mesuré, comme Concentration, Score ou Temps_secondes.
5.2 Exemple pratique de conversion pas à pas
Pour illustrer de manière tangible l’exécution de cette transformation, considérons un scénario empirique issu des sciences environnementales dans lequel des capteurs enregistrent simultanément la concentration de quatre polluants atmosphériques distincts : l’ozone, le dioxyde d’azote, les particules fines PM2.5 et les particules PM10, sur une série de stations géolocalisées. Le DataFrame initial au format large présente une colonne d’identification désignant la station, suivie de quatre colonnes continues consignant les mesures chimiques respectives.
L’application de la méthode melt sur cette structure implique d’assigner l’identifiant de la station au paramètre id_vars, tout en ciblant explicitement les quatre polluants via l’argument value_vars. L’analyste prendra soin de nommer la colonne catégorielle résultante Type_Polluant et la colonne quantitative Concentration_ug_m3. Lors de l’exécution, Pandas itère de façon vectorisée sur la matrice sous-jacente. Si le jeu de données d’origine contenait cent relevés pour chacune des quatre variables, le DataFrame issu de la conversion comportera exactement quatre cents lignes ordonnées et trois colonnes structurelles.
L’inspection critique des premières lignes du DataFrame restructuré, réalisée au moyen de la méthode head, permet de vérifier immédiatement la conformité du typage et de l’alignement des données. On constate que la colonne de station est répliquée de façon cyclique, garantissant qu’aucune traçabilité d’origine n’est égarée au cours de la manipulation. Cette nouvelle architecture constitue désormais le socle parfait pour alimenter les fonctions de visualisation statistique de Seaborn sans nécessiter la moindre intervention manuelle supplémentaire sur les séries numériques.
5.3 Gestion des cas complexes lors de la fusion
Dans les contextes d’analyse de données réelles, l’application de la fonction melt se heurte fréquemment à des singularités structurelles qui exigent une vigilance méthodologique accrue. La première complexité réside dans l’hétérogénéité des types de données présents dans les colonnes sources. Si l’utilisateur omet de borner strictement le paramètre value_vars et laisse la fonction capturer par mégarde des colonnes contenant des chaînes de caractères ou des dates mélangées à des nombres réels, Pandas sera contraint d’adopter le type générique object pour la colonne value_name résultante. Cette coercition de type empêchera Seaborn de calculer les quartiles mathématiques, provoquant des erreurs d’exécution ou des affichages erratiques.
La gestion des valeurs manquantes, représentées conventionnellement par des marqueurs NaN (Not a Number), constitue une autre problématique critique. Par défaut, melt préserve scrupuleusement les cellules vides, créant des lignes dont la colonne value_name contient une valeur nulle. Si Seaborn tolère nativement l’existence de valeurs manquantes en les excluant gracieusement du calcul des quartiles lors du tracé de chaque boîte, ces lignes incomplètes augmentent inutilement le volume d’enregistrements en mémoire vive. Dans le cadre de flux de données massifs, il est judicieux de purger explicitement ces enregistrements via la méthode dropna appliquée sur la colonne des valeurs numériques immédiatement après l’opération de fonte.
Enfin, lorsque l’on manipule des tableaux dotés d’index hiérarchiques (MultiIndex) au niveau des colonnes, situation fréquente lors de l’extraction de données issues de requêtes d’agrégation groupée sous Pandas, l’usage standard de melt requiert un aplatissement préalable des en-têtes. L’analyste doit concaténer les différents niveaux d’index en une chaîne de caractères textuelle unique et délimitée avant d’invoquer la restructuration, assurant ainsi que chaque variable conserve une dénomination non ambiguë lors de son report dans la colonne var_name du format long.
6. Création du boxplot multicolonne avec la syntaxe standard de Seaborn
6.1 Mise en œuvre de sns.boxplot() sur données restructurées
Une fois le jeu de données rigoureusement transposé dans le paradigme tidy data au format long, la création de la boîte à moustaches multicolonne s’opère avec une simplicité syntaxique exemplaire grâce à l’interface déclarative de Seaborn. L’invocation de la fonction standard sns.boxplot mobilise trois arguments fondamentaux qui scellent l’association entre la structure tabulaire et la géométrie visuelle : data, x et y. Cette séparation formelle des rôles garantit une lisibilité maximale du code source et facilite la maintenance des scripts de calcul.
Le paramètre data reçoit en référence le DataFrame résultant de la transformation par melt. L’argument catégoriel horizontal x se voit assigner le nom textuel de la colonne hébergeant les identifiants de variables (par exemple, Type_Polluant), tandis que l’argument quantitatif vertical y est couplé à la colonne rassemblant l’ensemble des mesures continues (par exemple, Concentration_ug_m3). En interprétant ces paramètres, Seaborn applique automatiquement une opération de scission, d’application et de combinaison (split-apply-combine) interne : les données sont partitionnées selon les modalités uniques de la variable x, les cinq nombres de Tukey sont calculés de manière autonome pour chaque partition, et les boîtes géométriques correspondantes sont tracées le long de l’axe horizontal aux positions désignées.
Cette approche standard présente l’avantage majeur de standardiser l’axe vertical des ordonnées sous une échelle dimensionnelle unique. Contrairement à des tracés isolés qui contraindraient le lecteur à réajuster mentalement les bornes de chaque graphique, la juxtaposition des boîtes sur une échelle partagée rend immédiatement manifestes les décalages de niveau global, les compressions d’amplitude et les variations de variabilité relative entre l’ensemble des colonnes investiguées.
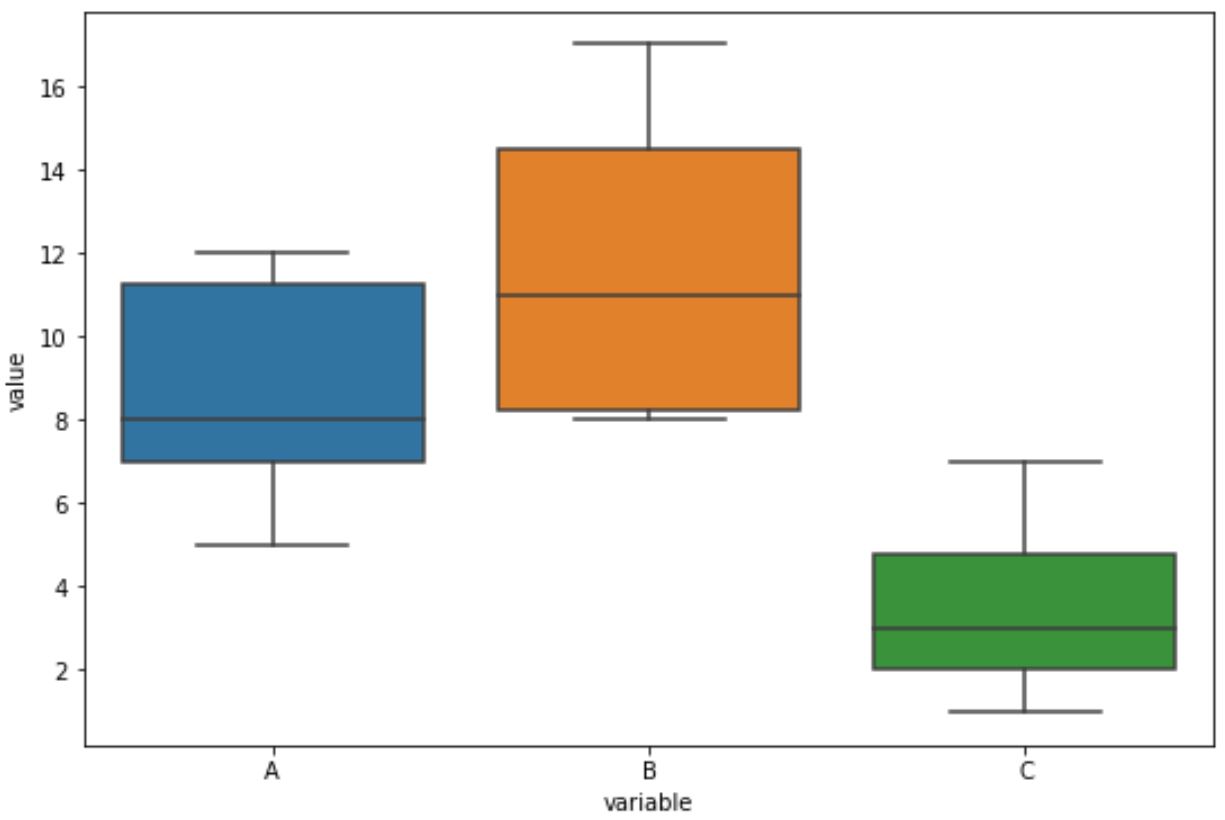
6.2 Interprétation graphique de la sortie standard
L’observation d’un diagramme multicolonne produit selon cette méthodologie permet une extraction d’informations statistiques d’une remarquable densité. L’évaluation comparative doit s’opérer de manière méthodique, en débutant par l’alignement des médianes, représentées par le trait horizontal renforcé coupant chaque boîte. Si les médianes de plusieurs colonnes se situent à des altitudes sensiblement équivalentes alors que leurs boîtes interquartiles affichent des hauteurs très dissemblables, l’analyste déduit que les phénomènes observés partagent une tendance centrale similaire mais diffèrent radicalement par leur dispersion interne.
L’examen de l’écart interquartile, matérialisé par la hauteur physique du rectangle délimité par Q1 et Q3, permet de mesurer l’homogénéité du cœur de distribution pour chaque variable. Une boîte très aplatie traduit une concentration extrême des données autour de la médiane, phénomène fréquemment constaté lors de processus industriels sous contrôle qualité strict ou lors de l’enregistrement de constantes physiologiques étroitement régulées par homéostasie. Inversement, une boîte allongée signale une hétérogénéité intrinsèque élevée au sein de la population échantillonnée.
Enfin, l’observation des points situés au-delà des moustaches théoriques renseigne immédiatement sur la fréquence et l’intensité des événements extrêmes spécifiques à chaque colonne. Il convient d’observer attentivement si les valeurs aberrantes se concentrent exclusivement d’un côté de la boîte (ce qui confirme une longue queue de distribution unilatérale) ou si elles se distribuent symétriquement de part et d’autre. L’identification visuelle d’une colonne présentant une profusion de points isolés à des distances considérables des moustaches suggère la présence potentielle d’un processus générateur de données distinct, nécessitant une investigation diagnostique approfondie avant toute modélisation prédictive.
6.3 Validation de l’intégrité de la représentation
Une étape essentielle, souvent négligée dans les flux de travail empiriques, consiste à valider rigoureusement l’intégrité de la représentation graphique en confrontant les éléments dessinés aux métriques numériques réelles calculées par Pandas. Il est vivement conseillé de générer conjointement un tableau de synthèse via la méthode describe appliquée aux colonnes d’origine afin de s’assurer que les valeurs affichées à l’écran coïncident au millimètre près avec les quantiles théoriques attendus. Cet audit permet d’écarter toute anomalie liée à une mauvaise interprétation des types de variables ou à un filtrage involontaire d’observations.
Un autre aspect déterminant de l’intégrité graphique concerne l’ordre de présentation des variables le long de l’axe des abscisses. Par défaut, Seaborn organise les catégories dans l’ordre de leur première apparition au sein du DataFrame restructuré, ou selon l’ordre alphabétique de leurs libellés. Cet agencement arbitraire peut nuire à l’intelligibilité de l’analyse, en particulier lorsque les colonnes sous-jacentes répondent à une logique temporelle, ordinale ou expérimentale précise (par exemple, des dosages pré-thérapeutiques, per-thérapeutiques et post-thérapeutiques).
Pour imposer une séquence visuelle rigoureuse et signifiante, l’analyste doit impérativement exploiter le paramètre optionnel order au sein de l’instruction sns.boxplot. En transmettant à cet argument une liste ordonnée contenant l’orthographe exacte des variables à afficher, on force Seaborn à caler les boîtes selon une progression intellectuelle logique. Cela permet également d’exclure sélectivement certaines colonnes de la visualisation sans avoir à modifier le DataFrame source : il suffit d’omettre leurs noms dans la liste transmise au paramètre order pour que Seaborn s’abstienne de les tracer, offrant ainsi un mécanisme de filtrage déclaratif extrêmement puissant.
7. Approche directe : tracer plusieurs colonnes sans restructuration explicite
7.1 Utilisation directe du format large avec sns.boxplot(data=df)
Bien que l’usage du format long incarné par l’approche Tidy Data représente la panacée méthodologique pour les pipelines de données complexes, Seaborn intègre une flexibilité conceptuelle remarquable permettant de visualiser instantanément plusieurs colonnes sans imposer la moindre restructuration préalable. La fonction sns.boxplot dispose en effet d’une capacité native à interpréter directement un DataFrame structuré en format large, réduisant l’opération de traçage à une expression élémentaire où l’on transmet l’objet tabulaire brut à l’unique paramètre data, sans spécifier explicitement les axes x et y.
Lorsque cette syntaxe directe est invoquée, le moteur d’inférence de Seaborn analyse la constitution interne du DataFrame. Il inspecte chaque colonne de la matrice, sélectionne automatiquement l’ensemble des séries associées à des types de données numériques (entiers ou réels à virgule flottante), et génère une boîte à moustaches distincte pour chacune d’elles. Dans cette configuration, les en-têtes de colonnes du tableau d’origine sont automatiquement projetés sur l’axe des abscisses pour servir d’étiquettes catégorielles, tandis que l’axe vertical capture l’amplitude commune de toutes les variables continues intégrées.
Cette approche par passage direct brille par son extraordinaire concision syntaxique. Dans les phases initiales de découverte de données, où l’analyste cherche à ausculter rapidement les distributions de cinq, dix ou quinze indicateurs sans s’engager dans une écriture verbeuse de code de manipulation, cette méthode permet de visualiser les disparités d’échelle et les anomalies majeures en une fraction de seconde, optimisant ainsi la réactivité de l’investigateur face à son matériau empirique brut.
7.2 Sélection d’un sous-ensemble spécifique de colonnes
Dans la pratique réelle de la science des données, il est exceptionnel qu’un DataFrame ne contienne que des variables quantitatives homogènes destinées à être projetées conjointement sur un même axe. Les tableaux comportent presque systématiquement des colonnes d’identification textuelle, des dates d’horodatage, des codes géographiques ou des variables catégorielles d’état civil qui ne sauraient être converties en boîtes à moustaches. L’invocation aveugle de la fonction sur le tableau complet peut alors générer des avertissements d’exécution ou produire des graphiques pollués par des représentations inadéquates.
Pour circonscrire le tracé à un sous-ensemble rigoureusement maîtrisé de variables d’intérêt, l’analyste dispose de plusieurs idiomes de sélection offerts par Pandas. La technique la plus explicite repose sur le découpage par indexation matricielle (slicing), consistant à transmettre à Seaborn une sous-sélection explicite de colonnes via une double paire de crochets, sous la forme syntaxique data=df[[‘Variable_A’, ‘Variable_B’, ‘Variable_C’]]. Cette méthode garantit un contrôle total sur les variables affichées et permet simultanément de figer leur ordre d’apparition à l’écran selon l’agencement défini dans la liste transmise.
Pour des jeux de données comportant plusieurs dizaines ou centaines de colonnes rendant l’énumération manuelle fastidieuse et sujette aux fautes de frappe, il est infiniment plus élégant et robuste d’exploiter la méthode programmatique select_dtypes. En formulant l’appel sous la forme data=df.select_dtypes(include=[‘float64’, ‘int64’]), l’environnement filtre de manière totalement dynamique l’ensemble des descripteurs purement numériques du tableau, écartant automatiquement les champs textuels, booléens ou temporels. Cette automatisation garantit la pérennité du code même si de nouvelles colonnes catégorielles venaient à être ajoutées en amont dans la base de données source.
7.3 Comparatif technique : melt() versus passage direct
Face à la dualité des approches offertes par l’écosystème Python, il est indispensable de poser un diagnostic comparatif objectif pour éclairer le choix de l’architecte de données selon le contexte du projet. Le tableau conceptuel suivant synthétise les compromis fondamentaux entre la manipulation préalable via melt() et le passage direct du tableau large :
- Sobriété du code : Le passage direct triomphe par sa compacité, ne réclamant aucune ligne de code dédiée à la reconfiguration matricielle, là où melt impose la rédaction de paramètres formels d’identification et de dénomination.
- Empreinte mémoire et coût computationnel : Pour des tables extrêmement denses, l’approche directe n’engendre aucune duplication de données en mémoire vive. La méthode melt, en revanche, génère un nouvel objet DataFrame dont la cardinalité des lignes est égale au produit du nombre d’enregistrements par le nombre de variables fusionnées, ce qui peut saturer la mémoire vive sur de très grands volumes.
- Extensibilité analytique (stratification) : C’est ici que l’approche tidy via melt révèle sa supériorité absolue. Il est rigoureusement impossible d’utiliser le paramètre hue pour subdiviser les boîtes selon une variable catégorielle tierce si l’on opère directement sur un tableau large, car l’architecture large ne dispose pas d’une colonne unifiée d’observations permettant de croiser deux facteurs catégoriels orthogonaux.
- Maintenabilité et standardisation : L’approche fondée sur melt et les principes Tidy Data s’inscrit au sein d’une chaîne de traitement homogène, directement compatible avec l’ensemble des fonctions avancées de Seaborn (comme catplot, PairGrid ou FacetGrid) et avec les bibliothèques statistiques inférentielles modernes (telles que Statsmodels). L’investissement consenti dans la restructuration s’avère donc hautement rentable sur le long terme.
8. Personnalisation esthétique et stylistique des boîtes à moustaches
8.1 Gestion des palettes chromatiques et de l’accessibilité
La dimension chromatique d’une visualisation de données ne répond pas uniquement à des considérations esthétiques ; elle constitue un vecteur fondamental de transmission de l’information statistique et un impératif d’éthique scientifique en matière d’inclusivité. Seaborn propose une collection raffinée de palettes de couleurs catégorielles et continues spécifiquement étalonnées pour assurer une distinction perceptuelle optimale. L’analyste peut assigner ces palettes globales via le paramètre palette au sein de la fonction sns.boxplot, transformant instantanément l’apparence des boîtes tracées pour chaque colonne.
Dans un contexte d’édition scientifique rigoureuse, il est impératif d’écarter les palettes criardes ou présentant des transitions de luminosité non monotones, qui peuvent induire le lecteur en erreur en attirant indûment son attention sur des groupes arbitraires. Seaborn intègre nativement la palette colorblind, construite selon les travaux fondateurs de Masataka Okabe et Kei Ito sur l’accessibilité visuelle. Cette palette garantit que les différentes nuances chromatiques demeurent parfaitement différentiables pour les individus atteints des formes les plus courantes de dyschromatopsie (deutéranopie, protanopie et tritanopie), ainsi que lors d’une impression du document en niveaux de gris purs.
Lorsque l’analyse exige de souligner une variable de référence parmi plusieurs colonnes témoins, il est méthodologiquement recommandé d’abandonner les palettes automatiques au profit d’un dictionnaire de nuances sur mesure. En transmettant au paramètre palette un dictionnaire associant explicitement chaque nom de colonne à un code hexadécimal précis, l’analyste peut affecter une teinte neutre et désaturée (comme un gris ardoise léger) à l’ensemble des colonnes de contrôle, tout en réservant une teinte vive et saturée (comme un bleu cobalt ou un pourpre intense) à la variable expérimentale critique, guidant ainsi immédiatement le regard de l’évaluateur vers le résultat central de l’étude.
8.2 Ajustement géométrique des boîtes
L’ergonomie d’un diagramme multicolonne dépend étroitement des proportions spatiales allouées aux entités graphiques qui le composent. Lorsque l’on compare un nombre restreint de colonnes (par exemple trois ou quatre), les boîtes tracées avec les dimensions par défaut de Seaborn peuvent apparaître démesurément larges et encombrantes, dégradant l’élégance globale de la figure. Inversement, l’affichage de vingt colonnes sur un canevas restreint peut compresser les boîtes jusqu’à rendre invisibles les moustaches et les traits de médiane.
Le contrôle de la largeur relative des rectangles s’opère par l’entremise du paramètre width, qui accepte une valeur flottante comprise usuellement entre 0.1 et 0.9, représentant la fraction d’espace allouée à chaque catégorie le long de l’axe des abscisses. Une valeur calibrée aux alentours de 0.5 à 0.6 permet généralement de conférer aux boîtes une silhouette svelte et aérée, dégageant un espace négatif suffisant entre les distributions pour éviter toute sensation de saturation visuelle.
La finesse du tracé vectoriel se configure avec une égale précision via le paramètre linewidth, qui régule l’épaisseur en points des bordures de boîtes, des hampes de moustaches et des chapeaux terminaux. Pour des figures destinées à être réduites lors de leur insertion dans une mise en page d’article sur deux colonnes, une épaisseur de 1.2 à 1.5 point garantit une parfaite lisibilité sans alourdir le tracé. Enfin, la transparence globale des surfaces rectangulaires peut être modulée via le passage d’arguments au dictionnaire boxprops (notamment le coefficient alpha), une précaution stylistique hautement recommandable lorsque l’on projette de superposer ultérieurement des nuages de points d’observations individuelles sur les boîtes.
8.3 Typographie et contextualisation des axes
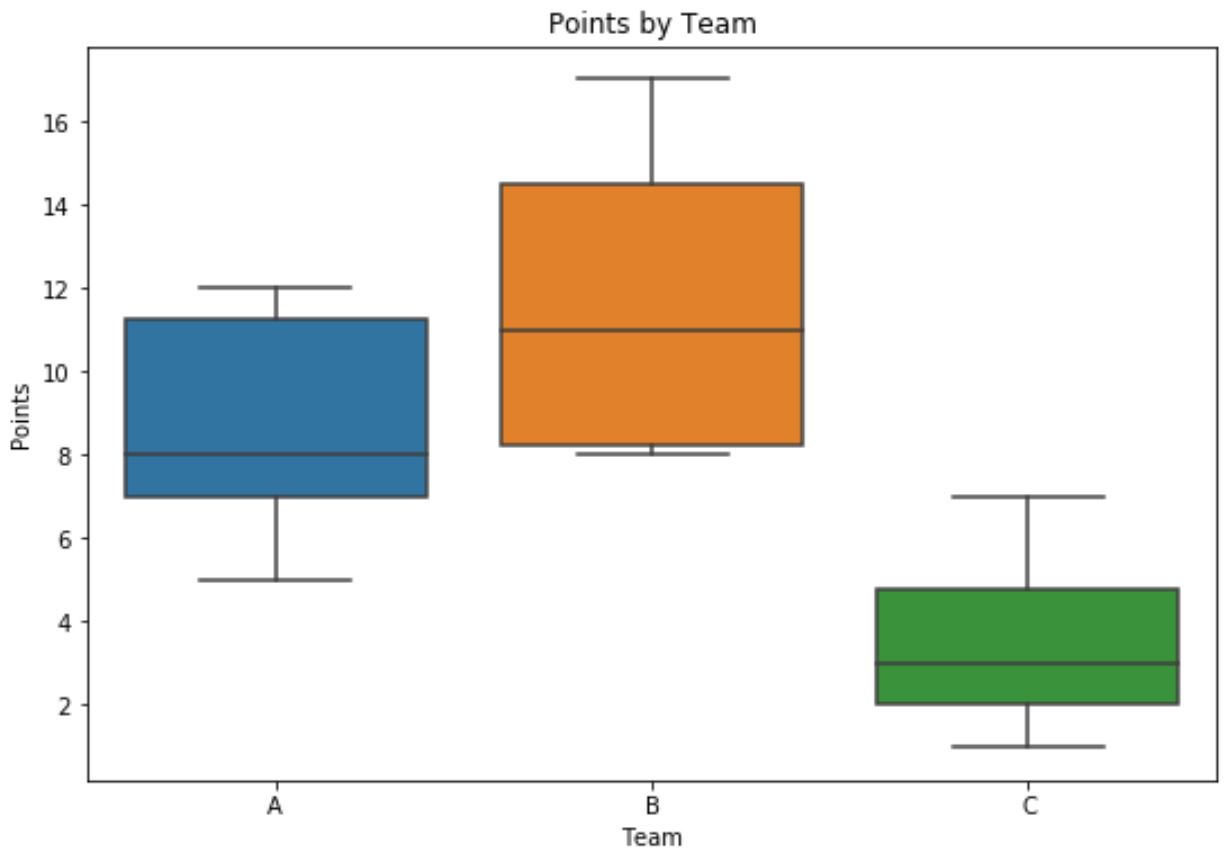
Une boîte à moustaches multicolonne ne possède de valeur scientifique que si son environnement contextuel est parfaitement documenté, éliminant toute ambiguïté quant à la nature des unités physiques représentées et à la signification des abréviations utilisées. L’analyste doit intervenir sur l’objet Axes renvoyé par la fonction sns.boxplot pour enrichir et clarifier l’appareil typographique. Le titre principal du graphique doit être explicite et concis, précisant souvent la taille globale de l’échantillon analysé afin de conférer une assise probabiliste immédiate à la lecture visuelle.
L’affichage de multiples colonnes pose un problème récurrent de collision spatiale entre les libellés de l’axe des abscisses lorsque les noms des variables dépassent quelques caractères. Pour remédier à ce chevauchement inélégant, la solution la plus courante consiste à appliquer une rotation angulaire aux étiquettes typographiques via la méthode plt.xticks(rotation=45, ha=’right’). L’argument ha=’right’ (alignement horizontal à droite) est ici fondamental : il assure que l’extrémité finale du texte de l’étiquette s’aligne rigoureusement sous le repère de graduation correspondant, évitant les erreurs d’attribution de nom entre colonnes contiguës.
Pour parfaire la mise en forme éditoriale, il convient de calibrer minutieusement l’axe des ordonnées. L’adjonction d’un libellé d’axe explicite incluant impérativement l’unité de mesure entre crochets ou parenthèses (par exemple Concentration sérique [mg/L]) est un prérequis incontournable de la rigueur scientifique. Enfin, l’activation d’une grille de fond orthogonale subtile, configurée avec des traits pointillés discrets et une couleur grise estompée, offre un appui visuel précieux permettant à l’œil d’interpoler avec précision la valeur numérique d’une médiane sans avoir à tracer mentalement une ligne imaginaire jusqu’à l’axe des ordonnées.
9. Orientation, mise à l’échelle et traitement des valeurs aberrantes
9.1 Bascule entre orientation verticale et horizontale
Bien que la disposition verticale représente la convention historique dominante pour les boîtes à moustaches, la configuration horizontale constitue une alternative méthodologique d’une efficacité redoutable, en particulier lorsque l’analyse porte sur un nombre élevé de colonnes ou lorsque les intitulés des variables sont constitués de termes techniques longs qui ne se prêtent pas à l’abréviation. Dans une perspective ergonomique, l’œil humain lit le texte horizontalement de gauche à droite ; contraindre un évaluateur à pencher la tête pour déchiffrer des étiquettes verticales inclinées crée une friction cognitive inutile.
La bascule vers une orientation horizontale s’effectue avec une fluidité déconcertante dans Seaborn. Dans le cadre de l’approche reposant sur le format long, il suffit d’intervertir rigoureusement les affectations des variables sur les axes : la colonne continue contenant les mesures numériques est attribuée au paramètre horizontal x, tandis que la colonne textuelle désignant le nom des variables est affectée au paramètre vertical y. Seaborn détecte automatiquement la nature catégorielle de l’axe y et déploie les boîtes le long de lignes horizontales parallèles, offrant un espace illimité sur la marge gauche pour afficher confortablement les libellés les plus verbeux.
Si l’on opère directement sur un DataFrame au format large, la transition s’exécute en ajoutant explicitement le paramètre orient=’h’ au sein de l’appel sns.boxplot(data=df, orient=’h’). Seaborn couche alors l’ensemble des colonnes numériques le long de l’axe des ordonnées. Cette disposition est particulièrement adaptée aux études génomiques, protéomiques ou financières comportant une trentaine d’indicateurs simultanés, car elle permet d’étendre la hauteur totale de la figure dans Matplotlib autant que nécessaire, transformant le graphique en une table visuelle ordonnée et immédiatement exploitable.
9.2 Personnalisation et neutralisation visuelle des outliers
Les valeurs aberrantes capturées au-delà du seuil de Tukey constituent souvent l’élément le plus informatif d’une distribution statistique, mais elles peuvent également saturer visuellement une figure si leur présence est massive, comme c’est le cas dans les ensembles de données issus du Big Data. Seaborn offre un éventail complet d’options pour moduler la restitution de ces points extrêmes sans déformer la structure mathématique des boîtes centrales. Le contrôle visuel fin des fliers s’opère par l’intermédiaire du paramètre flierprops, qui attend un dictionnaire de propriétés stylistiques conformes aux standards de Matplotlib.
Grâce à ce mécanisme, l’analyste peut réduire le diamètre physique des symboles de points, modifier leur morphologie géométrique (en substituant aux cercles par défaut de petites croix, des losanges ou des points discrets), ou ajuster leur niveau d’opacité. L’application d’un coefficient de transparence alpha élevé sur les points aberrants permet de révéler la densité locale des anomalies : un point isolé apparaîtra translucide et discret, tandis qu’une accumulation importante de valeurs extrêmes au même niveau créera une zone visuellement opaque par superposition, informant immédiatement le chercheur sur l’existence d’un amas pathologique concentré à une extrémité de la distribution.
Dans certaines circonstances méthodologiques précises, notamment lorsqu’une figure synthétique doit être présentée à un public non spécialiste ou lorsque les boîtes sont doublées d’une représentation exhaustive de tous les points de données par un tracé de dispersion superposé, il peut être justifié de neutraliser complètement l’affichage des fliers par la clause showfliers=False. Cette décision doit néanmoins faire l’objet d’une mention explicite dans la légende textuelle accompagnant la publication scientifique, car occulter les valeurs aberrantes sans en avertir le lecteur contrevient aux principes déontologiques de transparence statistique en dissimulant l’amplitude réelle de la variabilité observée.
9.3 Transformations d’échelle pour distributions asymétriques
L’un des défis majeurs rencontrés lors du tracé simultané de plusieurs colonnes réside dans la disparité potentielle de leurs ordres de grandeur. Si une colonne mesure un biomarqueur présent à des concentrations de l’ordre du microgramme par litre tandis qu’une colonne contiguë mesure une hormone présente à des concentrations de plusieurs centaines de milligrammes, la projection linéaire des deux variables sur un même axe vertical écrasera irrémédiablement la première distribution sous la forme d’un trait horizontal indistinct collé contre l’axe zéro, annihilant toute possibilité d’analyse de sa dispersion interne.
Pour résoudre ce dilemme sans recourir à une normalisation préalable des données qui dénaturerait les unités physiques d’origine, l’analyste peut appliquer une transformation d’échelle logarithmique directement sur l’axe des valeurs via l’instruction plt.yscale(‘log’) de Matplotlib. Cette transformation comprime l’espace visuel proportionnellement à l’ordre de grandeur, permettant de représenter harmonieusement sur un même canevas des variables dont les médianes diffèrent de plusieurs facteurs de dix. Les boîtes des faibles concentrations retrouvent alors une hauteur d’écart interquartile pleinement lisible, facilitant la comparaison de leur forme générale avec celle des variables de grande amplitude.
L’application d’une échelle logarithmique impose toutefois des précautions d’interprétation strictes qui doivent être impérativement communiquées au lectorat. Sur une échelle log, la distance géométrique apparente ne reflète plus des différences arithmétiques absolues, mais des rapports de proportions géométriques. De surcroît, les variables contenant des valeurs strictement nulles ou négatives ne peuvent faire l’objet d’un calcul logarithmique conventionnel sans générer d’erreurs mathématiques ; il convient alors de basculer vers des échelles symétriques spécialisées (telles que symlog sous Matplotlib) ou d’appliquer un décalage de translation constant en amont du tracé.
10. Intégration d’une dimension supplémentaire : l’argument ‘hue’
10.1 Subdivision des colonnes selon un facteur catégoriel
La puissance analytique de Seaborn se révèle dans toute sa plénitude lorsque l’on enrichit la comparaison de colonnes multiples par l’introduction d’un troisième axe d’investigation : la stratification par une variable catégorielle externe. Cette configuration avancée permet de répondre à des questions de recherche complexes, telles que : comment les distributions de nos différentes variables environnementales (colonnes 1 à 4) évoluent-elles selon que les mesures ont été effectuées durant la saison estivale ou la saison hivernale ? Ou encore : comment plusieurs métriques cliniques se comportent-elles lorsqu’on compare simultanément une cohorte de patients sous placebo et une cohorte sous principe actif ?
La mise en œuvre de cette stratification conditionnelle repose obligatoirement sur l’utilisation du format long obtenu via pandas.melt. Lors de l’opération de fonte, la variable de stratification (par exemple Traitement ou Saison) doit impérativement être intégrée au sein de la liste id_vars, garantissant qu’elle sera scrupuleusement dupliquée pour chaque ligne de mesure résultante. Une fois le tableau long configuré, il suffit de renseigner le paramètre hue au sein de la fonction sns.boxplot en lui transmettant le nom de cette colonne de segmentation.
En interceptant le paramètre hue, Seaborn procède à un partitionnement imbriqué (nested grouping). Pour chaque modalité présente sur l’axe x (chacune de nos colonnes initiales), la bibliothèque va instancier autant de sous-boîtes qu’il y a de niveaux distincts dans la variable de stratification, en attribuant à chaque sous-groupe une couleur différenciée issue de la palette active. Les sous-boîtes sont automatiquement juxtaposées côte à côte à l’intérieur de l’emplacement dévolu à chaque variable, autorisant une comparaison bivalente immédiate : on évalue simultanément les différences intrinsèques entre les colonnes et l’effet différentiel du facteur de stratification à l’intérieur de chaque colonne.
10.2 Optimisation du rendu des sous-groupes
L’insertion d’une dimension catégorielle supplémentaire complique inévitablement la lecture graphique et réclame un calibrage minutieux des espacements géométriques. Par défaut, le comportement de Seaborn est dicté par le paramètre booléen dodge=True. Ce mécanisme d’esquive automatique écarte physiquement les boîtes associées aux différentes modalités de hue afin qu’elles ne se superposent pas sur le même point central d’abscisse. Si l’on désactivait ce paramètre en positionnant dodge=False, les boîtes viendraient se tracer exactement l’une sur l’autre, générant un enchevêtrement visuel totalement inintelligible à moins d’appliquer une transparence drastique.
La présence d’un facteur hue déclenche également la génération automatique d’une boîte de légende contextuelle qui vient s’insérer par défaut à l’intérieur de l’espace de traçage. Si les données s’étendent sur toute la largeur et la hauteur du canevas, cette légende automatique peut venir recouvrir fâcheusement des boîtes à moustaches ou masquer des valeurs aberrantes critiques. L’analyste doit alors reprendre le contrôle du positionnement de la légende en utilisant la méthode plt.legend(bbox_to_anchor=(1.05, 1), loc=’upper left’, borderaxespad=0.), rejetant ainsi le cartouche explicatif à l’extérieur immédiat du cadre du tracé.
Sur le plan de l’interprétation, ce type de représentation permet de diagnostiquer des phénomènes d’interaction statistique remarquables. Si l’écart entre la modalité A et la modalité B demeure parfaitement constant à travers toutes les colonnes investiguées, on conclut à un effet principal uniforme du traitement. En revanche, si la médiane de la modalité A est considérablement supérieure à celle de B pour la première colonne, mais devient inférieure pour la troisième colonne, la boîte à moustaches multicolonne avec teinte révèle instantanément une interaction croisée, information capitale qui guidera la formulation des modèles d’analyse de variance factorielle (ANOVA) subséquents.
11. Superposition de représentations complémentaires (Stripplot et Swarmplot)
11.1 Combler les angles morts de la boîte à moustaches
En dépit de son élégance et de sa robustesse incontestées, la boîte à moustaches souffre d’une limitation épistémologique fondamentale dont chaque analyste de données doit avoir une conscience aiguë : elle résume la distribution à cinq nombres seulement, occultant totalement la densité locale réelle des observations. Deux jeux de données présentant des structures de densité radicalement discordantes peuvent engendrer des boîtes à moustaches rigoureusement identiques au pixel près. Une distribution bimodale marquée (présentant deux bosses distinctes) et une distribution parfaitement uniforme produiront des quartiles Q1, Q2 et Q3 indiscernables si les coupures statistiques coïncident par hasard.
Ce phénomène, popularisé sous différentes formes d’illustrations pédagogiques dans la littérature statistique contemporaine, rappelle qu’un boxplot ne permet pas de certifier la forme de la cloche sous-jacente. Il est incapable de révéler si le corps central de la boîte est constitué d’une masse continue d’observations homogènes ou s’il résulte de la juxtaposition de deux agrégats distants séparés par un vide total d’enregistrements (distribution en creux). De surcroît, la boîte ne fournit aucune indication intuitive sur l’effectif sous-jacent : un diagramme tracé sur vingt observations peut afficher des proportions similaires à un diagramme fondé sur un million de mesures, masquant l’incertitude d’échantillonnage inhérente aux cohortes réduites.
Pour dissiper ces angles morts sans abandonner les repères synthétiques des quartiles de Tukey, la solution méthodologique d’excellence consiste à superposer directement les points de données bruts sur la boîte à moustaches. Cette approche hybride offre le meilleur des deux mondes : la géométrie de la boîte fournit les repères formels de dispersion et de tendance centrale, tandis que le nuage de points sous-jacent dévoile sans fard la texture microscopique des données, certifiant l’unimodalité ou dénonçant immédiatement les sous-structures masquées.
11.2 Combinaison technique : sns.boxplot et sns.stripplot
La mise en œuvre de cette superposition s’exécute avec une remarquable fluidité sous Seaborn en exploitant la propriété d’accumulation graphique sur un même objet Axes de Matplotlib. Il suffit d’appeler successivement la fonction sns.boxplot puis la fonction sns.stripplot, en leur fournissant des références strictement identiques pour les paramètres data, x et y. Seaborn aligne automatiquement les deux géométries sur les mêmes repères d’abscisses sans qu’aucun décalage spatial ne vienne corrompre la superposition.
Pour assurer la réussite visuelle de ce mariage graphique, plusieurs réglages techniques sont indispensables :
- Gestion de la dispersion artificielle (jitter) : Dans un stripplot standard, si de multiples points partagent des valeurs numériques très proches, ils risquent de se superposer exactement sur une ligne droite verticale au centre de la boîte, créant un artefact de saturation. Le paramètre jitter=True (ou l’attribution d’une valeur flottante calibrée comme jitter=0.2) introduit une composante aléatoire horizontale qui disperse les points sur toute la largeur de la boîte sans altérer leur cote verticale sur l’axe des ordonnées.
- Atténuation chromatique des points : Afin de ne pas transformer le graphique en un fouillis visuel illisible, il est préconisé d’appliquer aux points du stripplot une couleur neutre (comme un noir profond ou un gris anthracite foncé) assortie d’une taille réduite (size=3 ou size=4) et d’un niveau de transparence modéré (alpha=0.5).
- Neutralisation de la boîte : Symétriquement, la boîte à moustaches située en arrière-plan doit adopter des couleurs pastel très douces, voire un fond blanc pur, tout en augmentant sa transparence pour que les points individuels situés à l’intérieur de l’espace interquartile demeurent parfaitement discernables sous la structure du tracé.
11.3 Alternative avec sns.swarmplot
Bien que le stripplot muni d’un paramètre de jitter constitue une réponse très honorable, il conserve une part d’aléatoire probabiliste qui peut parfois engendrer des agglomérations visuelles accidentelles. Pour une restitution déterministe et visuellement parfaite de la densité empirique, la bibliothèque Seaborn propose une alternative d’une grande sophistication : la fonction sns.swarmplot, fréquemment désignée sous l’appellation de tracé en essaim d’abeilles.
Le swarmplot met en œuvre un algorithme géométrique complexe d’évitement de contact : chaque point de donnée est positionné le long de son ordonnée exacte, mais sa position horizontale est calculée de manière dynamique pour garantir qu’aucun symbole de point ne chevauche ses voisins immédiats. Lorsque les données se concentrent massivement autour d’une valeur donnée, l’essaim s’évase horizontalement de manière proportionnelle, dessinant une silhouette qui rappelle le profil d’un violon ou d’un estimateur de densité à noyau (KDE). Lorsque les données s’égrènent de façon éparse, l’essaim se resserre en un filament étroit d’une précision microscopique.
L’association d’une boîte à moustaches épurée et d’un swarmplot produit une visualisation d’une richesse analytique incomparable pour l’évaluation comparée de multiples colonnes. L’observateur appréhende d’un seul regard les seuils de Tukey mathématiques et la répartition atomique des points réels. Il convient toutefois d’émettre une mise en garde méthodologique majeure quant à l’emploi du swarmplot : en raison de la complexité computationnelle de son algorithme de calcul de non-chevauchement spatial (qui procède par détection de collisions itératives), son exécution devient prohibitivement lente dès lors qu’un échantillon dépasse quelques milliers d’enregistrements. Son usage doit donc être strictement réservé aux jeux de données de taille petite à modérée (typiquement moins de 1 000 observations par colonne).
12. Bonnes pratiques académiques, pièges fréquents et export de figures
12.1 Pièges analytiques et erreurs méthodologiques récurrentes
L’utilisation apparemment simple des boîtes à moustaches dans les environnements de calcul de haut niveau comme Python peut paradoxalement masquer de graves écueils méthodologiques susceptibles d’invalider les conclusions d’une publication scientifique. Le premier piège réside dans la confusion intellectuelle, tragiquement répandue chez certains analystes, entre la dispersion empirique d’un échantillon et l’incertitude pesant sur l’estimation de sa tendance centrale. Une boîte à moustaches décrit l’étalement réel des individus observés ; elle ne matérialise en aucun cas un intervalle de confiance à 95 % de la médiane ni l’erreur standard de la moyenne (SEM).
Un autre contresens méthodologique récurrent concerne la juxtaposition aveugle de colonnes dont les métriques sont dimensionnellement incommensurables. Regrouper sur un même graphique une variable exprimée en pourcentage d’efficacité (bornée entre 0 et 100), une durée de survie exprimée en mois et un taux de cholestérol mesuré en millimoles par litre sans normalisation préalable (comme la conversion en scores Z centrés-réduits) constitue une aberration analytique majeure. La lecture visuelle d’un tel graphique n’a aucun sens mathématique, puisque l’ordonnée commune fusionne arbitrairement des échelles physiques totalement hétérogènes.
Enfin, l’omission de la taille de l’échantillon sous-jacent (N) représente un manquement épistémologique sévère. Deux colonnes affichant des boîtes rigoureusement identiques ne possèdent pas la même valeur probante si l’une repose sur l’analyse de 12 patients et l’autre sur une cohorte épidémiologique de 45 000 individus. L’analyste rigoureux prendra soin d’inscrire explicitement la taille de chaque sous-échantillon dans le libellé d’abscisse de chaque colonne (par exemple : Contrôle (N=15) vs Traitement (N=350)), conférant au lecteur le recul probabiliste indispensable pour pondérer son jugement face à la régularité visuelle des tracés.
12.2 Conformité aux exigences de publication scientifique
Les comités de lecture des revues internationales de premier rang (telles que Nature, Science, PNAS ou les revues de l’écosystème IEEE) imposent des normes de clarté visuelle extrêmement rigoureuses pour l’ensemble des figures soumises. Une boîte à moustaches multicolonne ne peut être insérée dans un manuscrit sans être accompagnée d’une légende autonome et auto-explicative. Cette légende doit stipuler de façon non équivoque la définition exacte appliquée à chaque composant du diagramme : la ligne médiane centrale, la nature des limites supérieure et inférieure de la boîte (premier et troisième quartiles), et surtout la formule précise régissant l’extension des moustaches (typiquement 1,5 fois l’écart interquartile de Tukey).
Si des points aberrants sont affichés individuellement, la légende doit expliciter la méthodologie de détection retenue. Dans l’éventualité où des points extrêmes ont été masqués via l’option showfliers=False pour des impératifs d’échelle, le texte doit impérativement déclarer le nombre exact d’observations ainsi tronquées pour chaque colonne ainsi que leurs valeurs absolues maximales, garantissant une intégrité scientifique irréprochable. De surcroît, les axes doivent être dépouillés de tout jargon informatique interne : les noms de colonnes bruts issus du code de programmation (comme var_mesure_1_corrige_final) doivent être impérativement traduits en un intitulé linguistique châtié, exempt d’underscores, comportant une casse typographique soignée et des unités formellement normalisées selon le Système International (SI).
L’harmonisation de la charte graphique de la figure avec la typographie globale du corps de l’article constitue une exigence éditoriale complémentaire. Les éditeurs académiques recommandent vivement l’utilisation de polices de caractères vectorielles standards et universelles (telles que Helvetica, Arial ou Times New Roman), en proscrivant les polices de fantaisie. La taille de corps des libellés d’axes, des graduations numériques et des légendes doit être calibrée pour demeurer parfaitement lisible lorsque la figure sera réduite à la largeur standard d’une colonne de composition (généralement entre 85 et 90 millimètres), ce qui implique d’adopter des tailles de police minimales de 8 à 10 points à l’échelle finale d’impression.
12.3 Export vectoriel haute résolution
L’ultime maillon de la chaîne de production d’une boîte à moustaches professionnelle concerne la procédure de sérialisation et d’exportation du fichier graphique depuis l’interpréteur Python vers le système de stockage persistant. L’utilisation d’outils de capture d’écran sommaires ou l’exportation vers des formats matriciels fortement compressés comme le JPEG doivent être formellement bannies : ils génèrent des artefacts de compression autour des arêtes fines et détruisent la netteté des polices de caractères lors de l’impression sur presse rotative professionnelle.
L’analyste mobilisera systématiquement la méthode plt.savefig de Matplotlib, en orientant son choix vers des formats vectoriels résolus tels que le PDF (Portable Document Format) ou le SVG (Scalable Vector Graphics). Les formats vectoriels ne codent pas l’image sous la forme d’une grille de pixels figée, mais comme un ensemble d’instructions mathématiques décrivant les coordonnées exactes des vecteurs, des polygones et des glyphes typographiques. Une figure vectorielle peut ainsi être agrandie à l’infini sans la moindre perte de définition, assurant une pureté de rendu parfaite quel que soit le support de publication final.
Dans l’éventualité où un éditeur exigerait impérativement un format matriciel (généralement requis pour les micrographies ou les images médicales sous forme de fichiers TIFF ou PNG non compressés), le script d’exportation doit spécifier de façon contraignante le paramètre dpi=300, voire dpi=600 pour satisfaire aux critères d’impression d’art. Enfin, il est impératif d’inclure systématiquement l’argument bbox_inches=’tight’ au sein de l’instruction savefig. Cette directive ordonne au moteur de rendu d’effectuer un recalcul dynamique de la boîte englobante de la scène graphique, garantissant qu’aucune étiquette d’abscisse inclinée, aucun titre supérieur et aucun cartouche de légende déporté ne soient accidentellement rognés lors de la découpe finale du fichier image.
Références
Cleaveland, W. S. (1993). Visualizing data. Hobart Press.
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
Krzywinski, M., & Altman, N. (2014). Visualizing samples with box plots. Nature Methods, 11(2), 119–120. https://doi.org/10.1038/nmeth.2813
McKinney, W. (2010). Data structures for statistical computing in Python. In Proceedings of the 9th Python in Science Conference (Vol. 445, pp. 51–56). https://doi.org/10.25080/Majora-92bf1924-003
Okabe, M., & Ito, K. (2008). Color universal design (CUD): How to make figures and presentations that are friendly to colorblind people. J-STAGE.
Spitzer, M., Wildenhain, J., Rappsilber, J., & Tyers, M. (2014). BoxPlotR: A web tool for generation of box plots. Nature Methods, 11(2), 121–122. https://doi.org/10.1038/nmeth.2811
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Waskom, M. L. (2021). Seaborn: Statistical data visualization. Journal of Open Source Software, 6(60), 3021. https://doi.org/10.21105/joss.03021
Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0