
L’écosystème contemporain du traitement de données au sein des tableurs en ligne a été profondément transformé par l’intégration d’outils analytiques avancés capables d’émuler la puissance des langages déclaratifs traditionnels. Parmi ces mécanismes, la fonction QUERY de Google Sheets s’impose comme une pierre angulaire algorithmique incontournable. Elle permet aux analystes d’extraire, d’agréger et d’ordonner des volumétries substantielles d’informations sans recourir à des scripts procéduraux complexes. Néanmoins, l’interaction entre ce moteur de requête relationnelle et les dimensions temporelles représente l’une des zones d’achoppement les plus ardues pour les praticiens de la manipulation de données. La gestion des dates ne relève pas d’une simple comparaison lexicale ou numérique élémentaire ; elle exige une compréhension exhaustive des strates d’abstraction sous-jacentes qui articulent l’interface utilisateur, le typage sériel des cellules et la compilation de commandes quasi-SQL.
Le filtrage par plage de dates constitue le paradigme d’interrogation le plus récurrent et critique dans les contextes de production, qu’il s’agisse de mesurer la performance financière périodique, d’analyser le cycle de vie d’utilisateurs ou d’auditer des séquences d’événements transactionnels. Pourtant, les disparités de représentations textuelles, les incompatibilités régionales entre les conventions francophones et anglo-saxonnes, ainsi que la nature stricte du compilateur textuel de l’API sous-jacente engendrent fréquemment des erreurs d’interprétation silencieuses ou des blocages syntaxiques explicites. Maîtriser le filtrage temporel dans Google Sheets requiert donc de dépasser le cadre de l’intuition empirique pour aborder les fondements théoriques de l’algèbre relationnelle adaptée aux tableurs en nuage.
Ce traité exhaustif a pour ambition d’analyser avec une rigueur absolue l’ensemble des dynamiques gouvernant la sélection, la délimitation et la manipulation des intervalles temporels au moyen de la clause WHERE de la fonction QUERY. De l’architecture bas niveau de l’API Google Visualization jusqu’aux optimisations complexes de calcul matriciel dynamique, chaque aspect sera examiné à la lumière de cas d’usage industriels, de décompositions syntaxiques pas à pas et de diagnostics préventifs d’anomalies. À travers ce guide méthodologique approfondi, l’utilisateur découvrira comment forger des architectures de classeurs d’une résilience irréprochable face aux ambiguïtés chronologiques.
1. Fondements conceptuels de la fonction QUERY et gestion temporelle dans Google Sheets
1.1 Architecture du moteur de calcul et API Google Visualization
L’implémentation de la fonction QUERY au sein de Google Sheets ne repose pas sur le moteur de calcul matriciel standard qui pilote les fonctions arithmétiques natives telles que SOMME ou RECHERCHEV. Elle constitue en réalité une passerelle directe vers le langage de requête de l’API Google Visualization. Cette architecture découplée implique que toute formule invoquant cette fonction transmet une matrice de données brute ainsi qu’une chaîne de caractères représentant une instruction formalisée dans un dialecte spécifique, inspiré du standard Structured Query Language (SQL). Le compilateur interne de cette API analyse la chaîne textuelle de façon autonome, séparément de la grille de calcul hôte, ce qui crée une frontière hermétique entre les règles d’évaluation classiques du tableur et celles du processeur de requêtes.
Cette distinction structurelle engendre des répercussions majeures sur le comportement du compilateur face aux valeurs temporelles. Alors qu’un tableur traditionnel interprète une date par référence directe à sa cellule mémoire sous forme d’un nombre à virgule flottante, le moteur Visualization exige des littéraux déclaratifs strictement typés lorsqu’une comparaison est formulée dans la commande textuelle. L’absence d’évaluation dynamique au niveau de la chaîne impose au développeur de formaliser explicitement le type de donnée manipulé avant même que la requête ne soit compilée et exécutée sur les vecteurs d’entrée.
En outre, la localisation régionale du classeur influe sur la manière dont les arguments de la fonction sont délimités (virgules ou points-virgules pour séparer la plage source de la clause textuelle), mais elle n’altère en aucun cas la syntaxe interne de la requête de visualisation. Ce découplage impose une discipline rigoureuse : l’utilisateur francophone doit composer avec des séparateurs de fonctions conformes à ses paramètres régionaux tout en maintenant une syntaxe de requête invariante calquée sur des normes universelles anglo-saxonnes, garantissant ainsi l’interopérabilité des structures de requêtes à travers différents environnements d’exécution.
1.2 La typologie interne des données temporelles dans les feuilles de calcul
Pour appréhender les subtilités du filtrage chronologique, il est impératif de disséquer la manière dont Google Sheets encode et stocke les entités temporelles au niveau binaire. À l’instar des conventions établies par les tableurs historiques, Google Sheets représente chaque instant sous la forme d’un nombre sériel continu dont le point d’origine, ou époque zéro, est fixé au 30 décembre 1899 à minuit. Chaque unité entière incrémentée à partir de ce pivot représente un jour civil complet. Les fractions décimales associées quant à elles quantifient l’écoulement des heures, minutes et secondes au sein de cette journée. Par exemple, la valeur sérielle 44927 correspond rigoureusement au 1er janvier 2023, tandis que 44927,5 désigne ce même jour à 12h00 précises.
Il existe par conséquent une divergence ontologique fondamentale entre l’affichage cosmétique visible dans une cellule et la valeur scalaire sous-jacente inscrite dans la mémoire vive du tableur. Une date présentée sous le masque 01/01/2023 ou 1 Janvier 2023 n’est qu’une projection graphique superficielle régie par un masque de formatage numérique. Lorsque ces données sont transmises à la fonction QUERY, le moteur de visualisation examine les valeurs scalaires tout en tentant d’inférer le type sémantique dominant de chaque colonne. Cette étape d’inférence constitue l’une des vulnérabilités les plus critiques du traitement temporel.
Le compilateur de l’API Visualization applique en effet une règle de majorité stricte : si une colonne contient un mélange hétérogène de dates sérielles valides et de chaînes de caractères textuelles représentant des dates mal saisies, le moteur détermine le type exclusif de la colonne sur la base d’un échantillonnage statistique majoritaire. Si le type ‘date’ est retenu, toute cellule contenant une chaîne de caractères sera impitoyablement convertie en valeur nulle (null) durant l’exécution de la requête. Réciproquement, si les textes prédominent, les numéros de série de dates seront interprétés comme des entités textuelles ou corrompues, annihilant toute possibilité de filtrage chronologique par inégalité mathématique.
1.3 Nécessité de la standardisation ISO 8601 pour les prédicats
Dès lors qu’une condition de sélection temporelle est introduite dans la clause WHERE d’une requête QUERY, le compilateur de requêtes refuse d’opérer sur des formats locaux ambigus. La chaîne de commande requiert l’adoption sans concession de la norme ISO 8601, qui prescrit la séquence ordonnée Année-Mois-Jour selon le modèle yyyy-mm-dd. Cette standardisation lexicographique stricte est la seule qui prémunisse l’interpréteur contre les confusions inhérentes aux formats régionaux, à l’image de la notation 03/04/2024 qui désigne le 3 avril dans les territoires francophones et le 4 mars au sein des juridictions nord-américaines.
Dans la grammaire de l’API Google Visualization, l’introduction d’un littéral de date au sein du prédicat d’évaluation exige la présence obligatoire du mot-clé date, immédiatement suivi de la valeur normalisée encapsulée entre apostrophes simples, respectant la structure formelle : date 'yyyy-mm-dd'. Ce préfixe agit comme un opérateur de coercition sémantique pour l’analyseur syntaxique, lui signifiant que la chaîne de caractères subséquente ne doit pas être traitée comme un objet textuel ordinaire, mais instanciée en tant qu’objet temporel absolu dans l’espace de comparaison relationnelle.
L’omission de ce mot-clé déclaratif ou la transmission d’une date formatée selon le schéma français conventionnel (par exemple WHERE A > '31/12/2023') provoque une rupture d’intégrité immédiate du processus de compilation. Dans un tel cas de figure, l’analyseur syntaxique traite l’expression comme une comparaison lexicographique basée sur la table des caractères ASCII ou Unicode. Conséquemment, la valeur ’01/01/2024′ serait paradoxalement évaluée comme inférieure à ’31/12/2023′ simplement parce que le caractère ‘0’ précède numériquement le caractère ‘3’. L’adhésion rigide au format ISO 8601 couplée au mot-clé date constitue donc le seul garant d’une évaluation chronologique valide.
2. Anatomie de la syntaxe de base pour le filtrage par date
2.1 Décomposition de la formule canonique de requête temporelle
L’invocation d’un filtrage temporel au sein d’une feuille de calcul Google Sheets requiert une maîtrise formelle de la structure d’appel de la fonction QUERY. La signature canonique de cette fonction s’énonce selon le schéma formel =QUERY(données; requête; [en_têtes]). Le premier argument définit l’espace matriciel bidimensionnel source, tandis que le second héberge la directive de traitement sous forme d’une chaîne textuelle continue. Le troisième paramètre, optionnel mais hautement recommandé pour des impératifs de déterminisme, explicite le nombre de rangées constituant l’en-tête de la table source.
Pour construire une condition temporelle au sein de la clause WHERE, le développeur doit opérer une imbrication méticuleuse de délimiteurs textuels. Au sein de la chaîne de requête globale délimitée par des guillemets doubles standard, le prédicat chronologique s’exprime ainsi :
=QUERY(A1:D100; "SELECT * WHERE A >= date '2023-01-01'"; 1)
Dans cette expression fondamentale, le mot-clé date ordonne au processeur de créer un objet temporel abstrait. Les apostrophes simples ceinturant la chaîne 2023-01-01 permettent d’isoler la valeur scalaire de la date sans clore prématurément la chaîne globale délimitée par les guillemets droits externes. Cette hiérarchisation des délimiteurs est impérative : toute collision entre des guillemets de même niveau sans séquences d’échappement adaptées engendre une exception de type PARSE_ERROR dès l’évaluation lexicale initiale.
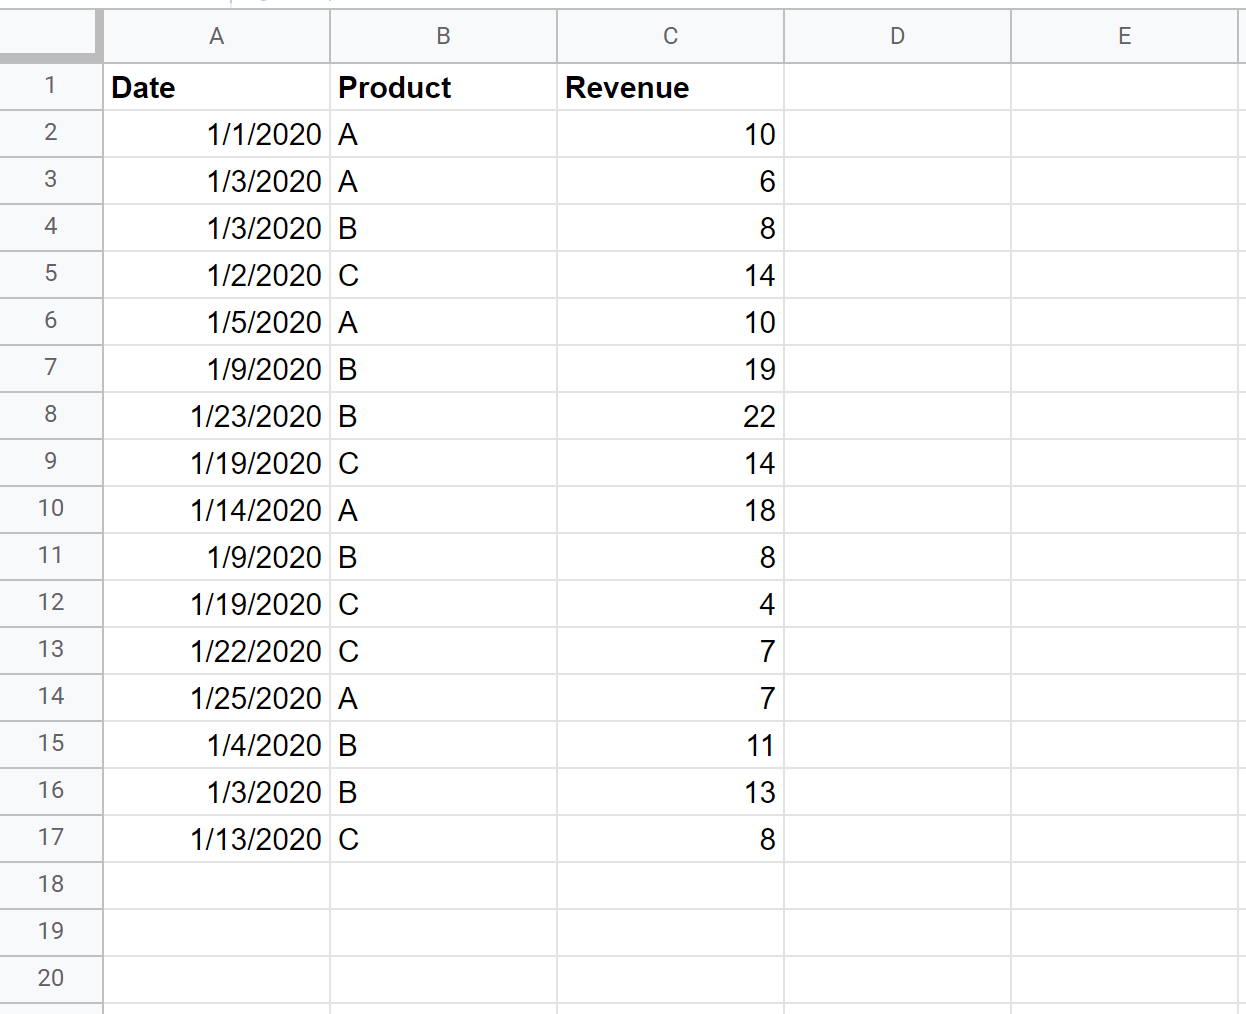
Lorsque la date pivot n’est pas codée en dur sous forme de constante textuelle mais provient d’une évaluation dynamique ou d’une référence externe, l’opérateur de concaténation perluète (&) intervient pour fragmenter la chaîne de requête principale. Le maintien de l’intégrité de la syntaxe finale exige que les apostrophes simples subsistent de part et d’autre de la valeur injectée dynamiquement, ce qui conduit à des formulations hautement compartimentées de type "SELECT * WHERE A >= date '" & [Expression_Date] & "'". La précision du positionnement de chaque caractère d’espacement et de délimitation conditionne l’acceptation de l’instruction par la grammaire de l’API.
2.2 Rôle et interaction des fonctions auxiliaires TEXTE et DATEVAL
Dans les contextes d’automatisation avancée, les dates servant de bornes de filtrage résident presque invariablement au sein de cellules satellites ou émergent du calcul de fonctions tierces. Dès lors, l’interaction directe entre ces valeurs et la fonction QUERY requiert l’intervention de fonctions de sérialisation et de transcodage, principalement les fonctions TEXTE et DATEVAL.
La fonction DATEVAL accomplit la conversion fondamentale d’une représentation textuelle humaine en une valeur sérielle entière propre à Google Sheets. Elle neutralise les scories de formatage et assure l’homogénéisation d’une chaîne brute en un point fixe sur l’axe chronologique. Réciproquement, la fonction TEXTE réalise l’opération inverse, absolument fondamentale pour la composition de requêtes QUERY dynamiques : elle saisit une valeur temporelle sérielle et force sa projection dans un gabarit textuel universel strictement contrôlé au moyen de son second argument formel.
Ainsi, l’assemblage TEXTE(F1; "yyyy-mm-dd") extrait la valeur contenue dans la cellule F1 et garantit qu’elle sera restituée sous la structure normalisée ISO 8601 requise par l’API Visualization, indépendamment de la manière dont la date est affichée visuellement dans F1. L’utilisation délibérée des caractères de masquage yyyy-mm-dd (ou aaaa-mm-jj selon les spécificités de la langue du système d’exploitation) au sein de la fonction TEXTE permet de garantir que les composantes du mois et du jour seront toujours complétées par un zéro initial (par exemple 05 au lieu de 5), respectant scrupuleusement la longueur de dix caractères obligatoire pour le parseur de l’API.
Dans les environnements configurés en langue française, le séparateur syntaxique des arguments au sein des fonctions est le point-virgule (;), tandis que la requête interne QUERY conserve une nomenclature universelle. L’imbrication méthodique s’articule comme suit :
=QUERY(A1:E; "SELECT * WHERE B > date '" & TEXTE(F1; "yyyy-mm-dd") & "'"; 1)
Ce schéma d’interfaçage constitue le mécanisme d’ingénierie le plus robuste pour prévenir toute distorsion temporelle lors du passage des frontières d’évaluation logicielle.
2.3 Sémantique de l’opérateur d’évaluation WHERE
La clause WHERE constitue le cœur logique de restriction au sein de l’algèbre relationnelle supportée par la fonction QUERY. Son rôle consiste à itérer virtuellement sur chaque tuple (rangée) de la matrice de données et d’appliquer une fonction d’évaluation booléenne sur la colonne spécifiée. Seules les rangées pour lesquelles le prédicat s’évalue à TRUE sont conservées dans le flux de sortie matriciel.
Lorsque la colonne cible contient des valeurs vides ou non définies (marquées conceptuellement par l’état null), le compilateur applique les principes stricts de la logique ternaire propre aux bases de données relationnelles. Toute comparaison temporelle impliquant une cellule vide — qu’il s’agisse d’une infériorité, d’une supériorité ou même d’une égalité stricte — renvoie systématiquement la valeur UNKNOWN. En vertu des règles d’exclusion de la clause WHERE, les rangées dont le résultat d’évaluation n’est pas strictement TRUE sont automatiquement rejetées. Cela implique que les lignes possédant des cases temporelles vierges ne seront jamais intégrées dans le résultat, prévenant ainsi les contaminations de données résiduelles sans exiger l’ajout systématique d’une condition AND A IS NOT NULL, bien que cette dernière puisse demeurer utile pour des raisons de documentation explicite de la logique d’affaires.
L’évaluation des opérateurs logiques dans la clause WHERE respecte une hiérarchie stricte de précédence opératoire. Les comparaisons scalaires élémentaires (=, <, >, <=, >=, !=) sont résolues en premier lieu, suivies par l’opérateur de négation NOT, puis par l’opérateur de conjonction AND, et enfin par la disjonction OR. L’incompréhension de cette table de priorité peut conduire à des catastrophes logiques lors de requêtes temporelles complexes combinant des filtres de dates et des segmentations catégorielles, rendant l’usage des parenthèses groupantes non seulement vertueux mais architecturalement indispensable.
3. Filtrage des enregistrements antérieurs à une date définie
3.1 Mise en œuvre de l’opérateur d’infériorité stricte (<)
Le filtrage d’antériorité stricte répond à la nécessité d’isoler des données historiques closes, en écartant méthodiquement tout enregistrement survenu à compter du point de démarcation temporel sélectionné. L’opérateur mathématique dédié à cette restriction est le symbole d’infériorité stricte <. La formulation syntaxique standard au sein du compilateur s’articule sous la forme :
WHERE A < date 'yyyy-mm-dd'
Cette condition instruit le moteur de calcul de vérifier si la valeur sérielle inscrite dans la colonne A est strictement inférieure au numéro de série équivalent à minuit (00:00:00.000) au jour spécifié. Cette précision mathématique sur l’heure implicite est déterminante lorsque les données d’entrée comportent des horodatages continus (timestamps) générés par des systèmes automatisés ou des formulaires d’acquisition de données.
Considérons un enregistrement dont la date d’acquisition est le 2023-05-15 08:30:00. Si le prédicat de la requête est formulé sous la modalité WHERE A < date '2023-05-15', l’enregistrement sera exclu de manière catégorique du jeu de résultats. Bien que le jour calendaire corresponde formellement au 15 mai 2023, la date spécifiée sans précision horaire correspond canoniquement au 2023-05-15 00:00:00. Sur le plan de la droite réelle, la valeur sérielle de l’événement (environ 45061,354) dépasse strictement la borne d’exclusion (45061,000). Il est donc vital d’intégrer que l’infériorité stricte à une date donnée exclut par définition l’intégralité de la journée désignée par ladite date dès le premier millième de seconde qui suit minuit.
Ce comportement est particulièrement adapté pour les scénarios de clôture comptable mensuelle ou d’archivage légal, où une partition nette doit être opérée entre les exercices révolus et les transactions d’une période courante débutant à un jour précis.
3.2 Mise en œuvre de l’opérateur d’antériorité inclusive (<=)
À l’inverse de la sélection stricte, l’opérateur de comparaison d’antériorité inclusive <= permet d’englober la borne supérieure au sein de l’échantillon extrait. Sa syntaxe générale s’établit comme suit :
WHERE A <= date 'yyyy-mm-dd'
L’usage de ce comparateur au sein des bases de données de tableur présente toutefois un risque technique majeur lié à la nature continue du temps par rapport à la granularité discrète des calendriers administratifs. Si la colonne examinée héberge des dates pures (c’est-à-dire dont la fraction décimale de la valeur sérielle est rigoureusement égale à zéro), l’instruction WHERE A <= date '2023-12-31' intégrera sans distorsion l’ensemble des événements rattachés au 31 décembre.
Cependant, si la source de données incorpore des horodatages détaillés, la comparaison inclusive révélera un comportement trompeur pour l’analyste non averti. Étant donné que le littéral date '2023-12-31' s’évalue conceptuellement à 2023-12-31 00:00:00, tout événement survenu au cours de cette même journée — par exemple à 14h15 — possèdera une composante sérielle supérieure à la borne. L’événement sera donc rejeté, en dépit de l’apparence inclusive du comparateur <=. Pour capturer véritablement l’intégralité d’une journée charnière contenant des horodatages continus, la rigueur analytique impose d’ajuster l’équation selon deux approches :
- Transposer la borne au jour supérieur au moyen d’un opérateur d’infériorité stricte :
WHERE A < date '2024-01-01'. - Recourir explicitement au typage littéral
datetimeavec spécification de la limite ultime de la journée :WHERE A <= datetime '2023-12-31 23:59:59'.
L’audit méticuleux de la granularité temporelle du jeu d’origine constitue un prérequis incontournable pour éviter l’éviction accidentelle d’enregistrements limites lors de la production de rapports financiers ou opérationnels critiques.
3.3 Étude de cas : Filtrage d’une base de transactions antérieures à une date butoir
Afin d’illustrer la mécanique opératoire de l’antériorité, considérons une structure de données d’entreprise stockée dans la plage matricielle A1:C17 d’un classeur opérationnel. Ce jeu d’épreuve consigne des flux financiers et se compose de trois colonnes : l’identifiant unique de transaction (colonne A, format textuel), la date d’exécution (colonne B, format date) et le montant monétaire valorisé (colonne C, format numérique).
L’objectif analytique consiste à isoler l’intégralité des transactions finalisées strictement avant le premier jour du second semestre fiscal de l’année 2023, c’est-à-dire avant le 1er juillet 2023. La formulation canonique mise en œuvre pour cette extraction s’écrit :
=QUERY(A1:C17; "SELECT A, B, C WHERE B < date '2023-07-01'"; 1)
Lors de l’évaluation, le compilateur analyse la rangée d’en-tête (grâce au troisième argument valorisé à 1) et conserve les titres de colonnes. Ensuite, pour chaque rangée de la table de données, la date sérielle présente dans la colonne B est comparée à la valeur scalaire associée au 2023-07-01 00:00:00. Les transactions horodatées au 2023-06-30 sont retenues, tandis qu’une transaction enregistrée le 2023-07-01 est exclue.
Les erreurs typiques observées dans ce type de manipulation résident dans la transposition erronée de conventions linguistiques. L’écriture "SELECT * WHERE B < '2023-07-01'" (omettant le mot-clé date) transforme l’analyse en comparaison alphabétique, générant des résultats aberrants dès lors que des formats de dates hétérogènes coexistent, ou que les dates ne sont pas strictement préfixées par quatre chiffres d’année. L’exactitude du typage protège l’analyste de toute distorsion dans la distribution statistique des données extraites.
4. Filtrage des enregistrements postérieurs à une date définie
4.1 Mise en œuvre de l’opérateur de supériorité stricte (>)
La prospection d’événements récents, l’évaluation de cohortes actives ou l’analyse des tendances post-déploiement reposent sur l’interrogation de segments chronologiques situés en aval d’une date charnière. L’opérateur de supériorité stricte > matérialise cette exigence logique. Son insertion dans la clause de filtrage s’exécute selon la formule type :
WHERE A > date 'yyyy-mm-dd'
Cet opérateur rejette formellement toute valeur dont le numéro de série est inférieur ou égal à l’instant zéro de la date mentionnée. Dans un système de prévision budgétaire ou d’allocation de ressources, cette écriture garantit que les observations passées ainsi que le point d’ancrage lui-même sont impérativement purgés de la vue de projection calculée.
Un avantage déterminant de l’opérateur de supériorité stricte vis-à-vis des valeurs manquantes ou des cellules corrompues réside dans la manière dont le moteur de visualisation évalue les anomalies. Une cellule contenant une chaîne vide ou une mention non conforme renvoie un statut d’incompatibilité de type qui s’évalue en logique ternaire à FALSE ou UNKNOWN. Ainsi, contrairement aux filtrages textuels où des chaînes vides peuvent parfois s’insérer de façon intempestive en fonction de la formulation des filtres, la comparaison mathématique temporelle élimine nativement tout résidu d’enregistrement dénué de cohérence chronologique.
Néanmoins, l’analyste doit demeurer vigilant quant au décalage provoqué par les fuseaux horaires sous-jacents (UTC versus fuseau local du classeur). Si des dates proviennent d’une source déportée via une connexion logicielle (API Web, Google Forms) sans réajustement du fuseau horaire du classeur défini dans les paramètres de la feuille, le comparateur de supériorité stricte peut écarter de façon non intentionnelle des événements enregistrés en début de journée calendaire locale.
4.2 Mise en œuvre de l’opérateur de postériorité inclusive (>=)
Pour intégrer intégralement une journée de référence dans le champ des observations contemporaines ou futures, l’opérateur de postériorité inclusive >= s’avère indispensable. La commande adopte la disposition suivante :
WHERE A >= date 'yyyy-mm-dd'
Cette condition présente une symétrie opérationnelle particulièrement robuste face aux horodatages continus. Dans la mesure où le littéral date 'yyyy-mm-dd' équivaut à minuit pile au commencement de la journée désignée, toute transaction survenue au cours de cette même journée — qu’elle se produise à l’aube, à midi ou aux ultimes secondes précédant le jour suivant — possédera une valeur sérielle strictement supérieure ou égale à ce seuil initial.
Par conséquent, l’opérateur >= ne souffre pas de l’asymétrie observée lors de l’application du comparateur <= sur des données horodatées. Il capte de manière exhaustive le cycle journalier complet de la date pivot saisie. Cette particularité en fait l’opérateur privilégié pour déterminer les seuils d’entrée des cohortes analytiques, des jalons de projets ou des ouvertures de périodes d’évaluation commerciale.
Il demeure toutefois nécessaire de s’assurer que le format d’affichage appliqué dans la feuille source n’induit pas l’utilisateur en erreur sur la nature de la valeur stockée. Une cellule affichant 15/01/2024 en raison d’un formatage personnalisé tronquant l’heure, mais stockant secrètement la valeur 14/01/2024 23:59:58 en raison d’un calcul intermédiaire résiduel, sera systématiquement exclue par un prédicat WHERE A >= date '2024-01-15'. L’audit de l’intégrité de la couche sérielle s’affirme donc une fois de plus comme une règle de gouvernance de données absolue.
4.3 Étude de cas : Extraction d’une cohorte d’utilisateurs postérieurs à une date charnière
Considérons un environnement applicatif consignant les inscriptions de nouveaux utilisateurs au sein d’une table matricielle étendue sur les colonnes A à E. La colonne A consigne l’identifiant client, la colonne B l’adresse électronique, et la colonne C enregistre l’instant d’activation du compte. Le département opérationnel requiert l’extraction de l’ensemble des comptes activés à partir du 1er septembre 2023 inclus, en prévision d’une campagne de réengagement ciblée.
La date pivot est consignée de façon dynamique dans la cellule H2 de la feuille de pilotage. Pour construire une extraction robuste et réutilisable qui tolère les modifications interactives de l’utilisateur en H2, la formule déployée au sein de la cellule de destination s’articule comme suit :
=QUERY(A2:E; "SELECT A, B, C WHERE C >= date '" & TEXTE(H2; "yyyy-mm-dd") & "' ORDER BY C ASC"; 0)
L’analyse de cette formule met en lumière plusieurs mécanismes de sécurisation :
- L’utilisation de la fonction
TEXTE(H2; "yyyy-mm-dd")force la coercition de la valeur de la cellule de commande vers la structure ISO 8601, neutralisant tout risque d’inversion jour/mois ou de dépendance aux paramètres linguistiques locaux du compte Google actif. - L’encapsulation de la variable dynamique à l’intérieur des fragments textuels de la requête au moyen de la perluète (
&) reconstitue fidèlement les délimiteurs d’apostrophes simples requis par le compilateur de requêtes. - L’adjonction de la directive
ORDER BY C ASCassure une restitution séquentielle et chronologique de la cohorte, garantissant que les rangées matricielles générées respectent le fil conducteur temporel des inscriptions.
Si la cellule H2 contenait une chaîne de caractères malformée (telle que "01-Sept-2023"), la fonction TEXTE renverrait une anomalie ou une transcription littérale inadéquate qui déclencherait un rejet catégorique du compilateur via l’erreur #VALUE! (PARSE_ERROR). Cela confirme l’impératif de valider strictement le type de données présent dans les cellules de pilotage externe.
5. Extraction de données au sein d’une plage temporelle délimitée
5.1 Articulation de l’opérateur logique AND pour encadrer un intervalle
L’opération analytique la plus commune et exigeante au sein des systèmes de gestion consiste à extraire un segment fini d’enregistrements compris entre deux bornes calendaires parfaitement identifiées. Contrairement aux langages de bases de données relationnelles avancés qui implémentent l’opérateur synthétique BETWEEN, le dialecte de l’API Google Visualization ne supporte pas nativement cette construction lexicale. Il est par conséquent obligatoire de recourir à l’articulation explicite de l’opérateur logique de conjonction AND.
Le schéma syntaxique universel pour borner un intervalle temporel sur une colonne d’évaluation unique prend la forme canonique suivante :
WHERE A >= date 'yyyy-mm-dd' AND A <= date 'yyyy-mm-dd'
Dans ce modèle d’évaluation booléenne, le compilateur soumet chaque ligne du jeu de données à une double validation séquentielle. La ligne n’est validée que si et seulement si l’ensemble des deux prédicats produit un état de vérité irréfutable. Si l’un des termes échoue, l’enregistrement est immédiatement écarté du flux matriciel résultant.
Il importe de souligner une erreur syntaxique courante commise par les utilisateurs habitués au langage naturel : l’ellipse de la colonne cible dans la seconde condition. La formulation WHERE A >= date '2023-01-01' AND <= date '2023-01-31' est structuralement invalide et induit l’interruption du processus d’analyse syntaxique. L’identifiant de la colonne (ici A) doit être explicitement répété de part et d’autre de l’opérateur de liaison logique, chaque membre de l’expression conjonctive devant former une proposition propositionnelle complète et autonome.
5.2 Gestion des frontières : intervalles fermés, ouverts et semi-ouverts
La théorie des ensembles appliquée aux bases de données enseigne que la délimitation des frontières d’un intervalle conditionne directement la validité des métriques de synthèse issues de cet échantillonnage. Selon les opérateurs de comparaison retenus, l’analyste manipule l’un des trois types fondamentaux de segments temporels :
- L’intervalle fermé [Date1, Date2] : Modélisé par la combinaison
A >= date '...' AND A <= date '...'. Ce schéma intègre les deux bornes. Il s’applique idéalement à des données calendaires pures sans granularité horaire. - L’intervalle ouvert ]Date1, Date2[ : Matérialisé par
A > date '...' AND A < date '...'. Ce cadre rejette formellement les deux extrémités, ne retenant que la substance temporelle strictement comprise entre elles. - L’intervalle semi-ouvert [Date1, Date2[ : Traduit par la syntaxe
A >= date '...' AND A < date '...'. Il représente le standard d’excellence en ingénierie de données financières et statistiques, particulièrement lorsque les jeux d’enregistrements comportent des composantes d’horodatage continues.
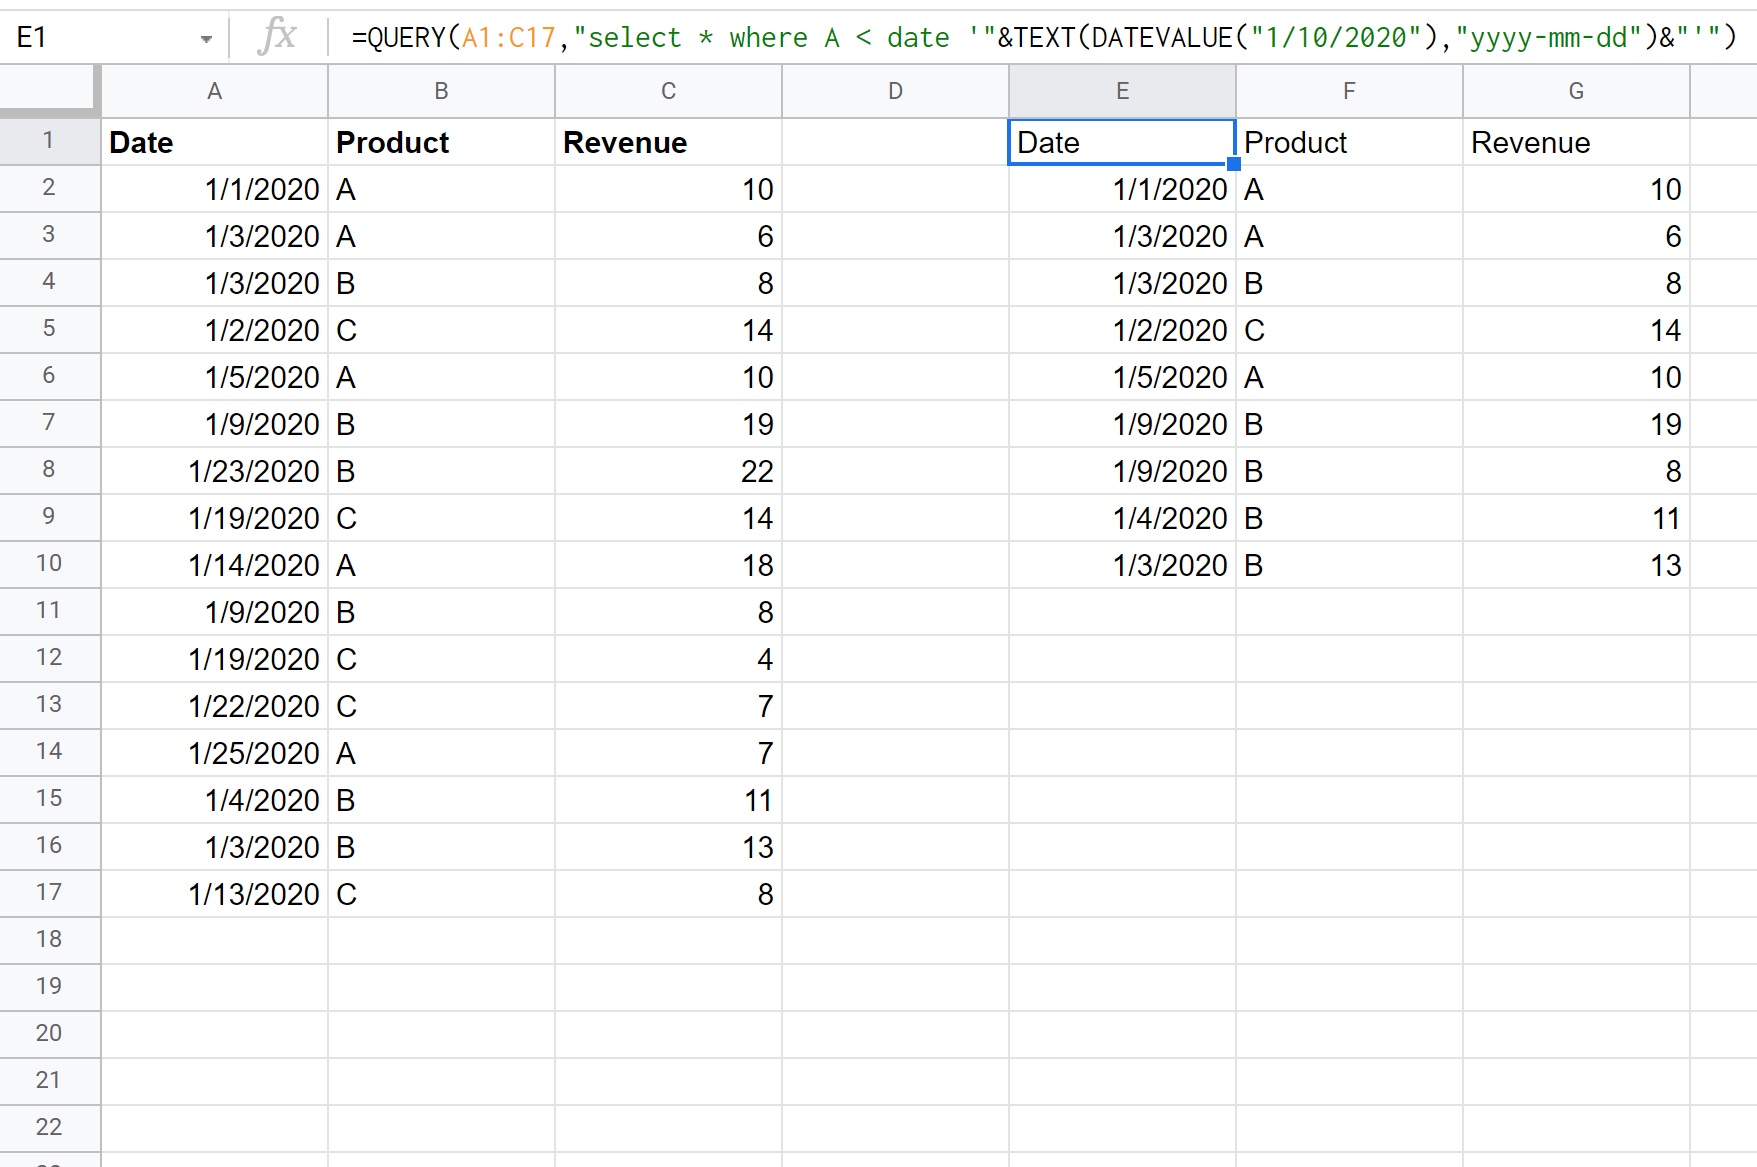
L’utilisation systématique de l’intervalle semi-ouvert élimine le risque d’omission ou de double comptage lors de la fragmentation d’une série temporelle continue en périodes adjacentes. Pour analyser le mois de mars d’une année non bissextile, l’analyste formulera sa restriction sous la forme :
WHERE A >= date '2023-03-01' AND A < date '2023-04-01'
Cette approche garantit qu’un événement survenu le 31 mars à 23h59m59s sera capturé de manière transparente sans qu’il soit nécessaire d’introduire des approximations artificielles sur les microsecondes, tout en préservant l’étanchéité absolue vis-à-vis du premier jour du mois d’avril.
5.3 Étude de cas : Filtrage exhaustif des transactions entre deux dates déterminées
Dans le but d’éprouver ces principes de segmentation dans un environnement contrôlé, établissons une base de données de dix-sept observations financières distribuées sur la plage A1:C17 d’une feuille de calcul. Le modèle de données associe chaque transaction à un code de référence (colonne A), une date de réalisation comptable (colonne B) et un flux de trésorerie net (colonne C).
Le mandat consiste à agréger l’ensemble des opérations financières conclues au cours du premier trimestre de l’exercice 2023, c’est-à-dire débutant le 1er janvier 2023 et s’achevant le 31 mars 2023 à minuit. En intégrant les cellules de saisie de critères E1 pour la borne basse et E2 pour la borne haute, la construction de la formule QUERY finale adopte une architecture modulaire sophistiquée :
=QUERY(A1:C17; "SELECT A, B, C WHERE B >= date '" & TEXTE(E1; "yyyy-mm-dd") & "' AND B <= date '" & TEXTE(E2; "yyyy-mm-dd") & "' ORDER BY B ASC"; 1)
L’analyse dynamique du flux d’exécution révèle comment le processeur de requêtes procède :
- Les fonctions
TEXTEimbriquées résolvent en amont les dates présentes dans les cellules de paramètresE1etE2pour les restituer sous la chaîne normalisée2023-01-01et2023-03-31. - L’opérateur d’assemblage
&fusionne ces projections dans la chaîne de commande principale, forgeant l’instruction finale transmise à l’API. - Le moteur compile la clause conjonctive et évalue simultanément les deux conditions pour chaque rangée de l’espace source.
- Les rangées dont la date sérielle satisfait simultanément les deux inégalités sont projetées dans la mémoire matricielle, puis triées chronologiquement selon le champ
Bavant d’être restituées sur la grille de calcul hôte.
Ce protocole assure une étanchéité analytique parfaite, éliminant tout risque de captation d’enregistrements appartenant aux trimestres adjacents et fournissant une base saine pour des calculs d’agrégation subséquents.
6. Paramétrage dynamique des filtres temporels par références cellulaires
6.1 Découplage de la logique de calcul et des paramètres d’entrée
Dans l’architecture de systèmes d’information décisionnels déployés sur tableur, l’inscription de constantes littérales au cœur des algorithmes de calcul — pratique communément désignée sous le terme de « codage en dur » (hardcoding) — constitue une anti-méthode préjudiciable à la maintenabilité et à l’évolutivité des solutions. La séparation structurelle entre le moteur de traitement logique (la formule QUERY) et l’interface utilisateur de saisie (les cellules de contrôle) représente un principe fondamental d’ingénierie applicative.
Le découplage confère à la feuille de calcul une réactivité opérationnelle immédiate : les utilisateurs finaux peuvent faire fluctuer les bornes d’analyse sans altérer l’intégrité de la syntaxe sous-jacente, prévenant ainsi les corruptions accidentelles de code. En outre, cette approche rationalise considérablement la maintenance : une formule centralisée dynamique peut être reproduite à l’identique au sein de multiples sous-feuilles sans requérir de réécriture contextuelle, dès lors que toutes pointent vers une cellule de pilotage standardisée.
Pour parfaire ce découplage, l’assignation de plages nommées aux cellules de contrôle représente une stratégie logicielle hautement recommandée. Assigner l’identifiant sémantique Date_Debut à la cellule B1 et Date_Fin à la cellule B2 clarifie instantanément la lisibilité de la chaîne de requête assemblée et immunise les formules contre les décalages de coordonnées géométriques consécutifs à l’insertion impromptue de rangées ou de colonnes dans la feuille de saisie.
6.2 Technique de concaténation des cellules pour la construction de la clause
L’incorporation de références cellulaires dynamiques au sein du langage quasi-SQL de Google Sheets nécessite une déconstruction rigoureuse du mécanisme d’échappement et de concaténation des chaînes de caractères. Dans la mesure où la requête globale est elle-même un littéral textuel délimité par des guillemets doubles, l’injection d’une valeur variable impose d’interrompre temporairement ce littéral, d’adjoindre la référence calculée via l’opérateur &, puis de réinstancier le littéral pour clore la grammaire de l’instruction.
Le patron syntaxique fondamental pour injecter une référence de date se déploie selon la décomposition séquentielle ci-après :
"SELECT * WHERE A >= date '" & TEXTE(Cellule_Reference; "yyyy-mm-dd") & "'"
Examinons en détail l’ordonnancement de ces caractères :
"SELECT * WHERE A >= date '": Ce premier segment textuel ouvre l’instruction et pose le mot-clédate, suivi d’un espace et d’une apostrophe simple qui demeure intentionnellement ouverte.& TEXTE(Cellule_Reference; "yyyy-mm-dd") &: L’opérateur d’assemblage interrompt la chaîne statique pour insérer le résultat normalisé de la fonction de coercition, garantissant que la date sera projetée sous la structureyyyy-mm-dd."'": Ce dernier segment rétablit une chaîne textuelle statique constituée exclusivement d’une apostrophe simple fermante, refermant hermétiquement le conteneur du littéral de date attendu par le compilateur Visualization.
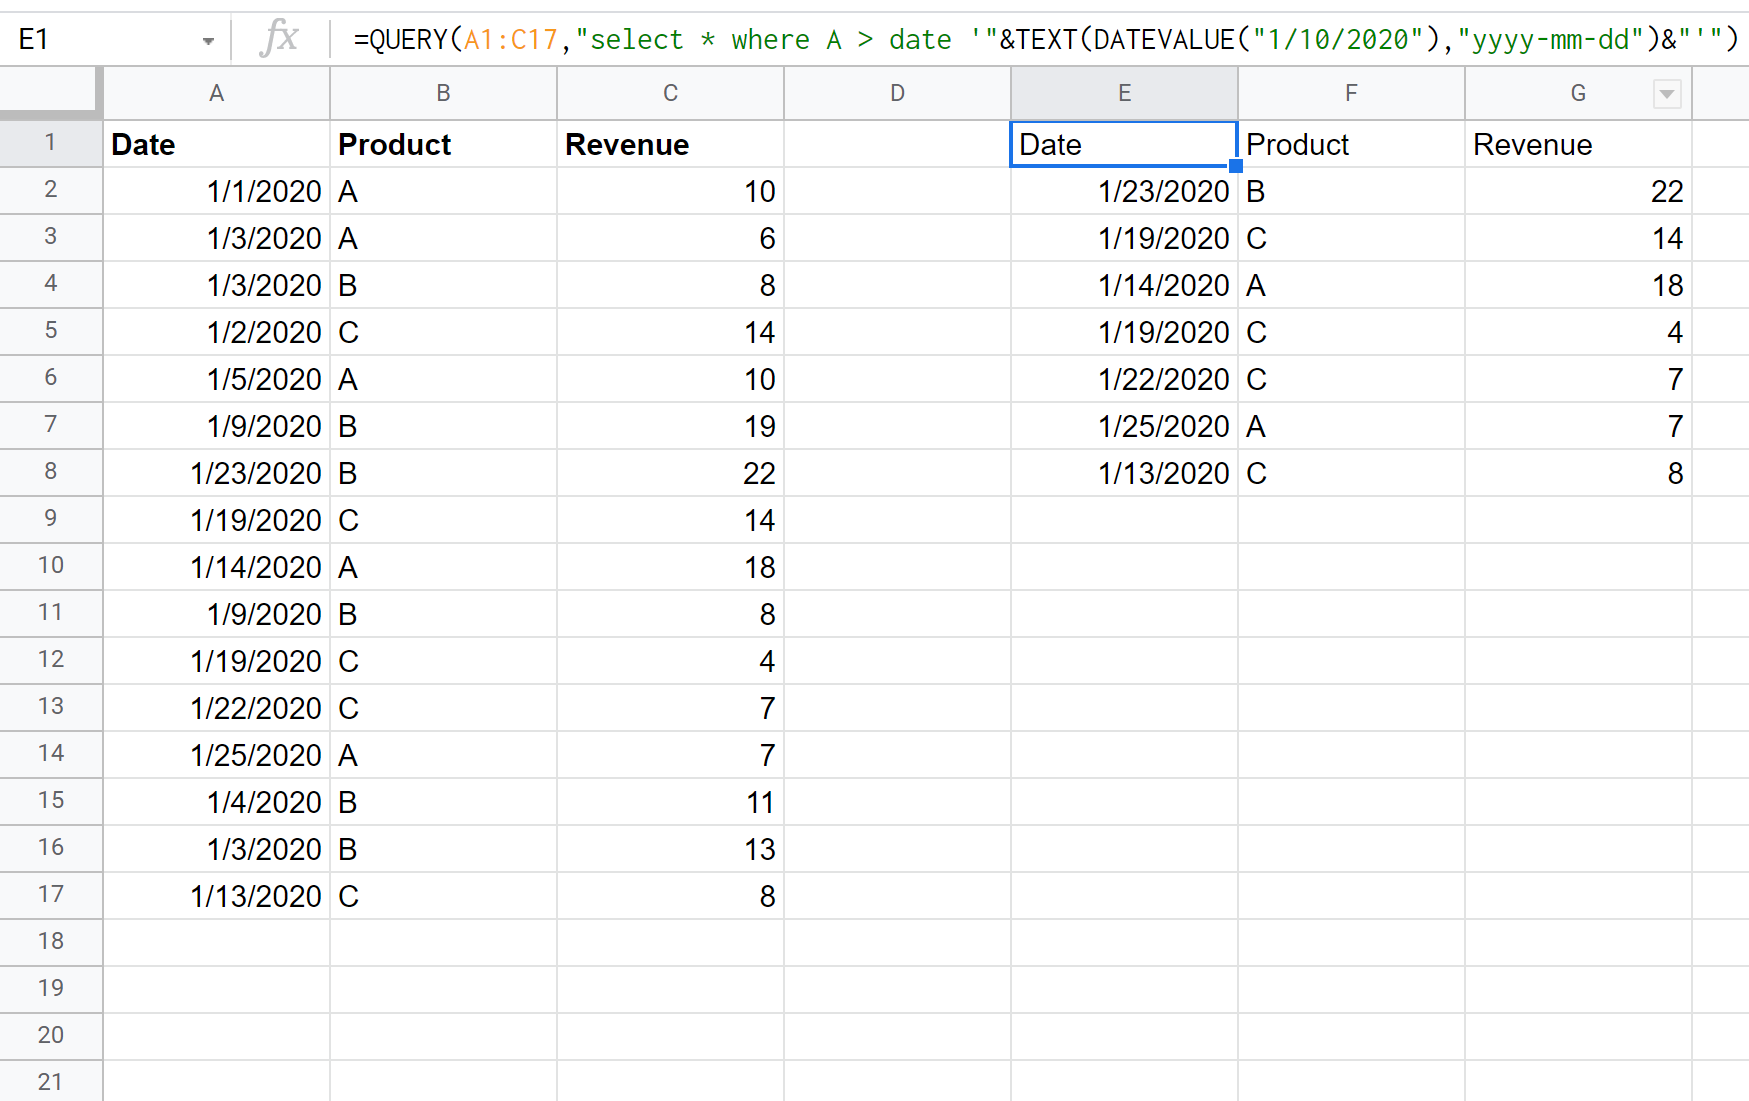
Tout déséquilibre dans cette ponctuation millimétrée — tel que l’oubli de l’apostrophe finale dissimulée au sein des guillemets doubles — est la cause première des notifications d’erreur de compilation du type PARSE_ERROR: Encountered <EOF>, le parseur attendant désespérément la balise de fermeture de la chaîne temporelle avant de rencontrer la fin inopinée de l’instruction.
6.3 Sécurisation de la saisie utilisateur et validation des données
Dès lors qu’une formule s’en remet à des paramètres de saisie humaine, la robustesse globale du système est conditionnée par l’éradication des entrées malformées en amont du calcul. La mise en place de barrières de validation des données sur les cellules de critères temporels s’avère indispensable pour neutraliser toute possibilité de saisie invalide.
Au niveau de l’interface de Google Sheets, l’analyste doit appliquer une règle de Validation des données stricte assignée aux cellules de référence, configurée sur le critère « Est une date valide » avec l’option « Rejeter la saisie » activée. Ce garde-fou élémentaire interdit l’inscription de valeurs typographiques aberrantes ou de descriptions textuelles non résolutives qui compromettraient l’exécution de la fonction TEXTE en cascade.
Par ailleurs, une cohérence chronologique élémentaire impose que la date de fin d’un intervalle soit temporellement postérieure ou égale à la date de début. Pour faire respecter cette contrainte d’affaires, une règle de validation personnalisée par formule peut être déployée sur la cellule de borne finale :
=B2 >= B1
Enfin, afin de parer élégamment aux situations transitoires où les cellules de référence demeurent momentanément inoccupées (engendrant des erreurs de type #VALUE! lors de l’exécution de QUERY), il convient d’encapsuler la formule dynamique au sein d’une structure conditionnelle préventive :
=SI(OU(ESTVIDE(B1); ESTVIDE(B2)); "Veuillez spécifier l'intervalle complet"; QUERY(A1:D; "SELECT * WHERE A >= date '" & TEXTE(B1; "yyyy-mm-dd") & "' AND A <= date '" & TEXTE(B2; "yyyy-mm-dd") & "'"; 1))
Cette disposition d’ingénierie défensive garantit que la fonction QUERY n’est sollicitée que lorsque l’ensemble de ses conditions initiales de calcul sont formellement réunies et validées.
7. Intégration de dates relatives et de fonctions calendaires dynamiques
7.1 Filtrage dynamique basé sur la fonction AUJOURDHUI (TODAY)
La conception de tableaux de bord opérationnels et de synthèses managériales exige fréquemment une actualisation continue des indicateurs en fonction du cycle calendaire réel, sans requérir d’intervention manuelle pour actualiser les bornes d’analyse. Pour concevoir ces « fenêtres glissantes », la fonction volatile AUJOURDHUI() (ou TODAY()) devient la force motrice de l’évaluation dynamique au sein de la clause QUERY.
La fonction AUJOURDHUI() génère automatiquement à chaque recalcul de la feuille la valeur sérielle entière correspondant au jour calendaire présent. Pour insérer ce repère mobile au cœur d’une requête de filtrage, la formulation standard s’appuie sur la concaténation de son format normalisé :
=QUERY(A1:E; "SELECT * WHERE A >= date '" & TEXTE(AUJOURDHUI() - 30; "yyyy-mm-dd") & "'"; 1)
Dans cet exemple paradigmatique, l’expression arithmétique AUJOURDHUI() - 30 retranche trente jours entiers à la date système courante avant que la fonction TEXTE ne formalise la chaîne ISO. Le filtre généré retient ainsi en continu les enregistrements survenus au cours des trente derniers jours calendaires glissants, s’ajustant de façon autonome à minuit chaque nuit.
Une vigilance technique particulière doit être accordée au paramétrage du fuseau horaire du classeur Google Sheets (accessible via Fichier > Paramètres > Paramètres du classeur). Si le fuseau horaire de la feuille diffère du fuseau de la machine cliente ou de l’infrastructure d’acquisition des données, la fonction AUJOURDHUI() basculera vers le jour subséquent avec un décalage potentiel de plusieurs heures, créant des anomalies de bordure imperceptibles mais statistiques au niveau des enregistrements quotidiens.
7.2 Utilisation de fonctions de calcul de décalage (MOIS.DECALER, FIN.MOIS)
Si la soustraction arithmétique simple suffit pour des périodes glissantes exprimées en jours fixes, elle s’avère inopérante pour capturer des cycles calendaires civils complets (mois, trimestres, années) en raison de la variabilité structurelle de la durée des mois (de 28 à 31 jours) et des années bissextiles. L’ingénierie de données dans Google Sheets mobilise à cet effet des fonctions de décalage calendaire spécialisées telles que MOIS.DECALER et FIN.MOIS.
La fonction FIN.MOIS(date_départ; mois) s’avère particulièrement redoutable pour circonscrire des fenêtres temporelles administratives nettes. Considérons la nécessité d’extraire automatiquement l’intégralité des transactions du mois civil précédent, indépendamment du jour courant où le rapport est consulté. La borne inférieure (le premier jour du mois précédent) s’obtient dynamiquement par l’expression :
FIN.MOIS(AUJOURDHUI(); -2) + 1
Tandis que la borne supérieure inclusive (le dernier jour de ce même mois civil antérieur) s’exprime par :
FIN.MOIS(AUJOURDHUI(); -1)
L’intégration de ces générateurs au sein de la fonction QUERY se concrétise selon l’architecture suivante :
=QUERY(A1:D; "SELECT * WHERE A >= date '" & TEXTE(FIN.MOIS(AUJOURDHUI(); -2) + 1; "yyyy-mm-dd") & "' AND A <= date '" & TEXTE(FIN.MOIS(AUJOURDHUI(); -1); "yyyy-mm-dd") & "'"; 1)
Ce procédé libère entièrement les équipes financières de l’obligation de recalculer manuellement les coordonnées temporelles lors de chaque clôture périodique, assurant une pérennité absolue des tableaux de bord institutionnels.
7.3 Gestion des timestamps précis avec la fonction MAINTENANT (NOW)
Lorsque la dimension d’analyse temporelle requiert une précision descendue à l’échelle de l’heure, de la minute ou de la seconde — situation récurrente dans les journaux de serveurs, les flux de télémétrie IoT ou les transactions de haute fréquence —, le type scalaire date devient sémantiquement insuffisant. Le moteur de visualisation de Google Sheets fournit alors un type dédié : le littéral datetime.
La construction syntaxique d’une condition basée sur un instantané précis impose une structure normalisée étirée, intégrant la projection horaire sous la forme datetime 'yyyy-mm-dd hh:mm:ss'. Pour extraire les événements survenus au cours des dernières vingt-quatre heures mobiles en exploitant la fonction volatile MAINTENANT(), la formule doit être formulée selon l’encodage textuel ci-après :
=QUERY(A1:E; "SELECT * WHERE A >= datetime '" & TEXTE(MAINTENANT() - 1; "yyyy-mm-dd hh:mm:ss") & "'"; 1)
Deux considérations d’ingénierie logicielle émergent lors de la manipulation d’instantanés haute fréquence :
- La fonction
TEXTEdoit impérativement adopter le gabarit formatéyyyy-mm-dd hh:mm:ss. L’omission des segments horaires ou l’usage de séparateurs non standardisés (tels que des tirets au lieu des deux-points pour les heures) déclenche une rupture d’incompatibilité immédiate lors de l’instanciation de l’objetdatetime. - L’usage intensif de la fonction volatile
MAINTENANT()provoque un recalcul perpétuel du graphe de dépendances de la feuille à chaque interaction utilisateur ou modification de données, ce qui peut dégrader significativement les performances globales de calcul sur des matrices hébergeant des dizaines de milliers d’enregistrements. Une pondération rigoureuse entre besoin de fraîcheur de données et réactivité de calcul s’avère donc indispensable.
8. Conjonction de critères : filtrage par dates et conditions multiples
8.1 Combinaison des filtres temporels et textuels via l’opérateur AND
Dans les applications analytiques réelles, les contraintes d’interrogation temporelle n’évoluent que très rarement de manière isolée. Elles s’insèrent au sein d’arbres de décision multidimensionnels associant des contraintes chronologiques et des critères de catégorisation textuelle ou quantitative. La maîtrise des requêtes combinées au moyen de l’opérateur de conjonction AND est le prérequis à toute segmentation métier rigoureuse.
Considérons une table de suivi logistique où la colonne A consigne la date d’expédition, la colonne B l’identifiant géographique de l’entrepôt expéditeur, et la colonne C le statut opérationnel de la livraison. Si l’analyste se propose d’extraire les commandes expédiées à partir du 1er novembre 2023, en provenance exclusive du centre de distribution « Paris-Nord », et dont le statut actuel n’est pas « Livré », la clause WHERE se structure sous une syntaxe multi-critères :
=QUERY(A1:D; "SELECT * WHERE A >= date '2023-11-01' AND B = 'Paris-Nord' AND C != 'Livré'"; 1)
L’optimisation du plan d’exécution impose de respecter une cohérence sémantique scrupuleuse dans l’ordonnancement des termes. Le compilateur évalue chaque proposition dans l’ordre de sa rédaction. Bien que le résultat logique final demeure invariant conformément aux axiomes de l’algèbre booléenne, l’analyse préalable des prédicats les plus restrictifs permet, sur le plan conceptuel, d’éliminer immédiatement les sous-ensembles les plus volumineux, allégeant la charge cognitive lors de la relecture et de l’audit de la formule.
Il importe de réitérer que les chaînes textuelles d’évaluation (à l’instar de 'Paris-Nord') doivent être impérativement encadrées par des apostrophes simples, tout comme les valeurs associées au mot-clé date, mais sans préfixe déclaratif d’aucune sorte, ce dernier étant le privilège exclusif des types temporels et d’instantanés.
8.2 Introduction de l’alternative logique avec l’opérateur OR
L’intégration de la disjonction logique au travers de l’opérateur OR permet d’échantillonner des plages temporelles non adjacentes, de modéliser des périodes discontinues ou de collecter des événements soumis à des conditions mutuellement exclusives. Toutefois, la combinaison hybride des opérateurs AND et OR au sein d’un même prédicat d’interrogation constitue l’une des sources les plus prolifiques de régressions logiques.
En vertu des lois canoniques de précédence opératoire du processeur de requêtes de Google Visualization, l’opérateur de conjonction AND possède une priorité intrinsèque supérieure à l’opérateur de disjonction OR. Cela implique que l’expression textuelle :
WHERE A >= date '2023-01-01' AND A <= date '2023-01-31' OR B = 'Prioritaire'
Sera compilée et interprétée comme étant :
WHERE (A >= date '2023-01-01' AND A <= date '2023-01-31') OR B = 'Prioritaire'
Le sous-ensemble résultant intégrera dès lors l’intégralité des transactions prioritaires de l’histoire du classeur, y compris celles survenues il y a dix ans, anéantissant totalement la volonté originelle de confiner l’extraction globale aux limites du mois de janvier 2023. Pour imposer la priorité logique et forcer l’évaluation conjointe de conditions temporelles et catégorielles intriquées, l’usage des parenthèses groupantes est formellement obligatoire :
WHERE (A >= date '2023-01-01' AND A <= date '2023-01-31') AND (B = 'Prioritaire' OR B = 'Urgent')
Cette formulation garantit que le filtrage chronologique s’applique uniformément à toutes les branches de l’alternative catégorielle sans distorsion structurelle.
8.3 Négation de conditions temporelles via l’opérateur NOT
Il se présente des circonstances analytiques où la modélisation d’une exception s’avère cognitivement et syntaxiquement plus efficiente que la déclaration exhaustive de multiples intervalles autorisés. L’opérateur de négation logique NOT fournit ce vecteur d’inversion sémantique au sein de la clause de sélection.
Considérons l’obligation d’extraire l’ensemble des données d’activité d’une chaîne logistique couvrant une année pleine, tout en excluant expressément la période de fermeture estivale survenue entre le 1er et le 15 août 2023 inclus. Deux formulations sont mathématiquement équivalentes :
- La formulation disjonctive segmentée :
WHERE (A < date '2023-08-01' OR A > date '2023-08-15'). - La formulation affirmative inversée par négation :
WHERE NOT (A >= date '2023-08-01' AND A <= date '2023-08-15').
L’utilisation de la négation encadrant une proposition conjonctive (NOT (...)) traduit avec une clarté remarquable l’intention métier : extraire tout enregistrement n’appartenant pas à la plage d’exclusion. Cette approche limite drastiquement les risques d’erreurs aux bornes inhérents à l’inversion manuelle des comparateurs (l’inversion d’un >= devant être un < strict, et non un <=, détail qui échappe fréquemment aux opérateurs).
Sur le plan des performances algorithmiques, le moteur de requêtes résout les arbres d’inversion logique avec un coût computationnel marginalement identique à celui d’une écriture standard. Il est cependant recommandé de ne pas multiplier l’imbrication d’opérateurs NOT au sein d’une même clause sous peine d’opacifier inutilement la maintenance logicielle pour les tiers auditeurs.
9. Harmonisation des données : formats régionaux et conflits textuels
9.1 Résolution des conflits entre paramètres régionaux francophones et syntaxe US
L’intégration de systèmes hétérogènes d’importation de données (fichiers CSV délimités par des virgules ou points-virgules, extractions de bases ERP, synchronisations d’outils SaaS) constitue un facteur majeur d’altération de l’intégrité temporelle dans Google Sheets. Le conflit d’interprétation des formats de dates entre les paramètres régionaux francophones (système métrique, notation JJ/MM/AAAA) et le formalisme imposé par la syntaxe américaine (système impérial, notation YYYY-MM-DD ou MM/DD/YYYY) représente l’écueil le plus destructeur pour la fonction QUERY.
Lorsqu’un flux textuel étranger injecte une valeur telle que 04/05/2023 au sein d’une feuille paramétrée en environnement France, le moteur natif de Google Sheets l’interprète légitimement comme le 4 mai 2023. Si cette même feuille est configurée avec des paramètres régionaux des États-Unis, la valeur sera convertie en 5 avril 2023. Pire encore, si la valeur importée est 14/05/2023, l’absence de 14ème mois sur l’échelle calendaire bloque la conversion sérielle automatique dans un classeur US : la valeur est alors stockée en tant que texte brut (« string »).
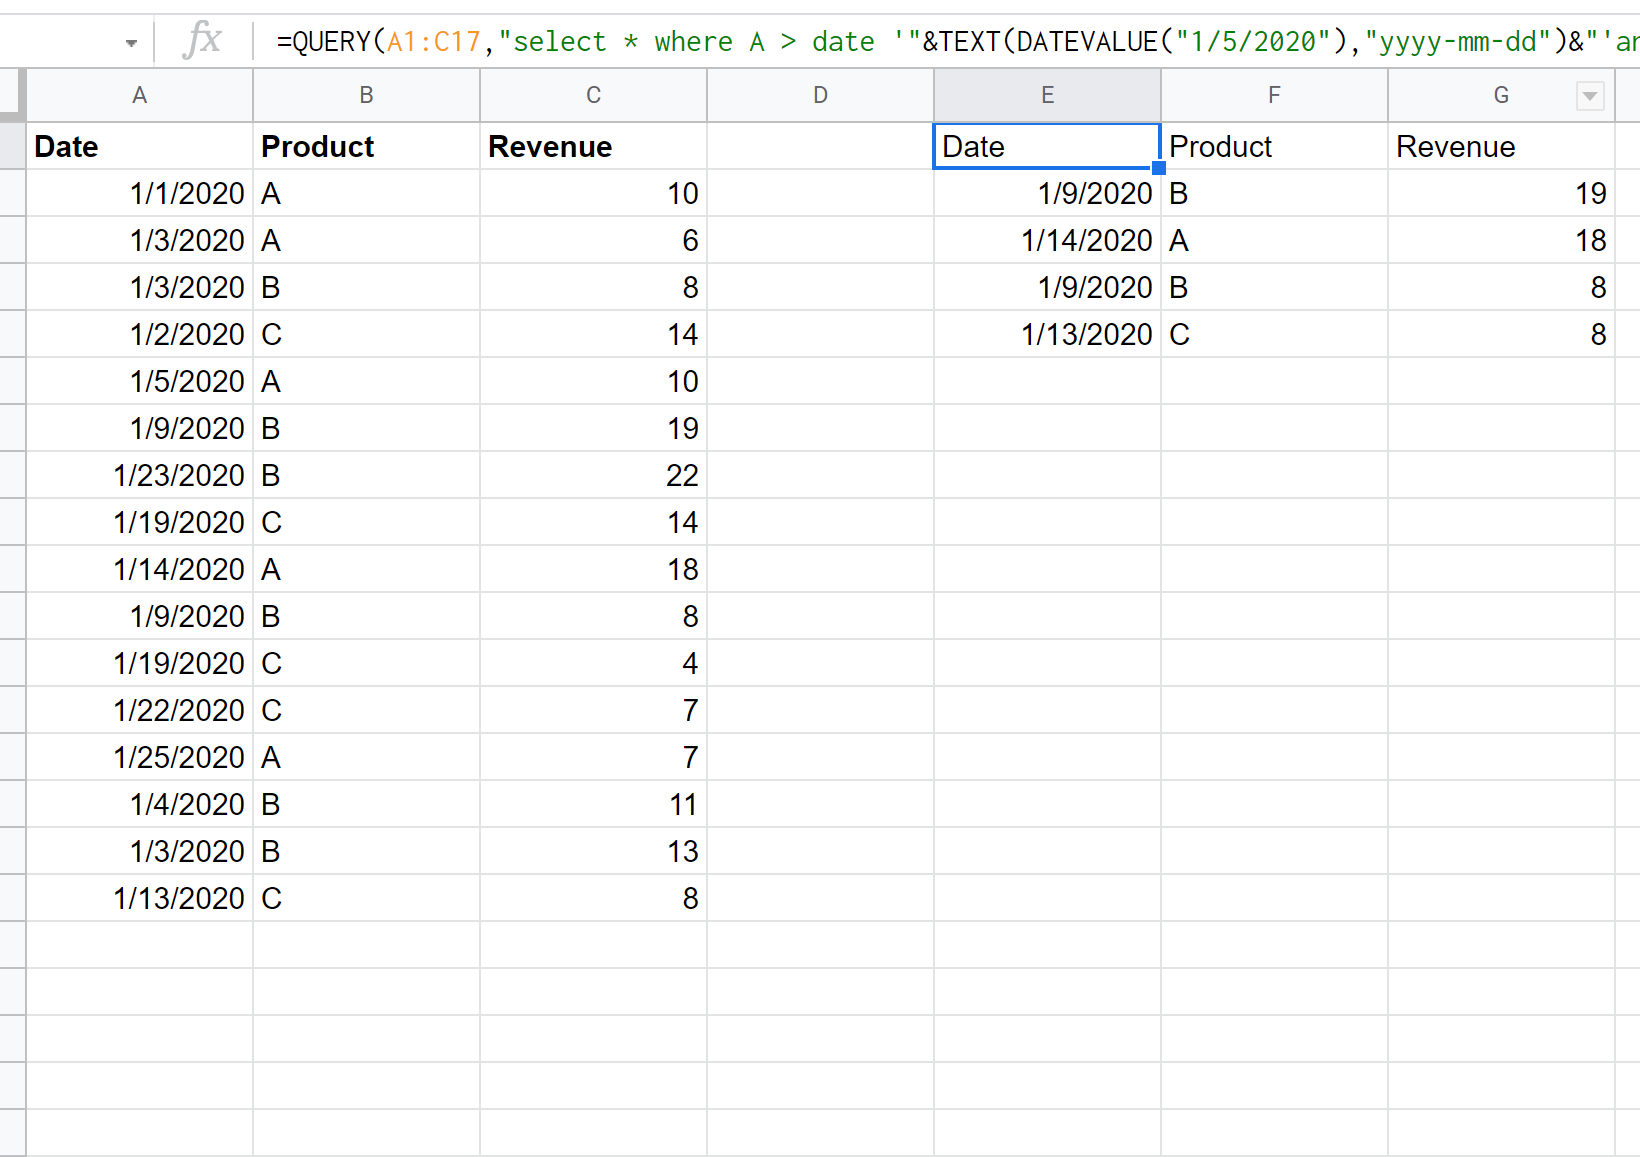
Cette coexistence de types scalaires bruts et de chaînes textuelles dissimulées sous une apparence similaire engendre l’effondrement silencieux de la fonction QUERY. Comme stipulé dans les fondements architecturaux, l’API Visualization procède à un vote majoritaire de typage par colonne. Si la majorité de la colonne est sérialisée sous forme numérique de dates, les enregistrements textuels non résolus sont convertis en valeurs nulles sans avertissement d’erreur explicite. Pour prémunir les classeurs contre cette instabilité, il est impératif d’uniformiser rigoureusement les paramètres linguistiques via Fichier > Paramètres et d’assainir systématiquement les flux entrants avant toute injection dans le pipeline relationnel.
9.2 Techniques de coercition pour transformer les faux textes en vraies dates
Dès lors qu’une colonne source a été corrompue par l’insertion de dates sous forme de texte brut (reconnaissables à leur alignement par défaut sur le bord gauche de la cellule, par opposition à l’alignement naturel des nombres et dates sur le bord droit), une opération de coercition et de nettoyage structural s’impose avant d’invoquer la commande QUERY.
Plusieurs stratégies de normalisation peuvent être déployées selon la structure du désalignement :
- La coercion unaire arithmétique : Si la chaîne de caractères respecte la typographie reconnue par le classeur mais est figée sous statut de texte, l’application d’une opération mathématique neutre force le moteur à réévaluer le type. L’expression matricielle
=ARRAYFORMULA(A2:A + 0)ou=ARRAYFORMULA(A2:A * 1)convertit instantanément ces faux textes en véritables entiers sériels. - La déconstruction textuelle chirurgicale : Si les dates sont encodées selon des formats exotiques (par exemple
20230514ou14.05.2023), il convient de fragmenter analytiquement la chaîne au moyen des fonctions GAUCHE, STXT et DROITE pour la réassembler à travers la fonction universelle DATE. Pour une chaîne logée enA2sous la formeAAAAMMJJ, l’expression de régularisation s’écrira :
=DATE(CNUM(GAUCHE(A2; 4)); CNUM(STXT(A2; 5; 2)); CNUM(DROITE(A2; 2)))
Une fois les valeurs sources réassignées à un véritable type temporel sériel, la colonne redevient éligible à l’interrogation par la clause WHERE date 'yyyy-mm-dd' de la fonction QUERY.
9.3 Audit de conformité des colonnes de dates avec ESTNUM et ESTTEXTE
Avant d’exposer une table critique à des filtres de dates complexes, le déploiement d’une procédure d’audit de conformité permet de valider l’intégrité de la typologie des données. Les fonctions de diagnostic ESTNUM et ESTTEXTE constituent les instruments d’auscultation idéaux.
Dans la mesure où toute date valide dans l’écosystème Google Sheets n’est qu’un nombre sériel enrichi d’une propriété d’affichage, la fonction ESTNUM(cellule) doit impérativement renvoyer la valeur VRAI pour l’ensemble des éléments de la colonne examinée. Réciproquement, la fonction ESTTEXTE(cellule) doit systématiquement renvoyer FAUX. L’implantation d’une colonne de contrôle temporaire bordant le jeu de données avec la formule :
=SI(ESTTEXTE(A2); "Anomalie : Texte détecté"; SI(ESTNUM(A2); "Conforme"; "Valeur Vierge"))
Permet d’isoler visuellement et immédiatement les anomalies d’encodage masquées par un alignement horizontal forcé par l’utilisateur. Pour automatiser cet audit sur des volumes massifs, une formule matricielle d’alerte globale peut être condensée au sein d’une unique cellule de synthèse :
=SI(NB.SI(ARRAYFORMULA(ESTTEXTE(A2:A)); VRAI) > 0; "Alerte : Présence de fausses dates textuelles"; "Base Intègre")
Ce protocole de surveillance continue garantit la conformité des entrées face aux exigences du compilateur de requêtes et prévient toute disparition silencieuse d’enregistrements lors des traitements décisionnels périodiques.
10. Synergie avec les autres clauses de la fonction QUERY
10.1 Tri chronologique des données extraites avec ORDER BY
L’extraction d’un sous-ensemble de données temporelles acquiert sa pleine utilité analytique lorsqu’elle s’accompagne d’une hiérarchisation séquentielle des flux. La clause ORDER BY permet d’ordonnancer les enregistrements extraits selon une logique chronologique ascendante ou descendante, s’insérant impérativement après la clause de filtrage WHERE.
La déclaration de la direction du tri repose sur les suffixes ASC (ascendant, par défaut de l’antérieur vers le récent) et DESC (descendant, du plus récent vers l’ancien) :
=QUERY(A1:D; "SELECT * WHERE A >= date '2023-01-01' AND A <= date '2023-06-30' ORDER BY A DESC"; 1)
Dans de nombreuses applications, plusieurs événements peuvent survenir au cours d’une même date calendaire. Afin d’éliminer toute indécision dans l’ordonnancement de sortie, il est judicieux de déclarer des critères de tri secondaires. Par exemple, pour ordonner les données chronologiquement, puis départager les transactions contemporaines en fonction de leur volume financier décroissant :
ORDER BY A ASC, C DESC
Le compilateur organise le résultat matriciel selon cette cascade de priorités, garantissant une lisibilité optimale des tables de reporting destinées aux directions financières et opérationnelles.
10.2 Agrégation temporelle des indicateurs avec GROUP BY et PIVOT
Au-delà de la simple extraction granulaire d’enregistrements, la fonction QUERY déploie toute son envergure analytique lorsqu’elle consolide des métriques quantitatives sur des intervalles temporels définis. La clause GROUP BY opère la réduction d’une multiplicité de lignes en un agrégat synthétique calculé (au travers de fonctions scalaires telles que SUM, AVG, COUNT, MAX, MIN), tandis que la clause PIVOT permet de transformer des dimensions d’analyse en colonnes croisées dynamiques.
Le moteur Google Visualization implémente des fonctions scalaires temporelles intrinsèques d’une puissance remarquable, notamment year(), month() et day(), qui extraient les sous-composantes d’une colonne de dates. Il convient d’observer une particularité technique majeure : la fonction month() de l’API de visualisation indexe les mois selon une base zéro (0 pour janvier, 1 pour février, …, 11 pour décembre). Dès lors, pour sommer les volumes de vente par mois sur l’année 2023, la formulation de la requête s’articule ainsi :
=QUERY(A1:C; "SELECT month(A)+1, SUM(C) WHERE A >= date '2023-01-01' AND A <= date '2023-12-31' GROUP BY month(A)+1 LABEL month(A)+1 'Mois Civil', SUM(C) 'Total Ventes'"; 1)
Cette formule filtre préalablement l’espace temporel pour circonscrire l’exercice d’intérêt, segmente les données selon le mois civil réindexé, et applique la fonction d’agrégation arithmétique tout en renommant dynamiquement les en-têtes de colonnes via la clause LABEL.
L’adjonction supplémentaire de l’opérateur PIVOT permet de transposer une colonne catégorielle (par exemple, la zone commerciale) sur l’axe horizontal, produisant ainsi un véritable tableau croisé dynamique entièrement piloté par une formule unique, recalculé en temps réel et préservé contre les corruptions manuelles.
10.3 Échantillonnage et segmentation avec LIMIT et OFFSET
Dans les contextes où l’analyse porte sur des volumes de données substantiels, ou lorsqu’il s’agit de bâtir des interfaces utilisateur fragmentées (pagination de tableaux de bord opérationnels), les clauses LIMIT et OFFSET apportent une granularité de contrôle indispensable sur le dimensionnement des flux d’extraction.
La clause LIMIT n contraint le moteur à n’émettre au maximum que les n premières rangées satisfaisant l’ensemble des conditions logiques antérieures. Couplée à un tri chronologique, cette directive permet d’isoler des extrêmes historiques. Par exemple, pour obtenir les cinq dernières transactions conclues avant une date d’échéance :
=QUERY(A1:D; "SELECT * WHERE A <= date '2023-12-31' ORDER BY A DESC LIMIT 5"; 1)
La clause OFFSET m instruit quant à elle le processeur d’éluder délibérément les m premières rangées de la sélection avant de commencer l’émission des données. L’articulation coordonnée de ces deux leviers permet de matérialiser une logique de pagination dynamique selon la séquence fonctionnelle :
LIMIT [Taille_Page] OFFSET ([Numero_Page] - 1) * [Taille_Page]
Ces mécanismes d’échantillonnage temporel restreignent considérablement l’empreinte mémoire sollicitée par le rendu graphique du navigateur client, fluidifiant la navigation au sein d’écosystèmes applicatifs hébergeant des dizaines de milliers de lignes historiques.
11. Diagnostic et résolution systématique des anomalies d’exécution
11.1 Déconstruction de l’erreur #VALUE! et du message PARSE_ERROR
L’interruption d’une requête QUERY se manifeste presque systématiquement par l’apparition d’une balise d’erreur #VALUE! sur la cellule hôte, accompagnée au survol du pointeur d’une notification technique explicite : Impossible d'analyser la chaîne de requête pour la fonction QUERY [...] PARSE_ERROR. Cette anomalie indique une faillite structurelle lors de la phase d’analyse lexicale opérée par le compilateur de l’API Visualization.
Les origines fondamentales de cette défaillance lors d’un filtrage temporel se ramènent invariablement aux typologies suivantes :
- Défaut d’appariement des délimiteurs : Une apostrophe simple ouverte avant le littéral de date mais non refermée, ou un désalignement des guillemets doubles lors des concaténations avec l’opérateur
&. - Omission du mot-clé ‘date’ : La formulation
WHERE A > '2023-01-01'peut être rejetée ou dégradée si le compilateur identifie que la colonneAa été typée comme une date pure par l’analyseur sémantique. - Format ISO non conforme : La transmission d’un format de date comportant des barres obliques (
yyyy/mm/dd) ou une séquence erronée (dd-mm-yyyy).
Pour débugger méthodiquement une telle anomalie, la stratégie d’ingénierie la plus efficiente consiste à externaliser la chaîne de requête au sein d’une cellule intermédiaire indépendante. En écrivant en Z1 la formule de concaténation pure :
="SELECT * WHERE A >= date '" & TEXTE(B1; "yyyy-mm-dd") & "'"
L’analyste visualise instantanément la chaîne telle qu’elle sera soumise au compilateur. Cette inspection oculaire directe permet d’identifier en quelques fractions de seconde l’absence d’un espace, une apostrophe manquante ou une projection anormale de la fonction de formatage, rétablissant la conformité syntaxique avant réinjection dans la fonction QUERY.
11.2 Traitement du problème de la sortie vide (Empty Output)
Un dysfonctionnement particulièrement insidieux réside dans la situation où la fonction QUERY ne soulève aucune erreur de syntaxe apparente, mais ne restitue que la rangée des en-têtes ou renvoie un état d’échec #N/A assorti de la mention La requête a généré une sortie vide (Empty query result).
Ce phénomène découle généralement de deux causes racines distinctes :
- Incohérence logique des prédicats : L’analyste a formulé des contraintes temporelles mutuellement exclusives au sein d’une clause conjonctive, par exemple :
WHERE A >= date '2023-05-01' AND A <= date '2023-04-01'. Aucune valeur temporelle ne pouvant être simultanément supérieure à mai et inférieure à avril sur la droite des réels, l’ensemble solution est formellement vide. - Biais d’horodatage résiduel : La condition interroge un jour calendaire précis au moyen d’un opérateur strict d’égalité (
WHERE A = date '2023-06-15'), alors que la colonne source contient des dates assorties d’heures, de minutes et de secondes. La valeur scalaire recherchée correspond strictement à2023-06-15 00:00:00. Tout enregistrement intervenu à08:30:00ce même jour sera rejeté par le test d’égalité stricte, conduisant à une restitution vierge d’observations.
Pour sécuriser les interfaces applicatives contre les interruptions visuelles inesthétiques causées par l’erreur #N/A, il est impératif d’encapsuler la commande QUERY au sein de la fonction SI.NON.DISP ou SIERREUR, fournissant un retour élégant et contextuel à l’utilisateur :
=SI.NON.DISP(QUERY(A1:D; "SELECT * WHERE A = date '" & TEXTE(F1; "yyyy-mm-dd") & "'"; 1); "Aucune donnée répertoriée pour cette échéance")
11.3 Anomalies de conversion implicite de type
L’architecture de l’API Google Visualization applique des règles d’inférence de type strictes basées sur un vote de majorité par colonne. Ce principe stipule que si une majorité absolue de cellules au sein d’une colonne donnée est évaluée comme appartenant à un type spécifique (par exemple, type ‘date’), l’intégralité de la colonne est irrévocablement verrouillée sous ce paradigme d’évaluation.
Conséquence critique : les cellules minoritaires qui dérogent à ce type dominant (comme des dates textuelles résiduelles, des annotations manuelles du type « En attente », ou des cellules contenant des erreurs de calcul) sont immédiatement converties en valeurs nulles (null) par le processeur de requêtes. Ce phénomène se traduit visuellement par l’apparition de cases désespérément blanches dans le tableau matriciel généré par QUERY, alors même que la cellule correspondante dans la feuille source affiche un texte explicite.
Pour pallier cette altération lorsque la source de données ne peut être assainie manuellement à l’origine, une solution d’ingénierie consiste à contraindre une conversion universelle de toute la matrice avant de la soumettre à QUERY au moyen de la combinaison avec ARRAYFORMULA et TO_TEXT, ou alternativement à forcer le formatage des dates via une plage calculée intermédiaire :
=QUERY({A1:A ARRAYFORMULA(SI(ESTDATE(B1:B); B1:B; DATEVAL(B1:B))) C1:C}; "SELECT Col1, Col2, Col3 WHERE Col2 >= date '2023-01-01'"; 1)
Notons que lors de l’utilisation d’accolades matricielles {...}, les identifiants de colonnes alphabétiques (A, B, C) cessent d’être opérants et doivent être obligatoirement substitués par la nomenclature de position relative Col1, Col2, Col3, tout en veillant scrupuleusement au respect de la casse (la graphie col1 étant rejetée).
12. Performance, maintenabilité et perspectives comparatives
12.1 Optimisation des performances de calcul sur de grands volumes de données
Bien que la fonction QUERY soit remarquablement optimisée pour l’analyse relationnelle dans le cloud, son déploiement à large échelle au sein de classeurs volumineux (dépassant 50 000 lignes ou multipliant les dépendances matricielles croisées) peut saturer les quotas d’exécution alloués par Google Sheets et ralentir considérablement le rendu visuel.
L’optimisation des performances repose sur des règles d’hygiène logicielle rigoureuses :
- Restriction stricte de la matrice d’entrée : Éviter absolument de déclarer des plages indéfinies ouvertes vers l’infini telles que
A:Zsi le jeu de données réel n’occupe que les colonnesAàEet s’arrête à la ligne 10 000. L’instructionQUERY(A1:E10000; ...)consomme une fraction infinitésimale de la mémoire vive comparativement à l’évaluation d’un million de cellules virtuelles vides. - Évitement de la multiplication des fonctions volatiles : L’intégration d’appels répétés à
AUJOURDHUI()ouMAINTENANT()au sein de multiples requêtes QUERY dispersées sur un même classeur déclenche des cascades de recalculs intégrales à chaque saisie élémentaire. Il est recommandé de consigner la date du jour au sein d’une unique cellule de référence maîtresse et d’orienter toutes les requêtes secondaires vers cette cellule unique. - Matérialisation de zones tampons : Lorsqu’une requête doit exécuter des filtrages temporels intriqués associés à des tris et des agrégations sur une volumétrie massive, il est opportun de procéder par étapes : filtrer préalablement le sous-ensemble temporel dans une feuille de transition, puis appliquer les calculs analytiques de regroupement sur cet échantillon réduit.
12.2 Étude comparative : QUERY face aux fonctions FILTER, SORT et SOMME.SI.ENS
L’analyste de données doit déterminer avec discernement si la fonction QUERY constitue systématiquement l’instrument le plus adapté à son objectif fonctionnel, ou s’il convient de lui préférer des fonctions matricielles natives spécialisées telles que FILTER, SORT ou SOMME.SI.ENS.
Le tableau suivant explicite les forces et les contraintes de chaque approche architecturale :
- La fonction QUERY :
- Atouts : Puissance expressive monumentale, concision du code (agrégation, pivot, tri et filtrage concentrés au sein d’une instruction unique), interopérabilité conceptuelle avec la pensée relationnelle SQL.
- Faiblesses : Rigueur syntaxique impitoyable, sensibilité au typage hétérogène des données, nécessité de coercition explicite des dates au format ISO 8601, latence marginalement supérieure sur des opérations élémentaires.
- La fonction FILTER :
- Atouts : Évaluation dynamique native exploitant directement les numéros de série des cellules sans exiger de conversion textuelle ISO (ex. :
=FILTER(A1:C; B1:B >= F1; B1:B <= F2)), conservation parfaite des types originaux, résilience face aux colonnes mixtes. - Faiblesses : Incapacité intrinsèque à agréger ou trier les données de façon autonome, imposant l’imbrication lourde de fonctions auxiliaires tierces telles que
SORT()ouCHOISIRCOLS().
- Atouts : Évaluation dynamique native exploitant directement les numéros de série des cellules sans exiger de conversion textuelle ISO (ex. :
- La fonction SOMME.SI.ENS :
- Atouts : Vitesse de calcul maximale sur des volumes immenses pour des synthèses numériques scalaires ponctuelles.
- Faiblesses : Limitée strictement à des opérations de sommation unaire, incapable de restituer des listes d’enregistrements granulaires découpées selon un calendrier.
La règle empirique d’arbitrage architectural s’énonce ainsi : dès lors qu’une opération requiert simultanément le filtrage par date, la projection sélective de colonnes, un tri chronologique et une agrégation synthétique, QUERY demeure la solution souveraine. Réciproquement, pour un simple affichage filtré sans transformation structurelle, la fonction FILTER offre une robustesse native et une tolérance aux formats locaux nettement plus indulgente pour des équipes d’utilisateurs non techniques.
12.3 Guide synthétique et feuille de route des meilleures pratiques
Pour assurer la pérennité, la lisibilité et l’intégrité opérationnelle de vos développements sur Google Sheets, il convient d’appliquer systématiquement la check-list méthodologique suivante avant toute mise en production d’une requête temporelle :
- Normalisation préalable : Vérifier l’homogénéité du typage de la colonne temporelle cible via la formule
ESTNUM(). Éradiquer impérativement tout faux texte ou date malformatée. - Formalisation ISO : S’assurer que chaque borne de date injectée dans la clause
WHEREest impérativement précédée du mot-clédateet transcrite sous le masque strict'yyyy-mm-dd'via la fonctionTEXTE(). - Délimitation millimétrée : Examiner méticuleusement la symétrie des apostrophes simples internes et des guillemets doubles ceinturant les expressions concaténées.
- Contrôle des frontières : Valider le modèle d’intervalle (fermé, ouvert ou semi-ouvert) au regard de la présence ou de l’absence de composantes horaires au sein des enregistrements afin d’éliminer les biais d’éviction sur les dates charnières.
- Gestion des en-têtes : Déclarer explicitement le troisième argument de la fonction QUERY (le nombre de lignes d’en-tête, généralement
1ou0) pour interdire au compilateur d’inférer aléatoirement la première rangée de données comme un titre textuel. - Protection défensive : Encapsuler systématiquement la formule matricielle globale dans une fonction de capture d’anomalies (
SI.NON.DISPouSIERREUR) pour maîtriser la réaction visuelle du classeur face aux sélections temporairement vides.
L’assimilation rigoureuse de ces concepts relationnels et informatiques transforme la fonction QUERY d’une simple formule de tableur en un moteur décisionnel d’une fiabilité absolue, apte à soutenir les architectures de données les plus sophistiquées au sein de l’entreprise moderne.
Références
- Google. (2024). Fonction QUERY : Référence du centre d’aide Google Docs. Google Support. https://support.google.com/docs/answer/3093343
- Google Developers. (2023). Google Visualization API Query Language Reference (Version 0.7). Google Developers Documentation. https://developers.google.com/chart/interactive/docs/querylanguage
- International Organization for Standardization. (2019). Date and time — Representations for information interchange (ISO Standard No. 8601-1:2019). ISO. https://www.iso.org/iso-8601-date-and-time-format.html
- Walkenbach, J. (2015). Excel 2016 Bible. John Wiley & Sons.
- Date, C. J. (2019). Database Design and Relational Theory: Normal Forms and All That Jazz (2nd ed.). Apress.
- Bluttman, K. (2020). Google Sheets for Dummies. John Wiley & Sons.