
Dans le champ du traitement analytique des données massives et de l’ingénierie biométrique, l’environnement SAS (Statistical Analysis System) s’impose depuis plusieurs décennies comme une référence cardinale pour la manipulation, la modélisation et la certification de la qualité informationnelle. Parmi les opérations matricielles et tabulaires élémentaires qui sous-tendent les architectures de recherche empirique, la concaténation de jeux de données représente une démarche fondatrice. L’acte d’unir verticalement des partitions disjointes de données ne se résume pas à un simple collage mécanique de lignes ; il engage une compréhension intime des mécanismes internes du compilateur SAS, de l’ordonnancement de la mémoire vive et de la cinématique séquentielle du vecteur de données de programme (connu sous l’acronyme PDV pour Program Data Vector).
Dans les protocoles expérimentaux contemporains, qu’il s’agisse d’études épidémiologiques longitudinales, d’enquêtes psychométriques multi-vagues ou d’évaluations cliniques randomisées, les corpus d’observations parviennent rarement sous la forme d’un monolithe consolidé. Ils sont intrinsèquement fragmentés à travers le temps, l’espace, ou les modalités logistiques de capture. Dès lors, la maîtrise méthodologique et technique de l’empilement vertical dans SAS conditionne l’intégrité globale du pipeline de données. Un défaut de concordance dans la typologie des attributs, une disparité d’allocation d’octets ou une divergence de nomenclature nominale peut introduire des biais systématiques dévastateurs, allant de la troncature silencieuse de libellés textuels à la génération indue de cellules de valeurs manquantes (missing values).
Ce traité technique se propose d’explorer de manière exhaustive, systématique et rigoureuse l’art et la science de la concaténation de données au sein de l’écosystème SAS. De la syntaxe canonique de l’étape DATA gouvernée par l’instruction SET aux alternatives transactionnelles optimisées offertes par la procédure APPEND ou les jointures unificatrices du moteur PROC SQL, chaque paradigme d’intégration sera disséqué. L’analyse portera une attention particulière aux défis structurels complexes : résolution des conflits de types scalaires et alphanumériques, gestion du tri intercalé (interleaving), traçabilité de provenance des unités statistiques via des indicateurs booléens, et déploiement de protocoles de validation métrologique garants de la reproductibilité scientifique.
1. Introduction théorique à la concaténation de données dans SAS
1.1 Définition et importance de l’empilement vertical de données
La concaténation de tables de données, couramment qualifiée d’empilement vertical ou d’adjonction séquentielle, constitue l’opération d’algèbre relationnelle par laquelle les enregistrements ou observations issus de deux ou plusieurs collections sont fusionnés le long de l’axe vertical des coordonnées matricielles. Contrairement à une adjonction horizontale qui étend l’éventail des descripteurs pour un individu donné, la concaténation accroît la profondeur de l’échantillon en agrégeant de nouvelles unités d’observation sous un schéma dimensionnel supposé isomorphe ou compatible. Cette opération élémentaire est au cœur de l’agrégation de séries temporelles discontinues, de la consolidation de relevés multi-sites et de la construction de mégadonnées issues de sources hétérogènes.
Sur le plan méthodologique, la gestion des cohortes longitudinales illustre parfaitement la nécessité impérieuse d’un empilement rigoureux. Lorsqu’un protocole d’observation s’étend sur plusieurs années, les vagues successives d’investigation génèrent des sous-ensembles de données distincts. L’analyse de trajectoires individuelles, l’ajustement de modèles à effets mixtes ou l’estimation d’équations différentielles stochastiques requièrent impérativement la réunion de ces strates temporelles au sein d’une structure matricielle continue. Si l’empilement vertical est opéré de manière défectueuse, la continuité métrologique des séries est compromise, induisant des erreurs d’estimation qui se propageront inévitablement jusqu’aux inférences causales finales.
L’impact de la concaténation sur la structure tabulaire se matérialise par l’accroissement du nombre total d’enregistrements (noté N), tout en préservant ou en harmonisant l’ensemble des colonnes ou variables (noté P). Dès lors que les métadonnées des tables sources convergent, l’opération produit une matrice unifiée de dimension (N1 + N2 + … + Nk) lignes par P colonnes. Cette régularité structurelle conditionne l’application des estimateurs statistiques standards, dont la plupart postulent l’indépendance conditionnelle ou la complétude du format long des données pour l’analyse des mesures répétées dans le temps.
1.2 Distinction fondamentale entre fusion (MERGE) et concaténation (SET)
Il existe, au sein de la communauté des praticiens de SAS, une confusion récurrente entre les opérations de fusion orchestrées par l’instruction MERGE et les démarches de concaténation pilotées par l’instruction SET. Sur le plan conceptuel, l’instruction MERGE procède à un accouplement horizontal : elle cherche à aligner des enregistrements provenant de sources distinctes sur la base d’une ou plusieurs clés d’identification communes (variables de tri déclarées dans une clause BY). L’objectif cardinal de MERGE est d’enrichir le profil informationnel d’une même entité en lui adjoignant de nouveaux attributs observés dans un autre contexte expérimental.
À l’inverse, l’instruction SET dans sa forme séquentielle simple opère une translation purement additive dans le sens de la hauteur. Elle ne requiert aucunement l’existence d’une clé d’appariement primaire ou secondaire pour procéder à la lecture des tables. Les flux d’enregistrements sont consommés de façon linéaire : le moteur SAS vide intégralement la première source d’entrée avant d’engager la lecture de la seconde. Les identifiants uniques des sujets, s’ils existent, ne sont pas exploités pour synchroniser les lignes mais sont simplement enregistrés tels quels, conservant leur rang chronologique au sein de leurs sous-populations respectives.
Cette divergence conceptuelle entraîne des disparités majeures quant à l’allocation de la mémoire vive et à la complexité algorithmique d’exécution. Alors que la fusion via MERGE impose une gestion rigoureuse des pointeurs de fichiers, une mise en mémoire tampon des correspondances multiples et un pré-tri obligatoire des tables sources sous peine d’interruption critique, la concaténation standard s’exécute selon une complexité temporelle linéaire en O(N). Le vecteur de données du programme n’a besoin de maintenir en mémoire active que l’observation présentement examinée, limitant drastiquement la surcharge computationnelle sur le sous-système de mémoire volatile.
1.3 Applications pratiques en modélisation statistique et psychométrie
Dans les domaines de la psychométrie appliquée et des sciences comportementales, la concaténation de jeux de données intervient fréquemment dans les protocoles d’étalonnage et d’analyse différentielle des items. La modélisation de la réponse aux items (IRT pour Item Response Theory) requiert souvent la mise en commun de réponses fournies par différents groupes d’étalonnage à des formes d’ancrage communes. L’empilement vertical des matrices de réponses individuelles constitue l’étape préparatoire indispensable pour estimer de concert les paramètres de discrimination et de difficulté des items, garantissant ainsi l’invariance métrique de l’instrument d’évaluation.
La standardisation préalable des corpus avant modélisation est une exigence méthodologique stricte. Lorsque des psychologues ou des sociologues combinent des échantillons issus de passations administrées via des supports hétérogènes (par exemple, des protocoles sur papier et des évaluations informatisées sur tablette), les jeux de données initiaux doivent être alignés sur une matrice de variables unifiée. La concaténation permet d’agréger ces effectifs pour soumettre l’ensemble du corpus à des analyses factorielles confirmatoires multi-groupes, destinées à vérifier l’invariance de configuration, métrique et scalaire des construits théoriques.
Enfin, le maintien de la cohérence des indicateurs latents à travers des passations répétées dépend étroitement de la rigueur de l’empilement tabulaire. Tout décalage dans la dénomination des échelles d’évaluation ordinale ou toute inversion de codage numérique lors de la concaténation altérerait irrémédiablement la matrice de covariance inter-items. La construction rigoureuse d’un fichier maître par concaténation séquentielle sécurise l’estimation des coefficients de fidélité, tels que le macro-coefficient oméga de McDonald ou le classique alpha de Cronbach, en évitant toute contamination artificielle des estimations de variance d’erreur.
2. Fondements syntaxiques de l’instruction SET dans l’étape DATA
2.1 Architecture globale de l’étape DATA pour la concaténation
L’étape DATA dans le langage SAS constitue un environnement de compilation et d’exécution spécifiquement conçu pour l’ingénierie et la transformation fine des matrices de données. Pour réaliser une concaténation, l’architecture minimale repose sur la déclaration conjointe de l’instruction DATA, qui instancie le nom de la table cible créée au sein d’une bibliothèque temporaire ou permanente, et de l’instruction SET, qui spécifie la séquence ordonnée des jeux de données d’entrée à ingérer. Cette architecture est systématiquement close par l’instruction délimitrice RUN, qui enjoint au compilateur de procéder à la matérialisation physique des opérations programmées.
L’instruction DATA remplit une fonction déclarative centrale en initialisant les structures de métadonnées de la table de sortie dans le dictionnaire interne du système. Lorsque le système rencontre le bloc syntaxique, il alloue les ressources nécessaires et détermine l’emplacement de stockage sur disque, généralement dans l’espace de travail temporaire nommé WORK, sauf indication explicite d’un libref personnalisé. L’instruction SET opère ensuite comme un routeur d’entrée séquentiel, créant un canal de communication direct entre les tables sources résidant sur le support de stockage et l’environnement d’exécution du compilateur.
L’omission de l’instruction de clôture RUN constitue une négligence stylistique qui peut compromettre la synchronisation de l’exécution, en particulier dans les architectures de scripts par lots (batch processing). RUN force la résolution immédiate des files d’attente d’instructions, libère les verrous d’entrées-sorties imposés sur les fichiers sources et imprime le compte-rendu d’exécution dans le journal SAS (la log). Cette rigueur déclarative garantit que les transformations subséquentes du pipeline analytique ne débuteront qu’une fois la table résultante parfaitement intègre et consolidée.
2.2 Mécanisme séquentiel du Program Data Vector (PDV)
La compréhension du Program Data Vector est indispensable pour appréhender les subtilités de la concaténation dans SAS. Le PDV est la structure de mémoire temporaire allouée par le système durant la phase de compilation d’une étape DATA pour héberger une observation unique pendant son traitement. Lors de l’initialisation du PDV, SAS inspecte les métadonnées de l’ensemble des tables listées dans l’instruction SET. Il crée ainsi un emplacement mémoire pour chaque variable distincte apparaissant dans au moins l’une des tables sources, configurant simultanément son type (numérique ou caractère) et sa longueur en octets.
Lors de la phase d’exécution, le moteur procède à une lecture séquentielle rigoureuse. La première table mentionnée dans l’instruction SET est ouverte. SAS lit la première ligne de cette table et transfère ses valeurs dans les cellules correspondantes du PDV. Les variables qui appartiendraient à d’autres tables de la liste mais qui sont absentes de cette première table reçoivent automatiquement la valeur manquante appropriée (un point pour les scalaires numériques, un espace blanc pour les chaînes de caractères). Le système exécute ensuite les éventuelles instructions programmatiques situées après le SET, puis l’observation est écrite sur le disque dans la table de destination.
Ce cycle itératif se répète pour chaque enregistrement de la première table. Contrairement à une lecture de fichier texte brut via l’instruction INPUT où les variables sont réinitialisées à missing au début de chaque itération, les valeurs issues d’une instruction SET bénéficient d’un mécanisme automatique d’écrasement continu. Dès que le pointeur de fichier atteint la marque de fin de fichier (EOF) du premier jeu de données, SAS referme silencieusement ce fichier, ouvre immédiatement le second, et poursuit son alimentation séquentielle du PDV jusqu’à épuisement complet de l’ensemble des sources énumérées.
2.3 Règles syntaxiques élémentaires et positionnement de SET
L’ordonnancement des arguments passés à l’instruction SET obéit à des règles syntaxiques strictes qui dictent la topologie finale de la table agrégée. Les noms des tables doivent être séparés par de simples espaces blancs, sans virgule ni délimiteur exotique, conformément à la grammaire lexicale fondamentale de SAS. L’ordre d’énumération des jeux de données dans l’instruction détermine directement la chronologie d’empilement des observations. Si le chercheur écrit SET source_A source_B;, l’ensemble des enregistrements de la source A apparaîtra rigoureusement avant la première ligne issue de la source B dans le fichier consolidé.
Le positionnement de l’instruction SET au sein de l’étape DATA influe également sur la préséance des instructions d’écrasement ou d’initialisation de variables. Toute déclaration d’attribut exécutée avant l’instruction SET (telle qu’une clause LENGTH ou ATTRIB) est prioritaire sur les métadonnées transportées par les tables sources. Cette règle de hiérarchie syntaxique est capitale : elle confère au développeur la possibilité d’imposer des contraintes dimensionnelles supérieures à celles dictées par les fichiers historiques, évitant ainsi des erreurs d’incompatibilité ou de tronquage.
Enfin, la présence de ponctuations erronées, en particulier le point-virgule malencontreusement inséré entre les noms de fichiers dans l’instruction SET, modifie radicalement le comportement du compilateur. L’instruction SET data1; SET data2; ne procède pas à une concaténation séquentielle, mais à une lecture simultanée destructrice dite de surimpression (one-to-one reading), qui écrase les colonnes et stoppe l’exécution dès que le jeu de données le plus court est entièrement parcouru. La rigueur syntaxique est donc la garante absolue de l’adéquation entre l’intention algorithmique et la matérialisation binaire des données.
3. Exemple canonique pas à pas : Concaténation de deux jeux de données
3.1 Génération des tables sources via DATALINES
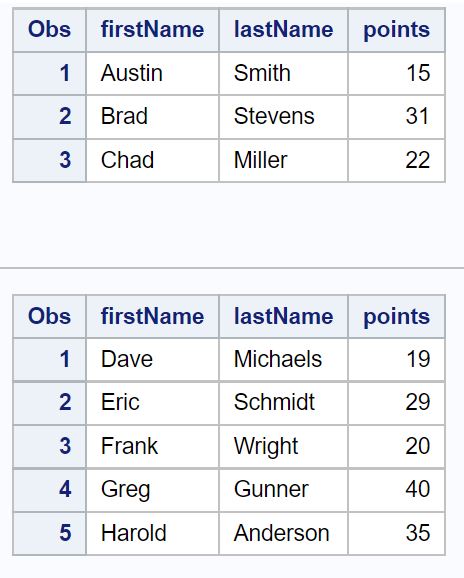
Afin d’illustrer de manière pragmatique et transparente le fonctionnement d’un empilement vertical, nous concevons ici un protocole synthétique mais représentatif, impliquant la création de deux tables sources au moyen de l’instruction DATALINES (synonyme de CARDS). Supposons l’évaluation des compétences analytiques de deux cohortes d’étudiants distinctes, suivies par deux départements universitaires autonomes. La première table, nommée data1, héberge les variables nominales firstName et lastName, ainsi qu’une variable quantitative continue nommée points, reflétant la performance à un examen d’évaluation cognitive.
La déclaration de cette première table fait intervenir l’instruction INPUT, qui précise la nomenclature et la nature des flux de caractères saisis. Les variables textuelles sont explicitement fléchées par le symbole du dollar ($), indiquant au compilateur de formater les cellules correspondantes en chaînes alphanumériques, tandis que la variable scalaire ne comporte aucun suffixe particulier, recevant par défaut le statut de nombre en virgule flottante double précision standard sur huit octets. La table data1 est ainsi instanciée avec une population initiale de quelques individus emblématiques.
De façon rigoureusement symétrique, la seconde table d’expérimentation, nommée data2, est compilée à partir d’un bloc DATA distinct. Elle reprend la même grille d’attributs fondamentaux (firstName, lastName et points) avec une population de sujets disjointe. Ce schéma symétrique constitue le point d’ancrage méthodologique idéal pour analyser le comportement pur de l’opérateur de concaténation, en isolant le processus d’empilement de tout artefact causé par des discordances taxonomiques ou typologiques.
3.2 Exécution du script de combinaison dans une table résultante
L’opération d’unification s’opère par l’introduction d’un troisième bloc d’instructions, matérialisant la table résultante data3. La commande séquentielle prend la forme canonique suivante : la déclaration DATA data3; initie la genèse de l’entité globale, immédiatement suivie de la directive unificatrice SET data1 data2;, puis scellée par la commande RUN;. Lors de l’envoi de cette séquence à l’interpréteur SAS, le système amorce la compilation en inspectant successivement l’en-tête de data1 puis celui de data2 pour figer l’organisation structurelle du PDV.
Durant l’exécution, le moteur SAS lit en premier lieu les enregistrements appartenant à data1. Chacun des individus est projeté dans le PDV, enrichi des attributs adéquats, puis déversé de façon séquentielle dans la table de destination. Lorsque la dernière ligne de data1 est consommée, le compilateur ne déclenche pas la terminaison du bloc DATA ; il commute de manière transparente son pointeur d’entrée logique vers le premier enregistrement de data2. Le flux d’informations se poursuit sans aucune discontinuité opérationnelle, empilant les nouvelles observations consécutivement aux précédentes.
Le contrôle de l’intégrité de cette passation réside dans le principe de conservation absolue des observations : si la cohorte source data1 contenait N1 observations et la cohorte data2 en dénombrait N2, la table finale data3 possédera rigoureusement N1 + N2 observations. L’empreinte mémoire sur le support physique s’accroît proportionnellement, sans qu’aucune ligne ne soit altérée, réordonnée ou écrasée. Cette stabilité intrinsèque du compilateur fait de l’instruction SET le socle fondamental des chaînes d’assemblage de données dans l’environnement SAS.
3.3 Inspection des résultats avec la procédure PROC PRINT
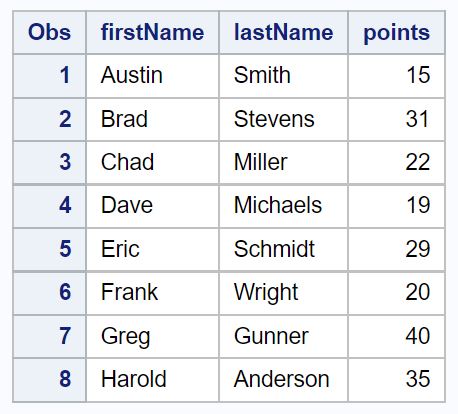
Une fois l’étape d’empilement vertical achevée, l’impératif méthodologique de validation impose une inspection visuelle et métrologique de la table finale à travers l’invocation de la procédure PROC PRINT. En programmant PROC PRINT DATA=data3 NOOBS; RUN;, le chercheur instancie l’affichage tabulaire exhaustif des enregistrements consolidés au sein de la fenêtre de résultats (ou interface ODS). L’option NOOBS permet de supprimer la colonne d’indexation automatique pour se concentrer sur l’exactitude des variables nominales et quantitatives déversées.
L’observation du rapport de sortie permet de corroborer formellement l’alignement parfait des variables firstName, lastName et points. Les lignes issues de la table data1 occupent l’espace supérieur du listage, tandis que celles issues de data2 leur succèdent dans une contiguïté absolue. Aucune discordance de colonnes ne doit être constatée dans cet exemple canonique : le nombre d’attributs demeure strictement constant d’une extrémité à l’autre de la table résultante.
Cette étape d’inspection ne doit jamais être négligée dans les environnements de production analytique. Au-delà de l’affichage textuel brut, elle confirme que l’interpréteur a correctement géré l’ensemble des séparateurs lexicaux et que les valeurs flottantes associées à la variable points ont conservé leur précision arithmétique initiale sans dégradation ni conversion d’encodage binaire. La vérification visuelle conforte ainsi la validité interne du processus d’ingénierie de données.
4. Extension à la concaténation multiple : Empilement de N tables
4.1 Généralisation de la syntaxe pour trois tables ou plus
Dans la pratique épidémiologique et les études de panel à grande échelle, le besoin d’unification ne se restreint presque jamais à un binôme de jeux de données. Il est courant d’agréger douze fichiers mensuels pour constituer un historique annuel, ou de consolider plusieurs dizaines de centres régionaux de collecte clinique. L’instruction SET offre une flexibilité syntaxique remarquable en autorisant l’énumération libre et exhaustive d’un nombre indéfini de tables d’entrée au sein d’une seule et même clause : SET table_1 table_2 table_3 … table_N;.
Le comportement du compilateur SAS demeure parfaitement prévisible et déterministe lors de cette généralisation multilatérale. Le vecteur de données du programme agrège l’ensemble des métadonnées de toutes les tables listées avant d’entamer le traitement unitaire. Le balayage séquentiel s’effectue dans l’ordre strict de l’énumération textuelle de gauche à droite. Le flux traverse la table 1 jusqu’à son marqueur de fin, bascule sur la table 2, poursuit son acheminement vers la table 3, et ainsi de suite jusqu’à l’extinction du dernier enregistrement de la N-ième source déclarée.
Cette architecture unifiée garantit une remarquable stabilité opérationnelle. Même en présence de volumes d’enregistrements massifs disséminés à travers des dizaines de structures partitionnées, le compilateur ne souffre d’aucune dégradation exponentielle de performance. Chaque fichier est ouvert, traité séquentiellement, puis refermé, évitant ainsi toute accumulation superflue de descripteurs de fichiers actifs au niveau du système d’exploitation de la machine hôte.
4.2 Gestion de volumes massifs : listes abrégées et préfixes
Lorsque le volume de tables à concaténer devient substantiel, la saisie nominale exhaustive de chaque source au sein de l’instruction SET devient fastidieuse et constitue un vecteur potentiel d’erreurs humaines. L’environnement SAS dispose de mécanismes de notation abrégée particulièrement élégants pour désigner des séries continues de fichiers. Si les tables obéissent à un motif de dénomination séquentiel uniforme comprenant un préfixe commun et un suffixe indicé numériquement (par exemple, cohorte1 à cohorte24), la clause syntaxique peut être condensée sous la forme SET cohorte1-cohorte24;.
Cette syntaxe à tiret médian ordonne au compilateur d’étendre dynamiquement la liste de toutes les tables intermédiaires existantes répondant à cet intervalle d’indices arithmétiques entiers. Une autre variante syntactique puissante repose sur la liste de noms à préfixe direct, désignée par l’opérateur deux-points. En écrivant SET cohorte: ;, le développeur instruit le système de rechercher et d’ingérer l’ensemble absolu des jeux de données présents dans la bibliothèque de travail active dont l’intitulé débute rigoureusement par le radical alphanumérique « cohorte », indépendamment de leur longueur totale ou de leur suffixation.
L’utilisation de ces masques de référence collective réduit considérablement le risque d’omission involontaire de fractions d’échantillons au sein des pipelines de recherche multicentrique. Elle permet également une automatisation dynamique du code SAS, où la routine d’empilement s’adapte sans modification manuelle à l’arrivée de nouveaux fichiers respectant la convention de nommage institutionnelle établie lors de la conception initiale du plan de gestion des données.
4.3 Impact sur les ressources système et optimisation
L’empilement de collections massives de données impose une réflexion approfondie quant à la consommation des ressources computationnelles, notamment en matière de bande passante d’entrées-sorties disque (I/O) et d’utilisation de la bibliothèque temporaire WORK. Lorsque l’on concatène plusieurs gigaoctets ou téraoctets de données au sein d’une nouvelle table globale via l’étape DATA, le système procède à une duplication physique intégrale des enregistrements. Il est donc impératif de s’assurer que le sous-système de fichiers hébergeant la bibliothèque de travail dispose d’un espace disponible strictement supérieur au volume cumulé des tables cibles.
Pour atténuer les goulots d’étranglement induits par la lecture et l’écriture de millions de rangées, le développeur chevronné peut paramétrer les options système BUFNO= (nombre de tampons en mémoire vive) et BUFSIZE= (taille de chaque page de mémoire tampon). En accroissant l’allocation de la mémoire tampon dédiée aux tables sources et à la table cible, SAS charge des blocs de données beaucoup plus vastes à chaque cycle d’accès direct, minimisant les micro-interruptions matérielles liées aux têtes de lecture et aux latences de bus.
Par exemple, spécifier une taille de tampon de 64K ou 128K associée à un pool de tampons multiple (BUFNO=4 ou 8) permet d’accélérer considérablement le débit séquentiel de l’instruction SET. Cette optimisation de bas niveau libère des cycles processeur et assure une réactivité optimale du système analytique global, condition sine qua non de la viabilité des chaînes de traitement intensives dans les centres de calcul biomédicaux.
5. Gestion des structures de variables discordantes : Noms et préséance
5.1 Le défi des variables asymétriques entre les tables d’entrée
Dans les contextes d’ingénierie appliquée, il est exceptionnel que deux jeux de données conçus à des époques différentes ou par des équipes distinctes partagent une architecture dimensionnelle rigoureusement symétrique. Il arrive fréquemment que la première source comporte des variables d’information clinique absentes de la seconde, ou que des mesures conceptuellement équivalentes aient été libellées sous des identifiants nominaux hétérogènes (par exemple, age_annees dans une table et age_patient dans l’autre). Face à cette asymétrie structurale, le compilateur SAS adopte un comportement algorithmique précis qu’il convient de maîtriser pour prévenir toute dégradation informationnelle.
Lorsqu’une variable n’apparaît que dans un sous-ensemble des tables convoquées par l’instruction SET, le compilateur l’intègre néanmoins dans le PDV global lors de la phase préliminaire. Par conséquent, la table finale unifiée disposera d’une colonne dédiée à cet attribut pour l’ensemble total des observations. Toutefois, lors du traitement séquentiel des fichiers où cette variable n’a pas d’existence physique, SAS affecte automatiquement et silencieusement une valeur manquante (système missing) à chaque itération du PDV pour ces enregistrements spécifiques.
Ce mécanisme d’injection de cellules vides engendre une matrice résultante clairsemée (sparse data). Sur le plan statistique, cette asymétrie non compensée peut fausser gravement les procédures de réduction de dimension ou les imputations multivariées ultérieures. Les logiciels d’analyse factorielle ou de modélisation prédictive excluent souvent les observations incomplètes par suppression de liste (listwise deletion), ce qui pourrait paradoxalement écarter l’intégralité d’un sous-groupe expérimental de l’analyse définitive simplement en raison d’une variable non collectée dans son protocole d’origine.
5.2 Uniformisation préalable via l’option RENAME
Pour pallier les discordances nominales entre tables sans altérer physiquement les fichiers sources enregistrés sur le stockage permanent, SAS propose l’option de jeu de données RENAME=. Cette option syntaxique s’applique directement à la suite du nom de la table cible ou source entre parenthèses, selon la formule standard (RENAME=(ancien_nom=nouveau_nom)). Son action se situe au cœur même du processus de compilation, avant que les données ne transitent dans le PDV pour l’affectation finale.
Considérons le cas où la table A nomme l’indicateur d’intérêt Score_Total tandis que la table B le nomme Total_Points. L’exécution de la commande SET tableA tableB(RENAME=(Total_Points=Score_Total)); informe immédiatement le compilateur que l’attribut Total_Points de la table B doit être réinterprété et mappé vers la case d’enregistrement Score_Total du PDV. Dès lors, les valeurs numériques des deux collections convergent harmonieusement vers une seule et même colonne continue dans la table finale unifiée.
Il est capital de distinguer l’application de l’option RENAME au niveau de l’instruction SET de son application au niveau de l’instruction DATA. Positionnée sur une table source au sein de SET, l’option opère la translation en amont de toute logique programmatique interne à l’étape de transformation. Si elle est placée sur la table cible dans l’instruction DATA, la modification n’interviendra qu’au moment de l’écriture terminale sur le support de sortie, ce qui contraint le développeur à manipuler l’ancien libellé tout au long de l’algorithme sous peine de générer des références d’attributs non résolues.
5.3 Sélection et exclusion d’attributs avec KEEP et DROP
L’adjonction de multiples jeux de données s’accompagne fréquemment de l’accumulation d’artefacts computationnels secondaires : horodatages d’extraction, identifiants temporaires de sessions ou variables auxiliaires caduques. L’inclusion non contrôlée de ces métadonnées périphériques obère l’espace de stockage et surcharge la mémoire volatile. Pour rationaliser la structure de la matrice consolidée, les options de jeu de données KEEP= et DROP= constituent des instruments de régulation indispensables.
L’utilisation de ces filtres peut s’opérer à l’entrée ou à la sortie de l’étape DATA. L’option KEEP= associée directement aux tables sources dans l’instruction SET restreint l’importation aux seules colonnes analytiquement justifiées, interdisant aux attributs superflus de pénétrer dans le PDV. Cette sélectivité précoce allège drastiquement la charge vectorielle du processeur. À l’opposé, l’option DROP= déclarée sur l’instruction DATA permet de manipuler toutes les variables pour des opérations de contrôle intermédiaire au sein de la boucle séquentielle, tout en écartant formellement certaines d’entre elles lors de l’enregistrement final sur disque.
Sur le plan de l’intégrité scientifique, le filtrage délibéré des attributs participe à la réduction de la charge cognitive du chercheur et minimise les risques de confusion taxonomique lors des étapes ultérieures de visualisation ou d’inférence. Une table dégraissée de ses scories techniques optimise le temps de calcul des procédures complexes de rééchantillonnage (bootstrap) ou d’estimation bayésienne par chaînes de Markov Monte-Carlo (MCMC), tout en garantissant une traçabilité documentaire exemplaire.
6. Conflits de types de variables : Détection et résolution technique
6.1 Diagnostic des incompatibilités de type (numérique versus caractère)
L’une des alertes critiques les plus invalidantes lors de la concaténation de données dans SAS réside dans le conflit de typage fondamental entre les variables numériques et les variables alphanumériques (de type caractère). Dans l’architecture rigide de SAS, une variable ne peut posséder qu’une et une seule signature typologique au sein d’une même table. Si la table 1 définit la variable Identifiant sous forme de chaîne textuelle de 10 caractères alors que la table 2 la déclare sous forme d’une valeur scalaire numérique, le compilateur refuse catégoriquement d’opérer la concaténation standard.
Lors de la survenue d’une telle anomalie, le journal SAS s’interrompt avec l’émission d’un message d’erreur d’une grande sévérité : ERROR: Variable Identifiant has been defined as both character and numeric. L’étape DATA avorte prématurément, interdisant la création physique du jeu de données unifié. Ce problème surgit massivement lors de l’intégration de données historiques issues de sources d’encodage hétérogènes, telles que des imports automatiques de fichiers plats (CSV ou tableurs) où des cellules contenant des zéros initiaux ou des symboles alphanumériques parasitaires ont fait basculer arbitrairement la variable en texte.
Le diagnostic de ces conflits impose l’examen attentif du dictionnaire de métadonnées préalablement à toute tentative d’assemblage. L’ingénieur de données doit identifier précisément la table fautive et évaluer la nature de la représentation souhaitée pour l’analyse terminale. Ignorer cette incompatibilité ou tenter de la contourner par des artifices hâtifs conduit inexorablement à l’échec de la compilation ou, pire encore, à la corruption des formats de lecture sous-jacents.
6.2 Conversion explicite des attributs à l’aide de INPUT et PUT
Pour surmonter une discordance typologique irrémédiable, le développeur SAS doit procéder à une transmutation explicite des types au moyen des fonctions internes INPUT et PUT. La fonction PUT réalise la sérialisation d’une variable numérique en chaîne de caractères selon un gabarit de formatage déterminé : chaine = PUT(variable_num, 8.);. Inversement, la fonction INPUT interprète une chaîne de caractères selon un informat spécifique pour la convertir en un scalaire continu exploitable par les opérateurs arithmétiques : scalaire = INPUT(variable_char, best12.);.
Cependant, en raison du fait qu’une variable ne peut changer de type au cours de la même étape DATA sous son nom historique, la conversion exige l’application d’un protocole de contournement élégant basé sur le renommage temporaire. Considérons une table B où la variable ID est numérique, tandis qu’elle est alphanumérique dans la table A. La stratégie consiste à renommer ID en ID_num lors de l’ingestion de la table B, puis à recréer la variable ID de type caractère via la fonction PUT :
DATA finale; SET tableA tableB(RENAME=(ID=ID_num)); IF ID = » THEN ID = PUT(ID_num, z6.); DROP ID_num; RUN;
Cette manœuvre algorithmique garantit que le vecteur PDV ne reçoit qu’un seul flux nommé ID de type caractère. Pour les observations issues de la table A, la variable est ingérée directement sous son type textuel natif. Pour celles émanant de la table B, la variable initiale transite par le canal temporaire ID_num, est transmutée en chaîne avec préservation des zéros de tête grâce au format d’affichage Z6, puis la variable de transition est définitivement détruite via la clause DROP. La cohérence typologique de la table cible est ainsi restaurée avec une intégrité absolue.
6.3 Harmonisation des longueurs de variables avec l’instruction LENGTH
Si les conflits de types numériques versus caractères provoquent l’interruption frontale du compilateur, les discordances d’allocation de longueur de chaînes textuelles entraînent un danger bien plus pernicieux : la troncature silencieuse des données. Par construction intrinsèque, lorsqu’une variable de type caractère apparaît pour la première fois dans une étape DATA, sa longueur maximale d’allocation dans le PDV est définitivement indexée sur la taille définie dans la première table inspectée par le compilateur.
Imaginons que la variable nominale diagnostic_medical soit configurée avec une longueur de 10 octets dans la table 1, mais requière une allocation de 50 octets dans la table 2 pour héberger des descriptions nosologiques détaillées. Si l’instruction est formulée sous la forme SET table1 table2;, le PDV fige la taille de la colonne à 10 octets pour l’ensemble du cycle de traitement. Lors de l’absorption des enregistrements de la table 2, toutes les chaînes excédant 10 caractères sont irrémédiablement coupées net par le compilateur, sans qu’aucun message d’erreur bloquant ne vienne alerter le chercheur dans le journal.
Pour prévenir cette mutilation dramatique du corpus textuel, il est impératif d’instancier explicitement une instruction LENGTH directrice en tête absolue de l’étape DATA, impérativement avant l’instruction SET. En écrivant LENGTH diagnostic_medical $50; SET table1 table2;, le compilateur alloue préventivement une case mémoire de 50 octets au sein du PDV dès l’initialisation. Les informations textuelles de la table 1 s’y inscrivent sans contrainte, complétées par des espaces blancs de remplissage (trailing blanks), tandis que les descriptions exhaustives de la table 2 trouvent l’espace d’accueil nécessaire à leur préservation intégrale.
7. Traçabilité et identification de l’origine des observations : L’option IN=
7.1 Principe et déclaration de la variable booléenne IN=
Lorsqu’une table unifiée agrège des centaines de milliers d’enregistrements provenant de dizaines d’échantillons stratifiés, la perte de repère quant à l’origine native de chaque ligne constitue une faute méthodologique majeure. L’environnement SAS résout ce défi de traçabilité grâce à l’option de jeu de données IN=, applicable directement aux tables déclarées au sein de l’instruction SET. Cette option permet d’instancier une variable drapeau (flag) temporaire, dotée d’un comportement booléen binaire (0 ou 1), qui reflète à chaque instant la provenance physique de l’observation transitant par le PDV.
La formulation syntaxique s’établit comme suit : SET table_A(IN=provenance_A) table_B(IN=provenance_B);. Dans cette configuration, provenance_A et provenance_B sont des variables éphémères générées par le compilateur au sein du PDV. Lorsque le système lit une observation appartenant à la table A, la variable provenance_A reçoit dynamiquement la valeur logique 1 (vrai), tandis que provenance_B demeure initialisée à 0 (faux). Dès que le flux franchit la frontière du fichier pour ingérer la table B, les polarités s’inversent instantanément.
Une caractéristique primordiale des indicateurs déclarés par l’option IN= réside dans leur nature strictement non persistante. Ces variables sont programmées pour vivre et mourir au sein du PDV : par défaut, le compilateur SAS supprime automatiquement ces drapeaux lors de la phase d’écriture finale sur le disque. Si le chercheur désire pérenniser l’information d’appartenance pour ses analyses subséquentes, il doit obligatoirement transférer explicitement cet état booléen vers une variable permanente de son cru au sein de la logique séquentielle de l’étape DATA.
7.2 Création d’une variable permanente d’origine de cohorte
La matérialisation d’une variable permanente de provenance s’accomplit par l’insertion de structures logiques conditionnelles IF/THEN immédiatement après l’instruction SET. En exploitant la valeur des variables temporaires générées par l’option IN=, le programmateur assigne un identifiant pérenne, textuel ou numérique, qui documentera sans ambiguïté l’ancrage institutionnel ou temporel de l’enregistrement dans la table consolidée.
Considérons l’agrégation de trois cohortes d’évaluation clinique. L’algorithme d’identification se formalise par la séquence suivante :
DATA cohorte_totale;
SET hopital_paris(IN=in_p) hopital_lyon(IN=in_l) hopital_marseille(IN=in_m);
LENGTH centre_origine $15;
IF in_p THEN centre_origine = « Paris »;
ELSE IF in_l THEN centre_origine = « Lyon »;
ELSE IF in_m THEN centre_origine = « Marseille »;
RUN;
L’introduction de la colonne permanente centre_origine confère une valeur analytique considérable au jeu de données unifié. Elle permettra ultérieurement d’ajuster des modèles d’analyse de variance multivariée (MANOVA) pour tester les effets de site, d’introduire des facteurs de stratification dans les régressions logistiques, ou de calculer des statistiques descriptives croisées pour contrôler l’homogénéité démographique des sous-échantillons regroupés.
7.3 Filtrage et validation sélective des flux d’enregistrements
Au-delà de la simple documentation de provenance, l’association de l’instruction SET avec l’option IN= offre un mécanisme de filtrage et d’aiguillage conditionnel extrêmement performant lors de la phase même de concaténation. Il devient possible de soumettre l’ingestion des enregistrements à des critères de sélection différentiels, spécifiques à chaque sous-cohorte, avant même leur validation définitive dans la table cible.
Supposons qu’un protocole méthodologique impose de n’inclure les sujets issus de l’échantillon A que s’ils présentent un âge strictement supérieur à 18 ans, tout en acceptant sans restriction l’intégralité des participants issus de l’échantillon B. Ce contrôle d’admission se programme aisément par l’instruction de filtrage sélectif : IF in_A AND age <= 18 THEN DELETE;. Le mot-clé DELETE stoppe immédiatement l’itération courante du PDV pour les sujets non conformes de la table A, court-circuitant l’écriture sur disque sans interrompre la lecture continue des flux sains.
Cette approche permet d’assainir les corpus lors de l’intégration, évitant de polluer la mémoire avec des données hors-champ d’investigation. Elle autorise également la génération simultanée de tables de rejets documentant l’attrition des données, consolidant la démarche d’assurance qualité en fournissant une traçabilité mathématique des sujets écartés en stricte conformité avec les recommandations des standards directeurs de publication scientifique (tels que les diagrammes de flux CONSORT).
8. Concaténation avec tri intercalé (Interleaving)
8.1 Différence conceptuelle entre concaténation simple et entrelacement
La concaténation simple, telle que nous l’avons disséquée jusqu’ici, correspond à un empilement passif par blocs monolithiques : les données du fichier B sont inconditionnellement placées après celles du fichier A. Dans de nombreuses configurations d’analyse biomécanique ou d’économétrie spatio-temporelle, cette ségrégation par blocs est sous-optimale, car elle détruit la contiguïté logique des observations appartenant à une même unité statistique suivie de manière répétée à travers le temps.
L’entrelacement, désigné dans la terminologie anglo-saxonne sous le concept d’interleaving, constitue une modalité sophistiquée de concaténation où les enregistrements provenant de multiples tables sources sont fusionnés verticalement tout en étant instantanément ordonnés et intercalés selon les modalités d’une ou plusieurs variables de tri directrices. Au lieu d’avoir toutes les mesures de la vague 1 suivies de toutes celles de la vague 2, l’entrelacement réunit immédiatement les observations successives de chaque participant les unes à la suite des autres.
Cette disposition ordonnée est indispensable pour l’application d’opérateurs de calcul de décalage temporel (comme l’évaluation des variations d’amplitudes via la fonction LAG), le calcul des durées inter-crises dans les modèles de survie ou l’analyse séquentielle des profils de changement individuel. L’entrelacement substitue à la logique d’empilement par blocs une dynamique d’insertion ordonnée au fil de l’eau, hautement structurante pour les analyses inférentielles avancées.
8.2 Syntaxe combinée des instructions SET et BY
Sur le plan syntaxique, la bascule d’une concaténation simple vers une concaténation entrelacée s’opère de manière spectaculairement concise : il suffit d’adjoindre une instruction BY immédiatement après l’instruction SET hébergeant la liste des tables sources. La déclaration s’énonce sous la forme :
DATA cohorte_entrelacee;
SET vague1 vague2 vague3;
BY participant_id temps_mesure;
RUN;
Sous le capot du système d’exécution, la présence de la clause BY transforme radicalement le fonctionnement séquentiel du PDV. SAS n’épuise plus intégralement le fichier vague1 avant de passer au suivant. À chaque pas itératif, le moteur SAS inspecte la valeur des variables d’ordonnancement dans la ligne active de chacun des fichiers d’entrée. Il compare les valeurs des clés participant_id et temps_mesure, puis sélectionne algorithmiquement pour l’écriture sur disque la ligne qui présente la plus petite valeur lexicographique ou arithmétique.
Cette gymnastique computationnelle s’accompagne de l’instanciation automatique de deux variables système temporaires d’une valeur inestimable pour le chercheur : FIRST.variable et LAST.variable. Ces drapeaux booléens permettent de savoir à chaque instant si l’observation injectée dans la table finale constitue la première ou la dernière mesure associée à un sujet donné, ouvrant la voie à des calculs de cumul, de réinitialisation de compteurs ou d’évaluation de différentiels longitudinaux d’une finesse algorithmique inégalée.
8.3 Préparation algorithmique via la procédure PROC SORT
L’utilisation de la concaténation entrelacée est soumise à un postulat technique absolu, non négociable et rigoureusement surveillé par le compilateur SAS : l’ensemble des jeux de données d’entrée doivent impérativement être pré-triés selon la séquence exacte des variables déclarées dans l’instruction BY. Si la moindre observation viole l’ordre croissant (ou décroissant, si explicitement paramétré) au sein de l’un des flux d’entrée, SAS interrompt brutalement l’exécution de l’étape DATA avec un message d’erreur fatal : ERROR: BY variables are not properly sorted.
La préparation algorithmique impose donc le recours systématique à la procédure PROC SORT sur chacun des fragments sources en amont de l’étape d’entrelacement. Par exemple :
PROC SORT DATA=vague1;
BY participant_id temps_mesure;
RUN;
PROC SORT DATA=vague2;
BY participant_id temps_mesure;
RUN;
Lors de cette phase de pré-tri, il est fréquemment pertinent d’exploiter les options de régulation d’unicité, telles que NODUPKEY, pour éliminer d’éventuelles redondances accidentelles de clés primaires qui compromettraient l’interprétation des variables FIRST. et LAST.. Lorsque les volumes de données sont considérables, l’optimisation des algorithmes de tri (utilisation de l’option TAGSORT ou allocation étendue de l’espace de tri mémoire via SORTSIZE=) constitue une étape préalable incontournable pour sécuriser la fluidité de la procédure d’entrelacement consécutive.
9. Approches alternatives : Concaténation via PROC SQL et PROC APPEND
9.1 L’approche déclarative SQL avec l’opérateur UNION ALL
Bien que l’étape DATA demeure le véhicule d’ingénierie le plus emblématique de SAS, le module d’algèbre relationnelle PROC SQL offre une approche déclarative alternative particulièrement prisée des développeurs issus de l’univers des bases de données relationnelles (SGBD). Pour accomplir l’équivalent fonctionnel d’un empilement vertical, le langage SQL met à disposition l’opérateur ensembliste UNION ALL. La formulation s’articule autour de l’interrogation de deux projections de tables chaînées par l’opérateur d’union :
PROC SQL;
CREATE TABLE data_sql AS
SELECT * FROM data1
UNION ALL
SELECT * FROM data2;
QUIT;
La distinction entre UNION et UNION ALL est d’une portée fondamentale sur le plan algorithmique. L’opérateur UNION simple applique implicitement une élimination exhaustive des doublons en forçant un tri lourd de l’ensemble du volume de données consolidé, ce qui induit une pénalisation sévère du temps CPU. À l’inverse, l’adjonction de la directive ALL ordonne au moteur SQL de préserver strictement l’intégralité des lignes sans aucun examen d’unicité ni tri inductif, reproduisant exactement la performance linéaire et la fidélité de l’instruction SET de l’étape DATA.
Il importe de noter que PROC SQL applique une gestion rigoureuse de la position relative des colonnes. Si les colonnes ne partagent pas le même ordonnancement physique dans les tables d’origine, l’utilisation de la clause CORR (pour CORRESPONDING) devient obligatoire afin de contraindre le compilateur SQL à apparier les attributs par leur libellé textuel plutôt que par leur indice ordinal de projection. Malgré sa souplesse, PROC SQL demeure généralement plus rigide que l’étape DATA face aux variations fines de formats et de longueurs de chaînes.
9.2 Optimisation extrême des entrées-sorties avec PROC APPEND
Lorsque les exigences de traitement se heurtent à des contraintes d’infrastructure extrêmes impliquant des tables comprenant des dizaines de millions d’enregistrements, la procédure PROC APPEND constitue la panacée absolue en matière d’efficacité computationnelle. Contrairement à l’étape DATA ou à PROC SQL, qui nécessitent obligatoirement la relecture intégrale de la table maîtresse et la reconstruction physique d’un nouveau fichier de sortie, PROC APPEND réalise une adjonction directe dite « in-place » (sur place).
La mécanique syntaxique de cette procédure fait intervenir deux arguments centraux : BASE=, qui désigne la table historique réceptrice permanente, et DATA=, qui pointe vers l’incrément de données à greffer :
PROC APPEND BASE=archive_globale DATA=nouveaux_releves_jour FORCE;
RUN;
Le gain d’efficacité repose sur une économie totale d’opérations d’entrées-sorties : le moteur SAS ouvre le fichier désigné par BASE, déplace directement son pointeur d’écriture à la fin exacte du fichier physique sur le disque de stockage, et y append séquentiellement les blocs de données issus de DATA sans jamais relire ni déplacer le bloc initial historique. Le temps d’exécution n’est plus fonction de la taille cumulée (Base + Data), mais uniquement du volume marginal de la table ajoutée, réduisant des traitements de plusieurs heures à quelques secondes.
L’utilisation de l’option FORCE est souvent requise pour contraindre la procédure à s’exécuter lorsque la table DATA présente des attributs plus courts ou des colonnes manquantes par rapport à la table BASE. Il convient néanmoins de manier FORCE avec circonspection : si une variable textuelle est plus longue dans DATA que dans BASE, PROC APPEND tronquera sans sommation le surplus d’octets pour contraindre les données à entrer dans le gabarit préexistant de la table d’accueil.
9.3 Grille comparative de performance computationnelle
Le choix entre l’étape DATA classique, la procédure déclarative PROC SQL et l’utilitaire d’adjonction PROC APPEND doit être dicté par une analyse rationnelle des besoins architecturaux, du volume d’octets en transit et des opérations de manipulation concomitantes. Chaque méthode présente un compromis spécifique entre flexibilité algorithmique et sobriété d’utilisation des ressources matérielles :
- Étape DATA (SET) : Présente une flexibilité algorithmique absolue (création conditionnelle de variables, harmonisation fine des longueurs, transmutations de types, utilisation des variables FIRST. et LAST.). Elle impose en contrepartie une réécriture intégrale de la matrice unifiée et consomme une empreinte disque égale à la somme des volumes d’entrée plus le volume de sortie durant le cycle de traitement.
- PROC SQL (UNION ALL) : Offre une interopérabilité conceptuelle idéale pour les environnements de bases de données distribuées et les architectures hybrides SAS/Cloud. Elle se révèle néanmoins syntaxiquement plus verbeuse pour gérer les discordances de structures et requiert une mobilisation temporaire substantielle de mémoire tampon lors de l’assemblage des projections.
- PROC APPEND : Démontre une supériorité absolue en vitesse brute et en économie d’entrées-sorties lors de l’alimentation incrémentale de tables volumineuses. Elle est en revanche dénuée de toute flexibilité logique : aucune transformation conditionnelle de variable ne peut être opérée à la volée durant le processus d’adjonction physique.
10. Assurance qualité et intégrité des données après concaténation
10.1 Vérification des volumes d’enregistrements via PROC CONTENTS
L’achèvement formel d’un script de concaténation ne saurait marquer la clôture du travail d’ingénierie ; il ouvre impérativement la phase d’assurance qualité et d’audit métrologique des données résultantes. Le premier jalon de cette validation consiste à interroger le dictionnaire des métadonnées de la nouvelle structure tabulaire au moyen de la procédure PROC CONTENTS. L’instruction PROC CONTENTS DATA=table_cible; RUN; édite un inventaire exhaustif des spécifications morphologiques du fichier consolidé.
Le point de contrôle primordial réside dans la vérification de l’égalité arithmétique élémentaire des flux : le nombre d’observations total (noté Observations dans le cartouche d’en-tête de la sortie SAS) doit correspondre avec une rigueur absolue à la somme arithmétique exacte des observations composant chacun des sous-fichiers sources. Tout écart, ne serait-ce que d’une seule unité statistique, signale une anomalie silencieuse : présence d’une instruction conditionnelle ayant éliminé des lignes à l’insu du programmeur, corruption d’en-tête de fichier ou arrêt prématuré par saturation d’espace disque.
L’examen des métadonnées doit également porter sur la stabilité des types et formats d’affichage. Il convient de vérifier que les variables n’ont pas subi de mutations inattendues de leurs informats d’entrée, que les longueurs déclarées correspondent aux gabarits maximaux attendus et que le moteur de compression (si activé via l’option système COMPRESS=YES) a correctement fonctionné pour réduire l’empreinte physique du stockage sans dégrader la restitution des cellules d’information.
10.2 Audit des doublons d’observations avec PROC FREQ
L’empilement vertical de sources multiples expose les corpus à un risque méthodologique majeur : l’intrusion de doublons accidentels résultant de chevauchements d’échantillonnage ou de ressaisies administratives. Si un participant a pris part à deux vagues successives d’évaluation tout en étant catalogué dans deux fichiers distincts sous une même clé primaire sans identification temporelle, son inclusion dédoublée biaiserait immédiatement les variances empiriques et gonflerait artificiellement les degrés de liberté des tests d’inférence.
L’audit de la structure relationnelle mobilise la procédure de distribution de fréquences PROC FREQ. En exécutant une table univariée sur l’identifiant des participants assortie de l’option ORDER=FREQ :
PROC FREQ DATA=table_cible ORDER=FREQ;
TABLES identifiant_sujet / NOPERCENT NOCUM;
RUN;
Le système ordonne l’édition des fréquences de la plus élevée à la plus basse. Toute occurrence supérieure à l’unité (ou au nombre contractuellement attendu de vagues de suivi pour un protocole longitudinal) démasque instantanément des redondances parasites qu’il conviendra d’élucider.
Dans les contextes de modélisation avancée, l’orthogonalité des sous-cohortes regroupées doit être confirmée par des tables de contingence bivariées croisant la variable permanente d’origine de cohorte avec les descripteurs démographiques clés (sexe, classe d’âge, centre de diagnostic). La détection d’asymétries massives dans ces distributions permet de déceler des biais d’échantillonnage introduits lors de la consolidation des flux.
10.3 Contrôle des valeurs manquantes et incohérences structurelles
L’étape terminale d’audit qualité requiert l’auscultation systématique des taux de cellules vides générées au sein de la table unifiée. Une poussée anormale de valeurs manquantes (missing values) sur une variable scalaire spécifique après concaténation constitue le symptôme révélateur d’un désalignement taxonomique en amont, causé par une variation orthographique mineure du nom de la colonne entre les tables sources (par exemple, pression_arterielle versus pression_art).
Pour quantifier et cartographier ces manques informationnels, l’analyste déploie la procédure PROC MEANS paramétrée avec l’option statistique NMISS, complétée par la directive N :
PROC MEANS DATA=table_cible N NMISS MIN MAX MEAN STD;
VAR _NUMERIC_;
RUN;
Cette instruction soumet l’intégralité des variables continues à un examen synthétique. Une colonne présentant un taux de NMISS égal exactement à l’effectif total de l’une des tables sources trahit immédiatement une absence de fusion nominale, l’attribut n’ayant été alimenté que par l’une des deux fractions d’échantillon.
Simultanément, l’inspection des bornes minimales et maximales permet de repérer des discordances d’unités de mesure entre les fichiers historiques agrégés. Si un centre hospitalier a enregistré les concentrations sériques en milligrammes par décilitre tandis qu’un autre les a relevées en millimoles par litre, l’inspection descriptive fera apparaître des distributions biomodales aberrantes ou des valeurs extrêmes irréalistes. L’identification précoce de ces incohérences garantit que les matrices de données ne feront l’objet de modélisations inférentielles qu’après une harmonisation scalaire irréprochable.
11. Erreurs fréquentes, pièges syntaxiques et débogage
11.1 Perte de données par troncature implicite
Parmi les pièges les plus dévastateurs de la concaténation SAS figure la troncature implicite des variables textuelles, évoquée précédemment dans son versant théorique. L’ingénieur doit être conscient des manifestations concrètes de ce phénomène dans le cadre de ses diagnostics d’erreurs. Lorsqu’une chaîne de caractères longue est tronquée silencieusement, la structure interne de l’enregistrement n’est pas brisée, mais le sens sémantique de l’attribut est irrémédiablement altéré. Dans le cas de libellés psychométriques standardisés ou de codes de diagnostic complexes (tels que la CIM-10), une coupure de quelques caractères transforme un diagnostic de pathologie sévère en une chaîne tronquée illisible ou ambiguë.
La détection de cette troncature ne génère aucun code retour d’erreur (return code différent de zéro) dans l’environnement SAS. Seul un œil averti examinant les affichages de PROC PRINT ou procédant à des tests de longueur effective de chaînes au moyen de la fonction LENGTH() ou KLENGTH() peut débusquer l’anomalie :
DATA controle_troncature;
SET table_cible;
longueur_reelle = LENGTH(chaine_texte);
RUN;
PROC UNIVARIATE DATA=controle_troncature;
VAR longueur_reelle;
RUN;
Si la distribution de longueur_reelle présente un plafond rigide calé sur la longueur de la variable dans la table 1, le diagnostic de troncature implicite est formellement établi. La seule remédiation consiste à reconstruire l’étape DATA en fixant une clause LENGTH chaine_texte $XX; avant l’appel de l’instruction SET, garantissant une enveloppe mémoire suffisante pour accueillir le plus long des libellés rencontrés dans l’ensemble des cohortes.
11.2 Omission involontaire d’instructions de séparation
La grammaire du compilateur SAS repose sur une ponctuation rigoureuse où le point-virgule marque la borne séquentielle définitive de chaque unité d’action déclarative. Une erreur fréquente commise lors de la rédaction de concaténations complexes réside dans la fragmentation accidentelle de l’instruction SET sur plusieurs lignes avec introduction erronée d’un point-virgule intermédiaire. L’écriture :
SET donnees_centre_nord;
donnees_centre_sud;
RUN;
ne provoque pas l’adjonction des deux centres. La première ligne est interprétée comme une ingestion complète de la première table, tandis que la seconde ligne, isolée, génère une erreur de syntaxe immédiate signalant que l’énoncé donnees_centre_sud n’est pas reconnu comme une instruction valide de l’étape DATA.
Un autre dysfonctionnement majeur provient de la répétition successive de plusieurs instructions SET distinctes au sein du même bloc : SET table1; SET table2;. Comme nous l’avons souligné, cette syntaxe ne réalise absolument pas une concaténation séquentielle, mais configure une lecture simultanée (appariement un pour un sans variable BY). Dès que la table la plus courte parmi les deux atteint son marqueur de fin d’enregistrement, l’étape DATA s’arrête instantanément. Il en résulte une perte massive et invisible d’observations issues de la table la plus volumineuse.
Le débogage de ces anomalies syntaxiques exige une lecture méthodique du journal SAS. Tout signalement mentionnant un arrêt prématuré du processus d’itération (NOTE: There were X observations read from the data set… avec un nombre d’itérations inférieur aux attentes arithmétiques) doit alerter le développeur sur un court-circuitage de la cinématique normale du PDV dû à une mauvaise orchestration des instructions d’entrée.
11.3 Gestion des conflits d’étiquettes de variables (LABEL)
Les métadonnées associées aux variables au sein des tables SAS incluent non seulement le type et la longueur, mais également des descripteurs documentaires nommés étiquettes de variables ou LABEL. Les étiquettes permettent d’associer des chaînes textuelles explicatives (pouvant atteindre 256 caractères) aux noms techniques des variables, facilitant la lisibilité des rapports édités par PROC PRINT ou PROC TABULATE.
Lors de la concaténation de multiples jeux de données, il arrive couramment que les développeurs des tables sources aient attribué des étiquettes discordantes à une même variable technique. Par exemple, la colonne PAS peut être labellisée « Pression Artérielle Systolique (mmHg) » dans la table 1 et « Pression Systolique au repos » dans la table 2. Dans cette configuration, le moteur SAS applique la règle universelle de préséance séquentielle : la première étiquette rencontrée au cours de la compilation est celle qui s’impose de façon exclusive à l’ensemble de la table finale consolidée.
Ce mécanisme de préséance peut dissimuler des nuances méthodologiques capitales entre les vagues d’évaluation. Pour neutraliser les conflits documentaires ou réassigner des étiquettes consensuelles standardisées qui rendent justice à la nature agrégée des données, le chercheur doit obligatoirement expliciter une instruction LABEL dédiée au sein de l’étape DATA finale, écrasant ainsi souverainement les métadonnées historiques discordantes héritées des différentes sources d’approvisionnement.
12. Synthèse méthodologique et recommandations pour la recherche
12.1 Arbre de décision pour le choix de la méthode optimale
Afin de guider rationnellement les équipes de recherche dans le choix de la méthodologie de concaténation la plus efficiente et robuste, nous proposons ici un cadre décisionnel synthétique basé sur les attributs clés du pipeline de traitement :
- Cas 1 : Concaténation standard avec transformations en vol. Si l’intégration exige des harmonisations de formats, des conversions explicites de types (fonctions INPUT/PUT), des filtrages d’observations conditionnels ou le traçage systématique des cohortes via l’option IN=, l’Étape DATA avec instruction SET s’impose incontestablement comme la méthodologie de référence, offrant une malléabilité algorithmique sans égale.
- Cas 2 : Suivi temporel intra-sujet avec pré-tri requis. Dès lors que le protocole méthodologique étudie l’évolution temporelle de cohortes longitudinales répétées et nécessite le regroupement contigu des mesures relatives à chaque individu, la Concaténation avec tri intercalé (SET avec clause BY) constitue l’approche obligatoire, adossée à une standardisation préalable via PROC SORT.
- Cas 3 : Intégration incrémentale massive sur tables monolithiques. Lorsque la table cible contient plusieurs centaines de millions de lignes et que l’objectif est d’y ajouter une fraction marginale de données fraîches sans subir le coût prohibitif de relecture et d’écriture de la totalité de la base historique, la procédure PROC APPEND (éventuellement adossée à l’option FORCE) représente la solution technique optimale pour préserver la bande passante machine.
- Cas 4 : Architecture hybride et intégration inter-SGBD. Si les données sources sont ventilées à travers des moteurs de stockage hétérogènes (par exemple, des tables résidant sur Oracle, PostgreSQL ou Snowflake accédées via SAS/ACCESS), l’emploi de PROC SQL avec l’opérateur UNION ALL offre une standardisation déclarative idéale, minimisant les idiosyncrasies lexicales locales.
12.2 Automatisation industrielle via les macros SAS
Dans les centres d’essais cliniques ou les instituts de statistique publique, les opérations de concaténation doivent fréquemment être exécutées de façon automatisée, récurrente et indépendante des interventions manuelles d’un opérateur. Pour atteindre ce niveau d’industrialisation logicielle, le langage macro de SAS (SAS Macro Language) offre des potentialités de métaprogrammation exceptionnelles, permettant de générer dynamiquement des blocs de concaténation à partir de l’interrogation directe des tables de contrôle du système.
L’exploitation de la vue système SASHELP.VTABLE permet d’identifier par programme l’ensemble des jeux de données répondant à des critères spécifiques de localisation ou de dénomination dans une bibliothèque donnée. Grâce à des procédures SQL combinées avec la clause INTO :macro_variable SEPARATED BY ‘ ‘, l’ingénieur peut concaténer en une fraction de seconde l’ensemble des tables découvertes dans le répertoire cible sans jamais avoir à saisir leurs noms en dur dans le code source :
PROC SQL NOPRINT;
SELECT memname INTO :liste_tables SEPARATED BY ‘ ‘
FROM sashelp.vtable
WHERE libname = ‘ETUDES’ AND memname LIKE ‘RELEVE_%’;
QUIT;
DATA archive_consolidee;
SET &liste_tables;
RUN;
Cette approche méta-programmatique garantit l’extensibilité totale des chaînes analytiques. L’arrivée inopinée de nouveaux fichiers mensuels respectant le standard de dénomination est prise en compte de manière totalement autonome lors de l’exécution subséquente de la routine, conférant au laboratoire une agilité opérationnelle et une fiabilité d’intégration maximales.
12.3 Protocole de documentation et reproductibilité scientifique
La recherche empirique contemporaine est soumise à des normes de reproductibilité et de traçabilité d’une rigueur croissante, encadrées notamment par les directives de la science ouverte et les principes FAIR (Findable, Accessible, Interoperable, Reusable). Dans cette perspective, la concaténation de données ne peut être traitée comme un simple bricolage algorithmique éphémère. Chaque étape de l’empilement vertical doit être méticuleusement archivée et documentée.
Le protocole de reproductibilité impose en premier lieu la sauvegarde systématique et l’horodatage des journaux d’exécution SAS (les fichiers .log). La log constitue la preuve juridique et scientifique incontestable du déroulement nominal de l’étape DATA. Elle atteste du nombre exact d’observations ingérées à partir de chaque fichier source, du nombre d’enregistrements projetés dans la table de destination, ainsi que de l’absence totale de messages d’alerte critiques (WARNING) relatifs à des troncatures de variables ou des conversions automatiques non maîtrisées.
Enfin, les scripts de concaténation doivent être assortis de méta-données descriptives précisant la provenance exacte des fractions d’échantillons, les versions des dictionnaires de variables mobilisés et les éventuelles règles de transcodage appliquées pour résoudre les discordances de typage. Ce niveau d’exigence documentaire assure que n’importe quel auditeur indépendant ou chercheur tiers pourra réitérer l’assemblage matriciel à partir des sources primaires et retrouver au bit près la structure informationnelle sur laquelle reposent les conclusions scientifiques publiées.
Références
- Cody, R. (2018). Learning SAS by Example: A Programmer’s Guide (2nd ed.). SAS Institute Inc.
- Delwiche, L. D., & Slaughter, S. J. (2019). The Little SAS Book: A Primer (6th ed.). SAS Institute Inc.
- Horstman, D. W. (2017). PROC SQL: Beyond the Basics Using SAS (3rd ed.). SAS Institute Inc.
- SAS Institute Inc. (2020). SAS 9.4 Language Reference: Concepts (6th ed.). SAS Institute Inc. https://documentation.sas.com
- SAS Institute Inc. (2021). Base SAS Procedures Guide. SAS Institute Inc. https://documentation.sas.com
- Whiting, H. (2015). Combining data in SAS: SET, MERGE, and SQL. Proceedings of the SAS Global Forum 2015 Conference, Paper 3422-2015. SAS Institute Inc.