
L’avènement des environnements de calcul distribué et des tableurs infonuagiques a profondément bouleversé le traitement des données semi-structurées au sein des organisations contemporaines. Jadis confiné à de simples opérations arithmétiques ou à des consolidations comptables rudimentaires, le tableur moderne, incarné avec force par Google Sheets, constitue désormais une véritable plateforme de modélisation algorithmique. Au sein de cet écosystème réactif, les analystes sont confrontés à une prolifération exponentielle de données textuelles hétérogènes : verbatims d’enquêtes qualitatives, registres d’erreurs de serveurs, référentiels de produits et métadonnées issues de systèmes transactionnels. Dans ce contexte, l’interrogation ciblée de sous-ensembles d’informations ne relève plus d’un simple confort ergonomique, mais d’une exigence méthodologique stricte visant à garantir l’intégrité et la reproductibilité des analyses.
Le filtrage textuel s’impose comme une opération fondamentale de réduction dimensionnelle. Contrairement aux variables numériques, immédiatement quantifiables et ordonnées sur une échelle continue ou discrète, les chaînes de caractères se distinguent par une complexité intrinsèque liée à la variabilité linguistique, aux conventions typographiques et à l’ambiguïté morphosyntaxique. Extraire avec exactitude des enregistrements répondant à la condition d’inclure une séquence de caractères spécifique exige une maîtrise rigoureuse des moteurs d’évaluation booléenne matriciels. La distinction entre une correspondance stricte d’égalité et la détection d’une sous-chaîne partielle constitue la pierre angulaire de cette démarche, requérant l’articulation harmonieuse de fonctions natives spécialisées et de la théorie des expressions rationnelles.
Ce traité exhaustif se propose d’explorer en profondeur la théorie et l’implémentation opérationnelle du filtrage de cellules contenant du texte dans Google Sheets. En examinant successivement les fondations épistémologiques du modèle matriciel réactif, la structure formelle de la fonction FILTER, la puissance sémantique de la fonction REGEXMATCH, ainsi que les alternatives computationnelles historiques et contemporaines, cet article établit un protocole d’ingénierie logicielle pour l’analyste de données exigeant. Nous aborderons également les questions critiques de résilience des calculs, de gestion de la mémoire face à des volumétries massives et de prévention des dérives méthodologiques lors de l’extraction de corpus textuels volumineux.
1. Fondements théoriques et épistémologie du filtrage textuel dans Google Sheets
1.1 Paradigme du filtrage de données en environnement matriciel
Le filtrage de données, envisagé sous l’angle de l’algèbre relationnelle, s’apparente à une opération de restriction (ou sélection) qui projette un sous-ensemble de tuples satisfaisant un prédicat unaire défini sur un schéma relationnel donné. Dans l’écosystème d’une feuille de calcul matricielle dynamique telle que Google Sheets, cette opération transcende le simple masquage visuel de lignes pour devenir un processus transformationnel réactif. Le filtrage algorithmique génère une nouvelle structure de données autonome, découplée de la matrice d’origine mais continuellement synchronisée avec elle par un lien de dépendance fonctionnelle.
La distinction conceptuelle entre les filtres statiques d’interface utilisateur — accessibles via les menus conventionnels et modifiant l’état visuel de la feuille — et les filtres algorithmiques basés sur des formules matricielles est d’une portée méthodologique majeure. Les premiers altèrent la présentation sans modifier la topologie des cellules adjacentes et demeurent tributaires des actions manuelles de l’utilisateur, ce qui introduit un risque non négligeable d’erreur humaine et d’altération de l’intégrité référentielle lors de manipulations concurrentes. Les seconds, en revanche, matérialisent un flux de données déclaratif : la formule spécifie l’invariant logique qui gouverne la sélection, laissant au moteur de calcul le soin de matérialiser instantanément le vecteur résultant.
Ce basculement du modèle tabulaire traditionnel vers le paradigme réactif redistribue les rôles analytiques. L’espace de calcul n’est plus un réceptacle passif de données immuables, mais un graphe orienté acyclique dans lequel chaque mutation de la cellule source déclenche une réévaluation déterministe des nœuds dépendants. La validité scientifique des corpus textuels extraits dépend ainsi de la rigueur mathématique avec laquelle les prédicats de sélection sont formalisés, interdisant toute approximation dans l’évaluation des conditions logiques appliquées aux séquences de caractères.
1.2 Rôle des chaînes de caractères dans l’analyse de données qualitatives
Au sein des bases de données organisationnelles, les données textuelles occupent une place singulière caractérisée par une forte densité sémantique et un degré élevé de désordre entropique. Elles se subdivisent généralement en trois typologies formelles : les variables catégorielles à faible cardinalité (telles que les états de statut ou les classifications géographiques), les étiquettes sémantiques contrôlées (telles que les identifiants de nomenclature produit) et les verbatims libres issus de champs ouverts, d’enquêtes de satisfaction ou de journaux de bord numériques. Chacune de ces catégories impose des contraintes analytiques spécifiques lors des opérations de tri et de filtrage.
Le traitement manuel de larges corpus lexicaux expose les analystes à des biais cognitifs majeurs, notamment l’attention sélective, la fatigue attentionnelle et la propension à ignorer les divergences orthographiques marginales. Lorsqu’un analyste tente d’isoler visuellement des occurrences textuelles sans formalisation algorithmique, le taux d’erreur croît de manière quasi exponentielle avec la taille du jeu de données. La variabilité inhérente au langage naturel — incluant les fautes de frappe, l’usage inconsistant de la capitalisation, l’adjonction fortuite d’espaces invisibles et la présence de synonymes — transforme la tâche d’extraction en un défi épistémologique où la précision de l’instrument de mesure conditionne la représentativité des conclusions scientifiques.
Dès lors, la formalisation des critères de recherche ne consiste pas uniquement à identifier une suite de glyphes, mais à circonscrire un espace sémantique rigoureux. Extraire les cellules qui « contiennent » un fragment textuel suppose d’isoler l’invariant lexical invariant face au bruit environnant. Cette formalisation mathématique transforme une appréciation qualitative subjective en un prédicat logique falsifiable, condition préalable indispensable à toute inférence statistique ou modélisation qualitative ultérieure.
1.3 Principe d’évaluation booléenne au sein d’une formule matricielle
Au cœur de l’architecture d’exécution de Google Sheets réside le mécanisme d’évaluation vectorielle des expressions logiques. Lorsqu’une condition est formulée à l’égard d’une plage multidimensionnelle, le système n’exécute pas une comparaison scalaire isolée, mais instancie un masque booléen. Ce masque se compose d’un vecteur ou d’une matrice de dimensions strictement identiques à la zone examinée, dont chaque composante élémentaire est évaluée sous la forme d’un atome logique binaire : VRAI (représenté numériquement par 1 dans certains contextes arithmétiques) ou FAUX (représenté par 0).
Le principe fondamental sous-jacent repose sur la correspondance bijective un-à-un entre l’indice de ligne de la structure d’entrée et la position séquentielle de l’élément au sein du vecteur booléen. Si la cellule située à l’indice i satisfait le prédicat textuel, la composante correspondante du masque arbore l’état VRAI. À l’inverse, toute discordance lexicale, anomalie de typage ou absence de données attribue immédiatement la valeur FAUX à cette position. Cette séparation étanche entre la phase d’évaluation logique et la phase d’extraction structurelle confère au système une robustesse algorithmique remarquable.
Cette mécanique est indissociable du comportement de propagation automatique, communément désigné sous le terme anglo-saxon d’array expansion ou de dynamique de déversement. Le moteur de calcul interne, inspiré des principes de la programmation fonctionnelle vectorielle, évalue l’expression de manière atomique sur l’ensemble du domaine de définition. L’application sélective du masque sur la matrice source permet de purger instantanément les lignes non concordantes, projetant dans l’espace de sortie uniquement la sous-matrice dont les indices coïncident avec les valeurs vérifiées du vecteur booléen générateur.
2. Anatomie structurelle de la fonction FILTER dans Google Sheets
2.1 Syntaxe formelle et spécification des arguments de FILTER
La fonction FILTER constitue l’opérateur primitif par excellence pour la restriction de matrices dans Google Sheets. Sa signature formelle s’énonce comme suit : =FILTER(plage, condition1, [condition2, …]). L’argument initial, désigné par le terme plage, délimite l’espace matriciel de sortie susceptible d’être extrait. Il peut s’agir d’un vecteur unidimensionnel ou d’un tableau à deux dimensions comprenant un nombre arbitraire de colonnes et de lignes contiguës.
Les arguments subséquents, représentés par condition1 et ses extensions facultatives, constituent les vecteurs de filtrage proprement dits. L’exigence fondamentale de cette syntaxe réside dans l’isomorphisme dimensionnel unilatéral : chaque vecteur conditionnel doit impérativement posséder une hauteur (un nombre de lignes) rigoureusement identique à celle de la matrice définie dans le premier argument, ou une largeur identique si le filtrage opère de manière horizontale. Toute violation de cette contrainte géométrique engendre l’interruption immédiate de l’évaluation et l’émission d’une erreur structurelle de dimensionnalité, interdisant le calcul du résultat.
Il convient de souligner l’indépendance fonctionnelle totale qui prévaut entre les colonnes constitutives de la plage de sortie et les données sollicitées pour l’élaboration des conditions. En d’autres termes, une matrice A1:C100 peut être filtrée selon un critère textuel portant exclusivement sur la colonne D1:D100, quand bien même cette dernière demeure totalement absente du résultat projeté. Cette disjonction architecturale accorde à l’analyste une liberté considérable dans la conception de modèles de restitution épurés, affranchis des variables auxiliaires de contrôle.
2.2 Dynamique d’exécution et recalcul automatique
L’exécution de la fonction FILTER est gouvernée par le moteur de dépendances réactives du tableur. Contrairement aux scripts procéduraux nécessitant une invocation explicite par l’utilisateur ou le déclenchement d’un événement système, la formule matricielle réagit de manière asynchrone et instantanée à toute mutation intervenant dans les cellules composant ses antécédents directs et indirects. Dès qu’une valeur textuelle est insérée, modifiée ou supprimée dans l’espace source, le graphe de calcul recalcule le masque logique et réajuste dynamiquement les bornes de la matrice résultante.
Ce mécanisme de restitution dynamique implique un comportement de « déversement » (spill). La cellule hébergeant la formule matricielle originelle agit comme le point d’ancrage supérieur gauche de la structure renvoyée. Si la configuration du classeur présente un obstacle physique — tel qu’une cellule non vide préexistante située dans l’empreinte spatiale requise par l’expansion du résultat —, le moteur de calcul interrompt la restitution et génère l’erreur bloquante #REF! avec la mention explicite d’écrasement potentiel de données adjacentes.
Par ailleurs, l’utilisation de plages ouvertes, telles que A2:A ou A2:C, impose une sollicitation accrue des ressources algorithmiques. Le système est contraint d’évaluer la totalité de la hauteur théorique de la grille (fréquemment plafonnée à plusieurs dizaines ou centaines de milliers de lignes). Bien que le moteur interne de Google Sheets optimise l’empreinte mémoire par des mécanismes de représentations éparses (sparse matrices), une conception non rigoureuse des plages conditionnelles peut induire une latence perceptible lors des calculs itératifs à large échelle.
2.3 Limites intrinsèques de la condition textuelle basique
Une confusion fréquente chez les praticiens novices réside dans la tentative d’exploiter les opérateurs de comparaison arithmétique standard pour satisfaire des exigences d’appariement textuel. Dans Google Sheets, l’opérateur d’égalité stricte (=) est conçu pour vérifier la parfaite identité séquentielle et typologique de deux chaînes de caractères. Par conséquent, une formulation du type =FILTER(A1:C17, A1:A17 = « East ») ne retiendra strictement que les enregistrements dont le contenu cellulaire correspond exactement à la séquence des quatre caractères spécifiés, à l’exclusion de tout autre élément.
Cette stricte égalité se révèle totalement inopérante dès lors que la cellule cible contient des termes contextuels, des préfixes, des suffixes ou des variations morphologiques (par exemple, « East Region », « North-East », ou « Sector East »). L’opérateur scalaire souffre d’une incapacité structurelle à traiter la troncature lexicale ou la recherche d’inclusions internes. Si un fragment textuel d’intérêt se trouve enchâssé au cœur d’une phrase ou d’un paragraphe descriptif, l’évaluation de l’égalité simple renvoie irrémédiablement la valeur FAUX.
Il devient donc théoriquement indispensable d’introduire des fonctions auxiliaires spécialisées dans la recherche intra-chaîne. Ces fonctions doivent être capables de balayer la séquence d’octets ou de caractères Unicode d’une cellule, d’y repérer la présence éventuelle d’un motif défini, et de convertir ce diagnostic séquentiel en un prédicat booléen immédiatement exploitable par l’argument conditionnel de la fonction FILTER. C’est à la confluence de ces deux principes que s’articule l’usage des expressions rationnelles au sein du tableur.
3. Intégration de REGEXMATCH avec FILTER pour le repérage de sous-chaînes
3.1 Mécanique d’évaluation de la fonction REGEXMATCH
La fonction REGEXMATCH constitue le pivot méthodologique central pour tout filtrage textuel avancé dans Google Sheets. Définie par la syntaxe élémentaire REGEXMATCH(texte, expression_régulière), elle a pour fonction exclusive d’analyser une chaîne de caractères et de retourner la valeur booléenne VRAI si le motif décrit par l’expression régulière est décelé au moins une fois au sein de la chaîne cible, et FAUX dans le cas contraire. Son formalisme d’interprétation s’appuie sur la syntaxe robuste standardisée de la bibliothèque RE2 de Google, réputée pour sa vitesse d’exécution déterministe et sa sécurité d’accès mémoire.
Lorsqu’elle est imbriquée au sein du second argument de la fonction FILTER, REGEXMATCH déploie un comportement d’évaluation vectorielle automatique. Bien que sa signature standard s’applique formellement à un argument textuel scalaire unique, son inclusion dans le contexte matriciel de FILTER force le moteur de calcul à évaluer la fonction sur chaque cellule de la plage passée en paramètre. Il en résulte la génération instantanée d’un vecteur logique vertical rigoureusement superposable aux dimensions de la matrice source.
Ce mécanisme élimine la nécessité d’avoir recours à des fonctions enveloppes matricielles déclaratives explicites telles que ARRAYFORMULA. La fonction FILTER applique implicitement une coercition vectorielle à ses arguments de condition. Dès lors, l’expression REGEXMATCH(A1:A17, « motif ») engendre un vecteur booléen pur, sans dérive de structure ni décalage indiciel, instanciant ainsi le filtre algorithmique le plus élégant et concis offert par l’environnement logiciel.
3.2 Avantages computationnels de REGEXMATCH par rapport aux fonctions traditionnelles
Historiquement, l’extraction de sous-chaînes au sein des feuilles de calcul imposait l’assemblage laborieux de fonctions issues de la manipulation de texte élémentaire, telles que FIND ou SEARCH, combinées à des tests de validation numérique de type ISNUMBER. La formulation classique prenait alors la tournure verbeuse : =FILTER(A1:C17, ISNUMBER(SEARCH(« motif », A1:A17))). Dans ce schéma, SEARCH renvoie la position ordinale entière du début de l’occurrence trouvée, ou déclenche une exception de type #VALUE! si le motif fait défaut, nécessitant l’intervention d’ISNUMBER pour convertir ce flux hétérogène en un booléen propre.
L’avantage cardinal de REGEXMATCH réside dans sa pureté logique intrinsèque : la fonction renvoie nativement un type de données booléen (VRAI/FAUX), éliminant une étape computationnelle intermédiaire de transformation de type. Sur le plan de la consommation de mémoire et de l’arbre syntaxique de la formule, l’empreinte algorithmique est substantiellement allégée. La formule gagne en lisibilité cognitive pour les pairs chargés de la maintenance du code et réduit le nombre de nœuds d’évaluation devant être traités par le compilateur interne de Google Sheets.
En contrepartie de cette concision, le moteur RE2 introduit une complexité algorithmique intrinsèque lors de la compilation du motif d’expression rationnelle. Toutefois, pour des motifs textuels simples ou moyennement élaborés, ce surcoût d’initialisation est largement amorti par la rapidité de l’automate fini non déterministe sous-jacent. REGEXMATCH conjugue ainsi une expressivité syntaxique maximale à une cohérence mathématique optimale pour les calculs vectoriels.
3.3 Sensibilité à la casse et typage de données
Par défaut, l’analyseur syntaxique de REGEXMATCH applique une politique de discrimination absolue quant à la casse typographique des glyphes rencontrés. Le caractère minuscule « e » est traité comme une entité binaire distincte du caractère majuscule « E ». Par conséquent, une requête ciblant le motif « east » rejettera systématiquement une occurrence contenant « East », « EAST » ou des permutations hybrides telles que « EaSt ». Cette rigueur, bien que souhaitable dans le cadre de codes industriels ou d’identifiants normalisés, pose d’importantes difficultés lors du dépouillement de verbatims en langage naturel.
Un autre défi méthodologique concerne le typage strict des données sous-jacentes. La fonction REGEXMATCH est rigoureusement typée pour le traitement de chaînes de caractères (strings). Si la plage d’évaluation contient des cellules formatées nativement sous forme de scalaires numériques purs (par exemple des entiers, des nombres à virgule flottante ou des dates sérielles standard), ou si elle intègre des cellules strictement vides (valeurs nulles), l’évaluateur peut générer une erreur de type #VALUE! ou adopter un comportement non conforme aux attentes de l’analyste.
Cette vulnérabilité algorithmique nécessite la mise en place de protocoles de coercition de type lorsque l’intégrité de la colonne source n’est pas structurellement garantie. L’utilisation stratégique de fonctions de conversion textuelle ou l’intégration de prédicats de vérification préliminaire permet d’immuniser le modèle matriciel contre les avaries d’évaluation causées par l’hétérogénéité des données d’entrée.
4. Cas pratique élémentaire : filtrer pour une occurrence textuelle unique
4.1 Décomposition pas à pas de la syntaxe standard
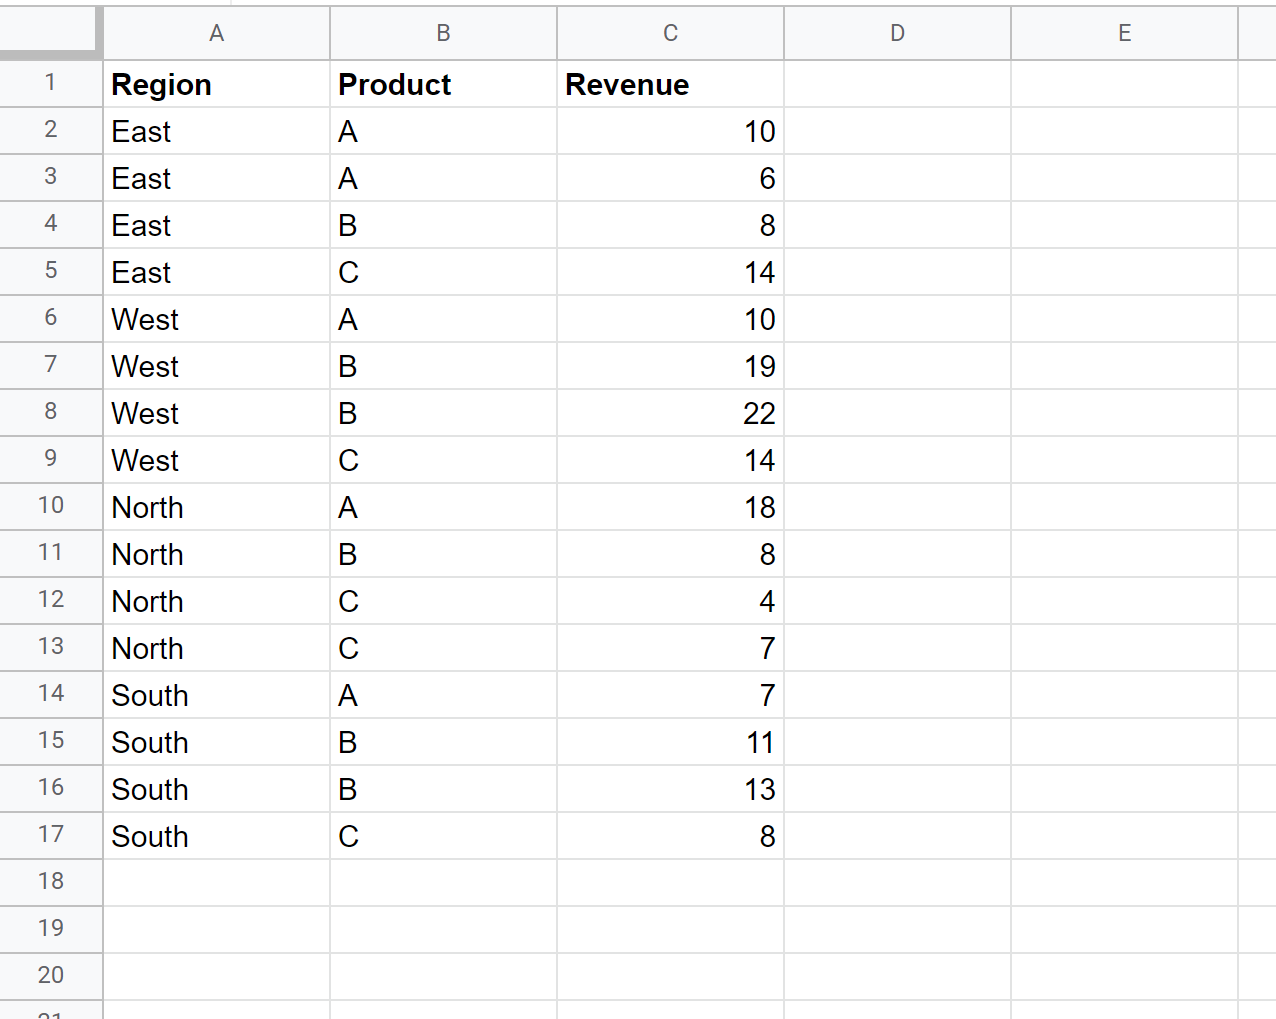
Afin de matérialiser l’implémentation opérationnelle de ce modèle, analysons de manière exégétique la formule canonique suivante :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « East »))
Dans ce schéma formel, le moteur d’exécution opère en deux phases chronologiques distinctes mais logiquement indissociables. Durant la première phase, l’expression interne REGEXMATCH(A1:A17, « East ») est isolée. Le moteur instancie un balayage séquentiel de chaque adresse mémoire comprise entre A1 et A17. Dès que le segment textuel continu « East » est détecté au sein du contenu de la cellule — qu’il soit placé en tête, au milieu ou au terme de la chaîne —, le système affecte la valeur VRAI à l’indice vectoriel correspondant.
Durant la seconde phase, la fonction FILTER ingère la matrice rectangulaire délimitée par A1:C17, englobant dix-sept lignes et trois colonnes d’attributs. Elle superpose le vecteur booléen précédemment constitué sur la dimension verticale de la matrice. Chaque ligne i de A1:C17 pour laquelle le masque booléen arbore la valeur FAUX est expurgée de la mémoire d’affichage. Les lignes indexées par VRAI sont en revanche conservées, compactées et projetées vers la destination cible sans aucune discontinuité spatiale.
La validation empirique impose de vérifier scrupuleusement l’alignement des bornes d’indexation. L’intervalle de sélection s’étend formellement de la ligne 1 à la ligne 17 au sein des deux arguments. Si l’analyste commettait l’erreur typologique de formuler =FILTER(A1:C17, REGEXMATCH(A1:A16, « East »)), l’interpréteur de Google Sheets bloquerait le calcul en renvoyant une erreur sur la taille des arguments matriciels, rappelant ainsi la stricte nécessité de conformité topologique entre l’espace de données et le vecteur de filtrage.
4.2 Scénario empirique d’application sur données d’enquête
Considérons à présent une étude empirique portant sur un échantillon d’observations sociologiques ou de retours d’utilisateurs. Soit une table source structurée en trois champs cardinaux : la colonne A consignant la désignation de la division territoriale assignée (« East District », « West Zone », « North-East Sector »), la colonne B enregistrant le patronyme de l’intervenant, et la colonne C quantifiant un score d’évaluation psychométrique discret compris entre 1 et 100.
L’objectif de l’analyse est de circonscrire exclusivement l’ensemble des enregistrements émanant des territoires orientaux. En appliquant la formule =FILTER(A1:C17, REGEXMATCH(A1:A17, « East »)), la cohorte d’observations est instantanément scindée. Non seulement les cellules libellées purement « East » sont extraites, mais les enregistrements composites tels que « East District » et « North-East Sector » satisfont également à la condition d’appariement. Le tableau résultant garantit ainsi l’inclusion exhaustive de toute unité spatiale affiliée au repère cardinal oriental, tout en évacuant les cohortes des zones « West », « South » ou « Central ».
Cette approche apporte la certitude qu’aucun individu appartenant à la classe d’intérêt n’est omis pour des raisons d’incohérence de saisie des suffixes territoriaux. L’analyste extrait ainsi une base de travail homogène, propice au calcul consécutif de métriques inférentielles telles que la moyenne d’évaluation ou la variance intergroupe au sein du sous-échantillon oriental.
4.3 Pièges courants lors de l’implémentation initiale
Malgré l’apparente sobriété de la syntaxe, l’implémentation pratique de ce type de formule expose l’analyste à divers écueils récurrents. Le premier de ces pièges relève de l’omission des guillemets doubles droits délimitant le littéral de chaîne. Écrire REGEXMATCH(A1:A17, East) sans encadrement textuel incite l’interpréteur de Google Sheets à chercher une plage nommée préexistante désignée sous le patronyme « East ». En l’absence d’une telle entité, le système interrompt la résolution par l’erreur #NAME?.
Le second écueil, plus insidieux sur le plan de la validité scientifique, réside dans l’apparition de correspondances parasites dues à des sous-chaînes fortuites. Si un chercheur tente d’extraire les données relatives au continent asiatique avec le motif « Asia », et que la colonne d’analyse contient accidentellement des mentions relatives au terme « Australasia », le prédicat d’inclusion validera ces observations sans distinction. Pour neutraliser ce phénomène de sur-génération lexicale, il devient impératif d’intégrer des limites de mots (word boundaries) propres aux expressions rationnelles, formalisées par la séquence d’échappement b, garantissant que le motif soit appréhendé comme une unité morphologique autonome.
Enfin, une divergence de granularité entre les en-têtes de colonnes et les corps de données génère fréquemment des décalages dommageables. L’inclusion involontaire de la ligne descriptive des titres dans la plage conditionnelle (par exemple, confronter un en-tête libellé « Région East » situé en A1 avec des données numériques en C2:C17) produit une distorsion de cardinalité génératrice d’erreurs matricielles, ou déverse des lignes d’en-têtes textuels au milieu d’agrégats de calcul quantitatifs.
5. Filtrage disjonctif : cibler plusieurs chaînes de caractères avec l’opérateur pipe
5.1 Logique booléenne de l’alternative dans les expressions rationnelles
Dans de nombreuses situations analytiques, la délimitation de la cohorte d’étude ne peut être restreinte à une étiquette unique, mais requiert l’union logique de plusieurs critères distincts au sein d’un même attribut catégoriel. Au lieu d’additionner des formules complexes ou d’empiler des prédicats disjoints au sein d’une structure conditionnelle lourde, les expressions rationnelles offrent un opérateur algébrique d’une exceptionnelle puissance : la disjonction binaire, matérialisée graphiquement par le symbole de la barre verticale, communément désignée sous le vocable informatique de « pipe » (|).
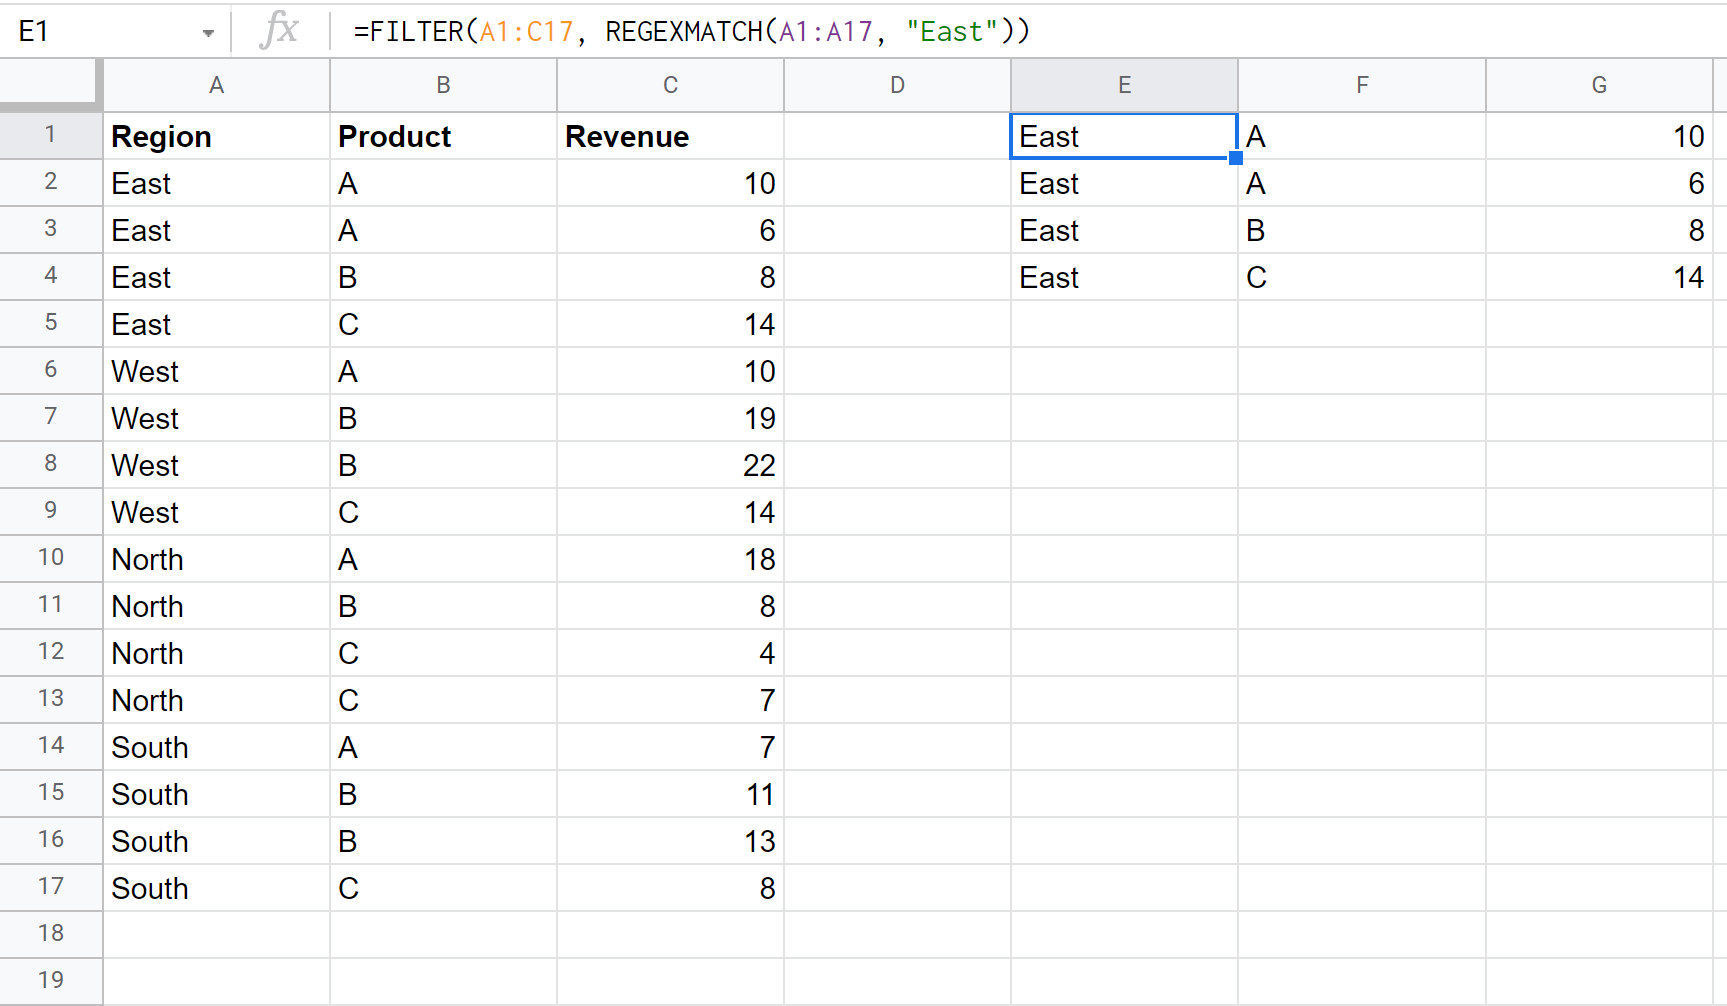
L’incorporation de cet opérateur transforme l’évaluation séquentielle en un choix alternatif formalisé par la syntaxe suivante :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « East|West »))
D’un point de vue de la théorie ensembliste, cette formule ordonne au processeur textuel d’affecter la valeur booléenne VRAI à toute cellule dont le contenu lexical démontre la présence de l’entité « East » OU de l’entité « West ». L’opération réalise de facto une union non redondante des sous-ensembles vérifiant l’un ou l’autre des termes de l’alternative.
Cette condensation syntaxique au sein d’un motif unique permet de supprimer l’appel redondant à de multiples fonctions d’évaluation. Sans l’expressivité de l’opérateur pipe, l’obtention d’un résultat strictement identique dans Google Sheets nécessiterait l’emploi de l’arithmétique booléenne matricielle par addition de masques logiques : =FILTER(A1:C17, REGEXMATCH(A1:A17, « East ») + REGEXMATCH(A1:A17, « West »)). L’utilisation du disjoncteur regex unifié optimise ainsi substantiellement la compilation du graphe de calcul.
5.2 Généralisation à des sélections multi-critères étendues
La puissance du connecteur disjonctif réside dans sa capacité de mise à l’échelle indéfinie. L’analyste peut concaténer autant de segments lexicaux qu’il le juge nécessaire au moyen d’expressions de structure « MotifA|MotifB|MotifC|MotifD|MotifE ». Le moteur RE2 compile l’ensemble de ces propositions sous la forme d’un automate arborescent unitaire qui inspecte chaque cellule cible en une seule passe algorithmique linéaire, sans dégradation mesurable des temps de traitement.
Cependant, lorsque le nombre de critères textuels croît de manière significative, la saisie statique en dur de la chaîne de motifs au cœur de la formule engendre une dette technique sévère, limitant considérablement la maintenabilité du modèle. Pour pallier cette rigidité, il est hautement recommandé d’adopter une approche par concaténation dynamique s’appuyant sur la fonction TEXTJOIN. Si une liste de critères autorisés est consignée au sein de la plage E1:E5, la formule matricielle prendra la forme modulaire et hautement évolutive suivante :
=FILTER(A1:C17, REGEXMATCH(A1:A17, TEXTJOIN(« | », TRUE, E1:E5)))
Dans ce paradigme d’ingénierie logicielle appliquée aux feuilles de calcul, la modification, l’adjonction ou la suppression d’un critère textuel dans la plage de pilotage E1:E5 met à jour dynamiquement le motif d’expression rationnelle sans exiger la moindre modification de la formule principale d’extraction matricielle. L’intégrité de la logique de calcul est ainsi préservée de toute altération accidentelle lors des phases de maintenance opérationnelle.
5.3 Gestion des priorités lexicales et regroupements sélectifs
L’introduction d’alternatives multiples au sein d’expressions rationnelles plus vastes soulève la question de la préséance des opérateurs. Par défaut, le symbole pipe possède une portée globale qui s’étend à l’ensemble des éléments situés à sa gauche et à sa droite jusqu’aux limites structurelles du motif. Cette caractéristique peut induire des erreurs logiques substantielles lorsqu’un préfixe ou un suffixe commun doit obligatoirement être articulé avec les variantes disjonctives.
Pour circonscrire précisément le domaine d’action de l’opérateur d’alternative, l’usage des parenthèses de regroupement est indispensable. Afin de ne pas surcharger inutilement la mémoire du processeur regex par la création de variables d’extraction superflues, il convient d’employer préférentiellement des parenthèses non capturantes formalisées par la syntaxe (?:…). Par exemple, si l’on cherche à filtrer des identifiants commençant impérativement par la chaîne « Zone_ » suivie alternativement de « East » ou de « West », le motif robuste s’énoncera : « Zone_(?:East|West) ».
Cette rigueur syntaxique élimine les collisions sémantiques indésirables. Une formulation naïve de type « Zone_East|West » serait interprétée par l’automate de calcul comme la recherche exclusive de la chaîne « Zone_East » OU de n’importe quelle occurrence du terme « West » isolé de son contexte. La délimitation explicite des sous-ensembles par des parenthèses garantit une isolation hermétique des branches de l’alternative et assure la conformité absolue de l’échantillon extrait par rapport aux attentes du protocole expérimental.
6. Gestion avancée de la casse et insensibilité typographique
6.1 Neutralisation de la sensibilité à la casse via les drapeaux regex
L’une des limites les plus prégnantes de l’analyse textuelle élémentaire réside dans la disparité de casse résultant des pratiques hétérogènes de saisie humaine ou de l’agrégation de flux de données non normalisés. Comme établi précédemment, REGEXMATCH opère par défaut une discrimination binaire stricte entre majuscules et minuscules. Pour neutraliser cette contrainte sans dénaturer la base de données originelle par des opérations de réécriture destructives, l’incorporation de modificateurs syntaxiques — couramment appelés drapeaux (flags) — constitue la solution la plus élégante.
Le moteur RE2 intégré à Google Sheets supporte le drapeau d’insensibilité typographique, formalisé par le préfixe (?i) inséré au tout début de l’expression rationnelle. En formulant :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « (?i)east »))
l’analyste indique formellement à l’analyseur lexical que chaque composante alphabétique du motif doit être mise en correspondance indifféremment avec sa version minuscule ou majuscule. Les séquences « east », « East », « EAST » ou « EaSt » deviennent alors rigoureusement équivalentes aux yeux de la logique de filtrage, garantissant une captation exhaustive du concept sémantique sous-jacent.
L’avantage cardinal de cette approche réside dans sa neutralité spatiale et temporelle : aucune colonne auxiliaire de conversion n’est requise, et la chaîne de caractères sous-jacente stockée en cellule conserve scrupuleusement sa mise en forme typographique originelle. Cette conservation s’avère déterminante pour les étapes d’audit ultérieures ou les exigences de restitution visuelle fidèle.
6.2 Approche alternative par normalisation préalable
Une démarche concurrente répandue dans la pratique des tableurs consiste à appliquer une fonction de transformation scalaire préalable sur l’intégralité de la plage conditionnelle avant de procéder à l’évaluation du critère textuel. Ce modèle repose typiquement sur l’utilisation de la fonction LOWER() (ou alternativement UPPER()), contraignant l’ensemble de l’alphabet à adopter une forme minuscule canonique unifiée :
=FILTER(A1:C17, REGEXMATCH(LOWER(A1:A17), « east »))
D’un point de vue purement algorithmique, cette méthode opère une transformation vectorielle intermédiaire : la matrice A1:A17 est temporairement convertie en un vecteur d’octets minuscules virtuel en mémoire volatile, sur lequel s’exécute ensuite l’évaluation du motif textuel lui-même typographié en minuscules. Bien que parfaitement fonctionnelle et immédiatement accessible aux utilisateurs moins familiers avec la grammaire des expressions régulières, cette construction souffre d’une surcharge computationnelle non négligeable.
L’adjonction d’une enveloppe fonctionnelle comme LOWER force le système à parcourir la totalité des chaînes de la plage pour en réécrire les glyphes avant même d’instancier l’analyseur de sous-chaînes. À l’opposé, le drapeau interne (?i) opère la comparaison tolérante au vol, sans allouer de mémoire tampon pour une structure de données intermédiaire. Par conséquent, sur des volumétries substantielles, la méthode du drapeau regex doit systématiquement être privilégiée au titre des bonnes pratiques d’ingénierie d’optimisation.
6.3 Implications psychométriques et heuristiques de saisie
La variabilité humaine de la saisie de texte dans les questionnaires ouverts ou les formulaires opérationnels ne se limite pas à la capitalisation ; elle soulève des considérations méthodologiques relatives à la fidélité des instruments de mesure. Lorsqu’un sujet ou un opérateur consigne une observation textuelle, des variations de casse peuvent être induites par les mécanismes de complétion automatique des terminaux mobiles, la présence involontaire de la touche de verrouillage des majuscules ou des conventions orthotypographiques individuelles divergentes.
L’absence de tolérance à ces disparités introduit un biais d’échantillonnage systématique dans l’extraction des données. En pénalisant arbitrairement les variations typographiques, le filtrage strict exclut des observations pourtant sémantiquement valides, altérant ainsi la distribution des fréquences et compromettant les estimations quantitatives subséquentes. La tolérance typographique n’est donc pas une simple commodité technique, mais une condition nécessaire à l’équité de mesure et à l’exhaustivité des échantillons qualitatifs.
Dans cette perspective, l’analyste doit néanmoins veiller à ce que l’élargissement de la tolérance ne génère pas d’effets pervers par l’induction d’homonymies accidentelles. Dans certains registres de codification industrielle ou de nomenclature chimique, la casse d’une lettre conditionne l’identité même de l’entité matérielle (par exemple la distinction fondamentale entre « CO » désignant le monoxyde de carbone et « Co » désignant le cobalt). La décision de neutraliser la casse via (?i) doit donc résulter d’un arbitrage méthodologique explicite, fondé sur l’ontologie du domaine d’étude considéré.
7. Combinaison conjonctive : filtrer les cellules contenant simultanément plusieurs motifs
7.1 Architecture du filtrage par conjonction logique (ET)
Au-delà de l’alternative disjonctive, l’extraction de données textuelles complexes impose fréquemment la validation conjointe de plusieurs critères lexicaux indépendants au sein de la même cellule ou à travers des colonnes distinctes. Dans la terminologie de la logique mathématique, il s’agit d’une opération de conjonction (opérateur ET), où l’inclusion d’un enregistrement exige que l’ensemble des prédicats formulés s’évalue simultanément à VRAI.
La fonction FILTER intègre nativement cette faculté par l’intermédiaire de ses arguments conditionnels séquentiels. Lorsque plusieurs plages conditionnelles sont séparées par des virgules dans la syntaxe native, le moteur de calcul exécute implicitement une conjonction logique par multiplication vectorielle booléenne :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « motif1 »), REGEXMATCH(A1:A17, « motif2 »))
Dans ce modèle d’exécution, le système évalue séparément le vecteur correspondant au premier motif, puis celui associé au second motif. Ensuite, pour chaque indice de ligne, il opère le produit d’intersection binaire. Seules les lignes pour lesquelles la condition 1 ET la condition 2 retournent la valeur VRAI franchissent la barrière de sélection. Cette formulation présente une lisibilité intellectuelle remarquable, car elle sépare distinctement les hypothèses logiques sous forme de blocs fonctionnels modulaires indépendants.
7.2 Utilisation des assertions avant positives (Lookahead) dans REGEXMATCH
Il existe néanmoins des cas d’usage où l’analyste désire condenser la conjonction de plusieurs motifs lexicaux non ordonnés au sein d’une unique expression régulière, sans recourir à de multiples arguments dans la fonction FILTER. Cette approche avancée mobilise les mécanismes d’assertions avant positives (positive lookahead), formalisées par la syntaxe (?=…) au sein du métalangage RE2.
Pour exprimer formellement la condition qu’une cellule doit contenir impérativement le mot « Alpha » ET le mot « Omega », quel que soit leur ordre d’apparition textuelle le long de la chaîne, l’expression rationnelle s’articule comme suit :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « ^(?=.*Alpha)(?=.*Omega) »))
La mécanique séquentielle de cette construction repose sur l’ancrage initial de position désigné par l’accent circonflexe (^). À partir de cette origine absolue de la chaîne, le moteur de calcul projette une première assertion exploratoire (?=.*Alpha) qui scrute l’espace de caractères sans consommer d’octets. Dès qu’une occurrence du terme « Alpha » est certifiée en aval, l’analyseur revient à sa position d’ancrage initiale pour projeter la seconde assertion (?=.*Omega). Si les deux vérifications confirment l’existence de leurs cibles respectives, l’expression globale est validée comme VRAI.
Cette méthodologie d’assertion compacte présente l’avantage computationnel d’exécuter la conjonction en une passe unitaire dans le moteur REGEXMATCH. Toutefois, sur le plan de la gouvernance des systèmes d’information et de la maintenance collaborative, elle exige un niveau de compétence élevé de la part des relecteurs de la feuille de calcul, augmentant potentiellement la charge cognitive requise pour auditer la formule.
7.3 Applications empiriques sur corpus documentaires complexes
La portée empirique de la conjonction textuelle se manifeste avec acuité lors du traitement de corpus documentaires volumineux, tels que des entretiens de recherche clinique, des procès-verbaux d’assemblées ou des comptes rendus d’incidents techniques industriels. Dans ces scénarios réels, l’analyste cherche rarement un mot isolé, dont la présence peut être purement anecdotique, mais cible plutôt la cooccurrence spatiale de descripteurs formant un motif thématique signifiant.
Considérons l’analyse de dossiers médicaux ou de protocoles de sécurité industrielle au sein desquels un événement critique n’est qualifié que par la conjonction d’un organe matériel et d’une défaillance spécifique. Un chercheur souhaitera par exemple isoler les observations textuelles mentionnant impérativement le composant « Valve_B » et l’état dégradé « Surchauffe ». L’usage du filtre conjonctif garantit l’évacuation des milliers d’enregistrements évoquant la « Valve_B » dans des conditions de fonctionnement nominal, tout comme les mentions de « Surchauffe » affectant d’autres éléments d’infrastructure.
La conjonction logique permet d’éliminer les faux positifs résultant de l’ambiguïté lexicale d’un terme unique. En calant le filtre sur l’intersection rigoureuse de plusieurs concepts sémiotiques disjoints, on affine la sélectivité de l’instrument d’extraction, élevant ainsi la fidélité de l’échantillon documentaire final avant d’entamer les opérations de codage qualitatif ou de traitement du langage naturel.
8. Approches alternatives : SEARCH, FIND et QUERY pour le filtrage textuel
8.1 La combinaison classique ISNUMBER(SEARCH(…))
Bien que l’association de FILTER et REGEXMATCH représente le paroxysme de l’élégance moderne dans Google Sheets, il demeure essentiel pour l’architecte de données de maîtriser les alternatives traditionnelles, particulièrement lorsqu’un impératif d’interopérabilité descendante avec d’autres tableurs comme Microsoft Excel s’impose. La méthode historique de détection d’inclusions partielles repose sur le binôme fonctionnel SEARCH (ou CHERCHE en interface francophone standard) et ISNUMBER (ou ESTNUM).
La formulation standardisée adopte la structure canonique suivante :
=FILTER(A1:C17, ISNUMBER(SEARCH(« East », A1:A17)))
La fonction SEARCH possède la propriété intrinsèque d’être totalement insensible à la casse sans nécessiter de paramétrage additionnel. Elle analyse chaque cellule du vecteur A1:A17 et renvoie un entier positif représentant la position du premier caractère correspondant au motif recherché. Cependant, si le motif est absent de la chaîne analysée, SEARCH ne renvoie pas la valeur FAUX, mais lève une exception d’erreur arithmétique bloquante #VALUE!. L’intervention de la fonction ISNUMBER est dès lors indispensable pour absorber cette erreur et la métamorphoser en FAUX, tout en convertissant les positions numériques ordinales en VRAI.
L’utilisation de la variante FIND (ou TROUVE) obéit à une architecture strictement analogue, à la seule différence que cette dernière applique une sensibilité rigoureuse à la casse typographique. Si cette méthode historique demeure universellement comprise et hautement portable d’un logiciel de calcul à l’autre, son verbiage syntaxique et la manipulation indirecte d’exceptions d’erreurs internes la rendent structurellement moins fluide que l’élégance native de REGEXMATCH.
8.2 L’approche par le langage SQL avec la fonction QUERY
Google Sheets propose un outil d’interrogation analytique unique au sein du paysage des tableurs grand public : la fonction QUERY. Celle-ci intègre un analyseur syntaxique inspiré du langage déclaratif SQL, permettant de soumettre des matrices de données à des requêtes formulées en langage textuel de type Google Visualization API Query Language. Pour isoler les cellules contenant un fragment lexical déterminé, la fonction mobilise l’opérateur d’inclusion textuelle contains :
=QUERY(A1:C17, « select * where A contains ‘East' », 0)
Cette approche présente un avantage concurrentiel majeur lors d’opérations analytiques combinées. La fonction QUERY permet de fusionner en une seule expression lisible le filtrage des lignes, la projection sélective des colonnes (clause select), le tri séquentiel du résultat (clause order by), l’agrégation de métriques (clause group by) et le plafonnement du volume de restitution (clause limit). Cette densité fonctionnelle évite l’empilement complexe de fonctions matricielles imbriquées telles que SORT(FILTER(…)).
Toutefois, le moteur de QUERY est soumis à des contraintes structurelles strictes. D’une part, l’opérateur contains est systématiquement et irrémédiablement sensible à la casse typographique, interdisant le filtrage flexible sans manipulation préalable de chaînes au sein de la clause where. D’autre part, QUERY impose une rigidité absolue de typage par colonne. Si une colonne présente une mixité de formats de données (comprenant par exemple 80% de scalaires textuels et 20% de valeurs numériques), le moteur typologique attribue arbitrairement un type dominant à la colonne et convertit silencieusement l’ensemble des données minoritaires en valeurs nulles, induisant une perte invisible mais dévastatrice d’informations.
8.3 Matrice comparative des paradigmes de filtrage
Pour arbitrer rationnellement entre ces différents paradigmes de filtrage lors de la conception d’un modèle de données opérationnel, il est nécessaire d’en évaluer les caractéristiques sous l’angle de critères objectifs de performance, de flexibilité et de résilience logicielle. Le tableau ci-après synthétise les propriétés distinctives de chaque approche :
- FILTER + REGEXMATCH : Expressivité maximale grâce au moteur d’expressions régulières. Insensibilité à la casse paramétrable via (?i). Préservation absolue des données hétérogènes. Excellente concision syntaxique. Limité aux environnements Google Sheets (non portable vers Excel standard).
- FILTER + ISNUMBER(SEARCH) : Portabilité universelle vers Microsoft Excel et autres tableurs conformes aux standards ouverts. Insensibilité à la casse native sans configuration additionnelle. Complexité syntaxique accrue due à la double imbrication fonctionnelle. Moindre expressivité pour les motifs complexes.
- QUERY avec clause ‘contains’ : Puissance exceptionnelle pour les requêtes complexes intégrant tri, agrégation et projection simultanés. Rigidité critique du typage de données avec risque de suppression silencieuse d’enregistrements en cas de mixité de types. Sensibilité stricte à la casse non débrayable directement dans l’opérateur.
Au regard de cette synthèse, il apparaît incontestable que pour toute opération de filtrage textuel pur au sein de Google Sheets, l’alliance de FILTER et de REGEXMATCH constitue l’optimum méthodologique, combinant une flexibilité d’appariement inégalée à une immunité structurelle contre les altérations de données hétérogènes.
9. Filtrage d’exclusion : isoler les cellules ne contenant pas un texte déterminé
9.1 Négation booléenne au sein de la fonction FILTER
La démarche analytique inverse — consistant à purifier un jeu de données en expurgeant systématiquement les enregistrements arborant un descripteur textuel indésirable — s’avère tout aussi cruciale pour l’assainissement de bases de données empiriques. Sur le plan de la logique booléenne élémentaire, cette opération s’incarne par l’inversion du masque de conformité : toute composante évaluée à VRAI par le prédicat d’appariement doit être convertie en FAUX, et réciproquement.
Au sein de Google Sheets, la formulation la plus directe et accessible pour concrétiser cette exclusion repose sur l’enveloppement de la condition de recherche textuelle par la fonction unaire de négation logique NOT() :
=FILTER(A1:C17, NOT(REGEXMATCH(A1:A17, « East »)))
Dans ce schéma opératoire, l’analyseur textuel exécute son balayage habituel. Dès qu’une cellule mentionne la chaîne « East », REGEXMATCH émet un signal VRAI qui est immédiatement inversé en FAUX par l’opérateur NOT. Par conséquent, la fonction FILTER écarte impitoyablement ces lignes de l’espace de déversement final. Les cellules dépourvues du terme indésirable génèrent quant à elles un signal FAUX, transmuté en VRAI par l’inversion unaire, garantissant leur maintien légitime dans la restitution finale.
Il importe toutefois de souligner une nuance d’implémentation : si la colonne conditionnelle intègre des cellules entièrement vides, l’évaluation de la négation peut engendrer des effets de bord inattendus selon la manière dont le moteur de calcul interprète la vacuité d’origine. Un audit attentif des vecteurs de sortie doit être systématiquement opéré pour s’assurer qu’aucune ligne valide n’a été indûment sacrifiée.
9.2 Négation interne via les expressions rationnelles
Une alternative d’un niveau d’abstraction supérieur réside dans l’intégration de la négation directement au sein du formalisme de l’expression rationnelle, évitant ainsi le recours à la fonction logique enveloppante NOT. Cette approche mobilise le concept d’assertion avant négative (negative lookahead), représenté dans la syntaxe des métacaractères par la séquence (?!…).
Pour ordonner au moteur de calcul d’isoler exclusivement les cellules dont le contenu textuel ne contient aucune occurrence de la chaîne « East », l’analyste peut déployer la structure suivante :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « ^((?!East).)*$ »))
L’exégèse de cette expression complexe révèle un mécanisme algorithmique d’une remarquable précision. Les symboles d’ancrage ^ (origine) et $ (terminaison) délimitent la totalité spatiale de la chaîne examinée. L’instruction centrale (?!East). impose au moteur d’avancer caractère par caractère (représenté par le point métacaractère universel) à la stricte condition que la séquence qui suit immédiatement ne corresponde en aucun cas au littéral « East ». L’astérisque de clôture de Kleene * indique que cette validation d’absence doit être réitérée avec succès jusqu’à l’épuisement total du texte cellulaire.
Bien que cette méthode atteste d’une profonde virtuosité dans le maniement des expressions rationnelles, elle induit une pénalité computationnelle substantielle due à la nécessité d’évaluer l’assertion négative à chaque incrément de positionnement de glyphe. Dans un contexte de production ou sur de vastes volumes de données, l’enveloppement par la fonction native NOT() demeure structurellement plus performant et infiniment plus lisible pour la maintenance organisationnelle.
9.3 Protocole d’assainissement de bases de données empiriques
Le filtrage soustractif constitue l’opération fondamentale des protocoles de nettoyage de données préliminaires aux traitements statistiques quantitatifs. Dans les environnements transactionnels réels, les bases de données sont fréquemment polluées par des artefacts d’enregistrement, des observations tests générées par les équipes de développement logiciel (portant des mentions explicites de type « TEST », « DUMMY », ou « INVALID »), ou des statuts de rejet administratif.
L’application d’un protocole d’assainissement rigoureux exige de documenter les critères d’exclusion avec la plus haute précision méthodologique afin de prévenir tout risque de suppression arbitraire d’observations critiques. L’analyste doit dresser un catalogue exhaustif des métadonnées de rejet, concaténées sous la forme d’un filtre d’exclusion disjonctif unifié, tel que :
=FILTER(A1:C1000, NOT(REGEXMATCH(A1:A1000, « (?i)test|invalide|erreur|démo »)))
Au terme de cette extraction soustractive, un contrôle qualité croisé s’impose. L’opérateur doit systématiquement comparer le nombre total de lignes du corpus d’origine avec la somme arithmétique des observations retenues et des observations exclues. Tout différentiel inexpliqué trahit une anomalie d’évaluation liée à la présence de valeurs nulles, d’erreurs matricielles préexistantes ou de disparités de dimensions entre les plages du modèle analytique.
10. Traitement des erreurs, cas limites et résilience des formules
10.1 Interception de l’erreur d’absence de concordance (#N/A)
Une caractéristique déroutante de la fonction FILTER dans Google Sheets réside dans son comportement par défaut lorsqu’aucune ligne de la matrice source ne parvient à satisfaire le prédicat logique imposé. Au lieu de renvoyer une matrice vide de dimensions nulles ou un message contextuel neutre, le moteur de calcul interrompt la chaîne de calcul et émet l’erreur structurelle #N/A, accompagnée du message d’avertissement : « Aucune valeur trouvée lors de l’évaluation du filtre ».
Pour un tableau de bord exécutif ou un rapport statistique destiné à des tiers, l’affichage de codes d’erreur bruts compromet la crédibilité ergonomique de l’outil et peut provoquer des réactions en chaîne d’erreurs dérivées dans les cellules dépendantes. Pour circonscrire cette fragilité, il est impératif d’encapsuler la formule de filtrage matriciel au sein d’une fonction d’interception d’exceptions, telle que IFERROR ou, de manière encore plus ciblée, IFNA :
=IFNA(FILTER(A1:C17, REGEXMATCH(A1:A17, « MotifInexistant »)), « Aucune concordance identifiée »)
Grâce à cette précaution d’ingénierie logicielle, l’absence d’occurrences textuelles est captée avec élégance. Le système déverse alors un message informatif explicite ou, si le second argument est laissé vide sous la forme de guillemets doubles sans espacement (« »), maintient l’espace cellulaire vierge sans interrompre la fluidité visuelle ni la complétude des agrégats périphériques de la feuille de calcul.
10.2 Gestion des cellules vides et des types de données disparates
L’hétérogénéité des données constitue le fléau des modèles matriciels réactifs. Lorsque la fonction REGEXMATCH est confrontée à une cellule rigoureusement vide, son comportement peut diverger selon la configuration des paramètres linguistiques ou des versions du moteur d’exécution. Dans la majorité des cas, une valeur vide soumise à un motif standard renvoie immédiatement la valeur logique FAUX, ce qui s’avère parfaitement adéquat pour un filtrage d’inclusion. Toutefois, dans le cadre d’un filtrage d’exclusion inversé par NOT(), la cellule vide sera transmutée en VRAI et indûment intégrée à la sortie.
Pour immuniser le modèle contre ce phénomène, il est nécessaire d’instituer un filtre de garde préliminaire au sein des arguments conjonctifs de la fonction FILTER, garantissant que seules les cellules non vides soient admises à l’étape d’évaluation lexicale :
=FILTER(A1:C17, A1:A17″ », REGEXMATCH(A1:A17, « East »))
Par ailleurs, si la plage conditionnelle abrite des données numériques sérialisées, des dates ou des booléens natifs, REGEXMATCH risque d’échouer avec une exception de non-conformité de type (#VALUE!). La parade architecturale la plus robuste consiste alors à forcer la conversion textuelle explicite du vecteur d’entrée au moyen de la fonction TO_TEXT. La formulation :
=FILTER(A1:C17, REGEXMATCH(TO_TEXT(A1:A17), « East »))
assure une coercition typologique préalable absolue, transformant tout scalaire arbitraire en une suite de glyphes textuels directement exploitables par l’analyseur RE2 sans défaillance de traitement.
10.3 Protection contre l’injection de caractères réservés regex
L’un des risques les plus subtils et destructeurs survient lorsque le motif textuel de recherche est alimenté dynamiquement par une référence cellulaire tierce (par exemple le contenu saisi par un utilisateur en cellule E1) et que ce texte contient accidentellement ou délibérément des métacaractères propres au langage des expressions régulières. Les caractères tels que le point (.), l’astérisque (*), le point d’interrogation (?), les crochets ([ ]), les parenthèses (( )) ou le signe plus (+) constituent des opérateurs réservés modifiant structurellement le comportement de l’analyseur RE2.
Si un utilisateur saisit innocemment la référence produit « [REF-404] » en E1 et que la formule exécute directement REGEXMATCH(A1:A17, E1), le moteur interprétera les crochets comme la déclaration d’une classe de caractères morphologiques. Non seulement la chaîne littérale « [REF-404] » ne sera pas reconnue, mais la syntaxe résultante risque de provoquer l’interruption du calcul par une erreur bloquante d’expression régulière invalide.
Pour neutraliser cette vulnérabilité sans contraindre l’utilisateur à saisir manuellement des séquences d’échappement complexes, il convient de programmer une neutralisation algorithmique préalable à l’aide de la fonction de substitution REGEXREPLACE. Cette formule préparatoire injecte une double barre oblique inverse de protection devant chaque métacaractère critique, désamorçant leur pouvoir programmatique pour les ramener à de simples entités lexicales inertes :
=FILTER(A1:C17, REGEXMATCH(A1:A17, REGEXREPLACE(TO_TEXT(E1), « ([.+*?[](){}|^$]) », « $1″)))
Cette sophistication garantit une résilience absolue face aux entrées textuelles imprévues, conférant au modèle la robustesse logicielle indispensable au déploiement en environnement de production critique.
11. Optimisation des performances et traitement de volumétries massives
11.1 Coût computationnel de l’analyseur d’expressions régulières
Si la bibliothèque RE2 de Google a été expressément conçue pour proscrire tout phénomène de retour sur trace catastrophique (catastrophic backtracking) — un écueil classique des moteurs d’expressions régulières naïfs qui bloque l’allocation processeur dans des boucles exponentielles face à des séquences ambiguës —, l’instanciation de l’automate à états finis n’en demeure pas moins consommatrice de cycles d’horloge. Sur un jeu de données modeste de quelques centaines de lignes, la latence est virtuellement imperceptible. En revanche, lorsque le modèle confronte des tables contenant plusieurs centaines de milliers d’enregistrements, le coût computationnel cumulé devient un facteur critique d’expérience utilisateur.
L’erreur la plus répandue chez les concepteurs de modèles réside dans l’usage démesuré de plages matricielles entièrement ouvertes sans borne supérieure d’indice, telles que A:C et A:A. Ce formalisme contraint le système à créer des espaces d’adressage virtuels pour l’ensemble des lignes allouées à la feuille de calcul, même si 90% d’entre elles demeurent vierges de tout contenu. L’évaluateur est forcé de scanner ces segments inoccupés, ce qui s’avère inutilement dispendieux en termes de mémoire de travail et d’échanges réseau avec les serveurs de calcul de Google.
La règle d’or pour préserver la réactivité optimale du classeur réside dans la délimitation stricte des plages de calcul aux strictes coordonnées physiques du corpus de données (par exemple A1:C15000), ou dans l’exploitation de plages dynamiques générées par des fonctions d’indexation calculées ajustant la hauteur d’évaluation au nombre effectif d’enregistrements non vides présents dans le système.
11.2 Minimisation des dépendances et de l’arbre de recalcul
Chaque formule matricielle hébergée au sein d’une feuille de calcul s’inscrit comme un nœud dans l’arbre de dépendance global du document. Si une formule complexe de type FILTER(…, REGEXMATCH(…)) dépend elle-même de cellules calculées en amont par d’autres formules matricielles volatiles (telles que NOW(), TODAY(), ou des références directes à des fonctions indirectes), la moindre modification apportée à un emplacement quelconque du classeur déclenche la réévaluation intégrale de la chaîne textuelle descendante.
Pour prévenir cette dégradation des performances lors du traitement de volumétries massives, il est vivement recommandé d’adopter une stratégie de découplage architectural strict. Cette gouvernance repose sur la ségrégation des fonctions :
- Une ou plusieurs feuilles réservées exclusivement à l’ingestion brute et au stockage des données sources statiques, affranchies de toute formule complexe.
- Une couche intermédiaire dédiée aux calculs de normalisation préparatoire, le cas échéant figés sous forme de valeurs statiques pour stabiliser les environnements lourds.
- Une feuille de restitution analytique accueillant la formule matricielle FILTER, interrogée exclusivement à la demande sans surcharge de fonctions volatiles annexes.
Dans les contextes industriels de production où les données sources n’évoluent plus (archives mensuelles ou historiques d’enquêtes terminées), la conversion ponctuelle des résultats filtrés par l’opération de « collage spécial en valeurs » (Paste as Values) permet d’éliminer définitivement l’arbre de recalcul dynamique, préservant ainsi l’intégralité des ressources machine pour les futures phases de modélisation.
11.3 Audit de la vitesse d’exécution dans Google Sheets
L’évaluation rigoureuse des temps d’exécution au sein de l’environnement applicatif Google Sheets impose une méthodologie indirecte, l’accès direct aux compteurs matériels et à la télémétrie du processeur serveur étant masqué par la couche applicative web. L’analyste de performance peut néanmoins auditer l’efficience de ses formules en surveillant attentivement l’indicateur de recalcul graphique (la barre de progression verte matérialisant le chargement du document en haut à droite de l’interface graphique) ou en instrumentant le classeur au moyen de scripts de mesure de temps d’exécution développés en Google Apps Script.
Des analyses comparatives de charge démontrent avec constance que face à des corpus volumineux dépassant 50 000 lignes :
- La fonction QUERY présente une vitesse d’exécution initiale très compétitive pour les opérations textuelles simples grâce à son moteur sous-jacent hautement optimisé, mais s’effondre face à des logiques conditionnelles complexes nécessitant des jointures textuelles.
- L’association FILTER + REGEXMATCH maintient une scalabilité temporelle linéaire d’une stabilité exemplaire face à l’accroissement de la complexité des expressions rationnelles, pourvu que la plage de recherche ne comporte pas d’ancrages ouverts infinis.
- La formulation FILTER + ISNUMBER(SEARCH) génère une charge processeur légèrement supérieure à celle de REGEXMATCH lors de calculs matriciels vectorisés, en raison de l’empilement successif des niveaux d’évaluation de fonctions dans la pile d’exécution.
La surveillance régulière de la réactivité du document et la simplification algorithmique systématique des motifs textuels garantissent un fonctionnement fluide et pérenne de vos infrastructures de calcul.
12. Synthèse méthodologique et protocoles d’implémentation opérationnelle
12.1 Matrice taxonomique des formules de filtrage textuel
Pour offrir aux analystes de données, auditeurs et scientifiques un cadre de référence opérationnel immédiatement exploitable, nous formalisons ci-dessous la matrice taxonomique des protocoles de filtrage de chaînes de caractères au sein de l’environnement Google Sheets :
- Inclusion d’une sous-chaîne unique (insensible à la casse) :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « (?i)cible »))
Cas d’usage : Recherche de mots-clés génériques au sein de champs de commentaires ou d’enquêtes d’opinion. - Inclusion d’une sous-chaîne unique (stricte sensibilité à la casse) :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « Cible »))
Cas d’usage : Extraction d’identifiants techniques normalisés, acronymes spécifiques ou nomenclatures industrielles. - Alternative disjonctive unifiée (Opérateur OU textuel) :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « (?i)motif1|motif2|motif3 »))
Cas d’usage : Regroupement sélectif de plusieurs territoires, catégories de produits ou cohortes d’intervention. - Conjonction de plusieurs termes (Opérateur ET textuel non ordonné) :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « (?i)^(?=.*motif1)(?=.*motif2) »))
Cas d’usage : Détection d’observations qualitatives caractérisées par la cooccurrence obligatoire de descripteurs distincts. - Exclusion soustractive (Opérateur NON textuel avec assainissement) :
=FILTER(A1:C17, A1:A17″ », NOT(REGEXMATCH(A1:A17, « (?i)exclure »)))
Cas d’usage : Purge des anomalies de saisie, données tests ou statuts d’erreur au sein de journaux système. - Concordance dynamique avec liste de critères administrable :
=FILTER(A1:C17, REGEXMATCH(A1:A17, « (?i) » & TEXTJOIN(« | », TRUE, E1:E10)))
Cas d’usage : Architecture modulaire pour tableaux de bord décisionnels pilotés par des listes de filtres évolutives.
12.2 Protocole de contrôle qualité et validation des extractions
L’implémentation opérationnelle d’une solution de filtrage matriciel au sein d’une organisation ne saurait être considérée comme achevée sans le déploiement d’un protocole d’audit et de contrôle qualité standardisé. L’analyste rigoureux doit soumettre son modèle d’extraction à une séquence d’étapes de validation empirique séquentielles :
Dans un premier temps, il convient d’exécuter un test d’intégrité de cardinalité. Ce contrôle vérifie que le volume d’enregistrements extraits est strictement égal au décompte direct d’occurrences textuelles mesuré au sein de la colonne d’origine. Cette vérification s’opère par l’évaluation croisée de la formule de comptage scalaire :
=COUNTIF(A1:A17, « *East* »)
ou par son équivalent dynamique fondé sur le calcul matriciel :
=SUMPRODUCT(REGEXMATCH(A1:A17, « (?i)East ») * 1)
Si la dimension verticale de la matrice générée par FILTER diverge de ce décompte scalaire, l’analyste se trouve alerté d’un dysfonctionnement structural (présence de cellules d’en-tête parasites, lignes masquées écrasées ou corruptions de plages d’évaluation).
Dans un deuxième temps, une vérification systématique de l’absence de faux positifs et de faux négatifs doit être opérée par échantillonnage aléatoire stratifié sur les bordures du filtre (notamment l’inspection des termes composés contenant la sous-chaîne cible comme préfixe ou suffixe involontaire). Enfin, chaque règle d’extraction intégrée à un modèle partagé doit faire l’objet d’une documentation formelle au sein d’un dictionnaire des métadonnées du projet, explicitant sans équivoque la logique du motif textuel et le traitement appliqué à la sensibilité à la casse.
12.3 Perspectives d’automatisation et intégration dans des flux de travail
Au-delà de la formulation statique au cœur de la feuille de calcul, la fonction FILTER enrichie par le repérage de chaînes s’insère au cœur des architectures d’automatisation d’entreprise modernes. Elle peut être couplée à des interfaces de saisie dynamiques, telles que des cellules de validation de données générant des listes déroulantes contextuelles. L’utilisateur final sélectionne un paramètre dans un composant visuel, dont la valeur est immédiatement insérée comme motif d’expression rationnelle au sein de la formule de filtrage maîtresse.
Pour des cas d’usage transcendant les limites déterministes des expressions rationnelles traditionnelles — notamment le traitement sémantique de verbatims nécessitant la détection de synonymes, la racinisation lemmatisée (lemmatization) ou l’analyse de sentiment —, l’infrastructure de Google Sheets s’ouvre harmonieusement vers l’écosystème Google Apps Script. Il devient aisé de concevoir des fonctions personnalisées (Custom Functions) en JavaScript exécutant un prétraitement linguistique sur les corpus textuels avant de réinjecter les données épurées au sein du moteur d’évaluation vectoriel matriciel.
En définitive, la parfaite maîtrise des interactions entre la fonction FILTER et les prédicats textuels confère à l’analyste de données une autonomie méthodologique complète. Elle transforme le tableur d’un simple registre statique d’inscription en une plateforme dynamique d’ingénierie analytique, capable d’isoler avec une précision absolue les signaux sémantiques pertinents au sein des larges corpus de données de l’organisation contemporaine.
Références
- Cox, R. (2007). Regular Expression Matching Can Be Simple And Fast (but is slow in Java, Perl, PHP, Python, Ruby, …). Swtch.com. https://swtch.com/~rsc/regexp/regexp1.html
- Friedl, J. E. (2006). Mastering Regular Expressions (3rd ed.). O’Reilly Media.
- Google. (s. d.). Documentation Google Cloud : Syntaxe de l’analyseur RE2. GitHub. https://github.com/google/re2/wiki/Syntax
- Google Workspace Support. (s. d.). Fonction FILTER dans Google Sheets. Aide Google. https://support.google.com/docs/answer/3093197
- Google Workspace Support. (s. d.). Fonction REGEXMATCH dans Google Sheets. Aide Google. https://support.google.com/docs/answer/3098292
- Google Workspace Support. (s. d.). Utilisation de la fonction QUERY dans Google Sheets. Aide Google. https://support.google.com/docs/answer/3093343
- Iverson, K. E. (1962). A Programming Language. John Wiley & Sons.
- McFedries, P. (2021). Formulas and Functions for Microsoft Excel and Google Sheets. Pearson Education.
- Wickham, H. (2014). Tidy Data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10