
Dans le domaine de l’ingénierie des données d’entreprise et de l’analyse décisionnelle informatisée, l’isolation sélective des valeurs extrêmes constitue l’un des piliers méthodologiques fondamentaux de l’exploration quantitative. Qu’il s’agisse de mesurer la concentration du chiffre d’affaires généré par un portefeuille de clients stratégiques selon le principe de Pareto, d’identifier les goulets d’étranglement opérationnels dans une chaîne logistique mondialisée ou de diagnostiquer les écarts critiques au sein de séries temporelles financières, la capacité à extraire avec une exactitude mathématique irréprochable les dix plus grandes grandeurs scalaires d’un ensemble univarié représente une compétence analytique déterminante. L’environnement logiciel Microsoft Excel, utilisé de manière universelle par les directions financières, les équipes de contrôle de gestion et les scientifiques des données, propose un éventail d’instruments algorithmiques allant des fonctions statistiques classiques aux moteurs matriciels dynamiques contemporains.
Toutefois, la transition d’une simple manipulation empirique vers une modélisation robuste, pérenne et automatisable requiert une compréhension intime des mécanismes de calcul sous-jacents. L’extraction des dix plus grandes valeurs d’une liste ne se résume pas à l’application machinale d’un tri décroissant, opération qui altère l’intégrité séquentielle de la table source et brise la traçabilité des enregistrements. Elle exige au contraire une maîtrise formelle de la théorie de l’ordre statistique, une gestion rigoureuse des structures matricielles, une résolution préventive du comportement algorithmique face aux doublons stochastiques ou structurels, ainsi qu’une orchestration sans faille de la synchronisation entre grandeurs quantitatives et métadonnées qualitatives associées. La fiabilité décisionnelle dépend directement de cette rigueur structurelle, où chaque formule doit être conçue pour résister aux variations dimensionnelles des jeux de données et aux recalculs itératifs.
Ce traité exhaustif a pour vocation d’exposer, selon une démarche académique et pratique progressive, l’ensemble des méthodes déterministes, semi-automatiques et programmées permettant d’isoler le décile supérieur ou un échantillon discret des dix plus grandes valeurs au sein d’un classeur tabulaire. À travers l’examen détaillé des fonctions fondamentales, l’exploration des avancées introduites par le moteur de calcul matriciel dynamique, l’application de filtres d’extraction avancés et l’intégration des architectures de données structurées, ce document fournit une référence technique intégrale. Chaque étape est minutieusement documentée afin de permettre aux praticiens de concevoir des modèles de calcul résilients, transparents, auditables et conformes aux meilleures pratiques de gouvernance de l’information quantitative.
1. Introduction méthodologique à l’extraction des valeurs extrêmes dans Excel
1.1 Importance de l’analyse des distributions et des valeurs seuils
L’analyse descriptive des distributions statistiques constitue le point de départ incontournable de toute modélisation décisionnelle. Dans la quasi-totalité des séries de données d’affaires, la répartition des observations ne suit pas une loi normale symétrique de Gauss, mais présente au contraire une asymétrie positive marquée, souvent formalisée par des distributions à longue traîne ou des lois de puissance. Cette propriété empirique implique qu’une fraction marginale des entités observées concentre une part prépondérante de la grandeur scalaire totale mesurée. En isolant méthodiquement le sous-ensemble constitué des dix plus grandes valeurs, l’analyste met en lumière le décile supérieur, vecteur principal de la création de valeur ou de l’exposition aux risques systémiques. Dès lors, la détermination exacte de ce seuil critique ne relève pas d’une simple curiosité descriptive, mais gouverne l’allocation optimale des ressources organisationnelles, la priorisation des audits de contrôle interne et l’orientation des investissements capacitaires.
Sur le plan cognitif, la restitution synthétique des extrêmes répond aux limitations inhérentes à la perception humaine face à des corpus de données volumineux. Lorsqu’un jeu de données comprend des dizaines de milliers de lignes de transactions, la surcharge informationnelle paralyse la prise de décision. Le filtrage ciblé sur les éléments saillants opère une réduction dimensionnelle efficace, permettant aux gestionnaires de focaliser leur attention sur les paramètres qui exercent un impact déterminant sur les indicateurs de performance clés. Cette simplification analytique ne doit cependant pas dégrader la rigueur de la mesure : l’extraction des dix premières occurrences doit s’opérer sans approximation ni altération du contexte contextuel environnant.
Il convient de souligner avec gravité les dangers méthodologiques associés à l’inspection visuelle manuelle des tableaux de données. Parcourir visuellement une liste non ordonnée à la recherche des valeurs maximales constitue une pratique sujette à un taux d’erreur inacceptable, amplifié par la fatigue cognitive et les biais d’inattention. De surcroît, le tri manuel statique d’une colonne de données introduit une vulnérabilité majeure au sein des classeurs partagés : il détruit l’ordre chronologique ou séquentiel originel des observations, brise les dépendances référentielles des formules périphériques et ne s’actualise aucunement lors de l’adjonction de nouvelles lignes d’information. Une modélisation professionnelle requiert donc le recours exclusif à des architectures d’extraction algorithmique dynamiques, insensibles à la manipulation physique des cellules sources.
1.2 Taxonomie des outils d’extraction quantitative sous Excel
La boîte à outils offerte par Microsoft Excel pour appréhender l’extraction de valeurs seuils s’articule autour de trois paradigmes technologiques distincts : l’approche statique, l’approche semi-automatique et l’approche dynamique à propagation. L’approche statique, reposant sur des manipulations manuelles de commandes de ruban ou des tris ponctuels, fige l’état de l’analyse à un instant donné. Elle présente un intérêt documentaire éphémère mais s’avère rédhibitoire pour l’élaboration de tableaux de bord pérennes en raison de son absence totale de réactivité face aux mutations du jeu de données sous-jacent. L’analyste se voit contraint de répéter manuellement la séquence opératoire à chaque cycle de reporting, multipliant ainsi le risque d’altération accidentelle des formules.
L’approche semi-automatique s’incarne principalement dans l’usage des Tableaux Croisés Dynamiques (TCD) et des composants d’extraction assistée. Bien que ces mécanismes permettent une agrégation puissante et proposent des filtres natifs préconfigurés pour afficher les dix premiers éléments d’une dimension, ils souffrent d’une latence intrinsèque liée à la nécessité de rafraîchir le cache de données. À l’opposé de cette relative inertie, l’approche dynamique par formules offre une actualisation en temps réel : toute modification d’une variable source propage instantanément ses conséquences arithmétiques à travers l’arbre des dépendances du classeur, garantissant une cohérence absolue de la restitution analytique.
Le choix de l’instrument analytique optimal dépend de critères précis : le volume global de l’échantillon statistique, la fréquence de mise à jour des données brutes, le niveau d’expertise des utilisateurs finaux du modèle et l’impératif d’interopérabilité avec les versions antérieures du logiciel. Alors que les fonctions statistiques traditionnelles assurent une compatibilité universelle sur l’ensemble du parc informatique d’une multinationale, les fonctions matricielles dynamiques de dernière génération simplifient considérablement la syntaxe et réduisent la maintenance des formules. Le tableau ci-dessous synthétise cette taxonomie opérationnelle afin de guider l’analyste vers la solution la plus pertinente au regard de ses contraintes opérationnelles.
- Approche par formules déterministes classiques : Fondée sur la fonction GRANDE.VALEUR combinée à des indexations explicites. Présente une compatibilité totale avec toutes les versions d’Excel depuis les années 1990 et une transparence mathématique absolue.
- Approche par moteurs matriciels modernes : Utilisant les fonctions TRIER, FILTRE, SEQUENCE et CHOISIRLIGNES. Offre une concision syntaxique exceptionnelle, élimine le besoin de colonnes auxiliaires et évite les erreurs de glissement de cellules.
- Approche par agrégation multidimensionnelle : Reposant sur les filtres Top 10 intégrés aux Tableaux Croisés Dynamiques. Idéale pour les synthèses massives nécessitant des regroupements hiérarchiques préalables sans rédaction de code formel.
- Approche par pipelines de transformation ETL : Exécutée dans l’environnement Power Query. Indiquée pour les flux d’ingestion complexes nécessitant un nettoyage lourd et une automatisation récurrente en amont de la feuille de calcul.
2. Fondements mathématiques et syntaxiques de la fonction GRANDE.VALEUR
2.1 Définition formelle et comportement algorithmique de LARGE
Sur le plan de la théorie des probabilités et de la statistique inférentielle, l’extraction sélective d’observations ordonnées relève de la discipline des statistiques d’ordre. Soit un échantillon fini de variables aléatoires réelles observées, noté sous la forme d’un ensemble discret $X = {x_1, x_2, dots, x_n}$. Si l’on réordonne ces observations par ordre de grandeur décroissant, on obtient la suite ordonnée formelle $x_{(1)} ge x_{(2)} ge dots ge x_{(n)}$, où $x_{(1)}$ représente la statistique d’ordre maximale (la valeur extrême absolue) et $x_{(n)}$ la statistique d’ordre minimale. Dans cette formalisation rigoureuse, la $k$-ième plus grande valeur correspond précisément à l’élément noté $x_{(k)}$. C’est exactement cette opération algébrique que matérialise la fonction native d’Excel dénommée GRANDE.VALEUR dans sa version francophone, et désignée sous le vocable LARGE au sein du moteur d’exécution anglophone international.
D’un point de vue algorithmique et computationnel, le moteur interne de Microsoft Excel ne se contente pas d’effectuer un tri exhaustif préalable de la liste selon des schémas d’une complexité de type $O(n log n)$, tels que le tri rapide (Quicksort) ou le tri fusion (Mergesort), lorsque seule une fraction marginale d’éléments doit être extraite. Pour identifier une statistique d’ordre $k$ spécifique, l’algorithme privilégie des variantes du processus de sélection linéaire de Hoare (Quickselect), dont l’espérance de complexité temporelle s’établit en $O(n)$. Cette optimisation structurelle permet à la fonction GRANDE.VALEUR de conserver des temps de réponse extrêmement véloces, même lorsque la matrice d’entrée comprend des centaines de milliers de lignes. Cependant, lorsque cette fonction est répétée individuellement dix fois pour des valeurs de $k$ allant de 1 à 10, la redondance des passes itératives sur les grands ensembles peut impacter la charge processeur, un aspect que l’analyste chevronné doit savoir monitorer.
Le comportement de GRANDE.VALEUR face aux anomalies typologiques mérite une attention soutenue. Par conception, la fonction filtre et ignore silencieusement les cellules contenant des chaînes textuelles, des valeurs booléennes pures (VRAI ou FAUX) ainsi que les cellules strictement vides. Cette tolérance intrinsèque confère une grande souplesse à l’outil, mais dissimule un danger conceptuel : une valeur numérique stockée sous forme de chaîne de caractères par inadvertance sera totalement exclue du calcul statistique d’ordre sans qu’aucun message d’alerte ne soit notifié à l’utilisateur. En revanche, la présence d’une valeur nulle explicite (le chiffre 0) participe pleinement au calcul et peut occuper une position dans le Top 10 si la population de nombres positifs est inférieure à dix éléments.
2.2 Décomposition structurelle de la syntaxe de base
L’implémentation formelle de la fonction statistique GRANDE.VALEUR repose sur une signature d’appel unifiée, exigeant impérativement deux arguments positionnels pour son évaluation par le processeur arithmétique. La syntaxe canonique s’énonce comme suit :
=GRANDE.VALEUR(matrice; k)
L’argument initial, intitulé matrice (ou array dans la nomenclature anglophone), désigne la référence spatiale à la plage de cellules contiguës, à la plage discontinue, ou au vecteur matriciel contenant les observations quantitatives à soumettre à l’analyse ordonnée. Cet argument constitue le référentiel des données au sein duquel l’algorithme procède au balayage numérique. La matrice peut se présenter sous la forme d’une plage de cellules standard (par exemple A2:A1000), d’une référence structurée à une colonne de tableau Excel, ou d’une constante matricielle calculée en mémoire volatile issue de l’évaluation d’une formule intermédiaire.
Le second argument, désigné par la variable scalaire k, spécifie le rang positionnel décroissant recherché au sein de la matrice ordonnée. Il s’agit d’une entité numérique entière strictement positive appartenant à l’intervalle fermé $[1, N]$, où $N$ matérialise le cardinal de l’ensemble des données numériques valides présentes dans la matrice source. Si la valeur attribuée à $k$ est égale à l’unité ($k=1$), le résultat délivré par la fonction est strictement équivalent à celui retourné par la fonction MAX. Si l’argument $k$ est égal à $N$, la fonction renvoie la valeur minimale absolue, coïncidant avec le résultat de la fonction MIN. Pour isoler le Top 10, l’analyste doit être en mesure d’itérer cet argument scalaire de la valeur 1 jusqu’à la valeur 10 de manière méthodique.
Tout écart par rapport à cette norme de définition déclenche immédiatement des exceptions d’évaluation que le système signale par des codes d’erreur normalisés. Si l’analyste fournit un argument $k$ inférieur ou égal à zéro ($k le 0$), ou si $k$ excède le nombre total de points de données numériques valides contenus dans la matrice d’entrée ($k > N$), Microsoft Excel interrompt l’évaluation et renvoie le code d’erreur #NOMBRE!. Par ailleurs, si la matrice désignée ne comporte aucune valeur numérique exploitable (par exemple une plage exclusivement constituée d’étiquettes textuelles ou d’espaces vides), la fonction échoue de manière identique avec cette même erreur. Enfin, si l’argument $k$ pointe vers une cellule contenant une chaîne textuelle non convertible ou un symbole d’erreur préexistant, l’environnement propage l’erreur d’évaluation #VALEUR!, exigeant un assainissement préalable des liaisons référentielles.
3. Préparation rigoureuse du jeu de données et structuration matricielle
3.1 Assainissement et normalisation de la série statistique
L’exactitude des calculs d’extraction dépend directement de la propreté structurelle du jeu de données source. Une base quantitative corrompue par des artefacts de saisie ou des scories d’exportation informatique conduira inéluctablement à un Top 10 biaisé, sapant la crédibilité des décisions d’affaires qui en découlent. L’étape inaugurale de tout projet d’analyse avancée consiste donc à purger la colonne cible de ses polluants typologiques les plus fréquents. Parmi ces derniers, les espaces insécables (dont le point de code Unicode est CHAR(160)), fréquemment générés lors de l’extraction de données issues d’Enterprise Resource Planning (ERP) ou de bases Web, empêchent le moteur d’Excel de reconnaître les séquences de chiffres comme des grandeurs scalaires, les reléguant au statut de texte inerte invisible pour la fonction GRANDE.VALEUR.
Pour assainir une série statistique polluée, il convient d’exécuter une procédure de conversion méthodique. L’utilisation conjointe des fonctions de nettoyage textuel et de coercition numérique permet de restaurer l’intégrité arithmétique de la série. La formulation suivante illustre une technique de normalisation avancée permettant de convertir une chaîne corrompue en un nombre réel pur :
=CNUM(SUBSTITUE(SUBSTITUE(A2; INCAR(160); ""); " "; ""))
Cette expression élimine successivement les espaces insécables et les espaces standards avant de contraindre la chaîne résultante en un scalaire exploitable via la fonction CNUM. De surcroît, l’analyste doit porter une attention scrupuleuse au séparateur décimal (point ou virgule), dont l’inadéquation avec les paramètres régionaux du système d’exploitation constitue l’une des causes majeures d’échec du traitement automatique des données quantitatives.
Au-delà des scories typographiques, la gestion des cellules vides et des valeurs aberrantes exige un arbitrage méthodologique explicite. Une cellule entièrement vide n’altère pas la valeur du rang calculé par GRANDE.VALEUR, mais réduit le cardinal $N$ de l’échantillon. En revanche, si une transaction a été codifiée par convention avec un nombre négatif arbitraire (tel que -9999 pour marquer un enregistrement défaillant) ou une valeur textuelle comme « N/A », une inclusion aveugle dans un modèle élargi peut corrompre les filtres statistiques. Il est impératif d’exclure formellement ces anomalies au moyen d’un filtrage préalable ou de les convertir en valeurs nulles transparentes avant d’engager le protocole d’extraction ordonnée.
3.2 Organisation spatiale de la feuille de calcul
La pérennité d’un classeur d’entreprise et sa capacité à être audité par des tiers reposent sur une ergonomie spatiale rigoureuse. L’architecture tabulaire doit impérativement respecter le principe fondamental de séparation fonctionnelle : la zone d’ingestion des données brutes, la zone de calcul intermédiaire et la zone de restitution décisionnelle doivent occuper des espaces géométriques strictement distincts, idéalement matérialisés par des onglets séparés au sein du même classeur. Implanter la zone d’affichage du Top 10 immédiatement en dessous ou sur les mêmes lignes qu’un tableau de données volumineux expose le modèle à des collisions référentielles lors des opérations futures d’insertion de lignes ou d’application de filtres automatiques.
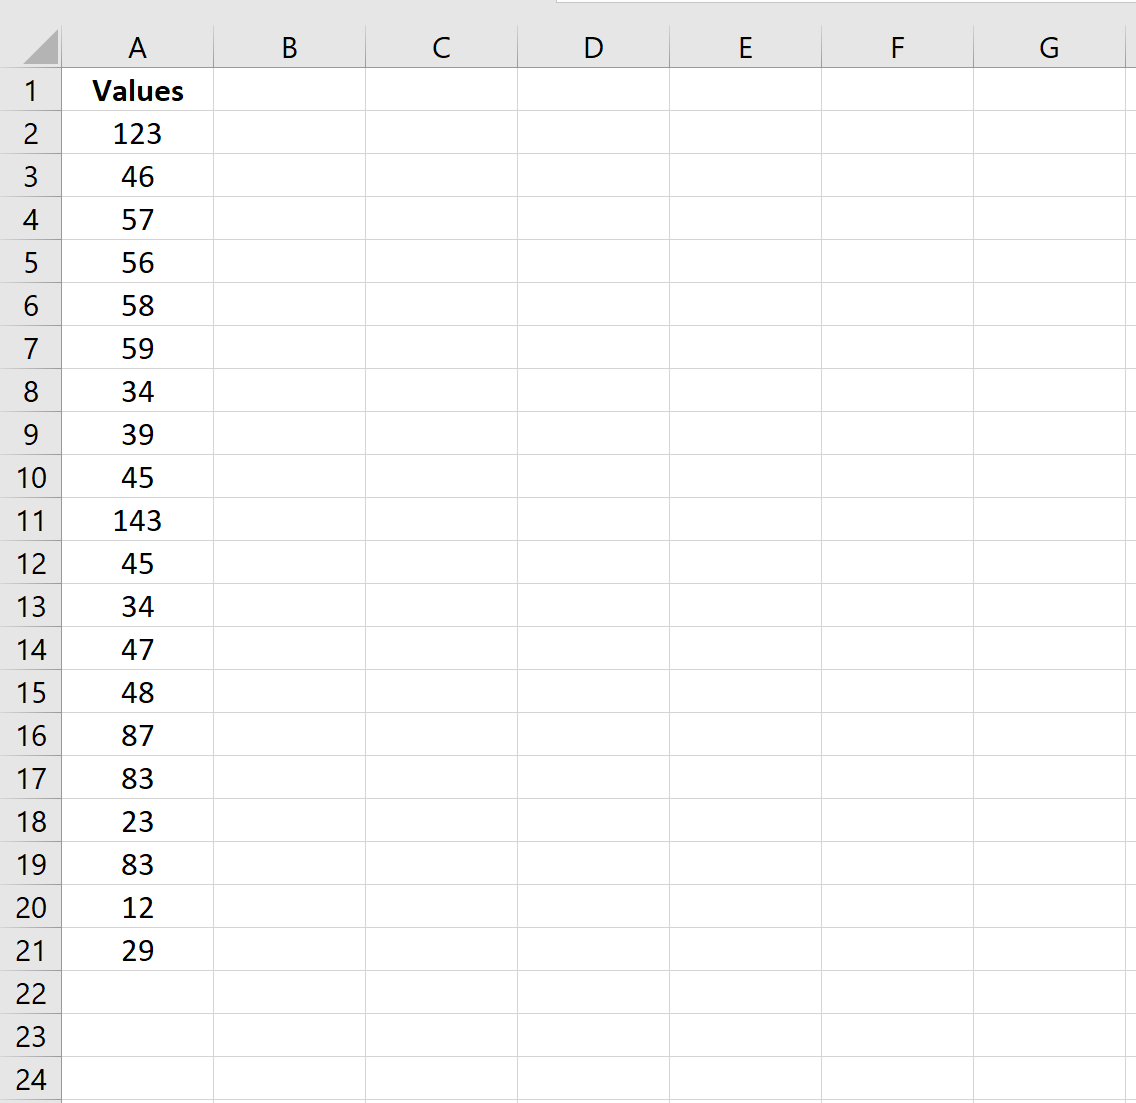
Pour construire une table de restitution du Top 10 hautement auditable, il est recommandé d’aménager un tableau dédié comprenant un en-tête clair, une colonne indicatrice du rang $k$ (contenant les entiers de 1 à 10 discrètement ordonnés), une colonne recevant les valeurs quantitatives extraites par le moteur de calcul, et les colonnes périphériques destinées à accueillir les métadonnées contextuelles rapatriées par voie de recherche. Cette disposition tabulaire garantit que chaque composant du modèle possède une responsabilité unique et identifiable.
L’application rigoureuse des standards de modélisation financière, tels que les principes édictés par le standard international FAST (Flexible, Appropriate, Structured, Transparent), requiert en outre l’utilisation d’une typographie et d’un code couleur normalisés. Les cellules réservées à la saisie de paramètres variables (par exemple la profondeur du Top $N$, si l’on souhaite rendre l’indice 10 modifiable) doivent adopter un format distinct des cellules accueillant des formules calculées pures. Ce formalisme visuel prévient les écrasements accidentels de formules par les utilisateurs opérationnels et permet aux auditeurs internes de vérifier l’intégrité structurelle du flux de données en un coup d’œil.
4. Protocole pas à pas : Implémentation de la fonction GRANDE.VALEUR pour le Top 10
4.1 Génération de la colonne d’index des rangs
La première phase opérationnelle du déploiement classique de la méthode réside dans l’établissement d’une colonne d’indexation continue. Cette colonne auxiliaire héberge la suite discrète des entiers naturels successifs $k in {1, 2, 3, 4, 5, 6, 7, 8, 9, 10}$. Bien qu’il soit techniquement concevable d’inscrire ces valeurs directement en dur au sein des formules individuelles (par exemple en saisissant manuellement l’argument 1 dans la première ligne, puis 2 dans la seconde), cette pratique constitue une faute de modélisation formelle : elle introduit une rigidité inutile et rend la formule impossible à propager par simple recopie incrémentale.
Pour instaurer cette séquence de rangs de manière optimale au sein d’une plage de cellules, par exemple dans la colonne C de la cellule C3 à la cellule C12, plusieurs mécanismes s’offrent au concepteur de classeurs :
- Incrémentation arithmétique manuelle : Saisie des valeurs 1 et 2 dans les deux premières cellules, puis extension de la série vers le bas via la poignée de recopie automatique jusqu’à atteindre l’indice 10. Cette technique élémentaire assure une stabilité absolue mais demeure totalement statique.
- Génération dynamique par indexation de position : Utilisation de la fonction
LIGNE()configurée pour renvoyer la position relative de la cellule. Par exemple, en plaçant enC3la formule=LIGNE(A1)ou=LIGNE() - 2, le système incrémente naturellement l’index lors du glissement de la cellule vers le bas. - Séquençage matriciel moderne : Pour les versions d’Excel prenant en charge le moteur dynamique, l’invocation de la formule
=SEQUENCE(10; 1; 1; 1)dans une cellule unique projette instantanément l’intégralité de la colonne d’indexation sans nécessiter la moindre duplication de cellule.
Il est fondamental de s’assurer que ces index soient rigoureusement typés sous forme de nombres entiers purs. L’alignement par défaut sur la droite de la cellule sous Excel témoigne de la reconnaissance correcte du format numérique scalaire. Toute anomalie typologique à ce stade initial compromettrait l’évaluation subséquente de la fonction de recherche de rang.
4.2 Rédaction et déploiement de la formule principale
Une fois la colonne des indices de rangs $k$ correctement calibrée, l’analyste procède à la rédaction de la formule maîtresse au sein de la première ligne de restitution, face à l’index de rang 1. Considérons un cas de figure classique où les données quantitatives brutes se situent dans la colonne A, précisément dans la plage délimitée de A2 à A500, et où la colonne des rangs $k$ débute en cellule C3 avec la valeur 1. La formule à inscrire en cellule D3 s’établit avec une rigueur absolue selon la syntaxe suivante :
=GRANDE.VALEUR($A$2:$A$500; C3)
L’observation attentive de cette expression révèle l’usage indispensable des symboles monétaires $ encadrant les références de colonnes et de lignes de la plage source. Ce verrouillage en référence absolue garantit que lors du déploiement vertical de la formule le long des lignes 3 à 12 du tableau de synthèse, la matrice source d’analyse demeure parfaitement immobile et ne dérive pas vers le bas. Simultanément, la référence à l’argument C3 est délibérément laissée sous forme relative (sans symbole dollar), permettant à l’argument $k$ de s’incrémenter naturellement : il consultera successivement C4 ($k=2$), C5 ($k=3$), et ainsi de suite jusqu’à C12 ($k=10$).
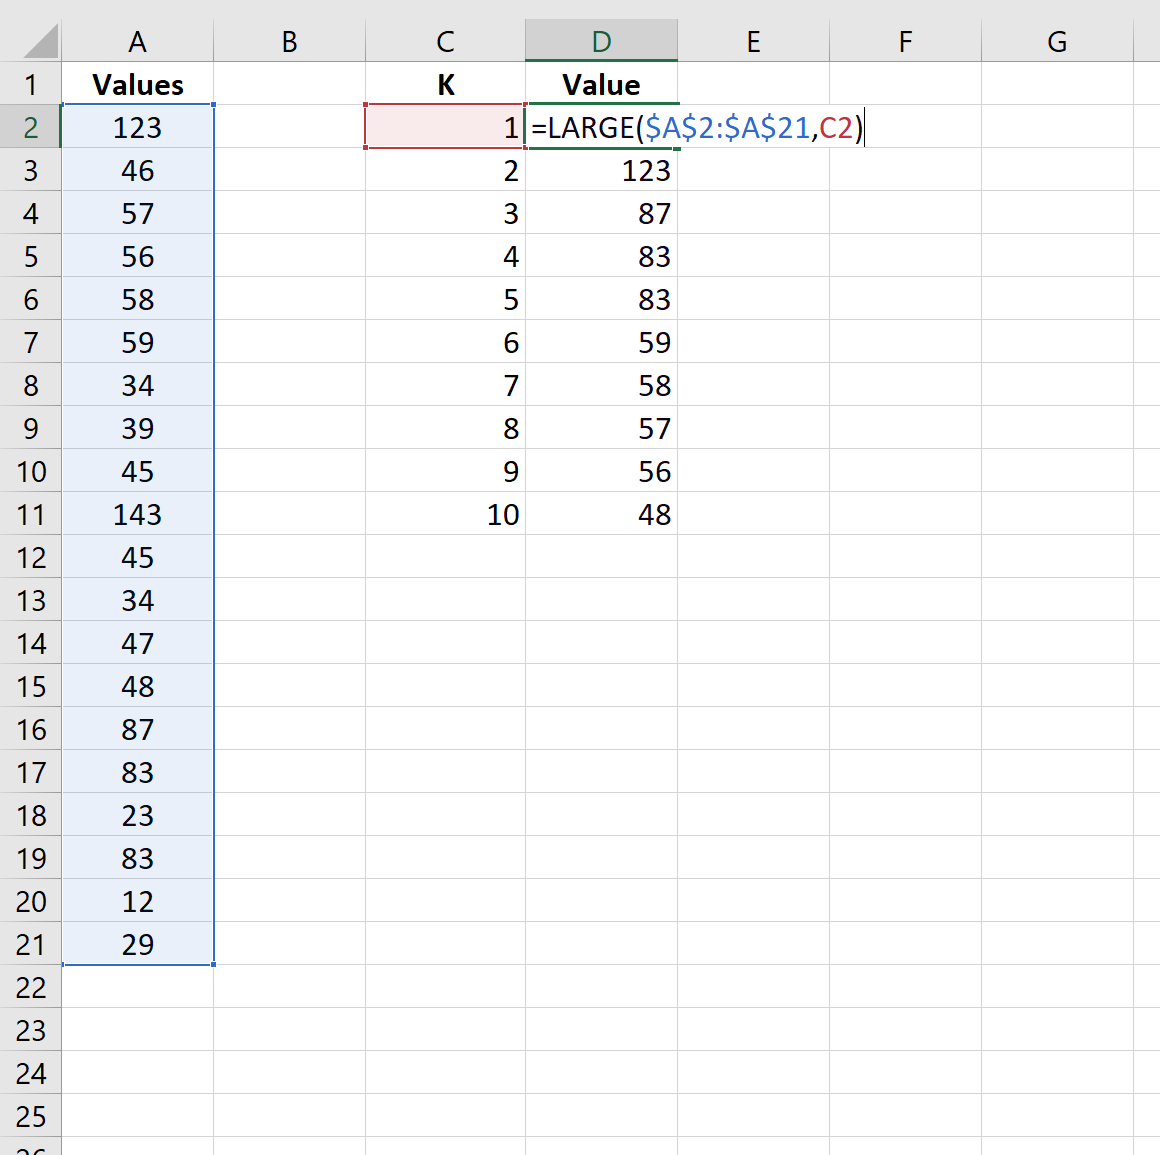
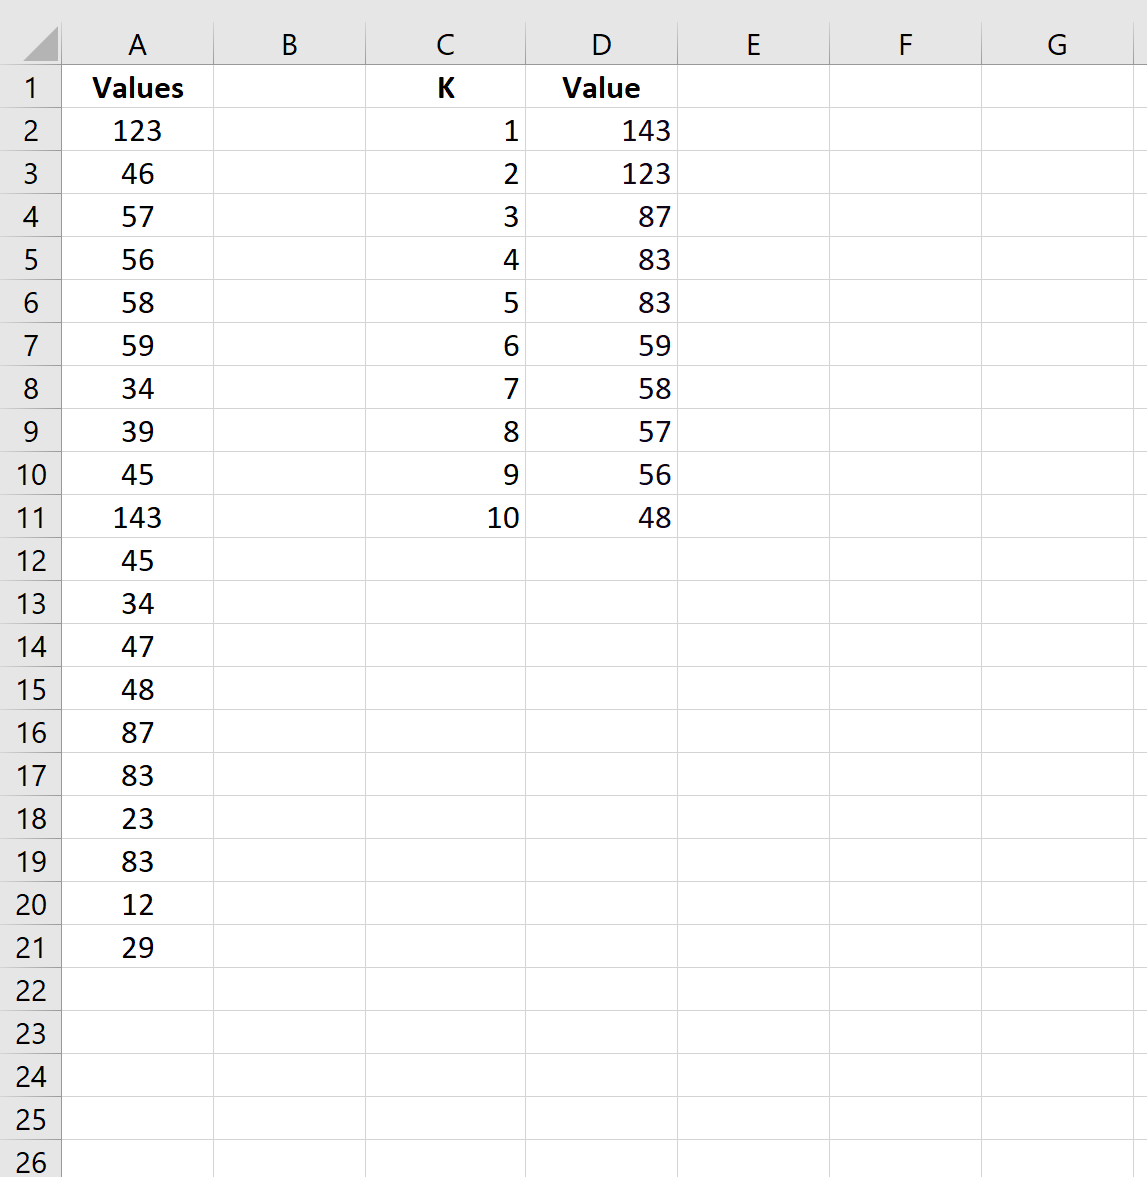
Le déploiement s’opère ensuite en double-cliquant sur le carré noir d’incrémentation situé dans l’angle inférieur droit de la cellule D3, ou en faisant glisser cette poignée de recopie vers le bas jusqu’à la cellule D12. Dès cette action exécutée, le moteur d’Excel calcule en temps réel et projette les dix grandeurs scalaires dominantes de l’échantillon. Pour valider formellement la cohérence des résultats extraits, l’analyste doit effectuer un contrôle croisé de base : la valeur retournée pour $k=1$ doit obligatoirement coïncider avec l’évaluation de =MAX($A$2:$A$500), tandis que la valeur associée au dixième rang doit être rigoureusement supérieure ou égale à la valeur minimale globale de l’échantillon retournée par MIN.
4.3 Génération autonome sans colonne auxiliaire via SEQUENCE
L’avènement du moteur de calcul matriciel dynamique au sein de Microsoft 365 et d’Excel 2021 a profondément révolutionné la syntaxe des classeurs en introduisant le concept de propagation matricielle (désigné par le terme anglophone spill). Grâce à cette avancée architecturale, il n’est plus nécessaire de construire artificiellement une colonne auxiliaire d’index de 1 à 10, ni d’effectuer une recopie verticale fastidieuse d’une formule scalaire sur dix cellules contiguës. La fonction SEQUENCE permet d’injecter directement un vecteur d’indices à l’argument $k$ de la fonction GRANDE.VALEUR.
Pour générer l’intégralité du Top 10 de manière instantanée, compacte et élégante, il suffit de saisir une unique formule dans la cellule supérieure gauche de la zone de restitution :
=GRANDE.VALEUR(A2:A500; SEQUENCE(10))
Dans ce schéma computationnel, la fonction SEQUENCE(10) génère en mémoire vive une matrice verticale d’entiers naturels ${1; 2; 3; 4; 5; 6; 7; 8; 9; 10}$. En recevant ce vecteur comme second paramètre, la fonction GRANDE.VALEUR se trouve vectorisée : elle s’évalue simultanément pour chacune des composantes de la matrice d’entrée et projette les dix résultats ordonnés dans les dix cellules situées en aval de la cellule d’ancrage. Cette matrice dynamique est délimitée visuellement à l’écran par une fine bordure bleue flottante signalant l’étendue de la plage propagée.
Les gains qualitatifs associés à cette écriture moderne sont considérables. D’une part, la charge de maintenance logicielle est drastiquement amenuisée : la modification de la plage source ou de la profondeur d’analyse (par exemple transformer le Top 10 en un Top 5 en remplaçant 10 par 5) s’effectue en un point unique d’édition sans nécessiter de redimensionnement manuel de la table de restitution. D’autre part, cette approche élimine tout risque de rupture de chaîne de calcul consécutive à l’écrasement involontaire d’une formule isolée au milieu de la plage de réception, le moteur garantissant l’intégrité de l’ensemble de la zone de déversement.
5. Gestion des contraintes d’adressage absolu et dynamique
5.1 Théorie du verrouillage par références absolues
La compréhension rigoureuse des modes d’adressage au sein de la grille de calcul est une condition sine qua non de la robustesse des modèles d’extraction quantitative. Dans le langage de programmation déclaratif d’Excel, chaque coordonnée de cellule saisie dans une formule est par défaut une référence relative. Cela signifie que le moteur d’exécution n’interprète pas la position d’une donnée comme un emplacement géographique figé dans l’espace de la feuille, mais comme un vecteur de déplacement orienté (un décalage d’un nombre déterminé de colonnes et de lignes) par rapport à la cellule hôte qui héberge la formule active.
Lorsqu’un analyste omet d’apposer les symboles d’ancrage absolu et formule son extraction de la manière suivante : =GRANDE.VALEUR(A2:A500; C3), puis recopie cette cellule vers le bas pour le rang $k=2$, la formule copiée devient mathématiquement =GRANDE.VALEUR(A3:A501; C4). Les conséquences de cette dérive dimensionnelle sont catastrophiques pour la justesse de l’analyse : la matrice d’observation est tronquée de sa première ligne (qui hébergeait potentiellement le maximum absolu de la distribution) et incorpore une ligne parasite en bas de plage. À la dixième itération, la plage analysée est devenue A11:A509, éliminant arbitrairement les dix premières observations historiques et restituant un échantillon totalement biaisé sans générer la moindre erreur logicielle apparente.
L’utilisation systématique de la touche de fonction F4 lors de la désignation de la plage d’entrée applique le verrouillage bidirectionnel $A$2:$A$500. Ce formalisme garantit une invariance référentielle absolue : quelle que soit la cellule de destination vers laquelle la formule est projetée, copiée ou déplacée, le champ d’investigation statistique demeure inaltérable. La maîtrise de ces subtilités d’adressage distingue l’opérateur novice du modélisateur professionnel, garantissant la conformité formelle des calculs déployés dans les environnements de production d’entreprise.
5.2 Utilisation des tableaux structurés et des références structurées
Bien que le verrouillage par références absolues pallie les risques de glissement spatial, il demeure intrinsèquement inefficace face à la dynamique d’extension des bases de données transactionnelles. Si de nouvelles opérations commerciales viennent s’ajouter aux lignes 501 à 600 du tableau, la formule statique $A$2:$A$500 ignore royalement ces ajouts récents, conduisant à une obsolescence immédiate du Top 10. Pour surmonter définitivement cette limitation sans recourir à des formules complexes basées sur les fonctions volatiles telles que DECALER ou INDIRECT, l’architecture préconisée repose sur l’emploi des tableaux structurés officiels d’Excel (connus sous l’objet programmatique interne ListObject).
La conversion d’une plage tabulaire brute en un tableau structuré s’exécute instantanément au moyen du raccourci clavier Ctrl + L ou Ctrl + T. Une fois cette transformation opérée, l’objet se voit attribuer un identifiant unique (par exemple TableauVentes) et chaque en-tête de colonne devient une variable sémantique explicite. Dès lors, la syntaxe d’extraction des plus grandes grandeurs s’affranchit totalement des coordonnées alphanumériques au profit d’une écriture sémantique intelligible et auto-documentée :
=GRANDE.VALEUR(TableauVentes[MontantTransaction]; C3)
Cette référence structurée présente des propriétés d’extensibilité dynamique remarquables : toute adjonction de nouvelle ligne à la base de données, qu’elle résulte d’une saisie manuelle, d’un collage volumineux ou d’une actualisation de connecteur externe, provoque l’expansion automatique et transparente des bornes du TableauVentes. La formule de calcul du Top 10 intègre instantanément ces données fraîches dans son évaluation ordonnée sans exiger la moindre intervention de l’analyste sur la formule initiale.
Par ailleurs, les références structurées procurent une immunité totale contre les erreurs humaines liées aux insertions intempestives de colonnes ou aux suppressions accidentelles de cellules dans le corps de la feuille de calcul. L’intégrité référentielle est préservée par le modèle objet sous-jacent, conférant aux classeurs une robustesse et une auditabilité alignées sur les plus hauts standards de gouvernance des systèmes d’information d’entreprise.
6. Traitement approfondi des ex aequo et des doublons
6.1 Comportement standard de GRANDE.VALEUR face aux répétitions
L’un des écueils analytiques les plus fréquents et les plus mal appréhendés dans la manipulation des distributions quantitatives réside dans l’occurrence de doublons au sein des valeurs de tête. Le comportement natif de la fonction GRANDE.VALEUR face à des grandeurs strictement identiques est strictement arithmétique : elle préserve rigoureusement la multiplicité algébrique de chaque observation. Cela implique que si la grandeur maximale de 100 000 euros apparaît à trois reprises dans la série statistique d’origine, les évaluations successives pour les rangs $k=1$, $k=2$ et $k=3$ renverront invariablement et exactement la même grandeur de 100 000 euros.
Cette caractéristique comportementale engendre une distinction conceptuelle fondamentale que tout analyste de données doit expliciter préalablement à la publication de ses travaux :
- L’extraction des dix premiers enregistrements (Top 10 des lignes) : Dans cette acception, chaque transaction ou ligne de la base constitue une entité autonome. Si trois entités partagent la même grandeur sommitale, elles occupent légitimement les rangs 1, 2 et 3 de la hiérarchie. La fonction
GRANDE.VALEURrépond parfaitement à cette définition sans altération. - L’extraction des dix grandeurs uniques (Top 10 des paliers de valeur) : Dans cette seconde perspective, l’analyste cherche à identifier les dix seuils financiers ou opérationnels distincts les plus élevés observés dans la population. Si le nombre 100 000 euros est présent trois fois, il ne doit occuper que le rang 1, le rang 2 devant obligatoirement présenter la valeur distincte immédiatement inférieure (par exemple 95 000 euros).
Confondre ces deux approches peut fausser l’interprétation managériale. Par exemple, au sein d’une entreprise industrielle confrontée à une concentration de prix de vente contractuels standardisés, afficher un Top 10 constitué de seulement deux valeurs répétitives réparties sur dix lignes n’offre aucune visibilité sur la dispersion réelle du reste de la distribution. Il devient alors indispensable d’adopter des stratégies d’épuration préalable ou de désambiguïsation algorithmique.
6.2 Extraction des 10 plus grandes valeurs uniques
Pour extraire les dix valeurs dominantes en purgeant scrupuleusement toute répétition de manière à isoler des paliers quantitatifs distincts, l’écosystème moderne de calcul offre une synergie particulièrement puissante en combinant la fonction matricielle UNIQUE avec l’opérateur d’ordre. La fonction UNIQUE se charge de filtrer la matrice source en mémoire vive pour n’en conserver qu’une occurrence par modalité scalaire, avant que la fonction d’ordre statistique ne hiérarchise cet échantillon assaini.
L’articulation syntaxique combinant ces deux mécanismes s’établit avec une concision exemplaire au sein d’une formule matricielle propagée :
=GRANDE.VALEUR(UNIQUE(TableauVentes[MontantTransaction]); SEQUENCE(10))
Dans ce modèle d’exécution, la fonction UNIQUE génère un sous-ensemble virtuel débarrassé de toute redondance. La fonction SEQUENCE(10) génère le vecteur des rangs ordonnés de 1 à 10. Enfin, GRANDE.VALEUR évalue l’ordre statistique $k$-ième directement sur ce flux unifié. Le tableau obtenu garantit que les dix valeurs affichées sont strictement décroissantes et mutuellement exclusives sur le plan arithmétique ($x_{(1)} > x_{(2)} > dots > x_{(10)}$).
Toutefois, une vigilance théorique s’impose : si la population statistique totale ne comporte pas au moins dix grandeurs distinctes (par exemple dans le cadre d’un échantillon restreint ne présentant que six niveaux de tarification différents), la fonction GRANDE.VALEUR générera l’erreur #NOMBRE! à partir de la septième ligne de restitution, puisque l’argument $k=7$ excédera le cardinal de la matrice épurée. L’analyste prévoyant encapsulera cette formulation dans un gestionnaire d’exception, tel que =SIERREUR(GRANDE.VALEUR(UNIQUE(TableauVentes[MontantTransaction]); SEQUENCE(10)); ""), afin d’assurer une présentation visuelle irréprochable exempte de scories logiques.
6.3 Désambiguïsation par clés discriminantes artificielles
Dans les versions d’Excel ne disposant pas du moteur matriciel dynamique, ou lorsque l’objectif consiste à associer chaque valeur dupliquée à son entité nominale propre sans collision de recherche (problématique examinée en détail à la section 7), une méthode d’ingénierie des données éprouvée consiste à introduire une micro-variation discriminante infinitésimale. Cette approche déterministe permet de briser mathématiquement les ex aequo tout en conservant la grandeur relative globale des données.
Le principe fondamental réside dans l’adjonction à chaque valeur numérique de la base d’une pénalité infinitésimale inversement ou directement proportionnelle à son numéro de ligne dans le tableau. Par exemple, au sein d’une colonne auxiliaire de calcul (nommée MontantAjuste), on injectera la formule suivante :
=A2 - (LIGNE(A2) / 1000000000)
En soustrayant une fraction négligeable (un milliardième du numéro de ligne), deux transactions affichant une valeur faciale rigoureusement identique de 50 000,00 euros se trouveront différentiées à la neuvième décimale (par exemple 49 999,999999998 face à 49 999,999999995). Cette altération arithmétique imperceptible pour l’œil humain et sans impact sur l’arrondi financier assure l’unicité mathématique stricte de chaque enregistrement.
Dès lors, la fonction GRANDE.VALEUR appliquée sur cette colonne ajustée ne rencontrera jamais de doublons et classera systématiquement la première transaction rencontrée dans l’ordre de la table devant la seconde. Lorsque le résultat final doit être affiché dans le tableau de bord décisionnel, il suffit soit de masquer les décimales superflues par un formatage monétaire standard à deux chiffres après la virgule, soit de réappliquer la fonction ARRONDI(valeur; 2) pour restaurer la pureté faciale de la transaction d’origine. Cette technique offre une solution pérenne et rétrocompatible pour l’ensemble des systèmes d’information décisionnels construits sur des architectures logicielles patrimoniales.
7. Rapatriement des métadonnées associées par recherche bidirectionnelle
7.1 Limites de la simple extraction scalaire sans contexte qualitatif
D’un point de vue décisionnel et cognitif, la restitution isolée d’une série de grandeurs numériques pures ne présente qu’une utilité stratégique marginale. Informer un comité d’administration que les trois plus importantes transactions de l’exercice fiscal s’élèvent respectivement à 1 250 000 euros, 980 000 euros et 875 000 euros soulève immédiatement une interrogation contextuelle : à quels clients ces opérations se rapportent-elles ? Quels commerciaux ont piloté ces négociations ? À quelles dates précises et dans quelles zones géographiques ces flux ont-ils été enregistrés ? L’extraction d’un chiffre coupé de ses métadonnées qualitatives constitue une rupture sémantique dommageable pour la gouvernance des processus métiers.
Cependant, le couplage entre une grandeur statistique extraite et son libellé descriptif sous-jacent recèle un piège logique redoutable, directement corrélé à la problématique des doublons exposée précédemment. Si deux clients distincts (par exemple la société « Alpha » et la société « Beta ») ont généré un chiffre d’affaires parfaitement identique de 500 000 euros, et que ce montant occupe les neuvième et dixième positions du Top 10, un algorithme de recherche élémentaire et mal paramétré consultera la matrice source et retournera invariablement le libellé de la première occurrence rencontrée dans le sens de lecture vertical.
En conséquence de ce court-circuit référentiel, la société « Alpha » apparaîtra erronément à deux reprises dans le tableau final face aux rangs 9 et 10, tandis que l’entité « Beta » sera purement et simplement invisibilisée du reporting exécutif. Ce risque de duplication illégitime impose l’application d’architectures de recherche avancées, capables de maintenir la stricte bijection entre chaque observation atomique et son contexte opérationnel propre.
7.2 Couplage avec la fonction RECHERCHEX (XLOOKUP)
Au sein des versions contemporaines d’Excel, la fonction RECHERCHEX constitue l’instrument d’excellence pour orchestrer la recherche bidirectionnelle exacte sans les rigidités historiques de la fonction RECHERCHEV. Elle autorise des recherches horizontales, verticales, vers la gauche ou vers la droite, tout en intégrant nativement la gestion des valeurs introuvables.
Dans un contexte où les données numériques ont été préalablement désambiguïsées (ou dans lequel l’analyste a la certitude formelle que la population ne recèle aucun doublon scalaire), l’association entre la valeur extraite et son contexte d’identification s’exécute avec une grande clarté. Supposons que les montants du Top 10 soient logés dans la plage D3:D12, que la base de référence contienne les noms des clients en colonne A (plage TableauVentes[NomClient]) et les montants en colonne B (plage TableauVentes[Montant]). La formule déployée en E3 pour récupérer le client associé s’écrit :
=RECHERCHEX(D3; TableauVentes[Montant]; TableauVentes[NomClient]; "Entité non identifiée"; 0)
L’argument 0 garantit une recherche par correspondance exacte stricte. Si la valeur requise n’est pas localisée, l’argument optionnel intercepte l’erreur pour renvoyer une chaîne signifiante. Toutefois, face à des doublons avérés, la fonction RECHERCHEX conventionnelle continue de buter sur la première occurrence rencontrée. Pour lever cette ambiguïté sans recourir à une colonne intermédiaire de micro-ajustement, il est possible d’exploiter la programmation matricielle pour filtrer dynamiquement les indices de lignes, comme détaillé ci-dessous :
=INDEX(TableauVentes[NomClient]; GRANDE.VALEUR(SI(TableauVentes[Montant]=D3; LIGNE(TableauVentes[Montant])-LIGNE(TableauVentes[#En-têtes]); ""); NB.SI($D$3:D3; D3)))
Cette expression matricielle sophistiquée utilise la fonction NB.SI sous forme de plage semi-expansible ($D$3:D3) pour compter le nombre d’occurrences de la grandeur recherchée déjà traitées au-dessus de la ligne courante. Ce compteur d’occurrence pilote dynamiquement le rang d’extraction au sein des positions d’égalités multiples, garantissant ainsi que deux montants identiques extraient séquentiellement et sans confusion les identités respectives des différents titulaires.
7.3 Méthode classique par INDEX et EQUIV
Pour assurer une rétrocompatibilité intégrale avec l’ensemble des installations de bureau historiques (versions Excel 2019, 2016, 2013 et antérieures), le binôme structurel composé des fonctions INDEX et EQUIV demeure la référence incontournable de l’ingénierie financière. Ce tandem dissocie structurellement l’identification spatiale de la coordonnée de ligne (confiée à EQUIV) de la restitution du contenu de la cellule d’intersection (opérée par INDEX).
La formulation standard univariée sans gestion avancée des ex aequo s’articule comme suit :
=INDEX($A$2:$A$500; EQUIV(D3; $B$2:$B$500; 0))
Pour immuniser ce mécanisme contre le problème structurel des doublons sans modifier la base source, la solution la plus robuste consiste à intégrer une condition matricielle multicritère dans l’argument de recherche de la fonction EQUIV. On évalue simultanément la concordance sur la grandeur financière et la non-concordance avec les éléments qualitatifs déjà rapatriés dans les cellules supérieures du tableau de restitution :
=INDEX($A$2:$A$500; EQUIV(1; ($B$2:$B$500=D3) * NON(ESTNUM(EQUIV($A$2:$A$500; $E$2:E2; 0))); 0))
Cette formule matricielle (devant être validée par la combinaison de touches Ctrl + Maj + Entrée sous les versions antérieures au moteur matriciel dynamique) crée en mémoire un vecteur booléen. Le produit logique (matérialisé par l’opérateur de multiplication arithmétique *) ne vaut 1 que si la transaction correspond exactement au montant recherché en D3 ET si le nom du client présent sur la ligne considérée n’a pas déjà été consigné dans la plage supérieure de restitution $E$2:E2. Le système identifie ainsi avec une précision mathématique la première occurrence non encore extraite, résolvant intégralement le problème de collision sans la moindre modification du jeu de données originel.
8. Approches alternatives modernes : Fonctions TRIER, FILTRE et CHOISIRLIGNES
8.1 Extraction directe par les fonctions dynamiques modernes
L’introduction des fonctions matricielles de traitement global au sein du moteur de calcul d’Excel permet de repenser l’extraction des dix valeurs supérieures non plus comme une succession de recherches ponctuelles scalaires, mais comme une opération globale de transformation et de découpage de flux de données. Au lieu d’extraire la grandeur maximale, puis d’exécuter un rapatriement périphérique pour chaque colonne contextuelle, les fonctions TRIER et CHOISIRLIGNES réalisent l’ensemble du processus en une instruction unique.
Considérons un tableau complet contenant trois colonnes : le nom du client (colonne 1), la région géographique (colonne 2) et le montant des transactions (colonne 3). L’objectif est d’extraire d’un bloc le Top 10 comprenant l’ensemble des trois attributs. La combinaison logique entre TRIER et CHOISIRLIGNES s’articule de la manière suivante :
=CHOISIRLIGNES(TRIER(TableauVentes; 3; -1); SEQUENCE(10))
La décomposition analytique de cette formule démontre son élégance opérationnelle :
- La fonction interne TRIER : Elle ingère l’intégralité du tableau
TableauVentes, applique un critère de classement sur sa troisième colonne (l’argument numérique 3), et ordonne les données selon une orientation strictement descendante spécifiée par l’argument d’ordre-1. L’ensemble de la table est alors réordonné virtuellement en mémoire vive sans modifier l’affichage physique de la source. - La fonction externe CHOISIRLIGNES : Elle reçoit ce tableau ordonné et découpe chirurgicalement les dix premières lignes désignées par le vecteur séquentiel
SEQUENCE(10).
Cette approche unifiée élimine définitivement toute divergence entre les valeurs quantitatives et leurs métadonnées associées. Chaque ligne extraite demeure intrinsèquement liée à ses attributs initiaux : les doublons éventuels de montants sont automatiquement préservés avec leurs clients respectifs sans aucune formule de désambiguïsation supplémentaire. La table entière se déverse sur dix lignes et trois colonnes depuis une unique cellule de formulation, offrant une concision et une maintenabilité optimales.
8.2 Filtrage conditionnel préalable avec la fonction FILTRE
L’une des limites historiques de la fonction GRANDE.VALEUR réside dans sa relative complexité lorsqu’il s’agit de soumettre l’analyse à des critères conditionnels multicritères (par exemple : identifier le Top 10 des transactions réalisées exclusivement dans le secteur « Europe du Nord » pour des montants libellés en euros). Sous l’ancien paradigme, cette exigence imposait la construction de formules matricielles lourdes encapsulant des fonctions conditionnelles SI, sources récurrentes de ralentissements computationnels.
Le moteur contemporain résout ce défi par l’adjonction de la fonction FILTRE. En plaçant un filtre en amont de l’algorithme de tri, l’analyste segmente la population statistique avant même d’en évaluer les extrêmes. La syntaxe combinée prend la forme structurelle suivante :
=CHOISIRLIGNES(TRIER(FILTRE(TableauVentes; TableauVentes[Region]="Europe"); 3; -1); SEQUENCE(10))
Ce pipeline de calcul exécute séquentiellement : le filtrage booléen strict des enregistrements d’intérêt, le tri décroissant sur la variable quantitative de performance, et l’isolation des dix premiers tuples d’enregistrements. Si la population filtrée est susceptible de comporter moins de dix observations valides, ce qui conduirait la fonction CHOISIRLIGNES à renvoyer une erreur d’indice hors limites, le modèle gagne à être dynamisé en bornant la fonction SEQUENCE à la taille réelle du sous-ensemble éligible :
=LET(donneesFiltrees; FILTRE(TableauVentes; TableauVentes[Region]="Europe"); donneesTriees; TRIER(donneesFiltrees; 3; -1); CHOISIRLIGNES(donneesTriees; SEQUENCE(MIN(10; LIGNES(donneesTriees)))))
L’introduction de la fonction LET permet d’assigner des variables intermédiaires locales en mémoire vive, évitant ainsi le recalcul répété de l’étape de filtrage et de tri. Cette pratique architecturale de haut niveau garantit une exécution rapide et protège le classeur contre toute rupture computationnelle lorsque l’échantillon analysé est clairsemé.
9. Mise en évidence visuelle sans extraction : Mise en forme conditionnelle
9.1 Règles intégrées d’identification des valeurs supérieures
Dans de nombreuses configurations de restitution opérationnelle, extraire physiquement des données vers un tableau périphérique distinct n’est ni nécessaire ni souhaitable. L’analyste cherche alors à orienter l’attention des utilisateurs directement au sein du corps du tableau principal sans en altérer la structure spatiale ni en déplacer les lignes. L’outil de Mise en forme conditionnelle d’Excel répond précisément à cette exigence en appliquant des attributs de mise en valeur graphique (colorations de fond, modifications typographiques, bordures d’accentuation) aux cellules qui satisfont à des critères mathématiques prédéfinis.
Excel dispose d’un module natif spécifiquement configuré pour l’identification des valeurs extrêmes. Accessible via le ruban Accueil > Mise en forme conditionnelle > Règles des valeurs de haut/bas de tableau > 10 valeurs les plus élevées…, cette fonctionnalité applique automatiquement un format différentiel aux dix plus grandes grandeurs d’une plage sélectionnée. L’utilisateur peut paramétrer interactivement la profondeur du seuil (choisir 5, 10 ou toute autre quantité discrète) et sélectionner une charte graphique appropriée, telle qu’un remplissage vert translucide assorti d’un texte vert foncé.
D’un point de vue perceptif et sémiologique, cette technique réduit drastiquement le temps d’exploration cognitive au sein de matrices denses. L’analyste peut également adjoindre des barres de données analytiques au sein des mêmes cellules. Ces barres horizontales proportionnelles créent un histogramme intégré in situ, matérialisant instantanément l’écart relatif séparant le leader absolu de la dixième observation. Toutefois, cette règle intégrée présente une limitation : elle agit exclusivement au niveau de la cellule numérique isolée, sans offrir la possibilité d’étendre la mise en valeur à l’ensemble de la ligne correspondante dans le tableau.
9.2 Règles personnalisées basées sur une formule dynamique
Pour surmonter le cloisonnement cellulaire de la règle native et mettre en surbrillance l’intégralité d’une ligne d’enregistrement (englobant le nom du client, la date, la région et le montant) dès lors que sa composante quantitative appartient au Top 10, le recours à une règle personnalisée gouvernée par une formule booléenne s’avère indispensable. Ce procédé transfère la puissance de la fonction GRANDE.VALEUR au moteur de rendu graphique d’Excel.
La mise en œuvre requiert une maîtrise rigoureuse des concepts d’adressage mixte afin d’assurer la cohérence du balayage d’évaluation. Supposons que notre tableau d’enregistrements s’étende de la cellule A2 à la cellule C100, les montants quantitatifs étant consignés dans la colonne B. Après avoir sélectionné l’intégralité de la plage cible A2:C100, l’analyste crée une nouvelle règle de mise en forme formulée comme suit :
=$B2>=GRANDE.VALEUR($B$2:$B$100; 10)
L’analyse structurelle de cette expression révèle la mécanique sous-jacente :
- La référence mixte $B2 : Le symbole dollar verrouille strictement la colonne d’évaluation sur la lettre
B, garantissant que lors de l’évaluation des cellules des colonnesAetCd’une même ligne, le système vérifie toujours le montant de la colonneB. L’absence de dollar devant le chiffre2permet à la règle de descendre dynamiquement pour évaluer chaque ligne du tableau individuellement. - La référence absolue $B$2:$B$100 : Elle sanctuarise le champ global au sein duquel la fonction
GRANDE.VALEURidentifie la valeur pivot marquant le plancher du Top 10. - L’opérateur relationnel >= : Il soumet chaque enregistrement à un test booléen : si la valeur de la ligne est supérieure ou égale au dixième plus grand montant du jeu de données, la formule renvoie
VRAI, déclenchant l’application du format graphique à l’ensemble des cellules de cette ligne spécifique.
Cette méthodologie garantit une synchronisation parfaite entre la dynamique de la feuille de calcul et son affichage contextuel : toute insertion ou réévaluation de données recalcule instantanément le seuil d’admissibilité du Top 10 et déplace en temps réel les mises en surbrillance sur les lignes méritantes, sans la moindre manipulation manuelle du modèle.
10. Automatisation par Tableaux Croisés Dynamiques et Power Query
10.1 Exploitation des filtres Top 10 dans les Tableaux Croisés Dynamiques
Lorsque le volume des données transactionnelles excède les capacités de restitution claire d’une feuille classique, ou lorsque l’analyse requiert des agrégations préalables (par exemple agréger des dizaines de milliers de transactions de détail pour identifier les dix clients ayant généré le chiffre d’affaires cumulé le plus important), les formules statistiques ponctuelles deviennent sous-optimales. Les Tableaux Croisés Dynamiques (TCD) constituent alors l’instrument d’agrégation multidimensionnelle par excellence.
La configuration d’un filtre Top 10 au sein d’un Tableau Croisé Dynamique bénéficie d’un algorithme interne optimisé. La procédure opérationnelle se déploie selon les étapes normalisées suivantes :
- Déposer l’attribut qualitatif dimensionnel (par exemple le champ NomClient) dans la zone des Lignes du panneau de configuration du TCD.
- Déposer la métrique quantitative de performance (par exemple le champ MontantVente) dans la zone des Valeurs, paramétrée sur l’opération arithmétique
SOMME. - Activer le menu déroulant contextuel situé sur l’en-tête de ligne du TCD, naviguer vers le sous-menu Filtres s’appliquant aux valeurs, puis sélectionner l’option formelle 10 premiers….
- Dans l’interface modale de configuration, valider les paramètres par défaut : filtrer les éléments du Haut, pour une quantité scalaire de 10, évalués selon le critère de la Somme de MontantVente.
L’avantage cardinal de cette méthode réside dans sa capacité à opérer une agrégation en amont du classement : le TCD calcule la somme globale de chaque entité avant d’isoler les dix premières, opération qui exigerait autrement l’imbrication complexe de fonctions SOMME.SI.ENS et GRANDE.VALEUR. Néanmoins, l’analyste doit impérativement garder à l’esprit la nature asynchrone du cache de données d’un TCD : les modifications apportées à la table source ne se répercutent pas instantanément sur l’affichage, imposant un rafraîchissement manuel par le ruban ou l’automatisation de la commande ActiveWorkbook.RefreshAll via une macro VBA ou un script Office.
10.2 Modélisation robuste du Top 10 avec l’outil ETL Power Query
Pour les architectures décisionnelles d’entreprise soumises à des rafraîchissements récurrents et manipulant des jeux de mégadonnées (comprenant plusieurs centaines de milliers voire des millions de lignes), l’intégration du Top 10 directement au sein de la feuille de calcul s’avère obsolète face aux capacités de l’environnement ETL (Extract, Transform, Load) intégré : Power Query. Cet outil permet de modéliser un pipeline de transformation immuable et documenté en amont de toute restitution visuelle.
Le pipeline de traitement garantissant une isolation industrielle des dix valeurs maximales s’articule autour d’une séquence formelle d’étapes rédigées dans le langage fonctionnel M :
- Importation et typage strict : Chargement des données brutes depuis la source externe (base SQL, fichier CSV ou table Excel) et application rigoureuse de l’étape de transformation
Table.TransformColumnTypesafin d’assigner le type numérique décimal ou entier fixe à la colonne des montants, écartant tout risque de corruption typologique. - Tri ordonné décroissant : Application de l’étape
Table.Sort(Source, {{"Montant", Order.Descending}}), qui ordonne formellement l’intégralité de la table dans l’espace mémoire de l’interpréteur de requêtes. - Troncature déterministe des lignes supérieures : Exécution de l’instruction
Table.FirstN(TableTrie, 10), qui isole de manière immuable les dix premiers enregistrements physiques de la table triée, éliminant purement et simplement l’ensemble des données résiduelles de la mémoire active.
Le produit d’une requête Power Query est ensuite déversé dans un tableau Excel sous la forme d’une table de restitution finale nette et légère. Cette approche présente des bénéfices de gouvernance inégalables : les formules de calcul sont totalement inexistantes dans la feuille de destination, éliminant tout risque d’altération accidentelle par un utilisateur final. La charge computationnelle est transférée lors de la phase d’actualisation de la requête, garantissant une fluidité de consultation absolue du classeur, même au sein de configurations informatiques aux ressources matérielles contraintes.
11. Diagnostic d’erreurs, optimisation des calculs et audit des formules
11.1 Typologie et résolution des anomalies courantes
La conception de modèles analytiques robustes requiert une démarche d’ingénierie préventive capable d’anticiper, d’intercepter et de neutraliser l’ensemble des anomalies d’exécution susceptibles de dégrader l’expérience utilisateur ou de fausser les restitutions de reporting. L’exploitation avancée de la fonction GRANDE.VALEUR expose le modélisateur à un catalogue d’erreurs bien documentées dont l’étiologie doit être parfaitement maîtrisée.
Le dysfonctionnement le plus universellement constaté s’incarne dans le code d’exception #NOMBRE!. Ce message est systématiquement levé par le moteur arithmétique lorsque la variable d’indice scalaire $k$ outrepasse les limites physiques des données disponibles. Ce cas de figure se matérialise de deux façons distinctes :
- L’échantillon quantitatif exploitable comporte moins de dix observations numériques valides (par exemple, une base de sept transactions soumise à l’extraction d’un Top 10 produira cette erreur sur les rangs 8, 9 et 10).
- L’argument $k$ est défini par inadvertance avec une valeur négative ou nulle ($k le 0$), violation flagrante du domaine de définition statistique de la fonction.
Pour immuniser les tableaux de bord contre la pollution visuelle induite par ce code d’erreur, il est préconisé d’encapsuler la formule au sein de la fonction d’interception SIERREUR. L’expression prendra la forme standardisée :
=SIERREUR(GRANDE.VALEUR($A$2:$A$100; C3); "")
Cette formulation substitue élégamment une cellule vide (« ») au message système lorsque le rang $k$ excède la taille de l’échantillon, offrant ainsi un tableau de synthèse impeccablement calibré, quelle que soit la densité des données sources sous-jacentes.
Une seconde anomalie, particulièrement pernicieuse car invisible lors d’un audit de surface, réside dans l’apparition d’ex aequo fictifs induits par les arrondis d’affichage visuel. Si deux transactions s’élèvent respectivement à 15 420,402 euros et 15 420,398 euros, et que la colonne est formatée pour n’afficher aucun chiffre après la virgule, les deux cellules présenteront l’aspect uniforme de 15 420 euros. Toutefois, le moteur de calcul ordonnera distinctement ces deux montants en sous-main, créant une incompréhension légitime pour l’utilisateur final qui perçoit un classement arbitraire entre deux lignes apparemment rigoureusement identiques. Il incombe donc au concepteur de vérifier scrupuleusement la précision réelle des grandeurs flottantes sous-jacentes et d’appliquer, si nécessaire, des fonctions d’arrondi explicites (ARRONDI, ARRONDI.INF) en amont de l’analyse d’ordre.
11.2 Optimisation des performances sur les mégadonnées (Big Data Excel)
Lorsque Microsoft Excel est mobilisé pour manipuler des corpus de données massifs approchant la limite structurelle des 1 048 576 lignes, le choix de l’architecture d’extraction quantitative exerce une influence déterminante sur le temps de cycle de recalcul du classeur et sur l’allocation de la mémoire vive du processeur. Une modélisation naïve peut rapidement dégrader les performances globales et provoquer des gels d’interface intempestifs.
Le premier impératif de performance réside dans l’éradication absolue des références à des colonnes entières (telles que A:A ou B:B). Bien que cette écriture soit couramment employée par facilité syntaxique, elle contraint le processeur de calcul à analyser l’intégralité du million de cellules de la grille, incluant des centaines de milliers de lignes vides résiduelles. Il est impératif de circonscrire l’espace d’investigation au périmètre strict des données réelles, idéalement via les références structurées de tableaux (Tableau1[Valeur]) qui bornent automatiquement l’espace de calcul sans la moindre cellule superflue.
De surcroît, la répétition de formules scalaires GRANDE.VALEUR individuelles sur une multitude de lignes analytiques multiplie le coût algorithmique global. Si un classeur calcule des dizaines de Top 10 pour différents segments d’activité au moyen de formules matricielles lourdes, chaque phase de recalcul déclenche une cascade de tris virtuels en mémoire. Dans ce cas de figure, l’abandon des formules dynamiques en temps réel au profit de structures pré-calculées via Power Query ou des Tableaux Croisés Dynamiques permet de réduire la charge processeur volatile de plus de 90 %.
Pour auditer avec précision l’arbre des dépendances et mesurer l’impact temporel d’une formule sur le classeur, les praticiens doivent mobiliser la suite d’outils d’audit intégrée au ruban Formules :
- La fenêtre Espion : Elle permet de surveiller en continu l’évolution de la valeur et du code d’erreur des cellules critiques du Top 10 lors de manipulations opérées sur d’autres feuilles éloignées du classeur.
- L’outil Évaluation de formule : Accessible par le ruban, cet instrument offre la possibilité de déboguer pas à pas le processus d’évaluation interne de la formule, décomposant chaque étape intermédiaire de substitution matricielle pour isoler avec précision l’origine d’un résultat inattendu.
12. Synthèse décisionnelle et guide de sélection méthodologique
12.1 Matrice comparative des différentes approches
Pour guider le praticien dans l’arbitrage architectural présidant au choix de la solution logicielle la plus adaptée à ses contraintes opérationnelles, une analyse multicritère comparative s’impose. Quatre dimensions déterminantes doivent être rigoureusement pondérées : la complexité de mise en œuvre (charge technique de conception initiale), le dynamisme (capacité à répercuter instantanément les modifications de données sources), la rétrocompatibilité (aptitude du classeur à fonctionner de manière transparente sur des parcs hétérogènes d’anciennes versions d’Excel), et la charge de calcul (impact computationnel sur la vélocité globale de la machine hôte).
Le tableau analytique ci-dessous synthétise ces arbitrages afin d’offrir une matrice décisionnelle claire pour les directions financières et les services d’audit analytique.
- GRANDE.VALEUR classique avec index : Complexité faible | Dynamisme élevé en temps réel | Rétrocompatibilité universelle absolue | Charge de calcul légère sur volumes moyens. Solution recommandée pour les rapports d’audit standardisés destinés à une large diffusion externe.
- GRANDE.VALEUR vectorisée via SEQUENCE : Complexité très faible | Dynamisme exceptionnel par propagation | Rétrocompatibilité restreinte (Microsoft 365 / Excel 2021+) | Charge de calcul minimale. Solution idéale pour les environnements de travail modernes et unifiés.
- Pipeline matriciel CHOISIRLIGNES / TRIER : Complexité modérée | Dynamisme maximal avec rapatriement intégral des métadonnées | Rétrocompatibilité restreinte (Microsoft 365 récent) | Charge processeur optimisée. Solution reine pour la conception de tableaux de bord exécutifs compacts.
- Tableaux Croisés Dynamiques (Filtre Top 10) : Complexité nulle | Dynamisme asynchrone (nécessite un rafraîchissement) | Rétrocompatibilité totale | Charge de calcul quasi nulle (moteur d’agrégation optimisé). Solution prioritaire lors du traitement d’échantillons massifs exigeant des regroupements hiérarchiques préalables.
- Pipeline ETL Power Query : Complexité avancée | Dynamisme sur commande ou automatisé | Rétrocompatibilité étendue (Excel 2010+) | Performance absolue sur Big Data. Solution industrielle incontournable pour les référentiels de données de gouvernance d’entreprise.
12.2 Directives pratiques pour une gouvernance rigoureuse des classeurs
Au terme de cette exploration méthodologique, il apparaît avec évidence que la qualité d’une analyse quantitative ne se mesure pas uniquement à l’ingéniosité syntaxique de ses formules, mais également à la rigueur de sa documentation interne et à sa résilience structurelle face au facteur humain. La production de tableaux de bord au sein de contextes d’entreprise régulés impose le respect strict de standards de gouvernance et de contrôle interne.
En premier lieu, tout modèle tabulaire implémentant une extraction d’extrêmes statistiques doit comporter un cartouche méthodologique explicite au sein de sa feuille de restitution. Ce cartouche doit documenter formellement les choix opérés : la définition retenue de la statistique d’ordre (Top 10 des transactions individuelles versus Top 10 des valeurs distinctes après dédoublonnage), la gestion appliquée aux ex aequo, ainsi que la date et la source d’alimentation des flux de données. Cette transparence épistémologique prévient toute divergence d’interprétation lors des comités décisionnels.
En second lieu, il est vivement préconisé d’instaurer des protocoles systématiques de validation croisée par double extraction indépendante. L’analyste diligent confrontera les résultats obtenus par sa formule principale GRANDE.VALEUR avec une validation de contrôle parallèle exécutée via un filtre ponctuel ou une requête Power Query miroir. Toute divergence scalaire ou d’ordre entre les deux résultats révèle une faille de conception (dérive de plage, présence de doublons non gérés ou artefacts de typage textuel) qui doit être impérativement résolue avant toute diffusion institutionnelle.
Enfin, la standardisation des classeurs doit se matérialiser par le verrouillage physique des cellules accueillant l’infrastructure analytique. La protection de la feuille de calcul (via le ruban Révision > Protéger la feuille), en ne laissant accessibles que les cellules dévolues aux paramètres opérationnels (tel que le choix interactif du rang d’analyse $N$), constitue l’ultime rempart contre la corruption accidentelle des modèles. En conjuguant rigueur mathématique, maîtrise algorithmique et discipline de modélisation, le professionnel de la donnée garantit une fiabilité décisionnelle absolue, transformant de simples séries quantitatives brutes en leviers stratégiques pérennes et hautement valorisables.
Références
- Alexander, M., Kusleika, R., & Walkenbach, J. (2019). Excel 2019 Bible. John Wiley & Sons.
- David, H. A., & Nagaraja, H. N. (2003). Order Statistics (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/0471722162
- FAST Standard Organisation. (2019). The FAST Standard for Financial Modelling (Version 02c). FAST Standard Organisation. https://www.fast-standard.org/
- Microsoft Corporation. (2024). Fonction GRANDE.VALEUR (LARGE). Support Microsoft. https://support.microsoft.com/en-us/office/large-function-3af0170a-e481-421b-816a-defcb95529a6
- Microsoft Corporation. (2024). Fonction RECHERCHEX (XLOOKUP). Support Microsoft. https://support.microsoft.com/en-us/office/xlookup-function-b7fd680e-6d10-43e6-84f9-88eae8bf5929
- Microsoft Corporation. (2024). Fonction SEQUENCE. Support Microsoft. https://support.microsoft.com/en-us/office/sequence-function-57467a98-57e0-4817-9f14-2eb78519ca90
- Microsoft Corporation. (2024). Fonctions matricielles dynamiques et comportement de propagation. Support Microsoft. https://support.microsoft.com/en-us/office/dynamic-array-formulas-and-spilled-array-behavior-205c6b06-03ba-4151-89a1-87a7eb36e531
- Winston, W. L. (2021). Microsoft Excel Data Analysis and Business Modeling (6th ed.). Microsoft Press.