
L’analyse empirique dans les sciences du comportement, la psychologie clinique et les sciences sociales repose traditionnellement sur le postulat d’une observabilité sans faille des variables d’intérêt. Les chercheurs conçoivent des protocoles sophistiqués, élaborent des batteries de tests psychométriques standardisés et déploient des études de cohortes longitudinales en espérant capter fidèlement les dynamiques sous-jacentes du comportement humain. Pourtant, la réalité de l’investigation empirique confronte quasi systématiquement le statisticien et le praticien à une incomplétude structurelle des données recueillies. Loin de constituer de simples anomalies sporadiques ou des accidents d’échantillonnage aisément contournables, ces lacunes méthodologiques traduisent des mécanismes profonds d’inobservabilité partielle qui mettent à rude épreuve les théories d’inférence statistique conventionnelles.
Deux manifestations majeures de cette incomplétude dominent la modélisation statistique avancée : les données censurées (censored data) et les données tronquées (truncated data). Bien que ces deux terminologies soient fréquemment confondues dans le langage courant des praticiens ou amalgamées sous le terme générique de données manquantes, elles renvoient à des processus générateurs de données fondamentalement divergents sur le plan probabiliste et épistémologique. La censure implique que l’existence d’une observation est confirmée au sein de l’échantillon, mais que sa valeur numérique précise demeure inconnue au-delà ou en deçà d’un certain seuil. À l’inverse, la troncation opère une sélection drastique en amont : les individus appartenant à certains intervalles de la distribution de probabilité sont totalement exclus de la base de données, sans laisser la moindre trace de leur existence au sein du processus de recueil.
Cette distinction conceptuelle n’a rien d’un pur raffinement sémantique. L’application mécanique d’outils statistiques paramétriques classiques, tels que la régression linéaire par les moindres carrés ordinaires, à des distributions censurées ou tronquées engendre des biais d’atténuation massifs, une sous-estimation systématique de la variance d’erreur et des distorsions préjudiciables de l’inférence causale. Le présent article propose une analyse approfondie et exhaustive des fondements théoriques, des formulations mathématiques et des implications appliquées des données tronquées et censurées. En s’appuyant sur des cas cliniques, psychométriques et comportementaux concrets, cette synthèse met en lumière les pièges méthodologiques inhérents à ces structures d’échantillonnage et détaille les approches analytiques de pointe — du modèle Tobit aux estimateurs de survie de Kaplan-Meier et aux corrections en deux étapes de Heckman — indispensables à la validité scientifique des recherches empiriques contemporaines.
1. Introduction aux concepts de données incomplètes en psychologie et sciences sociales
1.1 Le problème de la mesure imparfaite dans la recherche empirique
Dans le domaine des sciences psychologiques, cognitives et comportementales, l’opérationnalisation des concepts théoriques se heurte en permanence à la nature abstraite des construits évalués. Contrairement aux sciences physiques, où des instruments de haute précision mesurent des grandeurs tangibles telles que la masse ou la longueur d’onde, la psychométrie évalue des entités inobservables qualifiées de construits latents, comme l’anxiété, l’intelligence générale, le bien-être subjectif ou la propension à l’addiction. Ces dimensions psychologiques sont captées à travers des instruments imparfaits : échelles de Likert, inventaires cliniques auto-administrés, tâches de temps de réaction chronométrées ou grilles d’observation comportementale. Chaque instrument comporte une zone de sensibilité limitée, définie par ses bornes inférieures et supérieures de détection métrologique.
Cette limitation technique induit une conséquence méthodologique directe : l’inobservabilité partielle des variables latentes. Lorsqu’un individu obtient le score maximal à un inventaire d’évaluation de la dépression, l’instrument échoue à distinguer si son niveau réel correspond précisément au seuil supérieur de l’outil ou s’il se situe à une magnitude psychopathologique bien plus grave. De manière symétrique, un score nul ne signifie pas nécessairement l’absence absolue de la symptomatologie, mais simplement que le niveau du trait sous-jacent se situe en deçà du pouvoir de résolution de l’épreuve. L’analyste se trouve alors confronté à une information dégradée où la continuité de l’état psychologique réel est artificiellement compressée ou oblitérée par l’appareil de capture.
Il apparaît dès lors impératif de formaliser rigoureusement la frontière qui sépare une simple perte d’information ponctuelle — assimilable à une imprécision de mesure ou à une donnée manquante accidentelle — d’un mécanisme structurel de sélection de l’échantillon. Lorsqu’un phénomène psychologique génère des données où la visibilité d’un cas dépend de la valeur même de la variable mesurée, les hypothèses fondamentales d’échantillonnage aléatoire simple sont irrémédiablement violées. La prise en compte de ces ruptures d’information constitue l’objet central des méthodologies relatives aux données censurées et tronquées.
1.2 Importance de la différenciation précoce entre censure et troncation
La confusion entre censure et troncation constitue l’une des sources d’erreurs méthodologiques les plus destructrices dans la littérature en sciences sociales. La nécessité de différencier ces deux phénomènes dès la phase de conception du protocole de recherche tient avant tout à la construction de la fonction de vraisemblance statistique. Dans une modélisation paramétrique, la log-vraisemblance d’un échantillon dépend directement de la nature de l’espace probabiliste observé. Ignorer si les données non observées ont laissé une trace dans le dénominateur de probabilité conduit à maximiser une fonction mathématiquement erronée, produisant des estimateurs inconsistants et asymptotiquement biaisés.
Le risque de biais systématiques dans l’estimation des paramètres fondamentaux de la population — moyenne, écart-type, coefficients de régression partielle — s’avère particulièrement aigu. Alors que la censure préserve la connaissance de la taille globale de l’échantillon et informe le statisticien sur la proportion exacte d’individus situés au-delà d’un seuil critique, la troncation élimine purement et simplement ces individus de l’observation. Appliquer un estimateur conçu pour des données censurées à un jeu de données tronquées engendre une erreur d’ajustement drastique, car le modèle suppose connue une part d’information qui a en réalité été évincée du protocole d’échantillonnage.
Enfin, la validité interne et la validité externe des protocoles expérimentaux ou quasi-expérimentaux reposent sur cette distinction fondamentale. La validité interne se trouve compromise lorsque l’effet d’un traitement thérapeutique ou d’une intervention cognitive est calculé sur une distribution tronquée, masquant les effets indésirables chez les participants les plus fragiles exclus de l’analyse. Parallèlement, la validité externe — c’est-à-dire la capacité à généraliser les conclusions à la population parente — s’effondre si les chercheurs extrapolent à l’ensemble des citoyens des relations statistiques identifiées au sein d’une cohorte soumise à une troncation systématique non modélisée.
1.3 Cadre épistémologique et notations formelles
Pour appréhender rigoureusement les concepts de censure et de troncation, il convient d’établir un cadre mathématique précis reposant sur la notion de variable latente continue. Soit $Y^*$ une variable aléatoire continue non observable directement dans l’intégralité de son support, représentant la véritable intensité du construit psychologique, sociologique ou comportemental étudié. Cette variable latente est caractérisée par une fonction de densité de probabilité notée $f(y^*; \theta)$ et une fonction de répartition cumulative correspondante $F(y^*; \theta)$, où $\theta$ représente le vecteur des paramètres d’intérêt à estimer, généralement composé de la moyenne conditionnelle et de la variance du processus.
Introduisons ensuite un seuil critique d’observation, noté $c$, qui peut être déterministe (fixé par les limites d’un instrument psychométrique) ou stochastique (variant selon les individus ou les conditions de l’environnement expérimental). Ce seuil opère une partition de l’espace de la variable latente $Y^*$. Dans le cas d’une coupure fixe, la valeur $c$ agit comme un point de démarcation au-delà ou en deçà duquel la manifestation empirique de la variable latente subit une transformation structurelle. Dans les protocoles longitudinaux, ce seuil peut représenter une durée d’exposition maximale ou la date de clôture définitive d’une phase de recueil de données cliniques.
Le mécanisme de génération des données observées, notées $Y$, découle de l’interaction probabiliste entre la variable latente $Y^*$ et le seuil critique $c$. La variable observée $Y$ ne coïncide avec $Y^*$ que dans des régions spécifiques de l’espace d’échantillonnage. En dehors de ces régions, la variable observée $Y$ prend soit une valeur constante égale au seuil de censure, soit cesse purement et simplement d’exister au sein de l’espace mesurable dans le cas de la troncation. C’est l’expression formelle de cette transformation probabiliste qui dictera l’architecture des modèles économétriques et psychométriques adaptés à chaque situation.
2. Définition approfondie et mécanismes fondamentaux des données censurées
2.1 Concept structural de la censure (Censoring)
La censure (censoring) survient lorsqu’une variable d’intérêt est mesurable avec exactitude uniquement sur une plage restreinte de son spectre de valeurs potentielles, tout en garantissant que chaque individu sélectionné pour l’étude demeure présent dans la base de données finale. Dans une structure censurée, l’analyste ignore la valeur cardinale précise de la variable pour un sous-ensemble de sujets, mais dispose d’une information partielle capitale : il sait avec certitude que la valeur réelle de l’observation se situe au-dessus, en dessous ou à l’intérieur d’un intervalle défini par un ou plusieurs seuils critiques.
La caractéristique distinctive fondamentale des données censurées réside dans la conservation intégrale de l’effectif d’échantillonnage initial, traditionnellement noté $N$. Aucun sujet participant à l’investigation n’est rayé des registres en raison de son score extrême ou de son absence de survenue d’un événement clinique. L’information relative aux caractéristiques sociodémographiques, aux covariables explicatives et à la condition d’assignation expérimentale reste parfaitement documentée pour l’ensemble des $N$ observations. La censure n’affecte donc que le vecteur de réponse de la variable dépendante, sans dégrader la taille du panel expérimental.
D’un point de vue structural, la censure convertit une variable latente intrinsèquement continue en une distribution mixte, comportant à la fois une composante continue sur l’intervalle observable et une ou plusieurs composantes discrètes situées aux seuils de censure. Cette concentration de probabilité en des points uniques du support transforme la distribution statistique en un objet non gaussien qui défie les méthodes d’analyse standard, nécessitant des adaptations fondées sur la théorie du maximum de vraisemblance pour être traité sans déformation mathématique.
2.2 Censure informative versus censure non informative
L’analyse des distributions censurées impose d’examiner le degré de dépendance stochastique existant entre le mécanisme de censure et la variable d’intérêt sous-jacente. On qualifie une censure de non informative (ou aléatoire) lorsque la probabilité qu’une observation soit censurée est statistiquement indépendante de la valeur potentielle de la variable dépendante $Y^*$, conditionnellement aux covariables incluses dans le modèle. Dans ce cadre favorable, le processus qui engendre le masquage de la valeur cardinale ne fournit aucun indice supplémentaire quant à la gravité ou à la magnitude du trait latent au-delà du seuil constaté.
À l’opposé, la censure informative émerge dès lors que le mécanisme déterminant le passage sous le seuil de censure est corrélé directement avec la variable d’intérêt latente, ou avec des facteurs résiduels non observés qui influencent conjointement la variable dépendante. Par exemple, si dans un essai clinique évaluant un traitement antidépresseur, les patients souffrant des symptômes les plus intolérables abandonnent prématurément le protocole de recherche en raison d’effets secondaires sévères, l’interruption de leur suivi constitue un événement de censure informative. Traiter ces abandons comme s’ils survenaient de manière totalement aléatoire introduirait un biais d’optimisme flagrant dans l’estimation de l’efficacité thérapeutique.
Les implications méthodologiques de cette distinction sont profondes dans l’analyse causale et les modèles longitudinaux. Alors que la censure non informative autorise une factorisation simple de la fonction de vraisemblance — permettant d’estimer les paramètres d’intérêt sans modéliser explicitement le processus de censure —, la censure informative exige la spécification d’un modèle conjoint reliant l’équation de survie ou de réponse à l’équation gouvernant le temps jusqu’à la censure. L’omission de cette dépendance stochastique détruit l’identifiabilité des paramètres structurels et vicie les tests d’hypothèses statistiques.
2.3 Effets de plancher et de plafond en psychométrie
En psychométrie et en évaluation clinique, les formes les plus répandues de censure se manifestent sous l’appellation d’effets de plancher (floor effects) et d’effets de plafond (ceiling effects). Ces distorsions proviennent de l’incapacité d’une échelle psychométrique à discriminer les participants situés aux extrémités du spectre du trait latent mesuré. Un effet de plancher se produit lorsqu’un nombre anormalement élevé de répondants obtient le score minimal théorique permis par l’instrument, révélant que l’épreuve est trop difficile, trop discriminante ou inadaptée pour capturer des degrés d’intensité très faibles du construit sous-jacent.
Inversement, l’effet de plafond caractérise une situation où une proportion substantielle des sujets atteint le score parfait ou le niveau asymptotique maximal de l’échelle. Par exemple, dans un test de mémoire de travail appliqué à des étudiants universitaires hautement performants, une batterie de tests trop facile conduira à une saturation des performances au sommet de la distribution. Ces sujets présentent en réalité des aptitudes cognitives hautement hétérogènes, mais l’outil de mesure les agrège artificiellement dans une même classe numérique d’équivalence, correspondant à la limite supérieure du dispositif de notation.
Ces phénomènes de saturation instrumentale engendrent des répercussions désastreuses sur les propriétés métrologiques fondamentales des échelles psychologiques. D’une part, la variance empirique observée se trouve sévèrement comprimée, ce qui réduit artificiellement les corrélations bivariées avec d’autres variables psychologiques (biais d’atténuation). D’autre part, la distribution des scores s’écarte radicalement de l’hypothèse de normalité univariée ou multivariée, exhibant une asymétrie marquée et un pic de fréquence discret au niveau du seuil. Les indices psychométriques classiques de fidélité, tels que l’alpha de Cronbach, se révèlent alors profondément faussés dans ces conditions d’évaluation limitées.
3. Typologie systématique de la censure : droite, gauche et par intervalle
3.1 Censure à droite (Right Censoring)
La censure à droite représente la forme de données limitées la plus universellement documentée dans les sciences appliquées, notamment en épidémiologie, en biostatistique et en psychologie de la santé. Sur le plan formel, une observation est dite censurée à droite lorsque la valeur réelle de la variable d’intérêt $Y^*$ est strictement supérieure à une valeur de coupure connue $C$. L’observateur enregistre alors uniquement la valeur du seuil de coupure $C$, en conservant l’information qualitative selon laquelle la grandeur véritable vérifie l’inégalité fondamentale $Y^* ge C$.
Dans les recherches longitudinales examinant le temps écoulé avant la survenue d’un événement comportemental — tel que la récidive après une prise en charge psychothérapeutique ou la démission dans une organisation —, la censure à droite découle naturellement de la fin programmée de la période de collecte. Si une étude s’étend sur une durée maximale de 24 mois, tout participant n’ayant pas manifesté l’événement cible au terme des deux années d’observation est considéré comme censuré à droite. Sa durée de survie sans rechute est au moins égale à 24 mois, mais son issue finale ultérieure demeure inaccessible aux chercheurs.
Sur le plan analytique, une variable censurée à droite $Y$ est modélisée par le minimum stochastique entre la variable latente d’intérêt $Y^*$ et le mécanisme de censure $C$, soit l’expression mathématique :
$$Y = \min(Y^*, C)$$
On adjoint systématiquement à cette variable une indicatrice binaire d’événement, traditionnellement notée $\delta$, définie par $\delta = 1$ si l’événement d’intérêt est effectivement observé sans censure ($Y^* le C$), et $\delta = 0$ si l’observation est censurée à droite ($Y^* > C$). La gestion conjointe du couple aléatoire $(Y, \delta)$ constitue le socle des modèles de survie et des régressions paramétriques pour variables limitées.
3.2 Censure à gauche (Left Censoring)
La censure à gauche se présente de manière symétrique à la censure à droite, bien que sa prévalence empirique et ses implications interprétatives diffèrent dans les protocoles d’expérimentation. Une observation est dite censurée à gauche lorsque la véritable valeur de la variable d’intérêt $Y^*$ est inférieure ou égale à un seuil critique d’observation $C$. Dans une telle configuration, l’analyste sait uniquement que la variable réelle se situe quelque part sur l’intervalle semi-infini $]-\infty, C]$, sans pouvoir déterminer la distance exacte qui sépare la valeur latente du seuil de détection.
En psychologie du développement et en épidémiologie psychiatrique, ce phénomène émerge avec acuité lors du recueil d’antécédents cliniques rétrospectifs ou du suivi de cohortes de jeunes enfants. Supposons qu’un protocole vise à évaluer l’âge précis auquel les nourrissons développent l’angoisse de l’étranger face à un visage non familier. Si l’inclusion formelle des participants débute au huitième mois de vie et que certains nourrissons manifestent déjà ce comportement de détresse dès leur visite d’inclusion inaugurale, leur âge d’apparition est censuré à gauche : les chercheurs savent que l’événement s’est produit avant le huitième mois, mais ne peuvent en dater la genèse initiale.
La formalisation probabiliste d’une observation censurée à gauche repose sur l’opérateur de maximisation :
$$Y = \max(Y^*, C)$$
Toutes les réalisations de la variable latente qui s’avèrent inférieures au seuil critique $C$ sont écrasées et ramenées numériquement à la valeur constante $C$. Dans les analyses toxicologiques ou psychopharmacologiques mesurant la concentration salivaire ou sanguine de molécules de régulation émotionnelle, la censure à gauche est monnaie courante en raison de la limite de quantification minimale (Limit of Quantification, LOQ) imposée par la sensibilité des analyseurs de laboratoire.
3.3 Censure par intervalle (Interval Censoring)
La censure par intervalle constitue une généralisation plus complexe englobant conceptuellement la censure à droite et la censure à gauche comme des cas particuliers de limitation de l’information. Une observation est qualifiée de censurée par intervalle lorsque la variable continue d’intérêt $Y^*$ n’est pas mesurée de façon continue, mais est simplement connue pour être tombée à l’intérieur d’une plage temporelle ou quantitative délimitée par deux bornes identifiées, soit $Y^* in ]L, R]$, avec $L < R$.
Ce patron de données survient fréquemment dans les protocoles de suivi psychologique longitudinaux impliquant des évaluations médicales ou cliniques espacées dans le temps. Dans un protocole étudiant la rémission d’un trouble panique avec agoraphobie, les patients sont évalués à des visites périodiques programmées, par exemple au mois 3, au mois 6 et au mois 12. Si un patient répond aux critères diagnostiques de rémission au sixième mois alors qu’il présentait encore des attaques récurrentes au troisième mois, l’instant exact de sa rémission n’est pas connu au jour près : il se situe dans l’intervalle ouvert $]3, 6]$.
Le traitement analytique de la censure par intervalle exclut le recours aux estimateurs ponctuels simplistes, tels que l’affectation arbitraire du point médian de l’intervalle, méthode génératrice d’erreurs d’échantillonnage et de distorsions de variance. L’inférence requiert l’implémentation d’algorithmes d’optimisation non paramétrique ou semi-paramétrique sophistiqués, tels que l’estimateur non paramétrique du maximum de vraisemblance (NPMLE) formulé par Turnbull, capable de reconstruire la fonction de survie sans déformer la nature discrétisée des intervalles d’observation.
4. Exemples empiriques de données censurées dans la recherche comportementale
4.1 Étude des revenus déclarés dans les enquêtes de bien-être subjectif
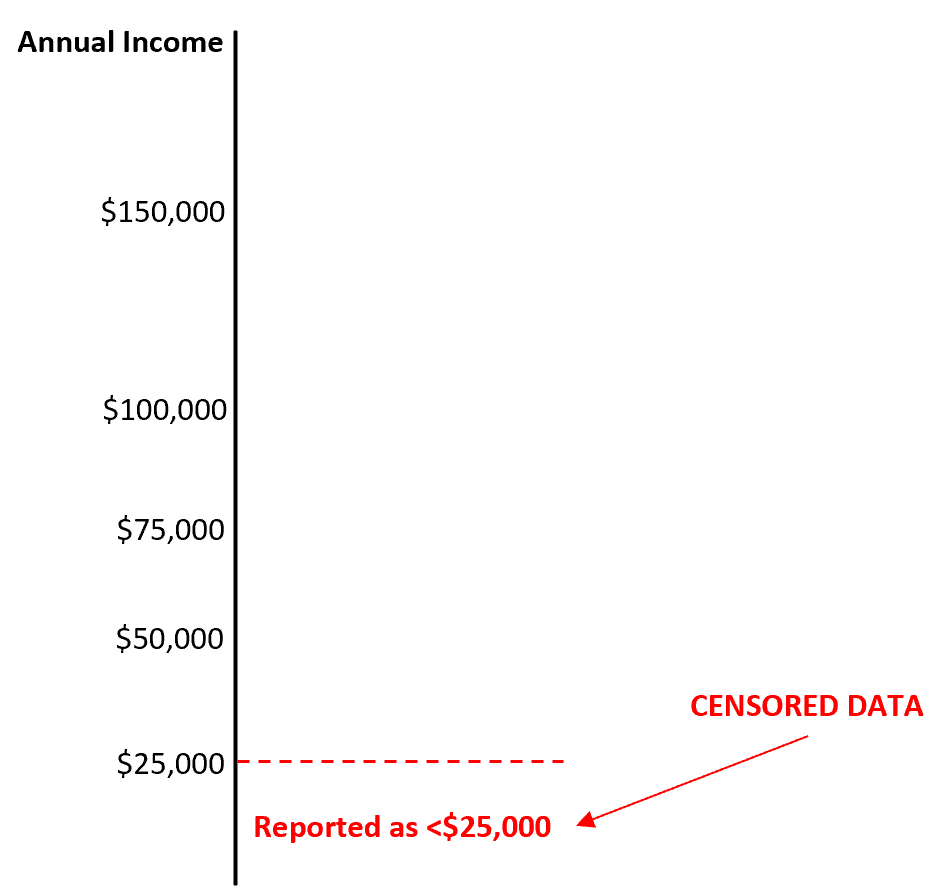
L’économie du bonheur et la psychologie sociale s’intéressent intensément à la relation qui unit les ressources financières au bien-être subjectif et à la satisfaction de vie. Toutefois, lors de l’administration des enquêtes nationales auprès des ménages, la collecte des revenus individuels se heurte à des réticences psychologiques majeures liées à la confidentialité et à la désirabilité sociale. Pour maximiser les taux de participation et réduire les refus de réponse catégoriques, les concepteurs de questionnaires ont coutume d’agréger les revenus au sein de tranches prédéterminées, tout en imposant une catégorie ouverte pour la tranche supérieure, par exemple : « Revenu net annuel supérieur à 100 000 euros ».
Cette décision administrative de conception transforme instantanément le revenu monétaire perçu en une variable censurée à droite au-delà de 100 000 euros. Parallèlement, des seuils planchers administratifs ou des tranches inférieures du type « Moins de 10 000 euros » génèrent des cas de censure à gauche ou par intervalle pour les catégories intermédiaires. L’ensemble des individus ayant répondu à l’enquête reste inclus dans l’analyse de régression expliquant le niveau de bonheur : la taille d’échantillonnage $N$ est rigoureusement préservée, et l’analyste dispose de la totalité de leurs scores psychométriques d’affect positif et de satisfaction.
Si le chercheur remplace naïvement la tranche ouverte par sa borne inférieure (100 000 euros) ou par une estimation arbitraire, il postule de facto que tous les hauts revenus de l’échantillon disposent d’un pouvoir d’achat strictement identique. Or, parmi les personnes sélectionnant cette modalité se trouvent des cadres gagnant 105 000 euros et des chefs d’entreprise générant plusieurs millions d’euros annuels. Cette sous-estimation structurelle de la richesse réelle des ménages les plus fortunés fausse considérablement l’analyse de l’effet d’atténuation du revenu sur le bien-être émotionnel (le paradoxe d’Easterlin) et biaise les élasticités de satisfaction estimées.
4.2 Temps de latence avant rechute dans l’évaluation des addictions
Dans la recherche sur les conduites addictives et l’efficacité des thérapies cognitivo-comportementales appliquées au sevrage tabagique, alcoolique ou aux jeux d’argent pathologiques, le temps de latence avant la première rechute constitue le critère de jugement principal (primary endpoint). Ces protocoles recrutent des cohortes de patients sevrés et les suivent activement durant une période déterminée à l’avance par les limites budgétaires de l’étude, couramment fixée à 6 ou 12 mois après la fin de la prise en charge clinique.
À l’issue des 12 mois d’investigation, une proportion importante de patients peut être parvenue à maintenir une abstinence totale et ininterrompue. Pour ces sujets résilients, la durée exacte jusqu’à une rechute potentielle future n’est pas documentée : leur temps de rechute est censuré à droite à la valeur de 365 jours. De surcroît, certains participants déménagent, refusent de répondre aux sollicitations téléphoniques ultérieures ou quittent le protocole pour des motifs personnels au cours du suivi. Ces perdus de vue constituent des observations censurées à droite à la date précise de leur dernière prise de contact validée.
L’exclusion systématique des participants abstinents sous prétexte que leur temps de rechute est inconnu constituerait une faute méthodologique désastreuse, éliminant précisément du calcul les cas illustrant le succès le plus éclatant de la thérapie évaluée. À l’opposé, fixer leur temps de survie arbitrairement à 365 jours conduirait à sous-estimer la durabilité de l’abstinence au-delà de la fenêtre d’observation. Seule l’intégration rigoureuse de ces durées censurées au sein de fonctions de survie paramétriques ou semi-paramétriques permet de restituer une trajectoire temporelle non biaisée de l’efficacité du protocole de soins.
4.3 Mesure des scores d’anxiété via l’inventaire de Beck (BAI)
L’Inventaire d’anxiété de Beck (Beck Anxiety Inventory, BAI) est un instrument psychométrique largement utilisé en psychiatrie et en psychologie pour évaluer la sévérité des symptômes anxieux chez l’adulte. Le questionnaire se compose de 21 items évaluant des manifestations somatiques et cognitives sur une échelle ordinale à quatre points, allant de 0 (« Pas du tout ») à 3 (« Sévèrement »). Le score global est obtenu par la somme arithmétique des réponses individuelles, délimitant un espace métrique théorique borné entre 0 et 63 points.
Dans les cohortes issues de la population générale ou chez des populations subcliniques, une fraction substantielle des répondants obtient un score de 0, indiquant qu’ils n’ont ressenti aucun des symptômes décrits au cours de la semaine écoulée. Ce score de zéro correspond à un effet de plancher massif (censure à gauche). Il masque une variabilité latente considérable : certains participants ont un tempérament extrêmement serein situé très en dessous du seuil d’activation anxieuse, tandis que d’autres sont à la limite exacte d’éprouver une légère appréhension sans franchir le premier échelon de l’instrument.
Simultanément, chez des patients hospitalisés en unité d’urgence psychiatrique pour des crises d’angoisse paroxystiques, le score maximal de 63 peut être atteint, manifestant un effet de plafond (censure à droite) où l’extrême sévérité de la panique n’est plus différenciable. Si un chercheur utilise une régression par les moindres carrés pour prédire le score BAI en fonction de biomarqueurs neurophysiologiques (tels que la variabilité de la fréquence cardiaque ou le taux de cortisol), les estimations des pentes de régression seront sévèrement dégradées vers zéro. L’application d’un modèle pour variables dépendantes limitées devient ici indispensable pour préserver la cohérence des paramètres.
5. Définition formelle et nature probabiliste des données tronquées
5.1 Concept fondamental de la troncation (Truncation)
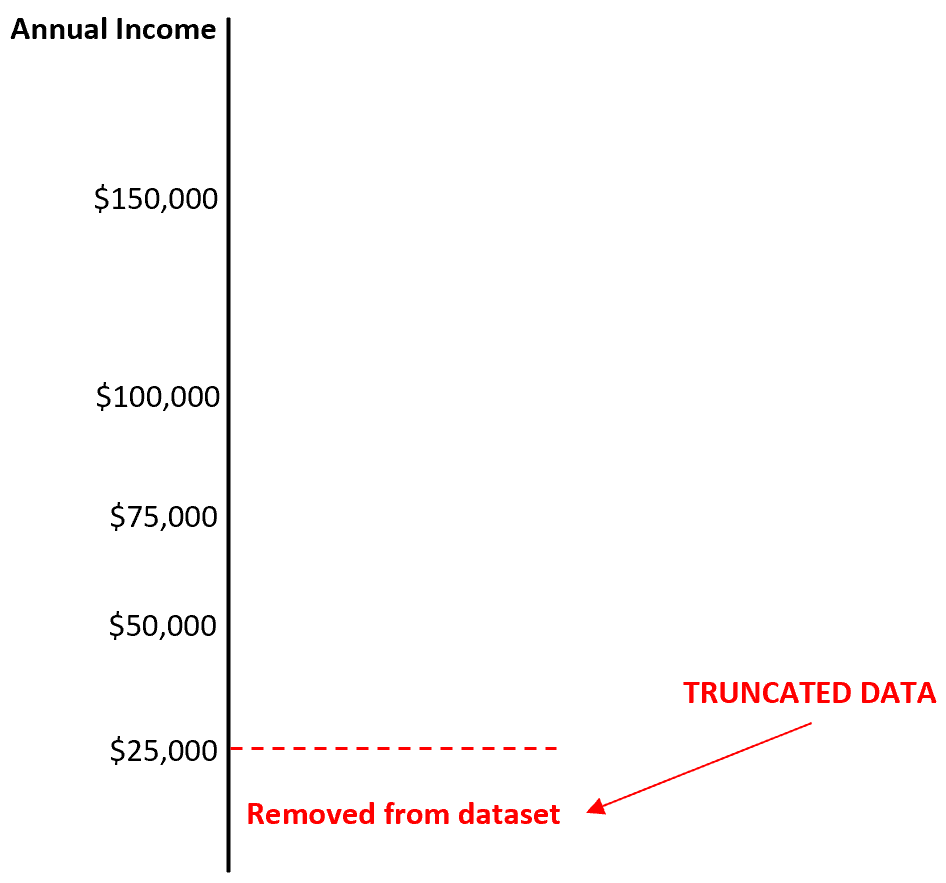
La troncation (truncation) se distingue radicalement de la censure par le fait qu’elle s’applique non pas à la seule précision numérique de la mesure, mais à l’existence même de l’observation au sein de l’échantillon analysé. Une variable est soumise à un processus de troncation lorsque les individus dont la variable d’intérêt latente $Y^*$ franchit un seuil de sélection défini sont systématiquement, mécaniquement et totalement exclus de la population échantillonnée. L’observateur n’a non seulement aucun moyen de mesurer leur valeur, mais il ignore jusqu’à leur identité et leur effectif précis.
Dans un contexte de données tronquées, la taille de l’échantillon observable $n$ ne correspond plus à l’effectif $N$ de la population source qui aurait pu être potentiellement interrogée. L’échantillon final est amputé d’une sous-population entière dont les caractéristiques répondent à la condition d’exclusion. Aucune information relative aux covariables sociologiques, démographiques ou cognitives de ces individus écartés n’est enregistrée dans la matrice de données. L’analyste se trouve confronté à une base de données dont la sélection est endogène à la variable d’intérêt elle-même.
Cette absence absolue de trace sur les individus évincés interdit tout calcul direct de probabilités inconditionnelles. Alors que dans le cas de la censure, la probabilité cumulée de se trouver au-delà du seuil peut être empiriquement évaluée par la fraction des sujets accumulés à ce point singulier, la troncation efface cette information empirique. Toute démarche inférentielle doit par conséquent opérer dans un cadre de probabilités conditionnelles restrictives, en redéfinissant formellement l’univers probabiliste de référence.
5.2 Densité conditionnelle et redimensionnement de l’espace d’échantillonnage
L’expression mathématique de la distribution d’une variable tronquée découle de la théorie des probabilités conditionnelles. Soit une variable aléatoire continue $Y^*$ possédant dans la population globale une fonction de densité de probabilité $f(y^*)$ et une fonction de répartition $F(y^*)$. Supposons que le protocole de sélection élimine toute observation dont la valeur est inférieure à un seuil fixe $c$. La variable observée $Y$ n’est définie que pour le sous-ensemble tel que $Y^* > c$.
Pour que la distribution de la variable observée $Y$ constitue une densité de probabilité valide, l’intégrale de cette fonction sur son nouveau domaine de définition restreint $]c, +\infty[$ doit impérativement être égale à 1. La fonction de densité conditionnelle de $Y$, notée $f_Y(y)$, est ainsi obtenue par renormalisation de la fonction de densité parente, en la divisant par la probabilité cumulative que la variable latente appartienne au domaine d’observabilité :
$$f_Y(y) = f(y mid Y^* > c) = \frac{f(y)}{P(Y^* > c)} = \frac{f(y)}{1 – F(c)}, \quad \forall y > c$$
Pour toute valeur $y le c$, la fonction de densité conditionnelle $f_Y(y)$ est rigoureusement nulle.
Ce redimensionnement modifie en profondeur la géométrie de la distribution statistique. L’aire sous la courbe d’origine au-dessus du seuil $c$ est uniformément dilatée par le facteur scalaire $\frac{1}{1 – F(c)}$. Par conséquent, la moyenne de la variable observée tronquée $E(Y mid Y^* > c)$ ne coïncide plus avec la moyenne de la population originelle $\mu$, mais se trouve décalée vers des valeurs supérieures. De façon analogue, la variance conditionnelle est structurellement plus faible que la variance de la population non tronquée, traduisant la restriction artificielle imposée à la dispersion des données.
5.3 Biais de sélection lié à la méthode d’échantillonnage
La troncation est indissociable du concept de biais de sélection (selection bias). Lorsque les observations parviennent au statisticien par l’intermédiaire d’un filtre sélectif opérant sur la variable dépendante elle-même, l’échantillon ne constitue plus un miroir représentatif de la population parente. Ce phénomène induit une altération pernicieuse de la validité de toute généralisation statistique, car les lois de comportement déduites du sous-échantillon observable ne s’appliquent pas aux individus situés dans la zone de troncature non observée.
Il importe de formaliser la distinction structurelle entre les données tronquées et le problème traditionnel des données manquantes, classifiées selon la typologie de Rubin en MCAR (Missing Completely at Random), MAR (Missing at Random) et MNAR (Missing Not at Random). Dans une situation de données manquantes, le chercheur dispose généralement de la liste exhaustive de l’ensemble des $N$ individus composant son échantillon ciblé, et observe pour chacun la présence ou l’absence d’une réponse. Dans la troncation, le dénominateur de l’échantillonnage est inconnu : les sujets ne font jamais partie de la base de collecte, rendant impossible l’estimation empirique directe du taux d’attrition ou de la fraction de la population exclue.
Ce biais d’échantillonnage touche particulièrement les populations vulnérables, marginalisées ou extrêmes dans les enquêtes sociologiques et sanitaires. Les études s’appuyant uniquement sur des individus ayant un domicile fixe, disposant d’un compte bancaire ou consultant spontanément des centres médico-psychologiques tronquent de facto l’espace social. L’absence totale de ces strates altère non seulement la moyenne estimée des variables de détresse psychologique, mais falsifie l’ensemble de la structure des covariances entre prédicteurs psychosociaux et états de santé mentale.
6. Typologie de la troncation : gauche, droite et échantillonnage tronqué double
6.1 Troncation à gauche (Left Truncation)
La troncation à gauche se définit comme une condition d’inclusion dans l’échantillon subordonnée à l’exigence que la variable d’intérêt latente dépasse une valeur seuil prédéfinie : $Y^* > c$. Tout individu pour lequel la valeur latente s’avère inférieure ou égale à $c$ n’est pas simplement non documenté : il est totalement invisible pour le chercheur et n’apparaît à aucun moment dans la constitution de la base de sondage.
Ce patron d’échantillonnage tronqué à gauche est particulièrement prégnant dans les études d’épidémiologie cognitive et de gérontologie portant sur les maladies neurodégénératives à début tardif. Considérons une cohorte épidémiologique recrutant des résidents en maisons de retraite spécialisées pour étudier la trajectoire de déclin de la maladie d’Alzheimer. L’âge à l’admission en institution constitue le point d’entrée dans l’étude. Les individus dont le déclin cognitif a été si fulgurant qu’ils sont décédés à domicile avant d’avoir pu intégrer une structure d’hébergement ne feront jamais partie de la cohorte observée.
Ce phénomène introduit ce que les épidémiologistes appellent le « biais d’immortalité » ou le biais de sélection par survie : pour être inclus dans la base de données à un âge avancé, un sujet doit nécessairement avoir survécu sans mourir de sa pathologie aux âges antérieurs. La modélisation mathématique d’une telle cohorte doit obligatoirement ajuster le temps d’observation par un processus d’entrée différée (delayed entry), sous peine de surestimer massivement l’espérance de vie des patients atteints de démence et de sous-estimer la vitesse réelle de détérioration de leurs facultés intellectuelles.
6.2 Troncation à droite (Right Truncation)
La troncation à droite survient lorsqu’un individu ne peut être observé que si sa variable d’intérêt est strictement inférieure ou égale à un seuil critique déterminé : $Y^* le c$. Dans cette architecture, les sujets présentant des réalisations de la variable situées au-delà de cette borne supérieure disparaissent complètement de l’espace de détection et ne figurent pas dans l’échantillon d’analyse.
Un exemple classique de troncation à droite dans le champ de la psychiatrie et de la psychométrie concerne les protocoles d’investigation menés spécifiquement sur des populations d’enfants scolarisés en sections d’enseignement adapté ou au sein de classes pour élèves en difficulté d’apprentissage. Si le critère institutionnel strict d’admission dans ces filières spécialisées exige l’obtention d’un quotient intellectuel (QI) strictement inférieur à 70 sur les échelles de Wechsler, l’ensemble des enfants ayant un fonctionnement intellectuel moyen ou supérieur ($QI ge 70$) est éliminé du protocole d’observation par construction de l’institution source.
Sur le plan épidémiologique et temporel, la troncation à droite se manifeste de façon critique lors de l’investigation des maladies infectieuses émergentes ou des troubles psychopathologiques à longue phase d’incubation. Si l’on tente d’estimer le temps d’incubation d’un trouble psychiatrique induit par un traumatisme en interrogeant uniquement les individus chez lesquels le trouble s’est déjà formellement déclaré avant une date de clôture de l’enquête, les personnes chez qui la période d’incubation sera exceptionnellement longue sont systématiquement écartées de l’échantillon. Cette troncation à droite non corrigée produit une estimation fallacieusement courte du temps moyen nécessaire à l’émergence des premiers symptômes cliniques.
6.3 Troncation bilatérale ou double (Double Truncation)
La troncation double, ou bilatérale, survient lorsque l’observation d’un sujet est conditionnée par l’appartenance de sa variable d’intérêt à un intervalle strictement délimité par deux seuils distincts, une borne inférieure $c_1$ et une borne supérieure $c_2$, de sorte que l’inclusion dans l’échantillon impose que $c_1 < Y^* < c_2$. Tout individu dont la valeur est soit inférieure à $c_1$, soit supérieure à $c_2$, est entièrement exclu du processus d'enregistrement métrologique.
Ce scénario d’échantillonnage contraignant caractérise fréquemment les essais cliniques randomisés en neuropsychopharmacologie et en psychologie clinique interventionnelle. Afin d’homogénéiser au maximum les groupes expérimentaux et d’éviter les effets de saturation de mesure, les protocoles de recherche stipulent couramment des critères d’inclusion et d’exclusion drastiques sur l’intensité des symptômes. Par exemple, un essai évaluant une nouvelle molécule anxiolytique peut décréter que seuls les patients ayant un score à l’échelle de Hamilton pour l’anxiété (HAM-A) compris strictement entre 18 (seuil d’anxiété modérée) et 30 (seuil de panique sévère) seront admis à participer.
Sur le plan computationnel, la fonction de densité conditionnelle d’une variable doublement tronquée prend la forme :
$$f_Y(y) = \frac{f(y)}{F(c_2) – F(c_1)}, \quad \forall y in ]c_1, c_2[$$
L’estimation statistique des paramètres de la population non sélectionnée à partir d’un tel échantillon doublement restreint exige une complexité de calcul accrue. La log-vraisemblance comporte au dénominateur la différence de deux fonctions de répartition cumulatives, ce qui accentue l’instabilité numérique des algorithmes de gradient et rend la convergence des paramètres hypersensible aux violations de l’hypothèse de forme fonctionnelle postulée sur les résidus.
7. Exemples concrets de données tronquées dans les études psychologiques
7.1 Recrutement universitaire et biais cognitif du quotient intellectuel
L’une des illustrations les plus emblématiques de la troncation dans la littérature sur les aptitudes humaines concerne l’analyse de la relation entre les scores d’intelligence psychométrique et la réussite académique ou professionnelle au sein d’universités hautement sélectives. Des cohortes d’étudiants intégrant les grandes écoles d’ingénieurs ou les programmes doctoraux de pointe sont régulièrement soumises à des batteries de tests d’évaluation cognitive afin d’estimer dans quelle mesure le QI prédit leurs performances aux examens terminaux.
Or, le processus d’admission lui-même opère une troncation drastique à gauche sur les capacités cognitives des candidats. Les examens d’entrée hautement compétitifs éliminent la totalité des postulants dont le niveau d’aptitude se situe en dessous d’un seuil critique très élevé, souvent situé à deux écarts-types au-dessus de la moyenne populationnelle (par exemple, un équivalent QI supérieur à 120 ou 130). Les chercheurs n’ont aucun accès aux données académiques qu’auraient obtenues les candidats recalés s’ils avaient été admis dans ces filières d’élite.
L’application d’un calcul standard de coefficient de corrélation linéaire de Pearson sur cet échantillon ultra-sélectionné aboutit invariablement à un résultat déconcertant : la corrélation entre les capacités intellectuelles mesurées et les notes obtenues à l’université apparaît souvent proche de zéro, voire légèrement négative. Cette observation fallacieuse ne signifie aucunement que l’intelligence ne joue aucun rôle dans la réussite académique, mais constitue une manifestation directe de la troncation de variance (phénomène d’atténuation par restriction d’étendue). En effaçant la variabilité cognitive de 95 % de la population générale, le chercheur supprime la variance nécessaire à la mise en évidence empirique de la relation linéaire sous-jacente.
7.2 Recherche sur le temps de réaction des athlètes d’élite
Dans le domaine de la psychologie du sport et des neurosciences comportementales appliquées à l’expertise motrice, les chercheurs s’attachent à identifier les déterminants sensorimoteurs de la performance exceptionnelle en étudiant les temps de réaction visuomoteurs simples et de choix. Pour constituer des cohortes homogènes d’athlètes de calibre olympique, les protocoles sélectionnent uniquement les sportifs ayant franchi des minima de sélection chronométriques rigoureux lors d’épreuves de sprint ou d’escrime.
Ce critère d’inclusion opère une troncation directe à droite sur la distribution des temps de traitement cognitivo-moteur. Les athlètes dont le temps d’exécution neuromusculaire excède un seuil déterminé (par exemple, un temps de réaction à l’ouverture du bloc de départ supérieur à 140 millisecondes) sont exclus de la sélection nationale, et par voie de conséquence, ne franchissent jamais les portes du laboratoire d’analyse haute performance. Ils n’existent pas dans les registres informatiques du protocole expérimental.
Si le chercheur modélise l’impact d’un entraînement cognitif de focalisation attentionnelle en utilisant des régressions linéaires par moindres carrés sur cette cohorte ultra-rapide, la variance résiduelle du modèle s’avérera profondément distordue. Parce que la distribution des temps observés est coupée net au seuil d’élimination sportive, les erreurs d’estimation ne suivent plus une distribution normale et l’homoscédasticité est irrémédiablement rompue. Sans une correction pour troncation, l’efficacité réelle de l’entraînement attentionnel sera mal évaluée, pouvant conduire à l’abandon prématuré d’innovations pédagogiques prometteuses.
7.3 Enquêtes cliniques hospitalières sur la dépression majeure
Un cas d’école de troncation dans la recherche psychiatrique fondamentale concerne le recrutement exclusif de participants au sein d’unités d’hospitalisation psychiatrique de soins intensifs. Une équipe médicale cherchant à modéliser les corrélats neurobiologiques de l’épisode dépressif caractérisé (via l’imagerie par résonance magnétique fonctionnelle et des dosages de cytokines pro-inflammatoires) peut choisir, pour des raisons de logistique médicale, d’échantillonner uniquement des patients hospitalisés sous contrainte ou admis en urgence pour risque suicidaire imminent.
Ce dispositif méthodologique induit une troncation bilatérale complexe, dominée par une troncation à gauche sur l’échelle de gravité clinique du trouble. Les individus de la collectivité souffrant de dépression légère, de dysthymie modérée ou d’épisodes dépressifs majeurs sans critères suicidaires aigus sont suivis en ambulatoire par des médecins de ville et ne font jamais l’objet d’une admission hospitalière. Ils sont par conséquent totalement exclus de l’échantillonnage hospitalier : ils ne sont ni répertoriés, ni caractérisés sur le plan biologique dans la base de recherche.
Vouloir inférer à partir d’un tel échantillon hospitalier les mécanismes étiologiques universels de la dépression dans la population générale constitue un écueil épistémologique majeur. Les associations observées entre certains marqueurs inflammatoires circulants et l’intensité du score dépressif peuvent être artificiellement gonflées par des comorbidités physiques sévères propres aux patients institutionnalisés. La troncation prive le modèle statistique du groupe de référence naturel composé des formes atténuées du trouble, interdisant toute extrapolation valide des paramètres à la médecine générale de premier recours.
8. Distinctions conceptuelles et méthodologiques majeures entre censure et troncation
8.1 Comparaison de l’information disponible sur l’échantillon
Pour clarifier la frontière conceptuelle entre les deux mécanismes, il convient de dresser une comparaison systématique de la nature de l’information statistique accessible au chercheur. Dans le cas de la censure, la quantité globale de sujets évalués demeure parfaitement connue et constante : la taille d’échantillonnage totale $N$ est un nombre déterministe fixé par le protocole expérimental. En revanche, dans le cas de la troncation, la taille d’échantillon finale observée $n$ est en elle-même une variable aléatoire conditionnelle, subordonnée à la probabilité de réalisation de l’événement d’inclusion dans l’espace échantillonnal.
Le traitement des cas extrêmes situés au-delà du seuil critique constitue le second point de divergence fondamental. Lors d’un processus de censure, le chercheur sait exactement combien d’individus ont dépassé la limite de quantification et conserve leurs caractéristiques auxiliaires (âge, sexe, groupe de traitement). Lors d’une troncation, les individus hors du domaine de visibilité s’évanouissent intégralement : l’analyste ne dispose d’aucun décompte numérique direct de leur volume, ni de la moindre donnée sociodémographique les concernant. L’information marginale sur les fractions de rejet est totalement anéantie.
Cette divergence structurelle se répercute directement sur le régime de calcul probabiliste à employer. L’inférence sur données censurées opère sur l’espace d’échantillonnage complet en combinant des distributions marginales pour les cas limites et des densités continues pour les cas mesurés. L’analyse des données tronquées exige quant à elle une restriction stricte du support de probabilité, imposant de raisonner en permanence au travers de distributions conditionnelles renormalisées par l’aire sous la courbe effective.
8.2 Représentation graphique et géométrique des deux phénomènes
L’examen des représentations graphiques permet de saisir immédiatement la divergence topologique entre distributions censurées et tronquées. Si l’on trace l’histogramme de fréquence d’une variable latente théoriquement gaussienne soumise à une censure à gauche au seuil $c$, le profil observé présente deux composantes géométriques bien distinctes : pour toute valeur strictement supérieure à $c$, la forme en cloche de la loi normale est préservée à l’échelle d’origine. En revanche, au point d’abscisse précis $Y = c$, apparaît une barre discrète verticale gigantesque, un pic d’accumulation qui concentre toute la masse de probabilité initialement dispersée sur la queue de distribution gauche $]-\infty, c]$.
Dans la configuration d’une troncation à gauche au même seuil $c$, le paysage géométrique est radicalement différent. La région située à gauche du seuil $c$ est entièrement vide de données : aucun point, aucune barre de fréquence n’est visible. Pour toute valeur supérieure à $c$, la courbe de densité normale reprend son tracé ascendant puis descendant, mais l’ensemble de la silhouette est uniformément surélevé par translation verticale proportionnelle au multiplicateur d’échelle $\frac{1}{1 – F(c)}$. Il n’existe aucun pic ponctuel discret au seuil : la distribution demeure strictement continue sur son domaine tronqué, mais son intégrale globale est étirée pour rétablir une surface unitaire égale à 1.
Sur un diagramme de dispersion (scatterplot) croisant un prédicteur continu $X$ et la variable dépendante $Y$, la censure se matérialise par un alignement horizontal parfait d’observations agglomérées sur la ligne droite $Y = c$, créant un plancher artificiel rigide à travers les différentes strates de $X$. Dans le cas de la troncation, le graphique ne montre aucun alignement artificiel, mais exhibe une découpe nette et abrupte du nuage de points : l’espace sous la ligne horizontale $Y = c$ est intégralement vierge, donnant l’illusion visuelle trompeuse que la dispersion des données est naturellement bornée au sein de la population.
8.3 Arbre décisionnel pour l’identification du type de donnée
Face à un jeu de données empiriques présentant une discontinuité ou une incomplétude de mesure, le chercheur doit déployer un raisonnement séquentiel rigoureux afin de poser le diagnostic statistique adéquat. L’arbre de décision méthodologique repose sur une série de critères diagnostiques hiérarchisés :
- Critère 1 : La taille totale de la population ciblée est-elle intégralement connue ? Si le chercheur dispose d’une liste de participants identifiés dont certains n’ont qu’une valeur qualitative indiquant le franchissement d’un seuil, la structure relève de la censure. Si les sujets situés hors du seuil n’ont jamais pu être dénombrés ou enregistrés, la structure relève de la troncation.
- Critère 2 : La non-observation découle-t-elle de l’instrument de mesure ou du processus de constitution de la cohorte ? Une saturation d’échelle de réponse (ex. score plafond à un test de mémoire) signale une censure instrumentale. Un critère d’éligibilité éliminant des sujets en amont du protocole (ex. exclusion administrative des QI inférieurs à 100) signale une troncation structurelle.
- Critère 3 : La probabilité de sélection dans l’étude dépend-elle de la valeur même de la variable réponse d’intérêt ? Si la sélection dépend d’une variable explicative exogène $X$ (ex. âge ou sexe), il s’agit d’un simple échantillonnage stratifié n’affectant pas la validité des pentes de régression. Si le filtre dépend de la variable dépendante $Y$ elle-même, le chercheur se trouve face à une troncation endogène imposant des corrections de vraisemblance conditionnelle.
La validation scrupuleuse de ces trois jalons décisionnels prévient l’utilisation erronée de modules informatiques inadaptés et guide immédiatement l’analyste vers la famille d’estimateurs mathématiquement congruente avec la nature probabiliste de son échantillon.
9. Conséquences statistiques de l’ignorance de la censure et de la troncation
9.1 Inadéquation des moindres carrés ordinaires (MCO)
L’une des dérives méthodologiques les plus destructrices en recherche empirique consiste à ignorer la censure ou la troncation et à appliquer machinalement une régression linéaire multiple estimée par les moindres carrés ordinaires. Le théorème de Gauss-Markov démontre formellement que l’estimateur des MCO n’est le meilleur estimateur linéaire non biaisé (BLUE) que sous la condition sine qua non d’une espérance conditionnelle des perturbations stochastiques rigoureusement nulle : $E(varepsilon mid X) = 0$.
Dès lors qu’une variable dépendante est censurée ou tronquée, cette hypothèse maîtresse est irrévocablement violée. Dans le cas d’une censure à gauche à zéro, l’erreur observée pour les cas accumulés au plancher dépend de manière déterministe des variables explicatives : plus la prédiction linéaire théorique $X\beta$ s’enfonce dans les valeurs négatives, plus le terme d’erreur résiduel $Y – X\beta = 0 – X\beta$ devient fortement positif. Il en découle une corrélation structurelle directe entre les perturbations résiduelles et les régresseurs du modèle :
$$E(\varepsilon mid X) \neq 0$$
La conséquence mathématique immédiate de cette rupture est un biais systématique d’atténuation des coefficients de régression. La pente de la droite des moindres carrés ($\hat{\beta}_{MCO}$) est invariablement aplatie et se rapproche artificiellement de zéro, sous-estimant la véritable magnitude de l’impact des variables prédictives sur la variable latente. Conjointement, l’ordonnée à l’origine (la constante du modèle) absorbe la distorsion et se trouve systématiquement décalée vers le haut dans le cas d’une censure à gauche, ruinant toute interprétation substantive des grandeurs marginales estimées.
9.2 Biais d’hétéroscédasticité et perte de puissance statistique
Au-delà de l’inconsistance des coefficients d’ajustement moyen, l’application de méthodes conventionnelles à des distributions censurées ou tronquées détruit l’hypothèse d’homoscédasticité, qui requiert une variance constante des termes d’erreur sur l’ensemble de l’espace des covariables : $Var(\varepsilon mid X) = \sigma^2$. Lorsque la variable subit un effet de seuil, la variance résiduelle devient mathématiquement une fonction conditionnelle directe des prédicteurs $X\beta$.
À mesure que la combinaison linéaire des variables indépendantes positionne l’espérance latente d’un individu à proximité immédiate ou au-delà du seuil de troncature, la dispersion observable des valeurs s’amenuise drastiquement pour tendre vers zéro. Cette structure de variance non constante induit une hétéroscédasticité endogène sévère. Les erreurs-types classiques calculées par la formule de la matrice de covariance standard des MCO deviennent radicalement fausses, invalidant l’ensemble des tests d’hypothèses statistiques : les statistiques $t$ de Student et les ratios $F$ de Fisher ne suivent plus leurs lois asymptotiques théoriques.
Cette perturbation engendre une double menace méthodologique : d’une part, une inflation dramatique du risque d’erreur de type I (rejet à tort de l’hypothèse nulle d’absence d’effet) due à la sous-estimation fréquente des erreurs-types asymptotiques ; d’autre part, une perte dramatique de puissance statistique pour détecter des effets réels chez les individus éloignés des seuils critiques. Les intervalles de confiance à 95 % déduits des procédures ordinaires offrent une couverture empirique trompeuse, s’écartant substantiellement du niveau de confiance nominal affiché.
9.3 Le paradoxe de Berkson et les corrélations illusoires
L’ignorance de la troncation d’échantillon constitue le berceau d’un artefact statistique retors formalisé par le biostatisticien Joseph Berkson en 1946, connu sous le nom de paradoxe de Berkson ou biais de sélection hospitalier. Dans sa formulation moderne issue de la théorie de l’inférence causale dirigée (modèles graphiques de Judea Pearl), ce piège correspond au phénomène de conditionnement sur un collisionneur (conditioning on a collider).
Supposons que deux troubles psychiatriques distincts — par exemple, un trouble de l’usage de substances et une dépression majeure — soient stochastiquement parfaitement indépendants dans la population générale. Si une étude clinique recrute ses sujets exclusivement parmi les patients admis en unité d’hospitalisation psychiatrique, la condition d’admission repose généralement sur la présence soit d’une addiction sévère, soit d’un état dépressif aigu, soit des deux à la fois. L’hospitalisation agit graphiquement comme un nœud collisionneur ($Addiction \rightarrow Hospitalisation \leftarrow Depression$).
En restreignant l’analyse aux seuls individus hospitalisés (ce qui équivaut à une troncation sur le statut d’admission), le statisticien conditionne artificiellement sur ce collisionneur. Dès lors, une association négative illusoire émerge mécaniquement entre les deux troubles : parmi les personnes hospitalisées, le fait de savoir qu’un individu ne souffre pas d’une addiction augmente drastiquement la probabilité qu’il soit hospitalisé pour une dépression majeure. L’analyste conclut imprudemment à l’existence d’une relation d’exclusion ou de corrélation inverse entre les deux pathologies, alors que cette dépendance empirique n’est que le pur produit mécanique de la troncation de l’échantillon d’observation.
10. Approches analytiques et modélisation des données censurées : Le modèle Tobit et extensions
10.1 Fondements mathématiques du modèle Tobit standard (Tobit I)
Pour surmonter l’impasse méthodologique des moindres carrés ordinaires face à une variable dépendante censurée, le lauréat du prix Nobel d’économie James Tobin a élaboré en 1958 le modèle pour variables dépendantes limitées, immortalisé sous l’appellation de modèle Tobit (ou modèle Tobit standard de type I). Ce cadre analytique conceptualise le processus empirique au travers d’une équation structurelle latente continue non observée directement :
$$Y_i^* = X_i\beta + \varepsilon_i, \quad \varepsilon_i \sim \mathcal{N}(0, \sigma^2)$$
La règle d’observation régissant la variable empirique collectée $Y_i$, dans le cas classique d’une censure à gauche à zéro, s’écrit de manière déterministe :
$$Y_i = \begin{\cases} Y_i^* &a\mp; \text{si } Y_i^* > 0 0 &a\mp; \text{si } Y_i^* le 0 \end{\cases}$$
La force majeure de l’approche de Tobin réside dans l’élaboration d’une fonction de vraisemblance composite qui intègre simultanément la nature continue des valeurs strictement positives et la nature discrète de l’accumulation au point zéro. Pour une observation non censurée ($Y_i > 0$), la contribution à la vraisemblance est donnée par la densité de probabilité normale :
$$\frac{1}{\sigma}\phi\left(\frac{Y_i – X_i\beta}{\sigma}\right)$$
Pour une observation censurée ($Y_i = 0$), la contribution correspond à la probabilité cumulative que la variable latente soit négative :
$$P(Y_i^* le 0) = \Phi\left(-\frac{X_i\beta}{\sigma}\right) = 1 – \Phi\left(\frac{X_i\beta}{\sigma}\right)$$
où $\phi(\cdot)$ et $\Phi(\cdot)$ représentent respectivement la fonction de densité et la fonction de répartition de la loi normale centrée réduite.
La log-vraisemblance globale de l’échantillon de taille $N$ agrège les deux régimes d’information :
$$\ln L = \sum_{Y_i = 0} \ln\left[1 – \Phi\left(\frac{X_i\beta}{\sigma}\right)\right] + \sum_{Y_i > 0} \left[ -\ln(\sigma) + \ln\phi\left(\frac{Y_i – X_i\beta}{\sigma}\right) \right]$$
L’estimation des paramètres $\beta$ et $\sigma$ s’obtient par la méthode du maximum de vraisemblance (MLE). Sous réserve que les erreurs suivent effectivement une loi normale homoscédastique, les estimateurs Tobit possèdent les propriétés asymptotiques optimales : ils sont asymptotiquement sans biais, convergents et efficaces, atteignant la borne inférieure de Cramér-Rao.
10.2 Modèles de survie et estimateur non paramétrique de Kaplan-Meier
Lorsque la censure s’applique à une variable continue représentant une durée temporelle (temps jusqu’à l’abandon d’une psychothérapie, durée de maintien dans l’emploi, délai de rechute schizophrénique), l’analyse de survie s’impose comme le cadre modélisateur universel. L’outil fondamental de cette discipline est l’estimateur de Kaplan-Meier (ou estimateur du produit-limite), conçu en 1958 par Edward Kaplan et Paul Meier. Il s’agit d’une procédure non paramétrique permettant d’estimer la fonction de survie $S(t) = P(T > t)$ sans imposer aucune hypothèse distributionnelle restrictive sur la forme de la fonction de risque sous-jacente.
Le calcul repose sur une décomposition séquentielle de la survie temporelle par le biais des probabilités conditionnelles de franchissement d’étapes. Soit une série ordonnée chronologiquement de temps de défaillance distincts observés : $t_1 < t_2 < dots < t_k$. À chaque instant singulier d'événement $t_j$, désignons par $d_j$ le nombre d'individus subissant l'événement cible (ex. la rechute clinique) et par $n_j$ l'effectif des individus à risque immédiatement avant cet instant (c'est-à-dire les participants vivants, suivis et non censurés jusqu'alors). La fonction de survie de Kaplan-Meier s'exprime sous la forme du produit cumulé :
$$\hat{S}(t) = \prod_{j: t_j le t} \left( 1 – \frac{d_j}{n_j} \right)$$
Le traitement des données censurées s’opère de façon transparente et fluide au sein de cet algorithme : les participants qui subissent un événement de censure entre l’instant $t_j$ et $t_{j+1}$ sont comptabilisés dans la population à risque $n_j$ lors de l’instant $t_j$, mais sont simplement retirés du pool de participants à risque pour l’instant $t_{j+1}$. Ils contribuent ainsi positivement à l’estimation de la fonction de survie jusqu’au dernier moment où ils étaient effectivement sous observation clinique, sans introduire de distorsion probabiliste dans les intervalles ultérieurs.
La comparaison rigoureuse des trajectoires de survie entre plusieurs groupes expérimentaux (par exemple, un groupe recevant une thérapie d’acceptation et d’engagement comparé à un groupe sous antidépresseurs standards) est couramment validée par le test du log-rank (ou test de Mantel-Cox). Ce test d’hypothèse non paramétrique pondère de manière égale l’information temporelle tout au long de la période de suivi, offrant une robustesse remarquable face à des volumes substantiels d’observations censurées à droite.
10.3 Modèle à risques proportionnels de Cox
Si l’estimateur de Kaplan-Meier permet de décrire adéquatement une fonction de survie univariée, il ne permet pas d’évaluer l’impact combiné de multiples covariables continues et catégorielles. C’est pour répondre à cette exigence que Sir David Cox a développé en 1972 le modèle semi-paramétrique à risques proportionnels. Ce cadre postule que la fonction de risque instantané d’un sujet, notée $h(t mid X)$, peut être décomposée en un produit multiplicatif associant une fonction de risque de base non spécifiée $h_0(t)$ et un terme exponentiel intégrant les prédicteurs vectoriels $X$ :
$$h(t mid X) = h_0(t) \exp(X\beta)$$
L’innovation majeure de la régression de Cox réside dans l’invention de la méthode de vraisemblance partielle (partial likelihood). Cette technique d’estimation permet de calculer les coefficients de régression $\beta$ (interprétables sous forme de ratios de risque instantané ou hazard ratios, $HR = e^\beta$) sans avoir à expliciter ou à estimer la composante temporelle de base $h_0(t)$. L’ordonnancement séquentiel des événements suffit entièrement à l’inférence.
Les données censurées à droite s’insèrent naturellement dans la construction de la fonction de vraisemblance partielle. À chaque temps de défaillance effectif $t_i$, la probabilité conditionnelle qu’un individu spécifique subisse l’événement plutôt qu’un autre membre du groupe à risque s’écrit :
$$L_i(\beta) = \frac{\exp(X_i\beta)}{\sum_{k in R(t_i)} \exp(X_k\beta)}$$
L’ensemble à risque $R(t_i)$ rassemble tous les sujets n’ayant pas encore connu l’événement d’intérêt ni été censurés avant l’instant $t_i$. Les sujets censurés quittent l’ensemble $R(t)$ dès leur instant de censure, éliminant tout bruit d’inférence ultérieur.
Le déploiement valide du modèle de Cox implique la vérification empirique scrupuleuse de l’hypothèse de proportionnalité des risques dans le temps. Cette contrainte stipule que le ratio des risques entre deux modalités d’une variable doit demeurer invariant au cours de l’ensemble de la période d’observation. L’analyse des résidus de Schoenfeld partiels permet d’identifier les déviations temporelles : si un coefficient varie en fonction du temps, des spécifications temporelles étendues (coefficients dépendant du temps ou stratification de Cox) doivent être mises en œuvre pour préserver l’intégrité de la conclusion causale.
11. Méthodes d’estimation et traitement des données tronquées : Régression tronquée et modèles de sélection
11.1 Régression tronquée par le maximum de vraisemblance
Lorsque la variable dépendante est tronquée à gauche au seuil $c$, éliminant de facto tout individu ayant une valeur latente $Y^* le c$, le modèle Tobit conventionnel n’est plus applicable car l’échantillon ne comporte aucune observation au point zéro. L’inférence requiert alors l’implémentation de la régression normale tronquée, estimée par la maximisation d’une log-vraisemblance strictement conditionnelle à l’événement de sélection.
L’équation sous-jacente reste celle d’une variable latente gaussienne : $Y_i^* = X_i\beta + \varepsilon_i$ avec $\varepsilon_i \sim \mathcal{N}(0, \sigma^2)$. Cependant, chaque terme de la log-vraisemblance pour un individu observable $i$ (dont la valeur observée est $Y_i = Y_i^*$) doit intégrer au dénominateur la probabilité d’observabilité $P(Y_i^* > c)$ afin de normaliser rigoureusement la fonction de densité conditionnelle :
$$\ln L = \sum_{i=1}^{n} \left[ -\ln(\sigma) + \ln\phi\left(\frac{Y_i – X_i\beta}{\sigma}\right) – \ln\left(1 – \Phi\left(\frac{c – X_i\beta}{\sigma}\right)\right) \right]$$
Ce redimensionnement continu rétablit l’adéquation de l’espérance conditionnelle mathématique :
$$E(Y_i mid Y_i > c) = X_i\beta + \sigma \lambda(\alpha_i)$$
où $\alpha_i = \frac{c – X_i\beta}{\sigma}$, et $\lambda(\alpha_i) = \frac{\phi(\alpha_i)}{1 – \Phi(\alpha_i)}$ représente le ratio inverse de Mills (inverse Mills ratio). L’estimateur du maximum de vraisemblance tronqué intègre dynamiquement ce décalage d’espérance, fournissant des estimations consistantes des paramètres de pente originaux $\beta$.
Néanmoins, la régression normale tronquée présente une vulnérabilité métrologique aiguë : sa consistance repose intégralement sur l’exactitude de l’hypothèse de normalité et d’homoscédasticité des erreurs latentes $\varepsilon_i$. Si les résidus réels présentent une asymétrie marquée, une leptocurtose prononcée ou une variance hétérogène corrélée aux variables explicatives, les estimateurs du maximum de vraisemblance deviennent inconsistants et biaisés, rendant primordiale l’exploration de solutions robustes semi-paramétriques.
11.2 Modèle de sélection en deux étapes de Heckman (Heckit)
Dans de multiples situations empiriques en psychologie clinique et en économétrie comportementale, la troncation ne découle pas d’une borne mécanique rigide sur la variable dépendante elle-même, mais d’une décision ou d’un processus comportemental de participation. C’est pour modéliser cette sélection endogène que James Heckman a formulé en 1979 sa célèbre méthode de correction en deux étapes, récompensée par le prix Nobel d’économie (souvent appelée procédure Heckit).
Le paradigme de Heckman articule le système autour de deux équations simultanées : une équation de sélection (équation de participation) et une équation d’intérêt substantielle (équation de résultat). Soit $z_i^*$ la variable latente régissant la probabilité de franchir le filtre d’inclusion :
$$z_i^* = W_i\gamma + u_i$$
L’indicateur d’observation empirique $s_i$ vérifie $s_i = 1$ si $z_i^* > 0$, et $s_i = 0$ sinon. La variable d’intérêt clinique $Y_i^*$ n’est observée ($Y_i = Y_i^*$) que si le sujet est sélectionné ($s_i = 1$) :
$$Y_i^* = X_i\beta + \varepsilon_i$$
Les termes d’erreur $(u_i, \varepsilon_i)$ suivent une distribution bivariée normale corrélée de matrice de covariance :
$$\begin{\pmatrix} u_i \varepsilon_i \end{\pmatrix} \sim \mathcal{N}\left(\begin{\pmatrix} 0 0 \end{\pmatrix}, \begin{\pmatrix} 1 &a\mp; \rho\sigma_\varepsilon \rho\sigma_\varepsilon &a\mp; \sigma_\varepsilon^2 \end{\pmatrix}\right)$$
Si la corrélation stochastique $rho$ est non nulle, estimer l’équation de résultat par les MCO sur le sous-échantillon des sujets observables engendre un biais d’omission de variable. L’algorithme ingénieux de Heckman résout cette difficulté en deux phases :
- Étape 1 : Un modèle Probit dichotomique est estimé sur l’ensemble de la cohorte initiale (incluant les participants et les non-participants) pour modéliser la propension à participer : $P(s_i = 1 mid W_i) = \Phi(W_i\gamma)$. À partir des coefficients estimés $\hat{\gamma}$, on calcule pour chaque sujet observable le ratio inverse de Mills : $\hat{\lambda}_i = \frac{\phi(W_i\hat{\gamma})}{\Phi(W_i\hat{\gamma})}$.
- Étape 2 : L’équation d’intérêt substantielle est estimée par les moindres carrés ordinaires en incluant le ratio inverse de Mills $\hat{\lambda}_i$ comme un régresseur auxiliaire de contrôle : $Y_i = X_i\beta + \beta_\lambda \hat{\lambda}_i + v_i$.
Le coefficient associé $\beta_\lambda = \rho\sigma_\varepsilon$ mesure directement la sévérité du biais de sélection. Si la statistique $t$ associée à $\hat{\beta}_\lambda$ est statistiquement significative, le chercheur rejette l’hypothèse nulle d’indépendance de sélection et conclut à la nécessité de la correction. Pour assurer l’identifiabilité robuste des paramètres structurels, il est hautement recommandé d’intégrer au moins une variable d’exclusion dans le vecteur $W$ (une variable qui influence fortement la probabilité de participation, mais qui n’a aucun lien théorique direct avec la performance ou la réponse $Y$).
11.3 Méthodes semi-paramétriques et non paramétriques robustes
L’extrême dépendance des modèles paramétriques (Tobit et régression normale tronquée) à l’hypothèse de normalité et d’homogénéité des résidus a stimulé le développement d’approches économétriques semi-paramétriques, conçues pour opérer sans imposer de distribution paramétrique stricte sur la structure d’erreur. L’avancée méthodologique la plus influente dans ce registre est l’estimateur des moindres carrés symétriquement tronqués (Symmetrically Censored Least Squares, SCLS) introduit par James Powell en 1986.
L’intuition conceptuelle de Powell repose sur un principe d’équilibrage géométrique : dans une distribution censurée à gauche à zéro, l’asymétrie résulte de la coupure unilatérale de l’aile gauche des perturbations résiduelles. Powell propose de rétablir artificiellement la symétrie de la distribution d’erreur en tronquant symétriquement la queue supérieure de la distribution pour chaque observation. En coupant les valeurs positives extrêmes à la hauteur exacte de la coupure négative prédictive ($2X_i\beta$), la loi des résidus redevient parfaitement symétrique autour de zéro.
L’estimateur SCLS minimise une fonction objectif non linéaire et ne requiert aucune hypothèse de normalité ni de forme spécifique de la densité conditionnelle, pourvu que les erreurs de l’équation latente soient indépendantes et symétriques. Des extensions comme l’estimateur des moindres déviations absolues censurées (Censored Least Absolute Deviations, CLAD), également formulé par Powell, offrent une robustesse remarquable face aux valeurs aberrantes extrêmes (outliers) et à des structures d’hétéroscédasticité complexes.
Dans ces environnements semi-paramétriques où les formules analytiques standard de variances asymptotiques sont excessivement complexes ou instables, le chercheur s’appuie massivement sur les techniques computationnelles de bootstrap adapté. Le rééchantillonnage par grappes ou par blocs, respectant les contraintes conditionnelles de troncature, permet de dériver des erreurs-types empiriques hautement fiables et des intervalles de confiance robustes, libérant ainsi l’inférence causale des hypothèses distributionnelles contestables.
12. Bonnes pratiques méthodologiques, implémentation logicielle et recommandations
12.1 Implémentation sous les environnements R et Python
L’opérationnalisation moderne de ces modèles statistiques avancés bénéficie d’écosystèmes logiciels puissants au sein des plateformes libres R et Python. L’analyste de données empiriques dispose d’un vaste éventail de bibliothèques spécialisées permettant d’estimer avec précision l’ensemble des modélisations présentées dans ce guide.
Dans l’environnement statistique R :
- Le package survival constitue la référence internationale incontournable pour l’analyse de survie longitudinale, offrant les fonctions maîtresses
Surv()pour encoder la censure,survfit()pour générer les courbes de Kaplan-Meier etcoxph()pour calibrer les régressions à risques proportionnels de Cox. - Le package censReg est spécialement optimisé pour l’estimation de modèles Tobit unilatéraux ou bilatéraux par le maximum de vraisemblance, interfacé de manière transparente avec les structures de syntaxe matricielle standard.
- Le package truncreg permet de paramétrer directement des modèles de régression tronquée gaussienne, en ajustant explicitement les seuils de troncature gauche ou droite.
- Le package sampleSelection implémente la modélisation Heckit en deux étapes ainsi que l’estimation jointe par maximum de vraisemblance complète (FIML) via la commande standard
heckit().
Dans l’écosystème Python :
- La bibliothèque Lifelines propose une interface orientée objet pour la survie, permettant le tracé interactif d’estimateurs de Kaplan-Meier, de Nelson-Aalen et l’ajustement du modèle de Cox (
CoxPHFitter) avec calcul automatisé des résidus de Schoenfeld. - La suite Statsmodels inclut des modules dédiés aux variables dépendantes limitées et permet de spécifier des fonctions de vraisemblance personnalisées pour les régressions Tobit et tronquées.
- La bibliothèque spécialisée scikit-survival transpose les concepts de données censurées dans l’univers de l’apprentissage automatique, intégrant des forêts aléatoires de survie (Random Survival Forests) et des machines à vecteurs de support adaptées aux événements compétitifs.
Il incombe à l’analyste de veiller à la cohérence de l’interprétation des sorties logicielles. Notamment, dans un modèle Tobit ou tronqué, les coefficients numériques affichés ($\hat{\beta}$) correspondent à l’impact marginal des variables explicatives sur la variable latente sous-jacente $Y^*$, et non directement sur la variable observée empiriquement $Y$. Le calcul des effets marginaux conditionnels réels, via la décomposition de McDonald-Moffitt, s’avère indispensable pour traduire les résultats dans les unités métriques compréhensibles pour les praticiens du champ d’application.
12.2 Optimisation du plan expérimental pour minimiser la troncature artificielle
Bien que la modélisation statistique avancée offre des outils correctifs puissants, la démarche méthodologique la plus vertueuse consiste à anticiper et à minimiser l’apparition des données censurées ou tronquées dès l’architecture fondamentale du plan expérimental. Une analyse rigoureuse des défaillances de mesure potentielles lors de la phase pilote d’une étude prévient de multiples écueils analytiques ultérieurs.
En psychométrie, l’optimisation des instruments requiert un calibrage méticuleux de la portée dynamique des échelles. L’application systématique des modèles de la théorie de la réponse aux items (Item Response Theory, IRT) permet d’analyser la courbe d’information du test à travers les différents niveaux du trait latent ($\theta$). L’adjonction délibérée d’items présentant des indices de difficulté très bas (pour contrer l’effet de plancher) et très élevés (pour neutraliser l’effet de plafond) garantit que l’instrument conserve une erreur standard de mesure faible sur l’intégralité du spectre psychologique de la population cible.
Dans les suivis longitudinaux de cohortes comportementales, la mise en œuvre de stratégies actives de rétention des participants limite l’hémorragie des données par censure informative liée aux perdus de vue. L’utilisation de protocoles d’évaluation écologique momentanée (Ecological Momentary Assessment, EMA) sur smartphones, combinée à des incitations financières échelonnées et au recueil de coordonnées de personnes référentes fiables, réduit drastiquement l’attrition précoce. Enfin, le pré-enregistrement (preregistration) systématique des protocoles sur des plateformes académiques institutionnelles oblige les équipes à déclarer explicitement les critères d’inclusion et les bornes métrologiques avant la collecte, évitant ainsi toute troncation opportuniste a posteriori destinée à forcer la significativité statistique.
12.3 Règles de reporting scientifique selon les normes académiques (APA)
La publication de recherches empiriques impliquant des variables censurées ou tronquées exige une transparence méthodologique absolue, conformément aux standards éditoriaux contemporains définis par les recommandations du Journal Article Reporting Standards (JARS) de l’American Psychological Association. Les rédactions de revues à fort impact rejettent de plus en plus vigoureusement les manuscrits qui dissimulent ou minimisent la présence de plafonds de score ou de sélections d’échantillons.
Les chercheurs doivent documenter de manière exhaustive, au sein de la section « Méthode », les éléments suivants :
- La proportion exacte et l’effectif numérique précis d’observations soumises à la censure (à gauche, à droite ou par intervalle) pour chaque variable dépendante analysée.
- La description opérationnelle exhaustive de tout critère d’exclusion ayant entraîné une troncation d’échantillon, en explicitant les flux de sélection au travers d’un diagramme de flux standardisé (type CONSORT pour les essais cliniques).
- La justification théorique et mathématique guidant le choix du modèle statistique de substitution à la régression ordinaire (justification du recours au modèle Tobit, à l’estimateur de Heckman ou aux risques proportionnels de Cox).
- La vérification scrupuleuse des hypothèses sous-jacentes du modèle choisi (tests de normalité résiduelle, tests d’hétéroscédasticité, vérification de la proportionnalité des risques de survie, justification des variables d’exclusion instrumentales dans le modèle de Heckman).
Enfin, la réalisation d’analyses de sensibilité systématiques constitue un prérequis incontournable à toute inférence robuste. Les auteurs se doivent de rapporter, en annexes ou au sein des résultats principaux, une confrontation directe entre les résultats issus des modèles statistiques standards (ex. MCO naïfs) et ceux délivrés par les modèles corrigés pour données censurées ou tronquées. Cette démarche de transparence permet aux pairs d’évaluer directement l’ampleur empirique du biais d’incomplétude et garantit la reproductibilité durable des conclusions scientifiques diffusées dans l’espace public.
Références
- Berkson, J. (1946). Limitations of the application of fourfold table analysis to hospital data. Biometrics Bulletin, 2(3), 47-53. https://doi.org/10.2307/3002000
- Cox, D. R. (1972). Regression models and life-tables. Journal of the Royal Statistical Society: Series B (Methodological), 34(2), 187-202. https://doi.org/10.1111/j.2517-6161.1972.tb00899.x
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153-161. https://doi.org/10.2307/1912352
- Kaplan, E. L., & Meier, P. (1958). Nonparametric estimation from incomplete observations. Journal of the American Statistical Association, 53(282), 457-481. https://doi.org/10.1080/01621459.1958.10501452
- Little, R. J. A., & Rubin, D. B. (2019). Statistical analysis with missing data (3rd ed.). John Wiley & Sons. https://doi.org/10.1002/9781119482260
- McDonald, J. F., & Moffitt, R. A. (1980). The uses of Tobit analysis. The Review of Economics and Statistics, 62(2), 318-321. https://doi.org/10.2307/1935777
- Pearl, J. (2009). Causality: Models, reasoning, and inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Powell, J. L. (1984). Least absolute deviations estimation for the censored regression model. Journal of Econometrics, 25(3), 303-325. https://doi.org/10.1016/0304-4076(84)90004-6
- Powell, J. L. (1986). Symmetrically trimmed least squares estimation for tobit models. Econometrica, 54(6), 1435-1460. https://doi.org/10.2307/1914308
- Tobin, J. (1958). Estimation of relationships for generalized truncated dependent variables. Econometrica, 26(1), 24-36. https://doi.org/10.2307/1907382
- Turnbull, B. W. (1976). The empirical distribution function with arbitrarily grouped, censored and truncated data. Journal of the Royal Statistical Society: Series B (Methodological), 38(3), 290-295. https://doi.org/10.1111/j.2517-6161.1976.tb01597.x
- Wooldridge, J. M. (2010). Econometric analysis of cross section and panel data (2nd ed.). MIT Press.