
L’inférence causale et l’analyse statistique contemporaines reposent sur un postulat épistémologique fondamental : la capacité d’extrapoler, à partir d’observations empiriques circonscrites, des régularités nomothétiques applicables à l’ensemble d’une population cible. Pourtant, la validité de cette démarche inductive est régulièrement compromise par des artefacts méthodologiques insidieux qui altèrent la structure même des données recueillies. Parmi ces distorsions, le biais de Berkson, également désigné sous le terme de paradoxe de Berkson ou d’effet de sélection sur collisionneur, constitue l’un des écueils les plus élégants et dévastateurs de la recherche scientifique moderne. Identifié initialement dans le contexte de la biostatistique hospitalière, ce phénomène met en lumière la manière dont un processus d’échantillonnage non aléatoire peut engendrer une corrélation statistique totalement artificielle entre deux variables intrinsèquement indépendantes, voire inverser le signe d’une association existante au sein de la population générale.
La puissance délétère de ce biais réside dans son caractère contre-intuitif. Contrairement aux erreurs de mesure classiques ou aux biais de confusion traditionnels résultant de causes communes non mesurées, le biais de Berkson naît du conditionnement involontaire sur une conséquence commune. Dans les sciences du comportement, la psychologie clinique, l’épidémiologie et les sciences sociales, les chercheurs manipulent fréquemment des cohortes issues de milieux institutionnels spécifiques : cliniques universitaires, plateformes numériques sélectives, ou échantillons de convenance estudiantins. Sans une modélisation causale rigoureuse, ces environnements tronqués transforment des variables mutuellement bénéfiques ou orthogonales en faux compromis antagonistes, alimentant ainsi une littérature scientifique saturée de fausses comorbidités, de théories compensatoires erronées et de résultats irréplicables.
Comprendre la genèse mathématique, la structure graphique et les manifestations cliniques du biais de Berkson est donc un impératif méthodologique incontournable. Ce traité approfondi propose une déconstruction systématique de cette anomalie statistique. De la formulation probabiliste originale de Joseph Berkson aux développements contemporains de l’inférence causale formalisée par Judea Pearl, nous examinerons comment ce piège d’échantillonnage opère, comment le détecter au moyen de simulations et de diagnostics économétriques, et quelles approches algorithmiques et protocolaires permettent de restaurer la validité externe des conclusions scientifiques.
1. Introduction fondamentale au biais de Berkson : Origine et conceptualisation
1.1 Origine historique et publication fondatrice de Joseph Berkson (1946)
L’émergence formelle du concept de biais de sélection remonte aux travaux séminaux du médecin et biostatisticien américain Joseph Berkson, alors directeur de la division de biostatistique à la prestigieuse Mayo Clinic. Au cours des années 1940, la communauté médicale assiste à l’essor spectaculaire des études cas-témoins conduites en milieu nosocomial, une méthodologie alors plébiscitée pour sa rentabilité économique et sa rapidité d’exécution face aux lourdes cohortes longitudinales en population générale. Berkson nourrissait un scepticisme profond à l’égard de ces protocoles qui postulaient implicitement que les patients hospitalisés constituaient un reflet miniaturisé fidèle des dynamiques étiologiques de la société dans son ensemble.
En 1946, Joseph Berkson publie son article historique intitulé « Limitations of the Application of Fourfold Table Analysis to Hospital Data » dans le Biometrics Bulletin. À travers une démonstration arithmétique d’une limpidité implacable, il démontre que si deux affections pathologiques distinctes possèdent chacune une probabilité propre d’entraîner l’hospitalisation d’un individu, l’acte même d’admettre ces patients dans un centre de soins induit mécaniquement une dépendance statistique entre ces deux maladies, et ce même lorsqu’elles se distribuent de façon parfaitement indépendante au sein de la population générale. Berkson ciblait particulièrement les études prétendant identifier des associations étiologiques directes entre des pathologies chroniques diverses à partir d’échantillons de patients alités.
L’accueil initial réservé par la communauté biostatistique fut teinté de perplexité et de résistance académique. De nombreux cliniciens et épidémiologistes contemporains considérèrent cette découverte comme une curiosité théorique mineure, un artefact mathématique marginal qui ne saurait invalider les vastes associations cliniques mises en évidence par l’observation hospitalière. Toutefois, au fil des décennies et à mesure que les études de terrain en population générale démentaient les corrélations hospitalières, les travaux de Berkson ont été élevés au rang de principe cardinal de l’épidémiologie méthodologique. Progressivement, cette conceptualisation a franchi les frontières biomédicales pour investir la psychologie expérimentale, les sciences cognitives et l’économétrie, s’imposant comme la grille d’analyse indispensable de tout protocole d’observation restreint.
1.2 Définition théorique du phénomène d’illusion statistique
D’un point de vue théorique formel, le biais de Berkson se définit comme une distorsion systématique de l’association statistique entre deux ou plusieurs variables, causée par un processus de sélection non aléatoire qui conditionne l’inclusion des unités d’observation dans l’échantillon sur les valeurs mêmes de ces variables ou de leurs corrélats immédiats. La manifestation la plus spectaculaire de cette illusion statistique réside dans l’apparition d’une corrélation fallacieuse négative entre deux caractéristiques qui sont en réalité orthogonales, c’est-à-dire totalement indépendantes dans la population d’origine, ou dans l’atténuation voire l’inversion paradoxale d’une véritable association positive générative.
Le mécanisme sous-jacent repose sur la rupture de la représentativité distributionnelle par un filtre d’admission déterministe ou probabiliste. Dès lors que l’inclusion au sein de l’espace échantillonné requiert la satisfaction d’au moins un critère parmi plusieurs (ou l’atteinte d’un seuil combiné), la présence avérée d’une variable favorable ou défavorable suffit à satisfaire la condition d’entrée. En conséquence, l’observateur n’enregistre jamais les individus qui échouent simultanément sur l’ensemble des critères. Cette troncature asymétrique crée l’illusion que la présence de la caractéristique A « explique » l’admission, rendant superflue ou statistiquement moins probable la présence simultanée de la caractéristique B chez les sujets observés.
Il est dès lors impératif d’établir une distinction épistémologique stricte entre la corrélation empiriquement observée au sein du sous-espace d’échantillonnage et la corrélation générative réelle au niveau ontologique ou populationnel. La corrélation observée est un artefact computationnel propre à la lentille d’observation, tandis que la corrélation générative traduit les mécanismes biologiques, psychologiques ou sociologiques régissant la nature. Confondre ces deux niveaux de réalité conduit à ériger en loi universelle ce qui ne constitue qu’une propriété géométrique d’un échantillon tronqué.
1.3 Importance épistémologique en psychologie et sciences du comportement
La vulnérabilité des sciences psychologiques et du comportement face au biais de Berkson est structurellement plus élevée que celle des sciences physiques ou biologiques dures. Cette fragilité provient du recours massif et récurrent à des protocoles de recrutement opportunistes, notamment par le biais de files actives de cliniques psychiatriques, de centres médico-psychologiques ou, plus fréquemment encore, de cohortes composées exclusivement d’étudiants de premier cycle universitaire en psychologie. Dans chacun de ces cas de figure, l’accès à la cohorte n’est pas un processus neutre : il dépend étroitement du niveau de détresse psychologique, des capacités cognitives, de la motivation intrinsèque ou du statut socio-économique des participants.
Les répercussions pratiques sur l’établissement de fausses comorbidités psychiatriques sont considérables. Les nosographies cliniques, telles que codifiées par le Manuel diagnostique et statistique des troubles mentaux (DSM), regorgent d’associations pathologiques postulées comme organiquement liées sur la seule base de leur co-occurrence clinique répétée. Or, si un individu souffrant d’un trouble anxieux consulte avec une probabilité accrue lorsqu’il développe un épisode dépressif majeur, et inversement, les cohortes cliniques présenteront une association dépression-anxiété artificiellement gonflée, occultant les dynamiques psychopathologiques autonomes observées chez les sujets non consultants au sein de la communauté.
En outre, le biais de Berkson constitue un facteur contributif majeur à la crise de la réplication qui secoue la psychologie différentielle et cognitive contemporaine. De multiples études pionnières identifiant des relations négatives supposément universelles entre des traits cognitifs distincts — par exemple entre la vitesse de traitement de l’information et la précision analytique, ou entre la créativité divergente et la régulation émotionnelle — échouent de manière retentissante lors de réplications conduites sur des panels représentatifs à grande échelle. Cette instabilité des conclusions n’est pas simplement attribuable à des fluctuations d’échantillonnage aléatoires, mais procède directement de la suppression du biais de sélection lorsque le protocole passe d’un environnement de laboratoire hautement sélectif à un échantillonnage probabiliste rigoureux.
2. Cadre mathématique et statistique du paradoxe de Berkson
2.1 Formulation probabiliste et probabilités conditionnelles
Pour appréhender avec exactitude la mécanique formelle du biais de Berkson, il convient de recourir au calcul des probabilités conditionnelles. Considérons deux événements binaires indépendants, notés $A$ et $B$, représentant par exemple la présence de deux pathologies distinctes chez un individu tiré au hasard au sein d’une population générale. L’indépendance marginale absolue entre ces deux événements implique rigoureusement que la probabilité conjointe de leur survenue simultanée est égale au produit de leurs probabilités marginales respectives :
$$P(A \cap B) = P(A) \times P(B)$$
Ce qui équivaut à affirmer que la probabilité conditionnelle de $A$ sachant $B$ est strictement identique à la probabilité marginale de $A$ :
$$P(A mid B) = P(A)$$
Introduisons désormais une troisième variable binaire, notée $S$, désignant le statut d’inclusion ou de sélection dans l’échantillon d’analyse (où $S = 1$ indique que le sujet est inclus dans la cohorte d’étude, par exemple suite à une hospitalisation ou une inscription sélective, et $S = 0$ indique son exclusion). Le processus de sélection est gouverné par la règle d’admission selon laquelle un sujet est sélectionné dès lors qu’il manifeste au moins l’un des deux événements, soit l’union booléenne : $S = 1 iff (A = 1 cup B = 1)$.
Examinons la distribution de probabilité conditionnelle au sein de la sous-population sélectionnée, c’est-à-dire sachant $S = 1$. La probabilité que l’événement $A$ se produise sachant que $B$ s’est produit et que le sujet appartient à l’échantillon sélectionné s’écrit formellement :
$$P(A = 1 mid B = 1, S = 1) = \frac{P(A = 1 \cap B = 1 \cap S = 1)}{P(B = 1 \cap S = 1)}$$
Puisque la condition $B = 1$ garantit de facto que $S = 1$ d’après notre règle de sélection, l’intersection $B = 1 cap S = 1$ se simplifie immédiatement en $B = 1$. Dès lors :
$$P(A = 1 mid B = 1, S = 1) = \frac{P(A = 1 \cap B = 1)}{P(B = 1)} = P(A = 1)$$
Considérons à présent la situation où l’événement $B$ ne s’est pas produit ($B = 0$) chez un individu faisant partie de l’échantillon sélectionné ($S = 1$). Dans ce cas de figure, l’intersection conditionnelle s’évalue comme suit :
$$P(A = 1 mid B = 0, S = 1) = \frac{P(A = 1 \cap B = 0 \cap S = 1)}{P(B = 0 \cap S = 1)}$$
Or, pour qu’un individu satisfasse simultanément les critères $B = 0$ et $S = 1$, il est mathématiquement indispensable que $A = 1$, car sans la présence de $A$, la condition d’admission $S = 1$ serait irrémédiablement violée. Il en résulte que $P(A = 1 cap B = 0 cap S = 1) = P(A = 1 cap B = 0) = P(A = 1)P(B = 0)$ en vertu de l’indépendance marginale originale. Par ailleurs, le dénominateur $P(B = 0 cap S = 1)$ est strictement égal à $P(B = 0 cap A = 1)$. Par conséquent :
$$P(A = 1 mid B = 0, S = 1) = \frac{P(A = 1)P(B = 0)}{P(A = 1)P(B = 0)} = 1$$
Dès lors que la prévalence de $A$ dans la population générale est strictement inférieure à 1 ($P(A = 1) < 1$), nous constatons l'inégalité fondamentale suivante :
$$P(A = 1 mid B = 1, S = 1) < P(A = 1 mid B = 0, S = 1)$$
Cette inégalité démontre mathématiquement que, conditionnellement à la sélection ($S = 1$), la probabilité de présenter $A$ est strictement plus faible lorsque $B$ est présent que lorsque $B$ est absent. L’indépendance marginale est anéantie : au sein de l’échantillon sélectionné, $A$ et $B$ exhibent une corrélation conditionnelle négative parfaite ou quasi-parfaite, générée exclusivement par l’opération de conditionnement sur la variable de sélection.
2.2 Transformation des coefficients de corrélation de Pearson
Lorsque nous transposons cette mécanique probabiliste discrète aux variables quantitatives continues sous distribution normale multivariée, le biais de Berkson opère une transformation directe du coefficient de corrélation linéaire de Pearson ($r$). Considérons deux variables aléatoires continues $X$ et $Y$, distribuées selon une loi normale bivariée au sein de la population générale, caractérisées par des moyennes $\mu_X, \mu_Y$, des variances $\sigma_X^2, \sigma_Y^2$, et un coefficient de corrélation paramétrique $\rho_{XY} ge 0$.
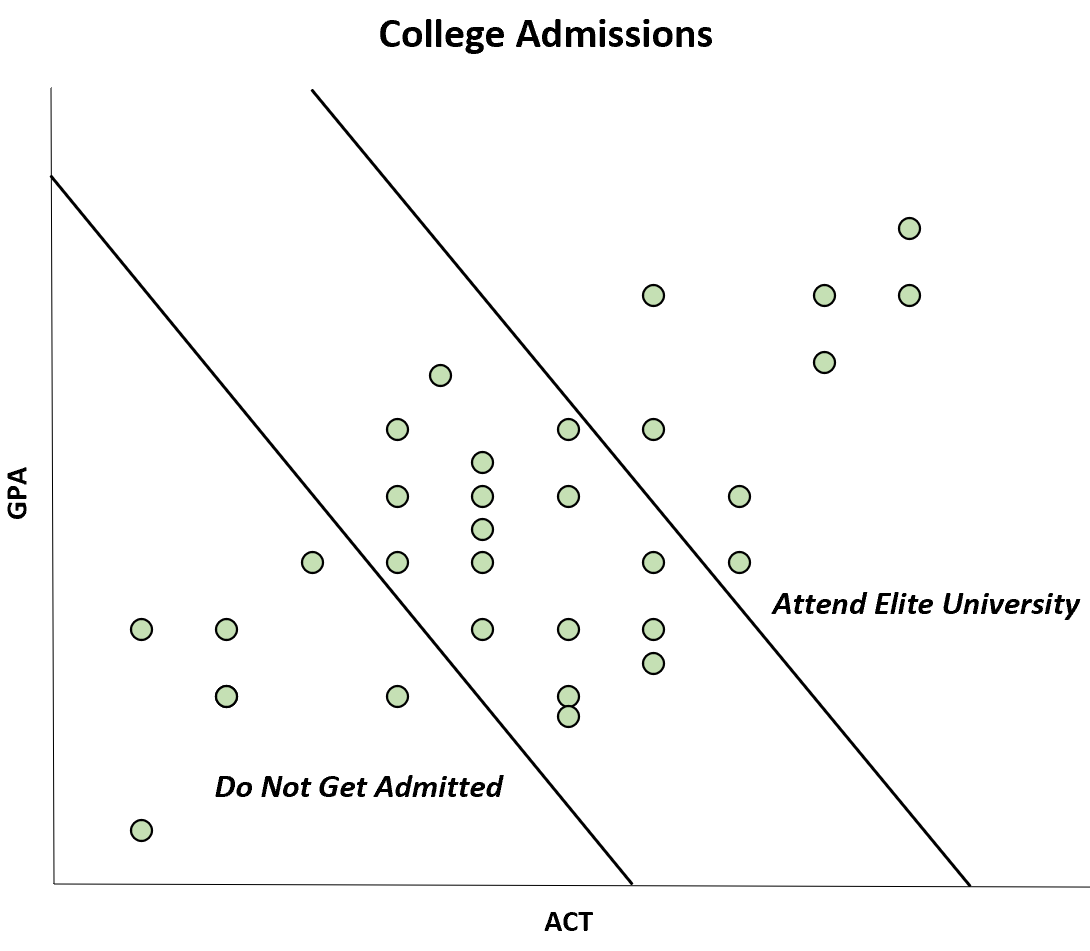
Le processus de sélection impose une frontière d’inclusion dépendant conjointement de $X$ et de $Y$. Supposons un modèle de sélection linéaire où un individu est retenu dans la cohorte si et seulement si sa combinaison linéaire dépasse un seuil critique $c$, soit $S = \mathbb{I}(w_1 X + w_2 Y ge c)$, où $w_1, w_2 > 0$ sont des coefficients de pondération positifs. Ce filtre élimine systématiquement le quadrant inférieur gauche du domaine de définition conjoint des variables.
Cette troncature multivariée altère profondément la matrice de variance-covariance des données observées. La covariance conditionnelle $\text{Cov}(X, Y mid S = 1)$ s’écarte radicalement de la covariance populationnelle $\text{Cov}(X, Y)$. Mathématiquement, la réduction drastique de la variance conjointe le long de l’axe de sélection induit un étirement artificiel des résidus orthogonaux. Dès lors, le coefficient de corrélation de Pearson calculé sur l’échantillon restreint, noté $r_{XY mid S=1}$, subit une dérive négative sévère :
$$r_{XY mid S=1} = \frac{\text{Cov}(X, Y mid S=1)}{\sigma_{X mid S=1} \sigma_{Y mid S=1}} ll \rho_{XY}$$
Si la corrélation initiale $\rho_{XY}$ était nulle, $r_{XY mid S=1}$ prend une valeur strictement négative ($r < 0$). Plus troublant encore, même dans l'hypothèse où les variables partagent une association générative positive substantielle (par exemple $\rho_{XY} = +0,40$), un seuil de sélection drastique imposé par la règle $w_1 X + w_2 Y ge c$ est mathématiquement capable d'inverser le signe de la relation observée, produisant un coefficient empirique négatif (par exemple $r = -0,35$), trompant totalement le statisticien sur la nature de la dynamique sous-jacente.
2.3 Modélisation de l’effet de troncature sur une distribution bivariée
La compréhension géométrique de cette distorsion éclaire le comportement des distributions bivariées continues soumises à un filtre de Berkson. Dans un repère cartésien bidimensionnel, une distribution normale bivariée sans corrélation ($rho = 0$) se projette sous la forme d’ellipses ou de cercles isodensités concentriques centrés sur le point moyen $(\mu_X, \mu_Y)$. Chaque zone du plan reflète la densité conjointe de probabilité $f(x, y)$.
L’application d’un critère de sélection déterministe agit comme un plan de coupe sécant qui oblitère irrévocablement une fraction de l’espace géométrique. Les sujets pour lesquels les valeurs conjointes de $X$ et de $Y$ sont simultanément faibles se situent sous la droite d’équation $w_1 X + w_2 Y = c$. Lorsque cette région inférieure est expurgée de l’analyse, l’espace échantillonné résiduel prend la forme d’un trapèze tronqué ou d’un triangle résiduel asymétrique.
Au sein de cet espace tronqué, une dynamique géométrique contraignante s’impose : pour tout point d’observation situé à une valeur extrêmement basse de l’abscisse $X$, la valeur de l’ordonnée $Y$ doit impérativement être élevée pour compenser ce déficit et franchir la ligne de démarcation du seuil de sélection. Inversement, une unité présentant une valeur de $X$ très élevée a la possibilité mathématique de présenter une valeur de $Y$ particulièrement faible tout en restant admise dans l’échantillon. Cette compensation géométrique obligatoire confère mécaniquement au nuage de points résiduel une pente descendante prononcée.
Ce remodelage géométrique ne modifie pas uniquement la pente de régression : il déforme profondément les erreurs standards et les statistiques de test conventionnelles ($t$ de Student, $F$ de Fisher). La réduction de la variance marginale observée, combinée à la distorsion de l’homosパédasticité aux abords de la frontière de sélection, génère une sous-estimation artificielle des intervalles de confiance réels, attribuant une significativité statistique éclatante ($p < 0,001$) à une relation purement fantomatique.
3. Mécanisme causal et théorie des graphes : Le conditionnement sur un collisionneur
3.1 Introduction aux graphes causaux orientés (DAGs)
La formalisation moderne de l’inférence causale, propulsée par les avancées mathématiques de Judea Pearl et formalisée dans le cadre des graphes acycliques orientés (Directed Acyclic Graphs ou DAGs), a permis de démystifier la nature fondamentale du biais de Berkson. Dans un DAG, les nœuds représentent des variables aléatoires et les arêtes fléchées encodent des relations causales directes orientées de la cause vers l’effet, interdisant toute boucle rétroactive fermée.
Au sein de cette topologie causale, une configuration structurelle élémentaire joue un rôle prépondérant : la structure de collisionneur (ou collider en terminologie anglo-saxonne). Un nœud $S$ est formellement qualifié de collisionneur sur un chemin causal liant les variables $X$ et $Y$ lorsque les flèches issues de ces deux variables convergent mutuellement vers lui, formant la structure graphique canonique :
$$X long\rightarrow S long\leftarrow Y$$
La théorie des graphes repose sur le concept mathématique de d-séparation (séparation directionnelle). Selon les règles de la d-séparation établies par Pearl, un chemin causal reliant deux nœuds $X$ et $Y$ est naturellement bloqué (ou inactif) si ce chemin contient un collisionneur $S$ qui n’est pas conditionné, et dont aucun descendant n’est conditionné. En l’absence de conditionnement sur $S$, les variables $X$ et $Y$ sont mutuellement d-séparées par la structure de collision, ce qui garantit leur indépendance statistique marginale : aucune information ne transite à travers le nœud convergent.
Toutefois, la règle de d-séparation stipule une contrepartie fondamentale : dès l’instant où un chercheur conditionne l’analyse sur un collisionneur (que ce soit par stratification, inclusion sélective dans l’échantillon, appariement ou ajustement dans un modèle de régression multivariée), le chemin causal précédemment bloqué se retrouve immédiatement ouvert ou activé. Ce conditionnement débloque un flux d’information non causal entre $X$ et $Y$, instaurant une dépendance statistique fallacieuse entre ces deux variables pourtant causalement isolées l’une de l’autre.
3.2 Le biais du collisionneur comme matrice formelle de Berkson
Le biais de Berkson n’est rien d’autre que l’incarnation historique et épidémiologique princeps du biais de conditionnement sur un collisionneur (collider stratification bias). Dans l’architecture d’une recherche scientifique, la variable d’inclusion dans l’échantillon d’étude, notée $S$, constitue par essence un nœud aval vers lequel convergent de multiples déterminants comportementaux, cliniques ou socio-démographiques.
Considérons la relation entre une variable d’exposition potentielle $E$ et une maladie d’intérêt $M$. Dans une population globale, $E$ ne possède aucun effet causal sur l’incidence de $M$ ($E perp M$). Supposons désormais que l’exposition $E$ augmente la probabilité de consulter un médecin ou de participer à une étude (flèche causale $E to S$), et que, de manière parallèle et indépendante, la pathologie $M$ accroisse également la propension à être recruté ou hospitalisé (flèche causale $M to S$). La variable de sélection $S$ se configure ainsi sous la forme exacte d’un collisionneur :
$$E long\rightarrow S long\leftarrow M$$
Lorsque le chercheur restreint son investigation empirique aux seuls individus ayant effectivement participé à l’enquête ou ayant été admis dans la cohorte hospitalière, il impose de fait la condition mathématique $S = 1$. Ce simple filtre opératoire conditionne l’analyse sur le collisionneur $S$, activant le chemin non causal $E dash\leftarrow S dash\rightarrow M$. Cette activation injecte une dépendance statistique parasite au sein de l’échantillon, faisant émerger un risque relatif ou un odds ratio substantiellement biaisé, suggérant fallacieusement que l’exposition $E$ est un facteur protecteur ou aggravateur de la maladie $M$.
3.3 Différenciation structurelle entre facteur de confusion et collisionneur
La distinction entre un facteur de confusion classique (confounder) et un collisionneur (collider) représente l’une des lignes de démarcation les plus critiques de l’épidémiologie computationnelle. La confusion classique découle d’une structure causale en fourche amont (cause commune), formalisée par le schéma :
$$X long\leftarrow Z long\rightarrow Y$$
Dans cette topologie en fourche, la variable $Z$ influence simultanément la variable explicative $X$ et le critère de jugement $Y$. Si le chercheur omet d’ajuster son analyse sur $Z$, le chemin causal amont $X \leftarrow Z to Y$ demeure ouvert, distordant l’estimation de l’effet causal de $X$ sur $Y$. Dans ce contexte précis, la méthode statistique appropriée exige impérativement de contrôler, stratifier ou ajuster sur le facteur de confusion $Z$ afin de bloquer ce chemin parasite et d’isoler l’effet causal pur.
À l’opposé diamétral, le conditionnement sur un collisionneur obéit à une logique inversée. Alors que le contrôle d’un facteur de confusion élimine un biais préexistant, l’ajustement ou le filtrage sur un collisionneur crée de toutes pièces un biais inexistant à l’origine. Le tableau suivant synthétise les propriétés mathématiques et méthodologiques fondamentales distinguant ces deux topologies causales :
- Topologie structurelle : Fourche amont ($X \leftarrow Z to Y$) pour la confusion versus convergence aval ($X to S \leftarrow Y$) pour la collision.
- État naturel du chemin : Ouvert sans conditionnement dans la confusion ; bloqué/inactif sans conditionnement dans la collision.
- Conséquence du conditionnement : Bloque le chemin parasite et élimine le biais pour la confusion ; ouvre un chemin parasite et induit le biais de Berkson pour la collision.
- Règle d’ajustement : Ajustement fortement recommandé en régression pour la confusion ; ajustement strictement prohibé pour le collisionneur.
L’une des erreurs méthodologiques les plus destructrices en régression multivariée contemporaine réside dans la pratique de l’ajustement systématique et indiscriminé sur toutes les covariables disponibles dans une base de données. En intégrant aveuglément des variables de sélection, d’adhérence thérapeutique ou des symptômes concomitants qui se comportent comme des collisionneurs, les analystes introduisent délibérément le biais de Berkson au cœur même de leurs modèles statistiques, invalidant la portée causale de leurs inférences.
4. L’exemple paradigmatique de Joseph Berkson : L’environnement hospitalier
4.1 Le cas classique du diabète et de la cholécystite
Pour illustrer empiriquement la réalité de cette illusion statistique, Joseph Berkson a élaboré un exemple clinique devenu paradigmatique, portant sur l’étude de l’association étiologique présumée entre le diabète de type 2 et la cholécystite (inflammation aiguë ou chronique de la vésicule biliaire). Au milieu du XXe siècle, plusieurs publications médicales s’interrogeaient sur l’existence d’un effet protecteur mutuel ou au contraire d’une pathogenèse croisée entre ces deux entités nosologiques distinctes.
Imaginons une population générale de taille théorique $N = 10,000$ individus au sein de laquelle la prévalence marginale du diabète ($D$) est de 10 % ($P(D = 1) = 0,10$) et la prévalence marginale de la cholécystite ($C$) est de 10 % ($P(C = 1) = 0,10$). Fait crucial pour la démonstration : ces deux maladies se développent selon des mécanismes étiologiques strictement indépendants au sein de la communauté. Par conséquent, la proportion d’individus cumulant les deux affections est rigoureusement égale au produit de leurs prévalences, soit 1 % ($P(D = 1 cap C = 1) = 0,01$).
Définissons à présent les taux d’hospitalisation différentiels propres à chaque état clinique au sein de cette population :
- Un individu sain (exempt des deux affections) possède une probabilité d’hospitalisation annuelle de fond très faible, notée $h_0 = 0,05$.
- Un patient souffrant uniquement de diabète présente une probabilité d’admission hospitalière accrue, notée $h_D = 0,15$.
- Un patient présentant une cholécystite aiguë subit des coliques hépatiques sévères, ce qui confère une probabilité d’admission élevée, notée $h_C = 0,20$.
- Un patient souffrant simultanément des deux pathologies cumule les risques cliniques, atteignant une probabilité conjointe d’hospitalisation de $h_{DC} = 1 – (1 – h_D)(1 – h_C) = 1 – (0,85 \times 0,80) = 0,32$.
Lorsque l’investigateur restreint son étude épidémiologique exclusivement aux dossiers médicaux des patients hospitalisés, le dénombrement effectif des sous-groupes révèle une surreprésentation spectaculaire des individus multimorbides par rapport aux individus sains ou modérément atteints. Parmi les sujets hospitalisés diabétiques, la proportion de patients souffrant de cholécystite se révèle paradoxalement inférieure à la proportion de cholécystite observée chez les hospitalisés non diabétiques. Le calcul empirique de l’odds ratio au sein de la cohorte hospitalière aboutit à une valeur substantiellement inférieure à 1,0 (par exemple $OR \approx 0,72$), conduisant le médecin hospitalier à la conclusion totalement fallacieuse que le diabète exercerait un effet protecteur biologique contre la survenue de la cholécystite.
4.2 Dynamique d’admission et probabilités d’hospitalisation combinées
La mécanique probabiliste qui régit cette distorsion repose sur l’interaction des taux d’admission concurrents. L’erreur conceptuelle fondamentale consiste à postuler que la probabilité d’hospitalisation pour une pathologie $A$ est indépendante de l’existence d’une pathologie $B$. En réalité, le système hospitalier agit comme un entonnoir de filtrage dont l’admission globale dépend d’une loi de survie binomiale concurrente. Si $P(H mid A)$ désigne la probabilité d’hospitalisation due à $A$ et $P(H mid B)$ la probabilité d’hospitalisation due à $B$, la probabilité conjointe d’admission pour un individu cumulant les deux conditions s’exprime par le complémentaire du produit des non-admissions :
$$P(H mid A \cap B) = P(H mid A) + P(H mid B) – P(H mid A) \cdot P(H mid B)$$
Ce mécanisme confère mécaniquement aux individus atteints des deux maladies un taux d’entrée dans l’échantillon d’analyse bien supérieur à celui de n’importe quel groupe mono-pathologique. Réciproquement, la population des patients admis en milieu hospitalier ne présentant pas la maladie $A$ est massivement enrichie en sujets présentant des formes graves de la maladie $B$, car c’est précisément la maladie $B$ qui a motivé leur hospitalisation.
En conséquence, au sein de l’hôpital, la prévalence de la pathologie $B$ parmi les non-$A$ est artificiellement gonflée par le motif d’admission, surpassant largement la prévalence de $B$ observée chez les sujets atteints de $A$, chez qui le motif d’admission était déjà amplement satisfait par la maladie $A$ elle-même. La généralisation directe des données nosocomiales à la population générale constitue ainsi un sophisme écologique et statistique d’une gravité exceptionnelle.
4.3 Répercussions historiques sur la recherche épidémiologique hospitalière
La formalisation du paradoxe de Berkson a profondément ébranlé les fondations de l’épidémiologie observationnelle de la seconde moitié du XXe siècle. L’une des controverses les plus emblématiques concernait les premières recherches étiologiques sur la toxicité du tabagisme. Lors des débats houleux opposant les pionniers de la santé publique aux défenseurs de l’industrie du tabac — parmi lesquels figurait ironiquement Joseph Berkson lui-même, sceptique quant aux biais d’échantillonnage —, la question de l’utilisation de témoins hospitalisés a suscité d’intenses interrogations.
Dans les premières études cas-témoins conduites dans les hôpitaux, les témoins recrutés étaient des patients admis pour d’autres affections (pathologies respiratoires bénignes, troubles cardiovasculaires, affections chirurgicales). Or, nombre de ces maladies d’admission étaient elles-mêmes corrélées au tabagisme passif ou actif. En recrutant des témoins en milieu hospitalier, les épidémiologistes risquaient de conditionner sur un collisionneur (l’admission hospitalière provoquée à la fois par le cancer bronchique et par les autres maladies liées au tabac), ce qui risquait d’atténuer artificiellement l’ampleur du lien causal réel liant le tabac au carcinome pulmonaire.
Ces constats méthodologiques ont précipité une rupture épistémologique majeure. La communauté scientifique a réalisé que la validité d’une inférence causale dépendait intrinsèquement de la nature probabiliste de l’échantillonnage. Ce tournant a impulsé la mise en œuvre de grandes cohortes prospectives en population générale, à l’instar de la célèbre Framingham Heart Study initiée dès 1948, explicitement conçue pour suivre des cohortes saines représentatives et s’affranchir définitivement des biais d’admission inhérents aux structures de soins tertiaires.
5. Illustration concrète et intuitive : L’analogie des restaurants
5.1 Le scénario des burgers et des milkshakes
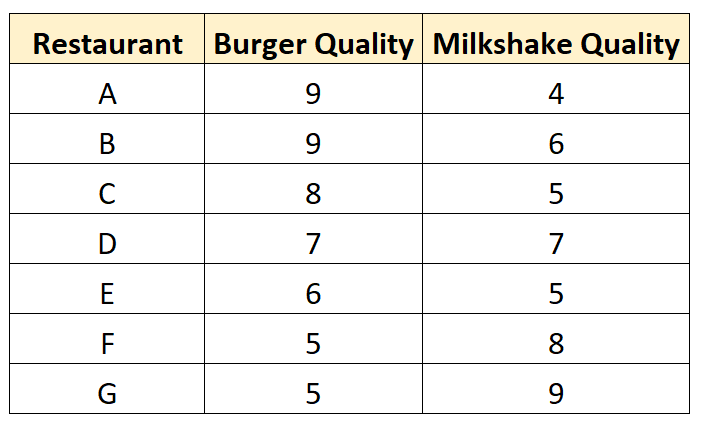
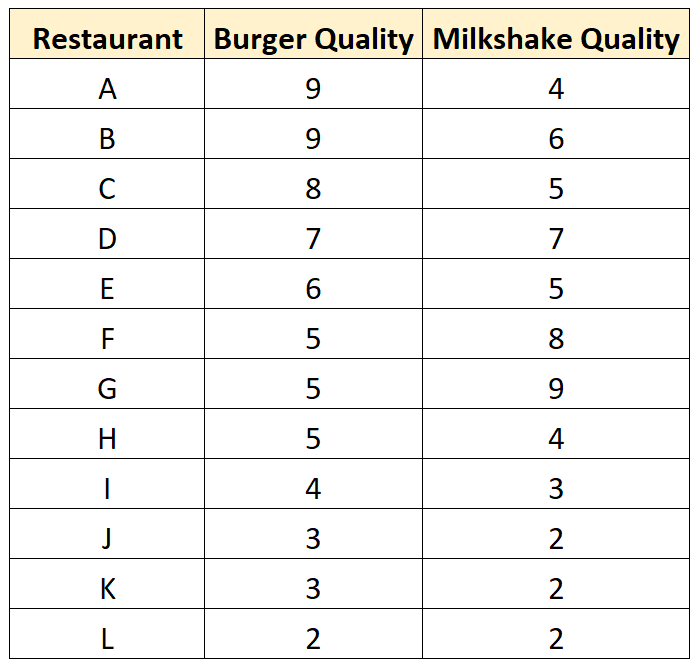
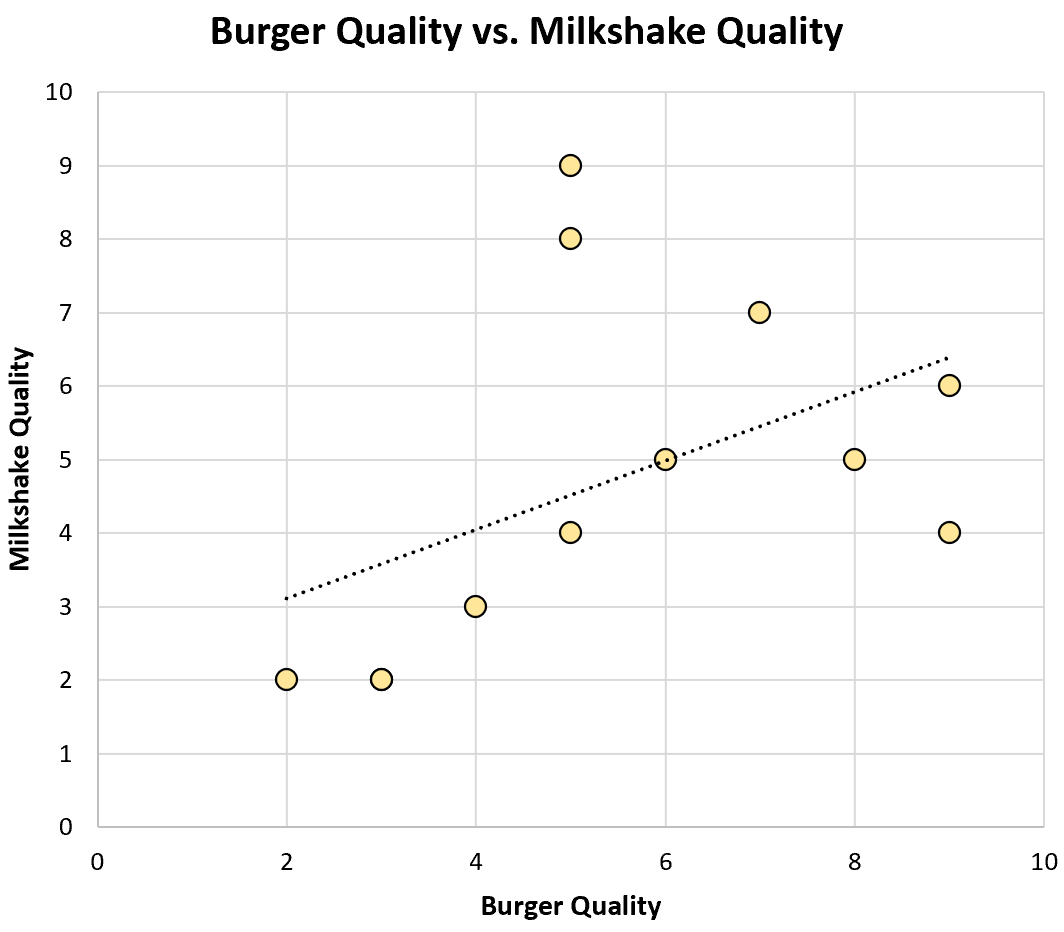
Pour appréhender intuitivement le biais de Berkson sans s’enliser immédiatement dans le formalisme des probabilités conditionnelles, l’analogie de l’évaluation culinaire des restaurants constitue une parabole pédagogique particulièrement féconde. Imaginons un univers gastronomique comprenant une grande diversité d’établissements de restauration rapide, chacun étant évalué sur deux dimensions strictement indépendantes : la qualité des burgers (notée sur une échelle de 0 à 10) et la qualité des milkshakes (notée également sur une échelle de 0 à 10).
Dans la population générale exhaustive de tous les restaurants existants au sein d’une métropole, supposons que les compétences culinaires d’un chef burger n’ont aucune influence causale sur la qualité des produits laitiers préparés par un autre employé. L’association réelle dans la population est donc nulle ($r = 0,00$), voire légèrement positive ($r = +0,30$) si l’on postule qu’un propriétaire exigeant applique des normes de management rigoureuses à l’ensemble des postes culinaires de sa brigade.
Considérons maintenant le comportement de sélection d’un consommateur moyen ou d’un critique gastronomique urbain. Ce dernier refuse catégoriquement de fréquenter ou de chroniquer des établissements médiocres. Sa règle de décision comportementale est limpide : il ne visite et ne recommande un restaurant que si ce dernier propose soit d’excellents burgers, soit d’excellents milkshakes, ou les deux. En termes formels, la condition d’inclusion dans son carnet d’adresses s’énonce ainsi :
$$\text{Note Burgers} + \text{Note Milkshakes} ge 12$$
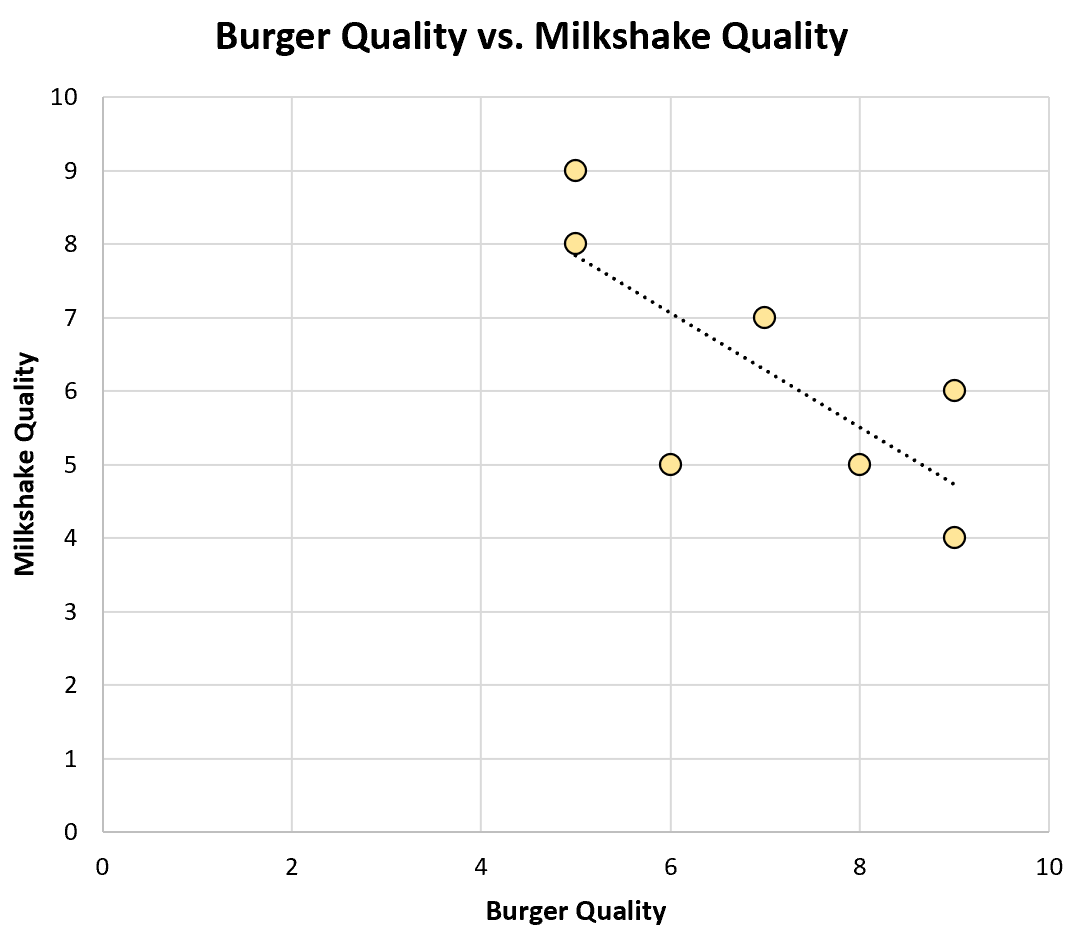
En appliquant scrupuleusement ce seuil de tolérance gustative, le consommateur élimine d’emblée de son champ d’expérience empirique l’immense majorité des établissements situés sous le seuil d’acceptabilité : les restaurants affichant des burgers infâmes couplés à des milkshakes insipides (le quadrant inférieur gauche de l’espace gastronomique).
5.2 Comparaison visuelle des diagrammes de dispersion
Si l’on dresse un diagramme de dispersion intégrant la totalité des restaurants de la ville, le nuage de points complet s’organise selon une ellipse symétrique ou un cercle parfait, reflétant une indépendance totale ou une légère tendance ascendante positive ($r = +0,46$). Les restaurants d’excellence côtoient les établissements moyens et les adresses déplorables sans distorsion structurelle.
Cependant, lorsque nous isolons uniquement le sous-ensemble des restaurants fréquentés par notre consommateur (la fraction tronquée par le seuil de sélection), la topologie géométrique du nuage de points subit une métamorphose spectaculaire. Le quadrant inférieur gauche étant intégralement supprimé par le filtre d’exclusion, la bordure inférieure gauche de l’échantillon résiduel est brutalement délimitée par la droite de coupure d’équation :
$$\text{Qualité Milkshakes} = 12 – \text{Qualité Burgers}$$
L’analyse statistique restreinte à ce sous-échantillon sélectif fait émerger une corrélation empirique violemment négative, oscillant souvent autour de $r = -0,75$. Si le consommateur commande un burger exceptionnel (noté 9/10), le restaurant peut parfaitement se contenter de servir un milkshake moyen (noté 4/10) pour avoir mérité sa place dans le classement. En revanche, si le consommateur commande un burger médiocre (noté 3/10), ce restaurant n’a pu franchir le seuil d’admission que parce que son milkshake atteignait le score mirifique de 9/10 ou 10/10.
Notre consommateur en déduit dès lors une théorie intuitive profondément fallacieuse : il formule l’hypothèse de l’existence d’un prétendu compromis gastronomique structurel (trade-off), affirmant doctement que les restaurants ultra-spécialisés dans la confection de burgers d’exception négligent inévitablement leurs desserts, et vice-versa. Il réifie sous forme de contrainte technique ou de loi commerciale ce qui n’est en réalité que le produit exclusif de son propre filtre de sélection à l’entrée.
5.3 Application du principe aux choix de consommation et biais cognitifs
Ce mécanisme psychologique et comportemental s’étend bien au-delà de la critique culinaire et façonne insidieusement de nombreux jugements portés par les acteurs économiques au quotidien. Le consommateur lambda observe régulièrement que les produits manufacturés extrêmement durables et robustes sont dépourvus d’ergonomie intuitive ou d’élégance stylistique, tandis que les objets au design épuré se révèlent souvent fragiles. Il en conclut hâtivement à une loi physique d’incompatibilité entre esthétique et robustesse mécanique.
En réalité, le marché concurrentiel impose un seuil d’utilité minimale pour la commercialisation d’un bien de consommation : un produit cumulant une fragilité rédhibitoire et un design hideux ne dépasse jamais le stade du prototype ou fait rapidement faillite, échappant ainsi à l’observation du client sur les étals. De la même manière, les logiciels ou applications numériques téléchargés massivement présentent fréquemment une relation inverse perçue entre richesse fonctionnelle et légèreté computationnelle : les programmes à la fois lents et dépourvus de fonctionnalités sont promptement désinstallés et oubliés.
Ces filtrages constants nourrissent des heuristiques cognitives fallacieuses. L’esprit humain, enclin à rechercher des justifications téléologiques aux anomalies apparentes du monde sensible, élabore des rationalisations a posteriori pour donner du sens à ces compromis illusoires. Ce faisant, il renforce des représentations erronées du fonctionnement des marchés, des dynamiques industrielles et des compétences professionnelles.
6. Manifestations du biais de Berkson en psychologie clinique et psychopathologie
6.1 La fausse comorbidité entre troubles de l’axe I et de l’axe II
Dans le domaine de la psychopathologie clinique et de la nosographie psychiatrique, le biais de Berkson déploie ses conséquences les plus délétères à travers l’illusion de comorbidité artificielle. Historiquement codifiés au sein des éditions antérieures du DSM sous la distinction entre Axe I (troubles cliniques majeurs tels que la dépression majeure, le trouble panique ou le trouble bipolaire) et Axe II (troubles de la personnalité structurels tels que le trouble de la personnalité limite ou narcissique), ces diagnostics ont longtemps été décrits comme présentant une affinité étiologique intime.
Une observation récurrente issue des unités de soins intensifs et des consultations hospitalières spécialisées mettait en exergue une co-occurrence massive : une proportion substantielle de patients traités pour un épisode dépressif caractérisé présentait simultanément les critères diagnostiques d’un trouble de la personnalité borderline. Les cliniciens en concluaient fréquemment que les traits de personnalité dysfonctionnels constituaient le lit étiologique direct ou le substrat neuropathologique vulnérabilisant précipitant la dépression clinique.
Or, l’application rigoureuse du cadre d’analyse de Berkson déconstruit impitoyablement cette certitude clinique :
- Un individu souffrant d’un trouble de la personnalité modéré sans décompensation dépressive gère souvent ses difficultés relationnelles dans sa sphère privée sans solliciter d’aide médicale institutionnelle ($P(\text{Soin} mid \text{Axe II}) \text{ faible à modérée}$).
- Un individu souffrant d’une dépression unipolaire isolée bénéficie d’une prise en charge ambulatoire par son médecin généraliste sans être systématiquement orienté vers un centre expert ($P(\text{Soin} mid \text{Axe I}) \text{ modérée}$).
- En revanche, un patient cumulant la labilité affective explosive d’un trouble de la personnalité et le désespoir sidérant d’un épisode dépressif sévère présente un risque suicidaire démultiplié, provoquant une intervention d’urgence et une hospitalisation psychiatrique quasi-systématique ($P(\text{Soin} mid \text{Axe I} \cap \text{Axe II}) to 1$).
Le recrutement de cohortes de recherche au sein des centres hospitalo-universitaires sélectionne ainsi massivement sur le collisionneur « hospitalisation psychiatrique ». Lorsque de vastes enquêtes épidémiologiques communautaires (telles que le protocole National Comorbidity Survey de l’OMS) sont ultérieurement conduites en population générale à l’aide d’échantillons probabilistes représentatifs au domicile des individus, l’ampleur de cette prétendue comorbidité s’effondre de manière spectaculaire, démontrant qu’il s’agissait en grande partie d’un artefact d’admission.
6.2 Le paradoxe des traits de personnalité chez les patients hospitalisés
L’exploration psychométrique des dimensions du modèle des Big Five (Modèle à cinq facteurs : Ouverture, Conscience, Extraversion, Agréabilité, Névrosisme) au sein des populations psychiatriques hospitalisées fournit une autre illustration éclatante du paradoxe de Berkson. Dans la population générale non institutionnalisée, les dimensions de Névrosisme (instabilité émotionnelle) et de Conscience (autodiscipline, méticulosité, sens des responsabilités) sont généralement indépendantes ou très faiblement corrélées négativement.
Cependant, dès lors que les données psychométriques sont collectées exclusivement auprès de patients admis en institution de santé mentale pour des troubles sévères du comportement ou des épisodes dépressifs réactionnels, une corrélation négative artificielle prononcée émerge entre ces deux traits. Le raisonnement sous-jacent s’articule autour des mécanismes compensatoires régissant la survie fonctionnelle en milieu ouvert :
Un sujet affichant un niveau de névrosisme exceptionnellement élevé ne parvient à maintenir son adaptation sociale et à éviter l’hospitalisation que s’il dispose d’un niveau de conscience extrêmement fort, lui permettant de structurer rigoureusement son quotidien en dépit de son anxiété interne. À l’inverse, un individu présentant un faible niveau de conscience s’adapte tant que son névrosisme reste modéré. Lorsque ces deux boucliers cèdent simultanément (névrosisme élevé ET faible conscience), l’effondrement adaptatif est immédiat, conduisant à l’internement.
En analysant uniquement les patients internés, les psychologues observent une surreprésentation aberrante de combinaisons déséquilibrées, créant l’illusion statistique que les traits protecteurs de la santé mentale agiraient comme des antagonistes universels. Cette distorsion fausse lourdement l’évaluation de l’efficacité thérapeutique des protocoles de psychothérapie, attribuant à tort l’échec ou la réussite des interventions à des configurations de personnalité factices.
6.3 Le cas des études sur l’addiction et les troubles anxieux
Le champ de l’addictologie clinique a longtemps été troublé par des discordances majeures entre les données empiriques recueillies en centres d’alcoologie spécialisés et celles issues des études épidémiologiques de santé publique. Pendant des décennies, les études cliniques ont rapporté une association négative inattendue ou une absence totale de corrélation entre la sévérité de la dépendance à l’alcool et l’intensité des troubles paniques sous-jacents parmi les patients en cure de désintoxication.
Ce phénomène s’explique par un biais de Berkson aigu gouvernant la trajectoire de recours aux soins. Les personnes aux prises avec un abus d’alcool isolé tardent souvent des années avant d’entreprendre une démarche de sevrage, le déni et la stigmatisation retardant la consultation. De même, les patients souffrant exclusivement de troubles anxieux consultent prioritairement en cardiologie ou en neurologie pour explorer leurs symptômes neurovégétatifs. Ce n’est que lorsque la souffrance panique devient intolérable que le patient utilise l’alcool comme automédication anxiolytique, précipitant une crise aiguë qui force l’admission dans un service d’addictologie d’urgence.
En conséquence, les centres de cure recrutent un contingent disproportionné d’individus présentant des seuils extrêmes d’anxiété pour des consommations d’alcool modérées, et inversement, des alcooliques massifs dont le profil émotionnel est paradoxalement anesthésié. Les chercheurs observant cet échantillon clinique modélisent alors une dynamique pharmacologique protectrice fictive de l’alcool sur l’angoisse panique, guidant de manière dangereuse l’élaboration de politiques de prévention et d’accès aux soins de santé mentale.
7. Le biais de Berkson dans les relations interpersonnelles et la psychologie sociale
7.1 Le paradoxe des rencontres amoureuses : Attractivité physique et gentillesse
L’un des adages les plus répandus de la psychologie populaire et des conversations contemporaines peut s’énoncer sous la forme d’une plainte existentielle récurrente : « Pourquoi les personnes séduisantes sont-elles systématiquement méchantes, arrogantes ou égocentriques ? ». Cette conviction profondément ancrée postule l’existence d’une compensation perverse entre l’esthétique physique et les qualités morales ou relationnelles fondamentales.
Si l’on postule, conformément à la vaste littérature en psychologie de l’attraction et de la personnalité, que la beauté physique objective et l’amabilité (agreeableness) sont des traits orthogonaux, génétiquement et développementalement non corrélés au sein de la population générale adulte ($r \approx 0,00$), comment expliquer la persistance universelle de ce stéréotype ? La théorie du collisionneur apporte une réponse mathématique implacable par le prisme du filtre d’acceptabilité amoureuse.
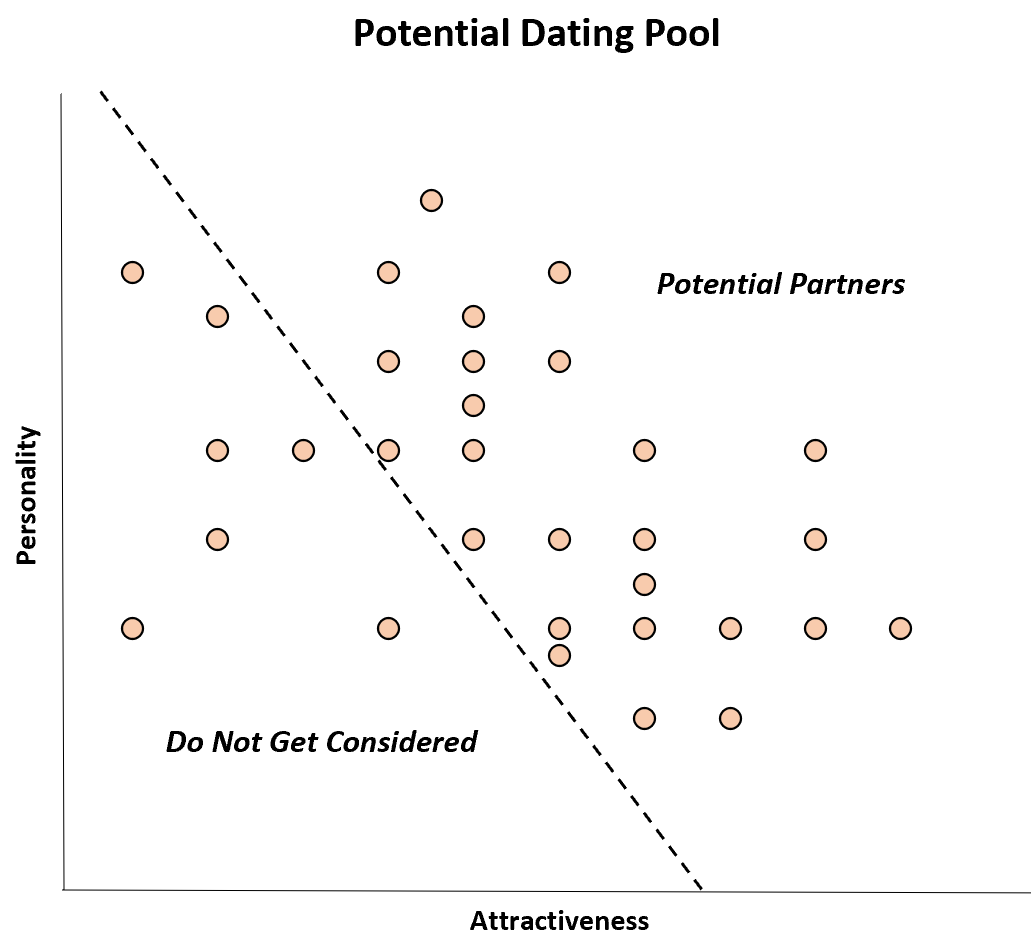
Dans l’univers des rencontres interpersonnelles (et particulièrement sur les applications de rencontre contemporaines), un individu ne retient pour une interaction amoureuse, un rendez-vous ou une relation de couple qu’un sous-ensemble extrêmement restreint de prétendants potentiels. Ce filtre de sélection personnel impose un critère d’admissibilité minimal qui agrège l’attractivité perçue et la gentillesse relationnelle :
$$\text{Attractivité} + \text{Gentillesse} ge \text{Seuil de Séduction}$$
Les individus qui cumulent un physique ingrat et une personnalité odieuse sont immédiatement écartés : ils n’accèdent jamais au statut de partenaire relationnel et sont donc totalement absents du pool d’expérience empirique de l’individu observant. Dès lors, parmi les personnes effectivement fréquentées :
- Si une personne présente une gentillesse exceptionnelle, une empathie profonde et une écoute remarquable, l’observateur tolérera volontiers un niveau d’attractivité physique très modeste.
- En revanche, pour qu’une personne profondément antipathique, méprisante ou narcissique parvienne malgré tout à franchir le filtre d’acceptabilité et à être fréquentée, il est indispensable qu’elle compense cette toxicité relationnelle par une beauté physique ou un magnétisme éblouissant.
Le résultat statistique au sein du cercle des partenaires effectifs est mathématiquement garanti : un coefficient de corrélation négatif prononcé émerge entre attractivité et gentillesse. L’observateur transforme ce biais d’échantillonnage personnel en une vérité sociologique universelle, accusant la beauté d’engendrer l’arrogance.
7.2 Sélection académique et professionnelle : Intelligence versus persévérance
Une distorsion cognitive et statistique rigoureusement analogue s’observe au sein des institutions universitaires d’élite (grandes écoles, universités de l’Ivy League) et des départements de recrutement des multinationales les plus prestigieuses. Les enseignants, recruteurs et pairs y partagent fréquemment l’impression que les étudiants ou employés dotés d’un quotient intellectuel (QI) fulgurant ou d’une vivacité analytique hors norme sont intrinsèquement paresseux, manquent d’autodiscipline ou présentent un sens de l’effort déficient.
Pourtant, la psychométrie différentielle démontre avec constance que, dans la population générale, l’intelligence générale (facteur $g$) et la persévérance (ou la dimension de conscience) partagent une association nulle ou modérément positive : la capacité à différer une gratification et à maintenir un effort soutenu coïncide fréquemment avec de hautes capacités cognitives. Le prétendu dilemme opposant « le génie dilettante » au « travailleur laborieux sans éclat » est une pure création du processus de sélection institutionnelle.
Les concours d’entrée aux grandes écoles ou les comités d’embauche sélectifs n’admettent qu’une proportion infinitésimale de candidats (par exemple le décile ou le centile supérieur), sur la base d’un score combiné évaluant les performances cognitives pures et la restitution de travaux académiques exigeant des milliers d’heures de travail assidu :
$$\text{Score d’Admission} = \alpha \cdot \text{Aptitude Cognitive} + \beta \cdot \text{Persévérance} ge K$$
Les candidats combinant des aptitudes cognitives moyennes et un rejet de l’effort sont impitoyablement recalés. Dès lors, au sein des amphithéâtres ou des promotions de ces institutions d’élite, les sujets affichant une intelligence moyenne n’ont pu être admis qu’en déployant une éthique de travail titanesque et un acharnement sans faille. Inversement, ceux qui ont réussi à intégrer l’institution tout en manifestant une paresse ostensible n’ont pu le faire que grâce à un potentiel intellectuel brut colossal leur permettant de survoler les épreuves.
Les recruteurs et professeurs observant ce microcosme hautement filtré internalisent un faux stéréotype professionnel : ils commencent à percevoir le génie et l’effort comme deux pôles antagonistes d’une balance hydraulique, pénalisant injustement dans leurs évaluations subjectives les étudiants brillants accusés par projection de paresse latente.
7.3 Stéréotypes sociaux et rationalisations cognitives associées
Sur le plan de la psychologie cognitive et sociale, le biais de Berkson opère comme un moteur de renforcement fondamental de la croyance en un monde juste, telle que théorisée par Melvin Lerner. L’être humain éprouve un besoin psychologique profond de postuler l’équité distributive de l’univers : l’idée qu’un individu puisse simultanément hériter d’une génétique exceptionnelle, d’une intelligence vive, d’une richesse matérielle et d’une personnalité bienveillante engendre une dissonance cognitive et un sentiment d’injustice intolérable.
Le biais de Berkson fournit à l’appareil cognitif une illusion d’objectivité statistique validant la « théorie de la compensation ». En observant dans ses cercles d’interaction sélectifs des relations négatives factices (entre beauté et gentillesse, talent et modestie, richesse et probité morale), le cerveau humain interprète ces corrélations d’échantillonnage comme la preuve irréfutable que la nature distribue des compensations équitables : quiconque est favorisé sur un trait se verrait nécessairement amputé sur un autre.
À l’ère contemporaine, ce mécanisme est démultiplié par l’architecture algorithmique des réseaux sociaux et des plateformes numériques sélectives. Les algorithmes de recommandation de contenus conditionnent la visibilité des créateurs sur des seuils d’engagement drastiques combinant controverse clivante et esthétique visuelle irréprochable. En filtrant sur le collisionneur de « l’extrême viralité numérique », les utilisateurs se retrouvent immergés dans un environnement médiatique virtuel saturé d’associations négatives illusoires, renforçant la polarisation sociale et l’ancrage de stéréotypes idéologiques artificiels.
8. Implications méthodologiques dans la recherche expérimentale et observationnelle
8.1 Le biais d’attrition dans les études longitudinales en psychologie
Dans les protocoles de recherche longitudinaux — indispensables pour appréhender les trajectoires développementales du vieillissement cognitif, de la psychopathologie infantile ou de l’évolution des traits de personnalité au cours de la vie —, le biais de Berkson se manifeste sous la forme pernicieuse du biais d’attrition non aléatoire. Une cohorte initiale peut parfaitement être recrutée au temps $T_0$ selon des procédures d’échantillonnage probabiliste rigoureuses, garantissant une parfaite représentativité écologique de départ.
Toutefois, au fil des vagues successives d’évaluation ($T_1, T_2, dots, T_n$), une fraction substantielle des participants abandonne l’étude, déménage, perd contact ou refuse de poursuivre son engagement. Cette déperdition n’est jamais purement aléatoire (Missing Completely at Random). L’attrition longitudinale est gouvernée conjointement par de multiples variables psychologiques et sociales : par exemple, le statut socio-économique défavorisé et le niveau de détresse psychologique augmentent tous deux la probabilité de décrochage de l’étude.
Dès lors que l’analyste restreint ses modélisations statistiques finales à la sous-cohorte des seuls participants ayant complété l’intégralité du suivi protocolaire ($S_{\text{complet}} = 1$), il conditionne rétroactivement son analyse sur un collisionneur d’attrition :
$$\text{Socio-économique} long\rightarrow \text{Rétention} long\leftarrow \text{Détresse Psychologique}$$
Ce conditionnement induit mécaniquement des relations longitudinales fallacieuses entre les variables prédictives initiales et les indicateurs finaux d’adaptation psychologique. Une intervention psychosociale modeste peut ainsi sembler dotée d’une efficacité spectaculaire sur les symptômes dépressifs résiduels simplement parce que les sujets cumulant précarité économique et résistance thérapeutique ont été filtrés par le processus d’attrition, laissant subsister un sous-groupe anormalement résilient et réactif.
8.2 L’utilisation d’échantillons de convenance universitaires (populations WEIRD)
Une proportion alarmante des connaissances fondamentales publiées dans les revues internationales de psychologie cognitive et sociale repose sur des protocoles conduits auprès d’étudiants de premier cycle universitaire, récompensés par des crédits de cours obligatoires. Ces échantillons représentent l’archétype même de ce que Henrich, Heine et Norenzayan (2010) ont désigné sous l’acronyme de populations WEIRD (Western, Educated, Industrialized, Rich, Democratic).
L’admission dans une institution d’enseignement supérieur agit comme un filtre de Berkson massif à l’échelle sociétale. Pour accéder à un cursus universitaire, un individu doit obligatoirement franchir des seuils combinatoires sélectifs intégrant les performances académiques antérieures, les capacités cognitives verbales et abstraites, le soutien financier familial et la stabilité comportementale. Les individus cumulant un faible capital culturel familial et des difficultés d’apprentissage scolaire sont exclus du vivier d’échantillonnage du laboratoire.
Cette troncature sociologique altère gravement la validité externe et interne des théories psychologiques élaborées à partir de ces panels :
- Les corrélations canoniques entre la motivation intrinsèque et les performances mnésiques sont fréquemment masquées ou inversées au sein des cohortes estudiantines, les étudiants les moins intrinsèquement motivés n’ayant pu accéder à l’université que grâce à des stratégies cognitives instrumentales ultra-performantes.
- La relation entre l’anxiété de performance et la réussite aux tests d’intelligence générale est lourdement distordue, les étudiants très anxieux encore présents dans l’échantillon étant ceux dont les ressources intellectuelles brutes permettent de compenser l’inhibition émotionnelle.
Prétendre déduire des « lois universelles du fonctionnement de l’esprit humain » à partir d’échantillons soumis à un tel filtre institutionnel de Berkson constitue un angle mort méthodologique majeur de la psychologie académique standard.
8.3 Conséquences sur les revues systématiques et méta-analyses
Les méta-analyses quantitatives contemporaines, positionnées au sommet de la pyramide de la preuve selon les standards de la médecine et de la psychologie fondées sur les données probantes (Evidence-Based Practice), ne sont nullement immunes aux ravages du paradoxe de Berkson. Lorsqu’un méta-analyste agrège des dizaines d’études primaires publiées sur une thématique d’intérêt clinique, il agrège fréquemment des protocoles souffrant tous, à des degrés divers, de conditionnements sur collisionneurs nosocomiaux ou institutionnels.
L’agrégation mathématique d’une multitude de coefficients de corrélation ou d’odds ratios individuellement biaisés par le mécanisme de Berkson n’annule pas l’erreur statistique : elle la consolide avec une précision illusoire accrue. En réduisant drastiquement l’erreur standard globale par l’augmentation de la taille cumulée de l’échantillon, la méta-analyse produit un intervalle de confiance extrêmement étroit autour d’une taille d’effet totalement artificielle.
Ce danger d’amplification des faux négatifs ou d’inversion d’effets est particulièrement aigu lors de l’évaluation méta-analytique de facteurs de risque étiologiques. Si la majorité des études incluses ont recruté des patients dans des structures spécialisées de soins sans ajuster pour les probabilités d’admission, la méta-analyse entérinera une absence d’effet causal, voire un effet protecteur illusoire, décourageant le financement de recherches étiologiques prometteuses et fourvoyant les recommandations thérapeutiques internationales.
9. Distinctions critiques : Berkson vs autres biais de sélection et paradoxes
9.1 Comparaison approfondie avec le paradoxe de Simpson
Dans la taxonomie des aberrations statistiques, le biais de Berkson et le paradoxe de Simpson (ou paradoxe de Yule-Simpson) sont fréquemment confondus en raison de leur conséquence observationnelle partagée : l’inversion spectaculaire du signe d’une corrélation ou de la direction d’une association statistique. Pourtant, leur architecture causale sous-jacente est rigoureusement opposée.
Le paradoxe de Simpson émerge typiquement de l’omission d’un facteur de confusion sous-jacent (une variable en fourche amont). L’association apparente entre une exposition $X$ et un résultat $Y$ s’inverse lorsque les données sont stratifiées par une troisième variable confondante $Z$ qui influence causalement à la fois $X$ et $Y$. Dans le cas de Simpson, la réalité causale réside au niveau des sous-groupes conditionnels stratifiés, tandis que l’association marginale globale agrégée est fallacieuse en raison de la non-prise en compte de la composition hétérogène des groupes.
À l’inverse, le biais de Berkson naît du conditionnement indu sur une variable commune descendante (un collisionneur $S$). Dans le scénario de Berkson, la réalité causale authentique se situe au niveau marginal dans la population générale globale, tandis que l’association observée au sein des sous-groupes sélectionnés est l’artefact artificiel provoqué par le filtre d’échantillonnage.
Le tableau comparatif suivant synthétise les divergences topologiques et opérationnelles fondamentales séparant ces deux concepts statistiques majeurs :
- Structure causale sous-jacente : Fourche amont ($X \leftarrow Z to Y$) pour le paradoxe de Simpson versus convergence aval ($X to S \leftarrow Y$) pour le biais de Berkson.
- Rôle de la troisième variable : Facteur de confusion méconnu ou ignoré pour Simpson ; collisionneur ou critère de sélection conditionné pour Berkson.
- Niveau d’analyse valide : L’analyse conditionnelle/stratifiée révèle la vérité pour Simpson ; l’analyse marginale en population globale révèle la vérité pour Berkson.
- Remède méthodologique : Ajuster impérativement sur la variable sous-jacente pour Simpson ; supprimer le conditionnement et éliminer le filtre de sélection pour Berkson.
9.2 Biais de Berkson versus biais de survie (survivorship bias)
Une confusion analytique fréquente subsiste également entre le biais de Berkson et le biais de survie (survivorship bias), rendu célèbre par les travaux historiques du mathématicien Abraham Wald durant la Seconde Guerre mondiale au sujet du blindage des bombardiers alliés. Bien que ces deux phénomènes relèvent de la grande famille des biais de sélection, ils opèrent à des niveaux temporels et structurels distincts.
Le biais de survie est un processus d’attrition temporelle séquentielle : l’échantillon observé n’inclut que les entités qui ont réussi à « survivre » à une succession d’épreuves létales ou éliminatrices dans le temps (les avions revenus intacts à la base, les fonds spéculatifs n’ayant pas fait faillite après dix ans, ou les patients cancéreux encore vivants au terme d’un essai clinique). Dans le biais de survie, l’analyste omet d’observer les sujets éliminés au cours du processus historique, ce qui biaise l’estimation des facteurs de résistance ou de rentabilité.
Le biais de Berkson, quant à lui, ne requiert nullement une dynamique temporelle longitudinale : il opère instantanément lors du franchissement synchrone d’un seuil d’admissibilité multidimensionnel. Il s’agit d’un problème de filtrage combinatoire à l’entrée d’un système plutôt que d’un filtrage par élimination au cours du temps. La spécificité de Berkson réside dans le fait que deux voies alternatives et indépendantes permettent de franchir le filtre d’admission, induisant la compensation statistique négative entre ces deux critères au sein du groupe sélectionné.
9.3 Différenciation avec l’effet de restriction de l’étendue (range restriction)
En psychométrie classique et en sélection du personnel, les théoriciens manipulent couramment le concept d’effet de restriction de l’étendue (range restriction), théorisé originellement par Robert L. Thorndike. La restriction de variance intervient lorsqu’un échantillon d’analyse est tronqué sur une seule variable prédictive : par exemple, lorsqu’une entreprise sélectionne les candidats sur la seule base de leur score à un test d’aptitude cognitive ($X > c$) et cherche ultérieurement à évaluer la corrélation entre ce score $X$ et la performance professionnelle future $Y$.
Dans la restriction de l’étendue univariée standard, la conséquence statistique prédominante est l’atténuation du coefficient de corrélation. La restriction de la variance marginale de la variable sélectionnée compresse la covariance observée, réduisant la magnitude absolue du coefficient de corrélation linéaire vers zéro ($|r_{\text{tronqué}}| < |r_{\text{pop}}|$) sans jamais en modifier la polarité fondamentale.
Le biais de Berkson transcende qualitativement la simple restriction de variance. Il s’agit d’une restriction bivariée ou multivariée conjointe dépendante. Contrairement à la restriction univariée de Thorndike qui préserve généralement le signe positif ou nul de la relation tout en en réduisant la magnitude, le mécanisme de conditionnement sur un collisionneur dans le biais de Berkson possède la capacité mathématique unique d’inverser activement le signe de l’association, métamorphosant un lien causal positif puissant en une relation négative statistiquement robuste au sein de l’échantillon sélectionné.
10. Détection empirique et modélisation du biais de Berkson dans les jeux de données
10.1 Indicateurs d’alerte et tests diagnostiques dans les études observationnelles
Identifier la présence insidieuse du biais de Berkson au sein d’une base de données empiriques constitue l’un des défis méthodologiques les plus ardus en science observationnelle, précisément parce que la distribution interne de l’échantillon paraît mathématiquement cohérente et parfaitement conforme aux hypothèses de normalité locale. Néanmoins, un ensemble d’indicateurs d’alerte et de tests diagnostiques rigoureux permet d’orienter le chercheur vigilant :
- Discordance externe systématique : Une divergence flagrante et répétée entre la taille d’effet mesurée au sein d’une cohorte clinique spécialisée et celle issue de vastes enquêtes probabilistes de santé publique constitue le premier signal d’alarme d’un biais de sélection d’admission.
- Taux de participation ou d’inclusion exceptionnellement faible : Dès lors qu’une cohorte de recherche ne parvient à recruter qu’une fraction marginale (inférieure à 10-15 %) du bassin de population ciblé à l’origine, la probabilité d’avoir instauré un conditionnement sévère sur un collisionneur d’adhérence est critique.
- Instabilité des coefficients par adjonction de variables de filtrage : L’intégration dans une régression logistique multivariée de variables prédisposant au recrutement institutionnel induit-elle une variation drastique ou un basculement de signe du coefficient de l’exposition principale ? Une telle instabilité paramétrique signale l’activation ou la désactivation d’un chemin de collision non causal.
L’inspection analytique minutieuse du processus de recrutement s’impose donc comme une étape préalable indispensable à toute tentative d’inférence causale, sous peine de théoriser des artefacts distributionnels.
10.2 Simulations numériques Monte-Carlo pour évaluer la sensibilité
L’utilisation de simulations numériques stochastiques de type Monte-Carlo constitue l’approche contemporaine la plus puissante pour quantifier la vulnérabilité d’un protocole d’observation face au paradoxe de Berkson. Ce protocole computationnel permet de créer une population contrefactuelle synthétique où les paramètres génératifs de causalité sont parfaitement calibrés par le chercheur, puis de simuler différentes fonctions d’inclusion sélective afin d’observer la dégradation du coefficient de corrélation.
Le protocole standardisé d’une simulation Monte-Carlo de Berkson s’articule selon les étapes algorithmiques suivantes :
- Génération d’une matrice de population de taille $N = 100,000$ sujets, comportant deux variables indépendantes $X \sim \mathcal{N}(0, 1)$ et $Y \sim \mathcal{N}(0, 1)$, garantissant un coefficient paramétrique théorique $\rho_{XY} = 0,00$.
- Modélisation d’une fonction d’inclusion latente $S^* = \beta_1 X + \beta_2 Y + \epsilon$, où $\beta_1$ et $\beta_2$ quantifient l’impact respectif des variables sur la sélection, et $\epsilon \sim \text{Logistique}(0, 1)$ injecte une stochasticité réaliste.
- Définition du filtre d’observation déterministe ou probabiliste : l’indicateur d’inclusion binaire prend la valeur $S = 1$ si $S^* > \theta$ (où le seuil $\theta$ calibre la sévérité du taux d’exclusion global).
- Calcul itératif du coefficient de corrélation de Pearson observé $r_{XY mid S=1}$ à travers des milliers de réplications stochastiques pour différentes valeurs de sévérité du seuil $\theta$.
Les résultats de ces simulations computationnelles démontrent avec une précision chirurgicale que plus le seuil d’admissibilité $\theta$ est sévère (c’est-à-dire plus l’échantillon final ne retient qu’une fraction élitiste ou hautement pathologique de la population simulée), plus l’effondrement du coefficient vers des valeurs négatives est violent. Ce type d’expérimentation in silico fournit aux chercheurs des tables de sensibilité indispensables pour estimer l’ampleur du biais nécessaire pour annuler un effet thérapeutique observé dans des données hospitalières.
10.3 Modélisation de sélection de Heckman en économétrie et psychométrie
Pour corriger mathématiquement les distorsions induites par un échantillonnage non aléatoire dans les modèles continus, l’économiste James Heckman a élaboré une approche statistique novatrice — récompensée par le prix de la Banque de Suède en sciences économiques en mémoire d’Alfred Nobel en 2000 — universellement désignée sous le terme de modèle de correction en deux étapes de Heckman (ou Heckit).
Le postulat de Heckman repose sur la reconnaissance formelle que le biais de sélection s’apparente fonctionnellement à un problème d’omission de variable pertinente dans l’équation de régression. Le protocole s’articule en deux phases méthodologiques successives :
Dans un premier temps, une équation de sélection est estimée à l’aide d’un modèle Probit sur l’ensemble de la population disponible (incluant les sujets sélectionnés et exclus), afin de prédire la probabilité qu’un individu soit inclus dans l’échantillon d’analyse :
$$P(S_i = 1 mid Z_i) = \Phi(Z_i \gamma)$$
Où $Z_i$ représente un ensemble d’instruments ou de prédicteurs de la sélection, $\gamma$ le vecteur des coefficients estimés, et $Phi$ la fonction de répartition de la loi normale centrée réduite.
À partir des prédictions de cette première équation, Heckman introduit un paramètre mathématique correctif fondamental : le ratio inverse de Mills (souvent désigné par la lettre grecque $lambda$), défini par le quotient de la fonction de densité de probabilité sur la fonction de répartition cumulative :
$$\lambda_i = \frac{\phi(Z_i \hat{\gamma})}{\Phi(Z_i \hat{\gamma})}$$
Dans la seconde étape du protocole, l’équation substantielle d’intérêt (la relation entre $X$ et $Y$) est estimée par la méthode des moindres carrés ordinaires sur le seul échantillon sélectionné, en incorporant explicitement ce ratio inverse de Mills $\lambda_i$ comme une covariable supplémentaire dans le modèle de régression :
$$Y_i = X_i \beta + \rho \sigma_u \lambda_i + \epsilon_i$$
L’introduction du ratio de Mills capture et neutralise l’effet de troncature non aléatoire du terme d’erreur. Si le coefficient associé à $\lambda_i$ s’avère statistiquement significatif, la présence d’un biais de sélection est formellement confirmée, et le vecteur de coefficients $\beta$ ainsi corrigé restitue fidèlement la véritable association causale dépouillée du biais de Berkson.
11. Stratégies méthodologiques pour prévenir et corriger le biais de Berkson
11.1 Protocoles d’échantillonnage probabiliste et recrutement en population générale
La stratégie préventive la plus solide sur le plan épistémologique pour immuniser un protocole de recherche contre le biais de Berkson consiste à abandonner purement et simplement le recrutement opportuniste au sein d’institutions closes au profit de protocoles d’échantillonnage probabiliste en population générale. Cette démarche exige de redéfinir la base de sondage de manière à conférer à chaque unité statistique de la population cible une probabilité non nulle et strictement connue d’être sélectionnée dans la cohorte d’analyse.
La mise en œuvre de telles cohortes communautaires requiert des techniques d’échantillonnage stratifié ou à plusieurs degrés combinant registres d’état civil, données de recensement national et bases de données électorales ou de sécurité sociale. En recrutant des individus directement au sein de leur écosystème de vie, le chercheur s’assure d’inclure les quatre quadrants de la distribution : les sujets sains sur tous les plans, ceux ne présentant qu’une seule affection ou caractéristique, et ceux cumulant les expositions d’intérêt.
De surcroît, lorsque les impératifs budgétaires imposent de conduire une étude cas-témoins hospitalière, la sélection des témoins représentatifs doit impérativement obéir aux règles de l’épidémiologie moderne formalisées par Miettinen. Les témoins ne doivent en aucun cas être recrutés parmi des patients admis pour d’autres pathologies concurrentes dans le même établissement hospitalier, mais doivent être tirés au sort au sein de la base de population générale ayant engendré les cas (population-based case-control design). Ce design protocolaire brise la configuration de collision à la racine en désactivant le conditionnement sur le motif nosocomial d’admission.
11.2 Pondération par l’inverse de la probabilité de sélection (IPW)
Dans les situations observationnelles où les données d’un échantillon tronqué ont déjà été colligées et où le processus de sélection sélective ne peut être réitéré, le recours aux techniques d’inférence causale algorithmique offre des perspectives de correction puissantes. Parmi ces méthodes, la pondération par l’inverse de la probabilité de sélection (Inverse Probability Weighting ou IPW) s’impose comme un outil méthodologique de référence, formalisé dans le traité fondamental de Hernán et Robins (2020).
L’architecture théorique de la méthode IPW consiste à reconstruire artificiellement une « pseudo-population » non biaisée en appliquant à chaque individu effectivement observé un coefficient de pondération statistique ($w_i$) inversement proportionnel à sa probabilité d’avoir été sélectionné dans l’échantillon d’analyse, conditionnellement à un ensemble exhaustif de covariables prédictives $L_i$ :
$$w_i = \frac{1}{P(S_i = 1 mid L_i)}$$
En surpondérant méthodologiquement les individus atypiques au sein de l’échantillon restreint — c’est-à-dire en accordant un poids statistique démultiplié aux sujets qui avaient une très faible probabilité prédictive d’être admis ou hospitalisés mais qui ont néanmoins franchi le filtre —, l’algorithme IPW compense exactement le déficit quantitatif induit par le processus de sélection de Berkson. Dans la pseudo-population synthétique ainsi pondérée, le nœud de sélection $S$ est structurellement découplé de ses causes prédictives amont, restaurant l’indépendance marginale originale et annulant le flux de dépendance non causale à travers le collisionneur.
La validité de cette correction repose toutefois sur deux conditions mathématiques rigoureuses :
- La condition de positivité : Chaque profil de participants au sein de la population doit posséder une probabilité strictement non nulle ($P(S=1 mid L) > 0$) d’être sélectionné. Si une catégorie d’individus subit une exclusion déterministe absolue (probabilité nulle), aucune repondération mathématique ne peut combler ce néant informationnel.
- La spécification correcte du modèle de sélection : L’équation prédisant la probabilité d’inclusion doit intégrer sans omission majeure l’ensemble des déterminants partagés guidant l’admission dans la cohorte d’étude.
11.3 Analyse de sensibilité et bornage des effets réels
Lorsque la structure de sélection demeure imparfaitement connue et qu’il est impossible de modéliser avec certitude les probabilités d’inclusion individuelles, les investigateurs rigoureux se tournent vers les méthodes d’analyse de sensibilité non paramétrique et les techniques de bornage des effets de Manski, initiées par l’économètre Charles F. Manski.
Cette approche épistémologique refuse d’imposer des hypothèses distributionnelles indémontrables pour forcer l’estimation d’une taille d’effet ponctuelle unique. Au lieu de cela, le cadre de Manski formalise l’espace de tous les paramètres possibles compatibles avec les données observées sous des hypothèses minimales de sélection. L’analyste évalue les scénarios extrêmes les plus pessimistes : que se passerait-il si la totalité des individus exclus de l’échantillon présentaient une issue clinique systématiquement favorable, ou à l’inverse rigoureusement défavorable ?
Cette démarche de bornage permet d’encadrer la véritable association causale à l’intérieur d’un intervalle d’incertitude structurelle (les bornes de Manski). Si l’intervalle résultant inclut la valeur nulle ou change de polarité selon la sévérité postulée du filtre d’exclusion de Berkson, le chercheur a le devoir déontologique de déclarer son résultat comme inconclusif, interdisant toute extrapolation péremptoire.
La transparence méthodologique contemporaine exige désormais des publications scientifiques qu’elles documentent de manière exhaustive l’entonnoir de recrutement (diagramme de flux CONSORT ou STROBE). La déclaration détaillée du nombre précis de sujets approchés, du volume des refus de consentement, des critères d’exclusion technique et des abandons en cours de suivi constitue la seule garantie permettant à la communauté scientifique d’évaluer la vulnérabilité intrinsèque d’une étude face aux déformations causées par le biais de Berkson.
12. Synthèse épistémologique et recommandations pour les chercheurs en sciences humaines
12.1 Conséquences sur l’interprétabilité des lois psychologiques
L’exploration approfondie du biais de Berkson impose une révision épistémologique profonde de la manière dont les psychologues et les spécialistes des sciences cognitives conçoivent et interprètent les corrélations empiriques. Une corrélation observée entre deux construits psychologiques ne possède aucune signification nomothétique intrinsèque en dehors d’une élucidation minutieuse de l’entonnoir d’échantillonnage qui l’a fait émerger dans le champ observationnel.
Le danger récurrent qui guette la psychologie réside dans la naturalisation erronée de traits corrélés : la propension cognitive spontanée à postuler des mécanismes neurobiologiques, adaptatifs ou génétiques profonds pour expliquer des associations qui ne sont que les artefacts passagers d’un seuil d’admission clinique ou d’un critère universitaire de sélection. Découvrir une association négative entre deux dimensions fonctionnelles au sein d’une clinique spécialisée ne renseigne en rien sur l’architecture fonctionnelle du cerveau humain : elle décrit simplement la mécanique de tri administratif opérée par le guichet d’accueil de ladite institution.
Pour prévenir ces dérives théoriques stériles, l’intégration formelle des graphes causaux orientés (DAGs) doit impérativement être systématisée dès la phase initiale de conception des protocoles de recherche en sciences humaines. Définir a priori les hypothèses sur les mécanismes d’accès à l’échantillon permet de cartographier les collisionneurs potentiels et d’ajuster l’architecture de collecte avant même que le premier participant ne soit interrogé.
12.2 Guide pratique pour l’évaluation critique de la littérature scientifique
Face à la prolifération de publications académiques proclamant des découvertes contre-intuitives sensationnelles — vantant fréquemment des compromis négatifs inattendus ou des effets protecteurs paradoxaux —, le lecteur critique, le relecteur scientifique (peer-reviewer) et le praticien de terrain doivent appliquer une grille de lecture méthodique. Le guide décisionnel suivant synthétise les questions diagnostiques clés à mobiliser systématiquement :
- Vérification du vivier d’origine : L’échantillon analysé est-il issu d’un environnement hautement sélectif (clinique tertiaire, cohorte d’étudiants d’élite, panel d’utilisateurs actifs d’une plateforme numérique spécifique) ou d’un échantillonnage probabiliste en population générale ?
- Identification structurelle des collisionneurs : L’inclusion dans l’étude nécessite-t-elle l’atteinte d’un seuil minimal de performance, de détresse ou de motivation qui dépend fonctionnellement des deux variables d’exposition et de résultat explorées ?
- Contrôle multivarié suspect : Le modèle de régression multivariée ajusté par les auteurs a-t-il inclus comme variables de contrôle des descripteurs post-expositionnels, des mesures d’adhérence ou des symptômes consécutifs qui pourraient se comporter comme des collisionneurs intermédiaires ?
- Cohérence écologique : Les résultats rapportés décrivent-ils un compromis négatif inattendu contredisant frontalement les modèles théoriques fondamentaux de la biologie de l’évolution ou de la psychologie différentielle ? Si oui, le biais de Berkson constitue-t-il l’explication la plus parcimonieuse ?
12.3 Perspectives futures à l’ère du Big Data et des algorithmes prédictifs
À l’ère contemporaine de l’explosion des mégadonnées (Big Data) et du déploiement massif de l’intelligence artificielle, l’intuition commune postule naïvement que la capture de téraoctets de données massives prémunirait la science contre les biais d’échantillonnage traditionnels des petites cohortes académiques. Cette croyance constitue un mirage statistique d’une dangerosité inédite.
Loin d’éliminer le biais de Berkson, les ensembles de données issus du Big Data — qu’il s’agisse des gigantesques bases de dossiers médicaux électroniques (EHR), des logs massifs d’utilisateurs de téléphones intelligents ou des cohortes d’utilisateurs de plateformes de streaming — en constituent souvent l’incarnation la plus insidieuse et la plus concentrée. L’appartenance à ces mégabases de données n’est jamais aléatoire : elle dépend d’accès aux technologies numériques, de comportements de consommation sélectifs et d’antécédents cliniques précis qui configurent autant de collisionneurs massifs.
Lorsque des modèles d’apprentissage automatique supervisé (Machine Learning) ou des réseaux neuronaux profonds sont entraînés sur ces flux de données sans une correction causale préalable de type Berkson, les algorithmes absorbent, reproduisent et immortalisent ces corrélations d’admission artificielles. Les systèmes d’aide au diagnostic médical ou les algorithmes de sélection prédictive des ressources humaines attribuent des scores d’évaluation faussés, privant d’opportunités des candidats méritants ou orientant de manière désastreuse les priorités de prescription médicale.
L’avenir de la méthodologie en psychologie, en médecine et en science des données réside impérativement dans le mariage harmonieux entre la puissance computationnelle brute des algorithmes prédictifs et la rigueur conceptuelle millimétrée de l’inférence causale moderne. Seule une prise de conscience lucide des mécanismes d’illusion statistique formalisés par Joseph Berkson permettra aux sciences contemporaines d’extraire la vérité causale du tumulte de leurs observations empiriques.
Références
- Berkson, J. (1946). Limitations of the application of fourfold table analysis to hospital data. Biometrics Bulletin, 2(3), 47–53. https://doi.org/10.2307/3002000
- Heckman, J. J. (1979). Sample selection bias as a specification error. Econometrica, 47(1), 153–161. https://doi.org/10.2307/1912352
- Henrich, J., Heine, S. J., & Norenzayan, A. (2010). The weirdest people in the world? Behavioral and Brain Sciences, 33(2-3), 61–83. https://doi.org/10.1017/S0140525X0999152X
- Hernán, M. A., Hernández-Díaz, S., & Robins, J. M. (2004). A structural approach to selection bias. Epidemiology, 15(5), 615–625. https://doi.org/10.1097/01.ede.0000135174.63482.43
- Hernán, M. A., & Robins, J. M. (2020). Causal Inference: What If. Boca Raton: Chapman & Hall/CRC. https://www.hsph.harvard.edu/miguel-hernan/causal-inference-book/
- Lerner, M. J. (1980). The Belief in a Just World: A Fundamental Delusion. Plenum Press. https://doi.org/10.1007/978-1-4684-3881-9
- Manski, C. F. (2003). Partial Identification of Probability Distributions. Springer-Verlag. https://doi.org/10.1007/b97478
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Pearl, J., Glymour, M., & Jewell, N. P. (2016). Causal Inference in Statistics: A Primer. Wiley.
- Sackett, D. L. (1979). Bias in analytic research. Journal of Chronic Diseases, 32(1-2), 51–63. https://doi.org/10.1016/0021-9681(79)90012-2
- Thorndike, R. L. (1949). Personnel Selection: Test and Measurement Techniques. John Wiley & Sons.
- Wald, A. (1980). A method of estimating plane vulnerability based on damage of survivors. CRC Memorandum, Center for Naval Analyses.