
L’histoire de la méthode scientifique est indissociable de la recherche d’une simplification maîtrisée du réel. Durant des siècles, la démarche empirique s’est appuyée sur l’isolation méticuleuse de quelques variables d’intérêt, contrôlées au sein d’environnements expérimentaux fermés. Les modèles inférentiels canoniques, élaborés au cours du XXe siècle par des statisticiens fondateurs tels que Ronald Fisher, Karl Pearson ou Jerzy Neyman, postulaient implicitement une condition fondamentale : la rareté des paramètres à estimer face à la disponibilité relative des observations empiriques. Dans ce paradigme traditionnel de basse dimension, le nombre d’individus ou de mesures physiques surpassait très largement le catalogue des caractéristiques recensées. La statistique classique pouvait ainsi s’épanouir en déployant des théorèmes limites solides, des tests de studentisation stables et des estimateurs asymptotiquement efficaces fondés sur le maximum de vraisemblance.
Cependant, la révolution technologique, l’essor de la puissance computationnelle et l’automatisation intégrale de l’acquisition instrumentale ont brutalement inversé cette configuration épistémologique. Aujourd’hui, les sciences quantitatives font face à un déluge de métadonnées, de capteurs continus, de séquençages génomiques et de scans d’imagerie médicale qui renversent l’équilibre séculaire des données. Désormais, il n’est plus rare de mesurer des dizaines de milliers, voire des millions de prédicteurs sur des cohortes d’une dizaine ou d’une centaine d’individus seulement. Ce passage d’une structure matricielle élancée à des matrices aplaties et démesurément larges définit l’entrée dans l’ère de la haute dimension. Loin de représenter une simple accumulation quantitative, cette transition constitue une rupture de phase méthodologique, mathématique et conceptuelle.
Les données de grande dimension soulèvent des défis vertigineux qui ébranlent les fondations mêmes de l’inférence statistique usuelle. Dans ces espaces géométriques contre-intuitifs, le volume spatial se dilate de manière exponentielle, les distances euclidiennes tendent à s’égaliser, annihilant la notion classique de proximité, et les systèmes d’équations deviennent structurellement indéterminés. En psychologie, en neurosciences cognitives, en psychiatrie computationnelle comme en génomique, cette abondance superficielle dissimule fréquemment une vacuité spatiale profonde : c’est le redoutable « fléau de la dimensionnalité ». Comprendre la nature exacte de ces données, caractériser leur géométrie sous-jacente, identifier les pièges statistiques qu’elles renferment et maîtriser les algorithmes modernes capables d’en extraire le signal invariant représente l’une des compétences méthodologiques les plus cruciales de notre temps.
1. Introduction et fondements conceptuels des données de grande dimension
1.1 Émergence du paradigme des données massives en sciences quantitatives
L’avènement contemporain des données massives résulte d’une profonde transformation de l’appareillage instrumental au sein des sciences de la vie et du comportement. Historiquement, la collecte de données empiriques nécessitait des protocoles manuels fastidieux, contraignant le chercheur à sélectionner a priori un nombre extrêmement restreint d’indicateurs opérationnels. Qu’il s’agisse de chronométrer des temps de réaction par des chronographes mécaniques, de recenser des fréquences de comportements par observation directe ou de mesurer des pressions artérielles au brassard, le coût logistique de chaque variable supplémentaire était considérable. Dès lors, les corpus demeuraient par nature condensés et hautement focalisés.
La numérisation omniprésente a aboli ce goulet d’étranglement matériel. Les plates-formes expérimentales informatisées, la télémétrie mobile, les biocapteurs miniaturisés et le séquençage à haut débit permettent aujourd’hui d’enregistrer des flux continus de données sans interruption ni surcoût marginal significatif. Les instruments scientifiques ne se contentent plus d’échantillonner un état ponctuel ; ils capturent des spectres continus, des dynamiques temporelles millimétriques et des architectures cellulaires complètes. Cette accumulation multicanale modifie la trajectoire épistémologique globale des sciences empiriques. L’expérimentation, autrefois hypothético-déductive et centrée sur la validation de quelques hypothèses strictement calibrées, s’articule dorénavant avec des approches de découverte exploratoire pilotées par les données (data-driven discovery).
Cette transition de l’analyse multivariée standard vers la statistique en haute dimension a des implications profondes pour la modélisation cognitive et psychométrique. Dans l’étude des processus mentaux, les modèles linéaires classiques devaient postuler que les traits latents se réduisaient à un agrégat parcimonieux de quelques facteurs isolables. L’accès direct à l’hétérogénéité des signaux comportementaux et physiologiques remet en cause ces simplifications. La complexité inhérente à l’architecture cognitive humaine ne peut plus être enfermée dans des matrices restreintes sans risquer d’amputer le signal sous-jacent. Ainsi, l’exploitation des données de grande dimension s’impose non comme un choix théorique arbitraire, mais comme l’unique moyen d’embrasser l’organisation distribuée et non-linéaire des systèmes vivants.
1.2 Clarification sémantique : variables, dimensions et observations
Pour aborder rigoureusement la théorie de la haute dimension, une formalisation mathématique préliminaire des objets manipulés s’avère indispensable. Au sein de l’analyse multivariée standard, l’ensemble des données recueillies est formalisé sous la forme d’une matrice empirique générale notée $\mathbf{X} in \mathbb{R}^{N \times p}$. Dans ce formalisme matriciel immuable, les $N$ lignes correspondent aux unités observationnelles — c’est-à-dire les individus, les participants expérimentaux, les réplicats biologiques ou les séances d’enregistrement —, tandis que les $p$ colonnes représentent les variables mesurées, également qualifiées de descripteurs, d’attributs ou de dimensions analytiques.
Chaque observation individuelle est géométriquement conceptualisée comme un vecteur ligne $\mathbf{x}_i = (x_{i1}, x_{i2}, dots, x_{ip})^top in \mathbb{R}^p$. L’espace ambiant dans lequel évoluent ces observations est donc un espace vectoriel réel à $p$ dimensions. Il existe une distinction ontologique fondamentale entre la taille absolue de l’échantillon $N$ — qui régit la puissance d’échantillonnage et la précision de l’approximation des lois de probabilité par la loi des grands nombres — et la dimensionnalité apparente $p$, qui définit les degrés de liberté géométriques au sein desquels les profils peuvent se disperser. Lorsque $p$ croît, le nombre d’axes de coordonnées augmente, multipliant les configurations spatiales possibles de façon combinatoire.
Il est crucial de dissocier la dimensionnalité apparente d’un ensemble de données de sa dimensionnalité intrinsèque. La dimensionnalité apparente désigne le nombre brut de variables collectées ($p$), c’est-à-dire l’espace de plongement vectoriel utilisé pour consigner les mesures. En revanche, la dimensionnalité intrinsèque renvoie au nombre minimal de paramètres ou de coordonnées latentes nécessaires pour modéliser le phénomène sans dégradation substantielle du signal d’information. Par exemple, si dix mille gènes s’avèrent tous régulés par un unique facteur de transcription, l’espace d’observation de dimensionnalité apparente $p = 10,000$ possède en réalité une dimensionnalité intrinsèque proche de 1. L’élucidation de ces structures latentes sous-jacentes constitue le pivot de l’interprétabilité clinique et cognitive, permettant de dépasser la redondance descriptive des mesures pour approcher la véritable dynamique fonctionnelle du système modélisé.
1.3 Pertinence critique pour la recherche contemporaine en psychologie
La recherche contemporaine en psychologie et en psychiatrie se heurte frontalement à ce bouleversement paradigmatique. Pendant près d’un siècle, les théories psychologiques ont reposé sur la validation de construits synthétiques mesurés par des échelles psychométriques univariées ou des questionnaires standardisés ne comportant que quelques dizaines d’items. Ces démarches traditionnelles opéraient dans un univers méthodologique confortable où la taille de l’échantillon $N$ était presque systématiquement supérieure de plusieurs ordres de grandeur au nombre de variables $p$. Dans cette configuration classique ($N gg p$), les tests inférentiels standards tels que le test $t$ de Student, l’analyse de variance (ANOVA) ou la régression linéaire ordinaire opèrent avec une efficacité mathématique optimale.
Or, la psychologie scientifique moderne s’est hybridée avec les neurosciences cognitives, l’imagerie cérébrale fonctionnelle, la génomique comportementale et l’informatique ubiquitaire. Les chercheurs se trouvent submergés d’enregistrements électrophysiologiques denses, de volumes tridimensionnels de résonance magnétique contenant des centaines de milliers de voxels, de métadonnées issues des téléphones intelligents et de millions de variants génétiques. L’utilisation mécanique des méthodes statistiques traditionnelles dans ce contexte est méthodologiquement désastreuse. Appliquer des ANOVA univariées à travers des dizaines de milliers de variables sans contrôle adéquat génère une cascade d’erreurs de type I, faisant pulluler les associations fortuites et sapant les assises de l’inférence théorique.
Cette inadéquation méthodologique explique en partie la crise de réplicabilité qui a secoué la psychologie et les neurosciences au cours de la dernière décennie. Les chercheurs ont fréquemment mobilisé des méthodes conçues pour de petits espaces de paramètres sur des jeux de données hautement dimensionnels, produisant sans le vouloir des faux positifs massifs baptisés « artefacts de modélisation ». Face à ce constat, une refonte méthodologique radicale est désormais requise. La psychologie computationnelle moderne doit abandonner les réflexes analytiques du siècle passé pour intégrer la géométrie spécifique des espaces de haute dimension, adoptant des procédures de régularisation, des contrôles stochastiques d’erreurs multiples et des modélisations parcimonieuses capables de garantir la reproductibilité et la solidité épistémologique de ses conclusions.
2. Définition mathématique rigoureuse : La relation fondamentale entre p et N
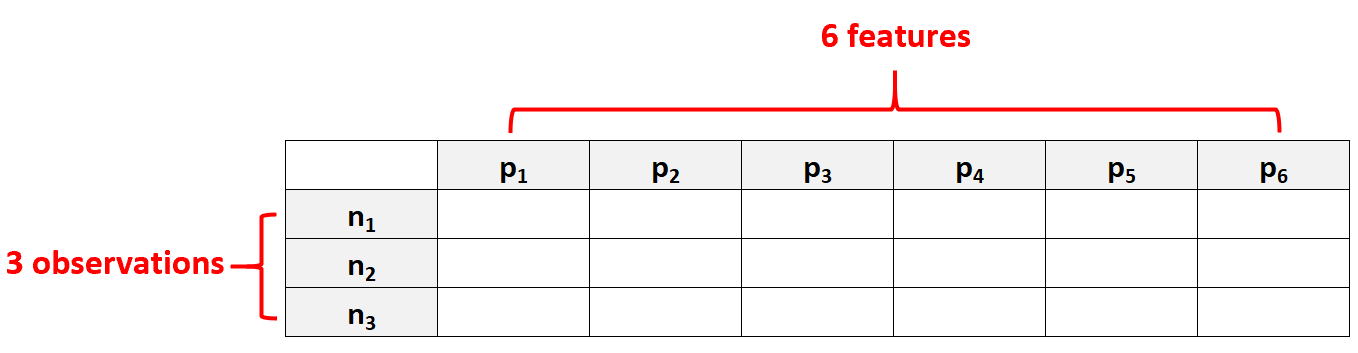
2.1 Le formalisme du rapport dimensionnel p versus N
Dans l’arsenal de l’algèbre linéaire et de la théorie des probabilités appliquées à la statistique, l’analyse des propriétés d’une matrice de données repose sur l’interaction structurelle entre ses deux dimensions fondamentales : le nombre d’observations $N$ et le nombre de prédicteurs $p$. Soit la matrice $\mathbf{X} in \mathbb{R}^{N \times p}$ dont chaque ligne représente une réalisation indépendante et identiquement distribuée (i.i.d.) d’un vecteur aléatoire multivarié de moyenne nulle et de matrice de covariance théorique $\mathbf{\Sigma} = \mathbb{E}[\mathbf{x}\mathbf{x}^top]$. L’estimateur sans biais usuel de cette matrice est la matrice de covariance empirique :
$$\mathbf{S} = \frac{1}{N-1}\mathbf{X}^top\mathbf{X}$$
La matrice $\mathbf{S}$ est un opérateur linéaire carré de dimension $p \times p$. Le théorème du rang impose que le rang algébrique d’un produit matriciel est borné par le rang des matrices opératrices. Par conséquent, $\mathrm{rang}(\mathbf{X}^top\mathbf{X}) le \min(N, p)$. Lorsque le nombre de prédicteurs surpasse le nombre d’individus mesurés ($p > N$, ou dans les cas extrêmes $p gg N$), le rang maximal de la matrice $\mathbf{S}$ ne peut dépasser $N$. Cela entraîne une conséquence immédiate : sur les $p$ dimensions de l’espace, au moins $p – N$ valeurs propres de la matrice de covariance empirique sont rigoureusement nulles. La matrice $\mathbf{S}$ est donc strictement singulière, non inversible et non définie positive.
Cette singularité spectrale ruine l’application de la quasi-totalité des algorithmes d’estimation classiques. Dans la théorie asymptotique standard établie par Ronald Fisher, les propriétés des estimateurs sont étudiées sous la condition que $N to \infty$ tandis que $p$ demeure fixé de manière invariable ($p = \mathcal{O}(1)$). Le ratio $\gamma = p/N$ converge alors asymptotiquement vers zéro. À l’opposé, le régime dit de haute dimension — fréquemment étudié dans le cadre de la théorie des matrices aléatoires formalisée notamment par Marčenko et Pastur — analyse le régime asymptotique double où $p to \infty$ et $N to \infty$ conjointement, de telle sorte que leur rapport dimensionnel converge vers une constante non nulle :
$$\lim_{N, p to \infty} \frac{p}{N} = \gamma in (0, \infty)$$
Dès lors que $\gamma > 0$, la distribution empirique des valeurs propres de $\mathbf{S}$ ne converge plus vers les valeurs propres théoriques de $\mathbf{\Sigma}$. Les spectres se déforment et s’étalent selon la loi de Marčenko-Pastur, provoquant une instabilité intrinsèque de toutes les métriques de corrélation, de distance ou d’inversion matricielle.
2.2 L’illusion de l’échantillon volumineux : démystifier l’abondance absolue
Une confusion récurrente consiste à assimiler la notion de grande dimension à la présence brute d’un volume massif de variables ($p$ élevé), indépendamment du nombre d’observations disponibles, ou à l’inverse à juger un échantillon satisfaisant sur la seule foi d’un grand $N$. Cette méprise découle d’une mauvaise appréciation de la relativité dimensionnelle. La grande dimension n’est pas une propriété absolue de la variable $p$ ou du paramètre $N$ pris isolément ; elle est exclusivement définie par la valeur relative du ratio $p/N$ et par la configuration de l’espace des paramètres.
À titre d’illustration comparative, considérons une cohorte épidémiologique comprenant $p = 10,000$ variables cliniques, sanguines et environnementales, recueillies sur un échantillon massif de $N = 100,000$ patients. Bien que le nombre absolu de variables soit considérable, le ratio dimensionnel vaut ici $\gamma = 10,000 / 100,000 = 0{,}1$. Dans cette situation, nous demeurons dans le régime où $N > p$. Bien que ce jeu de données présente des défis de calcul évidents, la matrice de covariance empirique est de plein rang avec une forte probabilité, et les théorèmes de convergence statistique continuent pour l’essentiel de s’appliquer. Les degrés de liberté résiduels pour estimer l’erreur ($N – p – 1 = 89,999$) demeurent largement suffisants pour assurer la convergence des estimateurs classiques.
Considérons à l’inverse une étude pilote en neuro-imagerie clinique portant sur une pathologie pédiatrique rare, évaluant seulement 6 biomarqueurs neurochimiques mesurés par spectroscopie sur une cohorte de 3 patients. Bien que $p = 6$ soit une valeur nominalement minuscule, le ratio dimensionnel s’élève à $\gamma = 6 / 3 = 2$. Nous sommes ici en plein régime de haute dimension sous-déterminé ($p > N$). Le système statistique est incapable de contraindre de manière univoque les paramètres d’un modèle linéaire standard, car les degrés de liberté sont négatifs par rapport au nombre de prédicteurs. Cet exemple minimaliste démontre que la problématique de la grande dimension peut survenir même dans des contextes à petite échelle, dès lors que la parcimonie empirique ne parvient pas à compenser le nombre de paramètres libres à déterminer.
2.3 Fondements selon l’école de statistique computationnelle
L’école moderne de la statistique computationnelle, dont les jalons théoriques majeurs ont été fixés par Trevor Hastie, Robert Tibshirani et Jerome Friedman dans leur ouvrage de référence The Elements of Statistical Learning, a radicalement repensé le cadre de l’apprentissage en présence de grands espaces de paramètres. Cette approche aborde le problème non plus uniquement sous l’angle de la théorie des tests, mais à travers la géométrie intrinsèque des espaces vectoriels et le compromis analytique entre biais et variance.
En statistique computationnelle, la défaillance des estimateurs classiques du maximum de vraisemblance en grande dimension est analysée comme une explosion catastrophique de leur variance. Lorsque $p/N to \gamma > 0$, l’absence de régularisation conduit les estimateurs ordinaires à s’ajuster excessivement aux fluctuations idiosyncratiques de l’échantillon d’entraînement. Hastie et ses collègues démontrent que la géométrie des espaces vectoriels réels de haute dimension se caractérise par une quasi-orthogonalité systématique entre tous les vecteurs tirés aléatoirement selon des lois isotropes. Dans un tel environnement géométrique, le conditionnement des matrices de design s’effondre, rendant l’inversion matricielle standard hautement toxique pour la stabilité numérique des algorithmes.
Parallèlement, la statistique computationnelle s’appuie sur des théorèmes fondamentaux de métrique tels que le lemme de Johnson-Lindenstrauss. Ce résultat mathématique fondamental énonce qu’un ensemble fini de $N$ points plongés dans un espace vectoriel de dimension arbitrairement élevée $p$ peut être projeté dans un sous-espace de dimension $k = \mathcal{O}(\epsilon^{-2} \log N)$ tout en ne distordant les distances euclidiennes relatives entre chaque paire de points que d’un facteur maximal de $1 \pm \epsilon$. Ce résultat prouve que, bien que la dimensionnalité ambiante $p$ puisse tendre vers l’infini, l’empreinte géométrique d’un échantillon discret reste régie par la taille $N$, offrant un fondement mathématique rigoureux à la compression d’information et aux techniques de plongement de données.
3. Le phénomène géométrique du fléau de la dimensionnalité
3.1 L’expansion exponentielle du volume spatial
L’expression « fléau de la dimensionnalité » (curse of dimensionality), initialement formulée par Richard Bellman en 1957 dans le cadre de la programmation dynamique et de la théorie du contrôle optimal, renvoie aux singularités géométriques spectaculaires qui émergent dès lors qu’un espace vectoriel gagne des dimensions supplémentaires. La manifestation la plus immédiate de ce fléau réside dans la dilatation géométrique exponentielle du volume des espaces hypercubiques ou hypersphériques.
Pour appréhender ce comportement analytique, considérons un hypercube unitaire dans l’espace euclidien $\mathbb{R}^p$, défini par l’intervalle $[0, 1]^p$, dont le volume global est conventionnellement égal à $1^p = 1$. Supposons que nous souhaitions échantillonner des points de données afin de maintenir une densité spatiale uniforme, par exemple en divisant chaque axe de coordonnées en 10 segments de longueur $0{,}1$. Pour un espace unidimensionnel ($p = 1$), 10 sous-intervalles suffisent pour couvrir l’espace. En dimension $p = 2$, le carré unitaire requiert $10^2 = 100$ petites cases de surface égale. En dimension $p = 3$, l’espace cubique exige $10^3 = 1,000$ cellules. En dimension $p = 100$, le nombre de cases élémentaires nécessaires pour couvrir cet hypercube devient $10^{100}$, une quantité astronomique surpassant le nombre d’atomes dans l’univers observable.
Cette expansion exponentielle entraîne une raréfaction absolue de la densité d’échantillonnage. Même avec une cohorte empirique colossale de plusieurs centaines de milliers d’individus, les points de données disséminés dans un hypercube de dimension $p > 50$ se retrouvent infiniment isolés les uns des autres. L’espace est en réalité totalement vide. Pour maintenir une densité d’échantillonnage constante à mesure que la dimension $p$ s’accroît arithmétiquement, la taille $N$ de l’échantillon devrait augmenter de façon exponentielle : $N(p) propto C^p$, où $C > 1$. Cette condition est physiquement et biologiquement impossible à satisfaire dans le cadre de la recherche empirique.
Une autre propriété géométrique troublante concerne la répartition de la masse volumique au sein de l’hypercube unitaire. Considérons la coquille extérieure de cet hypercube, définie par la couche périphérique d’épaisseur $epsilon$ adjacente aux frontières. Le volume du sous-cube intérieur résiduel de côté $1 – 2epsilon$ est donné par $(1 – 2\epsilon)^p$. La proportion du volume total de l’hypercube située dans la fine bordure externe est donc calculée par l’expression :
$$V_{\text{bordure}} = 1 – (1 – 2\epsilon)^p$$
Lorsque la dimension $p$ devient grande, pour tout $\epsilon in (0, 0{,}5)$ même infinitésimal, le terme $(1 – 2\epsilon)^p$ décroît exponentiellement vers zéro. Dès lors :
$$\lim_{p to \infty} V_{\text{bordure}} = 1$$
Cela démontre que dans un espace de grande dimension, la totalité du volume d’un corps géométrique régulier se trouve concentrée à proximité immédiate de sa surface ou de ses frontières extérieures. L’intérieur de l’espace est rigoureusement désertique. Toute observation empirique prélevée aléatoirement dans une distribution multivariée se comporte ainsi systématiquement comme un point marginal ou extrême.
3.2 Le comportement contre-intuitif des distances métriques
L’impact le plus débilitant de la haute dimension sur l’apprentissage statistique concerne l’altération structurelle du comportement des distances métriques usuelles, et particulièrement de la distance euclidienne canonique (norme $L_2$). Ce phénomène d’évanouissement métrique découle directement de la concentration de la mesure. Soient deux points indépendants $\mathbf{x}, \mathbf{y} in \mathbb{R}^p$ dont chaque composante $x_j, y_j$ est tirée de manière i.i.d. selon une loi de variance finie $\sigma^2$. Le carré de la distance euclidienne entre ces deux vecteurs s’exprime comme une somme de variables aléatoires indépendantes :
$$|\mathbf{x} – \mathbf{y}|_2^2 = \sum_{j=1}^p (x_j – y_j)^2$$
En vertu de la loi forte des grands nombres, lorsque la dimension $p$ tend vers l’infini, la moyenne empirique de cette somme converge presque sûrement vers son espérance mathématique. L’écart-type de cette distance augmente à un rythme proportionnel à $\sqrt{p}$, mais l’espérance de la distance elle-même croît également au rythme de $\sqrt{p}$. Dès lors, si l’on examine le rapport entre la variance des distances et la moyenne de ces distances, ce ratio tend asymptotiquement vers zéro :
$$\lim_{p to \infty} \frac{\mathrm{Var}(|\mathbf{x} – \mathbf{y}|_2)}{\mathbb{E}[|\mathbf{x} – \mathbf{y}|_2]^2} = 0$$
Ce résultat analytique, rigoureusement établi par les travaux fondateurs de Beyer et ses collaborateurs en 1999, engendre une conséquence désastreuse : pour tout ensemble de $N$ points et pour tout point de référence sélectionné, la distance euclidienne séparant ce point de référence de son voisin le plus éloigné ($D_{\max}$) converge vers la distance le séparant de son voisin le plus proche ($D_{\min}$). Formellement :
$$\lim_{p to \infty} \frac{D_{\max} – D_{\min}}{D_{\min}} = 0$$
Dans un espace de dimension suffisamment élevée, tous les points d’un jeu de données semblent se trouver à la même distance les uns des autres. La distribution spatiale des données ressemble aux sommets d’un simplexe régulier où chaque individu est équidistant de tous ses pairs. Ce phénomène d’égalisation ruine l’efficacité des algorithmes basés sur la proximité géométrique. Les méthodes des $k$-plus proches voisins ($k$-NN), les arbres de régression spatiale, les estimateurs de densité par noyaux (KDE) et les algorithmes de partitionnement tels que les $k$-moyennes (k-means) perdent leur pouvoir discriminant : la notion même de proximité locale perd tout sens géométrique distinctif.
3.3 L’effet d’illusion géométrique en haute dimension
Outre l’égalisation des distances métriques, la géométrie des espaces de haute dimension génère des illusions topologiques sévères qui égarent le modélisateur. L’une des plus spectaculaires est le paradoxe de l’orthogonalité presque sûre. Soient deux vecteurs aléatoires gaussiens indépendants et centrés $\mathbf{u}, \mathbf{v} \sim \mathcal{N}(\mathbf{0}, \mathbf{I}_p)$. Le cosinus de leur angle géométrique $\theta$ est donné par leur produit scalaire normalisé :
$$\cos(\theta) = \frac{\langle \mathbf{u}, \mathbf{v} \rangle}{|\mathbf{u}|_2 |\mathbf{v}|_2} = \frac{\sum_{j=1}^p u_j v_j}{\sqrt{\sum_{j=1}^p u_j^2}\sqrt{\sum_{j=1}^p v_j^2}}$$
Le produit scalaire au numérateur est une somme de variables aléatoires indépendantes centrées d’espérance nulle, dont l’écart-type d’échantillonnage croît comme $\sqrt{p}$. Les normes au dénominateur convergent chacune vers $\sqrt{p}$. Par conséquent, l’expression entière converge stochastiquement vers zéro au rythme de $\mathcal{O}(1/\sqrt{p})$ lorsque $p to \infty$. Dès que la dimensionnalité dépasse quelques centaines d’unités, deux vecteurs générés de manière totalement indépendante sont presque parfaitement orthogonaux ($\theta \approx 90^circ$).
Ce comportement géométrique génère des distorsions perverses lors de l’application d’algorithmes de classification non supervisée (clustering). Dans la mesure où l’espace est quasi-vide et les observations périphériques et mutuellement orthogonales, n’importe quelle projection linéaire ou non linéaire aléatoire peut donner l’illusion optique de regroupements discrets bien distincts. Les algorithmes de partitionnement peuvent scinder l’espace de manière arbitraire et identifier de pseudo-groupes aux propriétés statistiques en apparence distinctes, alors qu’il ne s’agit que de fluctuations stochastiques dans une structure homogène. En recherche clinique, ce phénomène constitue une trappe majeure : de prétendus sous-types de pathologies psychiatriques ou de profils de personnalité peuvent n’être que des artefacts géométriques induits par l’inadéquation de la métrique en haute dimension.
4. Implications statistiques : Pourquoi la grande dimension paralyse-t-elle l’inférence ?
4.1 La sous-détermination et l’indétermination du système linéaire
L’obstacle fondamental que pose le régime $p > N$ aux méthodes inférentielles réside dans la sous-détermination mathématique des systèmes linéaires sous-jacents. Dans un modèle de régression linéaire classique, nous cherchons à modéliser une variable dépendante scalaire $y_i$ en fonction d’un vecteur de régresseurs $\mathbf{x}_i in \mathbb{R}^p$ selon l’équation canonique $y_i = \mathbf{x}_i^top boldsymbol{\beta} + \epsilon_i$, ou sous forme matricielle consolidée :
$$\mathbf{y} = \mathbf{X}boldsymbol{\beta} + boldsymbol{\epsilon}$$
où $\mathbf{y} in \mathbb{R}^N$ est le vecteur des réponses empiriques, $\mathbf{X} in \mathbb{R}^{N \times p}$ représente la matrice des prédicteurs, $boldsymbol{\beta} in \mathbb{R}^p$ est le vecteur des paramètres inconnus à estimer, et $boldsymbol{\epsilon} \sim \mathcal{N}(\mathbf{0}, \sigma^2 \mathbf{I}_N)$ correspond au bruit aléatoire. L’estimateur canonique des moindres carrés ordinaires (MCO) vise à minimiser la somme des carrés des résidus $|\mathbf{y} – \mathbf{X}boldsymbol{\beta}|_2^2$, ce qui conduit aux équations normales :
$$\mathbf{X}^top\mathbf{X}boldsymbol{\beta} = \mathbf{X}^top\mathbf{y}$$
Pour obtenir une solution analytique unique $\hat{boldsymbol{\beta}}_{\text{MCO}} = (\mathbf{X}^top\mathbf{X})^{-1}\mathbf{X}^top\mathbf{y}$, la matrice de Gram $\mathbf{X}^top\mathbf{X}$ de dimension $p \times p$ doit être strictement inversible, ce qui exige qu’elle soit de plein rang ($p$). Or, dès lors que $p > N$, nous avons vu que le rang maximal de cette matrice est au plus $N < p$. Par conséquent, la matrice $\mathbf{X}^top\mathbf{X}$ n'est pas inversible : elle admet une valeur propre nulle avec une multiplicité algébrique d'au moins $p – N$. Le noyau (kernel) de l’opérateur linéaire $\mathbf{X}$ est de dimension strictement positive :
$$dim(ker(\mathbf{X})) ge p – N > 0$$
Cette condition algébrique implique qu’il existe une infinité continue de vecteurs non nuls $\mathbf{z} in ker(\mathbf{X})$ vérifiant $\mathbf{X}\mathbf{z} = \mathbf{0}$. Dès lors, si $\hat{boldsymbol{\beta}}$ constitue un vecteur de coefficients permettant d’ajuster le système, tout vecteur de la forme $\hat{boldsymbol{\beta}} + \mathbf{z}$ produit rigoureusement la même prédiction sur l’échantillon d’apprentissage :
$$\mathbf{X}(\hat{boldsymbol{\beta}} + \mathbf{z}) = \mathbf{X}\hat{boldsymbol{\beta}} + \mathbf{X}\mathbf{z} = \mathbf{X}\hat{boldsymbol{\beta}}$$
Le système est structurellement indéterminé. Il existe une infinité de combinaisons de paramètres qui s’ajustent parfaitement aux données d’observation en annulant les résidus empiriques. L’inférence statistique classique s’effondre : la matrice d’information de Fisher associée est singulière, rendant la variance d’échantillonnage théorique des estimateurs infinie ($\mathrm{Var}(\hat{boldsymbol{\beta}}) = \sigma^2 (\mathbf{X}^top\mathbf{X})^{-1} to \infty$). L’identification univoque de relations fonctionnelles devient impossible sans recourir à des contraintes de régularisation mathématique a priori.
4.2 Le surapprentissage extrême (Overfitting) et l’illusion de performance
L’indétermination du système linéaire débouche immédiatement sur la pathologie statistique la plus dévastatrice en science computationnelle : le surapprentissage extrême ou sur-ajustement (overfitting). Lorsqu’un modèle possède davantage de degrés de liberté que de contraintes d’observation, il n’apprend plus la structure générale ou le signal théorique reliant les variables ; il se contente d’interpoler point par point les données d’entraînement, absorbant intégralement le bruit aléatoire propre à l’échantillon.
Ce phénomène s’accompagne d’une illusion cognitive de perfection prédictive. Dans un modèle sous-déterminé $p > N$, le coefficient de détermination empirique $R^2$ atteint presque systématiquement la valeur théorique maximale de 1. L’erreur quadratique moyenne calculée sur le jeu d’entraînement tombe à zéro. Le modélisateur inexpérimenté peut interpréter ce résultat comme le signe d’une précision remarquable du modèle. Pourtant, cette performance est factice :
$$\lim_{p/N to \infty} R^2_{\text{train}} = 1 \quad \text{tandis que} \quad R^2_{\text{test}} ll 0$$
Dès lors que ce modèle surajusté est confronté à de nouvelles observations empiriques indépendantes issues de la même population, ses prédictions s’effondrent spectaculairement. L’erreur de généralisation explose, devenant souvent bien supérieure à celle d’une simple prédiction naïve par la moyenne. Pour déjouer cette illusion, l’application de protocoles stricts de partitionnement de données s’avère indispensable. En particulier, la validation croisée emboîtée (nested cross-validation) s’impose comme une exigence absolue : elle permet d’isoler hermétiquement les étapes de sélection d’hyperparamètres et de sélection de variables afin d’empêcher toute fuite d’information (data leakage) de l’ensemble de test vers l’ensemble d’apprentissage.
4.3 La crise des comparaisons multiples et découvertes fortuites
Lorsque l’on cherche à identifier des effets significatifs au sein d’une matrice hautement dimensionnelle en procédant par tests univariés répétés, on se heurte immédiatement à l’écueil de l’accumulation des erreurs de type I. Selon la théorie classique des tests d’hypothèses, chaque test individuel est calibré à un seuil de risque nominal de faux positifs noté $\alpha$ (généralement $\alpha = 0{,}05$). Ce seuil stipule que sous l’hypothèse nulle $H_0$ (absence d’effet réel), la probabilité de rejeter à tort cette hypothèse est de 5 %.
Cependant, si l’on effectue simultanément $p$ tests statistiques mutuellement indépendants, le taux global d’erreur au niveau de la famille d’hypothèses, appelé Family-Wise Error Rate (FWER), c’est-à-dire la probabilité d’obtenir au moins un faux positif, s’exprime par la formule probabiliste :
$$\text{FWER} = 1 – (1 – \alpha)^p$$
Pour un jeu de données moderne où le nombre de tests $p$ atteint des valeurs courantes comme $10,000$ (dans l’analyse de signaux neuro-imagerie ou de profils transcriptomiques), la probabilité d’observer au moins une découverte fortuite devient virtuellement certaine :
$$\text{FWER} = 1 – (1 – 0{,}05)^{10,000} = 1 – (0{,}95)^{10,000} \approx 1 – 10^{-223} \approx 1$$
Sous l’hypothèse nulle globale où absolument aucune variable n’exercerait d’effet, l’espérance mathématique du nombre de faux positifs déclarés significatifs au seuil usuel s’élève à $\mathbb{E}[\text{Faux Positifs}] = p \times \alpha = 10,000 \times 0{,}05 = 500$. Les revues scientifiques ont ainsi été inondées de centaines de publications rapportant des « découvertes majeures » qui n’étaient que de simples artefacts statistiques générés par l’absence d’ajustement aux comparaisons multiples.
Pour contrer cette dérive, des procédures de correction rigoureuses ont été développées. La plus conservatrice, la correction de Bonferroni, impose un seuil d’invalidation ajusté $\alpha^* = \alpha / p$. Bien qu’elle contrôle rigoureusement le FWER, cette méthode devient excessivement conservatrice en haute dimension, annihilant la puissance statistique et générant une avalanche d’erreurs de type II (faux négatifs), d’autant plus lorsque les variables sont corrélées entre elles. Pour surmonter cette limitation, l’approche fondamentale théorisée par Yoav Benjamini et Yosef Hochberg en 1995 a introduit le contrôle du taux de fausses découvertes (False Discovery Rate, ou FDR). Le FDR ne cherche pas à éliminer tout faux positif au sein de l’espace global des tests, mais borne la proportion attendue de fausses découvertes parmi l’ensemble des tests déclarés significatifs :
$$\text{FDR} = \mathbb{E}\left[ left. \frac{V}{R} right| R > 0 \right] \cdot \mathbb{P}(R > 0)$$
où $V$ représente le nombre de faux positifs et $R$ le nombre total de rejets de l’hypothèse nulle. Cette procédure algorithmique permet de préserver un niveau optimal de puissance statistique tout en protégeant les disciplines computationnelles contre l’illusion de découvertes fortuites.
5. Exemple 1 : Neuro-imagerie fonctionnelle et cartographie cérébrale (IRMf et EEG)
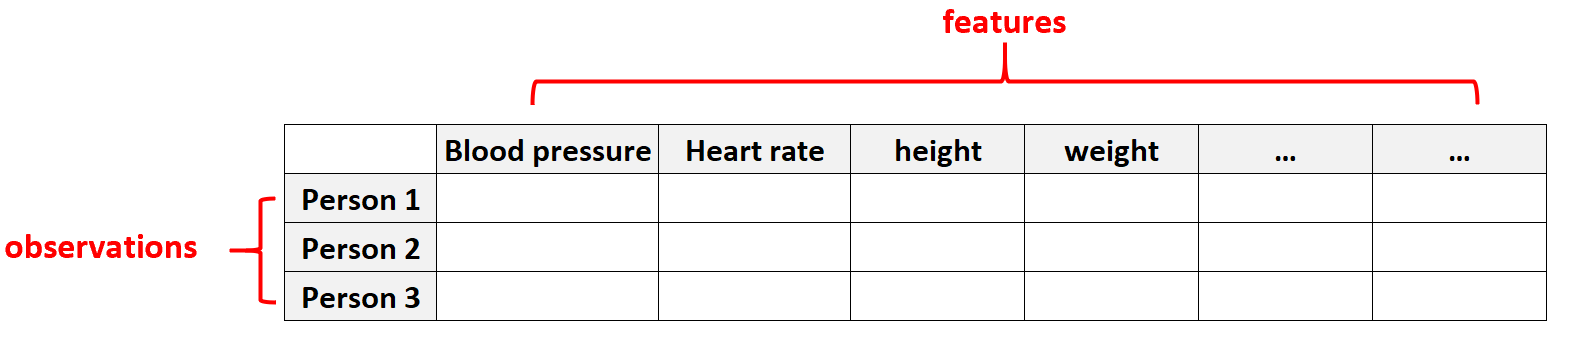
5.1 La structure spatiale et temporelle des signaux cérébraux
L’imagerie par résonance magnétique fonctionnelle (IRMf) constitue l’un des exemples les plus emblématiques du passage à l’ère de la haute dimension au sein des sciences cognitives. Lors d’une séquence d’acquisition standard, le volume cérébral est discrétisé en une grille volumétrique tridimensionnelle composée de centaines de milliers d’unités élémentaires appelées voxels (généralement d’une dimension de $1$ à $3\text{ mm}^3$). Pour chaque voxel individuel, la machine mesure l’évolution temporelle du signal dépendant du niveau d’oxygénation sanguine (signal BOLD, pour Blood Oxygen Level Dependent) à une fréquence d’échantillonnage de l’ordre de la seconde (temps de répétition, TR).
L’architecture matricielle résultante d’un seul examen cérébral se compose d’un volume spatial de l’ordre de $p \approx 100,000$ à $250,000$ voxels échantillonnés sur plusieurs centaines d’intervalles temporels. Lorsque le protocole de recherche vise à comparer des groupes cliniques (par exemple des patients diagnostiqués avec un trouble dépressif majeur face à des sujets contrôles sains), le recrutement est souvent restreint par d’importantes contraintes financières, logistiques et médicales. Les cohortes expérimentales regroupent ainsi fréquemment entre $N = 20$ et $N = 80$ participants. Nous nous trouvons plongés dans une configuration extrême où $p gg N$, le nombre de voxels surpassant le nombre d’individus de plusieurs ordres de grandeur.
Cette disproportion est d’autant plus difficile à traiter que le signal BOLD est particulièrement bruité. La dynamique hémodynamique induite par l’activité neuronale locale est noyée au sein de multiples sources de bruit physiologique et mécanique : pulsations cardiaques, cycles respiratoires, micro-mouvements de la tête du patient dans le champ magnétique et dérives thermiques des bobines réceptrices. Le ratio signal sur bruit y est structurellement défavorable. L’analyse spatio-temporelle de l’IRMf nécessite donc des chaînes de prétraitement computationnel complexes (recalage spatial, normalisation stéréotaxique, lissage spatial) préalablement à toute tentative de modélisation statistique.
5.2 L’analyse multivoxel (MVPA) comme illustration pratique
L’évolution de l’analyse des données de neuro-imagerie illustre parfaitement le passage conceptuel de la statistique univariée à l’apprentissage multivarié en haute dimension. Pendant deux décennies, l’approche dominante a reposé sur le Modèle Linéaire Général (GLM) appliqué de manière univariée voxel par voxel (mass-univariate analysis). Cette méthode teste indépendamment chaque unité spatiale pour déterminer si son intensité moyenne varie en fonction de la tâche cognitive, appliquant a posteriori des corrections drastiques pour tests multiples. Bien qu’utile, cette démarche ignore par conception la corrélation spatiale et l’organisation fonctionnelle distribuée du tissu cérébral.
Pour dépasser ces simplifications réductrices, la neuroscience computationnelle s’est tournée vers l’analyse de motifs multivoxels (Multi-Voxel Pattern Analysis, ou MVPA), conceptualisée par Jim Haxby et ses collaborateurs en 2001. La MVPA ne considère plus les voxels comme des entités indépendantes, mais exploite le patron spatial conjoint d’activation à travers un réseau complet de voxels pour prédire l’état cognitif, perceptif ou clinique d’un individu. Chaque condition cognitive devient un point d’apprentissage dans un espace vectoriel de dimension $p$.
Cette transition vers la classification multivariée soulève des pièges méthodologiques redoutables. Avec quelques dizaines de répétitions expérimentales par condition clinique et plusieurs milliers de prédicteurs spatiaux, les classificateurs linéaires (tels que les machines à vecteurs de support, SVM) sont capables de séparer n’importe quelle modalité expérimentale de manière artificielle si le pipeline n’est pas scrupuleusement partitionné. L’étude méthodologique célèbre menée par Bennett et ses collègues en 2009 sur un saumon mort — détectant des « activations cognitives » significatives lors de la présentation d’images socio-émotionnelles chez ce poisson sans vie — a mis en évidence de façon saisissante la vulnérabilité intrinsèque des analyses en haute dimension non corrigées : les fluctuations stochastiques d’un volume complexe peuvent facilement mimer des patrons fonctionnels hautement spécifiques.
5.3 Approches analytiques adaptées au signal neurocognitif
Pour analyser rigoureusement ces matrices cérébrales massives sans succomber au surapprentissage, la neuro-imagerie computationnelle a développé des approches théoriques fondées sur la topologie et la réduction de dimension guidée par la biologie. La première réponse mathématique historique réside dans l’application de la théorie des champs aléatoires gaussiens (Gaussian Random Fields). Plutôt que de traiter chaque voxel comme une variable discrète déconnectée, cette approche modélise la nappe d’activation cérébrale comme un processus stochastique continu dans l’espace $\mathbb{R}^3$. Le contrôle statistique s’opère non plus sur le nombre de tests élémentaires individuels, mais sur l’étendue spatiale et la hauteur des clusters contigus d’activation (seuillage topologique), réduisant drastiquement la sévérité des corrections univariées.
La seconde stratégie centrale repose sur la réduction de dimension guidée par des atlas anatomiques ou fonctionnels, un processus désigné sous le terme de parcellisation cérébrale. En agrégeant les voxels au sein de quelques centaines de régions d’intérêt corticales et sous-corticales scientifiquement homogènes (en utilisant par exemple les atlas de Glasser, de Schaefer ou de Shen), la dimension de l’espace des descripteurs est comprimée de $p \approx 200,000$ à $p \approx 400$. Cette opération réduit considérablement le ratio $p/N$ tout en augmentant substantiellement le rapport signal sur bruit grâce au moyennage spatial local.
Enfin, pour l’exploration de la connectivité fonctionnelle à l’état de repos (resting-state fMRI), les méthodes de factorisation non supervisée, à l’image de l’Analyse en Composantes Indépendantes (ICA), permettent d’isoler les réseaux neurocognitifs intrinsèques (comme le réseau du mode par défaut ou le réseau exécutif central) sans exiger de conditions expérimentales imposées. Ces décompositions spatiales et temporelles permettent d’extraire les signaux latents cohérents et d’évacuer les bruits systémiques de haute dimension.
6. Exemple 2 : Génomique psychiatrique et transcriptomique comportementale
6.1 L’architecture génétique des troubles psychiatriques complexes
La génétique humaine et la psychiatrie biologique offrent un autre terrain d’application paradigmatique de la haute dimension. Durant des décennies, la génétique comportementale postulait l’existence de quelques « gènes majeurs » dotés d’un effet causale direct et puissant sur les troubles psychiatriques, comme le transporteur de la sérotonine ou les récepteurs de la dopamine. L’essor technologique des puces à ADN et du séquençage du génome complet a balayé cette vision au profit de l’architecture hautement polygénique.
Les études d’association sur le génome entier (Genome-Wide Association Studies, ou GWAS) mesurent simultanément des millions de variations ponctuelles de nucléotides (polymorphismes nucléotidiques simples, ou SNP) disséminées le long des 23 paires de chromosomes. Les matrices de design génomique affichent des dimensions monumentales : $p ge 1,000,000$ à $10,000,000$ de variables génétiques par individu. En face, malgré la constitution de consortiums internationaux massifs regroupant des cohortes de plusieurs dizaines ou centaines de milliers de patients ($N \approx 50,000$ à $500,000$), le ratio dimensionnel demeure profondément contraint par la très faible taille d’effet de chaque variant individuel.
Contrairement aux maladies mendéliennes classiques causées par la mutation d’un locus unique, les troubles neuropsychiatriques complexes — tels que la schizophrénie, les troubles bipolaires, l’autisme ou la dépression majeure — résultent de l’action conjointe de milliers de variants génétiques dispersés sur l’ensemble du génome. Chaque variant n’explique qu’une fraction infime de la variance phénotypique globale (des rapports de cotes ou odds ratios oscillant fréquemment entre $1{,}02$ et $1{,}15$). Par conséquent, le signal statistique est microscopique et distribué dans un bruit de fond colossal. De surcroît, le génome n’est pas une séquence de segments indépendants : le phénomène de déséquilibre de liaison (linkage disequilibrium) induit une corrélation spatiale et temporelle intense (multi-colinéarité de grande échelle) entre SNP situés sur un même bloc chromosomique, complexifiant grandement l’isolation des signaux réellement causaux.
6.2 Construction et pièges des scores de risque polygénique (PRS)
Face à cette dispersion génomique de l’architecture des troubles, la discipline a développé un outil synthétique fondamental : le score de risque polygénique (Polygenic Risk Score, ou PRS). L’objectif du PRS est de résumer l’ensemble de l’architecture génétique d’un individu en un indicateur dimensionnel continu unique, reflétant sa susceptibilité héréditaire globale au développement d’un trait ou d’une pathologie neuropsychiatrique. Ce score est formellement calculé comme une somme pondérée des allèles de risque que porte un individu :
$$\text{PRS}_i = \sum_{j=1}^m \hat{\beta}_j X_{ij}$$
où $X_{ij} in {0, 1, 2}$ correspond au génotype de l’individu $i$ pour le variant génétique $j$ (exprimé en nombre d’allèles à risque portés), $\hat{\beta}_j$ représente le coefficient de régression estimé lors d’une GWAS indépendante de grande envergure pour ce même variant, et $m$ est le nombre de variants sélectionnés dans le modèle prédictif.
La construction des PRS constitue une parfaite démonstration des écueils de la haute dimension. Le premier piège méthodologique réside dans le choix du seuil de sélection des variants à inclure ($p$-valeur de coupure). Si l’on ne retient que les variants atteignant le seuil strict de significativité génomique ($\alpha = 5 \times 10^{-8}$, calculé après ajustement de Bonferroni pour un million de tests indépendants), on omet une part substantielle de l’héritabilité cachée contenue dans les milliers de variants aux effets très faibles non détectés. À l’inverse, si l’on relaxe le seuil d’inclusion pour intégrer des centaines de milliers de SNP, on injecte une quantité massive de bruit stochastique, favorisant le sur-ajustement et dégradant la capacité de généralisation du score.
Le second défi structurel majeur réside dans le biais de stratification des populations et le manque dramatique de transférabilité inter-populations. Les modèles GWAS ont été conduits de manière écrasante sur des cohortes d’ascendance exclusivement européenne. Or, en raison de dérives génétiques historiques, les fréquences alléliques et les blocs de déséquilibre de liaison varient considérablement entre les populations humaines. Appliquer un modèle de PRS calibré en haute dimension sur une ascendance européenne à un individu issu d’une population d’Afrique de l’Ouest ou d’Asie de l’Est conduit à des erreurs de prédiction massives. Le modèle capture l’ascendance biogéographique ancestrale sous-jacente plutôt que les véritables mécanismes biologiques du risque psychiatrique.
6.3 Épigénétique et expression génique dans le tissu cérébral
L’analyse de l’expression génique (transcriptomique) et des régulations chimiques de l’ADN (épigénétique, méthylation de l’ADN) dans le contexte neuropsychiatrique pousse la problématique de la haute dimension à un niveau critique de complexité méthodologique. Les technologies de séquençage d’ARN (RNA-Seq) mesurent le niveau d’expression de dizaines de milliers de transcrits d’ARN messager au sein d’un échantillon biologique ($p \approx 25,000$ à $50,000$), tandis que les puces d’épigénomique quantifient le niveau de méthylation de résidus cytosine-guanine (sites CpG) à travers plus de $850,000$ positions génomiques cibles.
Or, pour étudier l’impact de ces mécanismes moléculaires sur des troubles comme la schizophrénie, la dépression sévère ou l’addiction, l’accès direct au tissu cérébral humain est indispensable, le profil transcriptomique périphérique (sanguin) n’étant souvent qu’un proxy médiocre de la dynamique corticale. Ces analyses reposent donc presque exclusivement sur des échantillons de tissu cérébral prélevés post-mortem. Pour des raisons évidentes de rareté et de contraintes éthiques, ces cohortes post-mortem dépassent rarement quelques dizaines ou quelques centaines de cerveaux analysés ($N < 100$).
Le ratio dimensionnel qui en résulte ($p gg N$) est aggravé par une hétérogénéité biologique majeure inhérente aux prélèvements post-mortem : intervalle post-mortem variable (durée écoulée entre le décès et la congélation tissulaire), pH cérébral, cause du décès (souvent traumatique ou par hypoxie) et antécédents de pharmacothérapie lourde. Ces variables parasitaires agissent comme des facteurs de confusion massifs de haute dimension. Si elles ne sont pas isolées et soustraites à l’aide de modèles d’extraction de variables latentes (tels que les modèles Surrogate Variable Analysis, SVA), elles masquent entièrement le faible signal différentiel lié à la pathologie psychiatrique.
7. Exemple 3 : Évaluation psychométrique moderne et phénotypage numérique
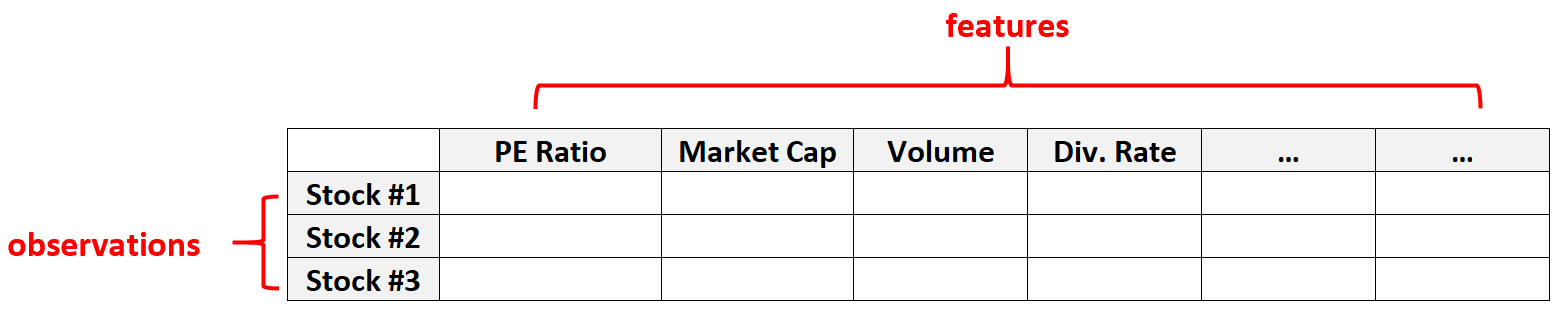
7.1 Du questionnaire psychométrique traditionnel aux traces comportementales continues
L’évaluation psychologique traverse une mutation méthodologique sans précédent avec l’avènement du phénotypage numérique (digital phenotyping). Pendant plus d’un siècle, la mesure des traits psychologiques et des états psychopathologiques reposait sur des outils psychométriques statiques et discrets : questionnaires d’auto-évaluation fondés sur des échelles de Likert, batteries de tests psychotechniques administrées en laboratoire ou entretiens diagnostiques semi-structurés. Ces protocoles recueillaient un ensemble restreint d’observations ponctuelles ($p le 50$ items) appliquées à des cohortes de taille modérée ou étendue ($N ge 200$), s’inscrivant naturellement dans un cadre d’estimation classique où la taille de l’échantillon dominait largement le volume des indicateurs.
Le déploiement des téléphones intelligents, des montres connectées et de multiples dispositifs portables (wearables) a profondément bouleversé cette dynamique. Ces appareils enregistrent en continu, sans solliciter activement l’utilisateur (captation passive), une constellation de signaux physiques, contextuels et comportementaux :
- Accélérométrie triaxiale et gyroscope (mesure de la motricité, des niveaux d’agitation motrice et des phases de repos).
- Capteurs de localisation GPS (mobilité spatiale, régularité des routines géographiques, rayon d’action quotidien).
- Métadonnées de communication numérique (fréquence et durée des appels, latence de réponse aux messages, activité sur les réseaux sociaux).
- Télémétrie physiologique continue (variabilité de la fréquence cardiaque, conductance cutanée, architecture des cycles du sommeil).
Cette captation produit un flux ininterrompu de données à haute fréquence. En extrayant quotidiennement des dizaines d’indicateurs de synthèse pour chaque participant, le nombre de variables descriptives $p$ explose en quelques semaines pour atteindre plusieurs milliers d’attributs temporels, fréquentiels et interactionnels par individu. Le paradigme psychologique traditionnel — fondé sur une approche nomothétique visant à positionner des individus sur quelques axes factoriels stables — se transforme en un cadre idiographique complexe où chaque participant génère à lui seul un espace de données hautement dimensionnel.
7.2 L’approche en réseau de la psychopathologie (Network Psychometrics)
Conjointement à l’essor des données comportementales continues, la modélisation théorique de la santé mentale a connu un renouveau conceptuel majeur avec l’émergence de la psychométrie en réseau (Network Psychometrics), théorisée notamment par Denny Borsboom et son équipe. Cette approche réfute le postulat implicite du modèle biomédical classique selon lequel les symptômes observables (insomnie, anhédonie, fatigue, pensées suicidaires) ne sont que les reflets épiphénoménaux d’une maladie latente sous-jacente non mesurable (comme « la dépression majeure »).
La psychométrie en réseau conçoit au contraire les troubles mentaux comme des systèmes dynamiques complexes d’interactions réciproques et directes entre symptômes. L’insomnie chronique induit de la fatigue diurne ; cette fatigue limite les activités physiques et professionnelles, générant un sentiment d’incompétence et d’isolement social, qui active en retour des ruminations anxieuses, lesquelles maintiennent et amplifient l’insomnie. Dans cette perspective, la pathologie mentale est le réseau lui-même : un état d’équilibre auto-renforçant au sein d’un graphe d’éléments en interaction dynamique.
Sur le plan statistique, ces systèmes sont formalisés sous la forme de modèles graphiques gaussiens (Graphical Gaussian Models, GGM) ou de réseaux de corrélation partielle. Dans un réseau comprenant $V$ symptômes distincts, chaque nœud représente un symptôme et chaque arête entre deux nœuds correspond à leur corrélation partielle, c’est-à-dire l’intensité de leur association linéaire conditionnelle après avoir contrôlé l’effet de tous les autres symptômes du réseau. Or, le nombre d’arêtes potentielles à estimer dans un réseau non orienté à $V$ sommets croît de manière combinatoire selon la relation mathématique :
$$p = \frac{V(V – 1)}{2}$$
Si l’on évalue une échelle psychopathologique détaillée englobant $V = 100$ symptômes ou critères cliniques, le nombre de paramètres d’interaction à déterminer s’élève à $p = 100 \times 99 / 2 = 4,950$ coefficients de corrélation partielle. Dès que l’échantillon clinique disponible ne comporte que quelques centaines de patients ($N < 500$), le problème bascule dans le régime de haute dimension. Estimer directement la matrice de précision (l'inverse de la matrice de covariance, $\mathbf{\Theta} = \mathbf{\Sigma}^{-1}$) par inversion empirique ordinaire produit des estimations instables et une prolifération d'arêtes fallacieuses dues au bruit d'échantillonnage.
Pour résoudre cette indétermination, les psychométriciens mobilisent l’algorithme du Graphical Lasso (GLasso). En imposant une pénalité de norme $L_1$ sur les éléments hors-diagonale de la matrice de précision inverse, le GLasso contraint les corrélations partielles les plus faibles à s’annuler strictement. Cette modélisation parcimonieuse force la structure du réseau à ne conserver que les arêtes structurellement robustes, garantissant ainsi la topologie et la stabilité diagnostique du graphe clinique.
7.3 Micro-analyses écologiques instantanées (EMA) et séries temporelles denses
L’évaluation écologique momentanée (Ecological Momentary Assessment, ou EMA) représente la modalité la plus fine de recueil des états subjectifs en psychologie clinique. Ce protocole consiste à interroger les individus directement dans leur environnement écologique quotidien, au moyen de notifications régulières diffusées sur leur téléphone portable (par exemple 6 à 10 fois par jour sur une durée de 30 à 90 jours). Les participants évaluent sur l’instant leurs affects positifs et négatifs, leur niveau de stress ressenti, leurs interactions sociales immédiates, leur consommation de substances et leurs processus cognitifs réflexifs.
Cette méthodologie génère une matrice temporelle dense d’observations multivariées répétées. Dès lors émerge le défi du paradigme « $N = 1$ » (ou N-of-1 trial) : modéliser la dynamique psychologique unique d’un seul patient afin de concevoir des interventions thérapeutiques personnalisées de haute précision. Dans cette configuration, le nombre d’observations $T$ correspond au total des points de mesure temporels complétés (par exemple $T = 300$ évaluations), tandis que le nombre de paramètres dynamiques à calibrer explose.
Si l’on déploie un modèle autorégressif vectoriel (VAR) d’ordre 1 pour quantifier l’influence croisée de chaque variable mesurée à l’instant $t-1$ sur chaque variable à l’instant $t$ :
$$\mathbf{y}_t = \mathbf{\Phi}\mathbf{y}_{t-1} + boldsymbol{\epsilon}_t$$
la matrice des coefficients de transition $\mathbf{\Phi}$ contient à elle seule $p^2$ paramètres à estimer. Avec seulement $p = 25$ états subjectifs évalués au fil de la journée, la matrice compte $25^2 = 625$ paramètres dynamiques distincts. Le nombre de paramètres à inférer surpasse le nombre de moments d’observation empiriques disponibles ($p^2 > T$). Nous retombons pleinement dans une configuration de haute dimension sous-déterminée au niveau individuel.
Ce défi computationnel est encore amplifié par la violation systématique des hypothèses classiques de la statistique temporelle. Les séries temporelles psychologiques sont fortement autocorrélées, non-stationnaires (la moyenne et la variance des affects dérivent selon les événements de vie du patient) et criblées de données manquantes (le participant omettant régulièrement de répondre lorsqu’il dort, conduit ou traverse une crise émotionnelle aiguë). Pour surmonter ces contraintes, la psychométrie computationnelle déploie des modèles d’autorégression vectorielle régularisés par pénalité Ridge ou Elastic Net, ou s’appuie sur des formulations bayésiennes hiérarchiques permettant de mutualiser la force statistique entre individus (partial pooling) tout en préservant l’idiographie de chaque trajectoire clinique.
8. Exemple 4 : Traitement automatique du langage naturel en psychologie clinique
8.1 La textualisation des états mentaux et transcriptions thérapeutiques
L’expression linguistique naturelle constitue l’une des sources les plus directes et les plus riches pour appréhender la subjectivité, la cognition et les perturbations psychopathologiques d’un individu. Qu’il s’agisse des transcriptions verbatim d’entretiens psychiatriques, de séances complètes de psychothérapie, d’écrits introspectifs de patients ou de publications spontanées déposées sur les réseaux sociaux, ces corpus textuels représentent un matériel sémiotique d’une valeur diagnostique majeure. Cependant, la conversion computationnelle du langage naturel en données numériques exploitables illustre de façon magistrale le passage immédiat dans des espaces de très haute dimension.
Dans l’approche classique du traitement automatique du langage naturel (NLP), la méthode historique de représentation repose sur le modèle du « sac de mots » (Bag-of-Words, BoW) ou sur la pondération par fréquence de terme-fréquence inverse de document (TF-IDF). Dans ce paradigme de vectorisation lexicale, chaque document clinique (par exemple la transcription d’une consultation) est converti en un vecteur dont chaque élément quantifie la présence ou le poids statistique d’un mot au sein d’un lexique de référence prédéterminé.
Le vocabulaire exhaustif d’une langue humaine vivante englobe des centaines de milliers d’unités lexicales distinctes. Même après l’application d’étapes classiques de normalisation textuelle — comme la suppression des mots vides (stop words), la racinisation (stemming) ou la lemmatisation —, le lexique effectif d’un corpus clinique compte typiquement entre $p = 10,000$ et $p = 50,000$ descripteurs distincts. En revanche, le recueil de séances thérapeutiques annotées par des psychiatres experts est un processus laborieux, confidentiel et coûteux, restreignant souvent les jeux de données disponibles à quelques dizaines ou centaines d’enregistrements cliniques ($N in [50, 500]$).
Cette disproportion matricielle ($p gg N$) s’accompagne d’une sparsité extrême : l’immense majorité des cellules de la matrice terme-document résultante sont nulles. Un individu n’utilise qu’une fraction minime du vocabulaire global au cours d’un entretien donné. Si l’on applique des algorithmes de discrimination non régularisés pour classifier des états de détresse psychologique à partir de cette représentation, le modèle a tendance à associer des diagnostics cliniques graves à l’occurrence stochastique de vocables rares totalement dénués de portée pathologique.
8.2 Plongements sémantiques (Word & Sentence Embeddings) et Transformers
Pour dépasser la sparsité et la superficialité du modèle sac de mots, le traitement automatique du langage moderne a fait émerger les modèles de plongements lexicaux et sémantiques distribués (Word Embeddings, tels que Word2Vec et FastText), suivis par les architectures d’attention profonde fondées sur les Transformers (BERT, RoBERTa, LLaMA).
Ces architectures ne projettent plus le texte sous forme d’indicateurs binaires de vocabulaire, mais encodent les représentations sémantiques dans des espaces vectoriels continus et denses de haute dimension. Au sein d’un modèle tel que BERT-base, chaque unité lexicale ou chaque séquence de phrases est convertie en un vecteur d’activation latent dont la dimensionnalité standard est fixée à $d = 768$ (et atteint $d = 4,096$ voire davantage dans les grands modèles de langage contemporains). Bien que ces espaces denses réduisent le nombre nominal de dimensions par rapport à un lexique brut de $50,000$ mots, ils introduisent une autre forme de haute dimension : un espace latent continu où chaque coordonnée correspond à une combinaison non-linéaire complexe de traits sémantiques distribués.
L’exploitation de ces plongements vectoriels denses pour l’extraction de biomarqueurs linguistiques fiables du risque suicidaire, de la dépression majeure ou des prodromes de décompensation psychotique (comme le déraillement du cours de la pensée) soulève d’immenses défis de robustesse statistique. Lorsque l’on ajuste (fine-tuning) un réseau de neurones comportant des dizaines de millions de paramètres libres sur un échantillon clinique restreint de quelques centaines de patients, le risque est omniprésent que l’architecture profonde apprenne des raccourcis non causaux. Le système peut par exemple classer un patient comme « dépressif » non pas en fonction de patterns syntaxiques ou affectifs altérés propres à l’anhédonie, mais parce que ce dernier évoque des marqueurs sociodémographiques idiosyncratiques (âge, régionalismes lexicaux) accidentellement surreprésentés dans l’échantillon d’entraînement.
8.3 Validation clinique et interprétabilité des prédicteurs textuels
L’opacité mathématique inhérente aux modèles d’apprentissage profond opérant dans ces espaces de représentations linguistiques de grande dimension soulève une objection majeure en milieu médical : le problème de la boîte noire algorithmique (black box). En psychiatrie et en psychologie clinique, un algorithme prédictif ne peut se contenter d’une performance apparente élevée ; les fondements de son attribution diagnostique doivent être auditables, compréhensibles et cliniquement étayés afin de soutenir la décision thérapeutique.
Pour déconstruire la prise de décision de ces modèles, des méthodes d’interprétabilité post-hoc en haute dimension ont été développées, notamment SHAP (SHapley Additive exPlanations) et LIME (Local Interpretable Model-agnostic Explanations). Fondées sur la théorie des jeux coopératifs, ces techniques évaluent la contribution marginale de chaque dimension textuelle ou mot individuel à la prédiction finale du modèle en générant des permutations locales dans l’espace des données. Cependant, ces techniques d’attribution sont elles-mêmes vulnérables au fléau de la dimensionnalité : la multiplication des interactions potentielles entre termes au sein des couches d’auto-attention engendre une instabilité algorithmique des explications, qui peuvent fluctuer radicalement sous l’effet de variations mineures du texte clinique analysé.
Par ailleurs, la généralisation écologique entre cohortes se heurte au manque d’alignement inter-culturel et démographique des espaces textuels. Un modèle entraîné sur des transcriptions issues d’un milieu hospitalier universitaire urbain échouera fréquemment lorsqu’il sera déployé en zone rurale ou au sein de populations allophones, car la géométrie de son espace sémantique n’a pas été calibrée sur ces variations de style communicatif. L’auditabilité computationnelle et la validation transculturelle s’imposent donc comme des prérequis éthiques absolus avant toute intégration clinique de l’aide diagnostique assistée par l’analyse textuelle.
9. Parcimonie et hypothèses structurales : L’antidote théorique à la grande dimension
9.1 L’hypothèse de parcimonie (Sparsity Assumption)
Face à l’indétermination algébrique et à l’explosion géométrique des espaces de grande dimension, l’esprit scientifique pourrait conclure à l’impossibilité théorique d’extraire des lois invariantes dès lors que $p > N$. Pourtant, l’apprentissage computationnel moderne parvient à triompher de ce blocage grâce à la formulation d’hypothèses structurales préalables sur la réalité empirique étudiée. L’hypothèse structurale la plus puissante et la plus féconde est incontestablement l’hypothèse de parcimonie (sparsity assumption).
L’hypothèse de parcimonie postule que, bien que nous ayons consigné un catalogue monumental de variables descriptives $p$ dans la matrice d’observation, seule une infime minorité d’entre elles exerce une influence fonctionnelle réelle sur le phénomène physique, biologique ou comportemental mesuré. Sous cette hypothèse, le « vrai » vecteur de paramètres sous-jacent $boldsymbol{\beta}^* in \mathbb{R}^p$ gouvernant la génération des données est dit parcimonieux. Formellement, si l’on note par $|boldsymbol{\beta}^*|_0$ la pseudo-norme $L_0$ comptabilisant le nombre de composantes strictement non nulles du vecteur :
$$|boldsymbol{\beta}^*|_0 = |{j in {1, dots, p} : \beta_j^* ne 0}| = s$$
l’hypothèse de parcimonie stipule que $s ll p$, et plus fondamentalement que $s < N$. Le problème réel n'est donc plus de dimension $p$, mais de dimension intrinsèque $s$. La parcimonie peut être qualifiée d'exacte si les $p – s$ autres coefficients sont rigoureusement égaux à zéro, ou d’approchée (parcimonie faible) si les coefficients ordonnés décroissent exponentiellement vers zéro selon une loi de puissance.
Cette hypothèse trouve un ancrage épistémologique profond dans le principe de simplicité ontologique dit du « rasoir d’Ockham » (lex parsimoniae) : face à une multiplicité d’explications possibles pour un même fait, l’explication mobilisant le plus petit nombre d’hypothèses doit être privilégiée. Dans le cadre de la génétique comportementale ou des neurosciences, ce principe s’avère biologiquement fondé : des millions de polymorphismes sont transcrits, mais seuls quelques circuits biochimiques critiques pilotent la vulnérabilité différentielle à une pathologie donnée. L’extraction du signal statistique revient alors à une tâche de sélection chirurgicale : localiser le sous-ensemble $s$ pertinent noyé au milieu des $p$ dimensions de bruit.
9.2 L’hypothèse des variétés différentiables sous-jacentes (Manifold Hypothesis)
La seconde hypothèse structurale majeure guidant l’apprentissage statistique en grande dimension est l’hypothèse des variétés (manifold hypothesis). Cette conjecture théorique énonce que les observations empiriques de haute dimension collectées dans le monde réel ne sont pas uniformément réparties à travers l’espace ambiant $\mathbb{R}^p$, mais se concentrent avec une très forte probabilité sur ou à proximité immédiate d’une sous-variété différentiable $\mathcal{M}$ de dimension intrinsèque $d$ très inférieure à la dimension ambiante ($d ll p$).
Considérons, à titre d’analogie géométrique, une feuille de papier de dimensionnalité intrinsèque bidimensionnelle ($d = 2$). Si cette feuille est chiffonnée ou enroulée au sein de l’espace tridimensionnel standard ($p = 3$), chaque point de sa surface nécessite trois coordonnées spatiales cartésiennes $(x, y, z)$ pour spécifier sa position apparente. Cependant, la liberté de mouvement d’une particule contrainte d’évoluer à la surface de cette feuille ne possède localement que deux degrés de liberté fondamentaux. L’espace ambiant est de dimension 3, mais la structure sous-jacente est une variété de dimension 2 immergée de manière non linéaire.
Dans l’étude des états mentaux, de la dynamique neuronale ou des trajectoires cliniques, l’espace ambiant des descripteurs est gigantesque (centaines de milliers de signaux d’activité ou de traces comportementales), mais les contraintes physiologiques, anatomiques et cognitives réduisent drastiquement le champ des états biologiquement admissibles. Le cerveau n’explore pas aléatoirement toutes les combinaisons possibles d’activation de ses milliards de synapses ; son activité est canalisée par des attracteurs dynamiques stables et des réseaux fonctionnels interconnectés. Les configurations cérébrales ou psychopathologiques habitent donc des sous-variétés différentiables de dimensionnalité intrinsèque modeste. L’objectif méthodologique de la réduction de dimension non-linéaire consiste précisément à apprendre la topologie de cette sous-variété $\mathcal{M}$ pour projeter les données vers un espace fonctionnel de base $\mathbb{R}^d$ ($d ll N < p$) sans détruire les relations sémantiques qui les unissent.
9.3 Théorie de l’acquisition comprimée (Compressed Sensing)
L’articulation formelle entre l’hypothèse de parcimonie et la géométrie des projections en haute dimension a trouvé son couronnement théorique dans les années 2000 avec l’émergence de la théorie de l’acquisition comprimée (Compressed Sensing), développée par Emmanuel Candès, Terence Tao et David Donoho. Cette avancée mathématique a révolutionné le traitement du signal en contestant le caractère indépassable du théorème d’échantillonnage canonique de Shannon-Nyquist.
Le théorème de Shannon-Nyquist stipule que pour capturer fidèlement et reconstruire parfaitement un signal analogique de bande passante limitée sans distorsion de repliement (aliasing), la fréquence d’échantillonnage temporelle ou spatiale doit être strictement supérieure au double de la fréquence maximale contenue dans le signal ($f_s > 2 f_{\max}$). Dans des technologies comme l’imagerie par résonance magnétique, ce réquisit technique imposait des durées d’examen très prolongées, durant lesquelles le patient doit rester immobile, rendant les protocoles difficiles à supporter pour des enfants ou des patients souffrant de troubles psychiatriques graves.
La théorie de l’acquisition comprimée démontre que si un signal physique $\mathbf{x} in \mathbb{R}^p$ est parcimonieux (c’est-à-dire qu’il admet une représentation avec seulement $s$ coefficients non nuls dans une base fonctionnelle appropriée, telle qu’une base d’ondelettes ou de Fourier), il peut être reconstruit de manière rigoureusement exacte à partir d’un nombre de mesures non adaptatives aléatoires $m$ très largement inférieur à la dimensionnalité globale $p$, selon la borne asymptotique fondamentale :
$$m ge C \cdot s \cdot \log(p / s) ll p$$
Pour garantir cette reconstruction exacte, la matrice de mesure aléatoire $\mathbf{\Phi} in \mathbb{R}^{m \times p}$ doit satisfaire la propriété d’isométrie restreinte (Restricted Isometry Property, RIP). Cette condition mathématique impose que la matrice préserve de manière quasi-isométrique les longueurs de tous les vecteurs à $s$-composantes éparses :
$$(1 – \delta_s)|\mathbf{z}|_2^2 le |\mathbf{\Phi}\mathbf{z}|_2^2 le (1 + \delta_s)|\mathbf{z}|_2^2$$
Dès lors que la condition RIP est validée avec une constante d’isométrie $\delta_{2s} < \sqrt{2} – 1$, la reconstruction exacte ne nécessite pas de résoudre un problème d'optimisation combinatoire intransportable de type $L_0$, mais peut être réalisée en temps polynomial par une simple optimisation convexe de minimisation de norme $L_1$ :
$$\min_{\mathbf{x} in \mathbb{R}^p} |\mathbf{x}|_1 \quad \text{sujet à} \quad \mathbf{\Phi}\mathbf{x} = \mathbf{y}$$
L’impact pratique en imagerie médicale et neurobiologique a été considérable : les durées d’acquisition en IRM ont pu être réduites d’un facteur de 4 à 10 sans dégradation perceptible de la résolution anatomique des tissus, illustrant magistralement comment la haute dimension peut être domptée par la formalisation mathématique de structures parcimonieuses.
10. Stratégies méthodologiques I : Réduction de dimension et extraction de traits
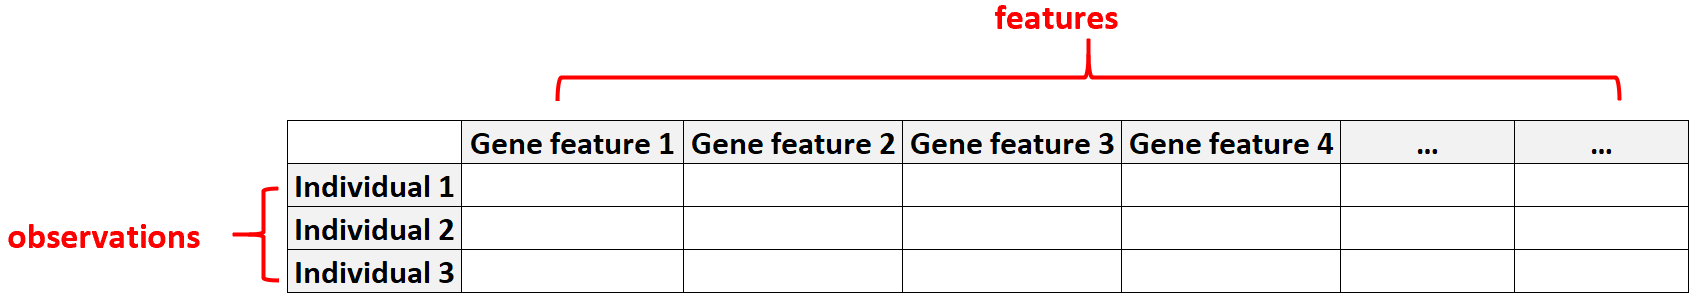
10.1 Méthodes linéaires non supervisées : ACP et Factor Analysis
Pour rendre calculables et interprétables des jeux de données de haute dimension, la première famille d’outils analytiques s’articule autour des projections linéaires orthogonales non supervisées, dominées au premier chef par l’Analyse en Composantes Principales (ACP). Développée par Karl Pearson puis Harold Hotelling, l’ACP vise à transformer un ensemble de $p$ variables originelles potentiellement corrélées en un nouvel ensemble de variables décorrélées appelées composantes principales, ordonnées par ordre décroissant de variance expliquée.
Sur le plan calculatoire, l’ACP repose sur la Décomposition en Valeurs Singulières (SVD) de la matrice de données centrée $\mathbf{X} in \mathbb{R}^{N \times p}$ :
$$\mathbf{X} = \mathbf{U}\mathbf{\Sigma}\mathbf{V}^top$$
où $\mathbf{V} in \mathbb{R}^{p \times p}$ est la matrice orthogonale contenant les vecteurs propres (les axes factoriels ou loadings) de la matrice de covariance empirique $\mathbf{X}^top\mathbf{X}$, $\mathbf{\Sigma}$ contient les valeurs singulières scalaires associées, et $\mathbf{U}$ représente les coordonnées projetées (les scores factoriels des observations). En ne conservant que les $k$ premières colonnes de la matrice de projection ($k ll min(N, p)$), l’ACP réalise la meilleure approximation linéaire de rang $k$ de la matrice originale au sens de la norme de Frobenius (théorème d’Eckart-Young-Mirsky).
Cependant, en régime de haute dimension où $p > N$, l’application naïve de l’ACP rencontre des limites théoriques majeures. Comme le prouve la théorie des matrices aléatoires, lorsque le ratio $p/N to \gamma > 0$, les valeurs propres empiriques se détachent du spectre théorique. Les premiers axes identifiés ont tendance à absorber du bruit stochastique plutôt que la véritable variance sous-jacente du phénomène (phénomène de distorsion spectrale). En psychométrie, l’analyse factorielle exploratoire (EFA) ou confirmatoire (CFA) subit également cette dégradation spectrale empirique, rendant délicate la détermination du nombre optimal de facteurs. Les règles heuristiques classiques (comme le critère de Kaiser d’une valeur propre supérieure à 1) s’effondrent systématiquement, imposant l’usage de protocoles de validation stochastique robuste à l’image de l’analyse parallèle de Horn par permutations d’échantillons aléatoires.
10.2 Réduction non-linéaire et plongement géométrique
Lorsque la structure relationnelle liant les observations en haute dimension obéit à des dynamiques intrinsèquement non-linéaires, les projections linéaires telles que l’ACP échouent à capturer la topologie de la variété. L’apprentissage statistique computationnel a alors imaginé des techniques de plongement de graphes géométriques et de réduction non-linéaire de dimension.
La technique la plus largement adoptée au cours des quinze dernières années est le t-Distributed Stochastic Neighbor Embedding (t-SNE), formalisé par Laurens van der Maaten et Geoffrey Hinton en 2008. Le t-SNE convertit les distances euclidiennes séparant les points dans l’espace ambiant de haute dimension en probabilités conditionnelles selon une loi normale, quantifiant la probabilité que le point $i$ choisisse le point $j$ comme voisin. Dans l’espace projeté de basse dimension (généralement $\mathbb{R}^2$ ou $\mathbb{R}^3$), le t-SNE modélise les probabilités de proximité équivalentes en s’appuyant sur une distribution de Student à un degré de liberté (loi de Cauchy). En minimisant la divergence de Kullback-Leibler entre les deux distributions par descente de gradient stochastique :
$$\mathcal{L}_{\text{t-SNE}} = \mathrm{KL}(P parallel Q) = \sum_{i ne j} p_{ij} \log\left(\frac{p_{ij}}{q_{ij}}\right)$$
le t-SNE résout élégamment le « problème d’écrasement » (crowding problem), préservant méticuleusement les voisinages locaux.
Plus récemment, l’algorithme UMAP (Uniform Manifold Approximation and Projection), proposé par McInnes et ses collègues en 2018, s’est imposé comme une alternative algorithmique plus véloce et théoriquement ancrée dans la topologie algébrique et la géométrie riemannienne. Contrairement au t-SNE, UMAP préserve non seulement les voisinages locaux, mais tend à maintenir la cohérence de la topologie globale de l’espace de données.
Toutefois, la recherche clinique et comportementale doit se garder d’une sur-interprétation de ces représentations graphiques bidimensionnelles. Ces méthodes sont optimisées pour la visualisation exploratoire, et non pour l’inférence. La distance relative séparant deux amas visuels distincts au sein d’une projection t-SNE ou UMAP est hautement dépendante des hyperparamètres d’initialisation (notamment la perplexité) et ne reflète pas fidèlement la distance métrique réelle dans l’espace originel. Tirer des inférences diagnostiques à partir de la seule contemplation de clusters formés sur un graphique t-SNE constitue une erreur méthodologique fréquente.
10.3 Techniques supervisées de projection sous contrainte
Lorsque l’objectif méthodologique ne réside pas dans l’exploration descriptive de la variance non supervisée mais dans la prédiction ciblée d’un critère clinique d’intérêt (par exemple, catégoriser la réponse thérapeutique à un psychotrope ou prédire le score d’une échelle clinique d’anxiété), les techniques de réduction non supervisées s’avèrent sous-optimales. Les axes de variance maximale dans $\mathbf{X}$ (capturés par l’ACP) ne coïncident pas nécessairement avec les axes discriminant au mieux le phénotype cible $\mathbf{y}$.
Les approches de projection supervisée optimisent simultanément la structure de la matrice des prédicteurs et sa corrélation avec la variable dépendante. L’Analyse Discriminante Linéaire régularisée (Regularized Linear Discriminant Analysis, ou RLDA) adapte la méthode classique de Fisher aux régimes de haute dimension. Face à la singularité de la matrice de covariance intra-classe empirique $\mathbf{S}_W$, la RLDA substitue à cette matrice une version stabilisée par contraction spectrale (shrinkage) :
$$\mathbf{S}_{W,\text{reg}} = (1 – \lambda)\mathbf{S}_W + \lambda \mathbf{I}_p$$
où $lambda in [0, 1]$ est un paramètre de régularisation et $\mathbf{I}_p$ est la matrice identité. Cette modification rétablit la stricte inversibilité de l’opérateur et conditionne numériquement la projection discriminante.
Parallèlement, la régression par les Moindres Carrés Partiels (Partial Least Squares, ou PLS) décompose conjointement la matrice des prédicteurs $\mathbf{X}$ et le vecteur ou la matrice réponse $\mathbf{Y}$ afin d’extraire des variables latentes maximisant leur covariance croisée :
$$\max_{\mathbf{w}, \mathbf{c}} \mathrm{Cov}^2(\mathbf{X}\mathbf{w}, \mathbf{Y}\mathbf{c}) \quad \text{sujet à} \quad |\mathbf{w}|_2 = 1, |\mathbf{c}|_2 = 1$$
La PLS est particulièrement efficace en présence de données hautement colinéaires telles que les métadonnées neurofonctionnelles ou transcriptomiques. Néanmoins, la nature supervisée de ces techniques impose une vigilance méthodologique sans faille : l’ensemble des projections factorielles et des réglages d’hyperparamètres doit impérativement être recalculé à l’intérieur de chaque pli d’apprentissage lors des procédures de validation croisée. Toute violation de cette étanchéité analytique produit une contamination par fuite d’information et un optimisme artificiel des scores de précision clinique.
11. Stratégies méthodologiques II : Régularisation et modélisation parcimonieuse
11.1 Pénalisation de norme L1 : La régression Lasso
Pour surmonter l’indétermination des moindres carrés en régime $p > N$ sans sacrifier l’interprétabilité des descripteurs, la méthode statistique par excellence repose sur la pénalisation de la fonction de coût par une contrainte de régularisation. Dans cette catégorie, la méthode la plus célèbre et révolutionnaire est le Lasso (Least Absolute Shrinkage and Selection Operator), formalisé par Robert Tibshirani en 1996.
Le Lasso redéfinit le problème de minimisation des résidus en lui ajoutant un terme pénalisant la somme de la valeur absolue des coefficients, c’est-à-dire leur norme $L_1$. Le problème s’exprime sous la formulation lagrangienne convexe suivante :
$$\hat{boldsymbol{\beta}}_{\text{Lasso}} = arg\min_{boldsymbol{\beta} in \mathbb{R}^p} \left{ \frac{1}{2N} |\mathbf{y} – \mathbf{X}boldsymbol{\beta}|_2^2 + \lambda |boldsymbol{\beta}|_1 \right}$$
où $|boldsymbol{\beta}|_1 = \sum_{j=1}^p |\beta_j|$ et $lambda ge 0$ représente l’hyperparamètre de pénalisation contrôlant la sévérité de la contrainte imposée sur le vecteur de poids.
La propriété mathématique singulière de la pénalité de norme $L_1$ réside dans sa capacité intrinsèque à opérer une sélection automatique et stricte des variables. Sur le plan de la géométrie de l’optimisation, la région de contrainte associée à la norme $L_1$ correspond à un polytope convexe présentant des sommets et des arêtes acérées (un losange ou un hyper-octaèdre). Lorsque les lignes de niveau elliptiques de la fonction de perte quadratique viennent heurter cette frontière, le contact optimal s’opère presque systématiquement sur l’un des sommets ou le long d’une facette de dimension réduite, annulant de manière exacte un grand nombre de coordonnées :
$$\exists j in {1, dots, p} \quad \text{tel que} \quad \hat{\beta}_{j,\text{Lasso}} \equiv 0$$
Le Lasso contracte simultanément les coefficients restants tout en forçant les coefficients secondaires à zéro, produisant un modèle parcimonieux directement lisible pour le clinicien ou le chercheur.
Cependant, le Lasso souffre de limitations théoriques intrinsèques en présence de grande dimension extrême. Premièrement, lorsque $p > N$, le Lasso ne peut sélectionner au maximum que $N$ variables distinctes avant de saturer ; toutes les autres sont obligatoirement écartées par l’algorithme, quelle que soit leur pertinence biologique potentielle. Deuxièmement, si un groupe de variables prédictives présente une forte corrélation mutuelle (ce qui est typiquement le cas pour des gènes appartenant à un même complexe moléculaire ou des voxels adjacents), le Lasso a tendance à sélectionner arbitrairement une seule variable au sein du groupe et à rejeter toutes les autres à zéro, démontrant une instabilité structurelle de la sélection sous forte colinéarité.
11.2 Pénalisation de norme L2 et compromis Elastic Net
Pour remédier aux carences du Lasso face aux réseaux de prédicteurs corrélés, il convient d’analyser la pénalité concurrente : la régression Ridge, introduite par Hoerl et Kennard en 1970. La régression Ridge applique une pénalité sur la somme des carrés des coefficients, c’est-à-dire le carré de leur norme euclidienne $L_2$ :
$$\hat{boldsymbol{\beta}}_{\text{Ridge}} = arg\min_{boldsymbol{\beta} in \mathbb{R}^p} \left{ \frac{1}{2N} |\mathbf{y} – \mathbf{X}boldsymbol{\beta}|_2^2 + \frac{\lambda}{2} |boldsymbol{\beta}|_2^2 \right}$$
Cette formulation admet une solution analytique exacte : $\hat{boldsymbol{\beta}}_{\text{Ridge}} = (\mathbf{X}^top\mathbf{X} + \lambda \mathbf{I}_p)^{-1}\mathbf{X}^top\mathbf{y}$. L’ajout d’une constante positive $lambda$ le long de la diagonale de la matrice de Gram singulière $\mathbf{X}^top\mathbf{X}$ la rend strictement définie positive et par conséquent inversible de manière stable, quel que soit le ratio $p/N$. La régression Ridge stabilise numériquement l’estimation et contracte uniformément l’amplitude des coefficients. En revanche, en raison de la forme sphérique et lisse de la boule unité en norme $L_2$, la régression Ridge n’annule jamais exactement les coefficients ($\hat{\beta}_{j,\text{Ridge}} ne 0, \forall j$) : elle ne réalise donc aucune sélection parcimonieuse de variables, préservant l’intégralité des $p$ dimensions dans le modèle final.
Pour synthétiser les avantages respectifs de ces deux approches, Hui Zou et Trevor Hastie ont formulé en 2005 la régression Elastic Net. L’Elastic Net combine linéairement les pénalités de norme $L_1$ et $L_2$ au sein d’une même fonction de coût convexe unifiée :
$$\hat{boldsymbol{\beta}}_{\text{ElasticNet}} = arg\min_{boldsymbol{\beta} in \mathbb{R}^p} \left{ \frac{1}{2N} |\mathbf{y} – \mathbf{X}boldsymbol{\beta}|_2^2 + \lambda \left( \alpha |boldsymbol{\beta}|_1 + \frac{1 – \alpha}{2} |boldsymbol{\beta}|_2^2 \right) \right}$$
où $\alpha in [0, 1]$ orchestre le compromis entre la sélection parcimonieuse ($L_1$) et la contraction groupée ($L_2$).
L’Elastic Net surmonte brillamment les blocages historiques du Lasso en haute dimension. Grâce à la composante $L_2$, le modèle peut sélectionner plus de $N$ variables pertinentes lorsque $p > N$. De surcroît, il possède une remarquable propriété de regroupement (grouping effect) : si un groupe de biomarqueurs hautement corrélés influence la variable dépendante, l’Elastic Net tend à inclure l’ensemble du groupe dans le modèle avec des coefficients d’amplitude similaire, évitant la sélection arbitraire d’une composante isolée. L’optimisation algorithmique de ces paramètres s’effectue avec une remarquable efficacité computationnelle via la méthode de descente de gradient coordonnée cyclique (cyclical coordinate descent).
11.3 Forêts aléatoires régularisées et sélection non-paramétrique
Les approches régularisées pénalisées telles que le Lasso et l’Elastic Net postulent une relation globalement linéaire (ou logistique) entre les descripteurs et le phénotype d’intérêt. Or, dans les systèmes neurobiologiques et comportementaux complexes, les effets d’interaction non-linéaires d’ordre supérieur (épistasie génétique, modérations contextuelles multiples) sont fréquents. Pour capturer ces dynamiques sans paramétrisation rigide en haute dimension, les forêts d’arbres décisionnels (Random Forests), formalisées par Leo Breiman en 2001, constituent une alternative non-paramétrique majeure.
L’algorithme de forêt aléatoire triomphe du bruit dimensionnel en s’appuyant sur deux mécanismes stochastiques conjoints de réduction de variance : le rééchantillonnage avec remise des observations (bagging) et la sélection aléatoire d’un sous-ensemble restreint de variables à chaque nœud de division de l’arbre (random feature subspace, généralement de taille $m_{\text{try}} \approx \sqrt{p}$). Cette sélection aléatoire de descripteurs empêche qu’une variable ultra-dominante ne biaise l’architecture de tous les arbres construits, décorrelant ainsi les prédicteurs individuels au sein de l’ensemble.
Pour raffiner cette dynamique en régime fortement clairsemé, des versions avancées telles que les forêts aléatoires régularisées (Regularized Random Forests, RRF) ont été développées. Les RRF imposent une pénalité sur l’indice d’impureté de Gini lorsqu’une nouvelle variable est sollicitée pour scinder un nœud, favorisant l’utilisation de prédicteurs ayant déjà démontré leur utilité dans les nœuds précédents de l’arbre. De plus, l’estimation de l’importance des variables doit être menée avec rigueur : l’indice standard de diminution moyenne de l’impureté (MDI, pour Mean Decrease Impurity) est notoirement biaisé en haute dimension en faveur des variables continues à forte entropie ou possédant de nombreuses catégories. Lui substituer l’importance par permutation (PFI, pour Permutation Feature Importance), calculée sur des données hors-sac (out-of-bag), permet d’obtenir un classement non paramétrique rigoureux des facteurs de vulnérabilité sans supposer d’hypothèse de linéarité a priori.
12. Reproductibilité, éthique et perspectives futures en recherche psychologique de grande dimension
12.1 Le défi de la reproductibilité scientifique face au bruit dimensionnel
L’exploitation des données de grande dimension en psychologie et en neurosciences computationnelles accentue considérablement les risques d’inférence fallacieuse regroupés sous le concept de crise de la réplicabilité. Dans un espace où le nombre de paramètres dépasse de plusieurs ordres de grandeur la taille des échantillons disponibles, la multiplicité des degrés de liberté du chercheur (researcher degrees of freedom) devient astronomique. Les choix analytiques — incluant le filtrage du signal, le choix des atlas anatomiques, la normalisation, le seuil de sélection des descripteurs, l’imputation des données manquantes et le réglage des hyperparamètres d’apprentissage — génèrent des milliers de combinaisons computationnelles alternatives (l’univers des analyses potentielles).
Dans un tel environnement, le risque de « $p$-hacking » inconscient ou d’exploration sélective est exacerbé : en testant un large éventail de pipelines de prétraitement sur une matrice de grande dimension, il est presque inévitable d’isoler une configuration méthodologique produisant une association statistiquement significative par pur hasard. Pour assainir ces pratiques et consolider la valeur probante des découvertes computationnelles, la communauté scientifique a mis en place des standards de transparence rigoureux :
- Le pré-enregistrement systématique des protocoles analytiques (preregistration), détaillant l’intégralité du pipeline d’extraction, de transformation et de modélisation statistique préalablement à l’accès aux données.
- Le partage obligatoire des données brutes harmonisées, des codes sources computationnels et des environnements logiciels conteneurisés (Docker, scripts d’analyse ouverts).
- La transition vers des approches d’analyse multivers (multiverse analysis), consistant à quantifier explicitement la robustesse des conclusions empiriques à travers l’ensemble des trajectoires analytiques techniquement plausibles.
Parallèlement, la réponse structurelle la plus déterminante face au ratio $p > N$ réside dans la mutualisation internationale des efforts d’échantillonnage au sein de mégabiobanques et de consortiums multicentriques ouverts, tels que ENIGMA (Enhancing NeuroImaging Genetics through Meta-Analysis), l’UK Biobank ou l’étude ABCD (Adolescent Brain Cognitive Development). En agrégeant les acquisitions cliniques de centaines d’instituts pour atteindre des cohortes de $N = 20,000$ à $N = 500,000$ individus, ces consortiums inversent enfin le ratio dimensionnel, transformant les régimes pathologiques $p gg N$ en régimes classiques asymptotiquement stables $N gg p$, assurant une réplicabilité robuste aux découvertes biomédicales et cognitives contemporaines.
12.2 Biais algorithmiques et équité dans les modèles de haute dimension
L’enthousiasme légitime suscité par le déploiement de modèles prédictifs de haute dimension en psychiatrie de précision et en médecine comportementale ne doit pas masquer les risques éthiques substantiels liés aux biais de sélection et à l’équité algorithmique (algorithmic fairness). Les algorithmes d’apprentissage statistique apprennent exclusivement à partir des distributions empiriques qui leur sont soumises ; or, ces distributions portent fréquemment la trace des inégalités socio-économiques, des disparités d’accès aux soins et des biais de représentativité historique.
En haute dimension, le risque de discrimination indirecte (proxy discrimination) est amplifié. Même si des variables sensibles protégées par la loi et l’éthique (telles que le genre, l’origine ethnique, l’orientation sexuelle ou le niveau de revenu) sont délibérément expurgées de la matrice d’entraînement, l’immensité de l’espace vectoriel permet aux modèles profonds ou fortement régularisés de reconstruire fidèlement ces caractéristiques sociodémographiques latentes par combinaison d’une multitude de signaux secondaires correlés (style d’élocution textuelle, fréquence d’utilisation d’applications mobiles, habitudes de déplacement GPS). Le modèle peut ainsi appliquer des discriminations diagnostiques ou prédictives systémiques tout en conservant une apparence d’impartialité formelle.
De plus, le manque d’équité prédictive inter-groupes constitue un problème majeur en santé mentale computationnelle. Un modèle d’évaluation du risque suicidaire ou de détection précoce des troubles neurodéveloppementaux entraîné sur une cohorte sociologiquement homogène et favorisée subira une dégradation massive de sa précision (hausse drastique des faux négatifs ou faux positifs) lorsqu’il sera appliqué à des minorités marginalisées ou à des populations issues de contextes culturels différents. La mise en œuvre d’audits éthiques formalisés, de métriques de parité de performance (comme l’égalité des chances et la parité prédictive) et d’approches de débiaisement algorithmique s’impose comme une obligation clinique impérative pour prévenir l’aggravation des inégalités de santé par des outils d’intelligence artificielle déficients.
12.3 L’avenir de la modélisation intégrative en santé mentale
L’horizon méthodologique de la recherche en santé mentale et en sciences cognitives s’oriente résolument vers la fusion multimodale unifiée. Pendant des décennies, chaque niveau d’analyse du vivant a évolué dans un silo disciplinaire distinct : les généticiens ont analysé leurs SNP, les neuroscientifiques leurs voxels BOLD, les psychométriciens leurs réseaux d’auto-évaluation et les informaticiens médicaux leurs corpus de dossiers électroniques. Pourtant, la souffrance psychologique et les mécanismes de l’esprit résultent de l’intrication dynamique de ces différents niveaux d’organisation, de la molécule à la société.
L’avenir de la discipline réside dans des architectures computationnelles intégratives capables d’ingérer simultanément l’ensemble de ces couches hétérogènes. Cette convergence mobilise aujourd’hui des paradigmes avancés issus de l’apprentissage auto-supervisé (self-supervised learning) et des modèles de fondation appliqués à la psychiatrie. En entraînant des architectures multimodales massives sur des flux continus de données cliniques sans étiquetage manuel préalable, ces modèles apprennent à capturer des représentations latentes transversales robustes, reliant la variabilité génomique aux altérations de connectivité cérébrale et aux manifestations comportementales en vie réelle.
Enfin, le défi intellectuel ultime consistera à articuler ces espaces statistiques hautement dimensionnels avec l’inférence causale computationnelle, guidée par les cadres mathématiques initiés par Judea Pearl. La corrélation observée au sein d’une variété de grande dimension ne suffit plus : les sciences quantitatives doivent être capables d’estimer les effets d’interventions ciblées pour prédire précisément quel ajustement pharmacologique, psychothérapeutique ou environnemental modifiera favorablement la trajectoire clinique unique d’un patient. Dans cette perspective scientifique renouvelée, le praticien et le chercheur abandonnent définitivement le rôle de simples observateurs de métriques isolées pour devenir les pilotes informés de trajectoires dynamiques hautement complexes.
Références
- Bellman, R. (1957). Dynamic Programming. Princeton University Press.
- Benjamini, Y., & Hochberg, Y. (1995). Controlling the false discovery rate: A practical and powerful approach to multiple testing. Journal of the Royal Statistical Society: Series B (Methodological), 57(1), 289–300. https://doi.org/10.1111/j.2517-6161.1995.tb02031.x
- Bennett, C. M., Miller, M. B., & Wolford, G. L. (2009). Neural correlates of interspecies perspective taking in the post-mortem Atlantic Salmon: An argument for proper multiple comparisons correction. NeuroImage, 47(Suppl 1), S125. https://doi.org/10.1016/S1053-8119(09)71202-9
- Beyer, K., Goldstein, J., Ramakrishnan, R., & Shaft, U. (1999). When is « nearest neighbor » meaningful? In C. Beeri & P. Buneman (Eds.), Database Theory — ICDT ’99 (pp. 217–235). Springer. https://doi.org/10.1007/3-540-49257-7_15
- Borsboom, D. (2008). Psychometric perspectives on diagnostic systems. Journal of Clinical Psychology, 64(9), 1089–1108. https://doi.org/10.1002/jclp.20503
- Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5–32. https://doi.org/10.1023/A:1010933404324
- Candès, E. J., Romberg, J., & Tao, T. (2006). Robust uncertainty principles: Exact signal reconstruction from highly incomplete frequency information. IEEE Transactions on Information Theory, 52(2), 489–509. https://doi.org/10.1109/TIT.2005.862083
- Devlin, J., Chang, M. W., Lee, K., & Toutanova, K. (2018). BERT: Pre-training of deep bidirectional transformers for language understanding. arXiv preprint arXiv:1810.04805. https://arxiv.org/abs/1810.04805
- Donoho, D. L. (2006). Compressed sensing. IEEE Transactions on Information Theory, 52(4), 1289–1306. https://doi.org/10.1109/TIT.2006.871582
- Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer. https://hastie.su.domains/ElemStatLearn/
- Haxby, J. V., Gobbini, M. I., Furey, M. L., Ishai, A., Schouten, J. L., & Pietrini, P. (2001). Distributed and overlapping representations of faces and objects in ventral temporal cortex. Science, 293(5539), 2425–2430. https://doi.org/10.1126/science.1063736
- Hoerl, A. E., & Kennard, R. W. (1970). Ridge regression: Biased estimation for nonorthogonal problems. Technometrics, 12(1), 55–67. https://doi.org/10.1080/00401706.1970.10488634
- Johnson, W. B., & Lindenstrauss, J. (1984). Extensions of Lipschitz mappings into a Hilbert space. Contemporary Mathematics, 26, 189–206. https://doi.org/10.1090/conm/026/737400
- Marčenko, V. A., & Pastur, L. A. (1967). Distribution of eigenvalues for some sets of random matrices. Mathematics of the USSR-Sbornik, 1(4), 457–483. https://doi.org/10.1070/SM1967v001n04ABEH001994
- McInnes, L., Healy, J., & Melville, J. (2018). UMAP: Uniform Manifold Approximation and Projection for dimension reduction. arXiv preprint arXiv:1802.03426. https://arxiv.org/abs/1802.03426
- Pearl, J. (2009). Causality: Models, Reasoning, and Inference (2nd ed.). Cambridge University Press. https://doi.org/10.1017/CBO9780511803161
- Tibshirani, R. (1996). Regression shrinkage and selection via the lasso. Journal of the Royal Statistical Society: Series B (Methodological), 58(1), 267–288. https://doi.org/10.1111/j.2517-6161.1996.tb02081.x
- van der Maaten, L., & Hinton, G. (2008). Visualizing data using t-SNE. Journal of Machine Learning Research, 9(86), 2579–2605. https://www.jmlr.org/papers/volume9/vandermaaten08a/vandermaaten08a.pdf
- Zou, H., & Hastie, T. (2005). Regularization and variable selection via the elastic net. Journal of the Royal Statistical Society: Series B (Statistical Methodology), 67(2), 301–320. https://doi.org/10.1111/j.1467-9868.2005.00503.x