
Dans l’arsenal des sciences stochastiques, de la modélisation statistique et de l’analyse computationnelle contemporaine, la distribution uniforme continue occupe une place matricielle singulière. Souvent appréhendée au premier abord comme le modèle probabiliste le plus intuitif en raison de son postulat d’équiprobabilité fondamentale, elle constitue paradoxalement l’un des piliers théoriques les plus profonds des mathématiques appliquées. Loin de se réduire à un simple cas d’école pédagogique, la loi uniforme continue matérialise l’absence absolue d’information directionnelle ou de biais a priori sur un support borné donné. Cette propriété d’indifférence épistémique, formalisée dès les travaux de Pierre-Simon de Laplace, fait de cette loi le socle méthodologique sur lequel repose l’ensemble des techniques de simulation stochastique, depuis les simples tirages pseudo-aléatoires jusqu’aux algorithmes les plus sophistiqués de la physique computationnelle et de l’inférence bayésienne.
L’environnement statistique R, conçu originellement par Ross Ihaka et Robert Gentleman comme une implémentation moderne du langage S, intègre nativement une boîte à outils algorithmique d’une rigueur absolue dédiée à la distribution uniforme. Les quatre fonctions fondamentales constituant ce noyau fonctionnel — dunif pour le calcul de la densité de probabilité, punif pour l’évaluation de la fonction de répartition cumulée, qunif pour la détermination des quantiles théoriques, et runif pour la génération de vecteurs pseudo-aléatoires — ne sont pas de simples commodités programmatiques. Elles représentent l’articulation logicielle directe de théorèmes fondamentaux de l’analyse probabiliste, au premier rang desquels figure le théorème de la transformation intégrale de probabilité. L’efficience numérique de ces routines repose sur des décennies d’optimisation en analyse numérique, reliant l’algèbre matricielle sous-jacente aux générateurs de congruence linéaire et aux algorithmes de torsion comme le célèbre Mersenne-Twister.
Ce traité exhaustif a pour vocation d’explorer l’ensemble des dimensions de la distribution uniforme continue au sein du système R. Nous aborderons tour à tour ses fondements mathématiques stricts, la dérivation analytique de ses moments statistiques, le fonctionnement interne et les subtilités paramétriques de ses fonctions dédiées, ainsi que ses applications pratiques en modélisation empirique, psychométrie expérimentale et méthodes de Monte-Carlo. À travers une démarche conjuguant rigueur formelle, pédagogie conceptuelle et démonstrations computationnelles détaillées, cet article fournira aux chercheurs, biostatisticiens, data scientists et étudiants avancés les clés indispensables pour exploiter pleinement la puissance de la distribution uniforme dans l’analyse de données moderne.
1. Fondements théoriques et mathématiques de la loi uniforme
1.1 Définition formelle et nature de la distribution continue
La distribution uniforme continue, classiquement notée U(a, b), formalise le comportement d’une variable aléatoire réelle X dont les réalisations sont confinées à un intervalle compact [a, b], où a et b désignent deux réels finis vérifiant la condition de stricte infériorité a < b. Le principe gouvernant cette loi réside dans l’équiprobabilité absolue de sous-intervalles de même longueur : la probabilité que la variable aléatoire appartienne à un sous-intervalle quelconque [c, d] inclus dans [a, b] dépend exclusivement de la mesure de Lebesgue de ce sous-ensemble, c’est-à-dire de sa longueur (d – c), et s’avère parfaitement indépendante de sa localisation géographique au sein du support.
Il est impératif de distinguer avec clarté la variable aléatoire uniforme continue de son analogue discrète. Alors que la loi uniforme discrète répartit une masse de probabilité identique 1/k sur un ensemble fini de k éléments distincts, la loi uniforme continue attribue une probabilité ponctuelle rigoureusement nulle à chaque événement élémentaire singulier P(X = x) = 0, pour tout x réel. Cette propriété découle directement de la non-dénombrabilité du continuum réel et impose de formaliser l’analyse non pas à travers des fonctions de masse, mais exclusivement via le calcul intégral appliqué à une fonction de densité de probabilité continue par morceaux.
Au sein de son support de définition, la distribution uniforme continue bénéficie d’une propriété d’absence de mémoire locale et d’invariance directionnelle totale. Si l’on restreint l’espace probabilisé à un sous-intervalle spécifique conditionné par un événement préalable, la distribution conditionnelle résultante demeure strictement uniforme sur ce sous-intervalle tronqué. Formellement, le domaine de définition de la variable aléatoire est borné par les limites d’arrêt a et b, ce qui se traduit mathématiquement par l’emploi de la fonction indicatrice I_[a, b](x), qui vaut 1 si le réel x se situe dans l’intervalle fermé et 0 dans le cas contraire. L’inclusion ou l’exclusion des points frontières singuliers a et b n’altère en rien les propriétés de mesure de la variable, la mesure de Lebesgue d’un singleton étant identiquement nulle.
1.2 Expression analytique de la fonction de densité de probabilité
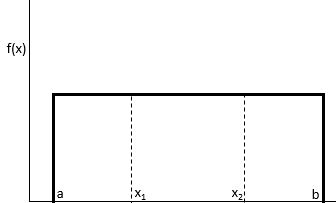
La fonction de densité de probabilité, communément désignée sous le sigle f(x) ou PDF (pour Probability Density Function), quantifie la concentration locale de probabilité par unité de mesure. Pour une variable aléatoire continue suivant la loi uniforme sur l’intervalle [a, b], l’exigence d’homogénéité impose que cette fonction soit strictement constante sur l’intégralité du support. Son expression analytique formelle s’établit comme suit : f(x) = 1 / (b – a) pour tout réel x appartenant à l’intervalle [a, b], et f(x) = 0 pour tout x n’appartenant pas à cet ensemble compact. Cette formulation explicite le rapport d’inverse proportionnalité qui lie la hauteur de la densité à l’amplitude du support d’évaluation.
La validité probabiliste d’une telle construction analytique requiert la démonstration de deux axiomes fondamentaux posés par Kolmogorov : la non-négativité de la fonction sur l’ensemble de l’axe réel et l’unitarité de son intégrale globale. La première condition est trivialement satisfaite puisque b > a entraîne 1 / (b – a) > 0. La seconde condition se vérifie par intégration directe au sens de Riemann sur la droite réelle : l’intégrale de f(x) dx évaluée entre moins l’infini et plus l’infini se réduit, en vertu de la nullité de f(x) en dehors de [a, b], à l’intégrale de 1 / (b – a) dx calculée entre les bornes a et b. L’évaluation de cette primitive donne immédiatement [x / (b – a)] entre a et b, ce qui équivaut à (b – a) / (b – a) = 1. L’espace probabilisé est ainsi rigoureusement normalisé.
D’un point de vue purement géométrique, la représentation de la fonction de densité de probabilité d’une loi uniforme dessine un rectangle parfait dont la base s’étire de l’abscisse a jusqu’à l’abscisse b, et dont la hauteur culmine invariablement à 1 / (b – a). L’aire sous la courbe, assimilable géométriquement à la surface de ce rectangle élémentaire, correspond exactement au produit de sa largeur (b – a) par sa hauteur 1 / (b – a), attestant de manière visuelle et immédiate de l’unitarité de la probabilité totale. Cette forme en créneau ou en boîte explique pourquoi cette distribution est régulièrement qualifiée dans la littérature anglo-saxonne de rectangular distribution.
1.3 Rôle de la distribution uniforme standard dans la théorie probabiliste
Au sein de la famille infinie des lois uniformes continues paramétrées par leurs bornes extrêmes, le cas particulier défini par les paramètres canoniques a = 0 et b = 1 joue un rôle architectural prépondérant : il s’agit de la distribution uniforme standard, universellement désignée par la notation U(0, 1). Sur cet intervalle unitaire, la fonction de densité de probabilité se simplifie pour adopter la valeur unitaire f(x) = 1 pour tout x compris entre 0 et 1. Cette distribution standardisée constitue le véritable dénominateur commun de l’analyse stochastique théorique et appliquée.
L’importance épistémologique de U(0, 1) s’enracine dans le célèbre théorème de la transformation intégrale de probabilité, également désigné sous le vocable d’échantillonnage par transformée inverse. Ce théorème stipule que si une variable aléatoire continue X possède une fonction de répartition cumulative F(x) strictement croissante et continue, alors la variable aléatoire transformée U = F(X) suit rigoureusement une distribution uniforme standard sur l’intervalle [0, 1]. Réciproquement, si U suit une loi U(0, 1), alors la variable aléatoire définie par l’application de la fonction quantile inverse, soit X = F^(-1)(U), admet exactement F(x) comme fonction de répartition.
Ce résultat mathématique remarquable confère à la loi U(0, 1) un statut de monnaie d’échange universelle en simulation numérique. Toute loi de probabilité continue arbitraire — qu’il s’agisse d’une loi normale, exponentielle, gamma, Weibull ou de Cauchy — peut être synthétisée à partir d’un flux de variables aléatoires indépendantes et identiquement distribuées selon la loi uniforme standard. La loi uniforme U(0, 1) constitue ainsi le moteur fondamental sur lequel s’appuient les architectures logicielles des générateurs de nombres aléatoires de tous les langages statistiques modernes, incluant l’environnement R.
2. Propriétés statistiques et moments de la loi uniforme
2.1 Espérance mathématique et mesures de tendance centrale
L’espérance mathématique d’une variable aléatoire continue X distribuée selon la loi U(a, b) représente la valeur moyenne théorique anticipée lors d’un nombre infini d’observations indépendantes. Formellement, elle se calcule comme le premier moment à l’origine via l’intégrale du produit de la variable x par sa densité f(x). En substituant la densité analytique, le calcul prend la forme de l’intégrale de x / (b – a) dx évaluée entre les bornes réelles a et b. L’intégration analytique conduit à l’évaluation de la primitive [x^2 / (2(b – a))] entre a et b, ce qui se développe algébriquement sous la forme (b^2 – a^2) / (2(b – a)). En factorisant la différence de carrés au numérateur par (b – a)(b + a), on obtient après simplification l’espérance canonique : mu = E(X) = (a + b) / 2.
Ce résultat démontre avec élégance que l’espérance mathématique de la loi uniforme coïncide rigoureusement avec le milieu arithmétique des bornes de son support de définition. En raison de la symétrie géométrique absolue de la fonction de densité de part et d’autre de cette valeur centrale, l’espérance mathématique est parfaitement identique à la médiane théorique de la distribution, qui sépare la masse de probabilité en deux moitiés égales de 0.5. Par ailleurs, bien que le mode ne soit pas unique au sens strict pour une fonction constante — chaque point du support possédant la même densité maximale —, la valeur centrale (a + b) / 2 est universellement adoptée comme le centre de symétrie naturel de la loi.
L’espérance mathématique de la loi uniforme obéit scrupuleusement aux propriétés d’invariance par translation et d’homogénéité liées à la linéarité de l’opérateur d’espérance. Si une variable X suit U(a, b), alors la variable transformée linéairement Y = c * X + d, avec c > 0, suit à son tour une distribution uniforme de paramètres [c * a + d, c * b + d], et son espérance mathématique s’établit exactement comme E(Y) = c * E(X) + d. Lors d’expérimentations empiriques ou de modélisations computationnelles sous R, le barycentre géométrique d’un échantillon simulé de taille substantielle converge asymptotiquement, conformément à la loi forte des grands nombres, vers ce point d’équilibre arithmétique parfait.
2.2 Variance, écart-type et dispersion des observations
La dispersion des réalisations d’une variable uniforme continue autour de sa valeur centrale est quantifiée par sa variance théorique, notée sigma^2 ou Var(X). La dérivation rigoureuse de la variance requiert le calcul préalable du moment d’ordre deux à l’origine, défini par l’intégrale de x^2 * f(x) dx sur le support [a, b]. En intégrant x^2 / (b – a) entre a et b, on obtient la primitive [x^3 / (3(b – a))] évaluée entre a et b, ce qui génère l’expression (b^3 – a^3) / (3(b – a)). La décomposition de la différence de cubes au numérateur par le produit remarquable (b – a)(b^2 + ab + a^2) permet de simplifier l’expression, aboutissant au deuxième moment E(X^2) = (a^2 + ab + b^2) / 3.
En appliquant le théorème de König-Huygens, la variance s’exprime par la formule Var(X) = E(X^2) – [E(X)]^2. En substituant les valeurs préalablement établies, le calcul s’articule comme suit : Var(X) = (a^2 + ab + b^2) / 3 – [(a + b) / 2]^2 = (a^2 + ab + b^2) / 3 – (a^2 + 2ab + b^2) / 4. La réduction au même dénominateur 12 transforme cette différence en [4(a^2 + ab + b^2) – 3(a^2 + 2ab + b^2)] / 12, ce qui conduit, après regroupement et réduction des termes semblables, à la formule fondamentale de la variance d’une distribution uniforme : Var(X) = (b – a)^2 / 12. L’écart-type théorique, mesurant la dispersion dans l’unité native de la variable, s’obtient immédiatement par extraction de la racine carrée : sigma = (b – a) / sqrt(12), ou encore sigma = (b – a) / (2 * sqrt(3)).
L’apparition du dénominateur arithmétique 12 au sein de cette formule revêt une signification mathématique majeure dans la métrologie et l’analyse d’incertitude expérimentale standardisée par le Bureau International des Poids et Mesures (Guide GUM). Lorsqu’un instrument de mesure numérique affiche une valeur arrondie au dernier digit, l’erreur d’arrondi est modélisée par une loi uniforme centrée d’amplitude delta. L’incertitude-type associée est alors systématiquement calculée en divisant la demi-étendue de l’intervalle par la racine carrée de 3, ce qui correspond exactement à l’application de la formule sigma = delta / sqrt(12). Comparativement à d’autres distributions continues partageant le même support compact, la loi uniforme présente une dispersion relativement élevée, ses masses de probabilité ne décroissant pas lorsqu’on s’éloigne du centre.
2.3 Moments d’ordres supérieurs, asymétrie et kurtosis
L’étude morphologique détaillée d’une distribution statistique nécessite l’examen de ses moments centrés normalisés d’ordres trois et quatre, lesquels quantifient respectivement l’asymétrie (skewness) et l’aplatissement relatif (kurtosis). Le coefficient d’asymétrie de Fisher, noté gamma_1, se définit comme le ratio du troisième moment centré E[(X – mu)^3] sur l’écart-type élevé à la puissance trois. Du fait de la symétrie rigoureuse et absolue de la fonction de densité f(x) par rapport à son espérance mu = (a + b) / 2, tous les moments centrés d’ordre impair d’une variable aléatoire uniforme continue s’annulent identiquement : E[(X – mu)^(2k+1)] = 0 pour tout entier k. En conséquence directe, le coefficient d’asymétrie de la loi uniforme est strictement nul : gamma_1 = 0.
Le coefficient d’aplatissement de Fisher, ou kurtosis excessif noté gamma_2, se calcule à partir du quatrième moment centré selon la relation gamma_2 = [E[(X – mu)^4] / sigma^4] – 3. Le calcul de l’intégrale du quatrième moment centré sur l’intervalle [a, b] donne la valeur E[(X – mu)^4] = (b – a)^4 / 80. En divisant ce résultat par le carré de la variance, qui vaut [(b – a)^2 / 12]^2 = (b – a)^4 / 144, on obtient pour le kurtosis brut une valeur exacte de 144 / 80 = 9 / 5 = 1.8. La soustraction de la valeur 3, correspondant à la référence de la distribution gaussienne mésokurtique, produit un kurtosis excessif fixé rigoureusement à gamma_2 = 1.8 – 3 = -1.2.
Ce résultat numérique négatif invariable qualifie la distribution uniforme de structure hautement platykurtique. Contrairement à la courbe en cloche normale qui exhibe un pic central proéminent et des queues de distribution s’amenuisant vers l’infini, la distribution uniforme ne possède aucune queue et s’arrête brusquement à ses bornes, avec une densité constante sur toute son étendue. La fonction génératrice des moments (MGF), définie formellement pour tout réel t non nul par M_X(t) = E[e^(tX)] = (e^(tb) – e^(ta)) / (t * (b – a)), synthétise de façon analytique l’ensemble de ces propriétés fondamentales à travers son développement en séries entières, confirmant mathématiquement le profil structurellement aplati de la distribution.
3. Évaluation de la densité de probabilité avec la fonction dunif dans R
3.1 Syntaxe de base et paramétrage de dunif()
Au sein du moteur R, l’évaluation numérique directe de la fonction de densité de probabilité de la loi uniforme s’effectue via l’appel à la fonction native dunif(). Cette fonction s’inscrit dans la nomenclature standardisée du langage R relative aux lois statistiques, où le préfixe d renvoie invariablement au terme density. L’architecture syntaxique complète de cette routine se structure sous la forme standardisée suivante : dunif(x, min = 0, max = 1, log = FALSE). Cette fonction est entièrement vectorisée, ce qui signifie qu’elle accepte des vecteurs numériques arbitraires pour l’ensemble de ses arguments formels.
L’argument central x constitue le vecteur numérique des points d’abscisse où la fonction de densité doit être rigoureusement évaluée. Les arguments min et max définissent respectivement les bornes inférieure a et supérieure b du support de la variable aléatoire. Par défaut, l’interpréteur R configure ces paramètres aux valeurs min = 0 et max = 1, ce qui fait correspondre l’évaluation par défaut à celle de la loi uniforme standard U(0, 1). Il est impératif que la condition de positivité stricte max > min soit respectée ; dans le cas inverse, R renverra un message d’avertissement formel et produira des valeurs indéfinies (NaN).
Le paramètre logique log, configuré par défaut sur FALSE, offre la possibilité d’obtenir directement le logarithme népérien de la densité de probabilité lorsque l’argument est basculé sur TRUE. Cette fonctionnalité s’avère absolument indispensable en calcul scientifique de haute précision et en modélisation statistique avancée, particulièrement lors de la construction de fonctions de log-vraisemblance ou d’algorithmes bayésiens. L’évaluation directe de ln(f(x)) = -ln(b – a) via l’option native log = TRUE prévient efficacement les phénomènes catastrophiques de sous-dépassement arithmétique (numerical underflow) qui peuvent survenir lorsque de multiples densités infinitésimales sont multipliées entre elles au format virgule flottante double précision.
3.2 Gestion des discontinuités et valeurs hors bornes
L’une des singularités mathématiques fondamentales de la distribution uniforme continue réside dans l’existence de discontinuités de première espèce (sauts finis) au niveau exact de ses bornes d’arrêt a et b. Pour toute valeur de l’abscisse x strictement inférieure au paramètre min ou strictement supérieure au paramètre max, la fonction dunif() attribue scrupuleusement la valeur numérique 0. Aux bornes exactes de l’intervalle, la convention implémentée en langage C dans le noyau algorithmique de R attribue la valeur pleine du plateau de densité, c’est-à-dire 1 / (max - min), garantissant ainsi une continuité à droite en min et une continuité à gauche en max.
Dans la pratique computationnelle, la manipulation de valeurs proches des bornes peut soulever des défis d’imprécision numérique inhérents à la représentation des nombres réels selon la norme internationale IEEE 754. Deux nombres virtuellement identiques en mathématiques pures peuvent différer d’une fraction infinitésimale de l’ordre de la précision machine (.Machine$double.eps) lors de calculs matriciels sous R. Si une observation empirique dépasse la borne supérieure ne serait-ce que de 1e-16 par suite d’une imprécision d’arrondi, dunif() basculera instantanément sa valeur de 1/(b-a) vers 0, introduisant une divergence potentiellement critique dans les chaînes d’estimation statistiques.
Concernant le traitement des anomalies structurelles au sein des données d’entrée, la fonction dunif() applique les standards stricts du langage R pour préserver l’intégrité vectorielle. Toute présence de valeurs manquantes identifiées par le symbole NA ou d’indéterminations arithmétiques matérialisées par NaN au sein du vecteur x se propage de manière déterministe dans le vecteur de sortie sous la forme de NA ou NaN aux indices correspondants. De surcroît, le recyclage vectoriel natif de R permet d’évaluer simultanément des vecteurs de requêtes multiples face à des vecteurs de bornes de dimensions hétérogènes, sous réserve que les longueurs respectives soient des multiples conformes les unes des autres.
3.3 Exemples concrets de modélisation de densités constantes
Pour illustrer la mise en œuvre pratique de dunif(), considérons la modélisation d’une grandeur physique continue dont on sait uniquement qu’elle est contrainte de manière uniforme entre a = 10 et b = 50 unités métriques. L’amplitude du support est ici de b – a = 40 unités. En appliquant la formule de densité, toute mesure observée à l’intérieur de cet intervalle doit présenter une densité théorique constante f(x) = 1 / 40 = 0.025. Sous R, la commande élémentaire dunif(c(10, 25, 50), min = 10, max = 50) renverra immédiatement le vecteur numérique c(0.025, 0.025, 0.025), confirmant le comportement stationnaire de la loi.
L’évaluation vectorisée sur une grille dense d’abscisses permet de cartographier finement la transition aux frontières du modèle. En générant une séquence régulière allant de 0 à 60 au pas de 0.1 à l’aide de la primitive seq(from = 0, to = 60, by = 0.1), le passage de ce vecteur complet dans dunif() génère instantanément un profil en créneau. Toutes les valeurs comprises dans l’intervalle [0, 10[ reçoivent un score de 0, la tranche [10, 50] est rigoureusement fixée à 0.025, et le segment ]50, 60] retombe immédiatement à zéro. Cette vectorisation sans recours à une boucle explicite for illustre l’élégance et la rapidité d’exécution du paradigme fonctionnel de R.
Dans le cadre de l’inférence bayésienne non informative, la distribution uniforme sur un intervalle borné est fréquemment mobilisée comme loi a priori (flat prior) pour modéliser une absence totale de connaissance préalable sur un paramètre thêta. L’évaluation de la log-vraisemblance de l’échantillon nécessite alors l’invocation de dunif(theta, min = 10, max = 50, log = TRUE), ce qui retourne une contribution constante de -log(40) = -3.688879 pour toute valeur plausible du paramètre. Cette contribution logarithmique uniforme agit comme une constante de normalisation additive dans la formule de Bayes, n’influençant nullement le calcul de la distribution a posteriori en dehors de la troncature des valeurs interdites.
4. Calculs des probabilités cumulées avec la fonction punif dans R
4.1 Mécanique théorique de la fonction de répartition
La fonction de répartition cumulative, universellement désignée par le sigle CDF (pour Cumulative Distribution Function) ou par la notation mathématique standard F(x), quantifie la probabilité cumulée qu’une variable aléatoire continue X prenne une valeur inférieure ou égale à un seuil d’intérêt spécifique x. Elle se définit rigoureusement par l’intégrale de la fonction de densité f(t) dt prise entre moins l’infini et la borne supérieure x. Pour une variable aléatoire distribuée selon U(a, b), cette formulation intégrale se décompose en trois régimes fonctionnels distincts selon le positionnement de x sur la droite réelle.
Pour tout réel x strictement inférieur à la borne inférieure a, l’intégrale est vide de toute masse probabiliste, ce qui impose F(x) = 0. Pour tout x compris dans l’intervalle compact [a, b], l’intégration de la constante 1 / (b – a) entre la borne initiale a et le point x produit l’équation linéaire F(x) = (x – a) / (b – a). Enfin, pour tout x strictement supérieur à la borne b, l’intégrale englobe l’intégralité de la masse de probabilité unitaire de la distribution, conduisant à F(x) = 1. Contrairement à sa fonction de densité qui exhibe des ruptures de continuité aux bornes, la fonction de répartition de la loi uniforme est absolument continue sur l’intégralité de l’ensemble des réels R, formant une rampe rectiligne continue raccordant le palier inférieur 0 au palier supérieur 1.
Cette linéarité parfaite de F(x) sur son intervalle de support constitue une propriété mathématique unique propre à la distribution uniforme. Elle exprime formellement le principe de proportionnalité directe : le taux d’accumulation de la probabilité cumulée est rigoureusement constant, avec une dérivée première F'(x) égale en tout point intérieur à la densité f(x) = 1 / (b – a). L’absence totale d’inflexion ou de courbure dans le tracé de F(x) démontre géométriquement l’absence de zones de concentration probabiliste privilégiées, illustrant le concept d’homogénéité stochastique spatiale.
4.2 Paramétrage avancé de punif() et gestion des queues de distribution
L’implémentation algorithmique de la fonction de répartition cumulative dans l’environnement R est dévolue à la fonction punif(), où le préfixe p renvoie à probability. Sa signature formelle comprend l’ensemble des arguments suivants : punif(q, min = 0, max = 1, lower.tail = TRUE, log.p = FALSE). Le premier paramètre, nommé conventionnellement q pour quantile d’évaluation, représente le seuil réel pour lequel l’utilisateur souhaite déterminer la masse de probabilité cumulée.
L’argument booléen lower.tail contrôle l’orientation de l’accumulation probabiliste. Lorsqu’il conserve sa configuration standard lower.tail = TRUE, la fonction renvoie rigoureusement la probabilité de la queue inférieure P(X <= q). Si l’utilisateur bascule cet argument sur lower.tail = FALSE, punif() calcule la fonction de survie ou probabilité de la queue supérieure, définie mathématiquement par P(X > q) = 1 – F(q) = (b – q) / (b – a) pour tout q situé dans le support [a, b]. Sur le plan computationnel, l’usage explicite de lower.tail = FALSE est vivement recommandé par rapport à la soustraction manuelle 1 - punif(...), car il évite des pertes critiques de chiffres significatifs (phénomène de cancellation numérique) lorsque la probabilité résultante est infinitésimale.
Le paramètre log.p, configuré par défaut à FALSE, permet d’extraire directement le logarithme naturel de la probabilité calculée ln(P) lorsque la valeur TRUE lui est assignée. Dans les scénarios d’analyse probabiliste portant sur des sous-intervalles quelconques compris entre deux bornes intermédiaires x1 et x2 (avec a <= x1 <= x2 <= b), la probabilité d’occurrence P(x1 <= X <= x2) se résout de manière vectorielle élégante par la simple soustraction arithmétique punif(x2, min, max) - punif(x1, min, max), traduisant l’application directe du théorème fondamental de l’analyse stochastique.
4.3 Résolution de problèmes d’intervalles probabilistes
Pour concrétiser l’application de punif(), examinons un cas pratique récurrent en recherche opérationnelle : la modélisation du temps d’attente d’une connexion ferroviaire automatisée se présentant de façon strictement cadencée toutes les 15 minutes. Le retard d’un voyageur arrivant de manière totalement aléatoire à la station peut être formulé rigoureusement comme une variable aléatoire continue X suivant une distribution uniforme U(0, 15), où l’unité temporelle est la minute.
Si la problématique consiste à déterminer la probabilité que le voyageur attende son train moins de 4 minutes, la requête s’exprime immédiatement sous R par la commande punif(4, min = 0, max = 15). L’évaluation interne exécute le ratio (4 – 0) / (15 – 0) = 4 / 15, renvoyant instantanément la valeur numérique 0.2666667, soit une probabilité d’exactement 26.67 %. À l’inverse, pour déterminer la probabilité d’une attente prolongée excédant 12 minutes, l’évaluation de la queue de distribution supérieure sera requise via l’instruction optimisée punif(12, min = 0, max = 15, lower.tail = FALSE), ce qui fournit (15 – 12) / 15 = 3 / 15 = 0.20, soit une probabilité théorique de 20 %.
L’exactitude des calculs vectoriels peut être attestée par la résolution de requêtes d’intervalles complexes. Si l’on souhaite quantifier la probabilité que l’attente soit comprise entre 5 et 10 minutes, la différence punif(10, 0, 15) - punif(5, 0, 15) conduit à (10 – 5) / 15 = 5 / 15 = 1 / 3, soit approximativement 0.3333333. La concordance arithmétique parfaite entre les dérivations manuelles déduites des théorèmes fondamentaux et les sorties numériques générées par punif() illustre la robustesse du moteur computationnel de R pour les calculs d’intégrales cumulatives.
5. Détermination des quantiles et seuils critiques avec qunif dans R
5.1 Inversion de la fonction de répartition uniforme
Dans l’architecture de la modélisation statistique, la fonction quantile, régulièrement identifiée comme l’inverse de la fonction de répartition ou CDF inverse, joue un rôle conceptuel fondamental. Notée formellement Q(p) ou F^(-1)(p), elle opère une transformation bijective de l’espace des probabilités cumulées [0, 1] vers le support réel de la variable aléatoire. Mathématiquement, pour une probabilité cible donnée p comprise entre 0 et 1, le quantile associé correspond à la valeur unique x telle que F(x) = P(X <= x) = p.
L’obtention de l’expression analytique de la fonction quantile pour la distribution uniforme U(a, b) procède par inversion algébrique directe de l’équation de répartition. En posant p = (x – a) / (b – a) pour tout p dans [0, 1] et tout x dans [a, b], l’isolation de la variable x s’effectue par simple multiplication scalaire puis addition de la borne d’origine : p * (b – a) = x – a, d’où l’expression universelle explicite : Q(p) = a + p * (b – a). Cette formulation traduit le fait que le quantile d’ordre p se positionne à une fraction p de la distance totale séparant la borne inférieure de la borne supérieure.
L’analyse des comportements aux limites de cette fonction inverse révèle une cohérence absolue avec la structure topologique du support compact. Lorsque p tend vers 0, le quantile converge rigoureusement vers la borne inférieure minimale de la distribution : Q(0) = a + 0 * (b – a) = a. À l’extrême opposé, lorsque la probabilité cumulée atteint son plafond unitaire p = 1, le quantile coïncide rigoureusement avec la borne supérieure maximale : Q(1) = a + 1 * (b – a) = b. Enfin, pour la probabilité centrale p = 0.5, on retrouve l’identité Q(0.5) = a + 0.5 * (b – a) = (2a + b – a) / 2 = (a + b) / 2, confirmant par une voie analytique distincte la valeur de la médiane théorique établie précédemment.
5.2 Syntaxe et application de qunif()
L’accès opérationnel à cette mécanique d’inversion sous le système R est assuré par la fonction qunif(), où le préfixe mnémonique q désigne les quantiles. Sa structure formelle de déclaration s’énonce comme suit : qunif(p, min = 0, max = 1, lower.tail = TRUE, log.p = FALSE). Le premier paramètre obligatoire p est un vecteur numérique renfermant les probabilités cumulées dont on cherche à déterminer les abscisses seuils correspondantes. Les conditions de validité imposent que toutes les valeurs de ce vecteur soient strictement cantonnées dans l’intervalle fermé [0, 1].
La puissance de qunif() se manifeste particulièrement dans le découpage paramétrique standardisé d’un domaine continu en centiles, déciles ou quartiles. L’évaluation de l’expression vectorisée qunif(c(0.25, 0.50, 0.75), min = 100, max = 200) calcule de manière instantanée les trois quartiles théoriques d’une loi uniforme s’étendant de 100 à 200 unités. Le moteur R renvoie avec une précision numérique totale les valeurs respectives 125 (premier quartile Q1), 150 (médiane Q2) et 175 (troisième quartile Q3), reflétant la régularité spatiale absolue de l’écart interquartile IQR = Q3 – Q1 = 50 unités, qui couvre exactement la moitié de l’étendue globale du support.
De surcroît, la fonction qunif() s’avère indispensable pour la construction d’intervalles de confiance théoriques ou de zones d’équiprobabilité symétriques bilatérales. Si un expérimentateur souhaite déterminer les bornes critiques englobant les 95 % centraux d’une distribution uniforme définie sur [0, 50], il lui suffit de spécifier les probabilités de coupure inférieure à 2.5 % et supérieure à 97.5 % via le vecteur c(0.025, 0.975). L’instruction qunif(c(0.025, 0.975), min = 0, max = 50) renvoie instantanément les bornes critiques précises 1.25 et 48.75 unités, isolant rigoureusement une probabilité d’exclusion de 5 % répartie de manière équilibrée sur les deux extrémités de la distribution.
5.3 Diagnostics statistiques et tracés quantile-quantile
Au-delà de la simple extraction de valeurs seuils, la fonction qunif() constitue le fondement algorithmique nécessaire à l’édification de diagnostics graphiques d’adéquation probabiliste, en particulier les diagrammes quantile-quantile, communément appelés graphiques Q-Q (Q-Q plots). Ces outils visuels ont pour finalité d’éprouver la conformité empirique d’un échantillon d’observations expérimentales par rapport à l’hypothèse nulle d’uniformité théorique, sans nécessiter d’arbitrage subjectif sur la largeur des classes d’un histogramme.
Pour construire manuellement un graphique Q-Q uniforme sans artifice logiciel, la démarche consiste à ordonner préalablement l’échantillon empirique de taille n par ordre croissant, noté x_(1) <= x_(2) <= … <= x_(n). Chaque observation ordonnée x_(i) est ensuite appariée à son quantile théorique correspondant, calculé par la formule de position de traçage p_i = (i – 0.5) / n via la commande qunif(p = (1:n - 0.5) / n, min = a, max = b). En projetant sur un repère cartésien les quantiles théoriques en abscisse et les quantiles empiriques observés en ordonnée, toute concordance parfaite entre les données et le modèle se matérialise par un alignement rigoureux des points le long de la bissectrice diagonale d’équation y = x.
L’analyse des déviations morphologiques par rapport à cette diagonale théorique offre une sensibilité diagnostique exceptionnelle pour déceler les anomalies de distribution. Si les points expérimentaux dessinent une courbe en forme de S (sigmoïde), cela trahit la présence de queues de distribution plus étirées ou d’un pic central prononcé, signalant une tendance gaussienne et l’inadéquation de l’hypothèse uniforme. En psychométrie expérimentale et en métrologie computationnelle, cette approche graphique permet de détecter avec une grande acuité les biais de calibration instrumentale ou les effets de plancher et de plafond qui tronquent artificiellement les mesures d’un protocole d’évaluation.
6. Simulation et génération pseudo-aléatoire avec la fonction runif
6.1 Algorithmes de génération sous-jacents dans le moteur R
La génération de nombres aléatoires sur un ordinateur déterministe représente un défi mathématique et technique de premier ordre. Dans le langage R, cette opération repose sur la fonction fondamentale runif(), où le préfixe r fait référence à random. Il convient toutefois de souligner qu’au sens philosophique et physique strict, les valeurs produites par cette fonction ne sont pas authentiquement aléatoires, mais rigoureusement pseudo-aléatoires : elles résultent de suites déterministes d’opérations arithmétiques sophistiquées imitant à la perfection les propriétés statistiques du hasard blanc.
Par défaut, depuis la version 1.0.0 de R, le moteur stochastique interne s’appuie sur l’algorithme Mersenne-Twister, développé par les mathématiciens Makoto Matsumoto et Takuji Nishimura en 1997, plus spécifiquement dans sa variante MT19937. Cet algorithme repose sur une récurrence matricielle linéaire appliquée sur le corps fini de Galois à deux éléments GF(2), exploitant les propriétés des nombres premiers de Mersenne. Sa période cyclique avant toute répétition de séquence est astronomique, atteignant 2^19937 – 1, soit approximativement 4.315e6001 itérations, une valeur qui dépasse infiniment toute contrainte d’échantillonnage concevable.
Outre sa période virtuellement infinie, l’algorithme Mersenne-Twister a été rigoureusement prouvé équidistribué dans un espace vectoriel allant jusqu’à 623 dimensions, ce qui garantit une absence totale de corrélations sérielles observables dans les simulations statistiques de grande envergure. L’implémentation de ce générateur au sein de R a brillamment satisfait l’intégralité des épreuves les plus impitoyables des batteries de tests stochastiques internationales, notamment la suite Diehard de George Marsaglia et la suite TestU01 mise au point par Pierre L’Ecuyer et Richard Simard. Cette robustesse algorithmique assure que les échantillons générés par runif() ne souffrent d’aucun artéfact structurel susceptible de biaiser une modélisation scientifique.
6.2 Reproductibilité scientifique et fixation de la graine aléatoire
Le caractère déterministe sous-jacent des générateurs pseudo-aléatoires modernes ne constitue pas une faiblesse conceptuelle, mais représente au contraire le garant absolu de la reproductibilité scientifique des calculs stochastiques. Dans le système R, l’état interne complet du générateur est entièrement stocké dans une variable d’environnement masquée nommée .Random.seed. Pour initialiser ce vecteur d’état dans une configuration parfaitement maîtrisée et documentée, le chercheur doit obligatoirement recourir à l’instruction fondamentale set.seed().
La syntaxe set.seed(seed) accepte un entier arbitraire comme paramètre d’amorçage. L’exécution de cette commande réinitialise de manière déterministe les registres de mémoire du générateur Mersenne-Twister. Dès lors, toute séquence d’instructions stochastiques invoquant ultérieurement runif() produira rigoureusement, à la décimale près, les mêmes séries de valeurs sur n’importe quel ordinateur doté d’une version équivalente de R, indépendamment de son architecture processeur ou de son système d’exploitation. Cette pratique est strictement requise par les normes éditoriales académiques internationales pour garantir l’auditabilité et la réplicabilité des modèles de simulation numérique publiés.
Dans les contextes modernes de calcul scientifique à haute performance faisant intervenir le calcul distribué ou la parallélisation sur grappes de microprocesseurs (multi-core computing), la gestion des graines aléatoires requiert toutefois des protocoles spécifiques. L’utilisation naïve de la même graine sur plusieurs processus parallèles peut engendrer des séries d’échantillons parfaitement redondantes, biaisant lourdement les estimations Monte-Carlo globales. R résout cette complexité architecturale à travers des packages spécialisés comme parallel, qui intègrent le générateur combiné récursif à choix multiples L’Ecuyer-CMRG (accessible via RNGkind("L'Ecuyer-CMRG")), permettant de créer des flux de nombres uniformes indépendants et décorrélés sur des sous-processus simultanés.
6.3 Génération vectorielle et manipulation dimensionnelle d’échantillons
L’utilisation de la fonction runif() s’avère d’une simplicité syntaxique exemplaire, tout en bénéficiant d’une vectorisation interne précompilée en langage C garantissant des performances d’exécution optimales. Sa signature d’appel se définit par runif(n, min = 0, max = 1), où n spécifie le nombre d’observations indépendantes à extraire de la distribution continue bornée par min et max. Par exemple, la commande élémentaire tirages <- runif(1000000, min = -5, max = 5) génère instantanément un million de variables aléatoires réelles réparties uniformément sur l’intervalle [-5, 5], le tout exécuté en une fraction infinitésimale de seconde.
La nature hautement optimisée de cette routine permet d’éviter l’allocation répétée de mémoire en construisant directement des structures dimensionnelles multidimensionnelles complexes. Puisqu’une matrice ou un tenseur sous R n’est rien d’autre qu’un vecteur atomique sous-jacent muni d’un attribut dimensionnel, la conversion d’un flux pseudo-aléatoire uniforme en une matrice spatiale de coordonnées aléatoires s’effectue sans aucune surcharge computationnelle. L’instruction combinée matrice_aleatoire <- matrix(runif(3000, min = 0, max = 10), nrow = 1000, ncol = 3) instancie immédiatement un nuage de mille coordonnées tridimensionnelles réparties de façon homogène au sein d’un cube spatial d’arête 10 unités.
Cette plasticité vectorielle et matricielle positionne runif() comme la brique structurelle irremplaçable pour l’échantillonnage par hypercube latin (LHS), la création de grilles de recherche stochastiques pour l’optimisation des hyperparamètres en apprentissage automatique, ou l’initialisation aléatoire des poids synaptiques au sein des architectures de réseaux de neurones artificiels. La maîtrise de l’allocation mémoire lors de tirages massifs (atteignant plusieurs dizaines de gigaoctets) requiert simplement de veiller à pré-allouer les conteneurs finaux afin d’éviter toute fragmentation du tas mémoire (heap fragmentation).
7. Visualisation graphique de la loi uniforme avec R de base et ggplot2
7.1 Représentations graphiques avec le moteur graphique de base
La communication scientifique et l’analyse exploratoire de modèles stochastiques requièrent des représentations visuelles rigoureuses capables de traduire fidèlement les concepts probabilistes sous-jacents. Le moteur graphique natif de R (connu sous le nom de base R graphics) offre un environnement performant pour représenter avec exactitude les fonctions théoriques de la loi uniforme ainsi que leur superposition avec des données empiriques.
Pour illustrer la fonction de densité théorique en créneau d’une loi U(2, 8), il convient de représenter la discontinuité aux bornes sans induire en erreur le lecteur par un tracé continu ininterrompu. L’utilisation conjointe de la fonction générique plot() et de la fonction vectorielle segments() permet de dessiner avec une fidélité géométrique irréprochable les trois composantes du profil : le segment d’abscisse horizontale à hauteur y = 0 pour x < 2, le plateau horizontal élevé à la hauteur théorique y = 1 / (8 – 2) = 0.1667 entre x = 2 et x = 8, et enfin le retour au palier nul pour x > 8. La fonction de répartition linéaire s’obtient avec une égale simplicité au moyen de la primitive curve(punif(x, min = 2, max = 8), from = 0, to = 10, col = "blue", lwd = 2, ylab = "F(x)", main = "Fonction de répartition théorique").
La superposition d’un histogramme empirique normalisé issu d’un échantillon simulé avec la courbe théorique constitue l’exercice fondamental de validation visuelle. En générant un vecteur de 50 000 tirages via echantillon <- runif(50000, min = 2, max = 8), l’histogramme doit être configuré impérativement sur la densité de probabilité et non sur les effectifs absolus en spécifiant le paramètre freq = FALSE (ou prob = TRUE). L’adjonction de l’instruction lines(x = c(2, 8), y = c(1/6, 1/6), col = "red", lwd = 3) permet d’attester graphiquement de la convergence des fréquences empiriques vers la densité théorique conformément aux théorèmes limites.
7.2 Visualisation avancée et esthétique moderne avec ggplot2
Le package ggplot2, fondé sur les principes théoriques de la grammaire des graphiques conceptualisée par Leland Wilkinson et adapté par Hadley Wickham, offre un niveau d’expressivité graphique sans équivalent pour la publication de figures académiques. La construction d’un tracé de densité uniforme théorique sous ggplot2 s’affranchit de la définition manuelle de tableaux de données denses grâce à l’utilisation de la directive analytique stat_function().
Dans un tel pipeline de rendu visuel, la surface de probabilité cumulée comprise entre deux bornes d’intérêt spécifiques — par exemple la probabilité qu’une variable U(0, 10) prenne une valeur entre 3 et 7 — peut être élégamment mise en exergue par un ruban géométrique ombré via la fonction geom_ribbon(). Ce composant visuel permet d’ancrer de manière didactique la correspondance directe entre l’intégrale d’une portion de surface géométrique continue et la probabilité réelle de l’événement associé. L’ajout d’une ligne directrice continue via stat_function(fun = dunif, args = list(min = 0, max = 10), color = "#2c3e50", size = 1.2) parfait le rendu formel du modèle.
La sophistication graphique de ggplot2 permet également d’intégrer des thèmes visuels épurés respectant les standards typographiques les plus stricts de la recherche scientifique. L’adjonction de theme_minimal() couplée à une personnalisation fine des légendes, des bordures d’axes et des annotations mathématiques formulées via la syntaxe parse = TRUE permet d’exporter des diagrammes haute résolution vectorisés directement exploitables pour les revues internationales à comité de lecture.
7.3 Comparaison visuelle entre distribution théorique et tirages empiriques
L’observation empirique de tirages pseudo-aléatoires permet de saisir intuitivement la dynamique de convergence asymptotique gouvernée par le théorème central limite et la loi forte des grands nombres. Lorsque l’on étudie la distribution uniforme, l’impact de la taille d’échantillon N sur la morphologie de la distribution empirique est visuellement saisissant.
Pour de petits échantillons (par exemple N = 30 ou N = 50 observations), un histogramme de données générées par runif() présente des variations considérables d’une classe à l’autre, alternant des pics artificiels et des creux marqués qui semblent contredire de prime abord l’équiprobabilité théorique sous-jacente. Cette variabilité d’échantillonnage aléatoire ne constitue nullement une déficience du générateur pseudo-aléatoire Mersenne-Twister, mais illustre au contraire la variance intrinsèque d’un processus binomial régissant le nombre d’observations tombant dans chaque compartiment d’échantillonnage.
En exploitant le mécanisme des facettes graphiques offert par la directive facet_wrap() de ggplot2, il devient possible de cartographier simultanément l’évolution de la structure de l’échantillon pour des valeurs de N croissant par ordre de grandeur : N = 100, N = 1 000, N = 10 000 et N = 100 000. À mesure que N augmente, les fluctuations relatives autour du plateau s’amenuisent de manière proportionnelle à l’inverse de la racine carrée de la taille de l’échantillon (1 / sqrt(N)). Pour cent mille observations, le profil de l’histogramme converge de manière spectaculaire vers un rectangle régulier, dont le sommet épouse parfaitement la ligne horizontale idéale de la densité de probabilité théorique.
8. Résolution de problèmes probabilistes concrets appliqués
8.1 Modélisation de temps d’attente régularisés
La modélisation de phénomènes d’attente constitue l’un des terrains d’application les plus fertiles pour la loi uniforme continue. Considérons la situation formalisée d’une liaison de navettes fluviales urbaines opérant entre deux stations riveraines. Le service garantit un passage à l’embarcadère strictement cadencé toutes les 20 minutes sans interruption. Un passager se présentant à l’embarcadère à un instant imprévisible dans la journée ne possède aucun regard sur l’horaire de départ de la navette précédente. Son temps d’attente effectif T, exprimé en minutes, est ainsi parfaitement modélisé par une loi uniforme U(0, 20).
Grâce aux propriétés formelles dérivées antérieurement, les caractéristiques d’attente s’établissent instantanément : le temps d’attente moyen théorique s’élève à E(T) = (0 + 20) / 2 = 10 minutes, tandis que la variance du temps d’attente atteint Var(T) = (20 – 0)^2 / 12 = 400 / 12 = 33.33 minutes au carré, équivalant à un écart-type de dispersion de sigma = sqrt(33.33) = 5.77 minutes. La probabilité que ce voyageur subisse une attente critique supérieure à 15 minutes se formule mathématiquement par P(T > 15) et s’évalue sous R par la commande punif(15, min = 0, max = 20, lower.tail = FALSE), retournant avec certitude un résultat de 0.25, soit une chance sur quatre.
Une simulation stochastique de type Monte-Carlo exécutée sous R permet de confronter immédiatement cette déduction analytique à une expérience computationnelle à grande échelle. En générant un million d’arrivées aléatoires de voyageurs via temps_simules <- runif(1e6, min = 0, max = 20), le calcul de la moyenne empirique mean(temps_simules) restitue approximativement 10.0003 minutes, la variance empirique var(temps_simules) s’établit à 33.3312, et la proportion de temps d’attente excédant 15 minutes mean(temps_simules > 15) affiche 0.25004. Cette concordance empirique illustre la puissance opérationnelle du formalisme uniforme pour l’ingénierie des transports.
8.2 Scénarios de contrôle qualité et tolérances d’instruments de mesure
Dans les industries de pointe telles que la microélectronique ou la fabrication de dispositifs médicaux implantables, le contrôle de conformité dimensionnelle d’une pièce usinée constitue un enjeu économique et sanitaire majeur. Supposons qu’un système d’usinage de haute précision fabrique des axes cylindriques en alliage de titane dont le diamètre nominal théorique doit être de 25.00 millimètres. Du fait des micro-vibrations mécaniques et de la dispersion thermique non orientée, l’écart de découpe delta se répartit de manière parfaitement homogène sur un intervalle de tolérance symétrique s’étendant de -0.06 mm à +0.06 mm, définissant une variable aléatoire uniforme X ~ U(24.94, 25.06).
Le cahier des charges impose que toute pièce dont le diamètre final s’écarte de plus de 0.04 mm par rapport à la consigne nominale (soit un diamètre réel situé hors de l’intervalle d’acceptation [24.96, 25.04]) soit irrémédiablement mise au rebut. La détermination de la proportion théorique de pièces défectueuses requiert l’évaluation de la probabilité de l’événement complémentaire P(X < 24.96) + P(X > 25.04). En vertu de la symétrie de la distribution uniforme, cette probabilité se traduit numériquement sous R par la commande simple 2 * punif(24.96, min = 24.94, max = 25.06).
L’évaluation computationnelle donne 2 * [(24.96 – 24.94) / (25.06 – 24.94)] = 2 * [0.02 / 0.12] = 2 * (1 / 6) = 1 / 3 = 0.3333, attestant qu’un tiers exact de la production industrielle est structurellement non conforme sous ces conditions d’usinage. Si chaque pièce défectueuse induit un coût de retraitement fixe de 45 euros, l’espérance mathématique de la perte financière par composant produit se calcule directement comme le produit de cette probabilité d’erreur par le coût unitaire, soit 15 euros par unité usinée. Cette quantification d’incertitude via punif() guide directement les arbitrages d’investissement dans des machines-outils de tolérance plus resserrée.
8.3 Modélisation de variables continues bornées sans a priori
Dans de nombreuses disciplines scientifiques, le chercheur se trouve confronté à des situations où il est avéré qu’une grandeur physique fondamentale est strictement bornée par des contraintes mécaniques ou thermodynamiques entre deux seuils indépassables a et b, mais où aucune donnée observationnelle supplémentaire ne permet de suspecter une concentration préférentielle au voisinage d’une valeur particulière. Cette situation d’ignorance probabiliste relève de l’application directe du principe d’indifférence formulé par Laplace.
En physique du bâtiment et en thermique environnementale, par exemple, le coefficient de convection d’une façade ventilée lors d’un épisode climatique exceptionnel peut n’être borné théoriquement que dans la plage [5, 25] W/(m²·K). Adopter une distribution gaussienne en fixant arbitrairement une moyenne et un écart-type introduirait une information synthétique illégitime, faussant la propagation des incertitudes dans les équations différentielles sous-jacentes. L’adoption d’un modèle U(5, 25) garantit le respect rigoureux de l’état d’information disponible, en attribuant à chaque sous-intervalle un poids proportionnel à sa seule étendue physique.
L’exploration de la sensibilité du système sous R consiste alors à injecter un vecteur de tirages uniformes massifs générés via runif(N, min = 5, max = 25) au sein du modèle mathématique déterministe pour observer la distribution empirique de la variable d’intérêt en sortie (par exemple la température intérieure maximale d’un bâtiment). L’évaluation subséquente de la dépendance des résultats vis-à-vis des bornes extrêmes a et b permet d’identifier si l’incertitude initiale s’amplifie ou s’amortit au cours de la modélisation, guidant ainsi l’affectation prioritaire des ressources métrologiques pour resserrer les bornes critiques du système.
9. Applications en psychologie cognitive et modélisation comportementale
9.1 Modélisation de l’équiprobabilité dans les choix forcés
La psychologie cognitive expérimentale et les neurosciences de la décision exploitent intensivement la distribution uniforme pour formaliser les modèles d’hypothèse nulle régissant le comportement de sujets humains ou animaux placés dans des protocoles de choix forcé à alternatives multiples (paradigmes n-alternative forced choice ou n-AFC). Lorsqu’un participant est invité à choisir une option parmi k alternatives sans disposer d’indice perceptif ou de renforcement préalable, l’hypothèse d’absence totale de stratégie décisionnelle se traduit formellement par une répartition parfaitement uniforme de la masse probabiliste 1/k sur l’ensemble des réponses possibles.
Dans les tâches perceptives continues où le sujet doit reproduire sur un cercle trigonométrique ou sur un axe linéaire la direction ou la nuance exacte d’un stimulus visuel mémorisé (par exemple une palette de couleurs s’étendant continûment de 0 à 360 degrés d’arc), le taux d’oubli complet se caractérise par des réponses qui s’émancipent totalement de la cible d’origine. Les modèles de mélange à variables latentes couramment utilisés dans l’étude de la mémoire de travail visuelle modélisent la distribution des erreurs de reproduction comme la combinaison linéaire d’une loi de von Mises (composante gaussienne circulaire centrée sur la cible mémorisée) et d’une distribution uniforme continue s’étalant sur [-pi, +pi], laquelle capte la proportion exacte de réponses produites par pur hasard stochastique.
Sous R, la fonction runif() constitue l’outil pivot pour randomiser l’ordre de présentation des stimuli expérimentaux au sein de générateurs d’expériences scriptés. La randomisation uniforme de l’ordre d’affichage prévient tout biais d’ordre, tout phénomène de fatigue préférentiel ou tout effet d’apprentissage systématique qui viendrait vicier la validité interne du paradigme scientifique, assurant une orthogonalité parfaite entre les conditions expérimentales testées.
9.2 Temps de réaction minimaux et fenêtres temporelles d’attention
L’analyse chronométrique des processus mentaux via l’enregistrement des temps de réaction (TR) représente un autre pan fondamental de la recherche cognitive contemporaine. Dans les tâches d’attention soutenue ou de détection de signaux élémentaires (telles que le test de vigilance psychomotrice, ou PVT), l’un des biais méthodologiques les plus critiques réside dans l’anticipation motrice : si l’intervalle temporel séparant l’avertisseur sonore du stimulus cible (l’intervalle inter-stimulus, ou ISI pour Inter-Stimulus Interval) est parfaitement fixe, le sujet calibre son engagement moteur pour déclencher son action de manière anticipée, contournant le traitement sensoriel direct.
Pour neutraliser cette stratégie préparatoire indésirable, les protocoles expérimentaux injectent systématiquement une incertitude temporelle en échantillonnant l’ISI de façon uniformément distribuée au sein d’une fenêtre temporelle d’attention, par exemple entre 2000 et 8000 millisecondes, via l’instruction isi <- runif(1, min = 2000, max = 8000). Cette variabilité uniforme empêche toute prédiction probabiliste de l’instant précis d’apparition du stimulus, contraignant le système attentionnel du participant à maintenir un état de vigilance homogène sur l’ensemble de la fenêtre d’attente.
Lors de la phase de post-traitement analytique sous R, la distribution des temps de réaction observés chez les participants requiert fréquemment un filtrage des réponses aberrantes. Tout temps de réponse inférieur au plancher physiologique de transmission axonale et synaptique (estimé classiquement à 150 ou 180 millisecondes chez l’humain) est considéré comme une réponse impulsive anticipatoire. En modélisant ces réponses parasites ultra-rapides comme un bruit uniforme superposé à la distribution véritable des processus de décision (souvent de type Ex-Gaussienne ou Diffusion de Wiener), les chercheurs parviennent à assainir les séries de mesures et à extraire les paramètres latents purs de la vitesse de transmission neurocognitive.
9.3 Calibration psychométrique et distribution des valeurs de p
L’une des propriétés théoriques les plus méconnues et pourtant les plus fondamentales de l’inférence statistique réside dans le comportement de la valeur de p (p-value) sous l’hypothèse nulle exacte H0. Si l’hypothèse nulle testée est strictement vraie et que l’échantillon obéit rigoureusement aux postulats du test statistique continue considéré (par exemple un test t de Student ou une analyse de variance), la valeur de p issue de ce test n’a pas plus de chance de tomber entre 0.01 et 0.02 qu’entre 0.85 et 0.86 : elle constitue une variable aléatoire continue distribuée rigoureusement selon une loi uniforme standard U(0, 1).
Cette uniformité structurelle découle directement de la transformation intégrale de probabilité évoquée précédemment. Si la statistique de test T admet une fonction de répartition F_0(t) sous H0, alors par définition la p-value s’exprime par p = 1 – F_0(T). Dès lors que F_0 est continue, la variable p suit de manière mathématiquement incontournable une distribution U(0, 1). Cette propriété fondamentale est exploitée massivement sous R pour concevoir des simulations démontrant le fonctionnement des risques d’erreur de première espèce (alpha) : en générant 100 000 tests statistiques sous H0 et en compilant les p-values résultantes, l’application de hist(p_values, breaks = 20, freq = FALSE) révèle un profil rectangulaire d’une platitude absolue.
Cette propriété constitue le socle méthodologique de l’analyse de la courbe des p (ou p-curve analysis), introduite par Uri Simonsohn, Leif Nelson et Joseph Simmons pour diagnostiquer les pratiques de recherche douteuses (questionable research practices) ou la falsification statistique sélective (p-hacking) dans les publications scientifiques. Lorsqu’un effet scientifique est authentique, la distribution des valeurs de p significatives (p < 0.05) doit présenter une courbure exponentielle fortement asymétrique orientée vers zéro (right-skewed). En revanche, si la littérature d’un domaine psychologique ne fait que rapporter des faux positifs artificiellement gonflés par de multiples analyses exploratoires non contrôlées, la distribution empirique des valeurs de p significatives conserve un profil plat, caractéristique indiscutable de la loi uniforme tronquée, trahissant l’absence d’effet expérimental réel.
10. Tests d’adéquation et validation statistique de l’uniformité dans R
10.1 Le test de Kolmogorov-Smirnov avec ks.test()
L’évaluation rigoureuse de l’hypothèse selon laquelle un échantillon de mesures quantitatives continues x provient effectivement d’une distribution uniforme U(a, b) ne peut reposer sur de simples impressions visuelles déduites d’un histogramme. L’approche inférentielle de référence réside dans le test non paramétrique d’adéquation de Kolmogorov-Smirnov. Ce test éprouve l’écart structurel entre la fonction de répartition empirique notée F_n(x), construite directement à partir des observations ordonnées de l’échantillon, et la fonction de répartition théorique cumulative continue F(x) = (x – a) / (b – a) spécifiée par l’expérimentateur.
La statistique de test centrale, universellement notée D, quantifie la distance suprémum (l’écart vertical maximal en valeur absolue) séparant ces deux fonctions sur l’intégralité du domaine de définition : D = sup_x |F_n(x) – F(x)|. Au sein du système R, l’exécution formelle de ce test s’opère via l’appel à la fonction native ks.test(). La syntaxe rigoureuse pour tester l’uniformité d’un vecteur empirique x sur le segment [a, b] s’énonce sous la forme : ks.test(x, "punif", min = a, max = b). Il est impératif de noter que le second argument doit être passé sous la forme d’une chaîne de caractères désignant explicitement la fonction de répartition cible.
L’interprétation de la sortie logicielle repose conjointement sur la valeur de la statistique empirique D et sur la p-value associée. Si la p-value calculée demeure strictement supérieure au seuil de significativité conventionnel de 5 % (p > 0.05), le statisticien ne dispose d’aucun élément probant pour rejeter l’hypothèse nulle, concluant à la compatibilité de l’échantillon avec le modèle U(a, b). Néanmoins, il convient de souligner une limitation méthodologique cruciale : le test de Kolmogorov-Smirnov estándar suppose formellement la stricte continuité des données et l’absence totale d’ex-aequo (ties). La présence de valeurs identiques répétées au sein de x altère la validité de la loi exacte de la statistique D, contraignant R à émettre un avertissement invitant à la prudence interprétative.
10.2 Test d’adéquation du Chi-deux sur données discrétisées
Une alternative classique pour éprouver l’adéquation d’un ensemble de mesures continues à la loi uniforme consiste à discrétiser préalablement la variable continue en un nombre fini k d’intervalles contigus d’amplitudes rigoureusement égales, pour appliquer ensuite le test d’adéquation du Chi-deux de Pearson (Goodness-of-Fit Chi-Square Test). L’hypothèse nulle postule que les effectifs d’observations tombant dans chacune des k classes doivent être statistiquement homogènes, chaque classe devant recueillir un effectif théorique espéré égal à E_i = n / k, où n représente la taille totale de la cohorte observée.
La transformation numérique sous R s’opère facilement par l’articulation de la fonction de partitionnement cut() et du test inférentiel chisq.test(). En supposant un échantillon donnees censé appartenir à l’intervalle [0, 100], la segmentation en dix classes déciles équidistantes s’effectue via l’instruction classes <- cut(donnees, breaks = seq(0, 100, length.out = 11), include.lowest = TRUE). Le décompte des fréquences observées s’obtient par la fonction table(classes), laquelle peut être injectée directement dans chisq.test(table(classes)). R compare automatiquement la distribution observée à un vecteur théorique uniforme par défaut.
Bien que conceptuellement très accessible, cette approche par discrétisation présente une puissance statistique systématiquement inférieure à celle du test de Kolmogorov-Smirnov pour les variables strictement continues, en raison de la perte irréversible d’information induite par l’agrégation en intervalles discrets. De surcroît, la validité asymptotique de l’approximation par la loi du Chi-deux impose le respect strict des critères de Cochran : aucun effectif espéré ne doit être inférieur à 1, et au moins 80 % des compartiments doivent présenter un effectif théorique supérieur ou égal à 5 observations. Le choix arbitraire du nombre de classes k constitue une source supplémentaire d’instabilité décisionnelle que le praticien doit manier avec circonspection.
10.3 Approches basées sur l’entropie et diagnostics résiduels
Dans la perspective de la théorie de l’information formalisée par Claude Shannon, la distribution uniforme continue sur un support compact [a, b] présente une propriété mathématique remarquable : elle constitue la loi de probabilité qui maximise l’entropie différentielle parmi toutes les distributions continues confinées au même intervalle borné. L’entropie continue théorique d’une variable U(a, b) s’exprime analytiquement par l’intégrale négative de f(x) ln(f(x)) dx, ce qui donne immédiatement H(X) = ln(b – a) nats.
Cette caractéristique fait de l’estimation non paramétrique de l’entropie d’un échantillon un puissant révélateur d’uniformité. En exploitant des packages R dédiés à la théorie de l’information statistique (tels que entropy ou infotheo), la comparaison entre l’entropie empirique calculée sur les données et la borne théorique maximale ln(b – a) permet de mesurer le degré de désordre stochastique ou d’homogénéité du signal. Tout déficit significatif d’entropie observée traduit une structuration indésirable, révélant la formation de conglomérats d’observations (clustering) ou d’évitements locaux contraires au principe d’équiprobabilité absolue.
Ces diagnostics peuvent être parachevés par l’analyse résiduelle de la fonction de répartition empirique. En définissant le vecteur des écarts verticaux delta_i = F_n(x_(i)) – (x_(i) – a) / (b – a), la projection cartographique de ces résidus en fonction des quantiles empiriques permet d’observer la trajectoire d’un pont brownien théorique. Toute dérive systématique et unilatérale de ces résidus au-delà des bandes de confiance calculées par le théorème de Donsker signale immédiatement un écart structurel majeur à l’uniformité, offrant un outil visuel d’une finesse diagnostique supérieure aux simples valeurs scalaires récapitulatives des tests d’hypothèse classiques.
11. Méthodes de Monte-Carlo et transformation inverse fondées sur la loi uniforme
11.1 Principe de la transformation inverse pour générer d’autres distributions
Le rôle opérationnel fondamental de la loi uniforme standard U(0, 1) en calcul scientifique moderne s’incarne magistralement dans la méthode d’échantillonnage par transformation inverse. Ce théorème fondamental d’analyse stochastique fournit un algorithme universel pour générer des réalisations pseudo-aléatoires d’une variable X suivant n’importe quelle loi de probabilité continue arbitraire dont on est capable d’inverser analytiquement ou numériquement la fonction de répartition cumulative F(x).
La démonstration mathématique de cette propriété est d’une concision exemplaire. Soit U une variable aléatoire continue distribuée selon la loi uniforme standard U(0, 1), dont la fonction de répartition F_U(u) est égale à u pour tout u compris dans [0, 1]. Définissons la variable transformée X = F^(-1)(U), où F est la fonction de répartition strictement croissante de la loi continue ciblée. La fonction de répartition induite de la variable X, notée F_X(x), s’évalue alors comme suit : P(X <= x) = P(F^(-1)(U) <= x). En appliquant la transformation strictement croissante F aux deux membres de l’inégalité interne, cette probabilité s’écrit de façon équivalente : P(U <= F(x)) = F_U(F(x)). Puisque F_U(u) = u pour toute valeur unitaire, cette identité se réduit immédiatement à F(x). La variable transformée X suit donc rigoureusement la distribution voulue.
Cette élégance théorique se traduit de façon immédiate sous R. Considérons la simulation d’une loi exponentielle de paramètre d’intensité lambda, dont la fonction de répartition s’écrit F(x) = 1 – exp(-lambda * x). L’inversion de l’équation p = 1 – exp(-lambda * x) produit la fonction quantile analytique x = -ln(1 – p) / lambda. Puisque la variable (1 – U) suit rigoureusement la même distribution U(0, 1) que la variable U elle-même, la génération directe d’un échantillon exponentiel d’intensité lambda = 2 s’exécute sans passer par la fonction native rexp() via l’instruction élémentaire : echantillon_exp <- -log(runif(10000)) / 2. La même démarche permet de simuler instantanément une loi de Cauchy par inversion de sa tangente via tan(pi * (runif(n) - 0.5)), ou une distribution logistique à travers la transformation logit log(u / (1 - u)).
11.2 Méthode du rejet (Acceptance-Rejection Sampling)
Lorsque la fonction de répartition cumulative d’une loi cible f(x) ne dispose pas d’expression analytique facilement inversible (comme pour la distribution normale standard, les distributions bêta ou gamma générales), la méthode de la transformation inverse devient difficilement exploitable sans approximations numériques coûteuses. L’alternative algorithmique fondamentale est alors la méthode du rejet, conceptualisée originellement par John von Neumann en 1951, laquelle repose structurellement sur deux flux simultanés de variables aléatoires uniformes.
Le principe consiste à introduire une densité instrumentale auxiliaire de proposition g(x) aisée à simuler (la loi uniforme continue U(a, b) constituant le choix naturel pour les densités cibles f(x) à support borné [a, b]), et une constante multiplicatrice finie M >= 1 calibrée de manière à ce que le produit M * g(x) majore strictement la densité cible f(x) en tout point de l’espace : f(x) <= M * g(x). À chaque étape de l’algorithme, un candidat X_cand est tiré uniformément sur [a, b] via un premier appel à runif(), puis une seconde variable uniforme indépendante U est tirée sur l’intervalle standard U(0, 1). La valeur proposée X_cand est acceptée au sein de l’échantillon définitif si et seulement si elle satisfait la condition de filtrage géométrique : U <= f(X_cand) / (M * g(X_cand)). Si cette condition n’est pas vérifiée, la valeur est rejetée et l’itération redémarre.
L’efficacité computationnelle de ce processus dépend directement de la constante d’enveloppe M : le taux d’acceptation global moyen de l’algorithme est rigoureusement égal à 1 / M. Plus l’enveloppe M * g(x) épouse étroitement la morphologie de la densité cible, plus le taux de rejet est faible et plus le temps de calcul processeur est optimisé. La méthode du rejet montre comment l’interaction conjointe de deux distributions uniformes permet de sculpter des densités de probabilités continues arbitrairement complexes, y compris des distributions multimodales ou tronquées hautement non linéaires.
11.3 Intégration numérique par méthode de Monte-Carlo
L’intégration numérique par méthode de Monte-Carlo constitue l’une des percées algorithmiques les plus marquantes du vingtième siècle, inaugurée par Stanislaw Ulam et Nicholas Metropolis lors de leurs travaux sur le projet Manhattan. Cette méthode propose une résolution probabiliste de l’évaluation d’intégrales définies complexes ou de dimensions élevées dont le calcul analytique formel par détermination de primitives s’avère impossible ou excessivement laborieux.
Le fondement mathématique repose sur l’expression de l’intégrale d’une fonction continue h(x) sur un intervalle borné [a, b] sous la forme d’une espérance mathématique liée à une variable uniforme X ~ U(a, b). L’intégrale de h(x) dx entre a et b peut être réécrite sans altération sous la forme : (b – a) * intégrale de h(x) * (1 / (b – a)) dx entre a et b, ce qui correspond rigoureusement à l’espérance mathématique scalaire (b – a) * E[h(X)]. En application directe de la loi forte des grands nombres, cette espérance théorique peut être approximée par la moyenne arithmétique empirique d’un grand nombre N de réalisations indépendantes générées uniformément sur [a, b] : I_approx = (b – a) * (1 / N) * somme de h(X_i).
Un cas d’école emblématique sous R consiste à estimer la constante mathématique transcendante Pi par méthode de Monte-Carlo via l’intégration géométrique d’un quart de disque unitaire. En tirant indépendamment deux vecteurs uniformes standard x et y de dimension N = 1 000 000 à l’aide de x <- runif(1e6); y <- runif(1e6), chaque paire (x_i, y_i) matérialise un point tiré au hasard dans le carré unitaire de surface 1. La condition d’appartenance au cercle s’exprime par la relation algébrique x^2 + y^2 <= 1. La proportion de points tombant à l’intérieur du quart de cercle converge vers le ratio des surfaces Pi / 4. L’instruction R concise pi_estime <- 4 * mean(x^2 + y^2 <= 1) renvoie typiquement une valeur approchée oscillant autour de 3.1415, avec une marge d’erreur stochastique qui décroît inexorablement selon le régime universel en O(1 / sqrt(N)).
12. Bonnes pratiques, performance algorithmique et pièges fréquents
12.1 Erreurs méthodologiques fréquentes lors de l’utilisation des fonctions unif
L’apparente simplicité conceptuelle de la loi uniforme continue dissimule plusieurs pièges méthodologiques et conceptuels dans lesquels s’égarent régulièrement les analystes novices comme les modélisateurs chevronnés. L’erreur la plus pernicieuse consiste à confondre la valeur de densité fournie par dunif() avec une probabilité ponctuelle de réalisation. Pour toute variable aléatoire rigoureusement continue, la probabilité d’observer une valeur scalaire infiniment précise est identiquement nulle : P(X = x) = 0. La fonction dunif(x) renvoie une densité de probabilité, c’est-à-dire une dérivée de mesure cumulative, et non une probabilité brute.
Une illustration saisissante de cette confusion réside dans le fait qu’une densité peut parfaitement dépasser l’unité sans violer aucun axiome probabiliste. Si l’on évalue dunif(0.2, min = 0, max = 0.25), la fonction renvoie la valeur 1 / (0.25 – 0) = 4.0, un nombre largement supérieur à 1 qui déconcerte les utilisateurs assimilant la densité à une probabilité. La seule contrainte imposée par les axiomes de Kolmogorov est que l’intégrale totale sous la courbe vaille 1, et non que la hauteur maximale de la densité soit bornée par l’unité.
Un second écueil classique concerne l’omission de la fixation de la graine aléatoire via set.seed() dans les scripts d’analyse scientifique. L’omission de cette précaution élémentaire engendre des rapports statistiques mouvants d’une exécution à l’autre, empêchant toute vérification par les pairs. Enfin, une confusion grave réside dans l’arrondi involontaire de variables uniformes continues (par exemple via round(runif(n, 0, 10))) pour générer des entiers pseudo-aléatoires. Cette pratique tronque artificiellement la probabilité des classes extrêmes 0 et 10, qui ne recueillent qu’un demi-intervalle d’arrondi comparé aux classes intérieures, ruinant l’équiprobabilité voulue au profit d’une discrétisation viciée. Dans ce contexte, l’emploi de sample() ou d’une troncature explicite par floor() s’impose impérativement.
12.2 Optimisation vectorielle et allocation mémoire pour les simulations massives
L’interprétation séquentielle du langage R peut entraîner d’importants ralentissements computationnels si le codeur applique des idiomes de programmation itératifs inadaptés. L’utilisation d’une boucle explicite for pour générer et manipuler séquentiellement des nombres aléatoires uniformes constitue l’anti-patron d’optimisation par excellence. Écrire une boucle appelant N fois l’instruction runif(1) s’avère plusieurs centaines de fois plus lent qu’une génération vectorisée unique invoquant runif(N), car chaque passage de boucle supporte le coût d’interprétation et d’allocation dynamique en mémoire.
Dans les simulations d’envergure nécessitant la manipulation de dizaines de millions de tirages uniformes, la gestion rationnelle de l’empreinte mémoire devient primordiale. En R, chaque nombre flottant en double précision occupe strictement 8 octets de mémoire vive. Dès lors, instancier inconsidérément un vecteur de 100 millions d’éléments aléatoires exige une allocation immédiate et continue d’environ 800 mégaoctets de RAM. Si ce vecteur est dupliqué au sein de fonctions non pures par suite du mécanisme de copie sur modification (copy-on-modify), la saturation du tas mémoire peut provoquer le recours fatal à la mémoire virtuelle d’échange sur disque (swapping), dégradant dramatiquement les performances d’exécution.
Pour profiler précisément la consommation de ressources et le temps de calcul des routines stochastiques sous R, l’emploi de bibliothèques d’analyse de performance comme bench ou microbenchmark est fortement conseillé. Lors de calculs intensifs, le recours à des structures de tableaux pré-allouées via matrix() combinées à des opérations vectorisées matricielles permet d’exploiter pleinement les bibliothèques d’algèbre linéaire optimisées sous-jacentes (BLAS/LAPACK), assurant un débit d’échantillonnage de plusieurs dizaines de millions de variables uniformes par seconde.
12.3 Synthèse et guide décisionnel pour le choix des fonctions unif
L’utilisation judicieuse de la suite logicielle dédiée à la loi uniforme sous R suppose une compréhension claire des responsabilités respectives de chaque fonction. Le tableau décisionnel suivant récapitule de manière synthétique l’architecture fonctionnelle mise à la disposition du biostatisticien et du chercheur :
| Fonction R | Rôle mathématique fondamental | Paramètres directeurs | Domaine de sortie standard | Cas d’usage emblématique |
|---|---|---|---|---|
| dunif() | Densité de probabilité théorique f(x) | x, min, max, log | [0, +infini[ (réel) | Calcul de log-vraisemblance, prior bayésien non informatif |
| punif() | Fonction de répartition cumulée F(q) | q, min, max, lower.tail, log.p | [0, 1] (probabilité) | Évaluation d’intervalles de risques, calcul de p-values de test |
| qunif() | Fonction quantile inverse Q(p) = F^(-1) | p, min, max, lower.tail, log.p | [min, max] (support réel) | Détermination de seuils critiques, tracés de diagrammes Q-Q |
| runif() | Génération pseudo-aléatoire stochastique | n, min, max | [min, max] (vecteur taille n) | Méthodes de Monte-Carlo, transformation inverse, randomisation |
Pour choisir sans hésitation la routine adéquate face à une problématique stochastique concrète, le praticien peut suivre un cheminement analytique rigoureux en trois étapes :
- S’agit-il d’évaluer une quantité déterministe sur un modèle théorique connu, ou de produire des données aléatoires empiriques ? Si l’on doit simuler un processus ou modéliser le hasard, l’unique fonction appropriée est runif().
- Si l’opération est déterministe, le problème part-il des abscisses spatiales pour évaluer un poids probabiliste, ou part-il d’un quota de probabilité pour identifier un seuil métrique ? Si la probabilité constitue la donnée de départ, la fonction d’inversion qunif() s’impose obligatoirement.
- Si la métrique spatiale est la donnée d’entrée, cherche-t-on une probabilité cumulée sur un intervalle continu ou la concentration locale ponctuelle pour un ajustement statistique ? La quantification d’événements cumulés exige impérativement punif(), tandis que le calibrage paramétrique d’une fonction de densité ou le calcul de vraisemblance requiert dunif().
En respectant scrupuleusement ces règles de décision algorithmique, en évitant les écueils de confusion dimensionnelle entre densité et probabilité cumulée, et en ancrant la traçabilité des codes informatiques dans la fixation systématique des graines génératrices, la communauté des scientifiques et analystes de données dispose avec l’environnement R d’une plateforme robuste, rapide et d’une rigueur mathématique irréprochable pour mener à bien toutes ses modélisations stochastiques fondées sur la loi uniforme continue.
Références
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299-314. https://doi.org/10.1080/10618600.1996.10474713
- Joint Committee for Guides in Metrology. (2008). Evaluation of measurement data — Guide to the expression of uncertainty in measurement (JCGM 100:2008). Bureau International des Poids et Mesures. https://www.bipm.org/en/committees/jc/jcgm/publications
- L’Ecuyer, P., & Simard, R. (2007). TestU01: A C library for empirical testing of random number generators. ACM Transactions on Mathematical Software, 33(4), Article 22. https://doi.org/10.1145/1268776.1268777
- Marsaglia, G. (1996). Diehard: A battery of tests of randomness. Florida State University.
- Matsumoto, M., & Nishimura, T. (1998). Mersenne Twister: A 623-dimensionally equidistributed uniform pseudo-random number generator. ACM Transactions on Modeling and Computer Simulation, 8(1), 3-30. https://doi.org/10.1145/272991.272995
- Metropolis, N., & Ulam, S. (1949). The Monte Carlo method. Journal of the American Statistical Association, 44(247), 335-341. https://doi.org/10.1080/01621459.1949.10483310
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Simonsohn, U., Nelson, L. D., & Simmons, J. P. (2014). P-curve: A key to the file-drawer. Journal of Experimental Psychology: General, 143(2), 534-547. https://doi.org/10.1037/a0033242
- von Neumann, J. (1951). Various techniques used in connection with random digits. National Bureau of Standards Applied Mathematics Series, 12, 36-38.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag New York. https://ggplot2.tidyverse.org