
Dans le champ de l’analyse quantitative et de l’inférence statistique, la modélisation de l’incertitude constitue le socle sur lequel repose toute prise de décision scientifique. Qu’il s’agisse de valider l’efficacité d’une molécule thérapeutique, de quantifier un changement cognitif consécutif à une remédiation neuropsychologique ou d’évaluer l’impact d’une politique publique, les chercheurs sont invariablement confrontés à une contrainte fondamentale : l’impossibilité pratique d’observer l’intégralité d’une population cible. Cette barrière épistémologique impose le recours à l’échantillonnage, processus par lequel un sous-ensemble fini d’observations est extrait afin d’en extrapoler des lois générales. C’est précisément à la frontière entre les données empiriques observées et la réalité populationnelle sous-jacente que se déploient les distributions de probabilité théoriques.
Parmi l’arsenal mathématique mis à la disposition des méthodologues, deux entités occupent une place prépondérante, souvent source de confusions conceptuelles majeures : la distribution normale (ou loi de Gauss-Laplace) et la distribution t de Student. Si toutes deux partagent une allure générale en cloche, symétrique et centrée sur l’espérance mathématique, leurs propriétés fondamentales, leurs hypothèses génératrices et leurs implications inférentielles diffèrent substantiellement. Le passage de l’une à l’autre ne relève pas d’une simple nuance stylistique ou computationnelle ; il incarne au contraire la formalisation mathématique de l’ignorance partielle du chercheur face aux véritables paramètres de dispersion du monde réel.
Comprendre en profondeur la divergence entre ces deux géants de la théorie probabiliste exige une déconstruction rigoureuse de leurs origines, de leurs propriétés analytiques et de leurs comportements asymptotiques. Choisir la loi normale là où la loi de Student s’impose conduit inéluctablement à un excès d’optimisme statistique, caractérisé par des intervalles de confiance trop étroits et une inflation incontrôlée des erreurs d’inférence. Inversement, ignorer la convergence de la loi t vers la loi normale peut priver le statisticien d’une simplification analytique précieuse. Cet article propose une exploration exhaustive, théorique et appliquée, de cette frontière cardinale de la statistique moderne.
1. Introduction aux lois de probabilité fondamentales en statistique
1.1 Importance des distributions théoriques en méthodologie quantitative
L’acte fondamental de la recherche quantitative consiste à traduire le désordre apparent des observations empiriques en structures mathématiques intelligibles. Lorsqu’un psychologue recueille les temps de réaction de plusieurs dizaines de participants soumis à une tâche d’attention sélective, ou lorsqu’un neuroscientifique quantifie les variations du signal BOLD dans une région d’intérêt cérébrale, les valeurs brutes obtenues présentent une variabilité stochastique intrinsèque. Cette variabilité résulte à la fois de fluctuations biologiques réelles, d’erreurs de mesure inhérentes aux instruments et de facteurs contextuels non contrôlés. Pour donner du sens à cette nébuleuse, la science fait appel aux distributions théoriques de probabilité, qui agissent comme des idéalisations mathématiques capables d’encadrer la distribution empirique.
Le rôle des modèles probabilistes dépasse la simple compression descriptive des données. En statistique descriptive, l’observateur se contente de calculer une moyenne arithmétique ou un écart-type pour synthétiser son échantillon. En revanche, le passage à la statistique inférentielle opère un saut qualitatif : il s’agit d’affirmer que les données recueillies ne constituent qu’une réalisation aléatoire parmi une infinité d’autres possibles, émanant d’un processus générateur latent régi par des paramètres fixes mais inconnus. La distribution théorique sert alors de passerelle déductive. En postulant qu’une variable aléatoire suit une loi déterminée, le chercheur peut déduire la probabilité d’observer un résultat donné sous certaines conditions fixées a priori.
Dans l’étude des processus psychologiques et cognitifs, cette modélisation repose sur l’hypothèse sous-jacente que les capacités humaines (telles que le raisonnement fluide, la capacité de mémoire de travail ou la vitesse de traitement) résultent de l’interaction additive d’une multitude de facteurs génétiques, développementaux et environnementaux microscopiques. Lorsque ces influences infinitésimales et indépendantes s’additionnent, la théorie mathématique prédit l’émergence d’une forme distributionnelle spécifique. Ainsi, le choix d’un modèle théorique n’est pas arbitraire : il constitue une hypothèse théorique forte sur la nature du mécanisme qui engendre les données observées au sein du système vivant.
1.2 Présentation générale du dilemme : distribution normale ou distribution t
Le dilemme opposant la distribution normale à la distribution t émerge précisément au moment où le chercheur tente d’estimer un paramètre populationnel (le plus souvent la moyenne $\mu$) à partir des données d’échantillonnage, tout en se heurtant à l’inconnaissance de la variance réelle ($\sigma^2$) de la population. Si le monde réel fournissait gracieusement la valeur exacte de l’écart-type populationnel $\sigma$, la loi normale régnante permettrait de calculer avec une précision absolue la distribution d’échantillonnage de la moyenne. Or, dans l’écrasante majorité des situations scientifiques concrètes, ce paramètre de dispersion demeure radicalement inaccessible. Le chercheur n’a d’autre choix que d’estimer $\sigma$ à travers la dispersion observée au sein de son échantillon, symbolisée par l’écart-type échantillonnal corrigé $s$.
Cette estimation de l’écart-type introduit une source d’incertitude supplémentaire. Dès lors, la statistique de test calculée ne suit plus une trajectoire purement gaussienne, car son dénominateur n’est plus une constante d’échelle mais une variable aléatoire elle-même soumise aux aléas de l’échantillonnage. Ignorer cet état de fait et appliquer mécaniquement la distribution normale revient à postuler une certitude absolue quant à la dispersion globale du phénomène. Les conséquences de cette confusion sur les décisions inférentielles sont loin d’être anecdotiques : les marges d’erreur sont systématiquement sous-évaluées, ce qui engendre des intervalles de confiance artificiellement resserrés et trompeurs.
Sur le plan de l’évaluation des hypothèses statistiques, une sélection erronée de la loi de référence distord gravement les taux d’erreur de type I (rejeter à tort l’hypothèse nulle d’absence d’effet) et de type II (échouer à détecter un effet pourtant réel). L’application d’une loi normale en lieu et place d’une loi t sur un échantillon restreint expose le chercheur à un taux d’erreur de première espèce bien supérieur au seuil nominal conventionnel de 5 %. Des découvertes prétendument significatives se révèlent alors n’être que de simples artefacts dus à la sous-estimation de la variabilité d’échantillonnage, contribuant directement aux crises de réplicabilité qui secouent régulièrement les sciences empiriques contemporaines.
2. La distribution normale : architecture, caractéristiques et théorème fondamental
2.1 Définition mathématique et fonction de densité de la loi normale
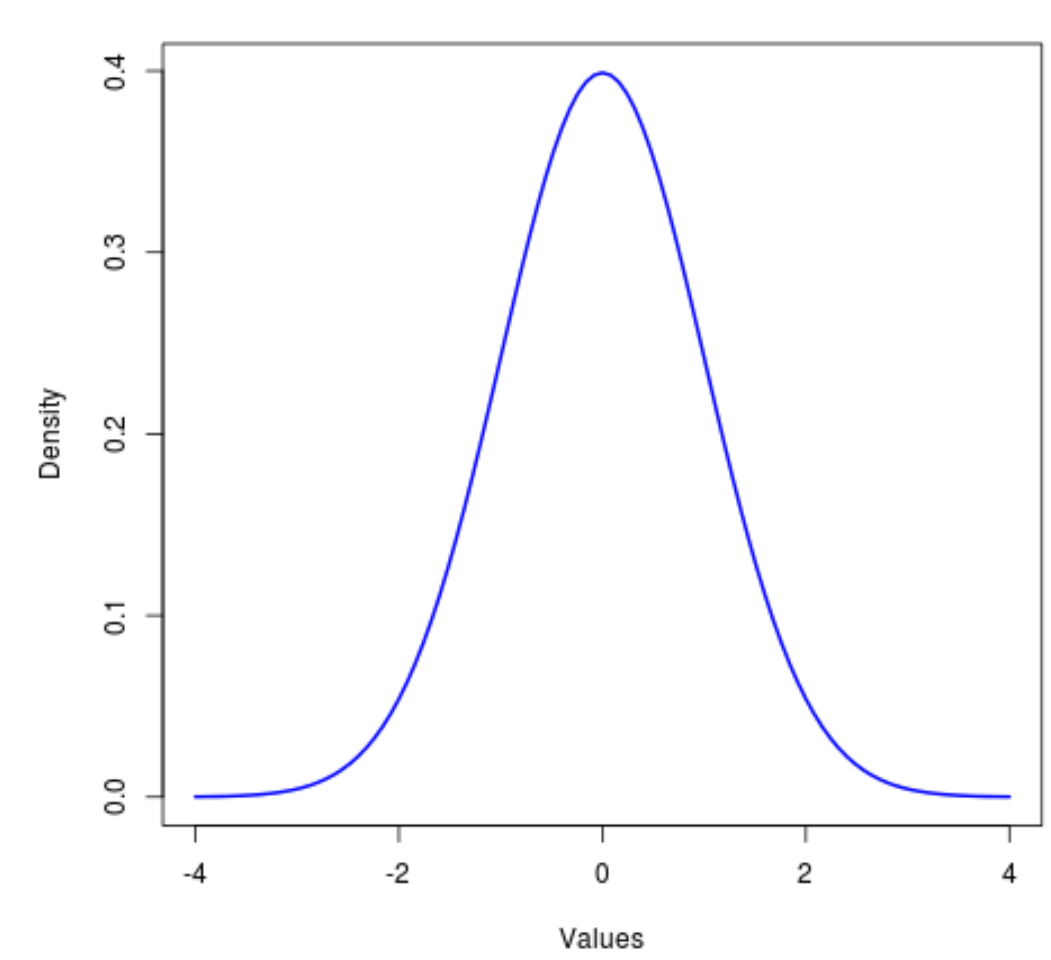
La distribution normale, souvent désignée sous le nom de loi de Gauss ou courbe de Laplace-Gauss, constitue l’étalon-or des distributions de probabilité continues. Sur le plan analytique, une variable aléatoire continue $X$ suit une distribution normale d’espérance $\mu in \mathbb{R}$ et de variance $\sigma^2 > 0$ (notée $X \sim \mathcal{N}(\mu, \sigma^2)$) si sa fonction de densité de probabilité $f(x)$ s’exprime, pour tout réel $x in ]-\infty, +\infty[$, selon la formulation suivante :
$$f(x) = \frac{1}{\sigma \sqrt{2\pi}} \exp\left( -\frac{1}{2} \left( \frac{x – \mu}{\sigma} \right)^2 \right)$$
Cette équation révèle l’interaction intime entre deux paramètres cruciaux. Le premier, $\mu$ (la moyenne ou espérance mathématique), agit rigoureusement comme un paramètre de position. Il détermine l’ancrage central de la distribution sur l’axe des abscisses, dictant le point de symétrie maximale où la densité de probabilité atteint son sommet absolu. Toute translation de $\mu$ déplace l’ensemble de la courbe le long de l’axe réel sans modifier le moins du monde sa courbure ou sa largeur intrinsèque.
Le second paramètre, $\sigma$ (l’écart-type), fonctionne comme un paramètre d’échelle et d’étalement. Présent à la fois au dénominateur du facteur de normalisation pré-exponentiel $\frac{1}{\sigma \sqrt{2\pi}}$ et au sein du terme exponentiel quadratique, il gouverne la dispersion de la cloche. Une valeur élevée de $\sigma$ engendre une courbe aplatie et étalée sur une plage étendue de valeurs, tandis qu’une valeur faible de $\sigma$ comprime la distribution autour de son espérance, produisant un pic aiguisé. La constante $\sqrt{2\pi}$ garantit quant à elle que l’intégrale de la fonction sur son domaine de définition soit strictement égale à 1, condition indispensable à toute loi de probabilité légitime.
2.2 Propriétés morphologiques et règle empirique 68-95-99,7
La morphologie de la fonction de densité gaussienne exhibe une perfection géométrique singulière. Elle est strictement symétrique par rapport à l’axe vertical d’abscisse $x = \mu$. Cette symétrie implique une coïncidence mathématique parfaite entre les trois mesures centrales fondamentales de la statistique : l’espérance mathématique (la moyenne arithmétique), la médiane (la valeur coupant l’aire sous la courbe en deux moitiés égales de 0,5) et le mode (le point où la fonction atteint son extremum local et absolu). Ainsi, pour toute loi normale, nous avons l’égalité stricte : $\text{Moyenne} = \text{Médiane} = \text{Mode} = \mu$.
Au-delà de cette triple identité, l’analyse différentielle de la fonction de densité révèle deux points d’inflexion morphologiques majeurs, situés précisément aux abscisses $x = \mu – \sigma$ et $x = \mu + \sigma$. En ces points, la dérivée seconde de $f(x)$ s’annule, marquant la transition où la courbe cesse d’être concave vers le bas pour devenir convexe vers le haut. Ces coordonnées délimitent la région où la densité de concentration des probabilités est la plus vigoureuse avant que les ailes de la cloche ne s’étirent de façon asymptotique vers l’infini sans jamais toucher l’axe horizontal.
Cette structure sous-tend la fameuse « règle empirique », souvent baptisée règle 68-95-99,7, qui quantifie la distribution des probabilités cumulées sous la courbe standardisée :
- Environ 68,27 % de la surface totale sous la courbe (et donc de la masse de probabilité) est confinée dans l’intervalle fermé $[\mu – \sigma, \mu + \sigma]$.
- Environ 95,45 % des probabilités résident dans l’intervalle s’étendant à deux écarts-types de la moyenne, soit $[\mu – 2\sigma, \mu + 2\sigma]$. Plus précisément, la valeur critique classique de $1,96\sigma$ délimite exactement 95,00 % de l’aire sous la courbe.
- Environ 99,73 % de la masse globale de probabilité se trouve circonscrite dans l’intervalle élargi à trois écarts-types, $[\mu – 3\sigma, \mu + 3\sigma]$.
Les observations situées au-delà de trois écarts-types de la moyenne constituent des événements exceptionnellement rares sous le modèle gaussien, représentant conjointement moins de 0,27 % des occurrences possibles.
2.3 Le rôle charnière du théorème central limite (TCL)
Si la distribution normale occupe un statut quasi hégémonique dans les sciences de la nature et du comportement, ce n’est nullement par commodité mathématique passive, mais en vertu d’un théorème d’une portée universelle : le théorème central limite (TCL). Établi sous différentes variantes par Abraham de Moivre, Pierre-Simon de Laplace puis formalisé rigoureusement par Aleksandr Lyapunov et Jarl Waldemar Lindeberg, ce théorème stipule que la somme (ou la moyenne arithmétique) d’un grand nombre de variables aléatoires indépendantes et identiquement distribuées (i.i.d.), dotées d’une espérance finie $\mu$ et d’une variance finie $\sigma^2$, converge en loi vers une distribution normale, quelle que soit la forme originelle de la distribution parente.
Soit un échantillon aléatoire $(X_1, X_2, dots, X_n)$ issu d’une population quelconque caractérisée par une moyenne $\mu$ et un écart-type $\sigma$. La moyenne d’échantillon, définie par $\bar{X}_n = \frac{1}{n}\sum_{i=1}^n X_i$, est elle-même une variable aléatoire qui possède une distribution d’échantillonnage propre. À mesure que la taille de l’échantillon $n$ croît vers l’infini, la distribution standardisée de cette moyenne converge asymptotiquement vers la loi normale centrée réduite :
$$Z_n = \frac{\bar{X}_n – \mu}{\frac{\sigma}{\sqrt{n}}} x\rightarrow{\mathcal{L}} \mathcal{N}(0, 1) \quad \text{quand } n to \infty$$
La puissance conceptuelle de ce résultat est vertigineuse : même si la variable d’intérêt au niveau individuel présente une asymétrie marquée (comme les revenus financiers ou les temps de réponse verbaux) ou une distribution discrète (comme le lancer d’un dé), la moyenne de ces observations tend inexorablement vers une morphologie gaussienne dès lors que les données s’agrègent. C’est précisément cette stabilité asymptotique qui explique l’omniprésence de la loi normale dans les phénomènes naturels. Tout trait phénotypique ou comportemental complexe résultant de la conjonction cumulative d’un vaste ensemble de micro-facteurs indépendants verra sa distribution empirique se conformer spontanément à l’architecture de la courbe de Gauss.
3. La distribution t de Student : genèse historique et conceptualisation mathématique
3.1 Histoire statistique : de William Sealy Gosset à Guinness
Malgré l’élégance universelle du théorème central limite, l’application pratique de la théorie gaussienne s’est heurtée à une impasse empirique majeure à l’aube du XXe siècle. Cette limite n’a pas été révélée dans les couloirs feutrés des départements de mathématiques pures, mais au cœur des cuves de fermentation de la célèbre brasserie Guinness à Dublin. En 1899, l’établissement irlandais recruta un brillant chimiste et mathématicien diplômé d’Oxford, William Sealy Gosset. Sa mission consistait à optimiser la qualité constante de la bière en analysant scientifiquement les rendements de l’orge, les teneurs en alcool et les souches de levures utilisées dans le brassage industriel.
Gosset fut confronté à une contrainte expérimentale drastique : la taille dérisoire de ses échantillons. Les expérimentations agronomiques et brassicoles étaient chronophages, coûteuses et destructives, limitant souvent les séries d’observations à des effectifs de trois, cinq ou dix mesures seulement ($n < 10$). Or, les statisticiens de l'époque, influencés par les travaux monumentaux de Francis Galton et Karl Pearson, appliquaient sans vergogne les formules de la loi normale à ces petits échantillons. Gosset constata avec effroi que cette pratique conduisait à des erreurs opérationnelles systématiques : les variations d'un lot à l'autre étaient largement sous-estimées, et les tests de conformité basés sur l'écart réduit normal rejetaient trop souvent des hypothèses correctes ou validaient des productions défectueuses.
La brasserie Guinness interdisait formellement à ses scientifiques de divulguer leurs travaux pour préserver le secret industriel face à la concurrence commerciale. Gosset obtint néanmoins l’autorisation de publier ses découvertes théoriques sous une condition absolue d’anonymat. C’est ainsi qu’en 1908 parut dans la prestigieuse revue Biometrika un article séminal intitulé « The Probable Error of a Mean », signé du modeste pseudonyme « Student ». Gosset venait d’accomplir une révolution épistémologique en démontrant que la distribution d’échantillonnage d’une moyenne standardisée à partir d’une variance d’échantillon ne suit pas la loi de Gauss, mais une distribution plus étalée dépendant intrinsèquement de la taille de l’échantillon : la distribution t de Student.
3.2 Définition formelle et construction stochastique de la loi t
Sur le plan mathématique formel, la distribution t ne constitue pas une simple modification empirique de la loi normale ; elle dérive rigoureusement de l’interaction stochastique entre deux variables aléatoires indépendantes distinctes. Considérons une variable $Z$ qui suit une loi normale centrée réduite standard, soit $Z \sim \mathcal{N}(0, 1)$, et une variable aléatoire $U$ suivant une distribution du Chi-carré à $\nu$ degrés de liberté, notée $U \sim \chi^2(\nu)$. Si ces deux variables sont stochastiquement indépendantes, alors la variable aléatoire composite $T$ définie par le quotient :
$$T = \frac{Z}{\sqrt{\frac{U}{\nu}}}$$
suit par définition une distribution t de Student à $\nu$ degrés de liberté, ce que l’on note $T \sim t(\nu)$. Cette construction mécanique capture précisément la réalité de l’estimation de la moyenne lorsque la variance est inconnue. Le numérateur $Z$ représente la déviation de la moyenne d’échantillon par rapport à la moyenne théorique sous l’hypothèse de la loi normale, tandis que le dénominateur $\sqrt{U/\nu}$ matérialise l’estimation de l’écart-type d’échantillon $s$, divisé par la vraie variance populationnelle $\sigma$, dont l’élévation au carré est distribuée comme une loi du Chi-carré divisée par ses degrés de liberté.
La fonction de densité de probabilité de cette variable aléatoire $T$ est définie sur l’ensemble des nombres réels par l’expression analytique suivante :
$$f(t) = \frac{\Gamma\left(\frac{nu+1}{2}\right)}{\sqrt{\pi \nu} , \Gamma\left(\frac{\nu}{2}\right)} \left(1 + \frac{t^2}{\nu}\right)^{-\frac{nu+1}{2}}$$
Dans cette formulation, $\Gamma$ désigne la fonction Gamma d’Euler, une fonction analytique généralisant la notion de factorielle aux nombres réels et complexes ($\Gamma(n) = (n-1)!$ pour tout entier strictement positif). Contrairement à la fonction gaussienne qui repose sur une décroissance exponentielle quadratique en $\exp(-t^2)$, la densité de Student présente une décroissance polynomiale en $(1 + t^2/\nu)^{-(nu+1)/2}$. Cette différence mathématique structurelle explique pourquoi la courbe de Student décroît beaucoup plus lentement vers zéro que la courbe normale lorsque l’on s’éloigne de l’origine.
4. Morphologie comparée : queues épaisses et kurtosis
4.1 Le concept de kurtosis (aplatissement) en analyse distributionnelle
Pour appréhender la divergence géométrique entre la distribution normale et la distribution de Student, il est indispensable de mobiliser l’un des quatre moments fondamentaux de la statistique théorique : le kurtosis, ou coefficient d’aplatissement. Tandis que le premier moment correspond à l’espérance (position), le deuxième à la variance (dispersion) et le troisième à l’asymétrie (skewness), le quatrième moment centré standardisé évalue la structure des ailes (ou queues) de la distribution et l’acuité de son sommet central par rapport à une loi de référence.
Le coefficient d’aplatissement de Pearson, noté $\beta_2$, est défini pour une variable aléatoire $X$ d’espérance $\mu$ et d’écart-type $\sigma$ par le rapport :
$$\beta_2 = \frac{\mathbb{E}[(X – \mu)^4]}{(\mathbb{E}[(X – \mu)^2])^2} = \frac{\mu_4}{\sigma^4}$$
Pour une distribution normale parfaite, ce coefficient prend invariablement la valeur mathématique stricte de 3. Afin de simplifier les analyses comparatives, les statisticiens emploient quasi unanimement le coefficient de kurtosis en excès (noté $\gamma_2$), défini par $\gamma_2 = \beta_2 – 3$. Ainsi, la loi normale sert de standard neutre avec un kurtosis en excès exactement nul ($\gamma_2 = 0$) ; elle est dite mésokurtique.
Les distributions dont le kurtosis en excès est négatif ($\gamma_2 < 0$) sont qualifiées de platykurtiques : elles présentent un sommet plus plat, des épaules plus larges et des extrémités qui s’éteignent très rapidement, limitant drastiquement la présence de scores aberrants. À l’inverse, les distributions exhibant un kurtosis en excès positif ($\gamma_2 > 0$) sont dites leptokurtiques. C’est précisément au sein de cette catégorie leptokurtique que se classe la distribution t de Student. Pour un nombre de degrés de liberté $\nu > 4$, son kurtosis théorique vaut :
$$\beta_2 = 3 + \frac{6}{\nu – 4} \quad implies \quad \gamma_2 = \frac{6}{\nu – 4} > 0$$
Cette formulation analytique prouve sans équivoque que la distribution t est intrinsèquement leptokurtique, caractérisée par une surconcentration d’observations au centre combinée à un allongement substantiel de la masse probabiliste logée dans ses extrémités latérales.
4.2 Analyse des ‘queues épaisses’ (heavy tails) de la distribution t
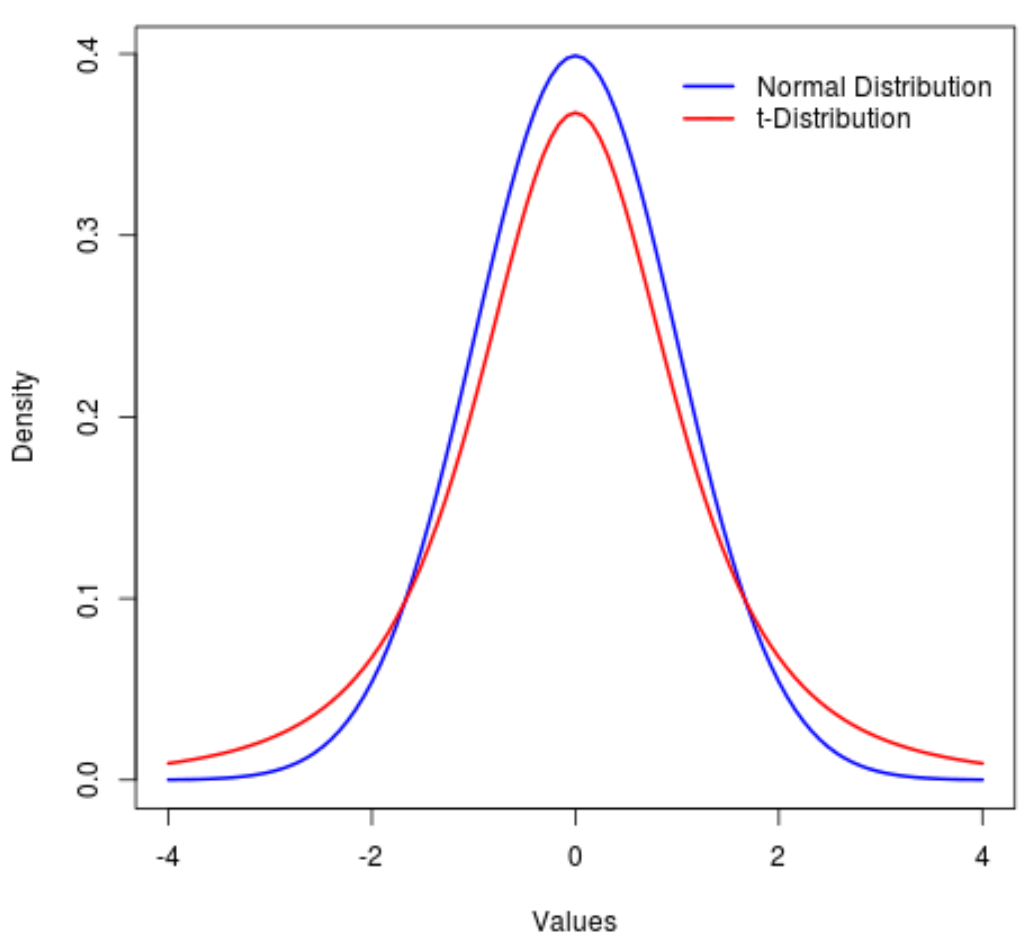
L’expression anglo-saxonne heavy tails, traduite en français par « queues épaisses » ou « queues lourdes », synthétise la divergence comportementale majeure de la loi de Student face au modèle gaussien. Dans une distribution normale, la probabilité d’observer un écart par rapport à la moyenne décroît à une vitesse fulgurante en raison du terme exponentiel négatif $-x^2/2\sigma^2$. Au-delà de trois écarts-types, l’aire résiduelle devient quasi négligeable, et au-delà de cinq écarts-types, l’événement relève de l’impossibilité pratique au sein d’une vie humaine (probabilité d’environ $2,87 \times 10^{-7}$).
Sous la loi t de Student, la décroissance polynomiale modifie radicalement cette dynamique stochastique. L’allure générale de la cloche paraît légèrement affaissée au niveau de son apex central et plus mince au niveau de ses flancs intermédiaires, mais ses ailes s’élèvent nettement au-dessus de celles de la loi normale lorsque l’on explore les valeurs éloignées du centre. Cette géométrie implique une surreprésentation relative massive des événements extrêmes par rapport à ce que prédirait un modèle normal.
Cette propriété reflète avec honnêteté intellectuelle la fragilité inhérente aux petits effectifs. Lorsqu’un chercheur observe un échantillon de 6 participants, l’écart-type d’échantillon $s$ fluctue violemment d’un tirage à l’autre. Il est tout à fait possible que le hasard de l’échantillonnage produise un $s$ anormalement petit par rapport au véritable $\sigma$ de la population. Si cet événement se produit, la statistique calculée $t = (\bar{X} – \mu)/(s/\sqrt{n})$ verra son dénominateur s’effondrer, propulsant le ratio final à une distance considérable du centre. Les queues épaisses de la distribution t n’expriment rien d’autre que cette vulnérabilité : la probabilité d’enregistrer des déviations importantes n’est pas le signe d’une découverte exceptionnelle, mais le simple contrecoup stochastique de l’imprécision de la mesure de dispersion.
4.3 Implications sur les probabilités critiques et les valeurs seuils
La présence de queues épaisses a des répercussions immédiates sur le calcul des valeurs critiques nécessaires au rejet de l’hypothèse nulle ($H_0$) lors d’un test statistique conventionnel. Supposons qu’un chercheur conduise un test bilatéral avec un seuil de signification standard fixé à $\alpha = 0,05$. Sous le règne de la loi normale centrée réduite $Z$, l’aire combinée des deux zones de rejet (soit 2,5 % à chaque extrémité de la distribution) est bornée par des abscisses critiques immuables de $-1,96$ et $+1,96$. Tout résultat excédant en valeur absolue 1,96 autorise formellement à rejeter l’hypothèse nulle au seuil de 5 %.
Si l’on substitue à ce cadre gaussien une distribution t de Student à 4 degrés de liberté (correspondant à un échantillon clinique de $n = 5$ patients), la distribution de masse change de géométrie. Pour isoler une surface équivalente de 2,5 % dans chaque queue, il est impératif de s’éloigner beaucoup plus profondément vers l’infini. La valeur critique bilatérale s’élève alors à $t_{crit} = \pm 2,776$. Si l’échantillon ne compte que 3 participants ($\nu = 2$), le seuil critique s’envole littéralement pour atteindre $t_{crit} = \pm 4,303$.
Le tableau suivant met en lumière la disparité flagrante des seuils critiques bilatéraux requis pour atteindre le niveau conventionnel de significativité $\alpha = 0,05$, en fonction des degrés de liberté :
| Distribution | Degrés de liberté ($\nu$) | Taille d’échantillon ($n$) | Valeur critique bilatérale ($\alpha = 0,05$) | Probabilité d’excéder $|x| ge 1,96$ |
|---|---|---|---|---|
| Distribution t | $\nu = 2$ | $n = 3$ | $\pm 4,303$ | $18,4 %$ |
| Distribution t | $\nu = 5$ | $n = 6$ | $\pm 2,571$ | $10,7 %$ |
| Distribution t | $\nu = 10$ | $n = 11$ | $\pm 2,228$ | $7,9 %$ |
| Distribution t | $\nu = 30$ | $n = 31$ | $\pm 2,042$ | $5,9 %$ |
| Distribution t | $\nu = 100$ | $n = 101$ | $\pm 1,984$ | $5,2 %$ |
| Distribution Normale ($Z$) | $\infty$ | $\infty$ | $\pm 1,960$ | $5,0 %$ |
Ce tableau révèle un enseignement fondamental : pour un échantillon de 3 observations, un score empirique de 2,00 semblerait statistiquement significatif si l’analyste commettait l’erreur de se référer à la loi normale ($p < 0,05$). Or, sous la loi t appropriée, la probabilité exacte d'observer un tel écart sous l'hypothèse nulle est de 18,4 % ! Conclure à l'existence d'un effet dans ces conditions reviendrait à commettre une monumentale erreur de première espèce.
5. Le rôle régulateur des degrés de liberté (df)
5.1 Définition mathématique et signification conceptuelle des degrés de liberté
Le concept de degrés de liberté (couramment abrégé en df pour degrees of freedom ou désigné par la lettre grecque $\nu$) constitue l’un des piliers les plus abstraits mais fondamentaux de l’inférence statistique. Dans son acception géométrique et stochastique, le nombre de degrés de liberté correspond au nombre de pièces d’information indépendantes et non redondantes qui entrent dans le calcul d’une quantité statistique, sous déduction du nombre de paramètres intermédiaires déjà fixés par une estimation préalable.
Pour illustrer ce principe de manière intuitive, considérons un ensemble de $n$ nombres réels $(x_1, x_2, dots, x_n)$. Initialement, cet ensemble possède $n$ degrés de liberté, car chacune des valeurs peut être choisie de manière totalement arbitraire sur l’axe réel. Supposons maintenant que nous imposions à ces nombres une contrainte formelle : leur moyenne arithmétique $\bar{x}$ doit être égale à un nombre fixe, par exemple 20. Dès lors que cette contrainte est posée, les $n$ observations perdent leur liberté totale. Nous pouvons choisir arbitrairement les valeurs des $n-1$ premiers individus, mais la valeur du $n$-ième individu se trouve alors strictement prédéterminée pour satisfaire l’équation :
$$x_n = n \cdot \bar{x} – \sum_{i=1}^{n-1} x_i$$
Lors de l’estimation de l’écart-type d’un échantillon à travers la formule classique $s = \sqrt{\frac{\sum (x_i – \bar{x})^2}{n-1}}$, nous calculons les déviations des scores par rapport à la moyenne d’échantillon $\bar{x}$, et non par rapport à la véritable moyenne populationnelle inconnue $\mu$. Étant donné que la somme de ces déviations centrées est obligatoirement nulle ($\sum (x_i – \bar{x}) \equiv 0$), il n’y a plus que $n-1$ écarts réellement libres de varier. C’est cette perte mécanique d’une unité de liberté qui impose la division par $n-1$ (la célèbre correction de Bessel) et qui détermine le paramètre unique gouvernant la distribution t de Student.
5.2 La famille des distributions t : une infinité de courbes
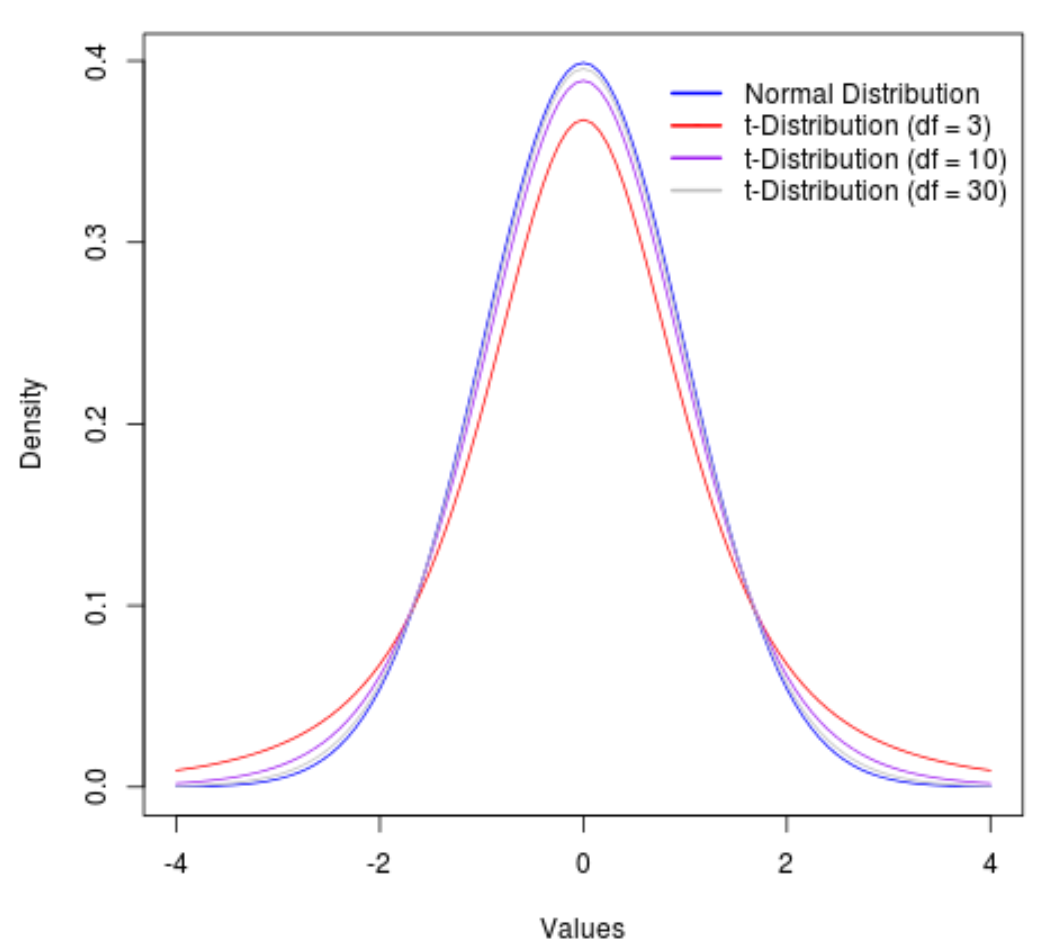
Il est erroné de parler de « la » distribution t au singulier comme s’il s’agissait d’un tracé géométrique unique. Contrairement à la distribution normale centrée réduite qui est figée dans le plan par des constantes universelles, la distribution t de Student représente en réalité une famille paramétrique infinie de courbes distinctes, entièrement régies par le nombre de degrés de liberté $\nu$. À chaque valeur entière positive attribuée à $\nu$ correspond une fonction de densité spécifique, exhibant une signature morphologique singulière.
Dans les cas extrêmes où $\nu = 1$ (ce qui advient lors d’une comparaison sur un échantillon minimal de $n = 2$ observations), la distribution t se métamorphose en une loi mathématique redoutable bien connue des théoriciens : la distribution de Cauchy. Pour cette configuration singulière, les queues de distribution sont à ce point surchargées d’incertitude que l’intégrale définissant l’espérance mathématique diverge vers l’indétermination. La loi t à un degré de liberté ne possède littéralement ni espérance mathématique finie, ni variance définie ! C’est le royaume de l’instabilité stochastique maximale.
Dès que $\nu$ franchit le seuil de 2, l’espérance mathématique se stabilise et devient égale à 0. Pour que la variance théorique existe et prenne une valeur finie, il faut que $\nu > 2$. Dans ce cadre, la variance s’exprime selon le rapport :
$$\text{Var}(T) = \frac{\nu}{\nu – 2} \quad (\text{pour } \nu > 2)$$
Cette relation met en évidence la dynamique interne de la famille t. Pour $\nu = 3$, la variance vaut $3 / (3 – 2) = 3$, soit le triple de la variance d’une loi normale centrée réduite ! À mesure que $\nu$ progresse ($4, 5, 10, 20dots$), le dénominateur rattrape le numérateur, et la variance se rapproche graduellement de 1. L’aplatissement de la courbe s’estompe de manière fluide : le sommet central remonte vers l’ordonnée de la gaussienne tandis que les ailes de la cloche se dégonflent continûment au profit du centre.
5.3 Convergence asymptotique vers la distribution normale
L’un des théorèmes de convergence les plus satisfaisants de l’analyse stochastique stipule que lorsque le nombre de degrés de liberté tend vers l’infini, la distribution t de Student converge ponctuellement et uniformément vers la distribution normale centrée réduite. Mathématiquement, cette propriété s’exprime à travers la limite classique régissant la fonction de densité :
$$\lim_{\nu to \infty} \left(1 + \frac{t^2}{\nu}\right)^{-\frac{nu+1}{2}} = \exp\left(-\frac{t^2}{2}\right)$$
Au regard de cette propriété de convergence asymptotique, la loi normale $\mathcal{N}(0, 1)$ peut être légitimement appréhendée comme un cas limite particulier de la distribution t, correspondant à une situation théorique où l’on disposerait d’un nombre infini de degrés de liberté : $t(\infty) \equiv \mathcal{N}(0, 1)$.
Sur le plan computationnel et pratique, cette équivalence soulève une interrogation constante chez les praticiens : à partir de quel seuil d’échantillon peut-on considérer que la différence entre les deux distributions devient négligeable ? Historiquement, une tradition pédagogique profondément ancrée dans les manuels universitaires du XXe siècle fixait ce pivot au seuil arbitraire de $n = 30$ (soit $\nu = 29$). À ce niveau, la valeur critique bilatérale à $\alpha = 0,05$ vaut $t = 2,045$, une valeur relativement proche de l’idéal gaussien $Z = 1,960$.
Cependant, les exigences de précision computationnelle contemporaines ont profondément remis en cause cette tolérance d’approximation. Si une divergence de quelques centièmes sur la valeur critique pouvait sembler tolérable à l’ère du calcul manuel avec tables papier, elle représente un biais inutile à l’ère algorithmique. La convergence est un processus asymptotique continu : à $\nu = 60$, la valeur critique est encore de $2,000$, et il faut dépasser $\nu = 120$ pour descendre sous la barre des $1,980$. L’équivalence théorique stricte n’existe qu’à l’infini mathématique.
6. Estimation des paramètres : écart-type de la population vs écart-type de l’échantillon
6.1 Le paramètre théorique sigma (écart-type populationnel)
Pour saisir l’origine stochastique qui sépare irrémédiablement le test Z du test t, il convient de disséquer la nature ontologique des paramètres de dispersion. Le paramètre $\sigma$ (lettre grecque minuscule sigma) représente l’écart-type de la population tout entière. Il s’agit d’une quantité mathématique fixe, invariable à un instant donné, qui caractérise la variabilité intrinsèque du phénomène sous observation à travers l’univers exhaustif des éléments qui le constituent.
Par exemple, si l’on s’intéresse à l’ensemble des scores obtenus à un test standardisé d’intelligence par l’intégralité des enfants scolarisés en classe de CM2 en France métropolitaine, $\sigma$ correspond à la dispersion calculée sur l’ensemble exhaustif des centaines de milliers d’élèves concernés. Dans cette situation hypothétique idéale, $\sigma$ n’est sujet à aucune fluctuation d’échantillonnage : c’est une constante déterministe.
Or, les conditions requises pour postuler la connaissance préalable de $\sigma$ sans recourir à l’échantillon présent sont rarissimes dans les sciences empiriques. Elles n’apparaissent que dans deux contextes extrêmement restreints :
- Dans le cadre de tests psychométriques standardisés à l’échelle nationale ou internationale (tels que les échelles de Wechsler, WAIS ou WISC), dont l’étalonnage a été préalablement verrouillé par des protocoles d’étalonnage colossaux sur des échantillons de plusieurs milliers d’individus représentatifs.
- Dans des processus de contrôle qualité industriel lourds, où une machine-outil a produit des millions de composants identiques pendant des décennies, fixant de manière quasi certaine la variabilité d’usinage mécanique de l’outil.
En dehors de ces niches expérimentales, postuler la connaissance de $\sigma$ relève d’une illusion méthodologique dangereuse, particulièrement dans les sciences humaines, biologiques et sociales.
6.2 L’estimateur s (écart-type échantillonnal corrigé)
Face à l’impossibilité d’accéder au $\sigma$ populationnel, le chercheur doit se résoudre à le remplacer par un estimateur calculé à partir de la fraction congrue de données qu’il a pu collecter. Cet estimateur empirique est l’écart-type de l’échantillon, universellement désigné par la lettre latine $s$. Sa formulation mathématique repose sur les écarts quadratiques des observations individuelles $x_i$ par rapport à la moyenne empirique observée $\bar{x}$ :
$$s = \sqrt{\frac{1}{n – 1} \sum_{i=1}^n (x_i – \bar{x})^2}$$
L’introduction du dénominateur $n – 1$ en lieu et place du nombre total d’observations $n$ constitue la célèbre correction de Bessel. Sans cette correction, l’estimateur de la variance $\frac{1}{n}\sum(x_i – \bar{x})^2$ souffre d’un biais systématique négatif : il a tendance à sous-estimer la variance populationnelle, car les données observées sont mathématiquement plus proches de leur propre moyenne $\bar{x}$ qu’elles ne le sont de la véritable moyenne $\mu$. La division par $n-1$ rétablit la stricte exactitude asymptotique, rendant l’estimateur de variance $s^2$ non biaisé ($\mathbb{E}[s^2] = \sigma^2$).
Cependant, même non biaisé au niveau de sa variance, l’estimateur $s$ possède une tare inévitable : c’est une variable aléatoire. Si dix équipes de recherche tirent simultanément au sort dix échantillons distincts de $n = 15$ individus au sein d’une même population, chacune d’elles obtiendra une moyenne différente, mais également un écart-type $s$ différent. Cette instabilité d’échantillonnage de $s$ se propage immédiatement dans le calcul de l’erreur-type de la moyenne (la déviation standard de la distribution d’échantillonnage de la moyenne), estimée par le ratio $SE = s/\sqrt{n}$.
6.3 Pourquoi la substitution de sigma par s impose l’usage de la distribution t
Cette distinction entre constante et variable aléatoire constitue le cœur conceptuel de toute cette problématique. Lorsque $\sigma$ est connu avec une certitude absolue, la standardisation d’une moyenne observée $\bar{X}$ se formalise par la formule du score Z :
$$Z = \frac{\bar{X} – \mu}{\frac{\sigma}{\sqrt{n}}}$$
Dans ce quotient, le seul élément soumis aux aléas du hasard d’échantillonnage est le numérateur $\bar{X}$. Le dénominateur $sigma/\sqrt{n}$ est une constante d’échelle totalement déterministe. Dès lors que la variable originelle $X$ est normalement distribuée, la division d’une variable gaussienne par une constante scalaire produit rigoureusement une autre variable gaussienne. La statistique $Z$ suit donc sans déviation la loi normale centrée réduite $\mathcal{N}(0, 1)$.
En revanche, dès l’instant où le chercheur substitue l’estimateur $s$ à la constante $\sigma$, l’architecture probabiliste s’effondre. La statistique résultante, baptisée $t$, se structure de la façon suivante :
$$t = \frac{\bar{X} – \mu}{\frac{s}{\sqrt{n}}}$$
Désormais, le ratio met aux prises deux variables aléatoires indépendantes :
- Le numérateur $(\bar{X} – \mu)$, qui fluctue selon une dynamique gaussienne normale centrée sur zéro.
- Le dénominateur $(s / \sqrt{n})$, qui fluctue selon la racine carrée d’une distribution du Chi-carré divisée par ses degrés de liberté.
Le ratio de deux variables aléatoires ne peut pas suivre la même distribution qu’un simple ratio impliquant une constante au dénominateur ! Lorsque $s$ fluctue et prend par malchance une valeur exceptionnellement basse, la valeur de $t$ est mécaniquement catapultée vers des sommets démesurés. Ce phénomène d’amplification stochastique au dénominateur génère le surplus de variabilité aux extrémités de la distribution. Utiliser la loi normale pour évaluer la statistique $t$ revient à fermer les yeux sur la volatilité de $s$. L’emploi de la loi t de Student compense très précisément cette double variabilité en ajustant les probabilités critiques en fonction exacte de la fiabilité de $s$, fiabilité directement indexée sur les degrés de liberté disponibles.
7. Inférence statistique et tests d’hypothèses : le test Z versus le test t
7.1 Structure et hypothèses fondamentales du test Z
Le test Z (ou test de l’écart réduit normal) représente le cadre inférentiel paramétrique le plus pur, mais également le plus restrictif de l’analyse bivariée. Ce test a pour vocation d’évaluer la probabilité qu’un échantillon appartienne à une population définie par une moyenne théorique $\mu_0$, sous la condition impérative que la dispersion générale $\sigma$ soit indiscutablement connue. La statistique calculée obéit à la formulation linéaire :
$$Z_{obs} = \frac{\bar{X} – \mu_0}{\frac{\sigma}{\sqrt{n}}}$$
L’exécution légitime d’un test Z repose sur un ensemble strict d’hypothèses opérationnelles :
- Hypothèse d’indépendance : Les observations collectées doivent être rigoureusement indépendantes les unes des autres (échantillonnage aléatoire simple sans remise au sein d’une population quasi infinie).
- Hypothèse de métricité : La variable étudiée doit être continue et mesurée sur une échelle d’intervalle ou de rapport.
- Hypothèse de dispersion : L’écart-type populationnel $\sigma$ doit être connu avec une certitude absolue a priori.
- Hypothèse distributionnelle : Les données sous-jacentes doivent être normalement distribuées au niveau de la population, OU la taille de l’échantillon $n$ doit être suffisamment massive pour que le théorème central limite garantisse l’écrasement de toute anomalie distributionnelle de départ.
La violation de l’hypothèse de connaissance de $\sigma$ rend le test Z invalide sur de petits échantillons. Si l’on applique le test Z en injectant $s$ à la place de $\sigma$ sans ajuster la loi de référence, la statistique n’obéit plus à la distribution standard. Le test perd son calibrage d’origine, devenant excessivement libéral : il affichera des valeurs $p$ trompeusement petites, incitant le chercheur à proclamer des effets imaginaires.
7.2 Typologie et exécution des tests t de Student
Pour répondre à la pluralité des designs expérimentaux rencontrés dans la pratique de la recherche, la statistique moderne décline le test t de Student en trois protocoles distincts, chacun ajustant le calcul de la statistique et de ses degrés de liberté aux contraintes de la collecte de données :
1. Test t pour échantillon unique (One-Sample t-test) :
Ce design vise à comparer la moyenne empirique $\bar{X}$ d’un groupe unique à une valeur de référence théorique fixée à l’avance $\mu_0$ (par exemple, tester si le QI moyen d’un groupe d’enfants porteurs d’une anomalie génétique diffère de la norme populationnelle séculaire fixée à 100). La statistique se calcule via $t = (\bar{X} – \mu_0)/(s/\sqrt{n})$, et les degrés de liberté sont strictement configurés à $\nu = n – 1$.
2. Test t pour échantillons indépendants (Two-Sample t-test) :
Ce protocole intervient lors de la comparaison de deux groupes mutuellement exclusifs formés d’individus différents (par exemple, un groupe témoin recevant un placebo versus un groupe expérimental recevant un principe actif). Sous l’hypothèse classique d’égalité des variances (homoscédasticité), on procède au calcul d’une variance combinée mutualisée (pooled variance, $s_p^2$) :
$$s_p^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
La statistique $t$ s’exprime alors selon le ratio de la différence des moyennes sur l’erreur-type combinée :
$$t = \frac{\bar{X}_1 – \bar{X}_2}{\sqrt{s_p^2 \left(\frac{1}{n_1} + \frac{1}{n_2}\right)}}$$
Dans cette configuration, les degrés de liberté totaux s’élèvent à $\nu = (n_1 – 1) + (n_2 – 1) = n_1 + n_2 – 2$, reflétant l’estimation indépendante de deux moyennes distinctes.
3. Test t pour échantillons appariés (Paired Samples t-test) :
Ce test intervient dans le cadre des plans d’expérimentation intra-sujets, où chaque participant est évalué à deux reprises distinctes (par exemple, mesure de l’anxiété avant et après un stage de méditation pleine conscience). Le calcul ne s’effectue pas sur les scores bruts, mais sur la série univariée des différences intra-individuelles $D_i = X_{i,\text{post}} – X_{i,\text{pré}}$. Le test se résout mathématiquement comme un test pour échantillon unique appliqué sur ces différences :
$$t = \frac{\bar{D} – 0}{\frac{s_D}{\sqrt{N_{\text{paires}}}}}$$
Les degrés de liberté sont ici de $\nu = N_{\text{paires}} – 1$, offrant une puissance statistique très supérieure grâce à l’élimination de la variabilité interindividuelle initiale.
7.3 Comparaison de la puissance statistique des deux approches
La puissance statistique d’un test probabiliste, formellement quantifiée par la valeur $1 – \beta$ (où $\beta$ représente le risque d’erreur de seconde espèce), mesure la capacité d’un test à détecter et rejeter une hypothèse nulle lorsqu’il existe bel et bien un effet réel d’une amplitude donnée dans la population cible. Face à des données strictement gaussiennes, la comparaison entre un test Z théorique (postulant $\sigma$ connu) et un test t (estimant $\sigma$ par $s$) révèle une disparité systématique d’efficacité.
Le test Z bénéficie d’une information parfaite sur la dispersion globale. Ses seuils critiques sont donc fixes et optimaux ($Z_{crit} = 1,96$ pour un test bilatéral à 5 %). Le test t de Student, contraint d’intégrer l’incertitude sur $s$, doit ériger des barrières critiques plus sévères ($t_{crit} = 2,57$ pour $n = 6$). En conséquence, pour une même taille d’effet brute observée, il est mathématiquement plus ardu pour la statistique $t$ de franchir le seuil d’exclusion. Le test t est délibérément plus conservateur que le test Z.
Cette pénalisation conservatrice réduit légèrement la puissance statistique du test t par rapport à un test Z hypothétique sur de petits effectifs. Pour un échantillon de taille $n = 10$, cette déperdition de puissance est de l’ordre de 5 à 10 %. Toutefois, cette modération est le prix à payer pour garantir l’intégrité du taux d’erreur de type I. Dès lors que la taille de l’échantillon s’élève pour franchir le cap de plusieurs dizaines d’individus ($n > 50$), la variance de l’estimateur $s$ s’effondre vers zéro. Dès lors, la puissance statistique du test t converge de manière quasi indistinguable vers celle du test Z.
8. Construction des intervalles de confiance : z-score vs t-score
8.1 Formulation mathématique de l’intervalle de confiance pour une moyenne
L’estimation ponctuelle d’une moyenne $\bar{X}$ ne fournit qu’une indication fragile de la localisation du véritable paramètre populationnel $\mu$. Pour intégrer formellement l’incertitude inhérente au processus d’échantillonnage, la méthodologie inférentielle recourt aux intervalles de confiance. Un intervalle de confiance à un niveau de confiance fixé $1 – \alpha$ (conventionnellement 95 %, où $\alpha = 0,05$) définit une plage stochastique de valeurs qui, sous l’hypothèse de répétitions infinies du protocole de mesure, couvrira la vraie moyenne $\mu$ dans une proportion exacte de $100(1 – \alpha)%$ des réplications.
Sur le plan structurel, tout intervalle de confiance univarié pour une moyenne obéit à la même syntaxe mathématique fondamentale :
$$\text{Intervalle} = \left[ \text{Estimation ponctuelle} \pm \text{Marge d’erreur} \right]$$
La marge d’erreur se décompose toujours comme le produit d’une valeur critique normative, issue de la distribution théorique choisie, et de l’erreur-type caractérisant la variabilité de la moyenne :
$$\text{Marge d’erreur} = \text{Valeur critique} \times \text{Erreur-type}$$
La bifurcation conceptuelle entre l’approche gaussienne et l’approche de Student s’incarne directement dans les deux équations concurrentes ci-dessous :
- Formule basée sur le score Z ($\sigma$ postulé connu) :
$$\text{IC}_{1-\alpha} = \left[ \bar{X} – Z_{1 – \frac{\alpha}{2}} \cdot \frac{\sigma}{\sqrt{n}} ; ; ; \bar{X} + Z_{1 – \frac{\alpha}{2}} \cdot \frac{\sigma}{\sqrt{n}} \right]$$
- Formule basée sur le score t ($\sigma$ estimé par $s$) :
$$\text{IC}_{1-\alpha} = \left[ \bar{X} – t_{1 – \frac{\alpha}{2}, , \nu} \cdot \frac{s}{\sqrt{n}} ; ; ; \bar{X} + t_{1 – \frac{\alpha}{2}, , \nu} \cdot \frac{s}{\sqrt{n}} \right]$$
Il est impératif de rappeler l’interprétation probabiliste rigoureuse de cet intervalle. Il est conceptuellement erroné d’affirmer qu’« il y a 95 % de chances que la vraie moyenne $\mu$ se trouve dans l’intervalle calculé ». Dans le paradigme fréquentiste orthodoxe, $\mu$ est un paramètre fixe et immuable ; il ne possède aucune distribution de probabilité propre. C’est l’intervalle lui-même qui est une entité aléatoire, variant à chaque nouvel échantillon. La proposition correcte est donc la suivante : « 95 % des intervalles ainsi construits contiendront la valeur fixe $\mu$ ».
8.2 Comparaison empirique de la largeur des intervalles
La disparité entre les multiplicateurs critiques $Z_{1-alpha/2}$ et $t_{1-alpha/2, , \nu}$ module directement l’étendue géométrique de l’intervalle de confiance. Sous le modèle normal, la valeur critique bilatérale à 95 % demeure rigoureusement invariante, fixée à $Z = 1,960$, que l’étude porte sur 4 participants ou sur 4 000 participants. La largeur de l’intervalle ne se resserre alors qu’en fonction directe de la diminution mécanique de l’erreur-type induite par le facteur $\sqrt{n}$ au dénominateur.
En revanche, sous la loi de Student, la marge d’erreur bénéficie d’un double ajustement. Pour les petits échantillons, la valeur de $t$ enfle massivement pour compenser la faiblesse informationnelle de $s$. Prenons l’exemple concret d’un échantillon expérimental de $n = 5$ observations ($\nu = 4$), affichant un écart-type empirique de $s = 10$. L’erreur-type vaut donc $SE = 10 / \sqrt{5} \approx 4,47$.
- Si l’on commettait la faute d’appliquer l’intervalle Z en injectant indûment $s$ :
$$\text{Marge d’erreur}_Z = 1,960 \times 4,47 \approx \pm 8,76$$
- En appliquant rigoureusement le modèle t approprié ($t_{0,975; , 4} = 2,776$) :
$$\text{Marge d’erreur}_t = 2,776 \times 4,47 \approx \pm 12,41$$
L’intervalle de Student légitime est ici plus large de 41,6 % que l’intervalle normal erroné ! Cet élargissement substantiel n’est pas un défaut de précision du modèle ; il s’agit d’un mécanisme de correction fondamental traduisant l’extrême incertitude qui pèse sur l’estimation de la variance avec seulement 4 degrés de liberté.
8.3 Conséquences pratiques pour la précision de la recherche
L’usage intempestif ou obsolète de la distribution normale pour construire des intervalles de confiance engendre un phénomène pernicieux : la surconfiance méthodologique. En affichant des bornes trop resserrées, les chercheurs trompent involontairement la communauté scientifique quant à la stabilité réelle de leurs découvertes. Dans des domaines critiques comme la pharmacologie clinique, la neurochirurgie ou l’évaluation psychométrique de risques médico-légaux, une telle sous-estimation des bornes de l’intervalle peut conduire à des décisions préjudiciables.
Par exemple, lors de l’évaluation d’un traitement neuroprotecteur expérimental sur une cohorte préliminaire de 8 patients victimes d’un accident vasculaire cérébral, un intervalle gaussien artificiel peut exclure la valeur zéro et suggérer que le gain moteur moyen est strictement positif. En revanche, l’intervalle de Student correctement configuré, intégrant la valeur critique $t_{7} = 2,365$, couvrira vraisemblablement la valeur zéro, alertant avec prudence les cliniciens sur le fait que le bénéfice observé pourrait parfaitement n’être qu’un pur caprice d’échantillonnage.
De surcroît, le calcul rigoureux des intervalles de confiance autour des tailles d’effet standardisées repose lui-même sur des structures mathématiques apparentées issues des distributions t non-centrales. Ignorer la spécificité des lois de Student perturbe l’ensemble des méta-analyses contemporaines, qui synthétisent les résultats d’une multitude de petits essais en pondérant chaque étude par l’inverse de sa variance d’estimation.
9. Applications spécifiques dans la recherche psychologique et comportementale
9.1 La réalité méthodologique des petits échantillons en psychologie
Les sciences psychologiques et cognitives constituent un terrain d’observation privilégié pour illustrer la nécessité vitale de la distribution t. Si certaines recherches en psychologie sociale ou en psychométrie peuvent mobiliser des protocoles d’enquêtes en ligne regroupant des milliers de répondants, de vastes pans de la discipline sont condamnés par leur nature même à opérer sous la contrainte sévère de petits effectifs d’échantillonnage.
En neuropsychologie clinique, les chercheurs explorent fréquemment des pathologies rarissimes, comme des amnésies pures consécutives à des lésions focales spécifiques du complexe hippocampique ou des agnosies visuelles consécutives à des nécroses localisées du cortex occipito-temporal. Trouver plus de cinq ou six patients présentant une lésion homogène et acceptant de se soumettre à des batteries de tests intensives relève souvent de l’exploit logistique international. Le statisticien doit alors inférer des profils cognitifs généraux à partir d’échantillons de taille $n in [3, 8]$.
Une contrainte similaire prévaut dans le domaine des neurosciences cognitives utilisant l’imagerie par résonance magnétique fonctionnelle (IRMf). Le coût prohibitif d’utilisation des scanners (plusieurs centaines d’euros de l’heure) et la lourdeur des protocoles de prétraitement ont longtemps confiné la taille des cohortes expérimentales entre 12 et 20 participants par étude. À chaque voxel cérébral (parmi des dizaines de milliers), la moyenne d’activation est testée à l’aide d’un test t univarié. Dans cet environnement méthodologique, prétendre appliquer la loi normale sans ajustement de Student serait synonyme d’une explosion de faux positifs, menant à cartographier des aires cérébrales « actives » qui ne correspondraient qu’à du bruit de fond hémodynamique aléatoire.
9.2 Évaluation de la taille d’effet : le d de Cohen et sa distribution
La simple déclaration d’une significativité statistique ($p < 0,05$) est désormais unanimement reconnue comme insuffisante par les standards méthodologiques internationaux de l'APA (American Psychological Association). Les chercheurs sont tenus de rapporter des indices standardisés de magnitude des effets, au premier rang desquels figure le d de Cohen. Cet indice quantifie l’écart entre deux moyennes en unités d’écart-type :
$$d = \frac{\bar{X}_1 – \bar{X}_2}{s_p}$$
Il existe un lien structurel direct entre la statistique de test $t$ calculée sur des groupes de tailles $n_1$ et $n_2$ et l’indice $d$ de Cohen d’échantillon :
$$t = d \cdot \sqrt{\frac{n_1 n_2}{n_1 + n_2}} \quad iff \quad d = t \cdot \sqrt{\frac{n_1 + n_2}{n_1 n_2}}$$
Lorsque deux groupes présentent des effectifs parfaitement équilibrés ($n_1 = n_2 = n$), cette équation se simplifie remarquablement en $t = d \cdot \sqrt{n/2}$. Cette relation démontre que la métrique $t$ et la taille d’effet empirique $d$ sont les deux faces d’une même médaille mathématique, liées par un facteur d’échelle gouverné par la racine carrée de la taille de l’échantillon.
Pour construire un intervalle de confiance rigoureux autour d’un $d$ de Cohen empirique ou pour concevoir un calcul de puissance statistique a priori (déterminer la taille d’échantillon nécessaire pour capturer un effet attendu), le recours à la simple loi normale est voué à l’échec. La distribution d’échantillonnage de $d$ ne suit pas une loi gaussienne, mais une distribution t non-centrale (notée $t(\nu, \delta)$), dont le paramètre de non-centralité $\delta$ matérialise l’ampleur du vrai effet latent :
$$\delta = \frac{\mu_1 – \mu_2}{\sigma} \sqrt{\frac{n_1 n_2}{n_1 + n_2}}$$
La distribution t non-centrale brise la symétrie classique de la courbe de Student, exhibant une inclinaison d’autant plus marquée que l’effet est volumineux. Maîtriser cette distribution avancée est indispensable pour planifier des études psychologiques réplicables et éviter le piège des échantillons sous-dimensionnés.
9.3 Études de cas réelles en psychologie cognitive et sociale
Pour ancrer ces développements théoriques dans la réalité concrète de la recherche expérimentale, examinons deux études de cas simplifiées mais représentatives des protocoles quantitatifs en sciences cognitives.
Cas 1 : Évaluation d’une psychothérapie innovante sur le syndrome de stress post-traumatique (SSPT)
Une équipe clinique teste un nouveau protocole d’intégration neuro-émotionnelle auprès de $n = 9$ patients diagnostiqués avec un SSPT sévère. Après huit semaines de prise en charge, la réduction du score sur l’échelle PCL-5 (Posttraumatic Stress Disorder Checklist) affiche une moyenne empirique d’amélioration de $\bar{X} = 14,2$ points, avec un écart-type d’échantillon de $s = 18,0$. L’hypothèse nulle stipule une absence totale de gain moyen thérapeutique ($\mu_0 = 0$).
- Erreur-type : $SE = 18,0 / \sqrt{9} = 18,0 / 3 = 6,0$.
- Statistique calculée : $t_{obs} = (14,2 – 0) / 6,0 = 2,367$.
- Analyse erronée sous la loi normale $Z$ : Le seuil critique bilatéral est $1,96$. Puisque $2,367 > 1,96$, la valeur $p$ associée vaut $p = 0,0179$. Le praticien proclame avec enthousiasme l’efficacité hautement significative de la thérapie au seuil conventionnel de 5 %.
- Analyse correcte sous la loi $t$ de Student ($\nu = 9 – 1 = 8$) : La valeur critique bilatérale au seuil $\alpha = 0,05$ pour $\nu = 8$ s’élève en réalité à $t_{crit} = 2,306$. La valeur $p$ exacte calculée sur la distribution $t(8)$ est $p = 0,0455$.
Bien que le résultat demeure de justesse statistiquement significatif au seuil nominal, l’analyse rigoureuse démontre que la valeur de probabilité a été multipliée par un facteur de 2,5 par rapport à l’illusion normale ! Si l’écart-type avait été ne serait-ce que très légèrement plus volatil ($s = 19,0$, induisant $t = 2,24$), la loi normale aurait faussement validé le protocole ($p = 0,025$), alors que la loi de Student aurait justement conclu à une absence de significativité statistique ($p = 0,055$).
Cas 2 : Mesure des temps de réaction sous privation de sommeil
Un laboratoire de chronobiologie évalue la vitesse de traitement perceptif de 10 opérateurs de tour de contrôle soumis à une garde continue de 24 heures. La variation de leur temps de réaction moyen par rapport à leur ligne de base reposée est mesurée en millisecondes. L’analyse révèle un ralentissement moyen de $\bar{D} = 45\text{ ms}$, avec un écart-type de la différence de $s_D = 65\text{ ms}$.
- Statistique : $t = (45 – 0) / (65 / \sqrt{10}) = 45 / 20,55 = 2,189$.
- Degrés de liberté : $\nu = 10 – 1 = 9$.
- La valeur critique bilatérale normale est $Z_{0,05} = 1,960$ ($p = 0,0286$).
- La valeur critique de Student à $\nu = 9$ est $t_{0,05} = 2,262$ ($p = 0,0563$).
Ici, la divergence est sans appel : un chercheur appliquant la loi normale conclurait à un effet statistiquement significatif de la privation de sommeil sur le temps de réaction ($p 0,05$). La loi normale aurait engendré une pure erreur d’inférence de type I, imputable exclusivement au refus de prendre en compte la dispersion aléatoire de l’échantillon.
10. Robustesse, violations des postulats et erreurs courantes
10.1 L’illusion de la règle ‘n supérieur ou égal à 30’
L’une des croyances les plus tenaces et dommageables de l’enseignement des statistiques appliquées est le dogme selon lequel « dès que la taille d’échantillon $n$ atteint ou dépasse 30, la distribution normale peut être employée sans réserve à la place de la distribution t ». Cette prétendue « règle des 30 » est un vestige archaïque datant de l’ère antérieure à l’informatique moderne, époque où l’impression typographique des tables de probabilités imposait d’économiser l’espace d’impression dans les annexes des manuels en arrêtant arbitrairement la table t à $\nu = 30$.
D’un point de vue purement mathématique, cette assertion est fausse pour deux raisons distinctes :
- La convergence de la statistique $t$ vers la variable $Z$ est un processus asymptotique continu. Il n’existe aucune discontinuité qualitative ou magique qui s’opère lorsque $n$ bascule de 29 à 30. Pour $\nu = 29$, la valeur critique est de $2,045$, ce qui représente toujours une erreur relative de plus de 4 % par rapport à $1,960$.
- Plus important encore, le théorème central limite (qui sert d’argument justificateur pour cette règle) garantit uniquement la normalité asymptotique de la distribution d’échantillonnage de la moyenne. Il ne confère aucune certitude quant à la convergence instantanée de l’écart-type d’échantillon $s$ vers la vraie valeur $\sigma$. Même avec $n = 30$, le dénominateur de la statistique demeure une variable aléatoire instable.
La recommandation des méthodologues contemporains est univoque : à l’ère où les progiciels statistiques (R, Python, SPSS, Jamovi, JASP) calculent instantanément et sans coût computationnel la valeur exacte des intégrales de la distribution t pour tout degré de liberté réel, il n’existe absolument aucun motif légitime pour commuter vers la loi normale lors d’un test portant sur une moyenne d’échantillon dont la variance est estimée. La loi de Student doit être appliquée systématiquement, que $n$ vaille 8, 30, 300 ou 30 000. Si $n$ est gigantesque, la distribution t fournira spontanément les mêmes décimales que la loi normale, sans jamais exposer le chercheur à une erreur de modélisation prématurée.
10.2 Sensibilité à l’asymétrie et à l’hétéroscédasticité
Le test t de Student repose formellement sur l’hypothèse que la population d’origine dont sont tirées les données suit une loi normale. Bien que le test soit réputé doté d’une remarquable robustesse face aux déviations modérées de cette hypothèse (particulièrement lorsque les échantillons sont parfaitement équilibrés et de taille modérée), cette tolérance s’effondre en présence d’asymétries structurelles profondes.
Lorsque la population d’origine est fortement asymétrique (skewed), la distribution d’échantillonnage de la moyenne hérite d’une asymétrie résiduelle sur de petits échantillons. Dans ce scénario, la statistique $t$ n’obéit plus fidèlement à la symétrie de la loi de Student. Les taux réels de fausses alertes ne correspondent plus au seuil $\alpha$ paramétré, particulièrement lors de l’exécution de tests unilatéraux où l’une des queues peut voir sa probabilité d’erreur doubler pendant que l’autre est divisée par deux.
Une menace encore plus dévastatrice concerne l’égalité des variances entre deux groupes comparés, postulat désigné sous le terme d’homoscédasticité. Lorsque le chercheur compare deux populations dont les variances réelles sont inégales ($\sigma_1^2 \neq \sigma_2^2$), le test t de Student classique pour échantillons indépendants devient profondément invalide, particulièrement si les tailles des deux groupes sont asymétriques ($n_1 \neq n_2$). Si le groupe le plus restreint présente la variance la plus volatile, le test t standard s’avère massivement libéral, déclarant hautement significatives des différences entièrement factices.
Face à cette vulnérabilité, la méthodologie moderne impose de délaisser le test t de Student originel au profit de l’alternative de Welch-Satterthwaite (ou test t de Welch). Ce test ne présuppose nullement l’homogénéité des variances. Il calcule l’erreur-type sans mutualisation et applique une pénalisation rigoureuse sur les degrés de liberté effectifs via l’équation :
$$\nu_{\text{Welch}} = \frac{\left( \frac{s_1^2}{n_1} + \frac{s_2^2}{n_2} \right)^2}{\frac{\left( \frac{s_1^2}{n_1} \right)^2}{n_1 – 1} + \frac{\left( \frac{s_2^2}{n_2} \right)^2}{n_2 – 1}}$$
Cette correction abaisse automatiquement le nombre de degrés de liberté (qui peuvent devenir non entiers), élargissant en conséquence la distribution théorique de référence pour refléter fidèlement l’incertitude liée à l’hétéroscédasticité des données.
10.3 Détection et gestion des observations aberrantes (outliers)
L’estimation de l’écart-type d’échantillon $s$ est notoirement sensible à la présence de valeurs extrêmes ou déviantes, couramment dénommées outliers. Cette vulnérabilité découle directement de l’élévation au carré des écarts à la moyenne dans le calcul de la somme des carrés $\sum(x_i – \bar{x})^2$. Une unique observation aberrante (résultant d’une erreur de frappe lors de l’encodage des données, d’une panne transitoire d’un capteur biomédical ou de l’inattention manifeste d’un participant) suffit à dilater démesurément la valeur calculée de $s$.
Cette inflation artificielle de $s$ produit un impact délétère immédiat sur la statistique $t$ : l’erreur-type au dénominateur augmente brutalement, ce qui écrase la valeur finale de $t$ vers zéro. Le test devient alors incapable de rejeter l’hypothèse nulle, commettant une grave erreur de type II. L’observation aberrante agit comme un écran de fumée statistique masquant un effet réel sous une variabilité factice.
Pour prévenir ces écueils distributionnels, la boîte à outils méthodologique offre plusieurs procédures diagnostiques indispensables :
- Le diagramme quantile-quantile (Q-Q plot) : Cet outil d’exploration graphique trace les quantiles observés des résidus de l’échantillon en ordonnée en regard des quantiles théoriques d’une loi normale idéale en abscisse. Si les données respectent les attendus de la loi normale, les points s’alignent le long de la bissectrice diagonale. Toute incurvation en forme de « S » ou déviation franche des extrémités trahit instantanément la présence de queues épaisses ou d’une forte asymétrie.
- Les tests de normalité formels : Les algorithmes inférentiels comme le test de Shapiro-Wilk ou le test d’Anderson-Darling évaluent l’hypothèse nulle selon laquelle l’échantillon provient d’une population parente normale. Le test de Shapiro-Wilk se révèle particulièrement performant sur les petits effectifs ($n < 50$), fournissant une alerte quantitative sur la non-conformité distributionnelle des données brutes.
11. Guide décisionnel méthodologique : quelle distribution appliquer ?
11.1 Arbre de décision pour le praticien et le chercheur
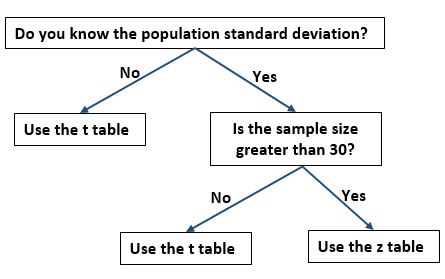
Face à la diversité des contraintes empiriques, le choix entre la distribution normale standard, la distribution t de Student et les alternatives non paramétriques peut être systématisé à travers un protocole décisionnel séquentiel en trois étapes fondamentales :
Étape 1 : Statut épistémologique de l’écart-type populationnel ($\sigma$)
Le chercheur doit se poser la question cardinale : l’écart-type exact de la population $\sigma$ est-il rigoureusement connu a priori (issu d’une norme populationnelle exhaustive ou d’un standard industriel invariable) ?
- OUI : Le test Z et la distribution normale peuvent être appliqués en toute légitimité, sous réserve que la normalité des données soit vérifiée ou que $n$ soit massif ($n ge 30$).
- NON : Le paramètre de dispersion doit être estimé à partir des données via $s$. L’application de la distribution normale est formellement proscrite. On s’oriente impérativement vers la famille des distributions t de Student. Passer à l’étape 2.
Étape 2 : Évaluation distributionnelle et morphologie des données
L’analyste inspecte la forme des données à travers l’inspection des diagrammes Q-Q et l’application d’un test de Shapiro-Wilk :
- Les données se conforment raisonnablement au modèle gaussien (ou $n$ est suffisant) : Passer à l’étape 3 pour vérifier l’homoscédasticité.
- Les données présentent une asymétrie violente, un kurtosis excessif ou des outliers indéracinables sur un échantillon restreint ($n < 20$) : Abandonner la modélisation paramétrique classique. Privilégier un test non paramétrique de rang (test de Wilcoxon-Mann-Whitney ou test des rangs signés de Wilcoxon) ou une approche par rééchantillonnage bootstrap.
Étape 3 : Diagnostic de l’homogénéité des variances (cas à deux groupes)
Si l’analyse compare deux groupes indépendants, appliquer un test de Levene ou de Brown-Forsythe :
- Les variances sont homogènes ($p > 0,05$) : Exécuter le test t de Student classique avec variance mutualisée ($s_p$) et $\nu = n_1 + n_2 – 2$ degrés de liberté.
- Les variances sont significativement hétérogènes ($p < 0,05$) : Exécuter systématiquement le test t de Welch avec ajustement de Satterthwaite pour les degrés de liberté. De nombreux méthodologues recommandent d’ailleurs d’utiliser le test de Welch par défaut sans même tester l’égalité des variances.
11.2 Tableau synoptique comparatif des deux lois
Pour condenser l’ensemble des dimensions morphologiques, mathématiques et opérationnelles abordées au fil de cet article, le tableau synoptique ci-dessous offre une synthèse comparative structurée des deux lois de probabilité :
| Critère de comparaison | Distribution Normale (Gaussienne $\mathcal{N}$) | Distribution t de Student ($t$) |
|---|---|---|
| Paramètres générateurs | Deux paramètres continus : moyenne/position ($\mu$) et écart-type/échelle ($\sigma$). | Un paramètre unique discret : les degrés de liberté ($\nu$ ou $df$). |
| Origine de la variance | Variance populationnelle $\sigma^2$ postulée rigoureusement connue et invariable. | Variance populationnelle inconnue, estimée via la variance échantillonnale corrigée $s^2$. |
| Morphologie des queues | Décroissance exponentielle quadratique rapide (queues légères, quasi nulles au-delà de $\pm 3\sigma$). | Décroissance polynomiale lente (queues lourdes, heavy tails, surreprésentation des valeurs extrêmes). |
| Kurtosis (Aplatissement) | Mésokurtique : kurtosis de Pearson $\beta_2 = 3$, kurtosis en excès $\gamma_2 \equiv 0$. | Leptokurtique : $\beta_2 = 3 + \frac{6}{\nu – 4}$ (pour $\nu > 4$), kurtosis en excès strictement positif. |
| Comportement asymptotique | Forme distributionnelle finale immuable, limite absolue garantie par le TCL. | Converge uniformément vers la distribution normale standard lorsque $\nu to \infty$. |
| Seuils critiques bilatéraux ($\alpha = 0,05$) | Invariants et constants : toujours $\pm 1,960$ quel que soit l’effectif. | Dynamiques et élargis : par exemple $\pm 4,303$ ($nu=2$), $\pm 2,228$ ($nu=10$), $\pm 2,042$ ($nu=30$). |
| Champs d’application privilégiés | Échantillons massifs de population, tests psychométriques standardisés avec étalonnage national. | Recherche clinique, imagerie fonctionnelle cérébrale, études expérimentales de laboratoire. |
| Sensibilité aux violations | Inapplicable sur les petits échantillons si $\sigma$ est estimé par $s$ (taux de faux positifs incontrôlé). | Robuste à la quasi-normalité, sensible à l’hétéroscédasticité (nécessite la correction de Welch). |
12. Perspectives avancées : au-delà des distributions paramétriques classiques
12.1 Les méthodes de rééchantillonnage comme alternatives non-paramétriques
Bien que la distribution t de Student résolve avec brio le problème de l’estimation de l’écart-type, elle demeure tributaire d’un postulat théorique contraignant : la normalité de la distribution parente sous-jacente. Lorsque cette hypothèse est brutalement violée et que la taille de l’échantillon ne permet pas d’invoquer sereinement le théorème central limite, l’analyse inférentielle moderne se tourne vers les méthodes de rééchantillonnage par calcul intensif, au sommet desquelles trône le bootstrap, conceptualisé par Bradley Efron en 1979.
Le principe du bootstrap computationnel repose sur une élégance conceptuelle désarmante : l’échantillon empirique observé est traité comme s’il était la meilleure représentation possible de la population globale elle-même. Dès lors, le chercheur génère de façon algorithmique des milliers de « pseudo-échantillons » virtuels (typiquement $B = 5,000$ ou $10,000$) de même taille $n$ en procédant à des tirages aléatoires avec remise au sein des données initiales. Pour chacun de ces pseudo-échantillons, la statistique d’intérêt (la moyenne, la médiane, un ratio de variances) est recalculée.
L’histogramme de ces milliers d’estimations engendre une distribution empirique d’échantillonnage qui ne dépend d’aucune formule analytique a priori, ni de Gauss ni de Student. Les intervalles de confiance bootstrapés (particulièrement via la méthode BCa : bias-corrected and accelerated) épousent spontanément les asymétries et les irrégularités intrinsèques des données réelles. Dans les situations limites où les degrés de liberté sont infimes et la métricité douteuse, le bootstrap affranchit le praticien des carcans paramétriques tout en offrant une couverture probabiliste d’une fiabilité remarquable.
12.2 L’approche bayésienne : intégration des distributions a priori
L’essor fulgurant de la statistique computationnelle au cours des deux dernières décennies a propulsé le paradigme bayésien au premier plan des méthodologies scientifiques. Dans cette perspective, la distribution t n’est plus simplement envisagée comme la loi d’échantillonnage d’une statistique pivotale fréquentiste, mais comme une fonction de vraisemblance hautement performante pour accomplir une régression ou une estimation robuste.
Dans un modèle bayésien standard, les paramètres inconnus (la moyenne $\mu$ et l’écart-type $\sigma$) ne sont pas des constantes fixes, mais des entités probabilistes dotées de distributions a priori (priors), actualisées par les données observées pour former les distributions a posteriori (posteriors). L’utilisation d’une loi de Student comme distribution d’observation (likelihood) en lieu et place d’une loi normale permet de réaliser ce que les modélisateurs nomment une « estimation bayésienne robuste » :
$$y_i \sim \text{Student-t}(\nu, \mu, \sigma)$$
En assignant aux données une vraisemblance issue d’une loi t dont les degrés de liberté $\nu$ sont eux-mêmes estimés comme un paramètre libre du modèle, le système acquiert une immunité naturelle contre les observations aberrantes. Si un score extrême surgit au cours de l’expérience, le modèle bayésien n’a pas besoin de tordre l’estimation de la moyenne $\mu$ ni de faire exploser la variance $\sigma$ : il lui suffit d’abaisser légèrement l’estimation du paramètre $\nu$ pour absorber l’observation déviante dans les ailes épaisses de la distribution de Student. Cette souplesse computationnelle est particulièrement exploitée dans les modèles hiérarchiques linéaires contemporains en psychologie cognitive.
12.3 Synthèse épistémologique sur la modélisation de l’aléa scientifique
Au terme de cette exploration comparative, une vérité méthodologique s’impose : la statistique n’est pas un recueil de recettes mécaniques vouées à produire des certitudes d’autorité, mais une discipline intellectuelle consacrée à la quantification honnête et rigoureuse du doute scientifique. La frontière qui sépare la distribution normale de la distribution t incarne précisément le passage d’un univers théorique idéalisé — où la variabilité globale du monde serait parfaitement connue de l’observateur — à la réalité empirique du laboratoire, où chaque nouvelle mesure constitue une approximation précaire d’un univers qui nous échappe.
William Sealy Gosset, en introduisant la loi de Student, n’a pas simplement corrigé une formule mathématique de quelques décimales ; il a forgé un instrument de modestie épistémologique. Il a démontré que l’acte d’estimer simultanément le centre et la dispersion d’une population fragilise nécessairement l’édifice inférentiel, imposant d’élargir nos marges d’erreur et de tempérer l’assurance de nos conclusions expérimentales.
Dans le contexte actuel de lutte contre la non-réplicabilité des données de la recherche, la maîtrise approfondie de ces mécanismes probabilistes s’avère plus indispensable que jamais. L’abandon résolu des règles empiriques approximatives (comme l’illusion du seuil de $n=30$), la modélisation systématique via les degrés de liberté exacts de la loi de Student et la vigilance face aux violations d’homoscédasticité constituent les prérequis incontournables d’une science quantitative transparente, robuste et reproductible.
Références
- Cohen, J. (1988). Statistical Power Analysis for the Behavioral Sciences (2nd ed.). Lawrence Erlbaum Associates. https://doi.org/10.4324/9780203771587
- Efron, B., & Tibshirani, R. J. (1994). An Introduction to the Bootstrap. Chapman and Hall/CRC. https://doi.org/10.1201/9780429246593
- Gelman, A., Carlin, J. B., Stern, H. S., Dunson, D. B., Vehtari, A., & Rubin, D. B. (2013). Bayesian Data Analysis (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/b16018
- Krushke, J. K. (2015). Doing Bayesian Data Analysis: A Tutorial with R, JAGS, and Stan (2nd ed.). Academic Press. https://doi.org/10.1016/B978-0-12-405888-0.09999-2
- Pearson, K. (1905). Das Fehlergesetz und seine Verallgemeinerungen durch Fechner und Pearson. A Rejoinder. Biometrika, 4(1/2), 169–212. https://doi.org/10.2307/2331536
- Student [Gosset, W. S.]. (1908). The Probable Error of a Mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika, 34(1/2), 28–35. https://doi.org/10.2307/2332510
- Wilcox, R. R. (2012). Introduction to Robust Estimation and Hypothesis Testing (3rd ed.). Academic Press. https://doi.org/10.1016/C2010-0-67044-1