
Dans le champ foisonnant des sciences du comportement, de la psychologie cognitive et de la recherche biomédicale, l’inférence statistique constitue la pierre angulaire sur laquelle repose l’édifice de la découverte empirique. Chaque jour, des centaines d’articles scientifiques soumettent des hypothèses relatives au comportement humain, à l’efficacité des psychothérapies ou au fonctionnement cognitif à l’épreuve des données numériques. Pourtant, au cœur de cette machinerie méthodologique réside une ambiguïté persistante qui fragilise l’interprétation des résultats : la confusion conceptuelle et opératoire entre la statistique de test — au premier rang de laquelle figure la valeur t issue du test de Student — et la probabilité conditionnelle associée, universellement désignée sous le nom de valeur p (ou p-value).
Bien que ces deux entités mathématiques soient intrinsèquement liées au sein du paradigme dominant du test de signification de l’hypothèse nulle (NHST, pour Null Hypothesis Significance Testing), elles remplissent des fonctions sémiotiques et quantitatives radicalement différentes. La valeur t opère comme un indicateur standardisé de la magnitude d’un effet par rapport à la variabilité aléatoire d’échantillonnage, agissant tel un rapport signal sur bruit. À l’inverse, la valeur p traduit cette grandeur en une mesure de plausibilité probabiliste, quantifiant l’incompatibilité théorique entre les données recueillies et un modèle stochastique prédéterminé postulant l’absence totale de divergence ou d’effet.
L’assimilation hâtive de ces grandeurs ou la relégation de la valeur t au rang de simple intermédiaire calculatoire au profit de la seule valeur p a engendré de profonds dérèglements épistémologiques dans la littérature scientifique contemporaine. Comprendre avec exactitude ce que mesure la statistique t, la manière dont elle engendre la valeur p sous des conditions géométriques et probabilistes strictes, et les pièges inhérents à leur interprétation conjointe s’avère indispensable pour tout chercheur, praticien ou étudiant désireux de naviguer avec rigueur et esprit critique à travers les données de la psychologie scientifique.
1. Introduction épistémologique : La distinction entre valeur t et valeur p en psychologie
1.1 La crise de reproductibilité et l’exigence de rigueur inférentielle
Depuis le début des années 2010, les sciences psychologiques traversent une zone de turbulences sans précédent, couramment qualifiée de crise de la reproductibilité. Des initiatives d’envergure, telles que les travaux coordonnés par le Center for Open Science, ont mis en lumière le fait qu’une proportion alarmante d’effets publiés dans des revues de premier plan ne pouvaient être répliqués lorsque les protocoles originaux étaient rigoureusement reproduits par des laboratoires indépendants. Au banc des accusés figurent non seulement des pratiques de recherche contestables comme la sélection opportuniste de variables ou l’interruption prématurée du recueil de données, mais également une incompréhension profonde des fondements de la statistique inférentielle.
Dans ce contexte troublé, la confusion endémique entre la statistique t et la valeur p joue un rôle insidieux mais majeur. De nombreux chercheurs traitent la valeur p comme une mesure magique de la véracité de leur hypothèse de recherche, oubliant que cette dernière n’est que la dérivée probabiliste d’une statistique d’échantillonnage (en l’occurrence t) assujettie à la taille de l’échantillon et aux postulats du modèle théorique. Lorsque la statistique de test est occultée au profit du seul verdict dichotomique « significatif / non significatif » conditionné par le seuil p < 0,05, la communauté scientifique perd de vue la métrique sous-jacente de l’effet observé.
Cette cécité méthodologique compromet directement la validité interne des publications scientifiques. En ignorant la distribution de la statistique t, les chercheurs en psychologie expérimentale s’exposent à surinterpréter des micro-effets dépourvus de substance clinique ou cognitive, ou à l’inverse, à balayer d’un revers de main des tendances prometteuses masquées par un manque flagrant de puissance statistique. La rigueur inférentielle moderne exige de rompre avec ce réductionnisme aveugle pour réancrer chaque décision probabiliste dans la matérialité de sa métrique de test.
1.2 Objectifs pédagogiques et cadre d’analyse
Cet article propose une déconstruction exhaustive, conceptuelle et mathématique, des deux métriques fondamentales de l’inférence bivariée que sont la valeur t et la valeur p. L’objectif premier consiste à démystifier l’appareil statistique hérité des travaux de William Sealy Gosset (connu sous le pseudonyme historique de Student) et de Sir Ronald Aylmer Fisher, en exposant précisément comment leurs apports respectifs s’articulent sans pour autant se confondre.
Il s’agit de tracer une frontière herméneutique nette entre, d’une part, la quantification de l’écart standardisé incarnée par la valeur t, et d’autre part, l’évaluation probabiliste de la rareté conditionnelle matérialisée par la valeur p. Pour le chercheur comme pour l’étudiant en psychologie, ce parcours permettra d’appréhender le passage de la donnée brute recueillie en laboratoire (temps de réaction, scores d’échelles d’anxiété, performances mnésiques) à sa projection dans un espace probabiliste abstrait.
Le cadre d’analyse adopté ici conciliera rigueur formelle et contextualisation pratique. Nous explorerons l’architecture mécanique des formules de Student, la dynamique d’intégration sous la courbe de densité de probabilité, ainsi que les implications concrètes de ces grandeurs sur la validation des hypothèses empiriques. En replaçant la statistique t et la probabilité p au sein d’un continuum inférentiel structuré, nous fournirons les outils intellectuels indispensables à la lecture critique, à l’analyse autonome et au rapportage irréprochable des données de recherche.
2. Fondements théoriques du test t de Student : De l’échantillon à l’inférence
2.1 Principes fondamentaux de l’inférence statistique
L’inférence statistique en psychologie répond à un défi méthodologique structurel : comment pouvons-nous tirer des conclusions valides concernant une population parente infinie ou inaccessible à partir d’un échantillon fini d’individus observés en laboratoire ? Dans l’étude des processus affectifs, cognitifs ou cliniques, les chercheurs ne peuvent manipuler que des cohortes restreintes, souvent composées de quelques dizaines ou centaines de participants. La statistique descriptive permet de résumer ces données empiriques par le biais de moyennes, d’écarts-types ou de médianes ; toutefois, ces indices ne décrivent que l’échantillon lui-même et demeurent muets quant à la réalité de la population générale.
Le passage crucial de la description à la décision s’opère par le concept de distribution d’échantillonnage. Si l’on extrayait d’une population une infinité d’échantillons indépendants de taille N et que l’on calculait pour chacun la moyenne d’un trait psychologique, ces moyennes d’échantillon varieraient selon une loi théorique précise. En vertu du Théorème Central Limite, cette distribution tend asymptotiquement vers une loi normale dès lors que la taille de l’échantillon devient suffisamment grande, quelle que soit la forme de la distribution sous-jacente dans la population d’origine.
Néanmoins, lorsque la variance de la population est inconnue — ce qui constitue la règle absolue en psychologie — et que l’échantillon est de taille modeste, la distribution de la moyenne standardisée ne suit plus une loi normale standard (loi Z), mais une distribution de Student. Cette distribution se caractérise par des « queues » plus épaisses, modélisant l’incertitude accrue liée à l’estimation concomitante de la moyenne et de la variance de la population. Les degrés de liberté (généralement notés df ou $\nu$), directement corrélés à la taille de l’échantillon, gouvernent précisément l’aplatissement de cette courbe, dictant ainsi la forme géométrique exacte de l’espace dans lequel s’inscriront nos inférences.
2.2 Les postulats méthodologiques du test t
Pour que l’édifice mathématique du test t produise des valeurs de t et de p interprétables sans distorsion systématique, un ensemble de postulats théoriques stricts doit être satisfait. Le premier de ces postulats concerne la nature et la normalité de la distribution de la variable dépendante. Celle-ci doit être mesurée sur une échelle d’intervalle ou de rapport continue, et ses scores doivent se distribuer de manière approximativement gaussienne au sein de chaque groupe étudié. Si le test t fait preuve d’une relative robustesse face à de légères déviations de la normalité pour de grands échantillons, des asymétries sévères ou la présence d’aberrations statistiques (outliers) peuvent altérer lourdement l’estimation de l’erreur type, gonflant ou dégonflant artificiellement le score t.
Le second postulat fondamental, propre aux designs comparant deux groupes indépendants, est l’homoscédasticité, ou homogénéité des variances. Ce principe stipule que la variabilité de la mesure doit être statistiquement équivalente dans chacun des sous-groupes examinés ($\sigma_1^2 = \sigma_2^2$). Lorsque cette hypothèse est violée — situation fréquente en psychopathologie où un groupe clinique manifeste presque systématiquement une variance résiduelle bien plus prononcée qu’un groupe témoin sain —, le test t classique de Student sous-estime l’erreur standard si le groupe le plus dispersé est le plus petit, générant ainsi un risque intolérable de faux positifs. L’application d’ajustements correctifs robustes, telle la correction de Welch-Satterthwaite, devient alors impérative.
Enfin, l’indépendance des observations constitue le postulat le plus critique et le moins négociable. Les réponses de chaque sujet expérimental ne doivent en aucun cas être influencées par celles des autres participants, ni par des mesures répétées non contrôlées. Une violation de l’indépendance (due par exemple à l’évaluation conjointe de sujets au sein d’une même dynamique de groupe ou à une non-prise en compte de l’effet de dyade) fausse complètement le calcul des degrés de liberté réels, invalidant d’emblée la distribution théorique de référence et rendant caduque la dérivation de la valeur p.
2.3 Formulation formelle des hypothèses
La mécanique du test t s’enclenche formellement par l’antagonisme théorique de deux propositions mutuellement exclusives : l’hypothèse nulle ($H_0$) et l’hypothèse alternative ($H_1$). Dans le cadre paradigmatique de la recherche quantitative en psychologie, $H_0$ est typiquement l’hypothèse de l’invariance ou du néant. Elle postule que la différence entre les moyennes des populations sous-jacentes est rigoureusement nulle :
$$H_0 : \mu_1 – \mu_2 = 0 \quad \text{ou} \quad H_0 : \mu_1 = \mu_2$$
Cette hypothèse nulle ne représente pas simplement une absence d’effet dans l’échantillon observé, mais affirme catégoriquement que tout écart perceptible entre les conditions expérimentales résulte exclusivement de fluctuations stochastiques d’échantillonnage, c’est-à-dire du « bruit » inhérent à la mesure du comportement humain.
À l’opposé, l’hypothèse alternative ($H_1$) traduit la prédiction théorique du chercheur, stipulant qu’un processus psychologique spécifique a induit une divergence systématique entre les distributions parentes. Cette hypothèse peut être formulée selon deux modalités distinctes :
- Non-directionnelle (test bilatéral) : $H_1 : \mu_1 \neq \mu_2$. Le chercheur postule qu’il existe une différence significative entre les groupes sans pour autant présupposer formellement le sens de cette divergence. C’est l’approche par défaut la plus prudente et la plus répandue en psychologie expérimentale.
- Directionnelle (test unilatéral) : $H_1 : \mu_1 > \mu_2$ ou $H_1 : \mu_1 < \mu_2$. Ici, le modèle théorique est suffisamment solide et contraint pour postuler a priori le sens de l’effet (par exemple, une prédiction explicite selon laquelle une nouvelle molécule antidépressive réduira davantage les scores sur l’échelle de Hamilton qu’un placebo).
Le choix rigoureux entre un cadre bilatéral et unilatéral structure intégralement la partition géométrique de la distribution de Student, dictant la répartition des régions critiques de rejet et conditionnant directement la conversion mathématique subséquente de la statistique t en probabilité p.
3. Anatomie de la valeur t : Définition, calcul et mécanique sous-jacente
3.1 Qu’est-ce qu’une valeur t (t-value) ?
Sur le plan fondamental, la valeur t n’est rien d’autre qu’un nombre pur, sans dimension unitaire, représentant le ratio standardisé entre un signal systématique et un bruit aléatoire. Dans toute recherche comportementale, les données collectées sont parasitées par de multiples sources de variance : variabilité génétique individuelle, fluctuations attentionnelles momentanées, erreurs de mesure des instruments ou instabilité des états émotionnels. Face à ce bruit de fond omniprésent, l’expérimentateur introduit une manipulation (le traitement expérimental, la tâche cognitive) dont il cherche à isoler l’effet.
La statistique t formalise cette balance épistémologique :
$$t = \frac{\text{Signal}}{\text{Bruit}} = \frac{\text{Effet observé}}{\text{Variabilité d’échantillonnage}}$$
Lorsque la valeur t est proche de zéro, cela signifie que la différence observée entre les moyennes empiriques est du même ordre de grandeur que les fluctuations stochastiques moyennes attendues par simple hasard. Plus la valeur absolue de t ($|t|$) s’élève, plus le signal expérimental émerge avec force du bruit résiduel.
D’un point de vue géométrique, le score t correspond à une coordonnée précise sur l’axe des abscisses de la distribution de probabilité théorique de Student. Il s’agit d’une métrique d’éloignement qui mesure, en nombre d’erreurs types, à quelle distance la configuration observée se situe du centre de gravité du modèle nul ($t = 0$). Une valeur $t = 2,50$ indique ainsi sans équivoque que la différence entre vos conditions expérimentales se situe à 2,50 erreurs types à droite de l’absence totale d’effet postulée par l’hypothèse nulle.
3.2 Décomposition de la formule mathématique du score t
Pour appréhender la mécanique profonde du score t, il convient de disséquer minutieusement ses composantes opératoires. Dans sa formulation générale pour deux échantillons indépendants, l’équation s’énonce comme suit :
$$t = \frac{(\bar{X}_1 – \bar{X}_2) – (\mu_1 – \mu_2)_{H_0}}{SE_{(\bar{X}_1 – \bar{X}_2)}}$$
Considérant que sous $H_0$, la différence postulée dans la population $(\mu_1 – \mu_2)_{H_0}$ est égale à zéro, la formule se simplifie en un ratio d’une grande limpidité structurelle :
$$t = \frac{\bar{X}_1 – \bar{X}_2}{SE_{(\bar{X}_1 – \bar{X}_2)}}$$
Le numérateur $(\bar{X}_1 – \bar{X}_2)$ constitue l’effet brut non standardisé. Il s’agit de la distance arithmétique directe entre les moyennes observées dans vos groupes, exprimée dans l’unité de mesure initiale de votre instrument psychométrique (secondes pour un temps de réaction, points pour une échelle psychologique, pourcentages d’erreurs cognitives). Ce terme isole le composant systématique de l’investigation.
Le dénominateur $SE_{(\bar{X}_1 – \bar{X}_2)}$, ou erreur type de la différence des moyennes, constitue le cœur probabiliste de la formule. Il modélise l’écart-type théorique de la distribution d’échantillonnage de cette différence. Dans le cas canonique de Student (variances homogènes), il se calcule à partir de la variance combinée (pooled variance, notée $s_p^2$) pondérée par la taille respective des sous-échantillons :
$$s_p^2 = \frac{(n_1 – 1)s_1^2 + (n_2 – 1)s_2^2}{n_1 + n_2 – 2}$$
$$SE_{(\bar{X}_1 – \bar{X}_2)} = \sqrt{s_p^2 \left(\frac{1}{n_1} + \frac{1}{n_2}\right)}$$
Cette décomposition met en relief le rôle transcendant joué par la taille de l’échantillon ($N = n_1 + n_2$). Puisque $N$ figure au dénominateur du terme d’erreur type, toute augmentation des effectifs entraîne mécaniquement une réduction de l’erreur type. Par conséquent, pour un effet brut strictement identique au numérateur, une hausse de la taille d’échantillon provoque inéluctablement une inflation substantielle de la valeur t. Ce comportement algébrique met en garde le méthodologue : un score t très élevé peut traduire soit un effet expérimental puissant au sein d’un échantillon moyen, soit une différence psychologiquement insignifiante mesurée sur un échantillon gigantesque.
3.3 Interprétation de la magnitude et du signe du t
La statistique t est un vecteur algébrique porteur d’une double information : une directionnalité (son signe) et une magnitude relative (sa valeur absolue). Le signe arithmétique (+ ou -) n’a qu’une valeur relative et dépend uniquement de l’ordre arbitraire choisi par le statisticien lors de la soustraction des conditions expérimentales au numérateur. Si le groupe traité présente une moyenne de 25 et le groupe témoin une moyenne de 20, poser $\bar{X}_{\text{traité}} – \bar{X}_{\text{témoin}}$ aboutira à un t positif (+2,5 par exemple), tandis que poser $\bar{X}_{\text{témoin}} – \bar{X}_{\text{traité}}$ produira exactement le même résultat affecté du signe négatif (-2,5). En substance, le signe indique simplement vers quelle condition expérimentale penche la balance empirique.
La magnitude absolue ($|t|$), quant à elle, informe sur la distance relative entre l’estimation échantillonnale et l’hypothèse nulle d’égalité parfaite. Dans un univers épistémique idéal, une valeur $|t| > 2,0$ dans un test à degrés de liberté modérés signale généralement que la différence observée s’écarte de plus de deux erreurs types de l’attente stochastique pure sous $H_0$. Cependant, une prudence interprétative majeure s’impose : la magnitude du t ne doit jamais être confondue avec l’importance clinique ou écologique de la découverte.
En outre, la valeur t est particulièrement vulnérable aux fluctuations d’échantillonnage locales dans les études à petits effectifs ($N < 20$ par groupe). Dans ces configurations instables, un individu atypique (outlier) présentant un score extrême peut comprimer ou élargir artificiellement l’écart-type d’échantillon ($s$), provoquant une variation erratique du dénominateur et aboutissant à un score t trompeur. De même, un manque de fidélité métrologique de l’outil d’évaluation psychologique (faible consistance interne, bruit de cotation) vient gonfler la variance résiduelle, laminant le score t indépendamment de la réalité du mécanisme psychique étudié.
4. Décryptage de la valeur p : Probabilité conditionnelle et signification réelle
4.1 Définition rigoureuse de la p-value selon l’école fisherienne
Contrairement à une conception profane largement répandue dans les sciences sociales, la valeur p (ou p-value) ne quantifie en aucun cas la probabilité que votre hypothèse de recherche soit vraie, ni même la probabilité que l’hypothèse nulle soit fausse. Ancrée dans l’approche inférentielle formalisée par Sir Ronald Fisher dans les années 1920, la valeur p est une probabilité conditionnelle stricte, définie comme suit :
La valeur p est la probabilité d’obtenir, sous l’hypothèse stricte que l’hypothèse nulle ($H_0$) est rigoureusement vraie dans la population, une statistique de test (comme t) au moins aussi extrême que celle effectivement observée dans l’échantillon étudié.
Mathématiquement, cette définition s’écrit formellement sous la conditionnalité épistémique suivante :
$$p = P(T ge |t_{\text{obs}}| mid H_0)$$
Le point capital de cette formulation réside dans la barre de conditionnalité « $mid H_0$ ». L’hypothèse nulle n’est pas ce que le test évalue probabilistement ; elle constitue la prémisse déductive préalable et indéboulonnable du calcul. On fait l’hypothèse méthodologique temporaire que le néant règne dans la population, que le traitement n’a rigoureusement aucun effet, et l’on mesure à quel point la statistique t calculée sur nos données est rare ou insolite sous cet état du monde hypothétique.
Il existe une asymétrie logique fatale entre $P(\text{Données} mid H_0)$ et $P(H_0 mid \text{Données})$. Inverser ces termes relève de la grave faute épistémologique connue sous le nom de sophisme de la conditionnelle transposée. Affirmer qu’une faible valeur p confère une faible probabilité à l’hypothèse nulle équivaut à affirmer que, sous prétexte que la probabilité d’être mouillé sachant qu’il pleut est de 0,99 ($P(\text{Mouillé} mid \text{Pluie}) = 0,99$), alors la probabilité qu’il pleuve sachant que l’on est mouillé est également de 0,99 (ce qui est faux si l’on sort tout juste d’une piscine). La valeur p dépend donc de manière exclusive et unilatérale du modèle stochastique théorique sous $H_0$.
4.2 Le seuil de signification alpha (α) et la prise de décision
Dans l’usage courant de la recherche en psychologie, les chercheurs fusionnent l’évaluation continue fisherienne (la valeur p en tant qu’indice de plausibilité) avec le modèle de décision rigide développé ultérieurement par Jerzy Neyman et Egon Pearson. Ce cadre théorique composite — le NHST — impose la fixation a priori d’un seuil de risque maximal désigné par la lettre grecque **$\alpha$ (alpha)**.
Ce seuil $\alpha$, conventionnellement fixé à 0,05 (5 %) ou 0,01 (1 %) dans la quasi-totalité des publications en sciences humaines, incarne la tolérance maximale consentie par la communauté scientifique face au risque d’erreur de première espèce (l’erreur de type I). Cette erreur consiste à rejeter formellement l’hypothèse nulle alors qu’elle est en réalité vraie dans la population globale (génération d’un faux positif scientifique). La règle décisionnelle s’énonce alors selon un algorithme binaire immuable :
- Si $p le \alpha$ : l’incompatibilité entre les données et le modèle nul dépasse le seuil toléré ; on rejette l’hypothèse nulle ($H_0$) et l’effet est qualifié de statistiquement significatif.
- Si $p > \alpha$ : l’incompatibilité n’est pas suffisante pour écarter le rôle du hasard d’échantillonnage ; on échoue à rejeter l’hypothèse nulle. Le résultat est qualifié de non significatif.
Il est fondamental de noter que l’échec du rejet de $H_0$ ne constitue en aucune manière une preuve de son exactitude empirique. Selon l’aphorisme célèbre de Carl Sagan, souvent repris par les statisticiens : « L’absence de preuve n’est pas la preuve de l’absence ». Une valeur p supérieure à 0,05 signifie simplement que les données actuelles ne permettent pas de trancher face au bruit stochastique d’échantillonnage, souvent en raison d’un manque de sensibilité méthodologique (erreur de type II ou risque $\beta$, le faux négatif).
4.3 Limites inhérentes à la valeur p
L’hégémonie historique de la valeur p dans la validation académique a fait l’objet de condamnations méthodologiques sans équivoque, culminant avec la déclaration officielle de l’American Statistical Association (ASA) en 2016 sur la signification statistique. La première faiblesse ontologique de la valeur p est sa totale cécité quant à la taille concrète de l’effet clinique ou psychologique. Une valeur $p = 0,0001$ ne garantit aucunement que l’écart mesuré entre deux thérapies possède la moindre utilité pratique dans la vie réelle d’un patient ; elle informe simplement que cet écart est très difficilement explicable par le seul hasard d’échantillonnage sous le modèle nul.
Deuxièmement, la valeur p souffre d’une hyper-sensibilité mathématique aux effectifs massifs. En vertu de la convergence de l’erreur type vers zéro lorsque $N to \infty$, n’importe quelle divergence infinitésimale et dénuée de tout intérêt psychologique (par exemple, une différence de 0,05 milliseconde sur une tâche d’inhibition cognitive entre bilingues et monolingues) atteindra inévitablement un seuil de significativité extrême ($p < 0,001$) si l’étude mobilise plusieurs dizaines de milliers de sujets. À l’inverse, dans une étude clinique pilote innovante portant sur une pathologie rare ($N = 12$), un effet thérapeutique spectaculaire peut demeurer englué à un niveau non significatif ($p = 0,08$) en raison d’une erreur type hypertrophiée par la petitesse de l’échantillon.
Enfin, la valeur p s’avère incapable d’évaluer de manière comparative le degré d’adéquation des données avec l’hypothèse alternative $H_1$. Puisque $H_1$ n’entre pas dans le calcul probabiliste fisherien — seule la distribution sous $H_0$ étant modélisée —, une valeur p minuscule ne vous dit jamais si les observations sont hautement probables sous votre théorie novatrice, mais uniquement qu’elles sont hostiles au néant statistique.
5. Typologie des tests t en psychologie : Spécificités de calcul de t et p
5.1 Test t à un échantillon (One-Sample t-test)
Le test t à un échantillon intervient lorsqu’un chercheur souhaite comparer la moyenne d’un groupe expérimental unique ($\bar{X}$) à une valeur de référence théorique, historique ou populationnelle préétablie ($\mu_0$). Ce design est fréquemment mobilisé en neuropsychologie clinique ou en psychologie différentielle pour déterminer si une cohorte particulière s’écarte substantiellement des normes standardisées établies sur de grands recensements psychométriques nationaux (par exemple, le score moyen de QI fixé à 100, ou la valeur d’étalonnage d’un inventaire d’anxiété comme le STAI fixé à une constante dans une tranche d’âge précise).
La statistique t se calcule alors en rapportant l’écart à l’erreur type de la moyenne unique :
$$t = \frac{\bar{X} – \mu_0}{\frac{s}{\sqrt{N}}}$$
Dans ce scénario, les degrés de liberté sont définis de manière canonique par $df = N – 1$. Supposons qu’un protocole évalue les scores d’anxiété-trait chez 30 internes en médecine d’urgence après une garde de 24 heures, révélant une moyenne empirique $\bar{X} = 58$ avec un écart-type $s = 10,95$, face à une norme en population générale établie à $\mu_0 = 50$. L’erreur type s’élève à :
$$SE = \frac{10,95}{\sqrt{30}} = \frac{10,95}{5,477} = 2,00$$
Le calcul du score t génère :
$$t = \frac{58 – 50}{2,00} = +4,00$$
Avec $df = 29$, la consultation des distributions théoriques de Student révèle que la probabilité d’observer sous $H_0$ un score t d’au moins 4,00 en valeur absolue est extrêmement ténue ($p \approx 0,0004$). La valeur t indique un écart de quatre erreurs types entières ; la valeur p atteste de l’improbabilité de cette configuration sous le modèle du hasard, permettant de rejeter formellement la conformité du groupe aux normes standards.
5.2 Test t pour échantillons indépendants (Two-Sample t-test)
Le test t pour échantillons indépendants constitue sans conteste l’outil expérimental par excellence en psychologie comparée et en recherche clinique interventionnelle. Il est déployé lorsque deux groupes d’individus distincts, sans interpénétration mutuelle, sont soumis à des conditions expérimentales contrastées : typiquement un groupe contrôle (placebo ou traitement usuel) et un groupe expérimental (nouvelle approche psychothérapeutique ou manipulation cognitive ciblée).
La formulation standard de Student présuppose l’égalité des variances des deux populations parentes ($\sigma_1^2 = \sigma_2^2$), ce qui autorise le calcul de la variance combinée (pooled variance) vue précédemment, les degrés de liberté s’établissant à :
$$df = n_1 + n_2 – 2$$
Toutefois, en sciences sociales contemporaines, le respect absolu de l’homoscédasticité demeure exceptionnel. Lorsque le test de Levene indique une violation substantielle de ce postulat ($p < 0,05$), le recours au test t de Welch devient obligatoire. Cette version modifiée n’utilise pas de variance combinée, mais applique une formule d’erreur type non contrainte :
$$SE_{\text{Welch}} = \sqrt{\frac{s_1^2}{n_1} + \frac{s_2^2}{n_2}}$$
La particularité remarquable du test de Welch réside dans le calcul de ses degrés de liberté effectifs, régis par l’équation de Welch-Satterthwaite. Ceux-ci cessent d’être un entier naturel pour devenir un nombre réel continu, souvent substantiellement inférieur à la somme $n_1 + n_2 – 2$. En réduisant ces degrés de liberté, la distribution théorique de Student de référence adopte des queues plus lourdes, ce qui élargit la région critique. Pour une même statistique t brute, la valeur p issue de la correction de Welch sera légèrement plus élevée que celle du test de Student non corrigé, immunisant ainsi l’analyste contre le risque pathologique d’inflation des faux positifs.
5.3 Test t pour échantillons appariés (Paired Samples t-test)
Le test t pour échantillons appariés (également désigné sous l’appellation de test t à mesures répétées ou intra-sujet) est la modalité privilégiée en neurosciences cognitives, en psychophysiologie et dans les études longitudinales pré-test / post-test. Dans ce paradigme, chaque participant est son propre témoin : il est soumis successivement aux différentes conditions de l’expérience, ou évalué avant et après une intervention psychothérapeutique spécifique.
La force méthodologique prodigieuse de ce design réside dans l’élimination quasi-complète de la variance interindividuelle. Chez l’être humain, des facteurs comme l’âge, l’intelligence générale, la vitesse de traitement perceptif de base ou la réactivité émotionnelle créent une dispersion considérable entre les individus. En travaillant en intra-sujet, on soustrait ce bruit interindividuel pour ne s’intéresser qu’à la dynamique de différence intra-individuelle $D_i = X_{1,i} – X_{2,i}$ pour chaque sujet $i$.
Le test se convertit alors mathématiquement en un test à un échantillon unique appliqué sur le vecteur des scores différentiels $D$ :
$$t = \frac{\bar{D} – 0}{\frac{s_D}{\sqrt{N}}}$$
où $\bar{D}$ représente la moyenne empirique des différences individuelles, $s_D$ l’écart-type de ces différences, et $N$ le nombre total de paires observées (avec $df = N – 1$). Parce que la corrélation positive ($r$) entre les mesures pré et post compresse considérablement l’écart-type des différences :
$$s_D = \sqrt{s_1^2 + s_2^2 – 2 r s_1 s_2}$$
l’erreur type résultante au dénominateur est drastiquement réduite par rapport à un design inter-sujets. Il en découle qu’à amplitude d’effet psychologique égale, un test t apparié produira une valeur t beaucoup plus imposante, propulsant la valeur p vers des niveaux d’infime probabilité, optimisant ainsi la puissance statistique de l’investigation sans exiger le recrutement de panels démesurés.
6. La dynamique d’interaction entre la valeur t et la valeur p
6.1 La valeur t comme déterminant direct de la valeur p
La relation qui unit la valeur t à la valeur p est de nature strictement mathématique, continue et univoque : la valeur t est la variable indépendante d’entrée dont la valeur p est la résultante intégrale directe, sous la contrainte paramétrique imposée par les degrés de liberté. Il est impératif de comprendre que la valeur p ne possède aucune autonomie ontologique ; elle est l’expression géométrique de la projection du score t sur la fonction de densité de probabilité de la loi de Student appropriée.
Dans un test bilatéral canonique, la valeur p correspond à l’aire sous la courbe (l’intégrale) délimitée par les queues de la distribution au-delà des bornes absolues $+|t|$ et $-|t|$ :
$$p = 2 \int_{|t_{\text{obs}}|}^{+\infty} f(t, df) , dt$$
où $f(t, df)$ est la fonction de densité de Student paramétrée par ses degrés de liberté $\nu = df$ :
$$f(t, \nu) = \frac{\Gamma\left(\frac{\nu + 1}{2}\right)}{\sqrt{\pi \nu} , \Gamma\left(\frac{\nu}{2}\right)} \left(1 + \frac{t^2}{\nu}\right)^{-\frac{\nu + 1}{2}}$$
Cette relation intégrale implique une monotonie décroissante rigide : à degrés de liberté constants, plus la valeur absolue du score t augmente, plus la surface géométrique résiduelle dans les queues de distribution se comprime, et plus la valeur p s’amenuise vers zéro. Réciproquement, à mesure que le score t s’approche de zéro, l’intégrale absorbe une fraction grandissante de l’aire totale de la courbe, conduisant la valeur p à converger vers 1,0.
6.2 Visualisation graphique de la transition t vers p
Pour conceptualiser la géométrie de cette conversion, imaginez la courbe en cloche symétrique de la distribution de Student centrée sur la valeur nulle $t = 0$. L’aire totale circonscrite sous cette fonction de densité est par définition rigoureusement égale à 1,00 (soit 100 % de l’espace probabiliste des issues possibles sous $H_0$).
Lorsque le chercheur fixe un niveau de signification $\alpha = 0,05$ pour un test bilatéral, il découpe mentalement les extrémités distales de cette courbe. Les 5 % de la surface totale sont scindés en deux tranches égales de 2,5 % ($0,025$) logées dans la queue d’extrême droite et la queue d’extrême gauche. Les coordonnées sur l’axe horizontal qui délimitent le début de ces zones de rejet constituent les **valeurs critiques de t** (notées $t_{\text{critique}}$).
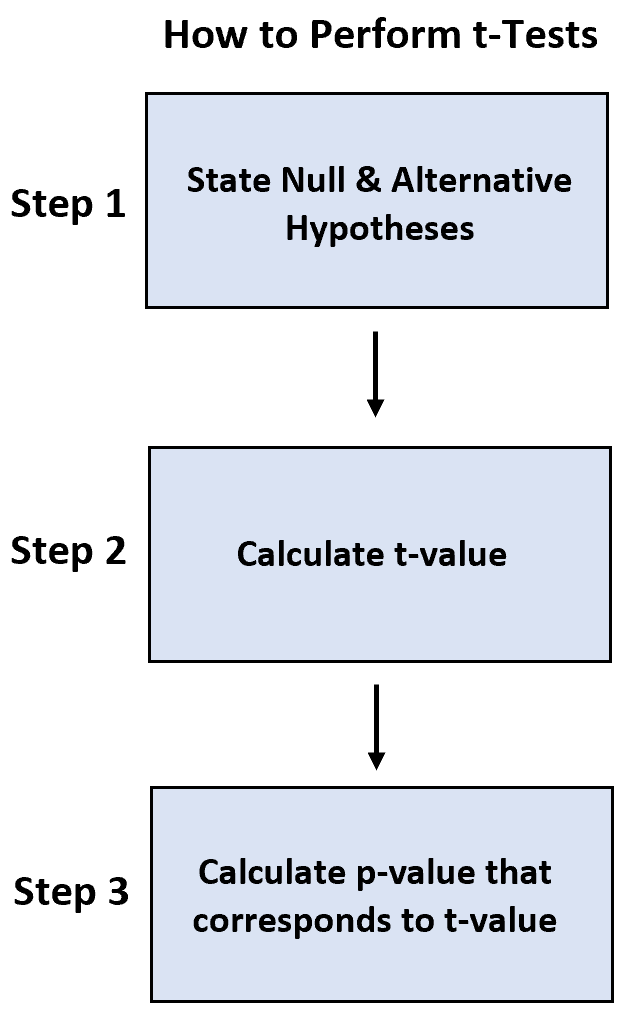
La statistique observée sur vos données, $t_{\text{obs}}$, vient se positionner sur cet axe horizontal. Si $|t_{\text{obs}}| < |t_{\text{critique}}|$, le point d’impact se situe à l’intérieur de la région centrale de non-rejet : l’aire sous la courbe s’étendant au-delà de cette coordonnée est supérieure à 0,05, d’où $p > 0,05$. En revanche, dès l’instant où $|t_{\text{obs}}| ge |t_{\text{critique}}|$, votre valeur t pénètre au cœur de la zone d’exclusion statistique : la surface résiduelle des queues découpée par ce seuil devient mécaniquement inférieure à 5 %, engendrant une valeur $p le 0,05$.
Ce comportement graphique illustre avec éclat l’impact de l’aplatissement (kurtosis) de la distribution de Student. Pour de très faibles degrés de liberté (par exemple $df = 5$), les queues de distribution sont épaisses et relevées ; il faut alors s’éloigner considérablement du centre horizontal ($t_{\text{critique}} = \pm 2,571$) pour ne laisser que 5 % de surface extérieure. Lorsque l’échantillon grossit jusqu’à $df = 120$, les queues s’écrasent pour fusionner avec la loi normale standard, et la coordonnée critique se stabilise à la valeur universelle bien connue $t_{\text{critique}} = \pm 1,960$.
6.3 Table de Student versus logiciels modernes de calcul
L’histoire de la pratique statistique en psychologie a profondément conditionné la manière dont les chercheurs perçoivent le lien entre t et p. Durant des décennies, avant la démocratisation de l’outil informatique, les étudiants et les universitaires dépendaient exclusivement des **tables statistiques imprimées** de Student figurant en annexe des manuels académiques. Ces tables matricielles croisaient les degrés de liberté en ligne avec une poignée de seuils alpha prédéterminés en colonne ($\alpha = 0,10 ; 0,05 ; 0,01 ; 0,001$).
Cette contrainte technologique imposait une pensée binaire par seuils d’inégalité. Le chercheur calculait son score t à la main ou à la calculatrice mécanique, puis cherchait à déterminer si son score empirique franchissait la barre critique tabulée. Le résultat était invariablement consigné sous une forme dichotomique et imprécise : « $t(48) = 2,14, p < 0,05$ » ou « $t(48) = 1,85, p > 0,05$ ». Cette pratique a gravé dans l’inconscient disciplinaire l’illusion qu’il n’existait qu’un monde discontinu scindé par une falaise magique située à $p = 0,05$.
L’avènement des logiciels contemporains de modélisation statistique (R, Jamovi, JASP, SPSS, Stata) a totalement révolutionné cette interaction en résolvant numériquement l’équation intégrale de densité en temps réel. Aujourd’hui, l’analyste n’a plus à manipuler de tables statiques : le logiciel lui retourne la **valeur p exacte et continue** (par exemple, $p = 0,03541$ pour un $t = 2,14$). Cette quantification fine restitue à la valeur p sa véritable essence fisherienne : celle d’un indicateur continu du degré de tension statistique entre le modèle nul et l’observation empirique, invitant l’analyste à dépasser les clivages doctrinaires dépassés.
7. Comparaison directe : Valeur t versus valeur p
7.1 Tableau comparatif des attributs statistiques
Afin de dissiper définitivement toute confusion terminologique et fonctionnelle, il est utile de confronter directement les propriétés formelles des deux métriques au sein d’une structure analytique rigoureuse :
| Caractéristique | Valeur t (t-value) | Valeur p (p-value) |
|---|---|---|
| Nature mathématique | Statistique d’échantillonnage standardisée continue (nombre réel non borné). | Probabilité conditionnelle cumulative continue (scalaire borné dans l’intervalle $[0, 1]$). |
| Unité de mesure | Nombre d’unités d’erreur type séparant l’effet du néant statistique. | Probabilité pure, adimensionnelle et invariante d’échelle. |
| Directionnalité | Signée ($+$ ou $-$) : indique la direction et l’orientation de l’écart observé. | Strictement positive et non directionnelle en elle-même (l’orientation dépend du test unilatéral ou bilatéral). |
| Fonction inférentielle | Mesure du rapport signal/bruit ; quantification de la force relative de l’effet dans l’échantillon. | Indice de plausibilité des données sous le postulat exclusif de l’hypothèse nulle ($H_0$). |
| Comportement sous $H_0$ | Se distribue selon la loi de Student centrée sur zéro : $t sim t(df)$. | Se distribue de façon strictement uniforme entre 0 et 1 : $p \sim \mathcal{U}(0, 1)$. |
| Interprétation isolée | Interprétable comme coordonnée physique d’écart sous réserve de connaître les df. | Directement interprétable par rapport au seuil de risque préétabli ($\alpha$). |
7.2 Différences de fonction dans le raisonnement scientifique
La distinction la plus profonde entre la valeur t et la valeur p s’articule autour de la spécialisation de leurs rôles épistémiques dans l’architecture de la preuve scientifique. La valeur t s’ancre dans le concret de la mesure empirique : elle synthétise en un coefficient standardisé unique les paramètres vitaux de votre expérience — la taille de votre échantillon, l’ampleur numérique brute de l’écart constaté entre vos conditions et la cohérence interne des réponses de vos participants traduite par la dispersion des scores.
En revanche, la valeur p opère un saut d’abstraction radical. Elle ne s’intéresse plus aux spécificités mécaniques de votre manipulation, mais traduit l’ensemble du résultat dans l’arène de la théorie de la décision en univers incertain. Sa fonction exclusive est d’évaluer la robustesse logique du rejet du modèle nul : à quel point la présence d’une telle coordonnée t violerait-elle les attentes si l’univers expérimental était strictement aléatoire ?
Il découle de cette spécialisation une complémentarité opérationnelle indispensable. L’un de ces indices ne saurait en aucun cas supplanter l’autre :
- Rapporter une valeur p sans mentionner la valeur t qui lui a donné naissance revient à présenter un verdict juridique en occultant l’ensemble des pièces à conviction et la balance des témoignages.
- À l’inverse, rapporter une valeur t brute sans en dériver la valeur p associée reviendrait à décrire une déviation physique sans disposer du modèle de probabilité permettant de savoir si cette déviation relève du banal ou de l’extraordinaire au vu de la taille de la cohorte testée.
L’interaction cohérente de ces deux termes constitue le langage standard indispensable à la communication des faits empiriques en psychologie.
7.3 Sensibilité comparée à la taille d’échantillon
L’exploration du comportement asymptotique de ces deux grandeurs face aux variations massives de la taille d’échantillon ($N$) constitue l’une des démonstrations les plus instructives de la méthodologie statistique. Lorsque $N$ tend vers l’infini ($N to \infty$), le terme d’erreur type converge inéluctablement vers zéro :
$$\lim_{N to \infty} SE = \lim_{N to \infty} \frac{s}{\sqrt{N}} = 0$$
Considérons un chercheur observant une divergence psychologique réelle mais microscopique, absolument dérisoire sur le plan clinique (par exemple, une différence de 0,1 point sur une échelle d’évaluation de la mémoire de travail allant de 0 à 100). Si ce chercheur recrute un échantillon conventionnel de 40 participants par groupe ($N = 80$), la valeur t sera très faible (par exemple, $t = 0,35$) et la valeur p sera largement non significative ($p = 0,73$). Les données concluront, à juste titre pour l’application pratique, à l’absence de signal exploitable.
Cependant, si ce même chercheur, animé par une quête obsessionnelle de significativité, réplique le protocole sur un panel massif issu du big data comprenant 100 000 participants par groupe :
- Le numérateur reste immuable : $\bar{X}_1 – \bar{X}_2 = 0,1$.
- Le dénominateur (l’erreur type) se trouve divisé par plusieurs ordres de grandeur sous l’effet du terme $\sqrt{N}$.
- La statistique t s’envole littéralement pour atteindre des valeurs vertigineuses, franchissant allègrement la barre de $t = 15,0$ ou $20,0$.
- La valeur p s’effondre de manière exponentielle, affichant des niveaux stratosphériques tels que $p < 10^{-50}$.
Dans cette configuration asymptotique extrême, la valeur p certifie avec une certitude absolue qu’un biais stochastique n’explique pas la divergence observée, tandis que la valeur t a été gonflée non par la magnitude du processus psychique, mais par la seule machinerie de la taille d’échantillon. Cet exemple met en lumière la dissociation fondamentale entre certitude de l’existence d’une divergence statistique et pertinence théorique de la découverte.
8. La prise de décision inférentielle : Seuils alpha, puissance et risques d’erreur
8.1 La matrice de décision de Neyman-Pearson
Pour réguler l’incertitude inhérente à l’analyse des échantillons en psychologie, le cadre formel développé par Neyman et Pearson conceptualise la déduction empirique sous forme d’une matrice d’arbitrage décisionnel. Dans ce modèle, l’état réel de la nature (l’hypothèse $H_0$ est soit vraie, soit fausse dans la population absolue) est confronté à l’action binaire posée par le chercheur (rejeter ou maintenir $H_0$).
Cette confrontation délimite quatre quadrants opérationnels fondamentaux :
- Décision correcte 1 : Conserver $H_0$ alors que $H_0$ est vraie dans la nature. La probabilité associée est le niveau de confiance, quantifié par $1 – \alpha$.
- Erreur de type I (faux positif) : Rejeter $H_0$ alors que $H_0$ est rigoureusement vraie. Le risque consenti est borné par le niveau de signification nominal **$\alpha$**, que l’on verrouille traditionnellement à 0,05.
- Erreur de type II (faux négatif) : Conserver $H_0$ alors qu’il existe un effet réel dans la population ($H_0$ est fausse). Ce risque de passer à côté d’une découverte authentique est désigné par la variable **$\beta$ (bêta)**.
- Décision correcte 2 (Puissance statistique) : Rejeter formellement $H_0$ lorsqu’un effet existe véritablement. La probabilité correspondante est la puissance du test, quantifiée par **$1 – \beta$**.
Dans ce modèle d’ingénierie de la décision, la valeur t est le capteur opérationnel qui actionne le levier, tandis que la valeur p sert de déclencheur automatique : dès que le seuil de tolérance aux faux positifs ($p le \alpha$) est franchi, la décision mécanique de rejeter $H_0$ est prise, indépendamment de toute conviction subjective.
8.2 Modulation de la puissance et impact sur les valeurs t et p
La puissance statistique ($1 – \beta$) est la cheville ouvrière trop souvent négligée de la recherche quantitative en psychologie. Elle dépend d’une articulation quadratique fermée reliant quatre paramètres indissociables : le seuil d’erreur alpha ($\alpha$), la taille de l’échantillon ($N$), la taille réelle de l’effet dans la population (par exemple, le d de Cohen théorique) et la variance des mesures. Une étude menée avec une puissance statistique sous-dimensionnée (par exemple $1 – \beta = 0,35$, configuration fréquente dans les études de psychologie expérimentale aux effectifs réduits de 15 à 20 sujets) engendre des distorsions perverses majeures sur la distribution des valeurs t et p.
Le premier fléau lié au sous-dimensionnement est la distorsion connue sous le nom de malédiction du vainqueur (Winner’s curse). Dans une recherche sous-puissante, un test t ne peut franchir le seuil critique de significativité ($p < 0,05$) que si, par pur accident d’échantillonnage, les fluctuations aléatoires sont venues gonfler artificiellement la différence des moyennes observées. Il en résulte que lorsqu’une étude à faible puissance rapporte un score t significatif et un $p < 0,05$, la magnitude de l’effet calculée sur cet échantillon sera presque systématiquement surestimée par rapport à la réalité ontologique du phénomène psychique.
Pour conjurer ces distorsions dévastatrices, le chercheur contemporain doit impérativement procéder à un calcul de taille d’échantillon a priori (à l’aide d’outils spécialisés tels que G*Power). En spécifiant le seuil alpha requis (par ex. $\alpha = 0,05$), le niveau de puissance ciblé (la norme académique exige au minimum $1 – \beta = 0,80$, voire 0,90 ou 0,95) et la taille d’effet minimale théoriquement pertinente, ce calcul détermine l’effectif $N$ exact requis pour garantir que la statistique t générée en laboratoire bénéficiera de la sensibilité nécessaire pour faire basculer la valeur p sous le seuil critique avec une régularité scientifique satisfaisante.
9. Erreurs conceptuelles et biais d’interprétation fréquents en psychologie
9.1 Les sophismes majeurs autour de la valeur p
La littérature consacrée aux dérives méthodologiques en sciences du comportement regorge d’inventaires documentant l’incompréhension généralisée de la valeur p chez les étudiants, les enseignants et les chercheurs confirmés. Le premier écueil, et sans doute le plus tenace, est le **sophisme de la probabilité inverse** : croire mordicus que si votre test t affiche $p = 0,03$, il n’y a que 3 % de chances que vos conclusions soient erronées ou que l’hypothèse nulle soit vraie. Répétons-le sans équivoque : la valeur p ne dit rien de la probabilité de $H_0$. Elle indique simplement que si $H_0$ était le modèle régulateur de la réalité, une telle configuration de données ne surviendrait que dans 3 % des réplications aléatoires.
Le deuxième piège récurrent est le **sophisme de la réplicabilité déductive**. De nombreux auteurs présument qu’un résultat arborant une valeur $p = 0,01$ garantit une probabilité de $1 – p = 0,99$ (soit 99 %) d’obtenir à nouveau un résultat statistiquement significatif lors d’une réplication directe ultérieure. Les démonstrations formelles, notamment celles de Geoff Cumming à travers le phénomène de la « danse des p-values », ont prouvé que la valeur p oscille de manière spectaculaire d’un échantillon à l’autre en raison de la variabilité d’échantillonnage de la statistique t. Pour un test affichant une puissance standard de 80 %, l’intervalle de prédiction à 80 % de la valeur p lors d’une réplication identique est extrêmement large, balayant typiquement un continuum allant de $p = 0,001$ à des zones franches de non-significativité ($p > 0,30$).
Enfin, l’erreur la plus dommageable pour la pratique clinique consiste à **assimiler la significativité statistique à la pertinence substantielle**. Observer un effet thérapeutique avec $p < 0,001$ suite à la prise en charge d’un trouble obsessionnel compulsif ne signifie pas que les patients sont guéris ni que l’allègement de leurs rituels est suffisant pour métamorphoser leur quotidien. Un résultat hautement significatif peut correspondre à une micro-amélioration thérapeutique totalement imperceptible pour le clinicien si la puissance de détection de l’essai était démesurée.
9.2 Mauvaises interprétations de la valeur t
Si la valeur p concentre une grande partie des critiques, la statistique t fait elle aussi l’objet d’erreurs d’interprétation majeures au sein des laboratoires. L’erreur la plus banale consiste à **confondre la valeur t avec la taille d’effet non standardisée**. Un jeune chercheur pourra s’enthousiasmer devant un $t = 6,80$, s’imaginant que son protocole d’apprentissage a généré un saut qualitatif majeur dans les scores de mémorisation de ses sujets, alors que ce résultat peut simplement découler d’un échantillon vaste combiné à une variance d’échantillonnage anormalement comprimée par la conception des stimuli.
Un deuxième angle mort concerne la **dépendance absolue du score t à la précision métrologique**. Si deux équipes de recherche évaluent indépendamment la même différence moyenne réelle de 5 points entre les mêmes sous-populations mais utilisent des instruments psychométriques de qualité distincte, leurs valeurs t divergeront radicalement. Le laboratoire utilisant un questionnaire entaché de bruit de mesure verra l’écart-type résiduel gonfler, faisant s’affaisser son score t (par exemple $t = 1,45, p = 0,15$). Le laboratoire mobilisant une échelle hautement fidèle et validée réduira le bruit au dénominateur, obtenant un $t = 3,20, p = 0,002$. La valeur t ne reflète pas seulement la dynamique de la psyché humaine ; elle est le miroir direct de la qualité des outils d’enregistrement du chercheur.
Enfin, la **vulnérabilité de la distribution théorique de t face aux asymétries de distribution** est fréquemment ignorée. Nombreux sont les praticiens qui appliquent le test t de Student sur des distributions de temps de réaction hautement asymétriques à droite (loi ex-gaussienne ou log-normale) sans procéder à des transformations de variables appropriées ni opter pour des méthodes non-paramétriques ou robustes (telles que le test sur moyennes tronquées d’Erceg-Hurn et Mirosevich). Dans ces conditions d’asymétrie sévère, la statistique empirique calculée ne suit plus la loi formelle de Student, et les valeurs t extrêmes observées ne correspondent plus aux percentiles théoriques présumés, biaisant à la racine l’estimation de la valeur p.
9.3 Dérives méthodologiques : p-hacking et HARKing
La focalisation quasi-obsessionnelle du milieu académique sur le couperet des « $p < 0,05$ » pour conditionner la publication d’un article a favorisé l’émergence de comportements de recherche déviants, regroupés sous le vocable de p-hacking (ou pêche aux données significatives). Ces pratiques consistent à exploiter les « degrés de liberté du chercheur » jusqu’à ce que la statistique t s’élève suffisamment pour faire glisser la valeur p sous la barre fatidique des 5 %.
Parmi ces manœuvres contestables figure l’arrêt optionnel du recueil de données (optional early stopping). L’expérimentateur évalue ses données après avoir recueilli 20 participants par groupe : le résultat indique $t = 1,75, p = 0,08$. Au lieu d’accepter ce résultat ou de mener une nouvelle étude calibrée, il décide d’ajouter 5 participants supplémentaires, recalcule le t, et réitère l’opération jusqu’à ce que la statistique t franchisse fortuitement le seuil critique critique à $p = 0,046$. Cette démarche viole directement la théorie d’échantillonnage : en multipliant les regards intermédiaires sur les données sans ajustement de correction probabiliste, le taux d’erreur de première espèce réel ne culmine plus à 5 %, mais peut grimper à plus de 30 % ou 40 %.
D’autres formes de dérives incluent :
- Le multi-testing sauvage : calculer des dizaines de tests t en croisant toutes les variables secondaires d’une base de données sans appliquer d’ajustement du taux d’erreur familial (comme les corrections de Bonferroni, Holm ou le contrôle du taux de fausses découvertes FDR), puis rapporter uniquement l’unique test ayant émergé à $p < 0,05$.
- Le HARKing (Hypothesizing After the Results are Known) : pratique consistant à concevoir rétrospectivement une hypothèse théorique sur mesure pour s’ajuster à un score t inattendu ayant révélé un $p < 0,05$ au cours d’explorations fortuites, en le présentant fallacieusement dans le manuscrit final comme une confirmation a priori issue d’une déduction conceptuelle rigoureuse.
10. Au-delà de t et p : Taille de l’effet et intervalles de confiance
10.1 La mesure de la taille de l’effet : Le d de Cohen
Pour s’émanciper des pièges conjoints de la dépendance de la valeur t à la taille d’échantillon et de l’arbitraire binaire de la valeur p, l’analyse moderne en psychologie impose le calcul systématique d’indices standardisés de taille de l’effet. Parmi ceux-ci, le **d de Cohen** s’est imposé comme l’étalon d’or universel pour les comparaisons de moyennes.
Le d de Cohen exprime l’écart constaté entre deux moyennes en fraction d’écart-type global combiné, s’affranchissant totalement de la taille de l’échantillon $N$ :
$$d = \frac{\bar{X}_1 – \bar{X}_2}{s_p}$$
La beauté mathématique de ce formalisme réside dans le pont algébrique direct reliant la statistique t, la taille des sous-échantillons et le d de Cohen empirique :
$$d = t \sqrt{\frac{1}{n_1} + \frac{1}{n_2}} = t \sqrt{\frac{n_1 + n_2}{n_1 n_2}}$$
Dans le cas de groupes équilibrés ($n_1 = n_2 = n$), l’équation se résume à une élégance limpide :
$$d = \frac{2t}{\sqrt{N}} = \frac{2t}{\sqrt{2n}} = t \sqrt{\frac{2}{n}}$$
Jacob Cohen a établi des balises heuristiques bien connues pour aider les chercheurs à situer l’ampleur d’un phénomène psychologique :
- Effet faible ($d \approx 0,20$) : la séparation entre les distributions est ténue (recouvrement d’environ 85 % des populations). Phénomène discret, difficilement décelable à l’œil nu sans instruments sensibles (ex. : une légère différence de tempérament entre deux cohortes).
- Effet moyen ($d \approx 0,50$) : divergence perceptible dans la vie courante par un observateur averti (recouvrement d’environ 67 %). C’est l’ordre de grandeur moyen des manipulations cognitives standards.
- Effet fort ($d ge 0,80$) : écart majeur, d’une grande visibilité clinique ou comportementale (recouvrement chutant sous les 53 %). Typique de la différence de taille entre hommes et femmes adultes ou du contraste clinique entre un état dépressif sévère et un état euthymique.
Contrairement à la valeur p qui ne fait qu’arbitrer un procès de non-conformité, le d de Cohen chiffre la magnitude du phénomène étudié.
10.2 L’estimation par intervalle de confiance
L’autre complément indispensable à la dyade t-p réside dans l’adoption de l’estimation par **intervalles de confiance (IC)**. Plutôt que de confiner la décision à un estimateur ponctuel unique ($\bar{X}_1 – \bar{X}_2$) flanqué d’une valeur p, l’intervalle de confiance à 95 % encadre la différence réelle des moyennes par une marge d’erreur dérivée directement de la statistique critique de Student :
$$\text{IC}_{95%} = (\bar{X}_1 – \bar{X}_2) \pm \left[ t_{\text{critique}}(df; 0,05) \times SE_{(\bar{X}_1 – \bar{X}_2)} \right]$$
Il existe un lien théorique consubstantiel et rigide entre l’intervalle de confiance à 95 % et le rejet de l’hypothèse nulle au seuil $\alpha = 0,05$ :
- Si l’intervalle de confiance à 95 % **n’englobe pas la valeur zéro** (par exemple, $\text{IC}_{95%} = [2,15 ; 8,40]$), cela garantit mathématiquement que la valeur p correspondante sera strictement inférieure à 0,05 ($p < 0,05$). L’effet est statistiquement significatif.
- Si l’intervalle de confiance **englobe la valeur zéro** (par exemple, $\text{IC}_{95%} = [-1,20 ; 5,60]$), la valeur p sera irrémédiablement supérieure à 0,05 ($p > 0,05$). L’effet n’est pas significatif.
Néanmoins, l’apport informationnel de l’intervalle de confiance surpasse immensément la simple valeur p. Là où la valeur p dissimule l’imprécision métrologique derrière un indice scalaire unique, la largeur de l’intervalle de confiance expose crûment le degré d’incertitude de la mesure. Un intervalle s’étendant de $[0,05 ; 18,90]$ produit un résultat formellement significatif ($p \approx 0,049$), mais sa béance démesurée hurle à l’analyste que son estimation est instable et que la véritable ampleur de l’effet reste pour l’heure indéterminée, ce qu’une lecture naïve de la seule valeur p n’aurait jamais révélé.
10.3 La transition vers l’approche bayésienne en sciences psychologiques
Face aux apories récurrentes et aux confusions psychologiques engendrées par le formalisme fisherien et neyman-pearsonien, une part croissante de la communauté méthodologique en psychologie opère une transition épistémologique vers la **statistique bayésienne**. Dans ce paradigme alternatif, on ne conditionne plus le calcul sur l’hypothèse d’une nullité absolue du monde ($P(\text{Données} mid H_0)$) ; on calcule directement la probabilité a posteriori des hypothèses conditionnée par les données empiriques recueillies ($P(\text{Hypothèse} mid \text{Données})$) à l’aide du théorème de Bayes.
Dans ce contexte, le pendant du test t classique est l’analyse par les **Facteurs de Bayes (Bayes Factors)**, souvent notés $BF_{10}$ ou $BF_{01}$. Le $BF_{10}$ quantifie le rapport de vraisemblance marginale entre l’hypothèse alternative et l’hypothèse nulle :
$$BF_{10} = \frac{P(\text{Données} mid H_1)}{P(\text{Données} mid H_0)}$$
Un $BF_{10} = 8,5$ indique sans ambages que les données empiriques recueillies sont 8,5 fois plus compatibles avec le modèle prédisant l’existence d’un effet ($H_1$) qu’avec le modèle postulant son absence totale ($H_0$).
L’avantage épistémologique colossal du Facteur de Bayes sur la valeur t et la valeur p conventionnelles réside dans sa capacité théorique à **quantifier la preuve en faveur de l’hypothèse nulle**. Alors que le test t fréquentiste ne peut jamais « prouver » $H_0$ — étant condamné à échouer à son rejet —, un indice $BF_{01} = 12,0$ permet au chercheur d’affirmer avec une parfaite légitimité probabiliste que ses données soutiennent 12 fois plus fermement l’absence d’effet que la présence d’une différence. Cette flexibilité offre une issue élégante aux débats scientifiques insolubles générés par les résultats non significatifs classiques ($p > 0,05$).
11. Études de cas appliquées : Analyse de résultats empiriques en psychologie
11.1 Cas 1 : Évaluation d’une psychothérapie pour le trouble dépressif majeur
Considérons un essai contrôlé randomisé mené au sein d’une unité de psychiatrie universitaire. Deux groupes de patients diagnostiqués avec un Trouble Dépressif Majeur (TDM) sont suivis pendant 12 semaines : le premier groupe ($n_1 = 25$) bénéficie d’une Thérapie Cognitive et Comportementale (TCC) structurée de dernière génération, tandis que le second groupe ($n_2 = 25$) est assigné à une liste d’attente avec suivi clinique de soutien (groupe contrôle). La variable dépendante continue est le score de sévérité mesuré à l’inventaire de dépression de Beck (BDI-II) à l’issue des 12 semaines d’intervention.
Les données descriptives révèlent :
- Groupe TCC : $\bar{X}_1 = 14,20$ ($s_1 = 5,10$)
- Groupe Contrôle : $\bar{X}_2 = 22,80$ ($s_2 = 6,30$)
La différence des moyennes brutes est substantielle : $\bar{X}_1 – \bar{X}_2 = -8,60$ points sur l’échelle BDI-II. Le test de Levene confirme l’homoscédasticité des variances ($F = 0,82, p = 0,37$). Le calcul de la variance combinée donne $s_p^2 = 32,85$, soit un écart-type combiné $s_p \approx 5,73$. L’erreur type de la différence s’élève à :
$$SE = 5,73 \times \sqrt{\frac{1}{25} + \frac{1}{25}} = 5,73 \times \sqrt{0,08} \approx 5,73 \times 0,2828 \approx 1,62$$
Le calcul de la statistique de Student produit :
$$t = \frac{-8,60}{1,62} = -5,31$$
Avec des degrés de liberté $df = 25 + 25 – 2 = 48$, l’intégration sous la courbe de Student donne une valeur $p < 0,00001$. Le calcul du d de Cohen indique quant à lui :
$$d = \frac{-8,60}{5,73} \approx -1,50$$
Diagnostic complet : Nous sommes ici en présence d’une conjonction expérimentale exemplaire. La valeur t ($t = -5,31$) atteste d’un signal émergeant à plus de 5 erreurs types du modèle nul. La valeur p ($p < 0,001$) balaie catégoriquement l’explication stochastique pure. Enfin, et surtout, le d de Cohen ($d = 1,50$) et la différence brute de 8,60 points sur le BDI-II certifient l’existence d’une magnitude clinique majeure, bien au-delà des seuils de pertinence thérapeutique minimale.
11.2 Cas 2 : Effet d’un amorçage attentionnel sur le temps de réaction en laboratoire
Examinons une expérience de chronométrie mentale en psychologie cognitive portant sur l’inhibition attentionnelle (paradigme de type Posner). Un protocole intra-sujet (mesures répétées) est administré à un échantillon pilote restreint de $N = 18$ étudiants universitaires. Chaque participant est soumis à deux conditions : condition avec amorce congruente et condition avec amorce neutre. La mesure enregistrée est la latence moyenne de réponse correcte en millisecondes.
Les résultats expérimentaux indiquent une différence intra-individuelle moyenne $\bar{D} = 12,50 \text{ ms}$ au bénéfice de l’amorce congruente, avec un écart-type des différences $s_D = 26,40 \text{ ms}$. L’erreur type du vecteur de différence se calcule comme suit :
$$SE_D = \frac{26,40}{\sqrt{18}} = \frac{26,40}{4,24} \approx 6,22 \text{ ms}$$
La statistique t pour échantillons appariés s’établit à :
$$t = \frac{12,50}{6,22} = +2,01$$
Avec $df = 18 – 1 = 17$, la projection de cette coordonnée $t = 2,01$ sur la distribution de Student bilatérale produit une valeur $p = 0,060$. Toutefois, si le chercheur décide unilatéralement de requalifier son test en directionnel sous prétexte qu’une facilitation était attendue, la valeur p est divisée par deux, franchissant miraculeusement le seuil : $p_{\text{unilatéral}} = 0,030$.
Diagnostic critique : Ce cas incarne la précarité méthodologique classique des protocoles sous-dimensionnés. La valeur de t oscille tout juste autour du point d’inflexion critique ($t = 2,01$). Dans un cadre bilatéral standardisé rigoureux, le résultat est strictement non significatif ($p = 0,060$). Tenter de forcer le résultat vers la significativité par une rationalisation post-hoc unilatérale relève du p-hacking. L’intervalle de confiance à 95 % de la différence $[-0,62 ; 25,62]$ croise le zéro. L’analyste intègre doit conclure à une tendance nécessitant une réplication sur un panel calibré avec une puissance adéquate ($N ge 60$) avant d’oser revendiquer un effet d’amorçage cognitif.
11.3 Cas 3 : Étude épidémiologique à large échelle sur le bien-être subjectif
Analysons une étude contemporaine à grande échelle portant sur l’impact de l’usage récréatif quotidien des écrans sur le bien-être subjectif des adolescents. En exploitant des bases de données ouvertes issues de cohortes nationales en libre accès, les chercheurs analysent les réponses d’un échantillon massif comprenant $N = 65 000$ adolescents répartis en deux groupes : utilisateurs modérés ($n_1 = 35 000$) et utilisateurs intensifs ($n_2 = 30 000$). Le bien-être est mesuré par une échelle globale standardisée étalonnée sur un score continu de 1 à 100 points ($s \approx 15,0$).
L’analyse des scores moyens met en évidence les données suivantes :
- Utilisateurs modérés : $\bar{X}_1 = 72,40$
- Utilisateurs intensifs : $\bar{X}_2 = 71,90$
L’effet brut constaté s’élève à $\bar{X}_1 – \bar{X}_2 = 0,50$ point sur l’échelle de bien-être. Calculons l’erreur type de cette différence sur cette cohorte colossale :
$$SE = 15,0 \times \sqrt{\frac{1}{35000} + \frac{1}{30000}} = 15,0 \times \sqrt{0,00002857 + 0,00003333} = 15,0 \times \sqrt{0,0000619} \approx 15,0 \times 0,007868 \approx 0,118$$
Le calcul de la valeur t produit un chiffre spectaculaire :
$$t = \frac{0,50}{0,118} \approx +4,24$$
Avec $df = 64 998$, la valeur p s’effondre dans des abysses probabilistes : $p \approx 0,000022$ ($p < 0,0001$). Pourtant, convertissons immédiatement ce score t en taille d’effet standardisée via le d de Cohen :
$$d = \frac{0,50}{15,0} \approx 0,033$$
Diagnostic méthodologique : Ce scénario illustre de manière magistrale le paradoxe de la significativité dans les mégadonnées. D’un point de vue purement inférentiel neyman-pearsonien, le test est un triomphe : la valeur t est stratosphérique ($t = 4,24$) et le résultat est certifié à $p < 0,0001$. Pourtant, la taille d’effet mesurée ($d = 0,033$) révèle que la manipulation n’explique qu’une fraction infinitésimale de la variance du bien-être (moins de 0,03 % de variance expliquée). Ce demi-point sur une échelle de 100 points est totalement indétectable dans la vie réelle d’un individu. Présenter cette découverte dans les médias en titrant sur les « ravages prouvés des écrans » sur la base de ce $p < 0,0001$ relève de la désinformation scientifique pure : la valeur p n’a fait que valider la sensibilité du panel sans conférer la moindre substance psychologique au phénomène.
12. Recommandations méthodologiques et rapportage des résultats selon les normes APA
12.1 Normes de rédaction APA (7e édition) pour les tests t
L’American Psychological Association (APA), dans la 7e édition de son manuel de publication, a formalisé des directives typographiques et méthodologiques d’une extrême précision concernant la manière de rapporter les résultats des tests inférentiels. Le principe directeur est la transparence totale : le lecteur doit pouvoir reconstruire mentalement l’intégralité de l’appareil inférentiel sans ambiguïté.
Les règles de mise en forme typographique imposent :
- L’assignation en **italique** des lettres représentant des paramètres ou des statistiques empiriques : t, p, d, M (moyenne), SD (écart-type).
- La mention explicite des degrés de liberté entre parenthèses, accolés immédiatement à la statistique t, sans espace : t(48).
- L’absence de zéro initial avant la virgule pour les grandeurs mathématiques ne pouvant théoriquement jamais excéder la valeur 1,00. Par conséquent, les valeurs de p s’écrivent obligatoirement **.035** et jamais 0.035. En revanche, le score t pouvant dépasser 1,00 sans limite, il conserve impérativement son zéro initial : t(48) = 2.45.
- Le rapportage de la **valeur p exacte à trois décimales** (ex. : p = .024, p = .451). L’usage de formules génériques comme p < .05 est désormais prohibé par l’APA, à l’exception exclusive des valeurs extrêmement faibles, qui doivent être consignées sous la forme **p < .001**.
- L’adjonction obligatoire d’une métrique d’amplitude d’effet (typiquement le d de Cohen) et, idéalement, de l’intervalle de confiance à 95 % de la différence des moyennes.
Voici des illustrations conformes prêtes à l’emploi pour les publications académiques :
Exemple 1 (test t indépendant) : « Les scores d’anxiété étaient significativement plus faibles dans le groupe ayant suivi la TCC (M = 14.20, SD = 5.10) que dans le groupe témoin (M = 22.80, SD = 6.30), t(48) = -5.31, p < .001, d = 1.50, IC 95% [-11.85, -5.35]. »
Exemple 2 (test non significatif) : « La différence de temps de réaction entre la condition congruente (M = 412 ms, SD = 45) et la condition neutre (M = 424 ms, SD = 50) n’a pas atteint le seuil conventionnel de significativité, t(17) = 2.01, p = .060, d = 0.47, IC 95% [-0.62, 25.62]. »
12.2 Guide pratique pour le chercheur et l’étudiant en psychologie
Pour naviguer avec assurance de la conception de la recherche à la rédaction du manuscrit, nous proposons ici une synthèse procédurale séquentielle sous forme d’arbre décisionnel et de critères d’assurance qualité :
Étape 1 : Conception a priori et puissance
- Définir formellement le cadre directionnel (privilégier systématiquement le test bilatéral à moins d’une justification théorique absolue).
- Exécuter un calcul de puissance statistique a priori (avec G*Power ou équivalent en R) pour verrouiller la taille de l’échantillon garantissant un minimum de $1 – \beta = 0,80$.
- Pré-enregistrer idéalement le protocole méthodologique sur des plateformes dédiées (Open Science Framework) afin d’attester de l’absence ultérieure de p-hacking.
Étape 2 : Vérification exploratoire des postulats
- Vérifier la forme de la distribution continue (indicateurs d’asymétrie skewness < |2| et d’aplatissement kurtosis < |7| ; diagrammes Q-Q plots).
- Tester l’homoscédasticité via le test de Levene. En cas de violation ($p < .05$), basculer immédiatement et sans hésitation vers le test t de Welch.
Étape 3 : Calcul et interprétation croisée
- Générer la statistique t, ses degrés de liberté effectifs et la valeur p continue exacte.
- Calculer systématiquement le d de Cohen standardisé et l’intervalle de confiance à 95 % de la différence.
- Ne jamais clore l’analyse sur la constatation binaire d’un $p < .05$. Évaluer conjointement : la direction du signal (signe de t), l’ampleur du signal en unités de variance (d de Cohen), la stabilité de la métrique (largeur de l’IC) et la plausibilité conditionnelle sous $H_0$ (valeur p).
En adoptant cette discipline méthodologique intégrée, le chercheur en sciences du comportement s’assure de produire des analyses d’une transparence irréprochable, contribuant activement à la consolidation empirique et à la maturité épistémologique de la psychologie contemporaine.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Cumming, G. (2014). The new statistics: Why and how. Psychological Science, 25(1), 7–29. https://doi.org/10.1177/0956797613504966
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Gelman, A., & Stern, H. (2006). The difference between « significant » and « not significant » is not itself statistically significant. The American Statistician, 60(4), 328–331. https://doi.org/10.1198/000313006X152607
- Kerr, N. L. (1998). HARKing: Hypothesizing after the results are known. Personality and Social Psychology Review, 2(3), 196–217. https://doi.org/10.1207/s15327957pspr0203_4
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, 231(694-706), 289–337. https://doi.org/10.1098/rsta.1933.0009
- Open Science Collaboration. (2015). Estimating the reproducibility of psychological science. Science, 349(6251), aac4716. https://doi.org/10.1126/science.aac4716
- Simmons, J. P., Nelson, L. D., & Simonsohn, U. (2011). False-positive psychology: Undisclosed flexibility in data collection and analysis allows presenting anything as significant. Psychological Science, 22(11), 1359–1366. https://doi.org/10.1177/0956797611417632
- Student. (1908). The probable error of a mean. Biometrika, 6(1), 1–25. https://doi.org/10.2307/2331554
- Wasserstein, R. L., & Lazar, N. A. (2016). The ASA’s statement on p-values: Context, process, and purpose. The American Statistician, 70(2), 129–133. https://doi.org/10.1080/00031305.2016.1154108