
Dans le vaste champ de l’économétrie appliquée et de la modélisation statistique en sciences humaines, l’analyse de régression linéaire par les moindres carrés ordinaires (MCO) demeure l’un des piliers méthodologiques les plus universellement exploités. Sa popularité s’explique par sa simplicité conceptuelle, son élégance calculatoire et la transparence interprétative de ses coefficients. Toutefois, la validité des déductions inférentielles tirées de ces modèles repose impérativement sur un faisceau d’hypothèses classiques formalisées par le cadre de Gauss-Markov. Parmi ces postulats fondamentaux figure l’homoscédasticité, c’est-à-dire l’invariance de la dispersion du terme d’erreur stochastique à travers l’ensemble des observations et des niveaux des variables explicatives.
Lorsque cette condition essentielle est enfreinte, les données manifestent ce que la littérature nomme l’hétéroscédasticité. Ce phénomène statistique, loin de constituer une simple anomalie marginale ou une curiosité mathématique, représente l’état habituel des mesures empiriques issues du monde réel, singulièrement en recherche psychologique, en sociologie quantitative et en économie comportementale. L’hétéroscédasticité reflète souvent des processus substantiels profonds : variations des stratégies d’apprentissage, instabilité des traits latents, asymétrie des ressources cognitives ou encore imperfections structurelles des instruments psychométriques. Ignorer sa présence expose le chercheur à des erreurs méthodologiques majeures susceptibles de fragiliser la reproductibilité scientifique.
La persistance de pratiques consistant à négliger le diagnostic de la variance des résidus conduit fréquemment à la publication de résultats faussement significatifs ou à l’abandon d’hypothèses théoriques pourtant valides. L’objet de cet article est de fournir une déconstruction rigoureuse et exhaustive des fondements théoriques, des sources psychologiques, des conséquences inférentielles et des stratégies contemporaines de remédiation de l’hétéroscédasticité. En combinant modélisation formelle, perspectives psychométriques et implémentations computationnelles modernes, ce guide propose aux chercheurs un itinéraire méthodologique complet pour diagnostiquer, corriger et valoriser la variance hétérogène dans leurs travaux empiriques.
1. Fondements théoriques de l’hétéroscédasticité dans le modèle linéaire classique
1.1 Définition formelle et postulat d’homoscédasticité
L’architecture mathématique du modèle de régression linéaire multiple s’articule autour de la relation vectorielle liant un vecteur de réponses observées à une matrice de régresseurs, augmentée d’un vecteur de perturbations aléatoires. Dans ce cadre, le postulat d’homoscédasticité s’exprime formellement par l’égalité stipulant que la variance conditionnelle du terme d’erreur, sachant les variables prédictives, est rigoureusement constante pour chaque observation individuelle. Mathématiquement, pour toute observation indicée i, la condition s’énonce sous la forme de l’espérance conditionnelle du carré de l’erreur diminuée de son espérance, aboutissant à une variance conditionnelle scalaire identique pour tout i appartenant à l’ensemble des données. Cette valeur constante est traditionnellement notée par le paramètre sigma au carré, traduisant une dispersion uniforme des résidus théoriques.
Il est impératif d’établir une distinction épistémologique et technique stricte entre les termes d’erreur populationnels, non observables, et les résidus d’échantillon calculés après l’ajustement du modèle. L’erreur stochastique correspond à l’écart latent entre l’observation réelle et la véritable droite de régression de la population mère. À l’inverse, le résidu d’échantillon représente la distance mesurée entre la valeur empirique et la valeur ajustée par l’algorithme d’estimation. Bien que les propriétés asymptotiques des résidus reflètent celles des perturbations latentes lorsque la taille d’échantillon tend vers l’infini, la structure de covariance des résidus d’échantillon n’est jamais rigoureusement homoscédastique au sens strict, en raison des degrés de liberté absorbés par l’estimation des paramètres de localisation.
La notion de variance conditionnelle dépendante des prédicteurs observés formalise la rupture directe de cette hypothèse fondamentale. Lorsque l’homoscédasticité est violée, la variance des erreurs devient une fonction mathématique explicite ou implicite des régresseurs, s’écrivant comme une variance indicée pour chaque unité d’observation. Cela implique que l’incertitude entourant la trajectoire de la variable dépendante s’amplifie ou se contracte selon les sous-espaces définis par les variables indépendantes, invalidant le postulat d’une dispersion isotrope dans l’espace multidimensionnel des variables de l’étude.
1.2 Le théorème de Gauss-Markov et la condition BLUE
Le théorème de Gauss-Markov constitue la pierre angulaire de l’inférence par la méthode des moindres carrés ordinaires. Ce théorème démontre mathématiquement que, sous un ensemble précis d’hypothèses incluant l’exogénéité stricte des régresseurs, l’absence de colinéarité parfaite, l’absence d’autocorrélation des erreurs et l’homoscédasticité, l’estimateur des moindres carrés ordinaires possède la variance d’échantillonnage minimale parmi tous les estimateurs linéaires sans biais envisageables. Cette propriété confère à l’estimateur le statut privilégié d’estimateur BLUE, acronyme désignant le Best Linear Unbiased Estimator, garantissant une efficacité statistique optimale pour tester des hypothèses scientifiques.
L’exigence d’homoscédasticité n’intervient pas dans la démonstration du caractère non biaisé de l’estimateur MCO, mais elle conditionne de manière irrévocable la preuve de sa variance minimale. Pour que la matrice de covariance de l’estimateur atteigne la borne inférieure définie dans le théorème, la matrice de variance-covariance des perturbations aléatoires doit impérativement être scalaire, se réduisant au produit du scalaire sigma au carré par la matrice identité. Dès lors que cette matrice cesse d’être diagonale uniforme, l’optimalité de l’estimateur MCO s’effondre. Bien que l’estimateur demeure linéaire et centré sur le paramètre vrai, il perd son qualificatif de meilleur estimateur au sens de la variance d’échantillonnage.
Les conséquences théoriques immédiates de cette rupture sont majeures pour la statistique inférentielle. D’une part, l’estimateur des MCO devient sous-optimal, signifiant qu’il existe d’autres estimateurs linéaires sans biais – notamment ceux fondés sur les moindres carrés généralisés – qui présentent une dispersion stochastique strictement inférieure autour de la valeur réelle du paramètre. D’autre part, les formules algébriques conventionnelles utilisées par les logiciels statistiques pour quantifier l’incertitude d’échantillonnage ne correspondent plus à la variance mathématique réelle de l’estimateur, conduisant à des inférences totalement erronées.
1.3 Typologies de l’hétéroscédasticité
Dans la littérature méthodologique contemporaine, l’hétéroscédasticité est subdivisée en plusieurs catégories analytiques distinctes. La première dichotomie structurelle oppose l’hétéroscédasticité inconditionnelle à l’hétéroscédasticité conditionnelle. L’hétéroscédasticité inconditionnelle désigne une fluctuation de la variance globale des erreurs qui ne dépend pas des valeurs prises par les variables explicatives du modèle, mais peut être liée à des facteurs temporels exogènes ou à des ruptures de régime structurelles dans la collecte des données. À l’opposé, l’hétéroscédasticité conditionnelle désigne une situation où la variabilité locale du terme d’erreur est explicitement conditionnée par le vecteur des prédicteurs, générant des zones de forte dispersion pour certains profils de variables et des zones de resserrement pour d’autres.
Sur le plan géométrique et analytique, la relation fonctionnelle gouvernant la variance conditionnelle peut adopter une multiplicité de configurations morphologiques. Les formes fonctionnelles les plus fréquemment rencontrées dans les données empiriques sont la forme linéaire, où l’écart-type résiduel croît de manière proportionnelle à l’amplitude d’un prédicateur continu ; la forme exponentielle ou multiplicative, où la variance explose dès que les prédicteurs atteignent des seuils élevés ; et la forme parabolique ou quadratique, où l’erreur résiduelle est minimale pour les valeurs médianes du prédicteur mais s’élargit drastiquement aux deux extrémités de la distribution observée.
Enfin, une différenciation fondamentale doit être opérée entre l’hétéroscédasticité structurelle et les artéfacts d’échantillonnage. L’hétéroscédasticité structurelle découle intrinsèquement de la nature des processus psychosociaux ou comportementaux sous-jacents, reflétant une véritable hétérogénéité de la réactivité humaine. En revanche, l’hétéroscédasticité artéfactuelle résulte de failles méthodologiques évitables, telles qu’une erreur de mesure fluctuant selon les conditions de passation, un échantillonnage stratifié disproportionné non corrigé ou la présence d’observations aberrantes exerçant un effet de levier asymétrique sur l’estimation de la variance locale.
2. Origines et mécanismes générateurs d’hétéroscédasticité en recherche psychologique
2.1 Processus d’apprentissage et variabilité comportementale interindividuelle
La recherche en psychologie cognitive et expérimentale fournit l’un des cadres les plus illustratifs de l’émergence endogène de l’hétéroscédasticité à travers l’étude de l’apprentissage et de l’acquisition d’habiletés motrices ou intellectuelles. Lorsqu’un protocole expérimental soumet des participants à des tâches répétées au fil de multiples sessions chronologiques, la variance des performances temporelles ou qualitatives ne demeure presque jamais stable. Selon la complexité intrinsèque de la tâche cognitive, deux trajectoires divergentes de dispersion sont classiquement documentées dans la littérature expérimentale.
Dans les tâches perceptivo-motrices relativement simples, on observe généralement une diminution progressive de la variance interindividuelle au fur et à mesure que l’entraînement progresse. Au début de l’expérimentation, les participants emploient des stratégies cognitives disparates et présentent des niveaux initiaux de familiarité très contrastés, engendrant une variabilité résiduelle massive. Avec la pratique, les sujets convergent vers une stratégie optimale commune, stabilisant leurs temps de réaction autour d’un seuil physiologique incompressible, ce qui génère un rétrécissement drastique de la variance résiduelle au fil du temps. Le modèle de régression liant la vitesse d’exécution au nombre d’essais affiche alors une hétéroscédasticité convergente hautement marquée.
À l’inverse, lors de l’apprentissage de compétences cognitives hautement complexes, telles que la programmation informatique, la résolution de problèmes mathématiques abstraits ou la maîtrise d’une langue étrangère, les différences interindividuelles s’amplifient de manière exponentielle avec l’exposition au matériel. Alors qu’une fraction des participants bénéficiant d’une capacité de mémoire de travail supérieure optimise rapidement ses performances, les participants confrontés à des limitations cognitives stagnent ou développent des stratégies sous-optimales désordonnées. Ce phénomène de divergence adaptative fait exploser la variance résiduelle pour les niveaux élevés d’entraînement, manifestant une hétéroscédasticité structurelle divergente qu’un modèle linéaire standard ne peut capturer fidèlement sans ajustement analytique.
2.2 Propriétés psychométriques et erreurs de mesure cumulatives
Les instruments d’évaluation psychométrique standardisés, tels que les questionnaires d’auto-évaluation reposant sur des échelles de type Likert, constituent une source majeure et omniprésente d’hétéroscédasticité artéfactuelle en psychologie sociale, clinique et organisationnelle. Ces échelles imposent par construction des bornes numériques rigides, généralement comprises entre un minimum et un maximum arbitraires. Cette délimitation artificielle engendre systématiquement des effets de plancher et de plafond qui déforment la distribution empirique des résidus d’échantillon aux extrémités de l’instrument.
Lorsqu’un individu présente un niveau extrêmement élevé ou extrêmement bas sur le trait latent mesuré – par exemple un niveau d’anxiété clinique ou une dépression sévère –, ses réponses se concentrent massivement sur la valeur maximale ou minimale de l’échelle. Par conséquent, la marge de variation stochastique autour de la valeur prédite est mécaniquement comprimée par la borne de l’instrument, créant une variance d’erreur résiduelle très faible pour les scores extrêmes. En revanche, pour les individus se situant à des niveaux intermédiaires du trait latent, les réponses peuvent librement fluctuer dans les deux directions, maximisant ainsi la dispersion résiduelle autour de la droite de régression. Cette variabilité hétérogène en forme de cloche inversée ou d’éventail constitue une violation directe de l’homoscédasticité.
De surcroît, la théorie moderne de la réponse aux items (TRI) démontre avec rigueur que la fidélité de mesure d’un instrument psychologique n’est jamais uniforme le long du continuum du trait latent. La quantité d’information fournie par un test atteint son apogée là où se concentrent les paramètres de difficulté des items. Lorsque l’on évalue des participants dont les aptitudes se situent dans les zones où le test fournit peu d’information psychométrique, l’erreur standard de mesure augmente de manière spectaculaire. Cette inconstance de l’erreur de mesure se répercute instantanément dans le terme d’erreur du modèle de régression, produisant une hétérogénéité résiduelle qui reflète la structure intrinsèque de l’instrument plutôt que la relation théorique examinée.
2.3 Erreurs de spécification du modèle et variables omises
Au-delà des caractéristiques intrinsèques des participants et des propriétés des instruments de mesure, l’hétéroscédasticité en recherche comportementale trouve très souvent son origine dans une modélisation mathématique défaillante de la réalité psychologique. L’omission d’une variable modératrice clé constitue le mécanisme générateur le plus pernicieux. Supposons une recherche évaluant l’impact du niveau de stress professionnel sur l’épuisement émotionnel sans intégrer la variable du soutien social perçu ou des stratégies de régulation émotionnelle. Si l’effet du stress dépend de la présence ou de l’absence de ce modérateur non mesuré, les participants soumis à un stress élevé présenteront une divergence considérable d’épuisement selon leurs ressources de protection individuelles, provoquant un étalement massif des résidus pour les valeurs fortes de stress.
La tentative inappropriée de linéariser des dynamiques psychologiques fondamentalement non linéaires représente un second facteur déterminant de fausse hétéroscédasticité. De nombreux processus psychologiques suivent des lois asymptotiques, sigmoïdes ou paraboliques, à l’instar de la célèbre loi de Yerkes-Dodson qui postule une relation en U inversé entre l’activation physiologique et l’efficacité de la performance. L’ajustement d’une simple droite de régression linéaire MCO sur de telles données force l’algorithme à minimiser globalement les écarts, ce qui génère une alternance systématique de sous-estimations et de surestimations locales accompagnée d’un écartement artificiel de la variance des résidus le long de l’axe prédictif.
Enfin, la sous-estimation de l’impact des interactions d’ordre supérieur exerce une influence délétère similaire. En négligeant d’inclure les produits croisés entre plusieurs prédicteurs continus ou catégoriels, l’analyste contraint son modèle à assumer des effets additifs stricts. La variance non expliquée par l’absence de ces termes d’interaction complexes vient alors se déverser directement dans le compartiment résiduel, adoptant une structure hétérogène corrélée aux différentes combinaisons des prédicteurs observés, ce qui mime parfaitement une hétéroscédasticité structurelle tout en signalant avant tout une mauvaise spécification fonctionnelle.
3. Conséquences statistiques de l’hétéroscédasticité sur l’inférence par les MCO
3.1 Préservation du caractère non biaisé des coefficients de régression
Face à la détection d’une hétéroscédasticité dans un jeu de données psychologiques, une confusion théorique fréquente consiste à croire que les estimations ponctuelles des pentes et de la constante de régression sont invalidées ou faussées dans leur valeur centrale. Il est impératif de souligner avec la plus grande rigueur mathématique que l’hétéroscédasticité n’induit aucun biais dans le calcul des coefficients de régression par les moindres carrés ordinaires. La propriété d’absence de biais dépend exclusivement de l’hypothèse d’exogénéité stricte, c’est-à-dire de la condition selon laquelle l’espérance conditionnelle du terme d’erreur sachant les variables explicatives est identiquement égale à zéro.
D’un point de vue analytique, l’expression de l’estimateur MCO s’écrit comme la somme de la vraie valeur paramétrique de la population et d’une combinaison linéaire pondérée des termes d’erreur stochastiques. Dès lors que l’espérance de ces perturbations aléatoires est nulle pour chaque configuration des variables indépendantes, l’espérance mathématique de l’estimateur MCO converge invariablement vers la véritable valeur du paramètre de population, que la variance des erreurs soit constante ou hautement volatile. En termes statistiques simples, l’estimateur MCO reste en moyenne parfaitement centré sur la cible théorique qu’il cherche à quantifier.
Cependant, cette préservation de la justesse de l’estimation ne doit en aucun cas être interprétée comme une validation de la méthode des MCO en contexte hétéroscédastique. L’absence de biais garantit simplement que si l’on répétait l’expérience un nombre infini de fois avec de nouveaux échantillons aléatoires, la moyenne de l’ensemble des pentes estimées égalerait la pente réelle. Cela ne garantit nullement que l’estimation issue d’un unique échantillon empirique isolé soit précise, ni surtout que les outils mathématiques conventionnels servant à quantifier la marge d’erreur de cette estimation soient fiables.
3.2 Perte d’efficacité et inefficacité relative des estimateurs
La conséquence structurelle immédiate de la rupture du postulat d’homoscédasticité réside dans la déchéance du statut d’estimateur le plus efficace pour les moindres carrés ordinaires. En présence d’une variance d’erreur inégale, l’estimateur MCO perd sa propriété de variance minimale au sein de la classe des estimateurs linéaires sans biais. Bien qu’il continue de cibler sans déviation systématique la valeur paramétrique réelle, la dispersion d’échantillonnage de ses estimations devient substantiellement plus large que celle qui pourrait être obtenue au moyen d’algorithmes d’estimation alternatifs exploitant l’information contenue dans la structure d’hétérogénéité.
Cette inefficacité relative s’explique intuitivement par le principe de pondération démocratique inhérent aux MCO. L’algorithme des moindres carrés classiques accorde un poids rigoureusement identique à chaque observation de l’échantillon pour déterminer la position de la droite de régression, minimisant la somme non pondérée des carrés des résidus. Or, du point de vue de l’information statistique, une observation caractérisée par une variance résiduelle massive apporte un signal théorique extrêmement flou et instable, pollué par un bruit stochastique prédominant. Inversement, une observation associée à une faible variance résiduelle fournit une mesure hautement précise et fiable de la relation sous-jacente.
En traitant ces observations hétérogènes avec une équité aveugle, l’estimateur MCO dégrade sa propre précision d’échantillonnage globale. L’inflation de la variance théorique réelle des coefficients estimés entraîne une dispersion accrue des estimations d’une réplication à l’autre. Dans les études expérimentales ou corrélationnelles menées avec des effectifs modérés – situation typique en psychologie clinique ou en neurosciences comportementales –, cette perte d’efficacité se traduit directement par une diminution drastique de la puissance statistique, rendant la détection empirique d’effets psychologiques réels particulièrement difficile.
3.3 Distorsion de la matrice de variance-covariance et des tests statistiques
Si la perte d’efficacité représente un inconvénient majeur en matière d’optimisation de la puissance, la conséquence la plus délétère de l’hétéroscédasticité concerne la distorsion systématique de la matrice de variance-covariance conventionnelle des estimateurs. Les logiciels d’analyse statistique standard calculent les erreurs-types des coefficients sous l’hypothèse tacite d’homoscédasticité, en utilisant une formule simplifiée où la variance résiduelle scalaire est factorisée hors du produit matriciel des prédicteurs. Lorsque la variance conditionnelle n’est pas constante, cette simplification algébrique devient caduque et le calcul conventionnel ne reflète plus l’incertitude réelle de l’estimation.
Dans la majorité des configurations empiriques courantes, notamment lorsque les régresseurs présentent une asymétrie positive conjuguée à une variance d’erreur croissante, la formule conventionnelle produit une sous-estimation systématique et sévère des véritables erreurs-types d’échantillonnage. Par conséquent, les statistiques de test calculées – qu’il s’agisse des tests t de Student pour évaluer la significativité individuelle des prédicteurs ou des tests F de Fisher-Snedecor pour apprécier la validité globale du modèle – sont artificiellement gonflées, car leur dénominateur est biaisé vers le bas.
Cette distorsion mécanique engendre une invalidation complète des seuils de décision probabilistes, culminant dans une inflation dramatique du taux d’erreur de première espèce, communément désigné comme le taux d’erreur de type I. Des coefficients qui ne reflètent que des fluctuations stochastiques ordinaires affichent des valeurs p fallacieusement inférieures au seuil critique conventionnel de 0,05. Le chercheur est alors conduit à proclamer l’existence d’effets psychologiques significatifs qui constituent en réalité de purs artéfacts computationnels générés par la non-prise en compte de l’hétéroscédasticité, alimentant ainsi directement la crise de réplication qui secoue les sciences du comportement.
4. Méthodes visuelles et exploration graphique des résidus
4.1 Le diagramme de dispersion des résidus en fonction des valeurs prédites
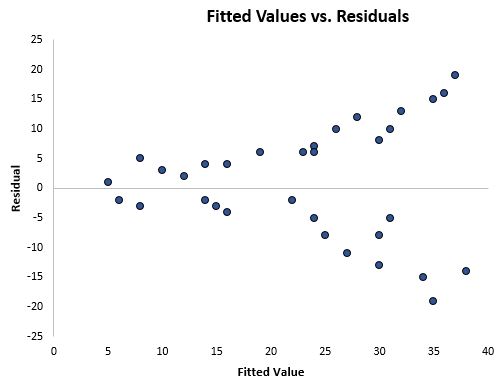
L’exploration visuelle constitue la première étape incontournable de tout protocole d’analyse diagnostique rigoureux face à un modèle de régression linéaire. Parmi l’arsenal graphique disponible, le diagramme de dispersion représentant les résidus d’échantillon sur l’axe des ordonnées en fonction des valeurs prédites par le modèle sur l’axe des abscisses est le dispositif le plus fondamental et le plus informatif. Sous l’hypothèse nulle d’homoscédasticité parfaite, ce graphique doit idéalement se présenter sous la forme d’un nuage de points aléatoire, homogène et dénué de structure morphologique identifiable, formant une bande de dispersion horizontale symétrique de part et d’autre de la ligne zéro.
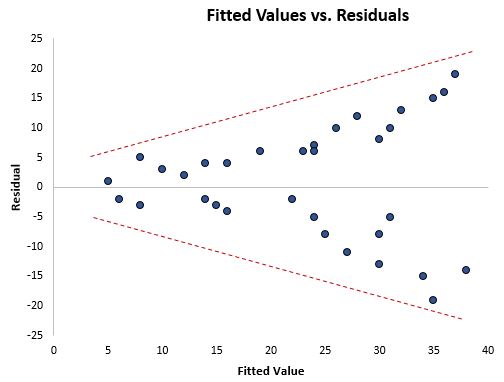
L’apparition d’un motif géométrique caractéristique en forme d’entonnoir, de mégaphone ou d’éventail constitue la signature visuelle immédiate de l’hétéroscédasticité. Lorsque la dispersion verticale des points résiduels s’élargit progressivement à mesure que l’on se déplace de la gauche vers la droite de l’axe horizontal, le chercheur observe de manière indubitable une croissance monotone de la variance conditionnelle des erreurs associée aux valeurs attendues élevées. L’inverse – une contraction de la bande résiduelle le long des valeurs prédites – illustre une hétéroscédasticité décroissante tout aussi problématique pour l’inférence conventionnelle.
Pour affiner l’évaluation clinique de ce diagramme, l’utilisation de résidus standardisés ou studentisés est formellement recommandée par rapport aux résidus bruts non standardisés. Les résidus bruts possèdent par construction une variance d’échantillon inégale induite par la matrice de projection orthogonale des prédicteurs. Les résidus studentisés éliminent ce biais géométrique intrinsèque en divisant chaque résidu brut par son écart-type d’échantillonnage théorique exact, offrant une échelle standardisée où les déviations résiduelles dépassant les seuils critiques de plus ou moins deux écarts-types sautent immédiatement aux yeux du statisticien.
4.2 Graphiques des résidus face à chaque variable explicative
Bien que le tracé des résidus face aux valeurs prédites synthétise efficacement le comportement global de l’erreur dans l’espace multidimensionnel du modèle, il ne permet pas d’isoler avec précision quelle variable explicative spécifique est responsable de l’instabilité de la variance. Pour remédier à cette indétermination diagnostique, il est nécessaire de construire une série de diagrammes de dispersion bivariés juxtaposant les résidus studentisés face à chacun des régresseurs individuels intégrés dans l’équation d’estimation.
En psychologie du développement ou en gérontologie cognitive, par exemple, la représentation des résidus d’un modèle cognitif face à l’âge chronologique des participants permet fréquemment d’identifier une hétérogénéité de variance localisée. Si la dispersion verticale des résidus est modeste chez les jeunes adultes mais s’évase considérablement à partir de 60 ans, cette observation graphique démontre que le vieillissement cognitif s’accompagne d’une différentiation interindividuelle croissante des performances. Un constat similaire peut être opéré dans l’étude des niveaux d’anxiété ou des scores de névrosisme, où les sujets présentant des scores élevés manifestent souvent des oscillations émotionnelles beaucoup plus imprévisibles.
Ces diagrammes individuels permettent en outre d’évaluer la symétrie locale et la dispersion marginale le long de l’étendue de chaque régresseur continu. Si la variabilité des résidus est asymétrique ou présente des groupements verticaux denses alternant avec des zones de dispersion clairsemée, ces signaux alertent le chercheur sur la présence potentielle de sous-populations cachées ou de relations interactives non modélisées, orientant ainsi vers des solutions structurelles plutôt que vers des correctifs purement mécaniques.
4.3 Diagrammes de position-dispersion (Scale-Location Plots)
L’œil humain éprouve une difficulté notoire à évaluer objectivement l’égalité de la largeur d’une bande de dispersion lorsque celle-ci fluctue autour d’une ligne centrale oscillante. Pour surmonter cette limitation perceptive inhérente à l’analyse du diagramme classique des résidus, les méthodologues recommandent systématiquement l’utilisation du diagramme de position-dispersion, fréquemment intitulé Scale-Location Plot ou graphique de dispersion-niveau dans les environnements logiciels spécialisés.
Ce graphique diagnostique sophistiqué repose sur une transformation mathématique spécifique des résidus studentisés : il projette la racine carrée de la valeur absolue des résidus studentisés en fonction des valeurs prédites par le modèle. La prise de la valeur absolue rabat l’intégralité des déviations négatives dans le quadrant positif, éliminant la distinction de direction pour se concentrer exclusivement sur l’amplitude de l’écart. L’application ultérieure de la transformation racine carrée a pour effet de normaliser la distribution de ces écarts absolus, réduisant l’asymétrie naturelle des distributions de variances et facilitant l’appréciation visuelle.
Sur ce diagramme, le diagnostic de l’homoscédasticité s’effectue par l’intermédiaire d’une ligne de lissage non paramétrique locale, généralement ajustée par l’algorithme LOESS. Si l’hypothèse de variance constante est scrupuleusement respectée dans les données, la ligne LOESS doit adopter une trajectoire rigoureusement horizontale et plate à travers toute la plage des valeurs prédites. Toute inclinaison ascendante continue de la courbe signale sans ambiguïté une amplification progressive de la variance d’erreur, tandis qu’une concavité ou une convexité prononcée indique une instabilité non linéaire de la dispersion résiduelle nécessitant une intervention analytique.
5. Tests statistiques formels de détection de l’hétéroscédasticité
5.1 Le test de Breusch-Pagan et son ajustement de Koenker
Bien que l’analyse graphique fournisse une appréciation intuitive irremplaçable du comportement des résidus, la rigueur scientifique exige souvent la confirmation de ces observations par des tests d’hypothèses formels. Parmi les procédures confirmatoires les plus largement documentées dans la littérature économétrique figure le test développé par Breusch et Pagan. Le fondement théorique de ce test repose sur l’estimation d’une régression auxiliaire dans laquelle le carré des résidus d’échantillon, normalisé par l’estimateur de variance globale, est régressé sur l’ensemble ou un sous-ensemble des variables explicatives suspectées d’influencer la dispersion.
La statistique de test initiale de Breusch-Pagan dérive du multiplicateur de Lagrange et suit asymptotiquement une loi du khi-deux dont les degrés de liberté correspondent au nombre de régresseurs inclus dans la régression auxiliaire. Sous l’hypothèse nulle d’homoscédasticité, les coefficients des régresseurs dans cette équation auxiliaire doivent être simultanément nuls. Cependant, la formulation originelle de Breusch-Pagan présente une vulnérabilité critique : elle repose sur l’hypothèse paramétrique stricte que les erreurs de population suivent une distribution normale multivariée. Si cette condition de normalité est violée – ce qui constitue la norme en psychométrie en raison de la présence fréquente d’asymétries et de kurtosis élevés –, le test de Breusch-Pagan rejette massivement l’hypothèse nulle à tort, confondant l’aplatissement de la distribution avec une véritable hétéroscédasticité.
Pour immuniser le test contre cette fragilité distributional, Koenker a formulé une modification majeure en substituant à l’hypothèse de normalité une estimation non paramétrique du moment d’ordre quatre des perturbations. Cette variante studentisée du test de Breusch-Pagan, universellement désignée comme le test de Koenker ou de Breusch-Pagan studentisé, utilise les résidus non normalisés et ajuste la statistique du test par la variance empirique de ces résidus au carré. Dans le cadre de la recherche en sciences comportementales et sociales, où la distribution gaussienne des variables est une fiction commode mais rarement vérifiée, l’emploi exclusif de la modification de Koenker s’impose comme un impératif méthodologique pour éviter des diagnostics faussement positifs.
5.2 Le test général de White
Dans de nombreuses investigations psychologiques exploratoires, le chercheur ignore totalement la forme fonctionnelle que pourrait emprunter l’hétéroscédasticité et ne peut déterminer a priori quelles variables indépendantes spécifiques en sont les vecteurs. Pour répondre à cette incertitude structurelle, Halbert White a développé un test d’une généralité remarquable qui ne requiert aucune hypothèse préalable sur la spécification morphologique de la variance d’erreur conditionnelle. Le test de White s’établit ainsi comme le standard par excellence pour tester l’hétéroscédasticité générale sans restriction paramétrique étroite.
Le principe opérationnel du test de White repose sur l’estimation d’une régression auxiliaire exhaustive où les résidus au carré issus du modèle original des MCO sont régressés non seulement sur chaque variable explicative prise sous sa forme linéaire simple, mais également sur l’ensemble des carrés de ces variables (effets quadratiques) ainsi que sur la totalité de leurs produits croisés deux à deux (termes d’interaction non linéaire). La statistique du test est calculée en multipliant la taille globale de l’échantillon par le coefficient de détermination obtenu dans cette régression auxiliaire étendue, suivant sous l’hypothèse nulle une loi du khi-deux dont les degrés de liberté égalent le nombre total de régresseurs dans l’équation auxiliaire.
Malgré sa robustesse théorique incontestable face aux non-linéarités complexes de la variance, le test de White présente un inconvénient méthodologique majeur : la consommation fulgurante de degrés de liberté dès que le modèle principal s’enrichit de plusieurs prédicteurs. Dans une équation de régression comprenant une dizaine de variables explicatives, le nombre de termes quadratiques et d’interactions croisées générés dans la régression auxiliaire explose de façon combinatoire, épuisant rapidement les degrés de liberté disponibles et anéantissant la puissance du test dans les échantillons de taille modeste. Dans ces conditions, une version restreinte du test de White, consistant à régresser les résidus au carré uniquement sur les valeurs prédites et sur le carré des valeurs prédites du modèle initial, offre une alternative parcimonieuse et hautement performante.
5.3 Le test de Goldfeld-Quandt
Le test de Goldfeld-Quandt adopte une philosophie méthodologique radicalement différente de celles de Breusch-Pagan et de White, en renonçant aux régressions auxiliaires basées sur les résidus au carré pour privilégier une comparaison directe de variances d’échantillon obtenues sur des sous-groupes partitionnés. Ce test est particulièrement élégant et puissant lorsque le chercheur dispose d’une hypothèse théorique claire désignant une variable continue ordonnée – telle que le revenu, le score de dépression ou l’âge chronologique – comme le déterminant monotone principal de l’hétérogénéité de dispersion.
Le protocole opératoire du test de Goldfeld-Quandt se déroule selon une séquence d’étapes standardisée. L’échantillon complet est initialement trié selon l’ordre croissant des valeurs de la variable suspectée de générer l’hétéroscédasticité. Ensuite, le praticien procède à l’omission délibérée d’une fraction centrale de l’échantillon ordonné, correspondant généralement à un quart ou un tiers des observations médianes, dans le but d’accentuer le contraste géométrique et statistique entre les deux sous-ensembles restants. Deux régressions linéaires indépendantes sont alors ajustées séparément sur les deux groupes extrêmes : le sous-échantillon des valeurs faibles et le sous-échantillon des valeurs élevées.
La statistique du test est ensuite construite en calculant le ratio de la somme des carrés des résidus du sous-groupe présentant la variance théorique la plus forte sur celle du sous-groupe présentant la variance théorique la plus faible, corrigé de leurs degrés de liberté respectifs. Sous l’hypothèse nulle d’homoscédasticité et sous condition de normalité des perturbations, ce ratio suit rigoureusement une distribution F de Fisher-Snedecor. Le test de Goldfeld-Quandt trouve un terrain d’application idéal dans les plans expérimentaux contrastés de la recherche psychologique, bien que son efficacité soit compromise lorsque l’hétéroscédasticité adopte une forme non monotone, comme une structure en cloche symétrique où les variances aux deux extrémités sont identiques.
6. Correction inférentielle : Les erreurs-types robustes à l’hétéroscédasticité (HCSE)
6.1 L’estimateur sandwich fondamental de White (HC0)
Lorsque la présence d’hétéroscédasticité est confirmée et que le chercheur souhaite conserver les estimations ponctuelles fournies par les moindres carrés ordinaires tout en restituant la validité des déductions inférentielles, le recours aux erreurs-types robustes à l’hétéroscédasticité – universellement désignées par l’acronyme HCSE (Heteroscedasticity-Consistent Standard Errors) – constitue la solution méthodologique contemporaine la plus adoptée. L’origine de cette avancée remonte aux travaux séminaux de Halbert White en 1980, qui a systématisé l’estimateur de variance empirique asymétrique désormais connu sous le nom de HC0.
L’architecture matricielle de cet estimateur repose sur une structure élégante baptisée estimateur « sandwich ». Dans cette formulation, les matrices externes, correspondant au « pain » de l’analogie, sont formées par l’inverse de la matrice des produits croisés des régresseurs, identique à celle employée dans le calcul conventionnel des MCO. La composante interne du sandwich, la « garniture », est constituée d’une matrice diagonale dont les éléments non nuls ne sont pas une constante sigma carrée, mais les carrés des résidus d’échantillon observés pour chaque individu. Ce produit matriciel complexe capture directement la structure empirique locale de la dispersion sans nécessiter la modélisation formelle d’une fonction mathématique de variance.
Sur le plan asymptotique, c’est-à-dire lorsque la taille de l’échantillon tend vers l’infini, White a démontré que l’estimateur HC0 converge en probabilité vers la véritable matrice de variance-covariance des coefficients de régression, garantissant que les tests t et les intervalles de confiance basés sur cet estimateur sont asymptotiquement exacts. Toutefois, des décennies d’expérimentations de Monte Carlo ont révélé une lacune critique de HC0 : dans les échantillons de taille petite à modérée (typiquement moins de 250 observations, ce qui représente l’immense majorité des études en psychologie empirique), HC0 produit un biais négatif substantiel, sous-estimant systématiquement les erreurs-types réelles et conduisant à une inflation inacceptable du taux d’erreur de première espèce.
6.2 Les évolutions pour petits échantillons : De HC1 à HC4
Afin de pallier les insuffisances flagrantes de l’estimateur HC0 dans les échantillons de taille restreinte, la littérature statistique a développé au fil des décennies une succession d’estimateurs correctifs conçus pour stabiliser l’inférence. Le premier raffinement, désigné sous le terme de HC1, a été proposé par MacKinnon et White. Il applique une correction globale des degrés de liberté en multipliant l’ensemble de la matrice sandwich par le ratio de la taille de l’échantillon sur le nombre d’observations diminué du nombre de prédicteurs. Bien que constituant une amélioration par rapport à HC0, l’ajustement de HC1 demeure insuffisant face à des structures de données fortement asymétriques.
Les avancées les plus décisives sont apparues avec la prise en compte explicite de la géométrie de l’espace des prédicteurs, concrétisée par les valeurs de levier (les éléments diagonaux de la matrice de projection orthogonale, ou hat matrix). L’estimateur HC2 intègre une pondération locale en divisant le carré de chaque résidu d’échantillon par la quantité un moins son levier individuel. Cette modification neutralise le fait mathématique que les résidus d’échantillon ont tendance à être naturellement comprimés pour les observations exerçant un fort levier géométrique. L’estimateur HC3 franchit une étape supplémentaire en divisant chaque résidu au carré par le carré de la quantité un moins son levier, appliquant une pénalité quadratique beaucoup plus sévère aux observations périphériques.
Dans le prolongement de ces travaux, Cribari-Neto a formalisé en 2004 l’estimateur HC4, spécifiquement calibré pour résister aux distributions de données caractérisées par la présence simultanée de points de fort levier et d’observations aberrantes influentes. Dans HC4, l’exposant appliqué au facteur de correction du levier n’est plus une constante, mais une fonction adaptative proportionnelle à la magnitude du levier individuel rapportée au levier moyen de l’échantillon, bornée supérieurement à 4. Cette formulation novatrice permet de gonfler considérablement la variance associée aux points hautement influents, protégeant ainsi l’analyste contre les faux rejets de l’hypothèse nulle même dans des conditions distributionnelles dégradées.
6.3 Directives de sélection empirique des estimateurs robustes
Face à la pluralité des estimateurs sandwich développés dans la littérature, le chercheur empirique en psychologie est confronté au choix cornélien de l’estimateur le plus approprié pour ses analyses. Une étude de simulation exhaustive de référence mondiale, conduite par Long et Ervin en 2000, a établi des directives méthodologiques claires qui font aujourd’hui autorité dans la communauté statistique. Leurs résultats démontrent que l’estimateur HC0 et l’estimateur HC1 ne devraient plus jamais être utilisés dans la pratique empirique contemporaine en raison de leurs performances médiocres dès que l’échantillon comporte moins de quelques centaines de participants.
Long et Ervin ont formulé une recommandation explicite en faveur de l’adoption quasi systématique de l’estimateur HC3 comme norme par défaut pour l’ajustement des modèles de régression par les moindres carrés ordinaires. Leurs simulations démontrent que HC3 maintient le taux d’erreur de première espèce à un niveau rigoureusement conforme au seuil théorique de 0,05, y compris dans des échantillons restreints comprenant moins de 50 observations, tout en conservant une puissance statistique remarquable et en surpassant ses concurrents sous une grande diversité de motifs d’hétéroscédasticité. De surcroît, lorsque l’échantillon est en réalité homoscédastique, le coût en efficacité de l’application de HC3 est virtuellement négligeable.
Toutefois, lorsque le jeu de données comporte des points de levier extrêmes susceptibles de déstabiliser même HC3, des investigations ultérieures ont corroboré la supériorité de l’estimateur HC4 ou de sa variante HC4m pour préserver l’exactitude des tests inférentiels. Pour le rapportage scientifique dans les manuscrits soumis aux revues à comité de lecture, il est désormais attendu que les auteurs explicitent formellement la variante employée (par exemple « erreurs-types robustes ajustées selon la correction HC3 de Long & Ervin »), assortie d’une justification relative à la taille de leur échantillon et à la structure de levier de leurs prédicteurs.
7. Méthodes de réestimation : Les moindres carrés généralisés et pondérés
7.1 Fondements des moindres carrés pondérés (WLS)
Bien que l’application des erreurs-types robustes de type HC3 restaure l’exactitude des tests d’hypothèses et des intervalles de confiance, elle ne résout aucunement la question de la perte d’efficacité intrinsèque des coefficients MCO évoquée précédemment. Lorsque l’objectif prioritaire de l’investigateur est d’obtenir l’estimation ponctuelle la plus précise possible en exploitant l’intégralité du signal informationnel contenu dans les données, la méthode des moindres carrés pondérés (WLS, pour Weighted Least Squares) s’impose comme l’approche d’estimation optimale.
Les moindres carrés pondérés constituent une spécialisation de la théorie générale des moindres carrés généralisés développée par Aitken. Le principe sous-jacent repose sur une transformation algébrique élégante du modèle linéaire originel : chaque observation – la variable dépendante ainsi que l’ensemble des régresseurs et le terme constant – est divisée par l’écart-type résiduel conditionnel théorique associé à cette unité spécifique. Cette opération de renormalisation a pour effet de diviser les observations hautement variables par une constante élevée, réduisant leur magnitude dans l’espace géométrique du modèle, tout en amplifiant l’influence des observations stables caractérisées par un faible écart-type d’erreur.
À l’issue de cette transformation univariée, le terme de perturbation stochastique du modèle renormalisé présente une variance conditionnelle rigoureusement égale à un pour toutes les unités d’observation. L’homoscédasticité est ainsi mathématiquement restaurée au sein du système transformé. L’application standard des moindres carrés ordinaires sur ces données convenablement pondérées permet alors de recouvrer l’intégralité des privilèges garantis par le théorème de Gauss-Markov : l’estimateur WLS redevient le meilleur estimateur linéaire non biaisé (BLUE), affichant une variance d’échantillonnage théoriquement inférieure à celle de l’estimateur MCO conventionnel.
7.2 Moindres carrés généralisés réalisables (FGLS)
L’application directe de la méthode des moindres carrés pondérés se heurte immédiatement à un écueil pratique considérable : dans l’immense majorité des applications empiriques en sciences psychologiques, la véritable fonction de variance conditionnelle de la population est totalement inconnue de l’expérimentateur. Pour surmonter cette indétermination, les statisticiens ont développé une procédure itérative ou semi-itérative en deux étapes désignée sous le terme de moindres carrés généralisés réalisables (FGLS, pour Feasible Generalized Least Squares).
Le protocole opératoire de la méthode FGLS débute par l’ajustement conventionnel d’un modèle initial par les moindres carrés ordinaires, dont l’unique finalité est d’extraire les résidus d’échantillon. Dans une seconde étape, le chercheur modélise explicitement la structure de dispersion en effectuant une régression auxiliaire du logarithme népérien des résidus au carré sur un ensemble de variables prédictives suspectées de structurer la variance. L’utilisation stratégique de la fonction logarithmique garantit que, lors du passage à l’exponentielle des valeurs ajustées de cette régression auxiliaire pour calculer les variances estimées, les poids statistiques attribués à chaque observation demeurent strictement positifs, écartant tout risque d’obtenir des variances négatives mathématiquement absurdes.
L’inverse de ces variances prédites issues du modèle auxiliaire sert alors de vecteur de pondération pour exécuter la régression finale par les moindres carrés pondérés. Il convient toutefois de souligner que les propriétés d’optimalité de l’estimateur FGLS sont strictement asymptotiques. Dans les grands échantillons, FGLS rivalise avec le modèle WLS idéal ; en revanche, dans les échantillons de taille modeste fréquemment exploités en psychologie expérimentale, l’incertitude stochastique inhérente à l’estimation des poids lors de la première étape peut introduire un biais substantiel dans l’estimation finale des coefficients et paradoxalement générer une précision inférieure à celle des simples MCO non corrigés.
7.3 Précautions méthodologiques et écueils de la pondération
Si la méthode des moindres carrés pondérés et son extension FGLS séduisent par leur élégance mathématique, leur mise en œuvre sur des données empiriques réelles recèle de multiples pièges méthodologiques qui justifient une extrême vigilance de la part des chercheurs. Le danger le plus redoutable réside dans la vulnérabilité dramatique de l’estimateur WLS face à une mauvaise spécification fonctionnelle de la variance. Si la régression auxiliaire utilisée pour modéliser la structure de dispersion omet des prédicteurs critiques ou spécifie une forme non linéaire erronée, les poids calculés seront fondamentalement faussés. Dans cette situation pathologique, l’estimateur WLS devient non seulement inefficace, mais ses coefficients peuvent devenir biaisés et instables, conduisant à des déductions scientifiques plus dégradées que celles issues des MCO.
Un second écueil omniprésent en psychométrie concerne l’instabilité extrême des poids statistiques en présence de valeurs atypiques ou aberrantes. Puisque les poids FGLS reposent sur l’inversion de prédictions issues des résidus au carré, une observation résiduelle inhabituellement proche de zéro en raison d’un pur hasard d’échantillonnage produira un poids artificiellement colossal, capturant de manière disproportionnée la trajectoire de la droite de régression. Inversement, une observation psychologique tout à fait valide mais située dans une zone de forte dispersion recevra un poids quasi nul, privant l’analyste d’une information substantielle précieuse.
Pour parer à ces risques opérationnels, une règle méthodologique impérative prescrit que l’ajustement d’un modèle par WLS ou FGLS ne dispense jamais de la vérification diagnostique a posteriori. Après avoir appliqué la pondération, le chercheur doit obligatoirement extraire les résidus pondérés et réexécuter l’ensemble des graphiques de diagnostic ainsi que les tests formels d’homoscédasticité sur ces nouveaux résidus. Si les résidus pondérés continuent de manifester une hétérogénéité significative, la modélisation de la variance doit être considérée comme un échec empirique et abandonnée au profit d’approches correctives plus robustes.
8. Transformations mathématiques des variables pour stabiliser la variance
8.1 La transformation logarithmique
Bien avant l’émergence computationnelle des erreurs-types robustes de White et des algorithmes FGLS, la stratégie historiquement dominante pour juguler l’hétéroscédasticité consistait à soumettre la variable dépendante – et parfois les variables explicatives – à une transformation mathématique non linéaire préalable visant à stabiliser la variance locale. Parmi les multiples fonctions mathématiques exploitables, la transformation logarithmique (qu’elle soit népérienne ou en base 10) représente l’opérateur le plus universellement mobilisé dans la pratique empirique.
Le mécanisme par lequel la transformation logarithmique stabilise la variance repose sur sa propriété fondamentale de compression d’échelle différentielle. La fonction logarithme compresse drastiquement les valeurs numériques élevées tout en étirant proportionnellement les valeurs numériques faibles. Dans les distributions empiriques où l’écart-type résiduel est directement proportionnel à l’espérance de la variable – situation extrêmement commune pour les variables comportementales strictement positives telles que les temps de réaction chronométriques, les indices de latence d’accès lexical, le revenu individuel ou la consommation de substances addictives –, le passage au logarithme compresse mécaniquement la zone de forte dispersion, transformant une relation multiplicative à variance divergente en une relation additive homoscédastique.
Cependant, cette stabilisation technique de la variance s’accompagne d’une mutation conceptuelle profonde qu’il convient d’assumer sur le plan théorique : la modification intégrale de l’interprétation des paramètres estimés. Dans un modèle log-linéaire où seule la variable dépendante est transformée, les coefficients de pente ne quantifient plus des variations marginales directes en unités de mesure originelles, mais représentent des pourcentages d’évolution relative, communément désignés sous le terme de semi-élasticités. Le chercheur doit veiller à ne pas rapporter ces résultats de manière trompeuse et doit maîtriser les techniques de ré-inversion exponentielle avec correction de smearing de Duan s’il souhaite retranscrire ses prédictions dans l’échelle métrique native du phénomène étudié.
8.2 Les transformations stabilisatrices spécifiques
En dehors des distributions continues asymétriques éligibles à la transformation logarithmique, la recherche comportementale manipule fréquemment des typologies de données aux propriétés d’échantillonnage spécifiques, exigeant des transformations mathématiques adaptées à leur loi probabiliste génératrice sous-jacente. La première famille concerne les données de comptage discret, illustrées par le nombre d’erreurs commises lors d’une tâche de mémoire, le nombre d’épisodes compulsifs par jour ou la fréquence de comportements agressifs observés en classe.
Ces variables de comptage suivent typiquement des processus de Poisson ou des distributions binomiales négatives, dans lesquels la variance théorique croît de manière intrinsèque avec la moyenne. Pour neutraliser cette corrélation mécanique entre position et dispersion, l’application de la transformation racine carrée (ou de sa variante de Freeman-Tukey) permet de stabiliser de façon remarquable la variance résiduelle autour d’une constante scalaire, rendant les données traitables par les procédures de régression linéaire classiques sans violer les conditions de Gauss-Markov.
Une seconde typologie de données hautement problématique concerne les taux de réussite, les pourcentages et les proportions bornées sur l’intervalle continu zéro-un. Pour ces grandeurs, dont la distribution s’apparente au modèle binomial, la variance résiduelle est maximale pour une proportion médiane de 0,50 et s’amenuise symétriquement au fur et à mesure que les scores approchent des bornes zéro ou un. La transformation arc-sinus de la racine carrée constitue l’instrument classique de stabilisation de la variance pour ce type de métrique. Enfin, pour les mesures de latence motrice ou de vitesse cognitive où la variance croît exponentiellement avec la durée temporelle, la transformation inverse (1 divisé par le temps d’exécution) permet fréquemment de convertir une mesure de durée hautement hétéroscédastique en une vitesse de traitement à variance parfaitement stable.
8.3 La méthodologie d’optimisation Box-Cox
Lorsque le statisticien constate une déviation flagrante par rapport à l’homoscédasticité et à la normalité mais hésite quant au choix de la fonction de transformation optimale à appliquer à sa variable dépendante, la méthodologie paramétrique développée par George Box et David Cox fournit une solution algorithmique d’une grande rigueur scientifique. La transformation Box-Cox définit une famille continue de transformations de puissance paramétrée par un unique coefficient scalaire, conventionnellement noté lambda.
Cette formulation unifiée englobe la majorité des transformations usuelles comme des cas particuliers le long d’un continuum mathématique : une valeur de lambda égale à un correspond à l’absence de transformation (identité) ; un lambda de 0,5 correspond à une transformation racine carrée ; un lambda de zéro équivaut rigoureusement à la transformation logarithmique népérienne ; et un lambda de moins un correspond à la transformation inverse. L’algorithme Box-Cox explore l’espace des valeurs possibles de lambda par la méthode du maximum de vraisemblance ou par minimisation de la somme des carrés des erreurs résiduelles afin d’identifier la valeur exacte du paramètre qui maximise simultanément l’homoscédasticité et la normalité de la distribution conditionnelle.
L’utilisation de la technique Box-Cox est toutefois soumise à deux contraintes méthodologiques majeures. D’une part, elle exige la positivité stricte de l’intégralité des valeurs observées de la variable dépendante, interdisant formellement la présence de scores nuls ou négatifs sauf à introduire une constante de translation arbitraire qui peut biaiser l’optimisation. D’autre part, la valeur optimale de lambda estimée par l’algorithme est rarement un entier ou une fraction simple ; obtenir un lambda optimal de 0,27 produit un modèle empiriquement homoscédastique mais dont les coefficients sont devenus théoriquement ininterprétables au regard des concepts psychologiques d’origine, compliquant considérablement la communication des résultats scientifiques.
9. Modélisation avancée : Régression hétéroscédastique et approches non paramétriques
9.1 Modèles de localisation-échelle (Location-Scale Models)
L’ensemble des approches méthodologiques examinées jusqu’à présent appréhende l’hétéroscédasticité comme une nuisance statistique qu’il s’agit de corriger, de neutraliser ou d’éliminer pour préserver la validité de l’estimation de la moyenne conditionnelle. Or, dans de nombreux paradigmes de recherche en psychologie clinique, différentielle et expérimentale, l’hétérogénéité de la variance constitue en elle-même le phénomène substantiel d’intérêt théorique central. Les modèles de localisation-échelle (Location-Scale Models) opèrent une véritable révolution conceptuelle en intégrant simultanément deux sous-modèles de régression au sein d’une même architecture paramétrique.
Dans ce cadre de modélisation avancée, le premier sous-modèle (le modèle de localisation) prédit l’espérance conditionnelle ou la moyenne de la réponse psychologique en fonction d’un premier vecteur de covariables, tandis que le second sous-modèle (le modèle d’échelle) prédit simultanément le logarithme de la variance résiduelle conditionnelle à l’aide d’un second vecteur de régresseurs, qui peut être identique ou distinct du premier. L’estimation des paramètres des deux composantes est réalisée conjointement par la maximisation de la fonction de vraisemblance globale du système via des algorithmes d’optimisation numérique tels que l’algorithme de Newton-Raphson ou l’algorithme espérance-maximisation (EM).
L’application de ces modèles offre une richesse heuristique incomparable. En psychopathologie, par exemple, un traitement pharmacologique ou une psychothérapie peut ne pas modifier significativement le niveau moyen d’anxiété d’une cohorte (composante de localisation stable), mais réduire drastiquement l’instabilité émotionnelle intra-individuelle et interindividuelle au fil du temps (composante d’échelle fortement négative). De même, l’étude du vieillissement cérébral démontre souvent que le déclin cognitif se manifeste prioritairement par une imprévisibilité accrue des performances avant d’induire une chute de la moyenne brute. Les modèles de localisation-échelle permettent d’élever la variance du rang d’anomalie perturbatrice à celui de variable explicative majeure.
9.2 Régression quantile face à l’hétérogénéité
Une seconde alternative méthodologique majeure pour transcender les rigidités du modèle classique face à l’hétérogénéité résiduelle réside dans la régression quantile, formalisée à l’origine par Roger Koenker et Gilbert Bassett. Alors que la régression par les MCO se concentre exclusivement sur l’estimation de la moyenne conditionnelle de la variable dépendante, la régression quantile permet d’ajuster des droites de régression spécifiques à n’importe quel quantile conditionnel d’intérêt (la médiane [quantile 0,50], le premier quartile [0,25], le neuvième décile [0,90], etc.).
Dans une distribution rigoureusement homoscédastique, les pentes des régressions quantiles associées à différents percentiles sont rigoureusement parallèles les unes aux autres, ne différant que par la valeur de leur constante d’ordonnée à l’origine. En revanche, lorsque les données manifestent une hétéroscédasticité substantielle, les pentes estimées divergent de façon spectaculaire le long des différents quantiles de la réponse. La régression quantile offre ainsi une cartographie panoramique détaillée de l’impact des prédicteurs, révélant par exemple qu’un programme de remédiation cognitive améliore très puissamment les performances des individus situés dans le dixième centile inférieur (les plus vulnérables) sans exercer le moindre effet sur les individus situés dans le quatre-vingt-dixième centile supérieur.
Sur le plan mathématique, l’estimation des paramètres de la régression quantile ne repose pas sur la minimisation d’une somme de résidus au carré, mais sur la minimisation d’une fonction de perte linéaire asymétrique par des méthodes d’optimisation linéaire (telles que l’algorithme simplexe ou les méthodes de points intérieurs). Par voie de conséquence, la régression quantile est intrinsèquement non paramétrique quant à la distribution des erreurs, insensible aux valeurs atypiques extrêmes sur la variable dépendante et totalement insensible à la violation de l’hypothèse d’homoscédasticité, constituant l’un des outils de modélisation les plus robustes à disposition de la recherche comportementale.
9.3 Méthodes de rééchantillonnage par bootstrap
Lorsque les données empiriques cumulent une violation manifeste de l’homoscédasticité, des distributions asymétriques non gaussiennes et des effectifs d’échantillon excessivement réduits qui compromettent la validité asymptotique des erreurs-types robustes HC3, les méthodologies de rééchantillonnage non paramétriques par bootstrap fournissent un cadre probabiliste d’une grande puissance inférentielle. Toutefois, le bootstrap conventionnel – consistant à rééchantillonner avec remise des paires d’observations complètes – peut s’avérer insuffisant pour corriger fidèlement des structures d’hétéroscédasticité complexes dépendantes des prédicteurs.
Pour surmonter cette faiblesse, Wu a développé le concept novateur du Wild Bootstrap (ou bootstrap sauvage), perfectionné ultérieurement par Mammen et par Davidson et Flachaire. Le principe du bootstrap sauvage consiste à fixer rigoureusement la matrice des variables explicatives d’origine sans la modifier, tout en rééchantillonnant les résidus d’échantillon pondérés par une variable aléatoire auxiliaire indépendante de moyenne nulle et de variance égale à un (telle que la distribution binaire de Rademacher). Cette multiplication stochastique garantit que la variance locale observée pour chaque valeur spécifique des prédicteurs est intégralement reproduite lors de chaque itération du bootstrap.
En générant des milliers de pseudo-échantillons par cette procédure sauvage, le chercheur dérive une distribution empirique de la statistique de test t ou F exempte de toute supposition paramétrique a priori. Les intervalles de confiance et les valeurs p empiriques ainsi calculés offrent une couverture probabiliste d’une exactitude irréprochable, surpassant nettement les corrections sandwich conventionnelles lorsque les degrés de liberté sont restreints ou que les régresseurs présentent des déséquilibres sévères. Le bootstrap sauvage représente ainsi le standard d’excellence pour l’inférence en présence d’hétéroscédasticité dans les plans de recherche expérimentaux complexes à petits effectifs.
10. Mise en œuvre empirique dans les environnements statistiques (R et Python)
10.1 Diagnostics et corrections sous le langage R
Dans l’écosystème open-source du langage de programmation statistique R, l’évaluation et le traitement de l’hétéroscédasticité s’articulent autour d’un ensemble de packages méthodologiques spécialisés et interopérables. Après avoir ajusté un modèle linéaire standard à l’aide de la fonction native lm(), l’analyste fait prioritairement appel au package lmtest pour administrer les épreuves diagnostiques formelles. La fonction bptest() exécute par défaut la version studentisée de Koenker du test de Breusch-Pagan, protégeant le chercheur contre les biais de non-normalité, tandis que la fonction gqtest() permet d’implémenter facilement le test de partitionnement de Goldfeld-Quandt en spécifiant la variable d’ordonnancement suspectée.
Pour la production de diagnostics visuels à haute résolution, le package car (Companion to Applied Regression) fournit des fonctionnalités graphiques avancées. La fonction residualPlots() génère automatiquement la matrice de dispersion des résidus studentisés face à chacun des régresseurs individuels ainsi que face aux valeurs ajustées globales, en y intégrant un test de courbure non linéaire. Parallèlement, la fonction spreadLevelPlot() construit le diagramme de position-dispersion et calcule algorithmiquement la puissance suggérée pour stabiliser la variance locale par transformation de variable.
Lorsque la remédiation inférentielle s’oriente vers l’usage d’erreurs-types robustes, le package sandwich constitue le moteur computationnel indispensable. Il permet de générer la matrice de covariance robuste à l’aide de la fonction vcovHC(), en configurant rigoureusement l’argument type = "HC3" ou type = "HC4". L’intégration finale de cette matrice corrigée dans les tests inférentiels s’effectue en associant la fonction coeftest() de lmtest à l’objet sandwich, réestimant instantanément l’ensemble des erreurs-types, des statistiques t et des valeurs p sans altérer la valeur des coefficients initiaux.
10.2 Analyses équivalentes sous Python avec Statsmodels
Dans l’environnement de la science des données sous Python, les bibliothèques scientifiques statsmodels, seaborn et matplotlib offrent un ensemble complet d’outils analytiques équivalents aux standards économétriques disponibles sous R. L’estimation du modèle de régression linéaire initial est réalisée via la classe OLS issue du sous-module statsmodels.api. L’accès aux tests statistiques formels s’effectue par l’intermédiaire du sous-module spécialisé statsmodels.stats.diagnostic, qui implémente les fonctions het_breuschpagan et het_white.
La fonction het_breuschpagan retourne simultanément la statistique du multiplicateur de Lagrange avec sa valeur p associée et la statistique du test F auxiliaire, garantissant une double vérification computationnelle de l’hypothèse nulle d’homoscédasticité. De son côté, la fonction het_white réalise le test général de White en générant automatiquement en interne l’ensemble des termes quadratiques et des interactions croisées des variables explicatives fournies dans la matrice de design.
Pour intégrer les erreurs-types robustes directement lors de la phase d’estimation, statsmodels se distingue par une ergonomie syntaxique remarquable. L’utilisateur peut spécifier directement l’estimateur sandwich souhaité lors de l’appel de la méthode d’ajustement du modèle, en configurant l’argument cov_type='HC3' ou cov_type='HC4' au sein de model.fit(). Cette commande modifie instantanément le tableau récapitulatif des résultats généré par summary(), remplaçant les erreurs-types conventionnelles par leurs homologues robustes et réajustant automatiquement les intervalles de confiance à 95% sans nécessiter de manipulations matricielles intermédiaires.
10.3 Comparaison pratique des sorties logicielles
L’observation concrète des sorties logicielles comparées entre un modèle de régression par les moindres carrés ordinaires conventionnel et sa version corrigée par l’estimateur robuste HC3 met en lumière l’impact décisif de la correction sur les déductions statistiques. Il est hautement instructif de constater que, conformément aux fondements théoriques exposés dans la section 3.1, la colonne relative aux coefficients de régression demeure rigoureusement identique entre les deux tableaux de résultats. La constante et les pentes de régression ne subissent aucune altération numérique.
En revanche, des modifications substantielles s’opèrent dès la deuxième colonne, dédiée aux erreurs-types d’échantillonnage. En présence d’une hétéroscédasticité croissante typique, les erreurs-types conventionnelles – initialement artificiellement comprimées – subissent un élargissement notable sous l’ajustement HC3. Cet accroissement du dénominateur entraîne une diminution corrélative de la valeur absolue de la statistique t de Student associée aux régresseurs affectés par l’hétérogénéité de dispersion.
Cette contraction des statistiques de test produit à son tour un glissement significatif des valeurs p vers le haut de l’échelle probabiliste. Un prédicateur psychologique affichant initialement une valeur p trompeuse de 0,028 sous l’hypothèse aveugle d’homoscédasticité peut voir sa significativité corrigée s’établir à 0,084 après l’application de l’estimateur HC3, franchissant ainsi le seuil conventionnel de significativité de 0,05. La synthèse tabulaire de ces divergences computationnelles illustre avec clarté comment l’omission du diagnostic de la variance résiduelle conduit les chercheurs à valider des hypothèses empiriques non étayées.
11. Études de cas appliquées aux paradigmes de recherche en psychologie
11.1 Étude de la relation entre niveau de stress et temps de réaction
Pour illustrer la manifestation empirique de l’hétéroscédasticité au sein des paradigmes expérimentaux en sciences cognitives, considérons une recherche examinant l’impact du stress aigu induit sur la vitesse de traitement de l’information. Dans ce protocole, cent cinquante participants sont soumis à un paradigme de stress validé en laboratoire (tel que le Trier Social Stress Test), à l’issue duquel leur concentration salivaire de cortisol (en nmol/L) est dosée comme indicateur biologique du niveau de stress, tandis que leur temps de réaction moyen (en millisecondes) est mesuré lors d’une tâche d’attention soutenue informatisée.
L’ajustement initial d’une régression linéaire par les MCO révèle une pente positive suggérant qu’un niveau de stress accru ralentit le temps de réaction global. Toutefois, l’exploration diagnostique des résidus met en évidence une rupture massive de l’homoscédasticité. Sur le diagramme des résidus studentisés face aux valeurs prédites, un motif en entonnoir hautement divergent apparaît : pour les faibles taux de cortisol, les temps de réaction des participants sont homogènes et étroitement regroupés autour de la droite de régression ; à l’inverse, pour les concentrations massives de cortisol, la variance des réponses explose de manière spectaculaire, certains sujets conservant une vitesse préservée tandis que d’autres manifestent un effondrement attentionnel complet. Le test de Koenker confirme cette intuition visuelle avec une statistique de test hautement significative.
Face à cette configuration clinique, la résolution méthodologique s’effectue par une double intervention raisonnée. Dans un premier temps, une transformation logarithmique est appliquée aux temps de réaction afin de réduire l’asymétrie positive naturelle des distributions chronométriques et de stabiliser partiellement la dispersion stochastique. Dans un second temps, le modèle est réajusté en associant à cette transformation un estimateur d’erreurs-types robustes HC3. Cette approche conjointe garantit que les déductions inférentielles finales relatives à l’impact du stress sur la cognition reposent sur un modèle dont les postulats fondamentaux sont rigoureusement respectés.
11.2 Évaluation de la satisfaction au travail en fonction des années d’ancienneté
Le second cas d’étude s’inscrit dans le champ de la psychologie du travail et du comportement organisationnel, à travers l’investigation de la dynamique temporelle liant l’ancienneté professionnelle (mesurée en années de service continu) et le niveau de satisfaction professionnelle globale, évalué par une échelle psychométrique standardisée auprès de quatre cents employés d’une multinationale.
L’application d’un modèle de régression par les moindres carrés ordinaires conventionnel indique une relation linéaire positive modeste, accompagnée d’une valeur p conventionnelle de 0,035 conduisant initialement l’équipe de recherche à conclure à une augmentation statistiquement significative de l’épanouissement professionnel avec les années d’expérience. Cependant, le diagnostic statistique de l’équation révèle un biais d’hétéroscédasticité sévère : le test général de White rejette massivement l’homoscédasticité. L’analyse des graphiques de dispersion par cohortes d’ancienneté met en lumière une réalité psychologique sous-jacente divergente : chez les jeunes recrues (moins de cinq ans d’ancienneté), la satisfaction est uniformément modérée avec une variance d’échantillon très resserrée ; en revanche, chez les employés comptant plus de vingt ans de service, la dispersion s’avère colossale, séparant de manière bivalente les seniors désabusés en phase d’épuisement professionnel de ceux accédant à des positions managériales hautement gratifiantes.
L’application d’un estimateur sandwich robuste HC3 rectifie immédiatement le diagnostic inférentiel : l’erreur-type de la pente d’ancienneté passe de 0,042 à 0,071, propulsant la valeur p à 0,148. La prétendue significativité statistique de l’ancienneté s’effondre, démontrant qu’il s’agissait d’un artéfact computationnel induit par la variance incontrôlée du groupe senior. Pour modéliser plus fidèlement cette réalité organisationnelle, l’investigateur abandonne le modèle univarié simpliste pour mettre en œuvre une régression par moindres carrés pondérés (WLS) intégrant le statut hiérarchique et la perception d’autonomie comme modérateurs structurels de la dispersion.
11.3 Analyse de la mémoire de travail selon l’âge chez les personnes âgées
La troisième étude de cas appliquée explore la neuropsychologie du vieillissement à travers l’évaluation de la capacité de la mémoire de travail (quantifiée par l’empan mnésique complexe envers) au sein d’une cohorte de trois cent cinquante adultes âgés de 60 à 92 ans. L’ajustement linéaire par les MCO traditionnel trace une trajectoire de déclin cognitif régulier d’environ 0,15 point d’empan par décennie de vie chronologique.
Toutefois, l’examen attentif du diagramme de position-dispersion (Scale-Location Plot) fait apparaître une ligne LOESS ascendante continue particulièrement raide, confirmée par un test de Goldfeld-Quandt hautement significatif comparant le sous-groupe des 60-70 ans à celui des 80 ans et plus. Cette hétéroscédasticité structurelle découle de la divergence cognitive biologique documentée en neurogérontologie : tandis qu’une fraction substantielle de la population âgée conserve une réserve cognitive intacte maintenant des capacités mnésiques comparables à celles d’adultes plus jeunes, une autre fraction de la même tranche d’âge subit des altérations neurodégénératives infracliniques précipitant l’effondrement de l’empan, ce qui génère un étalement massif des scores avec l’âge.
Plutôt que de contraindre ces données par une transformation de variable qui masquerait cette richesse différentielle, le chercheur applique une régression quantile simultanée sur le dixième, le cinquantième et le quatre-vingt-dixième centile conditionnel. Les résultats révèlent une absence quasi totale de déclin mnésique selon l’âge pour le quatre-vingt-dixième centile (la pente est statistiquement non différente de zéro pour les participants les plus performants), alors que la pente de déclin est extrêmement violente et abrupte pour le dixième centile inférieur. Cet éclairage méthodologique démontre avec éclat que la modélisation explicite de l’hétérogénéité de variance offre des avancées théoriques infiniment plus profondes pour les sciences humaines que la simple quête d’une moyenne conditionnelle aveugle.
12. Bonnes pratiques de publication et protocole de reporting scientifique
12.1 Standards de publication selon les normes de l’APA (7e édition)
L’évolution contemporaine des exigences méthodologiques au sein des revues scientifiques internationales de premier plan, notamment celles affiliées à l’American Psychological Association (APA), impose désormais une transparence absolue concernant la vérification des hypothèses distributionnelles des modèles statistiques. Dans le cadre de la septième édition du manuel de publication de l’APA, il ne suffit plus d’affirmer de manière stéréotypée que les données respectaient les postulats du modèle linéaire ; les auteurs doivent fournir des preuves explicites et reproductibles des démarches de vérification conduites.
Le protocole de rédaction académique exige que la section des résultats d’un manuscrit empirique détaille nommément les tests formels exécutés pour dépister l’hétéroscédasticité, en rapportant la valeur exacte de la statistique de test, les degrés de liberté associés ainsi que la valeur p précise (par exemple : « Le test studentisé de Breusch-Pagan a mis en évidence une violation significative du postulat d’homoscédasticité, chi-deux(3) = 14,82, p = 0,002 »). Cette déclaration doit impérativement être accompagnée d’une brève description morphologique de la dispersion observée lors de l’examen préalable des diagrammes de résidus standardisés.
Lorsque le recours à une procédure de correction inférentielle s’est avéré nécessaire, la justification de l’arbitrage méthodologique doit être formulée avec rigueur. Les recommandations de l’APA préconisent de nommer sans ambiguïté l’estimateur de variance robuste sélectionné (par exemple « Nous avons utilisé l’estimateur sandwich HC3 de Long et Ervin pour immuniser nos inférences contre les distorsions d’hétéroscédasticité ») et de rapporter systématiquement dans les tableaux de régression les erreurs-types corrigées ainsi que les intervalles de confiance à 95% recalculés. L’inclusion des diagrammes résiduels diagnostiques en annexe ou au sein des documents complémentaires en ligne (Supplementary Materials) est aujourd’hui considérée comme une excellente pratique éditoriale valorisant la reproductibilité scientifique.
12.2 Arbre décisionnel pour guider le choix méthodologique du chercheur
Afin de naviguer avec cohérence méthodologique au sein des multiples alternatives analytiques présentées tout au long de cet exposé, le chercheur confronté à une hétérogénéité de variance peut suivre un arbre de décision structuré en plusieurs étapes hiérarchiques.
- Étape 1 : Diagnostic préliminaire de la spécification structurelle. Avant toute correction statistique directe, vérifier scrupuleusement la spécification théorique du modèle. L’hétéroscédasticité est-elle le symptôme d’une relation curviligne non modélisée ou de l’omission d’un terme d’interaction majeur ? Si oui, enrichir la structure du modèle par les termes polynomiaux ou interactifs appropriés.
- Étape 2 : Évaluation des caractéristiques de la variable dépendante. La variable dépendante est-elle intrinsèquement asymétrique, strictement positive ou bornée (par exemple des temps de réaction ou des données de comptage) ? Si oui, une transformation stabilisatrice de variance (logarithme, racine carrée) ou le recours aux modèles linéaires généralisés (GLM) s’impose comme la priorité analytique.
- Étape 3 : Définition de l’objectif théorique principal. La variance elle-même constitue-t-elle l’objet de recherche substantiel ? Si oui, abandonner les MCO classiques pour s’orienter vers les modèles de localisation-échelle ou vers la régression quantile.
- Étape 4 : Choix du mode d’inférence en régression linéaire. Si l’objectif reste l’estimation de la moyenne conditionnelle et que la structure du modèle est théoriquement arrêtée, privilégier l’estimation des MCO couplée à l’application systématique des erreurs-types robustes HC3 (ou HC4 en cas d’observations influentes extrêmes) pour les échantillons de taille standard. En présence d’échantillons très restreints et asymétriques, recourir au bootstrap sauvage (Wild Bootstrap).
- Étape 5 : Réalisation d’analyses de sensibilité croisées. Comparer systématiquement les conclusions tirées du modèle MCO classique, du modèle avec erreurs-types robustes et du modèle réestimé par WLS/FGLS pour attester de la robustesse des inférences scientifiques face aux spécifications alternatives.
12.3 Grille de relecture critique pour réviseurs et chercheurs
Dans le cadre du processus d’évaluation par les pairs (peer-reviewing) ou lors de la phase d’auto-évaluation critique précédant la soumission d’un manuscrit, les chercheurs et les réviseurs scientifiques ont la responsabilité de s’assurer de la rigueur du traitement statistique de la variance. La grille de relecture critique suivante rassemble les interrogations méthodologiques fondamentales qui doivent guider cette évaluation académique :
- Les auteurs ont-ils explicitement vérifié le postulat d’homoscédasticité, ou assument-ils tacitement sa validité sans fournir d’éléments diagnostiques formels ou graphiques ?
- En cas de détection d’hétéroscédasticité, les auteurs se sont-ils contentés d’affirmer que les MCO restent non biaisés, en négligeant d’ajuster les erreurs-types des tests de significativité ?
- Quelle variante spécifique de matrice de variance-covariance robuste a été sélectionnée ? L’usage obsolète de HC0 ou HC1 a-t-il été écarté au profit d’estimateurs adaptés aux petits échantillons tels que HC3 ou HC4 ?
- Si une transformation non linéaire de variable (logarithmique, Box-Cox) a été opérée, l’interprétation théorique des coefficients a-t-elle été ajustée de manière appropriée pour éviter des déductions erronées sur les métriques originelles ?
- Si la méthode des moindres carrés pondérés (WLS) a été mise en œuvre, les auteurs ont-ils vérifié et rapporté l’homoscédasticité résiduelle effective des résidus après pondération ?
- Le code computationnel complet (scripts R ou Python) permettant de répliquer l’intégralité des diagnostics de résidus et des corrections robustes est-il déposé en libre accès sur un dépôt pérenne (Open Science Framework, GitHub, etc.) ?
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- Aitken, A. C. (1936). On least squares and linear combinations of observations. Proceedings of the Royal Society of Edinburgh, 55, 42–48. https://doi.org/10.1017/S037016460001443X
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Box, G. E. P., & Cox, D. R. (1964). An analysis of transformations. Journal of the Royal Statistical Society: Series B (Methodological), 26(2), 211–243. https://doi.org/10.1111/j.2517-6161.1964.tb00553.x
- Breusch, T. S., & Pagan, A. R. (1979). A simple test for heteroscedasticity and random coefficient variation. Econometrica, 47(5), 1287–1294. https://doi.org/10.2307/1911963
- Cribari-Neto, F. (2004). Asymptotic inference under heteroskedasticity of unknown form. Computational Statistics & Data Analysis, 45(2), 215–233. https://doi.org/10.1016/S0167-9473(02)00366-3
- Davidson, R., & Flachaire, E. (2008). The wild bootstrap, tamed at last. Journal of Econometrics, 146(1), 162–169. https://doi.org/10.1016/j.jeconom.2008.08.003
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
- Goldfeld, S. M., & Quandt, R. E. (1965). Some tests for homoscedasticity. Journal of the American Statistical Association, 60(310), 539–547. https://doi.org/10.1080/01621459.1965.10482079
- Hayes, A. F., & Cai, L. (2007). Using heteroskedasticity-consistent standard error estimators in OLS regression: An introduction and software implementation. Behavior Research Methods, 39(4), 709–722. https://doi.org/10.3758/BF03192961
- Koenker, R. (1981). A note on studentizing a test for heteroscedasticity. Journal of Econometrics, 17(1), 107–112. https://doi.org/10.1016/0304-4076(81)90062-2
- Koenker, R., & Bassett, G. (1978). Regression quantiles. Econometrica, 46(1), 33–50. https://doi.org/10.2307/1913643
- Long, J. S., & Ervin, L. H. (2000). Using heteroscedasticity consistent standard errors in the linear regression model. The American Statistician, 54(3), 217–224. https://doi.org/10.1080/00031305.2000.10474549
- MacKinnon, J. G., & White, H. (1985). Some heteroskedasticity-consistent covariance matrix estimators with improved finite sample properties. Journal of Econometrics, 29(3), 305–325. https://doi.org/10.1016/0304-4076(85)90033-6
- Mammen, E. (1993). Bootstrap and wild bootstrap for high dimensional linear models. The Annals of Statistics, 21(1), 255–285. https://doi.org/10.1214/aos/1176349025
- White, H. (1980). A heteroskedasticity-consistent covariance matrix estimator and a direct test for heteroskedasticity. Econometrica, 48(4), 817–838. https://doi.org/10.2307/1912934
- Wooldridge, J. M. (2020). Introductory econometrics: A modern approach (7th ed.). Cengage Learning.
- Wu, C. F. J. (1986). Jackknife, bootstrap and other resampling methods in regression analysis. The Annals of Statistics, 14(4), 1261–1295. https://doi.org/10.1214/aos/1176350142