
L’expérimentation scientifique en psychologie, en médecine et dans les sciences du comportement repose fréquemment sur la comparaison de plusieurs interventions thérapeutiques, pharmacologiques ou pédagogiques face à une condition de référence unique, généralement désignée sous les termes de groupe contrôle, témoin ou placebo. Lorsqu’un chercheur déploie un tel protocole expérimental à plusieurs groupes, la tentation initiale consiste souvent à exécuter une série de tests t de Student indépendants pour vérifier si chaque modalité active se distingue de cette référence. Cependant, cette démarche naïve expose l’analyste à un piège méthodologique redoutable : l’accroissement exponentiel du taux de faux positifs, également connu sous le nom d’inflation de l’erreur de première espèce. Pour parer à cette dérive tout en conservant une sensibilité statistique maximale, la méthode développée par le statisticien canadien Charles Dunnett s’impose comme le standard méthodologique par excellence.
Le test de Dunnett constitue une procédure d’inférence statistique post-hoc spécifiquement conçue pour traiter les plans d’expérience asymétriques où chaque groupe expérimental est exclusivement confronté à un groupe témoin commun. Contrairement aux approches omnibus ou aux techniques de comparaison toutes paires confondues qui explorent l’ensemble des combinaisons possibles entre tous les groupes, le test de Dunnett restreint délibérément le nombre d’hypothèses testées. Ce ciblage stratégique permet de préserver la puissance statistique globale du dispositif de recherche, rendant possible la détection de véritables effets thérapeutiques sans sacrifier la rigueur imposée par le contrôle strict du taux d’erreur par famille.
Ce guide exhaustif a pour vocation d’accompagner les chercheurs, cliniciens et analystes de données dans la maîtrise théorique et l’application opérationnelle du test de Dunnett. Depuis ses fondements mathématiques ancrés dans la distribution t multivariée jusqu’à sa programmation dans les logiciels statistiques modernes tels que R, SPSS, GraphPad Prism et JASP, chaque étape sera détaillée avec une rigueur académique sans concession. L’examen des conditions de validité, la gestion des déséquilibres d’échantillonnage, le calcul manuel des statistiques critiques, ainsi que les directives de publication selon les normes de l’American Psychological Association (APA) fourniront aux praticiens une boîte à outils méthodologique complète et directement exploitable.
1. Fondements théoriques de l’ANOVA et nécessité des tests post-hoc
1.1 Principes fondamentaux de l’analyse de variance unidirectionnelle
L’analyse de variance à un facteur, couramment désignée sous l’acronyme ANOVA unidirectionnelle, constitue la pierre angulaire de l’évaluation des différences entre plusieurs moyennes d’échantillons indépendants. Le principe directeur de cette méthode repose sur la décomposition analytique de la variance totale observée au sein du jeu de données en deux composantes mutuellement exclusives et orthogonales : la variance inter-groupes, qui capture la variabilité imputable aux effets différentiels des traitements appliqués, et la variance intra-groupe, souvent qualifiée d’erreur résiduelle, qui reflète les fluctuations aléatoires individuelles et les imprécisions inhérentes à la mesure psychométrique.
D’un point de vue mathématique, cette décomposition s’exprime à travers l’égalité de la somme des carrés totale avec la somme des carrés factorielle et la somme des carrés de l’erreur résiduelle. En divisant ces grandeurs par leurs degrés de liberté respectifs, le statisticien obtient les carrés moyens correspondants. Le ratio de Fisher, noté F, est défini par le quotient du carré moyen inter-groupes sur le carré moyen intra-groupe. Sous l’hypothèse nulle d’homogénéité globale des populations, ce ratio suit une distribution théorique de Fisher-Snedecor. Si la valeur empirique de F excède le seuil critique pour un niveau de signification donné, l’hypothèse nulle stipulant l’égalité conjointe de toutes les moyennes est rejetée avec un risque contrôlé.
Néanmoins, la portée inférentielle de ce test présente une limitation épistémologique majeure : son caractère omnibus. En effet, l’ANOVA globale atteste simplement qu’au moins une des moyennes de groupe diffère de manière significative des autres, sans fournir la moindre indication spatiale ou directionnelle quant à la localisation exacte de cette divergence. Elle ne permet nullement d’affirmer si toutes les conditions expérimentales s’écartent les unes des autres, si une seule modalité atypique porte l’intégralité de l’effet statistique, ou si les traitements actifs surpassent véritablement la condition de référence. Cette incapacité fondamentale de l’ANOVA globale à identifier la source précise de l’effet impose le recours méthodique à une analyse séquentielle en deux étapes, articulant le test omnibus initial à des procédures d’analyse détaillée dites post-hoc.
1.2 La problématique du taux d’erreur par famille (Family-Wise Error Rate)
Face à l’impossibilité pour l’ANOVA d’isoler les paires de moyennes en rupture d’homogénéité, le réflexe intuitif consisterait à effectuer des tests t de Student conventionnels pour chacune des comparaisons bilatérales envisageables. Cependant, cette pratique engendre une pathologie méthodologique grave connue sous le nom d’inflation exponentielle du risque d’erreur de type I. Dès lors qu’une série de tests d’hypothèses est conduite de manière simultanée sur un même ensemble d’observations empiriques, la probabilité d’obtenir par pur hasard au moins un résultat faussement positif augmente de façon dramatique.
Le taux d’erreur par famille (FWER, pour Family-Wise Error Rate) formalise cette probabilité conjointe. En faisant l’hypothèse de travail préliminaire d’une indépendance stochastique totale entre les tests réalisés, la formule mathématique modélisant le risque d’erreur cumulé pour un ensemble de c comparaisons indépendantes s’écrit formellement :
Alpha global = 1 – (1 – alpha)^c
Dans cette équation, alpha représente le seuil nominal conventionnel appliqué à chaque test individuel, couramment fixé à 0,05 dans la recherche expérimentale. Dès lors que le dispositif expérimental comporte cinq groupes distincts, le nombre total de comparaisons deux à deux possibles s’élève à dix. L’application de la formule révèle alors que le risque réel d’observer au moins une fausse découverte atteint approximativement 40 %, transformant une démarche censée être rigoureuse en une loterie inférentielle inacceptable.
Les conséquences scientifiques de cette prolifération de faux positifs s’avèrent désastreuses pour l’édifice des connaissances en psychologie clinique, en neuropsychologie et en sciences biomédicales. Des interventions inopérantes se trouvent prématurément validées, mobilisant inutilement des ressources de recherche considérables et faussant les protocoles thérapeutiques appliqués aux patients. Il s’avère donc impératif de mettre en œuvre des stratégies d’ajustement statistique rigoureuses, capables de brider l’erreur globale au seuil nominal de 0,05 tout en conservant une puissance de détection suffisante pour identifier les variations cliniquement déterminantes.
1.3 Typologie générale des procédures de comparaison multiple
Pour réguler rigoureusement cette inflation du risque d’erreur globale, les méthodologistes ont structuré l’arsenal des comparaisons multiples autour de deux axes conceptuels majeurs. Le premier axe sépare de manière stricte les contrastes planifiés a priori des tests post-hoc conduits a posteriori. Les contrastes a priori émanent de déductions théoriques explicites formulées avant la collecte du moindre élément empirique ; ils ne requièrent généralement aucune validation omnibus préalable par l’ANOVA et bénéficient d’une puissance statistique supérieure. À l’inverse, les tests post-hoc interviennent après examen exploratoire des données empiriques et nécessitent des pénalités d’ajustement plus sévères pour compenser l’absence d’hypothèse pré-spécifiée.
Le second axe taxinomique distingue la structure géométrique de l’espace de comparaison exploré. D’un côté figurent les procédures exhaustives évaluant toutes les paires possibles au sein du plan d’expérience. Parmi celles-ci, le test HSD (Honestly Significant Difference) de Tukey constitue la référence incontournable pour quantifier l’écart entre chaque groupe et l’ensemble de ses pairs, garantissant une protection sans faille contre le risque de première espèce grâce à l’usage de la distribution de l’étendue studentisée. De même, la méthode de Scheffé offre une flexibilité totale en autorisant le test a posteriori de n’importe quelle combinaison linéaire complexe de moyennes, mais au détriment d’un conservatisme mathématique extrême qui réduit considérablement sa puissance.
D’un autre côté se situent les procédures ciblées, restreignant volontairement leur champ d’investigation à un sous-ensemble prédéfini d’hypothèses ayant une signification théorique ou clinique fondamentale. C’est précisément au sein de cette catégorie hautement optimisée que s’inscrit le test de Dunnett. En renonçant explicitement aux comparaisons superflues entre les différents traitements expérimentaux eux-mêmes pour se focaliser uniquement sur l’opposition unilatérale ou bilatérale de chaque traitement à un témoin unique, la procédure de Dunnett maximise la puissance inférentielle sans jamais franchir la frontière critique du FWER.
2. Définition et spécificités du test de Dunnett
2.1 Objectif ciblé : comparaison systématique avec un groupe témoin
Le test de Dunnett répond de façon idéale à une architecture expérimentale asymétrique très fréquente dans les protocoles de recherche contemporains : la présence de k – 1 conditions d’intervention expérimentale que l’on souhaite individuellement mesurer et valider face à une condition de référence unique, étiquetée groupe témoin ou contrôle. Dans ce schéma méthodologique, le statisticien ne s’intéresse aucunement à la question de savoir si le traitement A surpasse le traitement B, ni si l’intervention C diffère de l’intervention D. L’interrogation scientifique centrale et exclusive consiste à établir si, parmi les k – 1 modalités thérapeutiques mises à l’épreuve, certaines produisent des altérations métriques significatives par rapport à l’état de base incarné par le témoin.
En éliminant méthodiquement l’intégralité des contrastes inter-traitements, le test de Dunnett évite le gaspillage substantiel de puissance statistique qui handicape lourdement les procédures toutes paires confondues. Si une étude examine quatre traitements actifs et un groupe placebo, le nombre total de comparaisons bilatérales s’élève à dix. L’application d’un test exhaustif pénalisera donc l’analyste pour dix hypothèses simultanées, alors même que six de ces comparaisons ne présentent aucun intérêt direct pour la validation d’efficacité thérapeutique. En limitant le faisceau de l’inférence à quatre tests ciblés, Dunnett permet d’obtenir des intervalles de confiance plus resserrés et des seuils de rejet moins draconiens.
Cette spécification structurelle trouve des applications directes et fécondes en psychopharmacologie expérimentale, où diverses molécules ou dosages sont testés contre un excipient neutre, ainsi qu’en psychologie cognitive et clinique. Dans ce dernier domaine, l’expérimentateur peut par exemple comparer les scores d’attention soutenue ou de détresse psychologique obtenus par différentes approches thérapeutiques brèves face à une cohorte de sujets assignés à une liste d’attente sans prise en charge active.
2.2 Origine statistique et modélisation probabiliste de Charles Dunnett
La paternité de cette percée méthodologique revient au bio-statisticien canadien Charles William Dunnett, qui publia en 1955 un article princeps intitulé « A Multiple Comparison Procedure for Comparing Several Treatments with a Control » dans les pages du prestigieux Journal of the American Statistical Association. Dunnett y identifiait avec acuité une anomalie structurelle dans l’usage des corrections de type Bonferroni ou des contrastes de Student standards : la non-indépendance fondamentale des statistiques de test générées par la présence récurrente du groupe contrôle au dénominateur ou au numérateur de chaque différence de moyennes.
Lorsqu’un chercheur calcule les écarts (Moyenne 1 – Moyenne 0), (Moyenne 2 – Moyenne 0) jusqu’à (Moyenne k-1 – Moyenne 0), l’estimation de la moyenne du témoin intervient de façon répétée dans l’ensemble des termes différentiels. Il en résulte obligatoirement une corrélation positive systématique entre toutes ces métriques de contraste. Si le groupe témoin présente par simple fluctuation d’échantillonnage une moyenne accidentellement basse, toutes les différences calculées avec les traitements actifs s’en trouveront artificiellement gonflées de façon synchrone. Traiter ces comparaisons comme des événements probabilistes indépendants constitue une hérésie mathématique qui induit des biais d’estimation marqués.
Pour résoudre cette dépendance stochastique, Dunnett a mobilisé la théorie de la distribution t multivariée sous structure de corrélation équivalente. En modélisant rigoureusement la matrice de covariance induite par l’inclusion systématique de la variance du groupe contrôle, Dunnett a calculé les probabilités exactes de dépassement simultané. Cette avancée théorique majeure a permis de définir des valeurs critiques spécifiques qui tiennent compte de la covariance inter-contrastes, offrant ainsi une solution exacte et optimale là où les approximations antérieures échouaient.
2.3 Distinctions majeures avec les tests de Tukey, Bonferroni et Scheffé
Pour bien appréhender la suprématie opérationnelle du test de Dunnett dans son domaine d’élection, il convient de le confronter méthodologiquement aux autres solutions usuelles de correction des comparaisons multiples. La comparaison la plus directe s’opère avec la procédure de Bonferroni. Cette dernière, d’une grande simplicité arithmétique, se contente de diviser le seuil d’erreur alpha nominal par le nombre de comparaisons exécutées. Bien qu’elle soit universellement applicable, la correction de Bonferroni repose sur l’inégalité de Boole et néglige délibérément la structure de corrélation positive entre les contrastes. En conséquence, le test de Dunnett s’avère uniformément plus puissant que celui de Bonferroni, car ses valeurs critiques intègrent la covariance commune, évitant ainsi un conservatisme excessif qui augmenterait le risque d’erreur de type II.
Face au test HSD de Tukey, la distinction relève de l’étendue de l’espace hypothétique exploré. Le test de Tukey calibre ses seuils critiques sur l’amplitude de la différence maximale entre deux moyennes quelconques parmi les k groupes disponibles, par le biais de la statistique de l’étendue studentisée q. De ce fait, Tukey paie le prix statistique d’une protection intégrale sur l’ensemble des k(k-1)/2 comparaisons possibles. Si l’expérimentateur n’a que faire des contrastes réciproques entre traitements actifs, recourir au test de Tukey revient à adopter un seuil critique inutilement sévère, pénalisant la découverte d’écarts pourtant réels face au témoin.
Enfin, le test de Scheffé représente le pôle le plus conservateur du continuum des procédures post-hoc. Formulé pour protéger l’analyste contre l’inflation du risque d’erreur de première espèce lors de l’exploration de n’importe quel contraste linéaire imaginable, même hautement complexe, sa pénalité mathématique est disproportionnée pour l’analyse de simples différences deux à deux. Le test de Dunnett, strictement paramétré pour les contrastes élémentaires au témoin, surpasse le test de Scheffé en termes de sensibilité empirique, s’imposant sans équivoque comme l’outil d’élection pour tout dispositif expérimental centré sur un groupe de contrôle.
3. Conditions préalables et hypothèses d’application en psychologie
3.1 Normalité distributionnelle des résidus expérimentaux
À l’instar de l’ANOVA paramétrique dont il constitue le prolongement inférentiel naturel, le test de Dunnett repose sur des postulats distributionnels précis que le chercheur se doit de valider scrupuleusement avant toute tentative d’interprétation des résultats. La première de ces conditions fondamentales concerne la normalité de la distribution de la variable dépendante au sein de chaque population parente échantillonnée, ou, de manière équivalente et plus élégante, la normalité des résidus de l’ensemble du modèle linéaire général.
L’évaluation rigoureuse de cette propriété mathématique nécessite la mise en œuvre de diagnostics à la fois analytiques et graphiques. Sur le plan formel, le recours au test de Shapiro-Wilk s’impose comme la méthode la plus robuste pour identifier une violation de la normalité au sein d’échantillons de taille modeste à modérée. Un test de Shapiro-Wilk non significatif conforte l’hypothèse nulle d’adéquation à la loi normale. Ce diagnostic statistique doit systématiquement être corroboré par l’inspection visuelle des diagrammes quantile-quantile (Q-Q plots) des résidus standardisés. Sur ces graphiques, l’alignement harmonieux des points empiriques le long de la bissectrice théorique atteste du respect raisonnable du postulat gaussien.
Sur le plan théorique, le test de Dunnett fait preuve d’une robustesse satisfaisante face à des entorses mineures ou modérées à la normalité, en vertu du théorème central limite, dès lors que les effectifs d’échantillons atteignent des seuils respectables (typiquement n ≥ 25 par cellule expérimentale). En revanche, la survenue d’asymétries sévères ou d’un aplatissement prononcé altère substantiellement la régulation du taux d’erreur de première espèce. Dans ces configurations critiques, la statistique empirique s’écarte de la loi t multivariée théorique, majorant de manière incontrôlée le risque de faux positifs ou réduisant dramatiquement la puissance du test.
3.2 Homoscédasticité et conséquences de sa violation
La seconde condition préalable indispensable au déploiement sans distorsion du test de Dunnett standard réside dans l’homoscédasticité, définie comme l’homogénéité parfaite des variances de la variable dépendante à travers l’ensemble des k groupes d’observation. Cette exigence découle directement du fait que la statistique de Dunnett utilise l’estimation de la variance intra-groupe (le carré moyen résiduel de l’ANOVA globale) comme un dénominateur commun censé représenter la variance intrinsèque unique partagée par l’ensemble des populations expérimentales sous-jacentes.
La vérification empirique de l’égalité des variances s’opère usuellement par le biais du test d’homogénéité des variances de Levene, ou de sa variante plus robuste centrée sur la médiane, le test de Brown-Forsythe. L’obtention d’une valeur p supérieure au seuil conventionnel de 0,05 permet de valider le postulat d’homogénéité. Si, à l’inverse, l’hypothèse nulle d’égalité des variances est rejetée, l’utilisation du test de Dunnett conventionnel devient hautement problématique. L’agrégation de variances disparates au sein d’un carré moyen résiduel unique engendre une distorsion notable de l’erreur type des contrastes.
Lorsque des variances hétérogènes coïncident avec des effectifs d’échantillons inégaux, les répercussions statistiques s’avèrent délétères. Si les groupes de petite taille présentent les variances les plus volumineuses, le test de Dunnett devient excessivement libéral, déclarant faussement significatives de simples variations stochastiques. Inversement, si les effectifs élevés sont associés aux plus fortes dispersions, la procédure devient ultra-conservative, interdisant la détection d’effets cliniques majeurs. Face à un rejet indiscutable de l’homoscédasticité, le chercheur devra obligatoirement renoncer à la version classique pour adopter des variantes correctrices adaptées, telles que la procédure T3 de Dunnett articulée sur les degrés de liberté de Welch-Satterthwaite.
3.3 Indépendance des observations et échantillonnage contrôlé
L’hypothèse d’indépendance statistique des observations représente la contrainte méthodologique la plus impérative et la moins tolérante aux violations dans l’ensemble des analyses d’inférence paramétrique. Dans le cadre de l’ANOVA unifactorielle et du test de Dunnett à groupes indépendants, elle stipule formellement que le score obtenu par un participant donné ne doit en aucun cas exercer la moindre influence sur les scores enregistrés par les autres sujets de la même condition ou des conditions adjacentes, et que les résidus du modèle ne doivent exhiber aucune structure d’autocorrélation résiduelle.
La garantie de cette indépendance stochastique ne procède pas d’une validation computationnelle a posteriori, mais repose exclusivement sur la rigueur du dispositif méthodologique déployé en amont de la récolte des données. Elle exige une assignation aléatoire stricte des participants aux diverses conditions expérimentales (randomisation simple ou par blocs équilibrés). Les protocoles faisant appel à des mesures répétées sur les mêmes individus au fil du temps, à un appariement par paires de sujets, ou à des cohortes de participants interconnectés (par exemple des élèves regroupés par classes ou des patients suivis au sein d’un même centre hospitalier) enfreignent frontalement ce postulat d’indépendance sans modélisation multiniveau appropriée.
Dans la pratique de la recherche psychologique et clinique, la préservation de l’indépendance exige également une standardisation maniaque du contexte expérimental. La passation des tâches cognitives ou l’administration des questionnaires d’auto-évaluation doivent être conduites de façon strictement isolée, afin d’éradiquer les phénomènes de contagion sociale, de facilitation réciproque ou d’apprentissage vicariant non contrôlé. Toute corrélation intraclasse non modélisée induit un effondrement artificiel des erreurs types, conduisant à des rejets d’hypothèse nulle fallacieux qui trompent le diagnostic de recherche.
4. Formulation des hypothèses statistiques du test de Dunnett
4.1 Définition de l’hypothèse nulle globale et des hypothèses spécifiques
L’architecture logique du test de Dunnett s’articule autour d’une partition précise de l’espace de décision statistique. Contrairement à l’ANOVA qui n’examine qu’une hypothèse omnibus indifférenciée, la procédure de Dunnett déploie une collection finie de k – 1 hypothèses nulles spécifiques, chacune faisant l’objet d’un test simultané et d’une décision inférentielle distincte. Soit k le nombre total de groupes composant le dispositif d’étude, la condition indexée par l’indice 0 désignant par convention universelle le groupe témoin de référence, et les indices i variant de 1 à k – 1 référant aux divers groupes de traitement expérimental.
L’ensemble des hypothèses nulles formulées pour chaque contraste s’écrit mathématiquement :
H0,i : mu_i = mu_0 pour tout i appartenant à l’ensemble {1, 2, …, k – 1}
Dans cette formalisation, le paramètre mu_i représente l’espérance mathématique de la population soumise au i-ème traitement expérimental, tandis que mu_0 désigne la moyenne théorique de la population assignée à la condition témoin. L’hypothèse nulle globale testée par la famille de contrastes correspond à l’intersection logique de l’ensemble de ces hypothèses partielles. L’expérimentateur postule qu’aucune des modalités d’intervention mises en œuvre ne produit d’écart moyen quantifiable par rapport à la trajectoire de base du témoin.
Les hypothèses alternatives associées se définissent quant à elles de manière symétrique ou asymétrique selon les objectifs du protocole. Dans le cadre d’un test bilatéral non directionnel, l’hypothèse alternative pour chaque sous-comparaison s’exprime sous la forme composite :
H1,i : mu_i ≠ mu_0
Cette segmentation rigoureuse permet de rejeter individuellement l’hypothèse nulle pour certaines thérapies qui se révèlent significativement différentes du témoin, tout en maintenant l’hypothèse nulle pour d’autres traitements dont les performances restent statistiquement indiscernables de la référence de contrôle.
4.2 Tests unilatéraux versus bilatéraux dans l’expérimentation clinique
Une des propriétés remarquables du test de Dunnett réside dans sa capacité native à être paramétré soit sous une forme bilatérale (à deux queues), soit sous une forme unilatérale directionnelle (à une queue), cette dernière option se subdivisant en tests de supériorité ou d’infériorité. Le choix entre ces deux paradigmes ne relève pas d’une simple opportunité computationnelle visant à maximiser artificiellement les chances de succès statistique, mais d’une justification épistémologique stricte ancrée dans les objectifs thérapeutiques du protocole.
Le cadre bilatéral représente la démarche standard par défaut dans l’expérimentation psychologique et comportementale. Il s’applique dès lors que l’expérimentateur admet la possibilité a priori que le traitement actif puisse soit améliorer la condition des participants, soit au contraire induire des effets indésirables conduisant à une détérioration métrique par rapport au groupe témoin. Ce cadre offre une surveillance bidirectionnelle impartiale mais impose, en contrepartie, une valeur critique tabulée plus élevée pour franchir le seuil d’admissibilité statistique.
À l’inverse, l’usage du cadre unilatéral restreint l’investigation à une seule direction de l’effet. Dans un essai évaluant l’efficacité d’un antidépresseur face à un placebo, l’analyste peut formuler l’hypothèse alternative directionnelle :
H1,i : mu_i < mu_0 (dans le cas d’une échelle de dépression où un score plus bas indique une amélioration clinique)
Dans cette configuration unilatérale rigide, toute variation empirique s’orientant dans le sens opposé (aggravation de la symptomatologie sous traitement) sera rigoureusement imputée au hasard, quelle que soit son amplitude. L’avantage majeur du test unilatéral réside dans son gain de puissance statistique : la masse critique de rejet étant concentrée sur une seule extrémité de la distribution, le seuil critique t_d requis pour rejeter l’hypothèse nulle est substantiellement plus bas. Les agences d’évaluation du médicament et les comités d’éthique n’autorisent généralement ce choix que lorsque des données précliniques irréfutables écartent tout risque d’inversion des effets.
4.3 Choix et rigueur méthodologique du niveau alpha nominal
La fixation du risque d’erreur de première espèce nominal constitue une étape fondatrice de l’architecture inférentielle. Par convention quasi universelle établie par Ronald Fisher dans la recherche biomédicale et psychologique, ce niveau alpha nominal est historiquement calibré à 0,05, ou plus restrictivement à 0,01 dans les essais d’homologation clinique à haute criticité diagnostique.
L’apport méthodologique central du test de Dunnett est de fournir une garantie mathématique exacte quant au maintien du FWER à cette valeur nominale de 0,05 pour l’ensemble des k – 1 comparaisons simultanées. Il existe à cet égard une distinction conceptuelle fondamentale entre le seuil d’erreur par comparaison individuelle (PCER, pour Per-Comparison Error Rate) et le taux d’erreur pour l’ensemble de la famille d’hypothèses (FWER). Si l’on utilisait un seuil de 0,05 par comparaison sur un ensemble de quatre traitements opposés à un témoin sans ajustement, le risque d’erreur de la famille culminerait à près de 18,5 %.
En adoptant la distribution de Dunnett, l’analyste accepte de facto un seuil effectif par comparaison plus contraignant (souvent voisin de 0,013 ou 0,015 selon le nombre de groupes), expressément calculé pour que la probabilité globale d’émettre au moins une fausse alerte sur l’ensemble du dispositif expérimental ne dépasse jamais le seuil cible de 0,05. Cette rigueur méthodologique protège la communauté scientifique contre l’illusion de causalité thérapeutique, tout en évitant l’extrême sévérité mathématique d’une pénalisation arbitraire non pondérée par la corrélation inter-groupes.
5. Dérivation mathématique et calcul des statistiques de test
5.1 Extraction du carré moyen intra-groupe (MSw) depuis l’ANOVA
L’opérationnalisation du test de Dunnett débute par l’extraction des composantes résiduelles issues de l’ANOVA préalable. Bien que certains auteurs considèrent que le test de Dunnett puisse être planifié de façon indépendante sans exiger la significativité préalable du ratio F de l’ANOVA, il demeure intrinsèquement tributaire du modèle linéaire pour l’estimation de la variance commune de l’erreur expérimentale, formellement désignée sous l’appellation de carré moyen intra-groupe (noté MSw pour Mean Square Within ou CMe pour Carré Moyen de l’erreur).
Ce carré moyen intra-groupe est obtenu en calculant la somme des écarts quadratiques entre le score de chaque participant individuel et la moyenne observée de son propre groupe d’appartenance, une grandeur formalisée par la somme des carrés intra-groupe (SSw). Cette somme est ensuite divisée par les degrés de liberté résiduels correspondants :
MSw = SSw / (N – k)
Où N symbolise la taille totale de l’échantillon agrégé sur l’ensemble de l’étude, et k le nombre total de groupes expérimentaux et contrôle. Le terme MSw représente l’estimateur non biaisé de la variance de la population générale (sigma carré), sous le postulat d’homoscédasticité. Plus l’échantillon global N est vaste par rapport au nombre de conditions k, plus le nombre de degrés de liberté de l’erreur est élevé, conférant à MSw une stabilité asymptotique accrue qui maximise la précision de l’erreur standard groupée utilisée au dénominateur du test.
5.2 Détermination de la valeur critique tabulée (t_d)
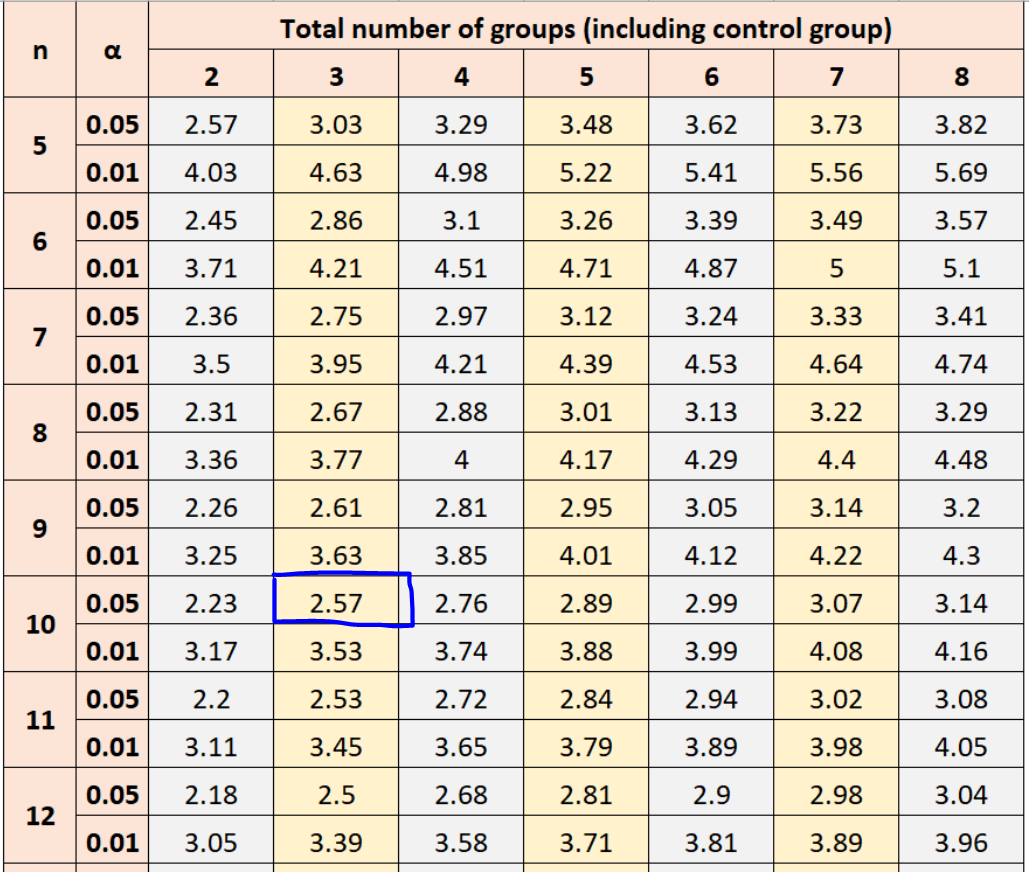
Une fois le paramètre de variance résiduelle extrait, l’analyste doit identifier la valeur critique théorique, désignée par t_d, qui servira de frontière décisionnelle pour rejeter ou non l’hypothèse nulle. Historiquement, cette démarche imposait la consultation de tables statistiques spécialisées compilées par Dunnett lui-même, tables qui se distinguaient nettement des tables standard de Student en raison de la nature multivariée de la loi sous-jacente.
Pour extraire la valeur t_d appropriée au sein de ces tables ou via un algorithme informatique moderne, trois paramètres d’entrée doivent impérativement être spécifiés :
- Le nombre total de groupes composant l’expérience (k), incluant impérativement le groupe témoin de référence ;
- Le nombre de degrés de liberté associés au carré moyen intra-groupe, à savoir df = N – k ;
- Le niveau de risque alpha global consenti (typiquement 0,05 ou 0,01), conjugué à la nature unilatérale ou bilatérale du test projeté.
Dans l’environnement computationnel contemporain, les logiciels n’utilisent plus de tables statiques mais calculent la valeur critique par intégration numérique directe de la fonction de densité conjointe d’un vecteur aléatoire suivant une loi de Student multivariée. Des algorithmes sophistiqués, tels que ceux développés par Alan Genz et Frank Bretz, procèdent par approximations quasi-Monte Carlo ou méthodes de quadrature adaptative pour délivrer une valeur critique exacte jusqu’à la sixième décimale, rendant compte avec une précision absolue des corrélations exactes induites par la taille respective des échantillons.
5.3 Calcul de la statistique t de Dunnett et de la différence minimale significative
Le calcul de la statistique de test empirique s’effectue pour chaque condition expérimentale active en confrontant sa moyenne observée à celle du groupe témoin. Pour un traitement expérimental i donné, la statistique t_Dunnett, souvent abrégée d_i, se calcule par le ratio suivant :
t_Dunnett,i = (Moyenne_i – Moyenne_0) / Erreur_Standard_i
L’expression algébrique de l’erreur standard associée au contraste fait intervenir directement le carré moyen intra-groupe extrait de l’ANOVA ainsi que la taille des deux sous-échantillons mis en jeu :
Erreur_Standard_i = Racine_Carrée [ MSw * ( (1 / n_i) + (1 / n_0) ) ]
Où n_i représente l’effectif spécifique du groupe expérimental i et n_0 l’effectif spécifique du groupe témoin. La règle de décision inférentielle s’énonce alors en toute clarté : si la valeur absolue de la statistique empirique calculée excède la valeur critique tabulée (soit |t_Dunnett,i| > t_d), l’hypothèse nulle spécifique H0,i est formellement rejetée au seuil FWER choisi.
Une approche analytique équivalente et particulièrement élégante consiste à convertir cette valeur critique en une métrique brute directement exprimée dans l’unité de mesure de la variable dépendante : la Différence Minimale Significative (DMS de Dunnett). Son équation s’établit par le produit de la valeur critique par l’erreur standard du contraste :
DMS_i = t_d * Racine_Carrée [ MSw * ( (1 / n_i) + (1 / n_0) ) ]
Dès lors, la décision statistique s’opère par simple confrontation visuelle directe : si la différence arithmétique brute |Moyenne_i – Moyenne_0| se révèle strictement supérieure à la DMS_i correspondante, le traitement évalué est déclaré significativement différent du témoin de référence avec une maîtrise absolue du risque d’erreur globale.
6. Construction et interprétation des intervalles de confiance de Dunnett
6.1 Équation fondamentale de l’intervalle de confiance simultané
Bien que le calcul des statistiques de test t et des valeurs p associées constitue la modalité historique de restitution des résultats, la pratique biomédicale et psychologique contemporaine accorde une prééminence méthodologique absolue à l’estimation par intervalles de confiance. Contrairement à une valeur p qui synthétise la force du signal contre l’hypothèse nulle sous un format binaire et dépendant de la taille d’échantillon, un intervalle de confiance quantifie simultanément la magnitude de l’effet clinique et le degré de précision métrique de son estimation.
Dans le cadre de la procédure de Dunnett, l’équation fondamentale permettant de borner l’intervalle de confiance simultané pour la différence réelle de moyennes dans la population (mu_i – mu_0) s’écrit formellement :
IC(1 – alpha) = (Moyenne_i – Moyenne_0) ± [ t_d * Erreur_Standard_i ]
Ce qui équivaut rigoureusement à encadrer la différence observée par l’ajout et la soustraction de la Différence Minimale Significative dérivée précédemment :
Borne Inférieure = (Moyenne_i – Moyenne_0) – DMS_i
Borne Supérieure = (Moyenne_i – Moyenne_0) + DMS_i
La singularité conceptuelle majeure de cette formulation réside dans son caractère simultané. La valeur critique t_d étant calibrée sur la distribution t multivariée, l’ensemble des k – 1 intervalles construits possède un taux de couverture conjointe garanti à exactement 100 * (1 – alpha) %. Cela signifie que si l’expérimentateur répétait indéfiniment son protocole expérimental dans des conditions strictement analogues, 95 % de ces familles complètes d’intervalles contiendraient simultanément les k – 1 véritables écarts de population, offrant un niveau de certitude globale considérablement supérieur à celui délivré par une série d’intervalles de confiance non ajustés.
6.2 Évaluation de l’inclusion de la valeur zéro et pertinence clinique
L’interprétation diagnostique de ces intervalles simultanés s’opère selon une double grille de lecture : statistique et clinique. Sur le plan de la décision inférentielle formelle, le critère d’exclusion de la valeur zéro agit comme le substitut direct du rejet de l’hypothèse nulle. Si l’intervalle de confiance à 95 % de Dunnett calculé pour le contraste entre le traitement A et le témoin n’englobe pas la valeur zéro (ses deux bornes étant soit strictement positives, soit strictement négatives), le chercheur en déduit que l’effet thérapeutique est statistiquement significatif au seuil FWER de 0,05. Si, en revanche, la borne inférieure est négative tandis que la borne supérieure est positive, le zéro réside à l’intérieur de la fourchette d’incertitude : l’hypothèse d’une absence d’écart réel ne peut dès lors être écartée.
Au-delà de cette démarcation inférentielle, l’examen de l’amplitude de l’intervalle éclaire la pertinence clinique pratique de l’intervention, un concept fondamental souvent occulté par la seule valeur p. L’expérimentateur peut en effet définir préalablement une Différence Minimale Cliniquement Importante (DMCI). Dès lors, trois configurations cliniques peuvent se dessiner :
- L’intervalle exclut le zéro et sa borne inférieure surpasse largement la DMCI : l’intervention présente une efficacité indiscutable et cliniquement déterminante pour le patient ;
- L’intervalle exclut le zéro mais se situe en deçà de la DMCI : l’effet thérapeutique, bien que statistiquement attesté en raison d’une taille d’échantillon pléthorique, s’avère d’une portée clinique dérisoire dans la pratique quotidienne ;
- L’intervalle englobe le zéro mais sa borne supérieure s’étend bien au-delà de la DMCI : l’étude manque cruellement de puissance statistique pour conclure formellement, mais signale une piste thérapeutique prometteuse exigeant un nouvel essai à effectifs élargis.
6.3 Représentation graphique des intervalles de dispersion
Afin de communiquer de manière limpide et transparente l’incertitude associée aux contrastes thérapeutiques, la représentation graphique des intervalles de confiance de Dunnett par le biais de graphiques en forêt (forest plots) constitue la modalité de publication préconisée par les revues académiques de premier plan. Ce mode de visualisation synthétique supplante avantageusement les diagrammes en barres classiques accompagnés de simples astérisques d’évaluation probabiliste.
Sur un graphique en forêt dédié aux comparaisons multiples avec un témoin, l’axe vertical liste méthodiquement chacune des conditions expérimentales actives testées face à la référence. L’axe horizontal quantifie l’amplitude brute ou standardisée de la différence de moyennes (Moyenne_i – Moyenne_0). Une ligne verticale continue est érigée au point zéro, matérialisant visuellement l’hypothèse d’absence d’effet (ligne de non-effet thérapeutique). Pour chaque intervention, l’estimation ponctuelle de la différence moyenne est matérialisée par un symbole géométrique central (tel qu’un carré ou un losange), enserré par une barre horizontale d’erreur dont les extrémités correspondent précisément aux bornes inférieure et supérieure de l’intervalle de confiance ajusté de Dunnett.
Cette visualisation graphique offre au lecteur une compréhension instantanée des dynamiques de l’essai : toute condition dont le segment horizontal coupe la ligne zéro est immédiatement identifiée comme non significative au seuil régulé. Parallèlement, l’étalement horizontal de chaque barre illustre sans ambiguïté la précision de la mesure expérimentale, des barres très resserrées traduisant une estimation robuste découlant d’une faible variabilité résiduelle ou d’effectifs substantiels.
7. Gestion des plans d’échantillonnage équilibrés et déséquilibrés
7.1 Cas classique : effectifs d’échantillons identiques (n équilibré)
L’architecture expérimentale la plus canonique en recherche quantitative correspond au plan factoriel équilibré, dans lequel l’expérimentateur alloue un nombre strictement identique de participants à chaque condition expérimentale et au groupe témoin, tel que :
n_0 = n_1 = n_2 = … = n_(k-1) = n
Cette configuration isométrique engendre des simplifications computationnelles substantielles. D’une part, l’expression de l’erreur standard devient rigoureusement identique pour l’ensemble des contrastes examinés au sein du protocole :
Erreur_Standard = Racine_Carrée [ 2 * MSw / n ]
D’autre part, sur le versant probabiliste fondamental, l’égalisation des effectifs d’échantillons confère une symétrie mathématique parfaite à la matrice de corrélation des statistiques de test multivariées sous-jacentes. Dans un tel contexte équilibré, les coefficients de corrélation inter-contrastes hors-diagonale deviennent tous égaux à une valeur constante universelle de :
rho = 0,5
Cette invariance théorique découle du fait que la variance du terme d’erreur résiduel partagé du témoin intervient dans chaque contraste avec un poids strictement égal à la variance de l’intervention active associée. Les tables historiques publiées par Charles Dunnett en 1955 avaient précisément été compilées sous cette hypothèse centrale d’équicorrélation à 0,5. Les plans équilibrés bénéficient d’une robustesse maximale face aux légères hétérogénéités de variance et confèrent au test une distribution optimale de sa puissance globale.
7.2 Adaptation computationnelle pour effectifs inégaux
Dans la réalité quotidienne de la recherche empirique, le maintien d’un équilibre strict des effectifs s’avère souvent compromis par des contingences logistiques incontournables : défections de participants au cours de l’essai (attrition), données manquantes consécutives à des artéfacts techniques, ou recrutement asymétrique dicté par la rareté de certaines populations cliniques. Dès lors que les effectifs deviennent inégaux (n_i ≠ n_j), le modèle mathématique standard de Dunnett doit subir un ajustement computationnel pour préserver l’exactitude de ses conclusions.
Sur le plan mécanique, l’erreur standard cesse d’être une constante et doit être calculée de façon individualisée pour chaque paire traitement-contrôle en intégrant les effectifs respectifs n_i et n_0. Plus fondamentalement, la rupture de l’équilibre numérique brise la symétrie de la matrice de covariance. Les corrélations entre la statistique de contraste i et la statistique de contraste j cessent d’être égales à 0,5 et deviennent dépendantes de la distribution relative des sujets, selon l’équation :
rho_ij = Racine_Carrée [ (n_i / (n_i + n_0)) * (n_j / (n_j + n_0)) ]
Face à une telle matrice de corrélation non constante, les tables statistiques conventionnelles deviennent inopérantes. Les logiciels contemporains ont donc recours à des procédures d’intégration numérique directe sur des hypercubes multidimensionnels asymétriques. L’utilisation des algorithmes de quadrature matricielle formulés par Genz et Bretz permet d’ajuster dynamiquement le calcul de la distribution t multivariée aux pondérations réelles des échantillons. Cette flexibilité computationnelle garantit que le FWER reste rigoureusement étalonné au seuil nominal, interdisant toute distorsion décisionnelle consécutive au déséquilibre d’échantillonnage.
7.3 Règle d’allocation optimale de l’échantillon pour le groupe témoin
Si la gestion des déséquilibres fortuits constitue une nécessité technique, il existe des situations méthodologiques où le déséquilibre des effectifs n’est pas une anomalie subie, mais une stratégie délibérément planifiée lors de la conception pré-expérimentale. Dans son article fondateur de 1955, Charles Dunnett s’est interrogé sur la répartition idéale d’un volume global de sujets N fixe dans le dessein d’optimiser au maximum la puissance statistique conjointe de son test.
En analysant le fait que l’estimation de la moyenne du groupe témoin intervient de façon récurrente dans l’ensemble des k – 1 contrastes calculés, Dunnett a démontré que la variance globale de l’estimation était disproportionnellement sensible à la précision du groupe de référence. Si le groupe témoin est sous-dimensionné ou de taille modeste, l’incertitude sur sa moyenne pénalise simultanément la totalité des comparaisons actives. Par conséquent, pour maximiser l’efficience globale du dispositif, il s’avère hautement avantageux d’allouer davantage de sujets au groupe témoin qu’à chacun des groupes de traitement actif.
Dunnett a établi la règle d’allocation optimale qui stipule que le ratio idéal entre la taille du groupe témoin (n_0) et la taille d’un groupe expérimental standard (n_i) doit être proportionnel à la racine carrée du nombre de traitements actifs testés :
n_0 / n_i = Racine_Carrée [ k – 1 ]
Ainsi, dans une étude clinique évaluant quatre approches thérapeutiques novatrices face à un groupe témoin (soit k = 5 groupes au total, dont 4 traitements), le ratio optimal d’allocation s’élève à Racine_Carrée(4) = 2. Cela signifie que l’expérimentateur devrait idéalement recruter deux fois plus de patients dans la cohorte témoin que dans chacun des bras d’intervention active. Cette sur-allocation stratégique de l’échantillon au contrôle réduit l’erreur type de tous les contrastes et maximise la puissance statistique globale du protocole pour un coût logistique globalement invariant.
8. Mise en œuvre pratique sous R pour la recherche psychologique
8.1 Préparation des données et vérification des présupposés avec R
L’écosystème open source R s’impose comme l’un des environnements les plus rigoureux et flexibles pour la conduite d’analyses statistiques avancées en recherche psychologique. L’exécution d’un test de Dunnett y requiert une structuration adéquate des données empiriques au format long (tidy data). Dans ce schéma organisationnel, chaque ligne du tableau de données correspond à une observation individuelle unique, tandis qu’une première colonne définit la variable quantitative dépendante (par exemple un score psychométrique) et qu’une seconde colonne catégorielle encode la variable indépendante de groupement sous forme de facteur.
La première étape méthodologique cruciale consiste à vérifier formellement que le groupe témoin est explicitement reconnu par le logiciel comme la catégorie de référence. Par défaut, R procède à un ordonnancement alphanumérique des modalités d’un facteur, ce qui assignerait de manière erronée la référence au premier libellé textuel dans l’ordre alphabétique. La rectification de cette assignation s’effectue au moyen de la fonction native relevel(), en configurant explicitement le groupe de contrôle en tant que modalité de référence :
donnees$Groupe <- relevel(donnees$Groupe, ref = "Temoin")
Une fois le facteur convenablement calibré, le chercheur ajuste le modèle linéaire unifactoriel sous-jacent à l’aide de la fonction standard aov() ou lm(). Cette modélisation préliminaire permet d’extraire instantanément les résidus de l’expérience afin de vérifier les postulats de normalité et d’homoscédasticité. L’exécution de la commande shapiro.test(residuals(modele)) permettra d’infirmer formellement une asymétrie résiduelle, tandis que le recours à la fonction leveneTest() hébergée au sein du package car assurera la validation stricte de l’égalité des variances inter-groupes.
8.2 Exécution via les packages multcomp et DescTools
Pour procéder au calcul effectif du test de Dunnett sous R, la communauté méthodologique s’appuie principalement sur deux extensions logicielles de référence : le package multcomp, développé par Torsten Hothorn, Frank Bretz et Peter Westfall, qui fait autorité sur le plan de la théorie des modèles linéaires généraux sous hypothèses simultanées, et le package DescTools, apprécié pour sa concision d’usage en analyse descriptive et inférentielle rapide.
L’implémentation par le package multcomp s’avère la plus puissante sur le plan théorique car elle intègre les algorithmes d’intégration de la distribution t multivariée de Genz et Bretz. La séquence de commande s’articule autour de la fonction glht() (General Linear Hypotheses Test). L’analyste transmet son modèle ANOVA pré-ajusté à la fonction en spécifiant une matrice de contrastes ciblée par l’argument linfct = mcp(Groupe = "Dunnett") :
dunnett_modele <- glht(modele_aov, linfct = mcp(Groupe = "Dunnett"))
summary(dunnett_modele)
Alternativement, pour une utilisation pédagogique ou rapide, le package DescTools met à disposition la fonction DunnettTest() qui applique une syntaxe directe formulée sous la forme d’une équation linéaire :
DunnettTest(x = donnees$Score, g = donnees$Groupe, control = "Temoin")
Cette commande exécute l’intégralité de la chaîne computationnelle en arrière-plan et délivre une table récapitulative contenant les écarts de moyennes bruts, les bornes des intervalles simultanés de Dunnett, ainsi que les valeurs p ajustées avec une régulation exacte du FWER.
8.3 Extraction, visualisation et interprétation des sorties de code
L’exécution de la commande summary() appliquée à l’objet glht généré par multcomp affiche une sortie textuelle extrêmement riche qu’il importe de décrypter avec méthode. Le tableau de résultats présente une série de lignes correspondant aux k – 1 contrastes opérationnalisés. Pour chaque paire, la colonne Estimate renseigne la différence empirique moyenne entre la modalité active et le témoin (Moyenne_i – Moyenne_0). La colonne Std. Error rapporte l’erreur type groupée spécifique du contraste, tandis que la colonne t value délivre la statistique empirique calculée.
La colonne finale, généralement libellée Pr(>|t|), livre la métrique décisive : la valeur p ajustée pour la multiplicité des tests par la distribution multivariée de Dunnett. Contrairement aux valeurs p brutes, cette valeur intègre nativement la correction stochastique : si elle se révèle strictement inférieure à 0,05, le rejet de l’hypothèse nulle d’égalité est formellement acté. L’extraction des intervalles de confiance simultanés s’obtient instantanément par l’application de la fonction confint(dunnett_modele), qui génère les bornes inférieure et supérieure à 95 % associées à chaque intervention.
Pour la restitution visuelle des inférences, la fonction graphique générique plot(confint(dunnett_modele)) produit automatiquement un graphique en forêt rigoureux. Ce tracé projette visuellement chaque segment de confiance face à la ligne verticale pointillée symbolisant la valeur nulle. Si l’analyste désire intégrer ces résultats dans un rapport éditable ou un manuscrit destiné à la publication, l’usage conjugué de packages de mise en page comme broom et knitr::kable() permet d’extraire la matrice des contrastes sous forme de tableaux élégamment formatés, conformes aux exigences des comités de rédaction internationaux.
9. Mise en œuvre pratique sous SPSS et autres logiciels statistiques
9.1 Procédure pas-à-pas dans IBM SPSS Statistics
Pour les praticiens et chercheurs évoluant au sein d’environnements hospitalo-universitaires ou de laboratoires de sciences humaines utilisant le logiciel commercial IBM SPSS Statistics, le déploiement du test de Dunnett s’opère par une interface graphique intuitive intégrée au module d’analyse paramétrique classique.
La procédure débute par l’ouverture de la boîte de dialogue dédiée accessible par le menu déroulant :
Analyse > Comparer les moyennes > ANOVA à un facteur…
L’utilisateur affecte ensuite sa variable quantitative dépendante au champ Liste des variables dépendantes, et sa variable indépendante catégorielle au champ Facteur. L’étape critique de configuration s’articule autour du bouton Post-Hoc…. Au sein de la fenêtre secondaire qui s’ouvre, dédiée aux tests de comparaisons multiples a posteriori, la section inférieure offre la commande spécifique Dunnett.
L’activation de cette case à cocher déverrouille deux options d’ajustement structurel fondamentales :
- Le choix de la catégorie de référence : l’utilisateur doit obligatoirement spécifier si son groupe témoin correspond à la Première catégorie ou à la Dernière catégorie dans l’ordonnancement interne codé par SPSS ;
- La directionnalité du test : la sélection entre le cadre standard 2 côtés (bilatéral) ou les orientations cliniques < Contrôle ou > Contrôle (unilatérales).
La validation par le bouton Continuer puis OK génère, dans la fenêtre de visualisation des résultats, le tableau standard de l’ANOVA globale suivi immédiatement d’un tableau spécifique intitulé Comparaisons multiples. Cette table synthétise pour chaque traitement comparé au témoin : la différence moyenne (I – J), l’erreur standard groupée, le seuil de signification exacte (valeur p corrigée de Dunnett), ainsi que les limites inférieure et supérieure de l’intervalle de confiance simultané à 95 %.
9.2 Configuration dans GraphPad Prism et JASP
En recherche préclinique, en neurobiologie et en psychologie expérimentale anglo-saxonne, deux autres plateformes statistiques jouissent d’une très large adoption : GraphPad Prism, plébiscité pour son ergonomie visuelle en laboratoire, et JASP, logiciel libre développé par l’Université d’Amsterdam qui conjugue modélisation fréquentiste rigoureuse et inférence bayésienne novatrice.
Sous GraphPad Prism, l’approche se distingue par son intégration graphique immédiate. Les données sont structurées au sein d’une table organisée en colonnes indépendantes où chaque colonne représente un groupe expérimental. Après avoir cliqué sur Analyze puis sélectionné One-way ANOVA (and nonparametric), l’utilisateur accède à l’onglet Multiple Comparisons. L’interface propose explicitement l’option : « Compare each cell mean with the control cell mean ». Le logiciel sélectionne alors automatiquement la méthode de Dunnett par défaut. Prism offre l’immense avantage de tracer instantanément sur le graphique des moyennes les barres d’écarts horizontales flanquées des annotations de signification exacte, simplifiant la préparation des figures expérimentales.
Sous JASP, l’analyse se déploie avec une grande élégance didactique au sein du module ANOVA > Classical > ANOVA. Après avoir transféré les variables dans les champs correspondants, l’utilisateur déroule l’onglet Post Hoc Tests. En faisant glisser le facteur d’intérêt dans la zone d’exécution active, JASP propose une série de cases à cocher sous la rubrique des corrections. En sélectionnant l’option Dunnett, le logiciel génère instantanément, dans un panneau de résultats synchronisé en temps réel, un tableau d’inférence au format APA irréprochable incluant les différences estimées, les valeurs t, les erreurs types et les valeurs p de Dunnett sans exiger le moindre script de commande.
9.3 Comparaison des sorties logicielles et écueils d’encodage courants
L’utilisation de ces différents environnements logiciels met en lumière des écueils d’encodage méthodologique récurrents qui peuvent altérer de façon dramatique l’exactitude des inférences rédigées dans les manuscrits scientifiques. Le premier piège, responsable d’une part substantielle des erreurs de publication, concerne l’assignation par défaut du groupe témoin.
Dans SPSS ou JASP, si le chercheur encode ses groupes avec des valeurs textuelles (par exemple « Placebo », « Traitement_A », « Traitement_B »), le logiciel appliquera par défaut l’ordre alphabétique. Dès lors, si l’on indique à SPSS d’utiliser la « Première catégorie » comme contrôle, le logiciel désignera « Placebo » comme témoin par accident favorable ; mais si le groupe témoin avait été libellé « Témoin », la première catégorie alphabétique aurait été « Traitement_A », conduisant à tester l’ensemble des interventions face à une thérapie active sans que l’utilisateur n’en ait conscience. Pour neutraliser définitivement cet écueil, il est impératif de vérifier l’en-tête du tableau de sortie pour certifier quelle catégorie a véritablement été soustraite.
Le second point de vigilance concerne l’orientation algébrique du calcul des contrastes. Selon les logiciels, la différence de moyenne peut être calculée dans le sens (Traitement – Témoin) ou (Témoin – Traitement). Cette inversion de polarité n’affecte nullement la valeur p bilatérale ni la valeur absolue de la statistique t, mais modifie radicalement le signe des bornes de l’intervalle de confiance et de l’écart moyen. Enfin, des divergences minimes de décimales peuvent occasionnellement être constatées entre R et d’anciens packages statistiques ; elles ne traduisent pas une erreur de calcul mais reflètent l’utilisation par R d’algorithmes stochastiques de Monte-Carlo pour l’intégration de la loi t multivariée, délivrant une précision asymptotique supérieure à celle des approximations polynomiales traditionnelles.
10. Étude de cas empirique en psychologie clinique et cognitive
10.1 Contexte expérimental : évaluation de thérapies brèves vs liste d’attente
Afin d’ancrer ces considérations mathématiques et logicielles dans la réalité appliquée de la recherche en santé mentale, examinons une étude clinique empirique fictive mais représentative, conduite au sein d’une unité de recherche en psychopathologie cognitive. Le protocole expérimental vise à évaluer l’efficacité différentielle de trois interventions psychothérapeutiques brèves standardisées dans la réduction de la symptomatologie anxieuse chez des patients diagnostiqués avec un Trouble Anxieux Généralisé (TAG).
Le dispositif expérimental s’articule autour d’un plan unifactoriel à quatre groupes indépendants équilibrés (k = 4). Un échantillon total de 120 patients (N = 120) est recruté selon des critères nosologiques stricts, puis assigné de manière strictement aléatoire à l’une des quatre conditions suivantes, avec un effectif de 30 participants par cellule (n_0 = n_1 = n_2 = n_3 = 30) :
- Groupe 0 (Témoin) : Liste d’attente avec suivi médical standard sans intervention psychologique active durant 8 semaines ;
- Groupe 1 (TCC) : Thérapie Cognitive et Comportementale brève axée sur la restructuration cognitive et l’exposition intéroceptive ;
- Groupe 2 (MBSR) : Programme de Réduction du Stress Basée sur la Pleine Conscience (Mindfulness-Based Stress Reduction) ;
- Groupe 3 (Thérapie Psychodynamique Brève) : Intervention focale explorant les conflits interpersonnels sous-jacents.
À l’issue des 8 semaines de protocole, le niveau d’anxiété résiduel de chaque participant est évalué au moyen de l’échelle d’anxiété de Hamilton (HAM-A), un instrument psychométrique quantitatif continu standardisé où un score plus élevé reflète une sévérité accrue des manifestations anxieuses. La question de recherche exclusive consiste à déterminer si l’une ou plusieurs de ces approches psychothérapeutiques permettent d’abaisser les scores d’anxiété de manière statistiquement significative par rapport à l’évolution spontanée observée dans le groupe témoin sur liste d’attente.
10.2 Calcul complet et déroulement analytique pas à pas
La collecte des données cliniques à l’issue du protocole livre les statistiques descriptives suivantes pour chaque cohorte expérimentale :
- Groupe Témoin (0) : Moyenne_0 = 24,50 ; Écart-type (s_0) = 4,20 ; n_0 = 30
- Groupe TCC (1) : Moyenne_1 = 17,20 ; Écart-type (s_1) = 3,80 ; n_1 = 30
- Groupe MBSR (2) : Moyenne_2 = 19,80 ; Écart-type (s_2) = 4,10 ; n_2 = 30
- Groupe Psychodynamique (3) : Moyenne_3 = 22,90 ; Écart-type (s_3) = 4,00 ; n_3 = 30
L’exécution de l’analyse de variance unidirectionnelle livre la partition suivante des sommes de carrés : la somme des carrés inter-groupes s’élève à SSb = 852,90 pour 3 degrés de liberté (df_b = 4 – 1 = 3), conférant un carré moyen inter-groupes de MSb = 284,30. La somme des carrés intra-groupe résiduelle s’établit quant à elle à SSw = 1885,00 pour 116 degrés de liberté (df_w = 120 – 4 = 116). Le carré moyen intra-groupe extrait s’élève donc à :
MSw = 1885,00 / 116 = 16,25 (variance résiduelle commune estimée)
Le ratio global de Fisher produit une valeur empirique de F = 284,30 / 16,25 = 17,495, hautement significative au seuil p < 0,001. Cette significativité globale autorise la mise en œuvre des comparaisons spécifiques par le test de Dunnett.
Le plan étant parfaitement équilibré (n = 30 pour tous les groupes), l’erreur standard commune à l’ensemble des contrastes avec le témoin se calcule aisément par la formule canonique :
Erreur_Standard = Racine_Carrée [ 2 * 16,25 / 30 ] = Racine_Carrée [ 1,0833 ] = 1,0408
La consultation de la distribution t multivariée de Dunnett pour un test bilatéral au seuil global alpha = 0,05, avec un nombre total de groupes k = 4 et 116 degrés de liberté résiduels, livre une valeur critique théorique de :
t_d = 2,39 (obtenue par interpolation numérique)
La Différence Minimale Significative (DMS) au seuil de 5 % s’établit par conséquent à :
DMS = 2,39 * 1,0408 = 2,487 points sur l’échelle HAM-A
Tout traitement actif dont la moyenne s’écarte de celle du témoin d’une valeur arithmétique absolue strictement supérieure à 2,49 points sera déclaré statistiquement supérieur à la liste d’attente. Procédons au calcul des statistiques de test et des intervalles de confiance simultanés pour les trois contrastes :
- Contraste 1 : TCC vs Témoin
Différence = 17,20 – 24,50 = -7,30 points.
Statistique de test : t_Dunnett = -7,30 / 1,0408 = -7,014 (|t| > 2,39 : Rejet formel de H0, p < 0,001).
IC simultané à 95 % : -7,30 ± 2,49 = [-9,79 ; -4,81]. La valeur zéro étant largement exclue, l’effet est hautement significatif. - Contraste 2 : MBSR vs Témoin
Différence = 19,80 – 24,50 = -4,70 points.
Statistique de test : t_Dunnett = -4,70 / 1,0408 = -4,516 (|t| > 2,39 : Rejet formel de H0, p < 0,001).
IC simultané à 95 % : -4,70 ± 2,49 = [-7,19 ; -2,21]. La valeur zéro est exclue, attestant d’une réduction significative de l’anxiété. - Contraste 3 : Psychodynamique vs Témoin
Différence = 22,90 – 24,50 = -1,60 point.
Statistique de test : t_Dunnett = -1,60 / 1,0408 = -1,537 (|t| < 2,39 : Maintien de l’hypothèse nulle H0, p = 0,324).
IC simultané à 95 % : -1,60 ± 2,49 = [-4,09 ; +0,89]. L’intervalle englobe la valeur zéro, interdisant de conclure à une efficacité clinique supérieure à la liste d’attente.
10.3 Synthèse interprétative et inférence diagnostique
L’inférence diagnostique tirée de cette analyse post-hoc de Dunnett permet de répondre de façon ciblée et robuste aux questionnements cliniques de l’équipe de recherche. L’analyse statistique démontre sans équivoque que seules deux des trois modalités psychothérapeutiques évaluées (la TCC et le programme MBSR) induisent un allègement statistiquement significatif de la détresse anxieuse mesurée par la HAM-A par rapport à l’évolution spontanée des sujets inscrits sur liste d’attente.
Pour mesurer la portée thérapeutique concrète de ces résultats, le statisticien procède à la standardisation des effets par le calcul du d de Cohen corrigé pour comparaison avec groupe témoin, formulé par :
d = (Moyenne_i – Moyenne_0) / Racine_Carrée(MSw)
L’application de cette métrique produit un d = -7,30 / 4,03 = -1,81 pour la TCC, ce qui traduit une taille d’effet massive selon les canons de Jacob Cohen. Pour le protocole MBSR, la taille d’effet s’établit à d = -4,70 / 4,03 = -1,17, représentant un effet robuste et très largement cliniquement pertinent. En revanche, l’intervention psychodynamique brève affiche un d = -0,40 qui, bien que non négligeable en valeur absolue, ne franchit pas le seuil de signification statistique imposé par le contrôle strict du taux d’erreur de première espèce (sa borne supérieure à +0,89 admettant même la possibilité d’une très légère aggravation relative).
Sur le plan des recommandations en santé publique et des directives cliniques en santé mentale, cette analyse séquentielle autorise les décideurs à recommander formellement l’intégration de la TCC et du MBSR au sein du panier de soins de première intention pour la prise en charge brève du TAG, tout en soulignant que la thérapie psychodynamique brève, sous sa forme actuelle de 8 semaines, ne délivre pas de preuves d’efficacité empirique suffisantes face à une simple prise en charge médicale sur liste d’attente.
11. Rédaction et communication des résultats selon les normes APA
11.1 Directives de l’APA (7e édition) pour rapporter les tests post-hoc
La communication scientifique des résultats inférentiels au sein des revues affiliées à l’American Psychological Association (APA, 7e édition) obéit à un ensemble de règles stylistiques et typographiques hautement standardisées. L’objectif cardinal de cette codification est d’assurer une transparence méthodologique totale, permettant aux lecteurs et évaluateurs de reconstituer instantanément la chaîne de décision statistique suivie par les auteurs.
La rédaction doit obligatoirement intégrer les statistiques descriptives complètes (moyennes et écarts-types) pour l’ensemble des groupes, les résultats de l’ANOVA omnibus de départ (avec ses degrés de liberté inter et intra-groupes, sa valeur F empirique exacte, son seuil de probabilité p et sa taille d’effet partielle eta-carré), suivis sans ambiguïté par la désignation nominative de la procédure de comparaison multiple mobilisée (le test de Dunnett) et l’identification explicite de la modalité définie comme groupe de contrôle.
Sur le plan typographique, les symboles statistiques universels doivent systématiquement être mis en italique : F, t, p, M, SD, ainsi que les lettres d’indices si elles représentent des variables. La valeur exacte du seuil de probabilité doit être rapportée jusqu’à trois décimales sans zéro introductif lorsque la valeur est bornée entre 0 et 1 (par exemple p = .024 et non p = 0.024), la notation p < .001 étant réservée aux grandeurs infinitésimales. Enfin, l’énoncé des contrastes doit systématiquement inclure l’estimation de la différence, son erreur type ou son intervalle de confiance simultané à 95 %.
Voici un modèle rédactionnel conforme aux exigences de l’APA pour notre étude de cas :
« Une analyse de variance unidirectionnelle a révélé une différence significative entre les conditions thérapeutiques sur les scores d’anxiété mesurés par la HAM-A à l’issue de l’intervention, F(3, 116) = 17,50, p < .001, eta2_p = .31. Des comparaisons multiples post-hoc réalisées au moyen du test bilatéral de Dunnett, en utilisant le groupe sur liste d’attente comme condition de référence (M = 24,50, SD = 4,20), indiquent que les scores d’anxiété étaient significativement plus faibles après la TCC (M = 17,20, SD = 3,80 ; différence de moyenne = -7,30, IC à 95 % [-9,79, -4,81], t = -7,01, p < .001) et après le programme MBSR (M = 19,80, SD = 4,10 ; différence de moyenne = -4,70, IC à 95 % [-7,19, -2,21], t = -4,52, p < .001). En revanche, la thérapie psychodynamique brève ne s’est pas montrée significativement supérieure à la condition contrôle (M = 22,90, SD = 4,00 ; différence de moyenne = -1,60, IC à 95 % [-4,09, +0,89], t = -1,54, p = .324). »
11.2 Conception de tableaux synthétiques de contrastes
Lorsque le dispositif expérimental incorpore un volume important de conditions de traitement (par exemple 5 à 8 interventions distinctes opposées au témoin), la narration textuelle brute devient rébarbative et nuit à la lisibilité générale du manuscrit. Les directives de l’APA préconisent alors la conception d’un tableau synthétique autonome, inséré au cœur de la section des résultats.
La mise en forme visuelle d’un tableau conforme aux normes APA obéit à une stricte sobriété graphique : tout quadrillage vertical est formellement banni, et seules trois lignes de séparation horizontales principales sont tolérées (délimitant la partie supérieure du tableau, le bas de la rangée d’en-têtes et le bas du corps de données). Le tableau doit comporter des en-têtes explicites renseignant pour chaque ligne de contraste :
- Le libellé de l’intervention active opposée au groupe témoin ;
- La différence brute de moyenne observée ;
- L’erreur standard du contraste (SE) ;
- L’intervalle de confiance simultané de Dunnett à 95 % (présenté sous la forme [Borne Inf., Borne Sup.]) ;
- La valeur de la statistique de test t ;
- La valeur p ajustée exacte de Dunnett ;
- Une métrique de taille d’effet standardisée (le d de Cohen ou le g de Hedges).
Le tableau doit obligatoirement être enrichi d’une note de bas de tableau explicative introduite par la mention Note. en italique. Cette note doit spécifier le niveau de risque FWER contrôlé, déclarer explicitement le groupe ayant servi de référence commune (par exemple, « Tous les contrastes ont été évalués par rapport au groupe Témoin (liste d’attente, n = 30) au moyen de la procédure bilatérale de Dunnett. Les intervalles de confiance à 95 % reflètent la couverture simultanée multivariée. »), et expliciter la signification de tout symbole d’annotation utilisé dans les colonnes.
11.3 Erreurs fréquentes d’interprétation à éviter dans les manuscrits
L’évaluation par les pairs (peer-reviewing) au sein des rédactions de revues de psychologie et de psychiatrie met régulièrement au jour trois erreurs épistémologiques et méthodologiques majeures liées à l’interprétation des sorties du test de Dunnett, qu’il convient de proscrire rigoureusement.
La première erreur, extraordinairement fréquente mais logiquement fallacieuse, consiste à inférer une équivalence thérapeutique ou une absence de différence entre deux traitements actifs au seul motif qu’ils affichent tous deux une supériorité statistique face au groupe témoin. Dans notre étude de cas, observer que la TCC et le MBSR se démarquent tous deux significativement de la liste d’attente n’autorise en aucun cas le chercheur à écrire que la TCC et le MBSR sont d’efficacité équivalente. Le test de Dunnett n’a jamais modélisé la variance de l’écart direct entre la TCC et le MBSR ; pour comparer ces deux thérapies actives entre elles, l’analyste doit impérativement mobiliser une procédure de contrastes exhaustifs telle que le test de Tukey ou planifier un contraste spécifique dédié.
La seconde bévue réside dans l’omission récurrente de préciser que l’erreur de type I a été contrôlée au niveau de la famille d’hypothèses. Certains auteurs rapportent les valeurs de test de Dunnett comme de simples tests t non ajustés, privant le lecteur de l’information cruciale garantissant que le risque d’erreur globale n’a pas excédé le seuil nominal de 0,05 en dépit de la multiplicité des comparaisons.
Enfin, la troisième dérive épistémologique concerne la confusion classique entre l’absence d’effet significatif et la preuve formelle d’une absence d’effet (le sophisme du maintien de l’hypothèse nulle). Conclure, suite au test non significatif de la thérapie psychodynamique (p = .324), que cette thérapie n’a « aucun impact » sur l’anxiété constitue une aberration inférentielle. L’analyste doit rigoureusement formuler que l’essai n’a pas permis de mettre en évidence une supériorité statistique face au témoin dans les conditions d’échantillonnage de l’étude, l’intervalle de confiance encadrant des variations potentielles allant d’un bénéfice modéré à une absence totale de gain.
12. Alternatives et extensions avancées du test de Dunnett
12.1 Test T3 de Dunnett en cas d’hétéroscédasticité
L’une des limitations fondamentales du test de Dunnett classique réside dans sa dépendance absolue envers l’hypothèse d’homoscédasticité. Lorsque le test de Levene rejette l’égalité des variances à travers les groupes expérimentaux, l’utilisation du carré moyen intra-groupe (MSw) comme dénominateur unique devient intenable, exposant l’inférence à des distorsions sévères du taux de fausses découvertes.
Pour contourner cet écueil majeur tout en conservant l’esprit d’une comparaison ciblée avec un groupe témoin, Charles Dunnett a formalisé en 1980 une extension robuste désignée sous l’appellation de **test T3 de Dunnett**. Cette procédure intègre l’approche de Welch pour s’émanciper de la contrainte d’une variance commune. D’une part, l’erreur standard n’agrège plus un MSw commun, mais combine de façon hétérogène les variances d’échantillon individuelles (s_i carré et s_0 carré) :
Erreur_Standard_T3 = Racine_Carrée [ (s_i^2 / n_i) + (s_0^2 / n_0) ]
D’autre part, les degrés de liberté ne sont plus fixés à N – k, mais subissent la correction analytique d’approximation de Welch-Satterthwaite, calculée spécifiquement pour chaque paire traitement-témoin. La valeur critique est alors dérivée de la distribution du module maximal studentisé (Studentized Maximum Modulus, SMM). Le test T3 de Dunnett offre une protection sans faille contre l’inflation du risque de première espèce en présence d’hétéroscédasticité avérée, même lorsque les effectifs de groupes sont hautement inégaux, s’imposant comme le substitut obligatoire dès que l’homogénéité des variances s’effondre.
12.2 Approches non paramétriques (test de Dunn avec ajustement)
Lorsque la variable quantitative mesurée enfreint de manière irrémédiable l’hypothèse de normalité gaussienne (distributions fortement asymétriques, phénomènes de plancher ou de plafond massifs, échelles ordinales à faible nombre de graduations), et que la taille globale de l’échantillon interdit tout recours serein au théorème central limite, l’édifice de l’inférence paramétrique s’effondre. Le recours à l’alternative non paramétrique de l’ANOVA, le test de Kruskal-Wallis sur rangs, devient alors incontournable.
Cependant, le rejet de l’hypothèse nulle par le test de Kruskal-Wallis laisse le chercheur face au même défi d’identification de la source des divergences. Pour transposer la logique de Dunnett dans l’espace non paramétrique, l’analyste déploie le **test de Dunn**, spécifiquement restreint aux comparaisons avec la condition témoin de référence. Cette méthode opère non pas sur les valeurs métriques brutes, mais sur les rangs moyens standardisés assignés à l’ensemble des observations agrégées.
La statistique de Dunn calcule l’écart entre le rang moyen du traitement actif et le rang moyen du groupe témoin, divisé par une erreur standard basée sur la variance des rangs de l’ensemble de l’échantillon. Pour contrôler le taux d’erreur par famille sur ces k – 1 contrastes de rangs, les analystes appliquent des procédures d’ajustement séquentiel de type Holm-Bonferroni ou Hochberg. Alternativement, le **test de Steel**, qui constitue l’analogue non paramétrique direct et exact du test de Dunnett basé sur des distributions multivariées de sommes de rangs de Wilcoxon-Mann-Whitney conjointes, peut être mobilisé pour une sensibilité statistique accrue dans les environnements logiciels spécialisés.
12.3 Intégration dans les modèles mixtes et mesures répétées
L’expérimentation psychologique et biomédicale moderne dépasse largement le cadre des simples plans factoriels transversaux à un facteur pour adopter des devis longitudinaux complexes comportant des mesures répétées, des blocs aléatoires ou des hiérarchies multiniveaux (patients nichés au sein de thérapeutes). Dans ces configurations, la méthode classique de l’ANOVA unidirectionnelle est supplantée par la modélisation linéaire à effets mixtes (LMM, pour Linear Mixed Models).
Le principe fondamental du test de Dunnett conserve néanmoins toute sa pertinence méthodologique au sein de ces modèles hiérarchiques. Un cas d’usage universel concerne les essais cliniques longitudinaux où l’on souhaite comparer le niveau d’un biomarqueur ou d’un symptôme à divers temps de suivi post-intervention (Semaine 4, Semaine 8, Semaine 12, Semaine 24) exclusivement face au niveau d’inclusion pré-thérapeutique de base (baseline), ce dernier jouant le rôle de référence temporelle de contrôle.
Sous R, l’intégration de la logique de Dunnett dans les modèles mixtes s’opère avec une flexibilité exemplaire grâce au package emmeans (Estimated Marginal Means). Après avoir ajusté un modèle mixte au moyen de la fonction lmer() du package lme4, le chercheur extrait les moyennes marginales estimées et sollicite la famille de contrastes de Dunnett via la syntaxe :
emmeans(modele_mixte, trt.vs.ctrl ~ Temps | Intervention, ref = 1)
La fonction dérive alors les contrastes longitudinaux par rapport à la ligne de base en tenant compte des corrélations intra-sujets, modélise les degrés de liberté résiduels selon la méthode de Kenward-Roger ou Satterthwaite, et délivre des valeurs p et des intervalles de confiance de Dunnett parfaitement ajustés pour la dépendance des mesures répétées. Cette hybridation contemporaine démontre la remarquable pérennité des concepts statistiques formulés par Charles Dunnett, qui continuent d’irriguer la recherche scientifique la plus sophistiquée sept décennies après leur conceptualisation initiale.
Références
Bretz, F., Hothorn, T., & Westfall, P. (2010). Multiple comparisons using R. CRC Press. https://doi.org/10.1201/b10816
Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2e éd.). Lawrence Erlbaum Associates.
Dunnett, C. W. (1955). A multiple comparison procedure for comparing several treatments with a control. Journal of the American Statistical Association, 50(272), 1096-1121. https://doi.org/10.1080/01621459.1955.10501294
Dunnett, C. W. (1964). New tables for multiple comparisons with a control. Biometrics, 20(3), 482-491. https://doi.org/10.2307/2528490
Dunnett, C. W. (1980). Pairwise multiple comparisons in the unequal variance case. Journal of the American Statistical Association, 75(372), 796-800. https://doi.org/10.1080/01621459.1980.10477551
Field, A. (2018). Discovering statistics using IBM SPSS Statistics (5e éd.). SAGE Publications.
Genz, A., & Bretz, F. (2009). Computation of multivariate normal and t probabilities. Springer-Verlag. https://doi.org/10.1007/978-3-642-01689-9
Hothorn, T., Bretz, F., & Westfall, P. (2008). Simultaneous inference in general parametric models. Biometrical Journal, 50(3), 346-363. https://doi.org/10.1002/bimj.200810425
Howell, D. C. (2012). Statistical methods for psychology (8e éd.). Wadsworth, Cengage Learning.
Lenth, R. V. (2022). emmeans: Estimated marginal means, aka least-squares means (R package version 1.8.0). https://cran.r-project.org/package=emmeans
Maxwell, S. E., Delaney, H. D., & Kelley, K. (2018). Designing experiments and analyzing data: A model comparison perspective (3e éd.). Routledge. https://doi.org/10.4324/9781315642956