
Dans l’écosystème contemporain du calcul scientifique et de l’ingénierie des données sous Python, l’environnement de développement interactif s’est imposé comme le standard prédominant pour l’exploration, le prototypage et la communication des résultats empiriques. L’avènement du projet IPython, initié par Fernando Pérez, a profondément transformé la relation entre le chercheur et sa machine en substituant au paradigme traditionnel de compilation et d’exécution par lots une boucle d’évaluation interactive hautement dynamique. Au cœur de cette révolution méthodologique, la restitution visuelle immédiate des distributions statistiques, des modélisations mathématiques et des trajectoires algorithmiques constitue un impératif cognitif fondamental pour quiconque cherche à transformer des flux de données abstraits en connaissances actionnables.
Cependant, l’intégration fluide d’un moteur de rendu graphique au sein d’un environnement documentaire distribué sur le Web ne va pas de soi sur le plan architectural. Historiquement, les bibliothèques de tracé telles que Matplotlib ont été conçues pour interagir avec des gestionnaires de fenêtres graphiques natifs propres aux systèmes d’exploitation sous-jacents, instanciant des processus graphiques autonomes déconnectés du flux linéaire d’un terminal d’instructions. C’est précisément pour abolir cette discontinuité spatiale et logique qu’a été conçue la directive magique %matplotlib inline. Véritable pont d’orchestration entre le noyau d’exécution et l’interface utilisateur, cette instruction a redéfini les standards de publication scientifique computationnelle en permettant l’enchâssement direct et immuable des figures au sein des cellules documentaires.
Le présent traité propose une analyse exhaustive et rigoureuse des mécanismes fondamentaux, des implications architecturales et des applications méthodologiques associés à la commande magique %matplotlib inline. À travers une exploration détaillée couvrant les fondements de la gestion d’événements dans les carnets de recherche, les spécificités de sérialisation des formats matriciels et vectoriels, ainsi que l’arbitrage critique vis-à-vis des backends interactifs modernes, cet ouvrage s’adresse aux analystes de données, aux chercheurs en sciences quantitatives et aux ingénieurs en apprentissage automatique désireux de maîtriser avec précision la chaîne de restitution graphique sous l’écosystème Jupyter.
1. Fondements et définition de la commande magique %matplotlib inline
1.1 Origine et nature des commandes magiques IPython
L’architecture de l’interpréteur de commandes interactif IPython repose sur une distinction conceptuelle fondamentale entre le code source relevant de la grammaire stricte du langage Python et les métacommandes destinées à piloter l’environnement d’exécution lui-même. Alors que l’interpréteur Python standard rejette toute instruction ne se conformant pas à sa syntaxe formelle, le noyau IPython intègre un analyseur lexical amont capable d’intercepter des directives spécifiques dénommées communément « commandes magiques ». Ces instructions ne constituent pas des appels de fonctions ou des déclarations d’objets au sens algorithmique traditionnel, mais agissent comme des mécanismes de configuration et d’instrumentation du système d’exécution interactif.
D’un point de vue typologique, ces commandes se subdivisent en deux catégories distinctes selon leur portée syntaxique. Les commandes magiques de ligne, préfixées par un caractère unique de pourcentage, appliquent leurs effets exclusivement aux arguments situés sur la même ligne textuelle, tandis que les commandes de cellule, identifiées par un double caractère de pourcentage, étendent leur champ d’action à l’intégralité du bloc d’instructions qui leur succède. La directive analysée dans cette étude s’inscrit rigoureusement dans la première catégorie, constituant une métacommande d’environnement conçue pour reconfigurer instantanément les paramètres internes du noyau interactif sans nécessiter l’instanciation verbeuse de modules sous-jacents.
Historiquement, l’apparition de ces métacommandes répondait à une problématique critique dans l’évolution des interfaces utilisateur scientifiques. Durant les premières décennies de l’informatique interactive, le basculement permanent entre un éditeur de texte, un interpréteur en ligne de commande et des fenêtres de rendu visuel fragmentait l’attention du chercheur. Le noyau IPython a donc été doté d’une couche logicielle intermédiaire, capable de traduire ces raccourcis syntaxiques en modifications profondes de l’état des modules résidents, préfigurant l’ergonomie intégrée des carnets de recherche contemporains et autorisant une manipulation beaucoup plus fluide des abstractions informatiques.
1.2 Définition formelle de la directive %matplotlib inline
Sur le plan formel, la directive magique %matplotlib inline est une instruction destinée au noyau IPython dont l’objectif univoque est de sélectionner et d’activer le composant dorsal de rendu graphique statique baptisé inline. Selon les spécifications fournies par la documentation officielle de Matplotlib et du projet Jupyter, cette commande ordonne au moteur de traçage de renoncer à l’ouverture de fenêtres graphiques indépendantes gérées par le système d’exploitation de la machine hôte. À la place, le sous-système de restitution graphique est intimement couplé au protocole de communication enrichi du carnet de recherche, assurant la conversion immédiate de chaque objet visuel en un composant intégré directement sous la cellule de code qui en a provoqué la genèse.
Cette intégration directe engendre une conséquence architecturale majeure : les figures produites perdent leur nature d’objets dynamiques mutables en temps réel pour adopter un statut de documents statiques pré-rendus. Dès que le cycle d’exécution d’une cellule s’achève, le graphique est sérialisé sous la forme d’un flux d’octets immuable, inséré directement dans la structure de données hiérarchique qui formalise le carnet de travail. Cette mutation rompt explicitement avec l’approche procédurale des interfaces graphiques de bureau traditionnelles, où l’état d’un canevas visuel persiste indéfiniment en mémoire vive tant que l’utilisateur n’en sollicite pas expressément la clôture.
Il importe de souligner la distinction conceptuelle profonde qui s’établit ici entre le moteur de calcul analytique et le moteur de rendu visuel. Alors que les structures matricielles et les algorithmes d’optimisation continuent d’évoluer au sein de la mémoire gérée par l’interpréteur Python, la restitution visuelle est déléguée à une interface de sérialisation découplée. La directive %matplotlib inline opère ainsi la jonction précise entre ces deux univers en dictant la manière dont les représentations géométriques bidimensionnelles ou tridimensionnelles doivent s’extirper de la mémoire du processeur pour s’inscrire au sein d’une page Web interactive sans déstabiliser l’environnement d’exécution.
1.3 Pertinence méthodologique pour l’analyse scientifique reproductible
L’adoption quasi universelle de la directive %matplotlib inline dans les protocoles d’analyse quantitative s’explique principalement par des impératifs épistémologiques liés à la reproductibilité de la recherche computationnelle. Dans une démarche scientifique rigoureuse, l’intégrité contextuelle entre les transformations mathématiques du code source et leurs manifestations visuelles doit être rigoureusement préservée. L’incorporation directe du rendu graphique sous le bloc logique qui l’a engendré garantit qu’aucune ambiguïté temporelle ou relationnelle ne puisse émerger lors de la réévaluation ultérieure des hypothèses ou de l’audit critique par des pairs.
Cette contiguïté spatiale facilite considérablement l’archivage pérenne des résultats. Dans les formats documentaires scientifiques contemporains, tels que les fichiers .ipynb fondés sur une notation d’objets standardisée, la figure n’est pas simplement liée par une référence externe volatile ou un chemin de fichier relatif précaire : elle est physiquement encapsulée au sein de la charge utile du document. Il devient ainsi possible d’exporter, de synchroniser par des systèmes de contrôle de version ou de soumettre à l’évaluation par les pairs un artefact complet, autonome et parfaitement auto-descriptif, éliminant le risque classique de disparition des ressources graphiques associées.
Enfin, sur le plan ergonomique et psychologique, cette disposition réduit de façon mesurable la charge cognitive pesant sur l’expérimentateur. L’exploration interactive de jeux de données empiriques volumineux exige une boucle de rétroaction sensorielle extrêmement serrée. Le fait de visualiser les distorsions de distribution, les ruptures de tendance ou les aberrations statistiques directement dans l’axe de lecture séquentiel de l’algorithme permet une correction itérative instantanée. L’analyste n’a plus à gérer la superposition chaotique de multiples fenêtres système, consolidant ainsi sa concentration sur la modélisation statistique pure.
2. Architecture des backends graphiques dans l’écosystème Matplotlib
2.1 Compréhension de la structure à deux niveaux de Matplotlib
Pour appréhender pleinement l’action de la directive %matplotlib inline, il est indispensable de disséquer l’architecture logicielle interne de la bibliothèque Matplotlib, qui s’articule rigoureusement autour d’un modèle en deux couches distinctes : la couche frontale orientée utilisateur et la couche dorsale désignée sous le vocable de backend. La couche frontale, matérialisée par l’interface matplotlib.pyplot, propose un ensemble unifié d’abstractions algorithmiques et de fonctions de haut niveau permettant de décrire la géométrie des courbes, la disposition des axes et la typographie des annotations textuelles sans se soucier du matériel de sortie.
À l’inverse, la couche dorsale ou backend est le sous-système d’infrastructure chargé de concrétiser ces instructions abstraites sous la forme de signaux physiques ou de structures de données matricielles interprétables par un périphérique numérique. Elle effectue les calculs de pixellisation, convertit les primitives vectorielles selon les conventions des moteurs de dessin sous-jacents, et dialogue avec le serveur d’affichage ou les pilotes graphiques. Cette dichotomie architecturale assure une portabilité remarquable : le même script de calcul statistique peut être exécuté à l’identique pour afficher une fenêtre interactive sur un poste de travail local ou pour produire silencieusement un tracé vectoriel au sein d’un cluster de calcul dépourvu d’écran.
Le choix délibéré d’un backend spécifique exerce un impact direct sur deux métriques critiques de l’informatique scientifique : la latence de calcul et le degré d’interactivité offert à l’utilisateur. Certains backends privilégient la rapidité d’exécution brute en réduisant au minimum la fidélité typographique, tandis que d’autres mobilisent des bibliothèques de rendu complexes pour garantir une précision vectorielle absolue au détriment du débit de traitement. La directive magique s’insère à ce niveau précis de la pile logicielle en venant supplanter la configuration par défaut du système hôte pour forcer la sélection d’un backend adapté aux particularités de l’environnement Web.
2.2 Typologie comparative des backends disponibles
L’écosystème Matplotlib classe traditionnellement ses moteurs de rendu en deux grandes familles opérationnelles : les backends interactifs et les backends non interactifs, parfois qualifiés de backends de sérialisation. Les backends interactifs sont conçus pour se lier intimement à des boîtes à outils d’interface utilisateur graphique installées nativement sur le système d’exploitation, telles que Qt, GTK, Tkinter ou WXWidgets. Ces architectures permettent la création de fenêtres d’affichage réactives, équipées de gestionnaires d’événements matériels autorisant le déplacement panoramique, le grossissement continu par zoom optique et la capture d’entrées clavier ou souris en temps réel.
À l’autre extrémité du spectre se trouvent les backends de publication statique, tels que Agg (Anti-Grain Geometry), PDF, PS et SVG. Ces moteurs sont spécifiquement programmés pour générer des fichiers de données conformes à des spécifications rigides destinées à l’édition typographique, à l’impression haute définition ou à l’archivage documentaire. Ils fonctionnent de manière purement asynchrone et sans état d’interface, ignorant totalement les sollicitations interactives de l’utilisateur pour focaliser l’ensemble des ressources de calcul sur l’exactitude de la rastérisation et l’élimination des artefacts de compression.
Les spécificités des interfaces Web distribuées telles que Jupyter Notebook ont rendu nécessaire l’émergence d’une troisième voie architecturale : les backends intégrés pour le Web. La manipulation de cohortes de données volumineuses au sein d’environnements virtualisés ou de conteneurs applicatifs interdit fréquemment l’usage de fenêtres système autonomes, en raison de l’absence de serveur d’affichage graphique de type X11 ou Wayland. Le choix d’un backend inadapté dans ces contextes peut rapidement conduire à une défaillance critique du noyau, liée à des blocages d’appels système ou à une consommation incontrôlée de mémoire vive par des sous-processus graphiques orphelins.
2.3 La place spécifique du backend inline
Au sein de cette typologie matricielle, le backend inline occupe une place singulière qui s’apparente à une déclinaison spécialisée et hybride du moteur Agg. Techniquement, le backend inline ne met pas en œuvre de routines de dessin inédites : il s’appuie intégralement sur la puissance et la robustesse de rastérisation de la bibliothèque logicielle Anti-Grain Geometry pour convertir les descriptions de figures vectorielles en un agencement précis de pixels colorimétriques dans l’espace colorimétrique RVBA.
Sa particularité réside dans l’abandon complet de toute boucle de gestion d’événements graphiques locaux et dans la délégation exclusive du traitement de sortie au protocole d’affichage enrichi d’IPython. Au lieu de transmettre les données rasterisées à un pilote de carte graphique ou d’écrire un fichier physique sur le disque dur, le backend inline transfère l’image générée sous la forme d’une chaîne de données binaire directement encodée en mémoire tampon, laquelle est ensuite encapsulée dans un message JSON destiné au client Web qui assure le rendu via le navigateur.
Cette dissociation totale de l’infrastructure matérielle locale confère au backend inline un avantage décisif lors de l’exécution de calculs sur des serveurs distants, des supercalculateurs ou des instances infonuagiques déportées. Aucune passerelle de redirection graphique complexe, telle que le protocole SSH avec transfert X11, n’est requise. Le calcul de la figure s’opère sur le serveur distant en mode purement logiciel, et le résultat visuel est restitué avec une intégrité parfaite au sein de la session du navigateur client, garantissant une résilience absolue face aux latences réseau.
3. Mécanisme de fonctionnement interne du moteur de rendu inline
3.1 Le cycle de vie d’une figure sous %matplotlib inline
L’orchestration d’une figure visuelle sous le régime de la directive %matplotlib inline obéit à un cycle de vie rigoureusement cadencé, profondément distinct du fonctionnement usuel des scripts impératifs de bureau. L’initialisation débute formellement dès qu’une instruction de traçage ou une demande de création de canevas est émise au sein de la cellule de calcul. Le gestionnaire d’état de Matplotlib instancie alors un objet de classe Figure au sein de la mémoire vive du processus Python, lui adjoignant un canevas virtuel configuré pour mobiliser le moteur de rendu matriciel approprié.
La divergence opérationnelle majeure intervient lors de la terminaison du bloc de calcul. Dans un script standard, la figure demeurerait active en mémoire dans l’attente d’une commande bloquante explicite d’affichage. Sous IPython équipé du backend inline, le système tire parti de crochets d’exécution d’événements, désignés techniquement sous le terme de post-execution hooks. Dès que l’interpréteur signale la fin du traitement de la dernière ligne d’instructions contenue dans la cellule active, ce crochet d’inspection scrute la pile d’état globale de Matplotlib pour identifier la présence éventuelle de figures actives non encore rendues.
S’il détecte un objet graphique valide, le système déclenche implicitement la routine de transformation en image, capture le flux binaire résultant et ordonne sans délai la clôture définitive de la figure via la fonction matplotlib.pyplot.close(). Cette purge systématique du gestionnaire d’état global est une condition sine qua non de la stabilité méthodologique : elle garantit de manière préventive que les commandes graphiques exécutées dans une cellule ultérieure ne viendront pas se superposer accidentellement sur le canevas d’une session précédente, préservant ainsi l’isolation contextuelle des tracés.
3.2 Sérialisation et persistance des images dans le format JSON du notebook
La persistance matérielle d’une visualisation sous la directive %matplotlib inline s’articule autour d’un processus de sérialisation hautement normalisé. Une fois la phase de composition graphique achevée par le moteur raster, la représentation matricielle bidimensionnelle est convertie en un flux binaire compressé au format standard PNG. Ce flux d’octets brut ne pouvant transiter de manière sécurisée sous forme binaire brute au sein des protocoles textuels du Web, il subit une transformation algorithmique par encodage de transfert Base64.
La chaîne de caractères ASCII résultante, représentative de la totalité de l’image pixel par pixel, est ensuite intégrée dans la structure arborescente du document de travail. Le fichier .ipynb, dont la spécification technique repose strictement sur le standard JSON, alloue à chaque cellule exécutée un champ structuré dédié aux sorties, dénommé outputs. Le graphique y est enregistré au sein d’une structure de type dictionnaire, associé au type MIME universel image/png, comme l’illustre la modélisation formelle du schéma suivant :
- data : Conteneur principal des représentations textuelles ou binaires de l’artefact généré.
- image/png : Clé de typage MIME associant la charge utile encodée en Base64 au moteur de rendu du navigateur.
- metadata : Dictionnaire des attributs géométriques complémentaires, stipulant notamment les dimensions nominales de la figure.
- output_type : Identifiant de flux classifiant l’élément comme le résultat d’un affichage exécutif enrichi.
Cette sérialisation textuelle interne confère au carnet de recherche une autonomie totale vis-à-vis de l’environnement d’exécution d’origine. Le document analytique peut être partagé avec un tiers, visualisé sur une plateforme d’hébergement de dépôts logiciels ou inspecté hors ligne sans qu’il soit nécessaire de disposer de l’interpréteur Python, des bibliothèques de calcul ou des jeux de données primaires. La restitution visuelle demeure pérenne, bien que ce choix d’ingénierie entraîne inévitablement une inflation pondérale de la taille du fichier sur disque, proportionnelle à la densité et à la résolution des graphiques inclus.
3.3 Interactions avec le ramasse-miettes et gestion de la mémoire
La gestion de la mémoire vive constitue un enjeu critique lors de l’exécution séquentielle d’analyses exploratoires extensives, au cours desquelles des centaines de visualisations peuvent être instanciées successivement. Dans l’architecture standard de Matplotlib, chaque figure instanciée est rattachée par une référence forte au module d’état global matplotlib.pyplot. Cette architecture en mémoire empêche le ramasse-miettes natif de Python de libérer l’espace alloué aux objets géométriques et aux canevas de pixels, même lorsque la variable référençant la figure n’est plus accessible dans la portée locale de la cellule.
Le backend inline résout cette vulnérabilité intrinsèque par l’application stricte de sa routine de clôture automatique en fin d’exécution de cellule. En invoquant systématiquement la destruction de la référence globale dès que le flux binaire a été sérialisé et expédié au client, la directive permet la désallocation rapide des canevas matriciels volumineux. Les objets temporaires deviennent immédiatement orphelins et sont ainsi éligibles à la collecte lors du cycle suivant du ramasse-miettes cyclique de l’environnement Python.
Cette modération de l’empreinte mémoire s’avère particulièrement salvatrice lors de l’exécution de boucles de traitement automatisées générant des séries visuelles complexes. En l’absence de ce mécanisme de clôture implicite propre au backend inline, l’accumulation progressive de descripteurs graphiques et de matrices de pixels non libérées conduirait inéluctablement à une fragmentation sévère de l’espace d’adressage virtuel, culminant dans des erreurs fatales d’épuisement de la mémoire vive pour les calculs de grande dimension.
4. Diagnostic du dysfonctionnement sans la directive d’affichage
4.1 Anatomie de l’exécution silencieuse sans rendu visuel
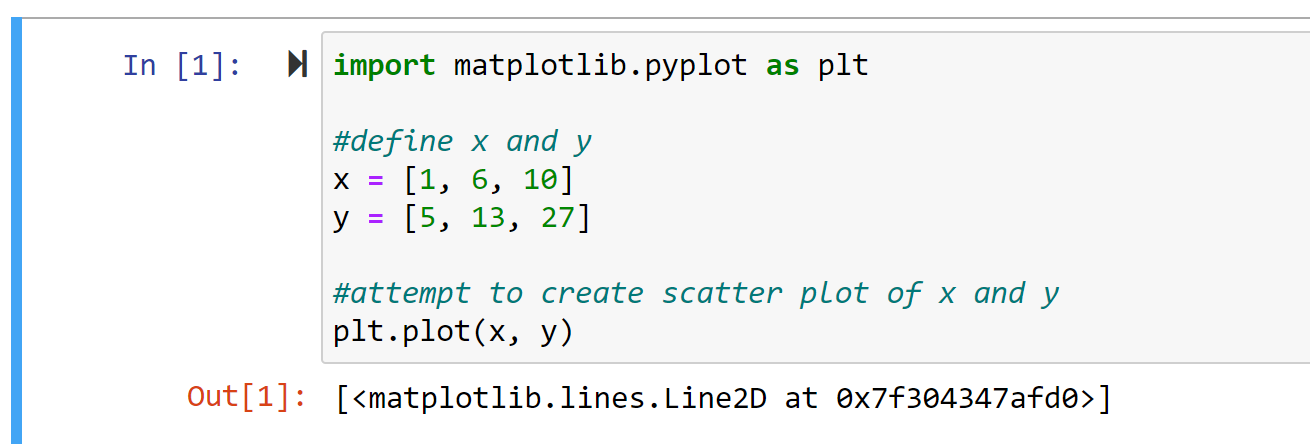
L’omission de la directive de configuration du backend dans un environnement qui n’a pas été explicitement préconfiguré conduit régulièrement à un comportement déroutant pour l’expérimentateur : l’exécution dite silencieuse. Dans cette situation pathologique, le noyau IPython interprète scrupuleusement l’ensemble des instructions de manipulation de tableaux, ajuste les paramètres statistiques et traverse les blocs de code sans lever la moindre exception syntaxique ou logique, mais ne produit aucun canevas graphique au terme de l’opération.
En lieu et place de la restitution visuelle attendue, l’environnement se contente fréquemment d’afficher la représentation textuelle de l’objet renvoyé par la dernière fonction évaluée au sein de la cellule de calcul. Le chercheur est alors confronté à un message sibyllin typique, signalant l’adresse mémoire du descripteur de l’objet graphique créé, analogue à la notification formelle suivante :
<matplotlib.lines.Line2D at 0x7f8b2c0d5a90><Figure size 640x480 with 1 Axes>
Cette absence d’image visible ne procède pas d’une défaillance logicielle au sens strict, mais d’une rupture dans la chaîne de signalisation du moteur de rendu. L’objet graphique a bel et bien été instancié et correctement configuré au sein de la mémoire du noyau Python ; toutefois, le backend actif par défaut étant dépourvu de passerelle de sérialisation vers le protocole enrichi du serveur Web et n’ayant pas accès à un serveur d’affichage graphique de bureau, la matrice de pixels demeure confinée dans la mémoire tampon sans qu’aucun canal de restitution ne soit activé pour l’exporter vers le document.
4.2 Limites de l’appel explicite à la méthode plt.show()
Face à cette carence d’affichage, une démarche intuitive couramment adoptée consiste à introduire un appel explicite à la méthode de finalisation procédurale matplotlib.pyplot.show() au terme de la cellule de traçage. Si cette pratique constitue la norme impérative absolue dans le cadre de l’exécution de scripts Python conventionnels exécutés depuis un terminal textuel, son efficacité au sein d’un carnet interactif est tributaire de l’état de configuration sous-jacent de l’environnement d’exécution.
Dans les configurations d’infrastructure où le backend de traçage est mal initialisé ou orienté vers une boîte à outils de bureau absente du système d’exploitation hébergeur, l’appel à la fonction plt.show() peut engendrer un gel complet du noyau de calcul. L’environnement tente d’initialiser une boucle d’événements matérielle bloquante, attendant des réponses d’un serveur d’affichage inexistant, ce qui immobilise l’exécution et contraint l’opérateur à redémarrer manuellement le noyau, avec le risque de perdre les variables de calcul précédemment élaborées.
De surcroît, même lorsque l’environnement parvient à contourner ce blocage, l’obligation d’insérer de manière redondante l’instruction plt.show() à la terminaison de chaque bloc logique alourdit inutilement la structure du code source. Cette verbosité superflue entre en contradiction avec la philosophie de concision des carnets de recherche interactifs, où l’accent doit être mis sur l’expression algorithmique des analyses quantitatives plutôt que sur la gestion manuelle des cycles d’affichage du moteur visuel.
4.3 Effets de bord sur l’analyse de données et la reproductibilité
L’incertitude liée à l’affichage visuel et le recours à des palliatifs empiriques non standardisés génèrent des effets délétères mesurables sur la rigueur du travail d’analyse statistique. Lorsqu’un analyste ne dispose pas de la certitude absolue que son canevas visuel sera restitué de manière déterministe sous chaque cellule, une friction méthodologique s’installe. Cette instabilité incite l’expérimentateur à multiplier les réexécutions anarchiques de cellules, une pratique délétère susceptible de corrompre l’état de l’espace de noms global par l’introduction d’effets de bord imprévus.
Le risque majeur réside dans la dissociation involontaire entre le résultat statistique calculé et l’image perçue. Si un bloc de traçage graphique ne purge pas correctement son état en raison d’une mauvaise initialisation du backend, le graphique affiché peut refléter partiellement des valeurs issues de variables modifiées lors d’exécutions antérieures, induisant l’analyste en erreur quant à la validité empirique de ses modèles. Cette corruption contextuelle est particulièrement pernicieuse dans les phases exploratoires d’ajustement de paramètres hypermodèles en apprentissage automatique.
Dès lors, la standardisation impérative du préambule de configuration au moyen de directives d’environnement rigoureusement définies s’impose comme une règle de gouvernance logicielle dans les équipes de recherche. Garantir dès l’entame du document que le sous-système graphique est configuré pour une émission statique prévisible et immuable constitue la condition préalable indispensable à toute validation croisée des analyses par un tiers évaluateur.
5. Guide d’implémentation étape par étape avec code d’illustration
5.1 Configuration du bloc d’initialisation dans le carnet
L’implantation rigoureuse de la chaîne de traitement graphique impose de regrouper l’ensemble des instructions de configuration environnementale au sein de la toute première cellule d’exécution du carnet analytique. Cette pratique méthodologique, désignée sous l’appellation de préambule d’initialisation, assure l’uniformité du comportement du moteur d’affichage pour toutes les étapes ultérieures du document. La directive magique %matplotlib inline doit y être insérée préalablement à toute utilisation effective des sous-modules de dessin.
Il est d’usage académique et professionnel de coordonner cette directive avec l’importation canonique des bibliothèques fondamentales dédiées au traitement quantitatif et à la manipulation matricielle, au premier rang desquelles figurent NumPy et l’interface procédurale pyplot de Matplotlib. La structure syntaxique formelle de ce bloc d’initialisation conventionnel se déploie selon la séquence d’instructions suivante :
- Directive d’environnement imposant le backend :
%matplotlib inline - Importation de la bibliothèque de manipulation matricielle vectorisée :
import numpy as np - Importation de la couche d’abstraction graphique :
import matplotlib.pyplot as plt
Il convient d’insister sur la rigueur de la casse typographique : toute altération syntaxique, telle que l’introduction d’espaces fautifs ou l’omission du caractère de pourcentage, empêchera l’analyseur lexical d’IPython d’identifier l’instruction comme une directive magique. Le noyau interprétera alors la ligne comme une commande Python standard invalide, levant instantanément une exception de type SyntaxError qui interrompra l’ensemble du protocole d’initialisation.
5.2 Exemple pratique 1 : Tracé linéaire d’une fonction continue
Pour observer l’opérationnalisation concrète de la directive, analysons le protocole de discrétisation et de représentation graphique d’une oscillation harmonique continue amortie. Cette formulation mathématique classique permet de valider le calibrage géométrique des axes de coordonnées, le lissage de l’interpolation numérique et l’encapsulation de la figure finale directement au bas de la cellule logicielle émettrice.
Le protocole algorithmique requiert la création d’un vecteur d’abscisses régulier au moyen d’un échantillonnage continu, suivi de l’application vectorisée d’une fonction combinant décroissance exponentielle et modulation trigonométrique sinusoïdale. La mise en œuvre logique s’articule rigoureusement selon les étapes algorithmiques suivantes :
- Échantillonnage du domaine temporel : discrétisation d’un segment compact de l’axe réel de 0 à 10 unités à travers une partition fine de 1000 nœuds d’évaluation équidistants.
- Calcul du vecteur de réponse : évaluation numérique de la fonction associant chaque point d’abscisse à l’amplitude résultant du produit de la décroissance exponentielle et de la fonction sinus.
- Génération du canevas d’observation : instanciation conjointe de la figure englobante et du système d’axes cartésiens au moyen de l’instruction canonique orientée objet
fig, ax = plt.subplots(). - Tracé géométrique continu : projection de la trajectoire sur le plan à l’aide de la méthode
ax.plot(), accompagnée de l’attribution des étiquettes dimensionnelles et d’une grille de référence.
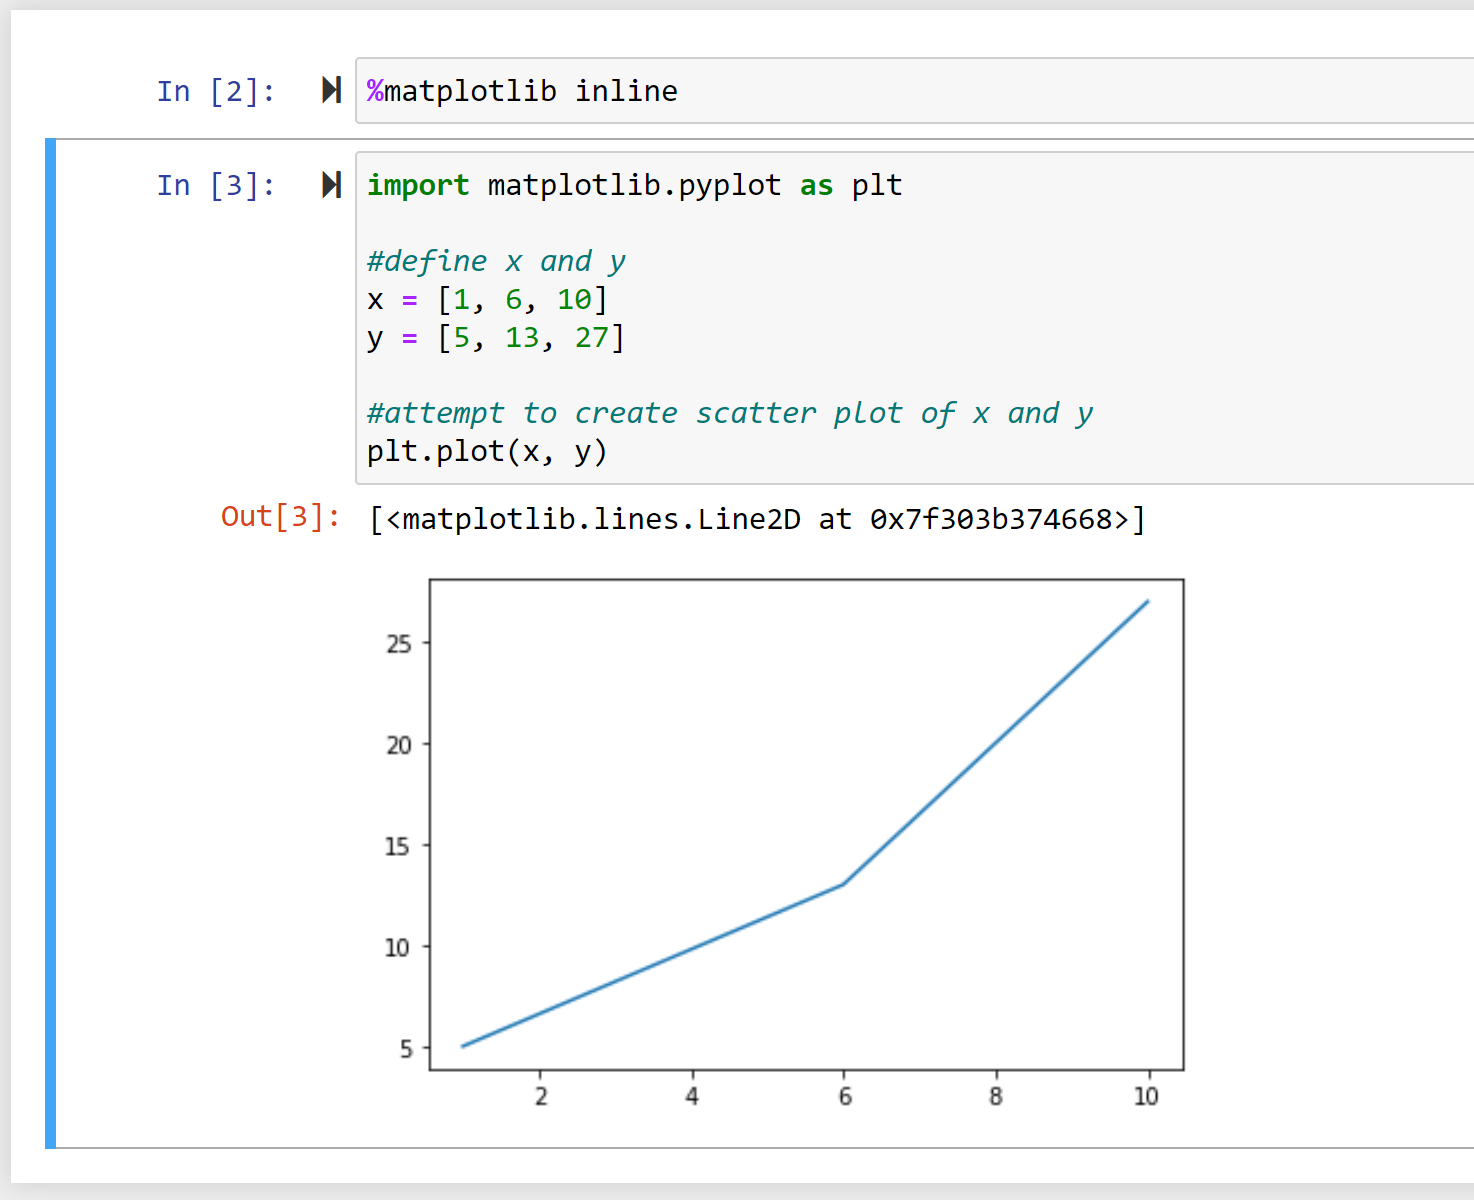
À l’achèvement du traitement de ces instructions, l’expérimentateur constate que le graphique se matérialise immédiatement au sein du carnet, sans qu’aucune fenêtre extérieure ne se manifeste. L’onde sinusoïdale amortie s’intègre harmonieusement dans le flux vertical du document, les axes de coordonnées sont précisément bornés et la figure demeure consultable de façon pérenne, témoignant du succès de la sérialisation statique opérée par le moteur inline.
5.3 Exemple pratique 2 : Nuage de points pour l’étude de corrélation
Une seconde application incontournable concerne l’exploration empirique des relations bivariées au moyen d’un nuage de points statistique. Ce cas d’usage met en lumière l’aptitude du backend inline à restituer avec netteté des distributions discrètes denses, soumises à des variations stochastiques simulant les aléas de mesures expérimentales au sein d’un laboratoire de recherche.
Pour ce faire, le protocole mobilise le générateur de nombres pseudo-aléatoires de NumPy afin de forger une variable explicative indépendante distribuée selon une loi gaussienne, couplée à une variable dépendante intégrant à la fois une relation de proportionnalité linéaire directe et une composante de bruit additif non corrélée. Les étapes de formalisation de cette expérience s’ordonnent de la manière suivante :
- Fixation de la graine aléatoire : initialisation du générateur stochastique garantissant la reproductibilité computationnelle stricte des tirages numériques.
- Génération des cohortes d’observation : simulation de cinq cents réalisations individuelles caractérisées par une distribution normale standard centrée réduite.
- Calcul du vecteur de corrélation : construction de la coordonnée ordonnée par combinaison linéaire du vecteur initial et d’un vecteur de perturbations aléatoires indépendantes.
- Restitution par projection discrète : appel à la méthode
ax.scatter()pour matérialiser chaque observation par un marqueur géométrique régulé en transparence et en chrominance.
L’exécution de cette séquence sous la directive %matplotlib inline démontre la pertinence de l’approche statique intégrée. La structure de dispersion bivariée s’affiche instantanément sous le code, permettant à l’analyste d’évaluer visuellement la colinéarité des grandeurs et l’homoscédasticité des résidus sans nécessiter de manipulation complexe d’interfaces de fenêtrage externes.
6. Diversité des représentations graphiques prises en charge
6.1 Visualisations univariées et distributions empiriques
L’adéquation du backend inline à la démarche exploratoire se manifeste pleinement lors de l’investigation des propriétés distributionnelles d’échantillons univariés. La caractérisation rigoureuse de la dispersion, de l’asymétrie et de l’aplatissement d’une variable quantitative nécessite la mobilisation conjointe d’histogrammes de fréquences discrétisées, d’estimations de densités continues et de représentations synthétiques non paramétriques.
Lors de la production d’un histogramme empirique supervisé via la fonction ax.hist(), le moteur inline restitue de façon optimale la discrétisation du support probabiliste en classes disjointes. La gestion automatique du canevas garantit que les labels d’intervalles numériques, les proportions volumétriques des rectangles d’estimation et les densités relatives conservent une lisibilité sans faille, quelle que soit la granularité de discrétisation sélectionnée par l’analyste.
Parallèlement, la construction de diagrammes en boîte, matérialisée par la commande ax.boxplot(), met en valeur les capacités de sérialisation statique pour l’analyse des quantiles et l’identification des observations atypiques. L’incorporation directe dans le document de travail offre une vue synthétique des cinq nombres de Tukey décrivant la distribution, facilitant la comparaison immédiate entre plusieurs cohortes expérimentales sans rupture d’agencement visuel.
6.2 Visualisations multivariées et structures matricielles
Dans le domaine de l’économétrie, de la bio-informatique et du traitement d’images, la manipulation de structures de données matricielles exige la génération de représentations multivariées denses, au premier rang desquelles trônent les cartes thermiques de corrélation et les grilles de sous-graphiques interconnectés. Le backend inline se distingue par sa stabilité remarquable lors de l’orchestration de figures comportant de multiples zones d’axes juxtaposées.
La projection d’une matrice de variance-covariance ou de corrélations de Pearson au moyen de la méthode d’affichage d’images numériques ax.imshow() ou via les abstractions de haut niveau de la bibliothèque Seaborn bénéficie pleinement du mode inline. L’ajustement dynamique de la barre d’échelle chromatique latérale s’effectue sans distorsion spatiale du canevas global, assurant une lecture proportionnée des coefficients d’association entre variables.
De surcroît, la création d’architectures visuelles complexes organisées en grilles régulières au moyen de l’outil plt.subplots(nrows, ncols) s’opère avec une rigueur géométrique absolue. Le moteur de rendu calcule précisément les marges d’espacement inter-panneaux pour prévenir le chevauchement typographique des graduations numériques, fournissant au chercheur une vue panoramique des interactions multivariées d’un seul coup d’œil synthétique au sein du carnet.
6.3 Diagrammes catégoriels et représentations comparatives
La communication des grandeurs d’intérêt en milieu scientifique repose très fréquemment sur des représentations catégorielles discrètes, où des indicateurs ponctuels sont confrontés à des mesures d’incertitude expérimentale. Le moteur de rendu inline prend en charge avec une précision méticuleuse ces visualisations décisionnelles, assurant l’alignement typographique des étiquettes textuelles et le positionnement exact des intervalles de dispersion.
L’élaboration de diagrammes en barres comparatifs, instanciés via ax.bar() ou ax.barh(), permet d’associer à chaque segment discret des barres d’erreur matérialisant des intervalles de confiance statistiques à 95 % ou des écarts-types d’échantillonnage. Le backend statique garantit que ces extensions géométriques de haute précision vectorielle ne subissent aucun décalage d’un pixel lors de la rastérisation finale en format matriciel.
Il importe néanmoins de mentionner une réserve sémiologique d’ordre académique quant à l’usage des graphiques sectoriels, parfois appelés diagrammes circulaires, bien que parfaitement supportés par le moteur via ax.pie(). En raison des limitations physiologiques de l’œil humain à apprécier avec justesse les variations angulaires par rapport aux longueurs linéaires, la recherche quantitative moderne préconise de substituer à ces représentations circulaires des diagrammes en barres hiérarchisés, optimisant ainsi l’intelligibilité objective des résultats restitués sous la cellule d’analyse.
7. Analyse comparative : %matplotlib inline face aux backends interactifs
7.1 Comparaison avec la directive %matplotlib notebook
Durant l’évolution des versions de l’écosystème IPython, la directive magique %matplotlib notebook a été introduite afin d’offrir une alternative dynamique au caractère purement statique du mode inline. Ce backend s’appuie sur une communication bidirectionnelle continue établie entre le noyau de calcul Python distant et le client JavaScript s’exécutant dans le navigateur Web, exploitant pour cela les canaux de communication temps réel de type WebSockets.
Cette sophistication architecturale octroie à l’utilisateur des fonctionnalités d’exploration directe indisponibles sous le mode inline : la possibilité d’effectuer des zooms continus sur des portions microscopiques de données, de translater les axes par cliquer-glisser à la souris, et de visualiser dynamiquement les coordonnées numériques précises du curseur survolant le canevas. Ces attributs font de %matplotlib notebook un outil précieux lors de l’inspection initiale de signaux complexes ou d’enregistrements temporels haute fréquence.
Toutefois, cette interactivité accrue s’accompagne d’un coût computationnel et d’une vulnérabilité méthodologique notables. Le maintien d’une connexion d’état vivante consomme des ressources système substantielles sur le serveur hôte. Dès que la session de calcul est interrompue ou que le carnet est partagé sous forme déconnectée, l’interactivité s’effondre irrémédiablement, laissant fréquemment un canevas vide ou inopérant si la figure n’a pas été explicitement convertie en image statique avant la clôture du processus.
7.2 Comparaison avec l’environnement moderne %matplotlib widget (ipympl)
Dans l’architecture moderne de l’écosystème JupyterLab, la directive interactive d’ancienne génération a été avantageusement remplacée par la solution %matplotlib widget, matérialisée par l’extension logicielle tierce standardisée ipympl. Cette implémentation contemporaine intègre pleinement les composants de tracé graphique au sein du paradigme unifié des contrôles interactifs Jupyter (Jupyter Widgets), reposant sur une communication asynchrone hautement modulaire.
L’utilisation de la directive %matplotlib widget procure une intégration ergonomique remarquable dans les interfaces de développement infonuagiques récentes. Elle autorise le redimensionnement flexible du canevas, l’incrustation de boutons de navigation directement au sein du modèle objet de document HTML et la manipulation réactive d’éléments graphiques en symbiose avec d’autres extensions interactives, tout en garantissant une compatibilité optimale avec les navigateurs respectant les derniers standards Web.
Néanmoins, cette puissance fonctionnelle requiert une chaîne de dépendances logicielles nettement plus lourde et exigeante que le minimalisme intrinsèque du mode inline. L’utilisateur doit impérativement veiller à l’installation conjointe de modules Python spécifiques et d’extensions JavaScript côté client. Toute disparité de version entre le serveur d’exécution et l’interface utilisateur peut entraîner un dysfonctionnement silencieux du composant, faisant de la directive %matplotlib inline un choix nettement plus fiable et résilient pour la diffusion universelle de travaux reproductibles sans prérequis d’infrastructure contraignants.
7.3 Matrice décisionnelle pour le choix du backend adapté
L’arbitrage rationnel entre le backend statique standard et ses homologues interactifs contemporains doit s’opérer au prisme d’une matrice décisionnelle articulant volume de données, canal de diffusion et infrastructure de calcul. Pour formaliser cette sélection méthodologique, les critères prédominants d’orientation technique peuvent être résumés au sein des axes stratégiques suivants :
- Volume de traitement et débit : Pour la manipulation séquentielle de cohortes massives de données ou l’exécution de pipelines automatisés par lots,
%matplotlib inlineoffre une vitesse de calcul maximale sans aucune surcharge liée à la gestion d’événements interactifs côté client. - Diffusion pérenne et archivage : Pour la production de documents destinés à l’évaluation par les pairs, à la publication sur des plateformes d’hébergement statiques de type GitHub ou à l’exportation vers des formats d’impression,
%matplotlib inlines’impose de façon exclusive grâce à son encapsulation sérialisée Base64. - Exploration géométrique locale : Pour l’ajustement fin de zooms sur des courbes denses, la détection visuelle manuelle d’anomalies de mesure ou la manipulation pédagogique interactive en temps réel,
%matplotlib widgetconstitue la solution la plus fonctionnelle, sous réserve d’une infrastructure logicielle compatible.
Ainsi, le choix du moteur de rendu ne procède pas d’une préférence esthétique arbitraire, mais découle d’un compromis calculé entre la flexibilité d’investigation locale et la robustesse épistémologique de la persistance des données au fil du cycle de vie du projet de recherche.
8. Configuration avancée de la résolution et des formats d’exportation
8.1 Optimisation de la densité de pixels pour les écrans haute définition
L’inconvénient originel majeur du backend inline dans sa configuration d’usine réside dans la résolution relativement modeste des images matricielles générées par défaut. Historiquement calibré pour des écrans d’affichage standards d’une densité de 72 à 96 points par pouce (DPI), le moteur produit des canevas PNG dont la rastérisation peut paraître floue, granuleuse ou pixellisée lorsqu’ils sont consultés sur des moniteurs contemporains à haute densité de pixels, tels que les dalles d’affichage Retina.
Pour pallier cette dégradation esthétique et textuelle sans abandonner la commodité du mode statique, l’environnement IPython met à disposition de l’analyste une métacommande de paramétrage fin du moteur de sérialisation : la directive %config InlineBackend.figure_format. En affectant la valeur 'retina' à cet attribut système, le noyau double la densité de rastérisation de l’image raster tout en ordonnant à la feuille de style de l’interface Web d’afficher la figure dans ses dimensions nominales originelles, réalisant ainsi un sous-échantillonnage de lissage optique d’une netteté absolue :
- Directive d’élévation de résolution :
%config InlineBackend.figure_format = 'retina'
Cette configuration haute densité transforme radicalement la lisibilité des représentations visuelles complexes. Les tracés de courbes multiples très rapprochées, la netteté des marqueurs géométriques de petite dimension, ainsi que le rendu typographique des étiquettes d’axes et des équations mathématiques composées en notation LaTeX bénéficient d’un lissage remarquable, élevant la qualité du document aux standards de l’édition typographique professionnelle.
8.2 Sélection du format vectoriel pour l’édition scientifique
Lorsque la finalité première du carnet de recherche consiste en l’édition d’articles académiques destinés à des revues à comité de lecture, la pixellisation matricielle inhérente au format PNG, même optimisé pour les écrans Retina, peut constituer une limitation rédhibitoire. Dans cette perspective, la substitution du format matriciel par un format vectoriel évolutif représente la démarche technique optimale.
L’activation du format vectoriel s’opère par une reconfiguration directe du moteur inline, en sollicitant l’encapsulation sous le format universel SVG (Scalable Vector Graphics) :
- Configuration vectorielle native :
%config InlineBackend.figure_format = 'svg'
Sous ce régime opérationnel, le canevas n’est plus transcrit sous forme de grille de pixels, mais sous la forme d’un ensemble structuré d’instructions géométriques XML dictant le tracé des segments, des courbes de Bézier et des glyphes typographiques. L’agrandissement de la figure au sein du navigateur ou son exportation vers des outils de mise en page n’entraîne strictement aucune perte de définition, autorisant une mise à l’échelle infinie sans altération de netteté.
Une mise en garde fondamentale s’impose néanmoins quant à l’emploi du format SVG lors de la manipulation de jeux de données massifs. Si l’analyse implique la représentation d’un nuage de points comportant plusieurs centaines de milliers d’observations individuelles, le fichier SVG contiendra autant d’éléments XML indépendants au sein de la structure DOM du navigateur. Cette inflation textuelle démesurée peut saturer la mémoire du navigateur client et paralyser l’affichage du document, situation dans laquelle le retour à une compression matricielle PNG haute résolution redevient impératif.
8.3 Personnalisation des paramètres globaux de style d’exécution
L’harmonisation de l’identité visuelle d’un carnet de recherche complet requiert de s’affranchir de la redéfinition manuelle des paramètres esthétiques au sein de chaque bloc logique individuel. Matplotlib intègre un dictionnaire de configuration global exhaustif, désigné sous le terme technique de rcParams, dont les valeurs par défaut gouvernent l’ensemble des mécanismes de tracé du moteur d’exécution.
La modification programmatique concertée de ce dictionnaire au sein du préambule de configuration du carnet permet de standardiser de manière pérenne la dimension physique des canevas, la typographie dominante, la taille relative des annotations textuelles et l’épaisseur nominale des tracés de courbes. Une instanciation rigoureuse s’articule traditionnellement autour des directives d’ajustement suivantes :
- Contrôle dimensionnel du canevas nominal :
plt.rcParams['figure.figsize'] = (10.0, 6.0) - Ajustement de la densité de rastérisation par défaut :
plt.rcParams['figure.dpi'] = 300 - Normalisation du calibrage typographique des étiquettes :
plt.rcParams['font.size'] = 12 - Optimisation du découpage automatique des bordures périphériques :
plt.rcParams['figure.autolayout'] = True
Ce paramétrage centralisé offre la garantie que chaque graphique généré ultérieurement sous le backend inline partagera une identité formelle rigoureusement uniforme, éliminant les disparités d’échelle et garantissant la conformité directe des artefacts visuels avec les chartes graphiques rigoureuses des éditeurs scientifiques internationaux.
9. Gestion de l’état graphique et persistance des objets dans Jupyter
9.1 Le paradigme d’état global vs l’approche orientée objet
Dans l’écosystème de programmation Matplotlib, deux paradigmes de conception logicielle coexistent de manière asymétrique : le modèle procédural fondé sur la gestion d’un état implicite global, calqué historiquement sur les conventions syntaxiques de MATLAB, et le modèle déclaratif orienté objet, fondé sur la manipulation explicite d’instances de classes dédiées. La compréhension de cette dualité est capitale pour appréhender la manière dont la directive %matplotlib inline isole ou partage l’état graphique entre des cellules consécutives.
L’interface procédurale, incarnée par l’usage exclusif de fonctions issues de l’espace de noms plt (telles que plt.plot() ou plt.title()), s’appuie sur une machinerie sous-jacente pointant en permanence vers une « figure courante » et un « axe courant ». Si cette approche autorise la génération rapide de tracés exploratoires sommaires au sein d’une unique cellule de calcul, elle présente des risques de confusion contextuelle majeurs dès lors que le flux analytique s’étend sur plusieurs blocs disjoints ou fait intervenir des sous-fonctions d’orchestration complexes.
À l’inverse, l’adoption systématique de la méthodologie orientée objet via la création explicite d’un couple formel d’instances constitué de la figure globale et de la zone d’axes de coordonnées confère une robustesse absolue au protocole de traçage. Le canevas est matérialisé par une variable distincte, garantissant que toutes les mutations géométriques appliquées à cet objet cibleront précisément l’espace de données souhaité, sans dépendre de l’état volatile d’un pointeur global caché :
- Instanciation déclarative robuste :
fig, ax = plt.subplots(figsize=(8, 5)) - Application méthodologique ciblée :
ax.plot(vecteur_x, vecteur_y)
Dans le contexte du backend inline, cette approche orientée objet est la seule garantissant une traçabilité rigoureuse. Elle prévient les interférences logiques et garantit que la clôture automatique de la figure orchestrée par les crochets d’IPython à la fin de la cellule s’exécute de façon déterministe sur les objets désignés, sans laisser d’états d’axes résiduels contaminer la mémoire vive du noyau.
9.2 Exportation concurrente sur disque et affichage direct
Un impératif d’ingénierie récurrent dans la pratique des sciences computationnelles réside dans la nécessité de concilier l’inspection visuelle immédiate d’un phénomène statistique au sein du carnet de travail et l’enregistrement simultané de la figure correspondante sous forme de fichier d’archive autonome sur le stockage persistant du serveur. La directive %matplotlib inline s’harmonise parfaitement avec ce double objectif, à condition de respecter scrupuleusement l’ordonnancement séquentiel des instructions de rendu.
Le point critique de cette cohabitation réside dans le positionnement systématique de l’appel à la fonction de sauvegarde persistante fig.savefig() en amont de la terminaison logique de la cellule de calcul. Dans la mesure où le backend inline applique une politique de clôture et de destruction immédiate de l’objet graphique dès que le contrôle est rendu à l’environnement Jupyter, toute tentative d’invocation ultérieure de l’enregistrement de l’objet dans une cellule séparée aboutirait à l’exportation d’un canevas vierge ou à la levée d’une exception logicielle signalant la vacuité de la figure active.
Le protocole technique exemplaire requiert d’adjoindre à l’enregistrement sur disque des paramètres de contrôle dimensionnel stricts, notamment la spécification d’un rognage serré des marges blanches périphériques via l’argument bbox_inches='tight', prévenant l’amputation involontaire des titres et des axes de coordonnées lors de l’écriture physique du flux d’octets. Ce procédé assure la création concurrente d’une image matricielle de très haute résolution stockée sur disque et d’une copie de travail compressée intégrée au carnet, conciliant ainsi archivage documentaire et ergonomie d’analyse exploratoire.
9.3 Comportement lors de la conversion du carnet vers d’autres formats
L’exploitation finale d’un carnet de recherche scientifique ne se limite pas à sa consultation interactive dans un navigateur Web ; elle implique fréquemment sa conversion algorithmique vers des formats d’édition institutionnels tels que les documents typographiés LaTeX, les rapports portables PDF ou les pages de documentation statique HTML. Cette métamorphose documentaire est assurée par l’infrastructure spécialisée nbconvert du projet Jupyter.
Lors de cette conversion automatisée, la nature sérialisée des figures issues du backend inline joue un rôle déterminant pour la stabilité structurelle du processus. Le processeur de conversion extrait directement les chaînes de caractères Base64 hébergées au sein des champs de métadonnées de sortie des cellules, les décode sous leur forme binaire originelle et reconstruit les fichiers graphiques autonomes sur le système de fichiers hôte, tout en générant les balises d’inclusion textuelle correspondantes (telles que les environnements begin{figure} et includegraphics sous LaTeX).
Ce mécanisme garantit que l’intégrité visuelle du rapport technique ou de l’article scientifique final est absolue, sans nécessiter la moindre réexécution du code source ou la réévaluation chronophage de modèles d’apprentissage volumineux. L’état graphique capturé au moment précis de l’interaction originale est fidèlement projeté au sein de la maquette d’édition finale, certifiant la correspondance parfaite entre le raisonnement numérique initial et sa matérialisation éditoriale.
10. Évolution technique et statut contemporain de la commande
10.1 L’activation implicite dans les versions modernes d’IPython
L’analyse historiographique de l’infrastructure IPython révèle une évolution significative quant au statut réglementaire de la commande magique %matplotlib inline. Durant les premières années de déploiement des carnets interactifs, l’absence d’inscription explicite de cette instruction en tête de document condamnait inexorablement l’expérimentateur à subir l’exécution silencieuse ou les dysfonctionnements d’affichage des fenêtres externes décrits précédemment. Son utilisation constituait un passage obligé, quasi rituel, de l’initialisation de toute session d’analyse de données.
Toutefois, face à la généralisation universelle de l’usage des carnets de recherche au sein de navigateurs Web déconnectés de gestionnaires de fenêtres locaux, les équipes d’ingénierie d’IPython et de Matplotlib ont fait évoluer cette configuration historique. Depuis la publication des branches majeures d’IPython 7.x et des versions concomitantes de Matplotlib, le noyau interactif est programmé pour détecter automatiquement son instanciation au sein d’une interface de carnet de type Jupyter Notebook ou JupyterLab. En présence d’un tel environnement client, le noyau procède désormais à l’activation implicite et automatisée du backend inline dès le premier appel à une commande de traçage graphique.
Néanmoins, en dépit de cette automatisation contemporaine qui rend l’instruction formellement facultative dans les environnements de pointe, la mention explicite de la directive %matplotlib inline demeure fermement recommandée par les guides de bonnes pratiques académiques et pédagogiques. Elle constitue une assertion de conception essentielle qui prémunit le document analytique contre des instabilités d’exécution imprévues lors de son déploiement sur des systèmes d’exploitation hétérogènes ou au sein de distributions logicielles archaïques dépourvues d’autoconfiguration automatique du backend.
10.2 Comportement sur les plateformes collaboratives dans le nuage
L’essor fulgurant des plateformes d’apprentissage automatique et de recherche quantitative hébergées dans le nuage, à l’instar de Google Colaboratory, de Binder ou des environnements gérés de calcul intensif, a largement consacré la pertinence du backend inline. Dans ces infrastructures distribuées, le noyau de calcul Python s’exécute au sein de conteneurs logiciels virtualisés légers hébergés sur des serveurs distants, totalement dépourvus de serveurs d’affichage graphique X11.
Dans ces écosystèmes conteneurisés, la présence de la directive %matplotlib inline assure une stabilité opérationnelle intégrale. Les plateformes infonuagiques intègrent par défaut cette préconfiguration au sein de leurs images systèmes, garantissant que tout flux de traitement visuel est immédiatement converti en flux de données Web transmissible à travers les pare-feux et les passerelles réseau d’entreprise sans nécessiter d’ouverture de ports de communication exotiques.
La pérennité de cette commande magique offre ainsi une transférabilité totale du code source entre l’ordinateur de développement local du chercheur et les architectures de calcul distribué à large échelle. Un carnet méthodologiquement structuré autour de l’activation explicite du mode inline peut être cloné et exécuté instantanément sur une instance infonuagique distante avec l’assurance que le comportement du moteur de rendu visuel sera strictement isomorphe à celui observé sur la machine locale d’origine.
10.3 Différences fondamentales avec l’exécution de scripts en ligne de commande
L’une des sources de confusion les plus fréquentes pour les développeurs formés à l’ingénierie logicielle classique réside dans l’incompatibilité radicale des métacommandes IPython avec l’interpréteur Python standard en ligne de commande. Si l’on extrait le code source d’un carnet de recherche interactif pour l’agréger au sein d’un fichier de script traditionnel doté de l’extension .py, l’interpréteur standard python script.py échouera brutalement dès la première ligne en présence de la directive %matplotlib inline.
L’analyseur syntaxique du langage Python natif ne reconnaît pas le caractère de pourcentage comme un préfixe d’instruction valide hors des opérations arithmétiques de calcul de reste modulo ou de formatage textuel historique de chaînes. L’exécution provoque la levée immédiate et irrévocable de l’exception suivante :
SyntaxError: invalid syntax
Pour concevoir des modules logiciels polyvalents, capables d’être exécutés indifféremment sous forme de scripts de production en ligne de commande ou de carnets interactifs exploratoires, l’ingénieur doit dissocier formellement la logique de calcul de la couche de visualisation. Une approche méthodologique rigoureuse consiste à interdire la présence de directives magiques dans les modules de bibliothèque purs, et à réserver leur emploi exclusif aux points d’entrée documentaires interactifs. Une autre alternative d’ingénierie logicielle avancée consiste à interroger l’espace de noms d’exécution pour détecter la présence de l’environnement IPython avant d’ordonner la sélection programmatique du backend approprié via la fonction matplotlib.use('Agg').
11. Diagnostic des erreurs fréquentes et bonnes pratiques méthodologiques
11.1 Résolution des erreurs typographiques et de placement syntaxique
Dans la pratique courante de l’analyse computationnelle, une proportion substantielle des anomalies d’exécution rapportées par les utilisateurs débutants découle d’altérations syntaxiques apparemment anodines appliquées à la directive magique. Les coquilles typographiques telles que l’oubli du caractère de préfixe pourcentuel, l’insertion d’espaces fautifs entre le symbole et le nom de la commande, ou la substitution de minuscules par des majuscules constituent autant d’obstacles invalidant instantanément l’interprétation de la directive par le noyau interactif.
Un autre dysfonctionnement classique réside dans le positionnement temporel inadéquat de la commande au sein du document d’analyse. Déclarer %matplotlib inline au milieu d’un carnet, postérieurement à l’instanciation de multiples figures graphiques opérées sous un backend alternatif, peut induire des états de concurrence hybrides où certaines figures demeurent associées à l’ancien gestionnaire d’affichage tandis que les nouvelles adoptent le mode de sérialisation statique, semant la confusion dans l’arborescence des sorties.
Lorsqu’un comportement erratique du moteur de traçage est constaté, consécutif à des modifications successives et désordonnées de l’ordre d’évaluation des cellules, la seule procédure de remédiation méthodologiquement saine consiste à opérer une réinitialisation complète du noyau de calcul. En sollicitant l’action « Restart Kernel and Run All Cells », l’analyste purge l’intégralité des modules d’état résidents en mémoire et s’assure que le préambule de configuration s’applique de manière pure et séquentielle sur un espace de noms vierge de toute pollution contextuelle antérieure.
11.2 Gestion des doubles sorties graphiques indésirables
L’un des phénomènes visuels les plus couramment observés lors de l’apprentissage de la chaîne de visualisation sous Jupyter concerne la duplication inopinée de l’affichage graphique sous une cellule de traçage unique, accompagnée ou non de chaînes de caractères descriptives superflues. Cette redondance visuelle disgracieuse procède directement de la conjonction mal comprise entre deux mécanismes de restitution distincts opérant au sein du noyau IPython.
Le premier mécanisme correspond au comportement standard du carnet, qui évalue et imprime systématiquement la représentation textuelle de l’expression terminale d’une cellule de code. Lorsqu’une méthode telle que plt.plot() ou ax.set_title() constitue la ligne finale du bloc, elle renvoie une instance d’objet que le noyau affiche sous forme de chaîne descriptive. Pour neutraliser cette émission textuelle parasite, la bonne pratique d’ingénierie consiste à apposer un caractère de point-virgule terminal à la toute dernière instruction de la cellule, ce qui a pour effet d’annuler silencieusement l’évaluation de sortie de la ligne :
- Suppression syntaxique de l’écho de sortie :
ax.plot(vecteur_x, vecteur_y);
Le second mécanisme à l’origine des doubles restitutions visuelles concerne la redondance entre l’appel explicite à l’instruction de clôture plt.show() et l’intervention automatique des crochets d’exécution post-cellule du backend inline. Dans certaines configurations historiques, l’usage combiné de ces deux directives provoquait un premier affichage forcé par l’appel à la méthode, immédiatement suivi d’un second tracé rasterisé engendré par la clôture automatique d’IPython. La suppression méthodique des appels superflus à plt.show() au sein des cellules exploitant le mode inline garantit une restitution unique, épurée et conforme aux standards de publication scientifique.
11.3 Guide de style et conventions pour les équipes de recherche
L’industrialisation des processus d’analyse de données au sein d’équipes de recherche collaboratives impose une normalisation rigoureuse des styles de programmation documentaire. Le carnet de calcul ne doit pas être abordé comme un brouillon informel, mais comme un artefact de communication scientifique obéissant à des critères stricts de modularité, de traçabilité et d’indépendance logicielle.
Pour assurer la pérennité et la transférabilité des travaux analytiques, les conventions méthodologiques suivantes doivent être adoptées de façon systématique par l’ensemble des collaborateurs d’un projet :
- Sanctuarisation du préambule : La première cellule de chaque carnet doit être exclusivement réservée à l’initialisation de l’environnement (directive
%matplotlib inline, configurations%config, imports fondamentaux et stylesrcParams), sans aucune instruction de calcul analytique. - Adoption exclusive de l’API Orientée Objet : L’usage des fonctions procédurales directes issues de
pltdoit être proscrit au profit de la manipulation explicite d’instancesfig, ax = plt.subplots(), conférant une clarté absolue à la géométrie de chaque panneau. - Documentation des versions d’environnement : Tout dépôt de code ouvert doit associer au carnet un fichier de verrouillage des dépendances logicielles (de type
environment.ymlourequirements.txt) consignant précisément les versions de Matplotlib et d’IPython validées pour l’exécution. - Séparation du calcul et du tracé : Les traitements statistiques chronophages ou les requêtes d’extraction de données massives doivent être isolés au sein de cellules dédiées en amont des blocs de visualisation, évitant le recalcul inutile des données en cas de simple ajustement esthétique de la figure.
Le respect scrupuleux de ces conventions de gouvernance logicielle prémunit les équipes scientifiques contre l’obsolescence méthodologique et assure une productivité maximale lors des revues critiques de code par les pairs.
12. Applications empiriques avancées dans la recherche en sciences quantitatives
12.1 Visualisation de séries temporelles longitudinales
La recherche quantitative dans des disciplines telles que la climatologie, l’économétrie financière ou la sismologie repose de manière prépondérante sur l’analyse de signaux séquentiels longitudinaux. La visualisation rigoureuse de ces trajectoires dynamiques exige un traitement méticuleux de la projection temporelle des axes, une synchronisation multi-échelles entre capteurs distincts et une représentation explicite de la volatilité stochastique sous-jacente.
Grâce à la commande %matplotlib inline, le rendu des séries chronologiques complexes bénéficie d’une stabilité d’affichage sans faille. L’analyste peut mobiliser le module spécialisé matplotlib.dates pour structurer les localisateurs et les formateurs d’intervalles temporels, garantissant que les axes de coordonnées adaptent dynamiquement leurs repères typographiques (marquage des années, des trimestres ou des microsecondes) sans déborder du cadre rasterisé intégré à la cellule d’analyse.
De surcroît, la représentation d’intervalles de confiance glissants ou de bandes de variabilité stochastique entourant la trajectoire de la moyenne empirique s’opère avec une fluidité remarquable au moyen de la méthode ax.fill_between(). L’incorporation statique directe permet d’évaluer visuellement la rupture d’homogénéité d’un régime financier ou l’émergence d’une dérive climatique à travers une inspection séquentielle continue au fur et à mesure du déroulement du carnet de travail.
12.2 Cartographie visuelle de modèles statistiques et régressions
Dans les applications d’apprentissage statistique et d’inférence économétrique, la validation empirique d’une modélisation ne saurait se limiter à l’inspection d’indicateurs synthétiques scalaires, tels que le coefficient de détermination $R^2$ ou l’erreur quadratique moyenne. La cartographie visuelle des surfaces de réponse estimées, confrontée à l’analyse diagnostique des résidus d’ajustement, constitue l’étape incontournable de tout protocole de validation robuste.
La puissance du mode inline permet de concevoir des panneaux d’évaluation intégrés où le plan de régression linéaire ou non linéaire est projeté directement sur le nuage d’observations expérimentales, complété par l’affichage d’intervalles de prédiction hyperboliques calculés rigoureusement à partir de la matrice d’information de Fisher. L’analyste peut appréhender d’un seul regard la qualité d’adéquation du modèle mathématique sur l’ensemble du domaine d’observation exploré.
Parallèlement, la détection des violations des hypothèses classiques de Gauss-Markov requiert l’inspection graphique immédiate de la structure des résidus. À travers la génération conjointe de diagrammes quantile-quantile (Q-Q plots) et de tracés de résidus standardisés confrontés aux valeurs ajustées, le chercheur identifie instantanément d’éventuels phénomènes d’hétéroscédasticité, de non-normalité des perturbations ou d’autocorrélation temporelle, orientant rationnellement le choix de transformations correctives ou la sélection de spécifications semi-paramétriques alternatives.
12.3 Synthèse visuelle pour la restitution des résultats de recherche
L’aboutissement ultime de toute démarche scientifique quantitative réside dans la restitution synthétique des connaissances découvertes à destination de la communauté académique, des décideurs ou du grand public. Cette mission de transfert exige l’élaboration de figures multipanneaux complexes prêtes pour l’évaluation par les pairs, respectant scrupuleusement les chartes sémiologiques rigoureuses des publications internationales de haut rang.
Le backend inline couplé aux outils avancés de gestion de la géométrie de Matplotlib, tels que le gestionnaire d’agencement GridSpec ou la méthode moderne subplot_mosaic(), permet d’échafauder des architectures documentaires d’une sophistication visuelle exceptionnelle. Des distributions univariées marginales peuvent être juxtaposées avec une précision chirurgicale autour d’un panneau central de dispersion bivariée, tandis que des histogrammes de résidus latéraux viennent enrichir la démonstration sans alourdir la perception globale.
Enfin, l’engagement délibéré pour une science ouverte, équitable et inclusive impose une vigilance accrue quant à l’accessibilité visuelle des résultats restitués. Le recours à des palettes chromatiques perceptuellement uniformes et universellement interprétables par les personnes atteintes de déficiences de la vision des couleurs (telles que les colormaps viridis, plasma ou cividis) est magnifié par la neutralité de restitution du mode inline. L’incorporation pérenne de ces représentations universelles au sein de carnets de recherche ouverts et reproductibles constitue le couronnement de la pratique contemporaine des sciences de données computationnelles.
Références
Hunter, J. D. (2007). Matplotlib: A 2D graphics environment. Computing in Science & Engineering, 9(3), 90–95. https://doi.org/10.1109/MCSE.2007.55
Kluyver, T., Ragan-Kelley, B., Pérez, F., Granger, B. E., Bussonnier, M., Frederic, J., Kelley, K., Hamrick, J. B., Grout, J., Corlay, S., Ivanov, P., Avila, D., Abdalla, S., Willing, C., & Jupyter Development Team. (2016). Jupyter Notebooks—a publishing format for reproducible computational workflows. In F. Loizides & B. Schmidt (Eds.), Positioning and Power in Academic Publishing: Players, Agents and Agendas (pp. 87–90). IOS Press. https://doi.org/10.3233/978-1-61499-649-1-87
Matplotlib Development Team. (2023). Backends in Matplotlib. Matplotlib documentation. https://matplotlib.org/stable/users/explain/backends.html
Pérez, F., & Granger, B. E. (2007). IPython: A system for interactive scientific computing. Computing in Science & Engineering, 9(3), 21–29. https://doi.org/10.1109/MCSE.2007.53
Rougier, N. P., Droettboom, M., & Bourne, P. E. (2014). Ten simple rules for better figures. PLOS Computational Biology, 10(9), Article e1003833. https://doi.org/10.1371/journal.pcbi.1003833
VanderPlas, J. (2016). Python Data Science Handbook: Essential Tools for Working with Data. O’Reilly Media.