
L’analyse statistique moderne et la modélisation stochastique constituent les piliers incontournables de la prise de décision éclairée au sein des organisations contemporaines, de la recherche scientifique et de l’ingénierie des processus. Parmi l’éventail des lois de probabilité fondamentales qui régissent les phénomènes naturels et socio-économiques, la distribution de Poisson occupe une place prépondérante dès lors qu’il s’agit de quantifier des événements discrets survenant au sein d’un continuum temporel, spatial ou surfacique déterminé. Qu’il s’agisse de mesurer la cadence d’arrivée de patients au sein d’une unité de soins intensifs, d’évaluer la fréquence de défaillances de composants microélectroniques ou de modéliser les occurrences de comportements rares au sein d’une cohorte clinique, cette loi offre un cadre mathématique d’une élégance et d’une efficacité remarquables.
Cependant, l’appropriation opérationnelle de ces abstractions théoriques nécessite des outils de calcul à la fois puissants, accessibles et capables d’interagir dynamiquement avec des architectures de données volumineuses. Si des langages spécialisés tels que R ou Python demeurent la norme dans les laboratoires de bio-informatique avancée, le tableur Microsoft Excel demeure la plateforme universelle la plus ubiquitaire en milieu professionnel et académique pour le prototypage, l’exploration empirique et le déploiement de modèles prédictifs rapides. L’implémentation de la loi de Poisson au sein du tableur ne se limite point à la simple saisie d’une commande arithmétique isolée ; elle requiert une compréhension intime de ses axiomes probabilistes, des subtilités computationnelles de ses fonctions natives et des limitations inhérentes aux représentations numériques en virgule flottante.
Ce guide exhaustif a pour vocation d’articuler avec une rigueur méthodologique absolue les fondements analytiques du processus de Poisson et son orchestration méthodique sous Excel. À travers un continuum d’analyses théoriques, de démonstrations algorithmiques pas à pas, d’études de cas empiriques résolues et de protocoles de diagnostic de validité statistique, ce corpus vise à transformer le praticien, l’analyste de données ou le chercheur en un utilisateur éclairé et méticuleux, capable de modéliser des systèmes stochastiques complexes, d’éviter les biais d’interprétation méthodologiques et d’automatiser des flux décisionnels hautement fiables.
1. Fondements théoriques de la loi de Poisson et pertinence statistique
1.1 Définition mathématique et propriétés du processus de Poisson
La loi de Poisson, formulée en 1837 par le mathématicien français Siméon Denis Poisson au sein de ses travaux sur l’administration de la justice et la théorie des probabilités, est une loi de probabilité discrète qui modélise le nombre d’occurrences d’un événement au sein d’un intervalle fixe de temps ou d’espace. Pour qu’une variable aléatoire discrète, traditionnellement notée X, suive rigoureusement une distribution de Poisson de paramètre d’intensité $lambda$ (lambda), le processus sous-jacent doit satisfaire à des conditions d’homogénéité et d’indépendance particulièrement strictes. Plus précisément, la probabilité d’occurrence d’un événement doit demeurer proportionnelle à la dimension de l’intervalle considéré, tandis que la probabilité d’apparition simultanée de deux événements distincts dans un sous-intervalle infinitésimal doit tendre vers zéro. De plus, les occurrences observées sur des sous-intervalles disjoints doivent être rigoureusement indépendantes sur le plan stochastique, écartant tout effet de mémoire ou de rétroaction séquentielle.
La formulation analytique de sa fonction de masse de probabilité, qui associe à tout entier naturel k la probabilité exacte d’observer précisément k événements au cours de l’intervalle de référence, s’exprime formellement par l’équation classique suivante :
P(X = k) = (λk × e-λ) / k!
Dans cette formulation canonique, la variable k appartient à l’ensemble des entiers naturels, le symbole e représente la base du logarithme népérien (la constante d’Euler approximativement égale à 2,718281828459), le terme k! désigne la factorielle de l’entier k, et $lambda$ incarne le paramètre central de la loi. Ce paramètre d’intensité $lambda$, nécessairement strictement positif, condense en sa seule valeur l’ensemble des dynamiques intrinsèques du phénomène modélisé. L’une des propriétés mathématiques les plus remarquables et discriminantes de la loi de Poisson réside dans le principe d’équidispersance. Sous cette distribution, l’espérance mathématique de la variable aléatoire, notée E(X), est strictement équivalente à sa variance, notée Var(X) :
E(X) = Var(X) = λ
Cette identité théorique confère à la loi une structure d’une grande compacité, l’écart-type n’étant autre que la racine carrée de l’espérance mathématique. L’équidispersance constitue simultanément la force prédictive de ce modèle et son principal point de vulnérabilité pratique, car la moindre déviation constatée entre la moyenne empirique et la variance d’un échantillon réel suggère une violation potentielle des hypothèses fondatrices du processus de Poisson, ouvrant la voie à des phénomènes de sous-dispersion ou de surdispersion que le statisticien doit impérativement déceler.
1.2 Applications de la distribution de Poisson aux sciences quantitatives et comportementales
La pertinence de la distribution de Poisson traverse l’ensemble des disciplines quantitatives, depuis l’épidémiologie clinique jusqu’à la psychométrie expérimentale, en passant par la gestion logistique et la finance quantitative. Dans le champ de la recherche biomédicale et des protocoles cliniques, la modélisation du taux d’arrivée de nouveaux sujets répondant à des critères d’inclusion contraignants repose fréquemment sur un processus ponctuel de Poisson. Lorsque des centres hospitaliers évaluent les flux d’admissions d’urgence pour des pathologies aiguës ou rares, la distribution de Poisson permet de dimensionner les infrastructures de réanimation et les équipes de garde en fonction d’un risque probabiliste maîtrisé, plutôt que sur la base d’estimations déterministes systématiquement défaillantes face à la volatilité stochastique.
En sciences comportementales, l’observation d’actes discrets au sein de fenêtres temporelles strictement contrôlées fournit une illustration probante de l’utilité du modèle. Qu’il s’agisse de comptabiliser les épisodes d’agressivité chez des patients atteints de démences neurodégénératives, les interruptions verbales lors de dynamiques de groupe contrôlées, ou encore le nombre de lapsus commis lors de protocoles de fluence verbale, les données issues de ces protocoles se caractérisent par leur nature discrète, positive et fortement asymétrique, rendant caduque l’utilisation des modèles linéaires gaussiens standard.
Sur le plan épistémologique, il est crucial de souligner la démarcation structurelle entre les processus continus gaussiens et les processus de comptage poissoniens. La loi normale, omniprésente dans l’enseignement introductif des statistiques, postule la continuité mathématique de la variable d’intérêt, une symétrie axiale stricte autour de la moyenne arithmétique et autorise, en théorie, des valeurs réelles négatives. Appliquer une distribution gaussienne à des données de comptage dont l’espérance est faible conduit inévitablement à des aberrations théoriques, telles que l’attribution d’une probabilité non nulle à des événements négatifs ou la sous-estimation dramatique de la probabilité d’événements extrêmes en queue de distribution. La loi de Poisson respecte intrinsèquement la positivité des entiers de comptage et capture fidèlement l’asymétrie positive caractéristique des phénomènes où les occurrences demeurent faibles face au champ des possibles.
1.3 Rôle et potentiel d’Excel pour le traitement des distributions discrètes
L’omniprésence du tableur Excel au sein des environnements d’entreprise et des laboratoires de recherche en sciences humaines en fait un vecteur privilégié pour l’application concrète des concepts probabilistes. Alors que l’apprentissage de plateformes d’analyse programmatique impose une barrière technique non négligeable liée à la syntaxe du code et à l’ingénierie logicielle, Excel démocratise l’analyse quantitative sans sacrifier la rigueur analytique fondamentale. Sa capacité à unifier la saisie brute des données, leur mise en forme tabulaire, le calcul probabiliste direct et la restitution graphique interactive offre un cadre d’exploration d’une efficacité redoutable pour les analystes.
Sur le plan de la métrologie algorithmique, le moteur de calcul d’Excel a fait l’objet d’améliorations significatives au fil de ses versions successives. Historiquement critiqué pour des imprécisions numériques lors de l’évaluation des queues de distributions statistiques ou lors de la manipulation de très grands nombres factoriels, le tableur implémente désormais des routines conformes aux standards de précision en virgule flottante double précision de la norme IEEE 754. L’évaluation conjointe des termes exponentiels décroissants et des puissances discrètes est stabilisée par des algorithmes optimisés qui évitent les dépassements de capacité arithmétique classiques lorsque les paramètres atteignent des valeurs substantielles.
Enfin, la force déterminante d’Excel réside dans sa connectivité native avec des bases de données de recherche structurées. L’analyste peut sans rupture logicielle alimenter des modèles probabilistes à partir de flux de données continus, intégrer des tableaux croisés dynamiques pour extraire les fréquences observées et recalculer instantanément les distributions de probabilités théoriques. Cette intégration fluide permet la construction de tableaux de bord décisionnels évolutifs, capables d’actualiser les prévisions de risques et les projections opérationnelles dès qu’une nouvelle vague d’observations empiriques est compilée dans le classeur.
2. Anatomie et syntaxe de la fonction LOI.POISSON.N dans Excel
2.1 Structure générale des arguments de la fonction
Au cœur de l’environnement Microsoft Excel, l’évaluation de la distribution de Poisson repose sur l’appel à une fonction standardisée introduite pour pérenniser l’exactitude des calculs : la fonction LOI.POISSON.N. Cette fonction s’articule autour d’une triade d’arguments précisément agencés dont la maîtrise conditionne la validité des résultats probabilistes obtenus. La formalisation syntaxique générale se présente sous la forme :
=LOI.POISSON.N(x; moyenne; cumulative)
Le premier argument, x, représente le nombre d’occurrences dont l’analyste cherche à déterminer la probabilité d’apparition. Bien que la loi de Poisson soit formellement définie pour les entiers naturels, cet argument admet l’injection de références cellulaires ou de constantes numériques. Si une valeur décimale est transmise par inadvertance, Excel procède automatiquement à sa troncature vers l’entier inférieur le plus proche, une convention technique qu’il convient de garder à l’esprit pour éviter des incohérences de calcul non signalées par le système.
Le deuxième argument, désigné par le terme moyenne au sein de la documentation francophone, correspond rigoureusement au paramètre d’intensité stochastique $lambda$ explicité dans les fondements mathématiques. Ce paramètre quantifie l’espérance mathématique du processus sur l’intervalle spatiotemporel retenu. Il doit s’agir impérativement d’une valeur numérique réelle strictement positive. Cet argument constitue l’élément d’échelle indispensable : un changement dans la fenêtre d’observation requiert une adaptation proportionnelle directe de cette moyenne avant son inclusion dans la formule.
Le troisième argument, cumulative, est un commutateur booléen qui dicte la nature même de la réponse renvoyée par le moteur de calcul. Si l’opérateur configure cet argument sur la valeur logique FAUX (ou la valeur numérique 0), la fonction renvoie la densité exacte de probabilité, autrement dit la probabilité ponctuelle P(X = x). Si l’argument est configuré sur la valeur logique VRAI (ou la valeur numérique 1), la fonction bascule en mode cumulatif et calcule la fonction de répartition, correspondant à la somme discrète des probabilités pour toutes les valeurs inférieures ou égales à x, soit P(X ≤ x). Cette dichotomie opératoire offre une modularité absolue pour l’analyse des risques continus et discrets.
2.2 Gestion des formats et compatibilité linguistique des arguments
L’utilisation d’Excel au sein d’environnements multilingues ou académiques internationaux requiert une vigilance accrue vis-à-vis de la translittération des fonctions et des séparateurs d’arguments. Dans les déclinaisons anglophones du tableur, la fonction correspondante est désignée sous la nomenclature POISSON.DIST. Lorsqu’un classeur est partagé entre des collaborateurs exploitant des versions linguistiques divergentes du système d’exploitation et d’Office, Excel assure une traduction dynamique transparente des noms de fonctions. Cependant, les séparateurs d’arguments obéissent rigoureusement aux paramètres régionaux du système hôte.
Dans la configuration francophone standard (système métrique et conventions typographiques continentales), le séparateur d’arguments obligatoire est le point-virgule (;), le séparateur décimal étant la virgule (,). À l’inverse, dans les environnements anglo-saxons ou au sein de configurations paramétrées selon les standards américains, les arguments sont séparés par des virgules (,) et les fractions décimales sont signalées par des points (.). La confusion de ces séparateurs engendre des erreurs d’analyse de formule bloquantes. L’instruction francophone standard :
=LOI.POISSON.N(A2; B2; FAUX)
se transcrit formellement en notation anglo-saxonne sous la syntaxe :
=POISSON.DIST(A2, B2, FALSE)
Une autre problématique opérationnelle récurrente concerne l’interaction entre les types de données numériques et les formats textuels. Si une cellule contenant le nombre d’occurrences ou la moyenne est malencontreusement formatée sous forme de texte (ce qui survient fréquemment lors d’imports bruts de fichiers CSV ou de bases SQL non nettoyées), la fonction renverra immédiatement un code d’erreur typologique. L’analyste doit veiller à forcer le format standard ou numérique sur l’intégralité des plages amont sollicitées par le modèle probabiliste.
2.3 Gestion des cas limites et conditions de validité mathématique
L’évaluation des fonctions statistiques sous Excel est encadrée par des garde-fous algorithmiques stricts destinés à empêcher l’émergence de non-sens probabilistes ou de singularités mathématiques. La première condition d’intégrité concerne la positivité absolue de la moyenne $lambda$. Si l’argument moyenne reçoit une valeur négative (inférieure à zéro), Excel interrompt le calcul et génère le code d’erreur #NOMBRE!. Une situation similaire survient si l’argument x est strictement inférieur à zéro : la distribution de Poisson n’étant définie que sur le domaine des entiers naturels positifs ou nuls, toute sollicitation d’un seuil d’occurrence négatif déclenche immédiatement cette même exception arithmétique.
Dans l’hypothèse spécifique où l’argument moyenne est exactement égal à zéro, le comportement mathématique d’un tel processus dégénéré impliquerait qu’aucun événement ne peut jamais survenir. Dans cette configuration singulière, la probabilité d’observer x = 0 devrait théoriquement être égale à 1, et la probabilité pour tout x > 0 devrait être nulle. Toutefois, le moteur de calcul d’Excel impose généralement une restriction stricte imposant $lambda > 0$, consignant toute valeur nulle au registre de l’erreur #NOMBRE! afin de prémunir les modèles contre des divisions par zéro sous-jacentes lors du calcul de distributions connexes.
Concernant les bornes supérieures, les capacités de calcul sont contraintes par la gestion interne des factorielles. La fonction factorielle conventionnelle sous Excel plafonne à la valeur 170! en raison de la limite de représentation numérique fixée à approximativement 1,7976931348623158 × 10308. Historiquement, tenter d’évaluer k! pour des valeurs de k > 170 entraînait un dépassement de capacité immédiat. Toutefois, l’architecture contemporaine de LOI.POISSON.N contourne cette limitation structurelle en évaluant la fonction de masse via des calculs logarithmiques intermédiaires, exploitant la fonction Gamma pour calculer ln(Γ(k + 1)) au lieu de développer la factorielle brute. Cela autorise l’évaluation de valeurs d’occurrences bien supérieures, bien qu’au-delà de certains seuils extrêmes de $lambda$ et de x, les erreurs de précision numérique recommandent d’opérer une transition vers l’approximation par la loi normale.
3. Calcul de probabilités ponctuelles exactes avec LOI.POISSON.N
3.1 Paramétrage de l’argument booléen FAUX pour les densités discrètes
L’estimation de probabilités ponctuelles exactes constitue le niveau d’analyse stochastique le plus élémentaire mais le plus crucial pour comprendre la distribution de masse d’un phénomène de comptage. Dans cette configuration, l’analyste ne s’intéresse pas à une enveloppe ou à un intervalle cumulatif, mais cherche à répondre à la question précise : « Quelle est la probabilité d’observer rigoureusement et exactement k réalisations de l’événement durant le cycle d’observation imparti ? ». Pour obtenir cette information analytique fondamentale, le troisième argument de la fonction LOI.POISSON.N doit être fixé sans équivoque sur FAUX.
L’expression fonctionnelle prend alors la tournure explicite :
=LOI.POISSON.N(k; lambda; FAUX)
Afin de valider la robustesse et la transparence des calculs exécutés par les boîtes noires algorithmiques du tableur, il est particulièrement instructif de comparer ce résultat natif avec une implémentation analytique directe décomposant la formule canonique de Siméon Denis Poisson à l’aide des fonctions mathématiques élémentaires d’Excel. En plaçant par exemple la valeur d’occurrence k en cellule A2 et le paramètre d’intensité $lambda$ en cellule B2, la formule développée suivante peut être saisie dans une cellule témoin :
=((B2^A2) * EXP(-B2)) / FACT(A2)
Cette vérification croisée démontre la parfaite congruence entre l’évaluation native de LOI.POISSON.N(A2; B2; FAUX) et la formulation analytique d’origine faisant appel aux fonctions EXP et FACT. Néanmoins, pour des valeurs de k excédant 170, la formule manuelle échoue inéluctablement en générant une erreur d’overflow sur la factorielle, tandis que la fonction native demeure pérenne grâce à son traitement en échelle logarithmique, illustrant la supériorité opérationnelle de la fonction statistique dédiée.
3.2 Cas pratique résolu : Vente et occurrences ponctuelles
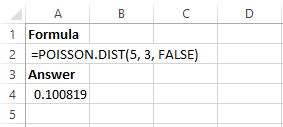
Afin d’ancrer cette méthodologie dans une réalité économique et décisionnelle concrète, analysons la situation d’un département logistique au sein d’une entreprise commercialisant des équipements biomédicaux à haute valeur ajoutée. L’historique d’exploitation rigoureusement compilé au cours des trois dernières années démontre que la demande pour un équipement d’imagerie spécifique présente une remarquable stabilité temporelle, caractérisée par une moyenne empirique de 3 unités vendues par mois civil (λ = 3). Le responsable de la planification logistique cherche à quantifier précisément la probabilité d’enregistrer une vente exacte de 5 équipements au cours du prochain mois, afin d’évaluer la pertinence de mobiliser des lignes d’assemblage dédiées sans risquer une immobilisation financière excessive.
Dans l’environnement de la feuille de calcul Excel, nous structurons les données en isolant les paramètres du modèle :
- Cellule A1 : Libellé « Espérance de vente (λ) », Cellule B1 : 3
- Cellule A2 : Libellé « Nombre d’unités cibles (k) », Cellule B2 : 5
- Cellule A3 : Libellé « Probabilité exacte P(X = 5) », Cellule B3 : =LOI.POISSON.N(B2; B1; FAUX)
L’exécution de cette formule génère un résultat numérique précis égal à 0,100818813, soit approximativement 10,08 %. Ce résultat probabiliste indique au gestionnaire qu’il existe une chance sur dix environ que la demande atteigne exactement 5 unités au cours du cycle mensuel standard. Sur le plan de la gouvernance logistique, ce chiffre démontre que bien que 5 représente une augmentation de près de 67 % par rapport à la demande centrale moyenne (3 unités), cette occurrence demeure dans un domaine de plausibilité stochastique significatif qui ne relève point de l’accident statistique. Une analyse de sensibilité démontre par ailleurs qu’une variation infinitésimale de la moyenne empirique (par exemple si $lambda$ passe de 3 à 3,2 sous l’effet d’une campagne promotionnelle) propulse immédiatement la probabilité de cette vente quintuple à 11,39 %, soulignant la sensibilité non linéaire des probabilités de queue discrète aux variations de l’espérance mathématique.
3.3 Automatisation matricielle des distributions de masse complètes
L’évaluation isolée d’un événement ponctuel ne fournit qu’une vision parcellaire de la dynamique stochastique globale. L’analyste rigoureux cherche invariablement à dresser la cartographie intégrale de la distribution de masse pour un spectre étendu de valeurs possibles de k. L’avènement des formules de tableau dynamique au sein des versions contemporaines de Microsoft Excel (notamment via le moteur de calcul d’Excel 365 et d’Office 2021) simplifie drastiquement cette construction matricielle, abolissant la nécessité de procéder à des recopies incrémentales manuelles vers le bas.
Pour générer l’ensemble de la distribution de probabilité pour un phénomène d’intensité $lambda = 4$ sur un horizon d’occurrences s’étendant de 0 à 15 événements, la démarche s’orchestre comme suit au sein d’une feuille vierge. En cellule A1, nous renseignons le paramètre $lambda$ avec la valeur 4. En cellule A4, nous injectons la fonction de génération de séquence matricielle :
=SEQUENCE(16; 1; 0; 1)
Cette instruction génère instantanément une colonne de 16 cellules adjacentes contenant les entiers séquentiels de 0 jusqu’à 15. En cellule B4, il suffit alors d’implémenter l’appel à la fonction de Poisson en faisant directement référence à la plage dynamique expansive par l’opérateur de propagation matricielle dièse (#) :
=LOI.POISSON.N(A4#; $A$1; FAUX)
D’un seul geste algorithmique, l’ensemble des 16 probabilités ponctuelles se déploie harmonieusement dans la colonne adjacente. Pour valider l’exhaustivité et la cohérence stochastique de cette table, l’application du premier axiome de Kolmogorov stipule que la somme de toutes les probabilités d’un espace probabilisé doit être rigoureusement égale à l’unité. En positionnant en cellule B21 la formule :
=SOMME(B4#)
Le tableur renvoie une valeur approchant 0,99999, confirmant que la troncature du spectre à 15 événements capture plus de 99,99 % de la masse probabiliste totale du processus sous-jacent, le reliquat résiduel infinitésimal étant consigné dans la queue de distribution asymptotique tendant vers l’infini.
4. Modélisation des probabilités cumulées unilatérales inférieures
4.1 Mécanisme de la fonction de répartition avec l’argument VRAI
L’ingénierie des processus, l’actuariat et l’analyse de risque s’intéressent rarement à la seule probabilité ponctuelle d’un événement isolé. Dans les situations d’exploitation réelle, la problématique cardinale s’articule quasi systématiquement autour de la capacité d’un système à absorber une charge globale sans rupture de service, ce qui revient à évaluer la probabilité que le nombre de sollicitations ne dépasse point un certain seuil critique k. Ce questionnement relève formellement du calcul de la fonction de répartition de la variable aléatoire, matérialisée par l’expression F(k) = P(X ≤ k).
Sur le plan mathématique, pour une variable aléatoire discrète de Poisson, la fonction de répartition s’obtient par la sommation discrète des probabilités ponctuelles depuis l’origine jusqu’à la borne supérieure k incluse :
P(X ≤ k) = ∑(i=0 à k) (λi × e-λ) / i!
Sous Excel, l’activation de ce mécanisme de sommation unilatérale s’effectue avec une remarquable simplicité en commutant le troisième argument de la fonction sur la valeur logique VRAI :
=LOI.POISSON.N(k; lambda; VRAI)
Ce calcul présente des propriétés mathématiques remarquables qu’Excel gère avec une précision constante. La fonction de répartition ainsi évaluée est intrinsèquement une fonction en escalier, monotone non décroissante, continue à droite et admettant des limites nulles en $-\infty$ et unitaire en $+\infty$. L’utilisation de l’argument cumulatif permet d’obtenir en une seule opération d’horloge machine un résultat probabiliste qui nécessiterait autrement la construction d’une matrice intermédiaire de cellules ponctuelles suivie d’une sommation agrégée, réduisant ainsi drastiquement la consommation de mémoire vive et les risques de décalage de plages cellulaires lors de manipulations structurelles du tableur.
4.2 Application à la gestion du risque et des capacités limites
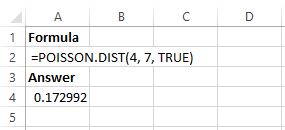
Pour illustrer la mise en œuvre de cette fonction cumulative au sein d’une problématique opérationnelle de gestion des capacités, considérons la direction d’un centre d’accueil psychologique d’urgence métropolitain. Les observations longitudinales indiquent que durant la plage horaire nocturne de crise (de 22h00 à 06h00), les appels d’urgence se conforment rigoureusement à un processus homogène de Poisson affichant une moyenne empirique de 8 appels par nuit (λ = 8). L’infrastructure actuelle permet de traiter simultanément et efficacement jusqu’à 11 appels au cours d’une vacation sans risquer d’abandon d’appel ou de mise en attente dommageable. L’analyste du service doit évaluer la probabilité que le système réponde adéquatement à la totalité de la demande sans subir de congestion saturante, soit P(X ≤ 11).
La structuration des calculs dans la feuille de calcul s’organise de la manière suivante :
- Cellule C1 : Valeur du paramètre d’intensité λ : 8
- Cellule C2 : Capacité nominale de traitement (k) : 11
- Cellule C3 : Probabilité d’absorption optimale : =LOI.POISSON.N(C2; C1; VRAI)
Le tableur délivre instantanément le résultat de 0,888075994, soit un taux de conformité opérationnelle d’approximativement 88,81 %. Une vérification pas à pas réalisée en sommant les probabilités ponctuelles individuelles générées pour les entiers 0, 1, 2, …, 11 confirme au quatorzième chiffre significatif la parfaite conformité du résultat renvoyé par le mode cumulatif interne. Grâce à cet indicateur probabiliste, la gouvernance de la structure sait que son dispositif actuel présente une marge de sécurité globale garantissant la couverture intégrale du service dans près de 89 % des vacations nocturnes, tout en révélant en creux un risque résiduel de saturation de 11,19 %, qui sera analysé à l’aide des probabilités de dépassement.
4.3 Probabilités strictes d’infériorité : modélisation de P(X < k)
Une source chronique d’erreurs méthodologiques chez les praticiens novices réside dans la confusion entre l’inégalité large (≤) et l’inégalité stricte (<). Dans le cadre des distributions statistiques continues, telles que la loi normale ou la loi de Student, la probabilité d’une valeur ponctuelle isolée est rigoureusement nulle (P(X = k) = 0), de sorte que P(X ≤ k) est rigoureusement identique à P(X < k). Au sein d’un univers probabiliste discret tel que celui régi par la loi de Poisson, cette équivalence s’effondre totalement, la masse de probabilité en un point entier donné étant strictement positive.
Si un analyste cherche à quantifier la probabilité qu’un système subisse strictement moins de k événements, intégrer la valeur k dans l’argument de la fonction cumulative constitue une erreur d’inclusion majeure qui faussera systématiquement les prédictions par excès. Puisque le domaine de définition de la variable est circonscrit à l’ensemble des entiers discrets non négatifs, l’événement X < k est stochastiquement équivalent à l’événement X ≤ k – 1. En conséquence, l’implémentation rigoureuse d’une probabilité d’infériorité stricte sous Excel impose impérativement la décrémentation préalable de l’argument du nombre d’événements :
=LOI.POISSON.N(k – 1; lambda; VRAI)
Pour illustrer l’impact quantitatif substantiel d’une telle omission, reprenons notre exemple du centre d’accueil d’urgence avec $lambda = 8$. Si l’on s’interroge sur la probabilité que la garde enregistre strictement moins de 6 appels, évaluer par erreur =LOI.POISSON.N(6; 8; VRAI) renvoie 0,313374 (31,34 %). En appliquant la formulation mathématiquement exacte =LOI.POISSON.N(6 – 1; 8; VRAI), qui s’évalue en =LOI.POISSON.N(5; 8; VRAI), le tableur restitue la valeur de 0,191236 (19,12 %). La différence absolue excède ici 12,2 points de pourcentage, une distorsion d’une telle magnitude pouvant conduire à des décisions de gestion des ressources humaines erronées lors de l’allocation des effectifs.
5. Évaluation des probabilités de dépassement et d’intervalles stricts
5.1 Formulation de la règle du complément pour P(X > k)
L’évaluation des événements de queue supérieure, souvent associés à des crises de saturation, des pannes industrielles majeures ou des dépassements de seuils critiques de tolérance, nécessite de quantifier la probabilité que le nombre d’occurrences excède strictement une borne déterminée, soit P(X > k). Les moteurs de calcul de tableurs ne disposent pas d’une fonction unilatérale droite native dédiée à la distribution de Poisson qui intégrerait directement cette queue supérieure. L’analyste doit impérativement convoquer l’axiome fondamental de complémentarité issu de la théorie des ensembles probabilistes.
L’événement « observer plus de k réalisations » étant le complémentaire probabiliste strict de l’événement « observer au maximum k réalisations », l’identité mathématique s’établit de façon incontestable par la relation suivante :
P(X > k) = 1 – P(X ≤ k)
La transposition algorithmique directe sous Excel s’exprime donc par la soustraction de la fonction de répartition cumulative unilatérale inférieure à la certitude unitaire :
=1 – LOI.POISSON.N(k; lambda; VRAI)
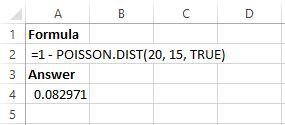
Cette structure de calcul constitue l’instrument prévisionnel par excellence pour dimensionner les marges d’urgence comportementales ou techniques. Dans un scénario clinique surveillant les épisodes d’agitation motrice sévère d’une cohorte où le taux moyen attendu est de 4 épisodes hebdomadaires, la probabilité d’assister à une décompensation marquée excédant 7 épisodes correspond à la formule =1 – LOI.POISSON.N(7; 4; VRAI), renvoyant la valeur de 0,051134 (environ 5,11 %). Si le seuil de tolérance de l’unité soignante est fixé à un risque de débordement de 5 %, le modèle indique immédiatement que l’organisation actuelle opère à la frontière critique de la rupture capacitaire.
5.2 Calcul de la condition d’au moins k événements : P(X >= k)
Dans un grand nombre de cahiers des charges industriels, de contrats de niveau de service (SLA) ou de protocoles expérimentaux, la préoccupation ne s’exprime point sous la forme d’un dépassement strict, mais sous la formulation conditionnelle suivante : « Quelle est la probabilité d’observer au moins k réalisations ? ». Sur le plan symbolique, cette interrogation correspond à l’inégalité large supérieure P(X ≥ k).
L’erreur structurelle classique consiste à substituer simplement le signe d’inégalité sans ajuster les frontières discrètes de l’ensemble d’inclusion. Puisque l’univers stochastique est constitué exclusivement d’entiers naturels, l’événement complémentaire strict de l’inégalité large X ≥ k n’est autre que X ≤ k – 1. En effet, l’événement X = k fait intrinsèquement partie intégrante de la cible recherchée et ne doit en aucun cas être retranché de l’unité par la fonction cumulative. La formulation théorique s’établit donc selon l’égalité :
P(X ≥ k) = 1 – P(X ≤ k – 1)
Au sein de la feuille de calcul Excel, cette démarche probabiliste se traduit par la formule standardisée :
=1 – LOI.POISSON.N(k – 1; lambda; VRAI)
Prenons le cas d’une centrale de traitement de données où l’incidence des déconnexions d’utilisateurs simultanés suit une loi de Poisson de paramètre d’intensité $lambda = 6$ incidents par heure. Pour déterminer la probabilité d’enregistrer au moins 4 déconnexions durant l’heure à venir, la formule à implémenter prend la forme explicite =1 – LOI.POISSON.N(4 – 1; 6; VRAI), ce qui équivaut à =1 – LOI.POISSON.N(3; 6; VRAI). Le résultat délivré par Excel est de 0,848796, soit 84,88 %. Si l’analyste avait omis la décrémentation unitaire de la borne en inscrivant par inadvertance =1 – LOI.POISSON.N(4; 6; VRAI), le résultat obtenu aurait été de 0,714943, masquant une probabilité de plus de 13,38 % et faussant l’évaluation du risque de surcharge de l’infrastructure réseau.
5.3 Mesure des probabilités bornées sur un intervalle fini : P(a <= X <= b)
L’estimation des probabilités circonscrites à un segment déterminé d’occurrences représente une problématique fréquente lors de l’établissement d’intervalles de confiance empiriques ou de corridors d’exploitation normale. Supposons qu’un analyste cherche à quantifier la probabilité que la variable de Poisson X prenne une valeur comprise inclusivement entre une borne inférieure a et une borne supérieure b (avec $a le b$), condition notée formellement P(a ≤ X ≤ b).
Le théorème de décomposition des fonctions de répartition discrètes démontre que cette probabilité d’intervalle fermé équivaut à la soustraction de la fonction de répartition à la borne inférieure stricte (soit la borne inférieure décrémentée d’une unité) de la fonction de répartition évaluée à la borne supérieure. La démonstration algébrique fondamentale se formule comme suit :
P(a ≤ X ≤ b) = P(X ≤ b) – P(X ≤ a – 1)
La transcription modulaire directe sous Microsoft Excel s’ordonne par la soustraction différentielle de deux fonctions de répartition cumulatives :
=LOI.POISSON.N(b; lambda; VRAI) – LOI.POISSON.N(a – 1; lambda; VRAI)
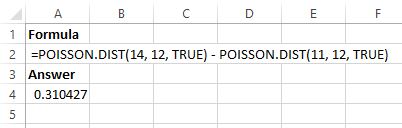
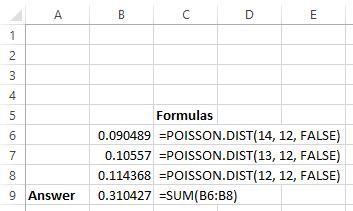
Examinons une illustration chiffrée. Supposons qu’un centre d’appels reçoive une moyenne de 12 demandes d’assistance technique par heure ($lambda = 12$). L’encadrement opérationnel souhaite mesurer la probabilité que le nombre d’appels reçus au cours d’une heure quelconque se maintienne dans un couloir optimal de productivité compris entre 8 et 14 appels inclusivement ($a = 8, b = 14$).
En assignant les paramètres aux cellules de la feuille de calcul (Borne $b$ en D1, Borne $a$ en D2, $lambda$ en D3), la formule combinatoire s’écrit rigoureusement :
=LOI.POISSON.N(D1; D3; VRAI) – LOI.POISSON.N(D2 – 1; D3; VRAI)
Ce qui correspond numériquement à l’évaluation différentielle :
LOI.POISSON.N(14; 12; VRAI) – LOI.POISSON.N(7; 12; VRAI)
Le tableur calcule la première composante à 0,772025 et la seconde à 0,089504, délivrant pour l’intervalle fermé une probabilité globale finale de 0,682521, soit environ 68,25 %. Afin de prévenir toute défaillance logique lors de la saisie utilisateur, il est vivement conseillé d’insérer des tests logiques préliminaires (à l’aide de la fonction SI) afin de vérifier que la condition d’ordre $b ge a ge 0$ est scrupuleusement honorée avant d’exécuter l’évaluation soustractive.
6. Rétrocompatibilité : Comparaison entre LOI.POISSON et LOI.POISSON.N
6.1 Évolution historique des algorithmes statistiques dans Excel
L’histoire de Microsoft Excel est jalonnée de refontes structurelles majeures touchant à son architecture mathématique. Avant la parution de la suite Microsoft Office 2010, l’évaluation de la distribution poissonienne dépendait d’une fonction ancestrale simplement libellée LOI.POISSON (ou POISSON en anglais). Bien que fonctionnelle sur les plages de valeurs conventionnelles, cette nomenclature historique souffrait d’un manque d’uniformité vis-à-vis des standards statistiques internationaux, notamment les référentiels de normalisation ISO/IEC relatifs aux terminologies scientifiques dans les systèmes logiciels.
Conscients des incohérences syntaxiques qui parasitaient les interactions entre ses fonctions de lois de probabilités (certaines distributions intégrant un point dans leur nom, d’autres non), les développeurs de Microsoft ont procédé à partir d’Office 2010 à une harmonisation systématique de la bibliothèque statistique. Cette démarche a vu naître la collection de fonctions dotées du suffixe « .N », symbolisant la nouvelle génération d’algorithmes statistiques conformes aux exigences accrues de précision computationnelle. Dans ce nouveau cadre, LOI.POISSON.N a été instituée en tant que fonction de référence standardisée.
Toutefois, en vertu du principe de conservation absolue de la rétrocompatibilité des classeurs patrimoniaux, Microsoft a délibérément maintenu l’ancienne fonction LOI.POISSON au sein d’une catégorie dédiée aux fonctions de compatibilité. Si un utilisateur ouvre aujourd’hui une feuille de calcul conçue sous Excel 2003, les formules anciennes continuent de s’exécuter sans générer d’interruption logicielle. Pour autant, cette coexistence pacifique ne doit pas masquer les évolutions sous-jacentes : sous le capot, les routines de calcul ont été substantiellement optimisées pour fiabiliser le comportement algorithmique au niveau des queues asymptotiques des distributions.
6.2 Différences de précision numérique et instabilités potentielles
La distinction entre l’ancienne implémentation LOI.POISSON et l’actuelle LOI.POISSON.N dépasse la simple cosmétique lexicale. Elle touche à la stabilité algorithmique face aux cas d’évaluation extrêmes. Dans les déclinaisons patrimoniales antérieures à Excel 2010, les routines internes de sommation pour l’argument cumulatif VRAI reposaient sur des algorithmes itératifs simples qui cumulaient des erreurs d’arrondi machine lorsque le paramètre $lambda$ devenait très grand, ou lorsque le nombre d’itérations de factorielles induisait des pertes de précision significatives sur les derniers bits de mantisse.
Ces imprécisions numériques devenaient particulièrement visibles lors de l’évaluation de valeurs extrêmes en queue de distribution unilatérale droite. Lorsque la fonction devait renvoyer des probabilités cumulées infinitésimales (par exemple des probabilités de dépassement situées en deçà de 10-12), l’ancienne routine pouvait produire des aberrations de troncature prématurée ou des retours à zéro anticipés, faussant les calculs actuariels de couverture de risques d’événements rarissimes. LOI.POISSON.N exploite des techniques d’évaluation numérique révisées basées sur la fonction Gamma incomplète régularisée, garantissant une préservation de la précision numérique jusqu’aux limites structurelles du format virgule flottante double précision.
Par ailleurs, la portabilité et la longévité des modèles tabulaires élaborés au sein des institutions contemporaines exigent de purger les dépendances techniques vis-à-vis des fonctions dépréciées. Bien que Microsoft maintienne le support des anciennes fonctions, aucune garantie de performance ou d’optimisation sur les architectures matérielles modernes n’est accordée à ces modules hérités, qui sont exclus des gains de vitesse procurés par le recalcul multithread et les optimisations vectorielles du moteur de tableau dynamique moderne.
6.3 Recommandations de standardisation académique des modèles
Dans le contexte des publications académiques évaluées par des pairs, des thèses doctorales ou des rapports d’expertise destinés à des comités d’audit réglementaires (tels que les exigences imposées par la Food and Drug Administration pour les essais cliniques ou les accords de Bâle pour l’exposition aux risques bancaires), l’emploi d’outils analytiques désuets constitue un motif d’interrogation méthodologique direct. L’utilisation d’une syntaxe périmée telle que LOI.POISSON trahit fréquemment un défaut de mise à jour des compétences techniques ou l’usage de classeurs hérités non validés méthodologiquement.
Il est dès lors formellement préconisé d’instaurer des protocoles de standardisation au sein des laboratoires et des équipes de recherche. Cela passe par l’implémentation d’audits systématiques des classeurs partagés. Pour identifier et éradiquer les résidus de fonctions obsolètes, l’analyste peut solliciter les outils d’audit natifs d’Excel, ou exécuter une recherche textuelle globale au sein des formules du classeur en ciblant le motif textuel « LOI.POISSON( » pour le substituer systématiquement par « LOI.POISSON.N( ».
De surcroît, les environnements collaboratifs modernes doivent configurer des masques de saisie et des règles de validation stricts. Si des scripts d’automatisation VBA ou des extensions en langage Office Scripts sont déployés, ceux-ci doivent interdire l’appel aux anciennes propriétés de l’objet WorksheetFunction.Poisson et exiger la liaison explicite vers WorksheetFunction.Poisson_Dist. Cette rigueur algorithmique garantit non seulement l’exactitude des résultats statistiques présentés, mais immunise également l’organisation contre des défaillances de compatibilité futures lors des migrations logicielles majeures.
7. Visualisation graphique de la distribution de Poisson dans Excel
7.1 Conception d’un diagramme en bâtons pour la fonction de masse
La communication scientifique et l’appropriation des résultats probabilistes par des parties prenantes non mathématiciennes passent impérativement par une restitution graphique irréprochable. La fonction de masse de probabilité d’une variable aléatoire discrète ne doit en aucun cas être représentée sous la forme d’une courbe continue et lissée, ce qui constituerait un contresens sémiologique flagrant en laissant supposer l’existence d’états d’occurrence fractionnaires continus. La visualisation standardisée d’une loi discrète requiert le recours exclusif au diagramme en bâtons ou à l’histogramme personnalisé à colonnes étroites disjointes.
Pour concevoir un diagramme de masse rigoureux sous Microsoft Excel, il convient d’agencer méthodiquement les données tabulaires. Supposons une plage d’occurrences k s’étalant de 0 à 12 en colonne A (cellules A2:A14), et les probabilités ponctuelles correspondantes évaluées via =LOI.POISSON.N(A2; 3; FAUX) en colonne B (cellules B2:B14). La procédure de conception graphique se déroule selon les étapes suivantes :
- Sélectionner l’ensemble de la plage de données calculée (A2:B14).
- Accéder au ruban Insertion du tableur, localiser la section des graphiques et sélectionner Insérer un histogramme ou un graphique à barres, puis choisir le format Histogramme 2D groupé.
- Faire un clic droit sur l’une des barres verticales générées et sélectionner Mettre en forme une série de données dans le menu contextuel.
- Dans le panneau latéral d’ajustement, modifier la valeur de l’option Largeur du coup d’œil (ou Largeur de l’intervalle) pour la positionner entre 100 % et 200 %, de sorte que les colonnes apparaissent nettement disjointes, matérialisant visuellement la discontinuité fondamentale du domaine de comptage.
- Éliminer tout lissage artificiel ou effet tridimensionnel déformant, ajuster le titre du graphique en stipulant explicitement la valeur du paramètre λ retenu, et labelliser l’axe des abscisses avec la nomenclature « Nombre d’occurrences (k) » et l’axe des ordonnées par « Probabilité P(X = k) ».
7.2 Représentation de la fonction de répartition en escalier
La visualisation de la fonction de répartition cumulative F(k) = P(X ≤ k) impose une contrainte géométrique différente. Étant donné que la fonction de répartition d’une variable aléatoire discrète demeure rigoureusement constante entre deux entiers consécutifs et accuse un saut de discontinuité vertical à chaque incrémentation entière, la représentation graphique exacte prend la forme d’un tracé en escalier (fonction dite « en marches d’escalier »). Un simple tracé linéaire reliant les points par des segments obliques est méthodologiquement incorrect, car il suggère une progression continue de la probabilité cumulée entre deux valeurs discrètes successives.
Pour construire ce tracé en marches d’escalier sous Excel sans recourir à des outils externes de programmation graphique, l’analyste doit doubler artificiellement les coordonnées de chaque point au sein de sa table de données source :
- Pour chaque modalité entière k, insérer deux lignes consécutives dans la table d’ordonnées graphiques.
- La première ligne reçoit l’abscisse k et l’ordonnée cumulée précédente F(k – 1).
- La seconde ligne reçoit l’abscisse k et la nouvelle ordonnance cumulée actualisée F(k) calculée par =LOI.POISSON.N(k; lambda; VRAI).
Une fois cette architecture de coordonnées étagée élaborée, il suffit d’insérer un graphique de type Nuage de points avec lignes droites (sans lissage spline). Le résultat visuel affiche une succession parfaite de paliers horizontaux interconnectés par des lignes de discontinuité verticales orthogonales. Pour enrichir la portée analytique de cette figure, il est pertinent d’ajouter des lignes de référence horizontales ponctuelles (matérialisées par des tracés en pointillés) indiquant les seuils probabilistes cardinaux de 0,50 (médiane stochastique théorique), ainsi que les centiles d’alerte à 0,95 ou 0,99, facilitant l’identification visuelle immédiate des seuils de criticité du modèle.
7.3 Création d’un tableau de bord dynamique avec curseur de paramètre
L’un des apports majeurs d’Excel réside dans son interactivité, permettant de transformer un modèle statistique statique en un simulateur décisionnel visuel en temps réel. Cette fonctionnalité se révèle particulièrement didactique pour observer la convergence asymptotique de la loi de Poisson : à mesure que le paramètre d’intensité $lambda$ croît, la distribution perd son asymétrie initiale prononcée pour converger progressivement vers une forme campaniforme symétrique caractéristique de la loi normale, conformément aux prédictions du théorème central limite.
L’orchestration d’un tel tableau de bord s’articule autour de l’utilisation d’un composant d’interface utilisateur natif, la barre de défilement (curseur interactif) :
- Activer l’onglet Développeur dans les options de ruban d’Excel si celui-ci n’est point apparent.
- Cliquer sur Insérer dans le groupe Contrôles, puis sélectionner le contrôle de formulaire Barre de défilement. Dessiner le composant au-dessus de la zone graphique.
- Effectuer un clic droit sur le composant, choisir Format de contrôle, et lier le curseur à une cellule cible maîtresse, par exemple $F$1. Configurer la valeur minimale à 1 et la valeur maximale à 30, avec un incrément unitaire de 1.
- Associer la cellule du paramètre $lambda$ (disons A1) à la cellule maîtresse $F$1 par une liaison directe =F1 (ou =F1/10 si l’on désire manipuler des intensités décimales fractionnaires).
- Lier la table de probabilités de masse à la cellule A1 via la formule matricielle dynamique vue en section 3.3.
Dès lors, en manipulant horizontalement le curseur graphique à l’aide de la souris, l’utilisateur déclenche le recalcul instantané de l’intégralité du moteur matriciel. L’histogramme associé s’anime dynamiquement : pour $lambda = 1$, la distribution accuse une chute exponentielle abrupte avec un mode culminant en $k = 0$ et $k = 1$ ; pour $lambda = 5$, une asymétrie droite résiduelle persiste ; tandis que pour $lambda ge 15$, le graphique déploie sous les yeux des décideurs une courbe en cloche d’une parfaite symétrie axiale, concrétisant visuellement les fondements de la théorie stochastique.
8. Ajustement d’une distribution de Poisson à des données empiriques
8.1 Estimation ponctuelle du paramètre lambda par le maximum de vraisemblance
L’utilisation de la loi de Poisson dans une démarche scientifique empirique impose une démarche inverse à celle de la simulation : confronté à une série brute de comptages observés sur le terrain, le chercheur doit estimer la valeur du paramètre $lambda$ qui décrit avec la plus grande fidélité la dynamique stochastique sous-jacente. La méthode d’estimation paramétrique de référence en statistique inférentielle est la méthode du maximum de vraisemblance.
La fonction de log-vraisemblance d’un échantillon indépendant et identiquement distribué de n observations de comptage $(x_1, x_2, dots, x_n)$ sous l’hypothèse d’une loi de Poisson s’établit par l’équation :
ln L(λ) = ∑(i=1 à n) [ xi × ln(λ) – λ – ln(xi!) ]
En dérivant analytiquement cette log-vraisemblance par rapport à $lambda$ et en annulant l’équation différentielle résultante pour déterminer l’optimum, on démontre rigoureusement que l’estimateur du maximum de vraisemblance, noté $\hat{\lambda}$, n’est autre que la moyenne arithmétique simple de l’échantillon observé :
λ̂ = x̄ = (1 / n) × ∑(i=1 à n) xi
Sous Excel, l’estimation opérationnelle de $\hat{\lambda}$ s’obtient donc immédiatement en appliquant la fonction native de moyenne statistique sur la plage contenant les observations brutes, par exemple =MOYENNE(A2:A500). Concomitamment, l’analyste doit impérativement évaluer la variance empirique de cette même série brute en invoquant la fonction d’estimation de variance sans biais =VAR.S(A2:A500). Cette démarche conjointe constitue le premier diagnostic exploratoire d’adéquation : si la variance calculée dévie de manière macroscopique par rapport à la moyenne empirique, l’hypothèse fondamentale d’équidispersance est compromise, suggérant qu’un ajustement de Poisson pur constituera une modélisation potentiellement lacunaire.
8.2 Calcul des effectifs théoriques attendus sous hypothèse de Poisson
Une fois le paramètre $\hat{\lambda}$ formellement estimé à partir de la moyenne empirique de l’échantillon d’effectif total N, l’étape subséquente consiste à construire la table de contingence confrontant les effectifs empiriquement observés pour chaque classe de comptage k aux effectifs théoriques prédits par le modèle mathématique de Poisson sous l’hypothèse nulle d’adéquation parfaite.
La méthodologie tabulaire se déploie selon la logique computationnelle suivante :
- Lister dans une colonne dédiée l’ensemble des modalités observées de comptage k (par exemple de 0 à la valeur maximale observée dans l’échantillon).
- Déterminer l’effectif observé réel pour chaque classe en utilisant la fonction matricielle ou de comptage conditionnel =NB.SI(Plage_Donnees; k).
- Calculer la probabilité théorique d’occurrence pour chaque niveau k à l’aide de la fonction exacte =LOI.POISSON.N(k; lambda_estime; FAUX).
- Générer l’effectif théorique attendu, noté $E_k$, en multipliant la probabilité théorique modale par la taille totale de l’échantillon $N$ :
Ek = N × P(X = k)
Formule sous Excel : =$N$1 * LOI.POISSON.N(k; $lambda$1; FAUX).
Une précaution méthodologique cardinale doit être observée lors de cette étape : pour la dernière classe de comptage représentée, il ne faut point utiliser la densité ponctuelle mais la probabilité cumulative supérieure d’intervalle ouvert P(X ≥ k_{max}), obtenue via =1 – LOI.POISSON.N(k_{max} – 1; lambda_estime; VRAI). Cette opération garantit que la somme des probabilités théoriques est rigoureusement égale à 100 %, et que la somme des effectifs théoriques égale exactement l’effectif réel N de l’échantillon étudié, préservant la validité des degrés de liberté du test ultérieur.
8.3 Test d’adéquation du Khi-deux d’ajustement sous Excel
La décision formelle de valider ou de rejeter l’adéquation de la distribution de Poisson aux données d’observation empiriques repose sur un protocole d’inférence d’ajustement du test du Khi-deux (χ² de Pearson). Ce test statistique quantifie la distance quadratique normalisée entre les effectifs observés $O_k$ et les effectifs théoriques attendus $E_k$.
La statistique de test globale se formule analytiquement selon l’expression canonique :
χ2 = ∑(k) [ (Ok – Ek)2 / Ek ]
Sous Excel, l’analyste crée une colonne adjacente évaluant pour chaque ligne le résidu quadratique pondéré : =((O_k – E_k)^2) / E_k, puis effectue la sommation intégrale de cette colonne via la fonction SOMME() pour obtenir la valeur de la statistique de test calculée, notée $\chi^2_{calc}$.
Cependant, l’application valide du test asymptotique du Khi-deux impose le respect strict de la condition de Cochran : aucun effectif théorique attendu ne doit être strictement inférieur à 1, et pas plus de 20 % des classes ne doivent présenter un effectif théorique inférieur à 5. Si cette condition est violée dans les queues de distribution (ce qui est systématique pour les valeurs de comptage élevées), l’analyste doit procéder au regroupement des classes contiguës adjacentes jusqu’à atteindre le seuil critique d’effectif requis ($E_k ge 5$).
La détermination des degrés de liberté (ddl) obéit à la règle de déduction paramétrique :
ddl = C – 1 – p
Où C représente le nombre final de classes après regroupement des effectifs faibles, la constante 1 sanctionne la contrainte de sommation des effectifs à N, et p représente le nombre de paramètres distributionnels estimés à partir des données empiriques. La loi de Poisson ne dépendant que du seul paramètre $lambda$, on a $p = 1$. L’équation devient donc :
ddl = C – 2
Pour statuer sur la significativité statistique sous Excel, l’analyste calcule la p-valeur asymptotique à l’aide de la fonction unilatérale droite intégrée :
=LOI.KHIDEUX.DROITE(statistique_chi2; ddl)
Si la p-valeur résultante est strictement supérieure au seuil de significativité conventionnel de 5 % ($\alpha = 0,05$), l’analyste ne peut rejeter l’hypothèse nulle ($H_0$) : les fluctuations entre observations et prédictions sont attribuables aux seules variations stochastiques d’échantillonnage, et la loi de Poisson constitue un modèle statistiquement recevable pour décrire le phénomène étudié.
9. Applications pratiques en recherche quantitative et psychométrie
9.1 Modélisation des comportements aberrants ou infractions cliniques
Au sein des dispositifs de surveillance épidémiologique et de psychométrie clinique, l’analyse d’événements comportementaux transgressifs ou aberrants (tels que des passages à l’acte impulsifs, des crises d’angoisse panique ou des épisodes d’automutilation légère au sein d’unités de psychiatrie institutionnelle) constitue un domaine d’élection pour le modèle de Poisson. La plupart des résidents ne manifestent que très rarement ces comportements, tandis qu’une fraction marginale d’individus concentre des occurrences répétées.
L’enjeu méthodologique réside dans la capacité à fixer un seuil d’alerte statistique objectif distinguant les fluctuations stochastiques inhérentes au bruit de fond comportemental régulier des ruptures pathologiques authentiques nécessitant une révision du protocole thérapeutique. En ajustant une loi de Poisson sur l’ensemble de la cohorte suivie, l’analyste calcule le taux d’occurrence moyen d’épisodes par patient et par mois (disons $lambda = 1,4$).
Pour déterminer le seuil d’anomalie correspondant au 99e centile stochastique, la fonction de répartition est sollicitée. L’analyste recherche la plus petite valeur entière k satisfaisant à l’inégalité de sécurité :
LOI.POISSON.N(k; 1,4; VRAI) ≥ 0,99
Une simple table d’évaluation incrémentale sous Excel révèle que pour $k = 4$, la probabilité cumulée atteint 0,9857 (soit 98,57 %), tandis que pour $k = 5$, elle franchit le seuil en culminant à 0,9968 (99,68 %). Par conséquent, observer 5 épisodes ou plus chez un sujet au cours d’un mois civil constitue un événement dont la probabilité stochastique sous l’hypothèse d’homogénéité est inférieure à 1 %. Ce résultat déclenche automatiquement un statut d’alerte clinique étayé mathématiquement, écartant l’arbitraire subjectif des évaluations qualitatives traditionnelles.
9.2 Analyse des temps d’arrêt et d’attente : Lien avec la loi exponentielle
L’un des théorèmes de dualité stochastique les plus fondamentaux établit un pont mathématique indissoluble entre le processus de comptage discret de Poisson et la distribution temporelle continue des intervalles séparant les événements consécutifs. Si le nombre d’occurrences d’un phénomène au sein d’une unité de temps suit rigoureusement une distribution de Poisson d’intensité $lambda$, alors la variable aléatoire continue T mesurant le temps écoulé entre deux événements successifs suit obligatoirement une loi exponentielle de paramètre d’échelle identique $lambda$.
Cette convergence théorique offre un puissant moyen de triangulation méthodologique au sein d’Excel. Si un protocole expérimental enregistre les durées inter-événements (exprimées en heures ou en minutes), l’analyste peut vérifier la cohérence du modèle poissonien en soumettant les intervalles temporels à la fonction native :
=LOI.EXPONENTIELLE.N(t; lambda; cumulative)
L’espérance mathématique du temps d’attente inter-événements est donnée par l’inverse du paramètre d’intensité du processus :
E(T) = 1 / λ
Supposons qu’un système d’assistance téléphonique reçoive un flux poissonien caractérisé par $lambda = 15$ sollicitations par heure. Le temps d’attente moyen entre deux appels consécutifs s’établit mécaniquement à $1 / 15$ d’heure, soit exactement 4 minutes. Si le régulateur souhaite déterminer la probabilité qu’un opérateur bénéficie d’un répit d’au moins 10 minutes (soit $10/60 = 0,1667$ heure) avant le prochain appel, il utilise la propriété de survie exponentielle sous Excel :
=1 – LOI.EXPONENTIELLE.N(10/60; 15; VRAI)
L’évaluation délivre immédiatement la valeur de 0,082085 (environ 8,21 %). Cette articulation bidirectionnelle entre comptages discrets poissoniens et durées continues exponentielles au sein d’un même classeur permet d’unifier l’analyse des capacités et celle des temps d’attente sans rupture d’hypothèses stochastiques.
9.3 Simulation d’efficacité organisationnelle en milieu hospitalier
L’optimisation des structures hospitalières d’urgence contemporaines est confrontée au paradoxe permanent de la maîtrise budgétaire et de l’obligation de prise en charge immédiate sans mise en péril vitale. L’application de la modélisation de Poisson sous Excel permet de concevoir des matrices d’aide à la décision RH capables de dimensionner les équipes médicales de garde au plus près des impératifs probabilistes.
Considérons une unité hospitalière psychiatrique dont le flux d’admissions nocturnes en situation de crise se conforme à une distribution de Poisson d’intensité moyenne $lambda = 5,2$ patients par tranche de garde de 8 heures. Chaque médecin de garde peut administrer simultanément et en toute sécurité l’admission médicale, l’évaluation psychométrique et la stabilisation pharmacologique d’un maximum de 2 patients au cours de sa vacation.
La direction cherche à déterminer le nombre optimal de médecins d’astreinte sur site, noté M, afin que le risque de saturation collective de l’équipe ne dépasse sous aucun prétexte le seuil toléré de 5 % ($P(\text{Saturation}) le 0,05$). La capacité maximale d’absorption de l’équipe s’exprime linéairement par $C(M) = 2 \times M$ patients. Le modèle requiert donc la résolution de l’inégalité de dépassement :
P(X > 2M) = 1 – P(X ≤ 2M) ≤ 0,05
Ce qui revient formellement à satisfaire la condition de couverture cumulée unilatérale :
LOI.POISSON.N(2M; 5,2; VRAI) ≥ 0,95
L’analyste implémente cette évaluation sous forme tabulaire dans la feuille de calcul Excel :
- Pour $M = 2$ praticiens (Capacité = 4 patients) : =LOI.POISSON.N(4; 5,2; VRAI) → Probabilité de non-saturation = 0,4061 (Risque de crise = 59,39 %). Configuration inacceptable.
- Pour $M = 3$ praticiens (Capacité = 6 patients) : =LOI.POISSON.N(6; 5,2; VRAI) → Probabilité de non-saturation = 0,7324 (Risque de crise = 26,76 %). Configuration insuffisante.
- Pour $M = 4$ praticiens (Capacité = 8 patients) : =LOI.POISSON.N(8; 5,2; VRAI) → Probabilité de non-saturation = 0,9181 (Risque de crise = 8,19 %). Configuration proche mais non conforme au critère de 5 %.
- Pour $M = 5$ praticiens (Capacité = 10 patients) : =LOI.POISSON.N(10; 5,2; VRAI) → Probabilité de non-saturation = 0,9832 (Risque de crise = 1,68 %). Seuil de sécurité validé.
Cette démonstration empirique révèle que la présence de 5 praticiens de garde est indispensable pour cantonner le risque de submersion stochastique en deçà de 5 %. Grâce à ce tableau prospectif articulé sur la loi de Poisson, la gouvernance médicale dispose d’un argumentaire quantitatif opposable lors des négociations budgétaires, transformant l’incertitude stochastique en un paramètre de gouvernance opérationnelle rigoureusement chiffré.
10. Diagnostic des violations d’hypothèses : Surdispersion et alternatives
10.1 Identification mathématique de l’hétérogénéité non observée
L’application non critique de la loi de Poisson à des jeux de données empiriques constitue l’un des pièges statistiques les plus pernicieux en modélisation appliquée. La condition fondamentale d’équidispersance ($Var(X) = E(X) = lambda$) repose sur l’hypothèse implicite que la population étudiée est parfaitement homogène, chaque individu ou unité spatiale partageant rigoureusement le même paramètre d’intensité stochastique latent $lambda$. Dans les données observationnelles réelles, cette homogénéité est quasi systématiquement violée en raison de variables confondantes non observées ou de dynamiques de contamination stochastique sous-jacentes.
Lorsque la variance de l’échantillon empirique excède de façon substantielle son espérance arithmétique, le phénomène est qualifié de surdispersion (ou overdispersion). Pour quantifier formellement cette distorsion structurelle sous Excel, l’analyste évalue l’indice de dispersion de Fisher, noté $ID$, défini par le rapport direct de la variance empirique sur la moyenne de l’échantillon :
ID = Var(X) / E(X)
Sous la syntaxe du tableur, en supposant les données de comptage brutes situées en plage A2:A300 :
=VAR.S(A2:A300) / MOYENNE(A2:A300)
Dans un processus de Poisson idéal, cet indice gravite étroitement autour de la valeur unitaire ($ID \approx 1$). Si l’indice de dispersion calculé franchit des seuils de l’ordre de 1,5 ou davantage, l’hypothèse d’équidispersance est formellement compromise. Les répercussions statistiques de cette violation sont majeures : maintenir aveuglément un modèle de Poisson pur sur un échantillon surdispersé induit une sous-estimation massive des erreurs-types des estimateurs, un rétrécissement artificiel des intervalles de confiance et une inflation dramatique du taux d’erreur de première espèce ($\alpha$), conduisant à décréter statistiquement significatifs des effets purement aléatoires.
10.2 Recours à la loi binomiale négative comme solution de repli
Lorsque le diagnostic exploratoire confirme une surdispersion structurelle irréductible, la méthodologie statistique prescrit d’abandonner la loi de Poisson simple au profit d’un modèle d’accueil stochastique plus flexible : la loi binomiale négative. Sur le plan théorique fondamental, la distribution binomiale négative peut être conceptualisée comme un modèle de mélange continu dit « Gamma-Poisson ». Sous cette spécification, le paramètre d’intensité $lambda$ n’est plus une constante déterministe fixe, mais est lui-même appréhendé comme une variable aléatoire continue suivant une distribution Gamma, capturant ainsi l’hétérogénéité individuelle non mesurée de l’échantillon.
La distribution binomiale négative réintroduit un paramètre supplémentaire d’hétérogénéité ou de dispersion, généralement noté $\theta$ ou $r$, permettant à la variance de s’accroître librement de manière quadratique en fonction de la moyenne :
Var(X) = μ + (μ2 / r)
Microsoft Excel intègre nativement l’évaluation de cette distribution de secours par l’intermédiaire de la fonction :
=LOI.BINOMIALE.NEG.N(nombre_echecs; nombre_succes; probabilite_succes; cumulative)
Bien que la paramétrisation originale de la fonction sous Excel fasse historiquement référence au nombre de succès et d’échecs au sein d’un schéma d’épreuves de Bernoulli répétées, il est aisé de reparamétrer ces arguments pour modéliser des comptages surdispersés en liant la moyenne $\mu$ et la variance $Var$ aux composantes de la fonction :
probabilite_succes = μ / Var
nombre_succes (r) = μ2 / (Var – μ)
En substituant cette formulation ajustée à la fonction LOI.POISSON.N dans les tableaux d’ajustement du Khi-deux examinés précédemment, l’analyste constate fréquemment un affaissement significatif de la statistique de discordance et une élévation de la p-valeur, validant le fait que la loi binomiale négative réconcilie le modèle prédictif avec la dispersion réelle des données observées.
10.3 Traitement de l’excès de zéros (Zero-Inflation)
Une pathologie distributionnelle encore plus spécifique des données de comptage observationnelles réside dans l’inflation de zéros (phénomène de Zero-Inflation). Cette situation émerge fréquemment en psychométrie comportementale ou en criminologie, lorsqu’une part substantielle de la population générale ne présente aucune propension latente à manifester l’acte étudié (générant des « zéros structurels »), tandis qu’une sous-population vulnérable participe au processus stochastique poissonien et peut enregistrer des scores nuls ou positifs (générant des « zéros stochastiques »).
Une distribution de Poisson standard échoue systématiquement à capturer cette accumulation bimodale à l’origine, sous-estimant la probabilité d’occurrence du zéro tout en surestimant celle des petites valeurs positives. Pour modéliser ce comportement sans quitter l’environnement de calcul d’Excel, l’analyste peut concevoir un modèle Poisson gonflé en zéros (Zero-Inflated Poisson ou ZIP) artisanal décomposé en deux étages probabilistes interconnectés à l’aide de la fonction conditionnelle SI.
Le modèle stipule qu’avec une probabilité $\omega$, l’observation est un zéro certain structurel, et avec une probabilité $(1 – \omega)$, l’observation est issue d’une loi de Poisson standard de paramètre $lambda$. La distribution résultante pour la modalité nulle s’exprime par :
P(X = 0) = ω + (1 – ω) × e-λ
Et pour toute valeur strictement positive ($k > 0$) :
P(X = k) = (1 – ω) × [ (λk × e-λ) / k! ]
Sous Excel, l’analyste structure sa feuille en isolant le paramètre de sur-zéro $\omega$ en cellule B1, et le paramètre $lambda$ en cellule B2. La formule pour une classe d’occurrence k renseignée en cellule A5 s’écrit formellement :
=SI(A5=0; $B$1 + (1 – $B$1) * EXP(-$B$2); (1 – $B$1) * LOI.POISSON.N(A5; $B$2; FAUX))
Cette décomposition modulaire élégante permet de calibrer un modèle à deux composantes au sein du tableur, offrant un ajustement d’une précision remarquable pour les séries statistiques lourdement chargées en scores nuls que les algorithmes standards ignorent.
11. Génération de variables aléatoires et simulation de Poisson sous Excel
11.1 Méthode d’inversion empirique par recherche dichotomique
L’évaluation analytique des formules closes ne constitue qu’un pan de l’analyse stochastique appliquée. L’autre versant réside dans la simulation numérique de trajectoires aléatoires (méthodes stochastiques de Monte-Carlo), indispensables pour tester la robustesse d’un système face à l’imprévu. Si Excel intègre un générateur pseudo-aléatoire uniforme standard via la fonction ALEA(), il ne dispose point d’une fonction native directe nommée ALEA.POISSON() capable d’échantillonner spontanément des entiers poissoniens.
Pour combler cette lacune sans recourir à la programmation d’extensions complexes, la démarche méthodologique la plus directe repose sur le principe de la méthode d’inversion de la fonction de répartition. Puisque la fonction de répartition cumulative F(k) = P(X ≤ k) est monotone croissante et bornée sur l’intervalle [0, 1], il est possible d’échantillonner un nombre pseudo-aléatoire uniforme $u \sim \mathcal{U}(0, 1)$ et de lui associer le plus petit entier k satisfaisant à la condition d’inversion $F(k) ge u$.
Pour déployer cette technique sur une feuille de calcul Excel :
- Construire dans une plage dédiée (disons M2:N20) une table de recherche de référence. La colonne M contient les valeurs de comptage k (de 0 à 18), et la colonne N compile les probabilités cumulées correspondantes évaluées par =LOI.POISSON.N(M2; lambda; VRAI).
- Décaler d’une ligne les bornes cumulées pour former des intervalles disjoints, ou utiliser directement la recherche dichotomique descendante.
- Dans la cellule où l’on désire générer le tirage aléatoire de Poisson, combiner la fonction d’extraction matricielle et le générateur uniforme :
=EQUIV(ALEA(); N2:N20; 1)
ou utiliser une formule combinée à base de RECHERCHEX configurée avec le mode de correspondance sur le premier élément supérieur :
=RECHERCHEX(ALEA(); N2:N20; M2:M20; ; 1)
Chaque recalcul de la feuille de calcul génère instantanément un nouvel échantillon aléatoire rigoureusement conforme à la distribution théorique prescrite par le paramètre $lambda$.
11.2 Algorithme multiplicatif de Knuth pour tirages discrets directs
Pour s’affranchir de la dépendance vis-à-vis d’une table de référence tabulaire externe (dont la troncature arbitraire peut poser problème lors de l’apparition de valeurs extrêmes), les informaticiens et analystes quantitatifs privilégient l’algorithme direct proposé par Donald Knuth au sein de son ouvrage de référence The Art of Computer Programming. Cet algorithme élégant repose sur le fait que l’intervalle temporel entre les événements d’un processus de Poisson suit une loi exponentielle, ce qui implique que la multiplication itérative de tirages uniformes standards équivaut à la sommation de variables exponentielles négatives.
La logique de l’algorithme de Knuth se déploie selon les étapes séquentielles suivantes :
- Initialiser un seuil multiplicateur limite $L = e^{-\lambda}$.
- Initialiser un compteur d’occurrences $k = 0$ et une variable d’accumulation de produit $p = 1$.
- Tant que la variable $p$ demeure strictement supérieure au seuil $L$ :
- Incrémenter le compteur : $k = k + 1$.
- Générer un nombre pseudo-aléatoire uniforme $u_k in ]0, 1[$.
- Actualiser le produit : $p = p \times u_k$.
- Lorsque la condition est rompue ($p le L$), la valeur générée finale est $k – 1$.
Bien que cet algorithme ne puisse être formulé dans une cellule unique standard sans circularité logique, il s’implémente avec une simplicité déconcertante au sein du module Visual Basic for Applications (VBA) d’Excel pour concevoir une fonction personnalisée utilisateur (UDF). Le code s’articule comme suit :
Function ALEA_POISSON(lambda As Double) As Long
Dim L As Double, p As Double, k As Long
L = Exp(-lambda)
p = 1#
k = 0
Do While p > L
k = k + 1
p = p * Rnd()
Loop
ALEA_POISSON = k – 1
End Function
Une fois cette routine compilée dans un module standard, l’utilisateur peut appeler directement dans n’importe quelle cellule du classeur l’instruction =ALEA_POISSON(4,5), bénéficiant d’un générateur stochastique autonome, léger en mémoire et affranchi de toute grille de recherche sous-jacente.
11.3 Exécution d’une simulation de Monte-Carlo sur tableur
L’intégration conjointe des générateurs stochastiques et des outils d’analyse d’hypothèses d’Excel ouvre la voie à l’exécution de simulations massives de Monte-Carlo, permettant de simuler le comportement d’un système sur des dizaines de milliers d’itérations en quelques secondes.
Pour mettre en place une simulation de Monte-Carlo comprenant 10 000 réplications d’un processus de comptage de Poisson sans saturer la feuille de calcul avec 10 000 lignes de formules redondantes, l’analyste exploite l’outil méconnu mais extrêmement véloce de Table de données à double entrée natif d’Excel :
- Configurer en cellule B1 la valeur de l’intensité cible λ (par exemple 6).
- En cellule B2, insérer la formule de génération stochastique unitaire : =ALEA_POISSON($B$1) (en exploitant l’UDF vue en section 11.2) ou la formule d’inversion par RECHERCHEX vue en 11.1.
- Définir une plage d’itérations en colonne D : numéroter les cellules de D2 à D10001 de 1 jusqu’à 10 000.
- En cellule E1 (immédiatement au-dessus de la première cellule de résultat de la simulation), lier la formule de résultat stochastique par l’instruction =B2.
- Sélectionner l’intégralité de la matrice de simulation englobant la plage D1:E10001.
- Accéder au ruban Données, localiser le groupe Prévision, cliquer sur Analyse de scénarios, puis sélectionner Table de données…
- Dans la boîte de dialogue, laisser le champ Cellule d’entrée en ligne rigoureusement vide, et désigner pour le champ Cellule d’entrée en colonne une cellule totalement vierge et isolée de la feuille (par exemple Z1). Cliquer sur OK.
Le moteur d’Excel itère alors instantanément 10 000 recalculs de la cellule source et fige les réalisations stochastiques au sein de la table matricielle. Il ne reste plus à l’analyste qu’à instrumenter les colonnes de synthèse en calculant la moyenne empirique simulée via =MOYENNE(E2:E10001), la variance simulée via =VAR.S(E2:E10001), et d’extraire les centiles critiques via la fonction CENTILE.EXCLURE(E2:E10001; 0,95). Cette démarche apporte une validation empirique spectaculaire de la loi des grands nombres, démontrant que la moyenne des réalisations expérimentales converge fidèlement vers la valeur théorique initiale de $lambda$.
12. Dépannage, optimisation des calculs et erreurs courantes dans Excel
12.1 Résolution des codes d’erreur système fréquents
L’exploitation intensive des fonctions statistiques d’Excel confronte régulièrement les utilisateurs à des messages d’erreur cryptiques qu’il importe de diagnostiquer avec méthode afin d’assainir les tableaux de bord décisionnels. Le code d’erreur le plus prévalent lors de la manipulation de LOI.POISSON.N est le code #NOMBRE!. Ce signal d’interruption arithmétique est systématiquement déclenché par l’un des trois facteurs causaux suivants :
- L’argument moyenne (λ) est strictement négatif (λ < 0) ou égal à zéro selon les contraintes de version. La loi n’étant définie que pour des taux positifs, l’algorithme rejette l’opération.
- L’argument d’occurrence x est un entier négatif. Aucun comptage ne pouvant être inférieur à zéro, la fonction échoue.
- L’argument x ou moyenne dépasse les bornes extrêmes de calcul de mantisse du logiciel, provoquant un dépassement de capacité numérique.
Le deuxième code d’erreur majeur est l’exception #VALEUR!. Cette anomalie signale une inadéquation typologique fondamentale : au moins l’un des arguments transmis à la fonction n’est pas reconnu comme une entité numérique par le compilateur. Cela se produit fréquemment lorsqu’un espace insécable s’est glissé dans la cellule, lorsqu’une chaîne alphabétique a été fournie, ou lorsque l’argument booléen cumulative est mal orthographié (par exemple « Fauxx » au lieu de FAUX sans que les guillemets ne permettent d’identifier le texte).
Pour immuniser les feuilles de calcul automatisées destinées à des utilisateurs finaux contre ces pollutions visuelles d’erreur, il est impératif d’encapsuler les formules au sein d’instructions préventives d’interception d’anomalies. L’emploi de la fonction SI.ERREUR ou SI.NON.DISP permet de neutraliser élégamment ces aléas en substituant une chaîne explicite d’avertissement ou une valeur par défaut neutre :
=SI.ERREUR(LOI.POISSON.N(A2; B2; FAUX); « Paramètres invalides »)
De plus, l’adjonction de règles de Validation des données en amont sur les cellules de saisie (interdisant la saisie de valeurs décimales pour x ou de valeurs inférieures ou égales à zéro pour $lambda$) constitue la meilleure pratique d’ingénierie tabulaire pour garantir l’intégrité pérenne des modèles stochastiques.
12.2 Optimisation des performances de calcul pour les modèles massifs
Lorsque des modèles d’entreprise ou des simulations actuarielles étendent l’appel à la fonction LOI.POISSON.N sur plusieurs centaines de milliers de lignes interconnectées, la charge computationnelle imposée au processeur peut dégrader substantiellement la fluidité de navigation au sein d’Excel. Ce phénomène est accentué par le fait que les fonctions statistiques avancées requièrent des développements en séries de Taylor ou des approximations de fonctions spéciales qui consomment un nombre significatif de cycles d’horloge machine par rapport à de simples opérations arithmétiques d’addition ou de multiplication.
Pour juguler cette latence de recalcul lors des phases de développement ou de manipulation de bases de données volumineuses, l’analyste avisé doit modifier le comportement du moteur de calcul :
- Naviguer vers l’onglet Formules du ruban.
- Cliquer sur Options de calcul et basculer le mode sur Manuel (en cochant si désiré l’option « Recalculer le classeur avant de l’enregistrer »).
- Dès lors, Excel suspend l’actualisation continue de ses grilles statistiques lors des saisies intermédiaires. Pour forcer l’évaluation globale lorsque la structuration des données est achevée, il suffit de presser la touche F9 pour un recalcul total, ou la combinaison Maj + F9 pour recalculer exclusivement la feuille active.
Par ailleurs, l’adoption systématique des formules matricielles dynamiques natives abordées au chapitre 3.3 (exploitant l’opérateur #) procure des gains de vitesse considérables par rapport à des dizaines de milliers de formules individuelles recopiées cellule par cellule. Les formules matricielles permettent au moteur de calcul d’optimiser l’allocation des registres vectoriels et de distribuer l’exécution de la boucle d’évaluation sur l’ensemble des cœurs physiques du microprocesseur via le multithreading natif, divisant fréquemment le temps d’exécution global par un facteur de trois à cinq sur des jeux de données denses.
12.3 Vérification des correspondances d’unités spatiotemporelles
La dernière défaillance méthodologique, et sans conteste la plus pernicieuse sur le plan des répercussions concrètes, concerne le défaut de synchronisation dimensionnelle entre l’unité de mesure du paramètre d’intensité $lambda$ et celle de la fenêtre temporelle ou spatiale associée à la variable d’occurrence $x$. La distribution de Poisson possède une propriété fondamentale de stabilité par sommation : si des événements indépendants surviennent selon un processus de Poisson homogène à un taux de base $\lambda_0$ par unité de temps, alors le nombre d’occurrences sur un intervalle de durée ou d’amplitude $T$ suit rigoureusement une loi de Poisson d’intensité :
λajusté = λ0 × T
Omettre cet ajustement d’échelle linéaire lors de la saisie des arguments conduit à des contresens probabilistes monumentaux. Prenons l’exemple d’un service de maintenance industrielle où les défaillances mécaniques d’un système complexe sont répertoriées à un taux moyen constant de $\lambda_0 = 0,5$ panne par jour civil. Si l’ingénieur de maintenance s’interroge sur la probabilité de n’enregistrer aucune panne au cours d’une semaine complète de production continue (soit $T = 7$ jours), injecter naïvement la moyenne journalière dans la formule sous la syntaxe =LOI.POISSON.N(0; 0,5; FAUX) renvoie 0,606531 (60,65 %).
Cette évaluation est mathématiquement erronée, car elle calcule la probabilité d’absence de panne sur une durée d’une seule journée. L’intensité stochastique hebdomadaire ajustée doit être préalablement recalculée :
λhebdo = 0,5 × 7 = 3,5 pannes par semaine
L’évaluation rigoureuse sous Excel s’exprime alors par :
=LOI.POISSON.N(0; 0,5 * 7; FAUX)
qui équivaut à =LOI.POISSON.N(0; 3,5; FAUX), délivrant le résultat réel de 0,030197, soit seulement 3,02 %. La négligence de l’ajustement d’échelle temporelle aurait conduit le gestionnaire à surestimer la probabilité de bon fonctionnement d’un facteur de vingt, illustrant avec force qu’en modélisation probabiliste sous Excel, la rigueur métrologique quant aux unités d’observation prime toujours sur la simple aisance computationnelle logicielle.
Références
- Cochran, W. G. (1954). Some methods for strengthening the common χ² tests. Biometrics, 10(4), 417–451. https://doi.org/10.2307/3001616
- Haight, F. A. (1967). Handbook of the Poisson distribution. John Wiley & Sons.
- IEEE Computer Society. (2008). IEEE standard for floating-point arithmetic (IEEE Std 754-2008). IEEE. https://doi.org/10.1109/IEEESTD.2008.4610935
- Johnson, N. L., Kemp, A. W., & Kotz, S. (2005). Univariate discrete distributions (3e éd.). John Wiley & Sons. https://doi.org/10.1002/0471715816
- Knuth, D. E. (1997). The art of computer programming: Seminumerical algorithms (Vol. 2, 3e éd.). Addison-Wesley Professional.
- Microsoft Corporation. (2024). Fonction LOI.POISSON.N. Support technique Microsoft. https://support.microsoft.com/fr-fr/office/loi-poisson-n-fonction-loi-poisson-n-d81f7296-817e-48f3-8172-72f144d50071
- Poisson, S. D. (1837). Recherches sur la probabilité des jugements en matière criminelle et en matière civile, précédées des règles générales du calcul des probabilités. Bachelier, Imprimeur-Libraire pour les Mathématiques.
- Ross, S. M. (2014). Introduction to probability models (11e éd.). Academic Press. https://doi.org/10.1016/C2012-0-06232-7
- Winston, W. L. (2021). Microsoft Excel data analysis and business modeling (6e éd.). Microsoft Press.