
Dans le paysage contemporain du calcul scientifique et de l’analyse computationnelle des données, l’étape initiale d’ingestion des flux d’informations brutes constitue une phase critique conditionnant l’ensemble de la chaîne de traitement empirique. Au sein de l’environnement statistique R, langage conçu dès son origine pour manipuler des structures quantitatives rigoureuses, l’importation de fichiers textes délimités s’appuie sur une collection historique et éprouvée de fonctions natives regroupées dans le paquetage de base. Parmi ces outils fondamentaux, la fonction read.delim occupe une place prépondérante, spécifiquement configurée pour traiter les fichiers structurés par des séparateurs de tabulation, un format omniprésent dans les sciences expérimentales, la psychométrie, la génomique et l’économétrie.
La pérennité des protocoles de recherche et la reproductibilité computationnelle dépendent étroitement de la compréhension fine des mécanismes sous-jacents à cette importation. Alors que les écosystèmes modernes proposent des extensions tierces optimisées pour des volumétries massives, l’utilisation maîtrisée des fonctionnalités natives de R demeure un gage d’indépendance logicielle, éliminant les risques de rupture de compatibilité descendante. L’analyse détaillée de read.delim révèle non seulement une syntaxe d’une apparente simplicité, mais surtout un ensemble sophistiqué de paramètres contrôlant l’inférence des types atomiques, la gestion des encodages multilingues et la préservation de l’intégrité référentielle des matrices d’observation.
Ce guide exhaustif a pour vocation d’analyser de manière approfondie les aspects méthodologiques, syntaxiques et computationnels de la fonction read.delim. En abordant successivement les fondements théoriques des fichiers plats délimités, la décomposition anatomique des arguments d’importation, l’optimisation des flux de données volumineux et les protocoles de validation d’intégrité, cet article offre aux chercheurs, statisticiens et analystes de données un cadre conceptuel et pratique complet pour maîtriser l’ingestion de données tabulaires dans leurs pipelines analytiques.
1. Introduction et fondements méthodologiques de l’importation avec read.delim dans R
1.1 Rôle et utilité de read.delim dans l’écosystème R de base
La fonction read.delim appartient au paquetage utils, composant structurel distribué nativement avec le noyau du langage R. Ce positionnement fondamental lui confère une disponibilité universelle sans nécessiter l’installation préalable de dépendances tierces ou de compilateurs externes. Dans une perspective de reproductibilité scientifique, s’appuyer sur les fonctions de base de R garantit qu’un script analytique rédigé à un instant donné demeurera fonctionnel plusieurs décennies plus tard, indépendamment des cycles de dépréciation fréquents observés dans les bibliothèques logicielles contemporaines.
Dans la recherche empirique, les formats délimités par des tabulations possèdent une valeur singulière. Contrairement aux virgules ou aux points-virgules, le caractère de tabulation n’intervient pratiquement jamais au sein des descriptions qualitatives, des chaînes de texte libre ou des identifiants alphanumériques complexes. L’utilisation de read.delim répond à cette réalité méthodologique en préconfigurant l’analyseur lexical pour ce séparateur précis, limitant drastiquement les ambiguïtés structurelles lors de la segmentation des colonnes.
La structuration matricielle des données brutes exige une correspondance exacte entre les enregistrements physiques inscrits sur le disque dur et les dimensions conceptuelles du tableau d’analyse. La fonction read.delim opère comme un transducteur syntaxique : elle ingère une succession de flux de caractères non structurés et les convertit en une structure de données fondamentale, le data frame, tout en allouant dynamiquement l’espace mémoire nécessaire à chaque vecteur selon sa typologie intrinsèque.
1.2 Distinction conceptuelle entre fichiers plats et structures relationnelles
Les fichiers plats délimités se distinguent fondamentalement des bases de données relationnelles ou des formats de sérialisation hiérarchiques par leur géométrie bidimensionnelle stricte. Dans un fichier plat au format texte brut, chaque enregistrement correspond physiquement à une ligne terminée par un caractère de contrôle de saut de ligne, et chaque attribut d’observation est séparé de son voisin par un marqueur invariable. Cette simplicité architecturale confère aux fichiers plats une universalité d’accès, les rendant lisibles par n’importe quel éditeur de texte ou environnement de calcul sans médiation d’un serveur de données complexe.
Le recours à la tabulation comme séparateur offre des garanties structurelles supérieures face aux séparateurs de type virgule, fréquents dans les fichiers CSV. Dans les contextes francophones ou européens, la virgule constitue le séparateur décimal conventionnel des nombres à virgule flottante, ce qui provoque des collisions syntaxiques majeures lors de la lecture d’un flux textuel standard. En adoptant la tabulation, read.delim isole formellement la délimitation des champs de l’expression arithmétique des valeurs quantitatives, réduisant le besoin de délimiteurs de chaînes d’encadrement complexes comme les guillemets.
L’interpréteur R traite le fichier plat comme un flux séquentiel d’octets. Au cours de ce processus de lecture, chaque bloc d’octets compris entre deux tabulations est temporairement stocké dans un tampon lexical, avant d’être analysé pour inférer la nature des données. La conversion de ce flux textuel linéaire en un data frame multidimensionnel implique des opérations d’allocation et de réallocation de mémoire vive qui expliquent les exigences computationnelles spécifiques observées lors du traitement de gros volumes de données.
1.3 Contexte d’application dans la recherche quantitative
Les protocoles de collecte de données en sciences cognitives, en psychologie expérimentale et en neurosciences comportementales génèrent une multitude de fichiers tabulaires issus de dispositifs informatisés. Des logiciels de passation standardisés tels que E-Prime, PsychoPy ou des plateformes en ligne à l’image de Qualtrics exportent majoritairement leurs journaux d’événements et matrices de passation sous forme de fichiers textes délimités par des tabulations. La fiabilité de la chaîne analytique repose sur la capacité d’ingérer ces enregistrements sans la moindre corruption des variables dépendantes.
Dans ces dispositifs, chaque milliseconde compte et chaque saisie de participant doit être enregistrée sans ambiguïté. Lors de la transition entre l’instrument de mesure expérimental et l’espace de travail R, des erreurs de typage ou des omissions de délimiteurs peuvent décaler l’alignement des colonnes, introduisant des biais silencieux dévastateurs. L’utilisation explicite et maîtrisée de read.delim permet de définir des points de contrôle stricts afin de garantir l’isomorphisme parfait entre l’événement comportemental capté par le matériel et l’objet numérique analysé statistiquement.
La recherche quantitative moderne requiert également le traitement de cohortes où les fichiers individuels de dizaines de participants doivent être compilés. Comprendre les paramètres de bas niveau de read.delim offre l’assurance technique nécessaire pour automatiser ces chargements au sein de boucles itératives ou de pipelines vectoriels, préservant l’intégrité des identifiants et des métadonnées contextuelles de chaque session d’enregistrement.
2. Analyse syntaxique et anatomie des paramètres de read.delim
2.1 Décomposition de la signature canonique de la fonction
La signature formelle de la fonction read.delim dans la documentation de R se présente comme un appel hautement spécialisé :
read.delim(file, header = TRUE, sep = "t", quote = """, dec = ".", fill = TRUE, comment.char = "", ...)
Cette déclaration met en évidence son statut de fonction d’encapsulation (wrapper) conçue pour soulager l’analyste de la saisie redondante d’arguments récurrents. L’argument file constitue le premier paramètre indispensable. Il peut prendre la forme d’une chaîne de caractères pointant vers un chemin sur le système de fichiers local (relatif ou absolu), d’un descripteur de connexion réseau ou même d’une adresse URL publique sécurisée.
La transmission d’un chemin relatif requiert une compréhension précise du répertoire de travail actif sous R. Si un chemin absolu assure un ancrage univoque sur une machine spécifique, il compromet la portabilité du code source lors du transfert du script vers une station de travail tierce ou un serveur de calcul distant. L’architecture interne de read.delim relaie l’ensemble des arguments fournis, y compris l’opérateur d’ellipse triple point (…), directement vers la fonction centrale générique read.table, qui orchestre l’allocation de la mémoire et le découpage lexical de bas niveau.
L’optimisation des valeurs par défaut au sein de la signature témoigne d’une ergonomie pensée pour les données tabulaires scientifiques anglo-saxonnes, où l’en-tête est présumé existant, la tabulation active et le point configuré comme séparateur décimal. Cette convergence de préconfigurations réduit le risque d’erreurs de syntaxe tout en assurant une vitesse d’exécution optimale lors du prototypage rapide de chaînes d’analyse.
2.2 Le rôle déterminant de l’argument header
L’argument logique header contrôle la détection et le traitement de la première ligne physique du fichier analysé. Lorsque ce paramètre est configuré sur sa valeur par défaut, à savoir TRUE, read.delim considère que la ligne inaugurale ne contient pas des observations numériques ou factorielles, mais les étiquettes textuelles désignant les variables respectives. Ces libellés sont immédiatement extraits pour constituer l’attribut names du tableau de données produit.
Une altération involontaire de ce paramètre engendre des dégradations structurelles majeures. Si un chercheur spécifie par mégarde header = FALSE sur un jeu de données contenant des intitulés textuels, la première ligne sera traitée comme une ligne d’observations courantes. En conséquence, l’algorithme d’inférence de type détectera la présence de texte au sommet de colonnes par ailleurs purement quantitatives, forçant l’ensemble de la colonne numérique à se convertir en vecteur de chaînes de caractères ou en facteurs catégoriels, neutralisant toute capacité de modélisation mathématique directe.
À l’inverse, si un fichier dépourvu d’en-tête est importé avec la valeur header = TRUE, la toute première observation empirique du protocole sera sacrifiée et convertie en noms de variables, faussant la taille totale de l’échantillon d’exactement une unité. Lorsque header = FALSE est scrupuleusement paramétré sur un flux sans étiquettes, le moteur syntaxique synthétise automatiquement des identifiants de colonnes standardisés sous la forme d’un vecteur de chaînes séquentielles : V1, V2, V3, jusqu’à épuisement de la dimension horizontale.
2.3 La spécification stricte du délimiteur via le paramètre sep
Le paramètre sep accepte une chaîne de caractères définissant le délimiteur inter-colonnes, avec pour valeur native l’échappement « t ». Dans la notation informatique standard, le caractère d’échappement représenté par la barre oblique inversée suivie de la lettre t symbolise le point de code ASCII 9, correspondant à la tabulation horizontale. Cette formalisation permet à l’interpréteur de différencier le saut de colonne structurel des simples espaces d’espacement typographique.
La gestion des séquences d’échappement exige une grande rigueur. L’analyseur lexical de R traite les délimiteurs de manière littérale : si le fichier cible contient des délimitations par espaces multiples ou des tabulations consécutives imprévues, le comportement de découpage peut varier considérablement. Dans la configuration par défaut de read.delim, la présence de deux tabulations adjacentes consécutives est interprétée comme la présence d’un champ nul ou manquant situé entre les deux bornes, ce qui garantit la préservation rigoureuse de la structure matricielle sans glissement de colonnes.
Cette approche contraste nettement avec celle adoptée par la fonction plus générale read.table avec son séparateur par défaut par chaîne vide, qui agrège les espaces blancs et tabulations contigus en un unique séparateur synthétique. En figeant sep = « t », read.delim assure une lecture déterministe convenant parfaitement aux flux issus de capteurs instrumentaux, d’enregistreurs physiologiques et de logiciels d’expérimentation standardisés.
3. Création contrôlée de données et démonstration pratique pas à pas
3.1 Instanciation d’un data frame source à des fins expérimentales
Afin d’illustrer la mécanique interne de la lecture de fichiers tabulaires sans dépendre d’une source externe volatile, il convient de générer programmatiquement une matrice d’expérimentation représentative au sein de la mémoire vive de R. Cette démarche pédagogique repose sur la création d’un objet de classe data.frame combinant des vecteurs numériques, des identifiants alphanumériques et des facteurs catégoriels simulant des mesures de performance cognitive.
Considérons un protocole évaluant l’effet de la privation de sommeil sur le temps de réaction et le taux d’exactitude motrice de sujets humains. Le jeu de données matriciel peut être structuré autour des dimensions suivantes : un identifiant unique de participant sous forme textuelle, un facteur d’appartenance de groupe catégorisant la condition expérimentale (par exemple « Contrôle » versus « Privation »), une variable continue mesurant la latence de réponse en millisecondes et un indice probabiliste d’exactitude compris entre 0 et 1.
Cette structure garantit la présence simultanée de multiples types atomiques fondamentaux du langage R : le type caractère pour les identifiants, le type facteur ou chaîne pour les groupes, et le type numérique à double précision pour les latences et pourcentages. Avant toute écriture physique sur le disque, l’intégrité dimensionnelle de cette matrice doit être validée, garantissant que chaque vecteur constitutif présente une longueur strictement identique, prévenant toute anomalie lors de la phase de sérialisation séquentielle.
3.2 Exportation tabulaire rigoureuse via write.table
L’enregistrement physique des données simulées sur le système de fichiers nécessite l’intervention de la fonction write.table, configurée avec des options strictes afin de produire un format tabulaire parfaitement conforme aux attentes de l’ingestion ultérieure par read.delim. La génération d’un fichier textuel propre évite l’injection d’artefacts syntaxiques indésirables qui pollueraient la lecture.
Trois paramètres cardinaux méritent une vigilance particulière lors de l’exportation :
- La spécification explicite du délimiteur via l’argument sep = « t » afin d’insérer des tabulations physiques entre chaque cellule du tableau.
- La neutralisation des guillemets entourant les données textuelles au moyen de l’argument quote = FALSE, ou leur encadrement contrôlé si le texte contient des retours à la ligne internes.
- La désactivation de l’exportation des noms de lignes via row.names = FALSE, prévenant l’apparition d’une première colonne anonyme qui créerait un décalage structurel lors de la relecture des en-têtes.
Une fois la commande exécutée, l’inspection brute du fichier texte via un utilitaire système ou un visualiseur hexadécimal confirme la disposition : les enregistrements se succèdent, délimités par le caractère de contrôle saut de ligne, tandis que les valeurs contiguës sont espacées uniquement par l’octet invisible correspondant à la tabulation. Le fichier ainsi forgé sur le support de stockage physique constitue un modèle idéal pour valider les mécanismes de lecture.
3.3 Lecture et instanciation du data frame cible avec read.delim
La phase d’ingestion s’exécute en invoquant read.delim en lui transmettant le chemin relatif menant au fichier précédemment sérialisé. R engage alors son analyseur lexical, parcourt le fichier depuis le premier octet jusqu’au marqueur de fin de transmission, alloue dynamiquement les vecteurs constitutifs et assemble l’objet final dans l’environnement global d’exécution.
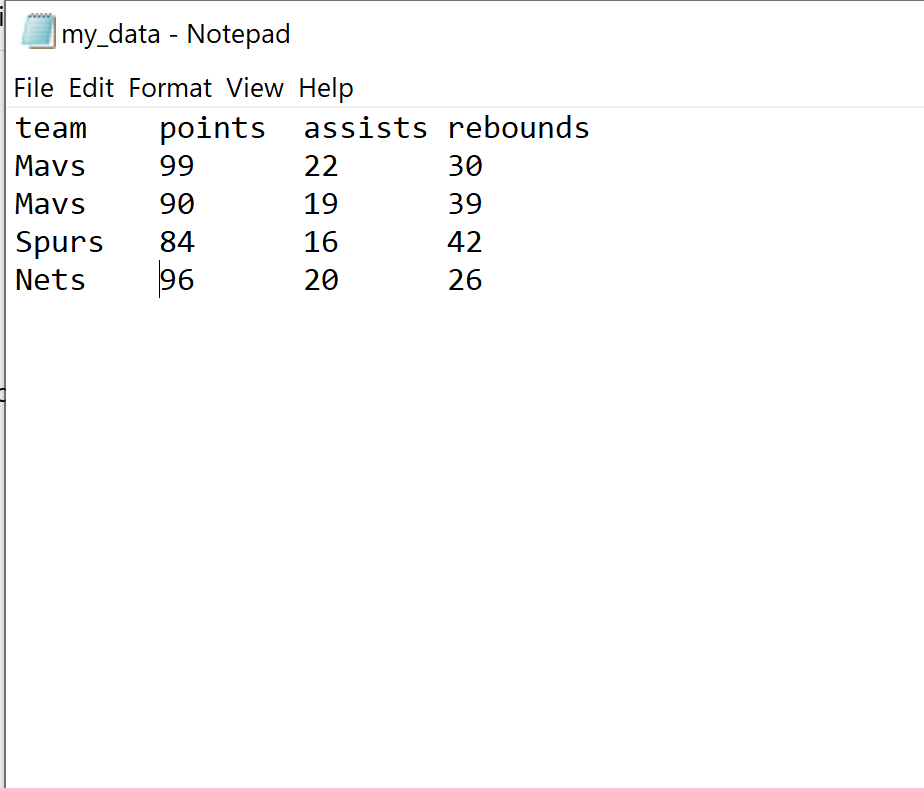
L’opération réalisée, le statisticien doit immédiatement procéder au contrôle de l’équivalence structurelle entre la matrice d’origine et le data frame nouvellement matérialisé. L’examen des métadonnées s’effectue au moyen de fonctions d’inspection cardinales :
- La fonction dim() pour vérifier la préservation scrupuleuse du nombre de lignes et du nombre de colonnes de la matrice originale.
- La fonction str() pour scruter l’architecture typologique sous-jacente et confirmer l’attribution des classes atomiques aux différents vecteurs.
- La fonction summary() pour s’assurer que les distributions statistiques descriptives (minima, quartiles, moyennes, maxima) n’ont subi aucune altération liée à une mauvaise troncature numérique.
Cette vérification méthodique clôture la boucle d’exportation-importation, démontrant la capacité de read.delim à reconstituer fidèlement en mémoire les structures informationnelles sérialisées sur disque.
4. Typage des données et inférence automatique des classes
4.1 Mécanismes d’inférence de classes atomiques par R
Lors de l’ingestion d’un flux textuel plat par read.delim, le système de lecture ne dispose d’aucune métadonnée explicite concernant la typologie des colonnes. R déploie alors un algorithme heuristique d’inférence de types sur chaque colonne prise individuellement. Ce mécanisme itératif scanne les valeurs textuelles et tente successivement de les interpréter sous des formes de plus en plus générales : d’abord logique (booléen), puis entier, ensuite numérique à virgule flottante, complexe, et enfin, si toutes les tentatives de conversion arithmétique échouent, sous forme de chaîne de caractères.
Ce processus est extrêmement sensible à la présence de symboles non numériques égarés dans les colonnes de mesures. Par exemple, la présence d’une seule chaîne textuelle ou d’un symbole typographique imprévu au milieu d’un millier d’enregistrements numériques force l’algorithme à rétrograder l’intégralité de la colonne vers le type chaîne de caractères. De surcroît, le séparateur décimal joue un rôle pivot : si le fichier utilise une virgule au lieu d’un point pour délimiter les fractions décimales, read.delim considérera chaque nombre comme une chaîne alphanumérique complexe, interdisant toute opération de calcul ultérieure.
L’argument dec permet de piloter ce comportement. Configuré par défaut sur le point décimal (dec = « . »), il ordonne au moteur de conversion numérique de reconnaître le point comme le marqueur de fraction flottante standard. La manipulation concertée de cet argument avec les mécanismes heuristiques assure que les colonnes conservent leur statut mathématique d’origine dès l’instanciation de l’objet en mémoire vive.
4.2 Gestion des facteurs et des variables textuelles
L’histoire de la gestion des chaînes de caractères dans le langage R a connu une transition méthodologique majeure lors du passage à la version 4.0.0. Historiquement, l’argument global stringsAsFactors était implicitement configuré sur TRUE dans toutes les fonctions de la famille read.table, incluant read.delim. Cette configuration archaïque convertissait d’office toute colonne non numérique en une classe factor, associant chaque modalité textuelle à un niveau d’indexation numérique interne.
Bien que cette approche présentât des avantages pour l’estimation de modèles linéaires sous des contraintes de mémoire vive strictes dans les années 1990, elle générait d’innombrables effets de bord dans les pipelines contemporains de manipulation textuelle. Depuis R 4.0.0, la valeur par défaut est devenue stringsAsFactors = FALSE. Les colonnes textuelles sont désormais préservées sous leur forme naturelle de vecteurs de caractères littéraux (character), offrant une flexibilité accrue pour le nettoyage et l’ingénierie des données.
Il demeure toutefois essentiel de savoir convertir de manière sélective et intentionnelle ces chaînes textuelles en facteurs ordinaux ou nominaux après importation. Pour des protocoles psychométriques où les variables qualitatives possèdent une hiérarchie stricte (échelles d’accord de type Likert, par exemple), le passage explicite par les fonctions factor() ou ordered() au sein du script analytique permet de contrôler rigoureusement l’ordonnancement des niveaux sans déléguer cette responsabilité cruciale à l’heuristique aveugle de la fonction d’importation.
4.3 Spécification explicite des types de colonnes avec colClasses
Afin de contourner l’incertitude et la surcharge computationnelle inhérentes à l’inférence heuristique automatique, l’utilisateur averti peut mobiliser le paramètre colClasses. Cet argument accepte un vecteur de chaînes de caractères spécifiant nominativement la classe atomique attribuée à chaque colonne du fichier à lire (telles que « numeric », « integer », « character », « logical », ou « Date »).
Le recours à colClasses procure plusieurs avantages déterminants :
- Une accélération drastique de la vitesse d’importation, l’analyseur lexical de R n’ayant plus besoin de tester successivement différentes typologies avant de figer la colonne.
- La neutralisation sélective de colonnes inutiles au moyen de la valeur réservée « NULL », ordonnant au processeur de lecture d’ignorer physiquement les champs ciblés sans les allouer en mémoire.
- La sécurisation absolue d’identifiants numériques nécessitant le maintien des zéros initiaux (codes postaux, identifiants de sécurité sociale, numéros de protocoles hospitaliers) en forçant leur ingestion sous la classe « character ».
Lorsque le vecteur colClasses est nommé, les associations entre les types déclarés et les colonnes s’effectuent sur la base des libellés d’en-tête, autorisant une robustesse totale face aux réordonnancements inattendus des colonnes dans le fichier plat d’origine.
5. Gestion approfondie des valeurs manquantes et anomalies de format
5.1 Paramétrage exhaustif des chaînes représentant des données manquantes
Dans les jeux de données issus d’investigations empiriques, l’absence de réponse ou la perte d’un signal expérimental est fréquemment encodée par des marqueurs spécifiques au protocole ou à la machine de collecte. Les systèmes archaïques ou certains progiciels statistiques déversent régulièrement des sentinelles numériques extrêmes (telles que -99, 999 ou -9999) ou des mentions textuelles hétérogènes comme « NR » (Non Renseigné), « N/A », ou de simples points isolés pour désigner une valeur vacante.
Par défaut, read.delim interprète la chaîne « NA » comme la représentation formelle de la valeur manquante intrinsèque de R. Si un jeu de données expérimental utilise d’autres conventions d’omission sans que l’analyste n’intervienne, ces sentinelles seront soit incorporées littéralement dans les calculs arithmétiques (faussant dramatiquement les moyennes en cas d’utilisation de -999), soit converties en chaînes textuelles, altérant le typage de toute la variable. Le paramètre na.strings permet de conjurer ce péril en accueillant un vecteur exhaustif de tous les marqueurs d’absence acceptés.
Il convient de distinguer scrupuleusement la chaîne textuelle vide (« ») de l’absence physique de saisie. Dans les fichiers tabulaires stricts, la juxtaposition immédiate de deux tabulations signale un champ dépourvu de tout caractère. Configurer na.strings = c(« NA », « -99 », « NR », « ») assure que l’ensemble de ces occurrences converge de manière homogène vers la constante logique NA de R, permettant un audit immédiat au moyen de la fonction logique is.na() sur l’ensemble de la structure importée.
5.2 Traitement des commentaires et des métadonnées en amont
De nombreux instruments de mesure scientifiques annotent automatiquement les fichiers bruts en préfaçant le corps tabulaire par des blocs d’informations contextuelles : date et heure de calibrage, version du micrologiciel, température ambiante du laboratoire ou paramètres d’amplification du signal. Ces métadonnées introductives, si elles sont absorbées sans précaution, brisent la géométrie bidimensionnelle du tableau et déclenchent des erreurs d’analyse lexicales insolubles.
Deux arguments permettent d’assainir l’ingestion face à ces architectures mixtes :
- L’argument comment.char, qui spécifie un caractère réservé (couramment le croisillon « # ») ordonnant à l’analyseur d’ignorer tout texte situé entre ce symbole et la fin de la ligne courante.
- L’argument skip, qui indique le nombre précis de lignes physiques initiales que le processeur de lecture doit sauter avant de commencer à interpréter l’en-tête et les données tabulaires utiles.
Une précaution critique s’impose quant à l’usage de comment.char dans les études qualitatives ou les corpus linguistiques. Si des chaînes de caractères de participants sont susceptibles de contenir naturellement le symbole de commentaire choisi, l’analyseur tronquera arbitrairement ces textes à la première occurrence du caractère. Dans une telle situation, la désactivation complète du filtrage via l’instruction comment.char = « » est impérative afin de préserver l’intégralité littérale des enregistrements empiriques.
5.3 Résolution des lignes asymétriques et tronquées
L’asymétrie matricielle, caractérisée par des lignes comptant moins de séparateurs que la norme définie par l’en-tête, représente un écueil fréquent résultant d’interruptions inopinées de processus d’enregistrement ou de formats d’exportation défaillants. Dans de telles circonstances, l’interpréteur de R se heurte à une contradiction entre le nombre attendu d’éléments par vecteur et les observations effectivement lues.
Le paramètre fill constitue le levier de régulation syntaxique de cette asymétrie. Configuré sur fill = TRUE (valeur par défaut de read.delim), il enjoint à l’analyseur de compléter automatiquement les lignes tronquées en injectant des valeurs manquantes NA dans les colonnes terminales non renseignées jusqu’à atteindre la dimension requise. Cette permissivité prévient l’interruption prématurée du script analytique et autorise le chargement partiel de jeux de données imparfaits.
Néanmoins, dans un cadre méthodologique rigoureux, cette complétion silencieuse comporte des risques insidieux : elle peut masquer des corruptions majeures de données ou des décalages d’enregistrements le long du fichier. Pour les protocoles expérimentaux exigeant une géométrie sans faille, désactiver explicitement cette sécurité via fill = FALSE permet de forcer R à lever une erreur fatale dès la première disparité de dimension, alertant immédiatement le statisticien sur la présence d’une anomalie physique au sein du support d’enregistrement.
6. Gestion des systèmes d’encodage et des formats internationaux
6.1 Problématique des caractères spéciaux et accents linguistiques
L’internationalisation des corpus textuels et la collecte de questionnaires multilingues exposent les flux tabulaires aux disparités d’encodage de caractères. Les divergences historiques entre les normes de codage telles que l’ASCII pur, la famille ISO 8859 (notamment Latin-1 / ISO 8859-1) et le standard moderne universel UTF-8 constituent l’une des sources majeures de corruption textuelle, phénomène désigné sous le terme technique de mojibake.
Lorsqu’un fichier encodé en UTF-8 comportant des caractères diacritiques ou des glyphes non latins est interprété sous un environnement système utilisant une page de code locale héritée (comme l’encodage Windows-1252), les séquences multi-octets sont fragmentées, transformant les voyelles accentuées en agrégats incohérents de symboles typographiques. Cette altération ne dégrade pas uniquement la lisibilité humaine ; elle fragmente artificiellement les niveaux des variables catégorielles, démultipliant les modalités d’un même facteur lors des analyses de variance ou des régressions logistiques.
Pour immuniser l’importation contre ces distorsions, read.delim expose le paramètre fileEncoding. En spécifiant explicitement l’encodage source (par exemple fileEncoding = « UTF-8 » ou fileEncoding = « latin1 »), l’analyste ordonne à la machine virtuelle de R de transcoder dynamiquement les octets incidents vers l’encodage interne de la session d’analyse. Cette discipline garantit la fidélité sémantique intégrale des réponses qualitatives et des noms de variables.
6.2 Variante read.delim2 et particularités géographiques
Les traditions typographiques et normatives régissant la notation arithmétique varient substantiellement selon les ères géographiques. Alors que la communauté scientifique anglo-saxonne a imposé l’usage du point comme séparateur des fractions décimales, la majorité des pays d’Europe continentale, d’Amérique latine et de la francophonie utilise traditionnellement la virgule pour scinder la partie entière de la composante décimale d’un nombre réel.
Afin de prendre en charge cette spécificité sans contraindre l’opérateur à redéfinir systématiquement l’argument dec = « , », les concepteurs du noyau de R ont formalisé une fonction sœur dédiée : read.delim2. La différence fondamentale entre les deux fonctions réside exclusivement dans la valeur par défaut de l’argument décimal, comme le résume le tableau conceptuel suivant :
- read.delim : configure nativement header = TRUE, sep = « t » et dec = « . » (conforme au standard international anglo-saxon).
- read.delim2 : configure nativement header = TRUE, sep = « t » et dec = « , » (conforme au standard continental européen).
Le choix judicieux entre ces deux wrappers prévient l’erreur classique d’ingestion silencieuse, où un jeu de données européen lu via read.delim transforme tous les indicateurs décimaux en chaînes de caractères brutes, paralysant la chaîne d’évaluation statistique.
6.3 Gestion des retours à la ligne selon les systèmes d’exploitation
La délimitation physique des enregistrements textuels le long du fichier dépend des conventions historiques des systèmes d’exploitation sous-jacents. Dans le monde Unix, Linux et macOS contemporain, la fin de ligne est signifiée par un unique octet de saut de ligne, désigné conventionnellement par LF (Line Feed, point de code ASCII 10 ou n). À l’inverse, l’écosystème Microsoft Windows utilise traditionnellement une paire d’octets consécutifs : un retour chariot suivi d’un saut de ligne, noté CRLF (Carriage Return + Line Feed, points de code ASCII 13 et 10, ou rn).
L’analyseur syntaxique intégré aux mécanismes de base de R est conçu pour tolérer et homogénéiser automatiquement ces différentes terminaisons. Toutefois, des défaillances surviennent lorsque des fichiers subissent des transferts réseau défectueux ou des manipulations croisées via des outils non conformes, générant des terminaisons de lignes hybrides ou orphelines (comme le simple CR hérité des architectures Macintosh pré-OS X).
Face à un fichier présentant des retours de chariot isolés, l’analyseur peut échouer à segmenter les lignes, tentant d’ingérer l’intégralité du document comme un enregistrement unique démesuré, ce qui conduit à l’épuisement immédiat de la pile de mémoire vive. La normalisation préalable des fins de ligne au moyen d’utilitaires dédiés ou le passage par une connexion de flux explicite via la commande file() assortie d’un mode de lecture binaire textuel permet de surmonter ces pathologies d’environnement.
7. Optimisation des performances et lecture de fichiers volumineux
7.1 Profilage de la consommation de mémoire vive
L’architecture interne du moteur d’évaluation de R impose que la totalité des objets manipulés réside directement dans la mémoire vive (RAM) de la machine hôte. Lors de l’exécution de read.delim, l’empreinte mémoire requise durant la phase d’ingestion dépasse largement la taille physique du fichier stocké sur le disque dur. L’analyseur textuel alloue temporairement de multiples structures intermédiaires pour procéder au découpage lexical et aux tests d’inférence des types avant de consolider la matrice finale sous forme de data frame.
Pour prévenir la saturation de la mémoire sur des jeux de données d’envergure, l’analyste peut procéder à une estimation prédictive des besoins en appliquant une formule de calcul vectoriel simple :
Mémoire théorique minimale = (Nombre d’observations) × (Nombre de variables) × (8 octets par élément numérique flottant)
En pratique, il est recommandé de disposer d’une réserve de mémoire vive physique équivalente à au moins trois à cinq fois la taille estimée du fichier brut pour absorber les copies temporaires générées par le ramasse-miettes (garbage collector) de R.
La préallocation optimale passe par l’utilisation conjointe des arguments colClasses et nrows. En fournissant à l’avance la typologie stricte des colonnes, le processeur alloue immédiatement des vecteurs atomiques aux dimensions cibles, supprimant les mécanismes de réallocation dynamique incrémentale qui dégradent considérablement les temps d’accès au processeur et fragmentent la mémoire vive.
7.2 Technique d’échantillonnage préalable pour l’inspection des données
L’exploration d’un fichier tabulaire imposant dont on ignore la pureté structurelle ne devrait jamais s’effectuer par un chargement global immédiat. La démarche méthodologique rationnelle consiste à réaliser une sonde préliminaire au moyen de l’argument nrows, qui restreint la lecture à un nombre arbitraire de lignes initiales.
Ce protocole d’échantillonnage s’articule en trois étapes successives :
- Lire un sous-ensemble minimal représentatif du fichier (par exemple, nrows = 100) sans figer de contraintes strictes.
- Auditer programmatiquement la structure de l’échantillon extrait au moyen de sapply(echantillon, class) pour valider ou corriger les inférences de types.
- Réutiliser le vecteur de classes ainsi validé pour configurer l’argument colClasses lors du chargement intégral subséquent, garantissant un processus rapide et stable pour l’ensemble du volume de données.
Cette approche par échantillonnage pilote sécurise la chaîne computationnelle en identifiant en quelques fractions de seconde d’éventuels conflits de format, évitant à l’analyste de patienter de longues minutes devant un traitement bloqué qui échouerait in fine en fin de parcours.
7.3 Limites de charge et goulots d’étranglement de read.delim
Bien que read.delim soit une fonction d’une élégance et d’une fiabilité incontestables pour les volumes d’échelle modeste à intermédiaire (jusqu’à quelques centaines de mégaoctets), son architecture séquentielle mono-threadée écrite en langage C classique rencontre des limites structurelles face aux exigences du Big Data.
L’analyseur lexical de base effectue de multiples contrôles de sécurité à chaque octet franchi : vérification des guillemets imbriqués, contrôle des caractères d’échappement, gestion dynamique des commentaires et alignement des séparateurs. Cette sophistication algorithmique induit un coût de traitement non négligeable par élément unitaire. Dès lors qu’un fichier tabulaire franchit le seuil du gigaoctet ou comporte plusieurs dizaines de millions d’enregistrements, le temps d’exécution de read.delim s’accroît de façon exponentielle comparé à des solutions utilisant des appels systèmes parallélisés.
L’identification de ce goulot d’étranglement dicte le moment précis où le statisticien doit abandonner les fonctions de base au profit d’outils optimisés pour les entrées-sorties intensives, tout en préservant read.delim pour les étapes de production standardisées où la légèreté et l’absence de dépendances priment sur la vitesse brute de lecture.
8. Comparaison méthodologique : read.delim face aux alternatives modernes
8.1 read.delim versus la famille read.table dans utils
Pour appréhender la singularité de read.delim, il est indispensable de la situer au sein de sa propre lignée algorithmique dans le paquetage utils. La matrice conceptuelle repose sur la fonction souche read.table, dont dérivent directement read.csv, read.csv2, read.delim et read.delim2. Ces fonctions secondaires ne constituent en réalité que des interfaces d’enrobage dotées de jeux de paramètres initiaux différenciés.
Les divergences fondamentales se résument aux valeurs assignées par défaut aux arguments cardinaux :
- read.table : header = FALSE, sep = « » (agrégation d’espaces et tabulations), dec = « . ».
- read.delim : header = TRUE, sep = « t » (tabulation stricte), dec = « . ».
- read.delim2 : header = TRUE, sep = « t » (tabulation stricte), dec = « , ».
Le choix de recourir explicitement à read.delim plutôt qu’à un appel verbeux à read.table rehaussé de multiples arguments améliore la lisibilité du code source, affichant clairement l’intention de traiter un fichier tabulaire strict conforme aux standards scientifiques internationaux.
8.2 read.delim face à readr::read_tsv
L’émergence de l’écosystème tidyverse a introduit le paquetage readr, qui propose la fonction alternative read_tsv. Spécialisée dans la lecture des flux délimités par des tabulations, cette commande moderne a été développée pour répondre aux limites de vitesse et de flexibilité des fonctions historiques du paquetage utils.
Sur le plan structurel, read_tsv génère un objet de type tibble, une reformulation contemporaine du data frame qui améliore l’affichage en console et désactive les coercitions d’indexation partielles. De plus, read_tsv emploie un analyseur écrit en C++ hautement optimisé, capable de parser les chaînes textuelles avec une rapidité nettement supérieure à celle de read.delim, tout en fournissant des journaux détaillés sur les anomalies d’incohérence de données sans interrompre le chargement.
Cependant, cette supériorité computationnelle s’accompagne d’un coût méthodologique : l’introduction d’un arbre complexe de dépendances externes. Pour des scripts institutionnels, des modules embarqués ou des calculs sur des serveurs sécurisés sans accès à Internet, l’obligation d’installer le paquetage readr peut poser des défis d’administration système majeurs. Dans ces contextes contraints, read.delim demeure l’étalon de référence pour sa portabilité absolue et son intégration sans faille avec le cœur du système R.
8.3 read.delim face à data.table::fread
Dans l’éventail des outils d’ingestion tabulaire sous R, la fonction fread issue de la bibliothèque data.table représente l’état de l’art en matière de performance brute et d’ingénierie mémoire. Conçue pour traiter des volumes massifs de données industrielles, fread s’appuie sur une architecture d’exécution multi-threadée exploitant l’ensemble des cœurs de calcul disponibles sur le microprocesseur.
Parmi les prouesses d’ingénierie de fread, figure sa capacité heuristique à détecter automatiquement le délimiteur de colonnes sans configuration préalable, tout en mappant les pages mémoire du fichier directement depuis le disque via des appels systèmes de bas niveau. Les gains de performance face à read.delim se mesurent fréquemment par un facteur de 10 à 50 sur des matrices dépassant plusieurs gigaoctets.
Néanmoins, cette automatisation poussée comporte une contrepartie : l’heuristique de fread peut occasionnellement opérer des choix inattendus sur des fichiers mal formés ou des cas limites exotiques. Pour les jeux de données scientifiques de taille petite à moyenne, la totale prévisibilité de read.delim, son respect scrupuleux des paramètres déclarés et son absence totale de configuration de compilation en font un outil méthodologique irremplaçable dans le bagage de l’analyste consciencieux.
9. Cas d’usage appliqués aux données psychométriques et expérimentales
9.1 Importation de matrices d’inventaires psychologiques à grande échelle
L’administration informatisée d’instruments psychométriques standardisés (tels que les inventaires de personnalité NEO-PI, les batteries d’évaluation de l’anxiété de Beck ou les échelles multidimensionnelles de dépression) génère des matrices d’évaluation structurées sous forme de fichiers tabulaires. Chaque ligne correspond à un sujet expérimental, tandis que les colonnes matérialisent les dizaines ou centaines d’items présentés au cours de la passation.
Les variables ordinales issues des échelles de réponse graduées (échelles de Likert en 5 ou 7 points) sont généralement enregistrées sous forme d’entiers numériques. L’importation via read.delim requiert une vigilance absolue quant au maintien de l’intégrité de ces colonnes :
- Les identifiants anonymisés des participants comportant des zéros préfixés (ex. « 00412 ») doivent impérativement être protégés via colClasses pour éviter leur conversion automatique en entiers scalaires, ce qui détruirait l’homogénéité du système d’indexation.
- Les scores d’items doivent conserver leur nature numérique afin de permettre le calcul vectoriel immédiat de sous-échelles, de scores composites ou de coefficients de cohérence interne d’échelle (alpha de Cronbach).
L’application d’un paramétrage strict garantit qu’aucune valeur de Likert n’est assimilée par inadvertance à une chaîne de caractères, sécurisant l’application consécutive d’analyses factorielles confirmatoires ou de modélisations sous la théorie de réponse aux items.
9.2 Traitement des séries temporelles de temps de réaction
Les paradigmes d’évaluation de la chronométrie mentale (tâches de type Stroop, amorçage sémantique, détection de signaux de Posner) génèrent des volumes considérables d’enregistrements continus événement par événement. Dans ces protocoles, chaque pression sur un manipulateur ou chaque mouvement oculaire génère une ligne tabulaire horodatée à la milliseconde près.
L’ingestion de ces séries chronologiques via read.delim impose une validation post-importation immédiate des bornes de validité temporelle. Les temps de réaction physiologiques humains ne peuvent descendre en dessous d’un seuil incompressible (typiquement 150 millisecondes) sans traduire une anticipation motrice non contrôlée, ni excéder des fenêtres d’abandon d’essai (plusieurs milliers de millisecondes). Une mauvaise lecture des décimales via un paramètre dec inadapté peut décaler les ordres de grandeur de plusieurs puissances de dix, ruinant la significativité des modèles mixtes appliqués subséquemment.
La structuration tabulaire permet en outre d’extraire rapidement les séries temporelles pour chaque sujet, vérifiant l’absence de dérive d’horloge matérielle entre le premier et le dernier essai de la passation expérimentale.
9.3 Fusion de fichiers tabulaires issus de protocoles multi-sessions
Dans la recherche empirique multi-centres ou multi-sessions, l’infrastructure d’acquisition produit typiquement une constellation de fichiers tabulaires indépendants, chaque sujet ou session générant son propre document texte délimité par des tabulations dans un sous-dossier dédié. L’analyste est alors confronté à l’obligation de compiler programmatiquement l’ensemble de ces fragments dans un data frame d’analyse consolidé.
Cette agrégation vectorielle s’opère méthodologiquement au moyen d’un pipeline combinant les primitives de R :
- Recensement exhaustif des chemins de fichiers au moyen de la fonction list.files() assortie d’un motif d’expression régulière ciblant les extensions tabulaires.
- Itération fonctionnelle de read.delim sur l’ensemble de la liste au moyen de lapply(), encapsulant chaque lecture dans un cadre de typage normalisé.
- Contrôle de l’homogénéité dimensionnelle et de la stricte identité des noms de colonnes entre chaque sous-matrice.
- Concaténation verticale définitive des tableaux individuels en une cohorte globale par l’invocation de do.call(rbind, liste_tableaux).
Cette approche fonctionnelle assure une traçabilité intégrale du processus de compilation, écartant tout risque d’erreur humaine lié à des fusions manuelles de fichiers au sein de logiciels de bureautique fermés.
10. Diagnostic et résolution méthodique des erreurs d’importation courantes
10.1 L’erreur récurrente : ‘line X did not have Y elements’
L’avertissement ou l’interruption fatale renvoyant le message classique « line X did not have Y elements » constitue sans conteste l’écueil syntaxique le plus fréquent lors de l’utilisation de la famille read.table. Cet incident indique sans équivoque une rupture d’isomorphisme : l’analyseur lexical a dénombré sur la ligne X un nombre de champs différent de celui déduit de l’en-tête ou de la première rangée du fichier.
Les étiologies sous-jacentes à ce dysfonctionnement sont multiples :
- L’insertion accidentelle d’une tabulation orpheline ou isolée au sein d’une case textuelle non protégée par des guillemets.
- La présence de guillemets d’encadrement asymétriques (un guillemet ouvrant jamais refermé), incitant R à ingérer toutes les lignes subséquentes comme une seule cellule textuelle multi-lignes continue.
- L’existence d’une ligne de métadonnée ou d’une note de bas de page insérée au milieu du jeu de données brut sans préfixe de commentaire.
La résolution méthodique passe par l’inspection textuelle chirurgicale de la ligne incriminée au moyen d’un éditeur de code ou d’une commande système de type sed ou head/tail. Si le problème découle d’une interprétation chaotique des guillemets dans un texte contenant des apostrophes littéraires, la désactivation explicite du système de délimitation de texte via l’instruction quote = « » permet fréquemment de restaurer instantanément l’alignement attendu.
10.2 Conversion intempestive de colonnes numériques en facteurs ou caractères
Un autre désordre analytique récurrent réside dans la conversion inopinée d’une colonne de mesures strictement quantitatives en vecteur textuel ou catégoriel. L’analyste ne découvre généralement cette altération qu’en observant des messages d’erreur énigmatiques lors de l’appel de fonctions arithmétiques comme mean() ou sd(), déclarant que les arguments ne sont pas numériques.
La cause fondamentale réside toujours dans la présence d’au moins un élément non convertible selon les règles arithmétiques établies :
- Une faute de saisie cléricale substituant accidentellement la lettre ‘O’ majuscule au chiffre zéro ‘0’.
- L’usage sporadique d’un espace insécable (point de code Unicode U+00A0) importé depuis un tableur, invisible à l’œil nu mais interprété comme un caractère alphanumérique par l’analyseur de R.
- Une incohérence dans le séparateur décimal, mélangeant points et virgules au sein d’une même série d’enregistrements.
Pour diagnostiquer rapidement l’élément perturbateur, le statisticien peut tenter une coercition forcée au moyen de as.numeric() sur la colonne incriminée. Les enregistrements problématiques seront immédiatement convertis en NA avec émission d’un avertissement d’introduction de valeurs manquantes par coercition. Il suffit alors de croiser les indices logiques de ces valeurs avec le vecteur textuel d’origine pour localiser avec une exactitude absolue la source de la contamination.
10.3 Échecs liés à la localisation du fichier ou permissions de lecture
Les interruptions de traitement se manifestant par le message d’erreur « cannot open file ‘…’: No such file or directory » relèvent de défaillances liées à la topologie du système de fichiers ou à la gestion du contexte d’exécution. R recherche le fichier désigné par rapport au répertoire de travail courant de la session active.
La sécurisation de l’accès requiert une discipline rigoureuse :
- Vérifier le répertoire de travail en cours au moyen de la primitive getwd().
- Éviter impérativement le recours à des chemins absolus codés en dur (ex. « C:/Users/Nom/Documents/… ») qui vouent le script à l’échec immédiat sur tout autre ordinateur.
- Recourir systématiquement à des chemins relatifs ancrés à la racine d’un projet formalisé.
Par ailleurs, sur les systèmes d’exploitation multi-utilisateurs de type Unix ou au sein d’environnements virtualisés (conteneurs Docker, serveurs HPC), l’erreur « Permission denied » signale que le processus d’exécution sous lequel opère la session R ne dispose pas des droits de lecture (read) sur le fichier ciblé. La rectification de ces permissions via les utilitaires de contrôle d’accès du système d’exploitation hôte est alors un prérequis technique incontournable.
11. Sécurisation, validation et audit de l’objet importé
11.1 Vérification systématique des dimensions et des distributions
L’ingestion de données brutes ne doit jamais être considérée comme achevée dès lors que la commande read.delim a retourné la main sans émettre d’erreur critique. L’audit d’intégrité commence par l’évaluation immédiate de la géométrie de la matrice au moyen de la fonction dim(), dont les deux valeurs retournées doivent coïncider rigoureusement avec le nombre d’enregistrements observés et le nombre d’attributs collectés.
L’inspection visuelle et programmatique des extrémités du tableau d’observations s’effectue traditionnellement par les fonctions head() et tail(), en requérant l’affichage des dix premières et des dix dernières lignes. Cette inspection rapide permet de s’assurer :
- Que l’en-tête n’a pas été décalé d’une case vers la gauche ou vers la droite en raison d’un séparateur surnuméraire en début de ligne.
- Que la queue du fichier ne contient pas des lignes résiduelles d’agrégation (moyennes globales, totaux) générées automatiquement par certains logiciels d’exportation.
- Que la distribution des valeurs numériques ne présente pas des valeurs manifestement aberrantes dues à un glissement de colonnes d’un bout à l’autre de la matrice.
Ce protocole de contrôle forme la première ligne de défense de l’intégrité scientifique des analyses ultérieures.
11.2 Validation formelle des types de colonnes et des contraintes d’intégrité
La seconde phase de validation réside dans l’audit exhaustif de la typologie interne de chaque vecteur composant le data frame. L’instruction sapply(mon_dataframe, class) génère un inventaire concis de la structure typologique, permettant de repérer instantanément toute anomalie de conversion (par exemple, une variable continue identifiée comme character).
Au-delà de la vérification de classe, la validation méthodologique impose la mise en place de tests d’assertions programmées vérifiant le respect des contraintes de domaine :
- Contraintes d’intervalle : s’assurer qu’une échelle de Likert bornée de 1 à 5 ne contient aucune valeur strictement inférieure à 1 ou strictement supérieure à 5.
- Contraintes d’unicité : valider que la colonne des identifiants participants ne comporte strictement aucun doublon au moyen de l’expression any(duplicated(mon_dataframe$identifiant)).
- Contraintes de complétude : évaluer le taux de valeurs manquantes par variable et vérifier que les omissions ne se concentrent pas anormalement sur un bloc spécifique du jeu de données.
L’automatisation de ces règles d’intégrité au sein du script analytique permet de stopper préventivement l’exécution si les données d’entrée violent les axiomes de validité de la recherche.
11.3 Documentation programmatique de l’étape d’ingestion des données
Dans un contexte d’assurance qualité et d’auditabilité scientifique, chaque chargement de données doit s’accompagner d’une traçabilité documentaire nativement intégrée au code source. Cela implique la consignation explicite de l’ensemble des paramètres ayant présidé à l’appel de read.delim.
La capture des avertissements émis par le compilateur lors de la lecture peut être interceptée programmatiquement au moyen de la structure tryCatch() ou de gestionnaires de conditions, consignant les messages d’alerte dans un journal textuel horodaté. De surcroît, le calcul d’une empreinte cryptographique (par exemple via une somme de contrôle MD5 ou SHA-256 calculée sur le fichier physique brut au moyen de la bibliothèque standard tools) permet de prouver mathématiquement que les données importées correspondent sans la moindre altération au fichier déposé dans les archives scientifiques de l’institution de recherche.
Ce niveau de rigueur confère au pipeline d’ingestion une valeur probante incontestable, alignée sur les standards les plus exigeants de la métrologie des données contemporaines.
12. Bonnes pratiques académiques et intégration dans un pipeline reproductible
12.1 Standardisation du code d’importation au sein d’un projet RStudio
L’intégration harmonieuse de read.delim dans un environnement de développement professionnel tel que RStudio repose sur une organisation spatiale standardisée du projet de recherche. L’arborescence du répertoire doit instaurer une ségrégation physique absolue et inviolable entre les données brutes (raw data) et les données nettoyées ou dérivées (processed data).
Le principe cardinal de la recherche computationnelle reproductible stipule que le répertoire contenant les fichiers textes délimités bruts doit être traité comme un espace en lecture seule : aucun script ne doit jamais écraser, altérer ou renommer un fichier source sur son support de stockage originel. Les transformations réalisées par R doivent s’opérer exclusivement en mémoire vive ou s’exporter vers un dossier dérivé distinct.
Pour éliminer définitivement les écueils liés aux chemins d’accès absolus, l’usage du paquetage here est hautement préconisé. En combinant here::here(« dossier_donnees », « fichier.txt ») avec read.delim, le chemin est résolu de manière dynamique et agnostique par rapport à l’emplacement exact de la racine du projet, assurant que le projet s’exécutera de manière fluide qu’il soit cloné sur un ordinateur portable sous Windows, une station de travail Unix ou un cluster d’exécution distant.
12.2 Encapsulation fonctionnelle de l’importation de données complexes
Lorsque des protocoles expérimentaux imposent des règles d’ingestion répétitives impliquant de multiples arguments (gestion des valeurs manquantes exotiques, désactivation des commentaires, configuration des classes de colonnes), la duplication de longs appels à read.delim le long des scripts accroît considérablement la dette technique et le risque d’erreurs de copie.
La pratique académique d’excellence commande de concevoir une fonction personnalisée d’encapsulation (wrapper function) au niveau du laboratoire ou du projet. Cette fonction dédiée internalise les paramètres invariables spécifiques au protocole expérimental :
- Elle préconfigure de façon centralisée les valeurs de sep, dec, na.strings et fileEncoding.
- Elle intègre une couche de programmation défensive vérifiant l’existence physique du fichier et la validité de son format avant de déclencher la lecture.
- Elle applique immédiatement les contrôles dimensionnels et typologiques standardisés avant de retourner un data frame parfaitement validé à l’utilisateur final.
Cette standardisation fonctionnelle assure une homogénéité totale des traitements analytiques menés par différents chercheurs ou étudiants au sein d’une même équipe de recherche.
12.3 Exigences de la science ouverte et pérennité logicielle
Le mouvement de la Science Ouverte (Open Science) préconise la mise à disposition publique non seulement des manuscrits scientifiques et des données empiriques, mais également de l’intégralité du code source ayant permis de forger les résultats quantitatifs. Dans cette optique, l’utilisation délibérée des formats tabulaires délimités par des tabulations et des fonctions natives de R de base comme read.delim incarne un choix épistémologique fort.
Les formats binaires propriétaires fermés ou dépendants de versions spécifiques de tableurs commerciaux s’exposent inéluctablement à l’obsolescence technologique : l’impossibilité de rouvrir un fichier binaire vieux de quinze ans est une réalité technique documentée. À l’inverse, un fichier texte plat délimité par des tabulations, exempt de tout artifice propriétaire, demeurera universellement déchiffrable tant qu’existeront des ordinateurs capables de lire des flux d’octets.
De même, en limitant l’adhérence logicielle aux seules primitives universelles fournies par le paquetage utils de R, le chercheur s’assure que son protocole computationnel pourra être réexécuté avec une fidélité mathématique absolue par les générations futures de scientifiques, concrétisant ainsi l’idéal méthodologique d’une science rigoureuse, transparente et pérenne.
Références
- Chambers, J. M. (2008). Software for Data Analysis: Programming with R. Springer. https://doi.org/10.1007/978-0-387-75936-4
- Chambers, J. M. (2016). Extending R. Chapman and Hall/CRC. https://doi.org/10.1201/9781315381305
- Gandrud, C. (2020). Reproducible Research with R and RStudio (3rd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9780429031809
- Ihaka, R., & Gentleman, R. (1996). R: A language for data analysis and graphics. Journal of Computational and Graphical Statistics, 5(3), 299–314. https://doi.org/10.1080/10618600.1996.10474713
- Peng, R. D. (2016). R Programming for Data Science. Leanpub. https://bookdown.org/rdpeng/rprogdatascience/
- R Core Team. (2023). R: A Language and Environment for Statistical Computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Wickham, H. (2019). Advanced R (2nd ed.). Chapman and Hall/CRC. https://doi.org/10.1201/9781351201315
- Wickham, H., & Grolemund, G. (2017). R for Data Science: Import, Tidy, Transform, Visualize, and Model Data. O’Reilly Media. https://r4ds.had.co.nz/
- Wilkinson, L. (2005). The Grammar of Graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0