
L’acquisition et l’incorporation des données brutes au sein d’un environnement de calcul statistique constituent le socle fondamental sur lequel repose l’ensemble de la démarche scientifique empirique. En psychologie cognitive, en neuropsychologie et dans les sciences du comportement au sens large, la transition entre l’observation expérimentale et la modélisation inférentielle exige une rigueur absolue lors du chargement des enregistrements numériques. Une erreur imperceptible lors de cette phase préliminaire — qu’il s’agisse d’une altération d’encodage, d’une permutation de colonnes ou d’une interprétation numérique inadéquate de valeurs manquantes — compromet irrévocablement la validité interne et la reproductibilité des analyses statistiques ultérieures.
Au sein du logiciel statistique open-source R, la fonction read.table représente la matrice originelle et le mécanisme de référence pour l’ingestion de structures matricielles et tabulaires stockées sous forme textuelle non structurée ou semi-structurée. Conçue pour offrir une adaptabilité totale face à l’hétérogénéité des formats de fichiers générés par les logiciels d’expérimentation et les dispositifs d’acquisition de mesures comportementales, cette fonction encapsule des décennies de principes méthodologiques relatifs au traitement de données délimitées. Maîtriser read.table ne se limite pas à connaître une simple commande utilitaire ; cela suppose de comprendre précisément la manière dont l’interpréteur R alloue la mémoire, segmente les flux de caractères et assigne les types atomiques aux vecteurs constitutifs d’un tableau de données.
Ce guide exhaustif a pour vocation d’analyser en profondeur l’architecture, la paramétrisation et l’application avancée de la fonction read.table. À travers une démarche didactique et technique, nous explorerons les fondements théoriques de l’importation de fichiers textes, les subtilités d’arbitrage entre les différents délimiteurs, l’optimisation des structures de mémoire pour les volumétries substantielles, ainsi que les stratégies de contournement des anomalies d’importation les plus complexes rencontrées par les chercheurs et analystes de données.
1. Introduction à la fonction read.table dans l’environnement R
1.1 Définition et rôle fondamental de read.table
La fonction read.table est la primitive canonique intégrée au package utils de base de R, destinée à convertir des flux textuels organisés en enregistrements discrets en un objet composite de première classe : le data.frame. Dans la nomenclature computationnelle de R, un tableau de données n’est pas une simple matrice de valeurs homogènes, mais une liste chaînée de vecteurs de longueurs strictement identiques, où chaque vecteur peut présenter un mode atomique propre (numérique, entier, textuel, logique ou facteur). L’utilité fondamentale de read.table réside dans sa capacité à analyser ligne par ligne (ligne de commande et enregistrement logique) un flux d’entrée, à identifier les frontières de chaque observation selon une règle de découpage prédéfinie, et à matérialiser instantanément cette abstraction en mémoire vive.
Le mécanisme interne de conversion repose sur une boucle d’analyse syntaxique programmée au niveau C sous-jacent à l’interpréteur R. Cette routine inspecte séquentiellement le contenu du fichier, quantifie le nombre d’entrées séparées par des marques délimitatrices, et applique une heuristique de détection de type pour instancier les vecteurs sous-jacents. Ce processus assure une passerelle standardisée entre le stockage persistant sur disque (fichiers textes plats, indépendants de toute plateforme propriétaire) et l’environnement de calcul interactif. La possibilité de contrôler chaque phase de cette conversion garantit l’intégrité numérique des données, ce qui élimine les transformations masquées ou les coercitions indésirables qui se produisent couramment dans les logiciels de tableur commerciaux.
Dans la perspective de la science ouverte et de la reproductibilité computationnelle, formalisée notamment par les directives de l’American Psychological Association, read.table constitue un garant méthodologique. Contrairement aux interfaces graphiques où l’importation dépend de clics manuels non consignés, l’écriture explicite des paramètres d’importation au sein d’un script textuel documente rigoureusement l’origine, la structure et les transformations initiales appliquées aux données brutes. Tout chercheur indépendant disposant du script et du fichier source peut ainsi réexécuter l’ingestion et obtenir une copie binaire strictement conforme du jeu de données originel.
1.2 Pertinence pour l’analyse de données en sciences psychologiques et comportementales
La recherche empirique contemporaine en sciences psychologiques s’appuie massivement sur des paradigmes expérimentaux informatisés. Des environnements logiciels tels que PsychoPy, E-Prime, OpenSesame ou des dispositifs matériels dédiés (systèmes d’oculométrie SMI/Tobii, appareils d’électroencéphalographie ou dispositifs de mesure de la conductance cutanée) exportent systématiquement leurs flux de mesures brutes sous la forme de fichiers textes tabulaires. Ces fichiers récapitulent les événements milliseconde par milliseconde : temps de réaction, précision de la réponse motrice, identifiants des stimuli visuels ou auditifs présentés, et conditions de neutralisation ou d’amorçage expérimental.
Toutefois, la morphologie textuelle de ces sorties expérimentales est rarement immédiatement compatible avec les fonctions d’analyse statistique multivariée sans un paramétrage sur-mesure. Les logiciels de passation intègrent régulièrement des métadonnées narratives en début de document (date de la passation, version du script, métriques d’étalonnage matériel), utilisent des séparateurs atypiques (multiples tabulations, espacements variables pour aligner visuellement le texte) et encodent les non-réponses par des conventions arbitraires (par exemple -999, « None » ou « N/A »). read.table s’avère particulièrement adaptée à ce niveau de complexité structurelle grâce à la granularité de ses options d’ajustement, permettant de standardiser les séries temporelles et les protocoles psychométriques sans altérer la fidélité des chronométrages de latence cognitive.
L’intégration de read.table au sein de pipelines de prétraitement permet également de construire des routines d’importation par lots (batch processing). Dans une étude impliquant une cohorte de plusieurs centaines de participants, où chaque sujet dispose d’un fichier textuel unique par session expérimentale, la robustesse de read.table permet d’itérer à travers l’arborescence des répertoires, de valider l’intégrité formelle de chaque enregistrement individuel, et d’agréger l’ensemble des données dans une matrice globale sans nécessiter d’interventions manuelles sujettes aux erreurs de manipulation humaine.
1.3 Positionnement par rapport aux fonctions dérivées
L’architecture du package utils de R propose une famille de fonctions d’importation qui dérivent directement de read.table. Des commandes telles que read.csv, read.csv2, read.delim et read.delim2 ne constituent pas des algorithmes distincts implémentés séparément au niveau système. Ce sont des enveloppes fonctionnelles (wrappers) qui invoquent read.table en modifiant simplement les valeurs par défaut de certains arguments critiques afin de s’adapter aux standards d’échange de données les plus répandus.
Ainsi, read.csv prédéfinit le séparateur de colonnes comme étant la virgule (sep = ",") et active par défaut la reconnaissance de la première ligne comme en-tête (header = TRUE), tout en conservant le point comme symbole décimal. À l’inverse, read.csv2 adapte ces règles aux conventions typographiques d’Europe continentale en utilisant le point-virgule comme délimiteur de champs (sep = ";") et la virgule comme délimiteur décimal (dec = ","). De manière analogue, read.delim configure le délimiteur sur la tabulation horizontale (sep = "t"). Bien que ces fonctions dérivées offrent un gain de concision syntaxique appréciable au quotidien, elles masquent les paramètres sous-jacents et peuvent introduire des hypothèses implicites erronées lors du traitement de formats composites ou non conventionnels.
Le recours direct à la fonction générique read.table s’impose dès lors qu’un fichier source dévie des formats stéréotypés. En exigeant du chercheur la spécification transparente et délibérée de chaque paramètre — de la gestion des espaces à la nature exacte des délimiteurs — read.table élimine les ambiguïtés structurelles. Cette transparence paramétrique est la condition sine qua non d’une traçabilité irréprochable dans les chaînes de traitement analytique complexes, garantissant que l’objet informatique produit reflète précisément la structure sémantique conçue lors de la collecte expérimentale.
2. Syntaxe fondamentale et anatomie des paramètres principaux
2.1 Spécification du paramètre file et gestion des chemins d’accès
Le premier argument formel de la fonction read.table est file. Il désigne la source d’information textuelle que le moteur d’analyse doit traiter. Dans sa déclinaison la plus classique, cet argument prend la forme d’une chaîne de caractères représentant le chemin d’accès vers un fichier stocké localement sur le système de fichiers de la machine hôte. On distingue l’utilisation des chemins absolus (qui décrivent l’intégralité de l’arborescence depuis la racine du disque dur, par exemple "C:/Recherche/Etude1/data.txt") et des chemins relatifs (qui localisent le fichier par rapport au répertoire de travail actif, accessible via getwd(), comme "donnees/data.txt").
Dans un contexte de programmation sous environnement Windows, un écueil récurrent concerne la transcription des séparateurs de dossiers. Les systèmes d’exploitation Windows emploient traditionnellement la barre oblique inverse (antislash ). Or, dans le standard de syntaxe du langage R, l’antislash est un caractère d’échappement utilisé pour introduire des caractères spéciaux (comme n pour le saut de ligne ou t pour la tabulation). Dès lors, un chemin rédigé sous la forme "C:etudesdata.txt" provoquera une erreur d’analyse lexicale. L’utilisateur doit impérativement doubler la barre oblique inverse ("C:etudesdata.txt") ou, de manière beaucoup plus portable et élégante, adopter la barre oblique conventionnelle (slash "C:/etudes/data.txt"), nativement interprétée par le sous-système de gestion des fichiers de R quel que soit le système d’exploitation hôte (macOS, Linux ou Windows).
Au-delà des fichiers locaux, l’argument file possède la capacité intrinsèque d’interagir directement avec des connexions distantes et des protocoles réseau. Il est parfaitement licite de transmettre une adresse URL sécurisée (par exemple "https://monsite.org/open_data/experience1.txt"). R instancie alors une connexion réseau temporaire, télécharge le flux d’octets dans un tampon mémoire et applique les règles de segmentation textuelle à la volée. Il est également possible de connecter read.table à des canaux virtuels, des descripteurs de fichiers compressés (via la fonction gzfile() ou unz()), ou même au flux d’entrée standard du système ("stdin"), offrant ainsi une flexibilité remarquable pour les infrastructures de calcul intensif en grappe ou les conteneurs de traitement automatisé.
2.2 L’argument header et la gestion de la première ligne
L’argument logique header informe le moteur d’ingestion sur le statut sémantique de la toute première ligne utile présente dans le flux textuel. Par défaut, dans la définition originelle de read.table, cet argument est assigné à la valeur booléenne FALSE. Ce réglage initial postule que chaque ligne du document, y compris la première, représente une observation expérimentale concrète, et qu’aucun libellé nominatif n’a été intercalé par le système exportateur. En conséquence, R attribue automatiquement des étiquettes génériques aux colonnes, conventionnellement formatées sous la forme V1, V2, …, Vn (pour Variable 1, Variable 2, etc.).
Lorsque le fichier source contient les intitulés des variables sur sa ligne inaugurale — ce qui constitue la pratique quasi universelle des logiciels contemporains (comme Participant_ID, Condition, Reaction_Time, Accuracy) — l’utilisateur doit impérativement expliciter header = TRUE. R interprète alors cette rangée initiale non pas comme des réalisations de variables aléatoires, mais comme les identifiants textuels devant être attachés à l’attribut names du data.frame résultant. Cette désignation préserve la signification des dimensions statistiques tout au long des étapes analytiques subséquentes.
Une discordance dans la configuration de cet argument engendre des corruptions structurelles sévères. Si un fichier comportant un en-tête est importé avec header = FALSE, la ligne contenant les noms de variables textuelles est traitée comme une ligne de données standard. Puisqu’un vecteur au sein d’un data.frame ne peut admettre qu’un unique type atomique de données (principe d’homogénéité vectorielle), la présence d’une chaîne de caractères sur la première observation force l’ensemble de la colonne correspondante — même si elle est composée à 99,9 % de valeurs numériques décimales de temps de réaction — à être convertie de force en mode character. Ce phénomène, qualifié de coercition implicite, paralyse l’exécution ultérieure de tests paramétriques élémentaires tels que la moyenne ou l’analyse de variance, jusqu’à ce qu’une correction manuelle et laborieuse soit appliquée.
2.3 L’argument sep et la nature des séparateurs
Le paramètre sep régit la logique de partitionnement horizontal du flux textuel, définissant le ou les caractères qui délimitent la frontière entre deux colonnes contiguës sur une même ligne d’enregistrement. Dans la fonction read.table, la valeur par défaut attribuée à cet argument est une chaîne vide spécifique : sep = "". Ce réglage possède une propriété algorithmique particulière : il indique au parseur de considérer tout espace blanc (qui inclut l’espace standard, la tabulation horizontale ou les sauts de tabulation) comme un délimiteur valide, tout en procédant à la fusion des espaces blancs successifs contigus.
Cette tolérance inhérente à sep = "" est particulièrement avantageuse lorsque les fichiers textes résultent de processus de mise en forme hérités d’anciens environnements de calcul (tels que les programmes écrits en Fortran ou les sorties formatées de terminaux de mesure), où des espaces multiples sont injectés de manière dynamique pour assurer un alignement visuel esthétique en colonnes régulières. Dans cette configuration, R considère une série de trois ou dix espaces consécutifs exactement de la même manière qu’un espace unique : comme une transition unitaire vers la cellule suivante de la matrice.
À l’inverse, dès lors qu’un séparateur explicite et rigide est spécifié (comme la tabulation sep = "t" ou l’espace unique strict sep = " "), la mécanique d’évaluation devient rigide. Deux séparateurs consécutifs ne sont plus amalgamés : ils signalent impérativement la présence d’une cellule intermédiaire vide ne contenant aucun caractère, ce qui déclenche l’instanciation automatique d’une valeur manquante ou d’une chaîne textuelle nulle. Le choix précis de la valeur de sep gouverne ainsi la fidélité de la restitution matricielle, conditionnant la juste concordance entre les données collectées sur le plan empirique et leur projection numérique au sein de l’espace de calcul R.
3. Préparation et diagnostic préliminaire des fichiers textuels
3.1 Inspection de la structure interne d’un fichier texte brut
Avant d’initier la moindre commande de lecture au sein de l’interpréteur R, l’investigateur doit impérativement procéder à un diagnostic morphologique direct du fichier brut. Cette inspection préalable requiert le recours à un éditeur de texte non formateur dédié au développement informatique (tel que Notepad++, Visual Studio Code, Sublime Text ou GNU Emacs). Les logiciels de traitement de texte orientés bureautique (comme Microsoft Word ou LibreOffice Writer) doivent être rigoureusement proscrits, car ils appliquent des altérations typographiques automatiques destructrices (substitution des guillemets droits informatiques par des guillemets typographiques incurvés, injection de codes de formatage propriétaires invisibles ou modification silencieuse des retours chariots).
Cette phase d’inspection oculaire et structurelle vise à vérifier plusieurs propriétés fondamentales du document. En premier lieu, il convient de déterminer si le document présente un nombre rigoureusement constant de champs par ligne. Les variations dans le nombre de délimiteurs résultent fréquemment d’interruptions inopinées lors de l’écriture matérielle par l’appareil expérimental ou d’enregistrements d’annotations libres de la part de l’expérimentateur en milieu de fichier.
En second lieu, l’attention doit se porter sur les éventuels blocs de métadonnées initiales. Les protocoles de neuro-imagerie fonctionnelle, d’oculométrie ou de tests cardiovasculaires préfixent souvent les matrices de mesure par une dizaine de lignes décrivant l’identité du sujet, la date de calibration, la fréquence d’échantillonnage et les versions des micrologiciels (firmwares). Ces éléments textuels libres rompent la régularité du tableau et doivent être précisément quantifiés en amont afin d’être neutralisés lors de l’appel à read.table grâce aux arguments de contournement dédiés.
3.2 Encodage des caractères et internationalisation
L’hétérogénéité des standards d’encodage de caractères constitue l’une des causes prépondérantes de corruption de données lors des recherches collaboratives internationales. Un encodage de caractères associe un motif binaire (une suite d’octets) à un glyphe linguistique déterminé. L’alphabet latin standard non accentué est codifié de façon quasi universelle sur 7 bits via la norme ASCII. Toutefois, l’inclusion de caractères accentués propres à la langue française (comme « é », « è », « à », « ç »), de cédilles, d’alphabets non latins ou de symboles mathématiques introduit une divergence majeure selon que le système générateur a employé le standard universel contemporain UTF-8 ou des normes patrimoniales plus anciennes telles que l’ANSI (Windows-1252 sur les systèmes d’exploitation Microsoft en Europe occidentale) ou l’ISO-8859-1 (Latin-1).
Lorsqu’un fichier encodé en UTF-8 comportant des étiquettes textuelles avec diacritiques est chargé par R sur une machine configurée avec une locale Windows-1252 sans précaution particulière, l’inadéquation de la table de décodage produit un phénomène d’anomalie typographique qualifié d’incompatibilité de codage (mojibake). Les caractères accentués se transforment en séquences de glyphes incohérents (par exemple, « Réponse » devient « Réponse »). Cela pose un risque analytique majeur : des modalités qualitatives supposées identiques risquent d’être partitionnées en niveaux de facteurs distincts et corrompus lors du traitement statistique.
Pour immuniser le processus de lecture contre ces dégradations, read.table met à disposition l’argument fileEncoding. La pratique recommandée en recherche internationale consiste à contraindre systématiquement la chaîne d’importation en explicitant le jeu de caractères employé lors de la sérialisation du fichier, en spécifiant par exemple fileEncoding = "UTF-8" ou fileEncoding = "Latin1". La déclaration explicite de cet argument force l’interpréteur R à transposer fidèlement la suite d’octets disques dans l’encodage interne de la session utilisateur, préservant la pureté orthographique des libellés de variables et des réponses qualitatives ouvertes.
3.3 Conventions des terminaisons de ligne
La délimitation verticale des enregistrements repose sur des conventions de fin de ligne (end-of-line ou EOL) dont la structure physique dépend de l’architecture historique des systèmes d’exploitation sous-jacents. Dans l’écosystème Unix, GNU/Linux et macOS moderne, un retour à la ligne est matérialisé par un unique octet nommé Line Feed (LF, représenté conventionnellement par n, code hexadécimal 0x0A). À l’opposé, les environnements Microsoft Windows emploient traditionnellement une séquence combinée de deux octets : Carriage Return suivi de Line Feed (CRLF, représenté par rn, codes hexadécimaux 0x0D 0x0A).
Le sous-système de lecture de R gère nativement et de manière transparente la grande majorité de ces transitions de fin de ligne lorsqu’il opère sur des fichiers textes standard. Néanmoins, des complications surviennent lorsqu’un fichier est transféré entre des architectures hétérogènes sans conversion appropriée, ou lorsqu’un flux de données s’interrompt brutalement avant la sérialisation du tout dernier marqueur de retour à la ligne (fichier tronqué). Dans cette dernière éventualité, l’analyseur lexical de R peut émettre un avertissement explicite indiquant une fin de fichier incomplète (incomplete final line found by readTableHeader).
Par ailleurs, si certaines lignes de données disposent de moins d’éléments délimités que la largeur établie par la structure générale du tableau (par exemple, si les dernières colonnes de mesures psychologiques ne comportent pas d’enregistrements et que l’exportateur a omis les séparateurs terminaux), read.table interrompra la lecture en générant une erreur fatale. Dans ces contextes asymétriques particuliers, l’argument logique fill = TRUE permet d’autoriser la capture de lignes de longueurs disparates en injectant systématiquement des valeurs manquantes (NA) dans les cellules terminales non matérialisées, assurant ainsi la clôture dimensionnelle du tableau sans bloquer la chaîne de traitement.
4. Exemple pratique pas à pas : Importation d’un jeu de données tabulaire
4.1 Étape 1 : Analyse structurelle du fichier source data.txt
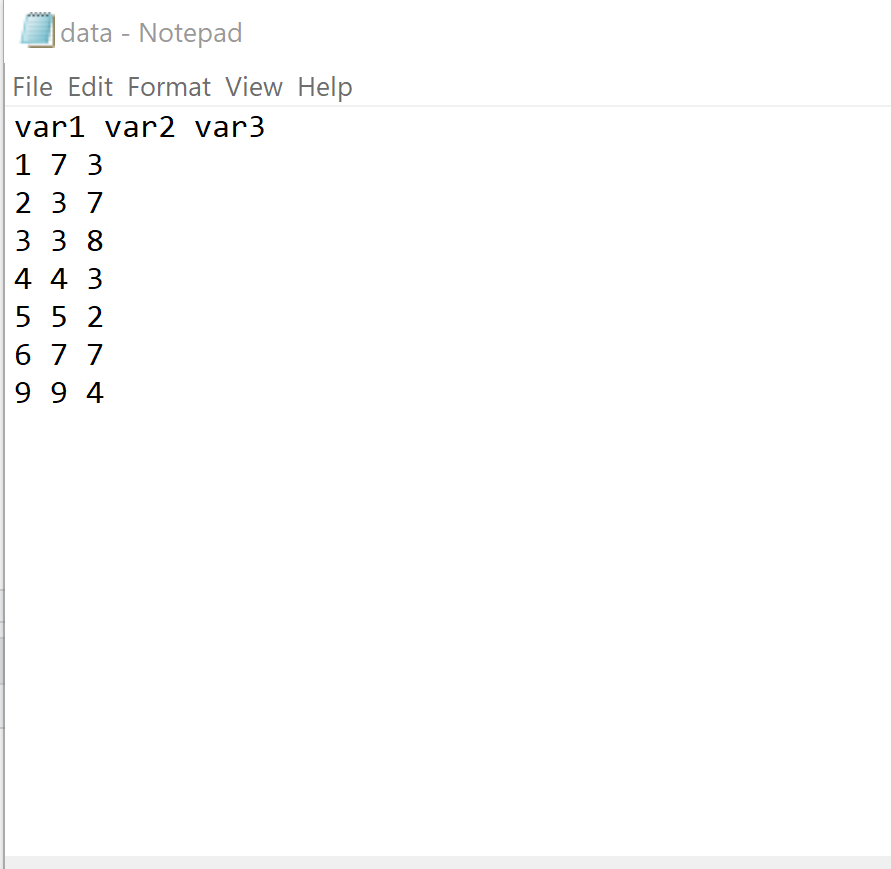
Afin d’illustrer concrètement la mise en œuvre pratique de read.table, nous allons étudier le cas concret d’une expérience en psychologie cognitive portant sur les relations entre le niveau d’anxiété situationnelle et l’efficacité du contrôle exécutif lors d’une tâche de type Stroop. Considérons un fichier textuel brut intitulé data.txt, issu du système d’acquisition de données expérimentales et localisé dans le sous-répertoire de travail donnees.
L’ouverture de ce document au moyen d’un éditeur textuel non formateur révèle la structure textuelle brute suivante :
Sujet Age Condition Anxiete Score_Stroop
S01 22 Incongru Fort 452.3
S02 24 Congru Faible 389.1
S03 21 Incongru Faible 412.7
S04 26 Congru Fort 401.5
S05 23 Incongru Moyen 438.9
S06 25 Congru Moyen 395.2
L’analyse structurelle de cette séquence brute permet de poser trois constats fondamentaux qui guideront notre paramétrisation de la commande :
- La première ligne du document ne contient pas des observations numériques, mais les descripteurs nominatifs des cinq variables étudiées (
Sujet,Age,Condition,Anxiete,Score_Stroop). La présence d’un en-tête impose donc l’utilisation du paramètreheader = TRUE. - Les colonnes sont délimitées de façon uniforme par un espacement simple. Toutefois, pour prémunir le script contre les variations d’espacements accidentelles (telles que la présence de doubles espaces de calage visuel), le recours au comportement par défaut de l’argument
sep = ""apparaît particulièrement approprié. - Les valeurs décimales associées au temps de réaction (colonne
Score_Stroop) utilisent la convention du point typographique anglo-saxon (ex.452.3), ce qui concorde parfaitement avec la valeur par défaut de l’argumentdec = "."de R.
4.2 Étape 2 : Écriture et exécution du code R d’importation
L’opération d’ingestion sous R se formalise par l’invocation explicite de la fonction read.table, assignée à un objet récepteur typé data.frame désigné sous le nom de df_stroop. La commande doit intégrer de façon méthodique le chemin relatif orienté vers la ressource textuelle, la déclaration explicite de la présence de l’en-tête, et l’indication de l’encodage du fichier source pour prévenir toute corruption lors de l’analyse :
# Définition du chemin d'accès relatif et importation structurée
chemin_fichier <- "donnees/data.txt"

df_stroop <- read.table(
  file = chemin_fichier,
  header = TRUE,
  sep = "",
  dec = ".",
  stringsAsFactors = FALSE,
  fileEncoding = "UTF-8"
)
Lors de l’exécution de cette instruction par l’interpréteur R, le flux de données textuel est lu en mémoire vive, découpé en six rangées d’observations et cinq colonnes de variables, puis encapsulé dans une table relationnelle interne. L’utilisation délibérée de stringsAsFactors = FALSE (standardisée depuis R 4.0.0) garantit que les colonnes Sujet, Condition et Anxiete demeurent sous la forme de vecteurs de chaînes de caractères pures au moment de leur matérialisation en mémoire, évitant ainsi toute contrainte d’indexation prématurée sous forme de facteurs ordinaux ou nominaux non maîtrisés.
4.3 Étape 3 : Vérification et exploration de l’objet importé
Une bonne pratique de recherche computationnelle consiste à ne jamais tenir pour acquis le succès d’une opération d’ingestion de données brutes sans déployer un protocole d’inspection diagnostique immédiat. Il s’agit de s’assurer de la concordance parfaite entre la structure matricielle théorique du fichier source et les caractéristiques dimensionnelles de l’objet nouvellement alloué dans l’espace global de travail.
Le contrôle s’articule autour d’une séquence de fonctions primitives de diagnostic :
# Inspection des premières et dernières lignes du tableau
head(df_stroop, n = 3)
tail(df_stroop, n = 2)

# Évaluation des dimensions scalaires globales
dim(df_stroop)
nrow(df_stroop)
ncol(df_stroop)

# Vérification des identifiants nominatifs des colonnes
colnames(df_stroop)

# Diagnostic de l'architecture interne et des types atomiques
str(df_stroop)
L’exécution de la commande dim(df_stroop) doit obligatoirement retourner le vecteur d’entiers c(6, 5), certifiant que l’en-tête n’a pas été incorporé comme une ligne d’observation supplémentaire (ce qui aurait généré une dimension verticale de sept rangées). Parallèlement, l’invocation de str(df_stroop) révèle la taxonomie atomique générée par le parseur : la variable Age doit être identifiée comme un vecteur d’entiers ou de réels (int ou num), le vecteur Score_Stroop doit figurer comme un vecteur de valeurs décimales (num), et les indicateurs catégoriels doivent se conformer au mode textuel (chr). Cet examen exhaustif valide la conformité mathématique de la matrice importée avant d’amorcer les traitements inférentiels.
5. Gestion experte des délimiteurs de colonnes avec sep
5.1 Différence cruciale entre sep = » et sep = ‘ ‘
Une incompréhension fréquente chez les utilisateurs de R réside dans l’assimilation erronée de sep = "" et de sep = " ". Bien que ces deux paramètres mobilisent conceptuellement l’espace typographique comme instrument de partitionnement horizontal, leurs moteurs de traitement algorithmique diffèrent radicalement dans leur traitement des motifs d’espacement contigus.
La spécification par défaut, sep = "", implémente une logique d’expression régulière assimilable au découpage par motifs d’espaces blancs continus (s+). Lorsqu’elle parcourt une ligne textuelle, la machine à états de R absorbe l’intégralité d’un bloc d’espaces consécutifs, qu’il soit constitué d’un espace simple, de cinq espaces successifs ou d’une combinaison hybride d’espaces et de tabulations. Ce bloc est condensé en un unique séparateur logique. Ce comportement procure une résilience remarquable face aux fichiers tabulaires générés avec des largeurs de colonnes ajustées visuellement pour l’œil humain.
À l’opposé, la spécification stricte sep = " " désactive cette agrégation intelligente des espaces consécutifs. Dans ce mode opératoire, chaque caractère d’espacement individuel est rigoureusement interprété comme une borne séparatrice unitaire. Par voie de conséquence, si deux espaces se succèdent au sein du document source (par exemple pour combler l’alignement d’un chiffre court), R considérera obligatoirement qu’une colonne invisible et vide s’intercale entre ces deux espaces. Cela entraîne instantanément un décalage structurel de la ligne concernée, provoquant la fameuse erreur d’inégalité du nombre d’éléments (line did not have X elements). Dès lors, sep = " " ne doit être réservé qu’aux fichiers d’une régularité absolue où chaque espace matérialise sans exception la transition vers la colonne suivante.
5.2 Séparateurs par tabulation (sep = ‘t’)
La tabulation horizontale, codifiée informatiquement sous la séquence d’échappement t, constitue l’un des standards les plus universels et fiables d’échange de données tabulaires (fichiers aux extensions .tsv ou .txt). Contrairement aux séparateurs fondés sur l’espace typographique, l’usage de la tabulation offre l’avantage majeur de découpler nettement le délimiteur inter-colonnes des espaces intra-colonnes.
Cette distinction s’avère déterminante lors de la collecte d’enregistrements psychométriques ou cliniques comprenant des données textuelles qualitatives, telles que les identifiants de protocoles hospitaliers, les dénominations de syndromes psychopathologiques ou les descriptions de comportements observables. Si une variable clinique contient des termes composés (par exemple "Trouble Panique" ou "Anxiete Generalisee"), l’utilisation d’un délimiteur par espacement (sep = " " ou sep = "") ferait éclater cette chaîne de caractères en deux colonnes disjointes, corrompant la matrice de données. La tabulation (sep = "t") isole parfaitement le libellé textuel dans son intégralité, le caractère espace n’étant plus considéré comme une marque de rupture tabulaire.
Considérons l’exemple concret de l’importation d’une matrice de corrélation ou d’un relevé d’observations psychiatriques structuré par des tabulations :
# Importation sécurisée d'un tableau à délimitation par tabulation
donnees_cliniques <- read.table(
  file = "donnees/evaluations_diagnostiques.tsv",
  header = TRUE,
  sep = "t",
  quote = "",
  fileEncoding = "UTF-8"
)
Cette instruction garantit une séparation étanche des colonnes de tests tout en autorisant la manipulation transparente de cellules contenant des chaînes textuelles riches sans risque de morcellement syntaxique.
5.3 Délimiteurs personnalisés : virgules, points-virgules et barres verticales
Dans la pratique scientifique, l’analyste de données est régulièrement confronté à des structures tabulaires fondées sur des délimiteurs arbitraires choisis par les ingénieurs concepteurs de logiciels propriétaires ou dépendants de contextes linguistiques régionaux spécifiques. La fonction read.table permet de faire face à ces formats hétérogènes en acceptant tout caractère scalaire au sein de l’argument sep.
Les fichiers délimités par des virgules (CSV standard anglo-saxon) s’importent directement via read.table(file, header = TRUE, sep = ","). Cependant, dans les pays de langue française et dans l’ensemble de l’Europe continentale, la virgule constitue le séparateur arithmétique officiel des fractions décimales (la norme AFNOR en France, par exemple). Afin d’éviter un conflit syntaxique irréconciliable où la virgule servirait simultanément à marquer les bornes des colonnes et la partie décimale des nombres réels, les logiciels de bureautique et les instruments de mesure configurés en environnement francophone adoptent le point-virgule (;) comme séparateur horizontal, conjugué à la virgule comme marqueur décimal.
L’adaptation de read.table à ce format francophone s’opère de manière totalement contrôlée en associant le paramètre sep = ";" au paramètre décimal dec = "," :
# Configuration pour exports francophones (ex. tableurs européens)
donnees_neuro <- read.table(
  file = "donnees/potentiels_evoques.csv",
  header = TRUE,
  sep = ";",
  dec = ",",
  fileEncoding = "Latin1"
)
De plus, certains systèmes de bases de données volumineuses ou dispositifs de capture de signaux physiologiques emploient la barre verticale (pipe |) ou le tilde (~) pour s’affranchir de toute collision avec les ponctuations textuelles courantes. L’instruction read.table(file, header = TRUE, sep = "|") traite ces formats sans nécessiter la moindre conversion logicielle préalable, illustrant la polyvalence universelle de la primitive de base de R.
6. Personnalisation et sécurisation des noms de colonnes
6.1 Importation de fichiers sans en-tête d’origine
Il est fréquent que les dispositifs de mesure comportementale automatisés, pour des raisons d’optimisation de la vitesse d’écriture sur disque ou d’économie de mémoire microcontrôleur, génèrent des fichiers de flux continus totalement dépourvus de ligne d’en-tête descriptive. Le fichier démarre alors immédiatement par la première mesure collectée.
Lorsqu’un tel fichier est pris en charge par read.table(..., header = FALSE), le parseur synthétise des étiquettes de colonnes par défaut en préfixant le rang indiciaire de la dimension par la lettre V :
# Simulation d'une lecture de flux brut sans métadonnées d'en-tête
flux_brut <- read.table(
  file = "donnees/flux_physiologique.raw",
  header = FALSE,
  sep = ""
)

# Constat des noms attribués automatiquement
names(flux_brut) # Renvoie c("V1", "V2", "V3", "V4")
Ce mode d’indexation anonyme (V1, V2, etc.) présente des risques analytiques majeurs. D’une part, il masque la sémantique de l’expérience, augmentant le risque d’appliquer une transformation statistique sur une variable inappropriée (par exemple, calculer l’écart-type d’un identifiant numérique de participant pris à tort pour une latence de réponse). D’autre part, il dégrade l’intelligibilité du code source pour la communauté scientifique, réduisant la lisibilité des scripts d’analyse. Il est donc indispensable d’accompagner systématiquement toute lecture sans en-tête d’une phase de requalification explicite des descripteurs de variables.
6.2 Injection explicite de libellés avec col.names
Pour contourner l’anonymisation générique des variables, read.table propose l’argument col.names. Ce paramètre attend un vecteur atomique de chaînes de caractères dont la dimension correspond strictement au nombre total de colonnes physiques présentes dans le fichier source à charger.
L’utilisation conjointe de header = FALSE et de col.names substitue directement les étiquettes fournies par l’utilisateur aux identifiants automatiques dès la phase d’ingestion mémoire, garantissant une clarté sémantique immédiate :
# Définition formelle du dictionnaire des variables expérimentales
etiquettes_variables <- c(
  "ID_Participant",
  "Temps_Fixation_ms",
  "Diametre_Pupillaire",
  "Statut_Saccade"
)

# Injection des noms lors de la lecture du fichier brut
df_pupillometrie <- read.table(
  file = "donnees/pupille_session1.txt",
  header = FALSE,
  sep = "t",
  col.names = etiquettes_variables,
  fileEncoding = "UTF-8"
)
Dans l’hypothèse où le fichier contiendrait déjà une première ligne descriptive mais que les intitulés fournis par l’expérimentateur s’avéreraient abscons, inadaptés ou erronés, il est parfaitement possible de combiner skip = 1 (pour ignorer la première rangée fautive) et col.names = etiquettes_variables, forçant ainsi une nomenclature propre et standardisée dès la porte d’entrée de l’environnement analytique.
6.3 Validation syntaxique des variables via check.names
Le langage R impose des contraintes strictes sur la validité syntaxique des identifiants d’objets et des noms de colonnes au sein d’un data.frame. Selon les conventions du langage, un nom de variable syntaxiquement valide doit impérativement débuter par une lettre alphabétique ou par un point (non immédiatement suivi d’un chiffre), et ne doit contenir aucun caractère réservé pour les opérateurs arithmétiques ou logiques (tels que +, -, *, /, %, $, ^, ou l’espace typographique).
L’argument booléen check.names régit la conformité des descripteurs de variables. Configuré par défaut sur check.names = TRUE, il active une routine interne d’assainissement lexical qui appelle la fonction make.names(). Tous les caractères invalides ou incompatibles détectés dans l’en-tête source sont automatiquement transformés en points (.). Ainsi, un intitulé brut extrait d’une échelle d’anxiété comme "Score Anxiete (Total - 2024)" sera transmuté en "Score.Anxiete..Total...2024.". De même, les noms de colonnes dupliqués se verront assigner des suffixes numériques progressifs (par exemple Item, Item.1, Item.2) afin d’assurer l’unicité référentielle des colonnes.
Bien que cette altération automatique garantisse la navigabilité du tableau via l’opérateur standard df$nom_variable, il existe des situations expérimentales — notamment lors de l’interfaçage avec des bases de données relationnelles SQL ou des formats d’annotation génomique rigides — où l’altération des identifiants initiaux est méthodologiquement proscrite. Dans ce cadre hautement spécifique, l’utilisateur peut paramétrer check.names = FALSE. Cela permet de conserver l’exactitude typographique brute des libellés de variables originaux, imposant en contrepartie l’usage systématique d’apostrophes inversées (backticks, par exemple `Score Anxiete (Total - 2024)`) pour référencer ces colonnes dans les routines ultérieures de manipulation de données.
7. Typage des données et optimisation de la mémoire avec colClasses
7.1 Le mécanisme d’inférence automatique des types par R
L’un des traits distinctifs les plus notables de read.table réside dans son mécanisme sophistiqué d’inférence dynamique des types de données. Lorsque l’argument colClasses n’est pas explicité par le programmeur (valeur résidant à NA par défaut), la fonction exécute une pré-lecture analytique du fichier textuel afin de déterminer la nature sémantique de chaque colonne. Cette heuristique interne évalue séquentiellement si le contenu d’un vecteur peut être assimilé à un mode logique (présence exclusive de TRUE, FALSE, T, F), entier (séquence de chiffres sans point décimal), numérique à virgule flottante (présence de fractions décimales ou notations scientifiques comme 1.2e-4), ou s’il doit être rangé par élimination dans la catégorie des chaînes textuelles (character).
Bien que cette automatisation simplifie l’analyse exploratoire, elle présente un coût computationnel considérable. Pour déduire le type adapté sans risquer d’erreur de troncature, R procède à une double évaluation des observations, ce qui accroît substantiellement la durée d’ingestion ainsi que l’empreinte mémoire temporaire mobilisée lors de la conversion des structures textuelles en vecteurs binaires. De surcroît, ce mécanisme n’est pas exempt de biais de classification : la présence isolée d’un caractère textuel fortuit (tel qu’une coquille de saisie ou un symbole résiduel d’expérimentation) au sein d’une série de dix millions d’enregistrements numériques poussera irrémédiablement le système à dégrader l’intégralité du vecteur en mode chaîne de caractères, générant des anomalies en aval du pipeline de traitement.
7.2 Définition manuelle et explicite avec colClasses
L’optimisation la plus efficace du processus d’importation via read.table consiste à court-circuiter l’inférence automatique en définissant explicitement la classe de chaque colonne au moyen du vecteur colClasses. Ce paramètre attend une collection ordonnée de chaînes de caractères spécifiant le type atomique exact assigné à chaque variable, par exemple "numeric", "integer", "character", "logical" ou "factor".
Considérons l’application de ce paramétrage d’optimisation :
# Spécification explicite des classes de colonnes
types_attendus <- c(
  "character",  # ID Sujet
  "integer",    # Âge du participant en années révolues
  "factor",     # Condition expérimentale catégorielle
  "numeric"     # Latence de réponse milliseconde
)

df_optimise <- read.table(
  file = "donnees/grande_cohorte.txt",
  header = TRUE,
  sep = "t",
  colClasses = types_attendus,
  comment.char = "",
  fileEncoding = "UTF-8"
)
Cette déclaration manuelle réduit drastiquement le temps d’exécution (pouvant diviser la durée de traitement par un facteur de deux à quatre sur des fichiers d’envergure) en éliminant les routines de test de type en langage C. De plus, colClasses offre une fonctionnalité précieuse pour la gestion de la mémoire vive : l’attribution de la valeur spéciale "NULL" à un indice vectoriel indique au moteur de lecture d’ignorer purement et simplement la colonne correspondante lors de l’importation. Les variables omises ne sont jamais allouées en mémoire vive, ce qui permet d’extraire sélectivement quelques colonnes d’intérêt au sein de matrices massives comportant des centaines de métriques superflues.
7.3 Application méthodologique aux échelles d’évaluation de Likert
Dans la recherche quantitative en psychométrie, la modélisation des questionnaires d’attitude et des inventaires de personnalité repose de manière prépondérante sur des échelles de réponse ordonnées de type Likert (allant généralement de 1 = « Pas du tout d’accord » à 5 ou 7 = « Totalement d’accord »). La gestion du format de ces variables lors de l’ingestion nécessite une grande rigueur méthodologique.
Si ces variables d’items sont importées sans précaution, l’inférence par défaut de R les classera automatiquement en tant que vecteurs réels (numeric) ou entiers continus (integer). Cette conversion implicite masque leur nature ordinale non continue et autorise involontairement le calcul de métriques inadaptées sans examen préalable des postulats de distribution. En mobilisant l’argument colClasses conjointement aux structures de typage de R, le chercheur peut contraindre ces variables à s’instancier sous forme d’entiers discrets ou préparer leur conversion immédiate en facteurs ordonnés :
# Définition des classes pour un inventaire de personnalité
classes_echelle <- c(
  "character", # Identifiant du sujet
  rep("integer", 10) # 10 items Likert scorés de 1 à 5
)

donnees_likert <- read.table(
  file = "donnees/inventaire_anxiete.txt",
  header = TRUE,
  sep = " ",
  colClasses = classes_echelle
)

# Conversion immédiate en facteurs ordonnés pour modélisation psychométrique
donnees_likert$Item_1 <- factor(
  donnees_likert$Item_1,
  levels = 1:5,
  ordered = TRUE
)
Cette rigueur méthodologique dès la lecture textuelle garantit la cohérence des structures algébriques soumises ultérieurement aux analyses factorielles de confirmation ou aux modélisations par équations structurelles.
8. Traitement rigoureux des données manquantes et symboles spéciaux
8.1 Identification des valeurs manquantes avec na.strings
L’existence de données manquantes représente une caractéristique incontournable de l’expérimentation comportementale et de l’épidémiologie clinique : omission de réponse d’un participant, défaillance transitoire d’une électrode de mesure ou dépassement du délai de réponse imparti (timeout). Au sein du langage R, l’absence de donnée est matérialisée par l’indicateur constant NA (Not Available), qui préserve les propriétés de calcul booléen et s’intègre rigoureusement dans les modèles d’inférence statistique.
Par défaut, la fonction read.table ne reconnaît comme valeurs manquantes que les cellules textuelles contenant explicitement la chaîne "NA". Or, les logiciels d’expérimentation et les instruments médicaux mobilisent une variété d’indicateurs conventionnels arbitraires pour marquer l’absence de valeur valide, parmi lesquels des codes numériques extrêmes (999, -999, -99), des mentions textuelles ("Null", "NaN", "Refus", "Manquant", "Omission") ou de simples points d’interrogation ("?").
Si ces conventions d’absence ne sont pas préalablement déclarées au moteur d’importation, les conséquences analytiques sont immédiates :
- Un code numérique tel que
-999ne sera pas considéré comme une valeur absente, mais comme une valeur empirique réelle. Le calcul ultérieur d’une latence moyenne de temps de réaction intégrera ce nombre hautement négatif, faussant dramatiquement la moyenne et l’écart-type de l’échantillon. - Une mention textuelle comme
"Refus"au sein d’une colonne numérique provoquera la coercition de l’ensemble de la variable vers le typecharacter, interdisant toute modélisation quantitative directe.
Pour neutraliser ces anomalies, read.table propose l’argument na.strings, qui reçoit un vecteur complet des conventions employées par le système source :
# Vectorisation des représentations de la non-réponse
codes_manquants <- c("NA", "-999", "999", "Refus", "TIMEOUT", "?", "")

df_psychophysio <- read.table(
  file = "donnees/reponses_biologiques.txt",
  header = TRUE,
  sep = "t",
  na.strings = codes_manquants,
  fileEncoding = "UTF-8"
)
Durant le processus d’analyse syntaxique, toute cellule dont le contenu textuel correspond exactement à l’une des entrées du vecteur na.strings est instantanément convertie en NA scalaire, garantissant ainsi l’intégrité de la structure dès la lecture.
8.2 Gestion des espaces vides et des chaînes vierges
Un cas délicat dans la gestion des données textuelles concerne le traitement des espaces résiduels non significatifs entourant les valeurs au sein des cellules (par exemple la chaîne " Controle " opposée à "Controle"). Si ces éléments ne sont pas assainis lors de la phase d’ingestion, R traitera ces variantes typographiques comme deux modalités distinctes lors de la factorisation, fragmentant artificiellement les groupes expérimentaux.
L’argument strip.white résout ce problème d’homogénéisation. Lorsqu’il est configuré sur strip.white = TRUE, le parseur élague automatiquement les espaces blancs situés en début et en fin de champ au sein de chaque cellule analysée. Il convient toutefois de souligner une contrainte technique fondamentale : strip.white n’est effectif que si un délimiteur explicite et rigide a été spécifié au niveau de l’argument sep (comme sep = "," ou sep = "t"). Il reste inopérant lorsque le partitionnement horizontal s’appuie sur le séparateur générique par défaut sep = "", ce dernier absorbant déjà les espaces contigus dans sa mécanique d’analyse.
En outre, l’inclusion de la chaîne vide "" au sein de na.strings permet d’établir une règle d’interprétation pour les cellules dépourvues du moindre caractère. Dans les protocoles de tests projectifs ou de questionnaires d’auto-évaluation, une chaîne vide correspond presque universellement à une omission de réponse de la part du participant. L’associer rigoureusement à NA évite l’instanciation de chaînes vides sans signification sémantique au sein des vecteurs de type character.
8.3 Implications psychométriques de la non-réponse
L’encodage approprié des données manquantes en entités formelles NA dépasse le simple cadre de l’hygiène informatique : il constitue un prérequis méthodologique déterminant en psychométrie contemporaine. Dans les théories modernes de la mesure (théorie des réponses aux items, modèles d’équations structurelles, imputation multiple de données manquantes selon les axiomes de Rubin), la nature du mécanisme de non-réponse — Missing Completely at Random (MCAR), Missing at Random (MAR) ou Missing Not at Random (MNAR) — conditionne la validité des conclusions scientifiques.
Une fois les données importées via read.table avec un vecteur na.strings rigoureux, le chercheur dispose d’outils statistiques puissants pour quantifier l’attrition et les motifs d’omission au sein de son échantillon :
# Quantification du taux d'omission global et par variable
taux_manquants_global <- mean(is.na(df_psychophysio))
taux_manquants_colonne <- colMeans(is.na(df_psychophysio))

# Synthèse descriptive respectueuse des indicateurs NA
summary(df_psychophysio)
Cette approche d’importation permet de préserver l’information relative à la complétude des protocoles expérimentaux. Si des valeurs manquantes avaient été laissées sous forme de codes numériques fictifs (-999), les algorithmes d’imputation multiple ou de modélisation bayésienne les auraient intégrées comme des valeurs empiriques réelles, introduisant un biais majeur dans les estimations paramétriques.
9. Contrôle des chaînes de caractères, encadrements et facteurs
9.1 L’évolution du paramètre stringsAsFactors
L’histoire de l’argument stringsAsFactors dans la fonction read.table reflète l’évolution épistémologique du langage R au fil des décennies. Depuis la conception initiale de R jusqu’à la publication de la version 3.6.3 en 2020, la valeur par défaut de cet argument était historiquement fixée à TRUE. Ce choix s’enracinait dans les pratiques biométriques et agronomiques du logiciel ancêtre S, où la majorité des chaînes textuelles correspondaient à des facteurs catégoriels désignant des blocs expérimentaux, des variétés de cultures ou des groupes de traitement.
Cependant, dans le contexte de la science des données moderne manipulant des volumes croissants de corpus textuels libres, d’identifiants alphanumériques non répétitifs et de métadonnées complexes, ce comportement historique s’est avéré particulièrement contraignant. Transformer automatiquement toute chaîne de texte en facteur interne (représenté par un entier sous-jacent associé à une table de libellés ou levels) provoquait des erreurs d’analyse insidieuses : concaténation de facteurs renvoyant des identifiants numériques plutôt que les chaînes textuelles d’origine, impossibilité d’introduire de nouveaux niveaux lexicaux sans redéfinition préalable de la variable, et surconsommation de mémoire pour des vecteurs à cardinalité élevée.
Depuis la mise à disposition de la version majeure R 4.0.0, l’équipe centrale de développement de R (R Core Team) a acté une transition méthodologique fondamentale en assignant désormais la valeur par défaut de stringsAsFactors à FALSE. Dans les versions contemporaines du langage, les colonnes textuelles sont donc préservées sous leur forme native de vecteurs de chaînes (character). Il est vivement conseillé de maintenir cette configuration par défaut lors de l’appel à read.table, puis d’opérer délibérément la conversion des variables véritablement nominales ou ordinales via la fonction factor() une fois l’intégrité de la structure vérifiée.
9.2 Neutralisation et gestion des guillemets avec quote
Les fichiers de données contenant des évaluations qualitatives, des transcriptions linguistiques ou des verbatims d’entretiens psychologiques encadrent fréquemment les textes par des caractères de citation (guillemets droits doubles " ou guillemets simples ') afin de sanctuariser les délimiteurs internes au texte. L’argument quote de read.table définit les symboles devant être traités comme des balises d’encadrement lexical (la valeur par défaut étant quote = ""'", qui englobe à la fois les guillemets simples et doubles).
Un dysfonctionnement critique survient fréquemment dans les fichiers rédigés en langue française lorsque les apostrophes grammaticales (caractère ') se trouvent au sein de chaînes non délimitées par des guillemets doubles. Considérons une transcription clinique contenant la phrase : Le sujet n'a pas manifeste d'anxiete. Si le parseur interprète l’apostrophe comme l’ouverture d’une zone de citation protégée, il attendra l’apostrophe suivante pour clore le bloc textuel. En l’absence de fermeture rapide, la routine d’analyse absorbera toutes les lignes de données subséquentes comme s’il s’agissait d’un unique champ textuel continu multiligne, générant une erreur fatale de lecture (EOF within quoted string).
Pour immuniser l’importation contre ce phénomène destructeur lors du traitement de corpus en langue naturelle, il convient de désactiver totalement l’interprétation des guillemets ou de la restreindre strictement au symbole double :
# Neutralisation complète de l'analyse des guillemets et apostrophes
df_verbatims <- read.table(
  file = "donnees/entretiens_cliniques.txt",
  header = TRUE,
  sep = "t",
  quote = "", # Aucun caractère n'est traité comme guillemet délimiteur
  fileEncoding = "UTF-8"
)
Cette directive neutralise l’action de l’apostrophe française comme opérateur d’encadrement, assurant une lecture continue et non corrompue de chaque enregistrement textuel sans rupture syntaxique.
9.3 Traitement des identifiants alphanumériques complexes
Dans la gestion des protocoles de recherche soumis aux exigences de confidentialité et d’anonymisation (notamment sous le Règlement Général sur la Protection des Données – RGPD), les participants se voient attribuer des identifiants alphanumériques uniques standardisés. Ces codes comportent fréquemment des zéros initiaux de calage numérique, par exemple 000142, 000143, etc.
Si la colonne correspondante est importée sans encadrement explicite, le mécanisme d’inférence de read.table constatera que la cellule ne renferme que des caractères numériques et la convertira automatiquement en entier mathématique standard (integer). Cette conversion implicite entraîne la suppression définitive des zéros de tête : 000142 devient le scalaire 142. Cette altération silencieuse complique considérablement l’appariement relationnel subséquent avec d’autres tables de données (données génomiques, biomarqueurs sanguins ou journaux de suivi journalier) dont les identifiants ont conservé leur formatage textuel complet à six caractères.
L’utilisation concertée de colClasses permet de prémunir l’analyste contre ce risque en imposant sans équivoque le mode textuel sur les identifiants :
# Préservation absolue des zéros initiaux des identifiants
df_sujets <- read.table(
  file = "donnees/cohorte_anonymisee.txt",
  header = TRUE,
  sep = " ",
  colClasses = c("ID_Anonyme" = "character")
)
En assignant colClasses = c("ID_Anonyme" = "character"), la chaîne d’importation conserve scrupuleusement la configuration textuelle intégrale de la métadonnée d’identification, garantissant une intégrité référentielle absolue lors des fusions de tables de données (opérations de type merge ou join).
10. Lecture sélective et filtrage préalable du flux de données
10.1 Omission des lignes d’introduction avec skip
La grande majorité des matériels scientifiques de mesure comportementale et neurophysiologique enrichissent leurs exports de données d’un ensemble de métadonnées administratives et techniques disposées sur les premières lignes du document source. Un enregistrement issu d’un dispositif oculométrique (eye-tracker) commence fréquemment par une quinzaine de lignes récapitulant les coordonnées du moniteur de stimulation, l’écart pupillaire inter-oculaire, la date du test et l’algorithme d’étalonnage exploité.
La tentative d’ingérer un tel document sans traitement préalable aboutit à une rupture immédiate de la commande read.table, les premières lignes ne respectant ni la délimitation ni la largeur matricielle des rangées d’observations proprement dites. L’argument skip fournit la solution technique adaptée à cette configuration : il reçoit une valeur entière k indiquant au parseur d’ignorer purement et simplement les k premières lignes physiques du fichier textuel avant d’amorcer le processus d’analyse tabulaire.
# Omission ciblée d'un en-tête instrumental de 14 lignes
df_oculometrie <- read.table(
  file = "donnees/eye_tracker_brut.txt",
  skip = 14,
  header = TRUE,
  sep = "t",
  fileEncoding = "UTF-8"
)
Dans les cas de figure où les métadonnées matérielles ont écrasé les noms des colonnes d’observation (ou lorsque ceux-ci figurent dans une section antérieure du document), il convient de combiner skip avec l’argument col.names détaillé à la section 6.2, permettant ainsi de passer outre le bloc préliminaire non structuré tout en injectant une nomenclature d’analyse rigoureuse sur le tableau de données utiles résultant.
10.2 Limitation du nombre d’observations avec nrows
Lors du développement d’une chaîne complexe de nettoyage et de modélisation statistique, manipuler d’emblée des fichiers volumineux — pouvant atteindre plusieurs gigaoctets et rassembler des millions d’enregistrements temporels — engendre une perte d’efficacité majeure lors de la phase de prototypage (temps d’attente d’ingestion prolongés, sollicitation excessive du processeur et de la mémoire vive).
L’argument nrows permet de circonscrire l’exécution de la lecture à un plafond quantitatif strict d’enregistrements. En stipulant par exemple nrows = 100, le moteur d’analyse de read.table interrompt sa boucle de capture dès que les cent premières rangées de données effectives ont été matérialisées dans la mémoire R :
# Prototypage rapide sur un sous-ensemble d'essai de cinquante lignes
df_echantillon_test <- read.table(
  file = "donnees/mesures_ecg_volumineuses.txt",
  header = TRUE,
  sep = "t",
  nrows = 50,
  fileEncoding = "UTF-8"
)
Cette lecture exploratoire offre l’opportunité de vérifier immédiatement l’adéquation des paramètres de délimitation, d’éprouver la syntaxe des noms de colonnes et de définir formellement le vecteur des classes colClasses. Une fois la routine d’analyse syntaxique parfaitement calibrée et validée sur ce sous-ensemble restreint, l’analyste peut alors relancer la commande sur la totalité de l’ensemble de données en supprimant l’argument nrows ou en lui affectant sa valeur par défaut -1.
10.3 Ignorer les commentaires textuels avec comment.char
Il est courant que des fichiers de données partagés au sein de la communauté scientifique ou issus de dépôts de données ouvertes (open data) comportent des annotations textuelles ou des commentaires rédigés par les chercheurs pour documenter des conditions particulières d’expérimentation (par exemple une interruption due à un bruit extérieur dans la pièce de test, ou le recalibrage d’un capteur). Ces lignes de commentaires sont traditionnellement préfixées par un symbole distinctif conventionnel, le dièse (#) constituant le standard de référence.
Par défaut, read.table possède le paramètre comment.char = "#". Dès lors qu’il rencontre le symbole #, le parseur ignore l’intégralité des caractères résiduels situés entre ce symbole et le saut de ligne suivant. Si une ligne entière débute par ce caractère de commentaire, elle est intégralement ignorée sans interférer avec la régularité du tableau de données. Il est par ailleurs possible d’adapter ce symbole aux standards d’autres langages scientifiques en modifiant l’argument, par exemple en spécifiant comment.char = "%" pour des matrices générées sous MATLAB ou LaTeX, ou comment.char = ";" pour des exports issus d’architectures d’assemblage informatique.
Il existe néanmoins un cas d’usage où ce mécanisme doit être impérativement désactivé : celui où les données empiriques elles-mêmes contiennent légitimement le caractère configuré comme marqueur de commentaire (par exemple des messages textuels capturés sur les réseaux sociaux intégrant des mots-dièses/hashtags #, ou des nomenclatures chimiques spécifiques). Dans ce contexte, maintenir l’activation de comment.char tronquerait accidentellement les phrases dès le premier symbole dièse rencontré. Pour annuler ce comportement et forcer le traitement du dièse comme un simple caractère textuel ordinaire, il est indispensable de renseigner une chaîne vide : comment.char = "".
11. Diagnostics et résolution des erreurs courantes avec read.table
11.1 Résolution de l’erreur : ‘line X did not have Y elements’
L’incident technique le plus fréquemment rencontré lors de l’utilisation de read.table prend la forme d’un message d’arrêt explicite du moteur d’analyse : Error in scan(file = file, what = what, sep = sep, ...) : line X did not have Y elements. Cette erreur indique sans ambiguïté que la routine d’analyse syntaxique de bas niveau a identifié une divergence dimensionnelle sur la rangée X du fichier : alors que la structure de référence attendait un total de Y colonnes, la ligne examinée en comporte un nombre distinct (supérieur ou inférieur).
Les origines étiologiques de cette anomalie structurelle sont généralement au nombre de trois :
- L’insertion accidentelle d’un séparateur supplémentaire non masqué au sein d’une cellule textuelle (par exemple, un espace non encadré par des guillemets lorsque
sep = " "est mobilisé). - L’omission d’un délimiteur final sur certaines lignes, générant des observations tronquées.
- La présence d’un guillemet textuel ouvrant sans guillemet de fermeture, conduisant R à agglutiner plusieurs lignes d’observations en une unique ligne artificielle déformée.
Pour diagnostiquer l’anomalie sans devoir ouvrir manuellement des fichiers massifs de plusieurs centaines de milliers de lignes, la boîte à outils primitive de R met à disposition la fonction hautement spécialisée count.fields(). Cette fonction opère une pré-analyse du fichier en retournant un vecteur d’entiers représentant le nombre exact de champs segmentés sur chaque ligne physique :
# Détection programmatique des lignes asymétriques
nb_champs_par_ligne <- count.fields(
  file = "donnees/mesures_psychologiques.txt",
  sep = "t"
)

# Identification des rangées s'écartant de la médiane attendue
largeur_attendue <- median(nb_champs_par_ligne)
lignes_fautives <- which(nb_champs_par_ligne != largeur_attendue)

# Affichage des indices de lignes corrompues
print(lignes_fautives)
Cette identification ciblée permet à l’analyste d’inspecter directement les lignes problématiques dans le fichier source à l’aide d’un éditeur textuel et de corriger l’asymétrie structurelle. Si l’irrégularité résulte simplement de données manquantes non délimitées en fin de rangée, l’adjonction temporaire de l’argument fill = TRUE au sein de read.table autorise l’interpréteur à absorber la ligne incomplète en compensant les manques par des valeurs NA.
11.2 Conflits de séparateur décimal (point versus virgule)
L’incohérence dans le choix du marqueur décimal constitue une source majeure de dégradation silencieuse des données quantitatives en recherche expérimentale. Alors que le monde académique anglo-saxon applique uniformément le point décimal (12.34), les pays francophones et une large part du continent européen utilisent historiquement la virgule décimale (12,34).
Lorsque la fonction read.table traite un fichier rédigé selon les conventions européennes sans ajustement de son paramètre par défaut (dec = "."), l’algorithme d’inférence de type analyse la présence de la virgule comme un caractère textuel non convertible en valeur flottante numérique. Par voie de conséquence, l’intégralité de la variable continue de temps de réaction ou de voltage électrophysiologique se trouve irrémédiablement coercée en vecteur de chaînes de caractères (character). L’analyste se retrouve alors dans l’incapacité d’effectuer les opérations arithmétiques fondamentales, toute tentative de calcul de moyenne générant le message d’erreur : argument n'est ni numérique ni logique: renvoi de NA.
La remédiation impose la configuration délibérée de l’argument décimal : dec = ",". De surcroît, une validation systématique post-importation doit être menée à l’aide de tests fonctionnels unitaires :
# Importation avec spécification du marqueur décimal continental
df_latences <- read.table(
  file = "donnees/latences_stroop_europe.txt",
  header = TRUE,
  sep = ";",
  dec = ",",
  fileEncoding = "UTF-8"
)

# Test d'assertion assurant la validité arithmétique de la variable
stopifnot(is.numeric(df_latences$Score_Stroop))
L’usage de stopifnot(is.numeric(...)) verrouille l’exécution du script si le vecteur a été dégradé en mode textuel, alertant immédiatement l’opérateur sur la présence d’un conflit de séparateur décimal avant l’amorce des modélisations inférentielles.
11.3 Erreurs de chemin d’accès et de permissions de lecture
L’interruption d’un script par le message cannot open the connection / cannot open file '...': No such file or directory indique l’incapacité de l’environnement R à localiser physiquement la cible mentionnée au sein du paramètre file.
La résolution de ce dysfonctionnement d’accès repose sur l’audit systématique du répertoire de travail courant (working directory) de la session R. L’utilisateur doit interroger son environnement au moyen de la fonction getwd(). Le chemin retourné forme la racine à partir de laquelle s’évaluent tous les chemins d’accès relatifs fournis dans les scripts. Si le fichier cible se trouve dans un dossier parent ou adjacent, le script ne parviendra pas à établir la liaison. L’harmonisation peut être opérée soit en reconfigurant temporairement le répertoire de travail via setwd("chemin/vers/dossier"), soit, plus judicieusement dans une optique de reproductibilité, en intégrant le système de gestion de projets de RStudio (projets .Rproj) qui ancre systématiquement le répertoire de travail à la racine du répertoire d’analyse.
Enfin, sous les systèmes d’exploitation modernes soumis à des politiques d’isolation et de sécurité strictes (notamment macOS avec le système de protection Gatekeeper ou les serveurs Linux sous profils SELinux/AppArmor), un message de type Permission denied signale que l’utilisateur exécutant le processus R ne détient pas les privilèges d’accès en lecture sur le fichier textuel ou son dossier hôte. Une modification des droits d’accès au niveau du système de fichiers (par exemple via la commande chmod +r sous environnement Unix) est alors requise pour permettre à R d’ouvrir le canal d’entrée en lecture.
12. Bonnes pratiques, reproductibilité et alternatives contemporaines
12.1 Standardisation du code d’importation pour la recherche reproductible
La formalisation du code d’importation de données constitue l’une des pierres angulaires de la méthodologie scientifique contemporaine, au même titre que la pré-enregistrement des hypothèses de recherche. Dans une perspective de reproductibilité totale des analyses statistiques, tout traitement interactif par clics ou manipulation manuelle directe des fichiers sources doit être banni au profit d’une écriture scriptée intégrale et déterministe.
Pour conférer à un script d’importation une pérennité maximale, il est fondamental de ne jamais s’en remettre aux comportements implicites de l’interpréteur R, car ces derniers peuvent changer au fil des versions du logiciel (comme l’a illustré la transition historique de stringsAsFactors). Un bloc d’ingestion robuste doit expliciter systématiquement et lisiblement l’ensemble des arguments critiques :
# Déclaration formelle standardisée pour la science ouverte
df_experience_finale <- read.table(
  file = file.path("donnees", "brutes", "mesures_cognitives.txt"),
  header = TRUE,
  sep = "t",
  dec = ".",
  quote = """,
  na.strings = c("NA", "-999", "NULL"),
  colClasses = c(
    "Sujet_ID" = "character",
    "Age" = "integer",
    "Condition" = "character",
    "Temps_Reaction" = "numeric",
    "Reponse_Correcte" = "integer"
  ),
  strip.white = TRUE,
  stringsAsFactors = FALSE,
  comment.char = "",
  check.names = TRUE,
  fill = FALSE,
  fileEncoding = "UTF-8"
)
Le recours à la commande file.path() garantit la portabilité universelle des chemins d’accès inter-dossiers, quel que soit le système d’exploitation utilisé par les relecteurs ou pairs évaluateurs de l’étude (résolvant automatiquement l’usage de barres obliques simples ou inversées). Parallèlement, l’archivage conjoint des données brutes en format texte plat immuable (non propriétaire) et du script d’importation complet constitue le standard d’or du partage de données scientifiques préconisé par le mouvement pour la science ouverte (Open Science).
12.2 Validation systématique de la conformité post-importation
L’exécution sans erreur apparente d’une commande d’importation ne certifie pas de facto la conformité absolue du jeu de données ingéré. Des décalages d’une colonne vers la gauche ou vers la droite consécutifs à la présence d’un délimiteur accidentel peuvent modifier l’alignement des données sans interrompre la lecture logicielle. Un protocole méthodologique de vérification post-importation s’impose donc systématiquement avant d’engager toute modélisation statistique.
Ce protocole diagnostique repose sur une série de contrôles de cohérence interne :
- Vérification dimensionnelle : Contrôler que le nombre total de lignes et de colonnes correspond rigoureusement aux prévisions du protocole expérimental (nombre de participants multiplié par le nombre d’essais administrés).
- Audit des plages de valeurs numériques (Range Checks) : Vérifier que les variables quantitatives respectent les limites théoriques et physiologiques plausibles. Un âge négatif ou un temps de réaction inférieur à 100 millisecondes trahit immanquablement un problème d’alignement de colonnes ou d’encodage des valeurs manquantes.
- Examen des cardinalités qualitatives : Vérifier que les variables catégorielles ne contiennent que les modalités strictement prévues par le plan expérimental factoriel, écartant ainsi les erreurs typographiques de saisie ou les variations de casse.
# Protocole d'assertion diagnostique d'intégrité
stopifnot(
  nrow(df_experience_finale) == 2400, # 40 sujets x 60 essais
  ncol(df_experience_finale) == 5,
  all(df_experience_finale$Age >= 18 &a\mp; df_experience_finale$Age <= 90),
  all(df_experience_finale$Temps_Reaction > 150, na.rm = TRUE),
  setequal(unique(df_experience_finale$Condition), c("Amorcage", "Controle"))
)
L’incorporation de ce bloc d’assertions logiques au sein du script garantit que l’analyse inférentielle ne sera exécutée que sur une structure de données parfaitement validée sur le plan computationnel et métrologique.
12.3 Comparatif technique : read.table, readr::read_delim et data.table::fread
Si la fonction primitive read.table demeure l’outil de référence absolu pour comprendre le fonctionnement fondamental de l’ingestion de données sous R, l’écosystème du langage s’est enrichi de bibliothèques tierces modernes offrant des optimisations substantielles pour les jeux de données volumineux. Les deux alternatives contemporaines dominantes sont la fonction read_delim du package readr (intégré au cadre Tidyverse) et la fonction fread issue du package data.table.
Le tableau comparatif suivant synthétise les propriétés architecturales, les avantages et les limites de ces trois paradigmes d’importation :
| Caractéristique technique | utils::read.table | readr::read_delim | data.table::fread |
|---|---|---|---|
| Dépendance logicielle | Native (R base, zéro dépendance externe) | Package tiers (Écosystème Tidyverse) | Package tiers (data.table) |
| Vitesse d’exécution | Modérée à lente sur grands fichiers (> 100 Mo) | Rapide (implémentation optimisée en C++) | Ultra-rapide (parallélisation multithread en C) |
| Type d’objet produit | data.frame standard |
tibble (extension moderne de data.frame) |
data.table (compatible avec data.frame) |
| Inférence des types | Heuristique conservative séquentielle | Évaluation sur un échantillon de 1000 lignes | Échantillonnage adaptatif et flexible |
| Barre de progression | Non disponible nativement | Disponible nativement dans la console | Disponible nativement avec estimation du temps |
| Cas d’usage préférentiel | Scripts académiques pérennes, autonomes, et formats textuels très irréguliers | Pipelines interactifs modernes intégrés au Tidyverse et à dplyr | Données massives (Big Data), enregistrements de neuro-imagerie et signaux continus |
En conclusion de ce comparatif, le choix de l’outil d’ingestion doit être guidé par la taille des fichiers à analyser et les contraintes de déploiement de l’environnement de calcul. Pour des flux massifs de données comportementales dépassant plusieurs centaines de mégaoctets, data.table::fread offre une accélération computationnelle inégalée grâce à son moteur de lecture parallélisé exploitant l’ensemble des cœurs du microprocesseur. De même, readr::read_delim s’intègre naturellement dans les flux d’analyses orientés Tidyverse grâce à sa gestion native des formats de dates ISO-8601 et à ses rapports d’erreurs détaillés sur les problèmes de parsing.
Néanmoins, la fonction read.table de base conserve une pertinence scientifique indéboulonnable. Dépourvue de toute dépendance logicielle externe, présente dans toutes les installations de R depuis les origines du langage et bénéficiant d’une stabilité d’API garantie par la R Core Team, elle assure que les scripts écrits aujourd’hui continueront de s’exécuter à l’identique dans vingt ans. Pour la recherche expérimentale et la reproductibilité à long terme de la science empirique, la maîtrise approfondie de read.table demeure l’une des compétences méthodologiques fondamentales de tout chercheur ou analyste de données.
Références
American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
Chambers, J. M. (2008). Software for data analysis: Programming with R. Springer. https://doi.org/10.1007/978-0-387-75936-4
Dowle, M., Srinivasan, A., Gorecki, J., Chirico, M., Hocking, T., & data.table team. (2023). data.table: Extension of ‘data.frame’ (R package version 1.14.8) [Logiciel informatique]. https://CRAN.R-project.org/package=data.table
Murrell, P. (2009). Introduction to data technologies. Chapman & Hall/CRC. https://doi.org/10.1201/9781420065183
Peirce, J., Gray, J. R., Simpson, S., MacAskill, M., Höchenberger, R., Sogo, H., Kastman, E., & Lindeløv, J. K. (2019). PsychoPy2: Experiments in behavior made easy. Behavior Research Methods, 51(1), 195–203. https://doi.org/10.3758/s13428-018-01193-y
R Core Team. (2024). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
Rubin, D. B. (1976). Inference and missing data. Biometrika, 63(3), 581–592. https://doi.org/10.1093/biomet/63.3.581
Wickham, H., & Grolemund, G. (2016). R for data science: Import, tidy, transform, visualize, and model data. O’Reilly Media. https://r4ds.had.co.nz/
Wickham, H., Hester, J., & Bryan, J. (2023). readr: Read rectangular text data (R package version 2.1.4) [Logiciel informatique]. https://CRAN.R-project.org/package=readr
Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer. https://doi.org/10.1007/0-387-28695-0