
L’ingestion initiale des données constitue le premier maillon d’une chaîne de traitement analytique au sein de l’écosystème statistique. Dans le domaine de la science des données, de l’économétrie ou de la bio-informatique, l’étape préalable à toute modélisation probabiliste ou analyse exploratoire repose sur la capacité à transférer des corpus textuels structurés depuis un support de stockage persistant vers la mémoire vive d’un interpréteur de commandes. Lorsque cette transition échoue ou introduit des artefacts non sollicités, l’ensemble des inférences ultérieures se trouve irrémédiablement biaisé. Parmi la multitude de formats plats existants, le fichier à valeurs séparées par des tabulations, couramment désigné par le sigle TSV (Tab-Separated Values), occupe une place prépondérante, notamment en raison de sa résilience face aux ambiguïtés syntaxiques inhérentes aux séparateurs textuels traditionnels.
Le langage de programmation R, développé initialement par Ross Ihaka et Robert Gentleman comme une implémentation libre du langage S, a toujours accordé une importance majeure à l’importation de tableaux rectangulaires. Au fil des décennies, son arsenal logiciel s’est enrichi de multiples paradigmes d’entrée-sortie. Si les fonctions de base historiques ont permis d’établir les fondations de l’analyse quantitative moderne, l’avènement de bibliothèques spécialisées comme readr au sein du méta-paquet tidyverse et data.table a transformé la rapidité, l’expressivité et la rigueur du traitement des données tabulaires. Maîtriser l’ingestion d’un fichier TSV exige une compréhension fine de la sémantique du fichier source, de l’architecture du parseur utilisé et du mode de représentation en mémoire de la structure de données résultante.
Le présent article propose une analyse approfondie et méthodique de l’importation des fichiers TSV dans l’environnement R. À travers l’examen détaillé des formats, la mise en œuvre pas à pas d’exemples empiriques, le diagnostic précis des défaillances de lecture et l’exploration des méthodologies de haute performance pour le traitement de volumétries massives, ce guide offre aux chercheurs, analystes et ingénieurs de données un cadre de référence opérationnel et conceptuel rigoureux pour garantir la reproductibilité intégrale de leurs flux de données numériques.
1. Introduction aux fichiers TSV et à leur utilisation dans l’environnement R
1.1 Définition et structure technique du format TSV
Le format TSV (Tab-Separated Values) relève de la famille des fichiers dits de texte brut délimité. Il est régi par des conventions structurelles simples mais rigides, formalisées notamment dans le cadre des spécifications de type MIME text/tab-separated-values de l’Internet Engineering Task Force (IETF). Sa caractéristique distinctive fondamentale réside dans l’utilisation du caractère de tabulation horizontale, représenté par la séquence d’échappement t ou le point de code décimal ASCII 9 (hexadécimal 0x09), comme délimiteur strict et exclusif entre chaque champ d’un même enregistrement. Contrairement à des formats binaires opaques, le fichier TSV se compose d’une succession de lignes textuelles, chacune correspondant à une observation statistique, séparée de la suivante par un retour à la ligne conforme aux standards conventionnels des systèmes d’exploitation (le saut de ligne simple n sur les environnements de type UNIX et Linux, ou la séquence de retour chariot et saut de ligne rn sous Windows).
Dans l’analyse comparative des formats textuels plats, la distinction entre le TSV et le CSV (Comma-Separated Values) revêt une importance capitale. Le format CSV recourt à la virgule (,) ou, dans de nombreux pays francophones et européens appliquant la virgule décimale, au point-virgule (;) pour segmenter les cellules. Cette approche engendre fréquemment des conflits d’interprétation lorsque les données brutes contiennent elles-mêmes des virgules au sein de chaînes textuelles, comme des descriptions narratives, des adresses postales ou des valeurs numériques formatées. Pour lever cette ambiguïté, le format CSV impose l’échappement par des guillemets doubles ("), alourdissant le travail d’analyse lexicale du processeur et multipliant les risques de corruption du tableau lors de troncatures accidentelles. À l’inverse, le délimiteur espace (caractère ASCII 32), utilisé dans les tables à largeur fixe ou les formats délimités par des espaces, s’avère particulièrement fragile lorsqu’une donnée qualitative comporte plusieurs vocables disjoints.
Le recours à la tabulation offre un avantage structurel majeur dans la manipulation de chaînes textuelles denses et hétérogènes. Comme la tabulation horizontale n’est pratiquement jamais employée dans la saisie humaine courante d’un texte littéraire ou scientifique, elle constitue un séparateur naturel qui n’interfère que très rarement avec le contenu linguistique de la cellule. Par conséquent, les fichiers TSV nécessitent beaucoup moins fréquemment de mécanismes d’encapsulation textuelle complexes. Ce dépouillement syntaxique simplifie considérablement la phase de découpage en jetons (tokenization) effectuée par les parseurs de données, réduisant ainsi les risques de mauvaises lectures et améliorant la vitesse de désérialisation sur des fichiers volumineux.
1.2 Importance de l’importation rigoureuse des données en recherche quantitative
Dans tout protocole de recherche quantitative, qu’il s’agisse d’études épidémiologiques, d’analyses bio-informatiques de séquençage à haut débit ou de modélisations microéconométriques, l’intégrité de la structure matricielle des données conditionne l’ensemble des résultats publiés. L’importation ne doit en aucun cas être perçue comme une simple formalité technique d’ouverture de fichier, mais plutôt comme la première opération de validation structurelle du processus analytique. Si un décalage horizontal survient lors de la lecture initiale, la correspondance univoque entre une variable expérimentale et sa colonne d’assignation se désynchronise, entraînant la permutation invisible de mesures physiques ou d’indicateurs cliniques.
Les erreurs d’alignement et de décalage des colonnes constituent les défaillances les plus pernicieuses dans la chaîne de traitement. Elles se produisent typiquement lorsqu’une cellule contient un délimiteur orphelin non échappé ou lorsque le parseur interprète erronément une valeur manquante comme une absence de séparateur. Dans un tel scénario, l’interpréteur de code décale l’intégralité des attributs subséquents vers la gauche ou vers la droite pour l’observation concernée. Si la table comporte des colonnes numériques adjacentes, le logiciel n’émettra pas nécessairement d’avertissement de non-conformité de type, intégrant ainsi des mesures aberrantes au calcul des moyennes, des covariances et des estimateurs économétriques sans alerter l’utilisateur.
Ce niveau de rigueur participe directement à la reproductibilité computationnelle, principe épistémologique défendu avec insistance par la communauté scientifique contemporaine. Un protocole analytique moderne doit garantir que n’importe quel chercheur indépendant, disposant du fichier source brut et du script informatique associé, parvienne rigoureusement au même état de la mémoire vive et aux mêmes tableaux récapitulatifs. Formaliser précisément le protocole de lecture des fichiers TSV, en contrôlant les délimiteurs, les encodages et les classes de variables, protège l’analyse contre les mutations imprévues du système hôte et documente fidèlement la trajectoire des données, depuis leur stockage sur disque jusqu’à leur formalisation matricielle.
1.3 Aperçu des fonctions disponibles dans l’écosystème R
L’écosystème R propose une grande variété d’outils pour répondre à la problématique de la lecture des fichiers délimités, chacun reflétant une époque de conception et des compromis spécifiques entre compatibilité, sécurité et performance. La solution contemporaine la plus ergonomique réside dans la fonction read_tsv(), fournie par le package readr, composant fondamental du méta-paquet tidyverse développé sous l’impulsion de Hadley Wickham. Conçue pour remédier aux défauts historiques des outils de base de R, la fonction read_tsv() intègre un parseur rédigé en C++ qui analyse les premières rangées pour inférer de manière rigoureuse les types de données tout en produisant nativement un objet de type tibble, moderne et informatif.
À côté de cette approche moderne, le socle standard de R propose depuis ses origines des fonctions natives d’une très grande stabilité, réunies sous l’égide du package utils préinstallé avec le moteur d’exécution. Les fonctions read.delim() et sa forme générale read.table() représentent les primitives historiques traditionnelles pour l’importation de fichiers à délimitation par tabulation. Bien qu’elles souffrent parfois d’une relative lenteur d’exécution sur de gigantesques fichiers plats et d’un comportement d’inférence parfois contraignant, elles conservent une valeur inestimable pour les scripts destinés à être exécutés dans des environnements contraints ou dépourvus de connexion Internet permettant l’installation de bibliothèques tierces.
Enfin, pour répondre aux exigences du calcul intensif et de la manipulation de fichiers massifs atteignant plusieurs gigaoctets, le package data.table met à disposition la fonction fread() (fast read). Cet utilitaire s’est imposé comme la référence absolue en matière de vitesse d’ingestion brute. Écrit en langage C bas niveau avec un ordonnancement multithread optimisé, fread() détecte automatiquement la structure interne, les séparateurs et les types de données, tout en minimisant les copies en mémoire. Le choix entre read_tsv(), read.delim() et fread() ne relève donc pas d’une préférence stylistique arbitraire, mais d’un arbitrage technique délibéré entre simplicité d’intégration, absence de dépendances logicielles et vitesse d’ingestion sur les processeurs modernes.
2. Configuration préalable de l’environnement de travail et des packages
2.1 Installation et chargement de la bibliothèque readr
Pour exploiter les fonctionnalités de la fonction read_tsv(), l’analyste doit au préalable s’assurer que le package hébergeant cette routine est correctement intégré à son instance locale de R. Le package readr peut être installé de manière isolée ou par l’intermédiaire du méta-package tidyverse, qui consolide un ensemble cohérent d’outils voués à la manipulation, la transformation et la visualisation graphique des données quantitatives. L’installation s’opère par l’appel de l’instruction standard install.packages("readr") ou install.packages("tidyverse") dans la console interactive.
Une fois les fichiers binaires ou les sources compilées déployés dans la bibliothèque logicielle de la machine, le chargement en mémoire s’effectue au début de tout script de traitement par la commande library(readr). Il est particulièrement recommandé d’isoler explicitement cette importation en tête de fichier source afin d’offrir une visibilité immédiate sur les dépendances nécessaires à l’exécution de la chaîne analytique. Durant cette étape de chargement, l’interpréteur R procède à l’attachement de l’espace de noms de la bibliothèque dans le chemin de recherche global, rendant accessible l’ensemble des méthodes de désérialisation du paquet sans nécessiter la syntaxe de préfixage absolu du type readr::read_tsv(), bien que cette dernière formulation demeure conseillée dans le cadre du développement de packages formels.
Il convient également de vérifier périodiquement l’adéquation entre la version du moteur d’exécution de R et les versions des bibliothèques installées. Les composants logiciels de l’écosystème tidyverse évoluent régulièrement pour intégrer des optimisations de sécurité et de performances. L’exécution de la commande packageVersion("readr") offre la possibilité de valider par voie programmatique le respect des prérequis techniques du projet, garantissant ainsi qu’aucune régression comportementale ne viendra altérer le traitement des flux de données tabulés sur les différents postes de travail d’une équipe de recherche.
2.2 Définition et vérification du répertoire de travail
La localisation relative du flux de données au sein de l’arborescence du système d’exploitation constitue un paramètre d’exécution déterminant. Lors de toute tentative d’ouverture de fichier, l’interpréteur de commandes R évalue les chemins d’accès par rapport à son répertoire de travail courant (working directory). La fonction getwd() permet d’interroger à tout instant l’environnement pour connaître le chemin absolu du dossier actif. Inversement, l’instruction setwd() permet de modifier ce point d’ancrage en fournissant une nouvelle chaîne de caractères représentant un chemin valide sur le système de fichiers hôte.
Toutefois, l’usage hardcodé de la commande setwd() au sein de scripts partagés est aujourd’hui considéré comme une mauvaise pratique majeure dans le génie logiciel appliqué à la recherche. L’affectation de chemins d’accès rigides et propres à une machine locale particulière rompt instantanément la portabilité du script lorsqu’il est transféré vers un autre utilisateur ou un serveur de calcul distant. Pour surmonter cette limitation, l’environnement de développement intégré RStudio a formalisé le concept de Projet, matérialisé par un fichier portant l’extension .Rproj. L’ouverture d’un tel projet positionne systématiquement et automatiquement la racine du répertoire de travail à l’endroit exact où réside le descripteur de projet, éliminant tout recours aux commandes de repositionnement manuel.
Dans cette perspective, une saine hygiène d’organisation informatique dicte la mise en place d’une structure arborescente standardisée au sein du répertoire de travail. On privilégiera la création d’un sous-dossier dédié exclusivement aux données sources immuables, généralement dénommé data ou data-raw, découplé d’un répertoire destiné aux scripts de traitement (R ou scripts) et d’un espace réservé aux sorties tabulaires ou graphiques (output ou figures). Ce cloisonnement spatial prévient l’écrasement involontaire des données brutes par des opérations de réécriture et simplifie l’expression des chemins d’accès relatifs lors des opérations d’ingestion.
2.3 Syntaxe de base et gestion des chemins de fichiers
L’accès programmatique au fichier TSV requiert une compréhension aiguë de la différenciation fondamentale entre chemins d’accès absolus et chemins d’accès relatifs. Un chemin absolu décrit l’itinéraire exhaustif depuis la racine du système de stockage jusqu’au fichier cible (par exemple, sous Linux /home/utilisateur/projets/data/echantillon.tsv ou sous Windows C:/Users/Utilisateur/Projets/data/echantillon.tsv). Si ce formalisme garantit l’accès au fichier tant que l’arborescence matérielle demeure strictement identique, il s’avère extrêmement instable dès que le projet change d’hôte ou est déployé dans un conteneur applicatif. À l’opposé, le chemin relatif stipule la trajectoire en prenant pour origine le répertoire de travail actuel (par exemple data/echantillon.tsv), autorisant ainsi le déplacement global de l’intégralité du dossier du projet sans rupture d’adressage.
Une source de confusion classique pour les programmeurs opérant sous le système d’exploitation Microsoft Windows réside dans l’utilisation conventionnelle de la barre oblique inversée (backslash, ) pour délimiter les niveaux de répertoires. En R, comme dans de nombreux langages de programmation hérités du C, la barre oblique inversée agit comme le caractère d’échappement par excellence au sein des chaînes textuelles littérales. Dès lors, une instruction telle que "C:UsersDatatest.tsv" sera mal interprétée par le parseur de R, qui tentera d’analyser des séquences d’échappement invalides comme U ou D. Pour pallier cet obstacle, l’utilisateur doit impérativement remplacer chaque barre oblique inversée par une barre oblique directe (slash, /), comme dans "C:/Users/Data/test.tsv", ou doubler la barre oblique inversée pour l’échapper explicitement : "C:UsersDatatest.tsv".
En formulant la requête minimale avec la bibliothèque readr, l’analyste fait converger ces principes au sein d’une assignation syntaxique limpide. La formulation élémentaire se résume à l’expression donnees <- read_tsv("data/mon_fichier.tsv"). Cette invocation unitaire mobilise les paramètres par défaut du moteur d’analyse lexicale, qui se charge de vérifier l’accessibilité du flux, d’établir la connexion en lecture seule, d’analyser les flux textuels séquentiels et de reconstituer le tableau de variables dans la mémoire vive de la session R courante sans altérer l’intégrité du document physique stocké sur le support magnétique ou électronique.
3. Mécanisme fondamental de la fonction read_tsv() du package readr
3.1 Architecture et comportement par défaut de read_tsv()
La fonction read_tsv() n’est pas un simple alias cosmétique d’une fonction de lecture générique, mais une interface hautement spécialisée s’appuyant sur le moteur d’analyse sous-jacent vroom, intégré aux versions modernes de readr. L’architecture interne repose sur une lecture par blocs et une analyse lexicale hautement vectorisée rédigée en langage C++. Lors de son exécution initiale, la fonction initialise un analyseur de flux qui commence par examiner les premières lignes du document sans charger l’intégralité du fichier en mémoire de façon séquentielle brutale. Cette approche permet de détecter la structure globale du document, de dénombrer les colonnes et de définir les délimitations spatiales de chaque enregistrement.
L’une des innovations majeures introduites par ce moteur réside dans son heuristique d’inférence automatique des types de données. Par défaut, read_tsv() ausculte les mille premières lignes du jeu de données pour échantillonner les valeurs de chaque colonne et déterminer la classe la plus appropriée. Le parseur tente successivement de convertir les chaînes observées selon une cascade de types de plus en plus générale : logique (booléen), entier, réel double précision, date, date-heure, et enfin chaîne de caractères brute si aucune autre typologie restrictive ne parvient à englober l’ensemble des éléments observés sans générer de contradiction. Cette analyse probabiliste garantit que les colonnes purement numériques ne demeurent pas à l’état de texte passif, tout en évitant de convertir précipitamment des valeurs alphabétiques en erreurs de conversion.
Dès que le moteur achève cette évaluation préliminaire, il transmet un rapport de typage détaillé directement au sein de la console de travail R. Ce message d’information, souvent désigné sous le terme de column specification, explicite pour chaque identifiant de variable la méthode d’analyse assignée, sous la forme d’un objet de classe col_spec. Cette restitution transparente permet à l’utilisateur de valider d’un simple regard la cohérence de l’interprétation automatique et, le cas échéant, d’intervenir chirurgicalement en cas de méprise du compilateur face à des valeurs aberrantes nichées au-delà des premières lignes analysées.
3.2 Avantages du format tibble par rapport au data.frame classique
L’objet matriciel produit en sortie de la fonction read_tsv() ne correspond pas à la classe native data.frame de R de base, mais adopte la forme perfectionnée d’un tibble, étiqueté par la classe composite tbl_df, tbl et data.frame. Le tibble a été conçu pour assainir et moderniser le comportement des tables rectangulaires sans compromettre leur compatibilité générale. Sur le plan de la présentation, l’impression par défaut d’un tibble dans le terminal évite les affichages massifs et incontrôlés qui surviennent fréquemment lorsqu’un data.frame traditionnel comportant des centaines de milliers de lignes est imprimé dans la console. Le tibble tronque intelligemment l’affichage aux dix premières observations et adapte le nombre de colonnes visibles à la largeur effective de la fenêtre de commande, en indiquant explicitement la nature typologique de chaque vecteur sous son nom respectif.
Sur le plan sémantique, la mutation fondamentale apportée par le tibble réside dans l’éradication totale de la conversion automatique et non sollicitée des chaînes de caractères textuelles en facteurs statistiques (strings as factors). Historiquement, les fonctions natives de R de base convertissaient systématiquement les variables qualitatives en facteurs catégoriels discrets encodés sous forme d’entiers associés à des niveaux textuels. Cette transformation causait d’innombrables bugs lorsque de nouvelles modalités imprévues apparaissaient lors de calculs ultérieurs ou que des identifiants alphanumériques se retrouvaient figés dans des grilles de niveaux rigides. Le format tibble préserve scrupuleusement la nature brute des chaînes de caractères (character) jusqu’à ce que le statisticien choisisse formellement d’instancier un facteur via des fonctions explicites.
De surcroît, le tibble impose des règles strictes en matière de sélection et d’extraction d’éléments par l’opérateur de crochetage [ ]. Alors qu’un data.frame standard réduit automatiquement une sélection d’une seule colonne en un vecteur atomique unidimensionnel (comportement d’effondrement dimensionnel via le paramètre interne drop = TRUE), le tibble maintient systématiquement sa structure bidimensionnelle, préservant ainsi l’intégrité structurelle du conteneur dans les boucles programmatiques et les fonctions automatisées. Il interdit également l’évaluation approximative des noms de variables (partial matching), forçant le développeur à désigner les attributs par leur orthographe exacte, éliminant ainsi les ambiguïtés catastrophiques dans les pipelines industriels de données.
3.3 Gestion de la mémoire et rapidité de traitement
La performance d’ingestion d’un volume de données volumineux dépend directement de la stratégie adoptée pour la gestion de la mémoire vive et la vitesse de lecture séquentielle des octets. L’implémentation algorithmique de read_tsv() tire profit des bibliothèques C++ modernes pour minimiser la copie récursive d’objets dans la mémoire vive (RAM). Alors que les anciennes méthodes de désérialisation allouaient des espaces tampons intermédiaires multiples à chaque transformation morphologique du fichier, read_tsv() exploite le partitionnement mémoire direct et, dans ses architectures les plus récentes basées sur vroom, l’indexation par projection mémoire (memory mapping ou mmap).
Cette technique de projection mémoire consiste à lier l’espace d’adressage virtuel du processus R directement au fichier binaire présent sur le support de stockage persistant. Dès lors, le système d’exploitation transfère les segments de données uniquement au moment où l’interpréteur de code accède effectivement aux colonnes concernées. Ce mécanisme d’évaluation paresseuse (lazy parsing) réduit drastiquement l’empreinte mémoire instantanée et autorise l’ouverture de fichiers volumineux qui excéderaient les capacités d’allocation séquentielle classique d’une session R 32 ou 64 bits conventionnelle.
Par ailleurs, la minimisation des allocations temporaires allège le travail du ramasse-miettes (Garbage Collector) de R. Dans les moteurs d’ingestion traditionnels, la génération effrénée de millions de micro-vecteurs textuels pour chaque élément tabulaire surcharge le gestionnaire de mémoire interne, provoquant des pauses régulières d’assainissement de la mémoire qui dégradent de façon spectaculaire les temps globaux de traitement. En réduisant drastiquement le nombre total d’allocations via des pointeurs directs vers les chaînes d’octets sources, read_tsv() offre une stabilité opérationnelle exemplaire lors du traitement de jeux de données massifs.
4. Exemple 1 : Importer un fichier TSV comportant des en-têtes de colonnes
4.1 Structure du jeu de données expérimental
Pour illustrer de manière concrète l’utilisation de la fonction read_tsv(), considérons une situation classique d’expérimentation biologique portant sur l’écologie fonctionnelle d’espèces végétales soumises à divers gradients de stress hydrique. Ce tableau rectangulaire fictif combine délibérément plusieurs typologies de variables afin d’examiner le comportement de l’analyseur face à des structures hétérogènes. La première ligne du document rassemble les identifiants textuels officiels de chaque colonne, respectant la convention universelle des fichiers de données scientifiques standardisés.
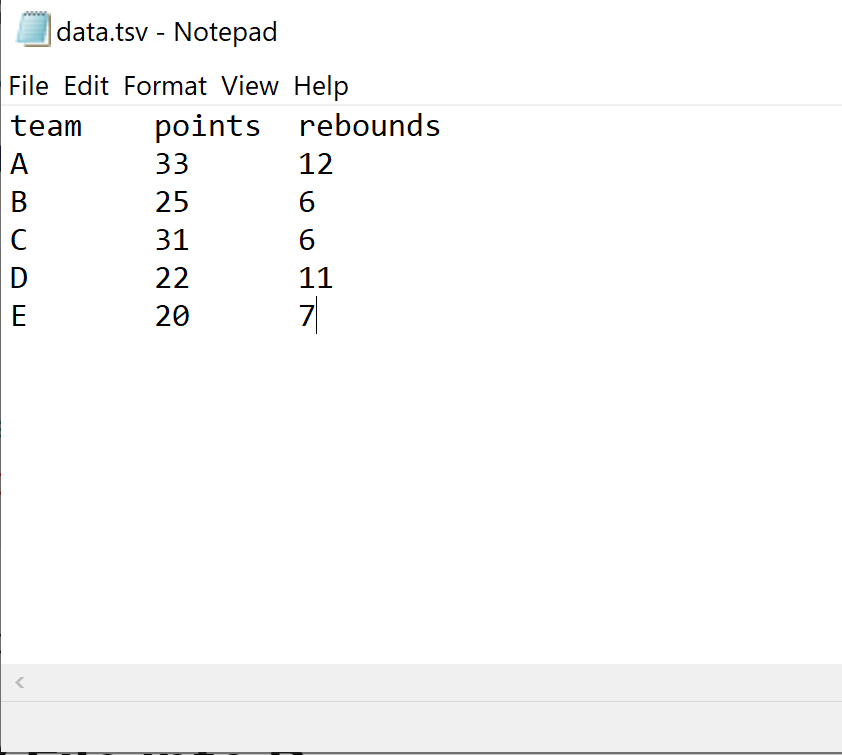
Examiné au moyen d’un éditeur de texte brut non formaté (tel que Vim, Nano ou Visual Studio Code), sans passerelle d’interprétation visuelle de type tableur, le fichier présente l’agencement textuel suivant, dans lequel la séquence invisible de tabulation sépare physiquement chaque donnée élémentaire :
id_echantillon	nom_taxon	altitude_metre	teneur_azote	presence_parasite	date_recolte

ECH_001	Quercus robur	450	2.34	TRUE	2023-05-12

ECH_002	Pinus sylvestris	1200	1.85	FALSE	2023-05-15

ECH_003	Fagus sylvatica	850	3.12	FALSE	2023-05-20

ECH_004	Betula pendula	310	2.05	TRUE	2023-06-02

ECH_005	Acer pseudoplatanus	620	2.78	FALSE	2023-06-11
Dans cette configuration, nous identifions distinctement six attributs expérimentaux : un identifiant alphanumérique (id_echantillon), un nom d’espèce en nomenclature binomiale latine (nom_taxon), une grandeur physique discrète entière (altitude_metre), une valeur biométrique continue à décimale (teneur_azote), une variable logique booléenne (presence_parasite) et un enregistrement chronologique normé selon le standard ISO 8601 (date_recolte). La présence explicite des tabulations entre chacun de ces champs fournit au parseur la matrice géométrique indispensable à la reconstruction du tableau sans nécessiter d’encapsulation par des guillemets.
4.2 Exécution pas à pas du code d’importation
L’opération d’ingestion de ce tableau structuré nécessite l’initialisation de l’instruction d’assignation dans un script R dédié. En supposant que le fichier a été enregistré sous l’appellation inventaire_forestier.tsv au sein du sous-répertoire data du projet actif, le code opérationnel s’énonce comme suit :
library(readr)

foret_df <- read_tsv("data/inventaire_forestier.tsv")
Dès l’exécution de cette commande, le moteur readr interroge le fichier physique, lit la première rangée pour capturer les six intitulés de variables, puis déploie son algorithme d’inférence de types sur les lignes subordonnées. Au terme de cette étape d’analyse, la console renvoie une rétroaction détaillée sous la forme suivante :
Rows: 5 Columns: 6

── Column specification ───────────────────────────────────────

Delimiter: "t"

chr  (2): id_echantillon, nom_taxon

dbl  (2): altitude_metre, teneur_azote

lgl  (1): presence_parasite

date (1): date_recolte
Ce diagnostic interactif atteste que l’interpréteur a identifié avec succès la tabulation comme délimiteur unique, qu’il a comptabilisé avec exactitude les cinq observations réparties sur six colonnes, et qu’il a su catégoriser de façon adéquate chaque série sans altération : deux colonnes textuelles (chr), deux colonnes numériques continues (dbl), une série de valeurs booléennes pures (lgl), et une colonne chronologique convertie nativement en structure calendaire de type Date. L’objet foret_df est désormais instancié dans l’environnement global, prêt pour l’analyse statistique.
4.3 Inspection et validation des données importées
L’achèvement de la phase d’ingestion impose une validation immédiate de la conformation géométrique et sémantique de l’objet nouvellement matérialisé. L’analyste averti ne procède jamais à des manipulations mathématiques sans avoir au préalable contrôlé visuellement et structurellement le conteneur de données. Trois fonctions diagnostiques fondamentales permettent d’examiner en détail l’objet résultant : head(), str() et la méthode hautement descriptive glimpse() issue de la bibliothèque dplyr.
L’appel de head(foret_df, n = 3) fournit une restitution synthétique des premières observations, permettant d’attester que les valeurs numériques n’ont pas été polluées par des caractères parasites et que les en-têtes sont correctement alignés avec les grandeurs respectives. L’usage de str(foret_df) ou de glimpse(foret_df) offre une vision transversale compacte, énumérant l’intégralité des attributs, leurs types fondamentaux respectifs et un échantillonnage horizontal des premières valeurs de chaque série. C’est l’occasion de confirmer que la variable presence_parasite a bien été reconnue comme un vecteur logique natif (contenant TRUE et FALSE) et non comme une banale chaîne de caractères textuels.
Enfin, le contrôle volumétrique formel s’effectue par les fonctions matricielles de base dim(foret_df), nrow(foret_df) et ncol(foret_df). L’exécution de dim(foret_df) renvoie le vecteur d’entiers c(5, 6), confirmant de manière irréfutable que la structure matricielle rectangulaire est strictement respectée, sans perte ni scission anormale d’observations. Ce triple contrôle dimensionnel, typologique et sémantique valide définitivement la phase d’ingestion et sécurise l’entrée des données dans la chaîne de traitement scientifique.
5. Exemple 2 : Importer un fichier TSV dépourvu d’en-têtes de colonnes
5.1 Problématique des fichiers sans étiquettes initiales
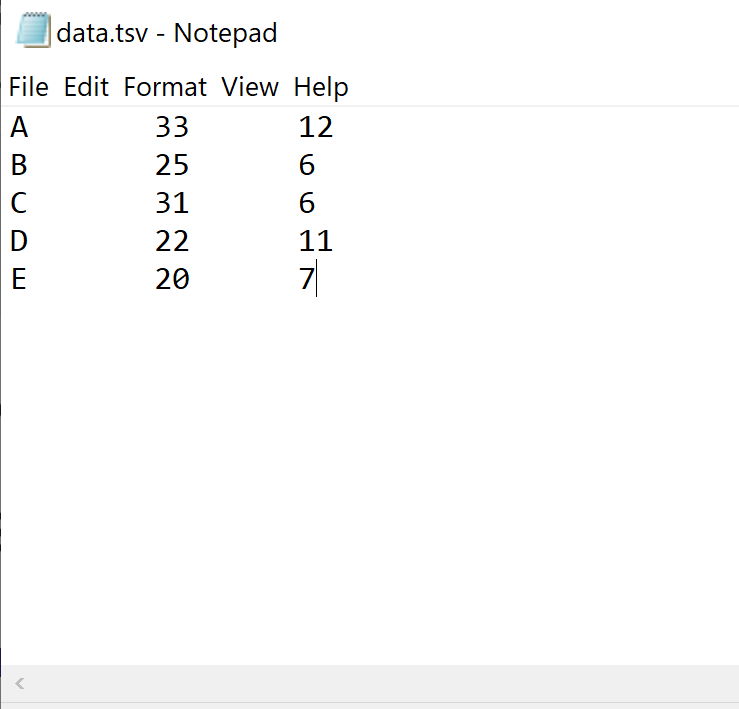
Il arrive régulièrement, notamment dans le contexte du traitement de flux issus d’automates de laboratoire, de capteurs environnementaux autonomes ou d’exports de bases de données relationnelles optimisées pour le transfert brut, que le fichier TSV ne comporte aucune ligne introductive d’en-tête. Dans un tel agencement, la toute première ligne physique du document correspond immédiatement à la première observation expérimentale du protocole, sans métadonnée textuelle préliminaire d’étiquetage.
Cette configuration représente un piège classique pour l’utilisateur non averti. Par défaut, la quasi-totalité des parseurs modernes, y compris read_tsv(), part du postulat selon lequel la première rangée héberge les intitulés nominatifs des variables. Si cette hypothèse par défaut est appliquée à un fichier sans en-tête, le moteur de lecture élève la première rangée de données empiriques au rang de descripteur de colonnes. Dès lors, cette observation initiale est irrémédiablement éliminée du corps du tableau de données statistiques, tronquant artificiellement l’échantillon d’une ligne d’enregistrement.
Cette troncature s’accompagne d’un risque majeur de corruption typologique. Si la première ligne de données contient des grandeurs numériques (par exemple la coordonnée géographique 45.128 ou une valeur de mesure 12), ces entités se retrouvent converties en chaînes textuelles servant d’étiquettes de colonnes. Pis encore, la présence éventuelle de doublons parmi ces données répliquées sur la première ligne oblige le système à déclencher des procédures de désambiguïsation syntaxique (comme l’ajout de suffixes artificiels ...1, ...2), dénaturant totalement la structure du jeu de données et faussant les calculs de taille d’échantillon ou de distribution de fréquences.
5.2 Application de l’argument col_names = FALSE
Pour prévenir toute distorsion structurelle lors de l’ingestion d’un flux dépourvu de ligne d’en-tête, la fonction read_tsv() propose le paramètre formel col_names. En assignant explicitement la valeur logique FALSE à cet argument, l’analyste signale formellement au parseur C++ que la totalité du document physique, dès le premier octet de la première ligne, constitue des données expérimentales à intégrer dans le corps de la matrice.
Considérons un fichier nommé mesures_capteurs.tsv composé uniquement de lignes d’enregistrements chronologiques et thermiques sans désignation nominale préalable. La commande d’importation s’exécute selon la formulation suivante :
capteurs_df <- read_tsv("data/mesures_capteurs.tsv", col_names = FALSE)
À la suite de cette instruction explicite, le moteur préserve intégralement la première rangée sous forme d’enregistrement statistique effectif. En l’absence de noms fournis par le document textuel brut, read_tsv() met en œuvre une politique d’étiquetage synthétique automatique : il attribue à chaque vecteur horizontal une étiquette standardisée constituée du préfixe alphabétique X immédiatement suivi du rang ordinal de la colonne considérée (par exemple, X1, X2, X3, …, Xn).
Cette procédure garantit l’intégrité intégrale de l’échantillon numérique. L’appel de nrow(capteurs_df) reflète fidèlement le nombre total de lignes présentes dans le fichier texte source, sans omission de la première unité observée. Les types de données de chaque colonne sont inférés en incluant formellement la ligne initiale dans l’échantillonnage de typage, évitant ainsi les faux diagnostics de conversion textuelle.
5.3 Attribution manuelle d’un vecteur de noms de colonnes
Bien que l’assignation de variables synthétiques sous la forme X1, X2 garantisse l’intégrité quantitative du fichier, cette nomenclature anonyme nuit grandement à la lisibilité et à l’expressivité du code d’analyse subséquent. Se référer à un attribut par une étiquette non sémantique accroît le risque d’erreur d’inversion conceptuelle dans les formules de modélisation de type lm(X3 ~ X1 + X2, data = capteurs_df). Il s’avère donc hautement préférable de désigner formellement les colonnes dès l’étape d’ingestion.
Pour parvenir à ce résultat, l’argument col_names présente une grande souplesse : au lieu d’un simple booléen, il peut recevoir directement un vecteur de chaînes de caractères (character vector) explicitant la série exhaustive des identifiants voulus. La commande prend alors la structure programmatique suivante :
noms_colonnes <- c("horodatage", "identifiant_sonde", "temperature_celsius", "humidite_relative")

capteurs_df <- read_tsv(

  "data/mesures_capteurs.tsv",

  col_names = noms_colonnes

)
Cette approche permet d’associer immédiatement la sémantique de chaque variable à son vecteur physique sans exiger une deuxième opération de renommage en mémoire vive. Néanmoins, si les étiquettes doivent être ajustées a posteriori, l’écosystème tidyverse permet de remanier la structure grâce à la méthode rename() de la bibliothèque dplyr, ou bien en assignant directement le vecteur de caractères via la primitive de R standard names(capteurs_df) <- noms_colonnes, garantissant une flexibilité d’adaptation optimale aux exigences du chercheur.
6. Gestion rigoureuse des types de variables lors de l’ingestion
6.1 Spécification explicite des types via l’argument col_types
Bien que l’heuristique de détection automatique des types de variables opérée par read_tsv() soit d’une grande fiabilité, elle repose sur un échantillonnage des mille premières observations du fichier. Ce mécanisme comporte une faille intrinsèque lorsque le jeu de données présente des distributions particulières : si une variable est composée d’entiers sur les premiers milliers d’enregistrements mais voit apparaître des valeurs textuelles ou décimales bien plus tard dans le fichier, le parseur aura initialement typé la colonne comme un entier ou un réel, provoquant des erreurs d’analyse (parsing failures) lors de la rencontre des premières chaînes de caractères inattendues.
Pour éliminer tout aléa et rendre le script totalement déterministe, il est recommandé de spécifier formellement les types attendus via l’argument col_types. La syntaxe la plus explicite mobilise la fonction constructrice cols(), au sein de laquelle chaque variable est associée à une fonction de déclaration spécifique telle que col_double() pour les réels, col_integer() pour les nombres entiers stricts, col_character() pour les données textuelles ou encore col_logical() pour les booléens purs :
types_definis <- cols(

  code_postal = col_character(),

  consommation_kwh = col_double(),

  nb_occupants = col_integer(),

  statut_proprietaire = col_logical()

)

energie_df <- read_tsv("data/consommations.tsv", col_types = types_definis)
Cette rigueur de typage est absolument impérative pour les colonnes contenant des identifiants numériques, tels que des numéros de sécurité sociale, des codes d’échantillons ou des codes postaux comportant des zéros initiaux. Si un code postal comme "06000" (Nice) est inféré comme un entier numérique par le système d’analyse automatique, le zéro de tête est instantanément tronqué mathématiquement, transformant la chaîne d’identification spatiale en l’entier 6000, introduisant une altération critique dans les analyses de jointure géographique.
Pour les tableaux comportant un nombre important de variables, readr propose également une notation synthétique compacte particulièrement efficace. Chaque colonne est alors désignée par un caractère unique (c pour character, d pour double, i pour integer, l pour logical, D pour date, _ ou - pour ignorer la colonne). L’instruction se résume alors à une formulation d’une grande concision : read_tsv("data/fichier.tsv", col_types = "cdil"), permettant d’établir un cahier des charges de typage rigoureux tout en préservant la compacité du code source.
6.2 Conversion et gestion des variables temporelles et de dates
La temporalité constitue l’un des aspects les plus délicats de l’ingestion de données en raison de l’hétérogénéité des formats calendaires internationaux. La fonction read_tsv() gère nativement le standard universel ISO 8601 (par exemple, AAAA-MM-JJ pour les dates et AAAA-MM-JJTHH:MM:SSZ pour les horodatages complets). Néanmoins, les fichiers générés par des environnements d’expérimentation nationaux s’écartent fréquemment de ce modèle en adoptant des représentations spécifiques comme JJ/MM/AAAA ou MM-JJ-AAAA.
Pour résoudre sans ambiguïté ces particularismes chronologiques, la fonction col_date() permet de formaliser le gabarit temporel exact au moyen des spécificateurs de conversion standards du protocole POSIX. Si une série de relevés exprime les dates sous la forme textuelle "24/10/2023", l’indication de formatage s’articulera avec une précision chirurgicale :
releve_temporel <- read_tsv(

  "data/series_temporelles.tsv",

  col_types = cols(

    date_mesure = col_date(format = "%d/%m/%Y"),

    moment_prelevement = col_datetime(format = "%d/%m/%Y %H:%M:%S")

  )

)
Le contrôle de la variable temporelle à l’ingestion prévient la conversion d’une date en simple chaîne de caractères statique ou, pire encore, l’inversion involontaire des mois et des jours (confusion entre le 5 décembre et le 12 mai) pouvant survenir lorsqu’un parseur anglo-saxon tente de décrypter un format européen sans paramétrage explicite.
6.3 Filtrage préventif et exclusion de colonnes non requises
Dans le traitement de corpus volumineux issus d’extractions industrielles ou de plates-formes de séquençage génomique, les fichiers TSV peuvent agréger plusieurs centaines, voire plusieurs milliers de colonnes auxiliaires dont seule une infime proportion présente une utilité effective pour l’hypothèse de recherche formulée. Charger l’ensemble de ces descripteurs superflus en mémoire vive gaspille les ressources du système et ralentit considérablement la vitesse des calculs ultérieurs.
Pour remédier à ce problème, l’argument col_types permet de mettre en place une exclusion sélective dès la phase de lecture sur disque. En combinant la fonction générale cols_only() avec les variables strictement nécessaires, le parseur C++ se focalise exclusivement sur les données d’intérêt et délaisse totalement les colonnes omises :
donnees_filtrees <- read_tsv(

  "data/donnees_massives.tsv",

  col_types = cols_only(

    id_sujet = col_character(),

    reponse_critique = col_double()

  )

)
À l’inverse, si l’on souhaite conserver la majorité des variables tout en excluant un petit nombre de colonnes volumineuses identifiées comme inutiles, il suffit d’associer ces attributs rejetés au spécificateur col_skip() au sein d’une déclaration conventionnelle via cols(). Cette technique allège substantiellement l’empreinte mémoire du tableau obtenu et simplifie la manipulation ultérieure des données.
7. Traitement des valeurs manquantes, caractères spéciaux et encodage
7.1 Définition des sentinelles de valeurs manquantes (argument na)
L’absence d’observation constitue une réalité inhérente à toute entreprise de collecte empirique. Dans les fichiers TSV, cette absence d’information se manifeste sous de multiples représentations selon le système générateur : la cellule peut être strictement vide (deux caractères de tabulation directement consécutifs tt), ou comporter des chaînes conventionnelles telles que NA, NULL, NaN, ou encore des codes sentinelles numériques propres à certains logiciels d’enquête comme 999, -9999, ou #N/A.
Par défaut, la fonction read_tsv() convertit les chaînes vides "" et les mentions "NA" en la valeur manquante native de R, symbolisée par la constante logique non disponible NA. Néanmoins, si le jeu de données recourt à des encodages spécifiques pour marquer l’absence de réponse, le parseur risque de considérer ces sentinelles comme des données réelles. Par exemple, la mention textuelle "Non Renseigne" au sein d’une colonne de mesures transformera irrémédiablement l’intégralité du vecteur en classe textuelle character, empêchant tout calcul ultérieur de moyenne ou d’écart-type.
Pour garantir une homogénéisation immédiate de l’absence de donnée, l’argument formel na permet de renseigner un vecteur exhaustif de toutes les représentations de valeurs manquantes rencontrées dans le fichier source :
enquete_df <- read_tsv(

  "data/enquete_sociale.tsv",

  na = c("", "NA", "NULL", "999", "Non Renseigne", "Refus")

)
Cette approche permet d’unifier l’ensemble des cellules concernées vers la primitive NA propre à R tout en préservant le typage réel ou entier sous-jacent de la colonne. L’analyste s’assure ainsi d’une manipulation statistique rigoureuse des données manquantes via des fonctions dédiées comme is.na(), prévenant l’intégration insidieuse de sentinelles comme 999 dans des moyennes arithmétiques.
7.2 Gestion rigoureuse des encodages de caractères (locale)
L’altération de la restitution des caractères diacritiques (accents, cédilles, caractères non latins) constitue une source majeure de dégradation qualitative lors de l’échange de fichiers entre différents systèmes d’exploitation. Historiquement, les postes de travail sous Microsoft Windows en Europe occidentale encodaient les textes selon la norme ANSI Windows-1252 ou ISO-8859-1 (Latin1), tandis que les environnements de type Linux et macOS utilisent universellement l’encodage multioctet UTF-8.
Lorsqu’un fichier TSV encodé en Windows-1252 est ouvert dans une session R configurée par défaut en UTF-8 sans ajustement préalable, les caractères accentués se trouvent corrompus en séquences incohérentes (phénomène connu sous le nom de mojibake, transformant par exemple le terme "Élève" en "Élève"). Cette corruption perturbe l’intégrité de la recherche d’éléments textuels, fausse les opérations de groupement avec group_by() et complique le tracé des étiquettes graphiques.
Pour neutraliser ces défaillances, read_tsv() intègre un paramètre de configuration spatiale et linguistique global via l’argument locale et la fonction dédiée locale(). En précisant explicitement l’encodage source de la table textuelle, l’analyste contraint le parseur C++ à traduire fidèlement chaque séquence d’octets vers la table de caractères appropriée :
donnees_fr <- read_tsv(

  "data/archives_anciennes.tsv",

  locale = locale(encoding = "ISO-8859-1")

)
Cette gestion chirurgicale garantit une restitution parfaite des chaînes de caractères dès l’ingestion des données brutes, préservant la fidélité des corpus textuels et facilitant les traitements de text-mining et d’analyse lexicométrique ultérieurs.
7.3 Paramétrage des délimiteurs décimaux
L’autre divergence internationale majeure concerne la notation du délimiteur décimal séparant la partie entière de la partie fractionnaire d’un nombre réel. Si la convention anglo-saxonne recourt exclusivement au point décimal (12.50), la tradition administrative, comptable et scientifique francophone ainsi que la majorité des pays d’Europe continentale emploient historiquement la virgule comme délimiteur officiel (12,50).
Si un fichier TSV issu d’un tableur francophone utilise la virgule décimale et qu’il est ingéré avec les paramètres anglo-saxons par défaut de read_tsv(), le parseur ne reconnaîtra pas ces valeurs comme des nombres décimaux valides. Constatant la présence d’une virgule au sein de ce qu’il attendait comme un chiffre anglo-saxon, il déclassera immédiatement l’intégralité de la variable en vecteur textuel de classe character. Toute tentative ultérieure de modélisation mathématique sur cette variable se soldera alors par une fin de non-recevoir programmatique.
L’ajustement du séparateur décimal s’effectue simplement en enrichissant l’argument locale à l’aide du paramètre formel decimal_mark :
resultats_labo <- read_tsv(

  "data/analyses_chimiques.tsv",

  locale = locale(decimal_mark = ",")

)
Grâce à cette spécification, le moteur traite la virgule comme un marqueur de fraction numérique légitime, restituant la colonne sous la forme d’un vecteur de réels à double précision (double) directement manipulable par les opérateurs arithmétiques standards, garantissant ainsi l’exactitude des calculs sans exiger de scripts de conversion textuelle correctifs a posteriori.
8. Méthode alternative : Utilisation des fonctions natives de R de base
8.1 Importation avec la fonction native read.delim()
Avant l’avènement des bibliothèques de manipulation moderne, le socle fondamental de R intégrait déjà des primitives complètes pour la désérialisation de fichiers de données tabulaires au sein du package préinstallé utils. Parmi celles-ci, la fonction read.delim() a longtemps représenté la méthode de référence pour le chargement d’archives tabulées. En tant que spécialisation directe de l’utilitaire d’importation général read.table(), elle préconfigure automatiquement le séparateur de champ sur le caractère de tabulation (sep = "t").
L’implémentation opérationnelle de base se formule au moyen de la syntaxe standard suivante :
base_df <- read.delim(

  file = "data/inventaire_forestier.tsv",

  header = TRUE,

  sep = "t",

  dec = ".",

  stringsAsFactors = FALSE

)
Le paramètre header = TRUE informe le système que la première ligne du fichier héberge les descripteurs de variables, tandis que l’argument dec = "." spécifie explicitement la convention du point pour les réels. Contrairement aux méthodes du tidyverse, read.delim() génère systématiquement en mémoire vive un objet répondant à la structure historique d’un data.frame standard, exempt de toute surcouche structurelle contemporaine.
La présence de stringsAsFactors = FALSE mérite une mention toute particulière. Jusqu’à la version 4.0.0 de R publiée au printemps 2020, ce paramètre était positionné par défaut sur TRUE, ce qui entraînait la coercition immédiate de l’ensemble des colonnes textuelles en facteurs statistiques catégoriels sans le consentement explicite de l’analyste. Bien que le réglage par défaut ait été corrigé depuis, l’inclusion explicite de cette instruction demeure fortement conseillée afin d’assurer la rétrocompatibilité sur de vieux serveurs d’exécution exécutant encore des versions historiques de R.
8.2 Utilisation générale de read.table() paramétrée
Pour un contrôle plus fin des paramètres de lecture au sein de la boîte à outils native de R, certains ingénieurs privilégient l’appel direct à la fonction générique read.table(). Cette méthode constitue le moteur originel sous-jacent à toutes les variantes de désérialisation textuelle du package utils, telles que read.csv() ou read.delim(). Son emploi explicite requiert un paramétrage minutieux de l’ensemble de ses arguments formels :
registre_df <- read.table(

  file = "data/inventaire_forestier.tsv",

  header = TRUE,

  sep = "t",

  quote = """,

  comment.char = "#",

  na.strings = c("NA", ""),

  stringsAsFactors = FALSE

)
L’utilisation directe de read.table() permet d’intervenir directement sur des variables d’analyse syntaxique comme quote, qui définit le caractère employé pour entourer les blocs textuels complexes comportant des délimiteurs internes, ou encore comment.char, qui permet de neutraliser dynamiquement les lignes de métadonnées documentaires préfixées par un croisillon.
Bien que cette fonction offre une compatibilité absolue avec tous les environnements R existants sans nécessiter l’installation de dépendances logicielles externes, elle implique une surcharge d’écriture et une rigueur accrue. L’omission par inadvertance du délimiteur sep = "t" conduira le moteur à fractionner les lignes sur l’espace par défaut, ce qui brisera instantanément l’alignement dès la première chaîne contenant un espace textuel.
8.3 Comparatif technique : read_tsv() versus read.delim()
La comparaison technique entre read_tsv() et read.delim() s’articule autour de trois dimensions majeures : la vitesse d’exécution algorithmique, la consommation des ressources de calcul et la robustesse du diagnostic syntaxique.
Sur le plan des performances pures, read_tsv() surpasse read.delim() d’un ordre de grandeur sensible. La fonction native de R effectue en effet de multiples allocations en mémoire et des vérifications séquentielles en langage R interprété, ce qui engendre une latence notable lorsque la volumétrie dépasse plusieurs dizaines de mégaoctets. À l’inverse, l’analyseur C++ de read_tsv() procède à une vectorisation bas niveau qui accélère considérablement l’ingestion des fichiers denses.
Concernant la normalisation des données, read.delim() modifie historiquement les noms de colonnes contenant des caractères non conventionnels ou des espaces en insérant des points à la place (par exemple, Teneur en eau devient Teneur.en.eau) sous couvert d’assurer la conformité syntaxique des noms de variables de R. De son côté, read_tsv() conserve scrupuleusement la nomenclature originelle du fichier source en encapsulant si nécessaire les identifiants complexes entre des accents graves (backticks, ` `), préservant ainsi l’intégrité de la sémantique de départ.
Enfin, la gestion des anomalies d’importation constitue un critère de divergence capital. Lorsqu’une discordance de dimension ou de type survient, read.delim() génère le plus souvent un avertissement générique peu explicite ou stoppe net l’exécution via une erreur fatale. À l’inverse, read_tsv() continue de lire le document en consignant minutieusement chaque incohérence dans une table de bord structurée, consultable ultérieurement au moyen de la fonction problems(), autorisant ainsi un débogage précis et sélectif des lignes défectueuses sans interrompre brutalement la chaîne analytique.
9. Méthode haute performance : Utilisation du package data.table
9.1 Introduction à l’utilitaire d’importation ultra-rapide fread()
Lorsque les corpus de données atteignent des dimensions massives se chiffrant en gigaoctets et comprenant plusieurs dizaines de millions d’enregistrements (comme dans le traitement de flux télémétriques, de journaux de serveurs web ou de matrices de variants génomiques), les méthodes de désérialisation traditionnelles montrent rapidement leurs limites. Dans ce contexte de calcul intensif, le package tiers data.table, développé par Matt Dowle et Arun Srinivasan, met à disposition une fonction d’ingestion hautement optimisée : fread() (fast read).
L’utilitaire fread() a été entièrement conçu en langage C avec pour objectif l’optimisation maximale de la vitesse d’accès et le contournement méthodique de tous les goulets d’étranglement de la mémoire vive. Il implémente une stratégie de parallélisation multithread s’appuyant sur l’interface OpenMP, répartissant automatiquement l’analyse lexicale des différents blocs du fichier entre tous les cœurs du processeur hôte. Cette architecture hautement vectorisée permet de saturer la bande passante du support de stockage physique (disques SSD NVMe), ramenant les durées de lecture à une fraction de celles observées avec les autres bibliothèques.
Une caractéristique remarquable de fread() réside dans son moteur d’auto-détection contextuelle. L’outil analyse la première portion du fichier d’entrée et déduit de façon autonome le délimiteur effectif, la présence d’une rangée d’en-têtes, le symbole décimal et les classes de colonnes, sans nécessiter la moindre intervention de l’analyste. Même face à un fichier d’extension arbitraire, fread() identifie avec une remarquable précision la nature délimitée par tabulation, simplifiant la phase d’intégration technique.
9.2 Syntaxe pratique et contrôle des arguments de fread()
La mise en œuvre pratique de fread() sur un fichier TSV se distingue par une syntaxe particulièrement épurée. Bien que la fonction soit en mesure de déterminer automatiquement le séparateur, la bonne pratique d’ingénierie recommande de formaliser explicitement le caractère d’espacement pour écarter toute incertitude :
library(data.table)

big_data <- fread(

  file = "data/releves_volumineux.tsv",

  sep = "t",

  header = TRUE,

  na.strings = c("NA", ""),

  data.table = TRUE,

  nThread = 4

)
Dans cette structure d’appel, l’argument nThread permet de calibrer explicitement le nombre de cœurs alloués au parseur afin d’ajuster l’effort de calcul en fonction des ressources disponibles sur la machine. Le paramètre data.table contrôle quant à lui la classe de l’objet produit en sortie. Lorsqu’il est positionné sur TRUE (sa valeur par défaut), la fonction instancie un objet de classe hybride data.table et data.frame, permettant d’enchaîner directement sur les algorithmes de filtrage et d’agrégation ultra-rapides propres à cette syntaxe.
Si l’analyste destine ensuite son jeu de données aux méthodes du tidyverse ou à des fonctions de modélisation n’acceptant que les structures classiques, il est possible de spécifier data.table = FALSE. L’objet résultant est alors automatiquement converti en un data.frame standard, permettant de profiter de la vitesse de désérialisation exceptionnelle de fread() sans contraindre le reste du pipeline logiciel à adopter la syntaxe spécifique du package data.table.
9.3 Performances comparées et analyse des temps d’accès
L’évaluation empirique des performances d’ingestion met en lumière des écarts majeurs entre les trois grandes approches du langage R (read.delim(), read_tsv() et fread()). Sur des fichiers de petite taille (moins de dix mégaoctets), ces disparités demeurent imperceptibles à l’échelle humaine. En revanche, dès que le volume des données franchit le seuil du gigaoctet avec des matrices de dix à cinquante millions de rangées, le choix de la méthode conditionne directement la faisabilité computationnelle du projet.
Les tests comparatifs (benchmarks) documentent régulièrement que read.delim() met fréquemment plusieurs dizaines de minutes à ingérer des fichiers denses, sollicitant intensivement le ramasse-miettes de R et saturant la mémoire vive par des allocations d’objets intermédiaires. La fonction read_tsv() du package readr, grâce à son architecture C++ moderne, réduit ce délai à quelques dizaines de secondes tout en assurant un contrôle strict des types et en produisant un tibble rigoureusement typé.
La fonction fread() du package data.table s’impose quant à elle comme la solution la plus rapide du panel. En exploitant la parallélisation multithread et un contrôle direct des zones tampons en mémoire, elle accomplit l’ingestion du même jeu de données en une poignée de secondes seulement. Pour les infrastructures d’analyse industrielle et les corpus massifs, fread() constitue donc l’outil de référence, tandis que read_tsv() offre un équilibre optimal entre rigueur, confort d’utilisation et sécurité logicielle au sein des environnements d’analyse interactifs du tidyverse.
10. Résolution des anomalies et erreurs d’analyse fréquentes
10.1 Problèmes de chemins de fichiers et erreurs d’inexistence
L’anomalie la plus fréquemment rencontrée lors du déploiement d’un script d’importation se manifeste par l’interruption brutale de l’exécution, assortie du message d’erreur caractéristique : cannot open the connection ou '...' does not exist in current working directory. Cet avertissement indique simplement que le sous-système d’entrées-sorties de R s’avère dans l’incapacité matérielle de localiser le document désigné à partir du chemin fourni.
Pour remédier méthodiquement à cette défaillance, l’analyste doit inspecter en premier lieu la cohérence du répertoire de travail actif par le biais de la commande getwd(). Une erreur courante consiste à présumer que le script s’exécute depuis son dossier de stockage physique, alors que l’interpréteur R actif demeure positionné à la racine du système ou dans un dossier parent. L’interrogation de la commande file.exists("chemin/vers/fichier.tsv") fournit un contrôle programmatique simple renvoyant un booléen qui confirme ou infirme sans équivoque la visibilité physique du fichier visé.
Une autre source fréquente d’invisibilité logicielle tient aux autorisations d’accès du système de fichiers ou à des altérations typographiques subtiles. Sur les systèmes de type UNIX, la sensibilité à la casse (case sensitivity) est strictement appliquée : le fichier Donnees.tsv est rigoureusement distinct de donnees.tsv. L’emploi de la fonction native list.files() permet de lister l’intégralité des éléments effectivement présents dans le répertoire cible et d’identifier instantanément les fautes d’orthographe ou les extensions cachées (telles que .tsv.txt, fréquemment générées par les gestionnaires de fichiers de systèmes grand public).
10.2 Lignes désynchronisées et irrégularités de délimiteurs
Une source critique de corruption lors de l’ingestion d’un fichier TSV réside dans l’apparition d’avertissements signalant des lignes désynchronisées (souvent formulés sous la mention parsing issue: expected X columns, found Y). Cette anomalie survient le plus souvent lorsqu’un champ de texte libre contient un caractère de tabulation orphelin non encapsulé par des guillemets d’échappement, ou lorsqu’un retour à la ligne prématuré a été accidentellement introduit au cœur d’un enregistrement expérimental.
Lorsque le parseur rencontre une tabulation supplémentaire au sein d’une phrase explicative, il interprète ce caractère comme le passage immédiat à la colonne suivante. L’ensemble des variables adjacentes de la ligne concernée se trouve alors décalé d’un rang vers la droite, créant une colonne supplémentaire orpheline qui ne trouve aucune correspondance dans le schéma de la table. Inversement, l’omission d’un séparateur décale l’enregistrement vers la gauche, générant des valeurs manquantes artificielles en fin de ligne.
Le package readr offre un outil de diagnostic particulièrement précieux pour inspecter ces défaillances structurelles : la fonction problems(). Appliquée directement sur l’objet retourné par read_tsv(), cette commande extrait un tableau de bord détaillant avec précision le numéro de chaque ligne corrompue, l’indice de la colonne affectée, la valeur textuelle effectivement rencontrée et la valeur théorique attendue par le moteur de lecture :
anomalies <- problems(foret_df)

print(anomalies)
Grâce à cette extraction méthodique, l’analyste peut localiser directement les lignes défectueuses au sein du fichier texte d’origine, comprendre l’origine précise du désalignement et corriger les enregistrements corrompus sans avoir à sonder manuellement des millions d’entrées.
10.3 Lignes de commentaires et métadonnées en préambule
De multiples générateurs scientifiques de fichiers plats insèrent en tête de document un bloc d’informations documentaires et de métadonnées contextuelles avant d’aborder la première rangée du tableau rectangulaire de données. Ces lignes préliminaires synthétisent généralement la version du matériel utilisé, l’opérateur responsable de l’expérience, la date d’extraction ou les paramètres de calibration, souvent introduites par un symbole de commentaire tel qu’un croisillon (#) ou des tirets doubles (--).
Si la fonction read_tsv() analyse un tel fichier sans configuration spécifique, elle traitera la toute première ligne de commentaire comme l’en-tête de colonnes du tableau, ce qui corrompra totalement l’agencement du jeu de données. Deux paramètres complémentaires permettent de contourner proprement cet obstacle. Lorsque le nombre de lignes documentaires d’en-tête est constant et connu à l’avance, l’argument skip permet de sauter directement le bloc introductif :
donnees_capteur <- read_tsv(

  "data/flux_station.tsv",

  skip = 10

)
Dans ce scénario, le parseur ignore purement et simplement les dix premières rangées du document et n’initialise sa lecture qu’à partir de la onzième ligne, qu’il traitera alors légitimement comme l’en-tête nominatif des colonnes. Lorsque la distribution des lignes d’annotations est irrégulière ou qu’elles se retrouvent disséminées au sein même du corps de données, l’argument formel comment fournit une solution robuste :
donnees_capteur <- read_tsv(

  "data/flux_station.tsv",

  comment = "#"

)
Cette directive ordonne au parseur de faire abstraction de toute ligne physique débutant par le caractère spécifié, permettant ainsi d’extraire la structure matricielle sans aucune pollution par les métadonnées textuelles environnantes.
11. Bonnes pratiques pour la reproductibilité et l’automatisation
11.1 Emploi du package here pour une portabilité totale des scripts
La pérennité et la reproductibilité des analyses de données dépendent directement de la capacité des scripts à s’exécuter de façon transparente sur n’importe quel poste de travail sans exiger de modification manuelle des chemins d’accès. L’usage de chemins absolus rigides ou de commandes contextuelles de type setwd() compromet cette portabilité. Pour répondre à cette faiblesse, le package here, développé par Kirill Müller et Jenny Bryan, propose une solution robuste devenue une référence dans l’écosystème R moderne.
Le package here met en œuvre une heuristique intelligente pour identifier la racine du projet d’analyse (en repérant par exemple la présence d’un descripteur .Rproj, d’un dossier de versionnement .git ou d’un fichier .here). La fonction here() construit alors dynamiquement des chemins absolus stables à partir de paramètres relatifs, garantissant la portabilité de l’adresse quel que soit le système d’exploitation ou le répertoire de travail effectif lors du déclenchement du script :
library(readr)

library(here)

chemin_acces <- here("data", "brutes", "inventaire_forestier.tsv")

mes_donnees <- read_tsv(chemin_acces)
Cette approche présente un avantage déterminant lors de l’intégration de sous-routines au sein de rapports dynamiques rédigés avec Quarto ou R Markdown. Ces moteurs de publication réinitialisent en effet par défaut le répertoire de travail actif au niveau du dossier immédiat de stockage du document .qmd ou .Rmd, rompant fréquemment les chemins relatifs naïfs. Grâce à la formulation here(), le chemin d’accès conserve son ancrage universel à la racine du projet, assurant la compilation reproductible du document quel que soit son emplacement dans l’arborescence.
11.2 Importation automatisée de multiples fichiers TSV en lot
Dans de multiples situations concrètes (suivis épidémiologiques longitudinaux, campagnes de capteurs météo ou études multicentriques), l’information se trouve fractionnée en un grand nombre de fichiers TSV disjoints partageant une structure matricielle strictement identique (par exemple un fichier distinct par jour, par station de mesure ou par patient). Reconstituer la série statistique globale exige d’automatiser l’ingestion et l’empilement de ces partitions au moyen d’un processus vectorisé robuste.
La première phase de ce processus consiste à répertorier l’ensemble des fichiers cibles au moyen de la primitive list.files(), en exploitant une expression régulière pour cibler exclusivement les extensions .tsv. Ensuite, la programmation fonctionnelle moderne mobilisant la bibliothèque purrr permet d’itérer sur chaque chemin d’accès tout en intégrant une traçabilité explicite de la source d’origine via l’argument id de read_tsv() :
library(readr)

library(purrr)

fichiers_cibles <- list.files(

  path = here("data", "lots"),

  pattern = ".tsv$",

  full.names = TRUE

)

table_globale <- map_df(

  fichiers_cibles,

  ~ read_tsv(.x, id = "source_fichier")

)
Cette séquence itérative procède à la lecture séquentielle de chaque fichier délimité et concatène automatiquement les sous-matrices par empilement vertical de leurs lignes (row-binding). L’argument id = "source_fichier" injecte dans le tableau résultant une colonne additionnelle consignant le chemin d’accès du fichier d’origine dont provient chaque observation. Cette traçabilité s’avère particulièrement utile pour identifier a posteriori d’éventuels biais d’instrumentation ou mener des audits de qualité sans rompre la chaîne de traitement.
11.3 Validation formelle de l’intégrité après importation
L’achèvement technique de la phase d’ingestion ne garantit pas que les données collectées répondent aux exigences statistiques attendues par les modèles mathématiques d’analyse. Des capteurs défaillants peuvent transmettre des températures négatives aberrantes, des identifiants supposés uniques peuvent comporter des doublons imprévus, ou des colonnes critiques peuvent présenter des proportions intolérables de valeurs manquantes. L’étape d’importation doit donc impérativement se clore par une procédure formelle de validation des données.
L’intégration de bibliothèques de validation programmatique comme pointblank ou assertr permet d’exprimer des assertions formelles directement en amont du pipeline de modélisation. Cette démarche applique les principes du développement piloté par les tests (Test-Driven Development) à l’analyse de données :
library(pointblank)

agent_validation <- create_agent(tbl = table_globale) %>%

  col_is_character(columns = vars(source_fichier)) %>%

  col_vals_not_null(columns = vars(id_echantillon)) %>%

  col_vals_between(columns = vars(teneur_azote), left = 0, right = 100) %>%

  interrogate()

print(agent_validation)
Ce protocole de vérification soumet l’objet importé à une suite d’assertions logiques vérifiant la complétude des clés primaires, le bornage des distributions numériques et la conformité des types de variables. L’agent consigne les résultats dans un rapport d’audit exhaustif, permettant de bloquer l’exécution du script en cas de non-conformité critique et garantissant ainsi qu’aucune donnée corrompue ne pénètre dans les phases ultérieures de calcul statistique.
12. Synthèse comparative et guide décisionnel pour l’importation TSV
12.1 Matrice comparative des différentes fonctions d’importation
Afin de structurer le choix méthodologique de l’analyste, il apparaît opportun de synthétiser les caractéristiques techniques, les atouts opérationnels et les contraintes propres à chacune des trois grandes fonctions examinées : read_tsv() (package readr), read.delim() (package utils) et fread() (package data.table).
Sur le plan de la simplicité et de l’intégration architecturale, read_tsv() offre une harmonie parfaite avec l’écosystème tidyverse. Sa capacité à générer nativement des objets tibble, son inférence automatique des dates et des horodatages selon les normes internationales et sa restitution d’un tableau d’anomalies via problems() en font l’outil le plus convivial pour les phases d’analyse exploratoire et la recherche académique standard.
La primitive historique read.delim() conserve pour elle l’avantage de la portabilité native absolue. Elle ne requiert aucune installation de paquet tiers, présente une rétrocompatibilité complète avec les anciennes versions du langage R et produit des objets data.frame de base universellement reconnus par les modules de calcul matriciel standard. En contrepartie, ses temps d’exécution s’avèrent pénalisants sur des volumes denses, et son comportement par défaut peut exiger des paramétrages manuels minutieux pour neutraliser des coercitions de typage imprévues.
La fonction fread() représente l’optimum technique dès lors que la vitesse d’exécution et la consommation mémoire constituent les contraintes directes du projet. Grâce à sa parallélisation multithread en C, elle garantit des débits d’ingestion imbattables sur des jeux de données massifs. Sa conception exige néanmoins l’installation du package tiers data.table et requiert, si l’on souhaite réintégrer le reste du tidyverse, une étape de conversion explicite de ses structures d’objets natives.
12.2 Arbre de décision opérationnel selon les caractéristiques du projet
L’arbitrage entre ces différentes options d’ingestion peut se résumer sous la forme d’un ensemble de règles de décision séquentielles adaptées au profil de chaque projet :
Dans le cas d’un projet d’analyse statistique standard s’appuyant sur les méthodes du tidyverse, traitant des fichiers TSV d’une taille modérée (inférieure à 1 gigaoctet), le recours systématique à read_tsv() constitue le choix le plus équilibré. Cette option assure une détection robuste des dates, fournit des tibbles explicites et sécurise la chaîne de traitement grâce à sa typologie préventive.
Dans le contexte du développement d’un package R autonome ou du déploiement de scripts au sein d’infrastructures de calcul institutionnelles hautement sécurisées dépourvues de connexion à internet, l’emploi exclusif des fonctions natives de R de base (read.delim() ou read.table()) s’impose comme une nécessité d’architecture. Ce choix garantit l’absence de dépendances externes et assure la pérennité fonctionnelle du code face aux évolutions futures de bibliothèques tierces.
Enfin, dès lors que le projet aborde des volumétries massives (fichiers dépassant le gigaoctet, dizaines de millions d’enregistrements) ou s’intègre dans des pipelines de traitement automatisés à haute fréquence où chaque seconde de calcul est comptée, l’emploi de fread() devient incontournable. Ses performances en calcul distribué et son faible impact sur le gestionnaire de mémoire vive en font la solution la plus pérenne pour le traitement intensif des données volumineuses.
12.3 Perspectives et transition vers l’étape de nettoyage des données
L’importation réussie d’un fichier TSV marque le terme de la phase d’ingestion technique et ouvre immédiatement la voie aux opérations de manipulation, de transformation et de nettoyage structurel (data tidying). Le jeu de données, désormais sécurisé en mémoire vive au sein d’une structure matricielle rigoureusement typée, peut être transmis aux opérateurs spécialisés de l’écosystème R contemporain.
Les étapes logiques consécutives s’articulent principalement autour des bibliothèques dplyr et tidyr. L’analyste entreprend alors les filtrages d’observations via filter(), la sélection ordonnée d’attributs via select(), la dérivation de nouvelles métriques avec mutate() et le restructuration dimensionnelle des tableaux par le biais de fonctions de pivotement comme pivot_longer() et pivot_wider(). Cette transition d’une table rectangulaire brute vers un tableau analytique ordonné concrétise le modèle des données dites « bien rangées » (tidy data).
Pour préserver l’intégrité de la démarche scientifique, l’ensemble de ces étapes doit être scrupuleusement documenté au sein d’un script source unique, exécutable du début à la fin de façon déterministe. En archivant conjointement le fichier TSV original non altéré et le script R d’ingestion et de nettoyage, la communauté scientifique se dote des moyens de garantir l’auditabilité et la reproductibilité intégrale des connaissances produites, élevant ainsi la rigueur computationnelle au rang d’exigence méthodologique fondamentale.
Références
- Bryan, J., & Müller, K. (2023). here: A simpler way to find your files (Version 1.0.1) [Logiciel R]. CRAN. https://CRAN.R-project.org/package=here
- Dowle, M., & Srinivasan, A. (2023). data.table: Extension of ‘data.frame’ (Version 1.14.8) [Logiciel R]. CRAN. https://CRAN.R-project.org/package=data.table
- Iannone, R., & Vargas, M. (2023). pointblank: Data validation and organization of metadata for data tables (Version 0.11.4) [Logiciel R]. CRAN. https://CRAN.R-project.org/package=pointblank
- Müller, K., & Wickham, H. (2023). tibble: Simple data frames (Version 3.2.1) [Logiciel R]. CRAN. https://CRAN.R-project.org/package=tibble
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing, Vienna, Austria. https://www.R-project.org/
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H., & Bryan, J. (2023). R packages: Organize, test, document, and share your code (2e éd.). O’Reilly Media. https://r-pkgs.org/
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science: Import, tidy, transform, visualize, and model data (2e éd.). O’Reilly Media. https://r4ds.hadley.nz/
- Wickham, H., François, R., Henry, L., & Müller, K. (2023). dplyr: A grammar of data manipulation (Version 1.1.4) [Logiciel R]. CRAN. https://CRAN.R-project.org/package=dplyr
- Wickham, H., Hester, J., & Bryan, J. (2024). readr: Read rectangular text data (Version 2.1.5) [Logiciel R]. CRAN. https://CRAN.R-project.org/package=readr