
L’analyse quantitative des processus mentaux, des comportements et des construits psychologiques repose fondamentalement sur notre capacité à modéliser mathématiquement des relations empiriques complexes au sein d’échantillons observationnels ou expérimentaux. Dans le vaste arsenal méthodologique dont disposent les chercheurs contemporains en sciences humaines et sociales, le modèle de régression linéaire occupe une place cardinale. Il constitue le socle conceptuel et opératoire à partir duquel s’articulent la quasi-totalité des analyses paramétriques modernes, depuis l’analyse de variance classique jusqu’aux modèles d’équations structurelles les plus sophistiqués. Comprendre en profondeur la mécanique de la régression linéaire ne relève pas d’un simple exercice de calcul, mais d’une exigence épistémologique indispensable pour qui souhaite sonder avec rigueur la dynamique des phénomènes psychologiques.
Au sein de l’environnement informatique R, qui s’est imposé comme le standard international pour le traitement de données scientifiques et la recherche reproductible, l’ajustement de ces structures mathématiques est principalement dévolu à la fonction native lm(), issue du paquetage statistique fondamental stats. Bien que sa syntaxe de base paraisse d’une trompeuse simplicité, cette fonction encapsule des algorithmes matriciels puissants et génère une arborescence d’objets statistiques riches dont l’interprétation requiert une acuité méthodologique irréprochable. Trop souvent, l’utilisateur débutant ou intermédiaire se contente d’extraire une valeur de probabilité sans mesurer la portée des postulats sous-jacents, ni saisir la nature exacte de la décomposition de la variance opérée par l’algorithme des moindres carrés ordinaires.
Ce guide encyclopédique a pour vocation d’offrir une immersion intégrale et exhaustive dans l’utilisation de la fonction lm() appliquée aux sciences psychologiques et comportementales. De la formalisation théorique du modèle linéaire général aux subtilités du codage des contrastes catégoriels, en passant par le diagnostic minutieux des résidus, la gestion des effets modérateurs et la restitution normalisée selon les canons stricts de l’American Psychological Association (APA), chaque étape fait l’objet d’une dissection théorique et pratique approfondie. En articulant rigueur mathématique, considérations psychométriques et implémentation computationnelle dans le logiciel R, ce traité permettra aux chercheurs et analystes de données de transformer leurs hypothèses conceptuelles en inférences statistiques solides et parfaitement reproductibles.
1. Introduction aux modèles linéaires et à la fonction lm() en psychologie
1.1 Importance de la modélisation linéaire en psychologie quantitative
La recherche en psychologie quantitative s’est construite historiquement autour de la quantification de variables inobservables directement, qualifiées de construits latents, telles que l’intelligence, l’anxiété état ou trait, la mémoire de travail ou l’extraversion. Pour relier ces mesures opérationnalisées via des tests standardisés ou des paradigmes expérimentaux chronométriques, les chercheurs ont besoin d’outils analytiques capables d’isoler la variance partagée tout en quantifiant l’erreur de mesure inhérente à l’observation humaine. La régression linéaire s’impose ici non seulement comme une technique d’ajustement prédictif, mais véritablement comme un outil explicatif permettant de formaliser comment une variation systématique au sein d’une ou plusieurs variables exogènes se traduit par une modification de l’espérance mathématique de la variable endogène.
Sur le plan épistémologique, il convient d’établir une démarcation nette entre la simple corrélation bivariée et la modélisation linéaire multivariée. La corrélation, bien que fondamentale, se borne à évaluer le degré d’association symétrique entre deux grandeurs sans présumer de l’asymétrie fonctionnelle liant les facteurs. En revanche, le modèle linéaire implique une directionnalité théorique forte où la variable dépendante est modélisée conditionnellement aux réalisations des variables indépendantes. Cette démarche permet d’opérer un contrôle statistique sur des covariables de confusion potentielles, neutralisant ainsi le phénomène des corrélations illusoires qui pollue fréquemment les plans quasi-expérimentaux en sciences sociales.
Cette approche s’inscrit au sein du Modèle Linéaire Généralisé (GLM pour General Linear Model), théorisé notamment par des statisticiens comme Jacob Cohen dans les années 1960. Cohen a démontré de manière magistrale que les tests traditionnels enseignés dans les cursus de psychologie, tels que le test t de Student, l’analyse de variance univariée (ANOVA) et factorielle, ou l’analyse de covariance (ANCOVA), ne représentent en réalité que des cas particuliers d’un unique et même modèle de régression linéaire sous des schémas de codage spécifiques. Adopter le cadre unifié de la régression linéaire libère le chercheur des carcans rigides des plans expérimentaux balancés et ouvre la voie à une analyse intégrée de prédicteurs continus et catégoriels sans perte artificielle d’information par dichotomisation arbitraire.
1.2 Présentation technique de la fonction lm() dans l’environnement R
Dans l’architecture native du logiciel R, la fonction lm(), acronyme direct de linear model, réside au cœur du paquetage stats. Contrairement aux approches computationnelles naïves qui tentent d’inverser directement les matrices de dispersion brute, la fonction lm() fait appel en coulisses à des routines compilées de haut niveau numérique, écrites en C et en Fortran, empruntant les techniques d’algèbre linéaire de la bibliothèque LAPACK. Plus spécifiquement, R implémente une décomposition orthogonale QR de la matrice des prédicteurs, garantissant une stabilité numérique remarquable même en présence de matrices mal conditionnées ou approchant de la singularité, un écueil fréquent lors de l’analyse d’échelles psychométriques présentant de fortes colinéarités.
Le rôle central de lm() repose sur la mise en œuvre de la méthode des moindres carrés ordinaires (MCO), dont la vocation est d’identifier le vecteur de paramètres qui minimise la somme des carrés des écarts entre les observations empiriques et les valeurs projetées par le modèle. Ce procédé repose sur la projection orthogonale du vecteur des réponses dans le sous-espace vectoriel engendré par les colonnes de la matrice des variables indépendantes. La fonction prend en charge l’instanciation d’un objet logiciel complexe de classe S3 doté de multiples attributs, prêt à être sondé par un ensemble cohérent de fonctions génériques.
L’utilisation de R et de la commande lm() confère des avantages méthodologiques décisifs par rapport aux logiciels propriétaires à interface graphique tels que SPSS ou SAS. D’une part, l’écriture sous forme de scripts garantit une traçabilité totale des manipulations de données, fondement incontournable de la crise de la reproductibilité qui traverse la psychologie contemporaine. D’autre part, la souplesse de l’écosystème R permet d’imbriquer l’objet généré par lm() dans des chaînes de traitement automatisées, facilitant l’extraction de métriques, la réalisation de simulations de Monte-Carlo, ou le couplage avec des outils de rendu dynamique pour la génération transparente de rapports de recherche.
1.3 Objectifs pédagogiques et méthodologiques du guide
L’ambition de cet ouvrage didactique est de doter les étudiants avancés, les doctorants et les chercheurs chevronnés en psychologie d’une maîtrise théorique et opérationnelle sans faille de la modélisation linéaire via lm(). Il ne s’agit pas de survoler superficiellement des recettes de codage toutes faites, mais de comprendre précisément les mécanismes mathématiques régissant l’estimation des paramètres et la distribution probabiliste des statistiques de test associées. La rigueur conceptuelle est la seule garantie contre les interprétations fallacieuses qui abondent dans la littérature empirique.
Au terme de ce document, le lecteur sera en mesure de disséquer méticuleusement chaque élément composant les sorties numériques produites par les fonctions de diagnostic de R. Cela implique la compréhension intime du tableau des coefficients, de l’erreur type résiduelle, des statistiques de Student et de Fisher, ainsi que des indices de détermination globale et ajustée. Une attention particulière est portée à l’adéquation de ces métriques aux particularités des distributions psychologiques, qui s’écartent fréquemment de l’idéal théorique en raison de biais d’échantillonnage, d’effets de plancher ou de plafond, ou encore de scores agrégés asymétriques.
Enfin, ce guide vise l’assimilation complète des protocoles de diagnostic des postulats fondamentaux de Gauss-Markov et la mise en pratique d’actions correctives appropriées face à leurs violations. L’objectif ultime consiste à transcrire ces résultats complexes sous une forme textuelle et tabulaire strictement alignée sur les préconisations du manuel de publication de l’APA dans sa septième édition. L’ensemble de la démarche concourt ainsi à hisser le traitement des données empiriques aux plus hauts standards de validité interne et de transparence scientifique.
2. Fondements théoriques et syntaxe de la fonction lm()
2.1 Syntaxe générale et grammaire des formules dans R
La puissance d’expression de la modélisation linéaire sous R repose sur la grammaire déclarative de ses formules, formalisée originellement par John Chambers et Trevor Hastie. L’appel standard prend la forme canonique d’une instruction où l’argument principal associe la variable réponse aux variables explicatives par le biais de l’opérateur tilde. Dans cette écriture, le terme situé à gauche du tilde désigne la variable dépendante continue, tandis que la partie droite recense l’ensemble des prédicteurs et leurs structures de dépendance ou d’interaction.
Les opérateurs arithmétiques standards adoptent une sémantique symbolique spécifique lorsqu’ils sont mobilisés à l’intérieur d’une formule de régression. Le signe d’addition ne désigne pas une sommation numérique des colonnes, mais l’inclusion conjointe et cumulative de prédicteurs distincts dans le modèle. L’opérateur deux-points exprime spécifiquement le produit croisé entre deux covariables, c’est-à-dire l’interaction pure, tandis que l’astérisque représente une notation synthétique puissante incluant simultanément les effets principaux des variables concernées ainsi que leur terme d’interaction. De plus, le signe de soustraction autorise le retrait explicite d’un élément, la syntaxe soustrayant un permettant par exemple d’annuler l’estimation par défaut de l’ordonnée à l’origine pour contraindre la droite à traverser le centre du repère cartésien.
La gestion de l’argument désignant le jeu de données revêt une importance capitale sur le plan du scoping lexical au sein de l’interpréteur R. Lorsque l’utilisateur spécifie explicitement la structure matricielle ou le tableau contenant les variables, la fonction lm() évalue prioritairement les symboles de la formule au sein de cet environnement local circonscrit. Si une variable n’y est pas retrouvée, la recherche remonte les arborescences de l’environnement global, ce qui peut engendrer des erreurs dramatiques d’écrasement ou d’analyse sur des versions obsolètes d’un vecteur. Il est donc hautement recommandé de maintenir l’ensemble des colonnes d’analyse regroupées au sein d’une même structure tabulaire unifiée.
2.2 Formalisation mathématique des moindres carrés ordinaires
Sur le plan de l’algèbre matricielle, le modèle linéaire standard pour un échantillon de taille n composé de p prédicteurs se formalise sous l’équation matricielle classique :
Y = Xβ + ε
Dans cette formulation rigoureuse, Y représente le vecteur colonne de dimension n par un regroupant les scores observés sur la variable dépendante psychologique. La matrice X, désignée sous l’appellation de matrice du plan d’expérience (design matrix), présente une dimension de n lignes par p plus une colonnes ; sa première colonne est entièrement constituée du chiffre un afin de modéliser le terme constant, tandis que les colonnes suivantes reçoivent les valeurs numériques associées à chaque sujet sur les variables indépendantes. Le vecteur β rassemble les paramètres inconnus de la population à estimer, et le vecteur ε symbolise les perturbations aléatoires ou erreurs de mesure stochastiques inhérentes à l’évaluation psychométrique.
Le principe fondamental des moindres carrés ordinaires réside dans la minimisation d’une fonctionnelle quadratique représentant la somme des carrés des résidus, notée S(β) = (Y – Xβ)'(Y – Xβ). En dérivant cette expression matricielle par rapport au vecteur des paramètres et en égalant le gradient résultant au vecteur nul, on obtient les équations normales bien connues. Pour autant que la matrice symétrique carrée résultante soit inversible, c’est-à-dire qu’aucune colonne ne soit une combinaison linéaire exacte d’autres colonnes, la solution analytique unique s’exprime sous la forme célèbre :
β_chapeau = (X’X)^(-1) X’Y
D’après le théorème fondamental de Gauss-Markov, cet estimateur des moindres carrés possède des vertus statistiques optimales. Si les postulats d’espérance conditionnelle nulle des erreurs, d’homoscédasticité et d’absence d’autocorrélation sont satisfaits, l’estimateur des MCO est qualifié de BLUE (Best Linear Unbiased Estimator). Cela signifie qu’au sein de la classe de tous les estimateurs linéaires non biaisés possibles des paramètres de la population, il présente la variance minimale d’échantillonnage, garantissant ainsi l’estimation la plus précise et efficiente possible des répercussions comportementales mesurées.
2.3 Gestion des arguments optionnels de la fonction lm()
Au-delà de la formule et de la désignation de la source de données, la fonction lm() propose un ensemble d’arguments optionnels paramétrables de manière très fine. Le paramètre subset constitue un outil puissant pour segmenter l’analyse sans altérer physiquement l’intégrité de la table originale. En psychologie clinique ou en neuropsychologie, cette option permet d’ajuster instantanément un modèle sur un sous-groupe diagnostique spécifique, par exemple uniquement les patients présentant un score modéré à l’inventaire de dépression, ou sur une strate démographique définie, tout en préservant le jeu complet pour d’autres inférences transversales.
L’argument weights ouvre la porte à la régression par les moindres carrés pondérés (WLS). Cette méthode devient indispensable lorsque le postulat d’homogénéité des variances résiduelles est violé de manière structurelle, ou lorsque les données analysées constituent des moyennes agrégées issues de sous-groupes de tailles inégales. En attribuant un poids inversement proportionnel à la variance présumée de chaque observation, le chercheur s’assure que les observations les plus bruitées pèsent moins lourdement dans le processus d’optimisation de la droite de régression, évitant ainsi une déformation erratique des pentes calculées.
Enfin, l’argument na.action régit le comportement computationnel de l’algorithme face aux données manquantes, un défi omniprésent lors de l’administration de questionnaires psychologiques ou d’expérimentations cognitives longues. Par défaut, R mobilise la directive qui élimine purement et simplement toute ligne contenant au moins une valeur indéterminée sur les variables mobilisées dans le modèle. Bien que cette approche par suppression de cas complets permette l’exécution sans accroc du calcul matriciel, elle peut générer de redoutables biais d’échantillonnage et une chute drastique de la puissance statistique, ce qui exige un contrôle vigilant de la part du méthodologue.
3. Préparation et structuration des données psychométriques
3.1 Organisation du jeu de données dans un data.frame R
Avant d’initier la moindre commande d’ajustement linéaire dans R, la structuration formelle du jeu de données psychométriques conditionne l’entière validité de la chaîne analytique. Les données brutes recueillies à travers des plateformes de passation en ligne ou des saisies manuelles en laboratoire doivent impérativement être converties en une structure rectangulaire standard où chaque ligne matérialise une unité observationnelle unique, le participant, et chaque colonne encapsule une variable mesurée ou manipulée. La nomenclature des colonnes doit obéir à des conventions strictes évitant les espaces, les caractères diacritiques ou les symboles réservés, afin de prévenir toute ambiguïté syntaxique lors de la spécification des formules.
Le contrôle rigoureux du typage des variables constitue l’étape la plus critique du prétraitement. R distingue fondamentalement les vecteurs numériques continus, aptes à recevoir des scores d’échelles d’intervalles ou de rapports, des facteurs conçus pour catégoriser des modalités discrètes. Une erreur classique en psychologie consiste à laisser une variable de condition expérimentale codée numériquement sous forme de zéros et de uns sans la convertir formellement en facteur via la primitive de typage correspondante. Dans un tel cas, lm() traiterait la condition comme une métrique continue, ce qui, bien que mathématiquement équivalent dans le cas binaire strict, engendre des confusions désastreuses dès que le plan expérimental comporte trois conditions ou plus.
Les variables issues de questionnaires standardisés nécessitent également un travail préalable d’agrégation et d’inversion des items rédigés en sens négatif. Les scores composites doivent être calculés en s’assurant que la consistance interne de l’instrument a été préalablement validée, par exemple via le calcul du coefficient alpha de Cronbach ou du coefficient oméga de McDonald. Standardiser les échelles via des scores centrés et réduits en amont permet fréquemment d’harmoniser des métriques hétérogènes, facilitant grandement la convergence de modèles plus larges et autorisant une comparaison directe de l’intensité des associations au sein de la matrice finale.
3.2 Gestion des valeurs manquantes et imputation statistique
La présence de valeurs manquantes représente la norme plutôt que l’exception lors de protocoles de recherche en psychologie, qu’il s’agisse de lassitude face à un inventaire de personnalité exhaustif, de dysfonctionnements d’enregistreurs physiologiques, ou d’attrition au cours d’études longitudinales. L’application par défaut de l’exclusion des cas incomplets par la fonction lm() repose sur le postulat restrictif que les données sont manquantes de manière totalement aléatoire (MCAR, pour Missing Completely at Random). Lorsque ce postulat s’avère faux, l’échantillon retenu subit un biais de sélection qui altère fondamentalement la représentativité des coefficients de régression obtenus.
En psychologie du développement ou en psychiatrie translationnelle, l’attrition des sujets est fréquemment corrélée au niveau de gravité du tableau clinique ou à des dimensions socio-économiques précarisées. Si les participants les plus instables abandonnent l’étude, l’analyse des cas complets sous-estimera l’ampleur des effets de dégradation ou surestimera l’efficacité d’une prise en charge psychothérapeutique. Avant de lancer un modèle linéaire définitif, il incombe au chercheur de quantifier le taux d’incomplétude pour chaque colonne et d’évaluer statistiquement si la vacuité des données dépend des scores observés sur les autres prédicteurs.
Face à des pertes substantielles de participants, les méthodes d’imputation multiple fondées sur des équations enchaînées doivent être privilégiées par rapport à l’amputation brutale de l’échantillon. En générant plusieurs jeux de données complets plausibles qui reflètent l’incertitude inhérente aux données manquantes, le chercheur peut ajuster le modèle linéaire avec lm() sur chaque réplique séparément, puis combiner les estimations vectorielles et les erreurs types associées selon les règles d’agrégation de Rubin. Cette démarche garantit la préservation de la puissance nominale du test tout en produisant des inférences beaucoup plus réalistes et défendables devant la communauté scientifique.
3.3 Exploration descriptive univariée et bivariée pré-ajustement
L’estimation aveugle d’un modèle linéaire sans diagnostic préliminaire de la morphologie distributionnelle des variables constitue une faute méthodologique majeure. L’exploration descriptive univariée impose le calcul exhaustif des indices de tendance centrale, à savoir la moyenne arithmétique et la médiane, complétés par les métriques de dispersion que sont l’écart-type et l’intervalle interquartile. En outre, le calcul des coefficients d’asymétrie de Pearson (skewness) et d’aplatissement de Fisher (kurtosis) permet d’identifier les déformations structurelles susceptibles d’affaiblir l’efficacité de l’estimateur des moindres carrés.
L’inspection graphique bivariée via des nuages de points enrichis de courbes de lissage local non paramétrique (comme l’algorithme LOESS) est incontournable pour vérifier visuellement le postulat de linéarité globale de la relation unissant les variables. Des relations cognitives bien documentées, telles que la loi de Yerkes-Dodson reliant l’éveil cortical à la performance sous la forme d’un U inversé, présentent une courbure fondamentale qu’un modèle linéaire simple écraserait totalement en concluant à tort à une absence d’association. Les boîtes à moustaches permettent quant à elles de déceler les asymétries de dispersion entre sous-groupes cliniques et de repérer les données se situant aux extrêmes de la distribution.
Enfin, l’examen préalable de la matrice des corrélations linéaires de Pearson et des corrélations de rangs de Spearman fournit une cartographie préliminaire de la connectivité entre les variables psychométriques. Cette analyse bivariée initiale renseigne non seulement sur l’intensité des liens entre la variable dépendante et chaque prédicteur potentiel, mais elle allume également les premiers voyants d’alerte quant à l’existence de redondances excessives entre les covariables prédictives. Un niveau de corrélation bivariée excessivement élevé entre deux échelles d’évaluation annonce invariablement des instabilités de convergence lors de la modélisation multivariée ultérieure.
4. Ajustement d’un modèle de régression linéaire simple
4.1 Modélisation univariée avec un prédicteur unique
La régression linéaire simple constitue la brique élémentaire de la modélisation statistique. Elle intervient lorsqu’un chercheur souhaite éprouver une hypothèse scientifique formalisée prédisant qu’une variable quantitative unique exerce une influence linéaire directe sur une variable réponse continue. Considérons une problématique classique en psychologie expérimentale et cognitive : l’impact de la privation de sommeil sur l’anxiété situationnelle. L’investigateur postule que l’accumulation des heures de veille continue majore de façon proportionnelle le niveau d’anxiété mesuré par une échelle auto-rapportée validée.
La transcription de cette hypothèse dans l’environnement R s’opère par l’invocation directe de la fonction lm() en désignant la variable dépendante d’anxiété à gauche du tilde et les heures de veille à droite, en ciblant le conteneur de données approprié. L’exécution de cette commande ne doit pas demeurer orpheline dans la console ; elle doit impérativement être assignée à un identifiant d’objet au sein de l’espace de travail global. Cette assignation instancie l’analyse et conserve en mémoire la totalité des calculs analytiques et des matrices de projection générés par le moteur d’optimisation.
Une fois l’objet généré, son affichage brut sans fonction auxiliaire renvoie simplement l’appel d’origine ainsi que les valeurs numériques estimées pour les deux coefficients du modèle : la constante, qui matérialise l’espérance mathématique de l’anxiété pour un temps de privation nul, et le coefficient de régression associé aux heures de veille. Cette seconde valeur indique l’incrément moyen théorique du score d’anxiété pour chaque heure additionnelle passée sans dormir. Ce résultat initial fournit la pente brute de la trajectoire linéaire ajustée sur les données du protocole.
4.2 Exploration structurelle de l’objet produit par lm()
L’objet retourné par la fonction lm() est une liste enrichie de métadonnées dont la structure interne est hautement sophistiquée. Pour le statisticien utilisateur de R, il est très instructif de comprendre les composantes fondamentales stockées sous le capot de cet objet S3. En explorant ses attributs à l’aide des primitives d’inspection du système, on découvre une vaste collection de vecteurs et de matrices calculés lors de la descente d’ajustement. Ces éléments sous-tendent l’intégralité des diagnostics qui seront sollicités plus tardivement dans le flux analytique.
Parmi les composantes fondamentales figurent le vecteur des coefficients estimés, le vecteur des valeurs ajustées représentant les projections de chaque participant sur la droite théorique, et le vecteur des résidus bruts, défini comme la différence arithmétique rigoureuse entre les réponses empiriques et les prédictions du modèle. L’objet renferme également le rang mathématique de la matrice du plan d’expérience, les degrés de liberté résiduels, ainsi que la décomposition QR ayant servi à l’inversion du système linéaire. Ces grandeurs permettent de reconstituer l’ensemble des grandeurs d’échantillonnage sans recalculer les produits scalaires.
Toutefois, les règles de bonne pratique de programmation statistique sous R déconseillent formellement l’extraction directe de ces composants par l’opérateur dollar au sein de routines automatisées. Il est largement préférable d’interroger l’objet de régression au moyen de ses méthodes génériques spécialisées, spécifiquement conçues pour garantir l’intégrité des types. L’extraction des coefficients doit donc reposer sur l’appel à la fonction coef(), celle des résidus empiriques sur la fonction residuals() ou resid(), et celle des estimations attendues sur la fonction fitted(). Ces accesseurs standardisés garantissent la stabilité du code face aux évolutions potentielles du moteur interne de R.
4.3 Calcul manuel et vérification computationnelle
Pour dissiper définitivement l’illusion d’une boîte noire magique et ancrer la compréhension de la méthode des moindres carrés ordinaires, il est extrêmement salutaire de reproduire pas à pas, à l’aide des fonctions arithmétiques fondamentales de R, le calcul algébrique exact des estimateurs d’une régression univariée. Pour un prédicteur unique X et une variable réponse Y, la pente du modèle est définie comme le rapport entre la covariance empirique des deux variables et la variance d’échantillonnage du prédicteur :
b_1 = Cov(X, Y) / Var(X)
En mobilisant les fonctions natives calculant la covariance et la variance d’un vecteur numérique, l’analyste peut déterminer directement cette valeur scalaire. Une fois la pente obtenue, l’estimation de l’ordonnée à l’origine, souvent désignée par la constante du modèle, découle immédiatement du principe géométrique voulant que la droite des moindres carrés passe obligatoirement par le centre de gravité de la distribution des données, défini par le point coordonné des moyennes respectives :
b_0 = Moyenne(Y) – b_1 * Moyenne(X)
En comparant les valeurs issues de ces deux lignes d’arithmétique élémentaire avec les coefficients extraits de l’objet lm() par la fonction standard, on constate une convergence numérique absolue, aux imprécisions infinitésimales de troncature binaire près. Cette concordance matérielle confirme que l’ajustement linéaire univarié n’est rien d’autre que la réexpression de la covariance standardisée par la dispersion de la variable prédictive, fournissant une interprétation géométrique limpide du concept de régression vers la moyenne mis en évidence par Francis Galton.
5. Analyse et interprétation approfondie des sorties de summary()
5.1 Décomposition du tableau des coefficients de régression
L’application de la méthode générique summary() sur un objet de régression constitue l’étape reine de l’inférence statistique sous R. Elle génère une synthèse tabulaire dense articulée autour de quatre colonnes cardinales détaillant l’estimation ponctuelle et la variabilité théorique de chaque paramètre. La première colonne, intitulée Estimate, consigne la valeur numérique de la constante et des pentes partielles calculées selon la formule des moindres carrés. Pour chaque prédicteur, cette valeur indique la modification unitaire attendue sur l’échelle de mesure de la variable dépendante lorsque cette covariable s’accroît d’une unité complète.
La deuxième colonne rapporte l’erreur type de l’estimateur (Std. Error), une grandeur psychométrique capitale dont dépend la puissance du modèle. L’erreur type formalise l’écart-type de la distribution d’échantillonnage théorique du coefficient si l’on répétait l’expérience un nombre infini de fois sur des échantillons de même taille tirés au sort dans la population mère. Sa magnitude est inversement proportionnelle à la taille de l’échantillon et à la dispersion propre du prédicteur, et directement proportionnelle à la variance des erreurs résiduelles. Une erreur type restreinte témoigne ainsi d’une excellente précision de l’estimation de la pente.
La troisième colonne présente la statistique de test, matérialisée par la valeur t de Student. Ce ratio se calcule simplement en divisant l’estimation du coefficient par son erreur type correspondante, ce qui revient à quantifier l’éloignement de l’estimation par rapport à la valeur nulle sous l’hypothèse de base :
t = (Estimateur – 0) / Erreur_Type
La quatrième colonne livre la valeur de probabilité bilatérale (p-value), calculée à partir de la fonction de répartition d’une loi de Student calibrée sur les degrés de liberté résiduels. Elle renseigne sur la probabilité exacte d’observer une pente au moins aussi extrême que celle mesurée sous l’hypothèse nulle d’absence totale d’effet linéaire dans la population. Il importe de rappeler avec insistance qu’une faible valeur de p ne traduit en aucun cas l’importance psychologique ou clinique d’un effet, mais réfute seulement la compatibilité des données observées avec un modèle purement stochastique.
5.2 Mesures d’ajustement global : R-carré et erreur type résiduelle
Au bas de la restitution fournie par summary() figurent les métriques globales renseignant sur la qualité d’ajustement du modèle à l’ensemble du nuage de points. La première métrique rencontrée est l’erreur résiduelle standardisée (Residual Standard Error, ou RSE). Elle correspond à l’estimation non biaisée de l’écart-type des perturbations aléatoires dans la population, calculée en divisant la somme des carrés des résidus par les degrés de liberté résiduels, puis en extrayant la racine carrée du résultat. La RSE quantifie l’incertitude résiduelle type dans l’unité de mesure exacte de la variable psychologique analysée, offrant ainsi une appréciation immédiate de l’étalement des erreurs de prédiction.
Le coefficient de détermination multiple, universellement désigné par R-carré, constitue la seconde statistique essentielle. Mathématiquement équivalent au rapport de la somme des carrés expliquée par le modèle sur la somme des carrés totale de la variable dépendante, il formalise le pourcentage de la variance globale de la réponse qui se trouve linéairement imputable aux prédicteurs intégrés. Variant rigoureusement entre zéro et un, un R-carré de 0,25 indique par exemple qu’un quart des fluctuations interindividuelles de l’anxiété clinique est expliqué par les variations de la privation de sommeil au sein de l’échantillon analysé.
Néanmoins, le R-carré multiple présente le défaut structurel d’augmenter mécaniquement dès que l’analyste ajoute des prédicteurs supplémentaires dans le modèle, même s’il s’agit de bruits blancs totalement dénués de sens théorique. Pour parer à cette dérive, R fournit systématiquement le R-carré ajusté, qui pénalise mathématiquement l’adjonction de paramètres au regard des degrés de liberté consommés. Enfin, la sortie livre la statistique globale F de Fisher-Snedecor, assortie de ses deux degrés de liberté associés, testant l’hypothèse nulle omnibus selon laquelle l’ensemble des coefficients de régression, à l’exception de la constante, seraient simultanément nuls dans la population.
5.3 Analyse de la distribution des résidus dans le résumé
Avant même de scruter les coefficients et les niveaux de significativité statistique, le regard d’un analyste méthodique doit se porter sur le petit tableau récapitulatif des résidus situé immédiatement sous le rappel de la formule dans la sortie de summary(). Ce paragraphe synthétise la distribution des erreurs observées à travers cinq repères morphologiques cruciaux : la valeur minimale, le premier quartile, la médiane arithmétique, le troisième quartile et la valeur maximale. Cet aperçu numérique offre une première sonde sur le respect des postulats distributionnels du modèle linéaire.
Par construction mathématique de l’estimateur des moindres carrés ordinaires, la somme algébrique des résidus bruts d’un modèle pourvu d’une ordonnée à l’origine est rigoureusement égale à zéro, ce qui implique que leur espérance mathématique empirique est strictement nulle. Toutefois, cela ne garantit en rien la symétrie de la distribution. Une médiane des résidus qui s’écarte substantiellement de zéro suggère une asymétrie marquée dans la répartition des erreurs de prédiction, signalant qu’une fraction asymétrique de l’échantillon est systématiquement sous-estimée ou surestimée par la droite de régression.
De même, la comparaison de la magnitude absolue du premier et du troisième quartile fournit une indication précieuse sur la symétrie du cœur de la distribution des erreurs. Si la distance entre le minimum et le premier quartile diverge de façon disproportionnée par rapport à l’écart séparant le troisième quartile du maximum, le chercheur doit suspecter la présence de queues de distribution épaisses, de contaminations aberrantes ou d’hétéroscédasticité sous-jacente. Ces indices sommaires incitent à ne pas accepter aveuglément les tests de Student rapportés sur la ligne des coefficients sans une investigation diagnostique approfondie des résidus.
6. Extension aux modèles de régression linéaire multiple
6.1 Formulation mathématique et spécification dans R
L’investigation des phénomènes psychologiques ne saurait que très rarement se cantonner à une dynamique bivariée, le comportement humain étant par essence multidéterminé. La régression linéaire multiple permet d’étendre le cadre formel univarié en intégrant simultanément un ensemble de k variables explicatives au sein de la même équation fonctionnelle. Dans l’environnement R, cette complexification conceptuelle s’exprime de manière d’une grande fluidité syntaxique en chaînant les variables indépendantes additionnelles au moyen de l’opérateur arithmétique d’addition au sein de la formule passée en argument à lm().
Dans ce modèle multivarié, le coefficient partiel associé à chaque prédicteur acquiert une signification théorique beaucoup plus exigeante et raffinée : il quantifie l’accroissement attendu sur la variable dépendante pour une hausse unitaire de ce prédicteur particulier, toutes choses étant égales par ailleurs (le fameux postulat de ceteris paribus). Autrement dit, le coefficient partiel reflète l’impact propre du prédicteur une fois que l’on a mathématiquement contrôlé, purgé et extrait la totalité de la variance qu’il partage avec l’ensemble des autres variables indépendantes incorporées dans l’équation.
Cette particularité permet d’opérer une distinction méthodologique fondamentale entre la contribution brute d’un construit psychologique, reflétée par sa corrélation bivariée simple avec la variable réponse, et sa contribution unique au modèle. Dans de nombreux paradigmes d’évaluation cognitive, des facteurs qui semblaient significatifs lors d’analyses univariées préliminaires perdent toute pertinence statistique dès lors qu’ils sont mis en concurrence au sein d’un modèle multiple. Cette disparition de l’effet témoigne du fait que leur variance prédictive apparente n’était en réalité qu’un artefact dérivé de leur corrélation avec une variable tierce plus fondamentale, illustrant ainsi la puissance du contrôle statistique par régression multiple.
6.2 Évaluation de la colinéarité et du facteur d’inflation de variance
L’inclusion d’une multiplicité de prédicteurs corrélés entre eux introduit le danger méthodologique de la multicolinéarité. Bien que la présence de corrélations modérées entre prédicteurs n’invalide pas en soi l’hypothèse de non-biais des estimateurs des moindres carrés, une multicolinéarité sévère détériore drastiquement la précision des estimations matricielles. Lorsque deux prédicteurs ou plus partagent une redondance conceptuelle excessive, la matrice d’information approche de la non-inversibilité géométrique, ce qui a pour effet de faire exploser l’erreur type des coefficients partiels et de rendre les estimations hypersensibles à la moindre fluctuation d’échantillonnage.
Pour mesurer rigoureusement l’ampleur de cette dégradation, le chercheur ne peut se satisfaire d’une simple lecture de la matrice des corrélations bivariées, car des dépendances linéaires complexes peuvent émerger de combinaisons linéaires impliquant trois prédicteurs ou davantage sans qu’aucune corrélation bivariée isolée n’atteigne des sommets alarmants. L’outil diagnostique par excellence est le facteur d’inflation de la variance (Variance Inflation Factor, ou VIF). Pour un prédicteur donné, le VIF mesure le facteur d’accroissement de la variance de son estimateur par rapport à ce qu’elle aurait été si cette variable était rigoureusement orthogonale à toutes les autres variables du modèle :
VIF_j = 1 / (1 – R^2_j)
où R^2_j représente le coefficient de détermination obtenu en régressant le prédicteur X_j sur la totalité des autres prédicteurs. Accessible sous R via la fonction spécialisée du paquetage car, le VIF fournit un critère décisionnel standard : une valeur supérieure à 5 signale une colinéarité préoccupante, tandis qu’un VIF excédant 10 indique une multicolinéarité critique imposant une intervention méthodologique d’urgence. Les stratégies de remédiation consistent alors à fusionner les échelles redondantes en un score factoriel unique via une analyse en composantes principales, à supprimer les indicateurs conceptuellement superflus, ou à adopter des approches de régression pénalisée comme la régularisation Ridge ou Lasso.
6.3 Comparaison de modèles emboîtés par analyse de variance (ANOVA)
Une démarche de recherche rigoureuse en psychologie quantitative repose fréquemment sur l’opposition de modèles théoriques concurrents par étapes successives d’adjonction ou de retrait de blocs de variables. On parle de modèles emboîtés lorsque l’ensemble des prédicteurs d’un modèle restreint constitue un sous-ensemble strict des variables contenues dans un modèle plus général. Pour déterminer formellement si l’ajout d’un bloc de variables explicatives procure un gain de prédiction statistiquement supérieur à ce que le simple hasard de l’échantillonnage laisserait présumer, le chercheur mobilise un test F de variation du R-carré.
Dans l’écosystème R, cette confrontation formelle s’exécute de façon exemplaire en passant simultanément les deux objets de régression emboîtés en arguments de la fonction anova(). L’algorithme calcule alors la réduction de la somme des carrés résiduels obtenue par le modèle élargi par rapport au modèle réduit, et met en balance ce gain de variance expliquée avec la consommation de degrés de liberté additionnels. Si la valeur de p associée au F incrémental est inférieure au seuil de significativité retenu, le chercheur dispose d’un argument robuste pour rejeter le modèle restreint au profit de la structure plus complexe.
En complément de ce test d’hypothèse classique, l’évaluation de la parcimonie relative des modèles peut être enrichie par la consultation des critères d’information pénalisés, au premier rang desquels figurent le critère d’information d’Akaike (AIC) et le critère d’information bayésien (BIC), mobilisables via leurs fonctions respectives intégrées dans R. Ces métriques pénalisent la log-vraisemblance du modèle par un facteur directement indexé sur le nombre de paramètres libres estimés. Contrairement aux tests de variance emboîtés, les critères d’information offrent l’avantage inestimable de pouvoir comparer des modèles statistiques non emboîtés, guidant ainsi l’analyste vers le modèle offrant le compromis optimal entre sobriété structurelle et adéquation empirique.
7. Intégration et codage des variables qualitatives
7.1 Fonctionnement du codage par défaut (Dummy Coding) dans lm()
L’expérimentation en psychologie implique de manière quasi constante l’administration de protocoles intégrant des facteurs qualitatifs discrets, tels que l’appartenance à un groupe clinique versus témoin, la modalité d’une consigne expérimentale ou l’assignation à différents protocoles d’intervention thérapeutique. Le modèle linéaire étant intrinsèquement une machinerie mathématique d’algèbre continue, il est incapable d’ingérer directement des chaînes de caractères textuelles. R résout cette incompatibilité par la transformation automatisée des colonnes factorielles en un ensemble de variables muettes indicatrices (dummy variables).
Par défaut, R applique un schéma de codage de traitement (treatment coding). Pour un facteur comportant k niveaux distincts, l’algorithme génère automatiquement k moins une variables indicatrices binaires prenant la valeur un si l’observation appartient au niveau considéré et zéro dans tous les autres cas. La première modalité du facteur, définie soit par l’ordre alphabétique soit par l’ordre explicite des niveaux attribués lors de la création de la variable, sert de groupe de référence implicite. Ce niveau de base est directement absorbé par l’ordonnée à l’origine du modèle.
Sous ce régime de codage, l’ordonnée à l’origine estimée par lm() ne représente plus le centre géométrique de l’échantillon global, mais la moyenne arithmétique empirique exacte du groupe de référence. Corrélativement, chaque coefficient associé à une variable muette quantifie la divergence moyenne constatée entre le niveau cible et ce groupe témoin fondamental. Pour modifier la condition servant de standard d’évaluation, le chercheur doit employer la fonction spécialisée relevel(), permettant par exemple de désigner un groupe recevant un placebo comme socle de comparaison plutôt qu’une condition sélectionnée arbitrairement par tri alphanumérique.
7.2 Schémas alternatifs de contrastes statistiques
Bien que le codage d’indicatrices binaires par défaut convienne à de nombreux contextes comparatifs de type essai clinique contre contrôle, il s’avère méthodologiquement inadapté ou sous-optimal lorsque les chercheurs souhaitent émuler les sorties classiques de l’analyse de variance ou tester des hypothèses théoriques a priori hautement structurées. R dispose d’un système de paramétrage matriciel des contrastes d’une puissance exceptionnelle, permettant d’aligner la machinerie des MCO sur n’importe quel plan d’inférence spécifique.
Le codage de somme (sum-to-zero contrasts, activable via la fonction contr.sum) constitue l’alternative la plus célèbre. Dans ce cadre, la somme des coefficients associés aux différents niveaux du facteur est contrainte à être strictement égale à zéro. Il en résulte que l’ordonnée à l’origine reflète désormais la grande moyenne non pondérée de l’ensemble des conditions expérimentales, et les coefficients mesurent les écarts de chaque groupe par rapport à cette moyenne globale. Ce paramétrage reproduit fidèlement la formalisation traditionnelle de l’ANOVA factorielle et s’avère indispensable pour interpréter correctement les effets principaux en présence d’interactions au sein de plans factoriels déséquilibrés.
D’autres schémas de contrastes sont pré-programmés dans le système ou peuvent être construits manuellement via la définition de matrices d’inversion. Les contrastes de Helmert, par exemple, comparent chaque modalité successive à la moyenne combinée des modalités qui la précèdent, ce qui présente un intérêt cognitif majeur lors de protocoles d’apprentissage séquentiel ou d’exposition graduelle à un stimulus anxiogène. Les contrastes polynomiaux orthogonaux permettent quant à eux de tester la présence de composantes de tendance strictement linéaires, quadratiques ou cubiques le long des paliers ordonnés d’un facteur d’intensité cognitive ou médicamenteuse.
7.3 Variables catégorielles polychotomiques et tests omnibus
Lorsqu’un facteur expérimental comprend plus de deux modalités, la lecture brute de la table des coefficients générée par summary() peut conduire à des erreurs d’interprétation pernicieuses. Chaque variable muette étant testée individuellement par sa statistique de Student respective, un chercheur non averti pourrait conclure à tort à l’absence d’effet du facteur global au motif qu’aucun contraste isolé n’atteint le seuil de significativité unitaire par rapport à la modalité de référence, ou inversement, commettre une inflation de l’erreur de type I en multipliant les examens bivariés non ajustés.
Pour évaluer l’influence générale et collective d’une variable polychotomique, il est impératif de réaliser un test omnibus de Fisher évaluant si le facteur pris dans sa globalité explique une part statistiquement significative de la variance de la variable dépendante. La commande la plus recommandée dans l’environnement R consiste à appliquer la fonction drop1() en spécifiant le test F sur l’objet de régression complet. Cette procédure évalue formellement la dégradation de l’ajustement qui résulterait de l’omission totale du facteur hors du modèle, produisant un test de Fisher rigoureusement identique à celui d’une ANOVA à un facteur de type III.
Si ce test global révèle un effet significatif du construit catégoriel, le chercheur peut alors légitimement explorer la topographie fine des différences entre paires de conditions. Afin de maîtriser l’inflation inévitable du taux d’erreur de première espèce induite par la multiplicité des comparaisons, il est fortement conseillé de s’appuyer sur le paquetage spécialisé emmeans (Estimated Marginal Means). Ce paquetage permet d’extraire les moyennes marginales estimées et d’exécuter des contrastes deux à deux sous contrôle rigoureux des procédures de correction d’ajustement post-hoc, telles que les méthodes de Tukey ou de Bonferroni.
8. Modélisation des interactions et effets modérateurs
8.1 Syntaxe R pour les effets modérateurs et croisés
L’exploration des processus psychologiques postule rarement que l’effet d’une variable environnementale ou biologique opère de manière uniforme et universelle au sein de toute une population. L’impact du stress chronique sur la vulnérabilité dépressive est fréquemment tempéré ou amplifié par des traits de personnalité sous-jacents, tels que le névrosisme ou le soutien social perçu. Dans le lexique de l’analyse multivariée, cette configuration correspond à un effet de modération, que le modèle linéaire traduit mathématiquement par l’inclusion d’un terme d’interaction multiplicatif.
Au niveau de la syntaxe formelle de lm(), l’analyste doit discriminer précisément l’usage des opérateurs de composition. L’écriture associant deux prédicteurs par un opérateur deux-points ordonne le calcul exclusif du vecteur issu du produit scalaire point par point de ces deux colonnes, représentant l’interaction pure sans leurs composantes individuelles. À l’opposé, l’usage du symbole astérisque active l’expansion hiérarchique complète : l’instruction demandant l’interaction entre deux variables génère automatiquement l’inclusion du premier terme, du second terme, ainsi que de leur produit croisé.
Le respect du principe de hiérarchie méthodologique impose comme une règle absolue d’inclure systématiquement les effets constitutifs d’ordre inférieur dès lors qu’un terme d’interaction d’ordre supérieur est conservé dans l’équation. Omettre les effets constitutifs directs pour ne conserver que l’interaction multiplicative fausse de manière désastreuse l’estimation des pentes et attribue arbitrairement à l’interaction une part de variance qui relève en vérité d’un décalage d’échelle ou d’un effet principal sous-jacent, compromettant irrémédiablement la validité épistémologique du modèle.
8.2 Centrage des prédicteurs continus pour réduire la multicolinéarité
L’insertion directe du produit multiplicatif de deux variables numériques continues sans prétraitement préalable engendre un problème méthodologique majeur : la colinéarité structurelle non essentielle. La variable produit résultante sera presque invariablement corrélée de manière très substantielle avec les prédicteurs originaux dont elle est issue, entraînant une inflation spectaculaire des erreurs types et une perte de puissance analytique sur les tests t de Student associés aux effets principaux respectifs.
De surcroît, sans transformation, l’interprétation des coefficients principaux devient fréquemment absurde d’un point de vue psychologique. Dans une régression avec terme croisé brut, le coefficient associé à un premier prédicteur s’interprète comme la pente de ce prédicteur spécifiquement lorsque le second prédicteur modérateur est rigoureusement égal à zéro. Si ce modérateur représente une échelle psychométrique standardisée ou un score de quotient intellectuel pour lesquels une valeur de zéro est impossible ou dénuée de sens physique, l’effet principal devient une pure abstraction mathématique impossible à contextualiser cliniquement.
La solution universelle à cette aporie réside dans le centrage des prédicteurs continus sur leur moyenne respective préalablement à la dérivation de l’interaction. Cette opération de soustraction translationnelle, exécutable sous R par la fonction native scale() en désactivant la mise à l’échelle unitaire, repositionne la moyenne de chaque prédicteur à zéro sans modifier d’un iota la variance ni la forme de la distribution. Grâce au centrage, la corrélation structurelle entre les composantes individuelles et leur terme croisé est minimisée, et l’effet principal d’une variable s’interprète désormais de manière élégante comme son effet moyen conditionné au niveau moyen du modérateur au sein de l’échantillon.
8.3 Décomposition et analyse des pentes simples (Simple Slopes)
L’obtention d’un coefficient significatif associé au terme d’interaction multiplicatif confirme formellement l’existence d’une modération statistique, mais ne renseigne en rien sur la directionnalité ni sur la dynamique concrète de l’effet modérateur sur le terrain comportemental. L’analyste doit procéder à une décomposition analytique dite d’analyse des pentes simples (simple slopes analysis), consistant à calculer et tester la significativité de la régression de la variable dépendante sur le prédicteur principal à différents niveaux fixés et standardisés de la variable modératrice.
La convention méthodologique préconisée de longue date par Leona Aiken et Stephen West recommande de sonder l’effet conditionnel à trois points stratégiques de la distribution du modérateur : à la moyenne (niveau modéré), à un écart-type en dessous de la moyenne (niveau faible) et à un écart-type au-dessus de la moyenne (niveau élevé). Dans l’écosystème contemporain de R, ces calculs décomposés s’exécutent de façon transparente grâce à des bibliothèques dédiées telles que interactions ou emmeans, qui recalibrent automatiquement les matrices de variance-covariance pour délivrer les erreurs types conditionnelles et les statistiques de Student associées à chaque palier.
Pour dépasser l’arbitraire relatif attaché au choix conventionnel du décalage d’un écart-type, la méthodologie moderne encourage le recours à la technique mathématique d’investigation continue de Johnson-Neyman. Accessible via des routines spécialisées dans R, cette procédure identifie analytiquement sur l’ensemble du continuum continu de la variable modératrice les seuils précis à partir desquels la pente du prédicteur bascule de la non-significativité à la significativité statistique. Cette cartographie fine offre aux chercheurs en psychologie un niveau de résolution incomparable pour délimiter les zones de résilience ou de vulnérabilité au sein d’une population ciblée.
9. Validation des postulats statistiques et diagnostics graphiques
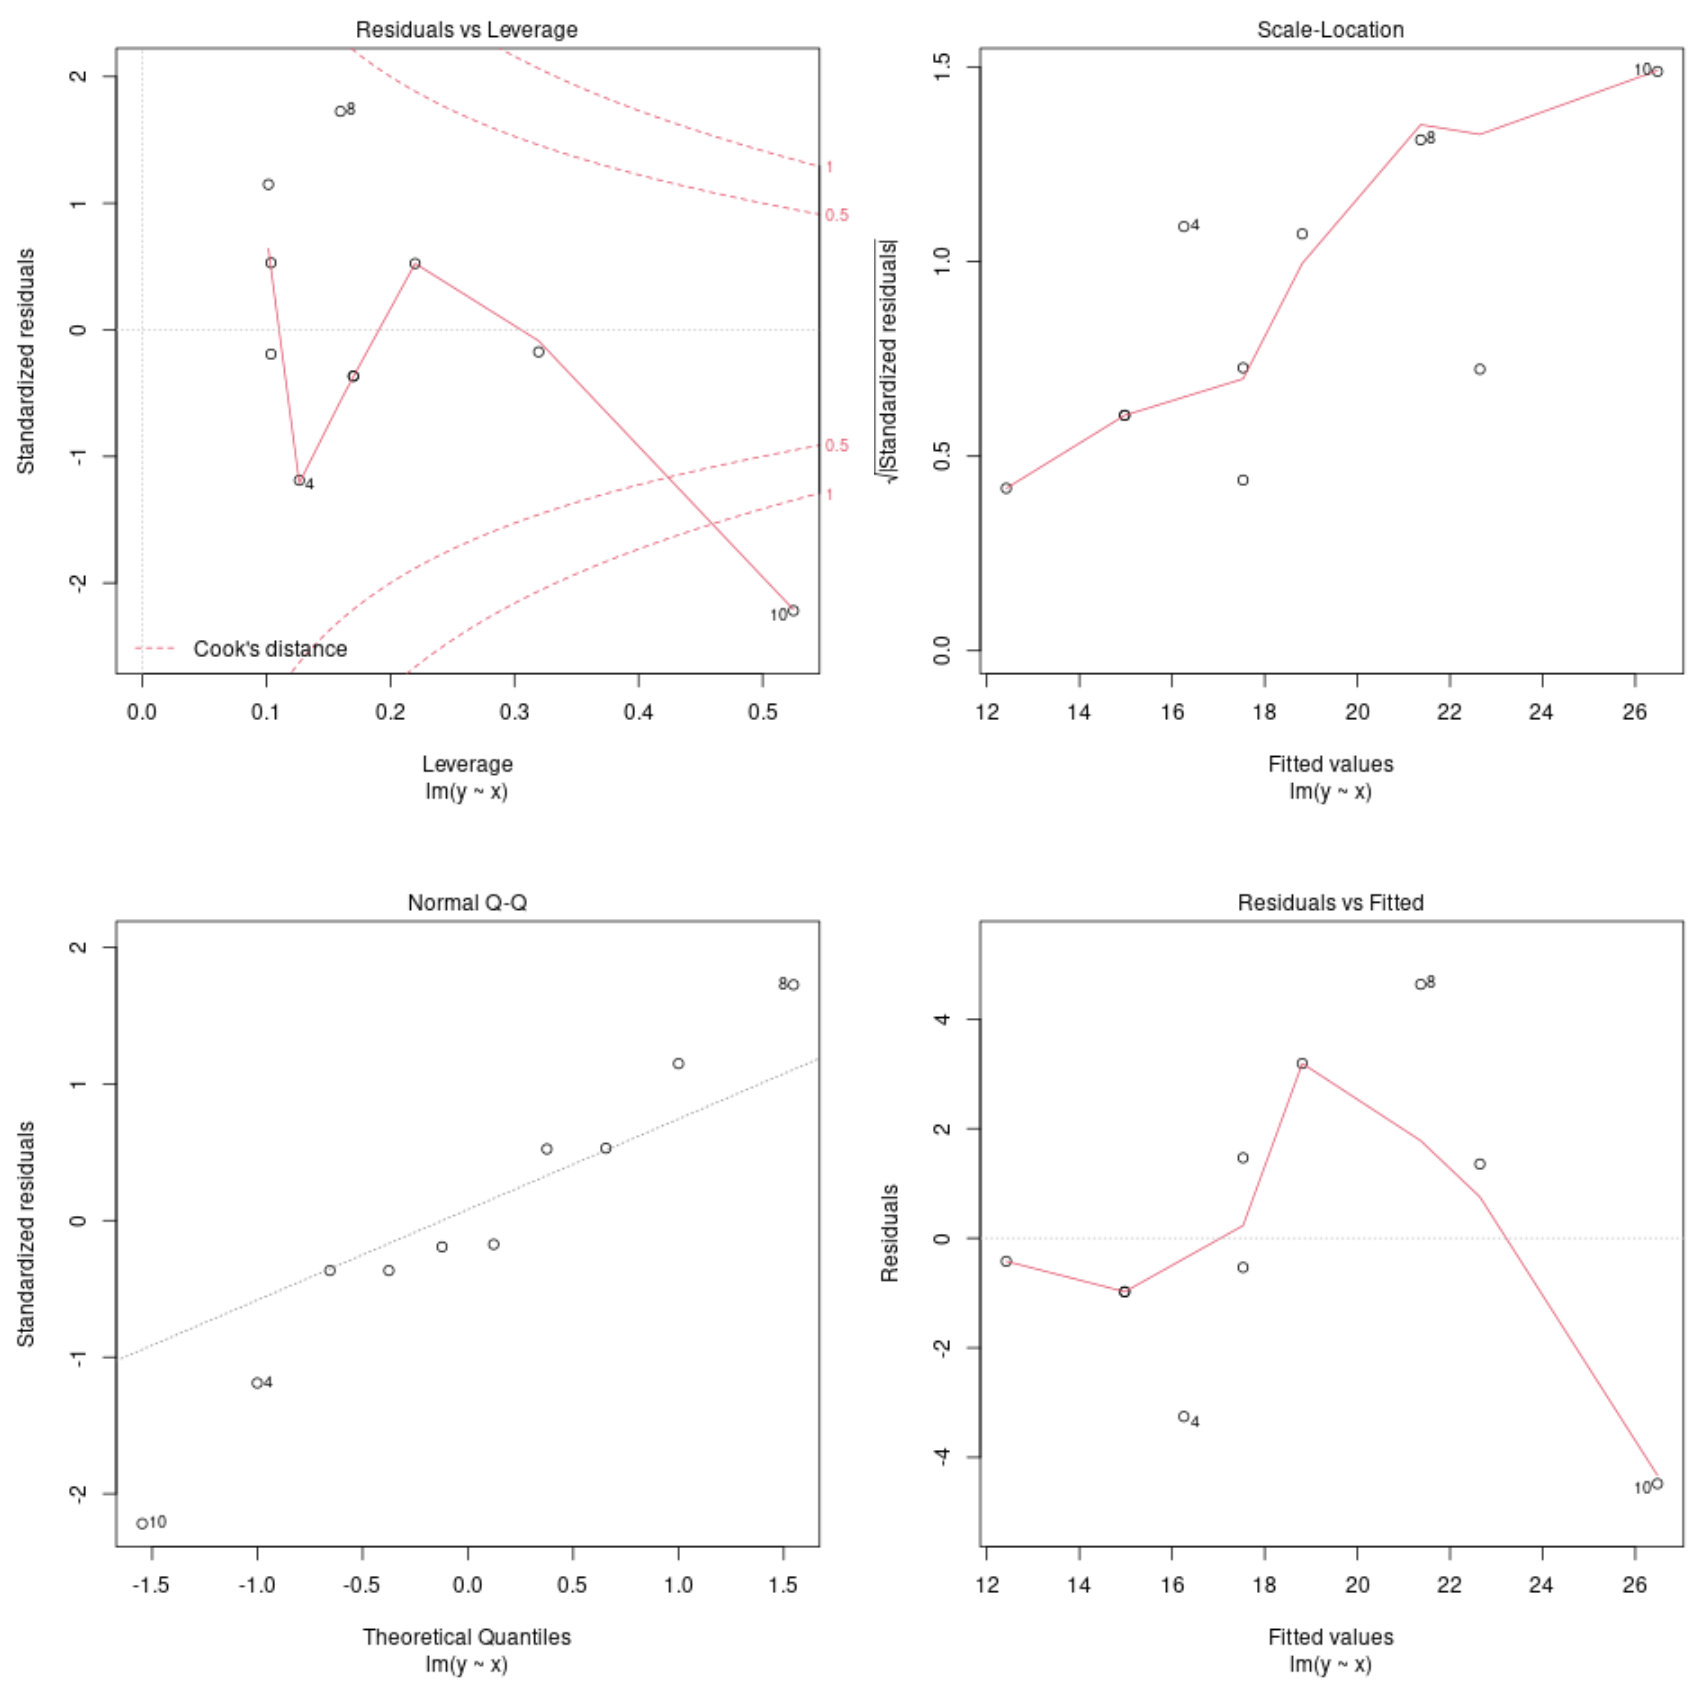
9.1 Génération et interprétation du quadrant de tracés diagnostiques
L’inférence paramétrique déduite d’un modèle de régression linéaire repose sur un ensemble d’axiomes fondamentaux régissant la distribution des perturbations stochastiques inobservables, dont les résidus observés constituent la seule approximation empirique disponible. L’invocation directe de la fonction générique plot() sur un objet de régression génère une séquence canonique de quatre tracés graphiques de contrôle, conçus pour inspecter visuellement les potentielles violations de ces hypothèses fondamentales.
Le premier tracé oppose les résidus bruts sur l’axe des ordonnées aux valeurs ajustées projetées sur l’axe des abscisses. Ce graphique permet d’évaluer deux postulats cruciaux : la linéarité fonctionnelle et l’homoscédasticité. Une dispersion aléatoire et homogène des points le long d’une bande horizontale centrée sur zéro, sans courbure systématique captée par la ligne de lissage rouge, valide l’hypothèse de linéarité. En revanche, l’apparition d’un motif en entonnoir, où l’écartement vertical des résidus croît ou décroît de manière monotone à mesure que les valeurs projetées augmentent, constitue la signature visuelle sans équivoque de l’hétéroscédasticité, indiquant une variance non constante des erreurs.
Le second panneau diagnostique présente le diagramme Quantile-Quantile normal (Q-Q plot), confrontant la distribution empirique des résidus standardisés aux quantiles théoriques d’une loi normale univariée. Si les erreurs suivent fidèlement une trajectoire gaussienne, les points doivent s’aligner de manière rectiligne sur la diagonale idéale d’ajustement. Des déviations systématiques aux extrémités supérieures ou inférieures dénoncent la présence de queues épaisses (distribution leptokurtique) ou d’asymétries structurelles, des déformations distributionnelles qui compromettent la validité asymptotique des tests de significativité de Student et de Fisher sur les petits échantillons.
9.2 Tests inférentiels de confirmation des hypothèses sous-jacentes
Bien que le diagnostic graphique soit indispensable pour saisir la morphologie des déviations, il doit être corroboré par des tests d’hypothèse formels capables d’objectiver mathématiquement le rejet des postulats de Gauss-Markov. Pour ausculter formellement l’homogénéité des variances résiduelles, le chercheur mobilise le test de Breusch-Pagan, disponible sous R via la fonction dédiée du paquetage lmtest. En régressant les résidus au carré sur l’ensemble des prédicteurs, ce test évalue si la variance d’échantillonnage de l’erreur est fonction linéaire d’une composante du modèle, une valeur de probabilité significative conduisant au rejet formel de l’homoscédasticité.
L’évaluation inférentielle de la normalité de la distribution des résidus s’appuie quant à elle préférentiellement sur le test statistique de Shapiro-Wilk, implémenté nativement dans R. Appliqué au vecteur extrait des résidus studentisés du modèle, il oppose l’hypothèse nulle d’adéquation gaussienne parfaite à l’hypothèse d’une contamination morphologique. Il convient néanmoins d’attirer l’attention de l’analyste sur la sensibilité extrême de ce test au sein de cohortes massives : pour des échantillons comprenant plusieurs centaines de participants, le test de Shapiro-Wilk rejettera fréquemment la normalité pour des déviations minuscules et sans aucune conséquence pratique sur l’inférence en vertu de l’action stabilisatrice du théorème central limite.
Enfin, dans les protocoles de psychologie cognitive séquentielle ou les études écologiques ambulatoires longitudinales où les mesures sont répétées dans le temps, l’indépendance mutuelle des résidus doit impérativement être vérifiée pour exclure toute corrélation sérielle. Le test statistique de Durbin-Watson permet d’évaluer la présence d’une autocorrélation d’ordre un au sein des séries d’erreurs. Une valeur de statistique s’éloignant sensiblement de la cible idéale de deux révèle une dépendance temporelle des mesures non modélisée, faussant dramatiquement à la baisse le calcul des erreurs types conventionnelles.
9.3 Stratégies de correction en cas de violation des postulats
Face à la mise en évidence formelle d’une transgression des postulats régissant le modèle linéaire ordinaire, le chercheur dispose d’un vaste éventail d’arbitrages méthodologiques pour redresser son analyse sans renoncer à la richesse de son modèle explicatif. Si la pathologie réside dans une non-linéarité modérée ou une hétéroscédasticité couplée à une asymétrie positive des scores dépendants, l’application d’une transformation mathématique non linéaire sur la variable de réponse s’avère souvent salutaire. Le recours à la transformation logarithmique népérienne ou à la famille généralisée des transformations de Box-Cox permet fréquemment de stabiliser la variance tout en linéarisant les trajectoires.
Lorsque l’hétéroscédasticité persiste sans qu’aucune transformation d’échelle ne soit théoriquement justifiée, la solution contemporaine la plus élégante et rigoureuse consiste à conserver les estimations ponctuelles des MCO tout en remplaçant la matrice de variance-covariance classique par une matrice robuste hétéroscédastique. En mobilisant l’architecture conjointe des paquets sandwich et lmtest, l’analyste peut recalculer les erreurs types et les tests de Wald associés aux coefficients au moyen de l’estimateur de White ou de ses variantes perfectionnées pour petits échantillons (telles que la correction HC3 ou HC4), restaurant ainsi des inférences fiables et immunisées contre l’hétérogénéité des variances.
Enfin, si les données présentent des contaminations non gaussiennes irréductibles, l’analyste peut abandonner l’optimisation par la fonctionnelle quadratique des moindres carrés pour migrer vers la régression robuste implémentée par l’algorithme des M-estimateurs, accessible via la fonction rlm() du paquetage fondamental MASS. Alternativement, le recours aux techniques non paramétriques de rééchantillonnage par bootstrap résiduel ou par paires permet de générer des distributions d’échantillonnage empiriques affranchies de toute hypothèse distributionnelle rigide, garantissant des intervalles de confiance d’une solidité statistique irréprochable.
10. Identification des valeurs atypiques et points influents
10.1 Différenciation théorique : Outliers, Leviers et Points d’influence
L’analyse des résidus ne saurait être complète sans un examen approfondi de la topologie locale des données visant à débusquer les observations extrêmes susceptibles d’exercer une distorsion disproportionnée sur les paramètres du modèle linéaire. Dans le cadre de la théorie statistique de la robustesse, il est fondamental de distinguer conceptuellement trois entités fréquemment confondues par les praticiens : les valeurs aberrantes (outliers), les points de fort levier (high leverage points), et les observations véritablement influentes.
Une valeur aberrante représente une observation qui présente un écart vertical considérable par rapport au plan d’ajustement modélisé par la régression. Elle correspond à une réponse psychologique atypique, dont la prédiction par les covariables est très médiocre. Ces déviations s’évaluent rigoureusement à l’aide des résidus standardisés et plus encore des résidus studentisés externes (résidus jackknife), pour lesquels l’erreur résiduelle associée à l’observation est standardisée en excluant préalablement ladite observation du calcul de la variance globale, révélant ainsi l’ampleur brute de son队长écart.
À l’inverse, l’effet de levier mesure l’éloignement d’une observation non pas sur l’axe vertical de la variable réponse, mais dans l’espace multidimensionnel formé par les prédicteurs. Mathématiquement, la valeur de levier d’un sujet est consignée sur la diagonale principale de la matrice de projection orthogonale dite matrice chapeau (hat matrix). Une observation présentant des scores extrêmement atypiques ou marginaux sur les variables indépendantes possédera une forte valeur de levier. Un fort levier confère au point un potentiel d’influence immense sur l’orientation de la droite de régression, mais cette influence ne s’actualise que si le point se trouve simultanément désaligné par rapport à la tendance centrale du reste de l’échantillon.
10.2 Métriques de diagnostic de l’influence : Distance de Cook et DFBETAS
L’influence réelle matérialise l’impact effectif d’une observation sur la configuration générale du modèle linéaire. Une observation est dite influente si son omission délibérée du jeu de données provoque un basculement substantiel du vecteur des coefficients ou une altération majeure des valeurs projetées. La métrique synthétique universelle pour quantifier cette déformation globale est la célèbre distance de Cook. Accessible directement sous R par la fonction native cooks.distance(), cette statistique agrège l’ensemble des décalages induits sur l’ensemble des valeurs ajustées lorsque la i-ième observation est éliminée du calcul.
Bien qu’un seuil critique absolu d’une distance de Cook supérieure à un ait longtemps été véhiculé par la littérature d’initiation, les méthodologues contemporains s’accordent sur un critère décisionnel beaucoup plus fin et adapté à la taille de la cohorte analysée, fixant le seuil d’alerte à la valeur quatre divisée par le nombre total de degrés de liberté résiduels ou simplement quatre sur la taille d’échantillon n. Tout sujet dépassant ce niveau doit être extrait pour faire l’objet d’un examen qualitatif minutieux afin de comprendre les raisons de sa singularité psychométrique.
Pour disséquer l’impact différentiel d’un point influent sur chaque prédicteur de manière isolée, le chercheur fait appel aux statistiques DFBETAS, disponibles via la primitive standard de diagnostic. Pour chaque sujet et pour chaque paramètre du modèle, le DFBETAS calcule le déplacement standardisé du coefficient de régression spécifique provoqué par le retrait du participant ciblé. Une valeur absolue excédant deux divisé par la racine carrée de la taille d’échantillon désigne un participant qui, à lui seul, fait basculer de manière décisive l’estimation de l’effet propre de la variable, fournissant un niveau de granularité diagnostique exceptionnel.
10.3 Décisions méthodologiques relatives au traitement des cas influents
L’identification de points influents confronte inévitablement l’analyste à un dilemme déontologique et méthodologique. L’élimination automatique et mécanique des observations signalées comme problématiques par la distance de Cook constitue une pratique scientifique déplorable, confinant à la manipulation arbitraire de données pour forcer l’émergence d’une significativité statistique désirée. La première démarche doit impérativement consister en un audit minutieux de la chaîne de saisie afin d’éliminer l’éventualité d’une banale erreur typographique ou d’un encodage numérique erroné d’une valeur manquante.
Si la valeur atypique correspond à une mesure psychologiquement authentique mais biologiquement ou cognitivement hors normes, le chercheur doit évaluer si ce participant n’appartient pas en réalité à une sous-population non ciblée par le protocole d’inclusion, telle qu’une personne présentant un déficit attentionnel non diagnostiqué lors d’une tâche de temps de réaction. Si la déviance reflète la variabilité écologique naturelle du construit psychologique, sa suppression arbitraire tronquerait artificiellement la variance et réduirait la validité écologique des inférences déduites du modèle.
La règle d’or en recherche quantitative réside dans la réalisation systématique et la publication transparente d’une analyse de sensibilité. Cette procédure consiste à ajuster le modèle linéaire avec l’intégralité de l’échantillon collecté, puis à réestimer l’ensemble des paramètres en excluant temporairement les observations influentes diagnostiquées. Les deux séries d’estimations doivent être présentées conjointement au lectorat scientifique au sein du rapport de recherche. Si les conclusions conceptuelles fondamentales demeurent inchangées entre les deux versions, le chercheur démontre la résilience de son patron de résultats ; si l’effet s’effondre, cette vulnérabilité empirique doit être discutée loyalement dans la section des limites méthodologiques de l’article.
11. Visualisation graphique avancée des modèles linéaires
11.1 Représentation bivariée avec droite de régression et intervalles
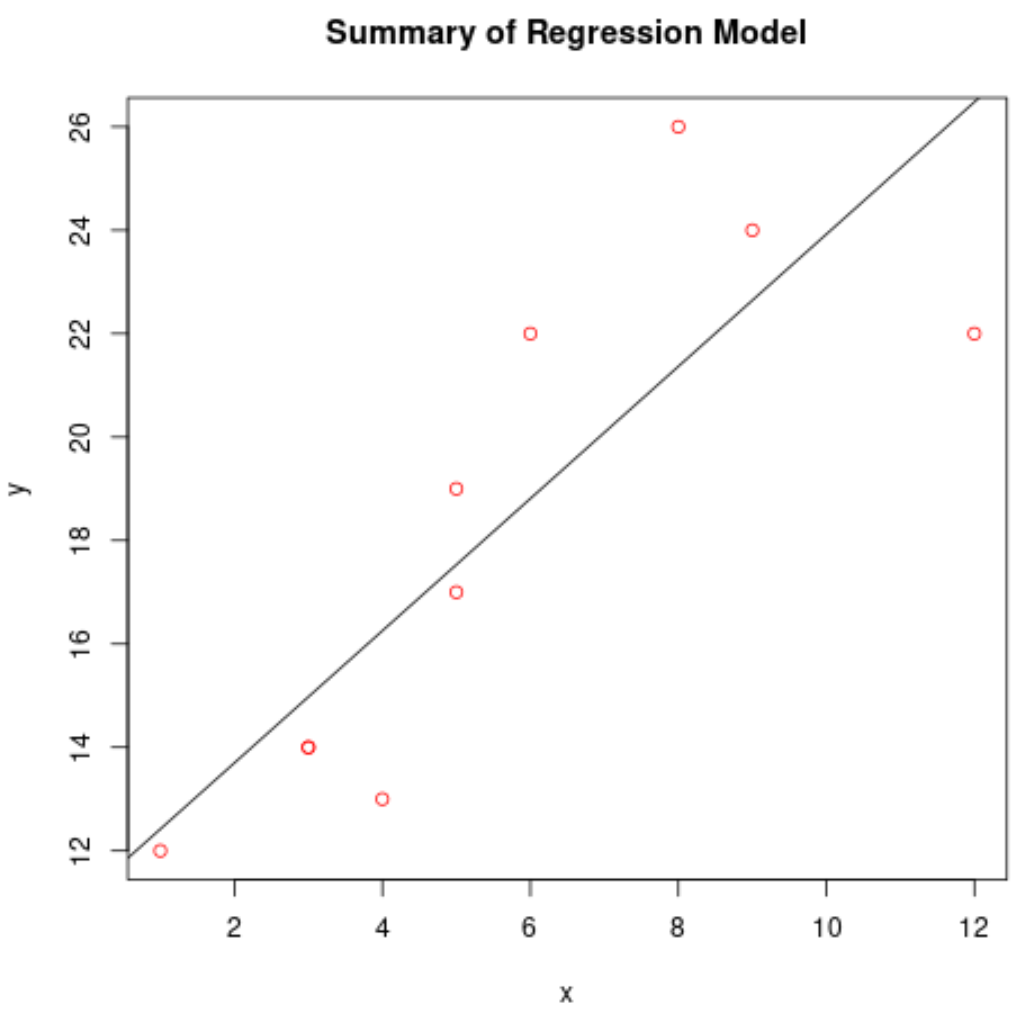
La communication scientifique moderne exige d’accompagner les tableaux de coefficients numériques d’une sémiologie graphique irréprochable et intuitive. Bien que le moteur graphique de base de R permette d’esquisser rapidement une droite de régression sur un nuage de points, l’écosystème graphique ggplot2 s’est imposé comme le standard académique absolu pour concevoir des figures de haute qualité éditoriale prêtes pour la publication dans les revues internationales de psychologie.
L’implémentation d’une représentation univariée élégante s’articule autour de la fonction de lissage géométrique en forçant explicitement la méthode linéaire via l’argument dédié. Cette simple directive calcule en temps réel la projection des moindres carrés et affiche automatiquement une bande d’incertitude semi-transparente entourant la droite de régression. Il est capital de préciser sur le plan théorique que cette bande matérialise l’intervalle de confiance à 95% de l’espérance conditionnelle moyenne de la droite, et ne doit sous aucun prétexte être confondue avec l’intervalle de prédiction individuel, lequel engloberait la variabilité stochastique résiduelle des sujets pris isolément.
Pour atteindre un degré de finition conforme aux exigences éditoriales les plus strictes, l’analyste personnalisera les couches esthétiques en appliquant des thèmes épurés, en calibrant les échelles continues avec des unités de mesure explicites et en intégrant un léger étalement aléatoire (jittering) sur les points empiriques lorsque l’échelle psychométrique sous-jacente est discrète. Cette précaution prévient la superposition opaque des points sur les mêmes coordonnées, offrant une appréciation visuelle fidèle de la densité réelle des données à chaque niveau de l’échelle d’évaluation.
11.2 Visualisation des plans d’effets pour les modèles multivariés
Lorsque le modèle linéaire intègre un faisceau complexe de prédicteurs continus, de facteurs catégoriels et de termes d’interaction croisés, la simple projection bivariée brute devient incapable de restituer la dynamique réelle des estimations, car elle ignore totalement le contrôle statistique opéré sur les autres covariables. L’analyste doit impérativement recourir à la cartographie des prédictions marginales ajustées, orchestrée de manière magistrale sous R par des bibliothèques telles que ggeffects ou effects.
Ces outils computationnels fonctionnent en isolant le prédicteur d’intérêt tout en fixant mathématiquement l’ensemble des autres variables indépendantes du modèle à des valeurs représentatives constantes, généralement leur moyenne empirique respective pour les variables continues et leur modalité de référence ou leur distribution pondérée pour les facteurs qualitatifs. En générant les prédictions du modèle sur cette grille contrainte et en extrayant les erreurs types associées via la méthode delta, ces paquets permettent de tracer les courbes d’effets purs rigoureusement purgées de l’influence parasite des covariables de confusion.
Pour les modèles impliquant des interactions d’ordre supérieur, cette approche graphique devient tout simplement indispensable pour l’intelligibilité de la démonstration psychologique. L’analyste peut générer des tracés où la relation unissant le prédicteur principal à la variable dépendante est déclinée en plusieurs lignes distinctes correspondant aux différents paliers fixés de la variable modératrice. La lisibilité des croisements de pentes, encadrés de leurs rubans d’intervalles de confiance respectifs, permet de matérialiser instantanément la nature qualitative de la modération, qu’elle soit de type amplificatrice, modératrice ou inversée.
11.3 Cartographie visuelle des résidus et des diagnostics avancés
Au-delà de la représentation des prédictions, la visualisation approfondie des pathologies potentielles du modèle bénéficie grandement des extensions graphiques multivariées. Les graphiques de résidus partiels, couramment désignés sous le terme de diagrammes composante-plus-résidu (component-plus-residual plots ou crPlots), accessibles au sein du paquetage car, constituent le dispositif d’imagerie le plus sophistiqué pour déceler la non-linéarité dissimulée au sein d’une régression multiple.
Pour un prédicteur particulier, le graphique de résidu partiel projette sur l’axe vertical la composante linéaire associée à cette variable additionnée du résidu brut du modèle complet, neutralisant ainsi la variance expliquée par l’ensemble des autres variables. La confrontation sur cette projection de la droite théorique estimée avec une courbe de régression non paramétrique locale permet de visualiser si le prédicteur considéré entretient une relation purement linéaire avec la réponse ou si sa dynamique sous-jacente requiert une spécification quadratique ou asymptotique, une détection totalement impossible sur de simples nuages de points bruts.
Enfin, la synthèse graphique contemporaine privilégie l’exposition visuelle standardisée de l’ensemble des coefficients de régression au moyen de diagrammes forestiers (forest plots). En alignant verticalement chaque prédicteur et en traçant son estimation ponctuelle entourée de barres d’erreur matérialisant son intervalle de confiance à 95%, ce mode d’affichage offre au lectorat une comparaison visuelle immédiate de l’amplitude relative et de la direction des associations au sein du modèle, remplaçant avantageusement la lecture fastidieuse d’interminables colonnes de chiffres dans le corps du texte académique.
12. Inférence statistique, prédiction et rédaction selon les normes APA
12.1 Génération d’intervalles de prédiction et de confiance
L’aboutissement opérationnel d’un modèle linéaire correctement ajusté réside fréquemment dans sa capacité à produire des projections prospectives sur de nouvelles observations issues de la population cible. Dans l’architecture R, la fonction générique predict(), lorsqu’elle s’applique à un objet de classe lm, orchestre ces calculs matriciels en exigeant comme argument fondamental un nouveau jeu de données structuré sous la forme d’un tableau contenant scrupuleusement les mêmes noms de variables que le modèle d’origine.
Une distinction statistique d’une importance capitale doit être opérée lors du paramétrage de l’argument désignant la nature de l’intervalle d’incertitude souhaité. Si l’analyste sélectionne l’option désignant un intervalle de confiance (interval = ‘confidence’), l’algorithme calcule l’intervalle encadrant l’espérance mathématique de la réponse pour une configuration donnée de prédicteurs. Cet intervalle reflète uniquement l’incertitude liée à l’échantillonnage dans l’estimation des paramètres de régression ; par conséquent, à mesure que la taille de l’échantillon d’ajustement tend vers l’infini, la largeur de cet intervalle converge mathématiquement vers zéro.
À l’inverse, si l’objectif consiste à prédire le score attendu pour un participant singulier se présentant dans une clinique, l’analyste doit impérativement paramétrer la commande pour requérir un intervalle de prédiction (interval = ‘prediction’). Cet intervalle intègre non seulement l’erreur d’échantillonnage associée aux coefficients, mais y additionne la variance stochastique intrinsèque de l’erreur résiduelle propre aux individus. Même avec une cohorte mère gigantesque, l’intervalle de prédiction conserve une amplitude minimale irréductible indexée sur l’écart-type des résidus, rappelant les limites inhérentes à toute prédiction psychologique individuelle face au caractère probabiliste du comportement humain.
12.2 Tailles d’effet et coefficients standardisés
La publication scientifique contemporaine en psychologie, sous l’impulsion répétée des comités éditoriaux de l’APA, interdit de restreindre la présentation des résultats à la seule dichotomie stérile des seuils de p-valeurs. Les chercheurs sont tenus de quantifier systématiquement la magnitude clinique ou théorique des effets mesurés à l’aide d’indices de taille d’effet standardisés affranchis des unités arbitraires des échelles psychométriques utilisées.
Dans le cadre de la modélisation linéaire univariée ou multiple, la mesure standard de la taille d’effet globale d’un bloc de prédicteurs s’exprime par le coefficient f-carré de Cohen. Calculé directement à partir du coefficient de détermination ou de son incrément par la formule :
f^2 = R^2 / (1 – R^2)
cet indice classe les effets en trois ordres de grandeur empiriques conventionnels selon les préconisations originelles de Jacob Cohen : une valeur de 0,02 caractérise un effet de petite taille, 0,15 matérialise un effet moyen, et 0,35 désigne un effet de grande ampleur conceptuelle. Ce paramètre s’avère en outre indispensable pour calibrer rétrospectivement ou prospectivement la puissance statistique des protocoles de recherche par le biais de modules de calcul comme G*Power.
Au niveau de chaque prédicteur individuel, la standardisation post-hoc des coefficients de régression bruts permet de comparer l’influence relative de variables exprimées sur des métriques hétérogènes, comme par exemple l’âge mesuré en années et un score de cortisol salivaire mesuré en microgrammes par décilitre. En mobilisant des fonctions dédiées disponibles dans des paquetages psychométriques tels que QuantPsyc ou parameters, l’analyste dérive les coefficients bêta standardisés. Un coefficient standardisé indique de combien d’écarts-types s’accroît la variable dépendante lorsque le prédicteur considéré progresse d’un écart-type complet, fournissant un dénominateur commun indispensable à la méta-analyse des données scientifiques.
12.3 Rédaction des résultats de régression conforme aux standards APA
La transcription des résultats issus de la modélisation avec lm() au sein d’un manuscrit soumis pour publication scientifique doit obéir scrupuleusement aux conventions typographiques et structurelles édictées dans le manuel de style de l’American Psychological Association (7e édition). La prose narrative doit rapporter avec précision la logique de construction du modèle, en spécifiant d’emblée la méthode d’ajustement retenue, les vérifications diagnostiques préalables et le traitement des données atypiques ou manquantes.
L’énoncé textuel standardisé doit intégrer systématiquement l’évaluation omnibus du modèle suivie de la caractérisation individuelle des prédicteurs significatifs. La formulation canonique s’articule selon le canevas suivant : « Une analyse de régression linéaire multiple a été conduite afin de prédire le niveau d’anxiété en fonction des heures de privation de sommeil et du score de névrosisme. Le modèle global s’avère statistiquement significatif et explique une part substantielle de la variance observée, F(2, 147) = 18,42, p < ,001, R² = ,20, R² ajusté = ,19. La privation de sommeil constitue un prédicteur positif significatif de l’anxiété, B = 0,45, SE = 0,11, β = ,32, t(147) = 4,09, p < ,001, IC à 95 % [0,23, 0,67]. » Il est impératif de souligner l’omission conventionnelle du zéro initial devant les statistiques bornées par définition entre zéro et un (telles que les p-valeurs, les coefficients bêta ou les coefficients de détermination).
Enfin, dès lors que le modèle dépasse deux prédicteurs ou intègre des étapes d’emboîtement successives, la présentation des données sous forme d’un tableau synthétique standardisé APA devient obligatoire. Ce tableau académique doit proscrire impérativement les lignes de quadrillage verticales et ne conserver que trois lignes horizontales majeures de démarcation. Chaque rangée détaillant une variable indépendante doit comporter rigoureusement la valeur du coefficient non standardisé (B), son erreur type associée (SE), le coefficient standardisé (β), la statistique t, sa significativité correspondante signalée par des astérisques d’usage, ainsi que les bornes inférieure et supérieure de son intervalle de confiance à 95 %. En accompagnant ce tableau de la mise à disposition ouverte du script d’analyse R sur des dépôts institutionnels certifiés comme l’Open Science Framework, le chercheur s’aligne de manière exemplaire sur les principes de la science ouverte et de la transparence méthodologique intégrale.
Références
- Aiken, L. S., & West, S. G. (1991). Multiple regression: Testing and interpreting interactions. Sage Publications.
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Chambers, J. M., & Hastie, T. J. (Eds.). (1992). Statistical models in S. Wadsworth & Brooks/Cole.
- Cohen, J. (1968). Multiple regression as a general data-analytic system. Psychological Bulletin, 70(6, Pt.1), 426–443. https://doi.org/10.1037/h0026714
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fox, J., & Weisberg, S. (2019). An R companion to applied regression (3rd ed.). Sage Publications.
- Hayes, A. F. (2018). Introduction to mediation, moderation, and conditional process analysis: A regression-based approach (2nd ed.). The Guilford Press.
- R Core Team. (2023). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.R-project.org/
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis. Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4