
Dans le champ contemporain de l’analyse exploratoire et de la communication scientifique, la représentation visuelle de données complexes constitue un défi cognitif et technique de premier ordre. Face à des ensembles d’observations caractérisés par une dimensionalité élevée, la superposition brute de strates géométriques au sein d’un repère orthogonal unique engendre fréquemment une saturation perceptive rédhibitoire, communément désignée sous le terme d’encombrement graphique (ou overplotting). Afin de préserver l’intégrité sémiotique des figures statistiques tout en autorisant des comparaisons systématiques entre sous-populations, l’architecture graphique moderne repose sur le concept fondamental de facettage.
Au sein de l’écosystème du langage R, la mise en œuvre de la grammaire des graphiques théorisée par Leland Wilkinson et opérationnalisée par Hadley Wickham dans l’extension ggplot2 a profondément transformé les pratiques de visualisation. Parmi les opérateurs de partitionnement spatial mis à la disposition des chercheurs et des analystes de données, la fonction facet_wrap() occupe une place centrale. Conçue pour réorganiser une séquence unidimensionnelle de sous-graphiques sous la forme d’un ruban bidimensionnel fluide, cette directive syntaxique permet d’isoler les dynamiques locales propres à chaque modalité d’un ou de plusieurs facteurs sans rompre la comparabilité globale du dispositif d’observation.
Le présent article propose une exploration exhaustive, rigoureuse et méthodologiquement étayée des potentialités offertes par facet_wrap(). À travers l’examen de ses fondements théoriques, de sa syntaxe modulaire, de ses interactions avec la structure formelle des jeux de données et de ses multiples degrés de personnalisation esthétique, nous exposerons la manière dont cette commande s’érige en instrument indispensable de l’analyse quantitative avancée. De la gestion dynamique des échelles d’axes jusqu’à l’orchestration typographique conforme aux critères éditoriaux les plus stricts, chaque dimension opérationnelle sera disséquée afin de fournir un cadre de référence pérenne aux praticiens de la recherche empirique.
1. 1. Introduction aux graphiques multi-panneaux et au facettage avec ggplot2
1.1 1.1 Le concept de petits multiples (Small Multiples) selon Edward Tufte
La théorie de la visualisation de données contemporaine doit une part substantielle de sa rigueur conceptuelle aux travaux pionniers du statisticien et professeur émérite Edward Tufte. Dans son ouvrage séminal, The Visual Display of Quantitative Information, Tufte introduit le principe fondamental des « petits multiples » (small multiples). Ce paradigme repose sur la juxtaposition ordonnée et répétitive d’une même structure graphique élémentaire, déclinée à travers différentes tranches ou sous-catégories d’un jeu de données. La force heuristique de cette méthode réside dans l’invariance du cadre de référence : dès lors que le système de coordonnées, la nature des axes et les variables représentées demeurent rigoureusement identiques d’un panneau à l’autre, l’effort perceptif alloué par l’observateur au décodage de la géométrie visuelle s’annule presque instantanément.
Sur le plan cognitif, cette approche contourne les limitations intrinsèques de la mémoire de travail humaine. Lorsqu’un analyste tente de discerner les particularités de cinq ou six groupes expérimentaux fusionnés au sein d’un unique nuage de points par le biais d’un codage chromatique complexe, le cerveau est contraint d’effectuer un va-et-vient permanent entre la légende et l’espace graphique, générant une charge cognitive extrinsèque substantielle. Les petits multiples éliminent cette friction sémiotique : le changement d’état entre les panneaux ne traduit pas une variation de métrique, mais une variation d’échantillon. Dès lors, le regard peut se focaliser sans interférence sur la comparaison des formes distributionnelles, l’identification d’asymétries locales ou la détection de ruptures de tendance.
L’évolution historique de la statistique graphique a progressivement conduit à la consécration de ce principe. Depuis les premières représentations manuelles de William Playfair jusqu’aux diagrammes matriciels mécanisés du milieu du vingtième siècle, la difficulté technique d’engendrer des dizaines de tracés uniformes a longtemps restreint l’usage des petits multiples aux publications cartographiques de premier rang. Il a fallu attendre la théorisation de la grammaire des graphiques pour que cette philosophie de conception s’affranchisse des contraintes matérielles et devienne un composant algorithmique natif de la modélisation statistique.
1.2 1.2 Rôle et architecture du facettage au sein du tidyverse
Au cœur de l’écosystème tidyverse développé pour R, la grammaire des graphiques formalisée par Leland Wilkinson et programmée dans le paquet ggplot2 décompose une image statistique en couches sémantiques interconnectées : les données, les correspondances esthétiques (aesthetic mappings), les objets géométriques (geoms), les transformations statistiques (stats), le système de coordonnées (coord) et, enfin, le facettage (facet). Au sein de cet agencement fonctionnel, le facettage n’intervient pas comme une couche géométrique supplémentaire, mais comme un mécanisme de partitionnement spatial qui s’applique transversalement à l’ensemble des couches sous-jacentes.
D’un point de vue architectural, il convient de distinguer nettement l’encodage esthétique direct du partitionnement par facettage. L’attribution d’une couleur, d’une forme de glyphe ou d’un type de tiret à une variable catégorielle projette les différentes modalités au sein d’une seule et unique arène visuelle. Bien que pertinente lorsque les groupes présentent des séparations nettes dans l’espace des données, cette méthode atteint rapidement un seuil d’illisibilité dès que les densités se chevauchent. Le facettage déplace quant à lui la différenciation catégorielle de l’axe des attributs visuels vers l’axe de la localisation spatiale absolue. Au lieu de surcharger un repère cartésien unique, il démultiplie le repère lui-même en conservant intacts les autres attributs esthétiques.
Cette modularité s’articule impeccablement avec la doctrine des données bien rangées (tidy data). Selon ce standard formel, chaque ligne d’une table d’analyse doit correspondre à une unité d’observation unique, chaque colonne à une variable mesurée, et chaque valeur à une cellule élémentaire. Le moteur de calcul de ggplot2 exploite cette uniformité structurelle pour exécuter un découpage algorithmique automatique : les données sources sont groupées en amont selon les niveaux de la variable de facettage, chaque sous-ensemble est acheminé de façon indépendante vers le pipeline de rendu géométrique, puis le moteur d’assemblage graphique recompose la scène finale sous forme de panneaux calibrés.
1.3 1.3 Applications empiriques dans la recherche quantitative
L’utilité méthodologique du facettage se manifeste avec une acuité particulière dans la recherche quantitative contemporaine, notamment au sein des disciplines confrontées à des structures de données hiérarchiques ou longitudinales. Dans les protocoles de mesures répétées, tels que les essais cliniques pharmacologiques ou les suivis épidémiologiques de cohortes, le traçage des trajectoires individuelles au fil du temps produit fréquemment ce que l’on nomme familièrement un « graphique spaghetti », caractérisé par un enchevêtrement inextricable de segments. En attribuant un panneau individuel à chaque sujet ou à chaque grappe de sujets homogènes au moyen d’un ruban graphique, l’hétérogénéité interindividuelle et la tendance intra-individuelle deviennent simultanément appréhendables.
Dans le domaine de l’économétrie et de la sociologie quantitative, les plans factoriels complexes impliquant des interactions d’ordre supérieur tirent un bénéfice considérable du facettage. L’évaluation de l’effet d’une politique publique sur plusieurs strates socio-économiques, subdivisées selon des zones géographiques ou des périodes temporelles distinctes, impose de visualiser des contrastes multivariés. Le facettage permet d’ancrer les comparaisons prioritaires au sein de chaque panneau (par exemple, la relation entre niveau d’éducation et revenu) tout en projetant les variables de conditionnement (telles que le genre ou le secteur d’activité) dans la dimension des panneaux.
Enfin, sur le plan de la validation des modèles statistiques, le recours aux petits multiples constitue un test visuel de robustesse d’une efficacité redoutable. En cartographiant les résidus d’ajustement, les distributions prédictives a posteriori ou les fonctions de sensibilité à travers une multiplicité de sous-échantillons stratifiés, le chercheur s’assure que les postulats de linéarité ou d’homoscédasticité ne sont pas violés de manière asymétrique au sein d’une sous-population particulière du modèle global.
2. 2. Fondements théoriques et syntaxe fondamentale de facet_wrap()
2.1 2.1 Anatomie formelle de la fonction facet_wrap()
La commande facet_wrap() se présente formellement comme une fonction de haut niveau au sein de l’espace de noms de ggplot2. Sa vocation technique consiste à fragmenter un jeu de données en fonction d’un ou de plusieurs facteurs discriminants et à disposer la collection de tracés qui en résulte dans une disposition matricielle bidimensionnelle dont le nombre de rangées et de colonnes peut être régulé de manière dynamique ou déterministe. La signature d’appel standard de la fonction révèle un ensemble d’arguments minutieusement calibrés pour offrir un compromis optimal entre automatisation statistique et précision typographique.
Le paramètre central de la fonction, désigné historiquement par le terme facets, définit la ou les variables conditionnantes chargées d’orchestrer la partition des enregistrements. Dans les versions modernes de ggplot2, ce paramètre accepte prioritairement une encapsulation syntaxique formalisée par la fonction auxiliaire vars(). Cette enveloppe sémantique permet d’évaluer les variables d’intérêt au sein de l’environnement immédiat du jeu de données actif, sans exiger l’emploi de guillemets explicites ou de préfixes référentiels complexes, s’inscrivant ainsi dans la philosophie d’évaluation non standard (non-standard evaluation ou tidy evaluation) qui caractérise le tidyverse.
Parallèlement, la tradition syntaxique de R préserve la compatibilité avec la notation par formule mathématique introduite au moyen du symbole tilde (~). Dans cette perspective déclarative, l’expression formelle s’écrit sous la forme d’un tilde unilatéral suivi du nom de la variable de regroupement. Bien que ces deux approches produisent des résultats visuels rigoureusement identiques dans les scénarios les plus simples, leur comportement computationnel interne diverge dès lors que l’on cherche à concevoir des fonctions personnalisées ou à manipuler programmatiquement des listes de symboles au sein de chaînes d’analyse automatisées.
2.2 2.2 Mécanisme de ruban unidimensionnel replié (Wrapping)
Le concept qui distingue radicalement facet_wrap() de sa contrepartie matricielle facet_grid() réside dans le principe mécanique du « repliement » (wrapping). Lorsque l’on procède à une stratification à l’aide de facet_wrap(), l’algorithme génère conceptuellement une chaîne continue, linéaire et unidimensionnelle de sous-graphiques, chaque maillon correspondant à une modalité distincte du facteur ciblé. Plutôt que d’étirer cette séquence sur une ligne infinie ou de la contraindre à une structure de tableau rigide dont les deux axes représenteraient obligatoirement des variables orthogonales distinctes, la fonction découpe ce ruban et le replie sur lui-même à la manière d’un paragraphe de texte sautant automatiquement à la ligne suivante dès qu’il rencontre la marge d’une page.
Cette approche apporte une flexibilité structurelle inégalée pour la visualisation de facteurs comportant un nombre impair ou élevé de modalités. Dans une grille stricte, un facteur unique disposant de sept niveaux contraindrait le système à afficher soit une unique ligne de sept colonnes démesurément étroites, soit une colonne de sept lignes disproportionnées. À l’inverse, l’opérateur de ruban fluide est capable de fragmenter ces sept panneaux en une matrice harmonieuse de trois colonnes sur trois lignes, laissant vacantes les cellules excédentaires du coin inférieur sans rompre l’échelle ni altérer l’alignement des repères fonctionnels.
L’optimisation spatiale opérée par ce mécanisme repose sur un algorithme heuristique interne qui calcule les dimensions par défaut de la grille d’affichage. Si l’utilisateur s’abstient de spécifier les dimensions voulues, ggplot2 évalue le nombre total de facettes à afficher et recherche la factorisation entière qui se rapproche le plus d’un format visuel rectangulaire équilibré, généralement proche du ratio doré ou des standards d’affichage vidéo horizontaux (rapport 4:3 ou 16:9). Cette automatisation assure que, même en phase d’exploration pure, le chercheur dispose immédiatement d’une vue d’ensemble ergonomique sans devoir paramétrer manuellement la géométrie de sa fenêtre de rendu.
2.3 2.3 Compatibilité des types de données pour le découpage
Le comportement de facet_wrap() vis-à-vis des types de données injectés constitue un point technique crucial pour la robustesse des chaînes de traitement statistique. Naturellement, la fonction est optimisée pour opérer sur des variables catégorielles formellement déclarées sous la structure de type factor au sein de R. Lorsqu’un facteur est utilisé, l’ordre d’apparition des panneaux individuels dans la grille finale ne dépend pas de l’ordre d’apparition des observations dans le tableau de données, ni d’un tri alphabétique fortuit, mais de la séquence explicite définie au niveau des attributs (levels) de l’objet vectoriel. Cette propriété s’avère indispensable pour manipuler des facteurs ordonnés (ordered factors), tels que des classes d’âge hiérarchisées ou des degrés de sévérité clinique.
Lorsque la variable désignée relève du type chaîne de caractères (character), le moteur interne procède à une coercition implicite en facteur non ordonné lors de la phase de calcul préliminaire. Dans ce cas de figure, les modalités sont invariablement réordonnées selon l’ordre alphanumérique standard propre aux paramètres régionaux (locale) de la session R en cours. Bien que cette conversion automatique soit pratique pour un examen rapide des données, elle expose l’analyste à des aberrations typographiques si la variable textuelle code en réalité des grandeurs ordinales mal formulées, comme des mois de l’année disposés par ordre alphabétique plutôt que chronologique.
Enfin, l’emploi de variables numériques continues au sein de facet_wrap() est formellement possible, mais induit des implications computationnelles et perceptives sévères. Si le vecteur numérique contient une collection finie et réduite de valeurs entières discrètes (par exemple, le nombre de cylindres d’un moteur ou le rang d’un protocole expérimental), le système traitera chaque valeur distincte comme une étiquette de groupe autonome. En revanche, si la variable numérique possède une densité continue sans valeurs répétées (telle que le poids corporel exact en kilogrammes ou une concentration sanguine continue), ggplot2 tentera de matérialiser autant de panneaux distincts qu’il existe d’observations individuelles uniques. Cette tentative déclenche immédiatement une saturation du processeur graphique et rend le document illisible, exigeant une discrétisation préalable en classes d’intervalles via des fonctions appropriées.
3. 3. Préparation et structuration des données de démonstration
3.1 3.1 Examen approfondi du jeu de données mpg
Afin de fonder nos illustrations techniques sur un substrat empirique reproductible et largement accessible, nous mobiliserons en premier lieu le jeu de données de référence mpg, nativement intégré dans l’extension ggplot2. Cette table d’échantillonnage rassemble les observations recueillies par l’Agence américaine de protection de l’environnement (Environmental Protection Agency) sur l’efficience énergétique et les attributs mécaniques de 234 modèles d’automobiles commercialisés aux États-Unis entre 1999 et 2008. Structuré sous la forme d’un tableau rectangulaire conforme aux préceptes du tidy data, ce corpus présente une combinaison équilibrée d’attributs quantitatifs continus, de grandeurs entières discrètes et de taxonomies nominales.
Dans le cadre de nos analyses visuelles comparatives, trois variables retiendront particulièrement notre attention : displ, qui quantifie la cylindrée du groupe motopropulseur en litres ; hwy, qui consigne la consommation de carburant sur autoroute exprimée en miles par gallon (variable d’efficacité énergétique inversement proportionnelle à la consommation volumétrique métrique) ; et class, une typologie nominale segmentant la population de véhicules en sept segments distincts (voitures deux places, sous-compactes, compactes, intermédiaires, familiales, véhicules utilitaires de loisir et camionnettes de ramassage).
Cette triade de variables se prête idéalement à l’exercice du facettage. La relation biomécanique globale unissant la cylindrée et l’efficacité énergétique répond à une loi d’échelle négative bien connue des ingénieurs : à mesure que la cylindrée s’accroît, la consommation de carburant augmente, ce qui se traduit par un fléchissement continu de la distance franchie par unité de carburant. Toutefois, cette trajectoire globale dissimule des variances locales considérables et des regroupements allométriques spécifiques à chaque classe de véhicule, ce que la visualisation conjointe au moyen d’un ruban à panneaux multiples mettra immédiatement en lumière.
3.2 3.2 Structuration d’un jeu de données expérimental complémentaire
Pour illustrer des scénarios d’analyse avancés empruntés aux sciences du comportement et à la psychométrie expérimentale, nous formalisons également un jeu de données synthétique contrôlé. Ce sous-ensemble d’observations simulées permet d’aborder des contraintes absentes des jeux de données d’ingénierie, telles que des déséquilibres de cohortes, des scores psychologiques normalisés présentant des variabilités hétérogènes et des structures d’interactions multivariées contrôlées. Cette table comprend des mesures standardisées de scores d’anxiété évalués sur une échelle de type Likert, des performances à des épreuves d’inhibition cognitive (exprimées en pourcentages de réussite) ainsi que des temps de réaction mesurés en millisecondes.
Ce jeu de données articule deux facteurs inter-sujets cruciaux : la condition d’intervention clinique à laquelle les participants ont été assignés de manière aléatoire (groupe témoin sous placebo, protocole d’intervention psychothérapeutique standardisé, et protocole intensif associant remédiation cognitive et soutien émotionnel), et la tranche d’âge chronologique des individus (cohorte de jeunes adultes, adultes d’âge mûr, et adultes âgés). L’intégration délibérée de ces facteurs stratifiés permettra de démontrer comment facet_wrap() résout avec élégance l’analyse de plans expérimentaux factoriels croisés 3×3.
L’avantage épistémologique de cette modélisation synthétique repose sur la maîtrise intégrale des paramètres statistiques sous-jacents. En fixant des coefficients de corrélation différentiels selon les sous-groupes, nous serons en mesure de démontrer dans quelle mesure le facettage empêche le statisticien de succomber au paradoxe de Simpson, en révélant instantanément des inversions de pente locale masquées par l’agrégation aveugle des sous-populations au sein d’une seule et même régression globale.
3.3 3.3 Nettoyage préalable et gestion des valeurs manquantes
L’intégrité du partitionnement visuel dépend directement de la rigueur du nettoyage préalable opéré sur le jeu de données. La présence d’observations incomplètes, matérialisées par le symbole NA (Not Available) dans R, introduit des anomalies directes dans l’organisation des grilles de facettes. Par défaut, si une variable sélectionnée pour le découpage comporte des valeurs non documentées, ggplot2 générera une facette additionnelle distincte dédiée à l’agrégation de toutes les lignes affectées de cette déficience informationnelle. Bien que cette caractéristique puisse constituer un atout pour l’audit de la non-réponse lors de la phase de nettoyage exploratoire, elle s’avère indésirable lors de l’élaboration de figures définitives destinées à la publication scientifique.
Pour remédier à cette vulnérabilité, une stratégie d’assainissement systématique doit être déployée au moyen des verbes de transformation de l’extension dplyr. Cette étape consiste à appliquer un filtrage strict qui élimine les observations dont les variables de facettage ou les variables d’axes fondamentaux sont manquantes. Ce protocole évite la distorsion des coordonnées spatiales et l’allocation inutile d’encre graphique à des cellules informativement stériles.
En outre, il est impératif d’harmoniser les niveaux de facteurs avant de soumettre les données au pipeline de tracé. Lorsqu’un sous-échantillon subit des filtrages successifs, certaines modalités de facteurs peuvent devenir complètement orphelines, ne contenant plus la moindre ligne d’enregistrement. Si ces niveaux orphelins ne sont pas explicitement purgés de la définition du facteur (par exemple, à l’aide de commandes d’élagage factoriel appropriées), le moteur graphique risque de conserver des cellules vides ou de désordonner la disposition structurelle du ruban. La synchronisation méticuleuse entre la structure réelle des données et les métadonnées catégorielles constitue ainsi un prérequis inviolable à tout travail d’ingénierie visuelle.
4. 4. Implémentation élémentaire : du graphique simple au multi-panneau
4.1 4.1 Construction du tracé de base à un seul panneau
Avant d’introduire le moindre mécanisme de subdivision spatiale, il est indispensable de poser les fondations architecturales du graphique de base. Dans l’esprit de la grammaire des graphiques, toute figure débute par l’initialisation de l’objet graphique au moyen de l’instruction génératrice ggplot(), au sein de laquelle on déclare formellement la source de données principale, suivie de la spécification des correspondances esthétiques via la fonction aes(). Dans notre contexte d’étude fondé sur le jeu de données automobile, nous associons l’abscisse (axe X) à la cylindrée mécanique (displ) et l’ordonnée (axe Y) au rendement énergétique autoroutier (hwy).
À cette déclaration d’espace abstrait s’ajoute ensuite la couche physique matérialisant l’observation des points individuels, obtenue par l’empilement de la fonction géométrique geom_point(). Le résultat de cette instruction élémentaire produit un graphique bivarié conventionnel à panneau unique. L’examen critique de ce rendu initial révèle immédiatement les pathologies visuelles classiques inhérentes aux jeux d’observations denses : une quantité substantielle de points s’agglutinent dans les régions de faible cylindrée, se chevauchant au point d’empêcher toute estimation précise de la densité réelle d’échantillonnage.
Pour tenter de pallier cette confusion, une première réaction consiste souvent à injecter un troisième paramètre au sein de l’esthétique, en assignant la catégorie du véhicule à la couleur du point. Cependant, l’apparition d’une palette de sept teintes distinctes sur un même canevas engendre une surcharge rétinienne immédiate. Les grappes de points multicolores s’entrecroisent, le décodage discriminatif devient laborieux, et la structure propre à chaque classe de véhicule se dilue dans une mosaïque visuelle difficilement exploitable par un comité de lecture rigoureux.
4.2 4.2 Application de facet_wrap() avec une variable unique
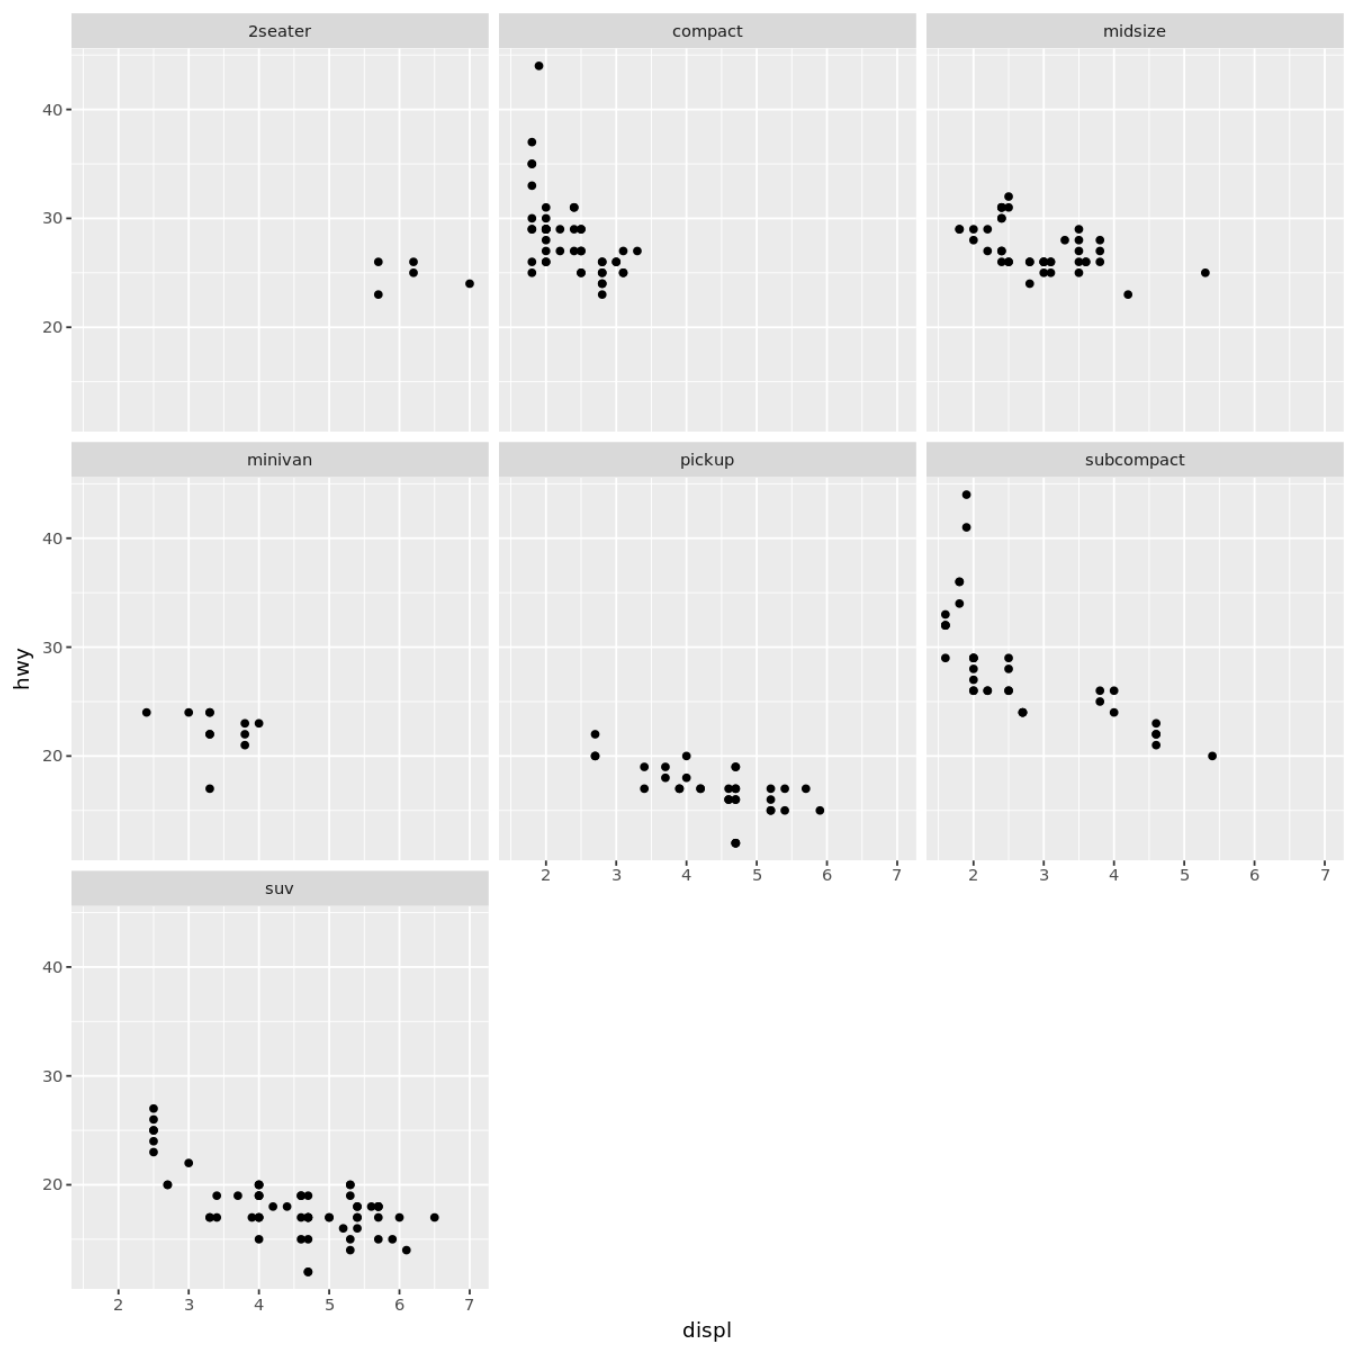
L’introduction de la directive facet_wrap() modifie instantanément la lisibilité de la scène graphique en opérant un désenchevêtrement spatial complet. En ajoutant simplement cet opérateur à la suite de la couche de dispersion géométrique, l’analyste ordonne à ggplot2 de scinder la collection globale de points en fonction des sous-ensembles logiques définis par la catégorie du véhicule. L’instruction syntaxique moderne prend la forme formelle d’un appel encapsulant la variable cible au sein de l’opérateur de sélection, sous la formulation facet_wrap(vars(class)).
Sous l’effet de cette commande, le panneau monolithique initial disparaît au profit d’une constellation coordonnée de sept sous-graphiques autonomes, chacun surmonté d’un bandeau d’en-tête explicitant le nom de la sous-catégorie représentée. L’observateur découvre alors avec une clarté analytique saisissante la distribution biomécanique réelle propre à chaque segment automobile : les voitures biplaces occupent une niche spécifique associant de fortes cylindrées à des rendements autoroutiers étonnamment préservés par leur aérodynamisme ; les véhicules utilitaires de loisir et les camionnettes s’alignent dans les quadrants d’inefficience énergétique structurelle ; tandis que les sous-compactes déploient une pente descendante étendue traduisant une grande hétérogénéité d’ingénierie.
Cette fragmentation organisée n’altère en rien l’aptitude de l’observateur à opérer des comparaisons transversales, car les échelles de coordonnées restent par défaut rigoureusement synchronisées. L’œil navigue d’une cellule à l’autre avec une fluidité naturelle, effectuant des calculs visuels d’écart, de translation et de dispersion sans avoir à décoder une légende de couleurs complexe. Le graphique multi-panneaux parvient ainsi à synthétiser une quantité d’informations multivariées substantiellement supérieure tout en réduisant la fatigue visuelle du récepteur.
4.3 4.3 Comparaison syntaxique : vars() versus notation par tilde
L’évolution de la base de code de ggplot2 a conduit à une dualité d’écriture qu’il convient de clarifier sur le plan méthodologique. Historiquement, le facettage s’appuyait de manière exclusive sur la syntaxe issue des formules statistiques linéaires sous R. Dans cette convention canonique, l’utilisateur déclarait la segmentation sous la forme facet_wrap(~ class). Cette syntaxe concise et élégante emprunte le tilde mathématique pour signifier que le tracé global est conditionné par la variable positionnée à sa droite, selon une logique analogue à la formalisation des modèles d’analyse de la variance ou de régression univariée.
Toutefois, lors du déploiement de la version 3.0.0 de ggplot2, l’équipe de conception a introduit la fonction auxiliaire vars(), recommandant désormais l’écriture facet_wrap(vars(class)). Ce changement de paradigme vise à harmoniser la syntaxe du facettage avec celle des autres composants du tidyverse, notamment les fonctions de transformation sélective telles que celles rencontrées dans dplyr. L’usage de vars() offre un avantage structurel décisif : il permet d’exploiter directement les mécanismes modernes d’évaluation tidy (tidy evaluation), autorisant l’injection de variables intermédiaires, le renommage dynamique à la volée et une gestion infiniment plus robuste des symboles non évalués au sein de macros ou de fonctions d’automatisation complexes développées par les utilisateurs.
Bien que la notation classique par tilde demeure parfaitement opérationnelle et maintenue pour assurer la rétrocompatibilité des scripts académiques historiques, les standards de style actuels encouragent vivement l’adoption systématique de la structure vars(). Outre sa rigueur sémantique accrue, elle dissipe les ambiguïtés d’interprétation lorsque plusieurs variables de conditionnement sont conjointement convoquées, garantissant une cohérence stylistique absolue au sein des pipelines de traitement contemporains.
5. 5. Contrôle dimensionnel de la grille : Configuration de nrow et ncol
5.1 5.1 Forçage d’une disposition horizontale ou verticale stricte
Le comportement algorithmique par défaut de facet_wrap() vise à produire une disposition matricielle équilibrée tendant vers un carré ou un rectangle proportionné. Cependant, les impératifs analytiques d’une démonstration scientifique imposent fréquemment de contraindre délibérément l’agencement spatial le long d’une dimension unique. La maîtrise conjointe des arguments nrow (nombre de lignes) et ncol (nombre de colonnes) confère à l’analyste le pouvoir de dicter l’orientation vectorielle du ruban graphique pour servir un objectif d’interprétation ciblé.
Le paramétrage explicite de l’attribut nrow = 1 force l’alignement horizontal intégral de l’ensemble des panneaux au sein d’une seule et unique rangée continue. Cette disposition linéaire s’avère méthodologiquement optimale lorsque la question de recherche fondamentale repose sur la comparaison minutieuse des positions relatives le long de l’axe des ordonnées (axe Y). Dans notre étude comparative de véhicules, un alignement horizontal strict permet d’apprécier d’un simple balayage du regard les variations de niveau d’efficience énergétique entre les classes, car l’alignement physique horizontal offre une ligne de base visuelle constante qui facilite l’estimation des décalages verticaux sans interférence de parallaxe.
À l’inverse, l’imposition de ncol = 1 empile la totalité des sous-graphiques dans une colonne verticale unique. Ce choix structurel s’impose lorsque l’axe d’intérêt prédominant est l’abscisse (axe X). Dans les contextes d’analyse temporelle séquentielle ou lors de l’étude de décalages de distributions spectrales, l’empilement vertical garantit que les coordonnées temporelles ou métriques demeurent alignées au millimètre près sur la trajectoire de lecture descendante, permettant au lecteur de détecter instantanément des retards de phase ou des asymétries de distribution le long de l’axe horizontal.
5.2 5.2 Optimisation du ratio d’aspect pour les publications scientifiques
La mise en page d’articles de recherche destinés à des revues à comité de lecture est assujettie à des contraintes dimensionnelles extrêmement strictes. Qu’il s’agisse d’un gabarit de publication à une seule colonne (largeur typique comprise entre 80 et 90 millimètres) ou d’une impression pleine page sur deux colonnes (oscillant entre 160 et 180 millimètres), la lisibilité géométrique d’un graphique à panneaux multiples dépend de la gestion de son ratio d’aspect (le rapport entre sa largeur et sa hauteur globales). Laisser le système de facettage générer des panneaux aux dimensions arbitraires conduit fréquemment à des graphiques compressés ou étirés, dénaturant la perception des pentes statistiques.
Le réglage concerté de nrow et ncol doit s’effectuer en anticipant le format physique final du document imprimé ou numérisé. Si un ruban de six facettes est intégré au sein d’une mise en page en format portrait de type A4, une configuration matricielle structurée en trois lignes et deux colonnes (nrow = 3, ncol = 2) préserve des proportions de panneau harmonieuses sans écraser les étiquettes textuelles des axes. En revanche, si la figure doit s’insérer au sein d’un bandeau panoramique supérieur s’étendant sur toute la largeur d’une double page, une structuration en deux lignes et trois colonnes (nrow = 2, ncol = 3) évite un étirement horizontal préjudiciable.
Cette régulation dimensionnelle conditionne également la perception des relations de corrélation. En vertu du phénomène psychophysique connu sous le nom d’illusion de pente, l’œil humain estime l’intensité d’une association linéaire en fonction de la proximité visuelle de la droite de régression avec la diagonale à 45 degrés. Un paramétrage inadéquat des lignes et colonnes de facettes, conduisant à des cellules excessivement aplaties ou anormalement étroites, induit une distorsion cognitive de l’ampleur des effets statistiques en modifiant artificiellement l’inclinaison apparente des nuages de points.
5.3 5.3 Gestion de l’orientation du flux de remplissage (as.table et dir)
Au-delà de la géométrie externe du cadre matriciel, l’ordre interne de cheminement des panneaux constitue un paramètre ergonomique déterminant. Par défaut, la fonction facet_wrap() orchestre le remplissage de la grille selon un balayage horizontal progressif, analogue à la lecture d’un texte occidental : le premier panneau s’insère dans le coin supérieur gauche, le second se place immédiatement à sa droite, et ainsi de suite jusqu’à épuisement de la première ligne, moment où le flux descend d’un cran pour entamer la deuxième rangée. Cette cinématique de rendu est gouvernée par le paramètre de direction dir, dont la valeur par défaut est assignée à la modalité horizontale (dir = « h »).
Dans des configurations spécifiques, notamment lorsque les facettes traduisent une hiérarchie catégorielle verticale ou que l’espace vertical disponible excède largement l’espace horizontal, il devient pertinent d’inverser ce flux d’organisation en déclarant dir = « v ». Sous ce régime de calcul, l’algorithme peuple prioritairement la première colonne du haut vers le bas avant de migrer vers la colonne adjacente. Cette orientation verticale facilite le suivi ordonné des éléments lorsque le lecteur est invité à parcourir des profils comparatifs selon une arborescence en colonnes parallèles.
Enfin, l’argument logique as.table module la disposition des rangées selon une analogie informatique ou tabulaire. Lorsque as.table = TRUE (comportement configuré par défaut), les facettes s’ordonnent à la manière d’une feuille de calcul ou d’une matrice mathématique conventionnelle, la modalité initiale s’affichant au sommet supérieur. Si cet argument est basculé sur la valeur FALSE, le système adopte la convention cartographique des tracés physiques, assignant la valeur de niveau la plus faible au coin inférieur gauche de l’écran et progressant vers le sommet supérieur, un choix syntaxique parfois requis lors de la modélisation de coupes géologiques ou de gradients altitudinaux.
6. 6. Paramétrage des échelles : Utilisation critique de l’argument scales
6.1 6.1 Comportement par défaut : Échelles fixes (scales = ‘fixed’)
La doctrine méthodologique de la visualisation scientifique préconise la standardisation absolue des unités d’observation. Dans cet esprit, l’architecture de facet_wrap() applique par défaut une contrainte d’invariance rigoureuse sur l’ensemble de ses repères cartésiens, matérialisée par l’argument implicite scales = « fixed ». Sous ce mode de fonctionnement, l’ensemble des sous-panneaux partage rigoureusement les mêmes valeurs d’abscisse minimale, d’abscisse maximale, d’ordonnée minimale et d’ordonnée maximale, calculées sur la base de l’étendue globale du jeu de données agrégé.
Les vertus épistémologiques des échelles fixes sont inestimables. Elles immunisent le récepteur de l’information contre toute conclusion hâtive dérivée de distorsions visuelles locales. Si une sous-population présente une variance ténue ou des valeurs infinitésimales par rapport à une autre cohorte, l’échelle fixe restitue visuellement cette petitesse avec une exactitude proportionnelle irréprochable. L’observateur appréhende immédiatement les vides d’échantillonnage, les regroupements marginaux et les disparités d’ordres de grandeur sans avoir à déchiffrer laborieusement la graduation numérique de chaque sous-axe.
Néanmoins, cette rigueur méthodologique possède son revers opérationnel. Lorsque la distribution globale d’un phénomène est dominée par des valeurs extrêmes confinées à un sous-groupe très spécifique, ou lorsque les différentes catégories possèdent des plages d’existence physiquement disjointes, la fixité des échelles a pour conséquence de reléguer les observations de certains panneaux à des bandes étriquées et illisibles au ras des axes. Dans une telle conjoncture, l’échelle fixe masque entièrement la structure de corrélation interne et la variance locale propre aux sous-populations d’intérêt, neutralisant tout effort d’analyse exploratoire fine.
6.2 6.2 Échelles totalement libres : scales = ‘free’
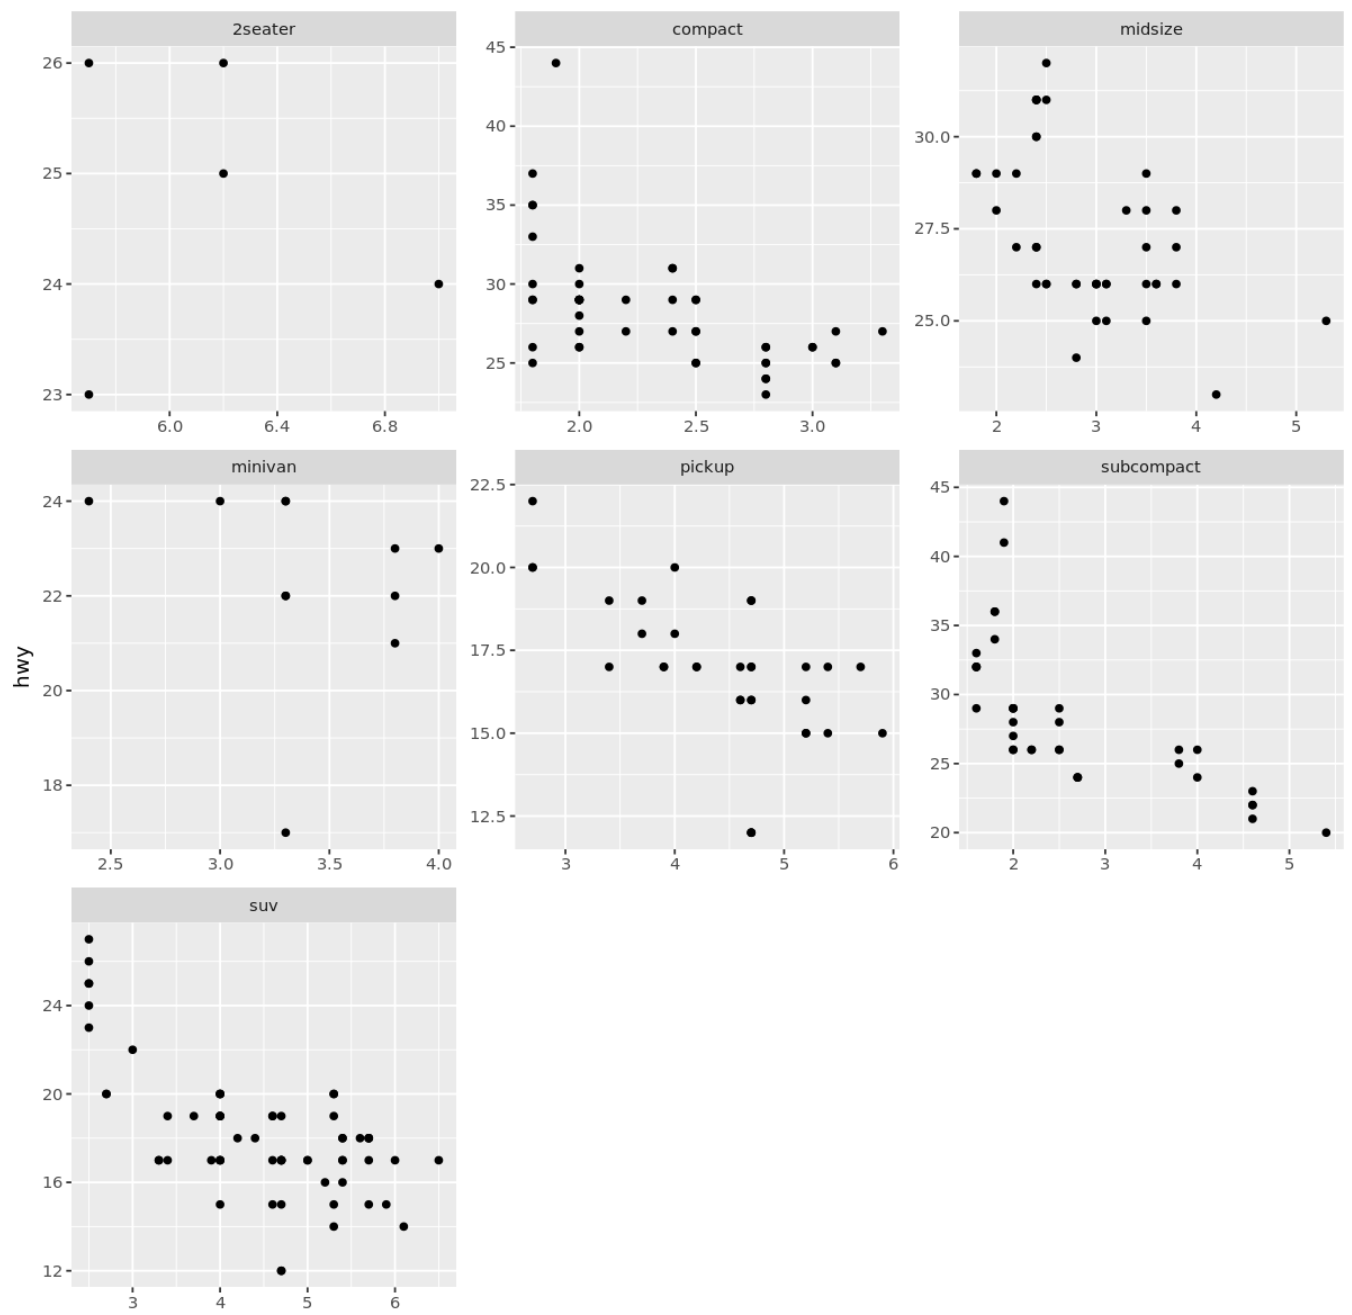
Afin de résoudre l’impasse descriptive posée par l’hétérogénéité d’échelle entre groupes, ggplot2 intègre l’option de découplage complet par le biais de la déclaration scales = « free ». Lorsqu’elle est activée, cette directive ordonne au moteur de calcul de réévaluer indépendamment pour chaque cellule matricielle les bornes des axes X et Y, en ajustant les limites du cadre au plus près des minima et maxima de la seule fraction d’observations assignée à ladite facette.
Ce déverrouillage total maximise l’utilisation de l’espace graphique disponible à l’intérieur de chaque panneau. Chaque nuage de points s’épanouit pleinement sur toute l’étendue de sa zone de traçage, révélant avec une netteté remarquable les configurations de distribution internes, l’ellipticité des regroupements locaux ou la présence d’aberrations statistiques spécifiques qui demeuraient invisibles sous le régime d’échelles fixes. Pour l’analyse exploratoire de profils d’expression génomique ou d’indices boursiers hautement divergents, ce mode de restitution s’avère indispensable.
Toutefois, l’usage des échelles totalement libres introduit des risques épistémologiques et perceptifs majeurs. Dès lors que les axes ne partagent plus de repères communs, la comparabilité directe d’un panneau à l’autre est formellement rompue. Un nuage de points dont la pente apparente paraît vertigineuse au sein d’une facette peut en réalité traduire une variation numérique infinitésimale si l’intervalle de son axe d’ordonnée est resserré, tandis qu’une pente visuellement douce au sein d’un panneau voisin peut masquer une amplitude phénoménologique monumentale. L’analyste se doit donc d’avertir explicitement le lecteur dès que les échelles sont libérées afin de prévenir des méprises d’interprétation critiques.
6.3 6.3 Échelles semi-libres : scales = ‘free_x’ et scales = ‘free_y’
Conscients de la nécessité de préserver un ancrage méthodologique partiel tout en allégeant les contraintes d’affichage, les concepteurs de ggplot2 ont instauré des options intermédiaires de semi-libération : scales = « free_x » et scales = « free_y ». Ces modalités hybrides permettent de déverrouiller une dimension spatiale précise tout en maintenant la standardisation métrique la plus absolue sur l’autre coordonnée orthogonale.
La configuration scales = « free_y » s’avère extrêmement précieuse lors de l’étude de populations présentant des volumes numériques divergents, mais évaluées sur une même échelle de référence en abscisse. Par exemple, si l’on modélise l’évolution de la vitesse de réaction cognitive en fonction de l’âge chronologique à travers différentes pathologies psychiatriques, l’abscisse doit rester rigoureusement unifiée afin de maintenir l’alignement temporel des classes d’âge. En revanche, si la fréquence absolue des symptômes mesurés varie de façon disproportionnée d’un syndrome à l’autre, libérer l’ordonnée permet d’examiner le tracé fonctionnel de chaque pathologie sans sacrifier la lisibilité des groupes les plus rares.
Réciproquement, la modalité scales = « free_x » s’illustre avec pertinence dans les situations où la grandeur dépendante en ordonnée est un indicateur biologique standardisé borné (tel qu’un pourcentage d’inhibition enzymatique ou un ratio de variabilité cardiaque), tandis que les cohortes observées évoluent au sein de fenêtres d’exposition temporelle ou de plages de concentrations totalement décalées. En figeant l’axe Y, la comparabilité de l’intensité de la réponse est scrupuleusement préservée, tandis que la flexibilité accordée à l’axe X évite la présence de vastes zones de vide expérimental au sein des panneaux individuels.
7. 7. Personnalisation avancée des étiquettes de facettes (Labellers)
7.1 7.1 Redéfinition manuelle des noms de modalités
La production de figures destinées à l’édition scientifique requiert un contrôle sémantique rigoureux sur les termes textuels affichés dans les bandeaux d’en-tête (strips). Dans les bases de données réelles, les niveaux de variables catégorielles sont fréquemment codés au moyen d’abréviations cryptiques, de sigles informatiques ou de formulations tronquées dictées par des impératifs d’économie de mémoire ou des contraintes d’importation logicielle. Conserver telles quelles ces étiquettes brutes au sein d’une publication savante compromet l’accessibilité de l’article.
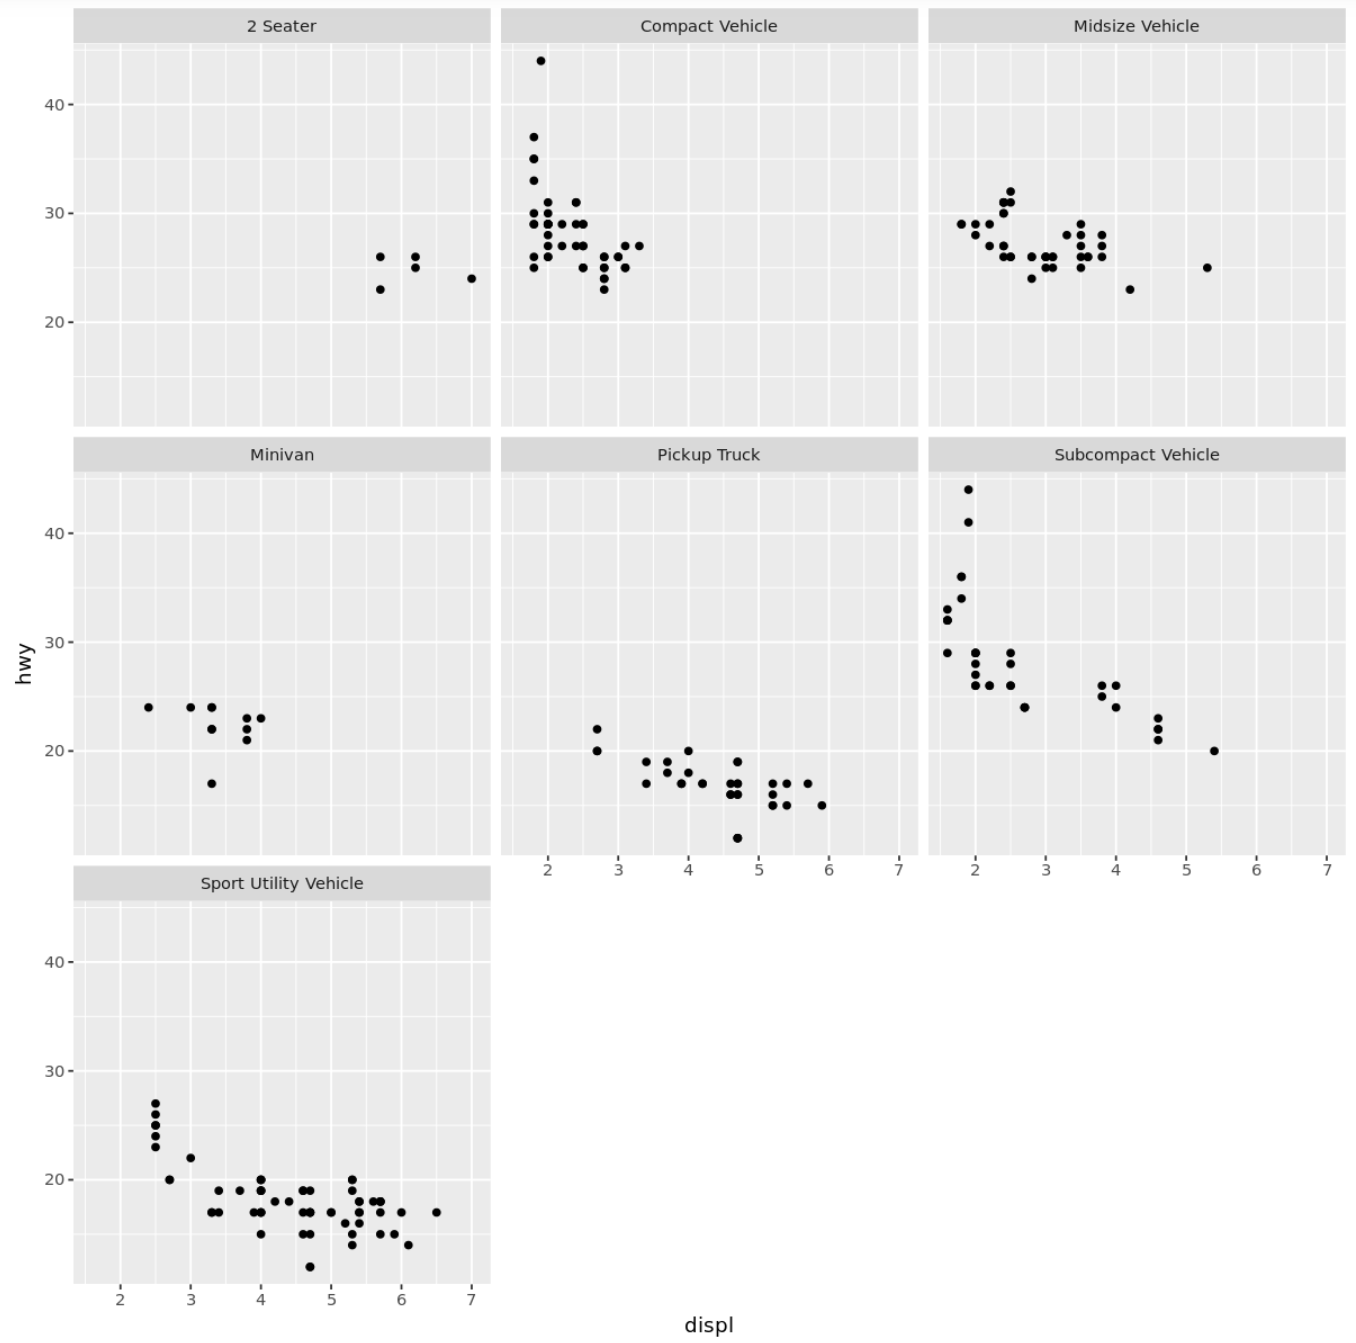
L’une des méthodes les plus robustes pour métamorphoser ces identifiants consiste à employer un étiqueteur personnalisé par le truchement de la fonction as_labeller(), associée à un vecteur de conversion nommé. L’analyste structure un dictionnaire d’équivalences au sein duquel chaque nom d’élément correspond rigoureusement à une modalité présente dans le jeu de données d’origine, tandis que la valeur textuelle associée contient la titulature scientifique intégrale, conforme aux standards éditoriaux les plus stricts.
En injectant cette table de correspondance dans l’argument labeller de facet_wrap(), le système substitue automatiquement les nouvelles chaînes de caractères lors de la phase d’instanciation des bandeaux. Cette approche présente l’immense avantage méthodologique de ne pas altérer la structure intrinsèque de la table de données d’origine : les calculs, les filtres et les regroupements statistiques demeurent arrimés aux variables natives, tandis que la transformation textuelle s’opère de façon purement cosmétique au stade ultime du rendu graphique.
7.2 7.2 Intégration du nom de la variable d’origine (label_both)
Dans les contextes d’investigation statistique exploratoire ou lors de l’élaboration de volumineux rapports méthodologiques compilant de multiples facteurs de stratification, la simple apparition de la modalité factorielle au sein du bandeau de facette peut induire des confusions d’interprétation chez le lecteur non initié. Si un panneau arbore uniquement la mention laconique « 4 », il est malaisé de déterminer de prime abord s’il s’agit d’un cycle moteur de quatre cylindres, d’un temps de réponse de quatre secondes, ou du stade clinique de phase quatre d’un essai thérapeutique.
Pour éliminer toute ambiguïté cognitive, l’opérateur label_both fournit une solution algorithmique directe et hautement efficace. En déclarant labeller = label_both au sein des paramètres de facet_wrap(), le moteur de tracé concatène systématiquement le nom formel de la variable de facettage avec la modalité spécifique assignée à chaque cellule. Le bandeau présentera dès lors une formulation parfaitement explicite de type « cylindres : 4 », fournissant instantanément le contexte sémantique indispensable au décodage de la figure.
De surcroît, ggplot2 offre la possibilité technique de moduler le séparateur typographique employé lors de cette concaténation. Par le paramétrage des fonctions d’encapsulation associées, l’analyste peut substituer au deux-points usuel un tiret cadratin, une flèche directionnelle ou une structure d’attribution mathématique (comme le symbole d’égalité), assurant ainsi une intégration visuelle parfaitement conforme à la charte graphique de la publication cible.
7.3 7.3 Expressions mathématiques et notation scientifique (label_parsed)
Les sciences dures, l’économétrie formelle et la psychométrie théorique recourent continuellement à des symbolismes mathématiques, des caractères de l’alphabet grec et des notations typographiques sophistiquées (indices, exposants, opérateurs différentiels) pour qualifier leurs concepts et leurs sous-échantillons. L’affichage d’étiquettes de facettes incorporant de telles grandeurs dépasse le cadre des simples chaînes de caractères textuelles et convoque le moteur de rendu mathématique de R, connu sous le nom de syntaxe plotmath.
La mobilisation de la directive labeller = label_parsed permet d’interpréter le contenu des modalités factorielles ou des dictionnaires d’étiquetage non comme du texte littéral, mais comme des expressions mathématiques formalisées. Grâce à ce mécanisme, une modalité rédigée sous la syntaxe formelle d’un symbole grec suivi d’un indice numérique sera fidèlement restituée à l’écran sous la forme d’un glyphe typographique impeccablement calligraphié, à l’instar des compositions issues de logiciels de typographie mathématique comme LaTeX.
Cette fonctionnalité s’avère cruciale pour identifier sans ambiguïté des sous-populations définies par des coefficients d’ajustement structurels, des seuils de significativité statistique (alpha de Cronbach, indices de corrélation de Pearson, coefficients de détermination r carré), ou encore des concentrations chimiques requérant des représentations en unités scientifiques exponentielles. L’élévation de la qualité éditoriale ainsi obtenue confère aux figures un niveau de professionnalisme indispensable pour franchir avec succès les étapes d’évaluation par les pairs.
8. 8. Structuration multidimensionnelle avec plusieurs variables catégorielles
8.1 8.1 Combinaison factorielle via vars(var1, var2)
Bien que facet_wrap() soit prioritairement appréhendé comme un opérateur de déroulement unidimensionnel, il possède la capacité architecturale de traiter simultanément de multiples facteurs discriminants. Lorsqu’un protocole d’observation implique une stratification multifactorielle croisée, l’injection conjointe de plusieurs identifiants au sein du sélecteur sous la forme facet_wrap(vars(var1, var2)) déclenche un mécanisme d’intersection combinatoire automatique.
Dans ce scénario opérationnel, le moteur de calcul dénombre l’ensemble des croisements effectifs existant entre les modalités de la première variable et celles de la seconde. Chaque combinaison factorielle observée donne naissance à un sous-graphique dédié, dont le bandeau sommital synthétise l’identité conjointe des deux attributs d’appartenance. Ce ruban combiné se déploie ensuite selon la grille matricielle fluide propre à la fonction, contournant l’obligation de rigidité dimensionnelle imposée par d’autres méthodes de partitionnement.
Cette approche s’avère visuellement beaucoup plus compacte et économe en espace graphique que la projection matricielle intégrale lorsque le plan expérimental est asymétrique ou partiellement rempli. Elle permet d’afficher en séquence continue des profils d’interaction complexes sans allouer d’espace visuel disproportionné à des combinaisons théoriques qui ne posséderaient aucune contrepartie observationnelle dans le monde réel, préservant ainsi une densité d’information graphique optimale.
8.2 8.2 Gestion des combinaisons sans données (drop = TRUE vs FALSE)
L’une des difficultés récurrentes de l’analyse multivariée en milieu expérimental réside dans le phénomène des plans factoriels incomplets ou déséquilibrés. Il est fréquent que certaines intersections entre variables catégorielles soient méthodologiquement interdites ou empiriquement absentes du jeu de données final. Face à cette situation, l’argument logique drop de facet_wrap() joue un rôle de régulation architecturale déterminant.
Par défaut, l’argument est calibré sur la valeur drop = TRUE. Sous ce mode de gestion pragmatique, toute combinaison théorique de facteurs qui ne contiendrait aucune observation concrète est purement et simplement élaguée de la séquence de rendu. Aucun panneau fantôme n’est instancié, et l’espace graphique est intégralement alloué aux seules cellules empiriquement documentées. Cette configuration garantit un affichage compact et évite de troubler la lecture avec des zones vierges d’information.
Néanmoins, dans certaines investigations de validation épidémiologique ou d’audit clinique, l’absence même d’observation constitue en soi une donnée scientifique primordiale qu’il convient de matérialiser. En configurant explicitement drop = FALSE, l’analyste contraint le système à matérialiser l’intégralité de l’espace combinatoire défini par les niveaux déclarés des facteurs. Les croisements orphelins sont alors représentés sous la forme de facettes vides, portant leurs axes et leurs bandeaux respectifs, signalant de façon éclatante au lecteur l’existence d’un vide expérimental au sein de la matrice d’investigation.
8.3 8.3 Ordonnancement rigoureux des sous-groupes par réorganisation des niveaux
L’efficacité narrative d’une planche de petits multiples dépend de manière critique de l’ordre d’enchaînement séquentiel des sous-graphiques. Un ordonnancement purement aléatoire ou dicté par un tri alphabétique fortuit force le cerveau à une gymnastique de recherche fastidieuse pour reconstituer une hiérarchie ou un gradient d’effet. Pour maximiser la puissance démonstrative d’une figure, la disposition des panneaux doit refléter fidèlement une logique quantitative ou conceptuelle intrinsèque.
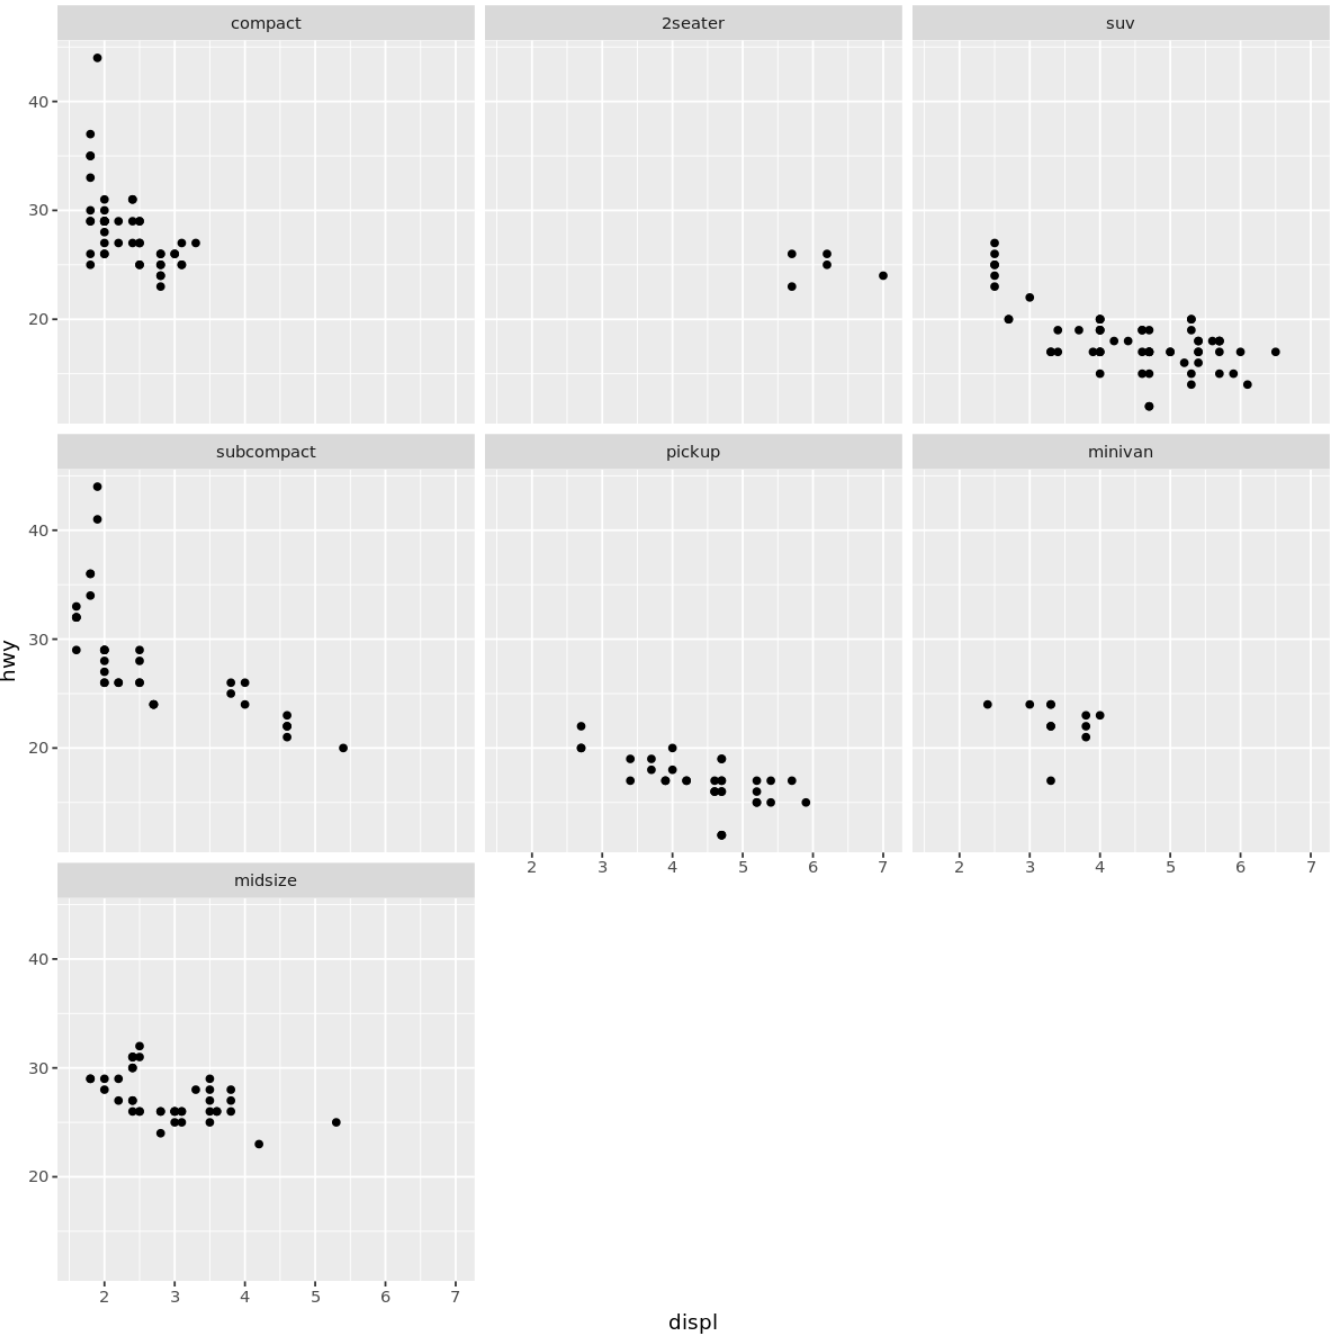
La régulation de cette cinématique s’effectue en amont du tracé, au niveau de la manipulation des données, grâce aux fonctions spécialisées de l’extension forcats. L’emploi de la fonction fct_reorder() permet notamment de réassigner l’ordre des niveaux d’un facteur en fonction d’une valeur statistique sommaire calculée sur une variable continue, telle que la médiane ou la moyenne arithmétique. Si l’on ordonne les catégories de véhicules selon leur efficience autoroutière médiane ascendante, les facettes résultantes s’organiseront sur la page dans une progression visuelle continue, le lecteur observant la distribution des points glisser harmonieusement vers le haut à mesure qu’il chemine à travers les panneaux.
Dans les cas où l’ordre répond à une chronologie clinique, à une posologie croissante ou à des regroupements théoriques non fondés sur une statistique continue simple, la fonction fct_relevel() offre la possibilité de fixer manuellement chaque niveau dans une séquence sur mesure. Ce contrôle absolu exercé sur la généalogie des facteurs garantit que la mise en scène graphique sert rigoureusement la démonstration scientifique, guidant le regard du récepteur selon un parcours cognitif parfaitement maîtrisé.
9. 9. Esthétique et stylisation des bandes de facettes via theme()
9.1 9.1 Typographie et alignement des titres de facettes (strip.text)
La personnalisation stylistique de l’environnement graphique constitue l’étape indispensable pour transformer une visualisation brute d’analyse exploratoire en une planche publiable dans les meilleures revues savantes. Dans le système de thématisation de ggplot2, l’apparence des textes des bandeaux d’en-tête de facettes est régie par l’élément textuel strip.text, accessible au sein de la fonction globale theme(). Cet élément se manipule via l’opérateur structurel element_text(), qui autorise un calibrage typographique d’une remarquable précision.
L’analyste chevronné peut ainsi réguler la famille de polices d’écriture employée afin d’assurer l’homogénéité avec le corps de texte du manuscrit hôte (qu’il s’agisse de polices avec ou sans empattement), moduler la taille des caractères exprimée en points typographiques relatifs, altérer la graisse (en sélectionnant des graisses grasses ou demi-grasses pour rehausser la visibilité du titre) et définir des teintes chromatiques adaptées au support de diffusion. De plus, il est possible d’ajuster l’alignement textuel horizontal et vertical au moyen des arguments hjust et vjust, permettant de centrer rigoureusement les intitulés ou de les justifier élégamment sur les marges intérieures du bandeau.
Dans des configurations avancées impliquant des facettages orientés selon des axes spécifiques, ggplot2 distingue les sous-composants strip.text.x et strip.text.y. Cette granularité permet, par exemple, d’appliquer une taille de caractère plus imposante sur les coordinateurs horizontaux tout en appliquant une inclinaison d’angle spécifique sur les étiquettes verticales pour éviter tout chevauchement typographique lorsque la densité des cellules augmente.
9.2 9.2 Personnalisation de l’arrière-plan des bandeaux (strip.background)
Par défaut, le style historique de ggplot2 encapsule le texte de facettage au sein d’un cadre rectangulaire ombré d’une teinte de gris soutenu, délimité par une bordure fine. Bien que fonctionnel pour distinguer nettement l’en-tête de la zone de données proprement dite, ce design par défaut s’avère souvent trop lourd sur le plan visuel et entre en contradiction directe avec les recommandations éditoriales de nombreuses sociétés savantes, notamment les normes formelles édictées par l’American Psychological Association (APA).
Le contrôle de cet arrière-plan s’opère par le truchement de la commande strip.background = element_rect() intégrée dans le bloc de thématisation. Cette interface permet d’alléger considérablement l’encre graphique non informationnelle : on peut opter pour un remplissage en blanc immaculé associé à une absence totale de filet de contour, ou pour une teinte subtile de gris très clair s’intégrant harmonieusement avec la grille de fond. Les attributs de remplissage (fill), de coloration du contour (color) et d’épaisseur de ligne (linewidth) offrent un contrôle intégral sur l’encadrement.
Pour atteindre un niveau de raffinement visuel ultime, conforme aux préceptes minimalistes contemporains, il est fréquent d’annuler purement et simplement le rectangle de bandeau en déclarant strip.background = element_blank(). Sous cette forme épurée, le titre de la facette flotte librement et directement au-dessus de la matrice de tracé, débarrassé de tout artifice ornemental superflu. Cette sobriété esthétique favorise une concentration cognitive maximale sur les seules données quantitatives affichées dans la zone de dessin.
9.3 9.3 Espacement inter-panneaux (panel.spacing)
L’aération générale de la scène graphique dépend étroitement de la distance physique séparant chaque panneau de ses voisins immédiats. Un espacement insuffisant conduit à une interpénétration désastreuse des graduations numériques d’axes, les chiffres d’un panneau venant chevaucher le bord du panneau adjacent, ce qui génère une confusion de lecture critique. Inversement, un éloignement excessif brise l’unité perceptive de la composition, empêchant le système visuel d’embrasser l’ensemble des petits multiples comme un système cohérent et interconnecté.
Le réglage de cette métrique spatiale s’effectue via l’élément panel.spacing, dont la valeur numérique doit impérativement être encapsulée dans une unité dimensionnelle formelle grâce à la fonction unit() (par exemple, en millimètres, centimètres, pouces ou fractions de cadratin). Cette approche dimensionnelle garantit que le tracé conservera un espacement physiquement contrôlé et reproductible, indépendamment de la taille absolue de la fenêtre de visualisation à l’écran.
De surcroît, ggplot2 autorise une différenciation vectorielle de cet intervalle spatial au travers des paramètres panel.spacing.x et panel.spacing.y. Dans les architectures graphiques étendues en largeur, il est d’usage de resserrer légèrement l’espacement vertical entre les rangées tout en préservant une marge horizontale plus généreuse pour loger confortablement les étiquettes de coordonnées sans risque de collision, atteignant ainsi un équilibre visuel optimal au regard de la densité de données à restituer.
10. 10. Application avancée : Visualisation de modèles et données psychométriques
10.1 10.1 Tracé de droites de régression par facette
L’une des forces majeures de l’intégration de facet_wrap() au sein du moteur d’analyse statistique de ggplot2 réside dans l’application automatique des transformations géométriques et des modélisations aux sous-populations représentées dans chaque panneau. L’insertion d’une couche d’estimation statistique, telle que celle matérialisée par l’opérateur geom_smooth(), n’ajuste pas un modèle unique global projeté uniformément partout, mais recalcule de manière entièrement autonome une régression locale distincte pour chaque facette individuelle.
En configurant cette couche pour appliquer un modèle linéaire paramétrique classique (method = « lm »), l’analyste obtient instantanément une évaluation visuelle directe de l’hétérogénéité des pentes statistiques à travers les différentes strates factorielles. Si la droite de régression présente une inclinaison fortement négative dans un panneau tandis qu’elle demeure strictement horizontale ou s’oriente positivement dans un autre, l’hétérogénéité des coefficients de régression est mise en évidence sans qu’il soit nécessaire de déchiffrer un tableau d’analyse de covariance touffu.
De surcroît, le moteur graphique superpose par défaut à chaque droite sa bande d’intervalle de confiance à 95 %, matérialisée par un ruban de dispersion semi-transparent calculé selon l’erreur-type propre à chaque sous-échantillon. Cette restitution graphique permet au statisticien d’évaluer d’un coup d’œil la précision de l’ajustement : des rubans étroits traduiront un échantillon volumineux et un modèle prédictif robuste, tandis qu’un évasement prononcé du ruban signalera une faiblesse d’échantillonnage ou une dispersion résiduelle substantielle au sein de la sous-catégorie considérée.
10.2 10.2 Présentation de données normatives et de lignes de référence
Dans la recherche médicale, clinique ou psychométrique, les observations individuelles prennent tout leur sens lorsqu’elles sont comparées à des bornes normatives préétablies, telles que des seuils diagnostiques de pathologie, des seuils de toxicité biologique ou des scores de référence issus d’étalonnages populationnels. L’incorporation de telles bornes théoriques au sein d’un ruban de facettes requiert une compréhension fine de la façon dont les données sont transmises aux couches géométriques auxiliaires.
Si la ligne de démarcation normative correspond à une valeur absolue universelle et constante pour toutes les facettes (par exemple, un seuil critique d’anxiété cliniquement fixé à 50 sur une échelle standardisée), son insertion s’effectue directement au moyen des fonctions conventionnelles geom_hline() (pour une ligne de référence horizontale) ou geom_vline() (pour une ligne verticale). L’instruction traversera l’ensemble de la grille spatiale, traçant ce repère avec une constance parfaite sur chaque panneau sans exiger de paramétrage complexe.
En revanche, si les normes comparatives varient spécifiquement d’une strate factorielle à une autre (par exemple, des seuils normatifs différenciés selon le genre ou la cohorte d’âge du sujet), la rigueur méthodologique impose de créer en amont une table de données secondaire distincte. Ce tableau satellite consolide les identifiants de la variable de facettage et la valeur exacte du seuil spécifique associé. En alimentant directement la géométrie de référence avec cette table subsidiaire, ggplot2 procède à un appariement automatique, projetant sur chaque facette sa ligne de référence personnalisée, permettant une évaluation diagnostique irréprochable de chaque sous-groupe.
10.3 10.3 Graphiques d’ombres contextuelles (Background Data Shadows)
Si le partitionnement par facettage résout brillamment le problème du chevauchement de données, il introduit un inconvénient structurel corollaire : en séparant physiquement les sous-groupes dans des cellules isolées, il complique parfois l’appréhension intuitive de la position globale de chaque sous-ensemble au sein de la population totale. Pour combler cette lacune sans réintroduire d’encombrement graphique, la méthodologie de visualisation avancée exploite la technique dite des « ombres de données contextuelles » (background data shadows).
Cette approche d’une grande élégance technique consiste à insérer, en dessous de la couche de données actives, une géométrie de dispersion préliminaire alimentée par une duplication délibérée du jeu de données intégrale, mais amputée de sa variable de facettage. Pour ce faire, l’instruction graphique déclare un premier geom_point() dont la source de données est transformée à la volée via une fonction anonyme supprimant la colonne de regroupement, et dont les attributs visuels sont calibrés sur une couleur grise très atténuée et une transparence accentuée.
Le résultat de ce montage est visuellement saisissant : sur chacun des panneaux de la grille, l’intégralité du nuage de points de la population globale se dessine en arrière-plan sous la forme d’une ombre fantomatique discrète, tandis que les observations spécifiques à la facette active se détachent au premier plan avec une coloration vive et un contraste net. L’analyste bénéficie ainsi du meilleur des deux mondes : la décomposition fine et non saturée propre aux petits multiples, combinée à la perception immédiate du contexte distributionnel d’ensemble.
11. 11. Comparaison méthodologique : facet_wrap() versus facet_grid()
11.1 11.1 Divergences architecturales et conceptuelles
Bien que facet_wrap() et facet_grid() constituent les deux piliers du partitionnement sous ggplot2, leurs fondations conceptuelles et leurs vocations analytiques reposent sur des géométries radicalement divergentes. Comme son nom l’indique sans équivoque, facet_grid() matérialise une structure matricielle stricte à deux dimensions, dans laquelle chaque variable de conditionnement est assignée de manière immuable soit à l’axe des lignes, soit à l’axe des colonnes. Dans cette architecture rigide, chaque intersection théorique entre les niveaux des facteurs croisés doit obligatoirement exister spatialement au sein du tableau final.
À l’opposé de cette orthodoxie cartésienne, facet_wrap() opère comme un ruban continu à une seule dimension qui se replie plastiquement sur lui-même dès qu’il atteint une limite arbitrairement définie par l’utilisateur ou par l’algorithme heuristique. Même lorsque l’on injecte plusieurs variables au sein de facet_wrap(), la fonction ne conçoit pas une matrice relationnelle croisée, mais une liste séquentielle de facettes résultant de la combinatoire factorielle, qu’elle dispose ensuite le long d’une grille d’affichage fluide.
Cette divergence architecturale a des implications majeures sur la gestion des tableaux de contingence clairsemés. Si deux facteurs expérimentaux ne partagent que quelques intersections empiriques au sein d’un vaste espace de combinaisons potentielles, l’emploi de facet_grid() génère une quantité substantielle de cellules matricielles intégralement vides, consommant une surface graphique considérable sans apporter de contenu informatif. Dans cette conjoncture, la souplesse de facet_wrap() s’avère infiniment supérieure, car elle condense l’affichage sur les seules cellules documentées, préservant la compacité et l’ergonomie visuelle globale.
11.2 11.2 Critères de décision pour choisir la structure adaptée
Le choix raisonné entre ces deux modes de facettage doit procéder d’une analyse scrupuleuse de la structure factorielle des données et des hypothèses de recherche sous-jacentes. L’arbitrage méthodologique peut être synthétisé selon un ensemble de critères décisionnels objectifs articulés autour de la dimensionnalité, de l’équilibre du plan et des objectifs de comparaison visuelle.
On privilégiera sans ambiguïté facet_grid() lorsque l’objet d’étude fondamental réside dans l’analyse explicite des effets d’interaction statistique entre deux facteurs qualitatifs orthogonaux équilibrés (par exemple, un plan expérimental croisant rigoureusement quatre dosages thérapeutiques avec trois durées d’incubation). L’alignement universel des lignes et des colonnes garantit alors que la comparaison marginale des effets principaux (suivi des lignes pour le facteur A, suivi des colonnes pour le facteur B) s’effectue le long de repères d’axes rigoureusement partagés et non répétés, maximisant l’efficience de la lecture matricielle.
Inversement, l’usage de facet_wrap() s’impose impérativement dans les cas suivants :
- Lorsqu’on stratifie les données selon une variable catégorielle unique comportant un nombre modéré à élevé de modalités (par exemple, de 5 à 30 entités territoriales ou sous-groupes démographiques) qui ne sauraient tenir sur une rangée ou une colonne unique sans déformer les tracés.
- Lorsque le chercheur étudie un facteur asymétrique ou une arborescence catégorielle déséquilibrée au sein de laquelle de nombreux croisements sont conceptuellement impossibles ou non documentés.
- Lorsque les contraintes physiques de restitution imposent un ratio d’aspect rectangulaire spécifique qui ne correspond pas aux factorisations entières de la matrice globale des facteurs croisés.
- Lorsque l’on désire accorder une libération asymétrique des échelles d’axes tout en préservant une continuité visuelle fluide sur des appareils à écran de taille réduite (tels que des terminaux mobiles ou des présentations diapositives en format panoramique).
11.3 11.3 Tableau de synthèse comparatif des fonctionnalités
Pour faciliter l’arbitrage technique au sein des protocoles de publication, le tableau comparatif ci-dessous formalise de façon synthétique les divergences de comportement, de flexibilité et de compatibilité syntaxique qui séparent les deux opérateurs fondamentaux de facettage de ggplot2.
| Propriété architecturale | facet_wrap() | facet_grid() |
|---|---|---|
| Nature de la partition | Ruban unidimensionnel replié en 2D de manière fluide | Matrice bidimensionnelle stricte (lignes versus colonnes) |
| Régulation dimensionnelle | Contrôle direct et arbitraire via nrow et ncol | Strictement déterminée par le nombre de niveaux des variables |
| Comportement sur cellules vides | Élimination native des combinaisons sans données (drop = TRUE) | Préservation obligatoire des intersections matricielles vides |
| Modularité des échelles (scales) | Découplage total possible (free, free_x, free_y) par panneau | Découplage contraint par rangée entière ou par colonne entière |
| Proportionnalité de l’espace (space) | Non supportée (tous les panneaux ont la même surface spatiale) | Supportée (panneaux dimensionnés selon l’amplitude des échelles) |
| Positionnement des bandeaux | Toujours localisés au sommet (ou à la base) de chaque cellule | Bandeaux partagés en bordure externe de ligne et de colonne |
12. 12. Diagnostic technique, pièges courants et optimisation de performance
12.1 12.1 Résolution des erreurs syntaxiques et comportementales fréquentes
L’implémentation opérationnelle de facet_wrap() peut occasionner des dysfonctionnements récurrents qu’un diagnostic méthodique permet d’élucider rapidement. L’une des anomalies les plus communes réside dans l’omission accidentelle de l’enveloppe syntaxique vars() lors de l’appel d’une variable simple sans opérateur de formule, déclenchant un message d’erreur explicite signalant l’incapacité du système à interpréter un symbole brut comme une spécification de facette. L’analyste veillera à proscrire des écritures isolées et à toujours formaliser la sélection via vars(variable) ou selon la formulation canonique par formule ~ variable.
Une autre source d’incompréhension réside dans l’apparition inopinée de panneaux orphelins non désirés. Ce phénomène survient fréquemment après une étape de sous-échantillonnage réalisée avec la fonction de filtrage de dplyr, lorsque les données source exploitent des variables typées en tant que facteurs dont certains niveaux ne comportent plus la moindre ligne d’enregistrement. La persistance de ces niveaux déserts au sein de la table de métadonnées du vecteur induit la création de facettes vierges de tout point géométrique. La solution consiste à purger préventivement le facteur via l’instruction d’élagage des niveaux orphelins avant l’envoi vers le tracé.
Enfin, lors de la libération unilatérale ou bilatérale des échelles via l’argument scales, les graduations textuelles des axes ont tendance à se multiplier et à encombrer le pourtour intérieur de chaque facette. Dans de telles configurations, il devient impératif de moduler la densité des marques d’axes en ajustant explicitement l’intervalle des graduations dans les fonctions d’échelle dimensionnelle correspondantes, ou en réduisant la taille de police des valeurs textuelles d’axes dans le bloc de personnalisation thématique pour prévenir toute superposition visuelle.
12.2 12.2 Enjeux de performance sur de très grands ensembles de données
L’application d’un partitionnement spatial sur des jeux de données d’envergure massive — regroupant des centaines de milliers à des millions d’observations — induit des contraintes computationnelles et graphiques sévères. Chaque sous-panneau généré par facet_wrap() n’est pas une simple duplication d’image matricielle, mais une sous-scène vectorielle autonome dotée de son propre système de coordonnées locales, de ses repères d’axes, de ses lignes de grille d’arrière-plan et de son conteneur d’encadrement. Multiplier inconsidérément le nombre de facettes sur un jeu volumineux surcharge considérablement le moteur de rendu graphique vectoriel et peut saturer la mémoire vive allouée à la session de travail R.
Pour optimiser la performance sans sacrifier la rigueur analytique, il est fortement conseillé de procéder à des transformations d’agrégation statistique en amont de la construction graphique. Plutôt que de confier à ggplot2 le calcul de densités ou de résumés statistiques au sein de chaque panneau à partir de millions de lignes individuelles, l’analyste gagne à mobiliser les algorithmes ultra-performants de dplyr ou de data.table pour précalculer les moyennes, les quantiles et les intervalles d’erreur, puis de transmettre cette table consolidée de taille modeste au pipeline de facettage.
Dans les contextes où l’affichage de la totalité des points bruts demeure incontournable, il convient de substituer aux formats d’exportation purement vectoriels des formats hybrides ou matriciels à haute densité. Le tracé de dizaines de milliers de glyphes vectoriels individuels au sein de quarante facettes produit des fichiers volumineux extrêmement lents à s’afficher dans des visionneuses de documents standards. L’emploi raisonné de couches de pixellisation haute résolution dédiées au nuage de points, tout en conservant le cadre de facettage et la typographie au format vectoriel, résout élégamment ce goulet d’étranglement informatique.
12.3 12.3 Exportation standardisée pour les revues à comité de lecture
L’étape finale du protocole réside dans la matérialisation physique de la figure sous la forme d’un fichier autonome destiné à l’éditeur scientifique. Cette opération s’exécute traditionnellement au moyen de l’instruction ggsave(), qui requiert une calibration dimensionnelle minutieuse pour préserver les proportions géométriques du ruban de facettes. Se contenter d’exporter le tracé selon la taille par défaut de la fenêtre active de l’environnement graphique conduit presque invariablement à des distorsions inacceptables : textes de bandeaux disproportionnés, chevauchement des graduations ou aplatissement excessif des ellipses de corrélation.
L’exportation standardisée impose de déclarer rigoureusement la largeur (width), la hauteur (height) et l’unité métrique (units, de préférence en centimètres ou en pouces) en parfaite harmonie avec la maquette éditoriale visée. Pour une publication insérant une planche multi-panneaux sur toute la largeur d’une double page savante, une largeur standard de 17 à 18 centimètres associée à une hauteur calibrée selon le ratio d’aspect idéal assurera un rendu typographique équilibré. Le facteur de mise à l’échelle global (scale) peut être ajusté pour agrandir ou réduire harmonieusement l’ensemble des éléments textuels sans rompre leurs proportions relatives.
Enfin, la sélection de la résolution spatiale et du format d’encodage constitue le dernier critère de conformité. Les revues scientifiques imposent typiquement une résolution minimale de 300 points par pouce (dots per inch ou dpi) pour les figures en demi-teinte, et de 600 à 1200 dpi pour les dessins au trait au format d’image matricielle de type TIFF ou PNG sans compression destructrice. Pour les formats vectoriels pérennes comme le PDF ou l’EPS, le moteur graphique garantit une netteté absolue à tout facteur de grossissement, sous réserve de vérifier que les polices d’écriture employées dans les bandeaux et sur les axes sont adéquatement incorporées au sein du flux de données vectoriel.
Références
- Cleveland, W. S. (1993). Visualizing data. Hobart Press.
- Tufte, E. R. (2001). The visual display of quantitative information (2nd ed.). Graphics Press.
- Wickham, H. (2010). A layered grammar of graphics. Journal of Computational and Graphical Statistics, 19(1), 3–28. https://doi.org/10.1198/jcgs.2009.07098
- Wickham, H. (2014). Tidy data. Journal of Statistical Software, 59(10), 1–23. https://doi.org/10.18637/jss.v059.i10
- Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer-Verlag. https://doi.org/10.1007/978-3-319-24277-4
- Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
- Wilke, C. O. (2019). Fundamentals of data visualization: A primer on making informative and compelling figures. O’Reilly Media. https://clauswilke.com/dataviz/
- Wilkinson, L. (2005). The grammar of graphics (2nd ed.). Springer-Verlag. https://doi.org/10.1007/0-387-28695-0