
Dans le champ de l’inférence statistique et de l’analyse quantitative des données en sciences humaines, la détermination précise des valeurs critiques constitue le socle fondamental sur lequel reposent la validité des conclusions expérimentales et la robustesse des décisions cliniques. Qu’il s’agisse d’estimer un paramètre de population inconnu par le truchement d’un intervalle de confiance ou de trancher entre deux hypothèses mutuellement exclusives dans le cadre d’un protocole expérimental rigoureux, le recours à la distribution normale centrée réduite s’avère omniprésent. Au cœur de cette mécanique probabiliste, la valeur critique désignée sous la notation conventionnelle zα/2 (ou z alpha/2) incarne l’exacte ligne de démarcation entre les fluctuations d’échantillonnage aléatoires attendues et les variations systématiques statistiquement significatives.
Pourtant, malgré son ubiquité dans les manuels de méthodologie et les logiciels d’analyse de données de pointe, l’identification, la dérivation et l’interprétation de zα/2 demeurent une source fréquente d’incompréhension conceptuelle et d’erreurs computationnelles, tant pour les étudiants en formation doctorale que pour les chercheurs chevronnés. L’indice fractionnaire « α/2 » ne relève pas d’une simple convention d’écriture anodine ; il cristallise la symétrie inhérente aux tests d’hypothèses bilatéraux et la scission délibérée du risque d’erreur de première espèce entre les deux extrémités distales de la courbe de Gauss. Maîtriser l’extraction et l’usage de cette valeur critique nécessite une appréhension fine des postulats sous-jacents à la théorie probabiliste, des propriétés analytiques de la loi normale et des arbitrages méthodologiques qui dictent le choix d’un seuil de signification.
Le présent guide exhaustif a pour vocation d’offrir une exploration intégrale et systématique de la valeur critique zα/2. Depuis ses fondements théoriques et mathématiques jusqu’à son calcul algorithmique par l’entremise de tables imprimées traditionnelles ou d’environnements computationnels modernes tels que R, Python et SPSS, chaque facette opérationnelle sera disséquée avec une rigueur académique sans concession. Parallèlement, une attention toute particulière sera accordée aux applications pratiques en psychologie clinique, en psychométrie et en neurosciences cognitives, démontrant comment un traitement adéquat de zα/2 garantit la reproductibilité des résultats scientifiques et protège l’investigateur contre les écueils récurrents liés aux faux positifs.
1. Introduction et fondements théoriques de la valeur critique zα/2
L’inférence statistique ne saurait progresser sans un cadre normatif permettant de quantifier le degré d’atypicité d’une observation empirique par rapport à une distribution théorique de référence. C’est précisément cette fonction de calibrage que remplit la valeur critique zα/2 dans les plans de recherche requérant une évaluation bilatérale.
1.1 Définition mathématique et conceptuelle de zα/2
D’un point de vue conceptuel et mathématique, le score z standardisé représente une mesure sans dimension quantifiant la distance, exprimée en unités d’écart-type, séparant une observation donnée ou une statistique d’échantillon de l’espérance mathématique de la population de référence. Dans le cadre de la loi normale standardisée, notée classiquement N(0, 1), toute distribution empirique continue est recentrée sur une moyenne de zéro et rééchelonnée selon une variance unitaire. La valeur critique zα/2 intervient dès lors qu’il s’agit d’isoler une région d’acceptation centrale d’une aire totale équivalente à 1 – α, reléguant la proportion résiduelle du risque d’erreur à l’extérieur de ces frontières.
La scission de l’indice alpha sous la forme « α/2 » découle directement de la volonté de partitionner l’erreur globale de type I en deux fractions parfaitement symétriques. Lorsqu’un chercheur consent à un niveau de risque nominal global de 5 % (α = 0,05), ce risque n’est pas concentré à sens unique ; il est uniformément divisé afin que 2,5 % de la probabilité réside dans la queue supérieure de la distribution et 2,5 % dans sa queue inférieure. Il convient de souligner avec force la dichotomie essentielle qui prévaut entre la valeur z observée (calculée empiriquement à partir des statistiques de l’échantillon recueilli) et la valeur critique zα/2. Cette dernière est une constante théorique prédéterminée, indépendante des données observées, fixée a priori en fonction exclusive du seuil de tolérance à l’erreur consenti par l’expérimentateur.
La symétrie axiale parfaite de la courbe de Gauss par rapport à son axe médian d’abscisse zéro confère à zα/2 une propriété géométrique remarquable : la borne critique délimitant la région de rejet inférieure est strictement l’opposée arithmétique de la borne supérieure. En d’autres termes, si la limite supérieure s’établit à +zα/2, le seuil inférieur correspond sans équivoque à –zα/2. Cette dualité permet de confiner la région de non-rejet de l’hypothèse nulle à l’intervalle fermé [-zα/2, +zα/2], conférant ainsi à l’estimation statistique une structure bilatérale harmonieuse et rigoureuse.
1.2 Pertinence de zα/2 dans la recherche en psychologie
Dans le domaine de la recherche en psychologie et des sciences du comportement, l’emploi de zα/2 s’avère indispensable pour conférer une valeur universellement intelligible aux mesures psychométriques. L’étalonnage des échelles standardisées, qu’il s’agisse de batteries évaluant l’efficience cognitive globale (telles que les échelles de Wechsler) ou de questionnaires d’évaluation de la personnalité (à l’instar du NEO-PI ou du MMPI), repose sur la normalisation des scores bruts en notes standardisées. La valeur critique bilatérale intervient alors pour établir des seuils de normalité diagnostique et identifier de manière non arbitraire les individus dont les performances s’écartent statistiquement du fonctionnement typique de la population générale.
La modélisation des distributions de traits latents — tels que l’anxiété-trait, les capacités de mémoire de travail ou l’intelligence fluide — postule très fréquemment que ces caractéristiques psychologiques se distribuent dans l’espèce humaine selon une courbe en cloche de Gauss. L’application de zα/2 permet aux neuropsychologues et aux cliniciens d’encadrer rigoureusement l’erreur de mesure intrinsèque à tout instrument d’évaluation. En construisant des intervalles de confiance fondés sur ce score critique autour du score observé d’un patient, le praticien évite de surinterpréter de légères variations de score qui ne reflètent que l’imprécision psychométrique inhérente au test administré.
Par ailleurs, au sein des protocoles expérimentaux en psychologie cognitive et en psychopathologie quantitative, la rigueur méthodologique impose de standardiser le seuil de décision statistique. Lorsque l’on compare les temps de réaction moyens face à des stimuli émotionnels ou l’efficacité relative d’un protocole de remédiation cognitive par rapport à une condition contrôle neutre, l’emploi de zα/2 garantit que l’effet proclamé ne saurait être attribué au simple bruit d’échantillonnage qu’avec une probabilité infinitésimale et maîtrisée, renforçant de facto la réplicabilité des paradigmes expérimentaux.
1.3 Différenciation fondamentale entre approches unilatérale et bilatérale
L’architecture logique d’une analyse statistique repose sur le choix primordial entre une formulation unilatérale ou bilatérale du modèle de décision. Dans un test unilatéral (ou directionnel), l’intégralité du risque d’erreur alpha est délibérément concentrée sur une unique queue de la distribution théorique. L’investigateur postule à l’avance le sens exclusif de la divergence (par exemple, affirmer de manière péremptoire qu’un traitement améliore nécessairement une compétence sans pouvoir en aucun cas la détériorer). Dès lors, la valeur critique mobilisée est zα, laissant une aire pleine de valeur α dans une seule extrémité distale de la courbe.
À l’inverse, la structure du test bilatéral répartit équitablement le risque d’erreur de première espèce entre les deux extrémités de la distribution, allouant précisément α/2 à la queue inférieure et α/2 à la queue supérieure. Cette configuration constitue la posture épistémologique par excellence en sciences humaines, où les hypothèses théoriques se doivent de demeurer ouvertes à des effets contradictoires inattendus. Face à une intervention psychothérapeutique novatrice, la probabilité d’observer une aggravation symptomatique (effet iatrogène) ne saurait être balayée a priori par simple commodité méthodologique ; le modèle se doit de détecter une divergence statistique significative aussi bien dans le sens d’un bénéfice clinique que dans celui d’un préjudice.
Cette distinction conceptuelle entraîne des répercussions directes et substantielles sur l’exigence mathématique du seuil de significativité. Pour un même seuil global alpha de 5 %, un test unilatéral mobilisera une valeur critique z0,05 égale à 1,645, tandis qu’un test bilatéral imposera d’atteindre une valeur critique z0,025 égale à 1,96. L’approche bilatérale élève ainsi mécaniquement le niveau de preuve exigé pour rejeter l’hypothèse d’absence d’effet. Elle incarne un conservatisme méthodologique vertueux qui prémunit la communauté scientifique contre l’inflation délétère des faux positifs induits par des postulats directionnels trop optimistes.
2. Compréhension approfondie du seuil de signification alpha (α)
Le paramètre alpha (α) ne constitue pas une simple valeur numérique abstraite ; il représente l’étalon éthique et probabiliste par lequel la communauté scientifique régule sa tolérance au risque dans le processus de validation des découvertes empiriques.
2.1 La nature probabiliste du risque d’erreur de première espèce
Dans la théorie de la décision formalisée par Ronald Fisher, Jerzy Neyman et Egon Pearson, l’erreur de type I (ou risque de première espèce) se définit rigoureusement comme la probabilité conditionnelle de rejeter à tort l’hypothèse nulle (H0) alors que celle-ci est fondamentalement vraie dans la population parente. Ce risque est paramétré par le scalaire α. Dans le contexte de la recherche empirique, commettre une erreur de type I équivaut à proclamer l’existence d’une corrélation, d’un effet thérapeutique ou d’une dissociation neuropsychologique qui ne relève en réalité que d’un artefact d’échantillonnage fortuit.
Le niveau de confiance sélectionné par le chercheur, conventionnellement défini par la quantité (1 – α), entretient une relation géométrique antagoniste avec l’amplitude de l’intervalle de décision. Plus l’investigateur exige un degré de certitude élevé — par exemple 99 % au lieu de 95 % —, plus l’intervalle de non-rejet s’élargit, entraînant une poussée mécanique de la valeur critique zα/2 vers les extrémités asymptotiques de la courbe. Ce mécanisme préserve l’intégrité de la conclusion mais accroît inévitablement, à taille d’échantillon constante, le risque de commettre une erreur de deuxième espèce (β), c’est-à-dire l’incapacité à détecter un effet pourtant authentique.
La prépondérance historique des seuils de 10 %, 5 % et 1 % dans la littérature scientifique contemporaine remonte aux prescriptions formulées par Sir Ronald Fisher dans les années 1920. Bien que ces conventions numériques revêtent une part d’arbitraire indiscutable, elles fonctionnent comme une norme régulatrice consensuelle au sein de la communauté des pairs. En psychologie empirique, le seuil α = 0,05 s’est imposé comme le point d’équilibre standard entre la sévérité méthodologique nécessaire pour endiguer les publications de faux positifs et la flexibilité heuristique autorisant l’émergence d’innovations théoriques remarquables.
2.2 Mécanisme de calcul de la probabilité résiduelle unilatérale α/2
Le passage logique du niveau de confiance stipulé a priori à la probabilité résiduelle unilatérale obéit à une formulation algébrique linéaire élémentaire mais rigoureuse :
α = 1 – Niveau de Confiance
Dès lors que la structure du protocole analytique requiert une décision bilatérale, la masse probabiliste d’erreur alpha doit impérativement être ventilée de manière équipartie sur les deux franges de la distribution. L’opération arithmétique de division par deux :
p = α / 2
permet de définir précisément l’aire surfacique assignée à chacune des deux zones critiques terminales.
À titre d’illustration concrète, considérons l’adoption conventionnelle d’un coefficient de sécurité de 95 %, formalisé sous forme décimale par 0,95. L’application séquentielle des relations précédentes dégage immédiatement :
α = 1 – 0,95 = 0,05
puis :
α / 2 = 0,05 / 2 = 0,025
Ce résultat indique sans ambiguïté que la borne critique supérieure recherchée zα/2 doit être telle que l’intégrale de la fonction de densité au-delà de ce point soit exactement égale à 0,025.
D’un point de vue purement géométrique, l’aire totale circonscrite sous la courbe de densité de Gauss étant strictement égale à 1, la probabilité résiduelle unilatérale α/2 incarne la surface de l’extrême segment de queue situé à droite de la coordonnée d’abscisse zα/2. Par effet miroir, une surface identique de 0,025 est circonscrite sous la queue de gauche, à gauche de la coordonnée –zα/2. Le corps central de la distribution, qui séquestre les 95 % de la masse probabiliste restante, constitue la zone géométrique d’homogénéité avec l’hypothèse nulle.
3. Propriétés mathématiques de la loi normale centrée réduite
L’identification opérationnelle des scores critiques requiert une assimilation approfondie des spécificités fonctionnelles de la distribution normale standardisée, formalisée par Carl Friedrich Gauss et Pierre-Simon de Laplace.
3.1 Caractéristiques intrinsèques de la courbe en cloche de Gauss
La distribution normale standardisée constitue un cas particulier emblématique de la famille des lois continues à densité symétrique. Ses propriétés fondamentales sont régies par des paramètres canoniques fixes : son espérance mathématique est strictement nulle (μ = 0) et son écart-type est égal à l’unité (σ = 1, et par voie de conséquence sa variance σ² = 1). La fonction de densité de probabilité régissant cette courbe s’exprime analytiquement par la formule différentielle :
f(z) = (1 / √(2π)) · exp(-z² / 2)
Cette fonction est continue, différentiable sur l’ensemble des réels et admet un maximum absolu unique à l’abscisse z = 0, où l’ordonnée atteint la valeur crête d’environ 0,3989.
La courbe présente deux points d’inflexion morphologiques remarquables situés rigoureusement à z = -1 et z = +1, coïncidant exactement avec les limites d’un écart-type autour du centre gravitationnel de la distribution. Vers l’infini positif et l’infini négatif, l’équation révèle un comportement asymptotique horizontal : l’axe des abscisses représente une asymptote pour la courbe, ce qui signifie mathématiquement que la fonction se rapproche indéfiniment de zéro sans jamais l’intercepter, quelle que soit la magnitude du score z considéré.
Une des pierres angulaires de l’axiomatique des probabilités réside dans la normalisation unitaire de l’intégrale globale de cette fonction de densité. L’aire totale sous la courbe, étendue sur l’intervalle ouvert ]-∞, +∞[, converge rigoureusement vers 1 :
∫-∞+∞ f(z) dz = 1
Cette propriété garantit que toute portion sous-jacente à la courbe représente une probabilité authentique. Enfin, la symétrie axiale parfaite autour de z = 0 implique l’égalité fonctionnelle f(z) = f(-z), fondant l’invariance dimensionnelle des valeurs critiques bilatérales.
3.2 La fonction de répartition cumulée Φ(z)
Tandis que la fonction de densité f(z) décrit la hauteur instantanée de la courbe pour une valeur standardisée donnée, la fonction de répartition cumulée, universellement désignée par la lettre grecque majuscule Phi, Φ(z), quantifie la probabilité accumulée qu’une variable aléatoire continue Z, suivant la loi normale standard, adopte une valeur inférieure ou égale à un seuil réel spécifique z :
Φ(z) = P(Z ≤ z) = ∫-∞z (1 / √(2π)) · exp(-t² / 2) dt
Cette intégrale eulérienne ne possédant pas de primitive close exprimable par des fonctions algébriques élémentaires, sa résolution numérique nécessite des développements en séries de Taylor ou des méthodes d’approximation polynomiale précises.
La relation analytique unissant la fonction de répartition à la probabilité de queue supérieure (droitier) constitue le cœur du processus d’extraction de zα/2. Par définition de l’événement complémentaire dans l’espace probabiliste, l’aire résiduelle logée à droite d’un seuil z positif s’énonce comme suit :
P(Z > z) = 1 – P(Z ≤ z) = 1 – Φ(z)
Par conséquent, poser que la queue supérieure doit confiner une probabilité équivalente à α/2 revient à formaliser l’équation implicite :
1 – Φ(zα/2) = α/2 ⇔ Φ(zα/2) = 1 – (α/2)
En vertu du principe de symétrie réciproque régissant les distributions unimodales centrosymétriques, la fonction de répartition satisfait l’identité fondamentale suivante pour toute coordonnée réelle négative :
Φ(-z) = 1 – Φ(z)
Cette propriété établit formellement que la recherche de la borne négative P(Z ≤ –zα/2) = α/2 renvoie exactement à la valeur opposée du quantile supérieur déterminé par Φ(zα/2) = 1 – (α/2), garantissant une cohérence arithmétique absolue lors des tests bilatéraux.
4. Méthode pas à pas pour repérer zα/2 dans une table Z standard
En dépit de l’omniprésence des calculateurs électroniques dans les laboratoires contemporains, la capacité à naviguer manuellement au sein d’une table statistique de la loi normale demeure une compétence fondamentale incontournable, garante d’une compréhension intime des surfaces probabilistes.
4.1 Typologie et lecture des différentes tables de distribution normale
L’une des sources majeures d’égarement lors de l’apprentissage statistique réside dans la prolifération de formats éditoriaux divergents pour les tables statistiques de la loi normale. Il existe principalement trois grandes familles d’architectures tabulaires dans les manuels académiques :
- La table cumulative unilatérale classique (de -∞ à z) : Cette table, de loin la plus fréquente et la plus standardisée internationalement, répertorie les valeurs directes de la fonction de répartition Φ(z). Pour tout z positif consigné, le corps matriciel indique l’intégralité de l’aire accumulée depuis l’infini négatif jusqu’à cette coordonnée. L’aire affichée pour z = 0 y est rigoureusement égale à 0,5000.
- La table cumulative centrale (de 0 à z) : Historiquement très présente dans les manuels francophones traditionnels, elle fournit la probabilité intégrée comprise strictement entre la moyenne centrale (0) et le seuil z. Les valeurs inscrites oscillent ainsi entre 0,0000 et 0,4999. Pour convertir une probabilité cumulée globale en lecture de table centrale, il est obligatoire de lui soustraire 0,5000.
- La table directe de queue supérieure (de z à +∞) : Prisée dans certains contextes anglo-saxons et d’ingénierie de la fiabilité, cette version fournit directement l’aire de rejet résiduelle située à droite du point z, répertoriant donc les probabilités décroissantes de 0,5000 vers 0,0000.
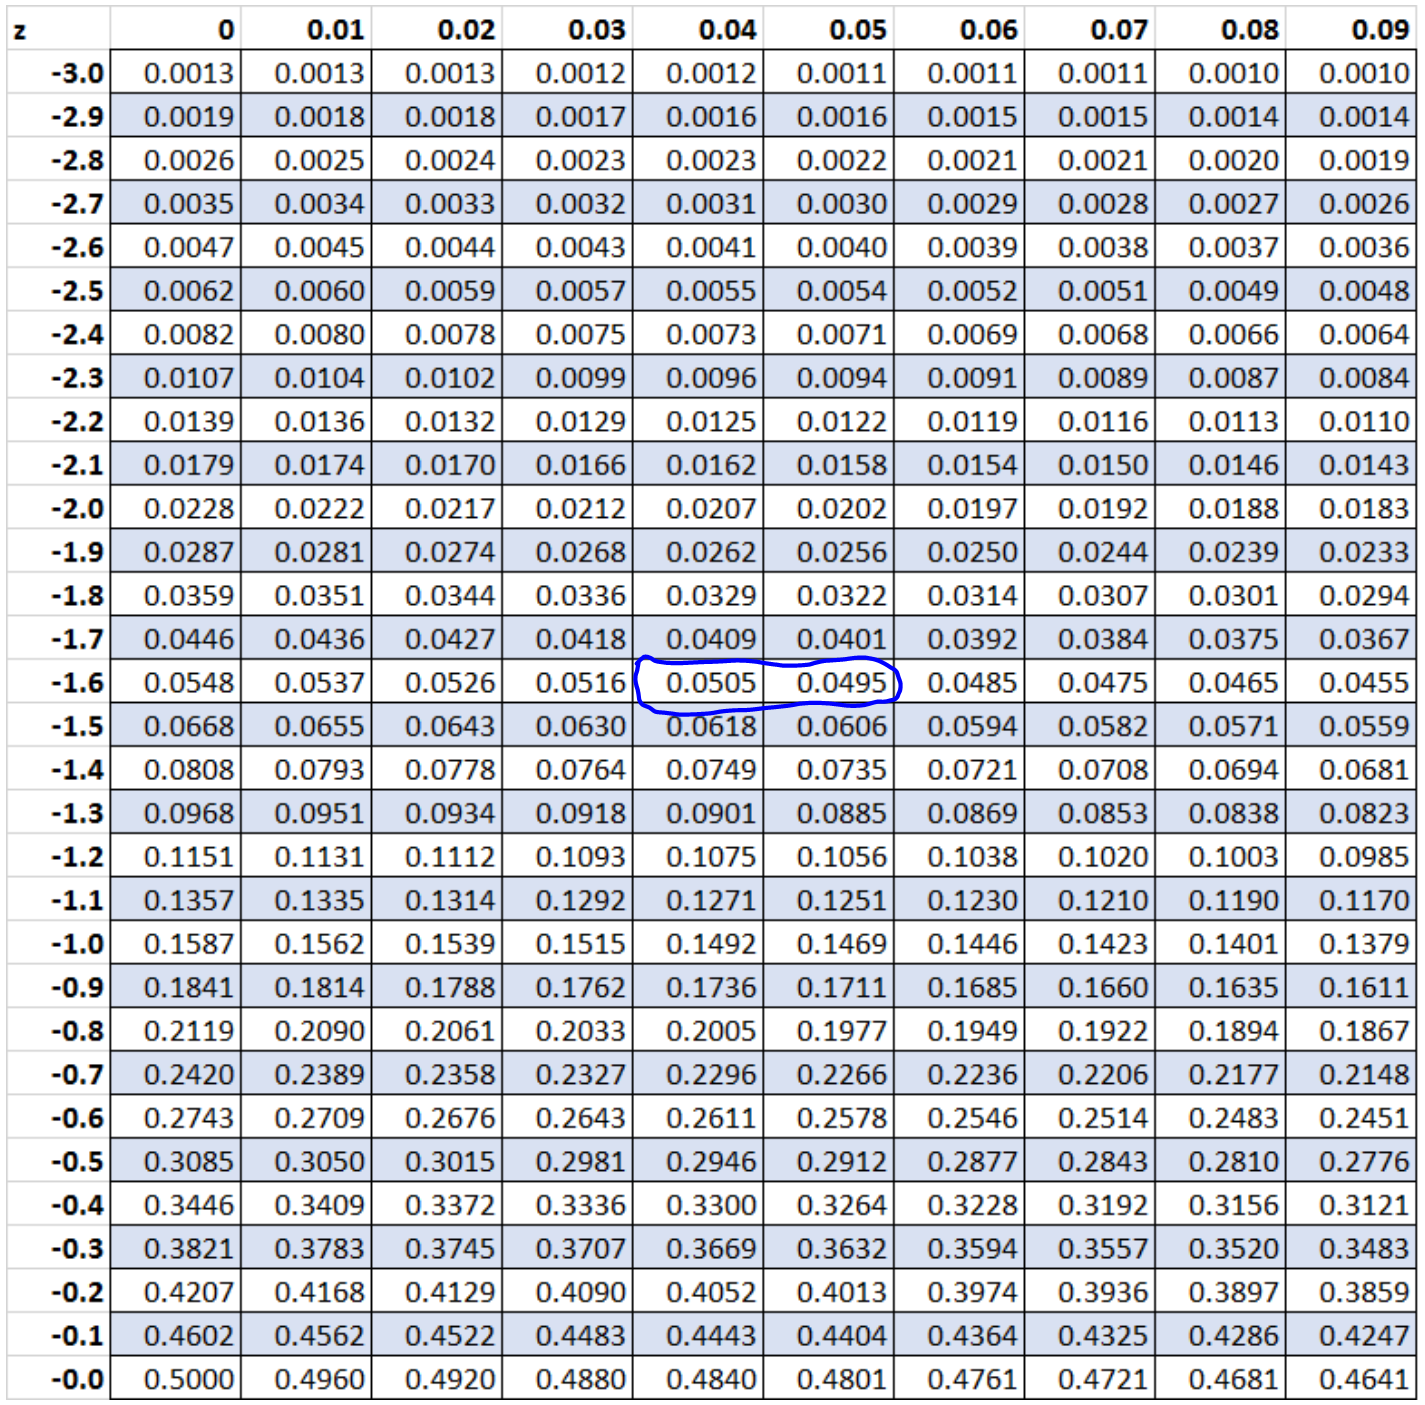
Sur le plan topographique, une table Z standard se compose d’une matrice bidirectionnelle. L’axe vertical de la marge gauche (les lignes) répertorie la composante tronquée du score z, associant sa partie entière et sa première décimale (par exemple 0.0, 1.6, 1.9). L’axe horizontal situé sur la bordure supérieure (les colonnes) décline la seconde décimale, c’est-à-dire l’ordre des centièmes (allant de .00 à .09). L’intersection matricielle précise entre une rangée et une colonne donnée révèle la probabilité scalaire associée.
4.2 Algorithme séquentiel de recherche manuelle
Pour déterminer manuellement sans la moindre équivoque la valeur de zα/2 au sein d’une table cumulative classique (de -∞ à z), le chercheur se doit d’appliquer un algorithme séquentiel rigoureusement borné en cinq étapes fondamentales :
- Étape 1 : Définition formelle du niveau de confiance. Le protocole expérimental fixe le degré de sécurité requis, classiquement 90 % (0,90), 95 % (0,95) ou 99 % (0,99).
- Étape 2 : Calcul arithmétique de la marge de queue α/2. L’erreur globale α = 1 – Niveau de confiance est déterminée puis divisée par 2. Par exemple, pour 95 %, α = 0,05, d’où α/2 = 0,0250.
- Étape 3 : Conversion de la queue en probabilité cumulée cible. Dans le système cumulatif standard, la table ne donne pas directement l’aire de queue mais l’aire à gauche de la borne. La valeur cible recherchée dans le corps matriciel s’exprime donc par l’équation Pcible = 1 – (α/2). Pour notre exemple, Pcible = 1 – 0,0250 = 0,9750.
- Étape 4 : Balayage réticulaire du corps intérieur de la table. L’expérimentateur parcourt les valeurs de probabilité inscrites au centre de la table jusqu’à isoler le chiffre 0,9750 (ou le point le plus rigoureusement adjacent).
- Étape 5 : Rétro-lecture orthogonale des ordonnées et abscisses. Dès la cellule 0,9750 localisée, la projection horizontale vers la marge gauche identifie la ligne « 1.9 », tandis que la projection verticale vers le sommet de la colonne identifie l’entête « .06 ». La concaténation de ces deux coordonnées produit la valeur critique finale : z0,025 = 1,96.
4.3 Résolution des cas d’équidistance et interpolation linéaire
Dans la pratique de la lecture tabulaire, il est fréquent que la probabilité cumulative cible issue du calcul théorique ne figure pas de manière exacte et explicite dans le maillage discret de la table, les valeurs étant généralement arrondies à quatre décimales. Deux configurations géométriques distinctes se présentent alors à l’analyste.
La première configuration est celle d’une proximité asymétrique : l’une des cellules matricielles s’avère manifestement plus proche de la valeur recherchée que ses voisines directes. Par convention méthodologique usuelle, le statisticien sélectionne le score z associé à la probabilité qui minimise l’erreur absolue d’approximation. Toutefois, la seconde configuration, hautement critique, relève du cas d’équidistance parfaite. L’exemple paradigmatique absolu se manifeste lors de la recherche du score zα/2 pour un intervalle de confiance à 90 % (soit α = 0,10 et α/2 = 0,05). La probabilité cumulée requise s’établit à :
Φ(z) = 1 – 0,0500 = 0,9500
En inspectant attentivement le corps de la table standardisée, l’observateur constate avec déconvenue que le nombre 0,9500 brille par son absence. En lieu et place, la table affiche deux probabilités adjacentes :
- Pour la coordonnée z = 1,64, la probabilité cumulée consignée est de 0,9495 (écart de -0,0005).
- Pour la coordonnée z = 1,65, la probabilité cumulée consignée est de 0,9505 (écart de +0,0005).
La probabilité visée de 0,9500 se trouve positionnée très exactement au centre mathématique de ce segment discret. Dans cette occurrence d’équidistance totale, l’arbitrage scientifique refuse d’opter unilatéralement pour l’une ou l’autre des bornes discrètes. On déploie dès lors une interpolation linéaire arithmétique simple entre les deux coordonnées d’abscisses :
z = 1,64 + ((0,9500 – 0,9495) / (0,9505 – 0,9495)) · (1,65 – 1,64) = 1,64 + (0,5 · 0,01) = 1,645
C’est précisément cette opération d’interpolation linéaire barycentrique qui justifie l’adjonction universelle de la troisième décimale dans la constante critique canonique 1,645.
5. Les valeurs critiques de zα/2 les plus courantes en sciences humaines
Bien que le spectre des niveaux de confiance théoriques soit continu sur l’intervalle ouvert ]0, 1[, la recherche empirique s’est canalisée autour de trois valeurs critiques fondamentales dont la signification méthodologique mérite une déconstruction fine.
5.1 Analyse détaillée du niveau de confiance à 90 % (z0,05 = 1,645)
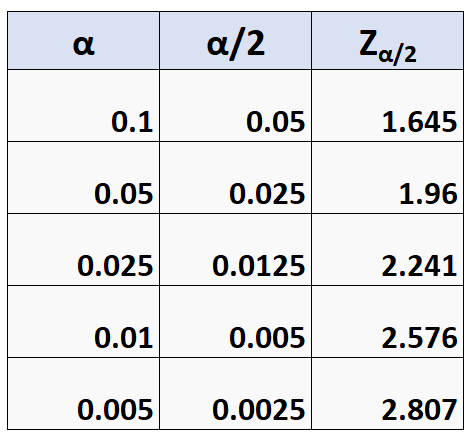
Le paramétrage d’un niveau de confiance fixé à 90 % (exprimé par le coefficient 0,90) renvoie à une tolérance au risque d’erreur globale α de 10 % (0,10). La procédure bilatérale répartit cette marge en affectant une masse surfacique de 5 % (α/2 = 0,05) à chacune des queues de la distribution normale. Comme établi lors de la démonstration précédente sur l’interpolation linéaire, la résolution de l’équation intégrale Φ(z) = 0,9500 culmine rigoureusement au seuil critique de 1,645.
Dans le domaine des sciences humaines et de la neuropsychologie expérimentale, l’usage de ce seuil à 90 % est généralement réservé aux études de nature exploratoire ou aux phases pilotes de recherche. Lorsqu’un investigateur explore un domaine vierge où les protocoles d’administration sont coûteux ou les cohortes cliniques extrêmement réduites, tolérer un risque d’erreur de 10 % permet d’augmenter substantiellement la sensibilité statistique du paradigme d’évaluation. Ce faisant, le chercheur maximise la puissance expérimentale du test, s’autorisant à détecter des signaux prometteurs qui mériteront une réplication confirmatoire ultérieure.
Le bénéfice géométrique immédiat de ce choix réside dans l’étroitesse remarquable de la marge d’erreur empirique qui en résulte. L’intervalle de confiance calculé avec un multiplicateur de 1,645 présente une largeur substantiellement plus resserrée qu’avec les seuils plus conservateurs, procurant une estimation apparemment précise du paramètre étudié. Néanmoins, ce resserrement de l’intervalle constitue une arme à double tranchant : en contrepartie de cette concision, l’investigateur s’expose consciemment à un taux d’échec d’encadrement multiplié par deux en comparaison du seuil d’usage standard à 95 %.
5.2 Analyse détaillée du niveau de confiance standard à 95 % (z0,025 = 1,96)
Le niveau de confiance à 95 % (0,95) constitue le pivot régulateur quasi hégémonique de l’inférence moderne en psychométrie, en psychiatrie translationnelle et en épidémiologie sociale. Il découle de la fixation d’un alpha global de 5 % (α = 0,05), se fractionnant symétriquement en deux queues distales de 2,5 % chacune (α/2 = 0,0250). L’identification tabulaire directe de la probabilité cumulée 1 – 0,0250 = 0,9750 renvoie sans aucune ambiguïté à la constante critique universelle 1,96.
Le statut d’étalon-or accordé à la valeur critique 1,96 est tel qu’il façonne la grande majorité des publications validées par les comités de lecture scientifiques internationaux. En psychométrie différentielle, c’est ce seuil exact de ±1,96 écart-type qui délimite l’enveloppe normative englobant 95 % de la cohorte d’étalonnage pour des instruments psychologiques majeurs évaluant les échelles composites d’intelligence ou les degrés de dépression clinique. Tout individu dont la note standardisée s’aventure au-delà de ces frontières voit ses caractéristiques cognitives ou thymiques classifiées comme atypiques sur le plan normatif.
Ce seuil de démarcation tire son autorité méthodologique des écrits fondateurs de Ronald Aylmer Fisher. Bien qu’il ait lui-même reconnu le caractère opérationnel contingent de cette limite, ce seuil s’est mué en un imperium philosophique : il représente le seuil au-delà duquel la communauté scientifique estime légitime de réfuter l’hypothèse de la simple fluctuation stochastique pour postuler la présence d’une régularité causale tangible dans les faits psychiques observés.
5.3 Analyse détaillée du niveau de confiance strict à 99 % (z0,005 = 2,576)
L’élévation du niveau d’exigence statistique à 99 % (0,99) traduit une volonté manifeste d’éradiquer au maximum l’illusion d’une découverte fallacieuse. Ce paramétrage comprime l’erreur de type I globale à une proportion congrue de 1 % (α = 0,01), ce qui génère une probabilité résiduelle pour chaque queue terminale limitée à 0,5 % (α/2 = 0,0050). La fonction de répartition cumulée correspondante s’établit à :
Φ(z) = 1 – 0,0050 = 0,9950
Dans les tables de distribution standardisée, la probabilité 0,9950 est bornée entre la coordonnée z = 2,57 (dont la probabilité cumulée associée est de 0,9949) et la coordonnée z = 2,58 (affichant 0,9951). Une interpolation barycentrique précise conduit au score critique de 2,5758, couramment tronqué ou arrondi selon les corpus à 2,576 (voire 2,58 dans les modélisations moins pointilleuses).
Ce seuil hautement sélectif s’impose d’autorité dans les contextes où l’annonce d’une fausse alerte emporte des conséquences éthiques, médicales ou sociétales délétères. En pharmacopsychologie, lors des phases d’essais cliniques évaluant des molécules psychoactives à marge thérapeutique étroite, ou lors de protocoles de validation de biomarqueurs neurodégénératifs, garantir un niveau de sécurité de 99 % prémunit les soignants contre l’adoption d’un traitement inefficace ou potentiellement nocif. Toutefois, le corollaire mathématique inévitable de cette protection maximale réside dans un élargissement substantiel de la marge d’erreur : l’intervalle de confiance devient volumineux, exigeant des cohortes expérimentales beaucoup plus vastes pour conserver une précision informative suffisante.
5.4 Tableau récapitulatif comparatif des valeurs critiques zα/2
Afin d’offrir une vision holistique et immédiatement actionnable des correspondances analytiques unissant les paramètres probabilistes, la matrice synthétique suivante récapitule les principales grandeurs employées dans la recherche empirique, incluant les seuils standards et les seuils marginaux spécifiques :
| Niveau de confiance (1 – α) | Risque global (α) | Risque par queue (α/2) | Probabilité cumulée Φ(z) | Valeur critique bilatérale (zα/2) |
|---|---|---|---|---|
| 80,0 % (0,80) | 0,20 | 0,1000 | 0,9000 | 1,282 |
| 85,0 % (0,85) | 0,15 | 0,0750 | 0,9250 | 1,440 |
| 90,0 % (0,90) | 0,10 | 0,0500 | 0,9500 | 1,645 |
| 95,0 % (0,95) | 0,05 | 0,0250 | 0,9750 | 1,960 |
| 98,0 % (0,98) | 0,02 | 0,0100 | 0,9900 | 2,326 |
| 99,0 % (0,99) | 0,01 | 0,0050 | 0,9950 | 2,576 |
| 99,9 % (0,999) | 0,001 | 0,0005 | 0,9995 | 3,291 |
L’examen minutieux de ce tableau met en relief la non-linéarité fondamentale caractérisant les queues de la distribution gaussienne. Alors que le passage d’un niveau de confiance de 90 % à 95 % n’exige qu’une translation du score critique de 0,315 unité (de 1,645 à 1,960), la progression de 95 % à 99,9 % impose une avancée de plus de 1,331 unité d’écart-type (de 1,960 à 3,291). Cette sensibilité logarithmique traduit la raréfaction exponentielle de la densité de probabilité au fur et à mesure que l’on s’aventure dans les parages extrêmes de la loi normale.
6. Utilisation des calculatrices et outils automatisés pour déterminer zα/2
La dématérialisation computationnelle contemporaine offre aux analystes des dispositifs technologiques puissants capables d’extraire instantanément toute valeur critique avec une résolution décimale arbitrairement élevée.
6.1 Exploitation des calculatrices scientifiques graphiques (TI, Casio)
Les calculatrices scientifiques graphiques, qu’elles appartiennent aux gammes Texas Instruments (TI-83, TI-84 Plus CE, TI-Nspire) ou Casio (Graph 35+, fx-9860G, ClassWiz), intègrent des micrologiciels pourvus de modules statistiques préprogrammés d’une grande fiabilité opérationnelle. Pour extraire un score critique bilatéral, le praticien doit solliciter l’algorithme de la fonction quantile normale inverse, couramment identifié sous le nom de commande invNorm (sur TI) ou NormIC / InvN (sur Casio).
Sur les architectures Texas Instruments traditionnelles, la commande invNorm requiert la saisie d’un argument scalaire représentant la probabilité cumulée accumulée depuis l’extrémité gauche de la distribution jusqu’au seuil visé. Par conséquent, pour obtenir la borne critique zα/2 relative à un intervalle de confiance à 95 %, l’utilisateur ne doit en aucun cas saisir directement 0,05 ni 0,95, mais bien la quantité cumulée :
1 – (α/2) = 1 – 0,025 = 0,975
L’exécution de l’instruction invNorm(0.975, 0, 1) renvoie instantanément la valeur 1,959963985… arrondie méthodologiquement à 1,96.
Les versions récentes de micro-systèmes TI et Casio proposent un perfectionnement ergonomique appréciable en permettant de renseigner l’aire sous la courbe conjointement avec son orientation spatiale via un paramètre dédié étiqueté « Tail » (Queue). L’utilisateur est alors invité à sélectionner l’orientation « LEFT » (gauche), « RIGHT » (droite) ou « CENTER » (centrale). Lorsque le mode « CENTER » est activé, il convient de renseigner directement le niveau de confiance nominal (soit 0.95) ; l’algorithme de la machine se charge de répartir automatiquement l’erreur résiduelle de façon bilatérale, affichant conjointement les deux bornes opposées {-1.96, +1.96}. L’incompréhension de ces conventions d’orientation demeure la cause première des erreurs de saisie lors des examens universitaires et des expertises quantitatives.
6.2 Outils de calcul statistique en ligne dédiés
Le recours à des applications web et des calculatrices statistiques en ligne spécialisées est devenu monnaie courante au sein des laboratoires de recherche. Ces outils reposent sur des implémentations numériques de la fonction quantile théorique, souvent optimisées via des langages compilés en WebAssembly ou exécutés via JavaScript côté client. Ils garantissent une extraction rapide sans nécessiter la manipulation manuelle de tables papier volumineuses.
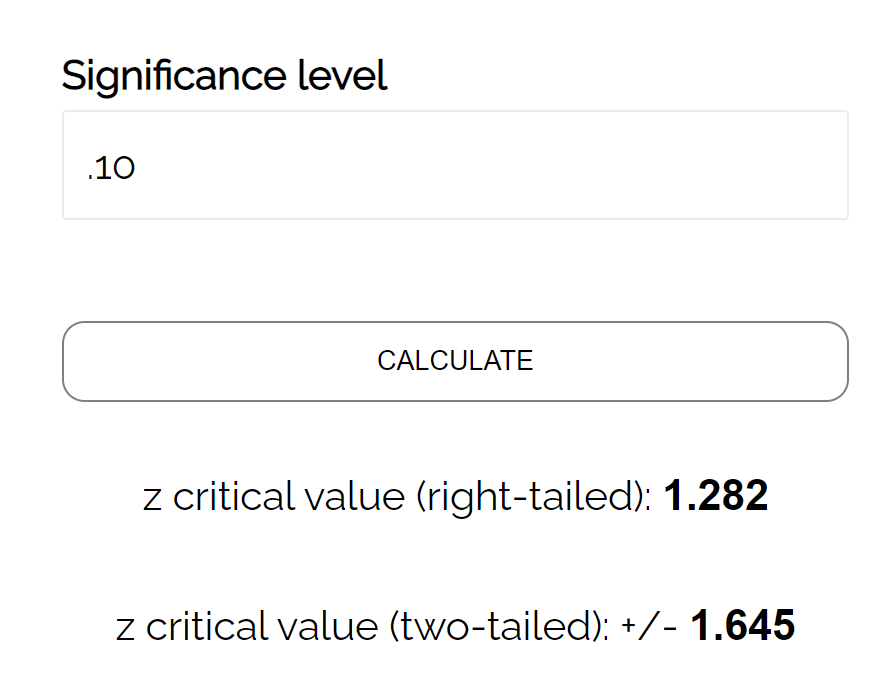
La saisie des données au sein de ces interfaces requiert une vigilance méthodologique accrue quant à la nature de la variable d’entrée sollicitée par le concepteur du site. Certaines plateformes exigent la spécification du niveau de confiance sous forme de pourcentage brut (ex. : « 95 » pour 95 %), tandis que d’autres réclament la probabilité d’erreur fractionnaire directe (ex. : « 0.05 » pour α) ou la probabilité unilatérale de queue (« 0.025 »). Confondre ces paramètres d’entrée engendre inévitablement des valeurs critiques erronées, susceptibles de biaiser l’ensemble d’une analyse d’échantillonnage.
En outre, l’intégrité numérique des résultats affichés doit être scrupuleusement vérifiée. Les calculateurs grand public effectuent parfois des arrondis hâtifs à deux décimales, ce qui s’avère préjudiciable lors de protocoles exigeant une haute fidélité métrologique. Pour des contextes de recherche clinique rigoureuse, il est impératif de privilégier des calculateurs développés sous l’égide de consortiums universitaires ou adossés à des bibliothèques logicielles open-source certifiées, garantissant une précision d’au moins six décimales et offrant une traçabilité totale des algorithmes d’inversion numérique mis en œuvre.
7. Détermination computationnelle de zα/2 avec R, Python et SPSS
Au sein de l’écosystème de la recherche quantitative contemporaine, l’automatisation scriptée garantit la parfaite reproductibilité des calculs statistiques, éliminant tout risque d’erreur humaine inhérent aux transcriptions manuelles.
7.1 Calcul de précision dans l’environnement R
L’environnement statistique de référence internationale R propose en natif la distribution gaussienne à travers sa famille de fonctions dédiées (dnorm, pnorm, rnorm et qnorm). C’est la fonction quantile qnorm() qui constitue l’opérateur canonique destiné à isoler la valeur critique zα/2 pour tout seuil prédéterminé.
Par défaut, la fonction qnorm(p, mean = 0, sd = 1) calcule la valeur z cumulée depuis la queue gauche (paramètre interne lower.tail = TRUE). Par conséquent, pour extraire la borne critique d’un intervalle de confiance bilatéral caractérisé par un risque d’erreur alpha de 5 %, la commande s’articule comme suit :
qnorm(1 - 0.05/2)
Ce calcul retourne avec une rigueur absolue la valeur 1.959964. Si le chercheur préfère cibler directement la queue supérieure sans exécuter manuellement l’opération complémentaire 1 – (α/2), il lui suffit de spécifier l’argument booléen opposé :
qnorm(0.05/2, lower.tail = FALSE)
Pour des protocoles d’analyse nécessitant d’opérer sur des seuils d’erreur infinitésimaux (par exemple dans le criblage pangénomique ou les méta-analyses à très haute puissance où α peut descendre à 10-8), R implémente un argument complémentaire capital : log.p = TRUE. Cet argument permet de renseigner directement le logarithme naturel de la probabilité, contournant avec brio les phénomènes de sous-dépassement arithmétique (underflow numérique) qui altèrent la précision des virgules flottantes standard sur les processeurs modernes.
7.2 Implémentation sous Python avec SciPy et NumPy
Dans l’écosystème du langage Python appliqué à l’ingénierie des données et aux neurosciences computationnelles, le calcul des valeurs critiques est centralisé au sein du module SciPy, plus particulièrement dans son sous-paquetage statistique scipy.stats. La classe dédiée norm implémente la méthode ppf() (acronyme de Percent Point Function, qui constitue la dénomination anglo-saxonne formelle de la fonction quantile inverse).
L’extraction programmée de la valeur critique s’opère par l’appel formel :
from scipy.stats import norm
z_critique = norm.ppf(1 - 0.05 / 2)
La méthode renvoie la valeur en virgule flottante double précision standard IEEE 754 (1.959963984540054). Alternativement, la méthode isf() (Inverse Survival Function) offre un accès direct à la fonction de survie unilatérale de queue supérieure, équivalant rigoureusement à l’appel de norm.isf(0.05 / 2).
Associée à la bibliothèque matricielle vectorisée NumPy, cette structure permet de générer de manière synchrone des vecteurs complets de valeurs critiques associées à des grilles multidimensionnelles de seuils de signification. De surcroît, la conjugaison de ces fonctions statistiques avec les modules graphiques Matplotlib ou Seaborn autorise les chercheurs à automatiser la génération de représentations visuelles de distributions gaussiennes annotées dynamiquement de leurs frontières de rejet critiques, consolidant ainsi la clarté pédagogique et diagnostique des rapports d’analyses.
7.3 Extraction des seuils sous SPSS et logiciels spécialisés
Le logiciel propriétaire IBM SPSS Statistics, prépondérant dans les cursus de formation en sciences sociales et en psychologie hospitalière, permet d’extraire les quantiles de la loi normale soit via son interface graphique de transformation de données, soit par la soumission directe de routines syntaxiques. L’opérateur de calcul interne standard s’énonce sous le vocable mathématique IDF.NORMAL.
Pour instancier dynamiquement une nouvelle variable contenant la valeur critique zα/2 dans une matrice de données active, l’utilisateur exécute l’instruction syntaxique de calcul vectoriel suivante :
COMPUTE z_critique = IDF.NORMAL(1 - (0.05 / 2), 0, 1).
EXECUTE.
Cette commande instancie une colonne dédiée au sein de laquelle la valeur 1,96 (ou sa variante décimale non tronquée) est affectée à l’ensemble des observations du fichier clinique.
Dans la majorité des procédures d’analyses inférentielles automatisées de SPSS — telles que la régression linéaire multiple (REGRESSION) ou les modèles linéaires généraux univariés et multivariés (GLM) —, le logiciel calcule de manière implicite ces valeurs critiques pour délimiter les intervalles de confiance des coefficients de régression non standardisés (B) et des paramètres d’effets principaux. La maîtrise de la syntaxe de base permet néanmoins d’exporter ces seuils théoriques vers des macro-commandes personnalisées, facilitant l’automatisation des bilans psychométriques standardisés et la standardisation des comptes rendus cliniques de routine.
8. Application méthodologique I : Construction d’intervalles de confiance
L’une des fonctions les plus fécondes de la valeur critique zα/2 réside dans l’édification des intervalles de confiance, offrant une estimation d’intervalle infiniment plus informative sur le plan scientifique qu’une simple estimation ponctuelle brute.
8.1 Formulation mathématique de l’intervalle de confiance pour une moyenne
L’estimation par intervalle de confiance pour la moyenne inconnue (μ) d’une population parente continue repose sur une formulation mathématique standard intégrant trois grandeurs fondamentales : l’estimateur ponctuel de tendance centrale calculé sur l’échantillon (la moyenne empirique X̄), l’écart-type connu de la population (σ) pondéré par la racine carrée de l’effectif d’observation (définissant l’erreur type de la moyenne), et la valeur critique bilatérale zα/2 faisant office de facteur multiplicatif d’échelle :
IC(1 – α) = [ X̄ – zα/2 · (σ / √n) ; X̄ + zα/2 · (σ / √n) ]
Dans cette équation structurelle, le produit :
E = zα/2 · (σ / √n)
définit l’entité géométrique dénommée « marge d’erreur » (parfois qualifiée de rayon de confiance). Le score critique zα/2 agit comme le levier multiplicateur direct déterminant la dispersion spatiale de l’intervalle autour de la moyenne observée.
Il est impératif d’adopter une interprétation fréquentiste rigoureuse de cet objet statistique afin d’éviter tout écueil sémantique. L’intervalle de confiance ne postule nullement qu’il existe « 95 % de chances que la vraie moyenne de population μ soit tombée à l’intérieur de l’intervalle empirique calculé ». Dans le paradigme fréquentiste orthodoxe, le paramètre populationnel μ est une constante fixe non aléatoire ; c’est l’intervalle calculé qui constitue une entité stochastique variable d’un échantillon à un autre. Par conséquent, affirmer que l’intervalle est établi à un niveau de confiance de 95 % signifie que si l’on répétait le protocole d’échantillonnage une infinité de fois dans des conditions méthodologiques identiques, 95 % des intervalles ainsi générés encapsuleraient effectivement la vraie valeur du paramètre μ.
Il convient par ailleurs de distinguer formellement l’intervalle de confiance d’un intervalle de dispersion ou de prédiction individuelle. L’intervalle de confiance n’a aucunement pour mission d’englober 95 % des scores des sujets de l’échantillon ; il circonscrit uniquement l’incertitude liée à l’estimation du barycentre populationnel de la variable mesurée.
8.2 Application clinique : Évaluation d’une intervention thérapeutique
Afin d’ancrer ces concepts dans la réalité de la recherche appliquée, considérons un essai clinique interventionnel conduit auprès de patients souffrant d’un trouble dépressif majeur caractérisé. Le protocole évalue l’impact thérapeutique d’un programme structuré de méditation de pleine conscience associé à une prise en charge comportementale. La variable dépendante continue correspond à la réduction quantitative du score à l’Inventaire de Dépression de Beck (BDI-II) après un suivi longitudinal de huit semaines.
Un échantillon de n = 64 patients est inclus dans l’étude. À l’issue du protocole, la réduction moyenne des scores dépressifs observée s’établit à X̄ = 6,8 points. Des données épidémiologiques antérieures robustes autorisent l’équipe soignante à postuler un écart-type populationnel connu pour cette métrique clinique fixé à σ = 4,0 points. L’investigateur principal exige la construction d’un intervalle de confiance bilatéral au niveau standard de 95 % (α = 0,05).
Le calcul séquentiel se déploie comme suit :
- Calcul de l’erreur type de la moyenne empirique : σX̄ = σ / √n = 4,0 / √64 = 4,0 / 8 = 0,5 point.
- Détermination de la valeur critique adaptée : pour un seuil bilatéral de 95 %, z0,025 = 1,96.
- Calcul de la marge d’erreur globale : E = 1,96 · 0,5 = 0,98 point.
- Calcul de la borne inférieure de l’intervalle : Borneinf = 6,8 – 0,98 = 5,82 points.
- Calcul de la borne supérieure de l’intervalle : Bornesup = 6,8 + 0,98 = 7,78 points.
L’intervalle de confiance résultant se formalise par IC95% = [5,82 ; 7,78]. Sur le plan de l’interprétation clinique, ce résultat atteste non seulement d’une efficacité thérapeutique statistiquement démontrée au seuil de 5 %, mais garantit avec une excellente fiabilité que l’amélioration moyenne attendue dans la population des patients s’élève au minimum à 5,82 points de Beck. Dans la mesure où la borne inférieure exclut formellement le score zéro (absence totale de réduction) ainsi que les seuils clinicopathologiques négligeables, les cliniciens disposent d’un fondement empirique étayé pour promouvoir ce protocole de soin au sein des recommandations hospitalières.
8.3 Calcul de la taille d’échantillon requise a priori
L’anticipation de la puissance statistique et la rationalisation des ressources matérielles et humaines imposent de déterminer avec exactitude la taille minimale d’échantillon (N) requise avant même le recueil de la première donnée empirique. Dès lors que l’expérimentateur s’assigne une marge d’erreur maximale tolérée admissible (E) et un niveau de confiance désiré, la réorganisation algébrique de l’équation de la marge d’erreur permet d’isoler analytiquement la variable d’effectif n :
E = zα/2 · (σ / √n) ⇔ √n = (zα/2 · σ) / E ⇔ n = (zα/2² · σ²) / E²
Cette relation met en évidence la sensibilité quadratique extrême de la taille de cohorte requise face à l’élévation du score critique zα/2. Supposons qu’un institut de recherche psychométrique souhaite standardiser un nouveau sous-test de fluence verbale où l’écart-type connu est de σ = 15 points. L’objectif est d’estimer la moyenne nationale avec une marge d’erreur absolue ne dépassant pas E = 2 points de score brut.
Si les chercheurs optent pour un niveau de confiance de 90 % (z0,05 = 1,645) :
n = (1,645² · 15²) / 2² = (2,706025 · 225) / 4 = 608,85 / 4 ≈ 152,21, soit au minimum 153 participants.
Si les chercheurs réévaluent leur exigence pour adopter un seuil standard de 95 % (z0,025 = 1,96) :
n = (1,96² · 15²) / 2² = (3,8416 · 225) / 4 = 864,36 / 4 = 216,09, soit au minimum 217 participants.
Si enfin le protocole exige une sécurité diagnostique stricte à 99 % (z0,005 = 2,576) :
n = (2,576² · 15²) / 2² = (6,635776 · 225) / 4 = 1493,05 / 4 ≈ 373,26, soit au minimum 374 participants.
Cette modélisation computationnelle démontre avec éclat que le passage d’une tolérance d’erreur de 10 % à 1 % nécessite plus que de doubler la taille de la cohorte expérimentale (l’effectif grimpant de 153 à 374 sujets). Le calibrage rigoureux de zα/2 représente donc un enjeu stratégique majeur dans l’optimisation budgétaire et logistique des programmes de recherche translationnelle.
9. Application méthodologique II : Tests d’hypothèses bilatéraux
Le second pilier méthodologique mobilisant la valeur critique zα/2 est le test d’hypothèse statistique formel (test Z pour une moyenne ou pour une proportion), qui régit la prise de décision empirique par la confrontation d’une statistique calculée à un critère normatif de rejet.
9.1 Formalisation de la règle de décision statistique
L’échafaudage épistémologique du test d’hypothèse selon le modèle classique requiert la formulation formelle et préalable de deux propositions antagonistes et exhaustives :
- L’hypothèse nulle (H0) : Elle postule l’absence de différence réelle, d’altération ou d’effet dans la population sous-jacente. Elle s’énonce classiquement sous la forme d’une égalité scalaire : H0 : μ = μ0.
- L’hypothèse alternative (H1) : Dans le cadre non directionnel d’un test bilatéral, elle postule une différence sans préjuger de sa polarité directionnelle : H1 : μ ≠ μ0.
Sur le plan topologique de la courbe normale N(0, 1), l’espace probabiliste se partitionne en trois sous-ensembles mutuellement disjoints délimités exclusivement par la paire de valeurs critiques {-zα/2, +zα/2}. La zone centrale, comprise entre ces deux bornes symétriques, correspond au domaine de non-rejet de l’hypothèse nulle, d’une surface totale de 1 – α. Les deux régions extrêmes résiduelles, situées respectivement à gauche de –zα/2 et à droite de +zα/2, constituent la région critique (ou zone de rejet), captant chacune une aire de α/2.
La règle d’inférence universelle s’énonce alors à travers la statistique de test standardisée observée (notée zobs ou zcalc) :
Si |zobs| ≥ zα/2, la décision méthodologique s’impose sans réserve : rejet péremptoire de H0 au seuil de risque α en faveur de H1.
Si |zobs| < zα/2, la décision méthodologique dicte le maintien (ou non-rejet) de H0 par défaut de preuves empiriques suffisantes.
Cette procédure de décision par comparaison de coordonnées critiques s’avère mathématiquement équivalente à l’évaluation de la valeur p bilatérale (p-value). Dans une approche bilatérale, la p-valeur correspond au doublement de l’aire unilatérale située au-delà de la statistique observée :
p = 2 · P(Z ≥ |zobs|)
La condition de rejet formulée en coordonnées de quantiles (|zobs| ≥ zα/2) coïncide rigoureusement avec la condition probabiliste p ≤ α.
9.2 Étude de cas en neuropsychologie cognitive
Pour illustrer la mise en œuvre pratique de cette architecture de décision, considérons une investigation expérimentale menée au sein d’un laboratoire de neuropsychologie cognitive. L’équipe explore les séquelles attentionnelles résiduelles chez de jeunes adultes ayant subi un traumatisme crânien léger (commotion cérébrale sportive). La tâche expérimentale consiste en un paradigme d’attention soutenue informatisé (Continuous Performance Test) mesurant le temps de réaction en millisecondes face à des cibles visuelles aléatoires.
Les paramètres normatifs de la population générale saine pour cette épreuve chronométrique sont parfaitement standardisés : la moyenne normative s’établit à μ0 = 250 ms, avec un écart-type populationnel documenté à σ = 30 ms. Une cohorte de n = 36 patients commotionnés est soumise à ce paradigme expérimental. La moyenne empirique obtenue par cette cohorte est de X̄ = 264 ms. Les investigateurs s’interrogent : ce temps de traitement reflète-t-il une altération cognitive authentique attribuable à la lésion cérébrale diffuse, ou s’agit-il simplement d’une fluctuation d’échantillonnage anodine ? Le seuil d’exigence méthodologique est fixé à un niveau très rigoureux de α = 0,01 (test bilatéral, soit un niveau de confiance de 99 %).
La séquence analytique s’organise rigoureusement selon les étapes suivantes :
- Énonciation formelle des hypothèses : H0 : μ = 250 ms contre H1 : μ ≠ 250 ms.
- Détermination de la valeur critique : pour α = 0,01 en test bilatéral, le quantile résiduel de queue est α/2 = 0,005. La table Z standard fournit la valeur critique z0,005 = 2,576. La règle de décision s’établit donc comme suit : rejet de H0 si |zobs| ≥ 2,576.
- Calcul de l’erreur type des moyennes : σX̄ = σ / √n = 30 / √36 = 30 / 6 = 5,0 ms.
- Calcul de la statistique de test observée : zobs = (X̄ – μ0) / σX̄ = (264 – 250) / 5,0 = 14 / 5,0 = +2,80.
- Comparaison formelle et verdict : |zobs| = 2,80. Or, 2,80 ≥ 2,576.
La statistique observée zobs se situe incontestablement à l’intérieur de la zone de rejet critique supérieure. Les chercheurs rejettent par conséquent l’hypothèse nulle au seuil de significativité de 1 % (p < 0,01). Sur le plan neuropsychologique, ce résultat autorise formellement l’équipe médicale à conclure que les patients commotionnés présentent un ralentissement significatif de la vitesse de traitement de l’information attentionnelle, excluant toute explication liée au simple hasard d’échantillonnage.
10. Diagnostic comparatif : Quand utiliser zα/2 plutôt que tα/2 ?
L’utilisation de la valeur critique normale standardisée zα/2 repose sur des hypothèses de distribution spécifiques dont la violation peut invalider les inférences statistiques. Il importe de délimiter rigoureusement sa frontière d’application face à la loi de Student.
10.1 Le théorème central limite et la loi des grands nombres
La justification théorique fondamentale autorisant le recours à la distribution normale lors de l’inférence sur des moyennes réside dans le prestigieux théorème central limite (TCL). Selon cet énoncé majeur de la théorie probabiliste, quelle que soit la forme de la distribution d’une variable aléatoire continue ou discrète dans la population parente (qu’elle soit symétrique, bimodale ou modérément asymétrique), la distribution d’échantillonnage de la moyenne empirique (X̄) converge asymptotiquement vers une loi normale dès lors que la taille de l’échantillon d’observation (n) tend vers l’infini.
Dans la pratique méthodologique des sciences humaines, une convention heuristique largement disséminée suggère que dès que n ≥ 30 observations indépendantes et identiquement distribuées, la distribution de la moyenne empirique peut être modélisée de manière acceptable par la loi normale. Néanmoins, cette règle des trente sujets doit être maniée avec un discernement critique mesuré. Lorsque la population parente sous-jacente présente une asymétrie substantielle ou une présence marquée de valeurs aberrantes, la convergence théorique garantie par le théorème central limite peut s’avérer beaucoup plus tardive, nécessitant des effectifs de n = 50, voire n = 100 observations pour que les queues de distribution ne dévient pas dangereusement de la loi de Gauss.
Si la population d’origine dont sont extraites les données est elle-même rigoureusement distribuée selon une loi normale, la distribution de la moyenne empirique suit alors exactement une loi normale pour toute taille d’échantillon, y compris pour des micro-cohortes de n = 5 ou n = 10 sujets. Dans cette occurrence idéale, la validité du score z est théoriquement irréprochable sous réserve d’une condition paramétrique capitale relative à la variance.
10.2 Statut de la variance de la population : σ connu versus σ inconnu
Le critère technique d’arbitrage suprême entre le recours au score critique zα/2 et le recours au score critique tα/2 issu de la loi de Student repose non pas tant sur la taille brute de l’échantillon que sur le statut épistémologique de la variance de la population (σ²) :
- Le paramètre σ est parfaitement connu a priori : Ce cas de figure se produit lorsque l’épreuve psychométrique ou psychophysique a fait l’objet d’étalonnages populationnels massifs auprès de dizaines de milliers de sujets, fixant ainsi l’écart-type de manière définitive. Dans cette situation, la statistique d’échantillonnage suit rigoureusement la loi normale centrée réduite N(0, 1), rendant l’usage de la valeur critique zα/2 formellement obligatoire, quelle que soit la taille d’échantillon n.
- Le paramètre σ est inconnu et estimé par l’écart-type de l’échantillon (s) : Dans la grande majorité des investigations cliniques et biologiques réelles, la variabilité globale de la population demeure inconnue. L’expérimentateur n’a d’autre choix que d’estimer la variance inconnue à partir des données de son échantillon en mobilisant l’estimateur sans biais s. Cette substitution introduit une seconde source de fluctuation stochastique dans le dénominateur de la statistique de test. La statistique standardisée résultante :
t = (X̄ – μ) / (s / √n)
ne suit plus une loi normale, mais suit formellement la distribution t de Student à ν = n – 1 degrés de liberté.
Sur le plan géométrique, la distribution t de Student présente une forme en cloche analogue à celle de la loi normale, mais ses queues sont substantiellement plus épaisses et plus lourdes (phénomène de leptokurticité). Par conséquent, pour un niveau de confiance donné (ex. 95 %), la valeur critique tα/2, ν est systématiquement supérieure en magnitude absolue à la valeur critique zα/2 = 1,96. Lorsque les degrés de liberté augmentent, la loi de Student converge asymptotiquement vers la loi normale standard : pour ν = 30, t0,025 = 2,042 ; pour ν = 120, t0,025 = 1,980 ; et lorsque les degrés de liberté tendent vers l’infini, la limite mathématique exacte de tα/2 est très exactement zα/2.
Substituer de manière abusive et prématurée la valeur critique zα/2 au seuil de Student tα/2 sur un petit échantillon clinique dont l’écart-type n’est qu’estimé (par exemple employer z = 1,96 au lieu de t = 2,262 pour un échantillon de n = 10 sujets) constitue une faute méthodologique sérieuse. Cette substitution entraîne une sous-estimation artificielle de la marge d’erreur, un rétrécissement indu des intervalles de confiance et une inflation non maîtrisée du taux d’erreur de première espèce au-delà du seuil nominal déclaré.
11. Erreurs fréquentes et pièges d’interprétation autour de zα/2
L’application machinale des recettes de calcul statistique sans réflexion épistémologique préalable génère un florilège d’erreurs récurrentes, susceptibles de vicier les conclusions de recherche les plus ambitieuses.
11.1 Confusions conceptuelles récurrentes chez les chercheurs
L’erreur la plus ubiquitaire et la plus préjudiciable observée chez les étudiants et les jeunes chercheurs consiste en l’omission pure et simple de la division par deux du seuil de risque lors de la conception d’un plan d’analyse bilatéral. Un investigateur souhaitant conduire un test bilatéral à un seuil d’erreur alpha de 5 % extrait régulièrement dans la table la valeur associée à la probabilité 0,9500, aboutissant au score z = 1,645. Ce faisant, il applique inconsciemment les paramètres d’un test directionnel unilatéral ou génère sans le savoir un intervalle de confiance dégradé à 90 %, laissant 5 % de risque résiduel dans chaque queue (soit une erreur totale cumulée de 10 % en lieu et place des 5 % contractuels).
Une seconde confusion réside dans l’incapacité à discriminer l’aire de queue unilatérale de l’aire cumulative centrale. Nombre d’analystes débutants manipulant une table mesurant l’aire entre 0 et z cherchent désespérément à localiser la valeur 0,9750 dans le corps d’une matrice qui plafonne à 0,5000. D’autres commettent l’impair de confondre le niveau de risque résiduel de queue α/2 avec la valeur z elle-même, cherchant à identifier la valeur z = 0,025 comme s’il s’agissait du seuil d’abscisse critique.
Enfin, la négligence de la valeur absolue dans les tests bilatéraux conduit parfois des évaluateurs à proclamer l’absence d’effet significatif sous le prétexte fallacieux que le z observé calculé est négatif (par exemple zobs = -2,45) et qu’il se trouve donc « inférieur » à la valeur critique positive +1,96. Une telle défaillance d’analyse démontre une incompréhension radicale de la centrosymétrie de la loi normale, où la région critique inférieure de rejet est matérialisée par la coordonnée –zα/2 = -1,96.
11.2 Erreurs d’utilisation des outils de table et logiciels
Dans l’usage des supports imprimés traditionnels, l’absence de lecture préalable de la notice d’orientation graphique accompagnant systématiquement le sommet des tables statistiques de référence constitue l’une des causes majeures d’échec méthodologique. Chaque éditeur adoptant une convention spécifique d’ombrage surfacique pour illustrer l’intégrale proposée, le chercheur pressé s’expose à mobiliser une probabilité unilatérale pour une probabilité cumulée globale.
Dans les environnements computationnels automatisés, un piège récurrent émerge lors de l’interfaçage avec les fonctions quantiles inverses. Sous R ou Python, fournir une valeur de probabilité brute non transformée sans tenir compte de la configuration par défaut de l’argument d’extrémité (comme omettre lower.tail = FALSE lorsque l’on saisit directement α/2) produit un score critique négatif. Bien que sa valeur absolue soit correcte, l’intégration non surveillée de ce signe moins dans des chaînes de calcul automatisées peut inverser les bornes inférieures et supérieures d’un intervalle de confiance dans un rapport clinique.
Par ailleurs, l’introduction intempestive d’arrondis décimaux prématurés au fil des étapes séquentielles de calcul dégrade la précision finale des résultats, particulièrement lors de la détermination de la taille d’échantillon ou de l’évaluation de p-valeurs limites très proches du seuil critique α. Il est impératif de conserver l’ensemble des décimales en mémoire logicielle tout au long des opérations matricielles et de ne tronquer l’affichage final qu’au moment de la rédaction définitive des conclusions.
Enfin, une confusion persiste lors de la lecture des sorties logicielles générées par des logiciels comme SPSS : le libellé « Sig. (2-tailed) » indique directement la p-valeur bilatérale globale. Certains praticiens divisent à tort cette p-valeur affichée par deux avant de la comparer au seuil alpha unitaire, doublant artificiellement le taux apparent de significativité de leurs résultats et générant des conclusions expérimentalement fallacieuses.
12. Synthèse pratique et guide de référence rapide pour le chercheur
Afin de consolider les acquis méthodologiques de cet ouvrage et d’offrir une matrice décisionnelle immédiatement mobilisable au laboratoire, cette section synthétise l’ensemble du processus de sélection et de restitution scientifique de zα/2.
12.1 Arbre décisionnel pour l’identification immédiate du bon score z
La sélection sans faille du score critique adéquat s’opère par le déroulement ordonné de l’arbre de décision méthodologique séquentiel suivant :
- Nœud décisionnel 1 : Nature de l’hypothèse de recherche.
- L’investigateur formule-t-il une hypothèse strictement directionnelle et justifiée par un corpus théorique inattaquable ? Si oui ➔ Approche unilatérale : utiliser la valeur critique zα (ex. z0,05 = 1,645).
- L’investigateur explore-t-il une différence potentielle sans certitude quant à sa polarité ou construit-il un intervalle de confiance ? Si oui ➔ Approche bilatérale : scinder l’erreur en deux et s’orienter vers zα/2.
- Nœud décisionnel 2 : Validation des conditions de normalité et de variance.
- La variance de la population (σ²) est-elle documentée et connue a priori ? Si oui ➔ Le recours à la loi normale et à zα/2 est parfaitement légitime.
- La variance σ² est-elle inconnue et estimée par s ? Si l’échantillon est de taille restreinte (n < 30) ou présente des asymétries ➔ Interrompre le protocole Z et s’orienter vers le test de Student et la valeur critique tα/2, ν. Si l’échantillon est vaste (n ≥ 100), la loi normale peut être mobilisée par convergence asymptotique.
- Nœud décisionnel 3 : Sélection du niveau de risque nominal α.
- α = 0,10 (Niveau de confiance 90 %) ➔ α/2 = 0,0500 ➔ zα/2 = 1,645
- α = 0,05 (Niveau de confiance standard 95 %) ➔ α/2 = 0,0250 ➔ zα/2 = 1,960
- α = 0,01 (Niveau de confiance strict 99 %) ➔ α/2 = 0,0050 ➔ zα/2 = 2,576
Le chercheur gagne à conserver en mémoire ces trois constantes fondamentales — 1,645 ; 1,960 ; 2,576 —, qui constituent la grammaire quantitative élémentaire sur laquelle s’échafaude l’immense majorité des publications empiriques indexées.
12.2 Recommandations méthodologiques pour la rédaction de publications
La présentation des analyses inférentielles au sein des revues savantes internationales obéit à des normes typographiques et formelles strictes, codifiées principalement par le style d’édition de l’American Psychological Association (APA, 7e édition). Lors de la consignation d’intervalles de confiance, l’indication explicite du niveau de sécurité retenu est obligatoire, de même que la délimitation formelle des bornes entre crochets, séparées par une virgule (ou un point-virgule dans l’espace francophone pour éviter la confusion avec les décimales) :
M = 264,00 ms, IC à 95 % [254,20 ; 273,80]
Dans les déclarations des résultats de tests d’hypothèses, la transparence méthodologique exige de spécifier la nature unilatérale ou bilatérale du test mené, la valeur observée exacte de la statistique de test, les paramètres de taille d’échantillon et la p-valeur précise :
z = 2,80, p = 0,005 (test bilatéral, α = 0,01)
Les protocoles de science ouverte contemporains préconisent vivement le pré-enregistrement des plans d’analyses sur des registres publics (tels que le réseau Open Science Framework – OSF). Cette formalisation préalable interdit la manipulation opportuniste et rétrospective du seuil alpha ou la commutation a posteriori d’un test bilatéral vers un test unilatéral (démarche assimilée au p-hacking) destinée à franchir indûment le seuil symbolique de la significativité.
Enfin, tout investigateur rigoureux doit veiller à préserver la frontière étanche qui sépare la significativité statistique basée sur la valeur critique zα/2 de la pertinence clinique ou sociétale de l’effet mesuré. Une statistique z observée exceptionnellement élevée (obtenue par exemple grâce à un échantillon gigantesque de dizaines de milliers de sujets) peut signaler un effet hautement reproductible mais dont l’amplitude réelle (taille d’effet quantifiée par le d de Cohen ou le g de Hedges) s’avère infinitésimale et dénuée de tout intérêt thérapeutique pratique. C’est dans ce dialogue dialectique permanent entre modélisation probabiliste rigoureuse et bon sens clinique contextualisé que l’inférence quantitative révèle toute sa noblesse épistémologique.
Références
- American Psychological Association. (2020). Publication manual of the American Psychological Association (7th ed.). American Psychological Association. https://doi.org/10.1037/0000165-000
- Cohen, J. (1988). Statistical power analysis for the behavioral sciences (2nd ed.). Lawrence Erlbaum Associates.
- Fisher, R. A. (1925). Statistical methods for research workers. Oliver and Boyd.
- Hogg, R. V., McKean, J., & Craig, A. T. (2018). Introduction to mathematical statistics (8th ed.). Pearson.
- Neyman, J., & Pearson, E. S. (1933). On the problem of the most efficient tests of statistical hypotheses. Philosophical Transactions of the Royal Society of London. Series A, Containing Papers of a Mathematical or Physical Character, 231(694-706), 289-337. https://doi.org/10.1098/rsta.1933.0009
- Tabachnick, B. G., & Fidell, L. S. (2019). Using multivariate statistics (7th ed.). Pearson.
- Weisstein, E. W. (2002). Standard Normal Distribution. MathWorld–A Wolfram Web Resource. https://mathworld.wolfram.com/StandardNormalDistribution.html