
Dans le champ contemporain de la recherche en psychologie quantitative, des neurosciences cognitives et des sciences du comportement, la validité des inférences statistiques repose fondamentalement sur la qualité métrologique des observations recueillies. L’avènement des protocoles expérimentaux hautement instrumentés, qu’il s’agisse de la chronométrie mentale mesurant des temps de réaction à la milliseconde près, de l’oculométrie ou des batteries de tests neuropsychologiques informatisés, a décuplé le volume de données brutes générées. Toutefois, cette abondance informationnelle s’accompagne d’un défi méthodologique majeur : la présence inévitable de données s’écartant substantiellement de la tendance générale de l’échantillon, couramment désignées sous le terme de valeurs aberrantes ou outliers. Loin de constituer de simples curiosités descriptives, ces anomalies numériques exercent une force gravitationnelle néfaste sur les estimateurs classiques, altérant la reproductibilité des résultats scientifiques et menaçant l’intégrité de la recherche empirique.
Face à la vulnérabilité bien documentée de la moyenne arithmétique et de l’écart-type, les statisticiens ont développé des outils issus de l’analyse exploratoire des données (EDA) permettant d’examiner les distributions sans imposer a priori des postulats paramétriques restrictifs. Parmi ces innovations méthodologiques, l’approche conceptualisée par John Tukey à la fin des années 1970, reposant sur l’écart interquartile (IQR pour Interquartile Range), s’impose aujourd’hui comme l’une des techniques les plus élégantes, intuitives et robustes pour détecter les déviances univariées. En s’affranchissant de la sensibilité excessive aux valeurs extrêmes qui caractérise les approches basées sur le score Z de Gauss, la règle du 1,5 × IQR fournit un cadre de décision objectif pour trier l’information pertinente du bruit expérimental.
Ce guide exhaustif a pour vocation d’offrir aux chercheurs, cliniciens et analystes de données un cadre de référence théorique et pratique pour la mise en œuvre de cette technique. De la décomposition mathématique des quantiles jusqu’aux subtilités algorithmiques des neuf méthodes d’interpolation standardisées, en passant par les implications déontologiques de l’élagage des données en psychologie, ce document détaille chaque étape du processus d’identification des valeurs aberrantes. À travers une démarche pédagogique rigoureuse, nous examinerons non seulement le calcul mécanique des clôtures de Tukey, mais également la manière de naviguer entre préservation de la variance écologique et assainissement des matrices de données destinées à la publication scientifique.
1. Introduction aux valeurs aberrantes et à leur impact en recherche psychologique
1.1 Définition conceptuelle d’une valeur aberrante
D’un point de vue épistémologique et statistique, une valeur aberrante se définit comme une observation qui semble s’écarter de manière marquée de la structure distributionnelle observée sur le reste de l’échantillon au sein duquel elle émerge. Dans les sciences du comportement, cette déviance ne doit pas être assimilée d’emblée à une erreur de mesure. Il est impératif d’établir une distinction conceptuelle fondamentale entre la variabilité interindividuelle naturelle, reflet de la diversité biologique et psychologique des participants, et la contamination réelle des données, qui découle d’un processus générateur exogène.
La typologie des anomalies rencontrées en laboratoire s’articule généralement autour de trois catégories distinctes :
- Les erreurs de mesure et de transcription : Celles-ci incluent les glissements d’encodage manuel (par exemple, la saisie d’un score de 77 au lieu de 7 sur une échelle de Likert bornée de 1 à 7), les dysfonctionnements matériels ou les bogues logiciels lors de l’enregistrement de latences cognitives.
- Les artefacts expérimentaux : Ces déviances résultent d’un non-respect temporaire du protocole expérimental par le sujet d’étude. En neuropsychologie, cela correspond fréquemment à un épisode d’inattention transitoire, à un assoupissement bref lors d’une tâche de vigilance de longue durée, ou à une réponse anticipée déclenchée par erreur avant l’apparition du stimulus cible.
- Les individus atypiques mais légitimes : Il s’agit de participants dont les caractéristiques cognitives ou psychologiques se situent réellement aux confins de la population générale, tels que des individus présentant des profils à haut potentiel intellectuel, des personnes atteintes de lésions cérébrales non documentées ou des patients en phase de crise psychiatrique aiguë.
Dans les protocoles de psychologie expérimentale, l’ambiguïté réside dans le fait que ces trois origines se manifestent par un même symptôme numérique : un point isolé sur l’axe des abscisses. Dès lors, le chercheur doit se doter d’une méthodologie formelle pour repérer ces occurrences sans introduire de biais de confirmation dans la sélection de ses sujets.
1.2 Conséquences statistiques de la présence d’observations aberrantes
L’intrusion d’observations discordantes dans une série de données entraîne des répercussions désastreuses sur les statistiques paramétriques classiques fondées sur la minimisation des moindres carrés. La moyenne arithmétique, en tant qu’estimateur du centre de gravité d’une distribution, présente une sensibilité extrême aux valeurs distantes : une unique valeur déviante de magnitude suffisante peut déplacer substantiellement la moyenne de l’échantillon, la rendant non représentative de la tendance centrale réelle de la cohorte observée.
Plus dommageable encore est l’effet de ces valeurs sur les mesures de dispersion. L’écart-type et la variance reposent sur la somme des écarts quadratiques à la moyenne. Par conséquent, une observation située à plusieurs unités d’écart-type du centre subit une élévation au carré qui gonfle artificiellement l’estimation de la variance globale. Cette distorsion rejaillit directement sur le calcul de l’erreur-type, provoquant un élargissement démesuré des intervalles de confiance et une perte drastique de la puissance statistique lors de la conduite de tests d’hypothèses conventionnels, tels que le test t de Student ou l’analyse de variance (ANOVA).
Dans le cadre des modèles de régression linéaire, les valeurs aberrantes combinées à un effet de levier élevé peuvent faire pivoter la droite de régression de manière totalement artificielle, créant une corrélation fallacieuse là où il n’existe aucune association dans la population parente, ou masquant à l’inverse une véritable relation biologique. Sur le plan de l’inférence, cette instabilité amplifie à la fois le risque d’erreur de type I (faux positifs, par altération des résidus) et de type II (faux négatifs, par destruction de la puissance des tests), menaçant directement l’édifice de la reproductibilité scientifique.
1.3 Nécessité d’adopter des méthodes de détection robustes
Historiquement, de nombreux praticiens ont eu recours à la méthode des scores Z normalisés, consistant à standardiser les observations et à exclure celles excédant un seuil arbitraire fixé à 2, 2,5 ou 3 écarts-types de la moyenne empirique. Or, cette démarche repose sur une circularité théorique fatale : l’identification de la valeur suspecte s’effectue au moyen d’un étalon (la moyenne et l’écart-type) qui est lui-même contaminé par la présence de ladite valeur. Ce phénomène, désigné en statistique robuste sous le terme d’effet de masquage (masking effect), fait que des anomalies massives peuvent augmenter l’écart-type à un point tel qu’elles ne parviennent plus à dépasser le seuil critique de standardisation.
Par ailleurs, le recours au score Z postule une distribution sous-jacente strictement gaussienne, une condition formelle presque systématiquement violée par les variables psychométriques réelles, telles que les temps de réaction ou les échelles de dépression, qui manifestent une asymétrie positive intrinsèque prononcée. Face à ces impasses méthodologiques, l’adoption d’outils statistiques non paramétriques et robustes constitue une nécessité scientifique incontournable.
L’écart interquartile (IQR) émerge précisément comme l’un des estimateurs de dispersion les plus résistants de la statistique descriptive. En fondant l’évaluation de la variabilité sur l’ordonnancement des rangs plutôt que sur les moments d’ordre supérieur, l’IQR offre une immunité remarquable contre les distorsions provoquées par les valeurs extrêmes. Il fournit ainsi un socle neutre et stable pour borner l’espace d’acceptabilité statistique d’une série d’observations, sans exiger l’adhésion préalable à une hypothèse théorique de normalité parfaite.
2. Fondements théoriques de l’écart interquartile (IQR)
2.1 Structure distributionnelle et décomposition en quantiles
L’analyse distributionnelle non paramétrique repose sur le concept fondamental de partitionnement de la masse de probabilité ou de l’échantillon empirique à travers des quantiles. Contrairement aux approches paramétriques qui décrivent une courbe de densité à l’aide de paramètres continus (espérance et variance), la segmentation en quantiles s’appuie sur la fonction de répartition empirique calculée à partir des données préalablement ordonnées par ordre croissant strict.
Dans ce paradigme, les quartiles représentent les trois points de coupure qui divisent une série statistique ordonnée en quatre segments d’effectifs rigoureusement identiques, chaque intervalle regroupant exactement 25 % de l’ensemble des observations disponibles :
- Le premier quartile ($Q_1$) : Également désigné sous le vocable de 25e centile, il correspond à la valeur numérique sous laquelle se situent 25 % des observations les plus basses de l’échantillon, et au-dessus de laquelle se trouvent les 75 % restants.
- Le deuxième quartile ($Q_2$) : Universellement connu sous le nom de médiane, il scinde l’échantillon en deux moitiés équiprobables. Il s’agit du centre robuste par excellence de la distribution, absolument insensible aux valeurs numériques réelles assignées aux observations terminales.
- Le troisième quartile ($Q_3$) : Correspondant au 75e centile, il matérialise le seuil au-dessous duquel reposent les trois quarts des données ordonnées de la série statistique.
Cette décomposition quantile permet de cartographier la morphologie interne de la distribution sans recourir au moindre calcul de variance pondérée par les carrés des écarts, neutralisant de facto les forces centrifuges propres aux valeurs marginales.
2.2 Définition mathématique et signification de l’IQR
Sur le plan formel, l’écart interquartile se définit par la différence arithmétique simple entre le troisième et le premier quartile de la distribution :
$$IQR = Q_3 – Q_1$$
Cette grandeur métrologique capture l’amplitude du domaine de variation au sein duquel s’inscrivent les 50 % centraux des données de l’échantillon. Graphiquement et conceptuellement, l’IQR ignore la dispersion des 25 % des scores les plus faibles ainsi que celle des 25 % des scores les plus élevés. Il concentre l’investigation descriptive sur le « noyau dur » de la distribution comportementale étudiée.
La puissance de l’IQR réside dans son insensibilité mathématique totale à ce qui se produit au-delà de ses bornes de définition. Que l’observation maximale d’un échantillon vaille 100 unités ou 100 000 unités, la valeur calculée de l’IQR demeure inchangée, pourvu que le classement des observations définissant $Q_1$ et $Q_3$ reste préservé. Cette caractéristique confère à l’indicateur une invariance remarquable face aux queues de distribution épaisses, asymétriques ou contaminées par du bruit technique, en faisant un paramètre de dispersion de premier choix dans toute analyse quantitative rigoureuse.
2.3 Propriétés métrologiques face à l’écart-type
Pour apprécier la robustesse d’un estimateur statistique, la théorie formalisée par Peter Rousseeuw et Frank Hampel mobilise le concept de point de rupture (breakdown point). Le point de rupture quantifie la proportion minimale d’observations arbitrairement aberrantes qu’un échantillon peut contenir avant que l’estimateur ne produise une valeur infiniment erronée ou totalement privée de sens.
Dans cette perspective métrologique :
- L’écart-type classique présente un point de rupture de :
$$\epsilon^* = \frac{1}{n} to 0$$
Il suffit d’une unique observation corrompue tendant vers l’infini pour faire diverger l’écart-type vers l’infini, anéantissant instantanément sa validité descriptive. - L’écart interquartile bénéficie d’un point de rupture élevé de 25 % :
$$\epsilon^* = 0{,}25$$
Cela signifie qu’il est possible de contaminer jusqu’à un quart des données de l’échantillon de façon unilatérale, ou 12,5 % simultanément aux deux extrémités, sans que l’IQR ne s’effondre ni n’explose vers des grandeurs aberrantes.
Cette stabilité face aux pollutions bilatérales s’avère particulièrement cruciale en psychométrie, où les instruments de mesure enregistrent fréquemment une dispersion hétérogène, marquée par des effets de plancher ou de plafond. Alors que l’écart-type réagit de façon hyperbolique à ces asymétries de mesure, l’écart interquartile conserve son étalonnage, reflétant fidèlement l’homogénéité du comportement de la population sous observation.
3. La méthode de détection de John Tukey et la règle du 1,5 x IQR
3.1 Origine historique de l’analyse exploratoire des données (EDA)
Au cours des années 1970, le statisticien américain John Wilder Tukey a opéré une véritable révolution paradigmatique en publiant son ouvrage séminal intitulé Exploratory Data Analysis (1977). Jusqu’alors, la pratique de la statistique académique était dominée par une approche exclusivement confirmatoire, centrée sur la modélisation formelle a priori et les tests de significativité d’hypothèses nulles (NHST), souvent appliqués de manière dogmatique sans examen approfondi de la structure réelle des distributions empiriques recueillies.
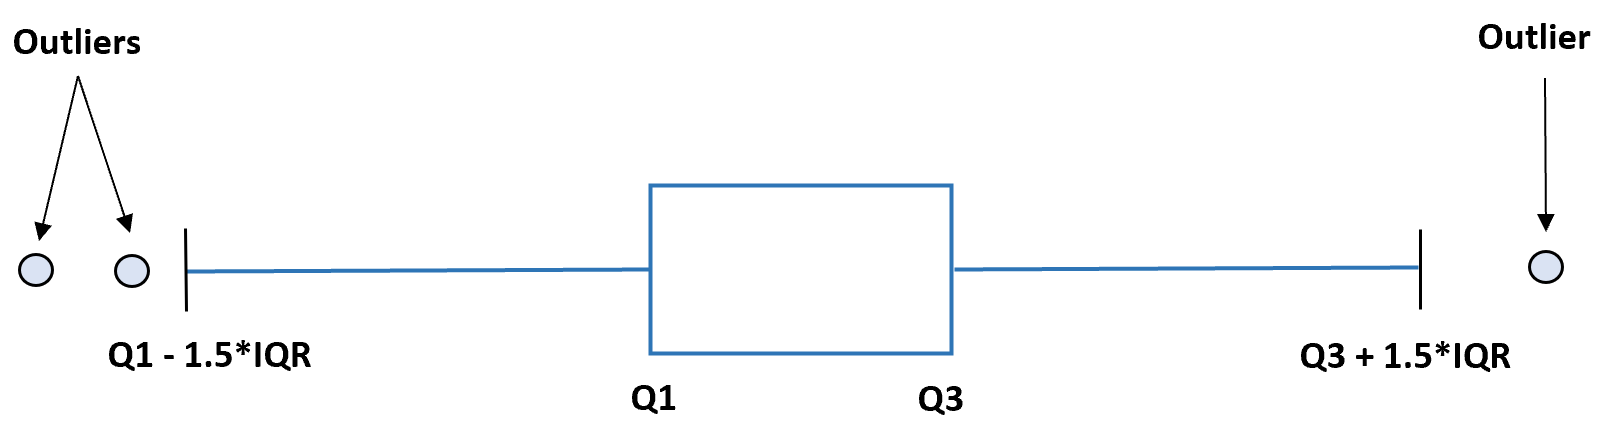
Tukey plaidait pour une attitude méthodologique complémentaire, analogue à celle d’un enquêteur criminel : avant de tester des lois théoriques, le chercheur doit examiner ses données à l’aide d’outils graphiques simples et d’indicateurs statistiques résistants, afin d’en déceler les régularités inattendues, les discontinuités et les artefacts potentiels. C’est dans ce contexte intellectuel foisonnant que Tukey a formalisé les critères objectifs de repérage des anomalies, abandonnant les jugements d’exclusion au doigt mouillé au profit d’une règle arithmétique standardisée qui fait autorité depuis plus de quatre décennies : les clôtures de Tukey basées sur un multiplicateur de l’écart interquartile.
3.2 Justification théorique du coefficient multiplicateur 1,5
Une interrogation récurrente chez les chercheurs concerne la provenance du facteur multiplicateur 1,5 : pourquoi ne pas avoir sélectionné 1,0 ou 2,0 ? Bien que Tukey ait initialement introduit ce facteur comme une heuristique empirique pragmatique équilibrant sensibilité et spécificité, ce seuil possède une justification probabiliste élégante lorsque l’on calibre la méthode sur une distribution normale standardisée théorique $\mathcal{N}(\mu, \sigma^2)$.
Dans le cadre strict d’une distribution gaussienne idéale :
- Le premier et le troisième quartile se situent aux points d’abscisse :
$$Q_1 = \mu – 0{,}6745\sigma$$
$$Q_3 = \mu + 0{,}6745\sigma$$ - L’écart interquartile s’exprime donc en fonction de l’écart-type selon :
$$IQR = 2 \times 0{,}6745\sigma = 1{,}349\sigma$$ - En appliquant le multiplicateur de 1,5 à cet IQR théorique, le pas de détection vaut :
$$1{,}5 \times IQR = 1{,}5 \times (1{,}349\sigma) \approx 2{,}0235\sigma$$ - Les clôtures de Tukey se trouvent alors positionnées à une distance exacte du centre de la distribution égale à :
$$0{,}6745\sigma + 2{,}0235\sigma = 2{,}698\sigma \approx 2{,}7\sigma$$
Sous la loi normale, la probabilité cumulée qu’une observation franchisse ces seuils fixés à $2,7\sigma$ est approximativement de :
$$P(|X – mu| > 2{,}698\sigma) \approx 0{,}00698$$
Soit environ 0,70 % de l’échantillon (ou 1 point sur 143 observations normales). Ce calibrage a été conçu de manière à minimiser drastiquement le risque de qualifier à tort d’anomalie une valeur simplement rare issue du processus gaussien standard, fournissant un compromis remarquable entre fausses alarmes et capacité d’extraction des vraies contaminations.
3.3 Distinction entre valeurs aberrantes modérées et extrêmes
L’apport de Tukey ne se limite pas à l’érection d’une barrière dichotomique rigide. Sa taxinomie sépare rigoureusement la sévérité des déviances observées en introduisant deux lignes de démarcation successives, connues sous le nom de clôtures intérieures (inner fences) et de clôtures extérieures (outer fences).
Cette graduation méthodologique s’établit selon les définitions suivantes :
- Les clôtures intérieures (seuil 1,5 × IQR) : Elles délimitent la zone au-delà de laquelle une observation est qualifiée de valeur aberrante modérée (ou valeur suspecte). L’observation sort du schéma distributionnel habituel et requiert une vérification contextuelle ciblée, mais ne signale pas nécessairement une corruption irréversible de la donnée.
- Les clôtures extérieures (seuil 3,0 × IQR) : Calculées en multipliant l’IQR par un facteur 3,0 et en l’ajoutant à $Q_3$ ou en le soustrayant de $Q_1$, elles identifient les valeurs aberrantes extrêmes (ou majeures). Dans le cadre d’une loi normale, la probabilité théorique qu’une valeur franchisse cette clôture est de l’ordre de deux pour un million ($p \approx 0{,}000002$). Une observation franchissant cette ligne rouge résulte presque immanquablement d’un incident de mesure flagrant ou d’une altération critique du signal.
Cette distinction hiérarchique permet aux scientifiques d’adopter des politiques de traitement différenciées : soumettre les points suspects à des analyses de sensibilité poussées, tout en procédant à l’invalidation justifiée des valeurs extrêmes non défendables.
4. Étape 1 : Préparation et ordonnancement des données psychométriques
4.1 Collecte et vérification de l’intégrité de l’échantillon
Toute entreprise de détection numérique d’anomalies doit être précédée d’un audit qualitatif rigoureux de la matrice de données brutes. En psychométrie et en sciences cognitives, il convient d’abord de vérifier la conformité des échelles de mesure utilisées. La méthode de l’IQR s’applique exclusivement à des variables quantitatives continues (chronométrie, potentiels évoqués, conductance cutanée) ou à des variables quantitatives discrètes possédant un nombre suffisant d’échelons ordonnés pour éviter une concentration massive d’ex æquo dénaturant les quantiles.
L’analyste doit effectuer un tri diagnostic préliminaire afin d’identifier les valeurs manquantes (valeurs null ou NaN) et de s’assurer que des codes d’absence conventionnels (comme -999 ou 9999) n’ont pas été accidentellement convertis en valeurs numériques continues. Considérons, à titre d’exemple expérimental de référence, une tâche informatisée d’attention visuelle soutenue (type Continuous Performance Test) mesurant les temps de réaction de 15 participants soumis à un paradigme d’inhibition motrice. Les latences brutes non traitées, exprimées en millisecondes, se présentent comme suit :
$$S_{\text{brute}} = {345,, 290,, 1120,, 312,, 280,, 355,, 410,, 325,, 298,, 785,, 305,, 330,, 275,, 360,, 180}$$
L’observation superficielle de cette série suggère immédiatement la présence de profils hétérogènes, avec des réponses ultra-rapides et des latences anormalement étirées qui pourraient correspondre à des décrochages attentionnels.
4.2 Protocole de tri séquentiel des données brutes
Le calcul des quartiles et de l’IQR ne s’opérant pas sur l’espace temporel de recueil mais sur l’espace ordonné des réalisations de la variable, la première opération calculatoire indispensable consiste à appliquer un algorithme de tri croissant exhaustif. Chaque donnée se voit attribuer un rang structural $i$, variant de 1 à $n$, où $n$ représente l’effectif total de l’échantillon sous analyse.
En ordonnant notre série de temps de réaction issue de la tâche d’attention soutenue ($n = 15$), nous obtenons la séquence rangée suivante :
$$S_{\text{triée}} = {180,, 275,, 280,, 290,, 298,, 305,, 312,, 325,, 330,, 345,, 355,, 360,, 410,, 785,, 1120}$$
Dans ce classement séquentiel :
- Le rang 1 ($i = 1$) est alloué au score minimal : $x_{(1)} = 180\text{ ms}$.
- Le rang médian ($i = 8$) est attribué au pivot central : $x_{(8)} = 325\text{ ms}$.
- Le rang maximal ($i = 15$) revient au score le plus élevé : $x_{(15)} = 1120\text{ ms}$.
Dans l’éventualité où des observations présenteraient des valeurs identiques (ex æquo), celles-ci doivent impérativement occuper des rangs consécutifs distincts dans l’indexation sans être amalgamées. Cette préservation intégrale de la cardinalité de l’échantillon garantit la stricte représentativité des proportions cumulées lors de l’application des formules de quantiles.
5. Étape 2 : Calcul précis du premier quartile (Q1) et du troisième quartile (Q3)
5.1 Méthodes de calcul selon la taille d’échantillon
Bien que la définition théorique d’un quartile apparaisse univoque, sa transposition algorithmique sur un échantillon discret fini donne lieu à des divergences de calcul notables dans la littérature statistique. La difficulté réside dans le positionnement exact de l’indice lorsque l’effectif $n$ ne permet pas une division entière par 4.
Deux grandes écoles méthodologiques dominent les manuels de référence :
- La méthode de John Tukey (dite des « charnières » ou hinges) : Elle identifie d’abord la médiane formelle de l’échantillon. Lorsque l’effectif $n$ est impair, Tukey intègre la médiane dans les deux sous-ensembles inférieur et supérieur servant à déterminer $Q_1$ et $Q_3$. Lorsque $n$ est pair, l’échantillon est naturellement scindé en deux moitiés égales sans partage de point central.
- La méthode de Moore et McCabe (utilisée par Minitab et fréquemment dans l’enseignement) : Contrairement à celle de Tukey, cette convention exclut strictement la médiane de tout calcul ultérieur lorsque $n$ est impair. Les quartiles correspondent alors aux médianes simples des sous-échantillons formés par les données situées de part et d’autre du centre.
Cette nuance conceptuelle influence marginalement l’estimation de l’amplitude de l’IQR sur des échantillons de très faible taille, soulignant l’importance pour le chercheur de consigner avec précision le protocole computationnel employé.
5.2 Procédures d’interpolation linéaire
Afin de normaliser ces disparités, Rob J. Hyndman et Yanan Fan ont formalisé en 1996 une typologie comparative démontrant que la plupart des logiciels statistiques appliquent l’un des neuf algorithmes d’interpolation continue. Ces méthodes calculent une position théorique continue $p$ du quartile au sein des rangs discrets, exprimée par une composante entière $k$ et une fraction décimale $f$ :
$$p = k + f$$
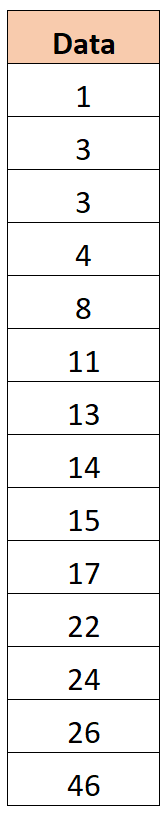
L’estimation de la valeur du quantile $Q(p)$ est alors obtenue par interpolation linéaire pondérée entre l’observation de rang $k$ et l’observation de rang $k + 1$ selon l’équation générale :
$$Q(p) = (1 – f) \times x_{(k)} + f \times x_{(k+1)}$$
Les logiciels R, Python (NumPy/Pandas) et SPSS adoptent par défaut des variantes différentes parmi ces neuf types standardisés :
- R (type 7) et Python Pandas (par défaut) : L’indice de positionnement s’exprime selon :
$$p = 1 + (n – 1) \times q$$
où $q$ représente la fraction quantile ciblée (0,25 pour $Q_1$ et 0,75 pour $Q_3$). Cette convention offre une régularité asymptotique idéale pour les variables continues. - IBM SPSS (type 6 de Hyndman & Fan) : Il utilise la règle de positionnement de Weibull :
$$p = q \times (n + 1)$$
Ce calcul produit un très léger écart par rapport à l’algorithme standard de R sur les petits effectifs.
5.3 Calcul effectif de Q1 et Q3 sur l’échantillon de démonstration
Appliquons méthodiquement la formule standard employée par le langage R (Type 7) et les bibliothèques d’analyse de données modernes à notre échantillon ordonné de 15 temps de réaction :
$$S_{\text{triée}} = {180,, 275,, 280,, 290,, 298,, 305,, 312,, 325,, 330,, 345,, 355,, 360,, 410,, 785,, 1120}$$
1. Détermination du premier quartile ($Q_1$, soit $q = 0{,}25$) :
La position théorique dans la série s’établit selon :
$$p_{Q1} = 1 + (15 – 1) \times 0{,}25 = 1 + 14 \times 0{,}25 = 1 + 3{,}5 = 4{,}5$$
La partie entière est $k = 4$ et la partie fractionnaire est $f = 0{,}5$. La valeur de $Q_1$ se situe à mi-chemin entre la 4e et la 5e observation :
- Observation de rang 4 : $x_{(4)} = 290\text{ ms}$
- Observation de rang 5 : $x_{(5)} = 298\text{ ms}$
L’interpolation linéaire fournit donc la valeur précise suivante :
$$Q_1 = x_{(4)} + 0{,}5 \times (x_{(5)} – x_{(4)}) = 290 + 0{,}5 \times (298 – 290) = 290 + 4 = 294\text{ ms}$$
2. Détermination du troisième quartile ($Q_3$, soit $q = 0{,}75$) :
La position théorique s’obtient de manière analogue :
$$p_{Q3} = 1 + (15 – 1) \times 0{,}75 = 1 + 14 \times 0{,}75 = 1 + 10{,}5 = 11{,}5$$
La position se situe à mi-chemin entre la 11e et la 12e observation ($k = 11$, $f = 0{,}5$) :
- Observation de rang 11 : $x_{(11)} = 355\text{ ms}$
- Observation de rang 12 : $x_{(12)} = 360\text{ ms}$
L’interpolation donne :
$$Q_3 = x_{(11)} + 0{,}5 \times (x_{(12)} – x_{(11)}) = 355 + 0{,}5 \times (360 – 355) = 355 + 2{,}5 = 357{,}5\text{ ms}$$
Contrôle de cohérence : La médiane formelle ($Q_2$) correspond au rang $1 + 14 \times 0{,}5 = 8$, soit $x_{(8)} = 325\text{ ms}$. L’inégalité $Q_1 le Q_2 le Q_3$ ($294 < 325 < 357{,}5$) est rigoureusement satisfaite, validant la cohérence structurelle de nos quantiles.
6. Étape 3 : Calcul arithmétique de l’écart interquartile
6.1 Soustraction algébrique directe
L’obtention des quartiles stabilisés permet de dériver l’écart interquartile par simple différence arithmétique. Cette grandeur synthétise en un scalaire unique la dispersion relative du cœur de l’échantillon expérimental.
En injectant nos estimations numériques précédentes dans la relation canonique :
$$IQR = Q_3 – Q_1$$
Nous obtenons immédiatement :
$$IQR = 357{,}5 – 294 = 63{,}5\text{ ms}$$
Par définition axiomatique, l’écart interquartile doit toujours constituer un nombre strictement positif ou nul ($IQR ge 0$). L’obtention d’un $IQR = 0$ traduirait une absence totale de variance sur la moitié centrale des sujets, situation pathologique rencontrée quasi exclusivement sur des échelles discrètes saturées par un effet plafond massif.
Dans notre étude de cas, la valeur de $63{,}5\text{ ms}$ reflète une mesure de dispersion hautement cohérente avec l’étalonnage temporel standard des processus décisionnels dans les tâches de type Go/No-Go.
6.2 Interprétation contextuelle de la dispersion des 50 % centraux
D’un point de vue neuropsychologique, une amplitude interquartile de $63{,}5\text{ ms}$ nous indique que le bloc médian des participants — ceux qui ne sont ni particulièrement rapides ni particulièrement ralentis — présente une remarquable homogénéité de performance cognitive, leurs temps de traitement se distribuant dans une fourchette étroite comprise entre $294\text{ ms}$ et $357{,}5\text{ ms}$.
La comparaison entre l’IQR et l’étendue totale de l’échantillon fournit un signal diagnostic immédiat sur l’état de la distribution :
- Étendue totale :
$$E = x_{(15)} – x_{(1)} = 1120 – 180 = 940\text{ ms}$$ - Rapport de concentration :
$$\frac{IQR}{E} = \frac{63{,}5}{940} \approx 0{,}0675 \quad (6{,}75,%)$$
Le fait que 50 % de l’échantillon total se concentre sur moins de 7 % de l’amplitude globale des valeurs observées atteste sans équivoque d’une distribution hautement comprimée au centre, avec une projection asymétrique extrême de la queue de distribution supérieure. Cette disproportion frappante illustre à quel point la variance classique — qui prend en compte l’ensemble des $940\text{ ms}$ d’écart — donnerait une impression fausse et hypertrophiée de la véritable dispersion du groupe.
7. Étape 4 : Détermination des clôtures inférieure et supérieure de Tukey
7.1 Calcul de la clôture inférieure (Lower Fence)
La borne inférieure de Tukey matérialise la frontière statistique en dessous de laquelle une observation est considérée comme suspecte en raison de sa trop faible valeur numérique. Son calcul s’opère en projetant vers le bas un levier de sécurité équivalant à une fois et demie la dispersion centrale de l’IQR, ancré sur le premier quartile.
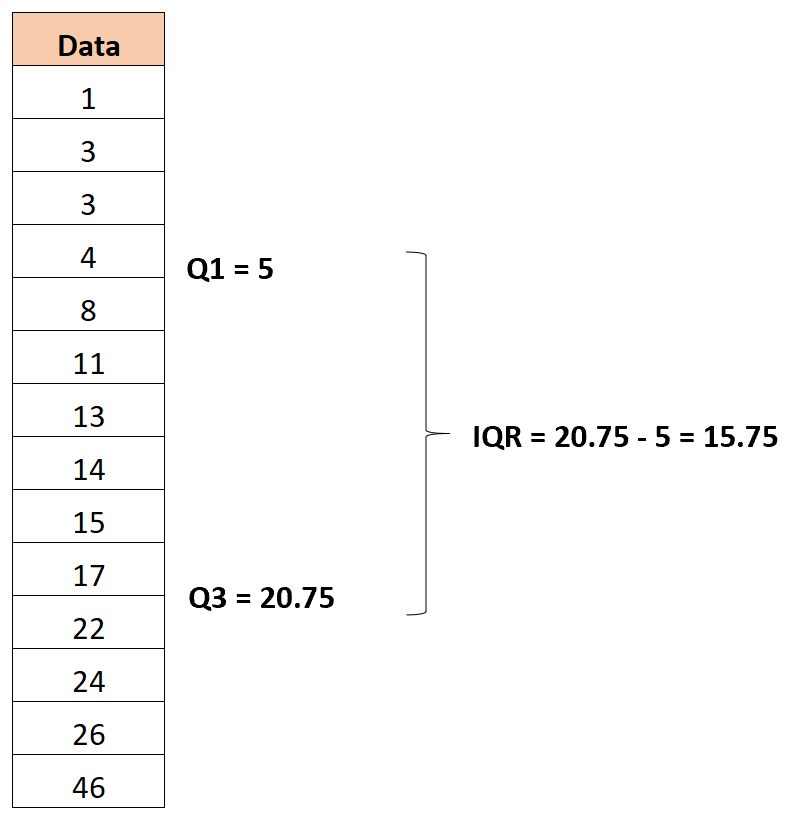
La formule algébrique de la clôture inférieure ($B_{\text{\inf}}$) s’énonce comme suit :
$$B_{\text{\inf}} = Q_1 – (1{,}5 \times IQR)$$
Appliquons cette équation à nos paramètres empiriques :
$$B_{\text{\inf}} = 294 – (1{,}5 \times 63{,}5) = 294 – 95{,}25 = 198{,}75\text{ ms}$$
Dans de nombreuses configurations psychométriques réelles, le calcul mathématique peut produire une clôture inférieure théorique négative. Lorsqu’il s’agit de grandeurs physiologiques ou chronométriques qui sont bornées physiquement par zéro, une clôture négative n’a pas de réalité concrète. Elle indique simplement qu’aucune observation issue de l’échantillon, aussi faible soit-elle, ne saurait être qualifiée d’aberrante par le bas sous ce modèle.
Dans notre cas d’étude, la clôture est positive et s’élève à $198{,}75\text{ ms}$. Ce seuil constitue la vitesse minimale en deçà de laquelle une réponse motrice ne peut plus être imputée avec certitude à un traitement visuel conscient et réfléchi du stimulus.
7.2 Calcul de la clôture supérieure (Upper Fence)
À l’autre extrémité de la distribution, la borne supérieure de Tukey ($B_{\text{\sup}}$) définit le plafond statistique tolérable au-delà duquel un ralentissement psychomoteur ne peut plus être assimilé à une simple fluctuation de vigilance classique. Son calcul consiste à translater le troisième quartile de cette même réserve de dispersion :
$$B_{\text{\sup}} = Q_3 + (1{,}5 \times IQR)$$
En introduisant nos valeurs calculées :
$$B_{\text{\sup}} = 357{,}5 + (1{,}5 \times 63{,}5) = 357{,}5 + 95{,}25 = 452{,}75\text{ ms}$$
L’intervalle de validité opérationnelle ou espace d’acceptabilité de Tukey pour notre tâche d’attention se trouve désormais rigoureusement borné par l’intervalle :
$$I_{\text{validité}} = [198{,}75\text{ ms} ;;; 452{,}75\text{ ms}]$$
Toute latence chronométrique s’inscrivant à l’intérieur de ces deux balises numériques est jugée représentative du modèle comportemental du groupe sous observation.
7.3 Extension aux clôtures extrêmes pour les déviances sévères
Afin de graduer avec exactitude la nature de l’anomalie, Tukey a étendu son dispositif géométrique en intégrant un second périmètre de sécurité beaucoup plus restrictif, fondé sur l’application d’un coefficient multiplicateur égal à 3,0.
Ces clôtures extérieures se calculent comme suit :
- Clôture extérieure inférieure :
$$B_{\text{ext_\inf}} = Q_1 – (3 \times IQR) = 294 – (3 \times 63{,}5) = 294 – 190{,}5 = 103{,}5\text{ ms}$$ - Clôture extérieure supérieure :
$$B_{\text{ext_\sup}} = Q_3 + (3 \times IQR) = 357{,}5 + (3 \times 63{,}5) = 357{,}5 + 190{,}5 = 548\text{ ms}$$
Grâce à cette double délimitation, nous disposons désormais de quatre zones de segmentation théorique distinctes :
- Zone de conformité : De $198{,}75\text{ ms}$ à $452{,}75\text{ ms}$ (données non aberrantes standard).
- Zone d’anomalie modérée : De $103{,}5\text{ ms}$ à $198{,}75\text{ ms}$ (zone basse) et de $452{,}75\text{ ms}$ à $548\text{ ms}$ (zone haute).
- Zone d’anomalie extrême : Inférieure à $103{,}5\text{ ms}$ ou strictement supérieure à $548\text{ ms}$.
8. Étape 5 : Identification et classification formelle des observations atypiques
8.1 Comparaison systématique de chaque point aux clôtures
Une fois les balises de Tukey formalisées, l’étape opérationnelle consiste à procéder à un balayage algorithmique complet de la série des données triées. Chaque valeur empirique $x_{(i)}$ est évaluée à l’aune d’une double condition de rejet logique :
$$x_{(i)} B_{\text{\sup}}$$
Réexaminons point par point notre séquence de données ordonnée face à notre intervalle d’acceptabilité $[198{,}75\text{ ms} ;;; 452{,}75\text{ ms}]$ :
- $x_{(1)} = 180\text{ ms}$ : $180 < 198{,}75$. La condition d'anomalie inférieure est formellement vérifiée. Le point est atypique.
- $x_{(2)}$ à $x_{(13)}$ ($275\text{ ms}$ à $410\text{ ms}$) : Tous ces scores s’insèrent strictement dans l’intervalle $[198{,}75 ;;; 452{,}75]$. Ils constituent des observations légitimes conformes.
- $x_{(14)} = 785\text{ ms}$ : $785 > 452{,}75$. La condition d’anomalie supérieure est formellement vérifiée. Le point est atypique.
- $x_{(15)} = 1120\text{ ms}$ : $1120 > 452{,}75$. La condition d’anomalie supérieure est formellement vérifiée. Le point est atypique.
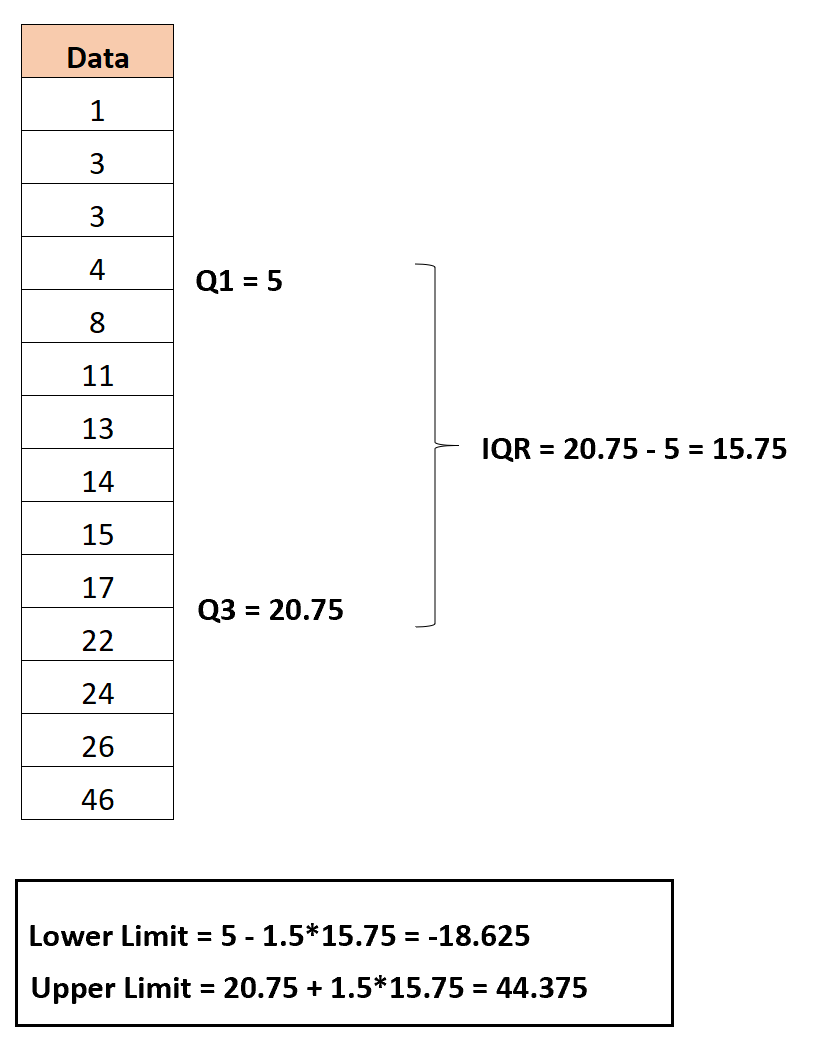
L’analyse identifie sans ambiguïté trois points s’extrayant du corridor de régularité statistique établi par la méthode de l’IQR.
8.2 Taxinomie des observations isolées
Il convient à présent de croiser ces détections primaires avec nos clôtures extérieures afin d’établir un diagnostic de sévérité statistique pour chacune des observations repérées :
- Le point $x_{(1)} = 180\text{ ms}$ : Situé en dessous de $B_{\text{\inf}}$ ($198{,}75\text{ ms}$), mais supérieur à la clôture extérieure inférieure ($103{,}5\text{ ms}$). Il est rigoureusement classé comme une valeur aberrante modérée. En chronométrie mentale, un temps de $180\text{ ms}$ suggère une réponse d’anticipation motrice réflexe où le participant a pressé la touche avant l’encodage perceptif complet du stimulus, mais sans qu’il s’agisse d’un bogue informatique à proprement parler.
- Le point $x_{(14)} = 785\text{ ms}$ : Largement au-delà de $B_{\text{\sup}}$ ($452{,}75\text{ ms}$), et également supérieur à la clôture extérieure supérieure ($548\text{ ms}$). Ce point accède ainsi au statut de valeur aberrante extrême (ou majeure). Un délai de près de $800\text{ ms}$ dénote une rupture totale de la focalisation de l’attention lors d’une tâche rapide.
- Le point $x_{(15)} = 1120\text{ ms}$ : Pulvérisant la clôture extérieure supérieure ($1120 > 548\text{ ms}$), ce point constitue une valeur aberrante extrême majeure, se trouvant à plus de 12 fois l’IQR au-dessus de la médiane de référence de l’échantillon.
Le chercheur est tenu de documenter scrupuleusement ces identifiants de sujets dans son journal d’analyse préalable à toute modélisation statistique inférentielle.
8.3 Étude de cas détaillée et chiffrée
Pour apprécier l’impact déstabilisateur massif de ces trois observations anormales sur l’analyse, comparons les propriétés de la distribution brute face à la distribution nettoyée de ces trois contaminations :
| Paramètre statistique | Échantillon global brut ($n=15$) | Échantillon sans anomalies ($n=12$) | Variation relative |
|---|---|---|---|
| Moyenne arithmétique ($\mu$) | $445{,}9\text{ ms}$ | $328{,}3\text{ ms}$ | $-26{,}4,%$ |
| Médiane ($Q_2$) | $325{,}0\text{ ms}$ | $321{,}0\text{ ms}$ | $-1{,}2,%$ |
| Écart-type ($s$) | $264{,}7\text{ ms}$ | $40{,}1\text{ ms}$ | $-84{,}8,%$ |
| Écart interquartile ($IQR$) | $63{,}5\text{ ms}$ | $55{,}5\text{ ms}$ | $-12{,}6,%$ |
| Coefficient d’asymétrie (Skewness) | $+2{,}07$ (extrême) | $+0{,}44$ (quasi symétrique) | Correction majeure |
L’examen de cette matrice comparative apporte une éclatante confirmation empirique aux concepts exposés : tandis que la moyenne brute a été surévaluée de plus de $117\text{ ms}$ ($+35,%$) et que l’écart-type a été artificiellement multiplié par plus de 6 en raison des trois observations déviantes, la médiane et l’IQR ont remarquablement préservé leur stabilité descriptive originelle. Ces chiffres démontrent avec éclat l’efficacité immunitaire de l’IQR face aux distorsions numériques.
9. Représentation graphique via la boîte à moustaches (Boxplot)
9.1 Anatomie d’un diagramme de Tukey conforme
La puissance d’application de la méthode de l’IQR doit son adoption massive à son articulation symbiotique avec un outil graphique devenu universel en science : la boîte à moustaches (boxplot), conçue par Tukey lui-même. Une boîte à moustaches rigoureusement conforme aux conventions de l’EDA s’articule autour d’une géométrie précise :
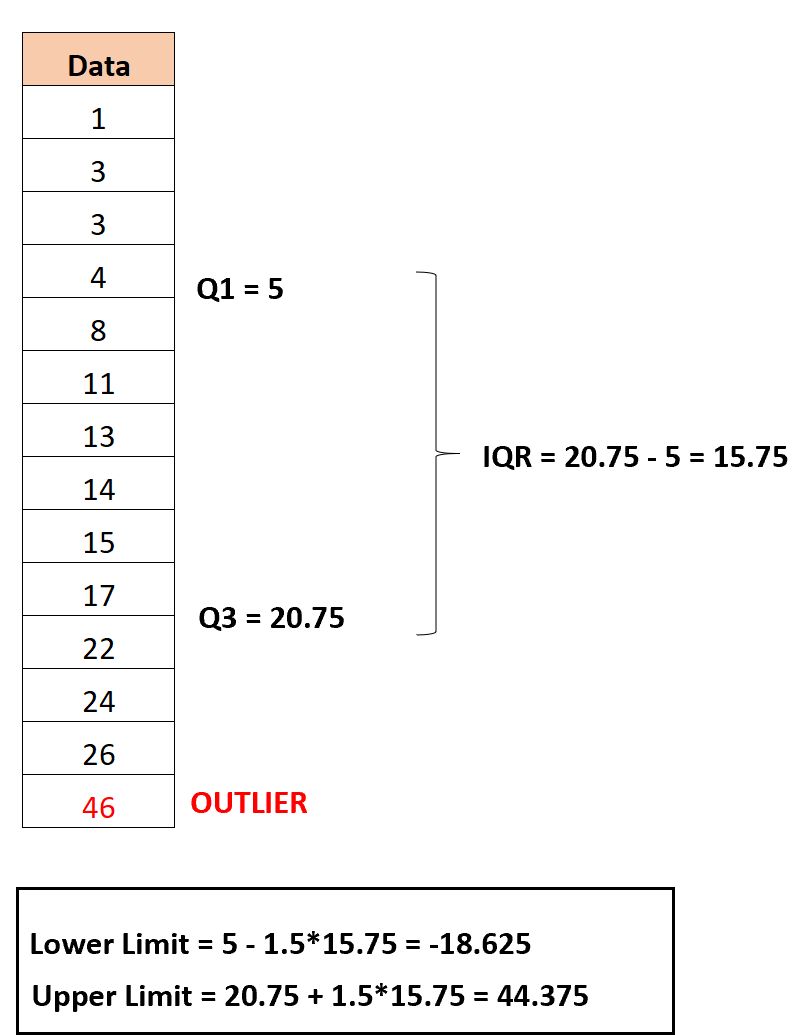
- Le rectangle central : Il est délimité à sa base par le premier quartile ($Q_1$) et à son sommet par le troisième quartile ($Q_3$). La hauteur absolue de cette boîte correspond donc très exactement à la magnitude de l’IQR. Elle contient les 50 % centraux des données observées.
- La ligne médiane : Une barre continue transversale est tracée à l’intérieur de la boîte au niveau précis de la médiane ($Q_2$), révélant instantanément le centrage de la distribution.
- Les moustaches (Whiskers) : Contrairement à une erreur d’interprétation fréquente, les moustaches ne se déploient pas aveuglément jusqu’aux clôtures mathématiques $B_{\text{\inf}}$ et $B_{\text{\sup}}$. Elles s’étendent de la bordure de la boîte jusqu’à l’observation réelle la plus éloignée qui reste située à l’intérieur des clôtures de Tukey. Dans notre cas, la moustache inférieure s’arrête à $275\text{ ms}$ (point valide le plus bas) et la moustache supérieure s’achève à $410\text{ ms}$ (point valide le plus haut).
- Les points hors clôtures : Toutes les observations localisées au-delà des moustaches sont tracées individuellement par des figurés géométriques isolés. La convention de Tukey prescrit d’utiliser de petits cercles évidés pour représenter les anomalies modérées (ici le point $180\text{ ms}$) et des astérisques pour les anomalies extrêmes situées au-delà de 3 × IQR (nos points $785\text{ ms}$ et $1120\text{ ms}$).
9.2 Lecture diagnostique de l’asymétrie et de l’étalement
La lecture clinique d’un boxplot constitue un exercice diagnostique de premier plan pour apprécier d’un coup d’œil l’architecture d’un jeu de données. La position relative de la ligne médiane au sein de la boîte centrale fournit une évaluation immédiate de l’asymétrie (skewness) de la distribution :
- Si la médiane se loge rigoureusement au centre équidistant de $Q_1$ et $Q_3$, la distribution manifeste une symétrie idéale.
- Si la barre médiane est plaquée vers le bas de la boîte, proche de $Q_1$, et que la moustache supérieure est significativement plus étirée que la moustache inférieure, cela démontre une asymétrie positive marquée (queue étirée vers les valeurs fortes), configuration typique des chronométries mentales.
De surcroît, le boxplot permet d’évaluer immédiatement la présence d’effets de seuil (plancher ou plafond). Une moustache inférieure totalement écourtée avec une médiane fusionnée sur le premier quartile signale qu’une proportion écrasante de participants a atteint le score minimal possible, invalidant d’emblée les modèles exigeant une dispersion continue non contrainte.
9.3 Avantages du boxplot comparé à l’histogramme
Si l’histogramme de fréquences conserve une utilité certaine pour appréhender les distributions multimodales complexes, le boxplot de Tukey présente des avantages comparatifs majeurs dans le travail d’exploration empirique routinier. Le premier écueil de l’histogramme réside dans sa dépendance aiguë vis-à-vis du choix de l’origine et du découpage de la largeur des classes (le paramètre de binwidth). En modifiant arbitrairement la largeur de ces intervalles, un analyste peut masquer une anomalie sévère ou faire naître artificiellement l’illusion d’une régularité gaussienne.
Le boxplot, étant indexé de manière invariable sur les centiles de l’échantillon, est totalement exempt de cette subjectivité de représentation. De plus, il brille par sa sobriété et son économie d’encre (ce que Tukey nommait le data-ink ratio). Il permet de juxtaposer sur un même plan horizontal ou vertical des dizaines de groupes ou conditions expérimentales simultanément, offrant aux chercheurs une comparaison immédiate de la médiane, de la dispersion centrale et de la prévalence des valeurs aberrantes entre cohortes cliniques et groupes contrôles, là où la superposition d’autant d’histogrammes aboutirait à une illisibilité graphique inextricable.
10. Gestion et traitement méthodologique des valeurs aberrantes en psychologie
10.1 Enquête diagnostique sur la source de l’anomalie
L’identification statistique d’une valeur aberrante par la méthode de Tukey ne constitue jamais un mandat automatique autorisant sa destruction aveugle. Dans le cadre de la déontologie scientifique de la recherche quantitative, l’exclusion arbitraire d’un point au seul motif qu’il se situe au-delà d’un seuil statistique constitue une faute méthodologique susceptible d’introduire des biais majeurs dans la taille d’effet estimée. Toute exclusion doit être motivée et documentée.
Le chercheur doit conduire une véritable enquête diagnostique en s’appuyant sur trois questions directrices :
- S’agit-il d’une erreur d’enregistrement ou d’un artefact physique ? En examinant les journaux informatiques et les notes de terrain de l’expérimentateur, il est parfois possible de vérifier qu’une latence anormale coïncide avec un éternuement du sujet, une interruption sonore extérieure ou un redémarrage impromptu du pilote d’affichage graphique. Dans ces conditions avérées d’interférence technique, la suppression de l’observation est scientifiquement légitime et nécessaire.
- L’observation découle-t-elle d’une mécompréhension de la consigne ? Si un participant présente un taux d’erreur de 50 % sur une tâche de choix forcé tout en générant des temps de réaction records, il est probable qu’il ait répondu au hasard sans traiter l’information, justifiant l’élimination de sa session complète de tests.
- S’agit-il d’un individu véritablement atypique ? Si l’observation provient d’un sujet ayant scrupuleusement respecté le protocole mais dont les capacités se situent naturellement aux bornes extrêmes du spectre humain, la valeur est biologiquement valide et son effacement réduirait artificiellement la variance naturelle de l’objet d’étude.
10.2 Stratégies d’ajustement sans suppression aveugle
Lorsque les données suspectes sont reconnues comme authentiques mais que leur maintien sous leur forme brute menace la conformité des hypothèses d’homosBundle et de normalité des tests ultérieurs, plusieurs démarches de remédiation conservatrices s’offrent au statisticien.
Ces stratégies incluent notamment :
- La winsorisation : Cette technique élégante consiste à recadrer les valeurs se situant au-delà des clôtures de détection en leur assignant la valeur exacte de la borne de Tukey correspondante ou un centile défini (par exemple le 5e et le 95e centile). L’observation anormale ne modifie plus démesurément la moyenne et la variance, tout en préservant intact l’effectif total ($n$) de l’échantillon ainsi que le rang ordonné du sujet au sein du groupe.
- Les transformations mathématiques non linéaires : L’application d’une transformation logarithmique $ln(x)$, d’une racine carrée $\sqrt{x}$ ou de l’inverse $-1/x$ permet de comprimer l’étalement des queues de distribution droites. Sous ces nouvelles métriques d’expression, les observations initialement aberrantes réintègrent fréquemment le giron d’une distribution symétrique compatible avec les modèles paramétriques.
- Le recours à l’estimation robuste et non paramétrique : Plutôt que de transformer artificiellement les valeurs brutes, l’approche la plus vertueuse consiste souvent à substituer aux tests classiques de Student et de Fisher des modèles fondés sur les rangs (test de Wilcoxon-Mann-Whitney, test de Kruskal-Wallis) ou sur les estimateurs $M$ de Huber, nativement immunisés contre l’action corruptrice des observations isolées.
10.3 Analyses de sensibilité et exigences de transparence académique
À l’ère de la crise de la reproductibilité et des exigences accrues d’intégrité formulées par l’American Psychological Association (normes APA 7e édition), la gestion des anomalies statistiques ne peut plus être reléguée au rang de bricolage silencieux de laboratoire. La pratique recommandée par les méthodologistes actuels est celle de l’analyse de sensibilité par double rapport statistique.
Le chercheur est tenu de conduire et de documenter explicitement l’ensemble de ses modélisations inférentielles sous deux conditions :
- Une première analyse incluant rigoureusement l’ensemble des données recueillies ($n_{\text{complet}}$).
- Une seconde analyse menée après élagage motivé ou ajustement des valeurs aberrantes identifiées via l’IQR ($n_{\text{restre\int}}$).
Si la trajectoire de significativité statistique ($p < 0{,}05$) et la magnitude de la taille d'effet (d de Cohen, $\eta^2$ partiel) demeurent stables et mènent à des conclusions convergentes dans les deux configurations, le chercheur apporte la démonstration formelle de la robustesse de son effet expérimental. Si, en revanche, la significativité dépend entièrement du maintien ou de l'éviction de deux ou trois points spécifiques, cette fragilité intrinsèque doit être rapportée de manière transparente dans la discussion de l'article, incitant à une prudence interprétative salutaire.
11. Implémentation computationnelle dans les logiciels d’analyse de données
11.1 Automatisation sous le langage R
Le langage open source R propose un écosystème fonctionnel particulièrement adapté pour le dépistage et l’extraction des anomalies de Tukey. L’analyste peut mobiliser la fonction native boxplot.stats(), qui extrait directement l’ensemble des métriques d’EDA sans exiger le tracé préalable d’une figure.
Le traitement programmatique d’un vecteur de données s’articule autour des syntaxes fondamentales suivantes :
Dans un premier temps, l’appel à la fonction quantile(x, probs = c(0.25, 0.75), type = 7) permet d’extraire de manière autonome les composantes $Q_1$ et $Q_3$. L’amplitude interquartile se dérive ensuite via l’instruction directe IQR(x, type = 7). Pour automatiser l’identification des points situés hors des bornes, l’extraction de l’objet boxplot.stats(x, coef = 1.5)$out isole instantanément le vecteur des valeurs aberrantes modérées et extrêmes.
Dans un pipeline moderne exploitant l’écosystème tidyverse, l’analyste peut injecter une fonction de filtrage conditionnel au sein d’une séquence de manipulation de tableau :
L’application consécutive de filter(temps >= (quantile(temps, 0.25) - 1.5 * IQR(temps)) & temps <= (quantile(temps, 0.75) + 1.5 * IQR(temps))) permet d’isoler en toute fluidité l’ensemble des observations conformes pour les analyses subséquentes, tout en assignant dans un sous-tableau distinct les lignes des sujets exclus afin d’en conserver une trace d’audit complète.
11.2 Implémentation en Python avec Pandas et SciPy
Au sein de l’environnement Python pour la science des données, les bibliothèques Pandas, NumPy et SciPy fournissent une approche vectorisée hautement performante pour traiter des matrices massives issues de protocoles expérimentaux complexes.
L’implémentation algorithmique de la règle de Tukey s’opère typiquement au moyen des fonctions intégrées aux DataFrames Pandas :
La déclaration q1 = df['temps'].quantile(0.25) et q3 = df['temps'].quantile(0.75) formalise les bornes de référence. La variable d’écart interquartile se calcule par la commande iqr = q3 - q1. Les clôtures de sécurité sont ensuite créées par les opérations vectorisées lower_fence = q1 - 1.5 * iqr et upper_fence = q3 + 1.5 * iqr.
Pour étiqueter les anomalies de manière automatisée, il suffit d’utiliser un masque booléen structuré :
L’expression outliers = df[(df['temps'] upper_fence)] isole directement l’ensemble des lignes discordantes. Couplée aux modules graphiques seaborn.boxplot() ou matplotlib.pyplot, cette démarche computationnelle permet de corroborer le filtrage numérique par une inspection visuelle immédiate au fil de l’exécution des scripts d’analyse.
11.3 Procédure opérationnelle sous IBM SPSS Statistics
Pour les chercheurs en sciences humaines privilégiant les environnements à interface graphique, le logiciel IBM SPSS Statistics intègre nativement la détection des valeurs aberrantes de Tukey via sa procédure exploratoire descriptive approfondie.
Le protocole opératoire standard sous l’interface se déroule comme suit :
- Naviguer dans les menus déroulants : Analyse → Statistiques descriptives → Explorer…
- Transférer la variable continue sous examen dans la boîte de dialogue Variables dépendantes. Pour des plans expérimentaux factoriels, la variable de partitionnement de groupe peut être simultanément renseignée dans la boîte Facteurs.
- Dans le sous-menu optionnel Graphiques, veiller à cocher la case relative aux boîtes à moustaches et sélectionner l’option Regrouper les variables.
- Cliquer sur le sous-menu Statistiques et s’assurer que la case Valeurs extrêmes est validée.
Dans les tableaux de sortie d’évaluation des sorties SPSS, le logiciel génère un tableau synthétique intitulé « Observations extrêmes », identifiant nominativement les cinq valeurs les plus basses et les cinq valeurs les plus hautes, accompagnées de leur numéro de ligne dans le fichier brut. Les observations franchissant la clôture intérieure (1,5 × IQR) y sont signalées par un symbole distinctif, tandis que celles dépassant la clôture extérieure (3 × IQR) reçoivent une indexation particulière facilitant leur encodage dans une nouvelle variable d’exclusion binaire.
12. Limites de la méthode IQR et approches alternatives avancées
12.1 Contraintes liées aux échantillons de petite taille
Bien que particulièrement résistant, l’écart interquartile n’est pas exempt de vulnérabilités méthodologiques, dont la principale concerne son instabilité intrinsèque lorsque la taille de l’échantillon devient très restreinte ($n < 20$). Dans de petites cohortes, telles que celles couramment étudiées en neuropsychologie clinique de cas uniques ou lors d'investigations exploratoires en neuroimagerie (TEP, IRMf), l'estimation de la position de $Q_1$ et $Q_3$ dépend de manière excessive du hasard de l'échantillonnage de deux ou trois sujets seulement.
Dans ce contexte de faible effectif, l’IQR présente un phénomène d’élasticité discrète : l’ajout ou le retrait d’un seul participant peut faire basculer brutalement la valeur calculée de l’IQR, déplaçant considérablement les clôtures de détection. Il s’ensuit un risque accru de commettre une erreur d’omission par masquage, où des valeurs indiscutablement corrompues échappent aux seuils en raison d’un élargissement artificiel de l’écartement interquartile. Pour les cohortes dont $n$ est inférieur à 15 ou 20 individus, la prudence commande de ne pas utiliser la règle stricte du 1,5 × IQR de façon isolée, mais de la croiser avec un examen visuel qualitatif individualisé.
12.2 Comportement sur des distributions fortement asymétriques
La formulation conventionnelle de la règle de Tukey applique un facteur de dispersion rigoureusement symétrique ($1{,}5 \times IQR$) de part et d’autre de la distribution, postulant implicitement que le comportement des données à gauche du centre de gravité est équivalent à celui observé à droite. Or, dans une multitude de paradigmes en psychologie cognitive, les variables mesurées suivent une loi naturelle asymétrique — comme les lois log-normales, de Weibull ou d’ex-Gaussienne gouvernant la chronométrie motrice.
Dans ces conditions d’asymétrie structurelle positive :
- La clôture supérieure calculée selon la méthode standard se révèle trop étroite, déclenchant une sur-détection systématique et abusive de fausses valeurs aberrantes dans la queue de distribution longue.
- Inversement, la clôture inférieure devient anormalement permissive, laissant passer des anomalies réelles dans les latences courtes.
Pour remédier à cette faille structurelle, Guy Brys, Mia Hubert et Peter Rousseeuw ont introduit en 2004 le concept d’Adjusted Boxplot (boîte à moustaches ajustée). Cette variante sophistiquée incorpore un estimateur robuste d’asymétrie nommé le médouple (medcouple, $MC$). Les clôtures ne sont plus équidistantes, mais s’adaptent dynamiquement à la courbure réelle des données via des fonctions exponentielles :
$$B_{\text{\sup_ajustée}} = Q_3 + 1{,}5 \times e^{3 \times MC} \times IQR \quad (\text{si } MC ge 0)$$
Cette correction permet de préserver l’étalement physiologique des temps de réaction prolongés sans les disqualifier à tort de l’analyse principale.
12.3 Comparaison critique avec d’autres estimateurs robustes
L’écart interquartile n’est pas le seul instrument disponible dans l’arsenal de la statistique résistante contemporaine. Deux estimateurs de dispersion alternatifs occupent une place de premier plan dans la littérature spécialisée :
1. La déviation absolue par rapport à la médiane (MAD pour Median Absolute Deviation) :
Formellement définie par la relation mathématique :
$$MAD = b \times \text{médiane}(|x_i – \text{médiane}(X)|)$$
(où $b = 1{,}4826$ sous l’hypothèse de calibration normale), la MAD dispose du point de rupture le plus élevé possible en statistique robuste :
$$\epsilon^* = 0{,}50 \quad (50,%)$$
Elle est capable de supporter une contamination atteignant la moitié de l’échantillon sans s’effondrer. Par comparaison, l’IQR plafonne à 25 %. Pour des données hautement déstructurées, la règle de détection basée sur la médiane ± 2,5 MAD est fréquemment considérée par les méthodologistes comme encore plus résistante que celle de Tukey.
2. Les estimateurs $S_n$ et $Q_n$ de Rousseeuw et Croux (1993) :
Bien que la MAD soit d’une robustesse exemplaire, son efficacité asymptotique sur des lois normales n’est que de 37 %, ce qui induit une perte d’information par rapport aux estimateurs classiques. Pour combler cette limite, Rousseeuw et Croux ont modélisé l’estimateur $Q_n$, calculé à partir du premier quartile de l’ensemble des distances deux à deux entre toutes les observations :
$$Q_n = c \times {|x_i – x_j| ; i < j}_{(k)}$$
Cet estimateur conjugue un point de rupture optimal de 50 % avec une très haute efficacité statistique (82 %), ne nécessite aucun calcul préalable de tendance centrale, et se montre insensible à l’asymétrie distributionnelle.
Le tableau comparatif ci-dessous synthétise les critères de sélection de l’estimateur optimal en fonction du design expérimental et de la nature des données :
| Estimateur de dispersion | Point de rupture ($\epsilon^*$) | Efficacité gaussienne | Sensibilité à l’asymétrie | Contexte expérimental de prédilection |
|---|---|---|---|---|
| Écart-type classique ($s$) | $0,%$ (extrême vulnérabilité) | $100,%$ | Très élevée (biais sévère) | Distributions strictement normales vérifiées, absence avérée d’artefacts. |
| Écart interquartile ($IQR$) | $25,%$ (haute résistance) | $37,%$ | Moyenne (nécessite l’Adjusted Boxplot si asymétrie extrême) | Exploration standard des données, reporting accessible, échantillons $n ge 30$. |
| Déviation absolue médiane ($MAD$) | $50,%$ (résistance maximale) | $37,%$ | Moyenne à faible | Dépistage de valeurs aberrantes sur des distributions symétriques fortement polluées. |
| Estimateur $Q_n$ de Rousseeuw | $50,%$ (résistance maximale) | $82,%$ (très haute) | Faible (très stable) | Modélisations avancées, apprentissage automatique, petits échantillons bruités. |
En synthèse de cette étude comparative, l’écart interquartile de Tukey demeure l’outil d’arbitrage le plus équilibré et universellement interprétable pour la pratique scientifique courante. Sa clarté arithmétique, conjuguée à sa puissance d’expression graphique au travers du boxplot, en fait une pièce maîtresse indéboulonnable du contrôle métrologique des données comportementales contemporaines.
Références
Bakker, M., & Wicherts, J. M. (2014). Outlier removal, data transforms, and the plausibility of results: High degrees of freedom in data analysis jeopardise research findings. Computers in Human Behavior, 34, 1-8. https://doi.org/10.1016/j.chb.2014.01.028
Brys, G., Hubert, M., & Rousseeuw, P. J. (2004). A robust measure of skewness. Journal of Computational and Graphical Statistics, 13(4), 996-1017. https://doi.org/10.1198/106186004X12632
Hubert, M., & Vandervieren, E. (2008). An adjusted boxplot for skewed distributions. Computational Statistics & Data Analysis, 52(12), 5186-5201. https://doi.org/10.1016/j.csda.2007.11.008
Hyndman, R. J., & Fan, Y. (1996). Sample quantiles in statistical packages. The American Statistician, 50(4), 361-365. https://doi.org/10.1080/00031305.1996.10473566
Leys, C., Ley, C., Klein, O., Bernard, P., & Licata, L. (2013). Detecting outliers: Do not use standard deviation around the mean, use absolute deviation around the median. Journal of Experimental Social Psychology, 49(4), 764-766. https://doi.org/10.1016/j.jesp.2013.03.013
Moore, D. S., McCabe, G. P., & Craig, B. A. (2017). Introduction to the practice of statistics (9th ed.). W. H. Freeman.
Osborne, J. W., & Overbay, A. (2004). The power of outliers (and why researchers should ALWAYS check for them). Practical Assessment, Research, and Evaluation, 9(1), Article 6. https://doi.org/10.7275/q71v-hn44
Rousseeuw, P. J., & Croux, C. (1993). Alternatives to the median absolute deviation. Journal of the American Statistical Association, 88(424), 1273-1283. https://doi.org/10.1080/01621459.1993.10476408
Tukey, J. W. (1977). Exploratory data analysis. Addison-Wesley.
Wilcox, R. R. (2012). Introduction to robust estimation and hypothesis testing (3rd ed.). Academic Press.